
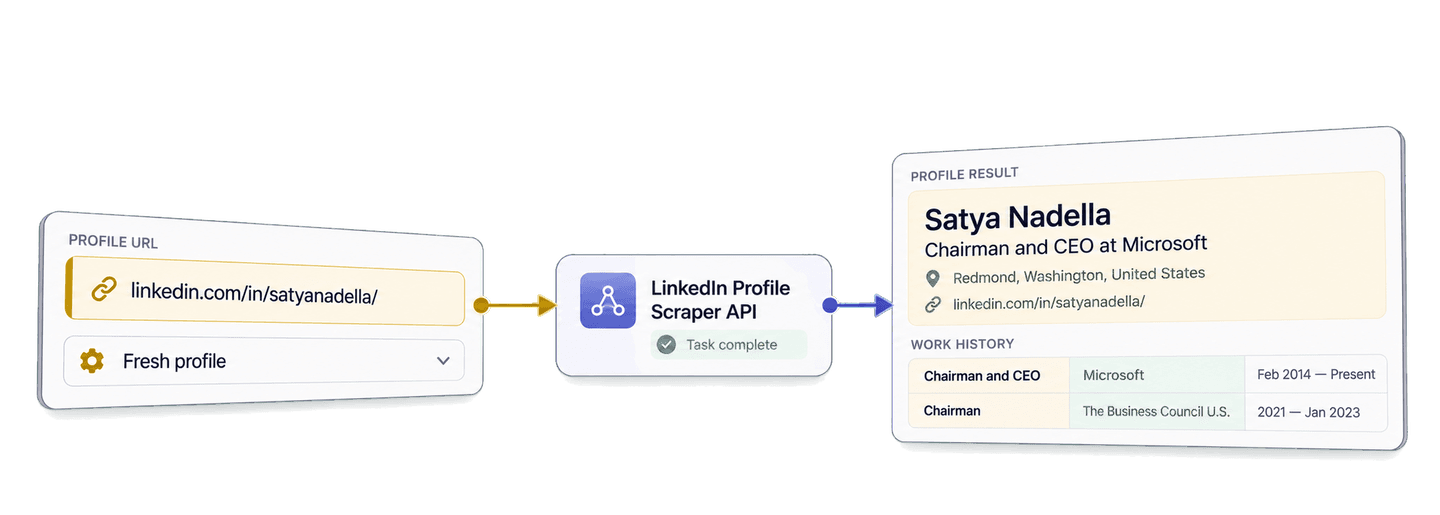
Je kunt LinkedIn-profielen scrapen met Python door bekende openbare profiel-URL's via de Requests-library naar Datablists LinkedIn Profile Scraper API te sturen. De API retourneert gestructureerde velden voor identiteit, locatie, werkervaring, opleiding en bedrijven. Daarmee kun je leadlijsten opbouwen en je outreach personaliseren met relevante informatie over iemands functie en bedrijf.
In deze handleiding gebruiken we de openbare profiel-URL van Satya Nadella als compact voorbeeld. Je voert een volledige scrapingtaak uit, interpreteert zijn functie bij Microsoft en de gedateerde werkervaringen, en koppelt het resultaat vervolgens aan je bronlead voordat je outreach voorbereidt.
🔑 Samenvatting voor wie haast heeft: Stuur bekende URL's van persoonlijke LinkedIn-profielen naar Datablist en ontvang beschikbare profiel-, locatie-, werkervaring-, opleidings- en bedrijfsgegevens als gestructureerde JSON. In het onderstaande Python-voorbeeld blijven deze gegevens aan elke bronlead gekoppeld, zodat je de lijst kunt kwalificeren en relevantere outreach kunt voorbereiden.
- Input: Bekende URL's van persoonlijke LinkedIn-profielen.
- Output: Gestructureerde profielgegevens die bij elk broncontact worden opgeslagen.
💡 Liever een no-code oplossing? Gebruik Datablists LinkedIn Profile Scraper om zonder code gegevens uit bekende profiel-URL's te halen.
De Datablist API en Python-omgeving instellen
Toegang tot de Datablist REST API is inbegrepen bij het Growth-abonnement. Het ophalen van profielen kost ook enrichment credits. In het onderdeel over kosten leg ik uit hoeveel.
Maak een Personal API Key aan via de pagina Datablist API account. Dit voorbeeld toont de notatie van een Personal API Key:
exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2🔑 Heb je al een API key? Oudere keys gebruiken
auth0|<userId>:<accountId>:<secret>:1. Deze worden nog steeds ondersteund. Blijf je bestaande key precies gebruiken zoals die is gegenereerd; je hoeft hem niet te vervangen of anders op te maken.
Het script leest je key uit de omgevingsvariabele DATABLIST_API_KEY en verstuurt hem in de header X-API-Key.
Voor dit Python-voorbeeld gebruik ik het package requests. De volgende installatiecommando's zijn bedoeld voor een macOS- of Linux-shell. Maak een projectmap, open die in je terminal en voer dit uit:
python -m venv .venv
source .venv/bin/activate
python -m pip install requestsMaak daarna een bestand met de naam scrape_linkedin_profiles.py en exporteer je key:
export DATABLIST_API_KEY="your-personal-api-key"Een volledig LinkedIn-profiel scrapen met Python
Het bronrecord in deze handleiding bevat een vaste contact-ID en één bekende profiel-URL:
{
  "contact_id": "contact-satya-nadella",
  "profile_url": "https://www.linkedin.com/in/satyanadella/"
}
Het script verstuurt contact_id als inputId van de API. Resultaten hoeven niet in dezelfde volgorde binnen te komen als de inputs. Met deze ID kun je ieder resultaat dus betrouwbaar aan het juiste broncontact koppelen.
Plak het volgende volledige script in scrape_linkedin_profiles.py:
import json
import os
import time
import uuid
import requests
def scrape_profiles(source_contacts, api_key):
"""Submit one task, wait for completion, and return every result page."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": contact["contact_id"],
"data": {"profileUrl": contact["profile_url"]},
}
for contact in source_contacts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "linkedin-profile-scraper",
"uniqueId": unique_id,
"settings": {
"experiencesNb": "5",
"educationsNb": "3",
"acceptCachedProfiles": False,
"includeUrn": False,
"includePictures": False,
},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
source_contacts = [
{
"contact_id": "contact-satya-nadella",
"profile_url": "https://www.linkedin.com/in/satyanadella/",
}
]
profile_results = scrape_profiles(source_contacts, api_key)
print(json.dumps(profile_results, indent=2))Voer het script uit met:
python scrape_linkedin_profiles.pyDe instellingen vragen vijf werkervaringen en drie opleidingen op. De API verwacht deze aantallen als strings. Met acceptCachedProfiles: false vraag je een nieuwe retrieval aan. De opties voor afbeeldingen en interne ID's blijven uitgeschakeld, omdat deze workflow duurzame tekst- en URL-velden gebruikt.
Gebruik voor iedere input een standaard openbare /in/-profiel-URL of een Sales Navigator lead-URL. Een persoonsnaam, LinkedIn-zoekpagina of bedrijfspagina hoort bij een ander type taak en is geen geldige profielinput voor deze scraper. Bevat je bron Sales Navigator-links, dan kan de geretourneerde profileUrl de genormaliseerde openbare profiel-URL zijn. Houd bij grotere lijsten iedere inputId uniek en stabiel; leid hem niet af van de positie van een rij.
De aantallen voor de historie bepalen hoeveel platte, genummerde velden voor werkervaring en opleiding de API kan retourneren. Ze veranderen niets aan het aantal credits per profiel. Vraag genoeg historie op voor je onderzoeksbeslissing, maar selecteer geen tien functies als je alleen de laatste paar rollen gaat bekijken.
Wat de drie API-calls doen
De POST-request verstuurt de gekozen instellingen en profielinputs. Datablist accepteert het werk als achtergrondtaak en retourneert de bijbehorende @id. Het script toont zowel de gegenereerde uniqueId als de geretourneerde taak-ID. Zo beschik je over de gegevens waarmee je de taak later kunt controleren.
De eerste GET-call controleert elke drie seconden de status van de taak. De Python-client blokkeert tijdens het wachten, maar de API-taak blijft op de achtergrond actief. De loop stopt bij completed, failed of stopped.
De tweede GET-call haalt resultaten op in pagina's van maximaal 100 records. Als nextCursor een waarde bevat, haalt het script de volgende pagina op. Het stopt zodra nextCursor gelijk is aan null.
Profielresultaten en retrieval-instellingen begrijpen
De verstuurde URL bepaalt welk profiel de scraper ophaalt. Datablist accepteert openbare URL's van persoonlijke profielen en Sales Navigator lead-URL's, normaliseert waar nodig de profiel-URL en zet de beschikbare openbare gegevens om in platte velden voor profiel, werkervaring, opleiding en bedrijf.
De nieuwe retrieval uit deze handleiding is succesvol voltooid en kostte 25 credits. Dit is het volledige resultaat:
{
  "inputId": "contact-satya-nadella",
  "status": "success",
  "outputs": {
    "profileUrl": "https://www.linkedin.com/in/satyanadella/",
    "fullName": "Satya Nadella",
    "firstName": "Satya",
    "lastName": "Nadella",
    "linkedInHeadline": "Chairman and CEO at Microsoft",
    "linkedInSummary": "As chairman and CEO of Microsoft, I define my mission and that of my company as empowering every person and every organization on the planet to achieve more.",
    "linkedInProfilePicture": "https://media.licdn.com/dms/image/v2/C5603AQHHUuOSlRVA1w/profile-displayphoto-shrink_800_800/profile-displayphoto-shrink_800_800/0/1579726625483?e=1794441600&v=beta&t=I1sL---bTuvjxqb1vdbNsNy-fAsLCpBj3-WtJjOGbOc",
    "linkedInInternalIdentifier": "ACoAAAEkwwAB9KEc2TrQgOLEQ-vzRyZeCDyc6DQ",
    "linkedInLocation": "Redmond, Washington, United States",
    "linkedInCity": "Redmond",
    "linkedInState": "Washington",
    "linkedInCountryName": "United States",
    "linkedInCountryCode": "US",
    "linkedInLanguages": "",
    "linkedInConnections": 832,
    "linkedInlastExpTitle": "Chairman and CEO",
    "linkedInlastExpCompany": "Microsoft",
    "linkedInlastExpEmploymentType": null,
    "linkedInlastExpLocation": "Greater Seattle Area",
    "linkedInlastExpStartsAt": "2014-02-01",
    "linkedInlastExpEndsAt": null,
    "linkedInlastExpDescription": null,
    "linkedInlastExpCompanyWebsite": "https://news.microsoft.com/",
    "linkedInlastExpCompanyPage": "https://www.linkedin.com/company/microsoft/",
    "linkedInlastExpCompanyIndustry": "Software Development",
    "linkedInlastExpCompanyRange": "10001+",
    "linkedInlastExpCompanyDescription": "Every company has a mission. What's ours? To empower every person and every organization to achieve more. We believe technology can and should be a force for good and that meaningful innovation contributes to a brighter world in the future and today. Our culture doesn’t just encourage curiosity; it embraces it. Each day we make progress together by showing up as our authentic selves. We show up with a learn-it-all mentality. We show up cheering on others, knowing their success doesn't diminish our own. We show up every day open to learning our own biases, changing our behavior, and inviting in differences. Because impact matters. \n\nMicrosoft operates in 190 countries and is made up of approximately 228,000 passionate employees worldwide.",
    "linkedInlastExpCompanyLogo": "https://media.licdn.com/dms/image/v2/D560BAQH32RJQCl3dDQ/company-logo_200_200/B56ZYQ0mrGGoAM-/0/1744038948046/microsoft_logo?e=1793836800&v=beta&t=4wXD40LQU4IfLY4DiEvT2bwvjUoPQPGgi5_T-vPsbQ8",
    "linkedIn2ExpTitle": "Chairman",
    "linkedIn2ExpCompanyName": "The Business Council U.S.",
    "linkedIn2ExpEmploymentType": null,
    "linkedIn2ExpStartsAt": "2021-01-01",
    "linkedIn2ExpEndsAt": "2023-01-01",
    "linkedIn2ExpDescription": null,
    "linkedIn2ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQGcnaZNpjMvrw/company-logo_200_200/company-logo_200_200/0/1630557702704/the_business_council_us_logo?e=1793836800&v=beta&t=Ejb0D8lV5sMTFwcz_-FKdfQvIvq-mKx_Nl8vRMib53k",
    "linkedIn3ExpTitle": "Member Board Of Trustees",
    "linkedIn3ExpCompanyName": "University of Chicago",
    "linkedIn3ExpEmploymentType": null,
    "linkedIn3ExpStartsAt": "2018-01-01",
    "linkedIn3ExpEndsAt": null,
    "linkedIn3ExpDescription": null,
    "linkedIn3ExpLogo": "https://media.licdn.com/dms/image/v2/D4E0BAQGDP-PXY3u8dw/company-logo_200_200/B4EaENqZTQGoAM-/0/1791230580227/uchicago_logo?e=1793836800&v=beta&t=NJGoETr0tY868Z2pvlyXeh939iXwW0WbSFwRctabEVU",
    "linkedIn4ExpTitle": "Board Member",
    "linkedIn4ExpCompanyName": "Starbucks",
    "linkedIn4ExpEmploymentType": null,
    "linkedIn4ExpStartsAt": "2017-01-01",
    "linkedIn4ExpEndsAt": "2024-01-01",
    "linkedIn4ExpDescription": null,
    "linkedIn4ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQEQxk9y2rk7Hw/company-logo_200_200/company-logo_200_200/0/1631316692275?e=1793836800&v=beta&t=NVjljhe0oI5KzvJHodAJjss5EdvxaOIzQQ2rAGyh_AQ",
    "linkedIn5ExpTitle": "Board Member",
    "linkedIn5ExpCompanyName": "Fred Hutch",
    "linkedIn5ExpEmploymentType": null,
    "linkedIn5ExpStartsAt": "2016-01-01",
    "linkedIn5ExpEndsAt": "2022-01-01",
    "linkedIn5ExpDescription": null,
    "linkedIn5ExpLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQGF4eOou62nvQ/company-logo_200_200/company-logo_200_200/0/1664795263764/fredhutch_logo?e=1793836800&v=beta&t=dJWSO-KkuBPd6I6aRYBoIcQVzcSEmGLwqYy-VMFXJQc",
    "linkedInlastEduSchool": "The University of Chicago Booth School of Business",
    "linkedInlastEduDegree": null,
    "linkedInlastEduField": null,
    "linkedInlastEduStartsAt": "1994-01-01",
    "linkedInlastEduEndsAt": "1996-01-01",
    "linkedInlastEduPage": "https://www.linkedin.com/school/universityofchicagoboothschoolofbusiness/",
    "linkedInlastEduLogo": "https://media.licdn.com/dms/image/v2/D560BAQFZO05jhYKSkw/company-logo_200_200/company-logo_200_200/0/1692627816910/universityofchicagoboothschoolofbusiness_logo?e=2147483647&v=beta&t=BTjFA4UVU5iKIIyicg8d44rhoiuMbetNDB97BmqpwhQ",
    "linkedIn2EduSchool": "Manipal Institute of Technology",
    "linkedIn2EduDegree": "Bachelor’s Degree",
    "linkedIn2EduField": "Electrical Engineering",
    "linkedIn2EduStartsAt": null,
    "linkedIn2EduEndsAt": null,
    "linkedIn2EduPage": "https://www.linkedin.com/school/manipal-institute-of-technology/",
    "linkedIn2EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQHodG_7cUqs6w/company-logo_200_200/B4DZ8hC8AUJQAE-/0/1782965846314/manipal_institute_of_technology_logo?e=2147483647&v=beta&t=jqJK15_r7lxUNgWdbbzdMq47aLa_PqnkDYxg4Jun4Zo",
    "linkedIn3EduSchool": "University of Wisconsin-Milwaukee",
    "linkedIn3EduDegree": "Master’s Degree",
    "linkedIn3EduField": "Computer Science",
    "linkedIn3EduStartsAt": null,
    "linkedIn3EduEndsAt": null,
    "linkedIn3EduPage": "https://www.linkedin.com/school/uwmilwaukee/",
    "linkedIn3EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQE47QlO_LG8SQ/company-logo_200_200/company-logo_200_200/0/1729615751602/uwmilwaukee_logo?e=2147483647&v=beta&t=l-w3ttd1mZRc-_j5aCPXEzNiYJzl1iJjMGw7q8B3eRI"
  },
  "creditsUsed": "25",
  "error": null
}
Bekijk de functietitel, werkgever, startdatum en einddatum altijd samen. De functie bij Microsoft begon in februari 2014 en heeft geen einddatum. De periode bij The Business Council U.S. loopt van 2021 tot januari 2023. Deze datums maken duidelijk of een vermelding nog loopt of is beëindigd en laten ook zien hoe functies elkaar kunnen overlappen.
linkedInlastExpTitle en linkedInlastExpCompany bevatten de huidige of laatst gekoppelde werkervaring. Die eerste gekoppelde vermelding kan uitgebreidere bedrijfsgegevens bevatten, zoals de bedrijfspagina, website, branche, beschrijving en werknemersklasse. De genummerde vermeldingen voegen eerdere functies, werkgevers en datums toe. In deze response is de geretourneerde website van Microsoft https://news.microsoft.com/. Deze URL biedt het leadrecord een nuttige bedrijfsbron naast de werkervaring van de persoon.
De velden linkedInlastEduSchool, linkedIn2EduSchool en linkedIn3EduSchool noemen The University of Chicago Booth School of Business, Manipal Institute of Technology en de University of Wisconsin-Milwaukee. De vermelding van Manipal bevat een Bachelor's Degree in Electrical Engineering en die van Wisconsin-Milwaukee een Master's Degree in Computer Science. Voor Chicago zijn de waarden voor diploma en studierichting leeg.
Gebruik voor experiencesNb de waarden "3", "5" of "10" en voor educationsNb de waarden "1", "3" of "5", afhankelijk van hoeveel historie je nodig hebt. Lees deze velden rechtstreeks uit outputs wanneer ze relevant zijn voor je onderzoek. Een lege optionele waarde betekent niet dat het volledige resultaat is mislukt.
De verse modus is geschikt voor het voorbereiden van leadlijsten wanneer je de beschikbare openbare profielgegevens opnieuw wilt ophalen. De cachemodus kan tegen minder credits een beschikbaar opgeslagen profiel retourneren. Is er geen profiel in de cache, dan kan de API alsnog terugvallen op een nieuwe retrieval. Kies op basis van de gewenste actualiteit en je creditbudget.
Leadrecords voorbereiden voor outreach
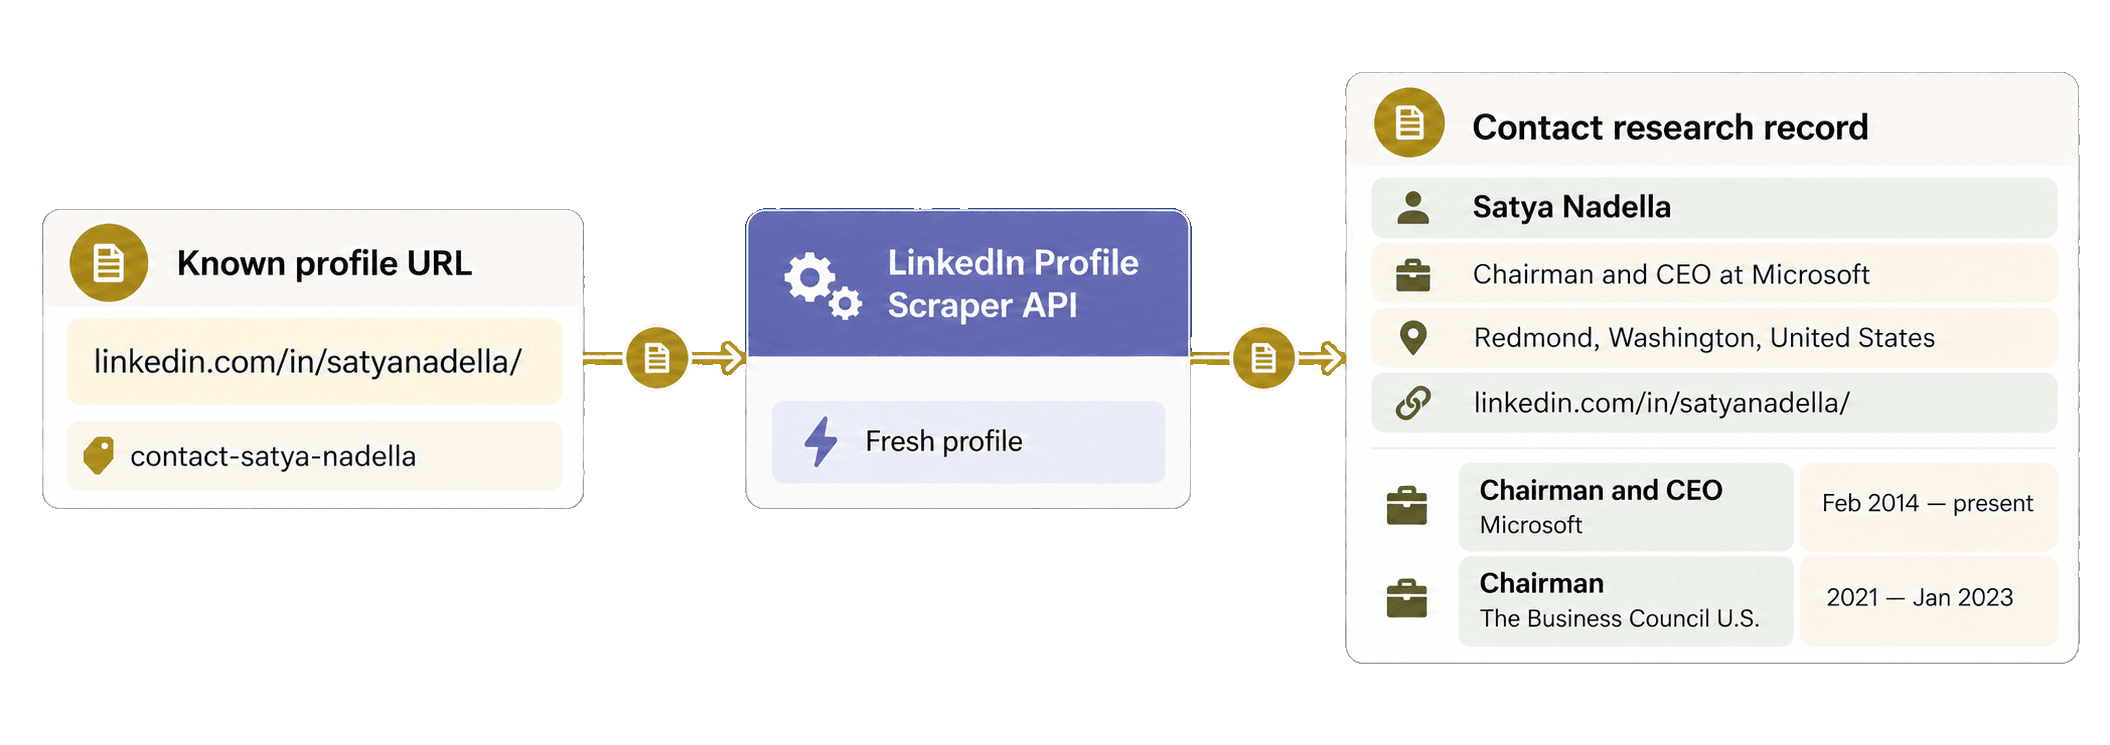
Zodra profile_results beschikbaar is, kun je iedere response aan het broncontact koppelen zonder een nieuwe taak te versturen. Het volgende blok hergebruikt de variabelen uit het volledige script:
results_by_input_id = {
result["inputId"]: result
for result in profile_results
}
contact_research = []
for contact in source_contacts:
result = results_by_input_id[contact["contact_id"]]
contact_research.append(
{
"contact_id": contact["contact_id"],
"source_profile_url": contact["profile_url"],
"result_status": result["status"],
"profile": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
research_record = contact_research[0]
profile = research_record["profile"]
print("Contact:", profile.get("fullName"))
print("Headline:", profile.get("linkedInHeadline"))
print("Location:", profile.get("linkedInLocation"))
print(
"First work entry:",
profile.get("linkedInlastExpTitle"),
"at",
profile.get("linkedInlastExpCompany"),
)De dictionary met inputId als sleutel verwerkt responses die in een andere volgorde binnenkomen. contact-satya-nadella blijft zowel de bron-ID als de API-ID, de bekende LinkedIn-URL blijft source_profile_url en in profile blijft het oorspronkelijke outputs-object ongewijzigd.
Deze wrapper houdt het volledige geretourneerde profiel bij elkaar met de bron-URL, API-status en het creditverbruik. Je kunt de weergegeven headline, locatie en eerste werkervaring gebruiken om de lead te kwalificeren en relevante functie- of bedrijfscontext aan je outreach toe te voegen. Mislukte API-rijen behouden hun geretourneerde status en foutmelding, zodat ze zichtbaar blijven in de leadlijst.
Je kunt het onderhouden blokkerende Requests-voorbeeld downloaden of, zodra de blokkerende flow duidelijk is, het asynchrone HTTPX-alternatief gebruiken.
Kosten van LinkedIn-profielen scrapen berekenen
Een nieuwe retrieval kost 25 credits per profiel. Als profielen uit de cache zijn toegestaan, kost een beschikbaar gecachet resultaat 20 credits. Bij een cache miss kan de API alsnog terugvallen op een nieuwe retrieval van 25 credits. Het verse voorbeeld met Satya Nadella kostte 25 credits.
Voor 1.000 profielen verbruikt de retrieval dus 20.000 credits als ieder opgevraagd profiel in de cache beschikbaar is, of maximaal 25.000 credits bij een nieuwe retrieval. Voor toegang tot de Datablist REST API heb je het Growth-abonnement nodig. Het abonnement, de inbegrepen credits en eventuele extra creditbundels zijn afzonderlijke onderdelen van de kosten. Bekijk de actuele opties op de pricing-pagina.
Met de huidige basisbundel van $ 20 voor 20.000 credits als rekenvoorbeeld, vertegenwoordigen de verbruikte credits naar schatting $ 20 voor 1.000 volledig gecachete profielen of $ 25 voor een nieuwe retrieval. Deze bedragen staan los van de kosten van het Growth-abonnement.
Veelvoorkomende fouten oplossen en taken herstellen
DATABLIST_API_KEYontbreekt: het script stopt voordat het een request verstuurt. Exporteer de variabele en voer het bestand opnieuw uit.- De API weigert de key: controleer de Personal API Key en verstuur uitsluitend de
X-API-Key-credential uit dit voorbeeld. - De profiel-URL ontbreekt of is ongeldig: gebruik een openbare URL van een persoonlijk LinkedIn-profiel of een ondersteunde Sales Navigator lead-URL. Een persoonsnaam, zoekpagina of bedrijfspagina is geen geldige profielinput.
- Je hebt onvoldoende credits: controleer je saldo en gebruik vervolgens inbegrepen credits of koop een extra bundel voordat je een nieuwe taak aanmaakt.
- De taak heeft de status
failedofstopped: controleer de foutmelding, beschikbare resultaten en het creditverbruik voordat je beslist of een nieuwe betaalde submission nodig is. - Een resultaat is beperkt,
no_resultoferror: controleer de status en openbare foutmelding en bevestig daarna de URL en instellingen. De beschikbare velden kunnen variëren door het profiel, de zichtbaarheid en de retrieval.
Als de verbinding tijdens de POST wegvalt, gebruik je de uniqueId die vóór de submission is weergegeven. Vraag recente scrapertaken op en vergelijk hun waarden voordat je een nieuwe taak aanmaakt:
response = requests.get(
"https://api.datablist.com/v1/enrichments/tasks",
headers={"X-API-Key": api_key},
params={"enrichmentId": "linkedin-profile-scraper", "limit": 100},
)
response.raise_for_status()
printed_unique_id = "paste-the-printed-unique-id"
tasks = response.json()["tasks"]
matching_task = None
for task in tasks:
if task["uniqueId"] == printed_unique_id:
matching_task = task
break
if matching_task:
print("Task ID:", matching_task["@id"])Je kunt de takenlijst filteren op enrichmentId, maar niet op uniqueId. Volg de nextCursor als de taak niet op de eerste pagina staat. Zodra je de taak-ID hebt, ga je verder met dezelfde status- en resultaat-URL's als in de hoofdfunctie. De documentatie van de task API legt de levenscyclus, paginering en het gedrag bij onderbrekingen uitgebreider uit.
Volgende stappen
Je hebt nu één herbruikbare Python Requests-functie die bekende LinkedIn-profiel-URL's omzet in gestructureerde resultaten, plus leadrecords die via een stabiele ID zijn gekoppeld. Vervang het voorbeeld door een kleine, gecontroleerde set URL's. Kies een nieuwe of gecachete retrieval op basis van de gewenste actualiteit en creditkosten, en gebruik de geretourneerde functie- en bedrijfscontext om leads te kwalificeren of outreach te personaliseren.
Bestaan je inputs uit URL's van bedrijfspagina's? Volg dan de Python-handleiding voor het scrapen van LinkedIn-bedrijfsgegevens.
Moet je de profiel-URL's nog vinden op basis van namen en een zoekterm voor een bedrijf of onderwijsinstelling? Volg dan eerst de aparte handleiding om LinkedIn-profielen te vinden met Python en een API voordat je deze scraper uitvoert.