
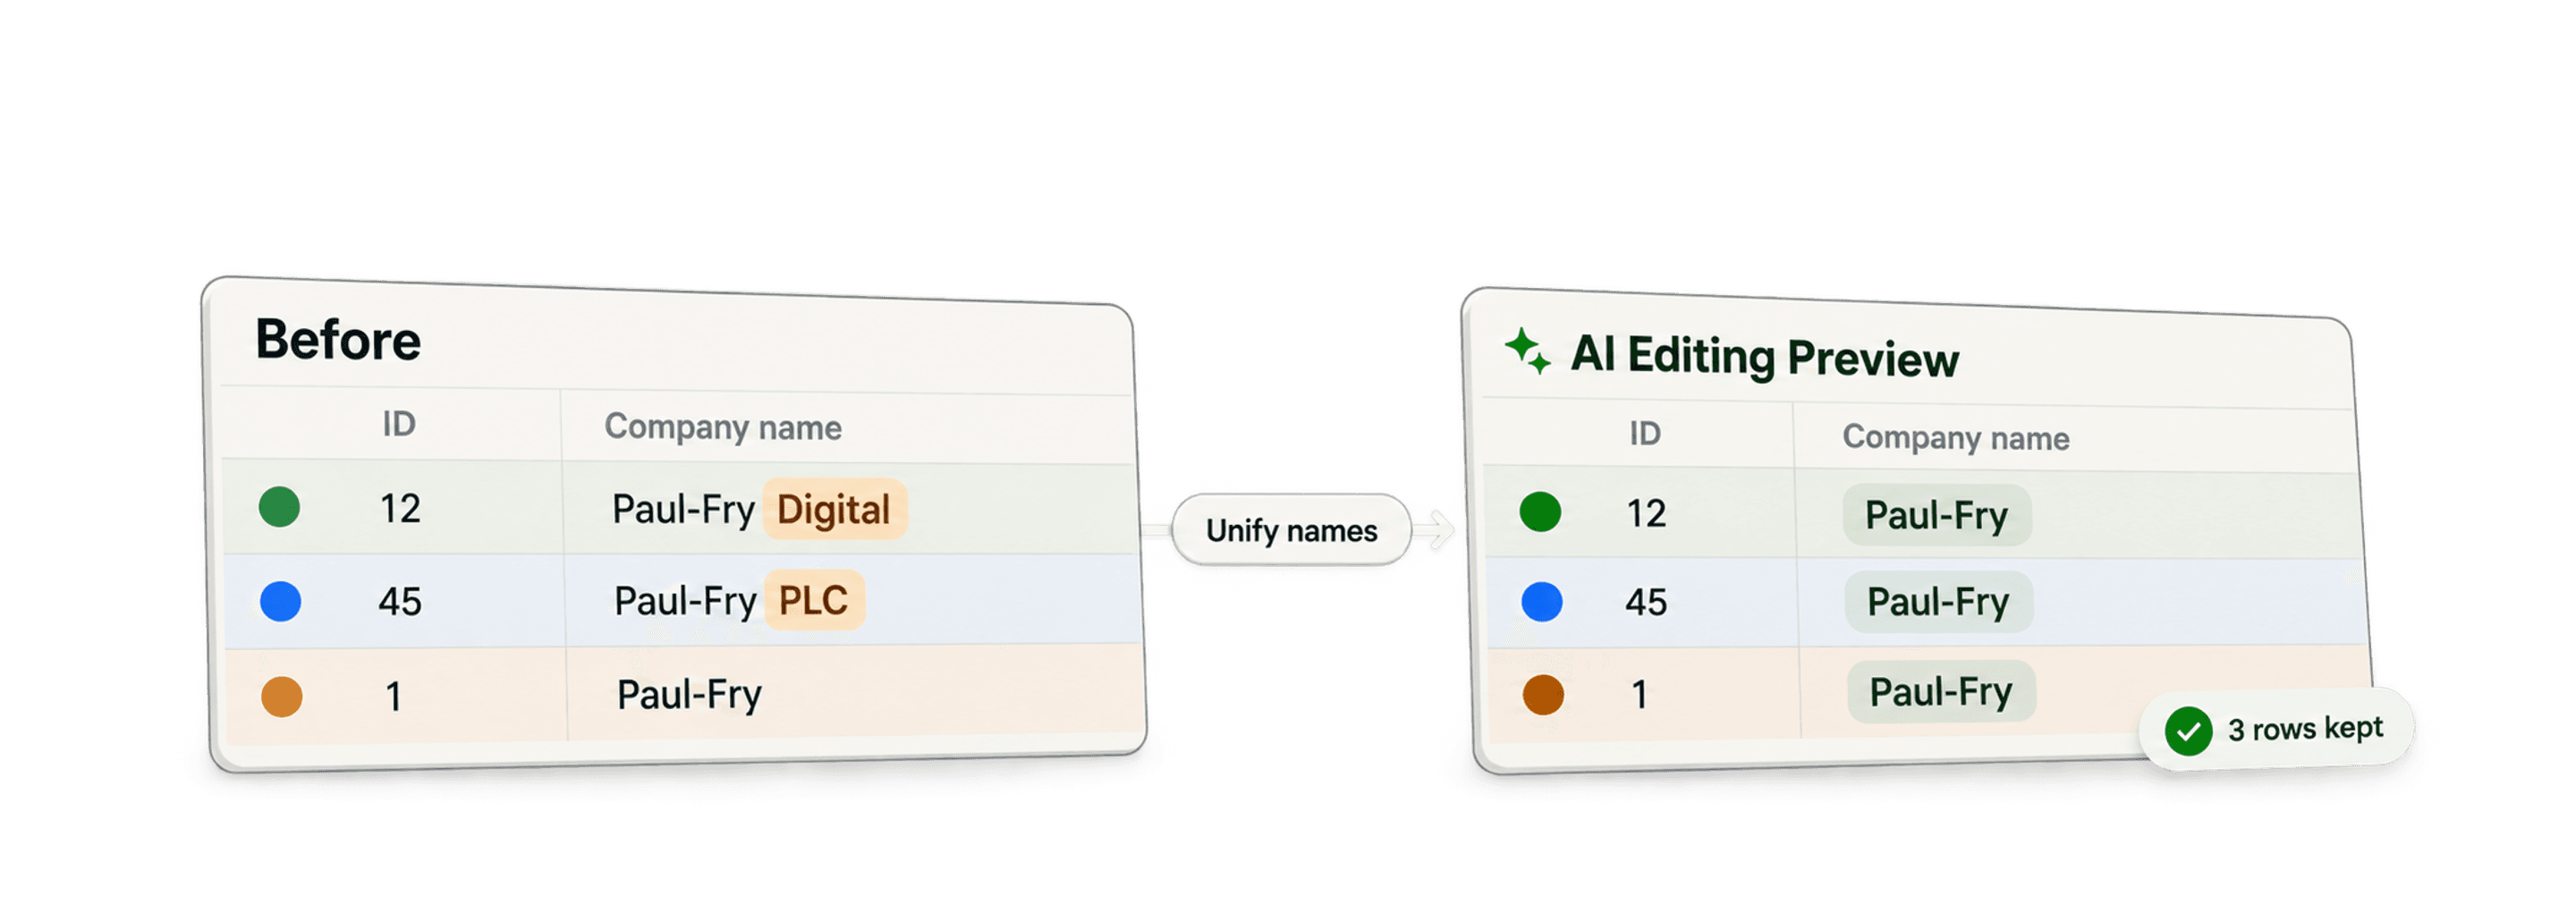
Om veldwaarden gelijk te maken zonder rijen samen te voegen, zoek je records die bij dezelfde entiteit horen, kies je één waarde voor het doelveld en kopieer je die naar de hele groep. Gebruik in Datablist Custom with AI in de Duplicates Finder en geef expliciet aan dat elk record behouden moet blijven.
Ik zou bedrijfsrecords eerst groeperen op basis van een betrouwbare identificatie, zoals hun website, en pas daarna de bedrijfsnamen standaardiseren. Alleen een vergelijkbare naam bewijst niet dat twee bedrijven dezelfde organisatie zijn. Door rijen gescheiden te houden, blijven hun ID's en brongegevens behouden. Een onjuist samengestelde groep kan er echter nog steeds toe leiden dat de verkeerde naam wordt overgenomen.
In deze handleiding leer je hoe je specifieke veldwaarden binnen groepen met duplicaten normaliseert, terwijl de afzonderlijke records intact blijven:
- Wat is datanormalisatie?
- AI Processing in Duplicates Finder
- Data in duplicaten normaliseren: stap voor stap
Wat is datanormalisatie?
Datanormalisatie betekent in deze context dat je data in een consistente indeling brengt. Bij duplicaten ontstaan vaak afwijkingen in specifieke velden. Bijvoorbeeld:
- Bedrijfsnamen: "Tech Solutions Inc.", "Tech Solutions, LLC", "Tech Solutions"
- Functietitels: "Software Engineer", "Software Dev.", "Eng., Software"
- Adressen: "Hoofdstraat 123", "Hoofdstr. 123", "hoofdstraat 123"
- Landen: "Nederland", "NL", "NLD"
Het doel van normalisatie is om één standaardwaarde te kiezen, zoals "Tech Solutions" of "Nederland", en die toe te passen op het betreffende veld in alle records die als duplicaten zijn aangemerkt.
Zo wordt je data schoner, eenvoudiger te analyseren en betrouwbaarder voor filters en rapportages, ook wanneer de dubbele records zelf gescheiden blijven. Het is een essentiële stap binnen data cleaning.
AI Processing in Duplicates Finder
De Duplicates Finder van Datablist is al een krachtige tool om vergelijkbare records te vinden. Naast uitgebreide opties om duplicaten automatisch of handmatig samen te voegen, biedt de modus AI Processing extra flexibiliteit.
In plaats van vooraf ingestelde regels te gebruiken, laat AI Processing jou de logica bepalen met een prompt in gewone taal. Je vertelt de AI precies hoe de duplicaten moeten worden verwerkt. Denk bijvoorbeeld aan:
- Een hoofdrecord selecteren op basis van specifieke criteria, zoals de meest recente update.
- Bepaalde velden samenvoegen en andere gescheiden houden.
- Berekeningen uitvoeren tijdens het samenvoegen, zoals waarden optellen.
- 👉 En essentieel voor deze handleiding: één specifiek veld in alle duplicaten bijwerken naar dezelfde genormaliseerde waarde, zonder de records samen te voegen.
Zo verandert een complexe taak waarvoor je normaal een script zou schrijven in een eenvoudig gesprek met onze AI.
Data in duplicaten normaliseren: stap voor stap
We doorlopen hoe je met AI Processing een veld, bijvoorbeeld Bedrijfsnaam, in dubbele records normaliseert.
Stap 1: Bereid je data voor
Eerst moet je data in Datablist staan.
- Maak een Collection: Klik in de zijbalk op de knop '+' om een nieuwe collection te maken.
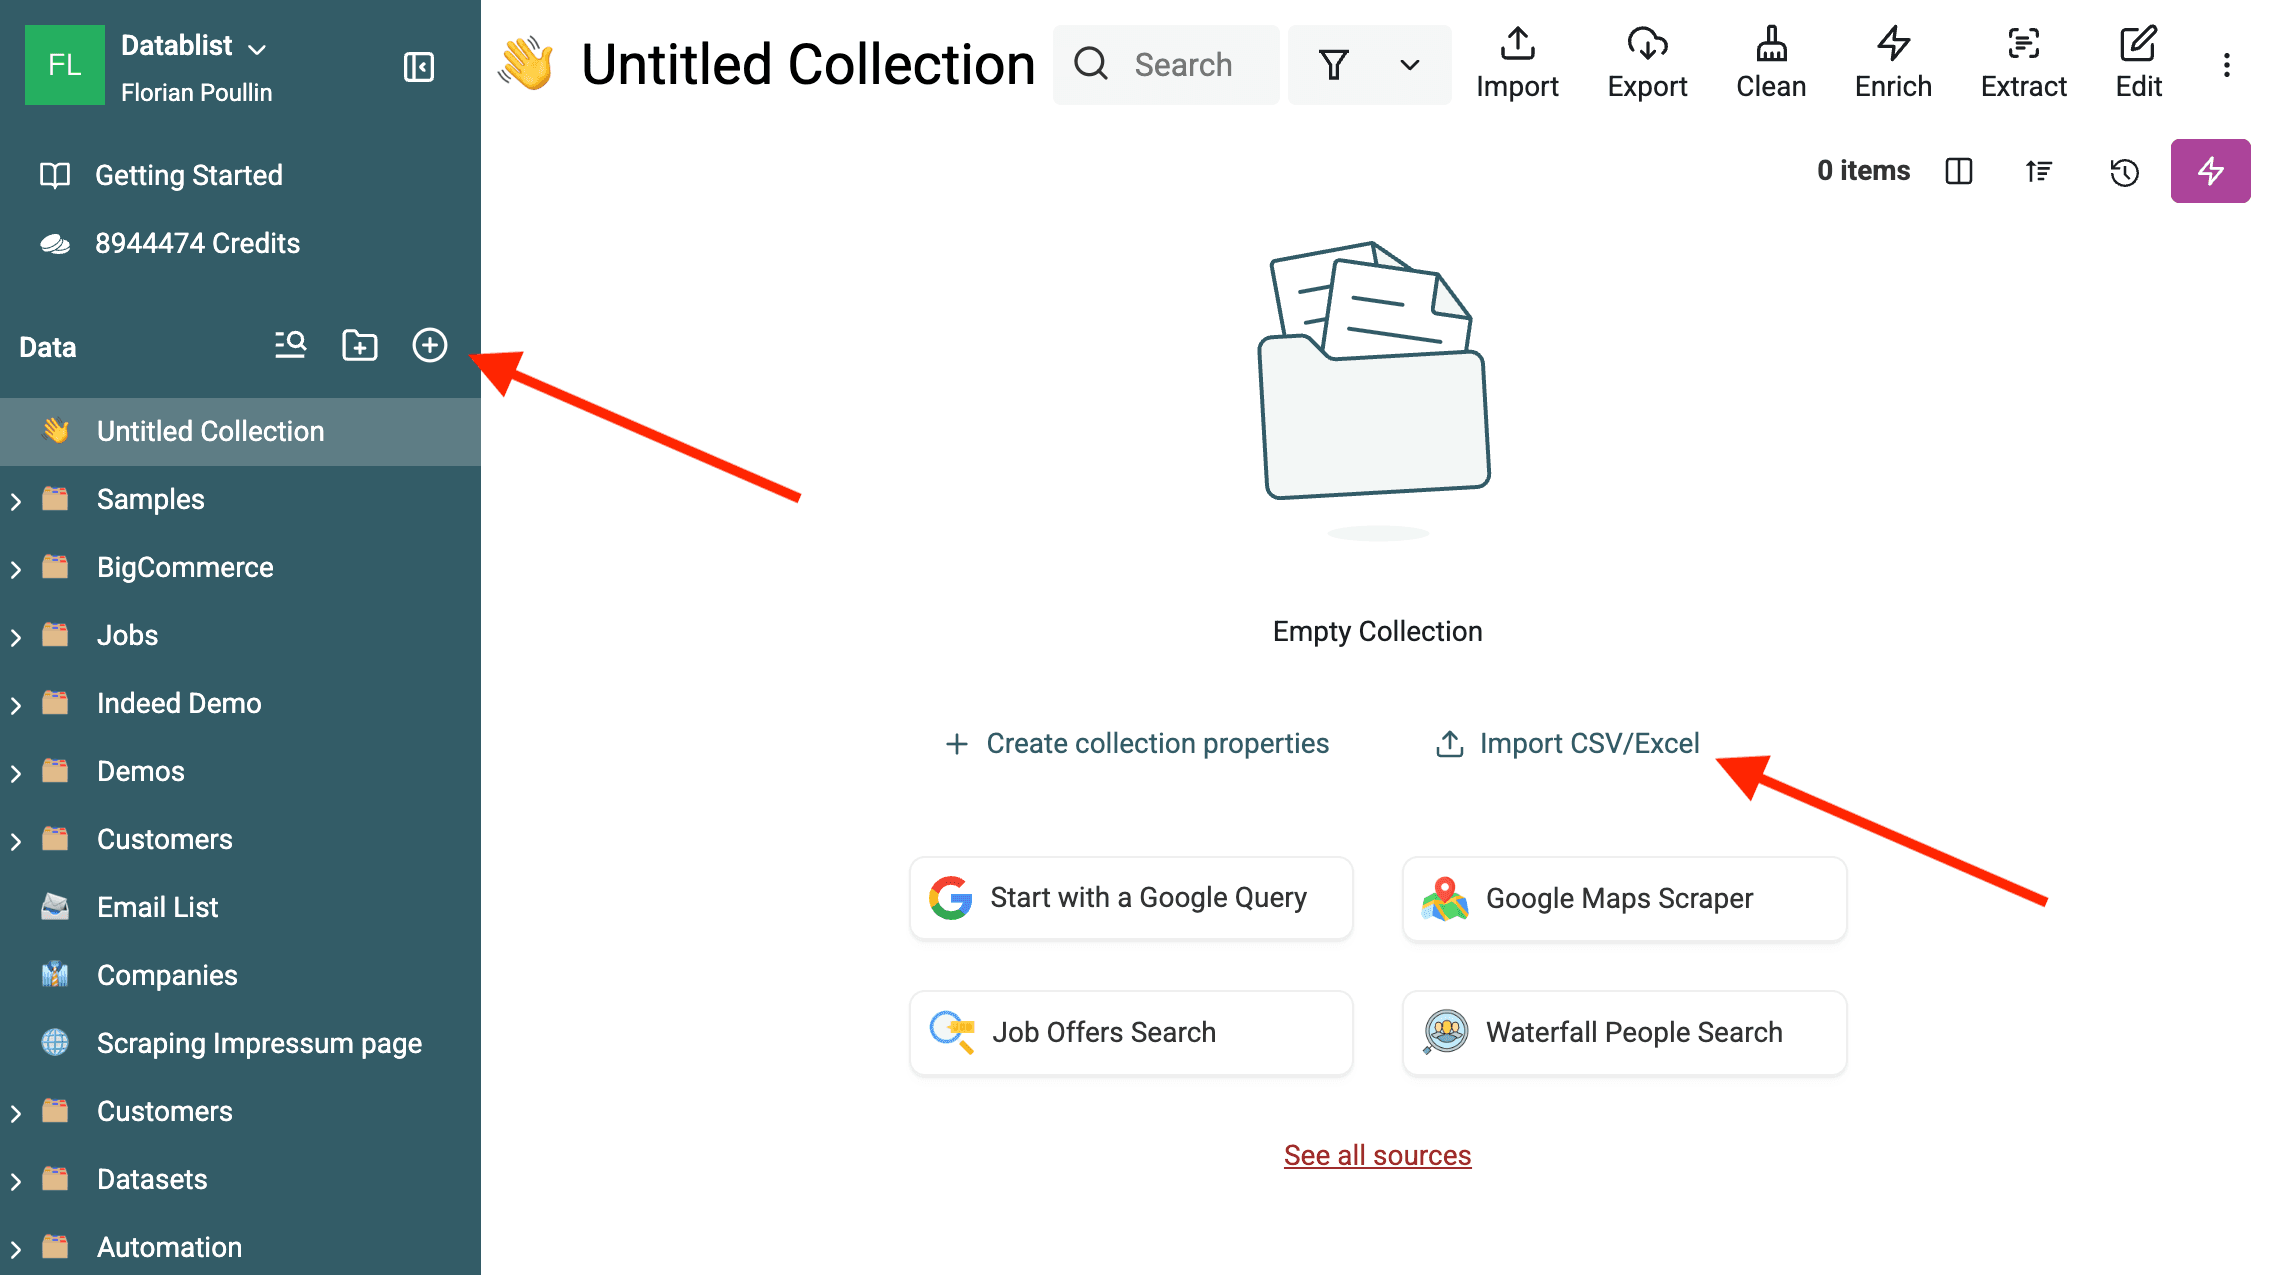
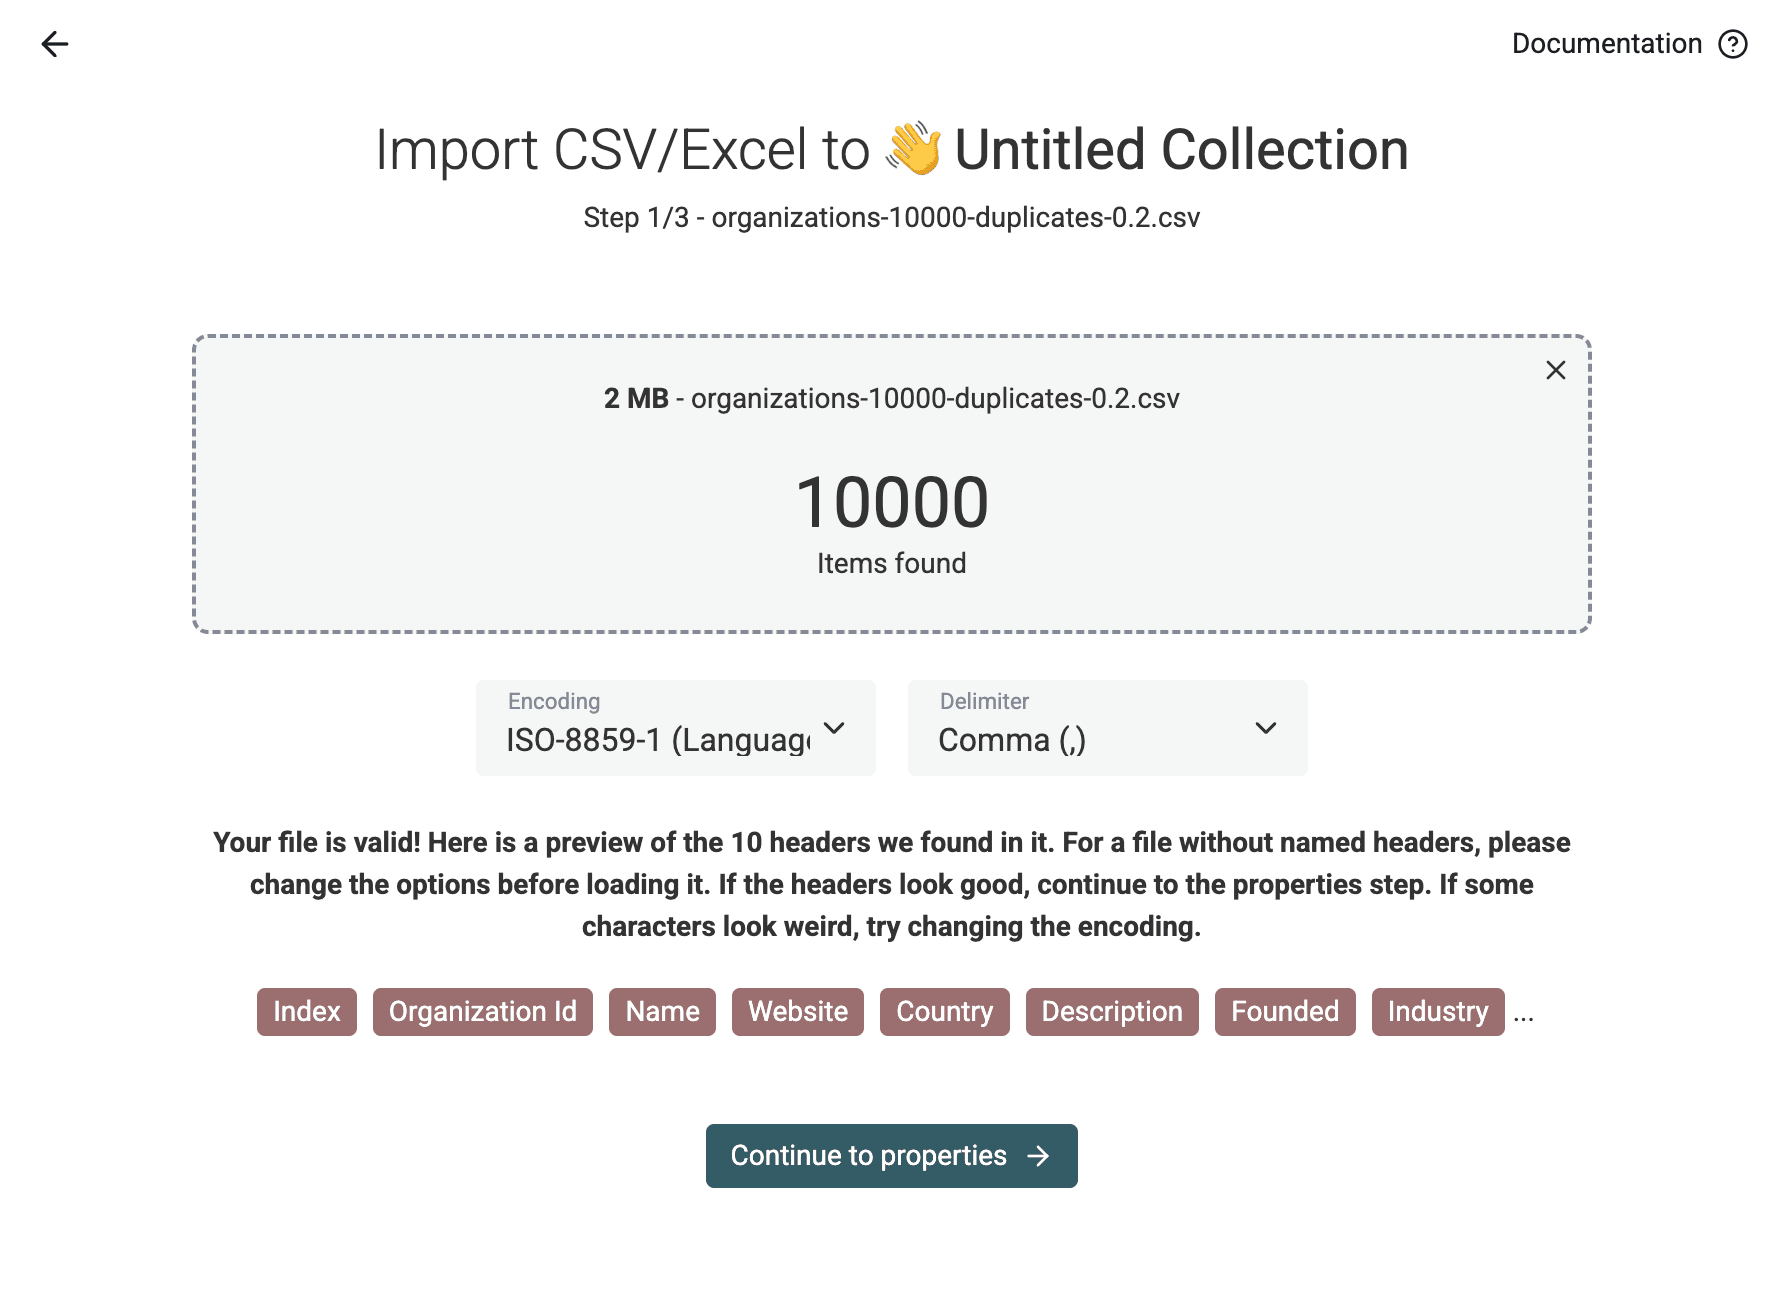
- Importeer data: Importeer je data uit een CSV- of Excel-bestand. Komt je data uit meerdere bestanden, importeer die dan in dezelfde collection. Datablist helpt je om kolommen aan properties te koppelen. Controleer of het veld dat je wilt normaliseren, bijvoorbeeld Bedrijfsnaam, en de velden waarmee je duplicaten identificeert, zoals E-mail of Website, correct zijn geïmporteerd.
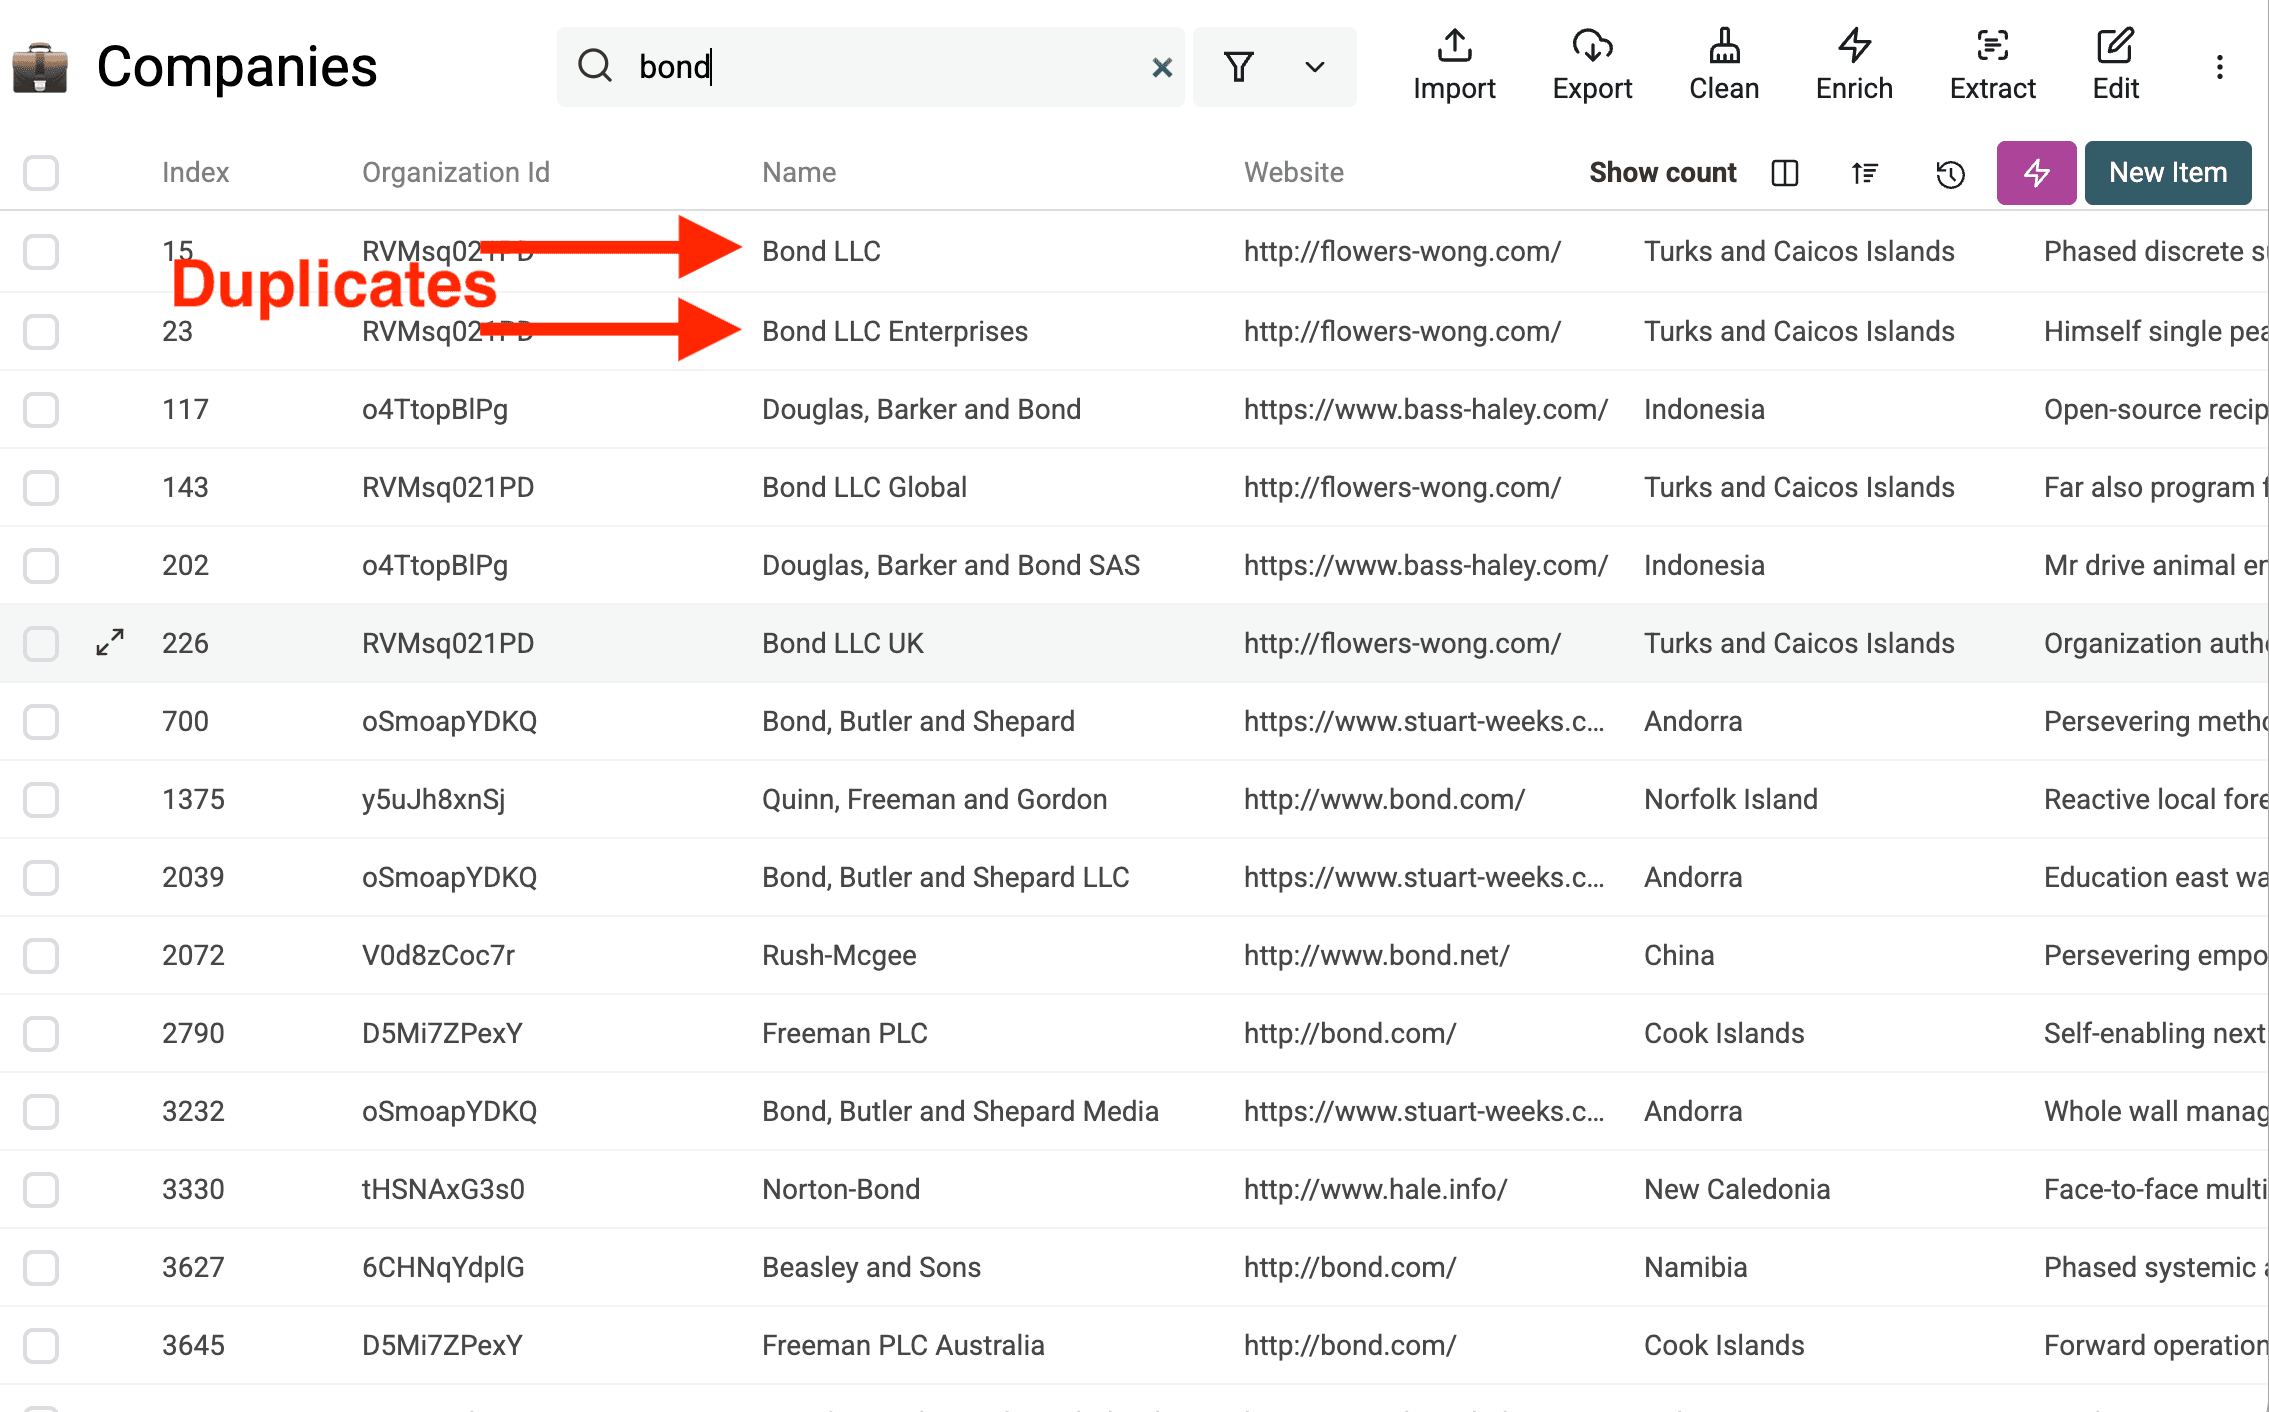
In deze voorbeelddata zien we al enkele dubbele bedrijfsnamen die moeten worden genormaliseerd.
Stap 2: Vind duplicaten
Identificeer nu de dubbele records.
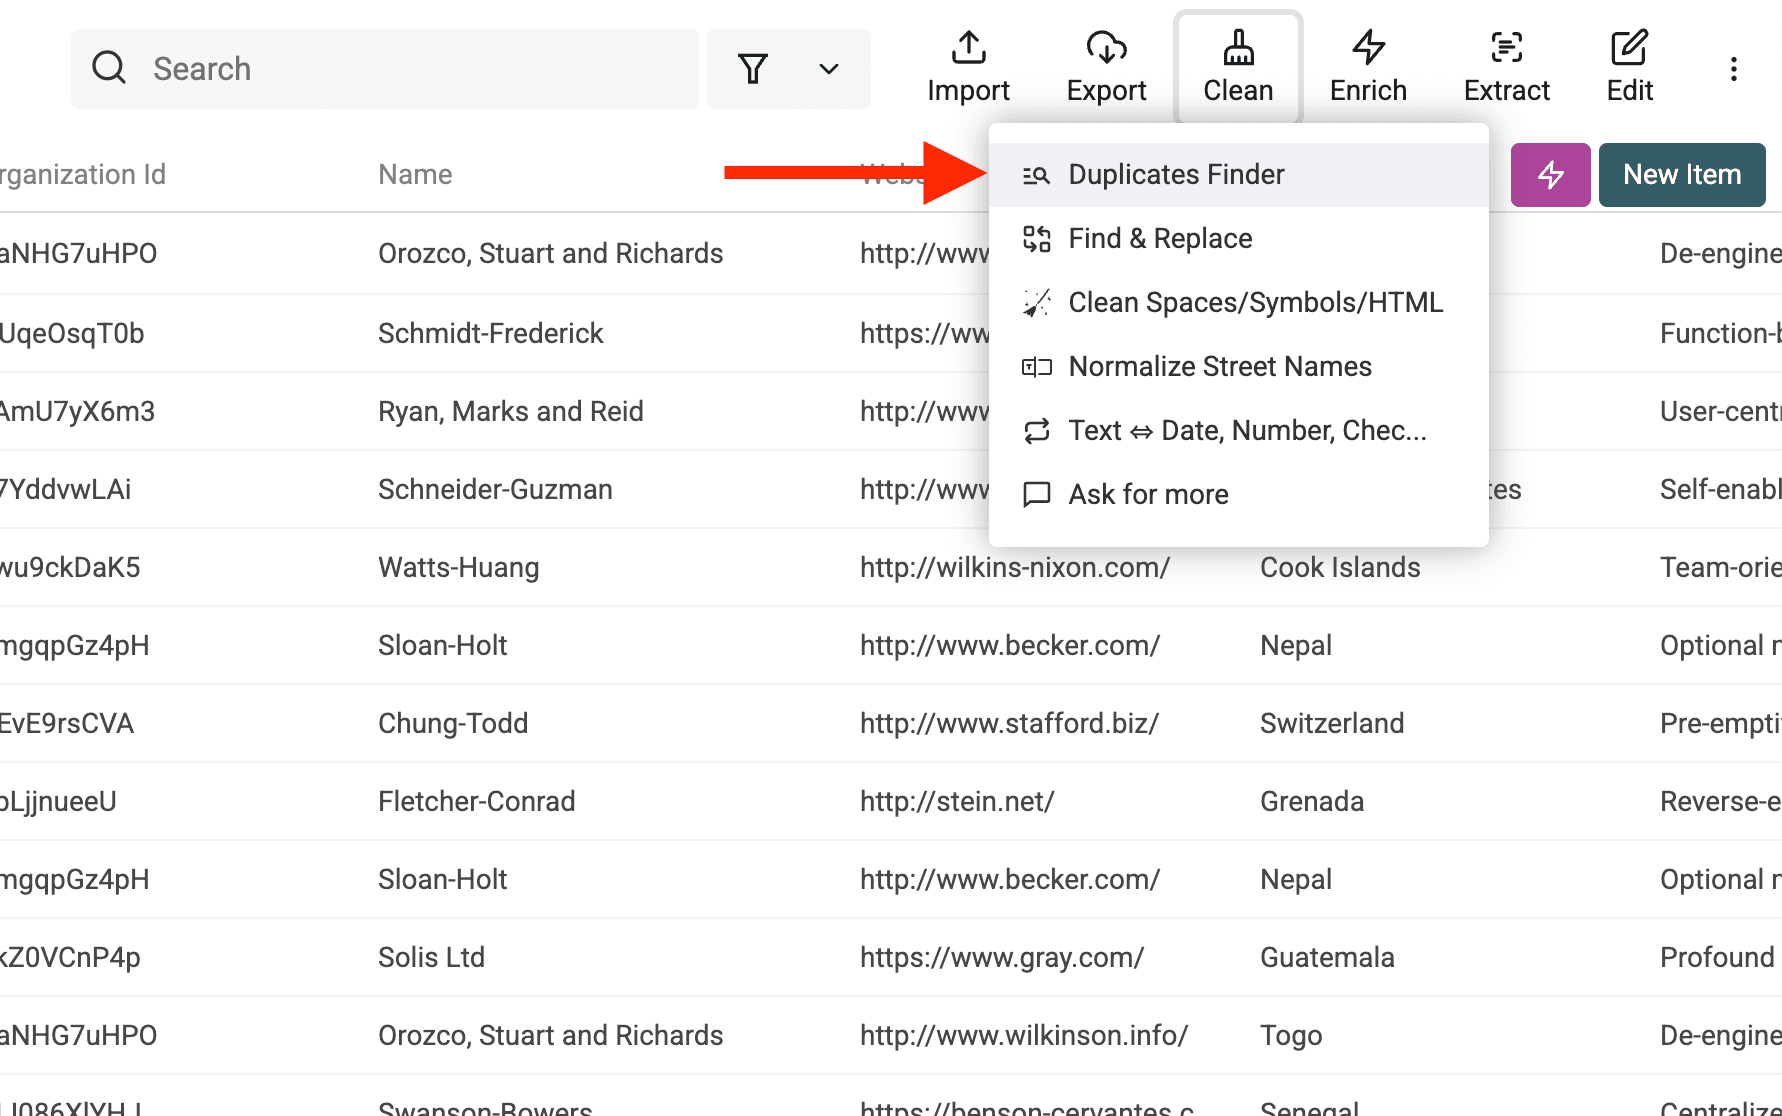
2.a. Open Duplicates Finder
Open Clean > Merge duplicates.
2.b Kies identificatievelden voor deduplicatie
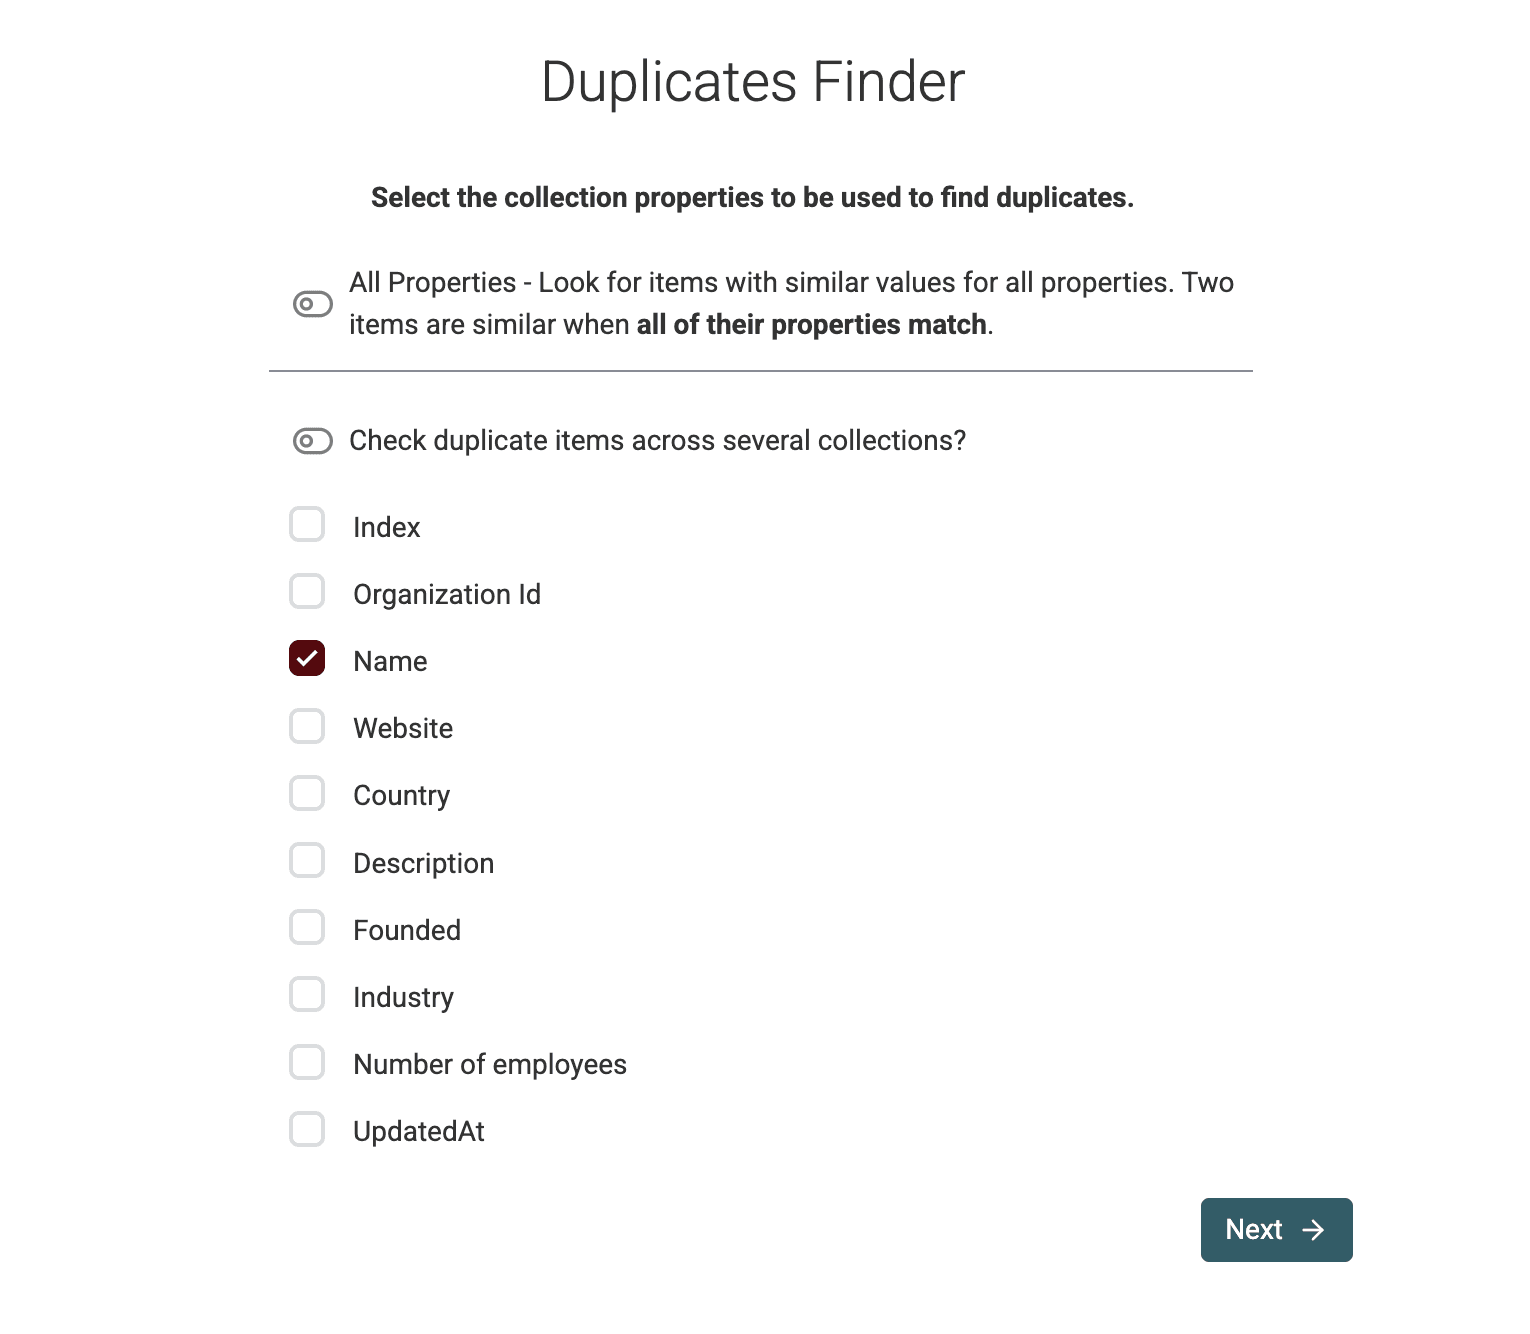
Selecteer de property of properties waarmee je een duplicaat eenduidig kunt identificeren.
Gebruik indien mogelijk een gedeelde website of bedrijfs-ID. Heb je alleen namen, volg dan de handleiding voor het matchen van bedrijfsnamen en controleer elke groep voordat je deze normaliseert. Vergelijkbare namen en verschillende juridische achtervoegsels kunnen bij afzonderlijke organisaties horen.
Voor bedrijven kun je ook
Website URLofLinkedIn Company Page URLgebruiken.Voor contacten zijn
Phone Numbergangbare keuzes.
2.c Configureer het algoritme
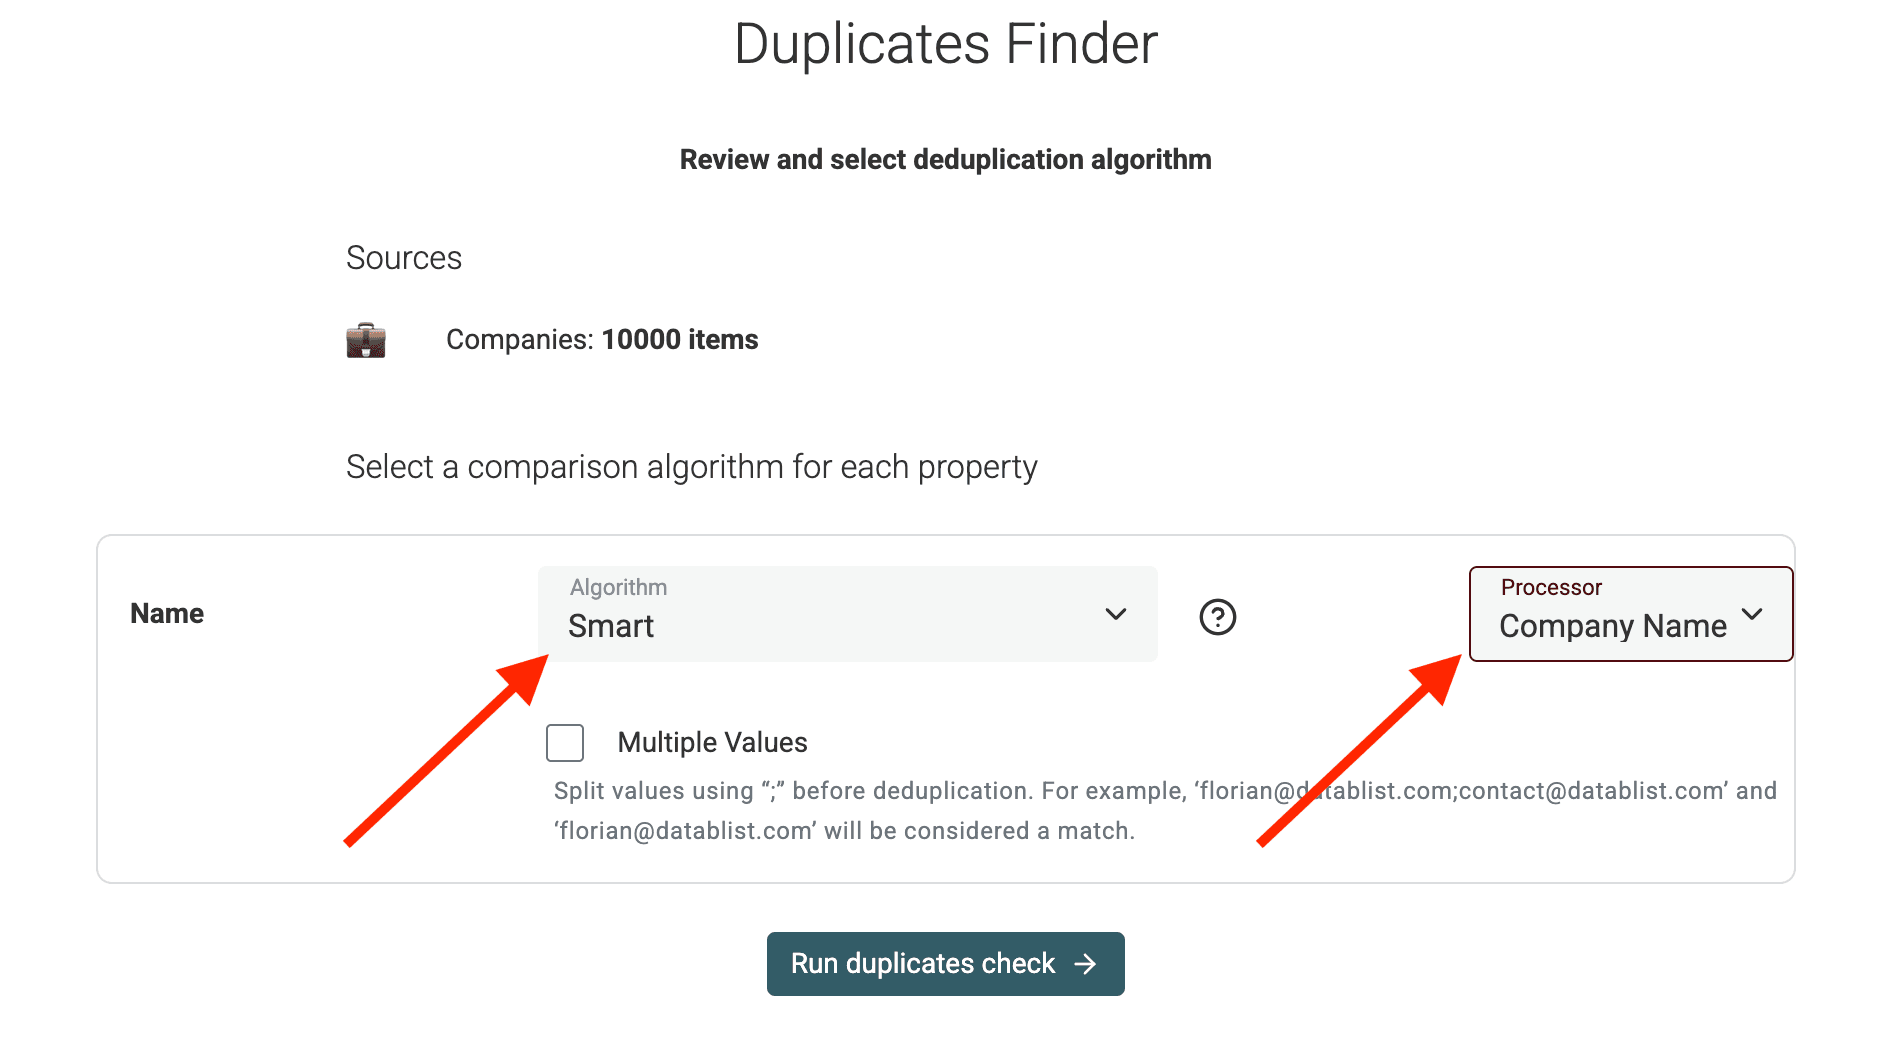
Kies in de volgende stap het matching-algoritme.
'Smart' werkt vaak goed voor URL's en e-mailadressen en houdt rekening met kleine verschillen. 'Exact' is strenger. Voor namen kun je ook fonetische of fuzzy matching gebruiken.
Kies de Processor voor het veld waarmee je duplicaten identificeert. Gebruik Url voor een website en Email voor een e-mailadres. Selecteer Company Name wanneer je varianten van bedrijfsnamen wilt matchen.
De processor bepaalt hoe waarden worden vergeleken, maar bewerkt de opgeslagen cellen niet. Je kunt hier groeperen op Website URL en in de latere AI-stap alsnog Company Name normaliseren. Het identificatieveld voor matching en het veld dat je wilt bijwerken, hebben elk een ander doel.
2.c Voer de controle uit
Klik op Run duplicates check.
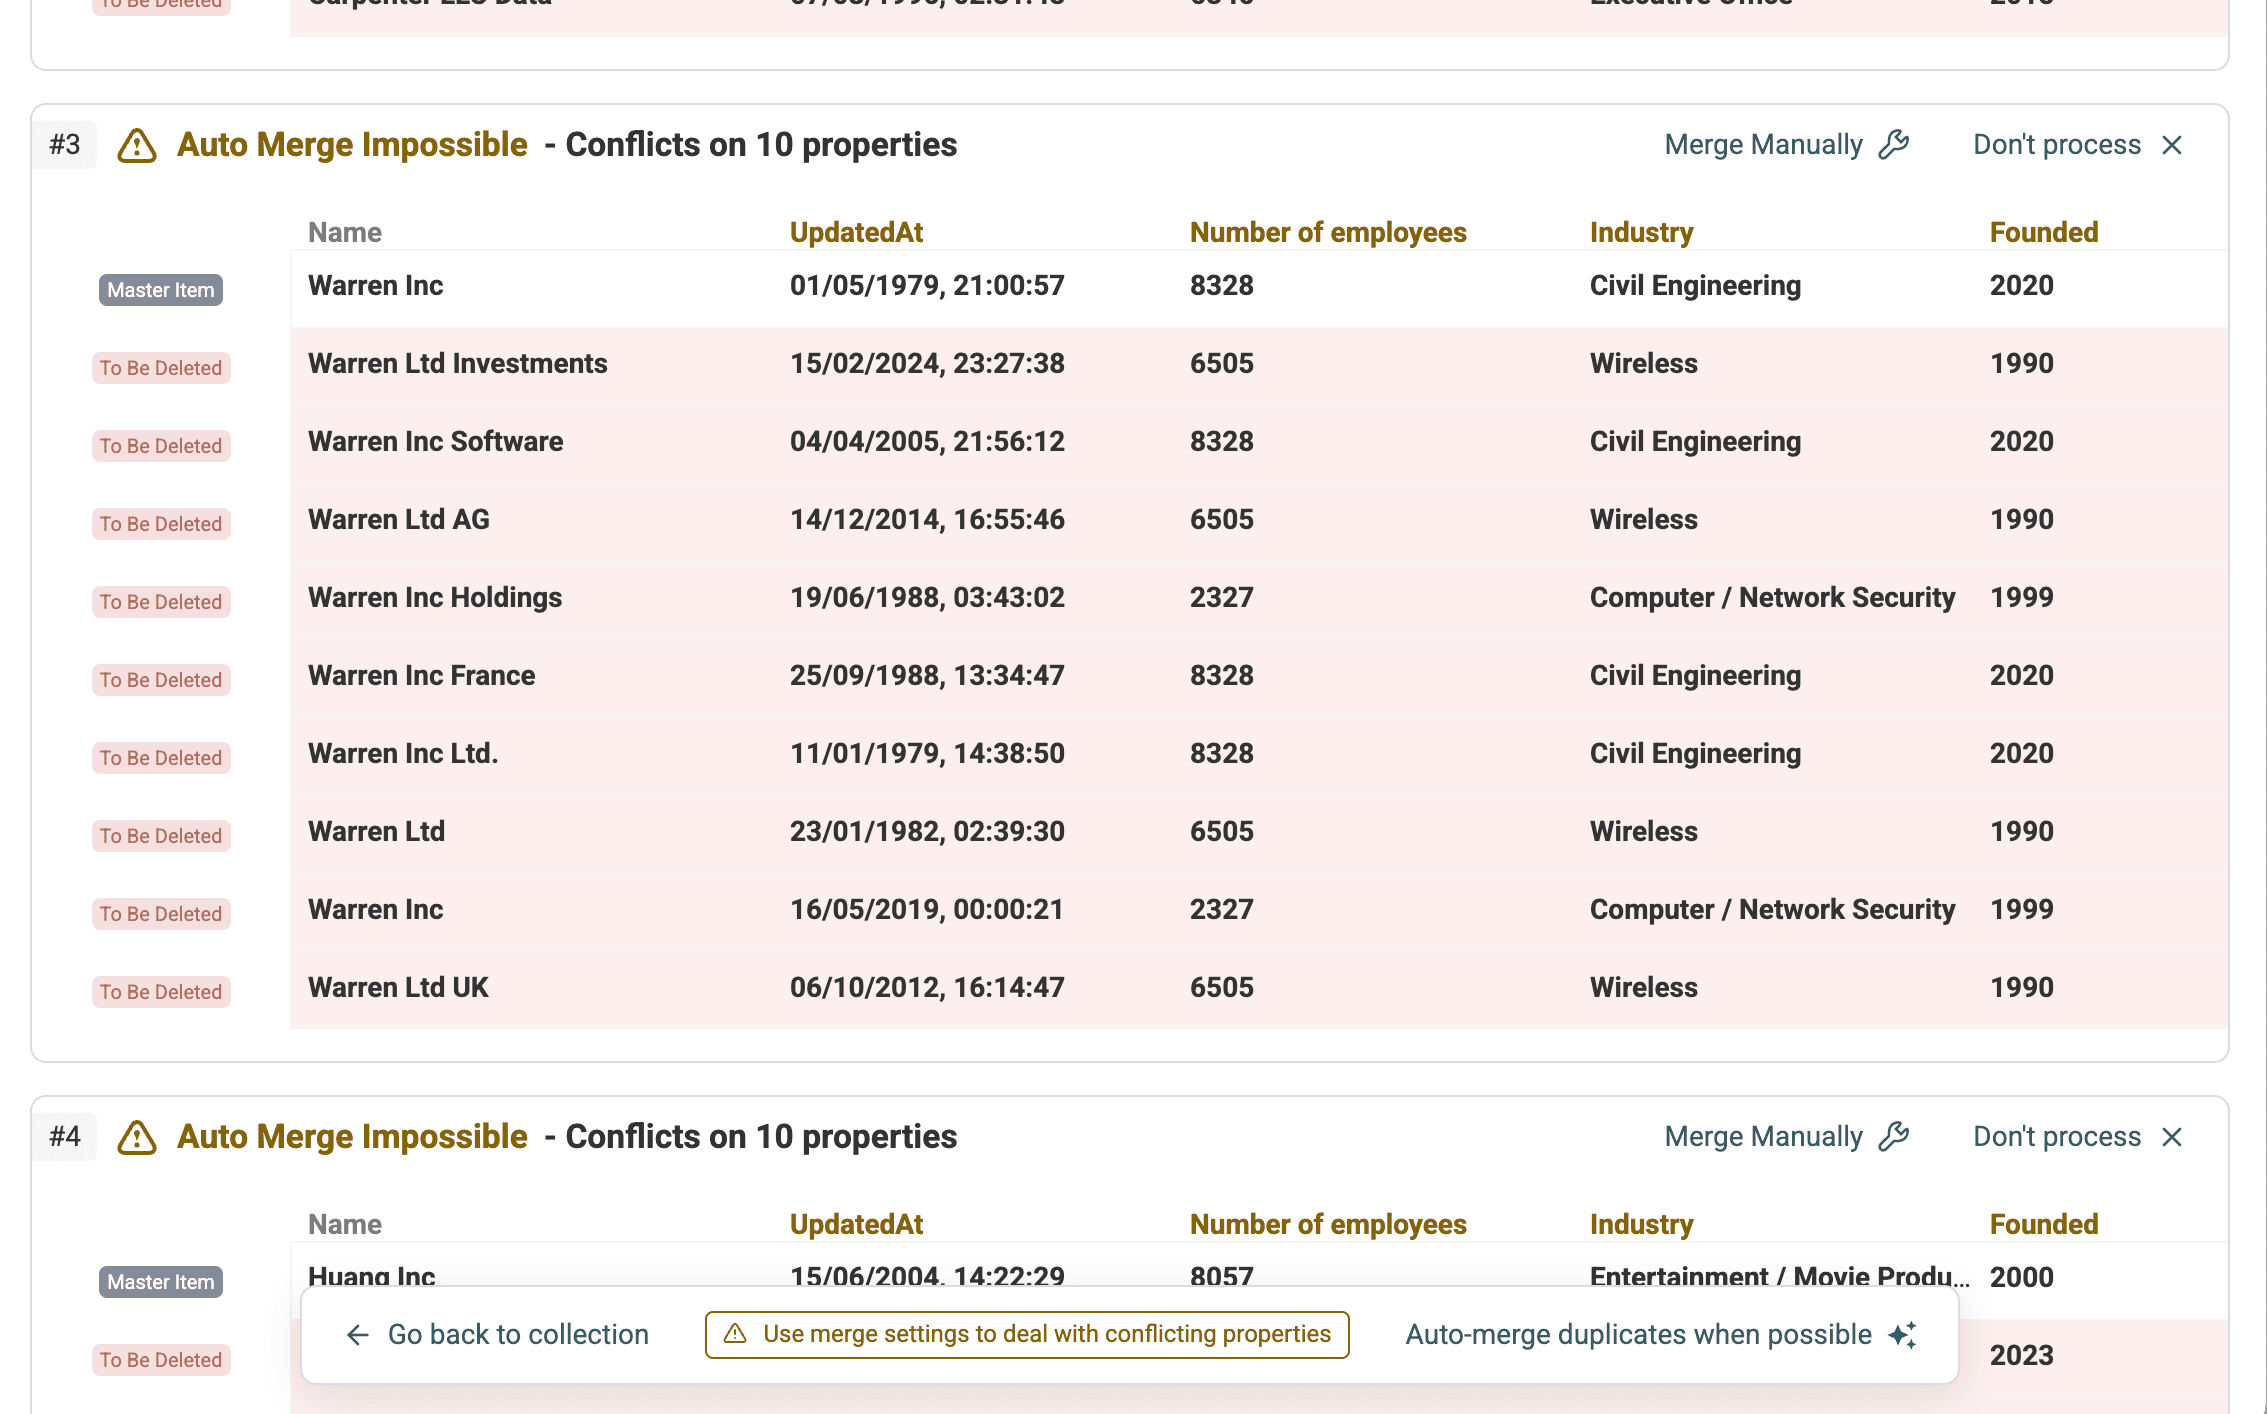
Datablist analyseert je data en toont groepen met mogelijke duplicaten.
Stap 3: Selecteer AI Processing
Selecteer Custom with AI op de resultatenpagina met duplicaten. De oudere screenshots hieronder tonen nog het voormalige label AI Editing. Deze modus genereert op basis van je instructies en een kleine steekproef een script en laat vervolgens een preview van de wijzigingen zien.
Stap 4: Schrijf de prompt voor normalisatie
Hier vertel je de AI wat er moet gebeuren. Geef de volgende instructies:
- Bepaal binnen elke groep met duplicaten de meest voorkomende waarde voor de doelproperty.
- Werk alle records in die groep bij met deze gemeenschappelijke waarde voor die specifieke property.
- Geef expliciet aan dat er geen records mogen worden verwijderd.
Hieronder staat een voorbeeldprompt om de property /Company Name te normaliseren:
Tel voor elke groep met duplicaten de niet-lege waarden in /CompanyName op basis van exacte tekstovereenkomsten. Als één waarde vaker voorkomt dan elke andere waarde, kopieer die dan naar /CompanyName in elk record van die groep, inclusief records met een lege CompanyName.
Als alle waarden leeg zijn of als twee of meer waarden even vaak voorkomen, sla de groep dan zonder wijzigingen over. Sla ook groepen over waarvan de waarden al identiek zijn. Behoud alle andere properties en voeg geen records samen en verwijder geen records.
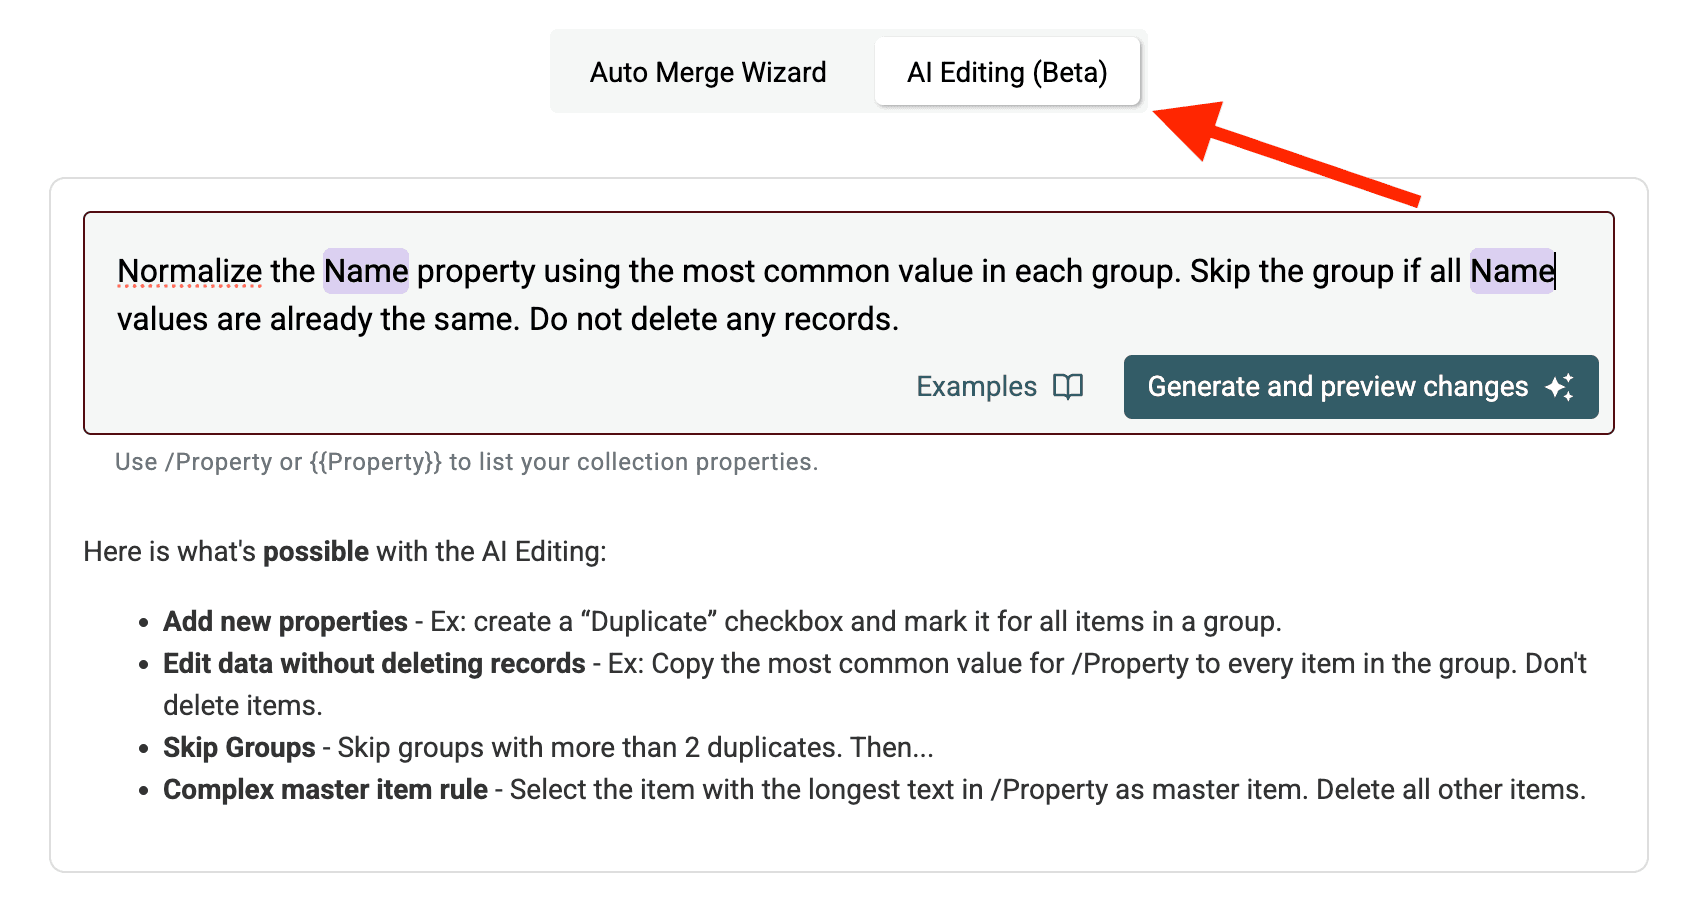
Uitleg van de prompt:
Normalize the /CompanyName property...: Hiermee geef je het doelveld aan. Gebruik/PropertyNameof{{PropertyName}}om naar je kolommen te verwijzen....count the non-empty values using exact text matches.: Hiermee bepaal je hoe de standaardwaarde wordt gekozen. Lege waarden kunnen niet winnen en een groep met een gelijke stand blijft staan voor controle. Je kunt ook andere criteria gebruiken, zoals "langste waarde", "kortste waarde" of een ander veld, bijvoorbeeld "gebruik de waarde van het record met de meest recente /UpdatedAt-datum".Skip the group if all /CompanyName values are already the same.: Een efficiëntie-instructie waarmee je onnodige verwerking voorkomt.Do not delete any records.: Dit is essentieel om ervoor te zorgen dat alleen velden worden bijgewerkt en dat er geen records worden samengevoegd of verwijderd.
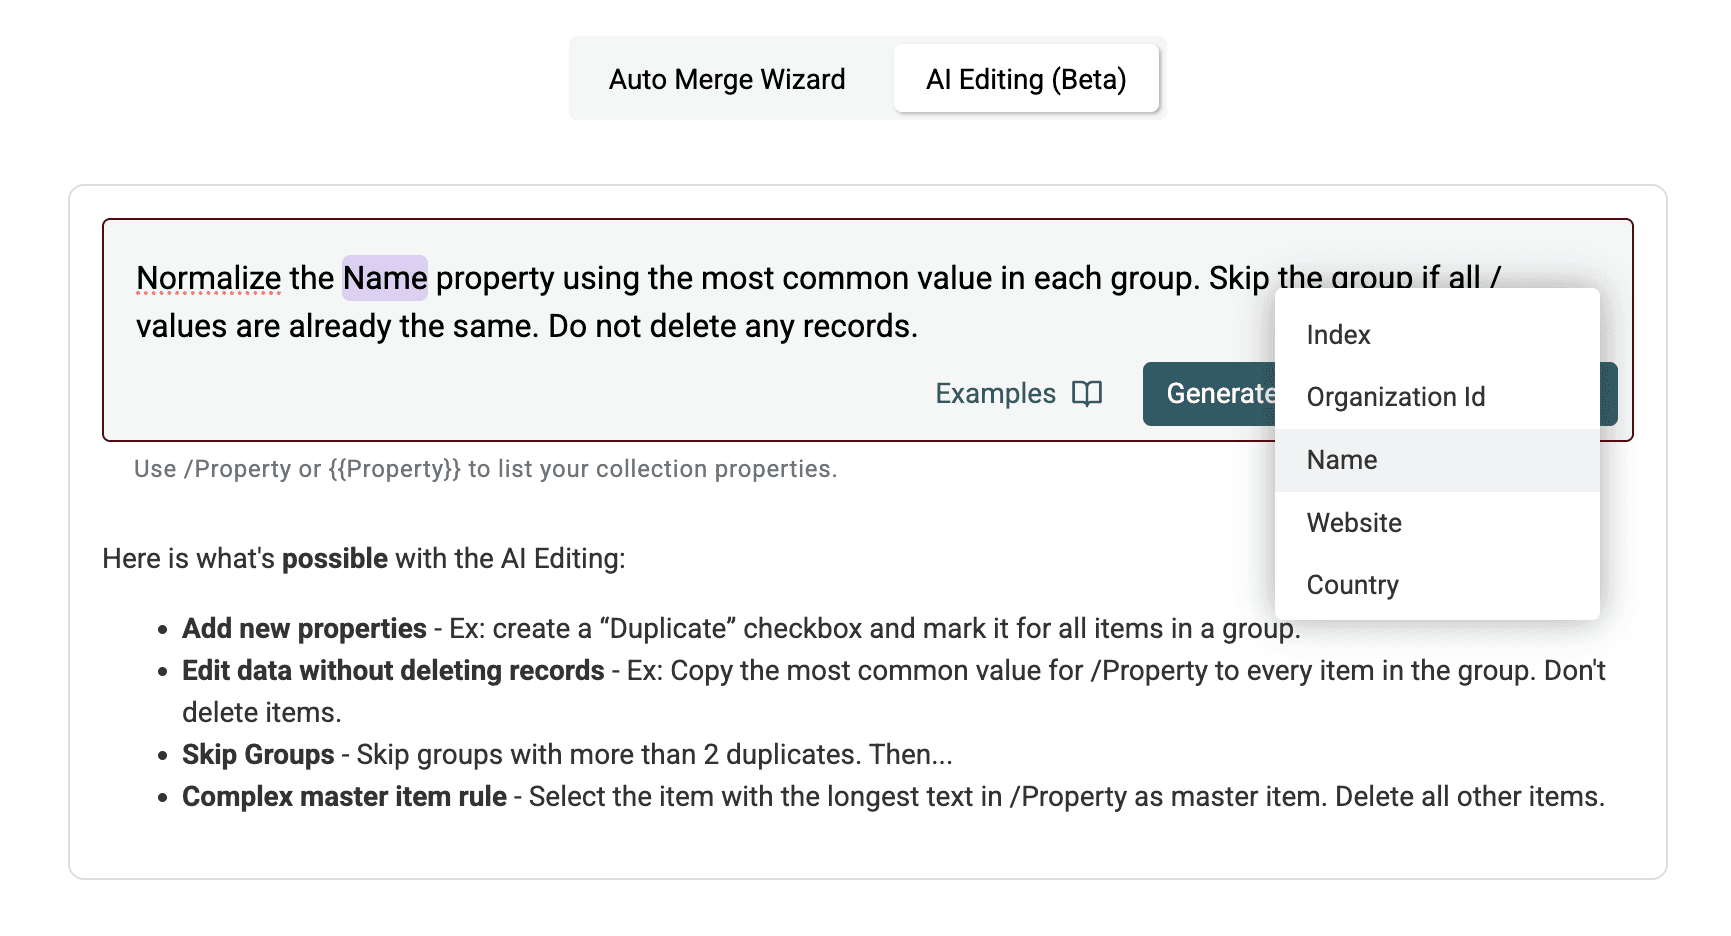
Stap 5: Genereer het script en bekijk de preview
Klik op Generate and preview changes. De AI van Datablist interpreteert je prompt en genereert een script dat de actie uitvoert.
Geen zorgen: je hoeft zelf geen script te schrijven of te bewerken.
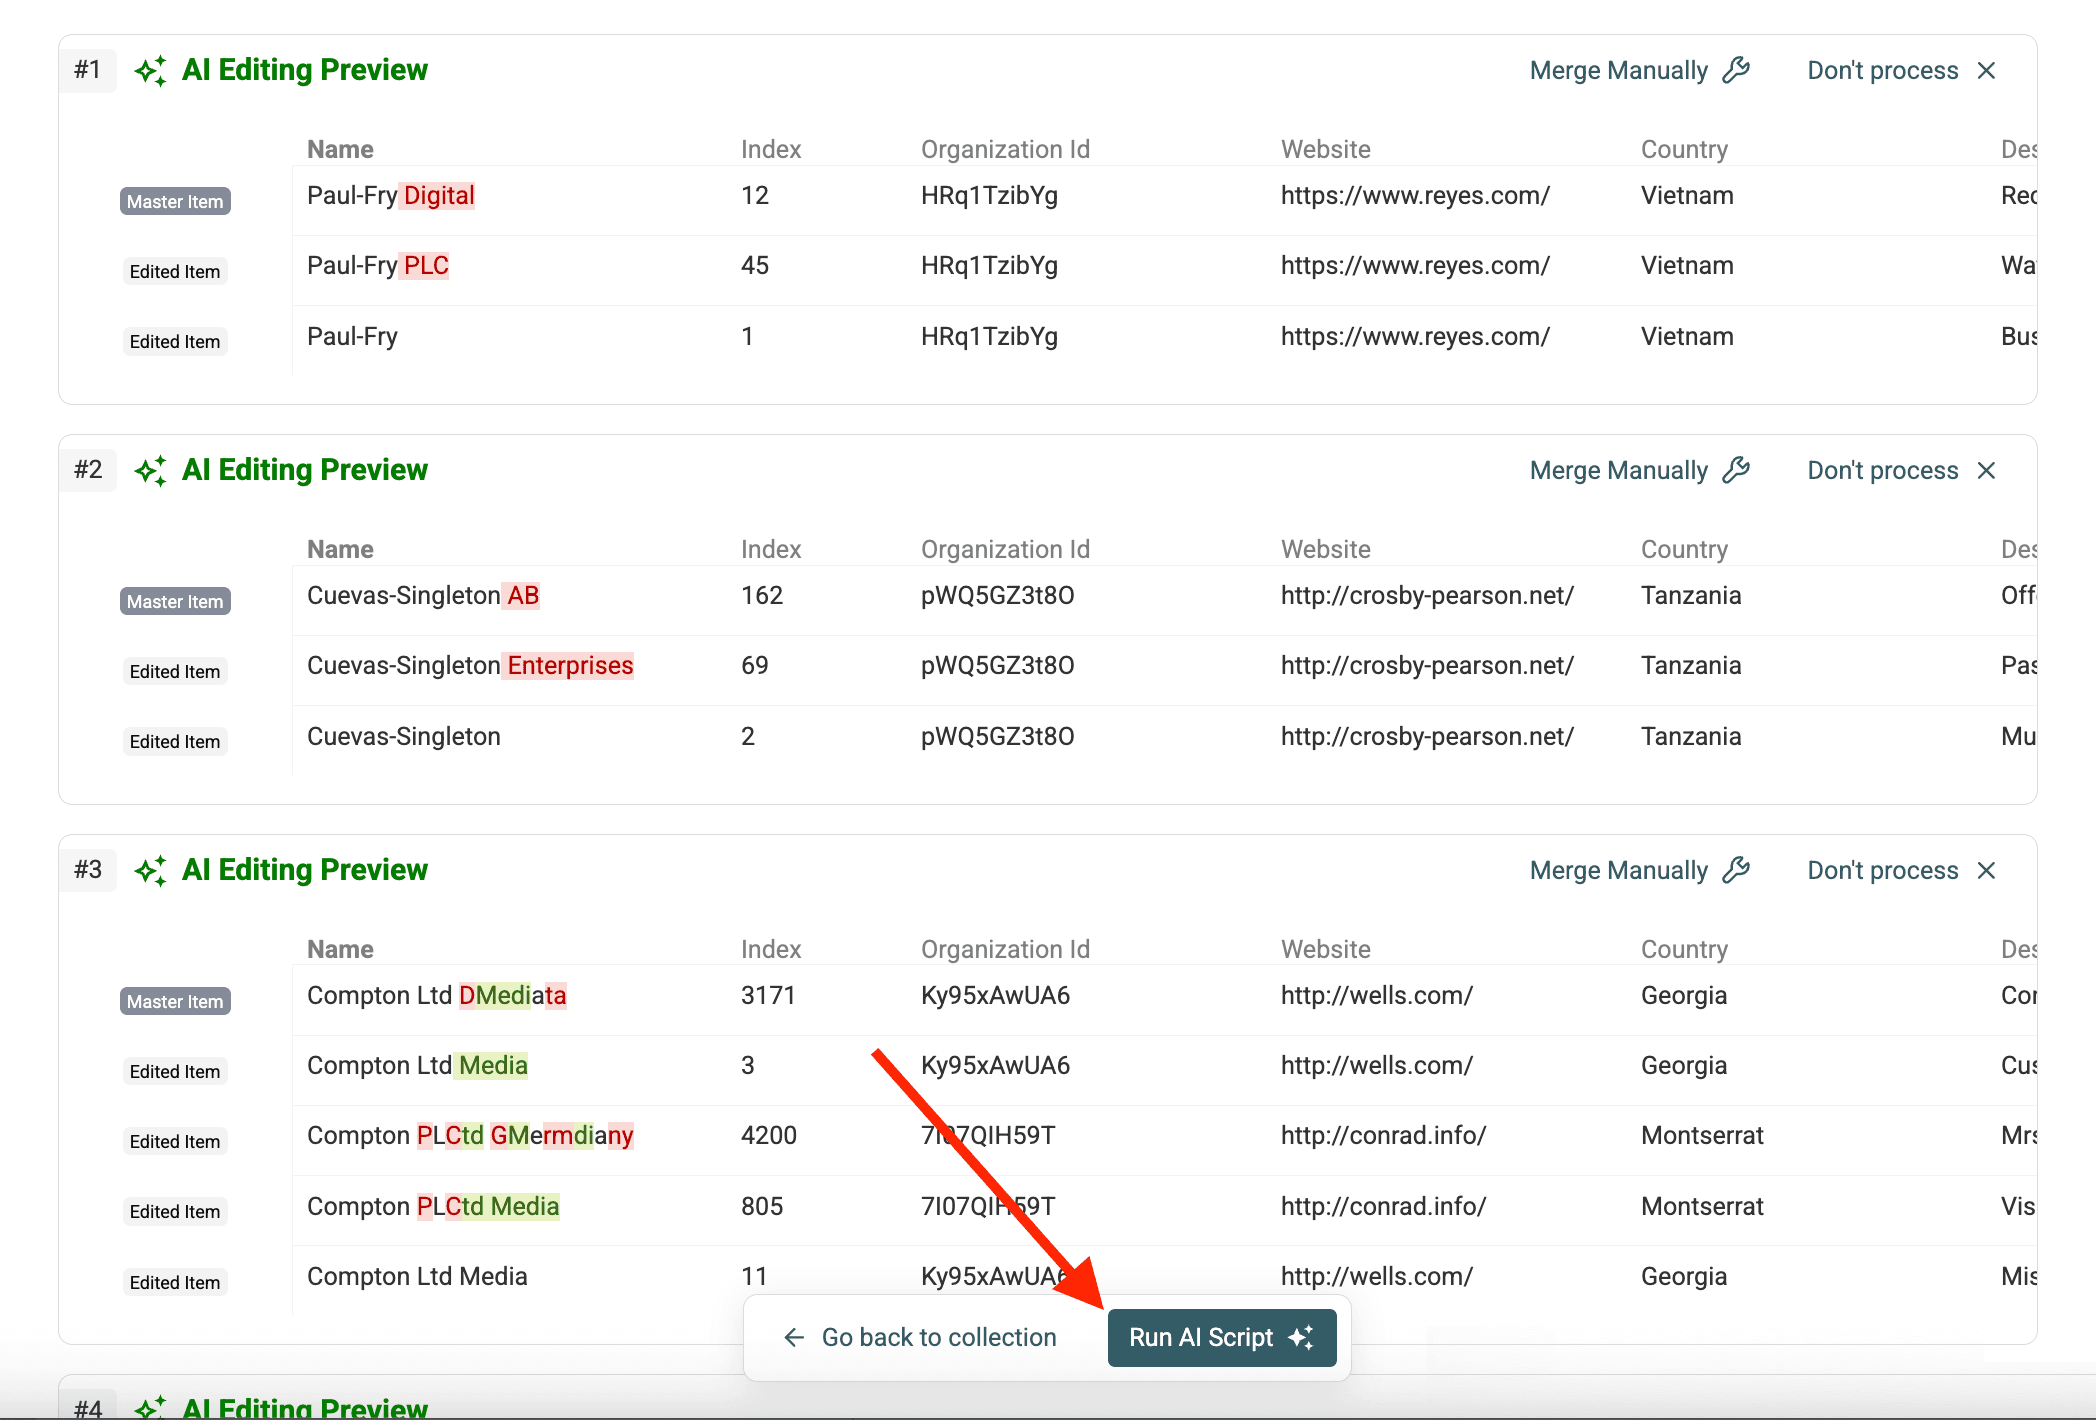
- Script Explanation: Een begrijpelijke Engelse samenvatting van wat het script gaat doen. Controleer of deze overeenkomt met je bedoeling.
- Result Preview: Een tabel die precies laat zien hoe het script een steekproef van je groepen met duplicaten zal aanpassen, voordat er wijzigingen worden doorgevoerd. Controleer in de preview het doelveld, bijvoorbeeld
/Company Name, en kijk of in de voorbeeldduplicaten de bedoelde genormaliseerde waarde wordt gebruikt.
Een groep met Acme Ltd, Acme Ltd en Acme Limited moet bijvoorbeeld drie rijen behouden, allemaal met Acme Ltd. Een groep met één keer Acme Ltd en één keer Acme Limited moet ongewijzigd blijven, omdat geen van beide waarden vaker voorkomt. Dit zijn voorbeelden van controles voor je preview, geen gemeten resultaten.
Controleer zowel de waarden als het aantal rijen. Bevestig dat lege waarden alleen worden ingevuld als er een duidelijke winnaar is, groepen met een gelijke stand ongewijzigd blijven en bron-ID's en niet-gerelateerde properties behouden blijven.
Stap 6: Voer het script uit
Kloppen de uitleg en de preview, klik dan op Run AI rules. Datablist voert het gegenereerde script uit voor alle gevonden groepen met duplicaten.
Stap 7: Controleer de wijzigingen
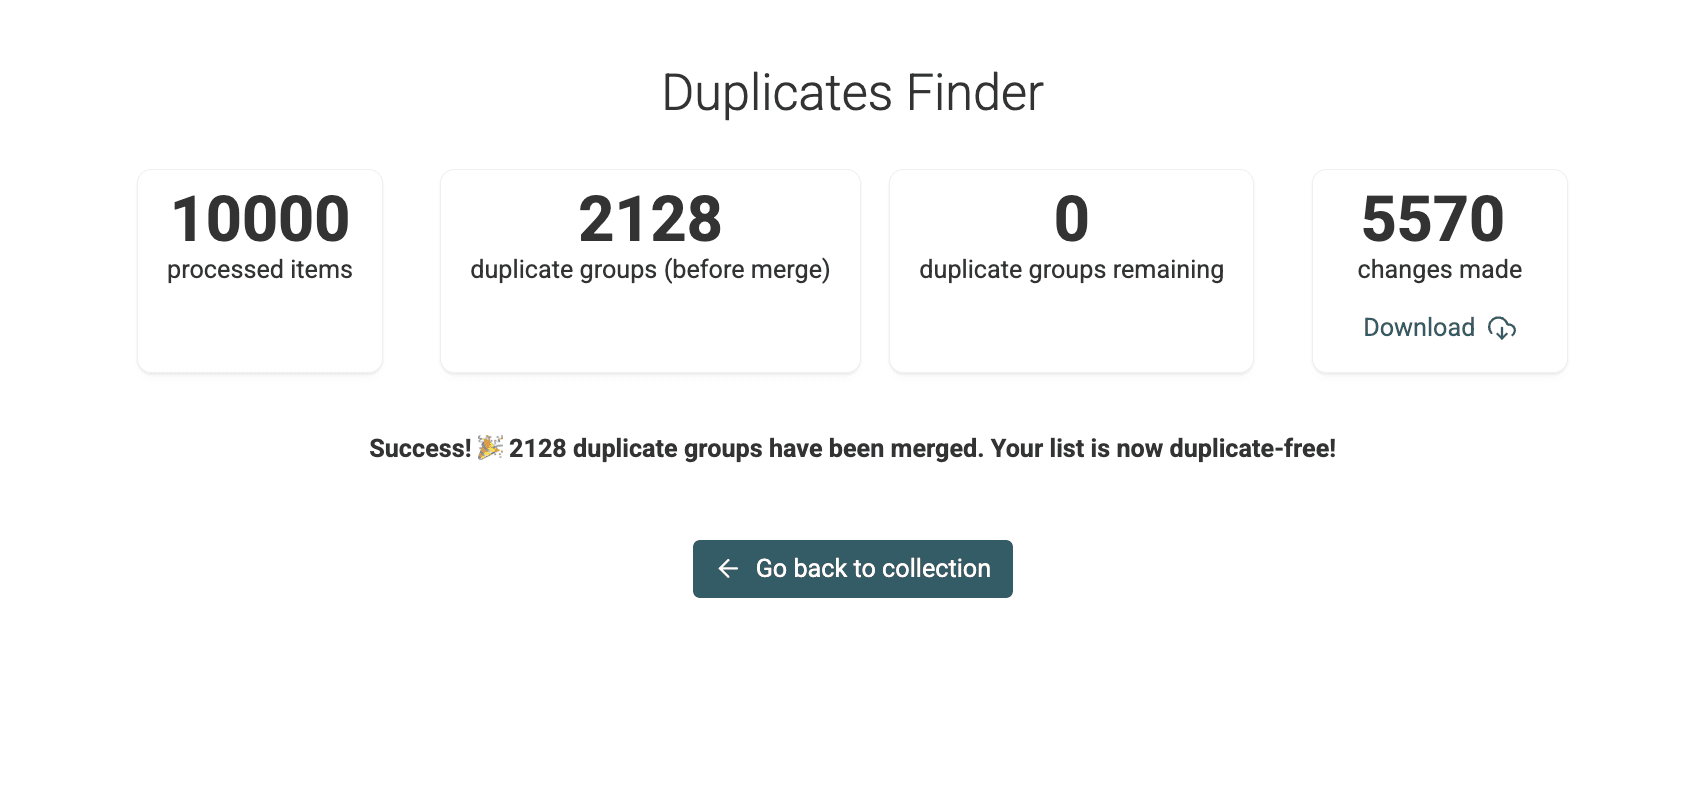
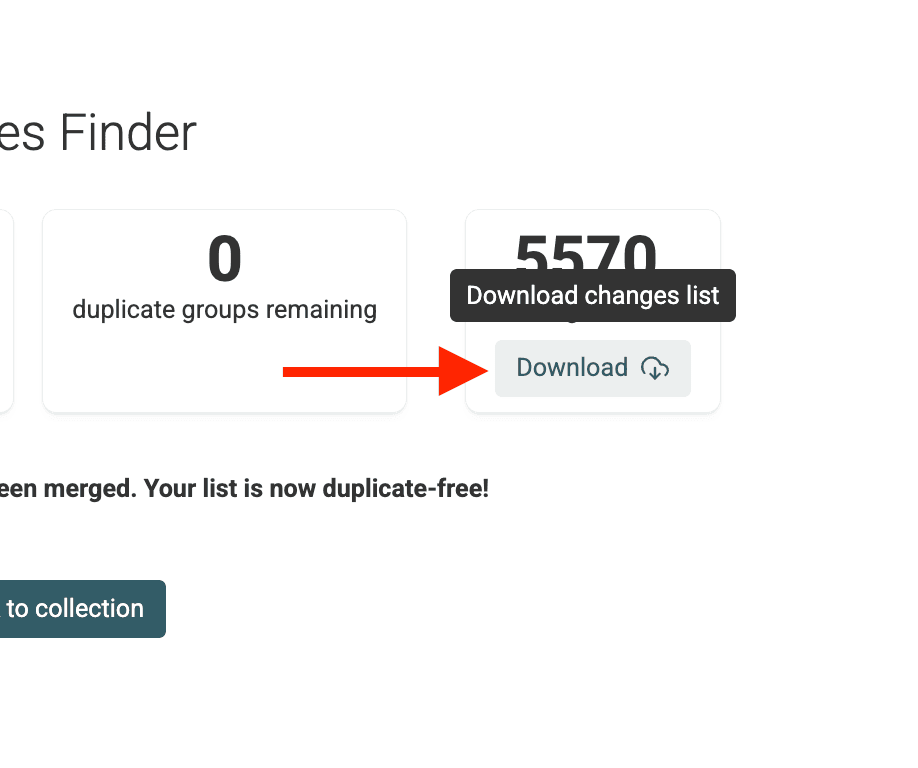
Nadat het script is voltooid, toont Datablist een samenvatting en een downloadbare Changes List.
Dit is handig als je de wijzigingen opnieuw moet uitvoeren in een extern systeem, bijvoorbeeld om CRM-leads te bewerken.
Ga terug naar de hoofdweergave van je collection. Je ziet dat het doelveld, bijvoorbeeld /CompanyName, nu consistent is in de records binnen elke groep met duplicaten, terwijl de records zelf gescheiden zijn gebleven.
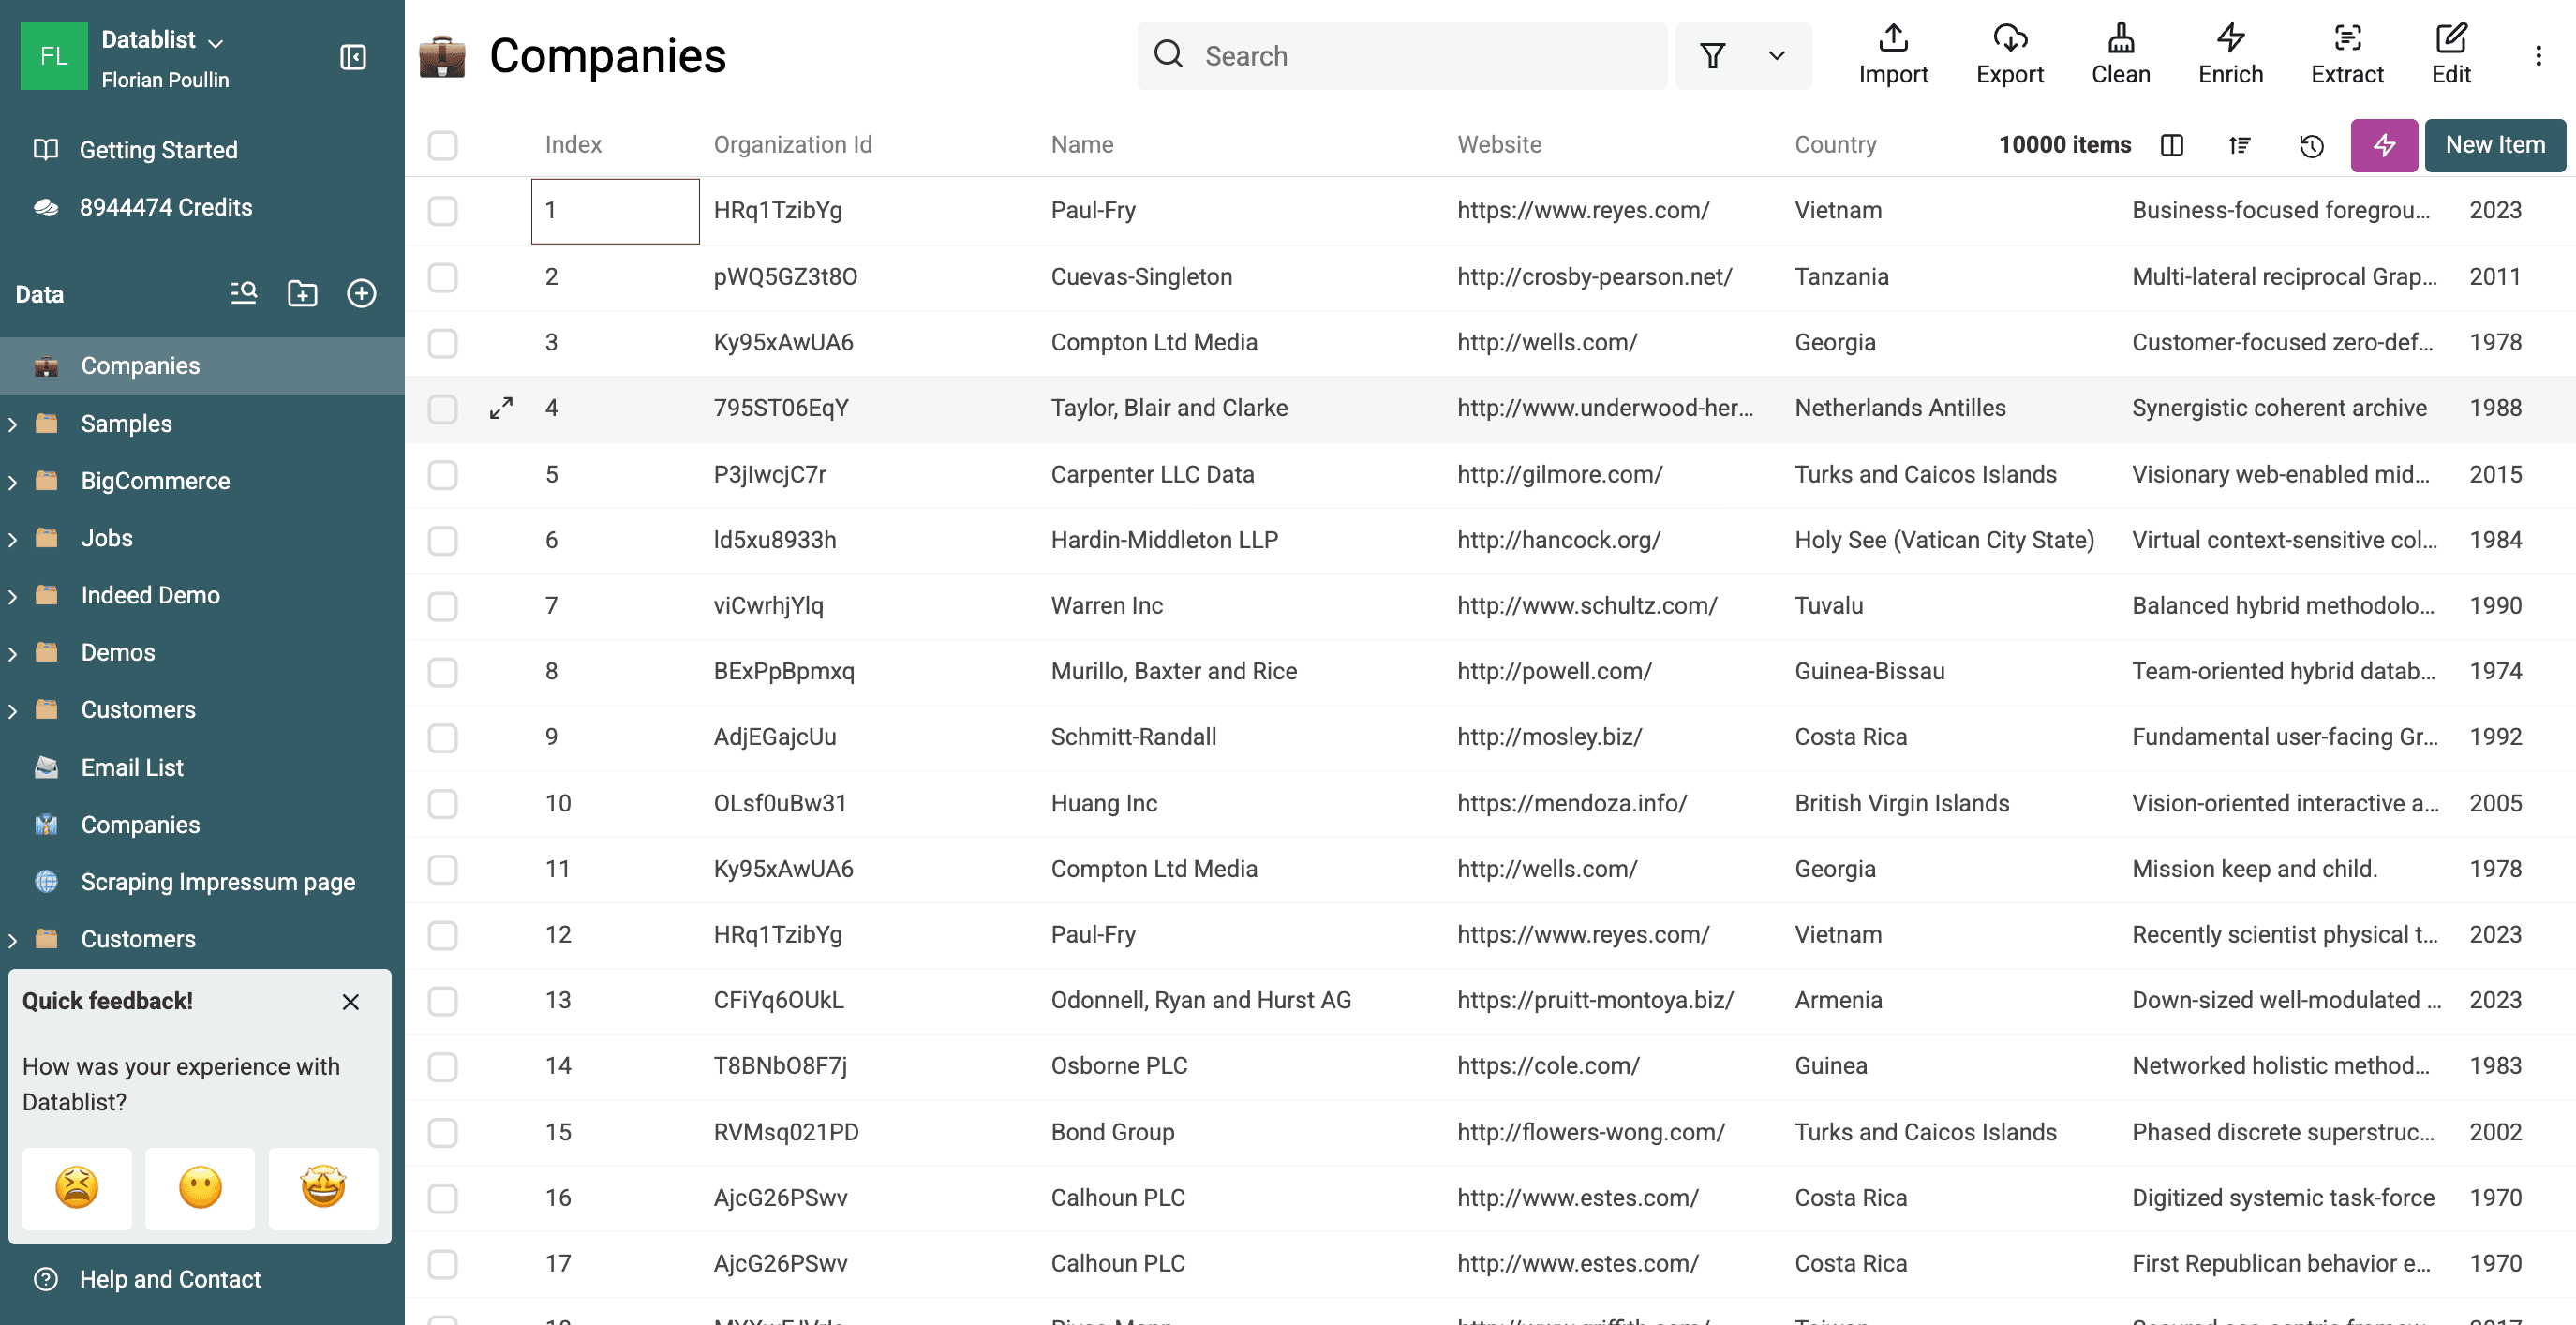
Je hebt nu met succes een veld in duplicaten genormaliseerd zonder records samen te voegen! 🚀
Wanneer normaliseren zonder samenvoegen?
Wanneer kies je voor het normaliseren van een veld in plaats van duplicaten volledig samen te voegen?
- Bedrijfs- of contactnamen standaardiseren: Maak varianten zoals "Example Ltd", "Example Limited", "Jan de Vries" en "J. de Vries" consistent voordat je een definitieve samenvoegstrategie kiest.
- Functietitels opschonen: Maak titels als "VP Marketing", "Vice President Marketing" en "Marketing VP" uniform voor consistente rapportages en analyses.
- Locaties normaliseren: Gebruik consistente landnamen, zoals "NL" en "Nederland", of provincieafkortingen in dubbele adresrecords.
- Een CRM-import of -update voorbereiden: Standaardiseer belangrijke velden voordat je data importeert in een CRM met strikte validatieregels, ook als je de duplicaten tijdelijk behoudt.
- Data-audits uitvoeren: Bewaar de oorspronkelijke dubbele records voor audits of historische controles, maar standaardiseer belangrijke identificatievelden om analyses eenvoudiger te maken.
- Stapsgewijs data opschonen: Normaliseer één veld per keer als onderdeel van een bredere workflow voor data cleaning, voordat je records definitief samenvoegt of verwijdert.
Waarom normaliseren in plaats van samenvoegen?
- Behoud van recorddetail: Afzonderlijke dubbele records blijven intact. Dat kan nodig zijn om de herkomst, specifieke interacties of historische data van elk record te volgen.
- Omgaan met onzekerheid: Handig wanneer duplicaten niet volledig overeenkomen. Door een belangrijk veld te normaliseren, creëer je consistentie zonder records met andere afwijkende gegevens mogelijk onterecht samen te voegen.
- Gefaseerde aanpak: Maakt een beter beheersbaar proces voor data cleaning mogelijk. Normaliseer eerst en bepaal na controle welke records je later samenvoegt of verwijdert.
- Eenvoud: Het is een gerichte actie. Je maakt één veld consistent zonder de overige data in de dubbele records te wijzigen.
Conclusie
Begin met een gecontroleerde groep, stel de regel voor het selecteren van de waarde vast en bekijk de preview. Controleer na het uitvoeren of het aantal rijen gelijk is gebleven en bekijk de groepen die vanwege een gelijke stand zijn overgeslagen. Vervolgens kun je consistente namen exporteren, terwijl elk bronrecord afzonderlijk behouden blijft.
FAQ
-
Is AI Processing inbegrepen in mijn Datablist-abonnement? AI Processing, inclusief het genereren en uitvoeren van scripts voor normalisatie, is beschikbaar in de betaalde abonnementen van Datablist. Bekijk onze Pricing Page voor meer informatie.
-
Kan ik meerdere velden met één prompt normaliseren? Ja, je kunt een prompt schrijven om meerdere velden tegelijk te normaliseren. Bijvoorbeeld: "Normaliseer de property /Company Name met de meest voorkomende waarde in elke groep. Normaliseer de property /Country met de meest voorkomende waarde in elke groep. Verwijder geen records."
-
Wat als de AI mijn prompt verkeerd interpreteert? Controleer altijd zorgvuldig de uitleg van het script en de preview voordat je het uitvoert. Klopt de preview niet, maak je prompt dan duidelijker en specifieker en genereer het script opnieuw.
-
Kan ik de wijzigingen van het AI-script ongedaan maken? Zodra het script is uitgevoerd, worden de wijzigingen direct toegepast. Datablist heeft een undo-functie voor recente acties binnen de sessie. Toch is het verstandig om je collection te klonen voordat je grote datatransformaties uitvoert, zodat je indien nodig kunt terugkeren naar de vorige versie.
-
Wat is het verschil met de standaardoptie "Combine conflicting properties"? De standaardoptie "Combine" voegt dubbele records samen tot één hoofdrecord en combineert conflicterende tekstwaarden in één veld. Met de juiste prompt werkt AI Processing het veld in alle dubbele records bij naar één gekozen waarde, terwijl alle records gescheiden blijven. Records worden niet samengevoegd en waarden niet gecombineerd, tenzij je daar expliciet om vraagt.