
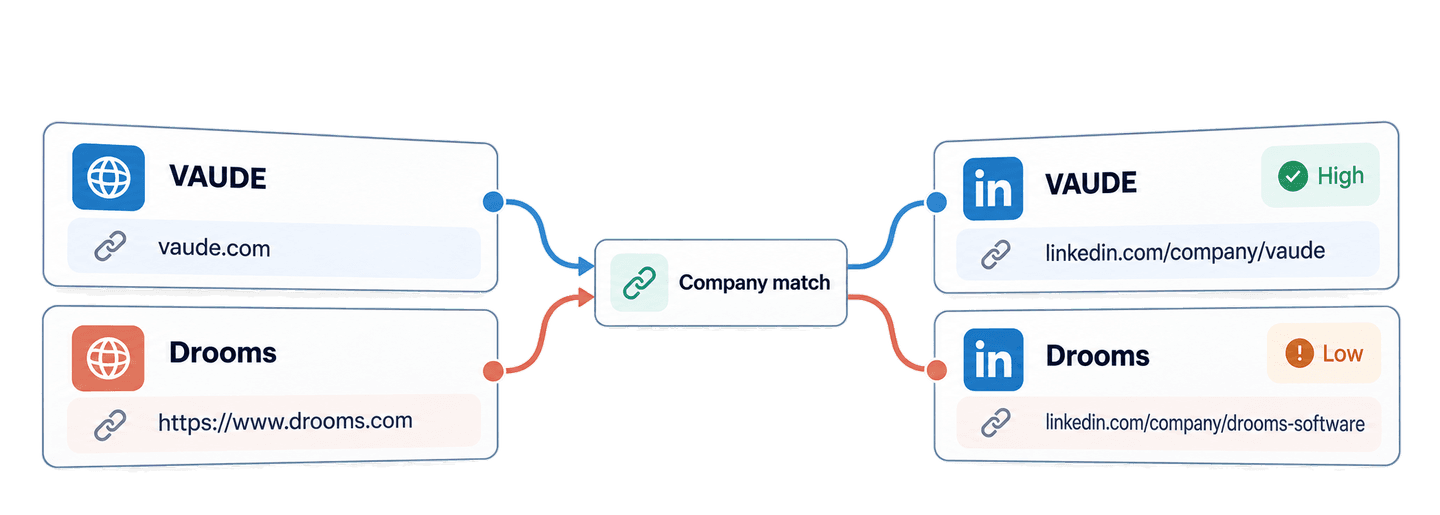
Bruk Datablists Company to LinkedIn API for å finne en LinkedIn-bedriftsside fra et nettsted med Python. Du kan sende inn et rent domene eller en fullstendig nettadresse, vente på matching-oppgaven og motta bedriftsnavn, nettsted, URL til LinkedIn-bedriftssiden og et konfidensnivå.
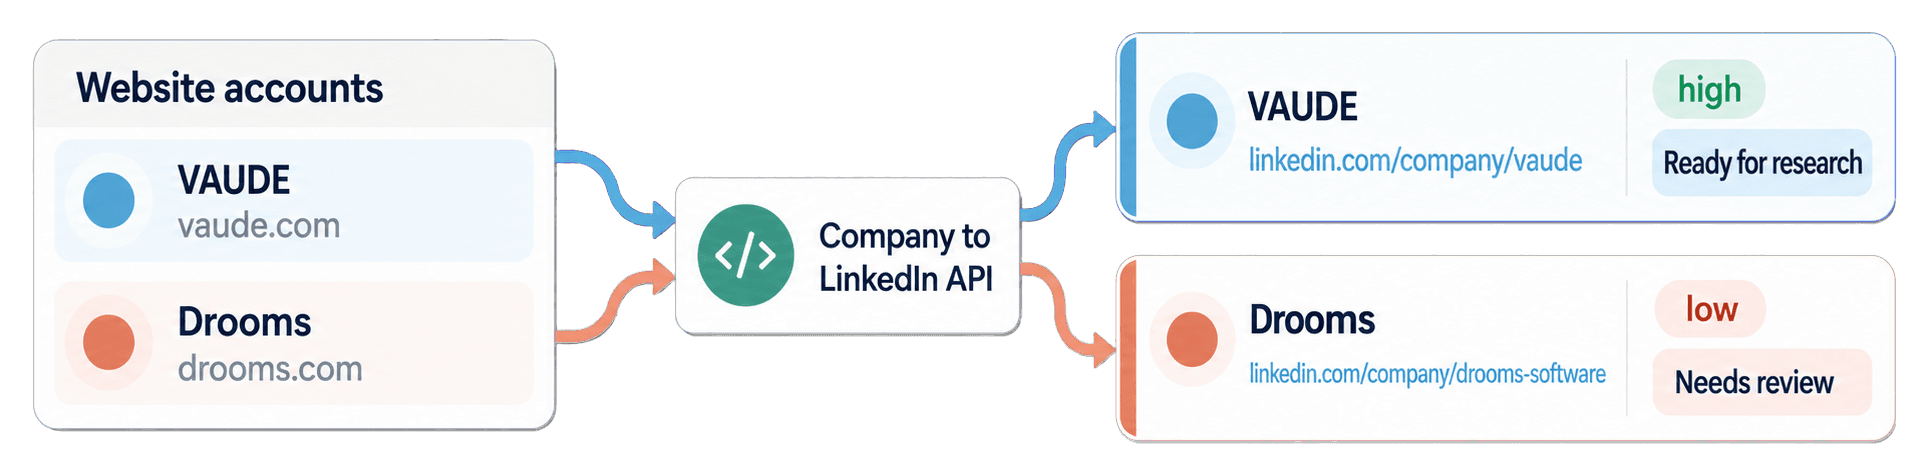
I denne veiledningen bruker jeg Python og Requests-biblioteket til å matche fem bedriftsnettsteder. Listen inneholder kjente programvareselskaper samt VAUDE, som leverer friluftsutstyr, og Drooms, som tilbyr virtuelle datarom. Deretter deler jeg resultatene i to lokale køer: matcher som er klare for bedriftsresearch, og matcher som må kontrolleres manuelt.
🔑 Kort oppsummert for deg som har det travelt
Send nettstedene fra account-listen din til Datablists Company to LinkedIn API. API-et returnerer URL-er til LinkedIn-bedriftssider og konfidensnivåer som hjelper deg med å avgjøre hvilke koblinger du kan bruke, og hvilke du bør kontrollere.
- Input: rene domener og fullstendige URL-er til bedriftsnettsteder.
- Output: bedriftsnavn, matchede nettsteder, URL-er til LinkedIn-bedriftssider og konfidensnivået
highellerlow, gruppert i køeneReady for researchogNeeds review.
💡 Foretrekker du en no-code-løsning? Bruk Datablists LinkedIn Company Pages & Domain Lookup til å matche bedriftsnettsteder og LinkedIn-sider uten å skrive kode.
Konfigurer Python og Datablist API-nøkkelen
I dette eksempelet bruker jeg pakken requests. Selve API-et kommuniserer via HTTP, så du kan senere tilpasse den samme sekvensen av forespørsler til et annet språk.
Du trenger en Datablist-konto med tilgang til REST API, som er inkludert i Growth-abonnementet. Vellykkede oppslag bruker også enrichment credits. Den nøyaktige beregningen av credits finner du senere i veiledningen.
Opprett en arbeidsmappe og filen find_linkedin_company_pages.py. Opprett deretter et virtuelt miljø og installer Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyOpprett en Personal API Key fra Datablist-kontoen din, og eksporter den som en miljøvariabel:
export DATABLIST_API_KEY="your-api-key"Skriptet leser denne verdien og sender den i headeren X-API-Key.
Finn LinkedIn-bedriftssider med én Python-funksjon
Eksempelet bruker disse fem kildekontoene:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Hver account_id blir API-ets inputId. Dette er viktig fordi resultatene ikke nødvendigvis kommer i samme rekkefølge som input-dataene. Med en stabil ID kan du koble hvert resultat til riktig kildekonto.
Lim inn hele skriptet nedenfor i find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Kjør det med:
python find_linkedin_company_pages.pyFunksjonen utfører tre typer kall i denne rekkefølgen.
Først sender POST-kallet de fem nettstedene med matchingDirection satt til domain_to_linkedin. API-et svarer med 202 Accepted og en oppgave-ID fordi matchingen kjører som en bakgrunnsoppgave. Requests-skriptet oppleves likevel som sekvensielt, fordi det venter før det går videre til neste trinn.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Deretter kontrollerer statusforespørselen oppgaven frem til den får statusen completed, failed eller stopped. Pausen på tre sekunder hindrer skriptet i å sende statusforespørsler kontinuerlig.
Til slutt leser resultatforespørselen sider med opptil 100 resultater. Hvis nextCursor inneholder en verdi, sender løkken den som cursor i neste forespørsel. Den stopper først når nextCursor er null.
Les matchene og avgjør hva som må kontrolleres
Her er hele resultatlisten for de fem input-verdiene:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Les status og confidence hver for seg. API-et returnerer et resultatobjekt for hver input, også for input som ikke gir treff. Statusen success betyr at API-et fant en mulig bedriftsside. Verdien i outputs.confidence forteller om koblingen til nettstedet ble validert. inputId knytter objektet til kildekontoen, mens creditsUsed registrerer kostnaden for raden og error inneholder strukturerte feildata hvis noe går galt.
Behold hele outputs-objektet i applikasjonen, selv om det første skjermbildet bare trenger LinkedIn-URL-en og konfidensnivået. companyName og companyWebsite gjør en manuell kontroll raskere, særlig når bedriftsnavnet har en annen bruk av store og små bokstaver, eller input-verdien var en fullstendig URL. Feltene gir deg også nyttig kontekst uten et nytt API-kall.
Matchingen begynner med å normalisere nettstedet som er sendt inn, og kontrollere bedriftsdatasett for en kjent kobling mellom nettstedet og LinkedIn. Deretter sammenlignes input-domenet med nettstedet som er publisert på den aktuelle LinkedIn-bedriftssiden. Et samsvar mellom registrerte domener gir high confidence.
Når datasettene ikke inneholder en LinkedIn-URL, kan oppslaget gjøre et målrettet Google-søk etter mulige bedriftssider. En kandidat som ikke kan valideres mot et publisert nettsted, kan returneres med low confidence. En kjent konflikt mellom nettsteder blir ikke godtatt.
Bruk konfidensnivået som en instruksjon for videre kontroll. VAUDE returnerte https://www.linkedin.com/company/vaude med high confidence og kan derfor legges i research-køen. Drooms returnerte https://www.linkedin.com/company/drooms-software med low confidence. Åpne nettstedet til Drooms og LinkedIn-siden før du stoler på denne koblingen.
Datablist, PostHog og n8n ga også matcher med høy confidence. Dette API-et finner koblingen mellom nettstedet og bedriftssiden. Hvis du trenger bedriftsstørrelse, bransje eller andre sidedata etter at du har kontrollert URL-en, kan du fortsette med veiledningen for LinkedIn company scraper API.
Lag en kø for account research fra resultatene
Bruk nå match_results på nytt for å lage en lokal kø for manuell bedriftsresearch. Denne kodeblokken kaller ikke API-et på nytt. Den indekserer resultatene etter inputId og går deretter gjennom den opprinnelige account-listen, slik at alle kildekontoer fortsatt er synlige selv om et fremtidig resultat skulle mangle.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Resultatordboken gjør koblingen uavhengig av rekkefølgen i svaret. account-vaude kobler den opprinnelige posten for vaude.com til VAUDE-siden som ble funnet, og legges i ready_for_research. account-drooms beholder både hele input-URL-en og hele API-resultatet, men legges i needs_review fordi confidence er lav, selv om resultatstatusen er success.
Den samme logikken beholder en manglende rad eller en rad med no_result eller feil i kontrollkøen. De to utskrevne listene gir teamet et tydelig utgangspunkt for manuell bedriftsresearch.
Du kan også laste ned det vedlikeholdte synkrone Requests-eksempelet. Repositoryet inneholder et asynkront HTTPX-eksempel for applikasjoner som trenger ikke-blokkerende HTTP, men den blokkerende versjonen ovenfor er enklere å følge i en første integrasjon.
Finn nettstedet fra en LinkedIn-bedriftsside
Den samme funksjonen godtar LinkedIn-bedriftssider når du endrer matching-retningen. Dette er nyttig når kildelisten inneholder URL-er til bedriftssider og du trenger nettsteder før en kompatibel company- eller work email-enrichment.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Et standardoppslag fra en LinkedIn-bedriftsside bruker den ordinære matching-prisen. Numeriske bedrifts-ID-er og Sales Navigator-bedrifts-URL-er kan koste 10 credits fordi de følger en annen reverse lookup-prosess. For en no-code-versjon av denne retningen kan du lese slik finner du nettadresser fra LinkedIn-bedriftssider.
Beregn credits for nettsted-til-LinkedIn-oppslag
Et vellykket, ordinært nettsted-til-LinkedIn-oppslag bruker 1,5 credits. De fem viste matchene brukte derfor 7,5 credits. Med samme pris bruker 1 000 vellykkede matcher 1 500 credits. Ugyldige input-verdier og rader uten resultat kan bruke null credits, så kontroller creditsUsed i hvert resultat for å se det faktiske forbruket.
Tilgang til REST API er inkludert i Growth-abonnementet, og månedsabonnementet er separat fra ekstra credits. En top-up på 20 USD gir 20 000 credits, så én credit koster 0,001 USD. Med 1,5 credits per vellykkede match bruker 1 000 matcher 1 500 credits til en verdi av 1,50 USD. Se Datablists priser for gjeldende abonnementer og pakker.
Løs vanlige problemer med input, oppgaver og resultater
DATABLIST_API_KEYmangler: Skriptet stopper før det sender en forespørsel. Eksporter miljøvariabelen og kjør kommandoen på nytt.- API-et avviser nøkkelen: Kontroller at du kopierte en Personal API Key, og at forespørselen bare sender den i
X-API-Key. - Input-verdien støttes ikke: Bruk et bedriftsnettsted eller domene for
domain_to_linkedin. For motsatt retning må du bruke en støttet URL til en bedriftsside, ikke en personlig profil eller tom verdi. - Du har for få credits: Kontroller saldoen, og bruk deretter inkluderte credits eller kjøp en top-up før du oppretter en ny oppgave.
- Oppgaven har statusen
failedellerstopped: Kontroller oppgavestatusen, feilen, eksisterende resultater og credit-forbruket før du avgjør om du skal sende inn oppgaven på nytt. - Et resultat har lav confidence,
no_resulteller feil: Behold kildenettstedet og hele resultatet ineeds_review. Åpne kandidatsiden hvis den finnes, og ikke gjett hvorfor et resultat mangler.
Hvis forbindelsen brytes mens oppgaven opprettes, bruker du uniqueId som ble skrevet ut før POST-kallet. Hent oppgavelisten og se etter denne verdien før du oppretter en ny oppgave:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"Oppgavelisten kan ikke filtreres etter uniqueId, så kontroller hver returnerte oppgave og følg nextCursor ved behov. Når du finner riktig verdi, bruker du oppgavens @id med de samme URL-ene for status og resultater som i skriptet.
Én oppgave kan inneholde opptil 10 000 input-verdier. Du finner alle grenser for forespørsler, oppbevaring av oppgaver og paginering i dokumentasjonen for Company to LinkedIn API.
Neste steg
Du har nå én gjenbrukbar Python Requests-funksjon som gjør bedriftsnettsteder om til kandidater for LinkedIn-bedriftssider. Den lokale køen holder matcher med høy confidence klare for research, samtidig som usikre eller mislykkede poster forblir synlige for kontroll.
Bytt ut de fem eksemplene med en liten account-liste, kontroller alle kandidater med lav confidence, og bruk deretter godkjente URL-er til manuell bedriftsresearch eller som input til LinkedIn company scraper API. Hvis kildelisten inneholder bedriftsnavn i stedet for nettsteder, begynner du med veiledningen for company website finder API.