
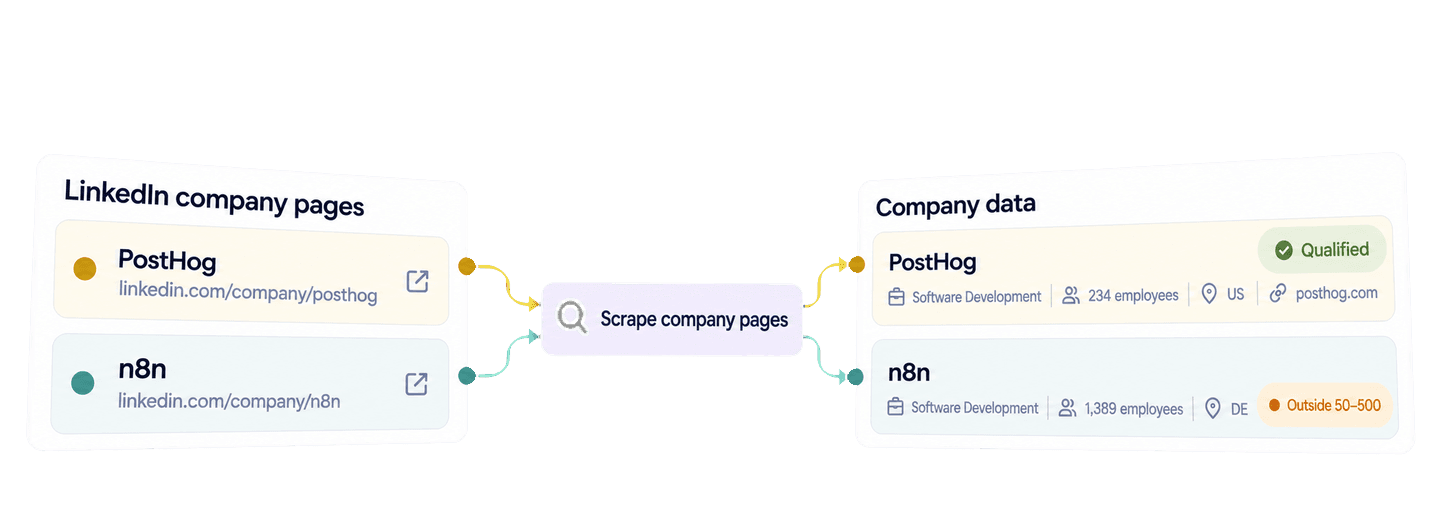
Du kan scrape bedriftsdata fra LinkedIn i Python ved å sende en liste over URL-er til bedriftssider til Datablists API med Requests-biblioteket. API-et returnerer strukturerte bedriftsoppføringer med felter som bransje, antall ansatte, hovedkontor, nettsted og beskrivelse når opplysningene er tilgjengelige på den offentlige bedriftssiden.
I denne guiden bruker jeg én oversiktlig Python-funksjon til å hente oppføringer for n8n, PostHog, Back Market og Datablist. Deretter bruker jeg resultatene til å kvalifisere software-bedrifter med 50 til 500 ansatte i USA eller Tyskland. Den kvalifiserte oppføringen beholder nettstedet og beskrivelsen for grundigere salgsresearch.
🔑 Kort oppsummert for deg som har det travelt
Datablist gjør kvalitetssikrede URL-er til LinkedIn-bedriftssider om til strukturerte bedriftsoppføringer som kan brukes i en arbeidsflyt for salgsresearch. Python-eksemplet nedenfor henter alle resultatsidene og bruker deretter et lokalt filter for å kvalifisere kontoene uten et nytt API-kall.
- Input: URL-er til LinkedIn-bedriftssider.
- Output: Tilgjengelige bedriftsopplysninger og en lokal kvalifiseringsbeslutning, der den opprinnelige URL-en og alle bedriftsdataene beholdes samlet.
💡 Foretrekker du en no-code-løsning? Bruk Datablists LinkedIn Company Page Scraper til å hente bedriftsdata fra kjente URL-er til LinkedIn-bedriftssider uten å skrive kode.
Konfigurer Python og Datablist API-nøkkelen
I dette Python-eksemplet bruker jeg pakken requests. Datablists REST API er tilgjengelig med Growth-abonnementet, og hvert oppslag på en bedriftsside bruker enrichment credits.
Opprett en Personal API Key på kontosiden for Datablist API.
Opprett en fil med navnet scrape_linkedin_companies.py. Klargjør deretter et virtuelt miljø og installer Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Scriptet leser nøkkelen fra DATABLIST_API_KEY og sender den i headeren X-API-Key.
Scrape LinkedIn-bedriftssider med én Python-funksjon
Kildelisten nedenfor inneholder bedrifter fra ulike bransjer, med forskjellig størrelse og hovedkontor i ulike land. Hver account_id blir API-ets inputId. Resultatene kobles ikke sammen etter plasseringen i responsen. Denne stabile ID-en er derfor det som knytter hvert resultat til riktig kilde-URL.
Lim inn hele dette scriptet i scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Kjør det med:
python scrape_linkedin_companies.pyDet viktigste du må endre, er oppføringene i accounts. Sørg for at hver account_id er stabil og unik, og erstatt deretter linkedin_company_url med en kvalitetssikret LinkedIn-bedriftsside. Funksjonen konverterer oppføringene til API-ets inputs-format og sender bedrifts-URL-en som companyLinkedInUrl. settings forblir tom fordi denne enrichment-funksjonen ikke har offentlige innstillinger.
POST-kallet oppretter en enrichment task som kjører i bakgrunnen. API-et svarer med 202 Accepted og en task-ID, mens Requests-klienten venter ved å sjekke status-URL-en regelmessig. Denne blokkerende Python-koden er praktisk i et lite script, men tasken kjører fortsatt asynkront hos Datablist.
Det første GET-kallet kontrollerer selve tasken. Den kan avsluttes som completed, failed eller stopped. Scriptet fortsetter bare etter completed. Ellers utløser det en feil som inkluderer task-ID-en og feilmeldingen fra API-et. Ta vare på ID-en under feilsøking, siden en task med status failed eller stopped fortsatt kan ha resultater og credit-bruk som bør gjennomgås.
Når tasken er ferdig, henter den siste løkken resultatsider med en grense på 100. Den henter neste side frem til nextCursor er null. Hvert resultat beholder inputId-verdien du oppga. Derfor kan den senere kvalifiseringsløkken koble resultatene riktig, selv om rekkefølgen i responsen avviker fra input-rekkefølgen.
Les bedriftsresultatet og forstå hentemetoden
LinkedIn-URL-en identifiserer bedriften direkte. Datablist normaliserer organisasjonens URL og henter tilgjengelige offentlige data fra bedriftssiden, i stedet for å søke etter og rangere flere mulige bedrifter. Med en URL til en navngitt bedrift tar prosessen utgangspunkt i den offentlige siden og kan fylle inn uavklarte felter fra administrerte reservekilder, samtidig som nyttige verdier som allerede er funnet, beholdes.
Dette skillet er viktig når du tolker resultatet. Valgfrie felter avhenger av hva som er offentlig tilgjengelig. En tom hovedkontoradresse eller manglende spesialfelt betyr ikke at hele bedriftsoppslaget mislyktes.
Her er hele resultatsiden som ble returnert for de fire URL-ene:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
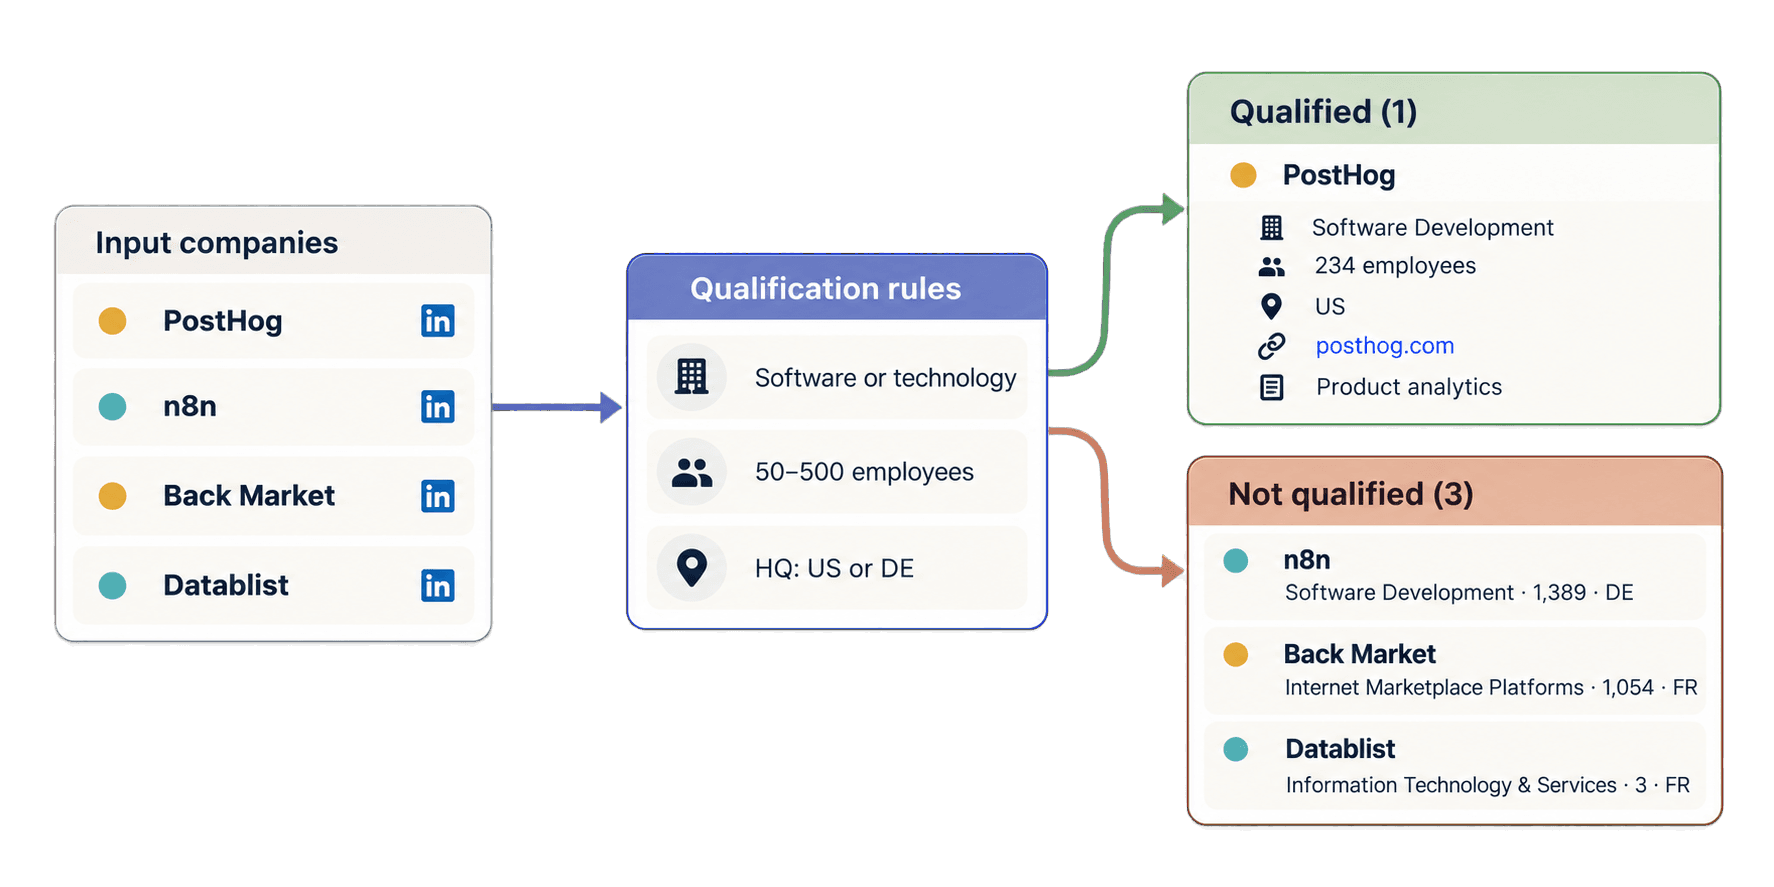
Alle de fire radene lyktes og brukte 25 credits hver. PostHog returnerte Software Development, 234 ansatte, hovedkontor i USA, nettstedet og beskrivelsen. n8n er også en software-bedrift i et av de valgte landene, men det returnerte antallet ansatte er 1 389. Back Market returnerte Internet Marketplace Platforms, 1 054 ansatte og hovedkontor i Frankrike. Datablist returnerte Information Technology & Services, 3 ansatte og hovedkontor i Frankrike.
Hele objektet er nyttig fordi account research sjelden stopper ved ett felt. Du kan kvalifisere etter bransje, antall ansatte og land, samtidig som du beholder det nøyaktige nettstedet og beskrivelsen som ble returnert til neste research-trinn.
I denne responsen er companySize det returnerte antallet ansatte, ikke et størrelsesintervall fra LinkedIn. companyHQCountry angir hvor hovedkontoret ligger, ikke alle landene bedriften opererer i. Disse skillene er viktige når du tilpasser størrelses- og landfiltrene til ideal customer profile.
Ikke alle valgfrie felter må være tilgjengelige for at en bedrift skal kunne kvalifiseres. En manglende adresse eller spesialisering kan forbli tom når bransje, antall ansatte og landet til hovedkontoret er tilgjengelig. Behold companyWebsite slik det returneres, i stedet for å anta at API-et konverterer det til et rent domene. Beskrivelsen kan hjelpe en salgsresearcher med å forstå bedriftens produkt og forberede account-spesifikk research før outreach. status, creditsUsed og error på resultatnivå bør lagres sammen med bedriftsfeltene når du gjennomgår eller lagrer oppføringen.
Kvalifiser kontoer for salgsresearch
La oss si at målgruppen din er software- eller teknologibedrifter med 50 til 500 ansatte og hovedkontor i USA eller Tyskland. Legg til denne løkken under hele scriptet. Den bruker company_results på nytt og sender derfor ikke inn en ny task:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog kobles tilbake til account-posthog selv om API-et returnerer radene i en annen rekkefølge. Bedriften kvalifiseres fordi Software Development, 234 ansatte og US består alle tre kontrollene. Løkken kopierer det opprinnelige resultatet med hele outputs, det returnerte nettstedet https://posthog.com/, beskrivelsen, creditsUsed og error. Den legger bare til kilde-URL-en og den lokale kvalifiseringsetiketten.
n8n kobles til account-n8n, men kvalifiseres ikke fordi 1 389 ansatte overstiger den øvre grensen. Back Market oppfyller verken de valgte kriteriene for bransje, størrelse eller land, mens Datablist ligger under størrelsesintervallet og utenfor de valgte landene. Fremtidige rader som mislykkes eller er ufullstendige, får needs_review i stedet for å bli forkastet uten videre.
Du kan laste ned det vedlikeholdte synkrone Requests-eksemplet eller bruke repositoriets asynkrone HTTPX-alternativ når applikasjonen trenger ikke-blokkerende kode.
Beregn credits for scraping av LinkedIn-bedrifter
En vanlig LinkedIn-side for en navngitt bedrift bruker 25 credits. En bedrifts-URL med numerisk ID kan bruke 75 credits når den siste fallback-kilden er nødvendig, men 75 credits er ikke prisen for alle numeriske URL-er. Mislykkede oppslag eller oppslag uten treff kan også bruke credits. Bruk derfor taskens totalforbruk og creditsUsed for hvert resultat som fasit for det faktiske forbruket.
De fire navngitte URL-ene i denne guiden brukte totalt 100 credits. Med standardsatsen bruker 1 000 bedriftssider 25 000 credits. Input med mange numeriske ID-er krever større margin på grunn av den mulige ruten som bruker 75 credits.
Tilgang til REST API krever Growth-abonnementet. Månedsabonnementet inkluderer 20 000 credits, mens ekstra credits kjøpes separat. Med dagens grunnpris i USD på $20 for 20 000 ekstra credits koster én credit $0,001. Med denne satsen tilsvarer 25 000 credits $25. Se Datablist-priser for gjeldende abonnementer og credit-pakker.
Løs vanlige problemer med input, tasks og resultater
DATABLIST_API_KEYmangler: Scriptet stopper før det sender en forespørsel. Eksporter variabelen og kjør filen på nytt.- API-et avviser nøkkelen: Kontroller din Personal API Key, og behold den i headeren
X-API-Keysom brukes i eksemplet. - Kilde-URL-en er ugyldig: Erstatt en personlig profil, et irrelevant nettsted, en tom verdi eller en feilformatert URL med en støttet offentlig LinkedIn-URL for en bedrift, skole, showcase-side, numerisk ID eller Sales Navigator-bedrift.
- Du har ikke nok credits: Kontroller saldoen, og bruk inkluderte credits eller kjøp flere før du oppretter en ny task.
- Tasken har status
failedellerstopped: Undersøk feilen, eksisterende resultater og credit-forbruket før du avgjør om du vil sende inn en ny betalt task. - Et resultat er mangelfullt eller har status
no_resultellererror: Behold kilde-URL-en, statusen, credits og feilen for gjennomgang. Kontroller at inputen er en offentlig bedriftsside før du sender den inn på nytt, uten å gjette hvorfor dataene ikke var tilgjengelige.
Hvis responsen ved opprettelse går tapt, bruker du request-ID-en som scriptet skrev ut før POST-kallet. List først opp tasks, og finn den tilsvarende verdien i uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"@id for tasken som samsvarer, er task-ID-en. Bruk den til å fortsette å kontrollere /v1/enrichments/tasks/{taskId} eller hente /v1/enrichments/tasks/{taskId}/results, i stedet for automatisk å opprette en ny task. Én forespørsel kan inneholde opptil 10 000 inputs og 10 MiB. Se task-dokumentasjonen for informasjon om lagringstid og andre detaljer om livssyklusen.
Neste steg
Du har nå én gjenbrukbar Python Requests-funksjon som gjør en liste med URL-er til LinkedIn-bedriftssider om til strukturerte bedriftsoppføringer. Du har også en lokal kvalifiseringsløkke som bevarer alle API-dataene for videre salgsresearch.
Erstatt de fire eksemplene med en liten, kvalitetssikret liste over kontoer, behold stabile ID-er, og tilpass reglene for bransje, antall ansatte og land til din ideal customer profile. Hvis utgangspunktet ditt er personer i stedet for bedrifter, kan du bruke API-guiden for LinkedIn Profile Scraper. Hvis du bare har bedriftsnavn, kan du begynne med å finne bedriftsnettsteder i Python.