
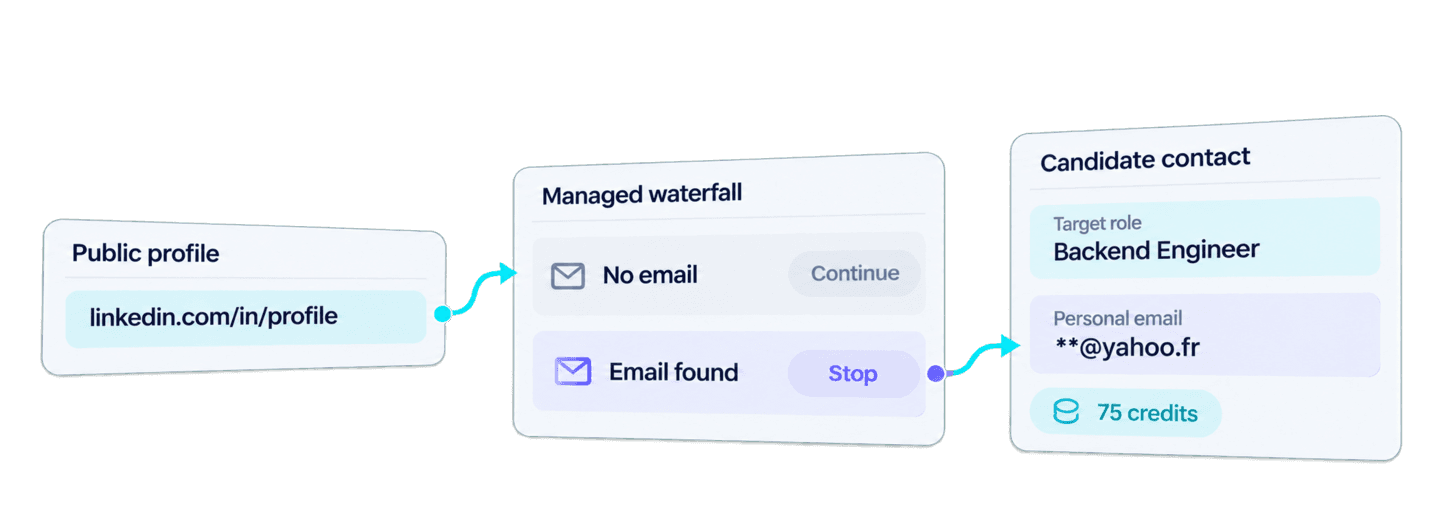
Du kan finne private e-postadresser fra LinkedIn i Python ved å sende offentlige profil-URL-er i formatet linkedin.com/in/... til Datablists Waterfall Personal Email Finder API. API-et kjører en administrert sekvens med kvalifiserte e-postleverandører og returnerer en privat adresse når en av dem finner et resultat.
Det komplette Requests-eksempelet nedenfor sender inn én bakgrunnsoppgave, venter til den er ferdig og henter alle resultatsidene. Når oppslaget fungerer, kan du bruke objektene som returneres, til å klargjøre kontaktoppføringer for rekruttering. Da beholdes kandidatens navn, LinkedIn-URL og aktuelle rolle sammen med e-postadressen som ble funnet.
Denne arbeidsflyten ser etter en privat e-postadresse som er uavhengig av kandidatens nåværende arbeidsgiver. Hvis du i stedet trenger en adresse knyttet til personens bedrift, kan du følge den separate veiledningen for å finne en jobb-e-post fra en LinkedIn-profil.
🔑 Kort oppsummert
Oppgi kandidatnavn, offentlige LinkedIn-profil-URL-er og aktuelle roller. Python-arbeidsflyten finner tilgjengelige private e-postadresser og kobler hver adresse til rekrutteringsopplysningene du startet med.
- Input: Kandidatnavn, offentlige
linkedin.com/in/...-profil-URL-er og aktuelle roller.- Output: Private e-postadresser koblet til riktige kandidatopplysninger.
💡 Foretrekker du en no-code-løsning? Bruk Datablists Waterfall Personal Email Finder til å finne private e-postadresser uten å skrive kode.
Hvis kildedataene inneholder navn, men ingen profil-URL-er, bør du først finne offentlige LinkedIn-profiler i Python og deretter sende URL-ene til dette API-et.
Konfigurer Python, Requests og Datablist API-nøkkelen
I dette eksempelet bruker jeg Python med pakken requests. Opprett en fil med navnet find_personal_emails.py, og installer deretter Requests:
python -m pip install requestsOpprett en Personal API Key i Datablist-kontoen din, og eksporter den som en miljøvariabel:
export DATABLIST_API_KEY='your-api-key'Tilgang til REST API er tilgjengelig med Growth-abonnementet. Et vellykket resultat for en privat e-postadresse bruker også credits. Kostnaden beregnes i kostnadsdelen nedenfor.
Finn en privat e-postadresse med én Python-funksjon
Listen candidates, som du kan redigere i dette skriptet, inneholder én kandidatoppføring. target_role er et eksempel på en kildeverdi som forblir lokal i rekrutteringsarbeidsflyten. Bare candidate_id og linkedin_url sendes i API-payloaden.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Kjør filen fra den samme terminalen:
python find_personal_emails.pyDu kan også laste ned det vedlikeholdte synkrone Requests-eksempelet. Skriptet ovenfor følger den samme sekvensen for innsending, polling og paginering, samtidig som det bruker kandidat-ID-er fra kildeoppføringene.
Send inn oppslaget
Funksjonen gjør hver kandidat om til en API-input. inputId får kandidatens stabile ID, mens data.profileUrl får URL-en til personens offentlige LinkedIn-profil. Det kreves en standard-URL i formatet linkedin.com/in/.... Sales Navigator-URL-er, bedriftssider, tomme verdier og navn uten profil-URL-er er ikke gyldig input for denne enrichment-funksjonen.
Forespørselen bruker waterfall-personal-email-finder som enrichmentId og et tomt settings-objekt, slik det vises i API-dokumentasjonen for Waterfall Personal Email Finder. Skriptet skriver ut den genererte uniqueId-verdien før innsending. Ta vare på denne verdien, siden den lar deg finne igjen en eksisterende oppgave hvis forbindelsen brytes etter at API-et har godtatt forespørselen.
Her er hele request body for eksempelet med én profil:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
En vellykket innsending returnerer HTTP 202 Accepted, med oppgave-ID-en i @id. Behandlingen fortsetter på Datablists servere etter dette svaret.
Vent på bakgrunnsoppgaven
Requests-skriptet blokkerer lokalt mens serveren kjører bakgrunnsoppgaven. Det kontrollerer oppgaven hvert tredje sekund og fortsetter så lenge statusen er queued eller running. En oppgave med status completed går videre til henting av resultater. Statusen failed eller stopped utløser en feil med oppgave-ID-en og den tilgjengelige feilmeldingen.
Hent alle resultatsidene
Resultat-endepunktet returnerer kilde-ID, status, outputs, credits og feil for hver rad. Den første forespørselen ber om opptil 100 resultater. Deretter hentes neste side helt til nextCursor er null.
Oppgaveresultatene beholder rekkefølgen fra inputen. inputId gir fortsatt hvert resultat en eksplisitt kobling til kandidatoppføringen, også når resultatene går over flere sider.
Når du tilpasser eksempelet til flere oppføringer, bør hver candidate_id være stabil i kildesystemet. Denne verdien gjør sammenkoblingen forutsigbar når oppgaven har flere resultatsider.
Slik finner personal-email-waterfallet et resultat
Datablist renser URL-en til den innsendte offentlige LinkedIn-profilen og sender profiler uten resultat videre gjennom de kvalifiserte leverandørene av private e-postadresser. Hvis én leverandør ikke returnerer en brukbar adresse, kan profilen gå videre til den neste kvalifiserte leverandøren. Når en leverandør finner en gyldig e-postadresse, stopper sekvensen for denne profilen og returnerer adressen som outputs.emailFound.
Datablist administrerer de kvalifiserte leverandørene, så integrasjonen din trenger verken leverandørspesifikke forespørsler eller egen fallback-kode. Det offentlige resultatet viser utfallet av e-postsøket, ikke en fast leverandørrekkefølge eller historikk over søkeforsøkene.
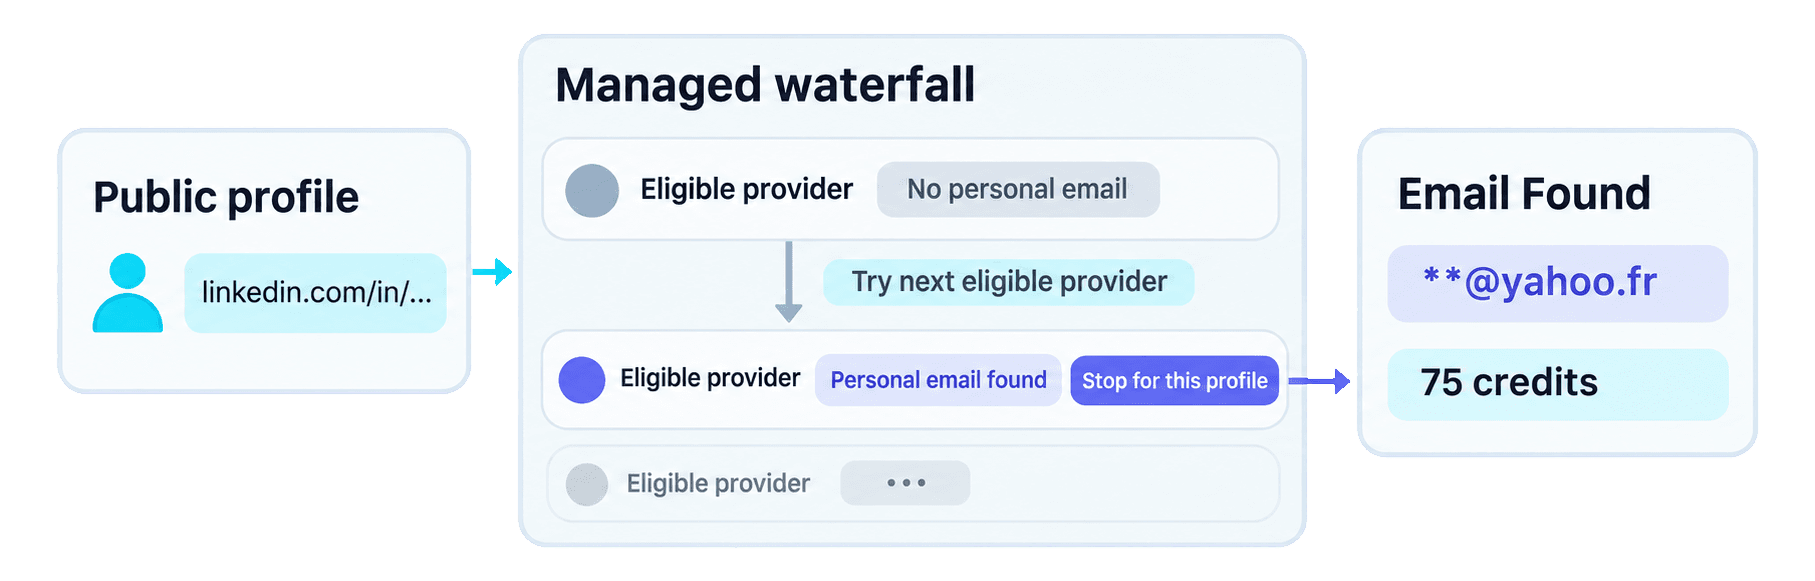
Waterfall er selve oppslagsmetoden. Polling har en annen oppgave: Det lar Python-klienten vente til bakgrunnsarbeidet er ferdig.
Derfor hjelper Waterfall internasjonale rekrutteringsteam
Leverandører av private e-postadresser bruker forskjellige datasett, og styrkene deres varierer derfor mellom land og markeder. Når den første leverandøren ikke har en e-postadresse til en kandidat, kan en annen leverandør i waterfallet finne en.
Rekrutteringsteam som jobber i flere land, får bredere leverandørdekning gjennom én API-integrasjon. Datablist administrerer sekvensen, slik at teamet kan finne kontakter som et oppslag hos én enkelt leverandør kunne gått glipp av, uten å måtte koble til og vedlikeholde flere leverandør-API-er.
Les hele resultatet
📘 Maskert e-postadresse: Den lokale delen av adressen er erstattet med
**nedenfor. API-resultatet ditt inneholder hele verdien.
Her er hele resultatsiden for kandidat-inputen:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
inputId er koblingsnøkkelen til kandidaten i kildedataene. outputs.emailFound inneholder den private adressen. creditsUsed er den autoritative kostnaden for denne raden, mens error: null betyr at API-et ikke returnerte noen feil på radnivå. Nullmarkøren bekrefter at svaret ikke har flere resultatsider.
Behandle adressen som et kontaktalternativ knyttet til den innsendte profilen, og gå gjennom den før den brukes i rekrutteringen.
Klargjør kandidatkontakter for rekruttererens gjennomgang
Når oppslaget er ferdig, kan du klargjøre en lokal liste som rekruttereren kan gjennomgå, uten en ny API-forespørsel. Kodeblokken nedenfor bruker de eksisterende variablene candidates og personal_email_results:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))For candidate-florian-poullin finner ordbokoppslaget resultatet med samme inputId. Den kopierte oppføringen beholder Florian Poullins navn, LinkedIn-URL og den aktuelle eksempelrollen Backend Engineer. Deretter legges hele API-objektet til under result, der rekruttereren kan lese result.outputs.emailFound.
Løkken starter med kandidatlisten fra kilden. Et fremtidig manglende treff, en feil på radnivå, et manglende resultat eller et tomt emailFound lar kildelisten forbli uendret, og kandidaten legges ikke til i prepared_contacts.
Hvis du ønsker en bredere prosess for gjennomgang og andre kontaktkanaler, kan du lese veiledningen om å finne e-postadressen til en kandidat som rekrutterer.
Beregn kostnaden for Waterfall Personal Email Finder API
Hver private e-postadresse som blir funnet, bruker 75 credits. Et oppslag uten resultat bruker 0 credits. For å finne den faktiske kostnaden bør du lese creditsUsed for hvert resultat i stedet for å gange med det totale antallet innsendte profiler.
Formelen for kostnadsestimatet er:
private e-postadresser funnet × 75 credits
Hvis du for eksempel sender inn 100 profiler og 20 av dem gir en privat e-postadresse, bruker oppgaven 20 × 75 = 1 500 credits. Dette er et kostnadsestimat, ikke en forventet treffrate. For større budsjetter bruker 100 treff 7 500 credits, mens 1 000 treff bruker 75 000 credits.
Med gjeldende grunnpris for påfylling i USD blir regnestykket $20 / 20 000 credits = $0.001 per credit. Én funnet e-postadresse bruker dermed credits til en verdi av $0.075, mens 100 treff tilsvarer $7.50. Estimatet viser verdien av credits som brukes. Growth-abonnementet som kreves for tilgang til REST API, kommer i tillegg. Se Datablist-priser for oppdaterte abonnementer og credit-pakker.
Løs vanlige feil og gjenopprett en eksisterende oppgave
De fleste problemer oppstår før innsendingen, i HTTP-forespørselen eller i et enkeltresultat. Bruk plasseringen av feilen til å velge neste tiltak:
- Manglende
DATABLIST_API_KEY: Skriptet stopper lokalt før det sender en forespørsel. Eksporter miljøvariabelen, og kjør deretter filen på nytt. - Feil ved HTTP-autentisering: Kontroller Personal API Key i
DATABLIST_API_KEY. Funksjonen sender den i headerenX-API-Key. Rett opp nøkkelen før du sender inn på nytt. - Profil-URL støttes ikke: Erstatt en Sales Navigator-URL, bedriftsside, tom verdi eller ugyldig URL med en offentlig personprofil i formatet
linkedin.com/in/.... - For få credits: Kontroller kontosaldoen og tilgjengelige credits før du sender inn flere oppgaver.
- Oppgaven har status
failedellerstopped: Undersøk oppgavefeilen, tilgjengelige resultater og credit-forbruket før du avgjør hva som fortsatt må kjøres. - En rad mangler resultat eller har en feil: Behold kandidaten fra kildedataene for gjennomgang eller bruk en annen kontaktkanal. Et resultatløst oppslag forklarer ikke hvorfor en adresse ikke var tilgjengelig.
Hvis POST-svaret går tapt, bør du liste opp oppgavene dine før du oppretter en ny. Søk i svaret etter uniqueId-verdien som skriptet skrev ut, og kopier deretter @id fra oppgaven som samsvarer:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Hvis oppgaven ikke finnes i det første svaret fra oppgavehistorikken, følger du pagineringsmarkøren som ble returnert, og kontrollerer neste side. Fortsett å kontrollere den gjenopprettede oppgaven eller hent de tilgjengelige resultatene i stedet for automatisk å opprette en ny betalt oppgave. Oppgavedokumentasjonen beskriver livssyklusen, pagineringen og hvor lenge resultater oppbevares.
Neste steg
Du har nå én gjenbrukbar Python Requests-funksjon for offentlige LinkedIn-profil-URL-er og en sammenslåing basert på stabile ID-er som kobler private e-postresultater til kildekonteksten for hver kandidat.
Erstatt eksempellisten med et lite utvalg av dine egne kandidatoppføringer. Behold en stabil ID og aktuell rolle for hver kandidat, og gå gjennom alle klargjorte kontakter før du bruker dem i rekrutteringsprosessen. Når applikasjonen trenger ikke-blokkerende samtidighet, kan du bruke det vedlikeholdte async HTTPX-eksempelet som neste implementeringstrinn.