
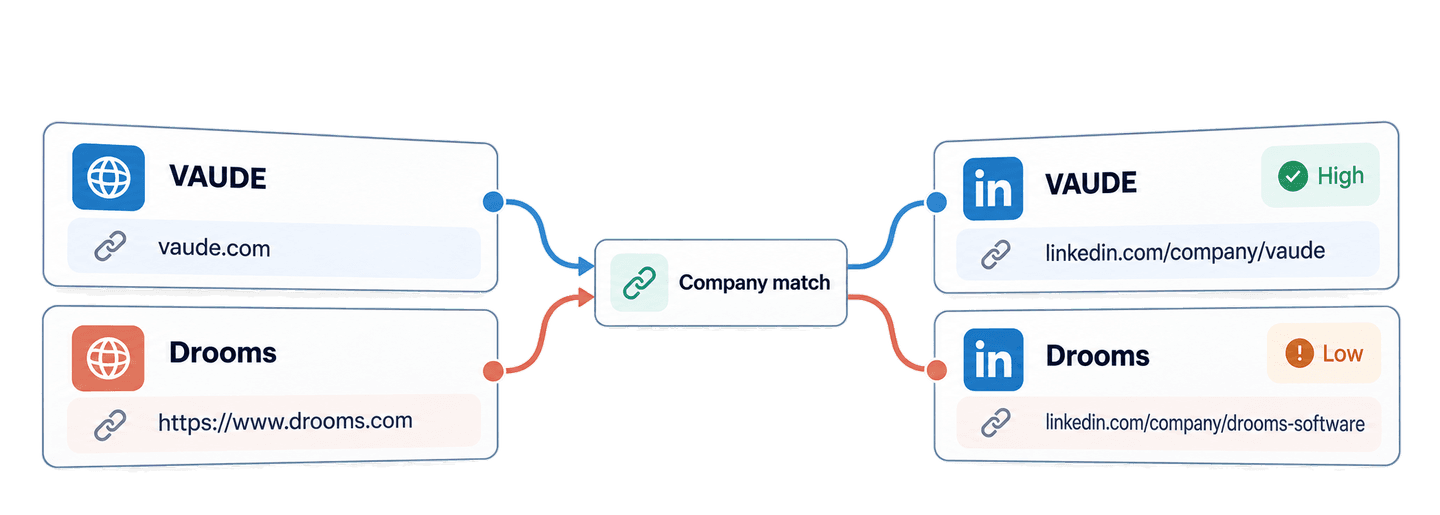
Użyj Company to LinkedIn API od Datablist, aby w Pythonie znaleźć stronę firmy na LinkedIn na podstawie jej witryny. Możesz przesłać samą domenę lub pełny adres URL, poczekać na zakończenie zadania dopasowywania i otrzymać nazwę firmy, witrynę, adres strony firmowej na LinkedIn oraz poziom pewności dopasowania.
W tym poradniku używam Pythona i biblioteki Requests, aby dopasować pięć witryn firmowych. Lista obejmuje znane firmy software’owe, a także VAUDE, producenta sprzętu outdoorowego, oraz Drooms, dostawcę wirtualnych data roomów. Następnie dzielę wyniki na dwie lokalne kolejki: dopasowania gotowe do analizy firmy oraz te, które wymagają ręcznej weryfikacji.
🔑 Podsumowanie dla zabieganych
Prześlij witryny z listy kont do Company to LinkedIn API od Datablist. API zwróci adresy stron firmowych na LinkedIn i poziomy pewności, dzięki którym zdecydujesz, które dopasowania wykorzystać, a które sprawdzić ręcznie.
- Input: same domeny i pełne adresy firmowych witryn.
- Output: nazwy firm, dopasowane witryny, adresy stron firmowych na LinkedIn oraz pewność
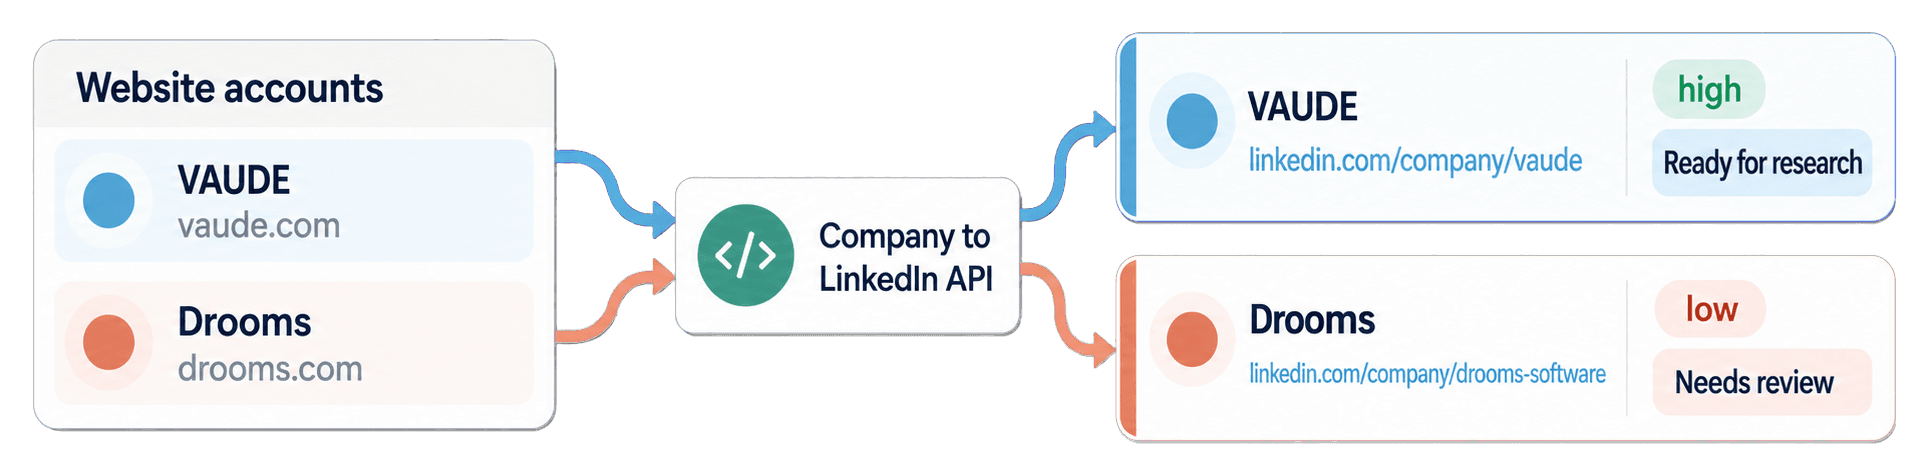
highlublow, podzielone na kolejkiReady for researchiNeeds review.
💡 Wolisz rozwiązanie no-code? Użyj enrichmentu Datablist LinkedIn Company Pages & Domain Lookup, aby dopasowywać witryny firm i strony na LinkedIn bez pisania kodu.
Skonfiguruj Pythona i klucz API Datablist
W tym przykładzie korzystam z pakietu requests. API działa przez HTTP, więc później możesz zastosować tę samą sekwencję requestów w innym języku.
Potrzebujesz konta Datablist z dostępem do REST API, dostępnym w planie Growth. Udane wyszukiwania zużywają również kredyty enrichment. Dokładny sposób ich naliczania omawiam w dalszej części poradnika.
Utwórz katalog roboczy i plik find_linkedin_company_pages.py, a następnie przygotuj środowisko wirtualne i zainstaluj Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyUtwórz Personal API Key na swoim koncie Datablist, a następnie wyeksportuj go jako zmienną środowiskową:
export DATABLIST_API_KEY="your-api-key"Skrypt odczytuje tę wartość i wysyła ją w nagłówku X-API-Key.
Znajdź strony firm na LinkedIn jedną funkcją Pythona
W przykładzie używamy pięciu kont źródłowych:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Każdy account_id staje się wartością inputId w API. To ważne, ponieważ wyniki nie muszą wracać w tej samej kolejności co dane wejściowe. Stały identyfikator pozwala połączyć każdy wynik z właściwym kontem źródłowym.
Wklej poniższy kompletny skrypt do pliku find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Uruchom go poleceniem:
python find_linkedin_company_pages.pyFunkcja wykonuje kolejno trzy rodzaje wywołań.
Najpierw request POST wysyła pięć witryn z parametrem matchingDirection ustawionym na domain_to_linkedin. API odpowiada statusem 202 Accepted i identyfikatorem zadania, ponieważ dopasowywanie odbywa się w tle. Skrypt wykorzystujący Requests nadal działa sekwencyjnie, ponieważ czeka na wynik przed przejściem do kolejnego kroku.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Następnie request sprawdzający status monitoruje zadanie, dopóki nie osiągnie ono stanu completed, failed lub stopped. Trzysekundowa przerwa zapobiega ciągłemu wysyłaniu zapytań o status.
Na końcu request pobierający wyniki odczytuje strony zawierające maksymalnie 100 rekordów. Jeśli nextCursor ma wartość, pętla przekazuje ją jako cursor w kolejnym requeście. Działanie kończy się dopiero wtedy, gdy nextCursor ma wartość null.
Odczytaj dopasowania i wybierz rekordy do weryfikacji
Oto kompletna lista wyników dla pięciu inputów:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Odczytuj status i confidence osobno. API zwraca obiekt wyniku dla każdego inputu, również tego zakończonego niepowodzeniem. Status success oznacza, że znaleziono kandydata na stronę firmową. Wartość outputs.confidence informuje, czy dopasowanie witryny zostało zweryfikowane. Pole inputId łączy obiekt z kontem źródłowym, creditsUsed zapisuje koszt danego wiersza, a error zawiera ustrukturyzowane informacje o ewentualnym błędzie.
Zachowaj w aplikacji cały obiekt outputs, nawet jeśli na pierwszym ekranie potrzebujesz tylko adresu LinkedIn i poziomu pewności. Pola companyName oraz companyWebsite przyspieszają ręczną weryfikację, zwłaszcza gdy zwrócona nazwa firmy różni się wielkością liter lub inputem był pełny URL. Zapewniają też przydatny kontekst bez wykonywania kolejnego wywołania API.
Proces dopasowywania zaczyna się od normalizacji przesłanej witryny i sprawdzenia w zbiorach danych firm, czy istnieje znana relacja między witryną a LinkedIn. Następnie domena wejściowa jest porównywana z witryną opublikowaną na stronie firmowej kandydata na LinkedIn. Zgodność zarejestrowanych domen daje poziom pewności high.
Jeśli zbiory danych nie zawierają adresu LinkedIn, wyszukiwanie może uruchomić precyzyjne zapytanie w Google w celu znalezienia kandydatów na stronę firmową. Kandydat, którego nie uda się zweryfikować na podstawie opublikowanej witryny, może otrzymać poziom pewności low. Znana niezgodność witryn nie jest akceptowana.
Traktuj poziom pewności jako instrukcję dotyczącą weryfikacji. Dla VAUDE zwrócono https://www.linkedin.com/company/vaude z pewnością high, więc rekord może trafić do kolejki researchu. Dla Drooms zwrócono https://www.linkedin.com/company/drooms-software z pewnością low. Zanim zaczniesz polegać na tym powiązaniu, otwórz witrynę Drooms i stronę firmy na LinkedIn.
Datablist, PostHog i n8n również uzyskały dopasowania z wysokim poziomem pewności. To API znajduje relację między witryną a stroną firmową. Jeśli po zweryfikowaniu adresu potrzebujesz informacji o wielkości firmy, branży lub innych danych ze strony, przejdź do poradnika LinkedIn company scraper API.
Przygotuj kolejkę kont do researchu
Teraz ponownie wykorzystaj match_results, aby utworzyć lokalną kolejkę do ręcznego researchu firm. Ten blok nie wywołuje API ponownie. Indeksuje wyniki według inputId, a następnie przechodzi przez pierwotną listę kont, dzięki czemu każde konto źródłowe pozostaje widoczne, nawet jeśli w przyszłości zabraknie któregoś wyniku.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Słownik wyników sprawia, że połączenie danych nie zależy od kolejności odpowiedzi. account-vaude łączy pierwotny rekord vaude.com ze znalezioną stroną VAUDE i trafia do ready_for_research. account-drooms zachowuje pełny wejściowy URL i cały wynik API, ale trafia do needs_review, ponieważ poziom pewności jest niski, mimo że status wyniku to success.
Ta sama logika pozostawia w kolejce do weryfikacji rekord brakujący, oznaczony jako no_result lub zawierający błąd. Dwie wyświetlane listy dają zespołowi jasny punkt wyjścia do ręcznego researchu firm.
Możesz też pobrać aktualizowany synchroniczny przykład z Requests. Repozytorium zawiera również asynchroniczny przykład z HTTPX dla aplikacji wymagających nieblokującej komunikacji HTTP, ale wersja blokująca przedstawiona powyżej jest łatwiejsza do zrozumienia przy pierwszej integracji.
Wyszukaj witrynę na podstawie strony firmy na LinkedIn
Ta sama funkcja przyjmuje strony firmowe na LinkedIn po zmianie kierunku dopasowywania. Przydaje się to, gdy lista źródłowa zawiera adresy stron firmowych, a przed kompatybilnym enrichmentem danych firmy lub służbowych adresów e-mail potrzebujesz witryn.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Standardowe wyszukiwanie na podstawie strony firmowej na LinkedIn korzysta ze zwykłej stawki dopasowania. Numeryczne identyfikatory firm i adresy firm w Sales Navigator mogą kosztować 10 kredytów, ponieważ korzystają z innej ścieżki reverse lookup. Wersję no-code dla tego kierunku znajdziesz w poradniku jak uzyskać adresy witryn ze stron firmowych na LinkedIn.
Oszacuj koszt wyszukiwania w kredytach
Jedno udane, standardowe wyszukanie strony LinkedIn na podstawie witryny zużywa 1,5 kredytu. Pięć pokazanych dopasowań kosztowało więc łącznie 7,5 kredytu. Przy tej samej stawce 1000 udanych dopasowań zużyje 1500 kredytów. Nieprawidłowe inputy i wiersze bez wyniku mogą nie zużywać żadnych kredytów, dlatego faktyczne wykorzystanie sprawdzaj w polu creditsUsed każdego wyniku.
Dostęp do REST API jest częścią planu Growth, a miesięczna subskrypcja jest rozliczana niezależnie od dodatkowych kredytów. Pakiet za 20 USD zapewnia 20 000 kredytów, więc jeden kredyt kosztuje 0,001 USD. Przy 1,5 kredytu za udane dopasowanie 1000 dopasowań zużywa 1500 kredytów o wartości 1,50 USD. Aktualne plany i pakiety znajdziesz w cenniku Datablist.
Rozwiąż typowe problemy z inputem, zadaniem i wynikiem
- Brakuje
DATABLIST_API_KEY: skrypt zatrzymuje się przed wysłaniem requestu. Wyeksportuj zmienną środowiskową i ponownie uruchom polecenie. - API odrzuca klucz: upewnij się, że skopiowano Personal API Key i że request wysyła go wyłącznie w
X-API-Key. - Input nie jest obsługiwany: dla
domain_to_linkedinużyj firmowej witryny lub domeny. W przeciwnym kierunku podaj obsługiwany adres strony firmowej zamiast profilu osobistego lub pustej wartości. - Brakuje kredytów: sprawdź saldo, a następnie wykorzystaj kredyty zawarte w planie lub dokup pakiet przed utworzeniem kolejnego zadania.
- Zadanie ma status
failedlubstopped: zanim zdecydujesz się wysłać je ponownie, sprawdź status, błąd, istniejące wyniki oraz wykorzystanie kredytów. - Wynik ma niski poziom pewności, status
no_resultlub błąd: zachowaj witrynę źródłową i pełny wynik wneeds_review. Jeśli istnieje strona kandydata, otwórz ją. Nie zgaduj przyczyny braku wyniku.
Jeśli połączenie zostanie przerwane podczas tworzenia zadania, użyj wartości uniqueId wyświetlonej przed requestem POST. Wyświetl listę zadań i odszukaj tę wartość, zanim utworzysz kolejne zadanie:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"Listy zadań nie można filtrować według uniqueId, dlatego sprawdź każde zwrócone zadanie i w razie potrzeby podążaj za nextCursor. Po znalezieniu właściwej wartości użyj jej @id z tymi samymi adresami URL statusu i wyników co w skrypcie.
Jedno zadanie może zawierać maksymalnie 10 000 inputów. Pełne informacje o limitach requestów, czasie przechowywania zadań i paginacji znajdziesz w dokumentacji Company to LinkedIn API.
Co dalej
Masz teraz jedną funkcję Pythona wykorzystującą Requests, która zamienia witryny firm w kandydatów na strony firmowe na LinkedIn. Lokalna kolejka pozostawia dopasowania o wysokim poziomie pewności gotowe do researchu, a niepewne lub nieudane rekordy — widoczne do weryfikacji.
Zastąp pięć przykładów niewielką listą kont, sprawdź każdego kandydata z niskim poziomem pewności, a następnie wykorzystaj zaakceptowane adresy do ręcznego researchu firm lub jako inputy dla LinkedIn company scraper API. Jeśli lista źródłowa zawiera nazwy firm zamiast witryn, zacznij od poradnika company website finder API.