
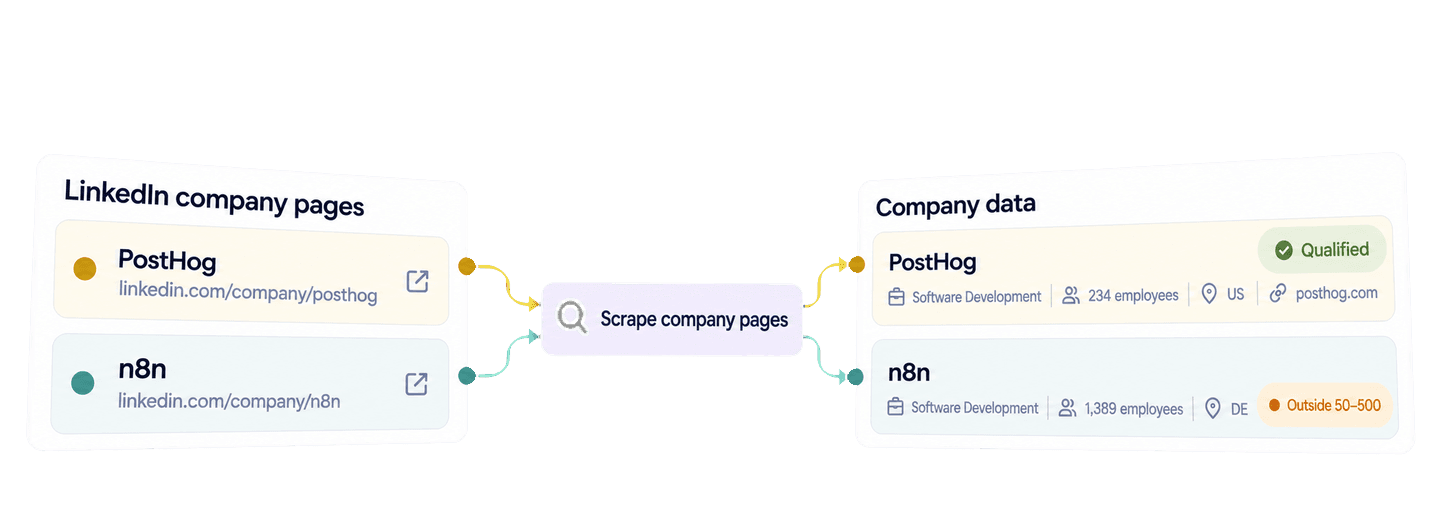
Dane firm z LinkedIn można pobierać w Pythonie, wysyłając za pomocą biblioteki Requests listę adresów URL stron firmowych do API Datablist. API zwraca ustrukturyzowane rekordy firm zawierające takie pola jak branża, liczba pracowników, siedziba, strona internetowa i opis — o ile są one dostępne na publicznej stronie firmy.
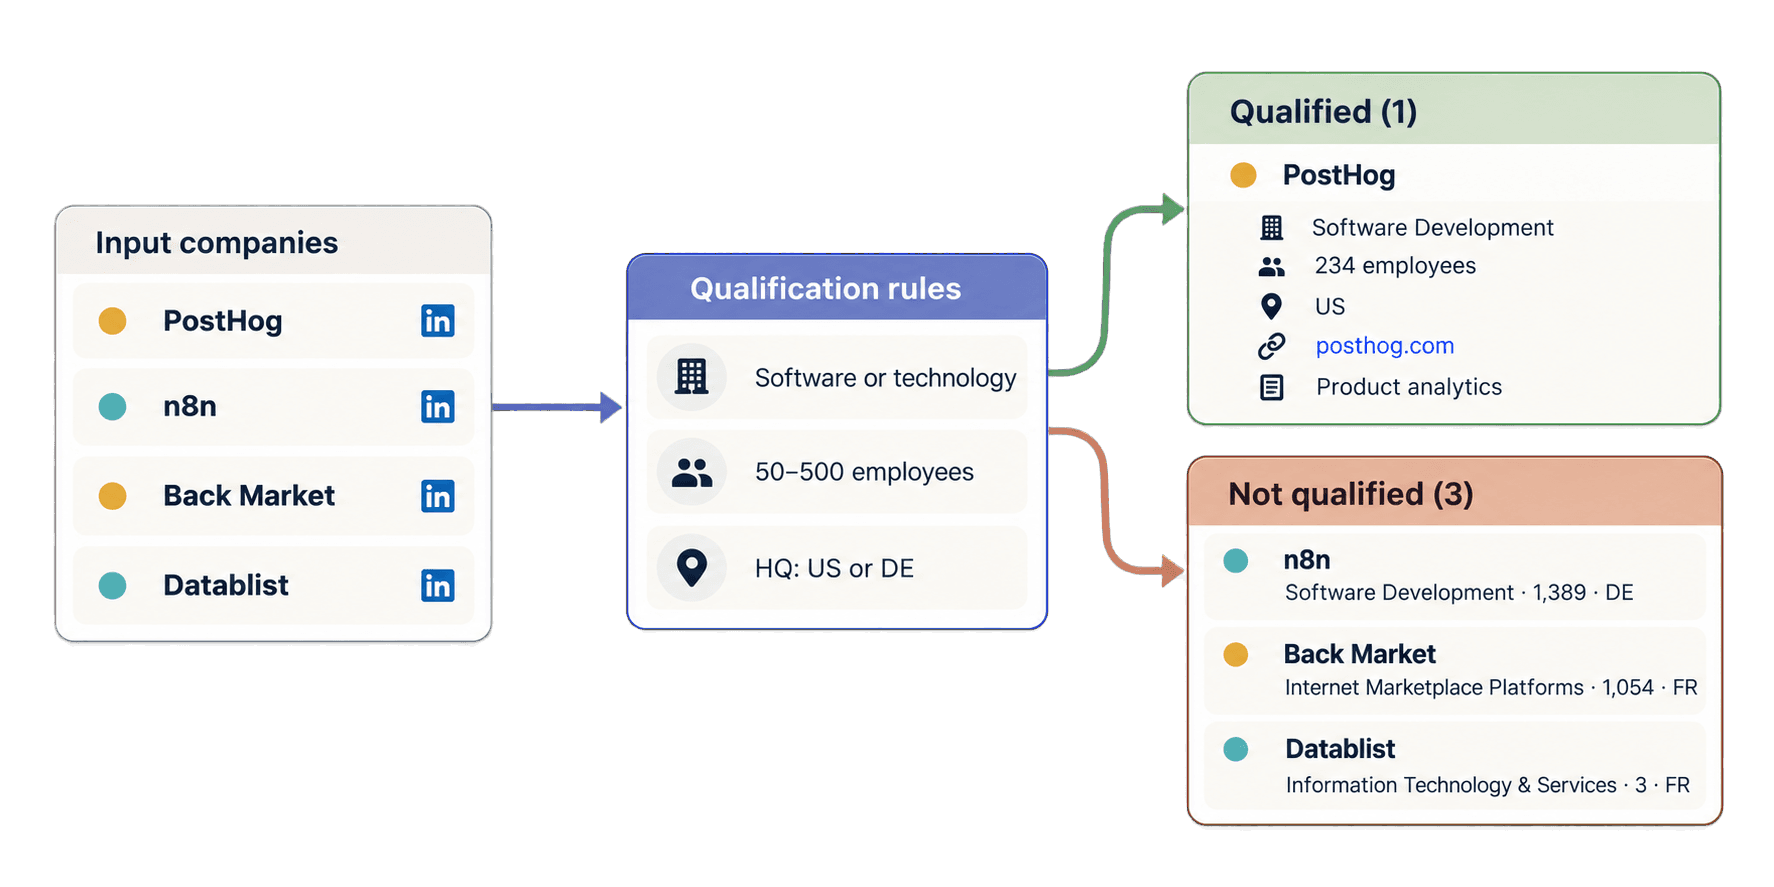
W tym poradniku wykorzystuję jedną czytelną funkcję w Pythonie, aby pobrać rekordy n8n, PostHog, Back Market i Datablist. Następnie na podstawie tych wyników kwalifikuję firmy z branży software, które zatrudniają od 50 do 500 osób i mają siedzibę w Stanach Zjednoczonych lub Niemczech. Zakwalifikowany rekord zachowuje adres strony internetowej i opis, co ułatwia dalszy sales research.
🔑 Podsumowanie dla zabieganych
Datablist przekształca zweryfikowane adresy URL stron firmowych LinkedIn w ustrukturyzowane rekordy firm, które można wykorzystać w procesie sales research. Poniższy przykład w Pythonie pobiera wszystkie strony wyników, a następnie lokalnie filtruje konta bez wykonywania kolejnego wywołania API.
- Input: adresy URL stron firmowych LinkedIn.
- Output: dostępne dane firm oraz lokalna decyzja kwalifikacyjna, wraz z oryginalnym adresem URL i pełnym wynikiem dotyczącym firmy.
💡 Wolisz rozwiązanie no-code? Użyj LinkedIn Company Page Scraper w Datablist, aby bez pisania kodu pobierać dane ze znanych adresów URL stron firmowych LinkedIn.
Skonfiguruj Pythona i klucz API Datablist
W tym przykładzie w Pythonie korzystam z pakietu requests. REST API Datablist jest dostępne w planie Growth, a każde wyszukanie strony firmowej zużywa kredyty enrichment.
Utwórz Personal API Key na stronie konta API Datablist.
Utwórz plik scrape_linkedin_companies.py, a następnie przygotuj środowisko wirtualne i zainstaluj Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Skrypt odczytuje klucz ze zmiennej DATABLIST_API_KEY i przesyła go w nagłówku X-API-Key.
Pobieraj strony firm LinkedIn jedną funkcją w Pythonie
Poniższa lista źródłowa zawiera firmy z różnych branż, o różnej wielkości i z siedzibami w różnych krajach. Każdy account_id staje się wartością inputId w API. Wyniki nie są łączone na podstawie pozycji w odpowiedzi, dlatego to właśnie ten stały identyfikator przypisuje każdy wynik do właściwego źródłowego adresu URL.
Wklej cały poniższy skrypt do pliku scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Uruchom go poleceniem:
python scrape_linkedin_companies.pyNajważniejsze wartości do zmiany to rekordy w accounts. Zachowaj stały i unikalny account_id, a następnie zastąp linkedin_company_url zweryfikowanym adresem strony firmowej LinkedIn. Funkcja przekształca te rekordy do formatu inputs wymaganego przez API i wysyła adres firmy jako companyLinkedInUrl. Pole settings pozostaje puste, ponieważ ten enrichment nie ma publicznych ustawień.
Żądanie POST tworzy zadanie enrichment działające w tle. API odpowiada statusem 202 Accepted i identyfikatorem zadania, a klient Requests czeka, cyklicznie sprawdzając adres URL statusu. Taki blokujący kod w Pythonie jest wygodny w małym skrypcie, ale po stronie Datablist zadanie nadal działa asynchronicznie.
Pierwsze żądanie GET sprawdza samo zadanie. Może ono zakończyć się statusem completed, failed lub stopped. Skrypt kontynuuje działanie tylko po otrzymaniu completed; w przeciwnym razie zgłasza błąd zawierający identyfikator zadania i komunikat błędu z API. Zachowaj ten identyfikator na potrzeby diagnostyki, ponieważ zadanie zakończone jako failed lub stopped może nadal zawierać wyniki i informacje o wykorzystaniu kredytów.
Po ukończeniu zadania ostatnia pętla pobiera strony wyników z limitem 100 rekordów. Kolejne strony są pobierane do momentu, gdy nextCursor przyjmie wartość null. Każdy wynik zachowuje przekazany inputId, dlatego późniejsza pętla kwalifikacyjna może poprawnie połączyć wyniki, nawet jeśli ich kolejność różni się od kolejności danych wejściowych.
Odczytaj wynik firmy i poznaj metodę pobierania
Adres URL LinkedIn jednoznacznie identyfikuje firmę. Datablist normalizuje adres organizacji i pobiera dostępne publicznie dane ze strony firmowej, zamiast wyszukiwać i oceniać kilka potencjalnie pasujących firm. W przypadku adresu URL wskazującego konkretną firmę proces rozpoczyna się od publicznej strony, a nierozpoznane pola mogą zostać uzupełnione z zarządzanych źródeł zapasowych, bez zastępowania przydatnych wartości znalezionych wcześniej.
Ta różnica ma znaczenie podczas analizy wyniku. Pola opcjonalne zależą od publicznie dostępnych informacji. Wartość null w adresie siedziby lub brak specjalizacji nie oznaczają, że całe wyszukiwanie firmy się nie powiodło.
Oto pełna strona wyników zwrócona dla czterech adresów URL:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
Wszystkie cztery rekordy zostały pobrane pomyślnie, a każdy z nich zużył 25 kredytów. Dla PostHog zwrócono branżę Software Development, 234 pracowników, siedzibę w USA, stronę internetową i opis. n8n również jest firmą software z jednego z wybranych krajów, ale zwrócona liczba pracowników wynosi 1389. Dla Back Market zwrócono branżę Internet Marketplace Platforms, 1054 pracowników i siedzibę we Francji. Dla Datablist zwrócono branżę Information Technology & Services, 3 pracowników i siedzibę we Francji.
Pełny obiekt jest przydatny, ponieważ research firmy rzadko kończy się na jednym polu. Możesz kwalifikować konta na podstawie branży, liczby pracowników i kraju, zachowując jednocześnie dokładny adres strony internetowej i opis zwrócone przez API do kolejnego etapu researchu.
W tej odpowiedzi companySize oznacza zwróconą liczbę pracowników, a nie przedział wielkości firmy z LinkedIn. companyHQCountry wskazuje lokalizację siedziby, a nie wszystkie kraje, w których firma prowadzi działalność. Te różnice mają znaczenie przy dostosowywaniu filtrów wielkości i kraju do profilu idealnego klienta.
Do kwalifikacji nie są potrzebne wszystkie pola opcjonalne. Brak adresu lub specjalizacji nie stanowi problemu, jeśli dostępne są branża, liczba pracowników i kraj siedziby. Zachowaj companyWebsite w zwróconej postaci, zamiast zakładać, że API zamieni ten adres na samą domenę. Opis może pomóc osobie prowadzącej sales research zrozumieć produkt firmy i przygotować research dopasowany do konkretnego konta przed rozpoczęciem Outbound. Podczas przeglądania lub zapisywania rekordu pozostaw pola status, creditsUsed i error obok danych firmy.
Kwalifikuj konta do sales research
Załóżmy, że szukasz firm software lub technologicznych, które zatrudniają od 50 do 500 osób i mają siedzibę w USA albo Niemczech. Dodaj poniższą pętlę pod pełnym skryptem. Wykorzystuje ona ponownie company_results, więc nie tworzy kolejnego zadania:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog zostaje poprawnie połączony z account-posthog, nawet jeśli API zwróci rekordy w innej kolejności. Firma przechodzi kwalifikację, ponieważ Software Development, 234 pracowników i US spełniają wszystkie trzy warunki. Pętla kopiuje oryginalny wynik wraz z pełnym obiektem outputs, zwróconym adresem https://posthog.com/, opisem oraz polami creditsUsed i error. Dodaje jedynie źródłowy adres URL i lokalną etykietę kwalifikacji.
n8n zostaje połączony z account-n8n, ale nie przechodzi kwalifikacji, ponieważ 1389 pracowników przekracza górny limit. Back Market nie spełnia kryteriów branży, wielkości ani kraju, natomiast Datablist znajduje się poniżej wybranego przedziału wielkości i poza wskazanymi krajami. Przyszłe rekordy zakończone niepowodzeniem lub zawierające niepełne dane otrzymają status needs_review, zamiast zostać po cichu odrzucone.
Możesz pobrać utrzymywany synchroniczny przykład z Requests lub skorzystać z asynchronicznej alternatywy HTTPX dostępnej w repozytorium, jeśli potrzebujesz nieblokującego kodu aplikacji.
Oszacuj kredyty na pobieranie danych firm z LinkedIn
Standardowa, nazwana strona firmowa LinkedIn zużywa 25 kredytów. Adres URL firmy z identyfikatorem numerycznym może zużyć 75 kredytów, jeśli konieczne jest użycie ostatniego źródła zapasowego, ale 75 kredytów nie jest ceną każdego numerycznego adresu URL. Wyszukiwania zakończone niepowodzeniem lub bez dopasowania również mogą zużywać kredyty, dlatego rzeczywiste wykorzystanie sprawdzaj na podstawie łącznej wartości dla zadania oraz pola creditsUsed każdego wyniku.
Cztery nazwane adresy URL z tego poradnika zużyły łącznie 100 kredytów. Przy standardowej stawce 1000 stron firmowych wymaga 25 000 kredytów. Dane wejściowe zawierające wiele adresów z identyfikatorami numerycznymi wymagają większego zapasu ze względu na możliwą ścieżkę kosztującą 75 kredytów.
Dostęp do REST API wymaga planu Growth. Miesięczny plan obejmuje 20 000 kredytów, a dodatkowe kredyty kupuje się osobno. Przy obecnej bazowej cenie doładowania wynoszącej 20 USD za 20 000 kredytów jeden kredyt kosztuje 0,001 USD. Według tej stawki 25 000 kredytów kosztuje 25 USD. Aktualne plany i pakiety kredytów znajdziesz w cenniku Datablist.
Rozwiąż typowe problemy z danymi, zadaniami i wynikami
- Brakuje
DATABLIST_API_KEY: skrypt zatrzyma się przed wysłaniem żądania. Wyeksportuj zmienną i ponownie uruchom plik. - API odrzuca klucz: sprawdź Personal API Key i upewnij się, że znajduje się on w nagłówku
X-API-Keyużywanym w przykładzie. - Źródłowy adres URL jest nieprawidłowy: zastąp profil osobisty, niepowiązaną stronę, pustą wartość lub błędnie zapisany adres obsługiwanym publicznym adresem LinkedIn typu company, school, showcase, numerical-ID albo Sales Navigator company URL.
- Brakuje kredytów: sprawdź saldo, a następnie wykorzystaj kredyty zawarte w planie lub kup doładowanie przed utworzeniem kolejnego zadania.
- Zadanie ma status
failedlubstopped: sprawdź błąd, istniejące wyniki i wykorzystanie kredytów, zanim zdecydujesz się wysłać kolejne płatne zadanie. - Wynik jest niepełny albo ma status
no_resultluberror: zachowaj źródłowy adres URL, status, kredyty i błąd do weryfikacji. Przed ponownym wysłaniem potwierdź, że dane wejściowe wskazują publiczną stronę firmy, i nie zakładaj z góry, dlaczego dane były niedostępne.
Jeśli odpowiedź na żądanie utworzenia zadania zaginie, użyj identyfikatora żądania wyświetlonego przez skrypt przed wykonaniem POST. Najpierw pobierz listę zadań i znajdź wartość pasującą do pola uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"Pole @id pasującego zadania zawiera jego identyfikator. Użyj go, aby dalej sprawdzać /v1/enrichments/tasks/{taskId} lub pobrać /v1/enrichments/tasks/{taskId}/results, zamiast automatycznie tworzyć kolejne zadanie. Jedno żądanie może zawierać maksymalnie 10 000 inputów i 10 MiB danych. Informacje o okresie przechowywania i pozostałych etapach cyklu życia znajdziesz w dokumentacji zadań.
Co dalej
Masz teraz jedną funkcję wielokrotnego użytku w Pythonie, opartą na Requests, która przekształca listę adresów URL stron firmowych LinkedIn w ustrukturyzowane rekordy firm. Masz też lokalną pętlę kwalifikacyjną, która zachowuje pełny wynik API na potrzeby sales research.
Zastąp cztery przykłady niewielką, zweryfikowaną listą kont, zachowaj stałe identyfikatory i dostosuj reguły dotyczące branży, liczby pracowników oraz kraju do profilu idealnego klienta. Jeśli punktem wyjścia są osoby, a nie firmy, skorzystaj z poradnika po LinkedIn profile scraper API. Jeśli masz tylko nazwy firm, zacznij od wyszukiwania stron firmowych w Pythonie.