

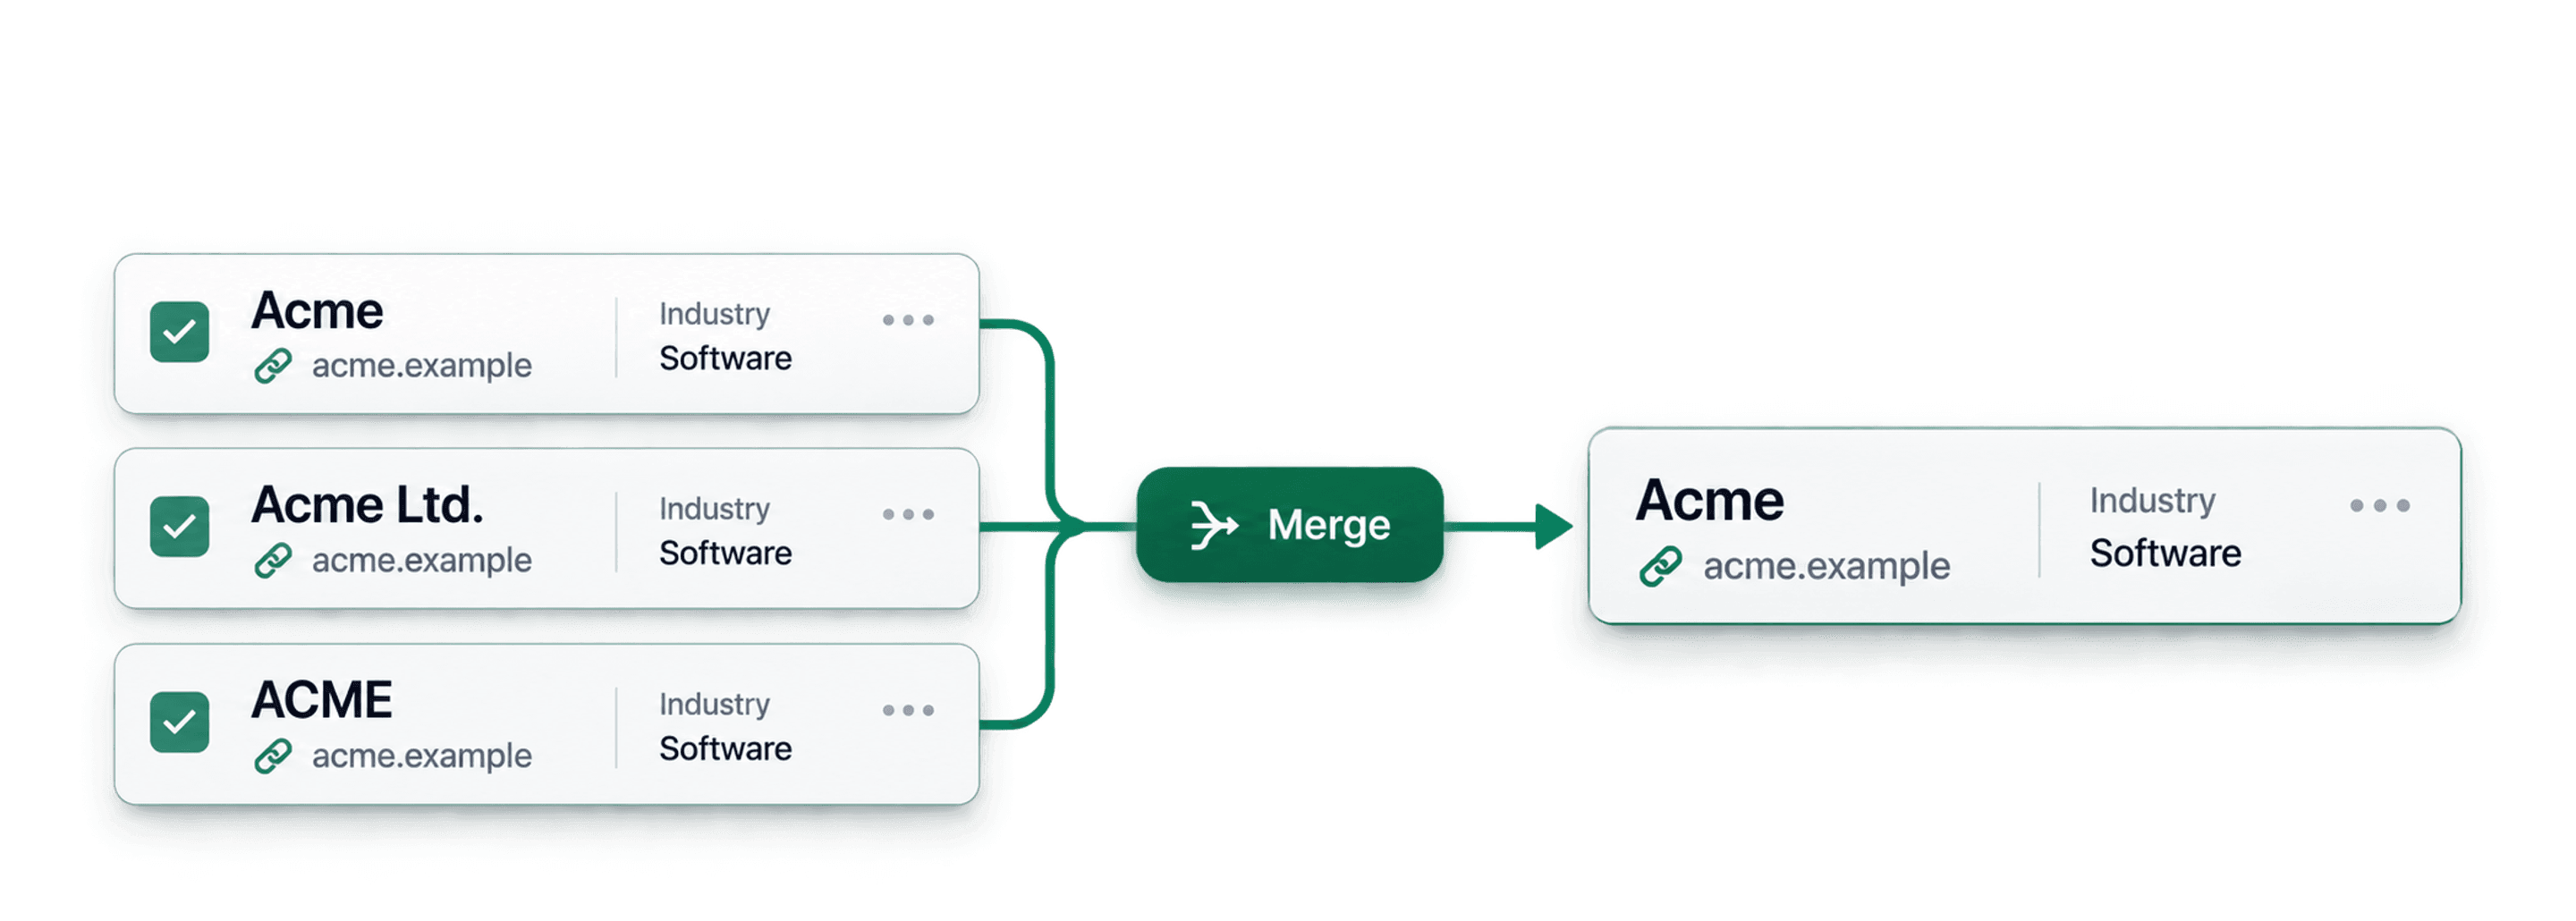
Para encontrar nomes de empresas duplicados, compare primeiro um domínio confiável e, depois, use a correspondência de nomes normalizados nos registros que não tenham um site válido. Revise os grupos sugeridos antes de uni-los, pois duas empresas podem ter o mesmo nome curto ou genérico.
Este guia mostra como:
- Importar sua lista com nomes de empresas
- Encontrar sites e nomes de empresas correspondentes
- Unir registros duplicados de empresas
Boas práticas para remover empresas duplicadas
Use o identificador mais confiável disponível. Um site ou domínio normalizado é um ponto de partida melhor do que o nome, pois empresas diferentes podem compartilhar nomes como Acme Services. Mantenha o nome original da empresa, o site e o ID do registro no CRM em propriedades separadas. Assim, você poderá verificar cada correspondência e relacionar a linha limpa à sua origem.
Faça a correspondência por nome em uma segunda etapa. O processador Company Name remove termos jurídicos, regionais e comerciais comuns antes da comparação. Isso pode agrupar Cedar Group LLC e Cedar, mas também pode fazer duas empresas sem relação parecerem iguais. Nos registros sem domínio, compare outro campo, como país, cidade ou endereço, antes de decidir pela união. Não considere uma correspondência de nome de 100% como prova de que as empresas são a mesma entidade.
Quando um grupo tiver telefones, responsáveis ou anotações diferentes, consulte Why matched e escolha quais valores devem ser mantidos. Se precisar de um histórico para auditoria, exporte primeiro os grupos de duplicatas. Faça a união somente quando puder explicar por que os registros pertencem à mesma empresa.
Se quiser criar uma coluna separada com nomes limpos para poucos registros, use o Company Name Cleaner gratuito antes de importar a lista. Mantenha os valores originais ao lado dos resultados. A limpeza facilita a comparação dos nomes, mas não determina quais empresas devem ser unidas.
Etapa 1: importe sua lista de empresas
Comece importando sua lista de empresas para o Datablist. Mantenha uma coluna de domínio ou site, caso tenha essa informação. Em geral, o domínio é um identificador de empresa mais confiável do que apenas o nome.
Para reproduzir o fluxo de trabalho medido abaixo, baixe a amostra de deduplicação com 1.000 linhas. Ela contém 800 entidades criadas para o teste, incluindo 50 pares com variações no nome e no site da empresa.
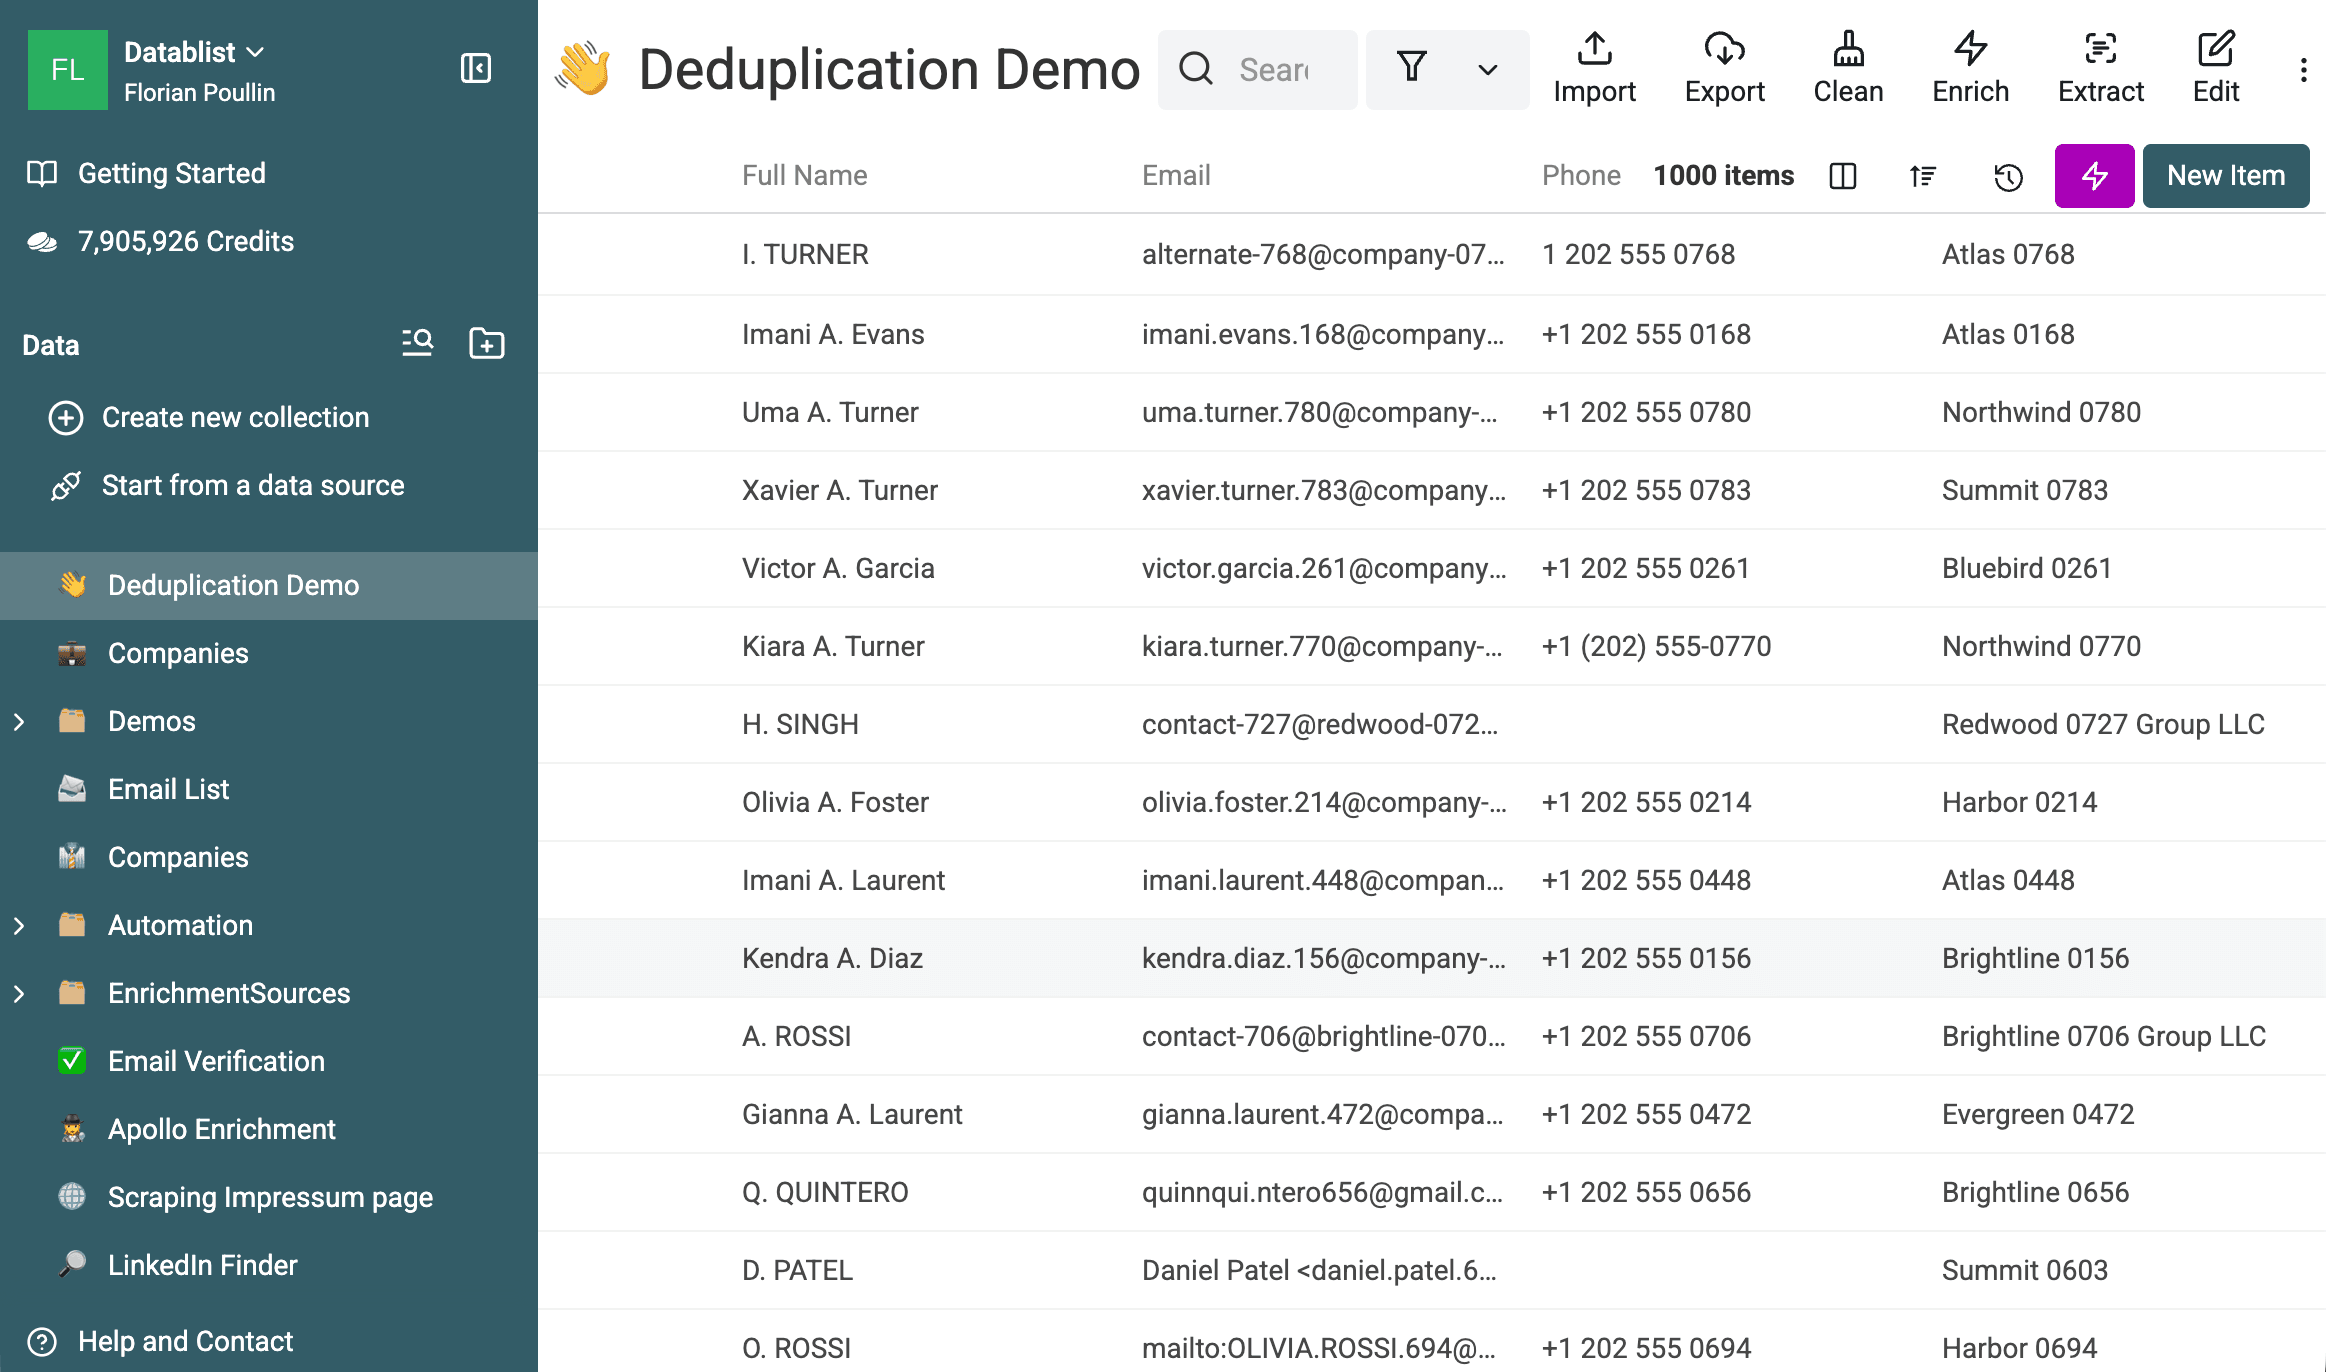
Revise as propriedades importadas e defina Website como URL quando aplicável. A propriedade Company pode permanecer como Text.
Etapa 2: identifique duplicatas com algoritmos
Abra Clean > Merge duplicates para detectar registros de empresas correspondentes.
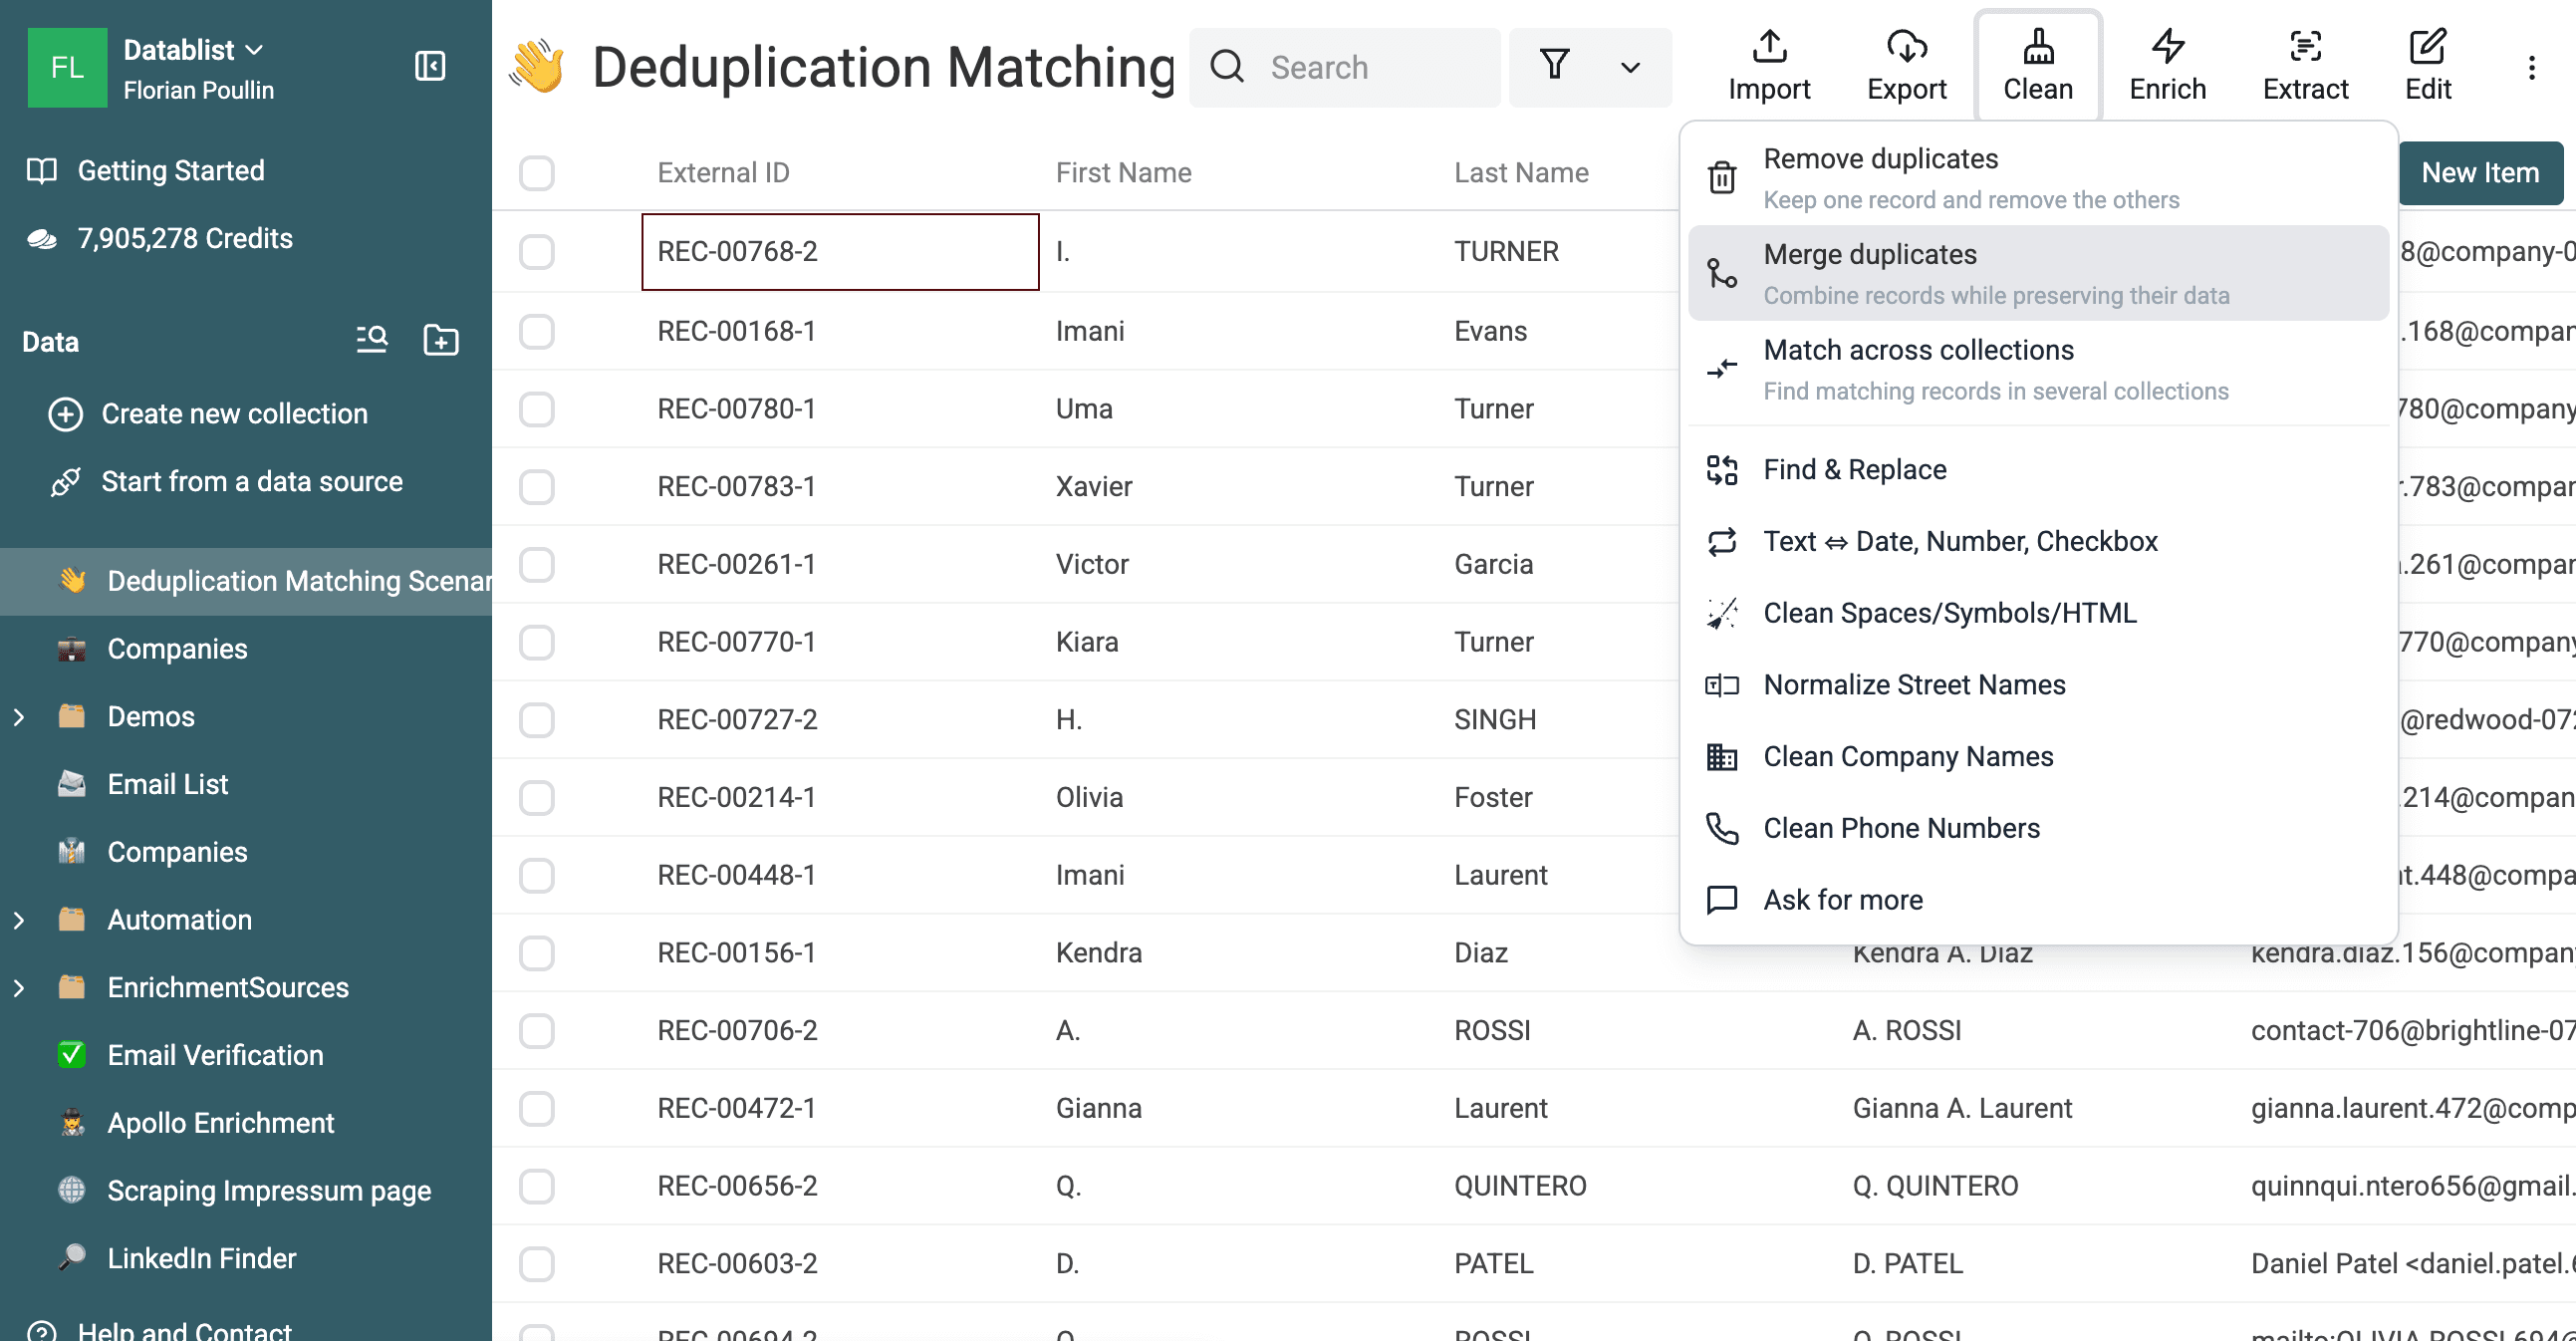
Quando a lista incluir sites, compare-os primeiro. Depois, faça uma verificação separada por nome de empresa nas linhas que não tenham um site ou domínio confiável.
Compare os sites das empresas
Desative All Properties e selecione apenas Website.
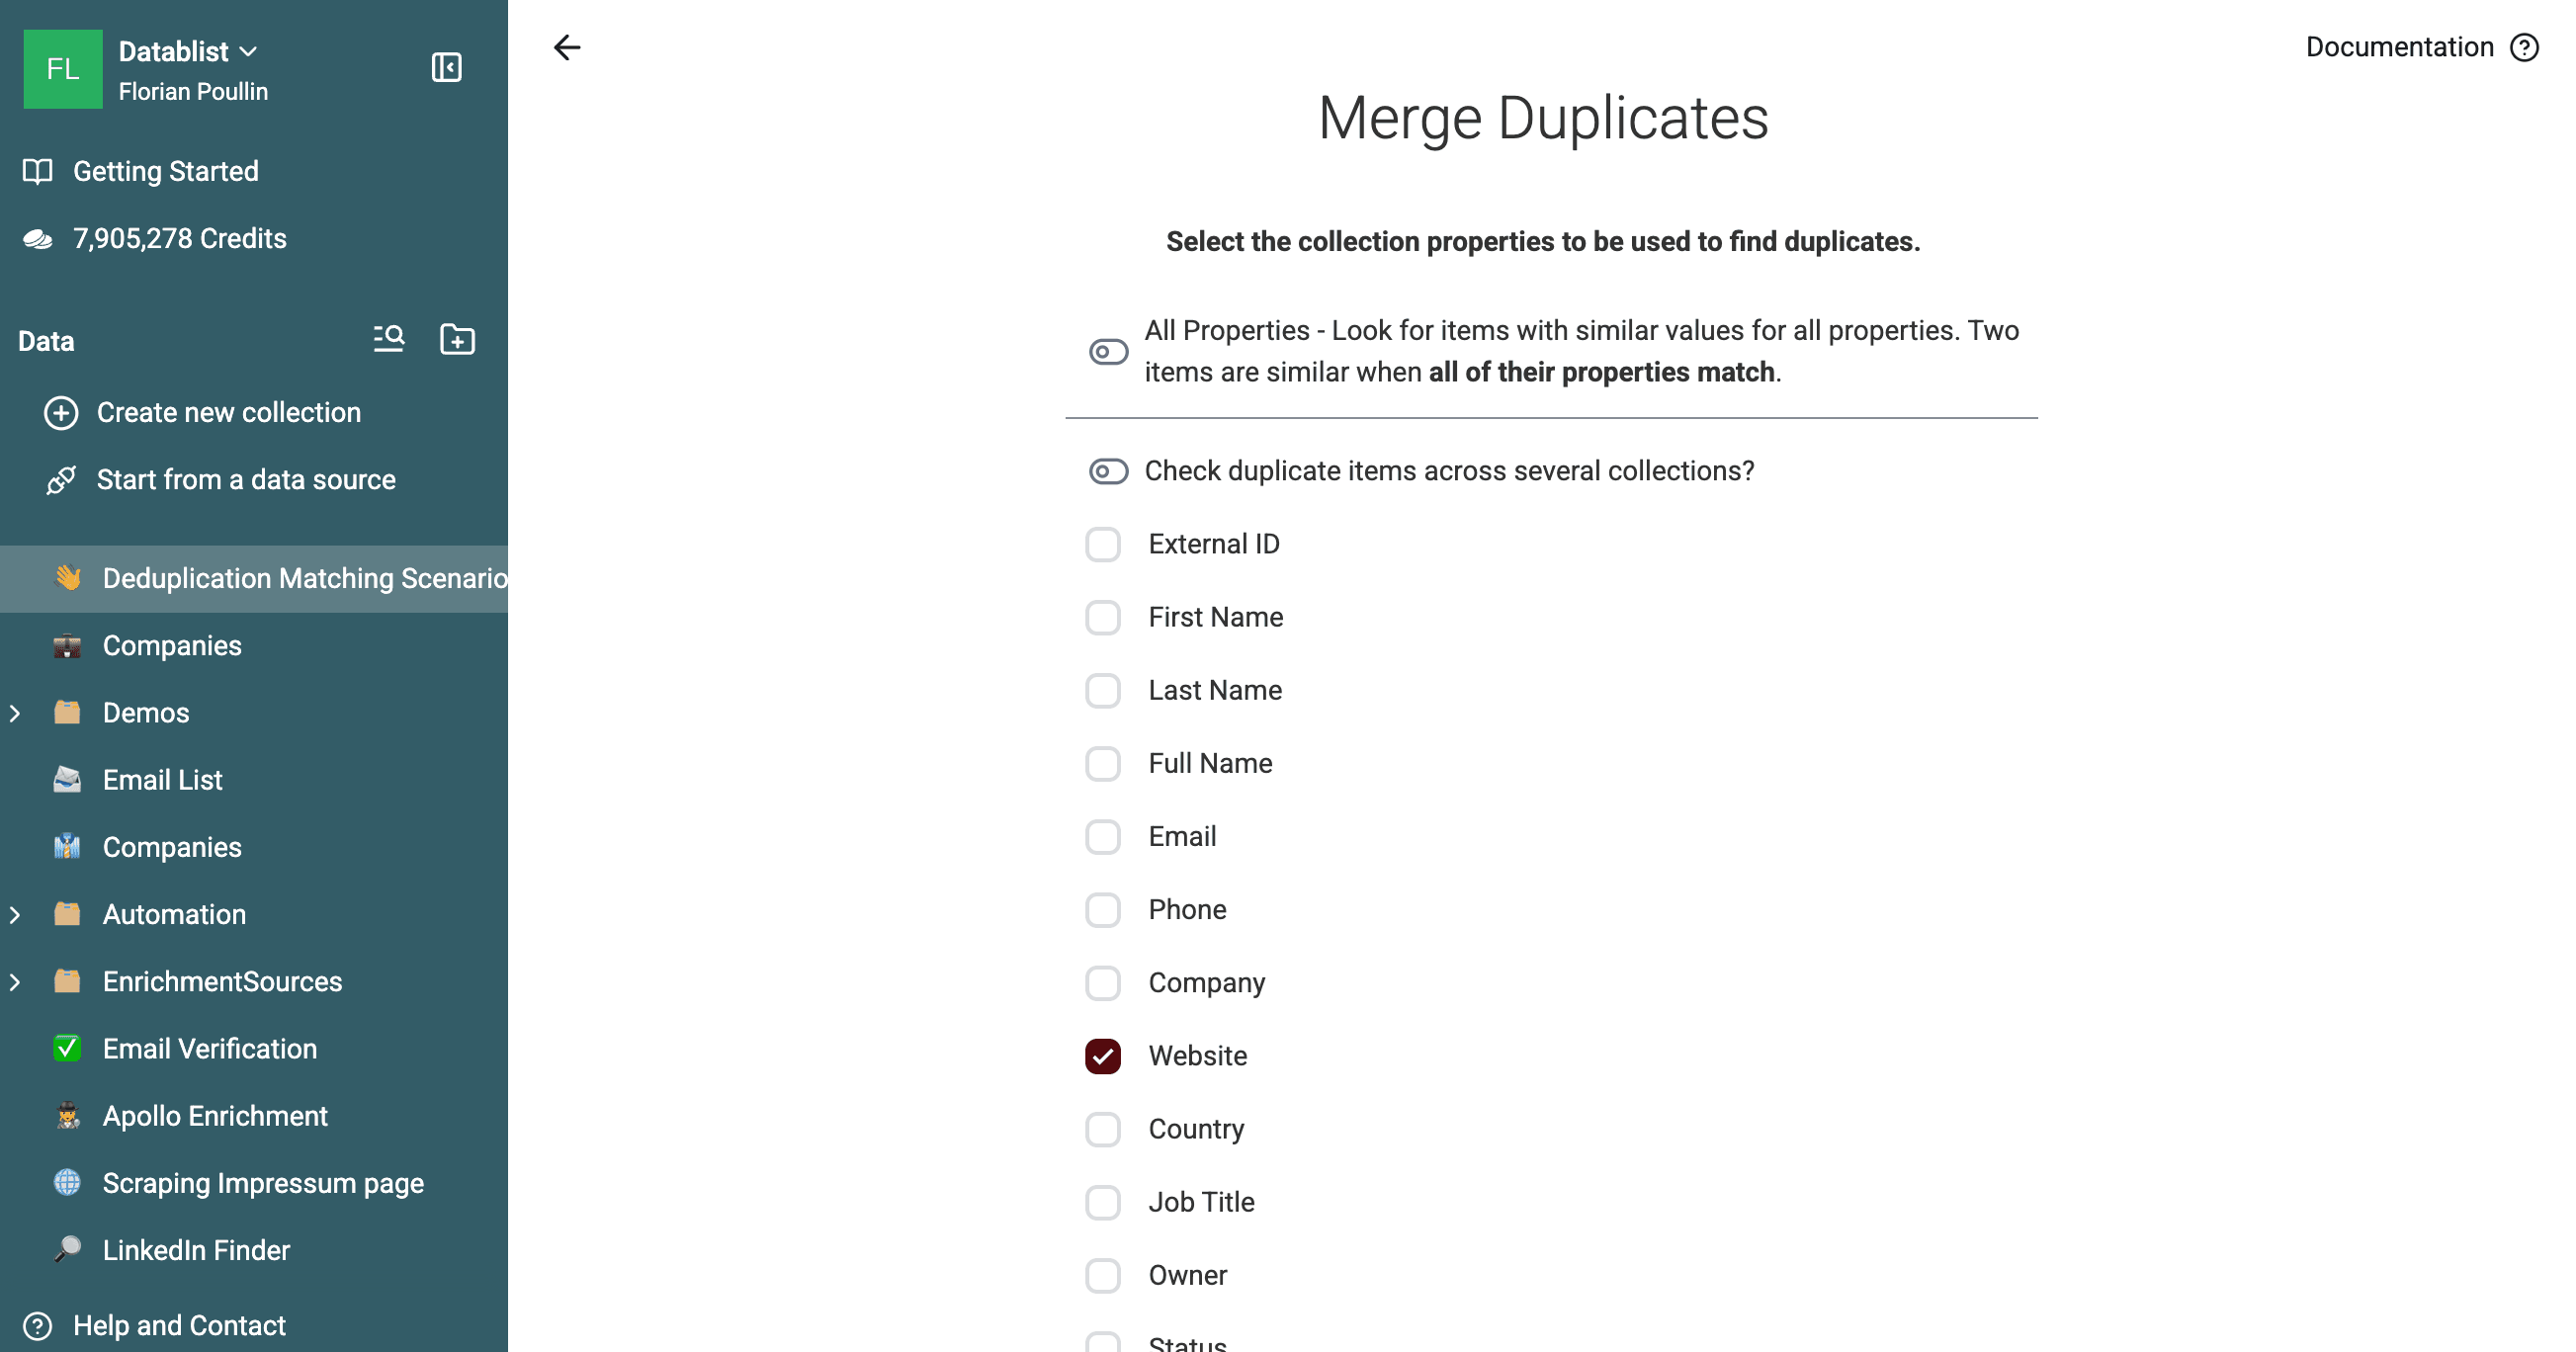
Escolha Smart com o processador URL. O processador ignora diferenças de protocolo e barras no final do endereço. Ative as configurações opcionais abaixo quando forem adequadas aos seus dados:
- Ignore Subdomain considera os subdomínios como parte do mesmo domínio registrado.
- Ignore Path compara o domínio sem os caminhos das páginas.
- Ignore Query Params remove parâmetros de rastreamento e outros parâmetros de consulta antes da comparação.
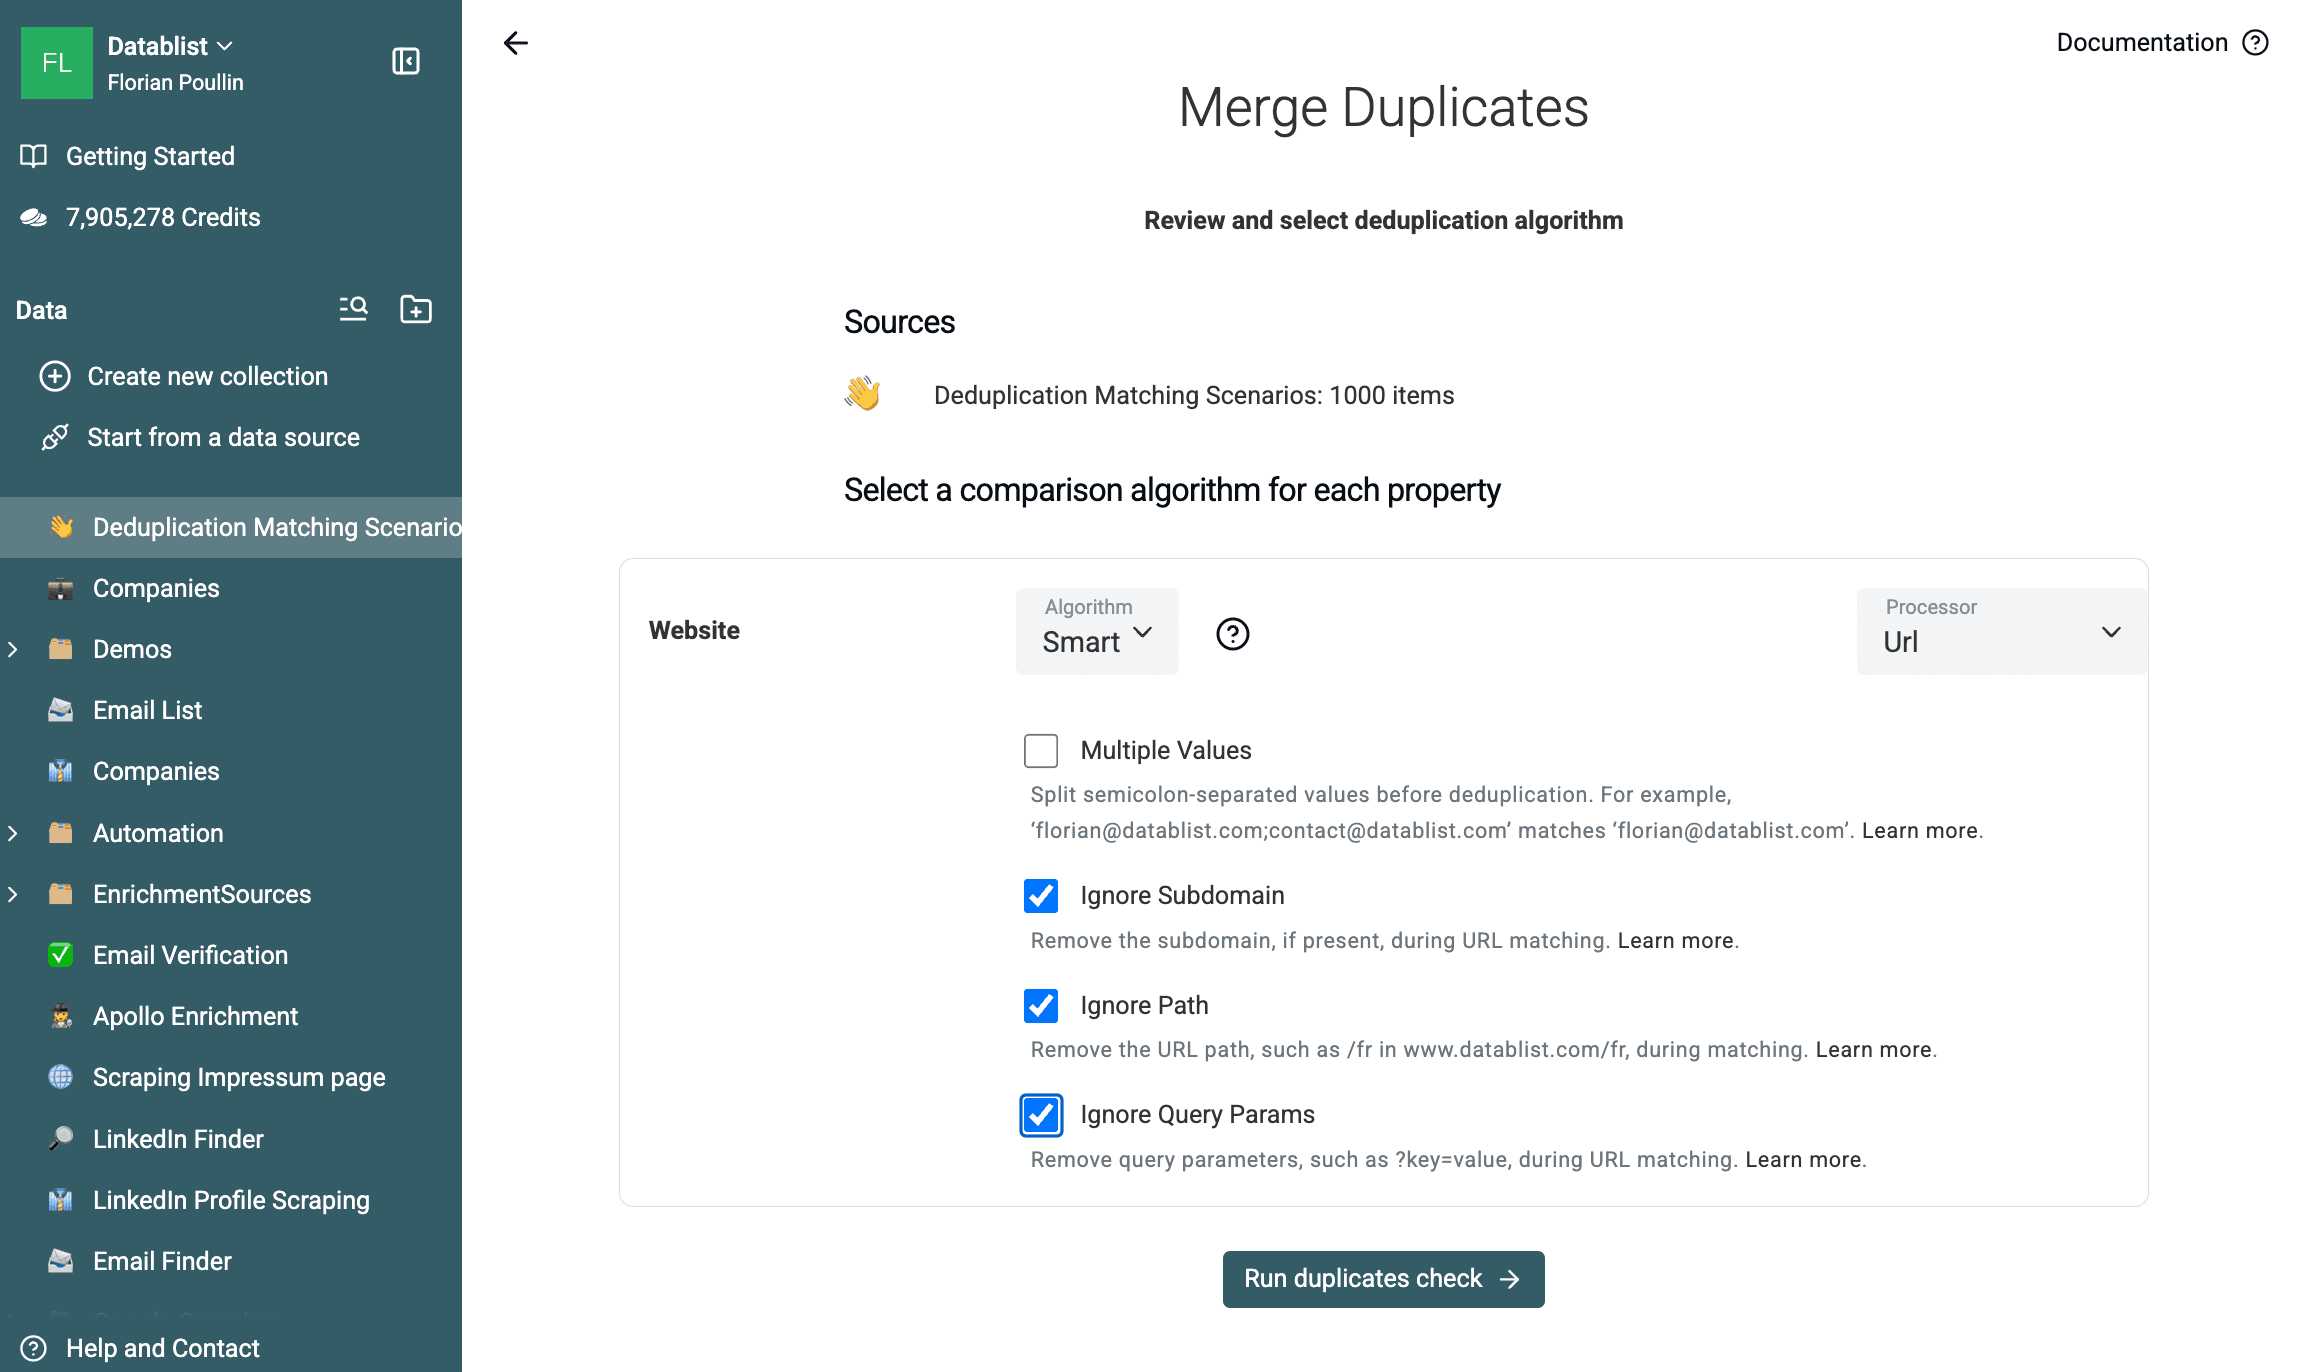
Use essas opções com cuidado. Dois subdomínios ou caminhos podem representar contas, filiais, produtos ou unidades diferentes. Preserve essas informações quando a distinção for importante.
A verificação por Website retornou 200 grupos de duas linhas na amostra de 1.000 linhas. Cinquenta pares contêm variações de URL criadas para o teste, enquanto 150 pares já compartilham o mesmo valor de Website. A validação dos grupos exportados não encontrou correspondências entre entidades diferentes.
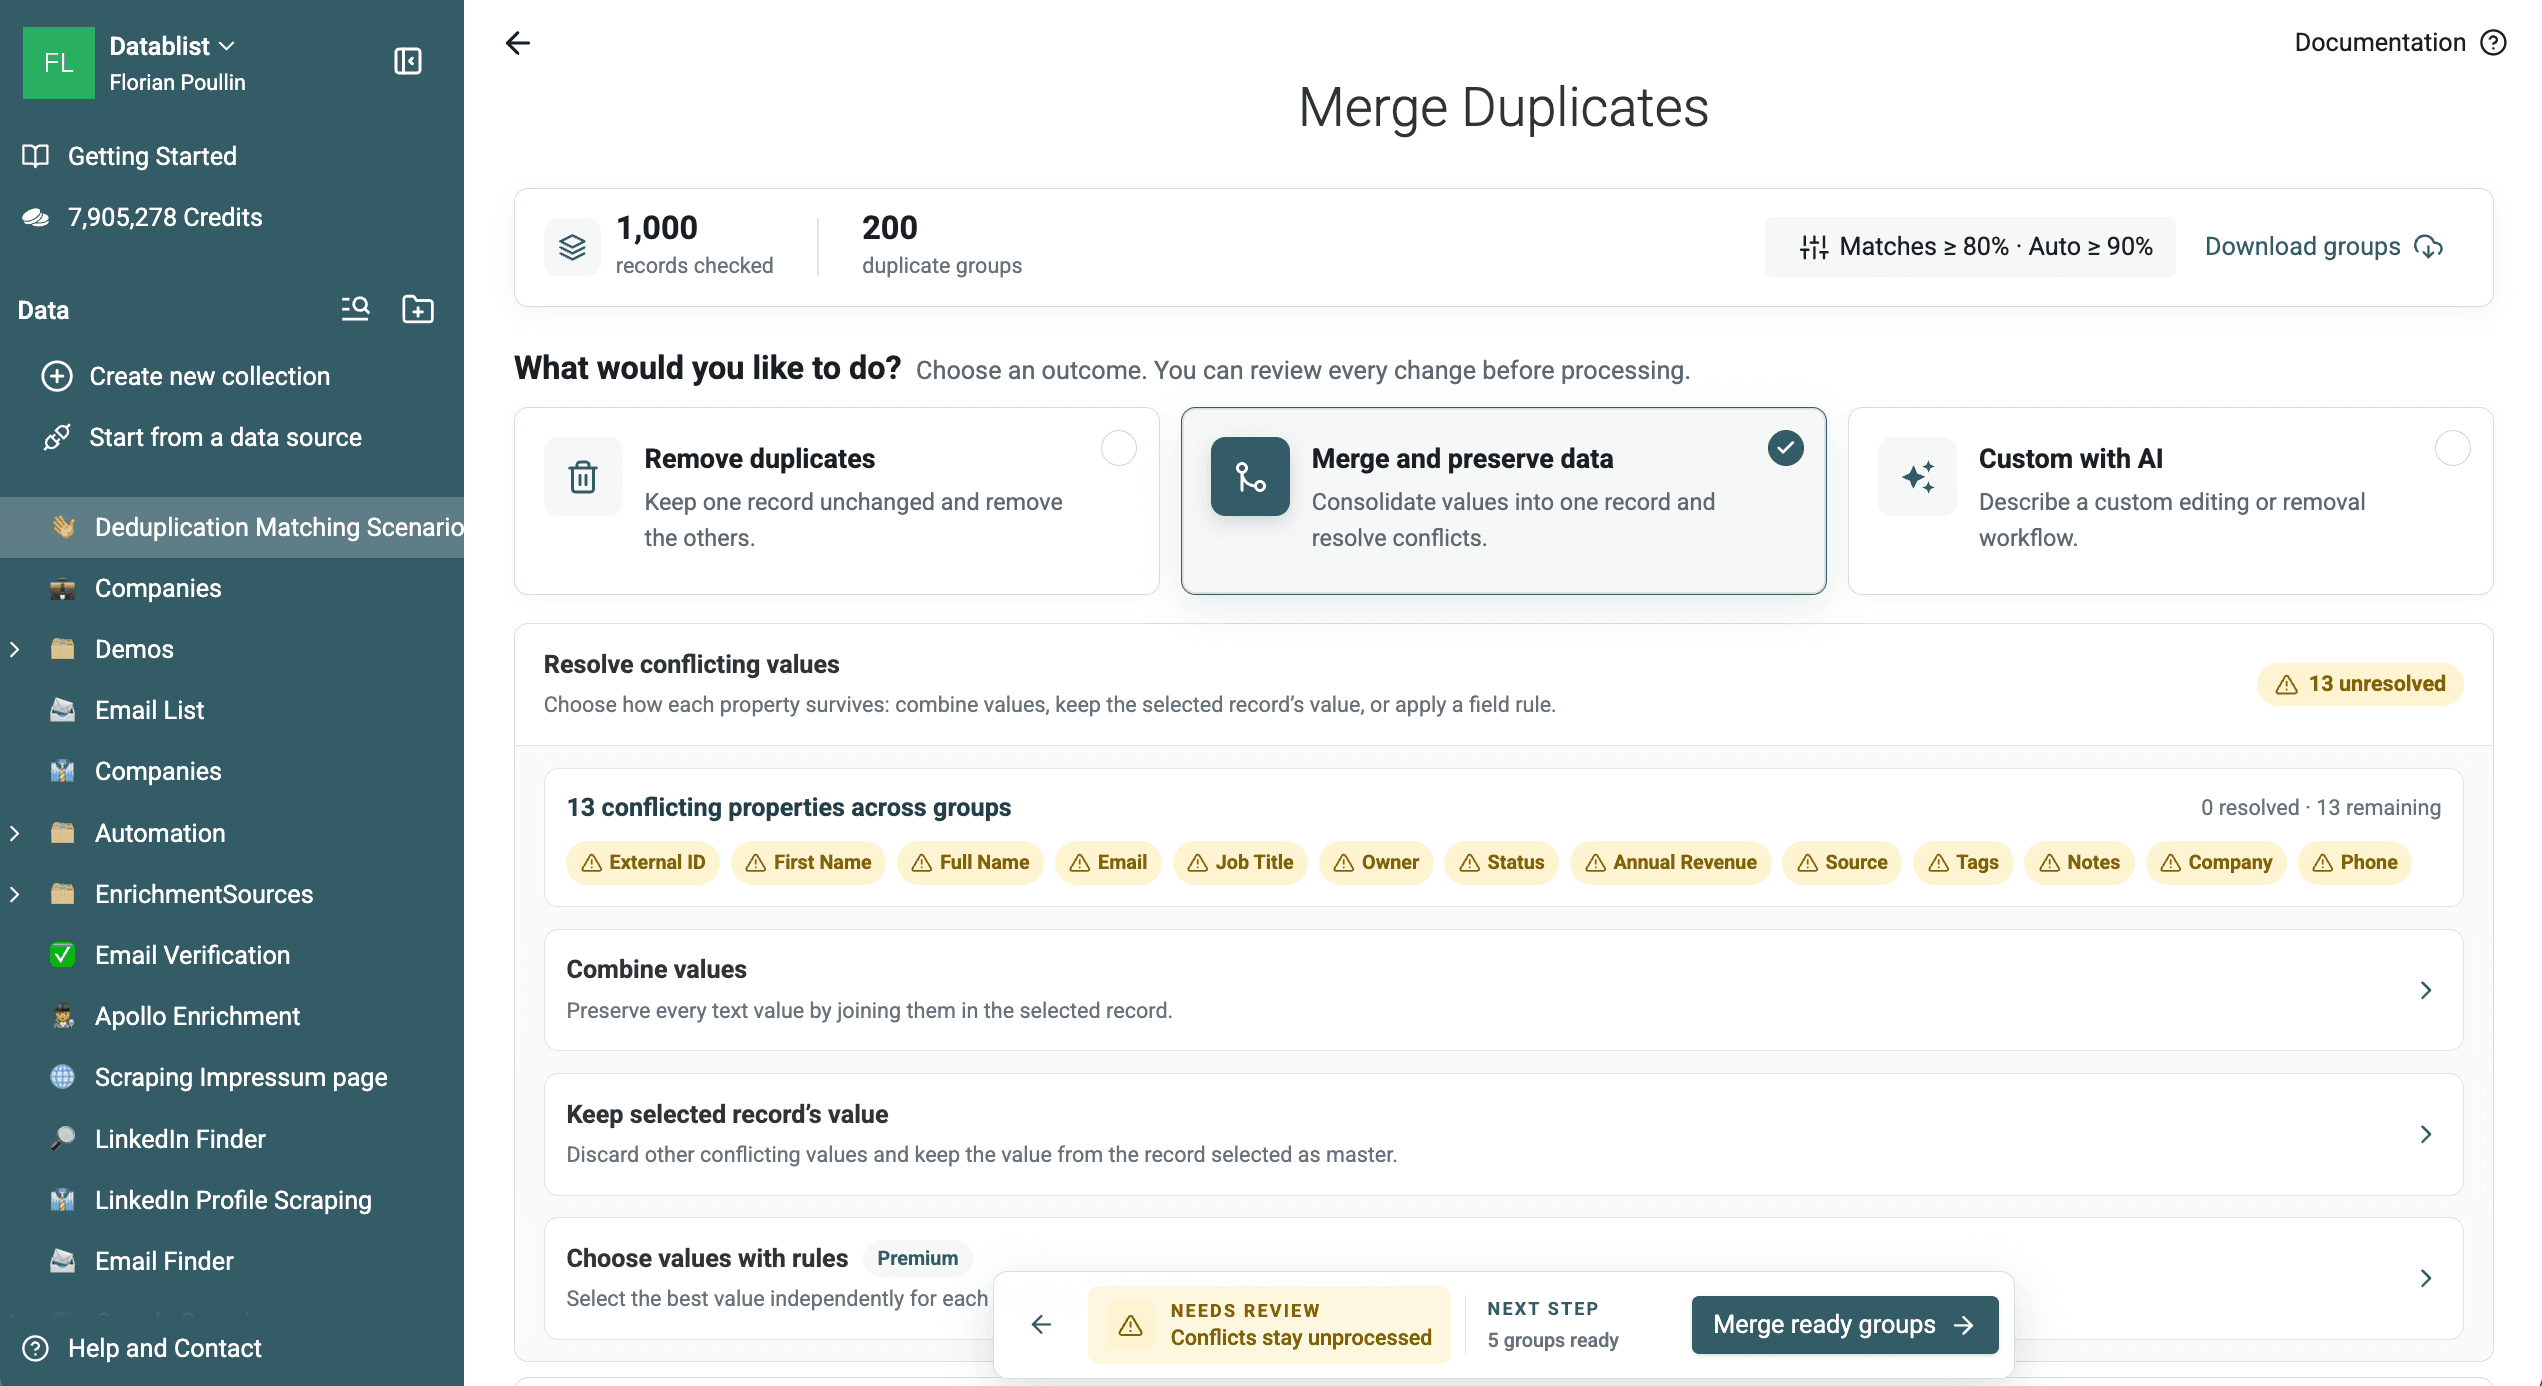
Abra Why matched antes de processar um grupo. Essa opção mostra a propriedade Website, o algoritmo Smart, o processador URL, as opções de URL ativadas e a pontuação da correspondência.
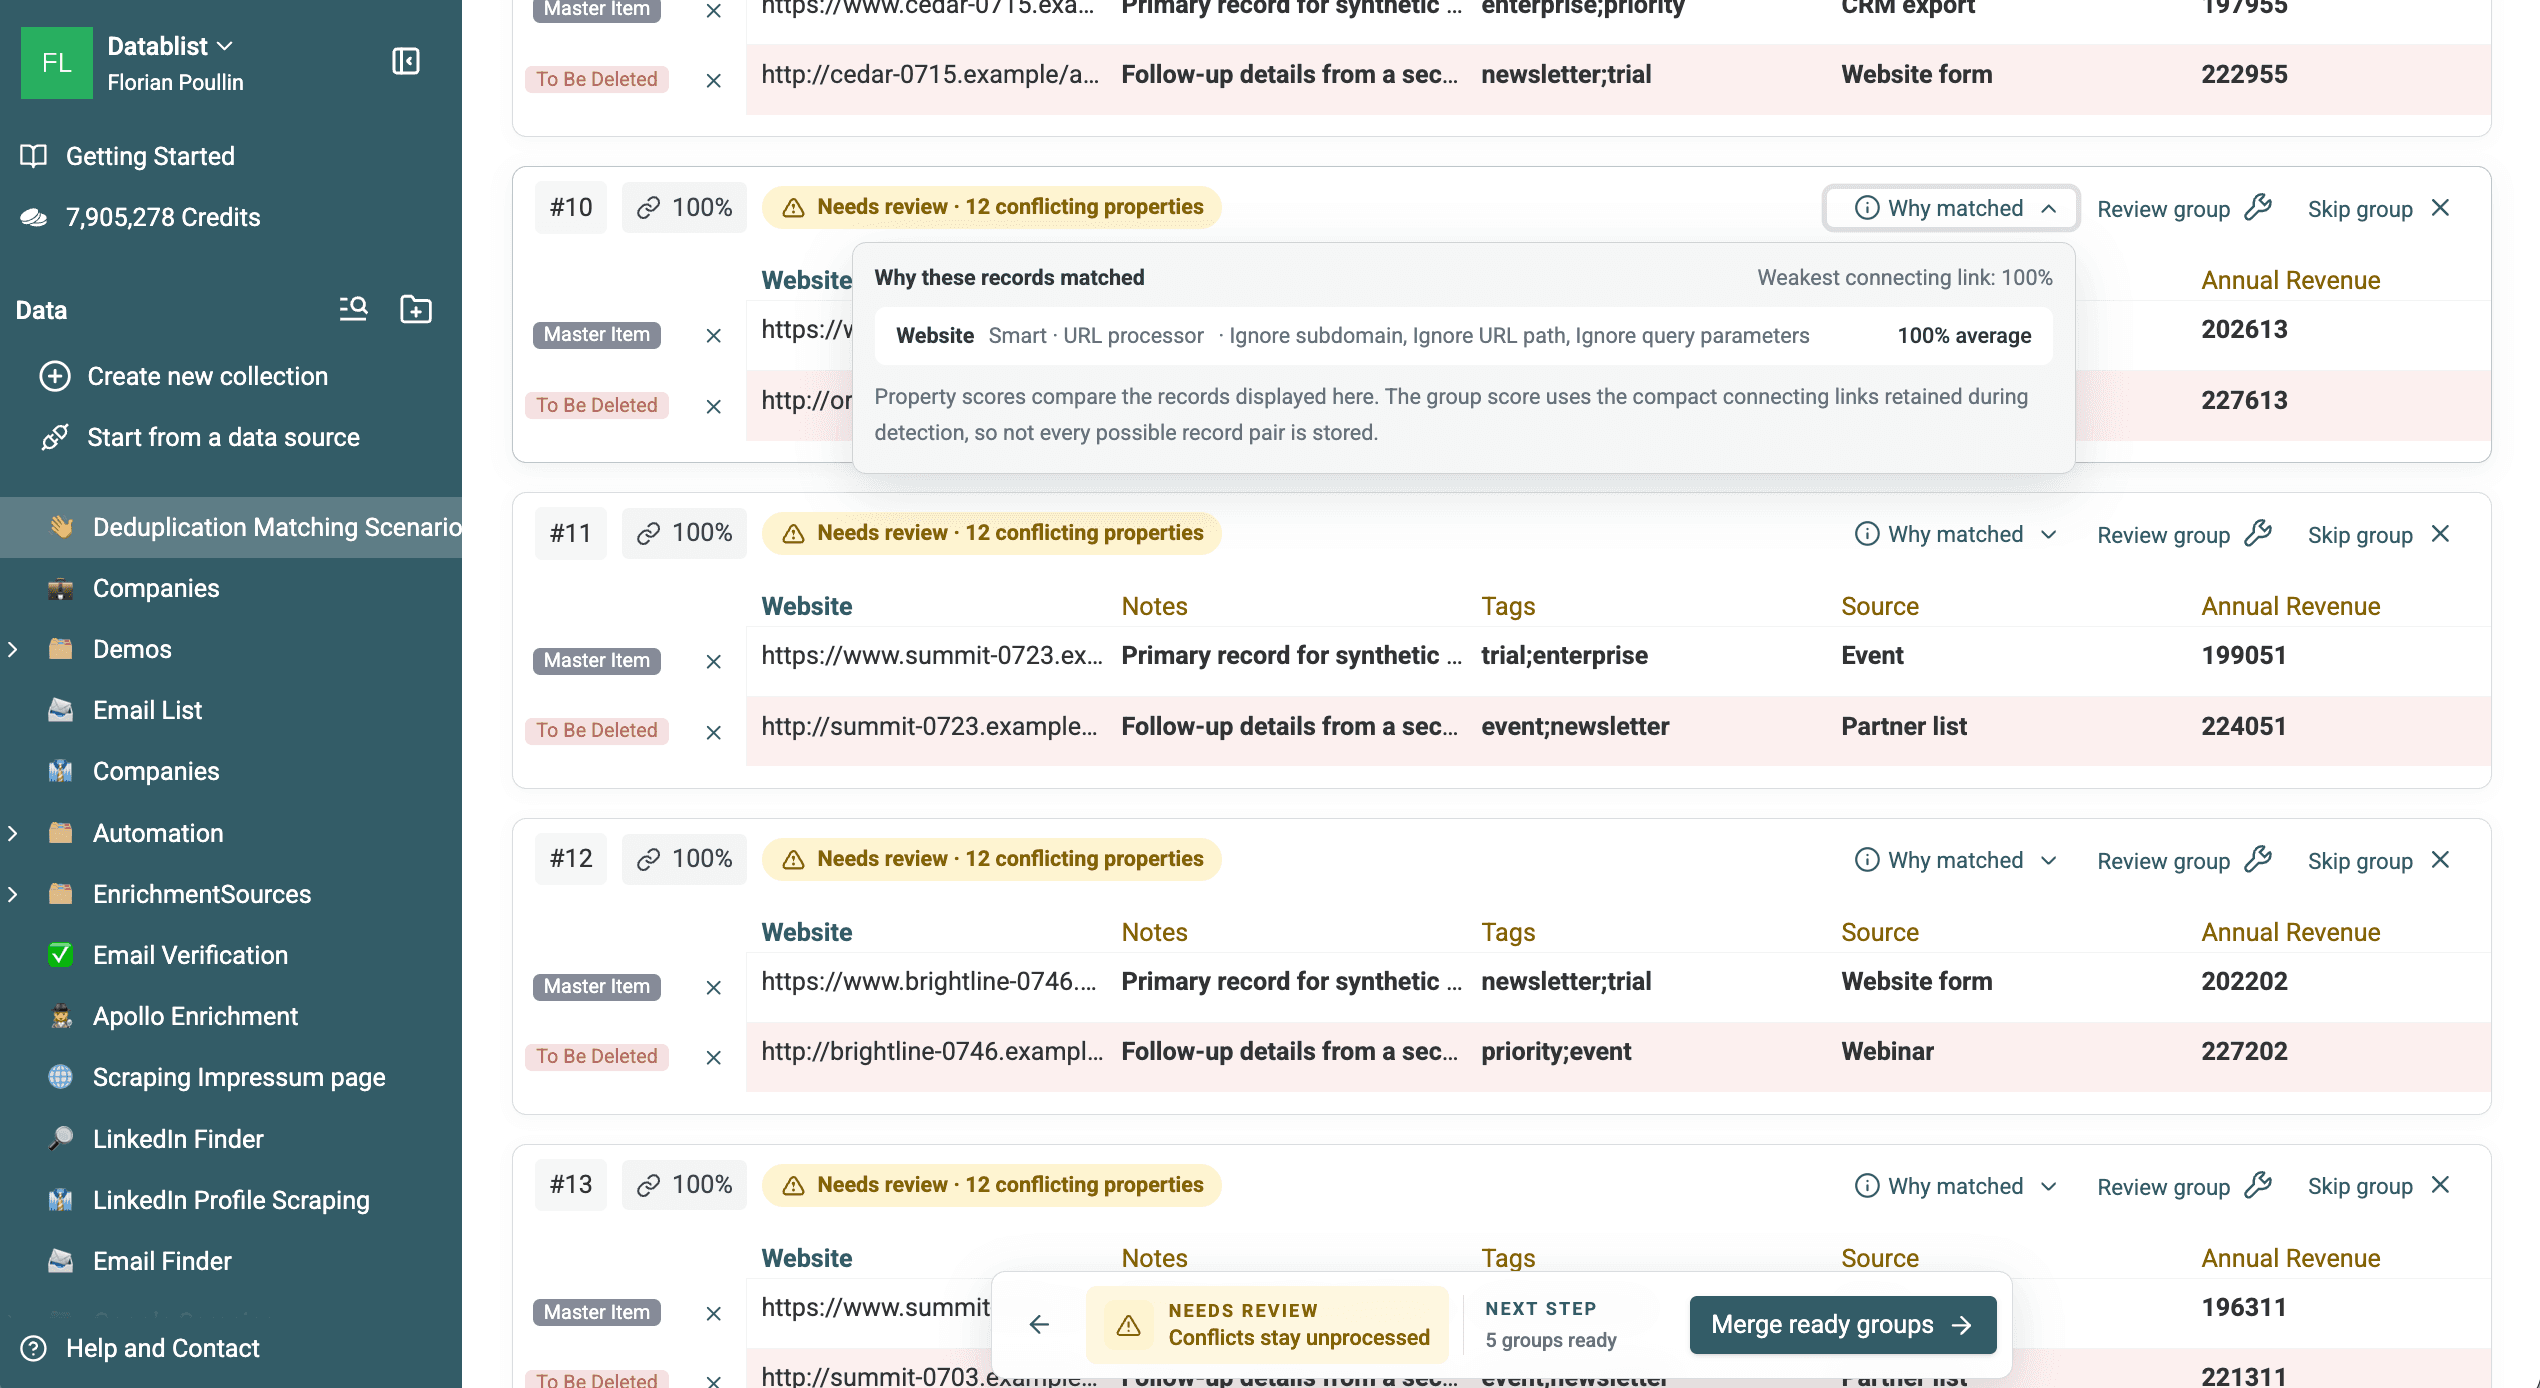
Baixe os 200 grupos de duplicatas encontrados por Website para analisar as linhas correspondentes.
Compare nomes de empresas normalizados
Selecione Company para fazer uma segunda verificação.
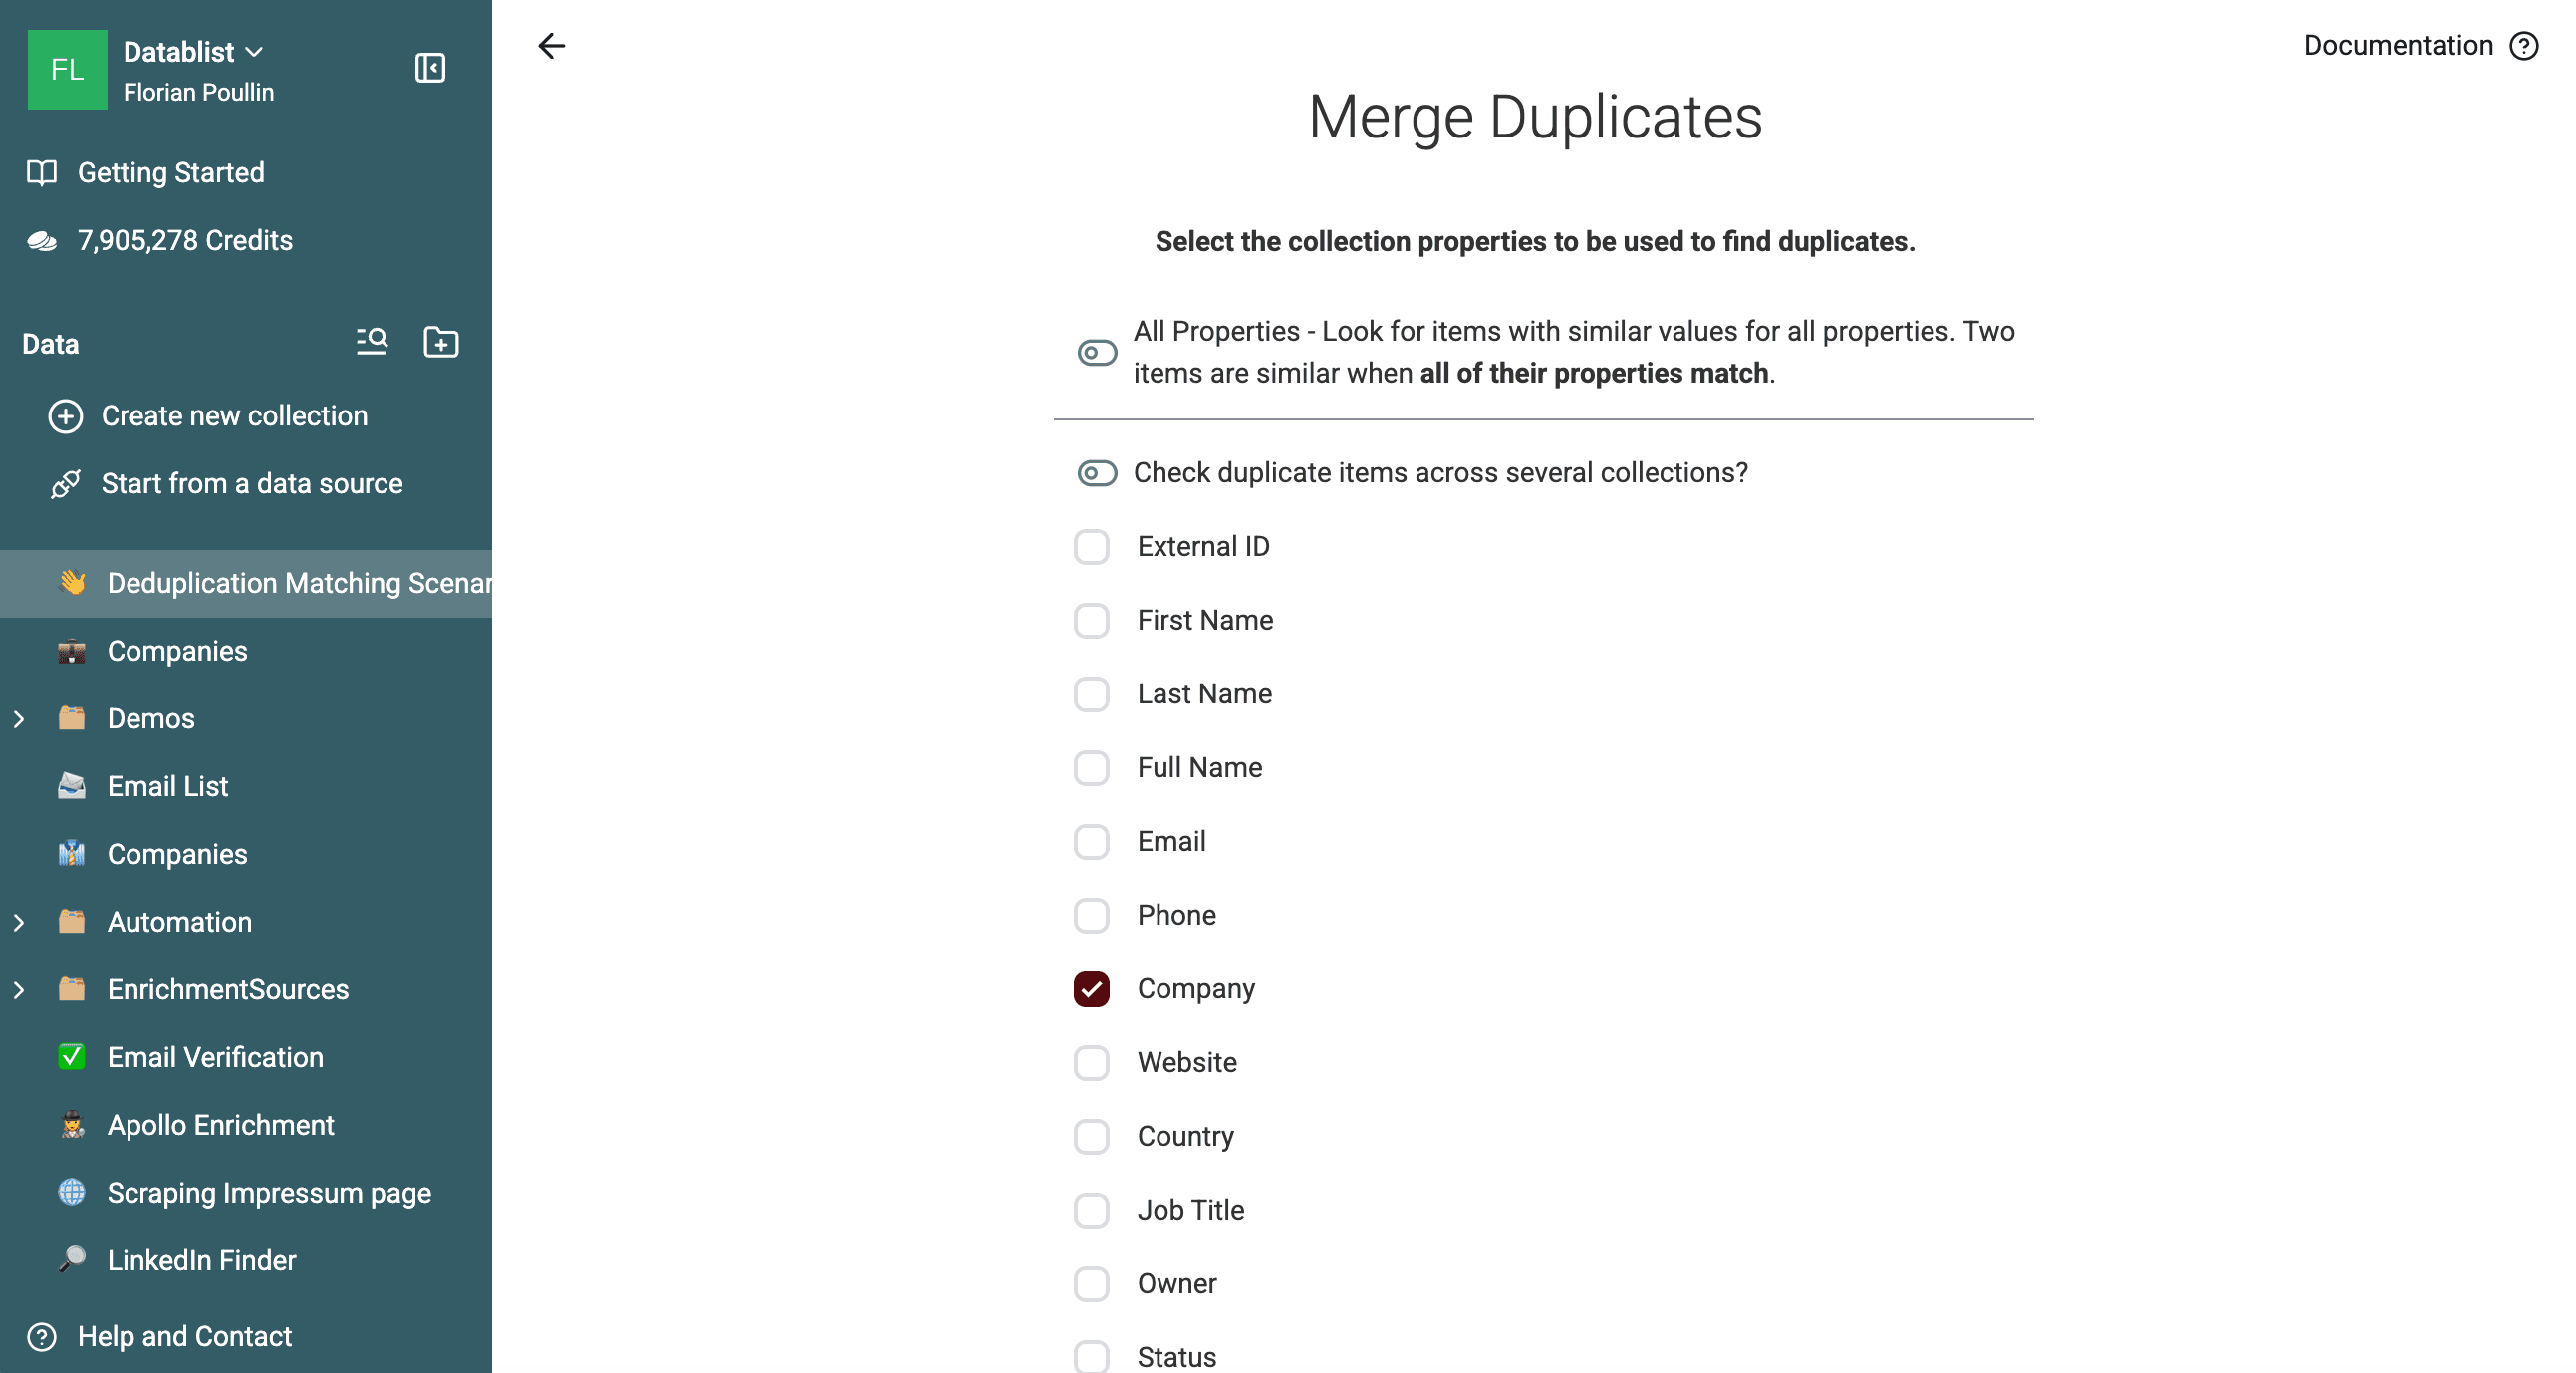
Escolha o método de comparação:
- Use Smart com o processador Company Name para remover termos empresariais comuns antes da comparação.
- Use Jaro-Winkler ou Levenshtein para variações ortográficas. Comece com um limite alto e mantenha os grupos de menor confiança em Needs review.
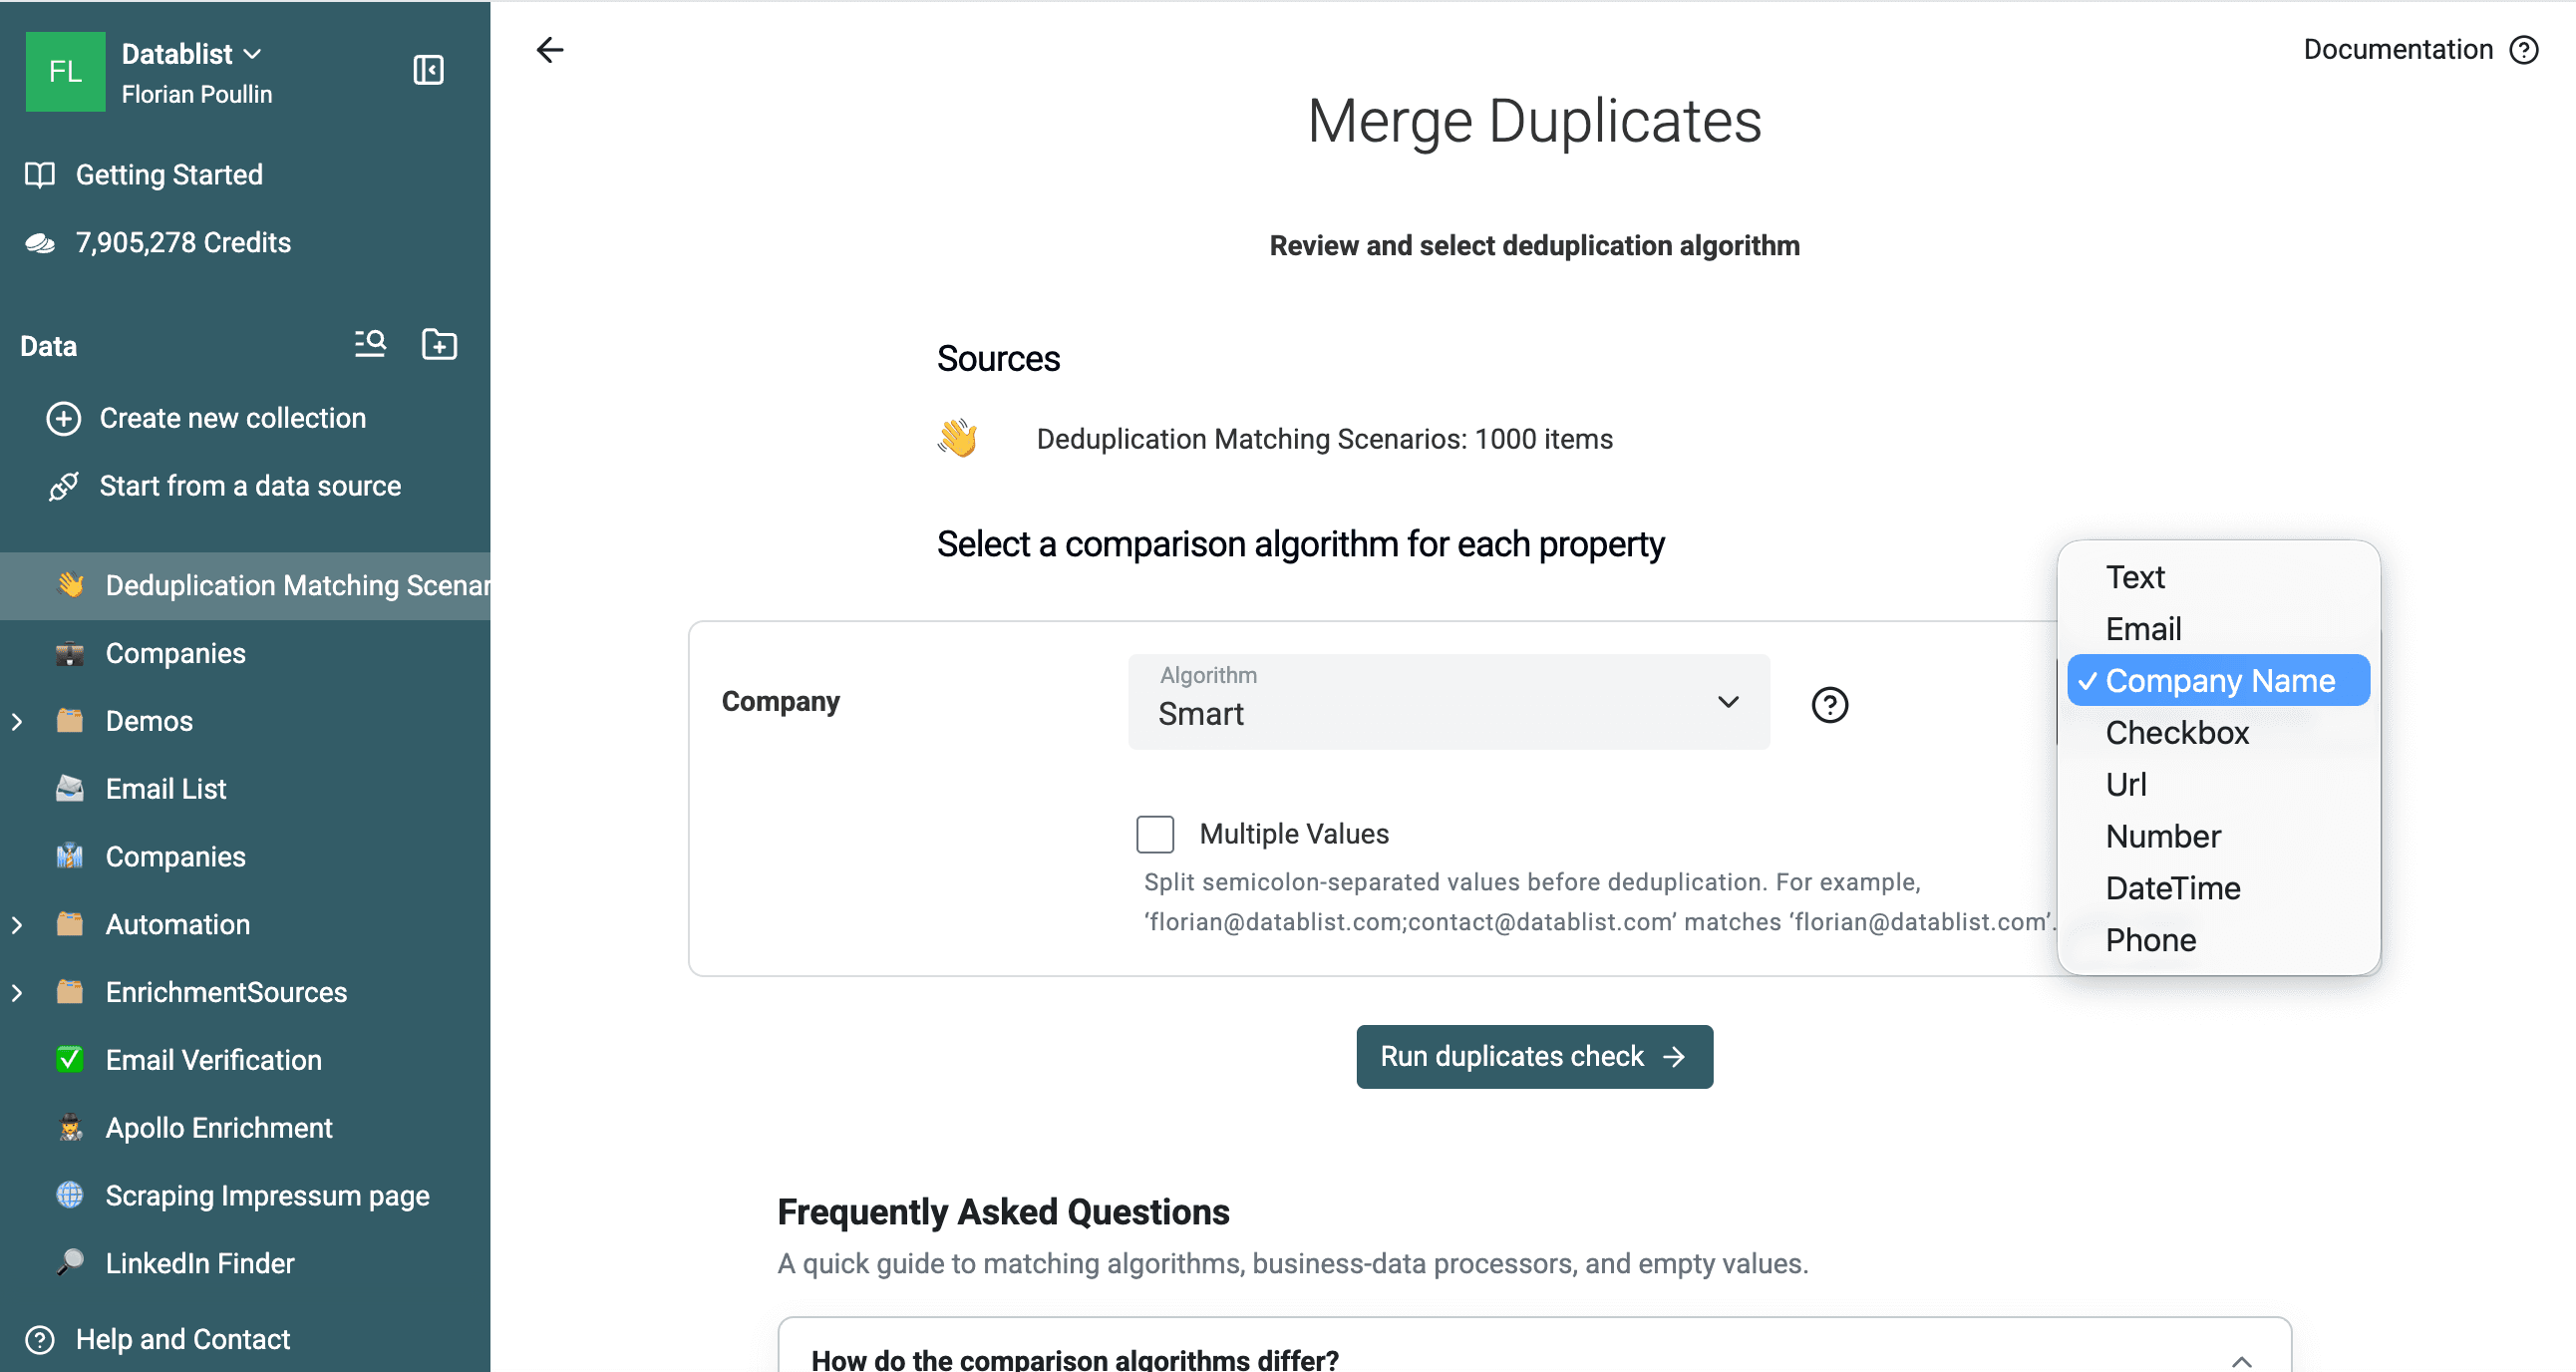
Execute a verificação de duplicatas para detectar registros correspondentes.
Como funciona o processador Company Name
O Company Name Processor é uma ferramenta específica que normaliza nomes de empresas antes da detecção de duplicatas. Isso é essencial porque os dados podem conter diversas variações do nome de uma mesma empresa.
O que ele faz:
- Remove sufixos jurídicos: LLC, Inc., Ltd. etc.
- Ignora termos geográficos: Europe, USA, UK etc.
- Elimina termos empresariais: Partners, Group, Technologies etc.
Exemplo
| Nome original | Nome normalizado |
|---|---|
| Apple Inc. | Apple |
| Apple USA LLC | Apple |
| Apple Technologies | Apple |
| Microsoft Corporation | Microsoft |
| Microsoft Ltd. UK | Microsoft |
Esses valores podem se tornar candidatos a uma correspondência. O processador Company Name é um recurso pago, e o grupo ainda precisa representar a mesma empresa para que os registros possam ser unidos.
Resultado medido na amostra de 1.000 linhas
A verificação por Company Name retornou 200 grupos de duas linhas entre os 1.000 registros analisados:
- 50 pares contêm variações de nomes criadas para o teste, como
Cedar 0715, Inc.eCedar 0715 Group LLC. - Outros 150 pares duplicados criados para o teste já compartilham um valor idêntico na propriedade Company.
Neste teste, todos os 200 grupos correspondem às entidades sintéticas corretas. Nenhum grupo reúne registros de entidades diferentes. Esse resultado se refere à amostra gerada e não representa uma garantia geral de precisão.
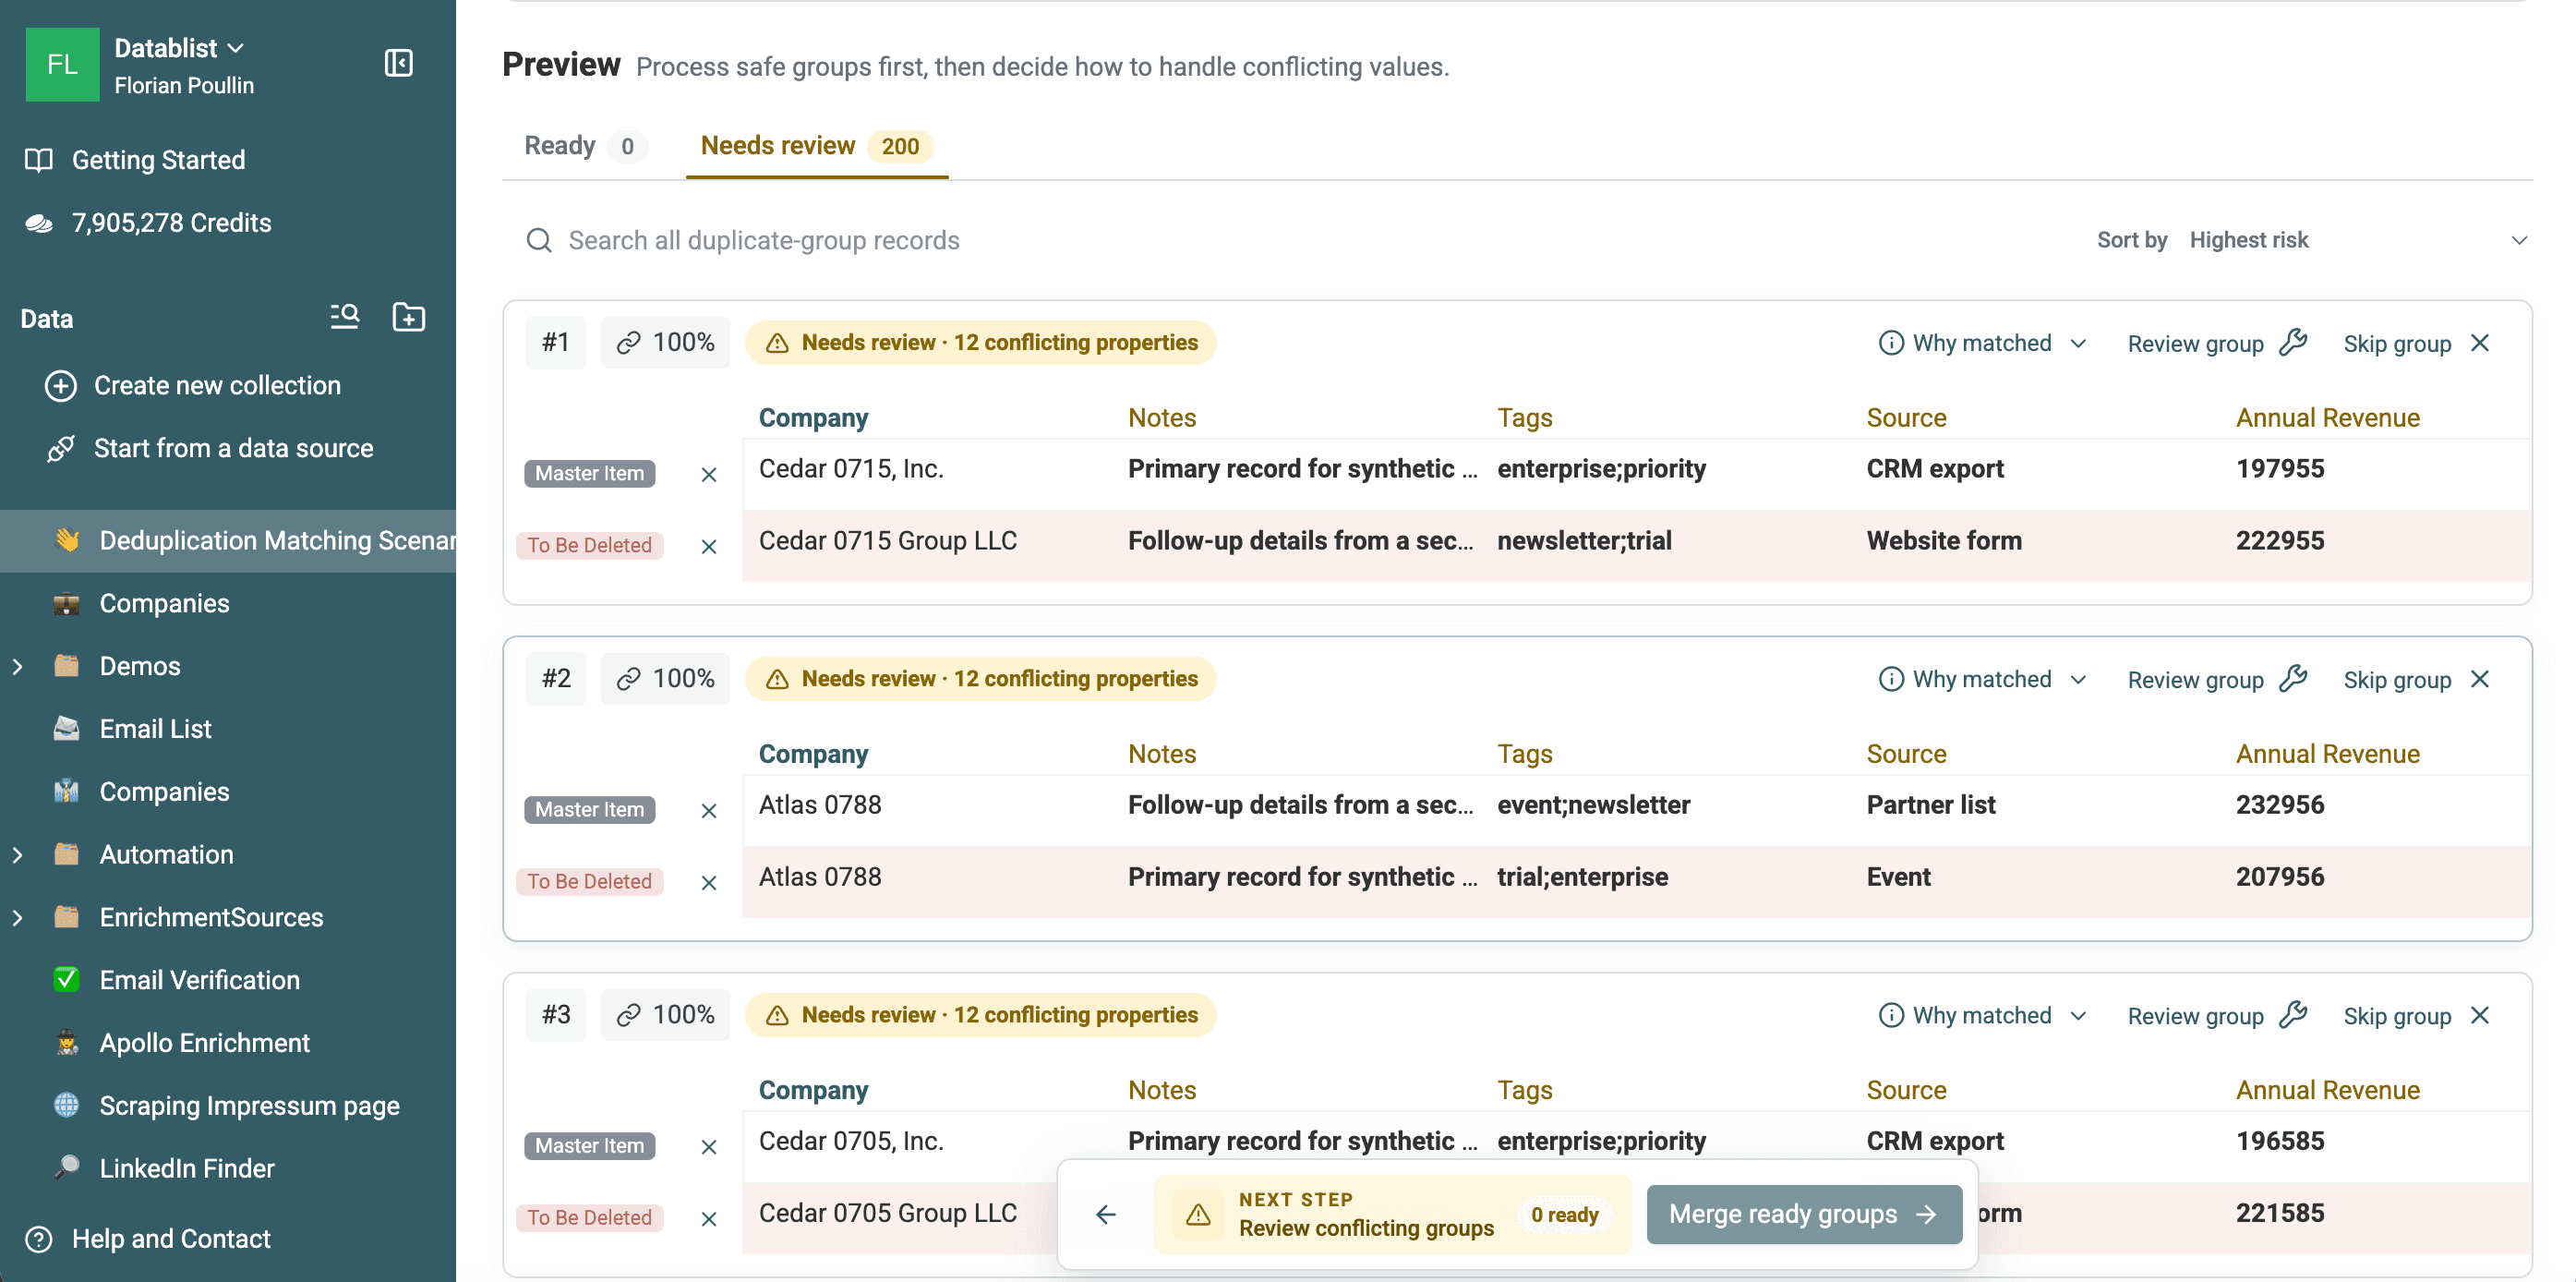
Os grupos exibem uma pontuação de correspondência de 100%. Eles aparecem em Needs review porque há conflitos em outras propriedades, e não porque a correspondência do nome da empresa tenha baixa confiança.
Abra Why matched para verificar a propriedade, o algoritmo, o processador e a pontuação usados em cada grupo.
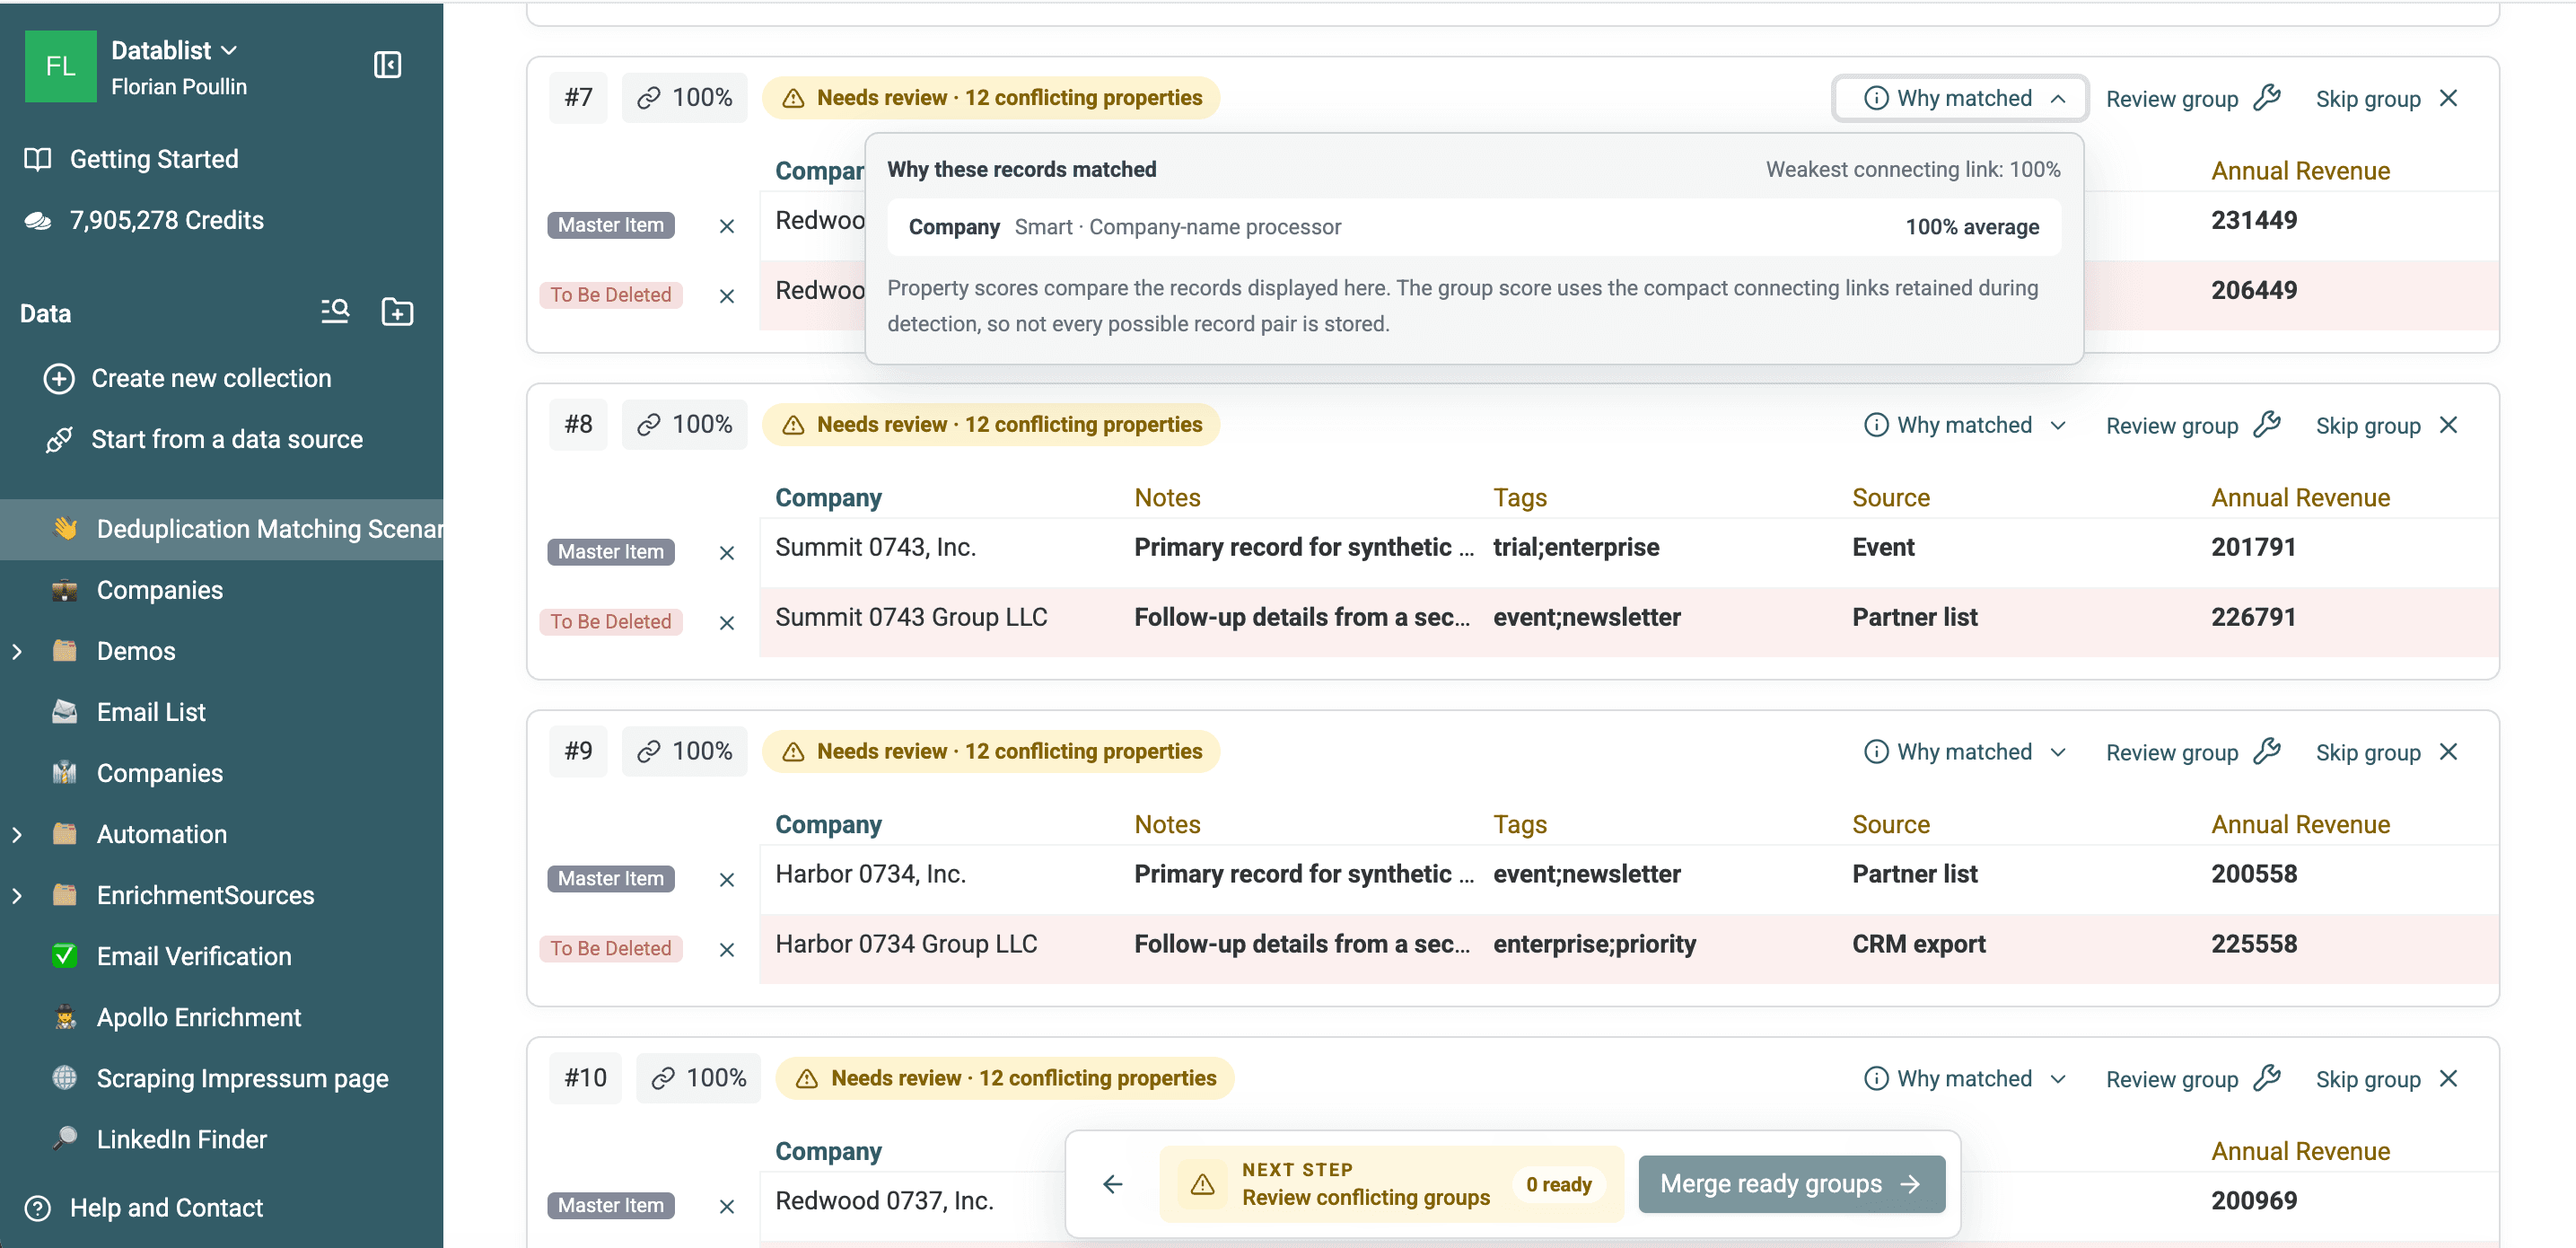
Baixe os 200 grupos de duplicatas exportados para analisar as linhas correspondentes e os valores de DuplicateGroupId.
Etapa 3: una registros duplicados de empresas
Se você precisar apenas de uma lista de correspondências, use Download groups e pare antes do processamento. Continue se quiser consolidar os registros no Datablist.
Resolva conflitos entre os registros
Uma propriedade conflitante indica que o mesmo campo tem valores diferentes entre os registros duplicados identificados.
Se os registros duplicados tiverem valores diferentes nos campos, você precisará decidir como uni-los.
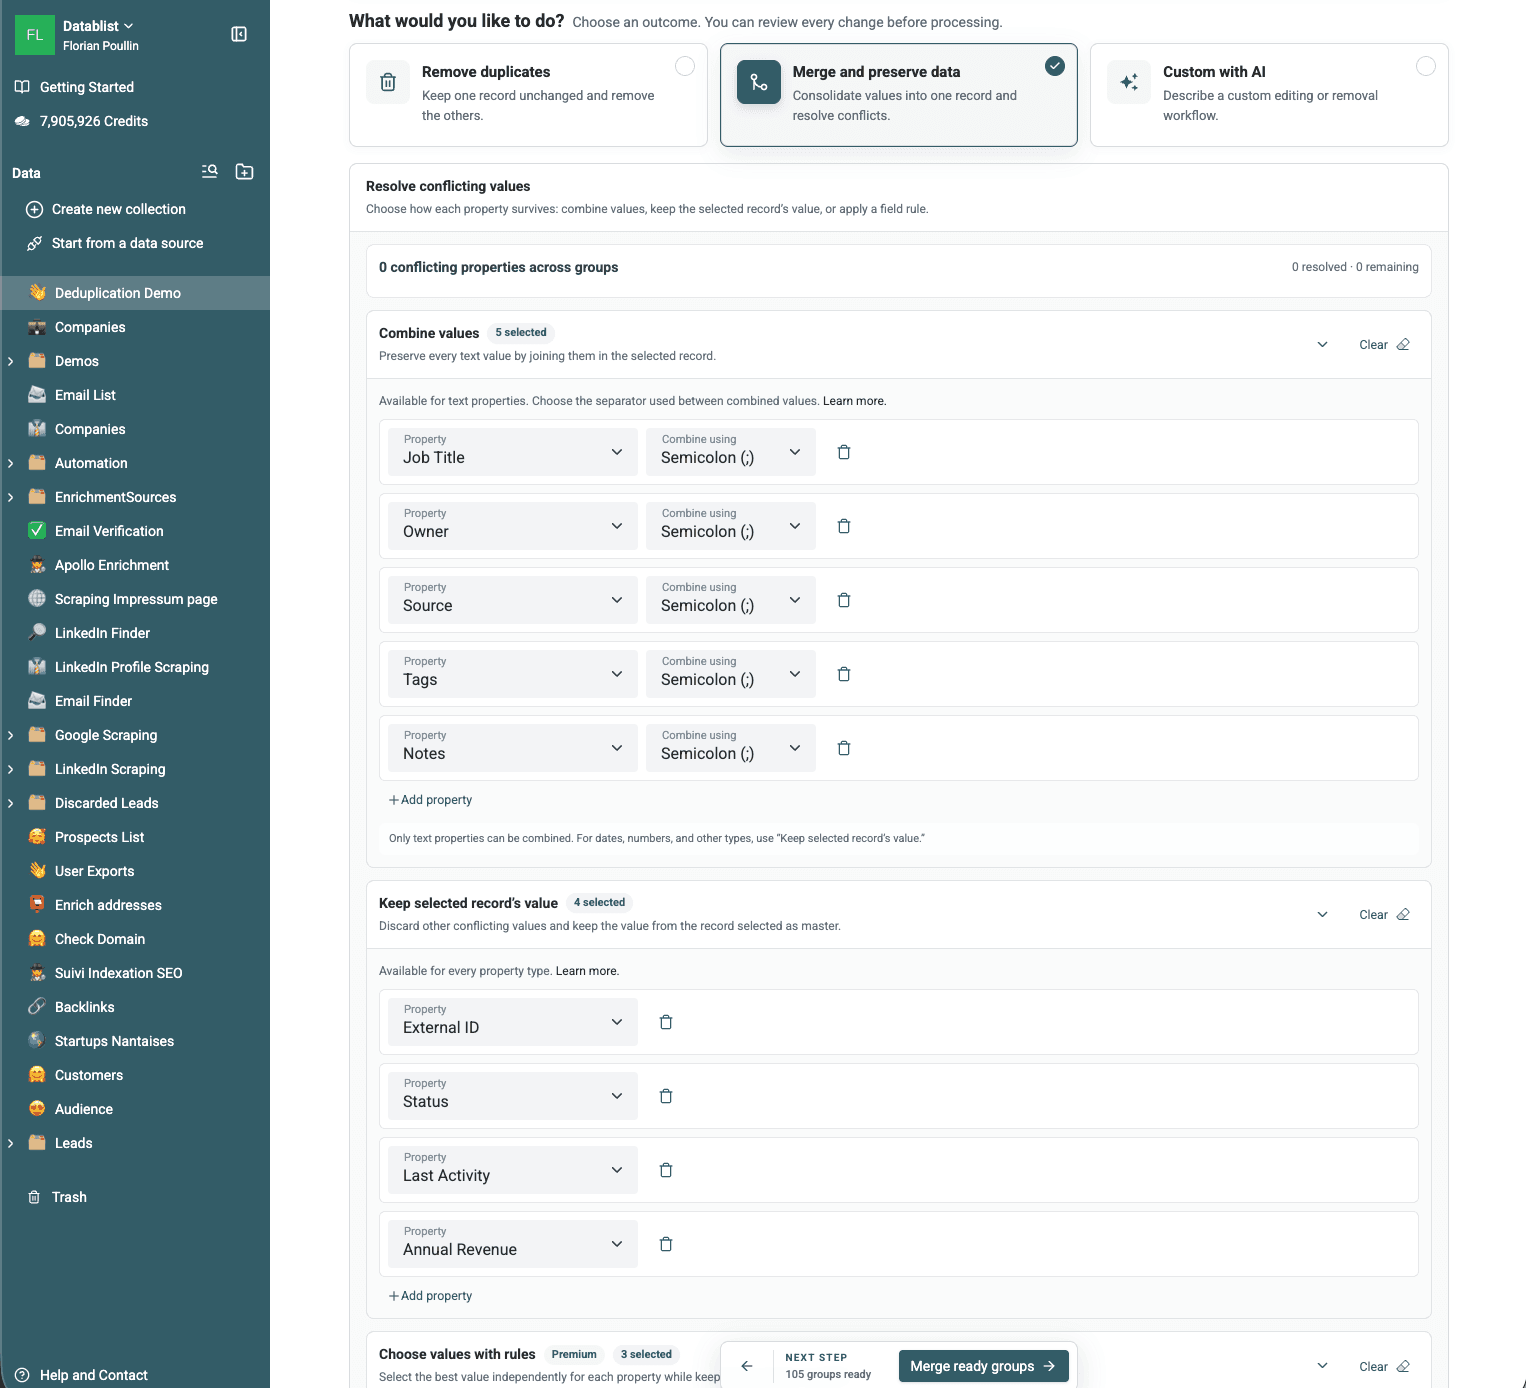
Escolha uma regra para cada propriedade conflitante:
- Combine preserva valores de texto diferentes usando um delimitador.
- Keep the selected record's value descarta os demais valores.
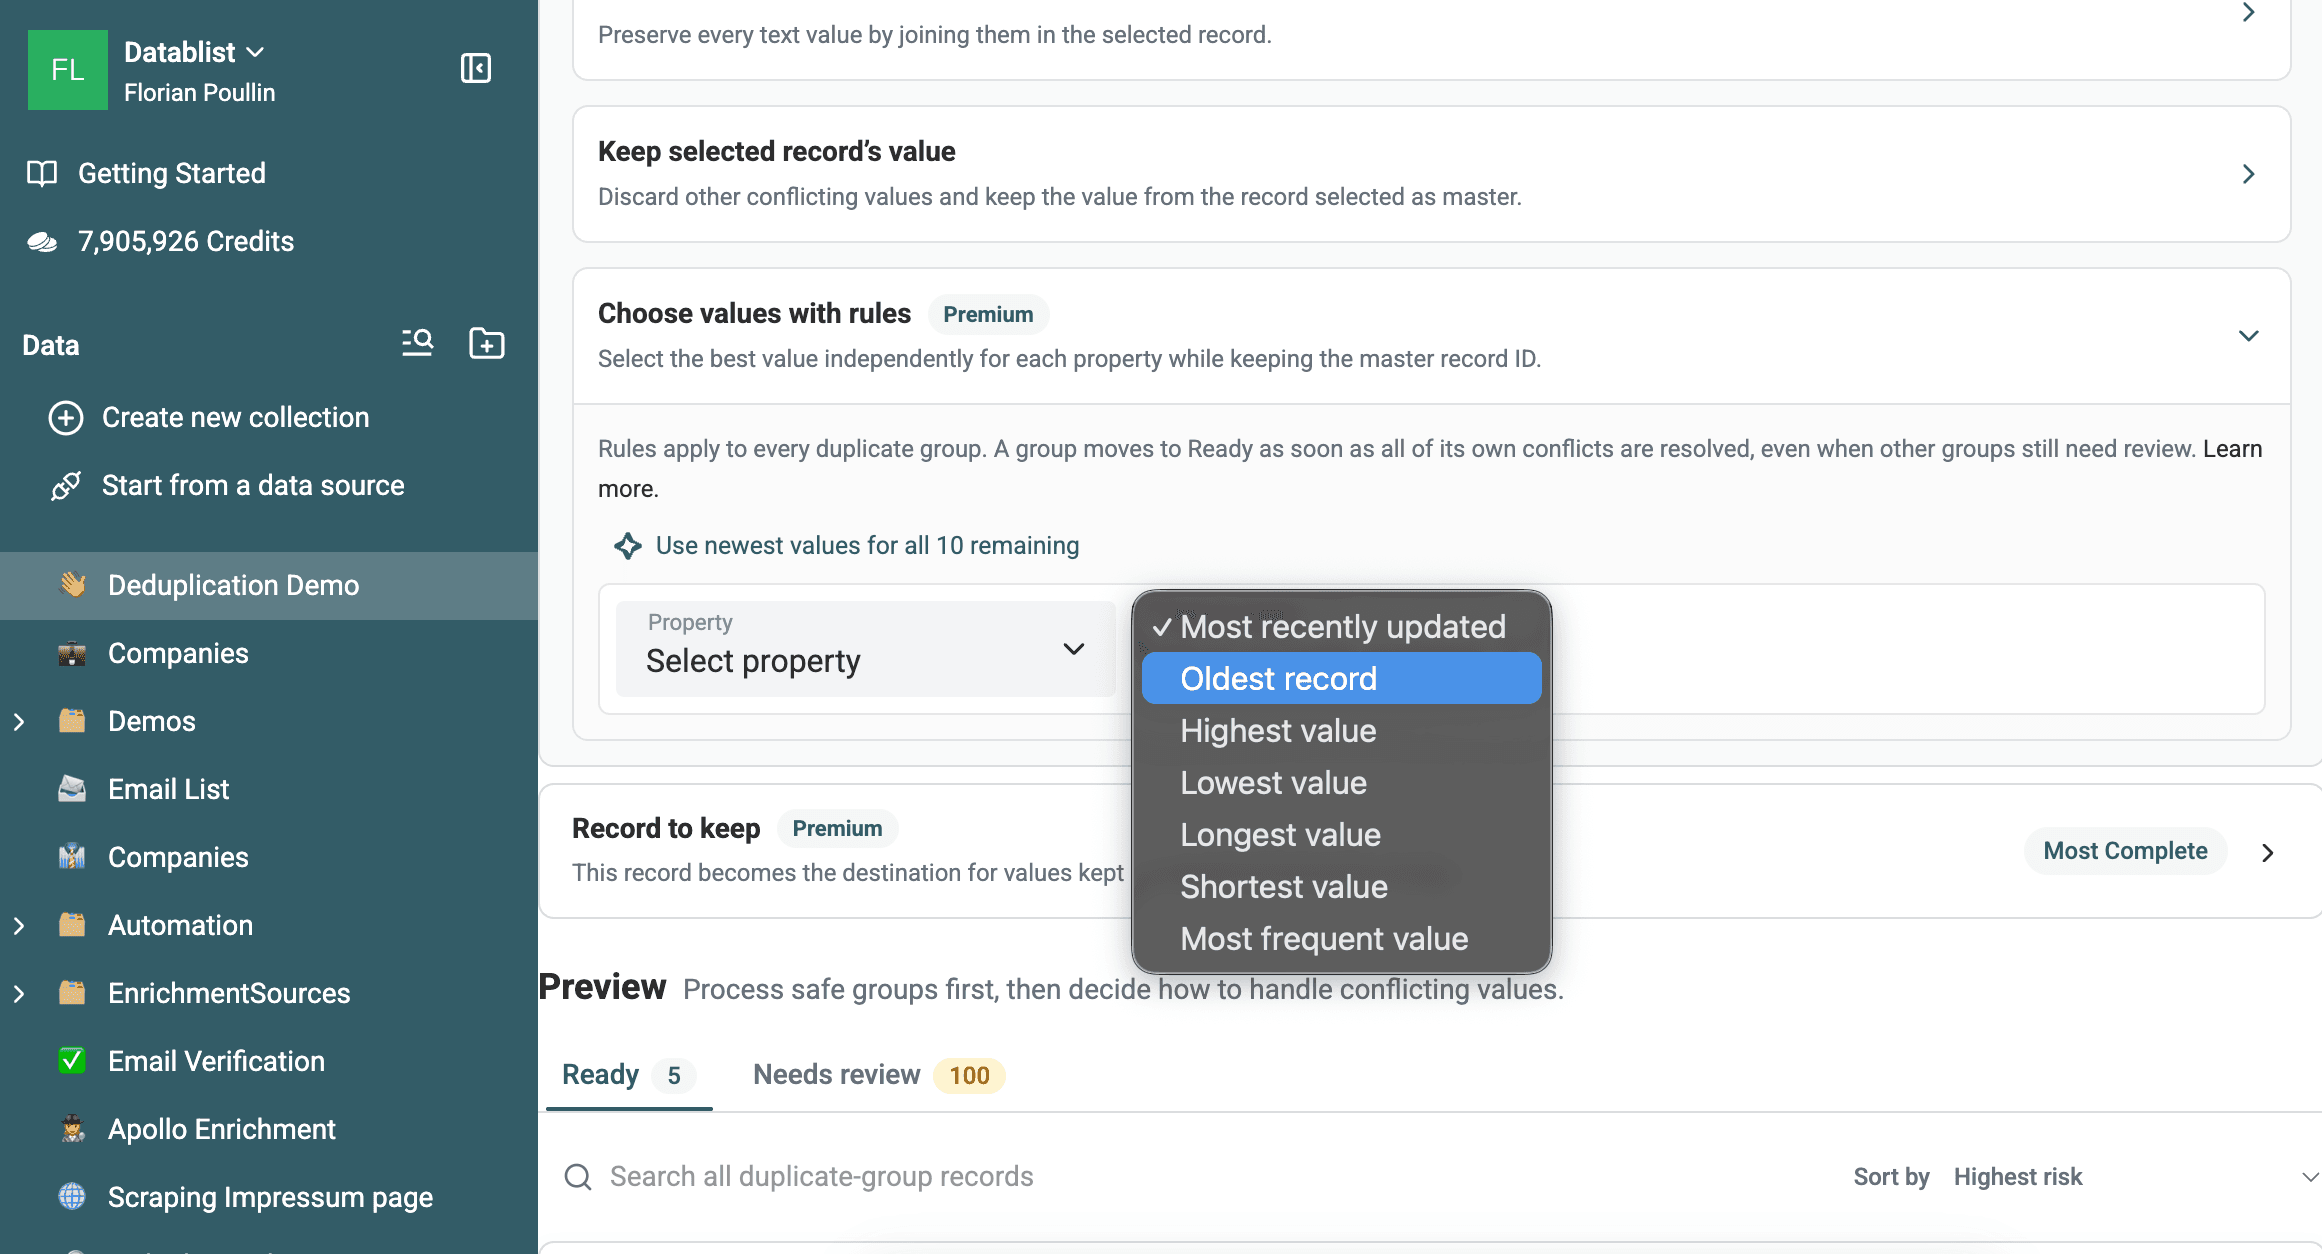
- Nos planos pagos, as regras de sobrevivência de campos podem selecionar o valor mais recente, mais antigo, mais longo, mais curto, maior, menor ou mais frequente.
Use o controle de atalho para aplicar a mesma regra a várias propriedades conflitantes. Depois, ajuste campos específicos quando necessário.
Escolha o registro principal
Um dos registros se torna o destino e mantém seu ID do Datablist.
Você pode fazer a seleção com base em:
- Most Complete: mantém o registro com o maior número de propriedades preenchidas.
- Last Updated: mantém o registro alterado mais recentemente.
- First Created: mantém o registro mais antigo.
- Highest Value ou Lowest Value: compara uma propriedade selecionada.
- Matching Value: mantém o registro que contém um valor específico em determinada propriedade.
Depois de configurar as regras de união e selecionar o registro principal, atualize a prévia para visualizar o resultado antes de confirmar as alterações.
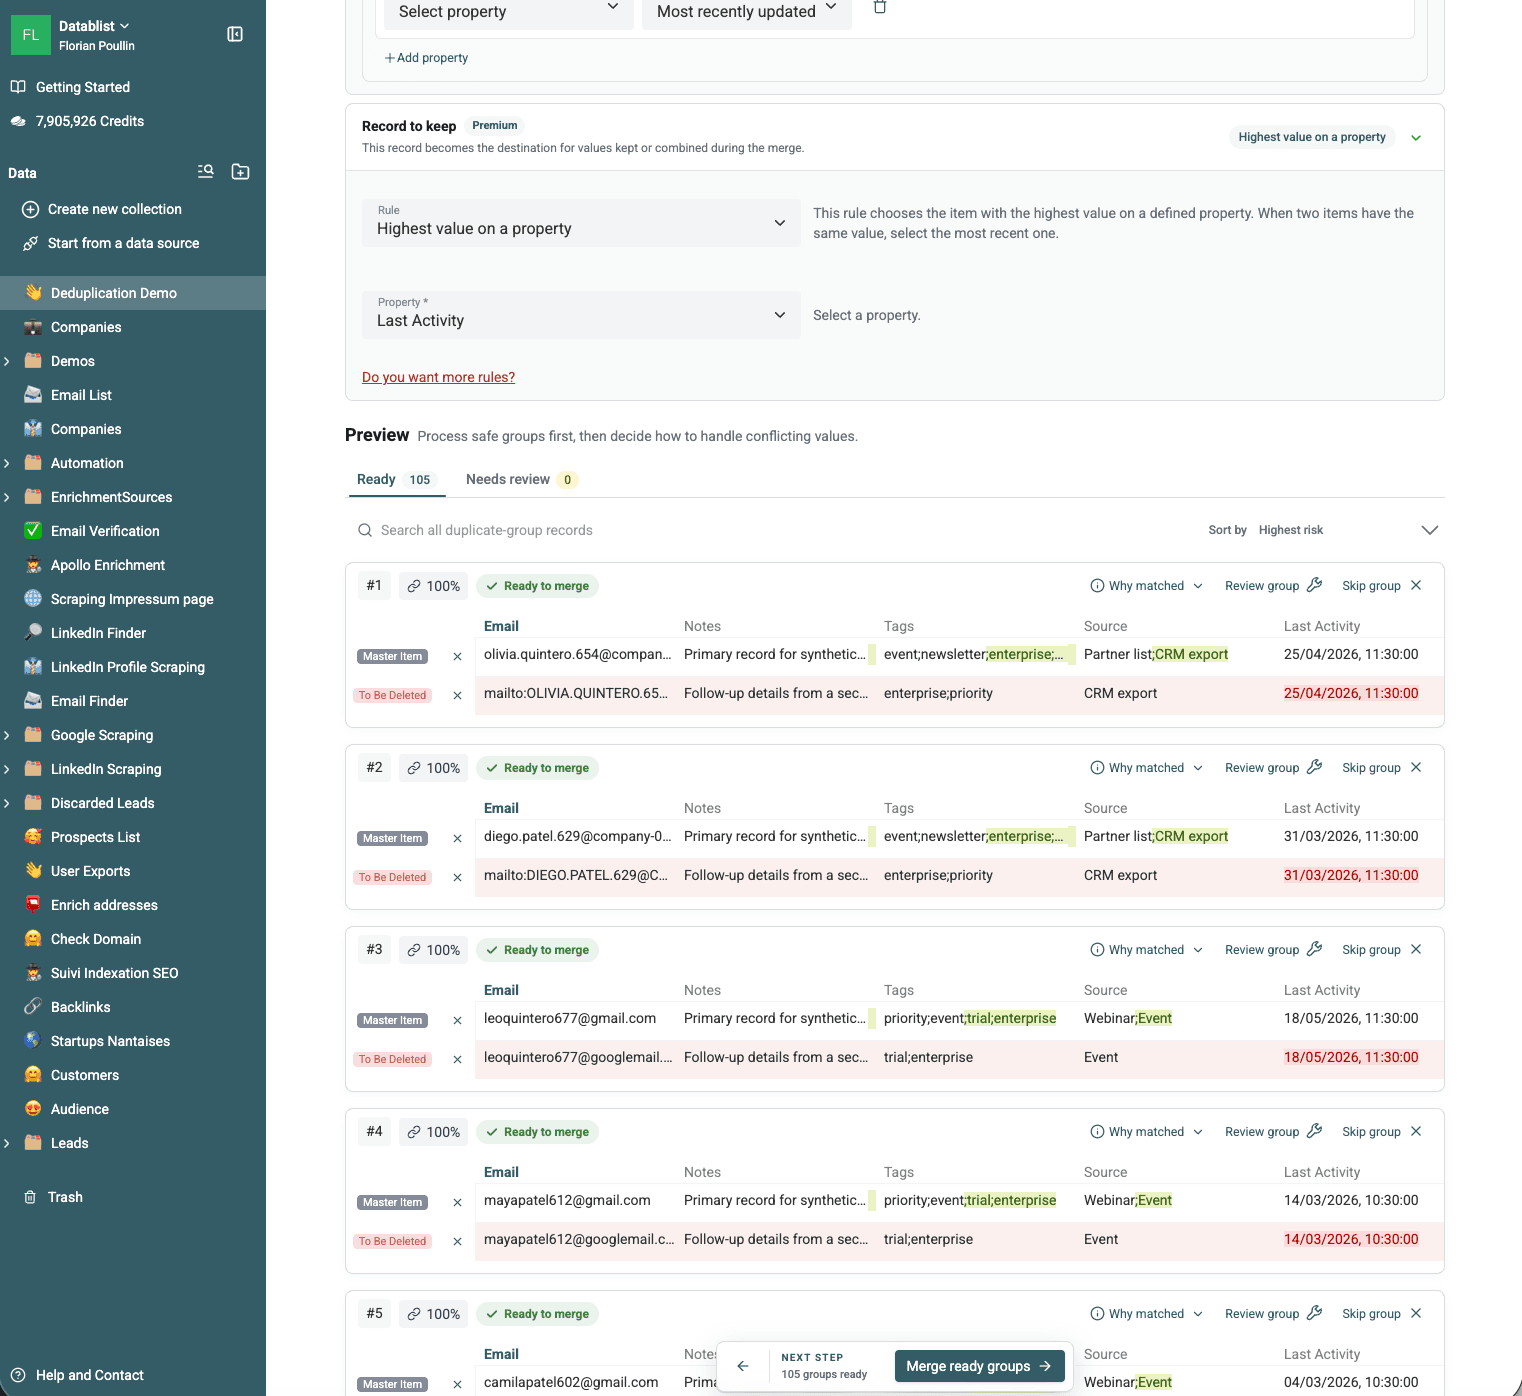
A prévia mostra os valores que serão excluídos ou combinados, além do registro principal definido para cada grupo de duplicatas.
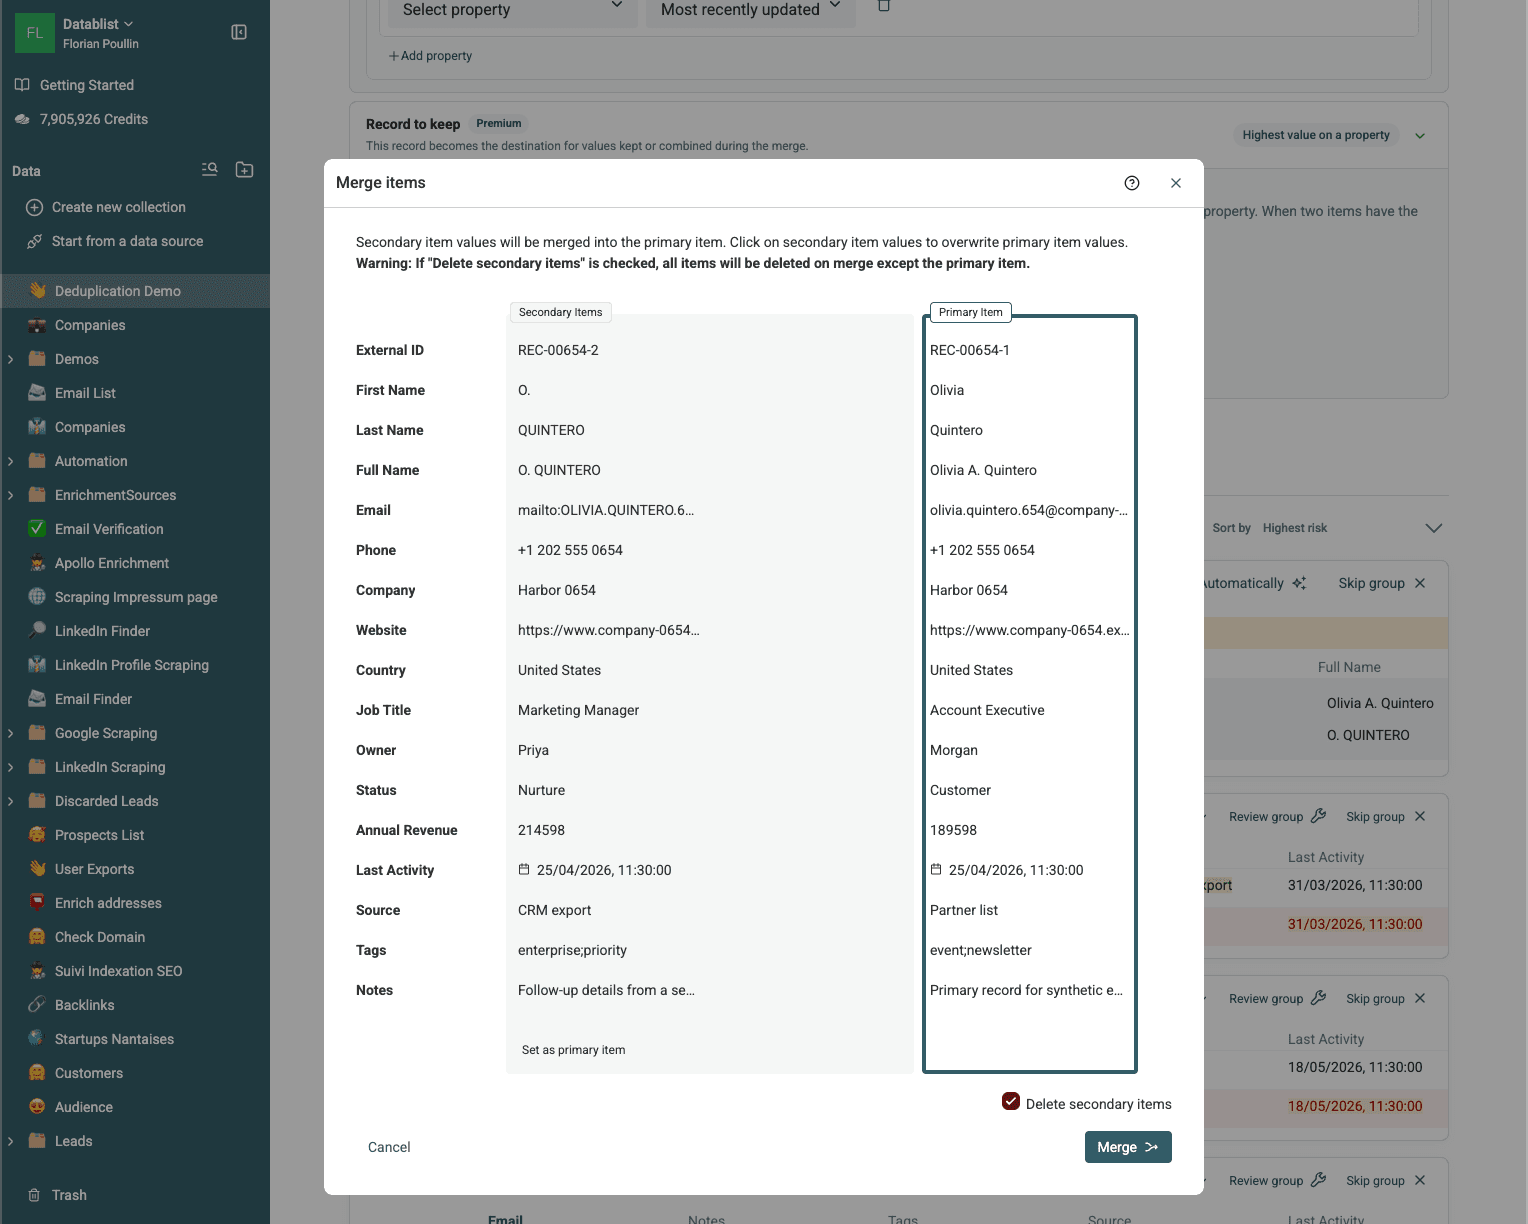
Para tratar exceções, abra Review group e escolha os valores manualmente.
Processe os grupos marcados como Ready. Os grupos que ainda estiverem em Needs review permanecerão inalterados.
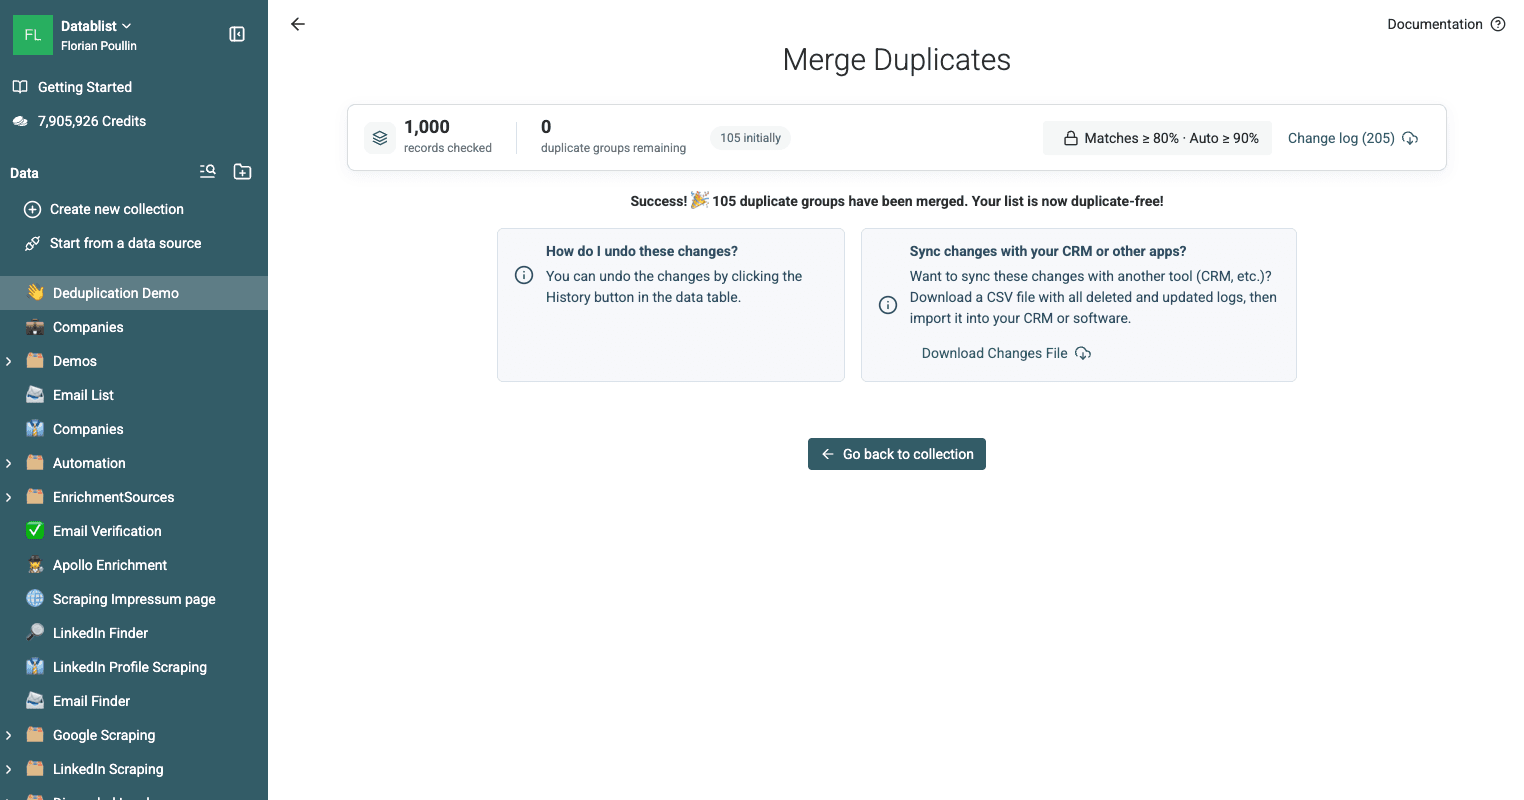
Após a união, use Export no cabeçalho da coleção para baixar a lista limpa em CSV ou Excel. O registro de alterações gerado após o processamento informa os IDs excluídos e atualizados quando você precisa manter um histórico para auditoria.
Para conhecer todas as configurações de correspondência, revisão e união, consulte a documentação do Duplicate Finder.