
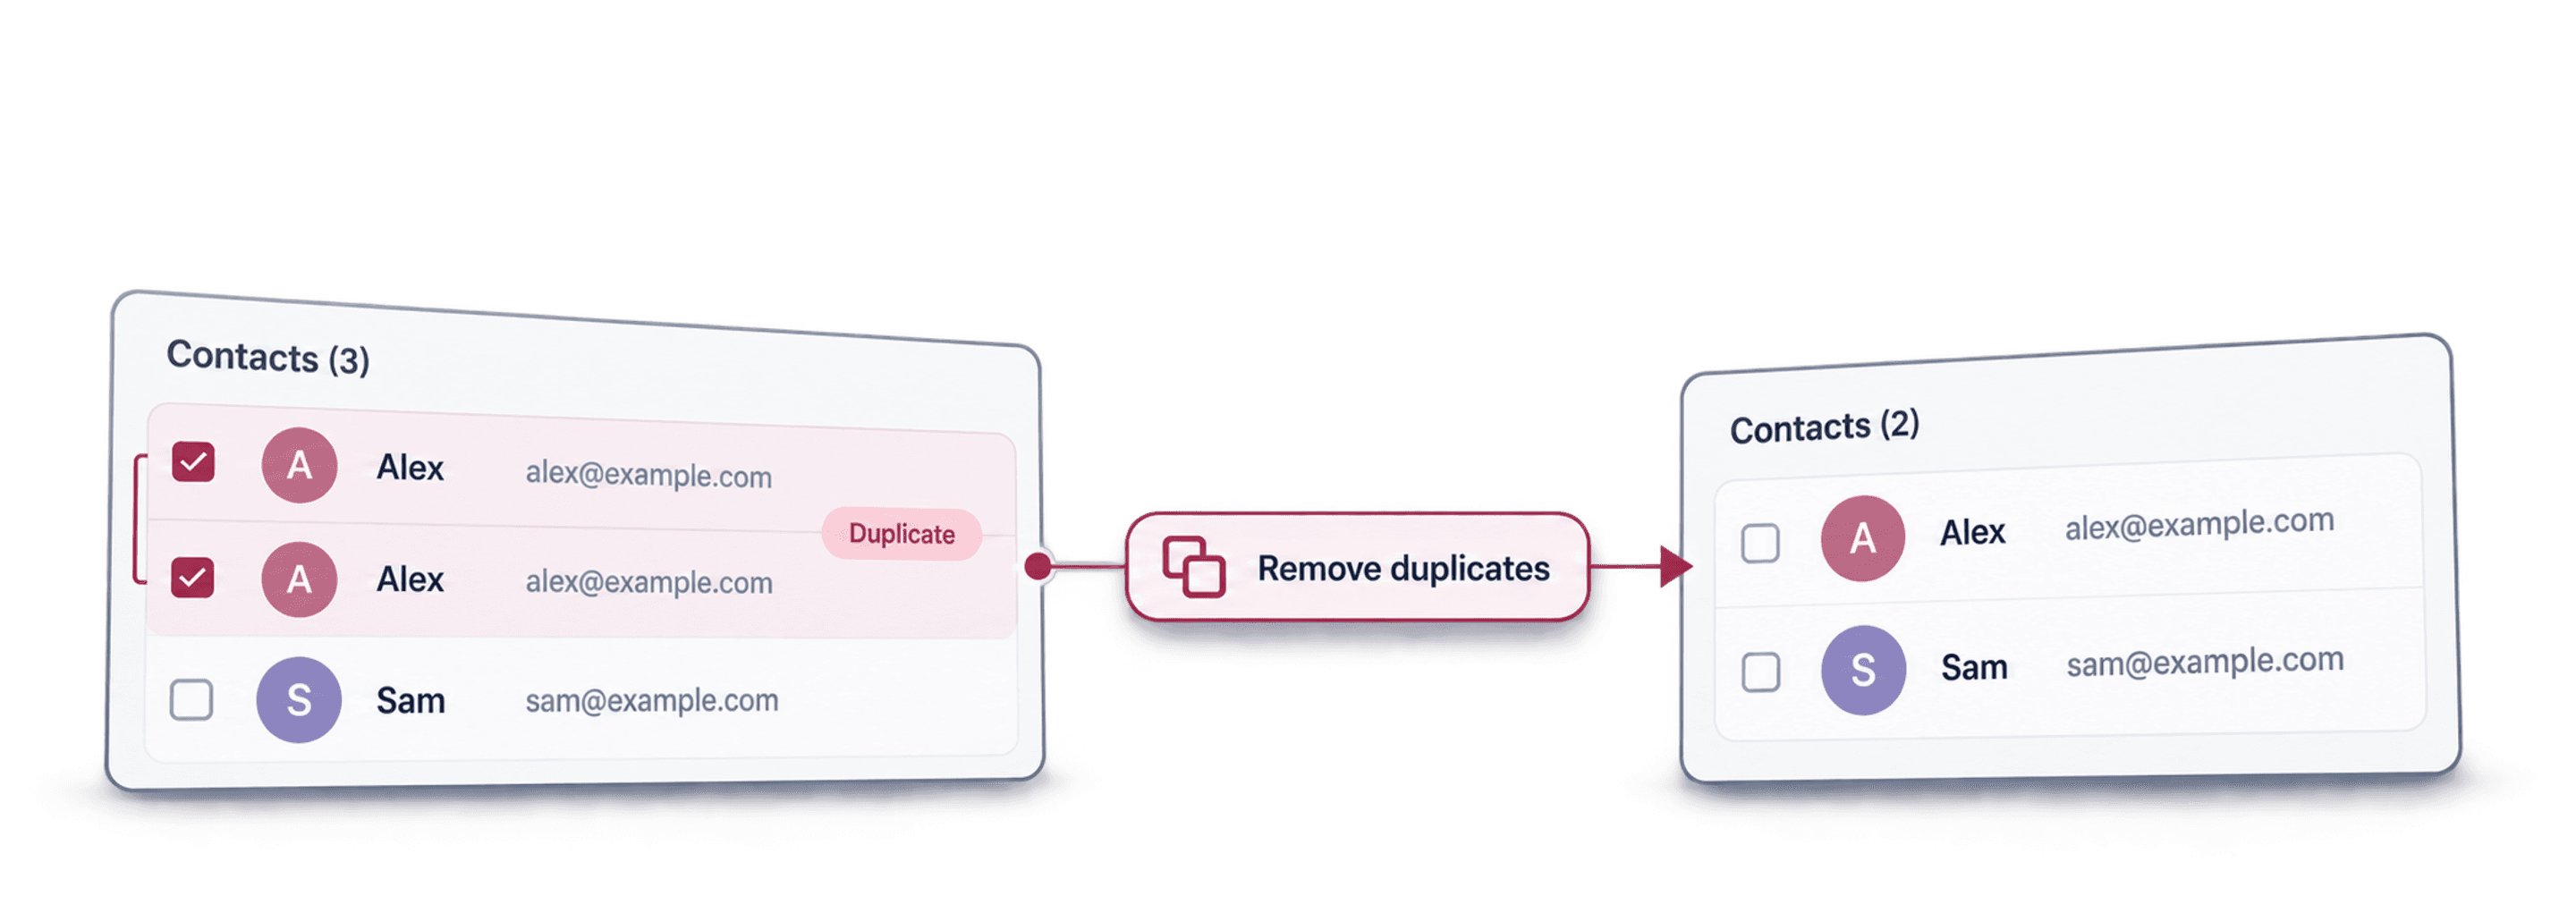
Para remover duplicados de uma lista online, primeiro escolha o campo que identifica cada pessoa, empresa ou produto. Faça uma busca com correspondência rigorosa, revise os grupos de duplicados sugeridos e, depois, mescle os valores úteis ou exclua as linhas que não acrescentam nada. Assim, a limpeza continua rápida sem tratar todo valor semelhante como uma correspondência segura.
O Datablist reúne todo esse processo em um único fluxo no navegador. Importe um arquivo CSV ou Excel, escolha as propriedades de correspondência, compare as linhas, revise o resultado e exporte a lista limpa. A verificação de duplicados é somente leitura até você iniciar uma ação de Remove, Merge ou processamento personalizado.
Este guia usa uma amostra de 1.000 linhas disponível para download, com cópias exatas, aliases de e-mail, variações de nomes de empresas, diferenças em URLs e na formatação básica de telefones, erros de digitação, valores conflitantes e registros complementares.
🔑 A regra para deduplicar com segurança
Faça a correspondência pelo menor identificador confiável, mas use a linha completa para decidir o que manter.
Remova duplicados de uma lista simples de valores
Se sua lista tiver um valor por linha, salve-a como um CSV de uma coluna, com um cabeçalho como Email, Domain ou Value. Importe o arquivo no Datablist e execute Clean > Remove duplicates nessa coluna usando Exact. Revise os grupos, escolha o registro que será mantido, processe as linhas duplicadas e exporte os valores restantes.
Por exemplo, uma lista ilustrativa com alpha.example, beta.example e alpha.example deve manter um valor alpha e um valor beta após a exclusão da linha repetida. Este é apenas um exemplo de entrada e saída, não uma nova medição da amostra disponível para download.
Eu usaria esse caminho para uma lista de identificadores. Se o arquivo tiver várias colunas, será preciso resolver registros duplicados: excluir uma linha também remove seus outros valores. Use o fluxo de mesclagem abaixo quando um e-mail repetido tiver um telefone ou uma observação útil em outra linha.
Mantenha os identificadores em branco separados. Na comparação padrão por propriedade selecionada, a ausência de um identificador textual não estabelece uma correspondência. Se precisar excluir linhas vazias, faça essa limpeza explicitamente, em vez de esperar que a deduplicação determine o que elas representam.
Defina o que torna cada registro único
Não comece pelo algoritmo de correspondência. Primeiro, defina a entidade.
Contatos, empresas, produtos e transações exigem identificadores diferentes:
| Lista | Identificadores iniciais fortes | Segunda verificação útil |
|---|---|---|
| Contatos | E-mail, telefone, URL do LinkedIn | Nome completo e empresa |
| Empresas | Domínio do site, ID da empresa | Nome normalizado da empresa |
| Produtos | SKU, EAN, GTIN, URL do produto | Nome do produto e marca |
| Leads no CRM | E-mail, telefone, ID do CRM | Nome e domínio da empresa |
| Pedidos | ID do pedido | ID do cliente e data do pedido |
Uma única verificação raramente encontra todos os duplicados. Um contato pode ter o mesmo e-mail em duas linhas, enquanto outro mudou de endereço de e-mail, mas manteve o telefone. Faça verificações separadas para cada identificador, em vez de criar uma regra com todas as propriedades.
Por exemplo:
- Compare os contatos pelo e-mail.
- Processe os grupos revisados.
- Normalize os telefones e execute uma verificação Exact na propriedade limpa.
- Faça uma verificação fuzzy cuidadosa pelo nome completo e pela empresa.
Adicionar e-mail, telefone, nome e empresa a uma única verificação torna a correspondência mais rigorosa. A linha precisa atender a toda a configuração; portanto, um único valor ausente pode ocultar um duplicado real.
Consulte os guias específicos quando o identificador exigir sua própria normalização:
- Remova e-mails e aliases duplicados
- Encontre nomes de empresas duplicados
- Remova duplicados de um campo com vários valores
- Normalize telefones locais e internacionais
Baixe a lista de exemplo com 1.000 linhas
Baixe o CSV de demonstração da deduplicação. Ele contém 1.000 linhas que representam 800 entidades criadas para o teste.
O arquivo combina vários casos de teste:
| Caso criado | Grupos de duplicados | Verificação de correspondência |
|---|---|---|
| Cópias exatas da linha inteira | 5 | All Properties com Exact |
| Aliases e encapsulamentos de e-mail | 100 | Email com Smart e o processador Email |
| Variações de empresa e URL | 50 | Processamento de Company Name ou URL |
| Diferenças básicas na formatação de telefones dos EUA | 25 | Phone com Smart, apenas formatação |
| Erros controlados em nomes | 15 | Jaro-Winkler ou Levenshtein |
| Variações fonéticas do primeiro nome | 5 | Metaphone |
| Registros sem duplicado criado | 600 | Devem permanecer separados |
Essas quantidades são resultados esperados definidos na criação da amostra, não uma promessa de que todo limite fuzzy produzirá o mesmo resultado. A correspondência por distância pode incluir candidatos adicionais quando o limite é baixo. Revise esses grupos antes de processá-los.
Veja três pares do arquivo:
| Caso de uso | Primeiro valor armazenado | Segundo valor armazenado |
|---|---|---|
| Alias de e-mail | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Empresa e URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Formatação básica de telefone | +1 (202) 555-0768 | 1 202 555 0768 |
As linhas também apresentam divergências em campos como cargo, responsável, status, receita, origem, tags e observações. Esses conflitos tornam o arquivo útil para testar regras de registro principal e preservação de campos.
Importe a lista para o Datablist
Abra o Datablist e importe o arquivo CSV ou Excel para uma collection. Uma collection funciona como uma planilha estruturada: as linhas são itens e as colunas são propriedades.
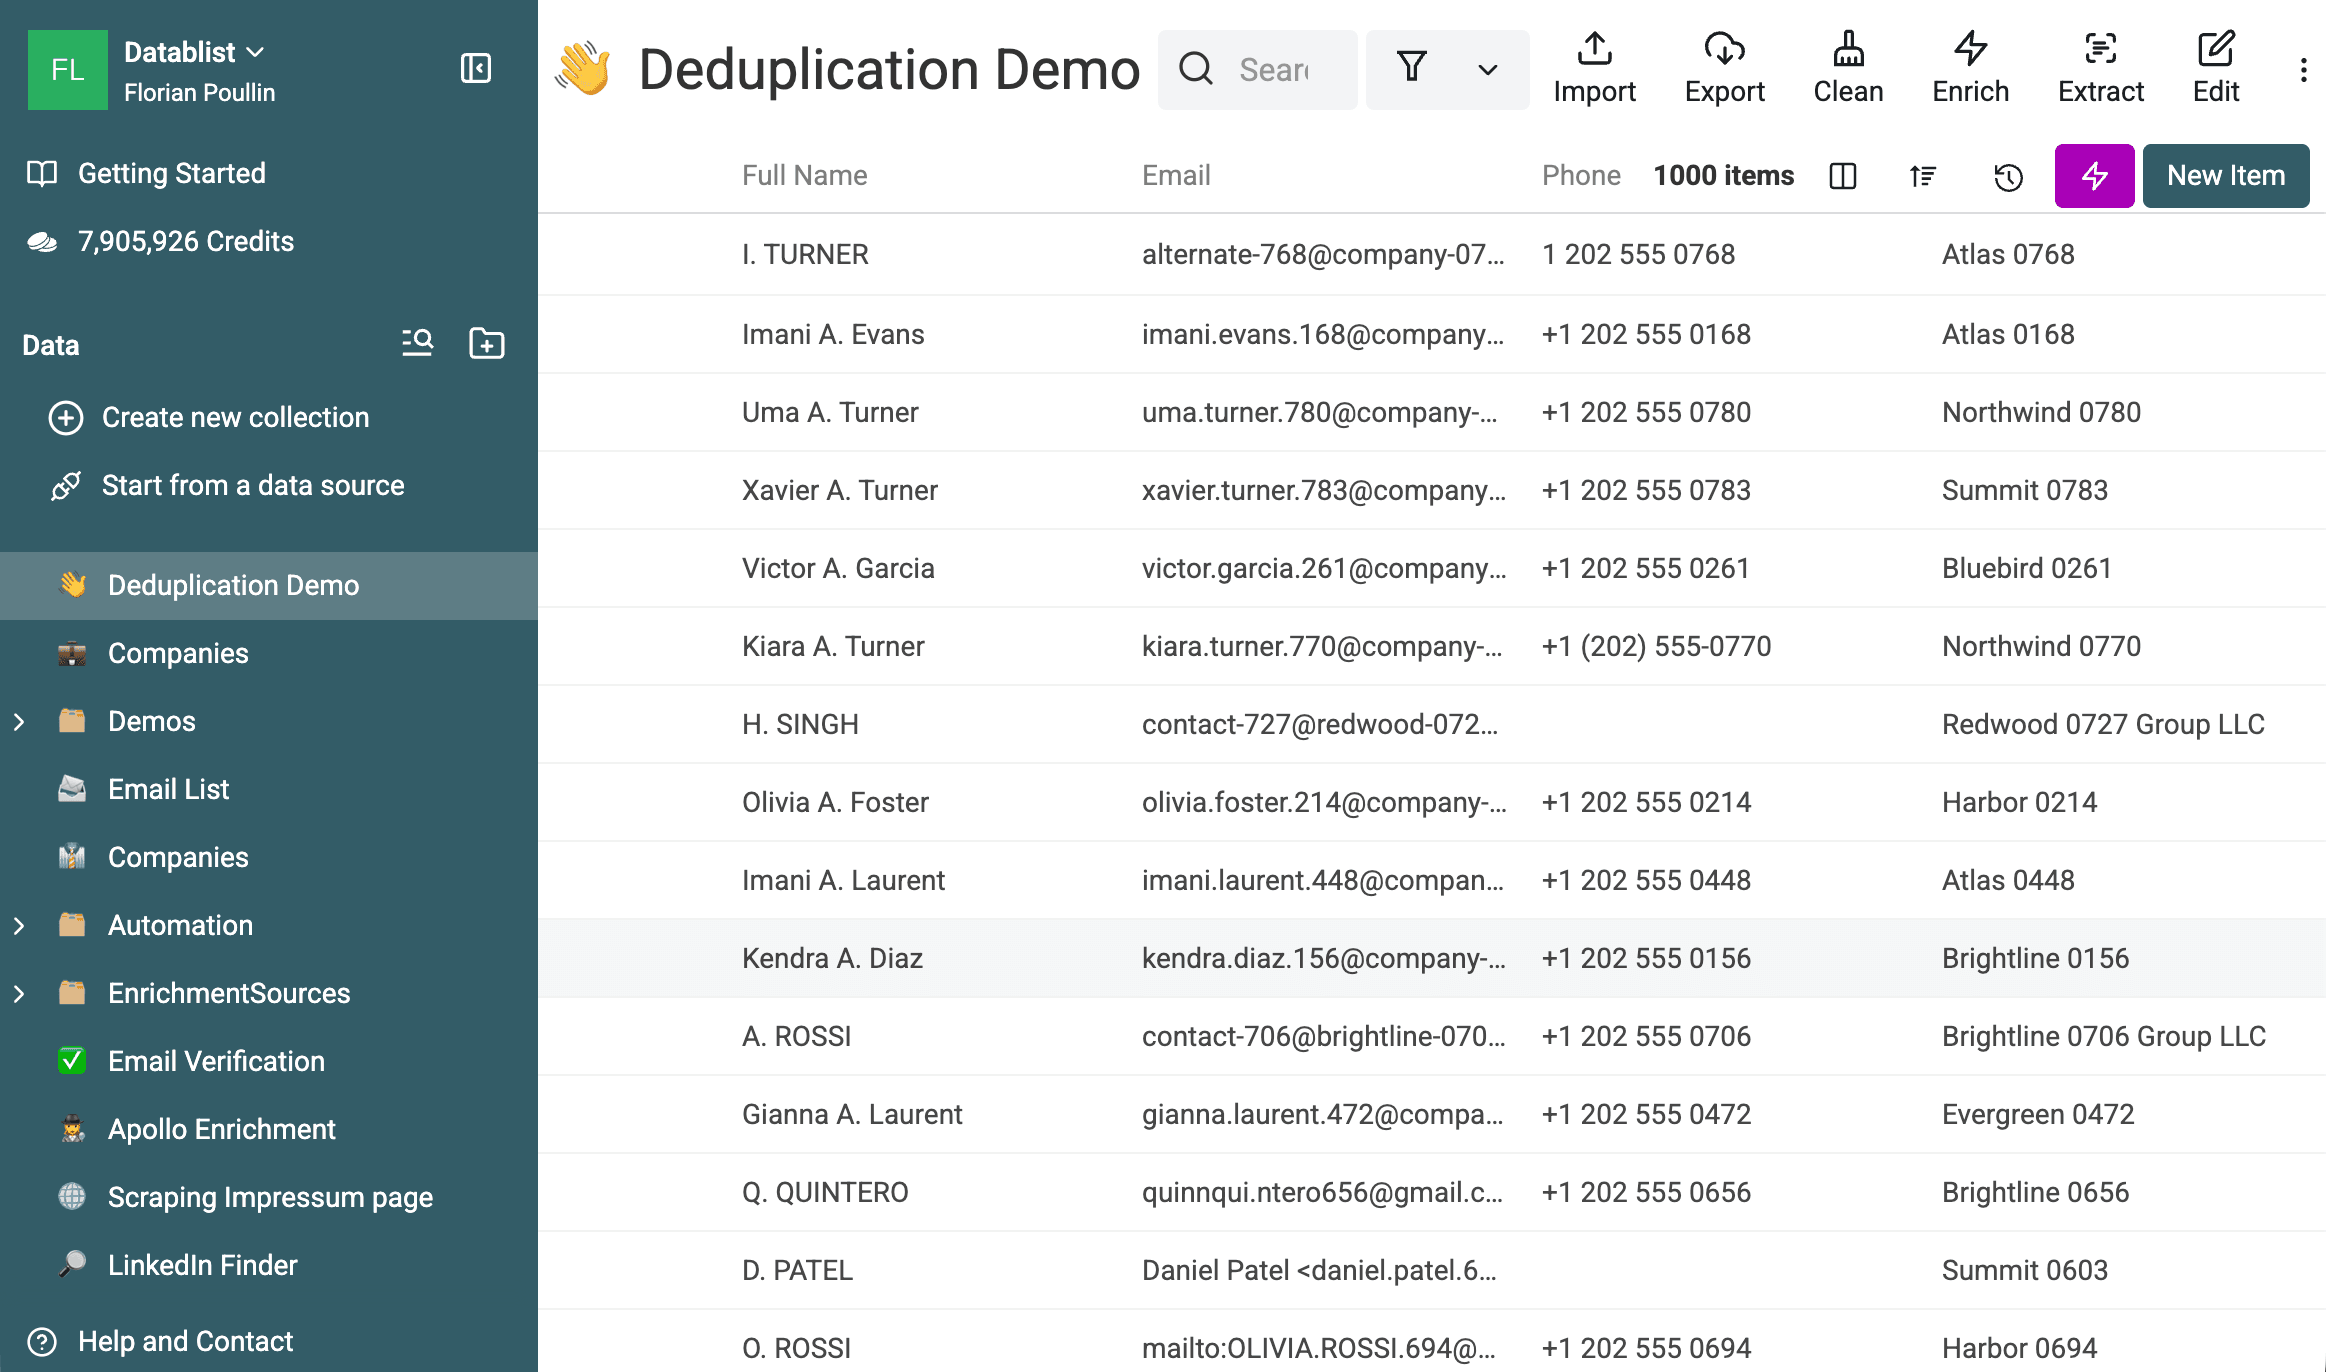
Confira os tipos de propriedade detectados durante a importação:
- Colunas de e-mail devem usar o tipo Email.
- Colunas de sites devem usar URL.
- Colunas de telefone devem usar Phone.
- Colunas de receita ou quantidade devem usar Number.
- Datas de atividade e criação devem usar DateTime.
Mantenha na collection as colunas de IDs, origem, responsável, observações e status. Elas ajudam a selecionar o registro correto e verificar o que a mesclagem preservará.
Execute correspondências Exact, Smart e fuzzy
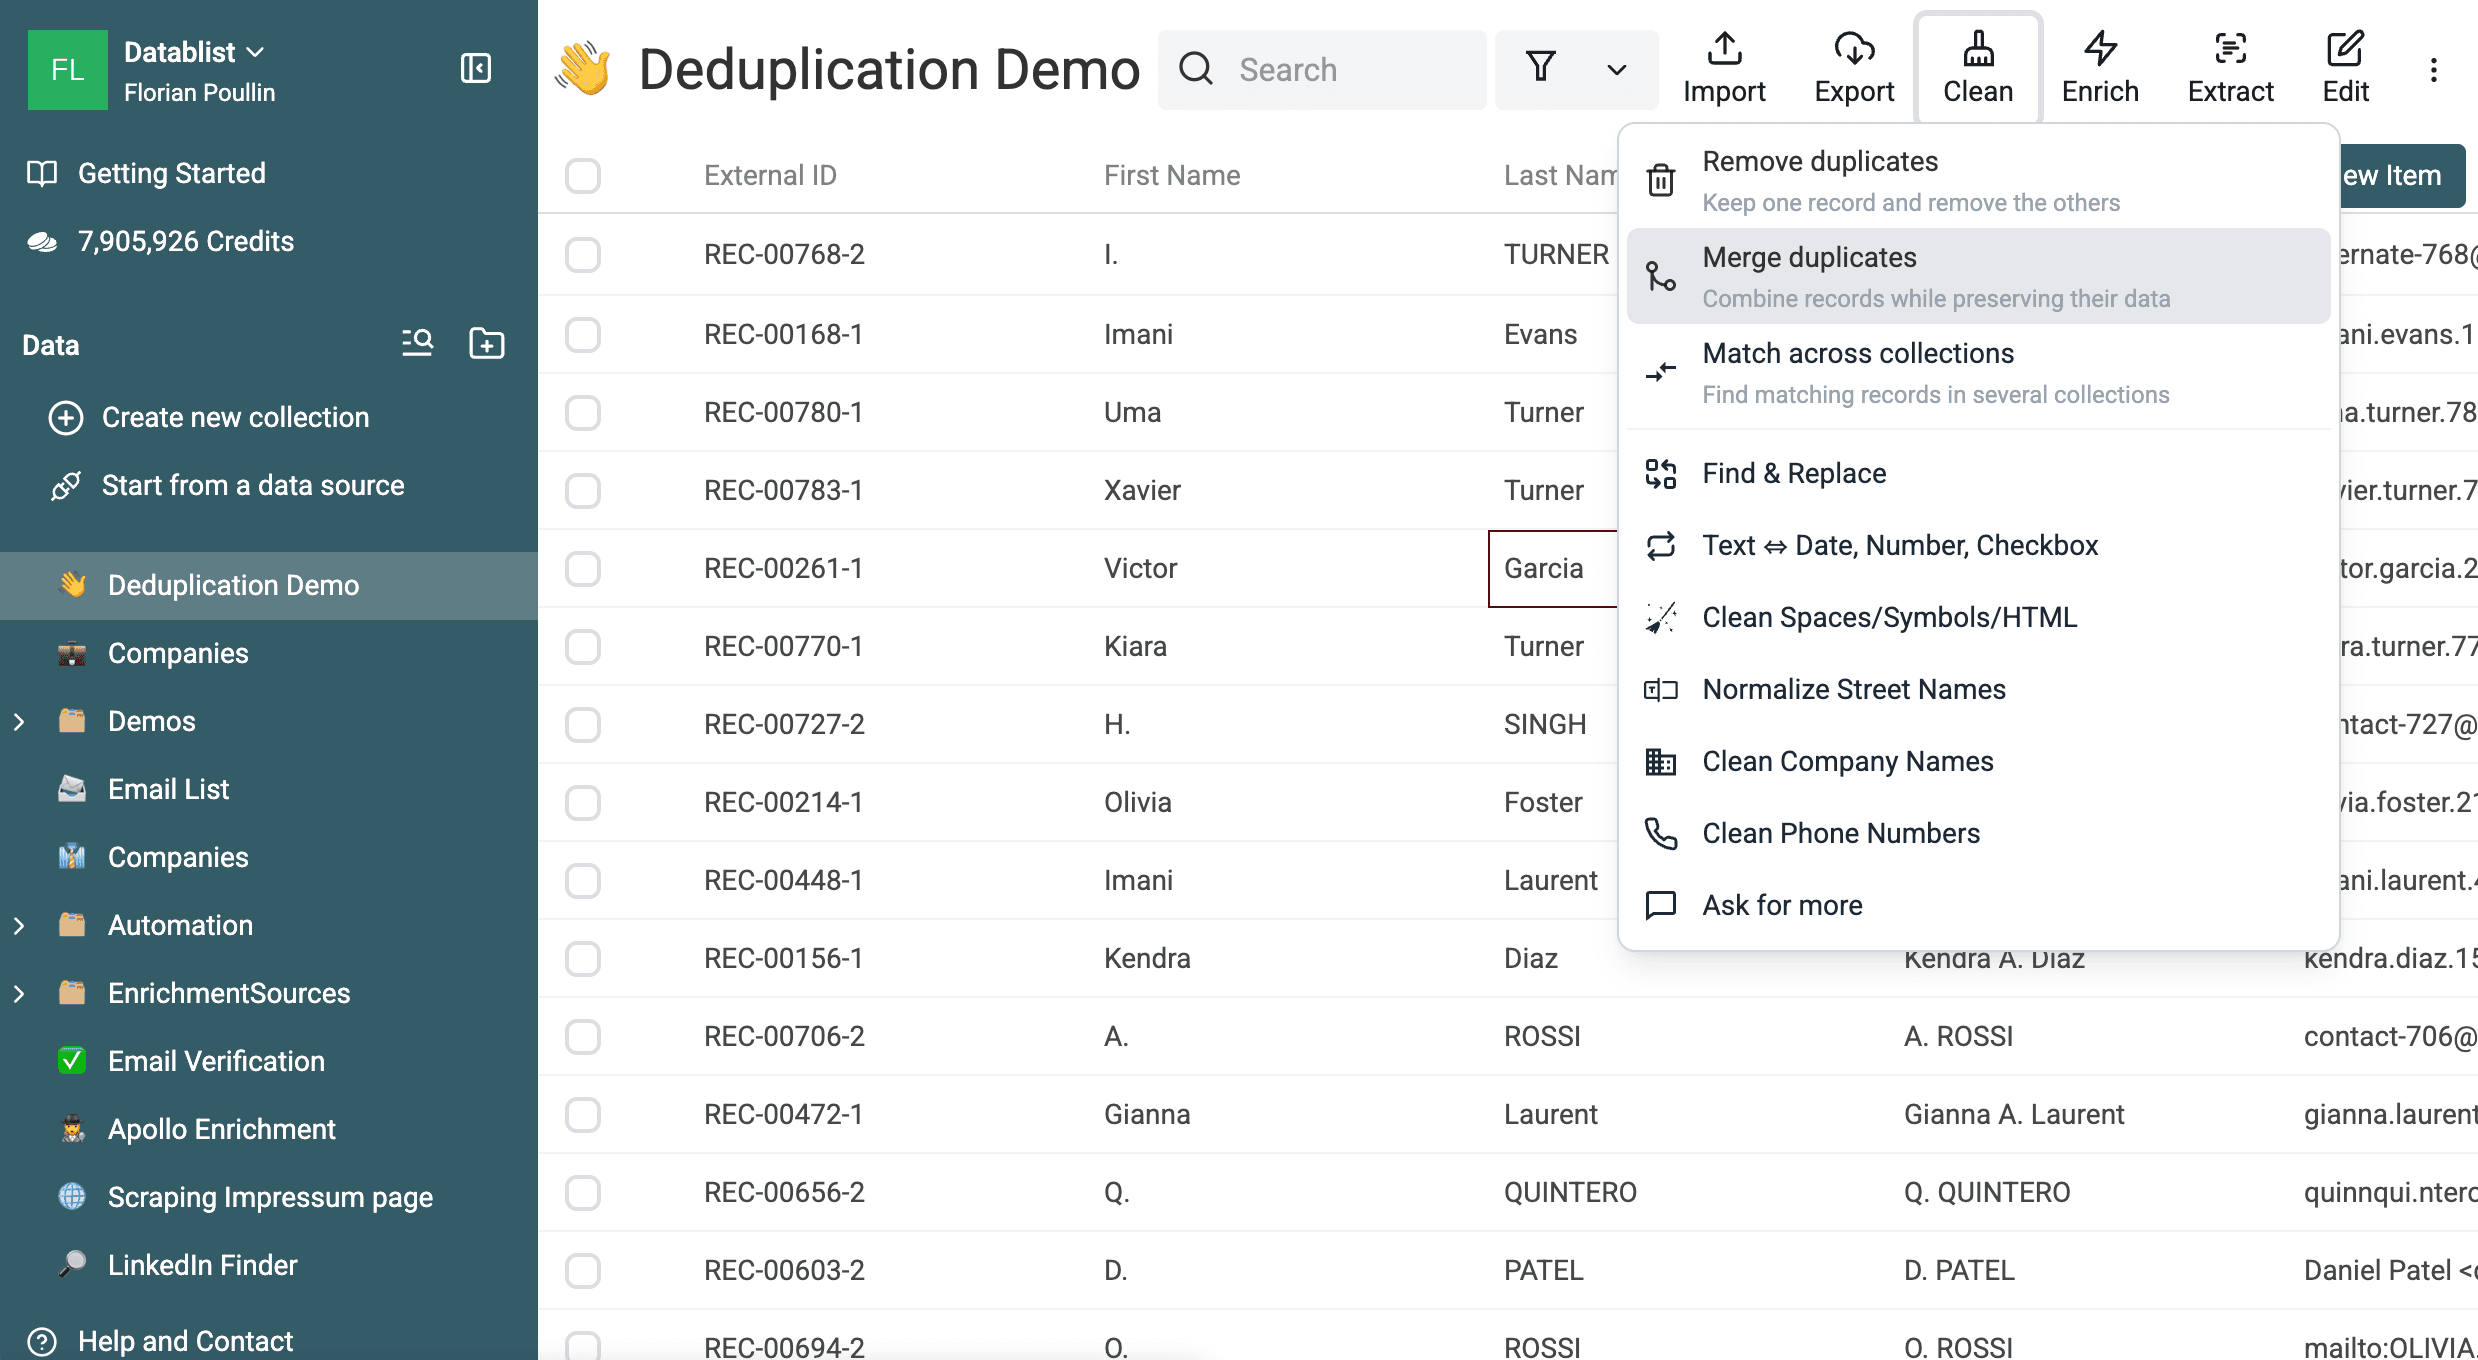
Abra Clean e escolha a ação adequada ao seu objetivo:
- Remove duplicates quando as linhas secundárias puderem ser descartadas.
- Merge duplicates quando as linhas tiverem informações que merecem ser preservadas.
- Match across collections quando os registros estiverem em collections diferentes.
As duas primeiras ações usam o mesmo mecanismo de detecção. Elas abrem a área de resultados com modos de processamento diferentes selecionados.
Comece pela correspondência Exact
Use All Properties com Exact para encontrar linhas copiadas duas vezes sem nenhuma alteração. Use Selected Properties quando um campo, como um ID externo, precisar ser idêntico.
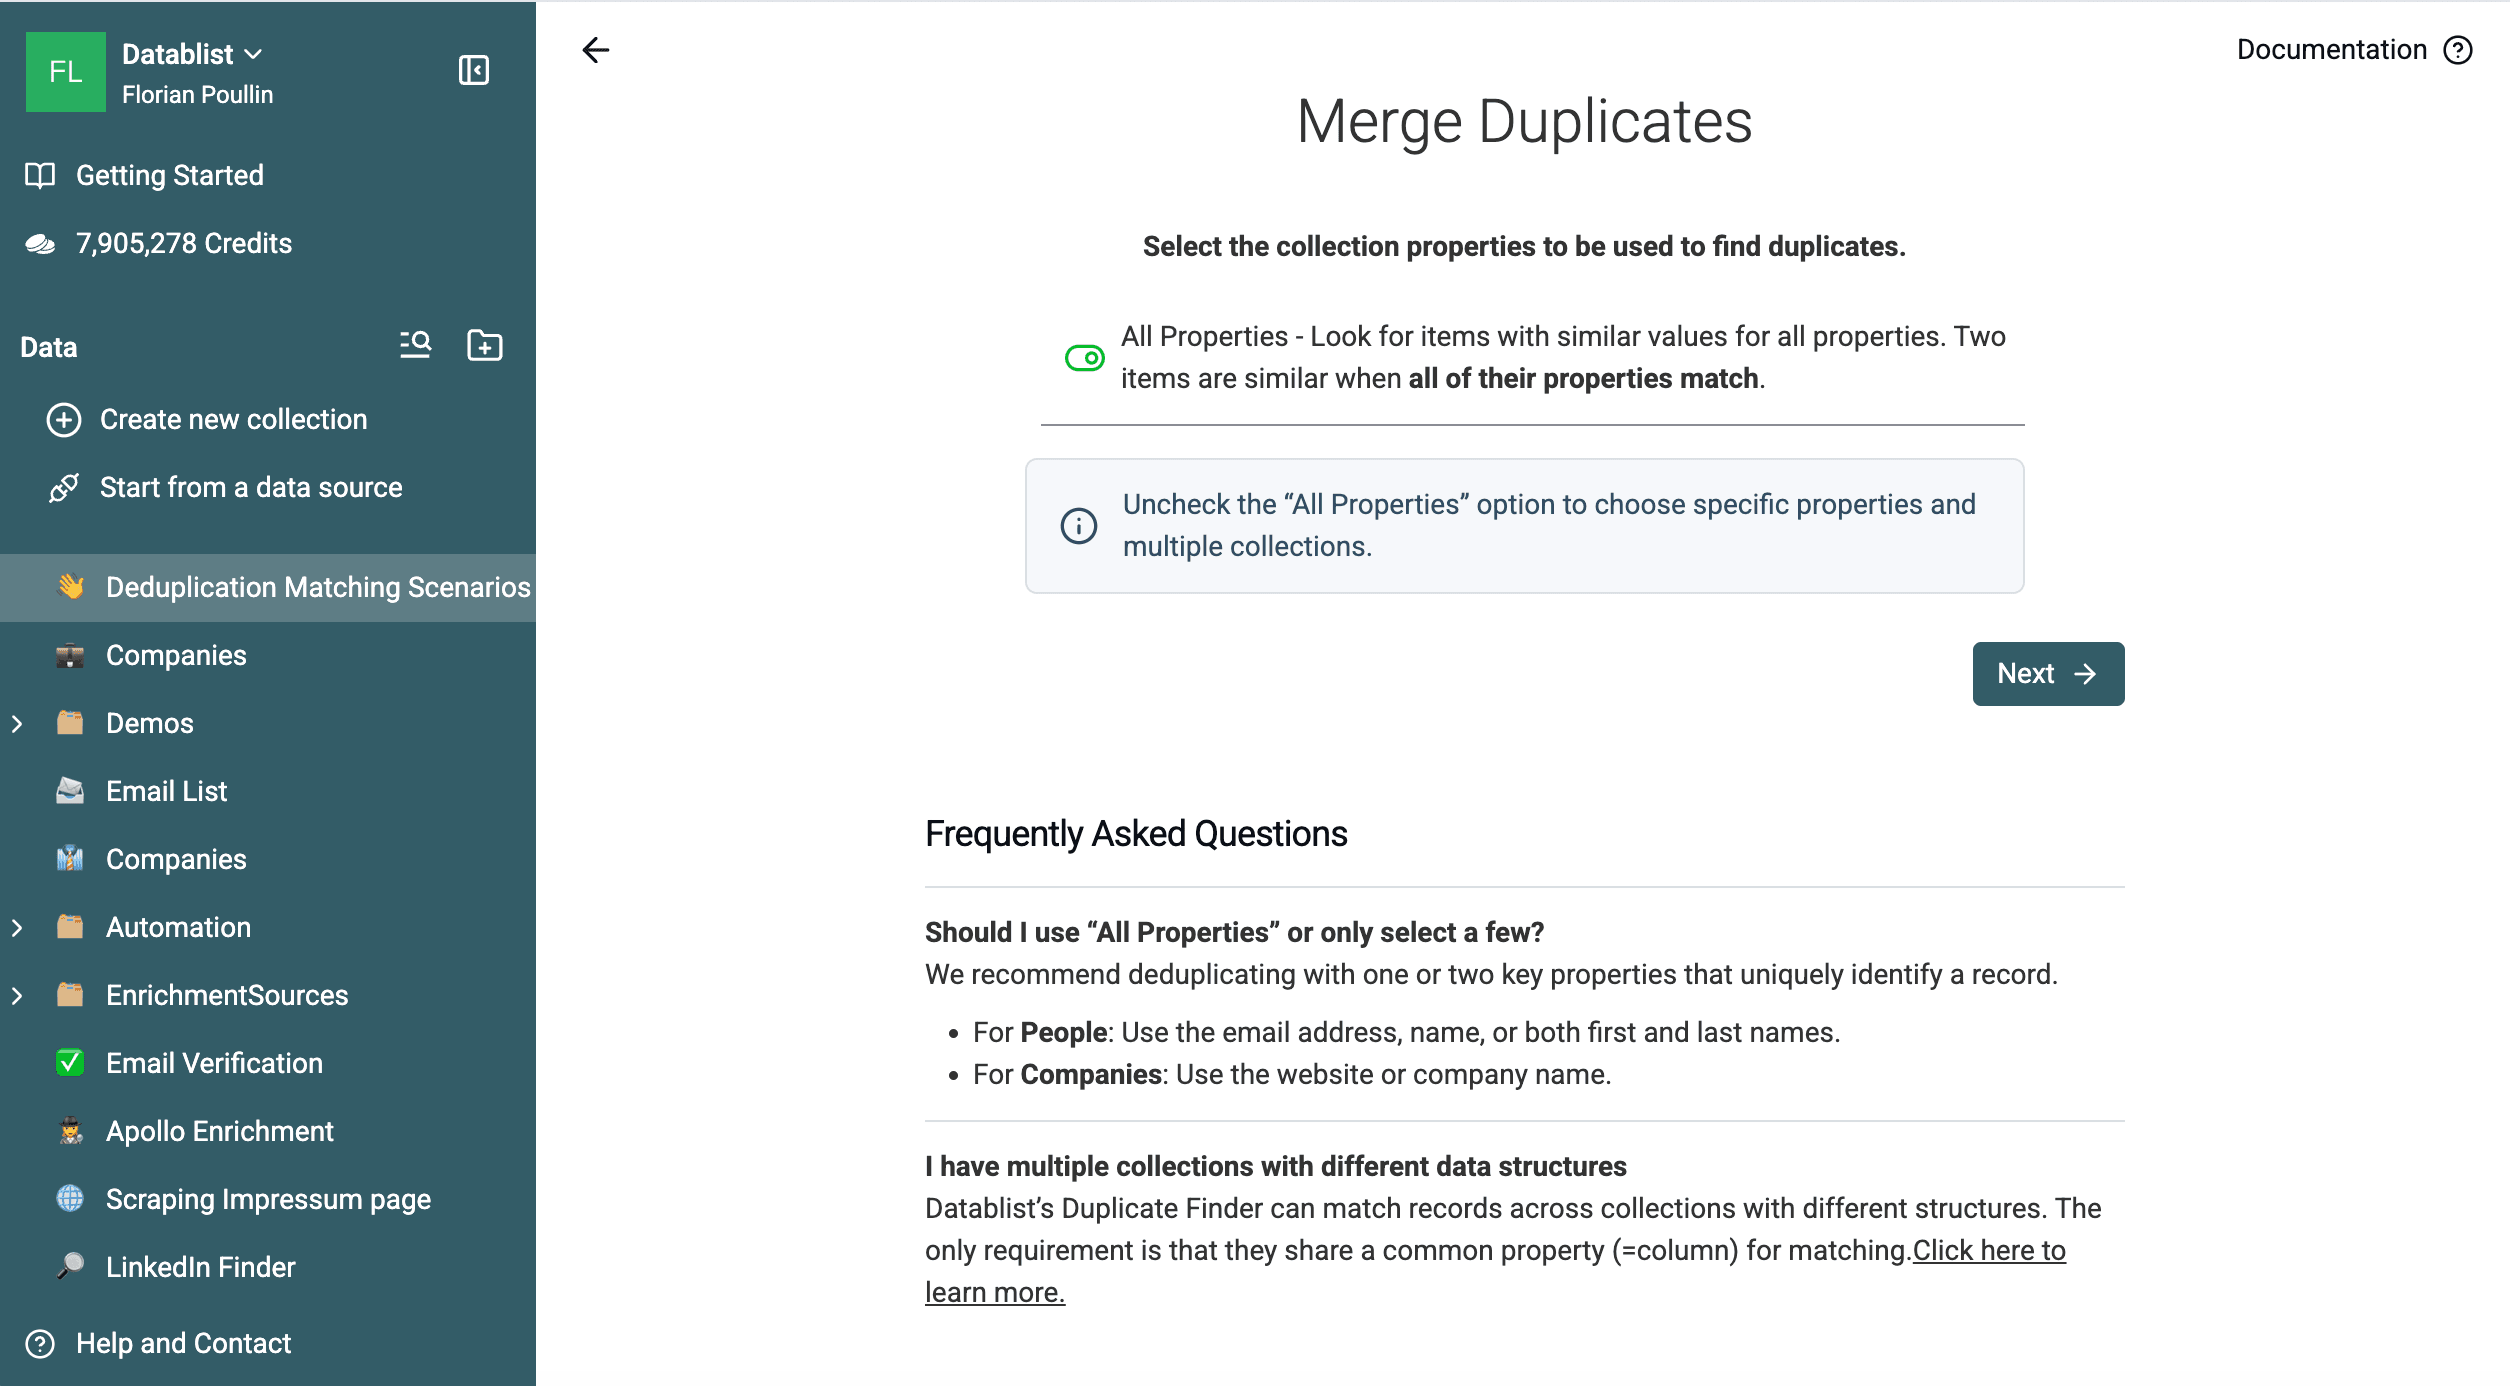
Na amostra de 1.000 linhas, essa verificação retorna cinco grupos de duplicados. Cada grupo contém duas linhas com valores idênticos em todas as propriedades.
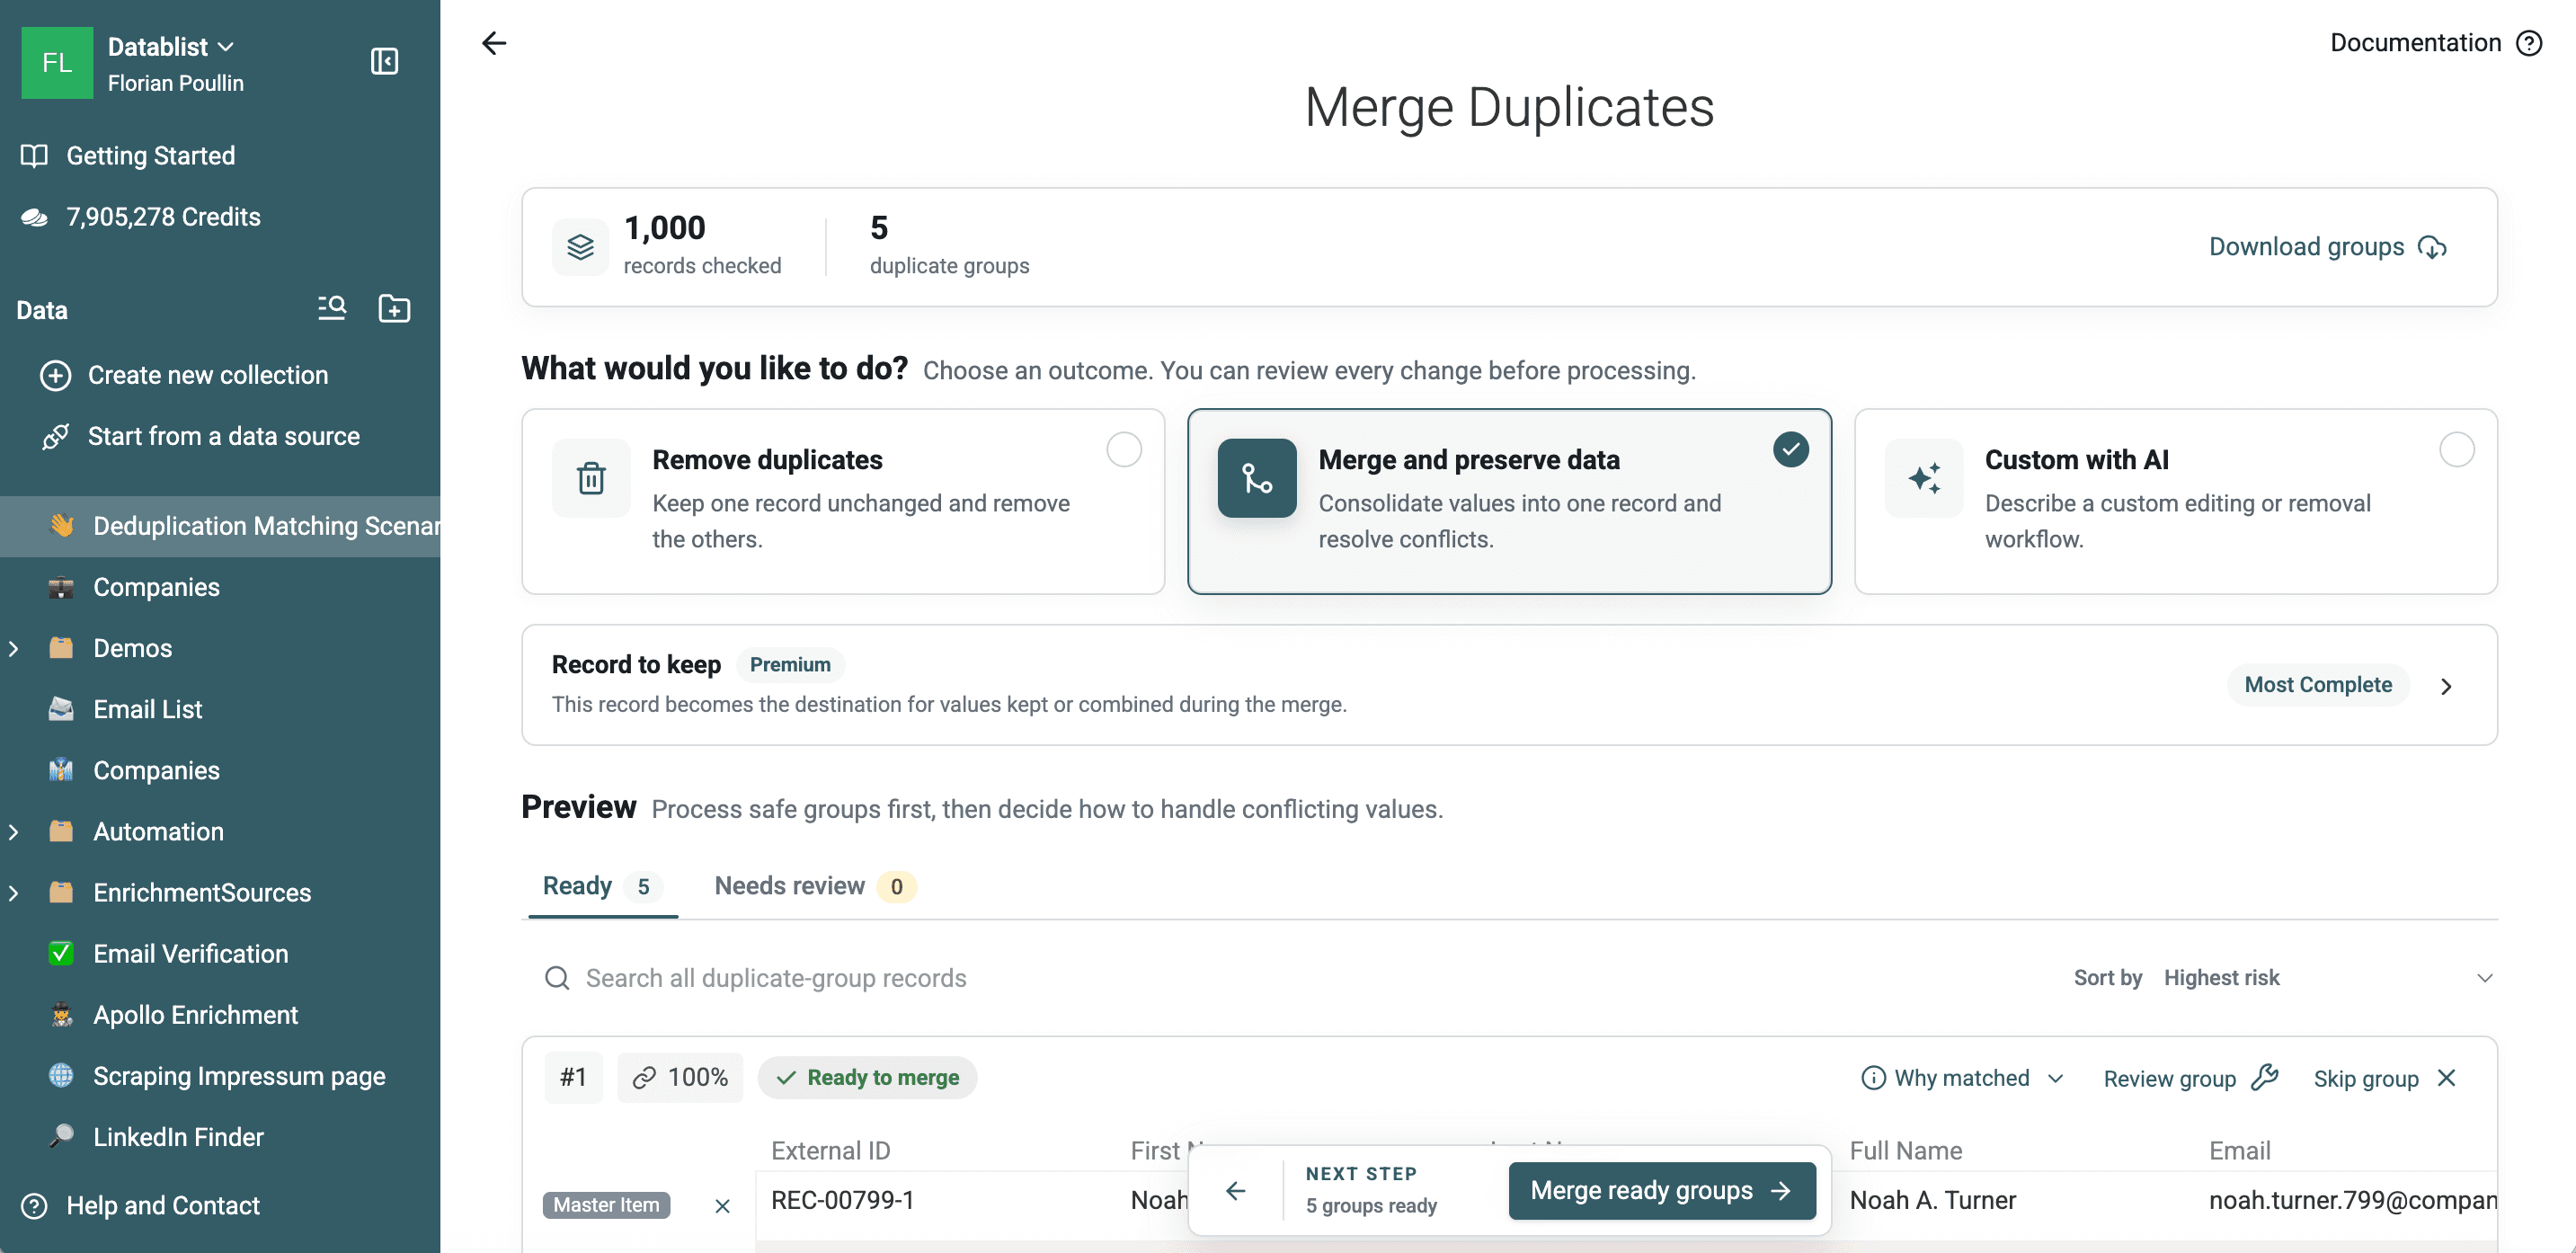
Exact é a verificação inicial mais segura, pois toda correspondência mantida atende a uma comparação rigorosa. Ela não encontrará Acme Inc. e Acme, um telefone formatado ou um alias de e-mail quando os valores armazenados forem diferentes.
Visitantes anônimos podem executar uma verificação Exact. Criar uma conta gratuita libera a comparação Smart e os demais recursos do plano Free.
Use Smart para comparar dados empresariais
A correspondência Smart padroniza os valores para compará-los sem reescrever as células armazenadas. Selecione o processador adequado à propriedade:
- Email trata diferenças entre maiúsculas e minúsculas, espaços ao redor, aliases com sinal de mais, pontos do Gmail,
googlemail.com, encapsulamentos com nome de exibição e valoresmailto:. - URL pode ignorar protocolos e a barra final, com controles opcionais para subdomínios, caminhos e parâmetros de consulta.
- Phone ignora caracteres de formatação. Ele não valida números, não usa uma propriedade Country nem infere um código de país ausente.
- Company Name remove termos jurídicos, empresariais e geográficos comuns.
- Text ignora acentos, espaços, pontuação, símbolos, diferenças entre maiúsculas e minúsculas e a ordem das palavras.
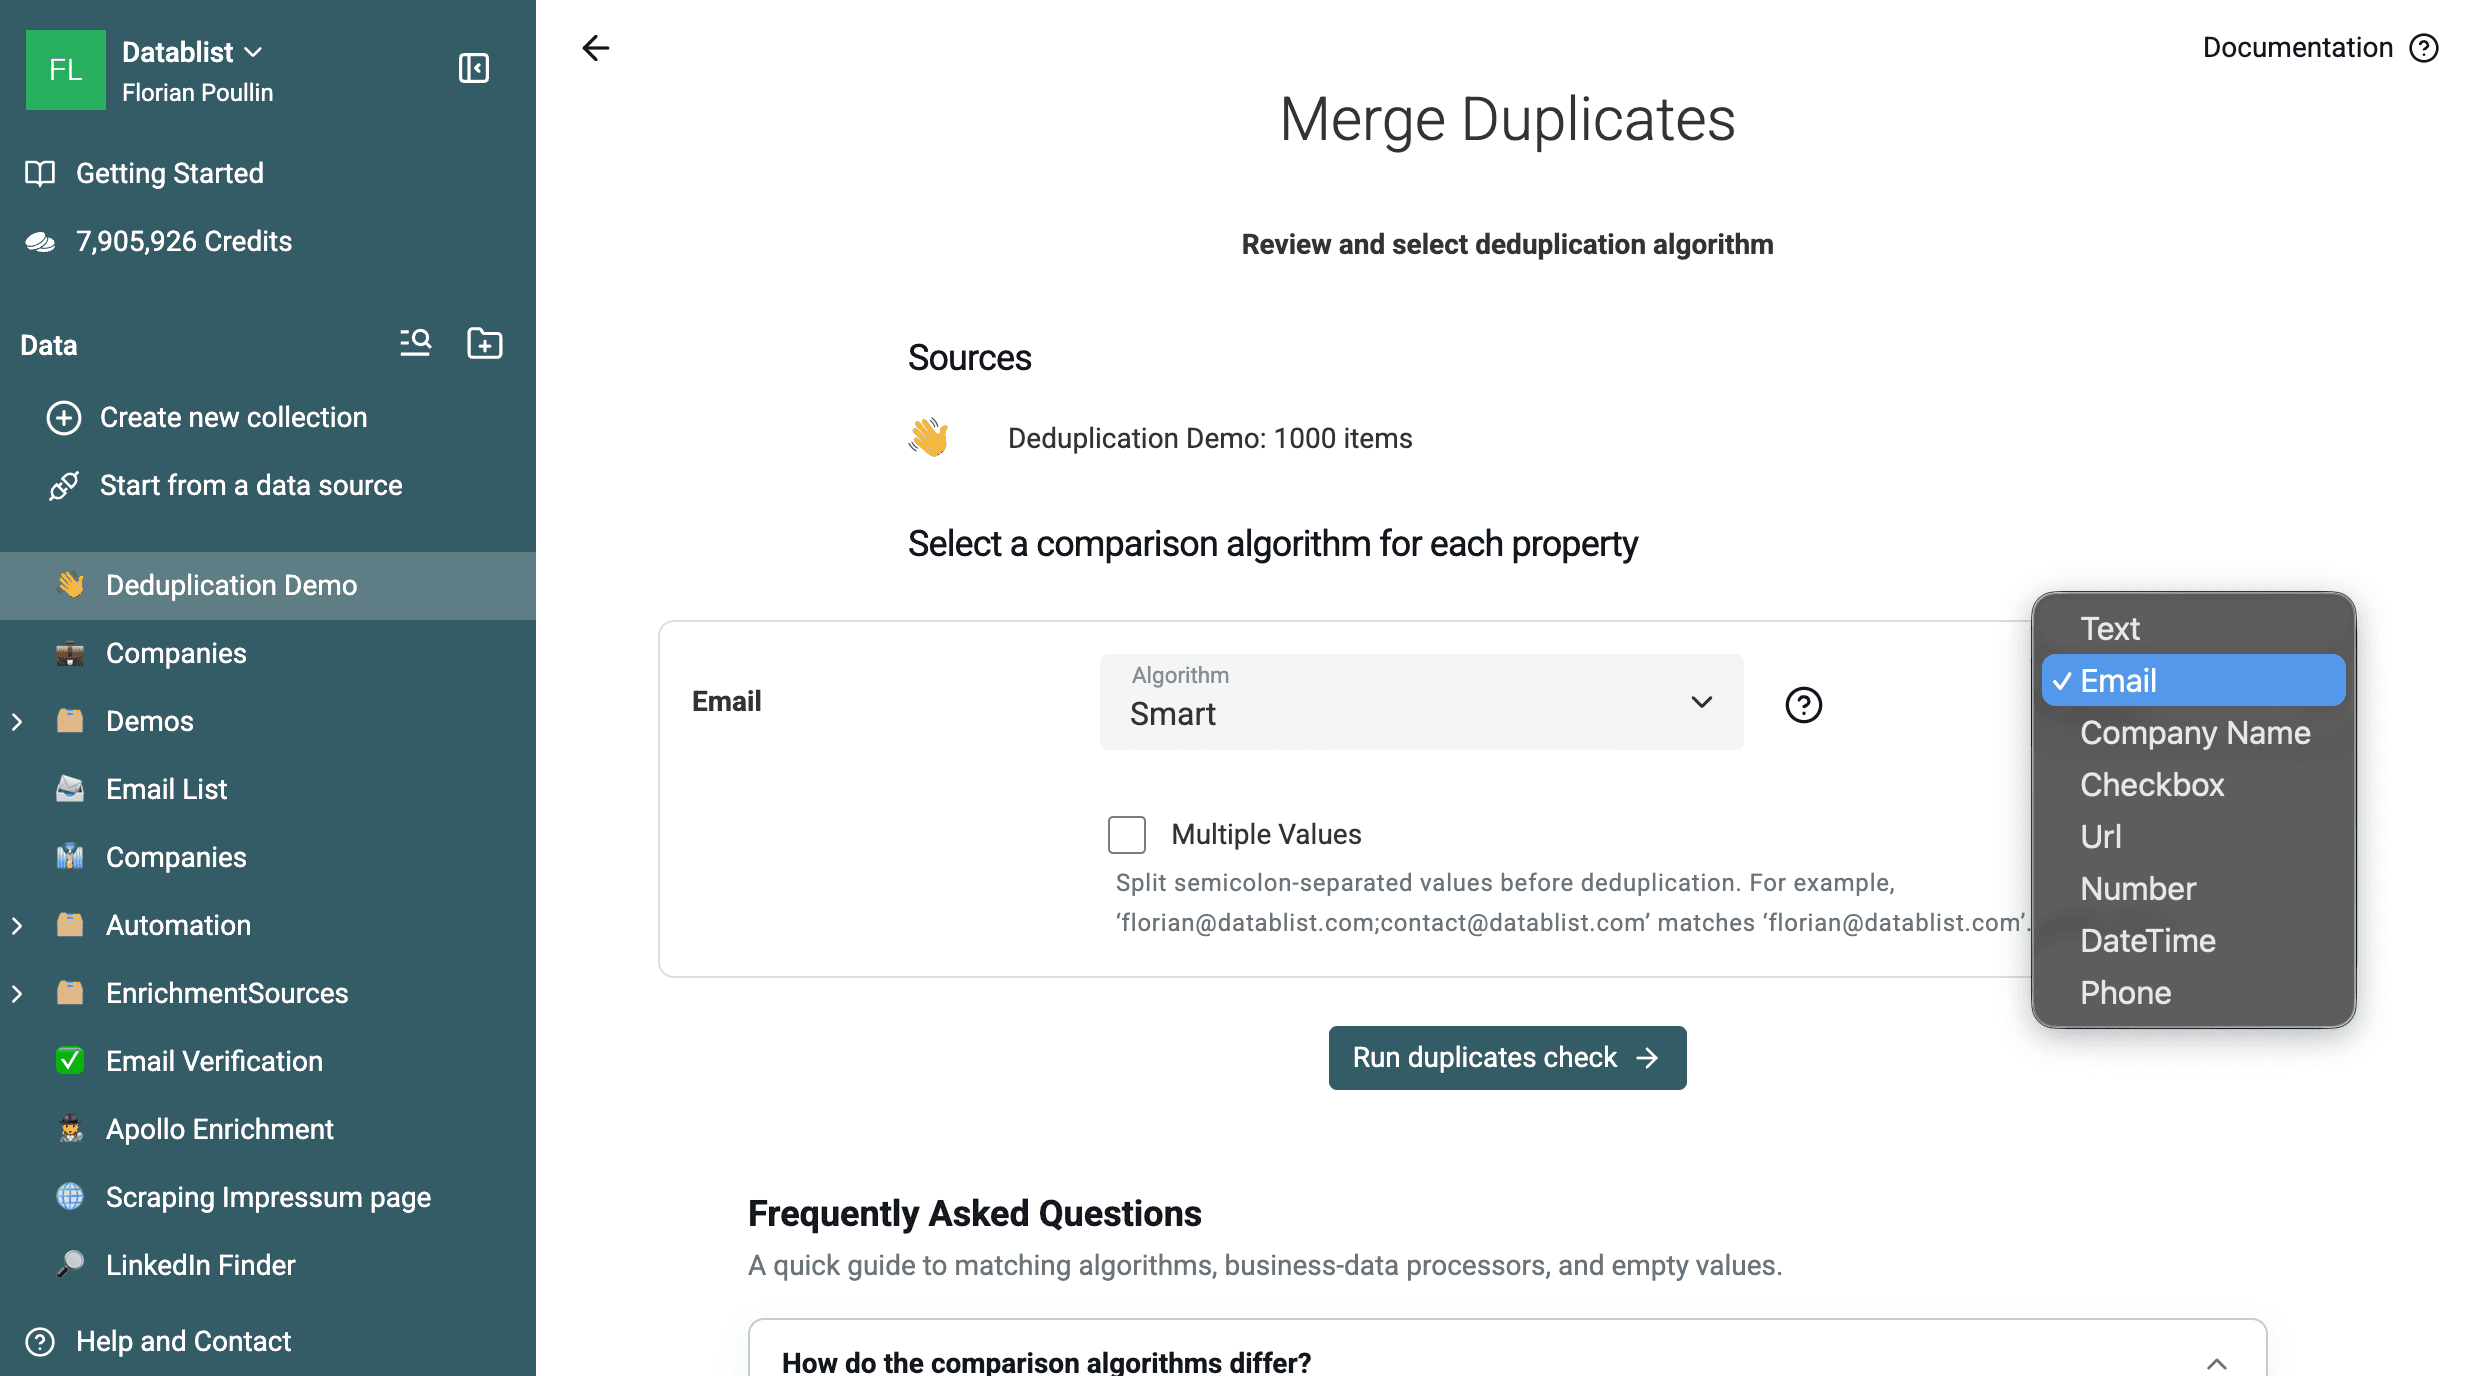
O processador Company Name, a correspondência de vários valores e os algoritmos avançados exigem um plano pago. Exact e Smart estão disponíveis no plano Free para correspondências em uma única collection, embora Smart exija uma conta gratuita.
Quando uma célula tiver vários identificadores separados por ponto e vírgula, ative Multiple Values. O Datablist compara cada parte e considera a propriedade correspondente quando pelo menos um par coincide. Por exemplo, uma célula com primary@example.com;shared@example.com pode corresponder a outra com shared@example.com.
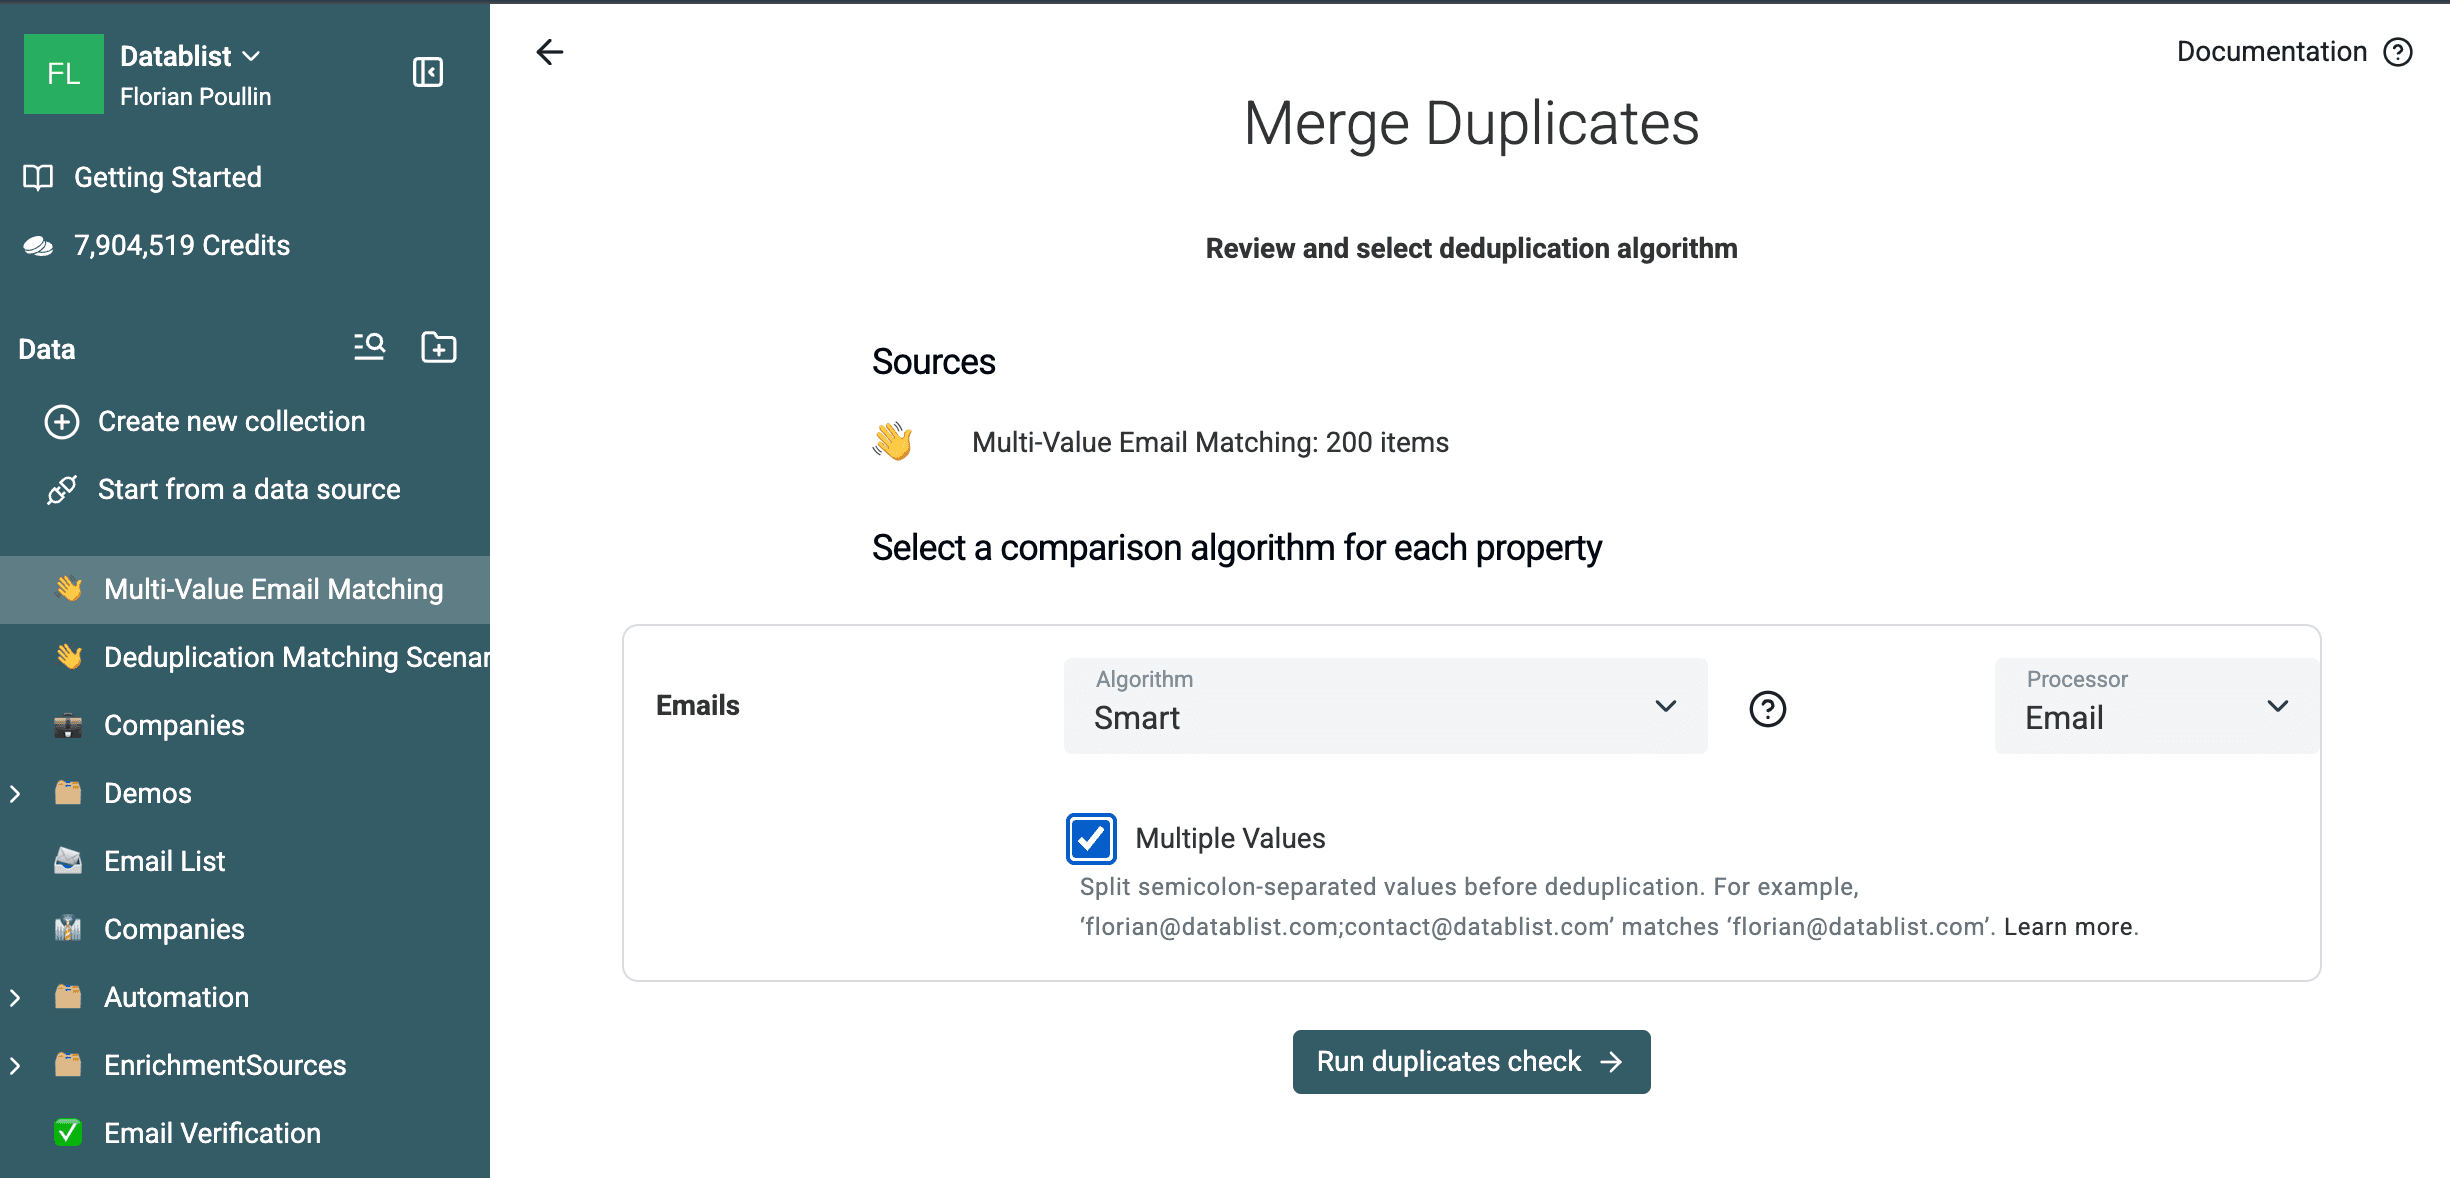
Na amostra específica de 200 linhas, essa configuração retornou 60 grupos de duas linhas. A validação dos resultados esperados encontrou todos os 60 pares criados e excluiu os 80 controles. Siga o fluxo de deduplicação de campos com vários valores para acessar o arquivo de amostra, o CSV de resultados e as decisões de mesclagem.
Essa verificação de e-mail retornou 105 grupos de duas linhas: 100 pares criados para testar a normalização de e-mails e os cinco pares de cópias exatas, que também compartilham o mesmo e-mail.
Normalize os telefones antes da correspondência
O processador Smart Phone é útil para um caso específico: valores com os mesmos dígitos, mas espaços, parênteses, hifens ou símbolos diferentes. Ele consegue associar (415) 555-0123 a 4155550123.
Ele não consegue determinar que um número local e um internacional são iguais. Por exemplo, 06 12 34 50 08 e +33 6 12 34 50 08 precisam do contexto do país antes da comparação.
Use o Phone Number Cleaner antes de deduplicar por telefone:
- Mapeie a propriedade
Phoneoriginal. - Para uma lista de um único país, selecione o país em Local Phone Countries. Para uma lista mista, ative Define country per item e mapeie a propriedade
Country. - Grave o resultado do enrichment em
Clean Phone Numbersem substituir o valor original. - Revise resultados vazios ou com falha. Eles não devem participar da correspondência por telefone.
- Execute o Duplicates Finder em
Clean Phone Numbercom Exact.
Baixe a amostra específica de 200 linhas com telefones. Ela contém 50 pares locais/internacionais dos Estados Unidos, França, Reino Unido, Alemanha e Espanha, além de 100 controles sem correspondência. A validação com a lógica do cleaner em produção retornou um telefone normalizado para cada uma das 200 linhas. Os 50 pares criados convergem para 50 valores internacionais compartilhados; os controles permanecem únicos.
Esse pré-processamento também valida o formato do telefone. Mantenha as propriedades Phone e Country originais ao lado do resultado limpo para poder conferir qualquer registro antes da mesclagem. Leia o que significa normalizar números de telefone para entender o papel dos códigos de país e dos valores internacionais.
Para registros de empresas, faça uma verificação separada em Website. Escolha Smart com o processador URL. Ative Ignore Subdomain, Ignore Path e Ignore Query Params apenas quando esses componentes da URL não identificarem outra empresa ou unidade.
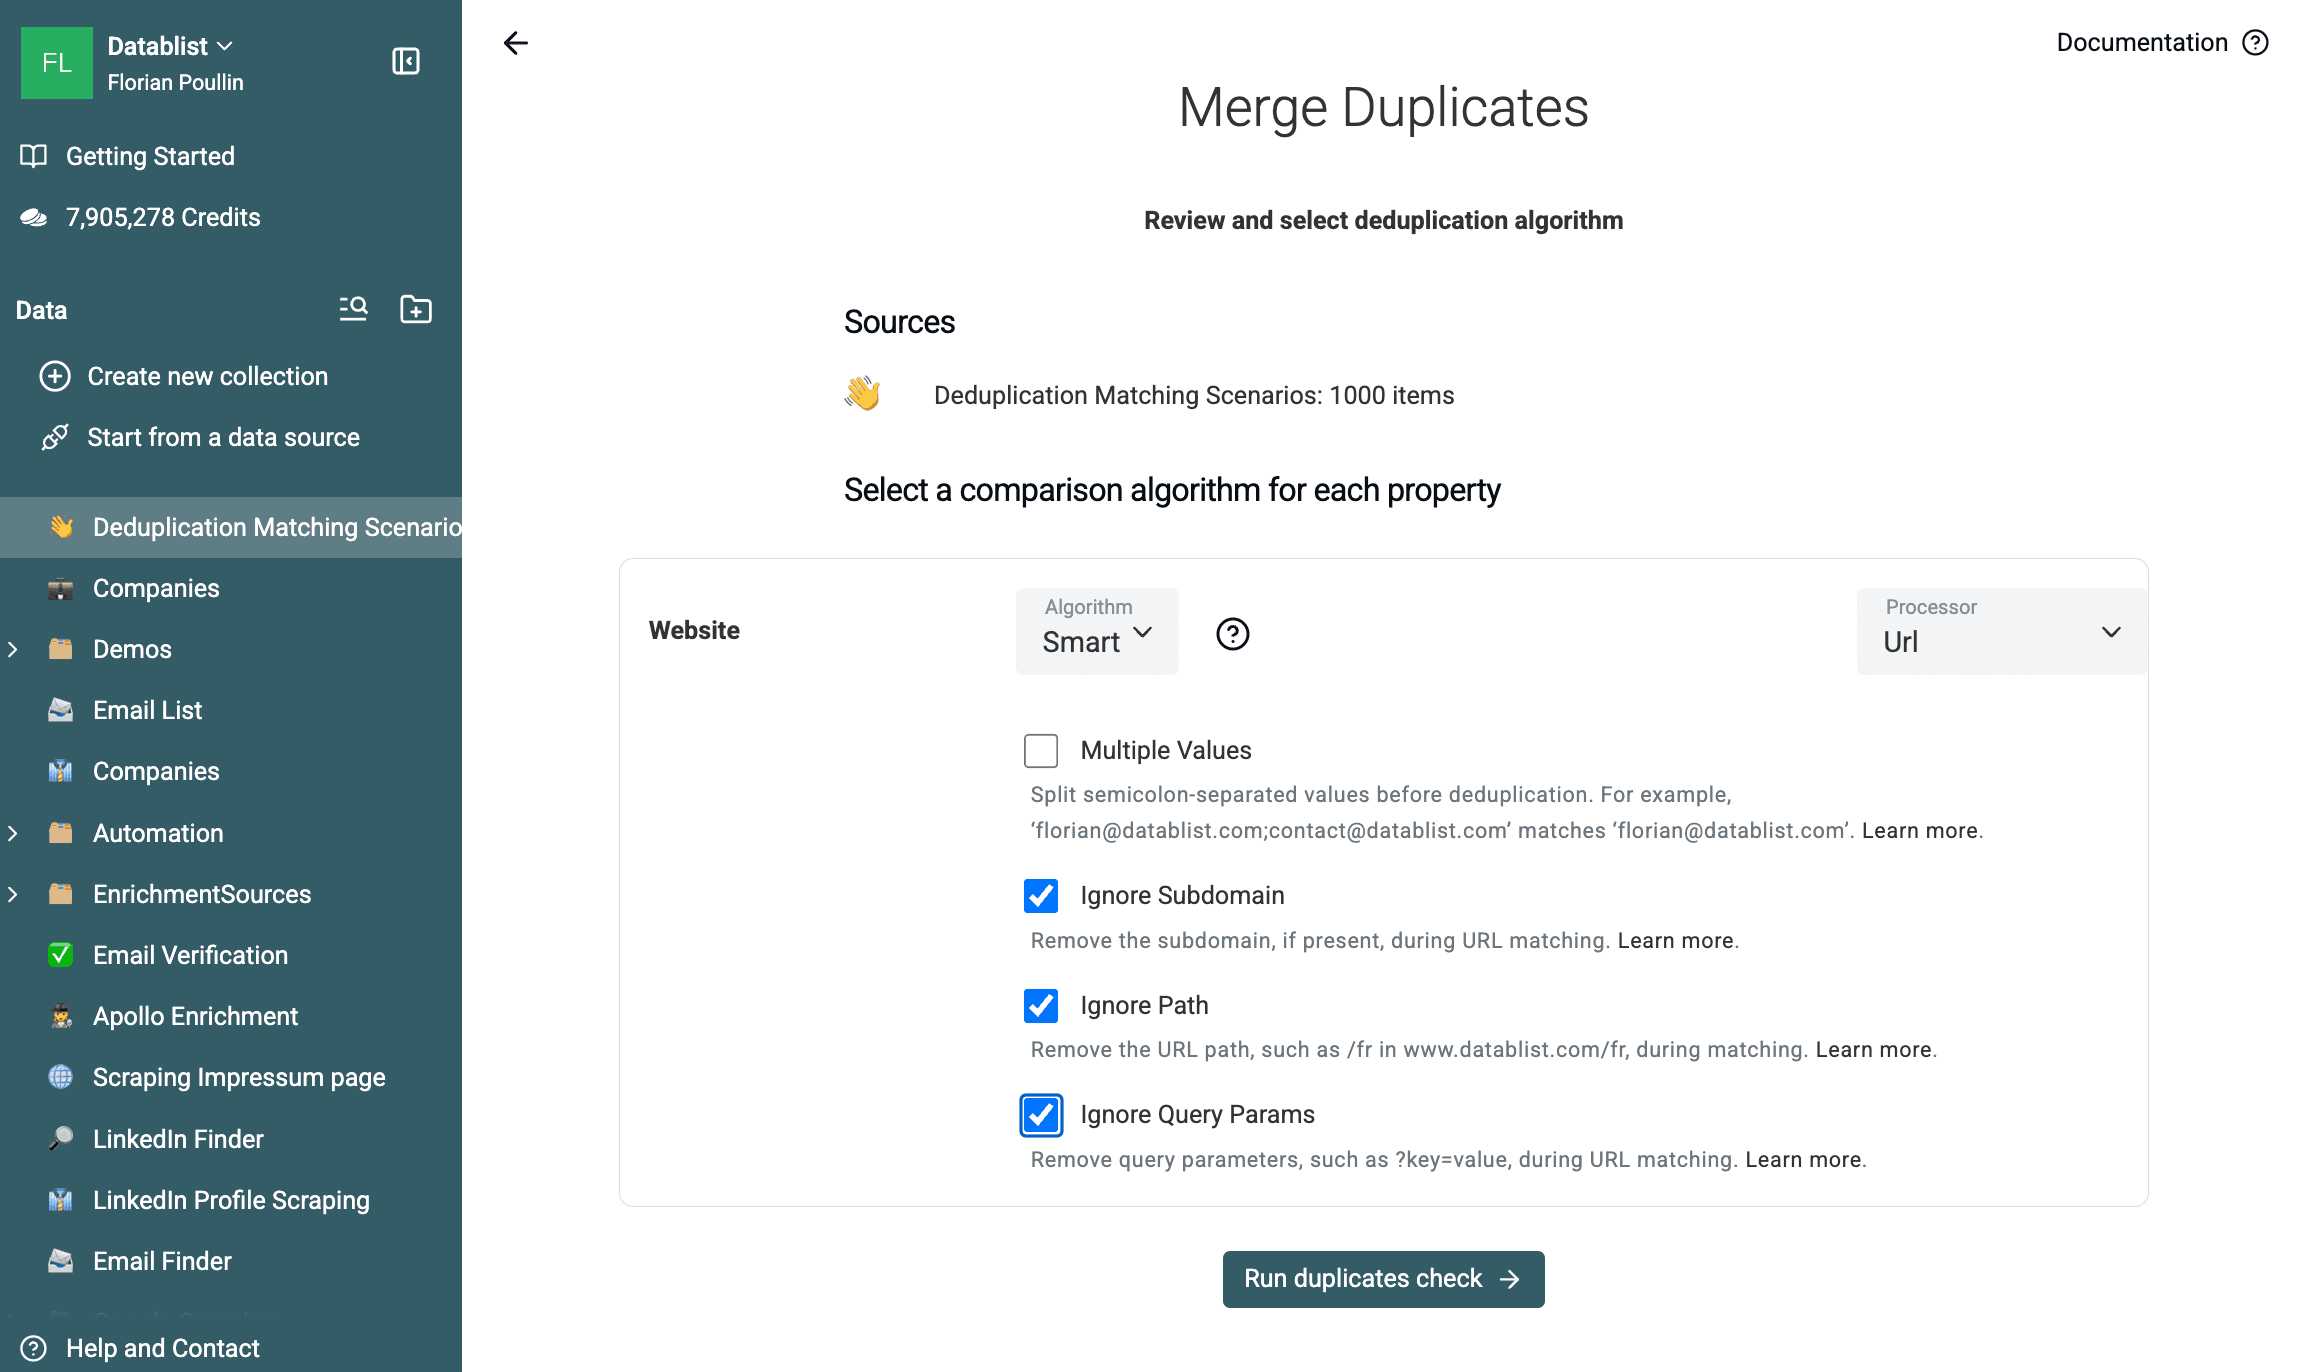
Na mesma amostra de 1.000 linhas, essa configuração retornou 200 grupos de duas linhas. Cinquenta pares contêm variações de URL criadas para o teste, enquanto 150 já compartilham um site idêntico. Nesse teste, todos os pares exportados resultaram no mesmo host normalizado.
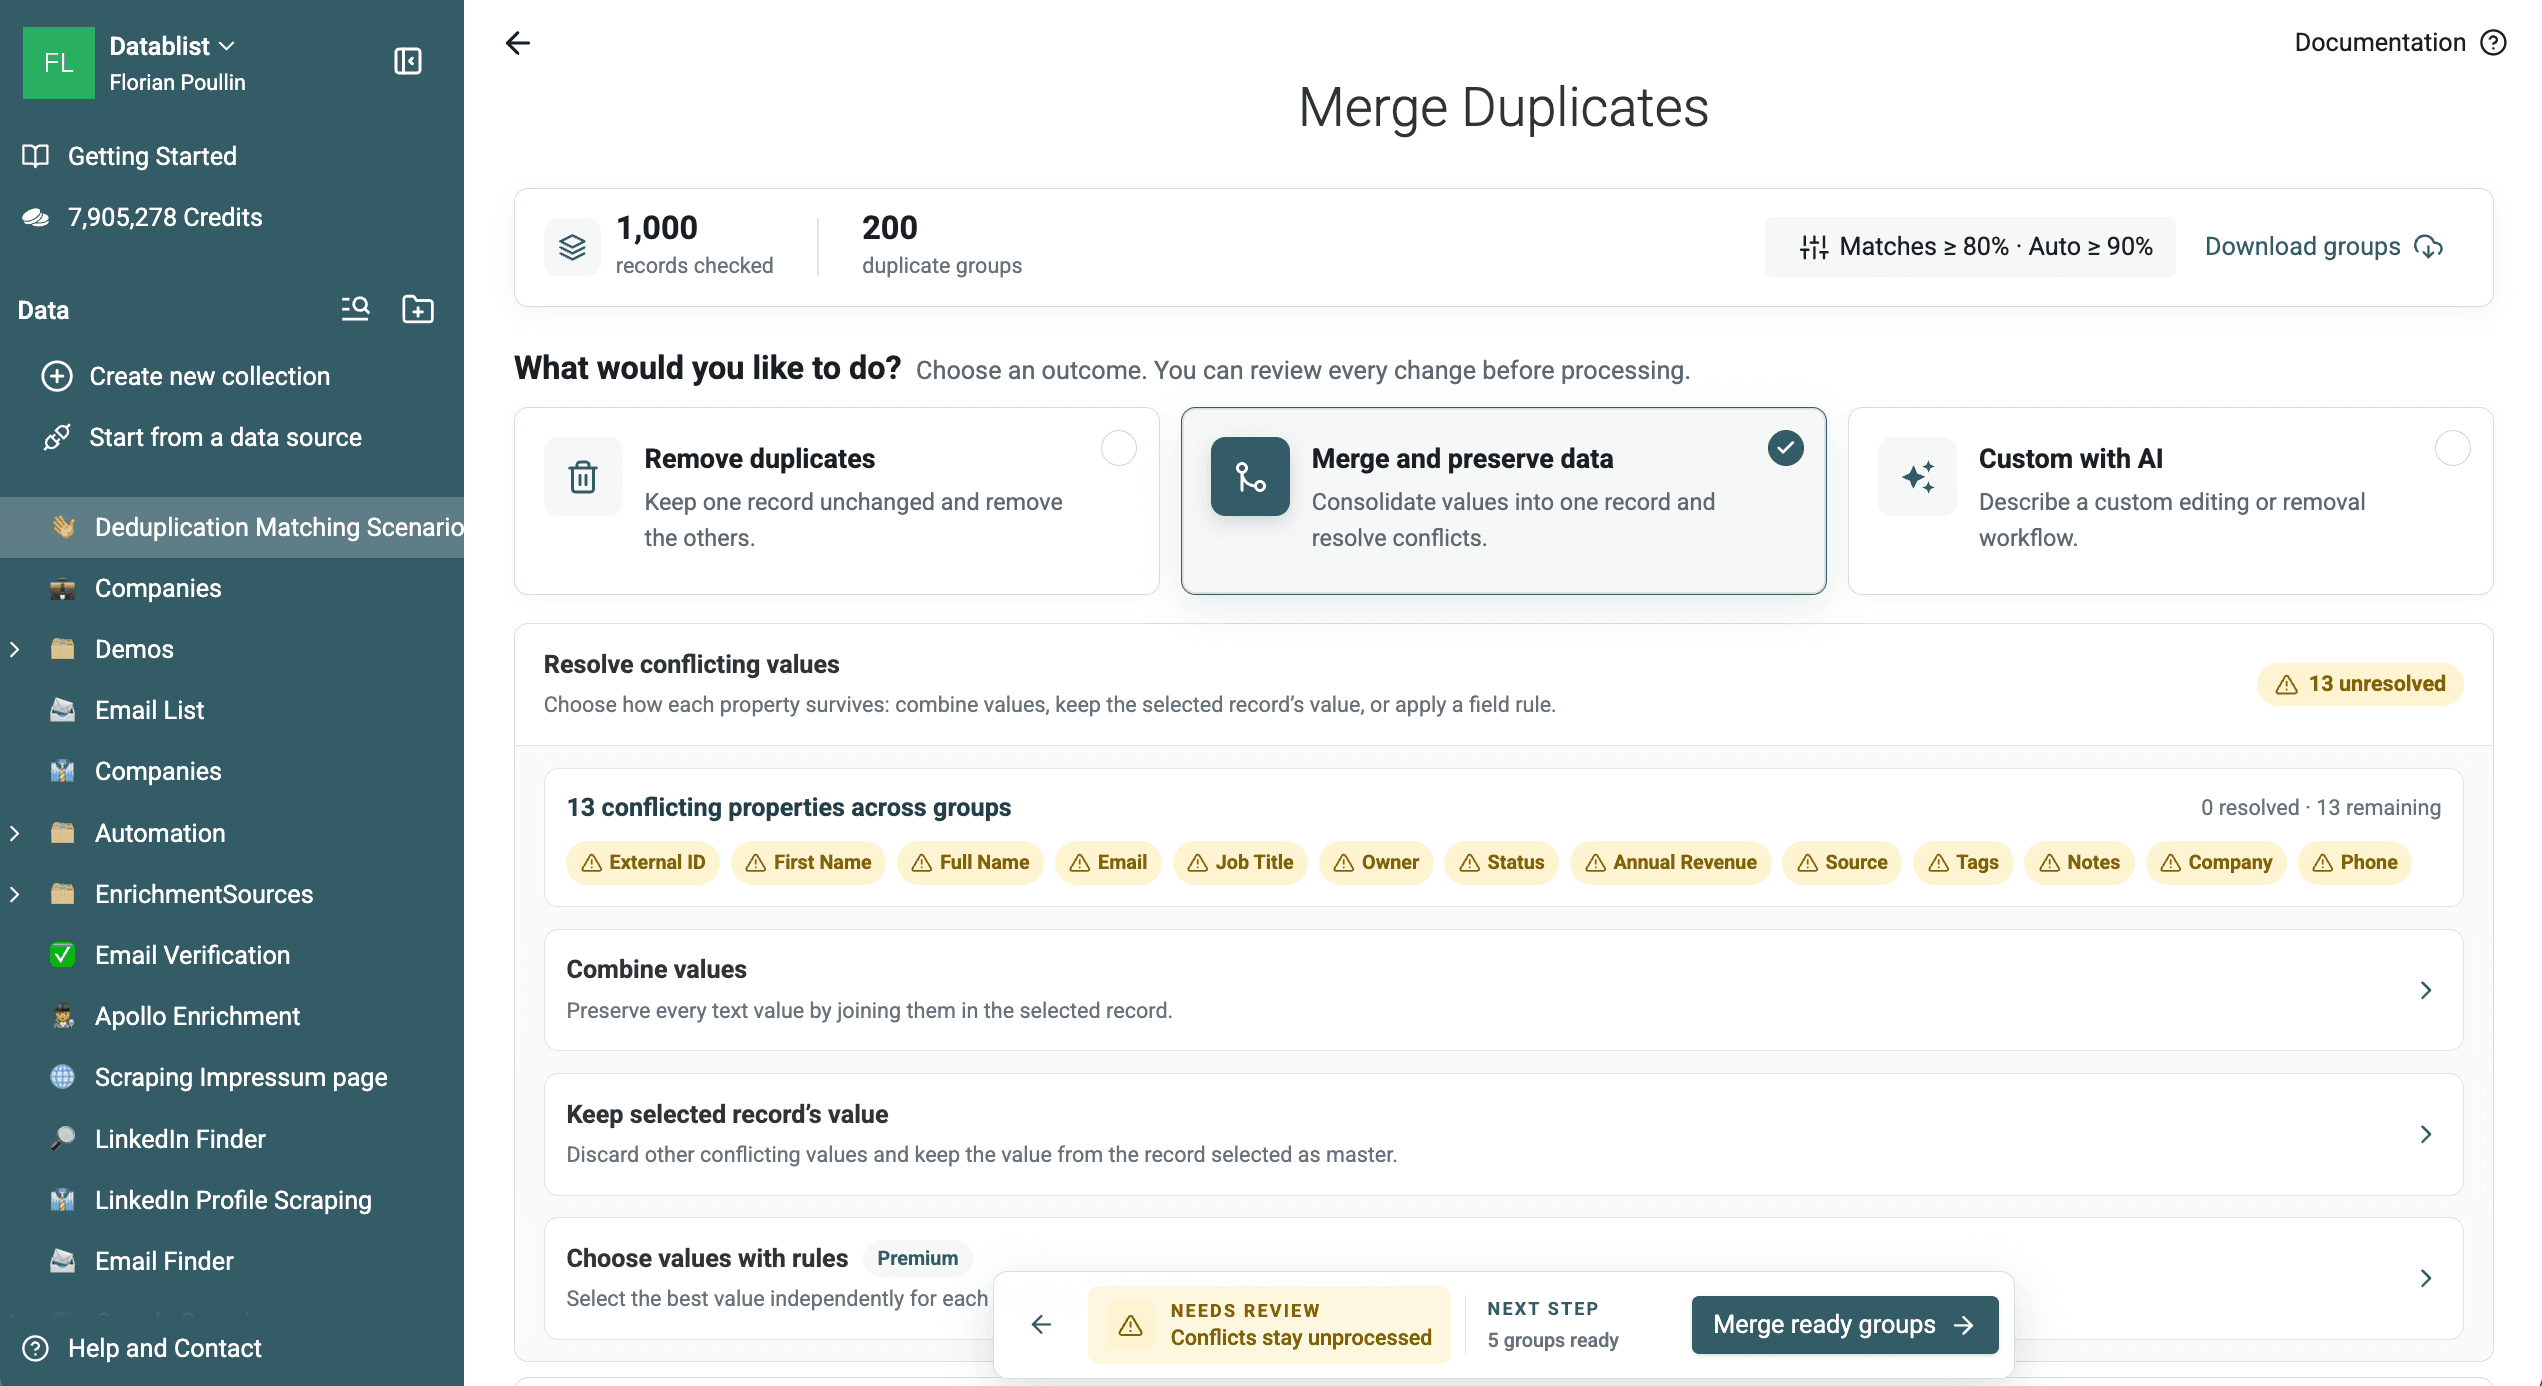
Baixe os 200 grupos de duplicados por Website ou consulte o fluxo de deduplicação de empresas para aplicar uma estratégia de correspondência que prioriza o domínio.
Use correspondência fuzzy ou fonética para revisão
Metaphone compara a sonoridade do texto. Jaro-Winkler e Levenshtein calculam uma pontuação de similaridade, o que ajuda a encontrar diferenças de grafia como Uma Turner e Uman Turner.
Correspondências fuzzy são candidatas, não duplicados confirmados. Comece com um limite alto, confira os grupos mais fracos e só reduza o limite dos resultados se a revisão continuar precisa.
Para uma verificação fuzzy mensurável, selecione Full Name, escolha Distance com Levenshtein, mantenha o processador Text e defina o limite como 90%.
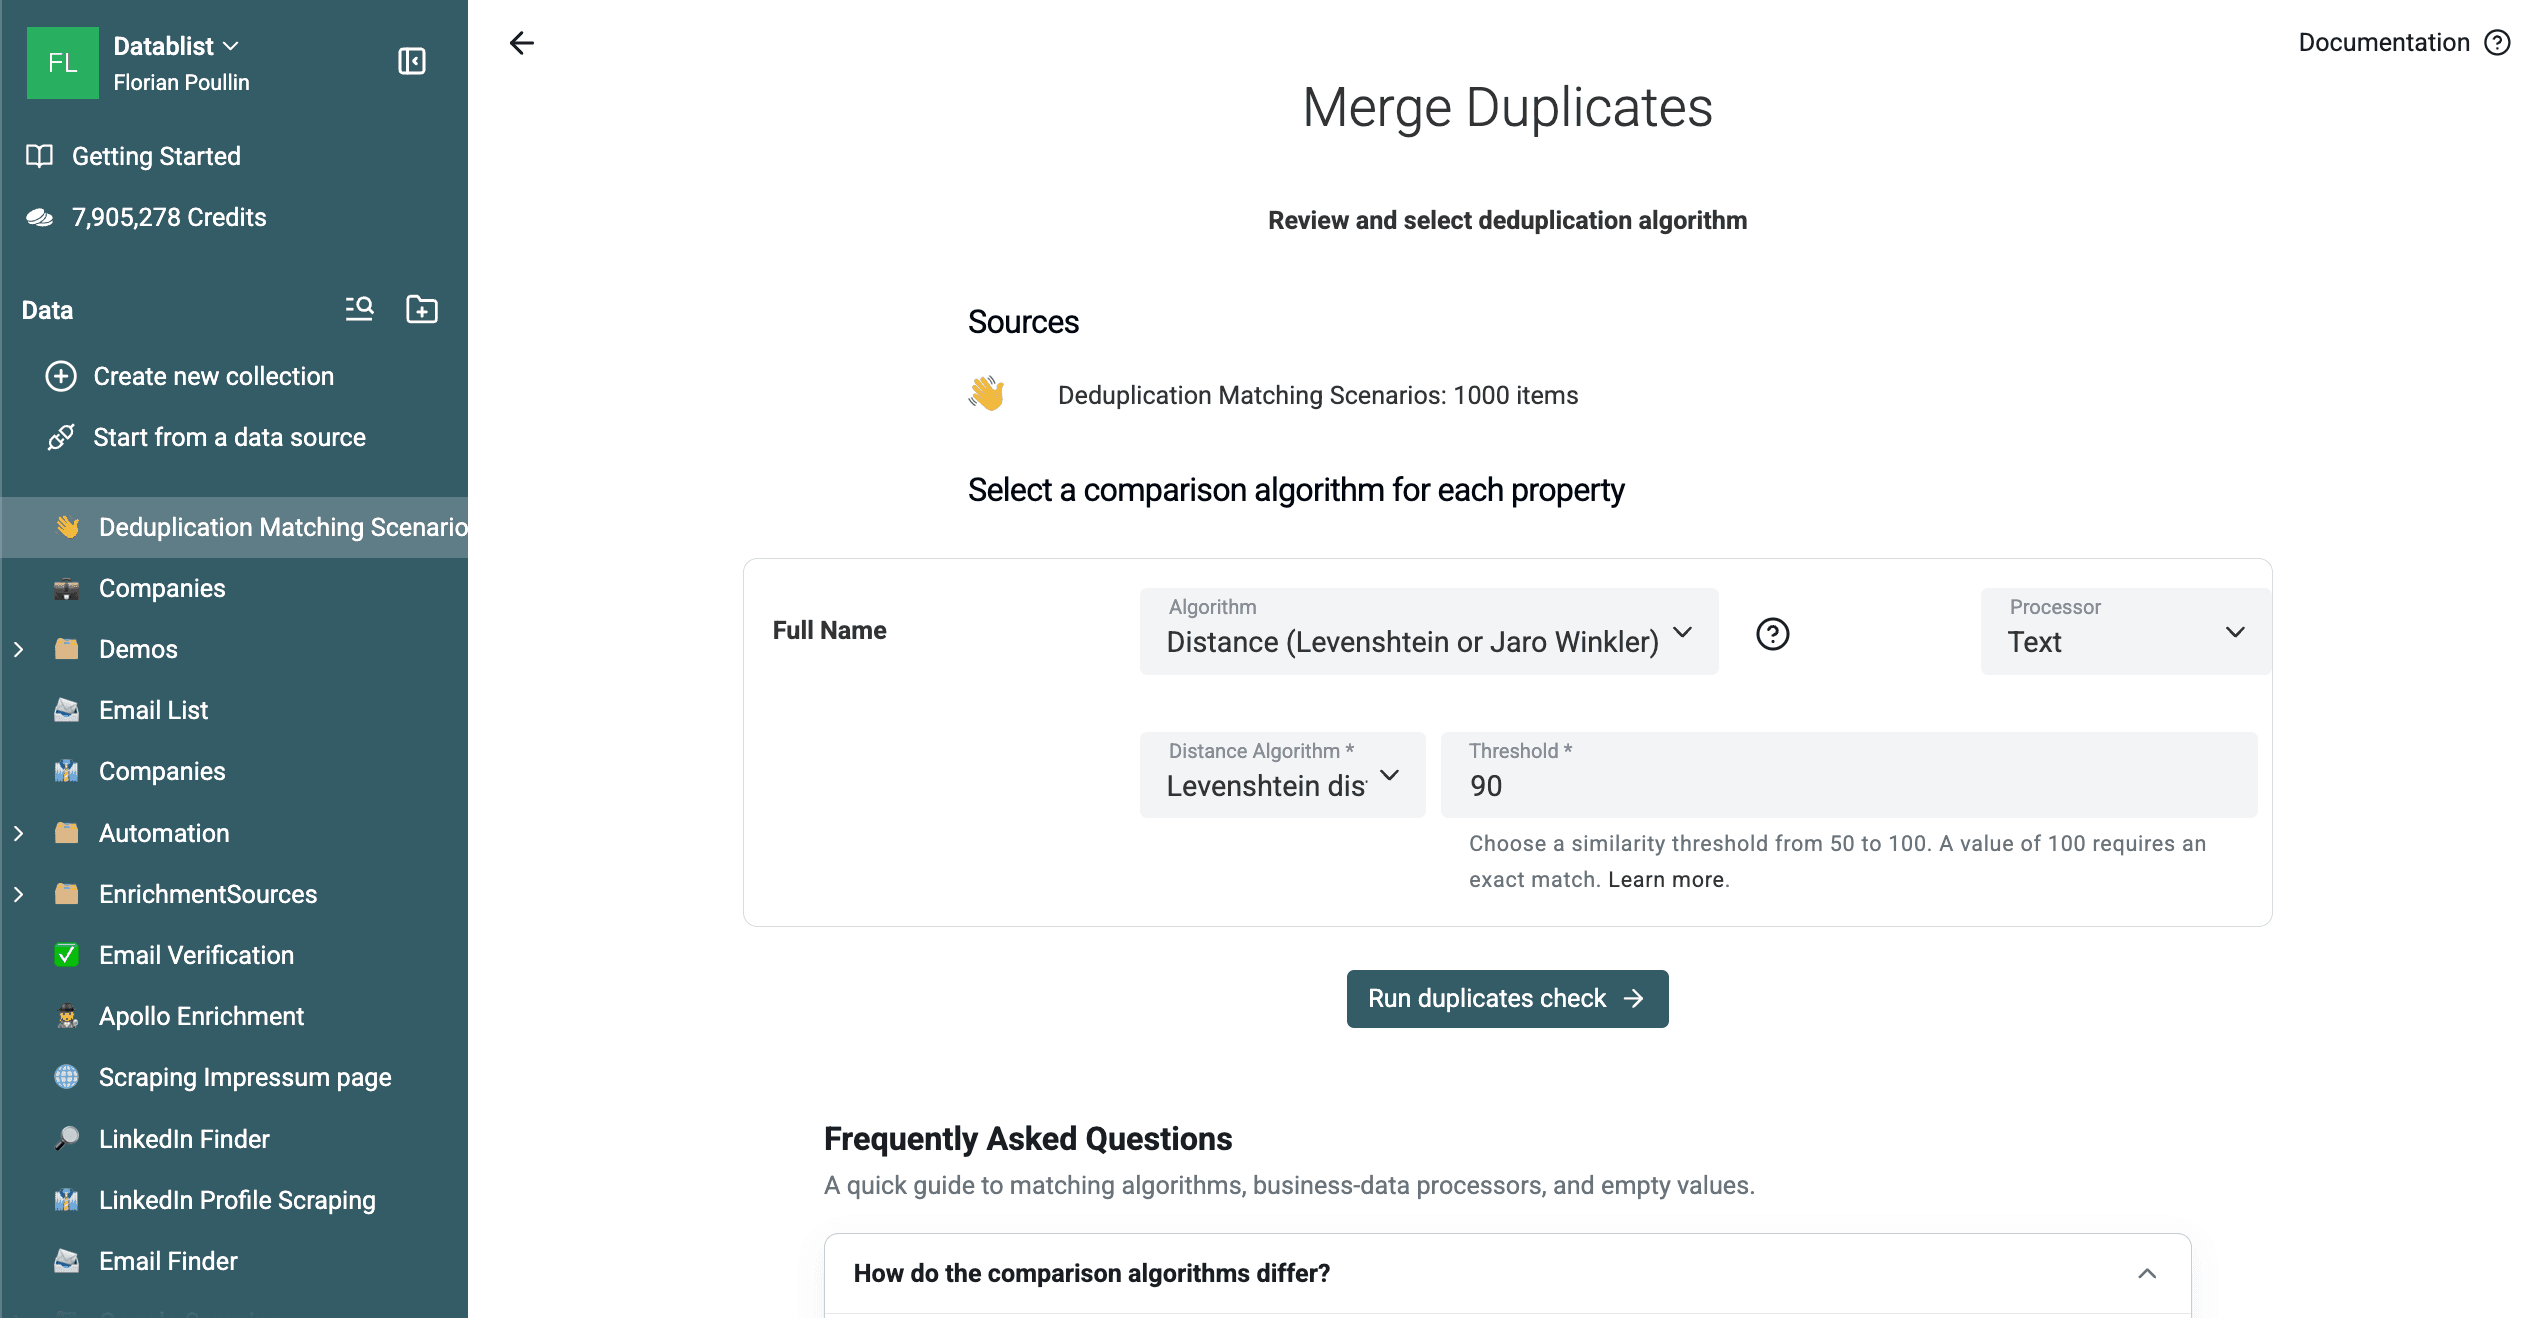
Essa verificação retornou 77 grupos de duas linhas na amostra de 1.000 linhas. A validação dos resultados esperados encontrou 21 grupos que associam a mesma entidade criada e 56 que associam entidades diferentes. A maioria dos falsos positivos eram nomes abreviados, como G. Rossi, nos quais apenas o valor de Full Name não permite distinguir duas pessoas.
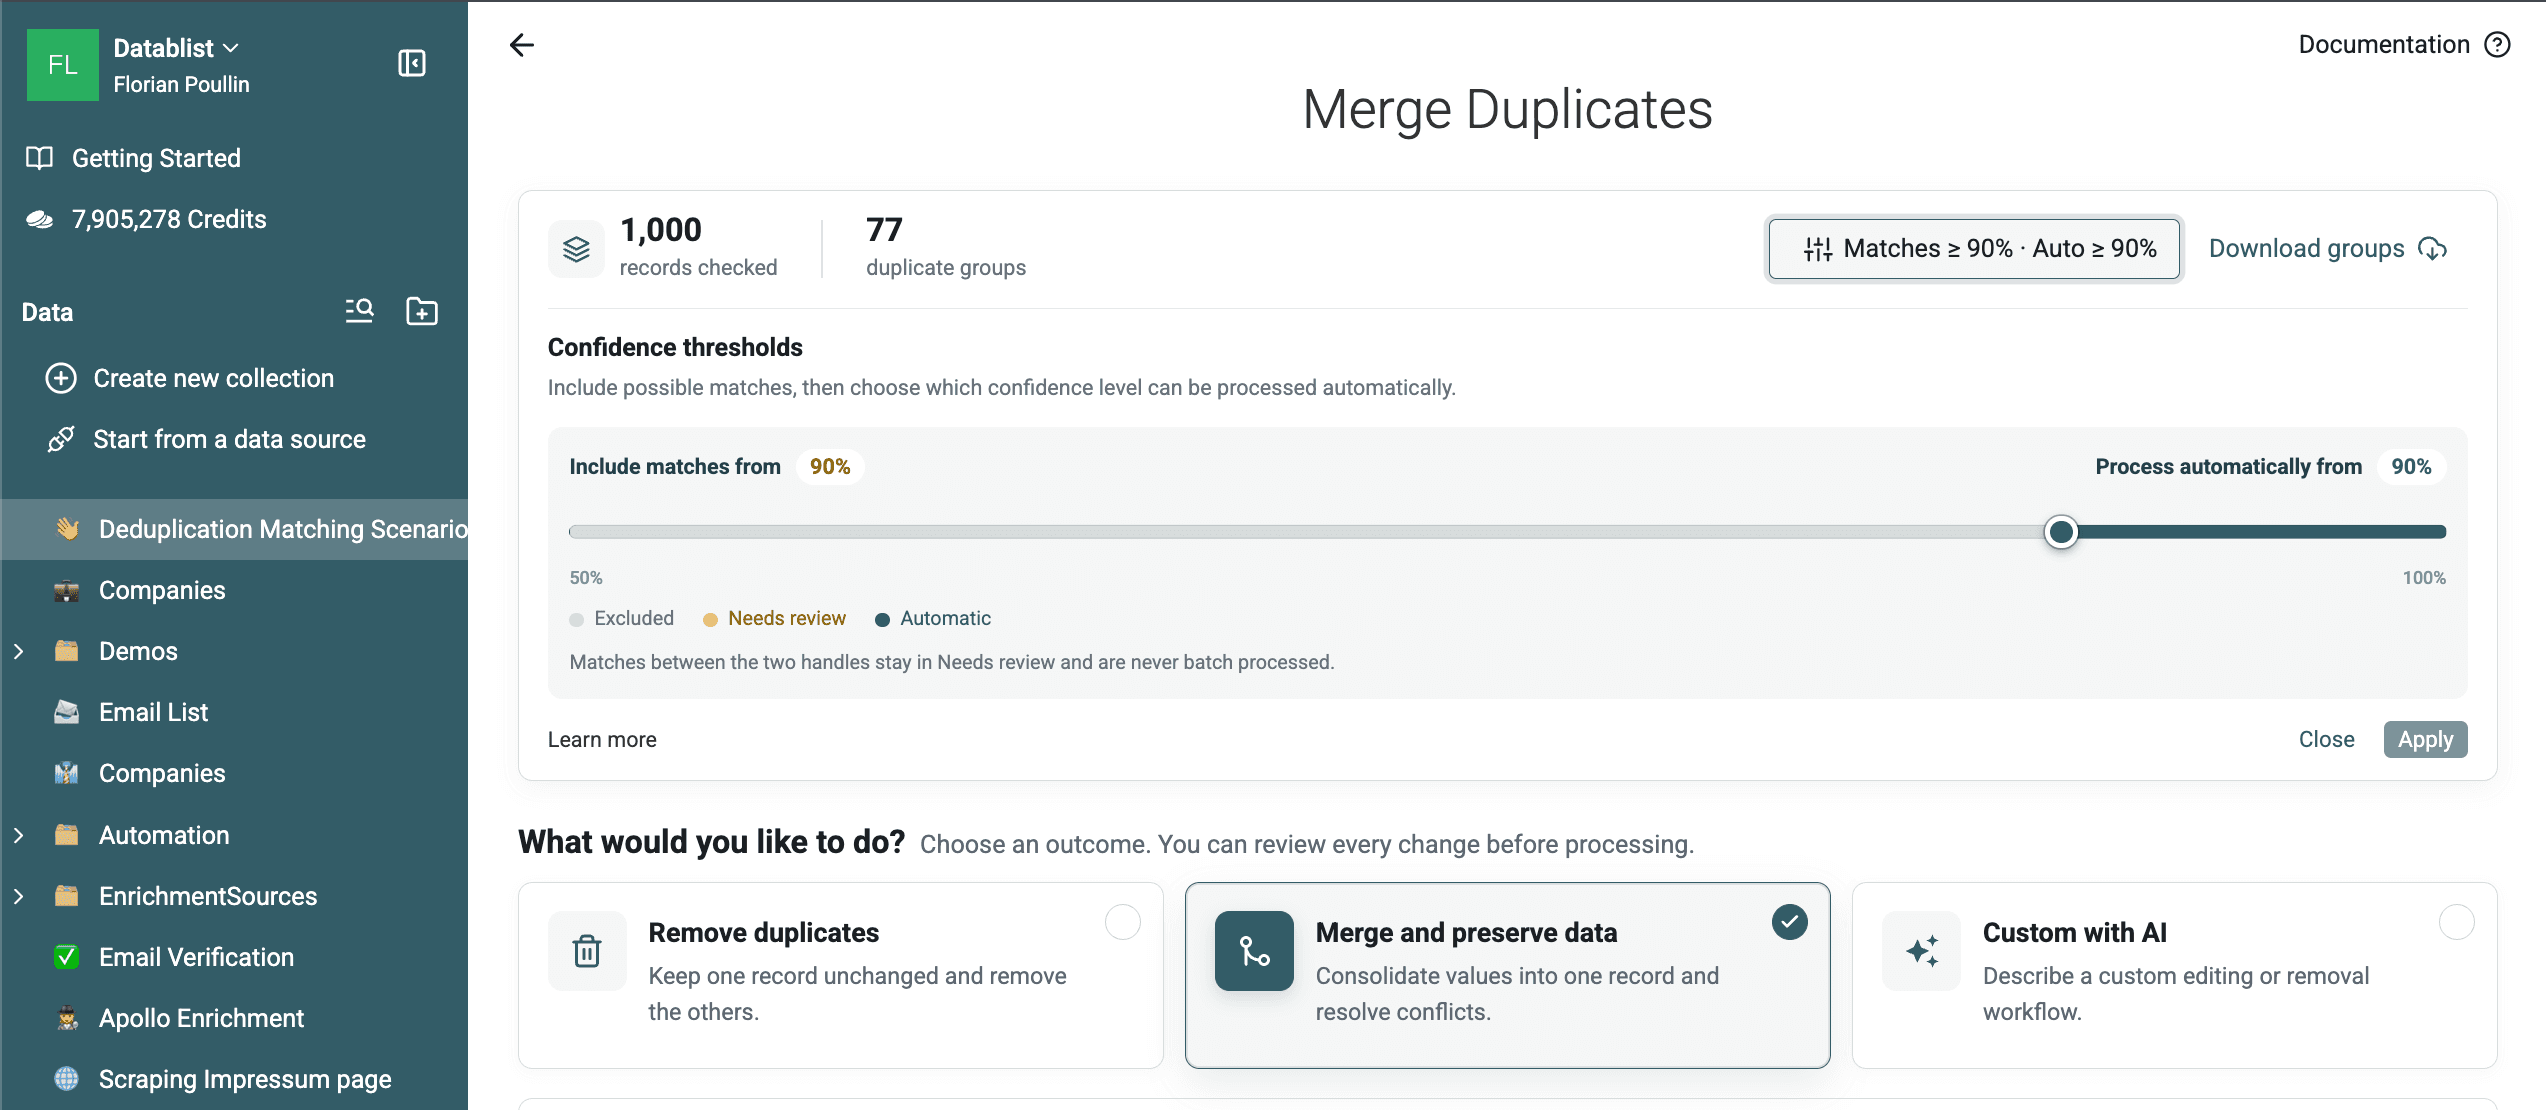
A verificação encontra variações intencionais de grafia, como Uma A. Turner e Uman A. Turner, mas também mostra por que correspondências fuzzy baseadas apenas no nome precisam ser revisadas.
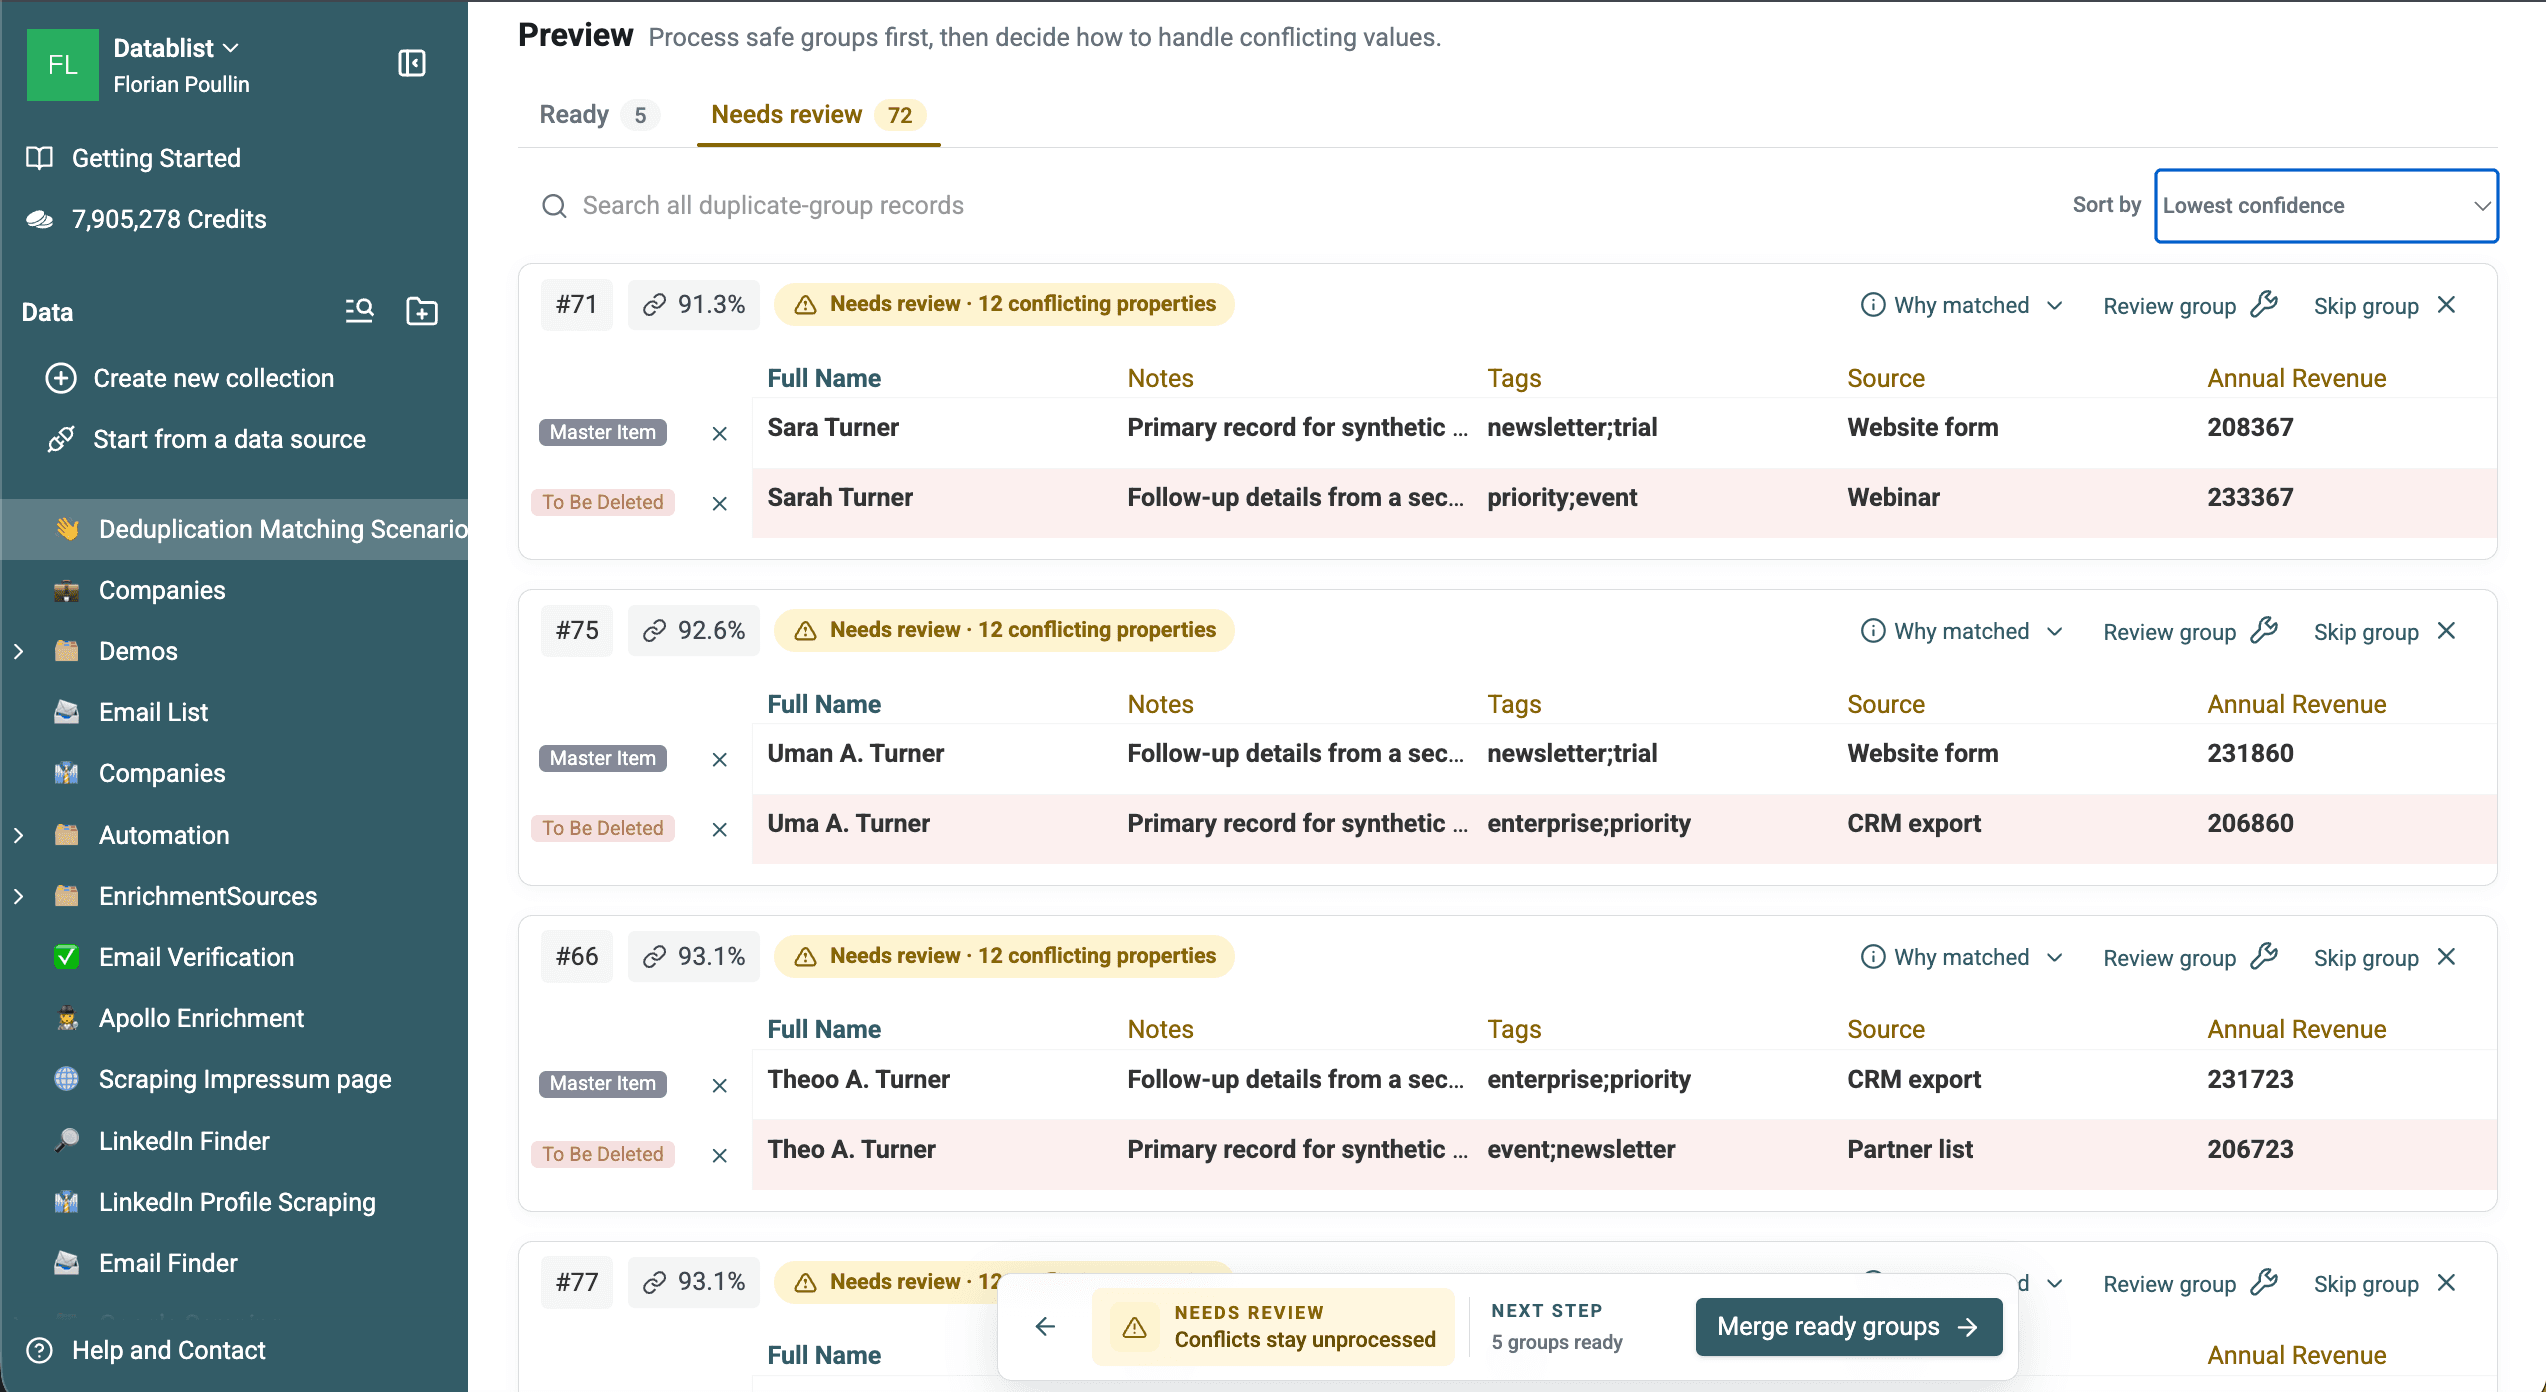
Baixe os 77 grupos exportados pelo Levenshtein para analisar tanto as correspondências úteis quanto os falsos positivos.
Para a correspondência fonética, selecione Full Name, escolha Metaphone e mantenha o processador Text.
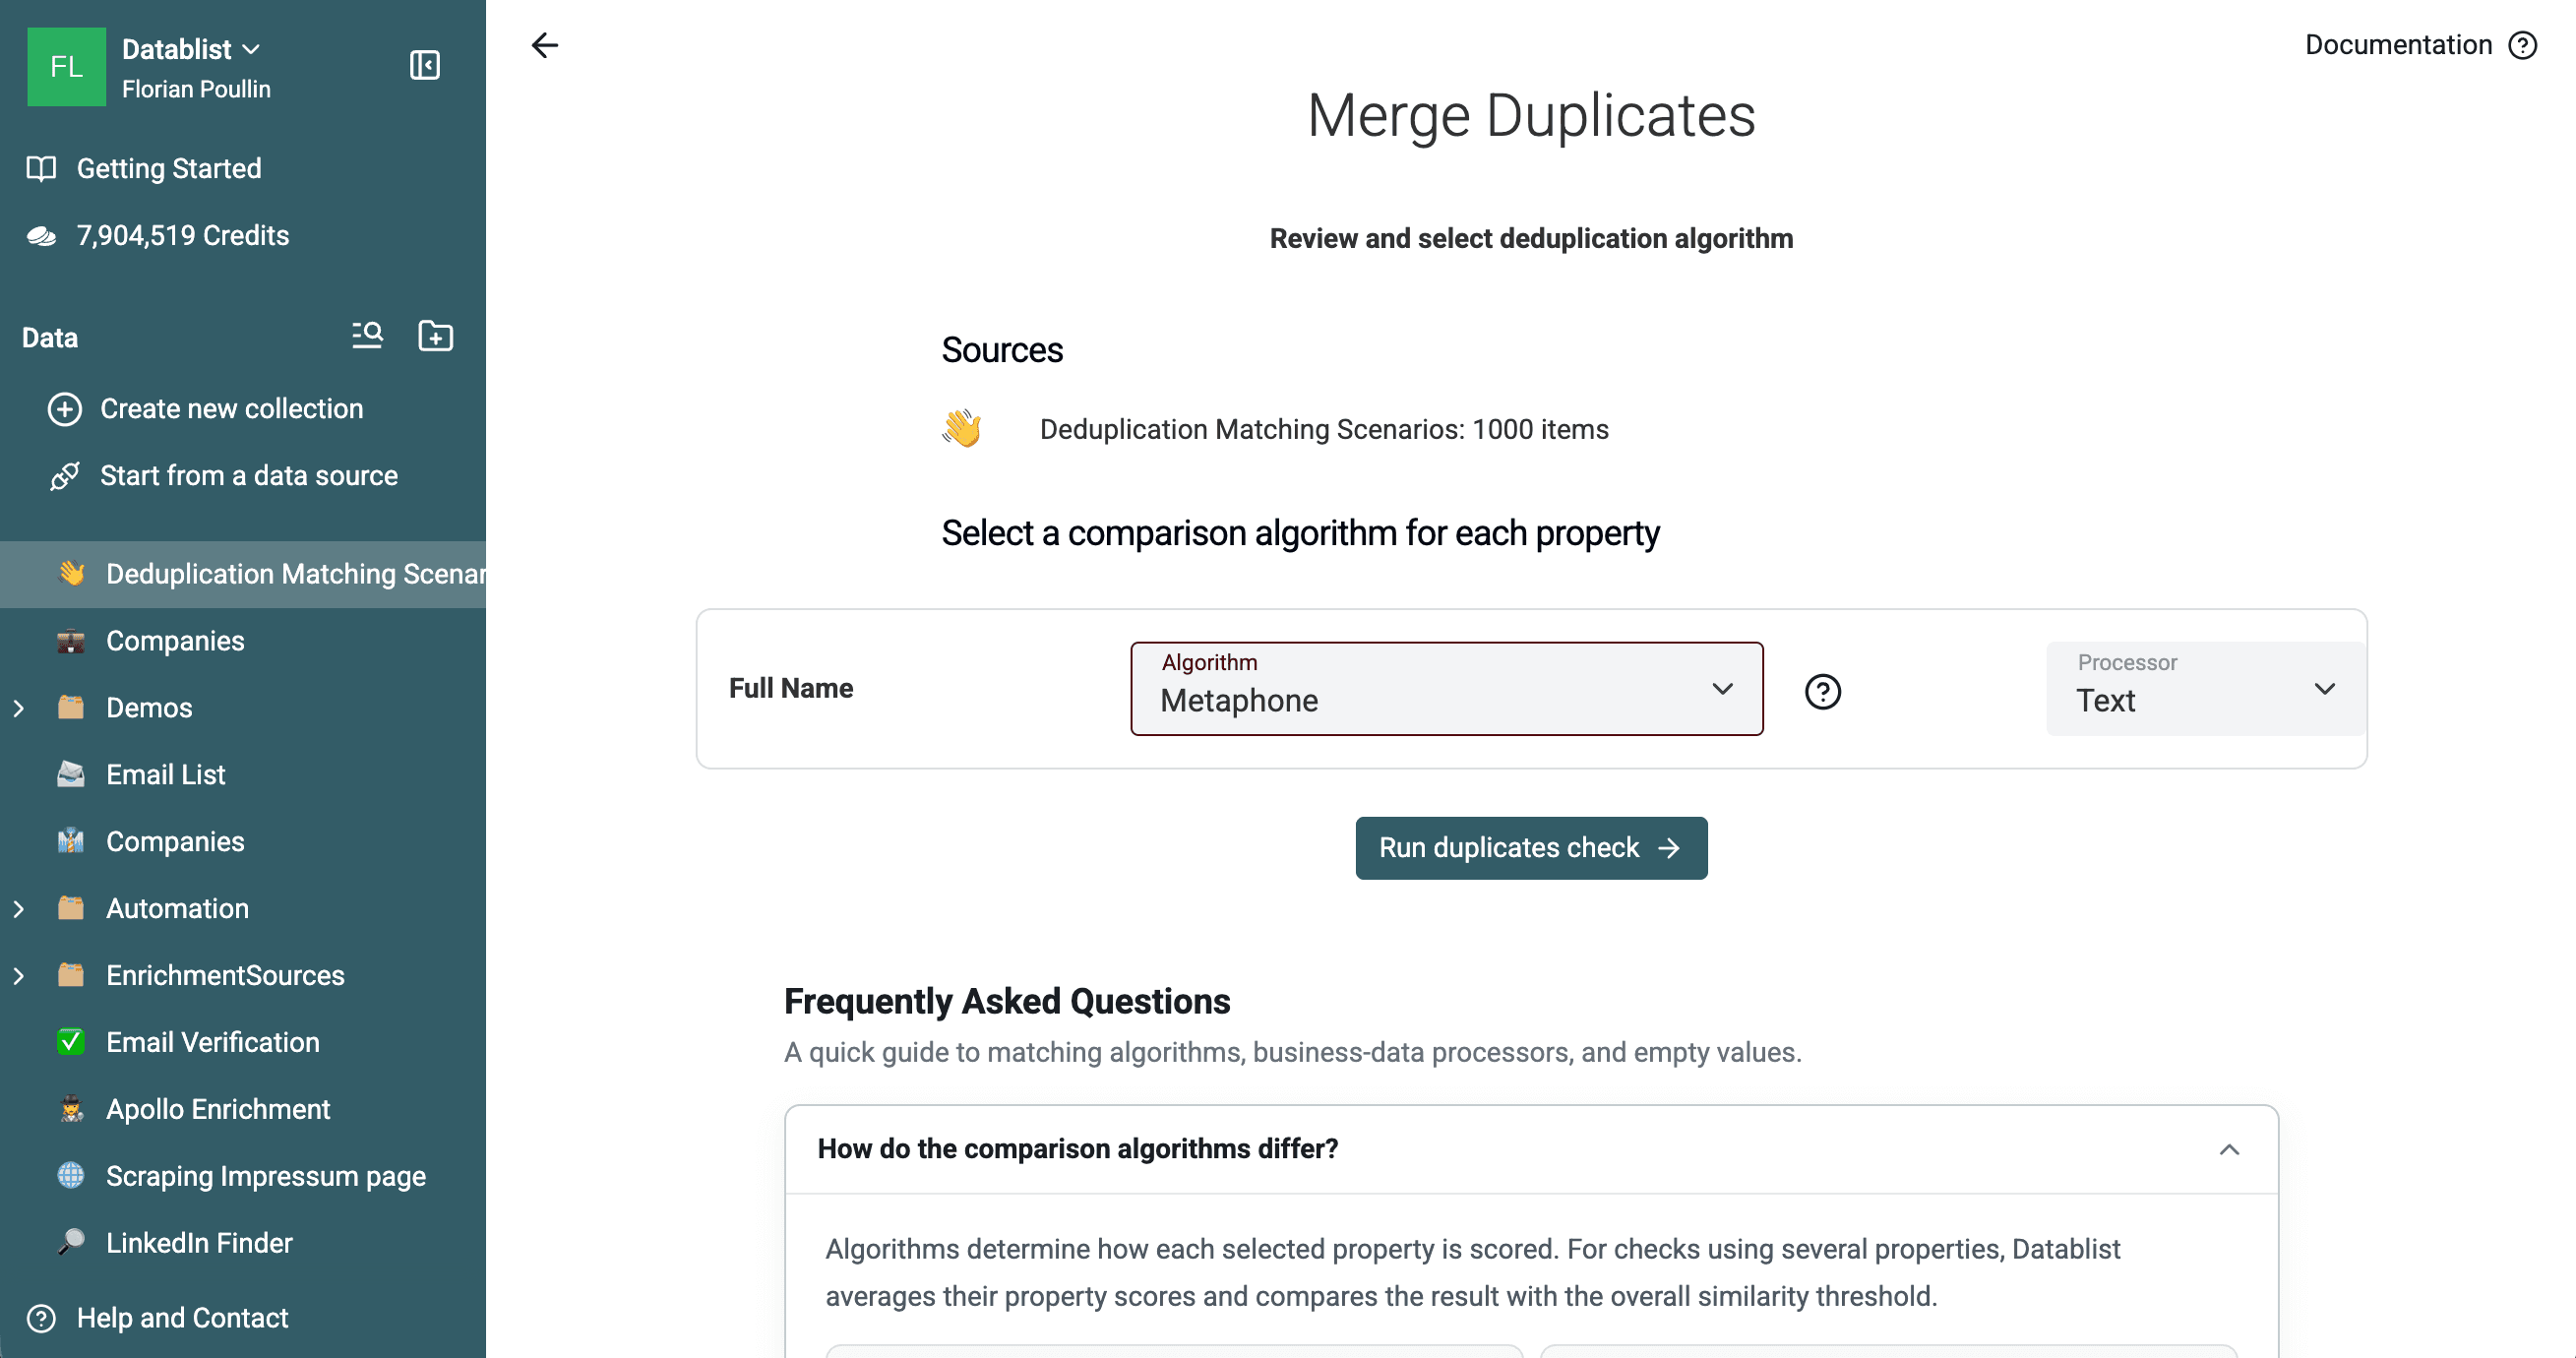
Essa verificação exibiu 69 grupos: 5 Ready e 64 Needs review. Os grupos exportados contêm 188 linhas. A validação com as entidades conhecidas da amostra encontrou 19 grupos formados apenas pela mesma entidade e 50 grupos que misturam pessoas diferentes. O tamanho dos grupos varia de duas a sete linhas.
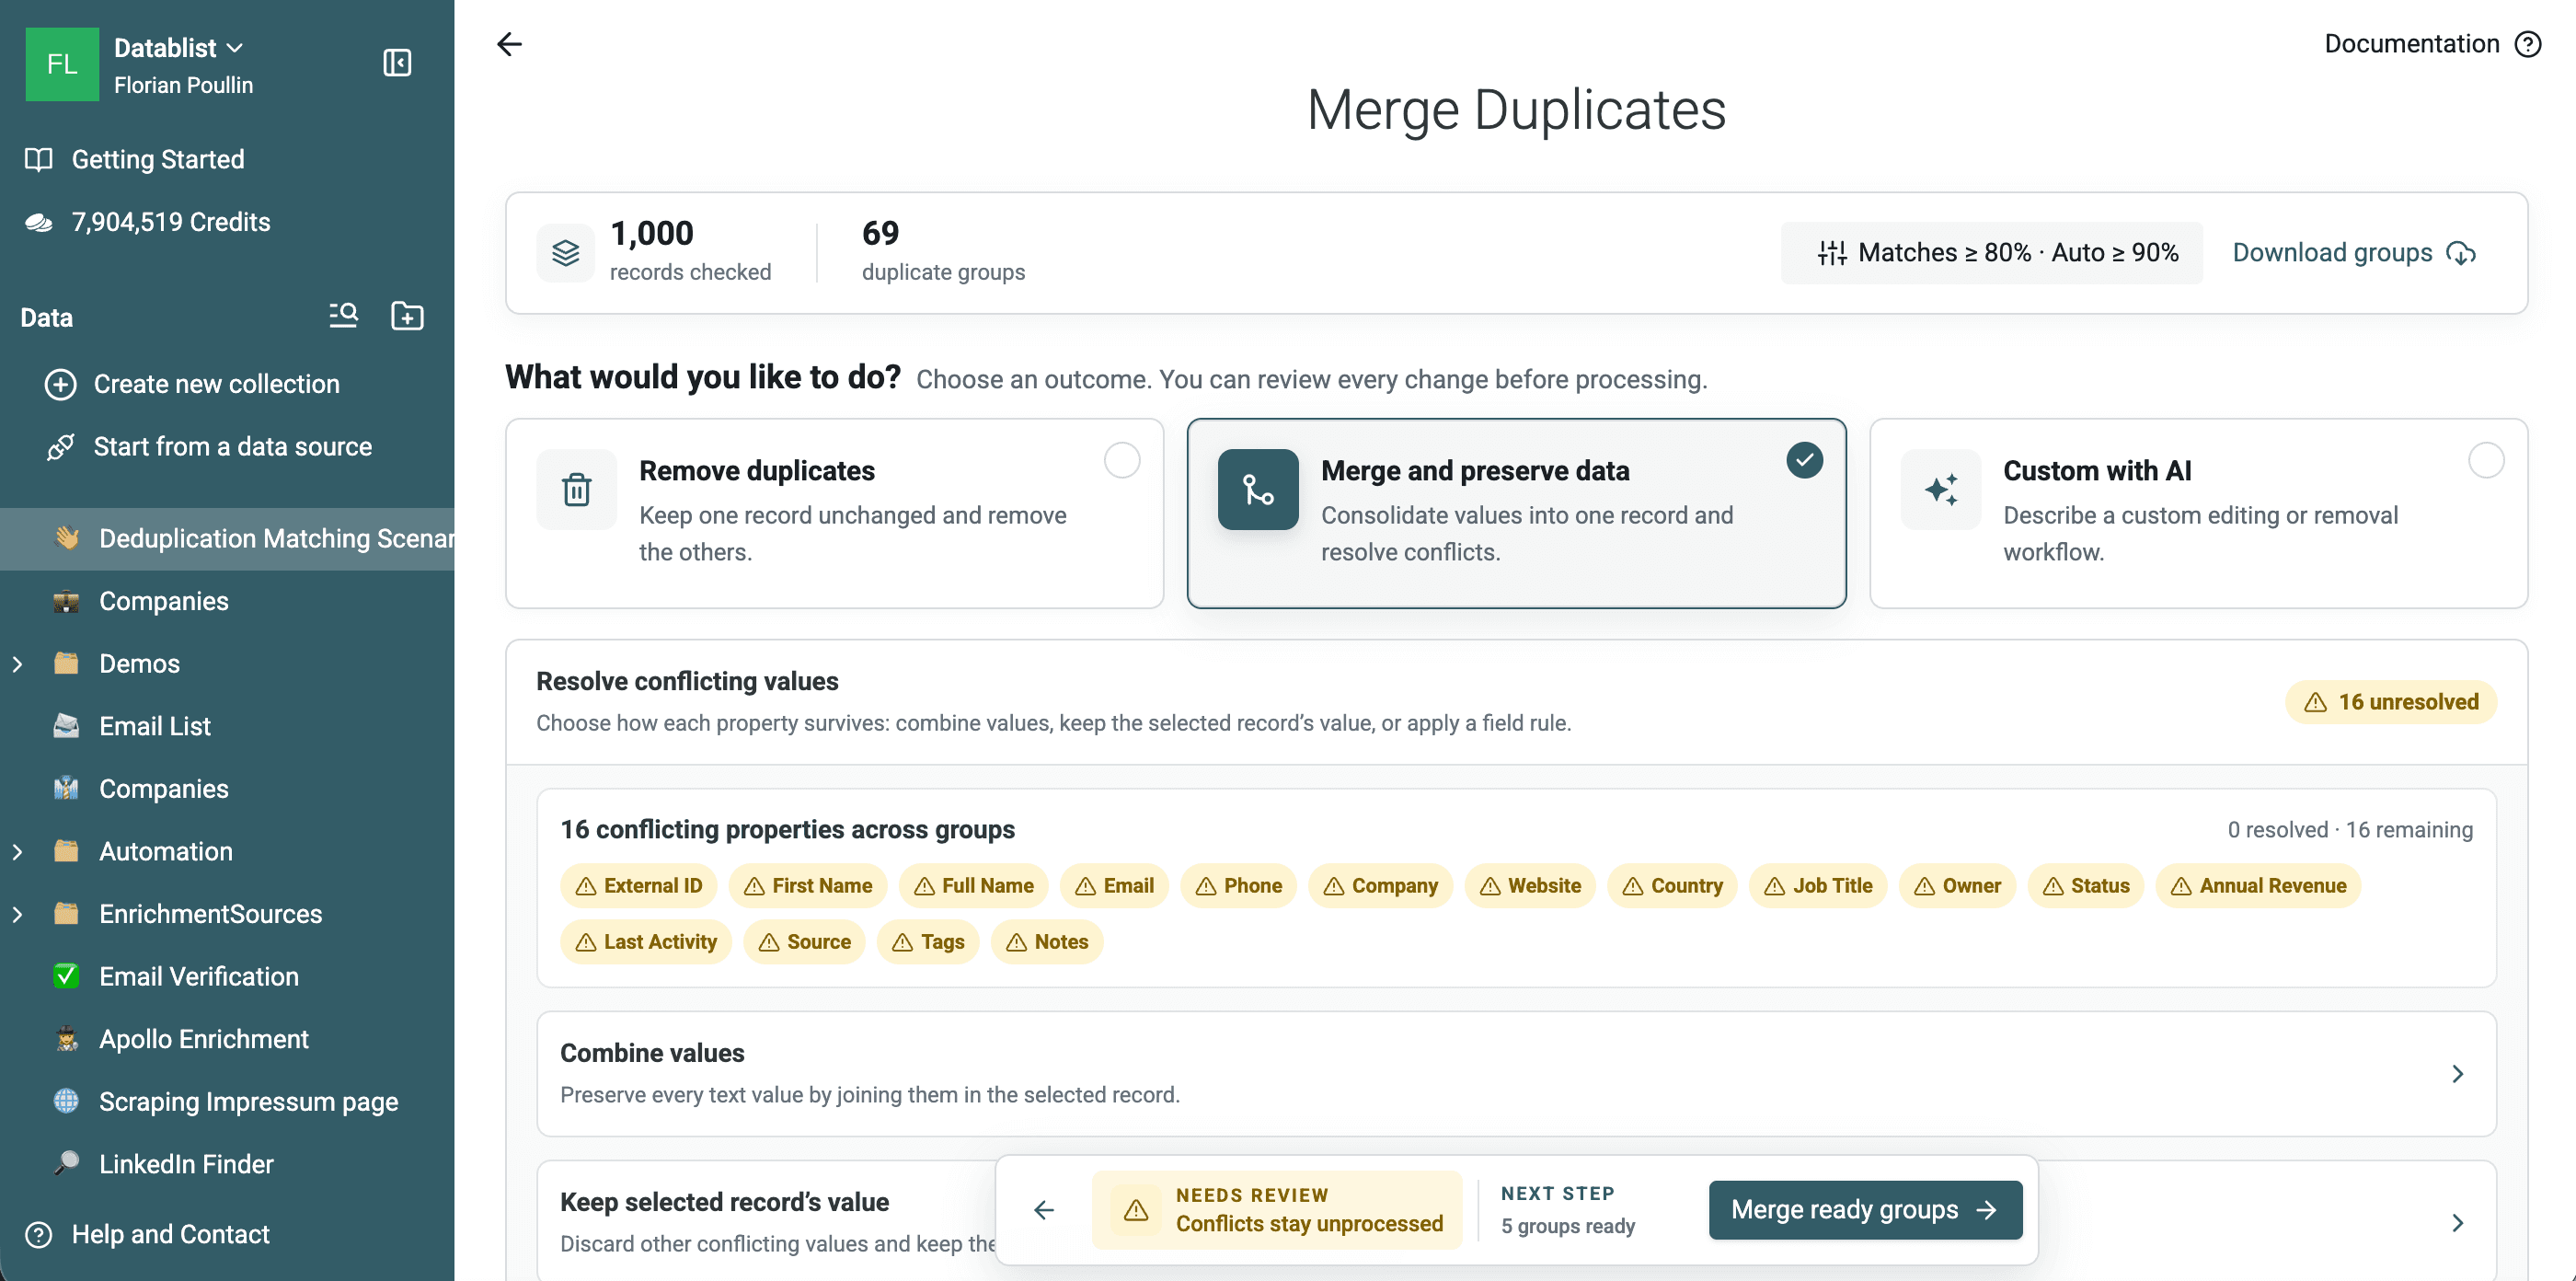
Why matched confirma a propriedade Full Name, o algoritmo Metaphone, o processador Text e a pontuação do grupo. Use esses detalhes para auditar a comparação, não para substituir uma verificação de identidade.
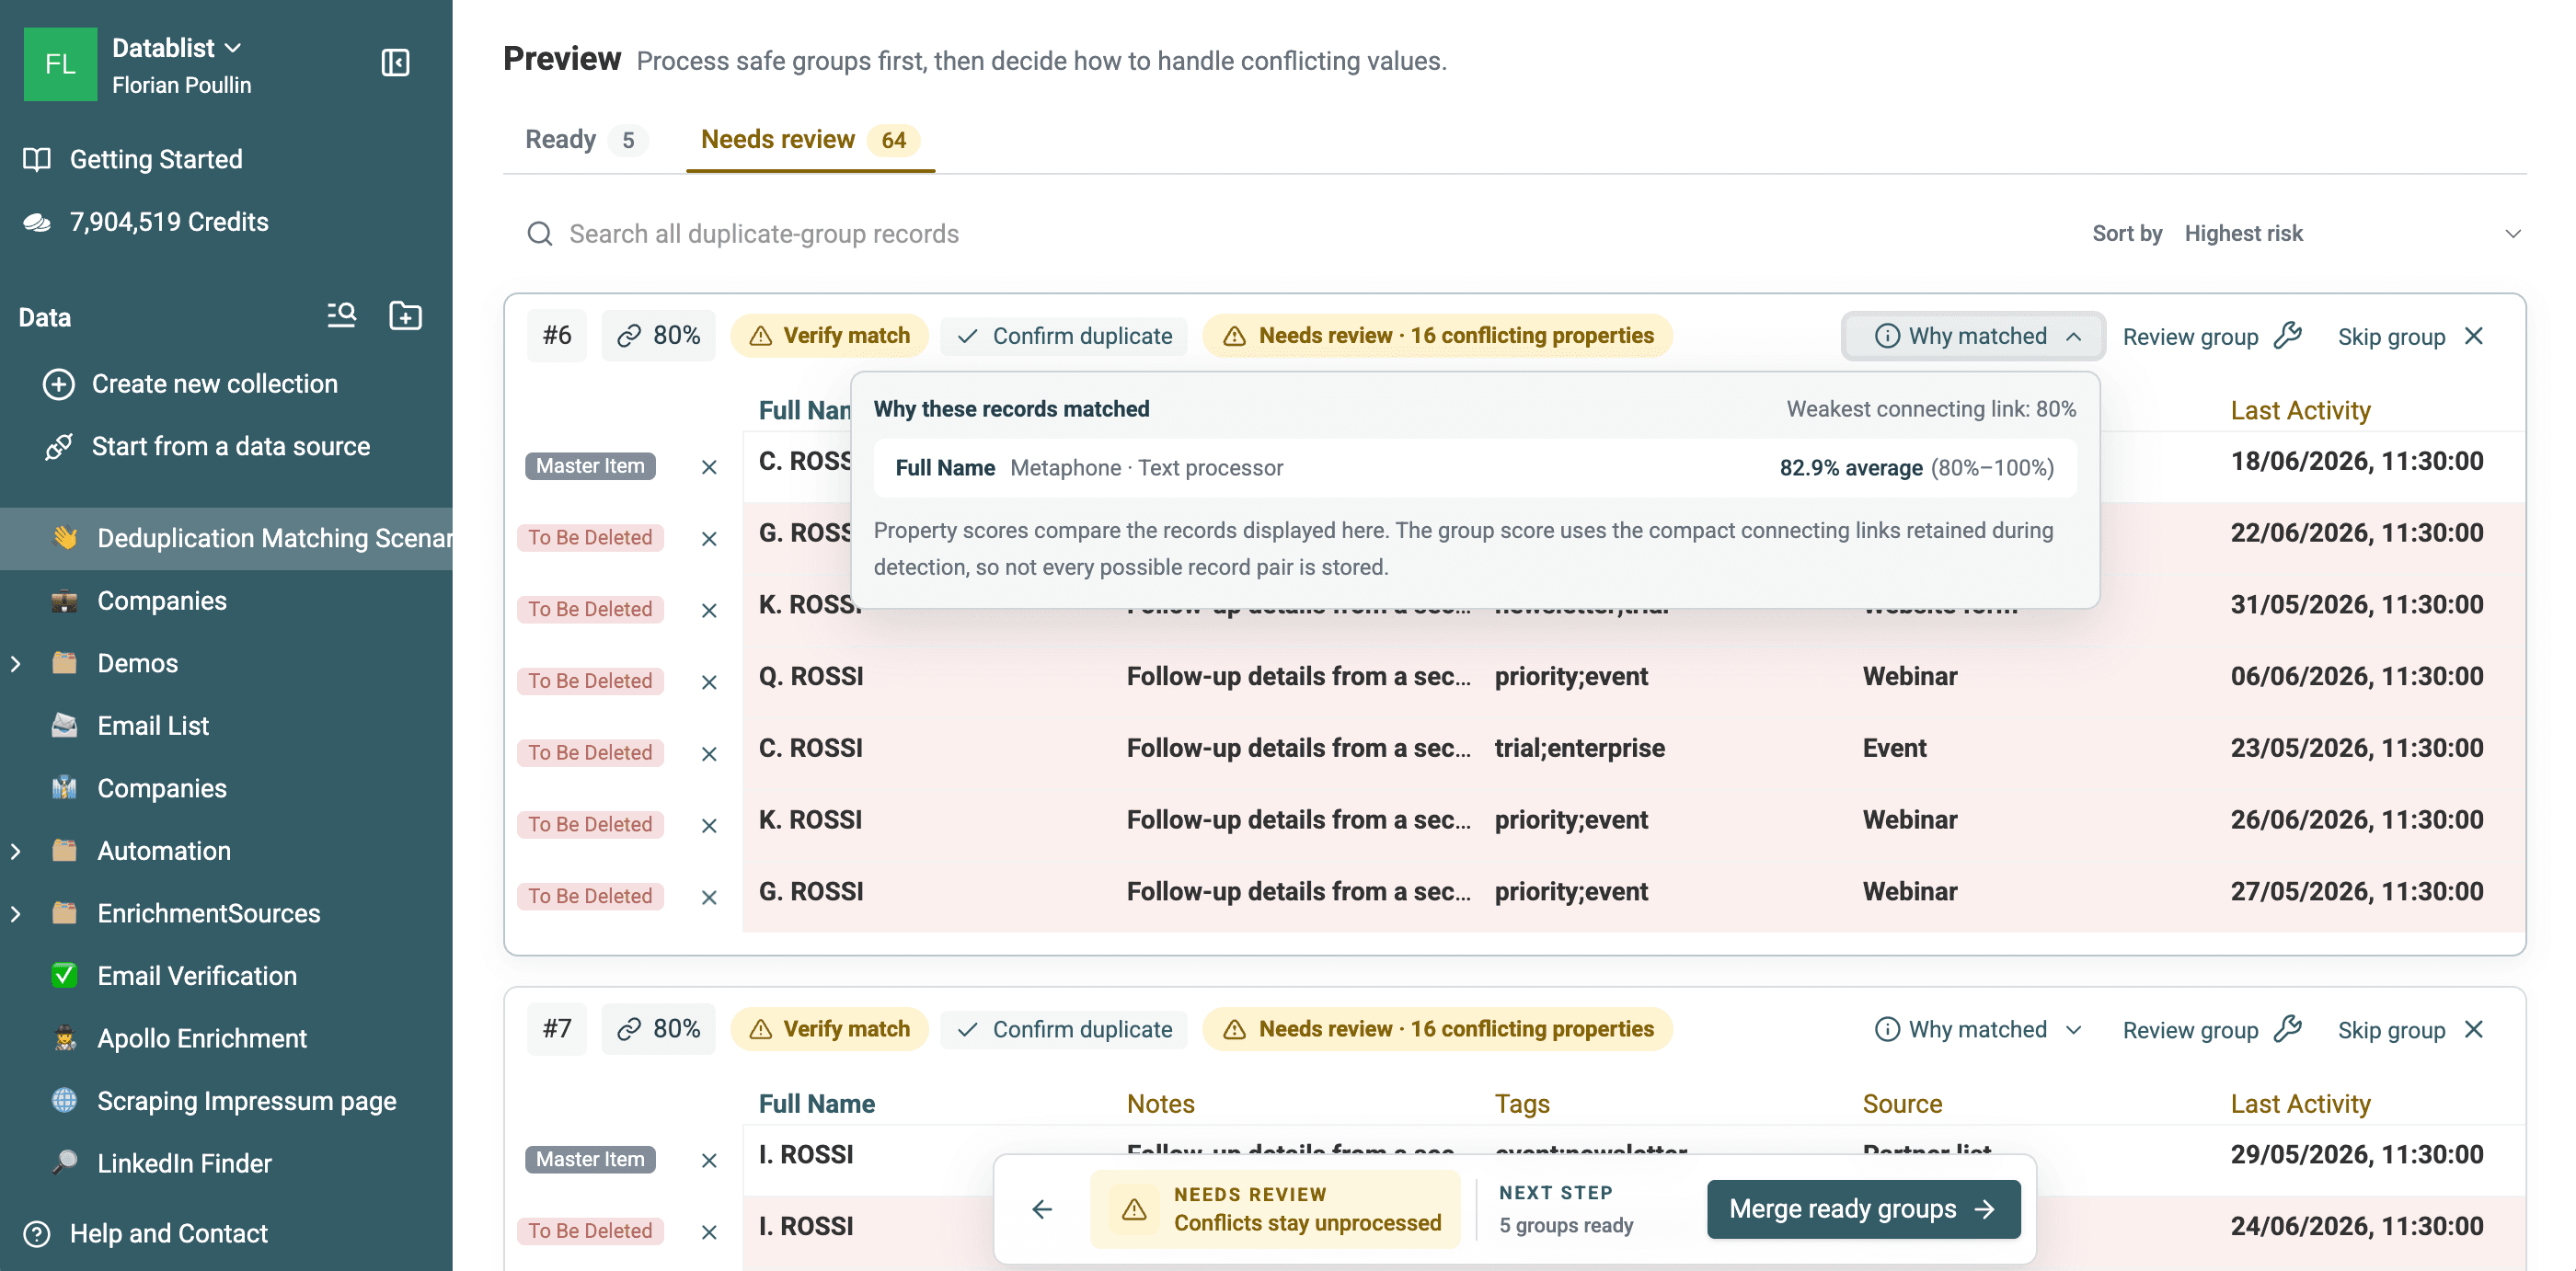
Baixe os 69 grupos exportados pelo Metaphone para analisar as correspondências fonéticas úteis e os falsos positivos. Os grupos maiores de falsos positivos costumam combinar iniciais com um sobrenome comum, como vários nomes Rossi abreviados. Os códigos fonéticos se sobrepõem, mas os nomes, sozinhos, não oferecem evidências de identidade suficientes para uma mesclagem automática.
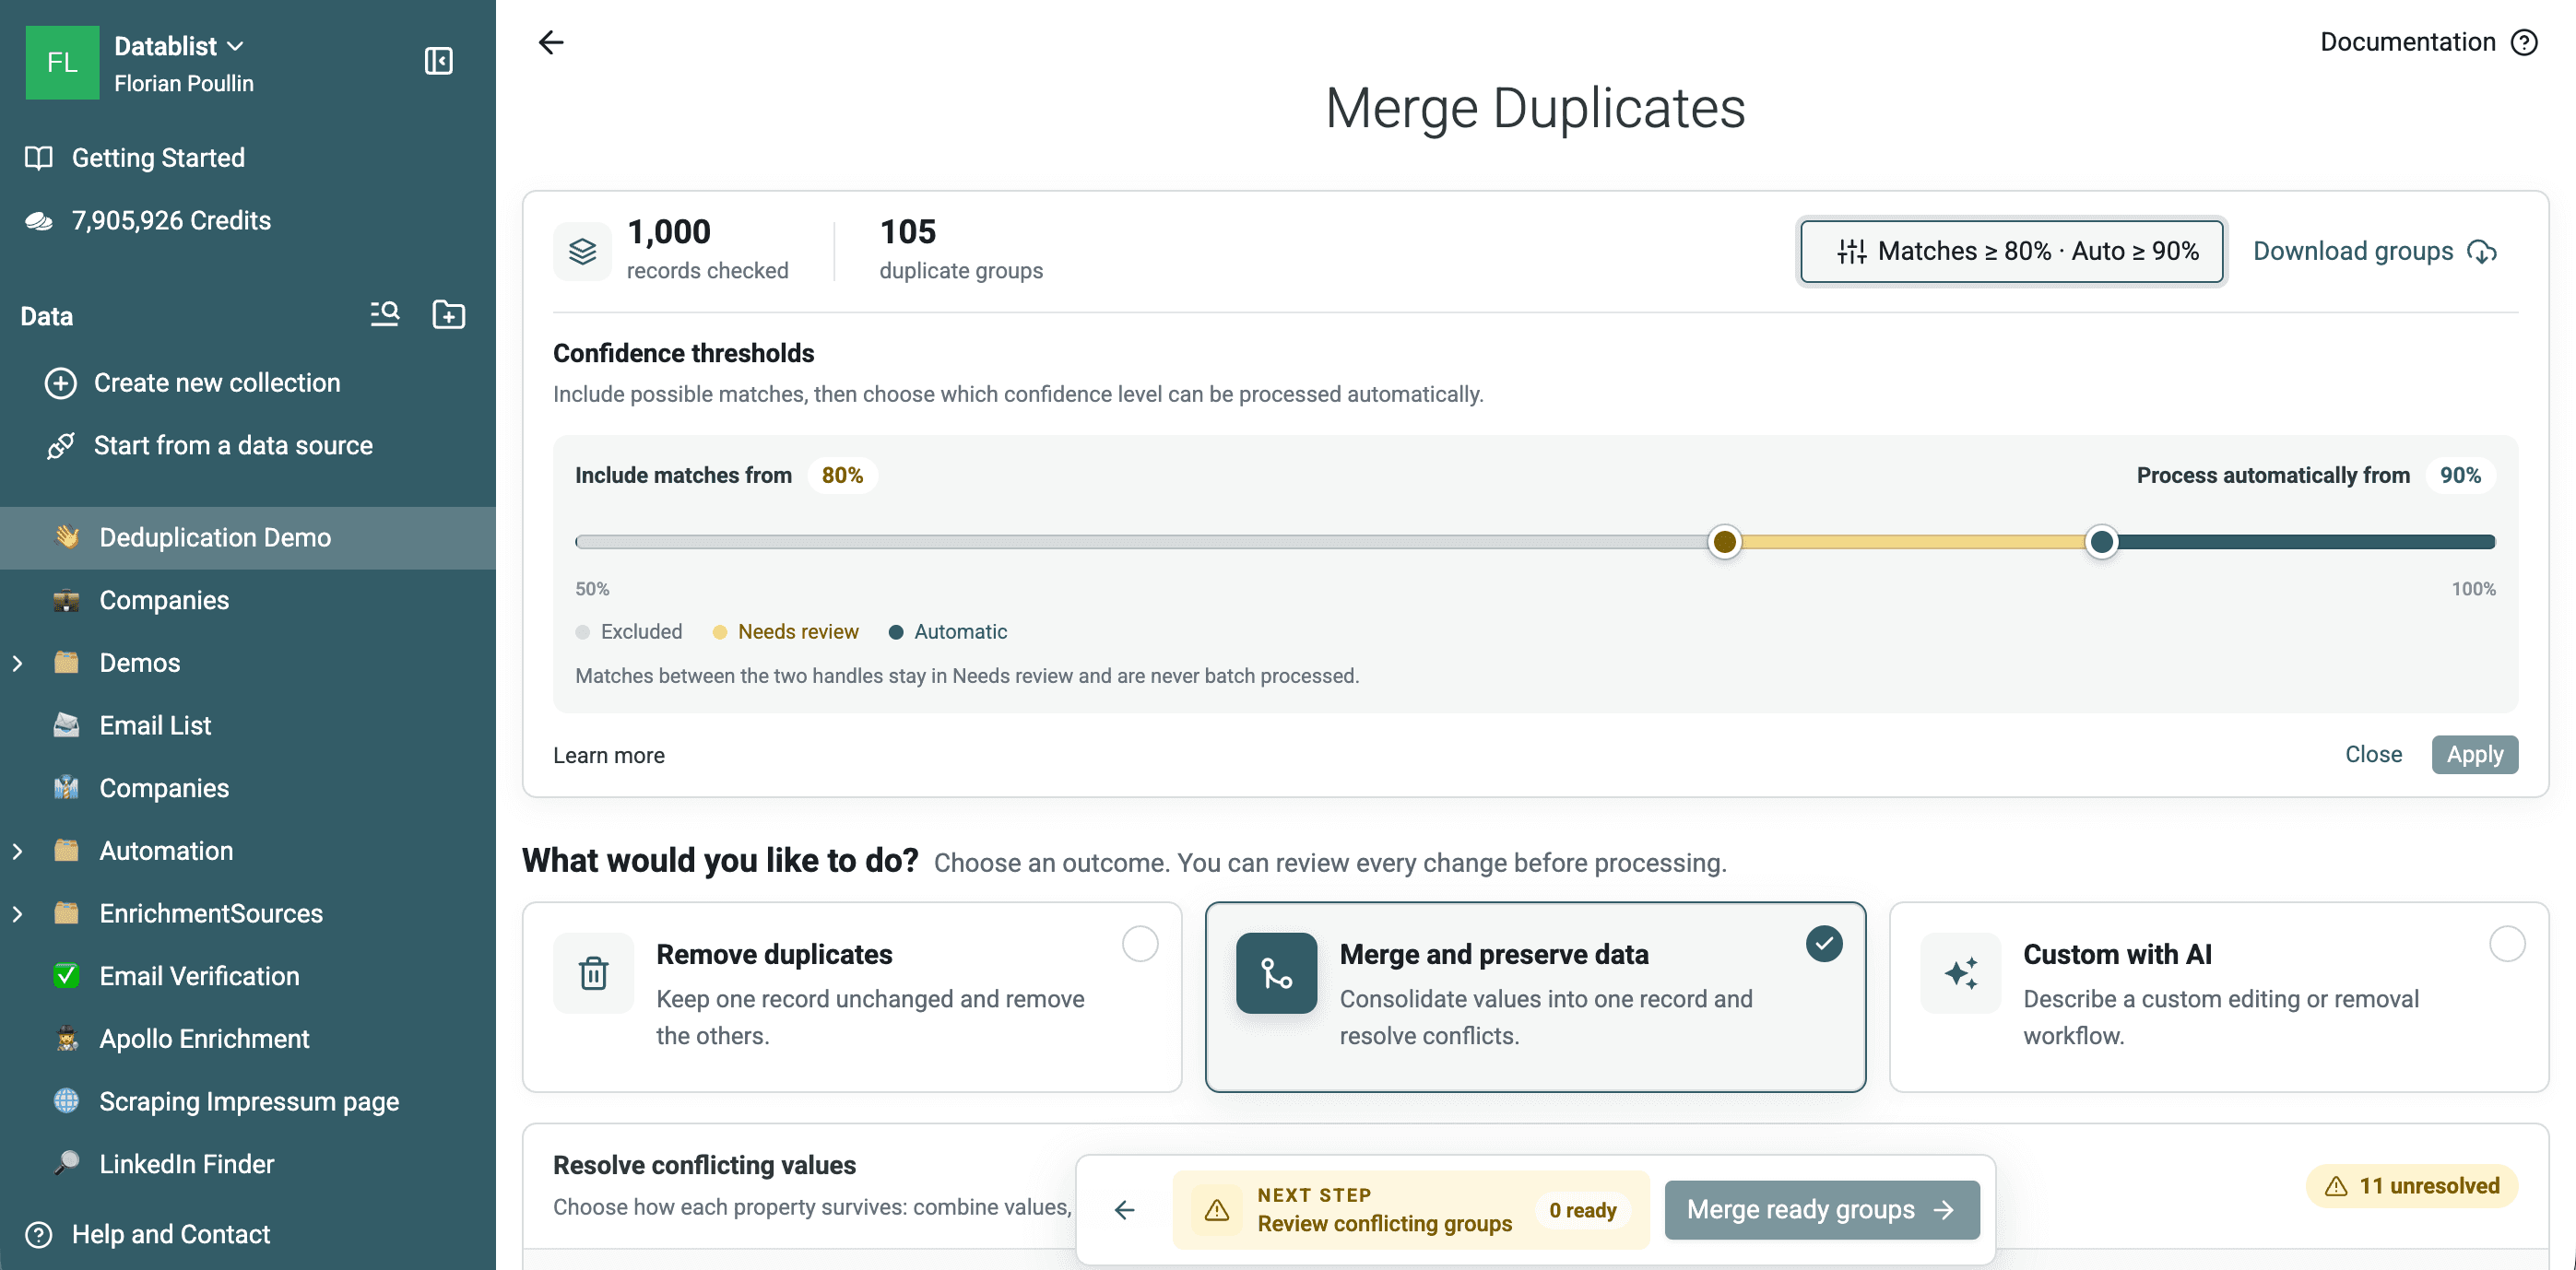
A página de resultados tem dois controles:
- Include matches from define quais grupos serão exibidos.
- Process automatically from mantém os grupos de menor confiança em Needs review e fora do processamento em lote.
Essa separação permite analisar uma seleção ampla de candidatos sem aplicar a mesma regra de automação a todos eles.
Revise os grupos de duplicados
A área de resultados separa os grupos de duplicados em Ready e Needs review.
- Grupos Ready têm um resultado de processamento definido e atendem ao limite de confiança automática.
- Grupos Needs review têm menor confiança, conflitos de mesclagem não resolvidos, uma regra de seleção de registro sem correspondência ou uma regra personalizada que decidiu ignorá-los.
Para cada grupo incerto, verifique:
- Todas as linhas representam a mesma pessoa, empresa ou produto?
- Qual identificador causou a correspondência?
- Há valores complementares?
- Qual é a fonte oficial?
- Excluir uma linha descartaria um telefone, ID, status, data ou observação?
- O grupo está conectado por meio de um terceiro registro fraco?
Use Why matched para conferir as propriedades, os algoritmos, os processadores e os intervalos de pontuação da correspondência. Em verificações fuzzy, a similaridade do grupo corresponde à conexão mantida mais fraca necessária para preservar o grupo.
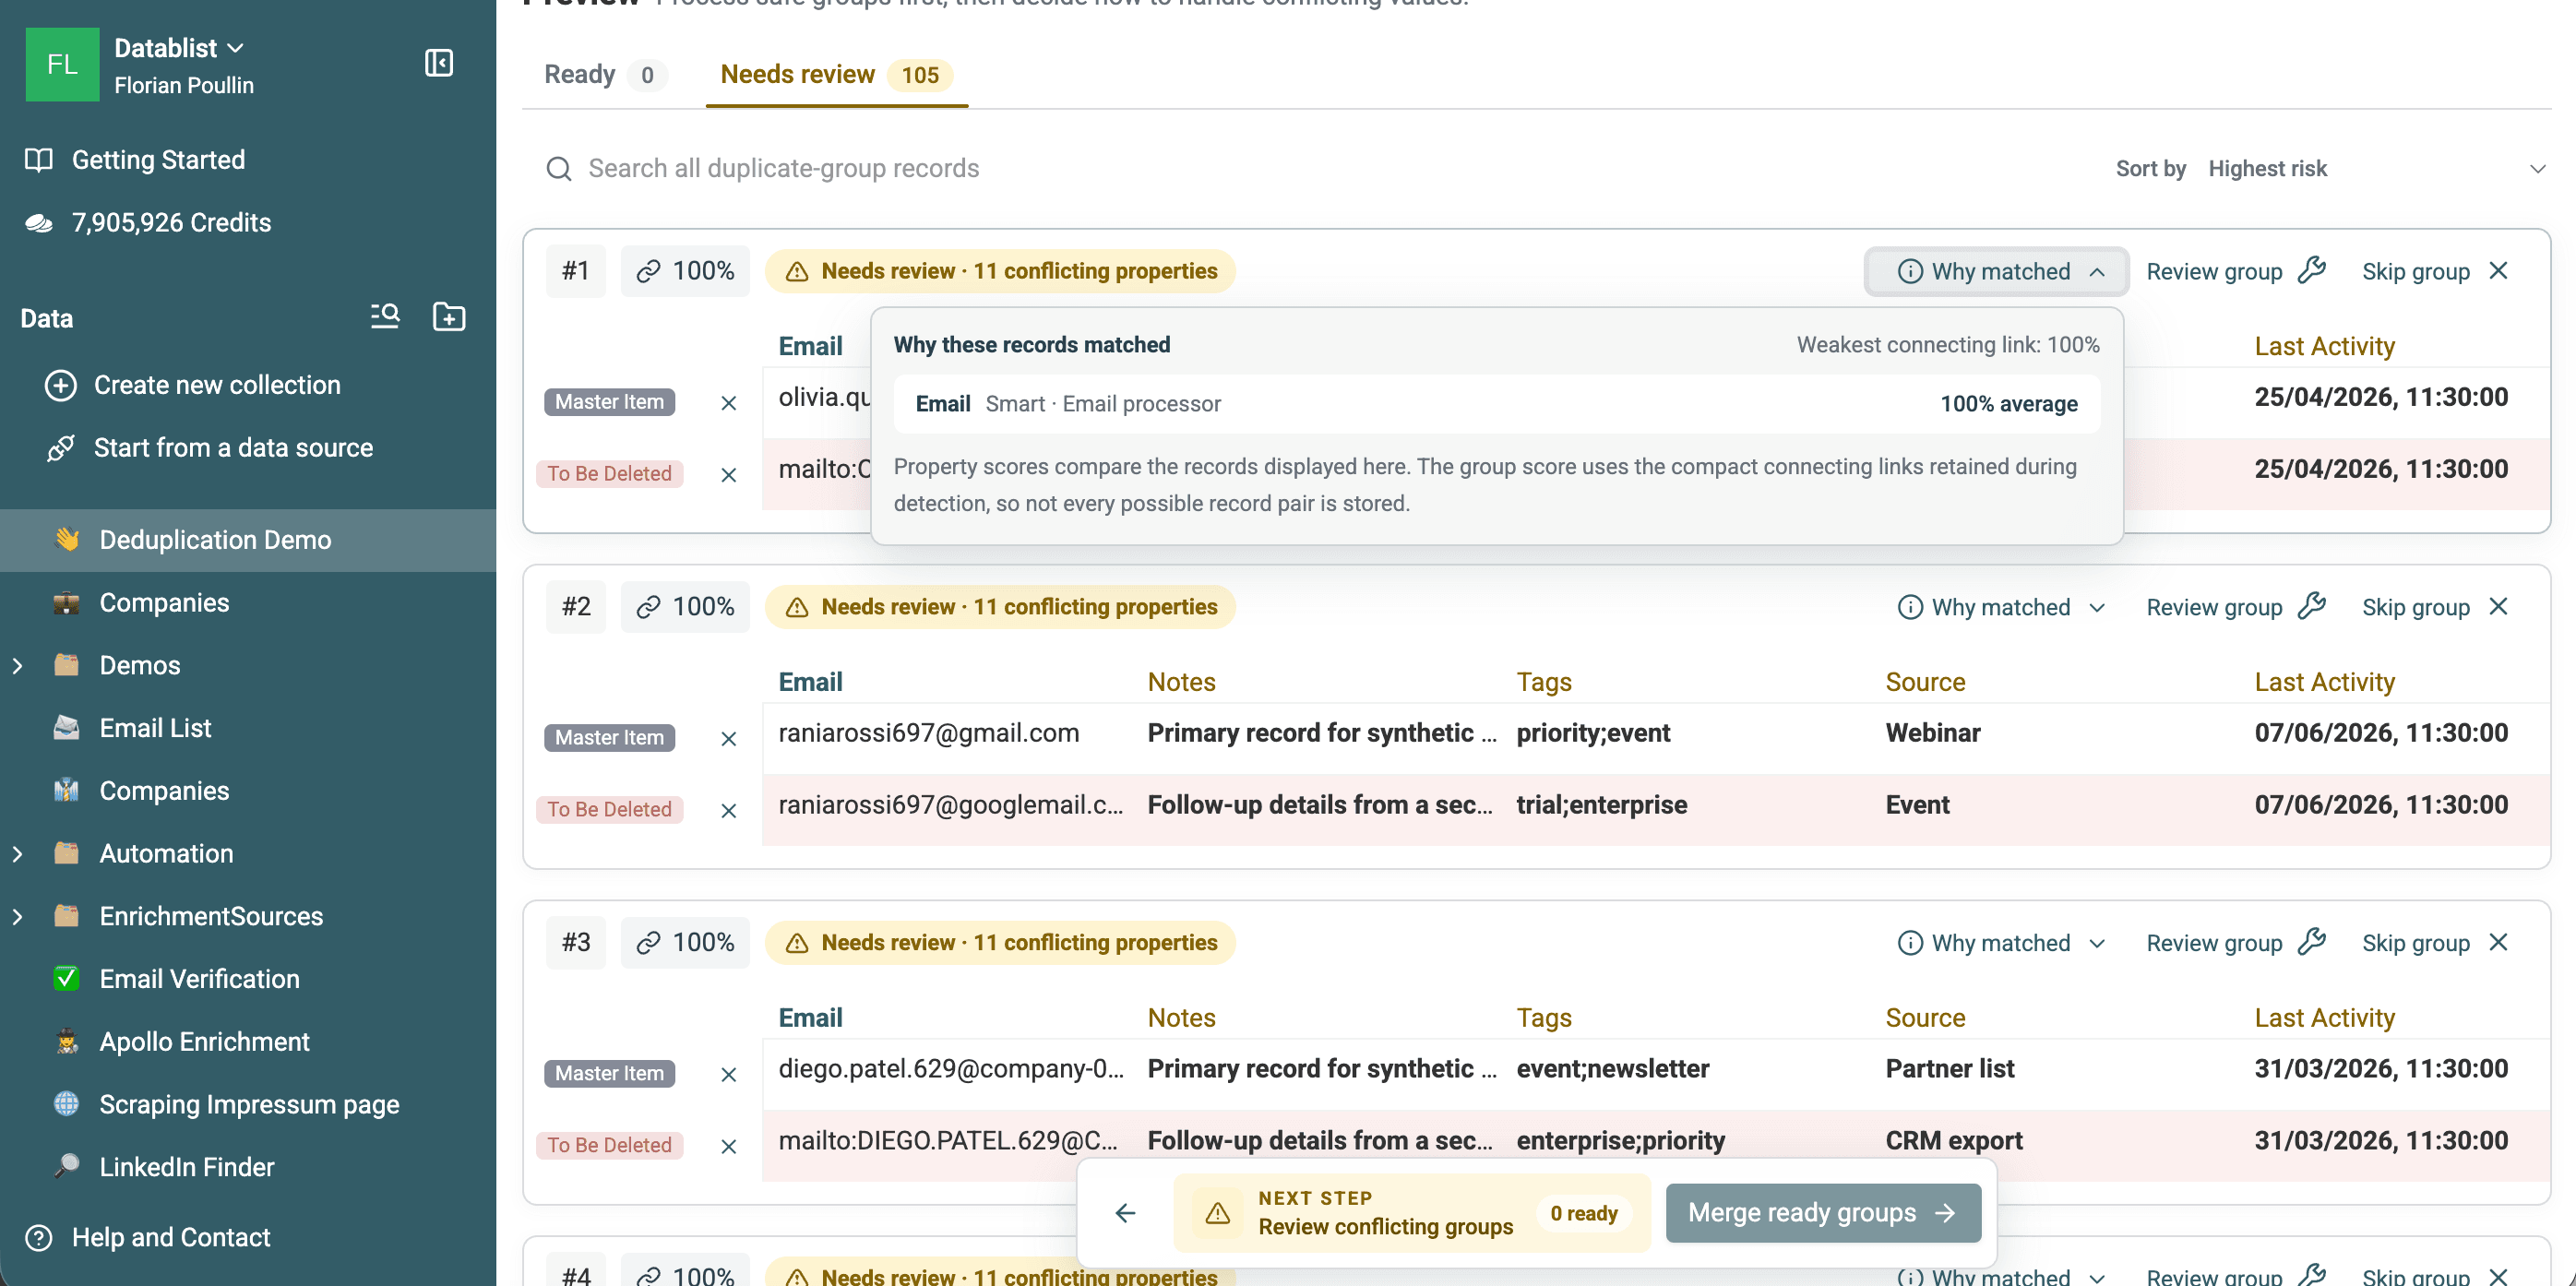
Você também pode:
- Confirmar uma correspondência de baixa confiança.
- Remover um registro do grupo sem excluí-lo.
- Ignorar o grupo.
- Abrir e editar um registro.
- Revisar o grupo no Merging Assistant.
- Pesquisar em todos os grupos restantes e ordenar primeiro os candidatos de maior risco.
⚠️ Não processe um grupo fuzzy apenas pela porcentagem
Nomes parecidos podem pertencer a pessoas diferentes. Revise os identificadores e os campos relacionados antes de confirmar o grupo.
Confira identificadores iguais e ausentes antes de mesclar
Uma caixa de entrada compartilhada, como info@company.example, pode pertencer a vários contatos. Duas pessoas com esse endereço podem corresponder pelo Email e ainda serem pessoas distintas. Da mesma forma, o domínio de uma empresa pode identificar um negócio, mas aparecer nos registros de muitos funcionários.
Eu manteria esses grupos fora da mesclagem automática de pessoas até que outro identificador confirmasse a correspondência. Se o objetivo for ter uma linha por empresa, o domínio compartilhado poderá ser a chave de agrupamento desejada. Defina a entidade antes de interpretar o resultado.
A regra de valores vazios também muda uma comparação por propriedades selecionadas. Em uma verificação com várias propriedades e uma comparação diferente de Exact, a configuração avançada Empty Value Rule oferece Value required (default) ou Match on empty value. A opção padrão exige que o identificador textual esteja presente; permitir correspondências de valores vazios flexibiliza essa exigência. Use essa opção apenas quando os outros campos comparados fornecerem evidências de identidade suficientes: dois e-mails ausentes não provam que duas pessoas são iguais.
Por exemplo, duas linhas com Email em branco e valores de Full Name diferentes não devem ser mescladas apenas para reduzir a quantidade de linhas. Uma linha sem e-mail ainda pode conter um contato que você precisa manter ou enriquecer depois.
Remova, mescle ou processe duplicados com regras próprias
Encontrar duplicados e resolvê-los são decisões diferentes. Escolha o modo de processamento depois de revisar o conteúdo das linhas secundárias.
Remova duplicados quando uma linha for a fonte oficial
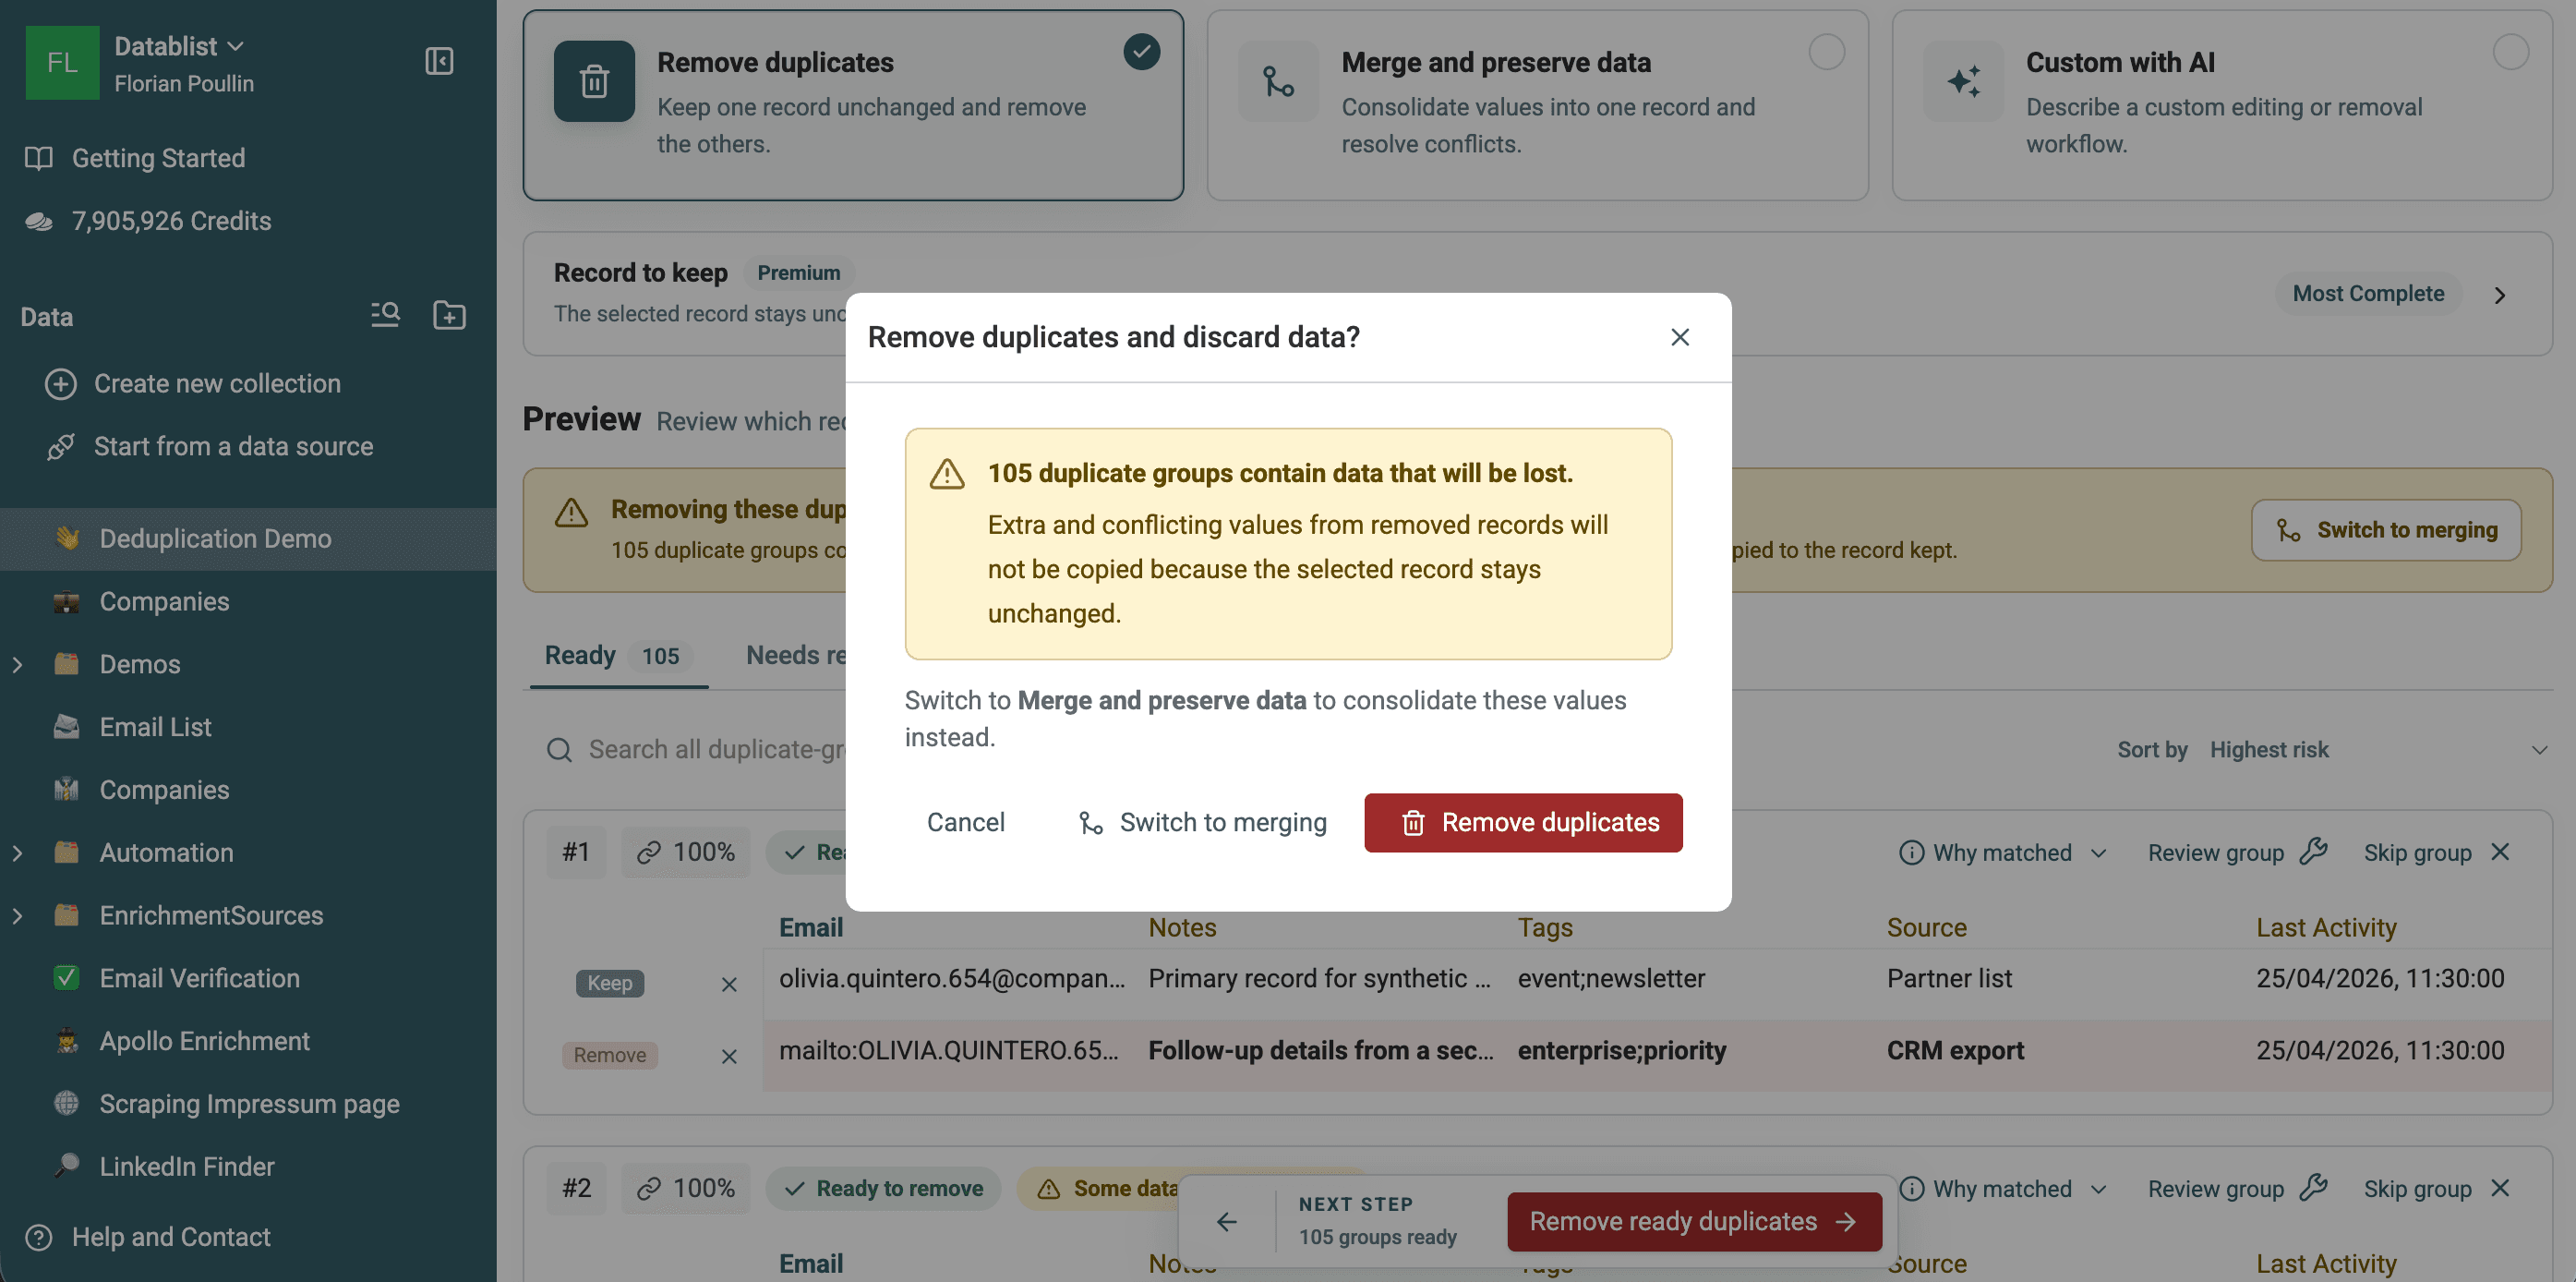
Remove duplicates mantém um registro selecionado sem alterações e exclui as outras linhas de cada grupo Ready.
Use essa opção para linhas copiadas, importações temporárias ou registros cujos valores secundários possam ser descartados. A prévia avisa quando os registros removidos contêm informações adicionais ou conflitantes. Esses valores não são copiados para a linha mantida.
Mescle quando as linhas tiverem dados úteis
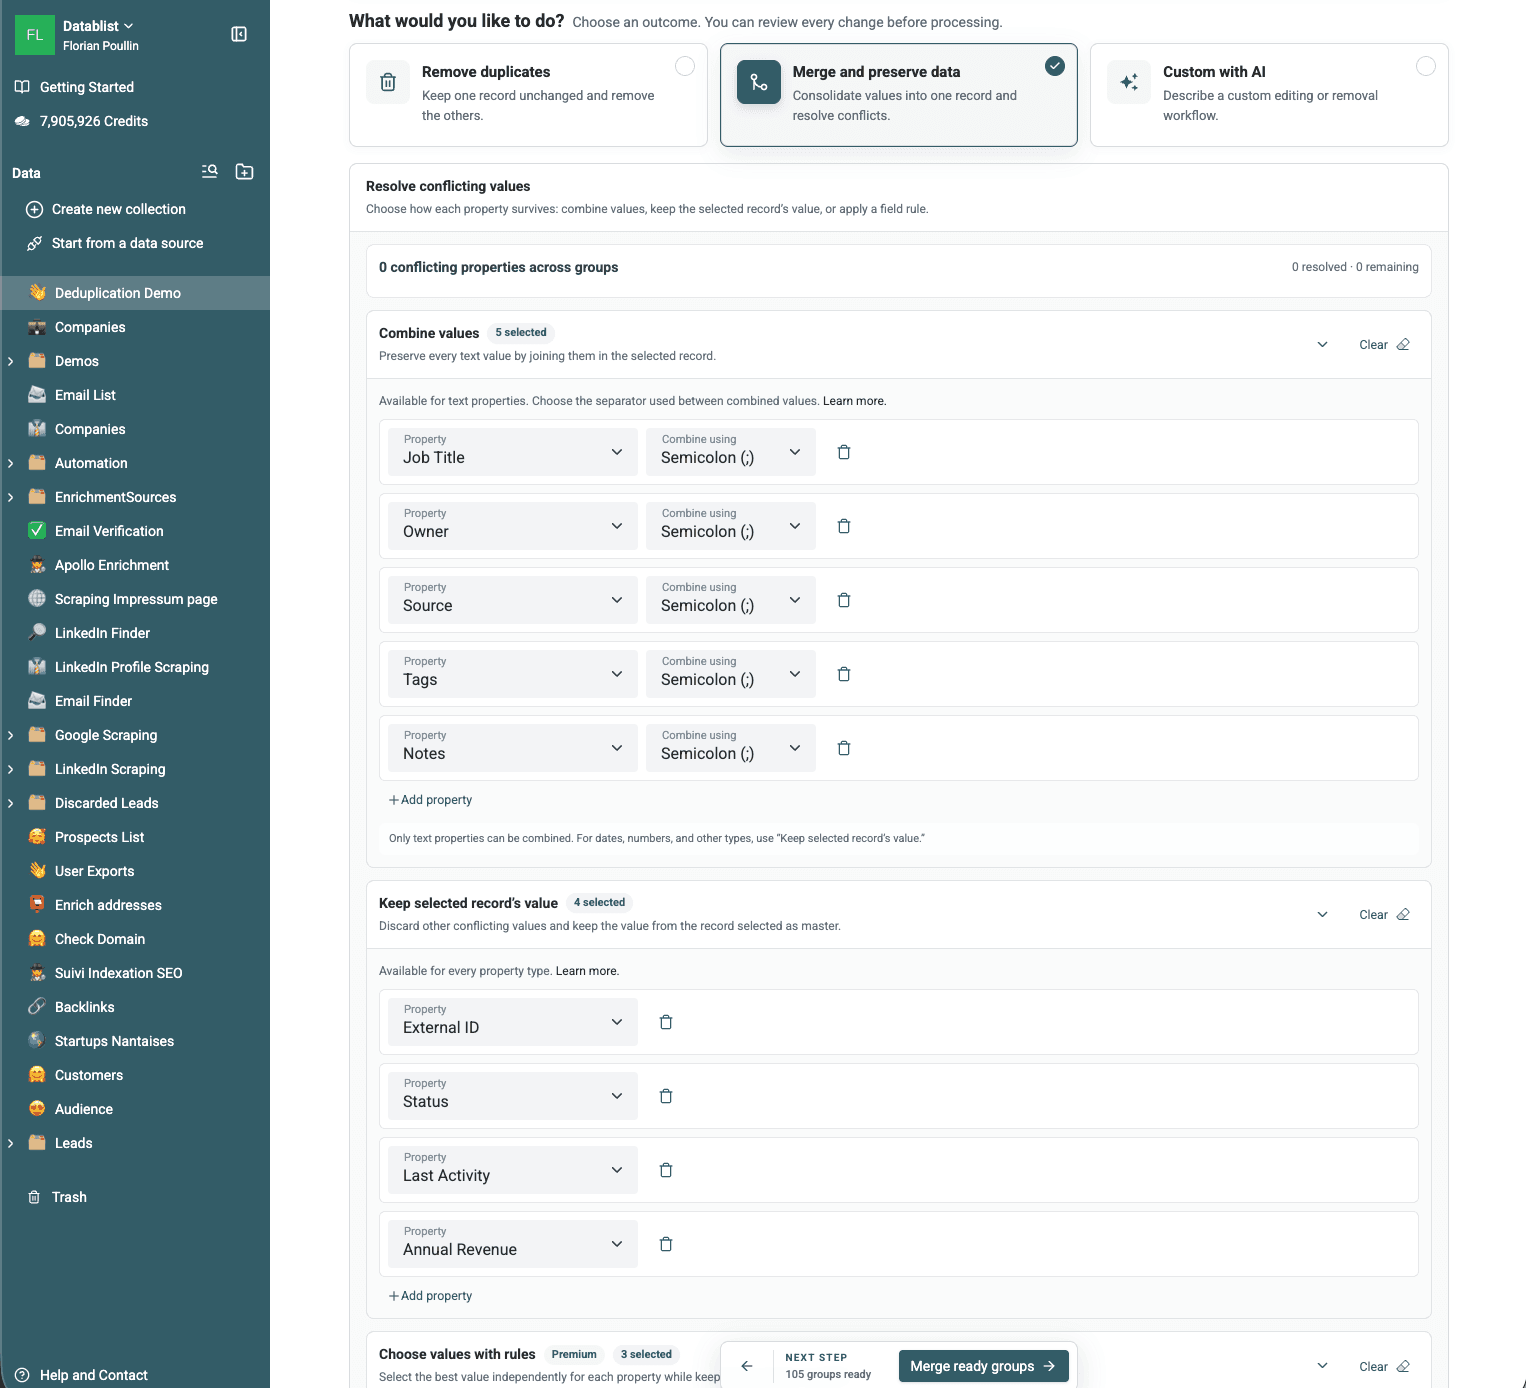
Merge and preserve data preenche as propriedades vazias do registro selecionado, resolve os conflitos configurados e exclui as linhas secundárias.
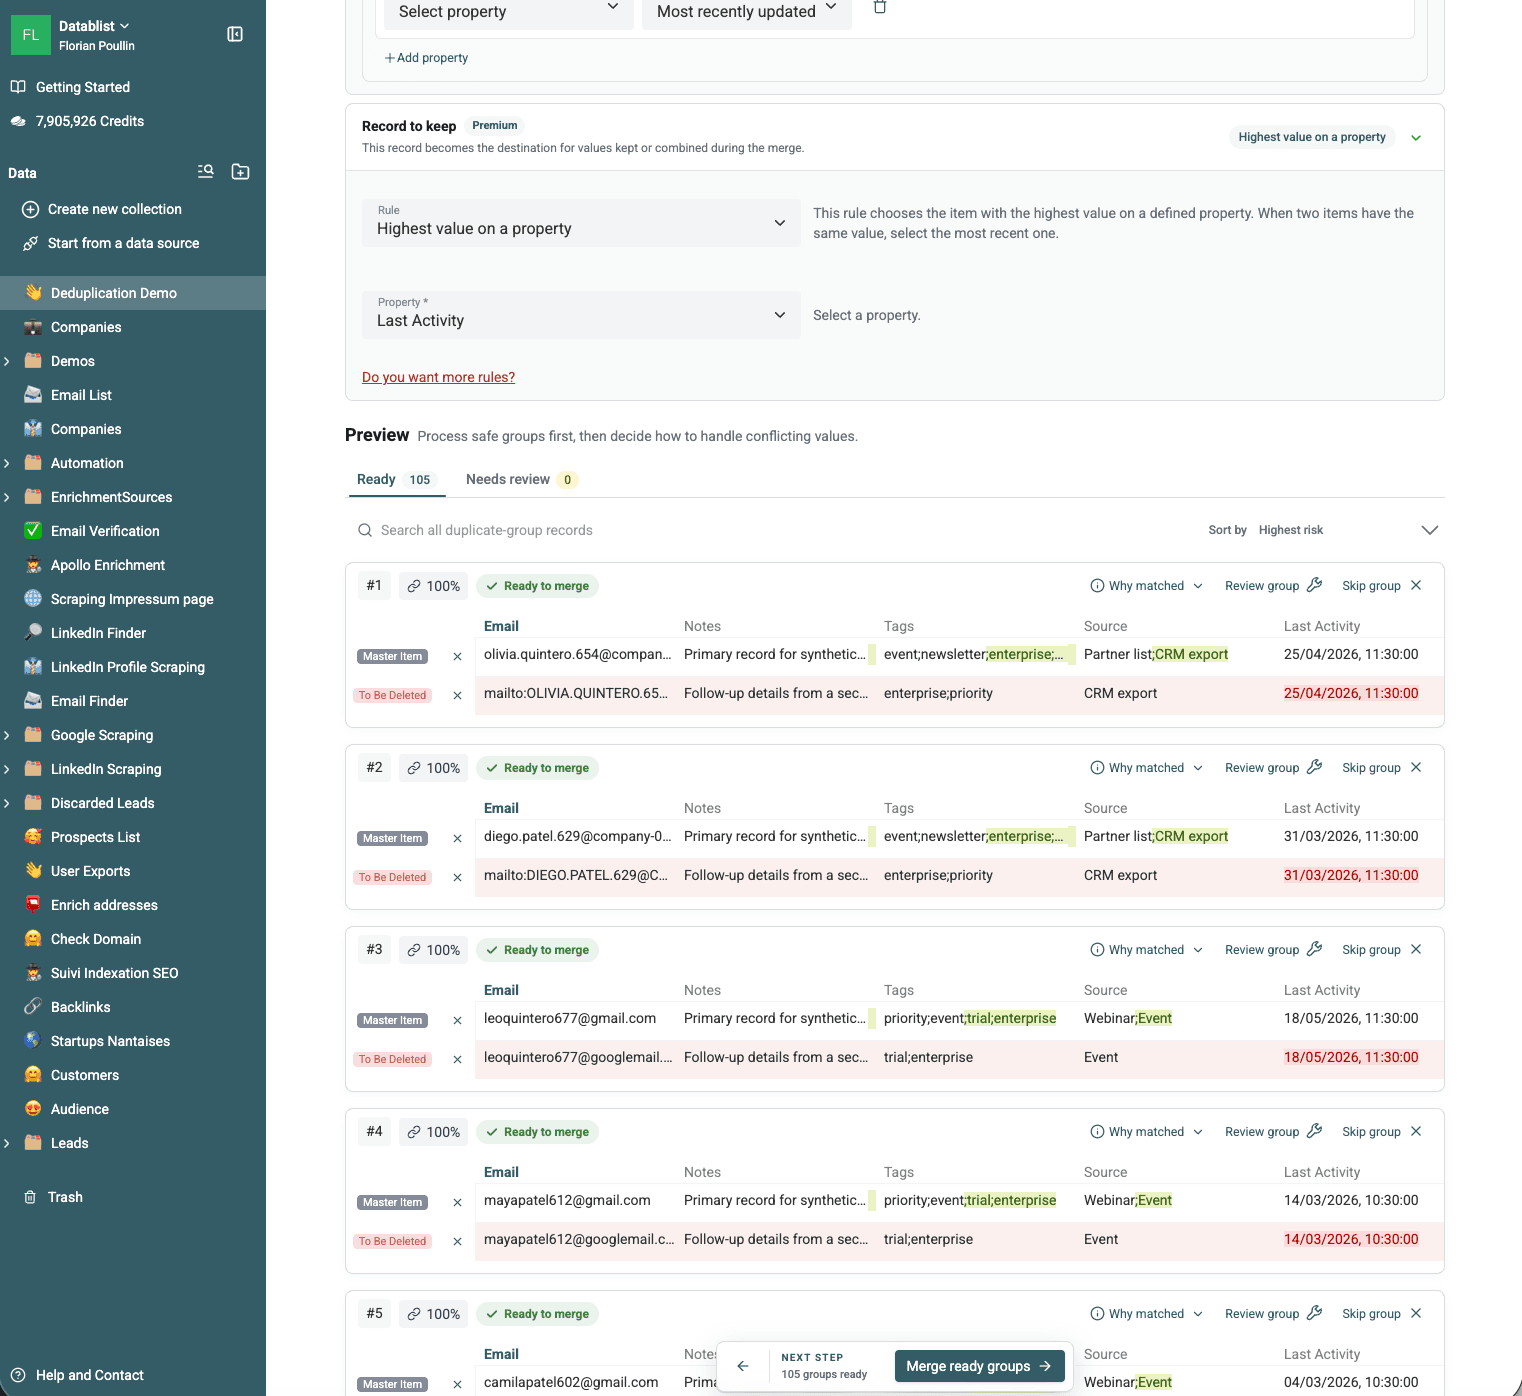
Comece pela regra Record to keep. Most Complete é a opção padrão. Os planos pagos permitem selecionar regras baseadas na data de criação, data de atualização, maior ou menor valor de uma propriedade ou presença de um valor obrigatório.
Em seguida, decida como preservar cada propriedade conflitante:
- Combine valores textuais distintos usando um delimitador.
- Mantenha o valor do registro selecionado.
- Nos planos pagos, escolha os valores de forma independente com regras como mais recente, mais antigo, mais longo, mais curto, maior, menor ou mais frequente.
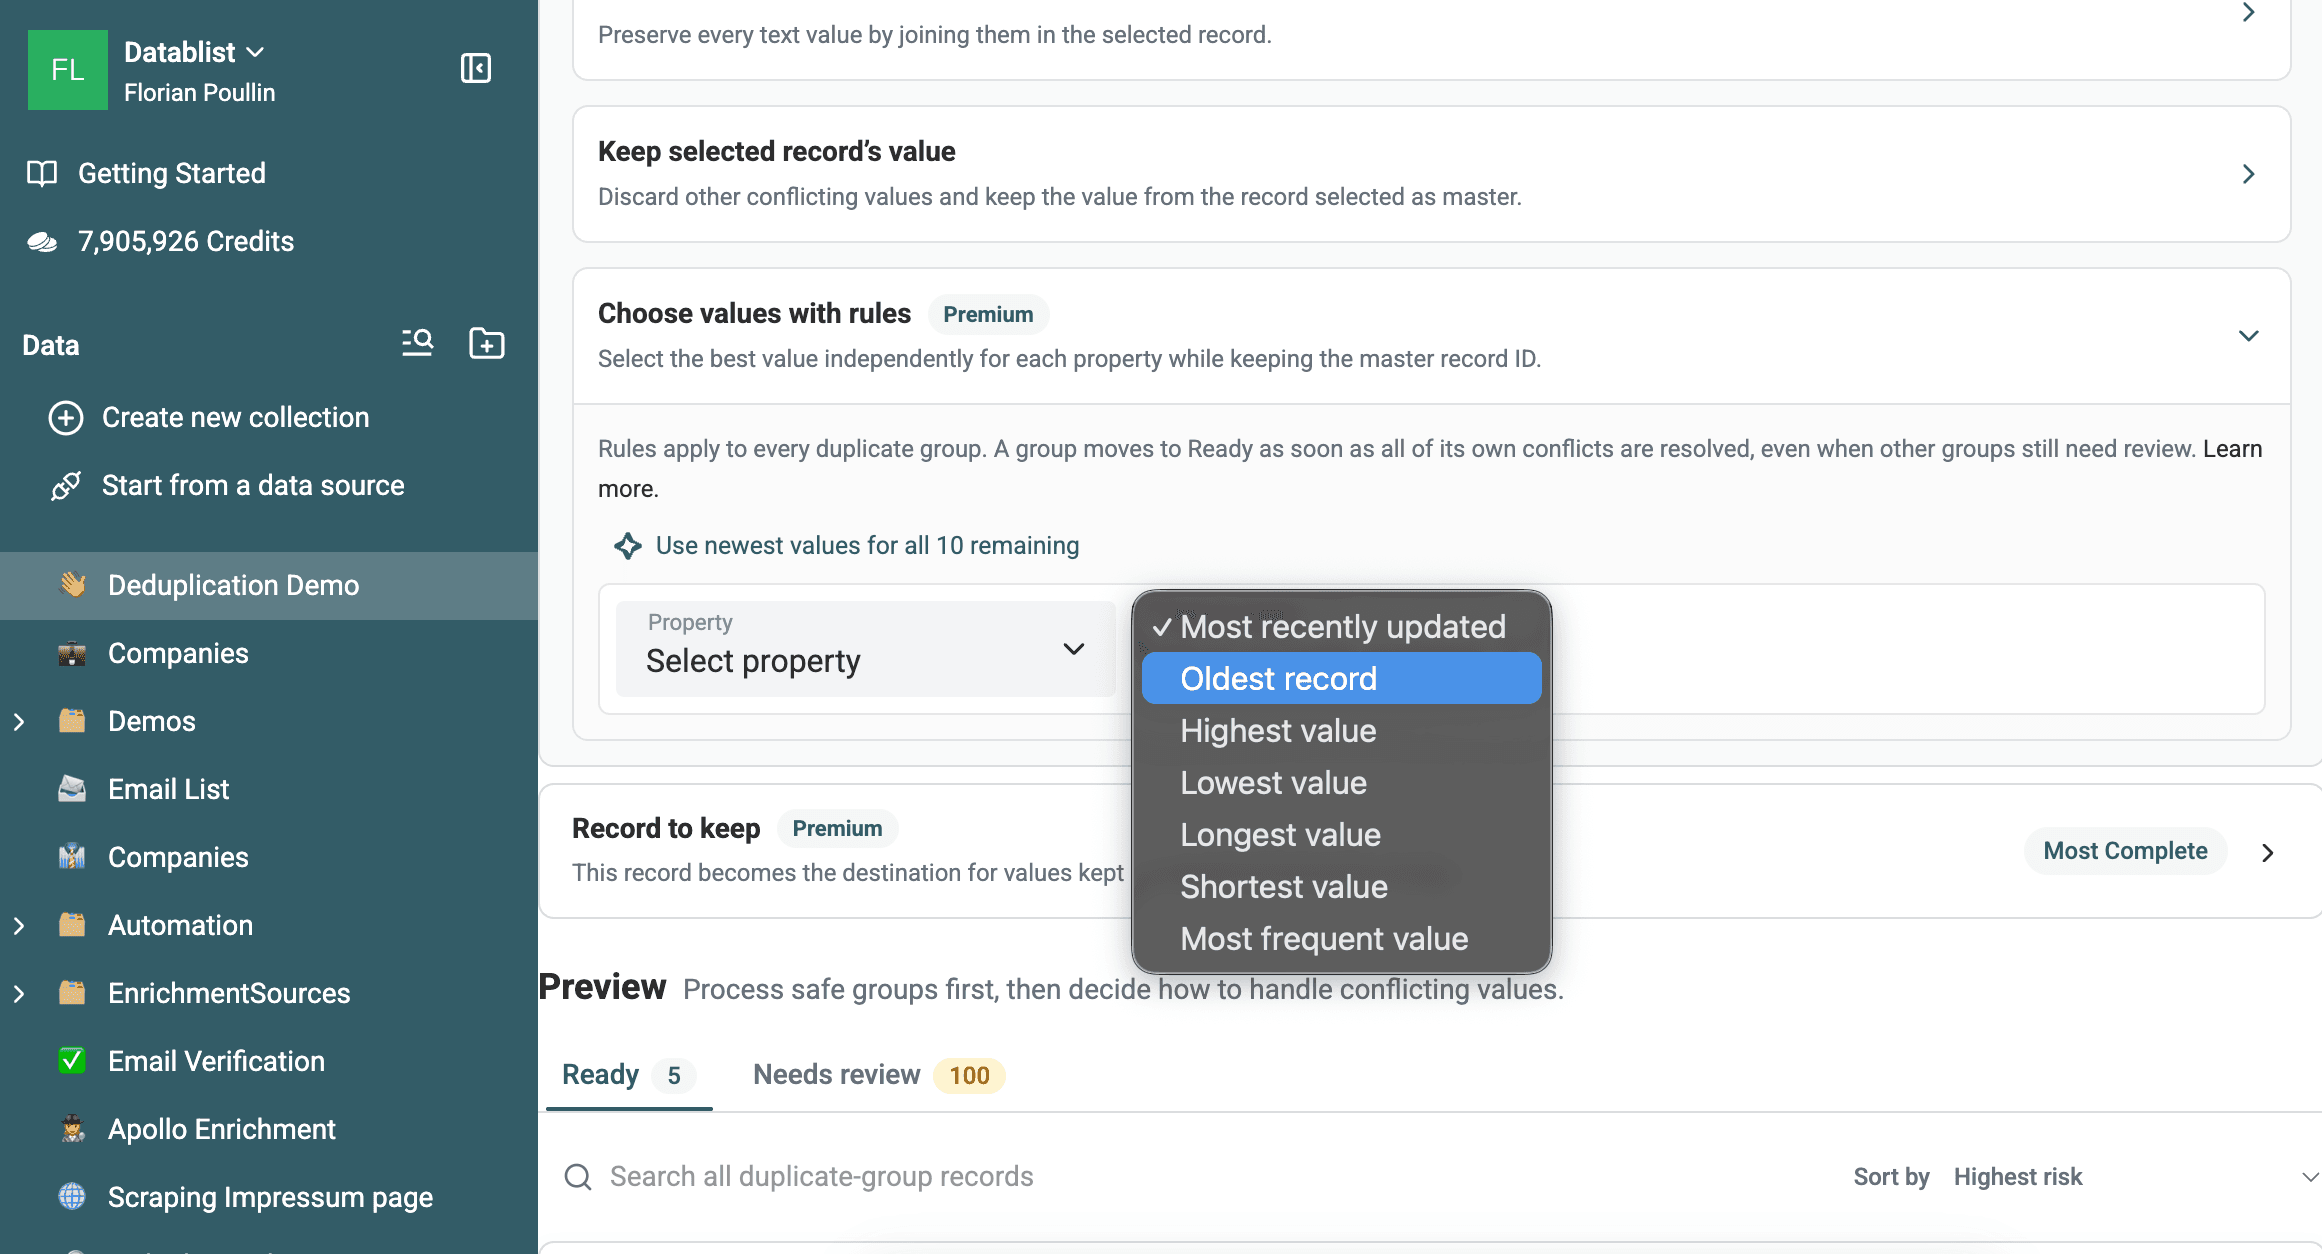
Use regras por campo quando nenhuma linha tiver o melhor valor para todas as propriedades. Você pode preservar o ID do registro selecionado e, ao mesmo tempo, usar um cargo mais recente, um nome de empresa mais longo e o status mais frequente de outras linhas.
Atualize a prévia depois de alterar o limite, o fluxo, a composição dos grupos, as configurações de conflito ou a regra de seleção do registro.
Use Custom with AI para aplicar regras por grupo
Custom with AI gera um fluxo de processamento de grupos a partir de uma instrução em linguagem natural. Ele pode selecionar um registro, copiar ou normalizar valores, adicionar uma propriedade de status, calcular o total do grupo, excluir linhas secundárias ou ignorar grupos que não atendam a uma condição.
Por exemplo:
Mantenha o registro cujo Source seja CRM export. Copie o Job Title do registro mais recente, combine Notes distintas usando quebras de linha, adicione uma caixa de seleção Duplicate Reviewed e exclua os registros secundários.
Faça referência às propriedades da collection usando /Property ou {{Property}}. Gere e confira a prévia do fluxo antes de executá-lo. Custom with AI está disponível para usuários autenticados em planos pagos.
Para exceções individuais, abra Review group e use o Merging Assistant, em vez de tornar a regra em lote mais complexa.
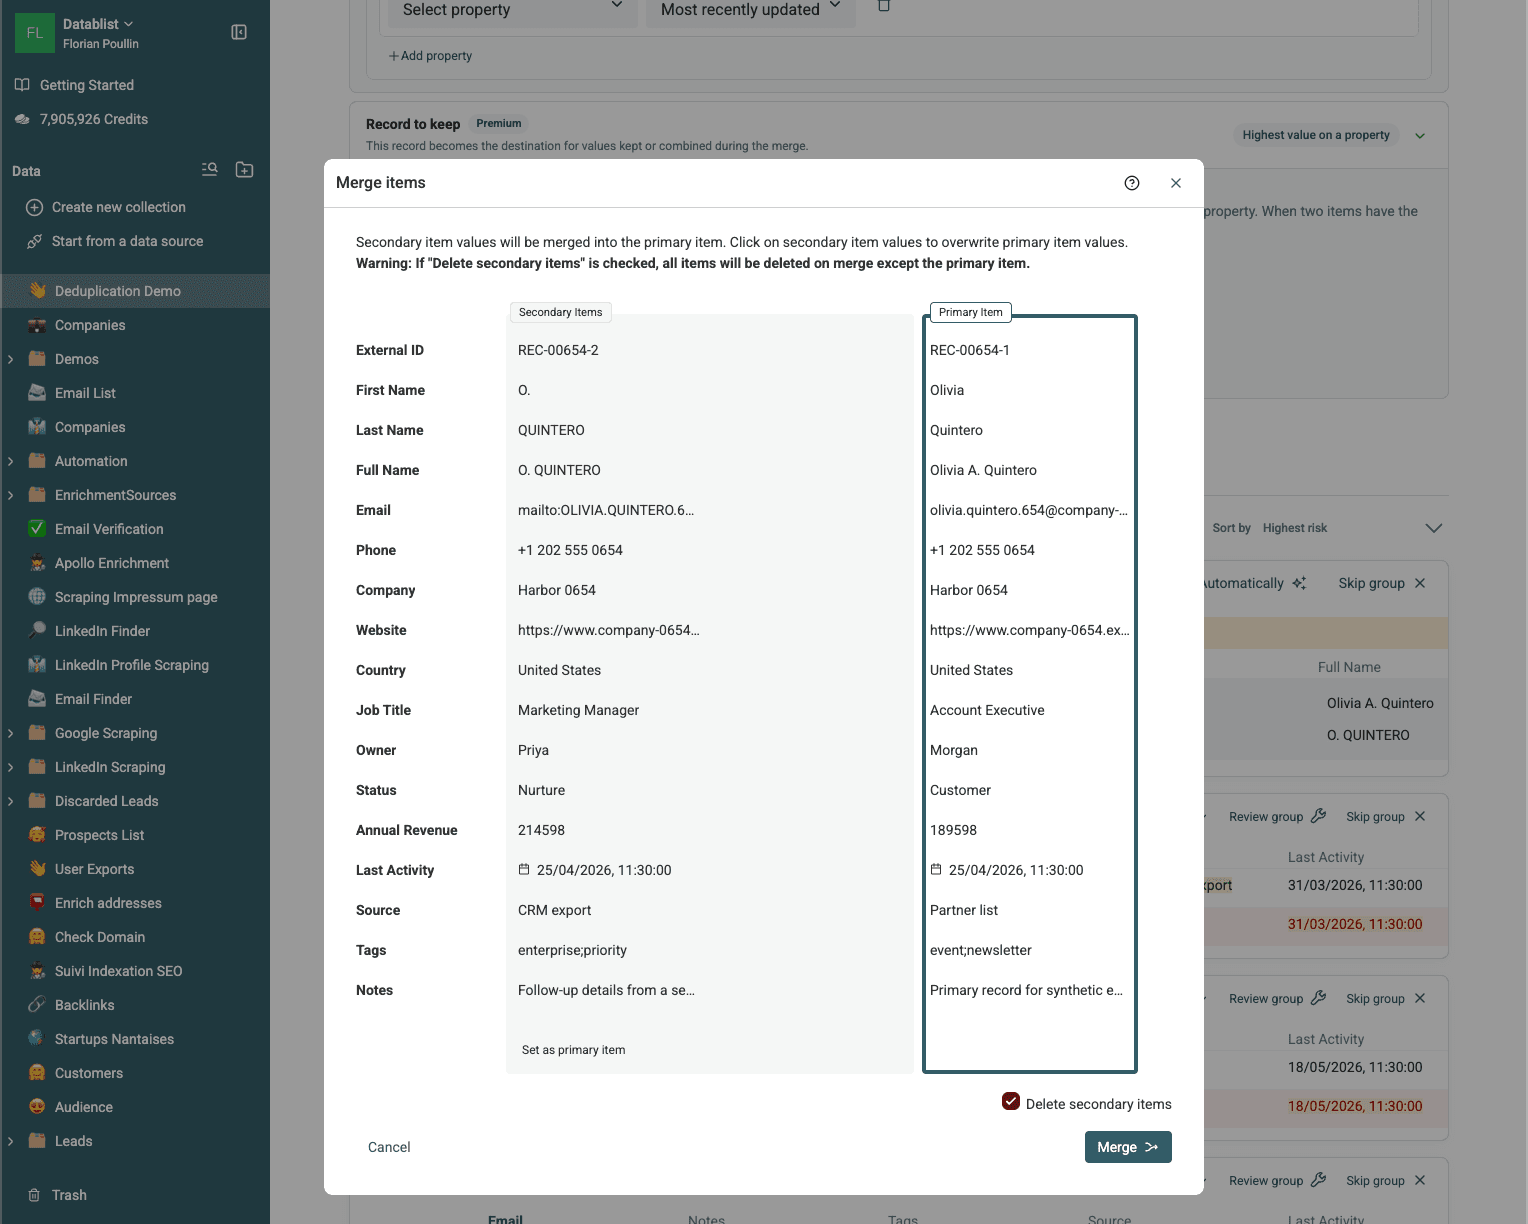
Valide e exporte a lista limpa
Antes de processar os grupos Ready, confirme:
- A prévia reflete as configurações atuais.
- Os grupos de baixa confiança e com identificadores compartilhados foram revisados.
- O registro selecionado tem o ID que você precisa preservar.
- Valores únicos de telefone, origem, observação e status serão preservados.
- Campos que aceitam apenas um valor não serão concatenados.
- A quantidade de Ready exibida corresponde ao escopo que você deseja processar.
Após o processamento, confira a quantidade de linhas:
Linhas iniciais - linhas secundárias excluídas = linhas finais
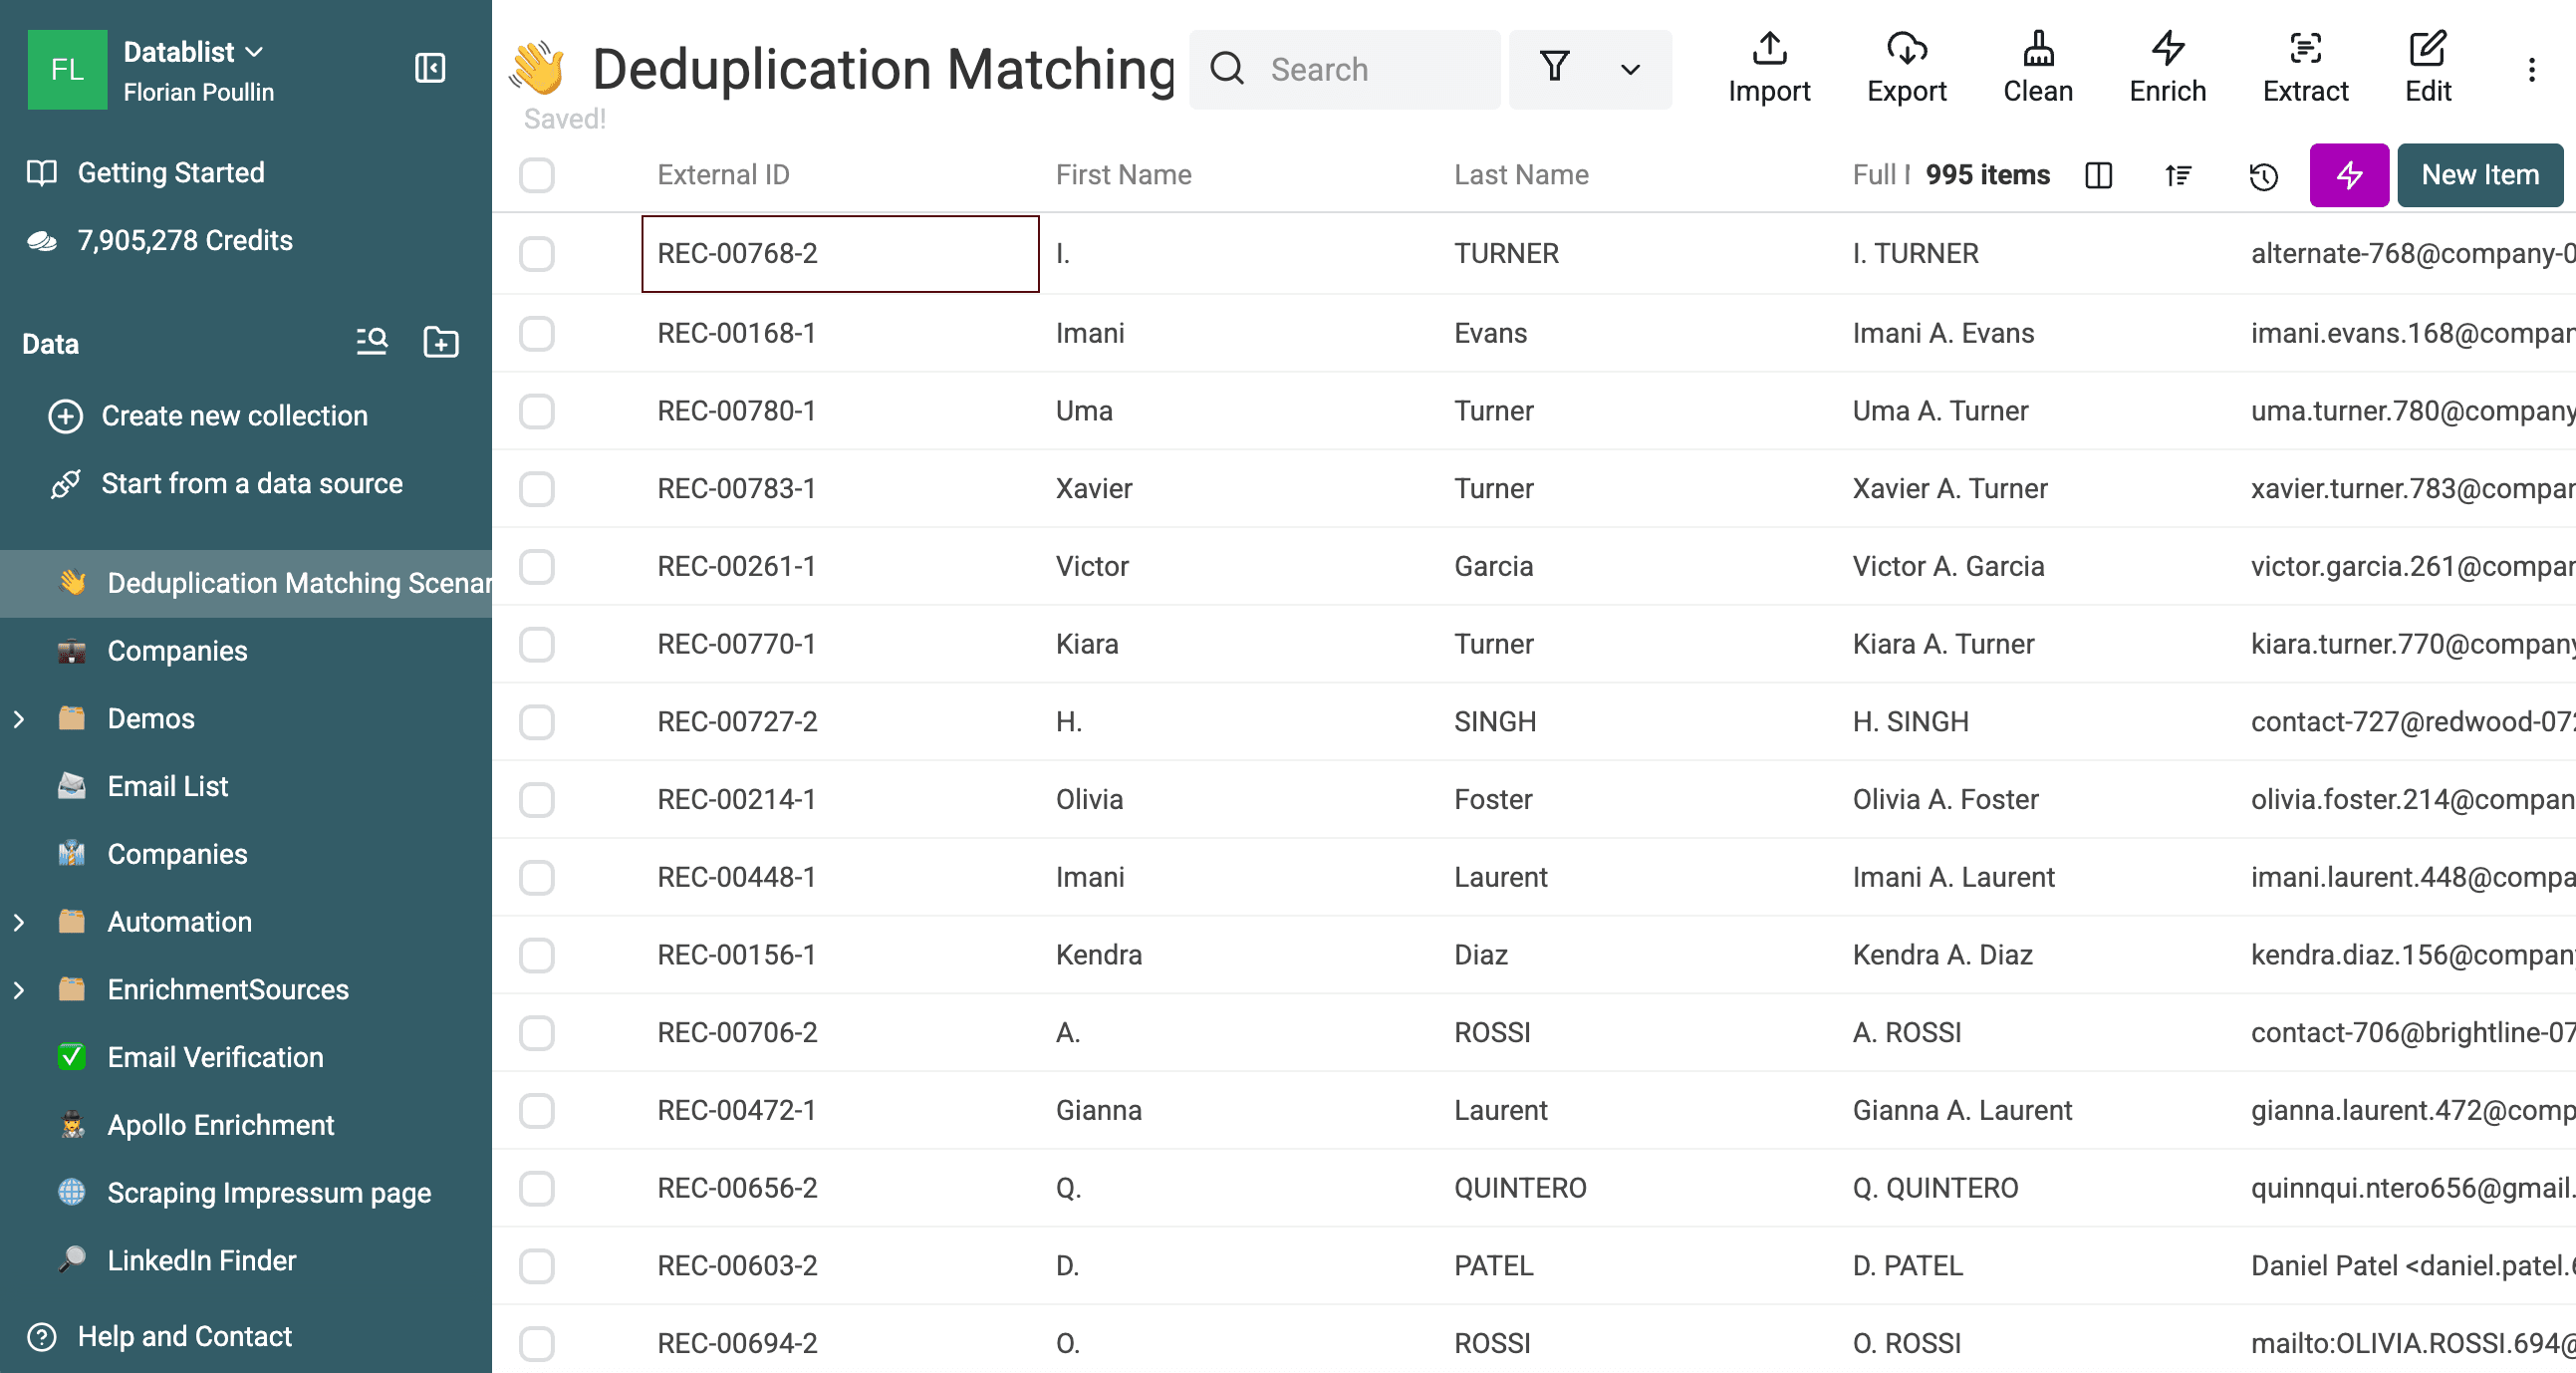
Na verificação Exact deste guia, o Datablist mesclou cinco grupos de duas linhas. Portanto, a collection passou de 1.000 para 995 itens.
Baixe os grupos de duplicados antes do processamento quando precisar de um arquivo externo para revisão. Os planos pagos incluem IDs utilizáveis dos grupos de duplicados e o registro de alterações após o processamento. Esse registro mostra os IDs do Datablist excluídos e atualizados, com os valores anteriores e finais.
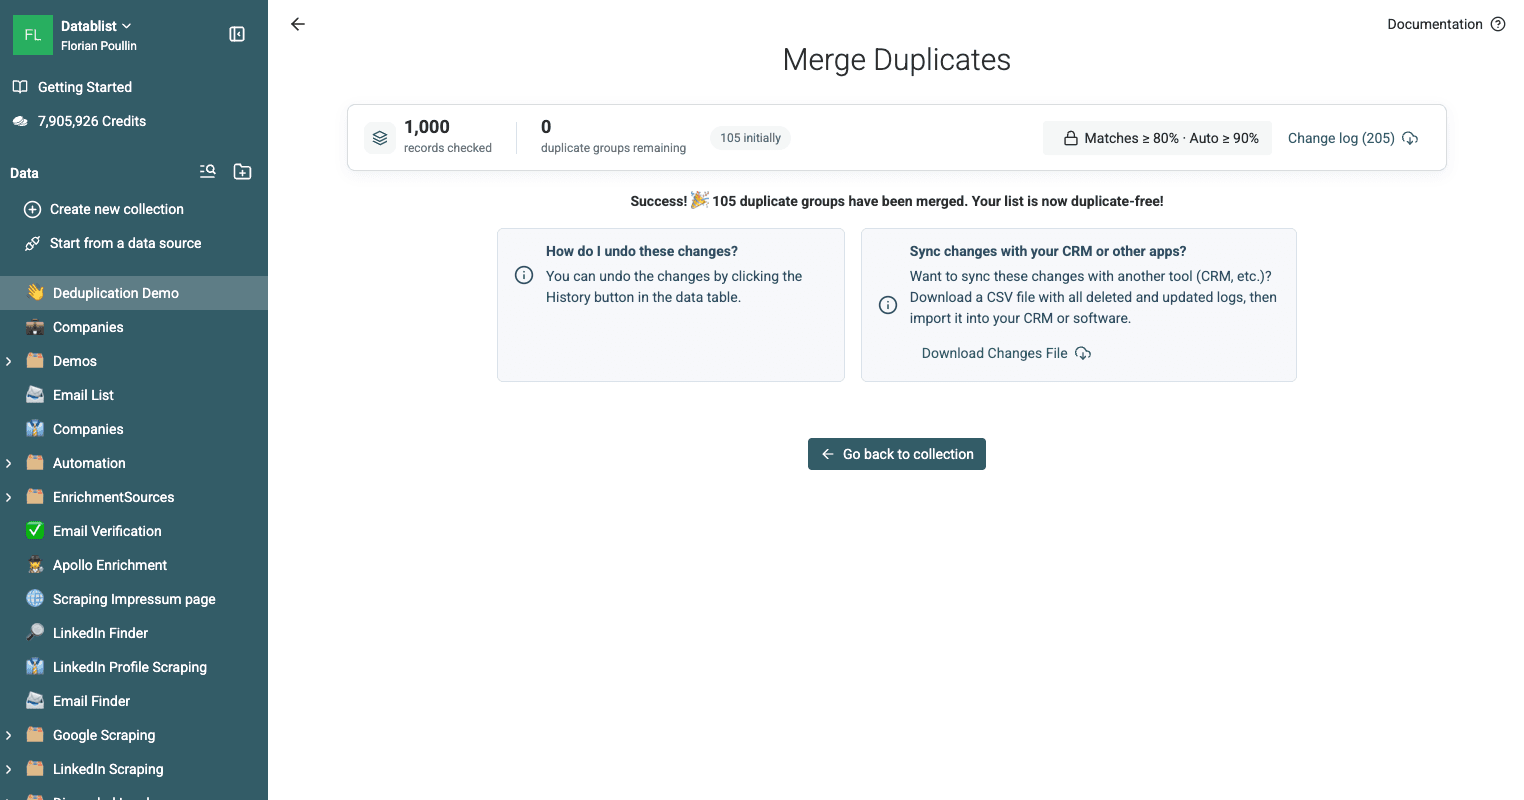
As operações automáticas de remoção e mesclagem também aparecem no History da collection, onde podem ser desfeitas.
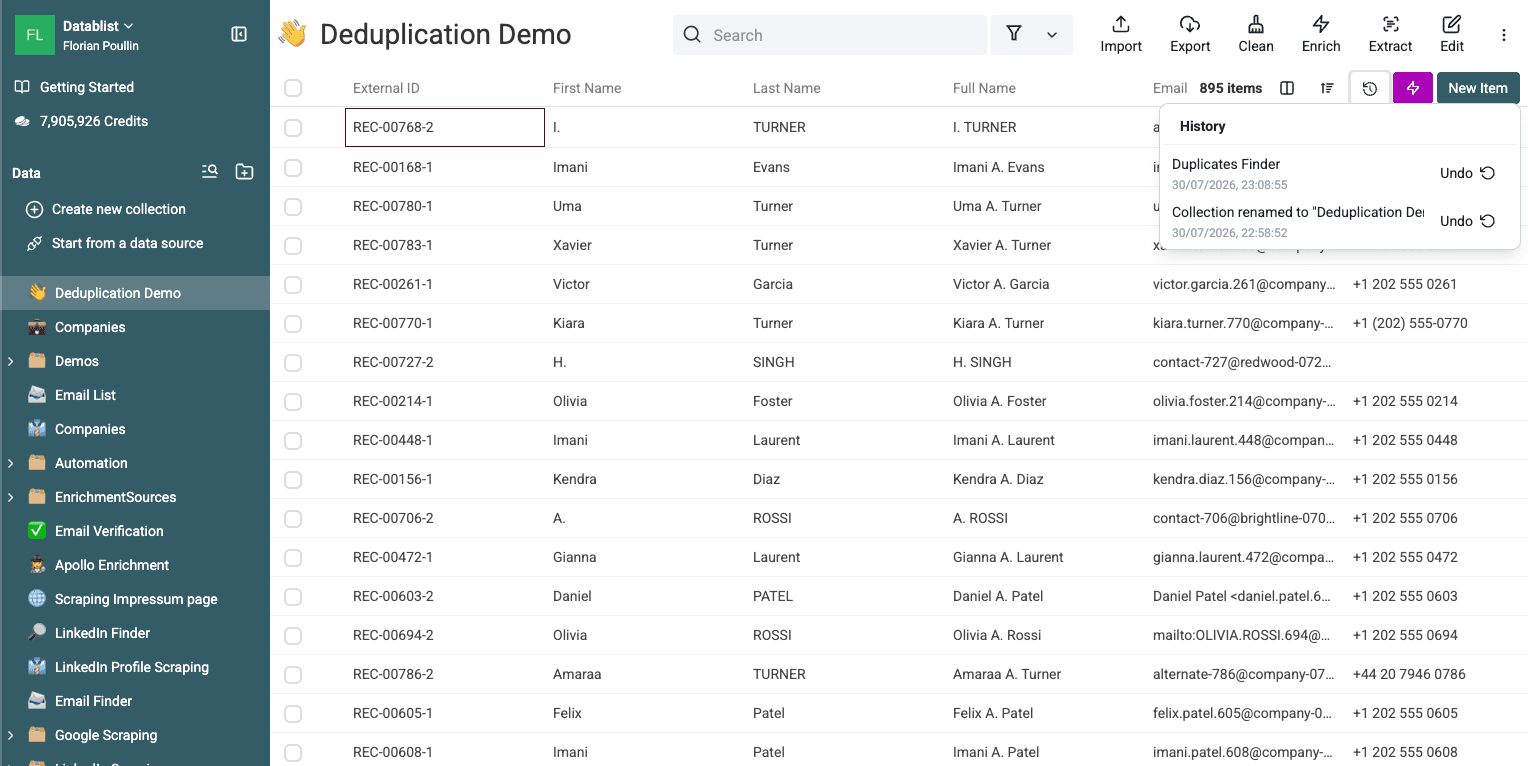
Volte à collection e abra Export para baixar o arquivo CSV ou Excel limpo.
Remova duplicados de várias listas
Use a correspondência entre collections quando um novo arquivo de leads precisar ser comparado com uma exportação do CRM. Trate o CRM como a lista de referência e remova suas correspondências da lista recebida antes da importação.
Baixe o arquivo de demonstração do CRM e o arquivo de demonstração do evento para testar esse fluxo. Os dois arquivos usam cabeçalhos diferentes e contêm 100 sobreposições de e-mail criadas para o teste. Cada arquivo começa com 250 linhas.
Importe cada arquivo para sua própria collection e abra Clean > Match across collections. Adicione as duas collections e mapeie as propriedades correspondentes, como Email e Attendee Email.
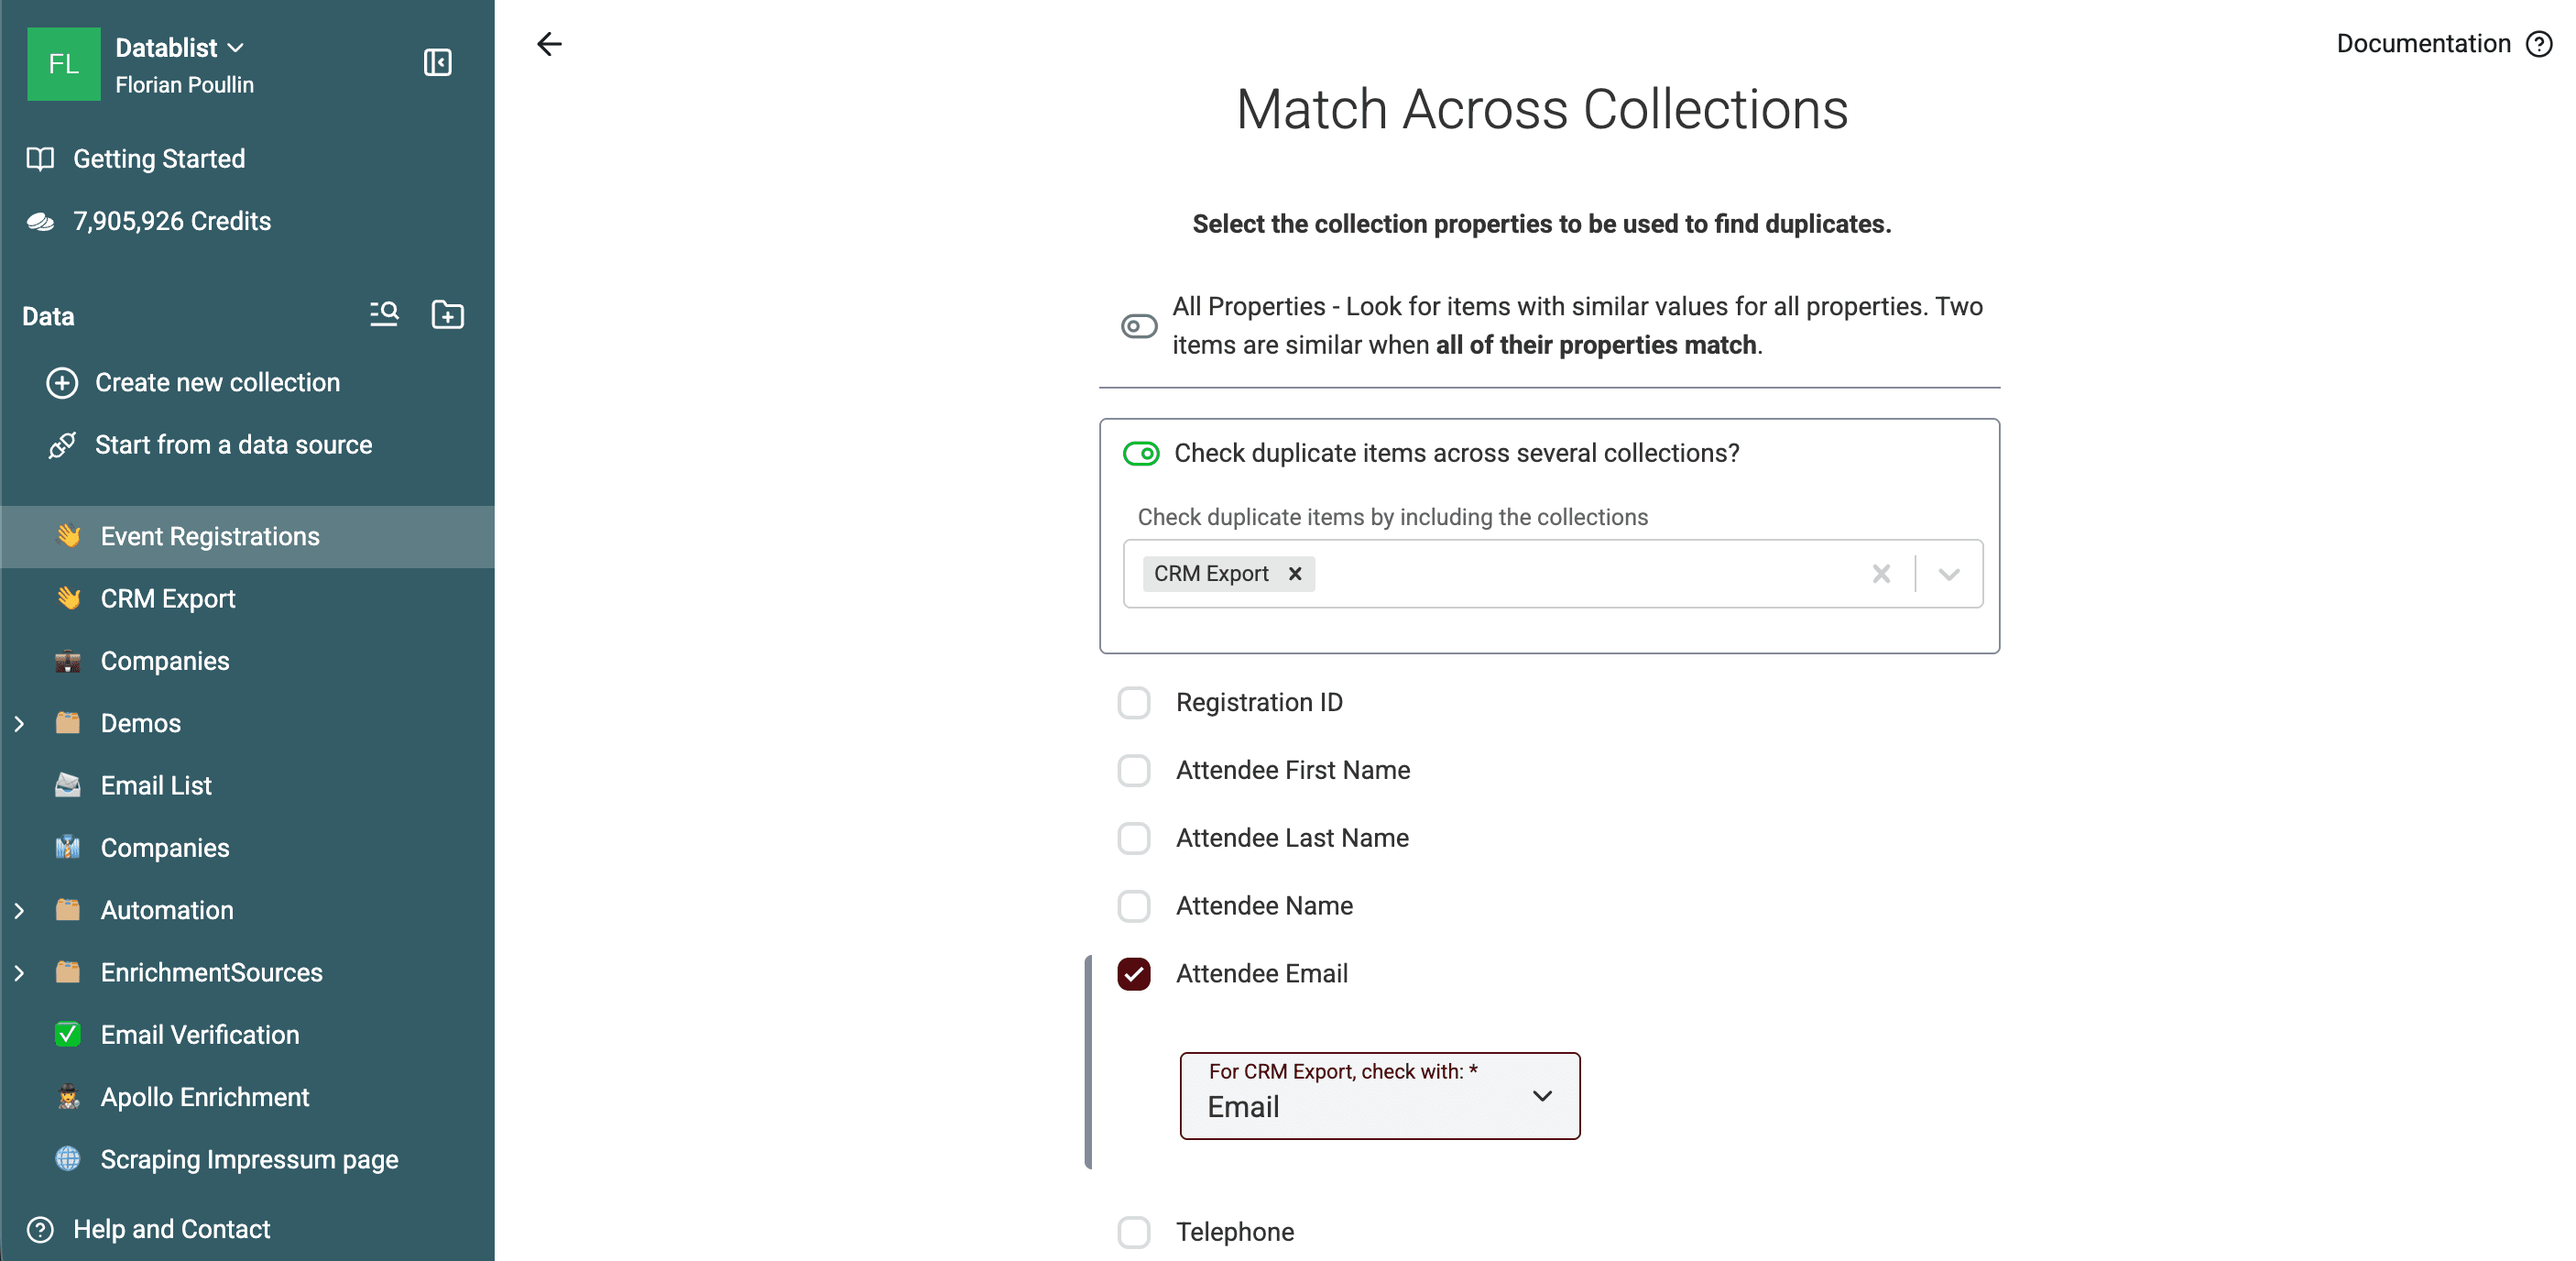
Nesse teste, a correspondência Smart com o processador Email retornou 100 grupos entre collections a partir de 500 registros verificados. Selecione Event Registrations em Remove duplicate items from collection {X} para manter o CRM inalterado e remover suas correspondências da lista do evento.
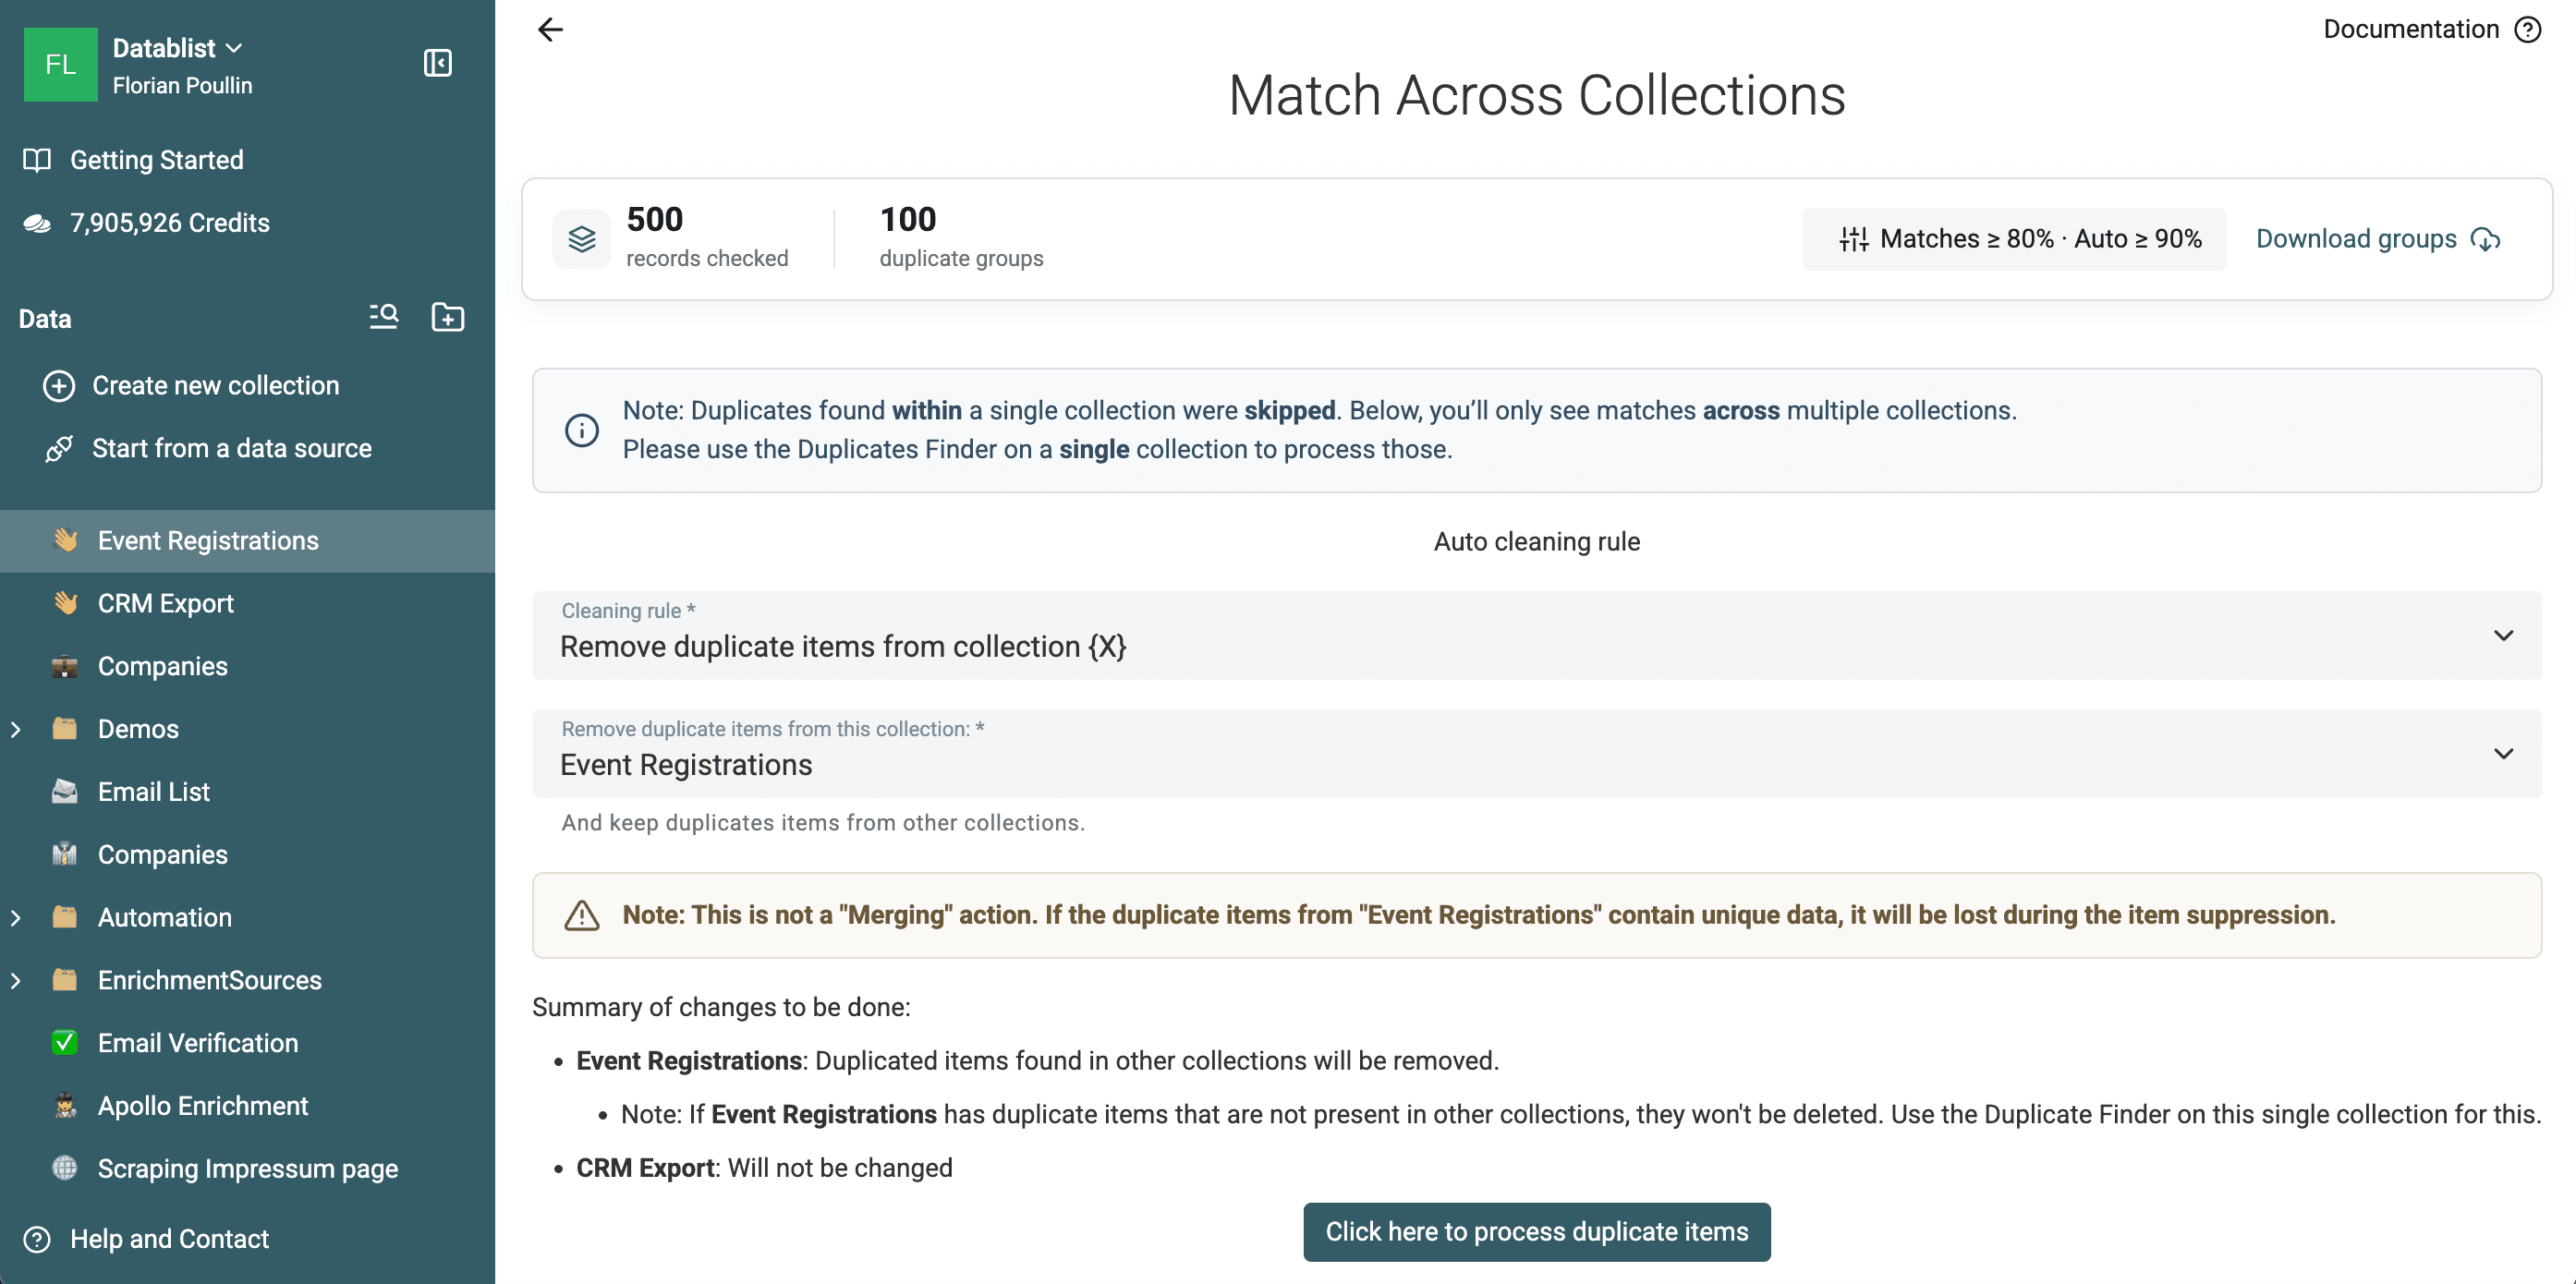
A limpeza automática entre collections remove linhas. Ela não mescla valores exclusivos do evento no CRM. Exporte ou revise os grupos primeiro quando os registros recebidos tiverem informações que você precisa preservar.
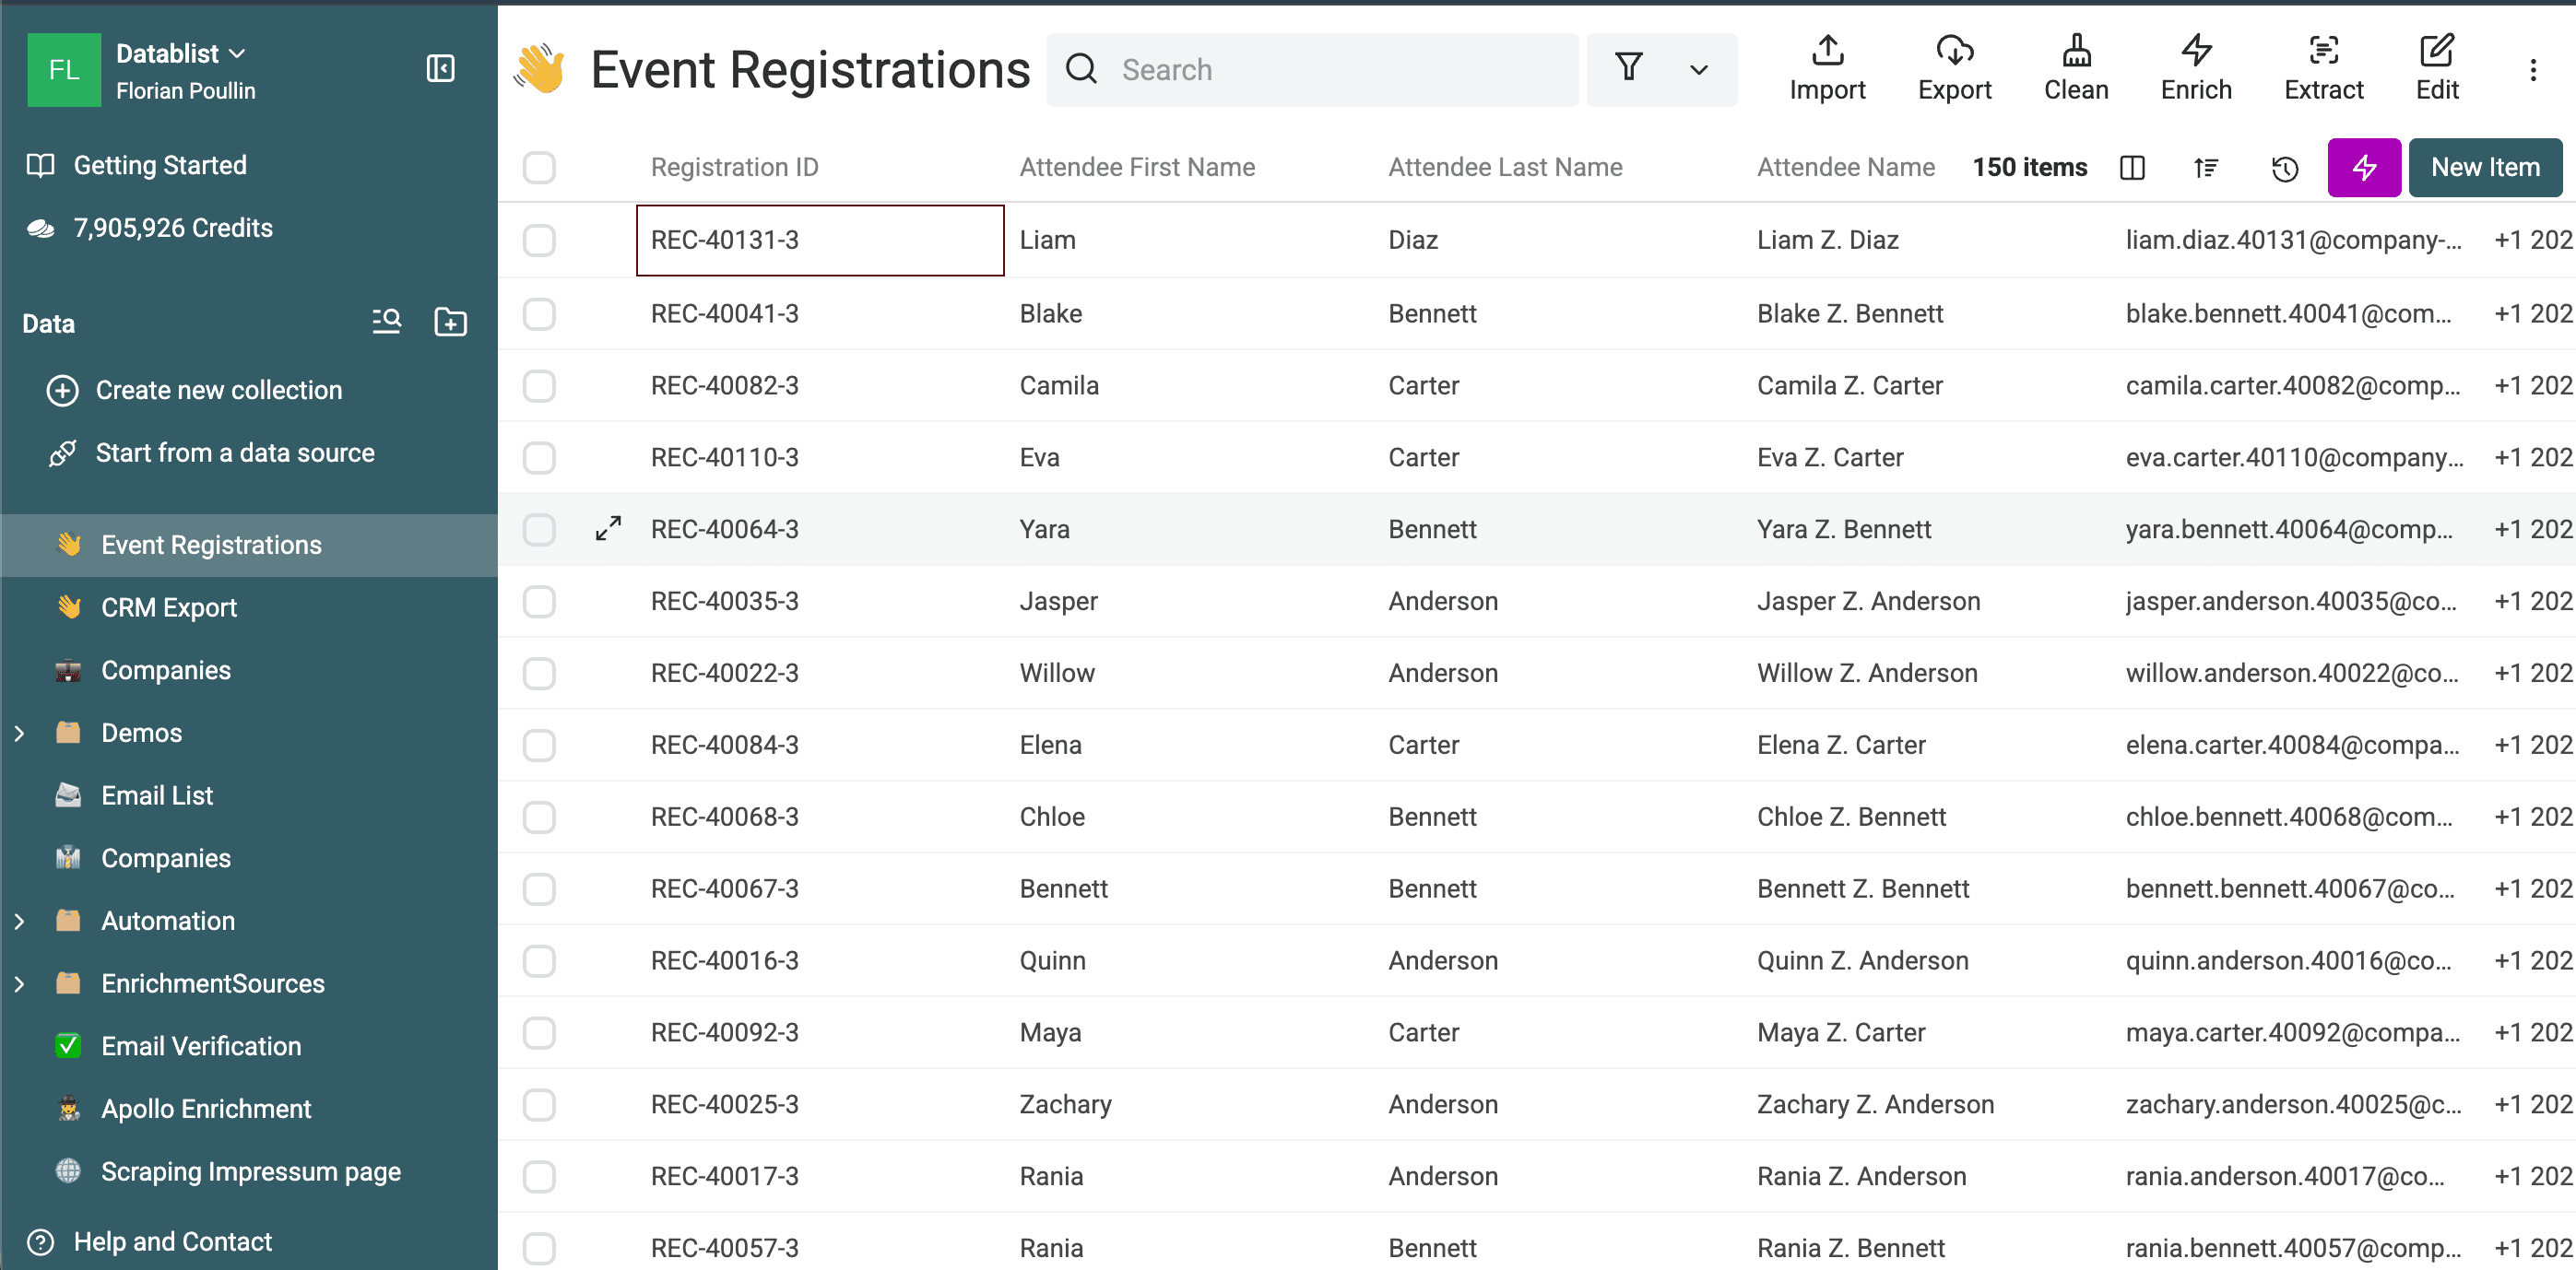
Após processar as 100 sobreposições, Event Registrations contém 150 contatos realmente novos.
A correspondência entre collections é um recurso Premium. Consulte o guia detalhado para remover duplicados de vários arquivos CSV ou Excel e conhecer as opções de mapeamento e processamento.
FAQ
Posso remover duplicados de uma lista online grátis?
Sim. Visitantes anônimos podem executar uma verificação Exact. Uma conta gratuita libera a correspondência Smart e os demais recursos do plano Free para uma única collection. Algoritmos fuzzy e fonéticos, processadores avançados, correspondência entre collections, regras configuráveis de preservação e Custom with AI exigem um plano pago.
Devo remover ou mesclar as linhas duplicadas?
Remova as linhas quando um registro for a fonte oficial e os outros não tiverem nada que você precise manter. Mescle quando as linhas secundárias contiverem valores úteis. A prévia de Remove avisa quando algum dado seria descartado.
O Datablist encontra duplicados com erros de digitação?
Sim. Jaro-Winkler e Levenshtein comparam a similaridade do texto, enquanto Metaphone compara sua sonoridade. Esses algoritmos avançados exigem um plano pago, e as correspondências devem ser revisadas.
Posso mesclar linhas duplicadas sem perder dados?
O Datablist pode preencher campos vazios, combinar valores textuais, manter o valor do registro selecionado ou aplicar regras de preservação por campo. Confira a prévia, pois qualquer valor que você decidir descartar não aparecerá no registro mesclado.
Qual pode ser o tamanho da lista?
O plano Free aceita até 1 milhão de itens por collection no armazenamento do navegador. Os planos pagos aceitam importações de até 2 milhões de itens por collection. Operações locais de grande porte ainda dependem do navegador e do dispositivo.
Posso revisar os duplicados sem alterar a lista?
Sim. A detecção é somente leitura. Você pode analisar os grupos, ajustar os limites, usar Why matched, pesquisar e ordenar os resultados e baixar as linhas duplicadas antes de iniciar qualquer ação de processamento.
Para conhecer todas as configurações e limitações, consulte a documentação completa do Duplicate Finder.