
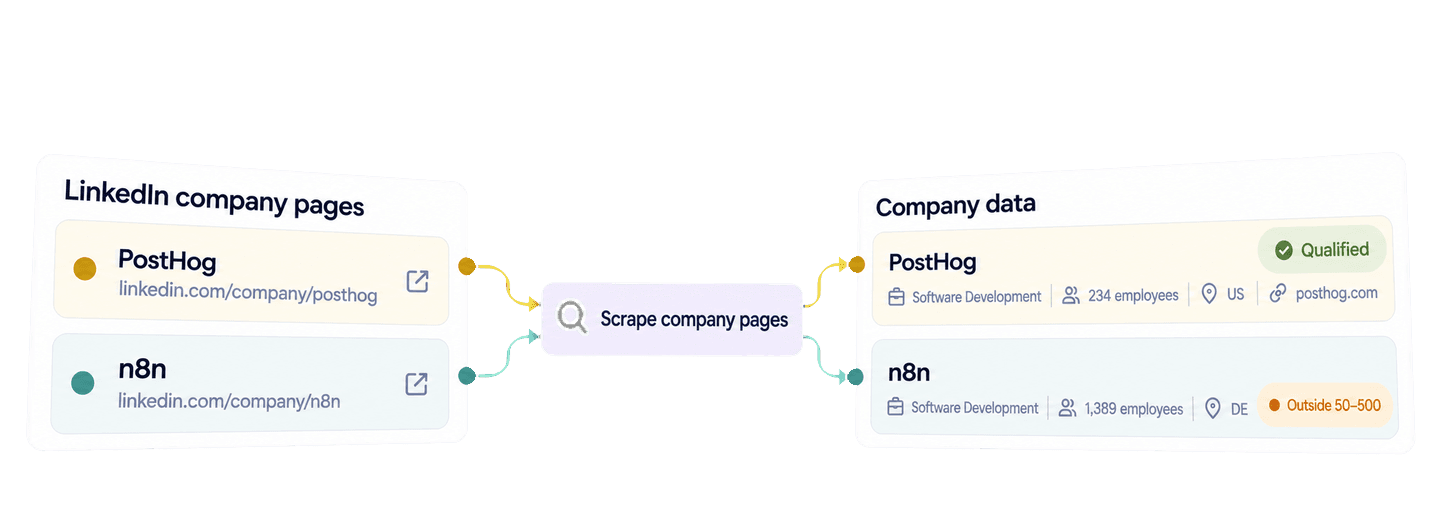
Данные о компаниях из LinkedIn можно парсить на Python: достаточно передать список URL страниц компаний в API Datablist с помощью библиотеки Requests. API возвращает структурированные записи с такими полями, как отрасль, число сотрудников, местонахождение штаб-квартиры, сайт и описание, если эти сведения доступны на публичной странице компании.
В этом руководстве мы используем одну понятную функцию Python, чтобы получить данные о n8n, PostHog, Back Market и Datablist. Затем применим результаты для квалификации компаний-разработчиков ПО со штатом от 50 до 500 сотрудников и штаб-квартирой в США или Германии. В квалифицированной записи сохранятся сайт и описание для более глубокого sales research.
🔑 Кратко для тех, кто спешит
Datablist преобразует проверенные URL страниц компаний в LinkedIn в структурированные записи, которые можно использовать в процессе sales research. Пример на Python ниже загружает все страницы результатов, а затем применяет локальный фильтр аккаунтов без повторного обращения к API.
- Входные данные: URL страниц компаний в LinkedIn.
- Результат: доступные сведения о компаниях и решение о локальной квалификации; исходный URL и полные данные компании хранятся вместе.
💡 Предпочитаете no-code решение? Используйте LinkedIn Company Page Scraper от Datablist, чтобы извлекать данные по известным URL страниц компаний в LinkedIn без написания кода.
Настройка Python и API-ключа Datablist
В этом примере на Python используется пакет requests. REST API Datablist доступен на тарифе Growth, а каждый запрос данных страницы компании расходует кредиты на enrichment.
Создайте Personal API Key на странице API вашего аккаунта Datablist.
Создайте файл scrape_linkedin_companies.py, затем подготовьте виртуальное окружение и установите Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Скрипт считывает ключ из DATABLIST_API_KEY и передаёт его в заголовке X-API-Key.
Парсинг страниц компаний LinkedIn одной функцией Python
В исходном списке ниже представлены компании из разных отраслей, с разным числом сотрудников и странами штаб-квартир. Каждое значение account_id становится полем inputId в API. Результаты не сопоставляются по позиции в ответе, поэтому именно этот постоянный идентификатор связывает каждый результат с правильным исходным URL.
Вставьте полный скрипт в scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Запустите скрипт:
python scrape_linkedin_companies.pyОсновные значения, которые нужно изменить, — записи в accounts. Оставьте каждый account_id постоянным и уникальным, а linkedin_company_url замените на проверенную страницу компании в LinkedIn. Функция преобразует эти записи в формат inputs для API и передаёт URL компании как companyLinkedInUrl. Поле settings остаётся пустым, поскольку у этого enrichment нет публичных настроек.
POST-запрос создаёт фоновую задачу enrichment. API отвечает кодом 202 Accepted и возвращает ID задачи, а клиент Requests ожидает завершения, периодически опрашивая URL статуса. Такой блокирующий код Python удобен для небольшого скрипта, хотя на стороне Datablist задача всё равно выполняется асинхронно.
Первый GET-запрос проверяет саму задачу. Она может завершиться со статусом completed, failed или stopped. Скрипт продолжает работу только при статусе completed; в остальных случаях он выдаёт ошибку с ID задачи и сообщением API. Сохраните этот ID для диагностики: даже у задачи со статусом failed или stopped могут быть результаты и сведения о расходе кредитов.
После завершения задачи последний цикл загружает страницы результатов с лимитом 100 записей. Он запрашивает следующую страницу, пока значение nextCursor не станет null. В каждом результате сохраняется переданный вами inputId, поэтому последующий цикл квалификации правильно сопоставит записи, даже если порядок ответа отличается от порядка входных данных.
Как читать результат и понимать метод получения данных
URL LinkedIn однозначно идентифицирует компанию. Datablist нормализует URL организации и извлекает доступные публичные данные со страницы компании, а не ищет несколько возможных совпадений и не оценивает их релевантность. При наличии URL конкретной компании сервис начинает с её публичной страницы и может заполнить недостающие поля из управляемых резервных источников, сохраняя уже найденные полезные значения.
Это различие важно при анализе результата. Наличие необязательных полей зависит от публично доступной информации. Значение null в адресе штаб-квартиры или отсутствие специализации не означает, что весь запрос данных компании завершился неудачно.
Ниже приведена полная страница результатов для четырёх URL:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
Все четыре записи были обработаны успешно, на каждую потрачено по 25 кредитов. Для PostHog вернулись отрасль Software Development, 234 сотрудника, штаб-квартира в США, сайт и описание. n8n также относится к разработчикам ПО и находится в одной из выбранных стран, но полученное число сотрудников составляет 1 389. Для Back Market вернулись отрасль Internet Marketplace Platforms, 1 054 сотрудника и штаб-квартира во Франции. Для Datablist — отрасль Information Technology & Services, 3 сотрудника и штаб-квартира во Франции.
Полный объект полезен, поскольку исследование аккаунта редко ограничивается одним полем. Можно квалифицировать компанию по отрасли, числу сотрудников и стране, сохранив точный сайт и описание из ответа для следующего этапа исследования.
В этом ответе companySize — полученное число сотрудников, а не диапазон размера компании из LinkedIn. companyHQCountry обозначает местонахождение штаб-квартиры, а не все страны присутствия компании. Учитывайте эти различия, адаптируя фильтры размера и страны под свой ideal customer profile.
Для квалификации не обязательно наличие всех необязательных полей. Адрес или специализация могут отсутствовать, если доступны отрасль, число сотрудников и страна штаб-квартиры. Сохраняйте companyWebsite в исходном виде и не рассчитывайте, что API преобразует адрес в чистый домен. Описание помогает sales researcher разобраться в продукте компании и подготовить персонализированное исследование аккаунта перед outreach. При проверке или сохранении записи держите поля status, creditsUsed и error рядом с данными компании.
Квалификация аккаунтов для sales research
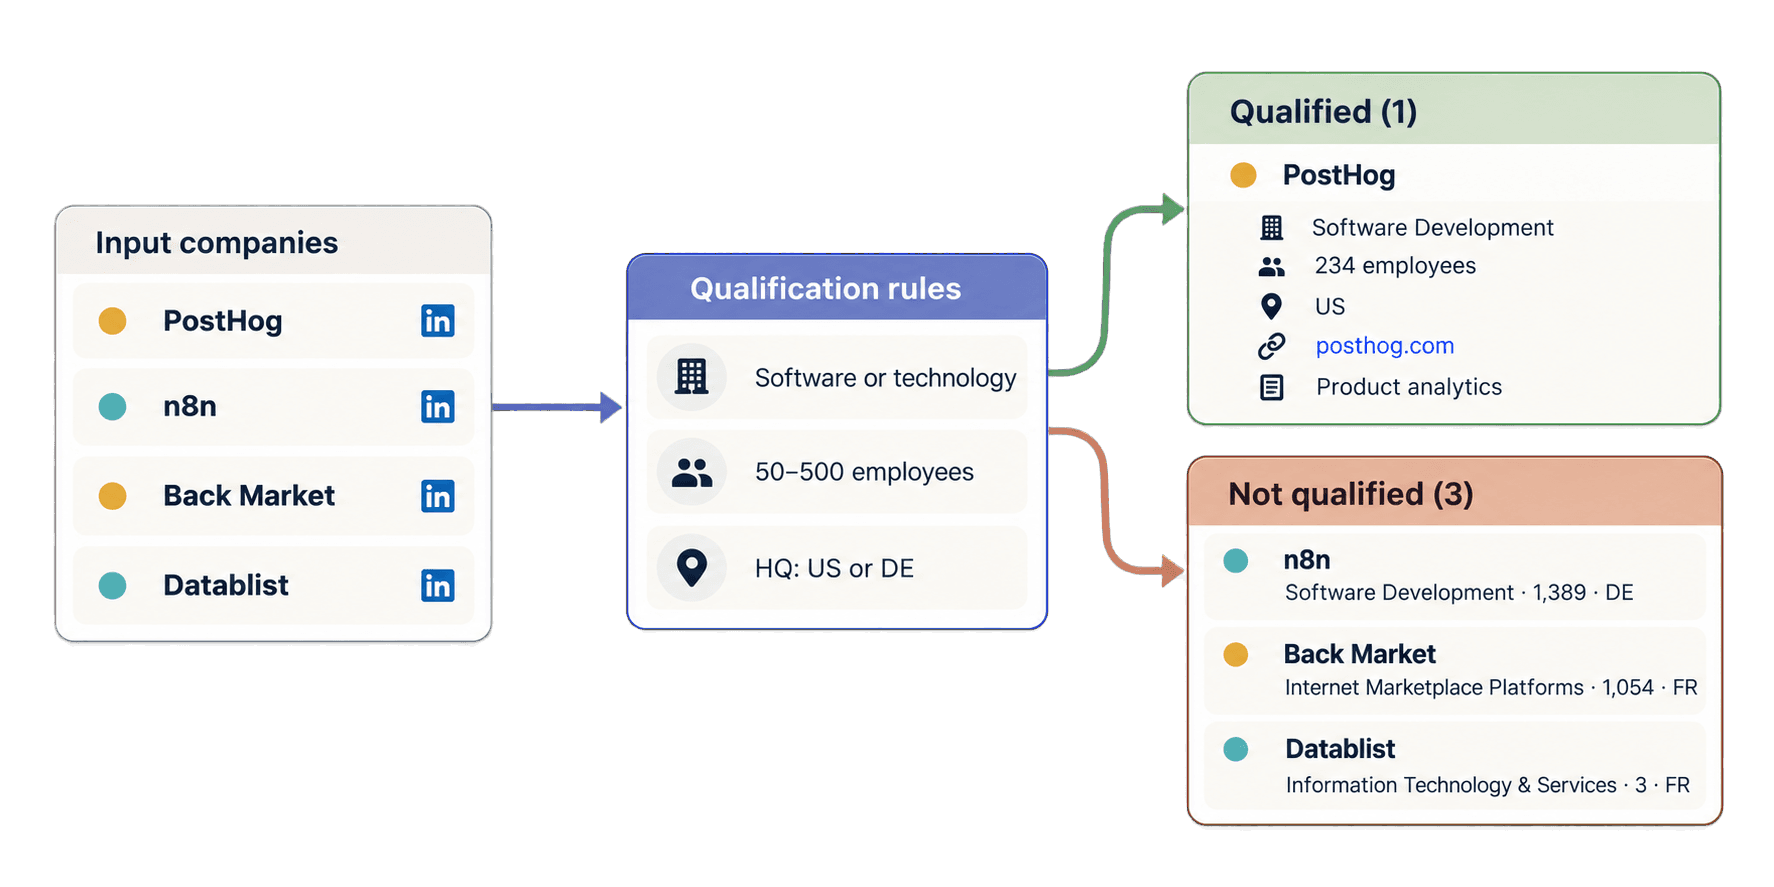
Предположим, ваша целевая аудитория — компании из сферы разработки ПО или технологий со штатом от 50 до 500 сотрудников и штаб-квартирой в США или Германии. Добавьте приведённый ниже цикл после полного скрипта. Он повторно использует company_results, поэтому новая задача не создаётся:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog сопоставляется с account-posthog, даже если API возвращает строки в другом порядке. Компания проходит квалификацию, поскольку Software Development, 234 сотрудника и US соответствуют всем трём условиям. Цикл копирует исходный результат вместе с полным объектом outputs, полученным сайтом https://posthog.com/, описанием, creditsUsed и error. Добавляются только исходный URL и локальная метка квалификации.
n8n сопоставляется с account-n8n, но не проходит квалификацию, поскольку 1 389 сотрудников превышают верхний предел. Back Market не соответствует выбранным критериям отрасли, размера и страны, а Datablist меньше заданного диапазона и находится за пределами выбранных стран. Будущие неуспешные или неполные строки получат статус needs_review, а не будут незаметно удалены.
Вы можете скачать поддерживаемый синхронный пример с Requests или использовать асинхронную альтернативу на HTTPX из репозитория, если приложению нужен неблокирующий код.
Расчёт кредитов для парсинга компаний LinkedIn
Обработка стандартной страницы компании LinkedIn с названием стоит 25 кредитов. URL с числовым ID компании может потребовать 75 кредитов, если понадобится последний резервный источник, однако это не означает, что каждый числовой URL стоит 75 кредитов. Неудачные запросы или отсутствие совпадений также могут расходовать кредиты, поэтому фактическое потребление следует определять по общей стоимости задачи и значению creditsUsed в каждом результате.
Четыре URL с названиями из этого руководства израсходовали в общей сложности 100 кредитов. По стандартному тарифу для 1 000 страниц компаний потребуется 25 000 кредитов. Если во входных данных много URL с числовыми ID, предусмотрите запас на возможный сценарий с 75 кредитами.
Доступ к REST API требует тарифа Growth. Ежемесячный тариф включает 20 000 кредитов, а дополнительные кредиты приобретаются отдельно. При текущей базовой цене пополнения — $20 за 20 000 кредитов — один кредит стоит $0,001. По этому тарифу 25 000 кредитов обойдутся в $25. Актуальные тарифы и пакеты кредитов смотрите на странице цен Datablist.
Решение частых проблем с данными, задачами и результатами
- Отсутствует
DATABLIST_API_KEY: скрипт останавливается до отправки запроса. Экспортируйте переменную и снова запустите файл. - API отклоняет ключ: проверьте Personal API Key и убедитесь, что он передаётся в заголовке
X-API-Key, как в примере. - Некорректный исходный URL: замените ссылку на личный профиль или посторонний сайт, пустое значение либо URL с ошибкой на поддерживаемый публичный URL компании, учебного заведения, showcase page, компании с числовым ID или компании в Sales Navigator.
- Недостаточно кредитов: проверьте баланс, затем используйте включённые кредиты или пополните счёт перед созданием новой задачи.
- Задача получила статус
failedилиstopped: изучите ошибку, имеющиеся результаты и расход кредитов, прежде чем отправлять ещё одну платную задачу. - Результат содержит мало данных либо имеет статус
no_resultилиerror: сохраните исходный URL, статус, кредиты и ошибку для проверки. Перед повторной отправкой убедитесь, что входная ссылка ведёт на публичную страницу компании, не пытаясь угадать причину отсутствия данных.
Если ответ на создание задачи был потерян, используйте ID запроса, который скрипт вывел перед POST-запросом. Сначала получите список задач и найдите соответствующее значение в uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"Поле @id найденной задачи содержит её ID. Используйте его, чтобы продолжить проверку через /v1/enrichments/tasks/{taskId} или получить результаты через /v1/enrichments/tasks/{taskId}/results, вместо автоматического создания новой задачи. Один запрос может содержать до 10 000 входных записей и занимать до 10 МиБ. Срок хранения и другие особенности жизненного цикла описаны в документации по задачам.
Следующие шаги
Теперь у вас есть готовая к повторному использованию функция Python Requests, которая преобразует список URL страниц компаний LinkedIn в структурированные записи, а также локальный цикл квалификации, сохраняющий полный ответ API для sales research.
Замените четыре примера небольшим проверенным списком аккаунтов, сохраните постоянные ID и настройте правила по отрасли, числу сотрудников и стране под свой ideal customer profile. Если исходные данные — люди, а не компании, воспользуйтесь руководством по API для парсинга профилей LinkedIn. Если у вас есть только названия компаний, начните с поиска сайтов компаний на Python.