
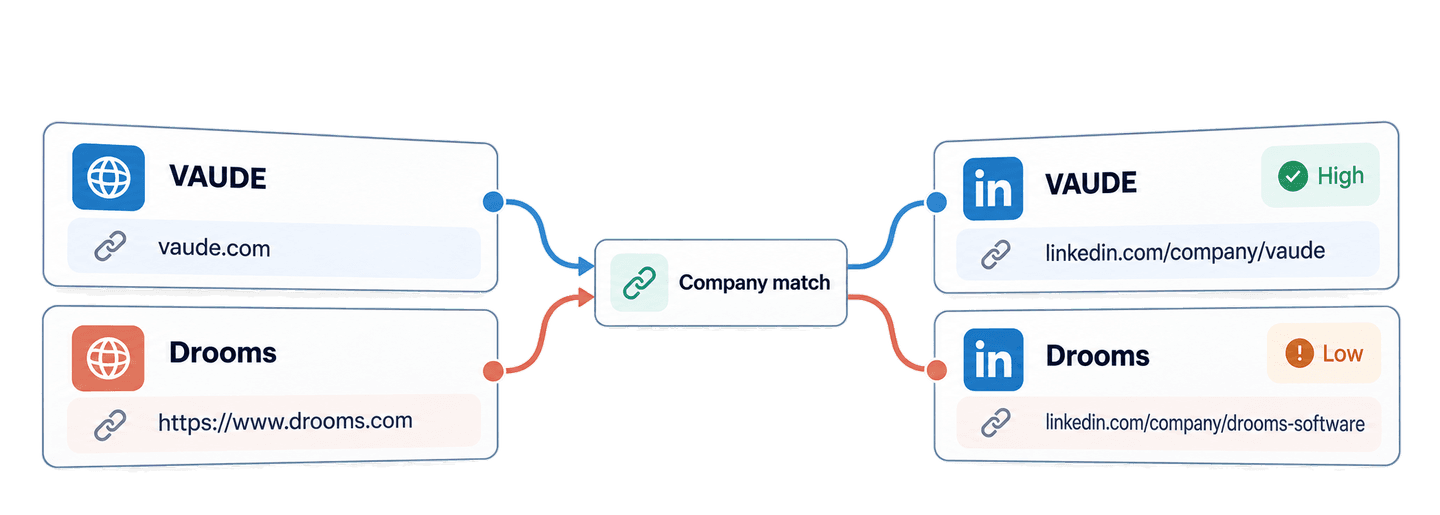
Используйте Company to LinkedIn API от Datablist, чтобы находить страницу компании в LinkedIn по её сайту с помощью Python. Можно отправить домен без протокола или полный URL сайта, дождаться выполнения задачи сопоставления и получить название компании, её сайт, URL страницы в LinkedIn и уровень достоверности.
В этом руководстве я использую Python и библиотеку Requests, чтобы сопоставить сайты пяти компаний. В список вошли известные разработчики ПО, а также VAUDE — производитель экипировки для активного отдыха — и Drooms, сервис виртуальных комнат данных. Затем я распределю результаты по двум локальным очередям: совпадения, готовые для исследования компаний, и совпадения, которые нужно проверить вручную.
🔑 Кратко для тех, кто спешит
Отправьте сайты из списка аккаунтов в Company to LinkedIn API от Datablist. API вернёт URL страниц компаний в LinkedIn и уровни достоверности, по которым можно определить, какие совпадения использовать, а какие проверить.
- Входные данные: домены без протокола и полные URL сайтов компаний.
- Результат: названия компаний, найденные сайты, URL страниц компаний в LinkedIn и уровень достоверности
highилиlow, распределённые по очередямReady for researchиNeeds review.
💡 Предпочитаете no-code решение? Используйте LinkedIn Company Pages & Domain Lookup от Datablist, чтобы сопоставлять сайты и страницы компаний в LinkedIn без написания кода.
Настройка Python и API-ключа Datablist
В этом примере используется пакет requests. Сам API работает по HTTP, поэтому впоследствии ту же последовательность запросов можно реализовать на другом языке.
Вам потребуется аккаунт Datablist с доступом к REST API, который предоставляется на тарифе Growth. За успешные запросы также списываются кредиты обогащения. Точный расчёт кредитов приведён ниже в руководстве.
Создайте рабочую директорию и файл find_linkedin_company_pages.py, затем создайте виртуальное окружение и установите Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyСоздайте персональный API-ключ в своём аккаунте Datablist, а затем экспортируйте его как переменную окружения:
export DATABLIST_API_KEY="your-api-key"Скрипт считывает это значение и передаёт его в заголовке X-API-Key.
Поиск страниц компаний LinkedIn одной функцией Python
В примере используются пять исходных аккаунтов:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Каждый account_id становится полем inputId в API. Это важно, поскольку результаты могут приходить не в том же порядке, что и входные данные. Стабильный идентификатор позволяет связать каждый результат с нужным исходным аккаунтом.
Вставьте следующий готовый скрипт в файл find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Запустите его командой:
python find_linkedin_company_pages.pyФункция последовательно выполняет три типа запросов.
Сначала POST отправляет пять сайтов с параметром matchingDirection, равным domain_to_linkedin. API отвечает статусом 202 Accepted и идентификатором задачи, поскольку сопоставление выполняется в фоновом режиме. При этом скрипт на Requests воспринимается как последовательный: он ждёт завершения операции, прежде чем перейти к следующему шагу.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Затем запрос статуса проверяет задачу, пока она не перейдёт в состояние completed, failed или stopped. Трёхсекундная пауза не позволяет скрипту непрерывно отправлять запросы статуса.
Наконец, запрос результатов загружает страницы максимум по 100 записей. Если nextCursor содержит значение, на следующем запросе цикл передаёт его в параметре cursor. Выполнение прекращается только тогда, когда nextCursor становится равен null.
Анализ совпадений и выбор записей для проверки
Ниже приведён полный список результатов для пяти входных записей:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Анализируйте status и confidence отдельно. API возвращает объект результата для каждой входной записи, включая записи без успешного результата. Статус success означает, что найден кандидат на страницу компании. Значение outputs.confidence показывает, подтверждено ли соответствие сайта. Поле inputId связывает объект с исходным аккаунтом, creditsUsed фиксирует списание за эту строку, а error содержит структурированное описание ошибки, если она возникла.
Сохраняйте в приложении весь объект outputs, даже если на первом экране нужны только URL LinkedIn и уровень достоверности. Поля companyName и companyWebsite ускоряют ручную проверку — особенно если регистр букв в найденном названии компании отличается или на вход был передан полный URL. Кроме того, они дают полезный контекст без дополнительного вызова API.
Сопоставление начинается с нормализации переданного сайта и поиска известной связи между сайтом и LinkedIn в базах данных компаний. Затем входной домен сравнивается с сайтом, указанным на найденной странице компании в LinkedIn. Совпадение зарегистрированных доменов даёт уровень достоверности high.
Если в наборах данных нет URL LinkedIn, система может выполнить целевой поиск кандидатов на страницы компаний через Google. Если кандидата нельзя подтвердить по опубликованному сайту, результат может получить уровень достоверности low. Кандидат с заведомо несовпадающим сайтом не принимается.
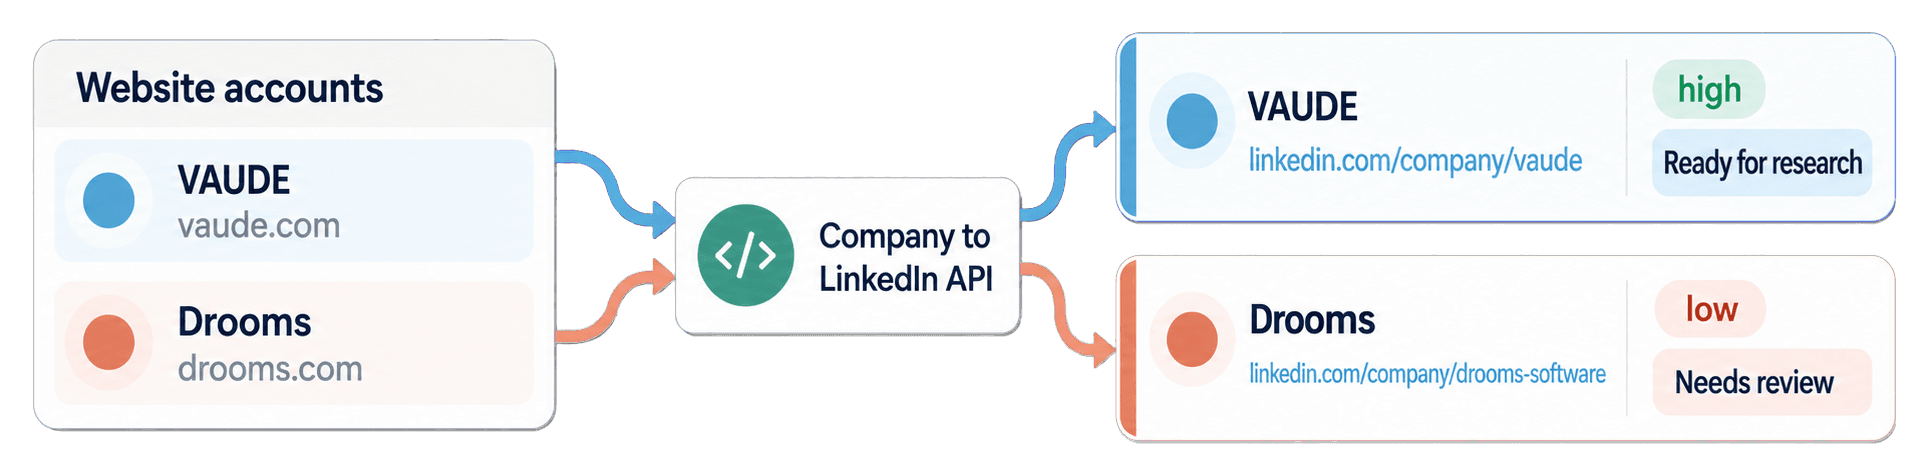
Воспринимайте уровень достоверности как инструкцию по проверке. Для VAUDE был найден адрес https://www.linkedin.com/company/vaude с уровнем high, поэтому запись можно добавить в очередь исследования. Для Drooms был возвращён адрес https://www.linkedin.com/company/drooms-software с уровнем low. Прежде чем полагаться на эту связь, откройте сайт Drooms и страницу компании в LinkedIn.
Для Datablist, PostHog и n8n также получены совпадения с высокой достоверностью. Этот API устанавливает связь между сайтом и страницей компании. Если после проверки URL вам нужны численность компании, отрасль или другие данные страницы, перейдите к руководству по LinkedIn company scraper API.
Создание очереди для исследования компаний
Теперь повторно используйте match_results, чтобы подготовить локальную очередь для ручного исследования компаний. Этот блок не обращается к API повторно. Он индексирует результаты по inputId, а затем проходит по исходному списку аккаунтов, чтобы каждая входная запись оставалась видимой, даже если в будущем для неё не окажется результата.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Словарь результатов делает объединение независимым от порядка ответа. Запись account-vaude связывает исходную строку vaude.com с найденной страницей VAUDE и попадает в ready_for_research. Запись account-drooms сохраняет полный входной URL и весь результат API, но направляется в needs_review, поскольку уровень достоверности низкий, хотя статус результата — success.
По той же логике отсутствующая строка или строка со статусом no_result либо ошибкой останется в очереди проверки. Два выведенных списка дают команде понятную отправную точку для ручного исследования компаний.
Также можно скачать поддерживаемый разработчиками синхронный пример на Requests. В репозитории есть и асинхронный пример на HTTPX для приложений, которым нужны неблокирующие HTTP-запросы, но для первой интеграции проще разобраться с приведённой выше блокирующей версией.
Обратный поиск сайта по странице компании LinkedIn
Та же функция принимает страницы компаний в LinkedIn, если изменить направление сопоставления. Это полезно, когда исходный список содержит URL страниц компаний, а сайты нужны для совместимого обогащения данных о компаниях или рабочих email.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Стандартный поиск по странице компании в LinkedIn тарифицируется по обычной ставке сопоставления. Поиск по числовым ID компаний и URL компаний из Sales Navigator может стоить 10 кредитов, поскольку для них используется другой сценарий обратного поиска. Если нужен no-code вариант, прочитайте, как получить URL сайтов по страницам компаний в LinkedIn.
Расчёт кредитов для поиска LinkedIn по сайту
Один успешный стандартный поиск страницы LinkedIn по сайту расходует 1,5 кредита. Следовательно, на пять показанных совпадений ушло 7,5 кредита. По той же ставке 1 000 успешных совпадений потребуют 1 500 кредитов. За некорректные входные данные и строки без результата может быть списано ноль кредитов, поэтому фактический расход проверяйте в поле creditsUsed каждого результата.
Доступ к REST API входит в тариф Growth, а ежемесячная подписка оплачивается отдельно от дополнительных кредитов. Дополнительный пакет за $20 включает 20 000 кредитов, поэтому один кредит стоит $0,001. При расходе 1,5 кредита за успешное совпадение 1 000 совпадений потребуют 1 500 кредитов стоимостью $1,50. Актуальные тарифы и пакеты смотрите на странице цен Datablist.
Решение частых проблем с данными, задачами и результатами
- Отсутствует
DATABLIST_API_KEY: скрипт остановится до отправки запроса. Экспортируйте переменную окружения и снова выполните команду. - API отклоняет ключ: убедитесь, что вы скопировали персональный API-ключ и запрос передаёт его только в заголовке
X-API-Key. - Формат входных данных не поддерживается: для
domain_to_linkedinиспользуйте сайт или домен компании. Для обратного направления укажите поддерживаемый URL страницы компании, а не личный профиль или пустое значение. - Недостаточно кредитов: проверьте баланс, затем используйте включённые в тариф кредиты или пополните счёт перед созданием новой задачи.
- Задача получила статус
failedилиstopped: проверьте статус задачи, ошибку, уже полученные результаты и расход кредитов, прежде чем отправлять её повторно. - Результат имеет низкую достоверность, статус
no_resultили ошибку: сохраните исходный сайт и полный результат вneeds_review. Если найдена страница-кандидат, откройте её. Не пытайтесь угадать причину отсутствия результата.
Если соединение прервалось при создании задачи, используйте значение uniqueId, выведенное перед запросом POST. Получите список своих задач и найдите это значение, прежде чем создавать новую задачу:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"Список задач нельзя отфильтровать по uniqueId, поэтому проверьте каждую возвращённую задачу и при необходимости переходите по nextCursor. Найдя нужное значение, используйте его @id с теми же URL статуса и результатов, что и в скрипте.
Одна задача может содержать до 10 000 входных записей. Полные сведения об ограничениях запросов, сроках хранения задач и пагинации приведены в документации Company to LinkedIn API.
Следующие шаги
Теперь у вас есть одна универсальная функция Python Requests, которая превращает сайты компаний в кандидатов на страницы компаний в LinkedIn. Локальная очередь оставляет совпадения с высокой достоверностью готовыми к исследованию, а сомнительные и неуспешные записи — доступными для проверки.
Замените пять примеров небольшим списком аккаунтов, проверьте каждого кандидата с низкой достоверностью, а затем используйте подтверждённые URL для ручного исследования компаний или как входные данные для LinkedIn company scraper API. Если исходный список содержит названия компаний вместо сайтов, начните с руководства по API для поиска сайтов компаний.