
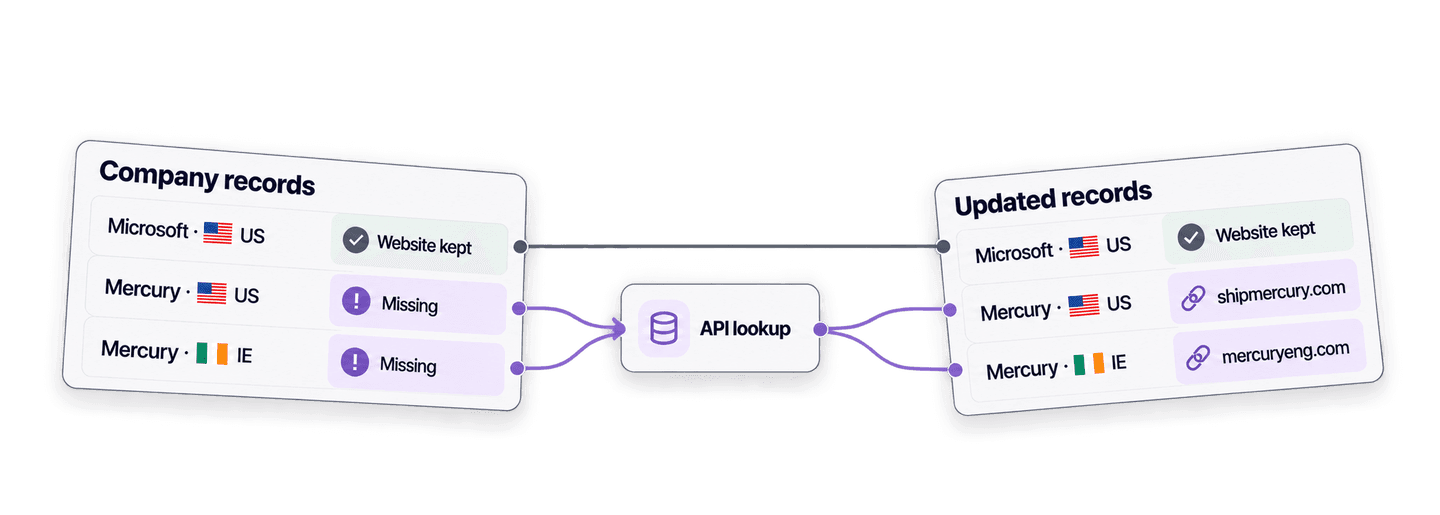
För att hitta ett företags webbplats utifrån företagsnamnet i Python skickar du namnet och eventuell tillgänglig landsinformation till Datablists Company Name to Domain API. API:et bearbetar sökningen i bakgrunden och returnerar sedan domänen och den fullständiga webbadressen.
Först visar jag en enkel API-request i Python. Därefter återanvänder jag samma funktion för att endast fylla i webbplatser som saknas i en lista med företagsposter, utan att ändra de URL:er som redan finns.
Om du föredrar ett kalkylbladsliknande gränssnitt kan du följa vår guide för att hitta webbplatser från företagsnamn i bulk.
💡 Snabb sammanfattning
Skapa en Python-funktion som hittar webbplatser från företagsnamn och använd den sedan för att komplettera poster där webbplatsen saknas, utan att ersätta kända URL:er.
- Input: företagsnamn med valfri landsinformation.
- Output: domän, fullständig webbplats-URL, konfidensnivå, resultatstatus och förbrukade credits.
Konfigurera Python och din Datablist API-nyckel
I det här exemplet använder jag paketet Requests för synkrona HTTP-anrop. Installera det i en virtuell miljö:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsDu behöver också Datablist Growth eftersom åtkomst till REST API är en Growth-funktion. Skapa en Personal API Key på din API-kontosida i Datablist och lägg sedan nyckeln i en miljövariabel:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Har du redan en API-nyckel? Äldre nycklar använder formatet
auth0|<userId>:<accountId>:<secret>:1. De stöds fortfarande. Fortsätt använda din befintliga nyckel exakt som den genererades – du behöver varken byta ut eller formatera om den.
Ersätt exempelvärdet ovan med nyckeln som genererades på din kontosida. Sökningar efter företagswebbplatser förbrukar credits. Innan vi skalar upp scriptet förklarar jag alternativen som kostar 1 respektive 2,5 credits. Aktuella priser hittar du på Datablists prissida.
Sök efter en företagswebbplats med Python
Skapa en fil med namnet find_company_websites.py. Scriptet skickar in namnen, väntar på att jobbet ska bli klart och hämtar resultaten i en och samma funktion. Varje input använder postens stabila ID som inputId, så att du kan koppla varje resultat till rätt post även om ordningen i svaret ändras.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Kör scriptet i terminalen där du exporterade nyckeln:
python find_company_websites.pySå här ser resultatet för Microsoft ut:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Använd inputId för att koppla resultatet till den ursprungliga posten. status kan vara success, no_result, error eller skipped. Ett lyckat resultat kan innehålla companyDomain, hela companyUrl och domainConfidence. creditsUsed visar kostnaden för denna input, medan error förklarar eventuella fel på postnivå.
Funktionen gör tre typer av API-anrop i tur och ordning.
Först skickar den in sökningen. Payloaden innehåller inställningarna och företagsposterna. POST-anropet returnerar 202 Accepted, och @id är det task-ID som behövs i nästa anrop:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Om DATABLIST_API_KEY inte är definierad utlöser Python ett KeyError när miljövariabeln läses, innan någon HTTP-request görs. Exportera variabeln och kör sedan scriptet igen. Om variabeln innehåller en ogiltig nyckel når POST-anropet API:et och returnerar HTTP 401. Kopiera en aktuell Personal API Key från din kontosida och ersätt det ogiltiga värdet.
Därefter pollar den jobbet. POST-anropet startar ett bakgrundsjobb, så scriptet hämtar dess status var tredje sekund tills den blir completed, failed eller stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Om jobbet misslyckas på grund av att det saknas credits anges orsaken credits_error i felmeddelandet. Lägg till credits eller vänta tills dina månadscredits förnyas, granska eventuella resultat som redan har returnerats och skicka sedan endast de ofärdiga posterna i ett nytt jobb.
Till sist hämtar den alla resultatsidor. Varje svar lägger till resultat i listan och innehåller den cursor som behövs för nästa request:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakScriptet fortsätter att hämta nästa sida tills nextCursor är null.
Scriptet skriver ut det genererade uniqueId före POST-anropet. Om anslutningen bryts innan du får svaret som bekräftar att jobbet skapats bör du först lista dina jobb och kontrollera deras status innan du skapar ett nytt:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Leta upp jobbet vars uniqueId matchar värdet som scriptet genererade och kopiera dess @id. List-endpointen kan filtrera efter enrichmentId, men inte efter uniqueId. Använd detta @id med samma URL:er för status och resultat som scriptet använder. Fortsätt polla jobbet om det fortfarande är aktivt. Om det har stoppats eller misslyckats bör du kontrollera om det finns delresultat innan du skickar in posterna igen.
Så fungerar datasetmatchning och landbaserad fallback
Scriptet använder dataset_google, vilket är den rekommenderade standardinställningen. Datablist söker först i sina företagsdataset. Om en matchning saknas eller om uppgifterna inte stämmer överens kan Google användas som fallback. Möjliga träffar kontrolleras innan en konfidensnivå returneras.
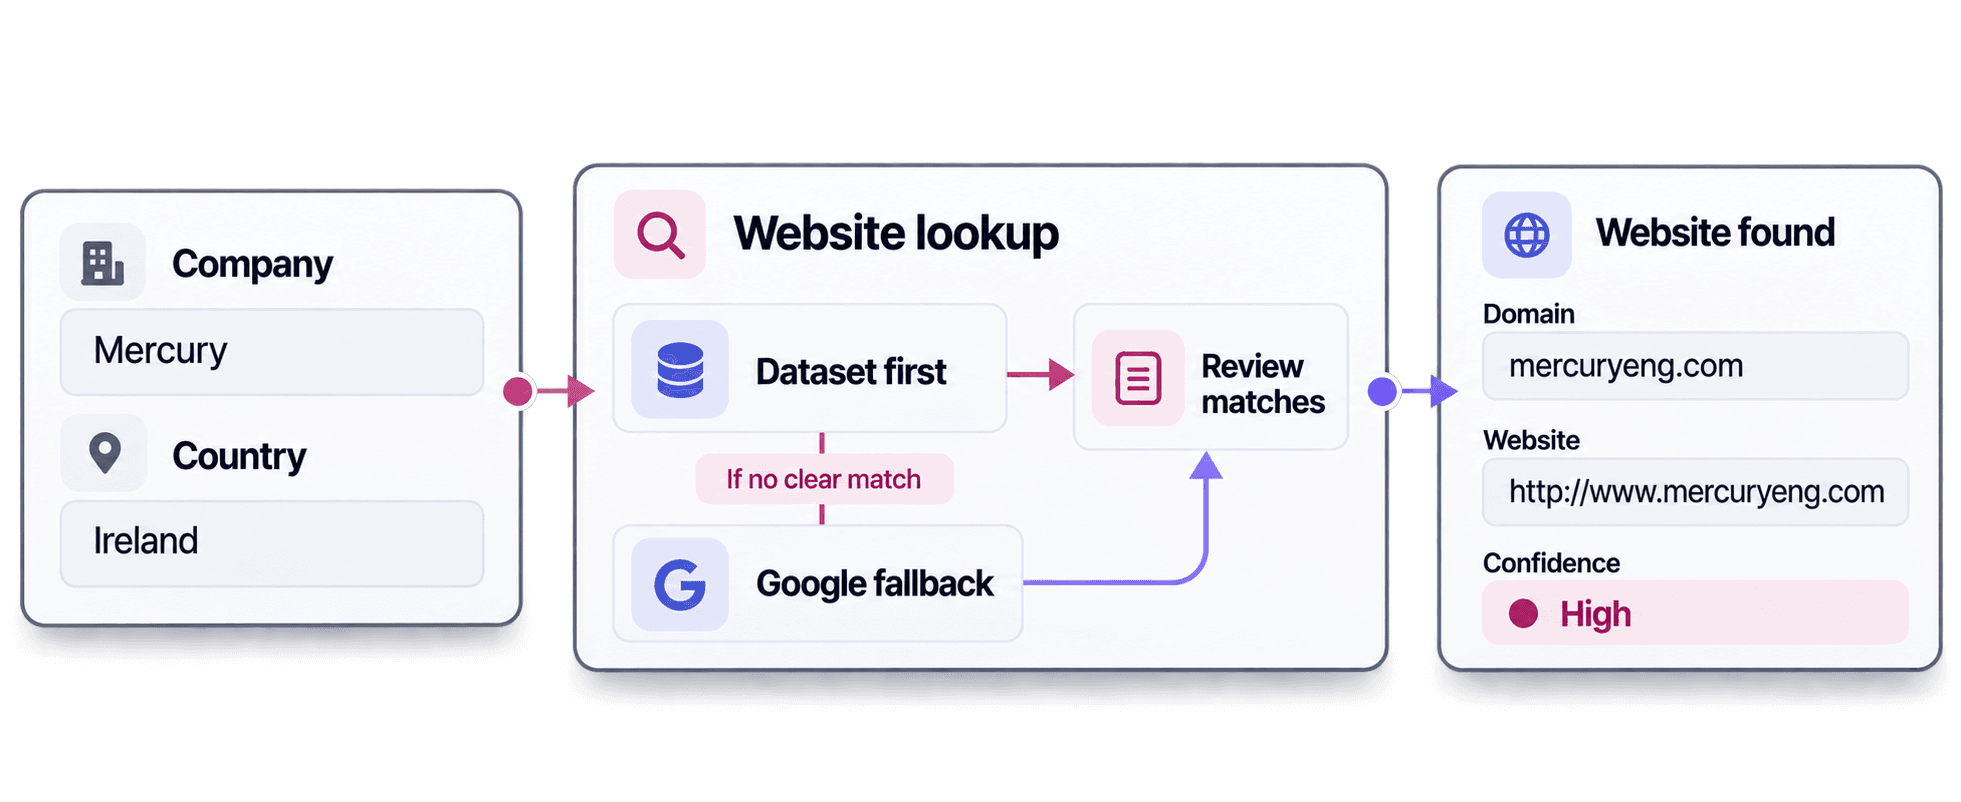
Landsinformation hjälper när företagsnamn är tvetydiga. I det här exemplet gav samma företagsnamn olika resultat:
MercurymedUSreturneradeshipmercury.comochhttps://www.shipmercury.com/.MercurymedIEreturnerademercuryeng.comochhttp://www.mercuryeng.com.
Båda hade konfidensnivån High. Landsinformationen hjälper sökningen att välja mellan företag med samma namn, medan konfidensnivån visar vilka resultat som behöver granskas.
När matchningen även beror på bransch, företagsstorlek eller annan affärskontext kan du använda research-flödet med AI Agent. Lägg till dessa uppgifter i din AI Agent-prompt, så att agenten kan hitta rätt företag med hjälp av mer detaljerad affärskontext.
Fyll endast i webbplatser som saknas
Nu när find_domains() kan hitta en webbplats från ett företagsnamn kan du återanvända funktionen för att endast fylla i saknade webbplatser i dina företagsposter. Poster som redan har en webbplats skickas inte till API:et. Deras värden förblir därför oförändrade och inga credits förbrukas för dem.
I find_company_websites.py ersätter du allt från companies = [ till och med den sista utskriftsloopen med kodblocket nedan. Behåll tilldelningen av api_key ovanför blocket. Kontrollen av tomma värden hanterar None, en tom sträng och blanksteg. Inget API-anrop görs om alla poster redan har en webbplats.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))Koden indexerar resultaten efter inputId och går sedan igenom originalposterna i ordning. Objektet website_lookup sparar utfallet och granskningsinformationen bredvid varje post som behandlats, inklusive misslyckade resultat och resultat som saknas.
För crm-001 returnerar website_is_missing() värdet False, eftersom Microsofts URL redan finns. Posten läggs inte till i records_to_lookup, så API:et tar aldrig emot den. Vid sammanslagningen behålls webbplatsen och statusen anges som not_requested.
För crm-002 är webbplatsfältet tomt, så bageriet skickas i requesten med inputId: crm-002. API:et returnerar samma inputId. results_by_id använder detta ID för att hitta rätt resultat, och vid sammanslagningen skrivs https://boulangerie-du-palais-lyon.eatbu.com till rätt post utan att koden behöver förlita sig på resultatens ordning.
| ID | Företag | Webbplats efter sammanslagning | Status | Domän | Konfidens | Credits |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
Bageriet använder en företagsspecifik subdomän, boulangerie-du-palais-lyon.eatbu.com. Behåll det värdet i stället för att korta ned det till eatbu.com, och spara den exakta adressen från companyUrl. Inställningen acceptNonRoot: true tillåter även en hostad företagssida vars adress innehåller en sökväg efter värdnamnet. Därför är hela URL:en viktig i båda fallen.
Ett slutfört jobb kan fortfarande innehålla poster med no_result, error eller skipped. Exemplet ändrar endast website när statusen är success och companyUrl finns. Vid no_result lämnas webbplatsfältet tomt och statusen syns fortfarande i website_lookup. Kontrollera först företagsnamnet och landet. Om någon av uppgifterna är fel rättar du den och skickar posten i ett nytt jobb. Annars låter du webbplatsfältet förbli tomt för manuell granskning.
Beräkna credits innan du skalar upp scriptet
Alla fem exempelsökningar returnerade success med konfidensnivån High och använde sammanlagt 5 credits.
En sökning som löses via datasetet kostar 1 credit. En sökning som bearbetas med Google kostar 2,5 credits. Du betalar för den väg som används, inte för båda. För 1 000 inputs innebär det 1 000 credits om alla löses via datasetet eller 2 500 credits om alla använder Google. Det här är beräkningsscenarier, inte ett löfte om att varje sökning ger ett resultat.
Flytta reglaget för att jämföra förbrukningen av credits för din lista.
Med ett pris på 20 USD för 20 000 credits kostar dessa scenarier 1 USD respektive 2,50 USD. Growth-prenumerationen är separat och innehåller för närvarande 20 000 credits per månad, vilka används före eventuella tilläggsköp. Se aktuella priser, eftersom priser och paket kan ändras.
Ett jobb kan ta emot upp till 10 000 inputs, med en gräns på 16 KiB per input och 10 MiB per request. Det här exemplet använder blockerande Requests-anrop för att skicka, polla och hämta resultat från ett litet asynkront Datablist-jobb. Det underhållna kodbiblioteket innehåller även exempel på CSV-batchning och icke-blockerande klienter.
Nästa steg
När du har verifierat att en returnerad webbplats tillhör rätt företag kan du scrapa dess Impressum med Python för att lägga till juridiska företagsuppgifter och URL:en till den juridiska källsidan i samma leverantörspost. Håll granskningen av webbplatsmatchningen åtskild från den efterföljande dataextraktionen.
Ersätt exempelposterna med ett litet urval av dina egna data. Kör sedan scriptet och granska de sammanslagna posterna. Behåll stabila ID:n och landsinformation, och skala inte upp förrän du har bekräftat att scriptet bevarar befintliga webbplatser och fyller i rätt tomma fält. Du kan utgå från de underhållna exemplen för Company Name to Domain API på GitHub om du vill ha ett nedladdningsbart script, CSV-batchning eller en asynkron version.