
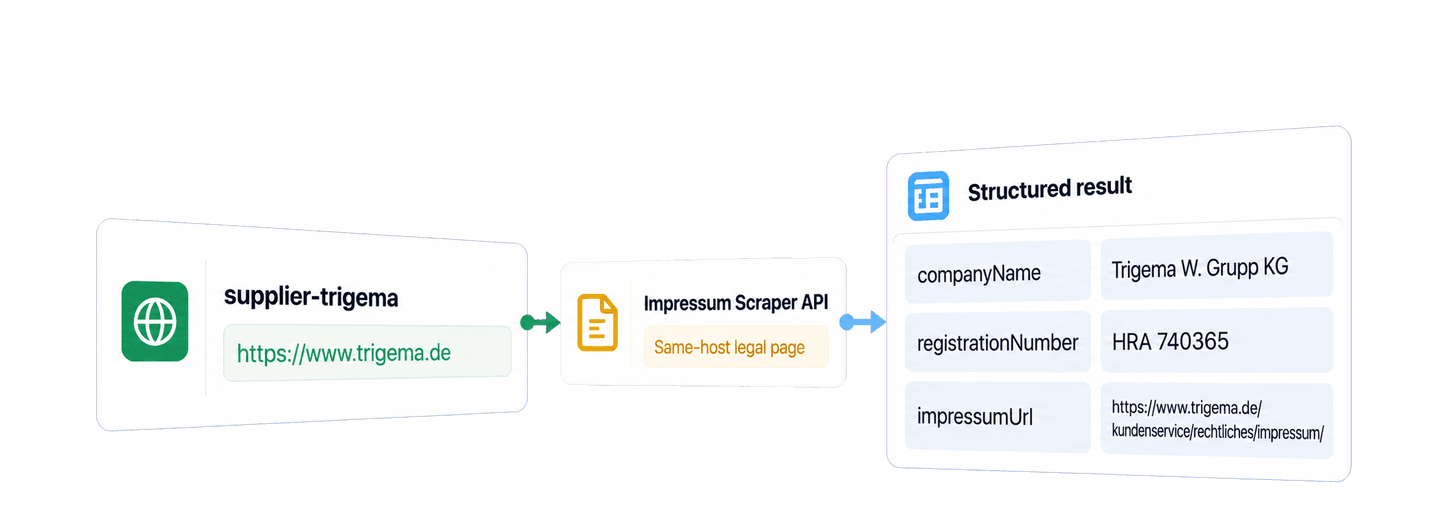
Skrapa Impressum-data i Python utan att bygga en egen crawler genom att använda Datablists Impressum Scraper API tillsammans med biblioteket Requests. Du skickar in företagens webbadresser, API:et hittar varje sajts Impressum-sida och extraherar strukturerade företags- och kontaktuppgifter.
I det här exemplet använder jag två etablerade tyska varumärken: klädtillverkaren Trigema och friluftsmärket VAUDE. Ett litet körbart Python-exempel utför sökningen och sparar sedan de extraherade uppgifterna och Impressum-sidans käll-URL tillsammans med varje leverantörspost.
📌 Snabb sammanfattning
Använd Datablists Impressum Scraper API för att omvandla tyska företagswebbplatser till strukturerade företags- och kontaktuppgifter. Python-exemplet skickar in två webbplatser, väntar på bakgrundsjobbet, hämtar alla resultatsidor och sparar URL:en till den juridiska källsidan tillsammans med varje post.
- Input: Webbadresser till tyska företag.
- Output: Företags- och kontaktuppgifter samt en länk till Impressum-källan.
💡 Föredrar du en no-code-lösning? Använd Datablists Impressum Scraper för att extrahera företagsuppgifterna utan att skriva kod.
Konfigurera API-nyckeln och Python-miljön
Skapa ett Datablist-konto och därefter en Personal API Key. Åtkomst till REST API ingår i Growth-planen. Så här kan nyckelns format se ut:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Exportera din egen nyckel som DATABLIST_API_KEY:
export DATABLIST_API_KEY="your-personal-api-key"I det här Python-exemplet använder jag paketet requests. Skapa en fil med namnet
scrape_impressum.py och installera paketet:
python -m pip install requestsVarje inskickad webbplats kostar 10 credits. Exemplet nedan med två webbplatser använder 20 credits när båda posterna behandlas.
Bygg funktionen scrape_impressums()
Klistra in hela skriptet i scrape_impressum.py:
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))Kör hela skriptet med:
python scrape_impressum.pyFunktionen följer API-flödet i tre steg. Den skickar in webbplatserna, väntar tills jobbet är klart och hämtar sedan alla resultatsidor.
Skicka in webbadresserna
Skriptet omvandlar varje leverantör till ett API-input i det här formatet:
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId är din egen beständiga identifierare. data.websiteUrl är företagets startsida som scrapern ska granska. Använd företagets egen webbplats, inte en katalog eller profil i sociala medier. Payloaden väljer den publika enrichment-funktionen impressum-scraper och använder ett tomt settings-objekt eftersom detta API inte kräver några publika inställningar.
POST-anropet skapar ett bakgrundsjobb. Datablist tar emot anropet och returnerar ett task-objekt där @id identifierar den aktuella körningen. Funktionen använder detta ID för att skapa URL:erna för status och resultat.
Ett förkortat svar när jobbet skapas ser ut så här:
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}
queued betyder att anropet har tagits emot, inte att resultatet är klart. Skriptet tar med det returnerade @id till de följande två stegen, så att du slipper kopiera jobbets URL:er manuellt. Det anropar också raise_for_status() innan varje svar läses. Ett autentiserings- eller valideringsfel stoppar därför körningen vid det HTTP-anrop som misslyckades, i stället för att felaktigt tolkas som en slutförd sökning.
Vänta på bakgrundsjobbet
Datablist behandlar jobbet i bakgrunden. Exemplet kontrollerar dess status var tredje sekund tills den blir completed, failed eller stopped. Requests är ett blockerande Python-bibliotek, så ditt lokala skript väntar under dessa anrop även om själva API-jobbet körs i bakgrunden.
Om jobbet avslutas med failed eller stopped genererar funktionen ett fel som innehåller jobbets ID och slutstatus. Spara detta ID när du undersöker det befintliga jobbet i stället för att direkt skicka in samma betalda arbete igen.
Hämta alla resultatsidor
När jobbet är klart begär skriptet upp till 100 resultat åt gången. Sidnumreringsregeln är enkel: hämta nästa sida tills nextCursor är null. När markören innehåller ett värde skickar skriptet med det i nästa anrop.
Koppla inte ihop de returnerade posterna med din applikation utifrån deras position i listan. Resultaten kan komma i en annan ordning än de inskickade posterna. Använd inputId som join-nyckel.
Så hittar API:et en Impressum-sida
Startsidan är utgångspunkten, inte sidan som API:et förväntas extrahera data från. Impressum Scraper använder AI för att granska interna länkar på den angivna hosten och identifiera en Impressum-sida eller en motsvarande juridisk sida eller kontaktsida. Det är viktigt eftersom länken kan ligga under benämningar som Rechtliches, Kontakt eller Legal i stället för på /impressum.
Om AI inte hittar någon lämplig intern länk testar scrapern de vanliga sökvägarna /impressum och /imprint på samma host. När den har nått en källsida använder den AI för att extrahera juridiskt företagsnamn, adress, kontaktuppgifter, registreringsnummer, VAT-nummer och källfält till ett enda resultat. Den använder inte någon sökmotor och går inte vidare till en extern katalog.
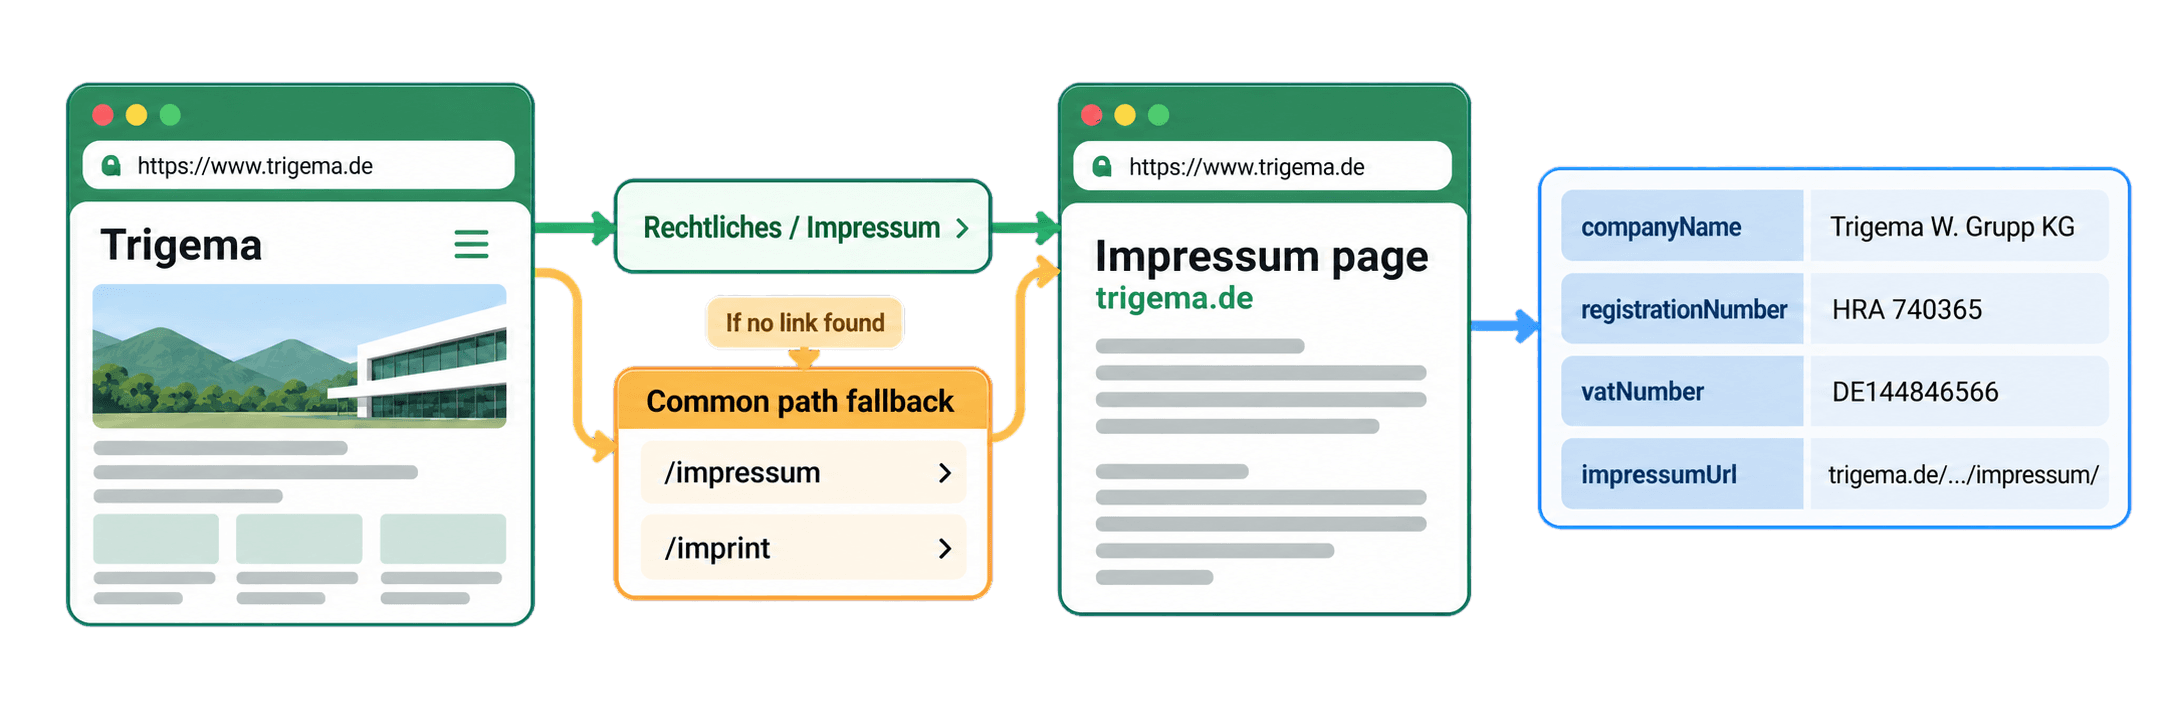
De två resultaten visar hur sökvägarna kan variera i praktiken. För Trigema returnerades /kundenservice/rechtliches/impressum/, medan VAUDE gav /de/de/impressum.html. Spara impressumUrl tillsammans med varje resultat, eftersom fältet anger den exakta källsidan för de extraherade uppgifterna.
Tolka resultaten för Trigema och VAUDE
Här är ett kompakt utdrag ur de två exempelresultaten.
📘 Exempel på e-postadresser: E-postadresserna är maskerade med
**nedan. API:et returnerar de fullständiga adresserna.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
Börja med namnen. Trigema är leverantörens etikett i Python-inputen, medan Trigema W. Grupp KG är det juridiska företagsnamn som extraherades från Impressum-sidan. Samma skillnad finns för VAUDE: etiketten i inputen är VAUDE, medan det returnerade företagsnamnet är VAUDE Sport GmbH & Co. KG. Genom att behålla båda värdena kan du spara det välkända namn som teamet använder och samtidigt lägga till den juridiska person som anges på företagets egen webbplats. Det är särskilt användbart när du jämför en leverantörspost med en faktura, ett avtal eller ett annat företagsdataset där det längre juridiska namnet kan användas.
De returnerade fälten besvarar olika frågor i din research:
firstNameochlastNameinnehåller namnet på vd:n eller grundaren som extraherats från sidan, när uppgiften finns. Här är det Wolfgang Grupp och Antje von Dewitz.postalAddressanger företagsadressen som extraherats från den juridiska sidan, medan fälten för e-post och telefon innehåller kontaktuppgifterna som publicerats där.registrationNumberochvatNumberbevarar identifierarna som står på sidan. För Trigema är värdenaHRA 740365ochDE144846566; för VAUDE är deHRA 631071ochDE203894755. Det ger dig konkreta värden att jämföra med identifierarna som redan finns i dina leverantörsdata.impressumUrlidentifierar sidan som användes för extraheringen. Den skiljer sig från den inskickade startsidan eftersom den ena anger företaget du utgick från och den andra dokumenterar källan till de juridiska företagsuppgifterna.
Båda posterna har status: success och använde 10 credits. agentConfidenceScore är en signal från 0 till 100 som hjälper dig att prioritera granskningen. Det är inte ett procentvärde för träffsäkerhet. Output-fält kan fortfarande vara tomma om ett värde saknas på sidan eller inte kan extraheras. Spara därför postens status och öppna den returnerade Impressum-URL:en när en uppgift är viktig för nästa steg.
Dokumenterad output kan även innehålla kön, telefonnummer och andra kontaktuppgifter. Se API-dokumentationen för Impressum Scraper för aktuellt schema.
Skapa leverantörsposter av resultatet
Det direkta API-anropet fungerar redan. Nu sätter vi in det i en researchprocess för leverantörer. När du hittar eller onboardar leverantörer får du kanske ett beständigt ID, det kortnamn teamet använder och en startsida. Impressum-resultatet kompletterar detta med det juridiska företaget bakom webbplatsen, dess publicerade identifierare och kontaktuppgifter samt sidan där informationen hittades.
Följande kod indexerar resultaten efter inputId och skapar lokala poster för företagsresearch. Lägg till den efter anropet till scrape_impressums() i det fullständiga skriptet:
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))För Trigema bevarar posten supplier-trigema, visningsetiketten Trigema och https://www.trigema.de. Det nästlade objektet outputs lägger till Trigema W. Grupp KG, företagets adress och identifierare, det returnerade namnet Wolfgang Grupp samt Impressum-sidans käll-URL. VAUDE-posten följer samma kedja från etiketten VAUDE och startsidan till VAUDE Sport GmbH & Co. KG och dess egen källsida. Nu kan du jämföra eller gruppera poster efter juridiskt företag utan att förlora den ursprungliga leverantörsidentitet som initierade din research.
Posten samlar de returnerade uppgifterna, lyckad API-status, förbrukningen på 10 credits och det publika felvärdet tillsammans med leverantörens ID, etikett och webbplats.
Den viktiga merge-regeln är uppslagningen i dictionaryn med leverantörens ID. Den kopplar fortfarande ihop rätt resultat om API:et returnerar VAUDE före Trigema. Kodexemplet behåller även misslyckade resultat i company_research, eftersom det inte filtrerar efter status. En post med no_result eller error finns därför kvar med sitt ID och felmeddelande i stället för att försvinna från granskningskön.
Koden förbereder lokala researchposter. Du kan serialisera listan eller skicka den vidare till din egen kod utan ytterligare ett API-anrop.
Beräkna kostnaden för API:et
Impressum Scraper kostar alltid 10 credits per inskickad webbplats. De två exempelwebbplatserna använde totalt 20 credits. Med samma pris använder 1 000 webbplatser 10 000 credits.
Growth-planen ger åtkomst till REST API och inkluderar credits i abonnemanget. Vid behov kan du köpa ytterligare credits genom top-ups. Planåtkomst, inkluderade credits och top-ups är separata delar av kostnaden. Kontrollera därför Datablists aktuella priser innan du planerar en större körning.
Lös vanliga problem utan att betala dubbelt
Skriptet stoppas innan något anrop görs
Om DATABLIST_API_KEY saknas genererar skriptet felet Set DATABLIST_API_KEY before running this script. Exportera variabeln i samma terminal och kör filen igen:
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyAPI:et avvisar anropet
response.raise_for_status() stoppar körningen vid ett HTTP-fel. Kontrollera att du har angett en giltig Personal API Key och att kontot har åtkomst till REST API. Detta skiljer sig från när variabeln saknas: ett ogiltigt värde når API:et och får ett HTTP-svar.
Jobbet misslyckas eller stoppas
Felmeddelandet innehåller jobbets ID och status. Granska det befintliga jobbet, dess resultat och credit-fält innan du skapar ett nytt jobb. Ett misslyckat eller stoppat jobb kan fortfarande innehålla resultat och ha förbrukat credits, så en omedelbar upprepning kan innebära att du betalar för samma arbete två gånger.
Ett resultat är ofullständigt
Ett slutfört jobb kan innehålla no_result, error eller ofullständig output på postnivå. Spara postens inputId, status, impressumUrl när den finns och det publika fältet error. Kontrollera att inputen är företagets egen startsida eller rotdomän och granska sedan sajten innan du avgör om en ny sökning är meningsfull.
Dokumentationen om tasks förklarar statusar, sidnumrering av resultat, jobbhistorik, gränser och lagringstider mer ingående.
Nästa steg
Nu har du en körbar integration med Python Requests som skickar in tyska företagswebbplatser, väntar på jobbet i Impressum Scraper, hämtar alla resultatsidor och sparar strukturerade företagsuppgifter tillsammans med deras käll-URL:er i lokala researchposter för leverantörer.
Ersätt de två exempelleverantörerna med dina egna beständiga ID:n och webbadresser. Granska sedan varje returnerad impressumUrl innan du använder de extraherade fälten i efterföljande processer. Du kan ladda ner det underhållna
synkrona Requests-exemplet
eller byta till repositoriets
asynkrona HTTPX-exempel
när du behöver icke-blockerande parallell körning.