
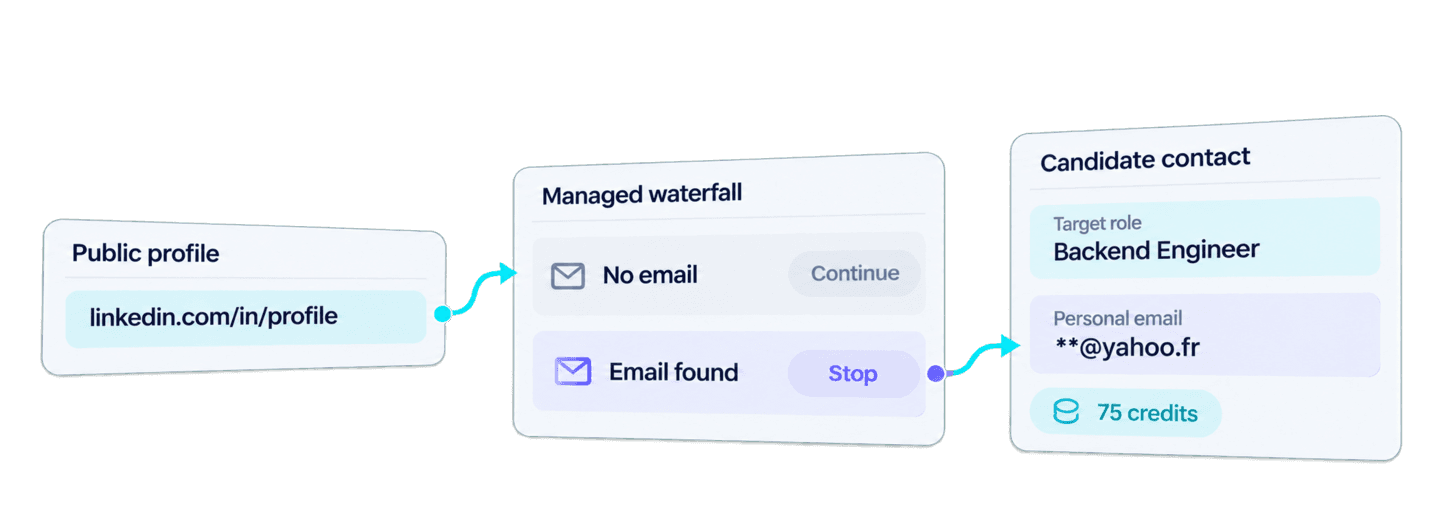
Du kan hitta privata mejladresser från LinkedIn i Python genom att skicka offentliga profil-URL:er i formatet linkedin.com/in/... till Datablists Waterfall Personal Email Finder API. API:et kör en hanterad sekvens av tillgängliga mejlleverantörer och returnerar en privat adress när någon av dem hittar ett resultat.
Det kompletta Requests-exemplet nedan skickar in en bakgrundsuppgift, väntar tills den är klar och hämtar samtliga resultatsidor. När sökningen fungerar kan du återanvända de returnerade objekten för att skapa kontaktposter för rekrytering, där varje kandidats namn, LinkedIn-URL och målroll sparas tillsammans med den hittade mejladressen.
Det här arbetsflödet söker efter en privat mejladress som är oberoende av kandidatens nuvarande arbetsgivare. Om du i stället behöver en adress kopplad till personens företag kan du följa den separata guiden om att hitta en jobbmejl från en LinkedIn-profil.
🔑 Snabb sammanfattning
Ange kandidaternas namn, offentliga LinkedIn-profil-URL:er och målroller. Python-arbetsflödet hittar tillgängliga privata mejladresser och sparar varje adress tillsammans med rekryteringsuppgifterna du började med.
- Input: Kandidatnamn, offentliga profil-URL:er i formatet
linkedin.com/in/...och målroller.- Output: Hittade privata mejladresser tillsammans med rätt kandidatuppgifter.
💡 Föredrar du en no-code-lösning? Använd Datablists Waterfall Personal Email Finder för att hitta privata mejladresser utan att skriva kod.
Om källdatan innehåller namn men inga profil-URL:er kan du först hitta offentliga LinkedIn-profiler i Python och sedan skicka URL:erna till detta API.
Konfigurera Python, Requests och din Datablist API-nyckel
I det här exemplet använder jag Python med paketet requests. Skapa filen find_personal_emails.py och installera sedan Requests:
python -m pip install requestsSkapa en Personal API Key i ditt Datablist-konto och exportera den som en miljövariabel:
export DATABLIST_API_KEY='your-api-key'Åtkomst till REST API ingår i Growth-planen. Ett lyckat resultat för en privat mejladress förbrukar också credits, vilket jag räknar på i kostnadsavsnittet nedan.
Hitta en privat mejladress med en Python-funktion
Den redigerbara listan candidates i skriptet innehåller en rekryteringspost. target_role är ett exempelvärde från källdatan som stannar lokalt i rekryteringsflödet. Endast candidate_id och linkedin_url skickas med i API-anropet.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Kör filen från samma terminal:
python find_personal_emails.pyDu kan också ladda ned det underhållna synkrona Requests-exemplet. Skriptet ovan använder samma flöde för att skicka in uppgiften, kontrollera status och hämta paginerade resultat, samtidigt som det använder kandidaternas ID:n från källposterna.
Skicka in sökningen
Funktionen omvandlar varje kandidat till ett API-input. inputId får kandidatens beständiga ID, medan data.profileUrl får den offentliga URL:en till personens LinkedIn-profil. En vanlig URL i formatet linkedin.com/in/... krävs. URL:er från Sales Navigator, företagssidor, tomma värden och namn utan profil-URL:er är inte giltiga inputs för denna enrichment.
Anropet använder waterfall-personal-email-finder som enrichmentId och ett tomt settings-objekt, enligt API-dokumentationen för Waterfall Personal Email Finder. Skriptet skriver ut sitt genererade uniqueId innan uppgiften skickas in. Spara värdet, eftersom det hjälper dig att identifiera en befintlig uppgift om anslutningen bryts efter att API:et har tagit emot anropet.
Här är hela request body för exemplet med en profil:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
När uppgiften har skickats in returneras HTTP 202 Accepted med uppgiftens ID i @id. Bearbetningen fortsätter därefter på Datablists servrar.
Vänta på bakgrundsuppgiften
Requests-skriptet väntar lokalt medan servern kör bakgrundsuppgiften. Det kontrollerar uppgiften var tredje sekund och fortsätter så länge statusen är queued eller running. När statusen är completed börjar resultathämtningen. Statusen failed eller stopped utlöser ett fel med uppgiftens ID och det tillgängliga felmeddelandet.
Hämta alla resultatsidor
Resultat-endpointen returnerar varje rads käll-ID, status, outputs, credits och eventuella fel. Det första anropet begär upp till 100 resultat. Nästa sida hämtas tills nextCursor är null.
Resultaten behåller ordningen från input. inputId ger fortfarande varje resultat en tydlig koppling till rätt kandidatpost, även när resultatet omfattar flera sidor.
När du anpassar exemplet för fler poster bör varje candidate_id förbli oförändrat från källsystemet. Det gör sammanslagningen förutsägbar när uppgiften har flera resultatsidor.
Så hittar Waterfall en privat mejladress
Datablist rensar URL:en till den inskickade offentliga LinkedIn-profilen och skickar profiler utan resultat vidare genom de privata mejlleverantörer som för närvarande är tillgängliga. Om en leverantör inte returnerar någon användbar adress kan profilen gå vidare till nästa tillgängliga leverantör. När en leverantör hittar en användbar mejladress stoppas sekvensen för den profilen, och adressen returneras som outputs.emailFound.
Datablist hanterar vilka leverantörer som är tillgängliga, så din integration behöver varken leverantörsspecifika anrop eller egen fallback-kod. Det publika resultatet visar utfallet för mejlsökningen, inte en fast leverantörsordning eller historik över försöken.
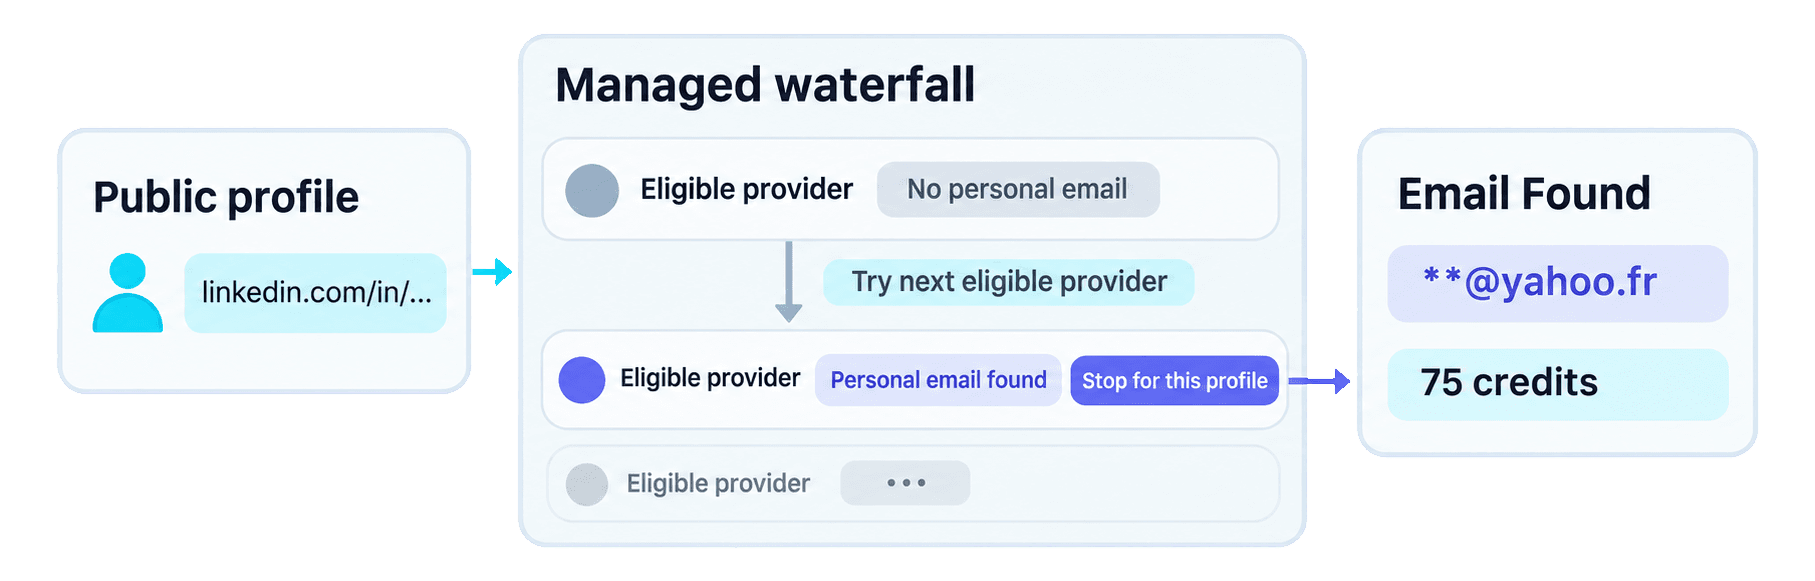
Waterfall är själva sökmetoden. Polling har en annan uppgift: det låter Python-klienten vänta tills bakgrundsarbetet är klart.
Därför hjälper Waterfall internationella rekryteringsteam
Leverantörer av privata mejladresser använder olika datakällor, och deras styrkor varierar därför mellan länder och marknader. Om den första leverantören saknar en mejladress till kandidaten kan en annan leverantör i Waterfall-sekvensen hitta den.
Rekryteringsteam som arbetar i flera länder får bredare leverantörstäckning genom en enda API-integration. Datablist hanterar sekvensen, så teamet kan hitta kontaktuppgifter som en sökning hos en enda leverantör kanske skulle missa, utan att behöva ansluta och underhålla flera leverantörers API:er.
Läs hela resultatet
📘 Maskerad mejladress: Den lokala delen av adressen har ersatts med
**nedan. Ditt API-resultat innehåller hela värdet.
Här är hela resultatsidan för kandidatens input:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
inputId är nyckeln som kopplar resultatet till kandidaten i källdatan. outputs.emailFound innehåller den privata adressen. creditsUsed visar den faktiska kostnaden för raden, och error: null betyder att API:et inte returnerade något fel på radnivå. Att cursorn är null bekräftar att svaret inte har någon ytterligare resultatsida.
Behandla adressen som ett kontaktalternativ kopplat till den inskickade profilen och granska den innan du använder den i rekryteringen.
Skapa kandidatposter för rekryterarens granskning
När sökningen är klar kan du skapa en lokal lista som rekryteraren kan granska, utan ytterligare API-anrop. Följande kodblock återanvänder de befintliga variablerna candidates och personal_email_results:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))För candidate-florian-poullin hittar dictionary-sökningen resultatet med samma inputId. Den kopierade posten behåller Florian Poullins namn, LinkedIn-URL och exempelmålrollen Backend Engineer. Därefter läggs hela API-objektet till under result, där rekryteraren kan läsa result.outputs.emailFound.
Loopen utgår från kandidatlistan i källdatan. Om ett framtida anrop saknar resultat, innehåller ett fel på radnivå, saknar en resultatpost eller har ett tomt emailFound, lämnas källistan oförändrad och posten läggs inte till i prepared_contacts.
För en bredare granskningsprocess och andra kontaktkanaler kan du läsa guiden om att hitta en kandidats mejladress som rekryterare.
Beräkna kostnaden för Waterfall Personal Email Finder API
Varje hittad privat mejladress kostar 75 credits. En sökning utan resultat kostar 0 credits. För den faktiska kostnaden bör du läsa creditsUsed för varje resultat i stället för att multiplicera det totala antalet inskickade profiler.
Formeln för budgetering är:
hittade privata mejladresser × 75 credits
Om du exempelvis skickar in 100 profiler och 20 av dem ger en privat mejladress använder uppgiften 20 × 75 = 1 500 credits. Det här är en budgetberäkning, inte en förväntad träffprocent. För större budgetar kostar 100 hittade mejladresser 7 500 credits och 1 000 hittade mejladresser 75 000 credits.
Med det aktuella grundpriset för påfyllning i USD gäller $20 / 20 000 credits = $0.001 per credit. En hittad mejladress förbrukar alltså credits till ett värde av $0.075, medan 100 hittade mejladresser motsvarar $7.50. Uppskattningen värderar de credits som används. Growth-abonnemanget som krävs för åtkomst till REST API tillkommer. Se Datablists priser för aktuella planer och credit-paket.
Lös vanliga fel och återställ en befintlig uppgift
De flesta problem uppstår före inskickningen, i HTTP-anropet eller i ett enskilt resultat. Utgå från var felet finns för att välja nästa åtgärd:
DATABLIST_API_KEYsaknas: skriptet stoppas lokalt innan något anrop görs. Exportera miljövariabeln och kör sedan filen igen.- Fel vid HTTP-autentisering: kontrollera din Personal API Key i
DATABLIST_API_KEY. Funktionen skickar den i headernX-API-Key. Rätta API-nyckeln innan du skickar in uppgiften igen. - Profil-URL stöds inte: ersätt en URL från Sales Navigator, en företagssida, ett tomt värde eller en felaktig URL med en offentlig personprofil i formatet
linkedin.com/in/.... - Otillräckligt med credits: kontrollera kontots saldo och tillgängliga credits innan du skickar in fler uppgifter.
- Uppgiften har statusen
failedellerstopped: granska uppgiftens fel, tillgängliga resultat och credit-förbrukning innan du avgör vad som fortfarande behöver köras. - En rad saknar resultat eller innehåller ett fel: behåll kandidaten från källdatan för granskning eller en annan kontaktkanal. En misslyckad sökning förklarar inte varför adressen inte var tillgänglig.
Om POST-svaret går förlorat bör du lista dina uppgifter innan du skapar en ny. Sök i svaret efter det uniqueId som skriptet skrev ut och kopiera sedan den matchande uppgiftens @id:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Om den matchande uppgiften inte finns i det första svaret från uppgiftshistoriken följer du den returnerade pagineringscursorn och kontrollerar nästa sida. Fortsätt att kontrollera den återställda uppgiften eller hämta dess tillgängliga resultat i stället för att automatiskt skapa ännu en betald uppgift. Dokumentationen om uppgifter beskriver livscykeln, pagineringen och hur länge resultaten sparas.
Nästa steg
Nu har du en återanvändbar Python Requests-funktion för offentliga LinkedIn-profil-URL:er och en sammanslagning med beständiga ID:n som kombinerar hittade privata mejladresser med varje kandidats källdata.
Ersätt exempellistan med ett mindre urval av dina egna kandidatposter, behåll ett beständigt ID och en målroll för varje kandidat och granska sedan alla förberedda kontakter innan du använder dem i rekryteringsprocessen. När applikationen behöver icke-blockerande parallellitet kan du använda det underhållna async HTTPX-exemplet som nästa steg i implementationen.