
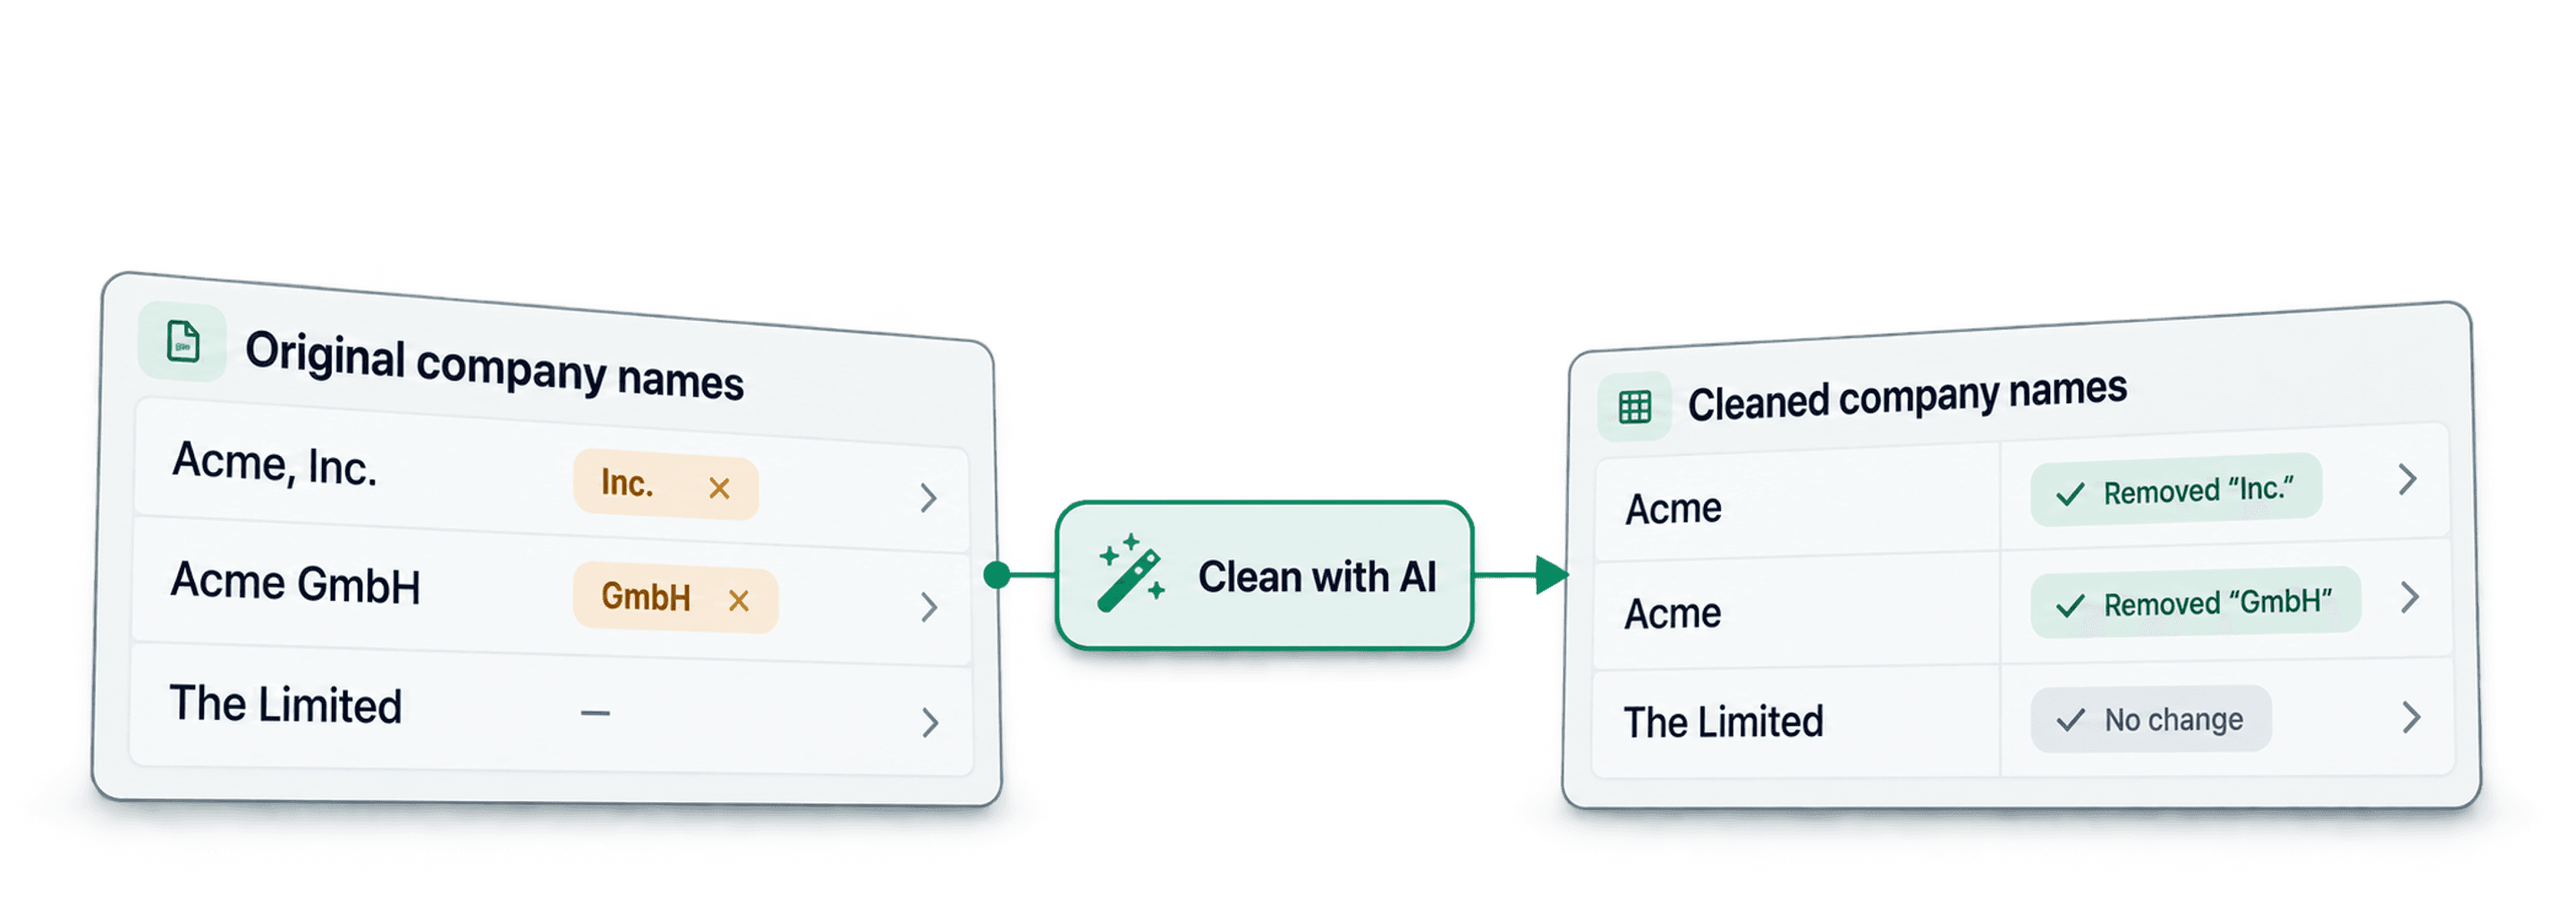
要清洗 Lead 列表中的公司名称,首先要明确预期输出:仅当法定实体后缀与品牌名称明显分开时才将其删除,同时统一空格与大小写,并保留属于品牌名称的词。例如,Acme, Inc. 可以变为 Acme,但不能直接把 The Limited 变成 The。
Datablist 提供两种方法,可将这些规则应用到 CSV 列。Company Name Cleaner 会使用 AI 逐行处理数据,而 AI Editing 则会生成 JavaScript 转换脚本,你可以先预览,再将其应用到整个 collection。请将原始名称保存在单独的 property 中,以便在开展 Outbound 或去重前比较结果并修正错误。
如果想先测试几个名称,可以使用免费的 Company Name Cleaner。粘贴最多 10 个名称,对比原始值和清洗后的值,再将相同方法应用到完整 CSV。
本指南将介绍:
公司名称清洗规则
先确定你需要的是适合 Outbound 沟通的常用名称,还是用于匹配记录的标准化名称。两者的输出可能不同。建议先采用以下规则,再逐一检查例外情况:
- 仅当
Inc.、LLC或GmbH等法定实体形式作为独立后缀出现时,才将其删除。 - 清理重复空格和多余标点,但不要改变可识别的品牌名称。
- 如果
Group、Holdings或Limited属于品牌名称,或仅凭名称无法判断,就应予以保留。 - 对无法确定的名称进行人工审核,不要猜测公司的真实身份。
| 输入 | 建议输出 | 审核要点 |
|---|---|---|
| Acme, Inc. | Acme | Inc. 是独立的法定实体后缀。 |
| Acme GmbH | Acme | 确认这个德国法定实体形式不属于品牌名称。 |
| The Limited | The Limited | 不要删除可能属于品牌本身的词。 |
方法一:使用生成式 AI 清洗公司名称
第一种方法会使用 AI 逐个处理公司名称。如果名称格式差异较大,而且你希望审核结合上下文得出的结果,而不是维护固定的后缀列表,可以选择这种方法。
Datablist 提供专用的 Company Name Cleaner enrichment。在对大型列表运行前,请先查看相关配置和 credit 消耗。
如果你偏好以代码为主的工作流,也可以通过 API 使用 Python 清洗公司名称。
下面逐步介绍这种方法的操作流程。
首先,通过 CSV 或 Excel 文件导入公司名称。
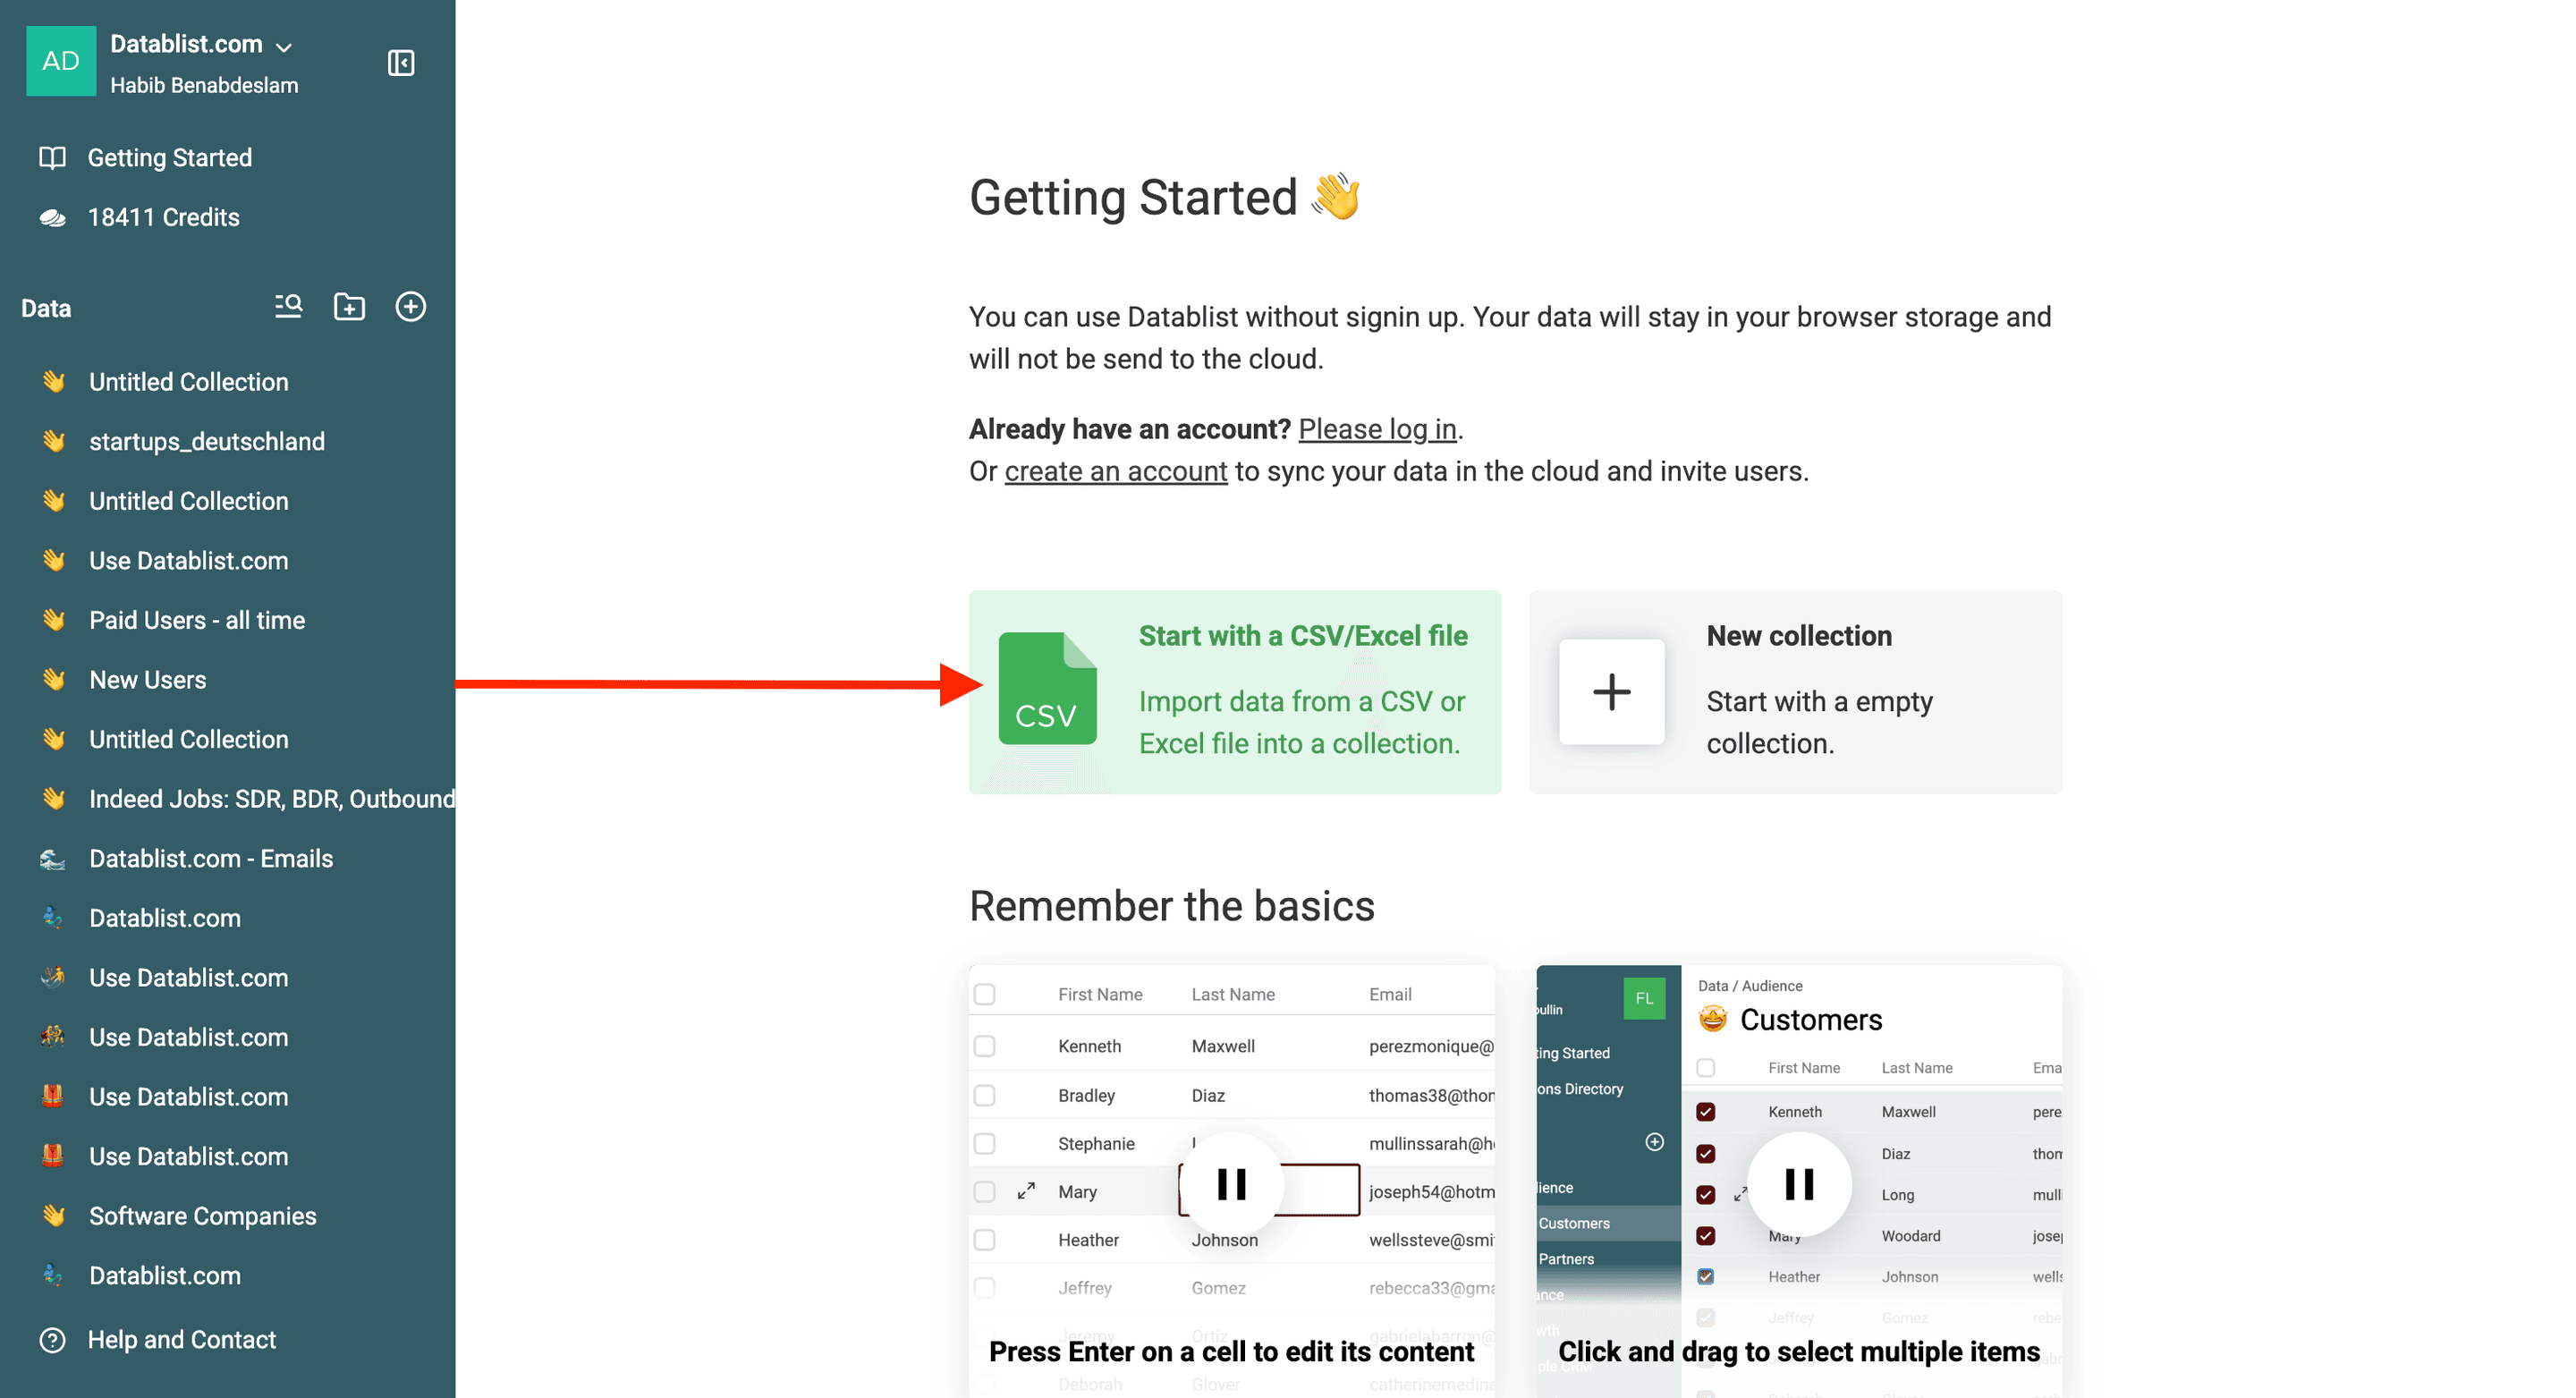
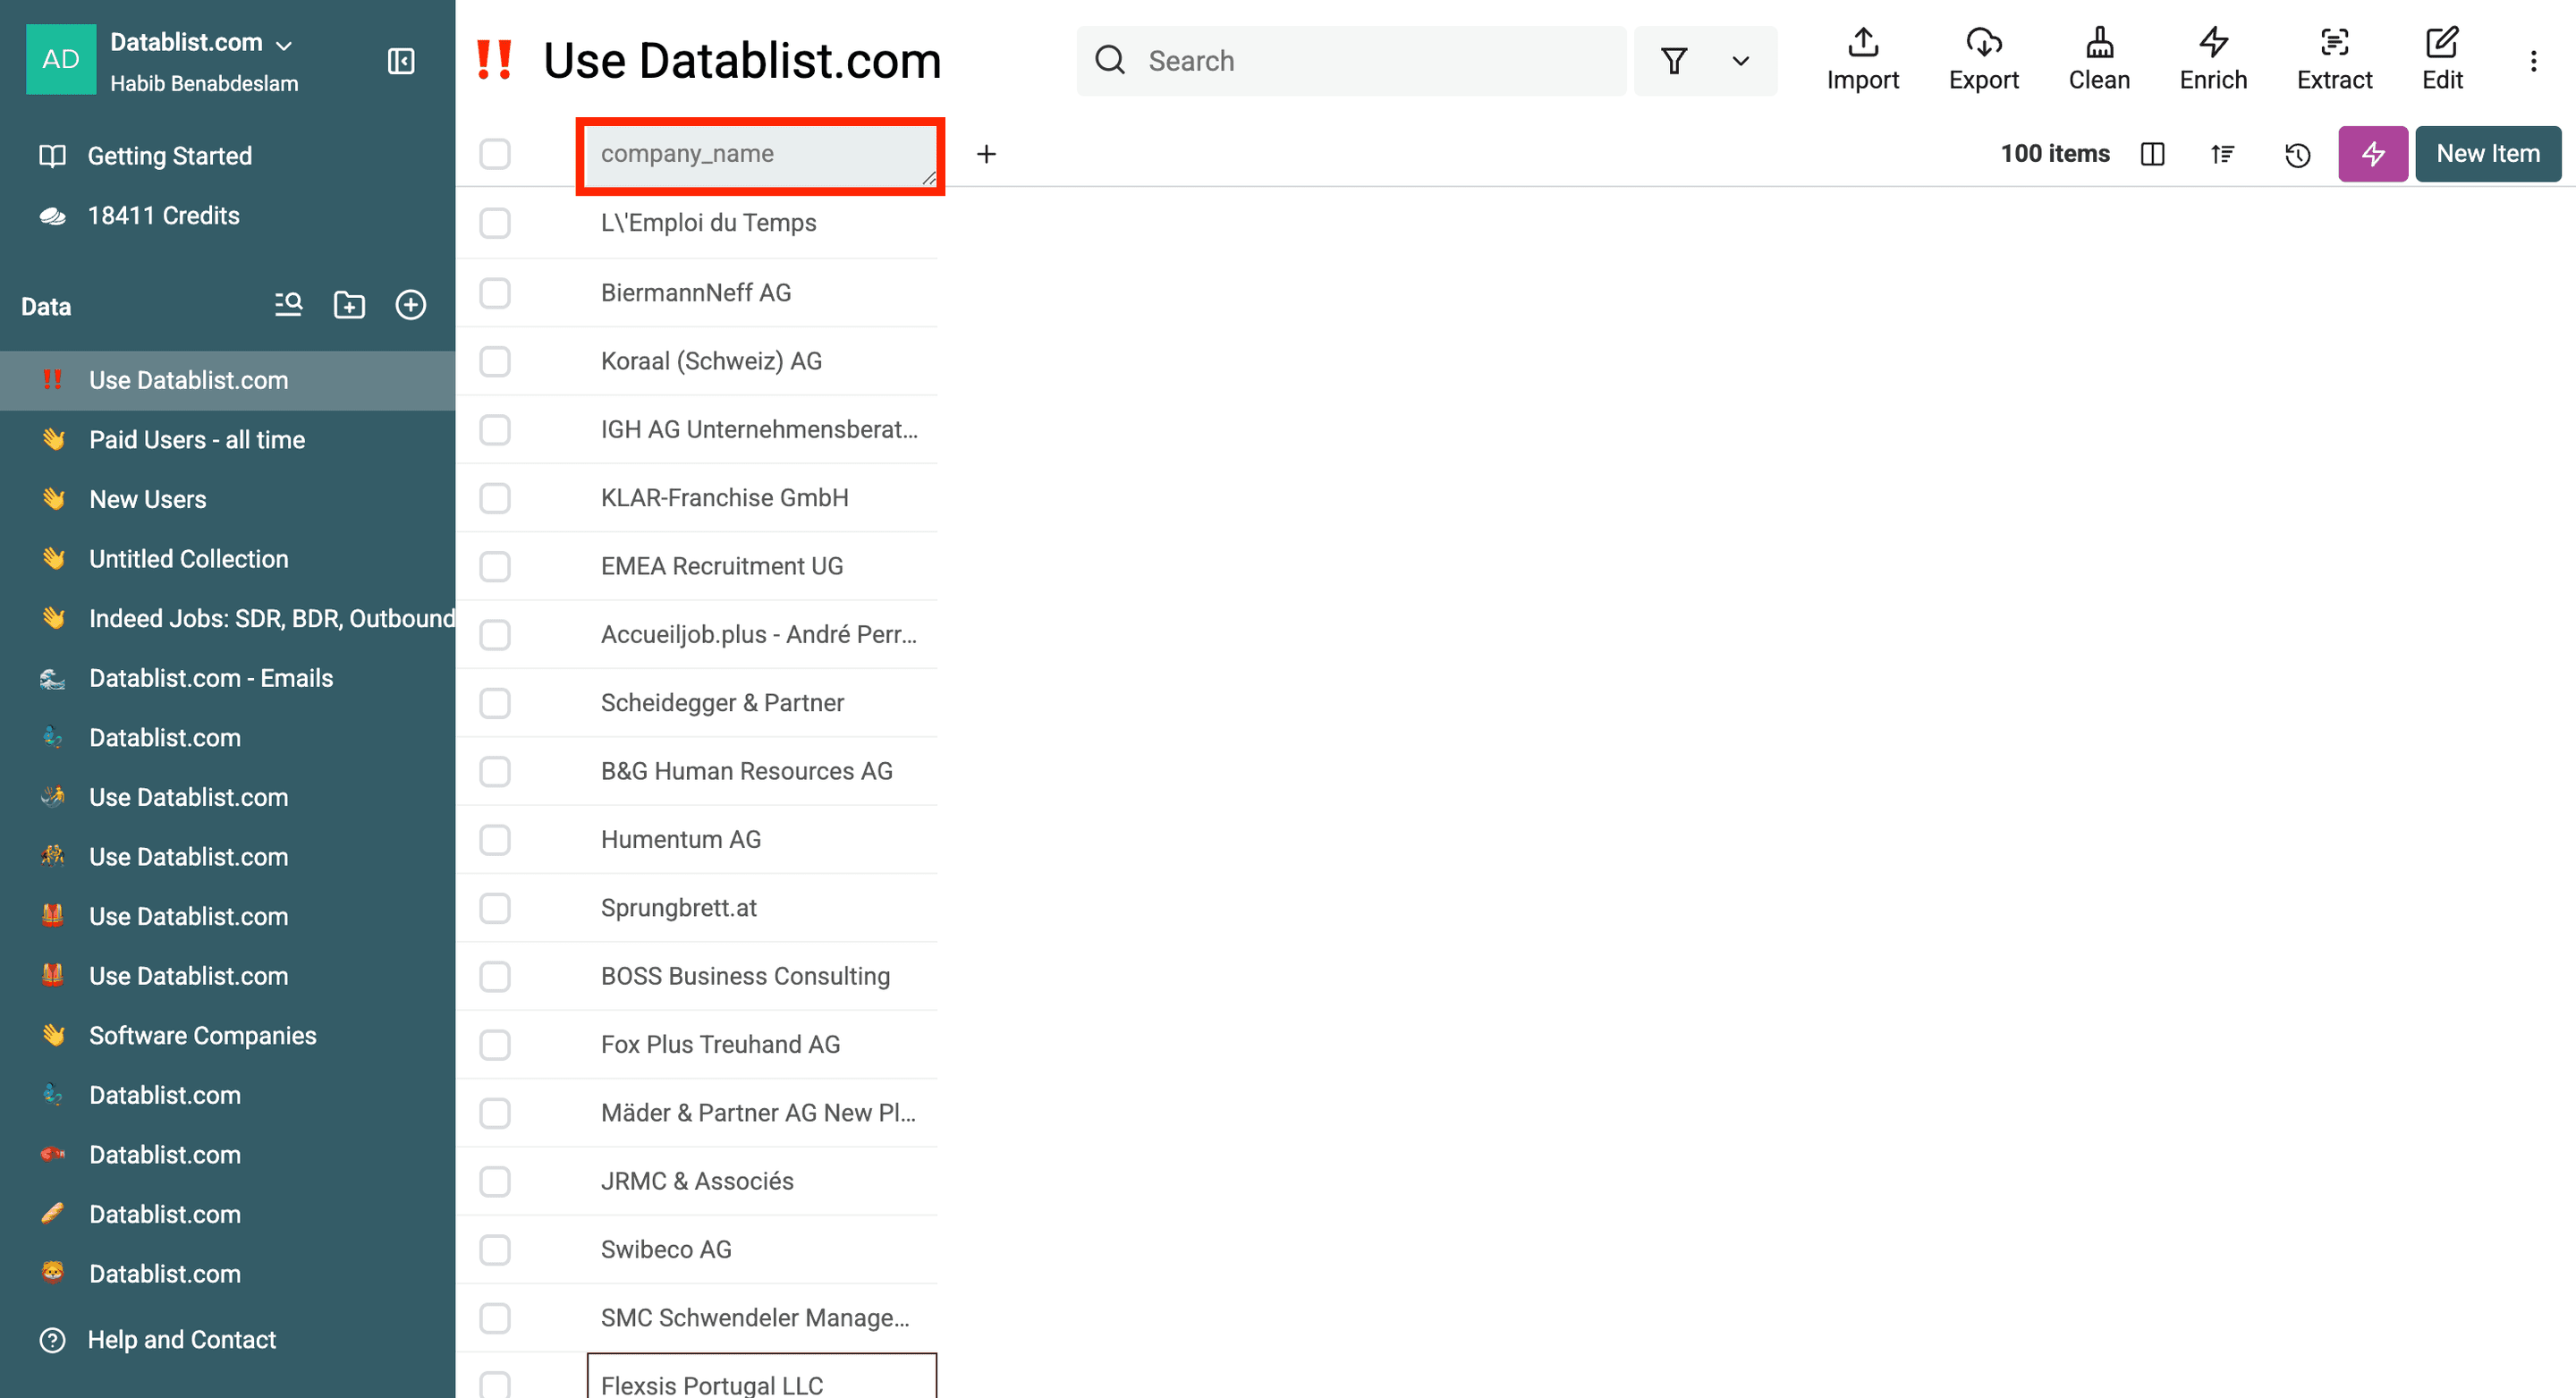
为了方便演示,我的文件中只有公司名称。不过,你也可以上传包含多个 property/列的常规文件,操作方式完全相同。
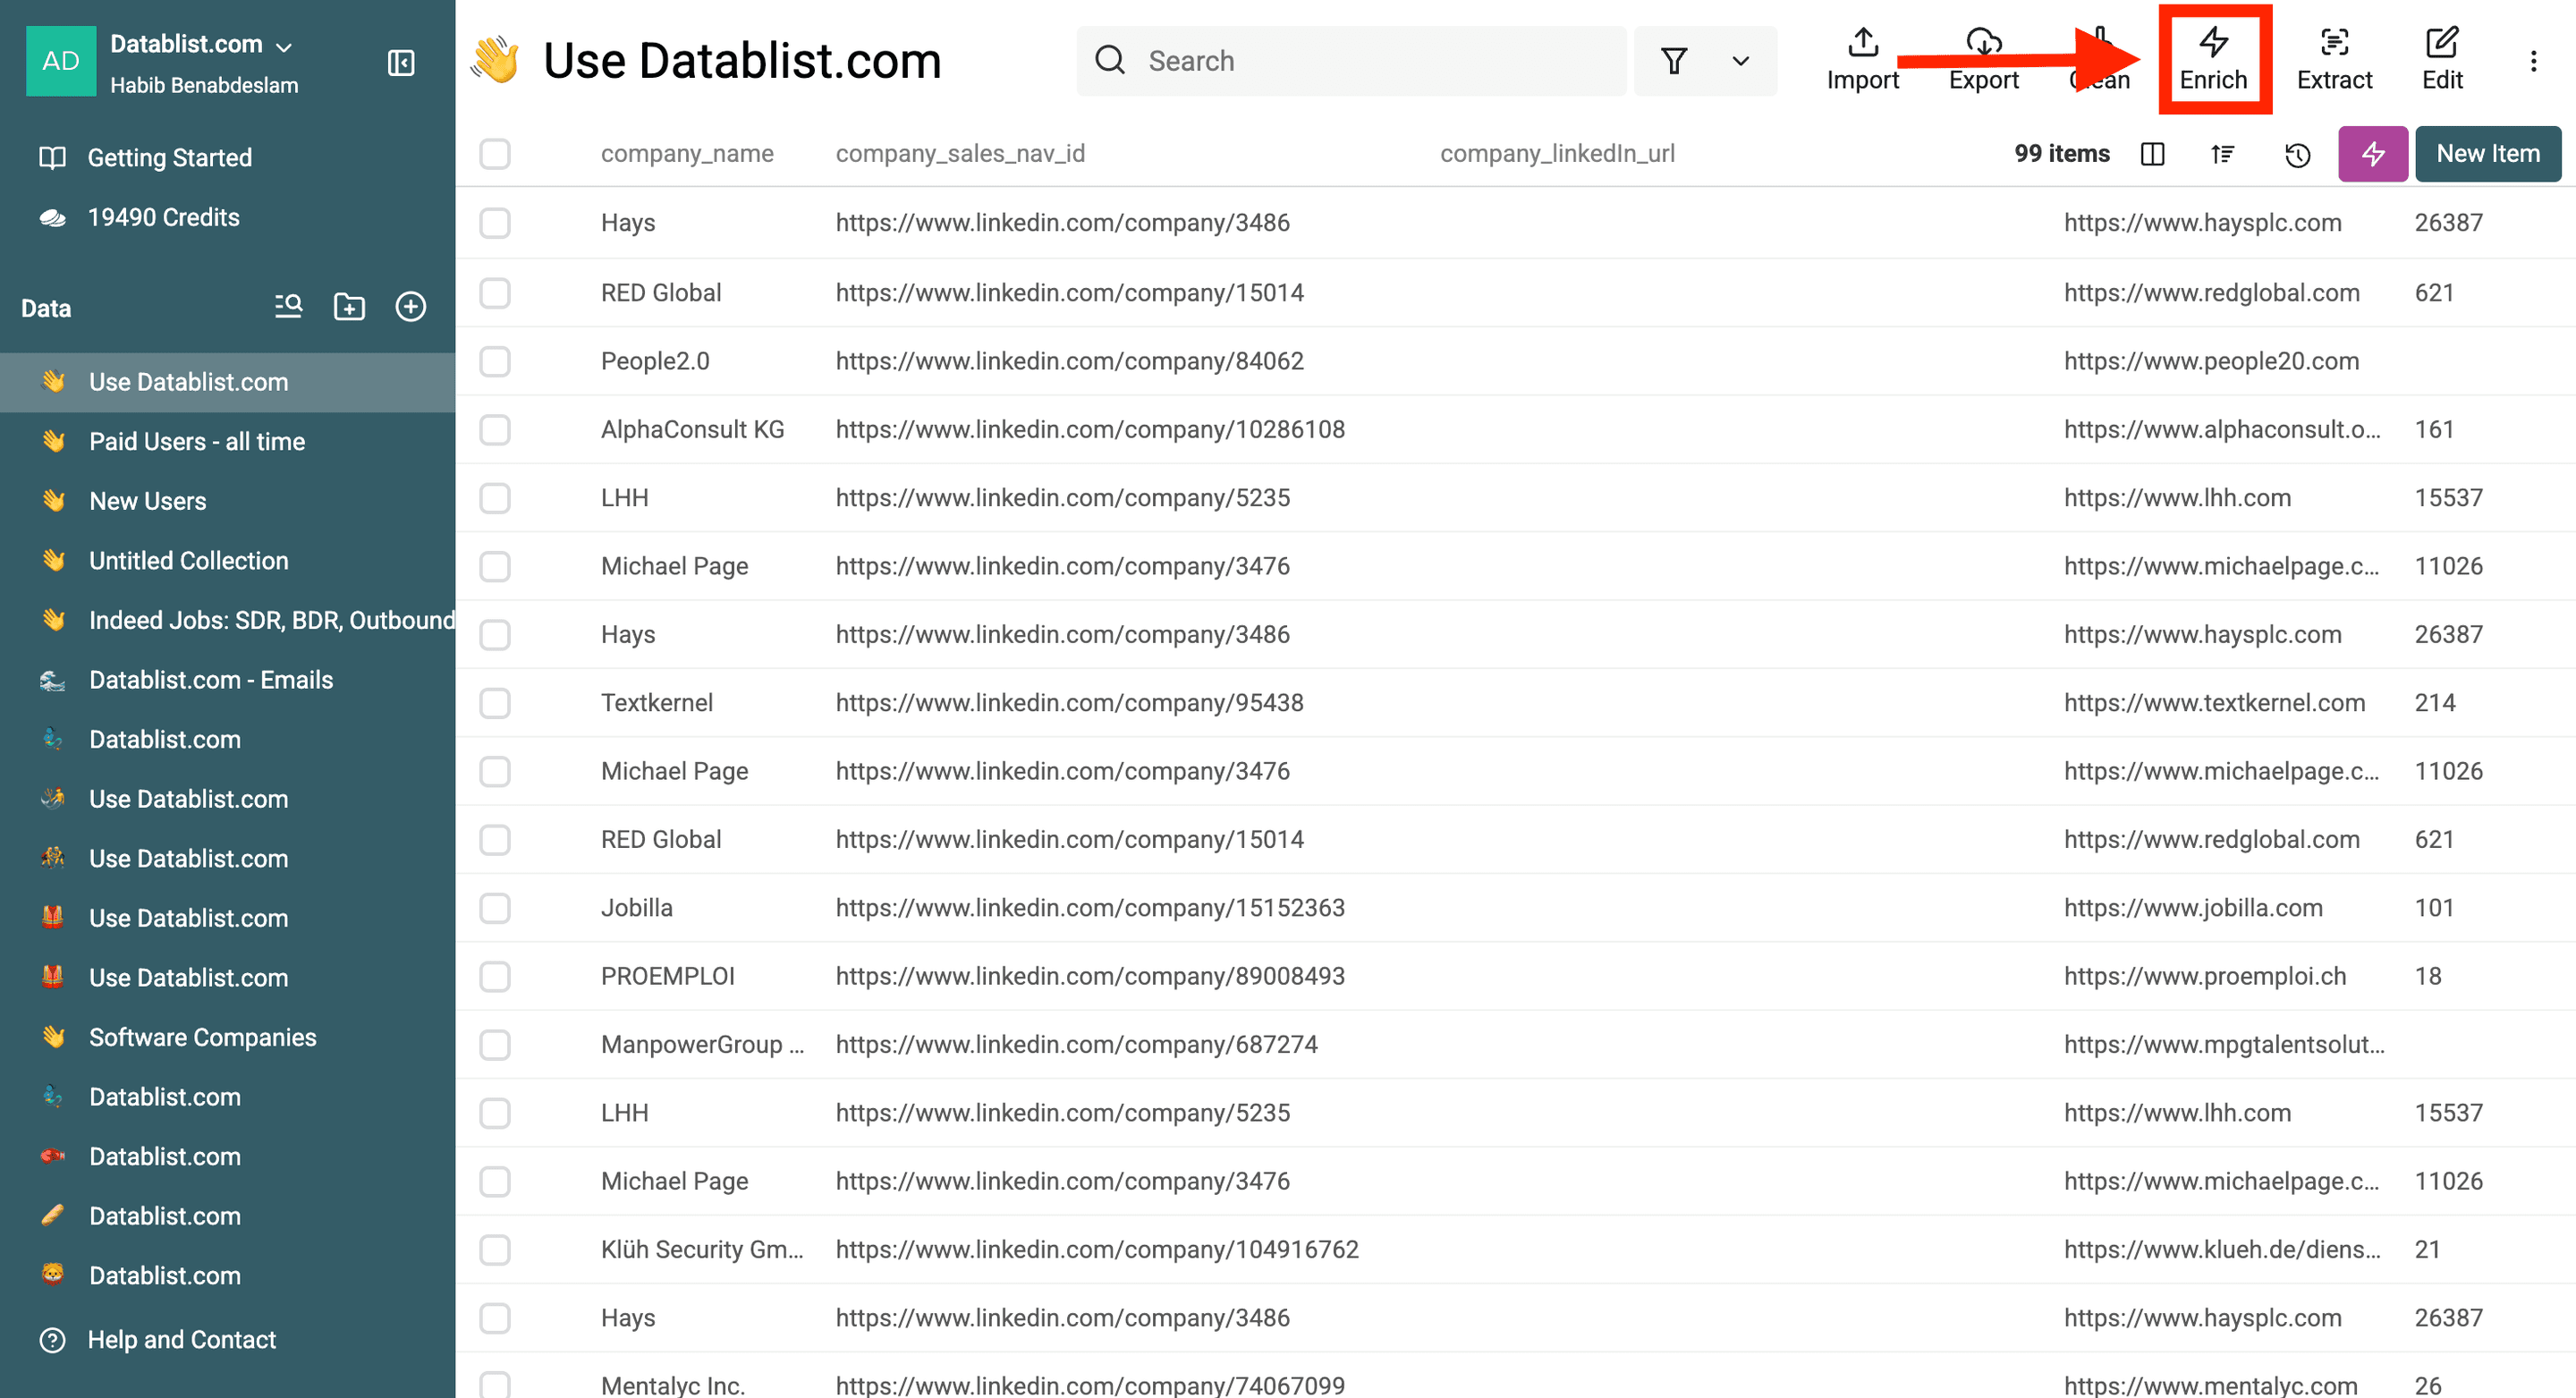
然后选择“Enrich”。
接下来选择 Enrichment Templates。
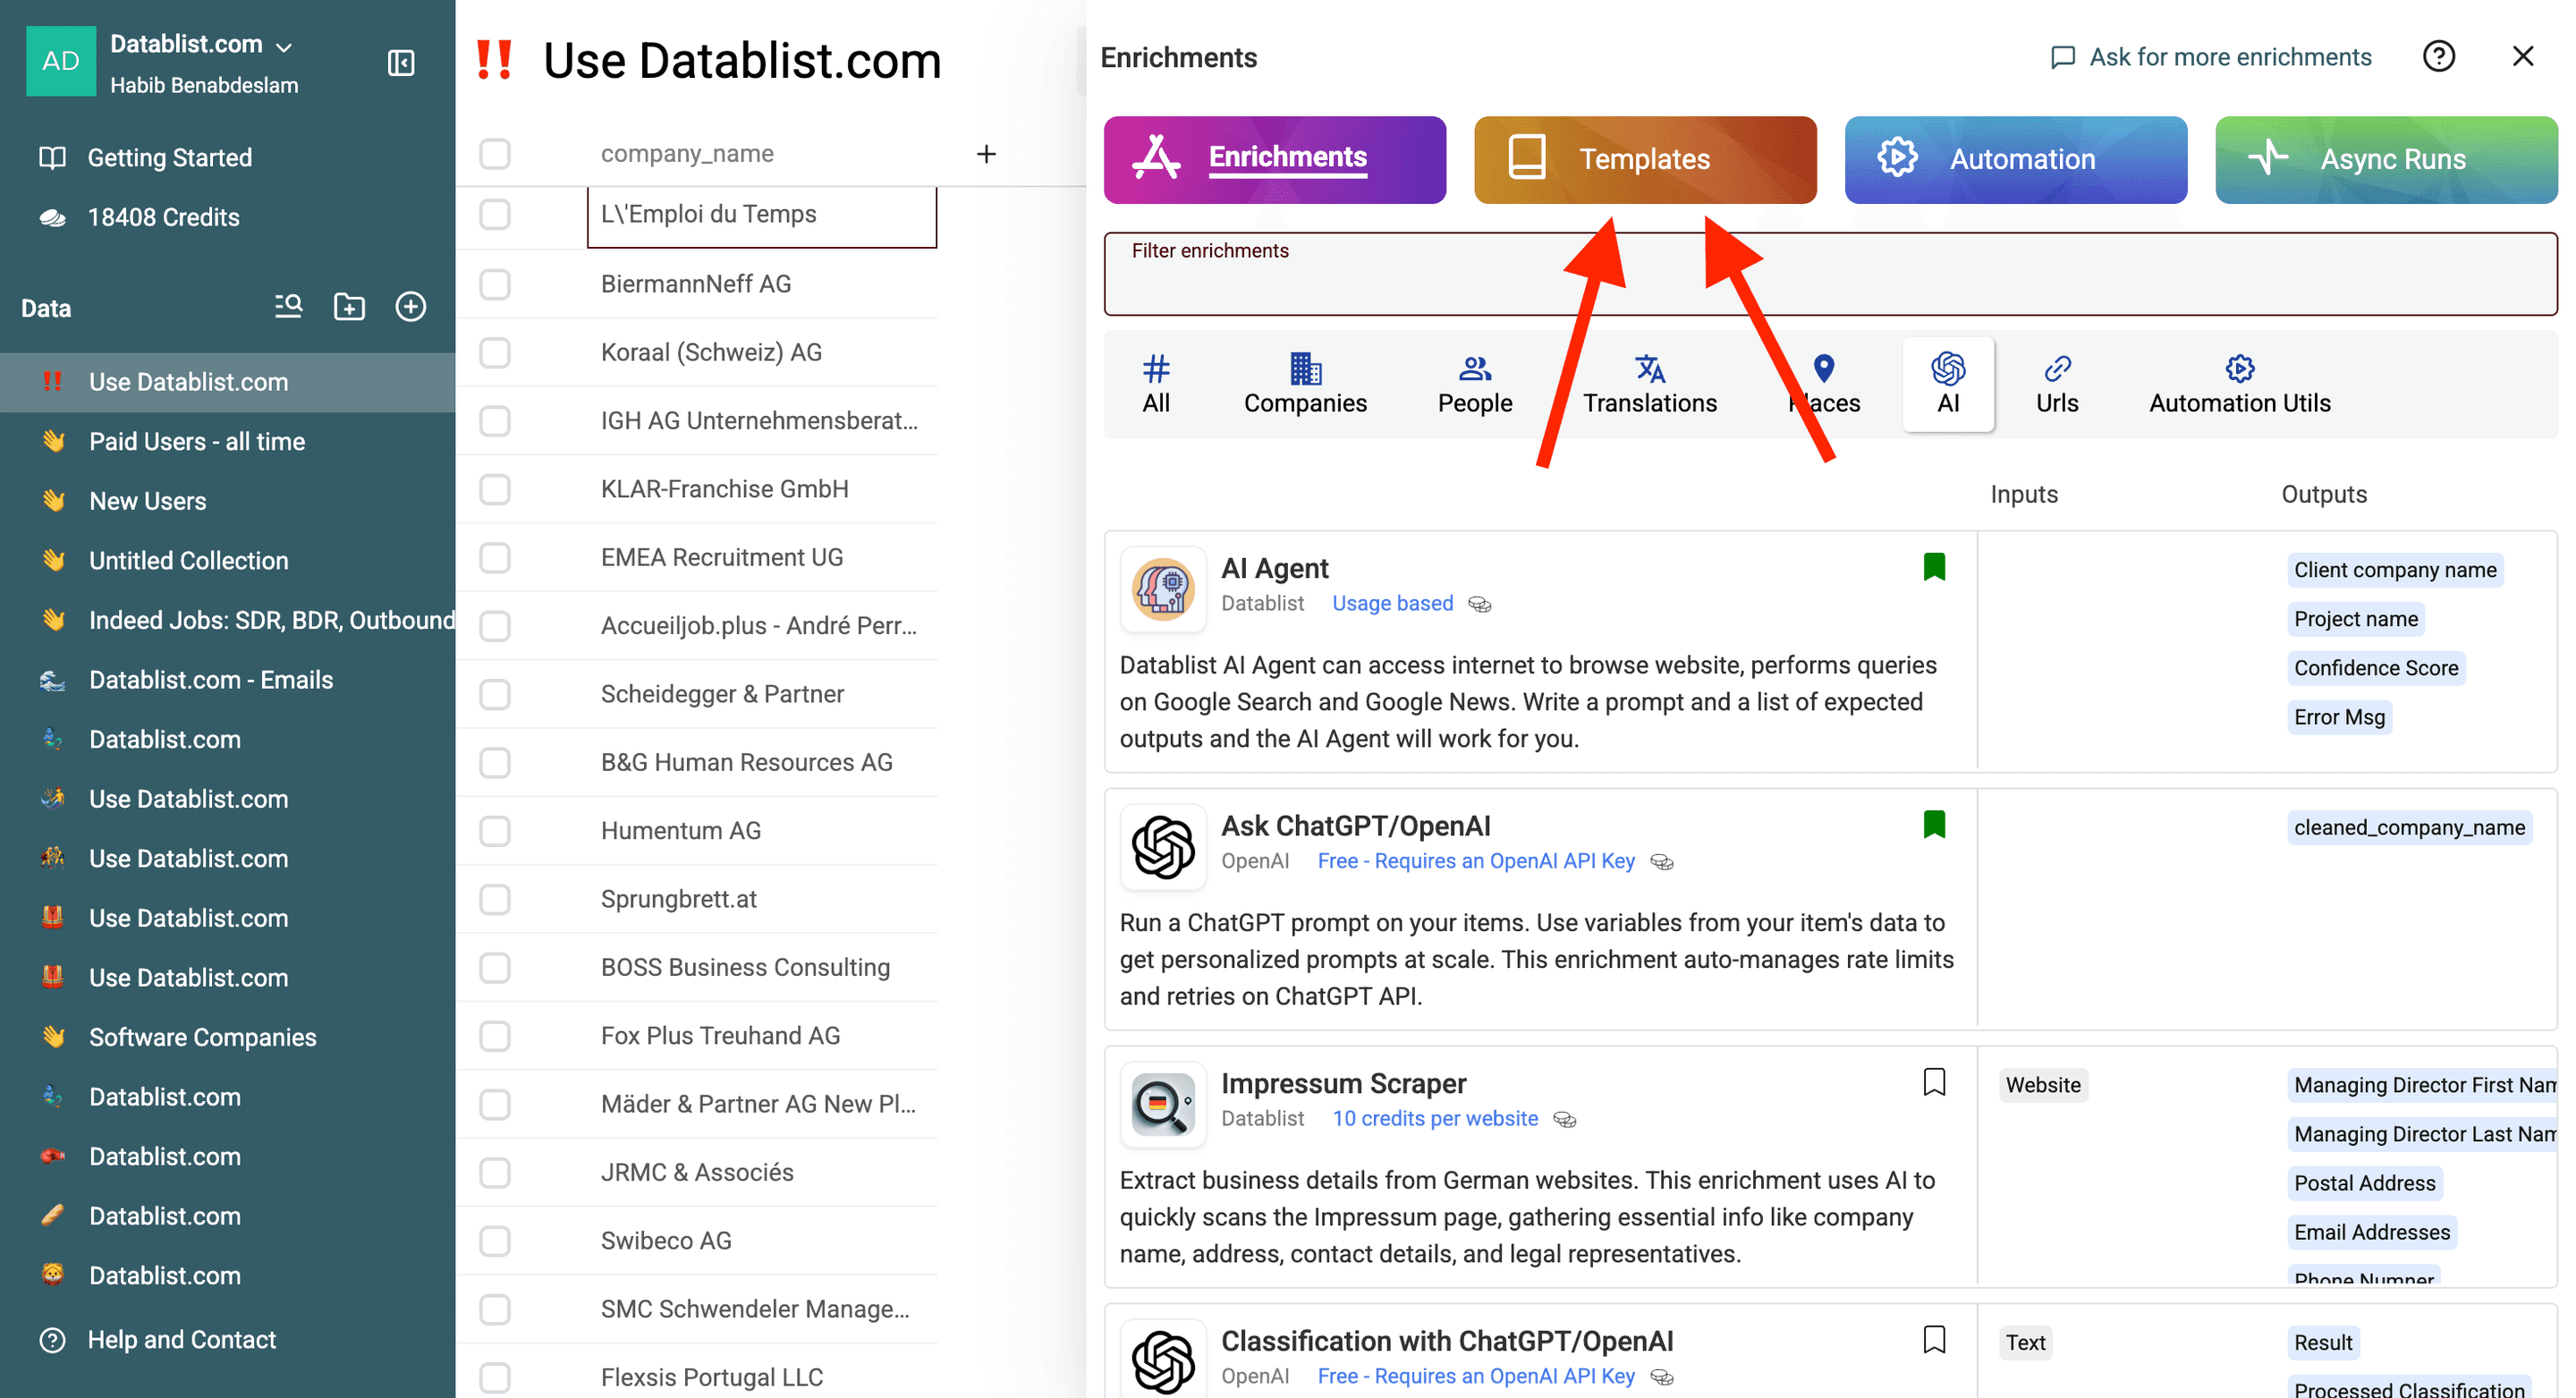
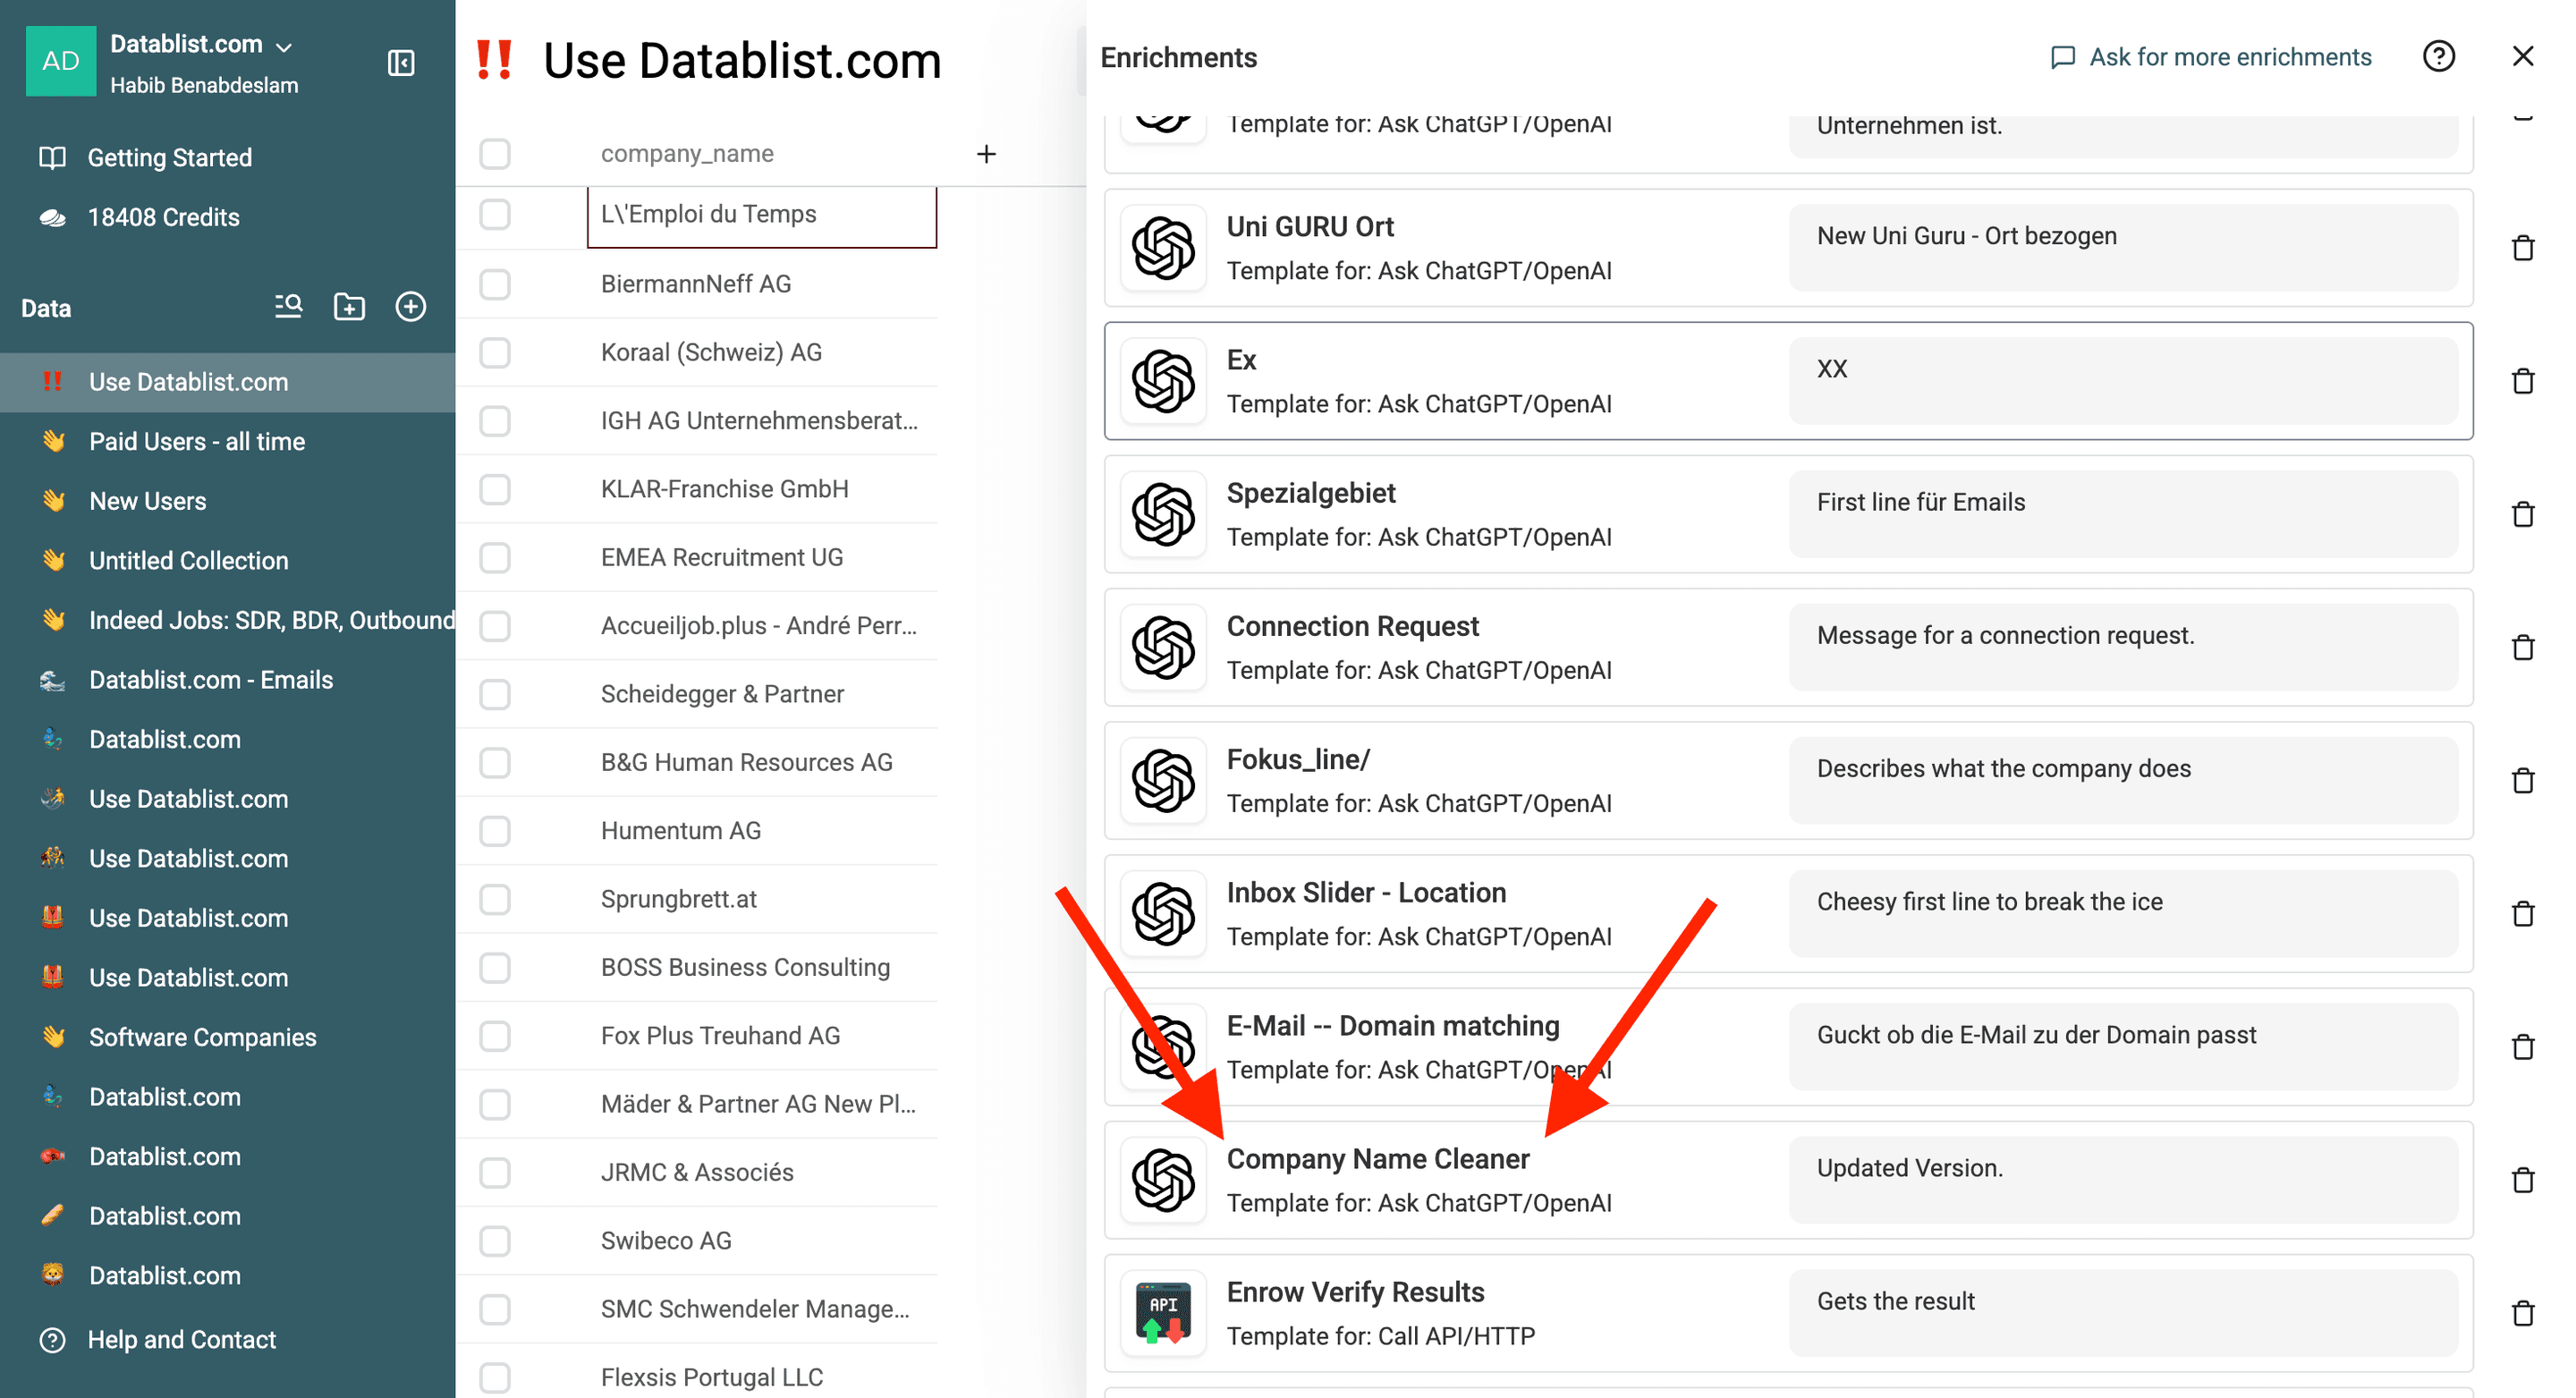
然后编辑 prompt,并使用 {{Name}} 或 /Name 选择包含公司名称的列。
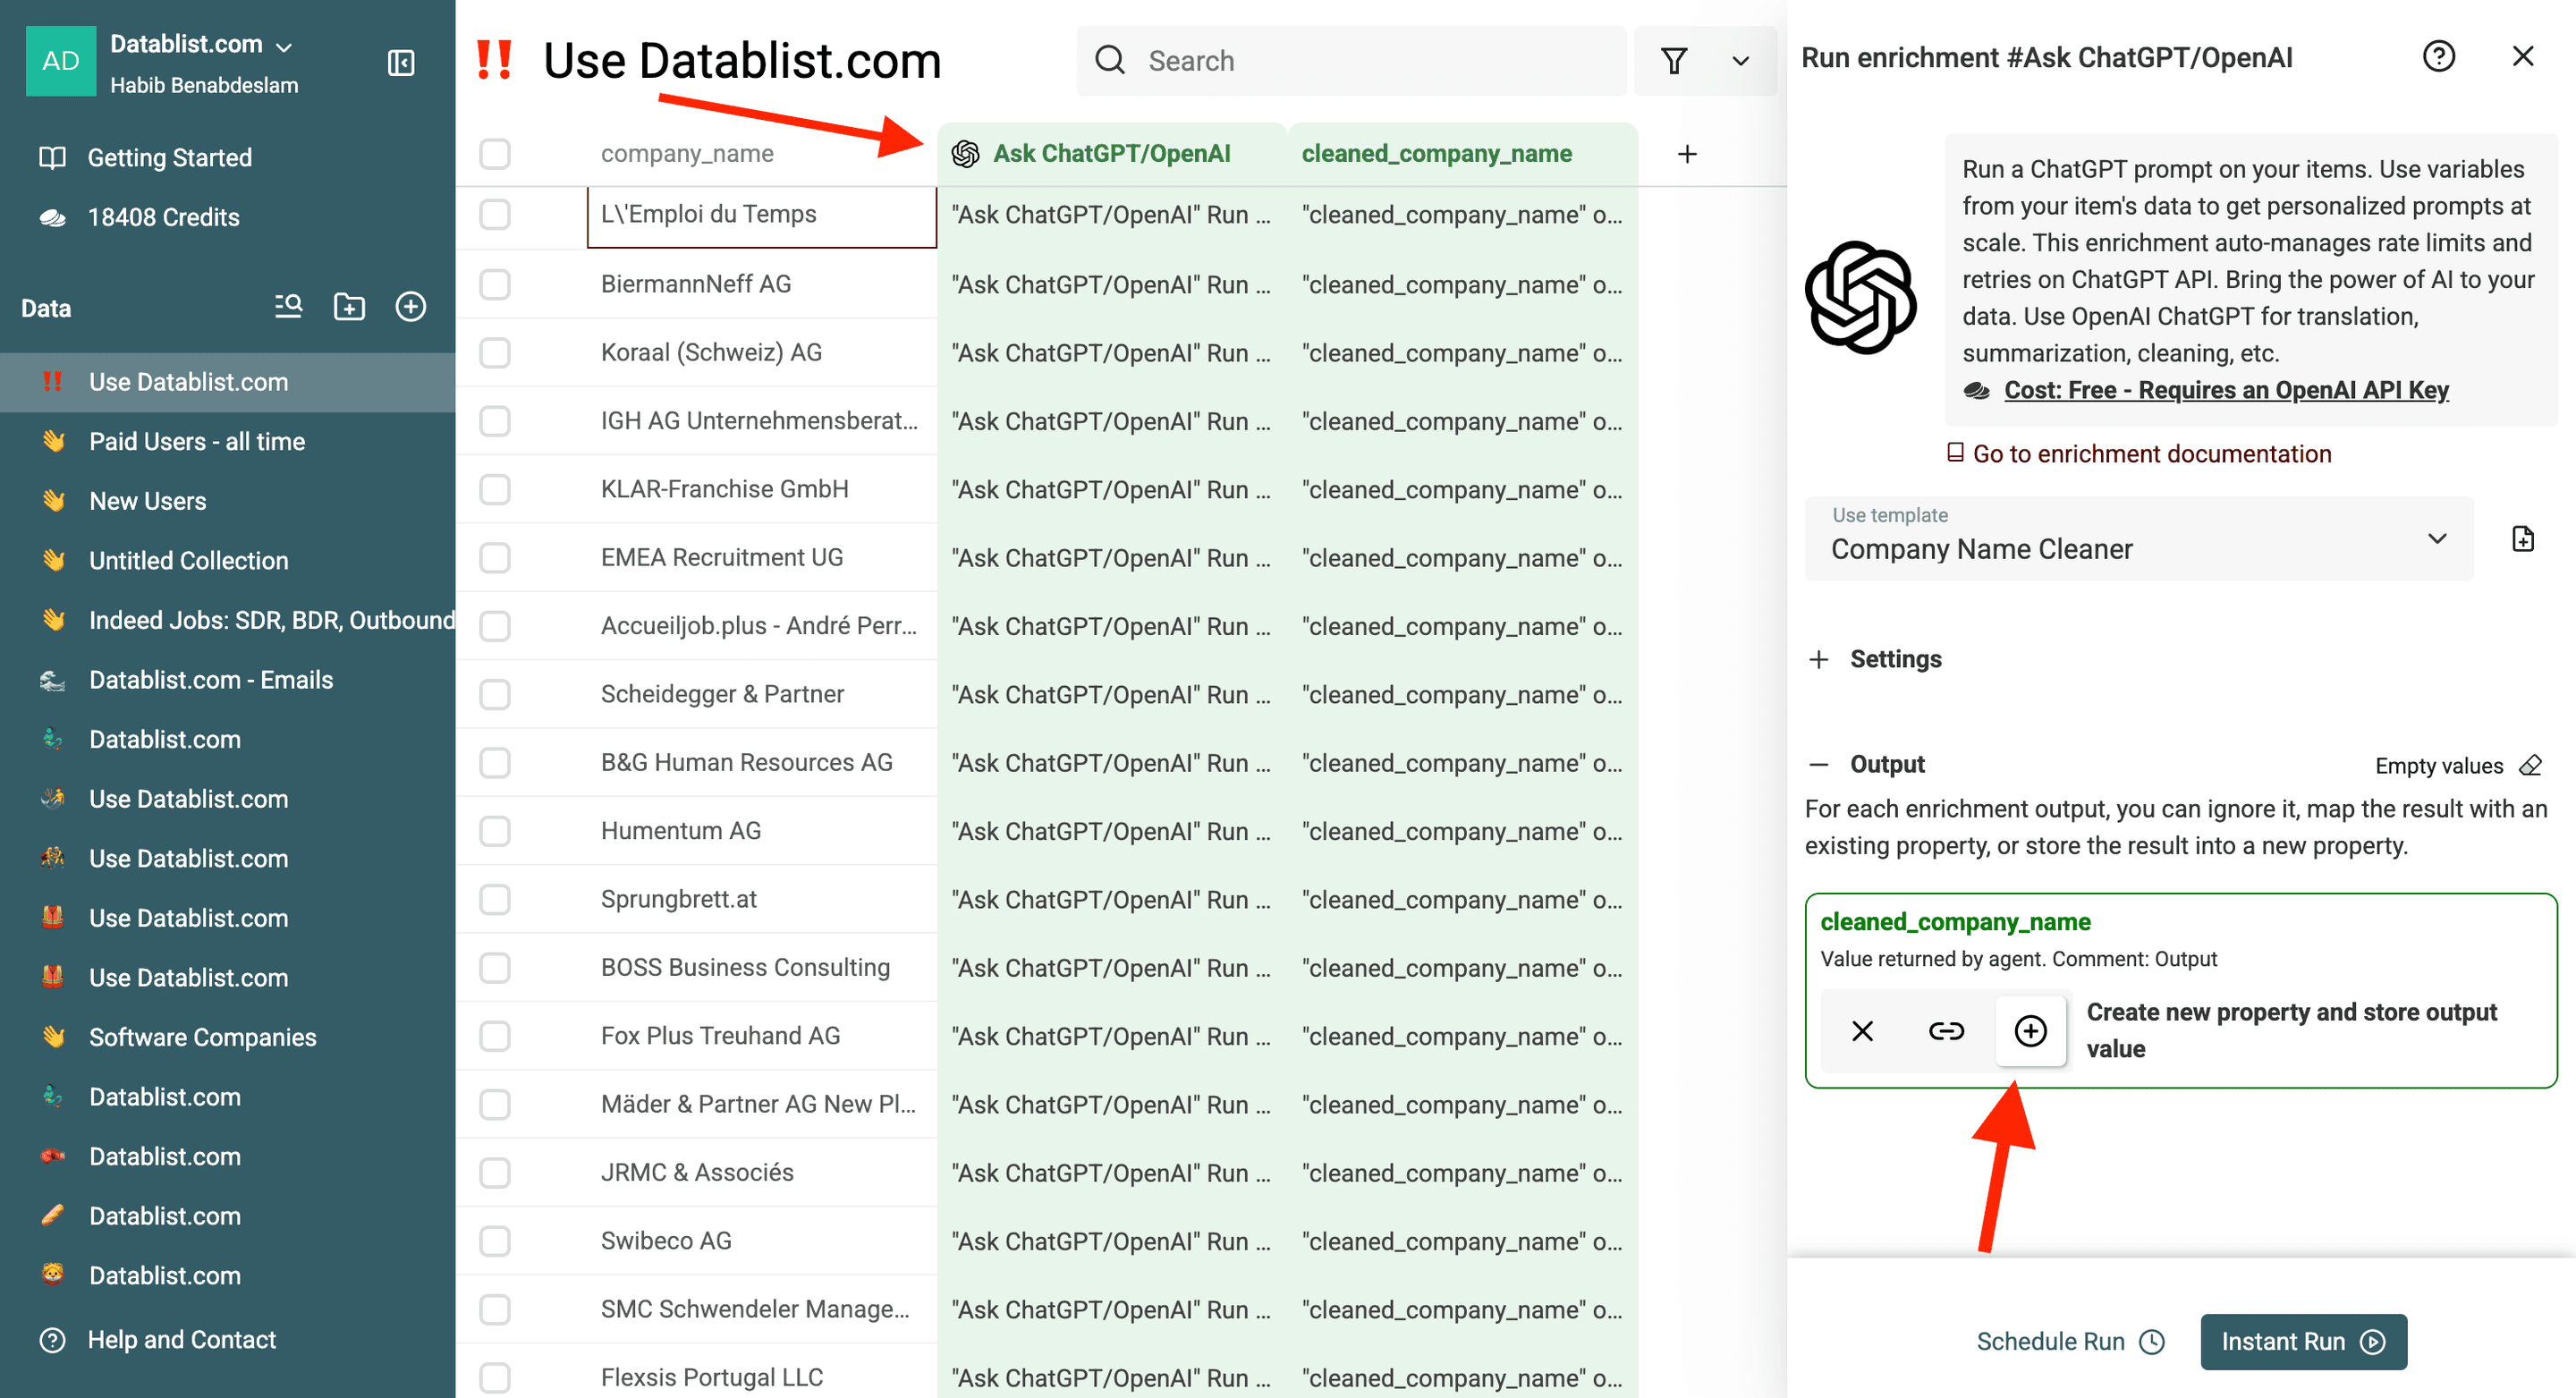
进入下一步配置输出。
你可以为输出新建一个 property,也可以将其映射到 collection 中已有的 property。
在这个示例中,我新建了一个 property。
Datablist 还会自动创建一个“Run Status”property,方便你追踪哪些名称已经处理,以及每次处理的成本。
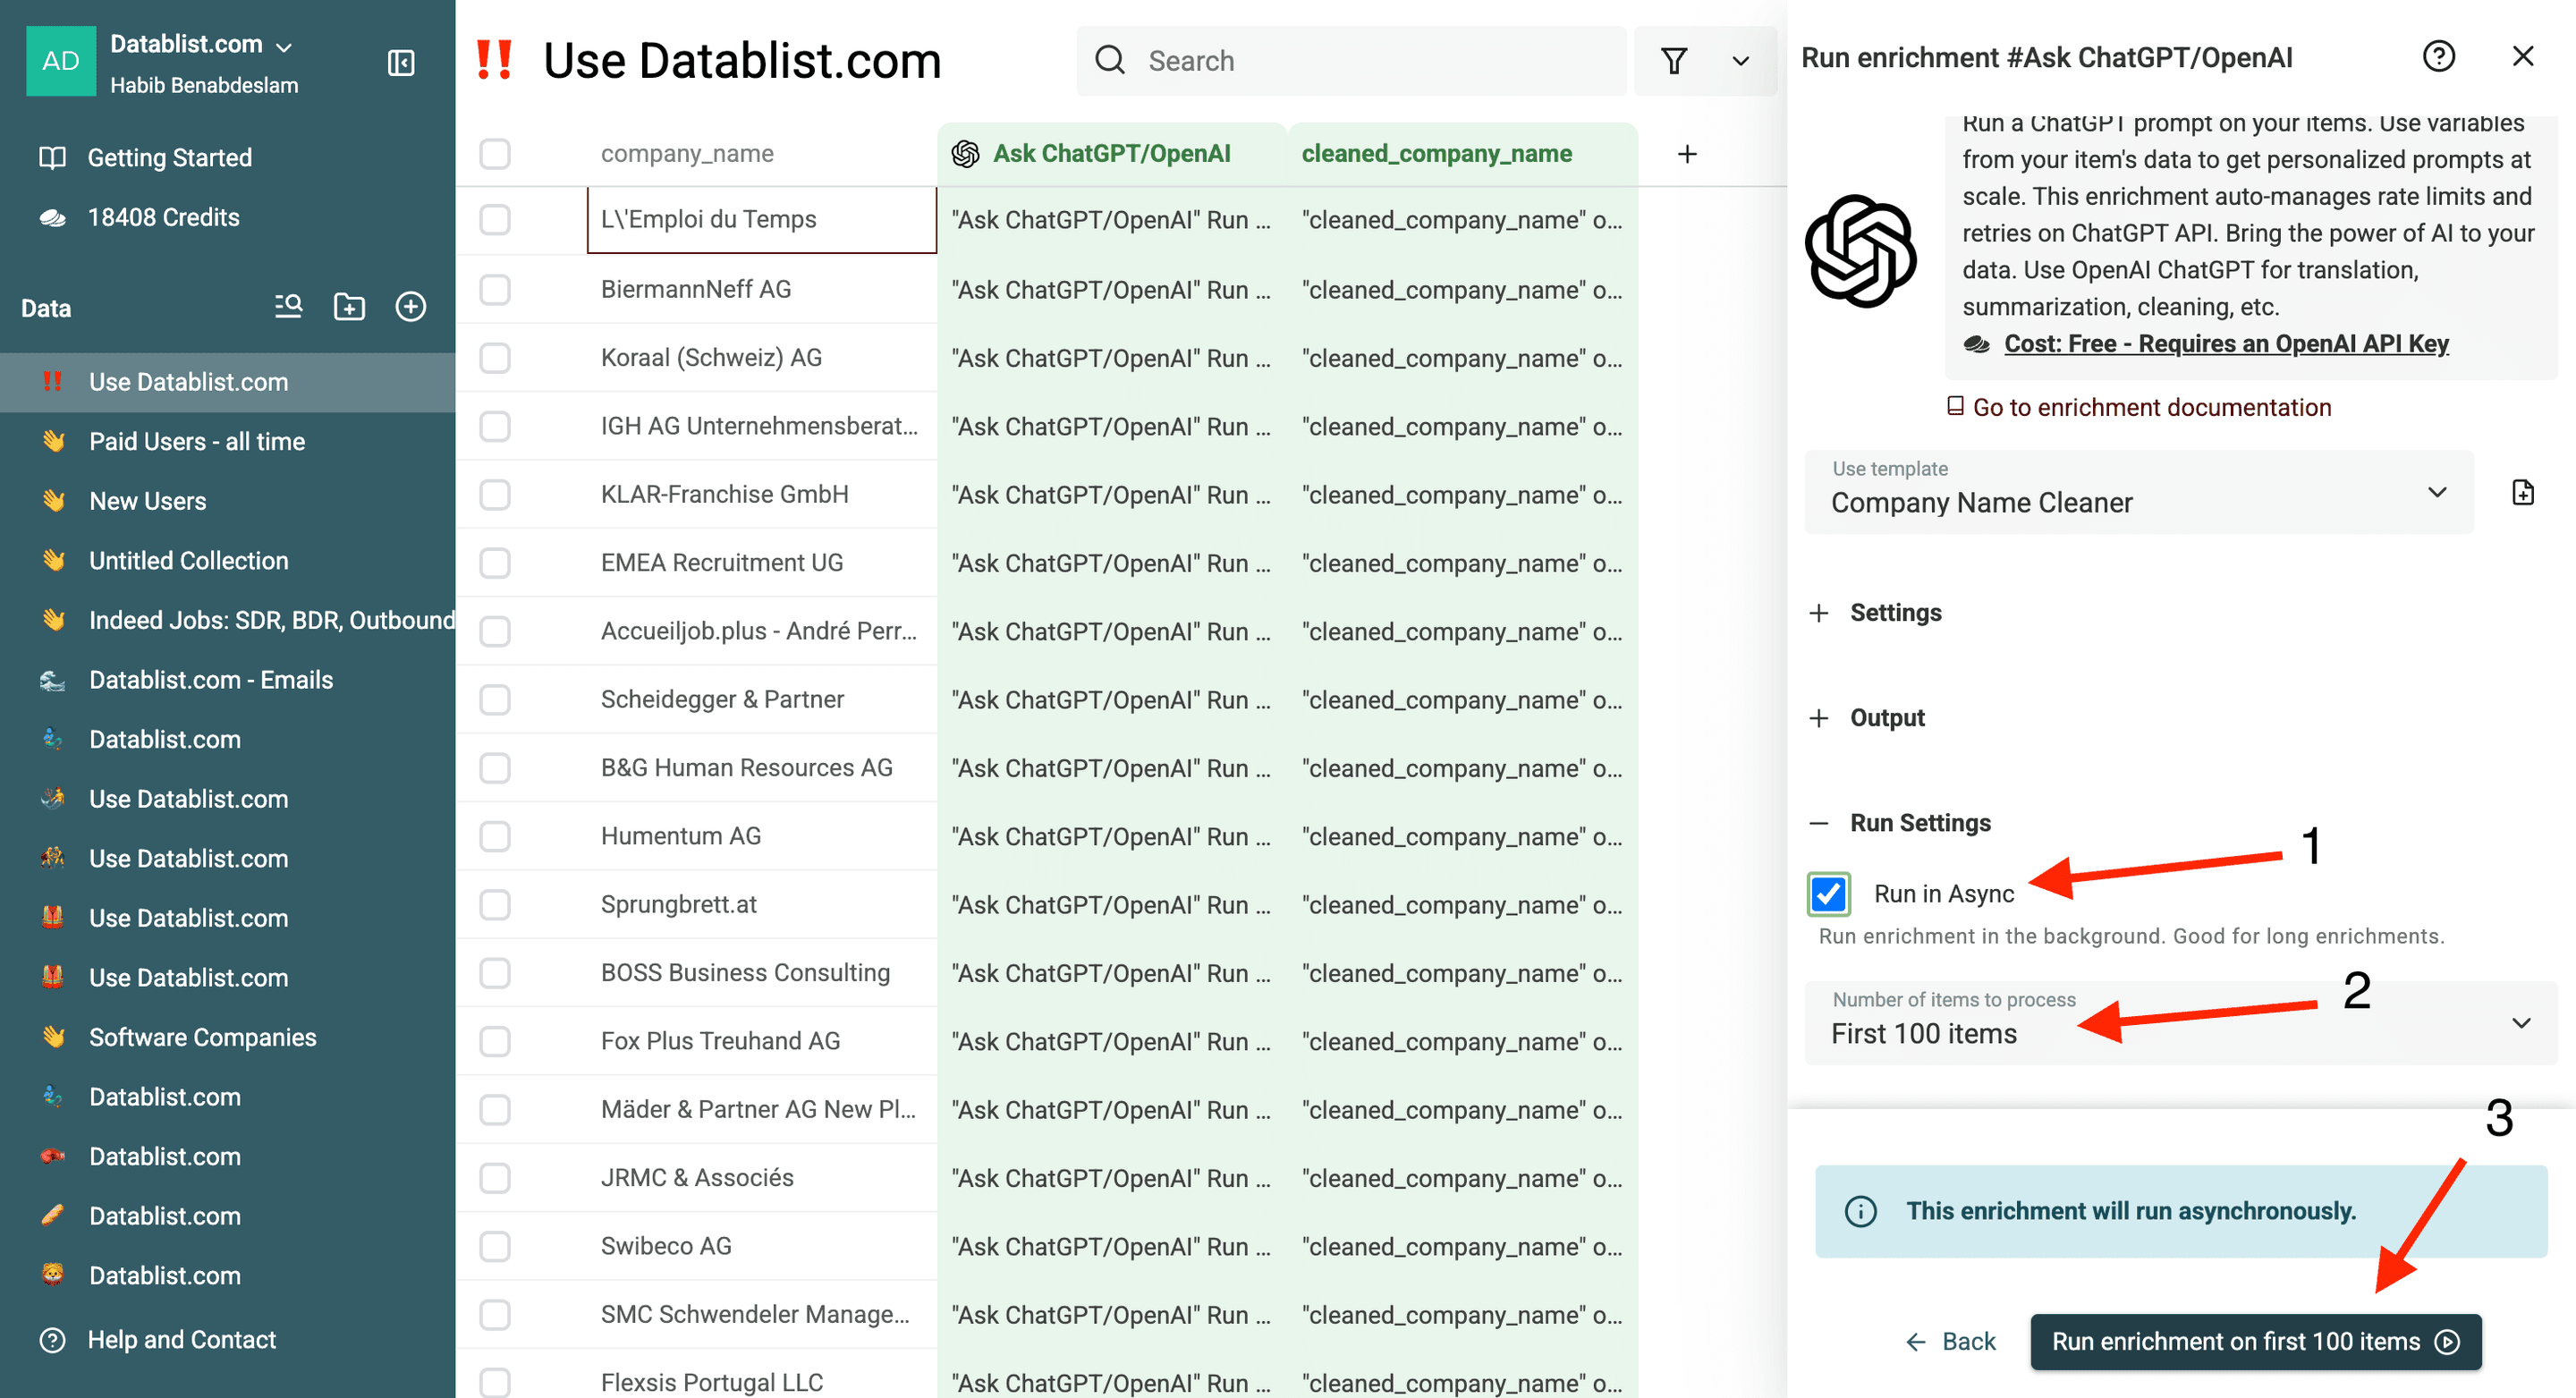
现在,你可以从以下选项中选择并配置运行设置:
- 以 Async 模式运行(在云端处理)
- 在前 10 条数据上测试
- 仅处理前 10 条或前 100 条数据,也可以自定义要清洗的数据量
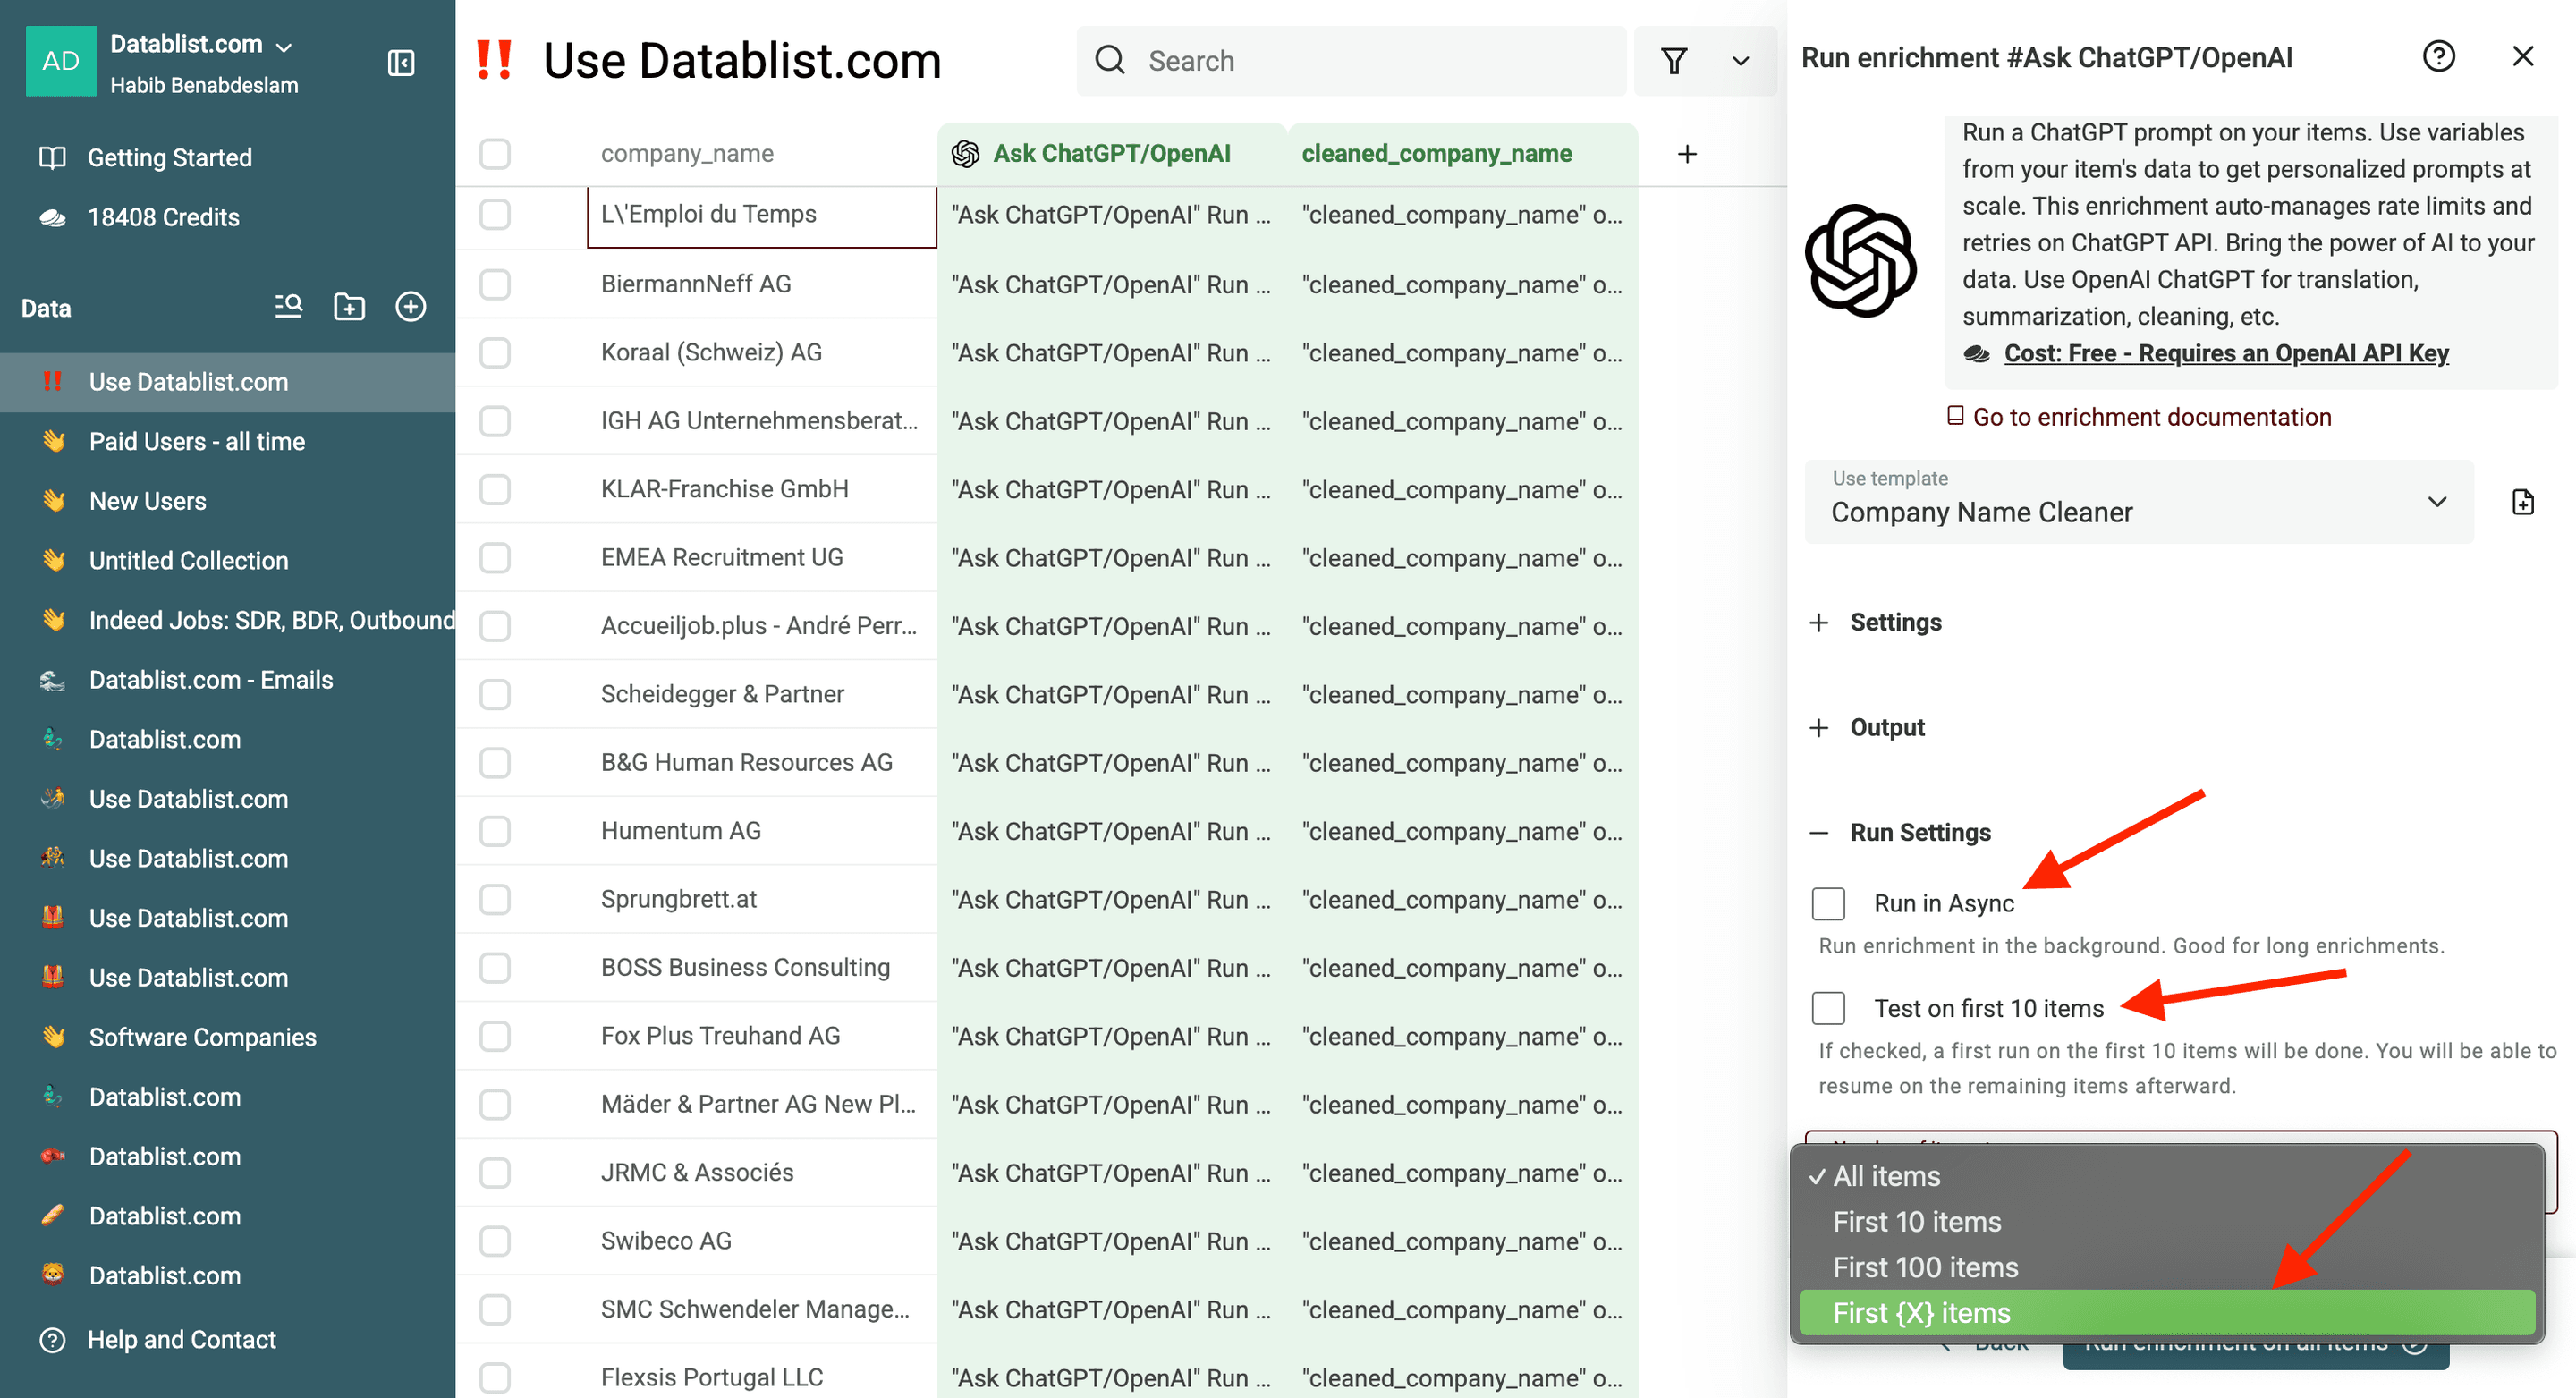
运行设置配置完成后,就可以启动 enrichment。
这是进入 enrichment 第二部分前的最后一步。
这里我选择以 Async 模式处理前 100 条数据。
enrichment 完成后,结果会显示在输出 property 中。请抽样对比原始名称,尤其要检查短名称、不同国家或地区的法定实体形式,以及包含 Group 或 Limited 等词的名称。
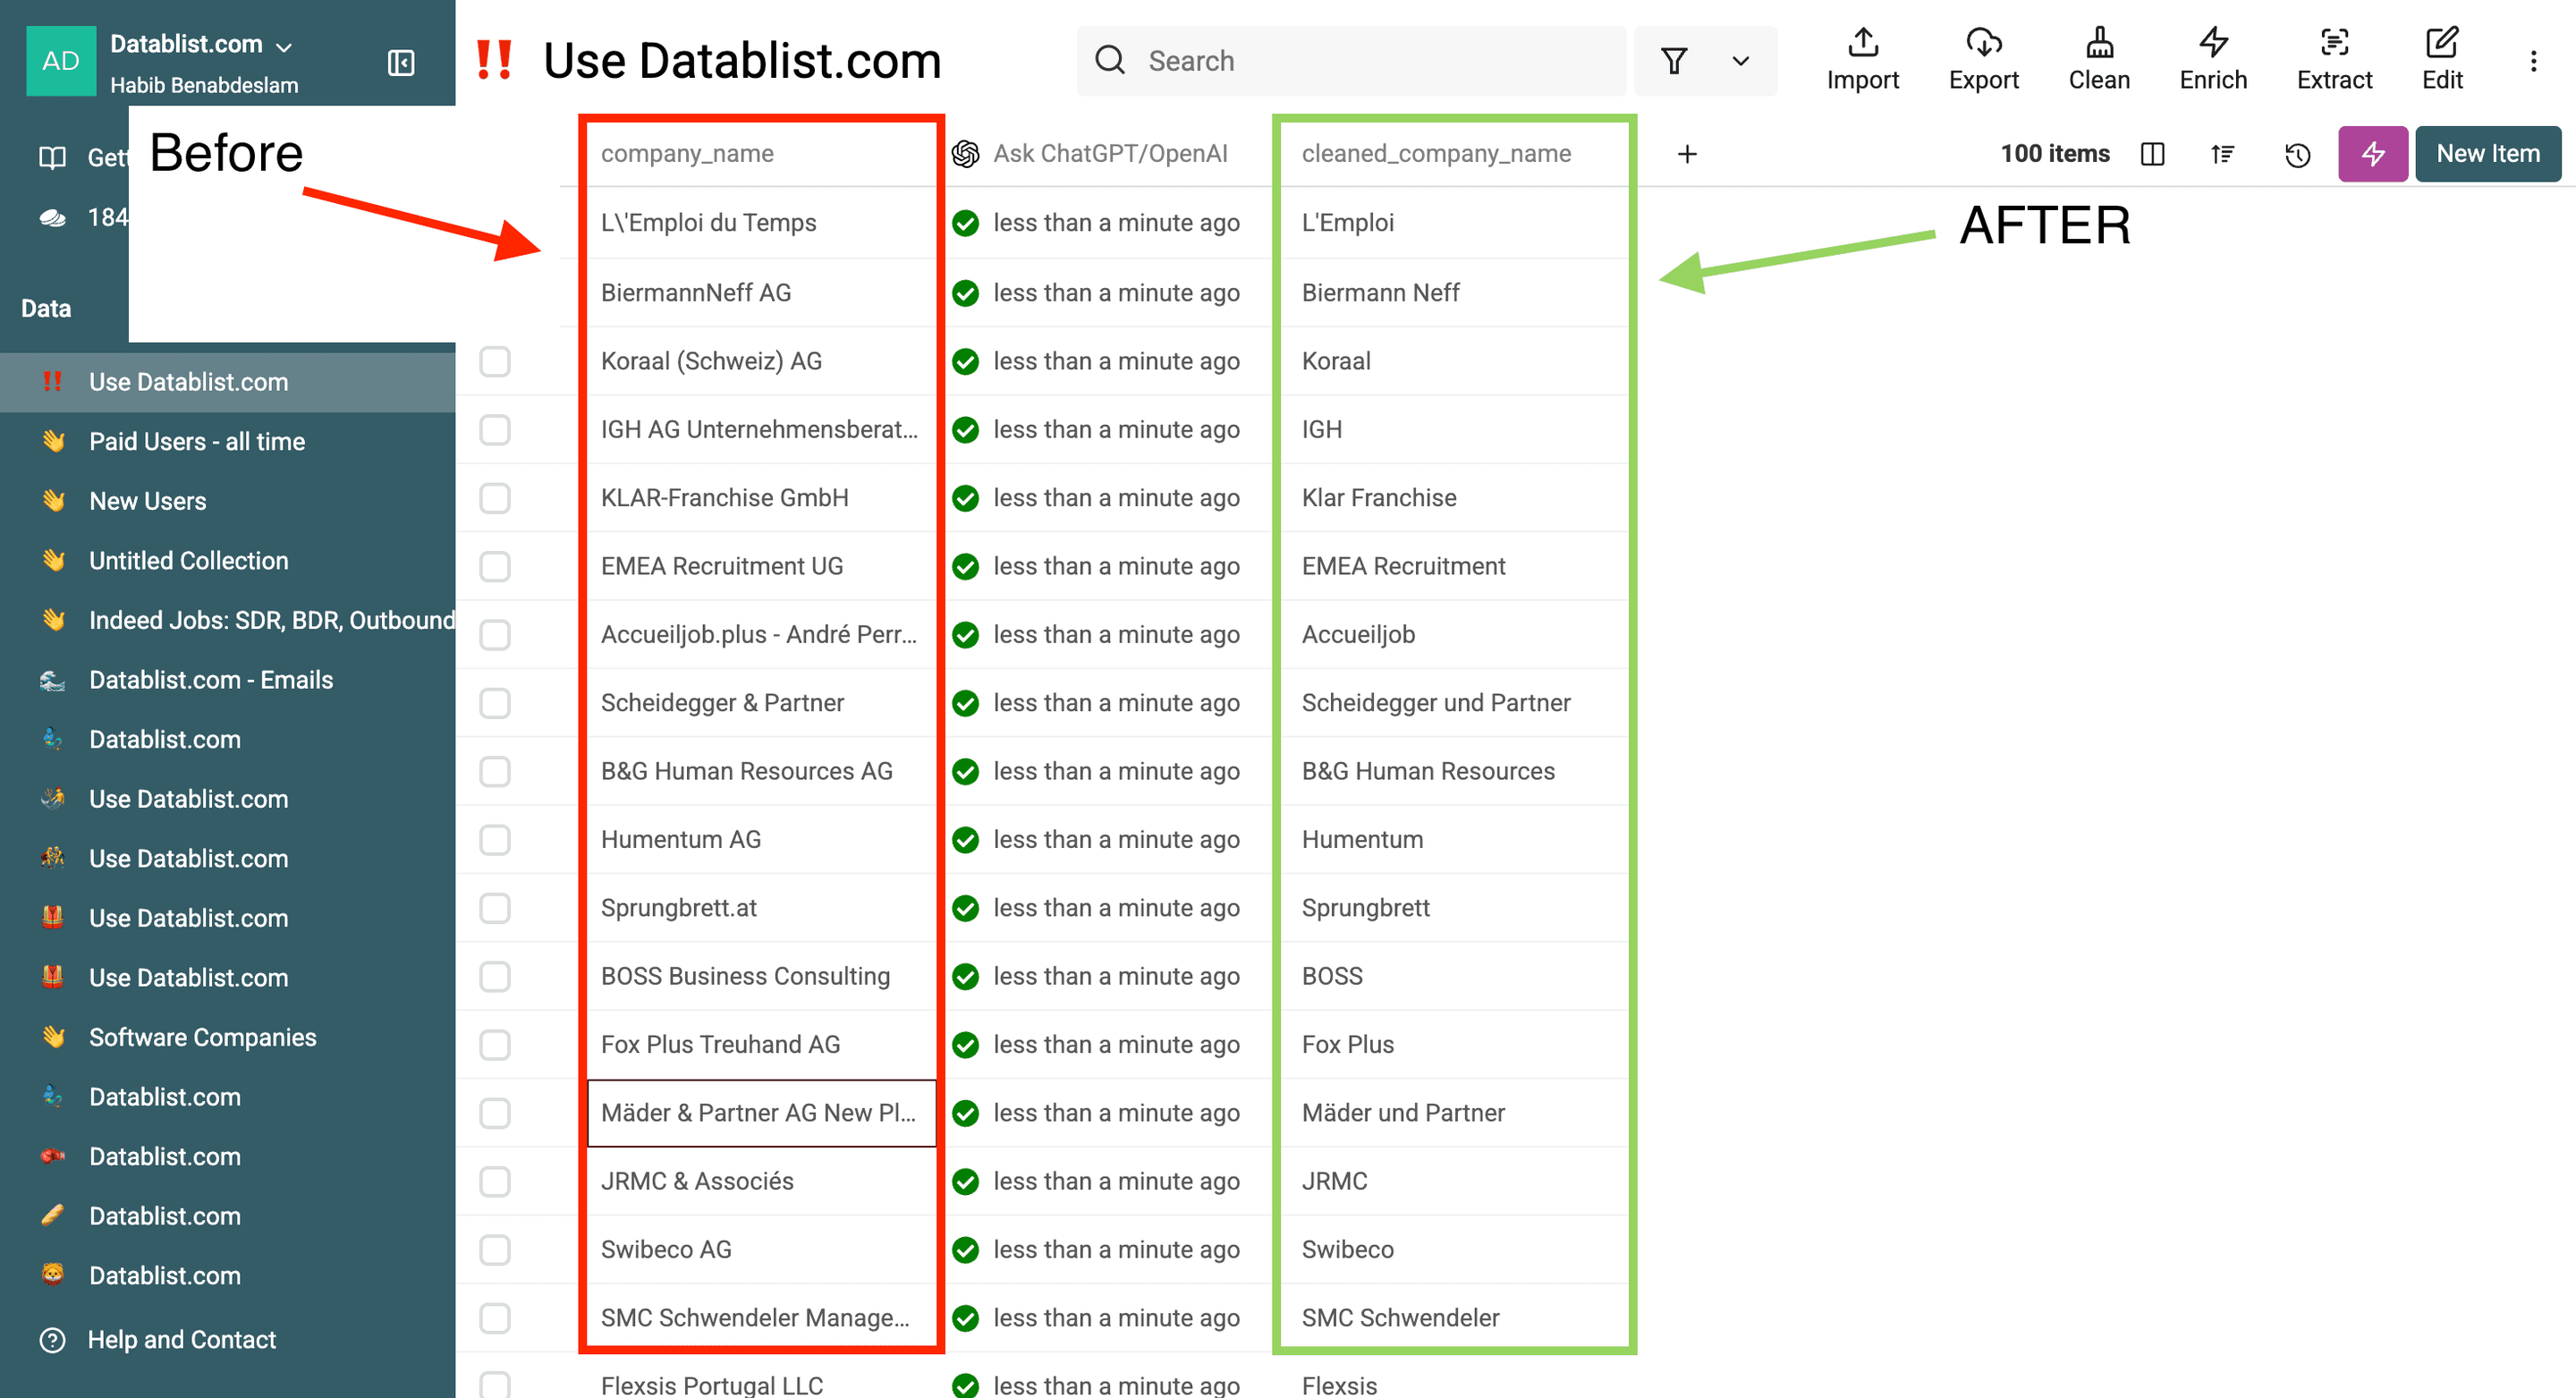
以下视频展示了公司名称的清洗流程:
方法二:用 AI 生成的 JavaScript 代码清洗公司名称
对于格式较为统一的列表,AI Editing 可以根据你的指令和最多 10 条样本数据生成 JavaScript 转换脚本。在编写脚本前,它不会读取 collection 中的每一个公司名称。请在 prompt 中明确列出需要处理的法定实体形式和例外情况,然后用有代表性的名称预览生成的代码,确认无误后再对完整列表运行。
这种方法无需为每一行调用 AI 模型,但生成的规则仍可能误删某些词。因此,请保留原始列,并优先测试难以处理的名称。
具体操作步骤如下。
首先,将公司名称导入 Datablist。你可以使用 CSV 或 Excel 文件。
为了演示,我的文件中只包含公司名称,但你也可以上传包含多个 property/列的文件。文件可以有数十万行数据,Datablist 非常适合打开大型 CSV 文件。
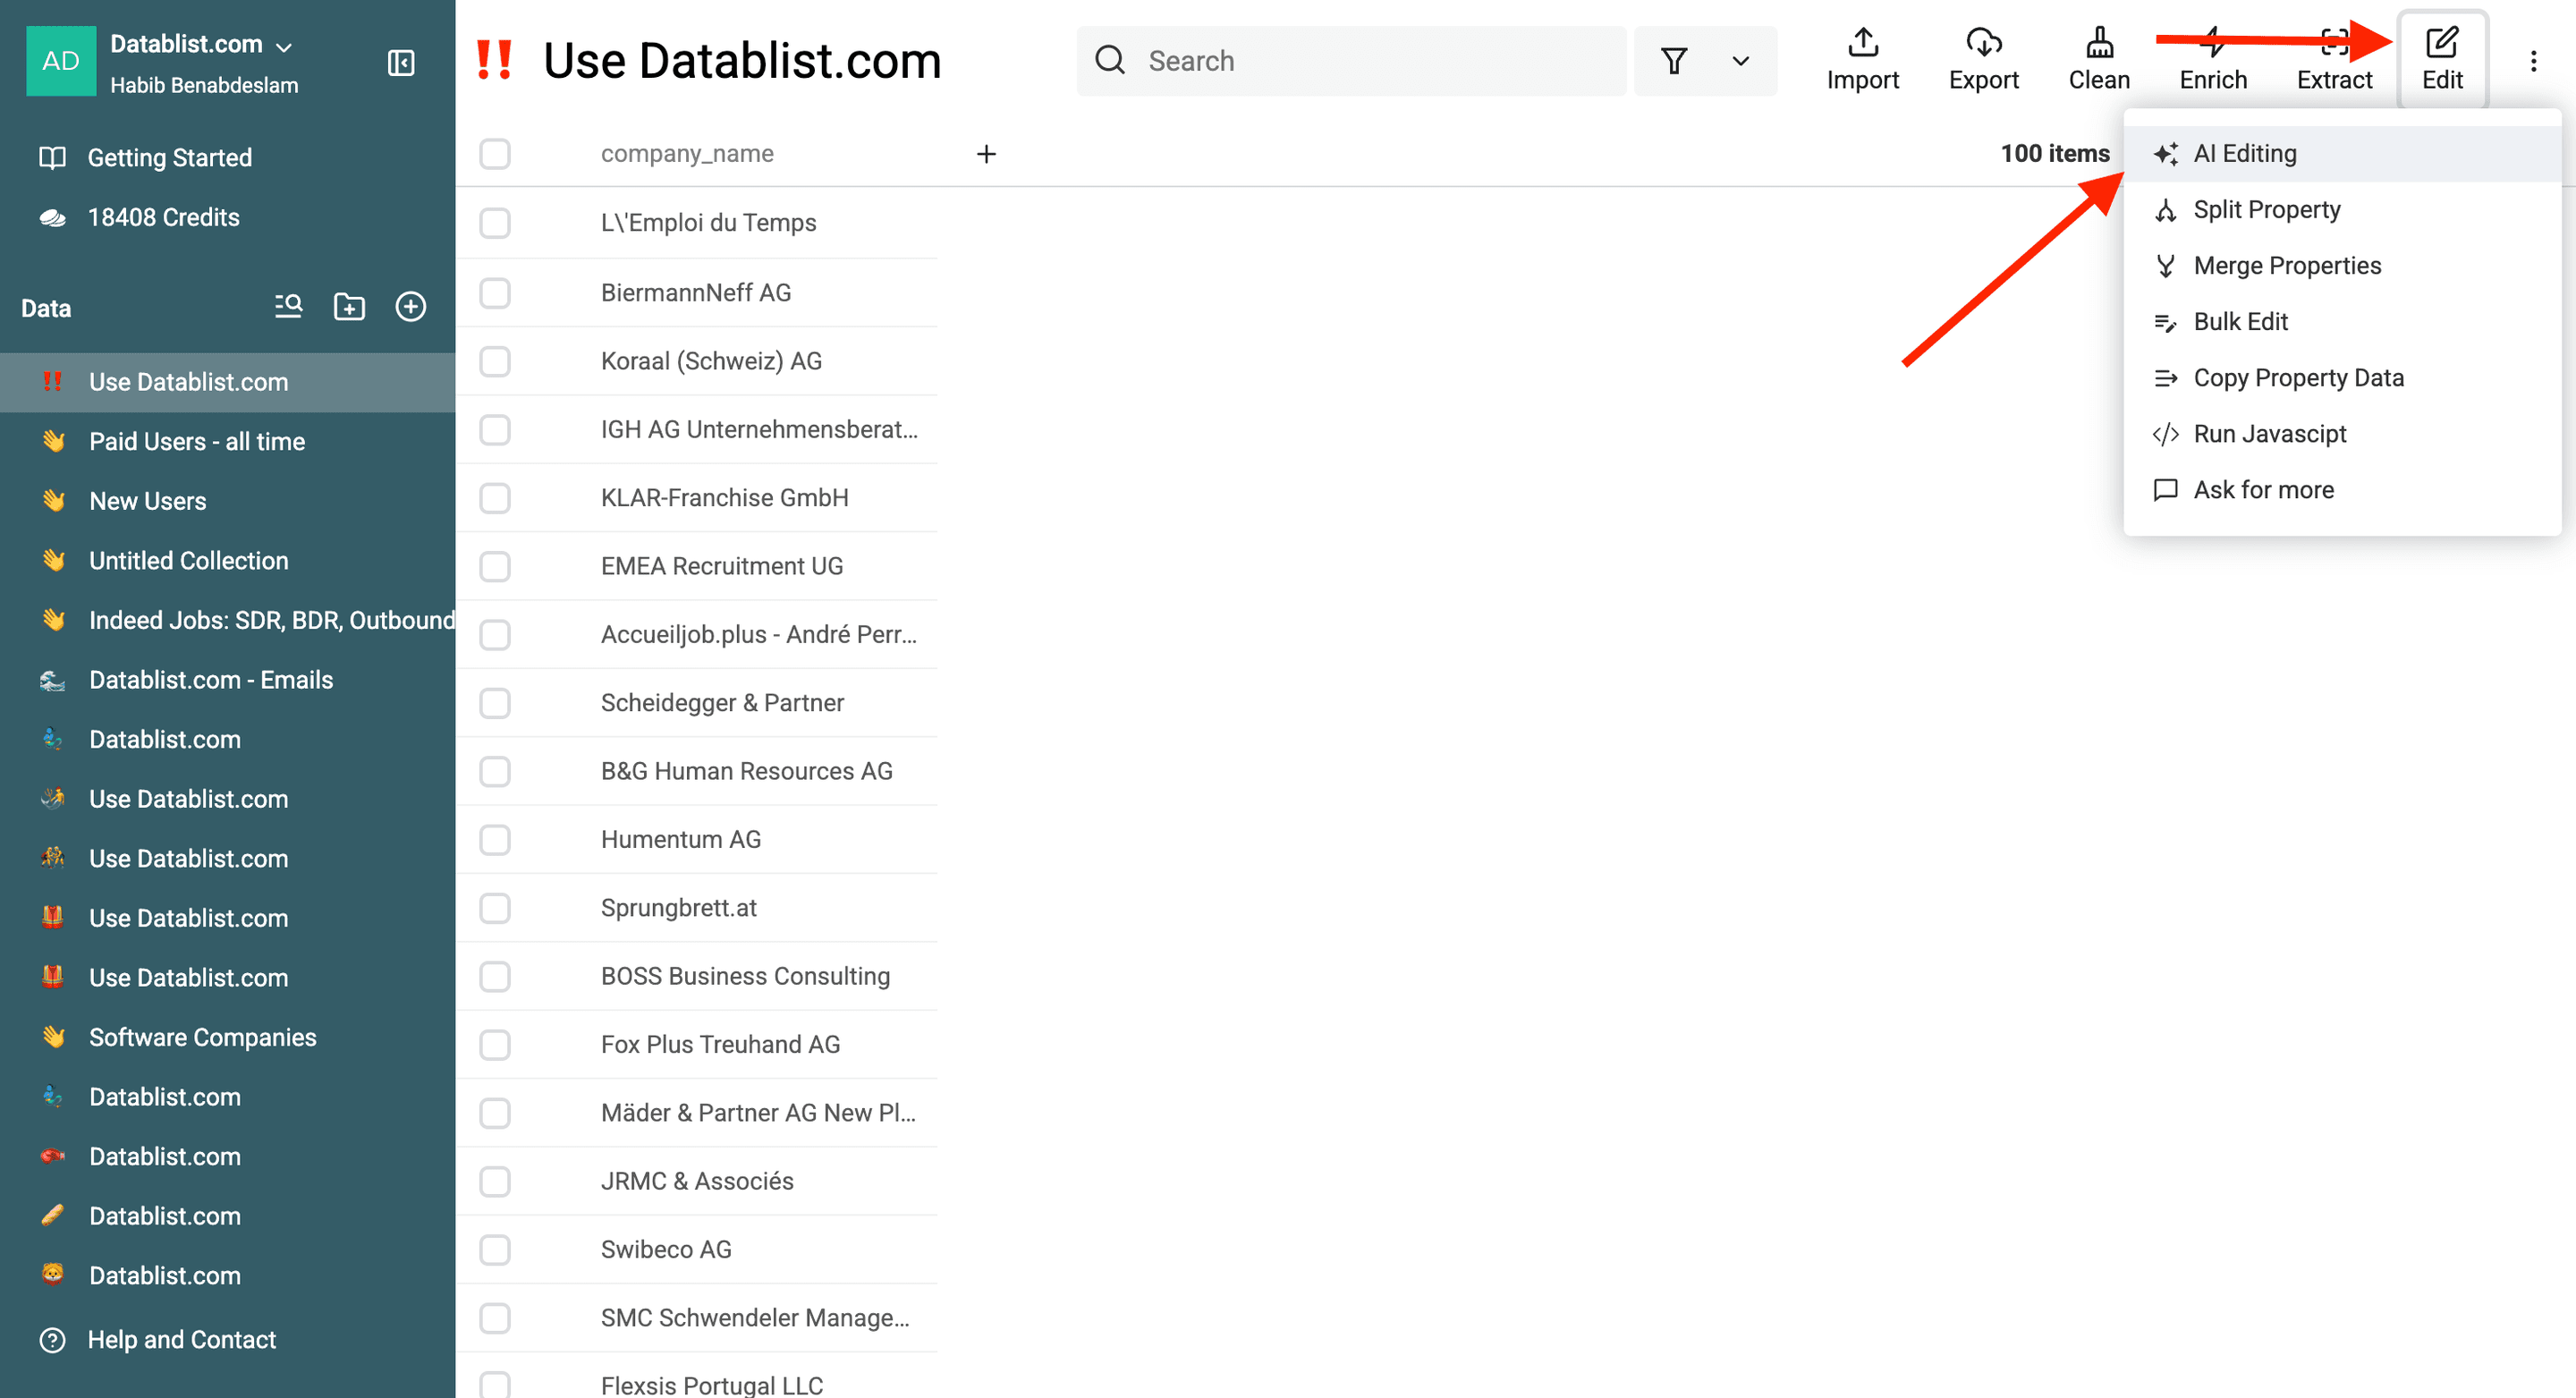
选择 Edit,然后选择 AI Editing。
编写规则 prompt,并引用包含公司名称的 property。请根据文件涉及的国家或地区补充后缀列表,不要假设前几条样本会涵盖所有法定实体形式:
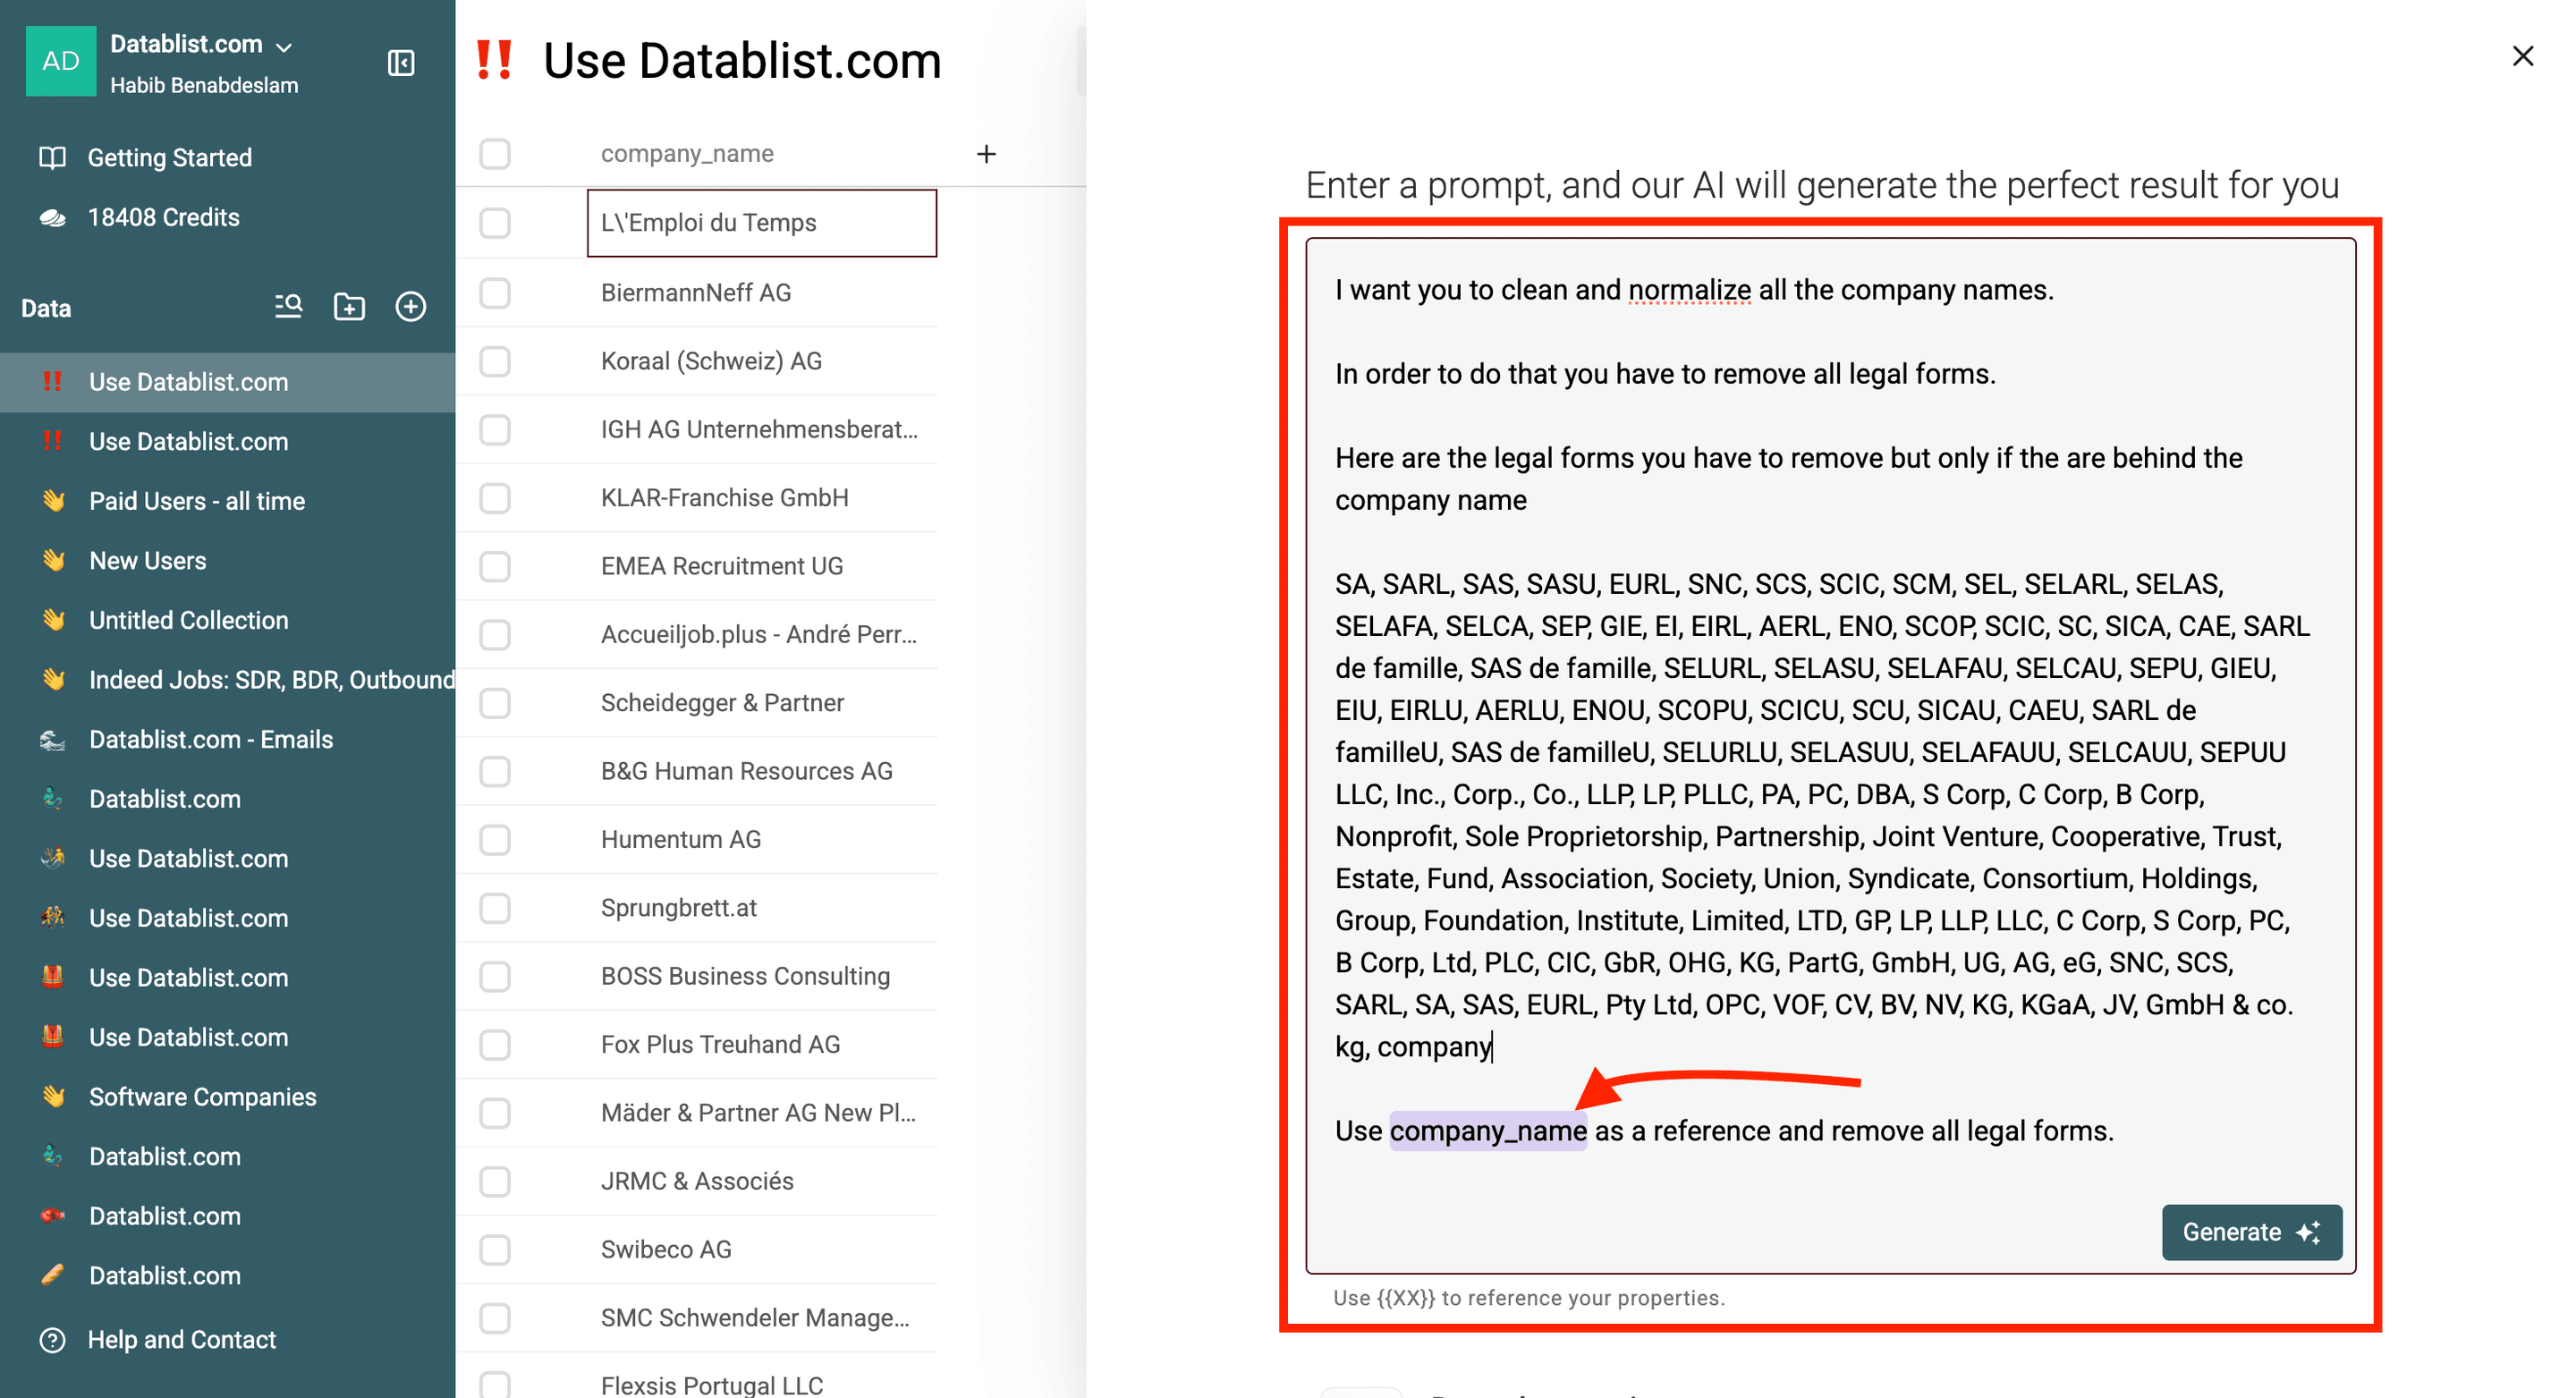
生成 JavaScript,读取 {{company_name}},并将清洗后的名称写入单独的 property。使用以下明确且不区分大小写的法定实体后缀列表:Inc.、Incorporated、LLC、L.L.C.、Ltd.、Limited、Corp.、Corporation、LLP、PLC、GmbH、GmbH & Co. KG、AG、B.V.、N.V.、S.A.、S.A.R.L.、SAS、S.r.l.、Pty Ltd、Pte Ltd 和 Co., Ltd.。仅匹配通过空格或标点与品牌名称分隔的完整结尾;先处理多词后缀,再处理较短后缀,并兼容常见的句点和空格写法。只删除后缀,随后清理残留的逗号、句点和空格。不要删除名称中间的这些词,也不要将名称缩减为“The”之类的通用词。如果 Group 和 Holdings 属于品牌名称,请予以保留。如果后缀存在歧义,则保持原名称不变。示例:“Acme, Inc.” -> “Acme”;“Acme GmbH & Co. KG” -> “Acme”;“The Limited” -> “The Limited”;“Limited Partners Group” -> “Limited Partners Group”。将相同规则应用到每一行,而不仅仅是样本数据。
注意:如果要使用同一个 prompt,请不要忘记用双花括号({{Property}})引用 property。
AI Editing 使用样本生成并预览脚本,并不会通过 LLM 逐行清洗数据。生成脚本前,请选择或筛选有代表性的行,确保预览涵盖多词法定实体形式、包含 Limited 或 Group 的品牌,以及没有法定实体后缀的名称。请同时检查生成的 JavaScript 和预览结果。如果脚本漏掉某个后缀或误删品牌词,请在 prompt 中加入明确规则或例外情况,重新生成脚本后再处理完整列表。
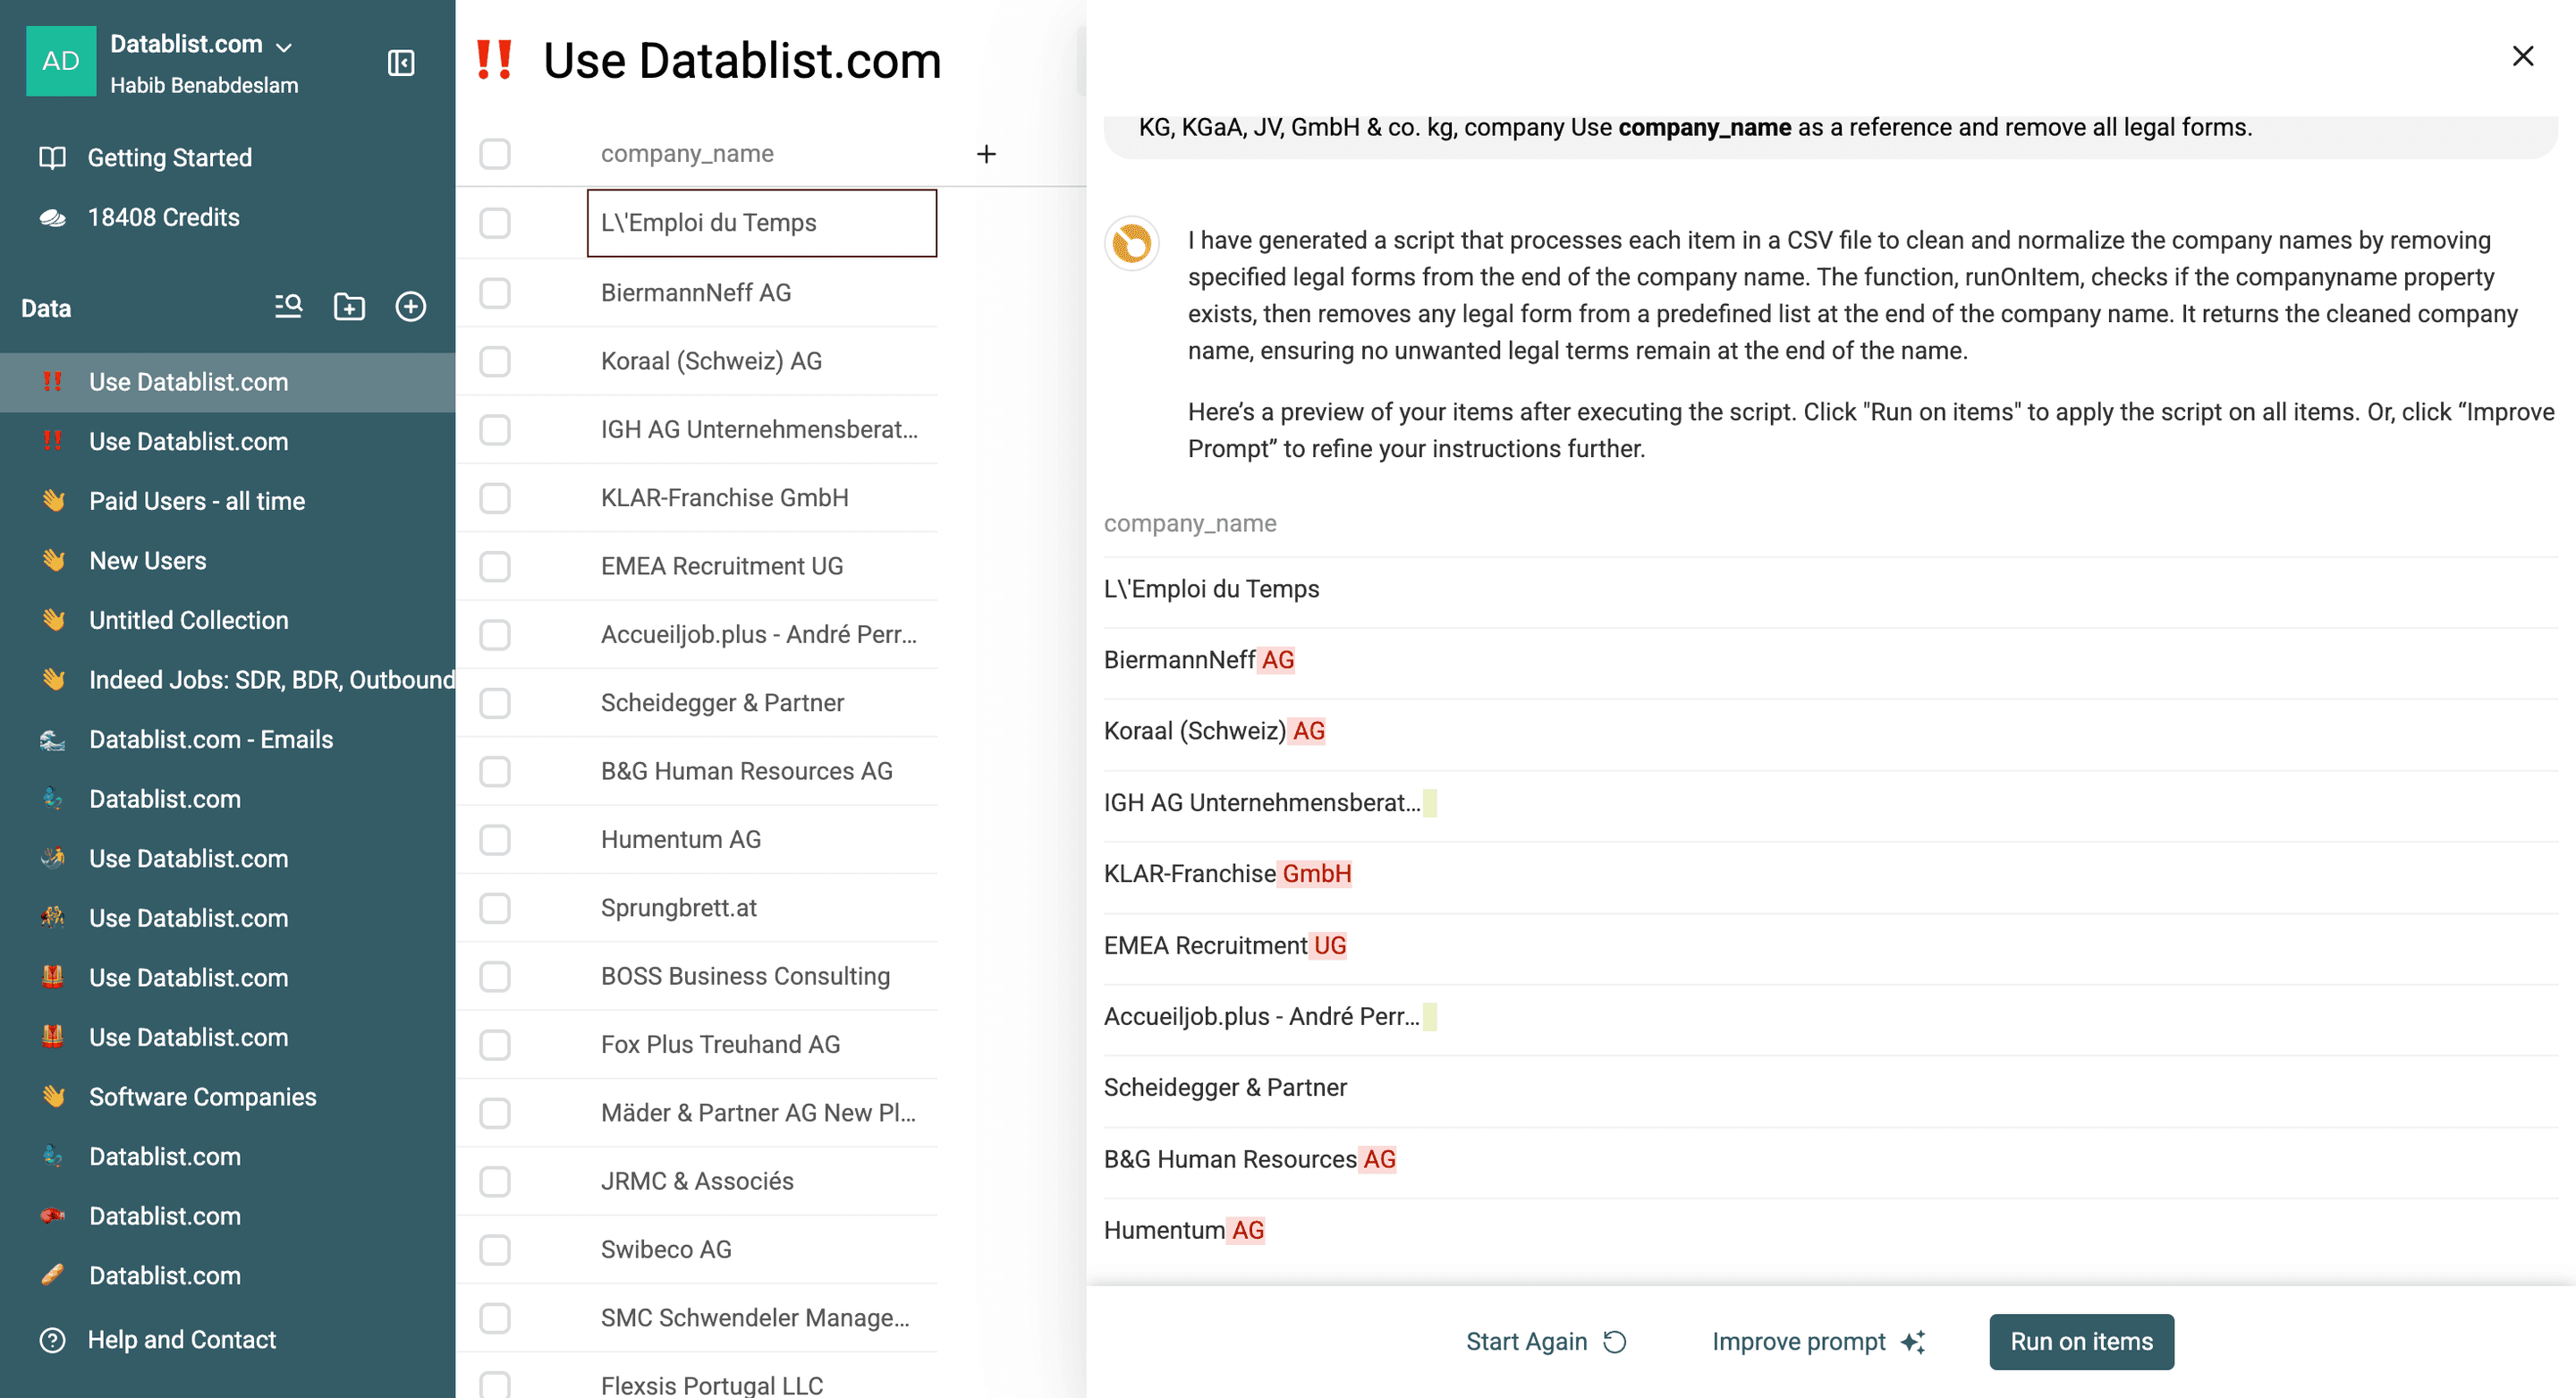
确认预览正确后,点击 Run on items,并将更多输出样本与原始 property 进行比较。
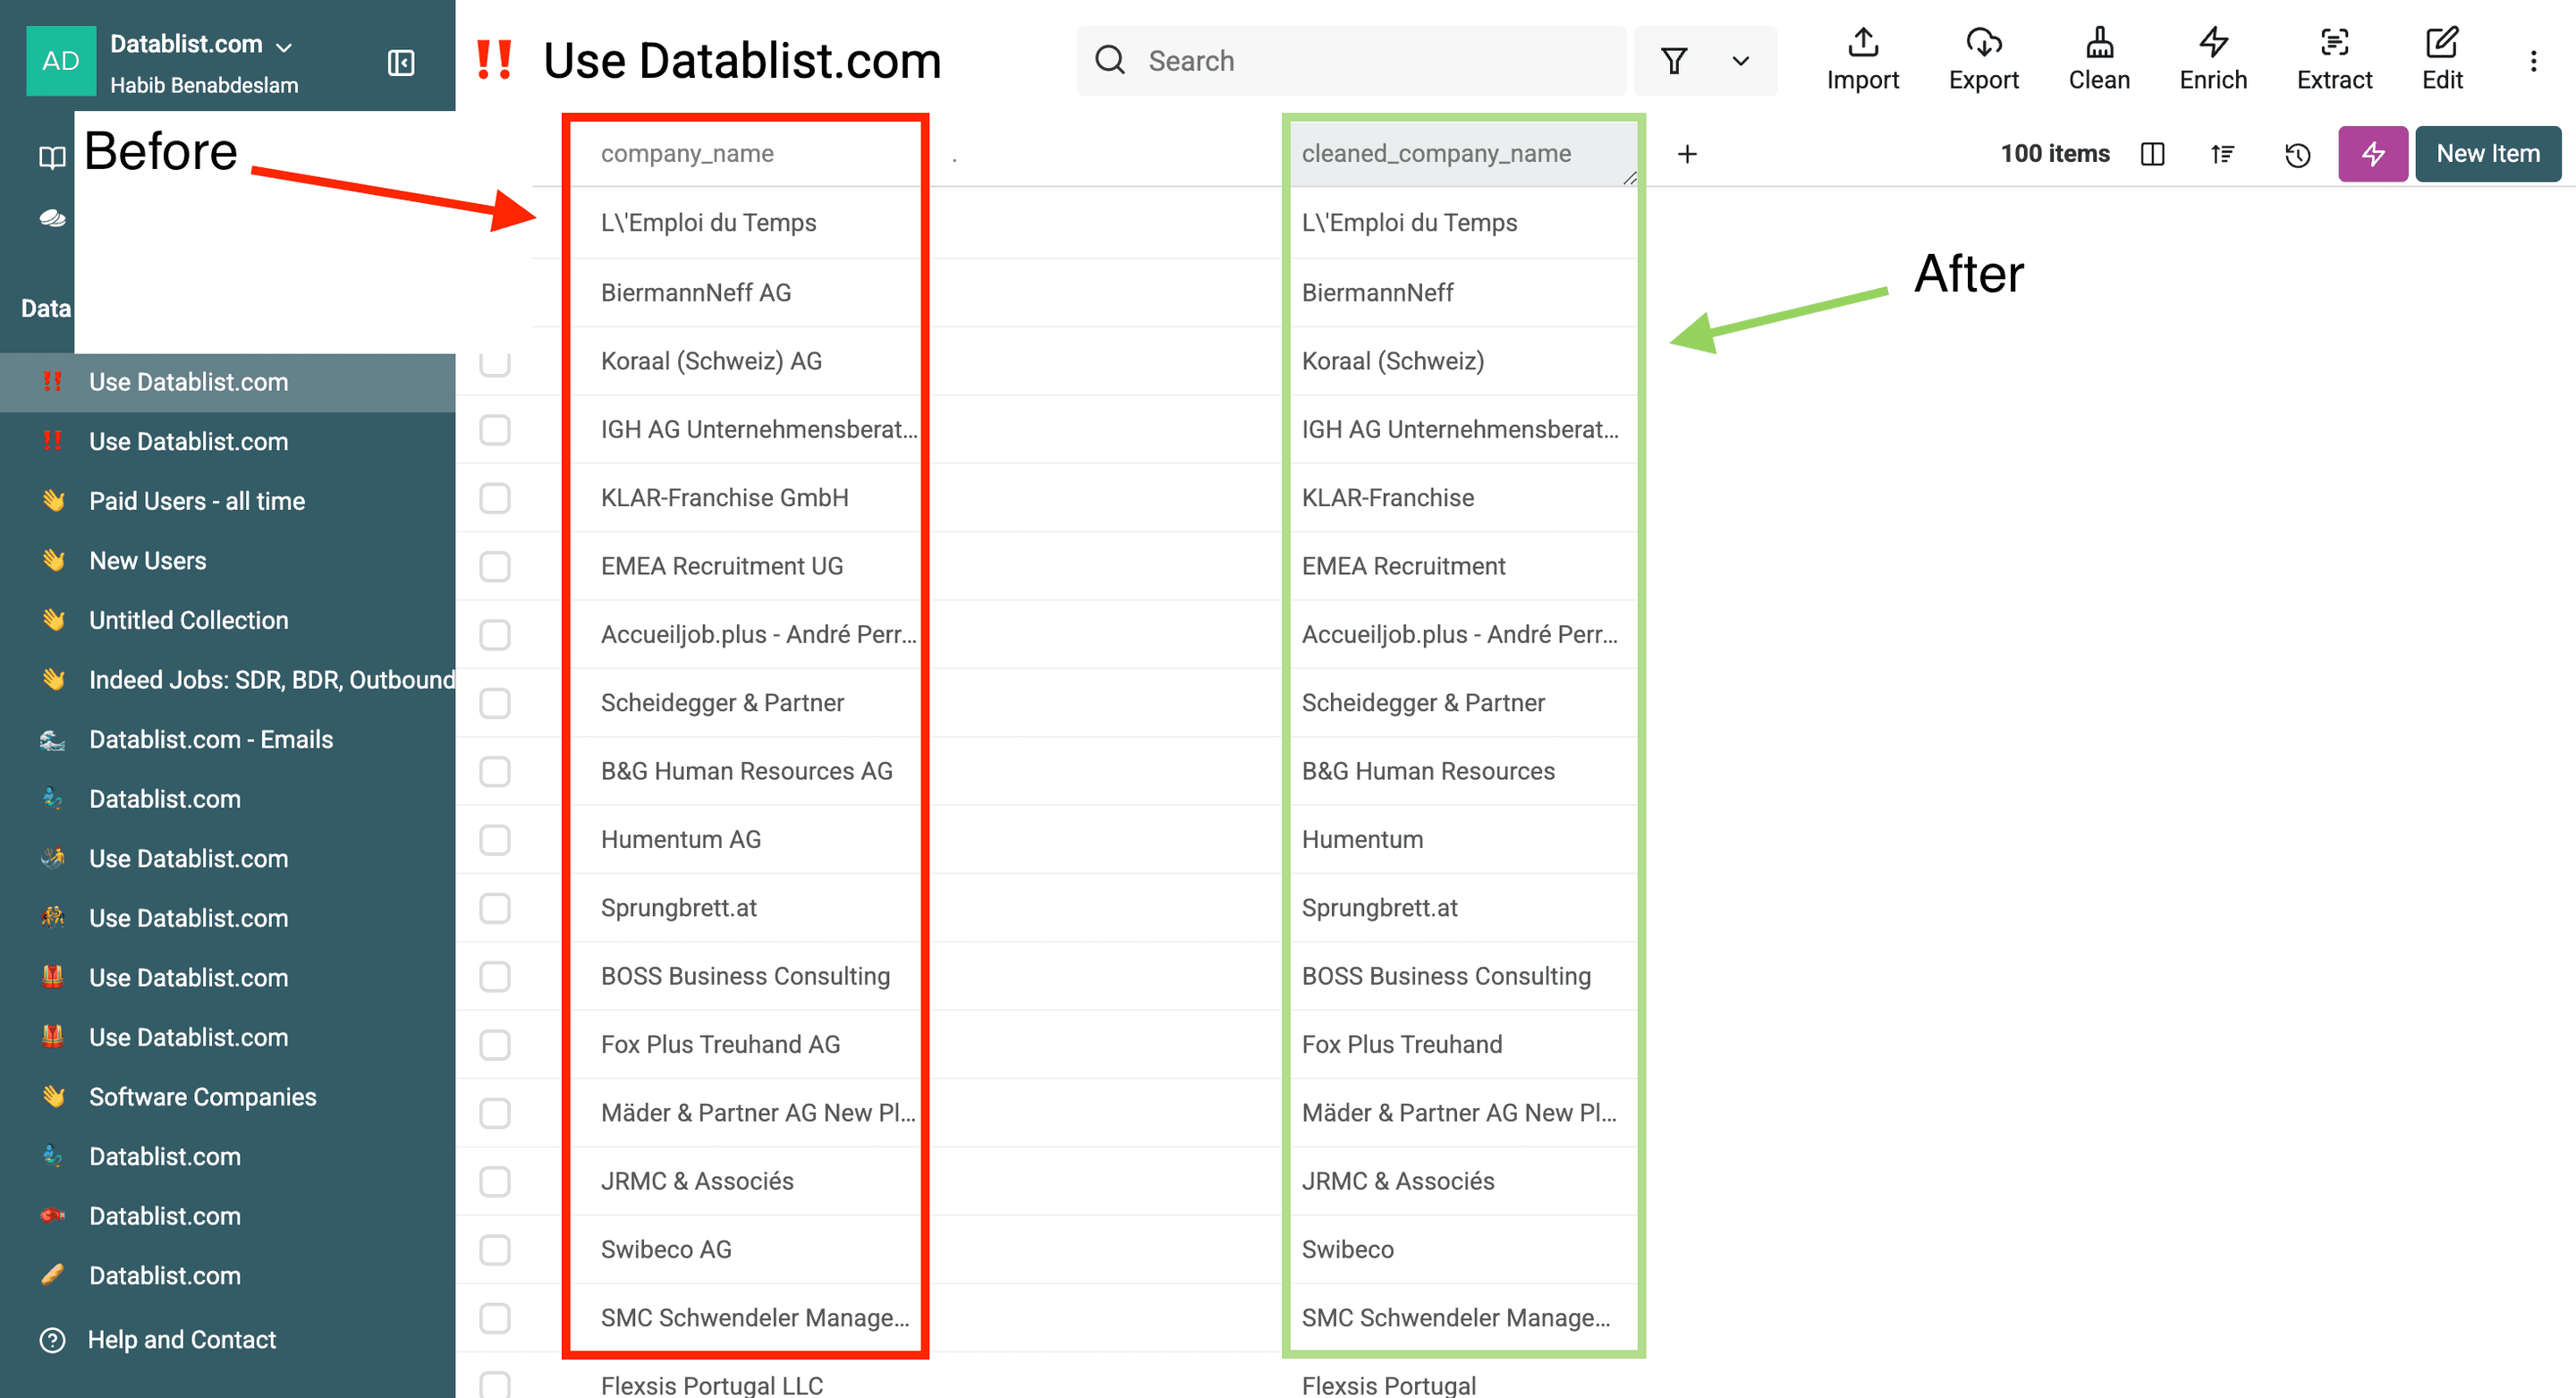
如果列表规模较小,可以参考免费的公司名称清洗工作流,了解如何审核清洗后的名称,并为后续去重保留稳定标识符。
两种公司名称清洗方法有何区别?
生成式 AI 清洗(方法一)会直接使用 AI 清洗公司名称,而方法二(AI 生成的 JavaScript)则使用 AI 创建负责清洗的 JavaScript 脚本。
方法一会对每个处理行使用 AI,因此需要消耗 credit。它更适合处理多样化的格式,但结果仍需审核。
方法二会根据明确规则和少量样本生成脚本,再将同一脚本应用到所有行。如果你能列出相关法定实体形式,并在完整运行前检查边界情况,这种方法更合适。
两种方法都能自动清洗公司名称,具体选择取决于列表规模、预算和准确性要求。
方法一和方法二应该如何选择?
生成式 AI 清洗(方法一)
- 列表包含多种格式和语言
- 名称需要结合上下文判断
- 你可以抽样审核 AI 的处理结果
AI 生成的 JavaScript(方法二)
- 列表遵循一致的规则
- 你可以预览并优化生成的脚本
- 你希望避免为每一行调用 AI
公司名称清洗常见问题(FAQ)
如何为 B2B Lead Generation 自动清洗公司名称?
导入 CSV,保留原始名称列,并将清洗后的名称写入新的 property。如果名称格式差异较大,请使用 Company Name Cleaner;如果需要可重复执行的固定规则,请使用 AI Editing。导出前务必抽样检查输出。
如何批量删除公司名称中的法定实体后缀?
明确指定要删除的后缀,并保留原始名称。预览短名称、来自不同国家或地区的名称,以及包含类似法定实体形式的品牌词。若规则错误修改了品牌名称,请及时调整。
AI 能清洗不同国家和语言的公司名称吗?
AI 可以处理不同国家和语言的公司名称,但各地的法定实体形式与品牌命名习惯并不相同。请加入列表中的真实示例,并审核含义不明确的输出,不要假设一套后缀规则适用于所有国家。
使用 AI 清洗 1000 个公司名称需要多久?
所需时间取决于采用的方法、collection 规模和处理条件。建议先测试一小批数据并检查输出,再根据本次运行情况规划更大规模的任务。