
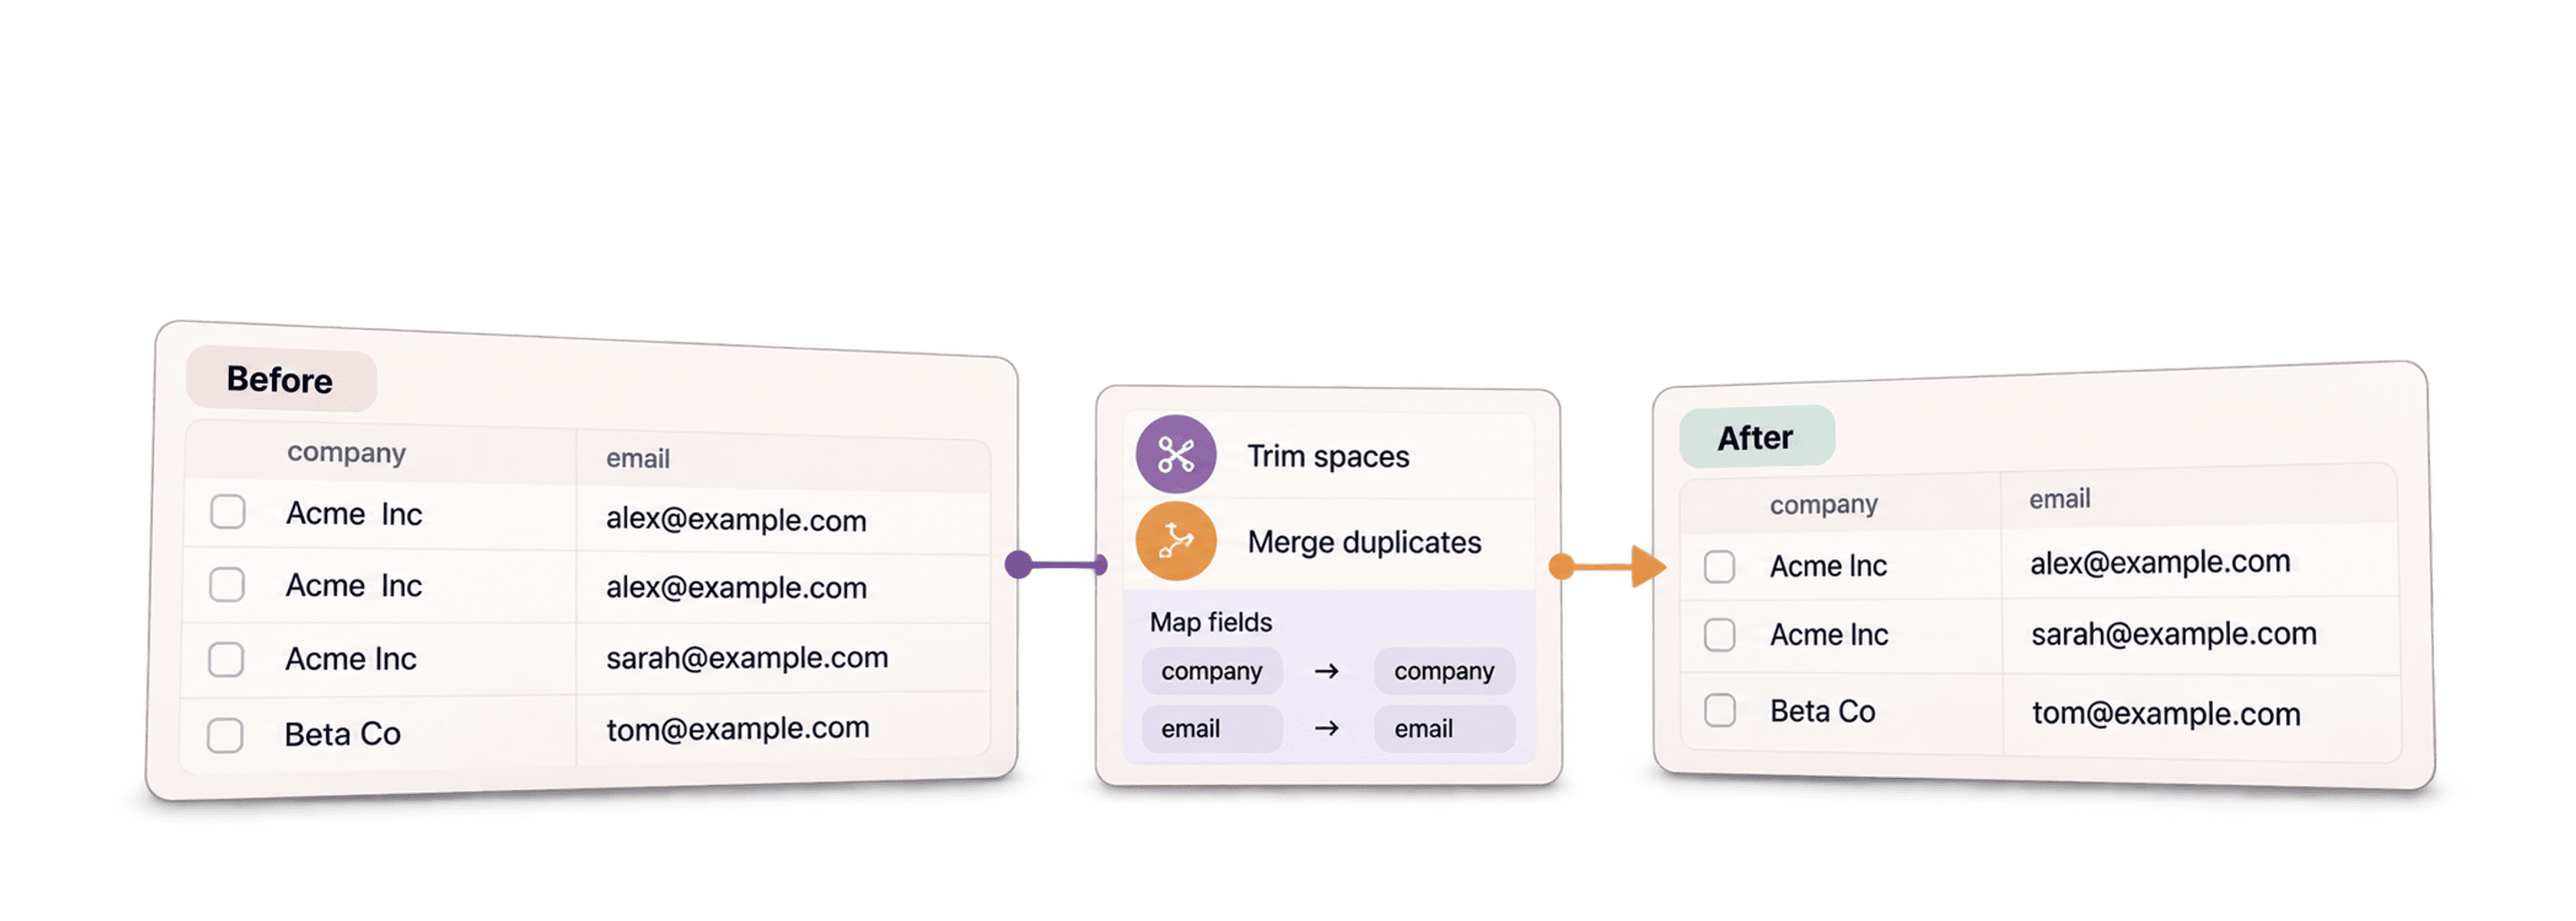
数据清洗,是指在使用数据集之前发现并修正其中的错误。对于 Lead 名单,这可能包括纠正日期、删除多余空格、拆分完整姓名,以及合并重复联系人。本指南将介绍如何在 Datablist 中完成这些操作,并在导出或 Enrich 名单前检查处理结果。
建议先处理用于识别记录的字段,例如 Email 地址或公司域名。统一格式并检查重复项后,再转换或提取其他所需数据。每完成一项操作,都要抽查几行数据,避免格式规则误改原本有效的内容。
以下是本文介绍的数据清洗操作概览:
- 将文本转换为 Datetime、Number、Boolean
- 将 HTML 转换为纯文本(删除 HTML 标签)
- 删除文本中的多余空格
- 标准化数据
- 删除文本中的符号
- 将完整姓名拆分为名字和姓氏
- 数据去重
- 从文本中提取 Email 地址和 URL 等信息
- 使用正则表达式筛选和验证数据
- 使用 JavaScript 编写自定义转换
- 验证 Email 地址
从 CSV 导入或粘贴数据
Datablist 是一款非常适合数据清洗的工具。它是一款在线 CSV 编辑器,提供数据清洗、批量编辑和 Enrichment 功能。 每个 collection 最多可处理数百万条记录。
对于包含多种语言的文本字段,你可以先为混合语言数据行添加语言标签,再进行筛选、分流或翻译。
打开 Datablist,然后加载你的数据源 collection。
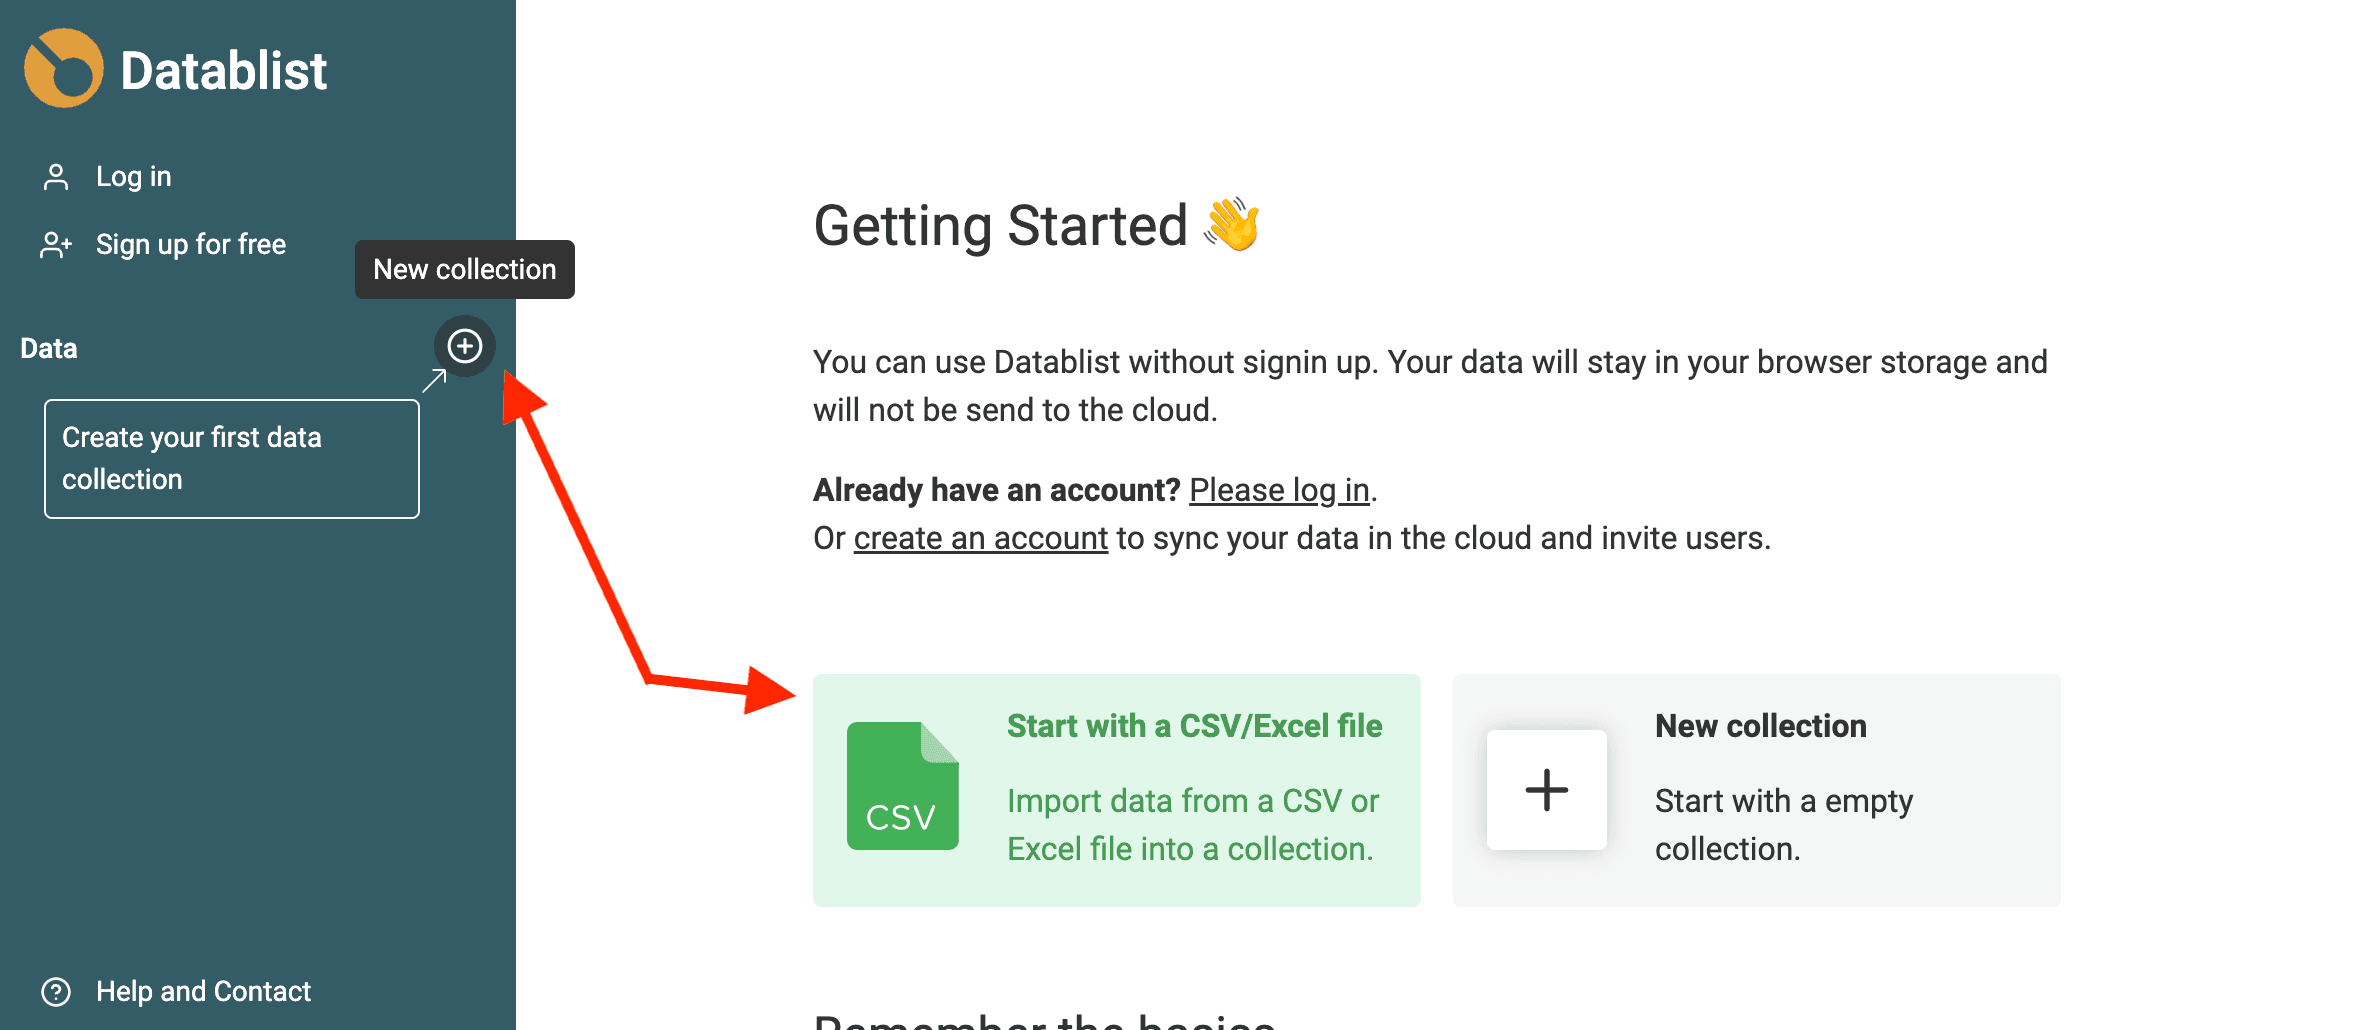
要创建新的 collection,请点击侧边栏中的 + 按钮,再点击“Import CSV/Excel”加载文件。你也可以点击入门页面上的快捷入口,直接进入文件导入步骤。
自动识别格式
只要数据格式正确,Datablist 的导入助手就能自动识别 Email 地址、ISO 8601 格式的 Datetime、Boolean、Number 和 URL 等数据。
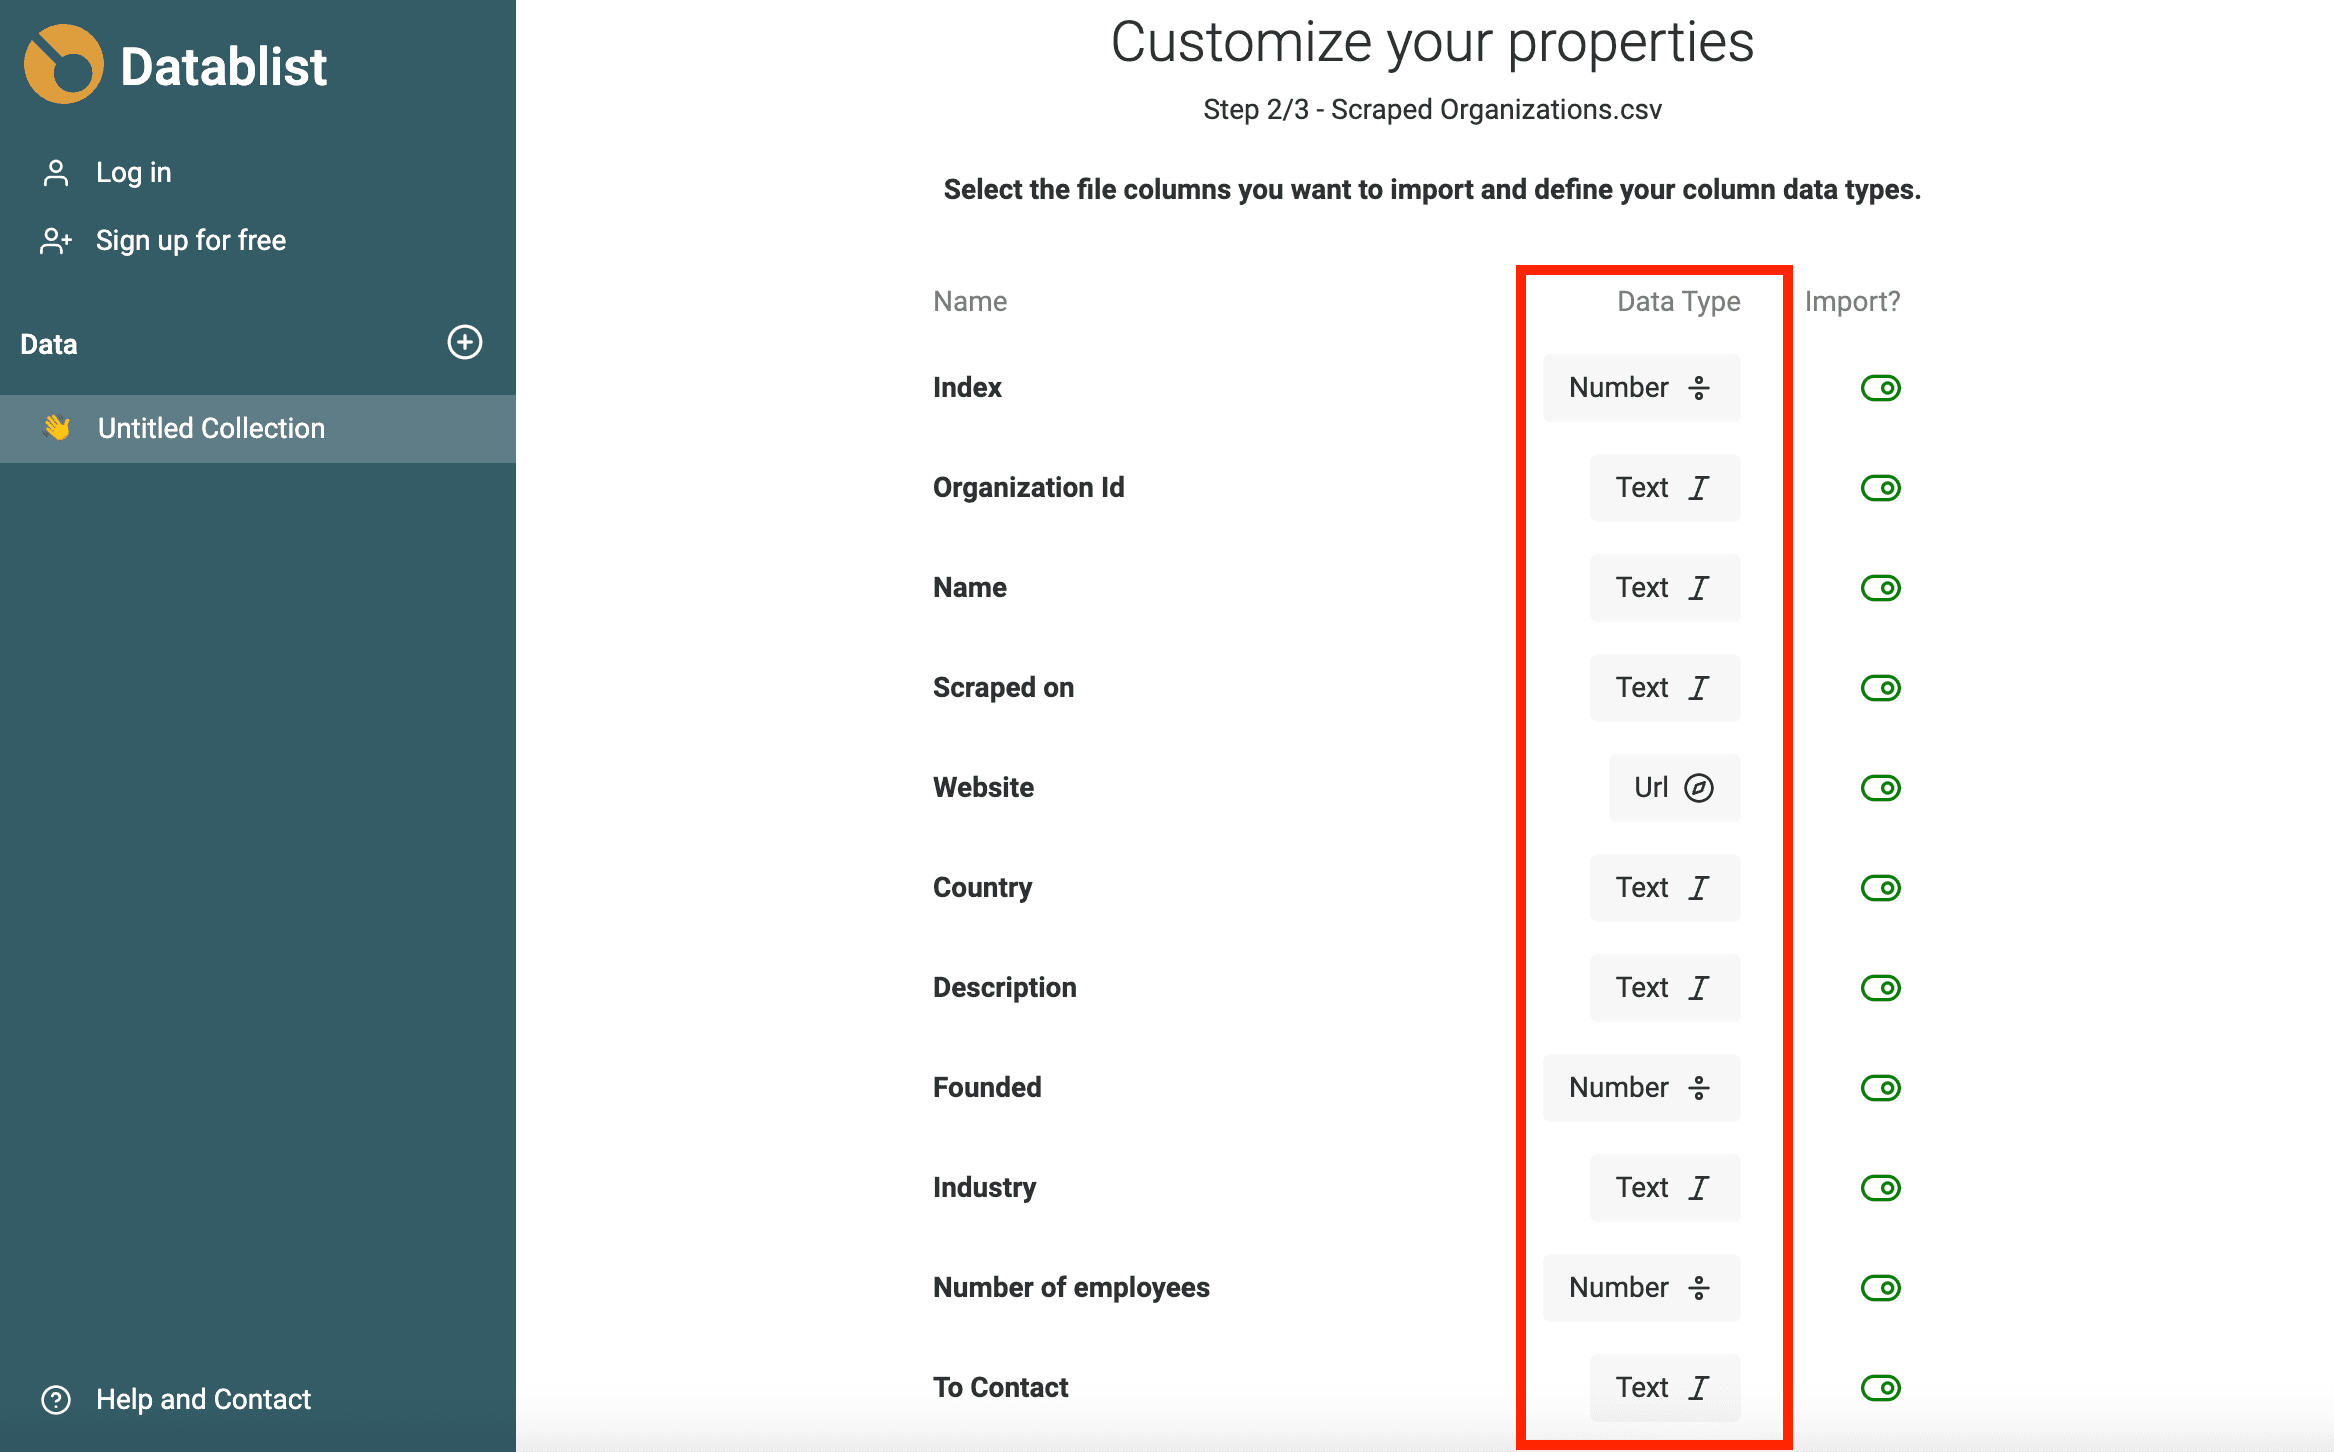
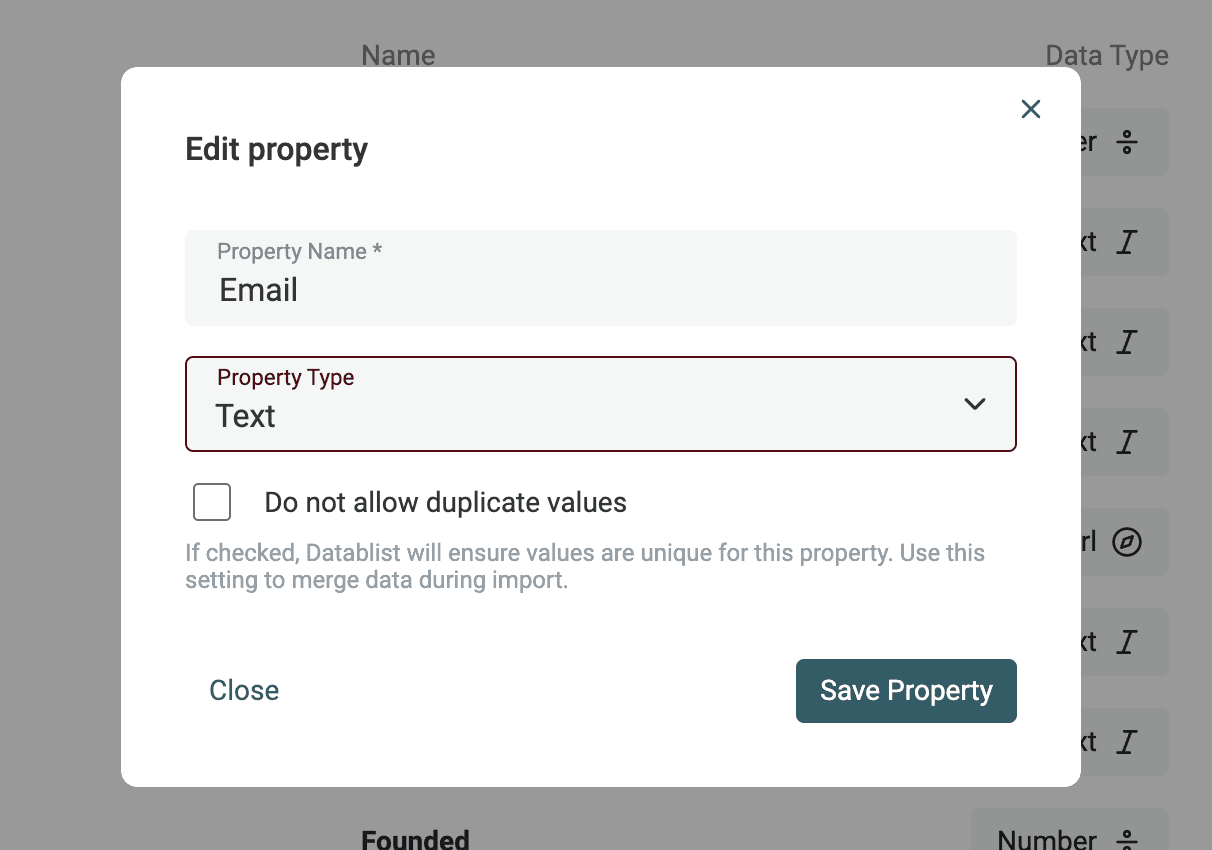
如果数据需要更复杂的分析,例如日期时间格式不同,或 URL、Email 地址中存在拼写错误,请先将其导入为 Text 属性。下一节将介绍如何把 Text 属性转换为 Datetime、Boolean 或 Number。
将文本转换为 Datetime、Boolean、Number
近藤麻理惠说:“真正的人生,从整理之后开始。”数据也一样:“真正的销售,从整理好数据之后开始!”😅
当日期(创建日期、融资日期等)、数字(价格、员工人数)或 Boolean 是原生数据对象,而不只是普通文本时,筛选会容易得多。
在“Clean”菜单中打开“Text to Datetime, Number, Checkbox”工具。
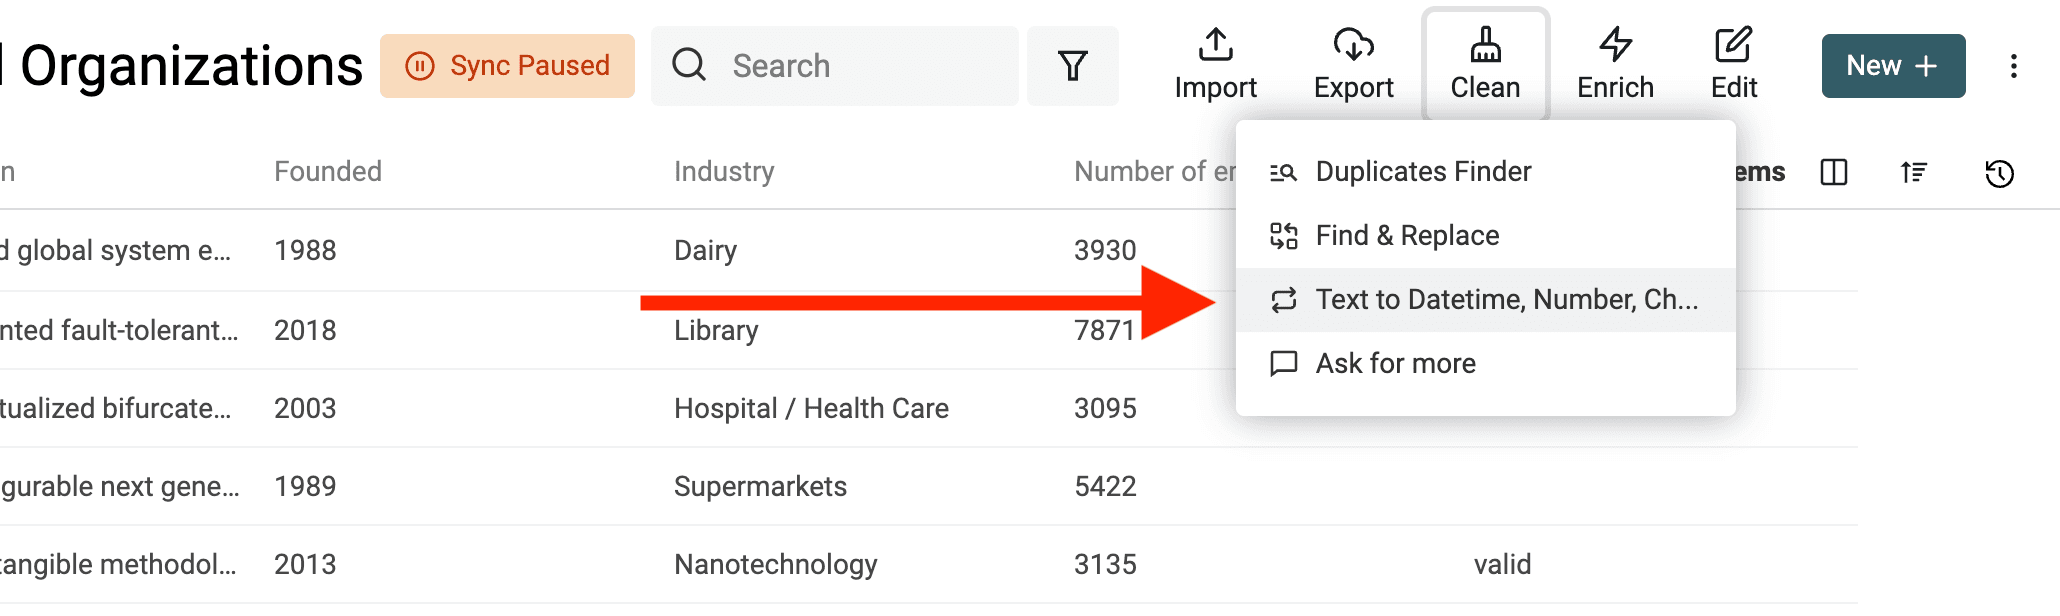
将任意文本转换为 Datetime 格式
Datetime 有一种结构明确的国际标准格式,即 ISO 8601。如果数据采用 ISO 8601 格式,导入时系统会自动创建 Datetime 属性来存储这些数据。
对于采用其他格式的 Date 和 Datetime 值,你需要指定当前使用的格式,以便 Datablist 将其转换为结构化的 Datetime 值。
选择要转换的属性,再选择“Convert to Datetime”。
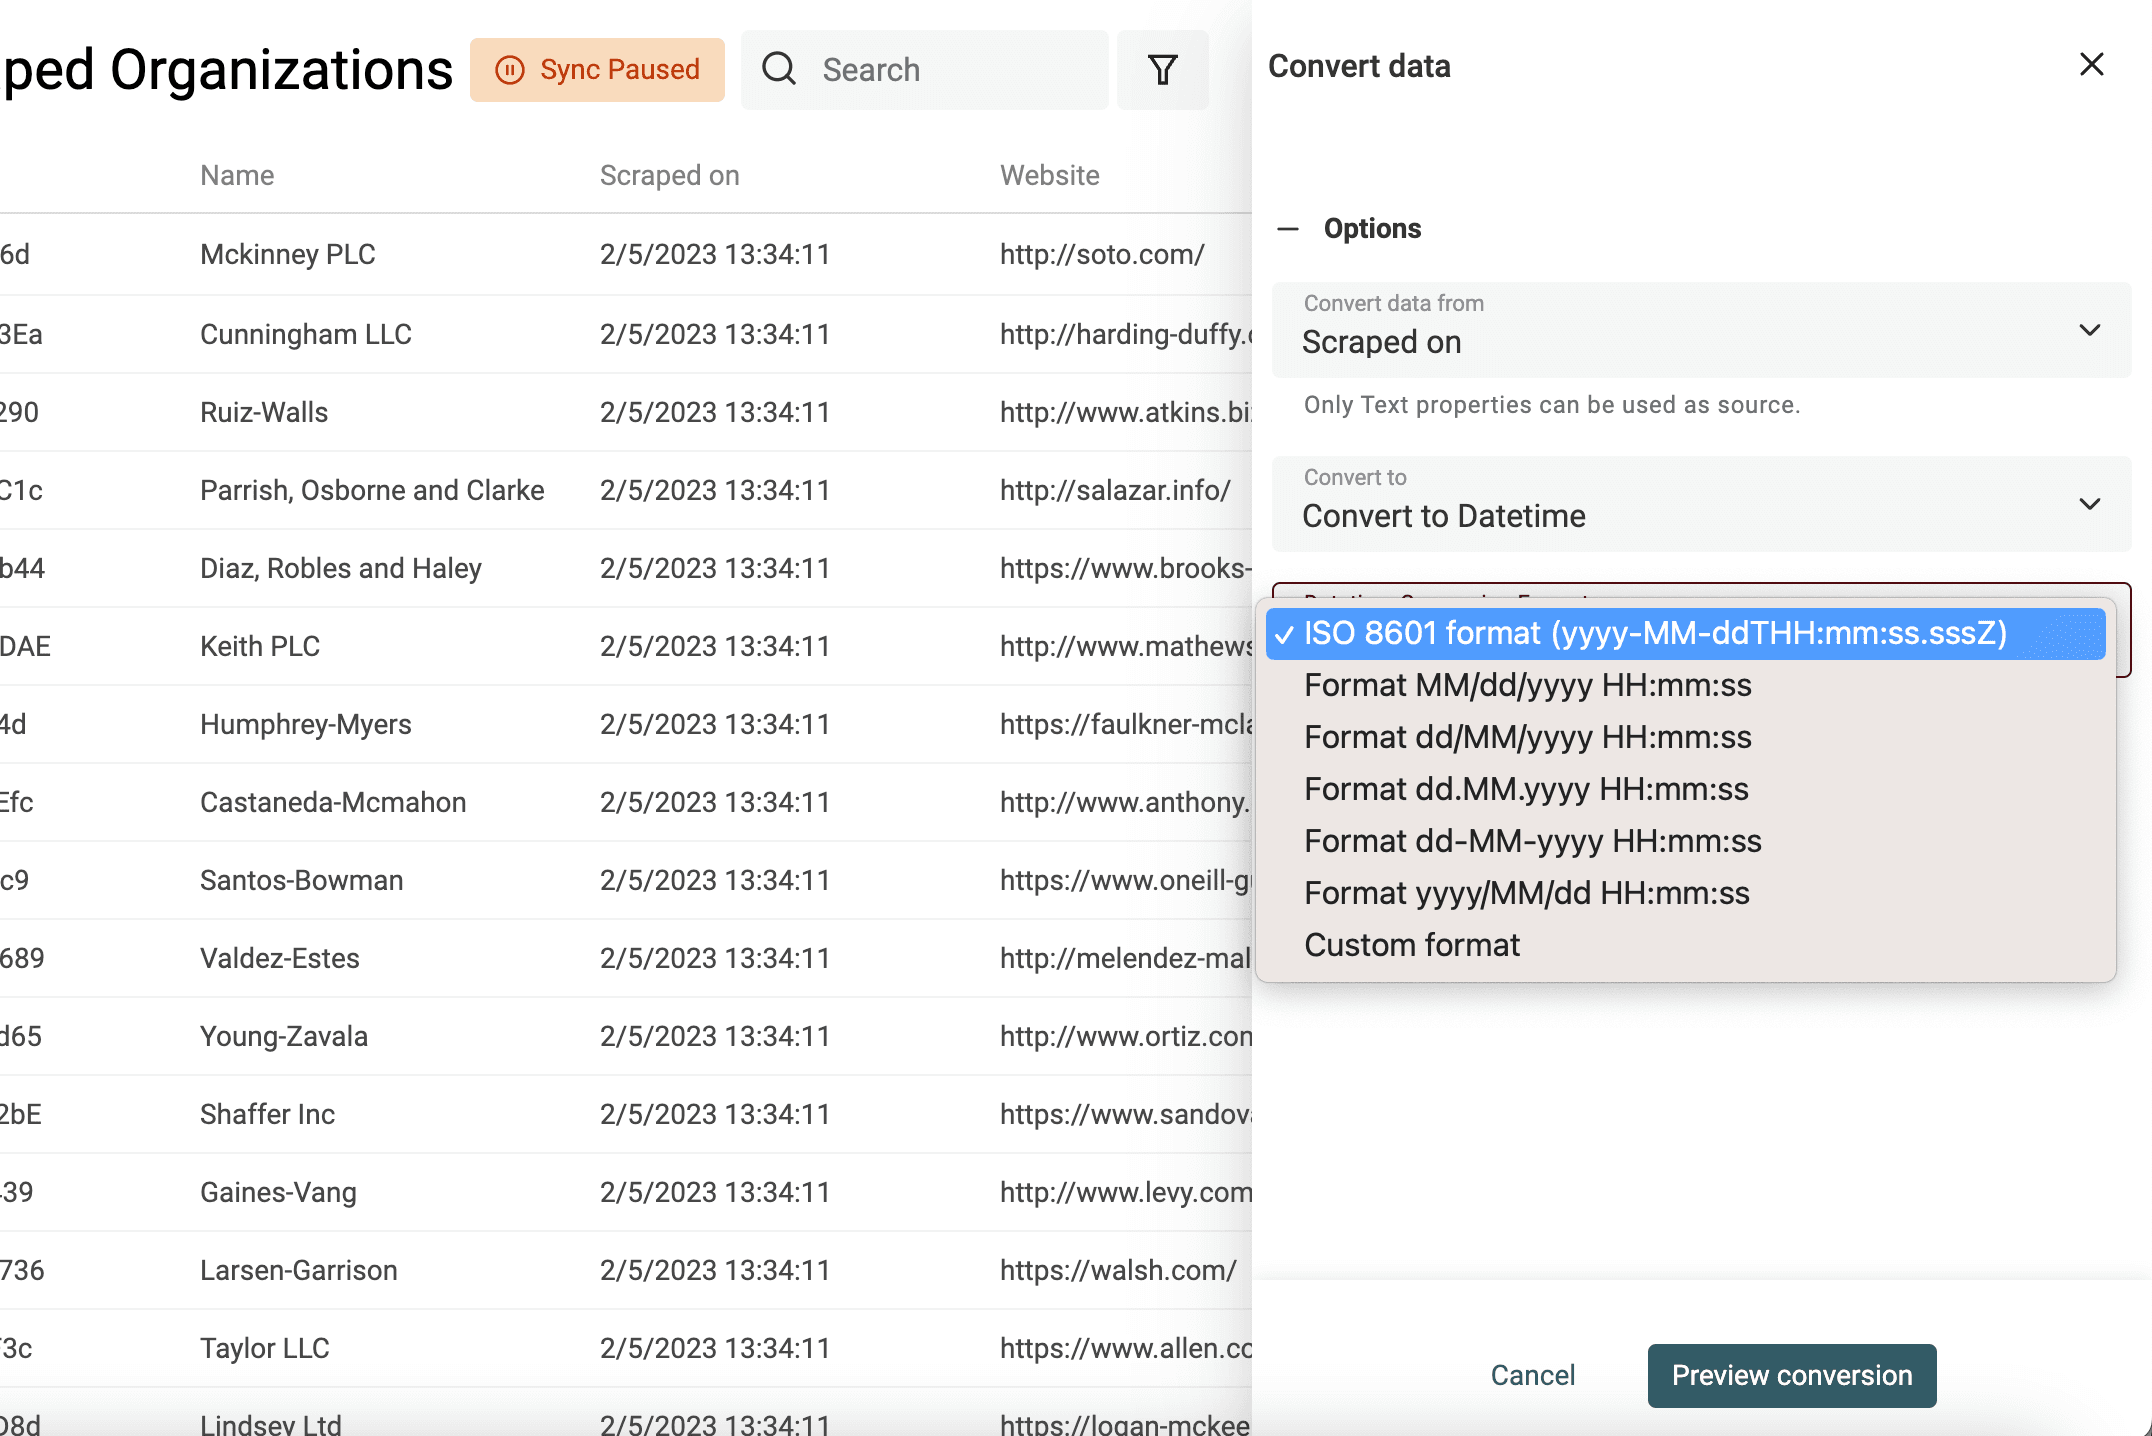
你可以直接选择常用格式,包括 Google Sheets 和 Excel 使用的日期时间格式,也可以选择“Custom format”定义自己的格式。
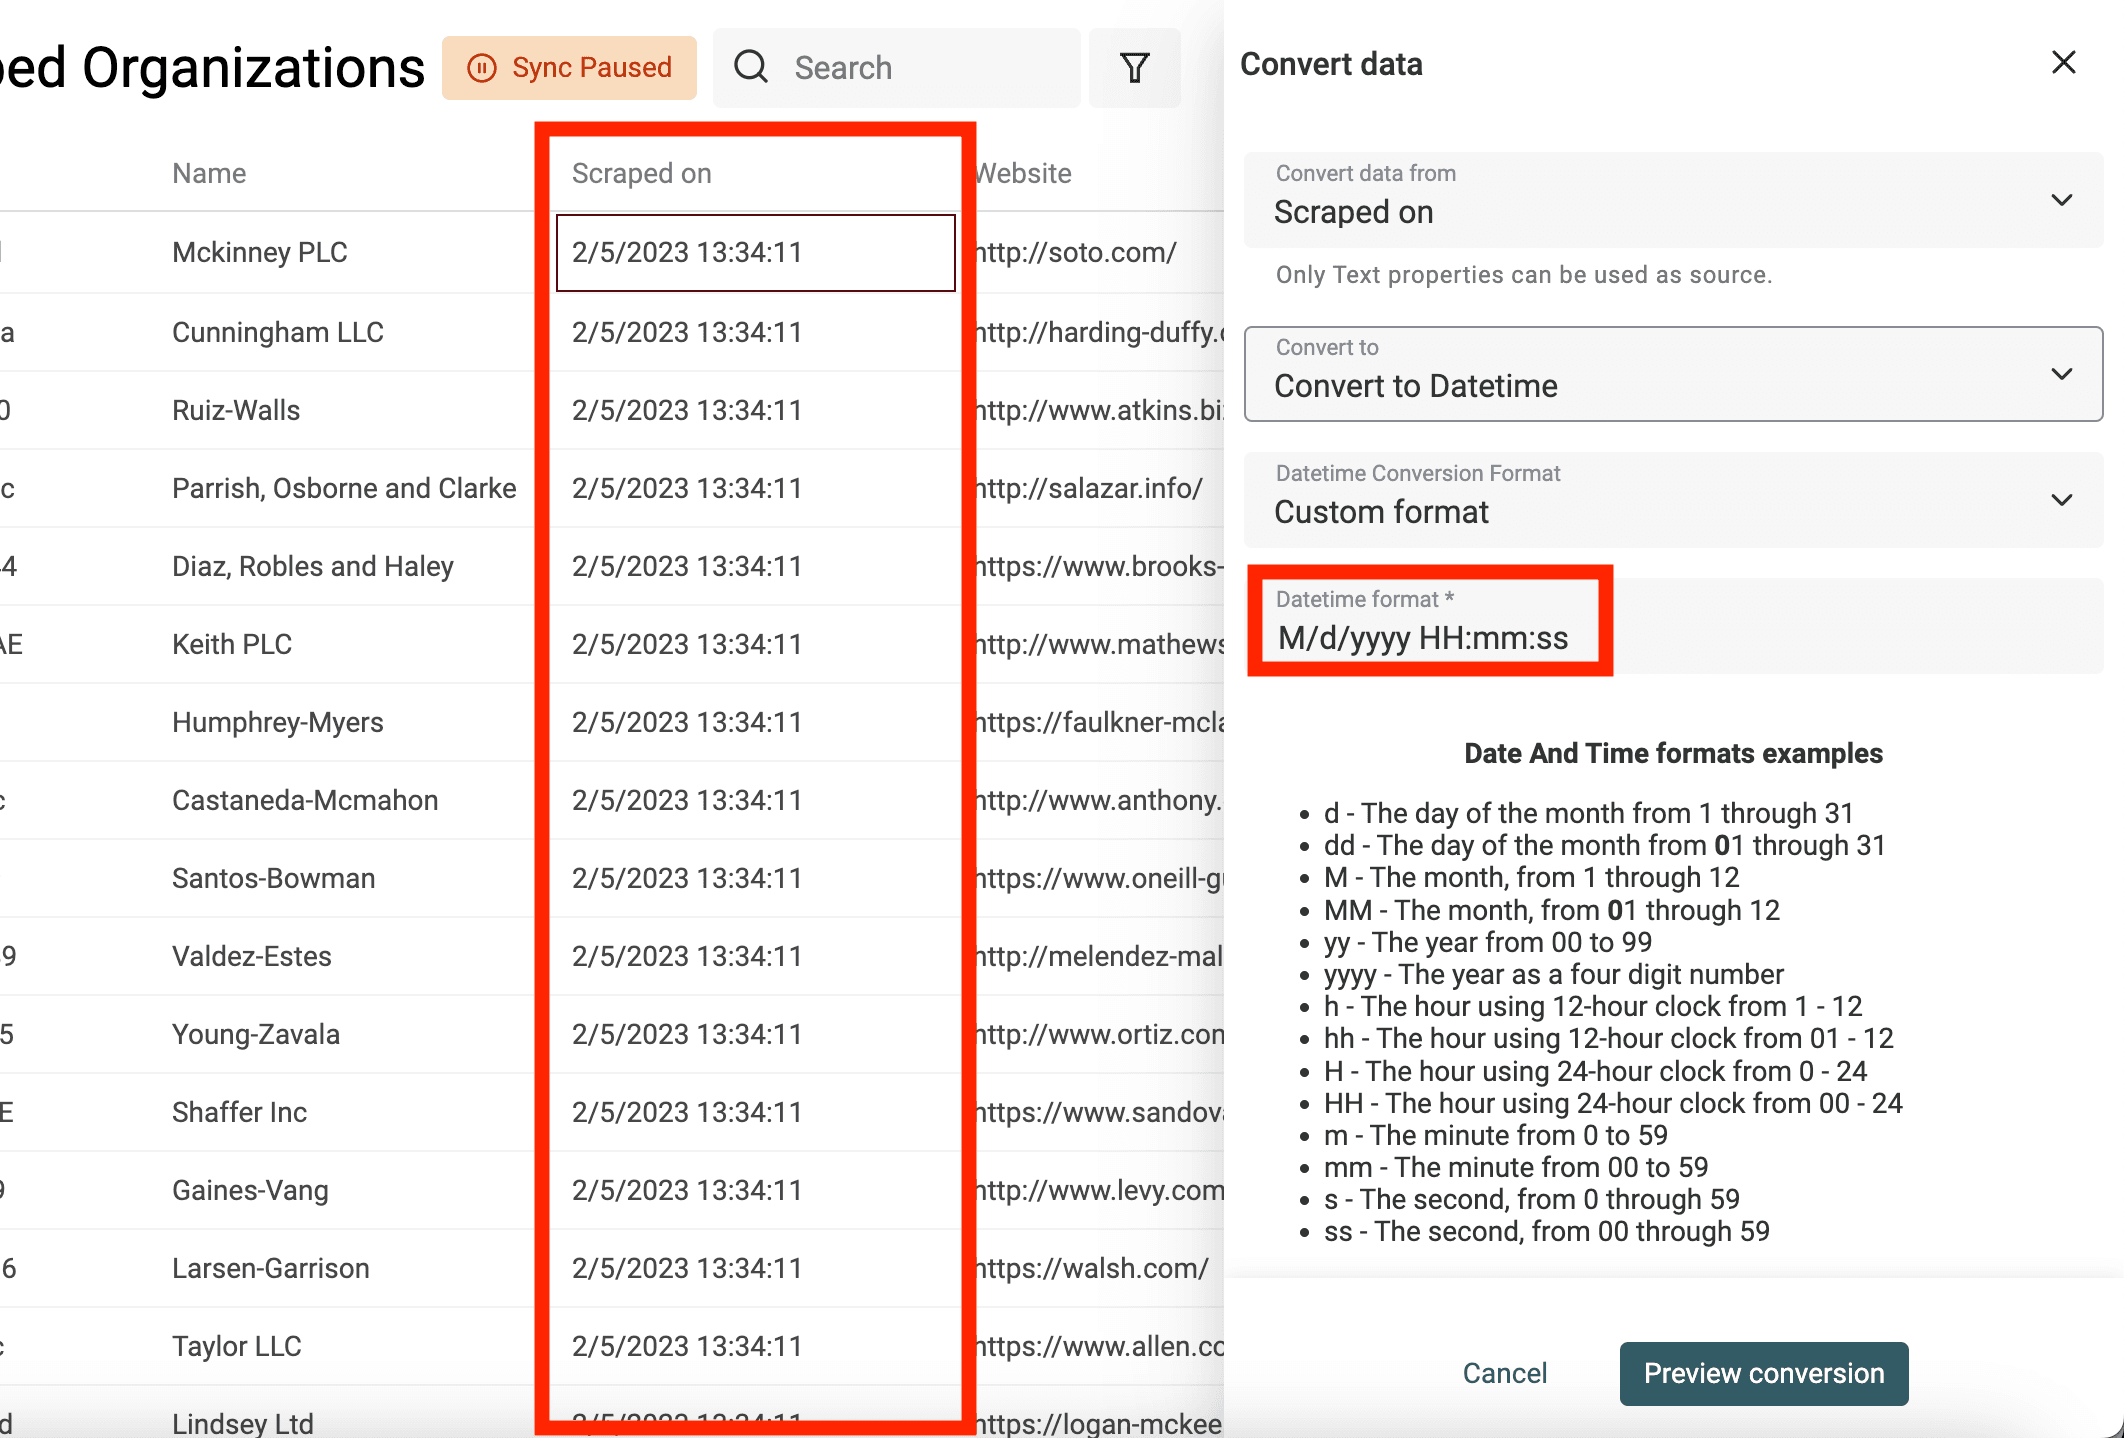
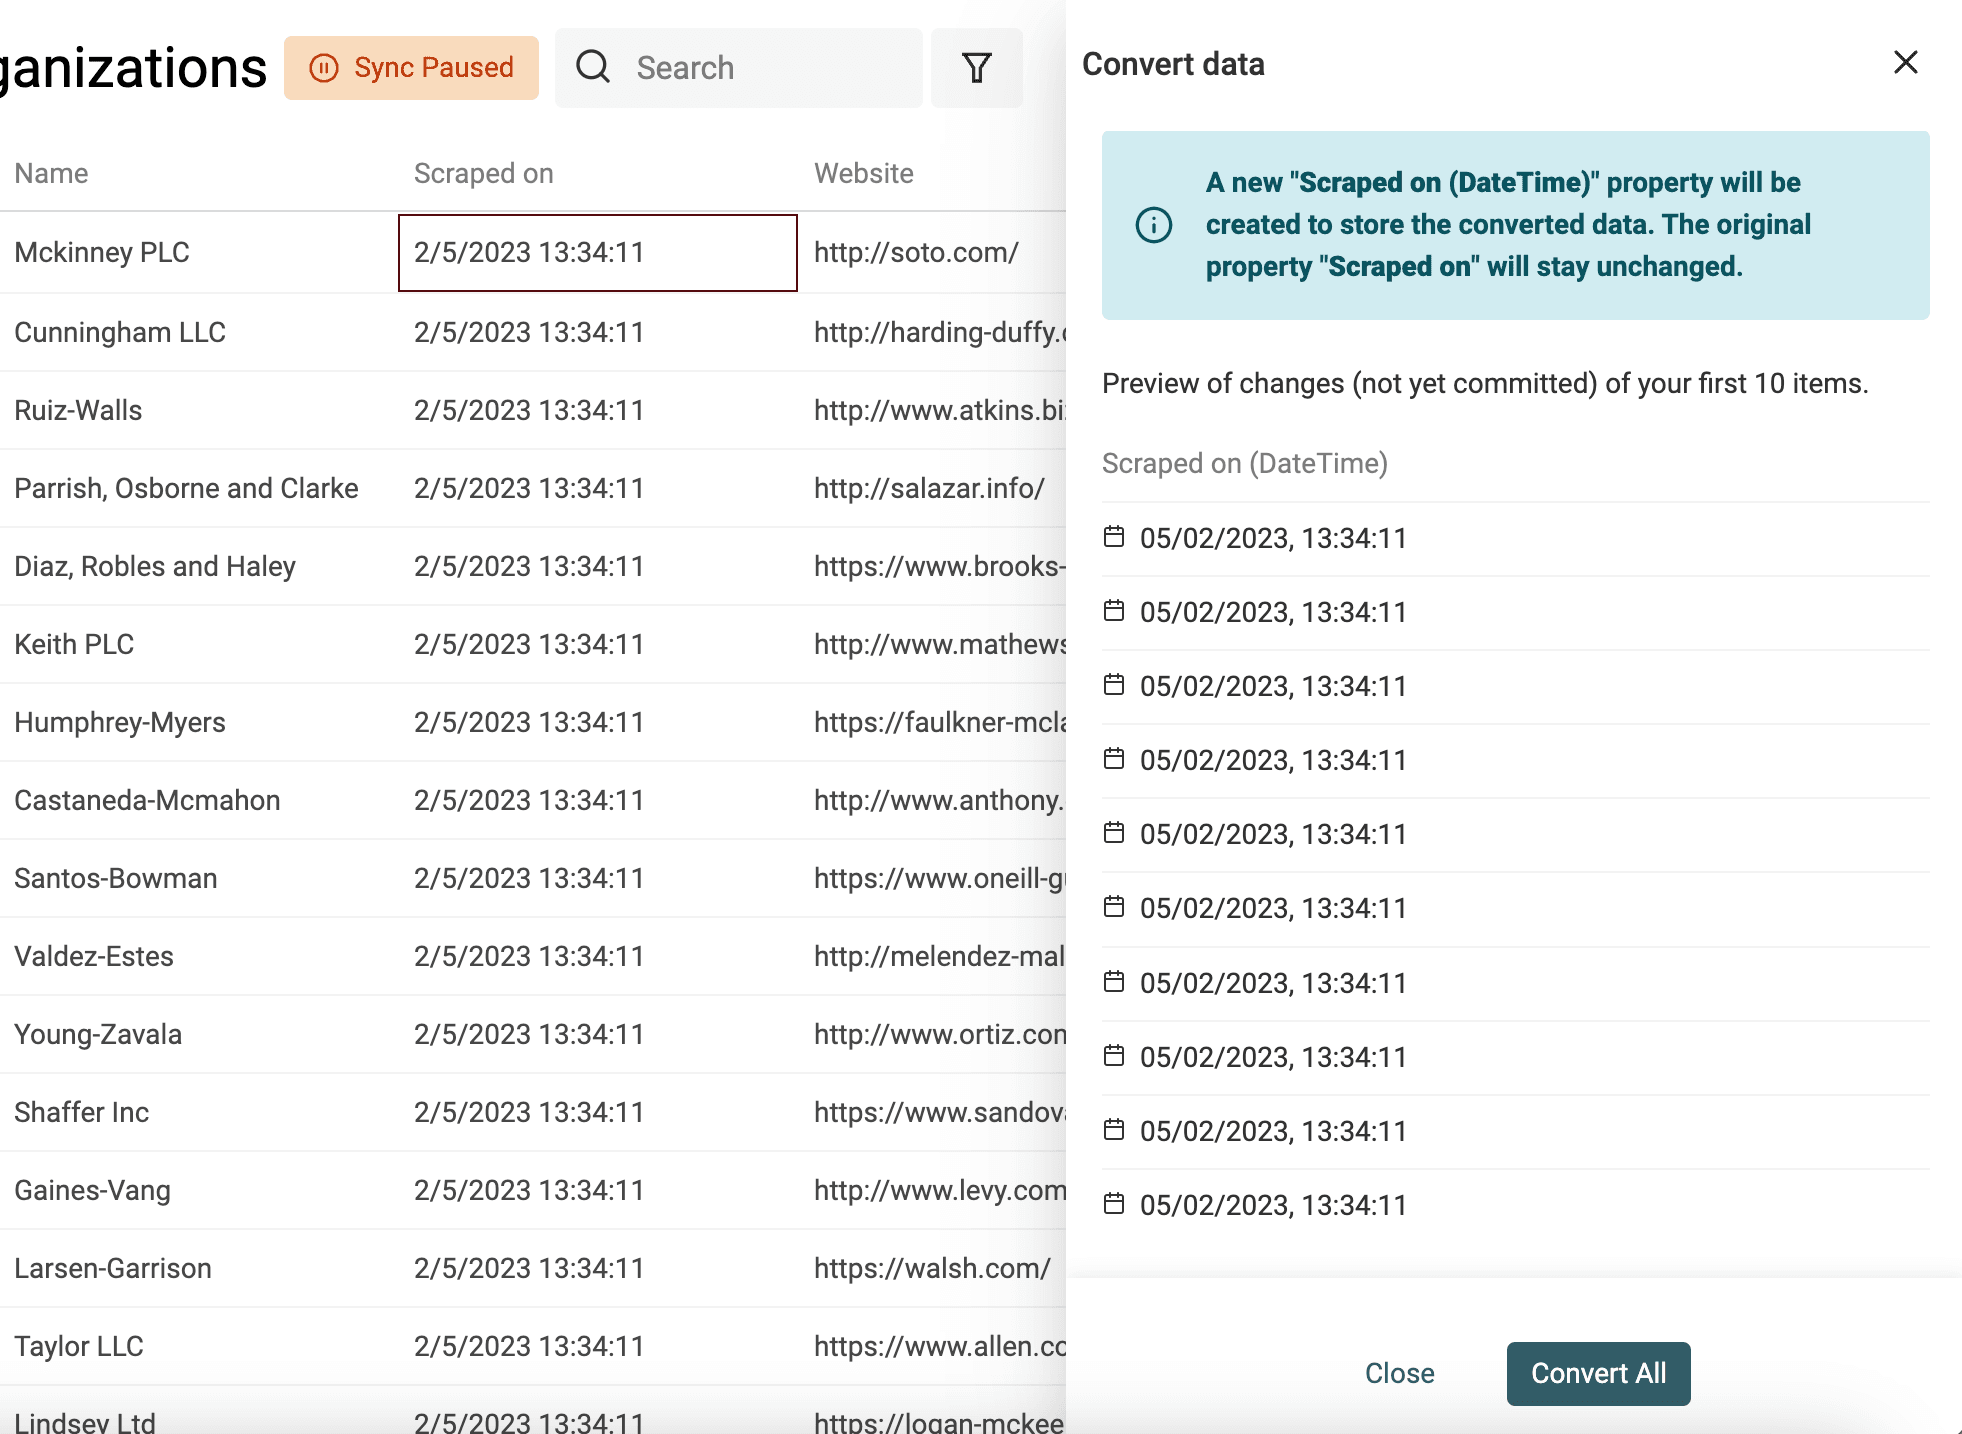
如果同一个属性中包含多种 Date 或 Datetime 格式,请在“Datetime Conversion Format”中选择“Custom or multiple formats”,然后每行输入一种格式。 Datablist 会从第一行开始逐一尝试,直到成功解析出有效的 Date。
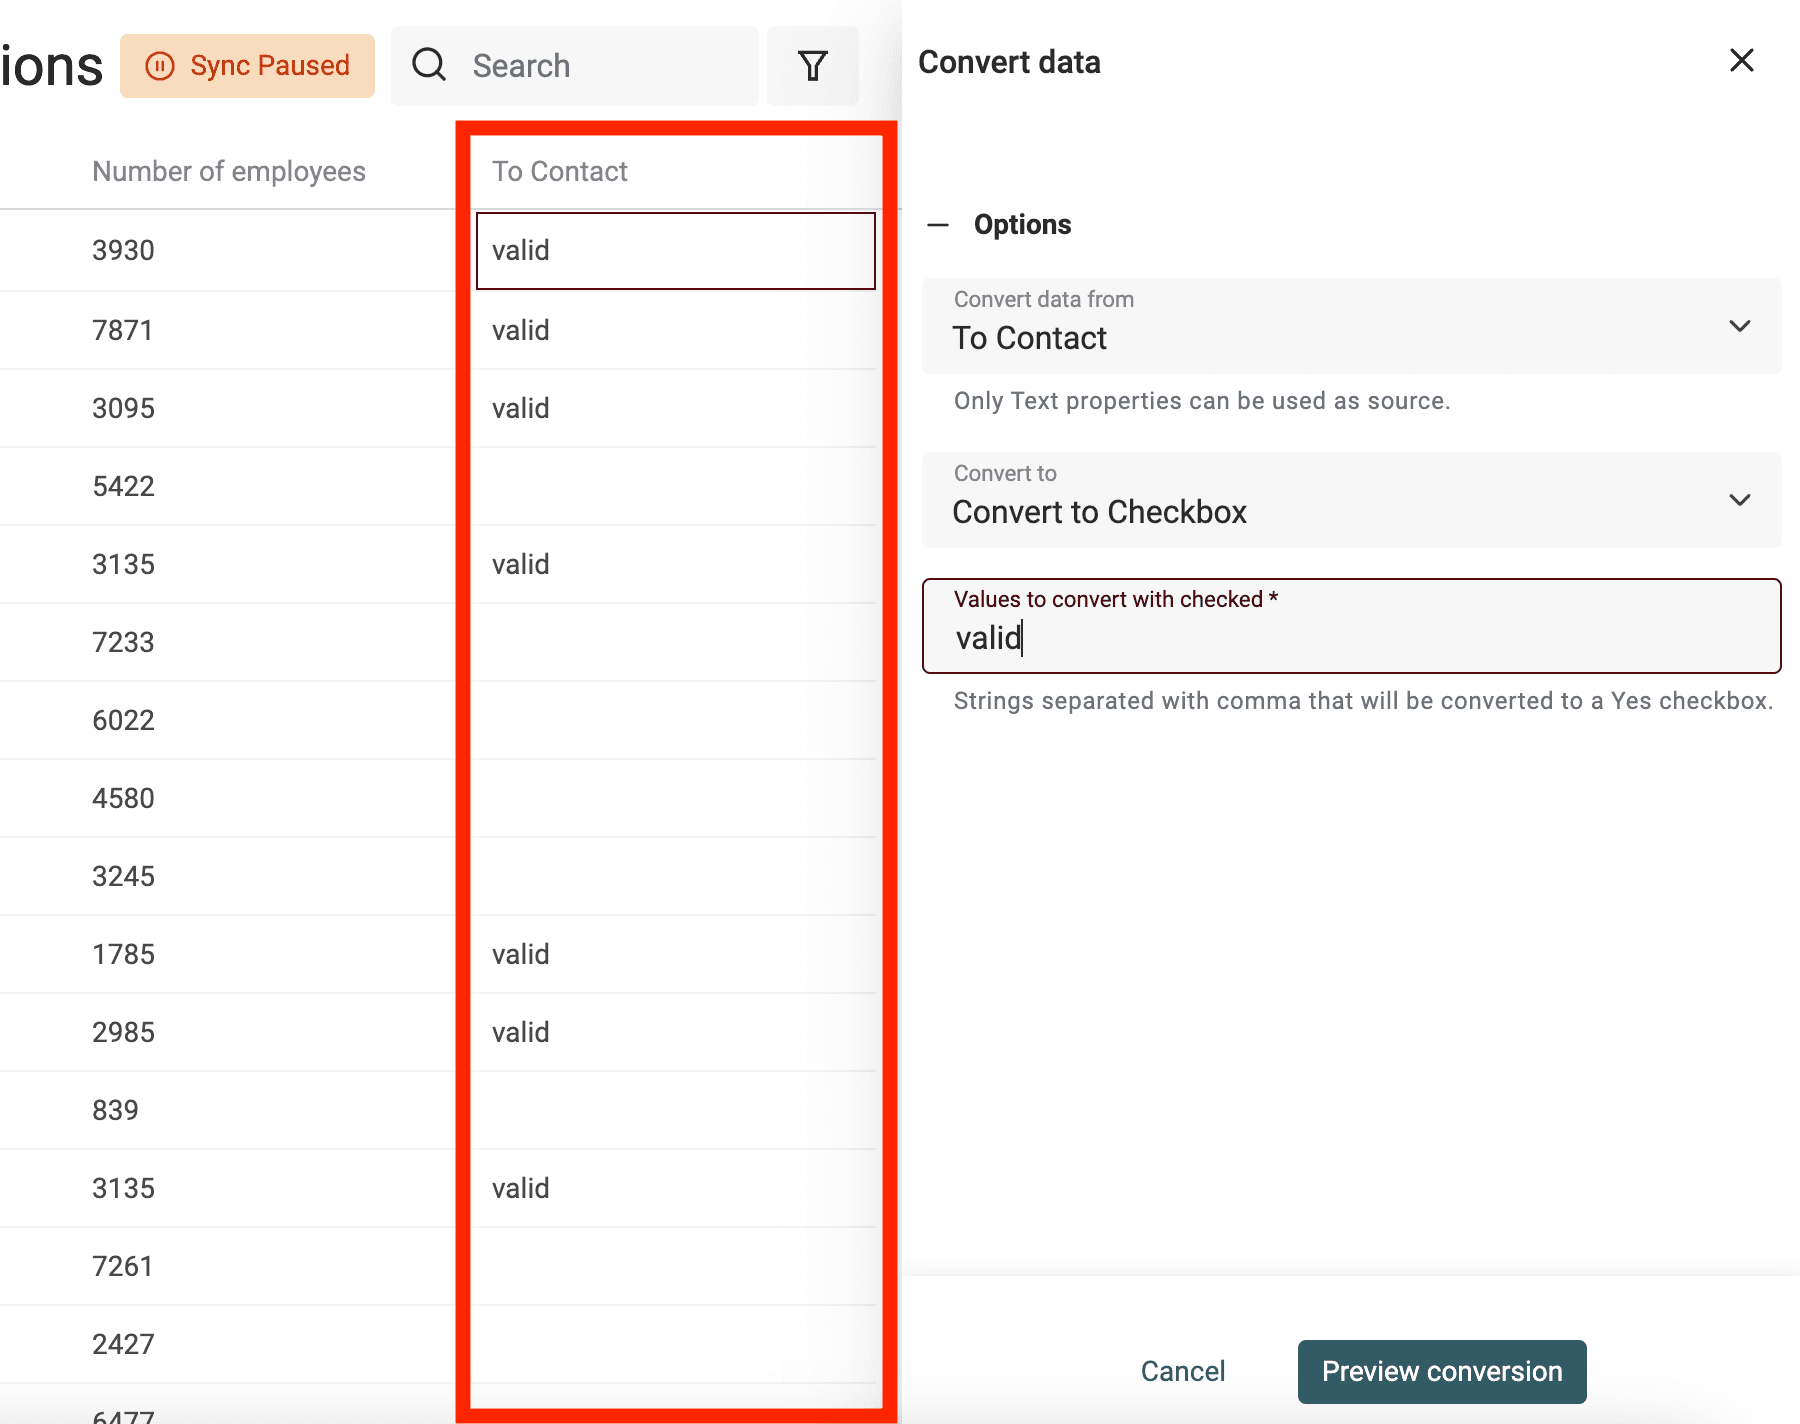
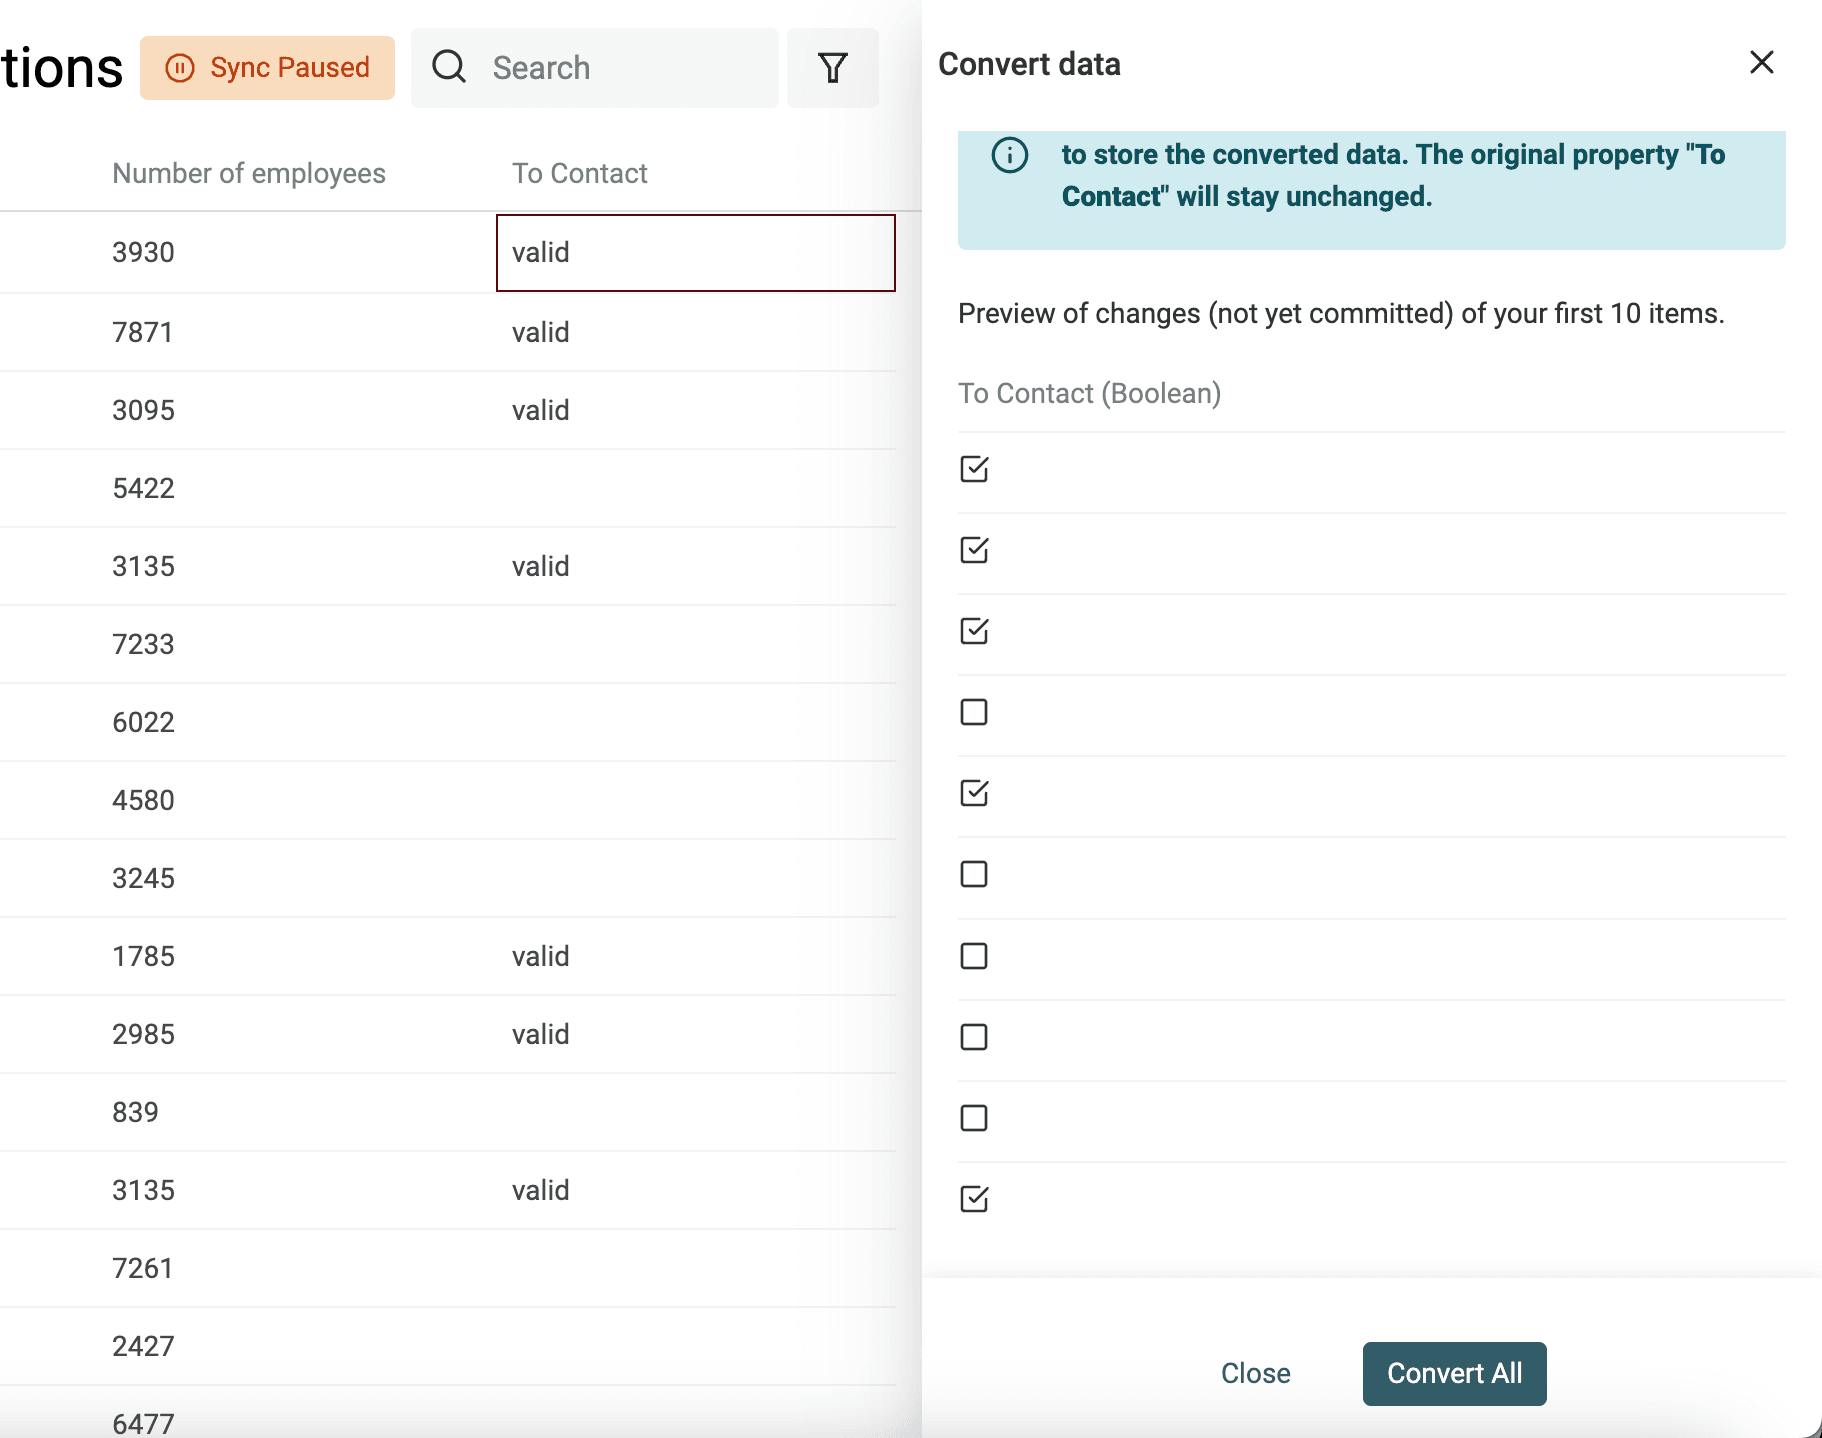
根据文本值创建 Checkbox(Boolean)
导入时,Datablist 会自动将包含“Yes, No”“TRUE, FALSE”等值的列转换为 Checkbox 属性。对于更复杂的情况,可以使用转换工具。
定义需要转换为选中状态的值,并用英文逗号分隔。其他值将保持为未选中状态。
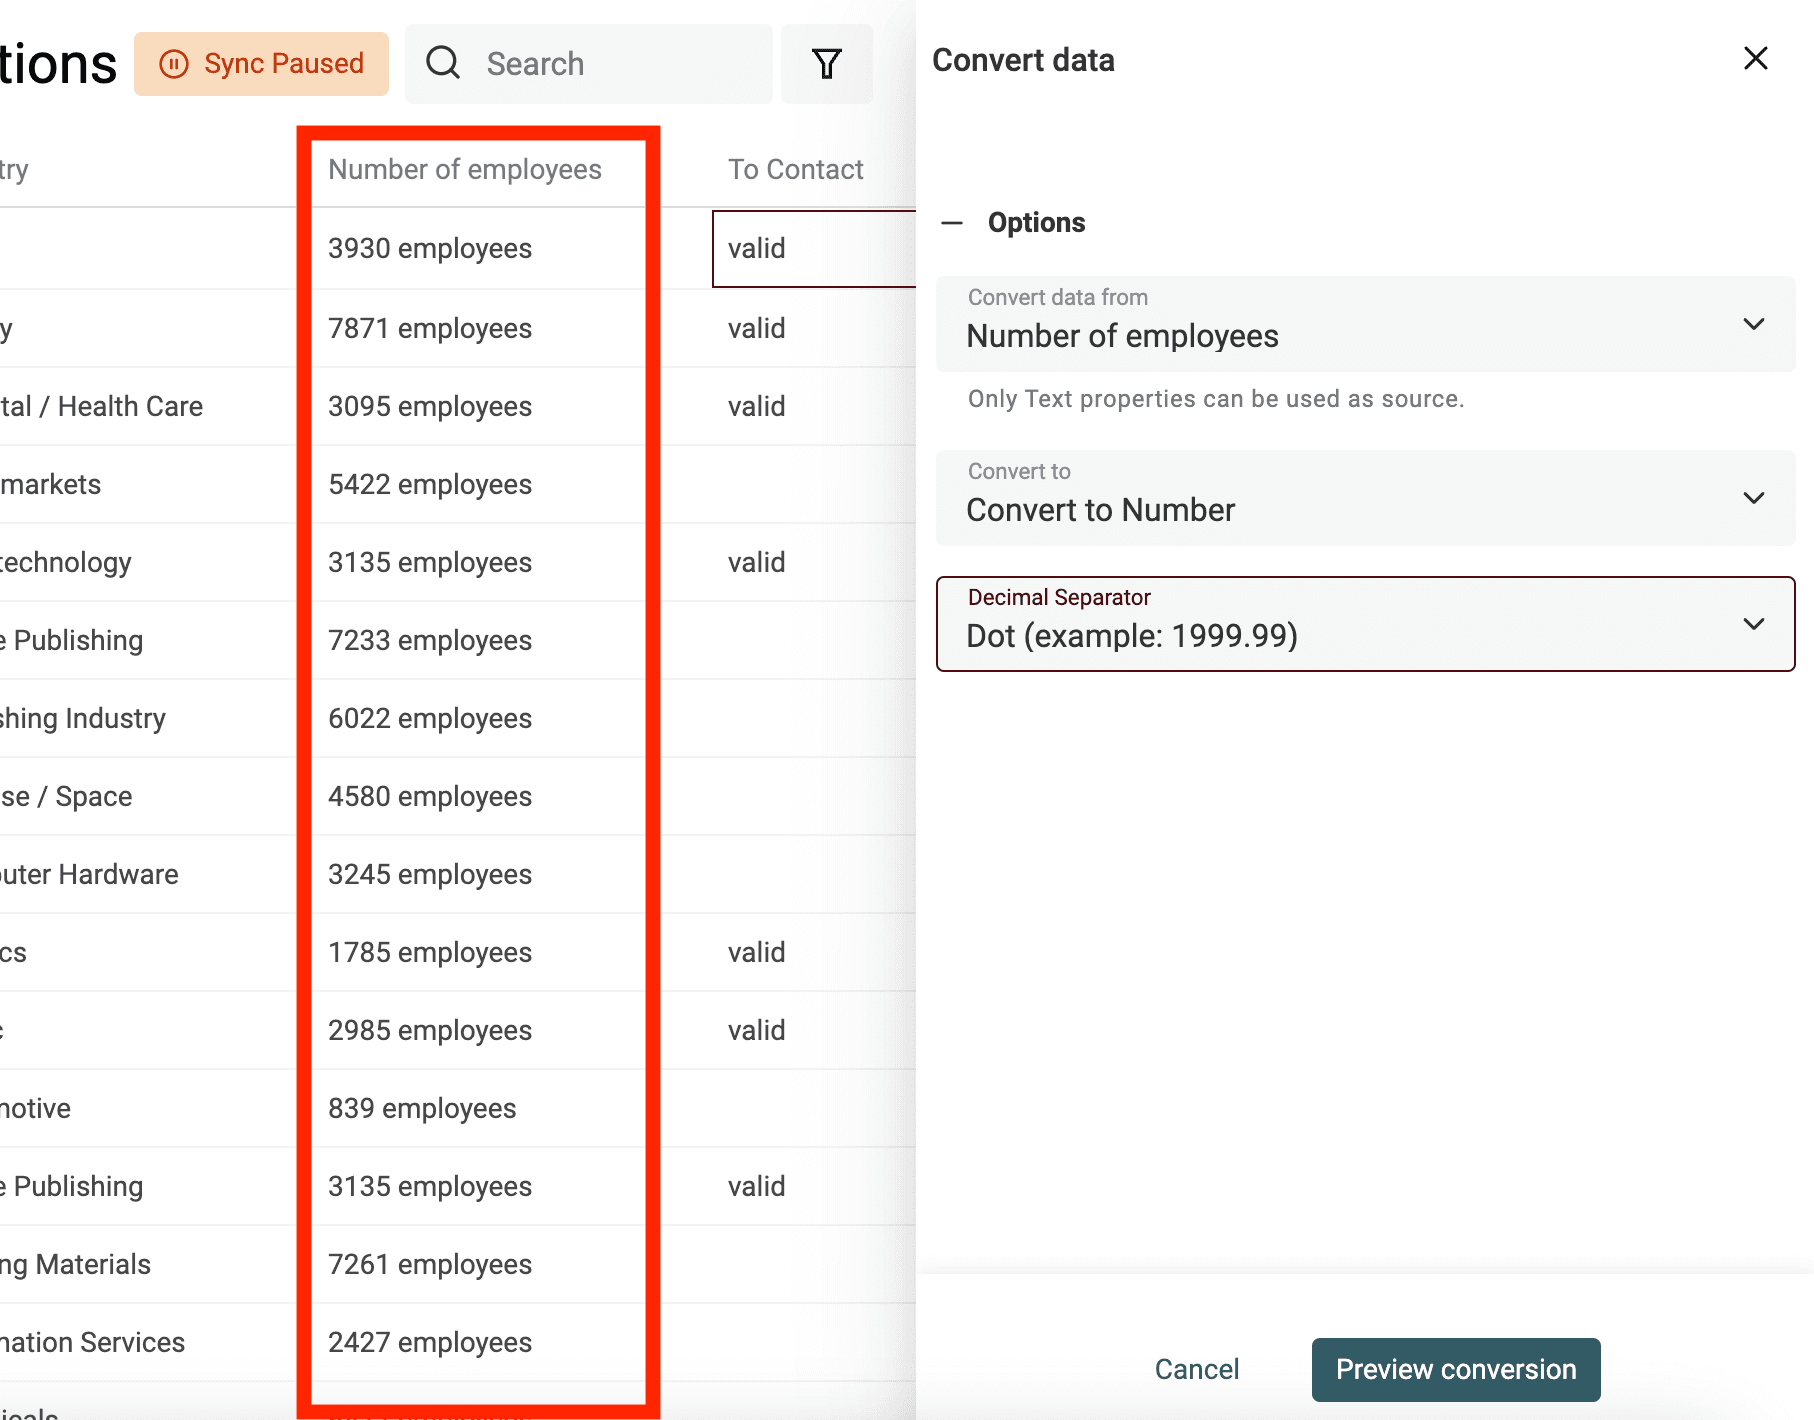
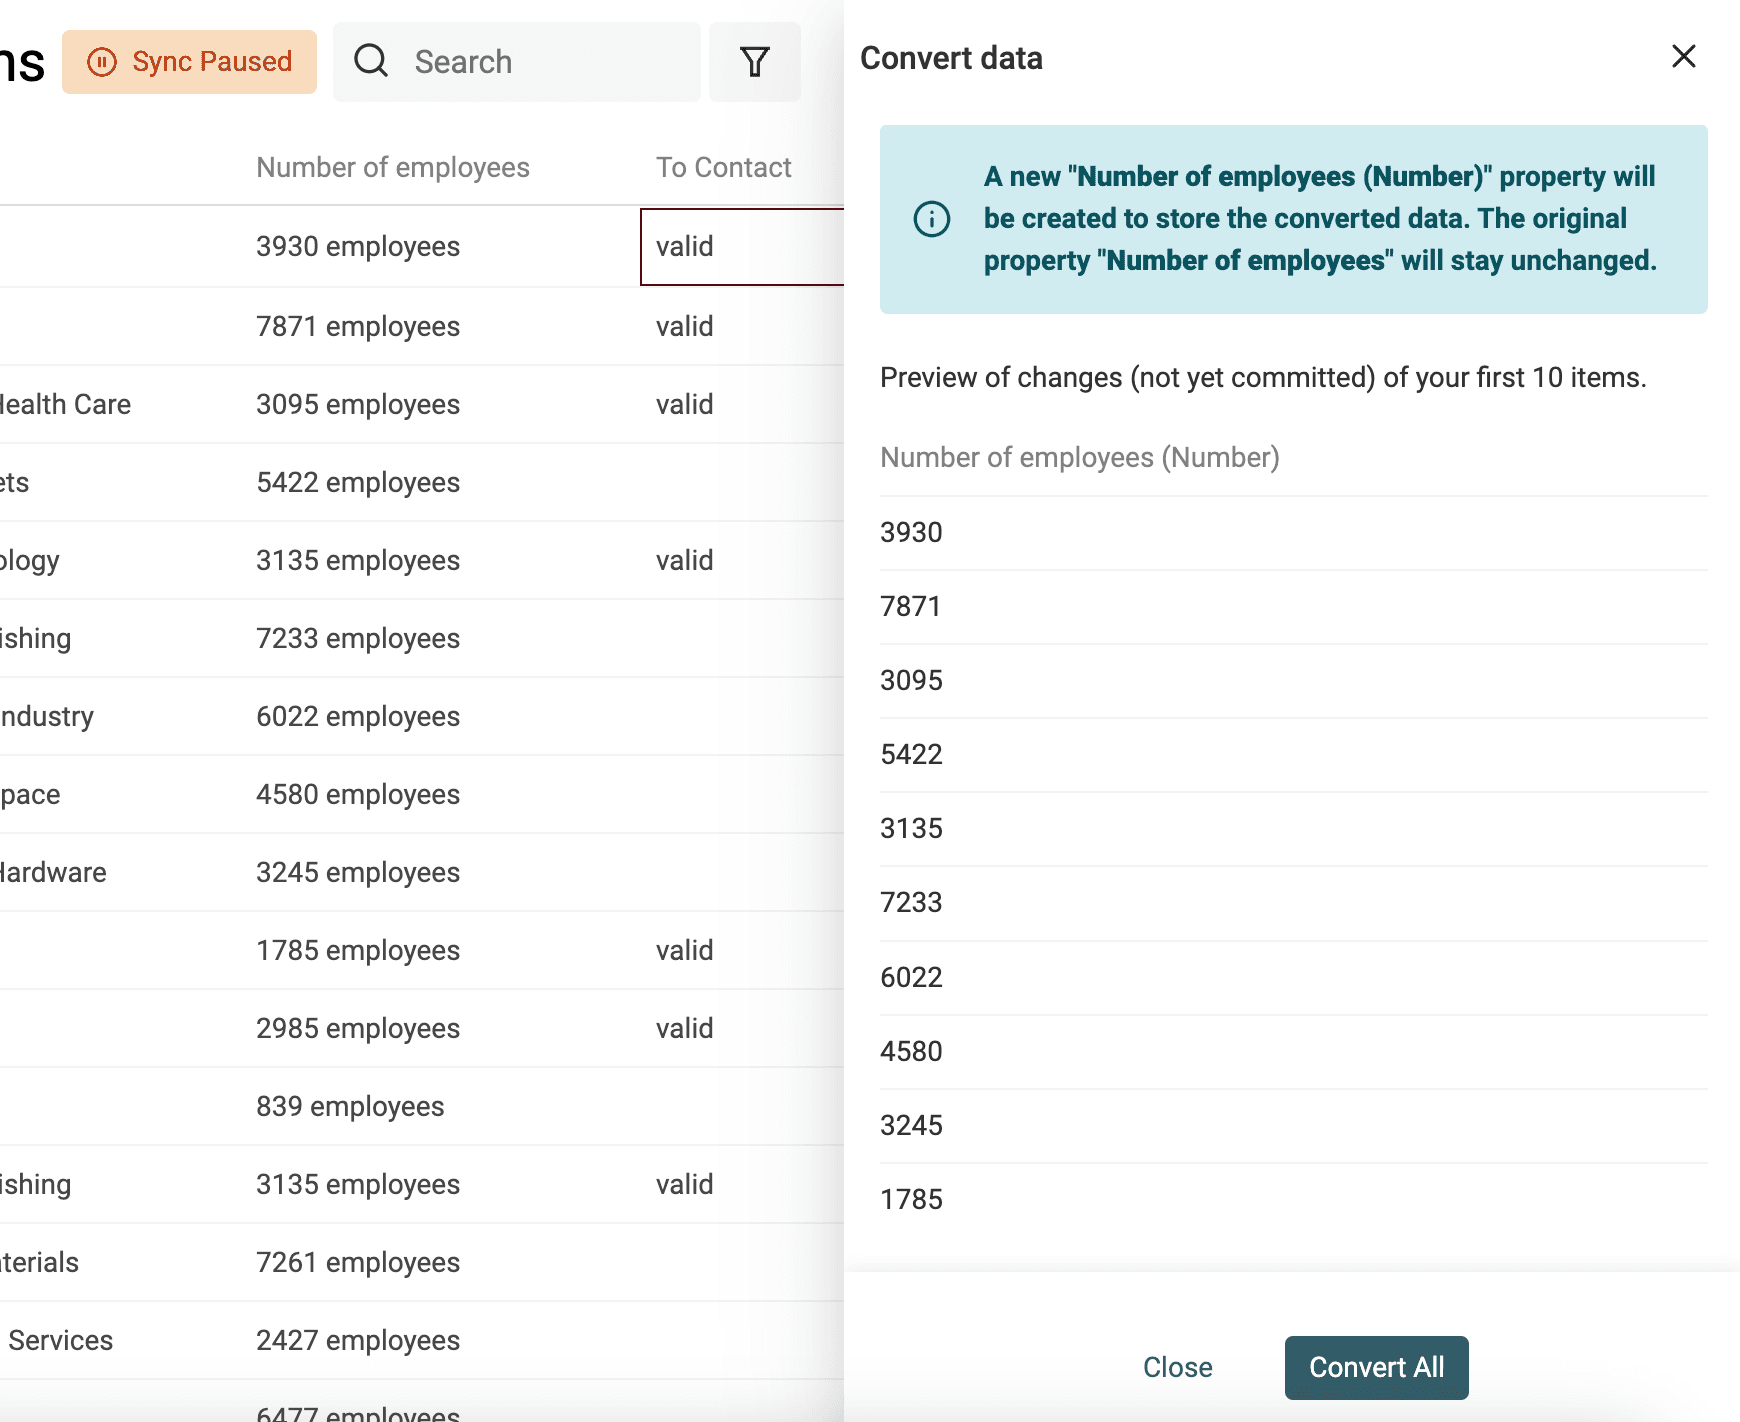
从文本中提取数字
使用“Text to number”转换工具可以:
- 使用自定义小数分隔符和千位分隔符统一数字格式
- 从包含字母的文本中提取数字
清洗数据
将 HTML 转换为纯文本
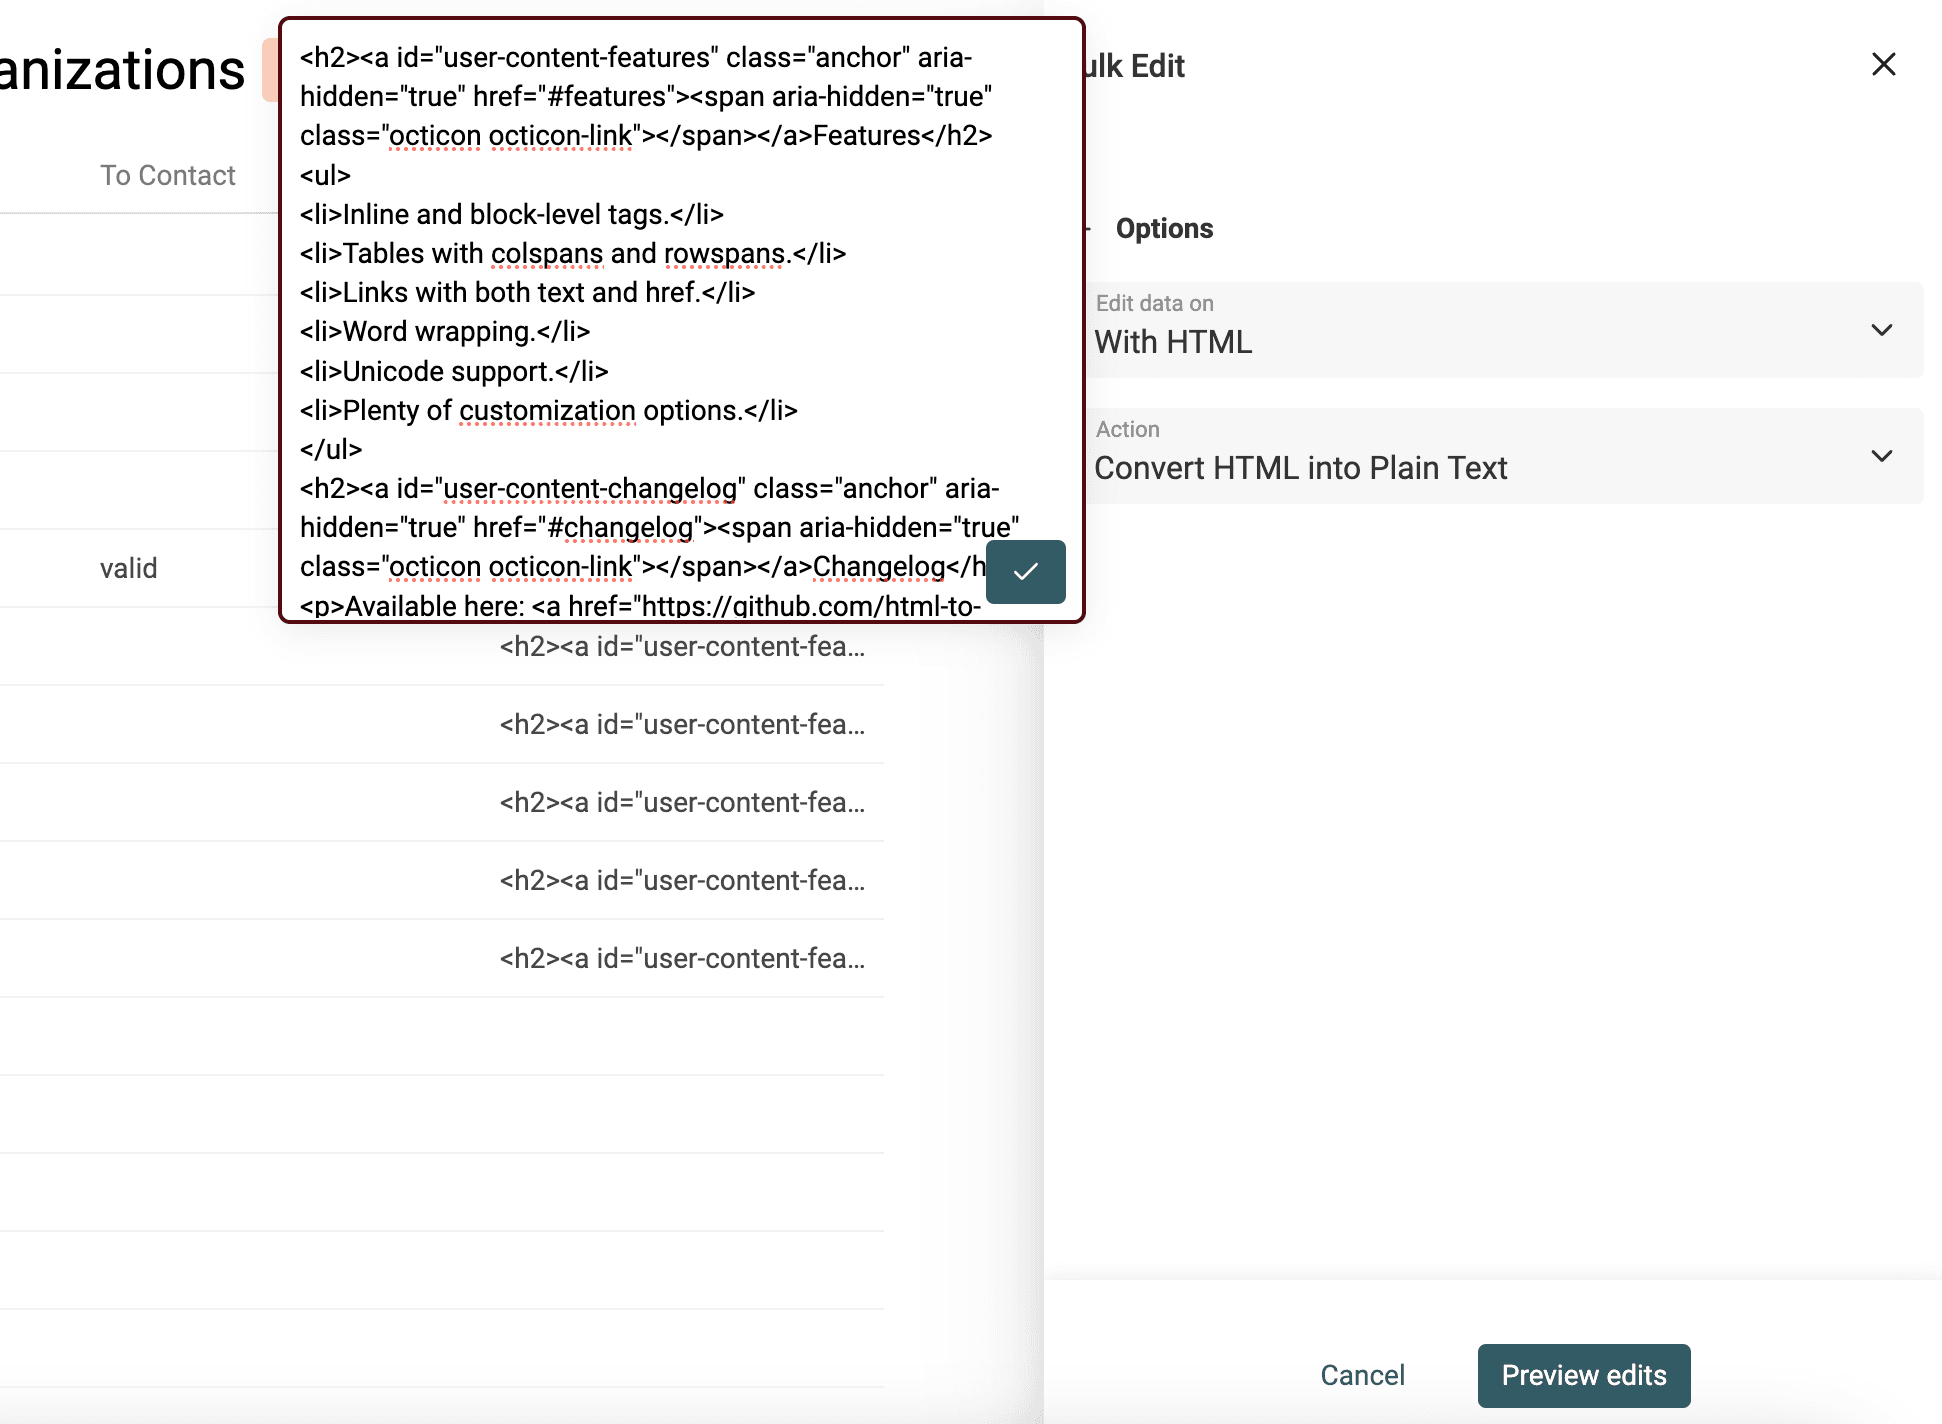
Scraping 工具会解析 HTML 代码,因此抓取到的文本中可能包含 HTML 标签。
HTML 代码包含链接、图片和项目符号列表,并通过段落和换行组织内容。
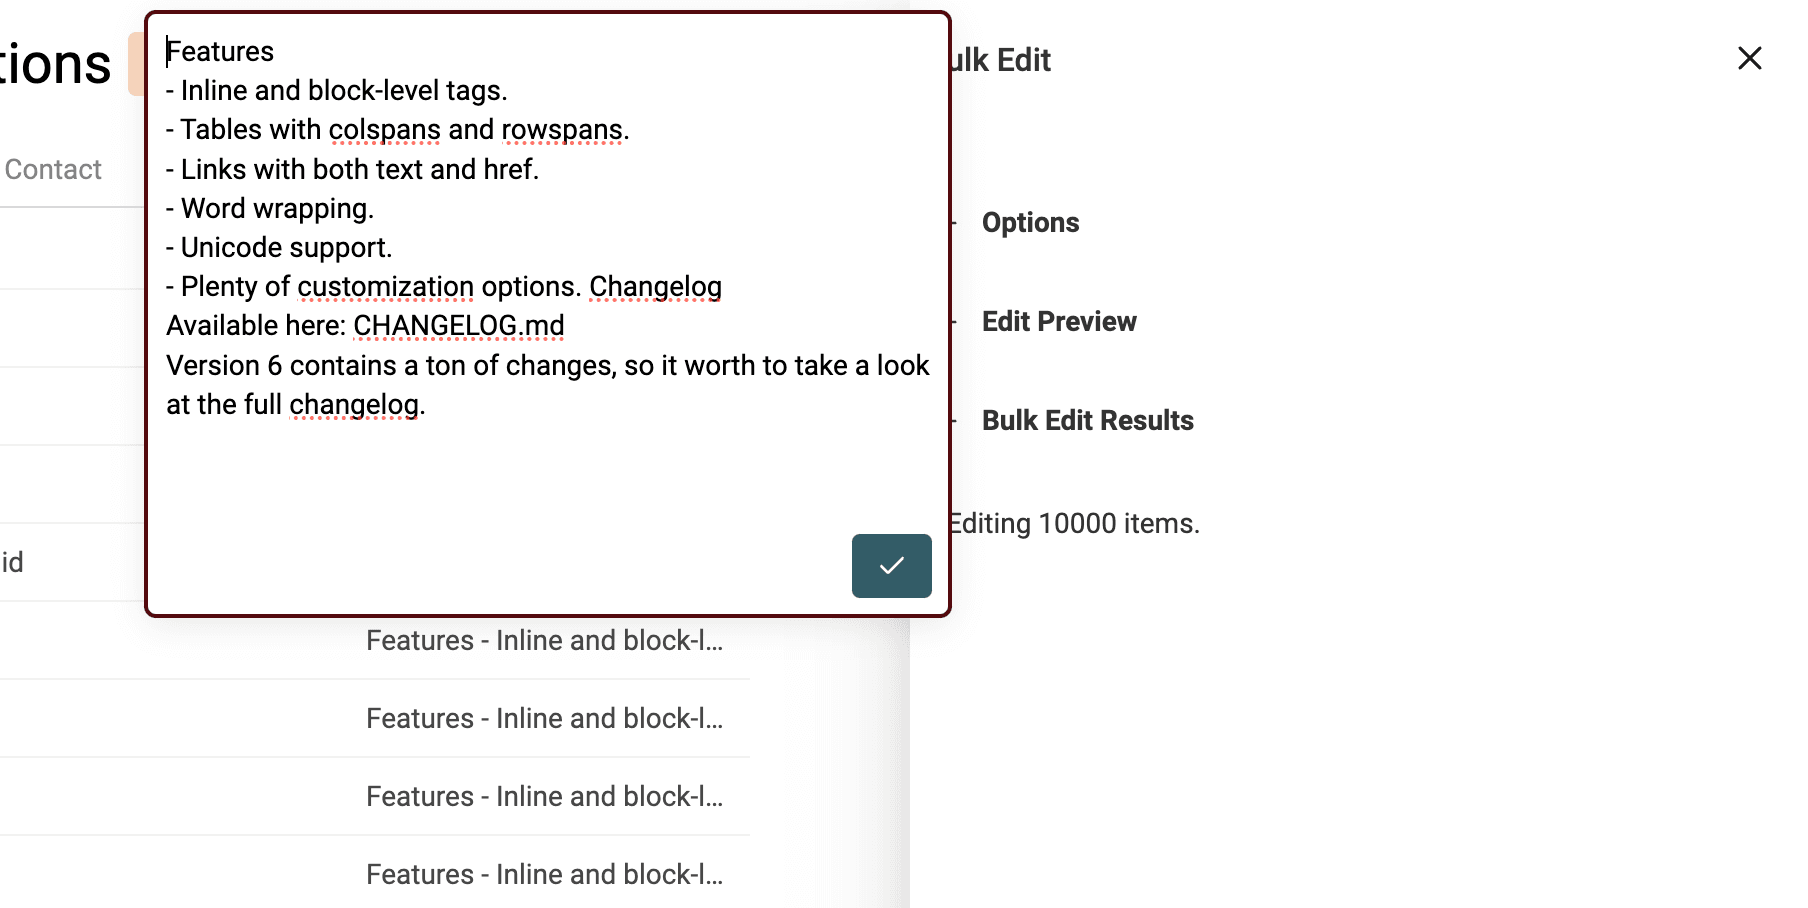
我们的目标是保留 HTML 带来的部分结构,同时把难以阅读的代码转换成纯文本。
Datablist 的 HTML to Text 转换工具会保留换行,并将项目符号转换成以 - 开头的列表。
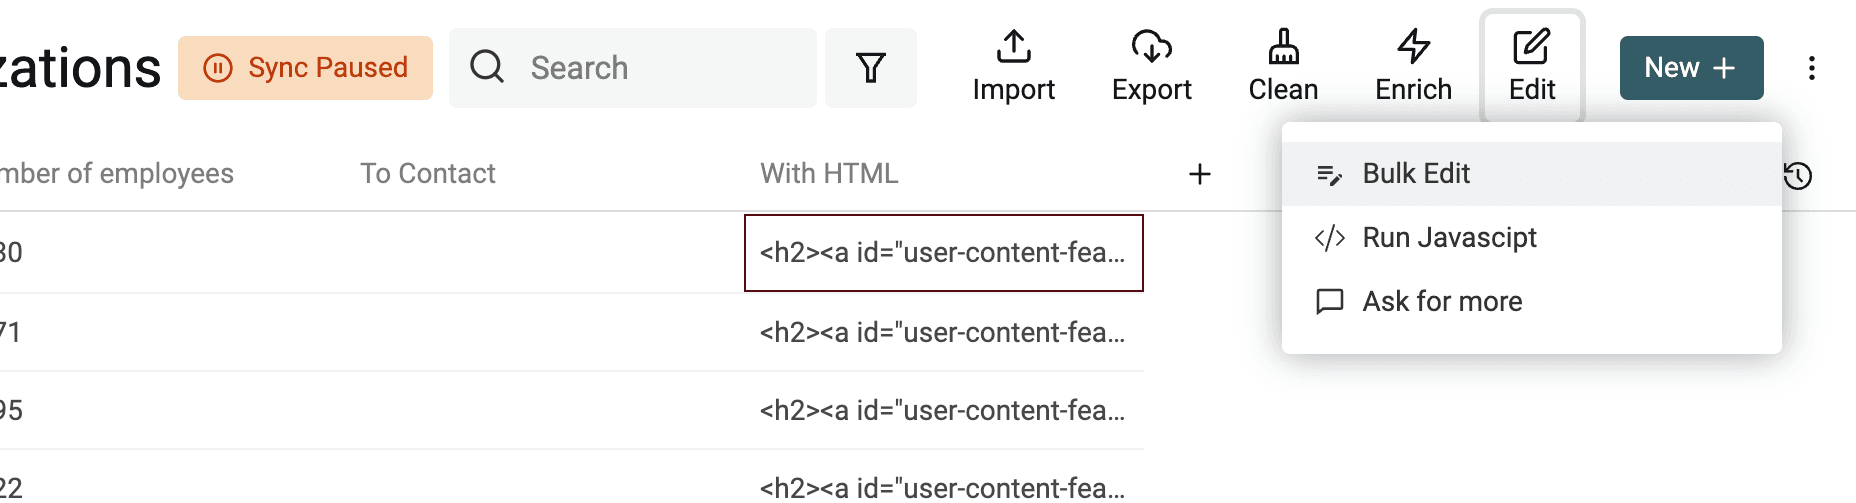
要将带有 HTML 标签的文本转换为纯文本,请在“Edit”菜单中打开 Bulk Edit 工具。
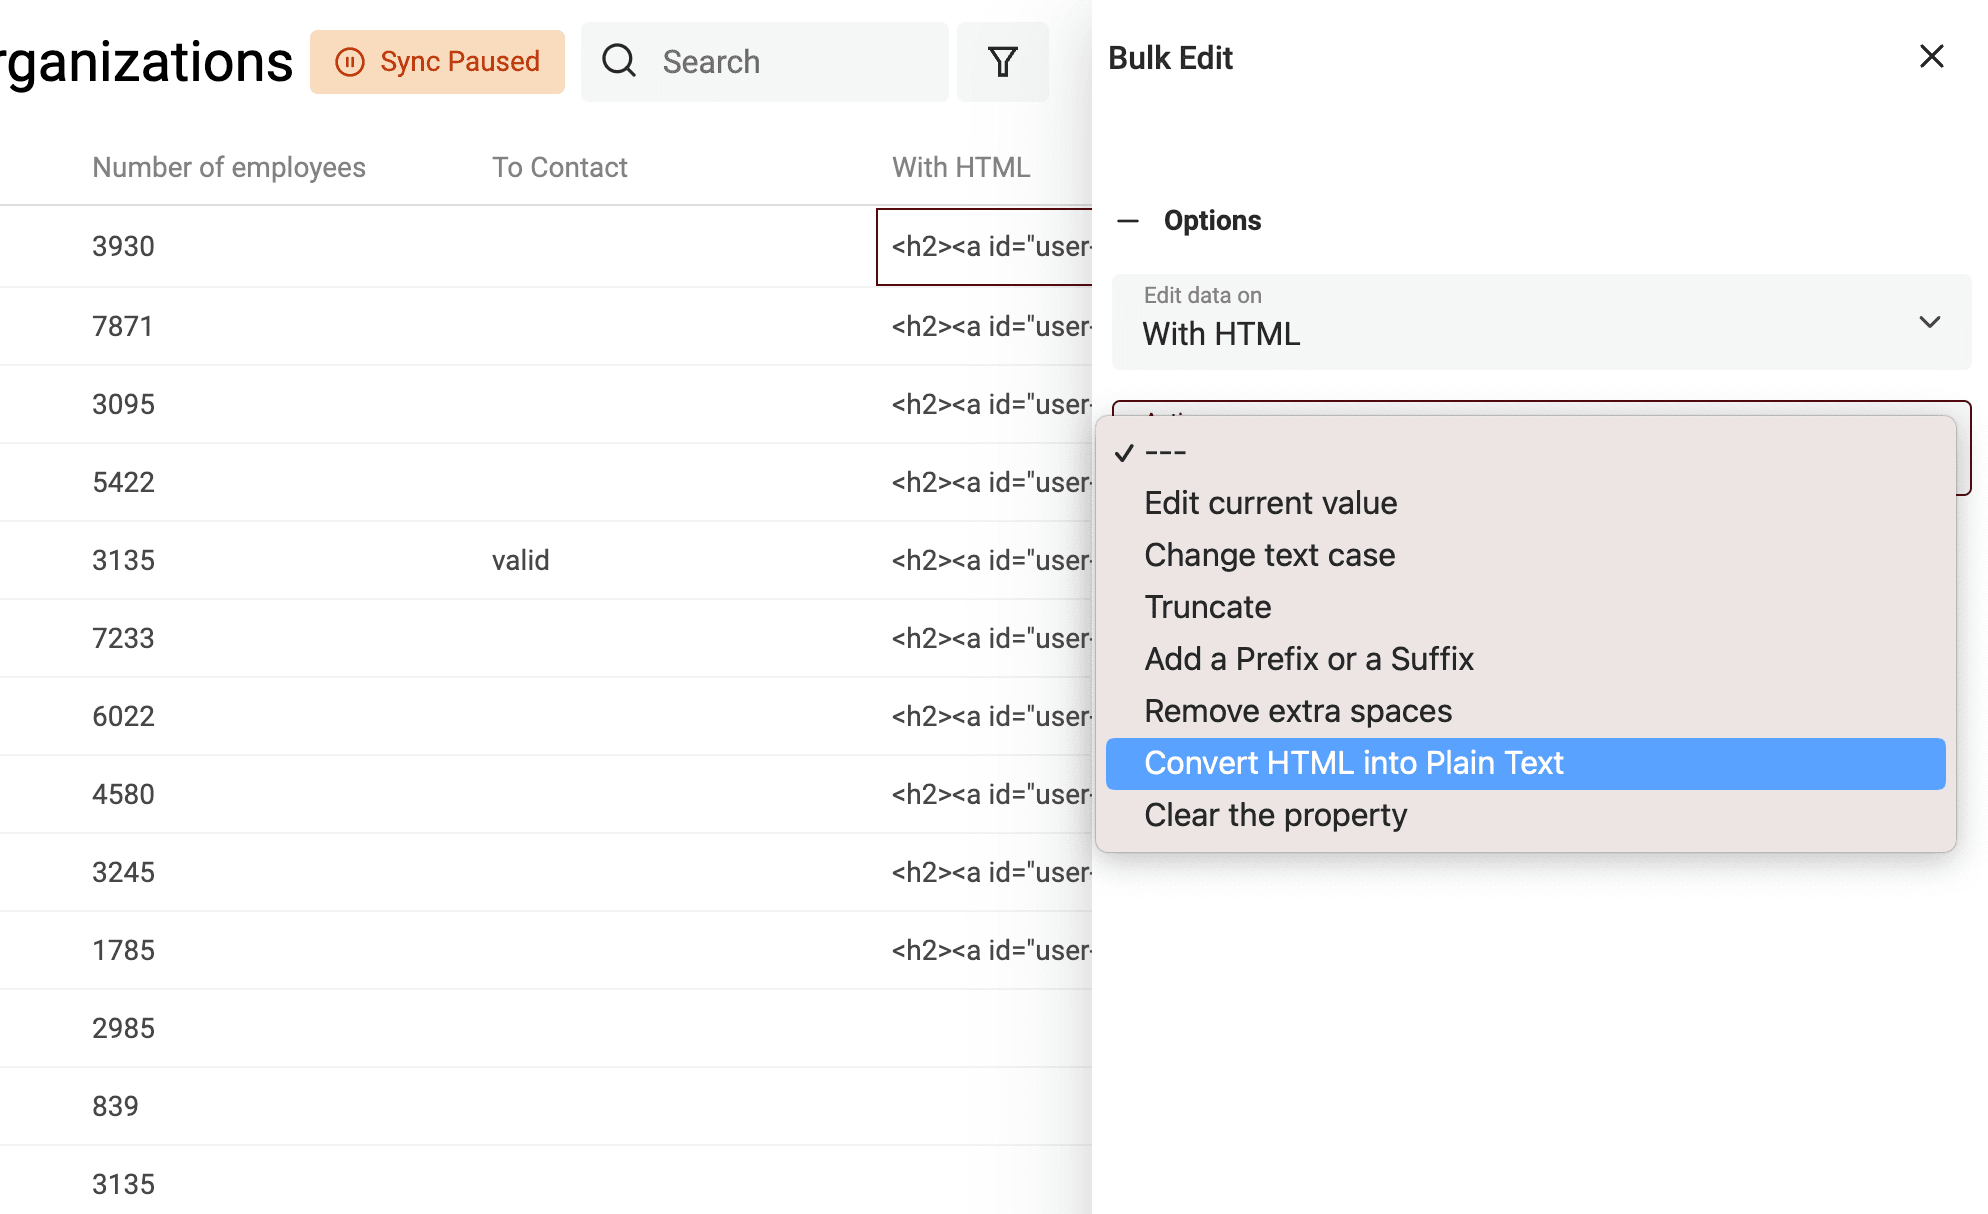
选择包含 HTML 标签的属性,再选择“Convert HTML into plain text”。
删除多余空格
脏数据中另一个常见问题是多余空格。这些空格可能来自换行符、Tab,以及 HTML 中其他代表空白的字符。
Datablist 内置了用于清除多余空格的数据清洗工具。
它提供两种模式:
- 模式 1:删除所有空格——该模式会删除所有空白字符,适合清洗电话号码、价格等只需要保留字母、数字或其他有效字符的数据。
- 模式 2:仅删除“多余空格”。
在第二种模式下,算法会:
- 删除单词之间的多余空格
- 删除空行
- 删除每行开头和结尾的空格
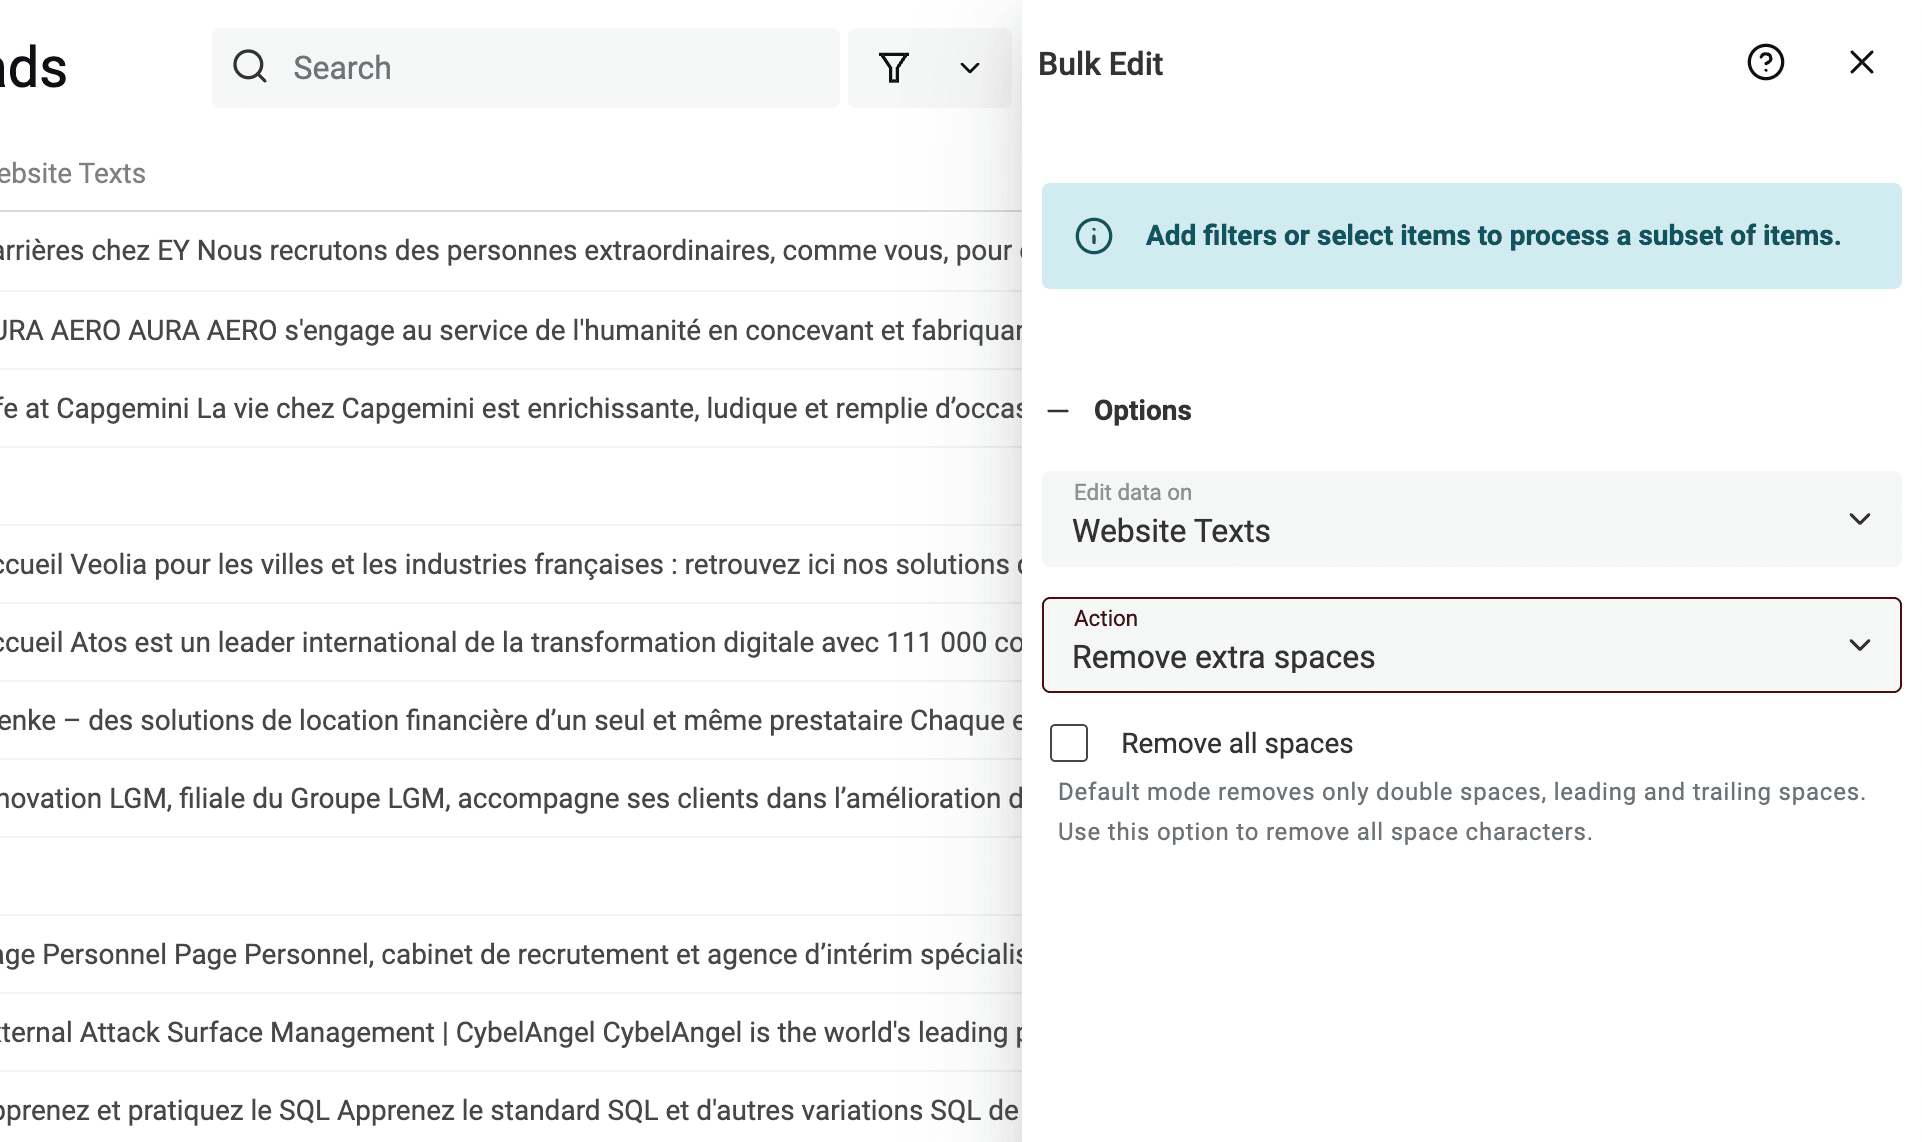
要删除多余空格,请从“Edit”菜单打开“Bulk Edit”工具,选择目标属性和“Remove extra spaces”操作。
勾选“Remove all spaces”可删除全部空白字符;如果只想删除“多余空格”,请不要启用该选项。
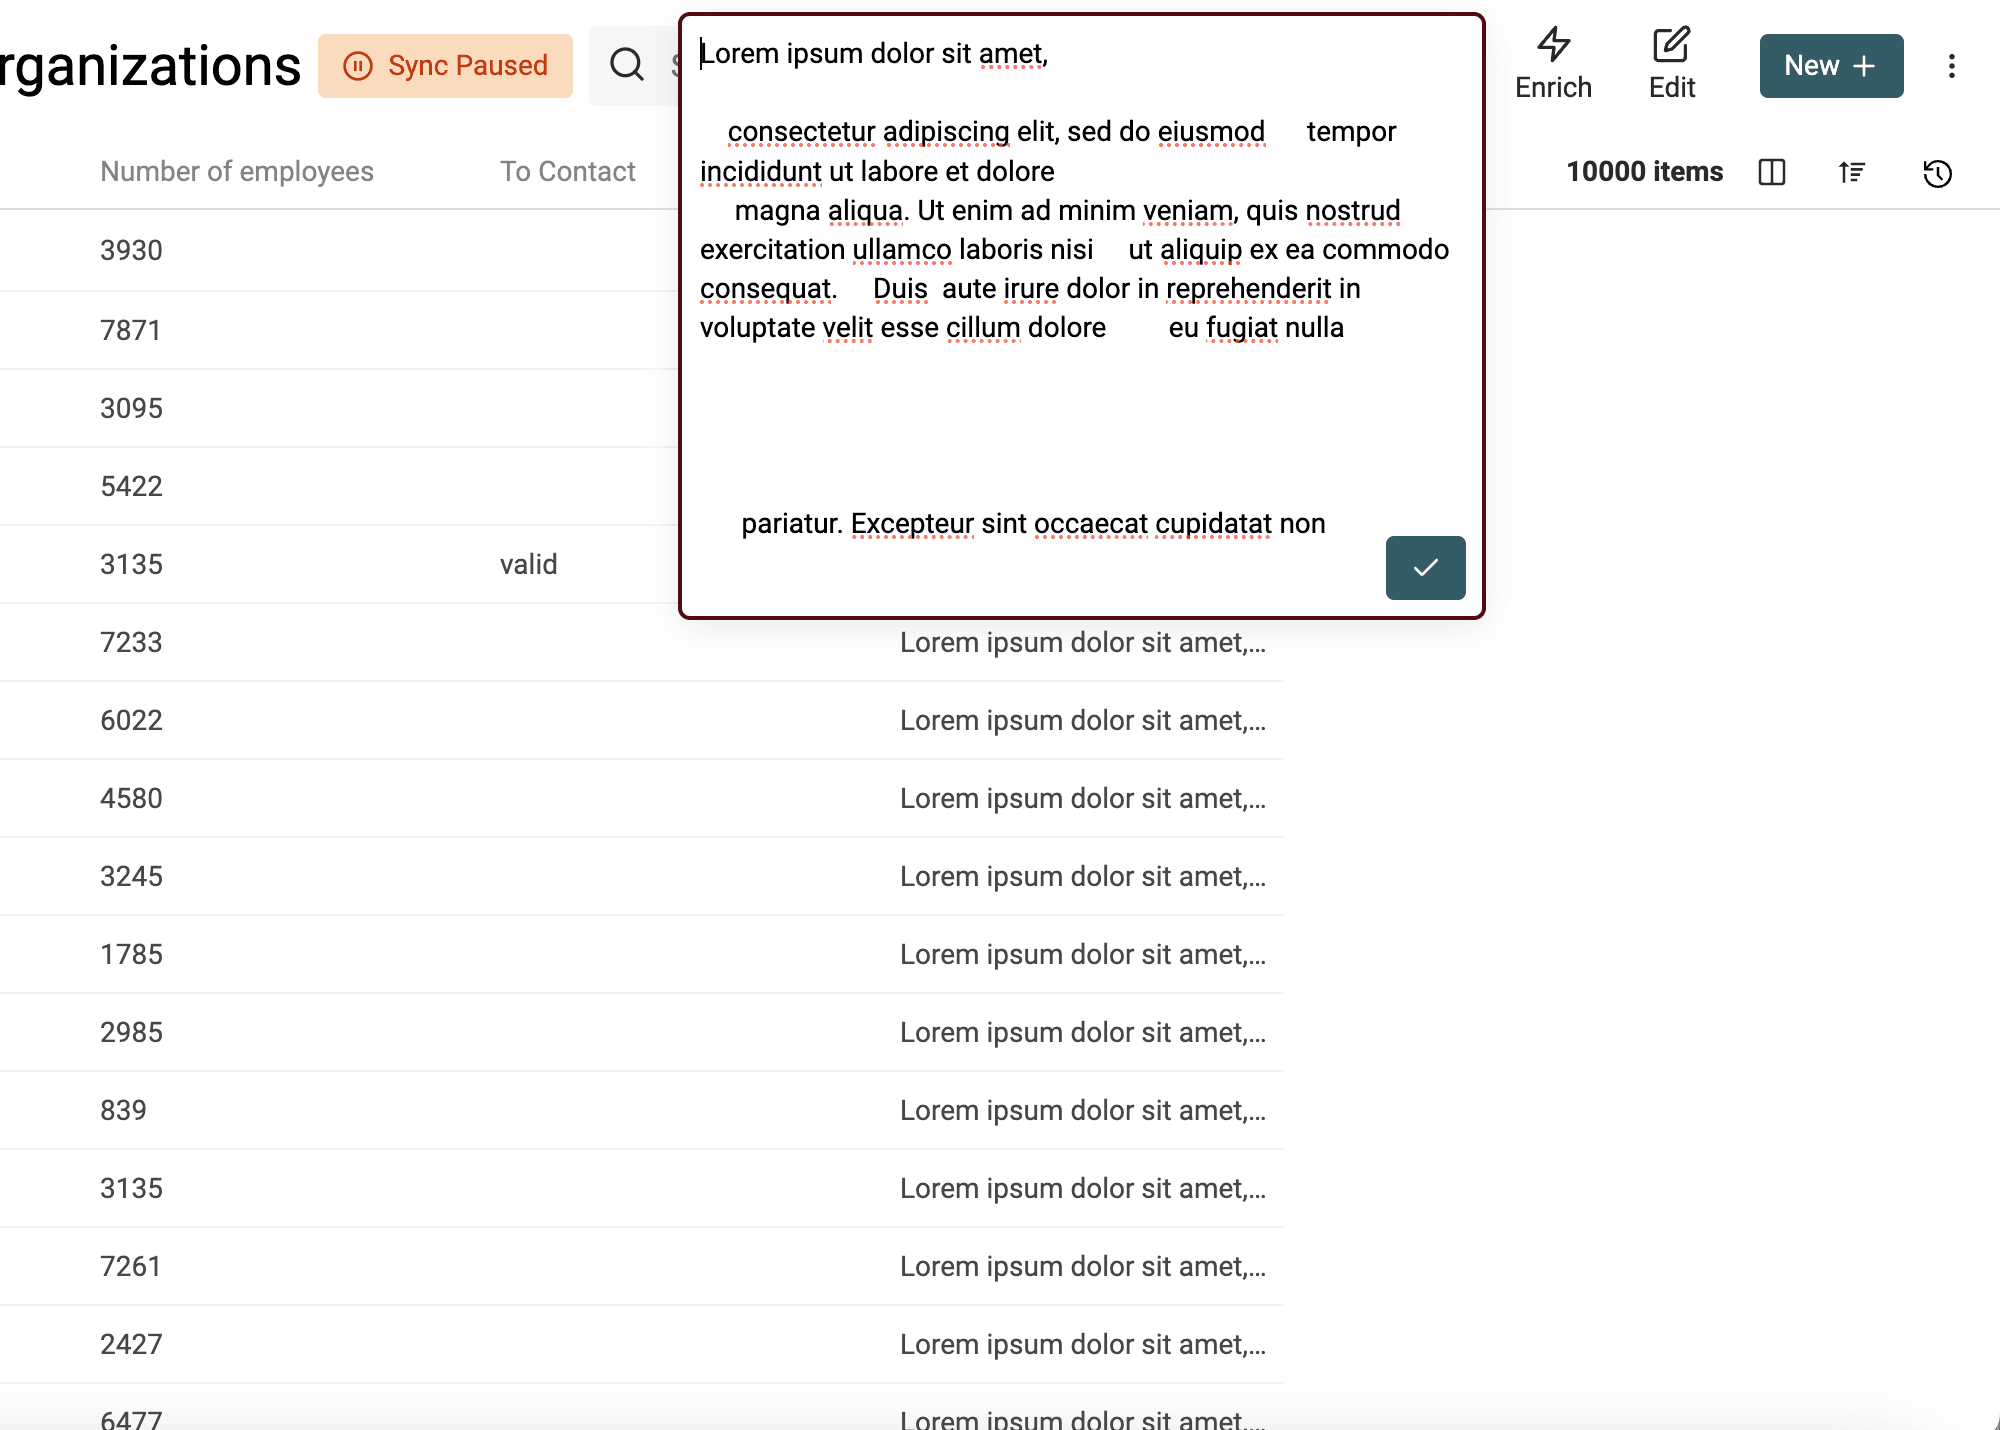
下面是使用算法删除多余空格前的示例:
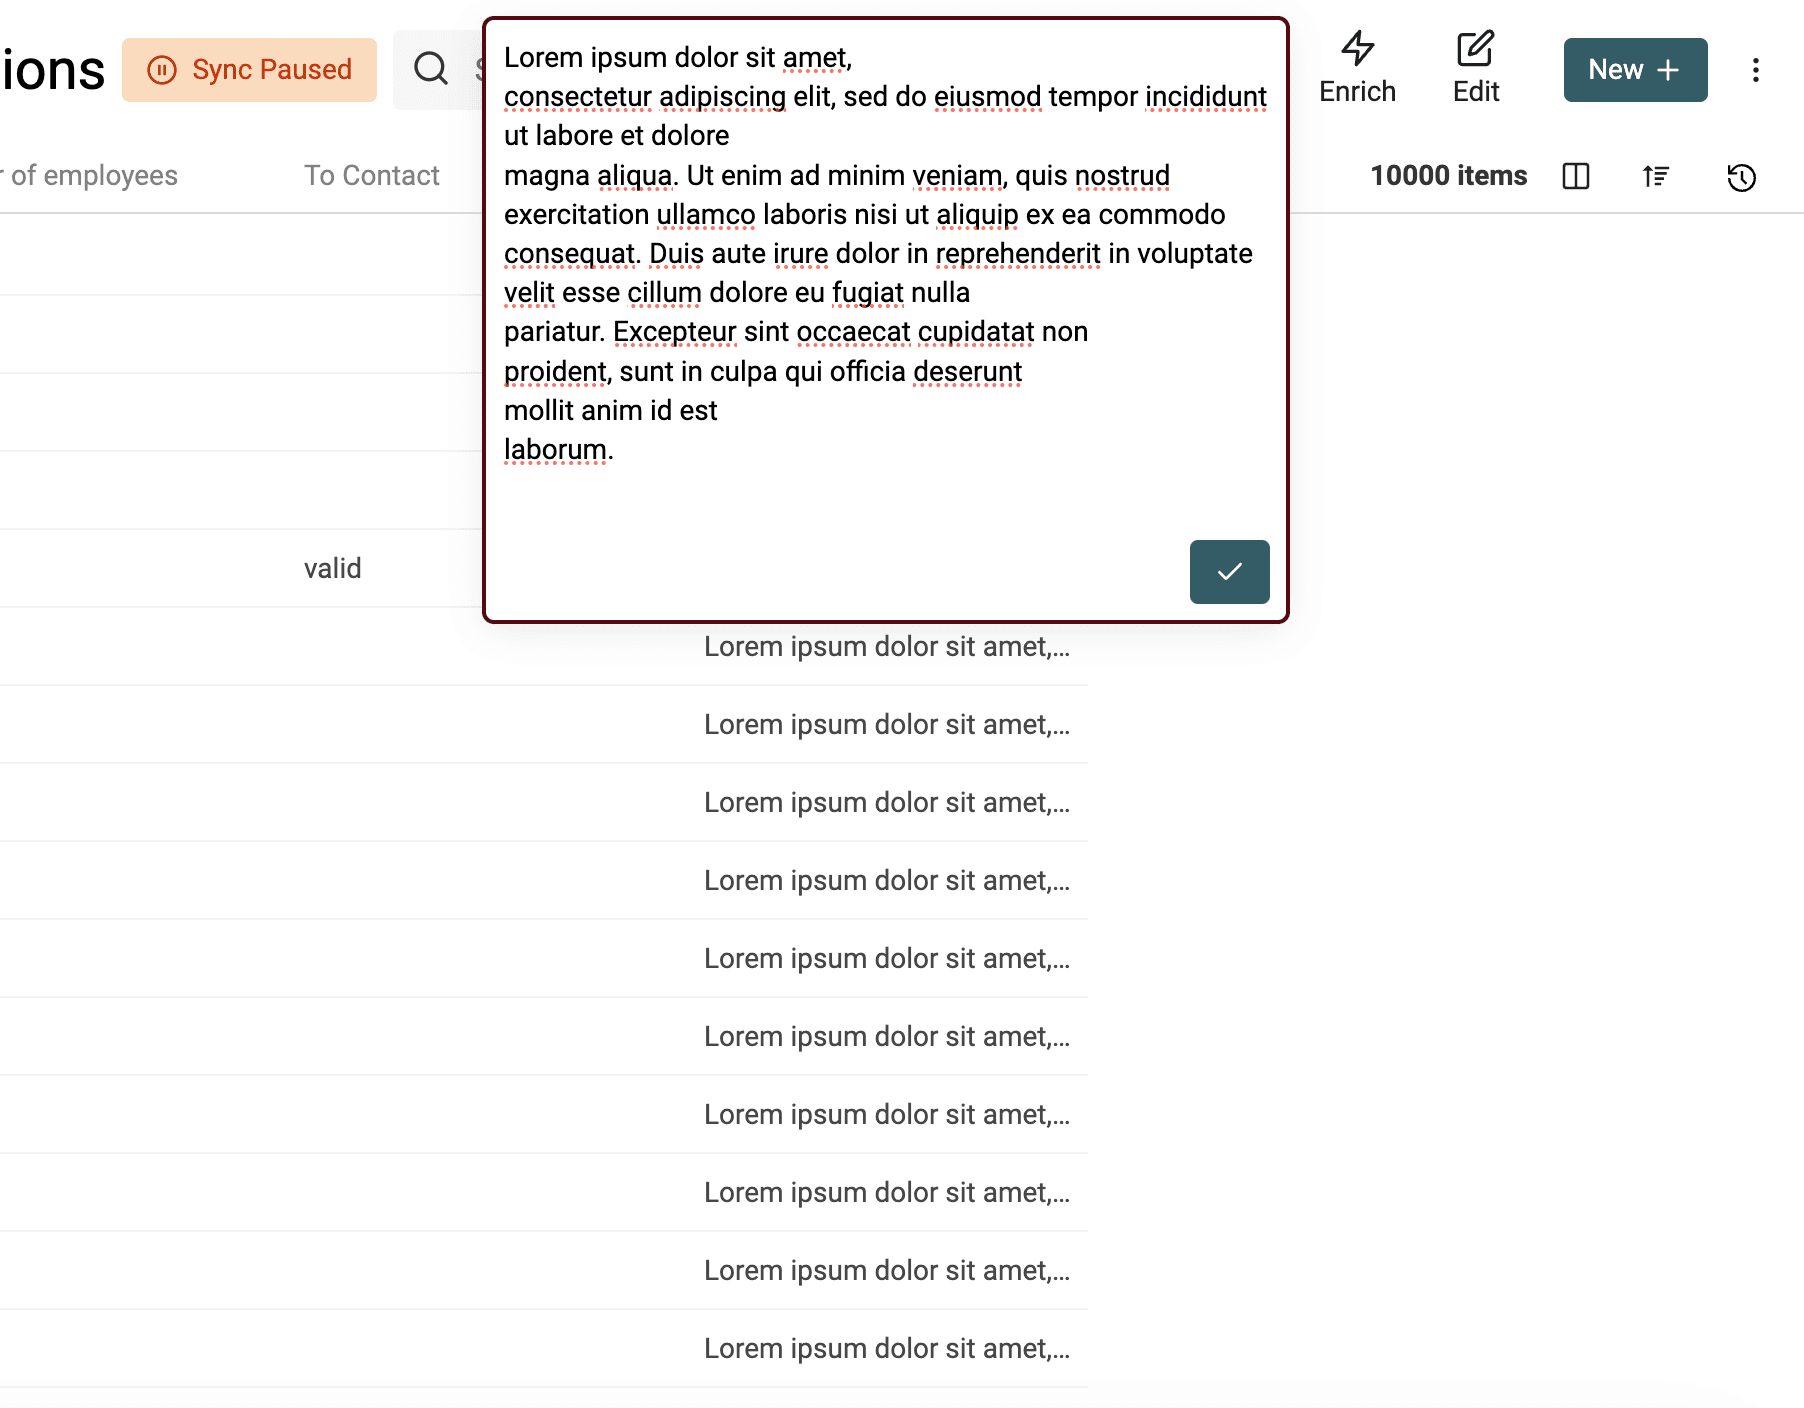
清洗完成后,多余空格已被删除:
统一文本大小写
更改文本大小写非常简单。在“Edit”菜单中打开“Bulk Edit”工具。
选择要处理的属性,再使用“Change text case”操作。
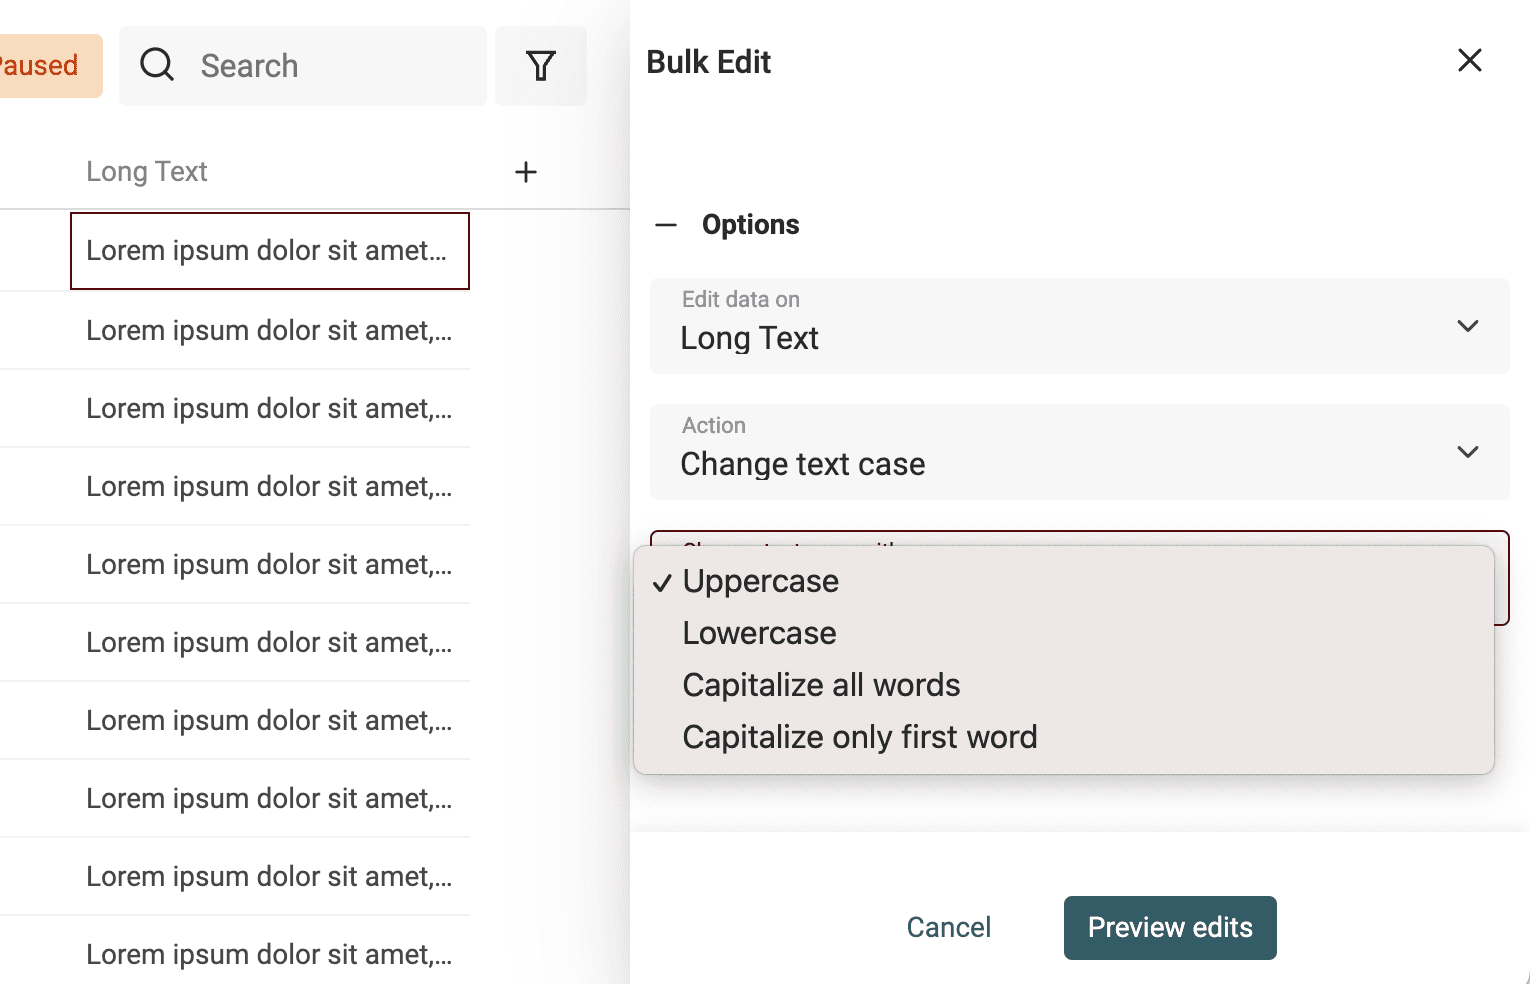
可使用以下模式:
- Uppercase——将所有字母转换为大写。例如:
john=>JOHN - Lowercase——将所有字母转换为小写。例如:
API=>api - Capitalize——将每个单词的首字母大写。例如:
john is a good man=>John Is A Good Man - Capitalize only the first word——仅将第一个单词的首字母大写。例如:
john is a good man=>John is a good man
删除文本中的符号
从 HTML 页面抓取的文本或用户输入的内容(例如 LinkedIn Profile 标题)可能包含表情和其他特殊符号,进而影响数据处理。姓名末尾一个简单的表情符号,就可能导致去重算法无法识别重复记录。
Datablist 内置了处理工具,可以删除数据中的非文本符号。
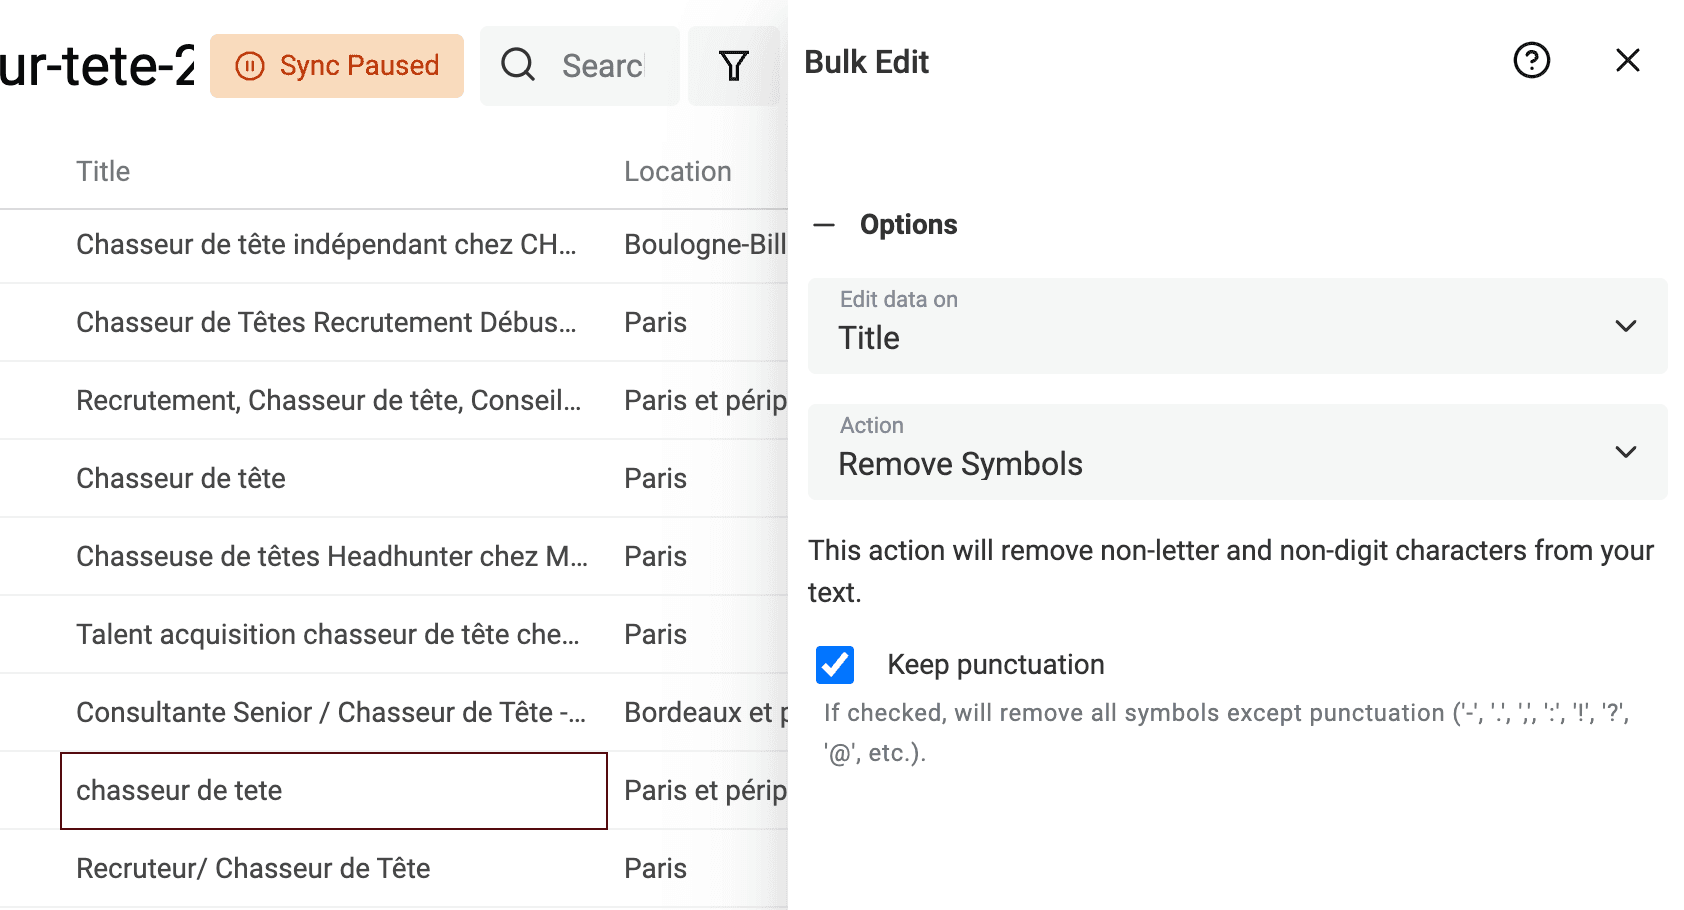
在“Edit”菜单中点击“Bulk Edit”,选择一个 Text 属性,再选择“Remove symbols”转换操作。
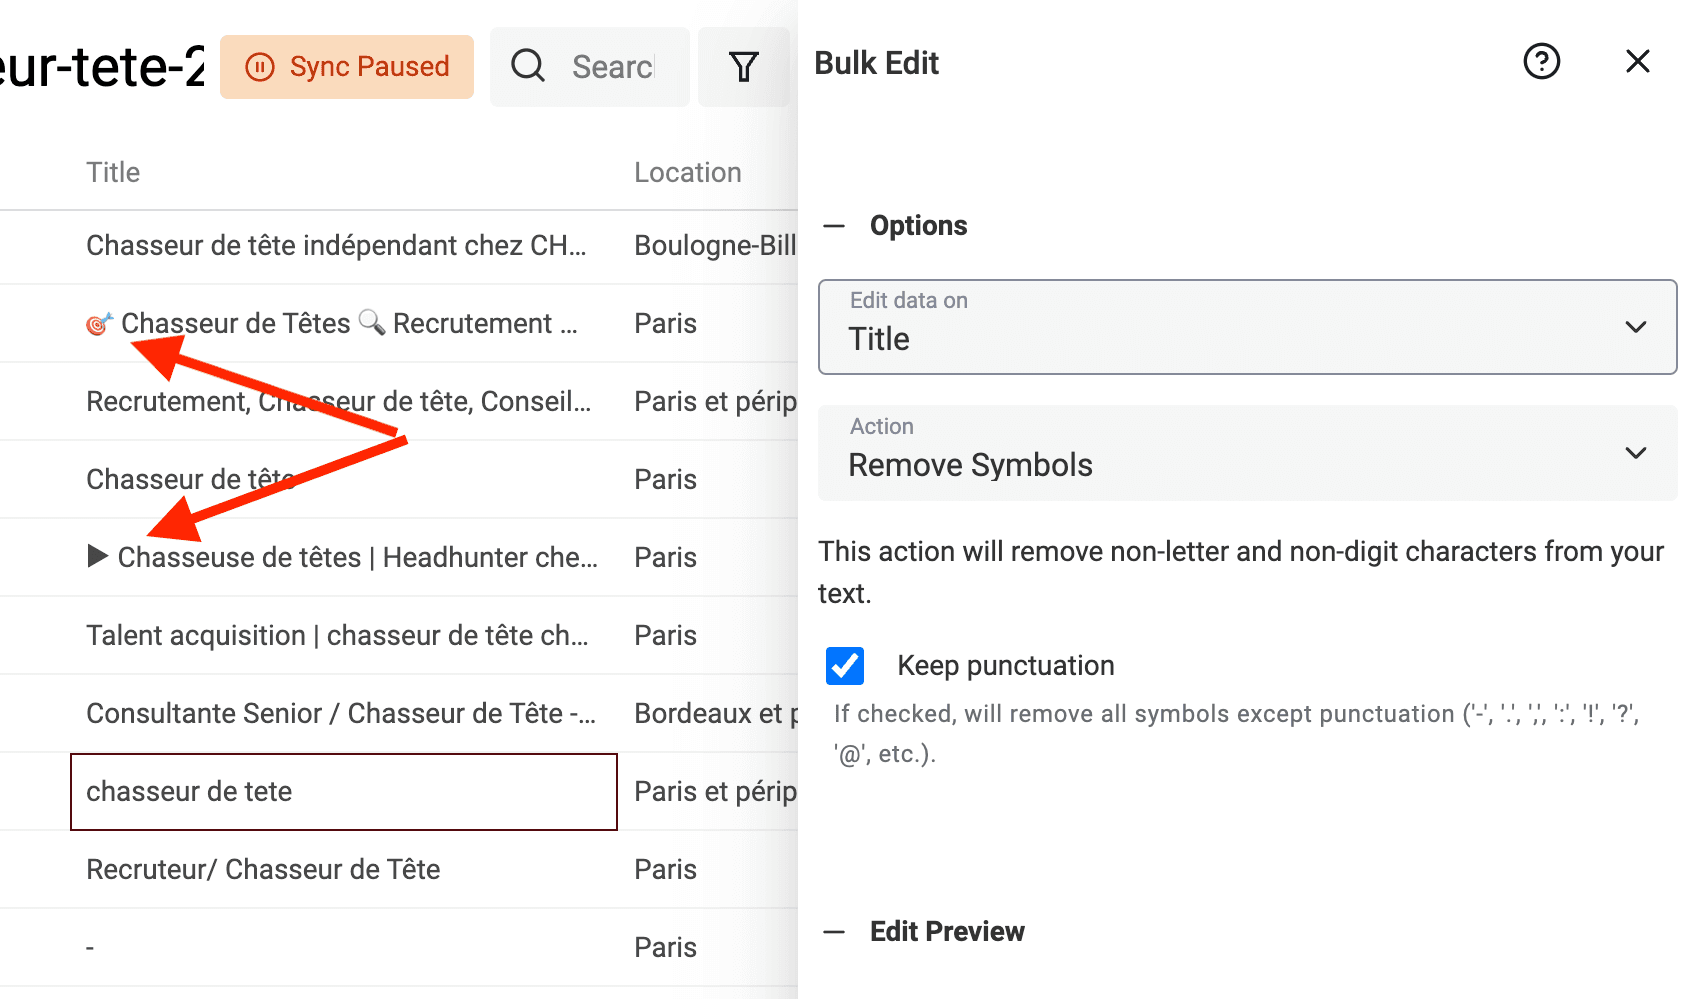
如果预览结果符合预期,即可运行转换并处理数据。
使用 Find and Replace 标准化数据
要在潜在客户名单中建立细分人群,首先需要标准化数据。
- 标准化职位名称
- 标准化国家和城市名称
- 标准化 URL
- 等等
你的目标,是将包含自由文本的属性整理成只有有限选项的属性,或把文本转换为更基础的形式,例如将带路径的 URL 简化为域名。
Datablist 提供强大的 Find and Replace 工具,既支持普通文本,也支持正则表达式。
正则表达式虽然复杂,但功能非常强大。
下面是几个使用 RegEx 清洗数据的示例。
删除 URL 中的查询参数
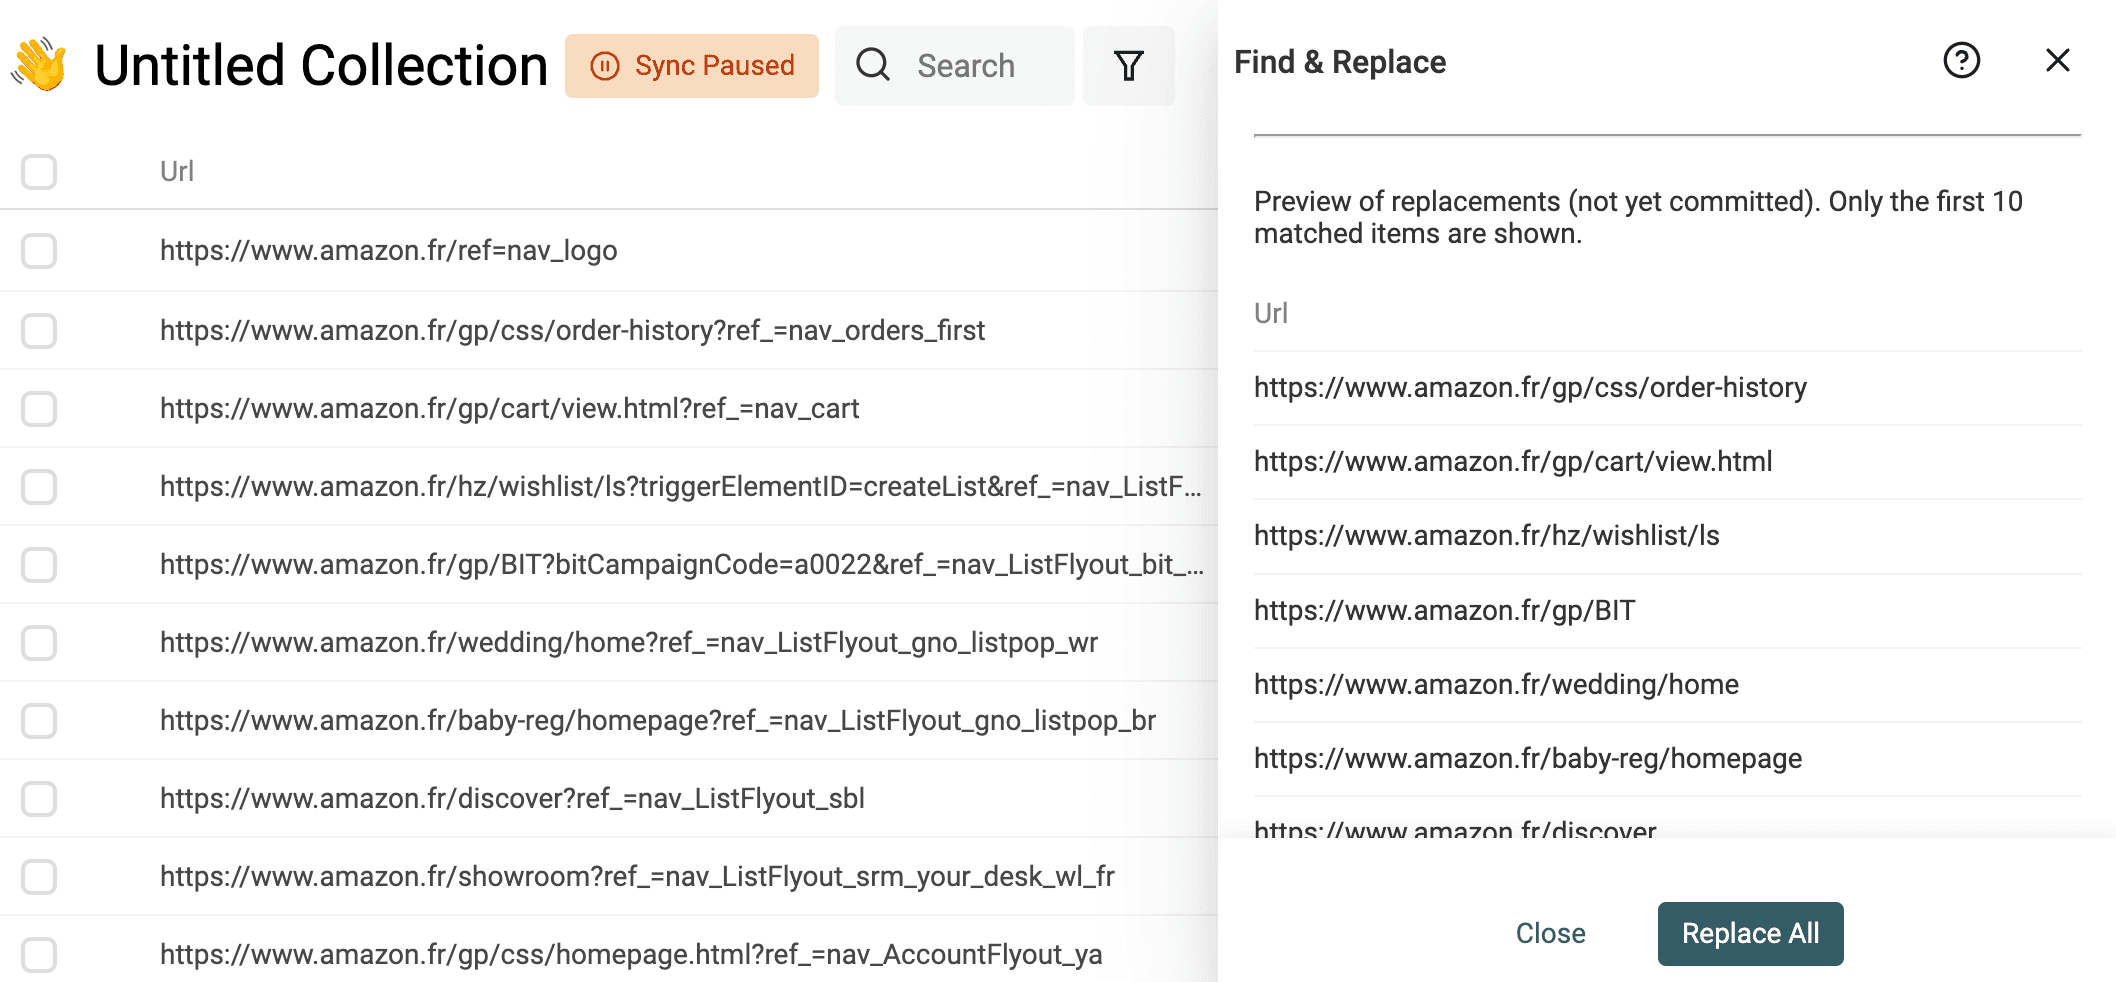
抓取到的 URL 往往包含用于追踪或营销、但实际并不需要的查询参数。删除这些参数可以得到干净的 URL;在使用 URL 查找重复记录时,也能提高去重效果。
要删除 URL 中的查询参数,请勾选“Match using regular expression”,输入以下正则表达式,并将替换文本留空:
\?.*$
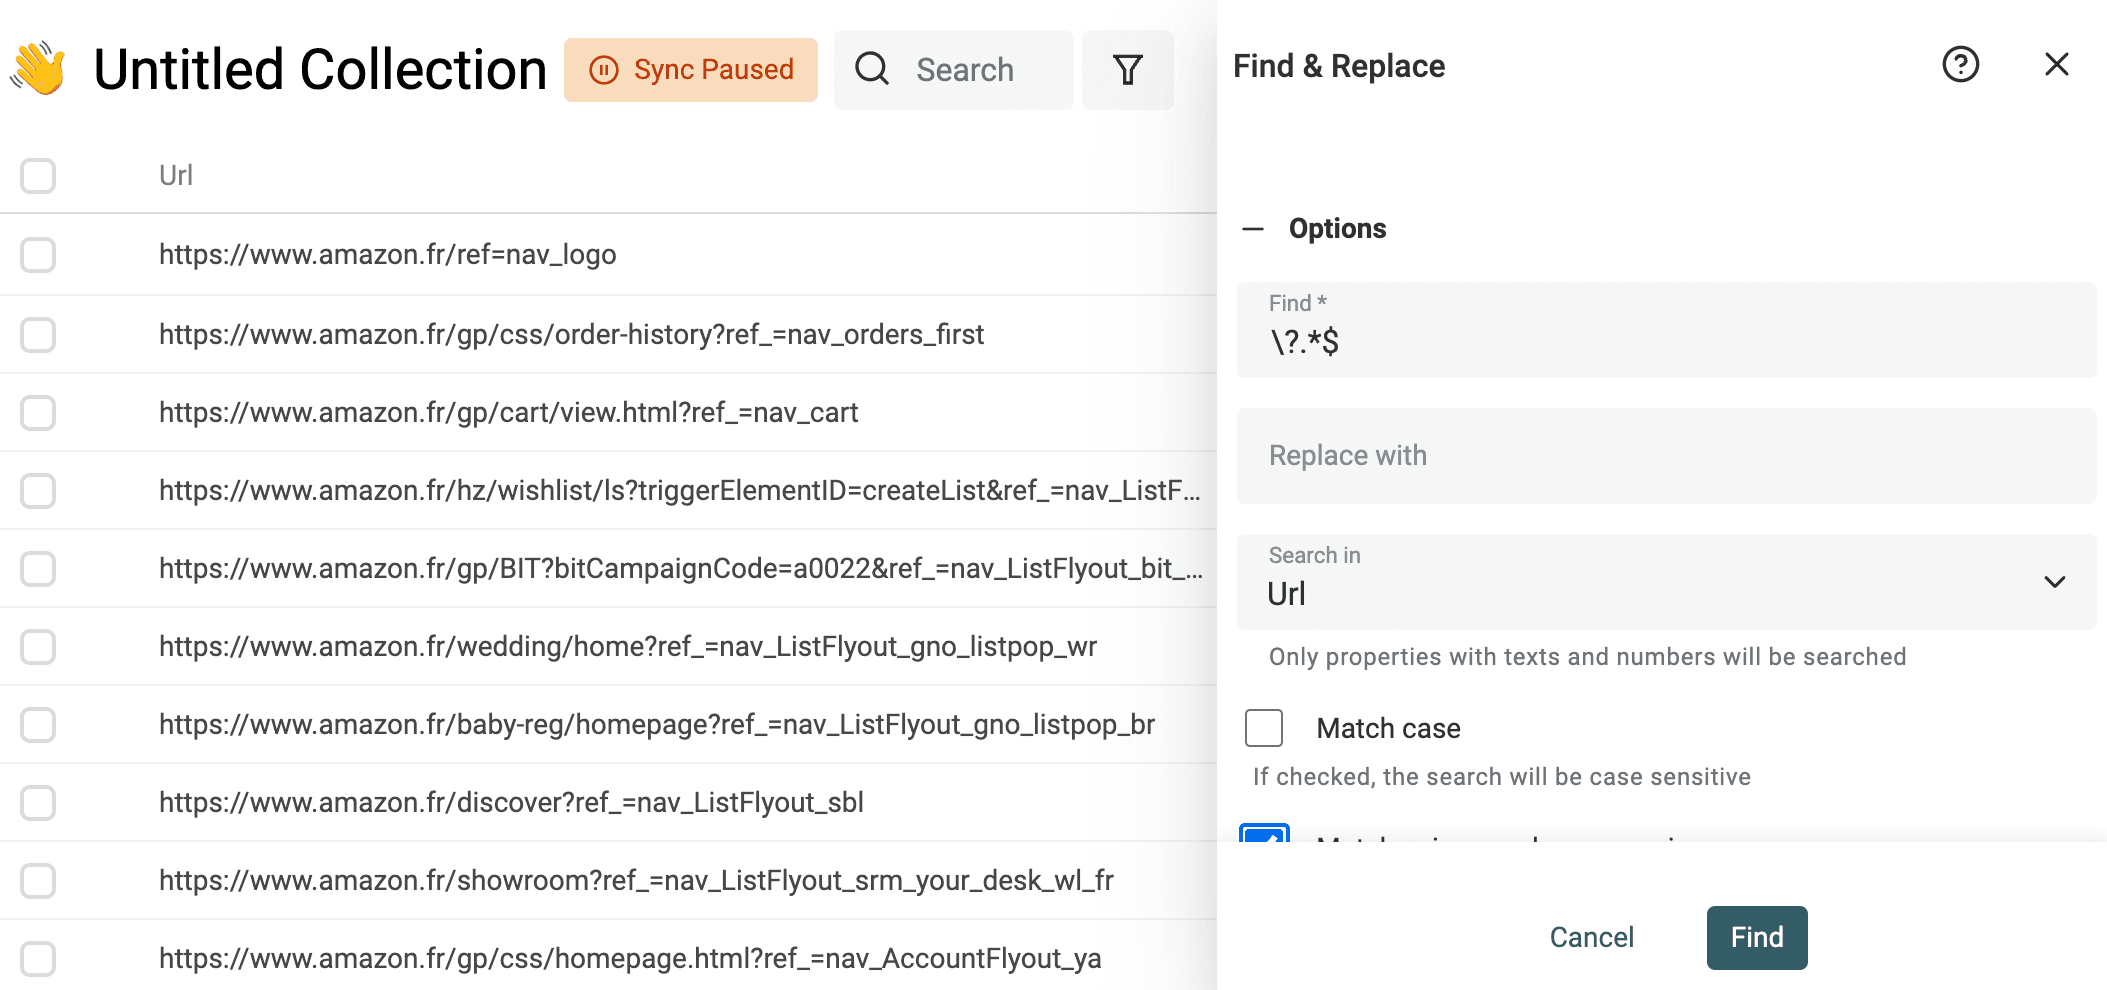
然后将其应用到 URL 属性。
从 Email 地址中提取域名
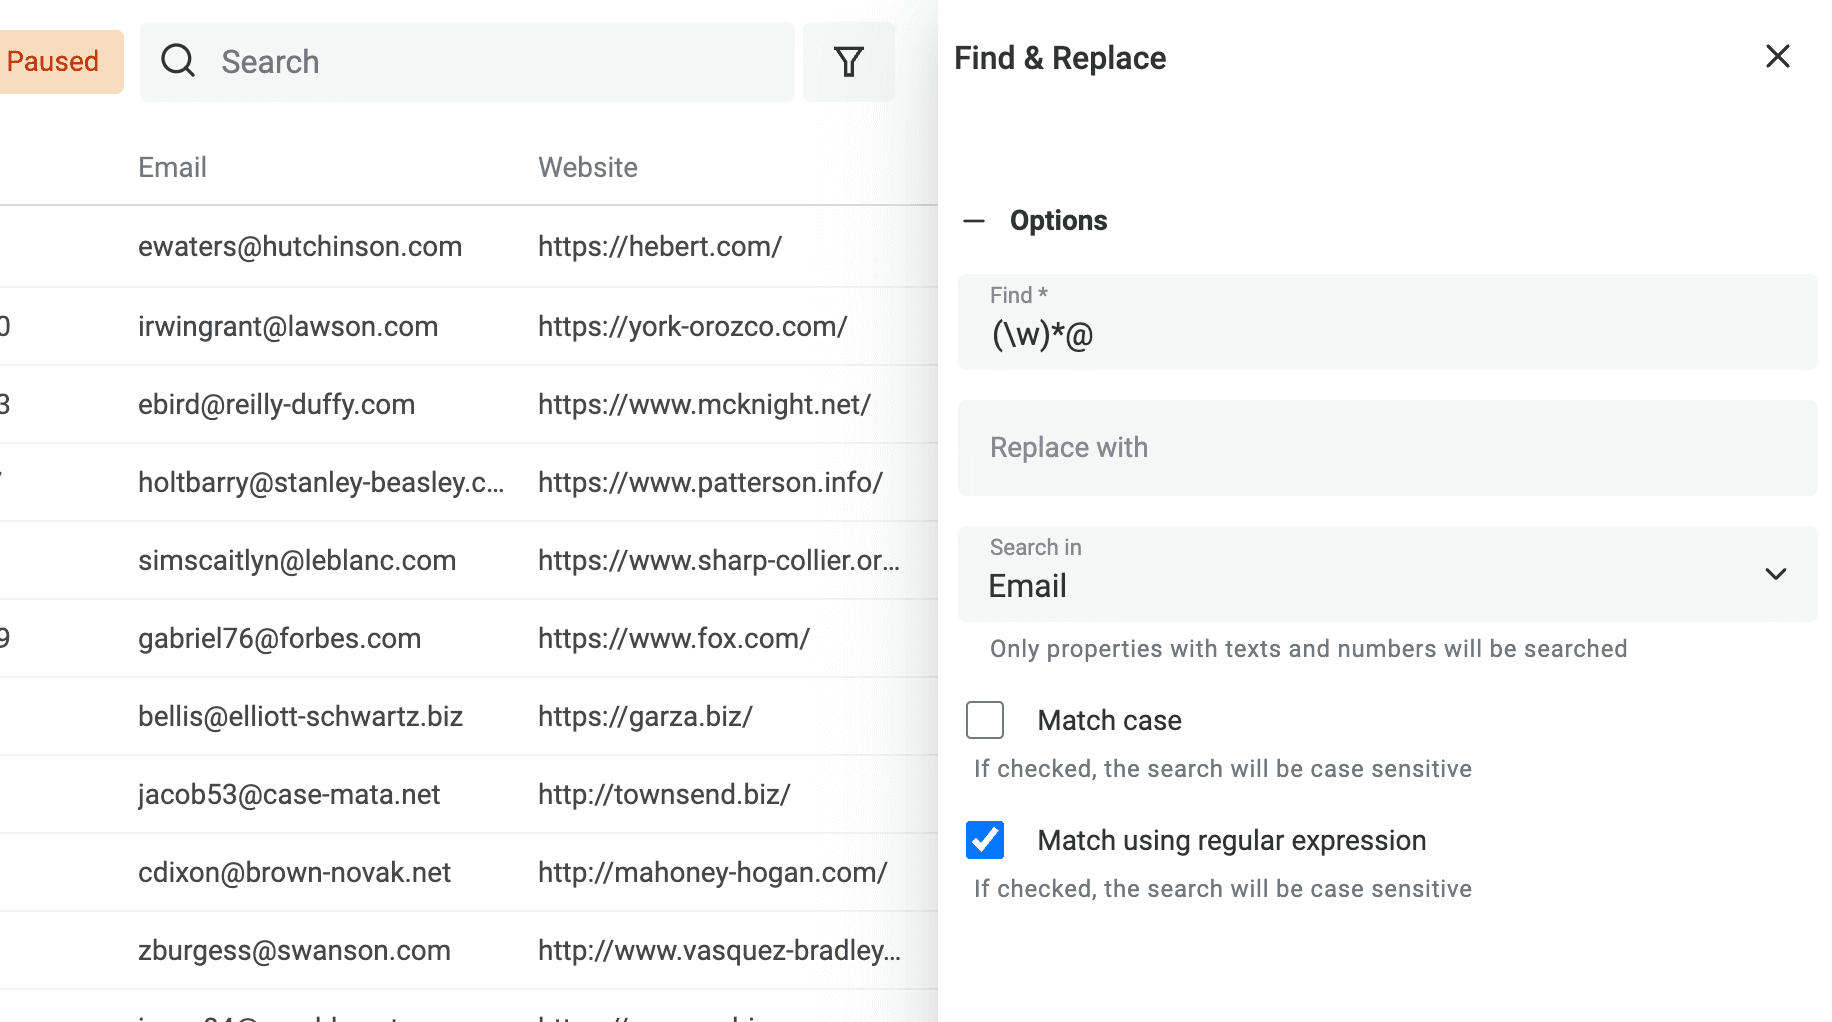
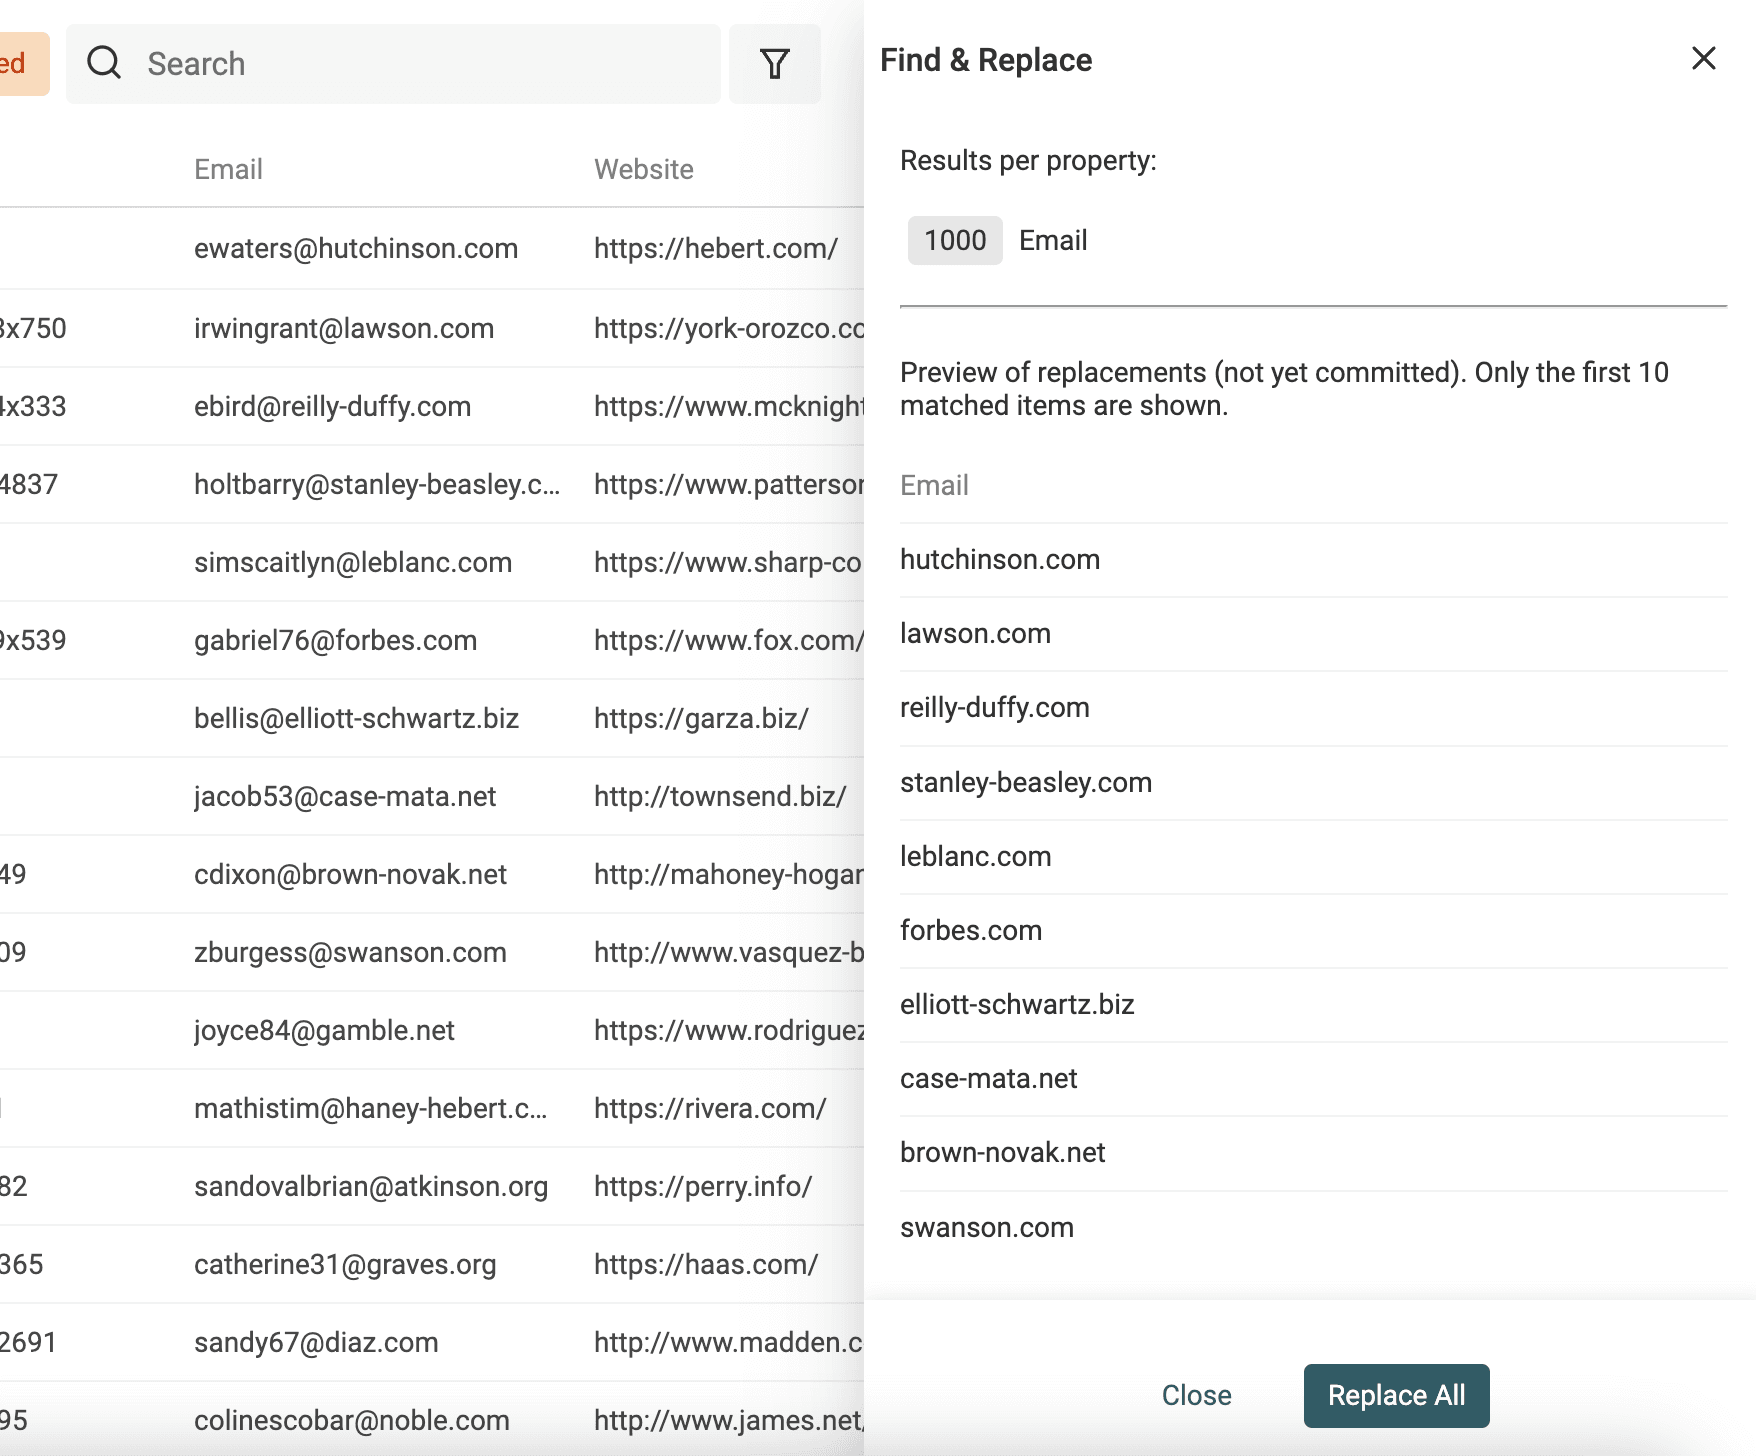
Find and Replace 与正则表达式的另一种用法,是从 Email 地址中提取网站域名。
先复制 Email 属性以保留源数据,再输入以下正则表达式,并将替换文本留空:
^(\w)*@
将完整姓名拆分为名字和姓氏
抓取 Lead 名单时,你通常会得到“Full Name”,之后还需要将其拆分为“First Name”和“Last Name”。准确解析姓名的各个组成部分,是数据处理中的关键一步。
将名字和姓氏分开,有助于在 Cold Emailing 营销活动中进行更个性化的称呼,也可用于判断联系人的性别或识别其学术头衔。
姓名拆分可能比较复杂。Datablist 提供了简单易用的工具,可以将空格作为分隔符,把“Name”拆成两个值。
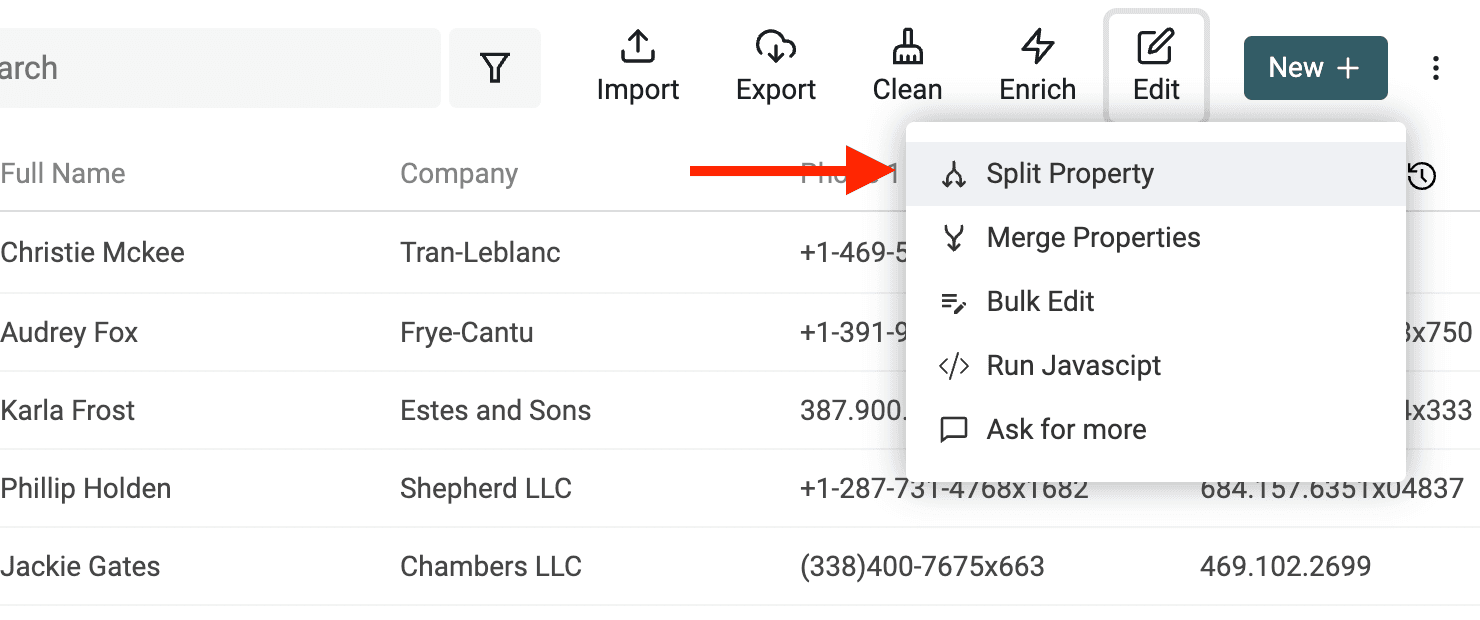
首先,在“Edit”菜单中打开“Split Property”工具。
然后选择包含待解析姓名的属性,将分隔符设为 Space,并将最大拆分数量设为 2。
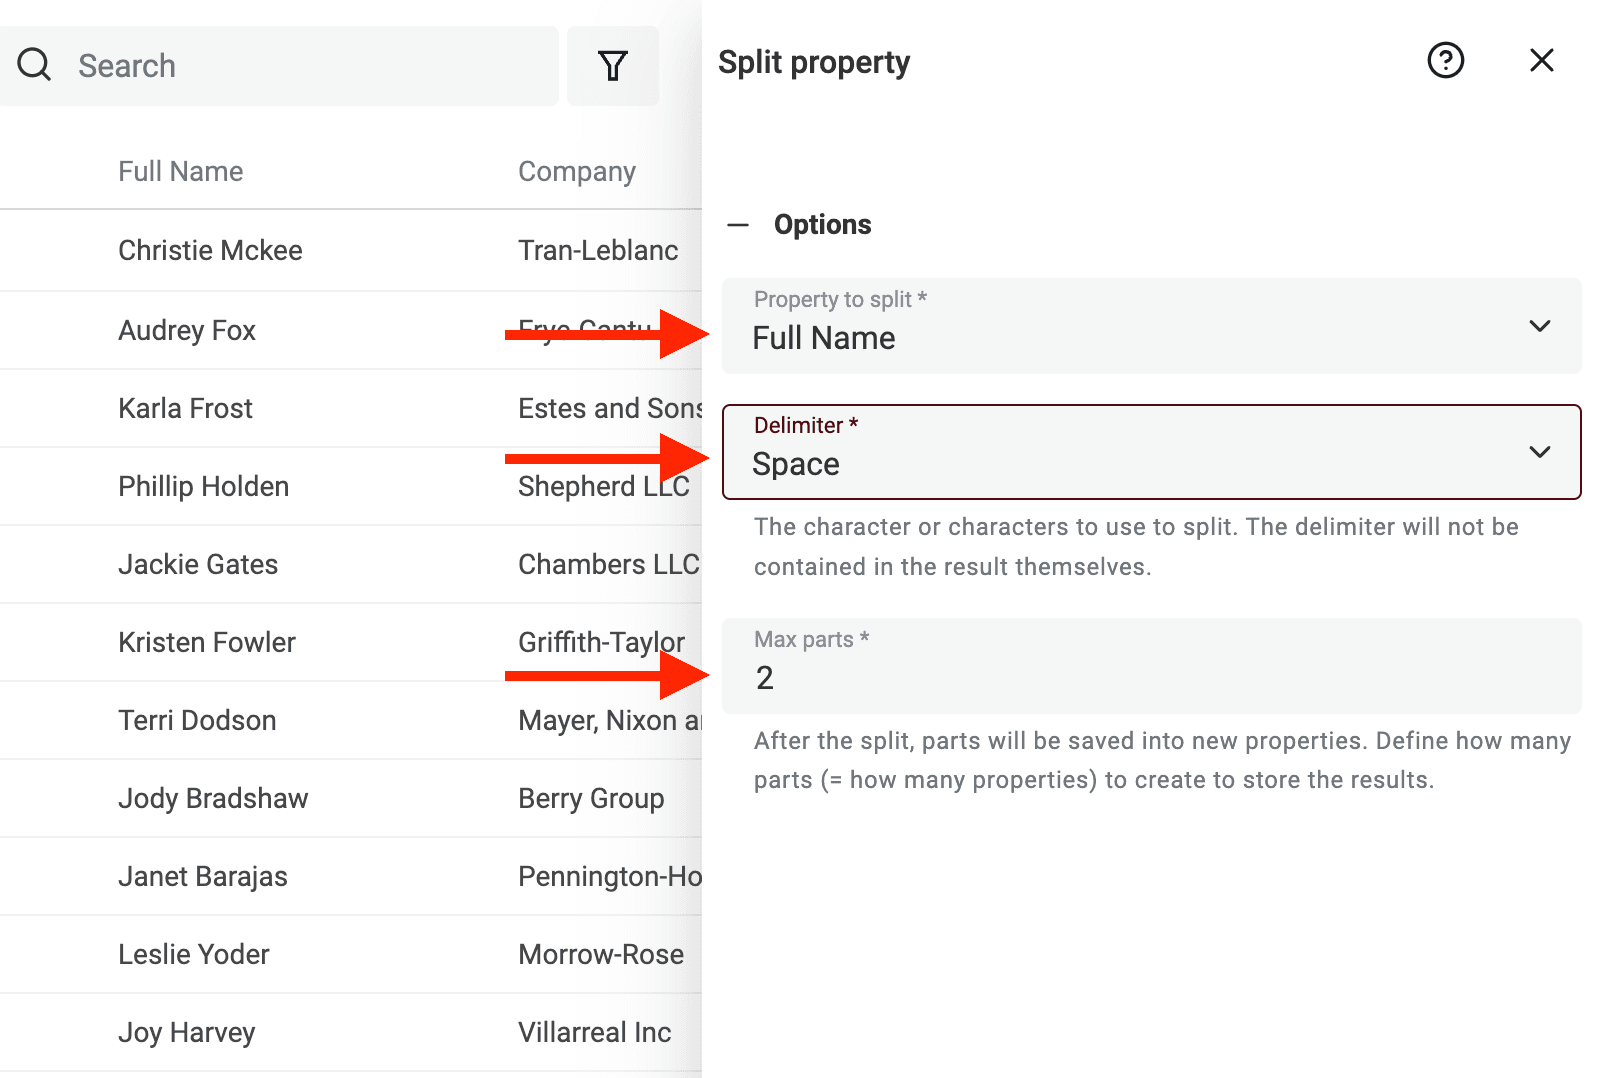
运行预览。Datablist 会解析前 10 条记录并生成预览。如果结果符合预期,点击“Split Property”,对当前所有记录运行算法。
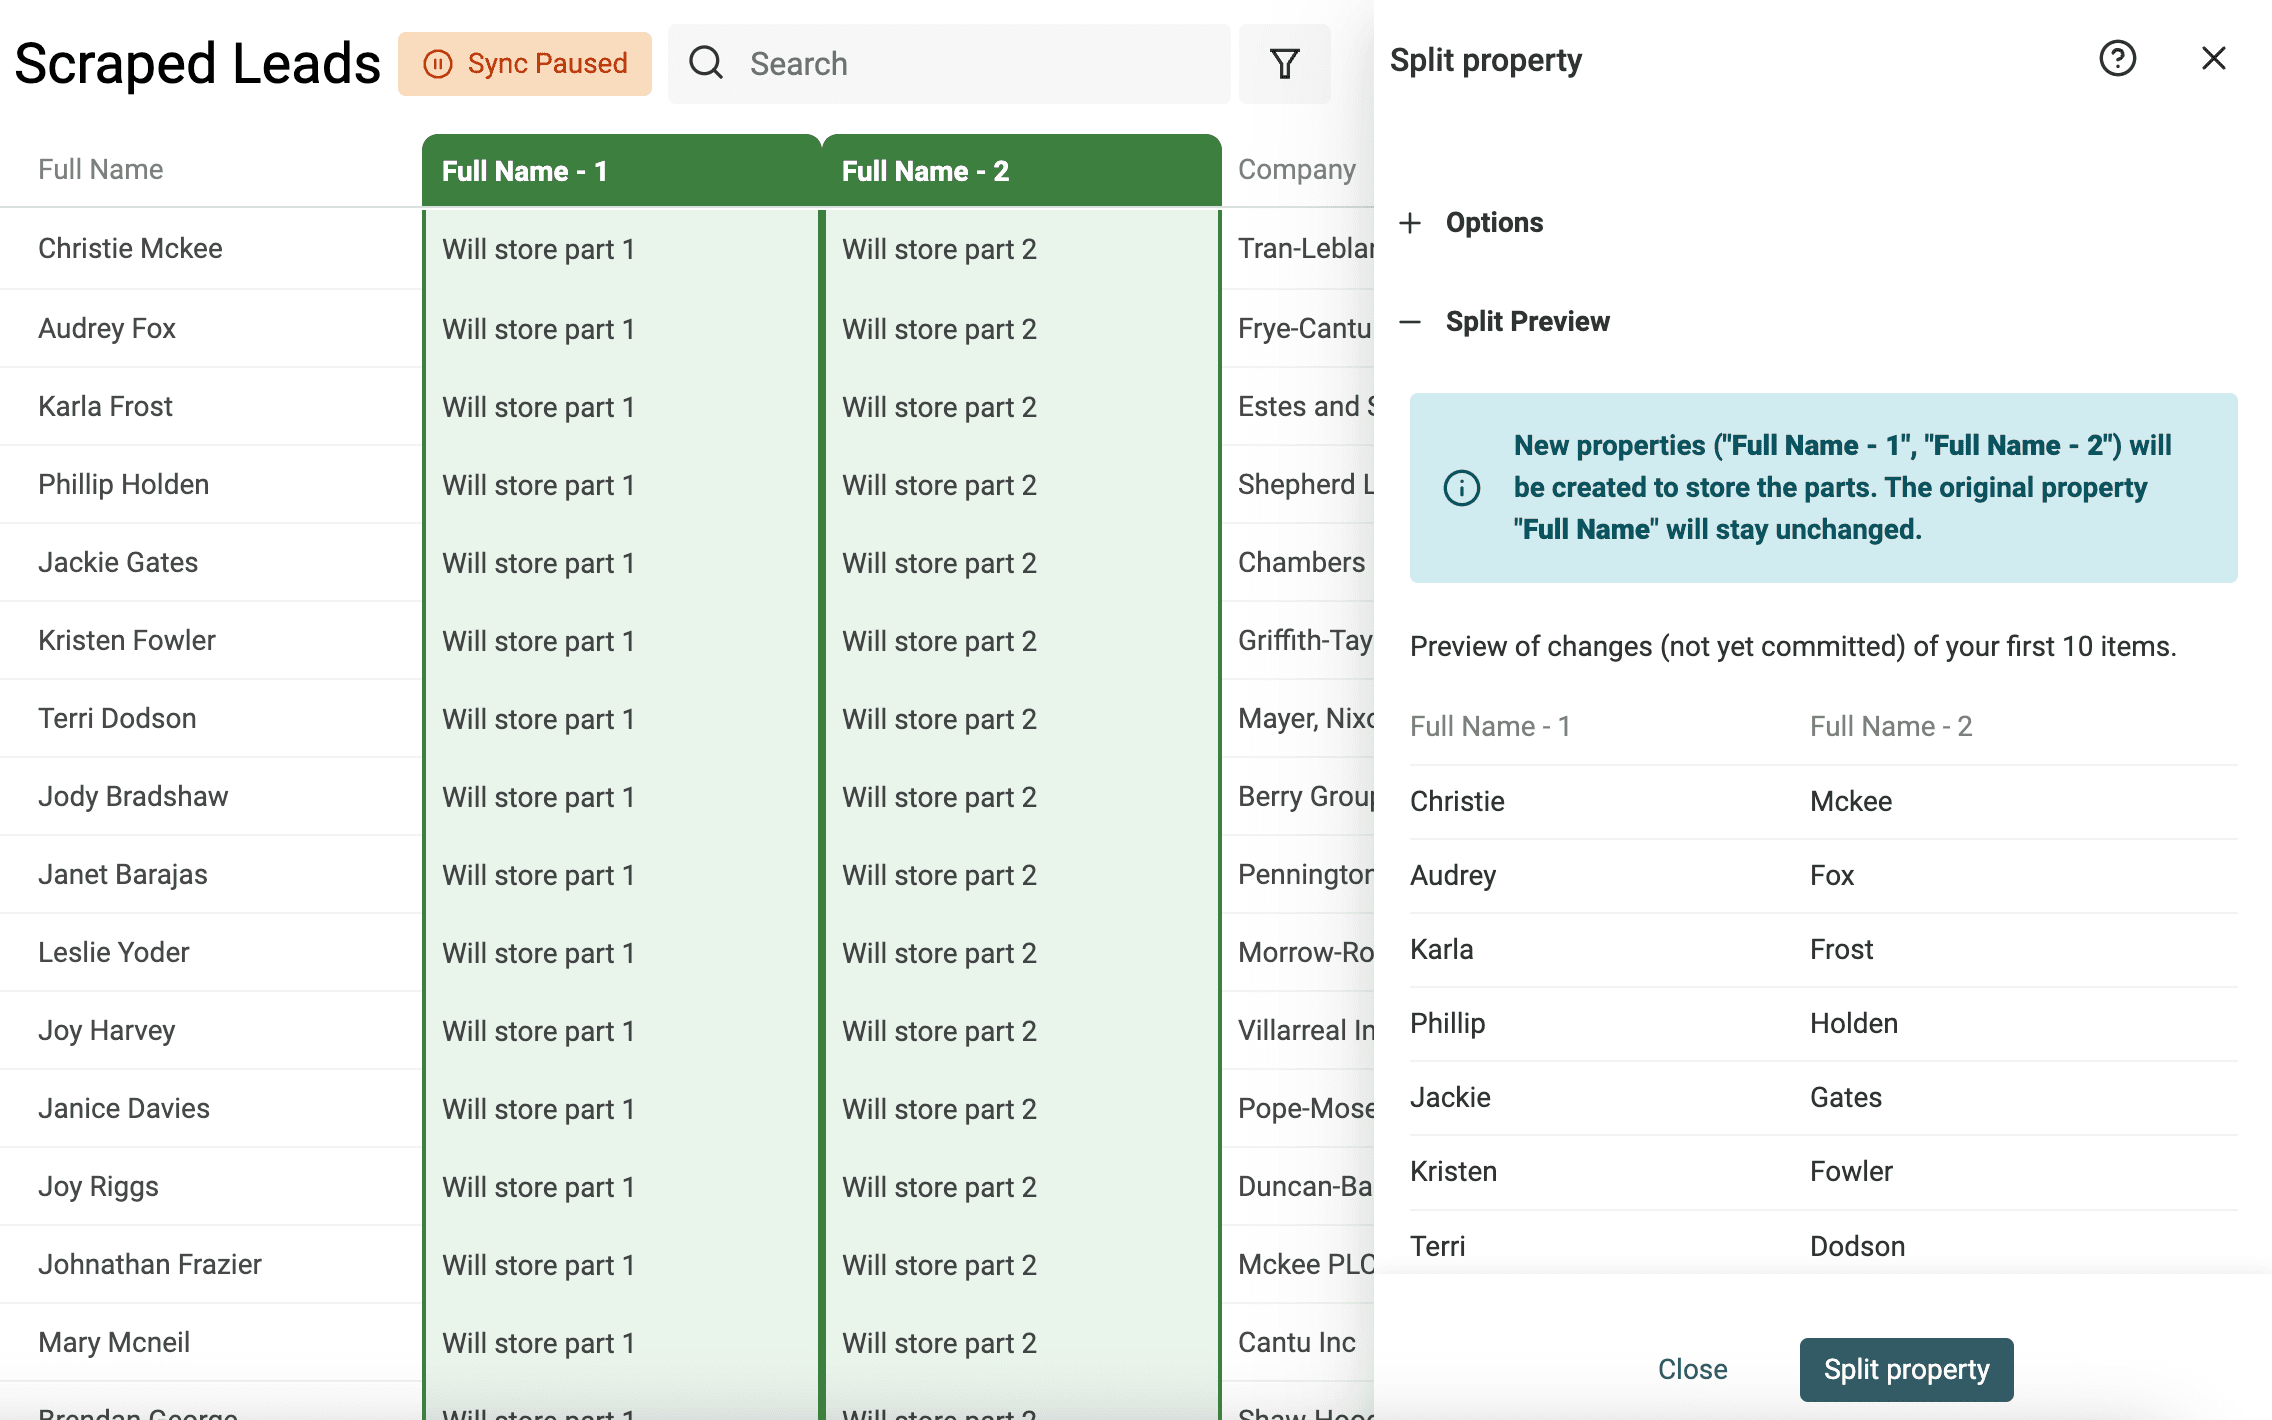
拆分完成后,将新创建的两个属性重命名为“First Name”和“Last Name”。
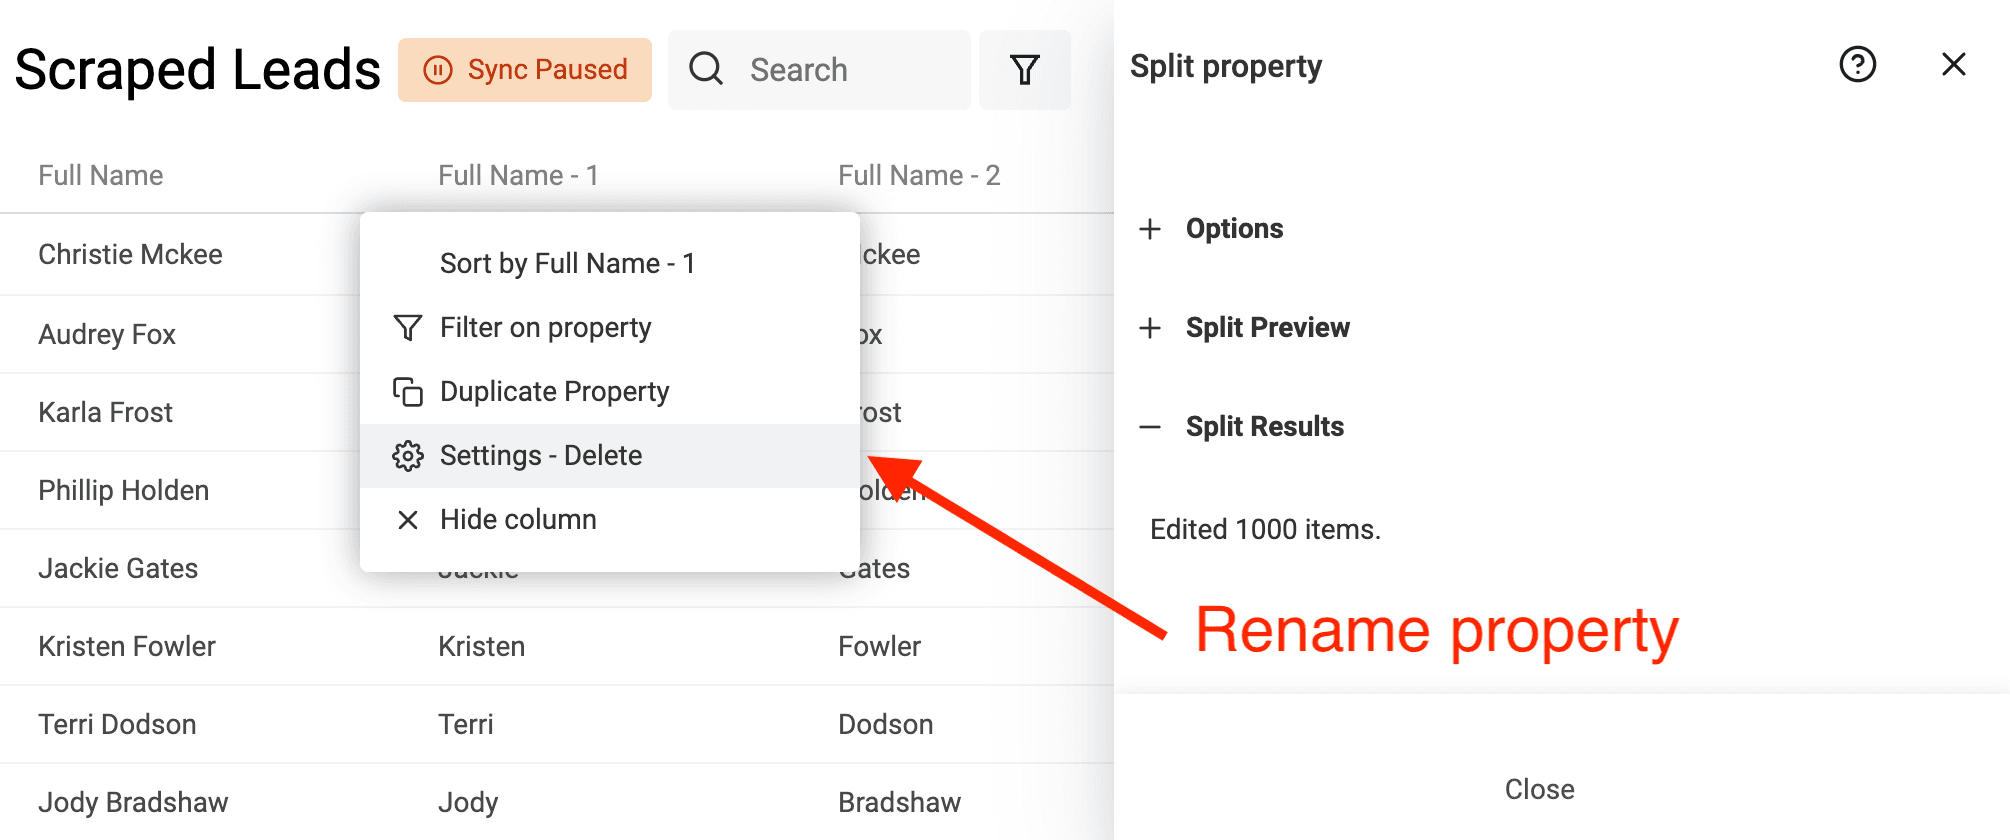
本例主要处理西方姓名,即通常由名字和姓氏组成的命名方式。面对非西方姓名、多个名字或复姓,以及带有头衔或后缀的姓名时,处理会更加复杂。
数据去重
Datablist 提供强大的去重算法,可用于删除重复记录。它能够根据一个或多个属性查找相似记录,并通过自动算法合并数据,避免信息丢失。
要运行去重算法,请在“Clean”菜单中点击“Duplicate Finder”。
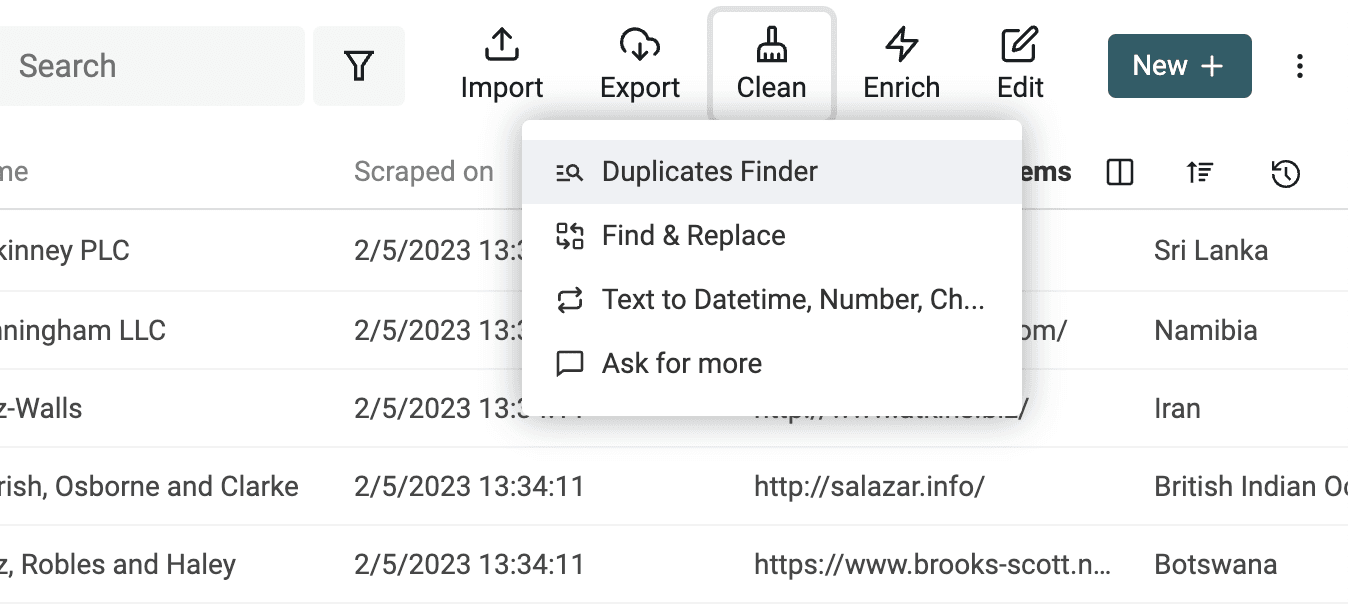
选择匹配时要使用的属性。
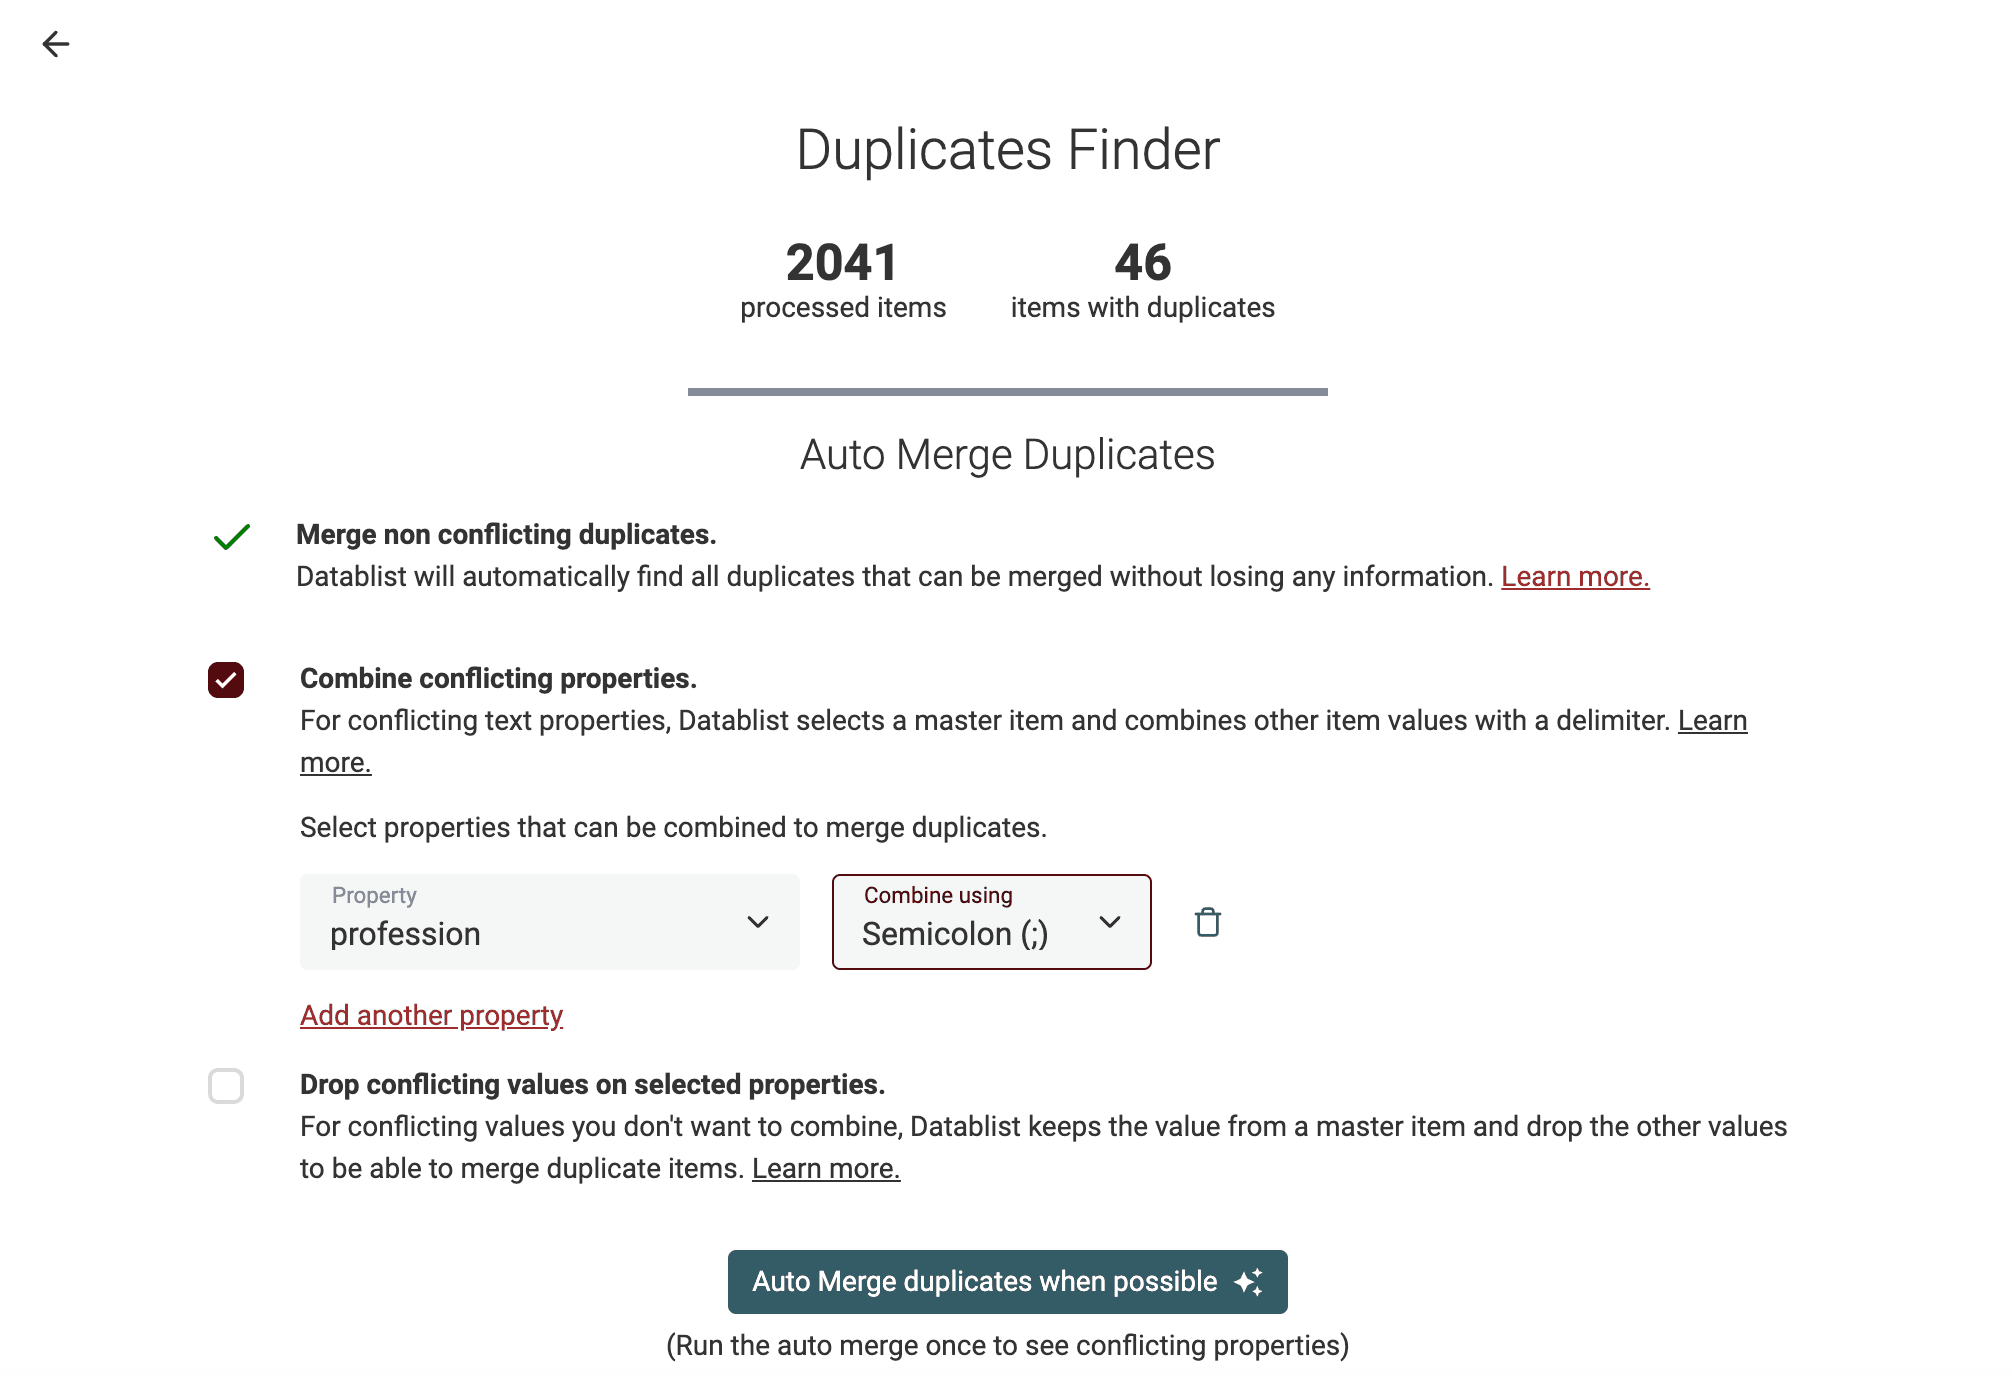
在结果页面中,先仅启用“Merge non-conflicting duplicates”选项,运行一次“Auto Merge”算法。系统会合并容易处理的重复记录,并列出存在冲突的属性。
去重算法提供两种处理冲突数据的方式。你可以使用分隔符“Combine conflicting properties”,也可以丢弃冲突值,只保留一条主记录。
👉 查看 CSV 文件重复记录合并指南。你也可以阅读根据公司名称查找并合并重复记录的指南。
从文本中提取 Email 地址和 URL 等信息
Datablist Data Extractor 可以解析非结构化文本并提取实体信息。
它通过模式识别检测:
- 文本中的 Email 地址
- 文本中的 URL
- URL 中的域名
- Email 地址中的域名
- 文本中的 Mention(例如 @name)
- 文本中的 Tag(例如 #tag)
Data Extractor 非常适合数据分析和数据结构化。获得格式规范的 Email 地址、URL 等数据后,你可以将数据连接到其他工具,并创建自动化工作流。
例如,提取 Email 地址后,可以通过 Enrichment 查找联系人信息;获得 URL 域名后,则可以查询网站流量排名等信息。
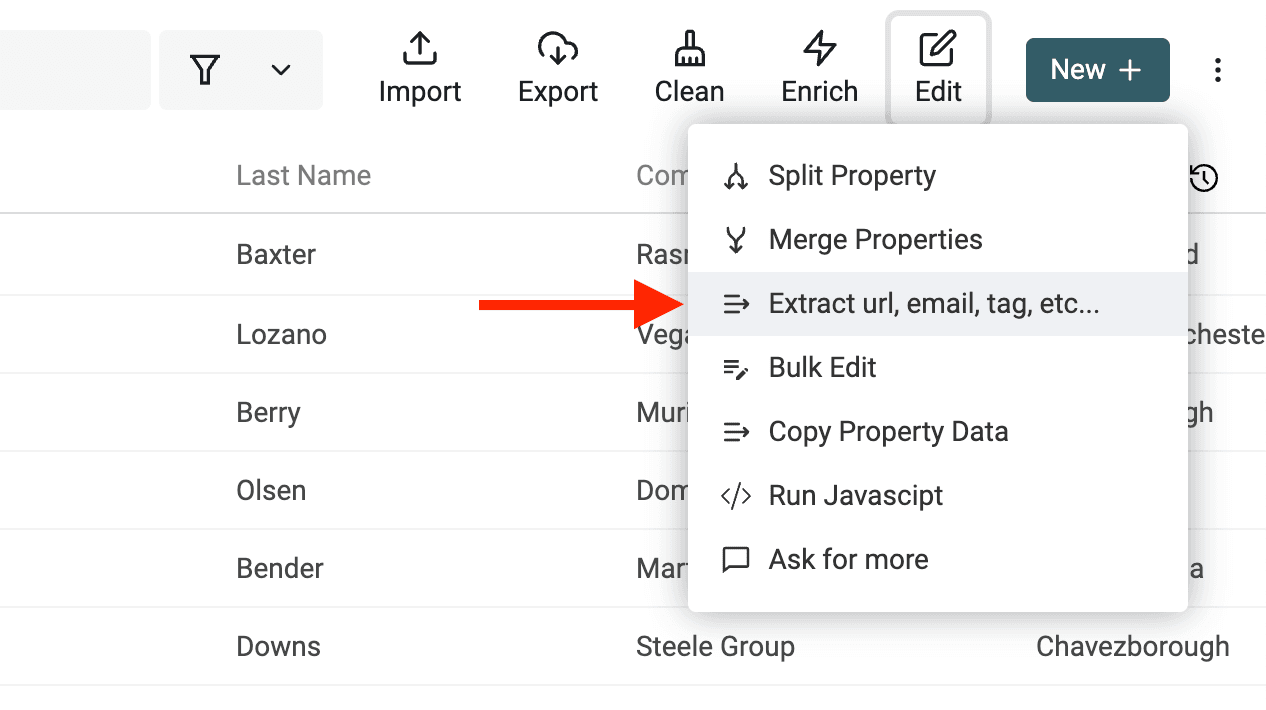
你可以通过“Edit Menu -> Extract url, email, tag, etc.”打开 Datablist Data Extractor。
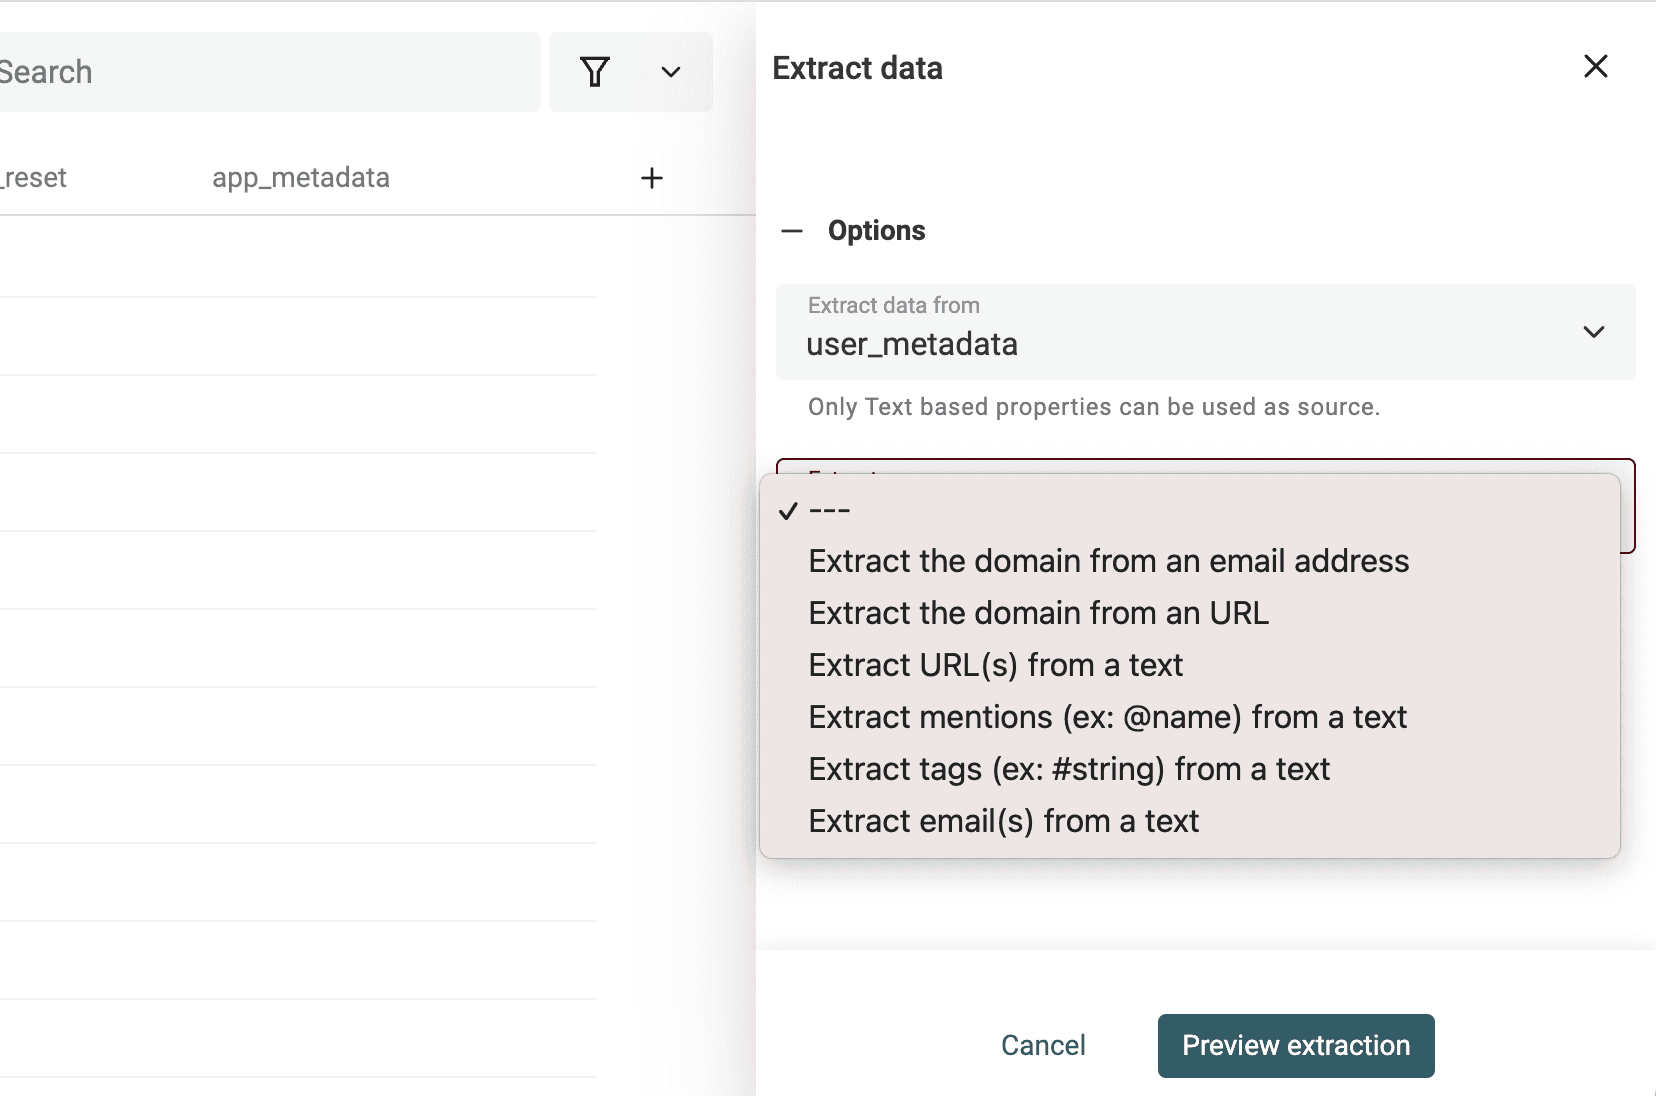
选择包含非结构化文本的属性,再选择一个 parser。
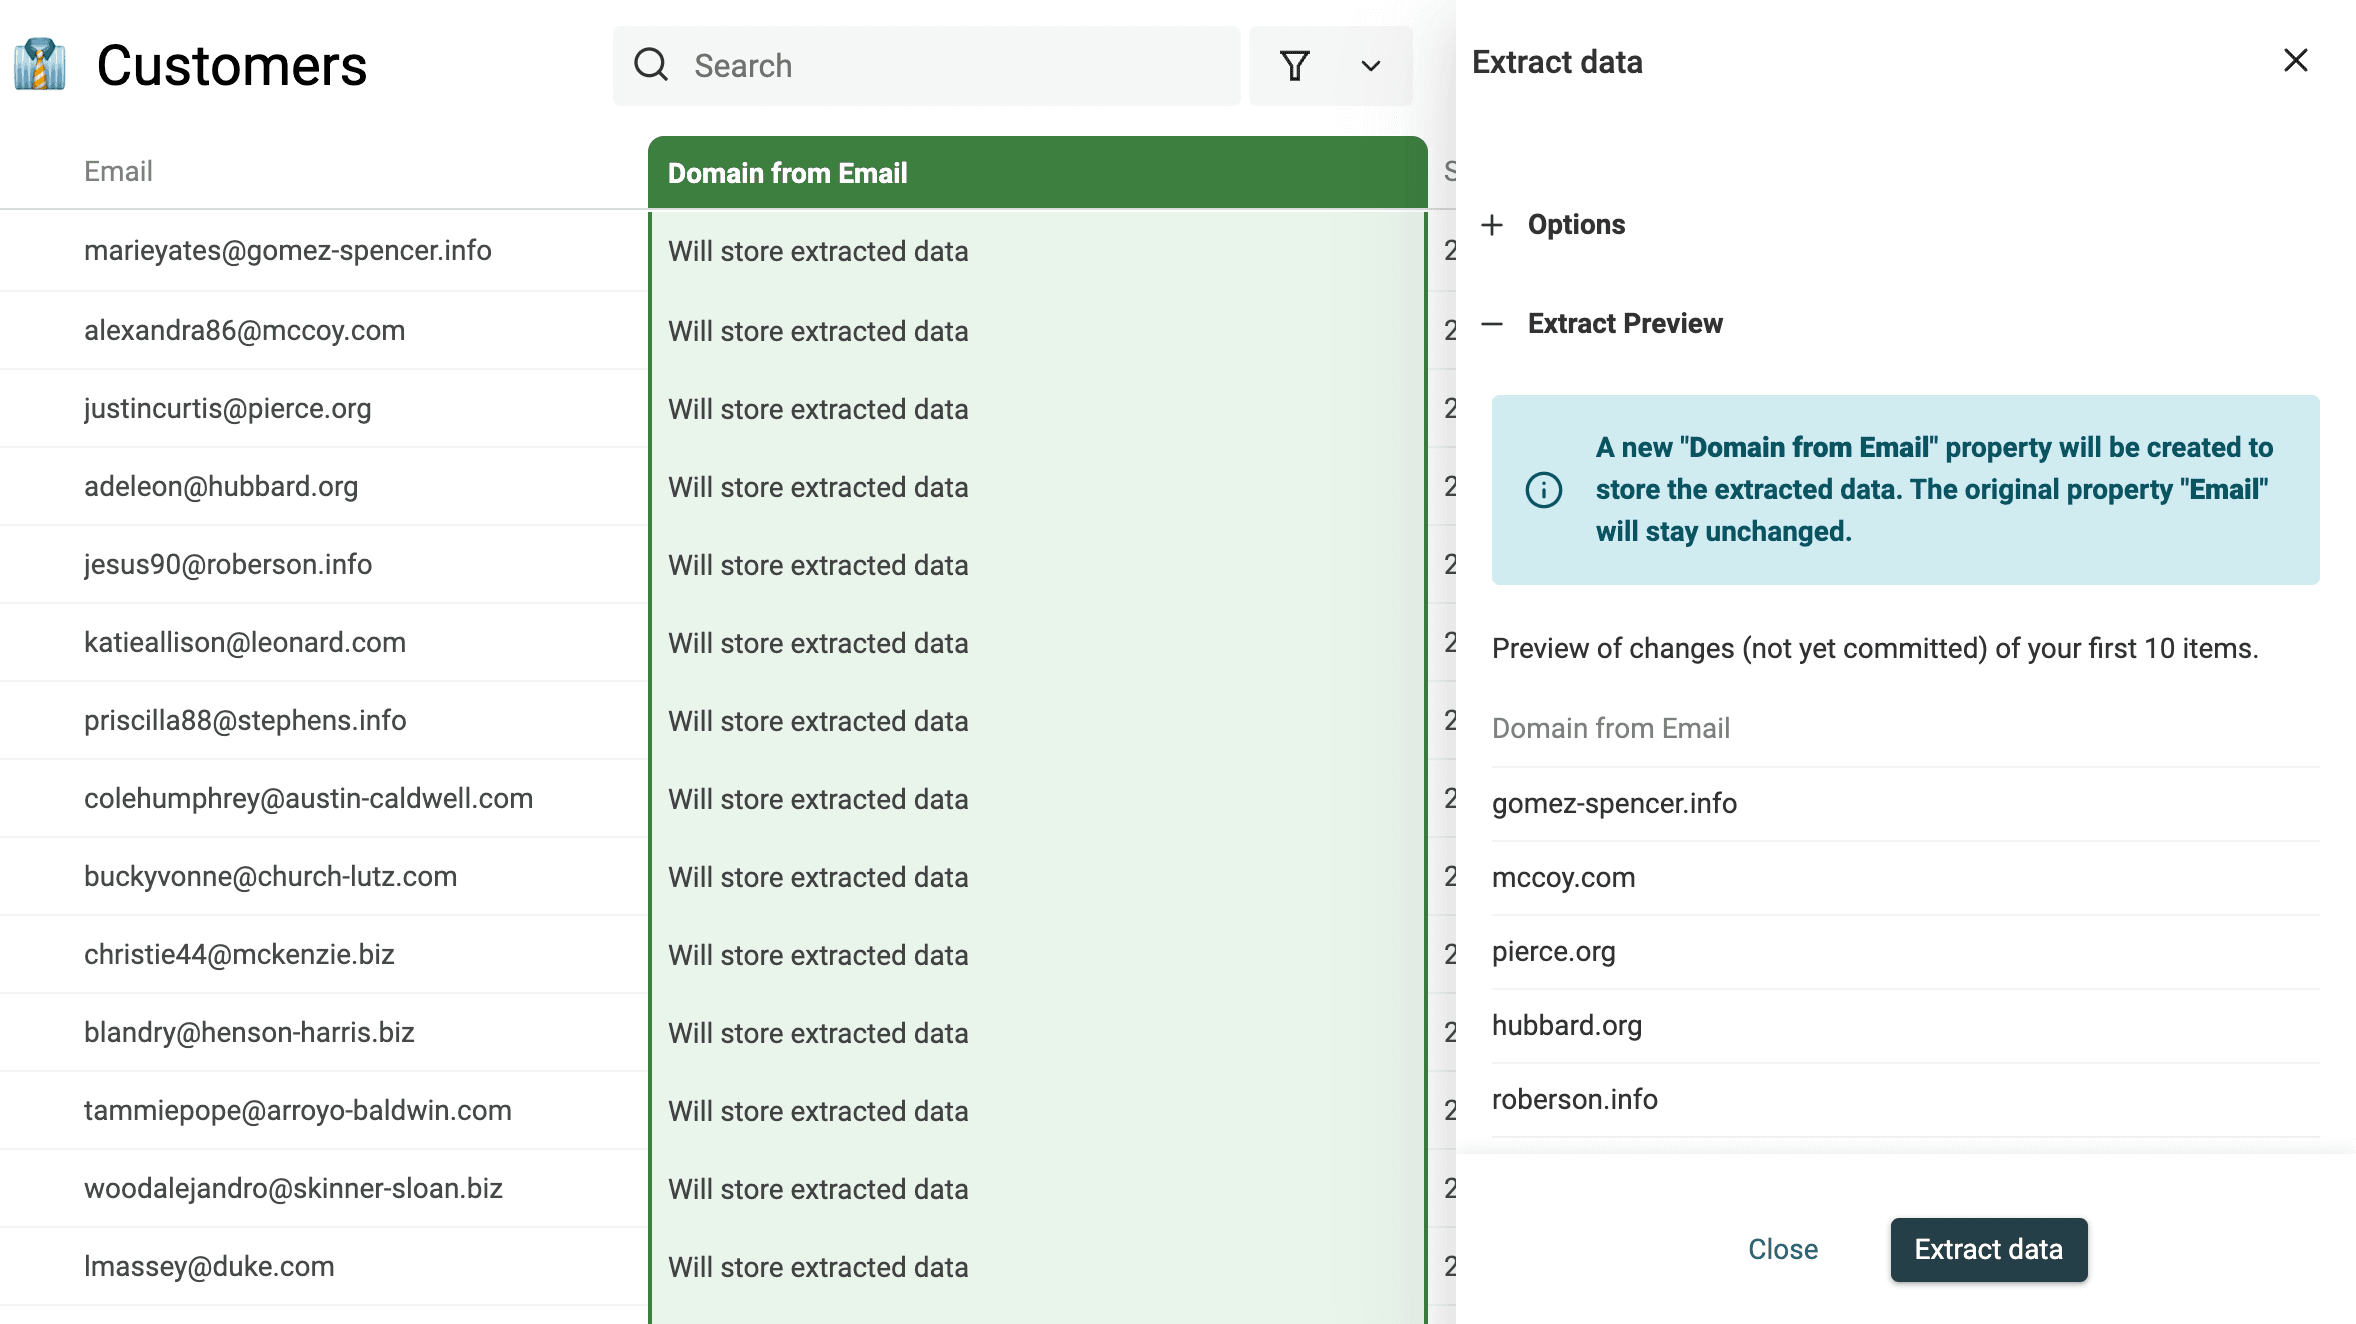
运行 parser 查看预览。如果结果符合预期,点击“Extract”处理所有记录。
使用正则表达式筛选和验证数据
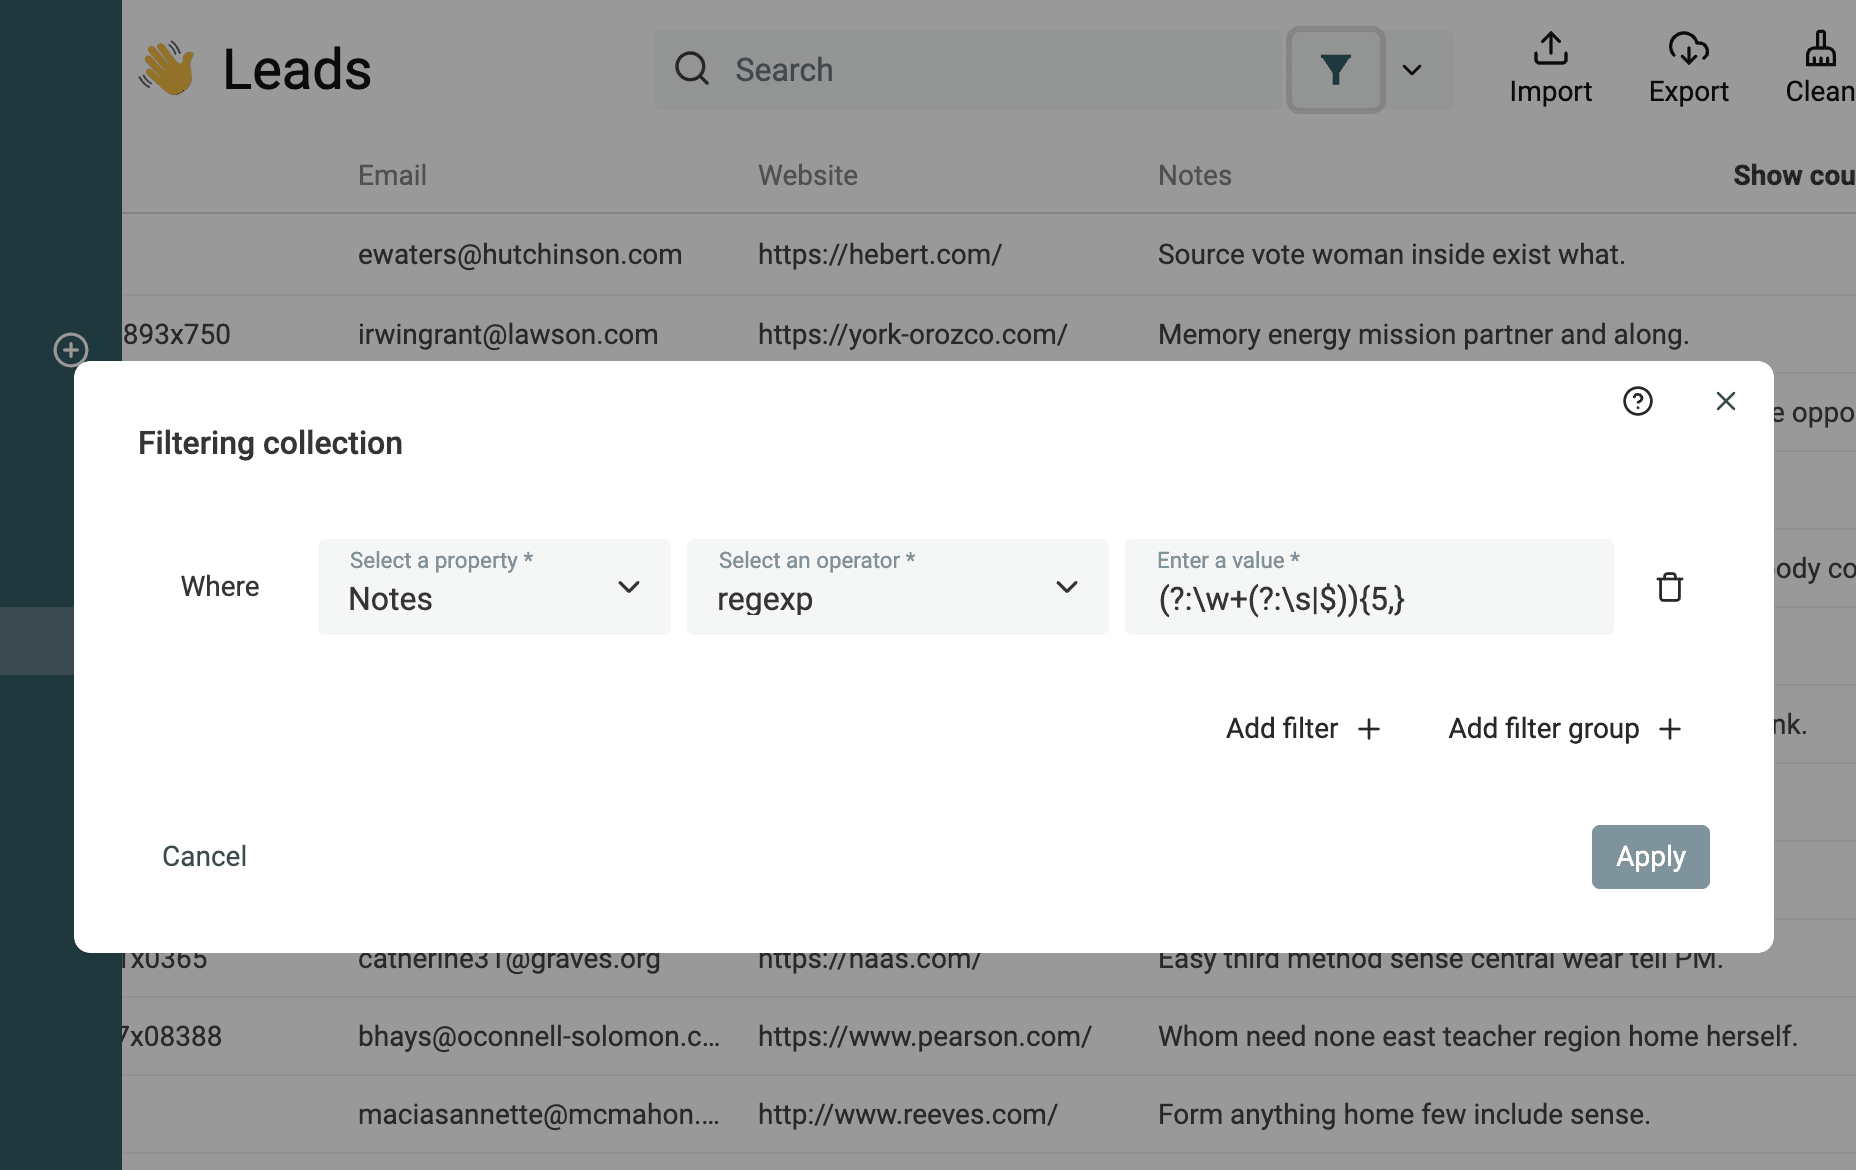
Datablist 支持使用正则表达式筛选数据。
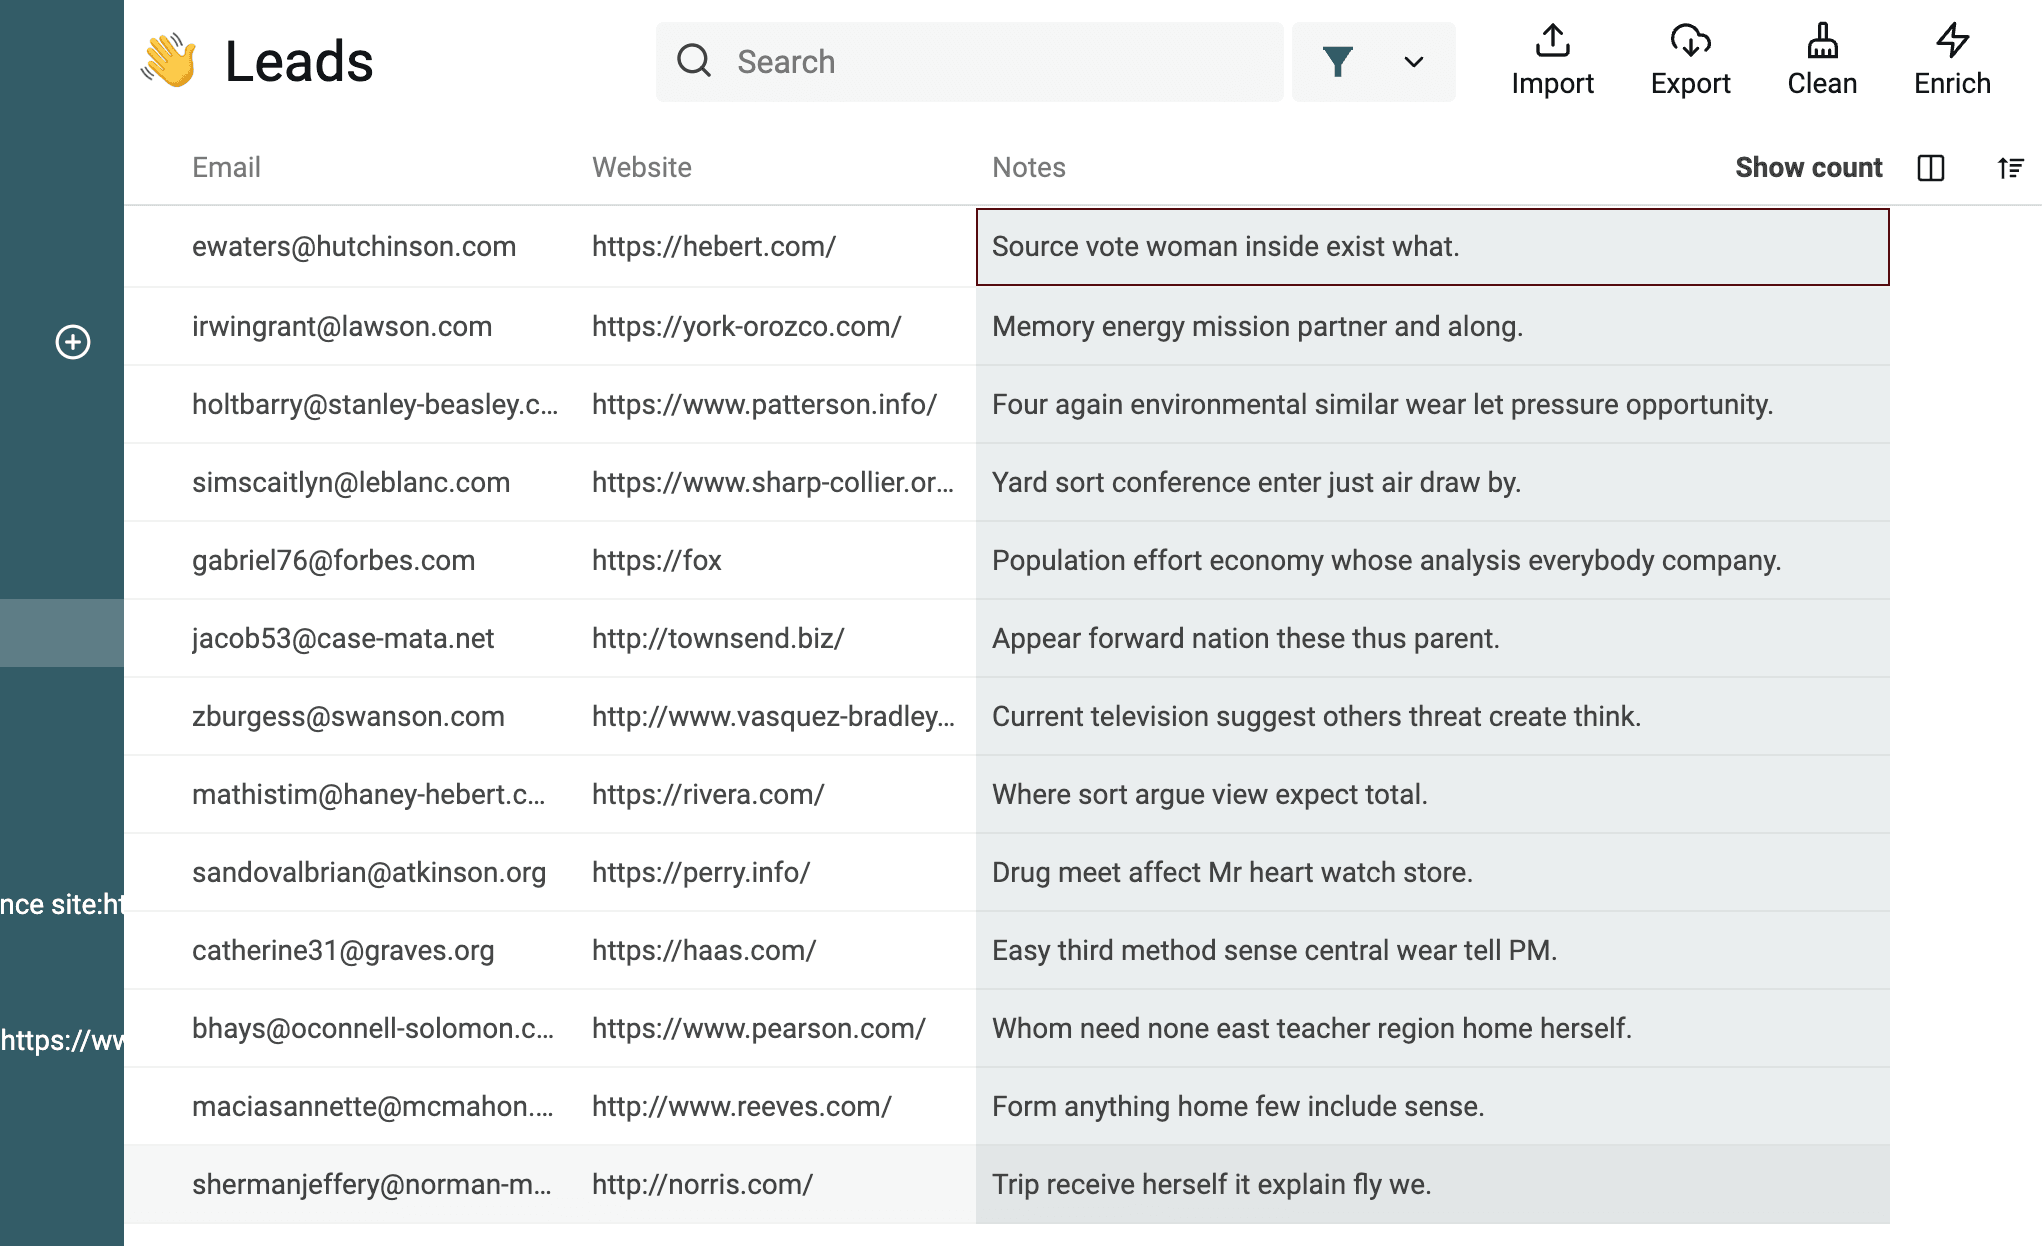
按单词数量筛选文本
使用以下正则表达式,可以筛选至少包含 {n} 个单词的文本:
(?:\w+(?:\s|$)){5,}(将 5 替换为任意数字)
该 RegEx 的其他写法包括:
(?:\w+(?:\s|$)){,5}:不超过 5 个单词的文本(包括正好 5 个单词)(?:\w+(?:\s|$)){5,10}:包含 5 到 10 个单词的文本
筛选无效 URL
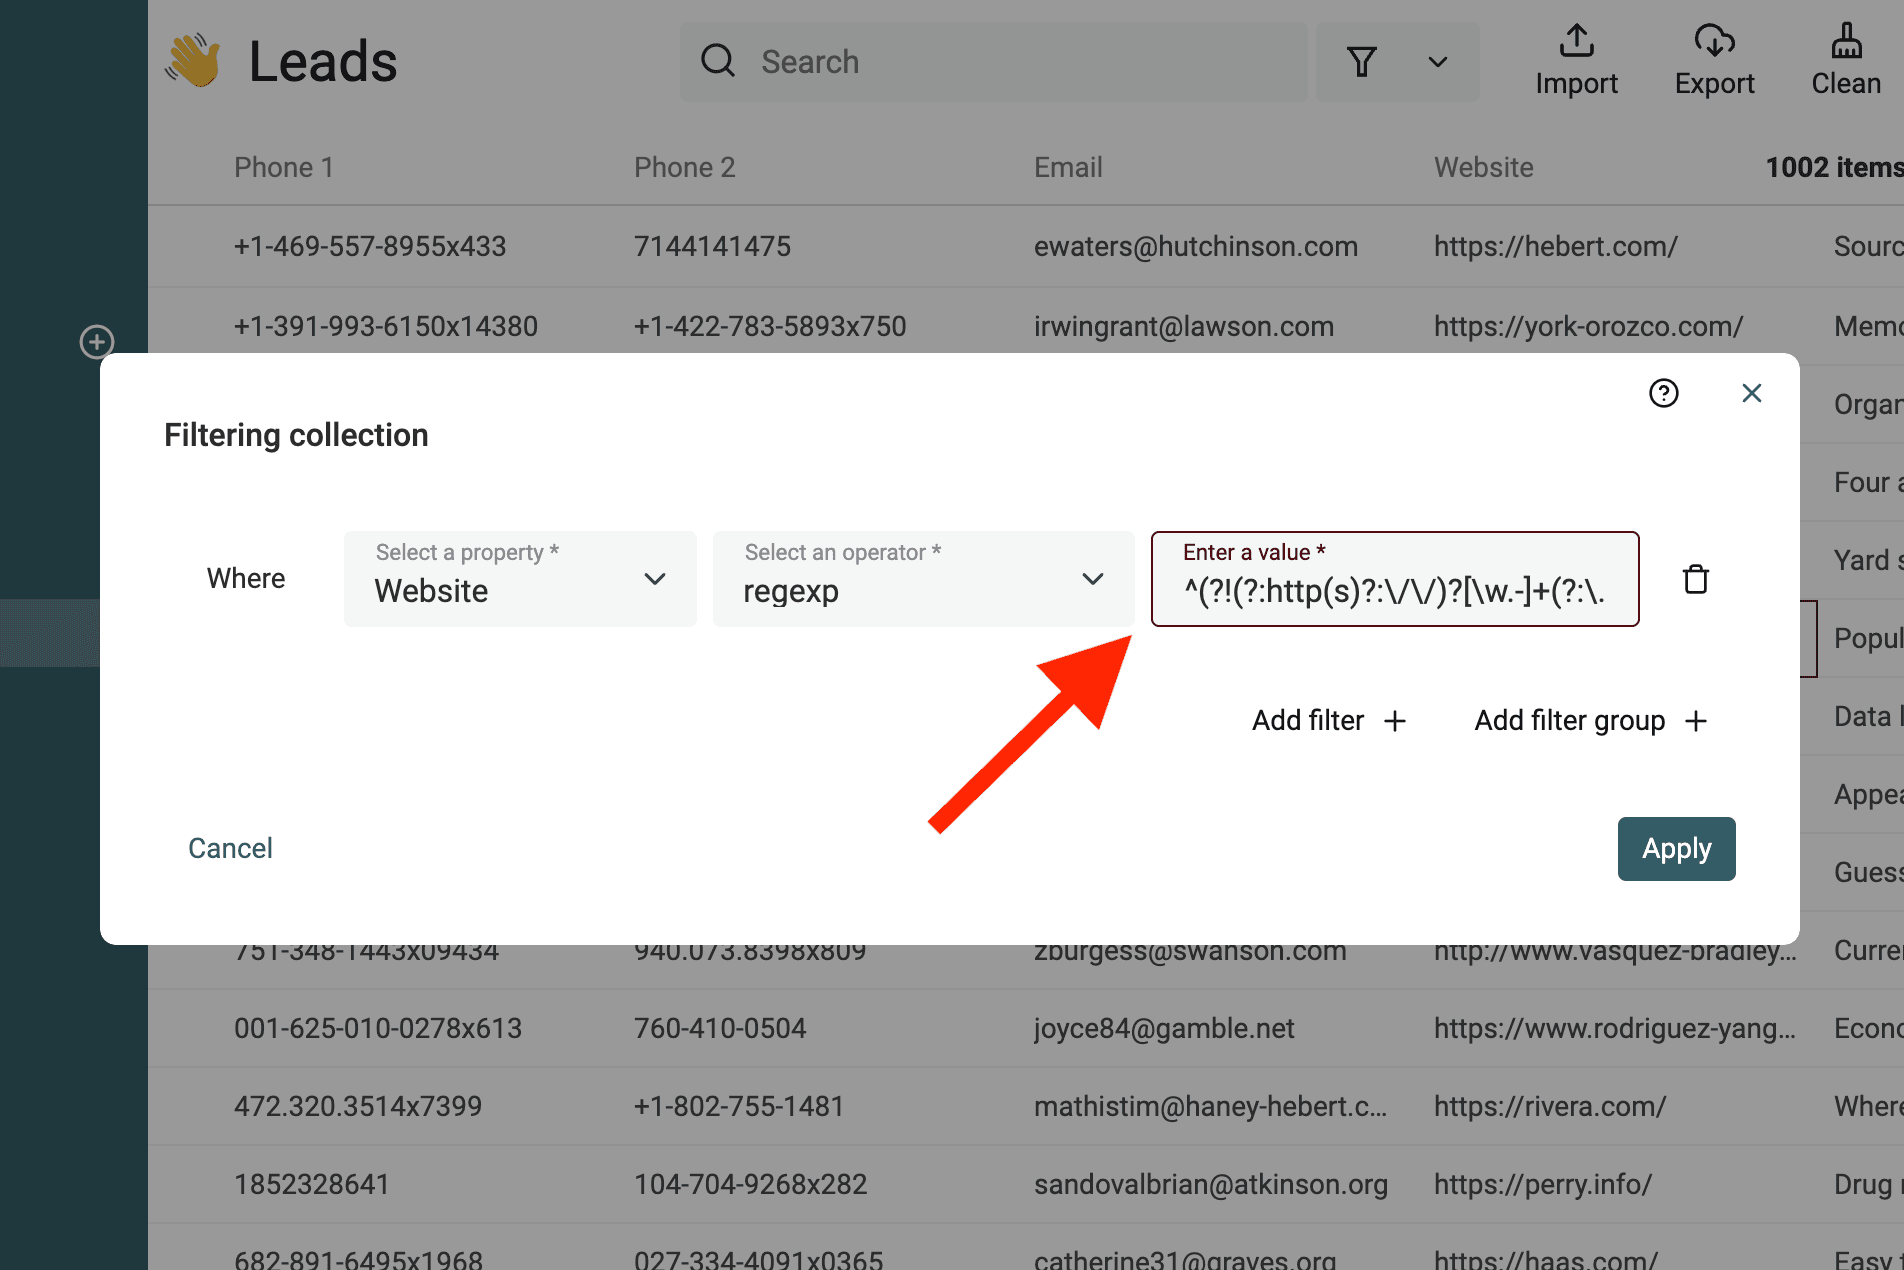
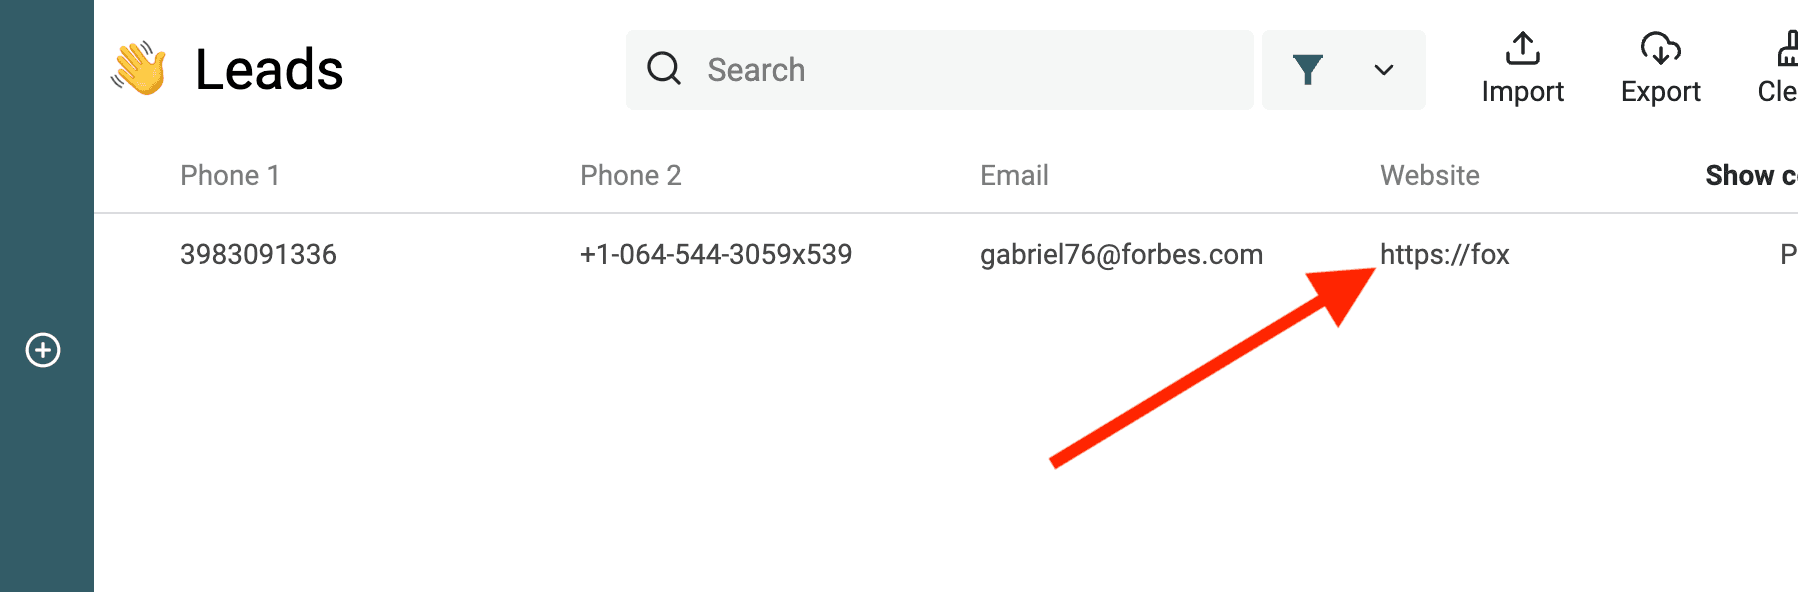
以下 RegEx 可以匹配无效 URL:
^(?!(?:http(s)?:\/\/)?[\w.-]+(?:\.[\w\.-]+)+[\w\-\._~:/?#[\]@!\$&'\(\)\*\+,;=.]+).*$
筛选无效 Email 地址
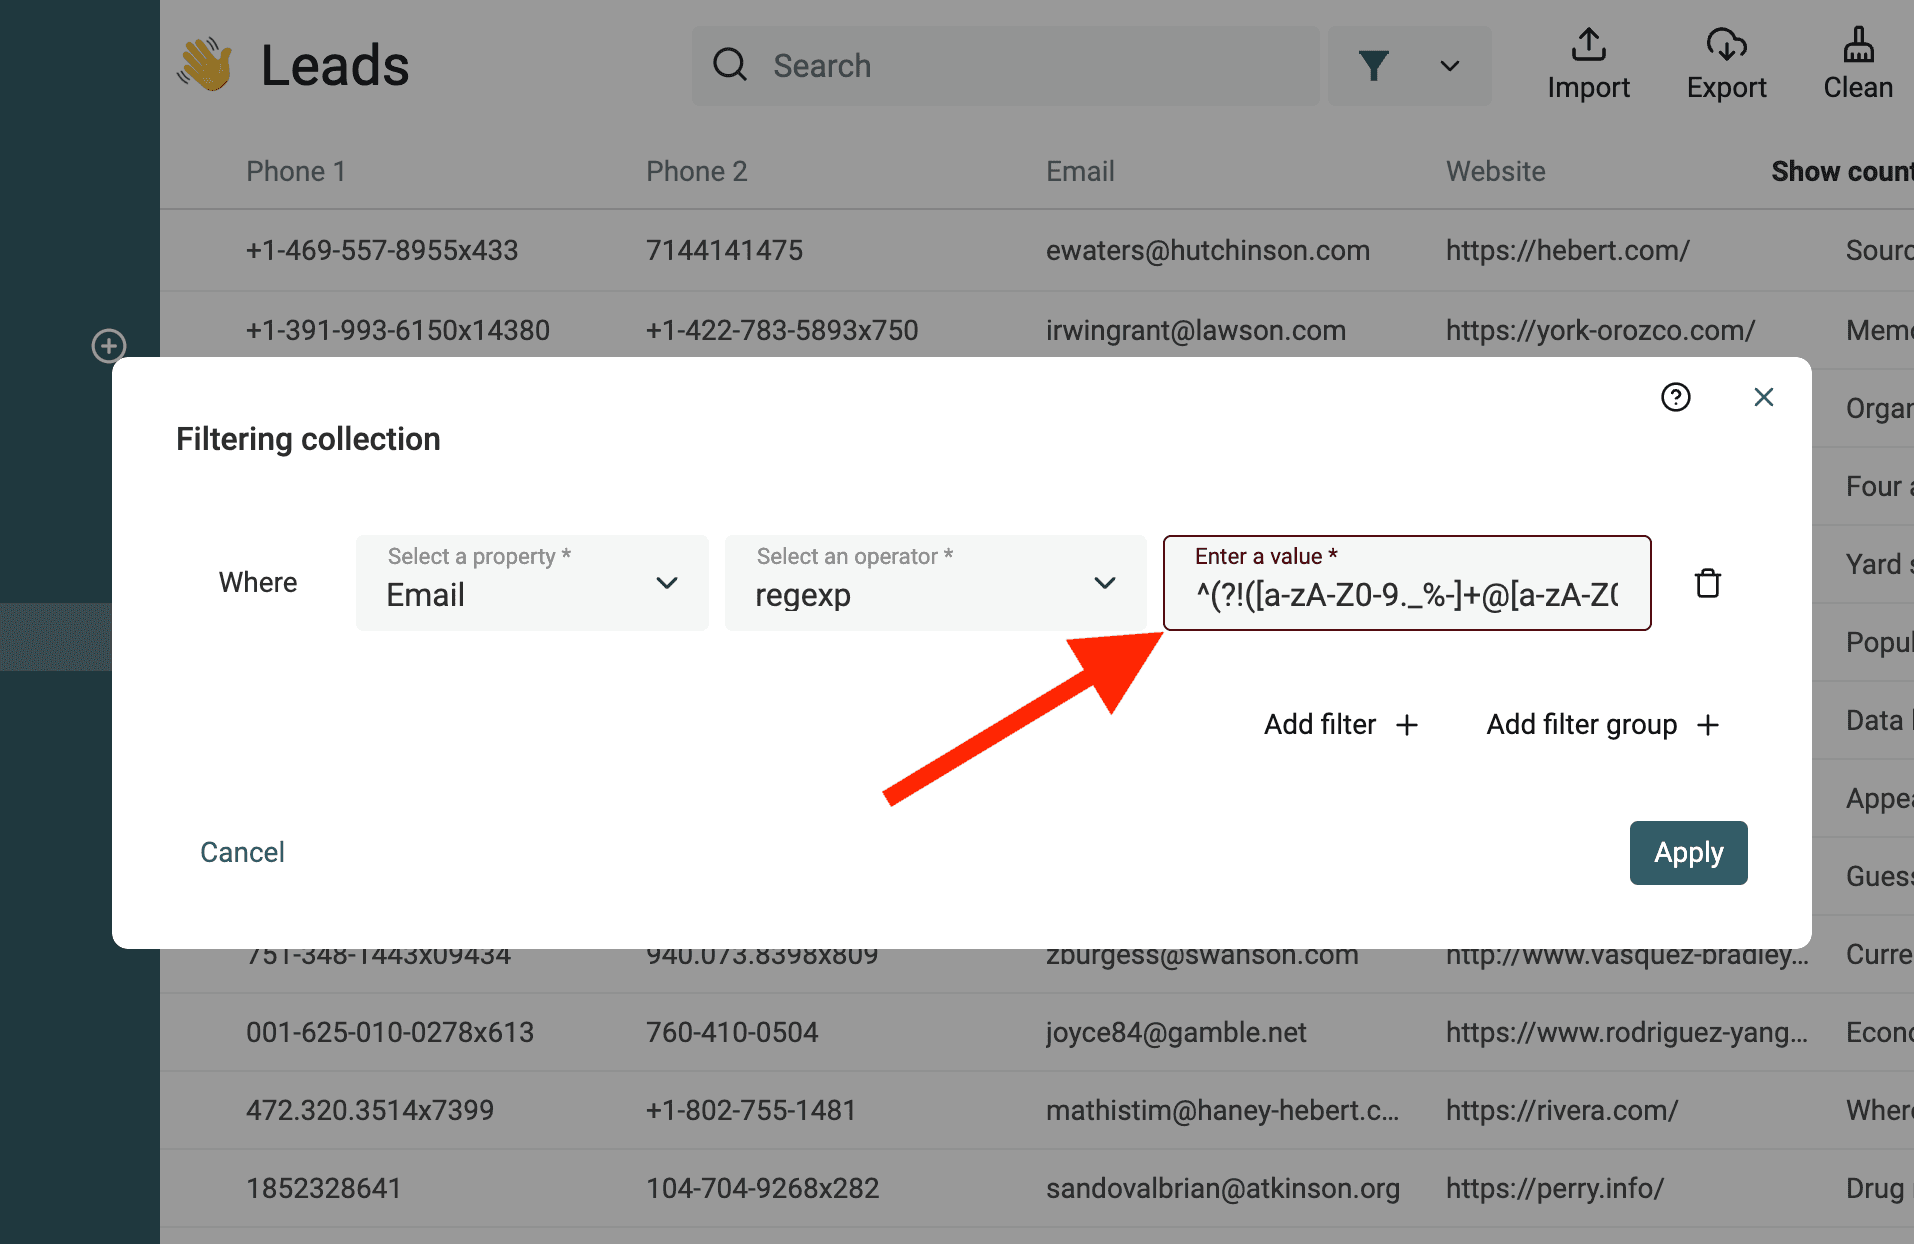
以下 RegEx 可以匹配无效 Email 地址:
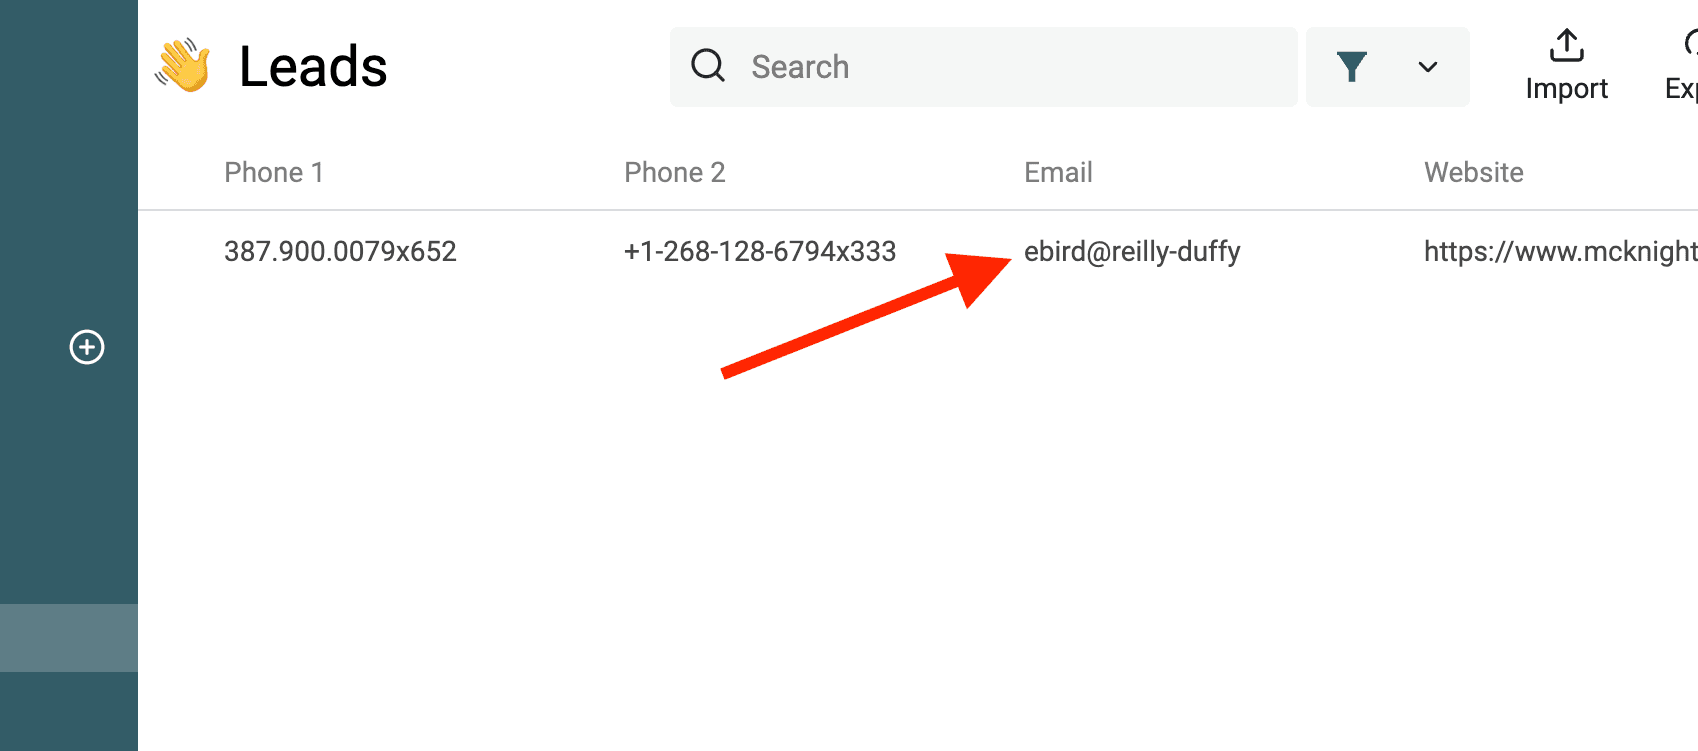
^(?!([a-zA-Z0-9._%-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,})).*$
使用 JavaScript 编写自定义转换
Datablist 允许你在数据上运行自定义 JavaScript 代码。借助自定义代码,你可以解决特有的数据问题、处理特殊数据格式、执行复杂计算,以及应用高级数据转换。
这项强大的功能可以充分发挥你在数据处理和转换方面的创意与经验。 你可以灵活应用自定义逻辑、创建循环和数据条件,并使用丰富的 JavaScript 函数,完成复杂的数据清洗任务。
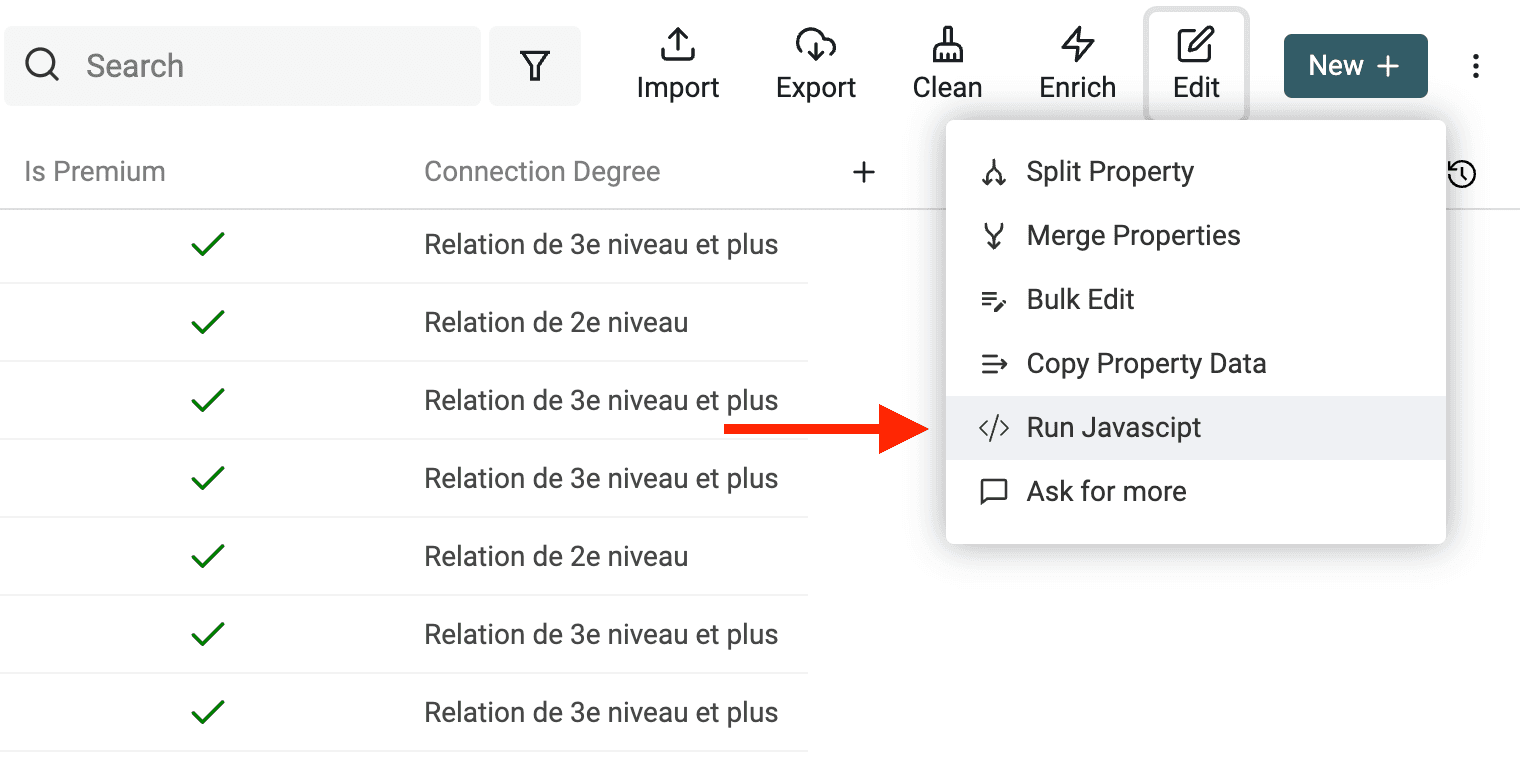
在“Edit”菜单中点击“Run JavaScript”,打开 JavaScript 编辑器。
验证 Email 地址
通过 Scraping 获取的数据可能已经过时、包含拼写错误,或者本身无效。 通过 Scraping 获取的 Email 地址尤其容易出现这些问题。
如果数据由用户填写,数据库中还可能出现虚假 Email 地址,或来自一次性邮箱服务商的地址。
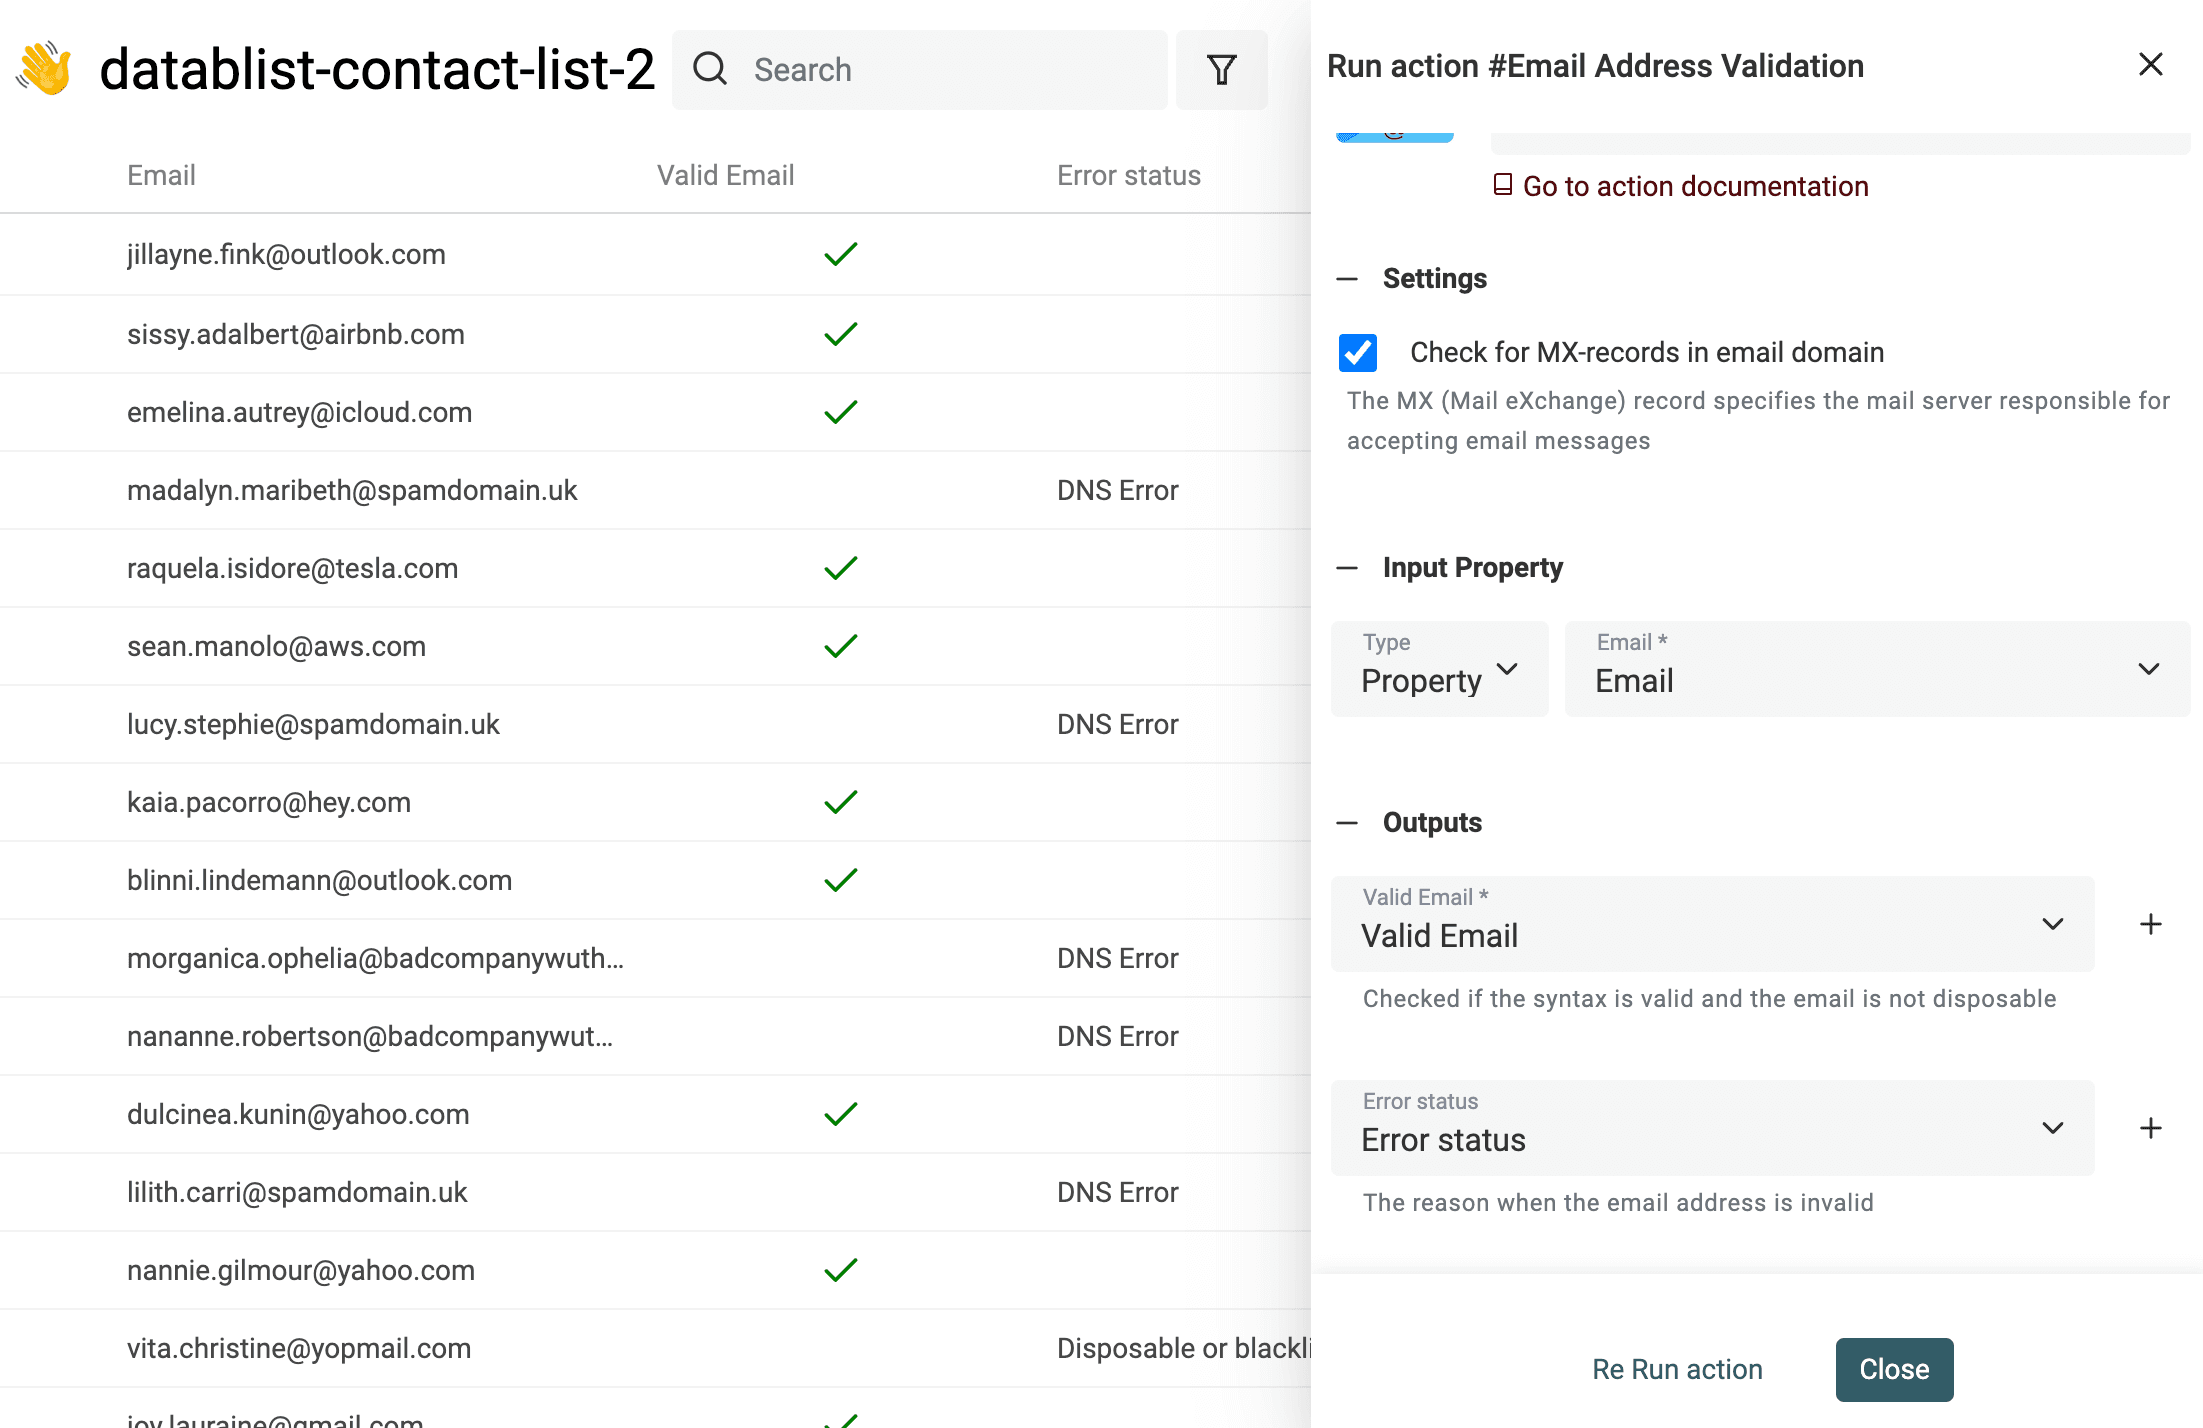
Datablist 内置 Email 验证工具,可以批量验证数千个 Email 地址。
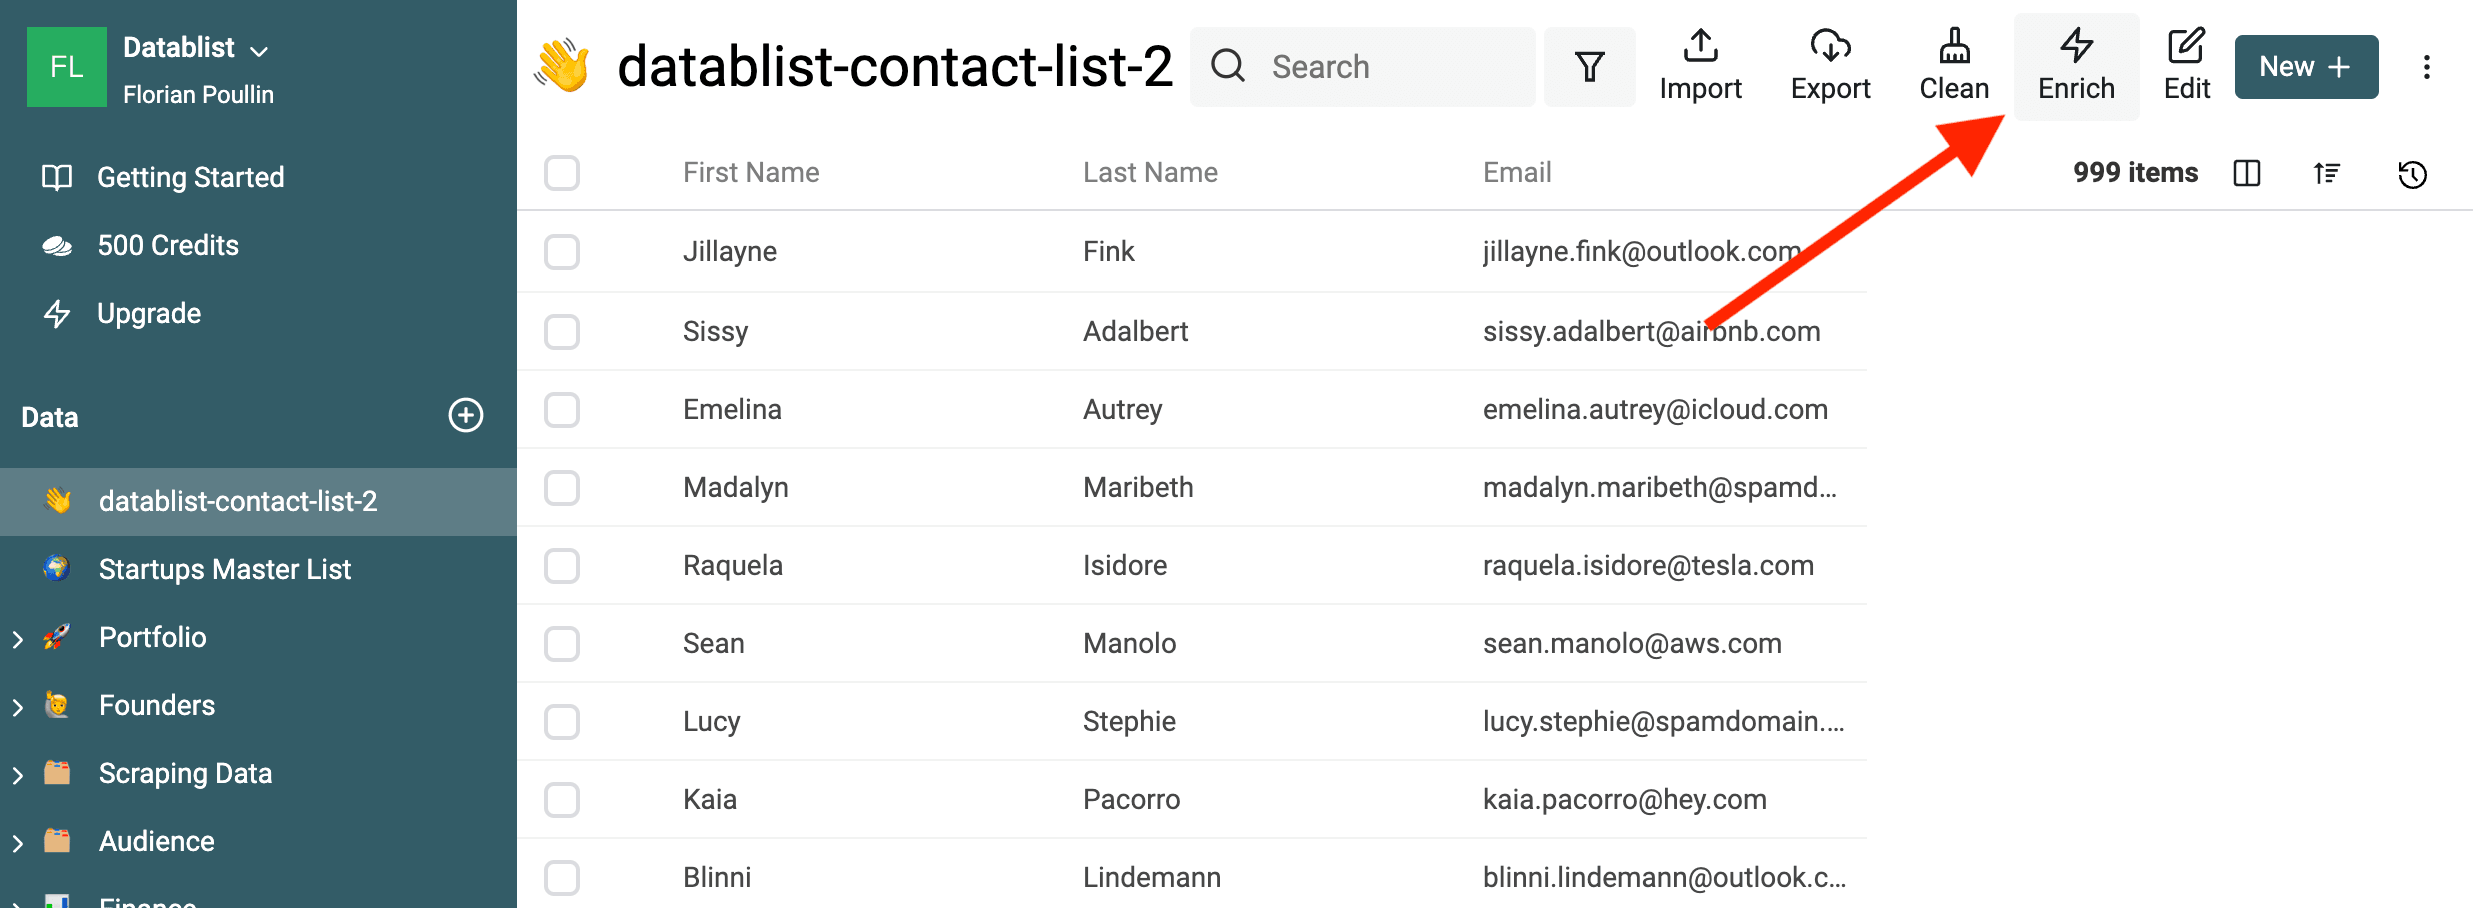
Email 验证服务提供以下检查:
- Email 语法分析——第一步是确认 Email 是否符合 IETF 标准,并进行完整的语法分析。该分析会标记缺少 @ 符号、域名无效等问题地址。
- 一次性邮箱服务商检查——第二步是识别临时邮箱。服务会检查域名是否属于 Mailinator、Temp-Mail、YopMail 等 Disposable Email Address(DEA)服务商。
- 域名 MX 记录检查——有效的 Email 地址必须对应一个已配置 MX 记录的域名。MX 记录用于指定接收该域名邮件的服务器;缺少 MX 记录通常意味着 Email 地址无效。 服务会检查每个 Email 域名的 DNS 记录并查找 MX 记录。如果域名不存在,Email 会被标记为无效;如果域名存在但没有有效的 MX 记录,也会被标记为无效。
- 企业与个人 Email 地址细分——对于通过 Lead Magnet 获取的潜在客户,或需要细分用户群的场景,你可能需要区分企业邮箱和个人邮箱。Email 验证服务会提供这项信息,用于丰富联系人数据。
FAQ
什么是数据清洗,为什么它很重要?
数据清洗也称 data cleansing 或 data scrubbing,是指识别并修正或删除数据集中的错误、不一致和不准确内容。它包括发现并处理缺失值、重复记录、格式错误、异常值,以及数据表达不一致等问题。
数据清洗是数据处理中的关键步骤,可以确保数据准确、可靠,并适合用于分析或其他应用场景。
还有哪些免费的数据清洗工具?
数据清洗工具既包括电子表格等通用工具,也包括针对特定任务开发的专业应用。除了 Datablist,以下免费工具也值得用于数据清洗。
OpenRefine
OpenRefine(原名 Google Refine)是一款开源工具,专注于探索、清洗和转换混乱、不一致的数据。
OpenRefine 是独立的桌面应用,支持表格文件(CSV、TSV)、Microsoft Excel 文件,以及 JSON、XML 等其他结构化文件。
OpenRefine 非常适合处理无效 CSV 文件:
- 能很好地处理 CSV 编码问题
- 提供修复 CSV 格式错误的选项
它的不足之处是学习曲线较陡,而且缺少一些面向业务的功能。它没有去重能力,也缺乏将一个数据集与另一份名单关联,以更新或整合数据的简单工作流。此外,它还缺少协作功能,以及业务相关的 Enrichment 和集成能力。
Microsoft Excel 和 Google Sheets
Microsoft Excel 和 Google Sheets 都是功能强大的电子表格应用,可用于数据清洗和准备工作。尽管两者存在一些差异,但都提供了丰富的功能,适合清洗和转换数据。
你可以使用公式进行数据转换和处理,也可以通过条件格式突出显示需要人工处理的无效值。
数据清洗需要帮助?
我一直希望听到更多反馈,也愿意帮助解决各种数据清洗问题。欢迎联系我,分享你的实际使用场景。