
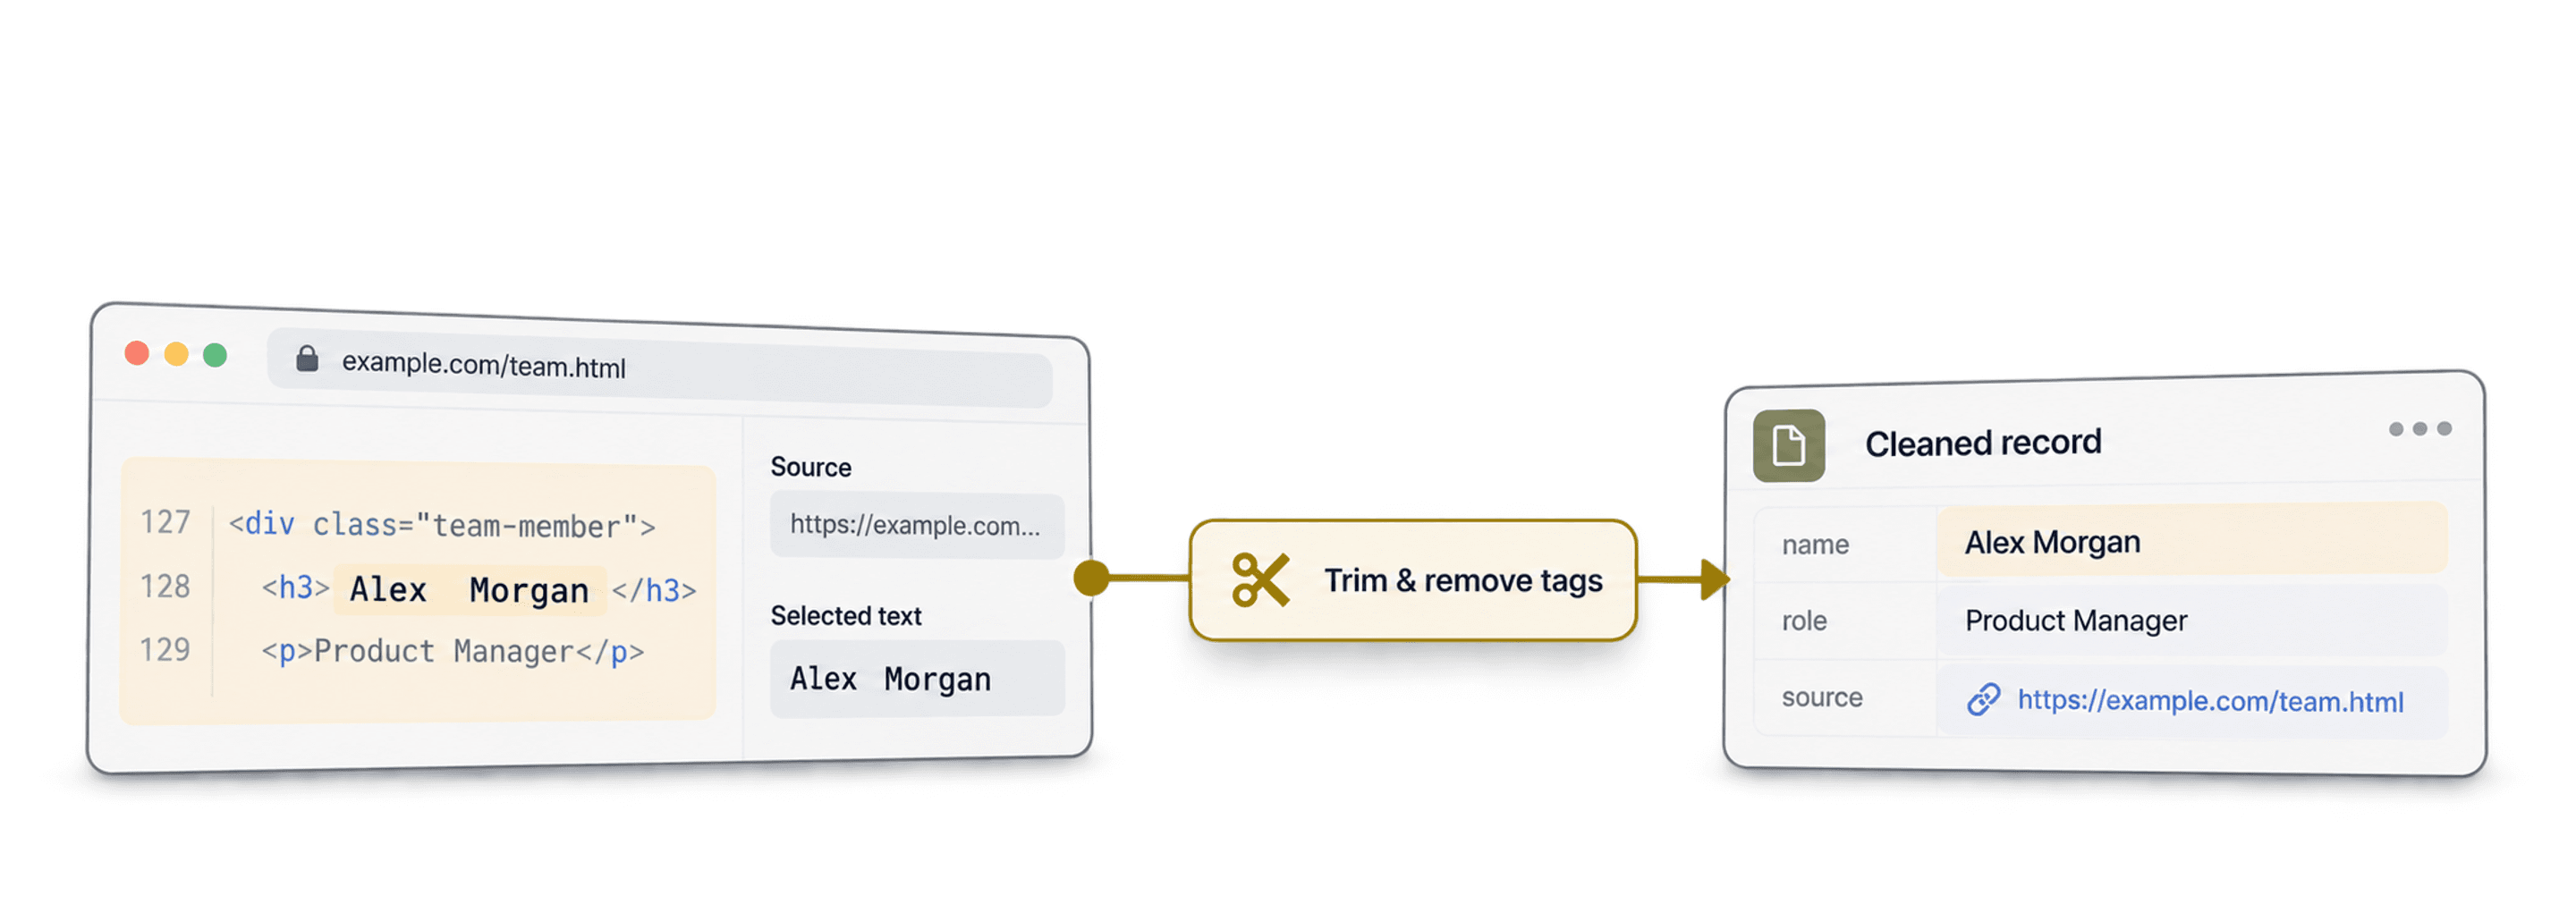
清理网页抓取数据时,首先保留原始值,再规范后续需要使用的字段,检查重复记录,并在导出前验证联系信息。
我通常会先复制一份源文件,因为看起来更整洁的数据也可能丢失关键信息。例如,URL 查询参数可能用于区分产品变体,而开头的 0 也可能是账号 ID 的一部分。因此,请在清洗字段旁保留源 URL 和原始文本。
对于抓取到的联系人名单,建议按以下顺序处理:
- 导入数据并检查系统建议的列类型。标识符应保留为 Text。
- 清除描述文本中的 HTML 和多余空格,然后仅规范筛选或匹配所需的字段。
- 确认日期和数量的格式后,再进行类型转换。
- 使用 Email 等可靠标识符匹配重复项,再决定保留哪些值。
- 检查 Email 格式和域名信息,审核异常项,然后导出清洗后的名单。
下面介绍的工具可帮助你直接在 Datablist 中完成每一步,无需编写公式。示例还会说明:将转换应用到整个 collection 之前,应重点检查哪些值。
以下是本文涉及的数据清洗操作概览:
- 将文本转换为 Datetime、Number、Boolean
- 将 HTML 转换为纯文本(删除 HTML 标签)
- 删除文本中的多余空格
- 规范化数据
- 删除文本中的符号
- 将 Full Name 拆分为 First Name 和 Last Name
- 删除重复记录
- 验证 Email 地址
- 从抓取文本中提取人名或企业名称
从 CSV 导入或粘贴数据
Datablist 是一款非常适合数据清洗的工具。它是一款在线 CSV 编辑器,提供数据清洗、批量编辑和数据 enrichment 功能。 而且每个 collection 都能处理数百万条记录。
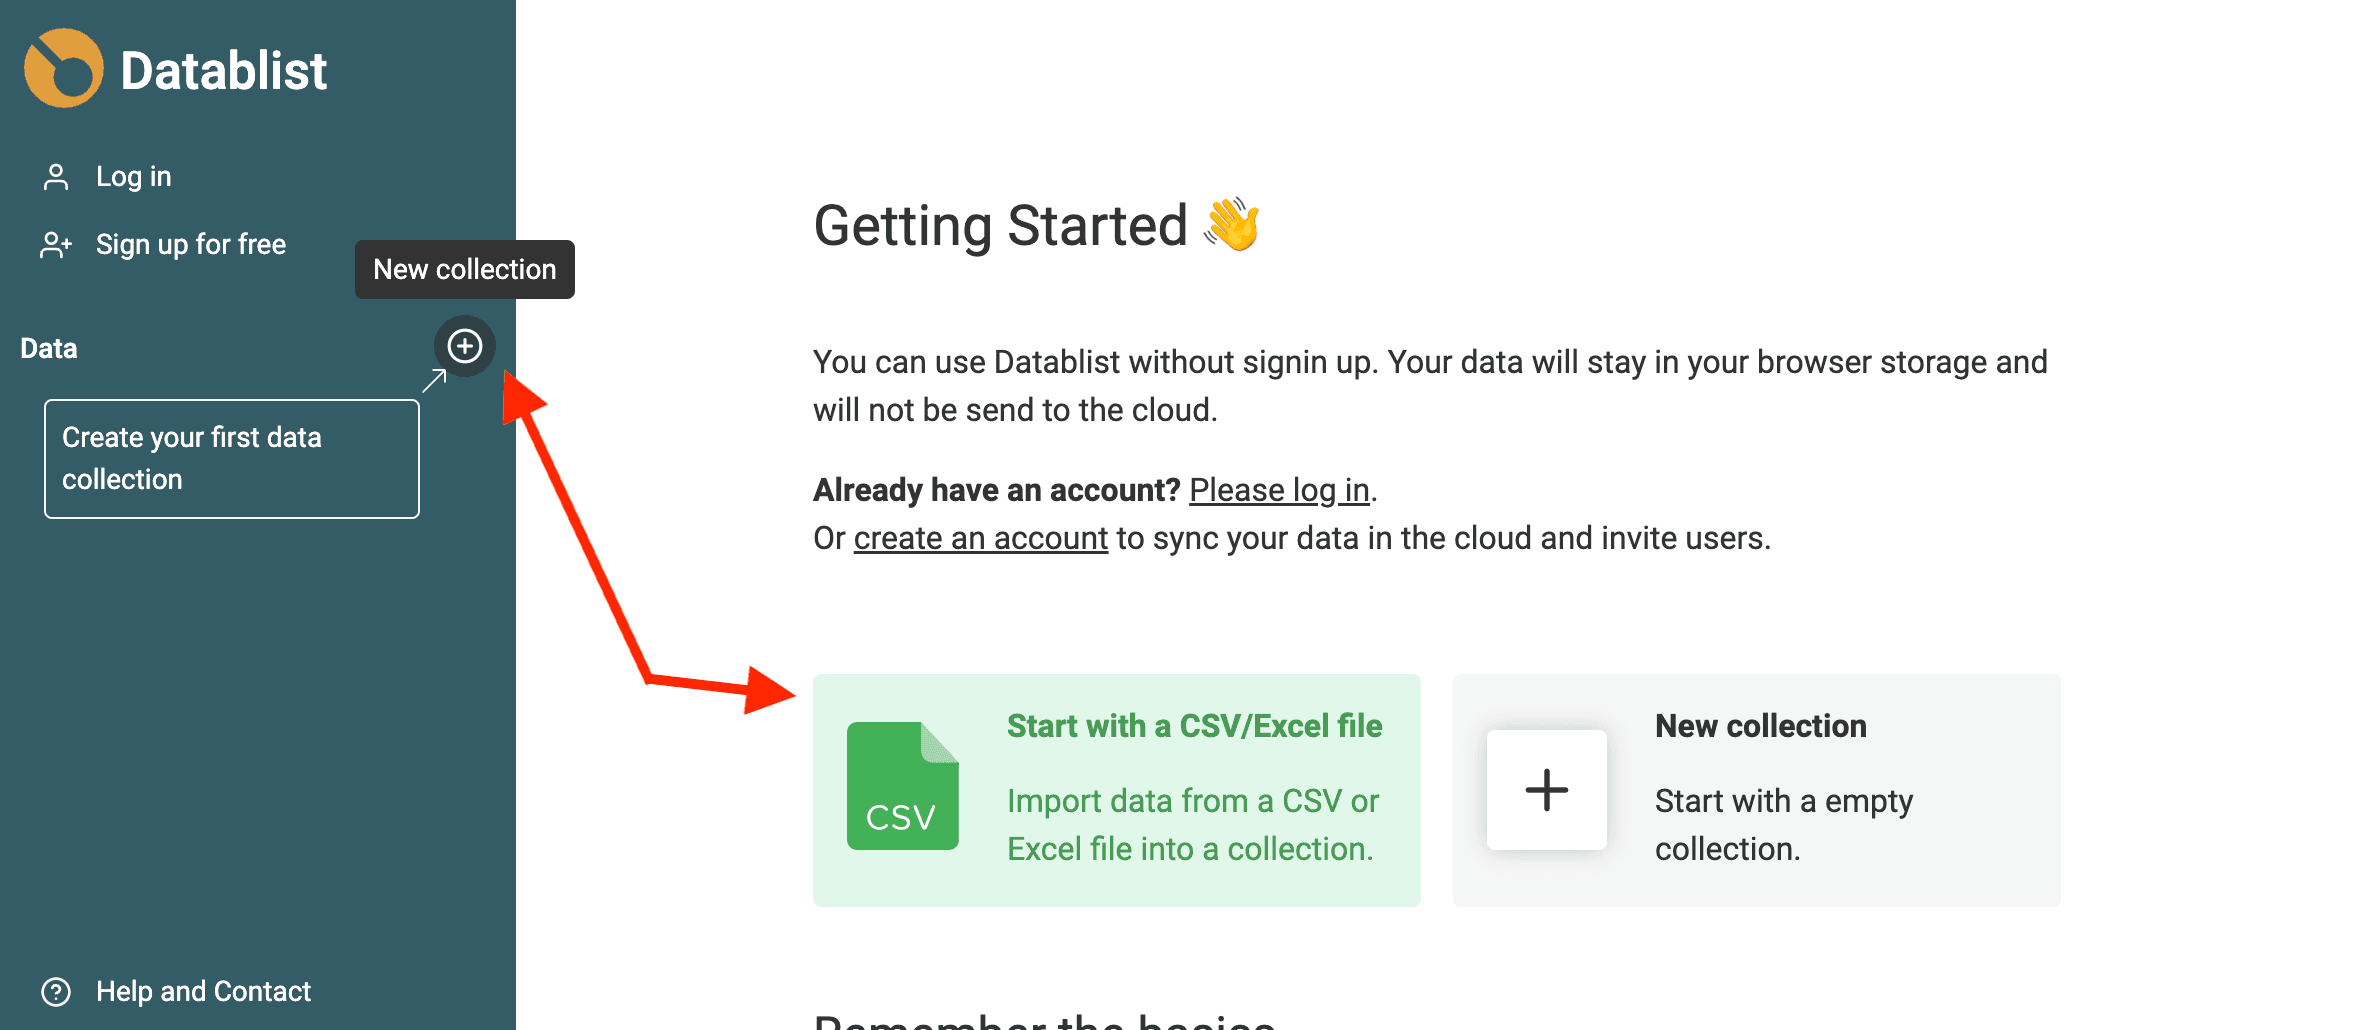
打开 Datablist,创建一个 collection,然后上传包含抓取数据的 CSV 文件。
如需新建 collection,请点击侧边栏中的 + 按钮,再点击 "Import CSV/Excel" 上传文件。你也可以点击入门页面上的快捷入口,直接进入文件导入步骤。
自动识别数据格式
如果数据格式规范,Datablist 的导入助手会自动识别 Email 地址、ISO 8601 格式的 Datetime、Boolean、Number、URL 等类型。
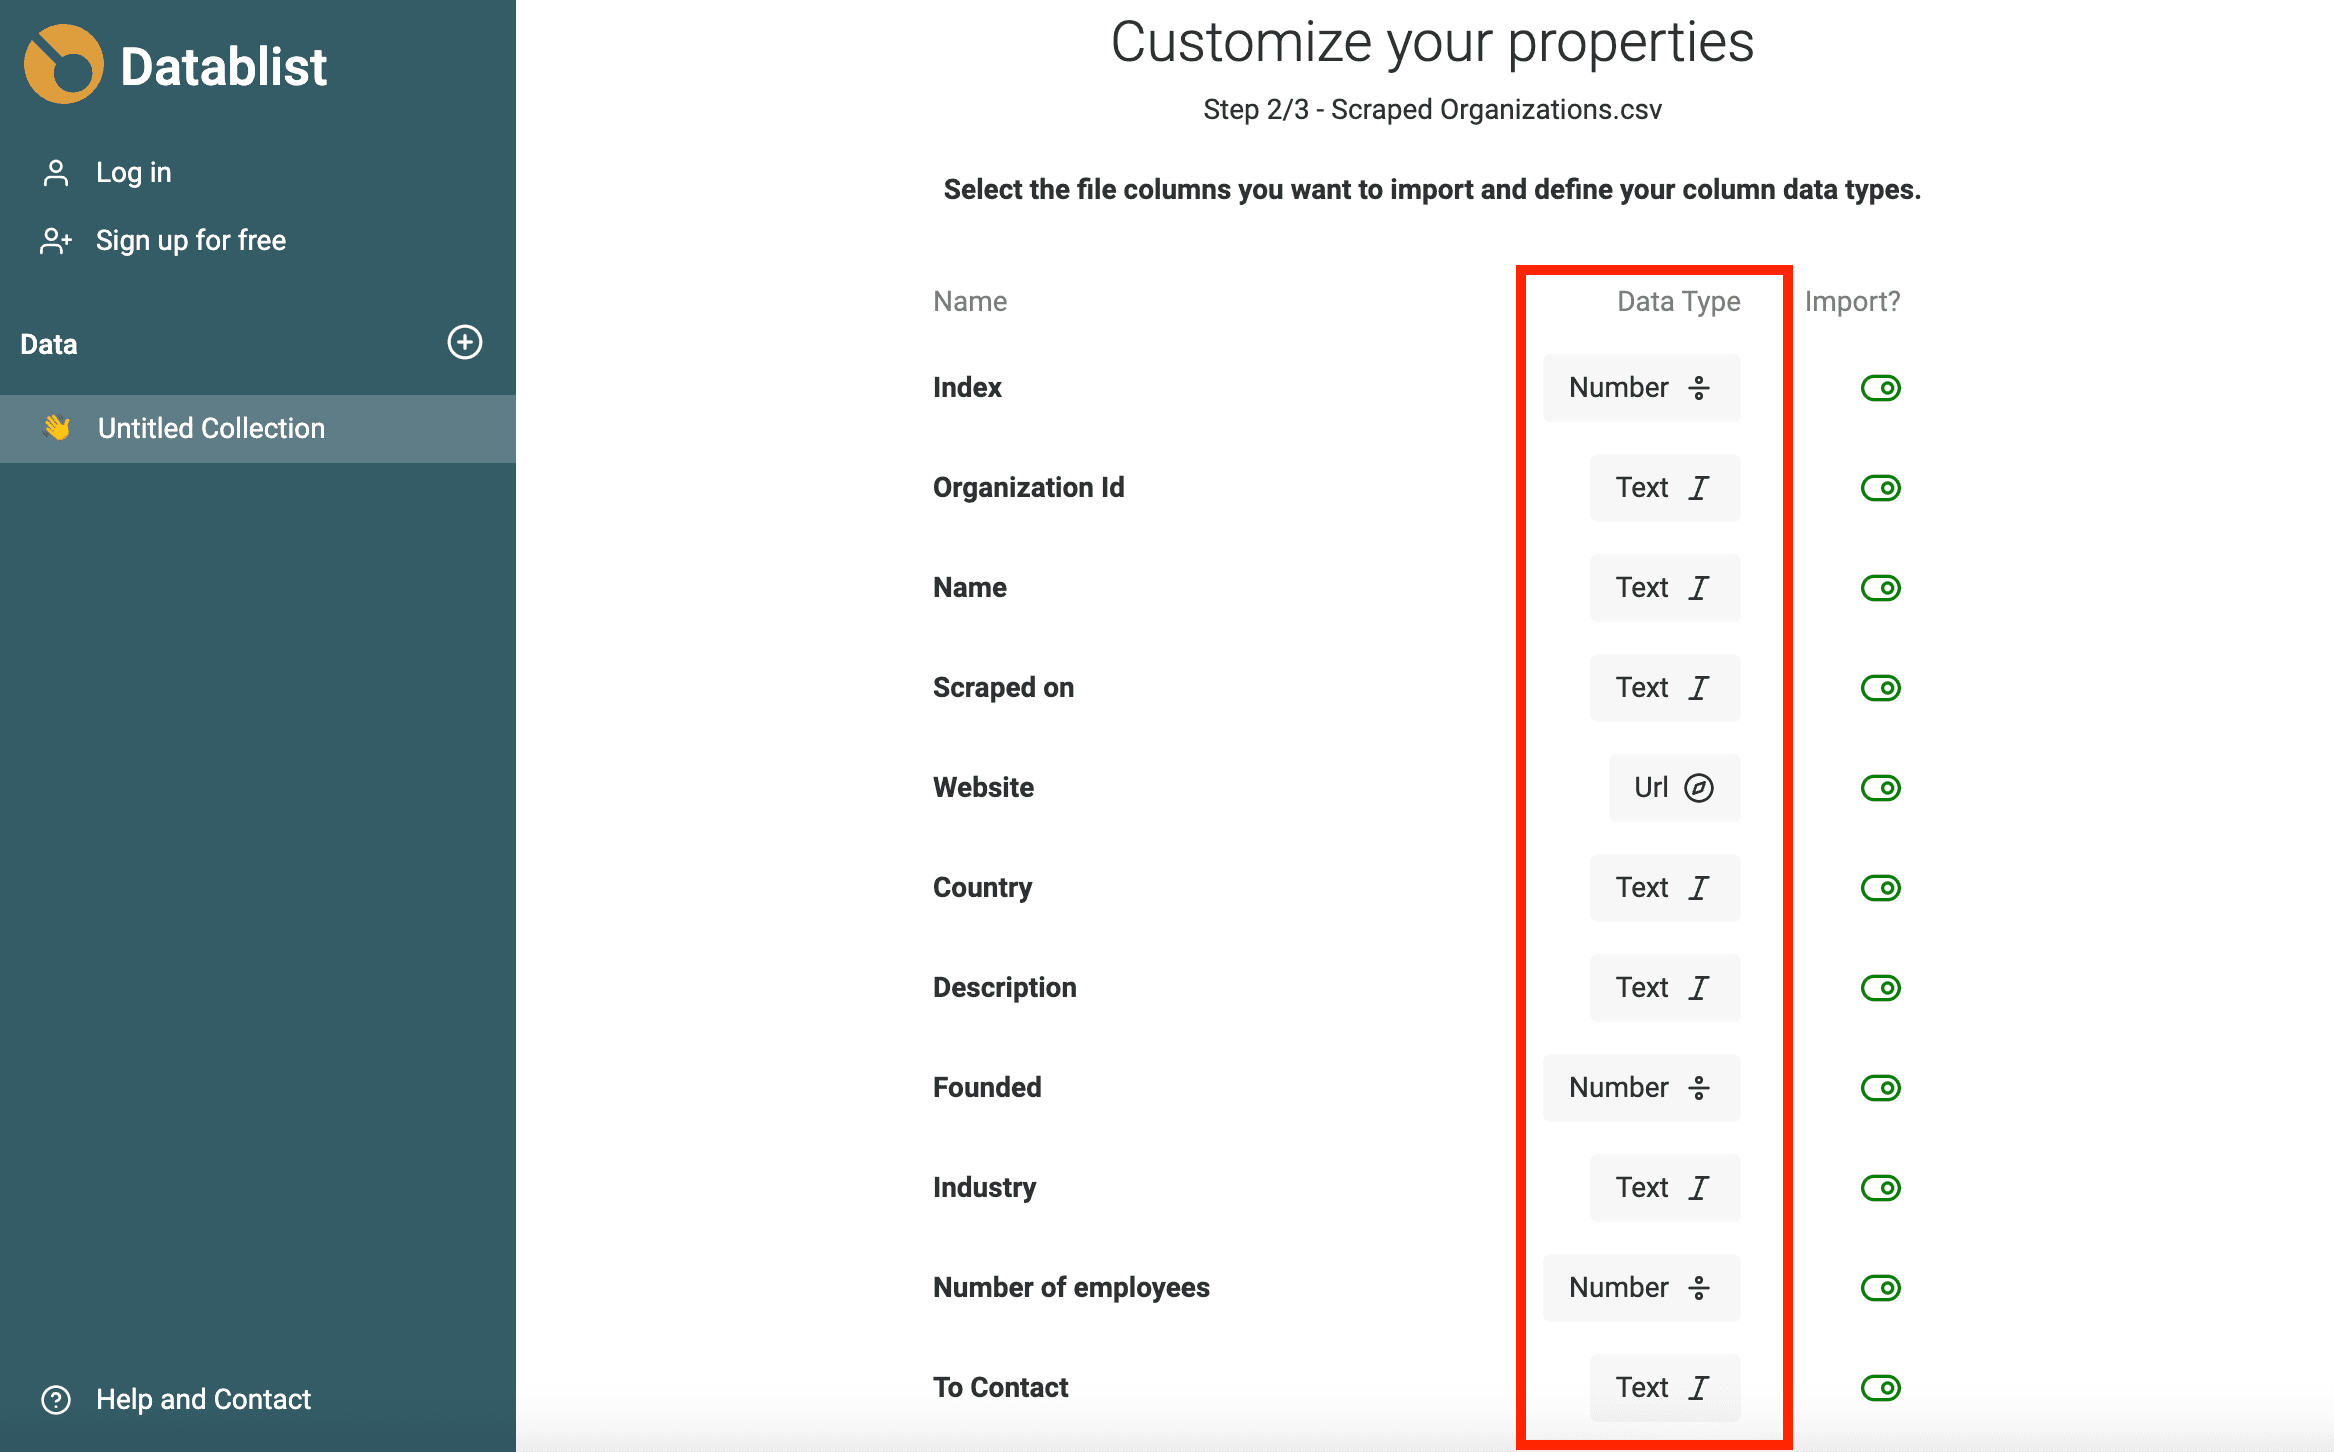
如果数据需要更复杂的分析,例如 Datetime 格式特殊,或者 URL、Email 地址中存在拼写错误,请先将其导入为 Text 属性。下一节会介绍如何将 Text 属性转换成 Datetime、Boolean 或 Number。
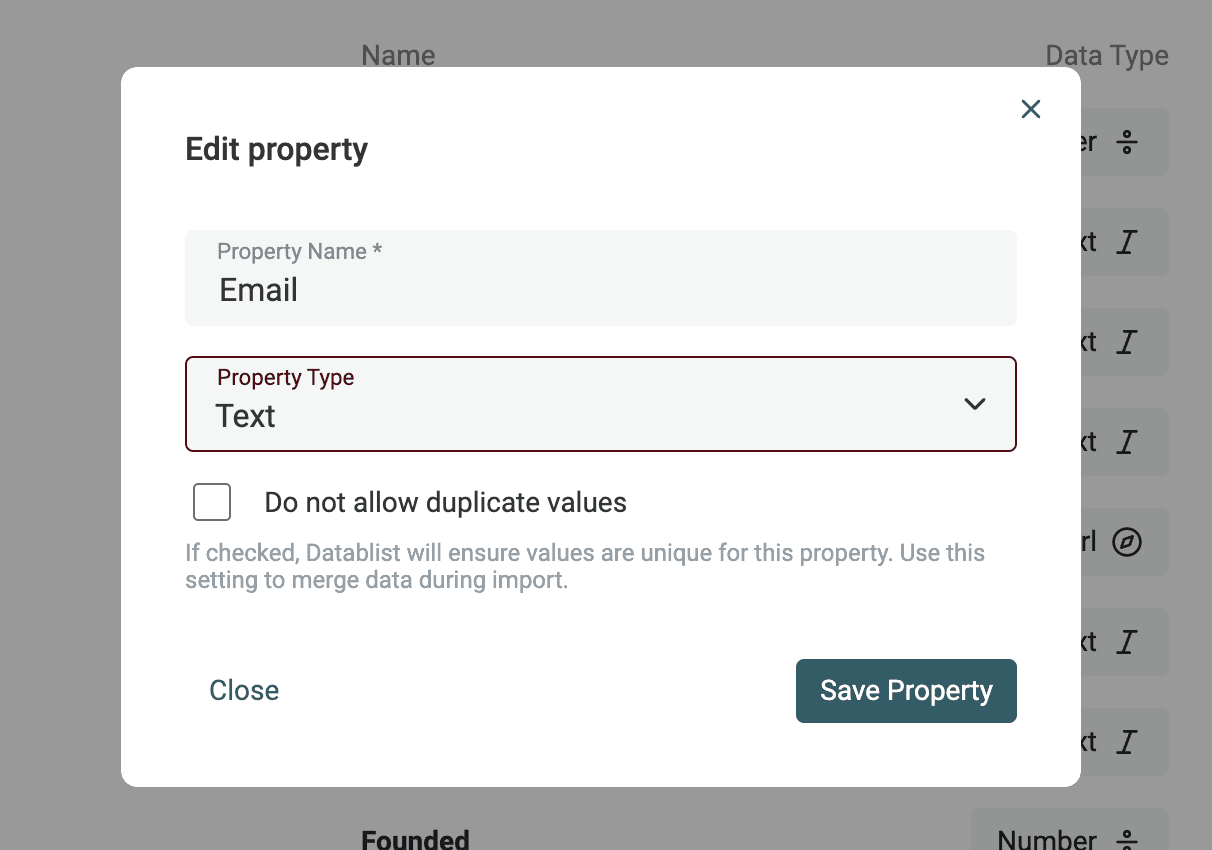
将文本转换为 Datetime、Boolean、Number
近藤麻理惠说过:“人生真正的开始,是在整理之后。”抓取数据也是如此:“把数据整理好,Sales 才真正开始!”😅
当日期(创建日期、融资日期等)、数字(价格、员工人数)或 Boolean 以原生对象而非普通文本存储时,筛选起来会轻松得多。
从 "Clean" 菜单中打开 "Text to Datetime, Number, Checkbox" 工具。
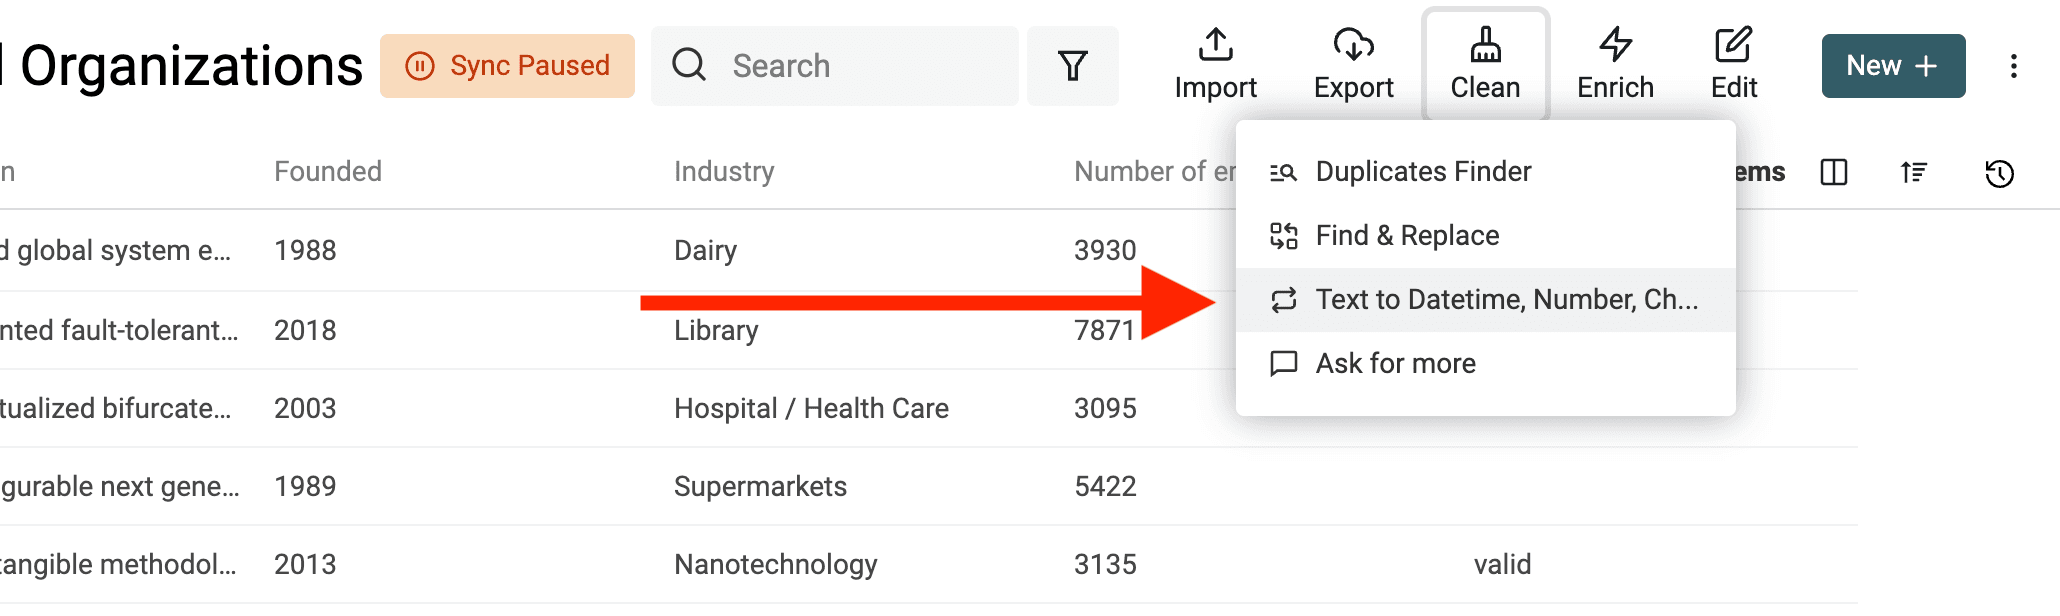
将任意文本转换为 Datetime
Datetime 有一种通用的国际格式 ISO 8601,其结构已有明确定义。如果你的数据采用 ISO 8601 格式,导入时系统会自动创建 Datetime 属性来存储这些数据。
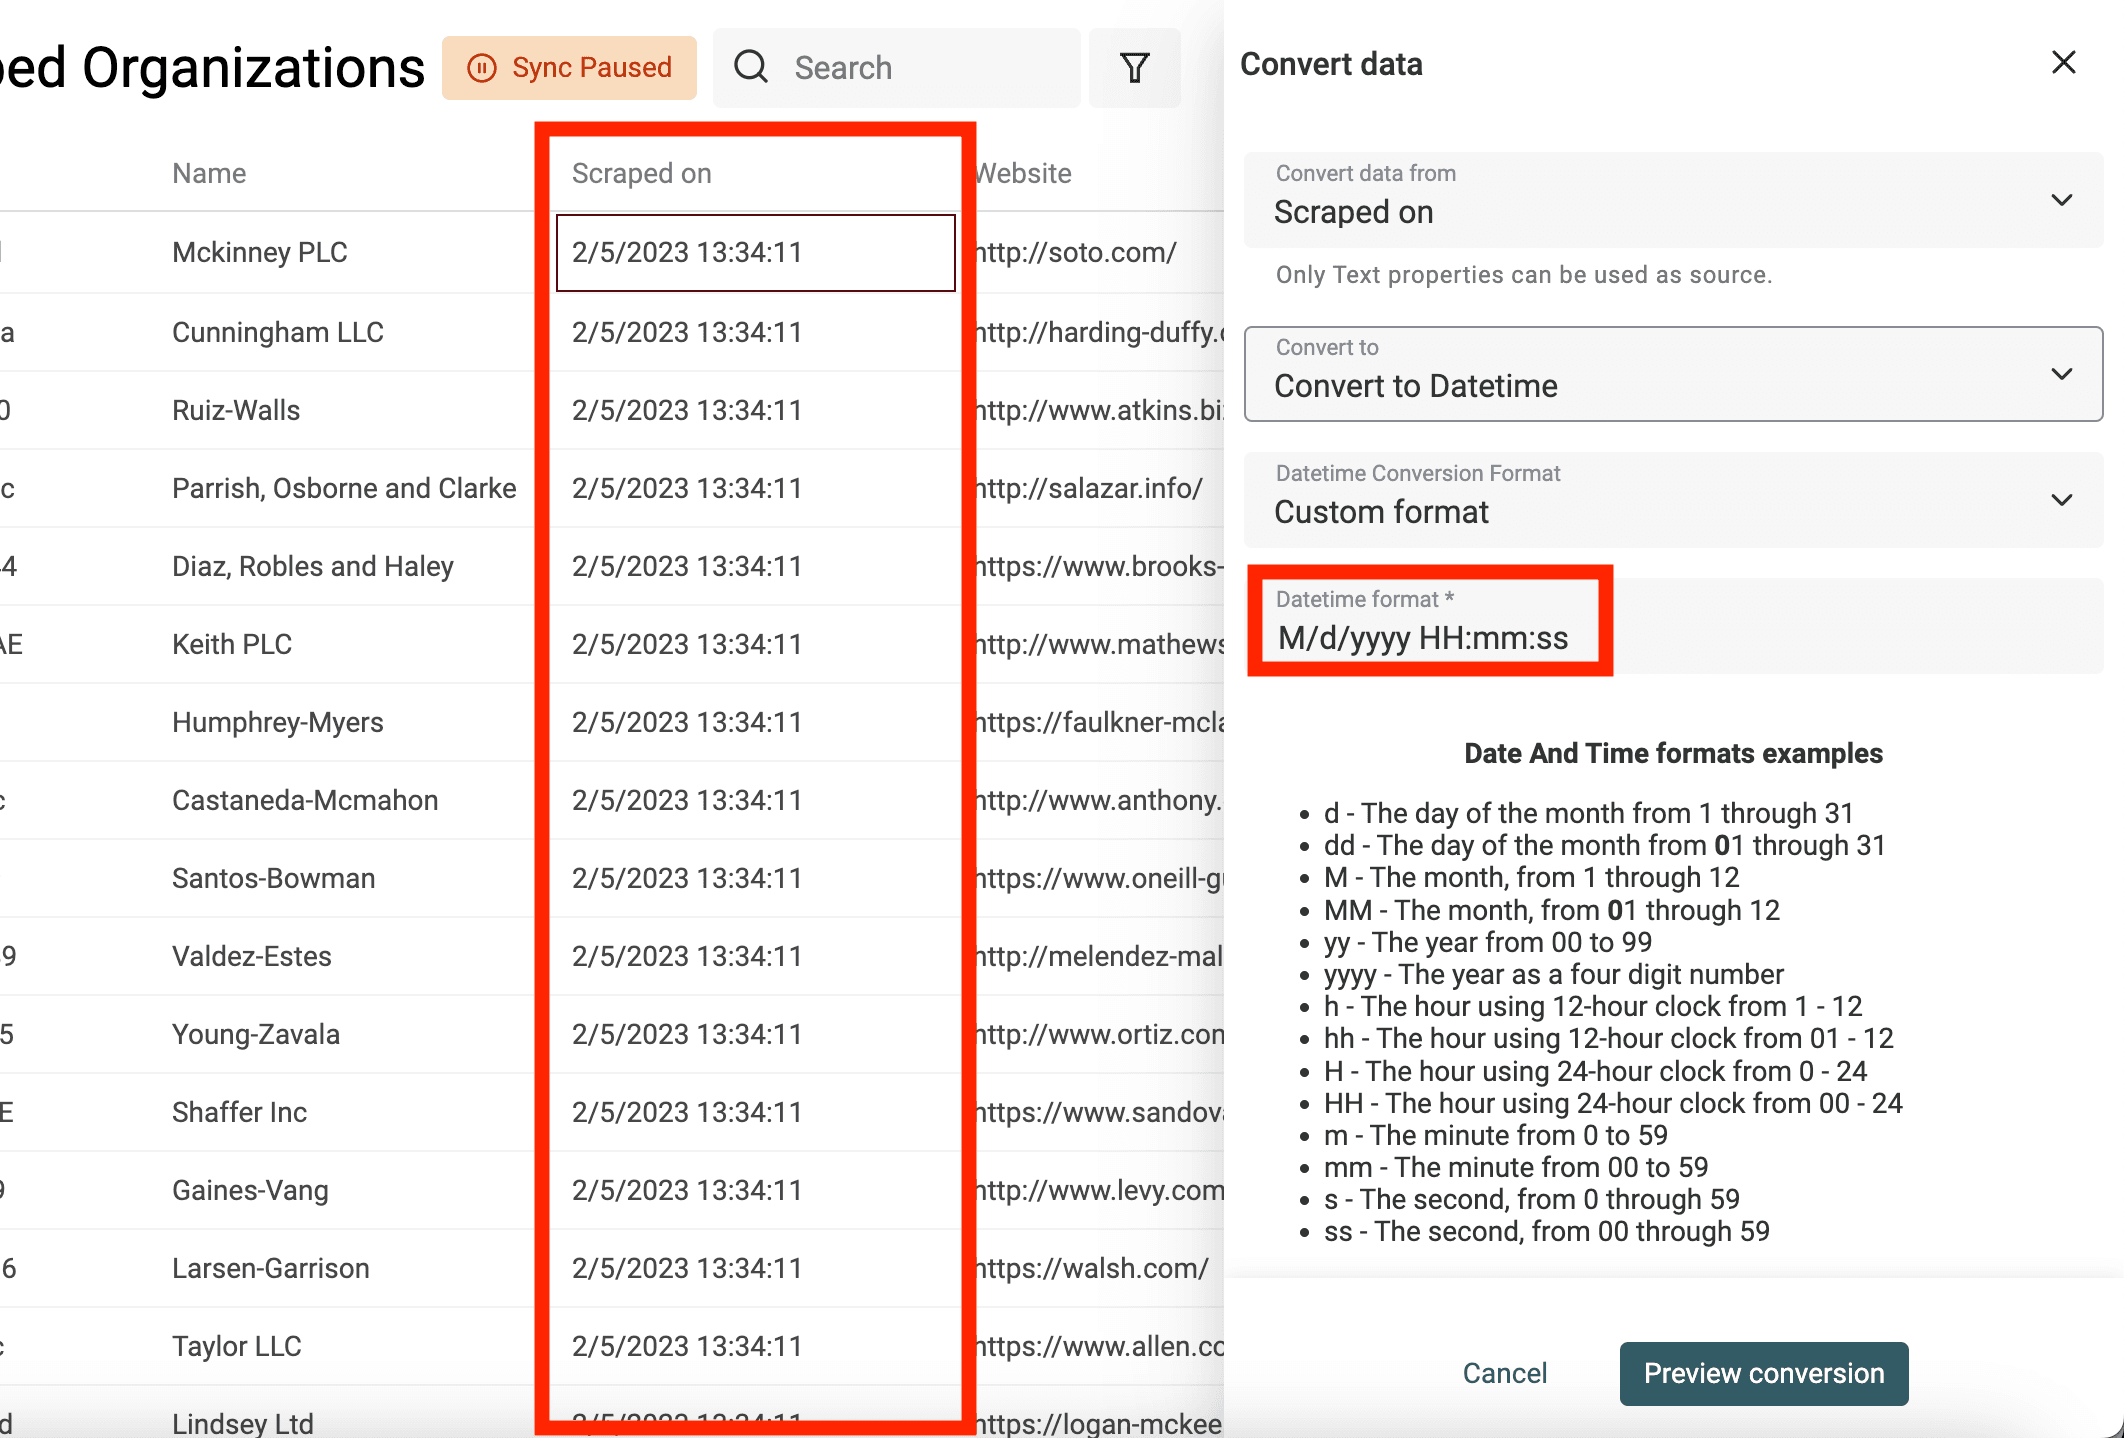
对于其他格式的 Date 和 Datetime 值,你需要指定当前使用的格式,以便 Datablist 将其转换为结构化的 Datetime 值。
选择要转换的属性,再选择 "Convert to Datetime"。
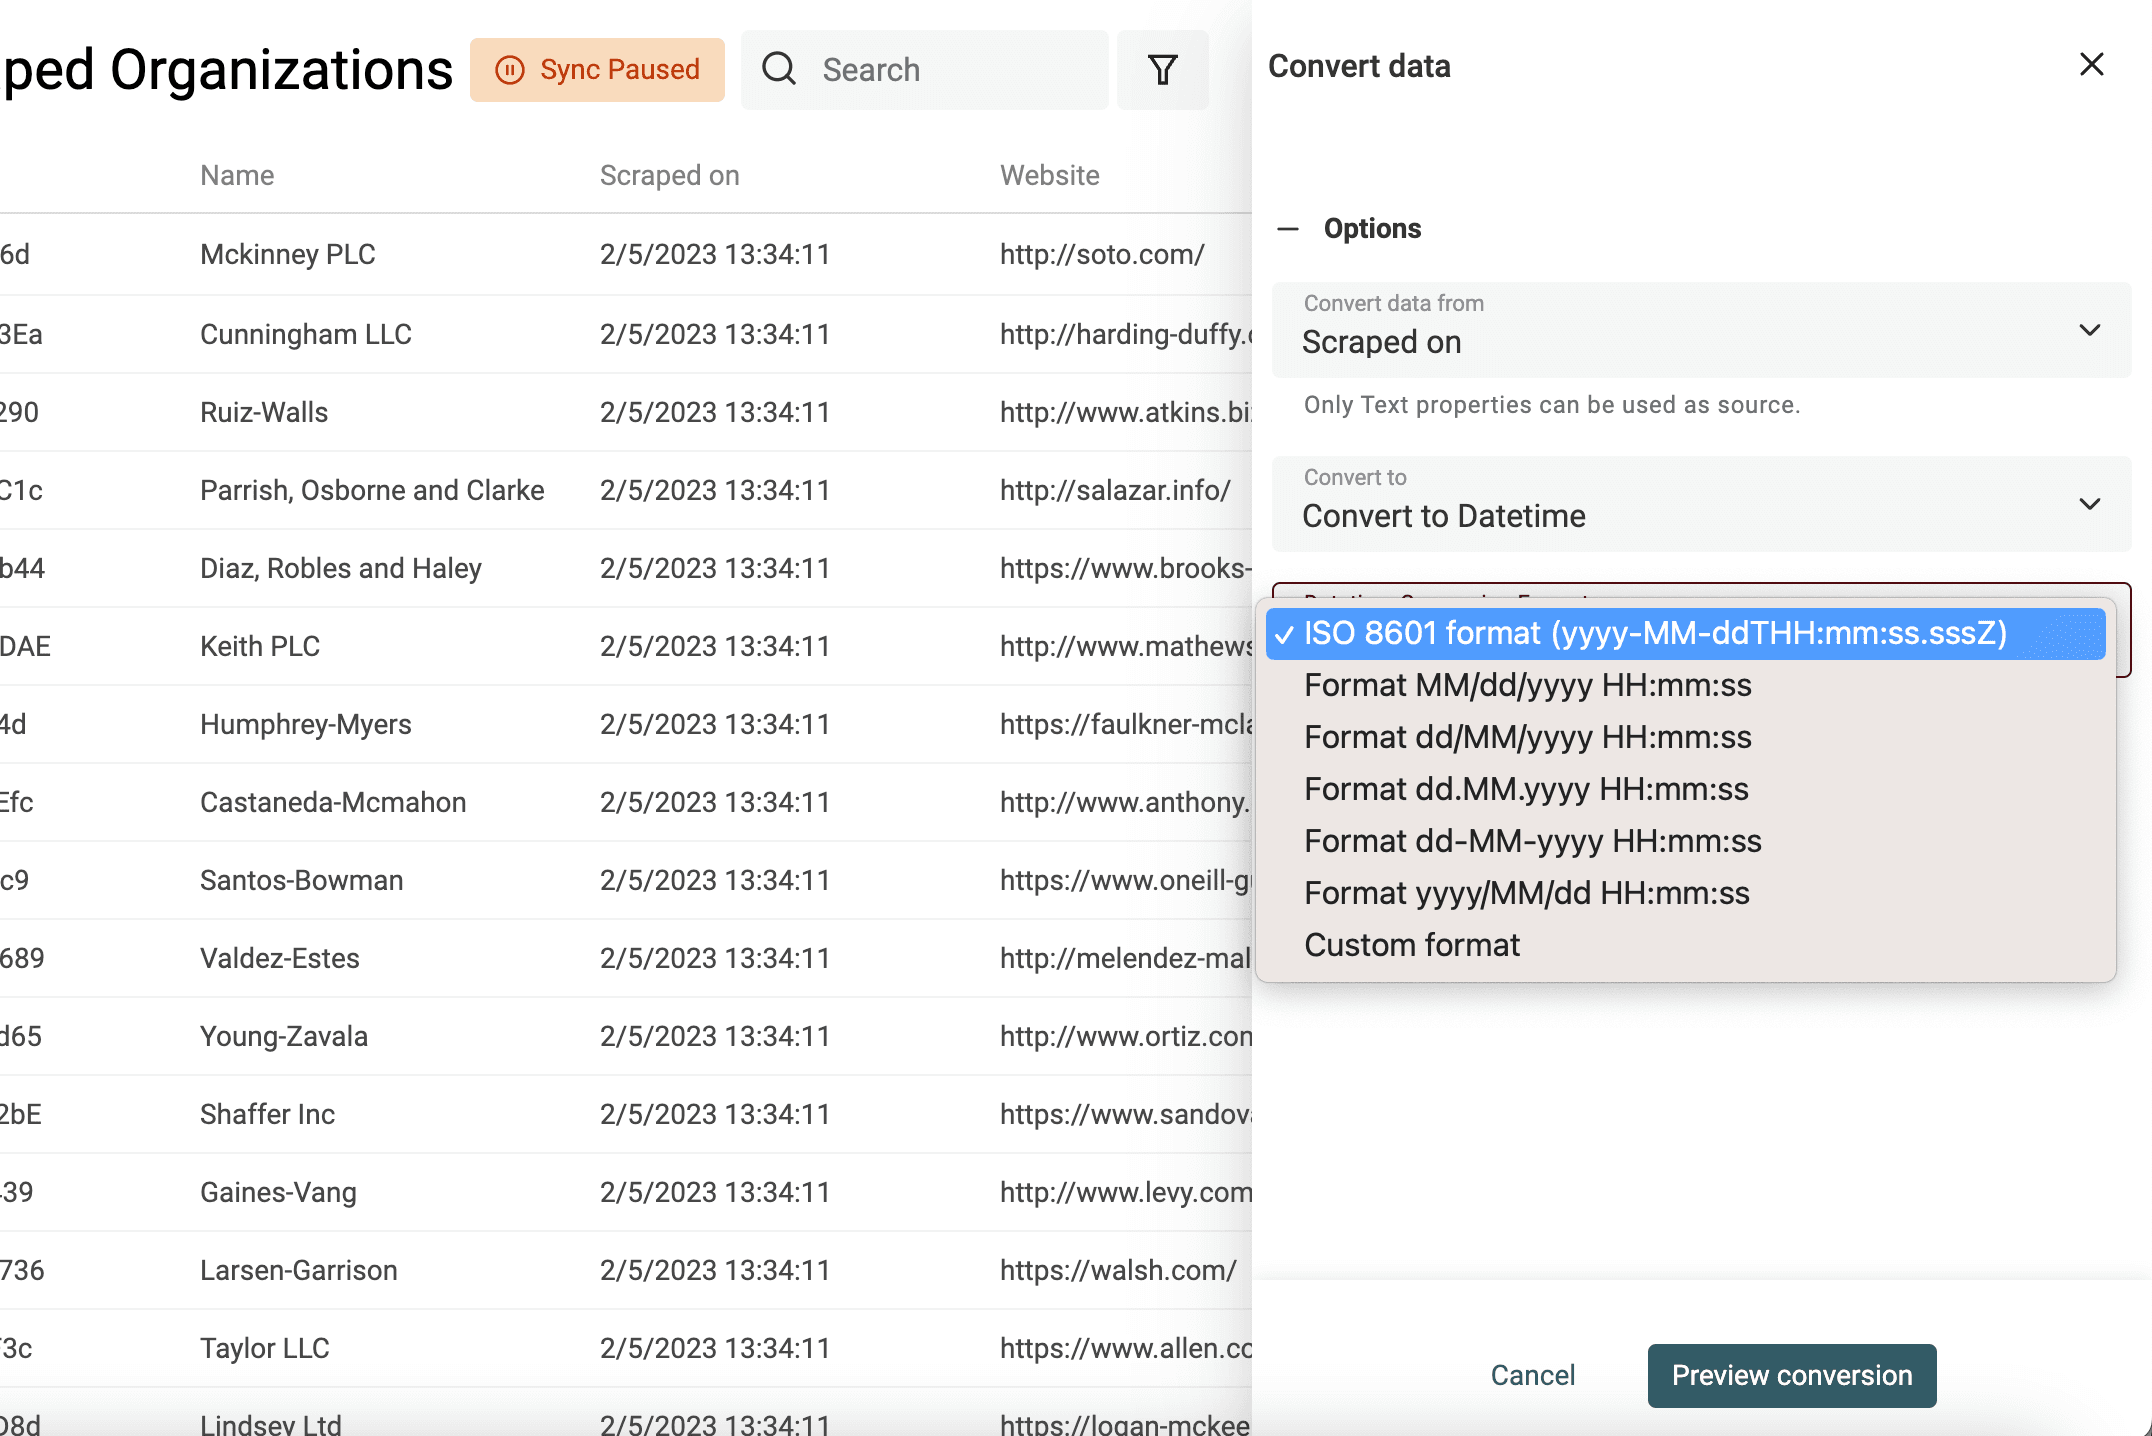
你可以从常见格式中选择,包括 Google Sheets 和 Excel 使用的 Datetime 格式;也可以选择 "Custom format",自行定义格式。
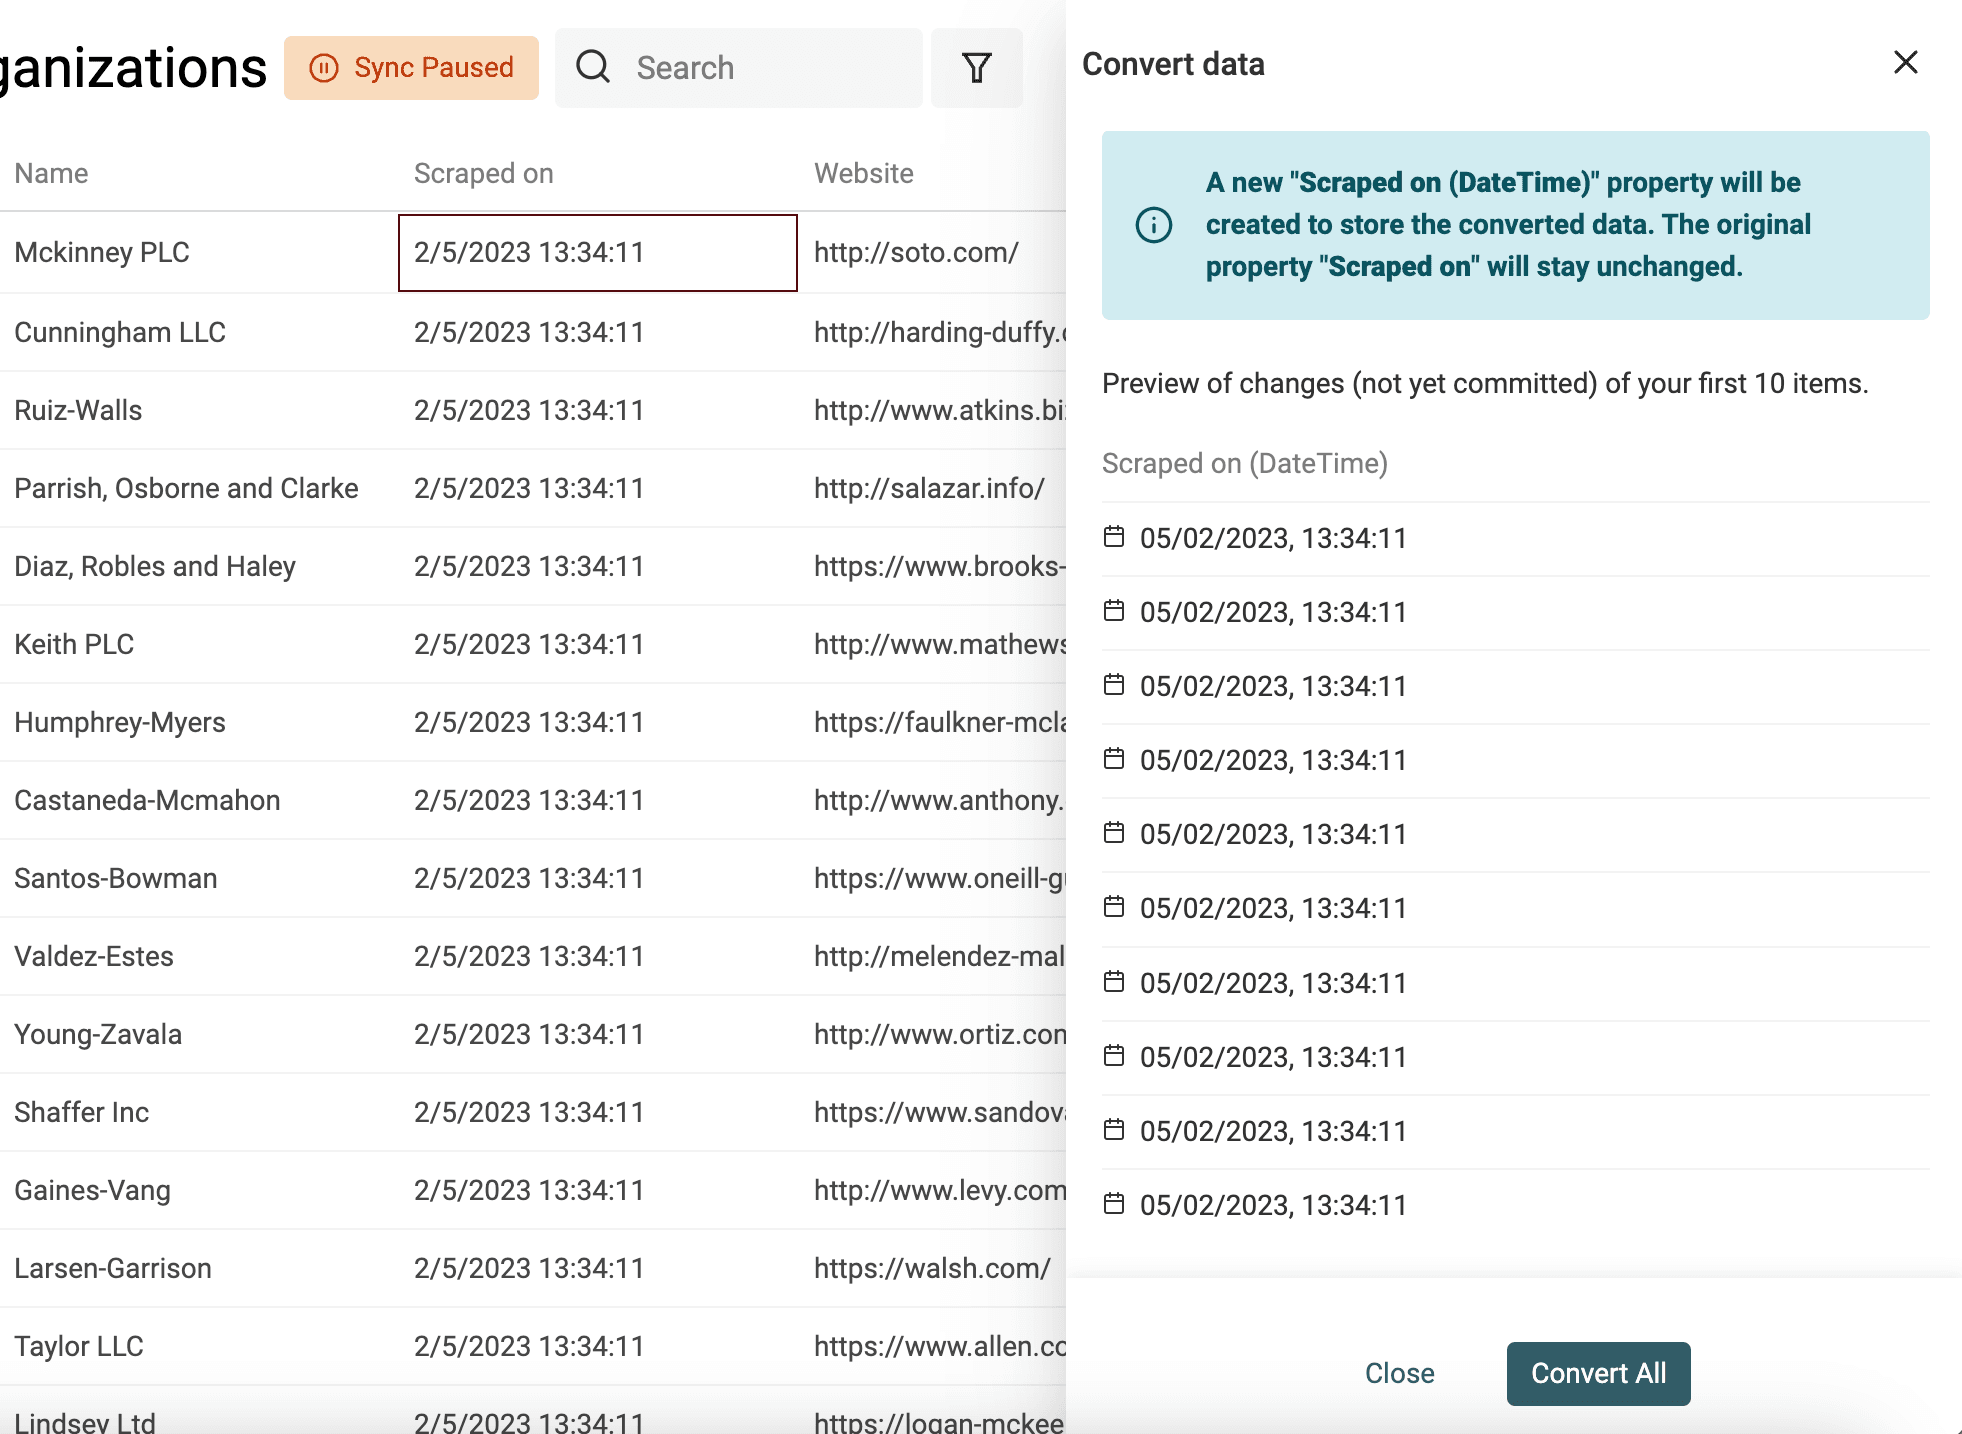
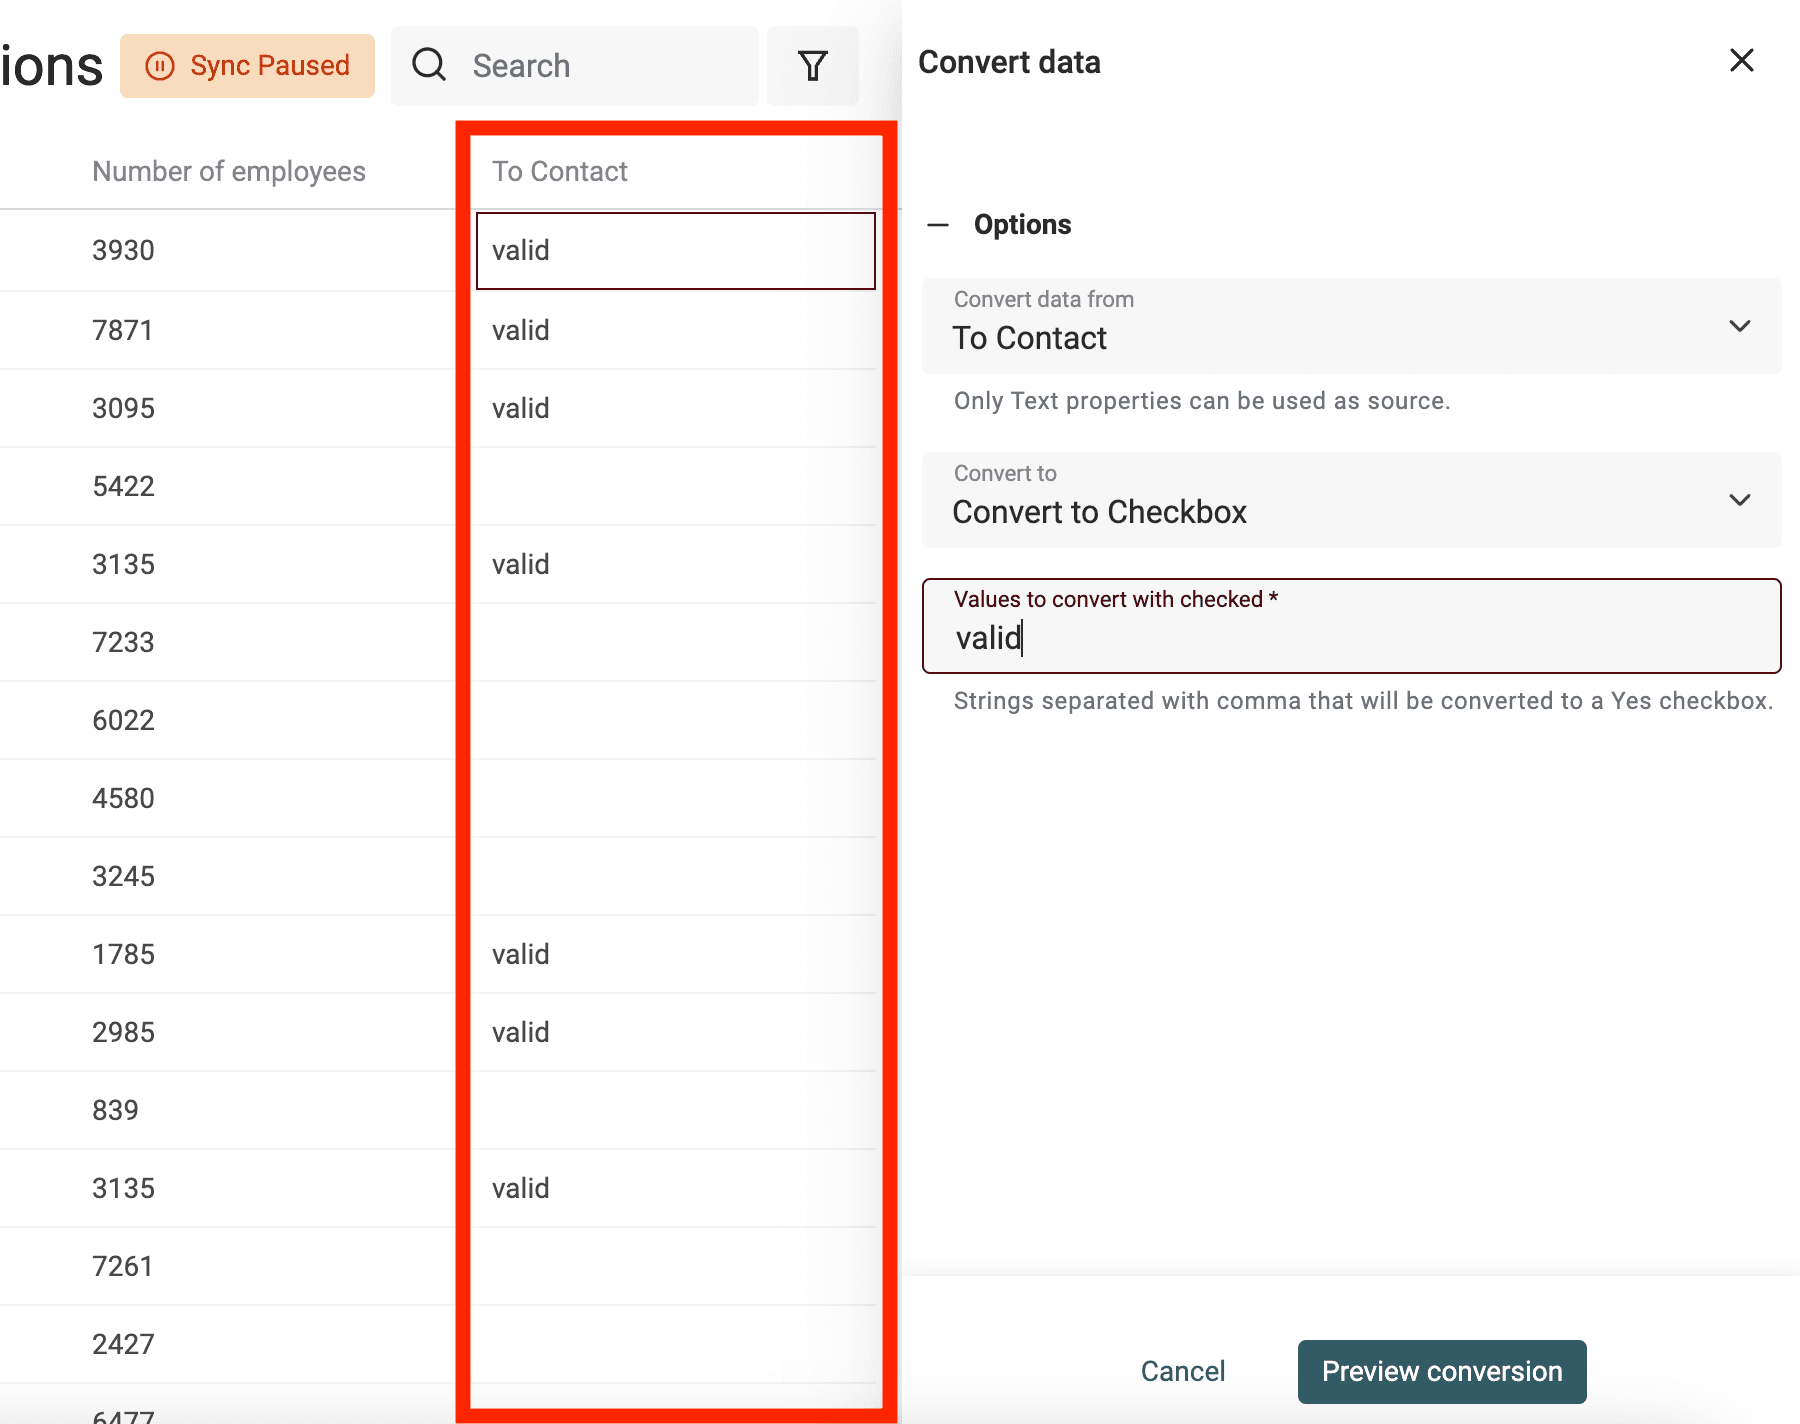
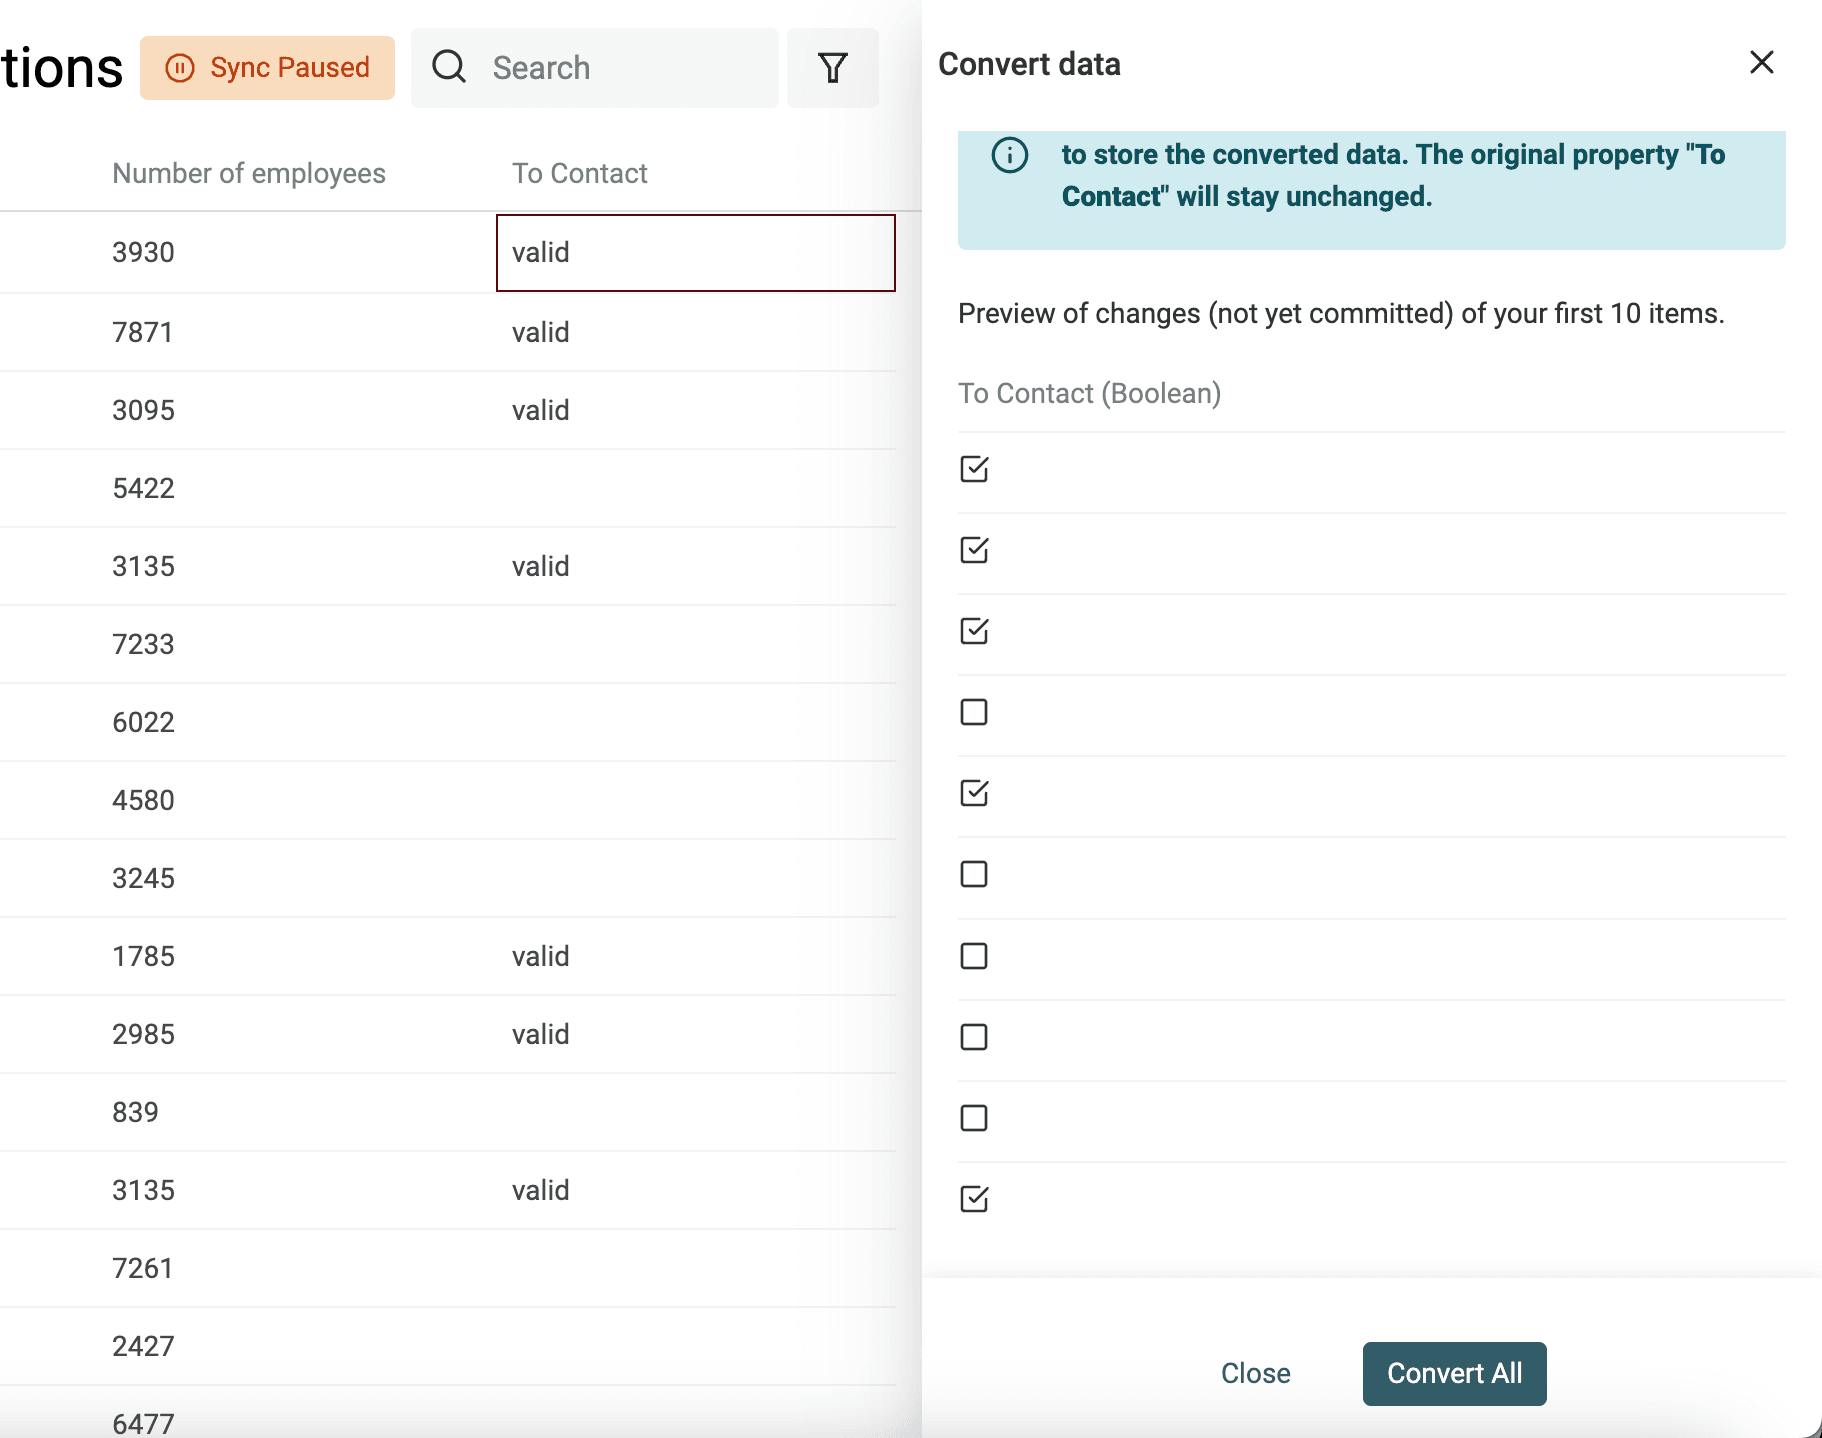
将文本值转换为 Checkbox(Boolean)
导入时,Datablist 会自动把包含 "Yes, No"、"TRUE, FALSE" 等值的列转换为 Checkbox 属性。如需处理更复杂的转换,请使用转换工具。
定义需要转换成选中状态的值,并用逗号分隔。其他值将保持未选中状态。
从文本中提取数字
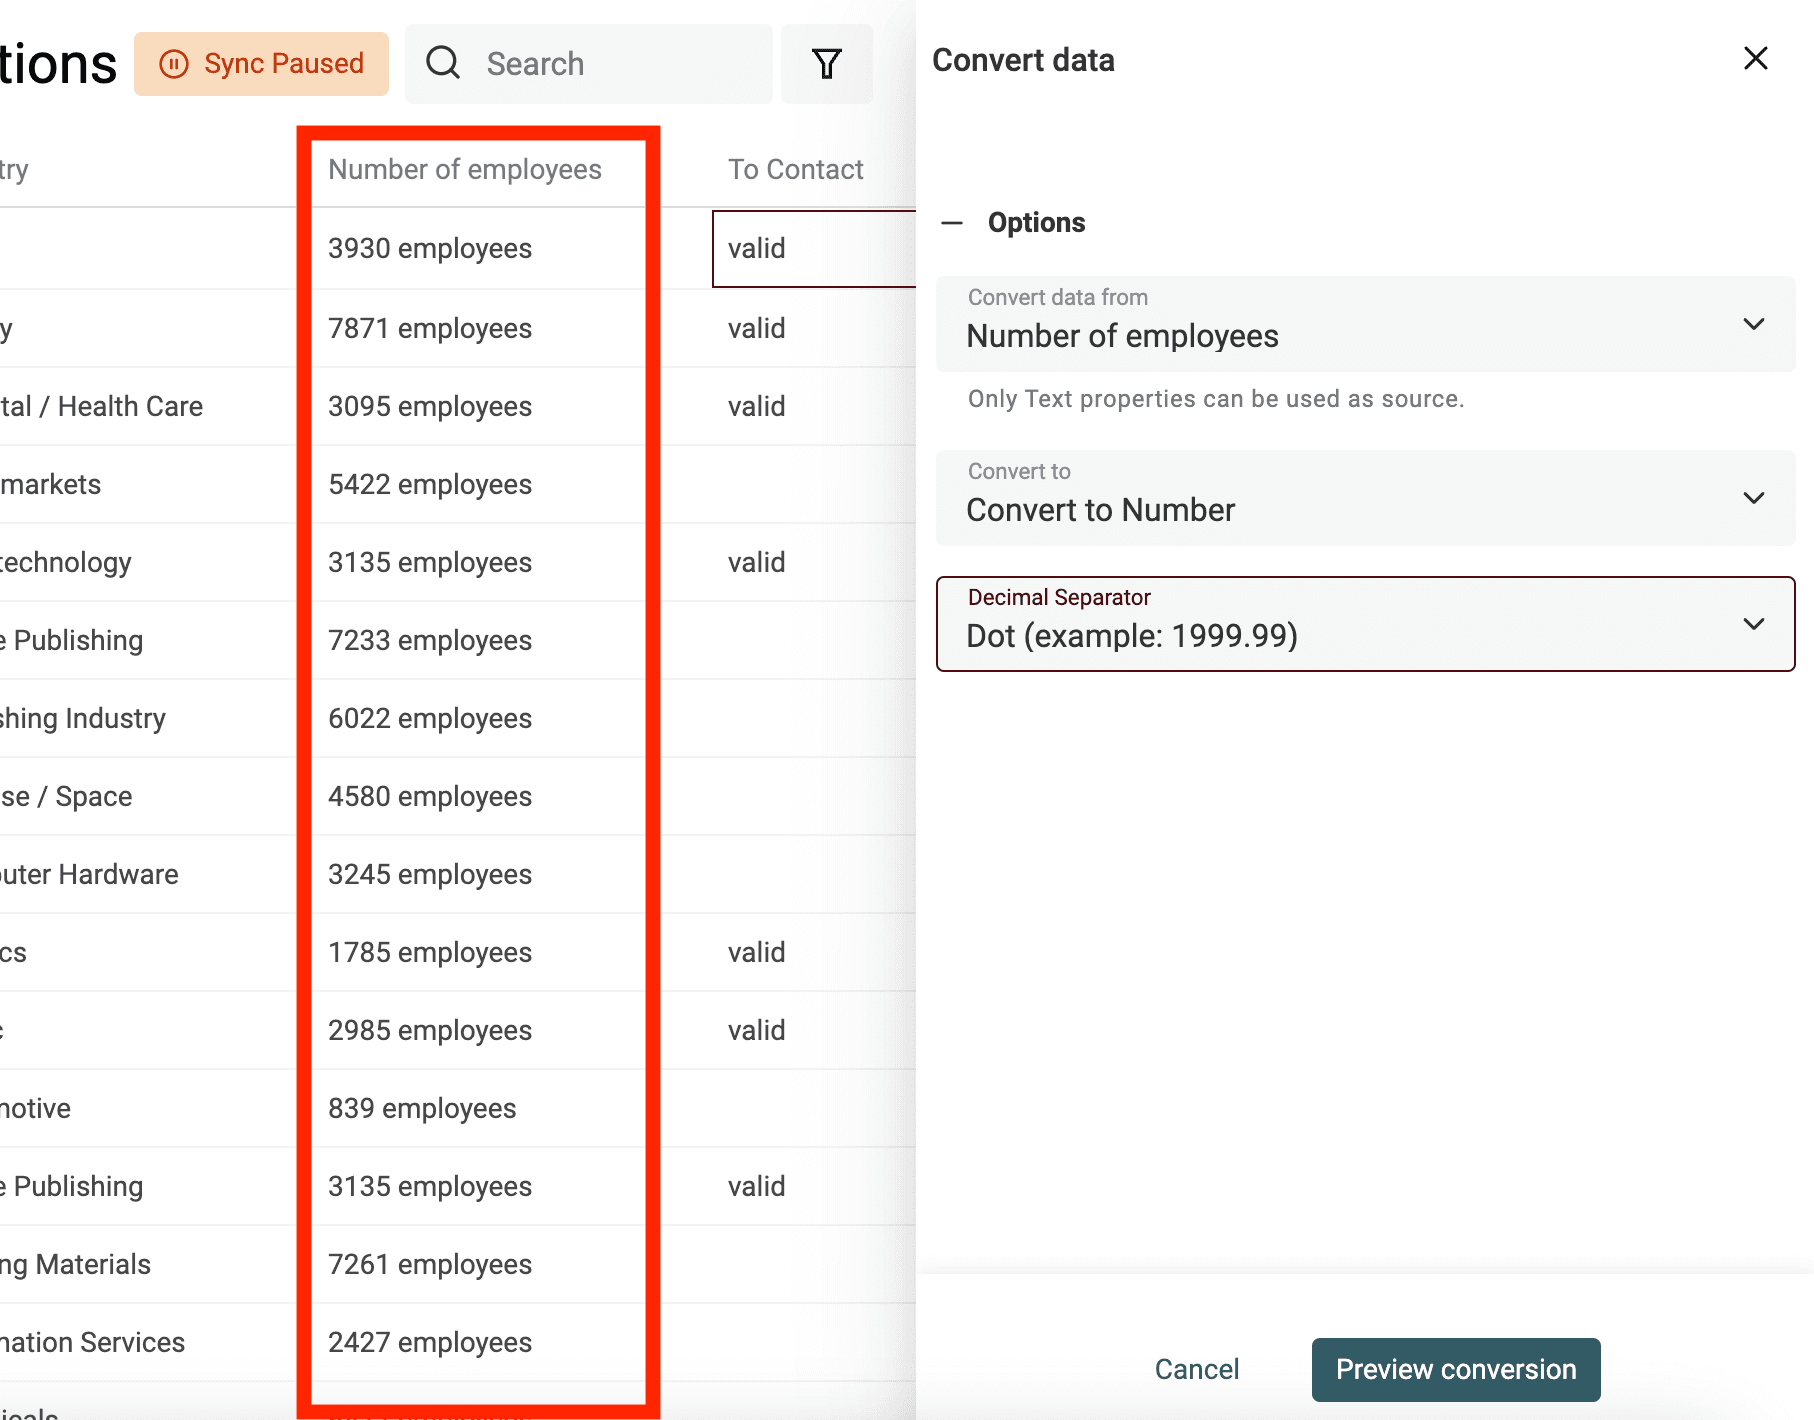
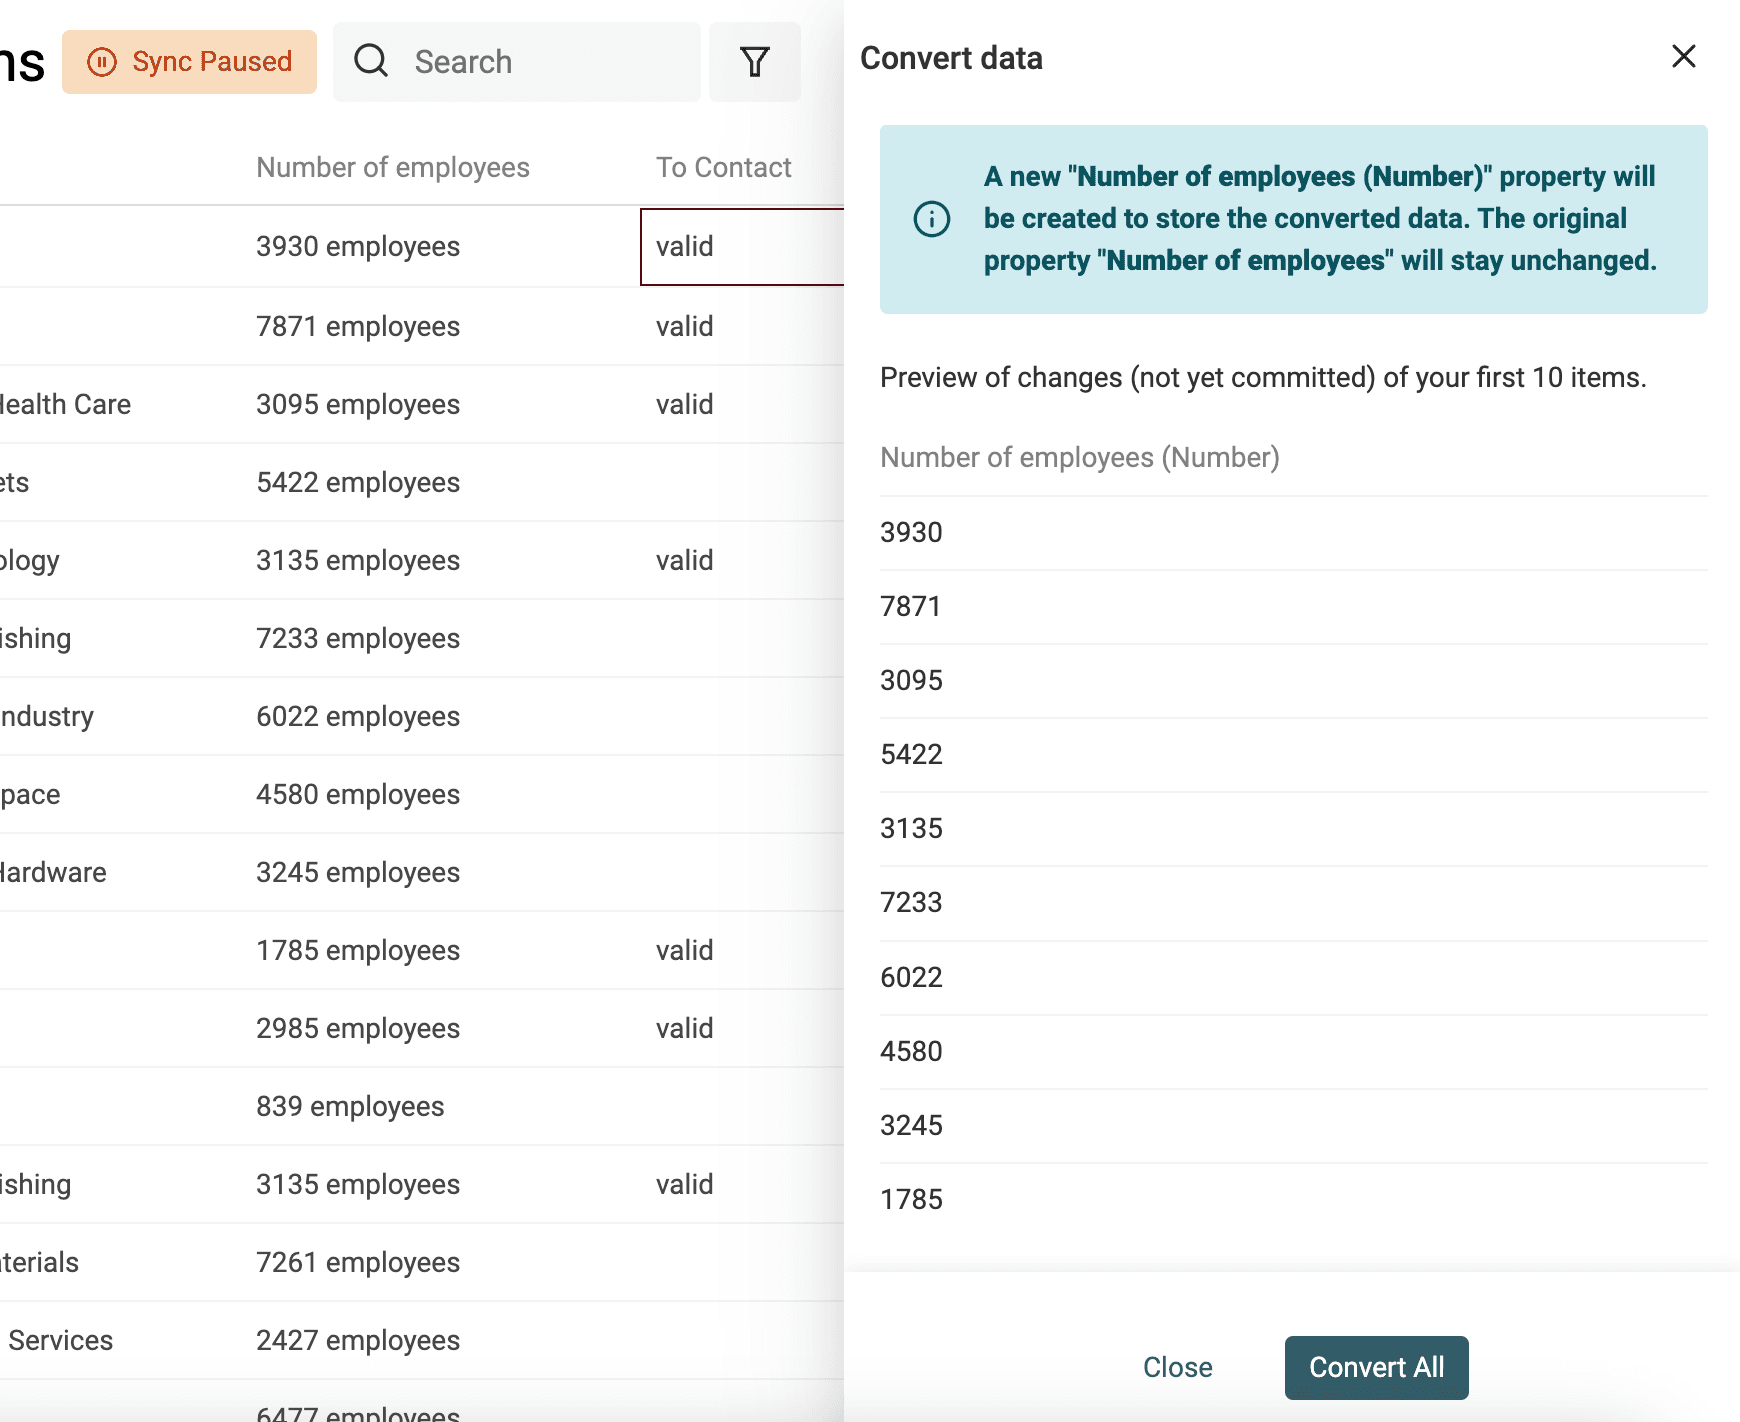
使用 "Text to number" 转换工具可以:
- 使用自定义小数点和千位分隔符规范数字
- 从含有字母的文本中提取数字
清洗数据
将 HTML 转换为纯文本
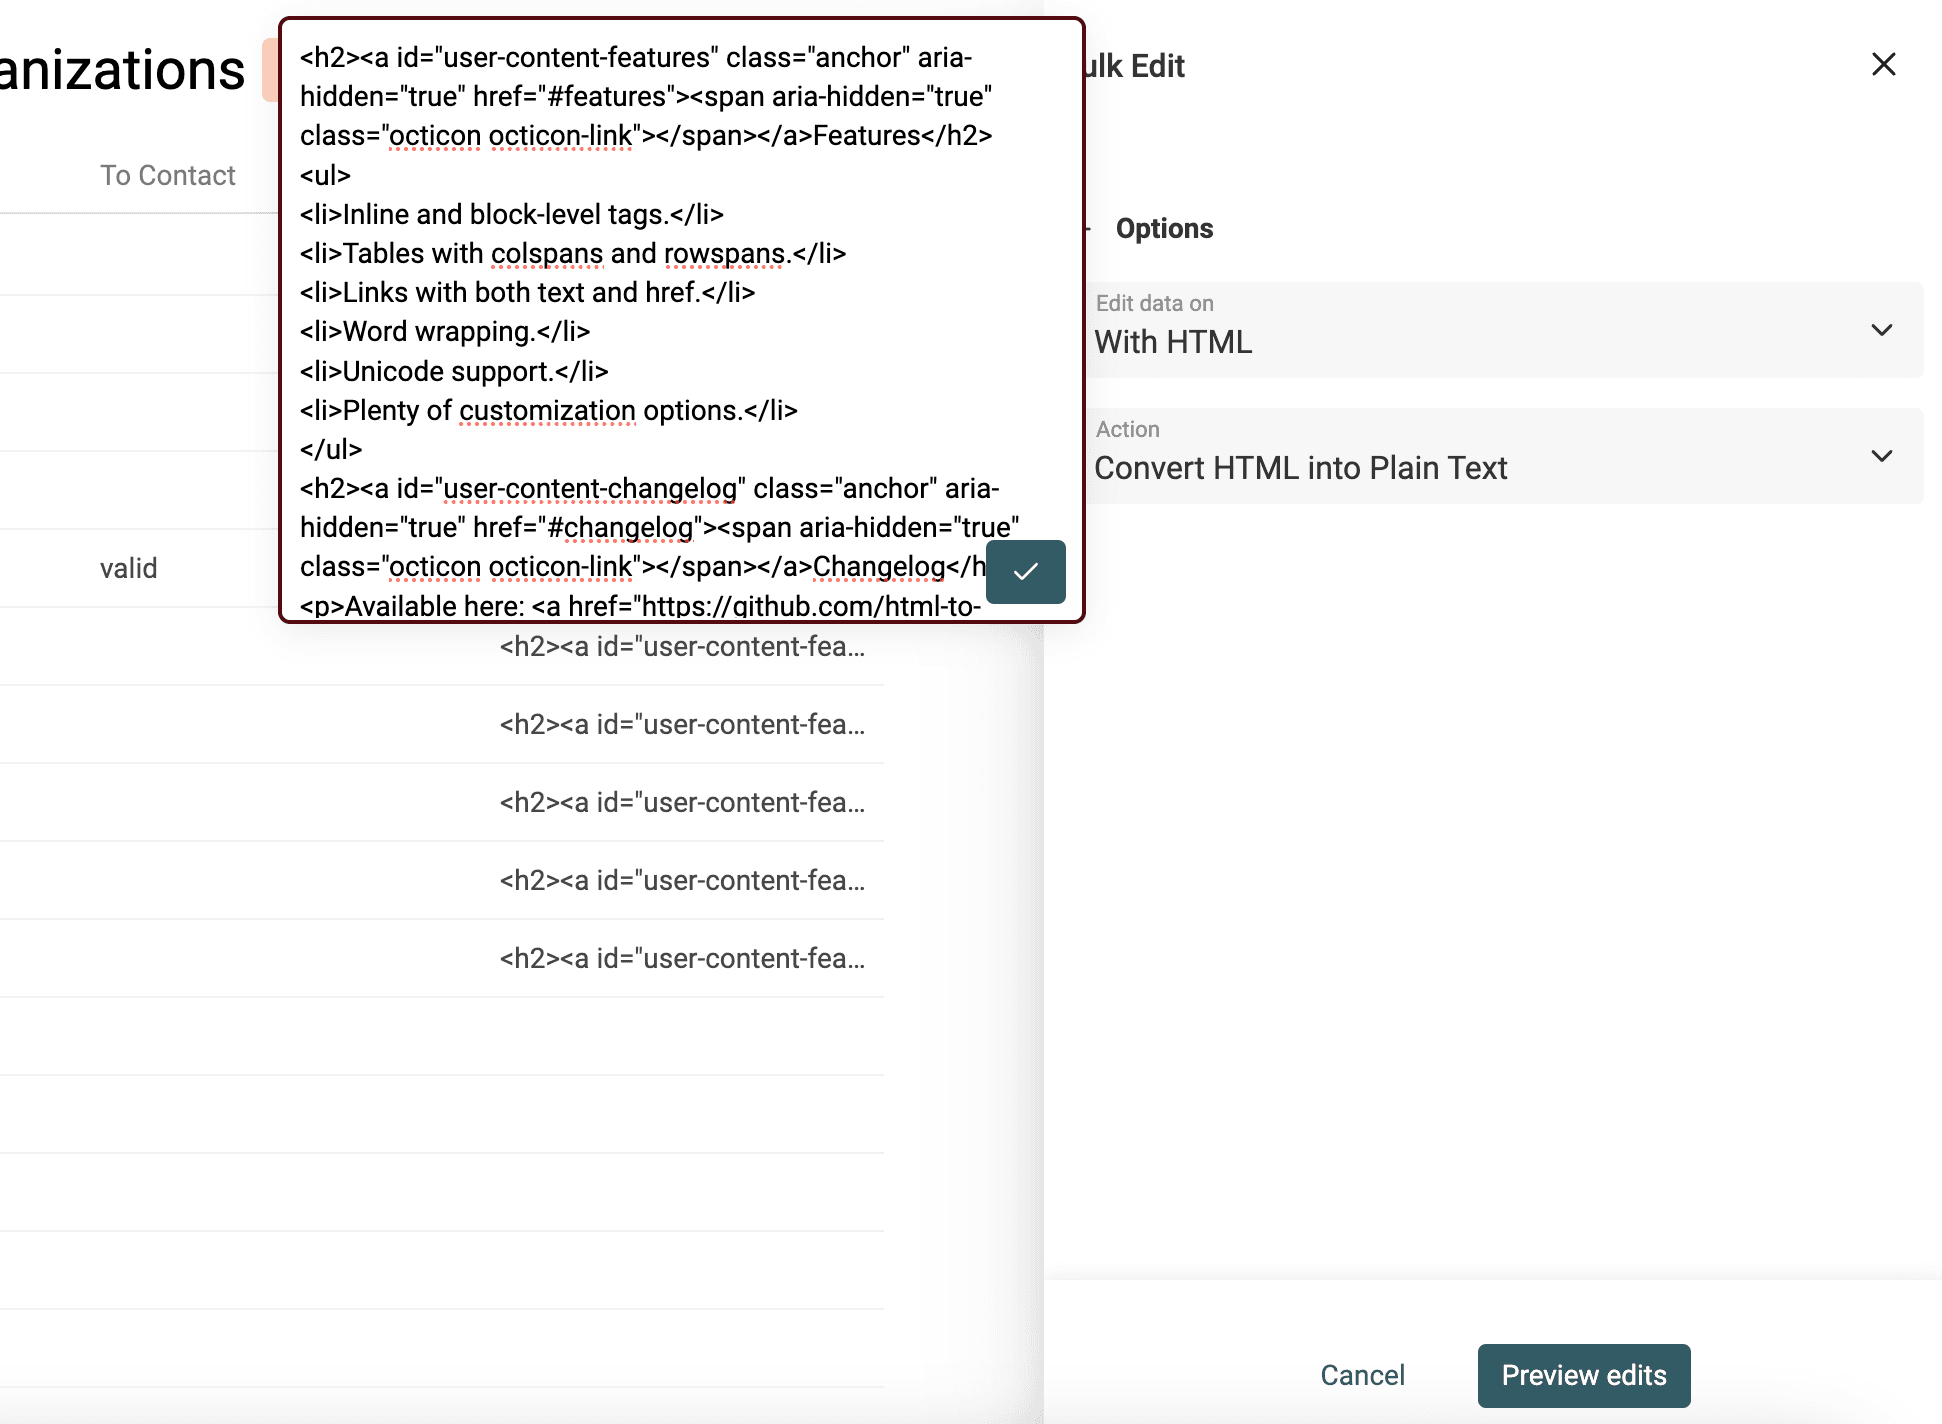
Scraping 工具会解析 HTML 代码,因此抓取到的文本中可能残留 HTML 标签。
HTML 代码包含链接、图片和项目列表,并通过段落和多行结构组织内容。
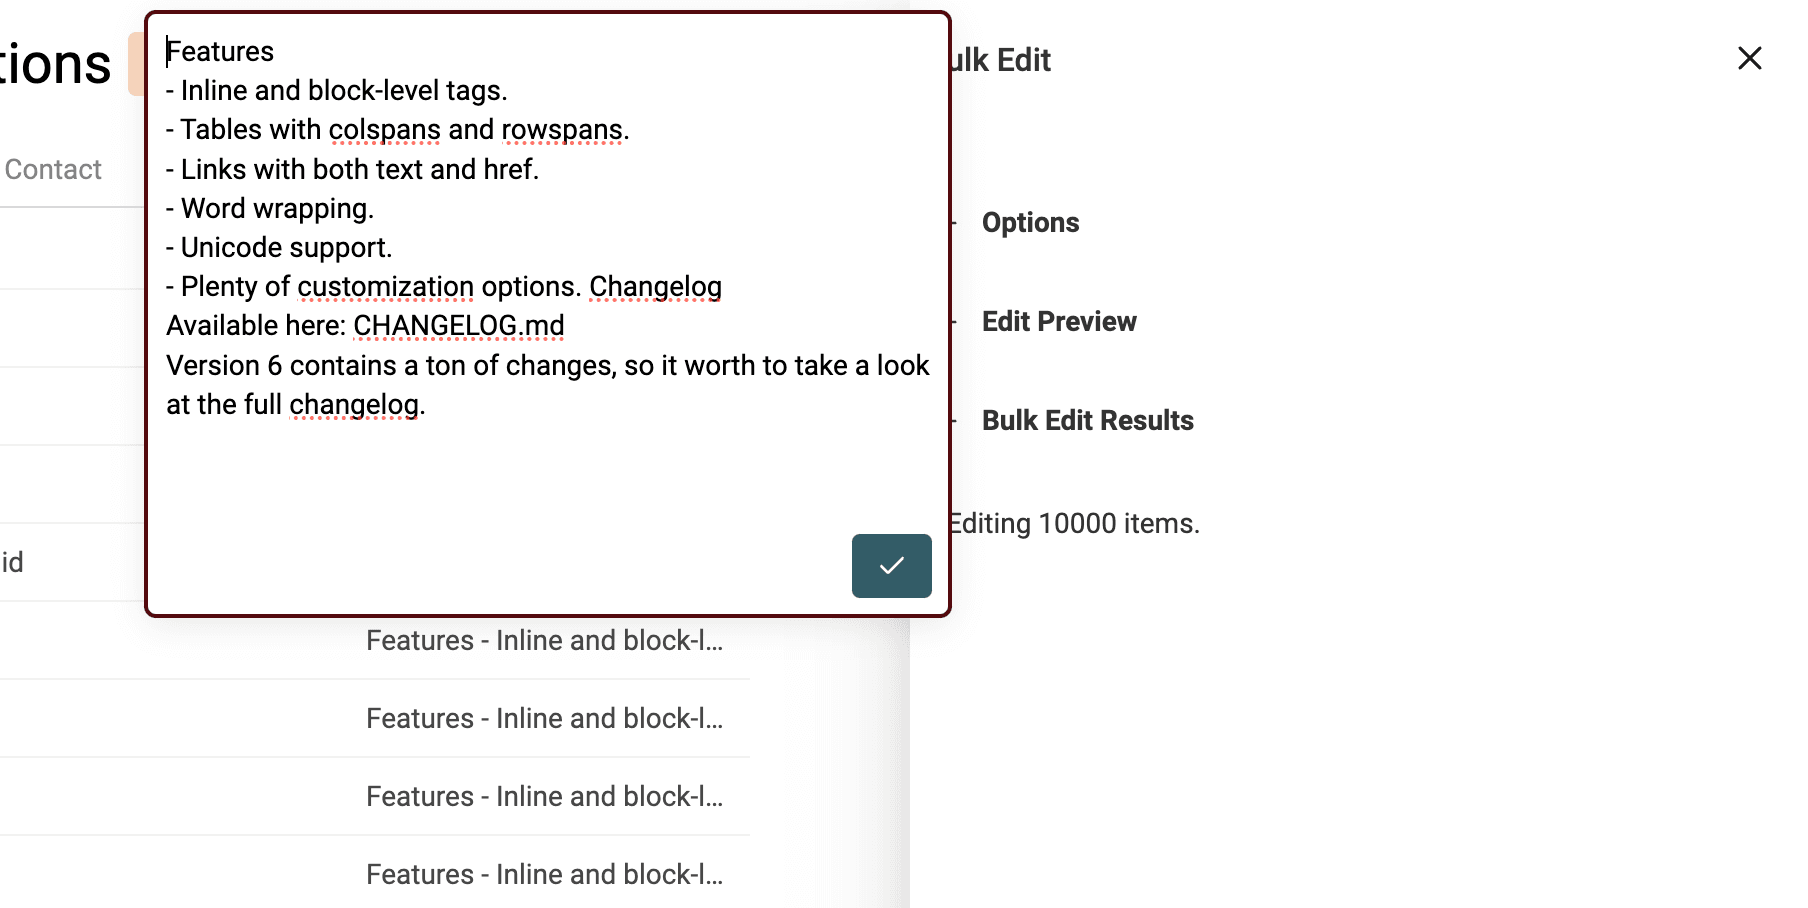
我们的目标是保留 HTML 带来的部分结构,同时把难以阅读的代码转换成纯文本。
Datablist 的 HTML to Text 转换工具会保留换行,并把项目符号转换为以 - 开头的列表。
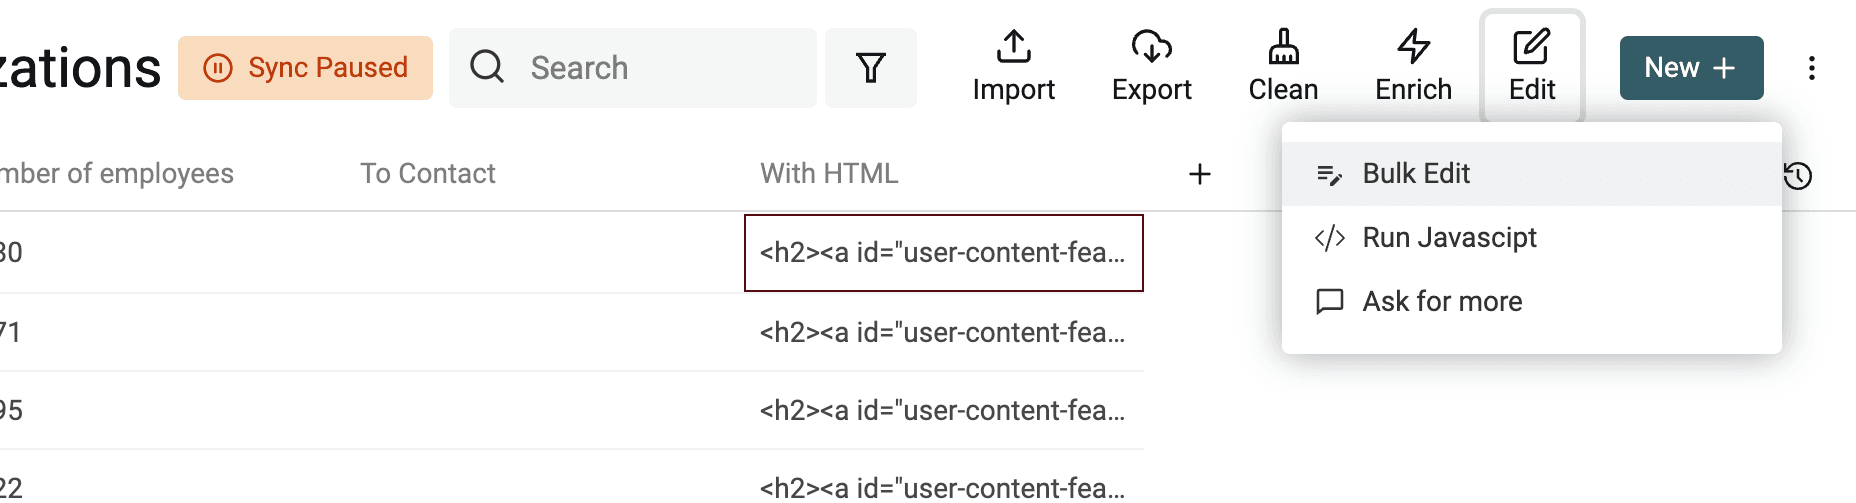
如需将带有 HTML 标签的文本转换为纯文本,请在 "Edit" 菜单中打开 Bulk Edit 工具。
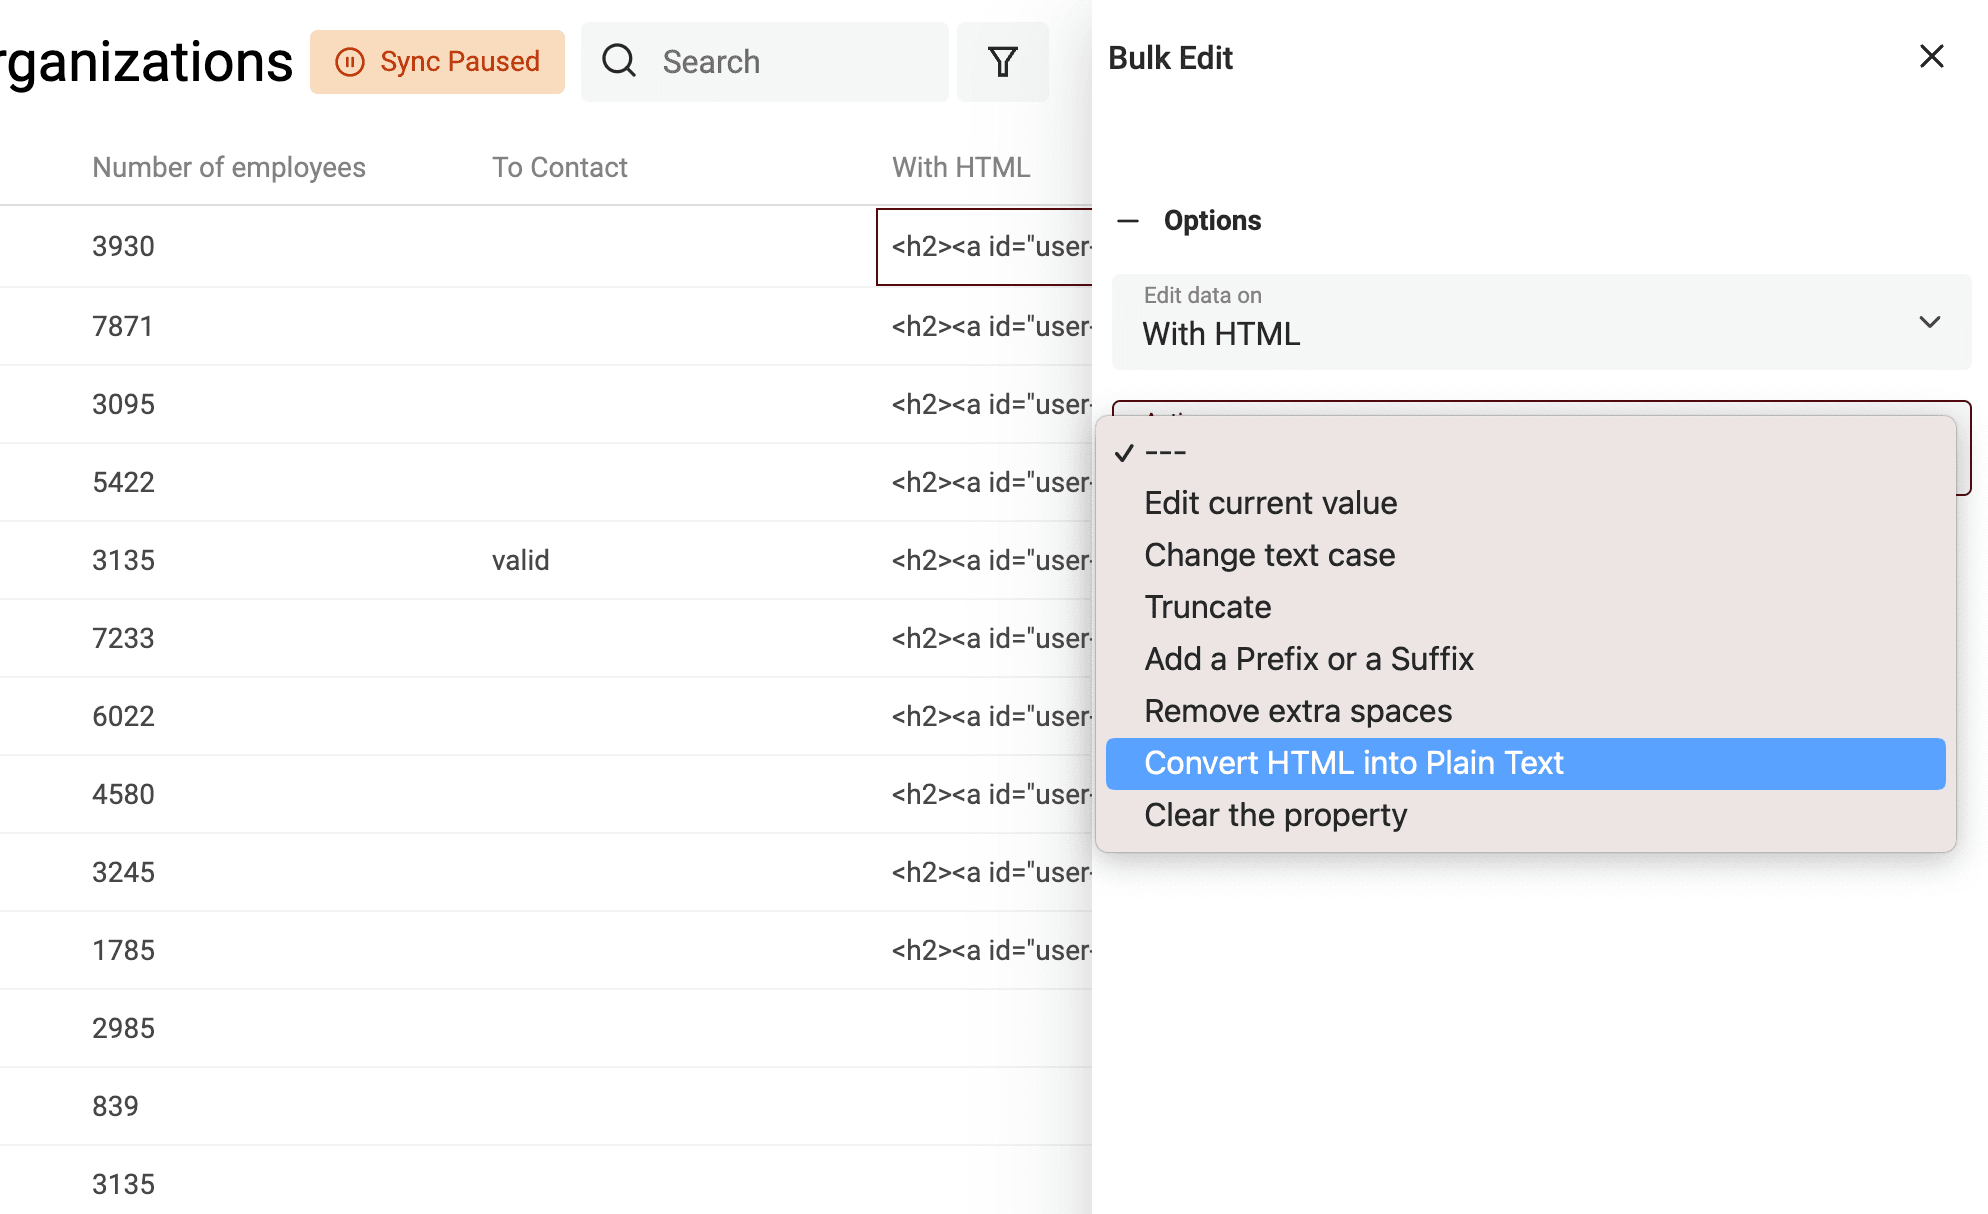
选择包含 HTML 标签的属性,再选择 "Convert HTML into plain text"。
删除多余空格
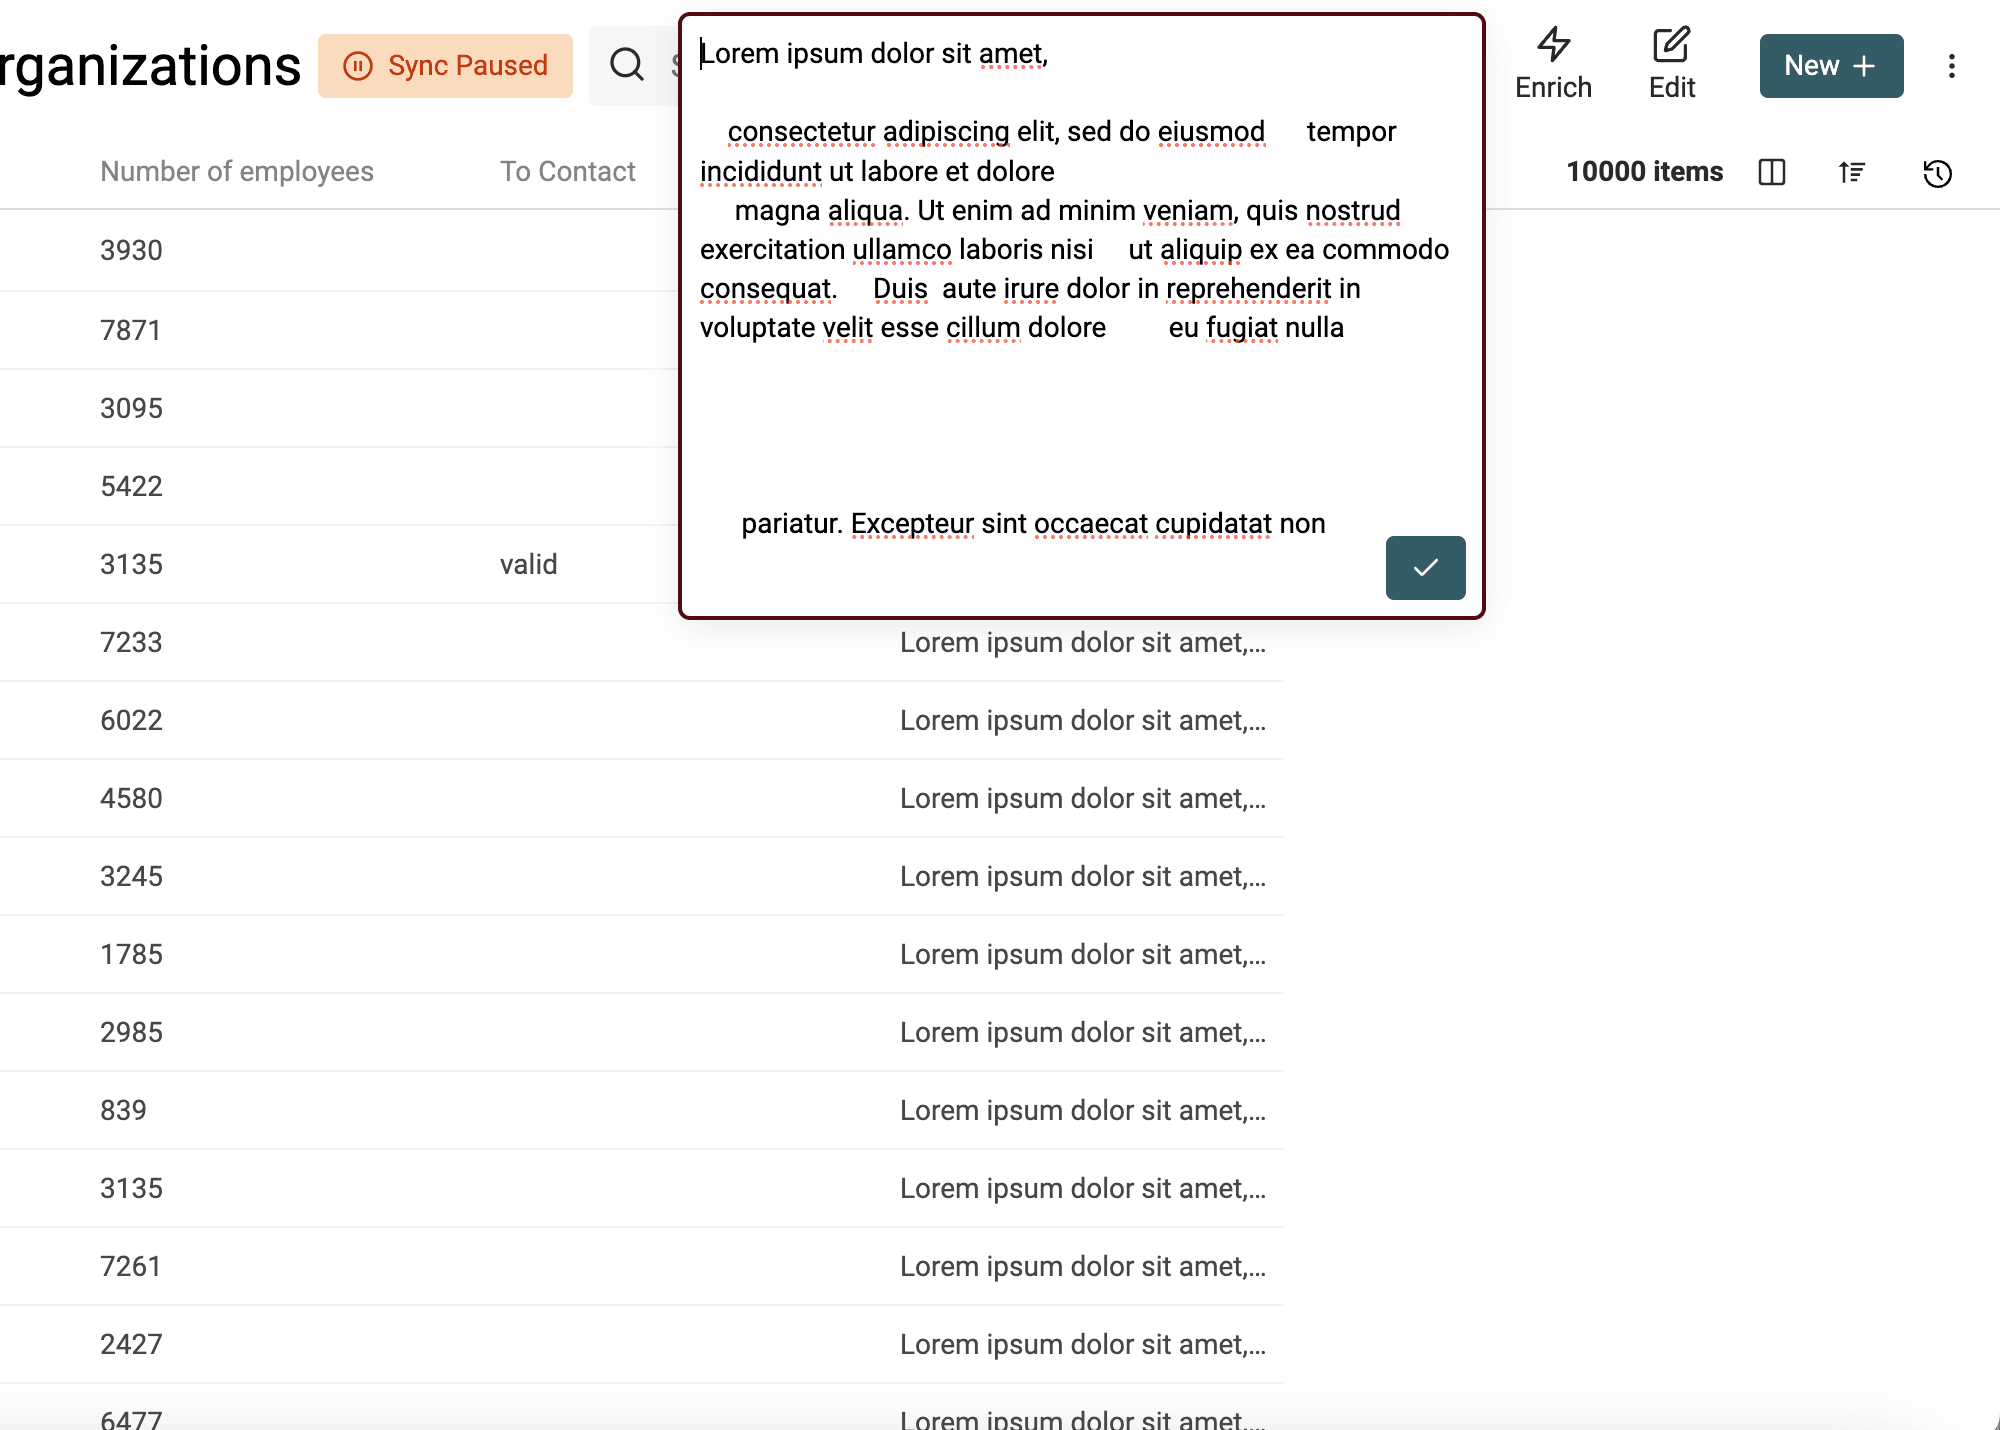
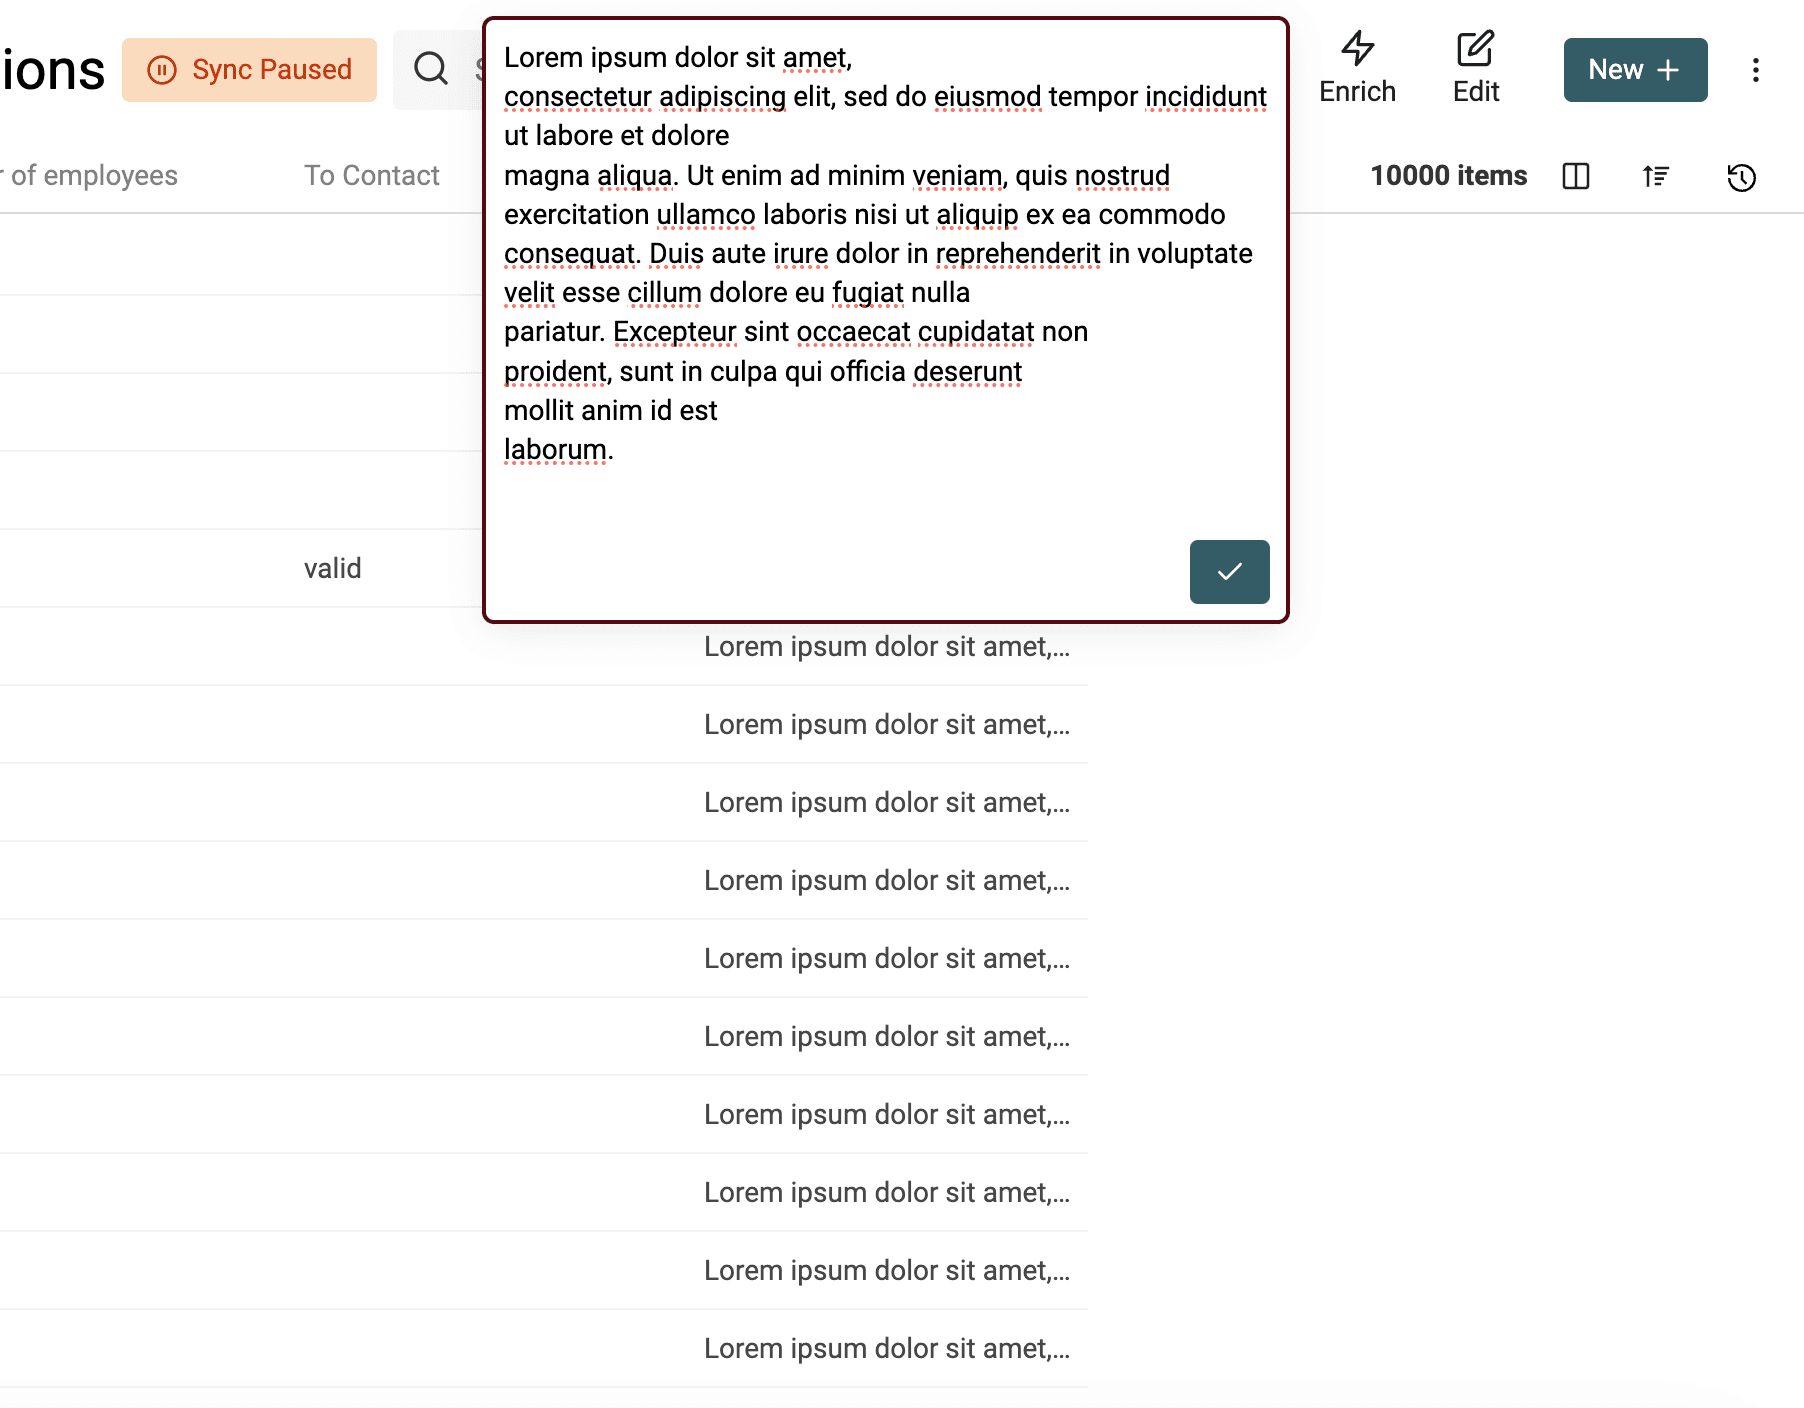
抓取数据的另一个常见问题是多余空格。这些空格可能来自换行、Tab,以及 HTML 中其他表示空白的字符。
Datablist 内置了清除多余空格的数据清洗工具。
- 删除单词之间的多余空格
- 删除空白行
- 删除每行开头和结尾的空格
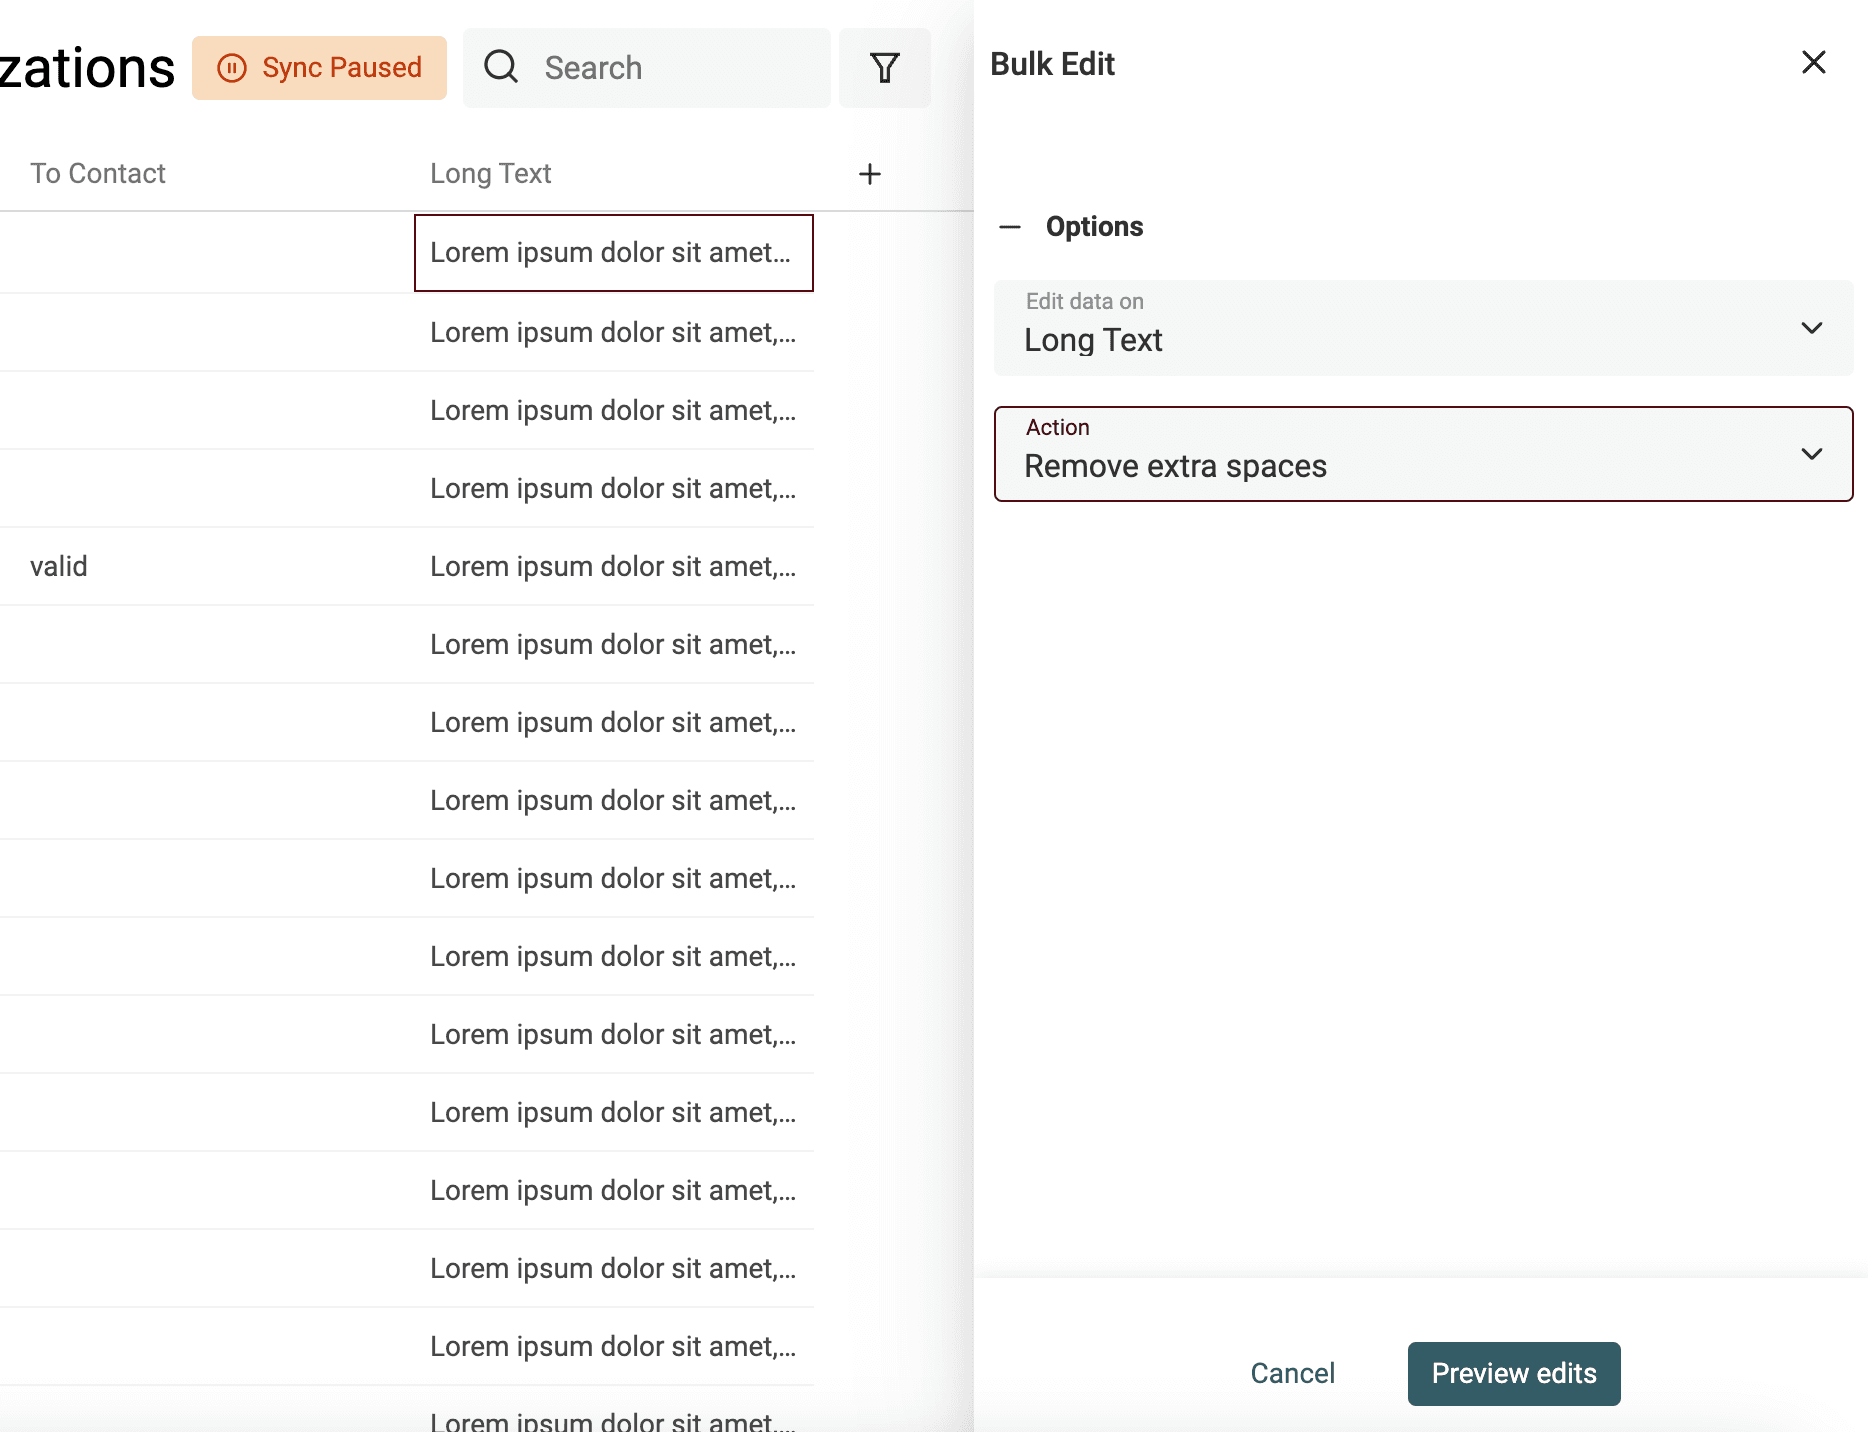
如需删除多余空格,请打开 "Edit" 菜单中的 "Bulk Edit" 工具,选择目标属性和 "Remove extra spaces" 操作。
统一英文大小写
调整文本大小写很简单。打开 "Edit" 菜单中的 "Bulk Edit" 工具。
选择要处理的属性,然后使用 "Change text case" 操作。
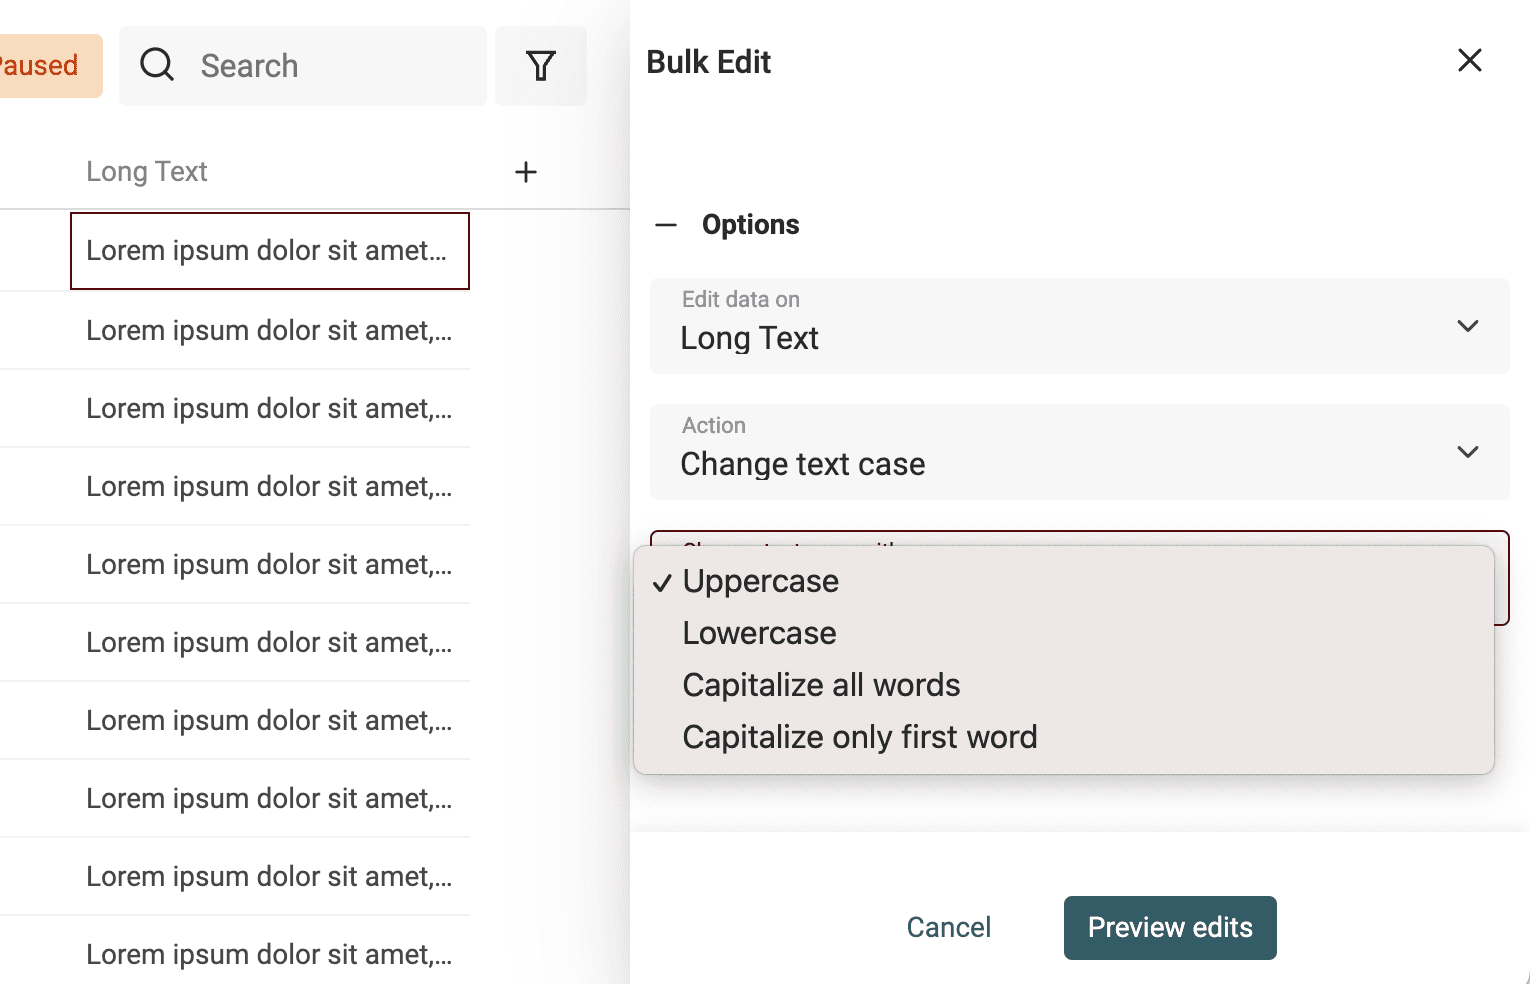
共有 4 种模式:
- Uppercase - 将所有字母转换为大写。例如:
john=>JOHN - Lowercase - 将所有字母转换为小写。例如:
API=>api - Capitalize - 将每个单词的首字母大写。例如:
john is a good man=>John Is A Good Man - Capitalize only the first word - 仅将第一个单词的首字母大写。例如:
john is a good man=>John is a good man
删除文本中的符号
从 HTML 页面抓取或由用户输入的文本,例如 LinkedIn 个人资料标题,可能含有表情符号及其他会影响数据处理的字符。姓名末尾一个简单的表情符号,就可能导致去重算法无法识别重复项。
Datablist 内置了一个处理器,可删除数据中的各种非文本符号。
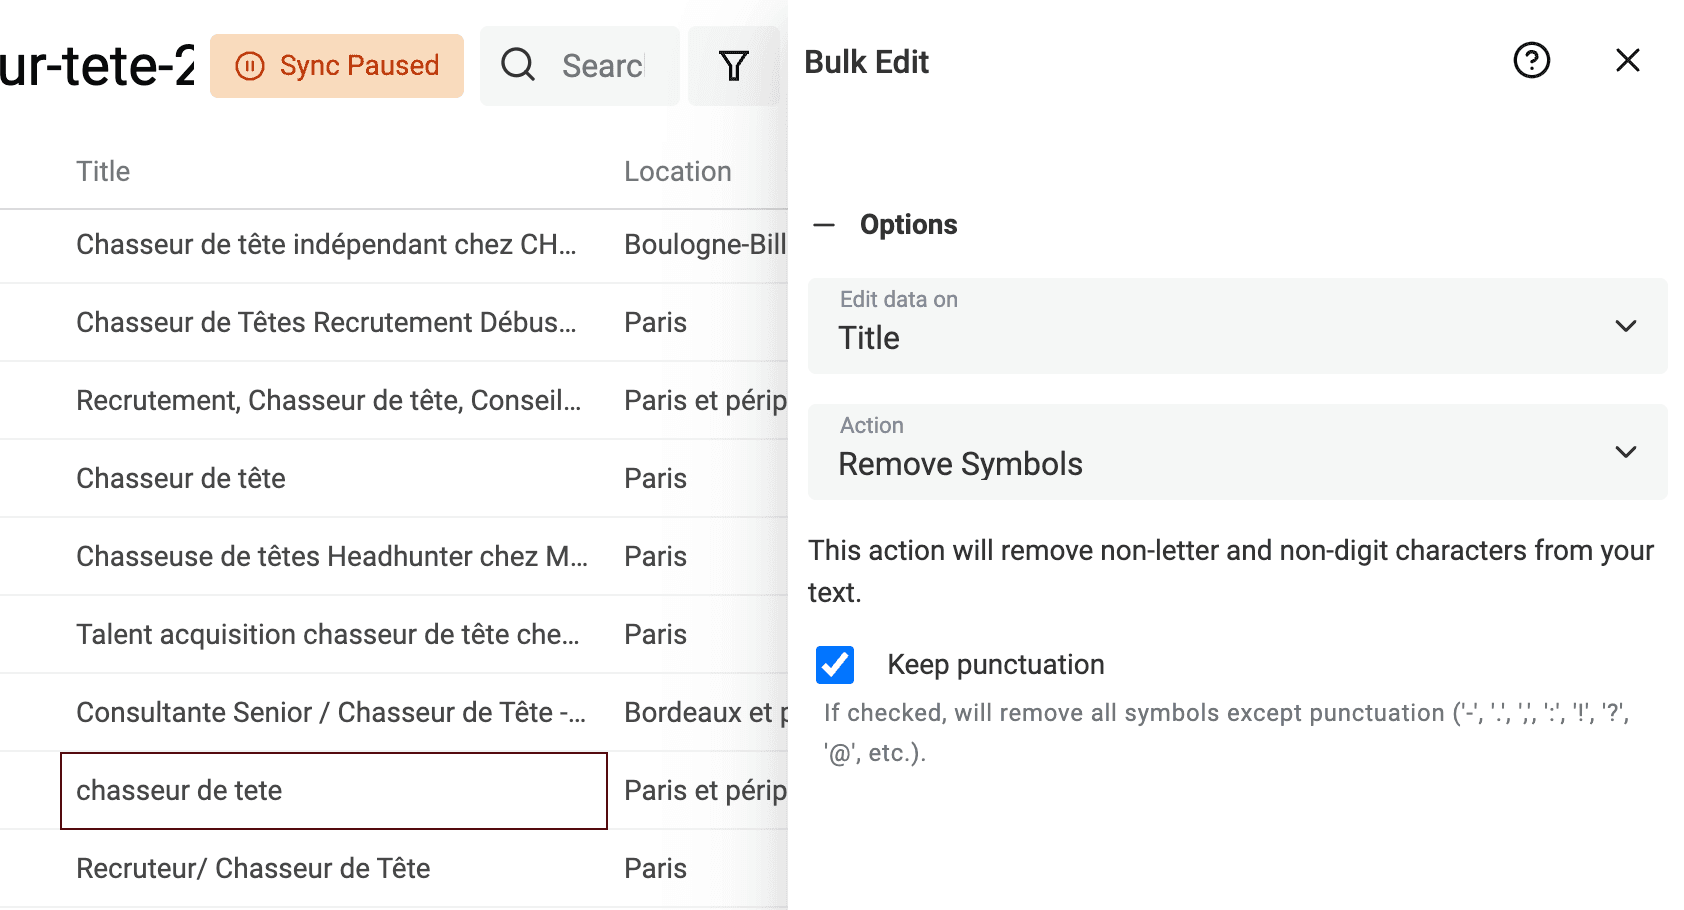
点击 "Edit" 菜单中的 "Bulk Edit",选择一个 Text 属性,再选择 "Remove symbols" 转换。
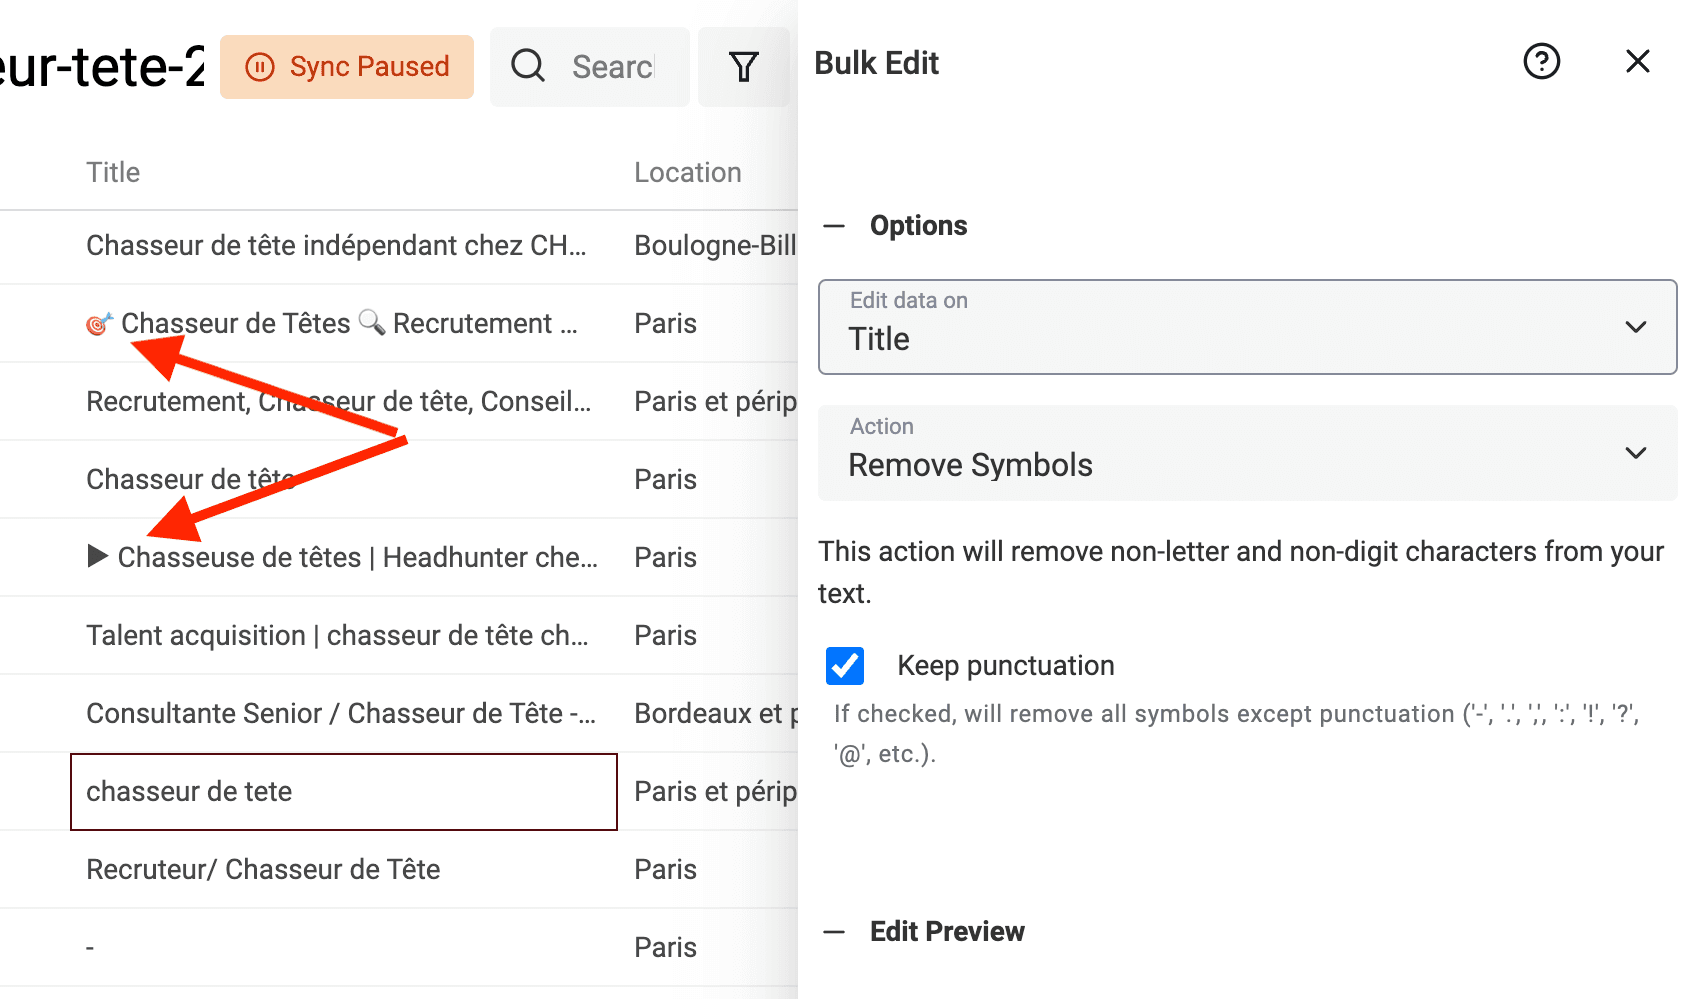
如果预览结果符合预期,即可运行转换来处理记录。
使用 Find and Replace 规范化数据
要对潜在客户名单进行细分,必须先规范数据。
- 规范职位名称
- 规范国家和城市
- 规范 URL
- 等等
你的目标是将一个包含自由文本的属性,整理成选项有限的标准化属性;或者将文本转换成更基础的形式,例如把带路径的 URL 转换为简单的 URL 域名。
Datablist 提供功能强大的 Find and Replace 工具,同时支持普通文本和正则表达式。
正则表达式虽然复杂,但功能非常强大。
以下是使用 RegEx 清洗数据的几个示例。
删除 URL 查询参数
有些 URL 参数用于追踪营销活动,另一些则用于选择产品、变体、搜索结果或页码。全部删除可能会导致不同记录被合并为同一个 URL。
请先复制源 URL 属性。只有在确认该列中的所有查询参数都可以删除时,才使用下面的表达式。例如,它可以从页面 URL 中删除 ?utm_source=newsletter,但同样也会从产品 URL 中删除 ?variant=blue。如果需要保留产品变体,请保留查询参数,或通过单独的转换仅删除特定追踪参数。
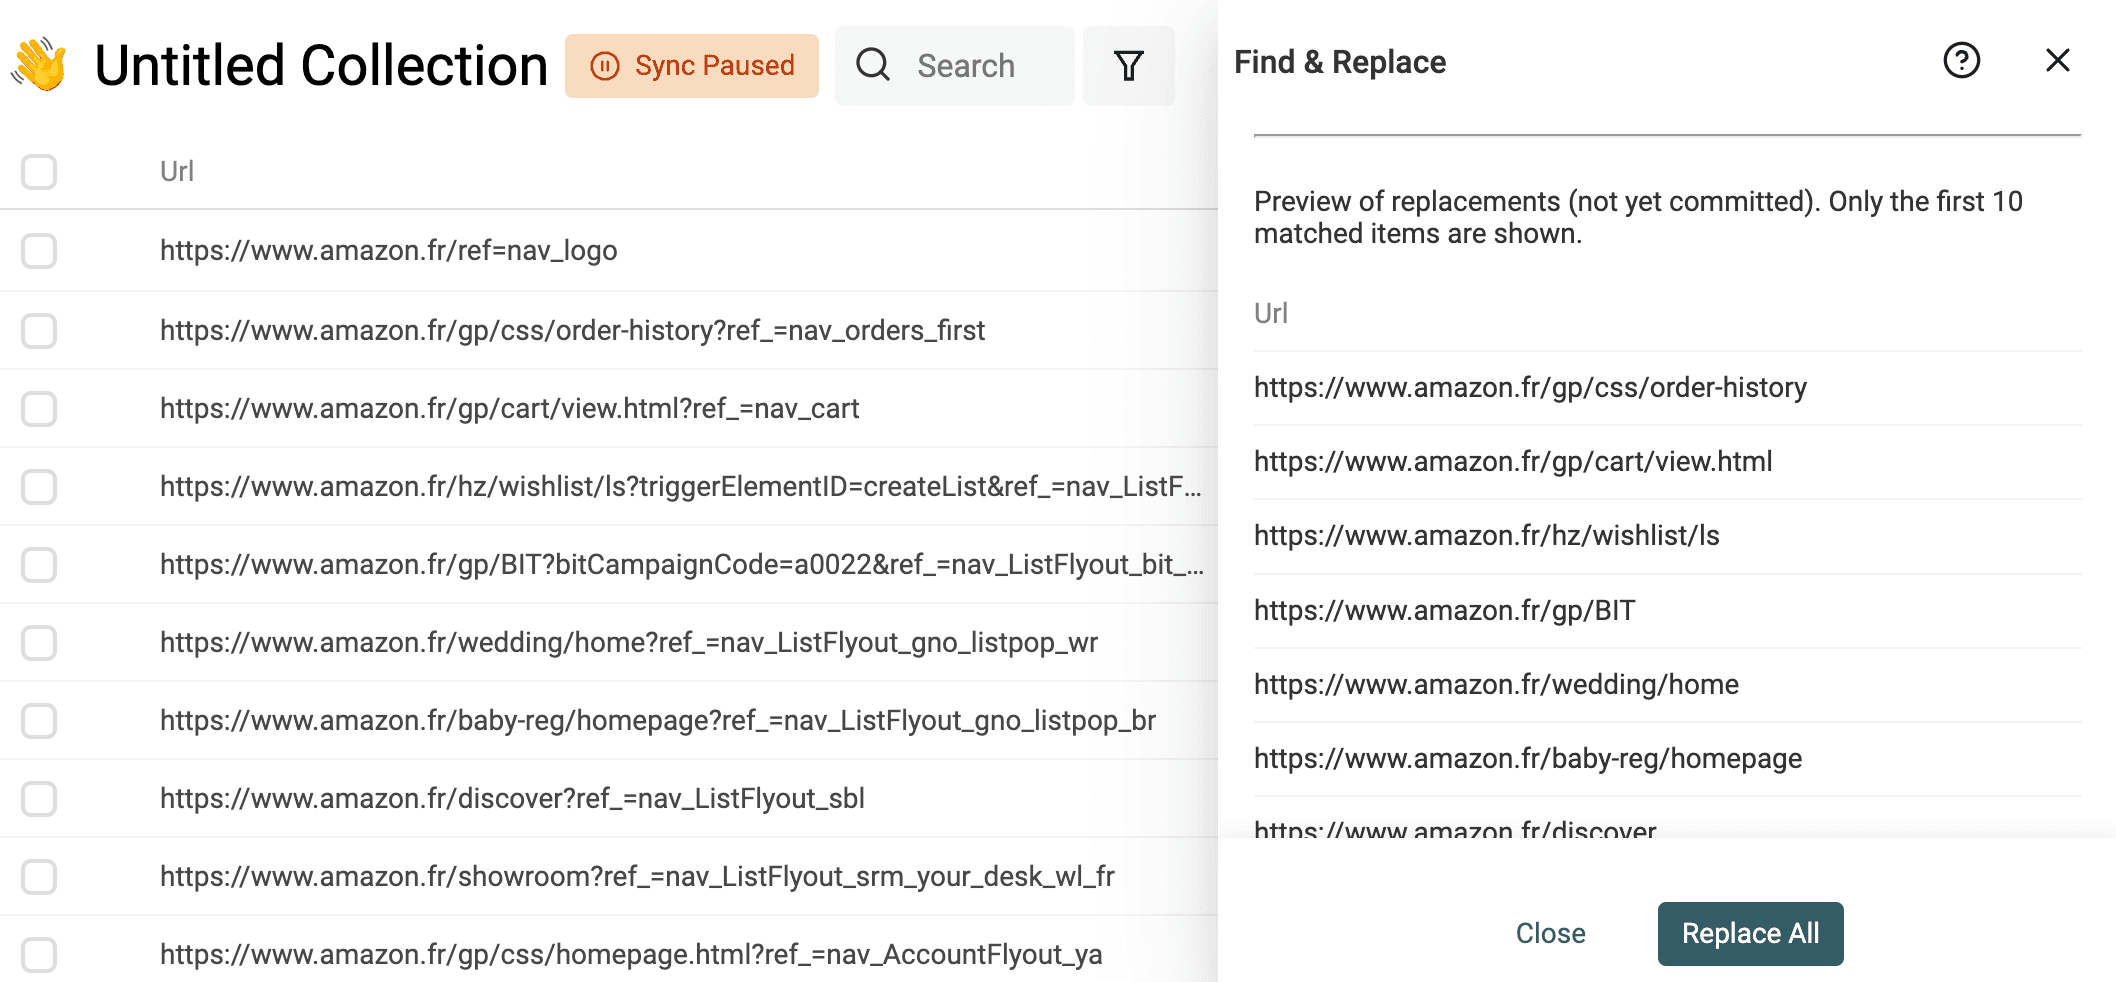
要删除整个查询字符串,请勾选 Match using regular expression,使用以下表达式,并将替换内容留空:
\?.*$
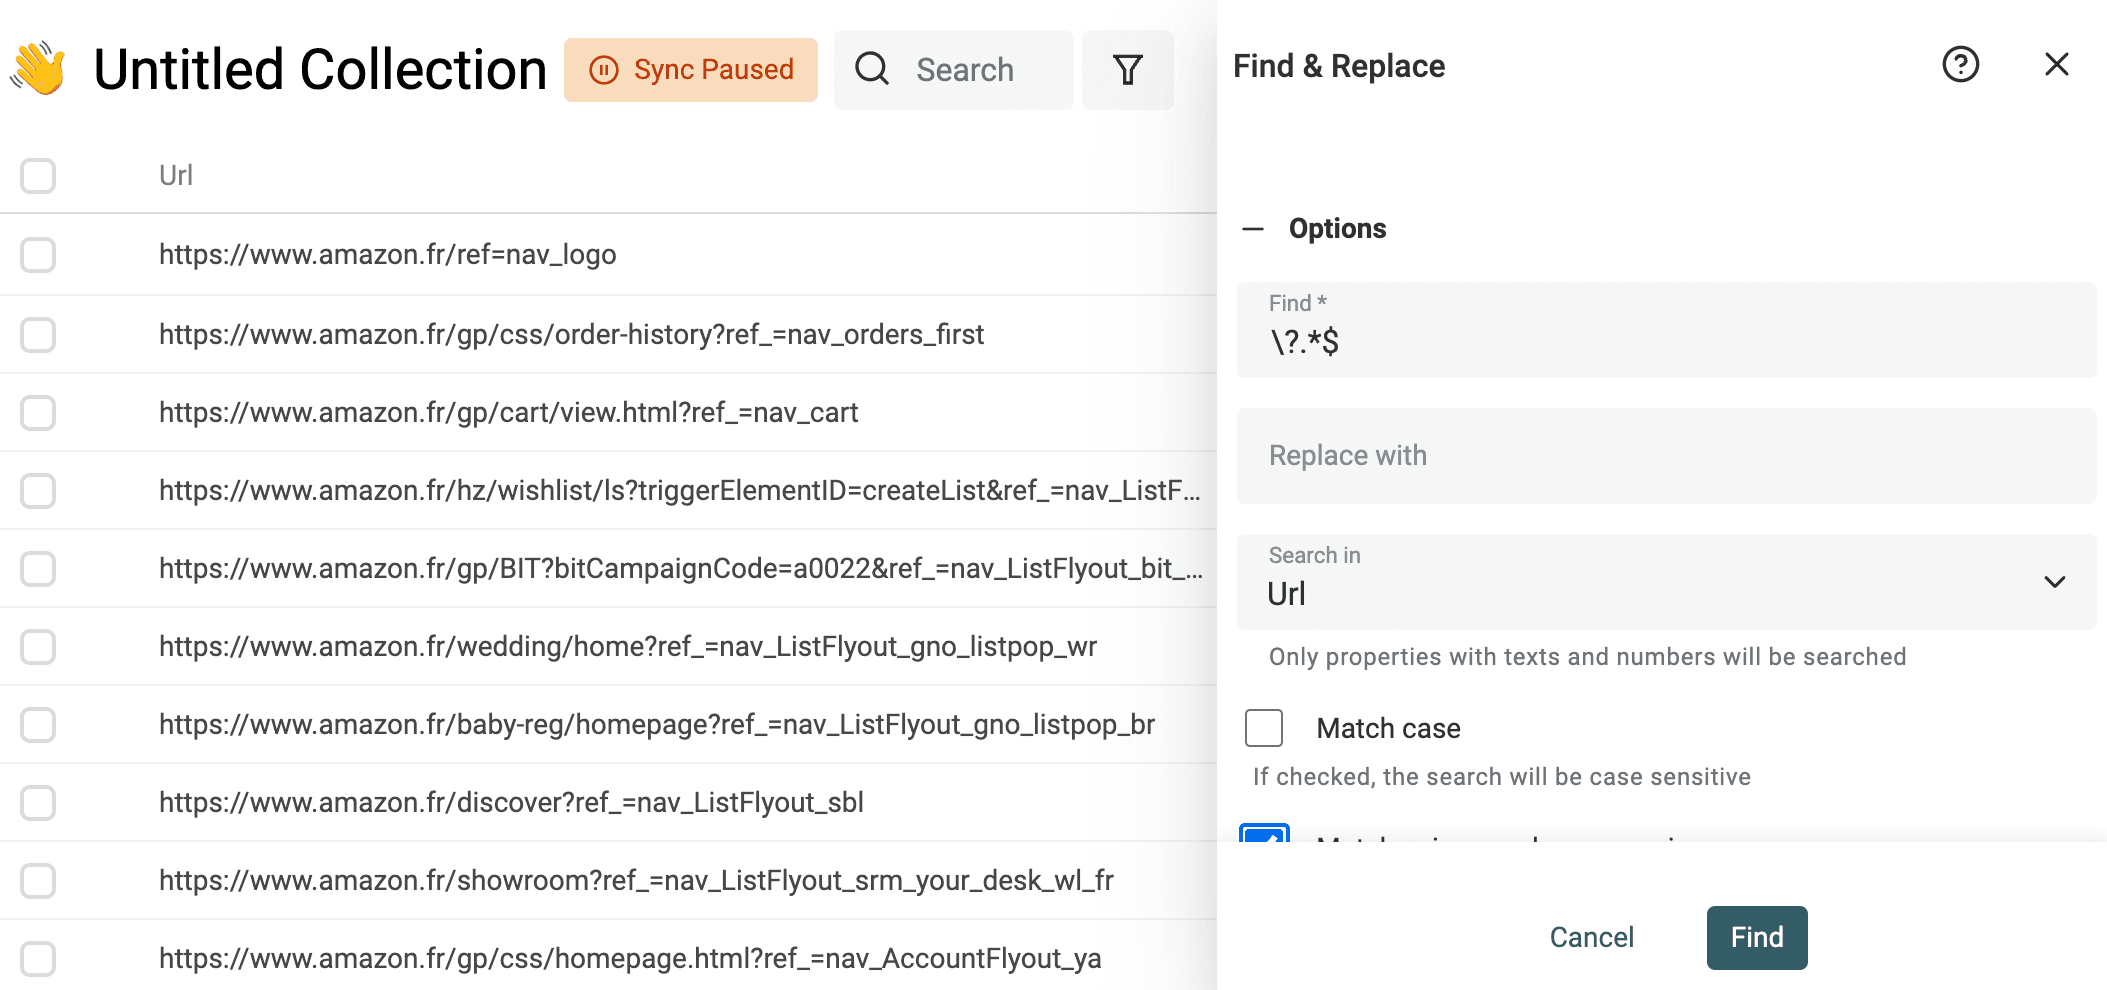
在预览中检查带查询字符串和不带查询字符串的 URL。确认它们仍指向预期页面后,再将转换应用于复制的 URL 属性。
从 Email 地址中提取域名
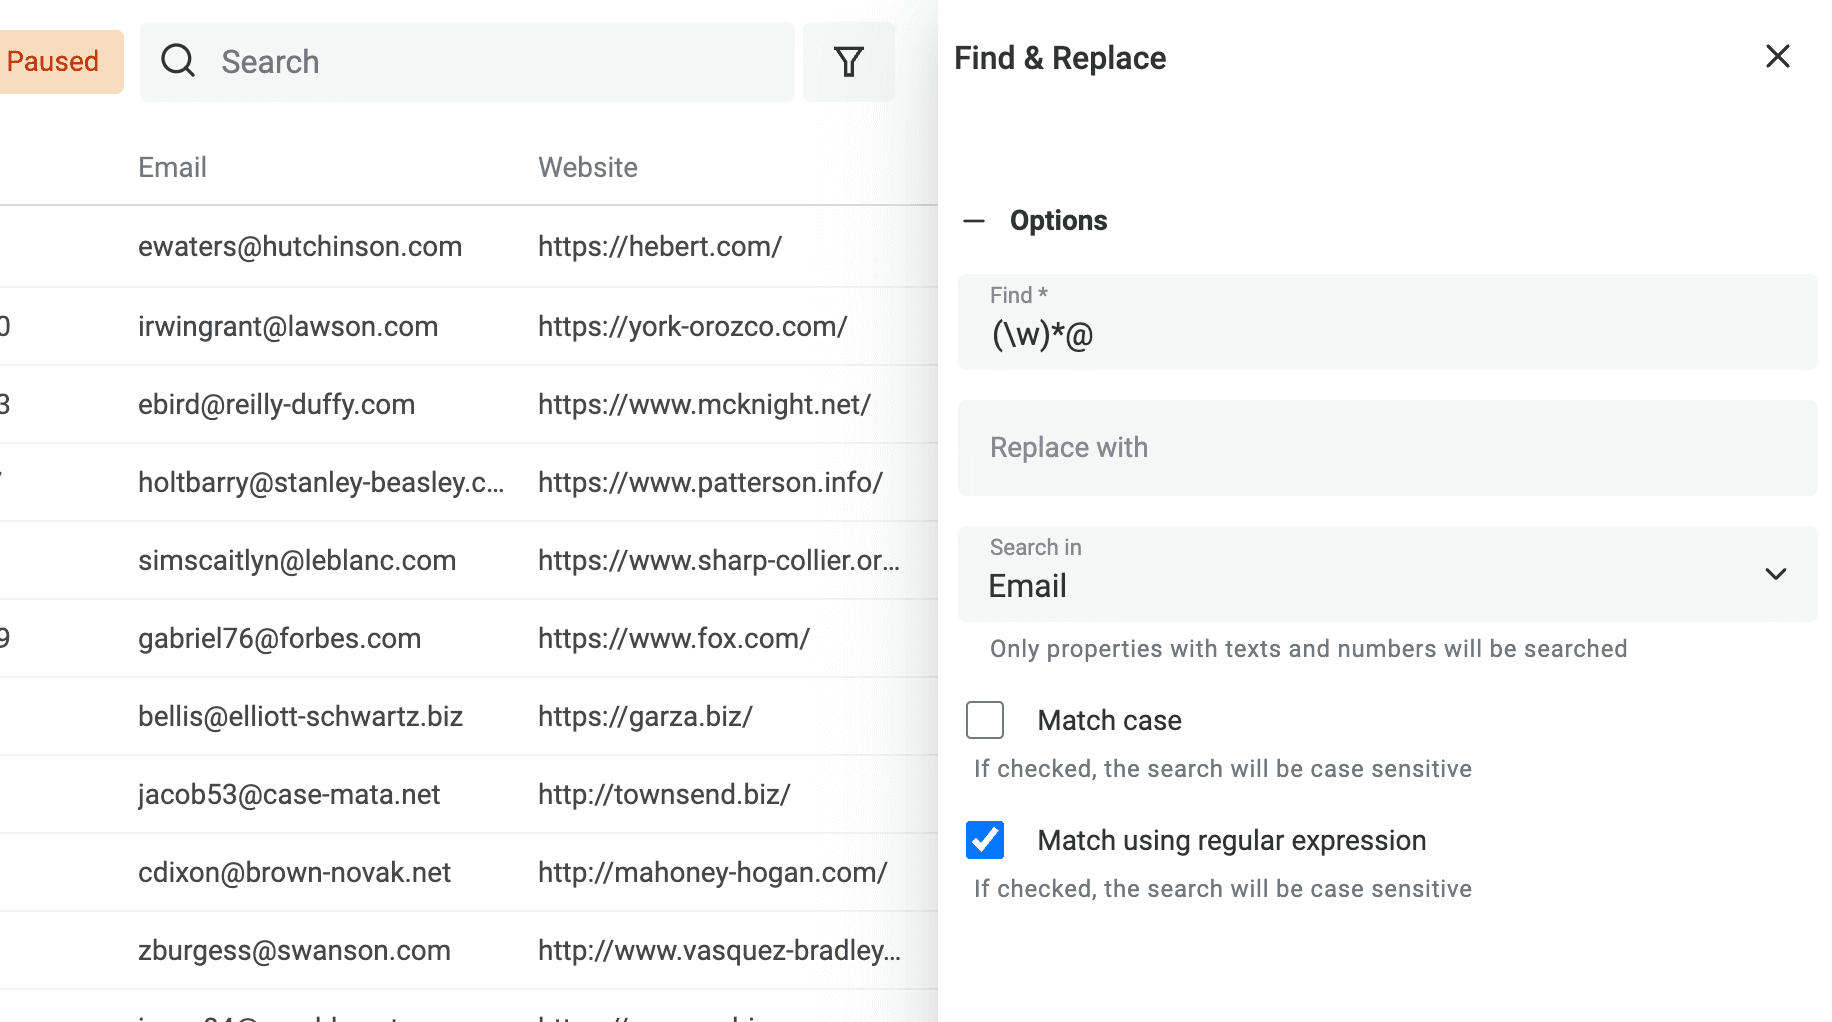
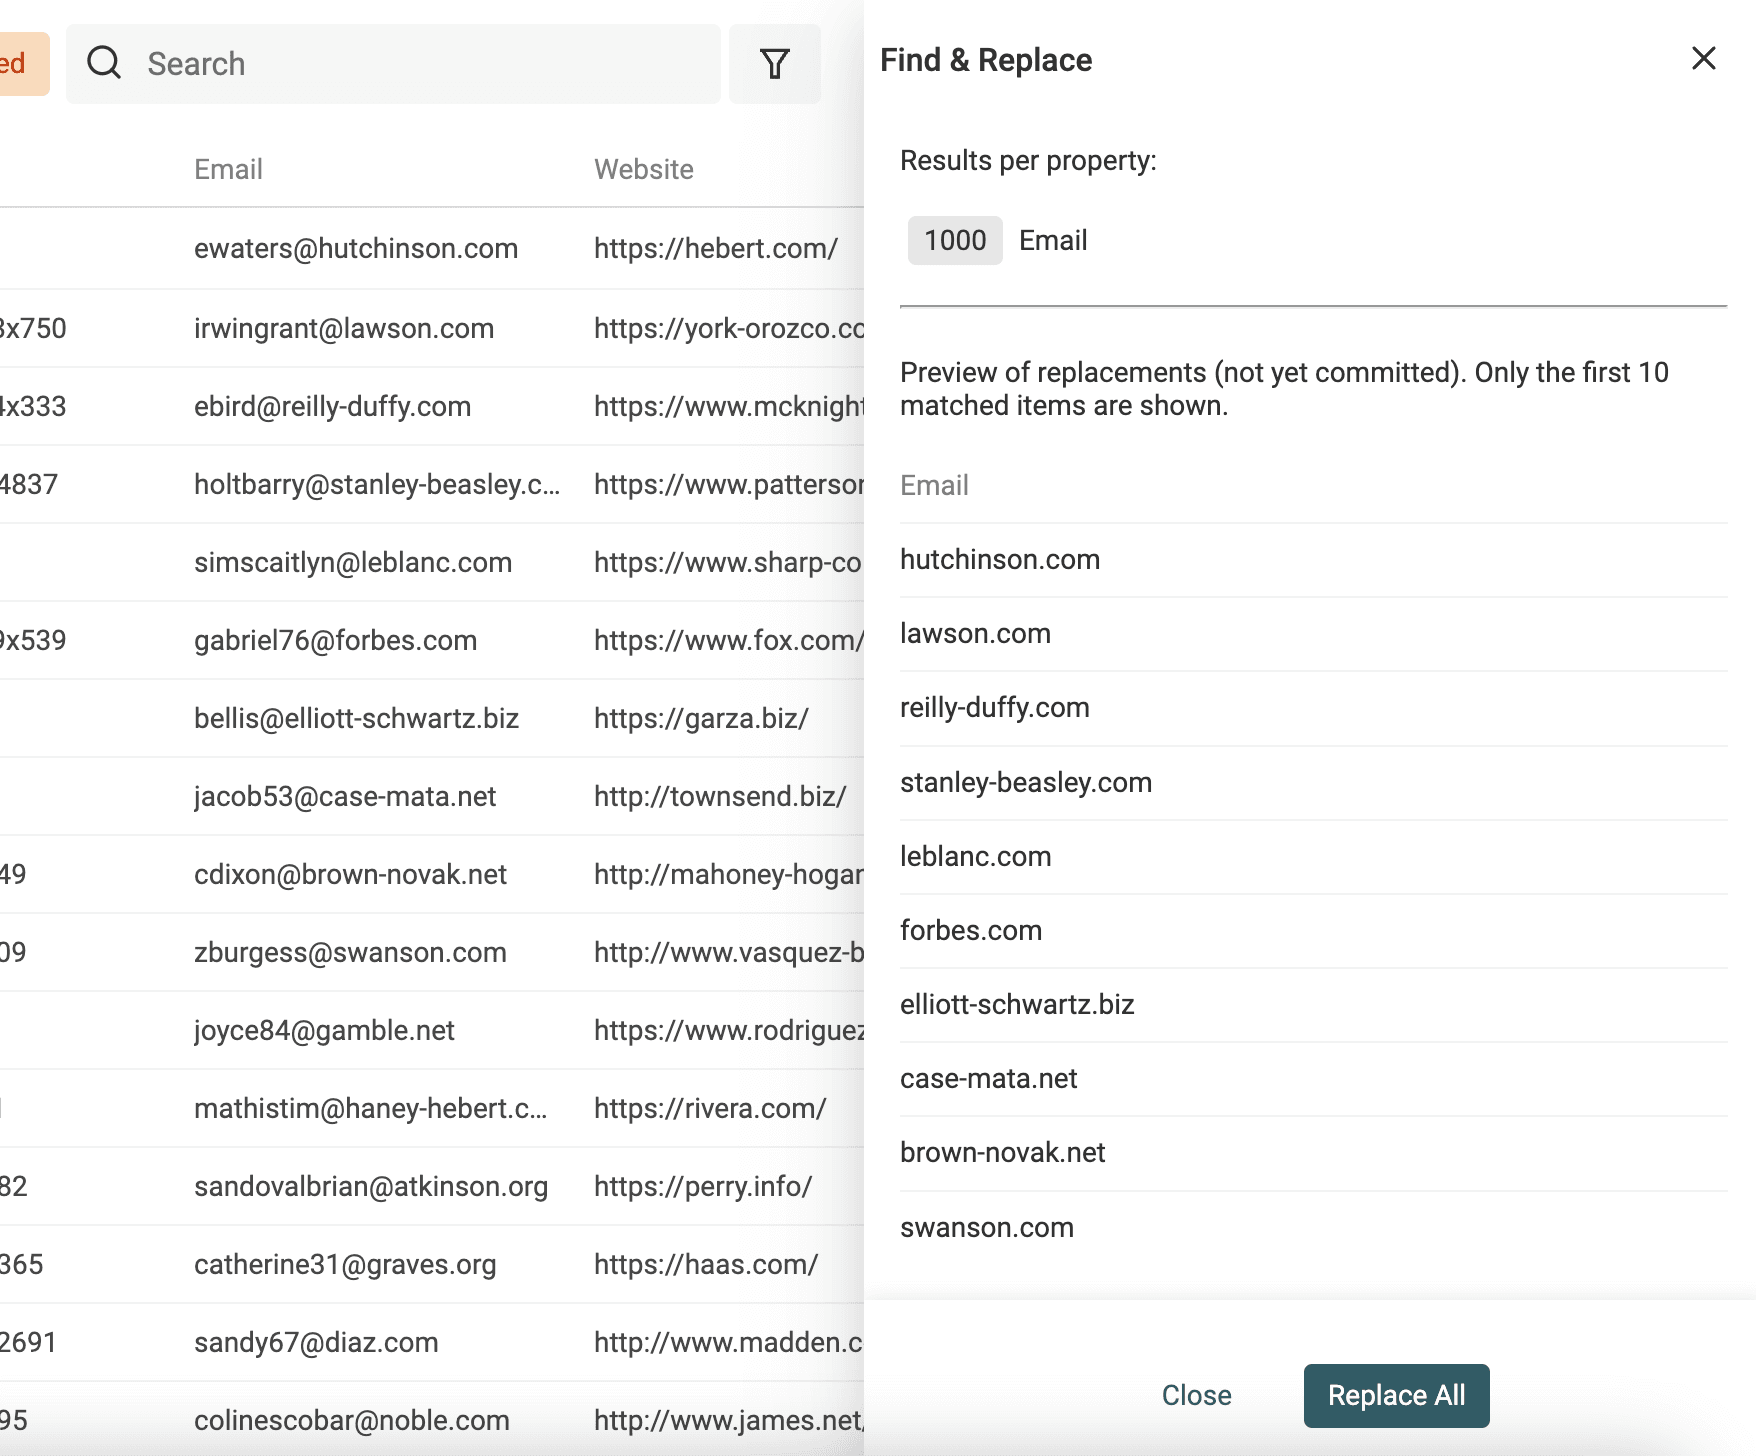
Find and Replace 的另一个用途是提取 Email 域名,也就是获取 @ 后面的部分。需要注意的是,它并不一定是企业官网域名,因为联系人可能使用个人邮箱服务商。
请先复制 Email 属性以保留源数据。对于仅包含一个纯 Email 地址的单元格,使用以下正则表达式,并将替换内容留空:
^[^@\s]+@(?=[^@\s]+$)
该表达式支持本地部分包含点号、加号和连字符。例如,jane.smith+sales@example.com 会变成 example.com。下方旧截图使用的匹配模式限制更多,请以本段提供的表达式为准。
请先删除地址前后的空格。包含显示名称、多个地址或格式错误 Email 文本的单元格,需要另行清洗。这个转换只能提取域名,并不能验证邮箱是否有效。
将 Full Name 拆分为 First Name 和 Last Name
抓取 Lead 名单时,你通常会获得联系人的 "Full Name",并需要将其拆分为 "First Name" 和 "Last Name"。准确地把姓名解析成不同组成部分,是数据处理中的关键一步。
拆分姓名字段有助于称呼联系人,以及将数据映射到 CRM。请保留完整姓名,以便检查错误的拆分结果;仅凭姓名无法确定一个人的性别或称谓。
姓名拆分可能很复杂。好在 Datablist 提供了简单易用的工具,可以空格为分隔符,将 "Name" 拆分成两个值。
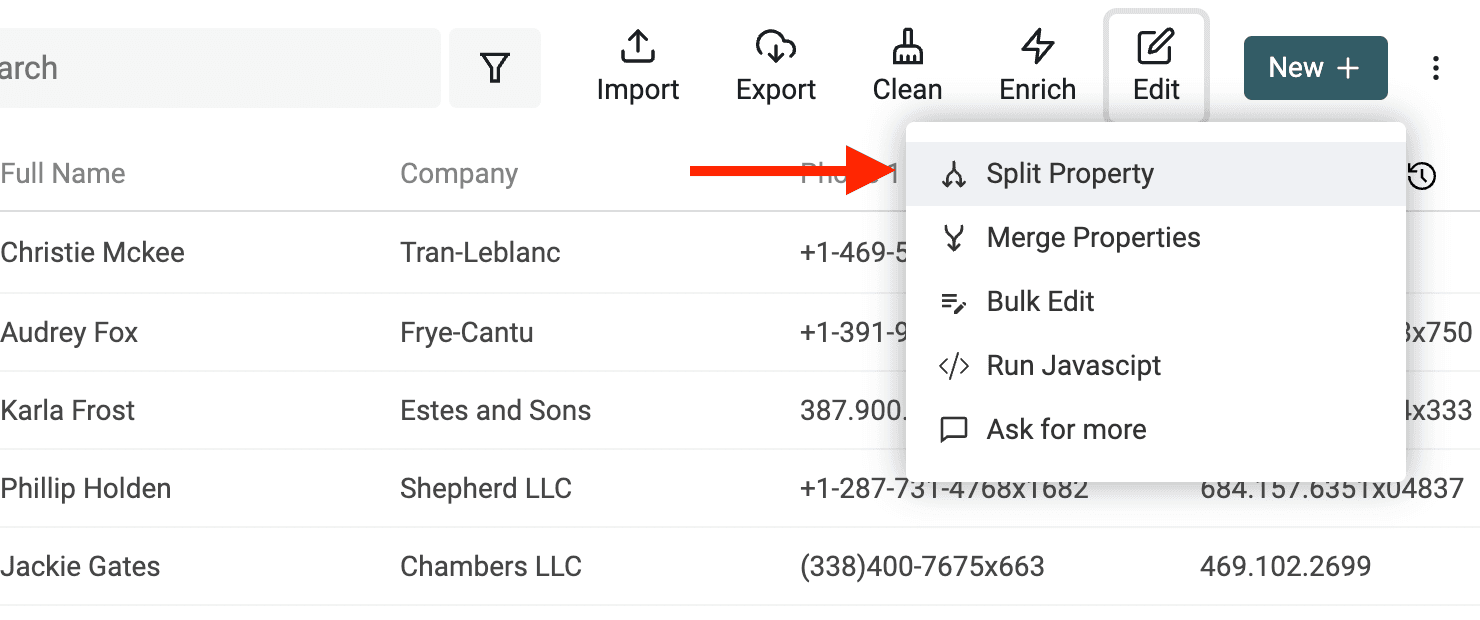
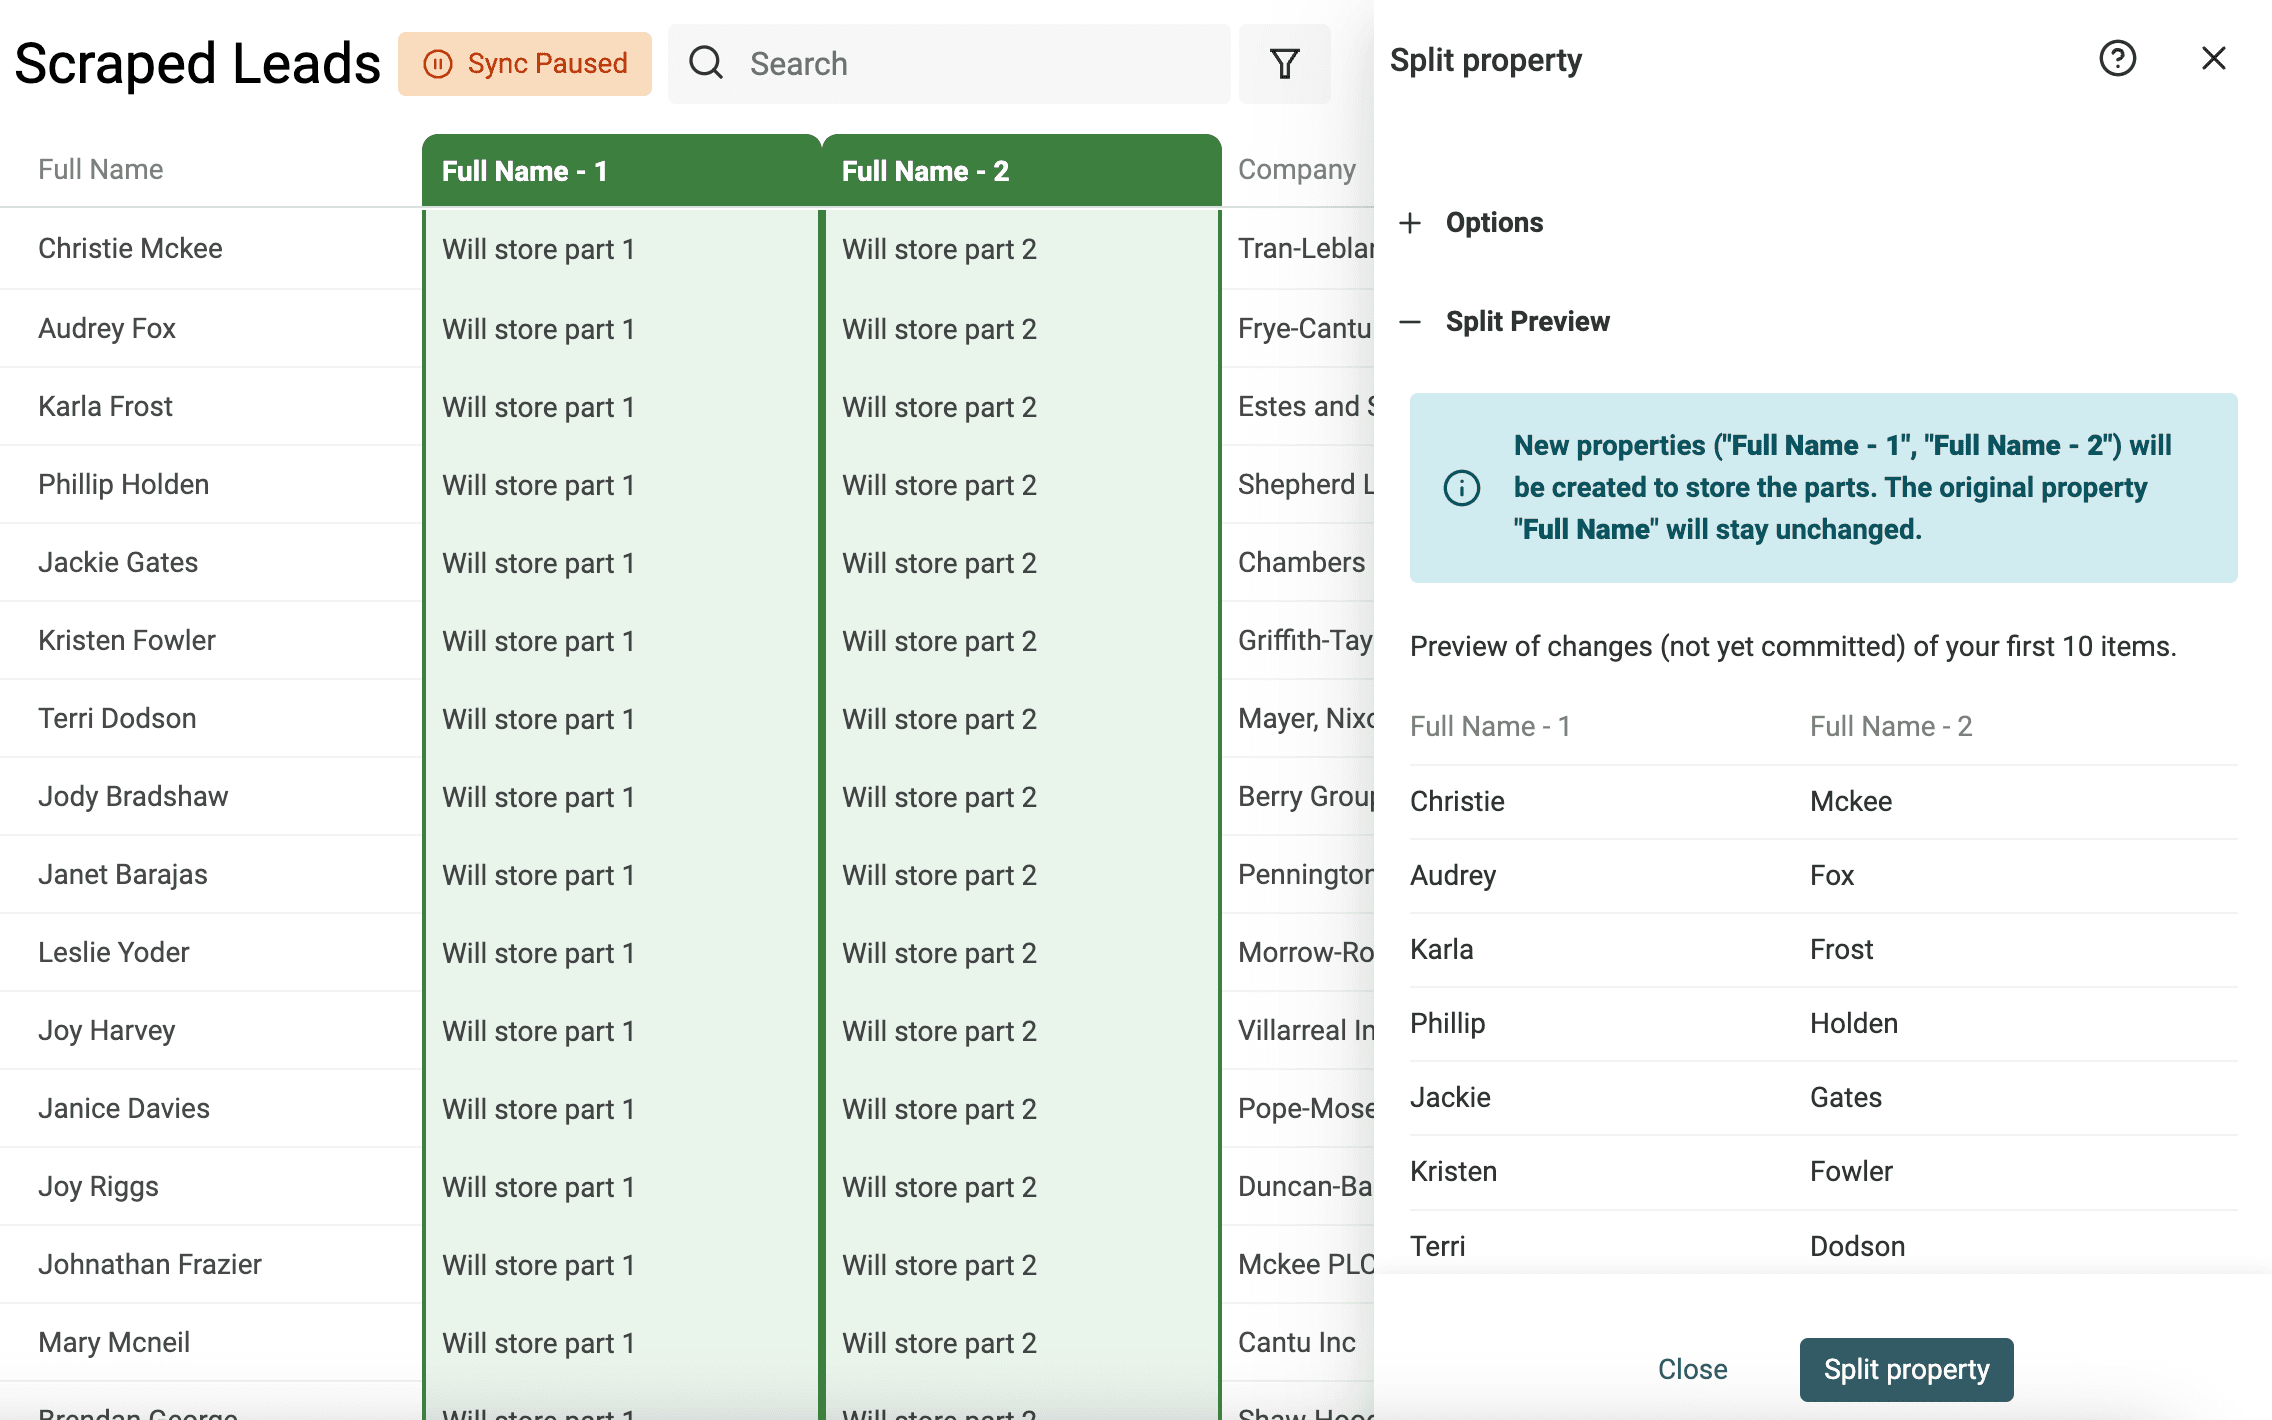
首先,在 "Edit" 菜单中打开 "Split Property" 工具。
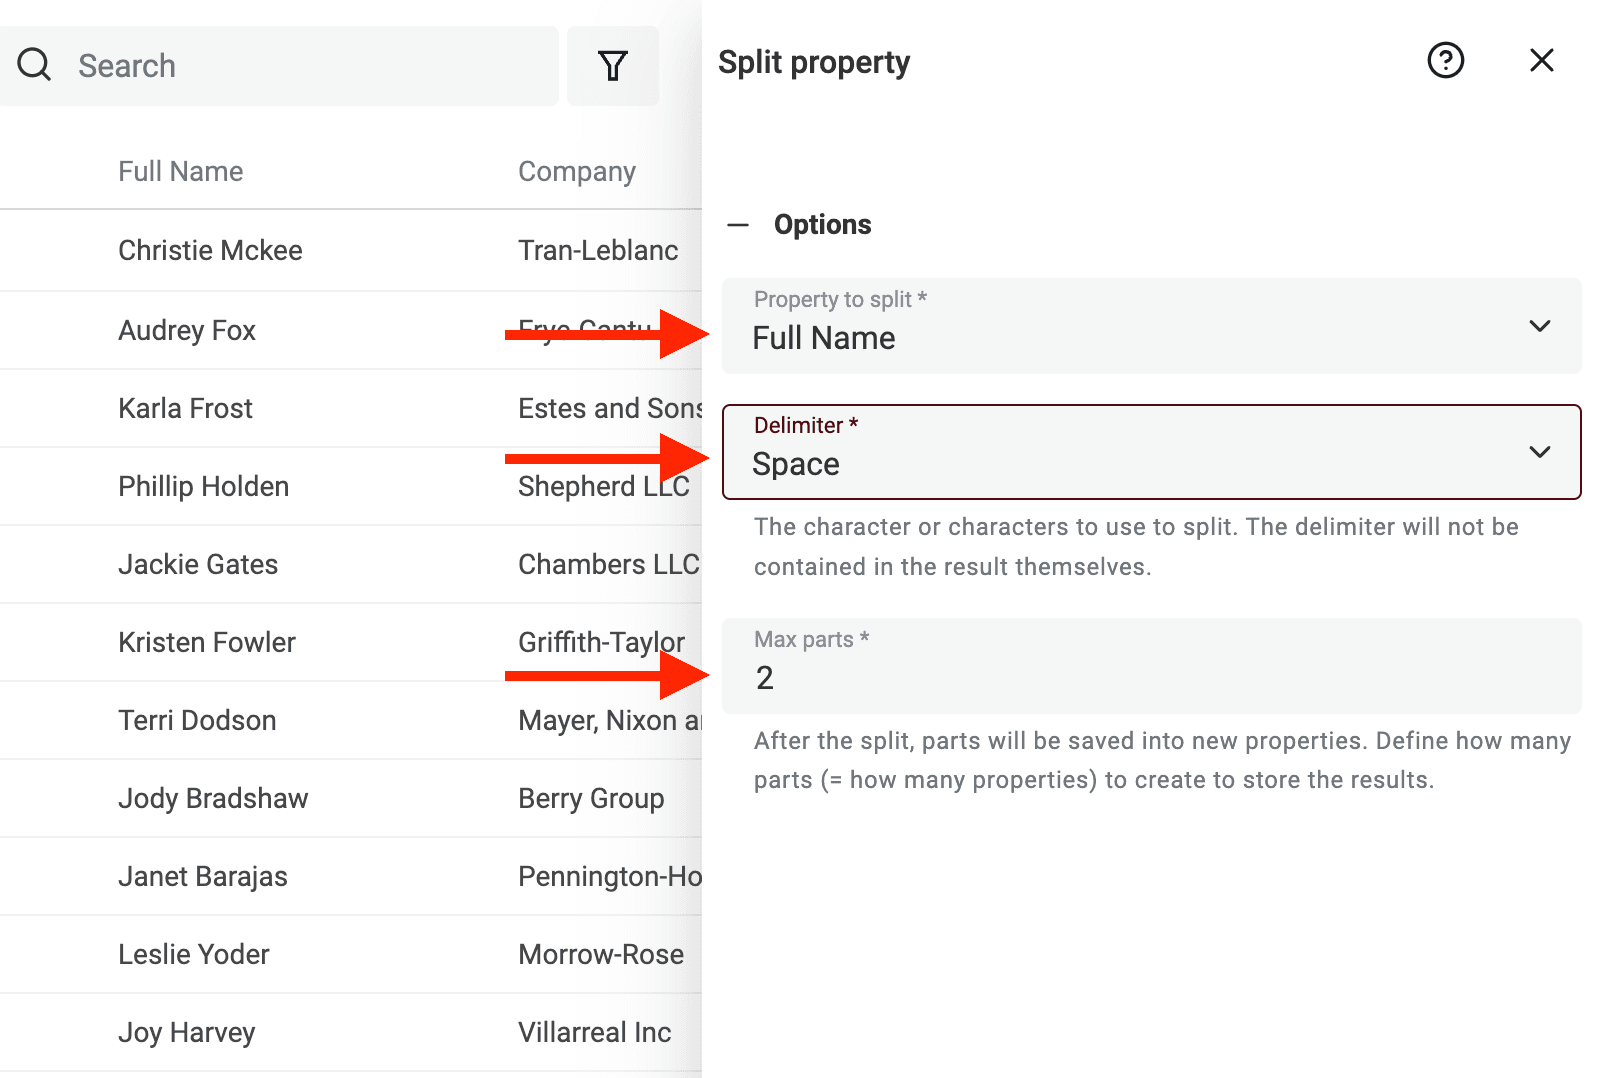
然后选择包含待解析姓名的属性,将分隔符设为 Space,并把最大拆分数量设为 2。
运行预览。Datablist 会解析前 10 条记录并生成预览。如果结果正确,请点击 "Split Property",对当前所有记录运行该算法。
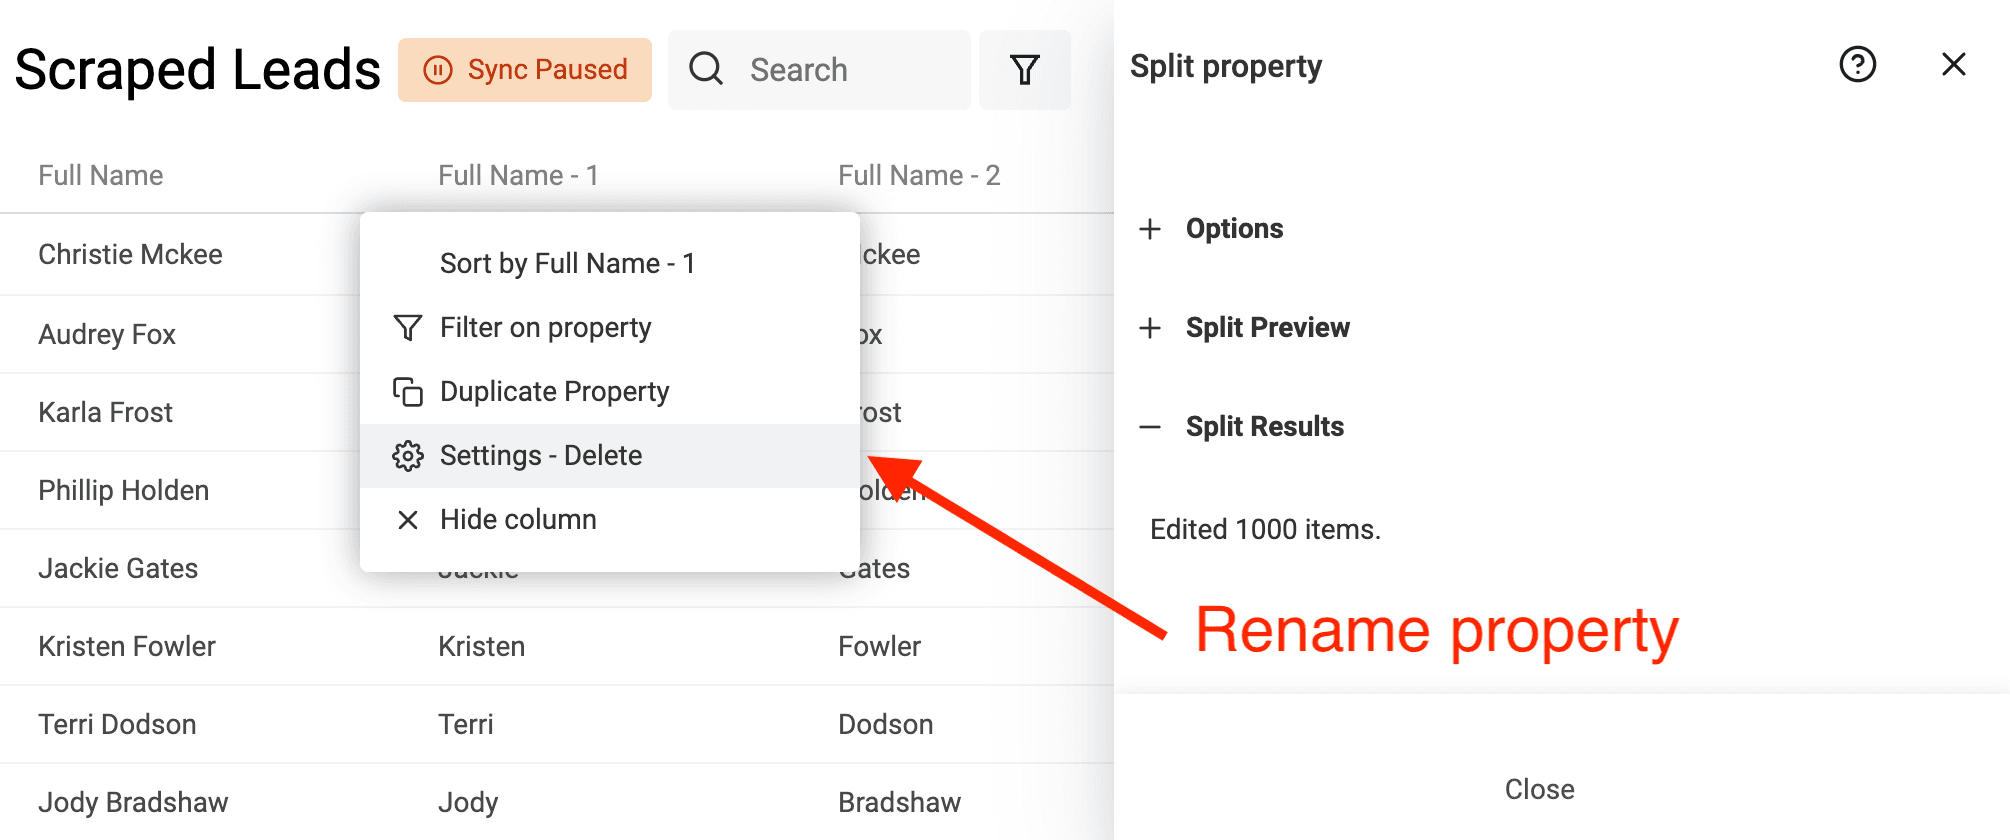
拆分算法运行完成后,将新建的两个属性重命名为 "First Name" 和 "Last Name"。
本示例主要解析西方姓名,通常由 First Name 和 Last Name 组成。对于非西方姓名,情况可能更复杂,例如包含多个名字或姓氏,或者姓名中带有称谓和后缀。中文姓名通常姓在名前,也不适合直接按西方规则拆分。
数据去重
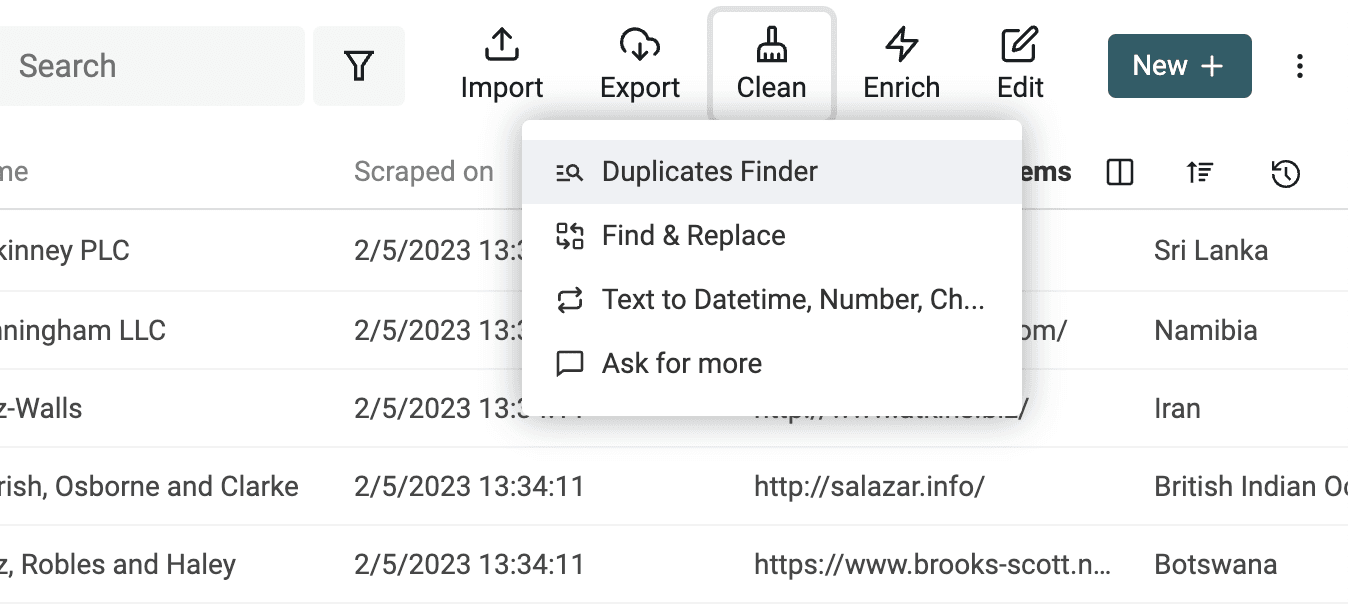
如果多行记录中都含有需要保留的信息,请打开 Clean > Merge duplicates。如果只想原样保留一行并删除其余记录,请使用 Remove duplicates。下方截图展示的是较早版本的菜单布局。
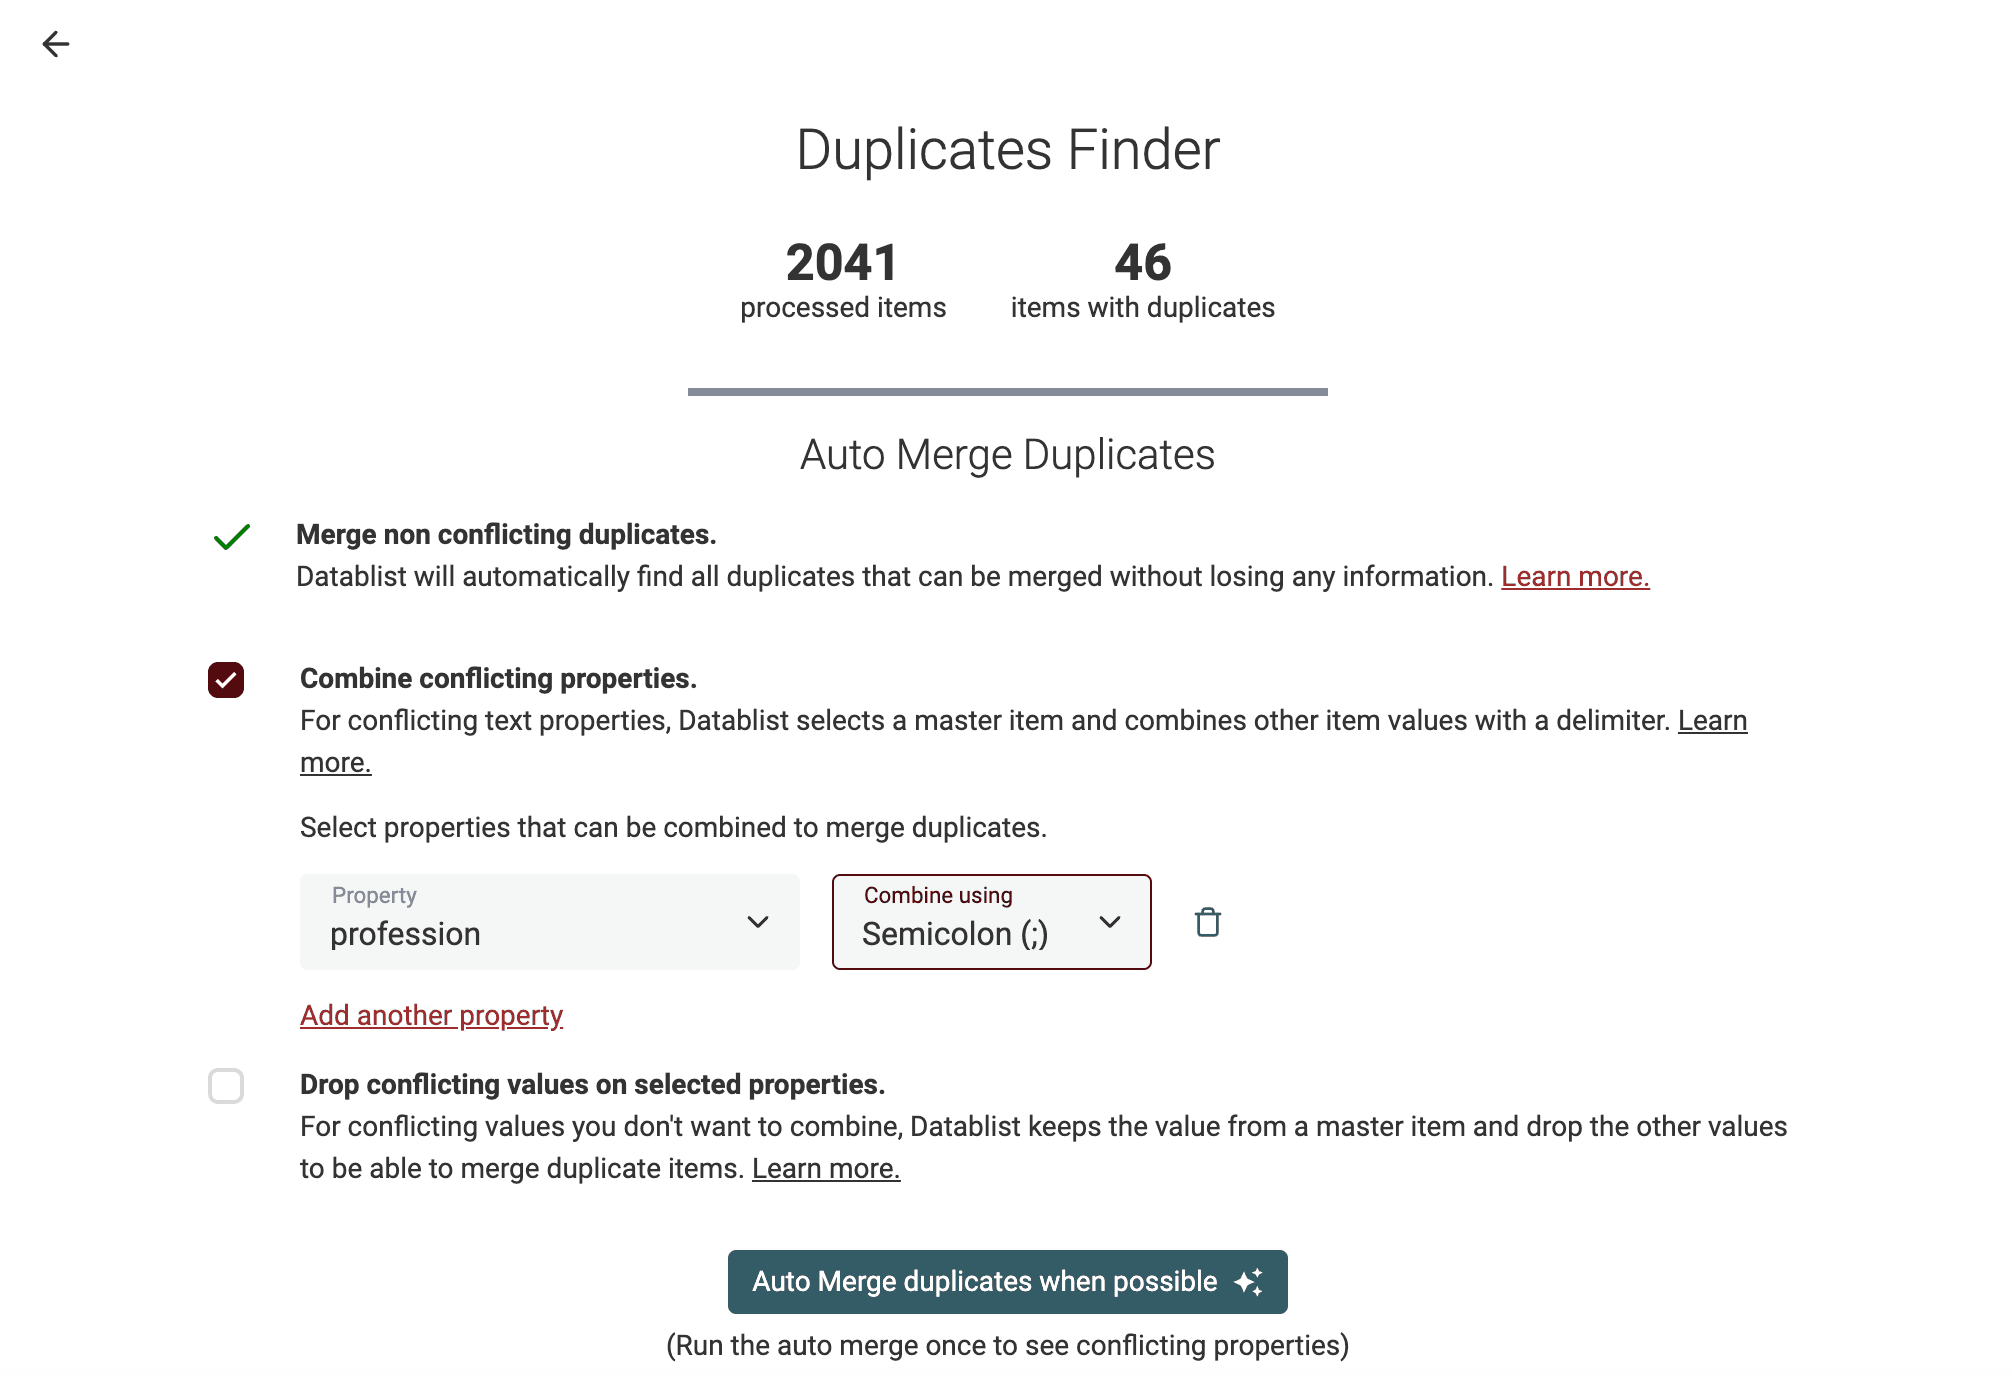
选择能够唯一标识一条记录的属性。我通常优先使用联系人 Email 或产品 URL,而不是只用企业名称。只要已有可靠的匹配键,就没必要规范化每个字段。
检查过程会创建可供审核的分组,不会直接修改数据。在结果 workspace 中,选择 Merge and preserve data,检查 Record to keep,并在 Resolve conflicting values 下配置规则。需要同时保留多个文本值时可进行合并;只有确定可以舍弃其他值时,才只保留一个值。
点击 Merge ready groups 前,请检查所有 Ready 分组。如果选择删除重复项,则要检查被删除行中是否存在额外数据,因为该模式不会把这些数据补充到保留行中。
验证 Email 地址
抓取的数据可能已经过时,也可能存在拼写错误或无效值。 对于通过 Scraping 获得的 Email 地址,这类问题尤其常见。
如果数据由用户生成,数据库中可能会出现虚假 Email 地址,或来自临时邮箱服务商的地址。
Datablist 内置 Email 验证工具,可一次验证数千个 Email 地址。
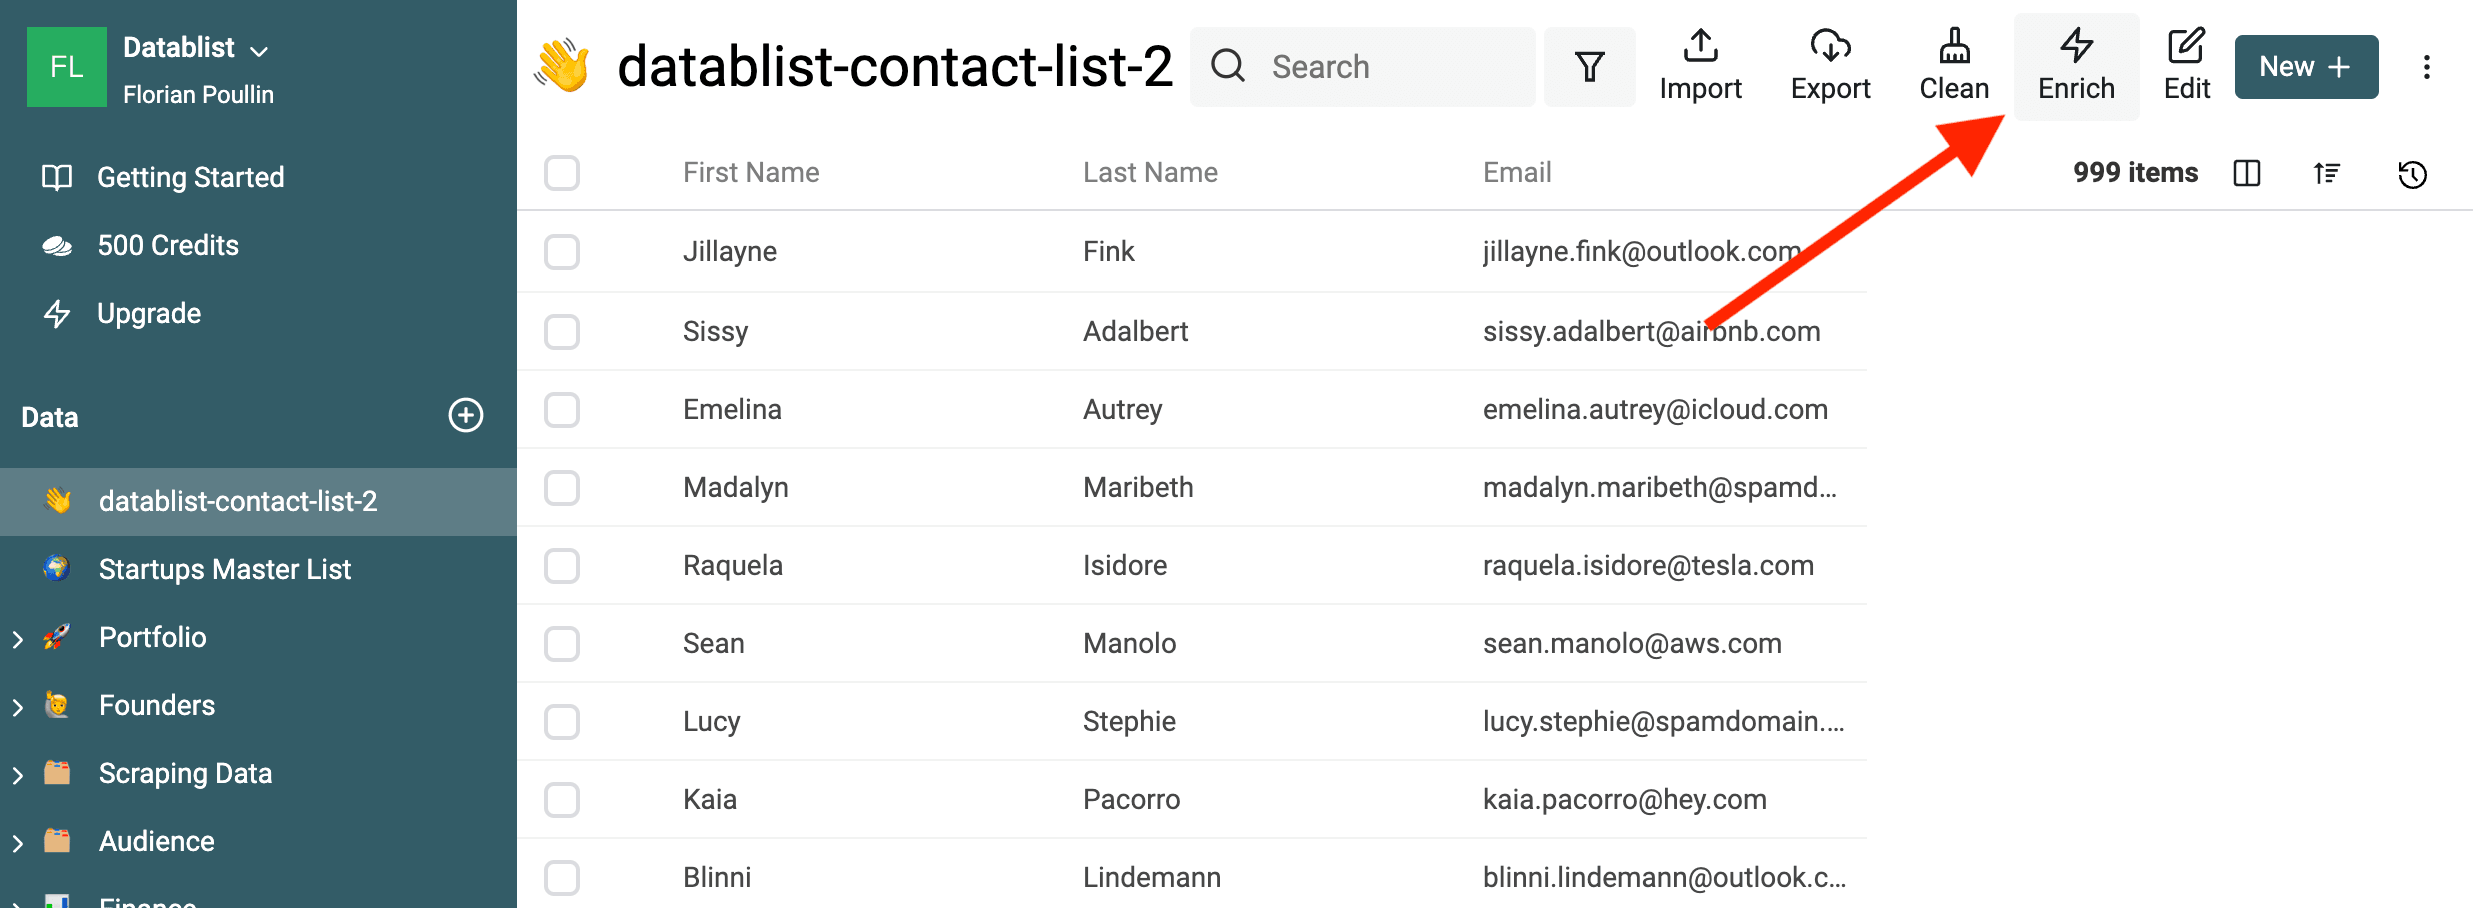
这项免费的 Email 清洗服务会检查格式、临时邮箱域名;启用相关选项后,还会检查域名的 MX 记录。这些检查并不能证明某个具体邮箱真实存在,也不能保证邮件一定可以送达。 请保留工具返回的状态或原因,以便审核异常项。
该服务提供以下检查:
- Email 格式分析 - 标记格式错误的地址,例如缺少
@符号,或域名格式无效的文本。 - 临时邮箱服务商检查 - 第二项检查用于识别临时 Email。该服务会查找属于 Disposable Email Address(DEA,一次性邮箱)服务商的域名,例如 Mailinator、Temp-Mail、YopMail 等。
- 域名 MX 记录检查 - 除非启用 Disable MX-records analysis,否则系统会查询域名的邮件服务器记录。DNS 查询失败或缺失的结果应与格式错误分开审核;这项检查针对域名,而非某个具体邮箱。
- Business 与 Personal Email 地址细分 - 如果 Lead 来自 Lead Magnet,或者你需要细分用户群体,可能会希望区分 Business Email 和 Personal Email。Email 验证服务会提供相关信息,用于丰富联系人数据。
从抓取文本中提取人名或企业名称
从网站或其他来源抓取文本时,提取人名或企业名称通常很有价值。这些信息可用于 Lead Generation、竞品分析等多种场景。然而,从非结构化文本中提取名称并不容易,因为名称形式多样,而且可能隐藏在大段文本中。
名称提取的一大难点,在于不同文化和语言采用的命名习惯与格式差异很大。例如,有些文化习惯姓在名前,另一些则习惯名在姓前;有些人有多个名字,也有人没有名字。此外,名称还可能存在拼写错误、缩写或非标准格式,因此很难仅靠简单的模式匹配准确识别。
一种常见方法是使用 Named Entity Recognition(NER,命名实体识别)。这是一项自然语言处理技术,可以识别文本中的命名实体并进行分类。NER 模型能够通过训练识别人名、组织名称、地点等不同类型的实体,也可以针对不同命名规则和变体进行定制。
Datablist 内置强大的 "Named Entity Recognition"(NER)模型,可直接处理你的文本。该模型支持阿拉伯语、德语、英语、西班牙语、法语、意大利语、拉脱维亚语、荷兰语、葡萄牙语和中文。
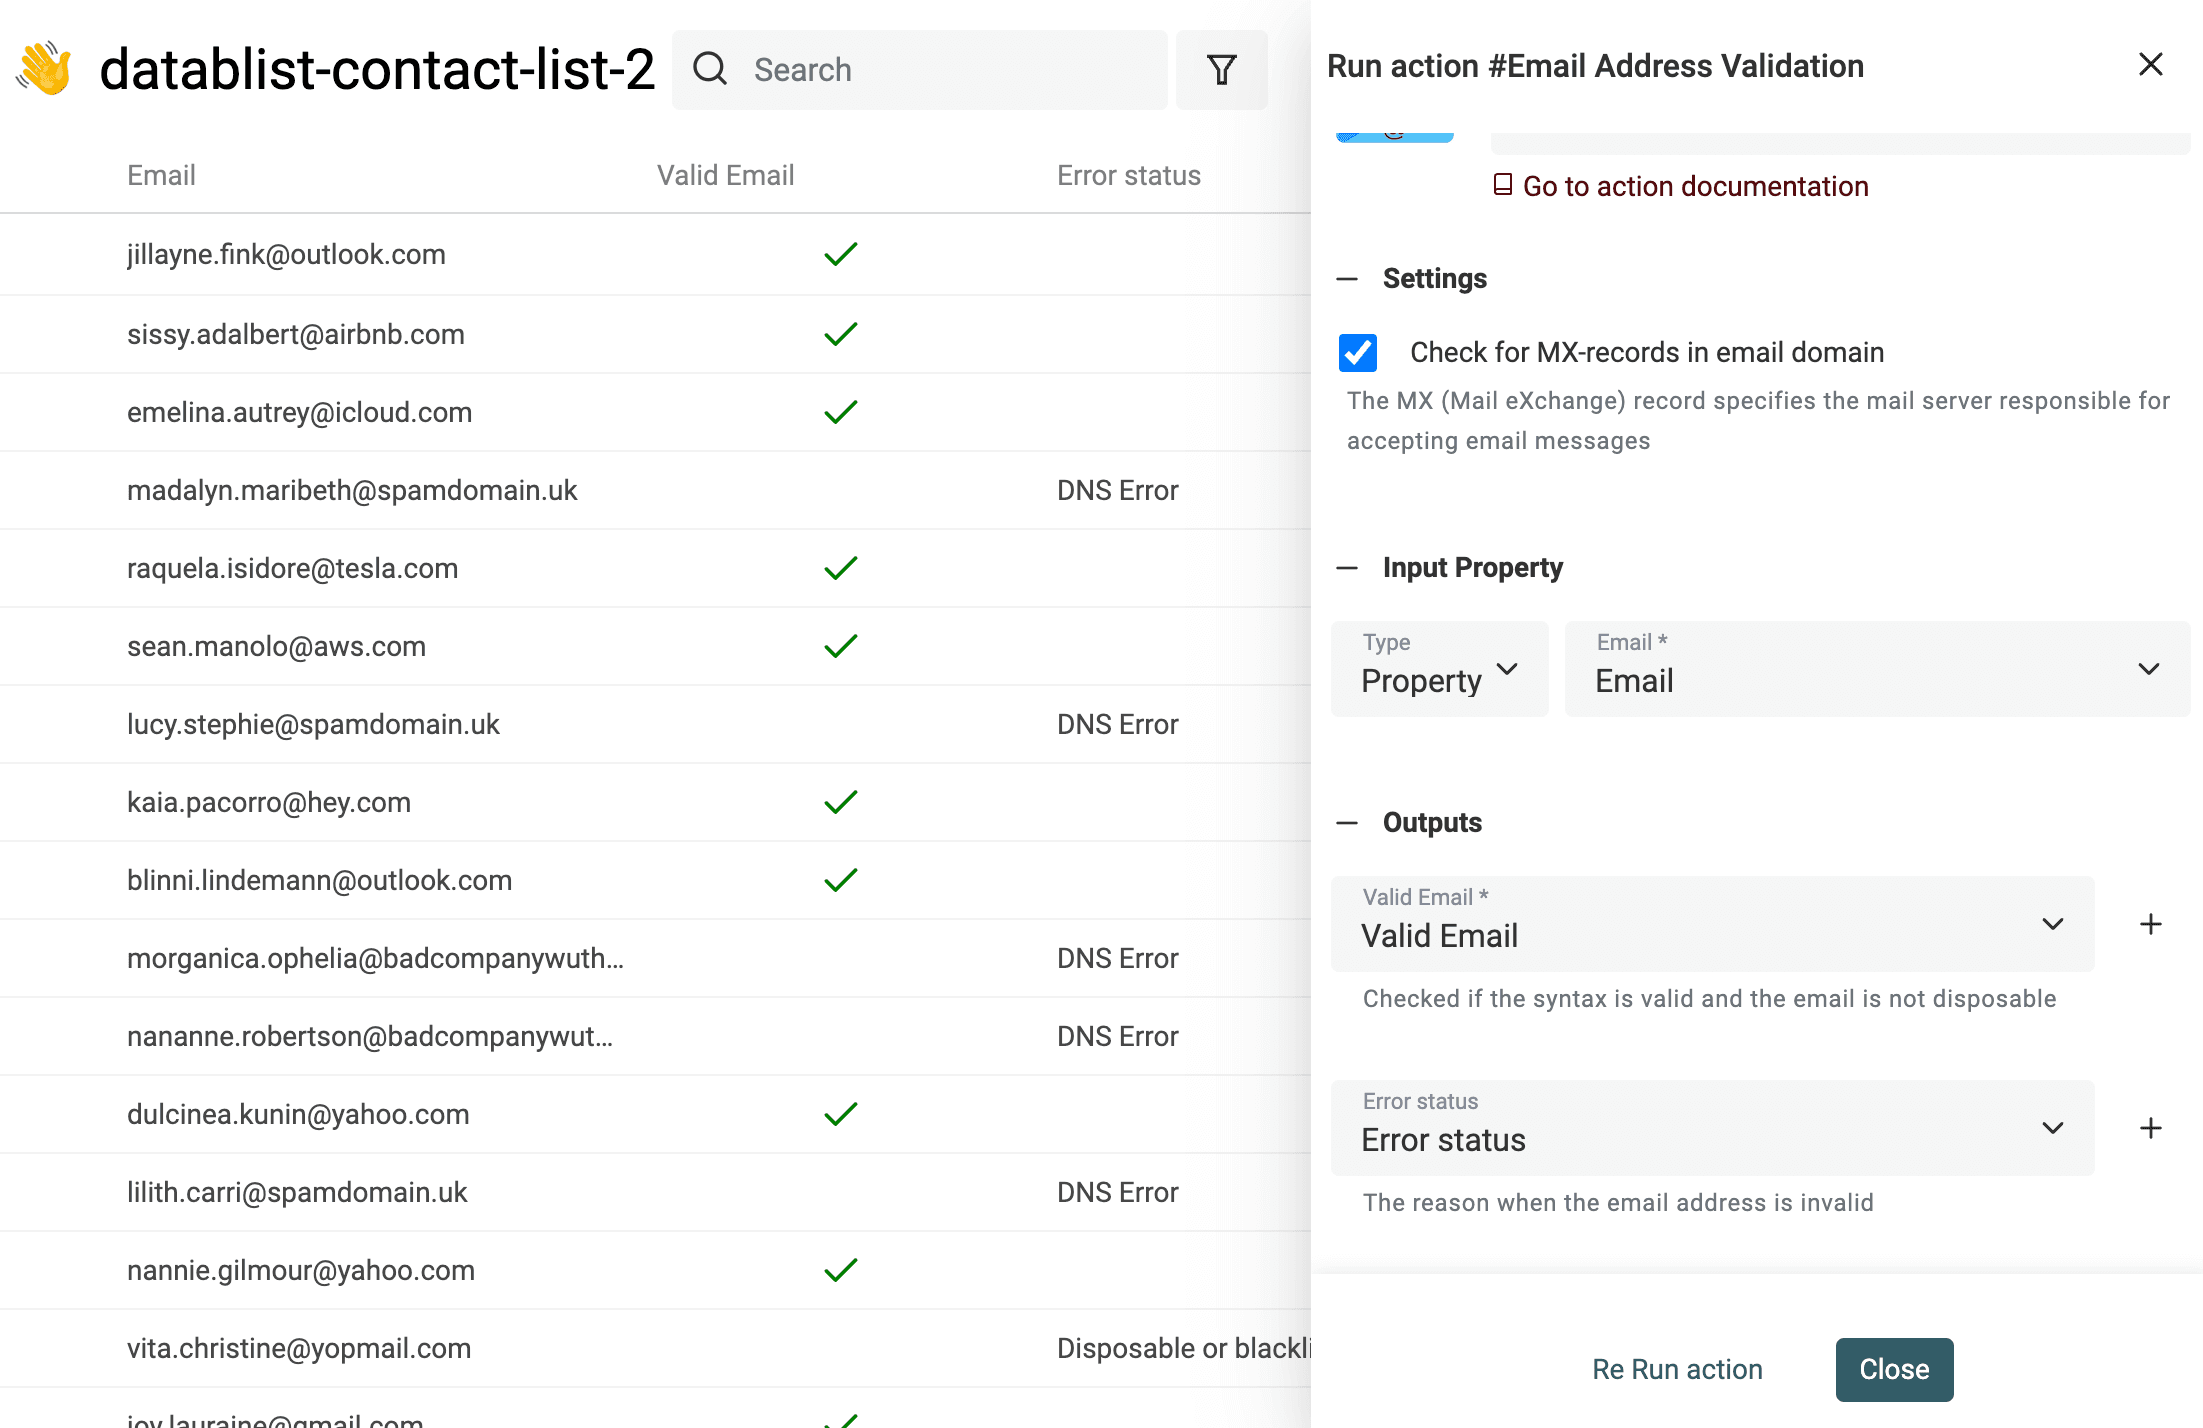
在 "Enrichments" 菜单中选择 "Entity name extraction"。
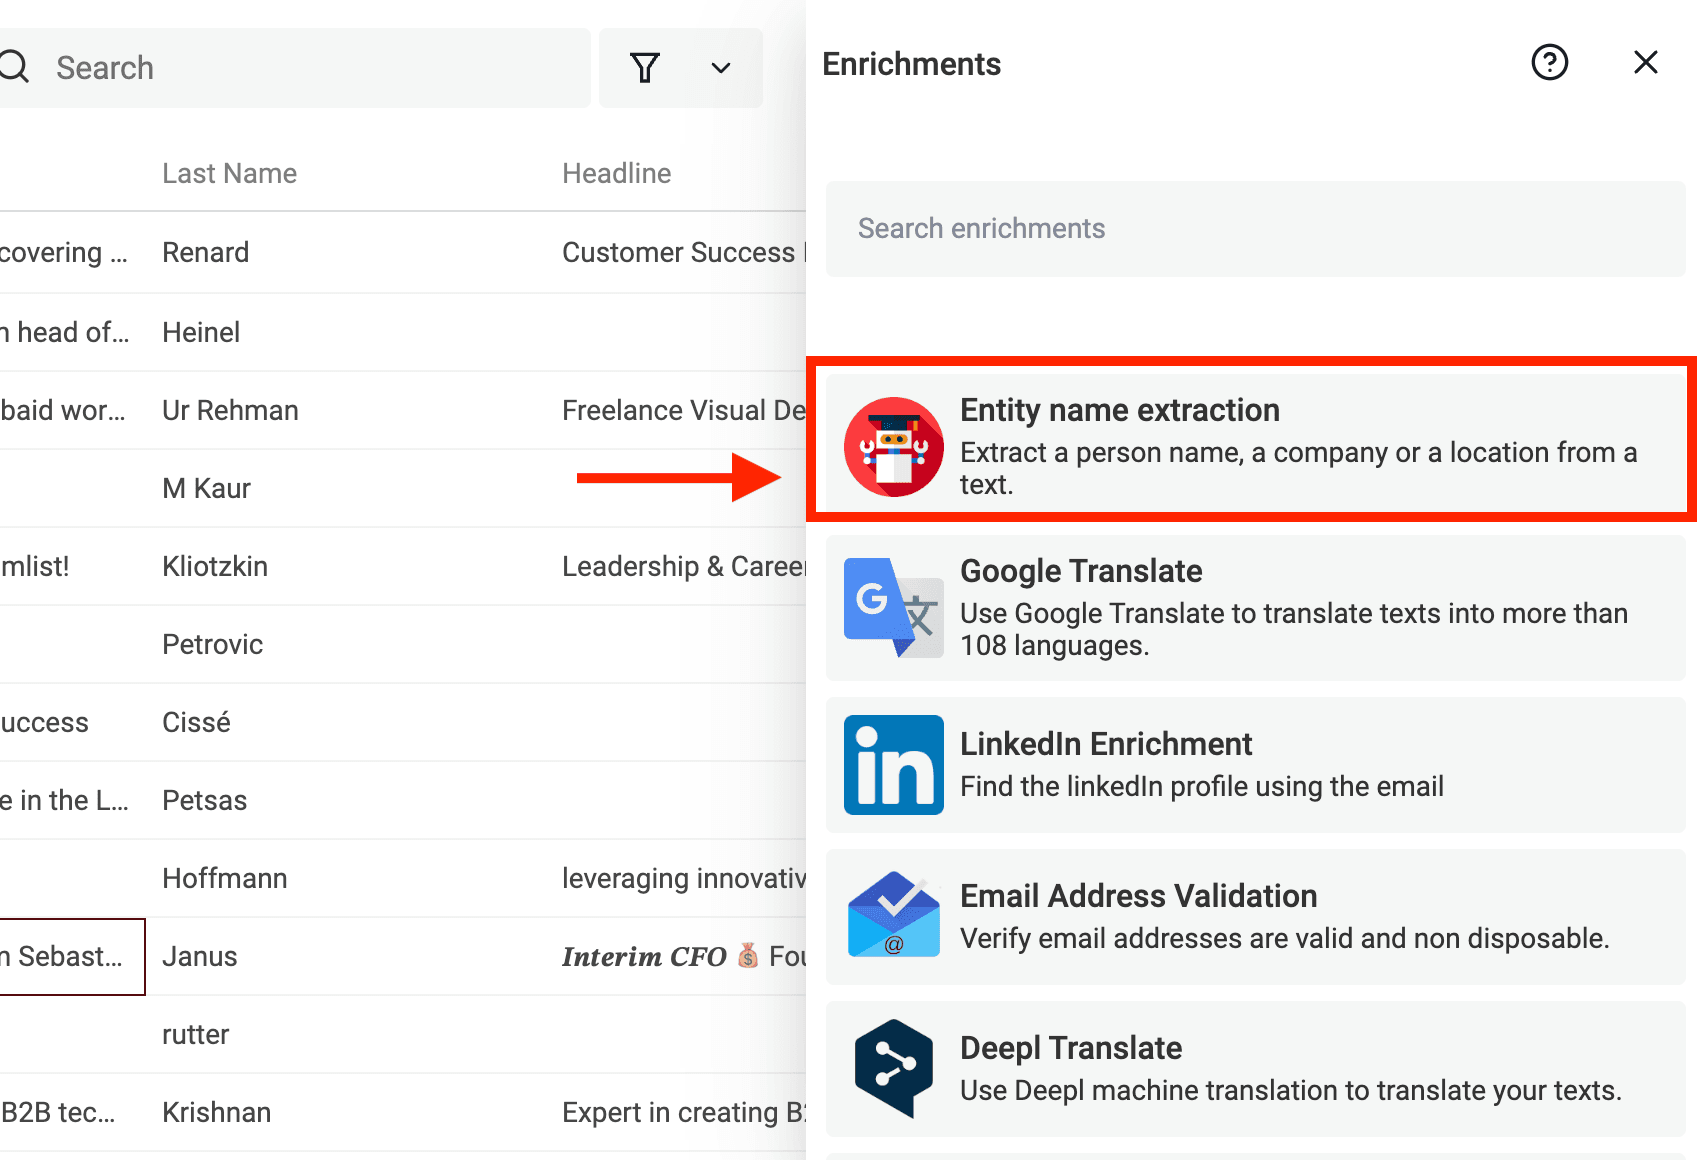
然后在输入选项中,选择需要从中提取名称的 Text 属性。
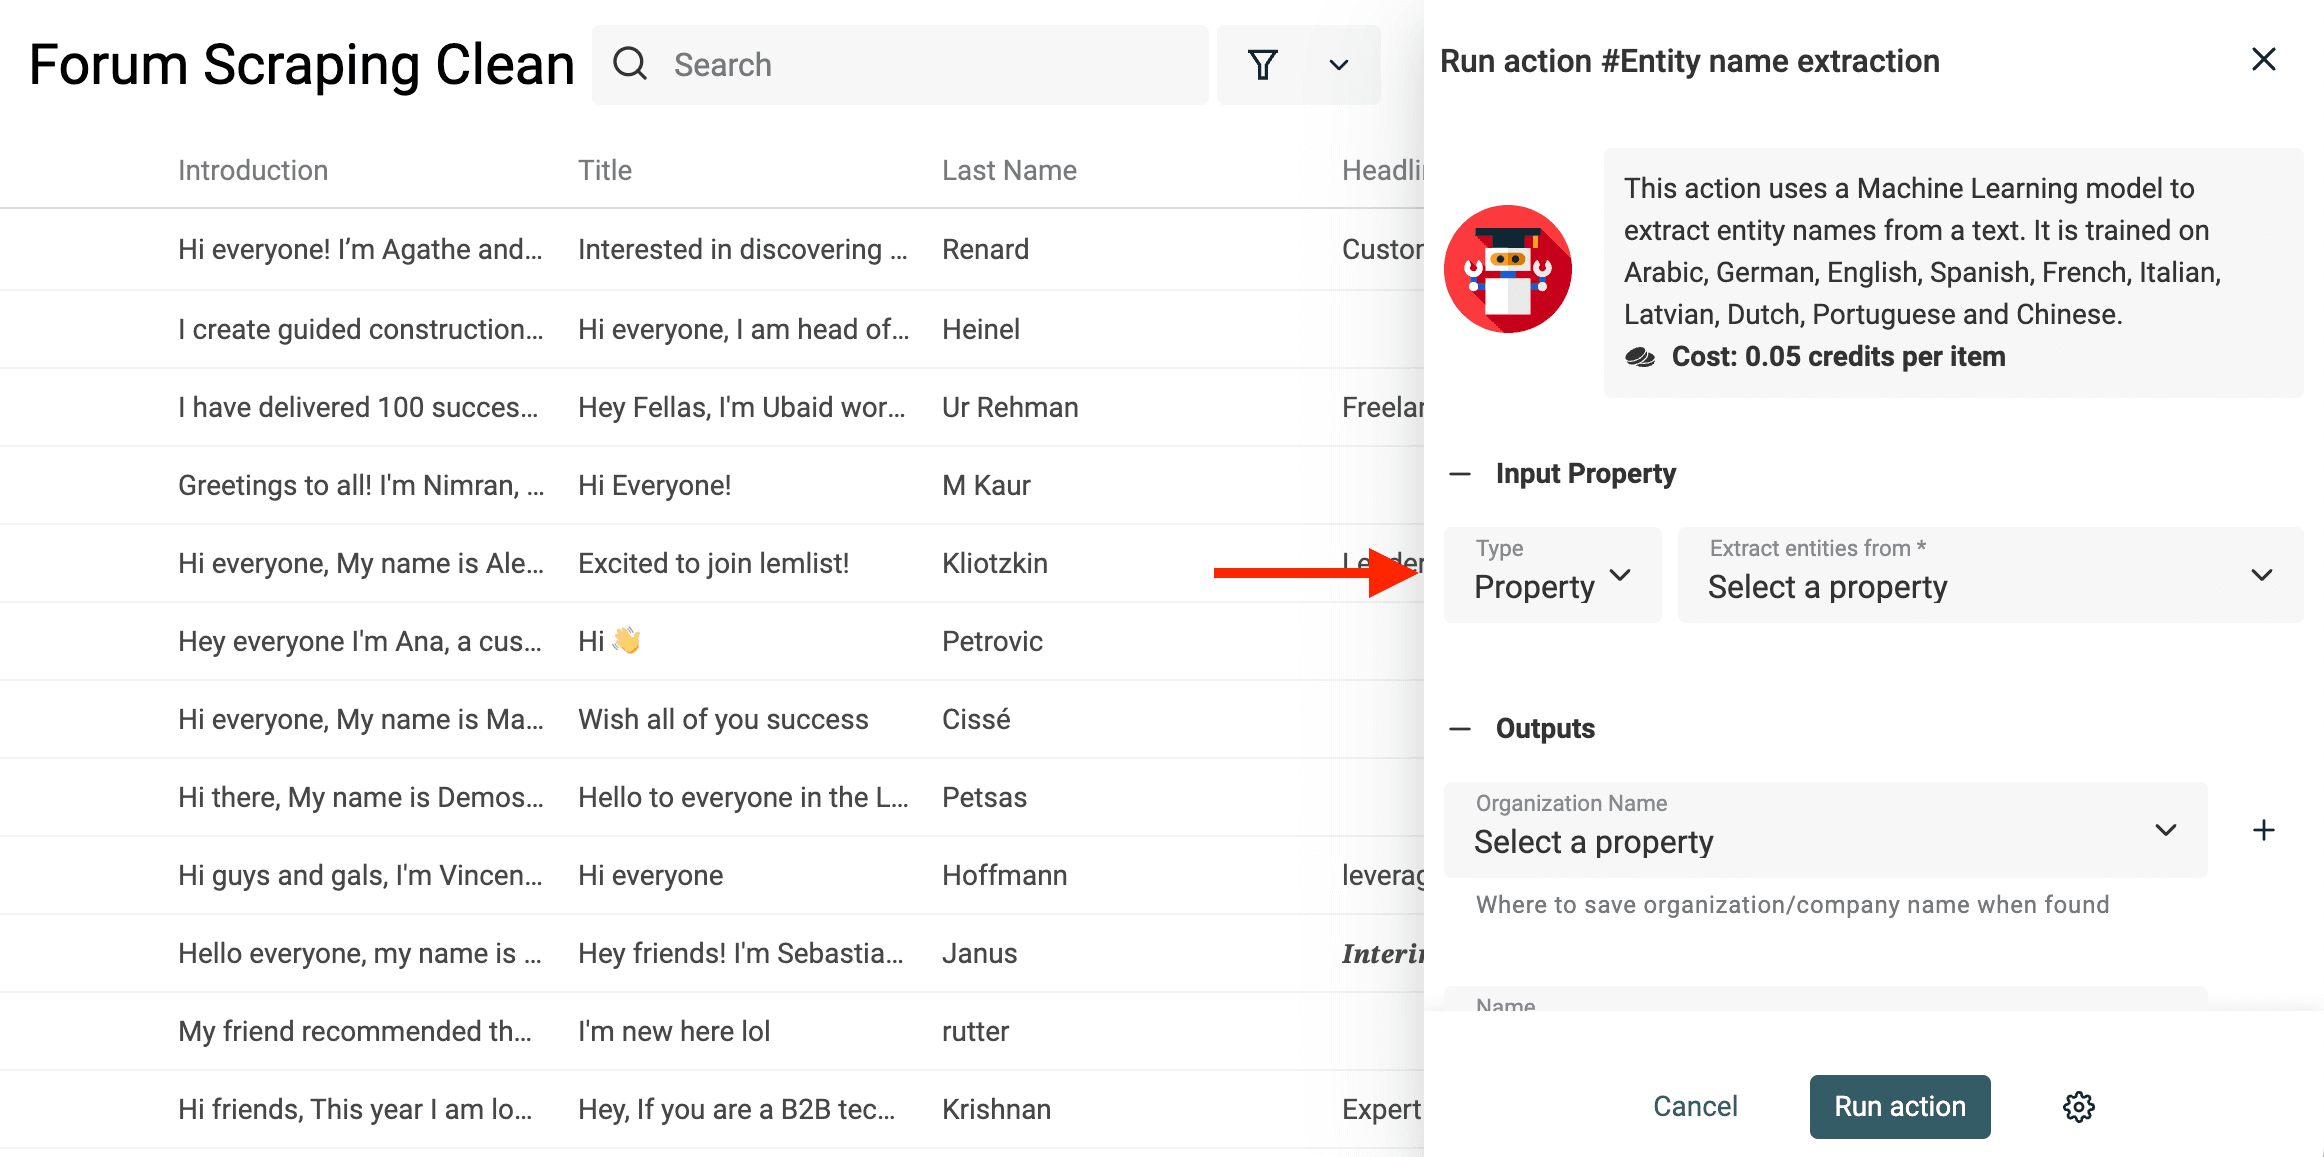
在输出设置中,针对每一种需要提取的名称类型,点击 "Create a new property" 按钮。
Datablist Entity Name extractor 可识别:
- Organization Name:例如企业名称。
- Person Name:Full Name 或 First Name/Last Name。
- Location:提取城市、国家和地点。
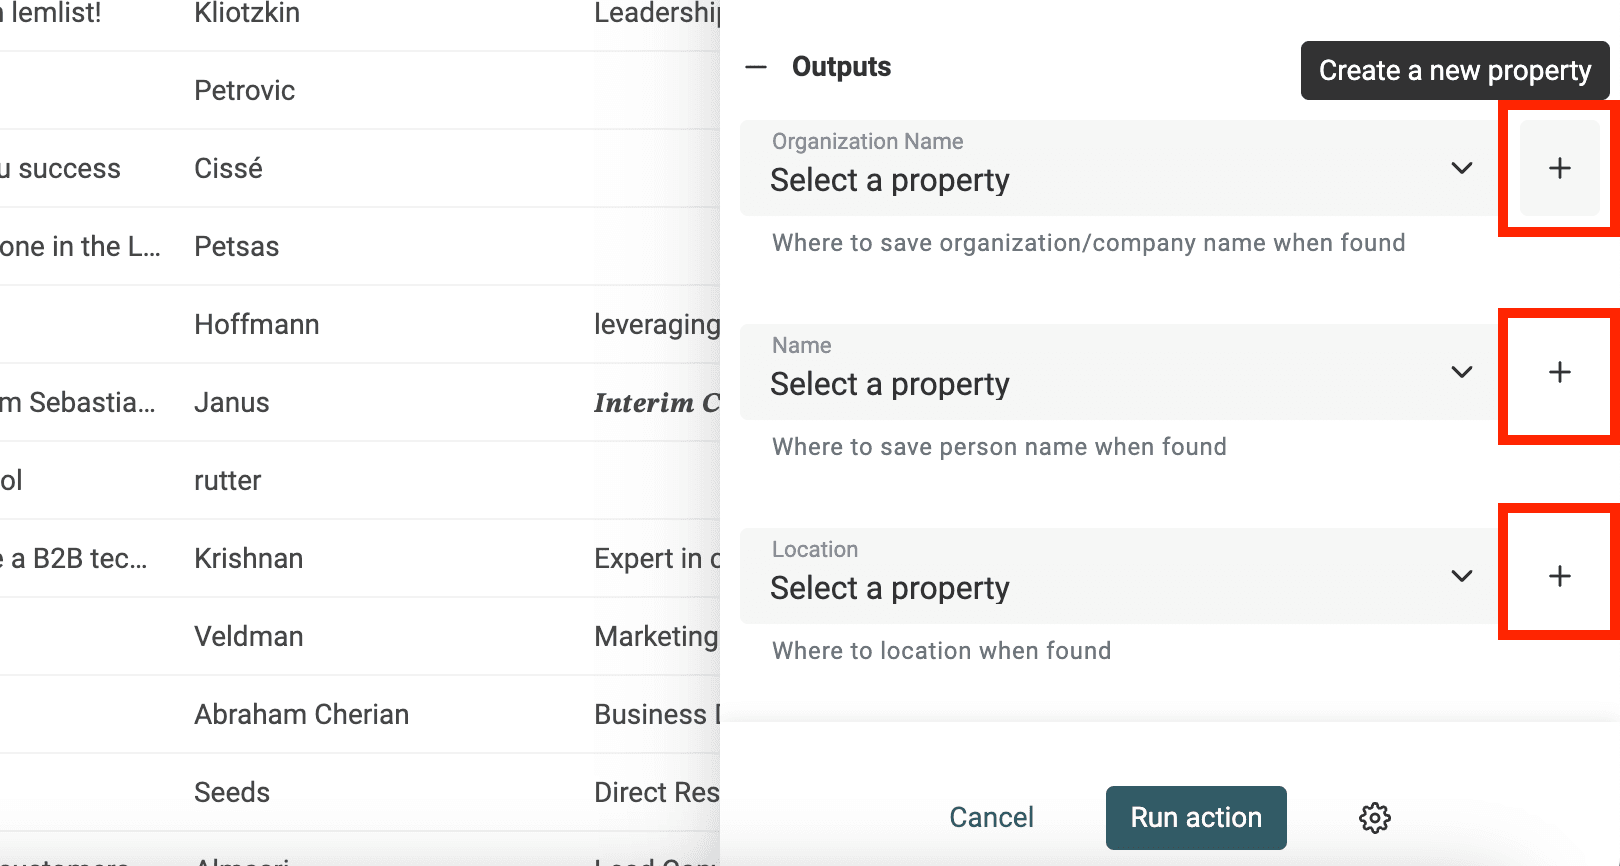
然后运行 enrichment。
需要数据清洗方面的帮助?
我一直希望听到更多反馈,也愿意协助解决数据清洗问题。欢迎联系我,分享你的具体使用场景。