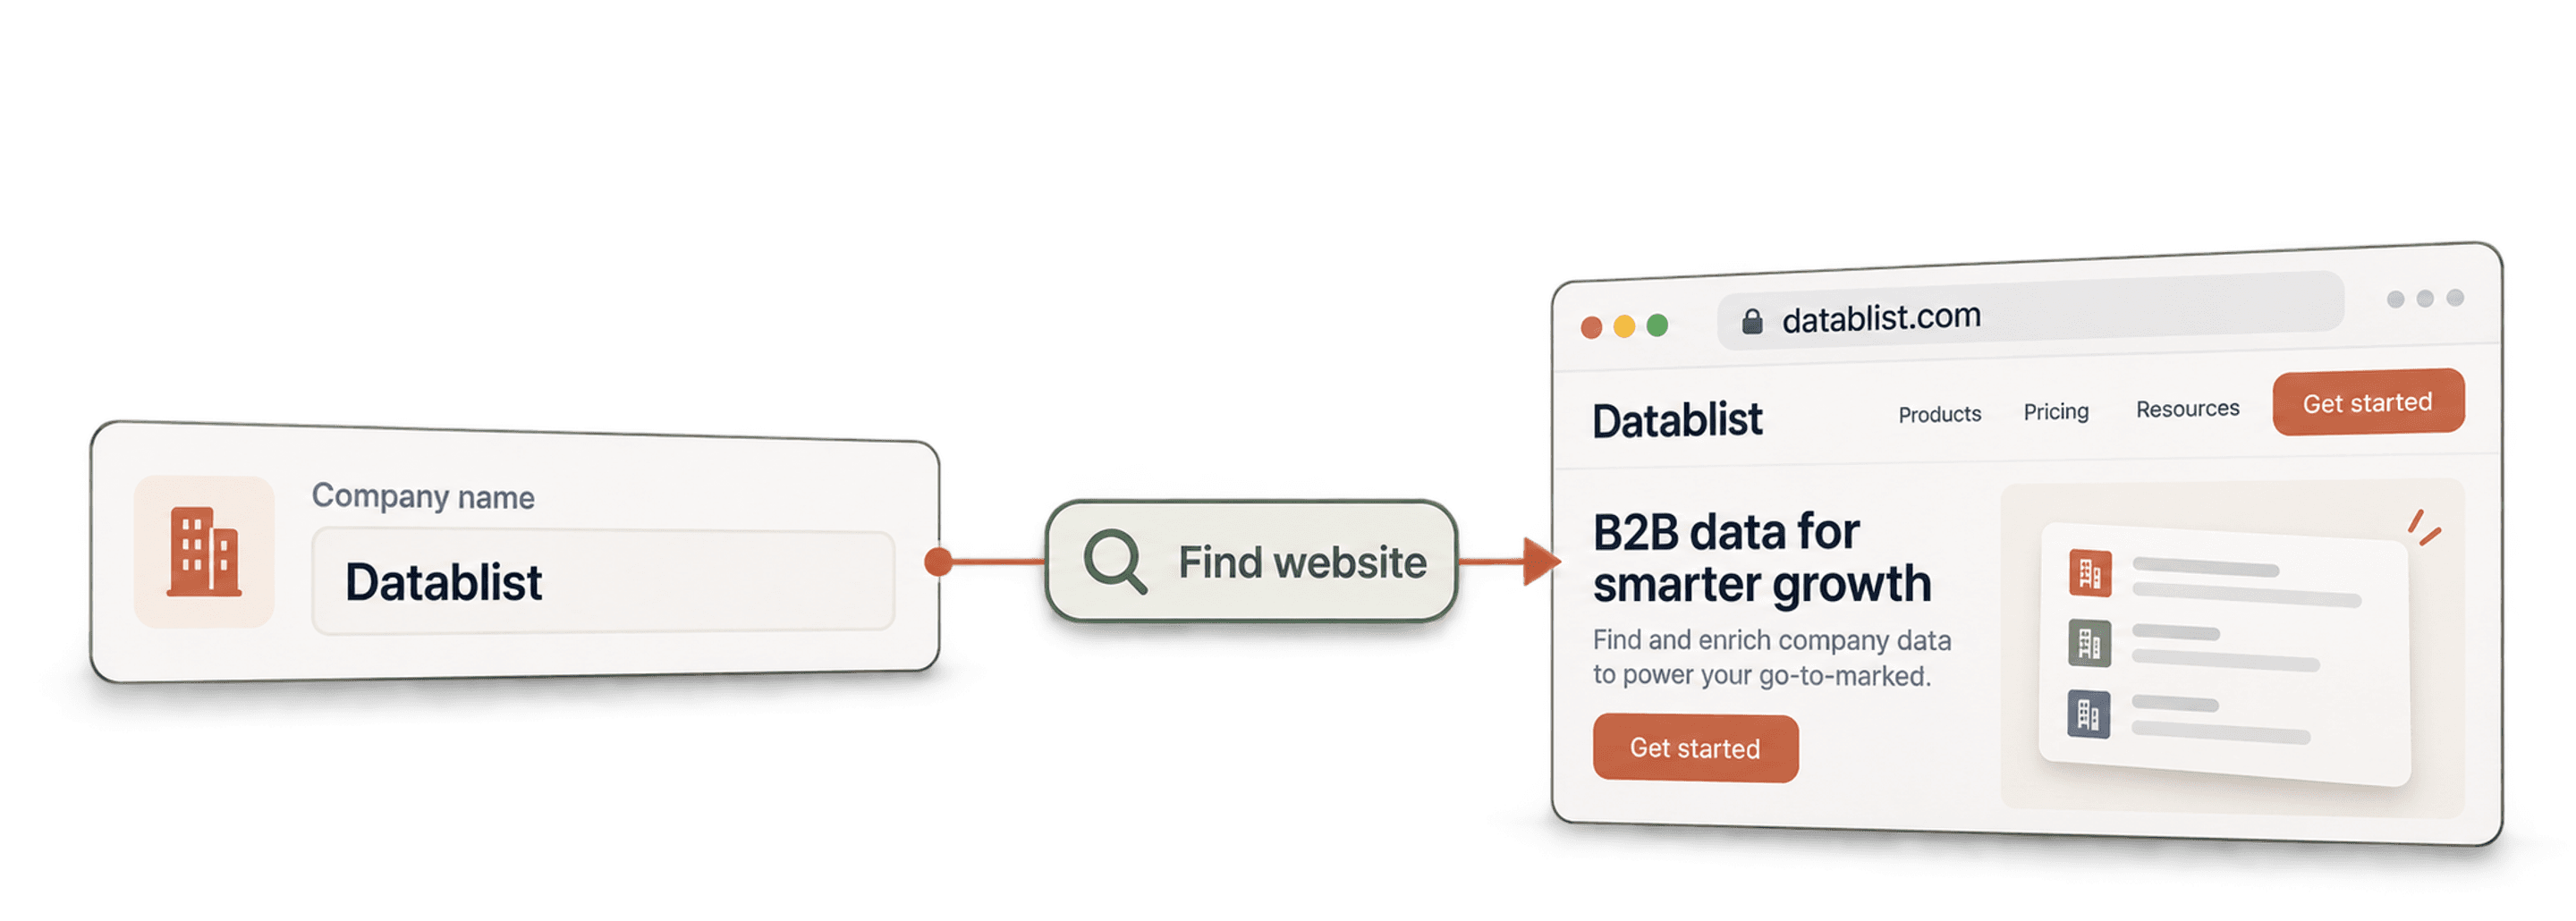
要批量完成公司名称转域名,请将名单导入 Datablist,然后运行 Find Company Domain from Company Name enrichment。先查询公司数据库,再将 Google 作为 fallback。检查置信度列,并仅将名称含义不明确或尚未匹配的记录发送至包含更多上下文的 AI Agent 模板。
最终,你会得到一张表格:每个成功匹配的公司名称旁都会显示公司域名和完整网站 URL。表格还会提供置信度,Datablist 则会自动记录运行状态。
如果名单较短,可以先试用免费公司名称转域名工具。粘贴最多 10 个公司名称,检查返回的域名和置信度,然后复制或下载结果;如需处理更多数据,再使用下文的批量工作流。
📌 工作流概览
**输入:**公司名称,以及国家/地区(如有)
**输出:**公司域名、完整 URL、置信度和自动运行状态
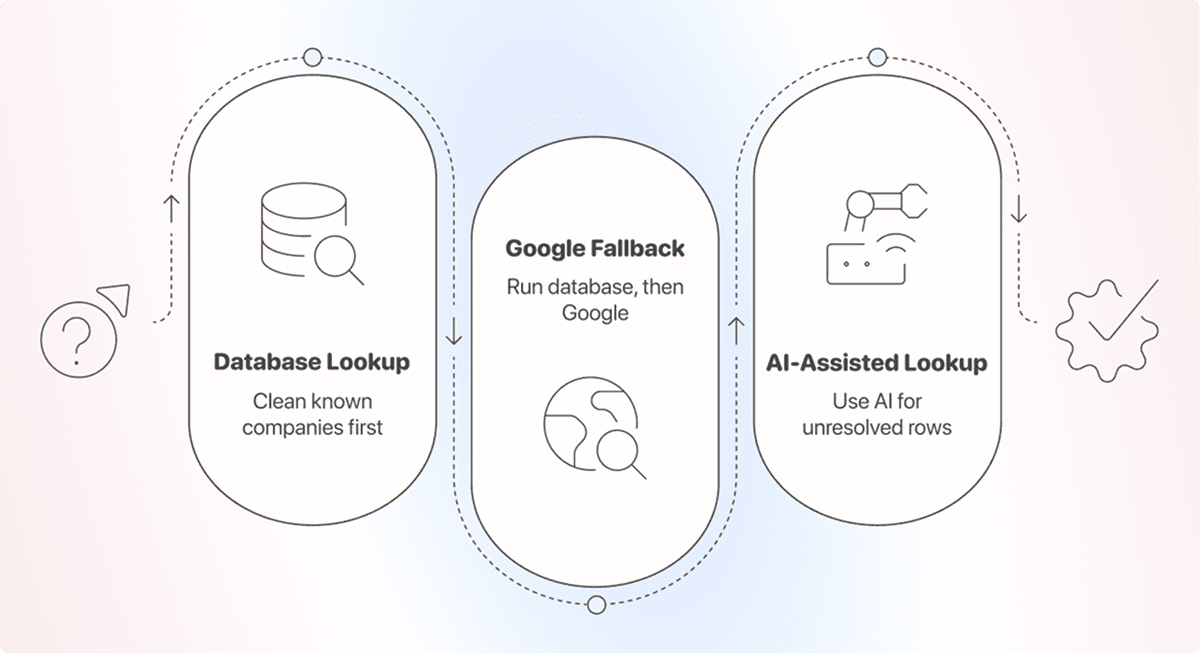
**推荐顺序:**公司数据库 → Google fallback → 用 AI Agent 处理含义不明确的记录
**已核实的 enrichment 费用:**数据库成功匹配为 1 credit;使用 Google 时为 2.5 credits。AI Agent 的费用取决于所需的研究量。
快速导航
预期结果
假设你从三个公司名称及其所在国家开始:
| 公司名称 | 国家 |
|---|---|
| Drooms | 德国 |
| EVACO GmbH | 德国 |
| tanner ag | 瑞士 |
完成 enrichment 后,同一批记录将包含查找邮箱、公司数据 enrichment、去重或导入 CRM 所需的字段:
| 公司名称 | 公司域名 | 公司完整 URL | 域名置信度 |
|---|---|---|---|
| Drooms | drooms.com | http://www.drooms.com | High |
| EVACO GmbH | evaco.de | http://www.evaco.de | High |
| tanner ag | mtannerag.ch | https://mtannerag.ch/en/ | High |
这些示例来自本指南后文展示的实际运行。域名是一个干净、规范的标识符,通常可传入其他 enrichment。需要访问或抓取网站时,完整 URL 更实用。
置信度是复核信号,而非准确性的证明。两个公司同名时,即使系统标记为高置信度,也可能匹配错误。因此,在下游使用这些域名前,我总会抽样检查。
准备输入表格
该 enrichment 只要求提供公司名称。加入国家/地区信息有助于区分名称相近的企业,也能改善 Google 本地搜索结果。
我更推荐以下输入结构:
| 字段 | 是否必填? | 示例 | 作用 |
|---|---|---|---|
| 公司名称 | 是 | Summit Logistics GmbH | 主要查询值 |
| 国家 | 推荐 | 德国 | 缩小数据库和 Google 结果范围 |
| 城市 | 用于 AI,可选 | 汉堡 | 帮助识别常见名称 |
| 行业 | 用于 AI,可选 | 货运代理 | 核对网站内容 |
| 描述 | 用于 AI,可选 | 冷链物流服务商 | 为 AI Agent 提供更多上下文 |
查询前,请先清理明显的噪声,删除备注、电话号码以及与公司名称无关的法律文本。若 GmbH 或 Ltd 等法律实体后缀有助于区分企业,则应保留。如果源数据较乱,请先执行公司名称清洗工作流。
质量较差的输入包括 Marketing Agency 这类宽泛标签、不含母公司名称的分支机构名称,以及在同一单元格中混入地址的公司名称。如果没有足够的上下文,任何查询方法都无法识别正确的企业。
下载包含 50 家公司的基准测试 CSV。其中包含来自八个国家的真实细分领域公司,并已提供行业和描述字段,可直接用于 AI fallback。文件不含预期域名,因此你可以在不提前提供答案的情况下测试工作流。
选择合适的查询方法
这项任务最适合采用 waterfall 工作流:先运行成本最低的方法,仅对确有需要的记录增加投入。
| 方法 | 适用场景 | 费用 | 主要限制 |
|---|---|---|---|
| Find Company Domain from Company Name enrichment | 有线上业务或网站的公司 | 数据库匹配为 1 credit;使用 Google 时为 2.5 credits | 遇到含义不明确的名称时,搜索可能选错公司 |
| AI Agent | 名称含义不明确,但有国家、城市、行业或描述等上下文 | 按使用量计费 | 速度较慢,且仍需人工复核 |
对于大多数名单,我会使用 Find Company Domain from Company Name enrichment。它能以较低成本处理容易匹配的记录,仅在数据库没有结果时搜索网页。
域名查找工具会返回 High、Medium、Low 或 Very Low 置信度。多个来源指向同一域名时,系统可能给出高置信度。Google 标题匹配和公司名称的模糊相似度也会影响评分。你可以据此决定接受、复核或重新研究哪些记录。
用 Datablist 批量查找公司官网
第 1 步:导入公司名单
创建 Datablist 账户,新建一个 collection,然后导入 CSV 或 Excel 文件。
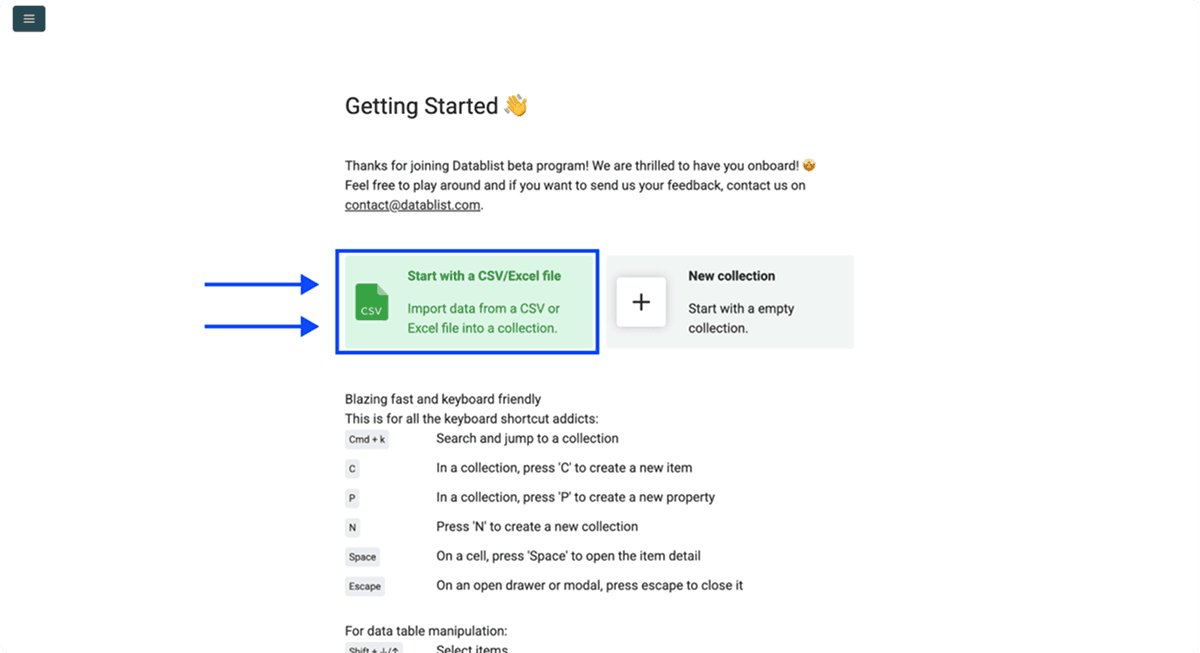
运行任何操作前,请检查导入的字段。公司名称应为文本属性。如果每条记录的国家不同,请将国家单独放在一个属性中。
第 2 步:打开域名查找工具
点击 Enrich,打开 Companies 分类,然后选择 Find Company Domain from Company Name。
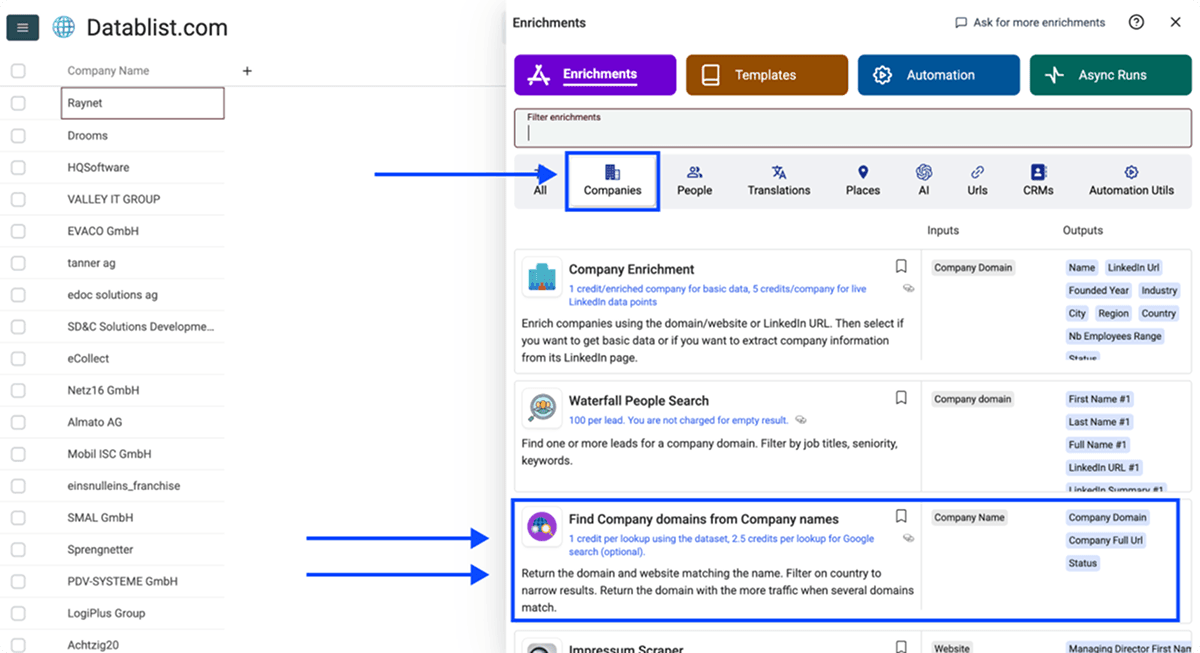
第 3 步:配置查询工作流
从以下工作流设置中选择一项:
- Use Companies Dataset + Fallback on Google: 处理混合名单时的默认选择
- Use only Companies Dataset: 成本最低的首轮查询
- Use only Google: 对每条记录执行实时搜索
如果整份名单都属于同一国家,请设置 Target Country。如果文件中已有国家字段,请启用 Define target country per item。
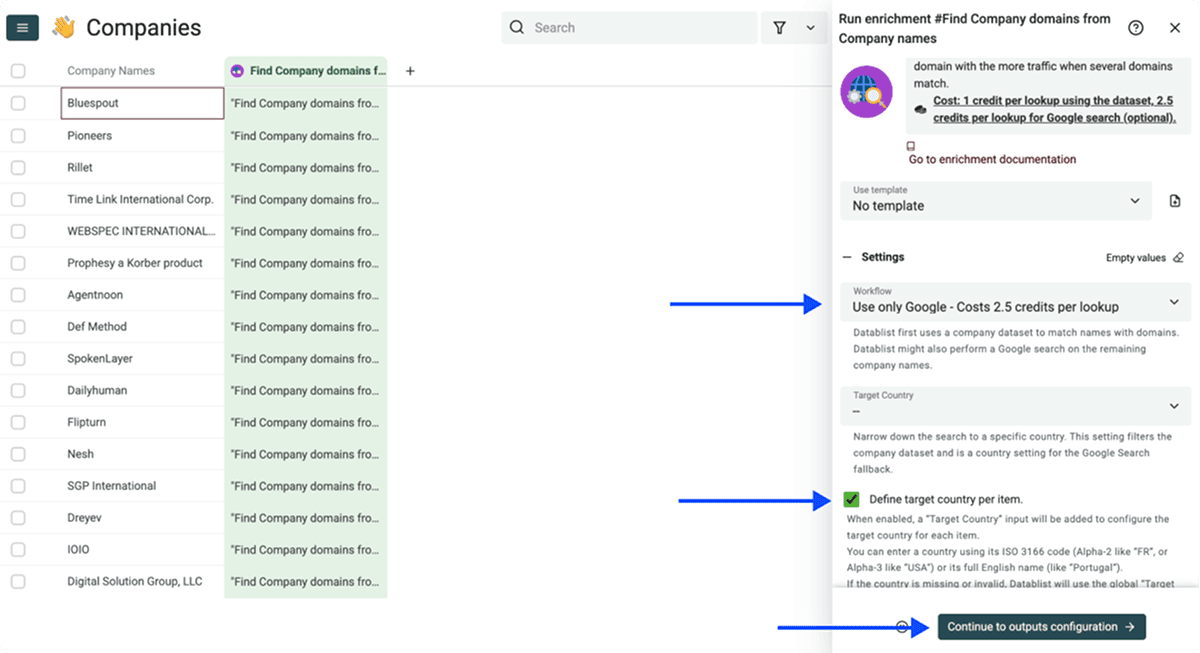
启用 Google 后,以下两项设置有助于处理较难的搜索:
- Accept non-root websites: 允许
platform.com/company-name这类结果。除非公司网站托管在共享平台上,否则建议关闭。 - Skip following domains: 排除反复出现的行业目录。Datablist 在结果评分时已默认跳过常见目录和社交网络。
Datablist 会根据所选国家进行搜索,并结合搜索结果排名、标题相似度等因素为靠前的结果评分。如果国家留空,Google 默认使用美国作为搜索位置。
第 4 步:映射输入与输出字段
将 Company Name 映射到存放公司名称的属性。如果已启用逐行设置国家,也请映射 Target Country。
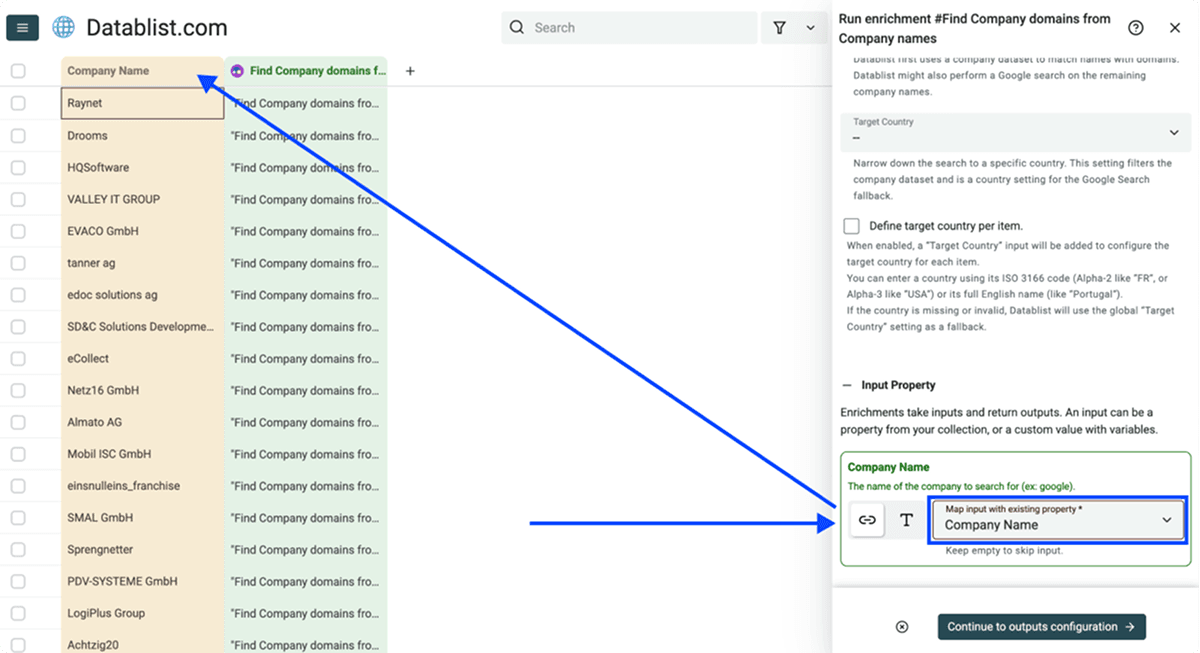
添加以下三个 enrichment 输出属性:
- Company Domain
- Company Full URL
- Domain Confidence
Datablist 还会自动添加运行状态列,用于显示记录处于排队、运行还是完成状态,并在任务结束后保留完成时间。
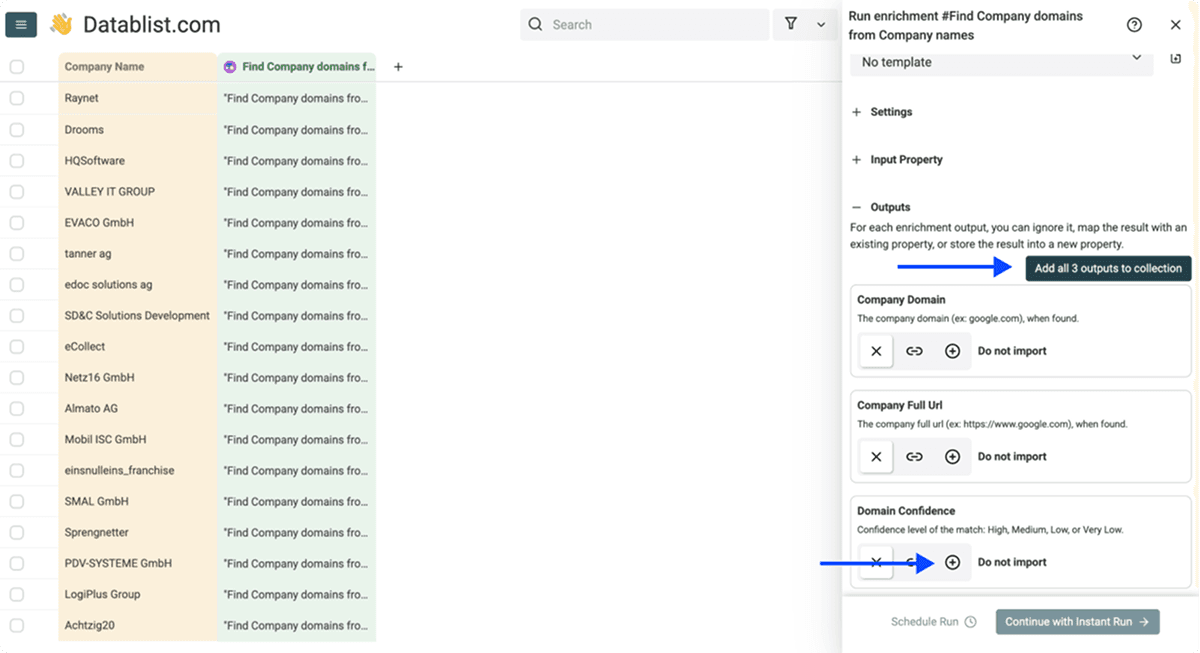
我会同时保留域名和完整 URL。域名更适合匹配和去重,完整 URL 则能保留 enrichment 最终选中的具体页面。
第 5 步:抽样测试后运行完整名单
先对前 10 条记录运行 enrichment。检查网站是否确实属于目标公司,尤其要留意较短或常见的名称。样本结果符合预期后,再处理当前 view 中的其余记录。
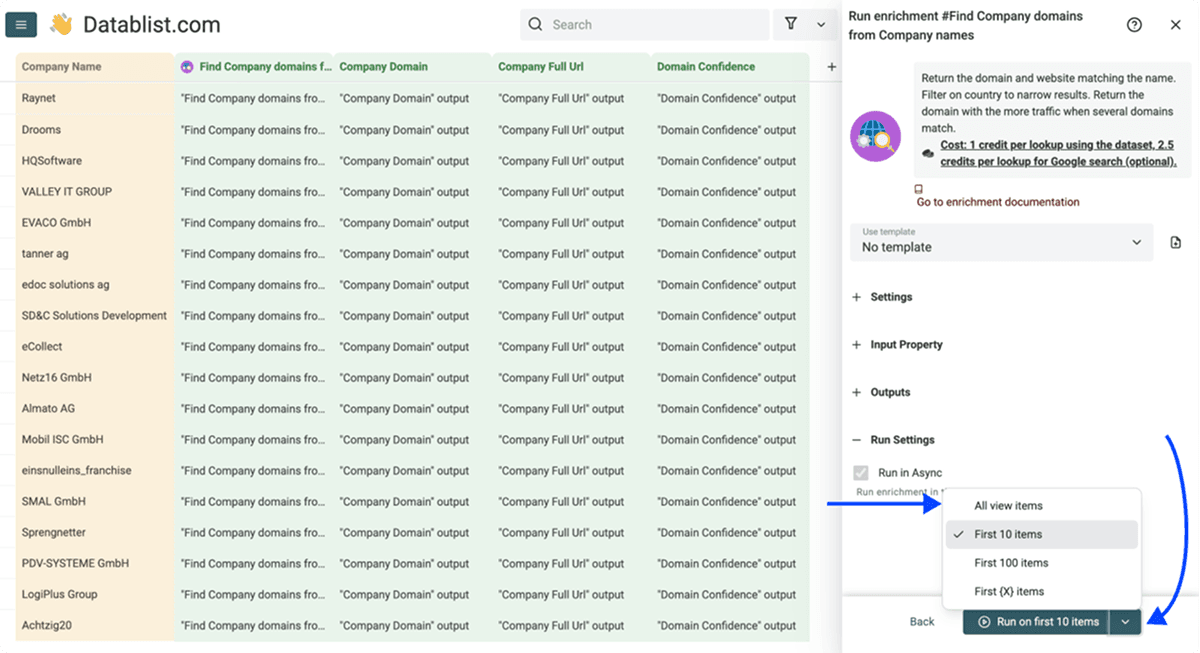
使用筛选器控制 waterfall。例如,在第二轮查询前筛选网站为空的记录,或在 AI 研究前筛选置信度为 Low 和 Very Low 的记录。这样便无需为已有可接受结果的数据重复付费。
用 AI 处理含义不明确的公司名称
Google 可能找到一个看似合理的网站,却匹配到错误的公司。短名称以及被多家企业共用的品牌名称,需要更多上下文才能判断。
筛选域名为空或置信度为 Low、Very Low 的记录。打开 Enrich,选择 AI Agent,然后加载 Advanced Company Name to Website 模板。
📌 注意事项
如果你拥有行业、国家或公司描述等上下文,建议将 AI Agent 作为主要方法,尤其是名单中的部分公司可能根本没有网站时。与标准域名查询不同,AI Agent 可以根据上下文核对候选公司的业务,排除误匹配,并在无法验证时不返回网站。
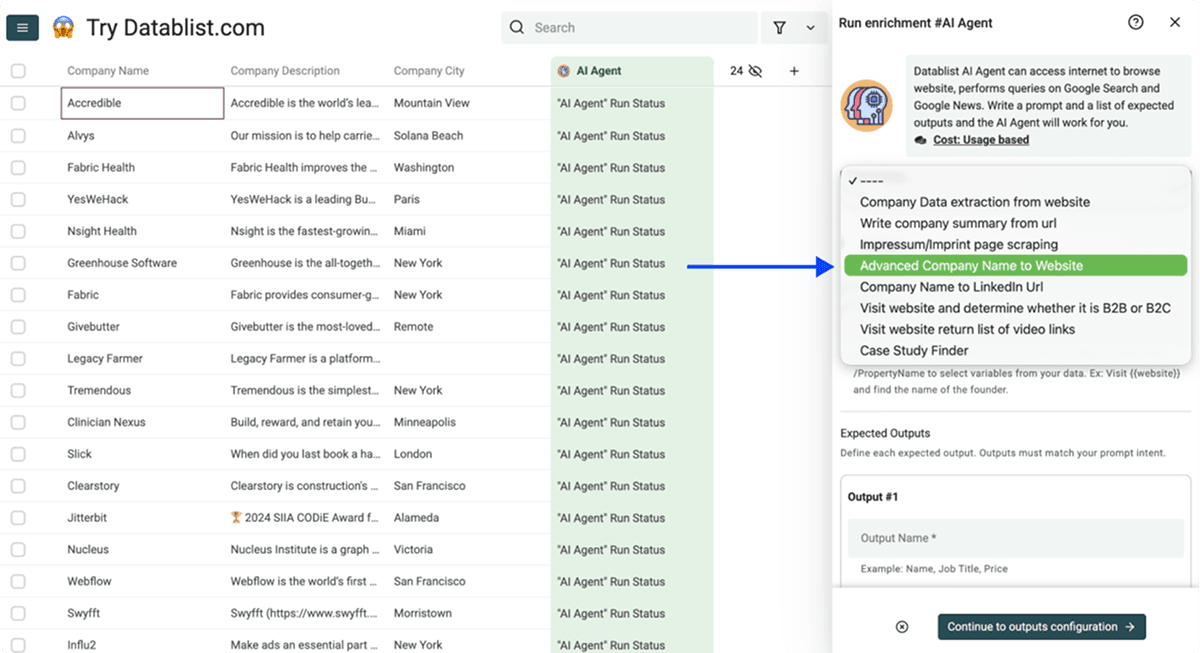
在 prompt 中逐一选择斜杠占位符,并绑定到相应的 collection 属性:
- 将
/Name绑定到公司名称; - 将
/Industry绑定到行业; - 将
/Country绑定到国家; - 将
/Description绑定到公司简介。
该模板会搜索候选结果、访问可能的网站,并根据所提供的上下文进行核对。它会排除目录、企业登记信息、地图、网店和社交网络。如果证据不足,也允许返回空结果。
模板会返回三个研究结果,以及 AI Agent 自动生成的数字置信度评分:
- **Website:**选中的网站根 URL;
- **Company Summary:**匹配企业的简短介绍;
- **Result Explanation:**证明网站与该条记录相关的依据;
- **Confidence Score:**0 到 100 的数值。
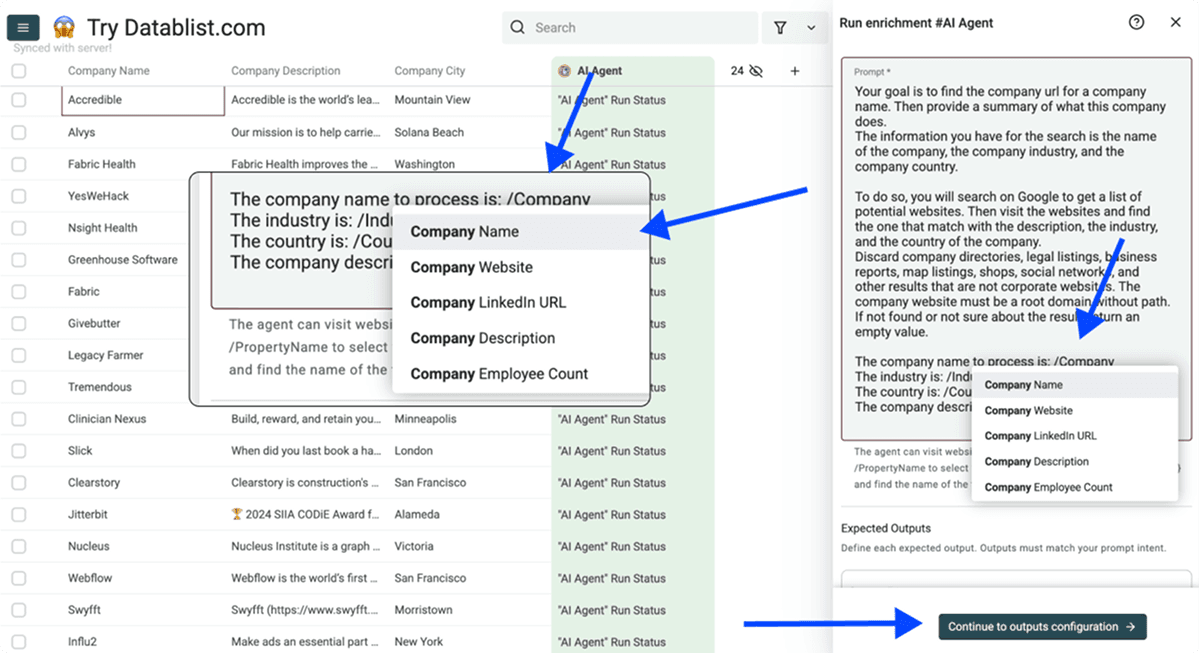
仅对尚未匹配或结果不确定的记录运行该模板。AI 研究费用会因公司而异,因为不同公司需要的搜索次数和网页访问量不同。运行前请设置研究迭代次数上限,以控制成本。
根据地址核对公司
当两家公司同名时,街道地址或城市通常比再次进行宽泛搜索更有价值。建议将这类上下文加入 AI prompt,并在审核通过前,将候选网站与最终确认的网站分别存放在不同字段中。
可使用以下指令调整模板。请将斜杠占位符绑定到 collection 属性,并删除你没有的输入项。
查找下述公司的官方网站。先搜索候选网站,再访问其“关于我们”“联系我们”或法律声明页面,对比公司名称、业务活动、国家和地址。
返回 Website、Company Summary 和 Result Explanation。在 Result Explanation 中附上支持身份匹配的页面 URL,并说明任何冲突信息。优先返回公司自己的根网站。不要把目录、社交主页或新闻文章当作官方网站。如果只找到母公司网站,请解释两者关系,不要声称它是子公司的独立网站。证据不足时,将 Website 留空。不要仅根据公司名称猜测域名。
公司名称:/Name
国家:/Country
城市或地址:/Address
行业:/Industry
描述:/Description
在输出映射中保留 Result Explanation。检查其中的佐证 URL,并在单独属性中将记录标记为已接受、已拒绝或待审核,然后再把候选 URL 复制到最终网站字段。
从邮箱地址或新闻文章开始
企业邮箱域名可以作为待核实的网站线索。Gmail、Outlook 或其他公共邮箱服务商的域名无法识别发件人所属公司。对于这些记录,请先补充公司名称和相关上下文,再运行此工作流。
如果公司名称来自新闻文章,请确认文章讨论的具体企业,而非发布媒体、投资方或母公司。保存文章 URL 作为上下文,并用其中的证据核对候选网站的业务和地址。同一页面提到的多家公司应分别建立为独立输入记录。
借助员工信息识别正确公司
有时你只知道某个人的姓名,却几乎没有可用的公司信息。这时,员工可以作为第二个身份识别信号。
加载 Find Company Domain from Company and Employee Names AI Agent 模板,并完成以下映射:
- 将
/Name绑定到公司名称; - 将
/FirstName绑定到员工名字; - 将
/LastName绑定到员工姓氏。
请从斜杠变量菜单中选择各个属性,并确认 Name、FirstName 和 LastName 在 prompt 中显示为高亮 chip。直接以纯文本输入占位符并不会绑定属性值。
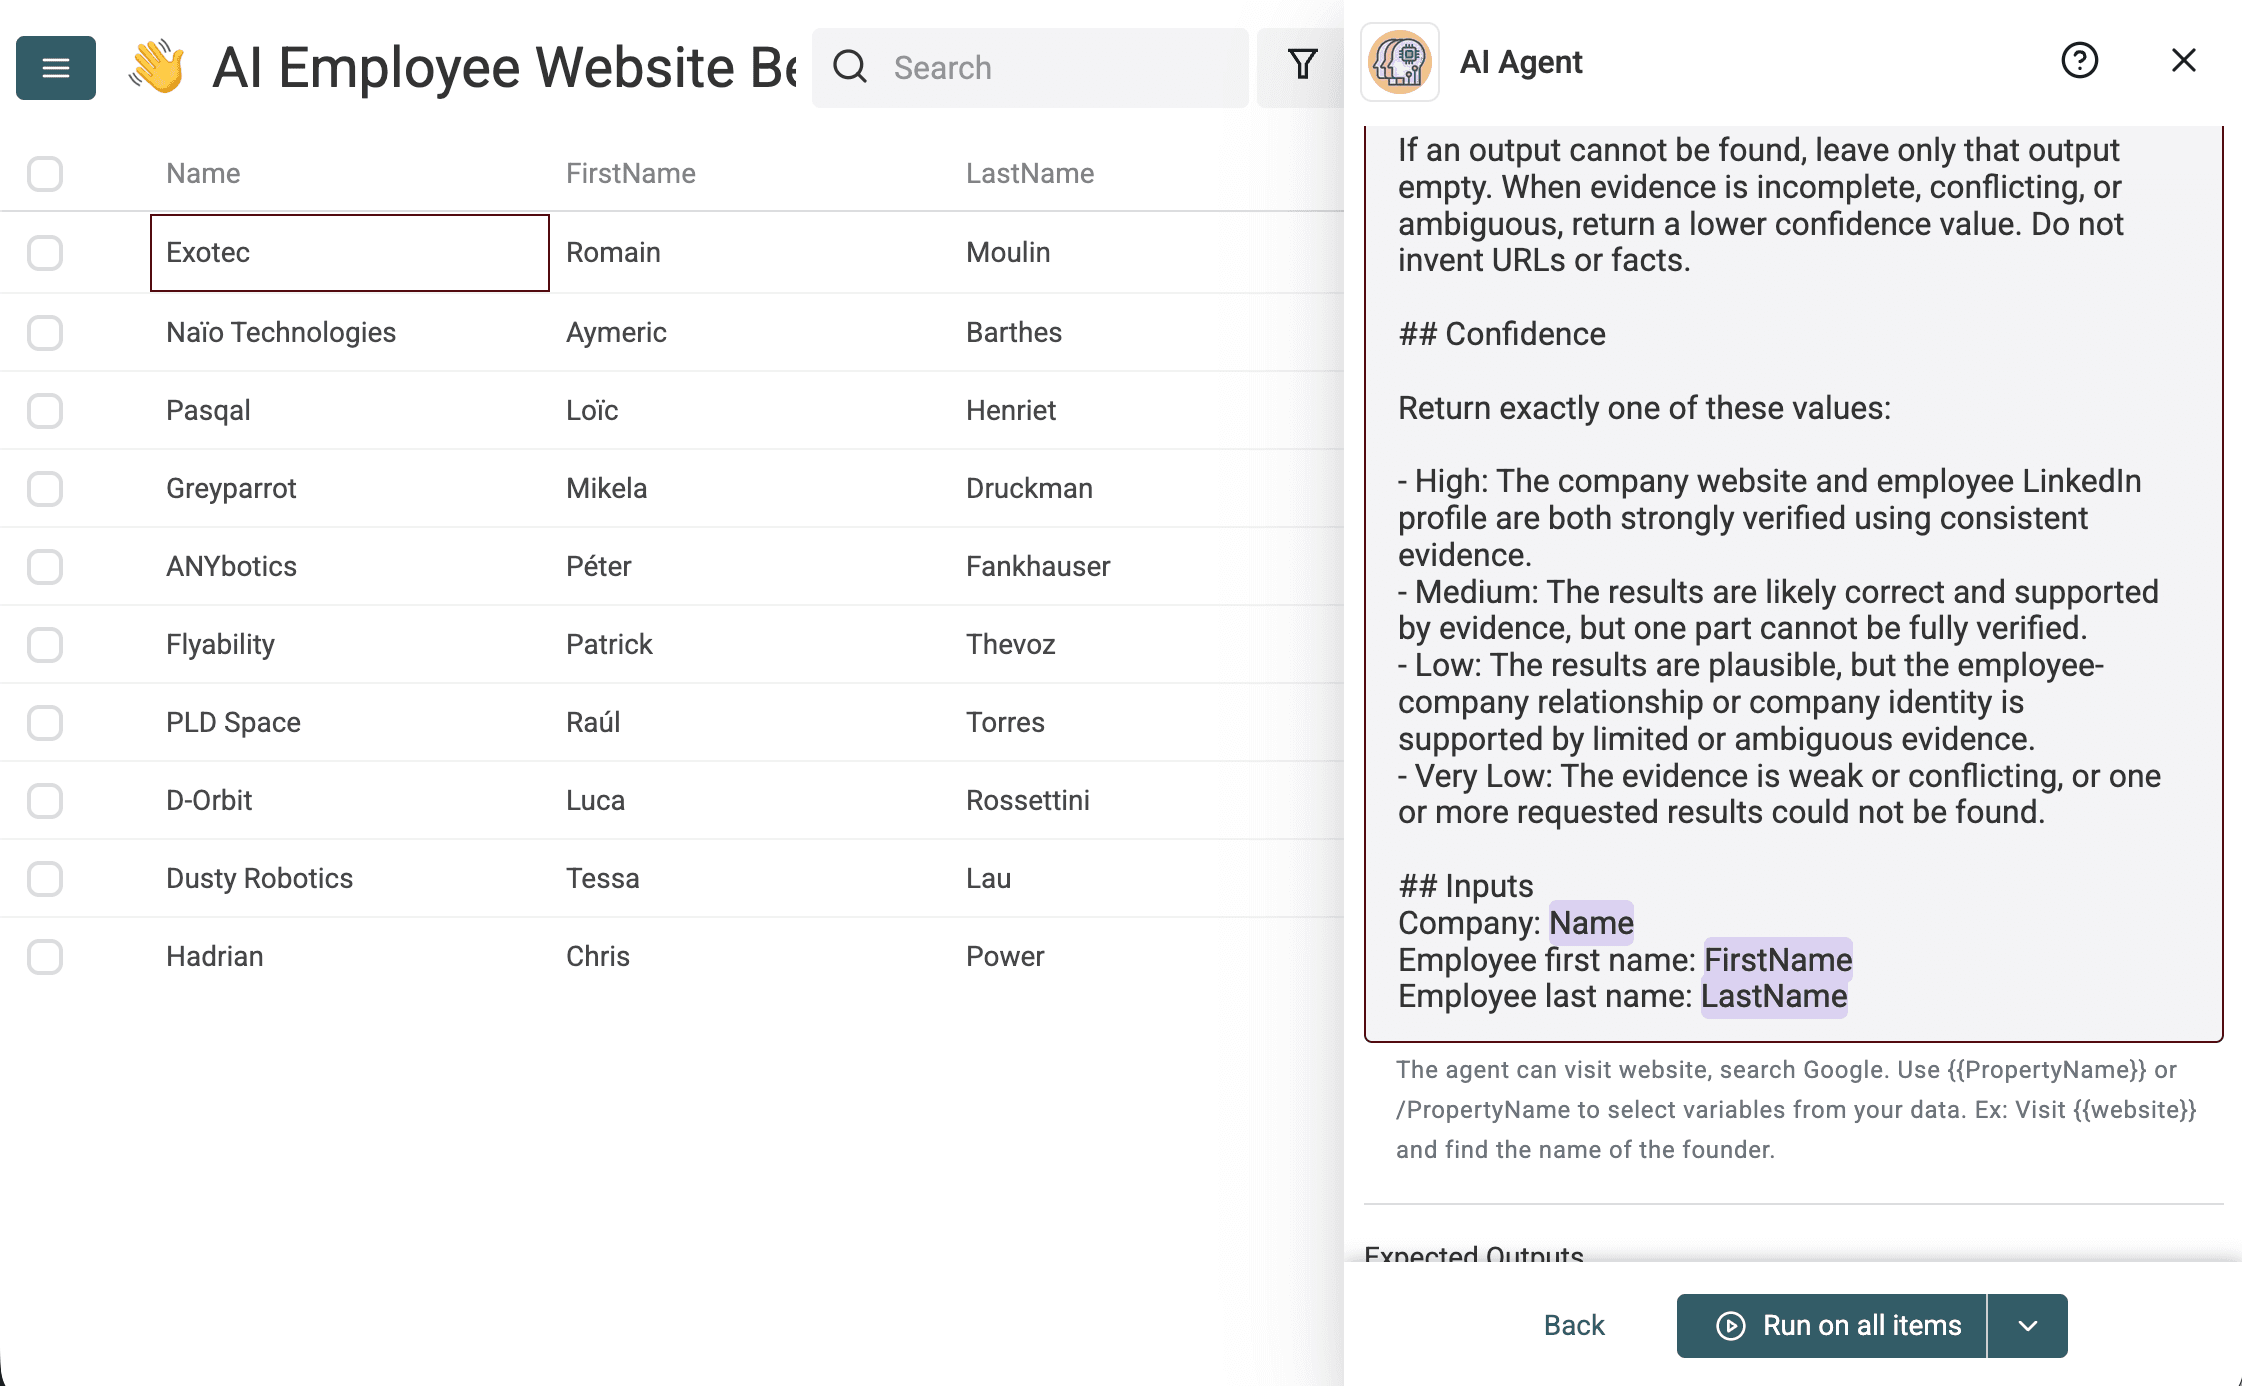
Agent 会验证网站是否属于目标公司,并检查公开 LinkedIn 个人资料是否同时匹配员工姓名和公司。它会返回:
- **Company Website:**官方网站的根 URL;
- **Company Summary:**简短且基于事实的介绍;
- **Employee LinkedIn Url:**找到的匹配公开资料;
- Confidence:
High、Medium、Low或Very Low。
AI Agent 还会自动添加一个 0 到 100 的数字 Confidence Score。
我使用十家拥有已核实创始人或高管的细分领域公司测试了该模板。它正确返回了 9 个官方网站,并找到了全部 10 位员工对应的公开 LinkedIn 资料。比较资料身份前,我对 LinkedIn 地区域名、URL 编码和语言路径做了规范化处理。
唯一失败的是 Hadrian。Agent 找到了 Chris Power 的正确资料,也正确概述了这家航空航天制造商,却返回了无关网络安全公司的 hadrian.io,而不是 hadrian.co。尽管如此,该记录仍被标记为 High,数字评分为 100。整轮运行中,所有分类置信度均为 High;九条数字评分为 100,一条为 95。
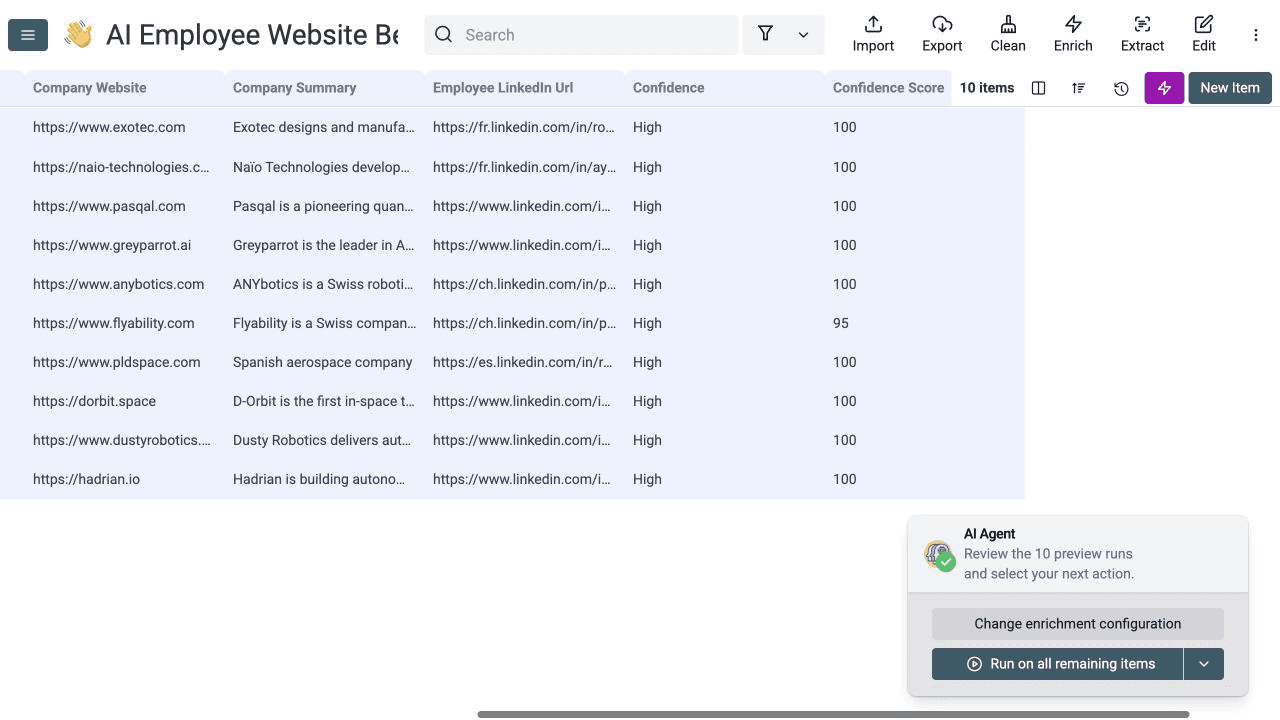
当一个名称对应多家企业、公司使用通用品牌名,或某人的公开工作经历是最可靠的线索时,可以使用该模板。员工资料正确,并不能证明返回的网站属于同一家公司,因此每项输出都应单独审核。
50 家公司实测结果
我于 2026 年 8 月 3 日运行了可下载的基准测试。测试集包含来自八个国家的 50 家真实细分领域公司,其中包括数字品牌、带重音符号的名称、短名称,以及域名与品牌名不同的公司。
- **处理的输入记录:**50
- **返回的域名:**50,覆盖率为 100%
- **完全匹配的 canonical domain:**50 个中有 48 个
- **跟随重定向后确认的官方网站:**50 个中有 49 个
- **明确的误匹配:**1
- **数据库与 Google waterfall 使用的 credits:**59
- **显示的 Domain Confidence:**50 条记录全部为 High
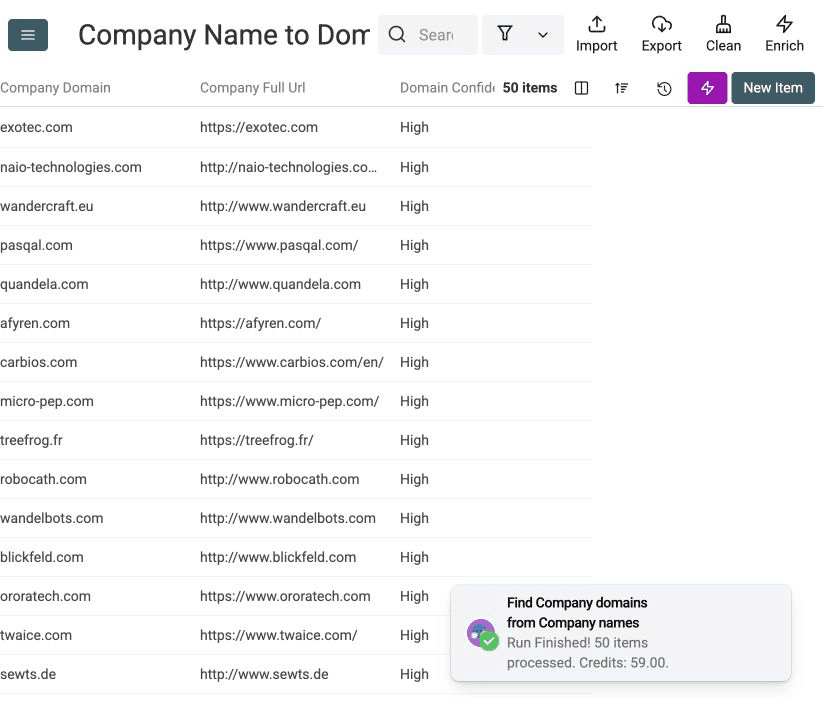
这个误匹配很有参考价值:9T Labs 匹配到了 Venturelab 目录页面,尽管结果被标记为 High。sewts.de 是公司自有的有效结果,但会重定向到 canonical domain sewts.com,因此我将其计为已接受,但不属于完全匹配。
随后,我只把三条有争议的记录发送给 AI Agent。它为三家公司都返回了当前官方根网站,其中包括 9tlabs.com,从而修正了标准 enrichment 的误匹配。自动置信度评分分别为 75、95 和 95。
| 公司 | 标准结果 | AI 结果 | 审核结论 |
|---|---|---|---|
| 9T Labs | venturelab.swiss/9t-labs | 9tlabs.com | AI 修正了目录页面误匹配 |
| Marvel Fusion | marvelfusion.com | marvelfusion.com | 当前域名完全匹配 |
| sewts | sewts.de | sewts.com | 国家代码域名会重定向到 canonical domain |
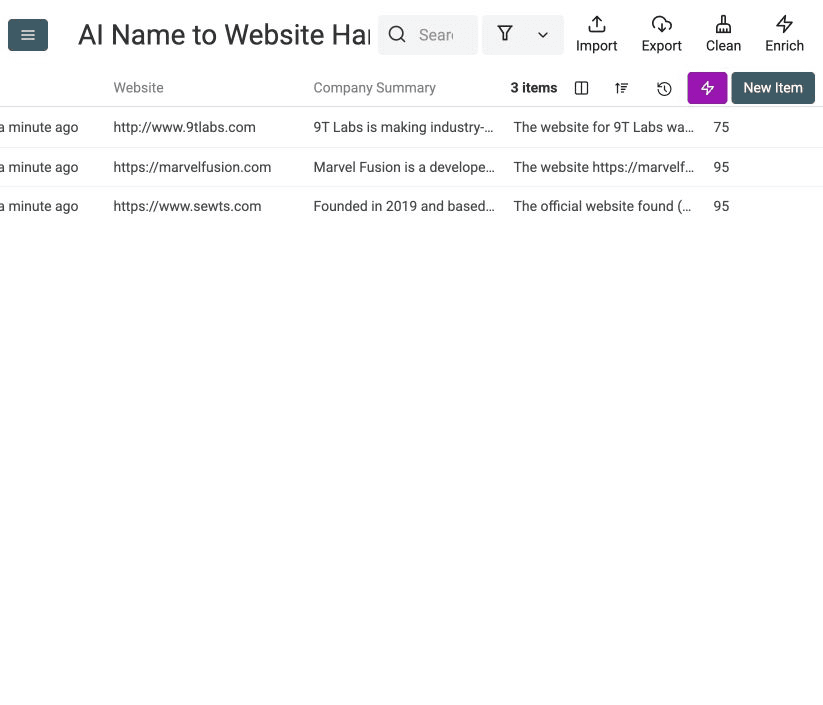
这是一次实测案例,并非准确率保证。在下游使用域名前,请检查含义不明确的品牌名称以及看起来像目录页面的 URL。
对于你自己的运行,建议记录以下四项指标:
- **覆盖率:**网站非空的记录数除以已处理记录数
- **高置信度覆盖率:**标记为 High 的记录数除以已处理记录数
- **样本准确率:**正确网站数除以人工核查的网站数
- **每个已接受网站的成本:**消耗的 credits 除以审核通过的网站数
这些指标可以帮助你比较不同工作流的效果,避免把“返回了 URL”误认为“结果一定正确”。
常见失败场景与限制
任何公司名称查询方法都不可能完美。请特别留意以下情况:
- **多家公司使用相同名称。**补充国家、城市、行业或描述,并使用 AI Agent。
- **公司没有网站。**Google 仍可能返回目录或名称相近的企业。与其强行匹配,不如接受空结果。
- **网站使用另一个品牌名称。**域名可能与公司法定名称毫无关联。请检查网站 footer、“关于我们”页面、地址或法律声明。
- **地区页面的搜索排名高于主站。**设置目标国家,并明确需要本地域名还是全球域名。
- **公司页面托管在共享平台。**仅当预计 URL 中包含路径时,才启用非根网站。
- **目录网站占据搜索结果。**将反复出现的目录域名加入跳过列表,再重新处理不确定的记录。
- **源名称不干净。**查询前先清理混入名称中的地点、备注或企业登记文本。
- **置信度不等于验证结果。**标准 enrichment 根据名称和搜索信号评分,但无法证明网站所有权。
Google 搜索结果会缓存 48 小时。如果你在此期间修改 Google 评分设置,Datablist 可能复用已保存的结果。这有利于测试排除规则,但重新运行时得到的结果未必来自新的实时搜索。
网站验证清单
导出数据或运行其他 enrichment 前,请检查以下事项:
- 公司域名可以打开正常运行的网站。
- 网站名称、产品或服务与该条记录中的公司一致。
- 如有国家、城市、地址或法律信息,均已核对一致。
- 结果是官方网站,而非目录、marketplace、社交主页或新闻文章。
- 已人工抽样检查标记为高置信度的记录。
- 已审核 Medium、Low 和 Very Low 记录,或将其发送至 AI Agent。
- 找不到可靠官方网站时,空结果仍保持为空。
- 已检查重复域名是否源于母公司、子公司或错误匹配。
- 已记录覆盖率、样本准确率、运行时间和 credits 消耗。
网站字段通过审核后,你可以将其用于邮箱查找、公司数据 enrichment 或干净的 CRM 导入。如果你的起点是 LinkedIn 公司主页 URL,而非公司名称,请使用从 LinkedIn 公司主页查找网站的工作流。
常见问题
查找公司网站最少需要哪些信息?
只需公司名称即可运行域名查找工具,但建议尽可能加入国家信息。对于含义不明确的名称,城市、行业、地址或简短描述可以提升 AI 研究环节的效果。
域名查找工具会返回什么?
它会返回公司域名、完整网站 URL 和 Domain Confidence。Datablist 还会自动创建运行状态列,方便你查看每条记录处于排队、运行还是完成状态。
查询一个公司名称需要多少费用?
公司数据库每次成功查询收取 1 credit。Google 每次查询收取 2.5 credits,即使没有返回网站也会计费。AI Agent 的费用取决于实际研究量,因此建议仅用于需要上下文判断的记录。
所有高置信度结果都可以直接接受吗?
不可以。高置信度仅表示现有匹配信号较强。将网站用于 Outbound、CRM 或后续 enrichment 工作流前,请先抽样检查,并核实含义不明确的名称。