
要从 LinkedIn 公司主页获取官网 URL,请先将公司主页 URL 导入 Datablist,选择 Company Domain/Website and LinkedIn Company Page Matcher,再选择从 LinkedIn 匹配官网的方向,并将返回的网站保存到新列中。在使用这些域名进行数据 enrichment 或 Outbound 之前,请先核对公司身份和状态。
如果开发者需要完整的公开公司资料,也可以使用相同的公司主页 URL,通过 Python 抓取 LinkedIn 公司数据。
如果你想从公司官网开始,则可以使用 Python 匹配公司官网与 LinkedIn 主页。
建议在整个工作流中保留原始 LinkedIn URL 和 Source ID。返回的官网只有确实属于目标公司时才有价值。遇到品牌、子公司、已更名企业或名称相近的公司时,需要仔细核查。
Matcher 可以先查询已有的公司数据,并在必要时使用备用查询。但这并不保证系统完全不会访问官网或 LinkedIn 主页,也不保证每个 URL 都能成功匹配,或所有返回的记录都是最新的。
什么是 Datablist?
Datablist 支持导入 CSV 或 Excel 列表、enrich 现有行、审核返回字段,并导出已确认的记录。对于本任务,请先准备一个包含 Source ID、Company Name 和 Company LinkedIn URL 的 collection。Company Name 可为审核提供参考,但 Matcher 的输入是 URL。如果源数据只有公司名称,没有公司主页 URL,请使用名称匹配域名的工作流;Datablist 与 CUFinder 对比介绍了两种方式在输入和审核要求上的区别。
例如,Datablist 的一条示例输入可以包含 https://www.linkedin.com/company/datablist/。预期输出包括 Company Website、返回的 Company LinkedIn Url 和 Status。这只是输入输出格式示例,并非实际查询结果。
请确保已接受和未解决的结果都能被清楚识别。这样,销售团队既能获得一份经过审核的公司官网清单,也能为需要补充信息的记录建立单独的处理队列。
匹配机制如何运作
该工作流用于解析公司官网与 LinkedIn 公司主页之间的对应关系。在从 LinkedIn 匹配官网时,系统会先检查公司数据;如果未找到匹配项,还可以尝试直接查询或通过数据提供商查询 LinkedIn。覆盖率取决于输入内容和可用数据。
数据库查询只是起始方式,并不代表每条结果都来自离线数据库。 当前工作流包含备用查询机制。不要根据旧版“仅查询数据库”的描述,推断账号安全性、使用权限或固定处理时长。
标准公司主页 URL 与 Sales Navigator 公司 URL 可能需要不同的处理方式。请保留原始值,并在系统返回标准 Company LinkedIn Url 时进行核查。linkedin.com/in/... 这类个人 Profile URL 属于另一种输入场景;此 enrichment 用于匹配公司官网与公司主页。
如需处理 Sales Navigator 公司标识符,请参阅转换 Sales Navigator 公司 URL。应查看所选 enrichment 当前显示的费用并先进行样本测试,不要把旧的费用估算套用到所有 URL 格式上。
如果你的起始数据是联系人,而不是公司主页,Sales Navigator Lead 搜索结果导入指南说明了在处理任职公司字段之前,如何保留 Profile 标识符和搜索上下文。
提取官网 URL:7 个步骤
开始前,请从运行范围中排除空白输入,并将公司 URL 与个人 Profile 分开。如果可信来源已经提供了官网,请将其保留在原始列中,以便与建议的匹配结果进行对比。
如需观看操作视频,请参阅现有的官网查询演示。截图和视频展示了整体工作流;如果应用界面有所变化,请以本文下方列出的当前控件名称为准。
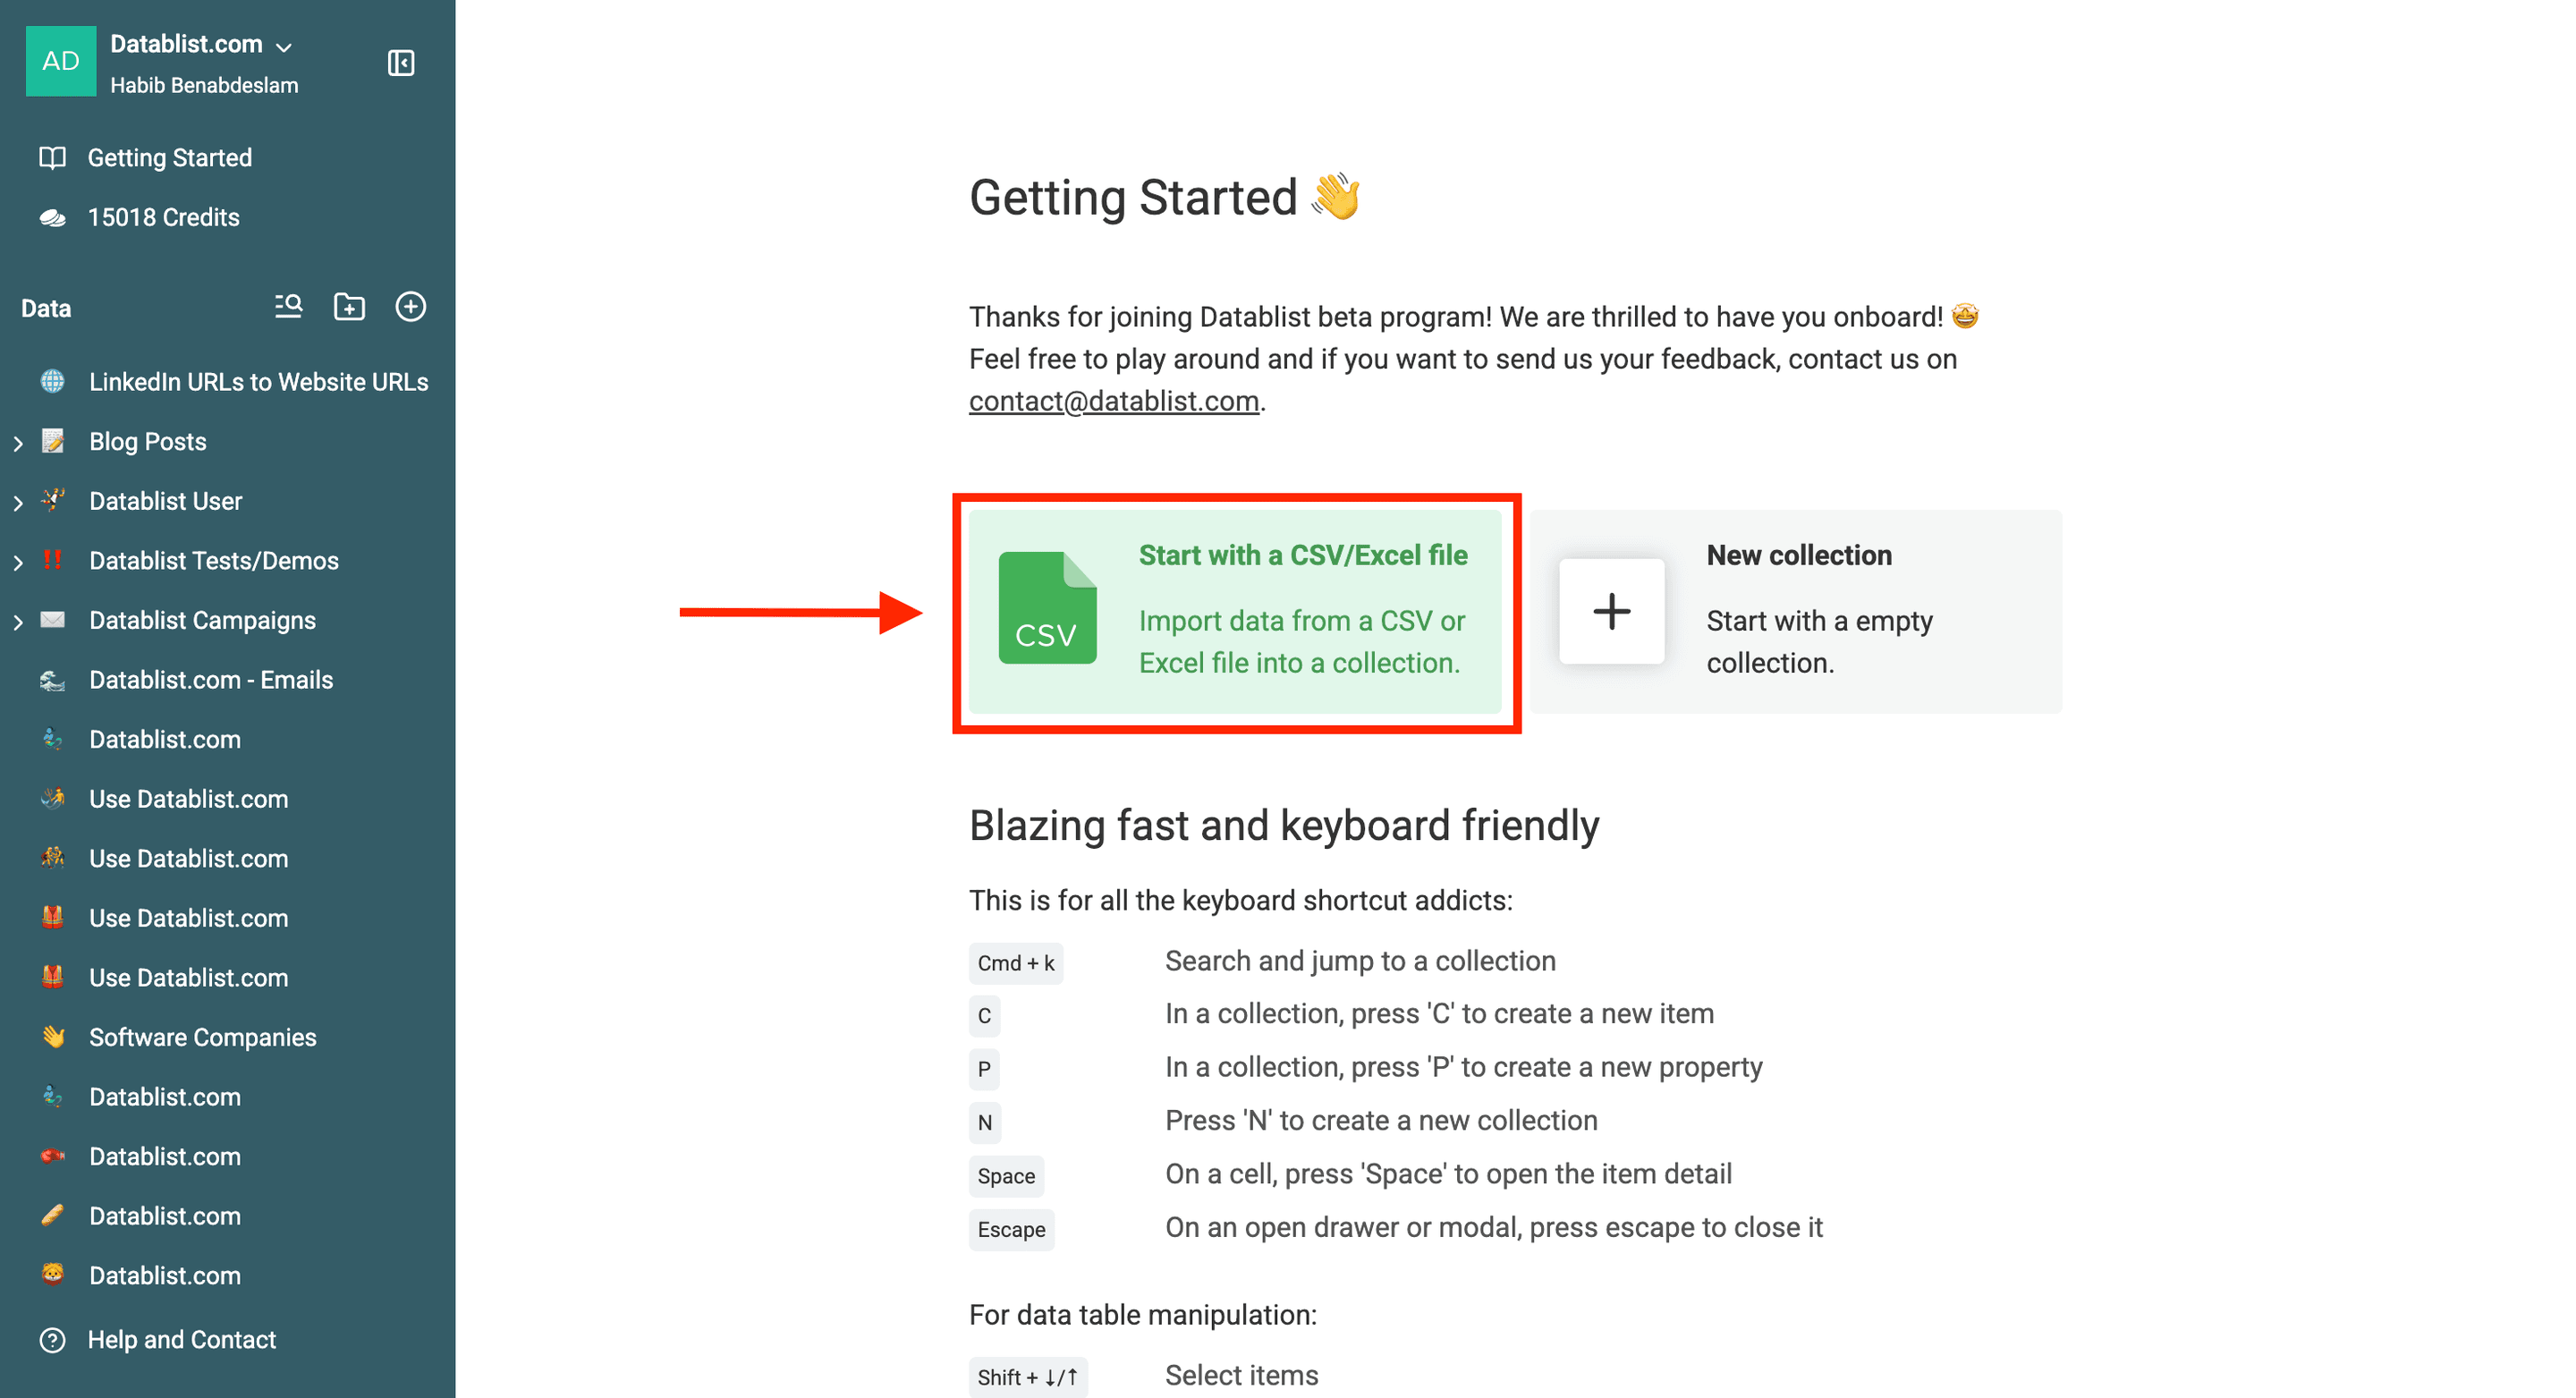
第 1 步:打开 Datablist 并导入文件
导入包含 Company LinkedIn URL 和 Source ID 的 CSV 或 Excel 文件。运行 enrichment 前,请先检查导入的数据行。粘贴的搜索结果 URL、没有 URL 的公司名称,或一个单元格内包含多个 URL 的情况,都需要先清理。
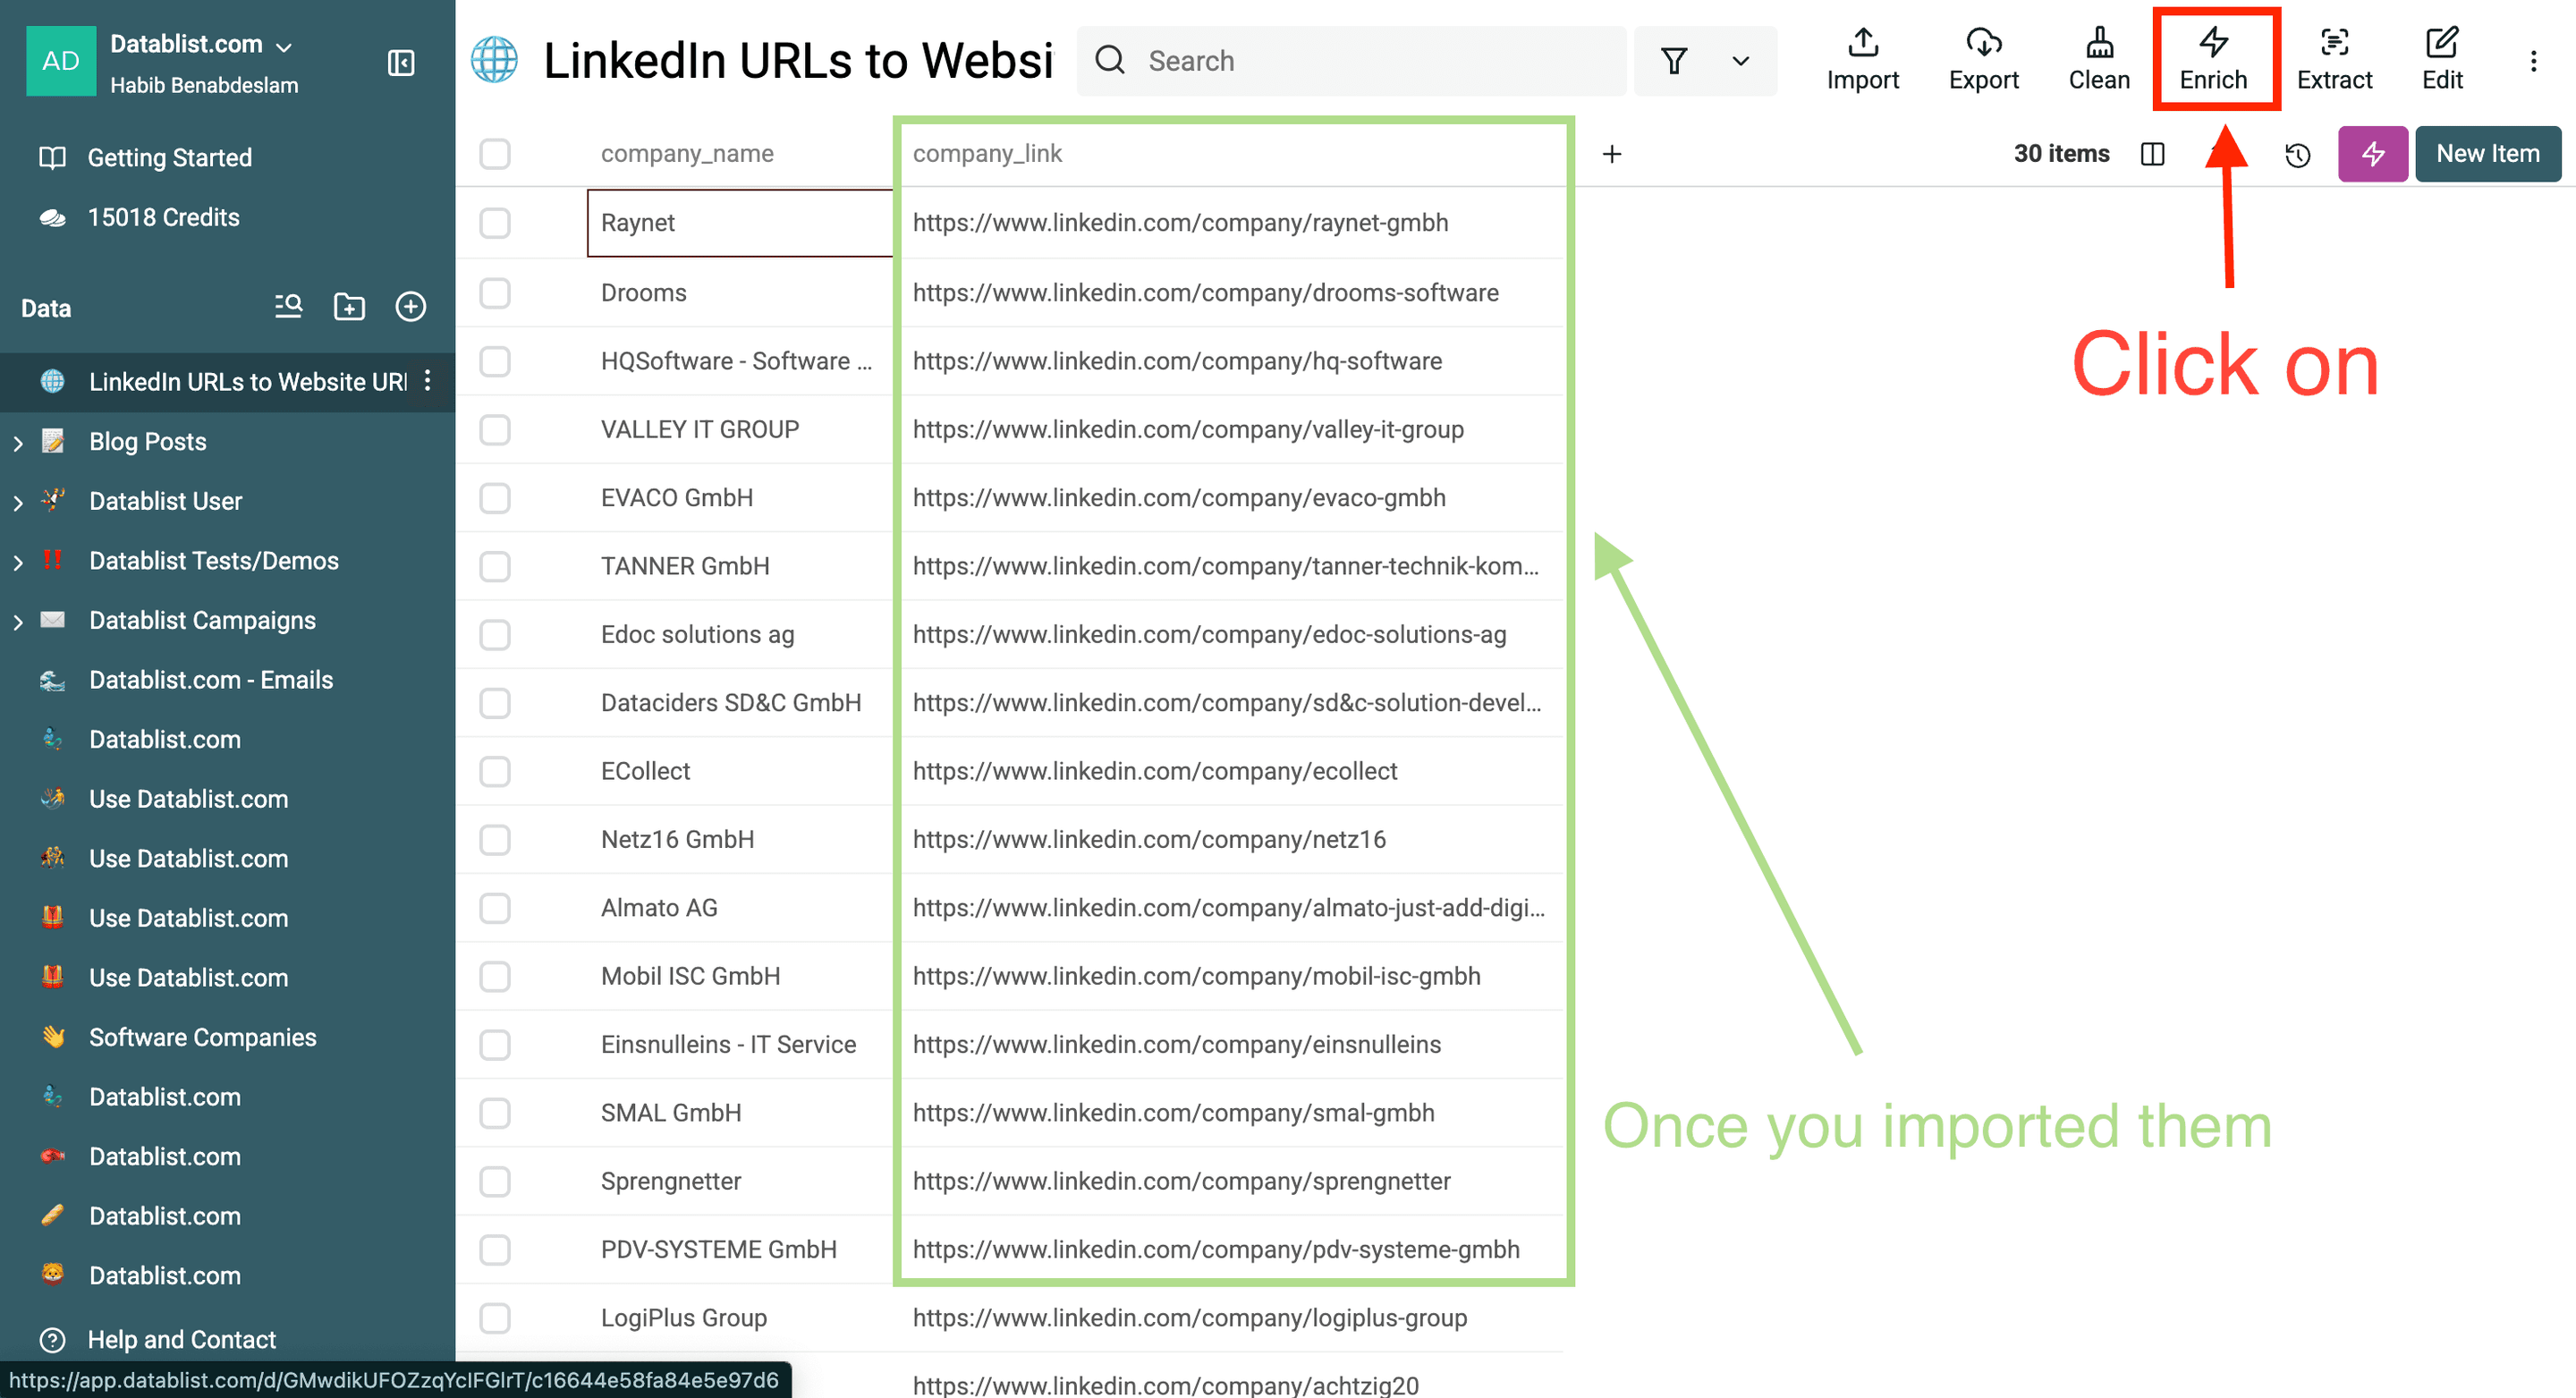
第 2 步:打开 Enrichment Catalog
选择需要处理的数据行或 view,然后打开 Enrich。请保留源数据列;首次审核时,应将输出写入新的 properties。
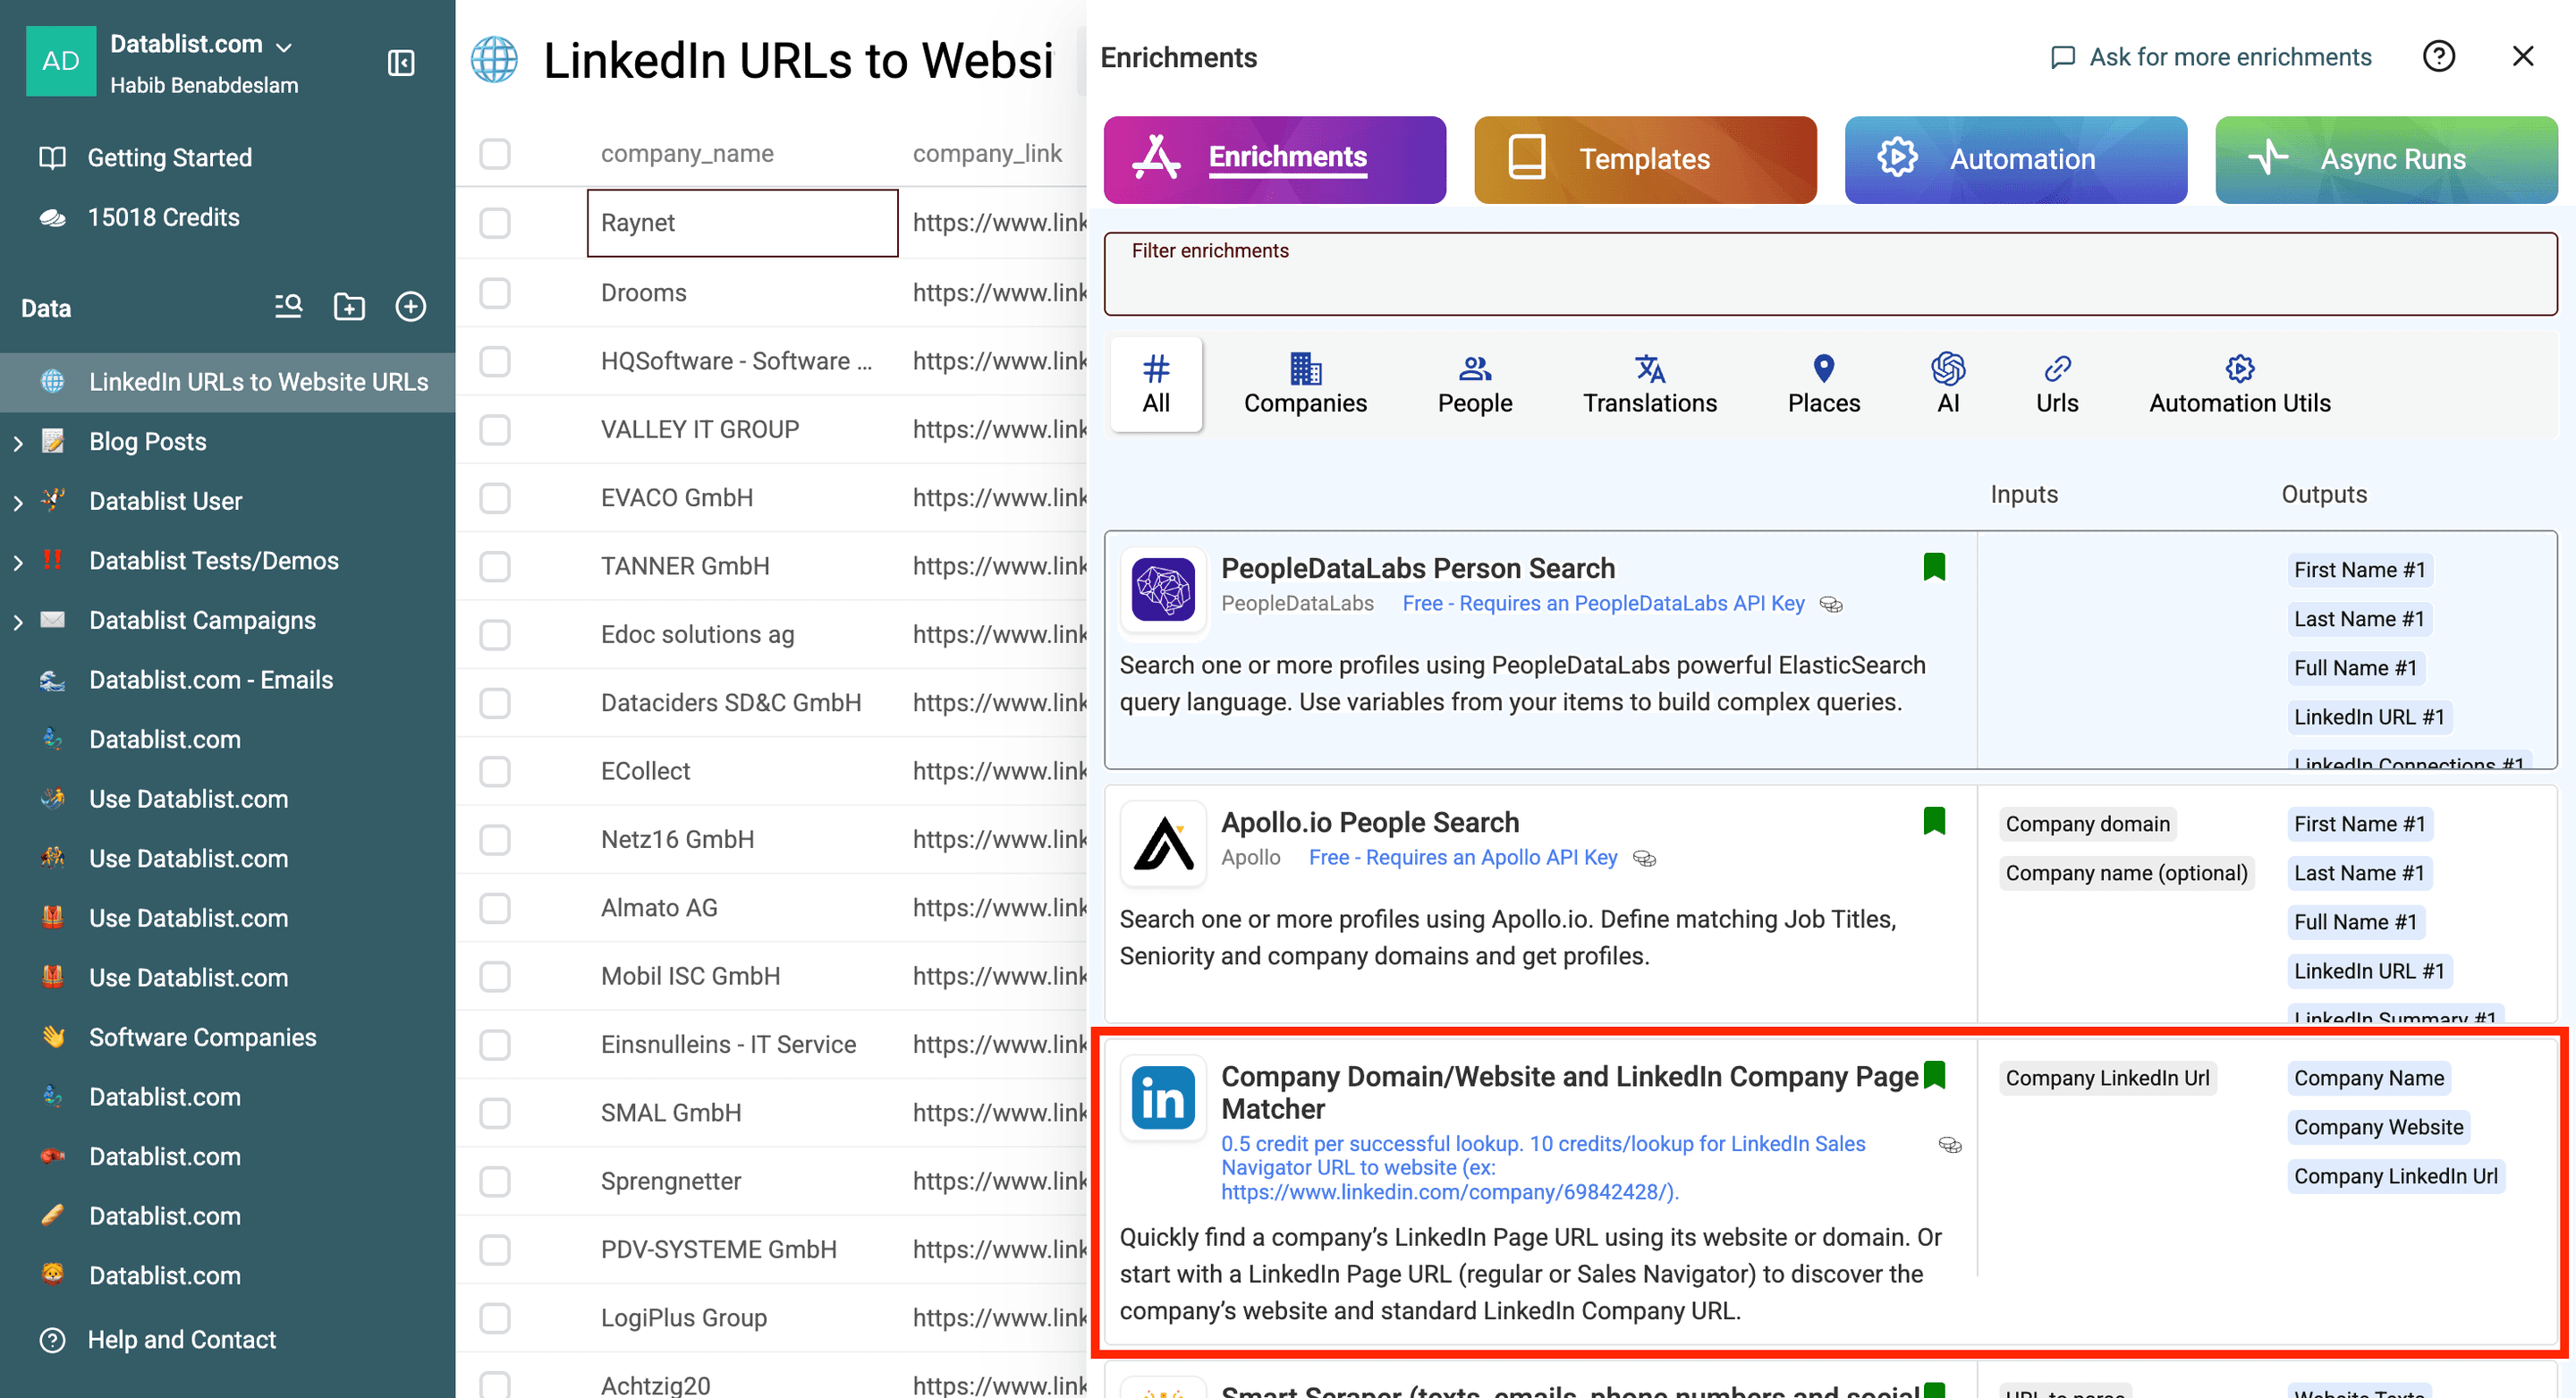
第 3 步:选择 Matcher
选择 Company Domain/Website and LinkedIn Company Page Matcher。如果你需要的是 URL 匹配工作流,请选择 Catalog 中的这一项,而不是完整的公司 Profile Scraper。
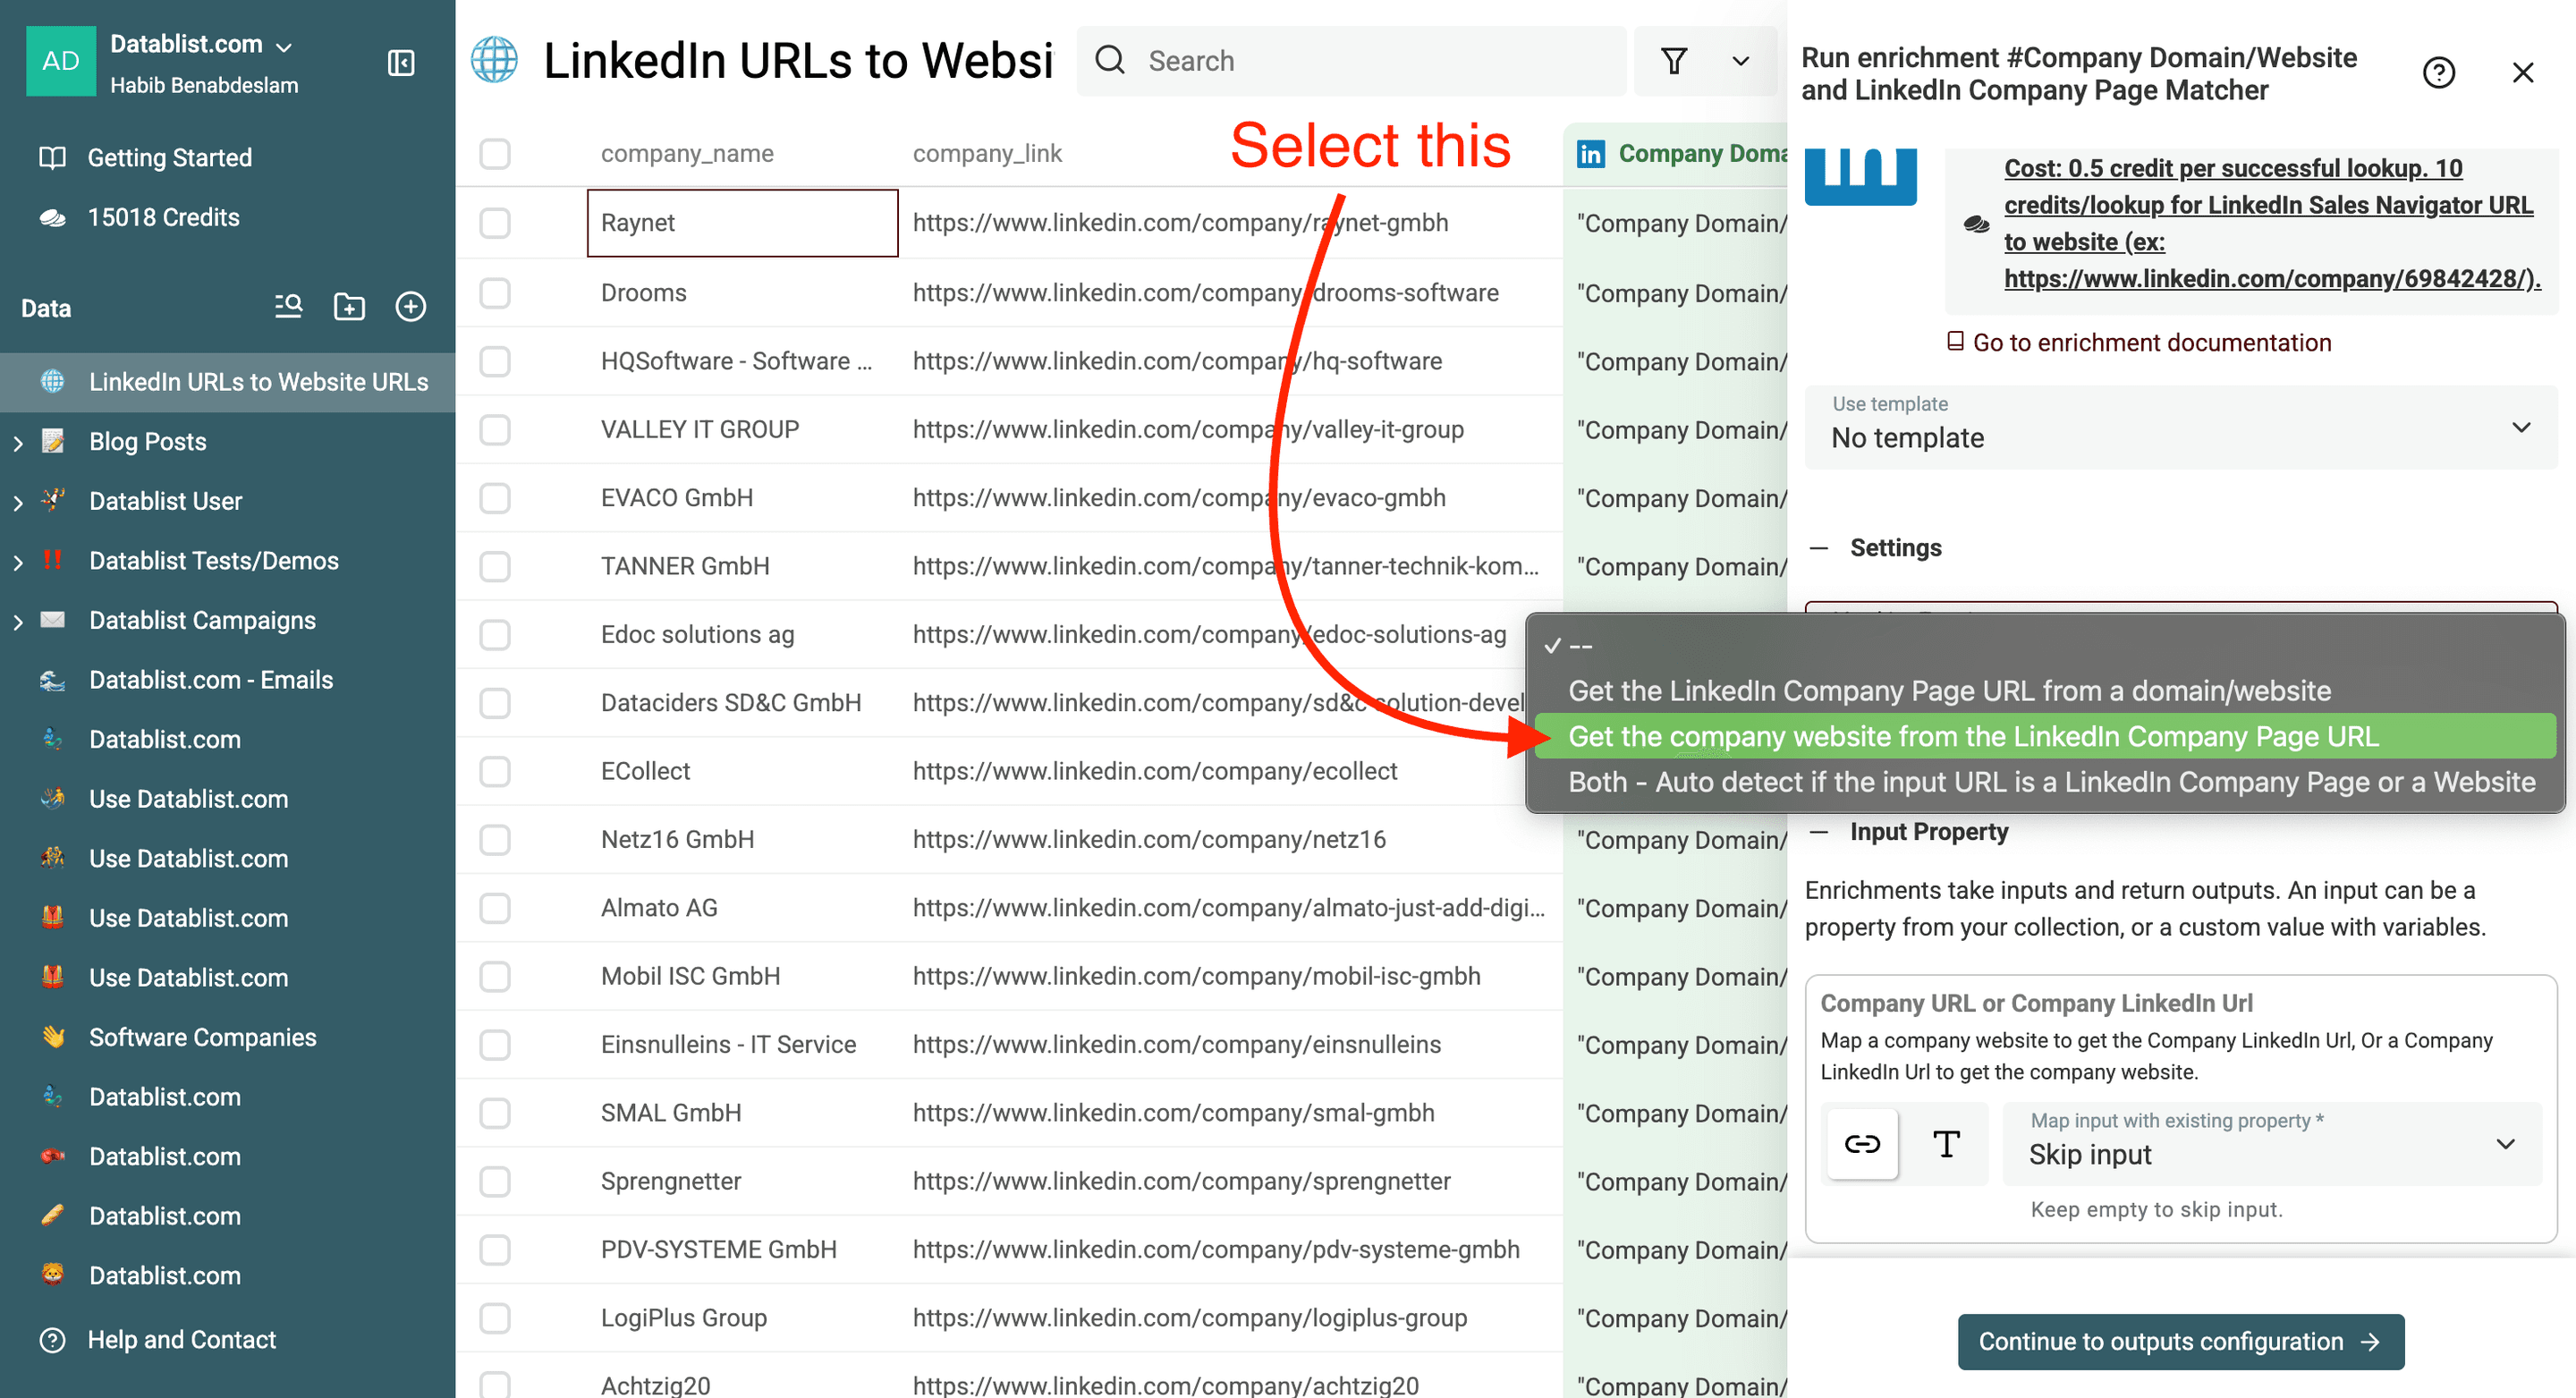
第 4 步:选择匹配方向
在 Matching Type 中选择 Get the company website from the LinkedIn Company Page URL。另一个方向以域名为起点,查找 LinkedIn 公司主页;不要依据旧截图中选项所在的位置进行选择。
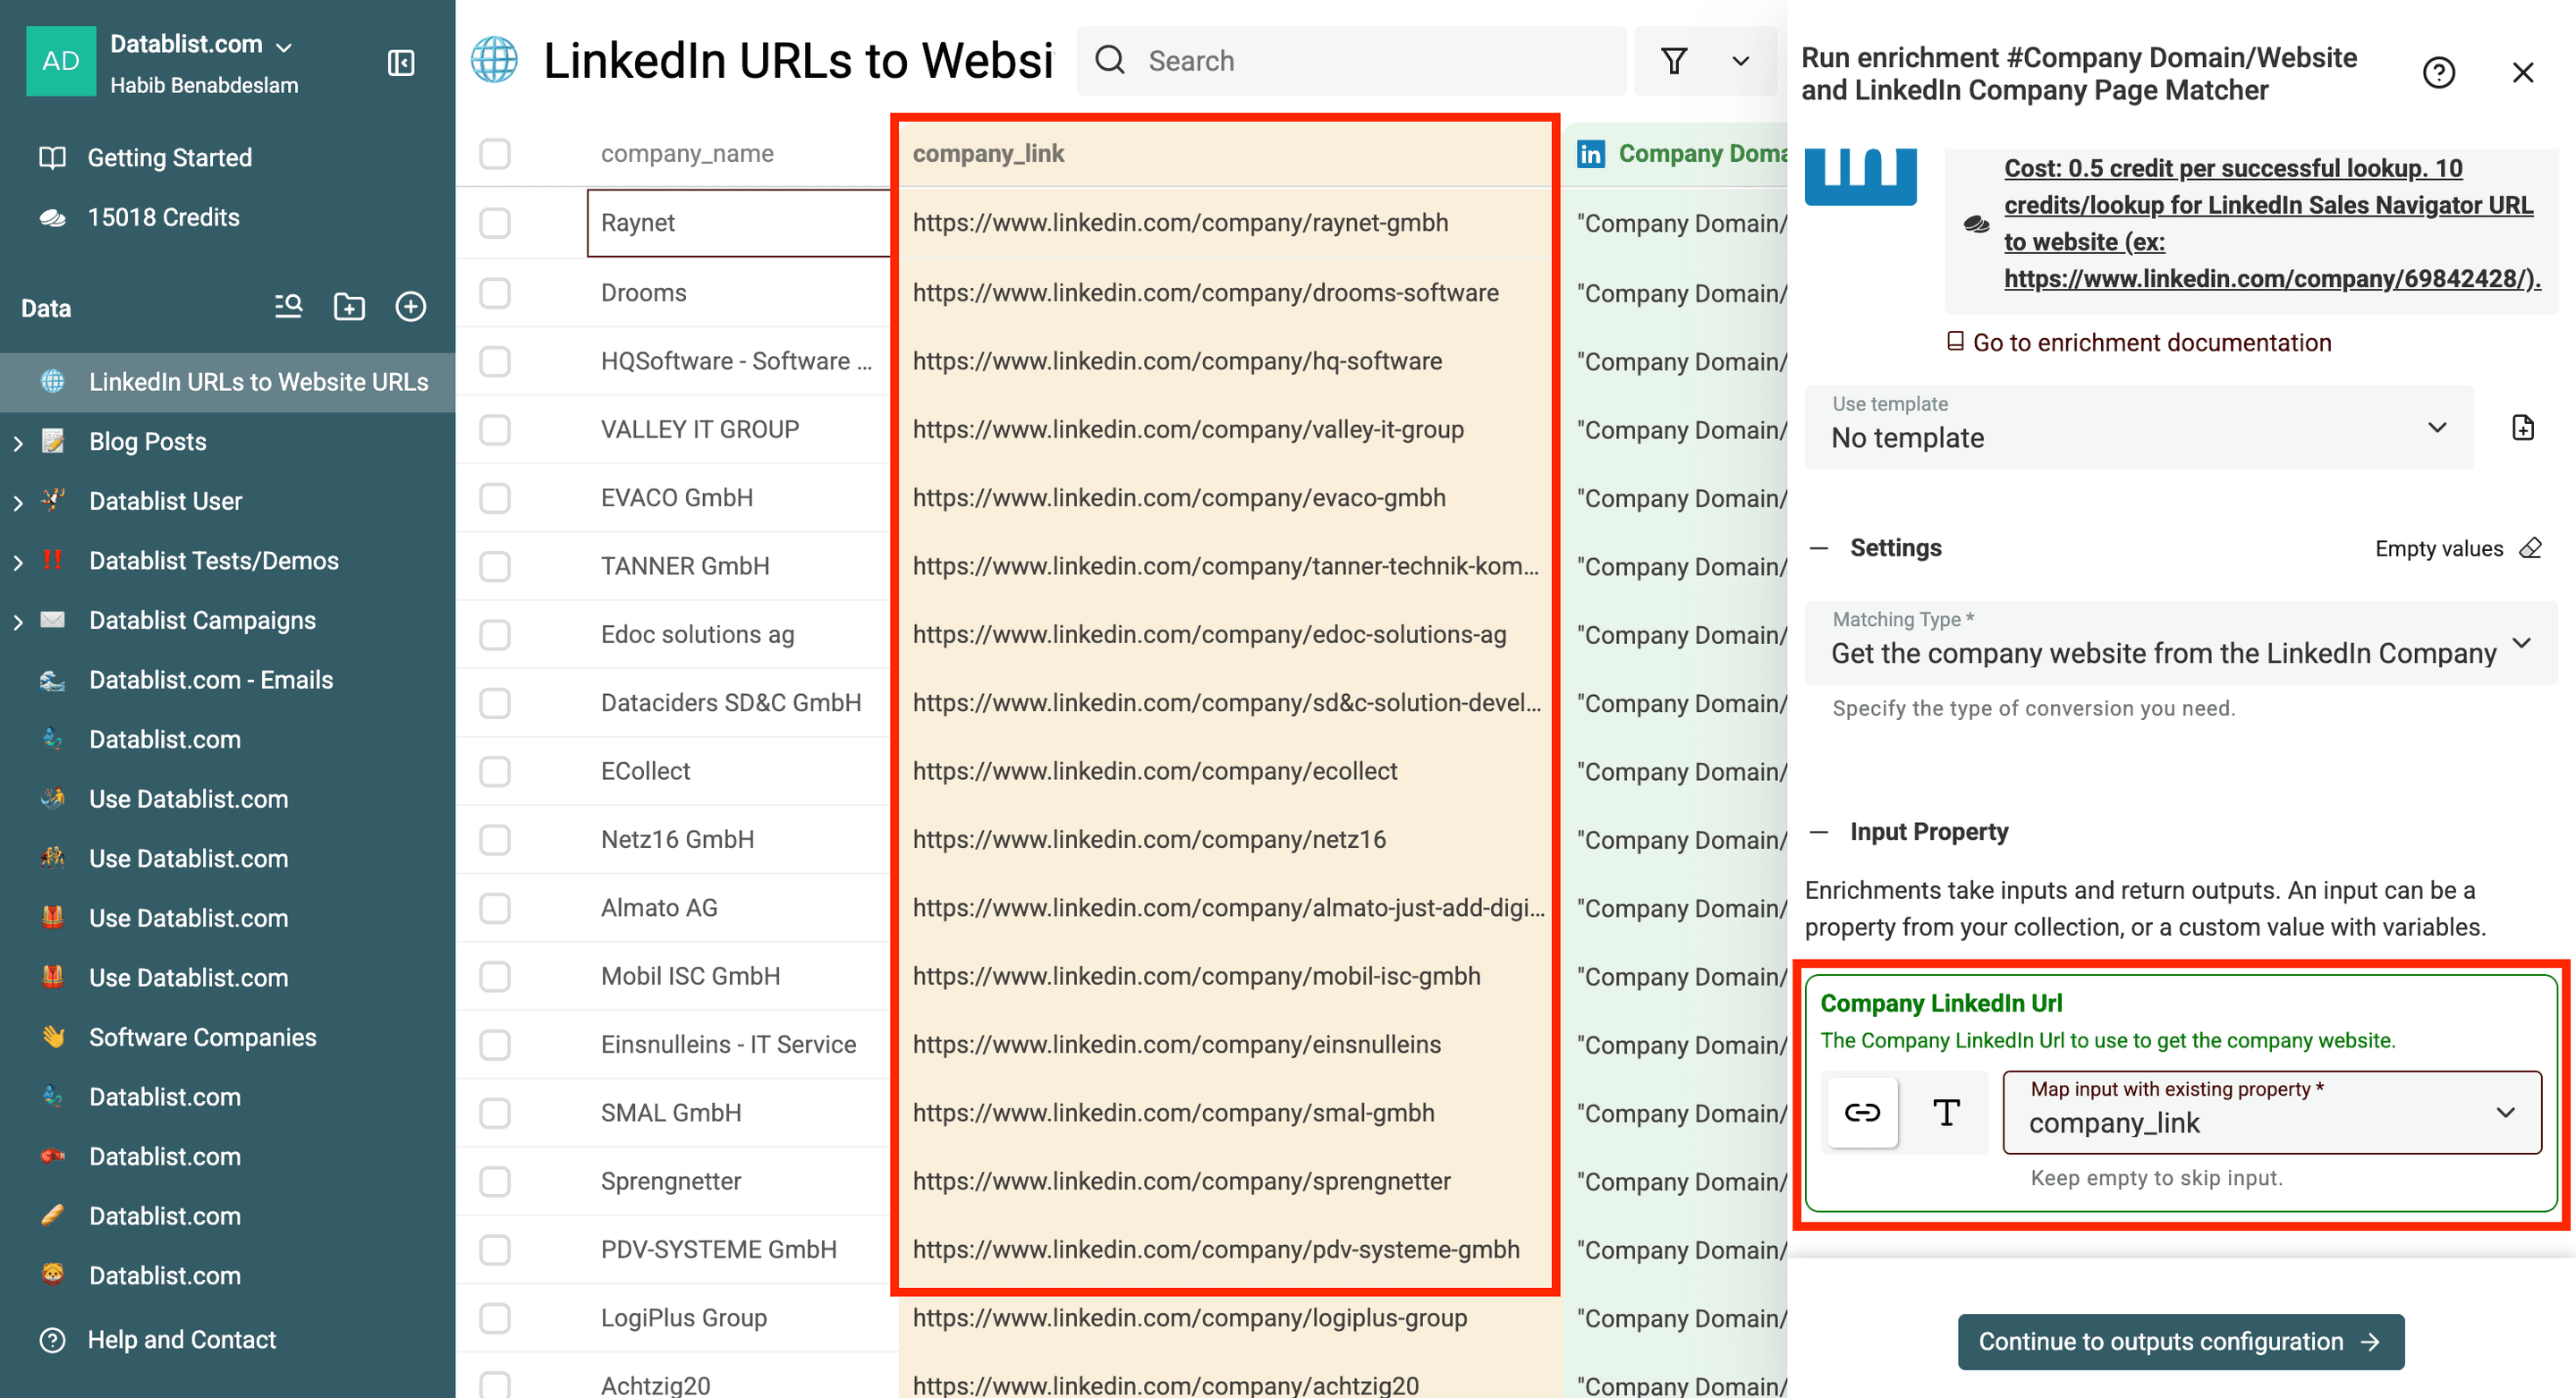
第 5 步:映射输入字段
将 Company LinkedIn Url 映射到源数据列。检查多个替换后的值,确认每一行都只包含一个目标公司的 URL。
如果部分记录是 Sales Navigator 公司 URL,请将其纳入测试样本,不要只测试普通公司主页 URL。不同输入格式的覆盖率和用量可能不同。
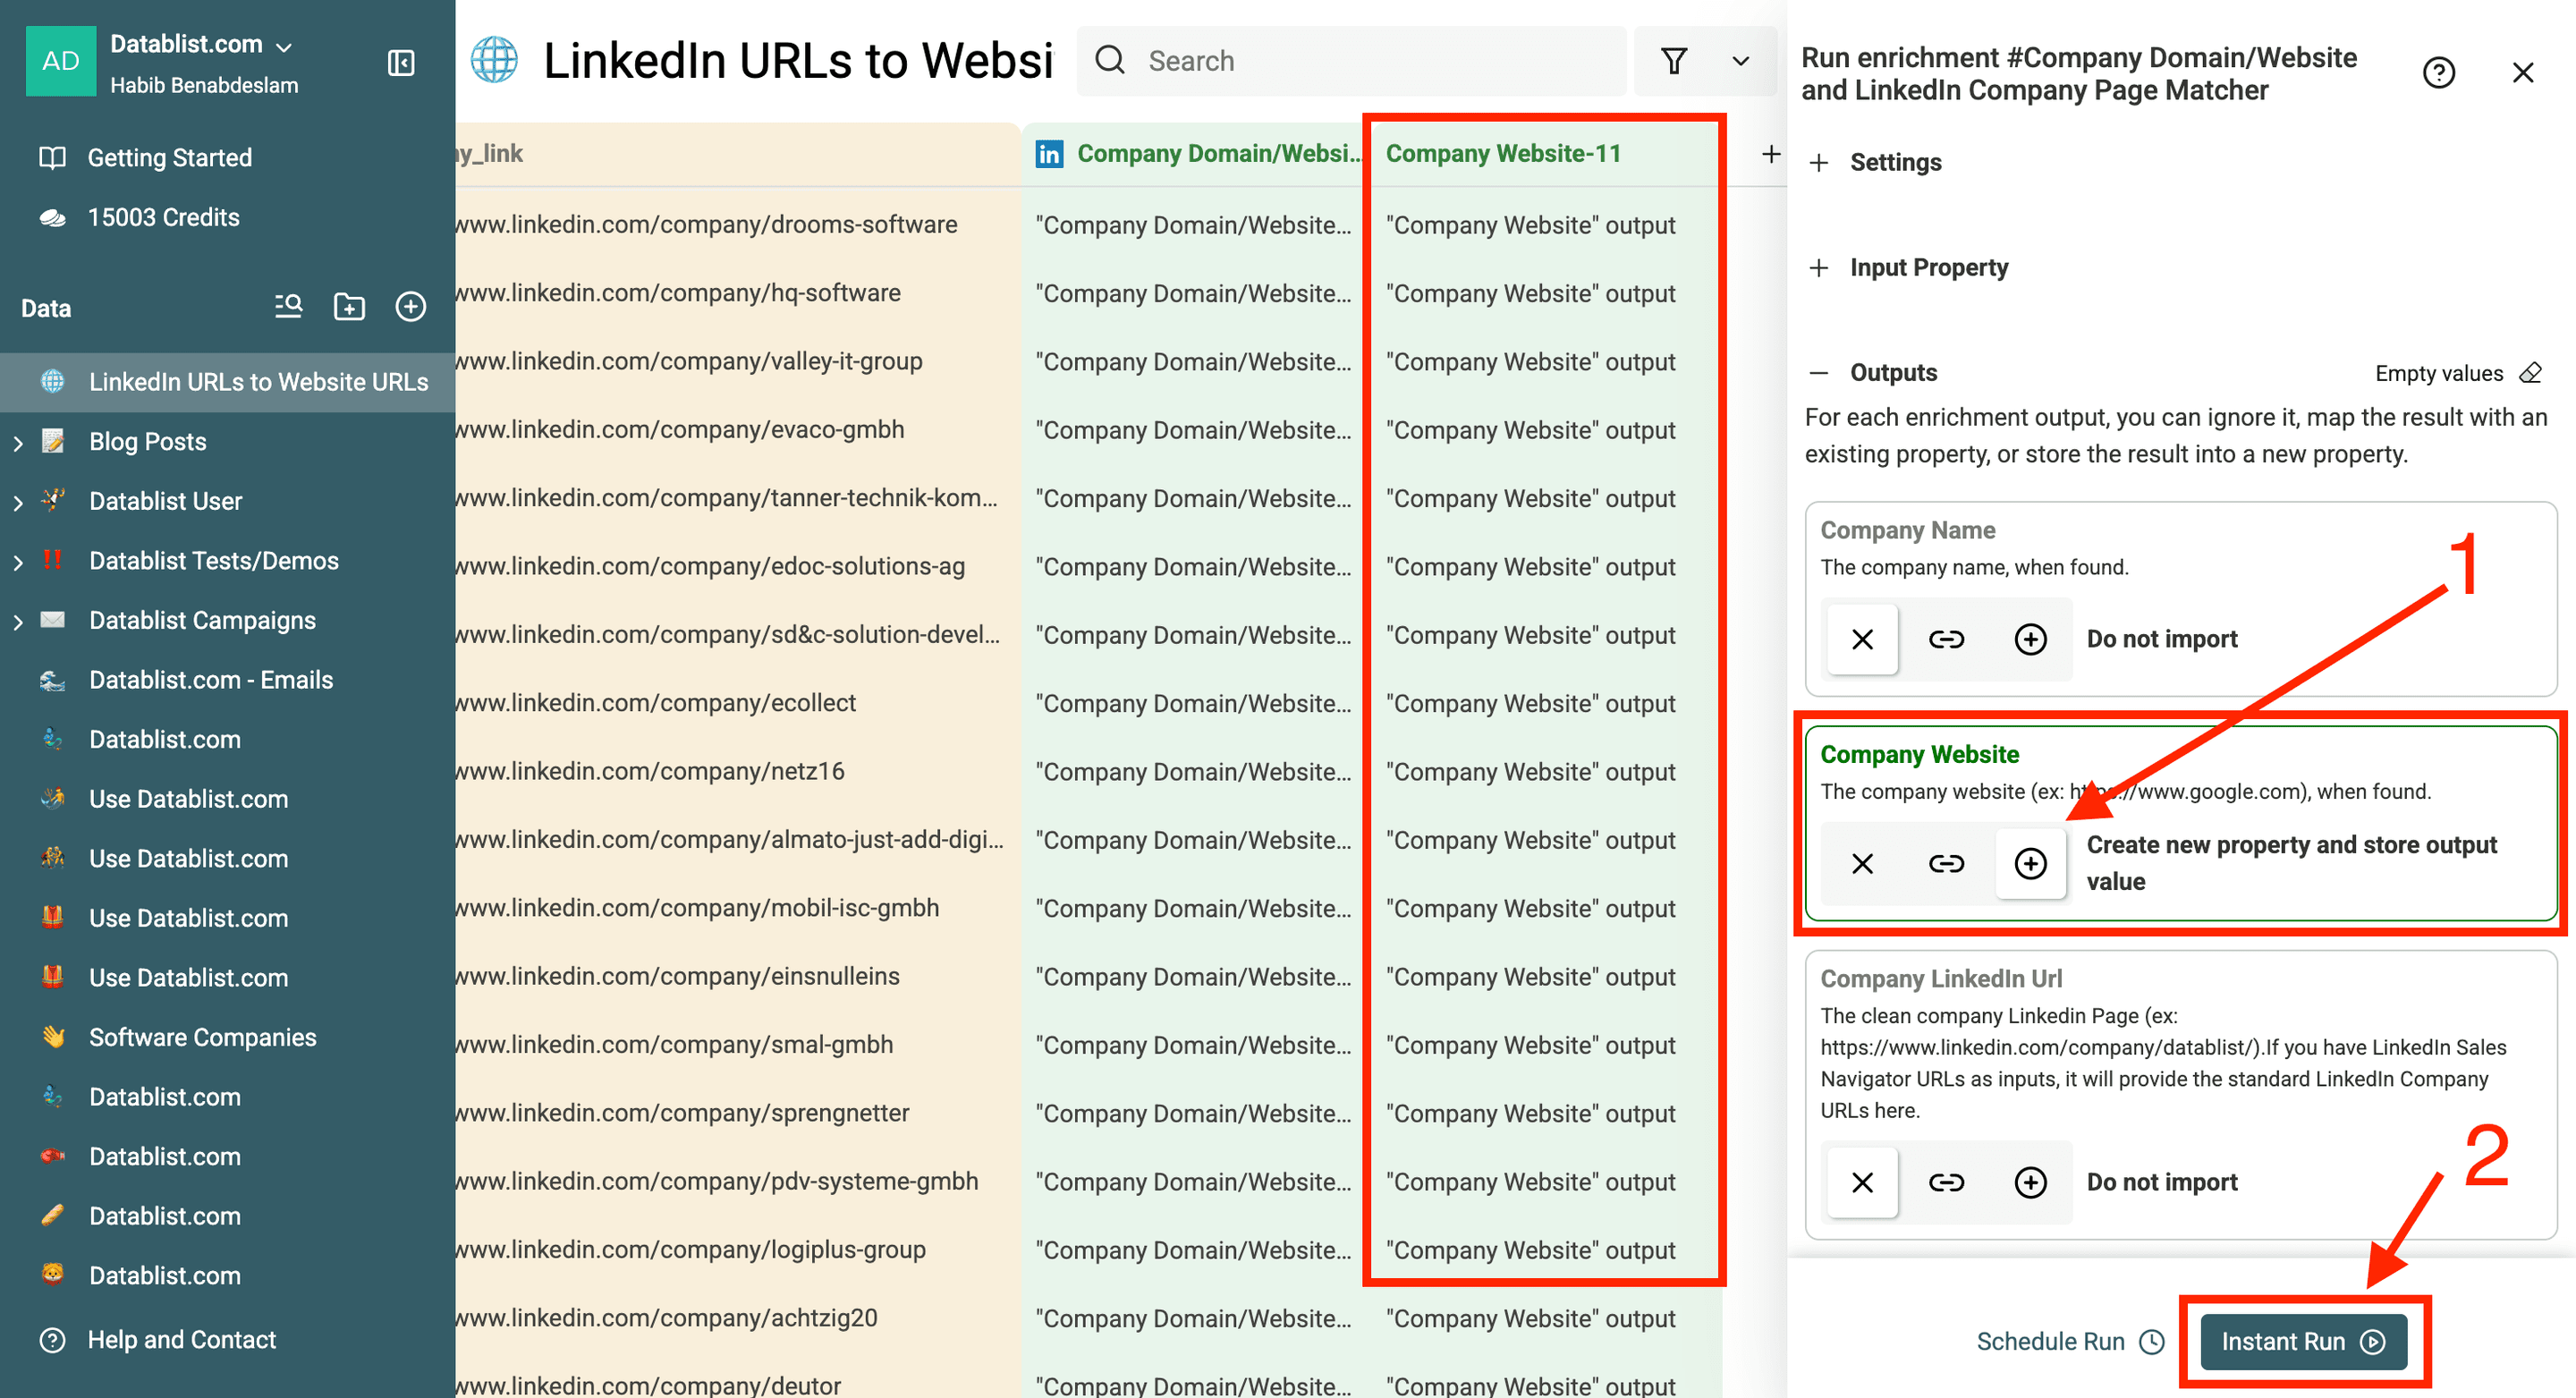
第 6 步:映射输出字段
根据需要,为 Company Website、Company Name、Company LinkedIn Url 和 Status 分别创建 properties。即使官网是你的主要目标,也应保留 Status;它可以解释为什么部分数据行没有生成可用的匹配结果。
完成映射后,选择 Continue with Instant Run。如果结果为空,应保持空白,不要根据公司名称猜测一个域名来填充。
第 7 步:批量处理前先测试和审核
请选择具有代表性的样本进行测试,包括已知公司主页、已更名公司、名称相近的公司,以及文件中存在的各种 URL 格式。检查运行范围和现有数据规则,避免样本测试覆盖此前已接受的官网数据。
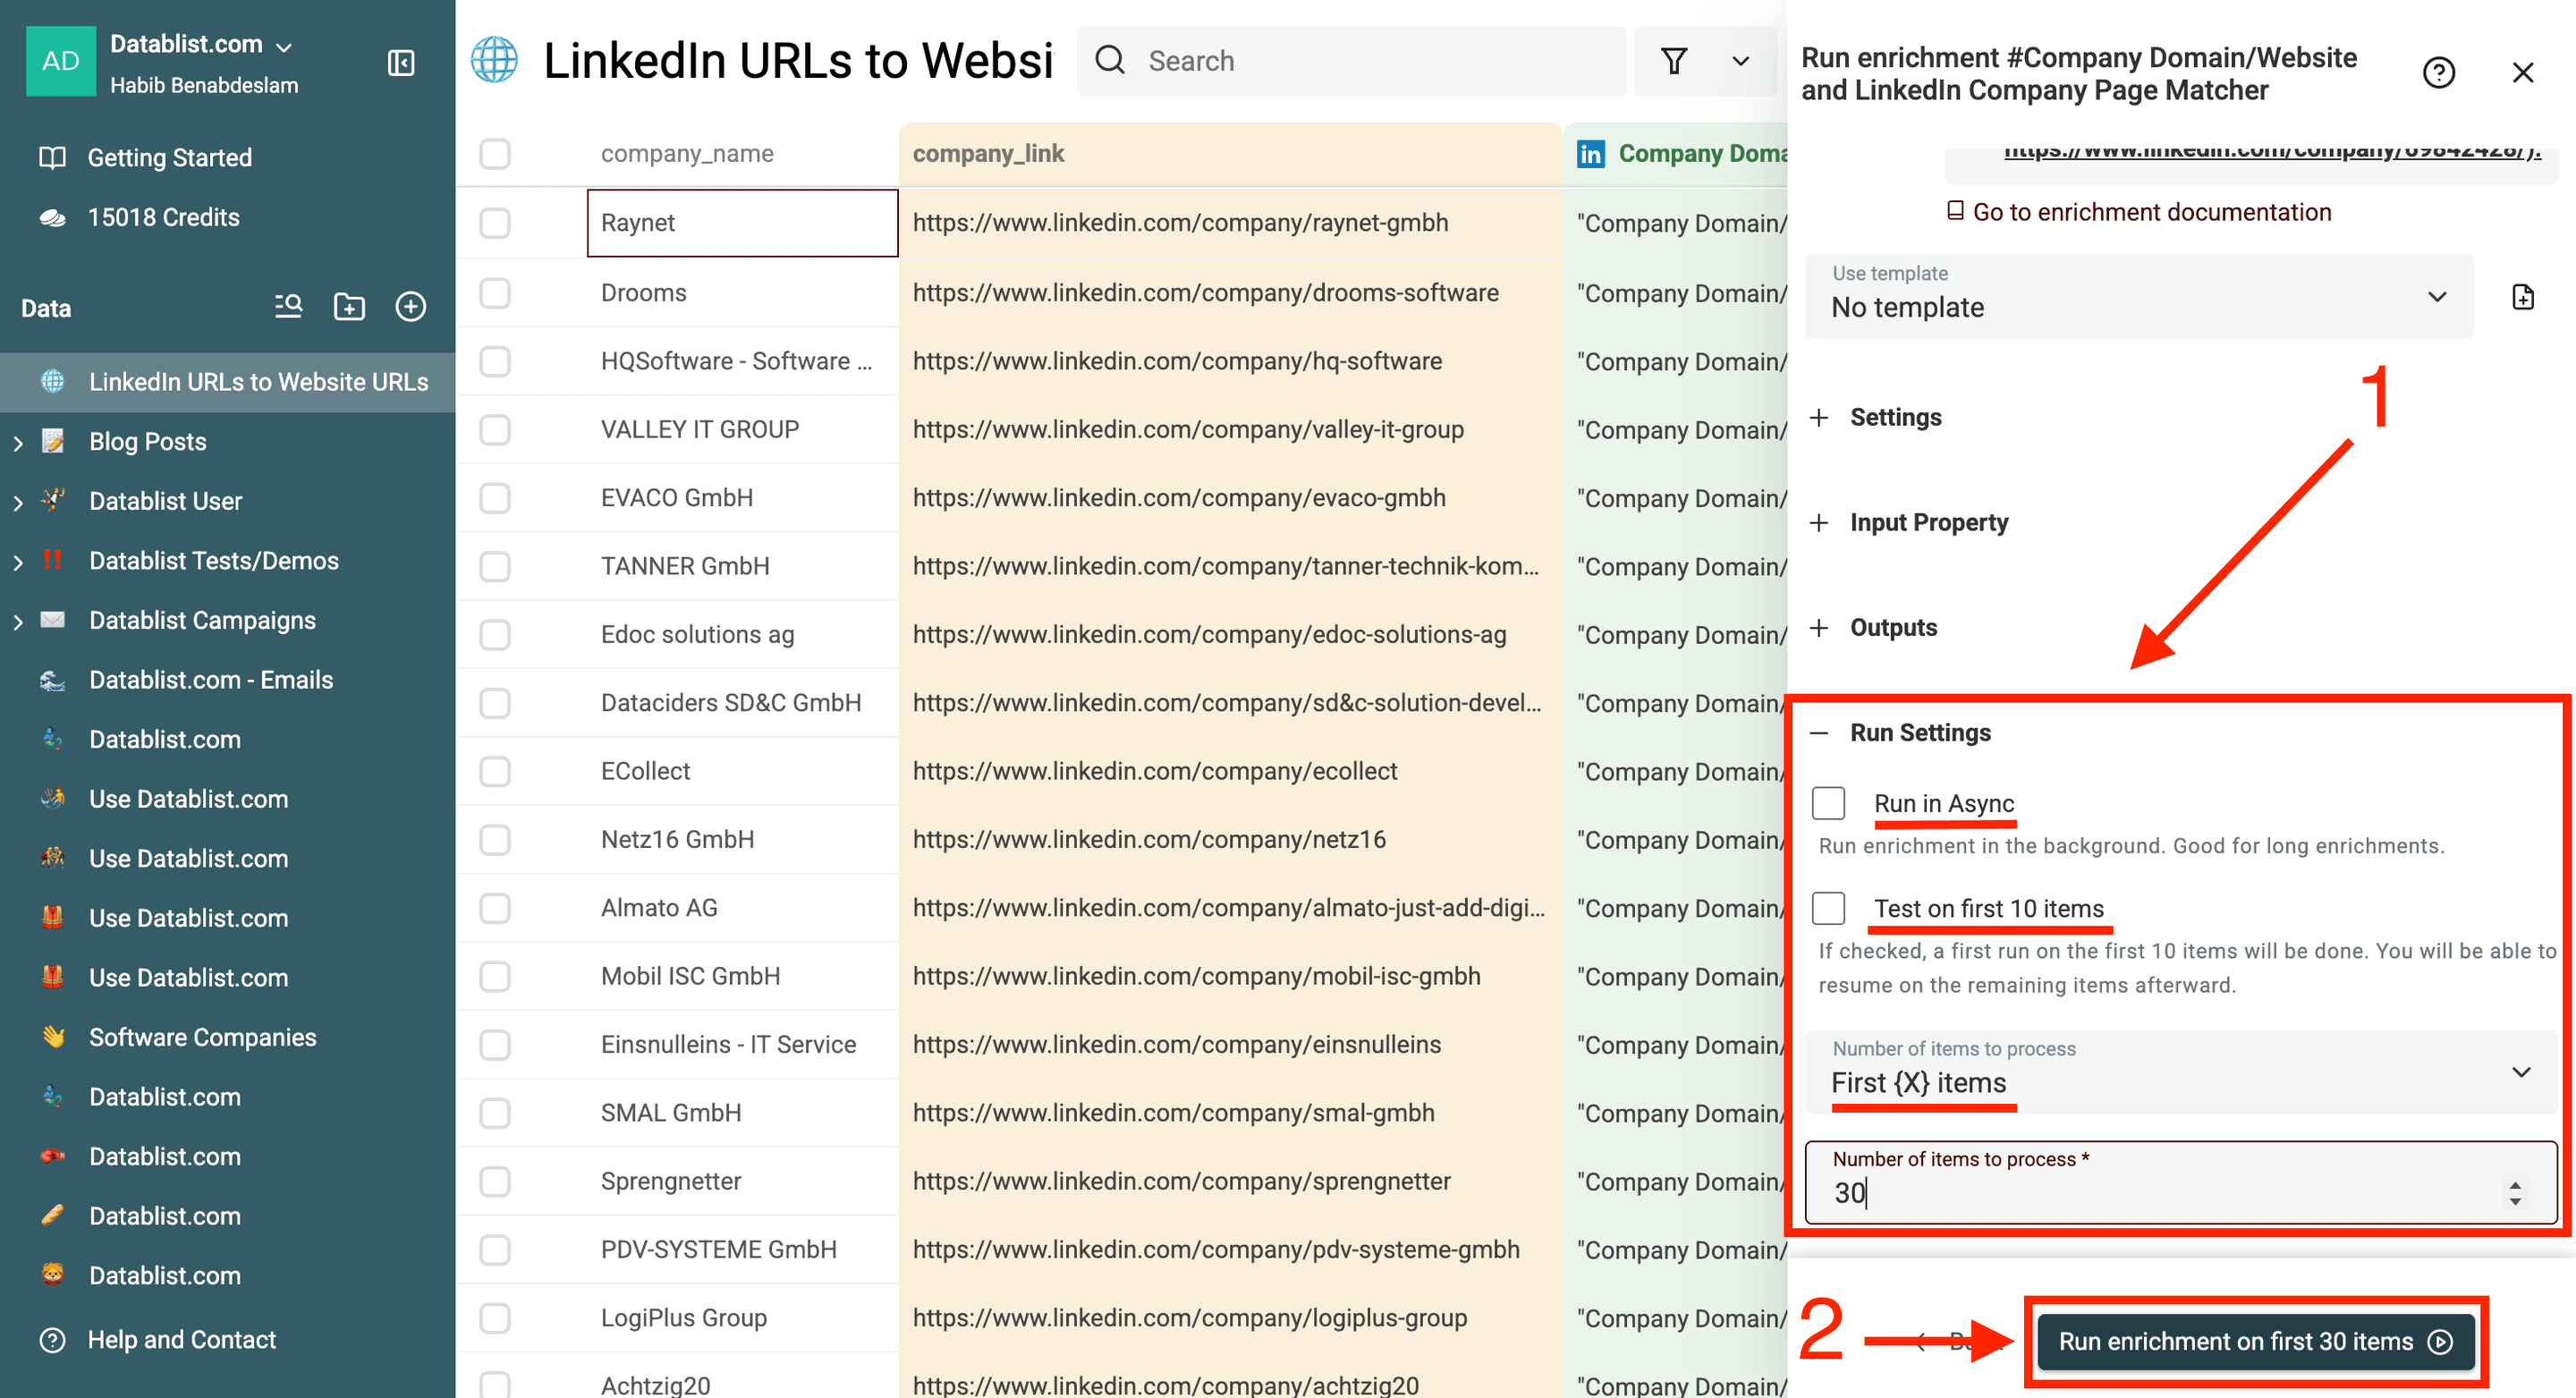
打开返回的官网,对比公司名称、品牌和源 LinkedIn 主页。请求成功或字段已有内容,并不代表该匹配结果适合直接写入 CRM。按域名合并记录前,请检查子公司和 URL 重定向情况。
结果:可审核的官网匹配记录
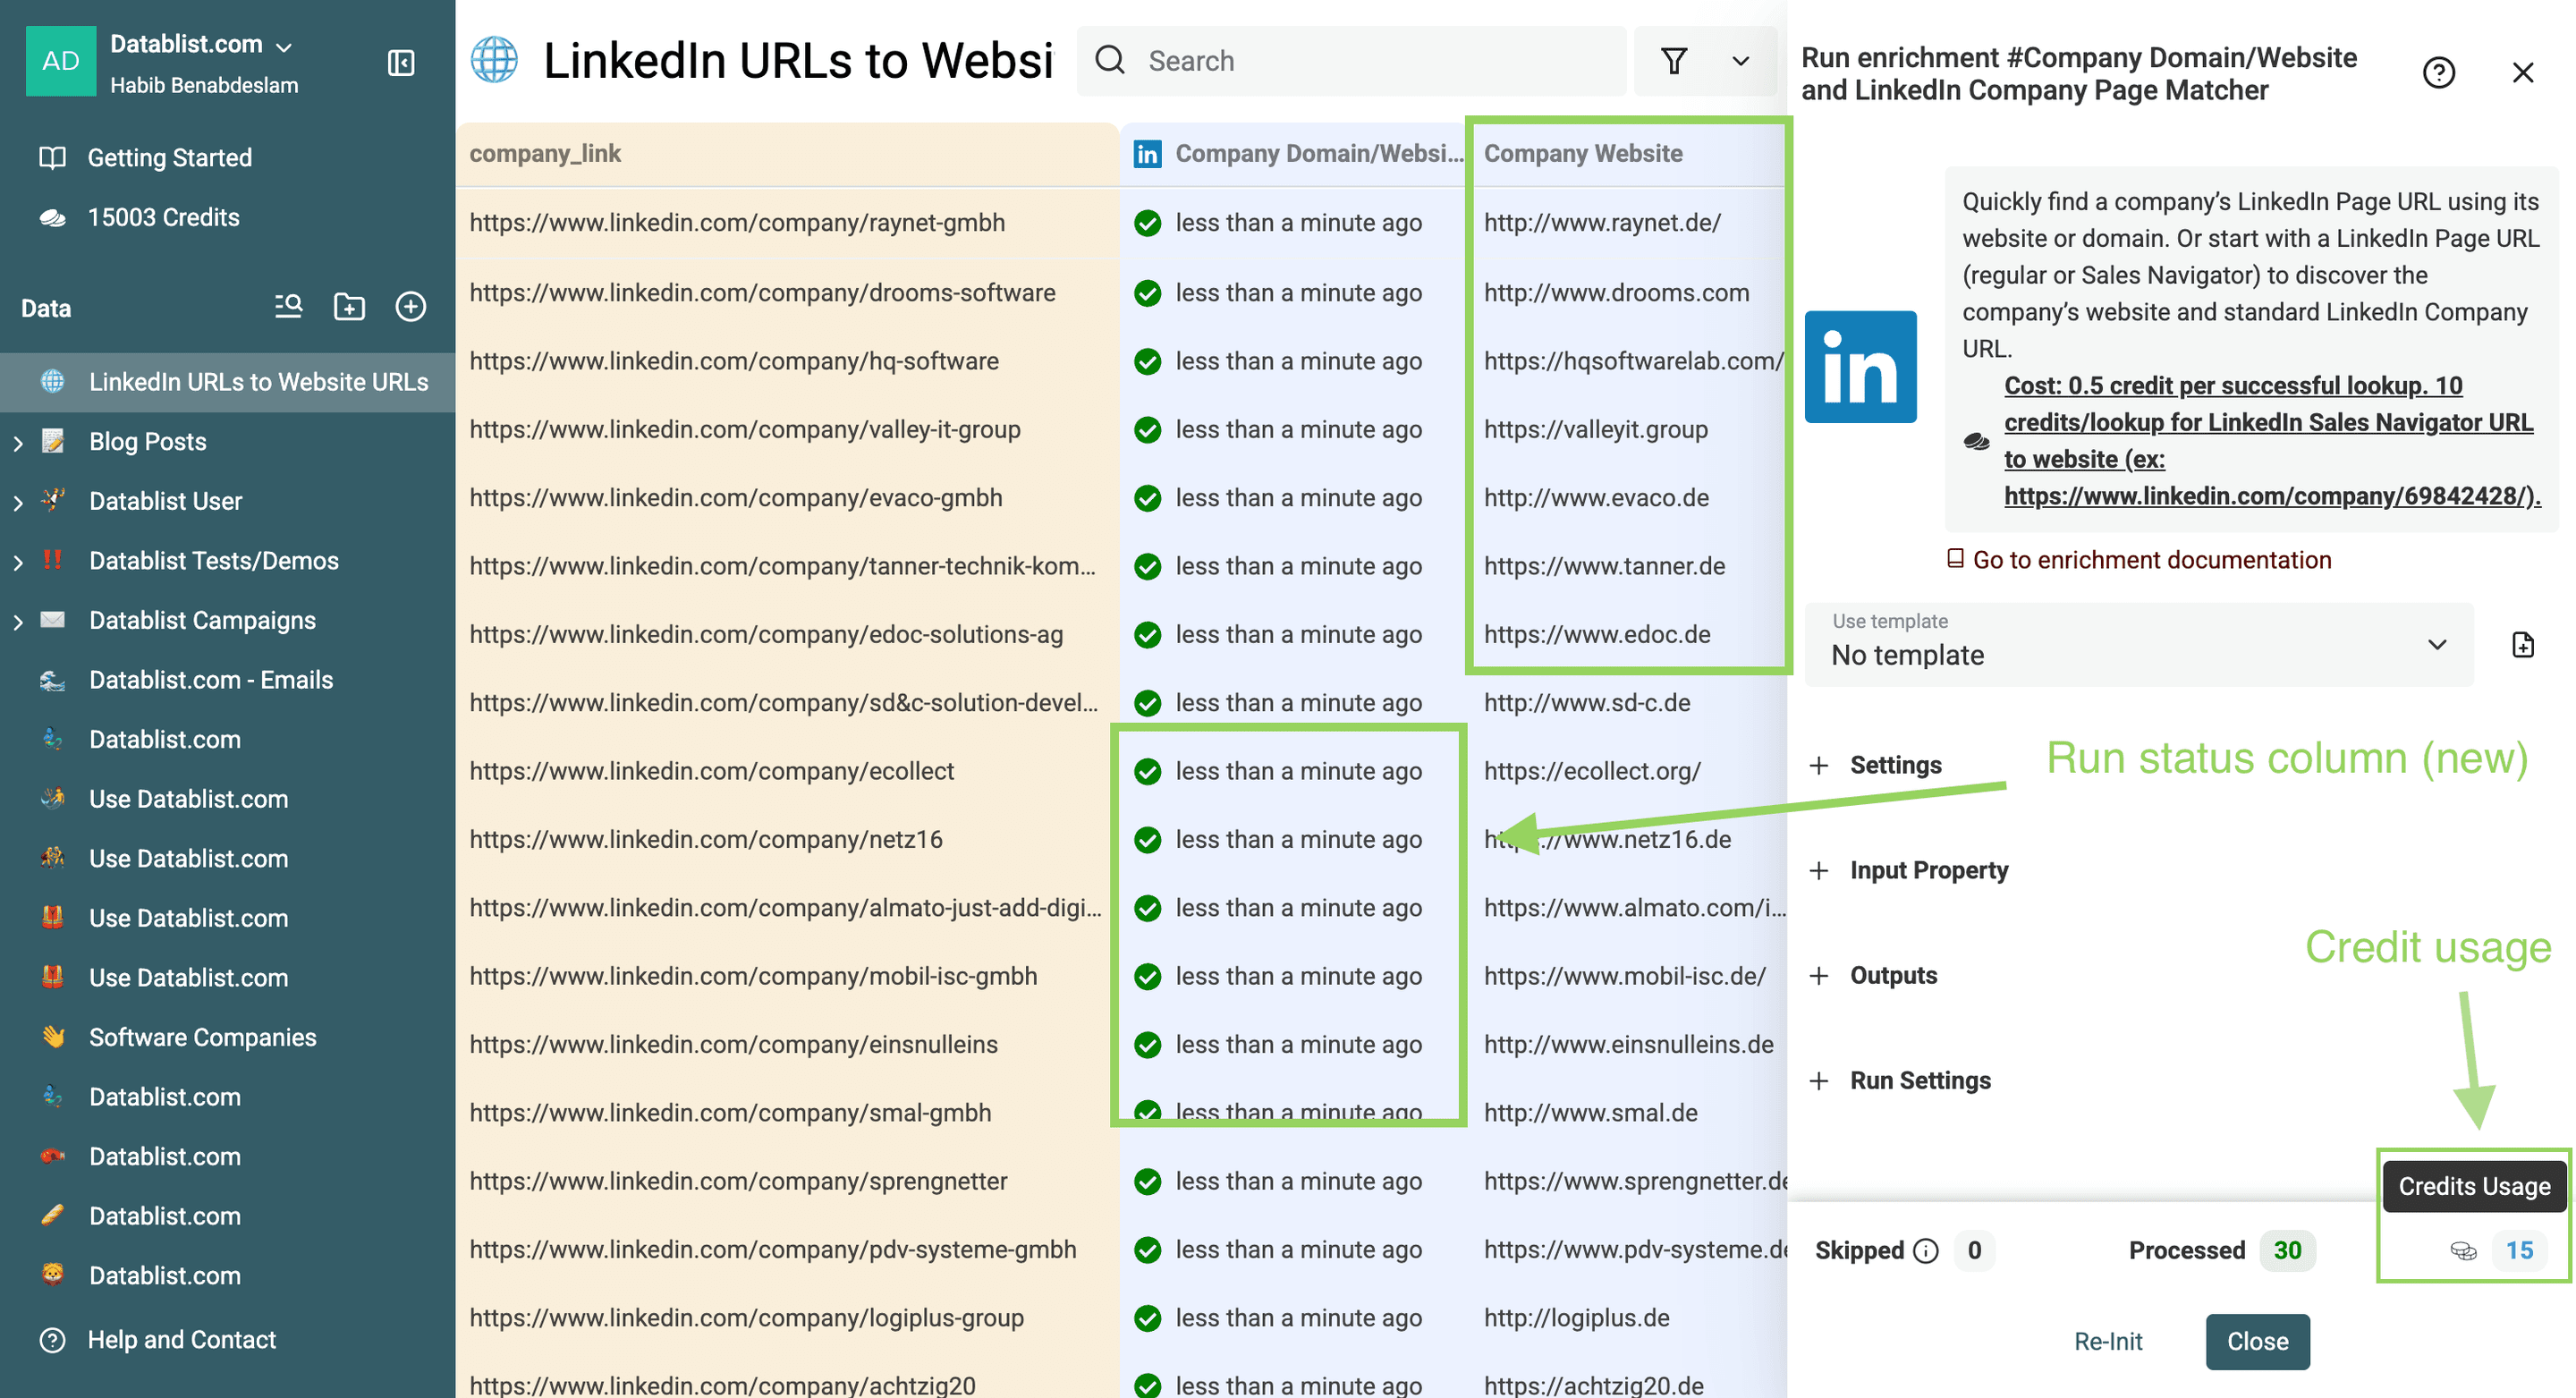
请将输出结果与 Source ID、原始 Company LinkedIn URL 放在一起。结果状态、请求错误和 Credit 用量应分别审核。
| Status | 在此工作流中的含义 | 下一步 |
|---|---|---|
success | Matcher 返回了对应关系。 | 接受结果前,核查官网和目标公司。 |
not_found | 本次查询未找到匹配项。 | 保留源 URL,并单独调查这条未解决的记录。 |
empty_data | 缺少必填输入。 | 修正源数据后再重试。 |
bad_data | 输入无法作为受支持的公司 URL 或域名使用。 | 检查格式,并确认该输入指向一家公司。 |
以上是 Matcher 的输出状态。服务或请求失败也需要进一步调查;不要把它理解为该公司没有官网的证据。返回的公司名称可以辅助审核,但不能取代对目标网站的实际检查。
如何选择匹配工作流
如果你需要建立官网与 LinkedIn 公司主页之间的对应关系,请使用 Matcher。如果你需要公司简介、所在地等更丰富的字段,请使用公司 enrichment 工作流。单个匹配结果不应被当作完整的公司 Profile。
对于只有名称的列表,应先确认目标公司,而不是把公司名称当作 LinkedIn URL。对于混合列表,Matcher 提供 Both - Auto detect if the input URL is a LinkedIn Company Page or a Website 选项。请单独测试此配置,并检查每一行返回了哪些字段。
建议通过样本比较实际可用性,不要承诺普遍适用的速度或价格优势。评估时不仅要看已返回官网的数据行,也要计入未解决记录和人工审核工作。处理剩余数据行前,请查看当前显示的用量。
导出已确认的公司官网
请将 Source ID、原始公司 URL、已确认的官网和审核结果一并导出。如果接收数据的系统要求官网字段不能为空,请将未解决的数据行单独保存。交付方式可参阅 CSV 和 Excel 导出指南。
已确认的公司域名可作为批量查找邮箱的输入。使用域名查询联系人前,请确认其当前任职公司。只有当所选记录确实代表同一家公司,而不是不同分支机构或品牌时,才应对公司域名去重。
如需查询单个联系人,请在免费 Email Finder中输入其名字、姓氏和已确认的域名。本指南使用的公司 LinkedIn URL 不是个人 Profile,不能替代这些联系人输入字段。
常见问题
如果找不到官网 URL 怎么办?
请保留原始 URL 和 Status。没有返回结果可能是因为数据覆盖有限或输入存在问题,并不能证明该公司没有官网。请检查格式、确认目标企业,并通过单独的审核工作流处理其余记录。
Matcher 是否一定不会访问 LinkedIn?
不会。该工作流可能使用已有公司数据和备用查询,包括访问 LinkedIn。仅凭工具的处理方式,无法确定某项数据收集或使用行为是否获得许可。不要根据旧版描述推断系统保证只查询数据库。
费用是多少?
请查看该 enrichment 当前显示的费用,以及针对你的输入格式进行样本测试后报告的用量。Sales Navigator 公司 URL 可能需要采用不同的处理路径。本指南不会把订阅额度换算成有保证的成功匹配数量。
可以从公司域名开始匹配吗?
可以。选择 Get the LinkedIn Company Page URL from a domain/website,并映射官网输入字段。这个方向除了匹配字段外,还可能返回 Confidence;它表示查询的验证状态,并不是经过测量的正确概率。请务必审核返回的公司主页。
批量查询需要多长时间?
处理时长取决于输入内容、备用请求和运行条件。请先用样本测试,并检查完成情况和错误信息。某一家公司的查询很快完成,并不代表大型 collection 中的每一行都能在相同时间内处理完毕。