
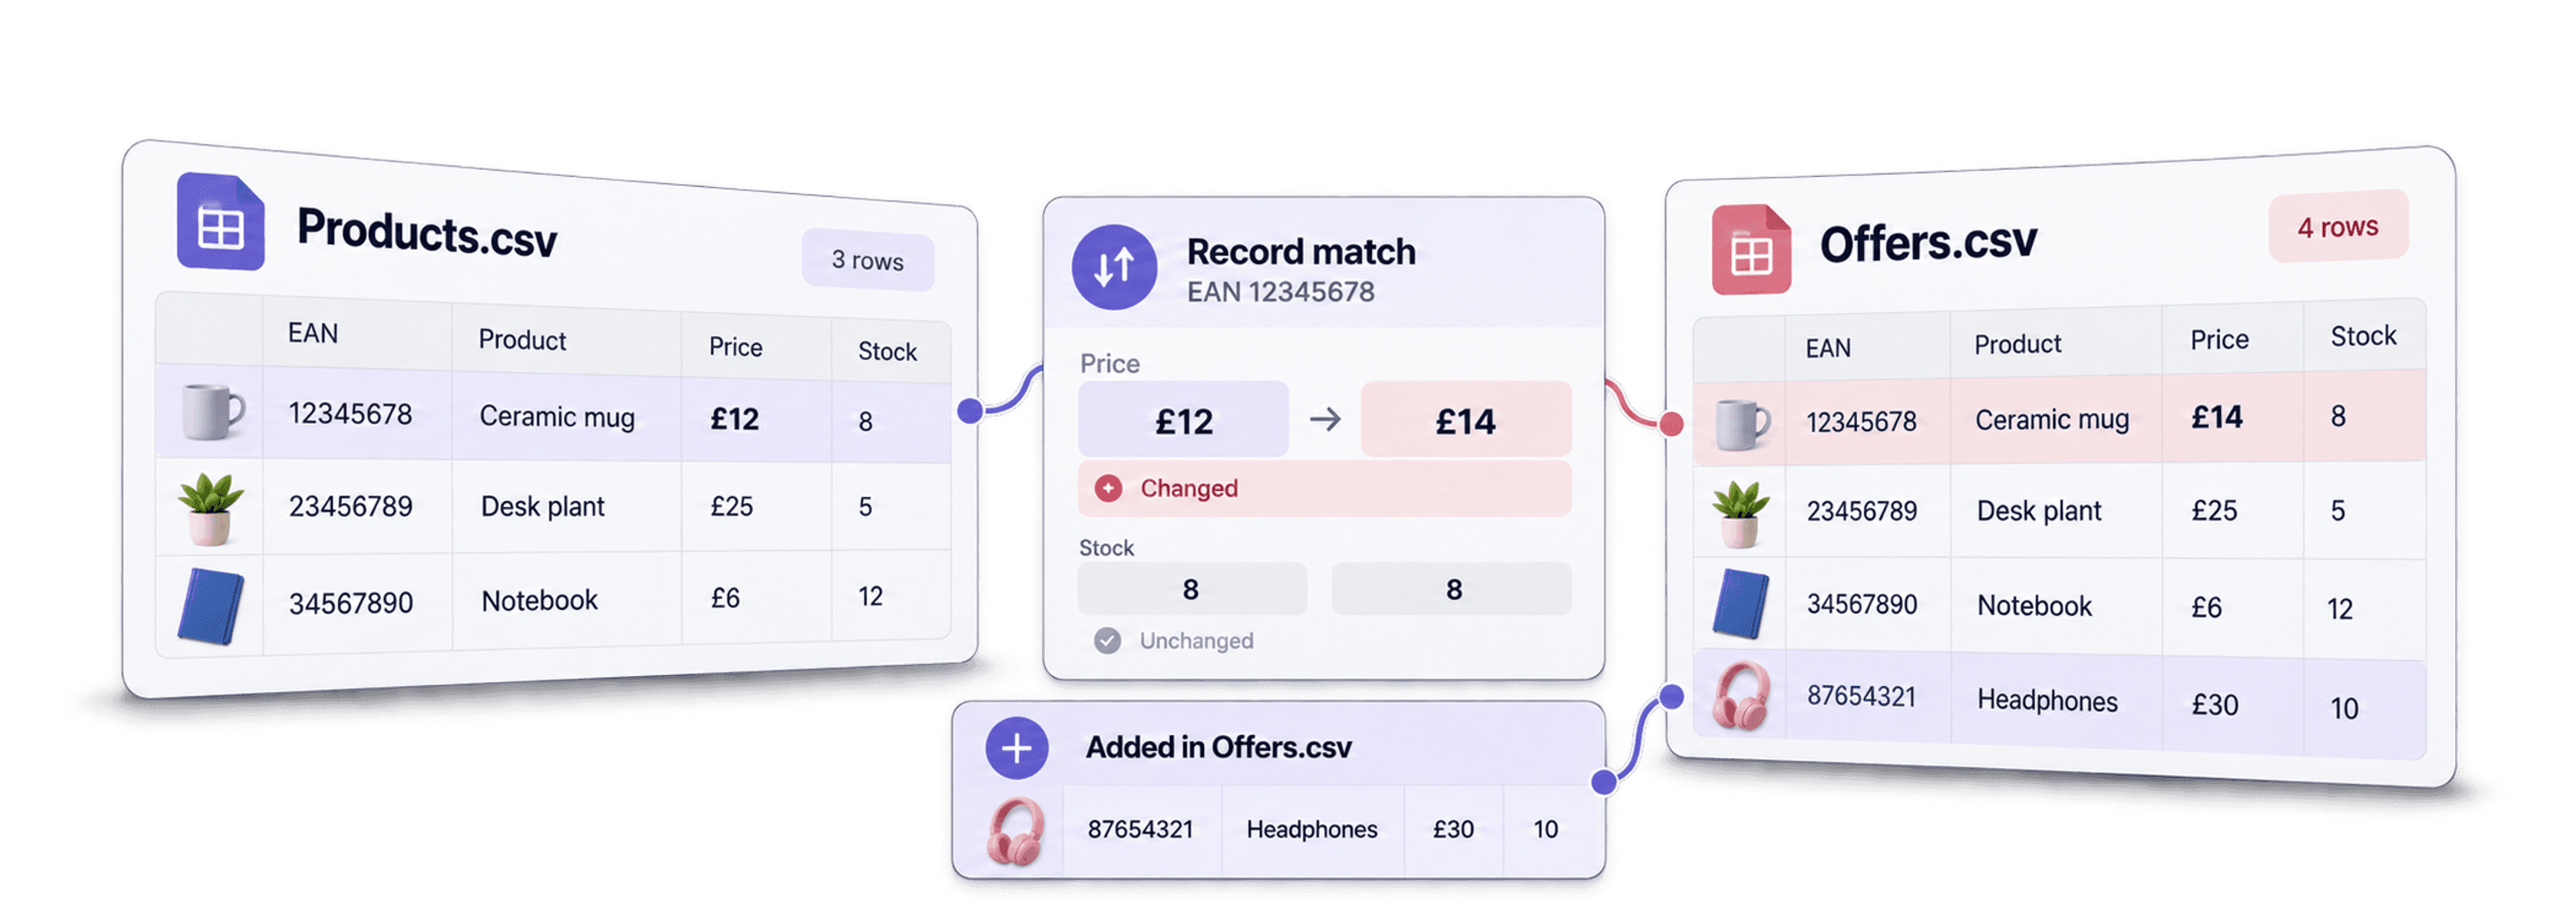
需要在线比较 CSV 文件时,我最不建议使用纯文本 diff。CSV 文件属于结构化数据:行的位置会变化,列名可能被修改,新的导出文件也可能增加字段。此时逐行比较只会产生大量无效差异。
更合理的方法是把文件当作表格来比较:选择稳定的 key,映射列,检查新增、删除、变更和未变更的行,最后导出 diff。这正是 Datablist CSV Diff tool 的用途。
本教程将比较一份较旧的商品目录导出文件和一份较新的供应商报价文件。两份文件的列并不完全相同,但都包含 EAN、Internal ID、Price 和 Stock。这是一个很贴近实际业务的例子:按 EAN 匹配商品,比较价格和库存,再导出结果。
快速导航
- 最快的 CSV 文件比较流程
- 示例数据:Products CSV 与 Offers CSV
- 第 1 步:上传原始和更新后的 CSV 文件
- 第 2 步:选择行匹配方式
- 第 3 步:映射名称不同的列
- 第 4 步:选择 join 类型和比较选项
- 第 5 步:检查差异
- 第 6 步:导出 CSV diff 结果
- 输出表示例
最快的 CSV 文件比较流程
如果两份文件已经准备好,整个流程很简单:
- 打开 Datablist 的 CSV Diff tool。
- 将较旧的文件上传为 original CSV。
- 将较新的文件上传为 updated CSV。
- 先使用 auto-detect,再确认 key 列。
- 如果两份文件使用不同的列名,请手动映射对应列。
- 第一次审核时保留 full outer join。
- 检查已变更、新增、删除和未变更的行。
- 第一轮先导出完整的 diff CSV。
- 如果需要更精简的交接文件,再切换为仅导出 changed rows。
这种方法比文本 diff 更有效,因为它依据记录而不是行号进行比较。如果 CRM 导出文件重新排列了联系人,或者供应商增加了一个新列,文本 diff 可能会让整个文件看起来都发生了变化。表格 diff 则能明确告诉你哪些记录和单元格发生了变化。
🔑 先选定行 key,再判断 diff 是否准确
合适的 key 列能把杂乱的比较结果变成真正有用的信息。请选择在两次导出之间保持稳定的 ID、email、SKU、EAN 或内部标识符。
示例数据:Products CSV 与 Offers CSV
本教程使用一组虚构的电商数据。第一份文件是较旧的商品目录导出,第二份文件是较新的供应商或 marketplace 报价 feed。
原始 Products CSV 如下:
| 序号 | EAN | 内部 ID | 名称 | 品牌 | 品类 | 价格 | 币种 | 库存 | 供货状态 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 5901234123457 | PRD-001 | 密封水瓶 | Acme Outdoor | 户外用品 | 24.90 | EUR | 42 | 有货 |
| 2 | 5901234123464 | PRD-002 | 便当盒 | Northline | 厨房用品 | 18.50 | EUR | 120 | 有货 |
| 3 | 5901234123471 | PRD-003 | 棉质托特包 | Urban Goods | 配饰 | 9.90 | EUR | 0 | 缺货 |
| 4 | 5901234123488 | PRD-004 | LED 台灯 | Luma | 办公用品 | 39.00 | EUR | 18 | 有货 |
| 5 | 5901234123495 | PRD-005 | 瑜伽垫 | BalanceFit | 运动用品 | 29.00 | EUR | 65 | 有货 |
| 10 | 5901234123549 | PRD-010 | 无线鼠标 | ClickPro | 电子产品 | 34.00 | EUR | 55 | 有货 |
更新后的 Offers CSV 包含的描述字段较少,但仍保留了我们关注的标识符和商业数据:
| 报价 ID | EAN | 内部 ID | 供应商 SKU | 库存 | 价格 |
|---|---|---|---|---|---|
| OFF-001 | 5901234123457 | PRD-001 | ACM-BTL-01 | 38 | 23.90 |
| OFF-002 | 5901234123464 | PRD-002 | NTH-LBX-02 | 120 | 18.50 |
| OFF-003 | 5901234123471 | PRD-003 | UGD-TOTE-03 | 25 | 9.90 |
| OFF-004 | 5901234123488 | PRD-004 | LMA-LAMP-04 | 18 | 35.00 |
| OFF-005 | 5901234123495 | PRD-005 | BFT-MAT-05 | 65 | 29.00 |
| OFF-008 | 5901234123556 | PRD-011 | CLP-CAB-11 | 44 | 16.50 |
这组文件包含 CSV diff 示例中常见的各种情况:值发生变化、新增行、删除行、未变更行,以及不同的 schema。使用完整样本时,预计 PRD-001、PRD-003、PRD-004、PRD-006 和 PRD-010 会被标记为 changed;PRD-011 和 PRD-012 会被标记为 added;PRD-008 和 PRD-009 则会被标记为 removed。
第 1 步:上传原始和更新后的 CSV 文件
打开 CSV Diff tool。页面上会显示两个上传区域:
- Original CSV:较早的导出文件、旧快照或基准文件。
- Updated CSV:需要与原始文件比较的较新导出文件。
文件顺序很重要。如果某一行只存在于 updated 文件中,Datablist 会将其标记为 added;如果只存在于 original 文件中,则会标记为 removed。
在商品示例中,我把 Products CSV 上传为 original 文件,因为它是较旧的目录导出;把 Offers CSV 上传为 updated 文件,因为它代表较新的供应商 feed。
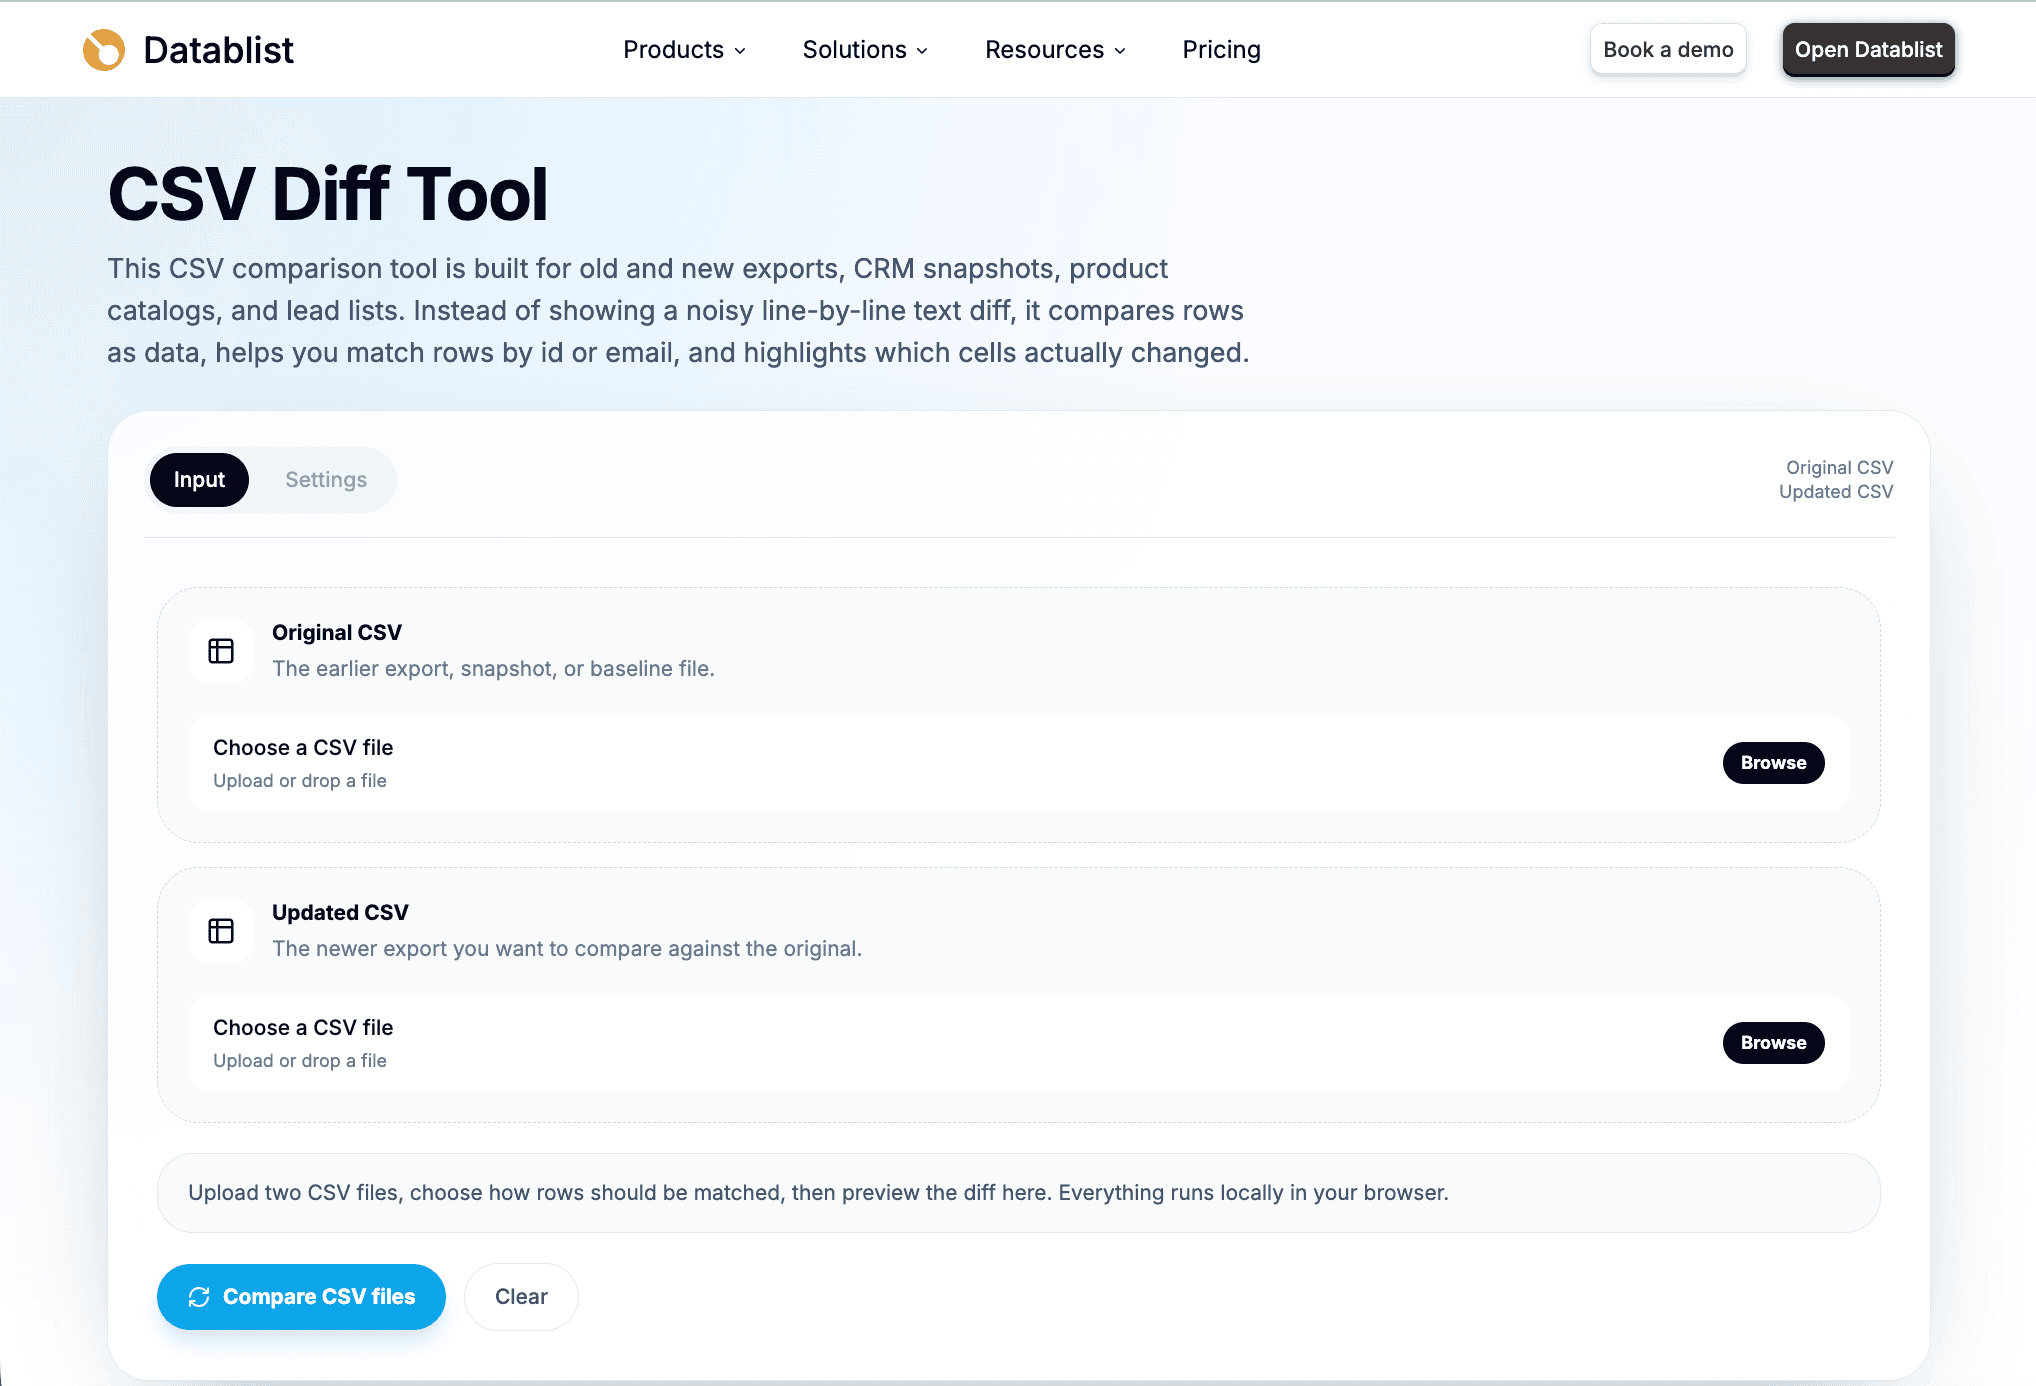
选好两份文件后,工具会解析文件并准备第一次比较。CSV 文件会直接在浏览器中解析和比较。解析器可以识别逗号、分号、Tab 和竖线等常见分隔符,也支持 UTF-8 和 Windows-1252 等常见编码。
查看结果前,我仍会再次确认文件顺序。很多错误的 CSV 比较,都是因为把新旧文件传反,继而把新增和删除记录完全看反了。
第 2 步:选择行匹配方式
行匹配是整个流程中最重要的设置。
Datablist 可以先通过 auto-detect 自动检测。它会寻找可能作为标识符的列,例如 id、email、sku、uuid、external_id、record_id、user_id、contact_id 和 company_id。
对于商品数据,我通常优先选择:
- 如果
EAN存在且唯一,就使用EAN。 - 如果 EAN 缺失、重复或因供应商而异,就使用
Internal ID。 - 只有两份文件采用相同 SKU 时,才使用
SKU。
对于 CRM 或 Lead 文件,对应的 key 可以是 email、contact_id、company_id 或 CRM 记录 ID。
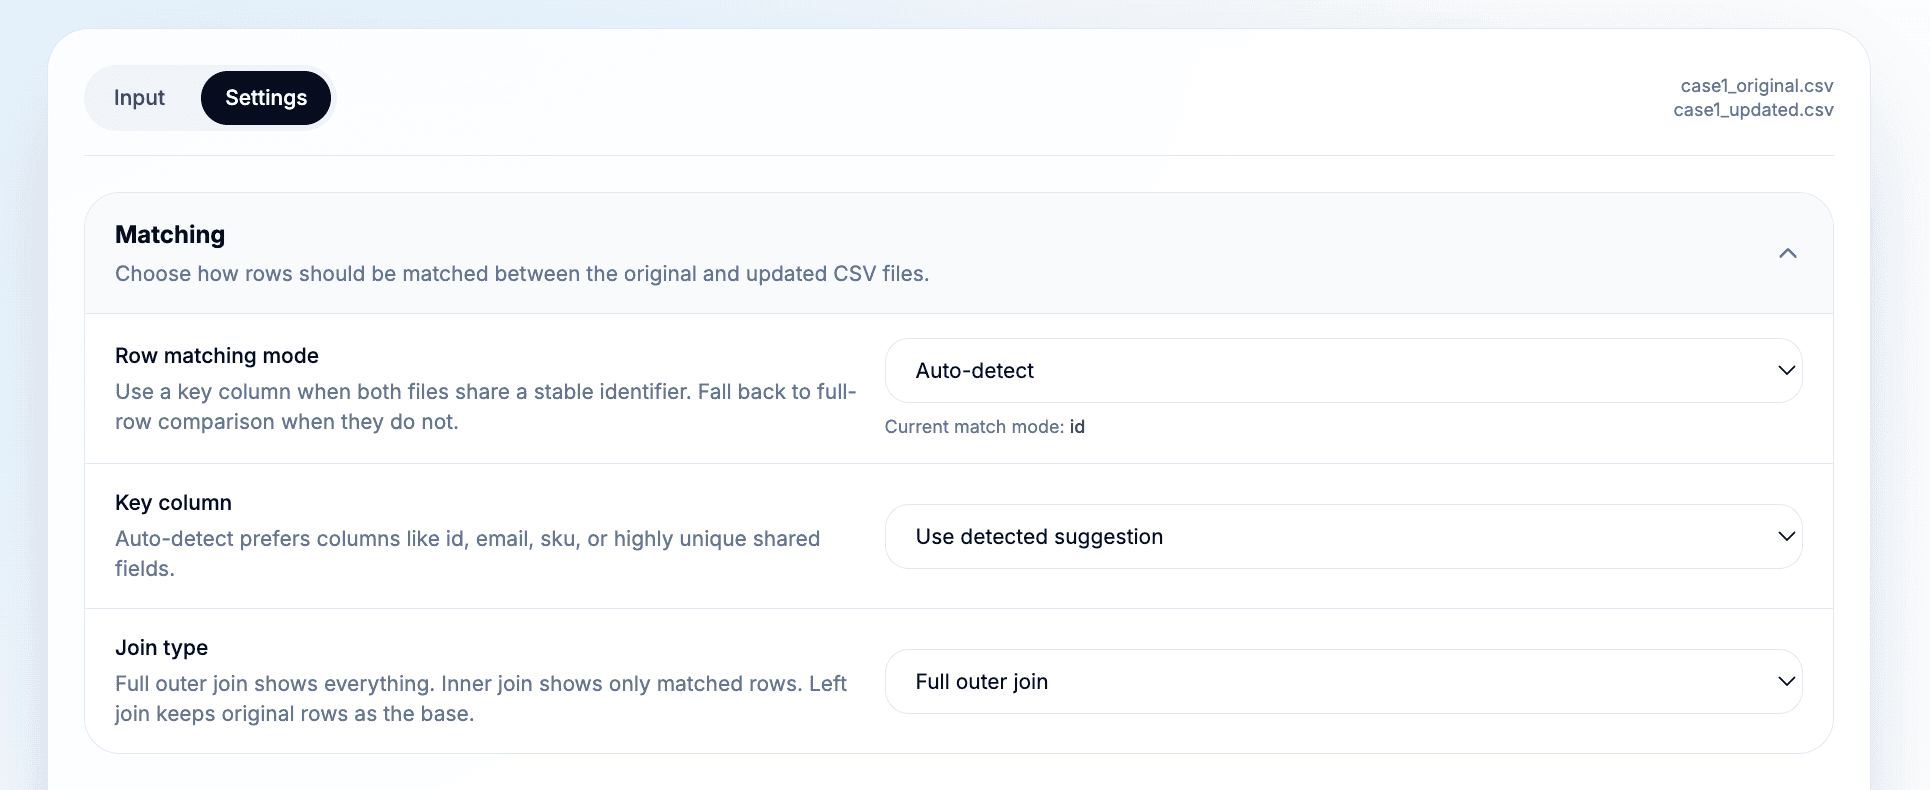
具体匹配模式取决于数据结构:
- 大多数导出文件适合 single-key matching。单个稳定列更容易审核。
- 如果一列不足以保证唯一性,请使用 multi-key matching,例如组合
Company Domain和Email。 - 只有在没有稳定标识符时,才使用 full-row comparison。
- 第一轮可以使用 auto-detect,但在相信统计结果之前,务必确认工具检测到的 key。
⚠️ 不可靠的 key 会制造大量虚假的新增和删除行
如果 key 在两次导出之间出现缺失、重复或格式变化,本应匹配的记录可能会显示为一条 removed 和一条 added。使用结果执行更新前,请先检查 duplicate-key 标记。
key 重复并不意味着 diff 完全无用,但它提醒你需要更谨慎。工具会标记重复 key;在采用统计数据前,我会先审核这些记录。
第 3 步:映射名称不同的列
列映射决定要比较哪些字段。
在商品示例中,两份文件都包含 EAN、Internal ID、Stock 和 Price。原始文件还包含 Name、Brand、Category、Currency 和 Availability,而更新后的文件则包含 Offer ID 和 Supplier SKU。
我不希望供应商文件独有的 metadata 被误判为变更。真正需要比较的是能够回答业务问题的列:
- 使用
EAN匹配行。 - 将
Stock与Stock比较。 - 将
Price与Price比较。 - 如果描述性列有助于审核记录,则保留它们作为上下文。
- 与比较无关的字段不要映射,避免其影响结果。
列名相同时,Datablist 可以按名称自动对齐,列的顺序无需一致。标签发生变化时,则需要手动映射。例如,一份 CRM 导出使用 customer_id,另一份使用 Customer ID。只有当二者代表同一个值时,才应进行映射。
💡 只映射你真正需要比较的列
供应商 feed 和 CRM 导出经常会增加新的 metadata 列。如果某个字段不应被视为变更,请不要映射它,或仅在审核时将其用作上下文。
这一步看似简单,却往往最能节省时间。错误的 key 会导致行匹配错误,错误的列映射则会导致变更数量失真。
第 4 步:选择 join 类型和比较选项
第一次运行时,建议采用以下设置:
- Full outer join。
- 一个稳定的 key 列。
- 忽略前后空格。
- 标准化空值和 null-like 值。
- 除非大小写无关紧要,否则保留区分大小写的比较。
Full outer join 是最佳默认选项,因为它会显示全部数据:匹配行、新增行和删除行。这样可以先获得完整的审核视图,再缩小结果范围。
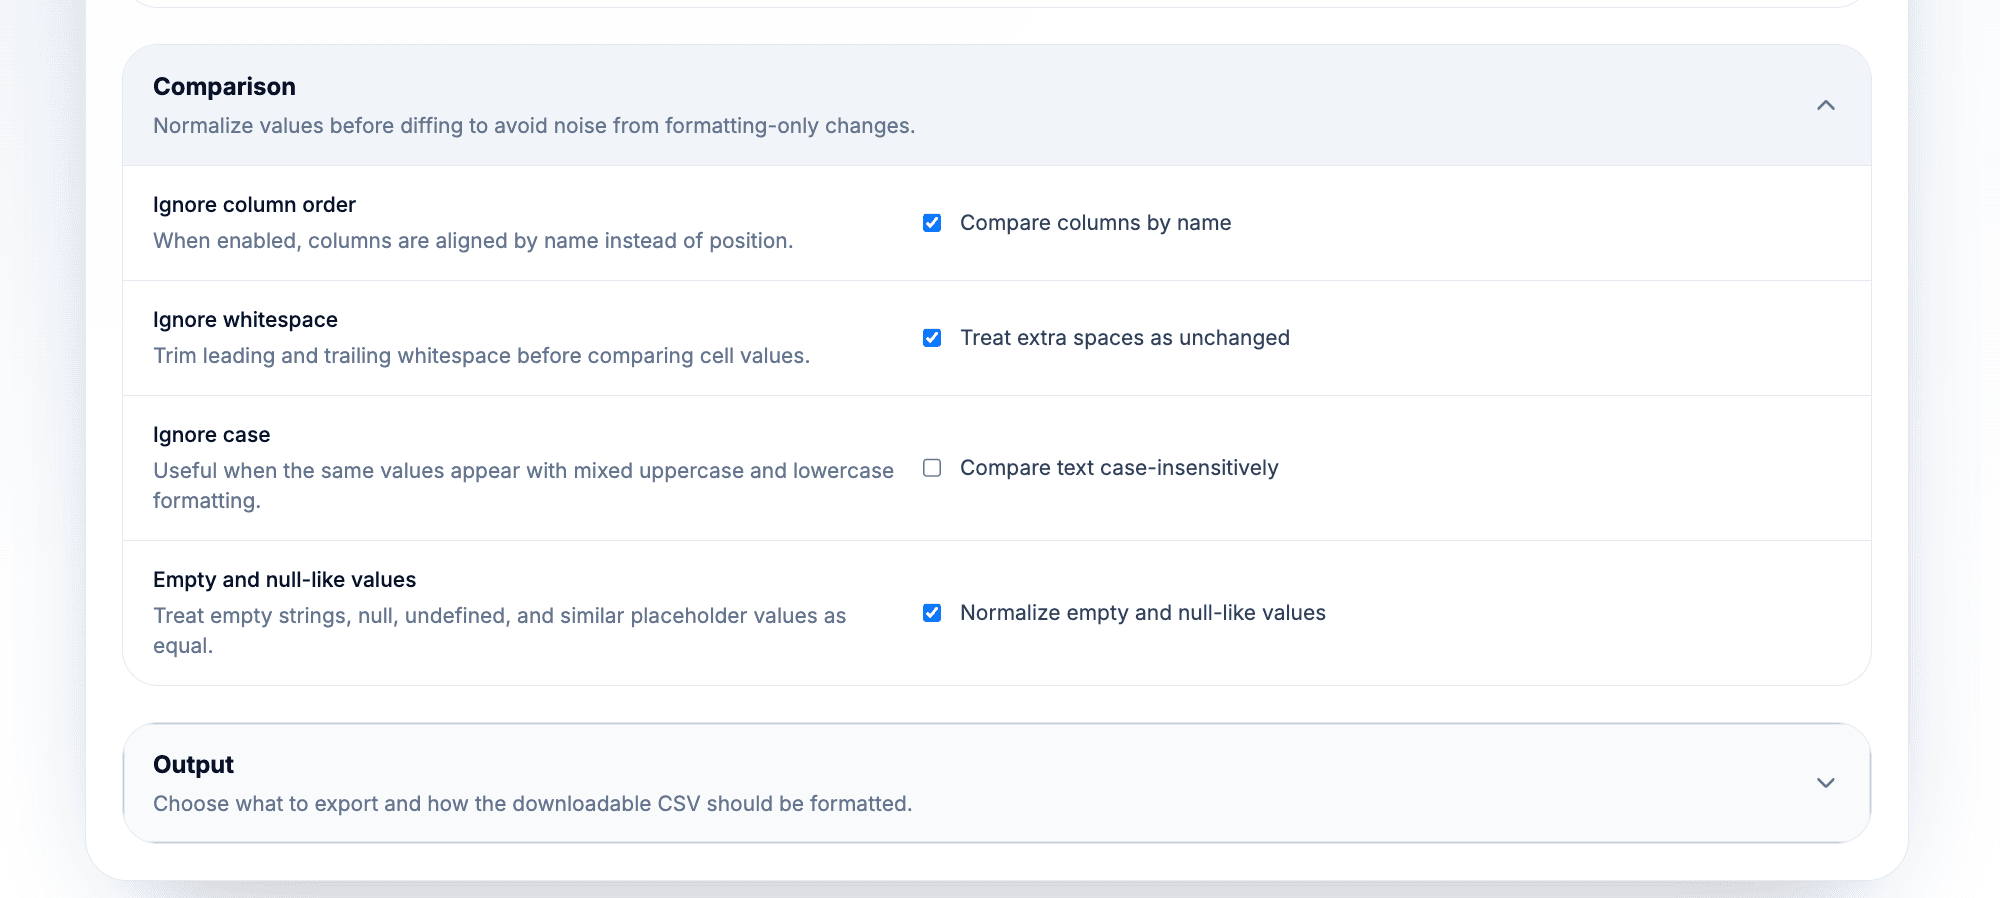
join 类型会影响结果中显示的内容:
- Full outer join 会显示匹配行、仅存在于 original 文件的行,以及仅存在于 updated 文件的行。
- Inner join 只显示两份文件中都存在的记录。仅关注共有记录的变化时使用它。
- Left join 以 original 文件为基础,并排除只存在于 updated 文件中的行。
比较选项可以减少格式差异带来的噪声:
- Ignore whitespace 会在比较前移除单元格首尾的空格。
- Ignore case 会将
Acme和ACME视为相同值。 - Empty and null-like normalization 会将空白、
null、undefined、nil、none、n/a和na视为等价的占位值。
📘 第一次审核请使用 full outer join
先查看完整结果,再逐步缩小范围。确认新增、删除和变更数量合理后,再导出更精简的 changed rows 文件供审核。
对于大型文件,浏览器和设备性能会影响处理速度。为保持响应流畅,预览内容会受到限制,但下载的 CSV 会基于完整结果生成。如果审核文件太大,不便直接比较,可以先将大型 CSV 拆分成多个较小的审核文件。
第 5 步:检查新增、删除、变更和未变更的行
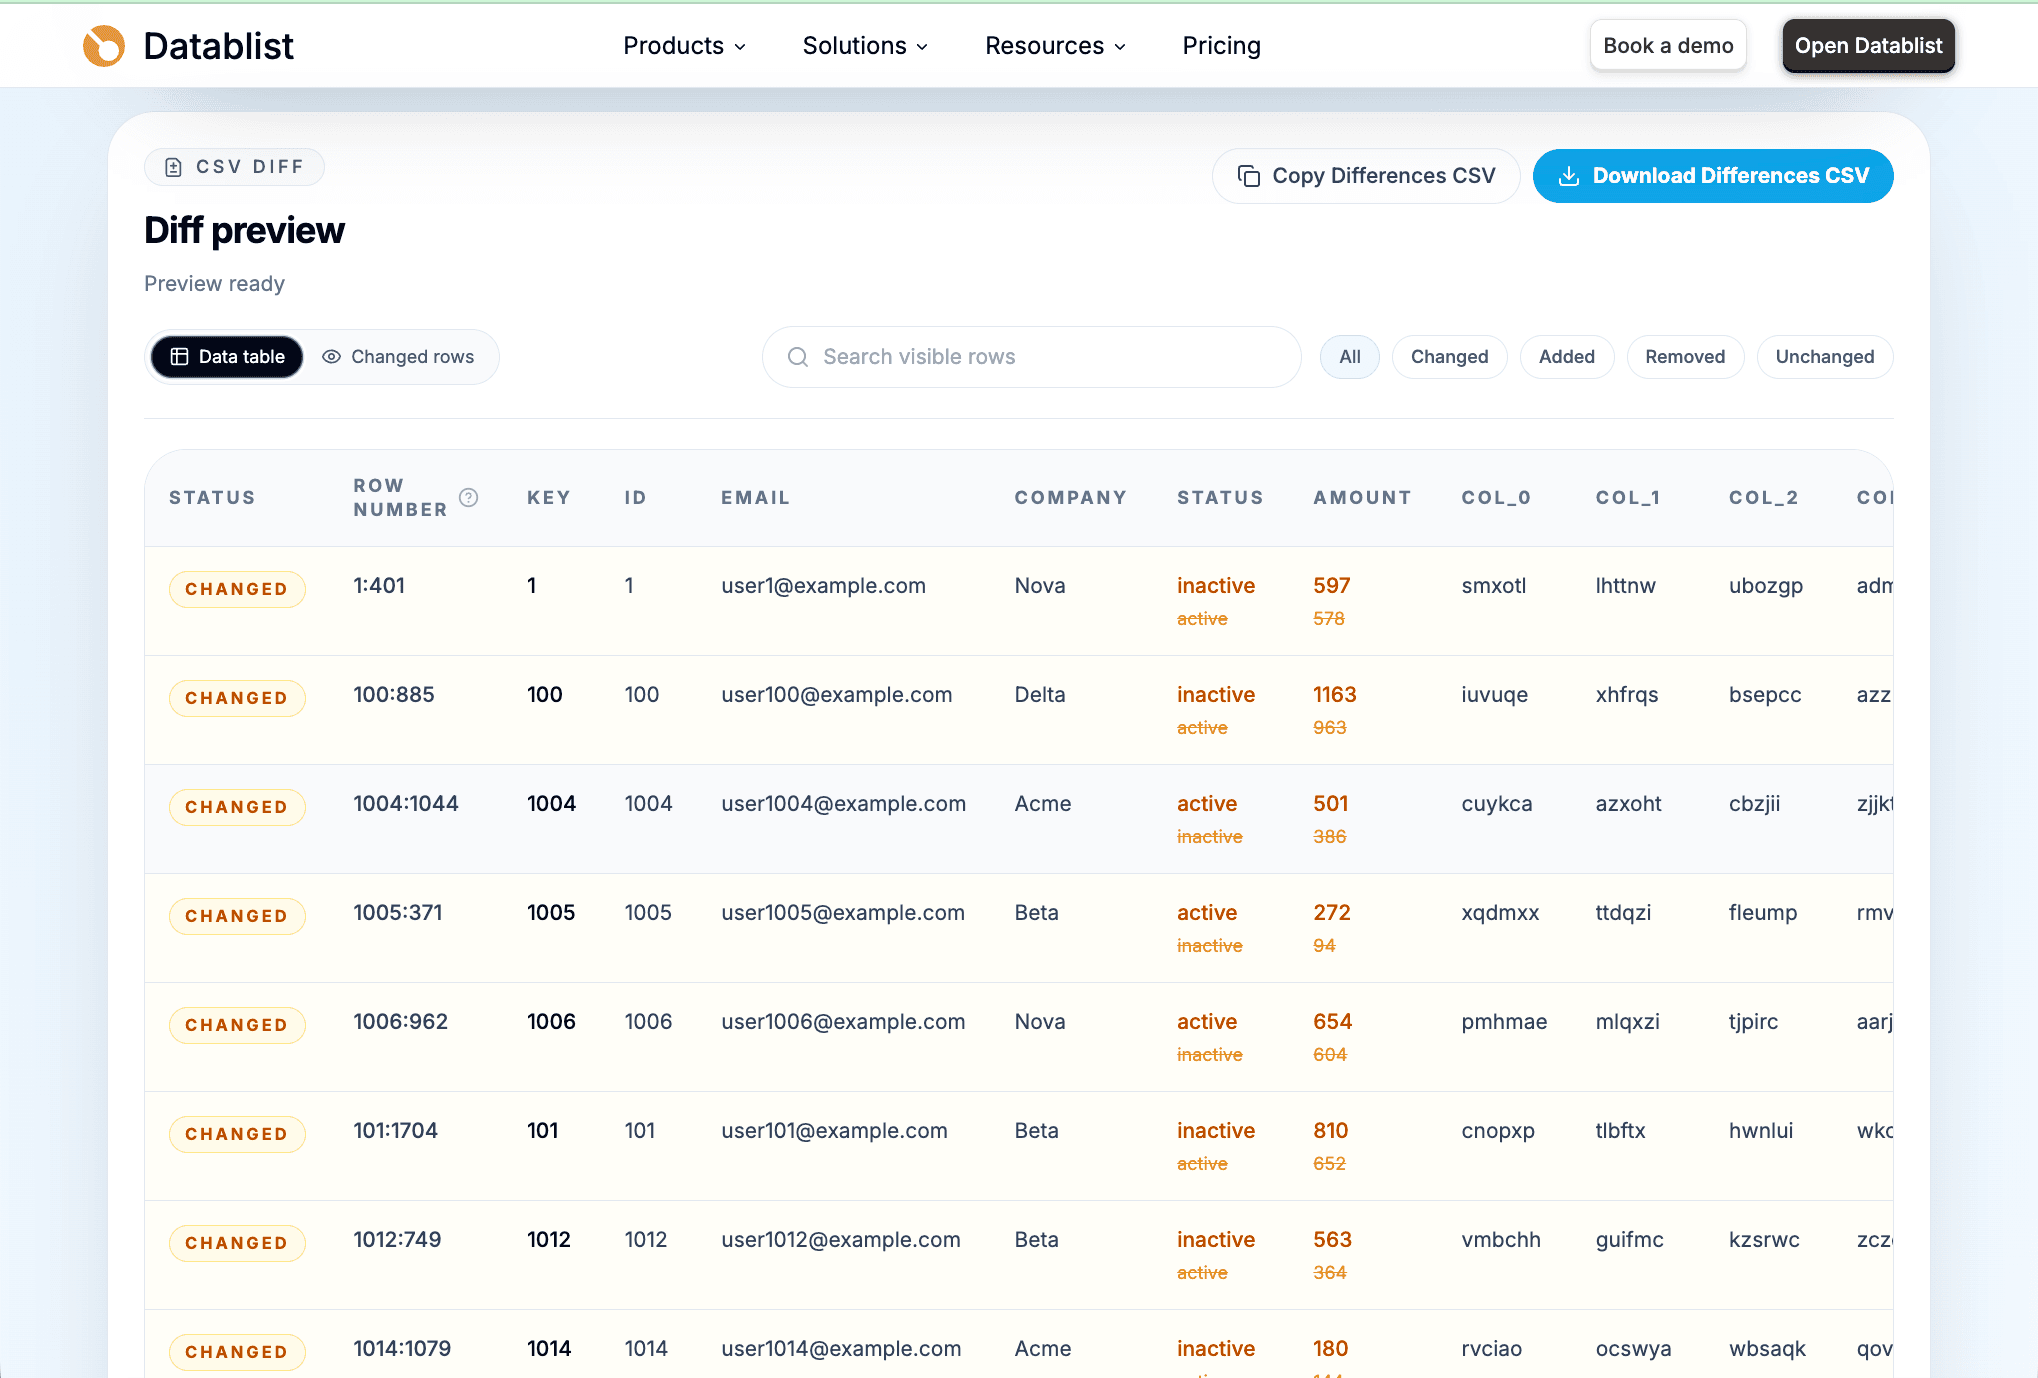
比较完成后,先查看行状态:
added:该 key 只存在于 updated CSV。removed:该 key 只存在于 original CSV。changed:该 key 同时存在于两份文件,但至少一个已映射的值发生变化。unchanged:该 key 同时存在于两份文件,且标准化后的映射值一致。
商品示例中包含几个很清晰的情况:
PRD-001被标记为 changed,因为Price从24.90变为23.90,Stock从42变为38。PRD-003被标记为 changed,因为库存从0变为25。PRD-011被标记为 added,因为它的 EAN 只存在于 Offers CSV。PRD-008被标记为 removed,因为它的 EAN 只存在于 Products CSV。
使用状态筛选器可以集中审核特定记录。我通常先查看 Changed,再检查 Added 和 Removed。除非需要完整的审计记录,否则会把 Unchanged 留到最后。
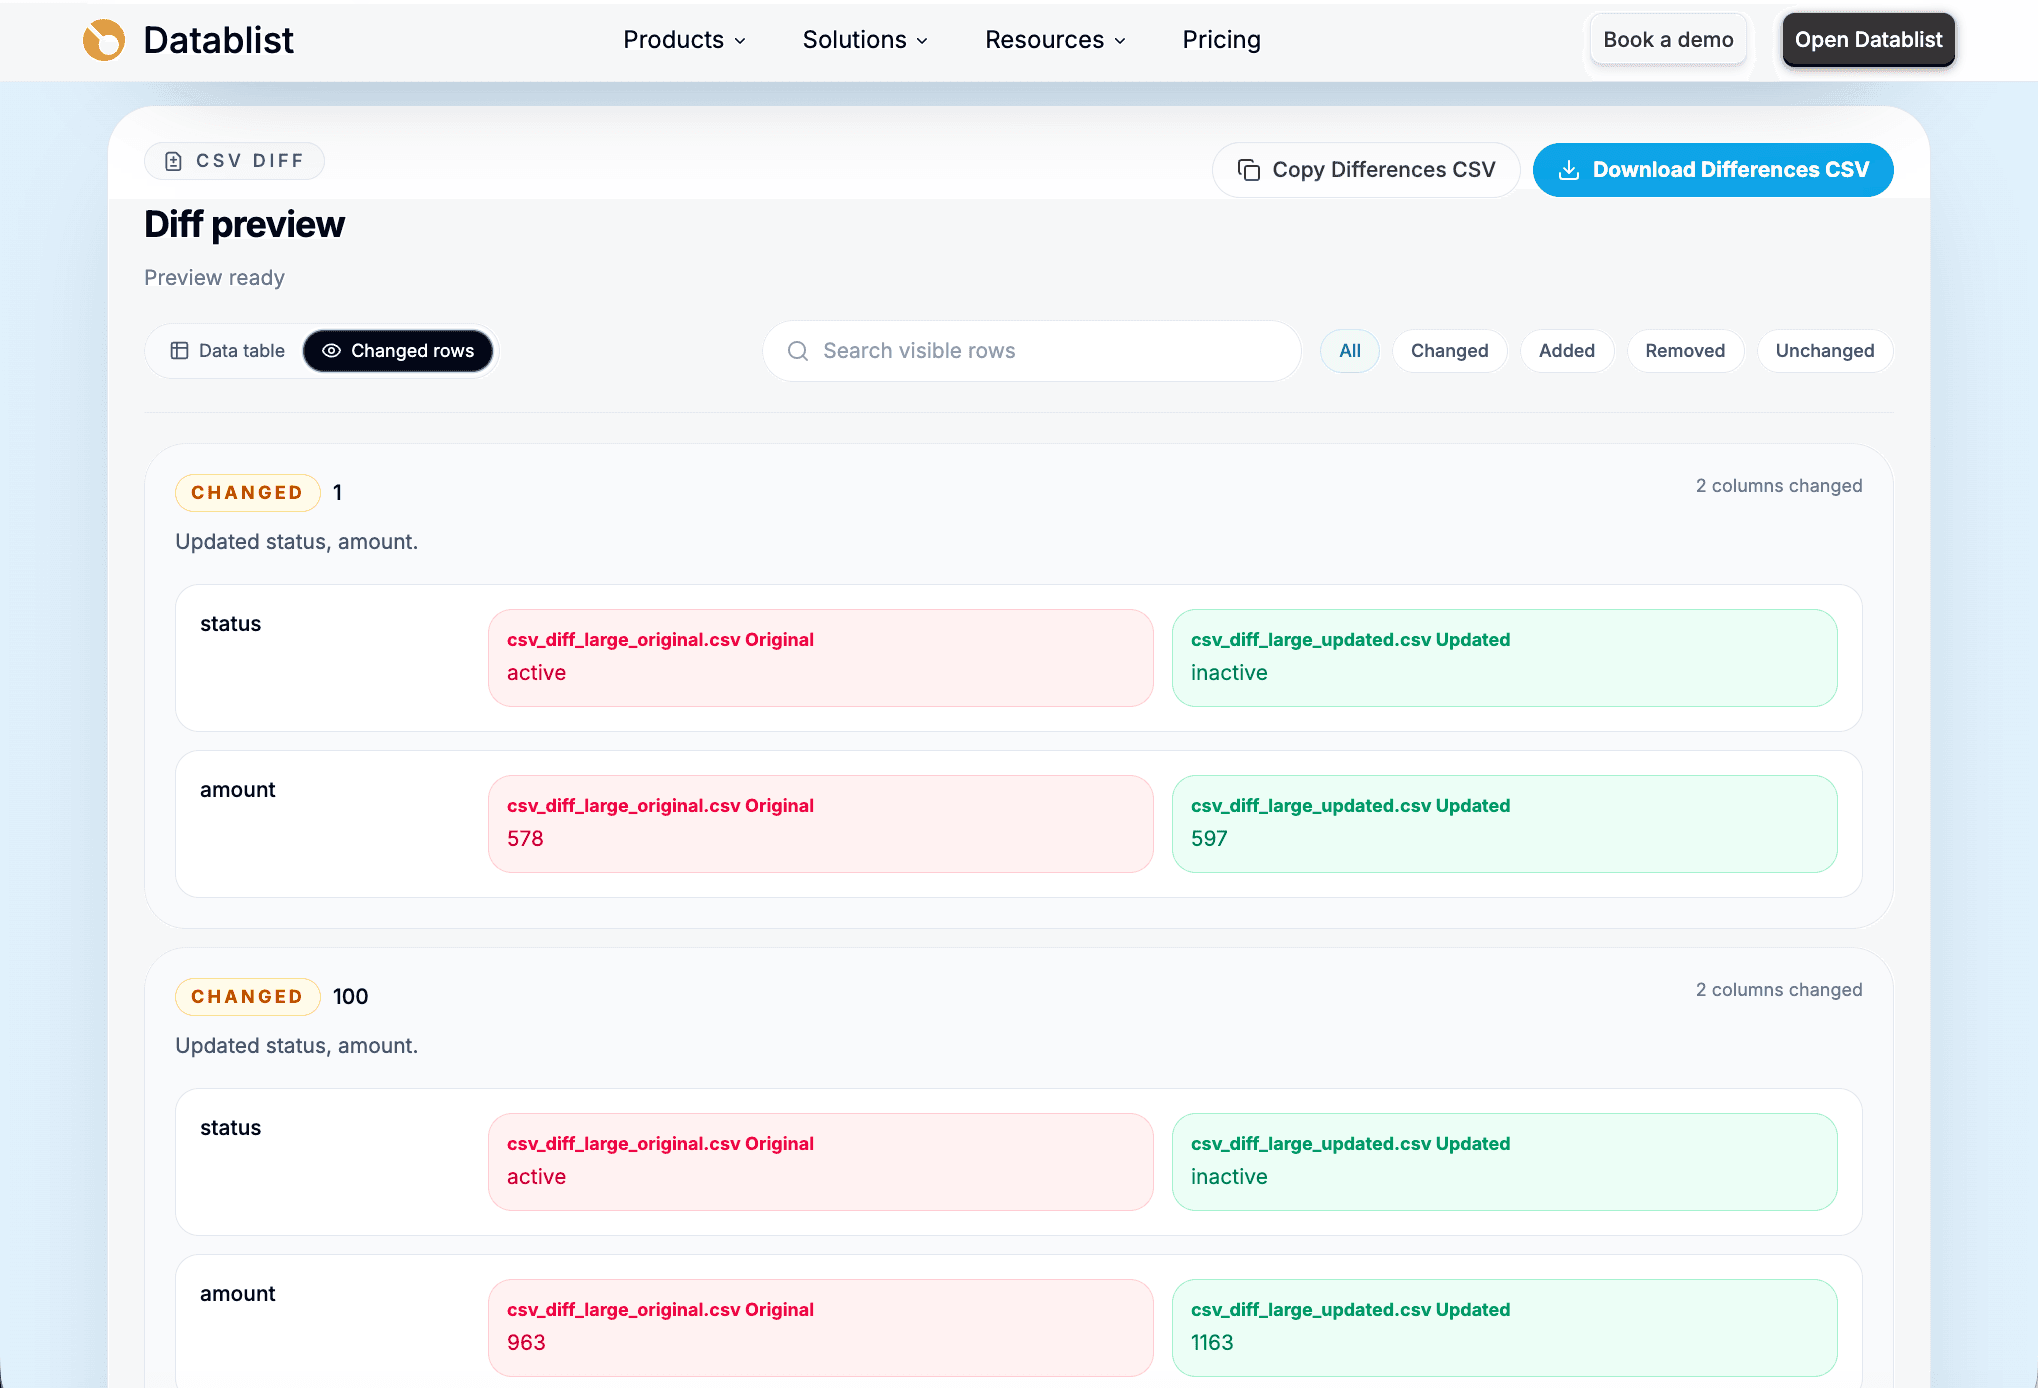
需要查看单元格级别的差异时,changed rows 视图非常实用。它会并排显示每个变更列的原始值和更新值。
导出前,我会进行一轮简短的质量检查:
- 新增和删除的数量是否合理?
- 工具是否使用了预期的 key 匹配记录?
- 是否标记了重复 key?
- 列映射是否正确?
- 是否按预期忽略了纯格式变化?
- 展开几条 changed 记录后,变化是否符合实际?
summary 区域还能帮助你快速复核。这里会显示处理详情、已映射列、duplicate-key 标记和各状态的数量。
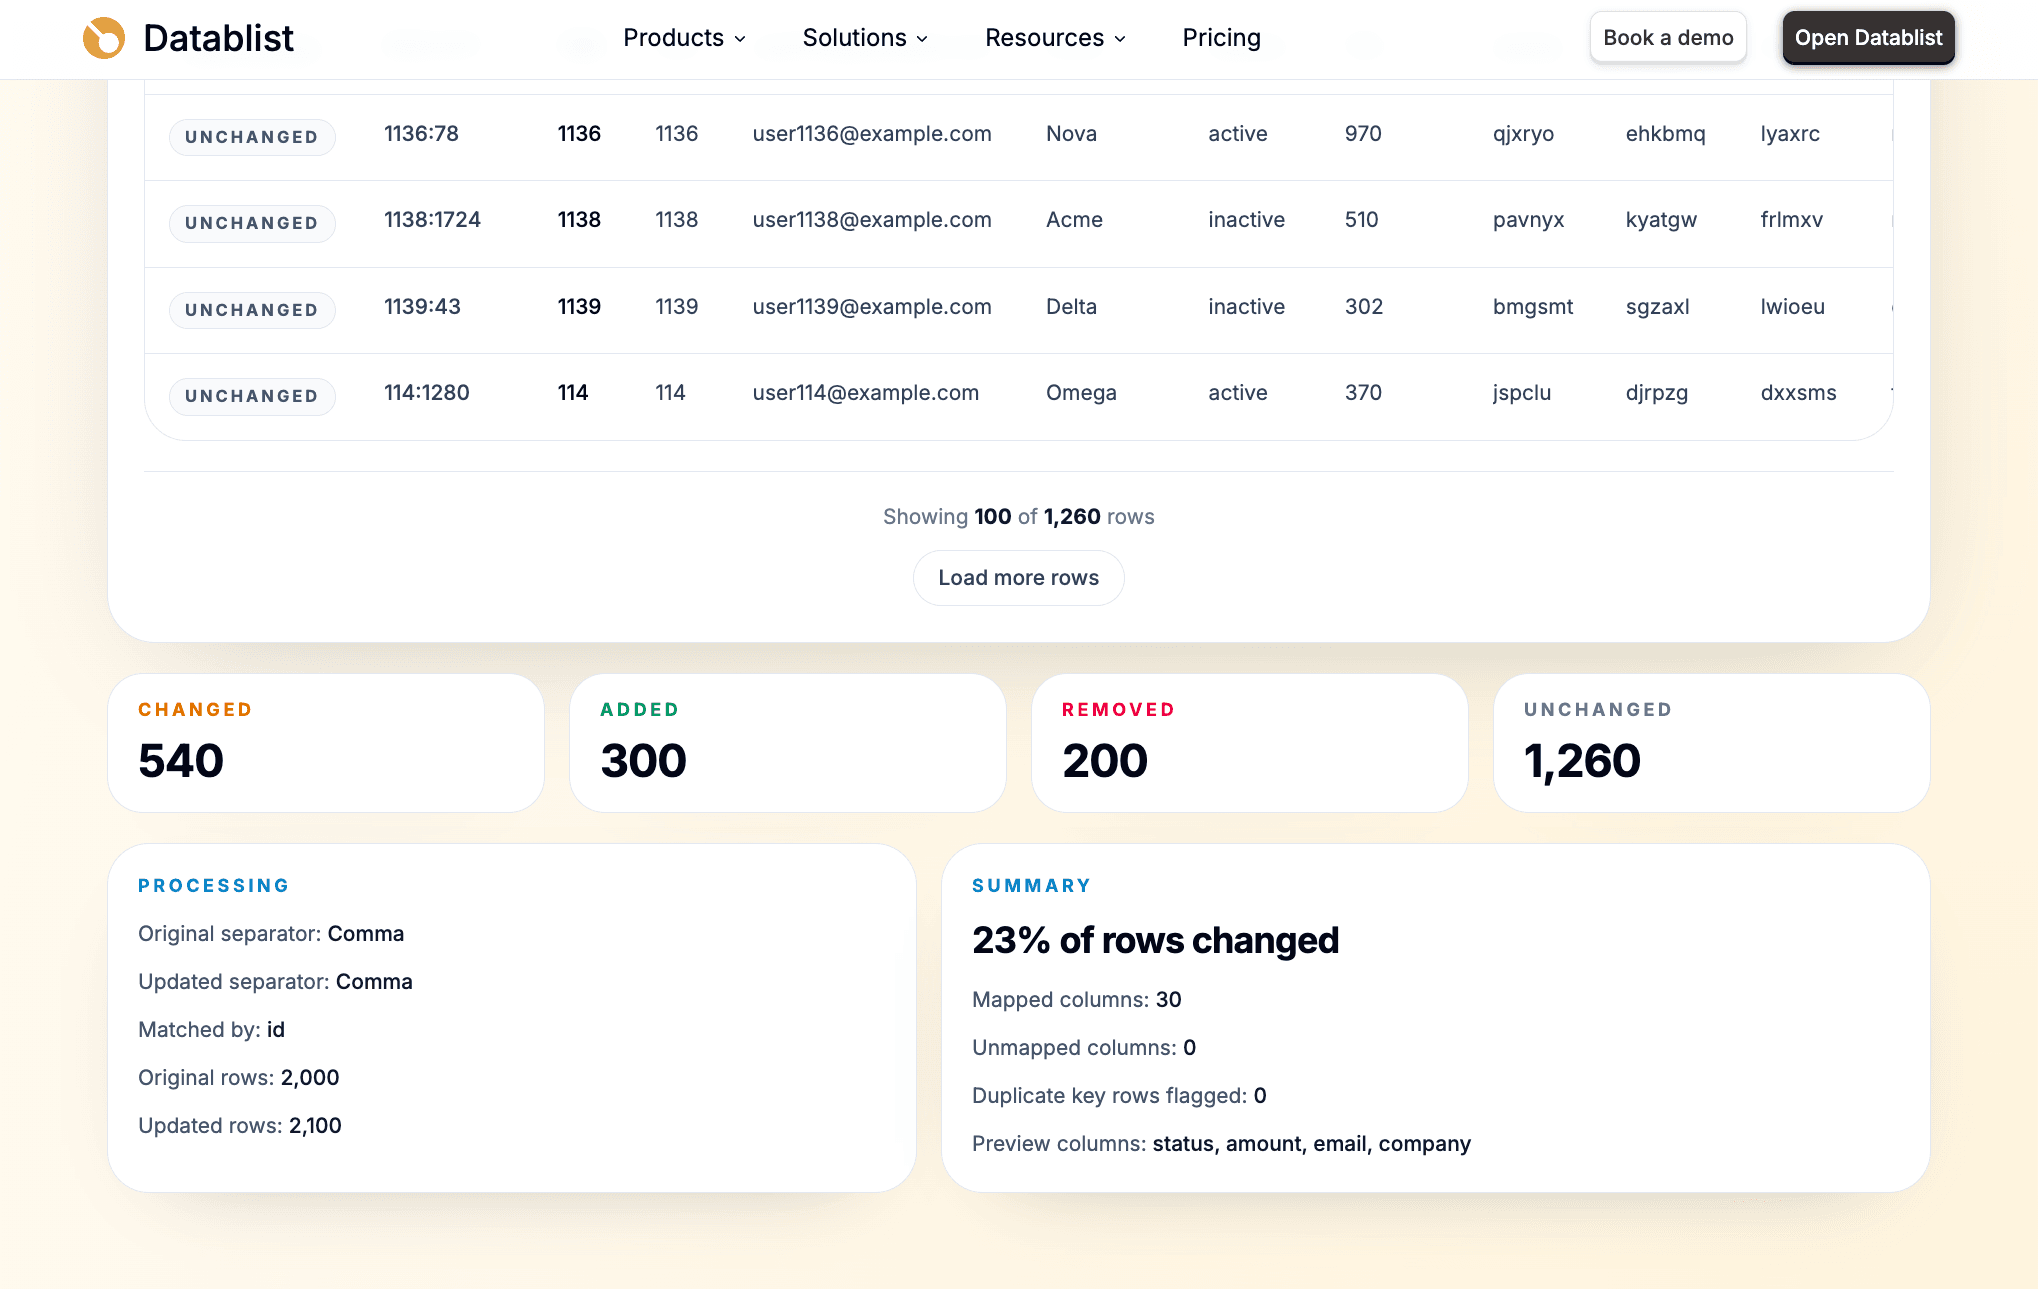
如果数字看起来不对,先不要导出。应首先返回检查 key 和列映射,因为大多数问题都出在这里。
第 6 步:导出 CSV diff 结果
确认预览结果正确后,即可导出。Datablist 会根据不同需求提供多种输出模式:
- Summary CSV:适合查看行状态、key、数量和便于审计的概览。
- Changed rows CSV:适合只需要审核存在差异的记录。
- Full diff CSV:适合并排查看原始值和更新值。
第一次运行时,我更倾向于使用 full diff CSV。它保留了更多上下文,方便日后解释某项变更。流程验证无误后,再改用 changed rows CSV,获得更精简的文件。
你还可以选择分隔符:
- 大多数电子表格工作流使用逗号。
- 如果本地格式或下游系统有要求,可使用分号。
- 对于要求特定格式的工具,可以使用竖线或 Tab。
你可以复制 differences CSV,也可以直接下载。下载文件遵循以下命名格式:
csv-diff-{originalBase}-vs-{updatedBase}.csv
如果导出结果较大,需要在分享前进行筛选或编辑,可以参考 Datablist 的在线编辑大型 CSV 文件指南。
CSV diff 输出表示例
下面是商品示例中 full diff 导出结果的一小部分。
| status | key | changed_columns | original:Price | updated:Price | original:Stock | updated:Stock |
|---|---|---|---|---|---|---|
| changed | 5901234123457 | Price|Stock | 24.90 | 23.90 | 42 | 38 |
| changed | 5901234123471 | Stock | 9.90 | 9.90 | 0 | 25 |
| added | 5901234123556 | 16.50 | 44 | |||
| removed | 5901234123525 | 7.50 | 88 |
导出的 CSV 可以包含:
status:added、removed、changed 或 unchanged。key:用于匹配行的值。__row_index_original:记录在 original CSV 中的行号(如存在)。__row_index_updated:记录在 updated CSV 中的行号(如存在)。__duplicate_key:所选 key 是否出现多次。changed_columns:发生变化的字段。changed_columns_count:发生变化的字段数量。summary:易于阅读的变更摘要。original:{column}和updated:{column}:用于并排审核的列对。
我喜欢这种格式,因为它很适合团队交接。接手人可以筛选 status = changed,按 changed_columns_count 排序,或者单独查看新增和删除的记录,无需重新运行比较。
哪些场景适合这样比较 CSV 文件
只要你有两个数据快照,并且想知道发生了哪些变化,就可以使用这套流程。常见场景包括:
- 更新商品目录中的价格和库存。
- 导入新报价前审核供应商 feed。
- 比较数据清理前后的 CRM 导出。
- 更新 Lead 名单。
- 比较库存快照。
- 审核电子表格交接文件。
- 比较由 JSON 转换流程生成的 CSV 导出。
例如,你可以先将嵌套 JSON 转换为 CSV,再使用 CSV Diff 比较两次生成的导出文件。如果正在为 CRM 准备记录,可以在更全面的数据清理之前运行 diff,先弄清楚哪些行发生了变化。
比较、join 还是去重:如何选择正确流程
比较 CSV 与 join 或去重文件并不是一回事。当你的问题是下面这样时,请使用 CSV Diff:
这两个数据快照之间发生了哪些变化?
当你的问题是下面这样时,请使用 join 工作流:
如何合并两份文件中的字段?
具体操作请参考按唯一标识符 join CSV 文件指南。
当你的问题是下面这样时,请使用去重流程:
一份或多份文件中有哪些重复记录?
具体操作请参考删除 CSV 重复项指南。
区分这些流程很重要,因为它们的目标各不相同。CSV Diff 用于比较数据快照并导出差异结果。它不是 fuzzy matching 工具,也不是文件 merge 工具。
常见问题与特殊情况排查
行显示为新增和删除,而不是变更
先检查 key 列。如果两份文件中的 key 发生了变化,Datablist 就无法把两行识别为同一条记录。另外也要检查文件顺序。如果 original 和 updated 文件传反,added 和 removed 也会颠倒。
显示为变更的单元格太多
检查比较选项。如果空格不应产生影响,请启用 whitespace trimming;如果大小写无关紧要,请使用 case-insensitive comparison;如果空白和占位值应视为相同,请标准化空值;另外还要检查已重命名字段的列映射。
两份文件的列名不同
使用手动映射。只有字段含义相同时才应进行映射;如果无关列不应影响比较结果,请不要映射它们。
出现重复 key
把重复 key 视为需要审核的信号。比较结果仍可能有帮助,但重复 key 说明所选标识符不够唯一。使用统计数据执行导入前,请先清理源文件或选择更可靠的 key。
文件处理缓慢或预览受限
大型文件的处理速度取决于浏览器和设备性能。可以使用预览功能进行审核,需要完整结果时再下载 CSV diff。
CSV 解析失败
检查是否存在未闭合的引号字段、特殊分隔符或编码问题。只要一个带引号字段格式损坏,就可能导致整个 CSV 文件无效。
总结
比较两份 CSV 导出文件的最佳方式,是把它们当作数据而不是文本。将旧文件上传为 original CSV,将新文件上传为 updated CSV,选择稳定的 key,映射需要比较的列,检查各类行状态,最后导出 diff。
我的默认设置很简单:full outer join、稳定的 key、移除首尾空格、标准化 null-like 值,并在第一次审核时导出 full diff。
你可以使用 Datablist 的 CSV Diff tool 完成整个流程。
FAQ
如何在线比较两个 CSV 文件?
打开 Datablist 的 CSV Diff tool,将较旧的文件上传为 Original CSV,将较新的文件上传为 Updated CSV,选择 key 列,检查结果,然后下载 diff CSV。
能否按 ID、email、SKU 或 EAN 比较 CSV?
可以。将两份文件共有的标识符设为 key 列。合适的 key 包括记录 ID、email 地址、SKU、EAN、内部 ID、公司 ID,以及在多次导出之间保持稳定的其他值。
如果两份文件中的行顺序不同怎么办?
使用基于 key 的匹配方式。只要通过稳定的 key 匹配记录,两份文件的行顺序就不需要一致。
能否比较列名不同的 CSV 文件?
可以。列名不同时手动进行映射。例如,如果一份文件中的 customer_id 与另一份文件中的 Customer ID 代表同一个标识符,就可以将二者映射起来。
CSV diff 应该选择哪种 join 类型?
第一次审核建议使用 full outer join。它会显示匹配行、新增行和删除行。只有在你仅关注同时存在于两份文件中的记录时,才使用 inner join。
能否忽略空格、大小写或空值?
可以。你可以移除首尾空格、使用不区分大小写的文本比较,并将空白或 null-like 占位值视为相等。我通常会启用 whitespace trimming 和 empty-value normalization。
能否只导出发生变更的行?
可以。需要更精简的审核文件时,选择 changed rows 输出。不过我仍建议先完整导出一次 full diff,以便验证比较结果。
added、removed、changed 和 unchanged 分别是什么意思?
added 表示该 key 只存在于 updated CSV;removed 表示该 key 只存在于 original CSV;changed 表示该 key 同时存在于两份文件,但映射值不同;unchanged 表示该 key 同时存在于两份文件,且映射值一致。
CSV 文件会上传到服务器吗?
CSV 文件会直接在浏览器中解析和比较。应将其视为一款基于浏览器的比较工具,而不是 Datablist collection 的导入或同步工作流。
可以比较大型 CSV 文件吗?
可以,但超大型文件的处理速度取决于浏览器和设备性能。为保持响应流畅,预览内容会受到限制,而下载的 CSV 则会基于完整结果生成。