

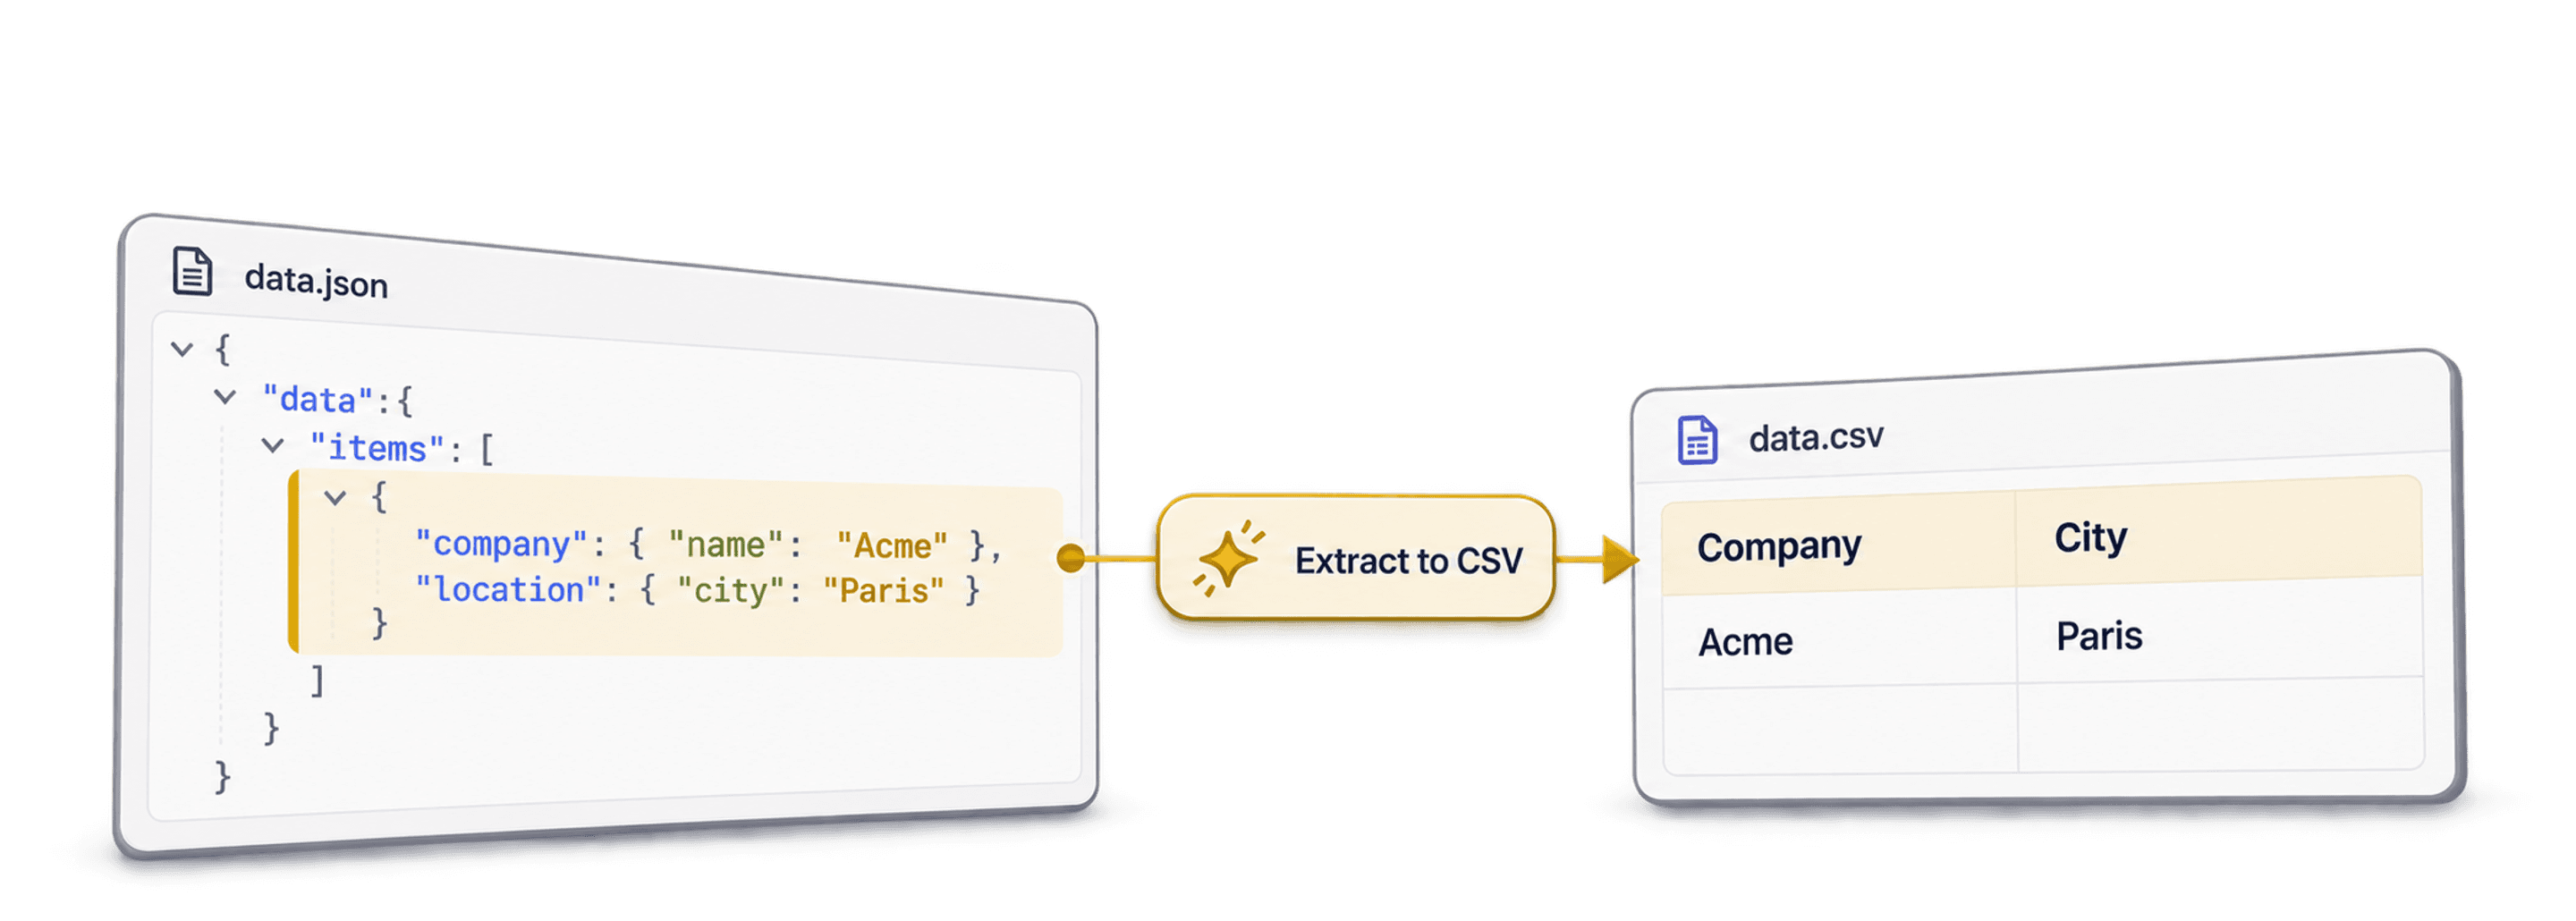
要将嵌套 JSON 转换为 CSV,可以使用支持选择 CSV 行所对应 JSON 数组的在线 JSON 转 CSV 工具。这一步比大多数人想象的更重要。真实的 JSON 导出文件通常以元数据、分页信息或包装对象开头,而真正需要的记录往往位于 results、data.items 或 payload.records 等路径下。
我通常把 JSON 转 CSV 拆成三个关键决策:
- 哪个数组应该转换为行?
- 哪些嵌套对象字段应该转换为列?
- 数组应该合并、保留为 JSON,还是展开为独立行?
确定这三点后,剩下的就是常规 CSV 工作流:预览输出、检查列,然后下载可用于电子表格、CRM、BI 工具或数据清洗流程的 CSV 文件。
📌 简要说明
首先确定每一行 CSV 应该代表什么。在本例中,我希望每行代表一家公司,因此行节点是
$.results。接下来,我可以展平公司指标,并决定如何处理contacts和tags等数组。
本指南将使用一个嵌套 JSON 导出文件,其中 results 下包含 20,000 条公司记录。同样的工作流也适用于 API 响应、抓取结果、Webhook 日志、CRM 导出,以及有效记录不在 JSON 根节点的 Marketplace 数据。
快速导航:
嵌套 JSON 文件示例
假设我们有一个来自 API 或抓取工具的大型 JSON 导出文件。文件大小约为 8.8 MB,顶层 results 数组中包含 20,000 条记录。
根对象如下:
{
  "meta": {
    "generatedAt": "2026-07-04T10:00:00Z",
    "source": "stress_test"
  },
  "results": [
    {
      "id": 0,
      "name": "NbDXeG4Gyg",
      "website": "https://example-0.com",
      "contacts": [
        {
          "name": "Ava Martin",
          "emails": [
            "ava@example-0.com"
          ],
          "phones": [
            "+1 555 0100"
          ]
        },
        {
          "name": "Noah Lee",
          "emails": [
            "noah@example-0.com"
          ],
          "phones": []
        }
      ],
      "tags": "enterprise",
      "metrics": {
        "employees": 124,
        "revenue": {
          "amount": 476171,
          "currency": "USD"
        }
      },
      "createdAt": "2026-06-25T09:12:00Z"
    },
    {
      "id": 1,
      "name": "DwwGmkzmBi",
      "website": "https://example-1.com",
      "contacts": [
        {
          "name": "Mia Chen",
          "emails": [
            "mia@example-1.com"
          ],
          "phones": [
            "+1 555 0101"
          ]
        }
      ],
      "tags": [
        "saas",
        "mid-market"
      ],
      "metrics": {
        "employees": 47,
        "revenue": null
      },
      "createdAt": "2026-06-26T14:33:00Z"
    }
  ]
}
这类文件往往会让简单的转换工具束手无策。记录并不位于根对象,而是嵌套在 results 中。此外,记录还包含嵌套对象、嵌套数组、字符串与数组混合值、空值和日期。
🔍 为什么这个文件适合用来测试
扁平 JSON 数组只能覆盖最简单的情况。这个文件则包含真实导出中需要认真处理的元素:包装层元数据、嵌套记录数组、对象字段、数组字段、混合值和空值。
前几行的数据结构如下:
| 行 | Website 数据结构 | 联系人数量 | Tags 数据结构 | 营收 |
|---|---|---|---|---|
| 0 | 字符串 | 2 | 字符串 | 金额和币种 |
| 1 | 字符串 | 2 | 数组 | 空值 |
| 2 | 数组 | 1 | 数组 | 空值 |
目标 CSV 应该每行对应一家公司。我希望把 id、name、website、employees、amount、currency 和 createdAt 等实用字段转换为列。对于 contacts 和 tags 等字段,则需要决定保留多少原始结构。
在 Datablist 中将嵌套 JSON 转为 CSV
打开 Datablist JSON 转换工具。你可以把 JSON 粘贴到编辑器中,也可以上传 .json 文件。
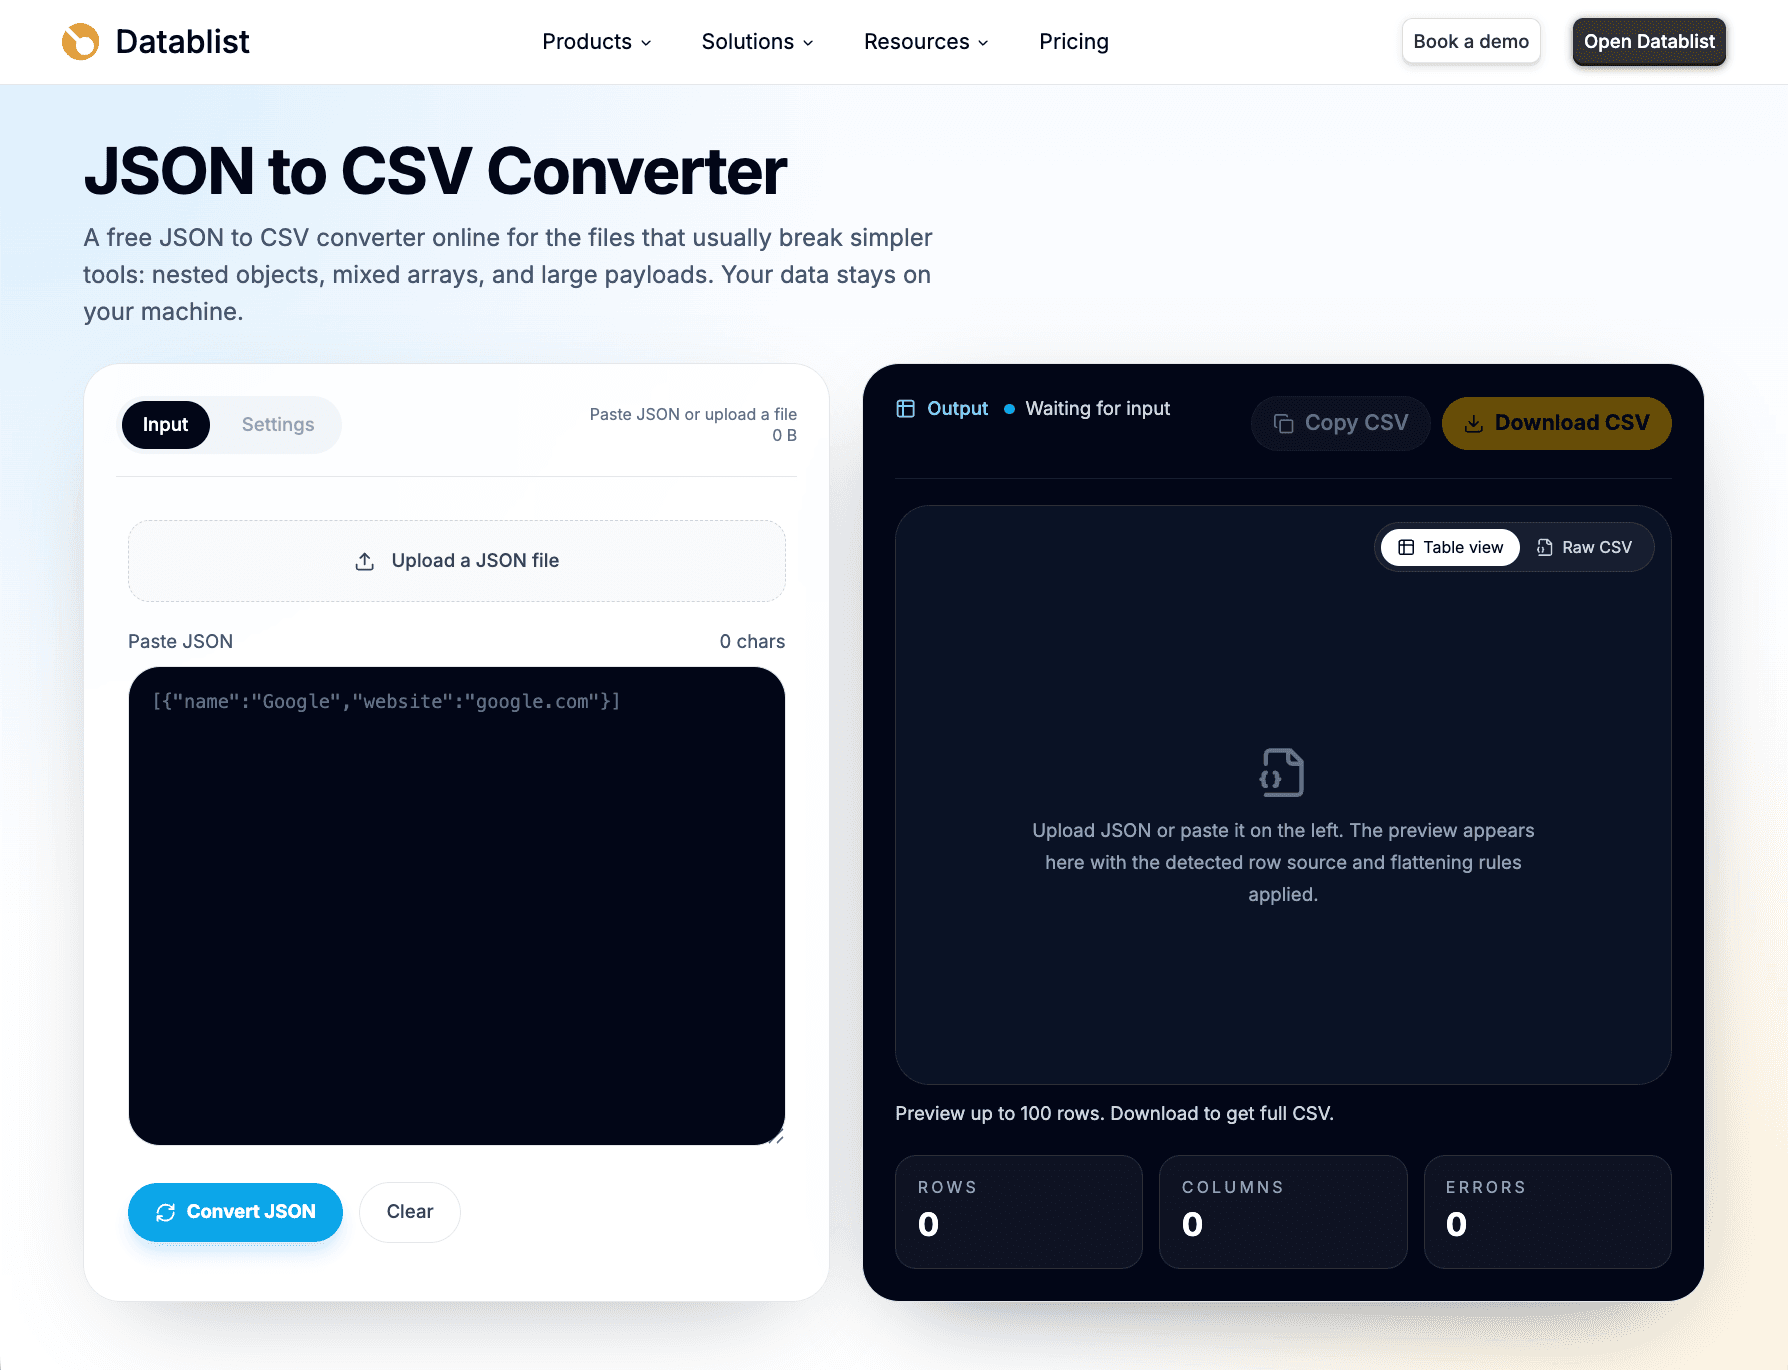
对于较小的 API 响应,直接粘贴就足够了。对于较大的导出文件,我更倾向于上传,因为这样可以避免复制粘贴时意外截断内容。文件内容会在浏览器中读取,转换也在本地浏览器内完成,而不会发送到 Datablist 服务器进行处理。
JSON 加载后,Datablist 会分析其结构并查找对象数组。它支持以数组或对象作为 JSON 根节点,并会扫描 $.results、$.data.items 等嵌套路径以及更深层的数组。
如果文件结构难以理解,我有时会先在 JSONCrack 中打开 JSON。它会生成可视化树状结构,帮助你找到应该转换为行的数组。这不是必需步骤,但当文件中存在多个候选数组时很实用。
在本例中,正确的行节点是:
$.results
我选择 $.results,因为目标是让每家公司占一行。该数组中的每个元素都会变成一行 CSV。
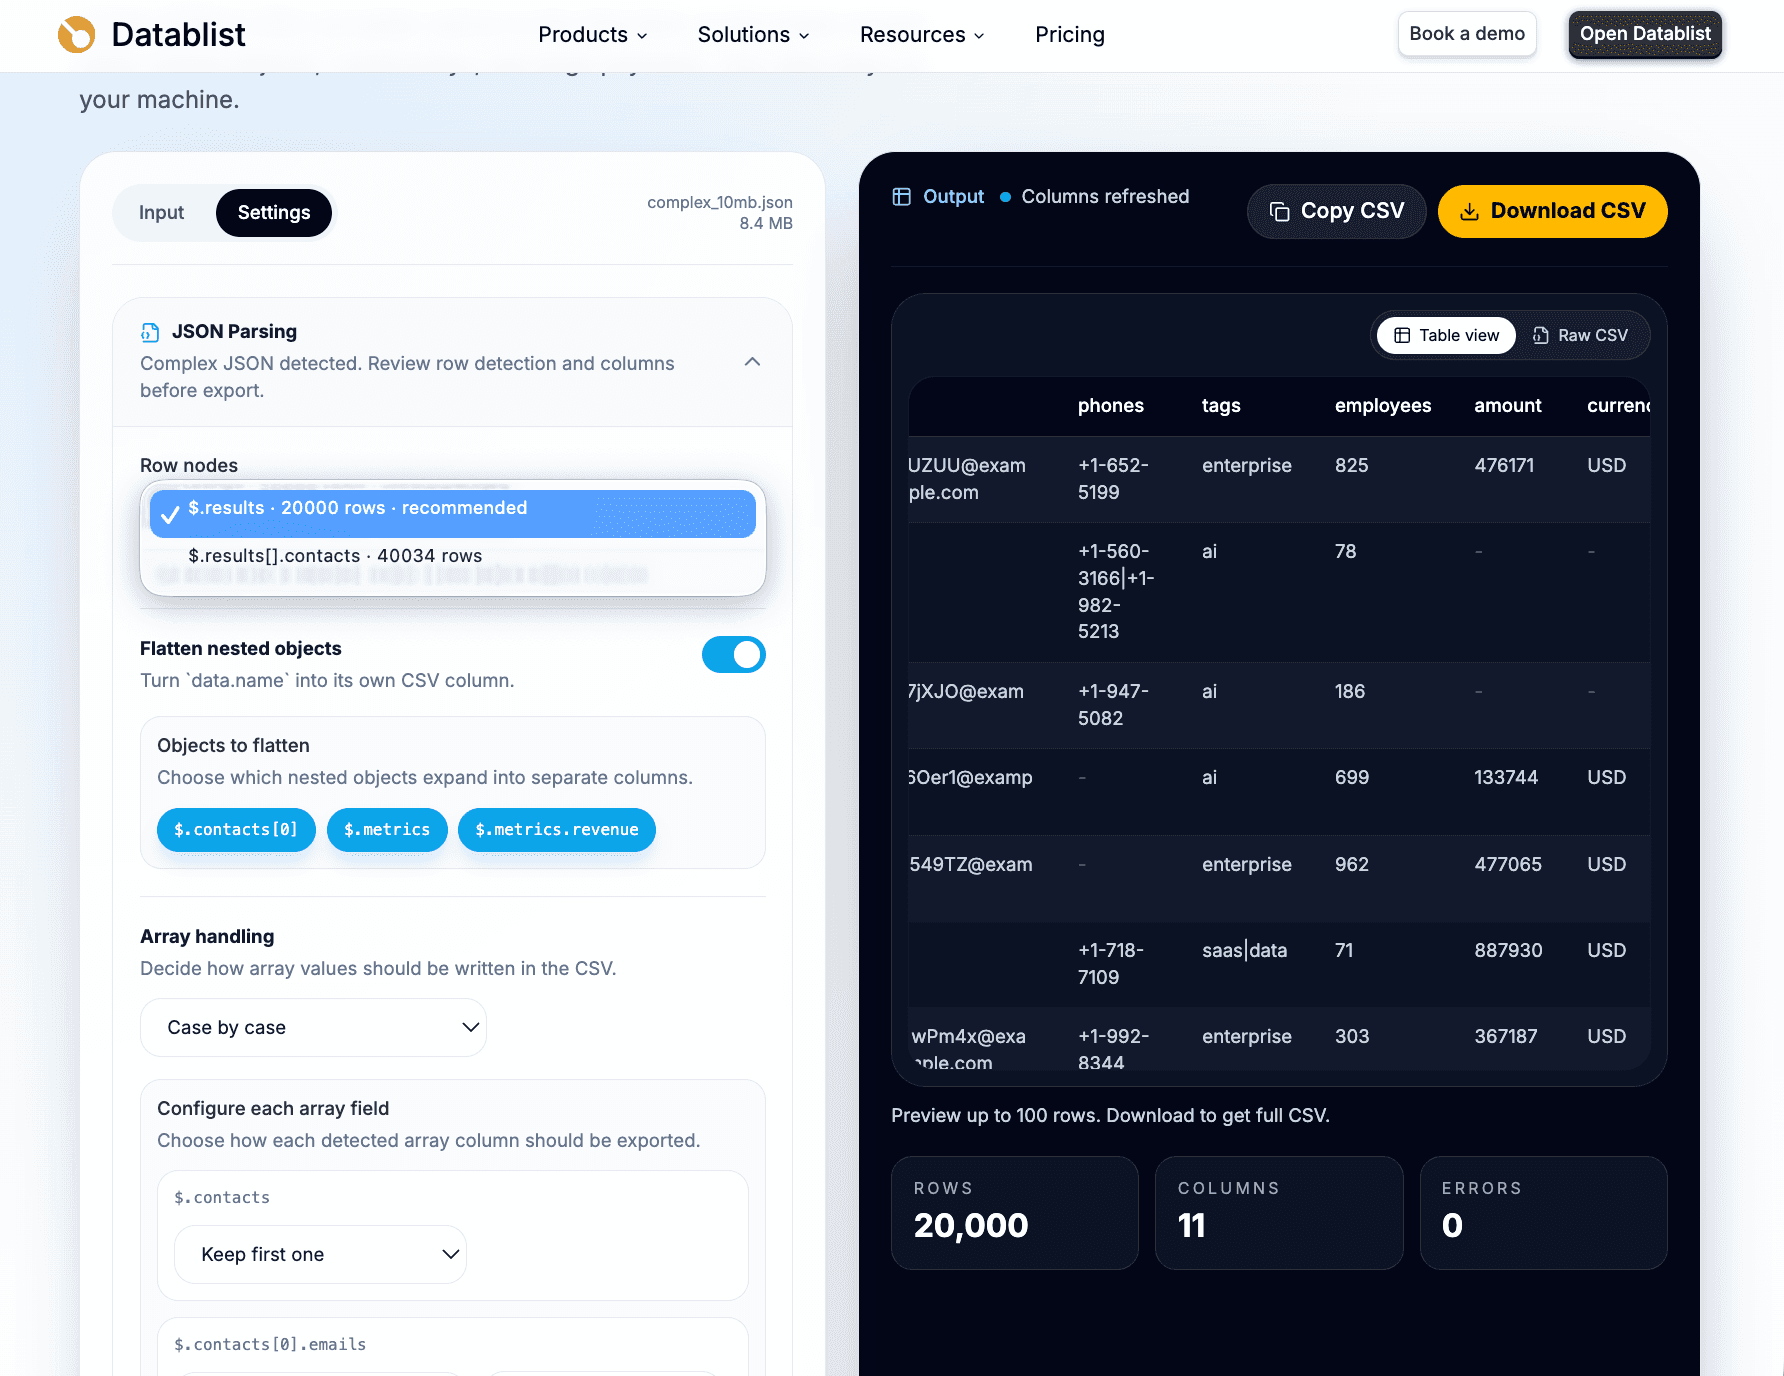
Datablist 可以推荐行节点,但我仍会手动核对。大多数转换错误都发生在这里。一个 JSON 文件可能同时包含公司父数组、联系人子数组,以及 tags 或 events 等其他子数组。它们都是数组,但只有一个符合你想要的 CSV 结构。
⚠️ 更改行节点会改变整个数据集
$.results和$.results[].contacts都是有效的行节点,但生成的 CSV 完全不同。需要公司或账户行时,应选择父数组;需要把嵌套元素作为数据集时,则选择子数组。
本文将保留父级行节点:
$.results表示每行对应一家公司或一个账户。$.results[].contacts表示每行对应一位联系人。
第二种选择有时也完全正确,但会改变输出结果。当你需要人员名单时,联系人级 CSV 很有用;当你需要清洗账户、丰富公司数据、将记录导入 CRM 或检查指标时,公司级 CSV 更合适。
选择正确的行节点
行节点是指其元素将被转换为 CSV 行的 JSON 数组。
最常见的路径如下:
| JSON 路径 | 适用场景 |
|---|---|
$.results | 记录存储在 results 键下 |
$.data.items | API 将记录包装在 data 对象中 |
$.payload.records | Webhook 或内部导出将记录包装在 payload 下 |
$.results[].contacts | 希望每位嵌套联系人各占一行 |
选择之前,我通常先问一个问题:每一行应该代表什么?
如果每行应该代表公司、账户、订单、产品、商品条目或事件,就选择父数组。如果每行应该代表联系人、电子邮件、订单明细、价格、评论或子事件,就选择子数组。
听起来很简单,但这个决定会改变整个 CSV。
使用 $.results 时,CSV 会保留公司上下文。除非你决定单独处理联系人,否则 contacts 字段会作为嵌套值保留在公司行中。使用 $.results[].contacts 时,CSV 会变成联系人列表;但除非转换工具未来加入相应功能,否则父级公司字段不会自动包含在内。
我的默认做法是先从父数组开始。这样第一次导出更稳妥,因为之后仍然可以检查嵌套数组。只有当嵌套元素才是真正的数据集时,我才会切换到子数组。
展平嵌套 JSON 对象
处理嵌套对象时,CSV 转换工具不能只是简单地改变文件格式。
在示例文件中,metrics 是一个对象:
{
  "metrics": {
    "employees": 124,
    "revenue": {
      "amount": 476171,
      "currency": "USD"
    }
  }
}
在电子表格中,我不希望看到一个装着整个 JSON 对象的 metrics 单元格,而是希望得到可以筛选和排序的列:
employeesamountcurrency
Datablist 会检测嵌套对象路径,并允许你选择需要展平的字段。我会展平有用的标量字段,因为它们在 CSV 工具中更容易处理。
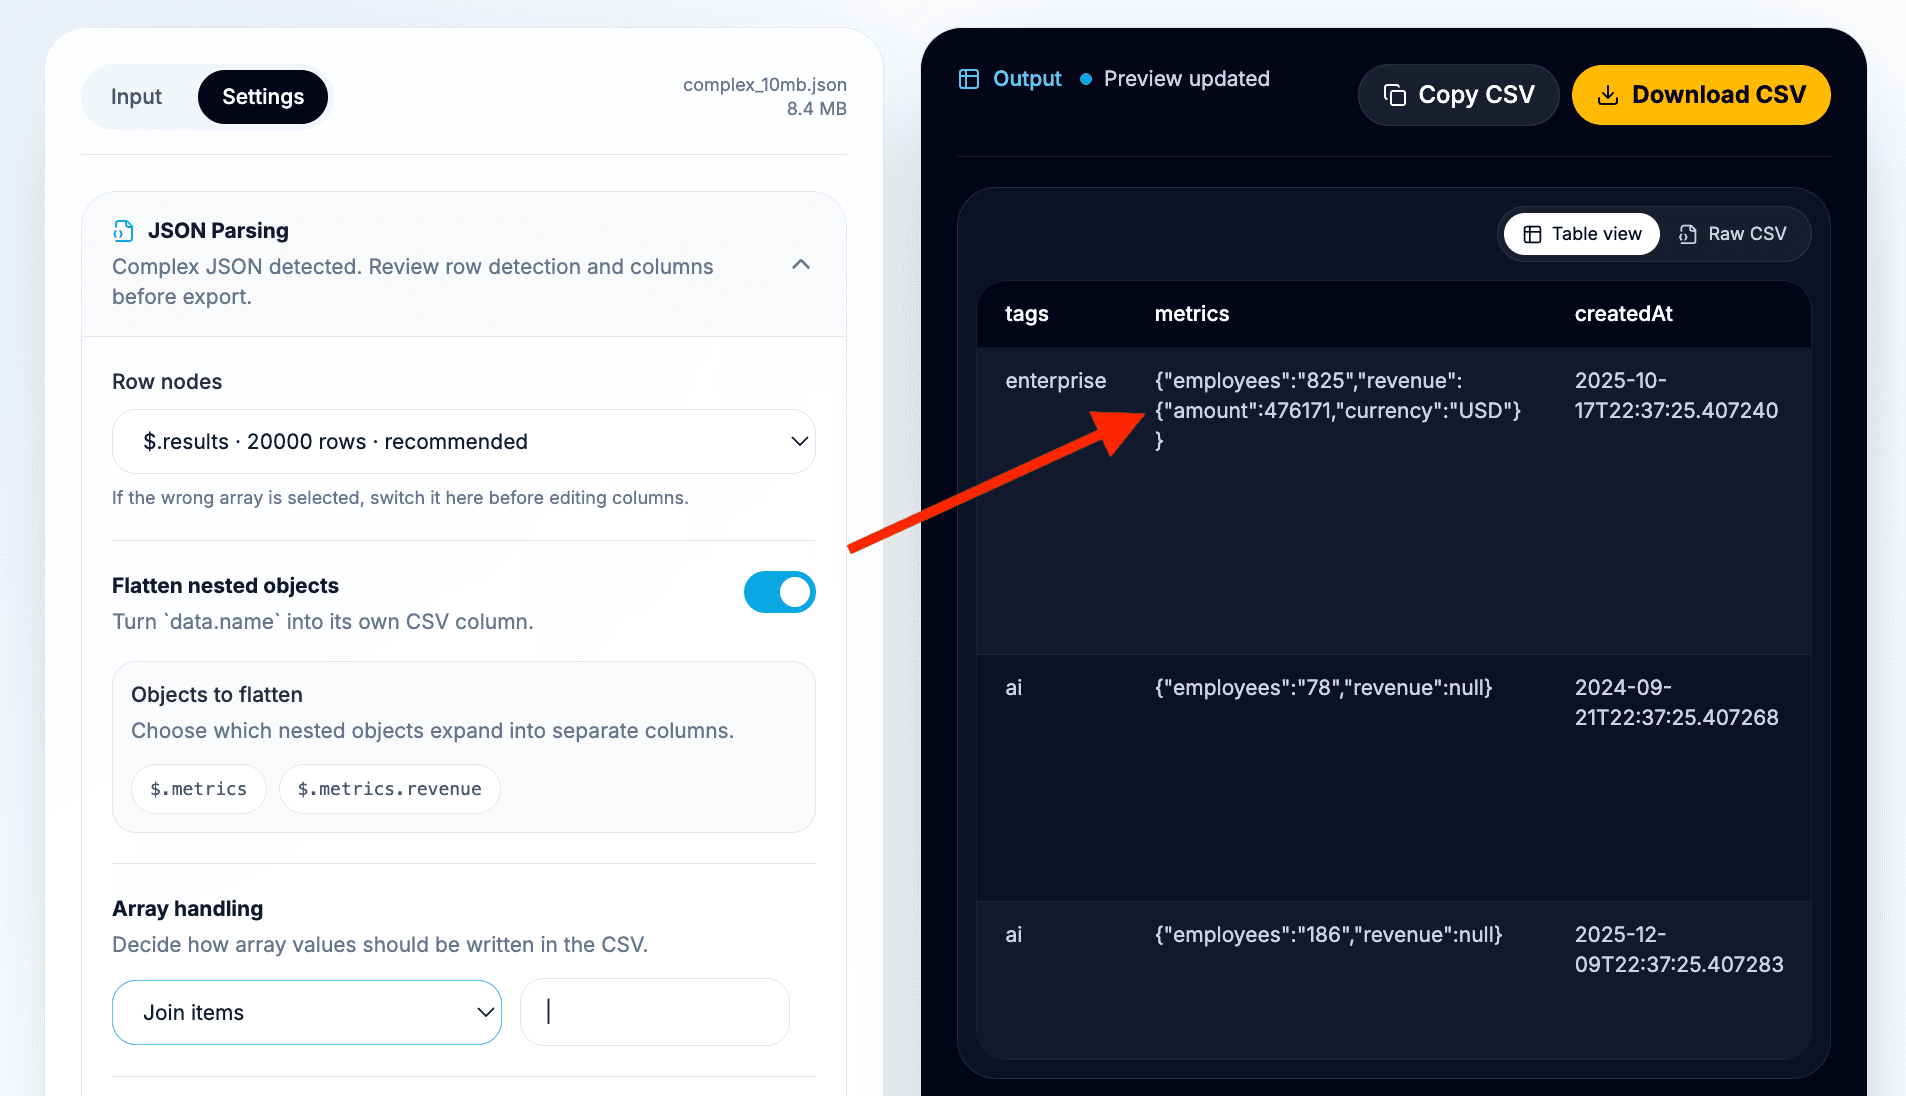
在本例中,我会展平:
- 将
metrics.employees转换为employees - 将
metrics.revenue.amount转换为amount - 将
metrics.revenue.currency转换为currency
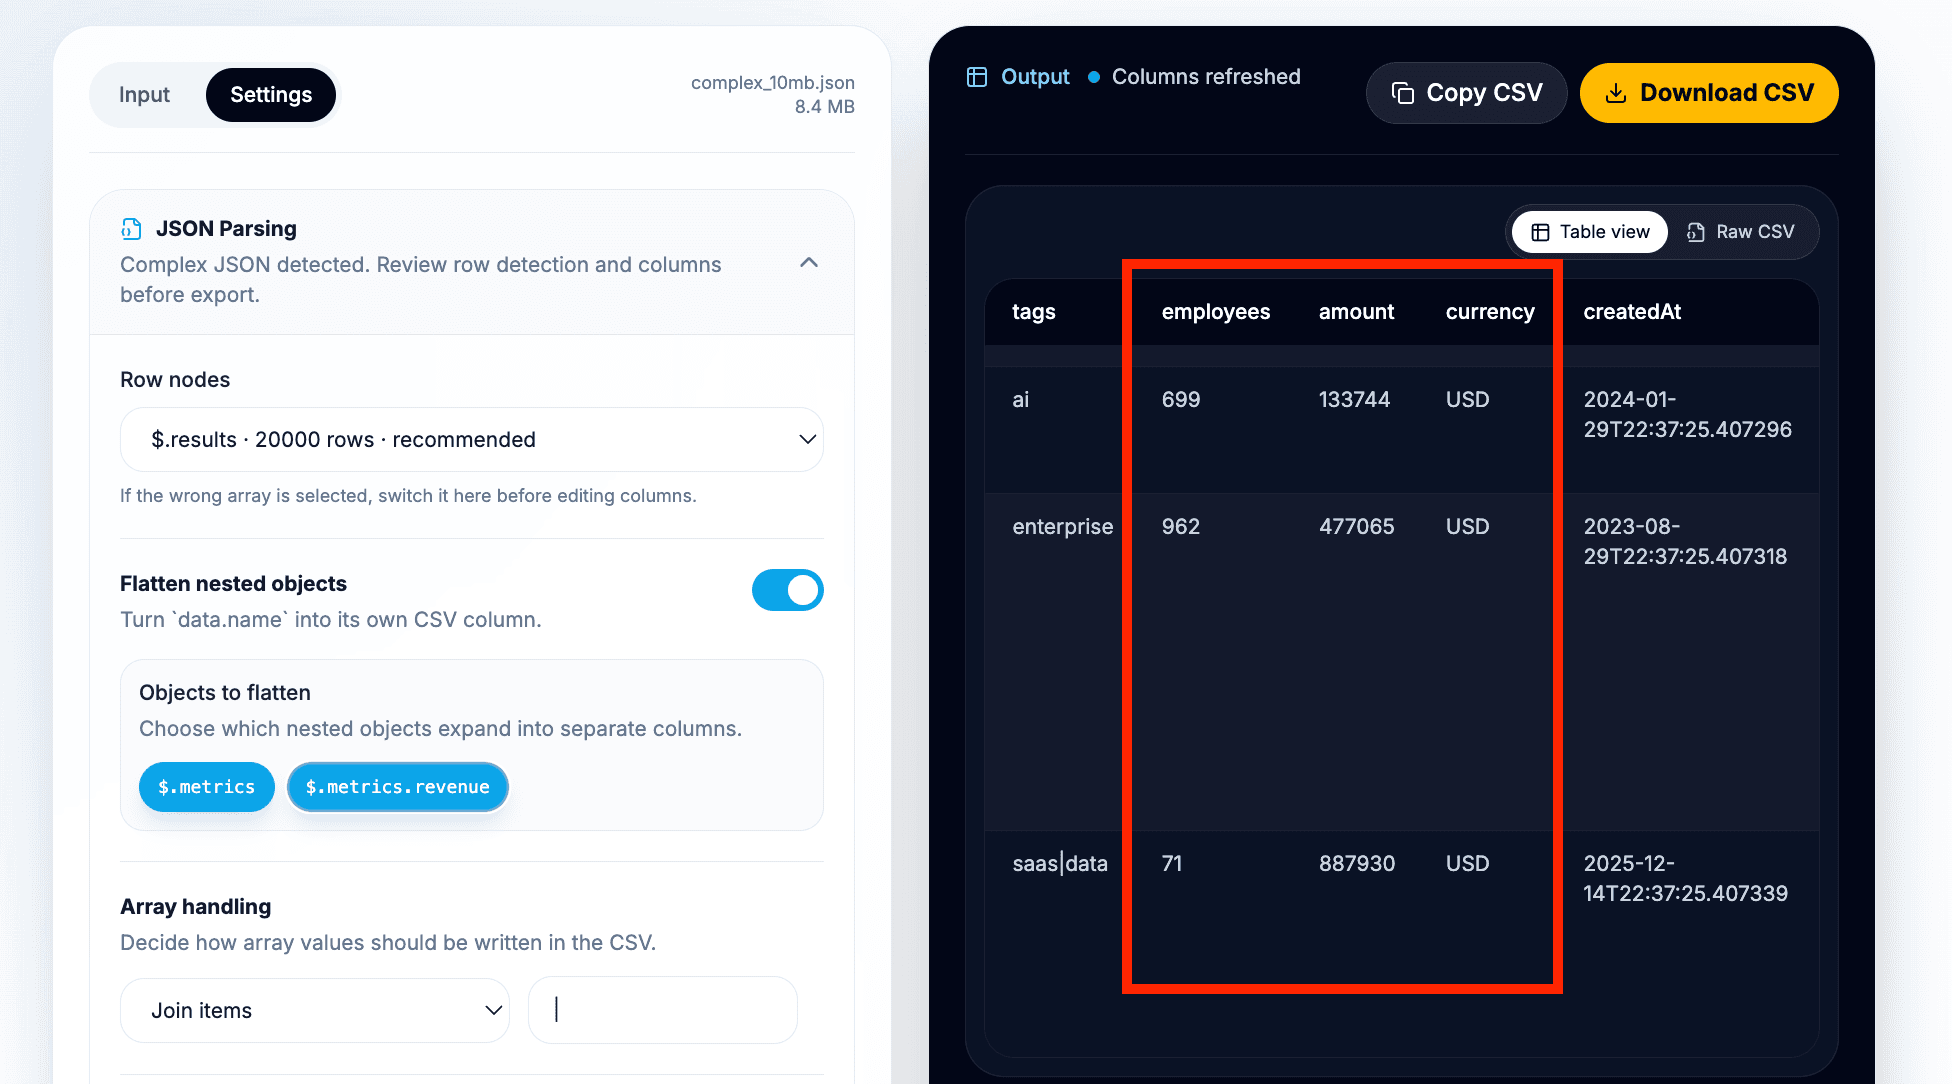
预期的公司级 CSV 如下:
| CSV 列 | 源数据 |
|---|---|
id | 行标识符 |
name | 公司或账户名称 |
website | 根据设置输出网站值、合并后的数组或 JSON 字符串 |
contacts | 每家公司一行时保留的嵌套联系人数据 |
tags | 合并后的标签或原始文本 |
employees | 来自 metrics.employees 的值 |
amount | 来自 metrics.revenue.amount 的值 |
currency | 来自 metrics.revenue.currency 的值 |
createdAt | 原始日期或格式化后的日期 |
第一次导出时,我更喜欢易读的列名。如果不同对象中存在同名字段,请务必在下载前检查预览。例如,未经确认,不应将 billing.amount 和 revenue.amount 都简化为含义模糊的 amount 列。
💡 我默认采用的展平方式
将需要筛选、排序或作为列导入的标量字段展平。如果展平会掩盖含义或生成难以阅读的单元格,则把结构化对象或数组保留为 JSON。
处理 JSON 行中的数组
数组需要单独处理,因为 CSV 单元格只能容纳文本,而 JSON 数组可以表达多种不同的数据关系。
标签列表和联系人列表并不相同,电子邮件列表也不同于订单明细列表。当各数组含义不同时,我不会对它们套用同一条全局规则。
对于示例文件,我会采用以下设置:
| 字段 | 建议处理方式 | 原因 |
|---|---|---|
tags | 合并值 | 标签是简单文本,适合放在同一个单元格中 |
website | 合并值或保留为 JSON | 重视可读性时合并;需要保留混合结构时使用 JSON |
contacts | 公司级行中保留为 JSON | 联系人对象拥有自己的嵌套字段 |
contacts | 联系人级行使用 $.results[].contacts 作为行节点 | 当联系人列表才是真正的输出目标时更合适 |
Datablist 支持多种数组处理方式,例如合并值、将数组保留为 JSON 字符串、仅提取第一项,以及为不同字段分别配置规则。
我的默认原则很简单:
- 合并 tags 等简单数组。
- 需要保留结构时,将结构化数组保存为 JSON 字符串。
- 只有当第一项具有明确含义时才提取它,例如主邮箱。
- 当数组中的每个元素都应该独占一行时,更改行节点。
对于公司级导出,我会将 contacts 保留为结构化值,因为每位联系人都有姓名、邮箱和电话号码。把它们全部展平到一个单元格中会让 CSV 十分混乱,而只提取第一位联系人又会丢失数据。
如果要导出联系人,我会改为选择 $.results[].contacts。此时 CSV 将包含以下联系人级列:
| CSV 列 | 源数据 |
|---|---|
name | 联系人姓名 |
emails | 合并后的邮箱列表或 JSON 字符串 |
phones | 合并后的电话号码列表或 JSON 字符串 |
其中的取舍在于上下文。公司级导出会完整保留公司行;联系人级导出则聚焦人员,但除非工具未来支持,否则父级公司字段不会自动复制到每一行联系人记录中。
配置 CSV 输出设置
确认行节点、展平方式和数组设置无误后,就可以配置 CSV 输出。
我通常从以下设置开始:
- 分隔符:标准 CSV 使用逗号。
- 表头行:启用。
- 日期格式:除非目标电子表格需要更易读的日期,否则保留原格式。
如果你的电子表格工具或地区设置要求使用分号分隔文件,请选择分号。在部分欧洲地区的电子表格设置中,逗号常被用作小数分隔符,因此这一点尤其重要。
第一次导出时,我倾向于保留源日期格式。如果源文件使用 ISO 时间戳,之后解析会很方便,而且可以保留时区信息。如果 CSV 是给非技术同事使用,格式化日期则会提高可读性。
下载前,请检查两种预览:
- 表格预览用于检查行和列。
- 原始 CSV 预览用于检查分隔符、引号和换行符。
🔑 导出前先预览
通过预览可以发现行节点错误、列缺失、数组混乱和分隔符问题。与其之后排查失败的 CRM 或电子表格导入,我宁愿先花 30 秒检查预览。
遇到数组或多行文本时,我一定会检查原始 CSV 预览。只需几秒钟,却能发现不少容易忽略的导入问题。
检查并下载 CSV
下载前,我会逐项检查:
- 行数是否与所选行节点匹配?
- 每一行是否代表我想要的实体?
employees、amount和currency是否拆分成了实用的列?- 数组是否易读,或在结构重要时保留为 JSON?
- 空的 revenue 值对下一步处理来说是否足够清晰?
- 日期是否符合电子表格或导入工具的要求?
- 原始 CSV 预览是否使用了预期的分隔符?
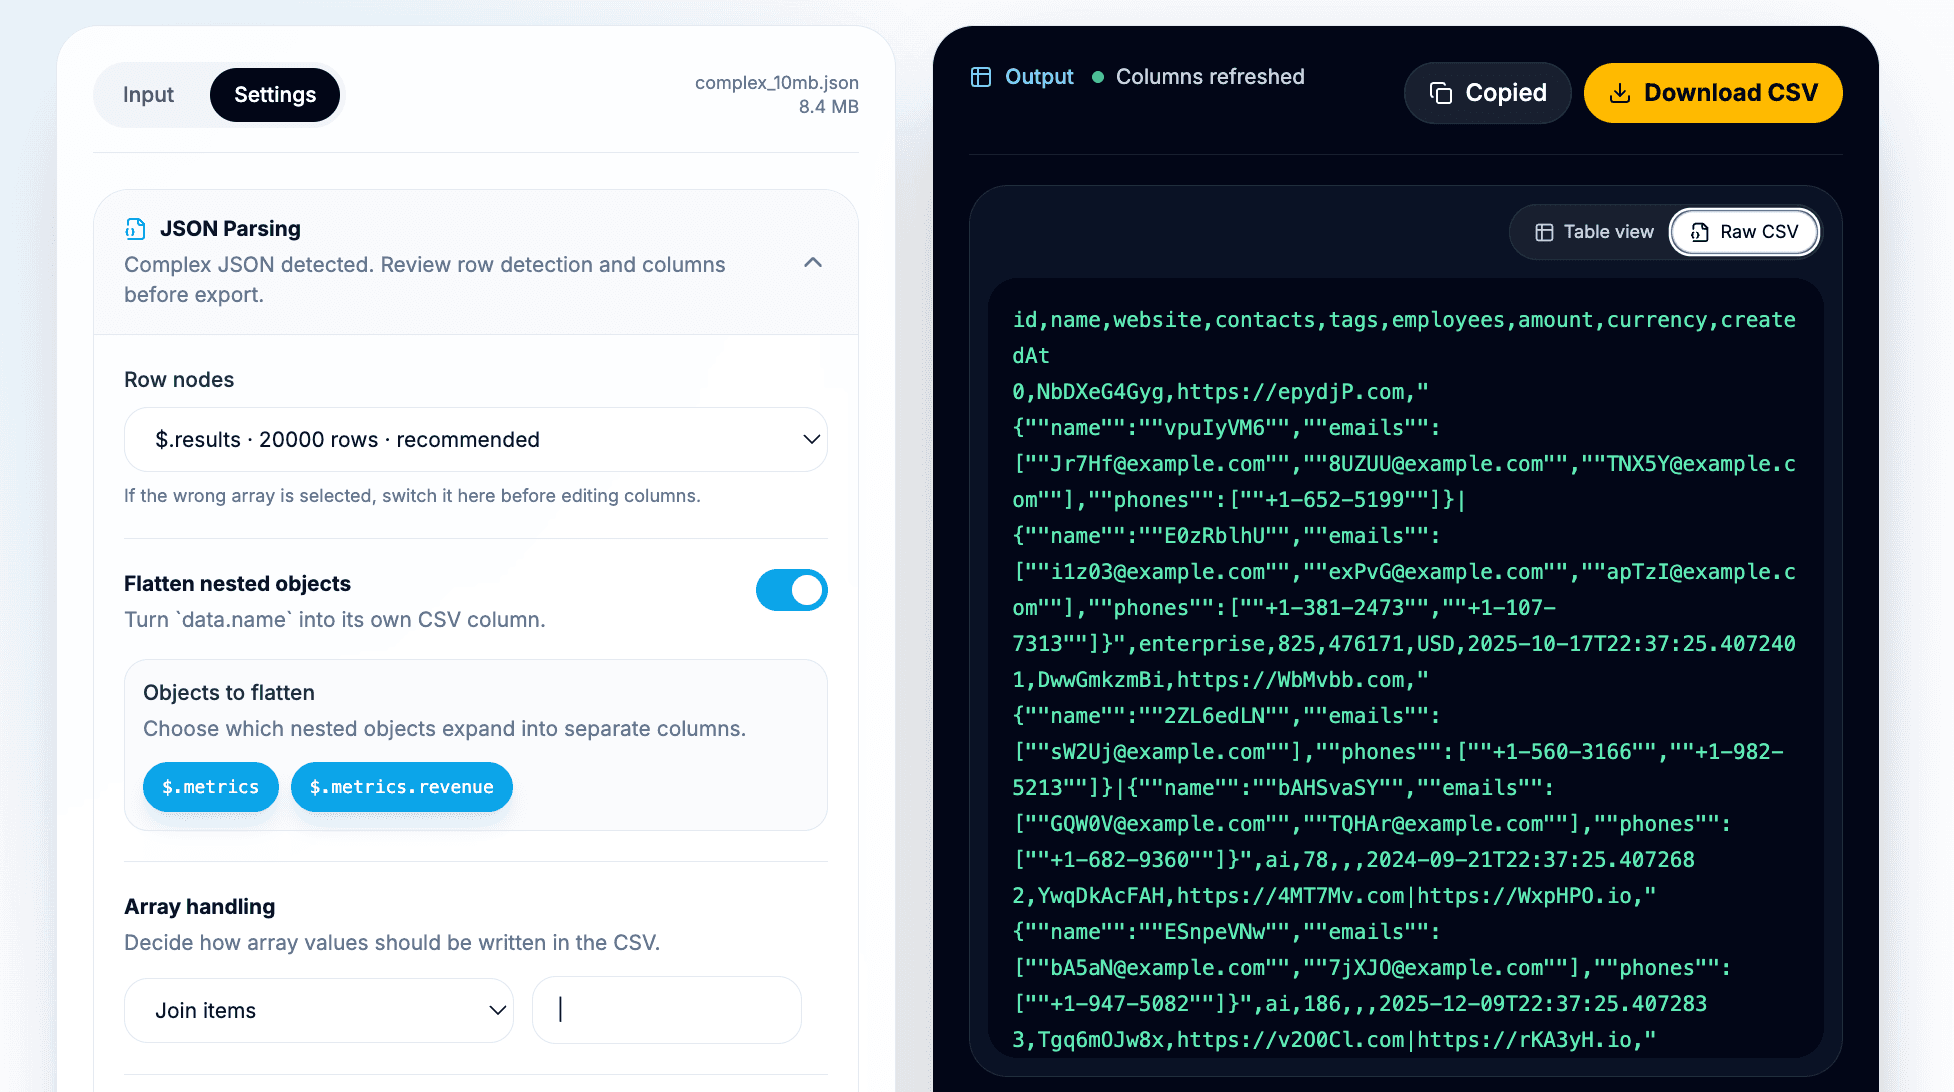
确认后即可下载 CSV。上传文件时,下载文件名可以基于源文件名生成,方便追溯 CSV 的来源。
导出后,可以在 Datablist 的 CSV 编辑器、Excel、Google Sheets 或下一款数据工具中打开文件。在 Datablist 中,你还可以继续进行数据清洗、筛选、去重、数据丰富或翻译。如果生成了多个导出文件,可以比较两个 CSV 文件。如果文件对其他工具来说太大,也可以将 CSV 拆分成多个小文件。
预期的 CSV 输出结果
选择 $.results 时,主要输出将是每家公司或账户各占一行。
| CSV 列 | 每行中的 JSON 路径 | 预期值 |
|---|---|---|
id | $.id | 行标识符 |
name | $.name | 公司或账户名称 |
website | $.website | 网站字符串、合并后的数组或 JSON 字符串 |
contacts | $.contacts | 每家公司一行时合并或保留为 JSON 的联系人数组 |
tags | $.tags | 合并后的标签或原始字符串 |
employees | $.metrics.employees | 员工人数 |
amount | $.metrics.revenue.amount | 存在时的营收金额 |
currency | $.metrics.revenue.currency | 存在时的营收币种 |
createdAt | $.createdAt | 原始日期或格式化后的日期 |
选择 $.results[].contacts 时,输出会变为每位联系人各占一行。
| CSV 列 | 每位联系人中的 JSON 路径 | 预期值 |
|---|---|---|
name | $.name | 联系人姓名 |
emails | $.emails | 合并后的邮箱列表或 JSON 字符串 |
phones | $.phones | 合并后的电话号码列表或 JSON 字符串 |
两种导出方式都正确,只是回答了不同的问题。
如果要清洗账户、检查公司属性数据、丰富公司记录或准备 CRM 导入,请使用公司级导出。如果目标数据集是人员,请使用联系人级导出。
何时使用这套转换流程
只要源格式是 JSON,而实际工作格式是 CSV,这套流程就能派上用场。
常见场景包括:
- 包含元数据、分页信息和嵌套
results数组的 API 响应。 - 包含商品条目、产品、联系人或事件的基于 API 的数据抓取结果。
- 公司记录中包含联系人、tags、指标和自定义字段的 CRM 与 RevOps 导出。
- 包含变体、价格、类目和供应商的 Marketplace 或产品目录导出。
- 事件嵌套在 payload 下的 Webhook 日志。
- 需要翻译转换后 CSV 的本地化工作流。
每次的处理模式都一样:找到代表数据行的数组,展平所需的对象字段,决定如何处理数组,并在导出前预览结果。