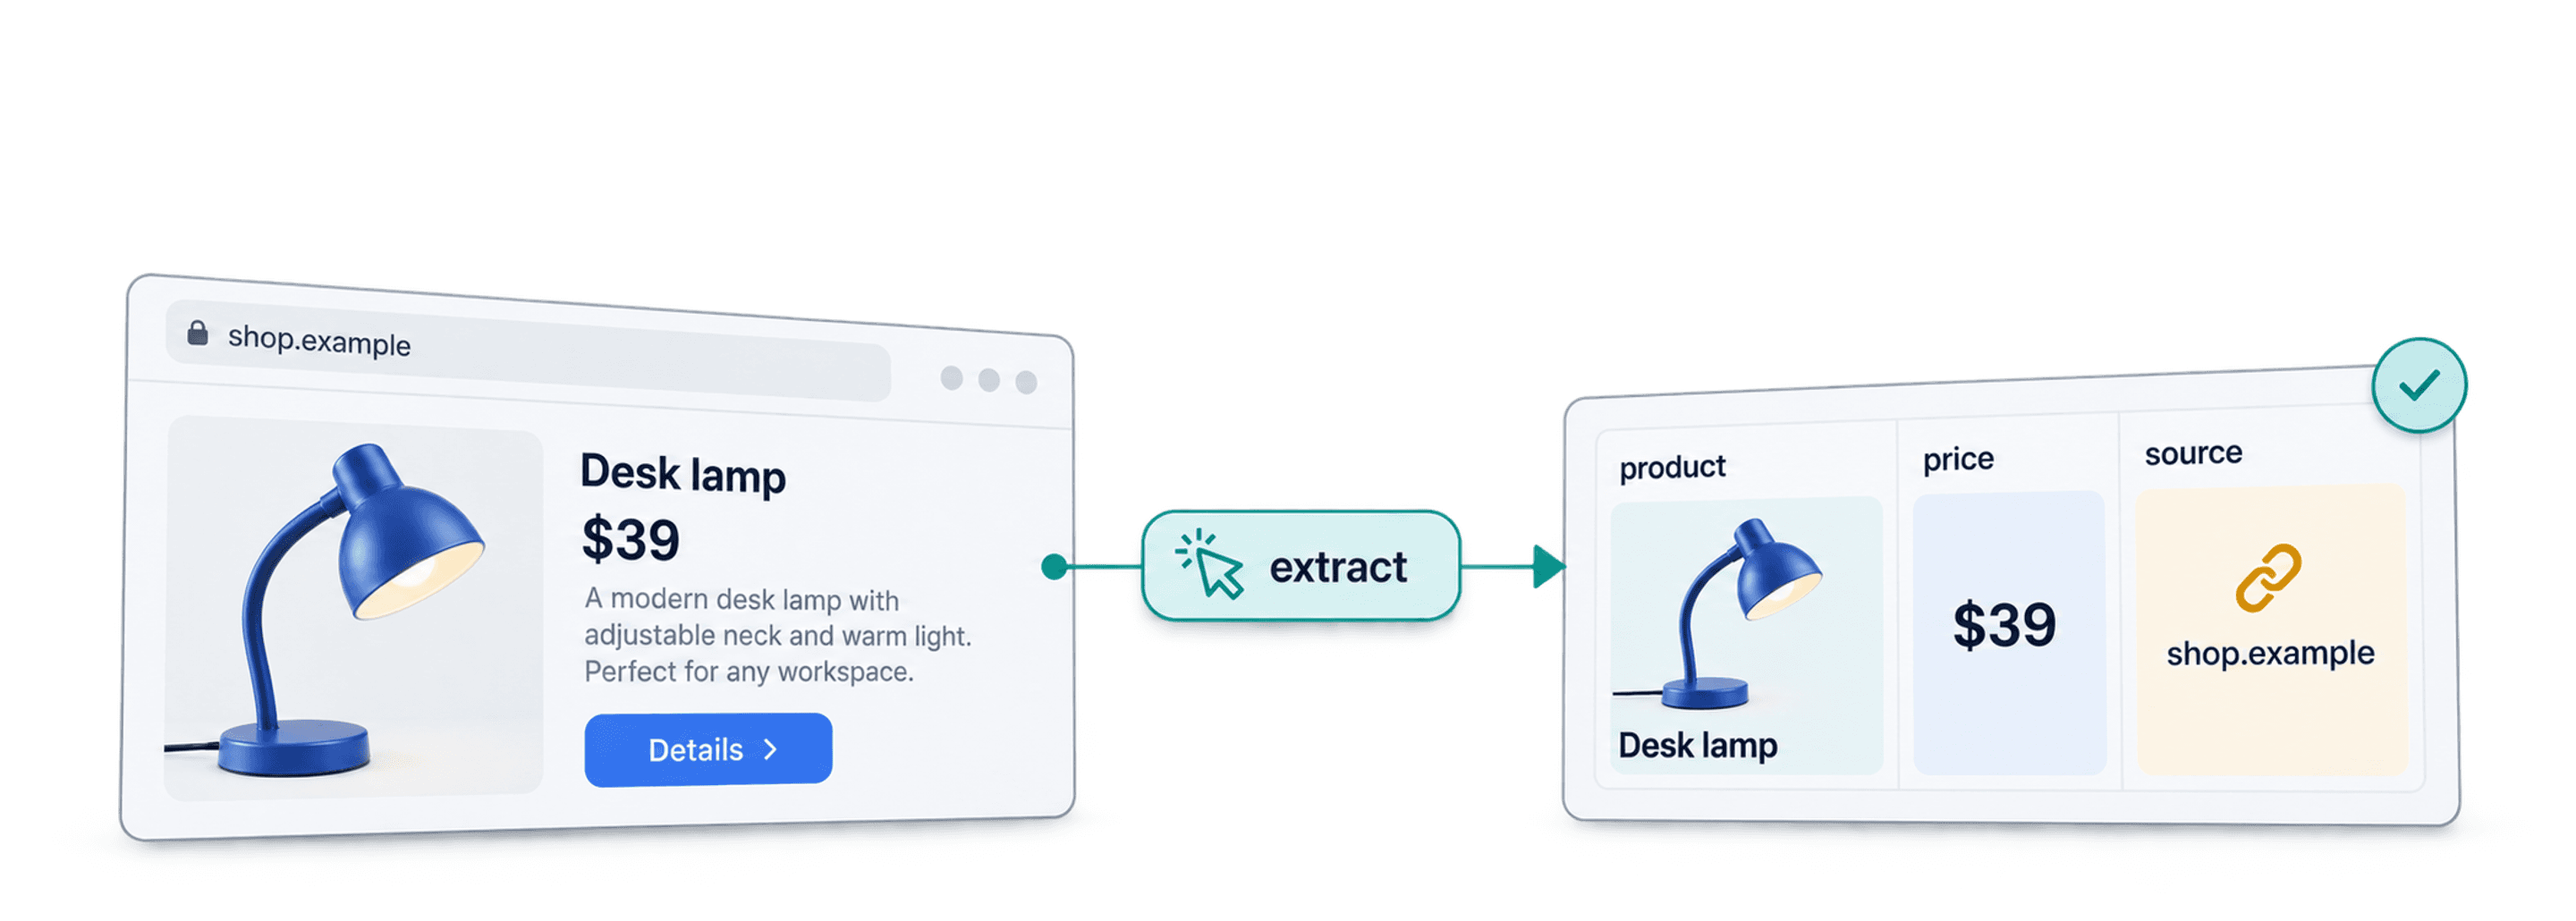
يستخدم استخراج بيانات الويب بالذكاء الاصطناعي نموذج AI لقراءة محتوى المواقع وإرجاع حقول محددة، مثل اسم المنتج والسعر ورابط المصدر. وبدلاً من كتابة CSS selector لكل حقل، تصف المعلومات التي تحتاج إليها وتربط المخرجات بالأعمدة. ومع ذلك، تظل مراجعة النتائج ضرورية: فقد يُغفل النموذج حقلاً، أو يخلط بين صفحتين، أو يعرض قيمة لا يدعمها المصدر.
على سبيل المثال، أعطِ Agent صفحة منتج واطلب منه اسم المنتج والسعر الحالي ورابط المنتج. ستكون النتيجة المفيدة صفاً واحداً يضم هذه الحقول الثلاثة، بعد مطابقة السعر مع صفحة المصدر. وإذا لم تعرض الصفحة سعراً واضحاً، فاترك الحقل فارغاً بدلاً من التخمين. يشرح هذا الدليل الفرق بين الاستخراج بالذكاء الاصطناعي وScraping القائم على القواعد، وكيفية اختيار سير العمل المناسب، وما يجب التحقق منه قبل استخدام البيانات.
ما الذي يغطيه هذا الدليل؟
- شرح مفهوم استخراج بيانات الويب بالذكاء الاصطناعي
- أهم فوائد استخدام الذكاء الاصطناعي في Scraping
- حالات استخدام عملية لـ AI Scraping
- طريقتان لاستخراج البيانات بالذكاء الاصطناعي
- أفضل أدوات AI Scraping في السوق
ما هو استخراج بيانات الويب بالذكاء الاصطناعي؟
تصف المصطلحات التالية النهج العام نفسه. وتظل الأداة بحاجة إلى محتوى مصدر يمكن الوصول إليه وحقول مخرجات محددة بوضوح.
Web Scraping وScraping واستخراج البيانات بالذكاء الاصطناعي
AI web scraping = AI scraping = AI data scraping
تشير هذه المصطلحات كلها إلى استخدام نموذج AI لتحديد المعلومات الواردة في محتوى الويب وتنظيمها. غالباً ما يحدد Scraper تقليدي العناصر باستخدام CSS selector أو XPath. أما سير عمل الاستخراج بالذكاء الاصطناعي، فيستخدم Prompt أو Schema لتحديد الحقول وفق معناها. يفيد ذلك عندما تختلف تخطيطات الصفحات، لكنه لا يلغي ضرورة التعامل مع الصفحات التي يتعذر الوصول إليها أو المحتوى المتغير أو المخرجات غير الصحيحة.
فوائد استخدام AI في Scraping
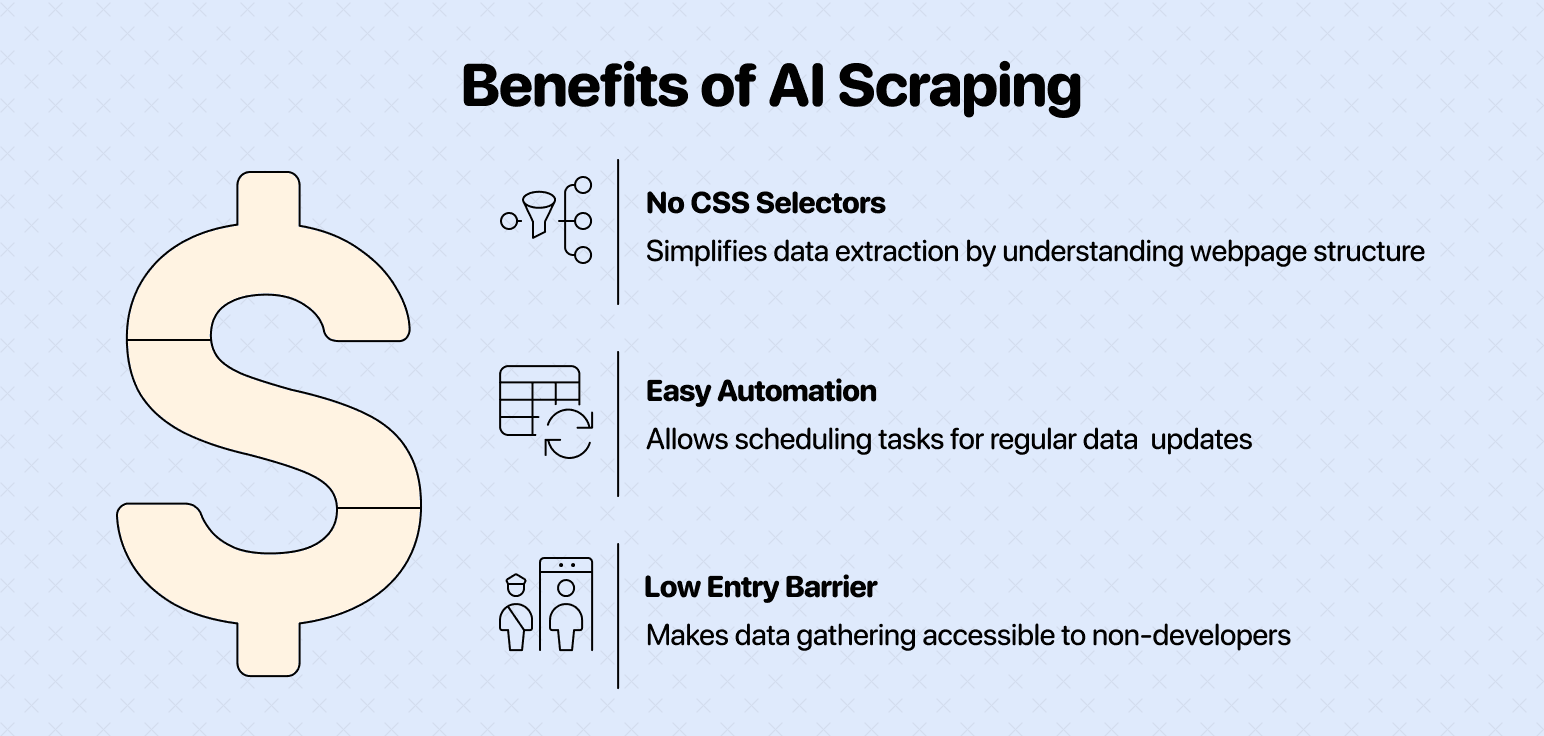
يكون الاستخراج بالذكاء الاصطناعي مفيداً عندما تظهر المعلومة نفسها في مواضع مختلفة عبر الصفحات، أو عندما تحتاج إلى تحويل نص غير منظم إلى أعمدة. وقد يكون Scraping القائم على القواعد أبسط وأقل تكلفة إذا كان تخطيط الصفحات ثابتاً وموحداً. اختر النهج وفقاً للمصدر والمخرجات التي تحتاج إليها.
بلا برمجة أو APIs
تتيح بعض أدوات AI Scraping إدخال Prompt بلغة طبيعية عبر واجهة المستخدم، بينما تتطلب أدوات أخرى API أو كتابة كود. وينبغي أن يحدد الطلب الواضح اسم كل حقل مطلوب وما يجب فعله عندما لا تتضمن الصفحة قيمة له.
بلا CSS Selectors أو XPath أو تعقيد
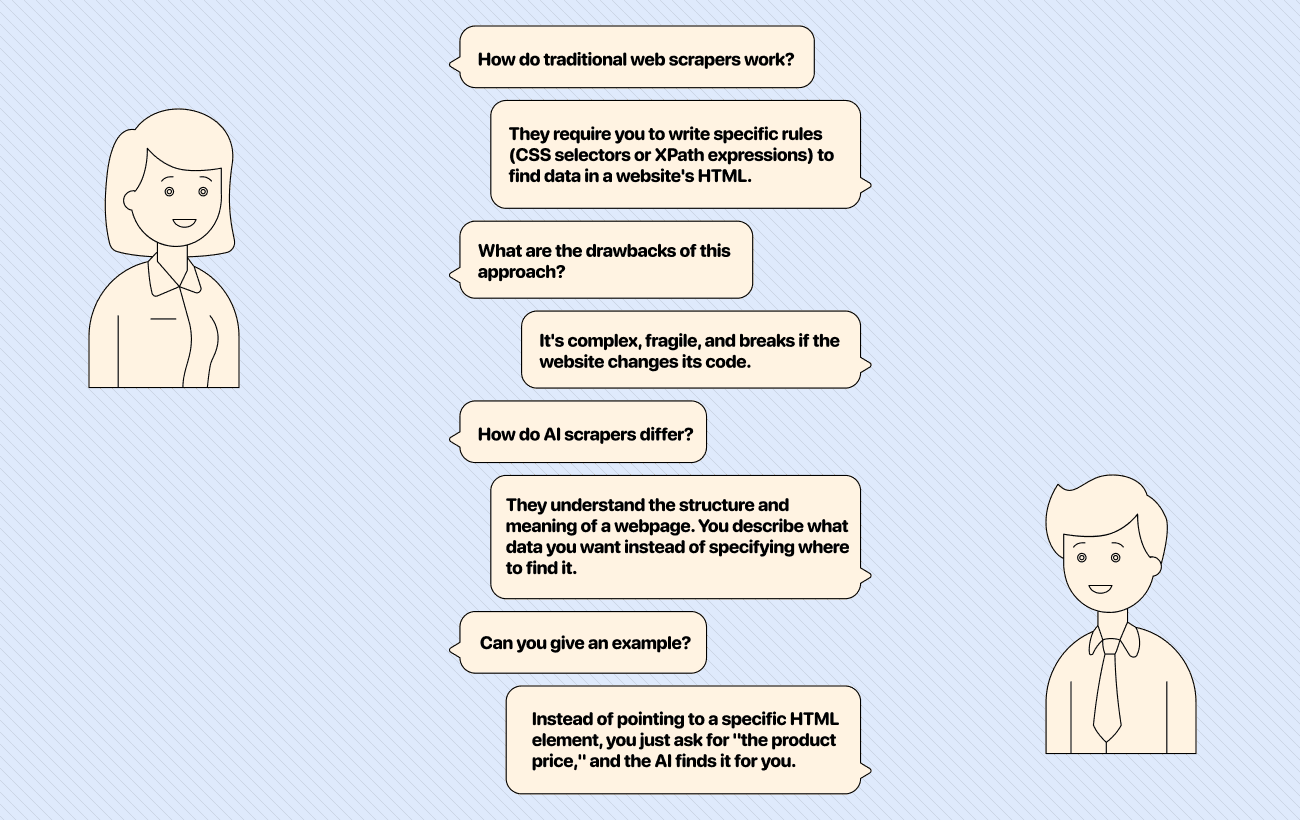
عند استخدام Scraper قائم على Selectors، تحدد عنصر HTML الذي يحتوي على القيمة. أما مع الاستخراج بالذكاء الاصطناعي، فيمكنك طلب حقل مثل «السعر الحالي للمنتج» من صفحات ذات تخطيطات مختلفة. اختبر النهجين على بضع صفحات ممثلة للمصدر. فقد يظل تغيير التخطيط أو حظر الصفحة أو غموض السعر سبباً يستدعي تعديل Prompt أو المراجعة اليدوية.
أتمتة سهلة ومتطلبات بدء بسيطة
يمكنك تشغيل سير عمل الاستخراج بالذكاء الاصطناعي على قائمة من عناوين URL، أو البدء من رابط موقع. وقبل تكرار التشغيل، افحص عينة من المخرجات بحثاً عن الحقول الفارغة والمطابقات الخاطئة والتغييرات في بنية الموقع المصدر. فالأتمتة تظل بحاجة إلى المراقبة.
حالات استخدام AI Scraping
تكاد تطبيقات AI Scraping تكون بلا حدود، إذ تمتد إلى معظم أقسام الأعمال. ومن خلال أتمتة جمع البيانات من الويب، تستطيع الفرق الوصول إلى رؤى مهمة والعمل بكفاءة أعلى.
إليك بعض الأفكار لما يمكنك إنجازه باستخدام AI Scraping:
- استخراج بيانات متاجر التجارة الإلكترونية
- يمكن للفرق استخراج تفاصيل المنتجات، مثل الأسماء والأسعار والأوصاف والصور، من آلاف القوائم.
- يفيد ذلك في تحليل المنافسين ومراقبة الأسعار وإنشاء كتالوجات المنتجات.
- استخراج تقييمات العملاء
- يساعد جمع تقييمات العملاء من مواقع مثل Yelp وG2 وAmazon الشركات على فهم الانطباع العام.
- يستطيع AI تحليل هذه البيانات لاكتشاف الموضوعات المتكررة وعيوب المنتجات والعوامل المؤثرة في رضا العملاء، بما يدعم تحليل المنافسين.
- مراقبة صفحات الأسعار
- يمكن لفرق المبيعات والتسويق تتبع أسعار المنافسين وعروضهم تلقائياً.
- يتيح ذلك تطبيق استراتيجيات تسعير ديناميكية ويساعد الشركات على الحفاظ على قدرتها التنافسية.
- استخراج دراسات الحالة
- تستطيع فرق التسويق جمع دراسات الحالة من مواقع المنافسين لفهم تموضعهم وقصص نجاحهم.
- تفيد هذه المعلومات في تحسين الرسائل التسويقية وعروض المبيعات الخاصة بهم.
- البحث عن بيانات غير متاحة في قواعد البيانات
- بعض المعلومات لا تتوفر ببساطة في قواعد بيانات منظمة.
- يمكن لأدوات AI Scraping استخراج بيانات فريدة من المنتديات والمدونات والمواقع المتخصصة لدعم أبحاث السوق أو الدراسات الأكاديمية أو الصحافة الاستقصائية.
💡 أدلة عملية لبدء استخدام AI Scraping
كيفية استخراج دراسات الحالة 👈🏼
كيفية استخراج المنتجات من مواقع التجارة الإلكترونية 👈🏼
كيفية استخراج تقييمات المستخدمين من Trustpilot 👈🏼
كيفية العثور على تفاصيل حسابات غير متاحة في قواعد البيانات 👈🏼
طريقتان لاستخراج البيانات بالذكاء الاصطناعي
تقدم أدوات AI Scraping أساليب مختلفة بحسب المهمة. ورغم تشابه التقنية الأساسية، تعتمد الطريقة المناسبة على ما إذا كنت تثري مجموعة بيانات حالية أم تستكشف موقعاً جديداً من الصفر.
لنلقِ نظرة على الطريقتين الأساسيتين:
- تشغيل AI Scraping Agent على قائمة من العناصر
- استخدام AI Scraping Agent لاستخراج بيانات موقع عبر رابط وPrompt
تشغيل AI Scraping Agent على قائمة من العناصر
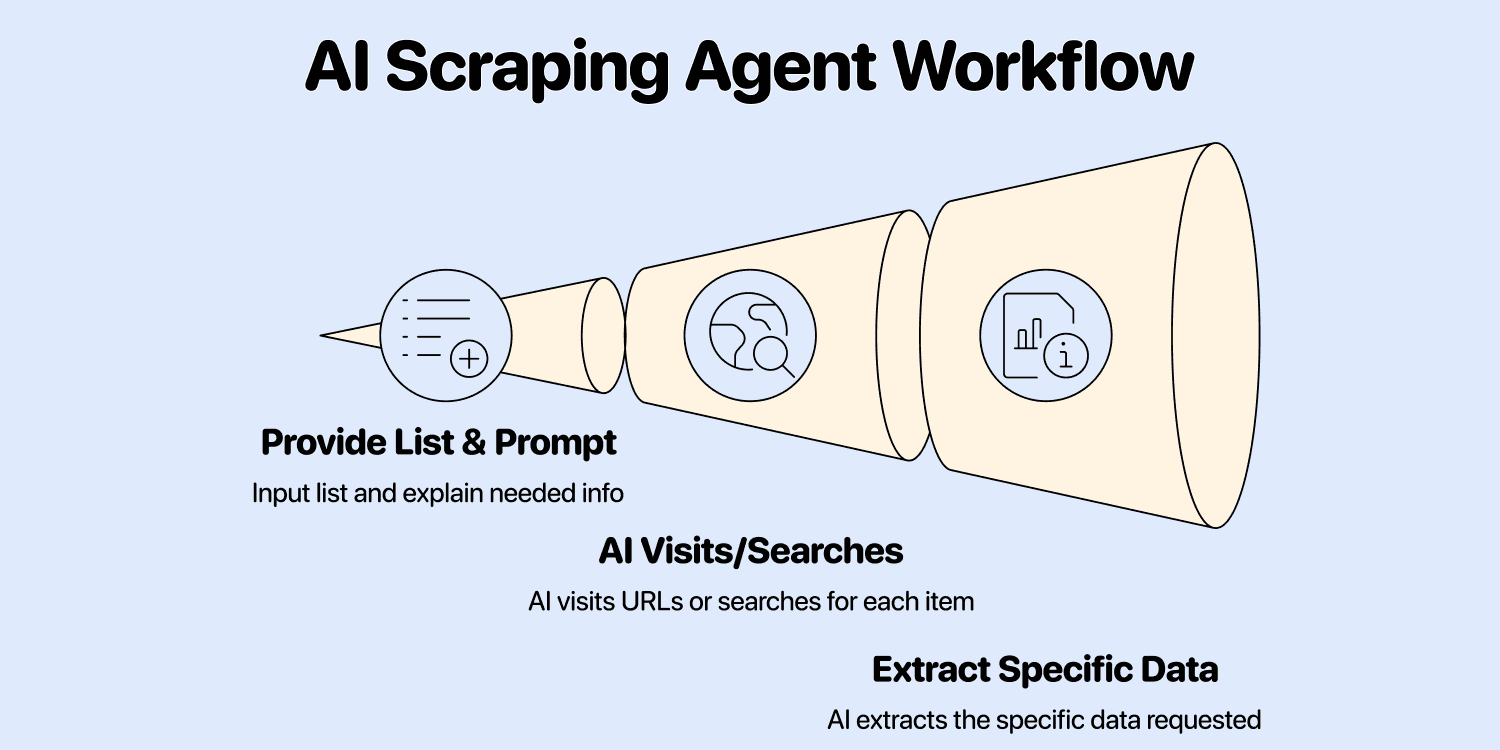
هذه الطريقة مثالية عندما تكون لديك نقطة بداية بالفعل، مثل جدول بيانات يضم أسماء شركات أو روابط منتجات. تقدم إلى AI Agent قائمتك وPrompt يوضح المعلومات الإضافية التي تحتاج إليها لكل عنصر.
بعد ذلك، يزور AI كل رابط أو يجري بحثاً عن كل عنصر، ثم يستخرج البيانات المحددة التي طلبتها.
- الأنسب لـ: إثراء مجموعات البيانات الحالية، مثل العثور على قطاع كل شركة في قائمة أو اسم CEO لكل حساب.
- المراجعة: اختبر عينة صغيرة أولاً وافحص صفحات المصدر للحقول المهمة.
استخدام AI Scraping Agent لاستخراج بيانات موقع عبر رابط وPrompt
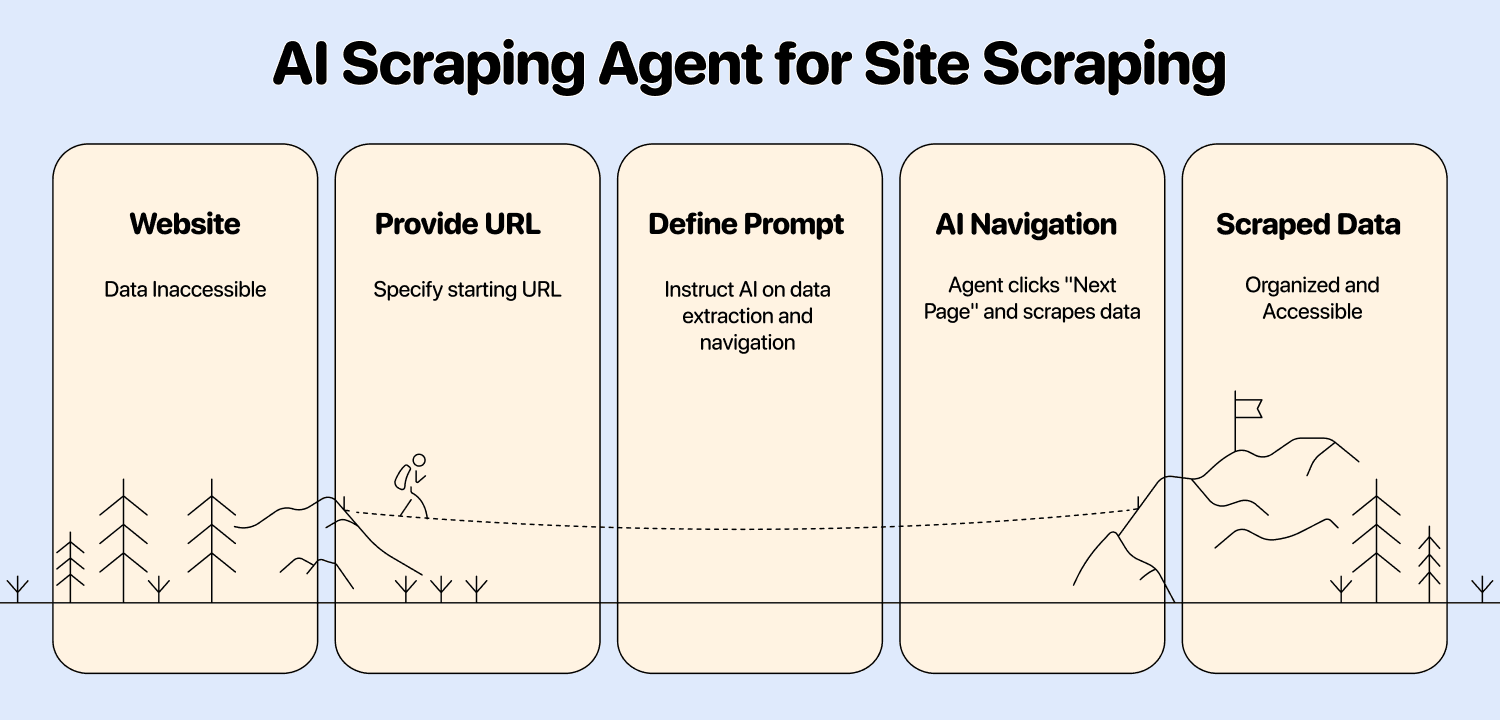
صُممت هذه الطريقة لاستكشاف البيانات واستخراجها من موقع كامل أو من قسم محدد فيه. تقدم رابط بداية، مثل صفحة فئة في متجر إلكتروني، وPrompt يوضح للذكاء الاصطناعي ما ينبغي البحث عنه وكيفية التنقل في الموقع.
لاستخدام Website Scraper من Datablist، أدخل رابط البداية وPrompt يصف العناصر المطلوب استخراجها. ويُعد Pagination اختيارياً؛ فعّله عندما يتضمن المصدر عدة صفحات من النتائج.
يشرح دليل إعداد Website Scraping وفحص العينات كيفية مطابقة المخرجات مع Prompt واختبار Rendering والتمييز بين الحقل المفقود والصفحة المحظورة.
- الأنسب لـ: استخراج قوائم المنتجات من مواقع مثل Amazon أو eBay، أو جمع المقالات من مدونة، أو استخراج القوائم من أي Directory.
- المراجعة: ابدأ بعدد محدود من الصفحات، ثم تحقق من أن الصفوف المعادة مصدرها الصفحات المقصودة قبل توسيع نطاق التشغيل.
أفضل أدوات AI Scraping
يشهد سوق أدوات AI Scraping نمواً سريعاً. ويعتمد اختيار الأداة المناسبة على مهاراتك التقنية وميزانيتك واحتياجاتك المحددة. فيما يلي ثلاثة خيارات مع أسعارها الابتدائية عند الدفع الشهري بالدولار الأمريكي.
| الأداة | الاستخدام الأساسي | السعر الابتدائي | الاستخدام الشهري المشمول |
|---|---|---|---|
| Datablist | Scraping بلا كود وإثراء جداول البيانات | 25 دولاراً شهرياً | 5,000 Credit |
| Firecrawl | بيانات الويب والاستخراج المنظم للتطبيقات | 19 دولاراً شهرياً | 5,000 Credit |
| ScrapingBee | Scraping API مع استخراج بالذكاء الاصطناعي | 19 دولاراً شهرياً | 75,000 API Credit |
تقيس أرصدة Credits أموراً مختلفة. تحتسب Datablist التكلفة وفق نموذج AI والأدوات المستخدمة، بينما تحتسب Firecrawl التكلفة بحسب الصفحة والتنسيق المحدد، وتضيف ScrapingBee تكلفة الاستخراج بالذكاء الاصطناعي إلى التكلفة الأساسية للطلب. توضح الأمثلة التالية لماذا لا يعني أكبر رصيد Credits بالضرورة سير العمل الأقل تكلفة.
Datablist: مصمم لفرق المبيعات والتسويق والعمليات
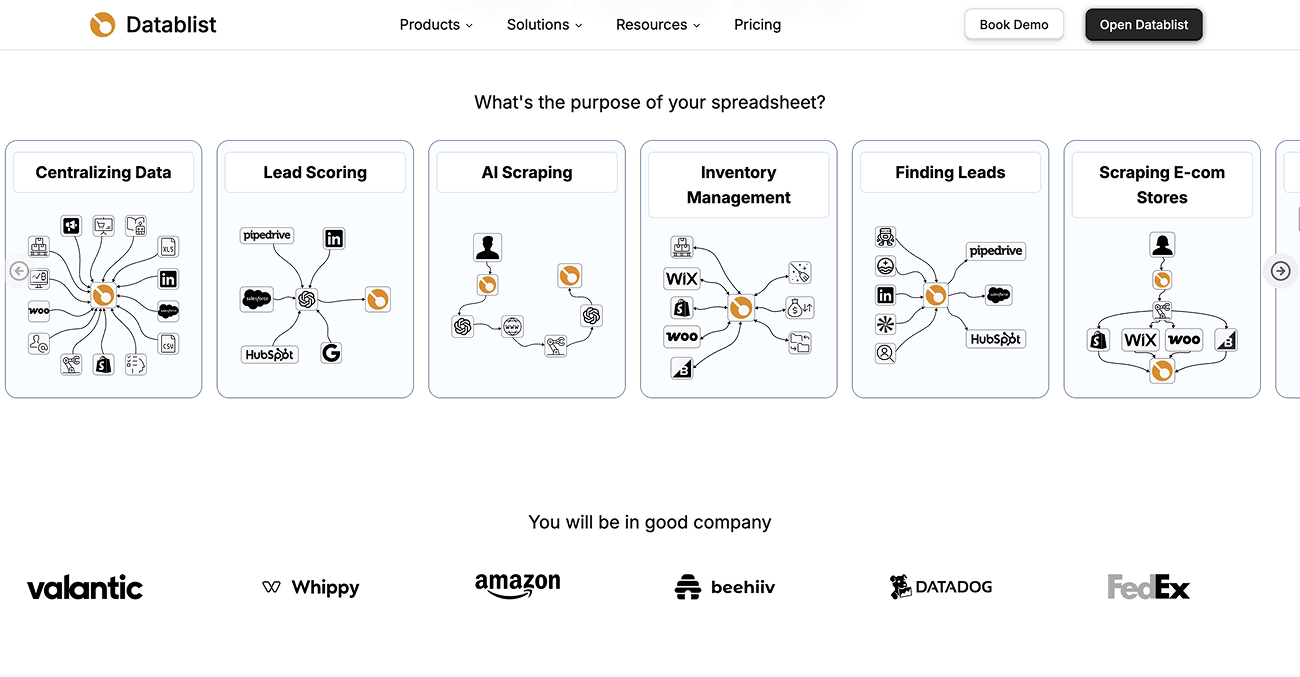
Datablist منصة لأتمتة البيانات تدمج إمكانات AI Scraping القوية ضمن واجهة جداول بيانات سهلة الاستخدام. وقد صُممت لفرق المبيعات والتسويق والعمليات التي تحتاج إلى جمع البيانات وإثرائها من دون كتابة كود أو إعداد APIs.
الميزات الرئيسية:
- إدخال Prompt بلغة طبيعية: صِف ما تحتاج إليه بلغة بسيطة، وسيتولى AI Agent الحصول عليه. لا حاجة إلى البرمجة أو إعدادات API المعقدة.
- نقطتا بداية: شغّل AI Agent على الصفوف الحالية، أو ابدأ من رابط موقع مع Prompt وPagination اختياري.
- إعدادات التشغيل: يتضمن Website Scraper حداً لعدد الصفحات وإعداداً اختيارياً لـ HTML Rendering. اختبر تشغيلاً صغيراً قبل زيادة عدد الصفحات.
- مخرجات منظمة: اربط الحقول المطلوبة بأعمدة Collection، وراجع الصفوف، وادمجها مع عمليات Enrichment أخرى عند الحاجة.
الأسعار:
- Starter: 25 دولاراً شهرياً مع 5,000 Credit. وتبلغ تكلفة Growth 50 دولاراً شهرياً مع 20,000 Credit.
- يختلف استهلاك AI Scraping باختلاف النموذج والأدوات والصفحات التي تتم زيارتها. ويضيف HTML Rendering مقدار 2 Credit لكل عملية Scrape عند تفعيله.
- بالنسبة إلى مهمة تستهلك 25,000 Credit، تبلغ تكلفة Starter مع حزمة إضافية من 20,000 Credit مقدار 45 دولاراً (25 + 20 دولاراً). هذا مثال على ميزانية Credits، وليس سعراً ثابتاً لعدد محدد من الصفحات. وتتطلب الحزم الإضافية اشتراكاً نشطاً، ولا تنتهي صلاحيتها.
💡 نقاط القوة الخفية في Datablist
ما يميز AI Scraper من Datablist أنه يقدم أكثر بكثير من مجرد AI Scraper. فهو AI Scraping Agent يستطيع البحث في Google، وزيارة Google News، واستدعاء APIs، واستخراج البيانات، والتنقل بين صفحات المواقع، وغير ذلك الكثير.
Firecrawl: Web Data API لتطبيقات AI
Firecrawl هو Web Data API مفتوح المصدر ومصمم للمطورين، يحول المواقع إلى بيانات جاهزة لنماذج LLM من أجل تشغيل تطبيقات AI.
الميزات الرئيسية:
- الاستخراج المنظم: قدم رابطاً وJSON Schema أو Prompt لوصف الحقول التي تحتاج إليها. ثم طابق القيم المعادة مع صفحة المصدر.
- مخرجات جاهزة لنماذج LLM: احصل على البيانات بتنسيقات متعددة، مثل JSON وMarkdown ولقطات الشاشة، لتصبح جاهزة فوراً للمعالجة بالذكاء الاصطناعي.
- نهج موجه للمطورين: مصمم باستخدام SDKs لـPython وNode.js، مع وثائق وأمثلة شاملة.
الأسعار:
- Hobby: 19 دولاراً شهرياً مع 5,000 Credit. وتبلغ تكلفة Standard 99 دولاراً شهرياً مع 100,000 Credit. هذه أسعار الدفع الشهري وليست الأسعار المخفضة عند الدفع السنوي.
- تكلف عملية Scrape أساسية لصفحة واحدة 1 Credit، وتضيف صيغة JSON مقدار 4 Credits، لذا يستهلك استخراج صفحة واحدة بصيغة JSON مقدار 5 Credits. وقد تغير الأوضاع الأخرى مقدار الاستهلاك.
ScrapingBee: AI Scraper للمطورين
ScrapingBee أداة Scraping تعتمد نهج API-first وتتولى التعامل مع Proxies والمتصفحات. يمكن للمطورين استدعاؤها من الكود، كما تتيح Integrations مثل n8n وMake للفرق ربطها بسير عمل آخر. ومع ذلك، تظل بحاجة إلى إعداد الطلب وربط البيانات المعادة.
الميزات الرئيسية:
- Web Scraping مدعوم بالذكاء الاصطناعي: يستخدم AI للمساعدة في تحليل البيانات واستخراجها، ما يجعله أكثر قدرة على التكيف مع تغييرات المواقع.
- الوصول عبر API: مصمم للمطورين كي يدمجوه في تطبيقاتهم وسير عملهم.
- JavaScript Rendering: قادر على استخراج البيانات من المواقع الحديثة والديناميكية التي تعتمد بكثافة على JavaScript.
الأسعار:
- Hobby: 19 دولاراً شهرياً مع 75,000 API Credit. وتشمل خطة Freelance البالغة 49 دولاراً شهرياً 250,000 Credit.
- يضيف الاستخراج بالذكاء الاصطناعي 5 Credits لكل طلب. ويستهلك الطلب الأساسي 1 Credit، أو 5 Credits مع JavaScript Rendering، قبل إضافة تكلفة AI Extraction. وقد تزيد إعدادات Premium Proxy التكلفة الأساسية أكثر.
ما تكلفة مهمة استخراج بيانات منظمة؟
تفترض هذه الأمثلة طلباً واحداً لكل صفحة واستخدام الإعدادات المذكورة. وهي تحسب تكلفة استخدام API، لا عدد السجلات الصحيحة المعادة.
| الأداة والمهمة | Credits المطلوبة | الخطة الشهرية والتكلفة |
|---|---|---|
| Firecrawl: 1,000 صفحة مع استخراج JSON | 5,000 | Hobby: 19 دولاراً |
| Firecrawl: 10,000 صفحة مع استخراج JSON | 50,000 | Standard: 99 دولاراً |
| ScrapingBee: 10,000 طلب AI Extraction من دون JavaScript Rendering | 60,000 | Hobby: 19 دولاراً |
| ScrapingBee: 10,000 طلب AI Extraction مع JavaScript Rendering | 100,000 | Freelance: 49 دولاراً |
بالنسبة إلى ScrapingBee، تُحسب القيمتان في الصفين الأخيرين وفق 10,000 × (1 + 5) و10,000 × (5 + 5). ويؤدي تفعيل Rendering إلى تجاوز المهمة للرصيد المتاح في Hobby. أما في Datablist، فنفّذ تشغيلاً صغيراً لتحديد استهلاك Credits وفق النموذج وPrompt وصفحات المصدر، ثم ضع ميزانيتك بالاستناد إلى رصيد خطة Starter البالغة 25 دولاراً وأسعار الحزم الإضافية المذكورة أعلاه.
كيفية التحقق من نتائج AI Scraping
قارن عينة من الصفوف بصفحات المصدر قبل استخدام مجموعة البيانات. تأكد من أن كل قيمة تخص العنصر الصحيح، وأن الوحدات والعملات محفوظة، وأن القيم غير المتاحة تظل فارغة. وإذا تعذر الوصول إلى صفحة المصدر أو كانت النتيجة غير مؤكدة، فعدّل Prompt أو راجع الصف يدوياً. وأعد فحص العينة عند تغير الموقع المصدر.
الأسئلة الشائعة عن AI Scraping
هل يستطيع ChatGPT استخراج بيانات الويب؟
يستطيع نموذج AI استخراج الحقول من محتوى الويب الذي تقدمه له. ولتنفيذ عمليات متكررة على عدد كبير من عناوين URL، استخدم سير عمل يسجل روابط المصادر، ويربط الحقول بالأعمدة، ويتيح لك مراجعة الصفوف الفاشلة أو غير المؤكدة.
ما هو AI Scraping؟
يستخدم AI Scraping نموذجاً لتحديد الحقول المطلوبة في محتوى المواقع وإرجاع نتائج منظمة. ويمكنك وصف الحقول في Prompt بدلاً من تحديد CSS selectors، لكن ينبغي التحقق من النتائج المهمة بمقارنتها مع المصدر.
هل Scraping قانوني؟
تختلف القواعد باختلاف الموقع والبيانات والولاية القضائية. راجع شروط الموقع والمتطلبات القانونية المعمول بها قبل جمع البيانات أو استخدامها، خصوصاً المعلومات الشخصية.
ما هو Data Scraping؟
يعني Data Scraping استخراج المعلومات من مصدر مثل موقع ويب أو مستند. ويستخدم AI Scraping نموذج AI لتحديد المعلومات المطلوبة أو تنظيمها.
ما الفرق بين AI Scraping وWeb Scraping التقليدي؟
يستهدف Scraping القائم على Selectors عناصر محددة في HTML الصفحة. أما الاستخراج بالذكاء الاصطناعي، فيستخدم Prompt أو Schema لتحديد الحقول وفق معناها. وقد يفشل كلا النهجين عندما يتغير الموقع أو تصبح الصفحة غير متاحة؛ لذلك قارن النتائج على صفحات ممثلة للمصدر.
ما المهارات اللازمة لبدء استخدام AI Scraping؟
مع Datablist، يمكنك تقديم رابط أو قائمة من الصفوف، ووصف الحقول المطلوبة، وربط المخرجات من دون كتابة كود. ومع ذلك، ينبغي مراجعة عينة من النتائج.
هل تتعامل أدوات AI Scraping مع تغيّر تخطيط المواقع؟
أحياناً. فقد يستمر Prompt في العثور على الحقل بعد تغيير التخطيط، لكن الصفحات المحظورة والمحتوى المفقود والتسميات الغامضة قد تظل سبباً للأخطاء. أعد فحص عينة بعد تغير الموقع المصدر.
المصادر
- [1] Datablist. تبلغ تكلفة Starter 25 دولاراً شهرياً مع 5,000 Credit، وتكلفة Growth 50 دولاراً مع 20,000 Credit، ويمكن للمشتركين النشطين شراء حزم Credits إضافية.
- [2] Firecrawl. تبلغ أسعار Hobby وStandard الشهرية 19 و99 دولاراً؛ وتكلف عملية Scraping الأساسية 1 Credit لكل صفحة، بينما تضيف JSON مقدار 4 Credits.
- [3] ScrapingBee. تبلغ تكلفة Hobby 19 دولاراً شهرياً مقابل 75,000 Credit، وتكلفة Freelance 49 دولاراً مقابل 250,000؛ ويضيف AI Extraction مقدار 5 Credits إلى التكلفة الأساسية للطلب.