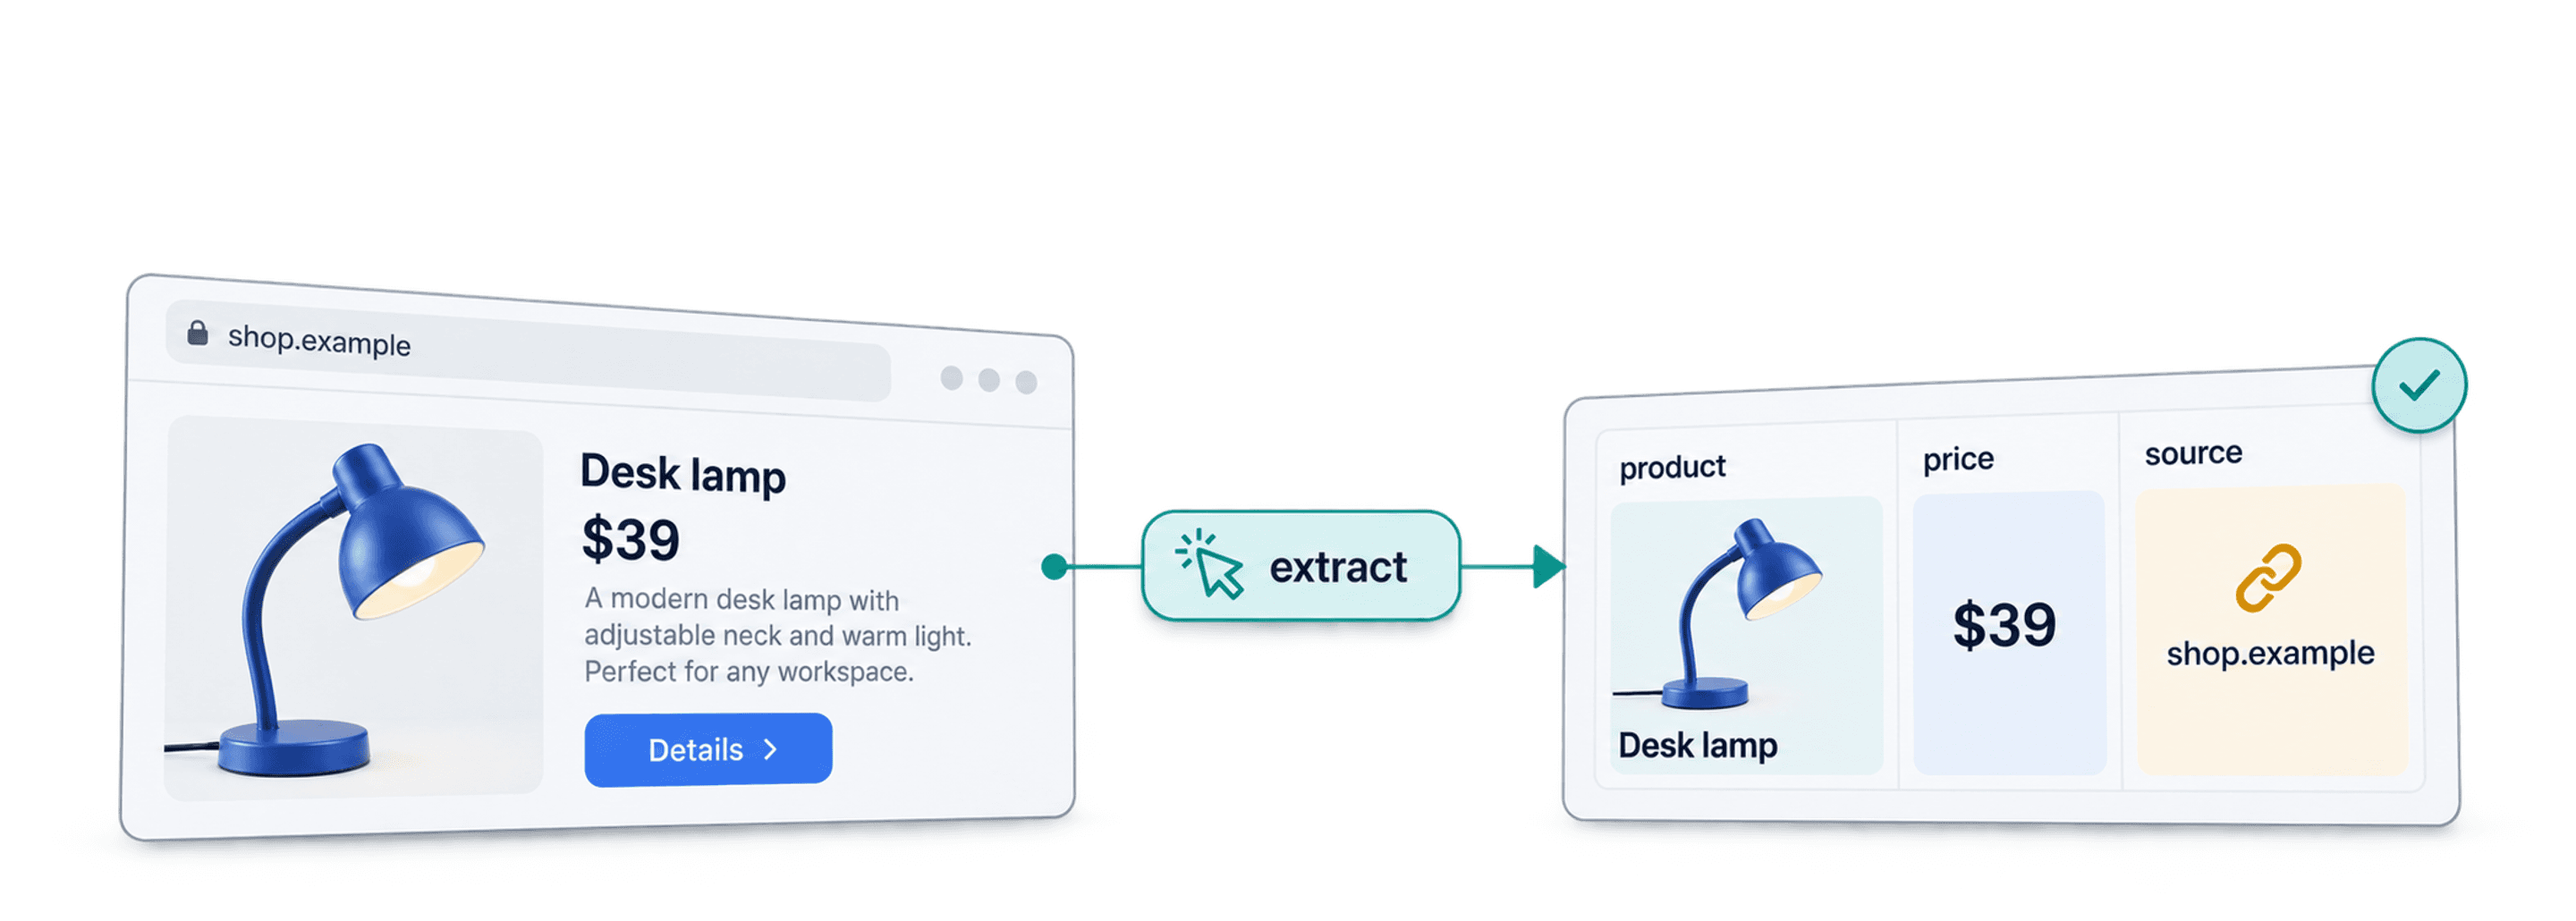
AI-webscraping bruger en AI-model til at læse indhold på websites og returnere bestemte felter, f.eks. produktnavn, pris og kilde-URL. I stedet for at skrive en CSS-selector for hvert felt beskriver du de oplysninger, du har brug for, og knytter outputtet til kolonner. Du skal stadig kontrollere resultatet: En model kan overse et felt, forveksle to sider eller returnere en værdi, der ikke understøttes.
Du kan f.eks. give en agent en produktside og bede om Produktnavn, Aktuel pris og Produkt-URL. Et brugbart output er én række med disse tre felter, hvor prisen er kontrolleret mod kildesiden. Hvis siden ikke viser en pris, skal feltet stå tomt frem for at blive udfyldt med et gæt. Denne guide forklarer, hvordan AI-baseret dataudtræk adskiller sig fra regelbaseret scraping, hvilket workflow du bør vælge, og hvad du skal kontrollere, før du bruger dataene.
Det får du med i denne guide
- Hvad er AI-webscraping?
- De største fordele ved AI-scraping
- Praktiske anvendelser af AI-scraping
- To metoder til AI-scraping
- De bedste værktøjer til AI-scraping
Hvad er AI-webscraping?
Begreberne nedenfor dækker over den samme overordnede metode. Værktøjet har stadig brug for adgang til kildeindholdet og klart definerede outputfelter.
AI-webscraping, AI-scraping og AI-data scraping
AI-webscraping = AI-scraping = AI-data scraping
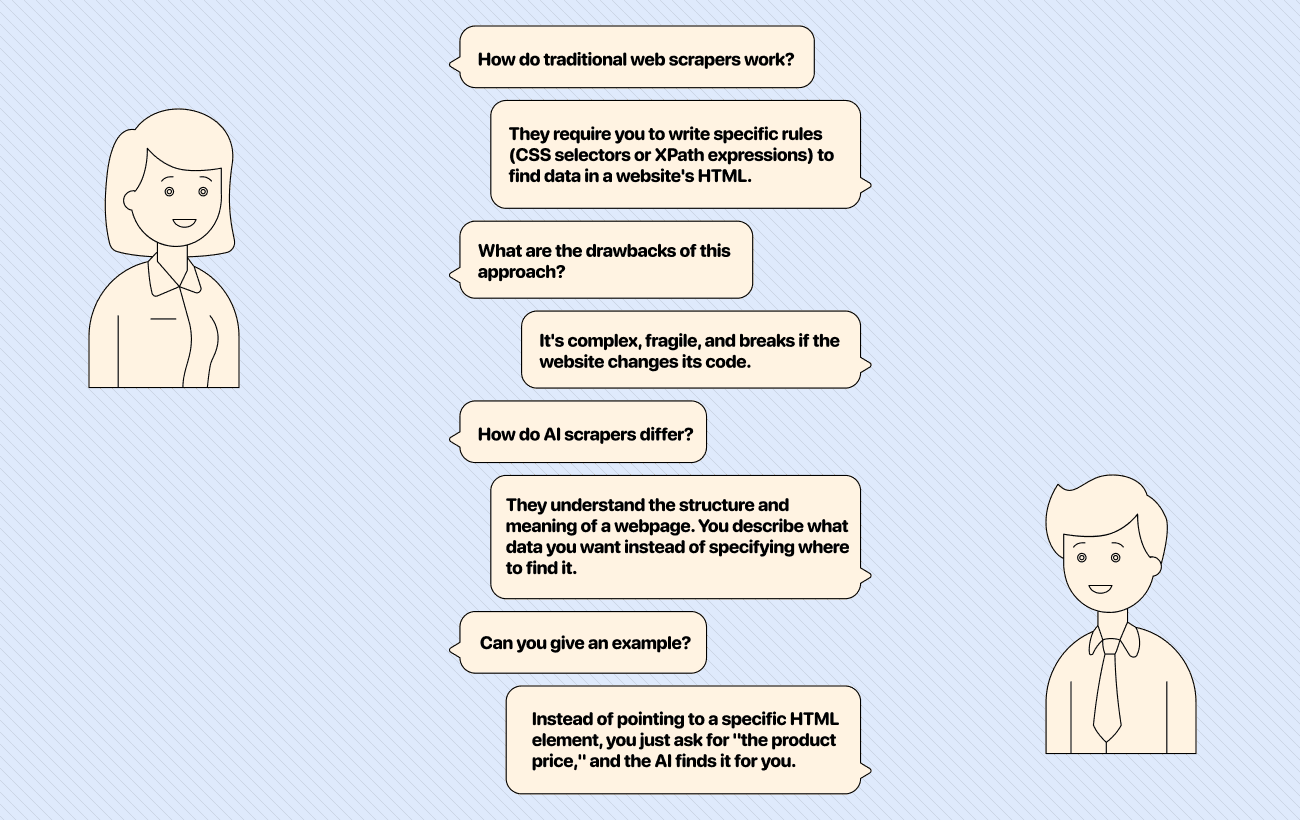
Alle begreberne handler om at bruge en AI-model til at identificere og strukturere oplysninger fra webindhold. En traditionel scraper vælger ofte elementer via en CSS-selector eller XPath. I et AI-baseret workflow bruges der i stedet en prompt eller et schema til at finde felter ud fra deres betydning. Det kan være en fordel, når sidernes layout varierer, men det fjerner ikke behovet for at håndtere utilgængelige sider, ændret indhold eller forkerte outputs.
De største fordele ved AI-scraping
AI-baseret dataudtræk er nyttigt, når den samme oplysning står forskellige steder på forskellige sider, eller når ustruktureret tekst skal omdannes til kolonner. Regelbaseret scraping kan være enklere og billigere, hvis sidernes layout er ensartet og stabilt. Vælg metode ud fra kilden og det output, du har brug for.
Ingen kode og ingen API'er
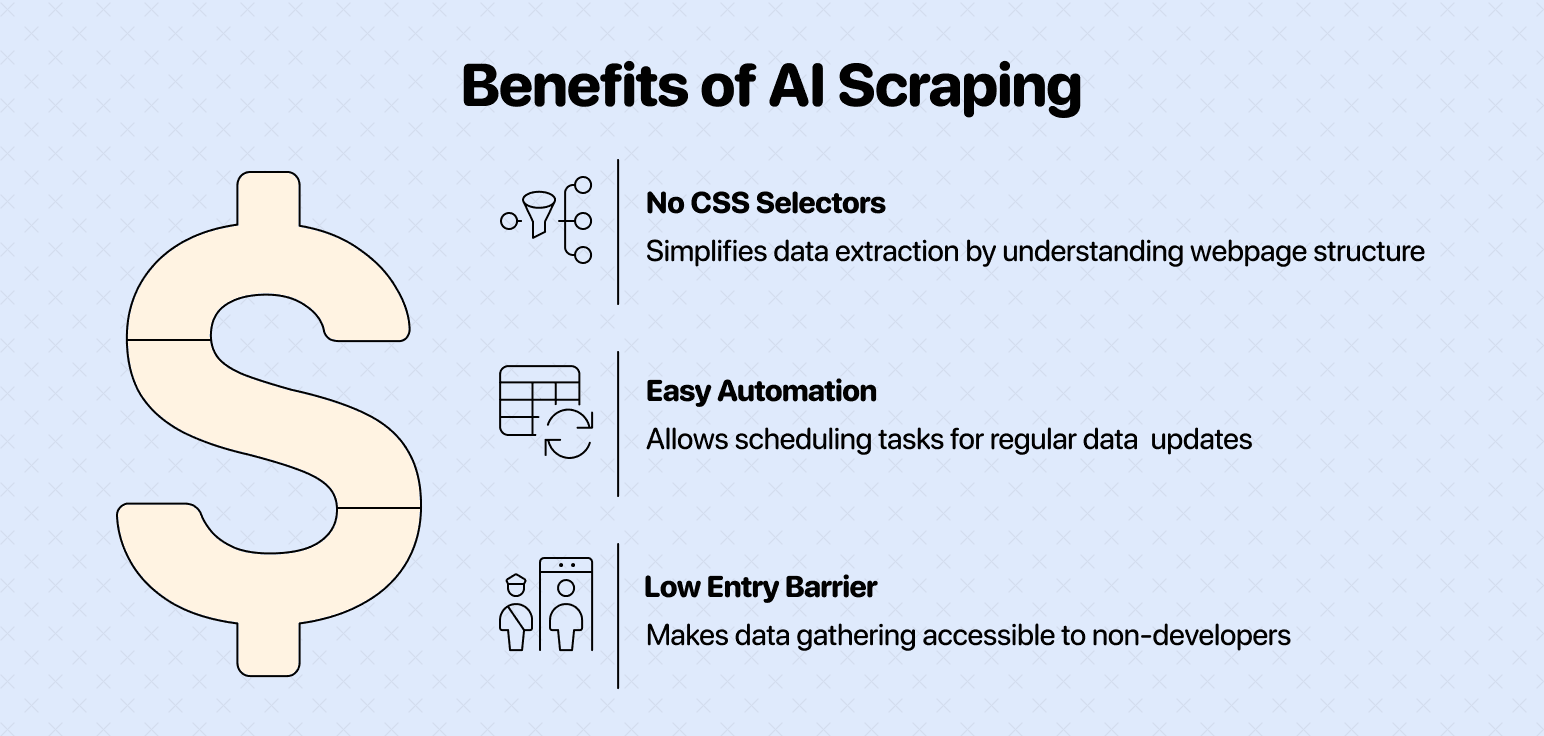
Nogle AI-scrapingværktøjer tager imod prompts i naturligt sprog direkte i brugerfladen. Andre kræver en API eller kode. En tydelig anmodning bør angive hvert outputfelt og forklare, hvad der skal ske, hvis siden ikke indeholder en værdi.
Ingen CSS-selectors, XPath eller unødig kompleksitet
Med en selector-baseret scraper udpeger du det HTML-element, der indeholder en værdi. Med AI-baseret dataudtræk kan du bede om et felt som ”aktuel produktpris” på tværs af sider med forskellige layouts. Test begge metoder på nogle få repræsentative sider. Ændringer i layoutet, blokerede sider eller uklare priser kan stadig gøre det nødvendigt at justere prompten eller gennemgå resultatet manuelt.
Nem automatisering og lav adgangsbarriere
Du kan køre et AI-baseret workflow på en liste med URL'er eller begynde med adressen på et website. Før du gentager en kørsel, bør du kontrollere et udsnit af resultaterne for tomme felter, forkerte matches og ændringer i kildesidens struktur. Automatisering kræver stadig overvågning.
Praktiske anvendelser af AI-scraping
Mulighederne med AI-scraping er næsten ubegrænsede og dækker stort set alle dele af en virksomhed. Ved at automatisere indsamlingen af data fra nettet kan teams få værdifuld indsigt og arbejde mere effektivt.
Her er nogle idéer til, hvad du kan bruge AI-scraping til:
- Scraping af webshops
- Teams kan udtrække produktoplysninger som navne, priser, beskrivelser og billeder fra tusindvis af produktannoncer.
- Det er nyttigt til konkurrentanalyse, prisovervågning og opbygning af produktkataloger.
- Scraping af anmeldelser
- Ved at indsamle kundeanmeldelser fra platforme som Yelp, G2 eller Amazon kan virksomheder få indblik i den generelle kundestemning.
- AI kan analysere dataene og identificere gennemgående temaer, produktsvagheder eller faktorer bag kundetilfredshed i en konkurrentanalyse.
- Overvågning af prissider
- Salgs- og marketingteams kan automatisk følge konkurrenternes priser og kampagner.
- Det understøtter dynamiske prisstrategier og hjælper virksomheder med at bevare deres konkurrenceevne.
- Scraping af kundecases
- Marketingteams kan indsamle kundecases fra konkurrenternes websites for at forstå deres positionering og succeshistorier.
- Oplysningerne kan bruges til at skærpe egne marketingbudskaber og salgspitches.
- Research af data, der ikke findes i databaser
- Nogle oplysninger findes ganske enkelt ikke i strukturerede databaser.
- AI-scrapers kan hente unikke data fra fora, blogs eller nichewebsites til brug for markedsanalyse, akademiske undersøgelser eller undersøgende journalistik.
💡 Praktiske guides til at komme i gang med AI-scraping
Sådan scraper du kundecases 👈🏼
Sådan scraper du produkter fra webshops 👈🏼
Sådan scraper du brugeranmeldelser fra Trustpilot 👈🏼
Sådan finder du kontooplysninger, der ikke findes i databaser 👈🏼
To metoder til AI-scraping
AI-scrapingværktøjer tilbyder forskellige metoder afhængigt af opgaven. Selvom den bagvedliggende teknologi er den samme, afhænger dit valg af, om du vil berige et eksisterende datasæt eller udforske et nyt website fra bunden.
Lad os se på de to vigtigste metoder:
Kør en AI Scraping Agent på en liste
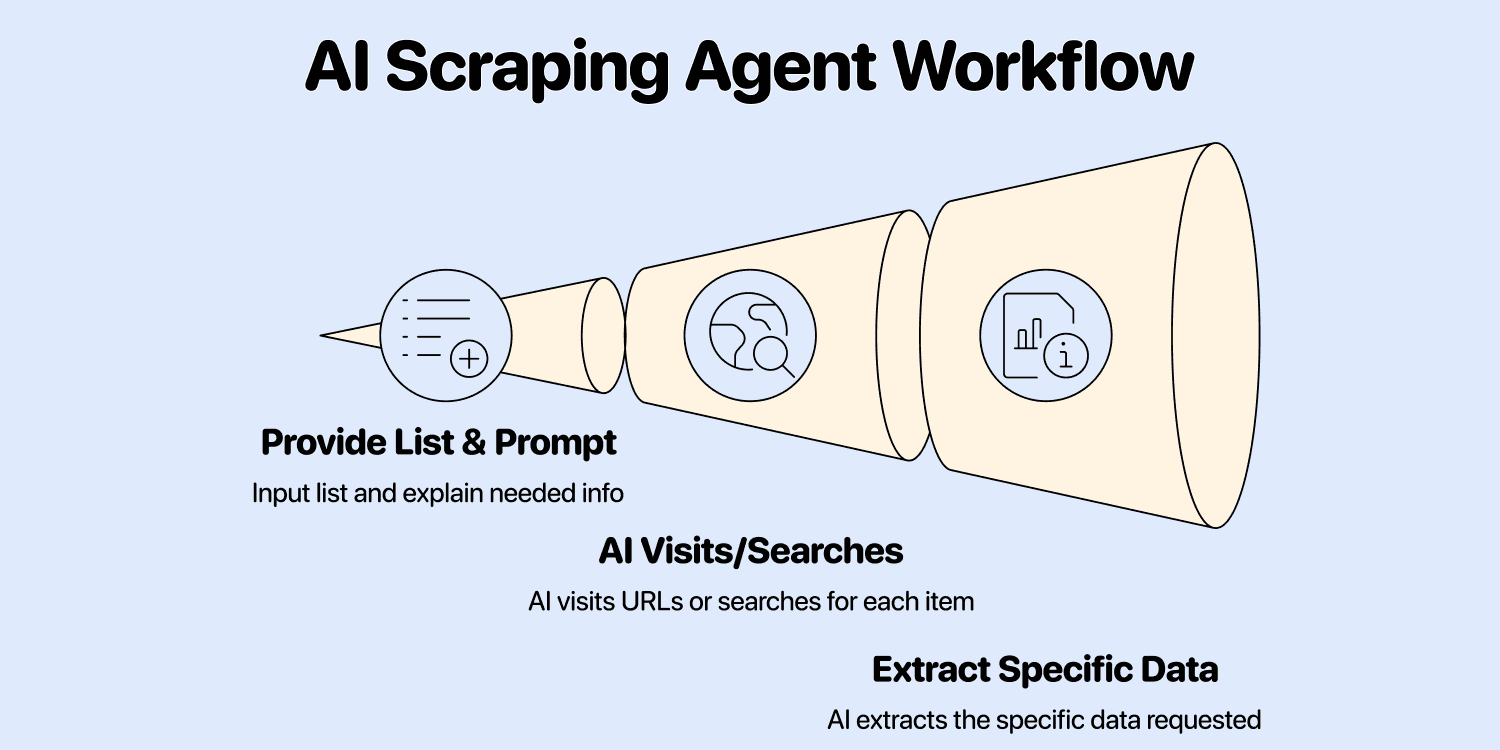
Denne metode er oplagt, når du allerede har et udgangspunkt, f.eks. et regneark med virksomhedsnavne eller produkt-URL'er. Du giver AI-agenten din liste og en prompt, der forklarer, hvilke yderligere oplysninger du ønsker for hvert element.
AI'en besøger derefter hver URL eller søger efter hvert element og udtrækker de data, du har bedt om.
- Bedst til: Berigelse af eksisterende datasæt, f.eks. at finde branche for en liste med virksomheder eller navnet på CEO'en for en liste med accounts.
- Kontrol: Test først et lille udsnit, og gennemgå kildesiderne for de felter, der er vigtige.
Brug en AI Scraping Agent som site scraper
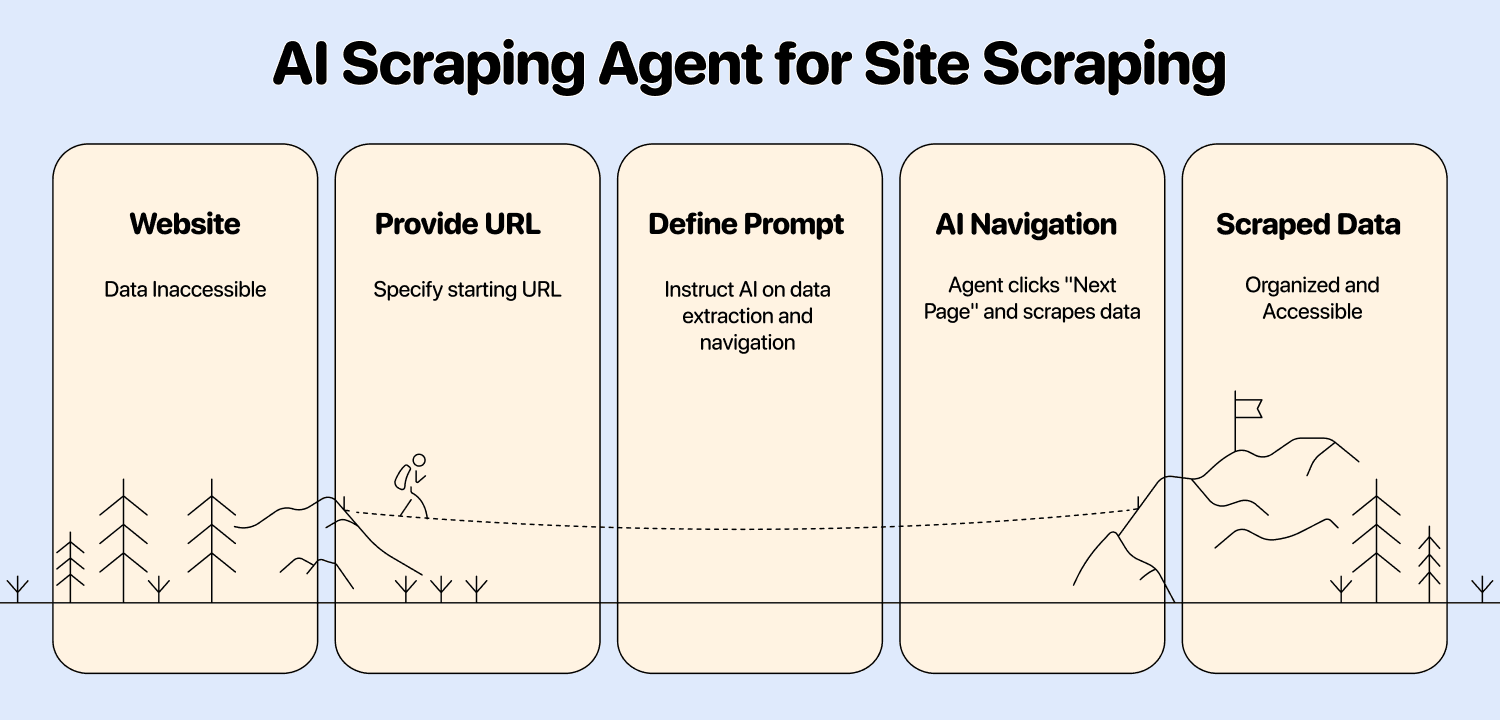
Denne metode er udviklet til at udforske og udtrække data fra et helt website eller en bestemt del af det. Du angiver en start-URL, f.eks. en kategoriside på en webshop, og en prompt, der fortæller AI'en, hvad den skal lede efter, og hvordan den skal navigere på websitet.
Til Datablists website scraper skal du angive en start-URL og en prompt, der beskriver de elementer, som skal udtrækkes. Pagination er valgfrit og skal konfigureres, når kilden har flere resultatsider.
Guiden til opsætning af website scraping og kontrol af stikprøver gennemgår, hvordan du matcher output med prompten, tester rendering og skelner mellem et manglende felt og en blokeret side.
- Bedst til: Scraping af produktlister fra websites som Amazon eller eBay, indsamling af blogartikler eller udtræk af opslag fra kataloger.
- Kontrol: Begynd med et begrænset antal sider, og kontrollér derefter, om de returnerede rækker kommer fra de ønskede sider, før du udvider kørslen.
De bedste værktøjer til AI-scraping
Markedet for AI-scrapingværktøjer vokser hurtigt. Det rigtige valg afhænger af dine tekniske færdigheder, dit budget og dine konkrete behov. Her er tre muligheder med deres startpriser ved månedlig betaling i USD.
| Værktøj | Primær anvendelse | Startpris | Inkluderet månedligt forbrug |
|---|---|---|---|
| Datablist | No-code scraping og berigelse af regneark | 25 USD/måned | 5.000 credits |
| Firecrawl | Webdata og struktureret dataudtræk til apps | 19 USD/måned | 5.000 credits |
| ScrapingBee | Scraping API med AI-baseret dataudtræk | 19 USD/måned | 75.000 API-credits |
De tre løsninger opgør credits på forskellige måder. Datablist tager betaling for den AI-model og de værktøjer, der bruges; Firecrawl afregner efter side og valgt format; og ScrapingBee lægger AI-baseret dataudtræk oven i anmodningens grundpris. Eksemplerne nedenfor viser, hvorfor flest credits ikke automatisk er lig med det billigste workflow.
Datablist – udviklet til salg, marketing og drift
Datablist er en platform til dataautomatisering, der integrerer effektiv AI-scraping i en brugervenlig regnearksgrænseflade. Den er udviklet til salgs-, marketing- og driftsteams, der har brug for at indsamle og berige data uden at skrive kode eller konfigurere API'er.
Vigtigste funktioner:
- Prompts i naturligt sprog: Beskriv dit behov på almindeligt engelsk, så finder AI-agenten oplysningerne for dig. Det kræver hverken kode eller komplekse API-opsætninger.
- To udgangspunkter: Kør en AI Agent på eksisterende rækker, eller begynd med et websites URL, en prompt og valgfri pagination.
- Kørselsindstillinger: Website scraperen har en sidegrænse og en valgfri indstilling til HTML-rendering. Test med en lille kørsel, før du øger antallet af sider.
- Struktureret output: Knyt de ønskede felter til kolonner i din collection, gennemgå rækkerne, og kombiner dem efter behov med andre enrichments.
Priser:
- Starter: 25 USD/måned med 5.000 credits. Growth koster 50 USD/måned med 20.000 credits.
- Forbruget til AI-scraping varierer alt efter model, værktøjer og besøgte sider. HTML-rendering koster yderligere 2 credits pr. scrape, når funktionen er aktiveret.
- Til en opgave, der bruger 25.000 credits, koster Starter plus en top-up på 20.000 credits 45 USD (25 USD + 20 USD). Dette er et eksempel på et creditbudget og ikke en fast pris for et bestemt antal sider. Top-ups kræver et aktivt abonnement og udløber ikke.
💡 Datablists skjulte styrker
Fordelen ved Datablists AI Scraper er, at den faktisk er meget mere end en AI Scraper. Det er en AI scraping agent, der kan søge på Google, besøge Google News, kalde API'er, udtrække data, gennemgå sider via pagination og meget mere.
Firecrawl – Web Data API til AI-apps
Firecrawl er en open source Web Data API til udviklere, som omdanner websites til LLM-klare data, der kan bruges i AI-applikationer.
Vigtigste funktioner:
- Struktureret dataudtræk: Angiv en URL og et JSON schema eller en prompt, der beskriver de ønskede felter. Kontrollér de returnerede værdier mod kildesiden.
- LLM-klart output: Få data i flere formater som JSON, Markdown og screenshots, der er klar til AI-behandling med det samme.
- Udviklerorienteret tilgang: Bygget med SDK'er til Python og Node.js samt omfattende dokumentation og eksempler.
Priser:
- Hobby: 19 USD/måned med 5.000 credits. Standard koster 99 USD/måned med 100.000 credits. Det er månedspriser og ikke de lavere priser ved årlig betaling.
- Et grundlæggende scrape af én side koster 1 credit. Vælger du JSON, lægges 4 credits oveni, så én side med JSON extraction bruger 5 credits. Andre modes kan ændre forbruget.
ScrapingBee – AI Scraper til udviklere
ScrapingBee er et API-first scrapingværktøj, der håndterer proxyer og browsere. Udviklere kan kalde det fra kode, mens integrationer som n8n og Make gør det muligt for teams at forbinde det med andre workflows. Du skal stadig konfigurere anmodningen og mappe de returnerede data.
Vigtigste funktioner:
- AI-baseret webscraping: Bruger AI til at fortolke og udtrække data, så løsningen bedre kan håndtere ændringer på websites.
- API-adgang: Udviklet til integration i udviklernes egne applikationer og workflows.
- JavaScript-rendering: Kan scrape moderne, dynamiske websites, der i høj grad er afhængige af JavaScript.
Priser:
- Hobby: 19 USD/måned med 75.000 API-credits. Freelance-abonnementet til 49 USD/måned inkluderer 250.000.
- AI extraction koster yderligere 5 credits pr. anmodning. En grundlæggende anmodning bruger 1 credit eller 5 med JavaScript-rendering, før AI extraction lægges oveni. Indstillinger til premium proxyer kan øge grundprisen yderligere.
Hvad koster struktureret dataudtræk?
Eksemplerne bruger én anmodning pr. side og de angivne indstillinger. De viser prisen på API-forbruget, ikke antallet af korrekte poster, der returneres.
| Værktøj og opgave | Nødvendige credits | Månedsabonnement og pris |
|---|---|---|
| Firecrawl: 1.000 sider med JSON extraction | 5.000 | Hobby: 19 USD |
| Firecrawl: 10.000 sider med JSON extraction | 50.000 | Standard: 99 USD |
| ScrapingBee: 10.000 anmodninger med AI extraction uden JavaScript-rendering | 60.000 | Hobby: 19 USD |
| ScrapingBee: 10.000 anmodninger med AI extraction og JavaScript-rendering | 100.000 | Freelance: 49 USD |
For ScrapingBee er de sidste to rækker henholdsvis 10.000 × (1 + 5) og 10.000 × (5 + 5). Indstillingen til rendering løfter opgaven over grænsen i Hobby-abonnementet. Med Datablist bør du bruge en lille kørsel til at fastslå forbruget for din model, prompt og dine kildesider. Derefter kan du lægge et budget ud fra de 5.000 credits i Starter til 25 USD og priserne på top-ups ovenfor.
Sådan kontrollerer du resultater fra AI-scraping
Kontrollér et udsnit af rækkerne mod kildesiderne, før du bruger datasættet. Bekræft, at hver værdi hører til det rigtige element, at enheder og valutaer er bevaret, og at manglende værdier står tomme. Hvis kildesiden er utilgængelig, eller resultatet er usikkert, skal du justere prompten eller gennemgå rækken manuelt. Kontrollér udsnittet igen, når kildesitet ændres.
Ofte stillede spørgsmål om AI-scraping
Kan ChatGPT bruges til webscraping?
En AI-model kan udtrække felter fra webindhold, som du giver den. Til gentagne kørsler på tværs af mange URL'er bør du bruge et workflow, der registrerer kilde-URL'er, knytter felter til kolonner og giver dig mulighed for at gennemgå mislykkede eller usikre rækker.
Hvad er AI-scraping?
AI-scraping bruger en model til at identificere ønskede felter i indhold fra websites og returnere strukturerede resultater. Du kan beskrive felterne i en prompt i stedet for at angive CSS-selectors, men vigtige resultater bør kontrolleres mod kilden.
Er scraping lovligt?
Reglerne afhænger af websitet, dataene og jurisdiktionen. Kontrollér sidens vilkår og de relevante lovkrav, før du indsamler eller bruger data – især personoplysninger.
Hvad er data scraping?
Data scraping betyder, at oplysninger udtrækkes fra en kilde som et website eller et dokument. AI-scraping bruger en AI-model til at identificere eller strukturere de ønskede oplysninger.
Hvordan adskiller AI-scraping sig fra traditionel webscraping?
Selector-baseret scraping er målrettet bestemte elementer i en sides HTML. AI-baseret dataudtræk bruger en prompt eller et schema til at identificere felter ud fra deres betydning. Begge metoder kan fejle, når et website ændres, eller en side er utilgængelig. Sammenlign derfor resultaterne på repræsentative sider.
Hvilke færdigheder kræver AI-scraping?
Med Datablist kan du angive en URL eller en liste med rækker, beskrive de ønskede felter og mappe outputtet uden at skrive kode. Du skal stadig kontrollere et udsnit af resultaterne.
Kan AI-scrapers håndtere ændringer i layoutet?
Nogle gange. En prompt kan muligvis fortsætte med at finde et felt efter en layoutændring, men blokerede sider, manglende indhold og tvetydige labels kan stadig skabe fejl. Kontrollér et udsnit igen, når kildesitet ændres.
Kilder
- [1] Datablist. Starter koster 25 USD/måned med 5.000 credits; Growth koster 50 USD med 20.000, og aktive abonnenter kan købe ekstra credits som top-ups.
- [2] Firecrawl. Månedspriserne for Hobby og Standard er 19 og 99 USD; grundlæggende scraping koster 1 credit pr. side, og JSON koster yderligere 4.
- [3] ScrapingBee. Hobby koster 19 USD/måned for 75.000 credits, og Freelance koster 49 USD for 250.000; AI extraction lægger 5 credits oven i anmodningens grundpris.