
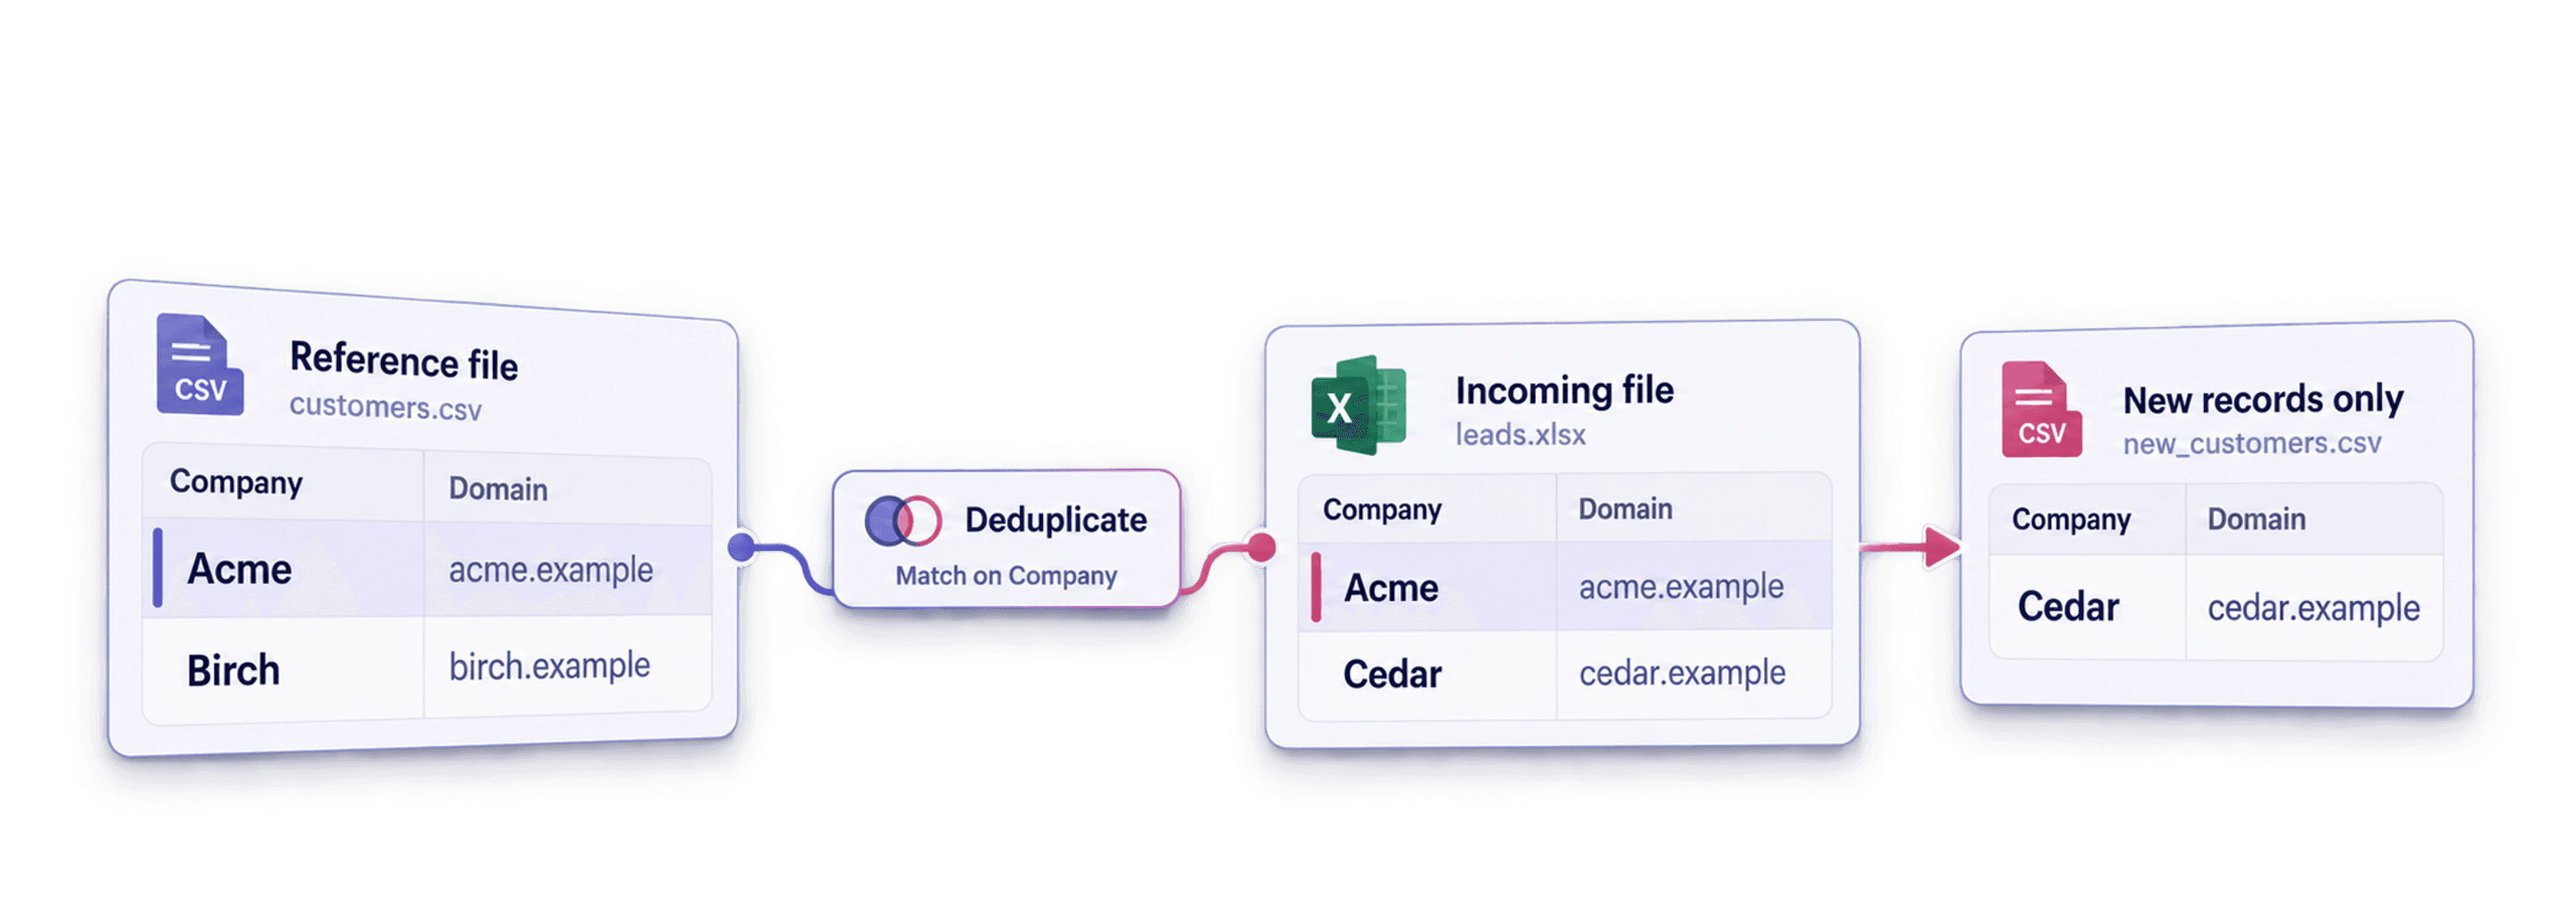
Hvis du vil fjerne dubletter på tværs af flere Excel- eller CSV-filer, skal du gemme hver fil i en separat Datablist-collection, mappe de egenskaber, der identificerer den samme post, og sammenligne dine collections. Derefter kan du fjerne matchende rækker fra en ny liste uden at ændre din referenceliste.
Denne arbejdsgang er nyttig, når du har et CRM-udtræk og en ny liste med prospects. Den besvarer et konkret spørgsmål: Hvilke prospects findes allerede i CRM-systemet?
Den automatiske handling er en ekskludering, ikke en fletning. Den fjerner matchende poster fra den collection, du vælger. Unikke værdier fra disse poster kopieres ikke til en anden collection.
Denne guide gennemgår en reel test med to CSV-filer med hver 250 rækker:
| Collection | Rolle | Rækker før oprydning | Egenskab til matching |
|---|---|---|---|
CRM Export | Referenceliste, der skal bevares | 250 | Email |
Event Registrations | Ny liste, der skal renses | 250 | Attendee Email |
Filerne indeholder 100 bevidst oprettede overlap mellem listerne. Når disse matches er fjernet fra Event Registrations, er der 150 helt nye eventkontakter tilbage.
I dette eksempel matches der på e-mail. Hvis listerne mangler e-mailadresser eller indeholder flere kontaktidentifikatorer, bør du læse om deduplikering af leads, før du beslutter, hvilke matches det er sikkert at fjerne.
Download de to eksempelfiler
Brug disse filer til selv at gennemføre testen:
Kolonneoverskrifterne er med vilje forskellige. CRM-filen bruger Email, First Name og Last Name. Eventfilen bruger Attendee Email, Attendee First Name og Attendee Last Name. Ved at mappe egenskaber på tværs af collections kan filerne beholde deres oprindelige struktur.
Testdataene indeholder variationer i formateringen af e-mailadresser og aliaser. Derfor er Smart-matching med Email-processoren mere nyttig end en simpel eksakt sammenligning.
Importér hver fil i en collection
Åbn Datablist, og importér hver CSV- eller Excel-fil i sin egen collection. Navngiv dine collections efter deres roller, så det er nemt at kontrollere oprydningsreglen.
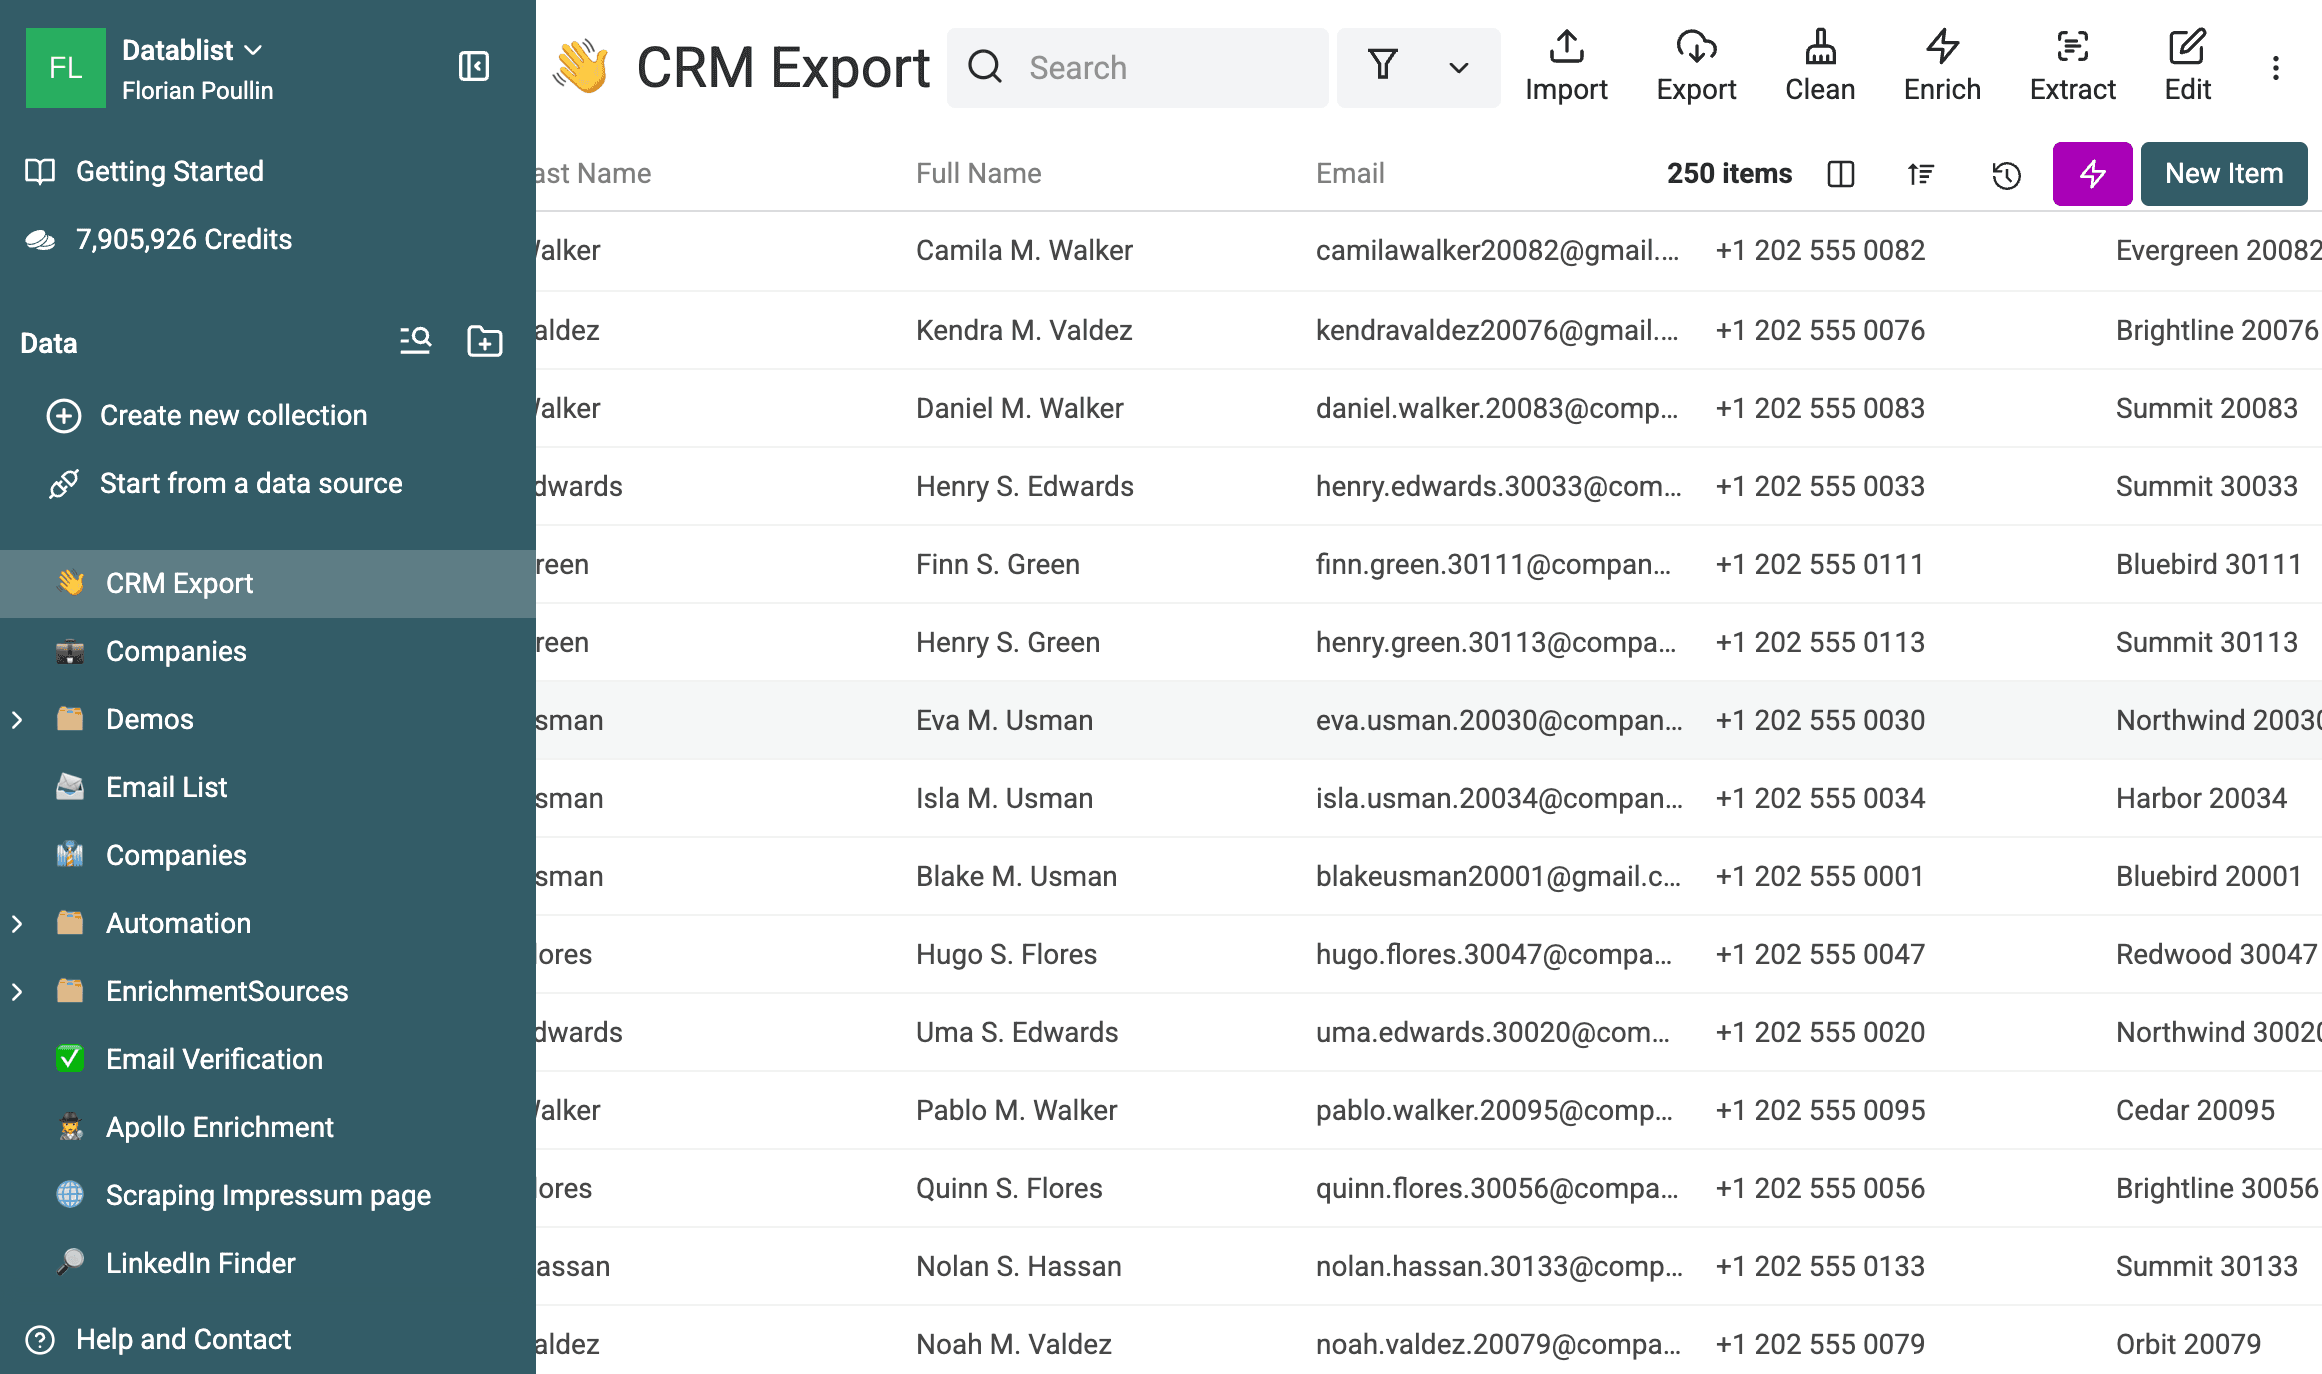
Den første collection i denne test er CRM-referencelisten. Den indeholder 250 poster og skal forblive uændret.
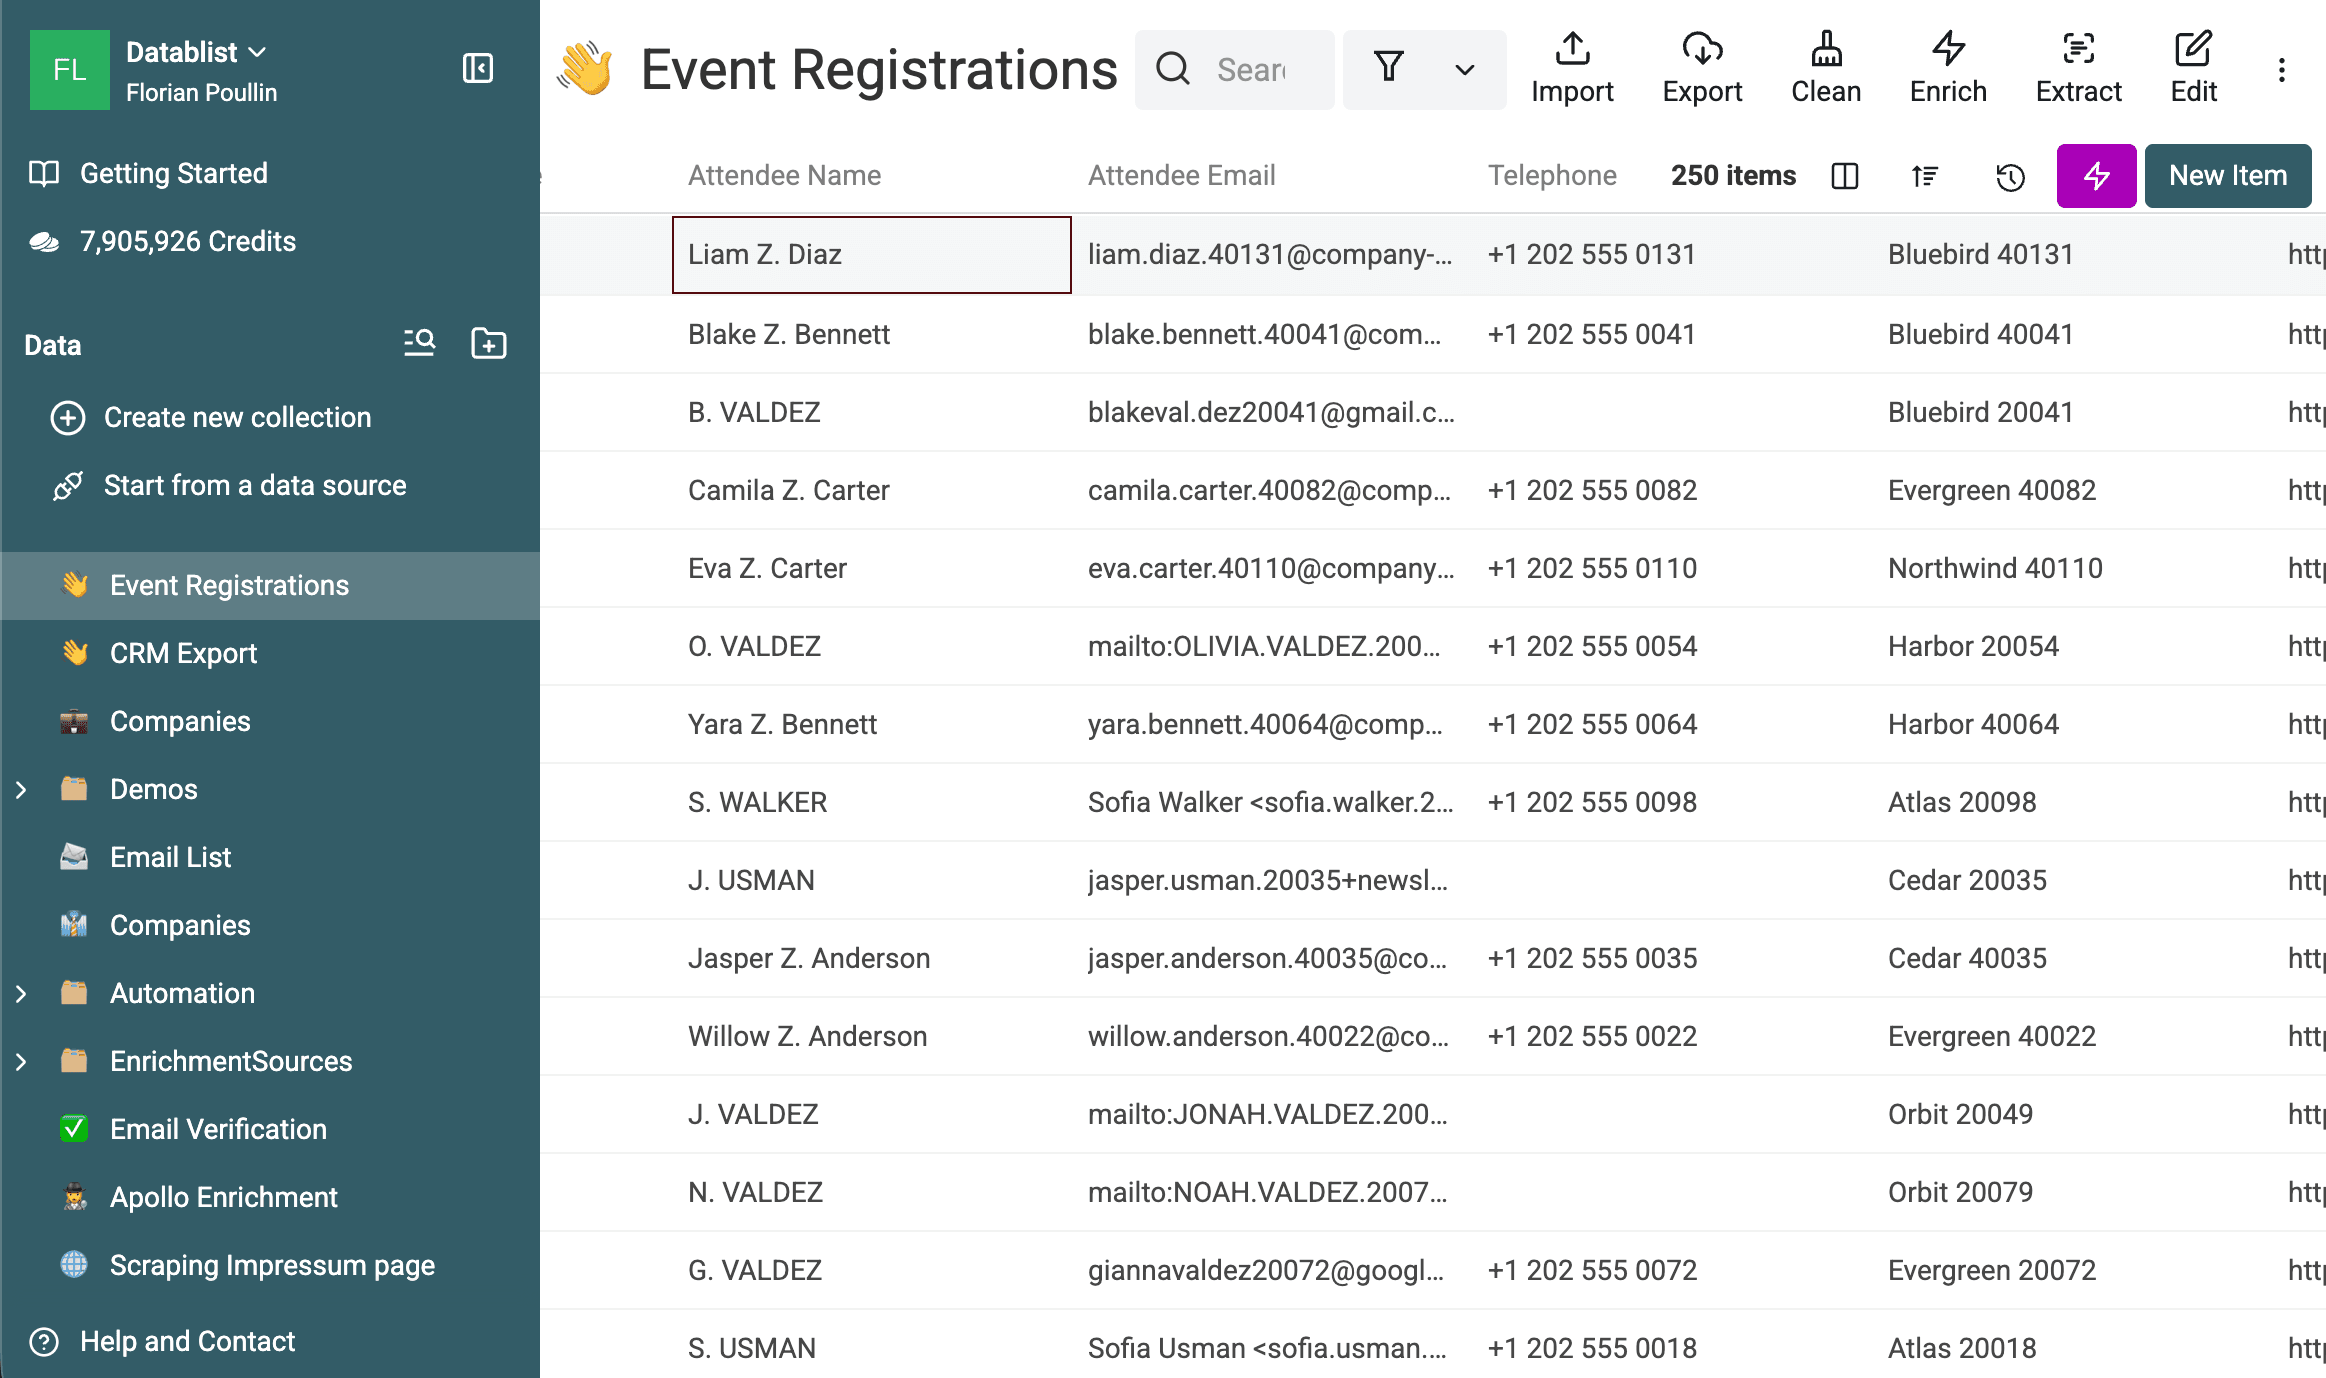
Den anden collection er den nye eventliste. Den indeholder også 250 poster fra start.
Kontrollér egenskabstyperne under importen. Angiv typen Email for begge e-mailkolonner. Behold eksterne ID'er, navne, telefonnumre og andre felter, da de gør det lettere at gennemgå tvivlsomme matches.
Map de identificerende egenskaber
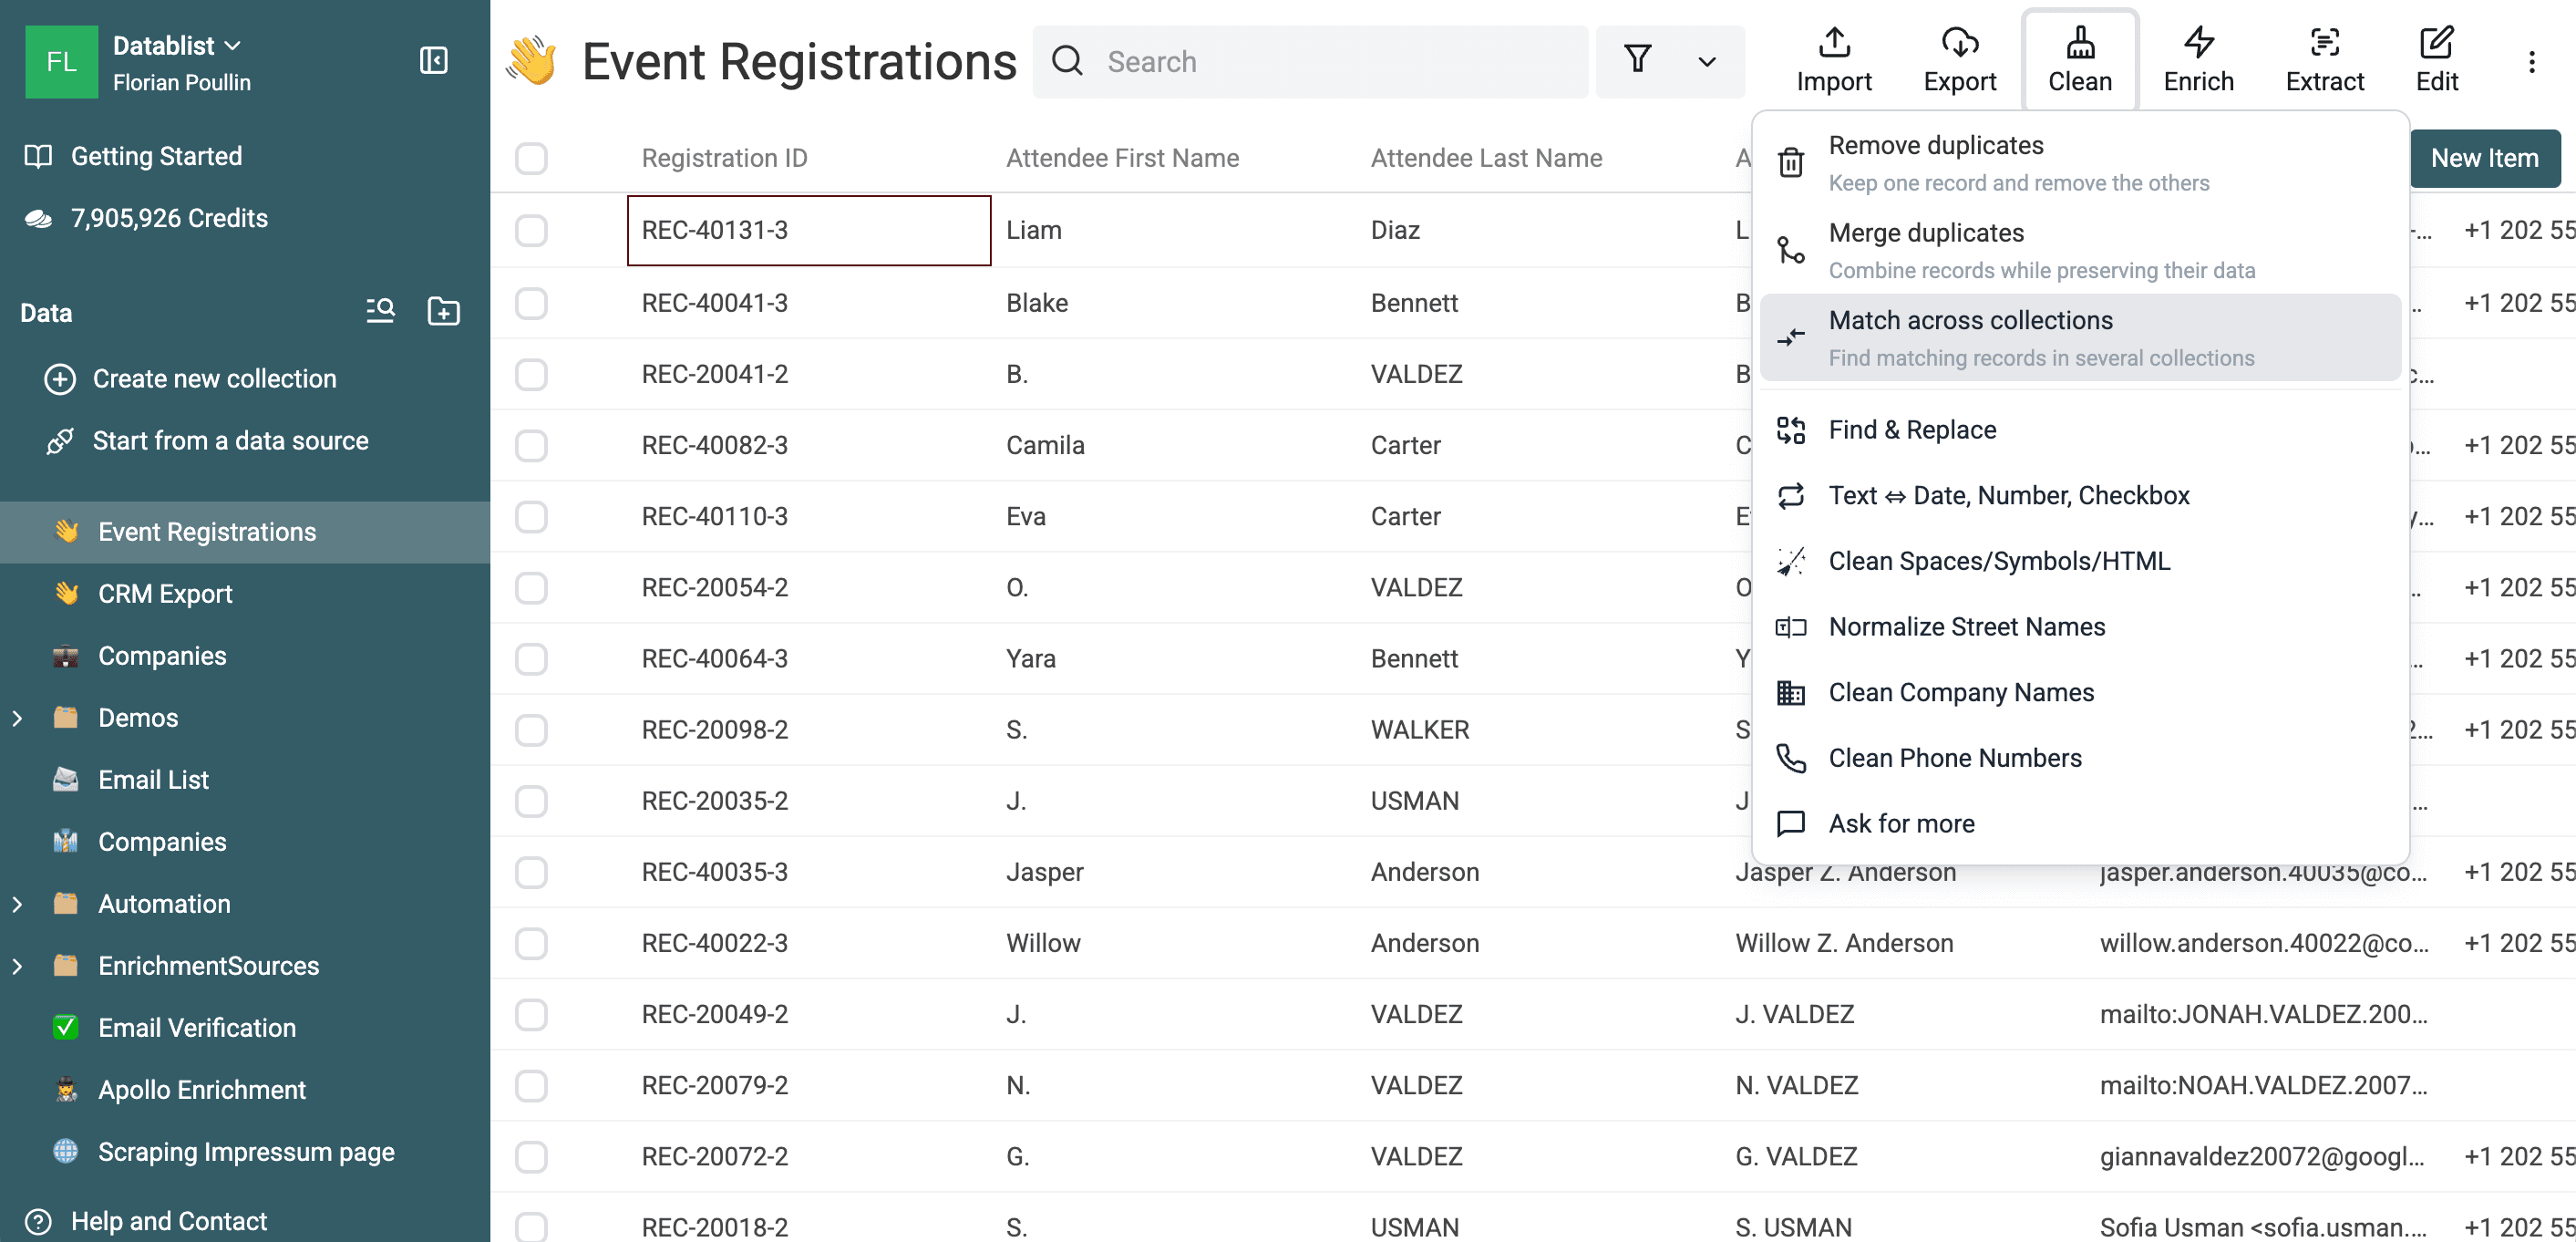
Åbn den nye collection Event Registrations. Vælg Clean > Match across collections.
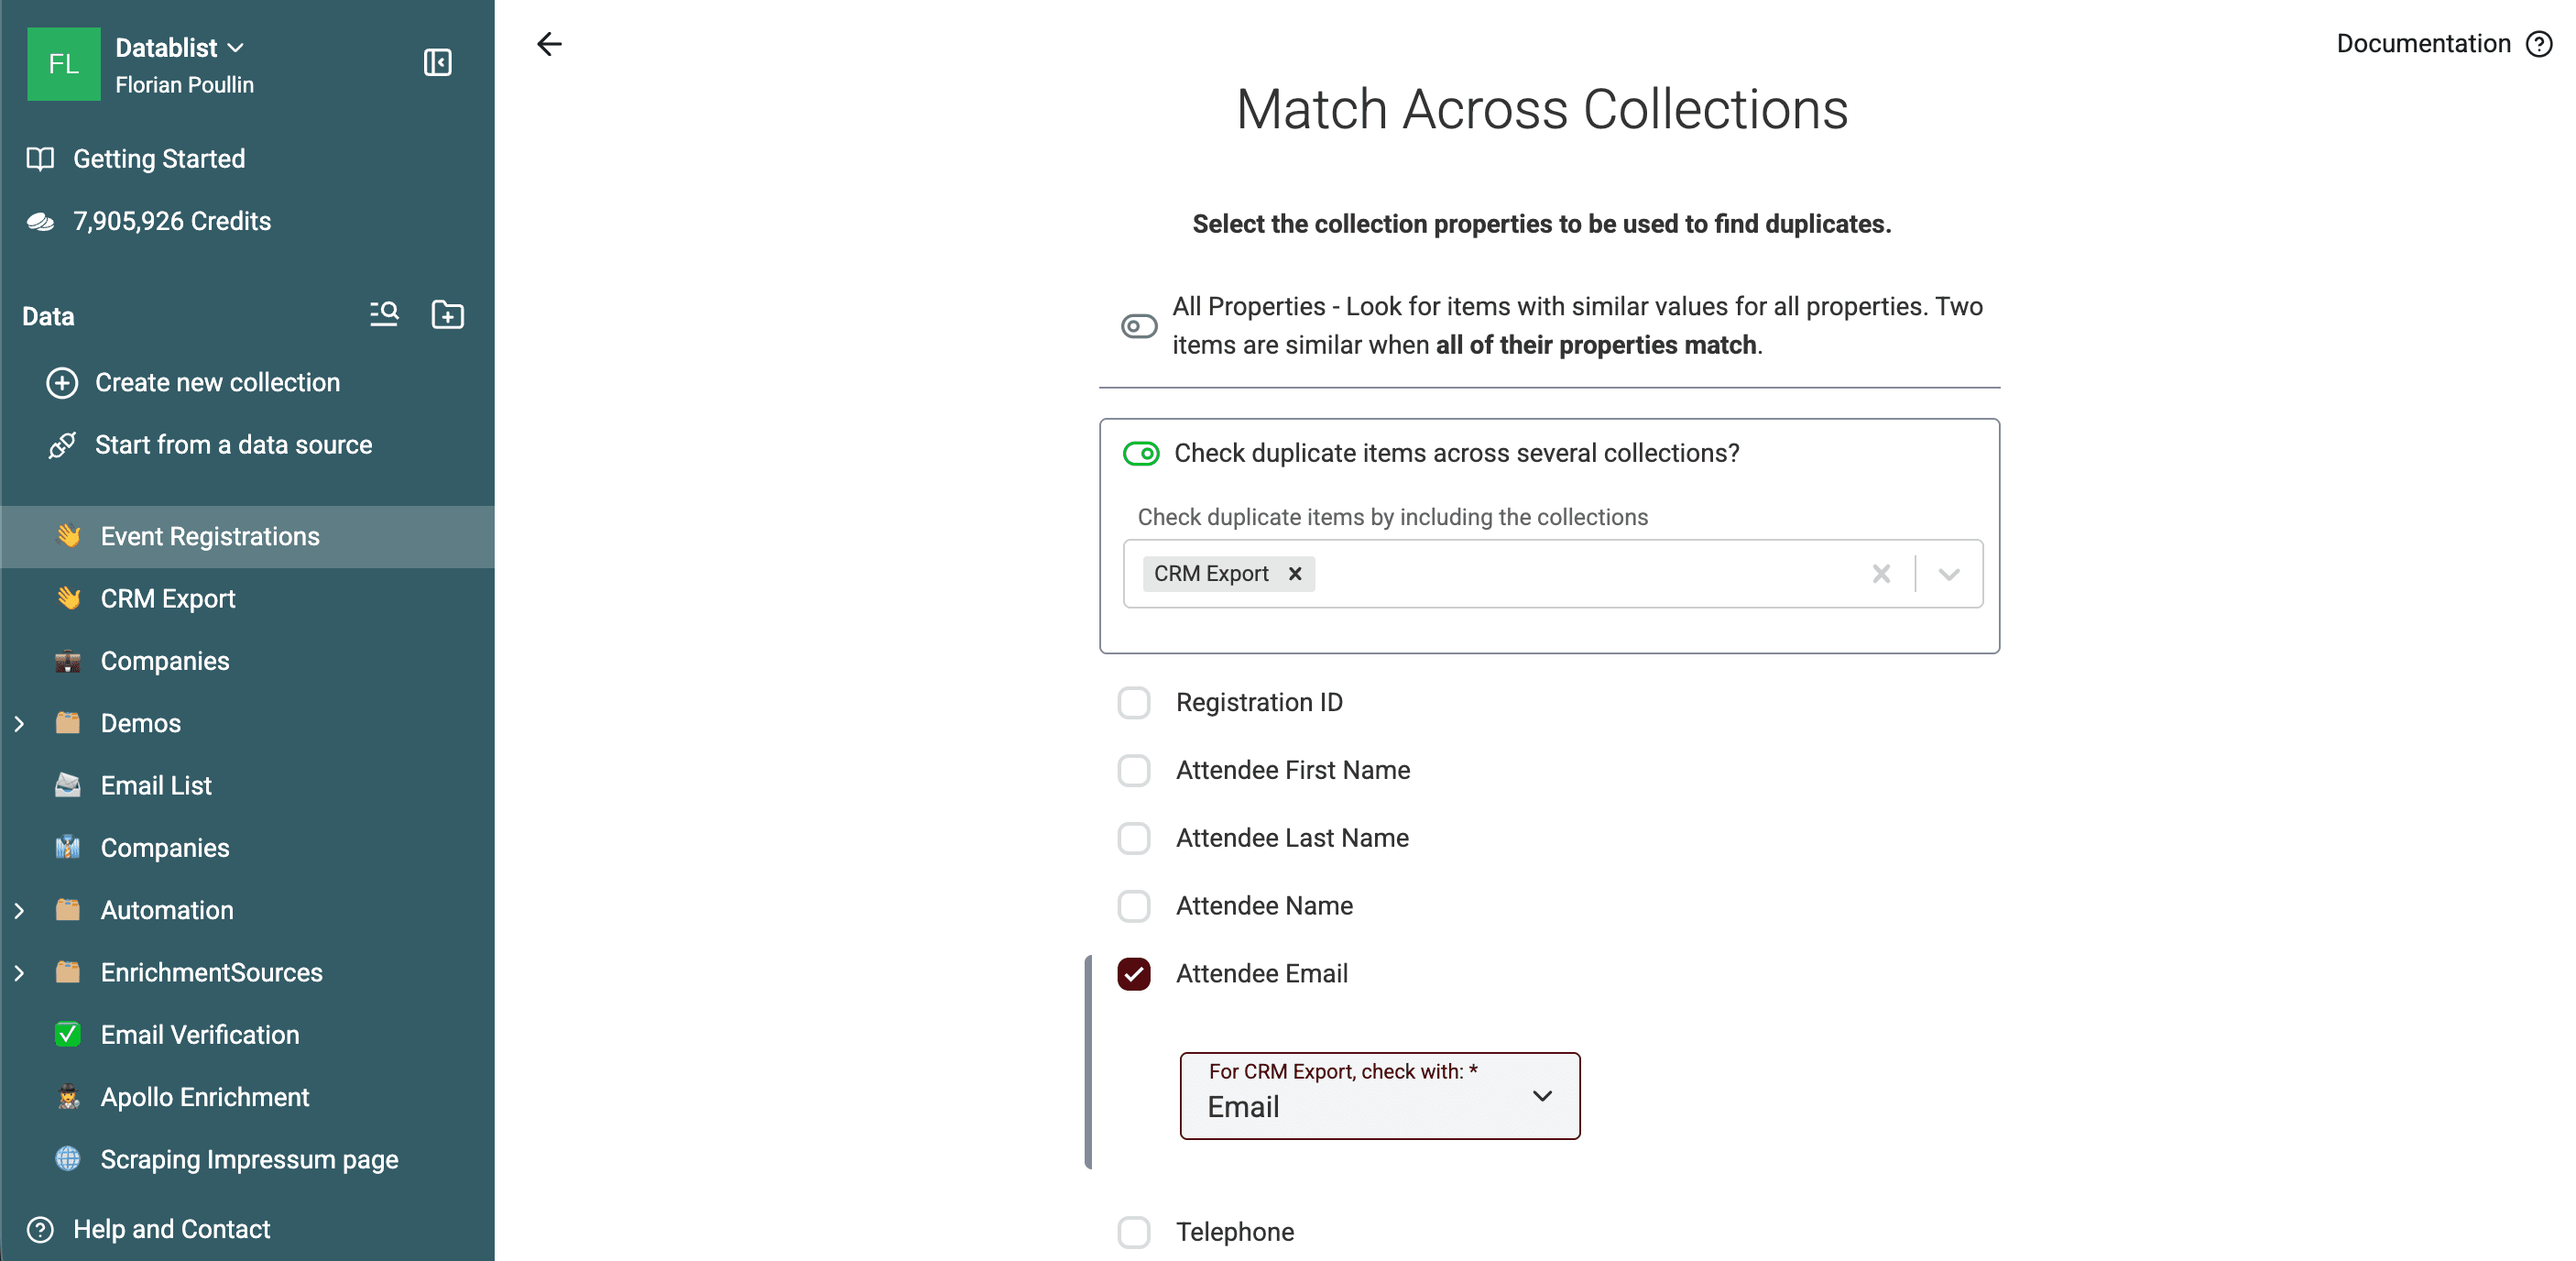
Aktivér Check duplicate items across several collections?, og tilføj CRM Export.
Vælg Attendee Email i eventlisten, og map egenskaben til Email i CRM-listen.
En stærk identifikator er vigtigere end kolonnens navn. Gode muligheder er blandt andet:
- E-mailadresse for kontakter.
- Telefonnummer, når begge filer bruger kompatible landekoder.
- LinkedIn-URL til prospectlister.
- Websitedomæne for virksomheder.
- SKU eller en anden stabil identifikator for produkter.
Undgå at matche udelukkende på fornavn. Mange forskellige personer kan have det samme navn.
Hvis du vælger flere egenskaber, vurderer Datablist deres samlede score. Kør separate kontroller, hvis du vil matche uafhængigt på henholdsvis e-mail og telefonnummer. Med Match on empty value får egenskaber, der er tomme i begge poster, en score på 100 %, hvilket kan hæve gennemsnittet. Kontrollér udfyldte identifikatorer, og se eksemplet på scoring af tomme værdier, før du fjerner en gruppe.
Konfigurer sammenligningen
Brug Exact til stabile ID'er, der skal være identiske. Til e-mailadresser skal du vælge Smart med Email-processoren.
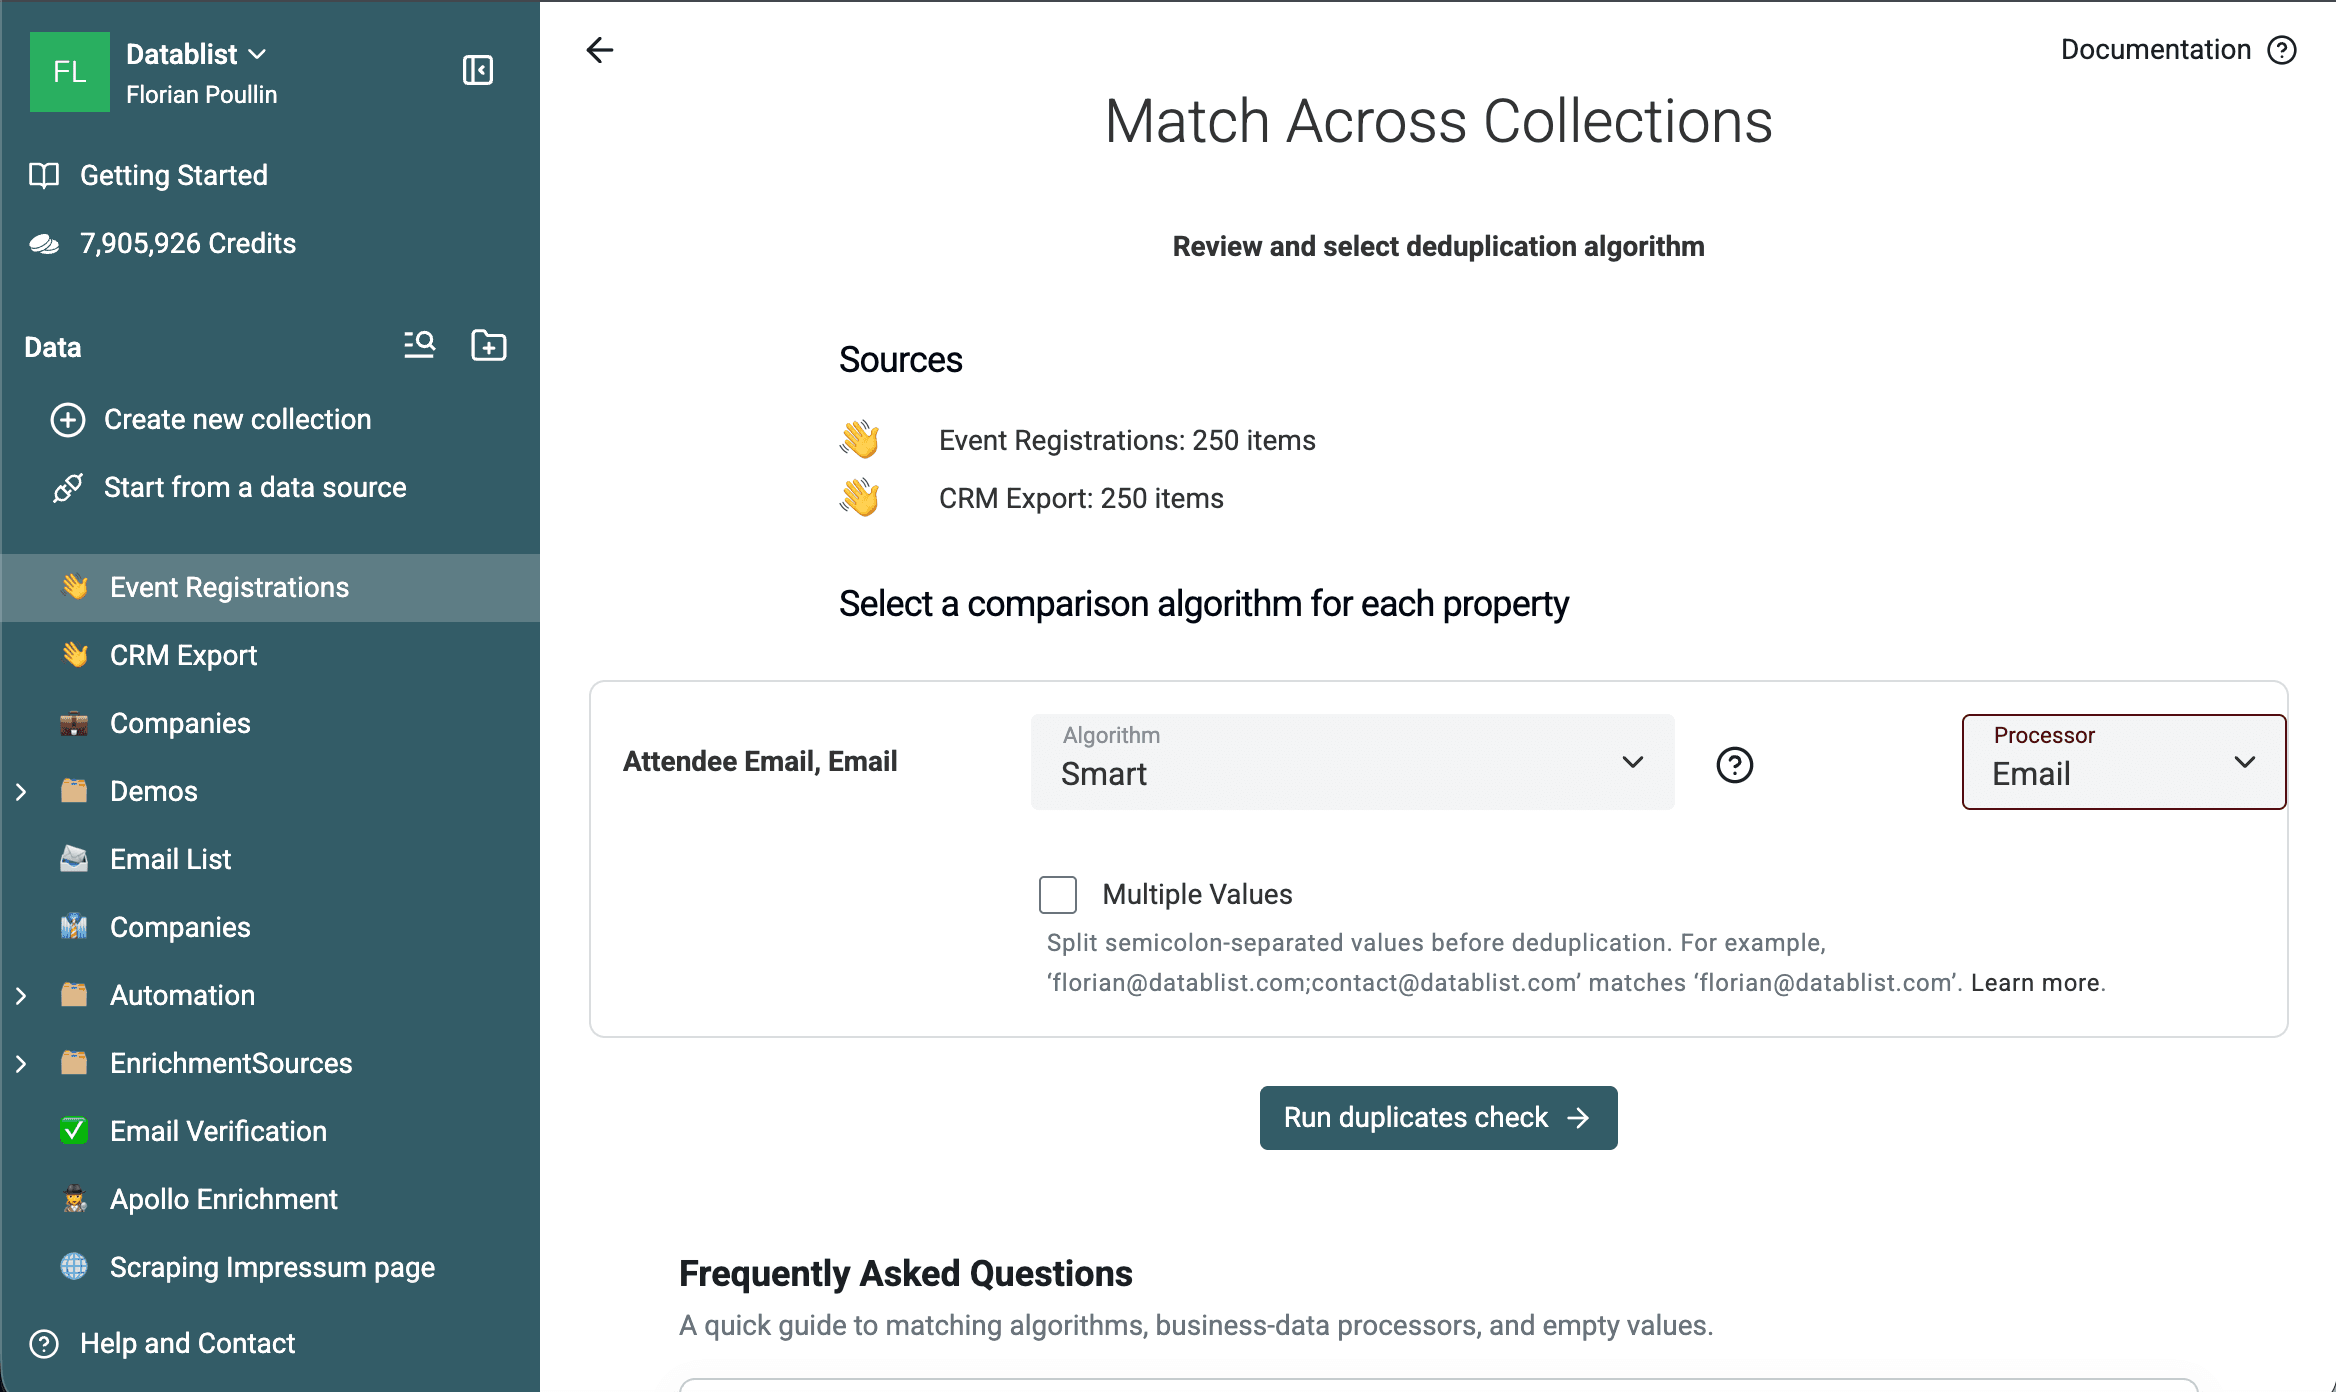
Email-processoren standardiserer understøttede variationer af e-mailadresser under sammenligningen uden at ændre kildecellerne. I den særskilte guide kan du læse mere om funktioner og begrænsninger ved at fjerne dubletter blandt e-mailadresser og aliaser.
Klik på Run duplicates check, når du har kontrolleret de to datakilder, antallet af poster, de mappede egenskaber og indstillingerne for sammenligningen.
Gennemgå matches på tværs af lister
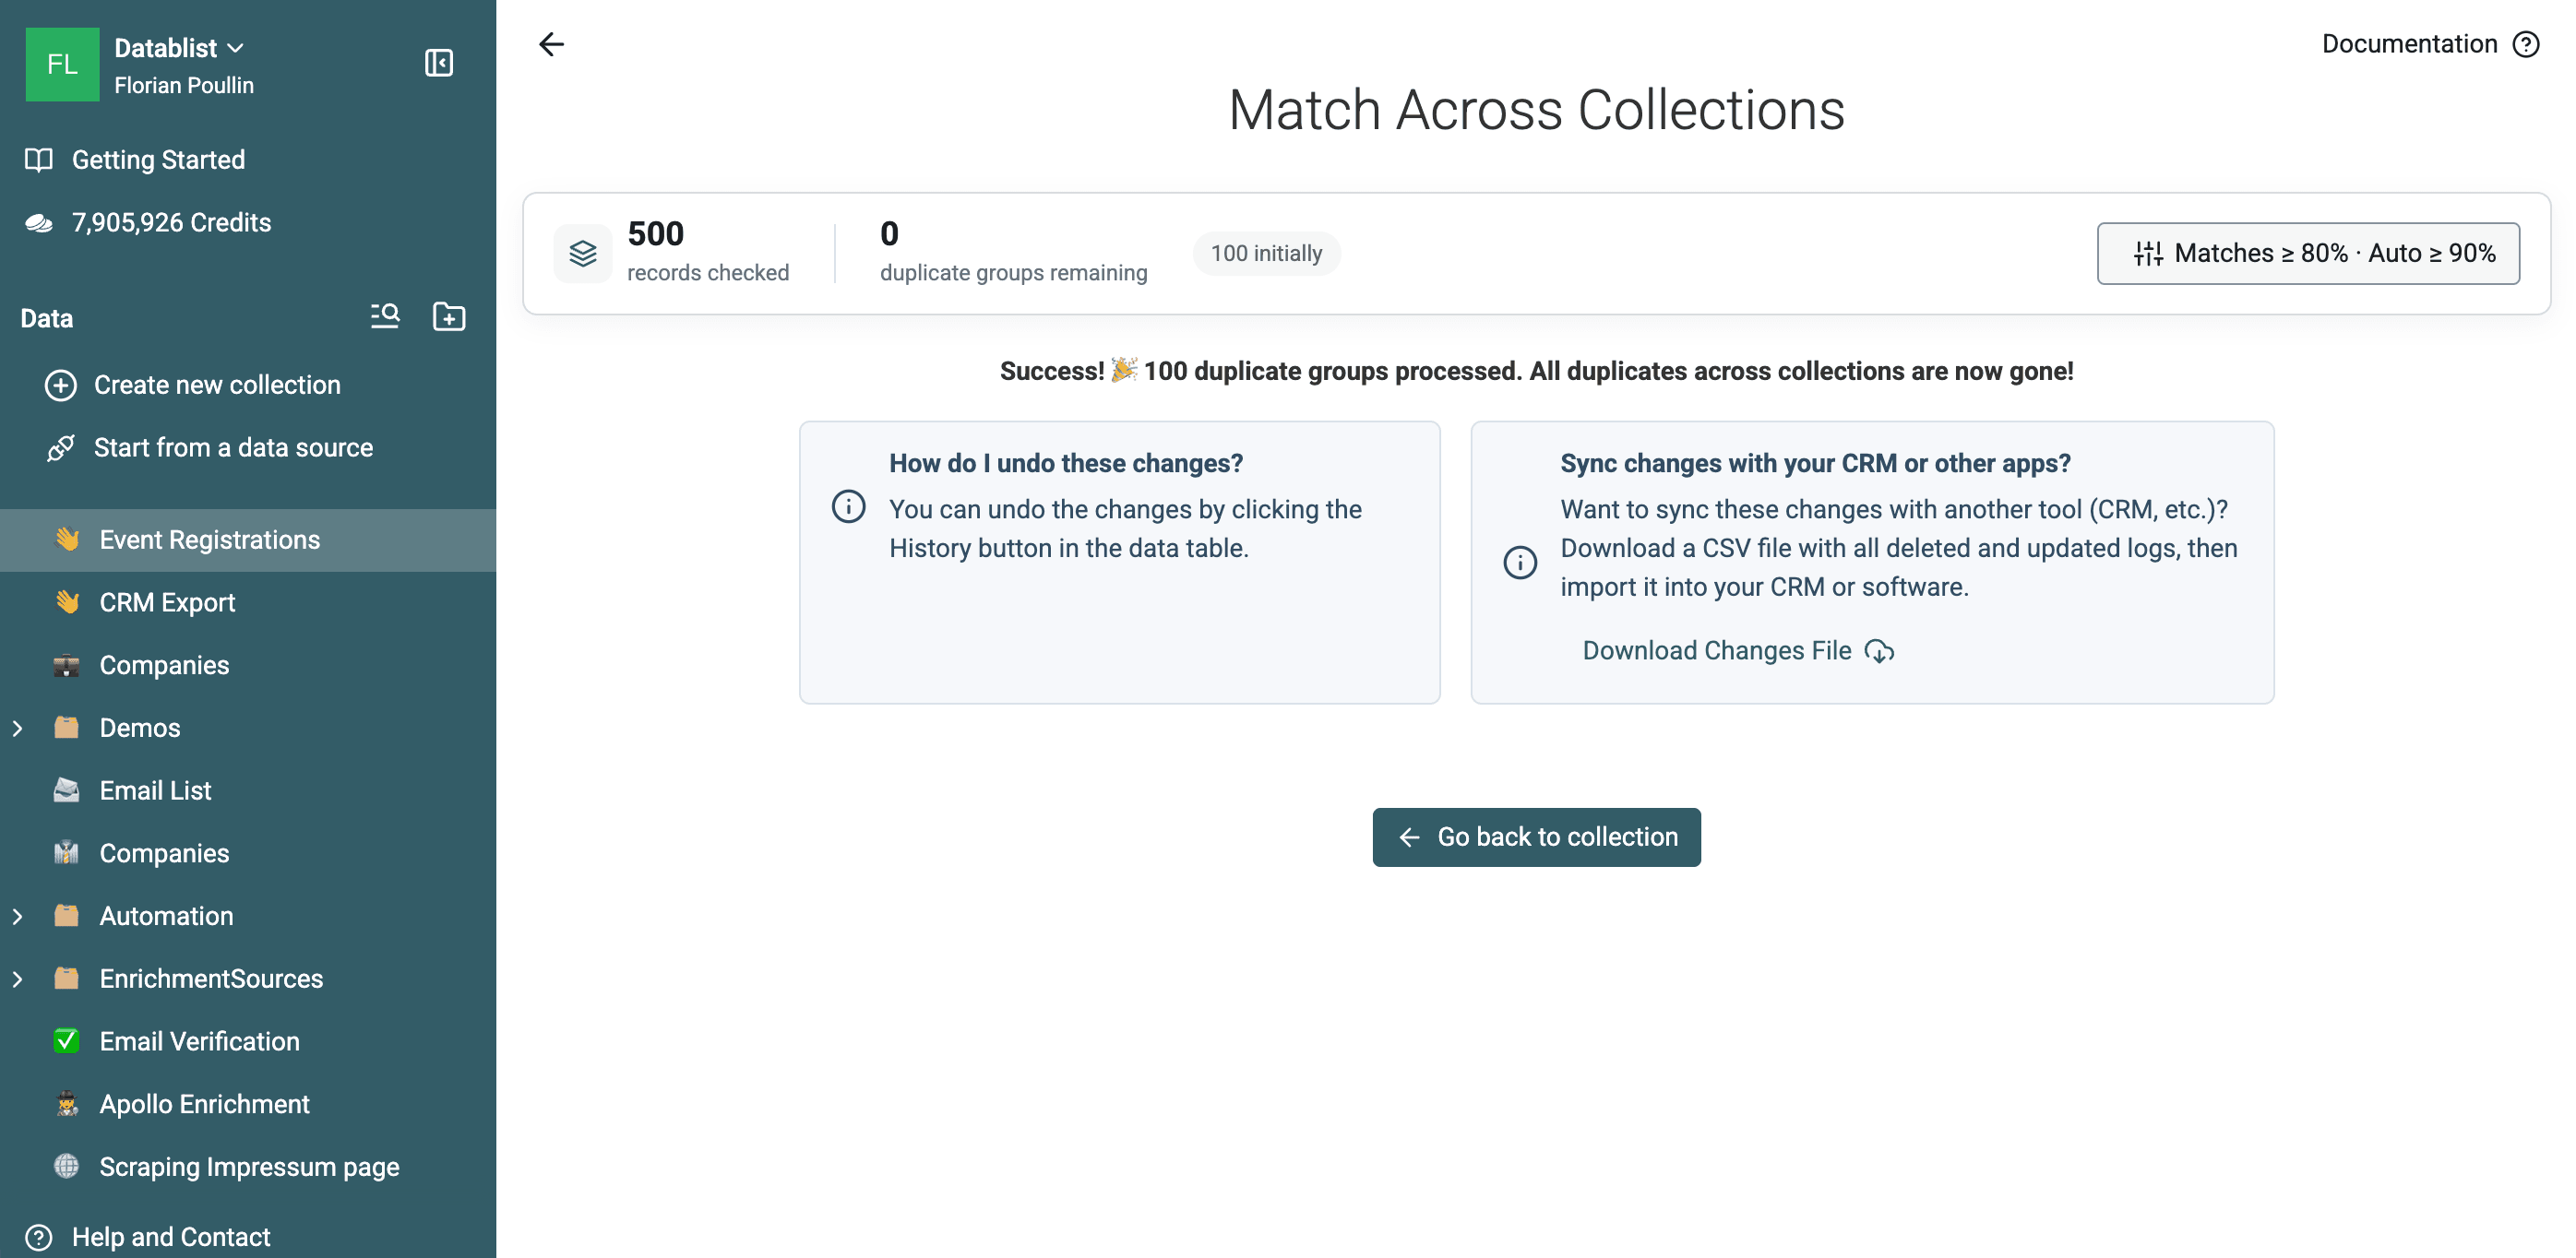
I denne test blev 500 poster kontrolleret, og der blev fundet 100 grupper med dubletter på tværs af collections.
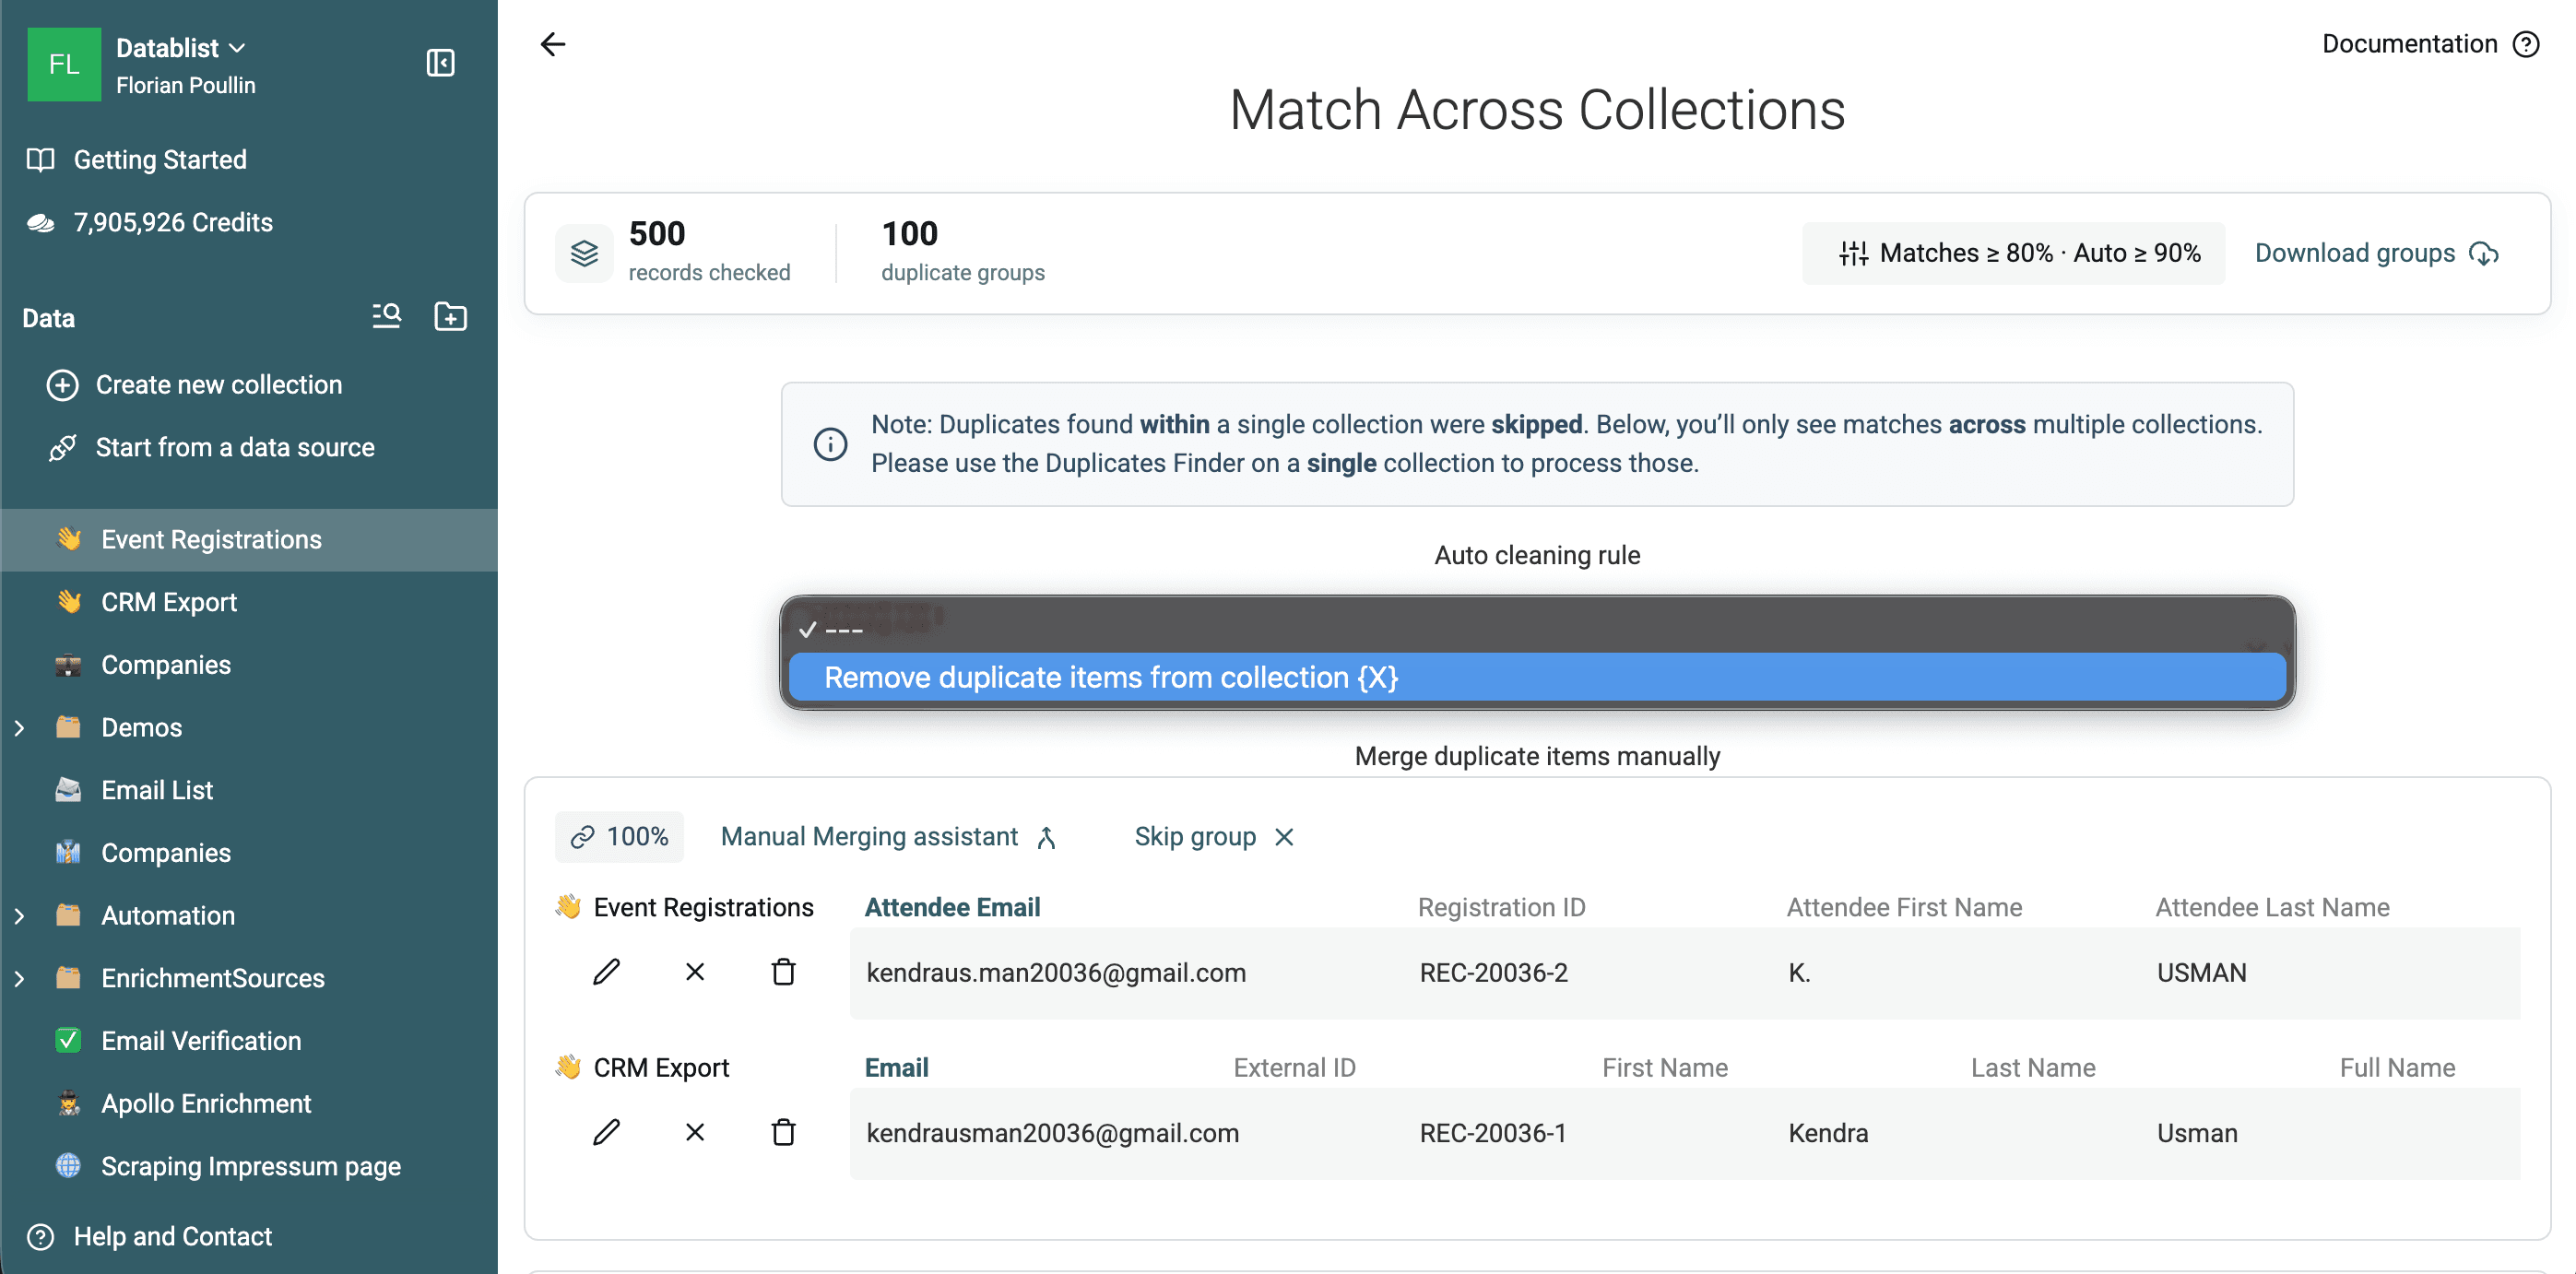
Denne tilstand viser kun grupper, som indeholder poster fra mere end én collection. Dubletter, der udelukkende findes i CRM Export eller Event Registrations, springes over.
Gennemgå grupperne, før du sletter noget:
- Bekræft, at den mappede identifikator tilhører den samme person eller virksomhed.
- Kontrollér, om den nye række indeholder unikke data.
- Bekræft, hvilken collection der er referencelisten.
- Download grupperne, hvis en anden person skal godkende ekskluderingen.
- Brug Manual Merging Assistant til individuelle grupper, der skal flettes i stedet for at blive fjernet.
Hvis du også vil rydde op i dubletter internt i en af filerne, skal du køre Duplicates Finder-arbejdsgangen for en enkelt collection separat på den pågældende liste.
Fjern overlap fra den nye liste
Vælg Remove duplicate items from collection {X}, og vælg derefter Event Registrations som den collection, der skal renses.
Datablist viser konsekvenserne, før behandlingen starter:
- Matchende poster i
Event Registrationsbliver fjernet. CRM Exportændres ikke.- Eventposter uden et match i CRM-systemet bevares.
- Unikke værdier, der kun findes i en fjernet eventpost, går tabt.
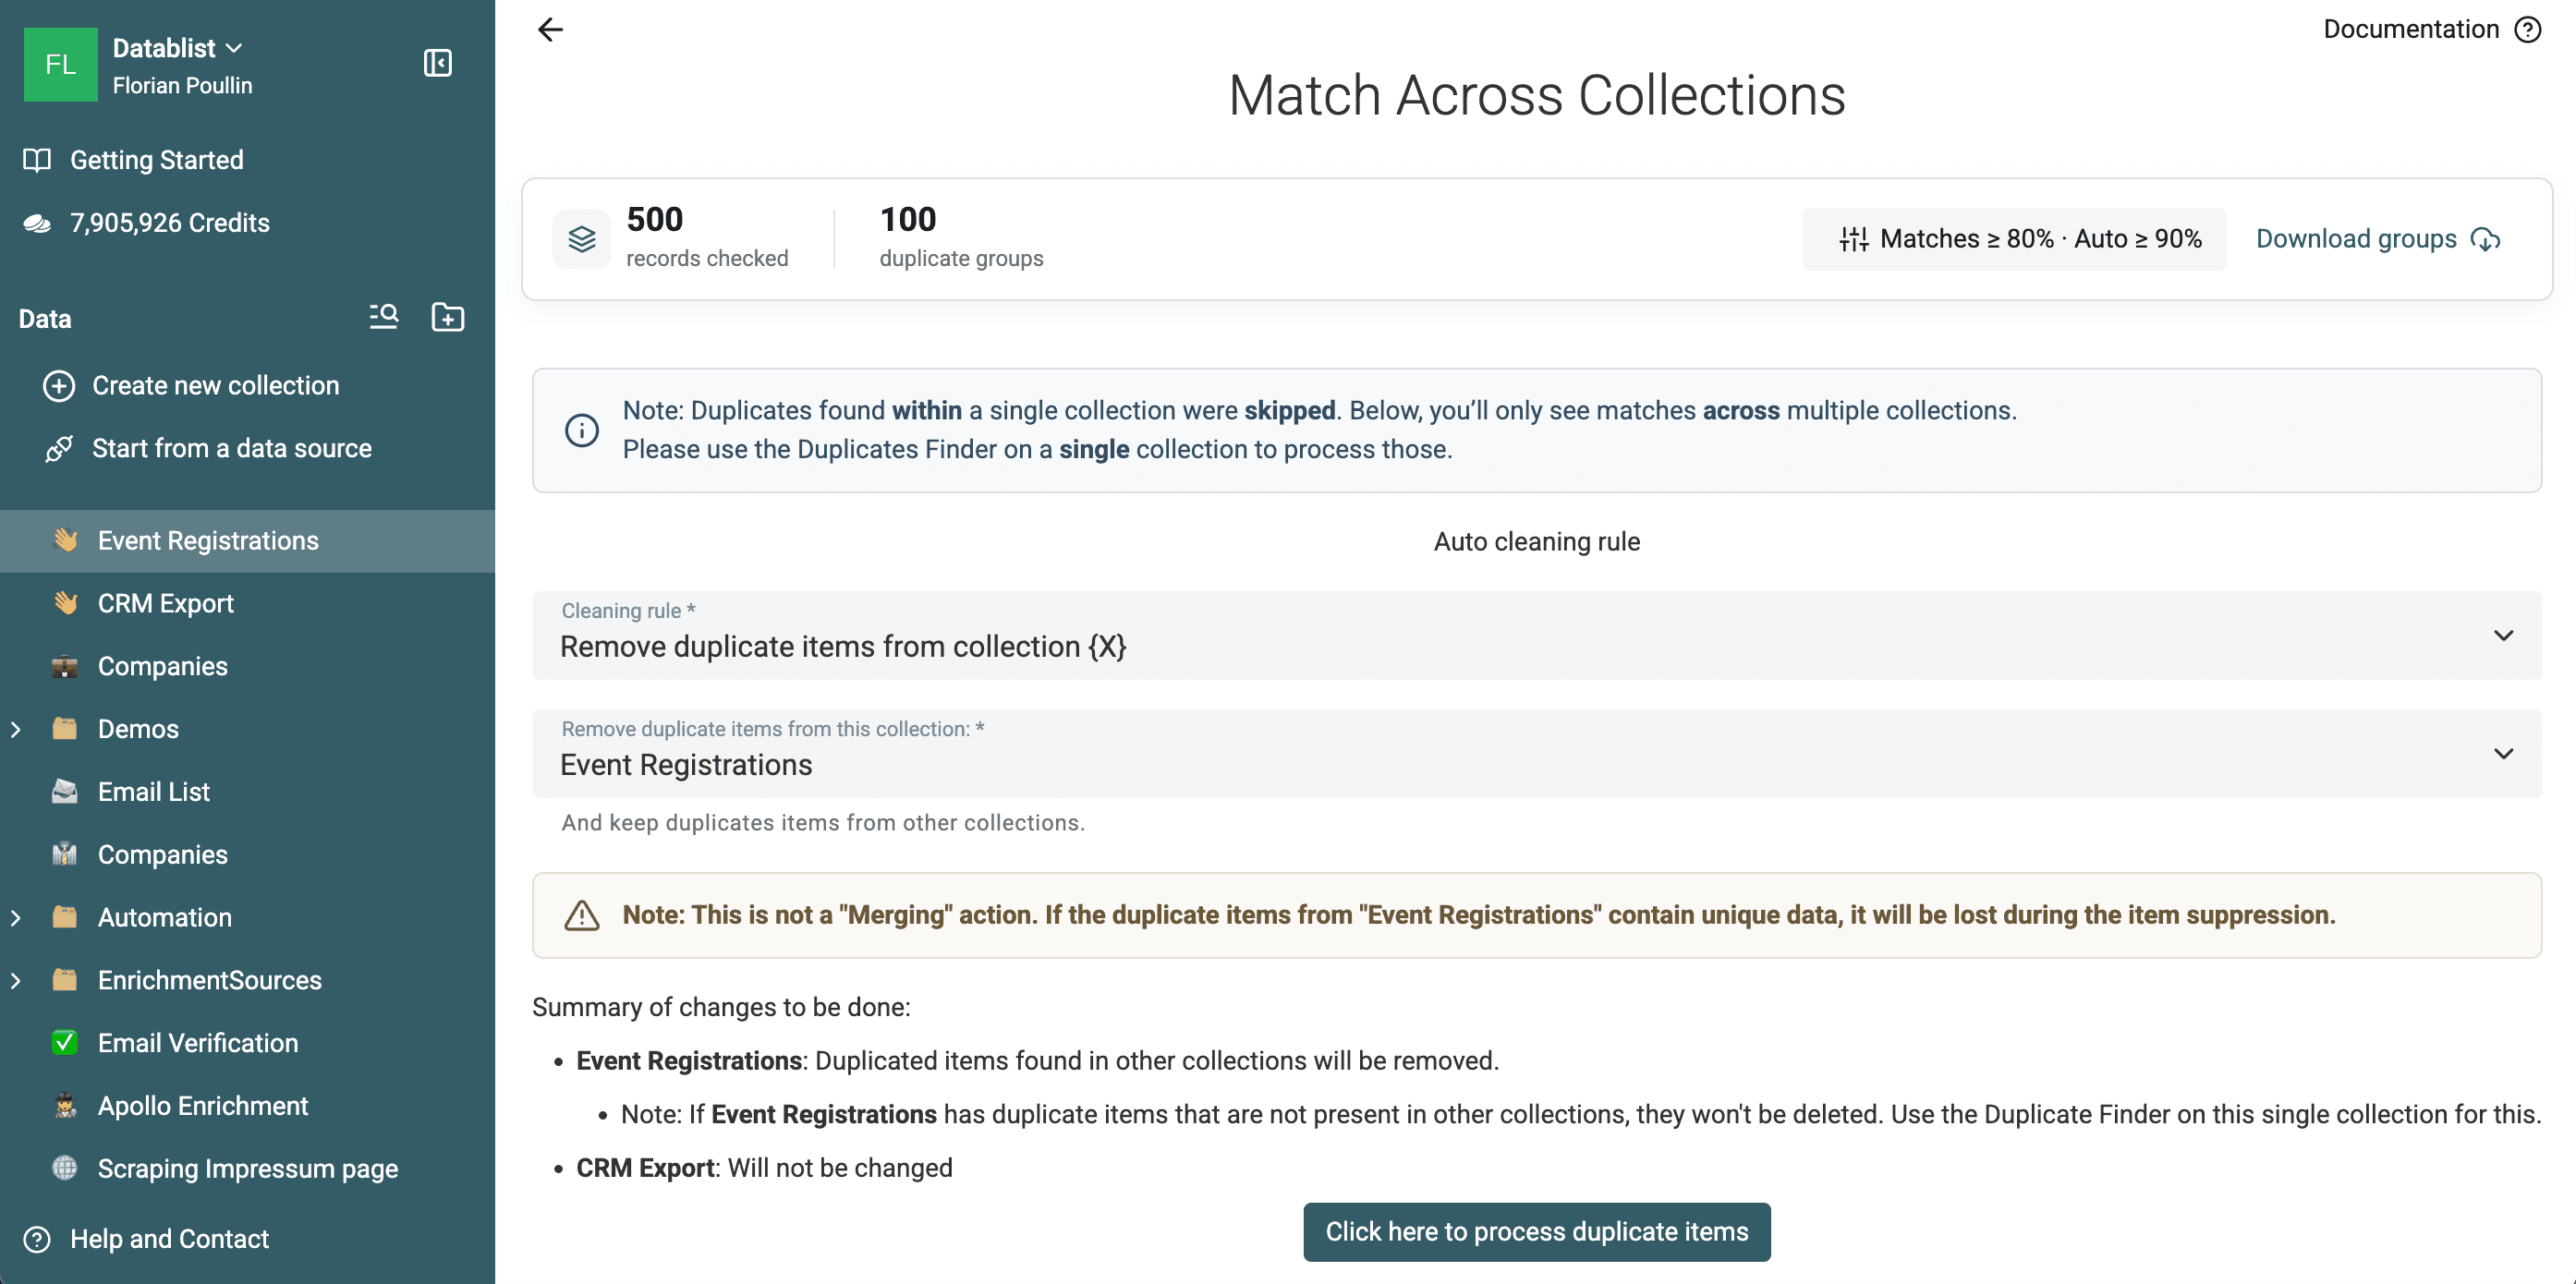
⚠️ Denne handling fletter ikke data ind i CRM-systemet
Hvis en eventpost indeholder et nyttigt telefonnummer, en kilde, et samtykkefelt eller en note, som mangler i CRM-systemet, bliver oplysningerne ikke kopieret ved automatisk ekskludering. Gennemgå eller eksportér grupperne først, eller brug Manual Merging Assistant til de berørte grupper.
Hvis du arbejder med tre eller flere collections, tilbyder Datablist også en regel, der kun beholder dubletter i én valgt collection. Kontrollér opsummeringen grundigt før behandlingen, da handlingen kan fjerne poster fra flere datakilder.
Klik på Process duplicate items, når den valgte collection og opsummeringen svarer til den handling, du ønsker at udføre.
Datablist behandlede alle 100 grupper med dubletter på tværs af collections i denne test. Resultatsiden viste derefter, at der ikke var nogen grupper tilbage.
Kontrollér den rensede liste
Gå tilbage til Event Registrations. Denne collection indeholder nu 150 poster.
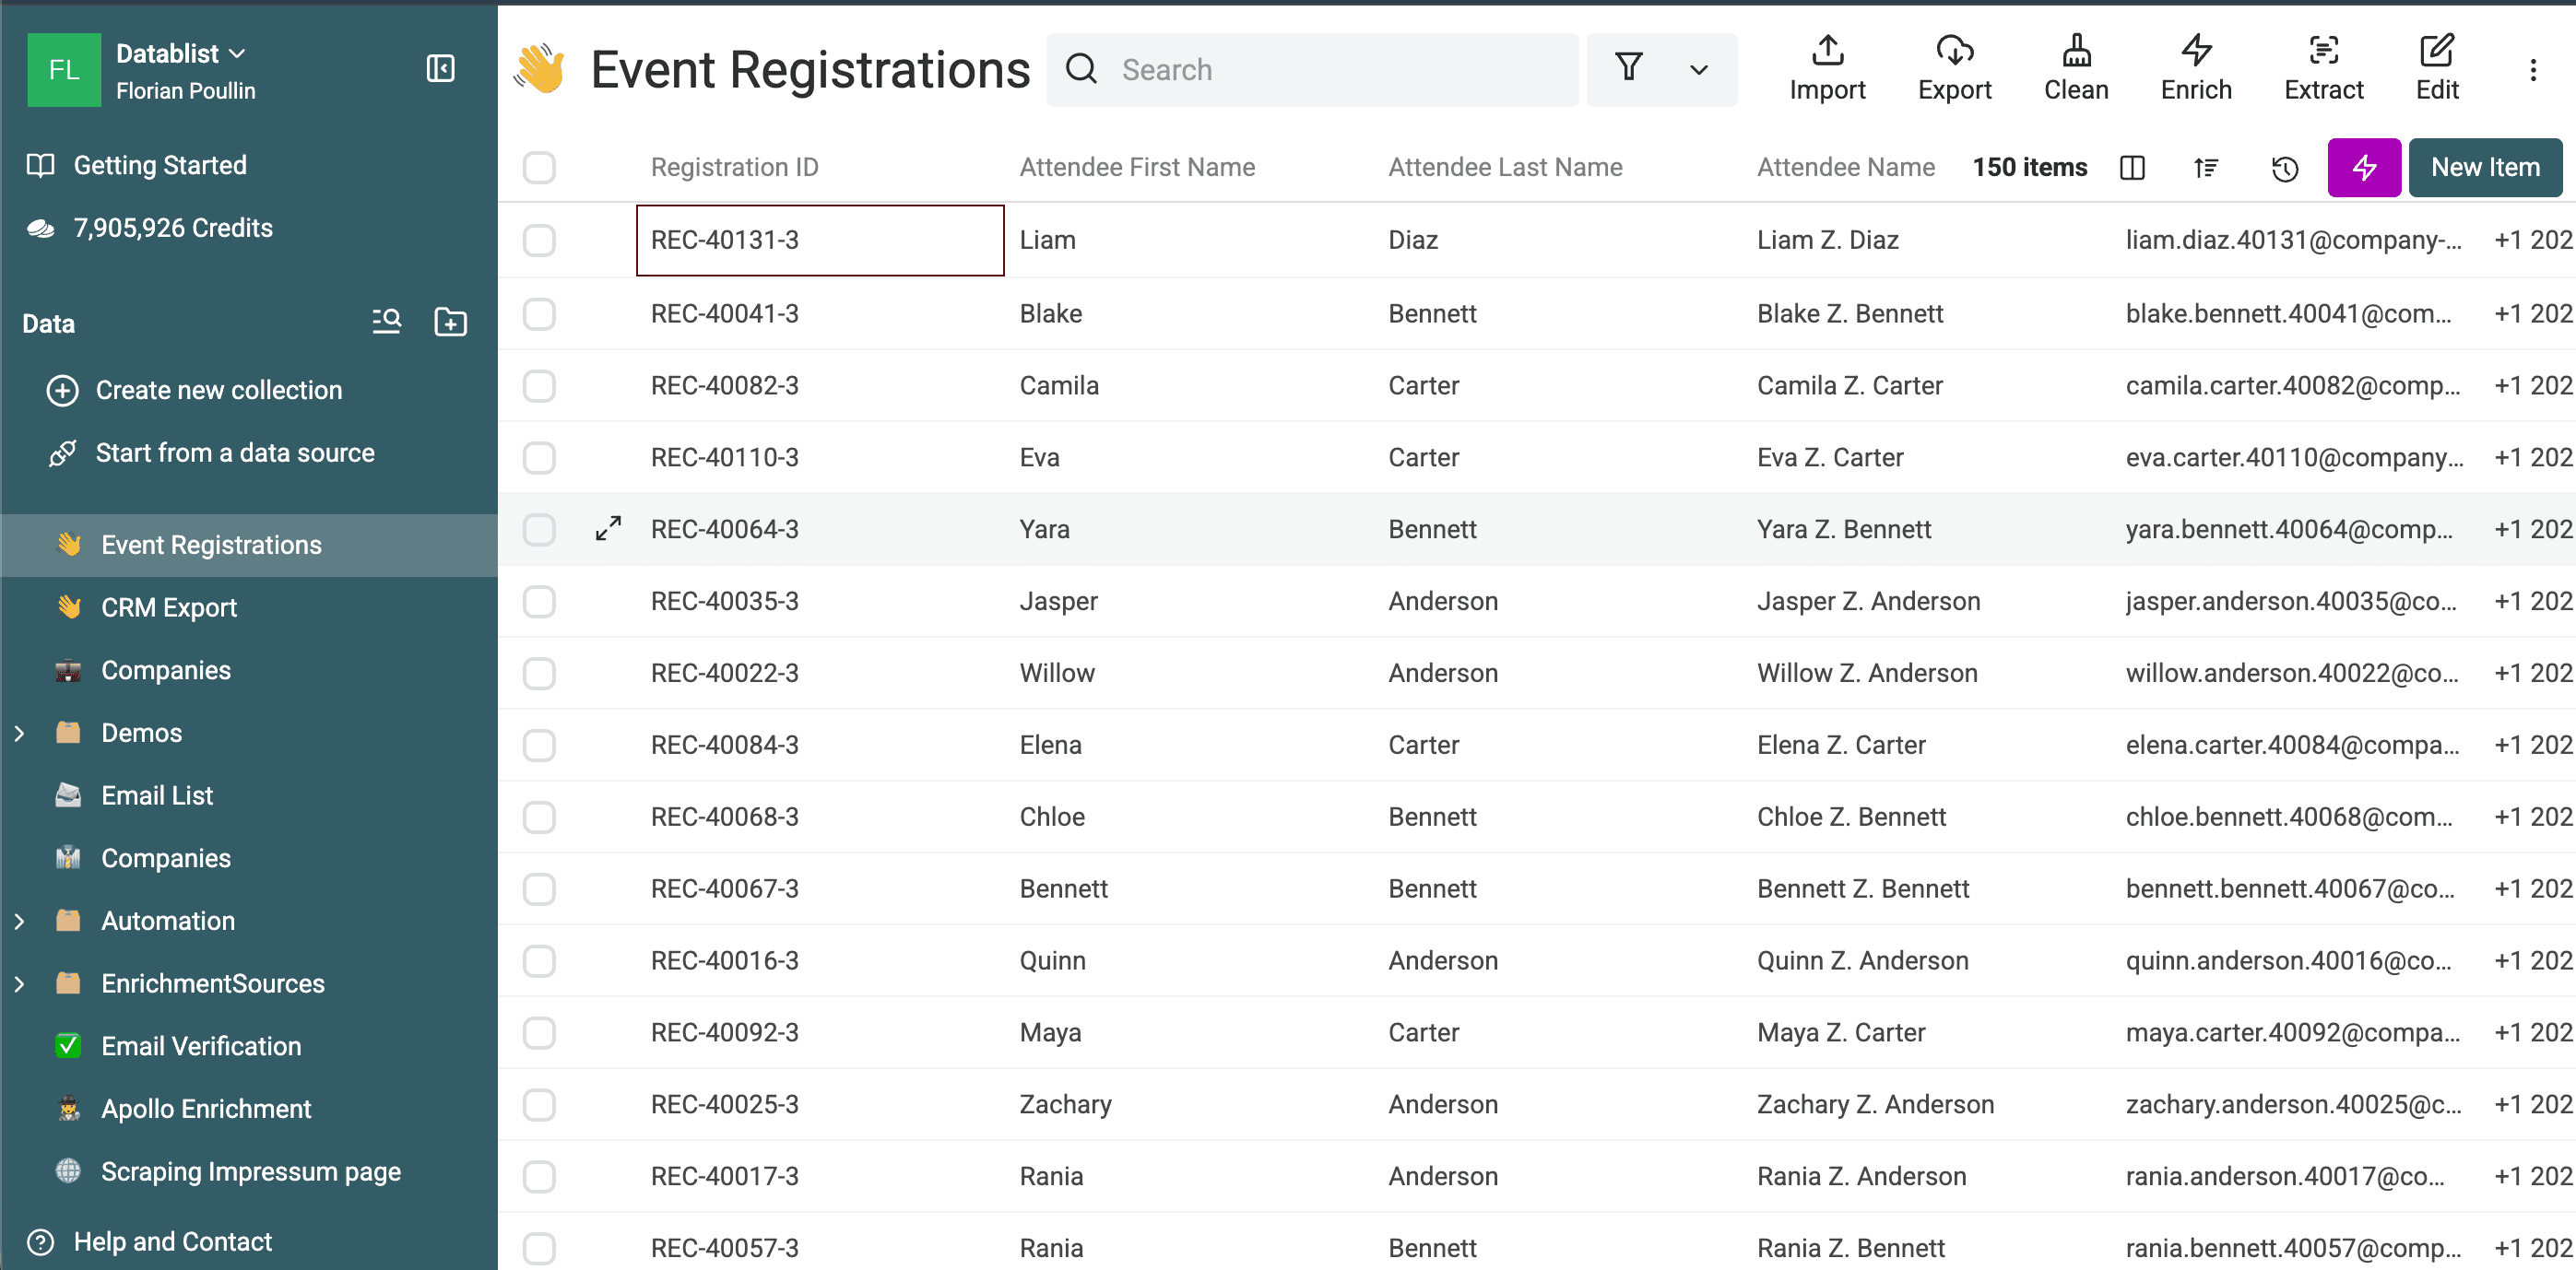
Afstemningen af antal rækker ser sådan ud:
250 nye rækker - 100 matchende CRM-kontakter = 150 helt nye rækker
Kontrollér følgende før eksport:
CRM Exportindeholder stadig 250 poster.Event Registrationsindeholder 150 poster.- Nogle kendte e-mailadresser fra CRM-systemet findes ikke længere på eventlisten.
- Eventkontakter uden et match er bevaret.
- Den gennemførte handling vises under History, så du kan fortryde den, hvis det bliver nødvendigt.
Eksportér den rensede eventliste til CSV eller Excel. Den er nu klar til en arbejdsgang med helt nye leads, uden at kontakter, der allerede findes i CRM-systemet, importeres igen.
Begrænsninger ved deduplikering på tværs af lister
Matching på tværs af collections har et mere afgrænset formål end at flette filer:
- Automatisk behandling fjerner poster. Den samler ikke felter på tværs af collections.
- Interne dubletter i én collection springes over.
- Alle egenskaber, der bruges til sammenligning, skal mappes på tværs af de valgte collections.
- Matches på valgte egenskaber afhænger af den samlede score og indstillingerne for tomme værdier.
- Smart, fuzzy og fonetisk matching kan finde kandidater, der kræver manuel kontrol.
- Matching på tværs af collections kræver et betalt abonnement.
Brug denne arbejdsgang til ekskluderingslister, kontrol før CRM-import, oprydning i eventleads, udelukkelse fra kampagnemålgrupper eller andre processer, hvor én liste skal bevares som den autoritative datakilde.
Hvis du skal samle filer i én tabel før deduplikering, kan du følge guiden til at flette regneark. Hvis du vil bevare supplerende værdier i én collection, kan du bruge arbejdsgangen til en enkelt liste og flette dublerede leads uden at miste data.