
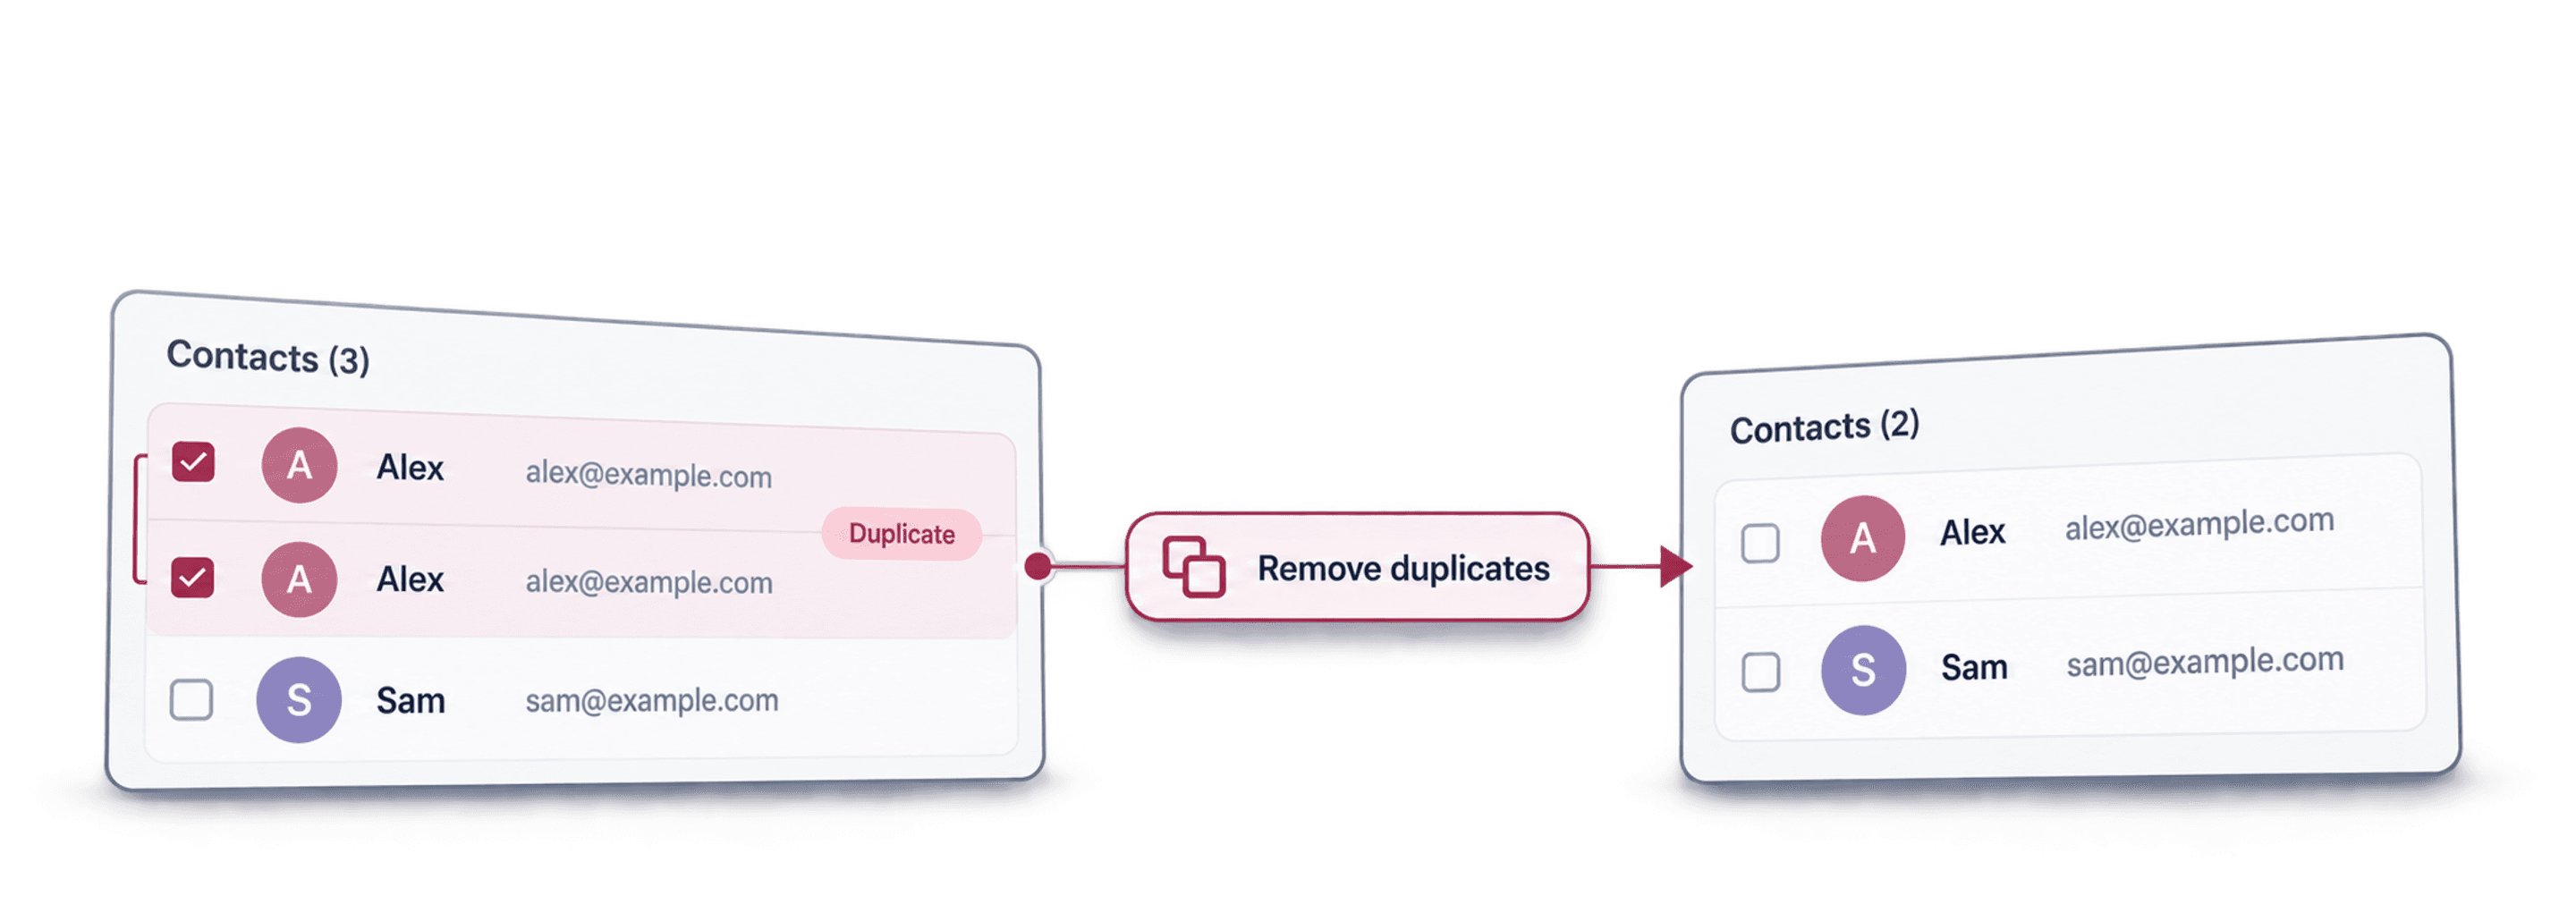
For at fjerne dubletter fra en liste online skal du først vælge det felt, der identificerer en person, virksomhed eller et produkt. Kør først en streng matchning, gennemgå de foreslåede dubletgrupper, og flet derefter nyttige værdier eller fjern de rækker, der ikke bidrager med noget. Så går oprydningen hurtigt, uden at alle lignende værdier automatisk betragtes som sikre matches.
Datablist samler hele processen i én browserbaseret arbejdsgang. Importér en CSV- eller Excel-fil, vælg egenskaberne til matchning, sammenlign rækkerne, gennemgå resultatet, og eksportér den rensede liste. Dubletkontrollen er skrivebeskyttet, indtil du starter en Remove-, Merge- eller brugerdefineret behandling.
Denne guide bruger et eksempel med 1.000 rækker, som du kan downloade. Det indeholder identiske kopier, e-mailaliaser, variationer af virksomhedsnavne, URL-forskelle, enkle forskelle i telefonnummerformatering, stavefejl, modstridende værdier og poster, der supplerer hinanden.
🔑 Den sikre regel for deduplikering
Match på den mindst omfattende pålidelige identifikator, men brug hele rækken til at afgøre, hvad du vil beholde.
Fjern dubletter fra en enkel liste med værdier
Hvis din liste har én værdi pr. linje, skal du gemme den som en CSV-fil med én kolonne og en kolonneoverskrift som Email, Domain eller Value. Importér den i Datablist, og kør Clean > Remove duplicates på kolonnen med Exact. Gennemgå grupperne, vælg den post, der skal beholdes, behandl dubletrækkerne, og eksportér derefter de resterende værdier.
En illustrativ liste med alpha.example, beta.example og alpha.example bør eksempelvis indeholde én alpha-værdi og én beta-værdi, når den gentagne række er fjernet. Dette er et foreslået eksempel på input og output – ikke endnu en måling fra eksempelfilen, der kan downloades.
Jeg ville bruge denne metode til en liste med identifikatorer. Hvis filen indeholder flere kolonner, handler opgaven om at afstemme dubletposter: Når du fjerner en række, forsvinder dens øvrige værdier også. Brug fletteprocessen nedenfor, hvis en gentaget e-mailadresse har et nyttigt telefonnummer eller en note i en anden række.
Hold tomme identifikatorer adskilt. I standardsammenligningen af valgte egenskaber skaber en manglende tekstidentifikator ikke et match. Hvis du vil slette tomme rækker, skal du håndtere det eksplicit i oprydningen i stedet for at forvente, at deduplikeringen afgør, hvad de repræsenterer.
Vælg, hvad der gør en post unik
Begynd ikke med matchningsalgoritmen. Start med at definere entiteten.
Kontakter, virksomheder, produkter og transaktioner kræver forskellige identifikatorer:
| Liste | Stærke identifikatorer til første matchning | Nyttig anden matchning |
|---|---|---|
| Kontakter | E-mail, telefon, LinkedIn-URL | Fuldt navn plus virksomhed |
| Virksomheder | Websitedomæne, virksomheds-ID | Normaliseret virksomhedsnavn |
| Produkter | SKU, EAN, GTIN, produkt-URL | Produktnavn plus brand |
| CRM-leads | E-mail, telefon, CRM-ID | Navn plus virksomhedens domæne |
| Ordrer | Ordre-ID | Kunde-ID plus ordredato |
En enkelt matchning finder sjældent alle dubletter. En kontakt kan have samme e-mailadresse i to rækker, mens en anden har skiftet e-mailadresse, men stadig bruger samme telefonnummer. Kør separate matchninger for forskellige identifikatorer i stedet for at opbygge én regel med alle egenskaber.
Eksempel:
- Match kontakter på e-mail.
- Behandl de gennemgåede grupper.
- Normalisér telefonnumrene, og kør derefter en Exact-kontrol på den rensede egenskab.
- Kør en forsigtig fuzzy-kontrol på fuldt navn plus virksomhed.
Vælg reglen for tomme værdier, før du føjer flere felter til samme kontrol. Med Value required kan en manglende identifikator udelukke en relevant kandidat.
Med Match on empty value får egenskaber, der er tomme i begge poster, en score på 100 % og kan hæve gennemsnittet: Et e-mailmatch plus et manglende efternavn giver 87,5 %. Hvis der tilføjes tre egenskaber, som er tomme i begge poster, stiger scoren til 95 %. Se eksemplet på scoring af tomme værdier, før du antager, at flere kolonner giver stærkere dokumentation.
Brug de dedikerede guides, når en identifikator kræver sin egen normalisering:
- Fjern dubletter blandt e-mailadresser og aliaser
- Match dubletter af virksomhedsnavne
- Fjern dubletter i et felt med flere værdier
- Normalisér lokale og internationale telefonnumre
Download eksempellisten med 1.000 rækker
Download CSV-demoen til deduplikering. Den indeholder 1.000 rækker, som repræsenterer 800 konstruerede entiteter.
Filen indeholder flere testscenarier:
| Konstrueret scenarie | Dubletgrupper | Matchning |
|---|---|---|
| Identiske kopier af hele rækken | 5 | All Properties med Exact |
| E-mailaliaser og wrappers | 100 | Email med Smart og Email-processoren |
| Variationer af virksomhed og URL | 50 | Behandling af Company Name eller URL |
| Enkle amerikanske forskelle i telefonnummerformatering | 25 | Phone med Smart, kun formatering |
| Kontrollerede stavefejl i navne | 15 | Jaro-Winkler eller Levenshtein |
| Fonetiske variationer af fornavne | 5 | Metaphone |
| Poster uden en konstrueret dublet | 600 | Skal forblive adskilt |
Tallene er konstruerede ground truth-resultater – ikke et løfte om, at alle fuzzy-tærskler giver samme resultat. Distancebaseret matchning kan medtage ekstra kandidater, når tærsklen er lav. Gennemgå grupperne, før du behandler dem.
Her er tre par fra filen:
| Brugsscenarie | Første gemte værdi | Anden gemte værdi |
|---|---|---|
| E-mailalias | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Virksomhed og URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Enkel telefonnummerformatering | +1 (202) 555-0768 | 1 202 555 0768 |
Rækkerne er også uenige om felter som stillingsbetegnelse, ejer, status, omsætning, kilde, tags og noter. Disse konflikter gør filen velegnet til at teste regler for masterposter og valg af overlevende feltværdier.
Importér listen i Datablist
Åbn Datablist, og importér CSV- eller Excel-filen i en collection. En collection fungerer som et struktureret regneark: Rækker er items, og kolonner er properties.
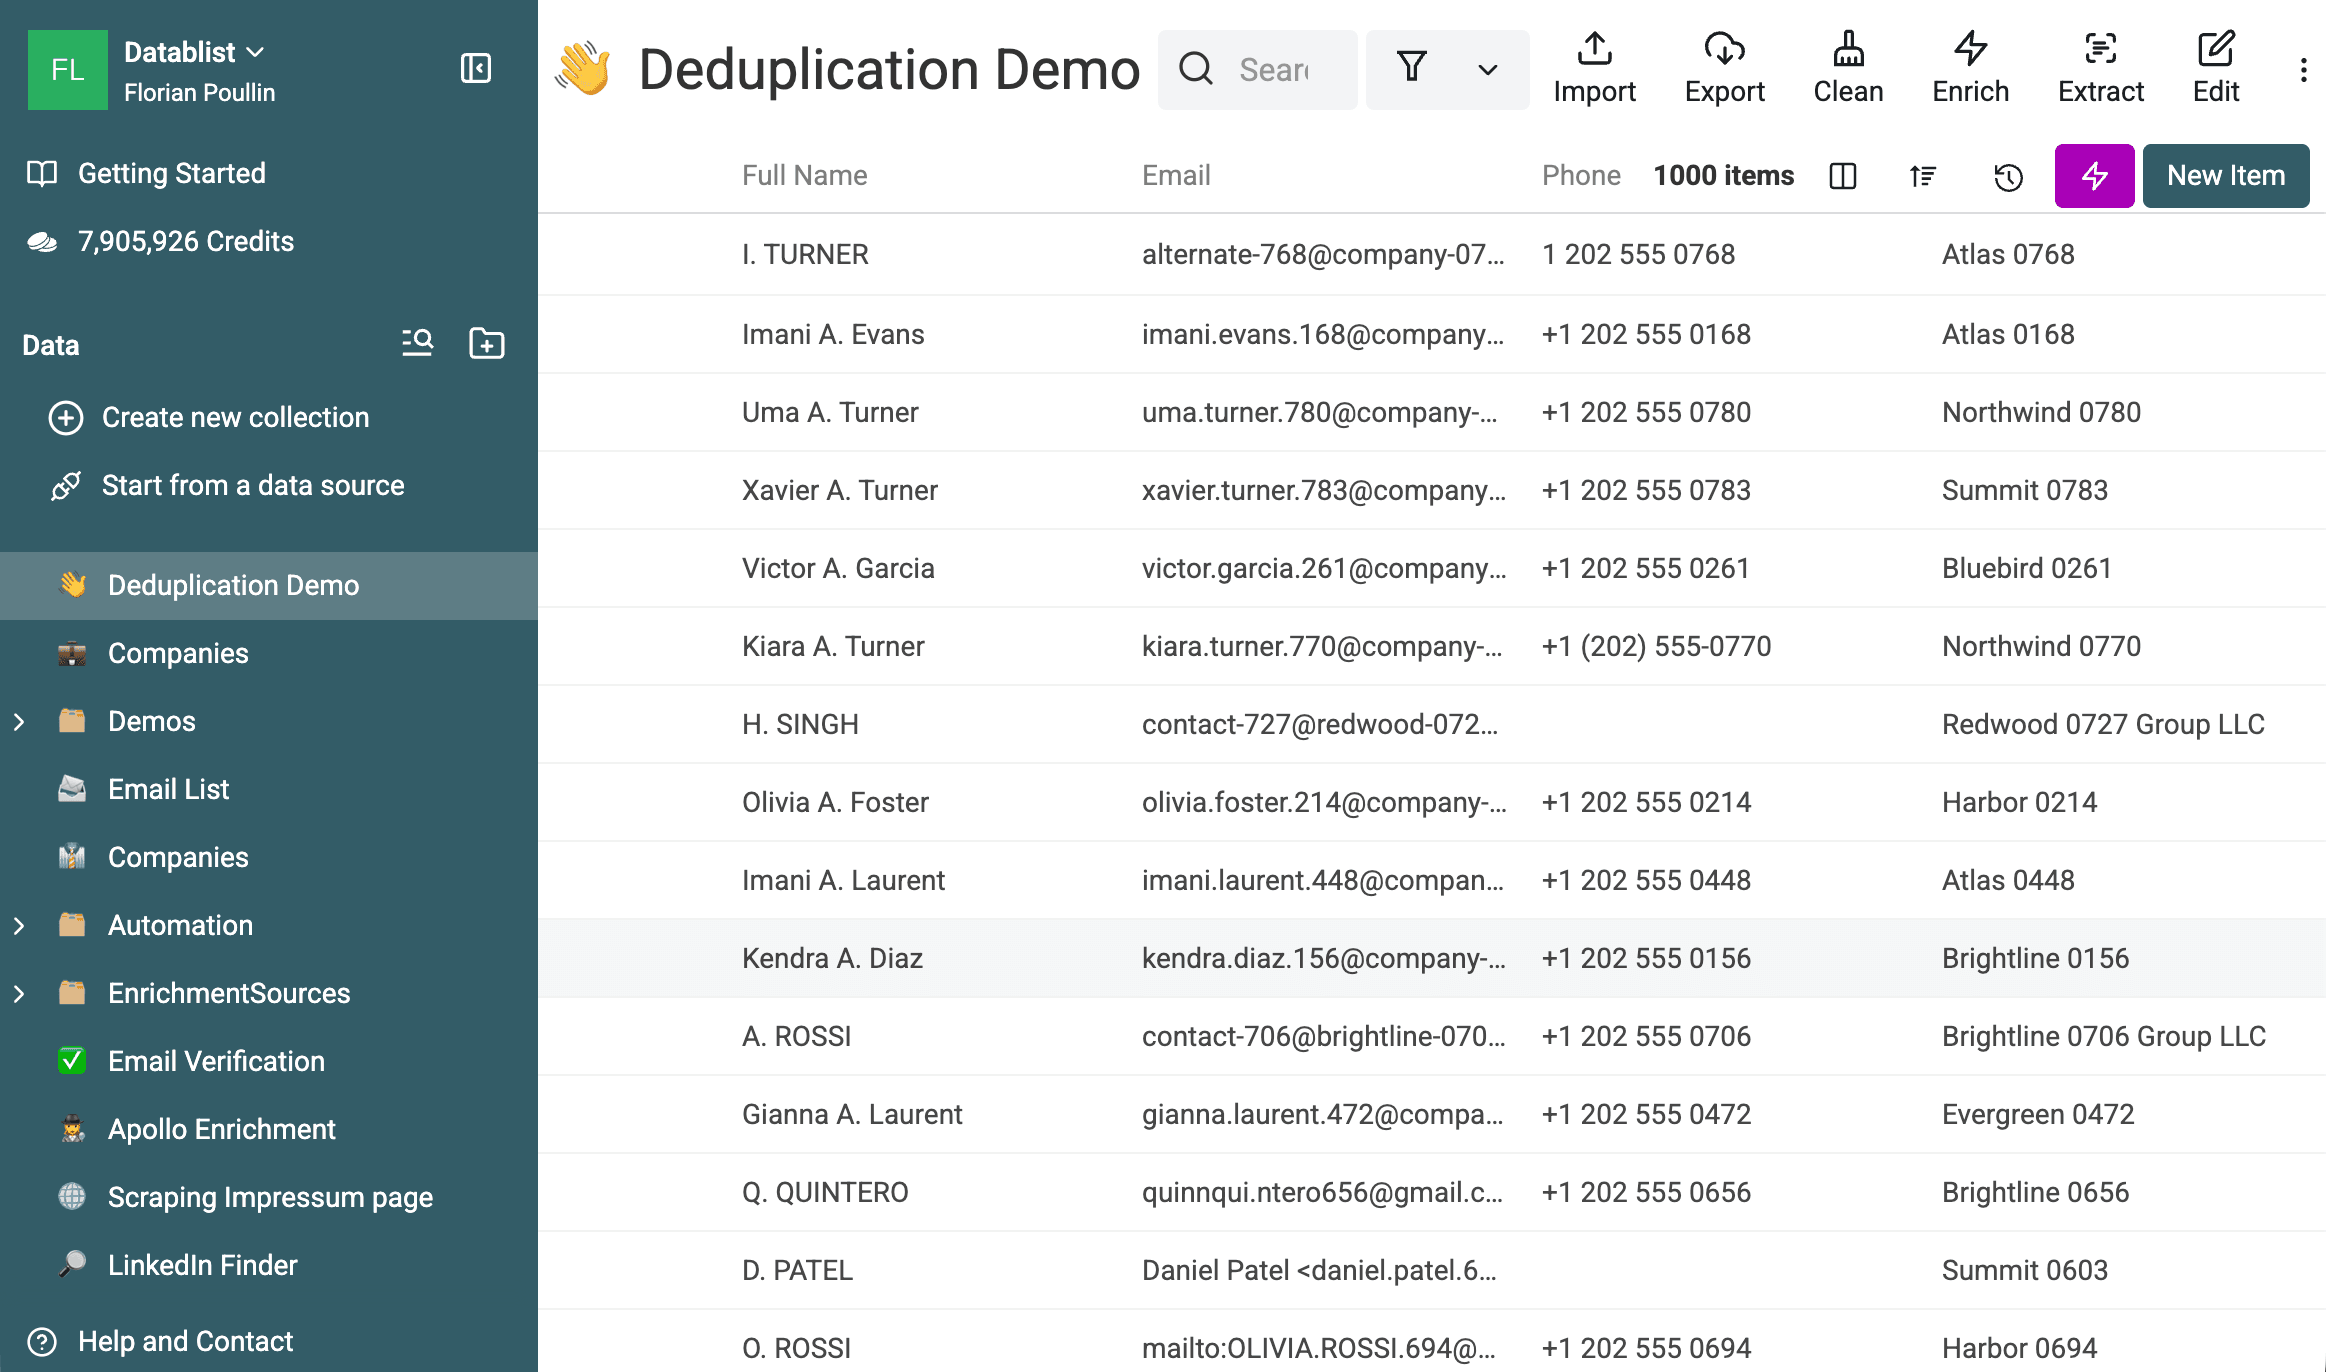
Kontrollér de registrerede property-typer under importen:
- E-mailkolonner skal bruge typen Email.
- Websitekolonner skal bruge URL.
- Telefonkolonner skal bruge Phone.
- Kolonner med omsætning eller antal skal bruge Number.
- Aktivitets- og oprettelsesdatoer skal bruge DateTime.
Behold kolonner med ID, kilde, ejer, noter og status i din collection. De hjælper dig med at vælge den rigtige post og kontrollere, hvad der bevares ved en fletning.
Kør Exact-, Smart- og fuzzy-matchning
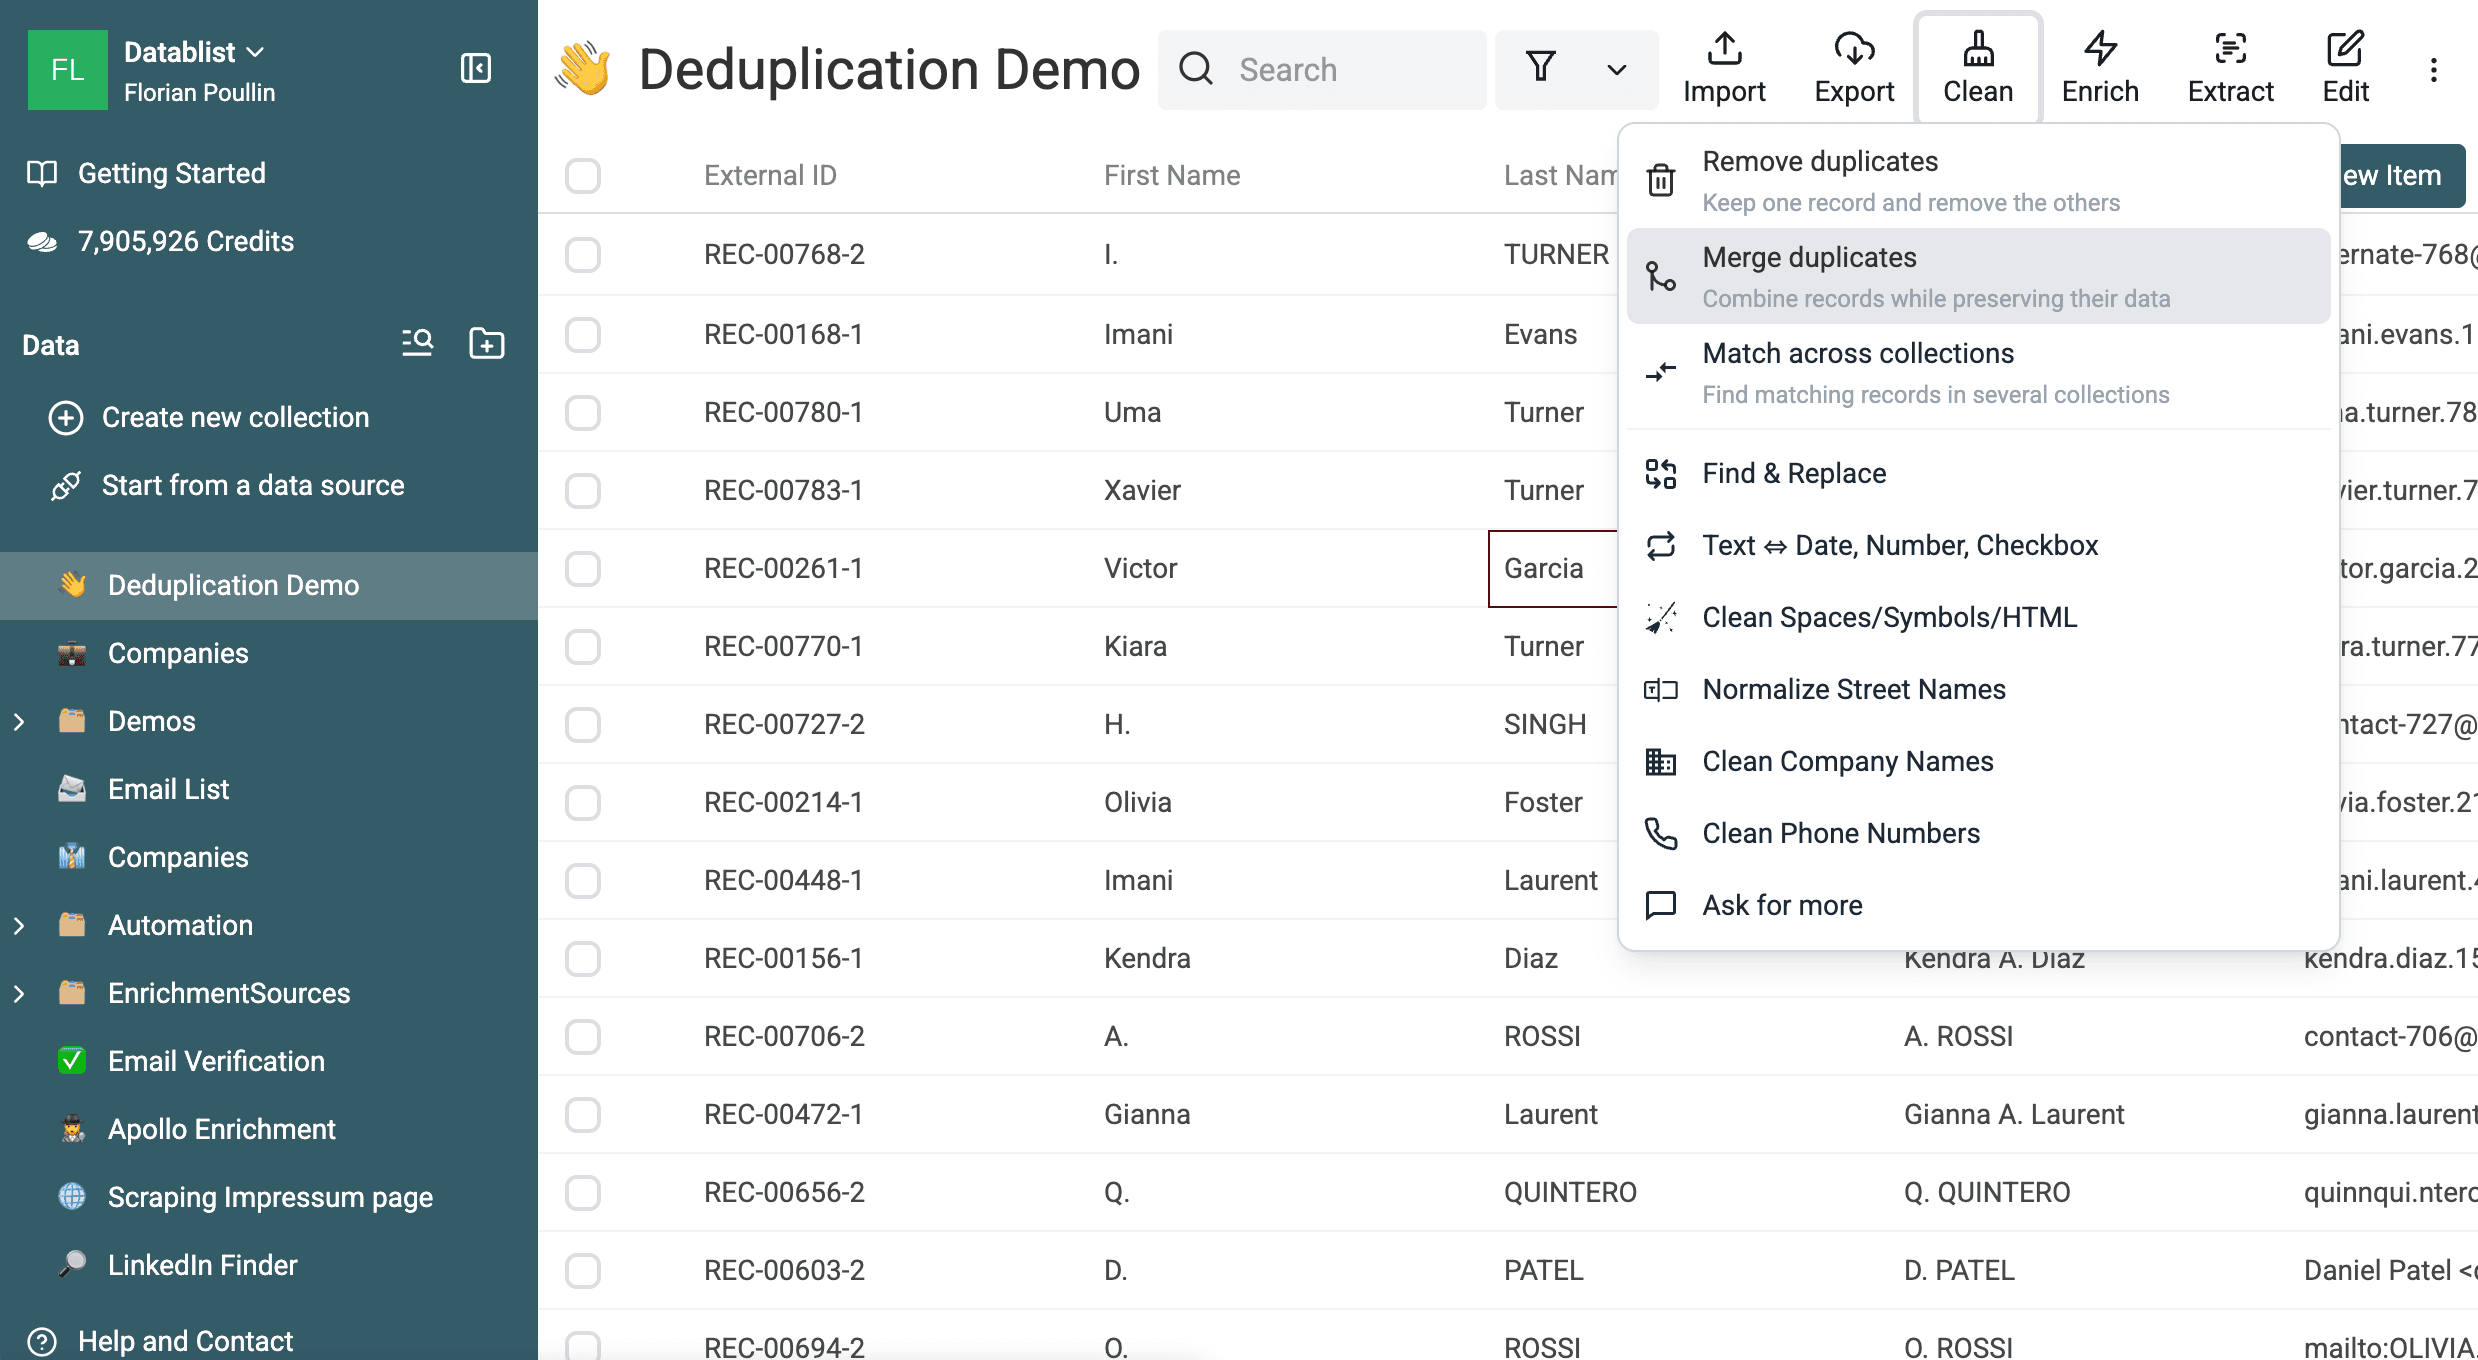
Åbn Clean, og vælg den handling, der passer til dit mål:
- Remove duplicates, når sekundære rækker kan kasseres.
- Merge duplicates, når rækkerne indeholder oplysninger, der skal bevares.
- Match across collections, når posterne ligger i separate collections.
De første to handlinger bruger samme registreringsmotor. De åbner resultatområdet med hver sin behandlingstilstand valgt.
Start med Exact-matchning
Brug All Properties med Exact til at finde rækker, der er kopieret to gange uden ændringer. Brug Selected Properties, når ét felt, eksempelvis et eksternt ID, skal være identisk.
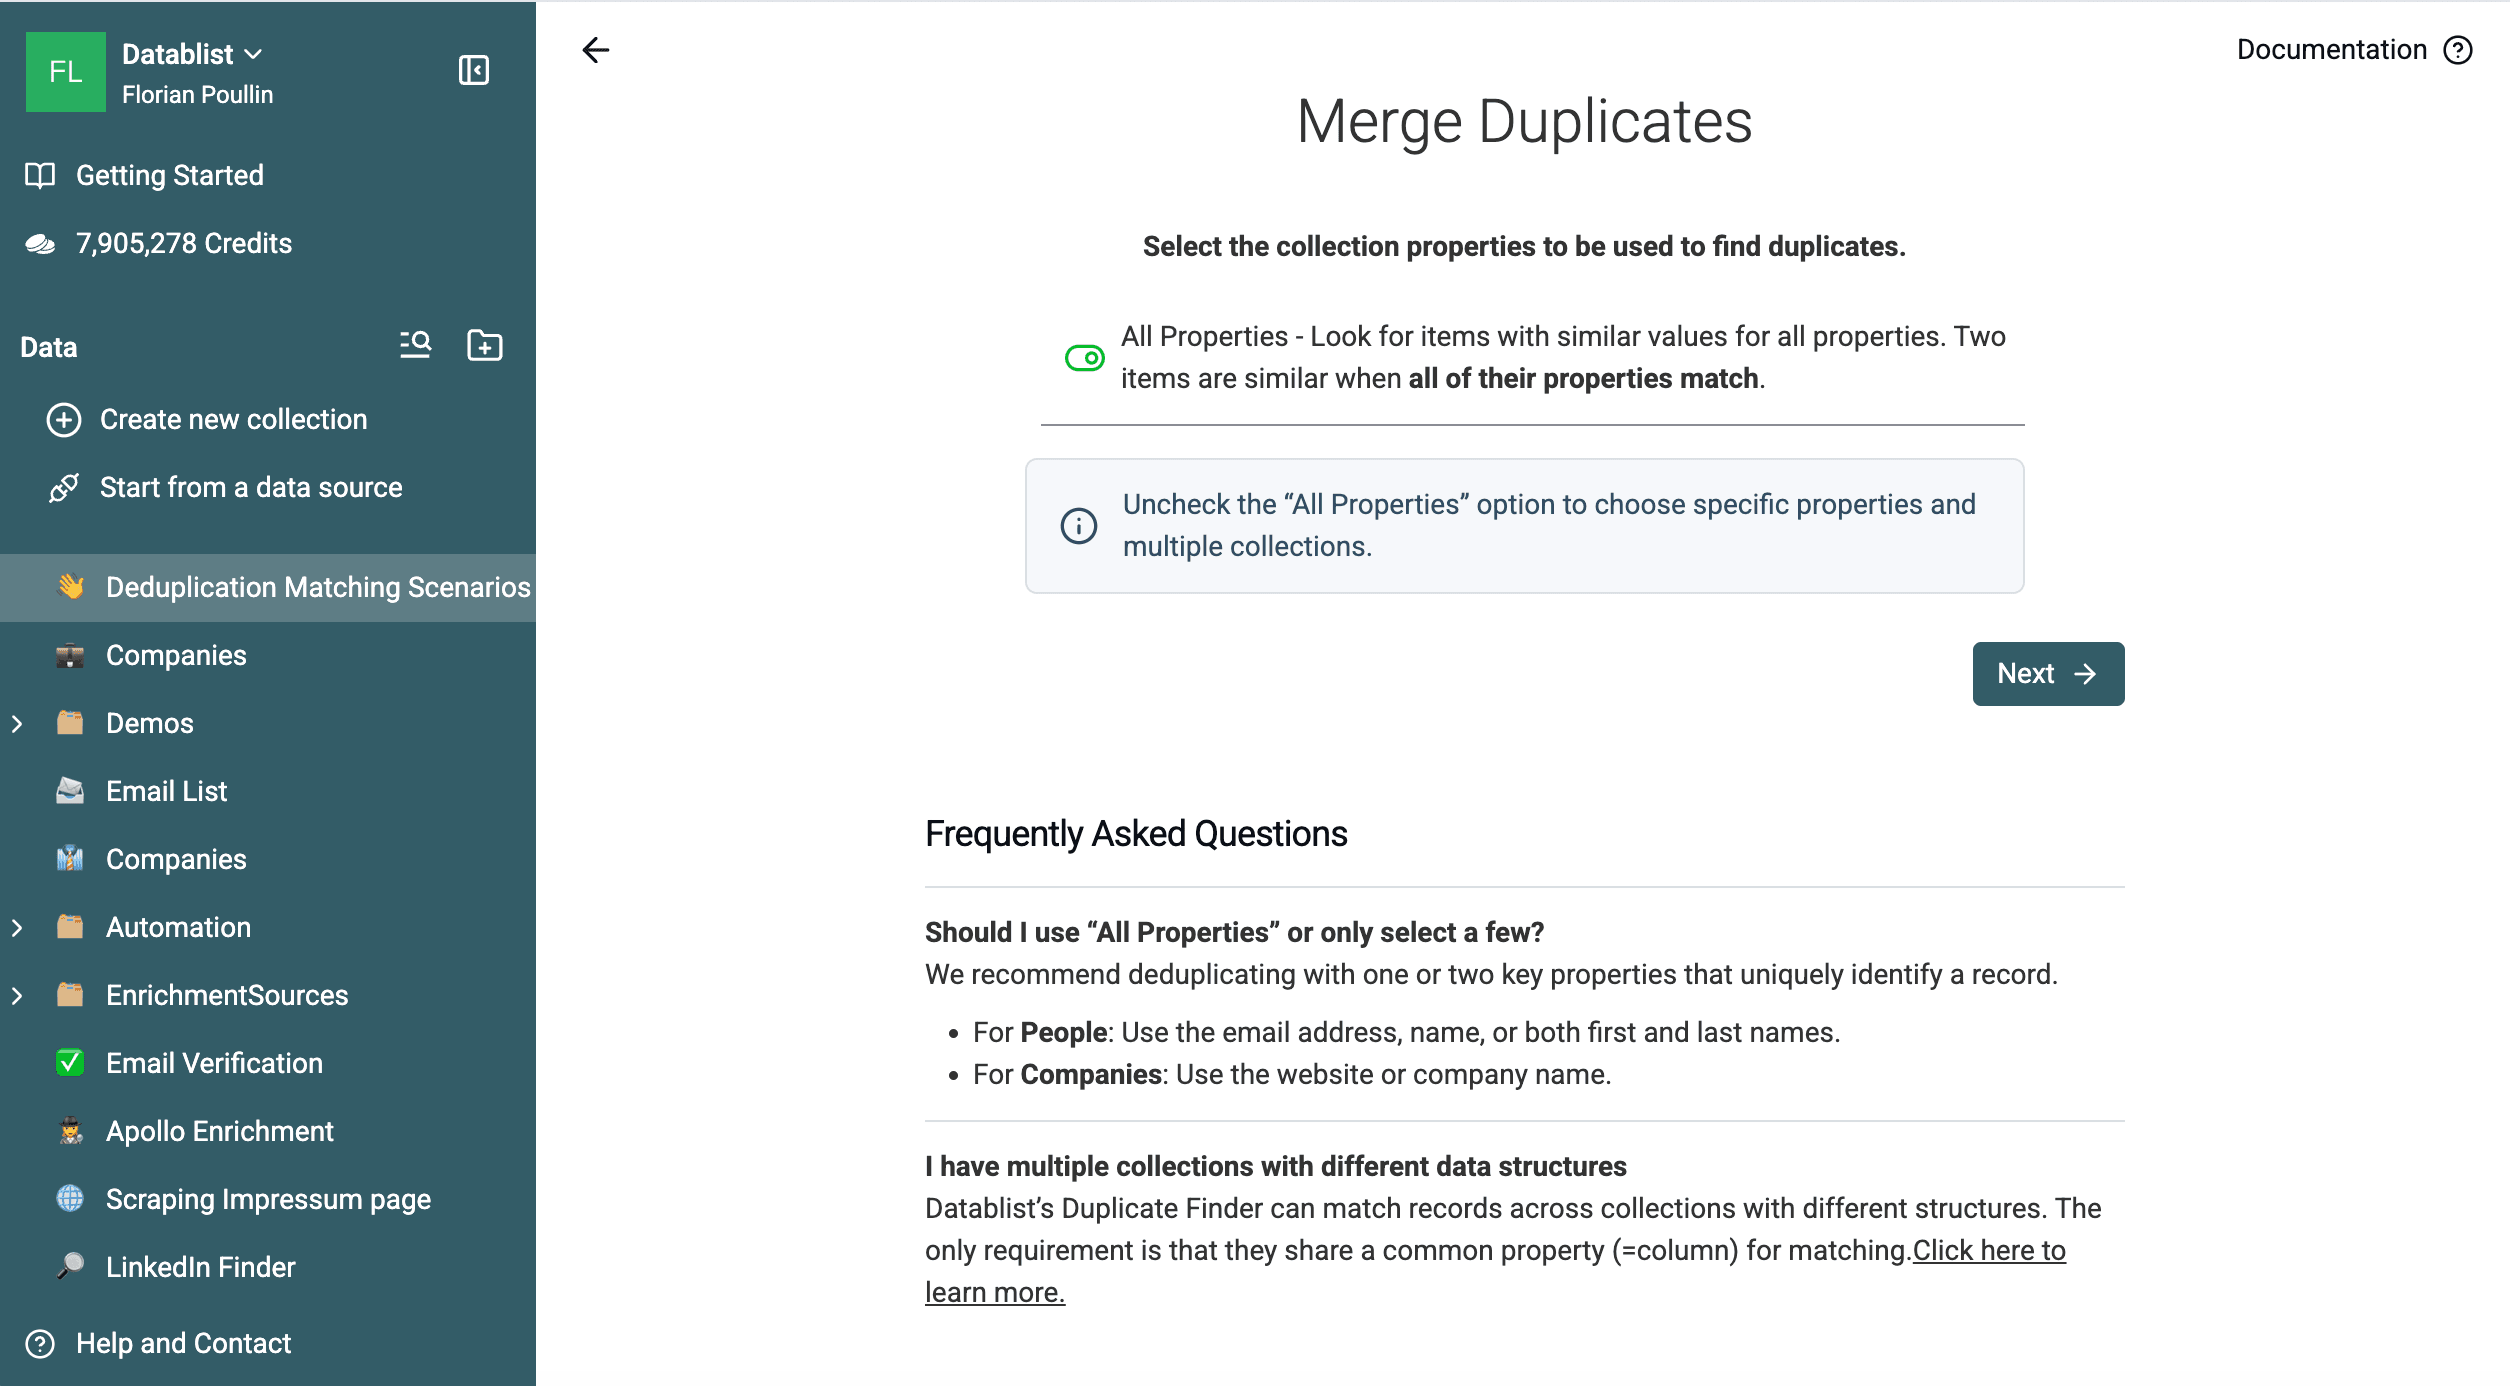
På eksemplet med 1.000 rækker finder denne matchning fem dubletgrupper. Hver gruppe indeholder to rækker med de samme værdier på tværs af alle properties.
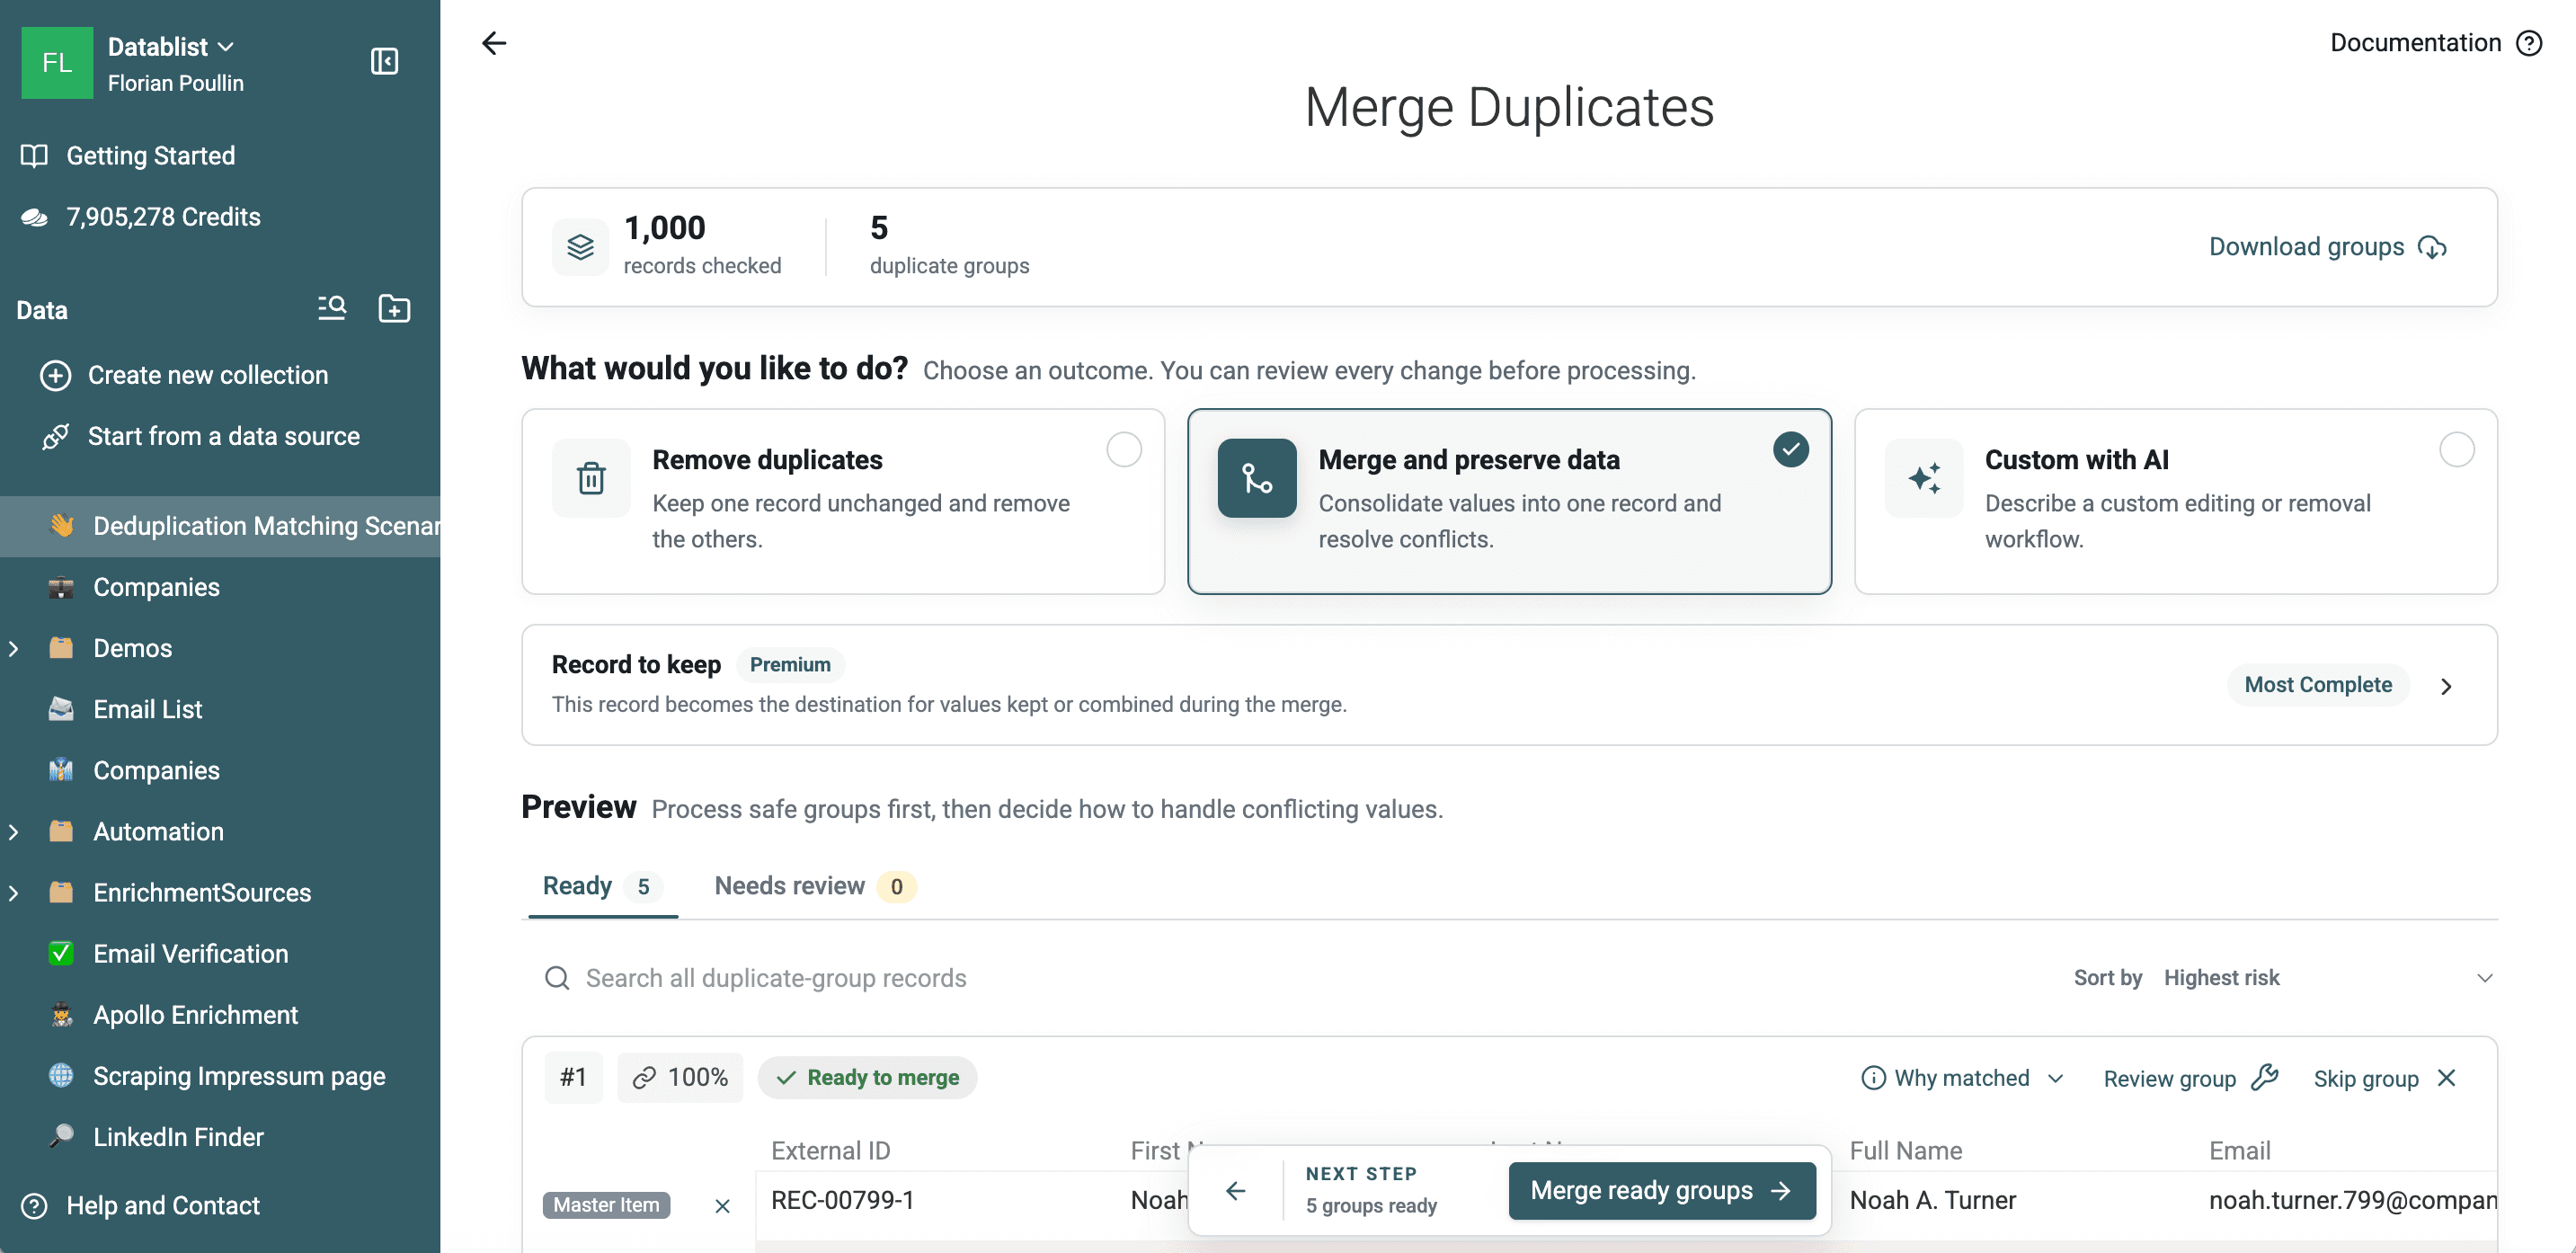
Exact er den sikreste første matchning, fordi hvert fund opfylder en streng sammenligning. Den finder ikke Acme Inc. og Acme, et formateret telefonnummer eller et e-mailalias, når de gemte værdier er forskellige.
Besøgende uden en konto kan køre en Exact-dubletkontrol. En gratis konto giver adgang til Smart-sammenligning og de øvrige funktioner i Free-abonnementet.
Brug Smart-matchning til virksomhedsdata
Smart-matchning standardiserer værdierne til sammenligningen uden at omskrive de gemte celler. Vælg en processor, der passer til den pågældende property:
- Email håndterer store og små bogstaver, omgivende mellemrum, plus-aliaser, punktummer i Gmail-adresser,
googlemail.com, wrappers med visningsnavne ogmailto:-værdier. - URL kan ignorere protokoller og en afsluttende skråstreg med valgfri indstillinger for underdomæner, stier og forespørgselsparametre.
- Phone ignorerer formateringstegn. Den validerer ikke numre, bruger ikke en Country-property og udleder ikke en manglende landekode.
- Company Name fjerner almindelige juridiske, forretningsmæssige og geografiske betegnelser.
- Text ignorerer accenter, mellemrum, tegnsætning, symboler, store og små bogstaver samt ordstilling.
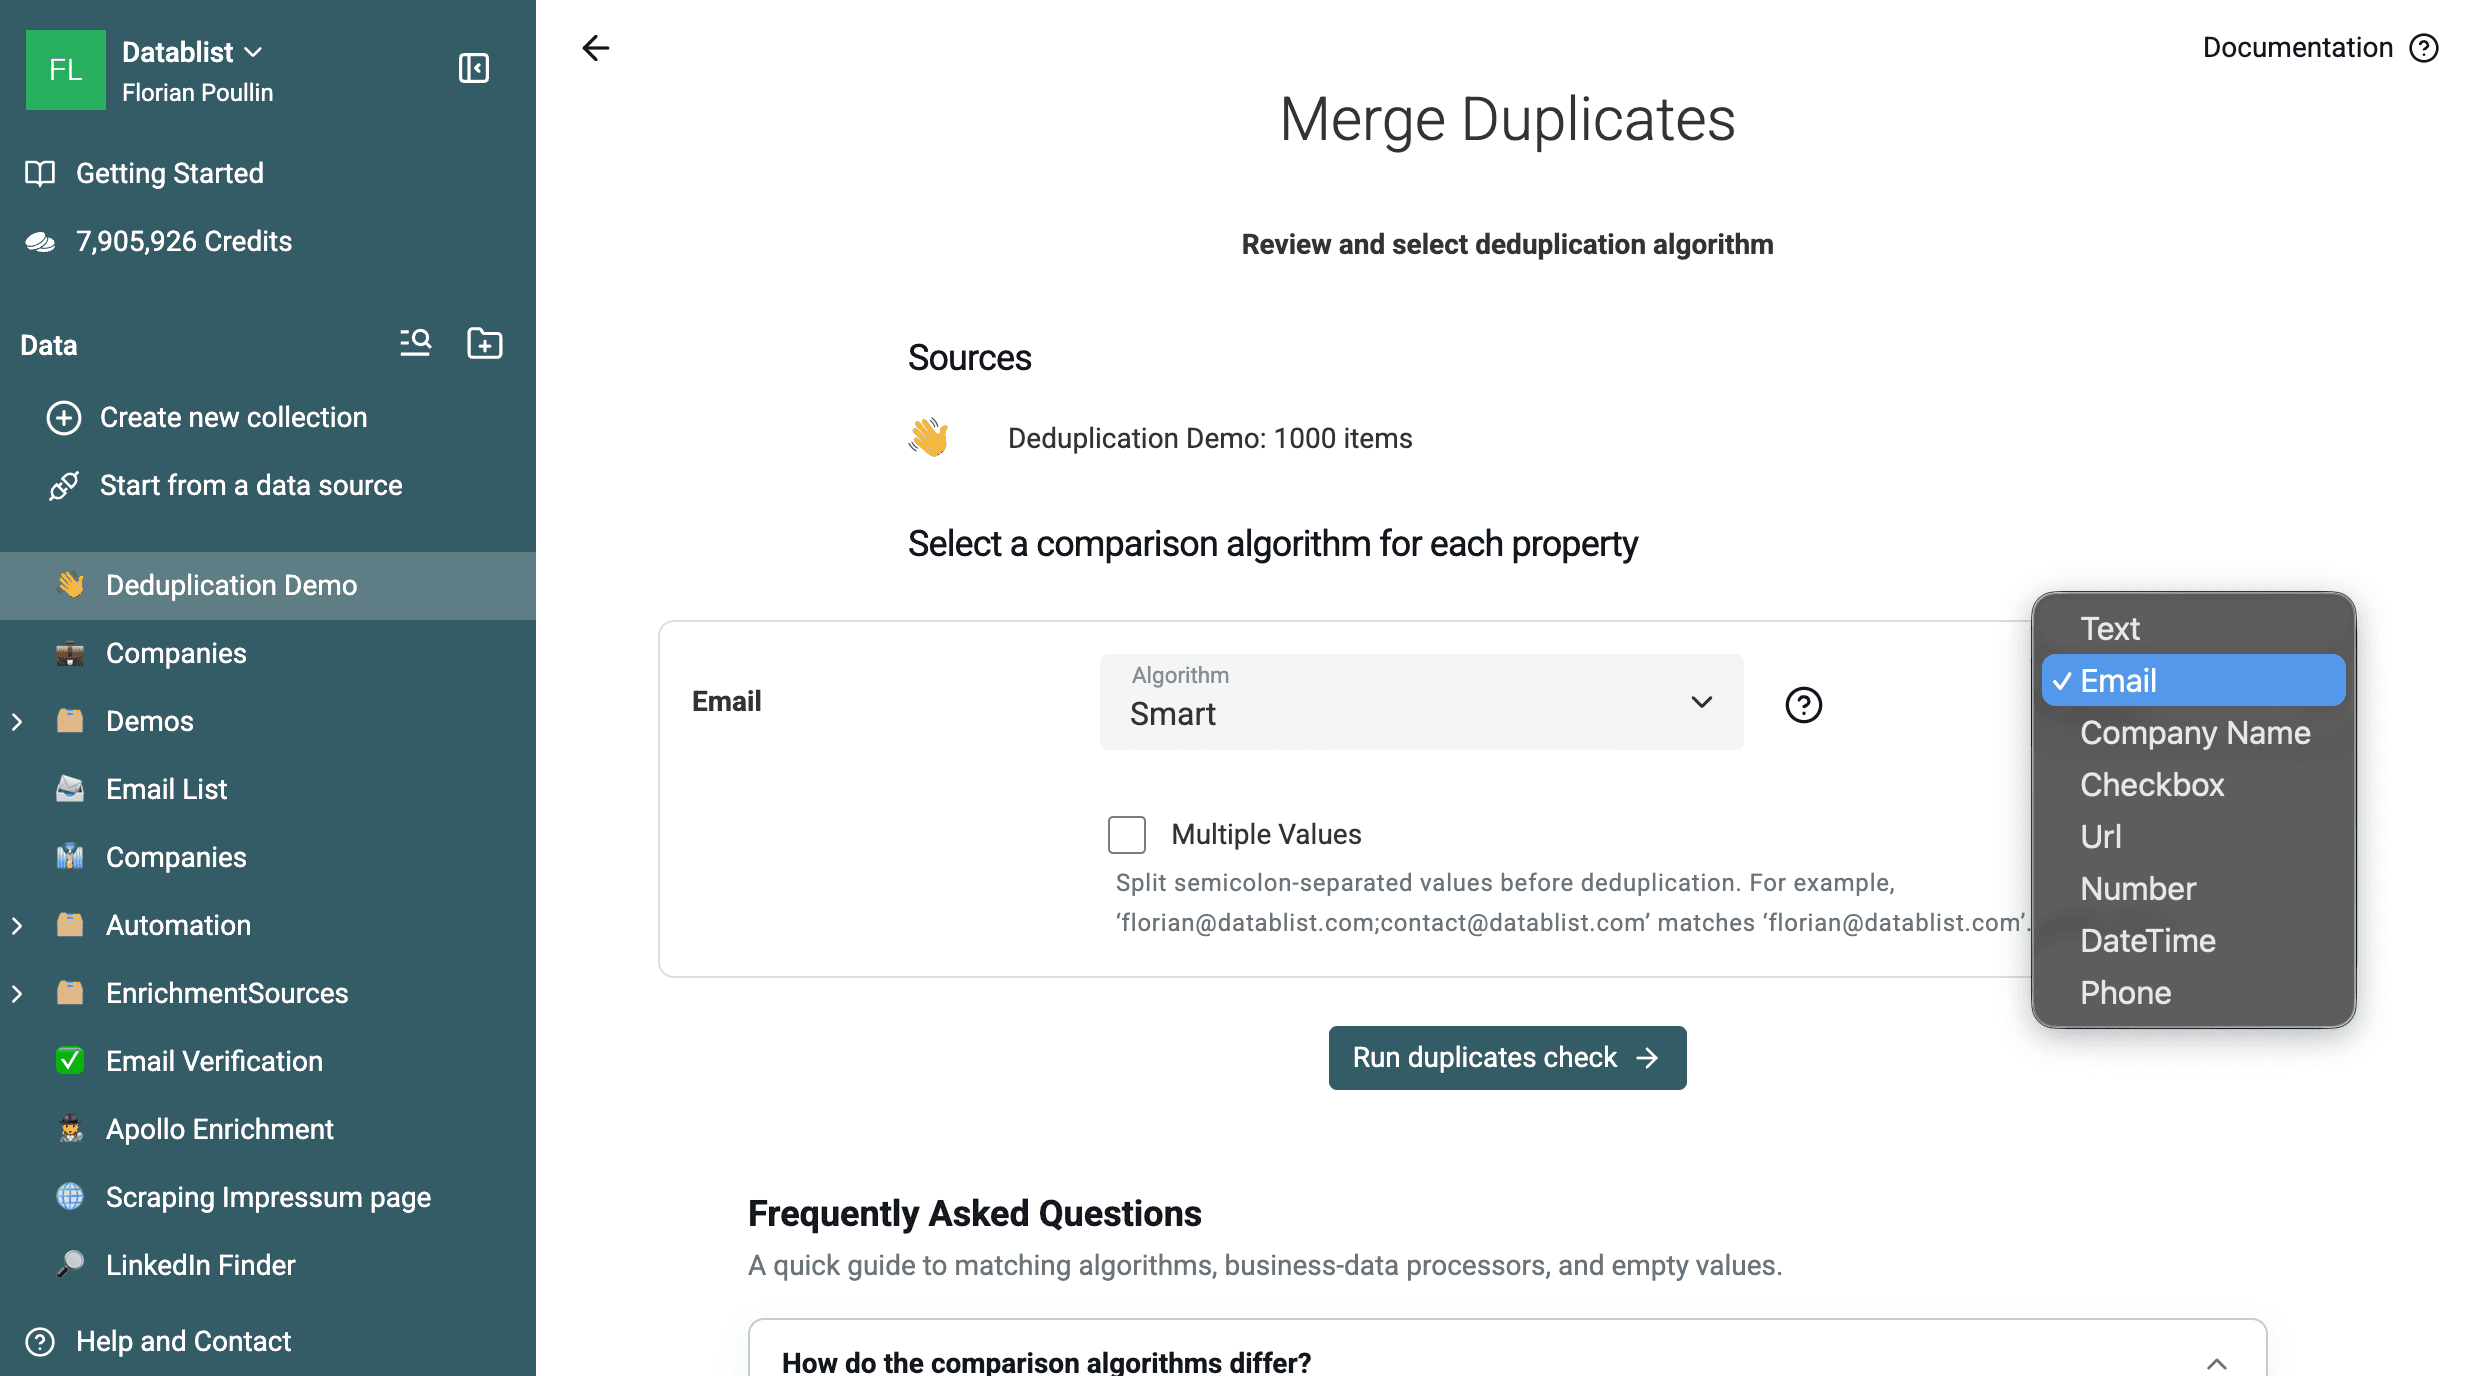
Company Name-processoren, matchning af flere værdier og avancerede algoritmer kræver et betalt abonnement. Exact og Smart er tilgængelige til matchning i én collection med Free-abonnementet, men Smart kræver en gratis konto.
Når én celle indeholder flere identifikatorer adskilt af semikolon, skal du aktivere Multiple Values. Datablist sammenligner hver del og matcher egenskaben, når mindst ét par matcher. En celle med primary@example.com;shared@example.com kan eksempelvis matche en anden celle med shared@example.com.
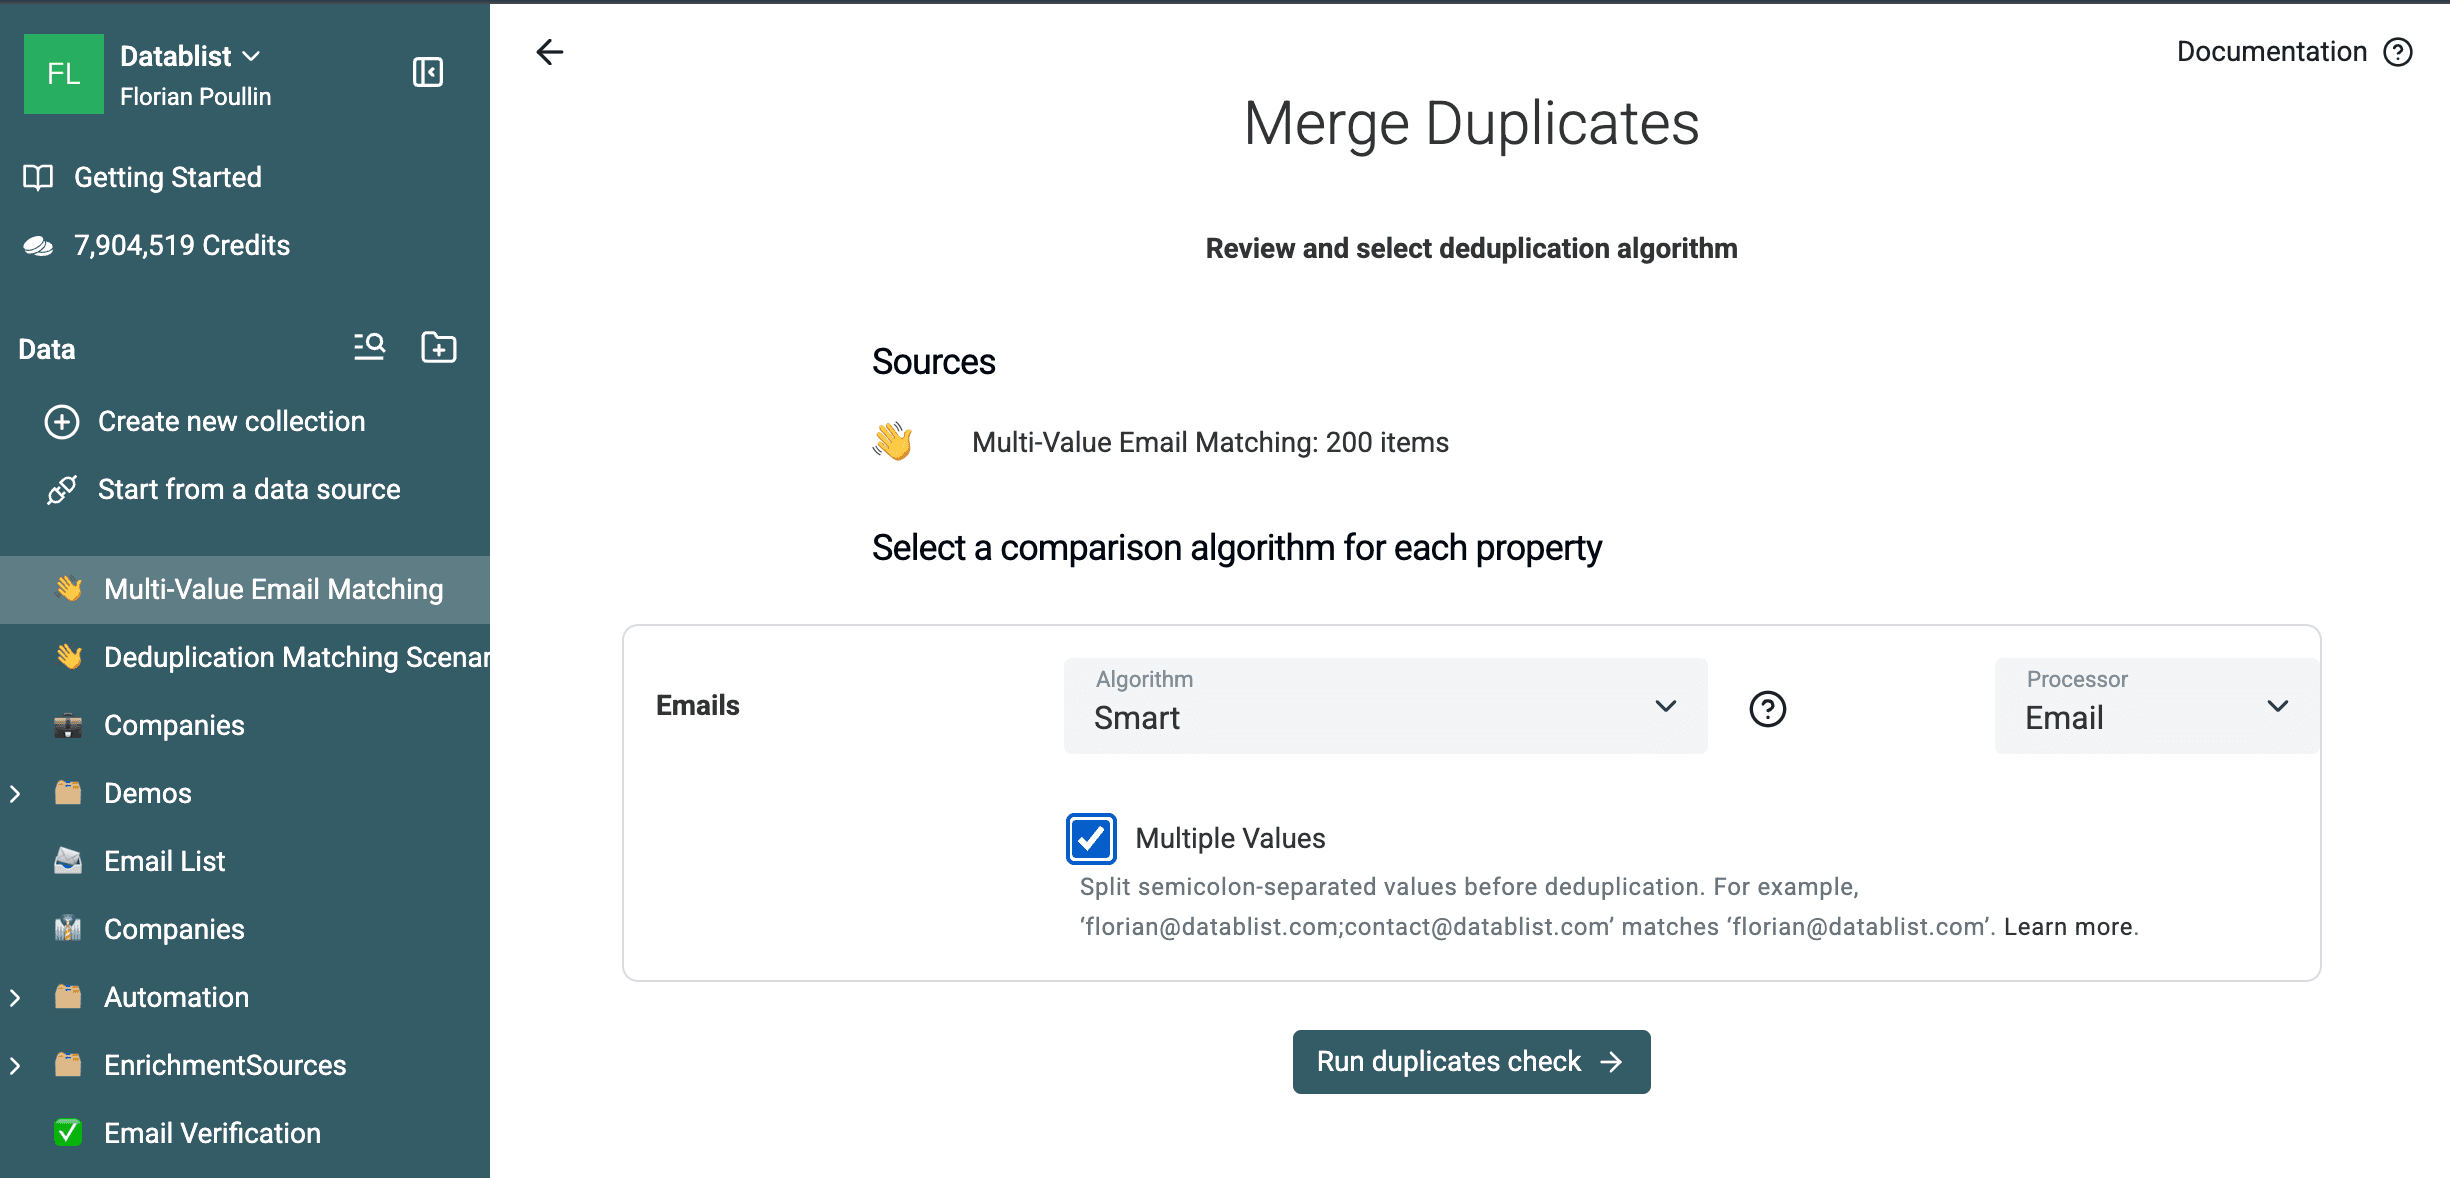
På det dedikerede eksempel med 200 rækker gav denne konfiguration 60 grupper med to rækker. Ground truth-valideringen fandt alle 60 konstruerede par og udelukkede alle 80 kontrolposter. Følg arbejdsgangen til deduplikering af felter med flere værdier for at få eksempelfilen, resultat-CSV'en og vejledning til flettebeslutninger.
Denne e-mailmatchning gav 105 grupper med to rækker: 100 konstruerede par, der kræver e-mailnormalisering, og de fem identiske kopipar, som også har samme e-mailadresse.
Normalisér telefonnumre før matchning
Smart Phone-processoren er nyttig i ét afgrænset scenarie: værdier med de samme cifre, men forskellige mellemrum, parenteser, bindestreger eller symboler. Den kan matche (415) 555-0123 med 4155550123.
Den kan ikke afgøre, om et lokalt og et internationalt nummer er det samme. Eksempelvis kræver 06 12 34 50 08 og +33 6 12 34 50 08 landekontekst, før de kan sammenlignes.
Brug Phone Number Cleaner før telefonbaseret deduplikering:
- Map den rå
Phone-property. - For en liste fra ét land skal du vælge landet under Local Phone Countries. For en blandet liste skal du aktivere Define country per item og mappe din
Country-property. - Skriv enrichment-resultatet til
Clean Phone Numberuden at overskrive den rå værdi. - Gennemgå mislykkede eller tomme resultater. De bør ikke indgå i telefonbaseret matchning.
- Kør Duplicates Finder på
Clean Phone Numbermed Exact.
Download det dedikerede telefoneksempel med 200 rækker. Det indeholder 50 lokale/internationale par fra USA, Frankrig, Storbritannien, Tyskland og Spanien samt 100 kontrolposter, der ikke matcher. Validering med logikken fra den aktive cleaner gav ét normaliseret telefonnummer for alle 200 rækker. De 50 konstruerede par samles til 50 fælles internationale værdier, mens kontrolposterne forbliver unikke.
Denne forbehandling validerer også telefonnummerets format. Behold de oprindelige Phone- og Country-properties ved siden af det rensede resultat, så du kan kontrollere en post før fletning. Læs hvad normalisering af telefonnumre betyder for at forstå betydningen af landekoder og internationale værdier.
For virksomhedsposter skal du køre en separat matchning på Website. Vælg Smart med URL-processoren. Aktivér kun Ignore Subdomain, Ignore Path og Ignore Query Params, når disse URL-dele ikke skal identificere en anden virksomhed eller lokation.
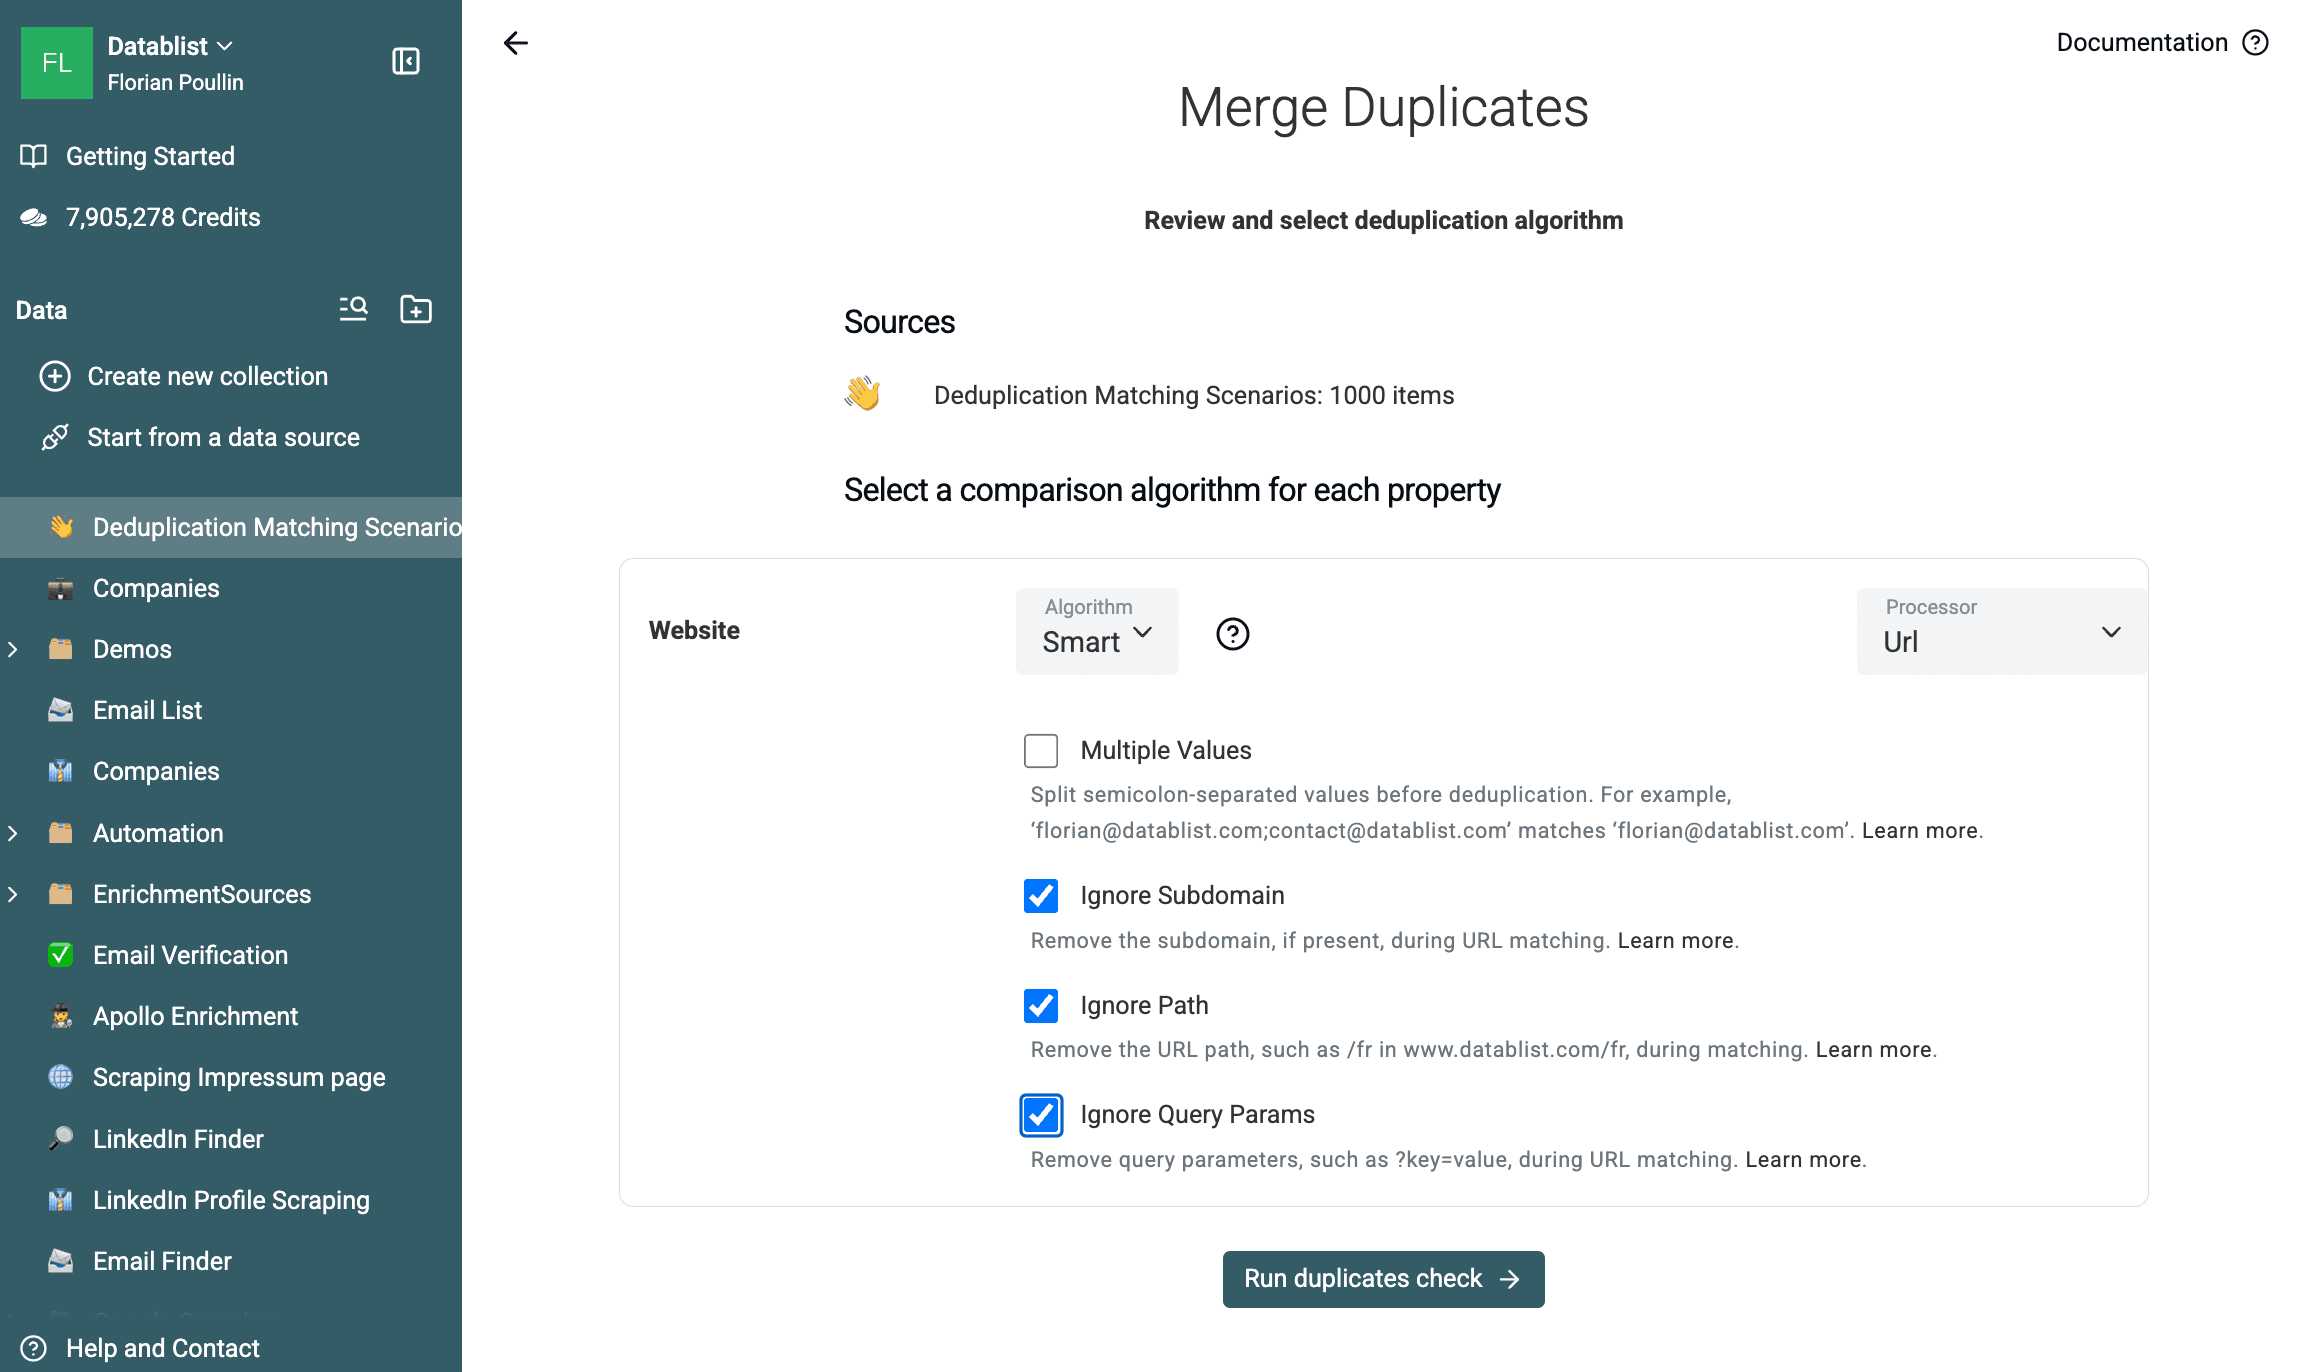
På det samme eksempel med 1.000 rækker gav denne konfiguration 200 grupper med to rækker. 50 par indeholder konstruerede URL-variationer, mens 150 par allerede deler et identisk website. I denne test blev hvert eksporteret par knyttet til den samme normaliserede host.
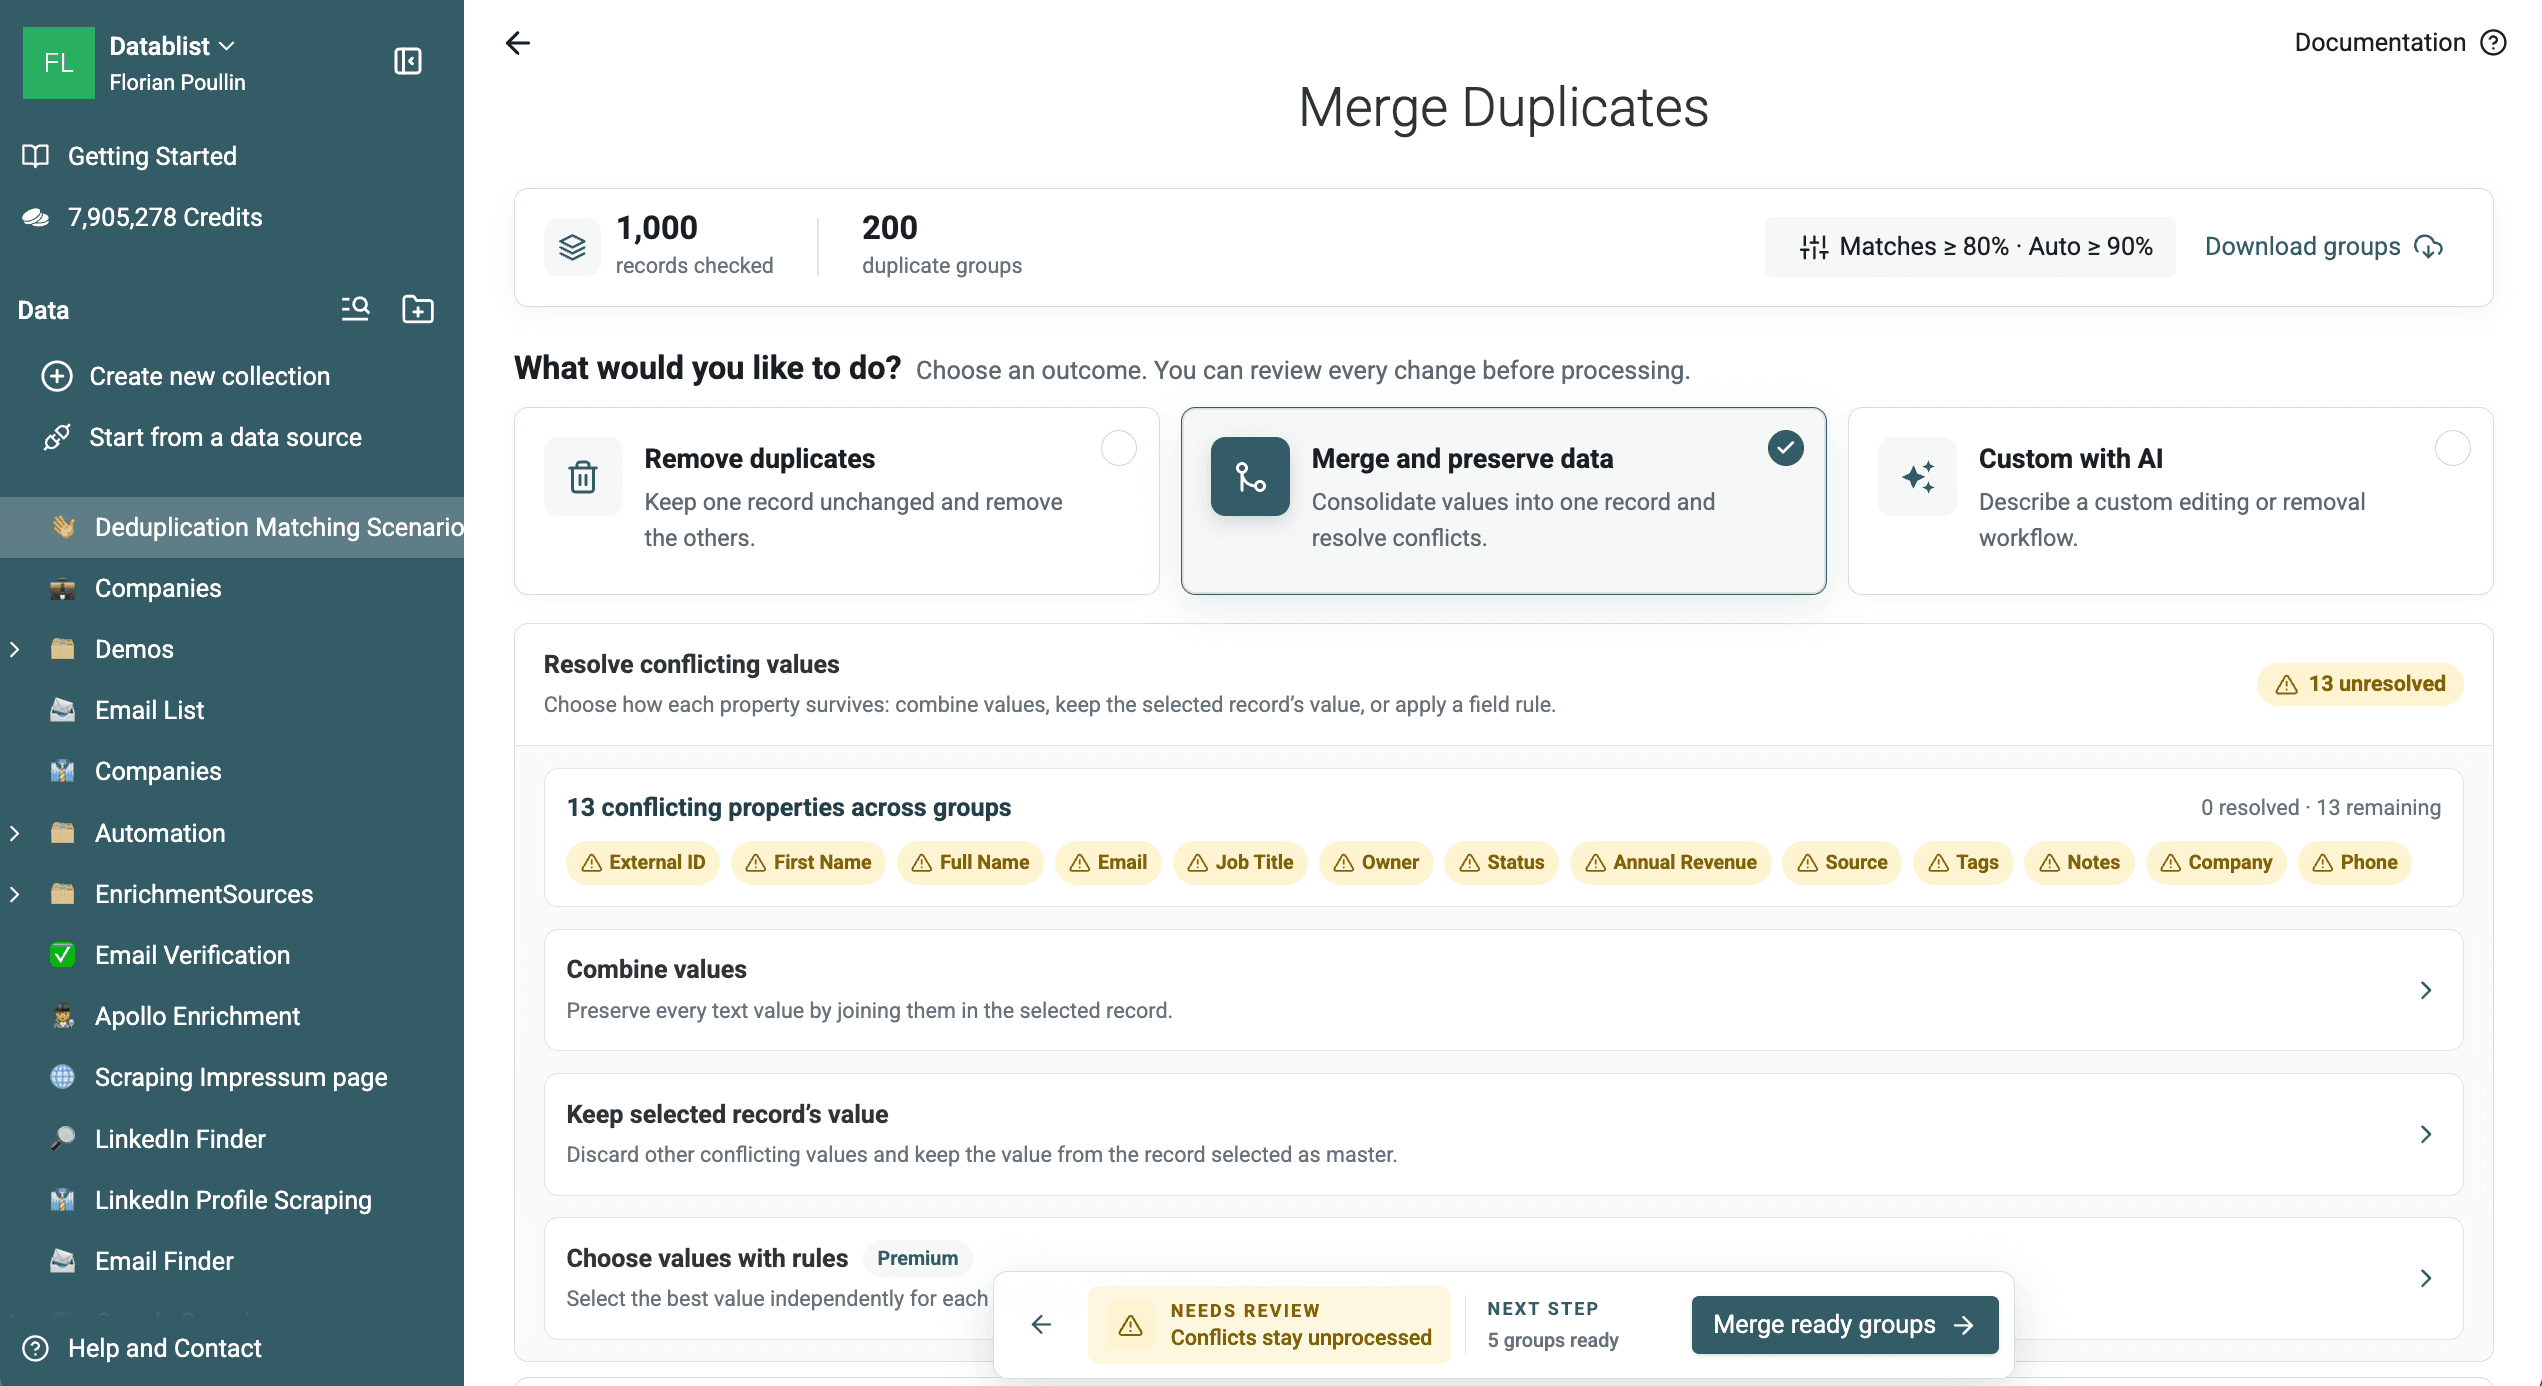
Download de 200 dubletgrupper for Website, eller se arbejdsgangen til deduplikering af virksomheder for en domænebaseret matchningsstrategi.
Brug fuzzy- eller fonetisk matchning til gennemgang
Metaphone sammenligner, hvordan tekst lyder. Jaro-Winkler og Levenshtein beregner en lighedsscore, som kan finde stavevariationer som Uma Turner og Uman Turner.
Fuzzy-matches er kandidater – ikke bekræftede dubletter. Begynd med en høj tærskel, kontrollér de svageste grupper, og sænk kun resultattærsklen, hvis gennemgangen fortsat giver præcise resultater.
Vælg Full Name, Distance med Levenshtein og Text-processoren, og sæt tærsklen til 90 % for at køre en målbar fuzzy-matchning.
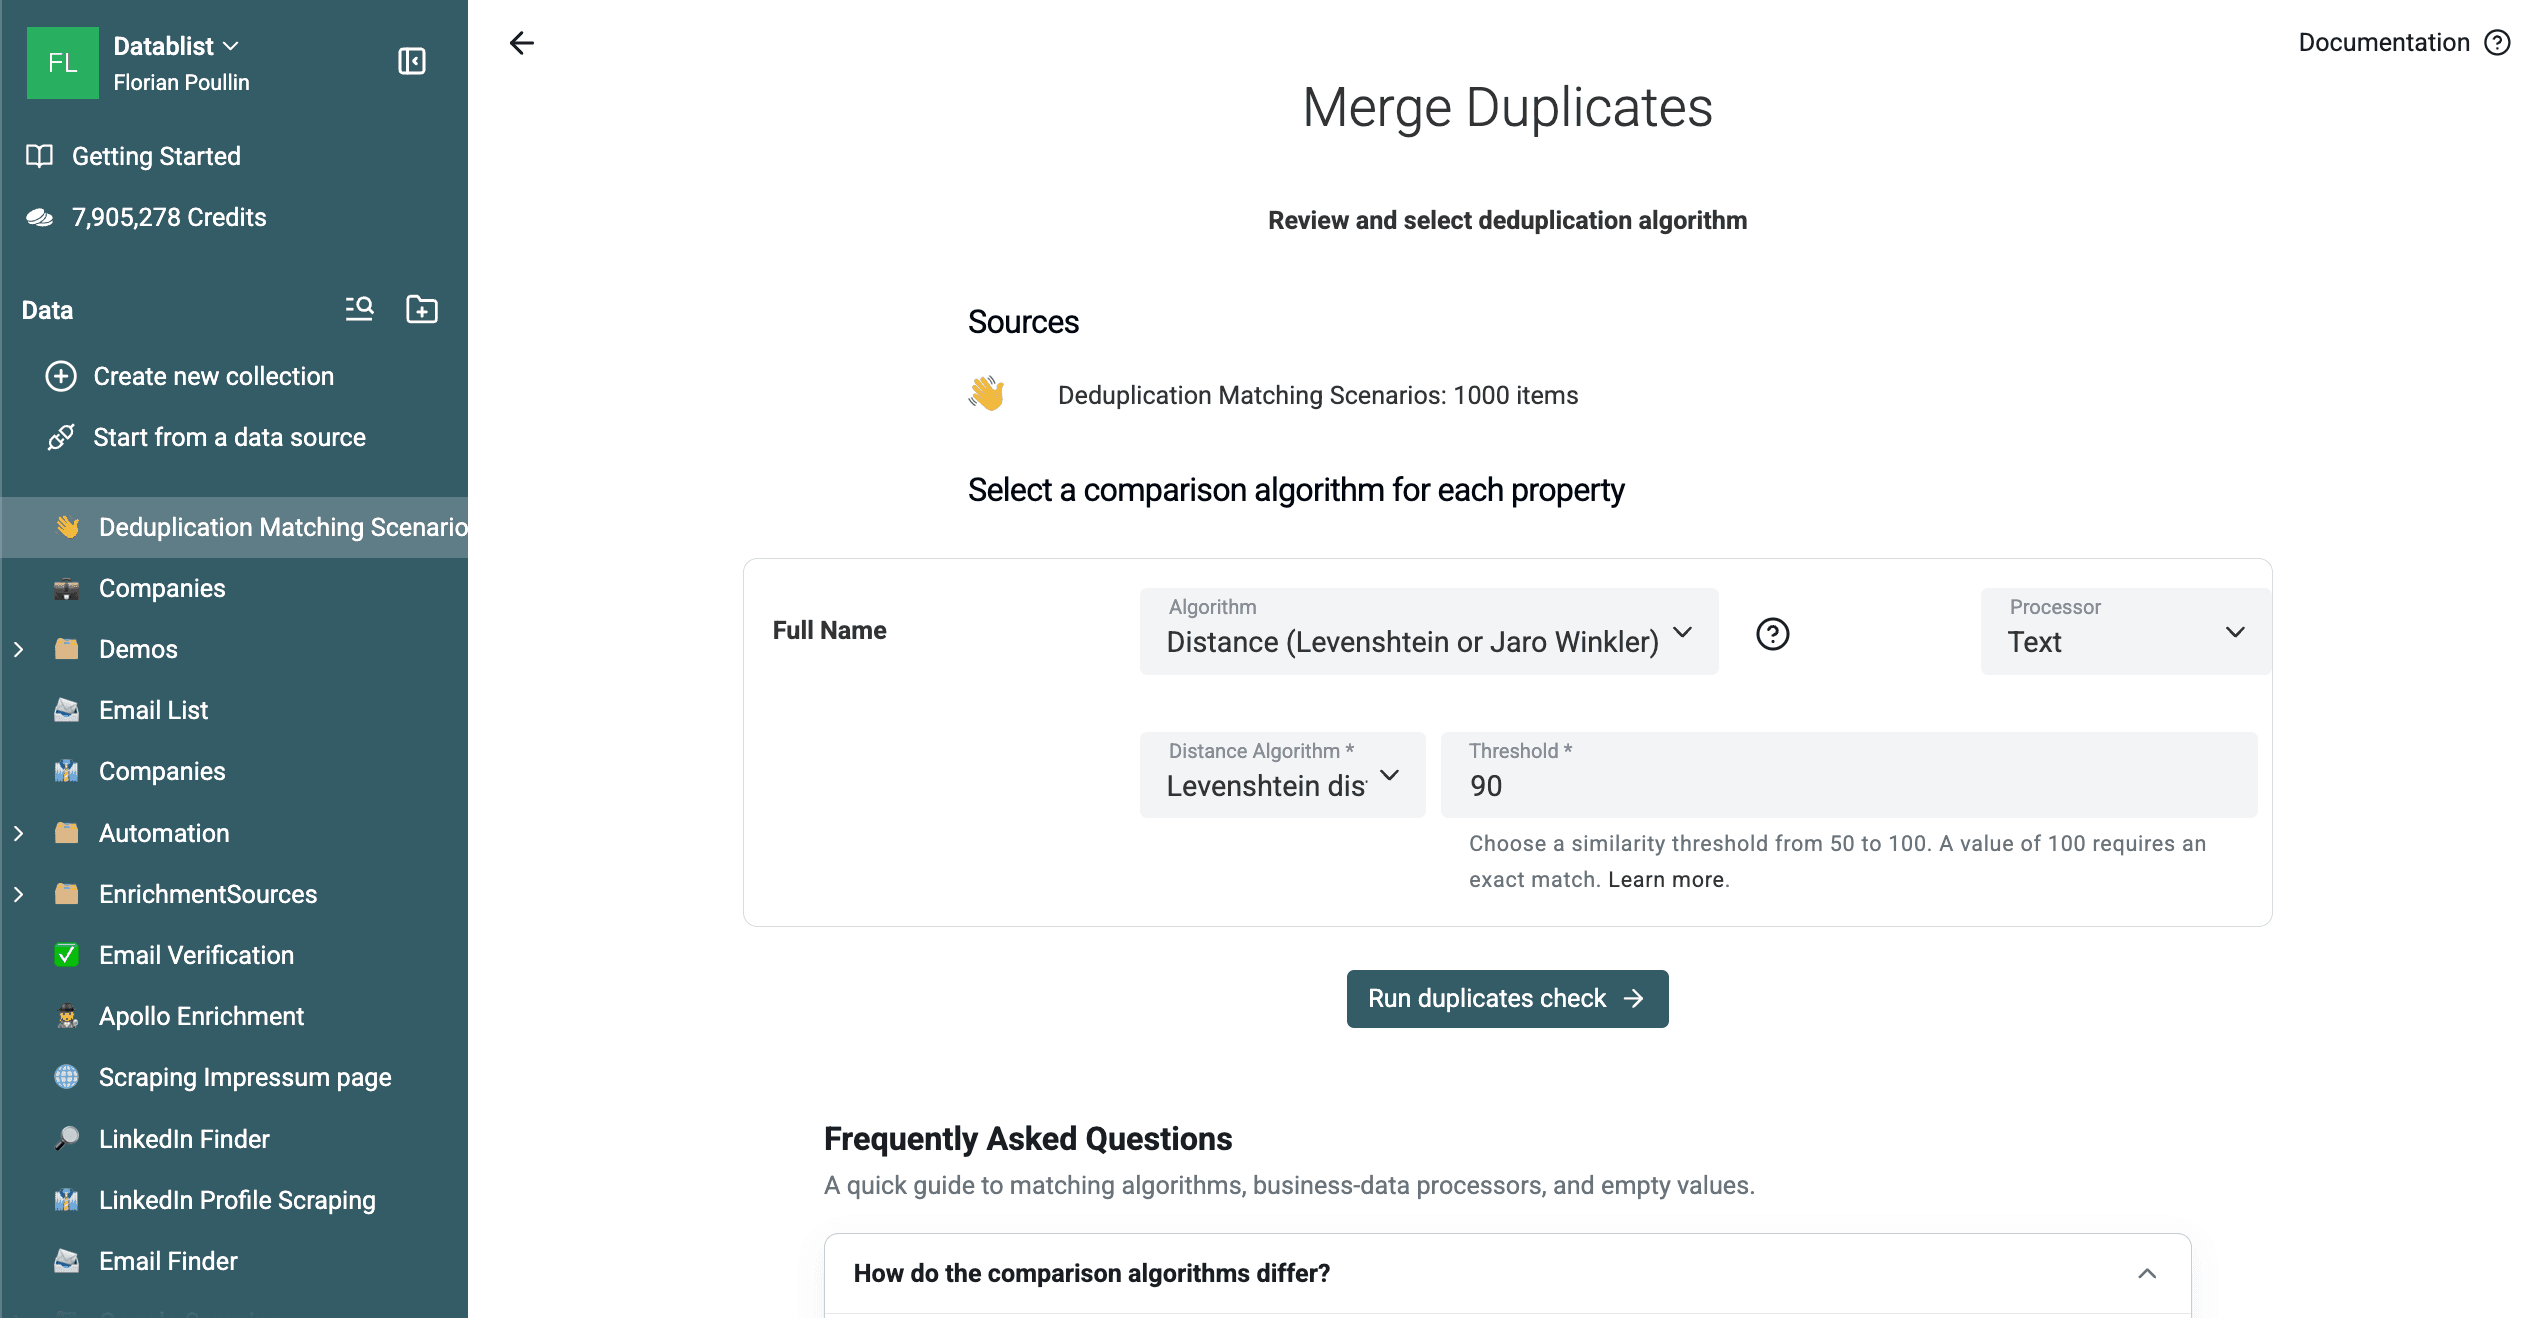
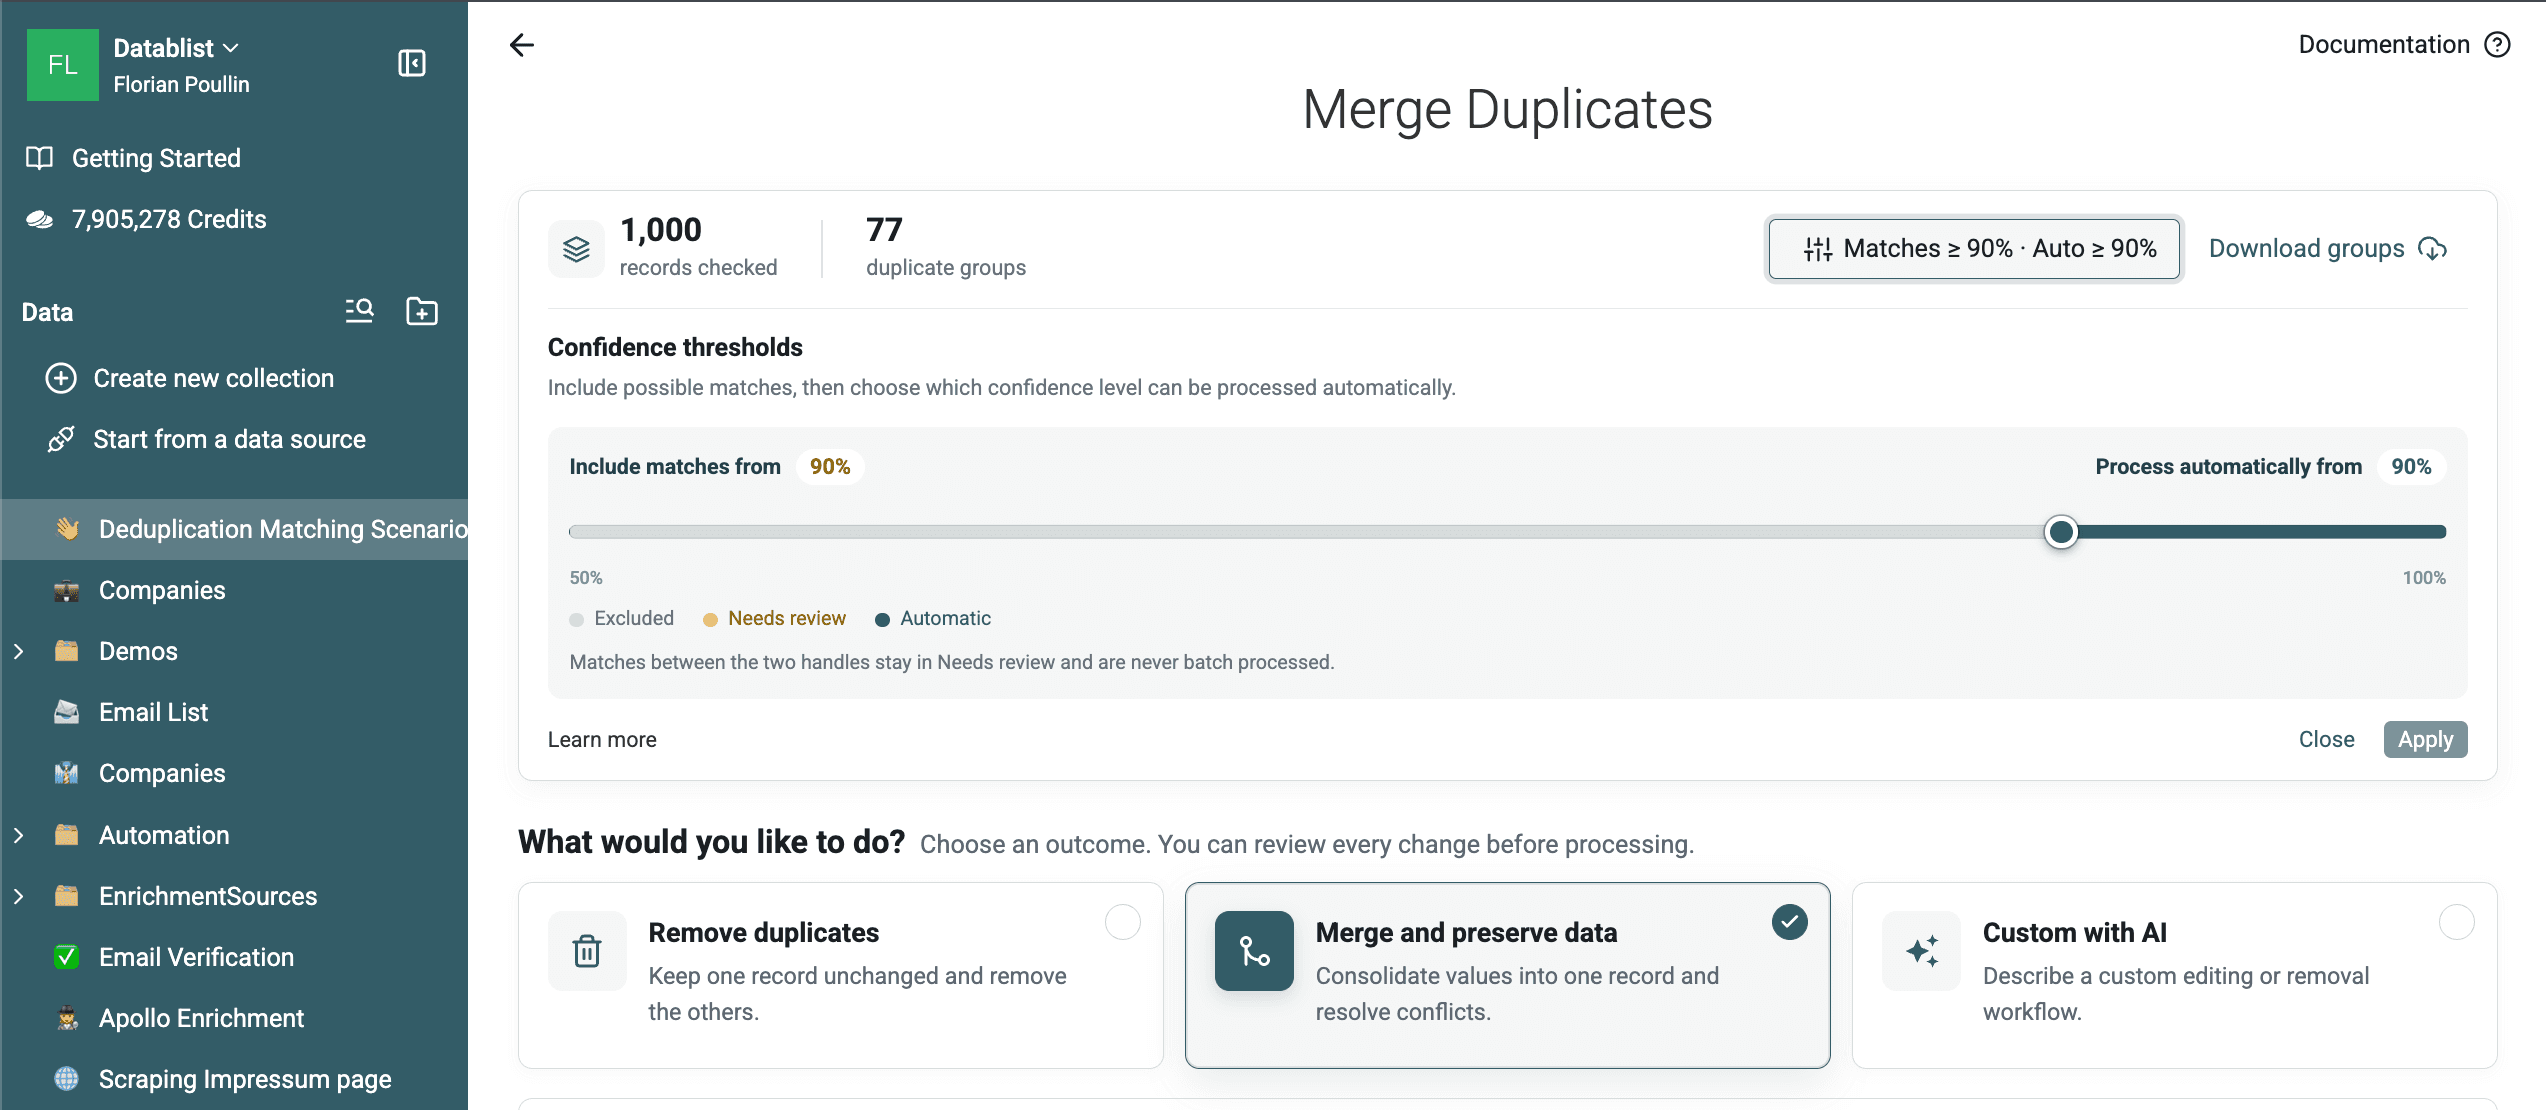
Denne kontrol gav 77 grupper med to rækker fra eksemplet med 1.000 rækker. Ground truth-valideringen fandt 21 grupper, der forbinder samme konstruerede entitet, og 56 grupper, der forbinder forskellige entiteter. De fleste falske positiver var forkortede navne som G. Rossi, hvor værdien i Full Name ikke i sig selv kan skelne mellem to personer.
Matchningen finder tilsigtede stavevariationer som Uma A. Turner og Uman A. Turner, men viser også, hvorfor fuzzy-matches baseret på navnet alene skal gennemgås.
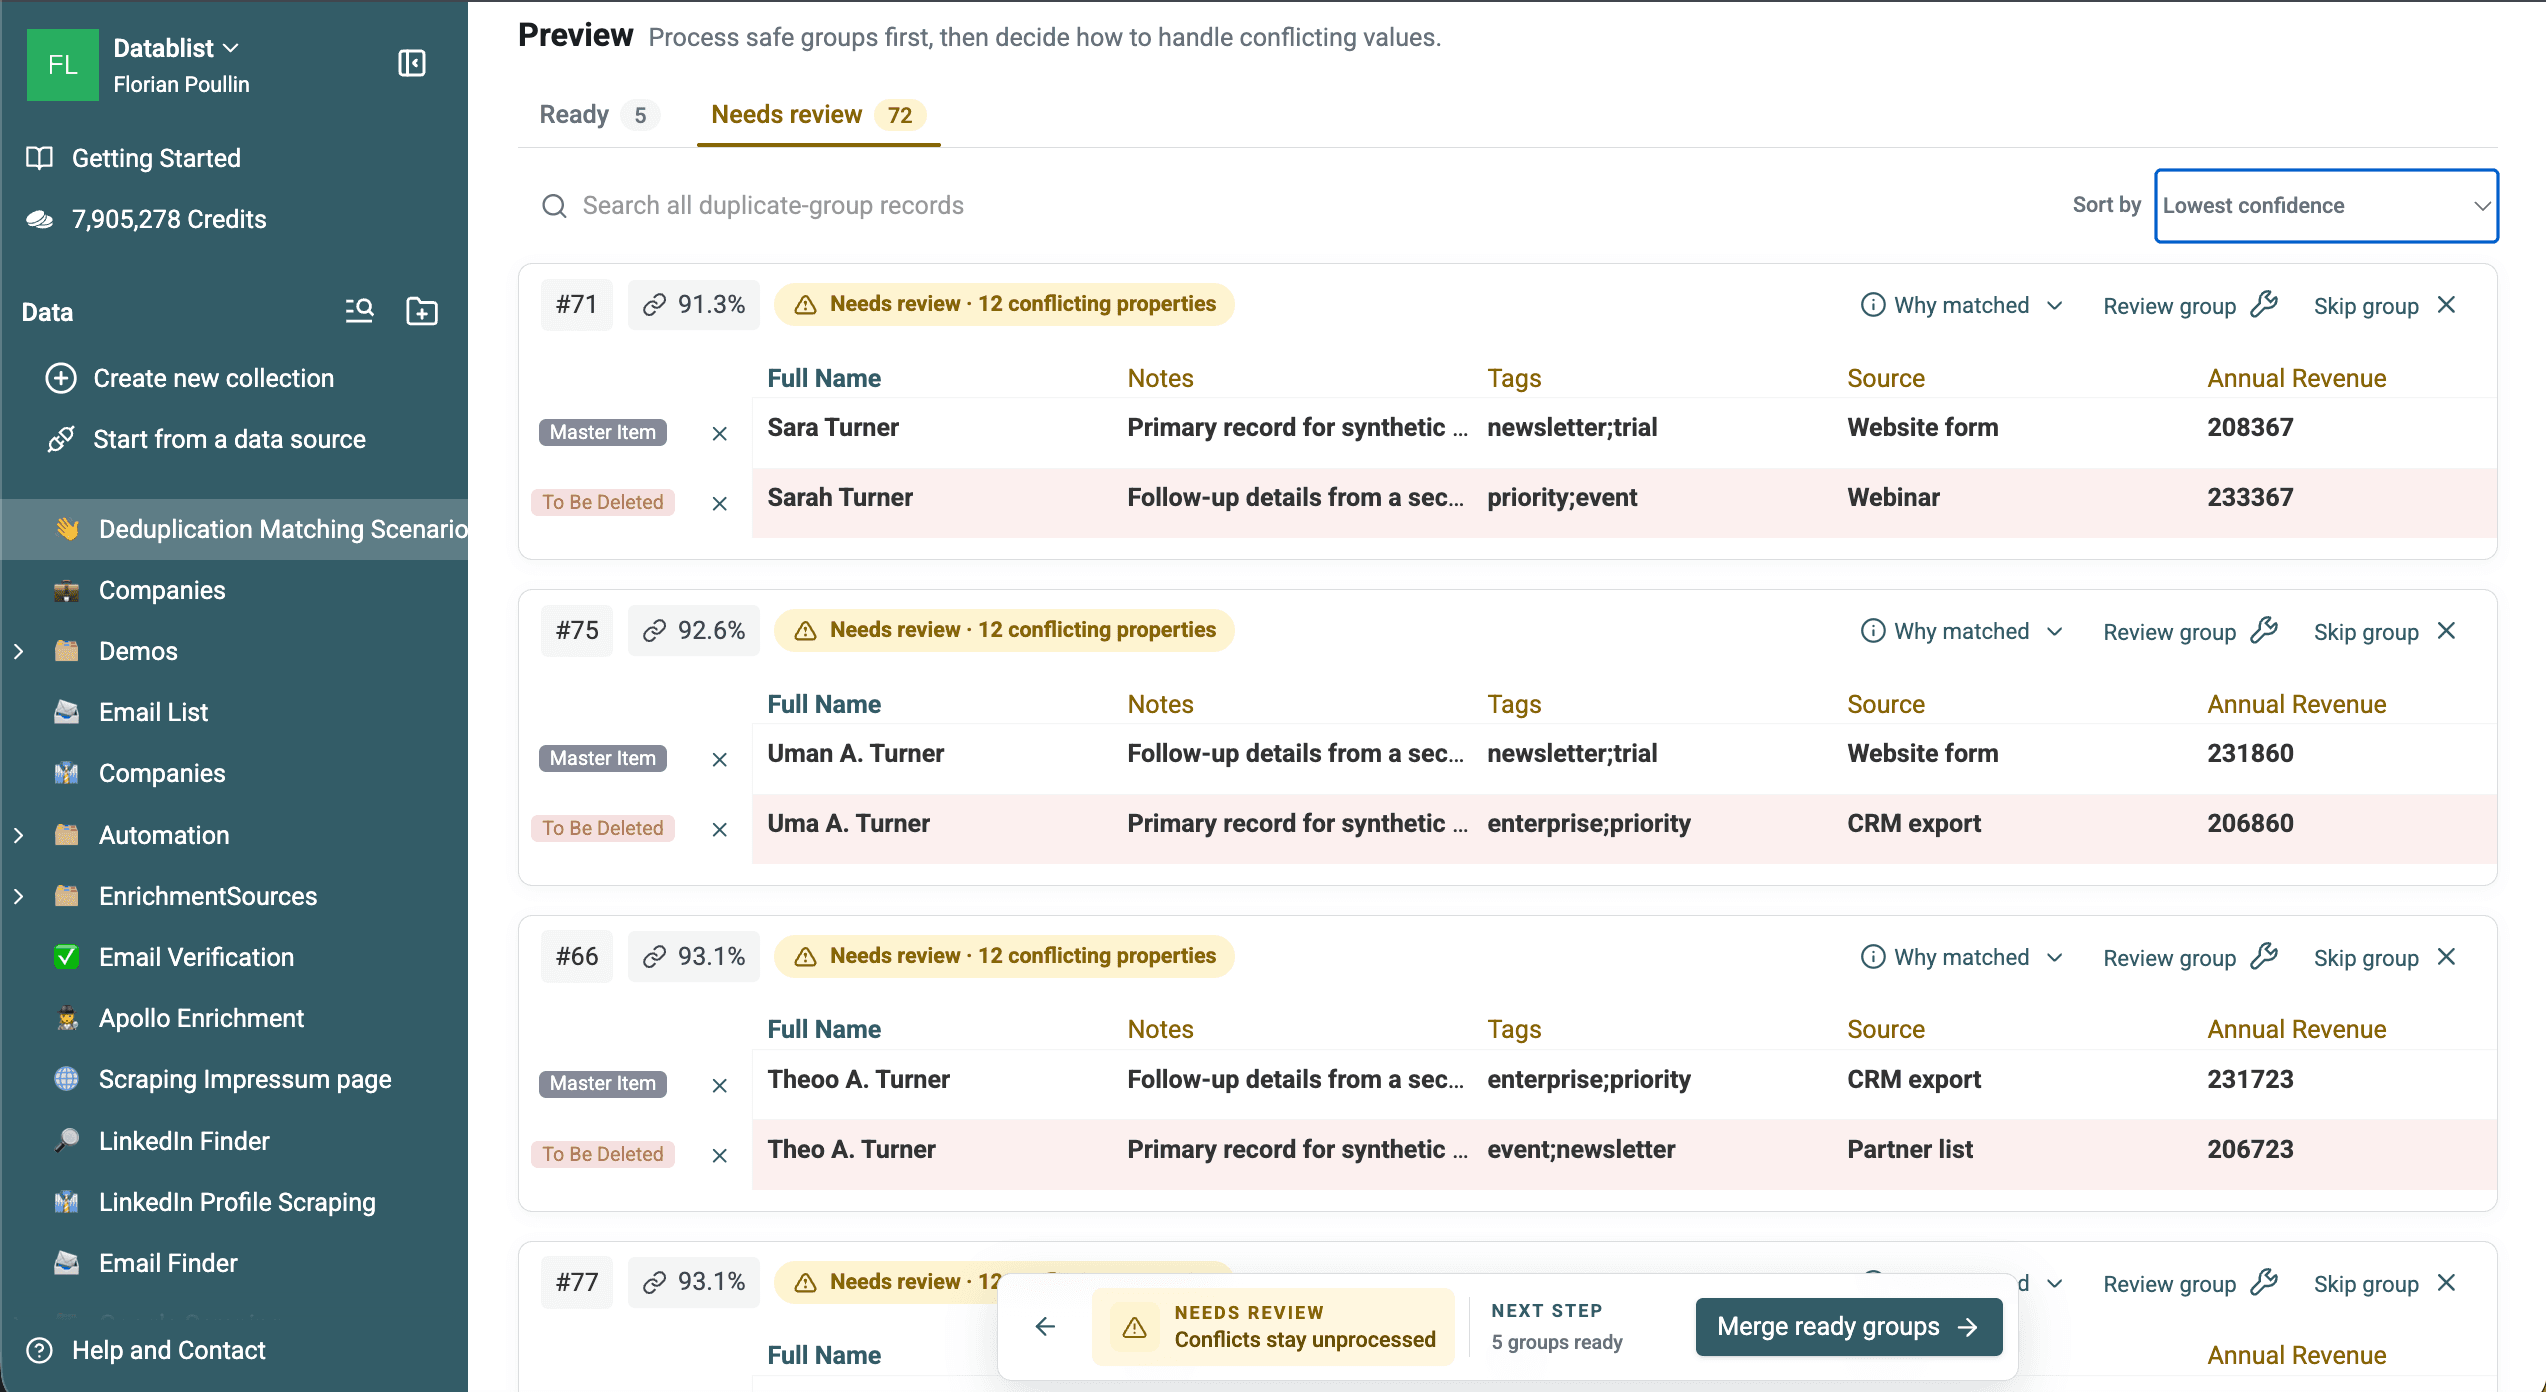
Download de 77 eksporterede Levenshtein-grupper for at kontrollere både nyttige matches og falske positiver.
Ved fonetisk matchning skal du vælge Full Name, Metaphone og beholde Text-processoren.
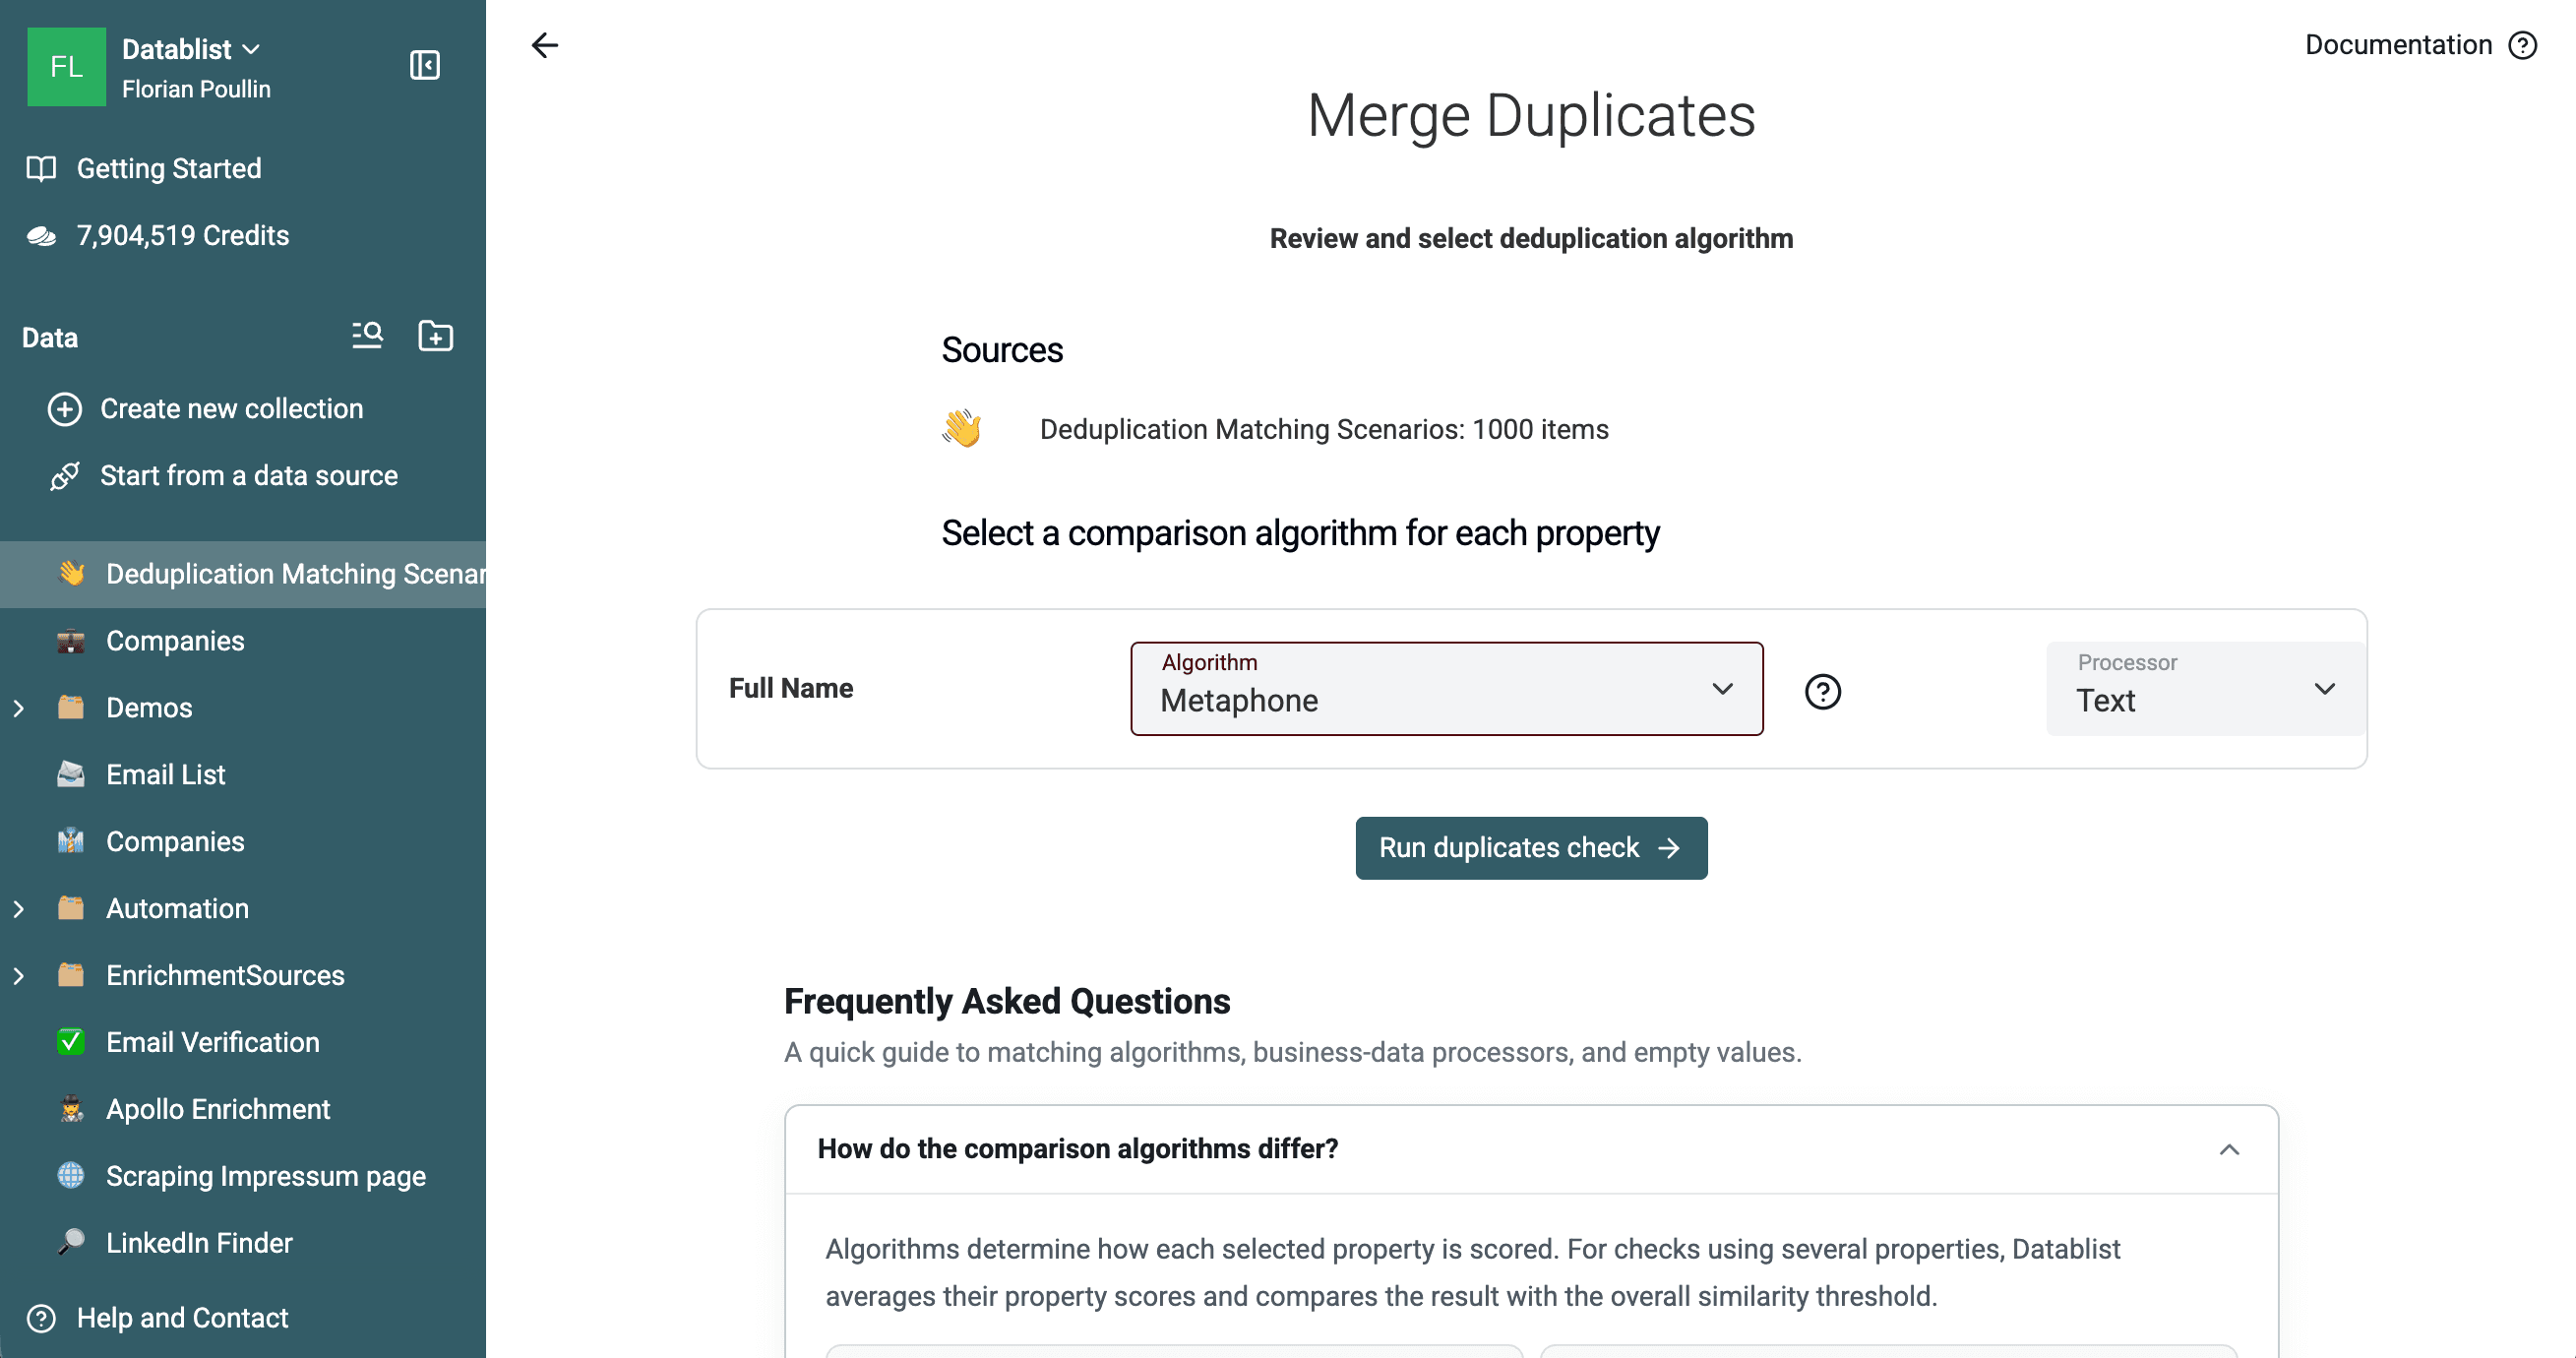
Denne matchning viste 69 grupper: 5 Ready og 64 Needs review. De eksporterede grupper indeholder 188 rækker. Valideringen mod eksemplets kendte entiteter fandt 19 rene grupper med samme entitet og 50 grupper med forskellige personer. Gruppestørrelserne varierer fra to til syv rækker.
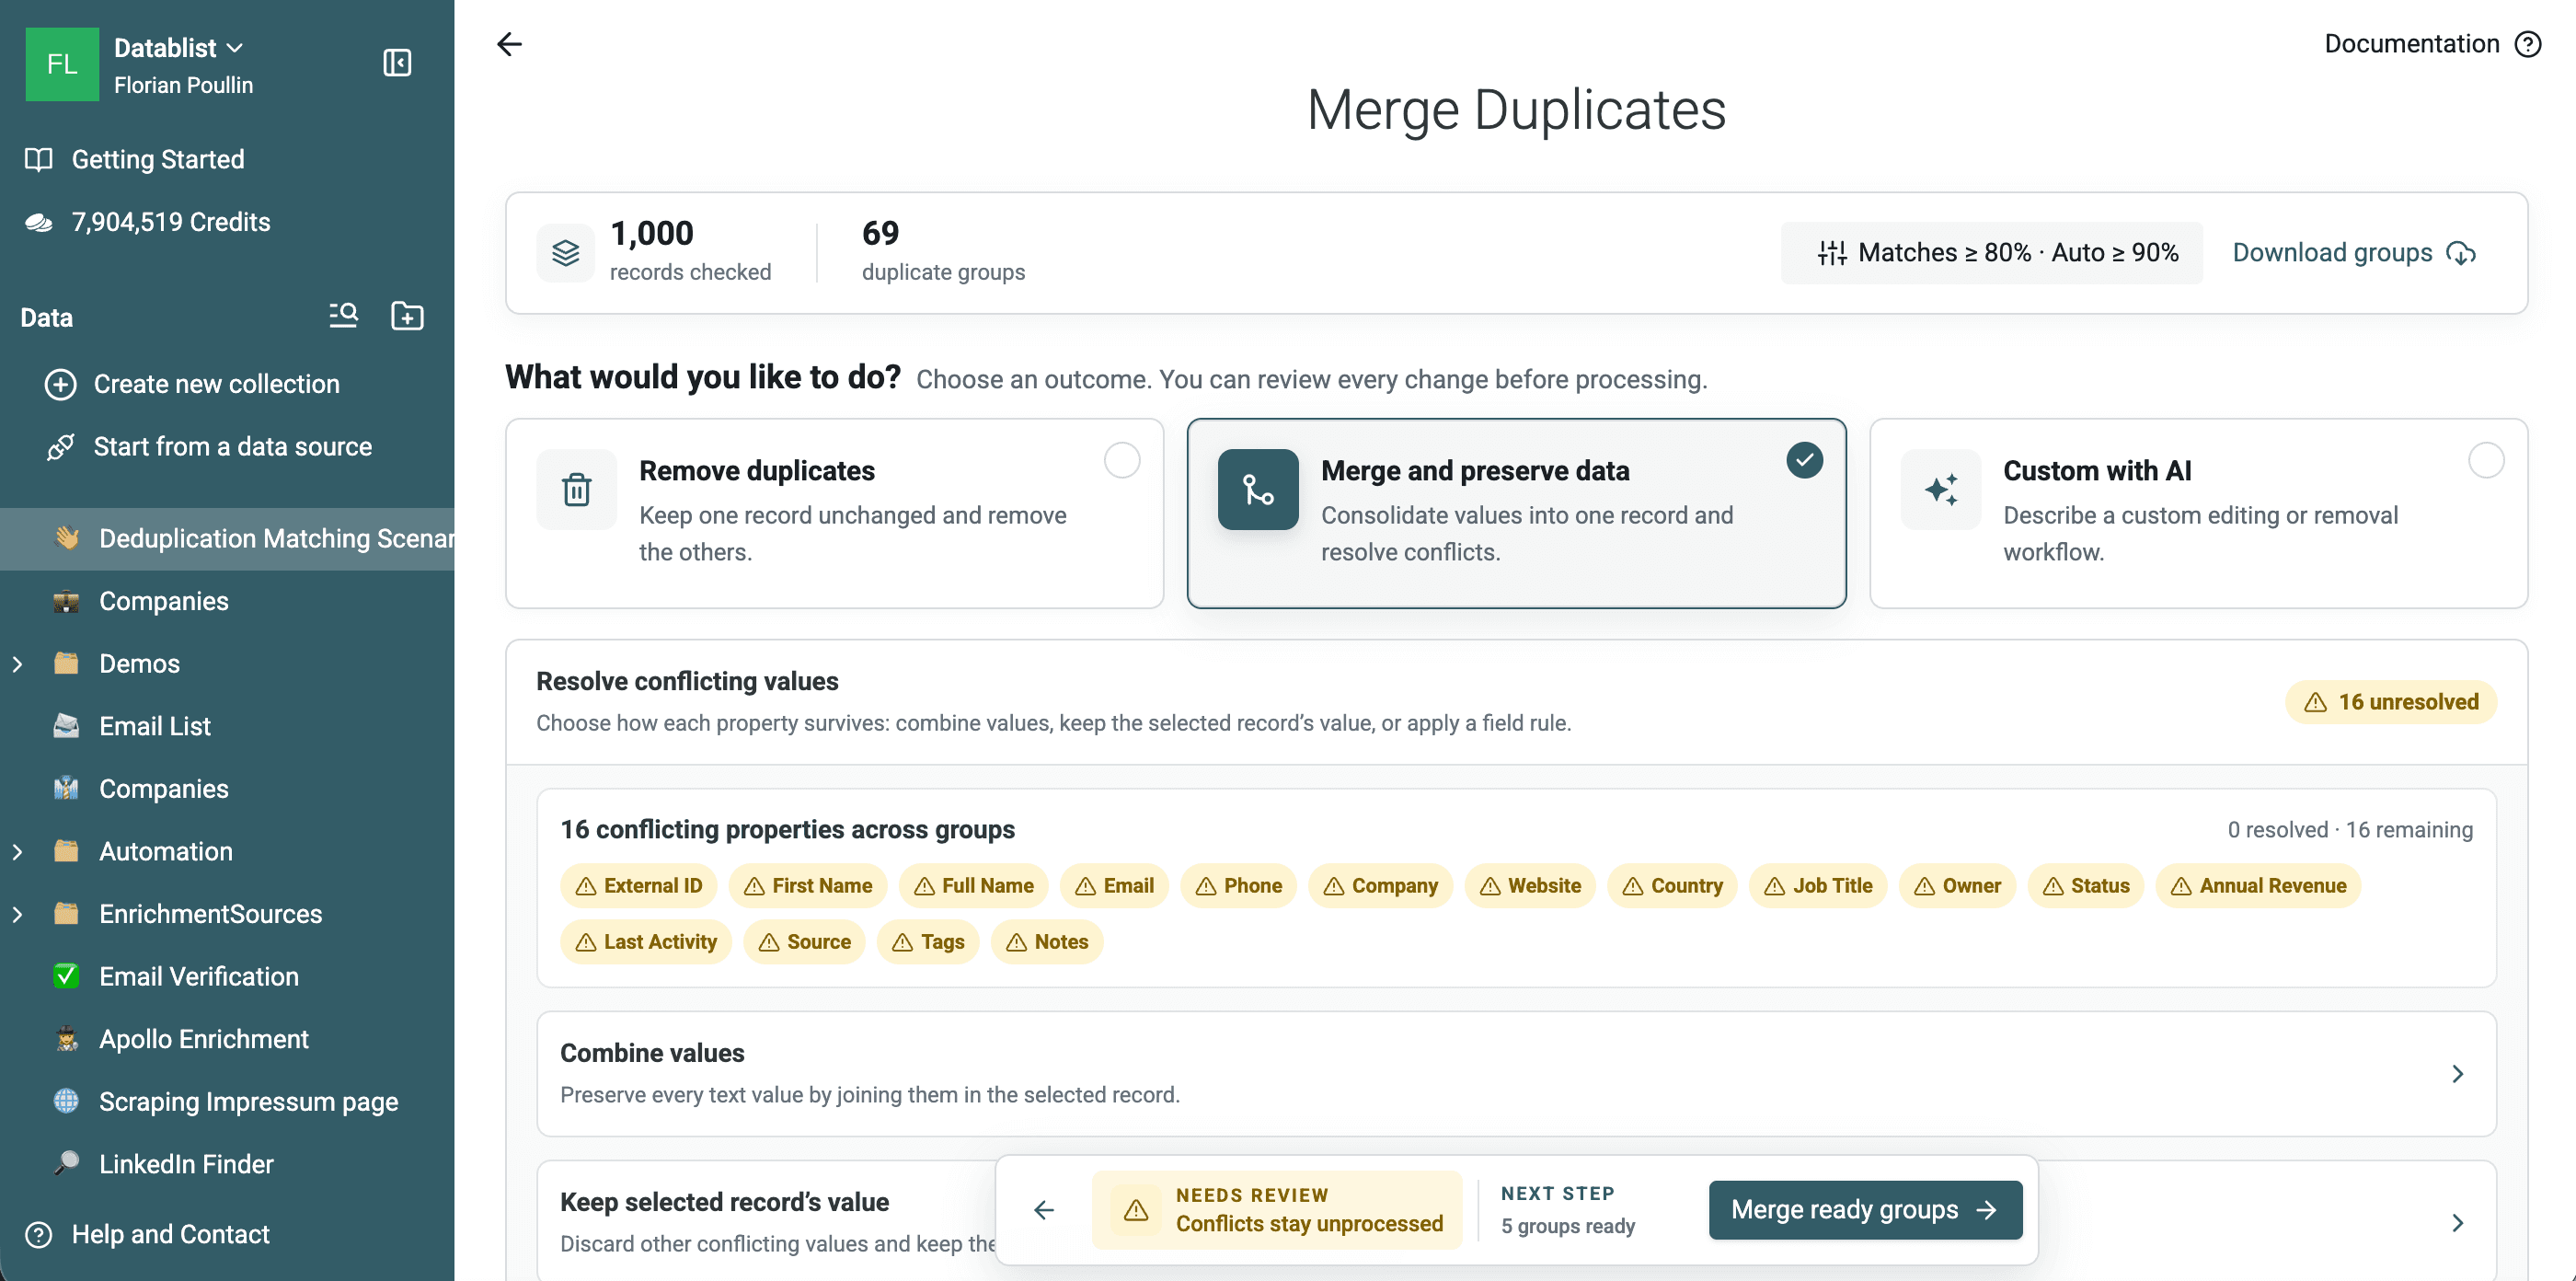
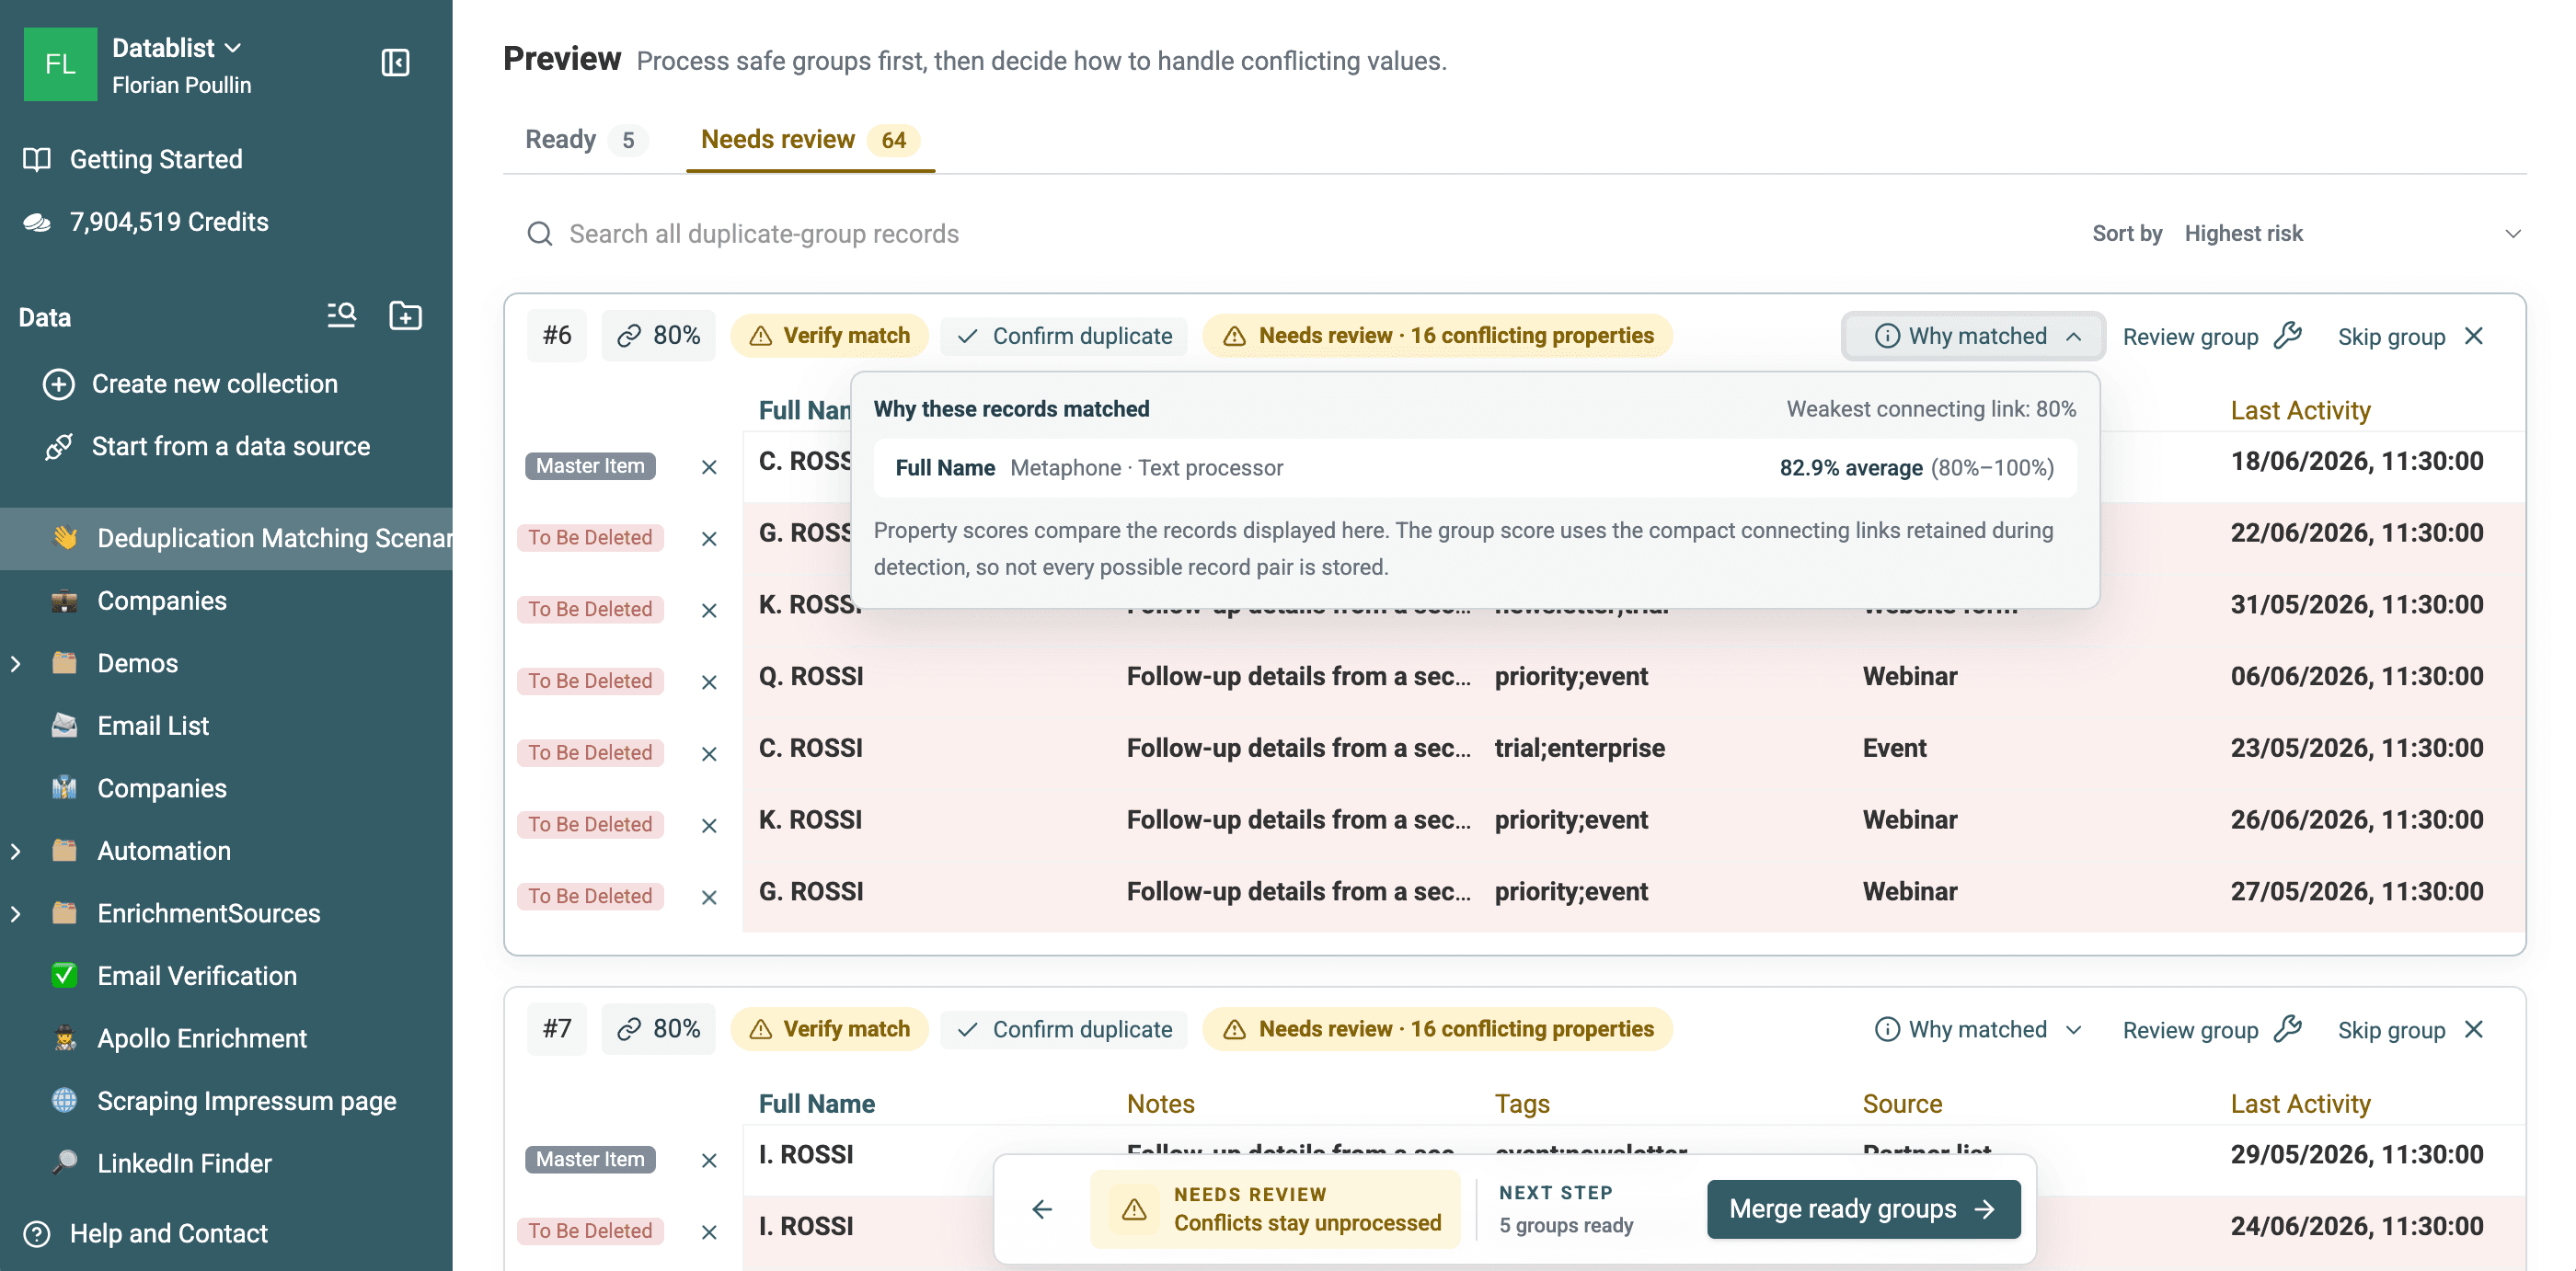
Why matched bekræfter egenskaben Full Name, Metaphone-algoritmen, Text-processoren og gruppens score. Brug disse oplysninger til at kontrollere sammenligningen – ikke som erstatning for et identitetstjek.
Download de 69 eksporterede Metaphone-grupper for at kontrollere de nyttige fonetiske matches og de falske positiver. De større grupper med falske positiver kombinerer ofte initialer med et almindeligt efternavn, eksempelvis flere forkortede Rossi-navne. Deres fonetiske koder overlapper, men navnene alene er ikke tilstrækkelig dokumentation for en automatisk fletning.
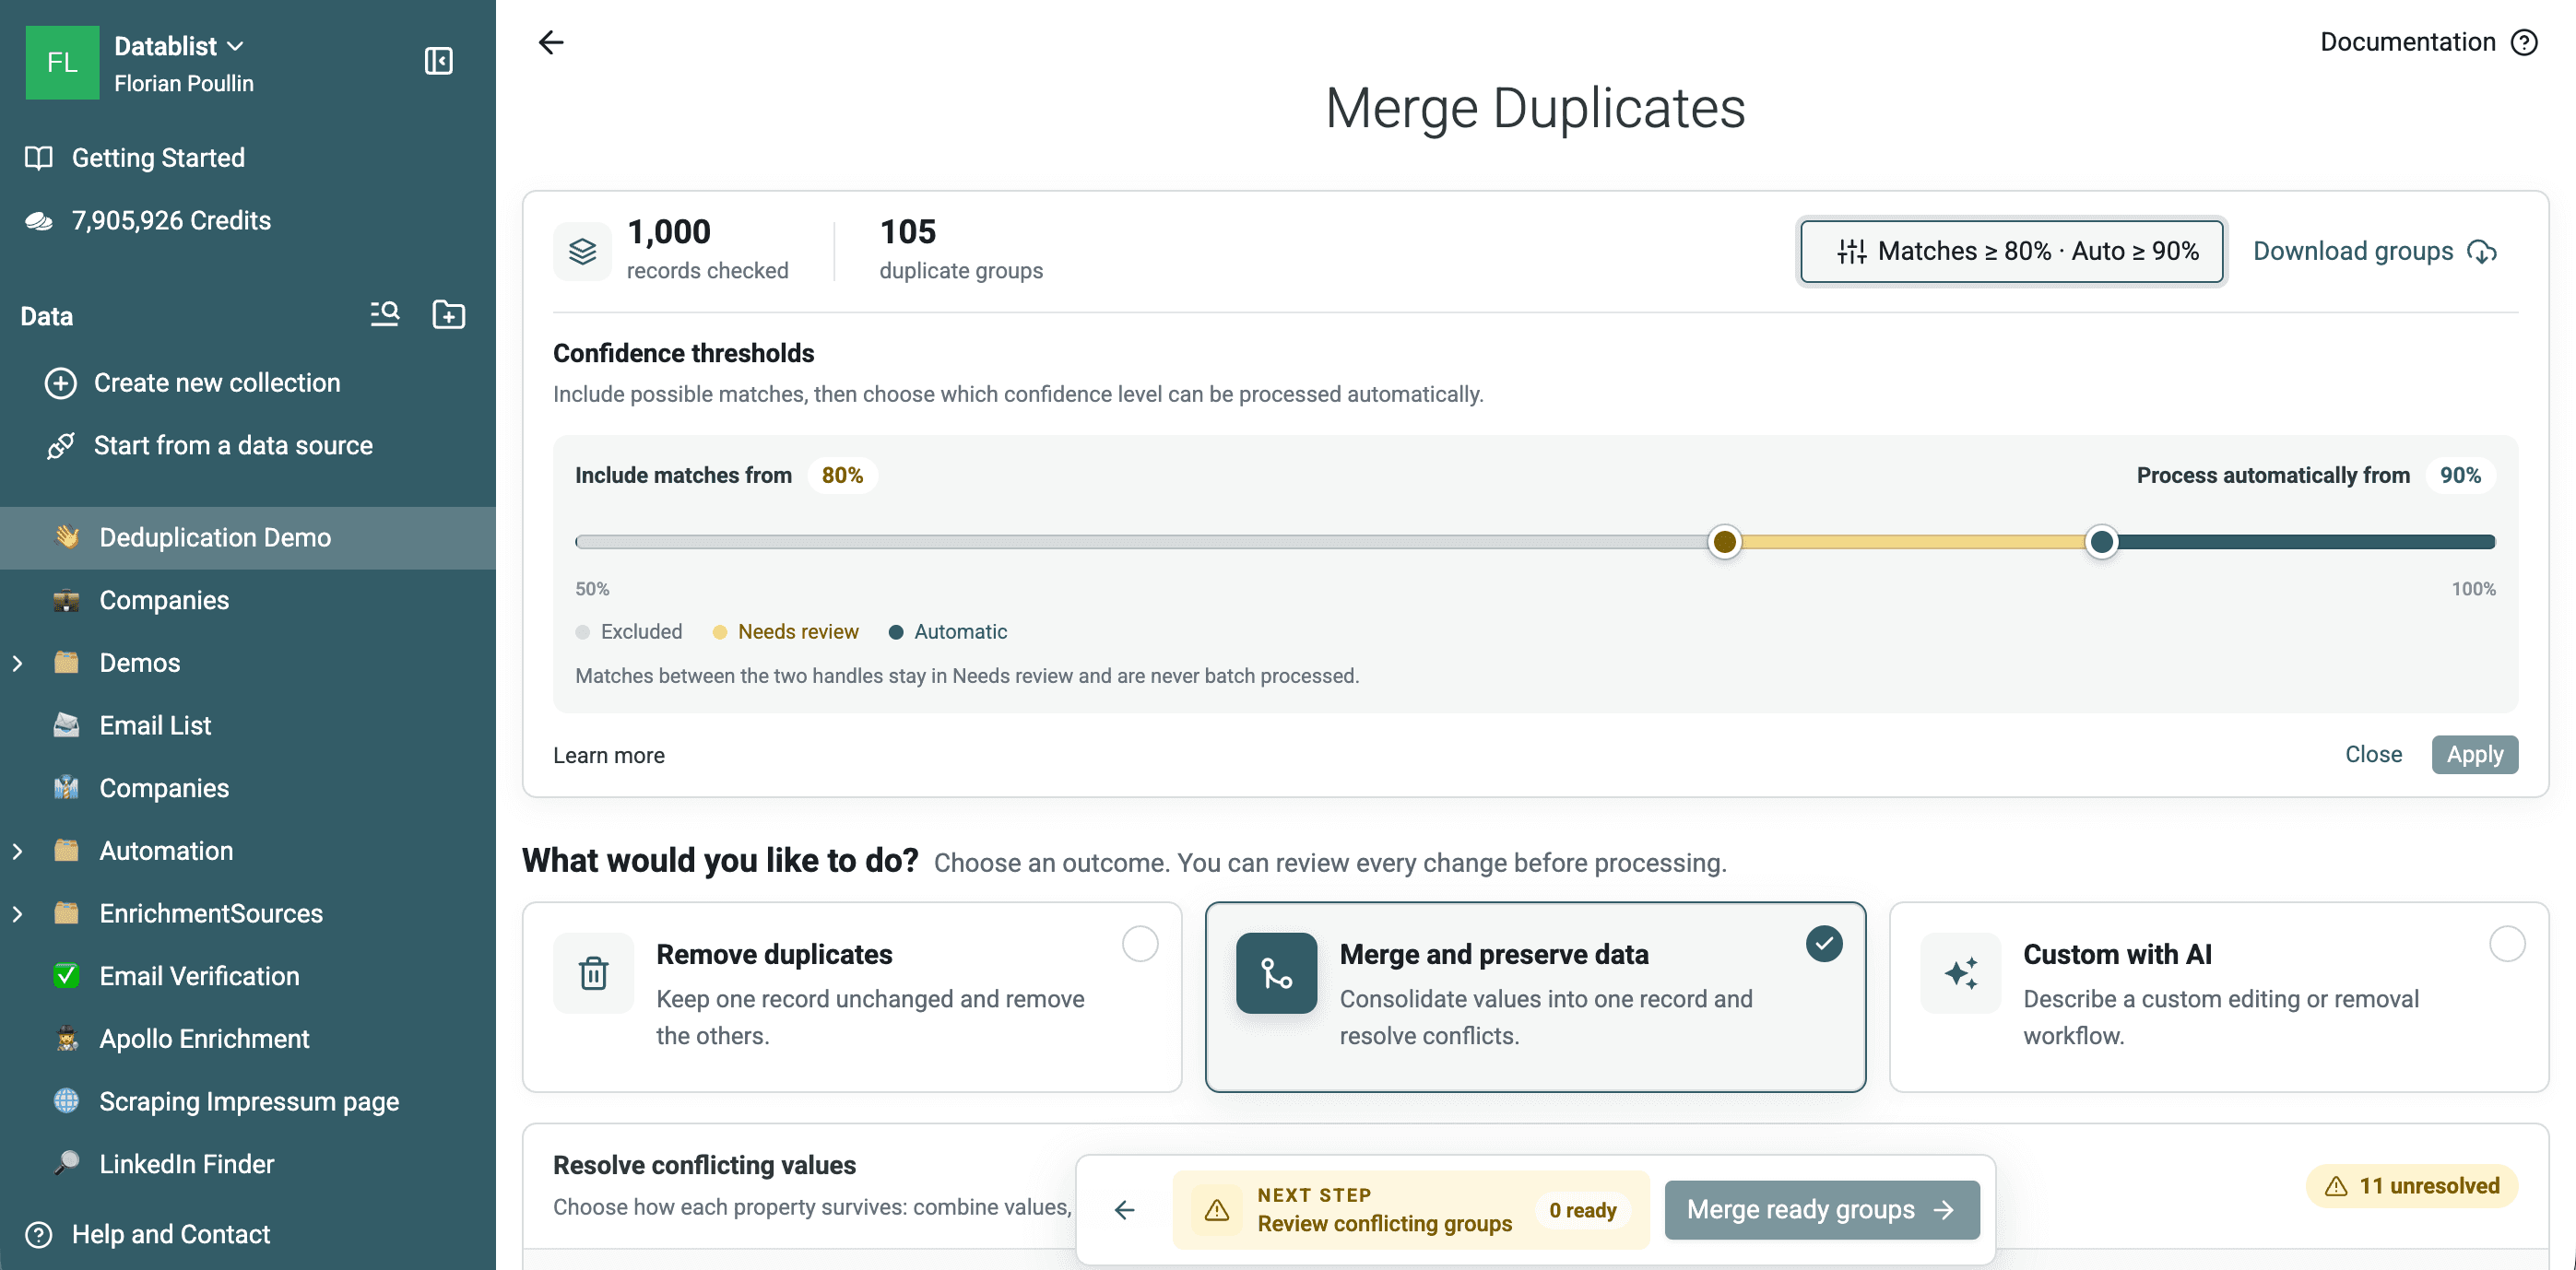
Resultatsiden har to indstillinger:
- Include matches from bestemmer, hvilke grupper der vises.
- Process automatically from placerer grupper med lavere sikkerhed i Needs review og udelukker dem fra batchbehandling.
Denne opdeling gør det muligt at gennemgå brede kandidatresultater uden at anvende samme automatiseringsregel på dem alle.
Gennemgå dubletgrupperne
Resultatområdet opdeler dubletgrupper i Ready og Needs review.
- Ready-grupper har et konkret behandlingsresultat og opfylder den automatiske sikkerhedstærskel.
- Needs review-grupper har lavere sikkerhed, uløste flettekonflikter, en regel til valg af post, der ikke gav et match, eller en brugerdefineret regel, der sprang dem over.
Kontrollér følgende for hver usikker gruppe:
- Repræsenterer alle rækker den samme person, virksomhed eller det samme produkt?
- Hvilken identifikator udløste matchet?
- Supplerer nogle af værdierne hinanden?
- Hvilken kilde er autoritativ?
- Vil fjernelse af en række slette et telefonnummer, ID, en status, dato eller note?
- Er gruppen forbundet via en svag tredje post?
Brug Why matched til at kontrollere egenskaberne, algoritmerne, processorerne og scoreintervallerne bag matchet. Ved fuzzy-kontroller er gruppens lighedsscore den svageste bevarede forbindelse, der kræves for at holde gruppen samlet.
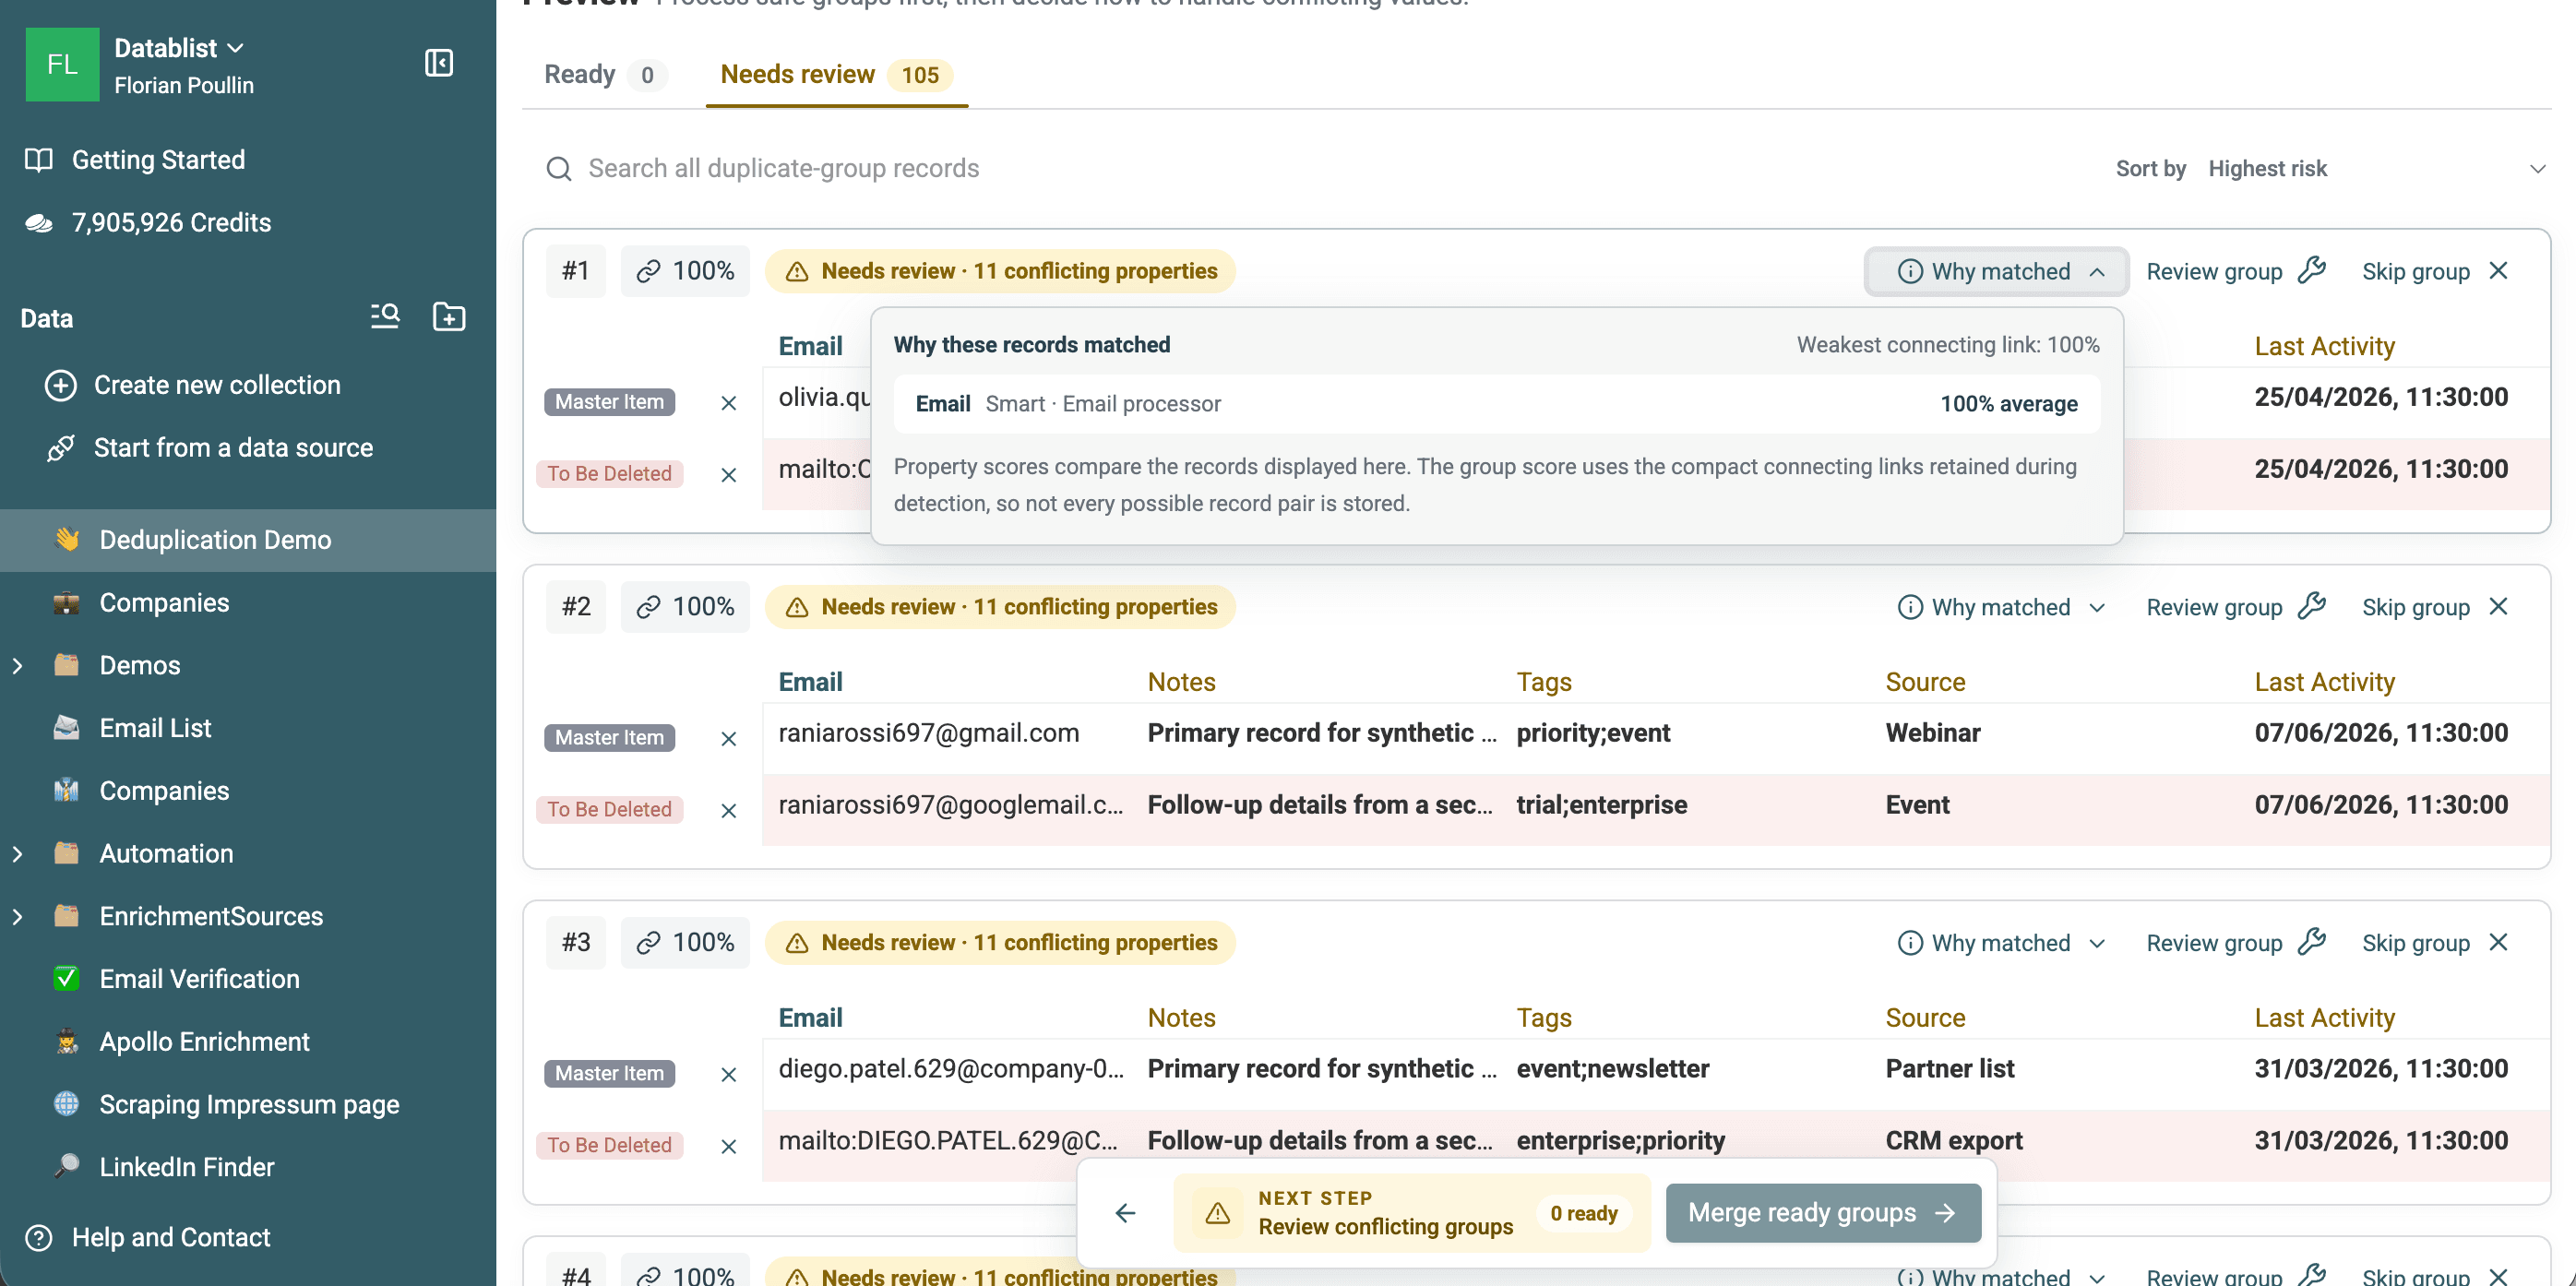
Du kan også:
- Bekræfte et match med lav sikkerhed.
- Fjerne en post fra en gruppe uden at slette den.
- Springe gruppen over.
- Åbne og redigere en post.
- Gennemgå gruppen i Merging Assistant.
- Søge i alle resterende grupper og sortere de mest risikable kandidater først.
⚠️ Behandl ikke en fuzzy-gruppe ud fra procentsatsen alene
Lignende navne kan tilhøre forskellige personer. Gennemgå identifikatorerne og de øvrige felter, før du bekræfter gruppen.
Kontrollér fælles og manglende identifikatorer før fletning
En fælles indbakke som info@company.example kan tilhøre flere kontakter. To personer med denne adresse kan matche på Email og stadig være forskellige personer. På samme måde kan et virksomhedsdomæne identificere én virksomhed, men optræde i mange medarbejderposter.
Jeg ville holde disse grupper ude af automatisk fletning på personniveau, indtil en anden identifikator understøtter matchet. Hvis dit mål i stedet er én række pr. virksomhed, kan det fælles domæne være den tilsigtede grupperingsnøgle. Definér entiteten, før du fortolker resultatet.
Reglen for tomme værdier ændrer også en sammenligning af valgte egenskaber. Ved en kontrol af flere egenskaber med en anden sammenligning end Exact tilbyder den avancerede indstilling Empty Value Rule valgene Value required (default) og Match on empty value. Standardindstillingen kræver, at tekstidentifikatoren er udfyldt. Hvis matches på tomme værdier tillades, lempes kravet. Brug kun denne mulighed, når de øvrige matchende felter giver tilstrækkelig dokumentation for identiteten. To manglende e-mailadresser er ikke bevis for, at to personer er den samme.
To rækker med tom Email og forskellige værdier i Full Name bør eksempelvis ikke flettes alene for at reducere antallet af rækker. En række uden e-mailadresse kan stadig indeholde en kontakt, som du skal beholde eller enrich senere.
Fjern, flet eller behandl dubletter med egne regler
At finde og håndtere dubletter er to forskellige beslutninger. Vælg behandlingstilstanden, når du har gennemgået indholdet i de sekundære rækker.
Fjern dubletter, når én række er autoritativ
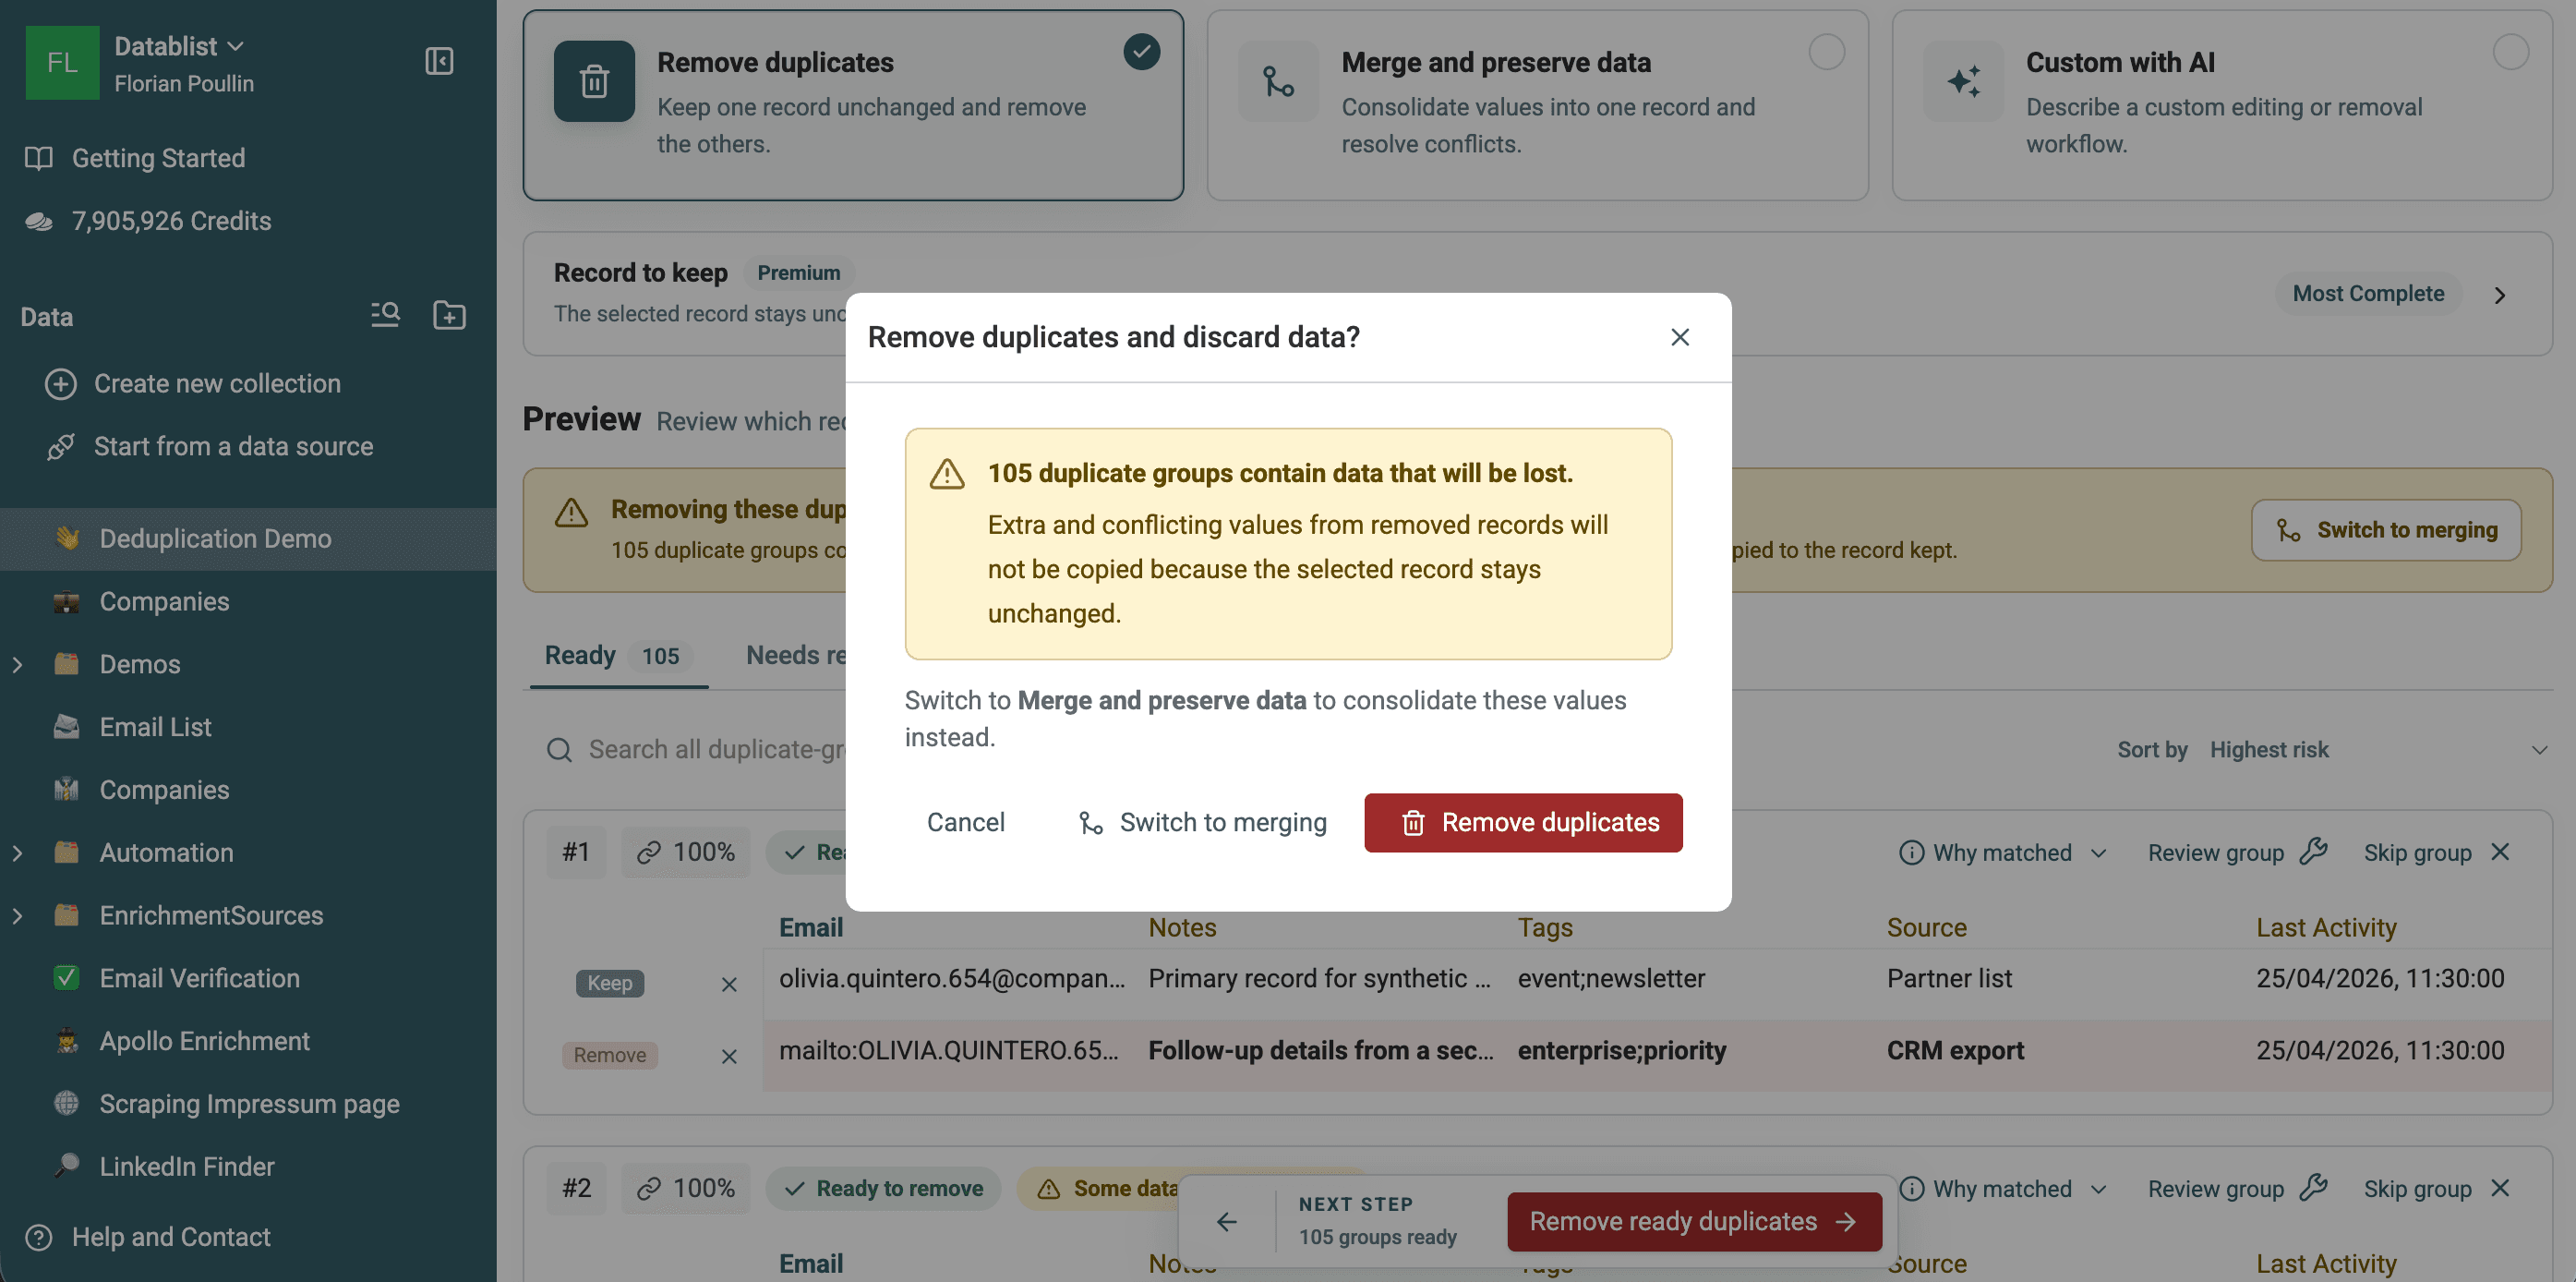
Remove duplicates beholder én valgt post uændret og sletter de øvrige rækker i hver Ready-gruppe.
Brug funktionen til kopierede rækker, midlertidige importer eller poster, hvor værdierne i de sekundære rækker kan kasseres. Forhåndsvisningen advarer, når de poster, der fjernes, indeholder yderligere eller modstridende oplysninger. Disse værdier kopieres ikke til den bevarede række.
Flet, når rækkerne indeholder nyttige data
Merge and preserve data udfylder tomme egenskaber i den valgte post, løser konfigurerede konflikter og sletter derefter de sekundære rækker.
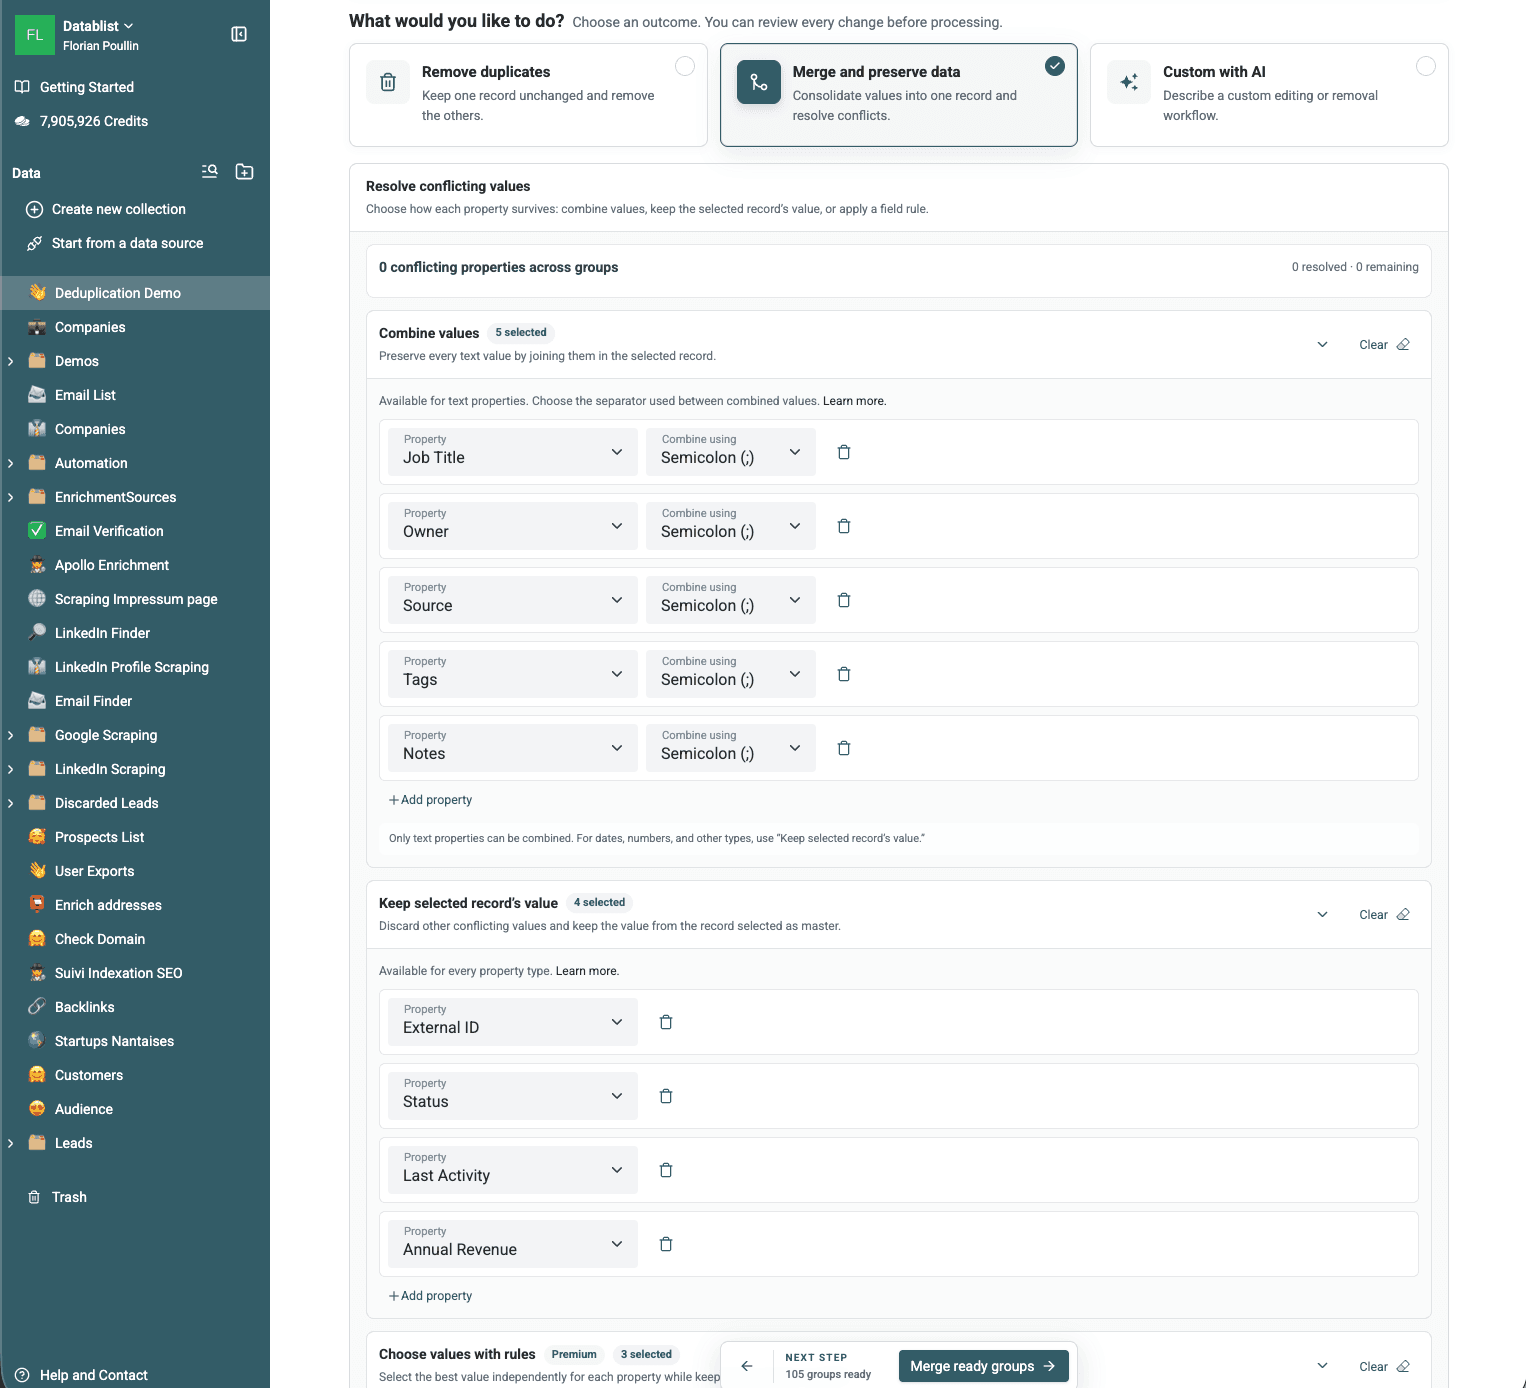
Begynd med reglen Record to keep. Most Complete er standardindstillingen. Betalte abonnementer giver mulighed for at vælge regler baseret på oprettelsestidspunkt, opdateringstidspunkt, højeste eller laveste egenskabsværdi eller en påkrævet egenskabsværdi.
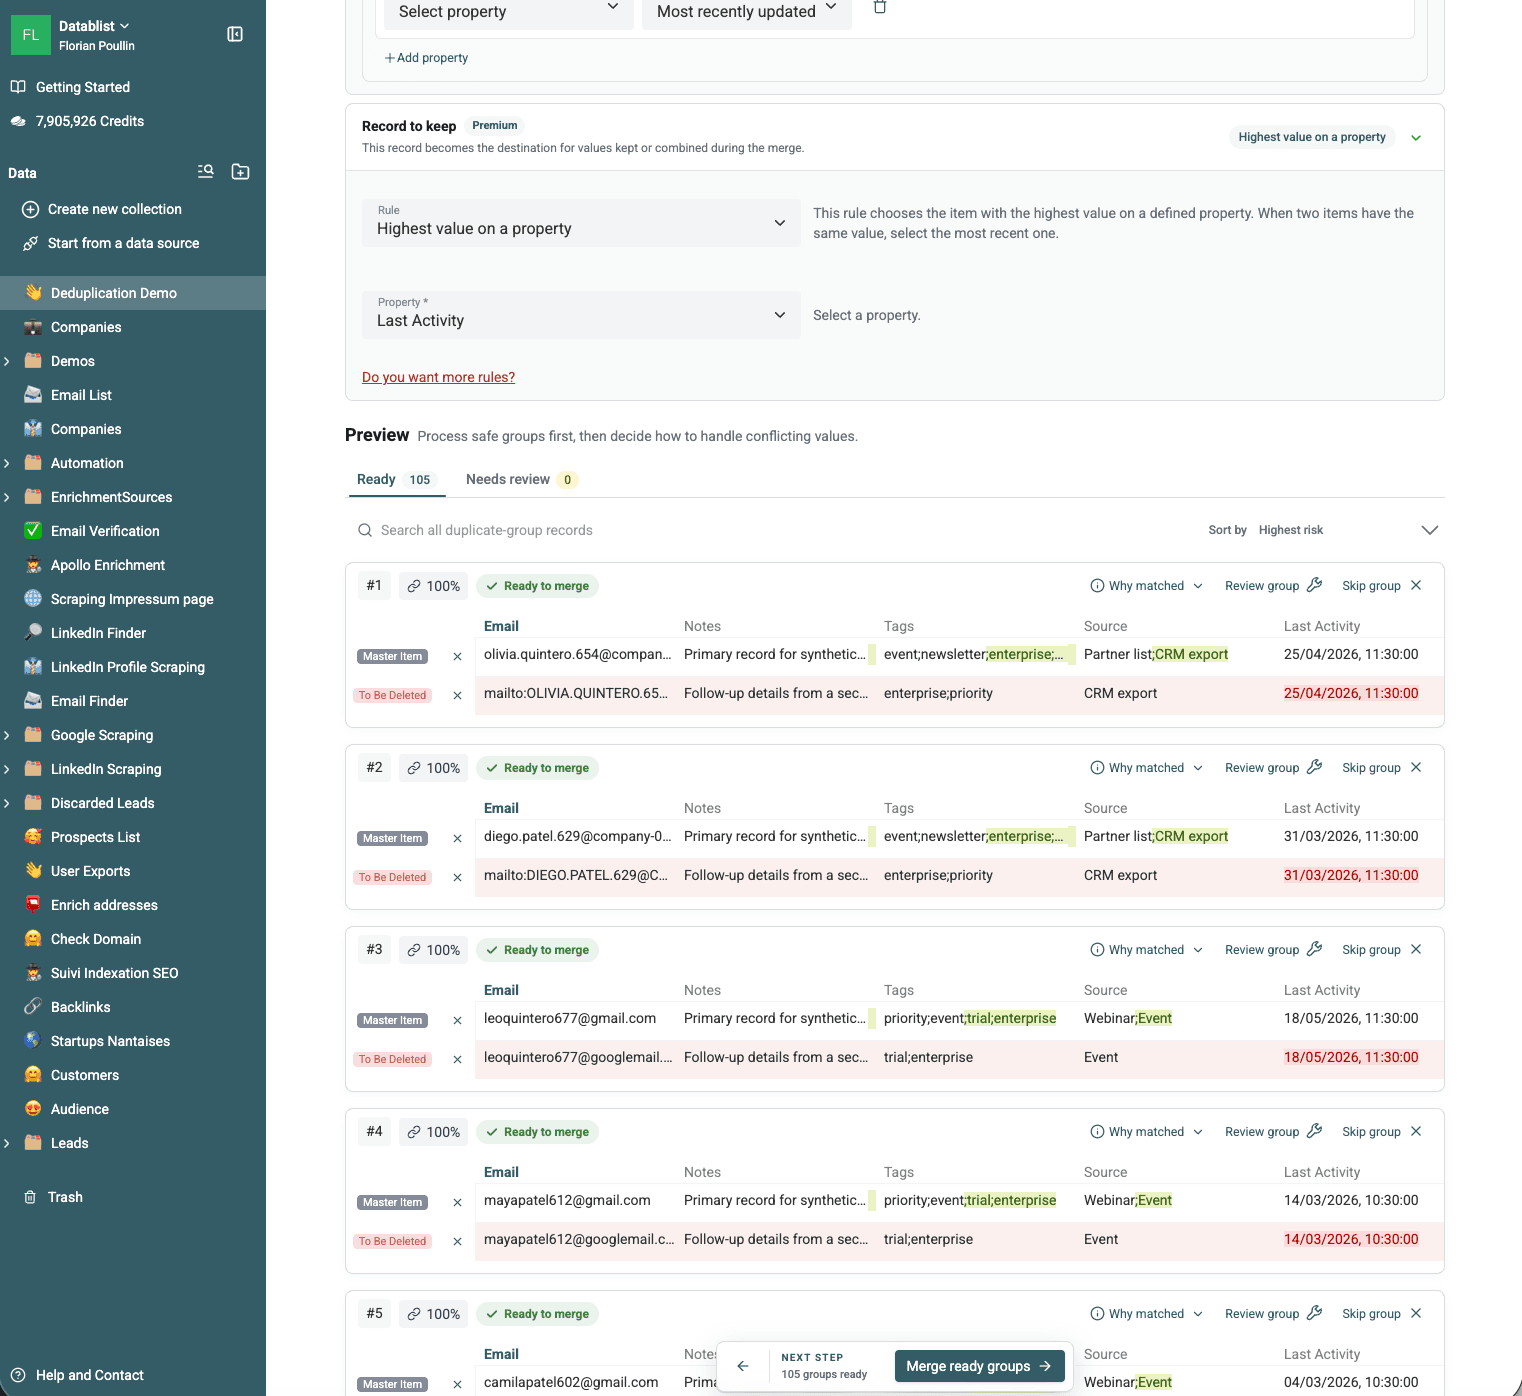
Vælg derefter, hvordan hver modstridende egenskab skal bevares:
- Kombinér forskellige tekstværdier med en separator.
- Behold værdien fra den valgte post.
- Med betalte abonnementer kan værdier vælges uafhængigt med regler som nyeste, ældste, længste, korteste, højeste, laveste eller hyppigste.
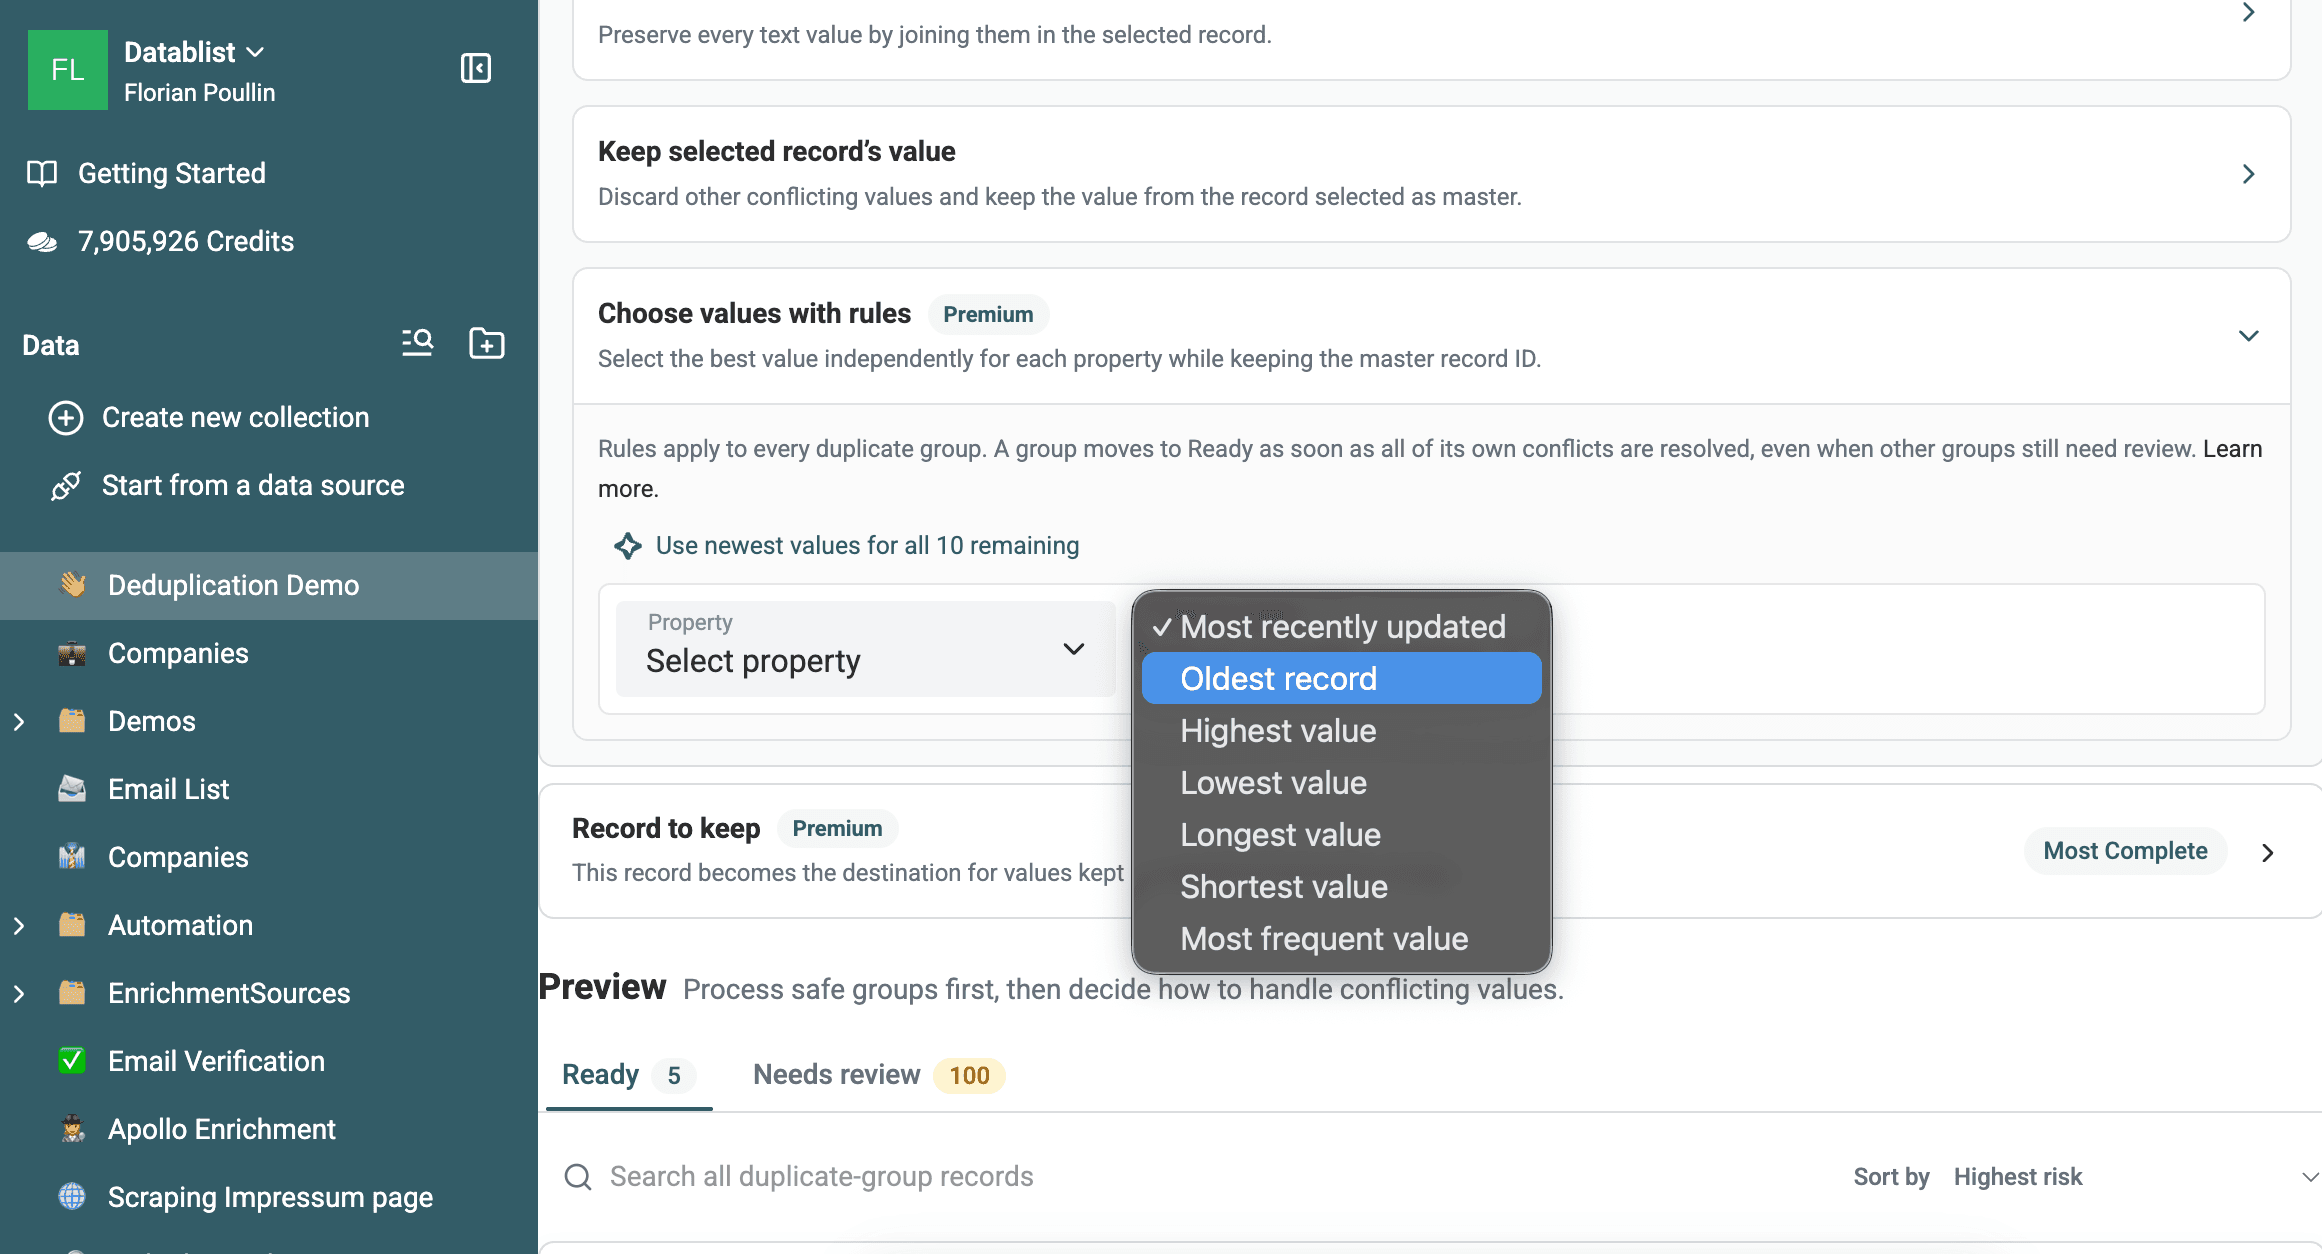
Brug regler på feltniveau, når ingen enkelt række har den bedste værdi for alle egenskaber. Du kan bevare ID'et fra den valgte post og samtidig hente en nyere stillingsbetegnelse, et længere virksomhedsnavn og den hyppigste status fra andre rækker.
Opdatér forhåndsvisningen, når du har ændret tærsklen, arbejdsgangen, gruppemedlemskabet, konfliktindstillingerne eller reglen til valg af post.
Brug Custom with AI til gruppespecifik logik
Custom with AI genererer en arbejdsgang til behandling af grupper ud fra en instruktion i almindeligt sprog. Funktionen kan vælge en post, kopiere eller normalisere værdier, tilføje en statusegenskab, beregne en gruppetotal, slette sekundære rækker eller springe grupper over, som ikke opfylder en betingelse.
Eksempel:
Behold den post, hvor Source er CRM export. Kopiér Job Title fra den seneste post, kombinér forskellige Notes med linjeskift, tilføj afkrydsningsfeltet Duplicate Reviewed, og slet derefter de sekundære poster.
Henvis til egenskaber i din collection med /Property eller {{Property}}. Generér og kontrollér arbejdsgangen i forhåndsvisningen, før du kører den. Custom with AI er tilgængelig for brugere med et betalt abonnement, som er logget ind.
Ved enkelte undtagelser skal du åbne Review group og bruge Merging Assistant i stedet for at gøre batchreglen mere kompleks.
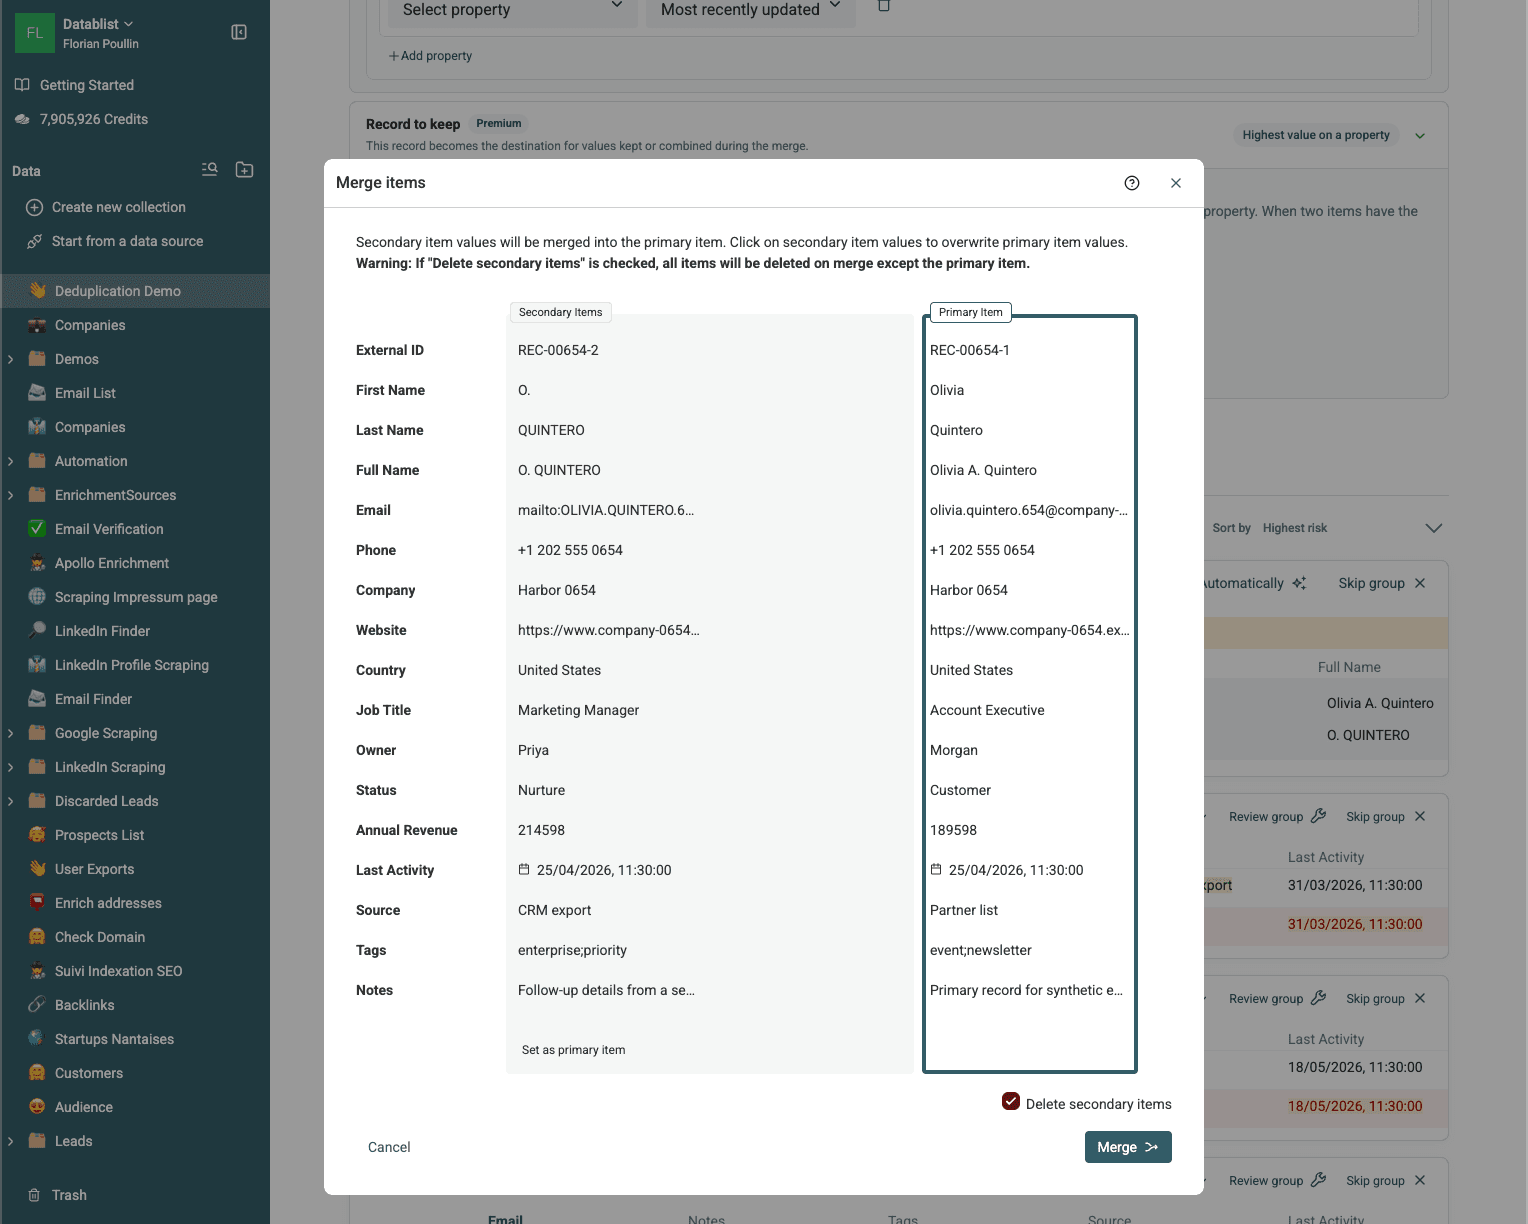
Validér og eksportér den rensede liste
Kontrollér følgende, før du behandler Ready-grupper:
- Forhåndsvisningen afspejler de aktuelle indstillinger.
- Grupper med lav sikkerhed eller fælles identifikatorer er blevet gennemgået.
- Den valgte post har det ID, du skal bevare.
- Unikke værdier for telefon, kilde, note og status bevares.
- Felter, der kun må indeholde én værdi, bliver ikke sammenkædet.
- Det viste antal Ready-grupper svarer til det omfang, du vil behandle.
Afstem antallet af rækker efter behandlingen:
Antal rækker ved start - slettede sekundære rækker = antal rækker til sidst
Ved Exact-matchningen i denne guide flettede Datablist fem grupper med to rækker. Din collection gik derfor fra 1.000 til 995 items.
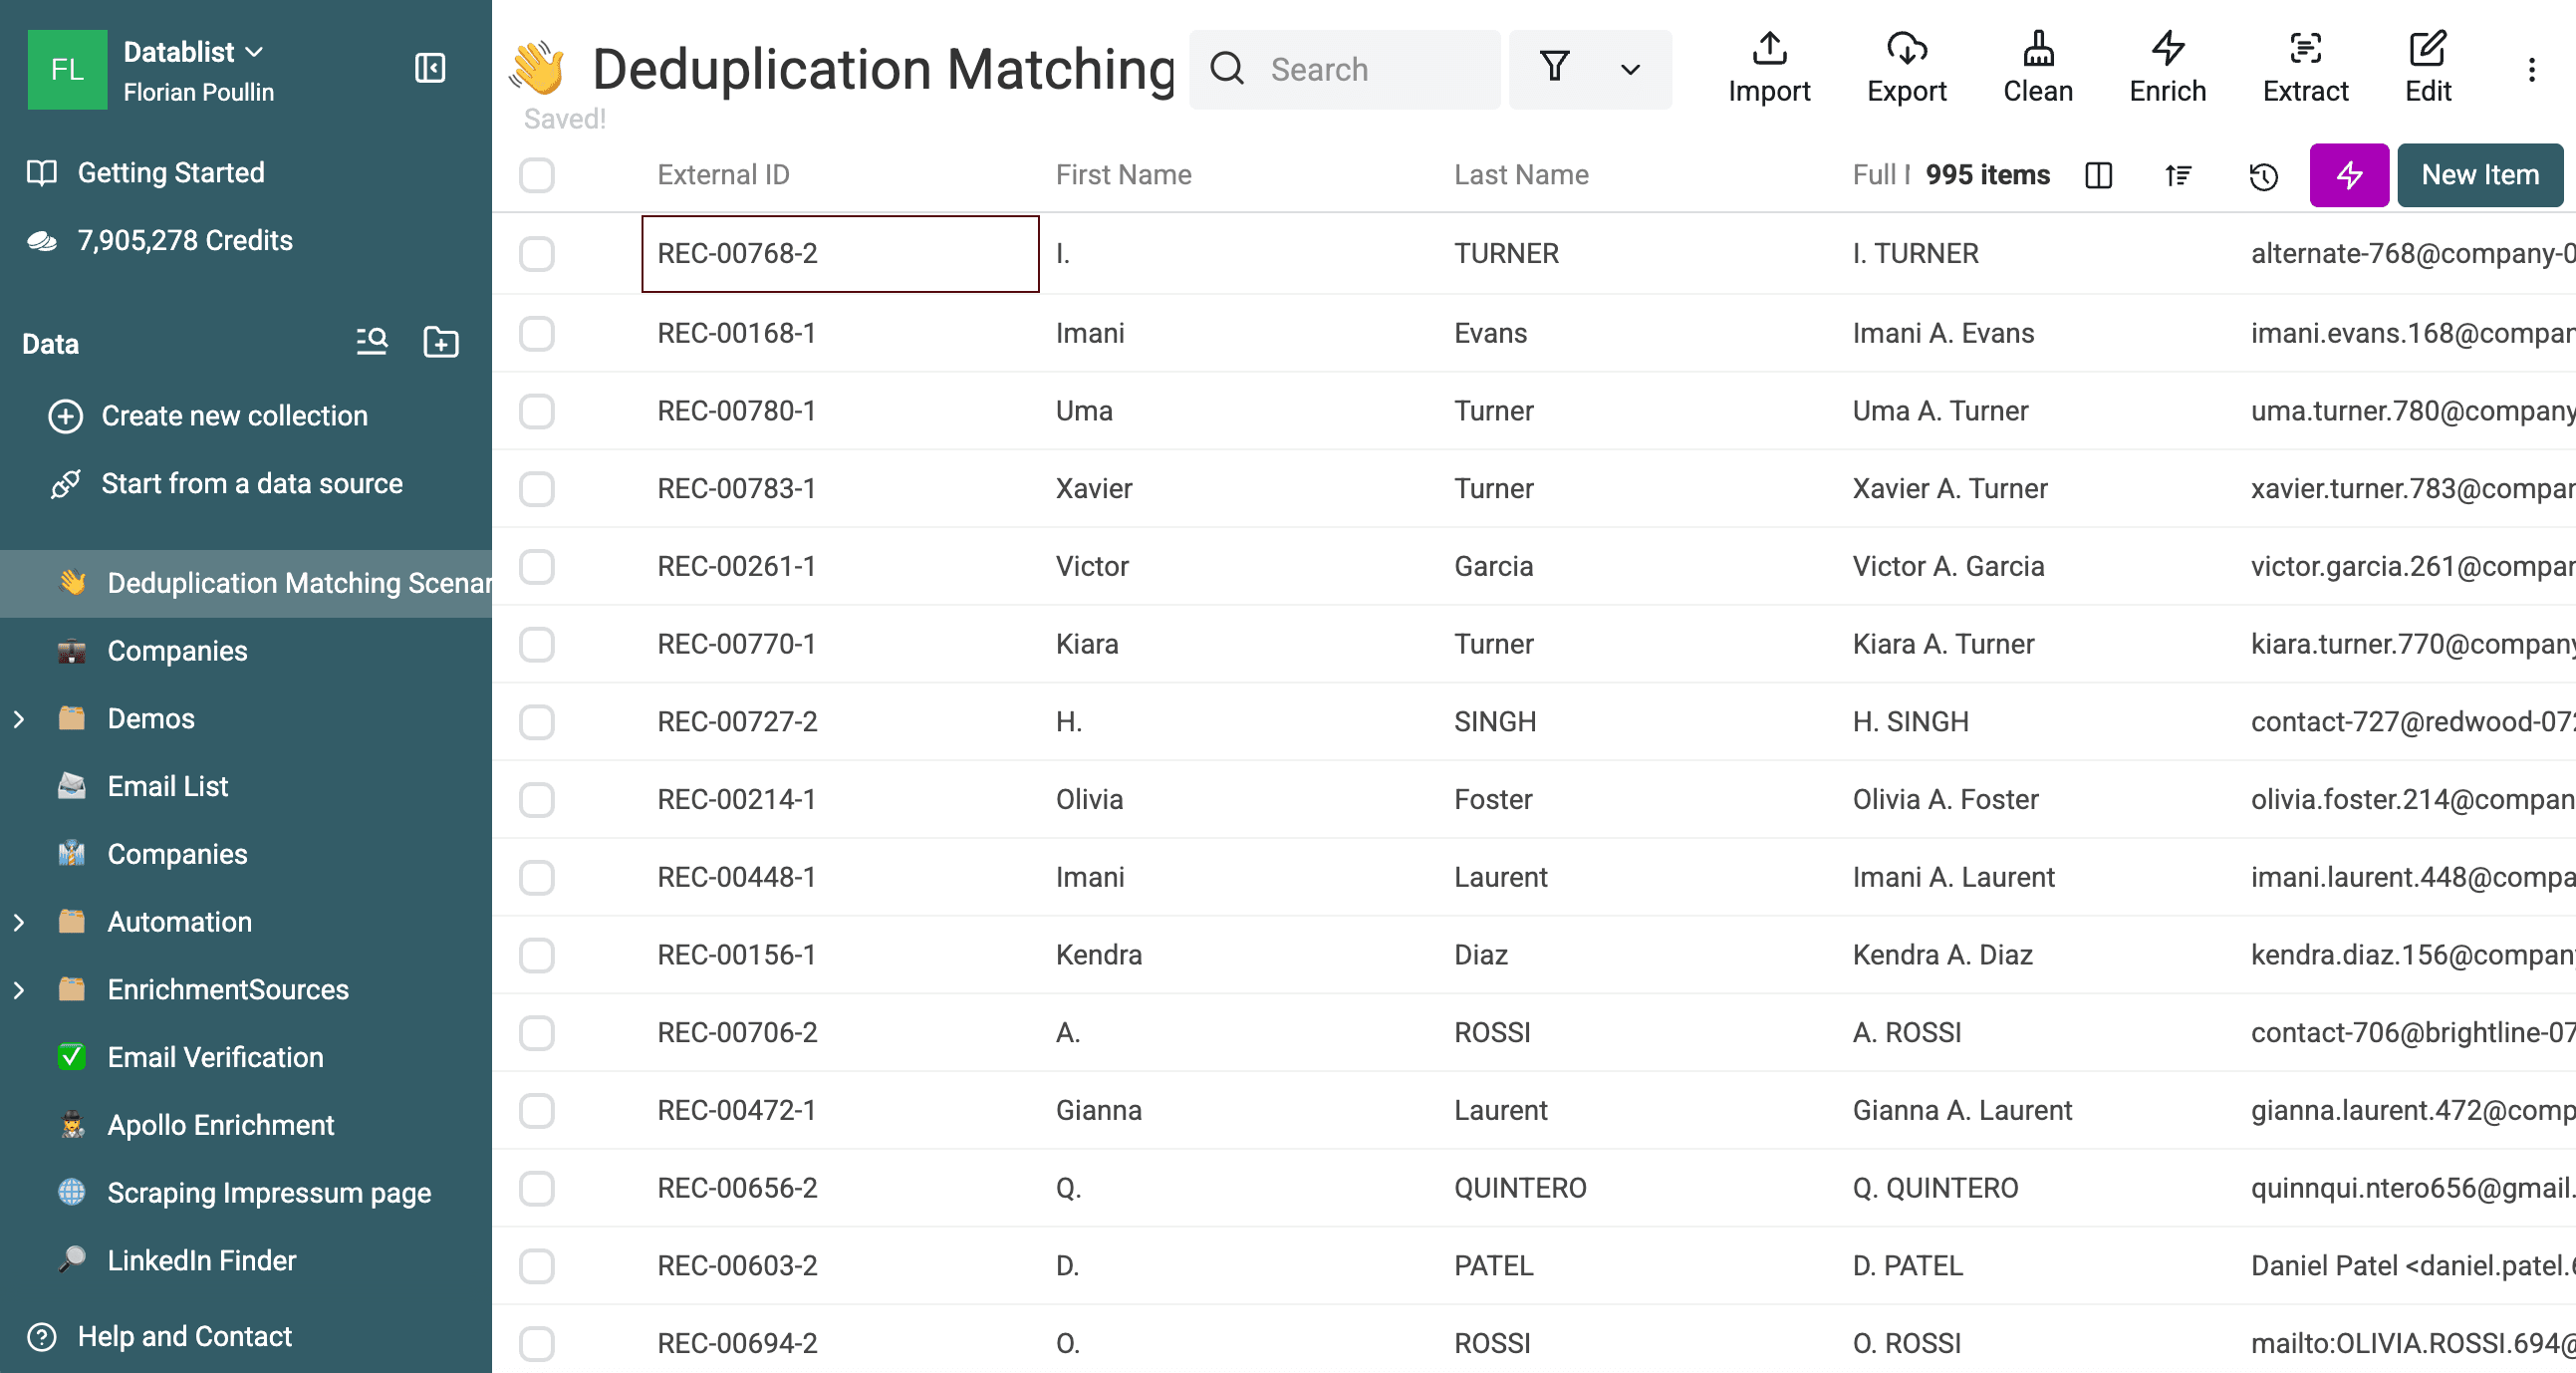
Download dubletgrupperne før behandlingen, hvis du har brug for en ekstern fil til gennemgang. Betalte abonnementer inkluderer anvendelige ID'er for dubletgrupper og en ændringslog efter behandlingen. Ændringsloggen registrerer slettede og opdaterede Datablist-ID'er med de tidligere værdier og destinationsværdierne.
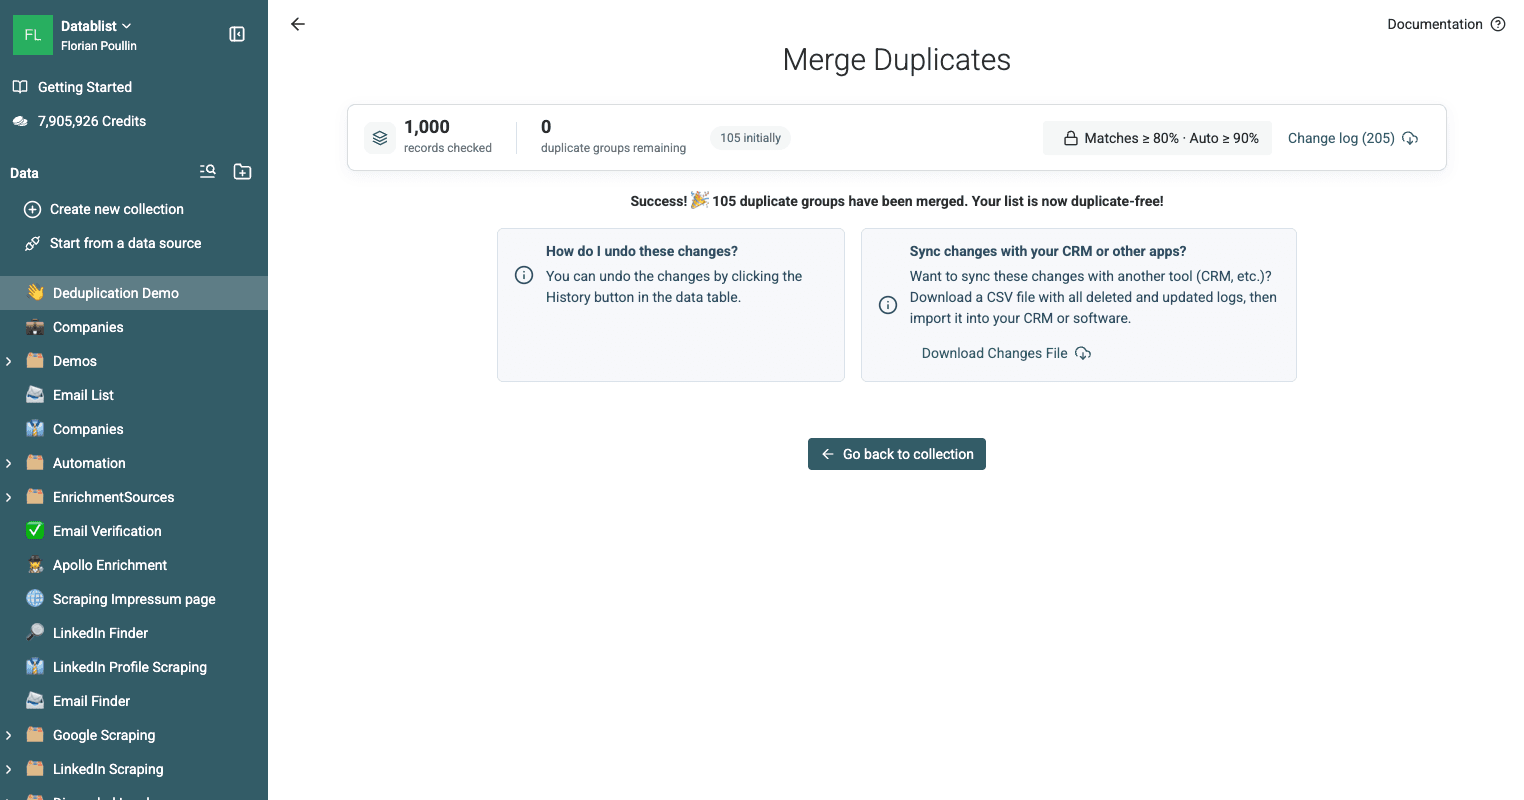
Automatiske fjernelses- og flettehandlinger vises også under History i din collection, hvor du kan fortryde dem.
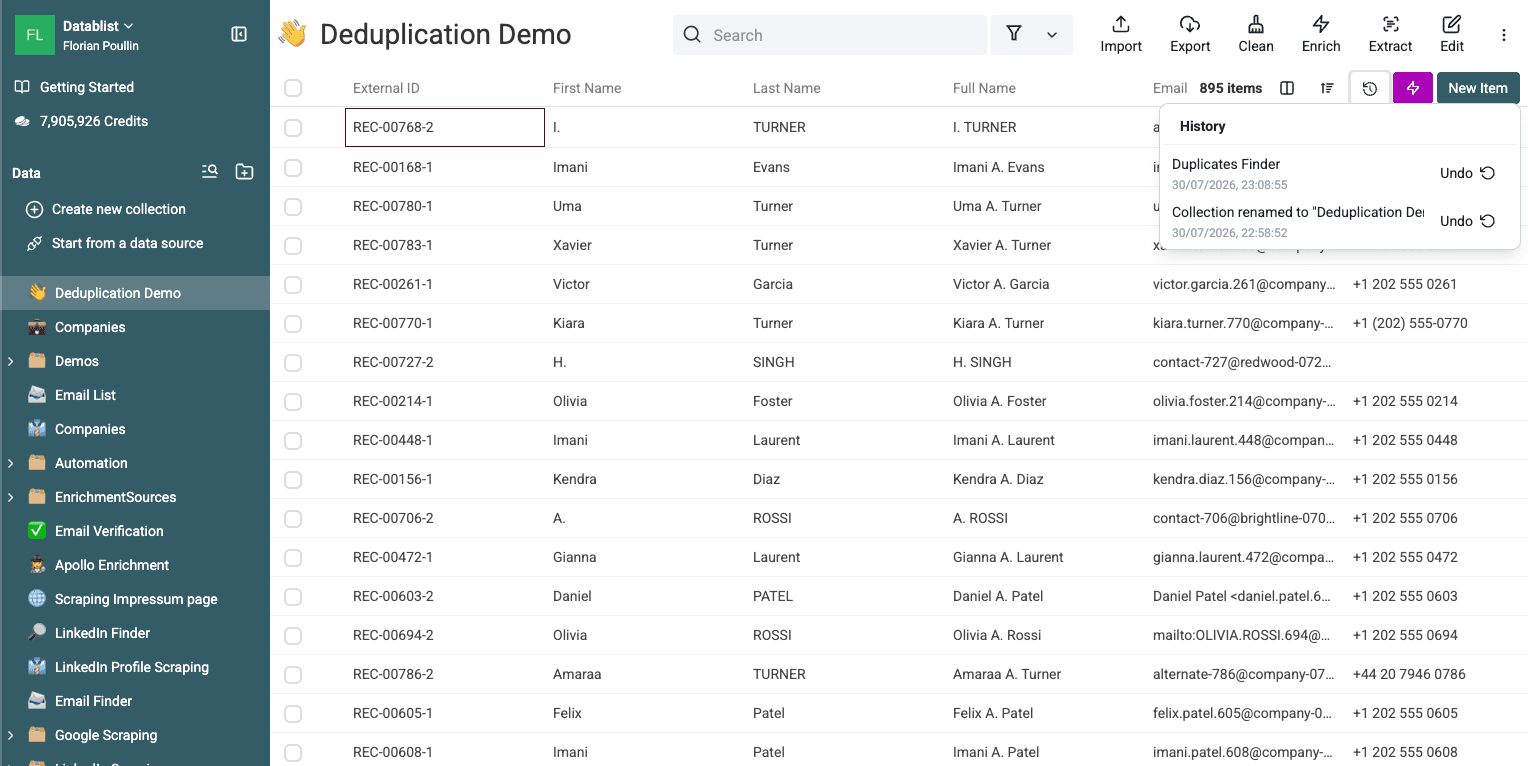
Gå tilbage til din collection, og åbn Export for at downloade den rensede CSV- eller Excel-fil.
Fjern dubletter på tværs af flere lister
Brug matchning på tværs af collections, når en ny leadfil skal sammenlignes med en CRM-eksport. Brug CRM-systemet som referenceliste, og fjern matchene fra den indgående liste før import.
Download CRM-demofilen og demoens eventfil for at teste arbejdsgangen. De to filer bruger forskellige kolonneoverskrifter og indeholder 100 konstruerede overlap på e-mailadresser. Hver fil indeholder oprindeligt 250 rækker.
Importér hver fil i sin egen collection, og åbn derefter Clean > Match across collections. Tilføj begge collections, og map de tilsvarende egenskaber, eksempelvis Email til Attendee Email.
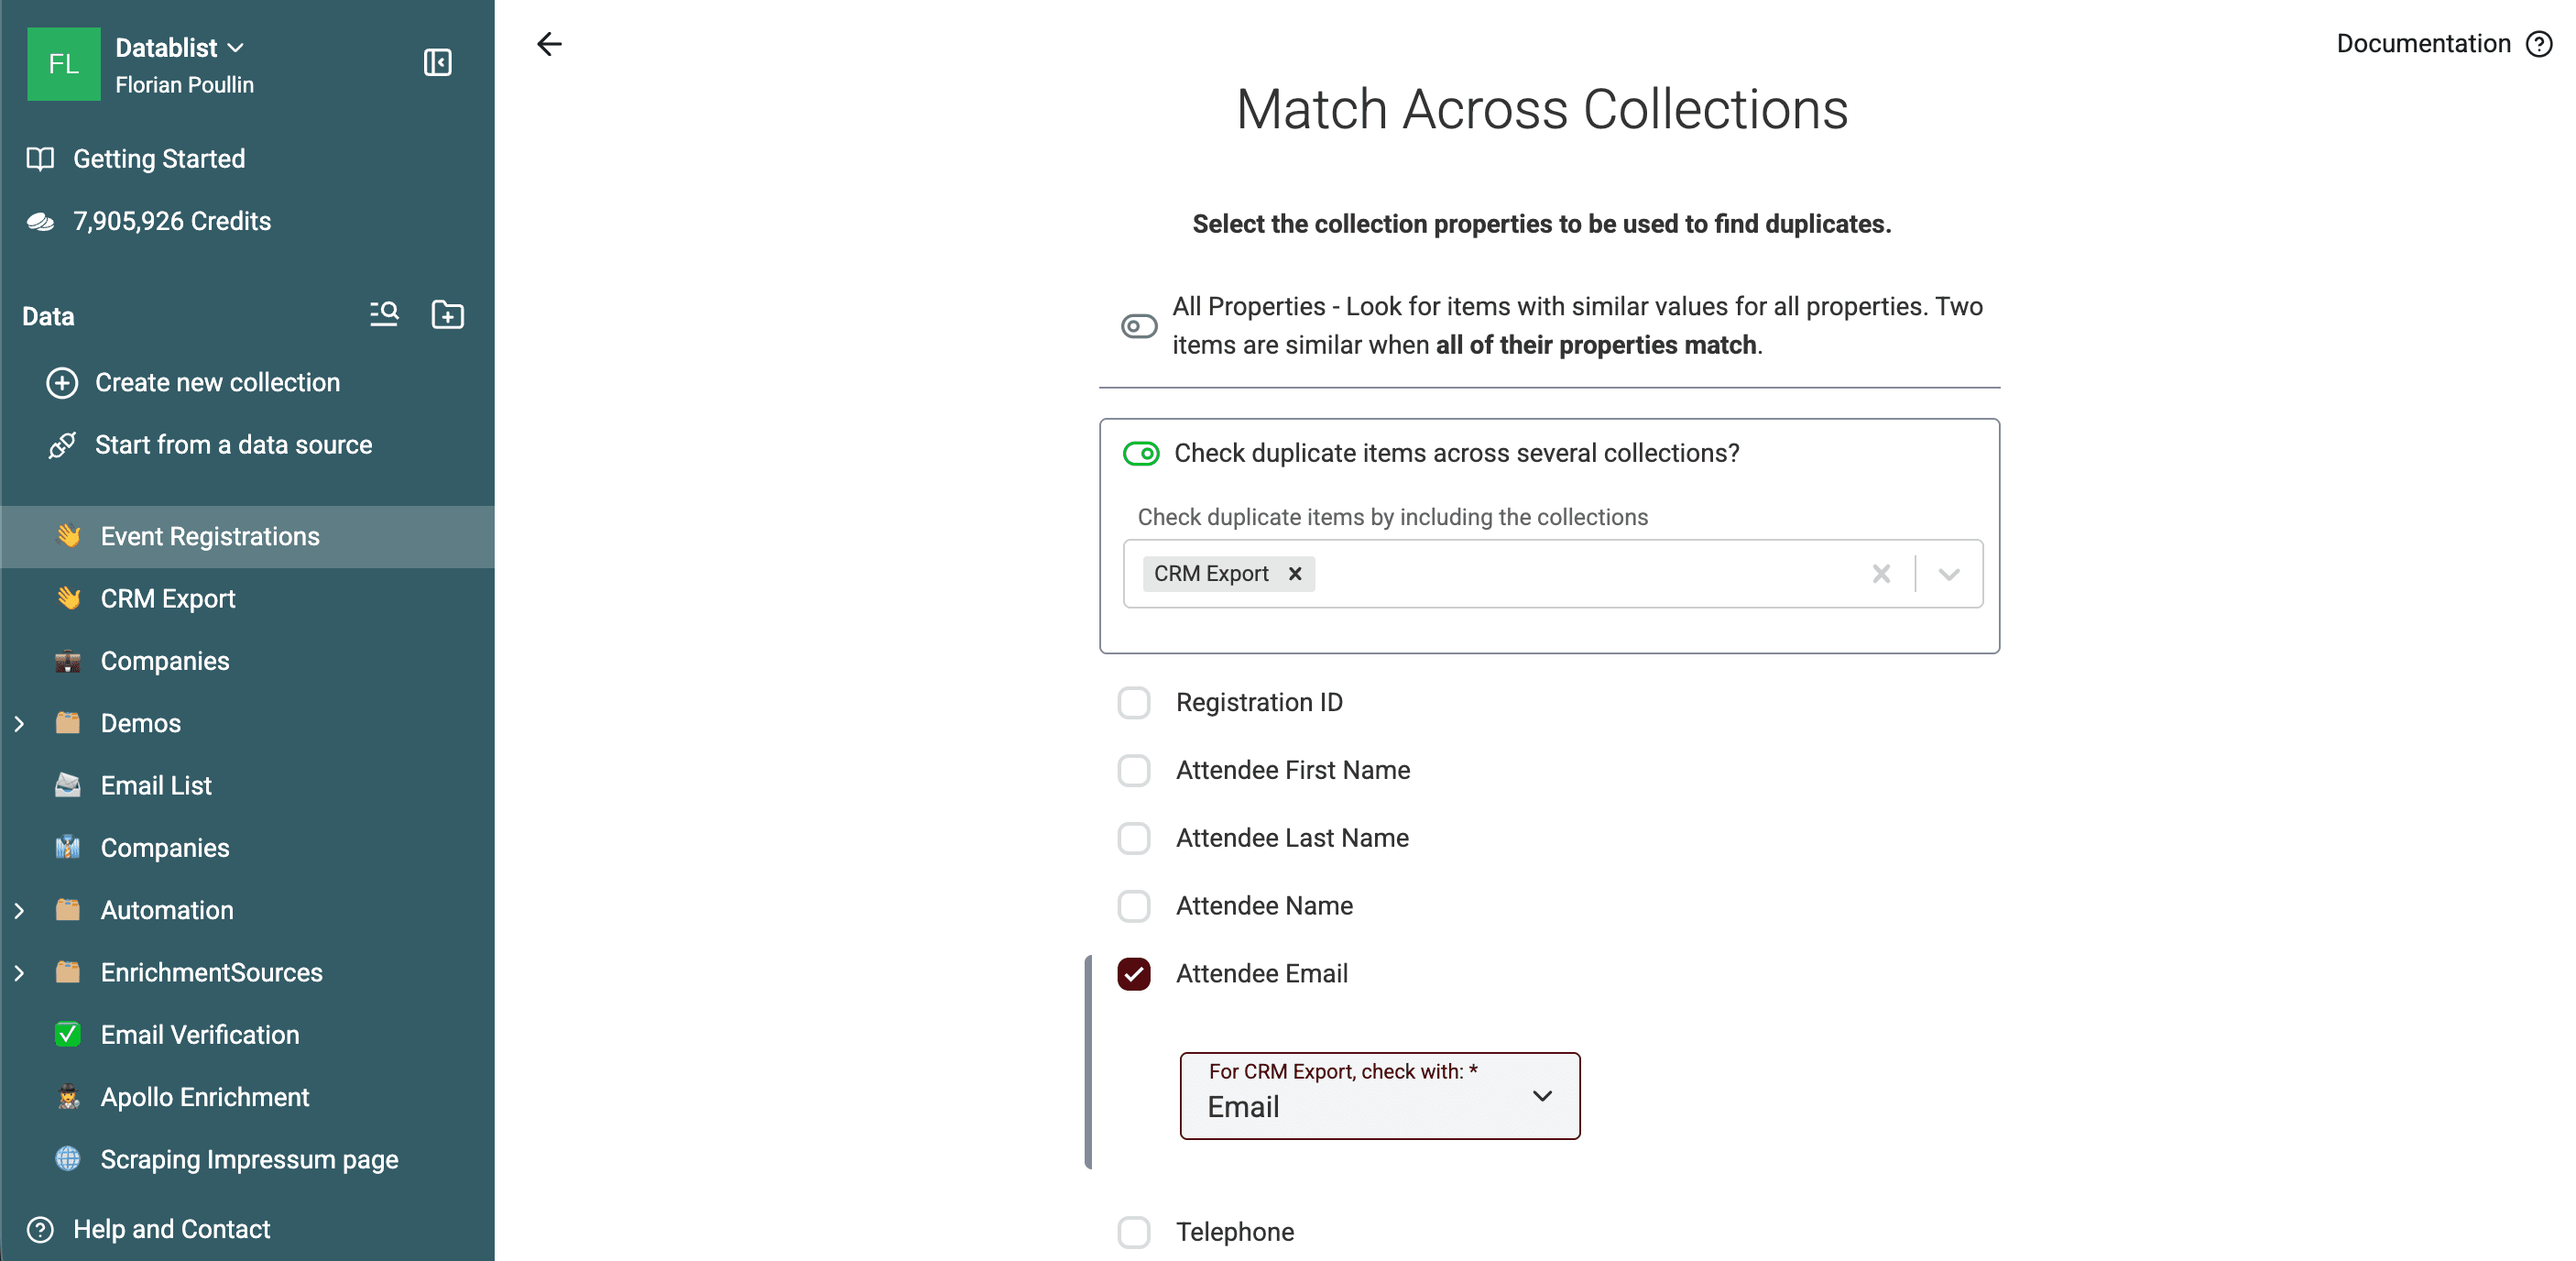
I denne test gav Smart-matchning med Email-processoren 100 grupper på tværs af collections ud af 500 kontrollerede poster. Vælg Event Registrations under Remove duplicate items from collection {X} for at lade CRM-dataene forblive uændrede og fjerne deres matches fra eventlisten.
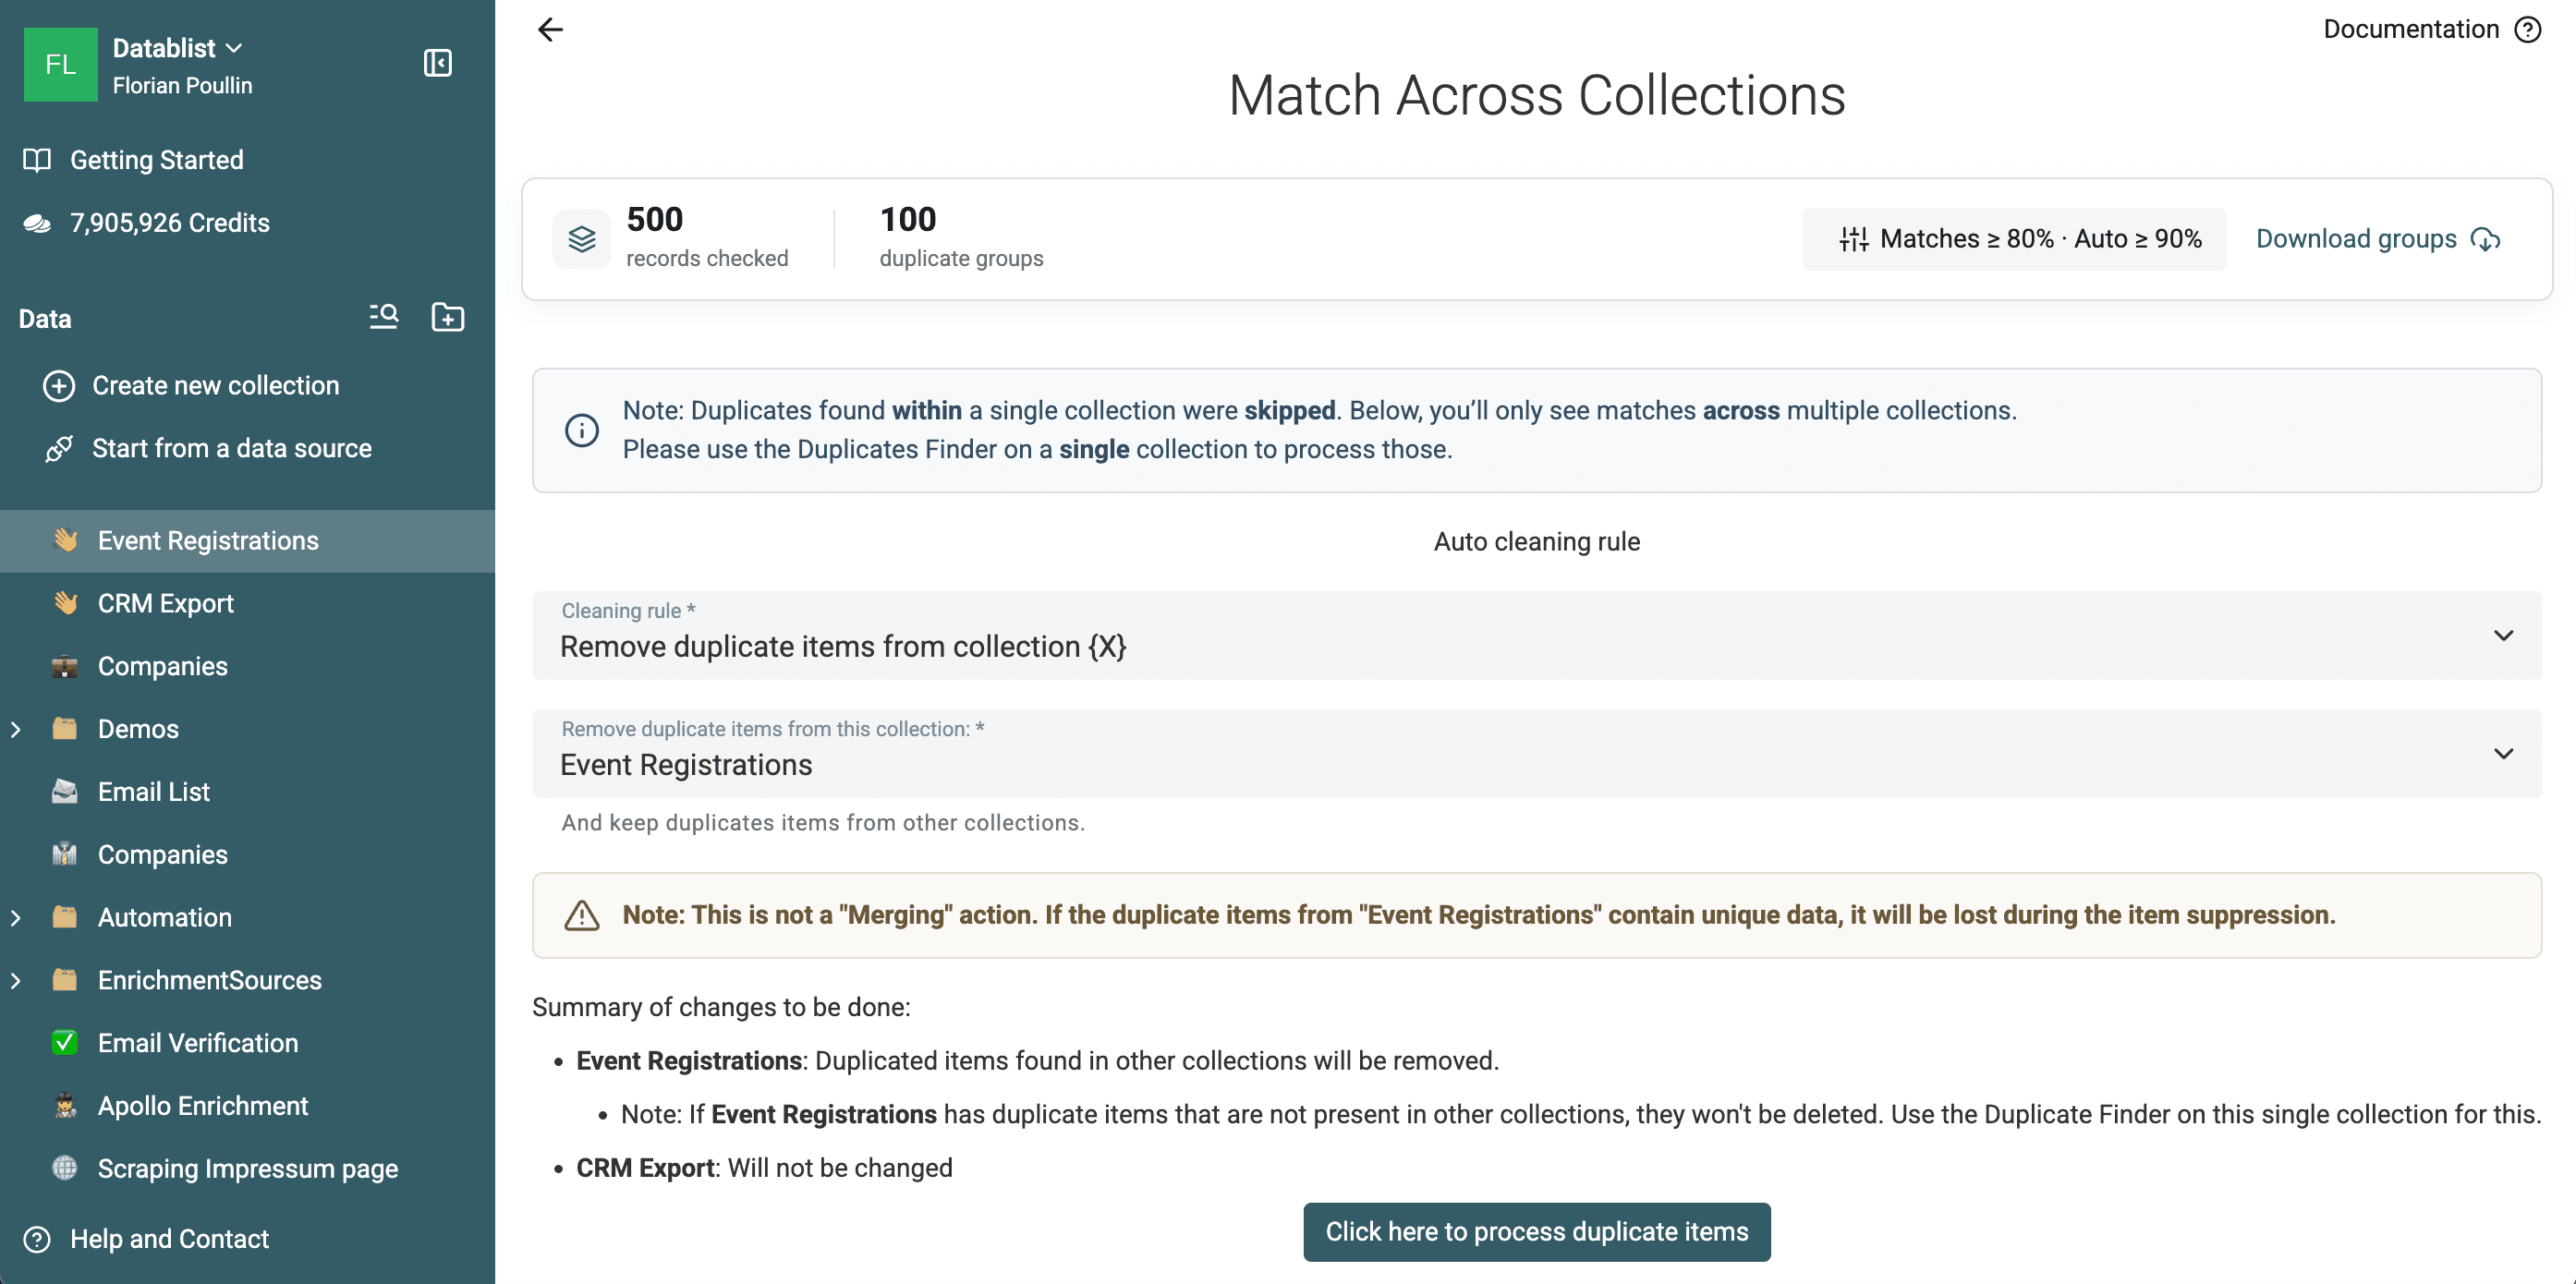
Automatisk oprydning på tværs af collections fjerner rækker. Den fletter ikke unikke eventværdier ind i CRM-systemet. Eksportér eller gennemgå grupperne først, hvis de indgående poster indeholder oplysninger, du skal bevare.
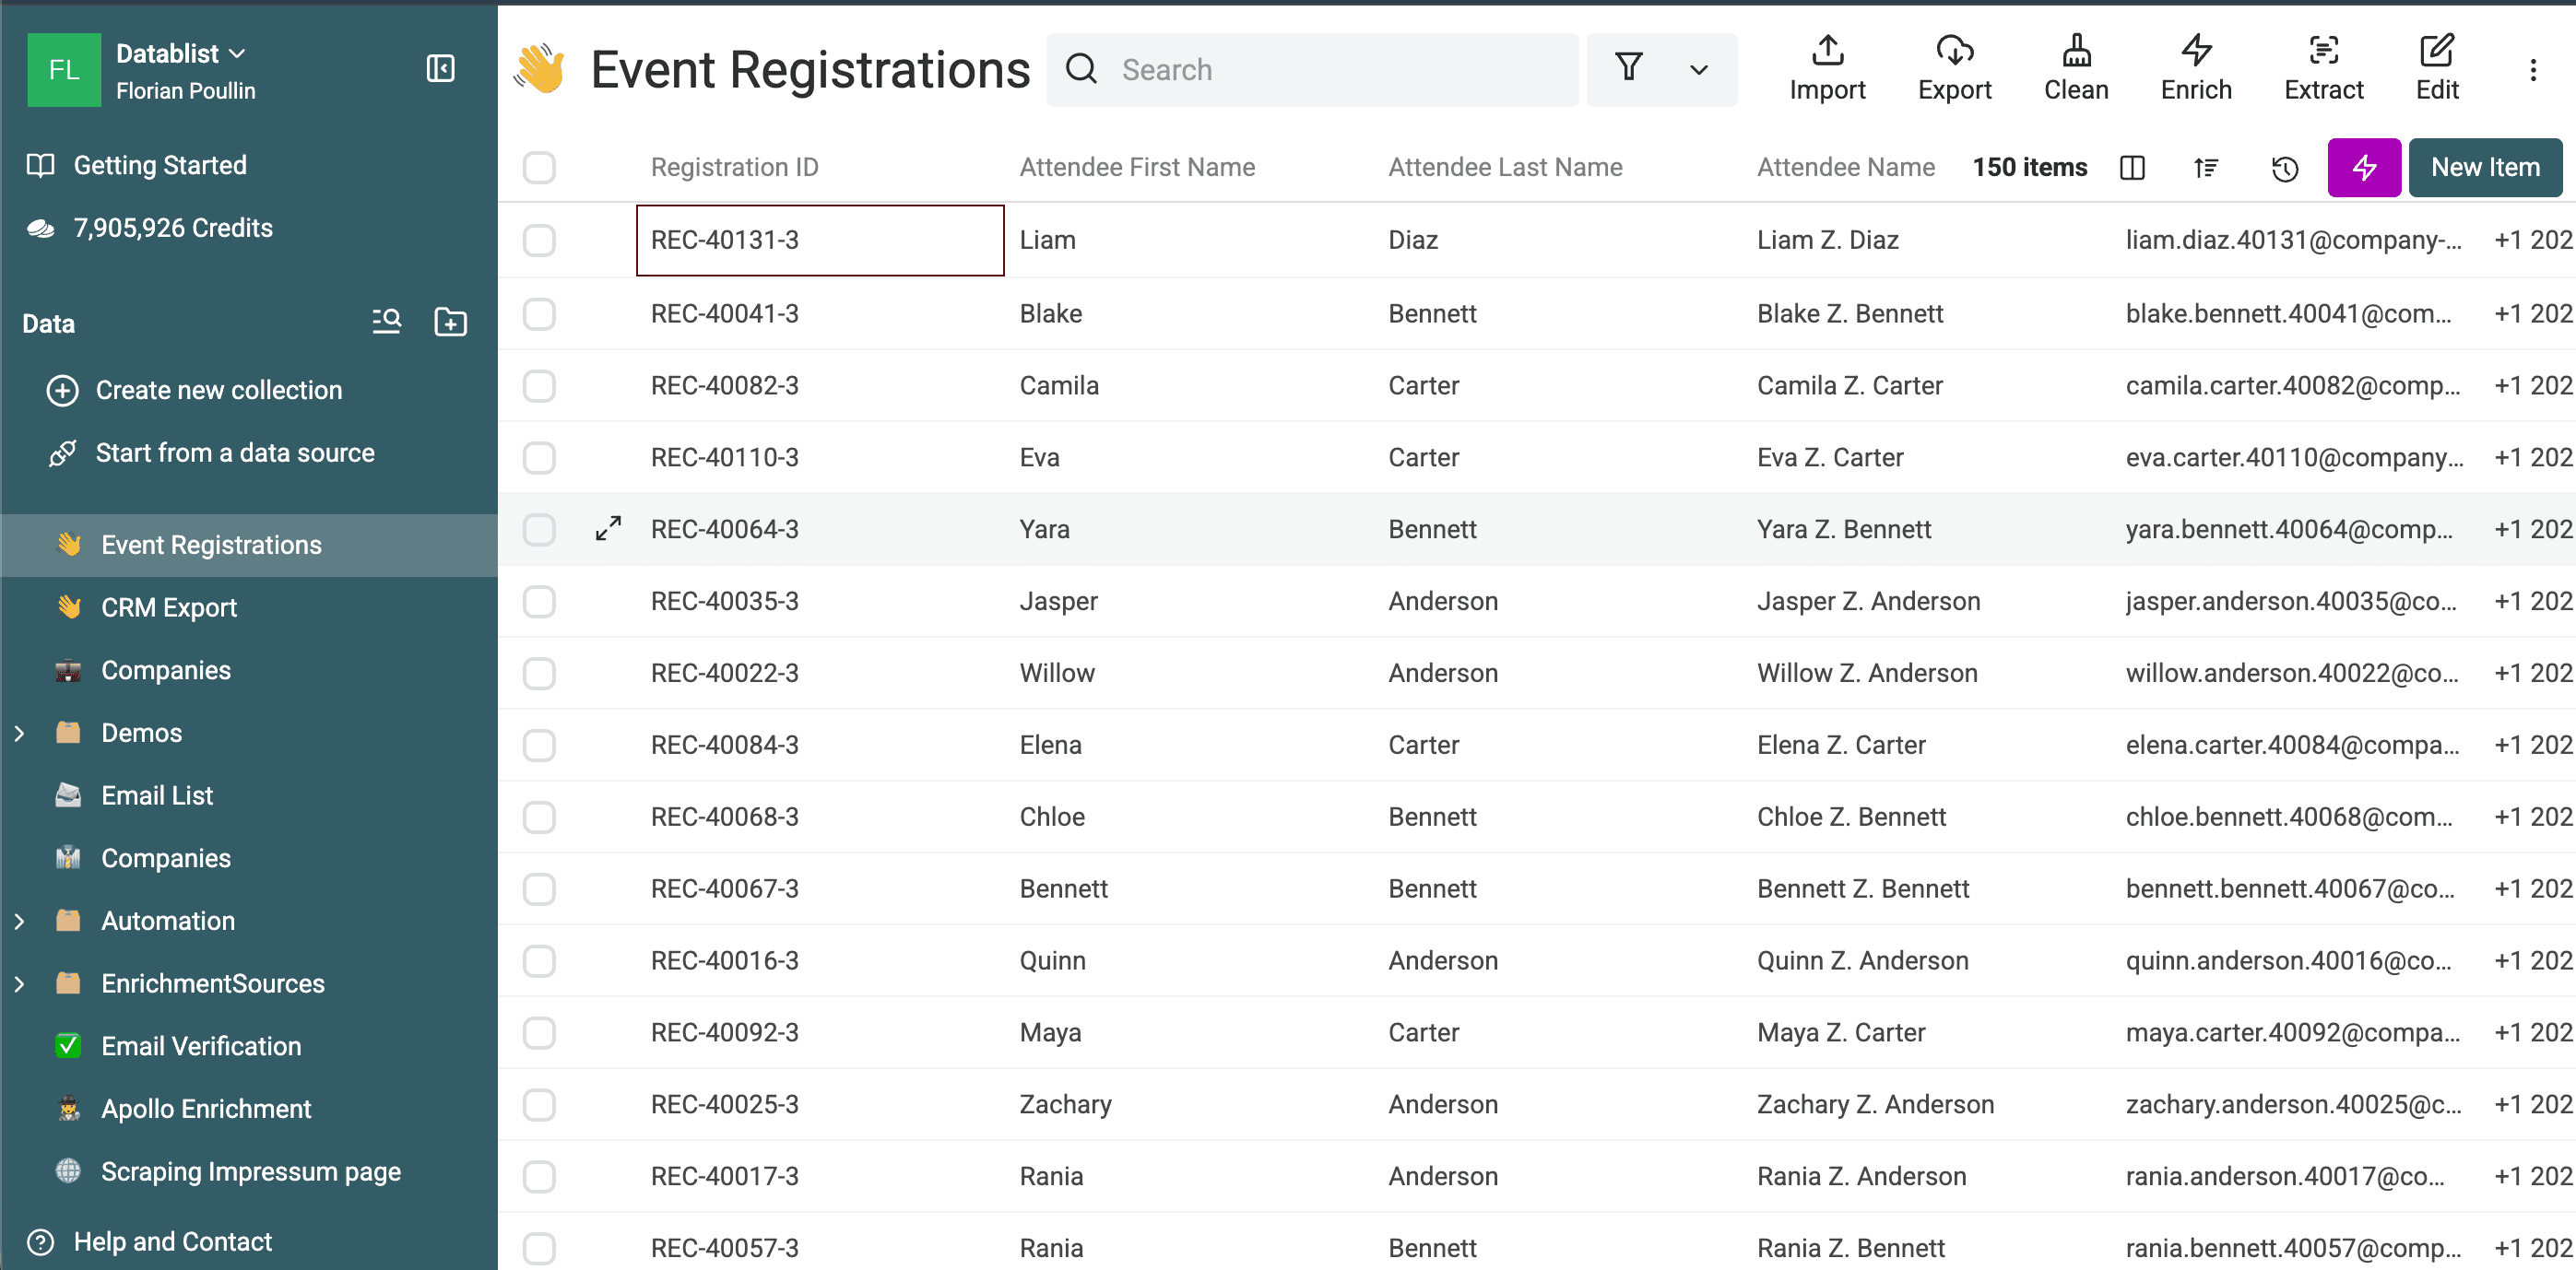
Efter behandlingen af de 100 overlap indeholder Event Registrations 150 helt nye kontakter.
Matchning på tværs af collections er en Premium-funktion. Læs den detaljerede guide til at fjerne dubletter på tværs af flere CSV- eller Excel-filer for at få oplysninger om mapping af collections og behandlingsmuligheder.
FAQ
Kan jeg fjerne dubletter fra en liste gratis online?
Ja. Besøgende uden en konto kan køre en Exact-kontrol. En gratis konto giver adgang til Smart-matchning og de øvrige funktioner til én collection i Free-abonnementet. Fuzzy- og fonetiske algoritmer, avancerede processorer, matchning på tværs af collections, konfigurerbare regler for overlevende værdier og Custom with AI kræver et betalt abonnement.
Skal jeg fjerne eller flette dubletrækker?
Fjern rækker, når én post er autoritativ, og de øvrige ikke indeholder noget, du skal bruge. Flet dem, når sekundære rækker indeholder nyttige værdier. Forhåndsvisningen i Remove advarer, når data vil blive kasseret.
Kan Datablist finde dubletter med stavefejl?
Ja. Jaro-Winkler og Levenshtein sammenligner tekstlig lighed, mens Metaphone sammenligner, hvordan teksten lyder. Disse avancerede algoritmer kræver et betalt abonnement, og deres matches bør gennemgås.
Kan jeg flette dubletrækker uden at miste data?
Datablist kan udfylde tomme felter, kombinere tekstværdier, beholde værdien fra den valgte post eller anvende regler for overlevende værdier på feltniveau. Kontrollér forhåndsvisningen, da værdier, du vælger at kassere, ikke kommer med i den flettede post.
Hvor stor kan listen være?
Free-abonnementet understøtter op til 1 million items pr. collection i browserens lager. Betalte abonnementer understøtter import af op til 2 millioner items pr. collection. Store lokale handlinger afhænger stadig af browseren og enheden.
Kan jeg gennemgå dubletter uden at ændre listen?
Ja. Registreringen er skrivebeskyttet. Du kan gennemgå grupper, justere tærskler, bruge Why matched, søge og sortere resultater samt downloade dubletrækker, før du starter en behandling.
Læs den komplette dokumentation til Duplicate Finder for at se alle indstillinger og begrænsninger.