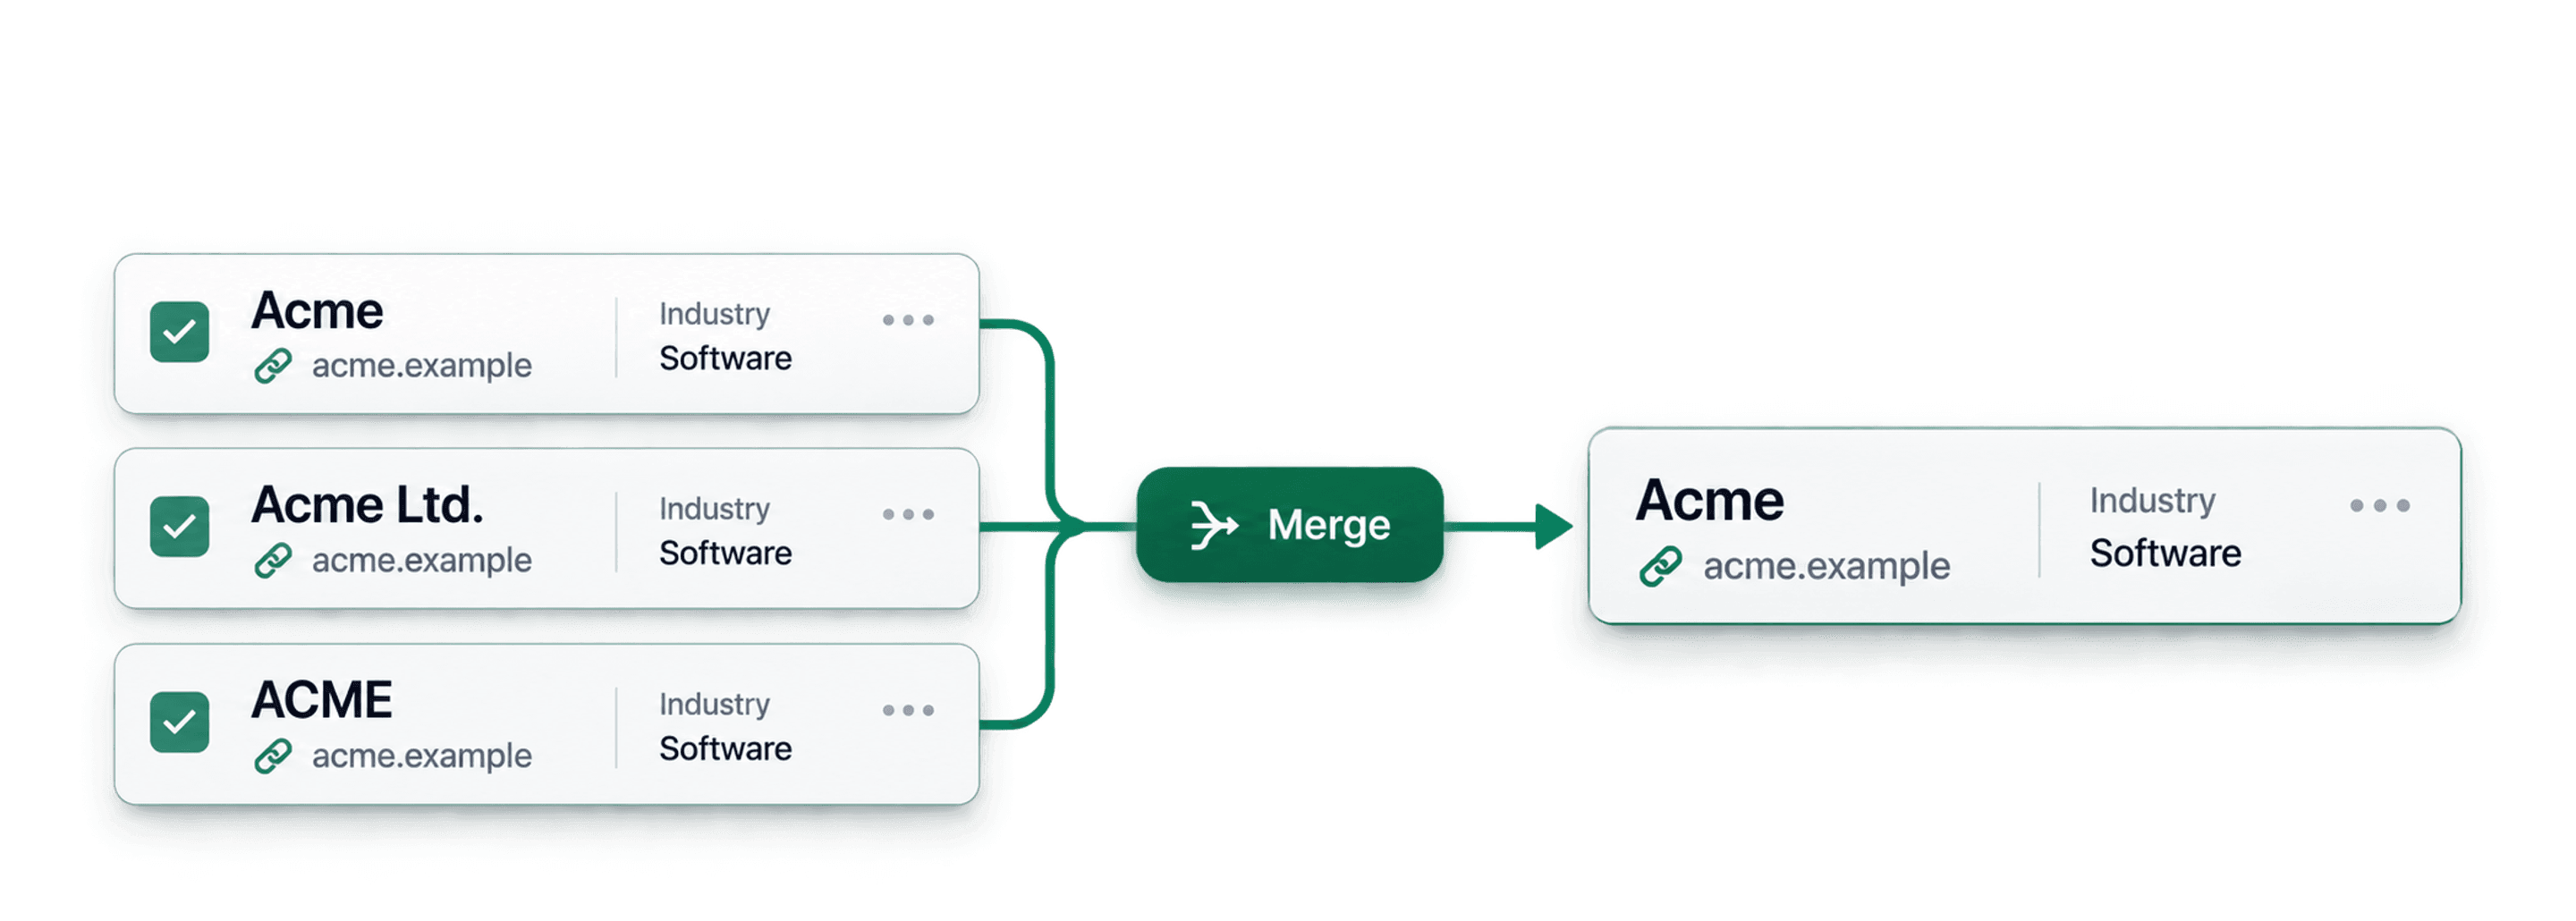
Para detectar nombres de empresa duplicados, compare primero un identificador estable, como el dominio, y después aplique la normalización de nombres de empresa a los registros que no tengan un sitio web fiable. Revise los grupos propuestos antes de fusionarlos, ya que dos empresas pueden compartir un nombre corto o genérico.
En esta guía aprenderá a:
- Importar su lista de empresas
- Encontrar sitios web y nombres de empresa coincidentes
- Fusionar registros de empresas duplicados
Buenas prácticas para eliminar empresas duplicadas
Utilice el identificador más fiable disponible. Un sitio web o dominio normalizado es un mejor punto de partida que el nombre, porque distintas empresas pueden llamarse, por ejemplo, Acme Services. Guarde el nombre original de la empresa, el sitio web y el ID del registro del CRM en propiedades separadas. Así podrá revisar cada coincidencia y vincular la fila depurada con su fuente.
Compare los nombres en una segunda pasada. El procesador Company Name elimina términos jurídicos, geográficos y empresariales habituales antes de realizar la comparación. Esto puede agrupar Cedar Group LLC y Cedar, pero también hacer que dos empresas sin relación parezcan iguales. En los registros sin dominio, compare otro campo, como el país, la ciudad o la dirección, antes de decidir si debe fusionarlos. Una coincidencia de nombre del 100 % no demuestra por sí sola que se trate de la misma entidad.
Cuando un grupo contenga distintos números de teléfono, propietarios o notas, consulte Why matched y elija qué valores desea conservar. Si necesita una trazabilidad completa, exporte primero los grupos de duplicados. No los fusione hasta que pueda explicar por qué los registros corresponden a la misma empresa.
Si necesita una columna independiente con los nombres depurados de unos pocos registros, utilice la herramienta gratuita Company Name Cleaner antes de importar la lista. Mantenga los valores originales junto a los resultados. Limpiar los nombres facilita la comparación, pero no determina qué empresas deben fusionarse.
Paso 1: Importar su lista de empresas
Empiece importando su lista de empresas en Datablist. Si dispone de un dominio o sitio web, conserve esa columna. Por lo general, el dominio es un identificador de empresa más fiable que el nombre por sí solo.
Para reproducir el proceso medido que se explica a continuación, descargue la muestra de deduplicación con 1.000 filas. Contiene 800 entidades creadas para la prueba, incluidos 50 pares con variaciones en el nombre y el sitio web de la empresa.
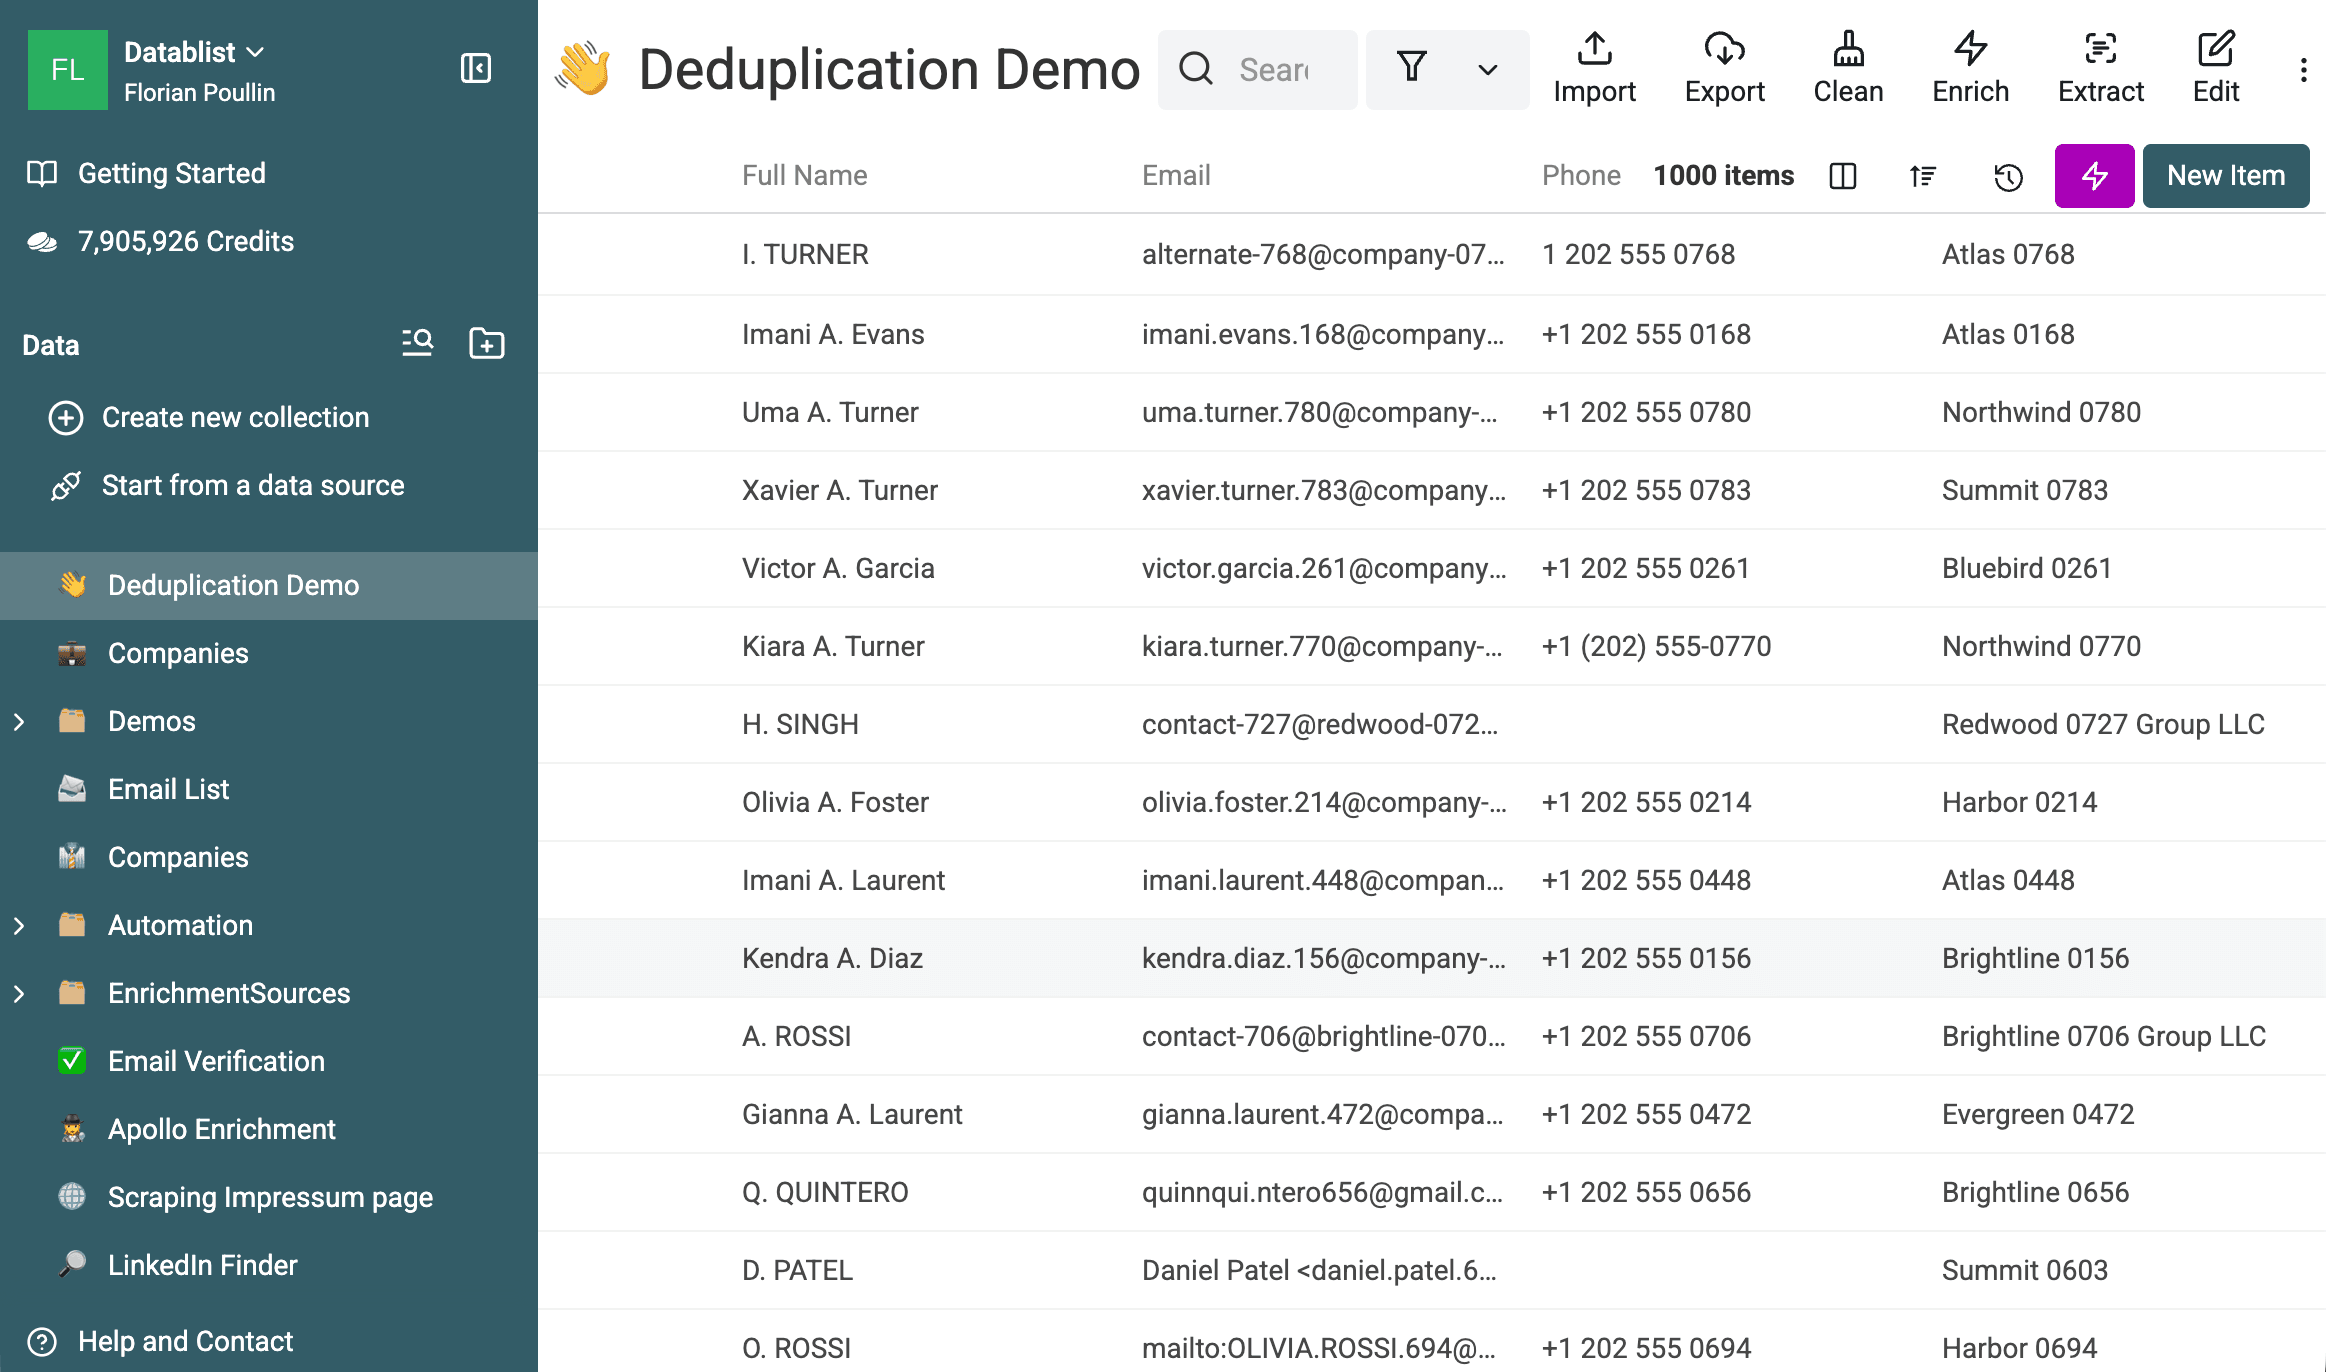
Revise las propiedades importadas y asigne a Website el tipo URL cuando corresponda. La propiedad Company puede permanecer como Text.
Paso 2: Detectar empresas duplicadas
Abra Clean > Merge duplicates para detectar registros de empresa coincidentes.
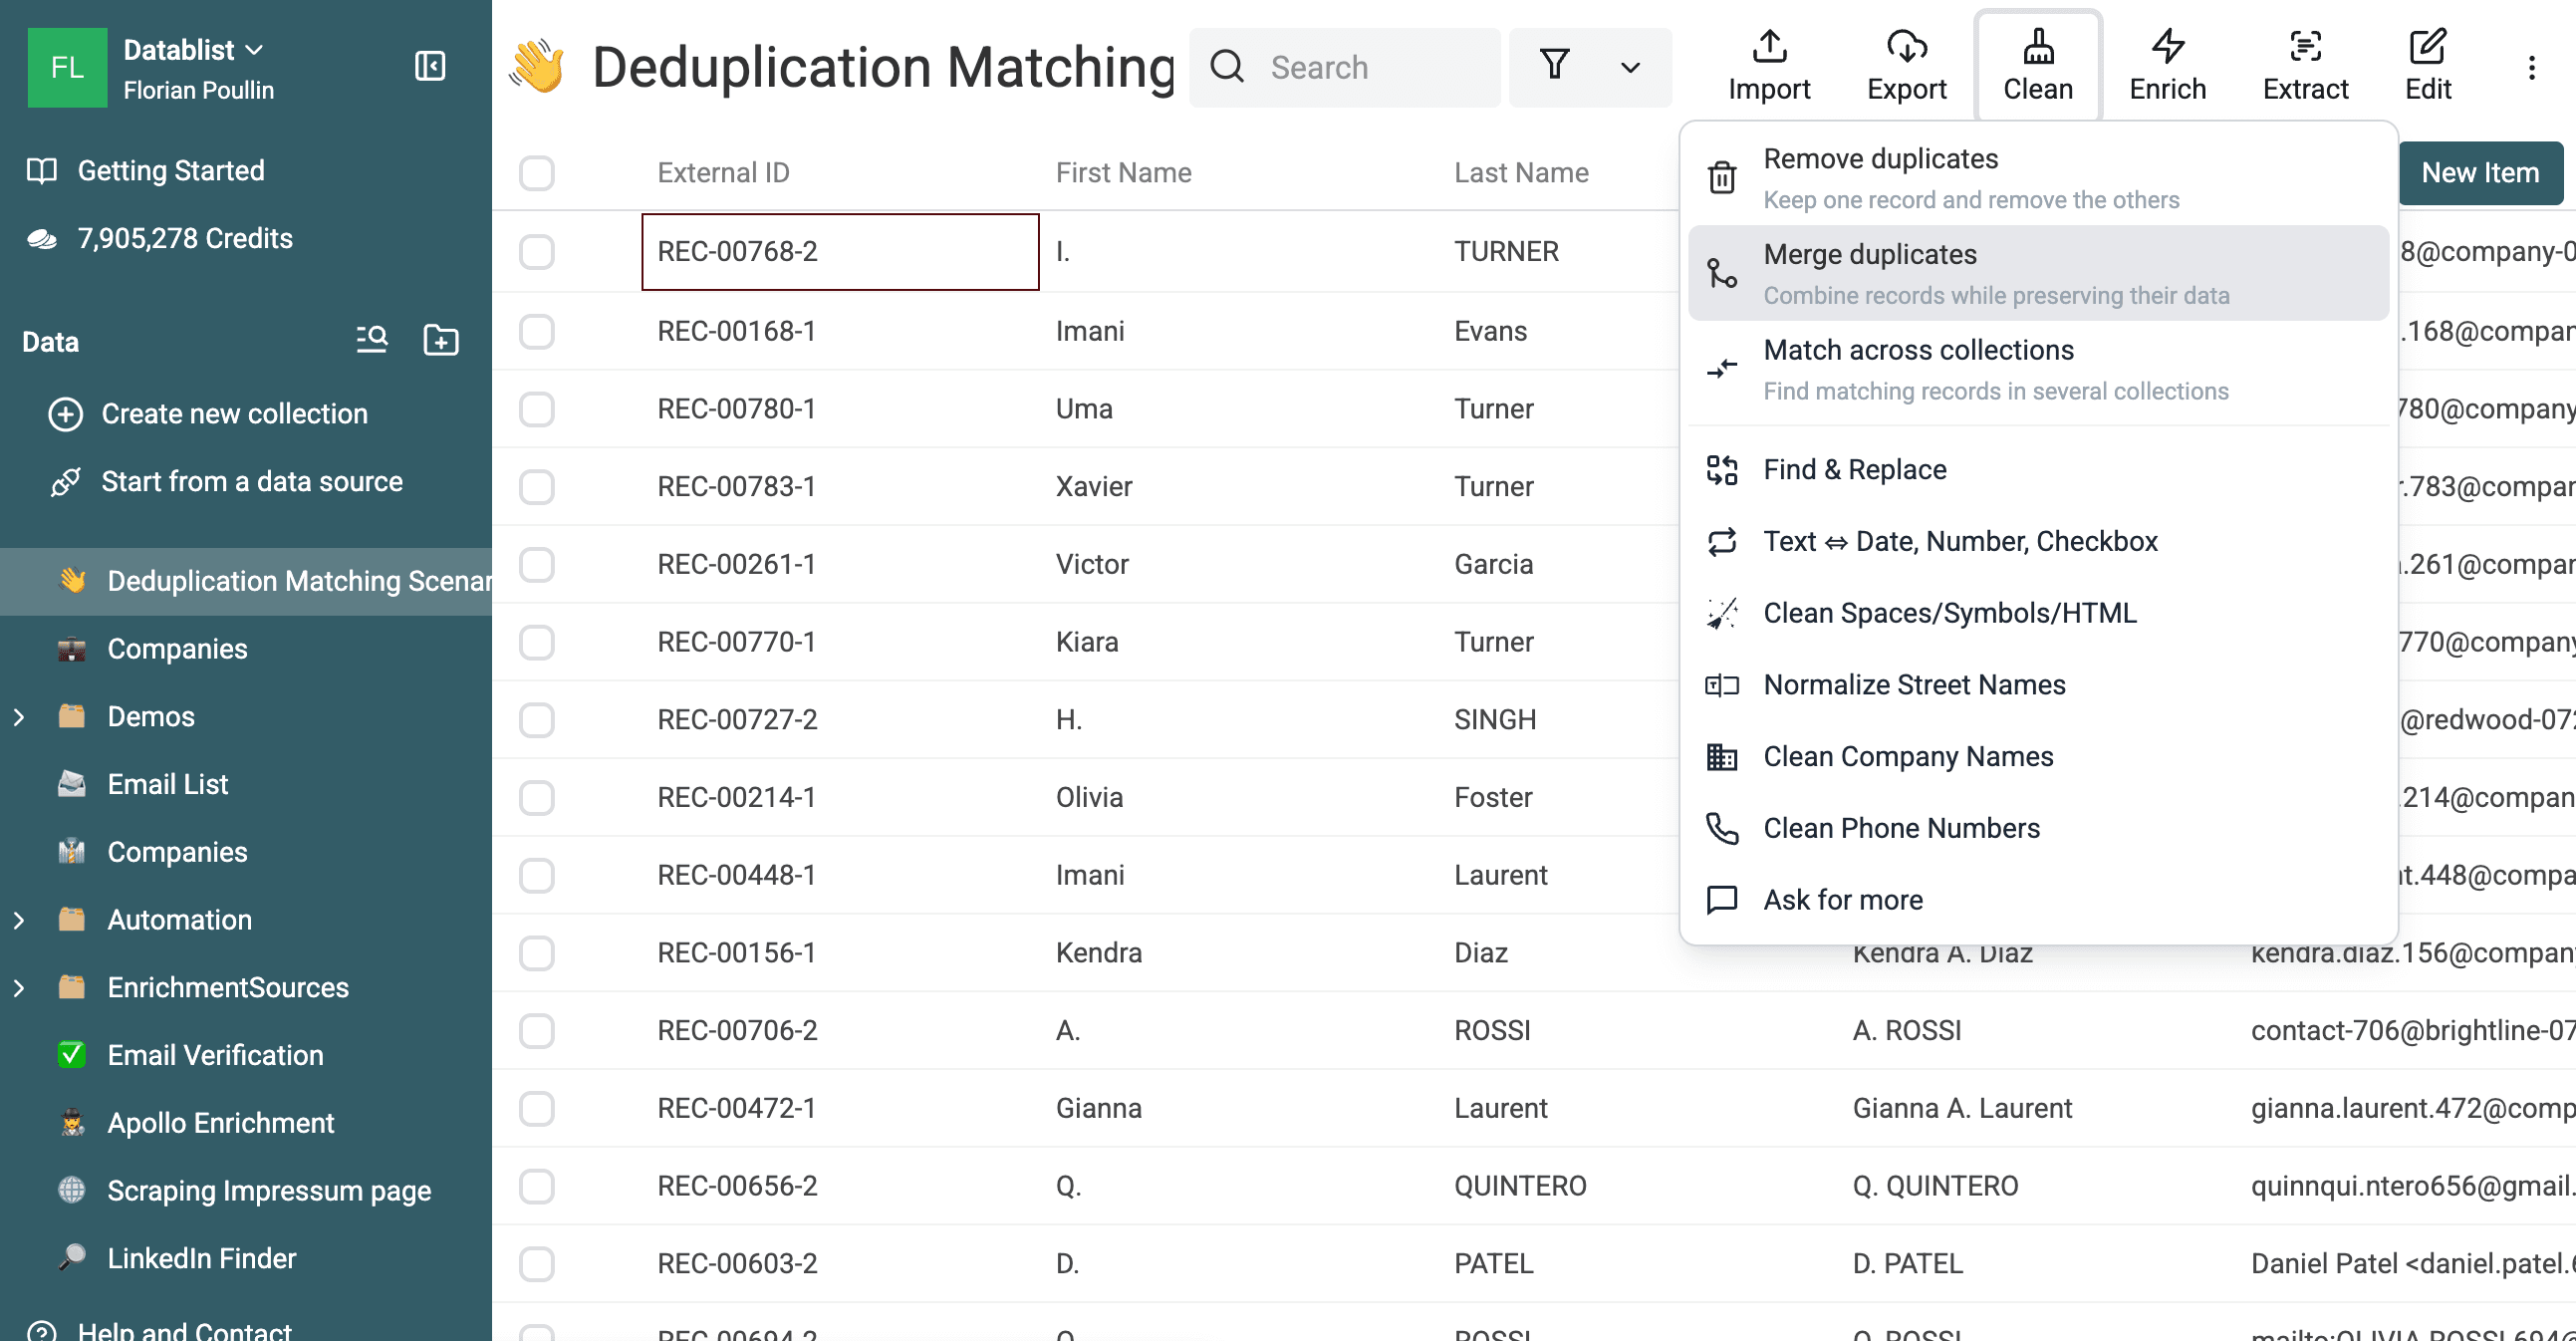
Si la lista contiene sitios web, compárelos primero. Después, realice otra búsqueda por nombre de empresa para las filas que no tengan un sitio web o dominio fiable.
Comparar los sitios web de las empresas
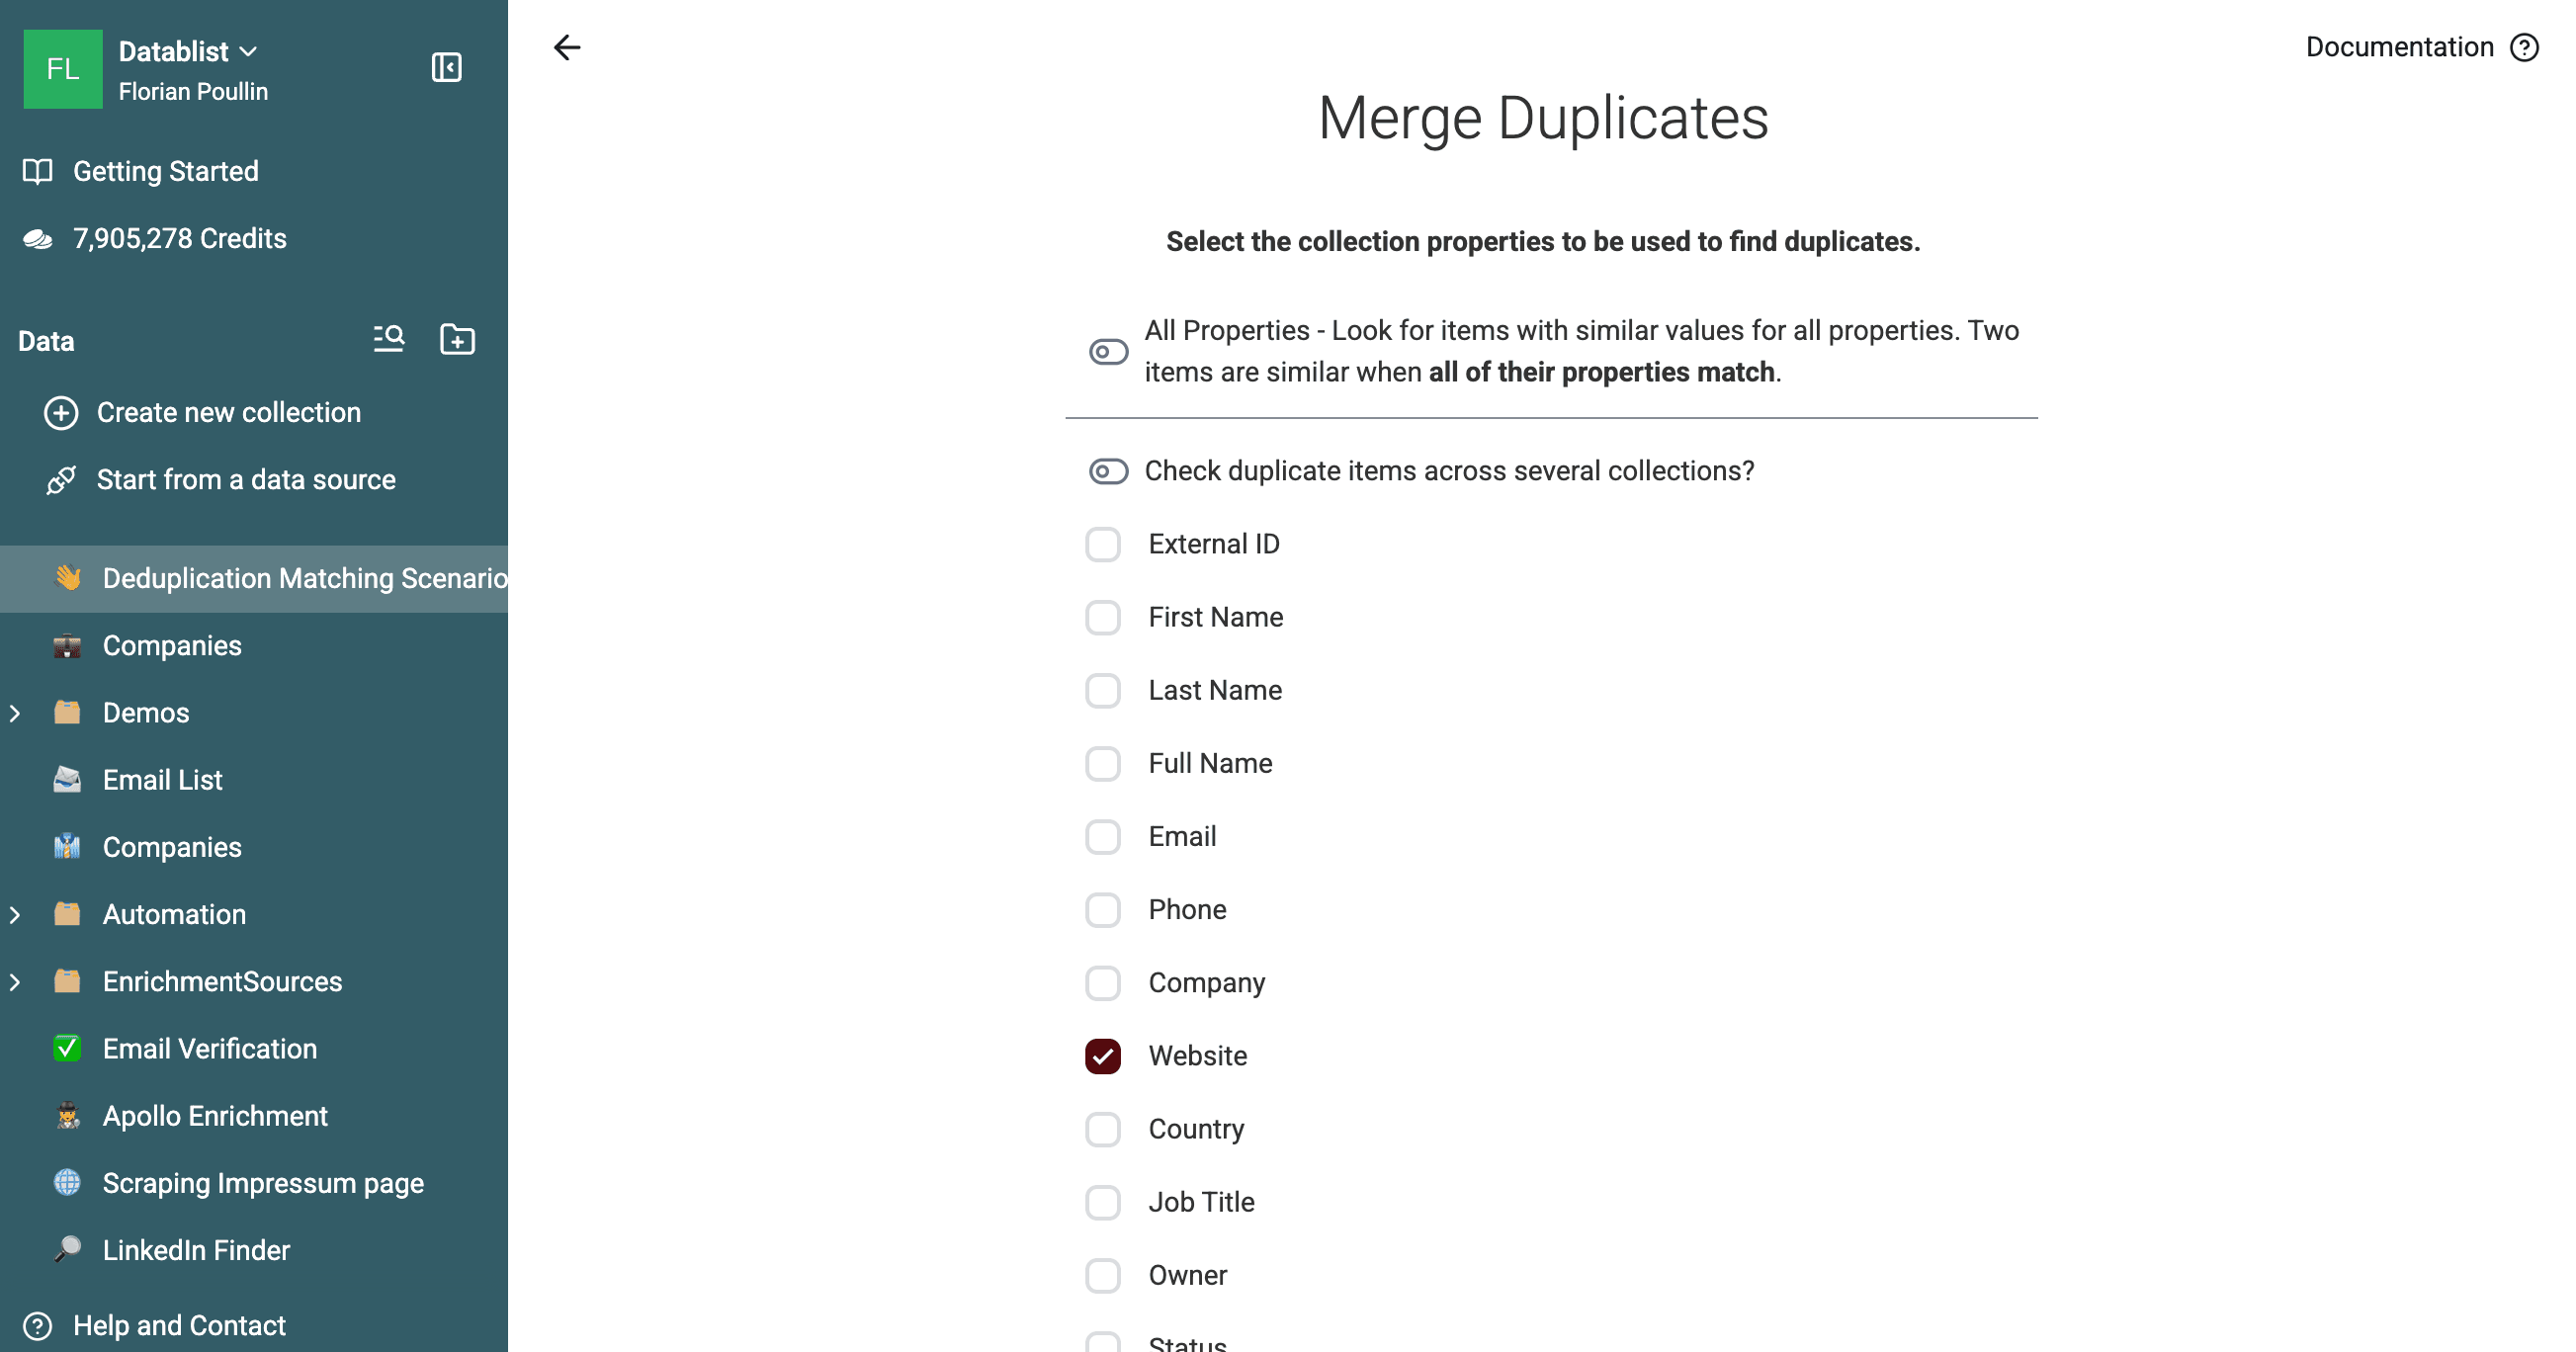
Desactive All Properties y seleccione únicamente Website.
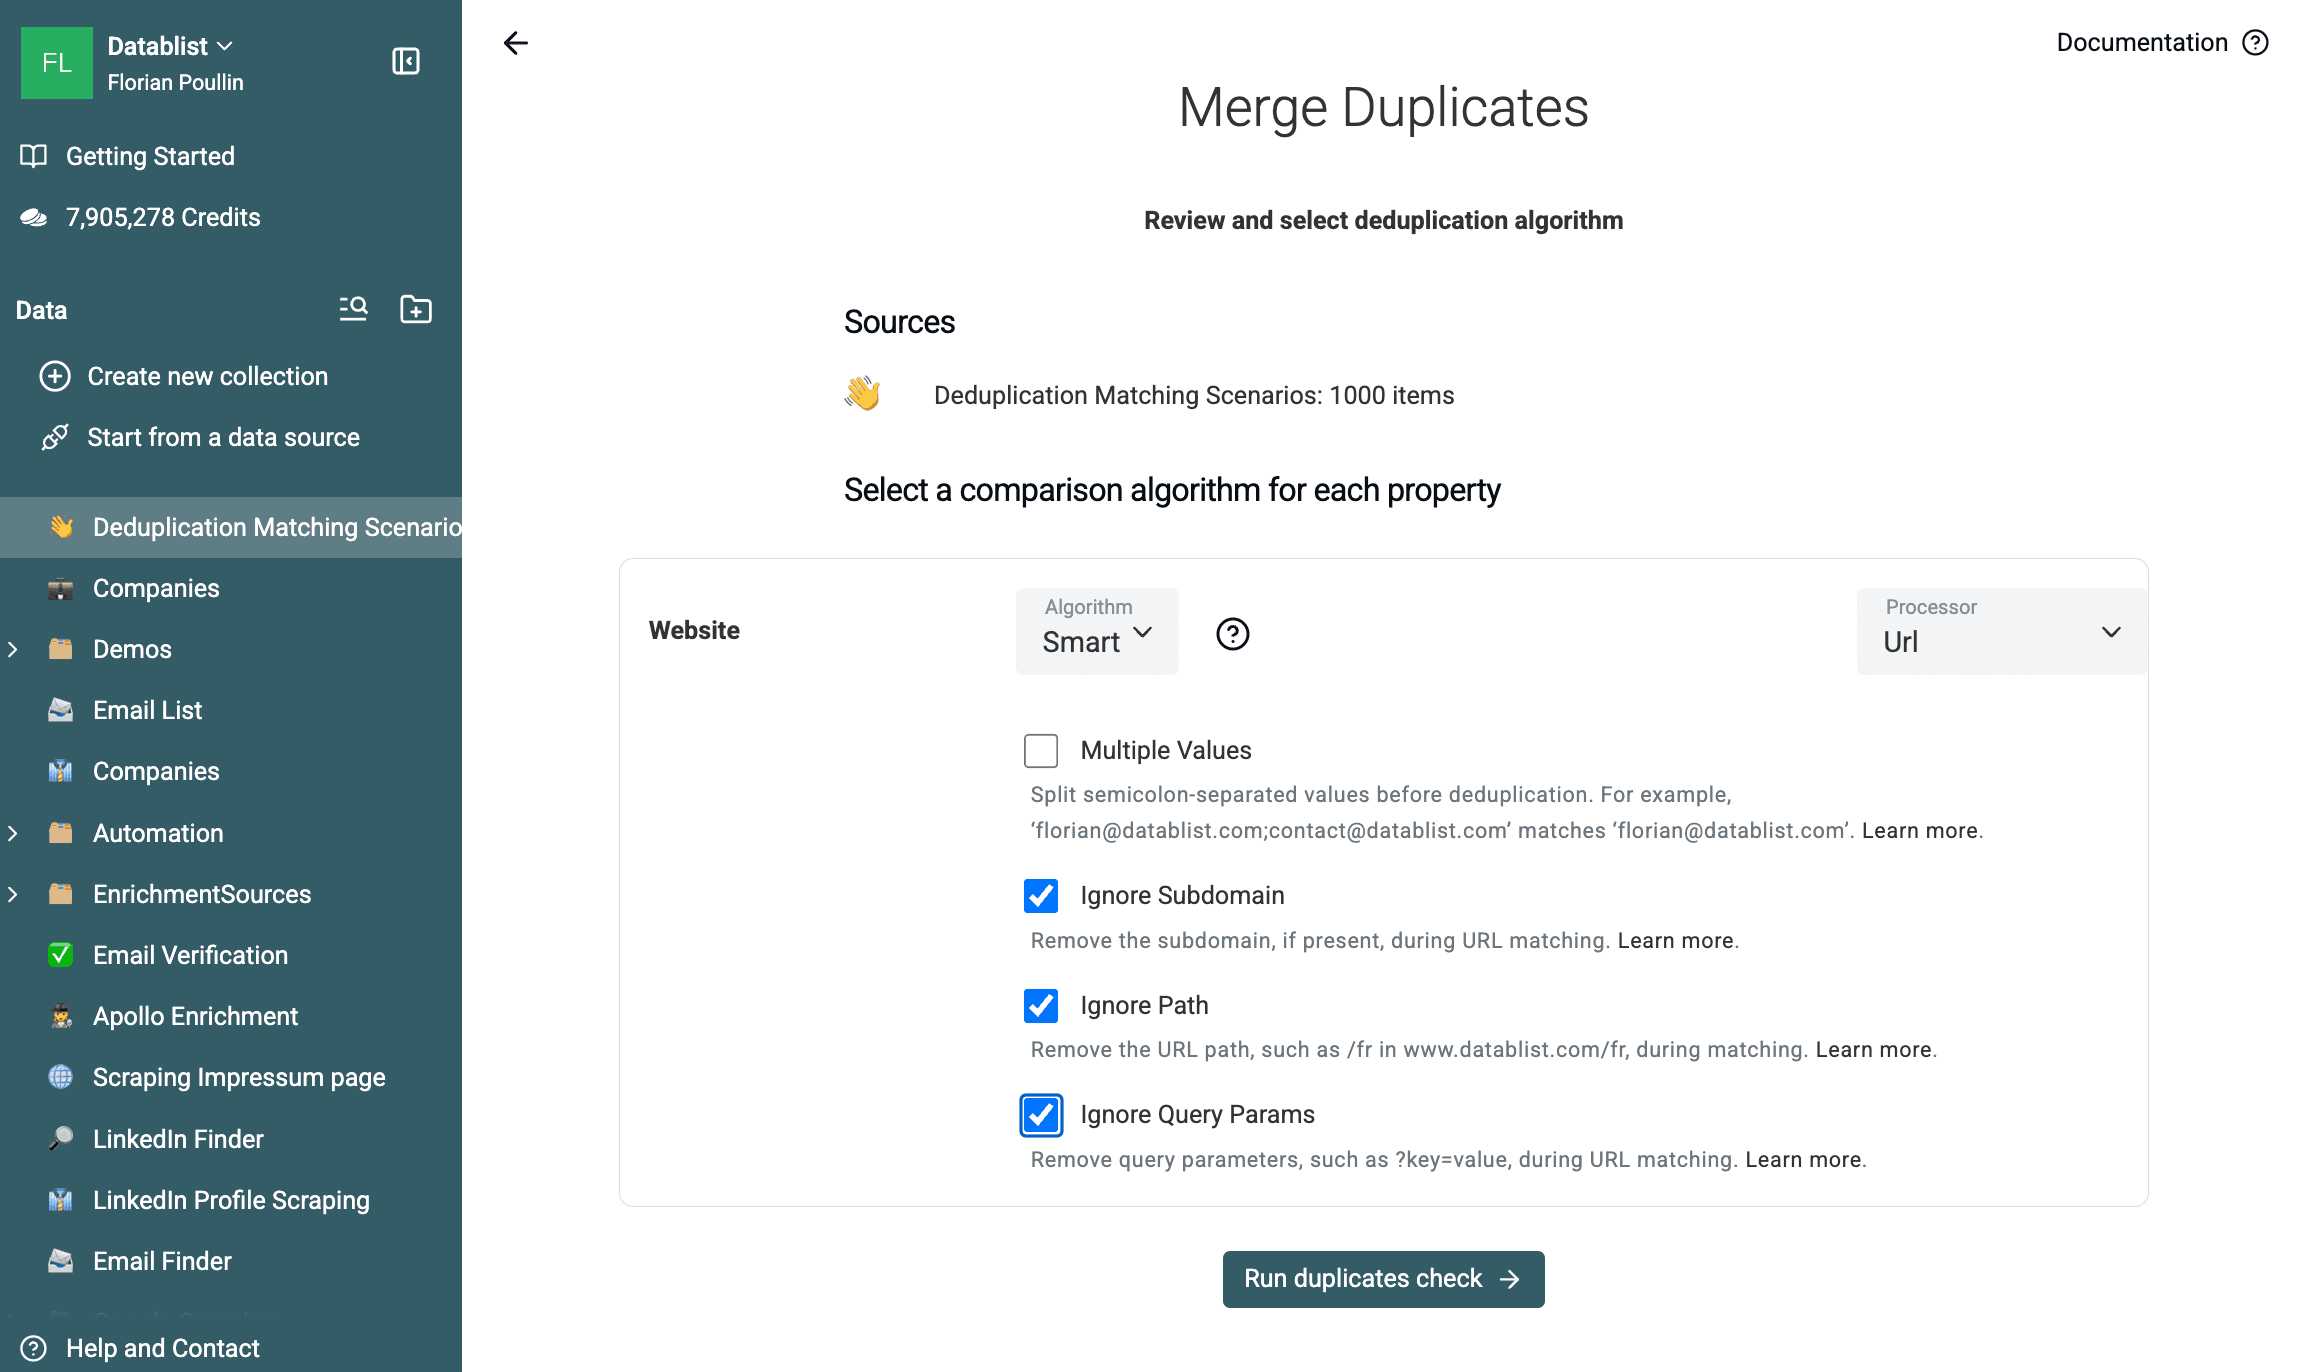
Elija Smart con el procesador URL. Este procesador ignora las diferencias de protocolo y las barras finales. Active las siguientes opciones cuando resulten adecuadas para sus datos:
- Ignore Subdomain considera los subdominios como un mismo dominio registrado.
- Ignore Path compara el dominio sin las rutas de las páginas.
- Ignore Query Params elimina los parámetros de seguimiento y otros parámetros de consulta antes de comparar.
Utilice estas opciones con cuidado. Dos subdominios o rutas pueden representar cuentas, sucursales, productos o ubicaciones diferentes. Consérvelos cuando esas diferencias sean relevantes.
La comparación por Website devolvió 200 grupos de dos filas a partir de la muestra de 1.000 registros. Cincuenta pares contienen variaciones de URL creadas para la prueba y otros 150 ya comparten el mismo valor de Website. La validación de los grupos exportados no detectó ninguna coincidencia entre entidades distintas.
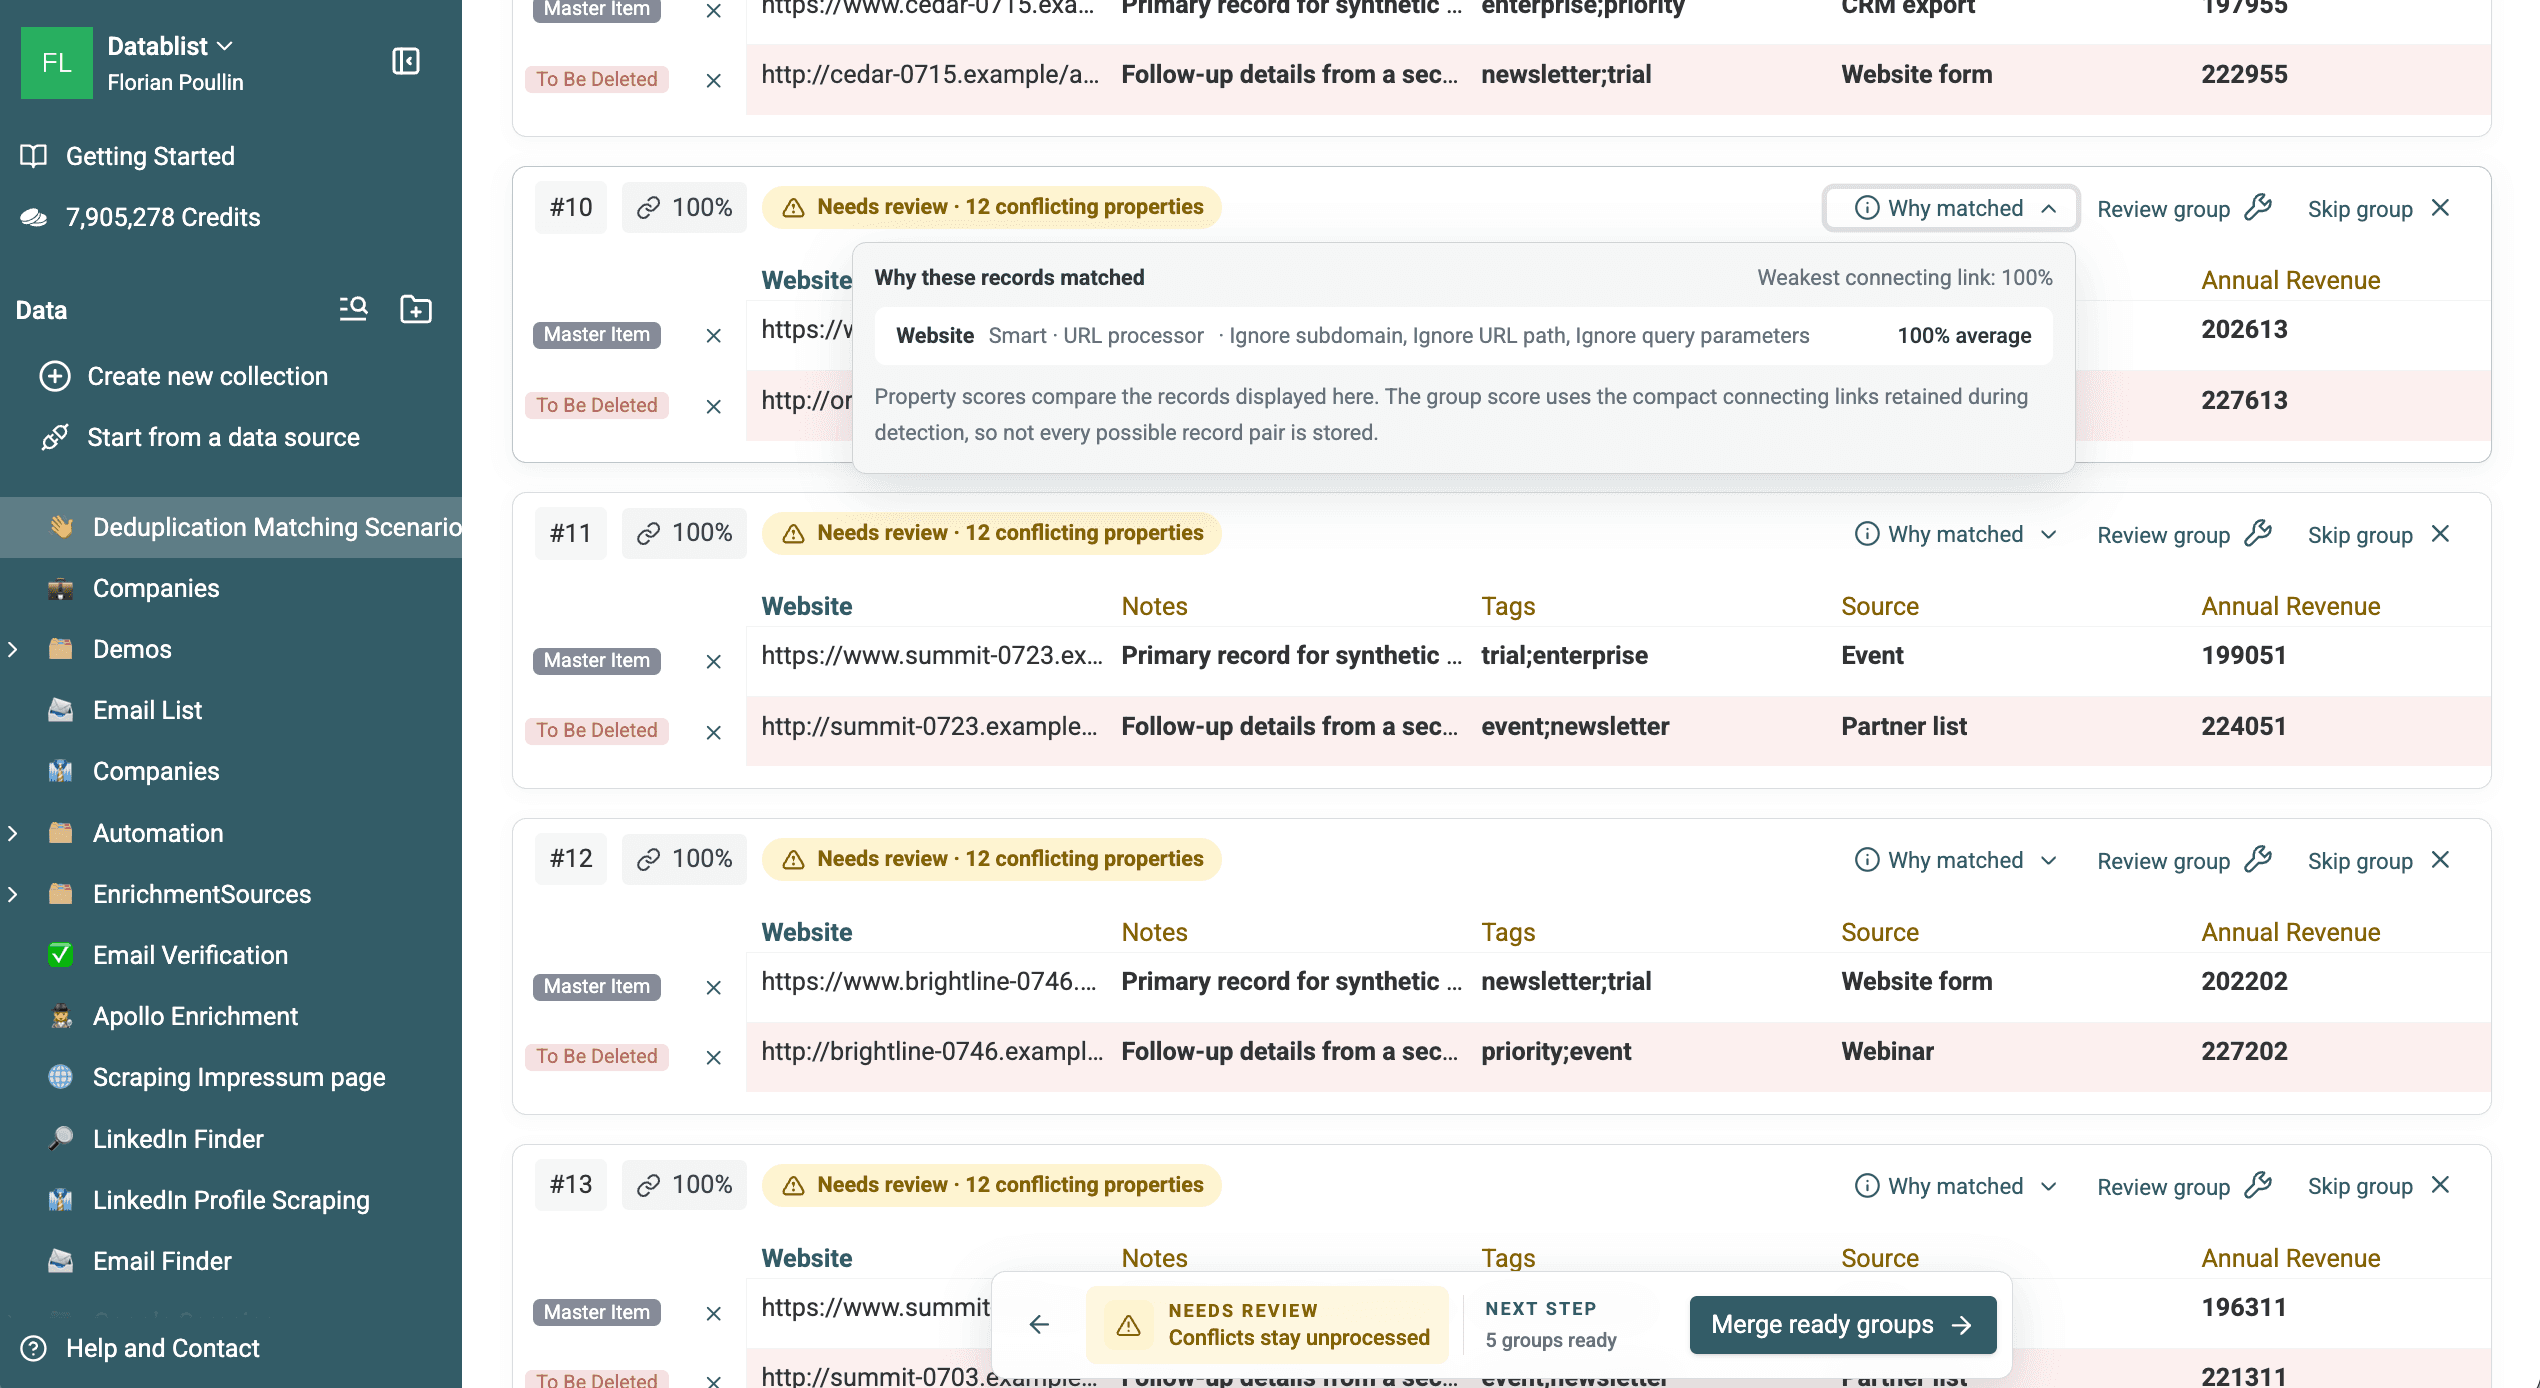
Abra Why matched antes de procesar un grupo. Allí verá la propiedad Website, el algoritmo Smart, el procesador URL, las opciones de URL activadas y la puntuación de coincidencia.
Descargue los 200 grupos de duplicados encontrados por Website para revisar las filas coincidentes.
Comparar nombres de empresa normalizados
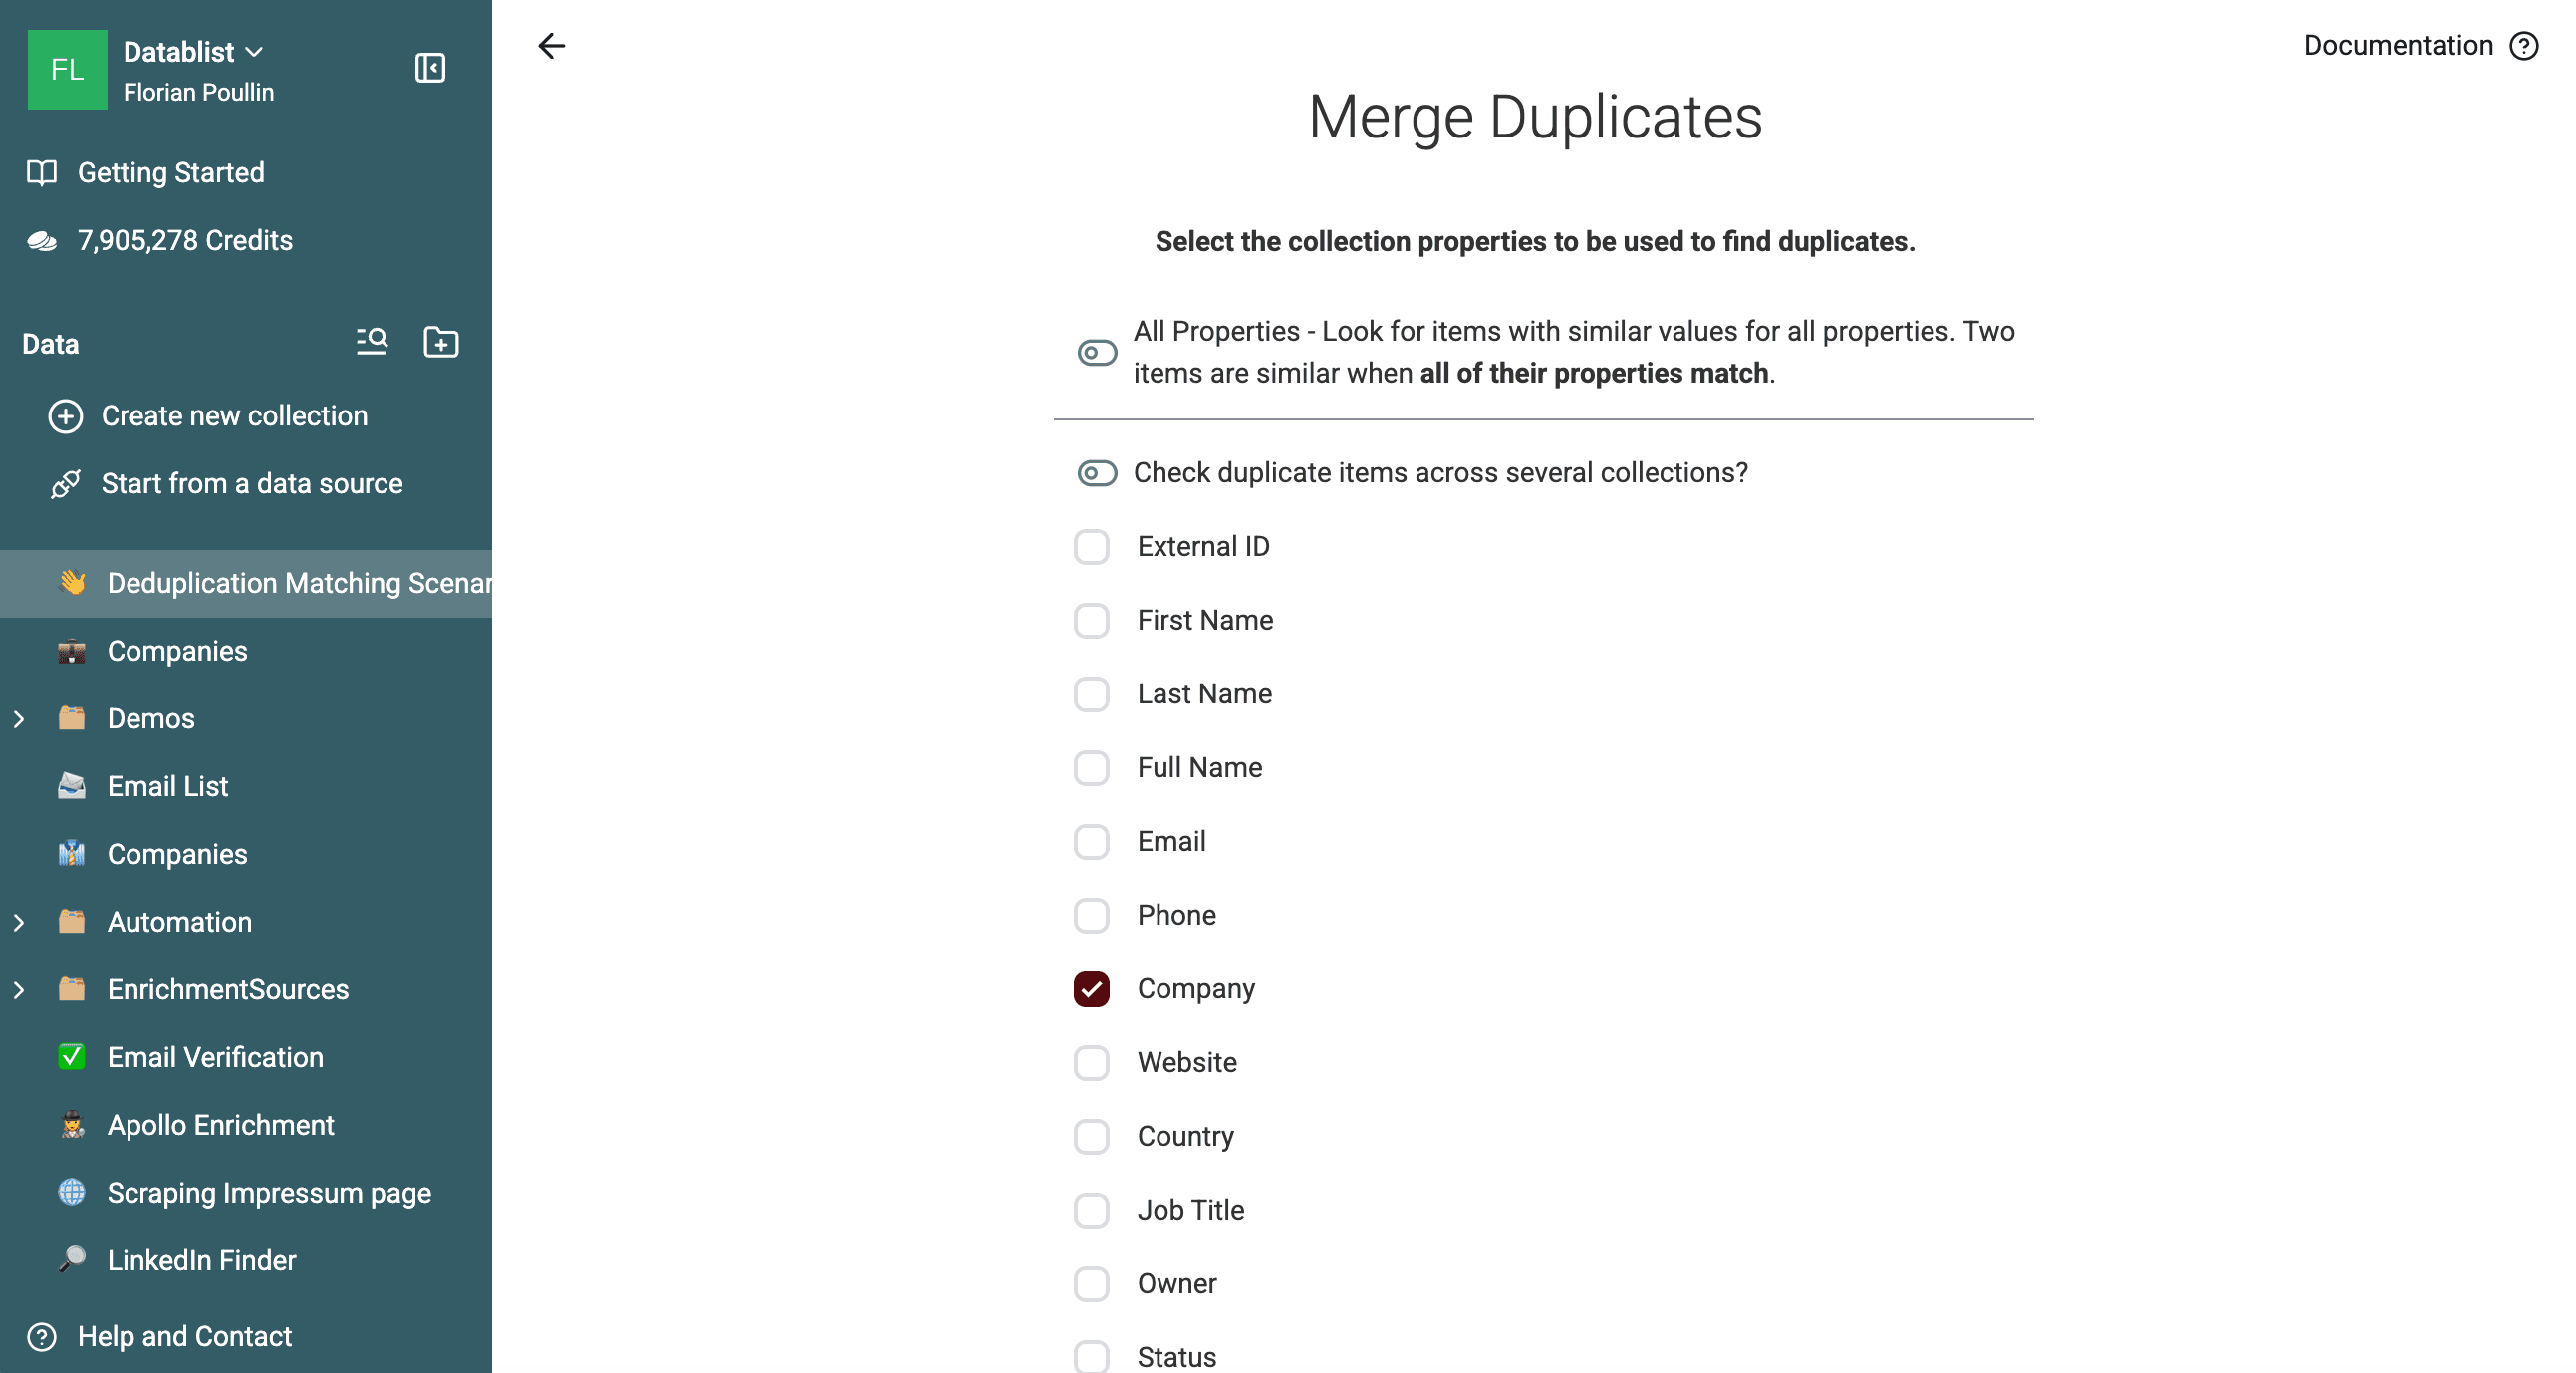
Seleccione Company para realizar una segunda pasada.
Elija el método de comparación:
- Utilice Smart con el procesador Company Name para eliminar términos empresariales habituales antes de comparar.
- Utilice Jaro-Winkler o Levenshtein para detectar variaciones ortográficas. Empiece con un umbral alto y mantenga los grupos con menor nivel de confianza en Needs review.
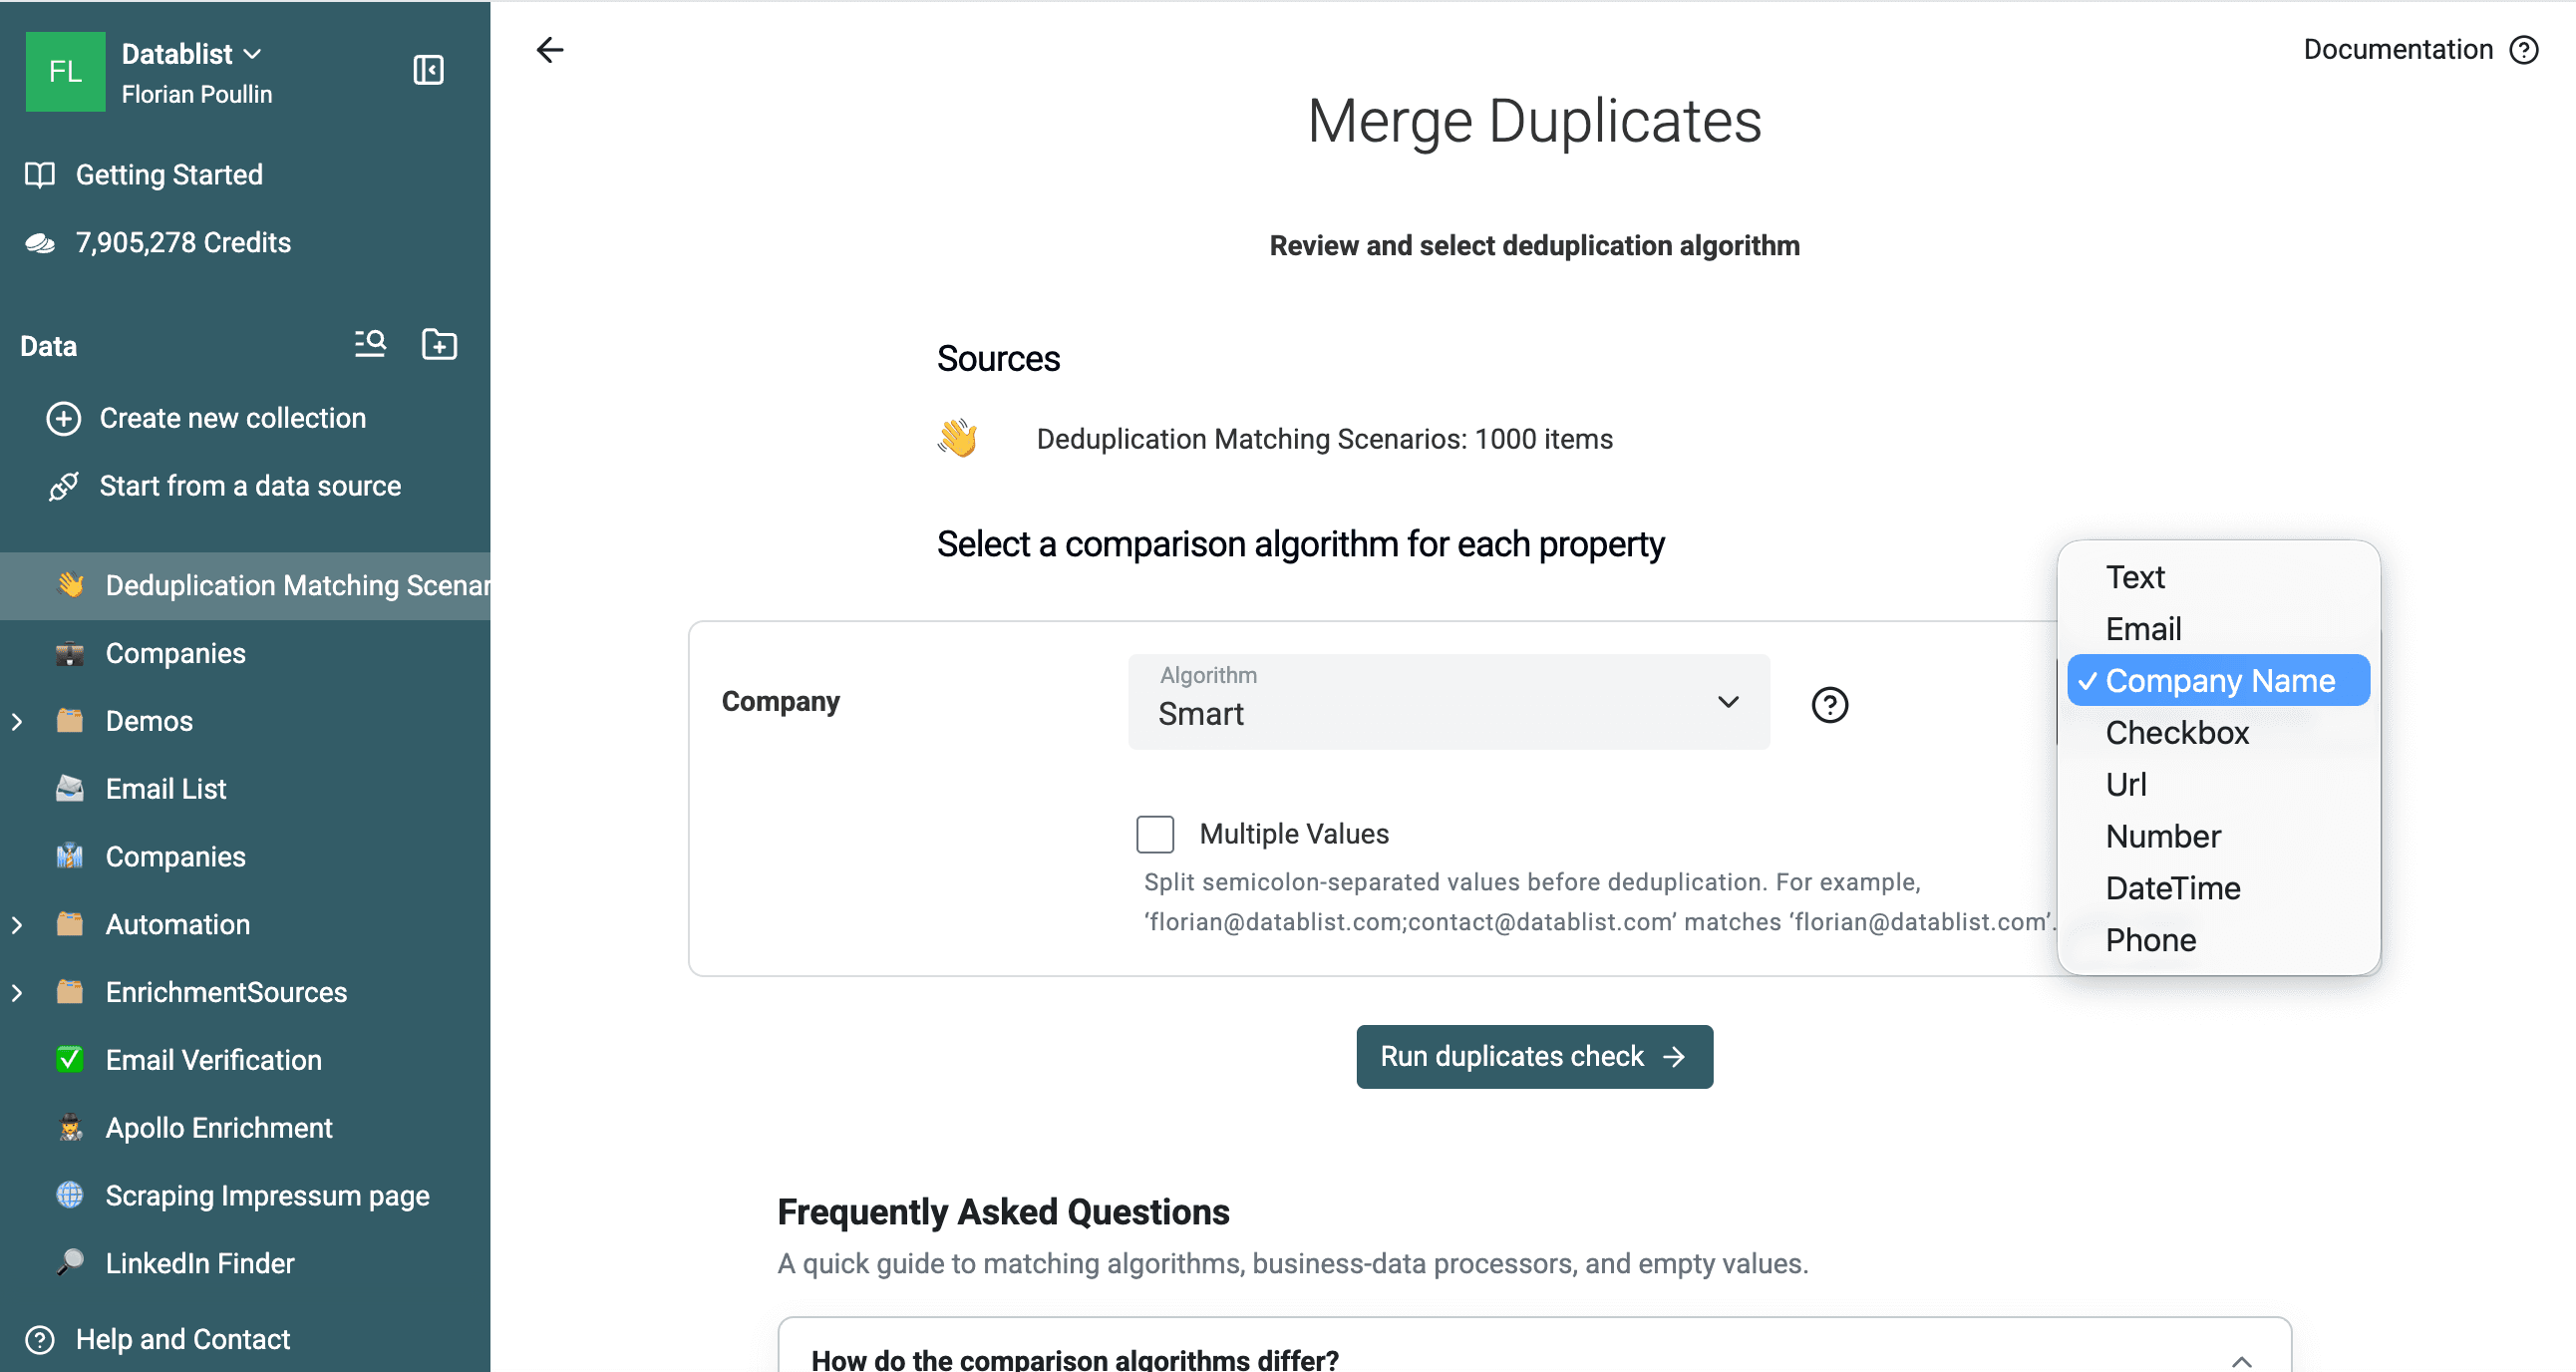
Ejecute la comprobación de duplicados para detectar registros coincidentes.
Cómo funciona el procesador Company Name
El procesador Company Name es una herramienta específica que normaliza los nombres de empresa antes de buscar duplicados. Es fundamental porque una misma empresa puede aparecer con distintas variantes de su nombre en sus datos.
Qué hace:
- Elimina sufijos jurídicos: LLC, Inc., Ltd., etc.
- Ignora términos geográficos: Europe, USA, UK, etc.
- Suprime términos empresariales: Partners, Group, Technologies, etc.
Ejemplo
| Nombre original | Nombre normalizado |
|---|---|
| Apple Inc. | Apple |
| Apple USA LLC | Apple |
| Apple Technologies | Apple |
| Microsoft Corporation | Microsoft |
| Microsoft Ltd. UK | Microsoft |
Estos valores pueden convertirse en candidatos a coincidencia. El procesador Company Name es una función de pago y, antes de fusionarlo, deberá comprobar que el grupo representa realmente a la misma empresa.
Resultado medido con la muestra de 1.000 filas
La comparación por Company Name devolvió 200 grupos de dos filas tras analizar 1.000 registros:
- 50 pares contienen variantes de nombres de empresa creadas para la prueba, como
Cedar 0715, Inc.yCedar 0715 Group LLC. - Otros 150 pares de duplicados ya comparten un valor idéntico en Company.
En esta prueba, los 200 grupos corresponden a las entidades sintéticas correctas. Ningún grupo combina registros de entidades diferentes. Este resultado solo es válido para la muestra generada y no constituye una garantía general de precisión.
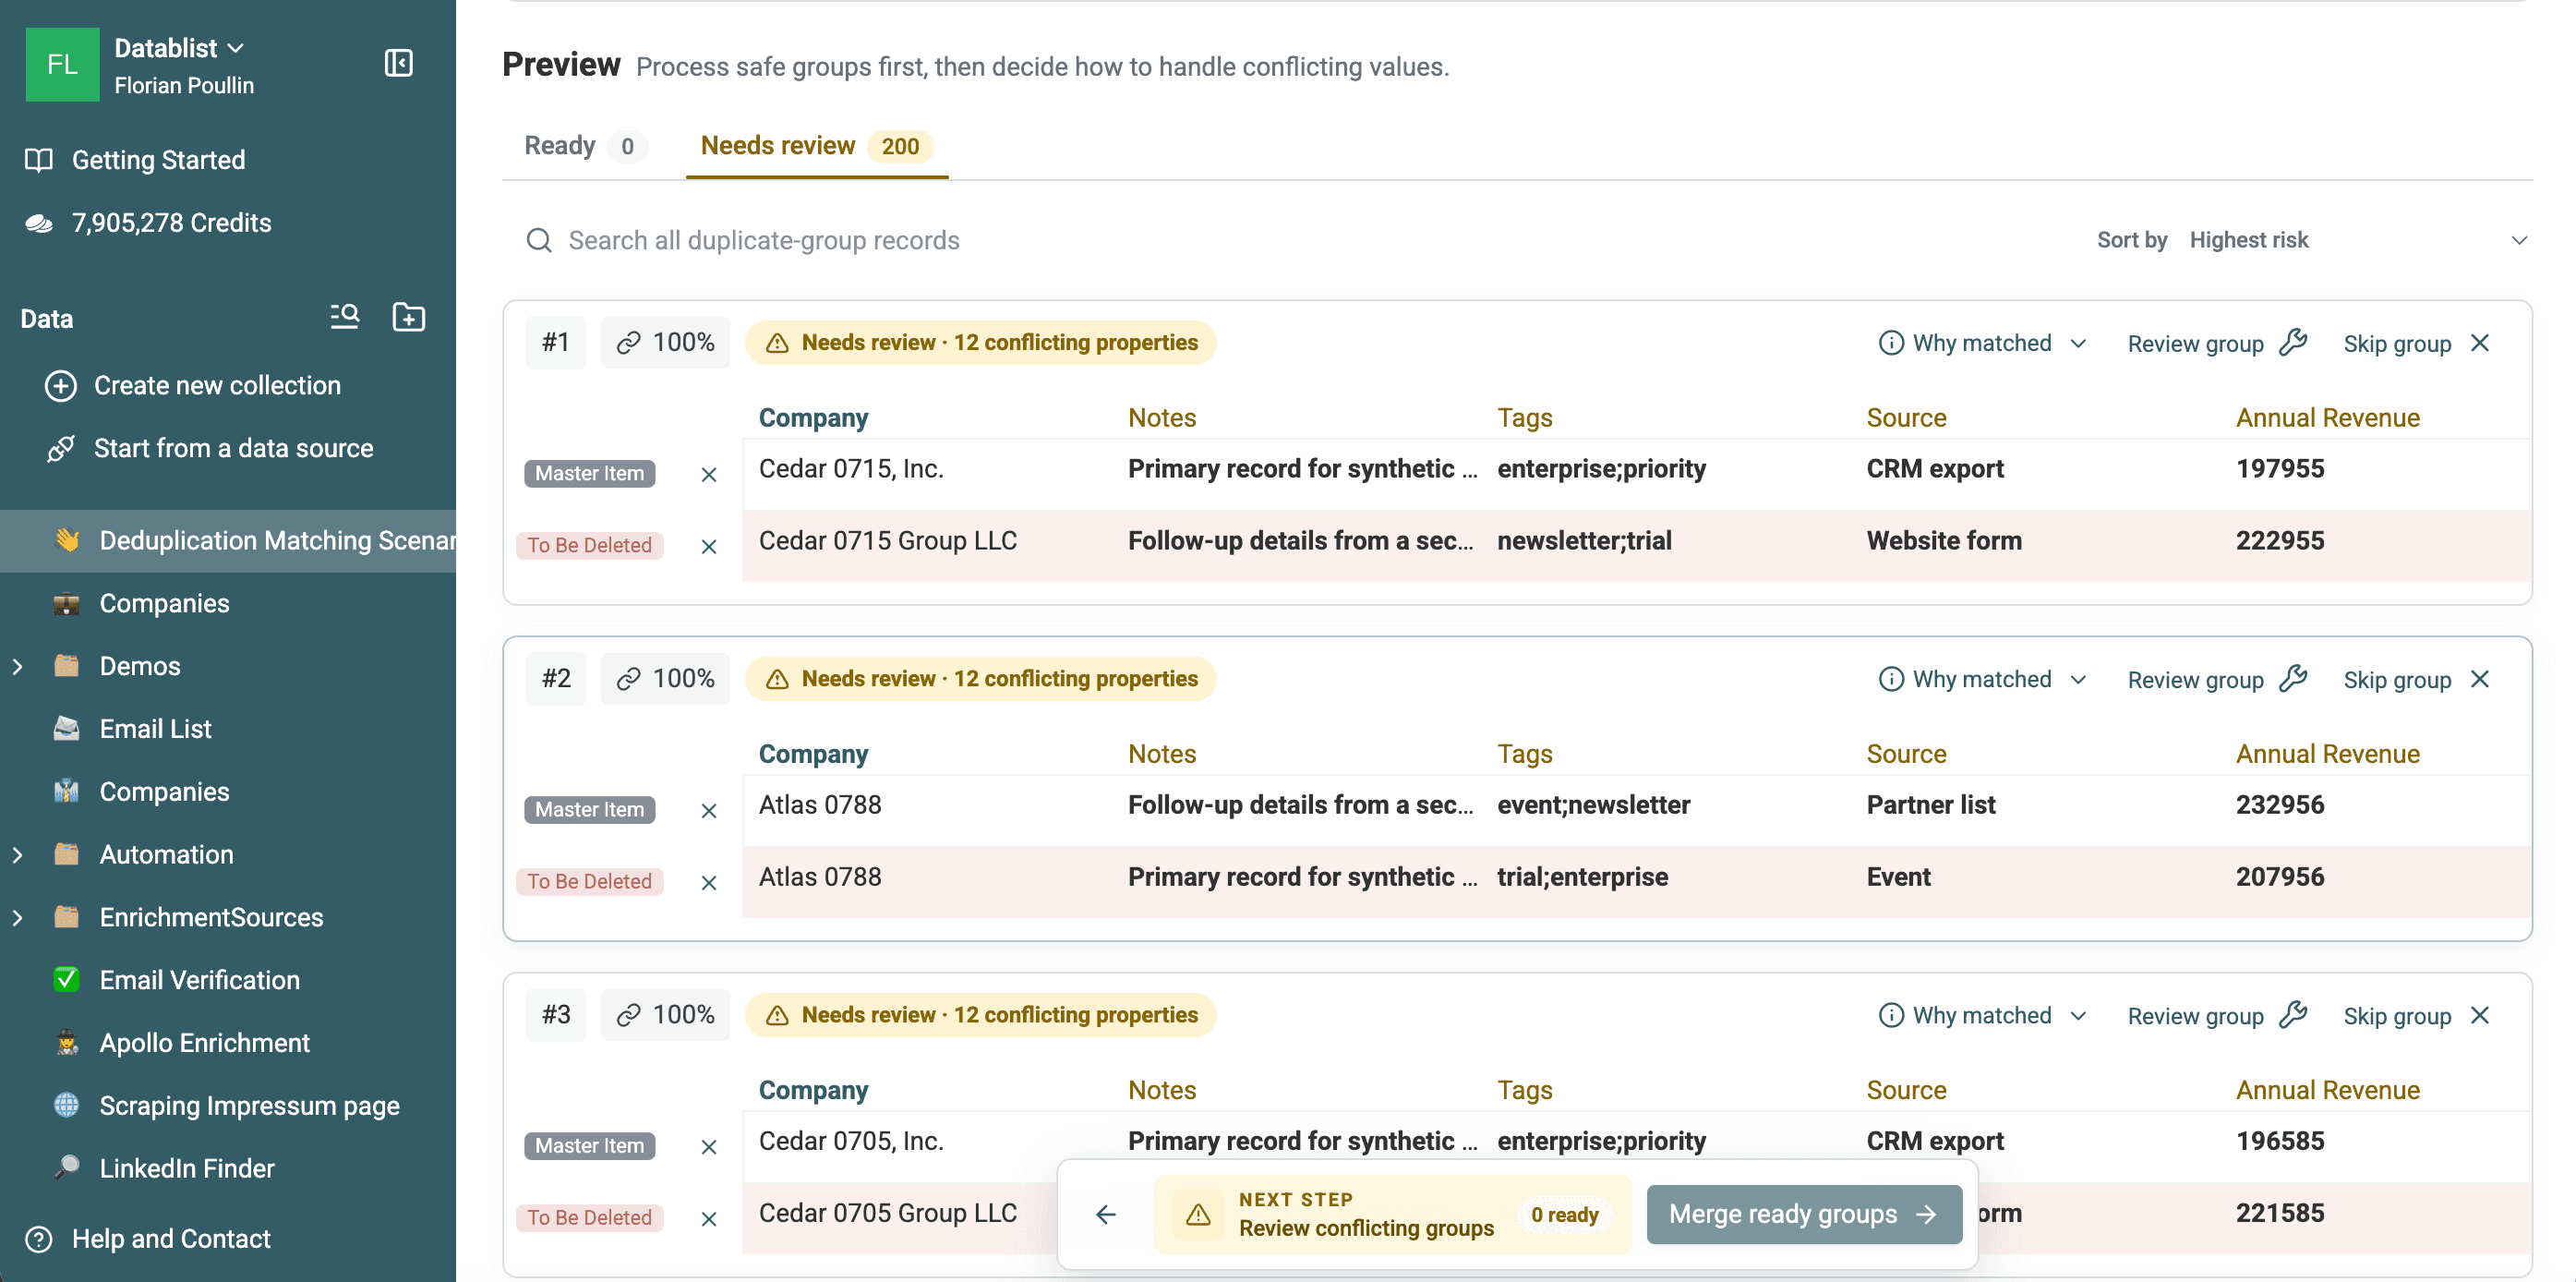
Los grupos muestran una puntuación de coincidencia del 100 %. Aparecen en Needs review porque existen conflictos en otras propiedades, no porque la coincidencia del nombre de empresa tenga un nivel de confianza bajo.
Abra Why matched para comprobar la propiedad, el algoritmo, el procesador y la puntuación utilizados en cada grupo.
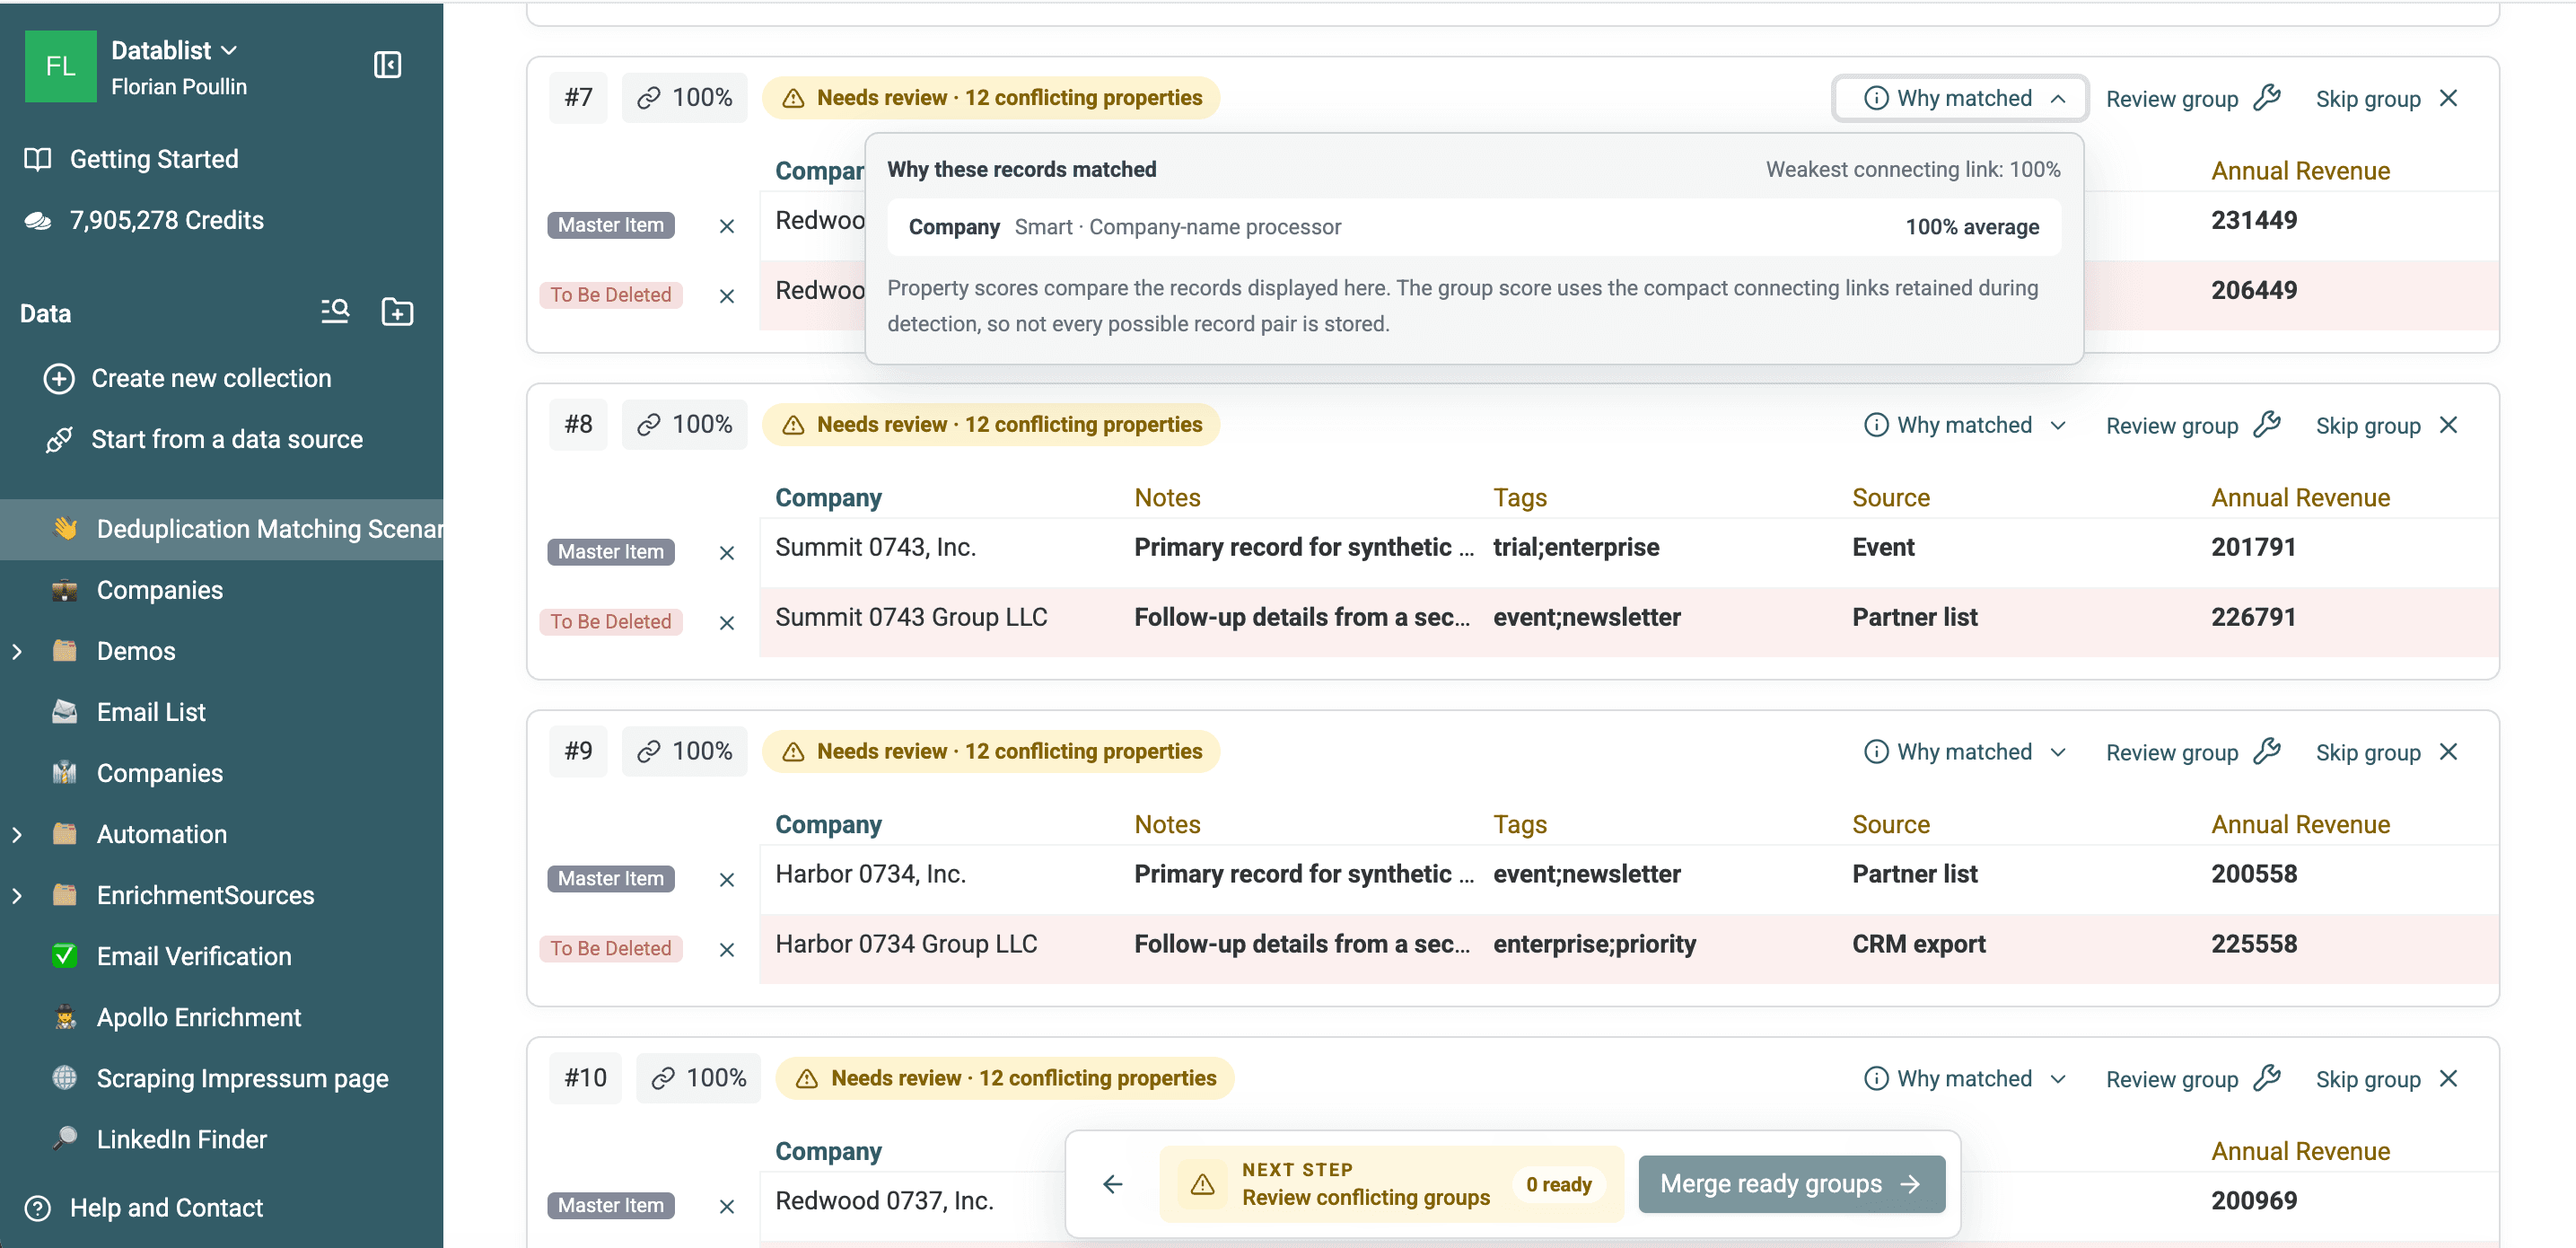
Descargue los 200 grupos de duplicados exportados para revisar las filas coincidentes y los valores de DuplicateGroupId.
Paso 3: Fusionar registros de empresas duplicados
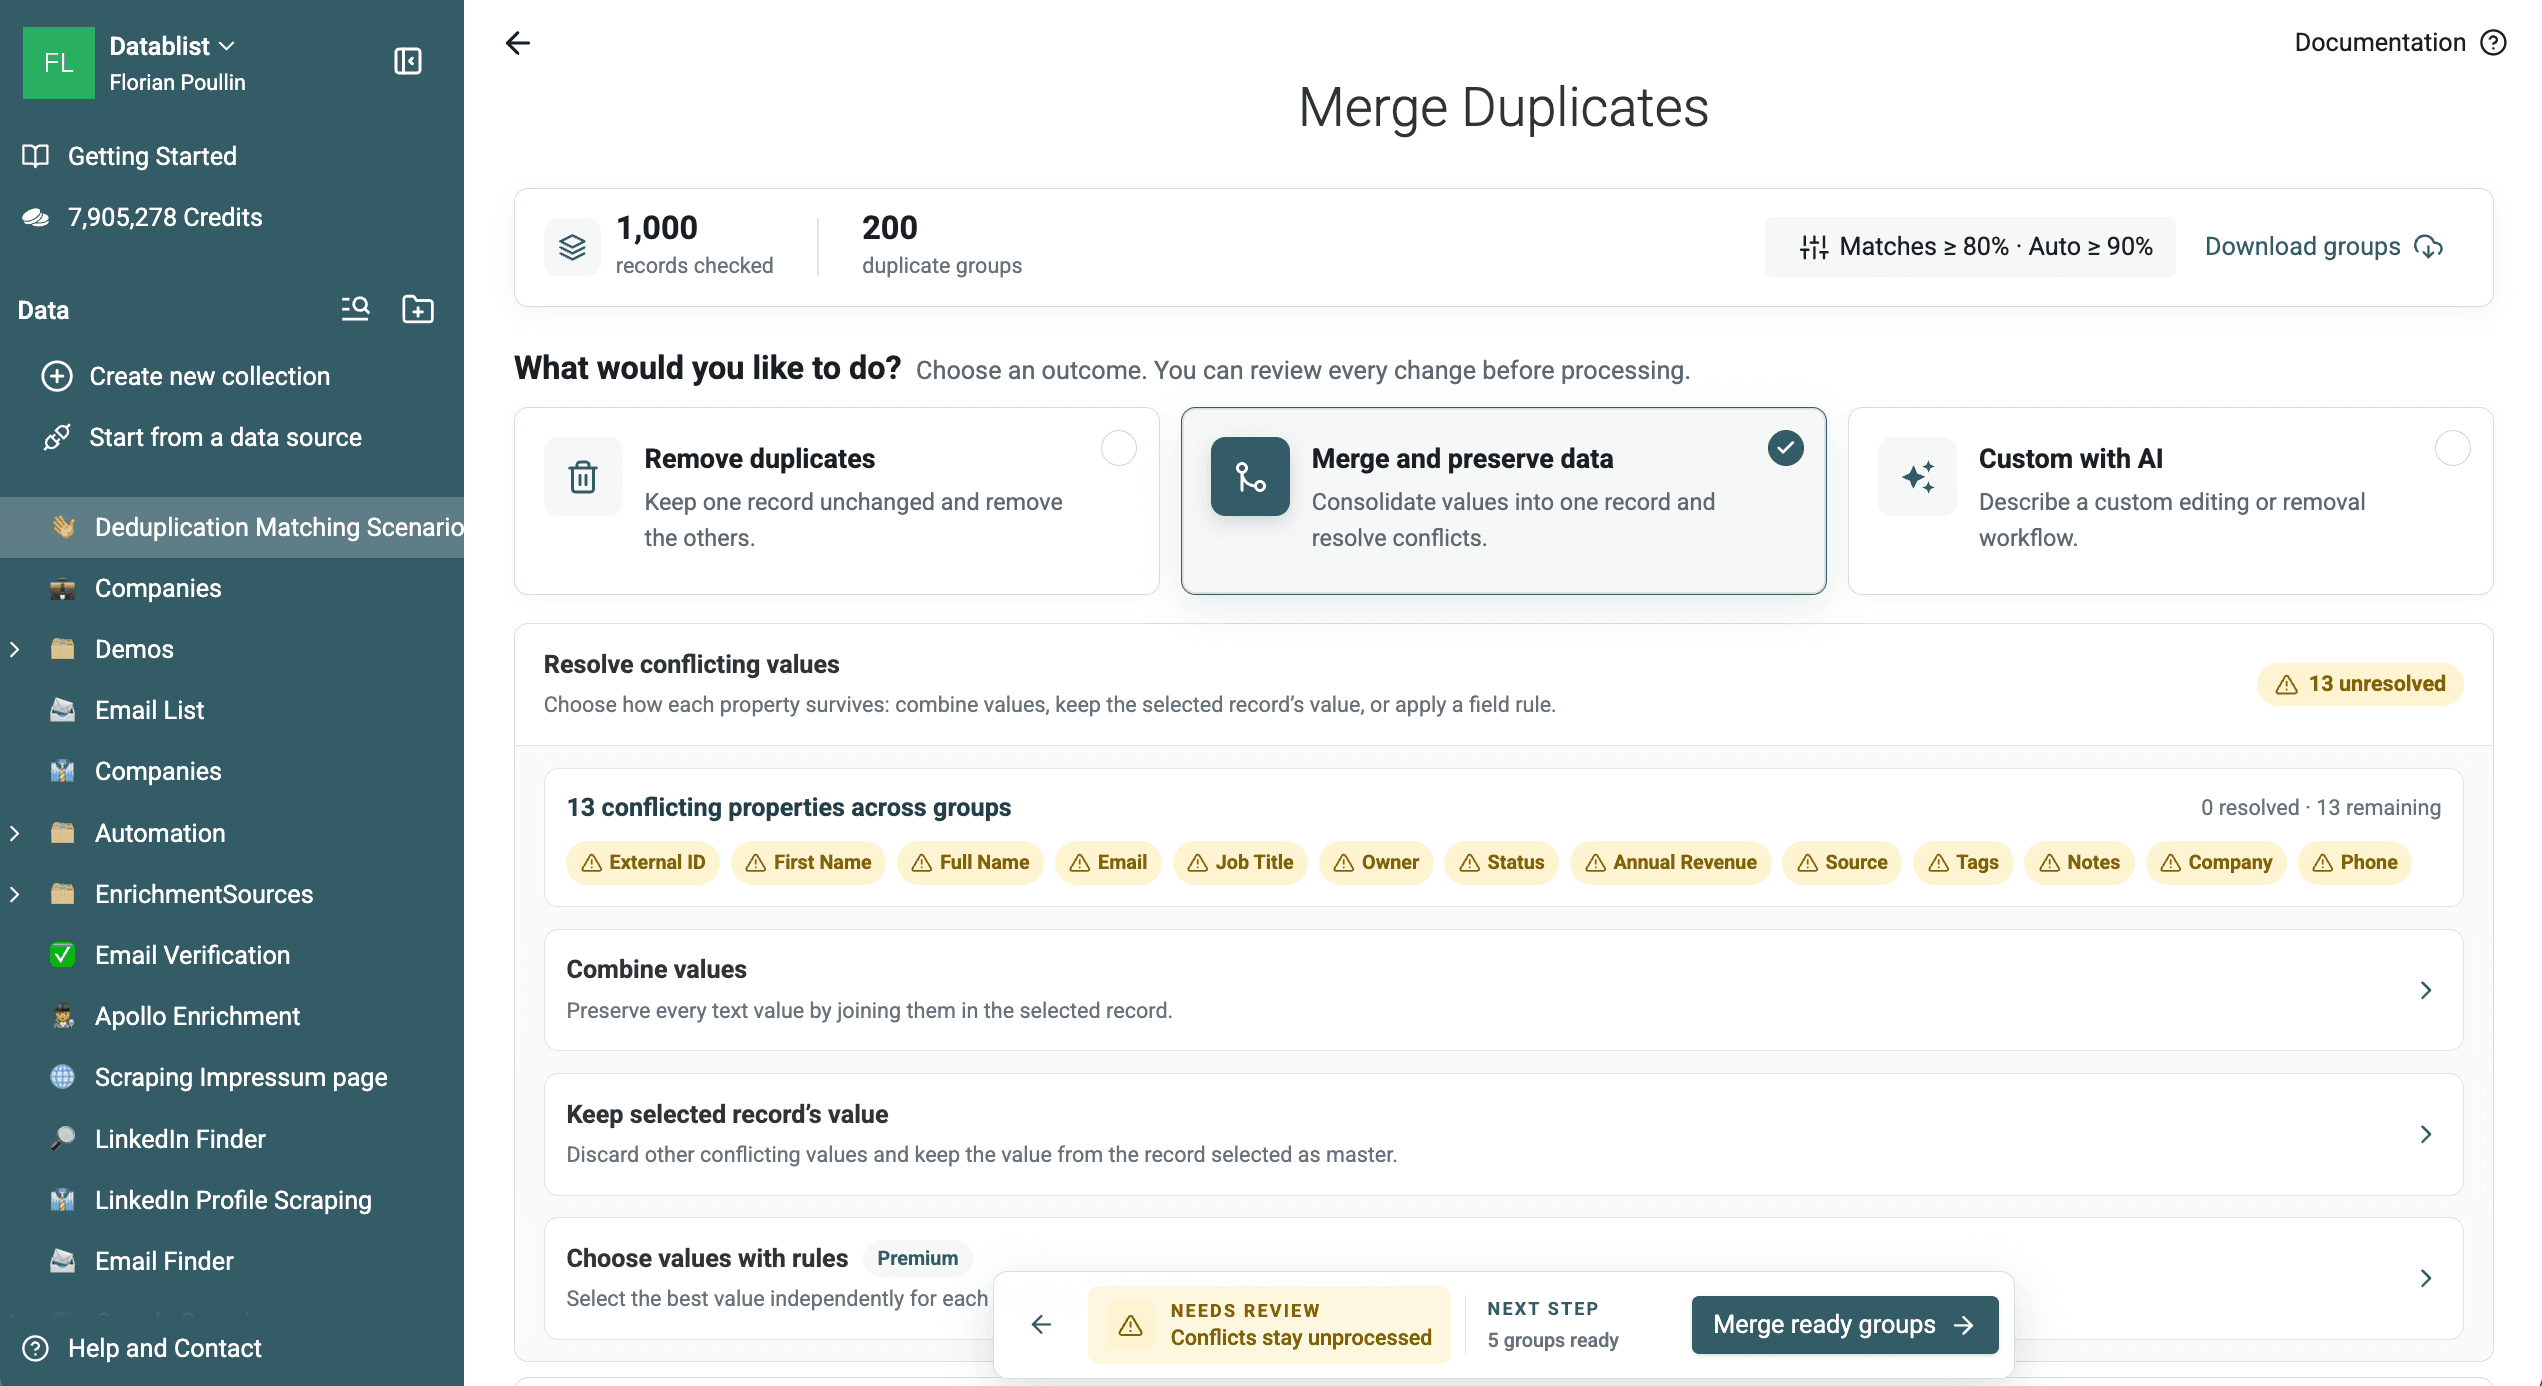
Si solo necesita una lista de coincidencias, utilice Download groups y deténgase antes de procesarlas. Continúe si desea consolidar los registros en Datablist.
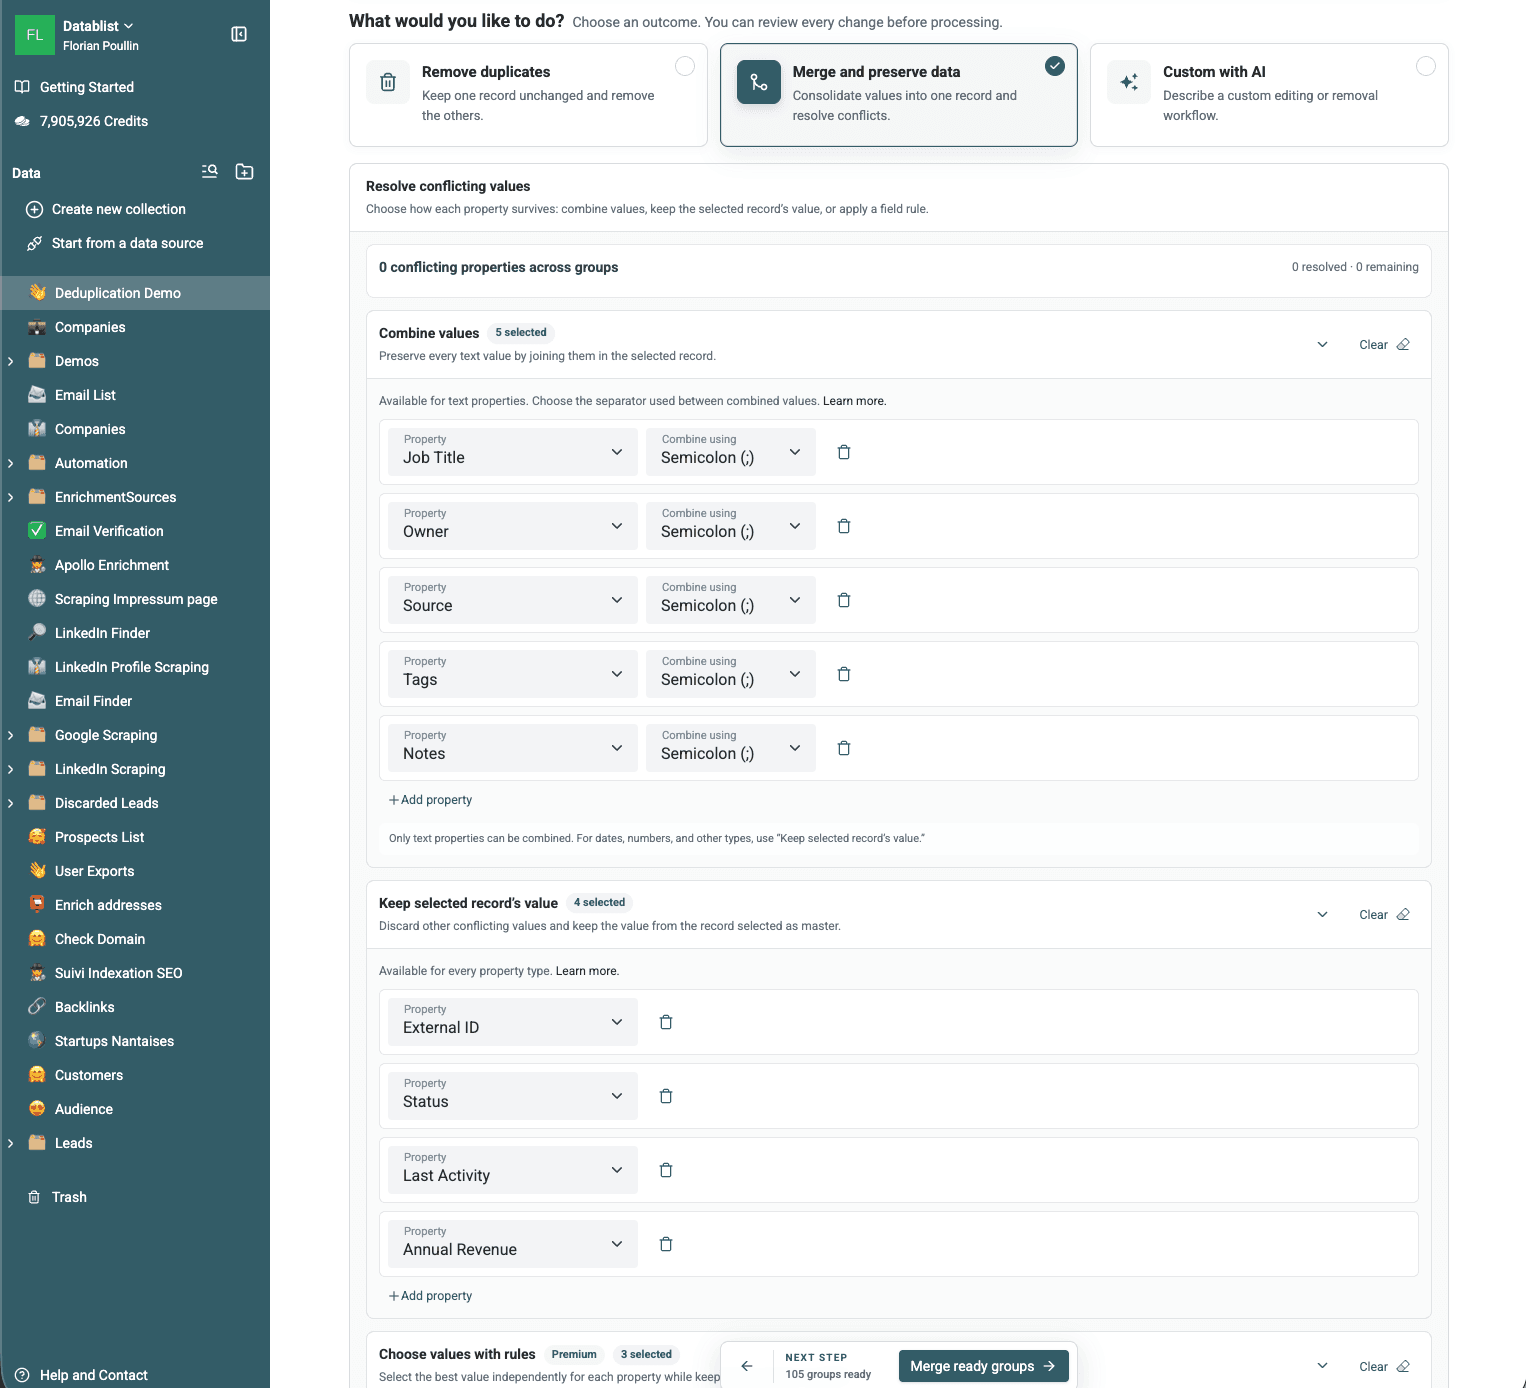
Resolver conflictos entre registros
Una propiedad en conflicto indica que los registros identificados como duplicados contienen valores distintos para un mismo campo.
Si los registros duplicados presentan valores diferentes, deberá decidir cómo fusionarlos.
Elija una regla para cada propiedad en conflicto:
- Combine conserva los distintos valores de texto y los separa con un delimitador.
- Keep the selected record's value descarta los demás valores.
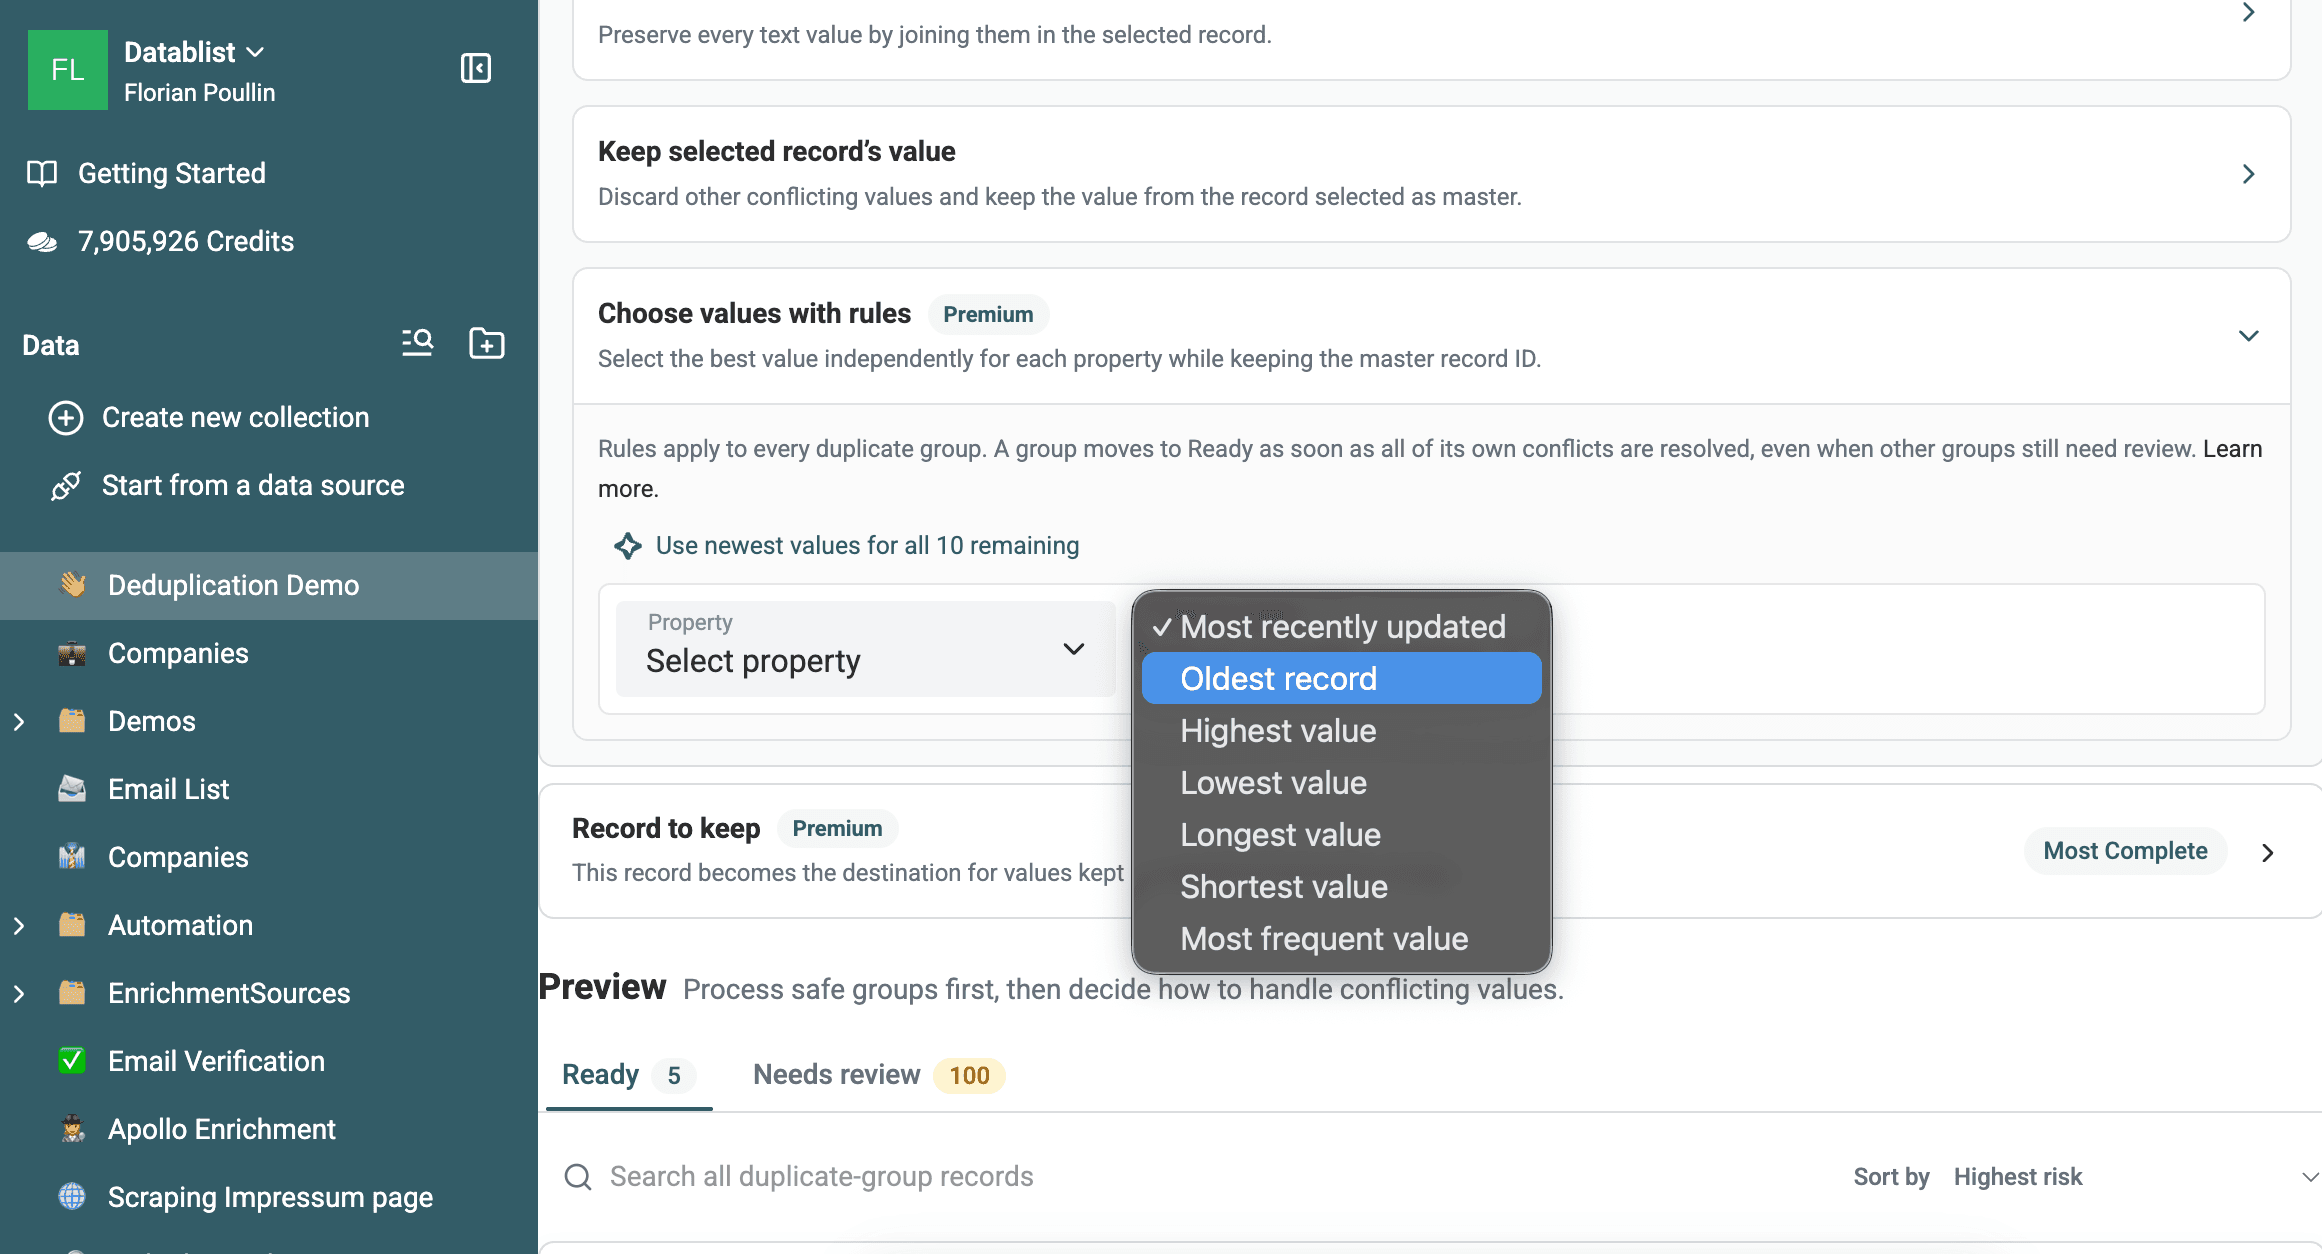
- En los planes de pago, las reglas de supervivencia de campos permiten elegir el valor más reciente, más antiguo, más largo, más corto, más alto, más bajo o más frecuente.
Utilice el control rápido para aplicar la misma regla a varias propiedades en conflicto y, después, ajuste cada campo cuando sea necesario.
Elegir el registro maestro
Uno de los registros se convierte en el destino y conserva su ID de Datablist.
Puede seleccionarlo según estos criterios:
- Most Complete: conserva el registro con más propiedades cumplimentadas.
- Last Updated: conserva el registro modificado más recientemente.
- First Created: conserva el registro más antiguo.
- Highest Value o Lowest Value: compara una propiedad seleccionada.
- Matching Value: conserva el registro que contiene un valor específico en una propiedad.
Después de configurar las reglas de fusión y elegir el registro maestro, actualice la vista previa para comprobar el resultado antes de confirmar los cambios.
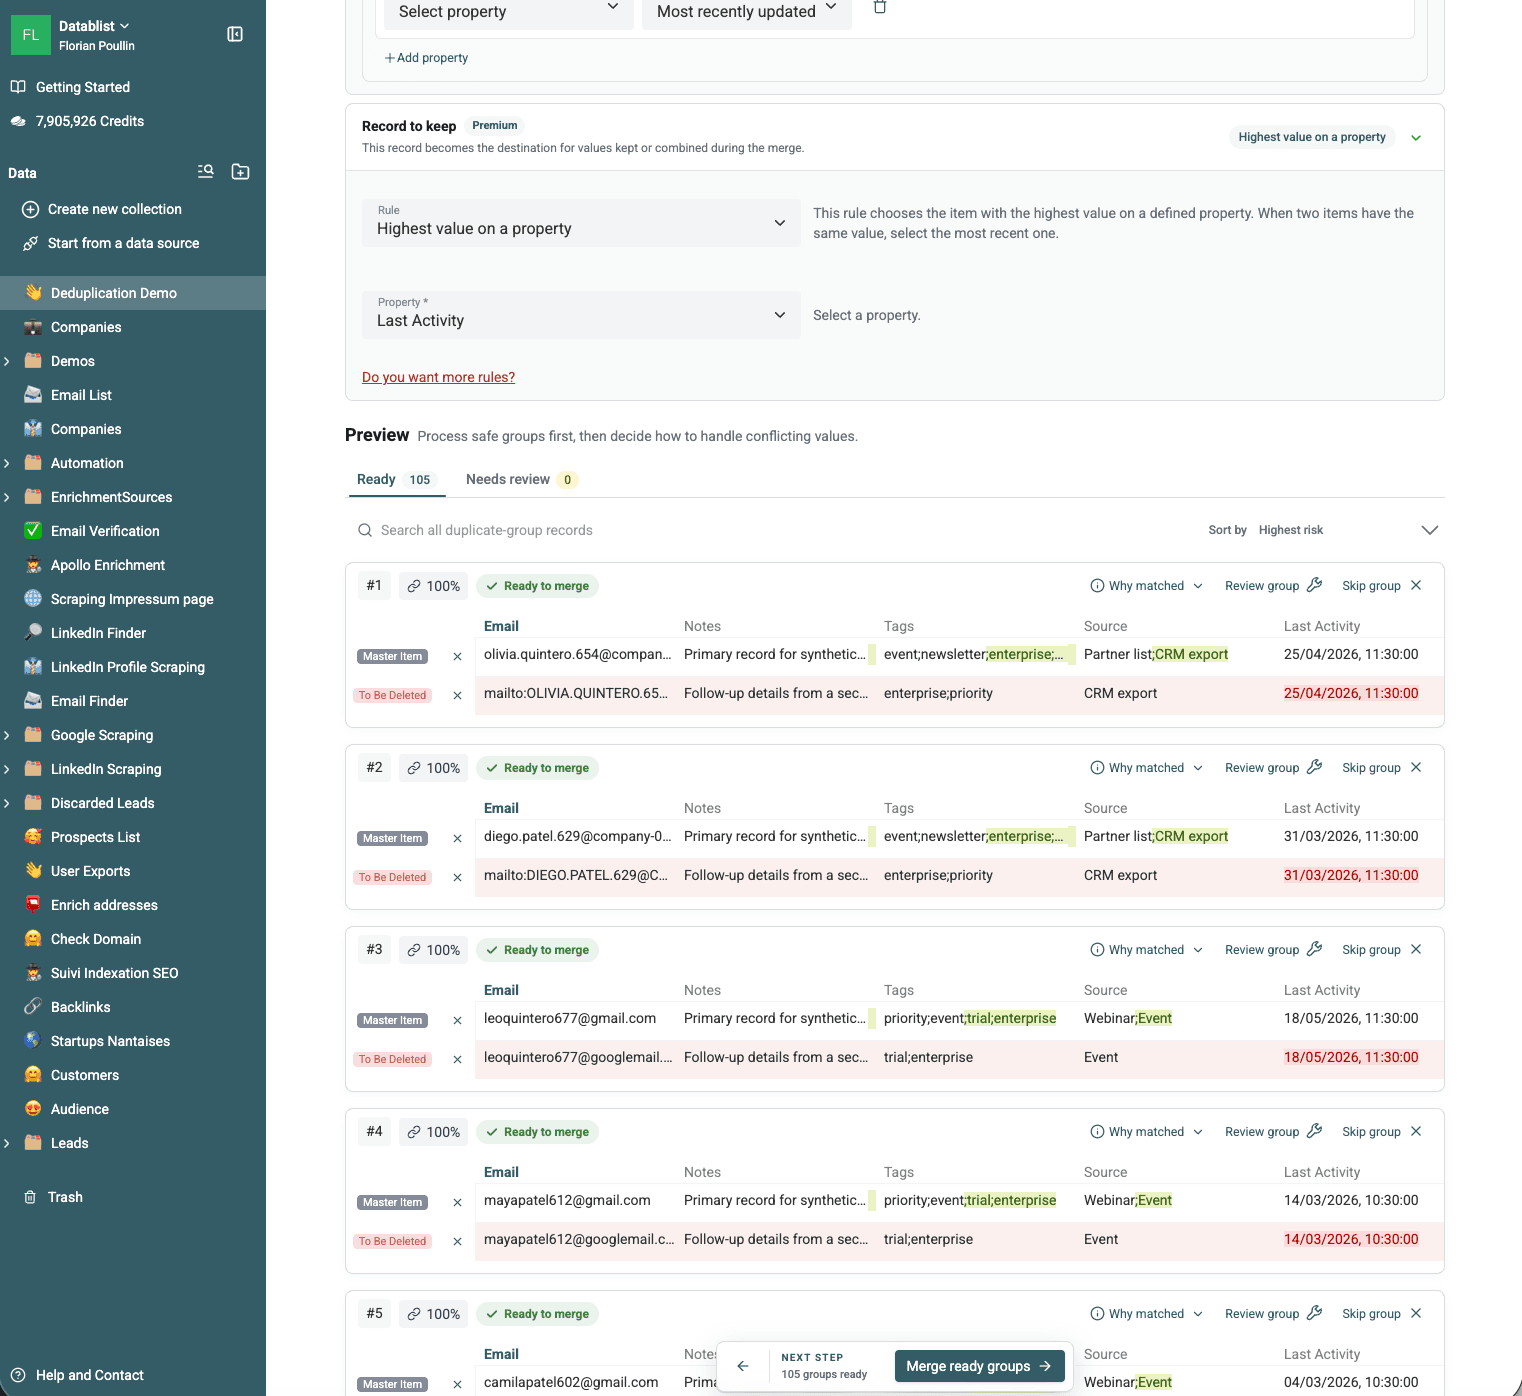
La vista previa muestra los valores que se eliminarán o combinarán, así como el registro maestro asignado a cada grupo de duplicados.
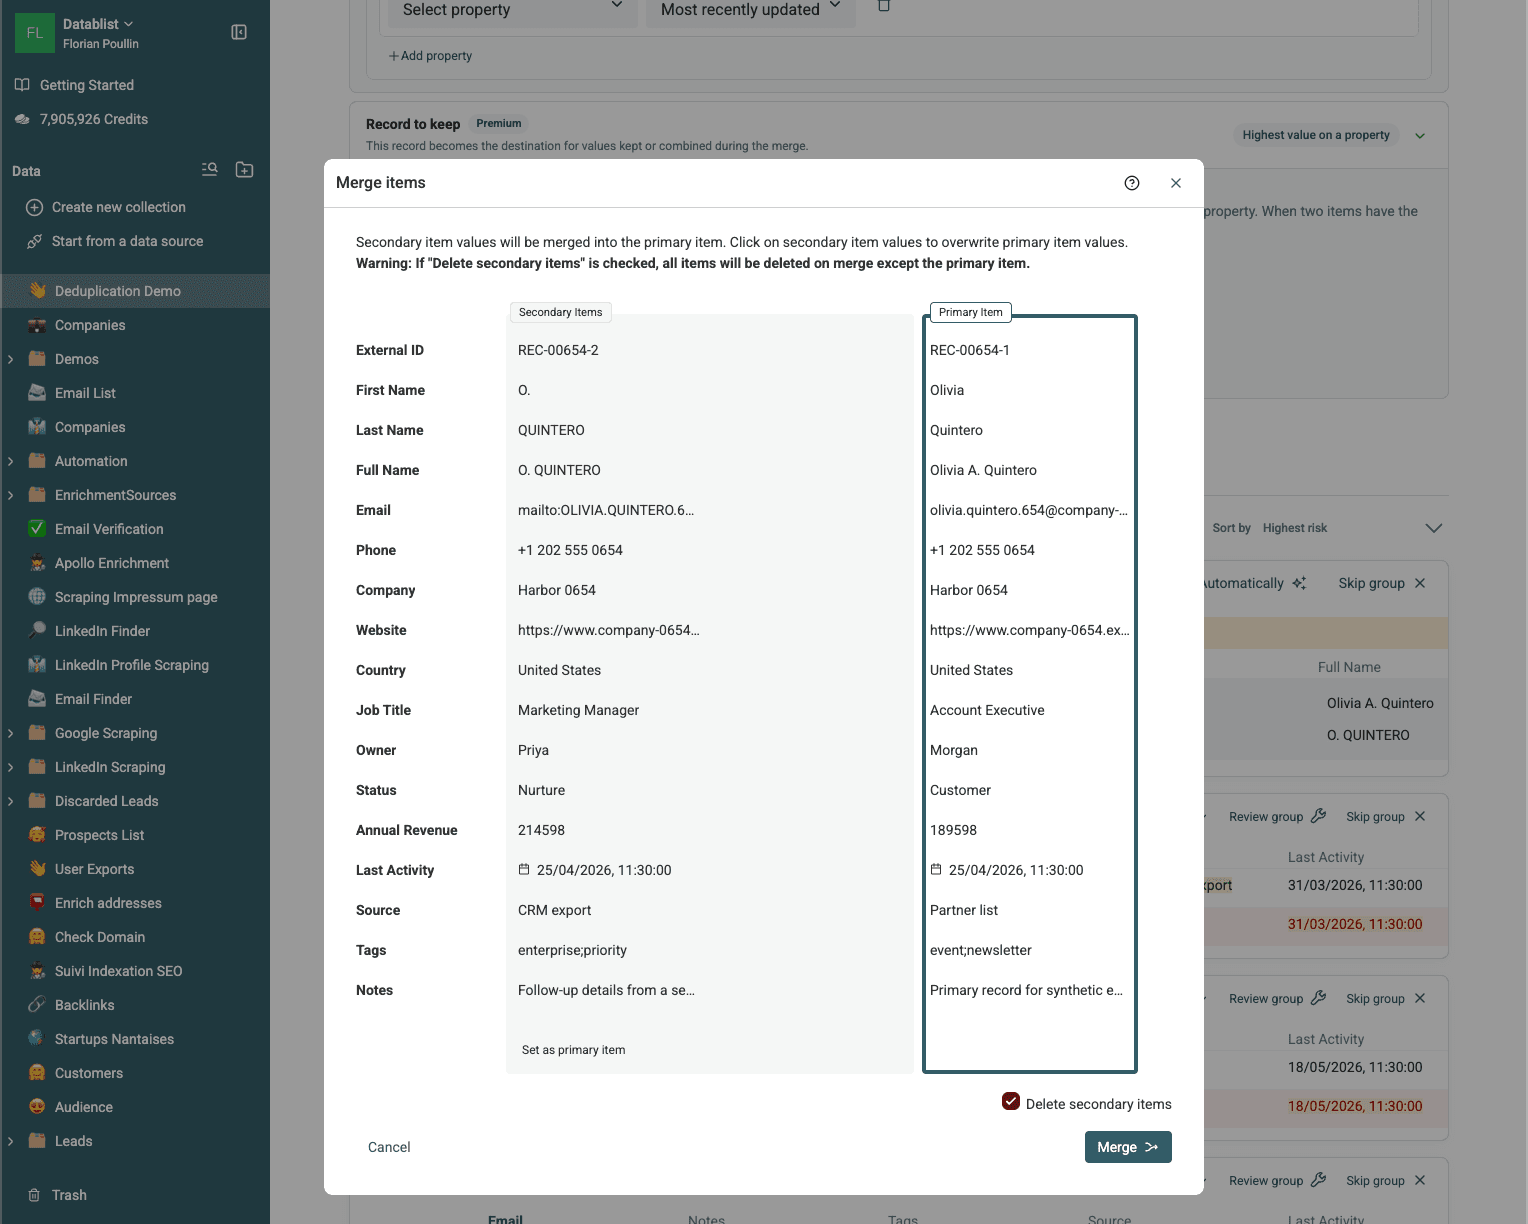
Para gestionar excepciones, abra Review group y seleccione los valores manualmente.
Procese los grupos marcados como Ready. Los que sigan en Needs review no se modificarán.
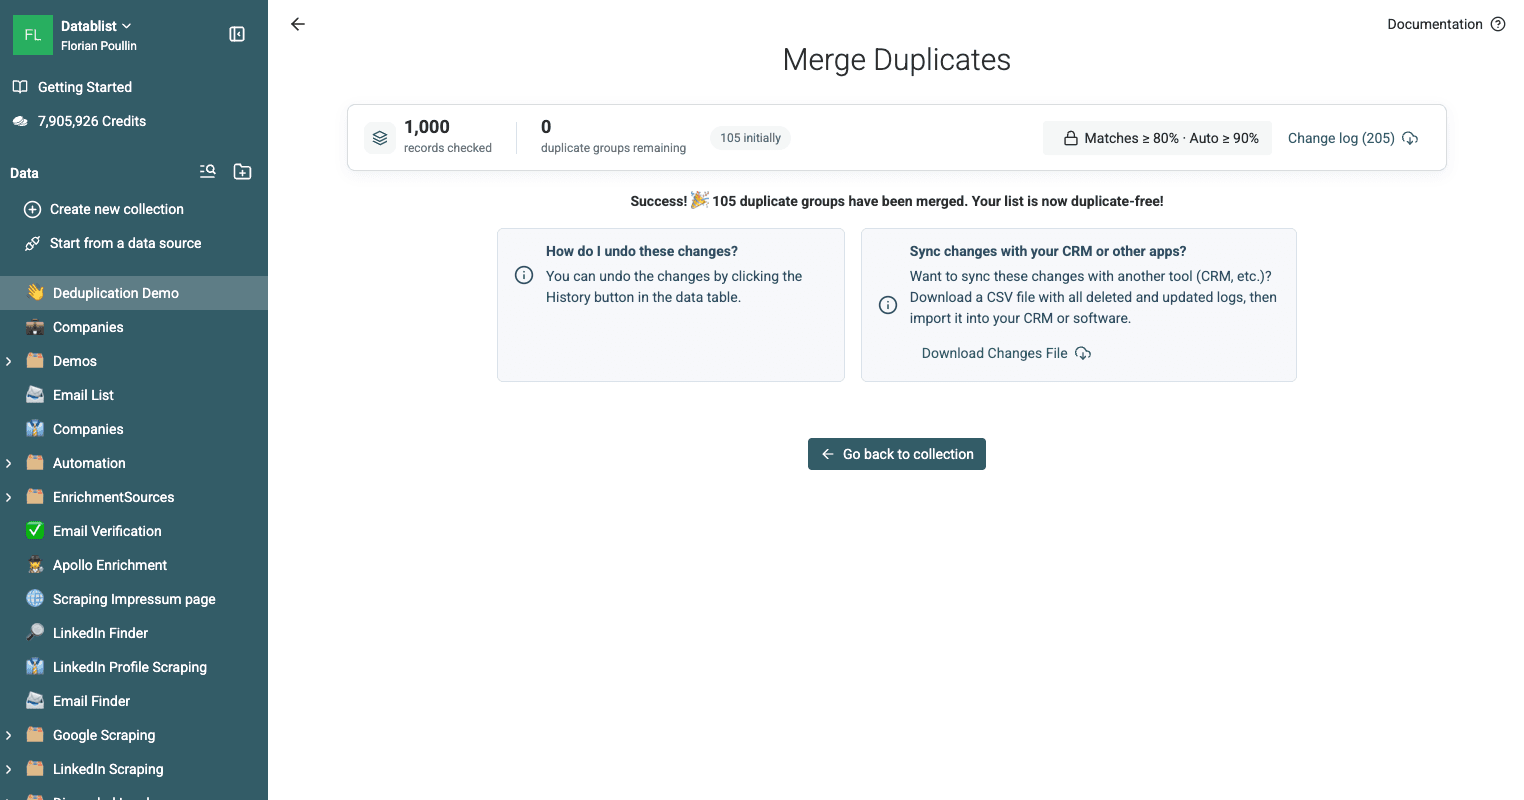
Después de fusionar los registros, utilice Export en la cabecera de la colección para descargar la lista depurada en formato CSV o Excel. El registro de cambios posterior al procesamiento conserva los ID eliminados y actualizados cuando necesita una pista de auditoría.
Para consultar toda la configuración de búsqueda, revisión y fusión, lea la documentación de Duplicate Finder.