
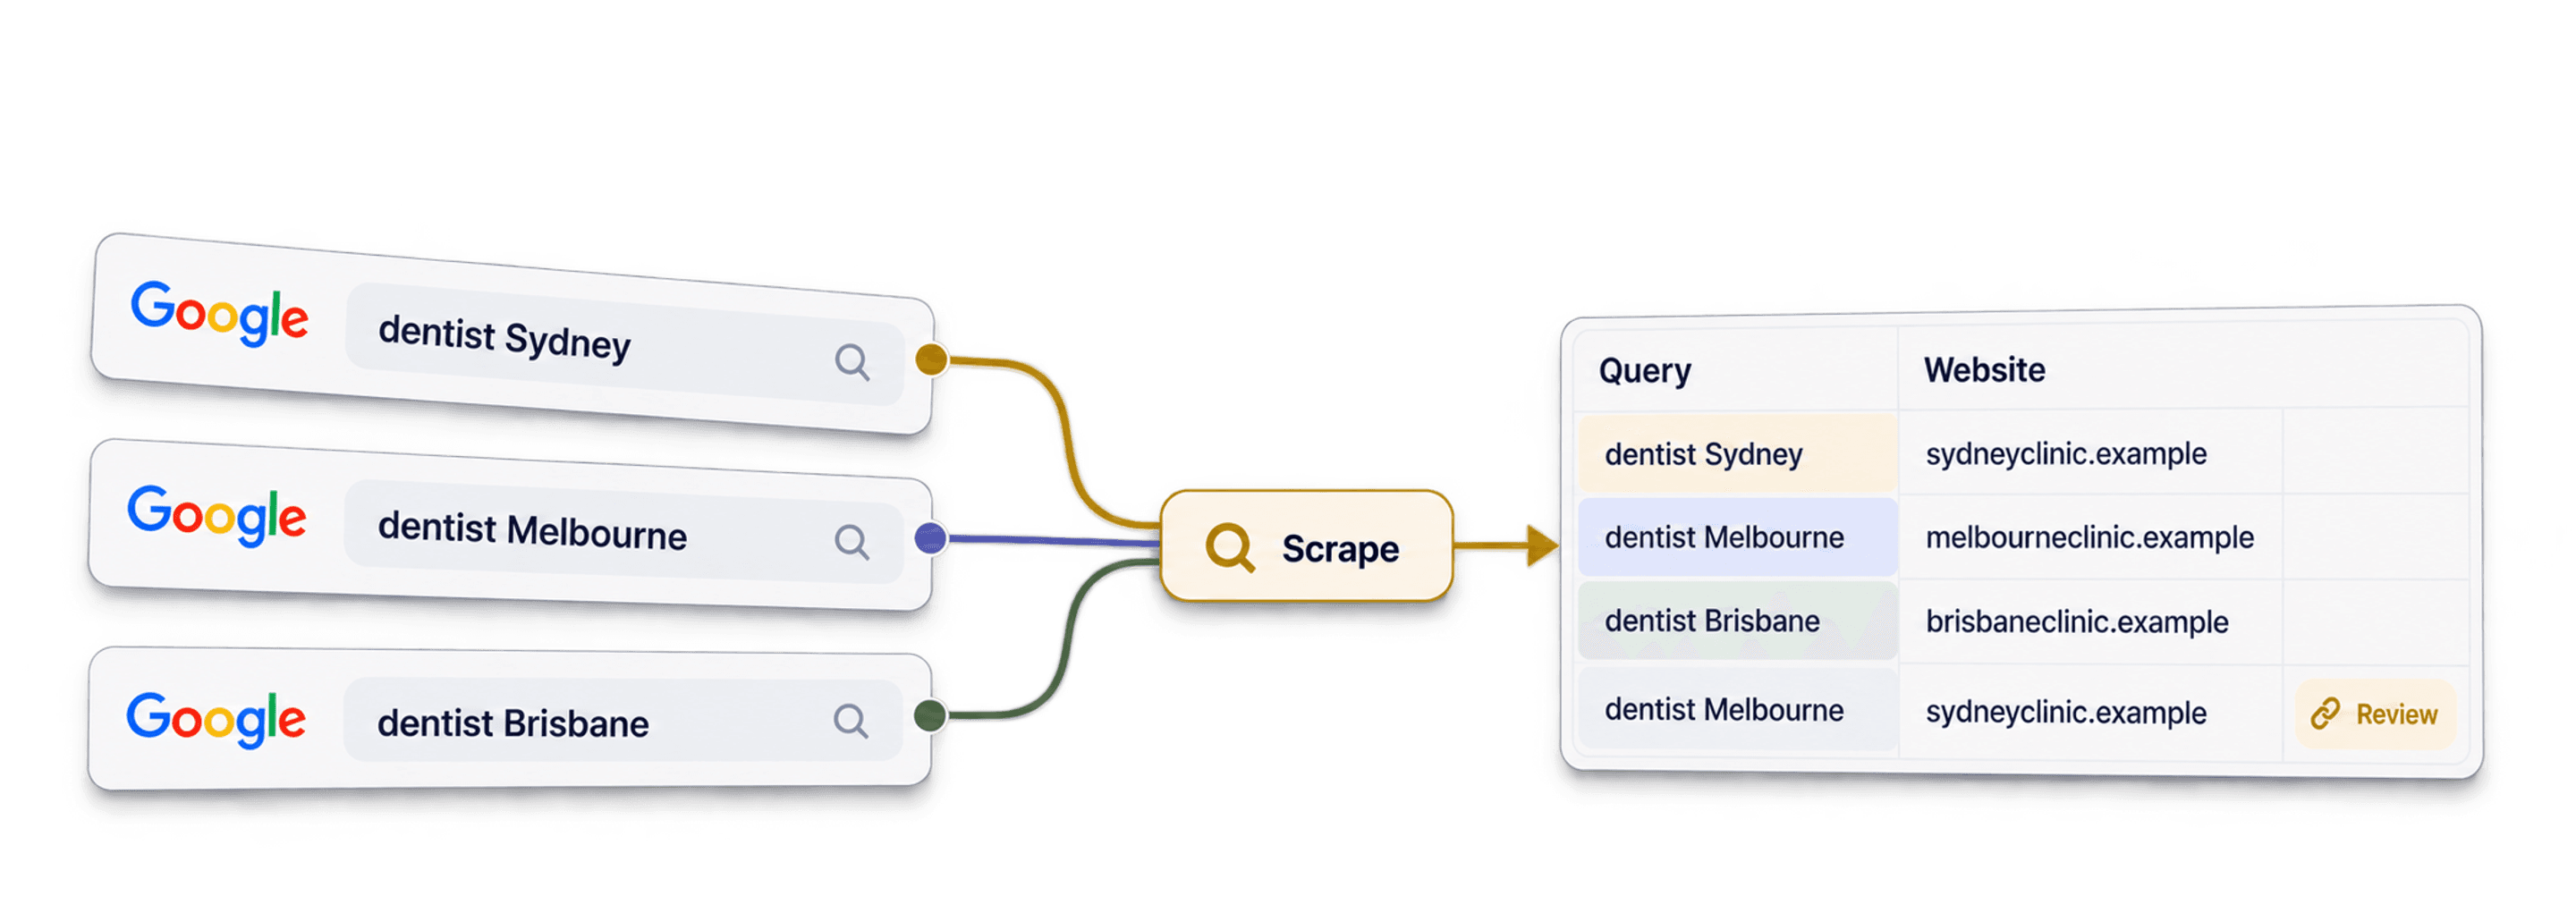
Pour scraper les résultats Google de plusieurs requêtes, préparez une liste de recherches précises, collez-la dans la source Start with Google Search Queries de Datablist, choisissez le pays, la langue et la limite par requête, puis examinez les URL obtenues. Par exemple, recherchez dentiste Paris, dentiste Lyon et dentiste Marseille plutôt que de vous appuyer sur une seule requête générale comme dentiste France.
Chaque requête peut renvoyer un ensemble de pages différent. Les résultats dépendent de ce que Google fournit pour chaque recherche, et certaines variantes peuvent se recouper. Le nombre final ne correspond donc pas nécessairement au nombre de requêtes multiplié par la limite définie. Avec le plan gratuit, seuls la première requête et ses 200 premiers résultats sont traités. Pour lancer plusieurs requêtes en une fois, utilisez un run éligible avec un plan payant. Vérifiez l’estimation avant de dépenser vos crédits.
📌 Exemples de cas d’usage
- Créer une liste de leads à partir de profils LinkedIn
- Rechercher des profils Instagram avec des mots-clés
- Cibler des entreprises selon les technologies utilisées sur leur site
- Constituer des bases d’entreprises locales dans des centaines de villes
Accès rapide aux sections :
- Pourquoi une requête générale manque des résultats
- La méthode multi-requêtes et utiliser l’IA pour varier les requêtes
- Guide du scraping Google multi-requêtes avec Datablist
- Nettoyer et dédupliquer vos données
- Enrichir vos résultats de recherche
- Coût du scraping Google avec un petit budget
Pourquoi une requête générale manque des résultats
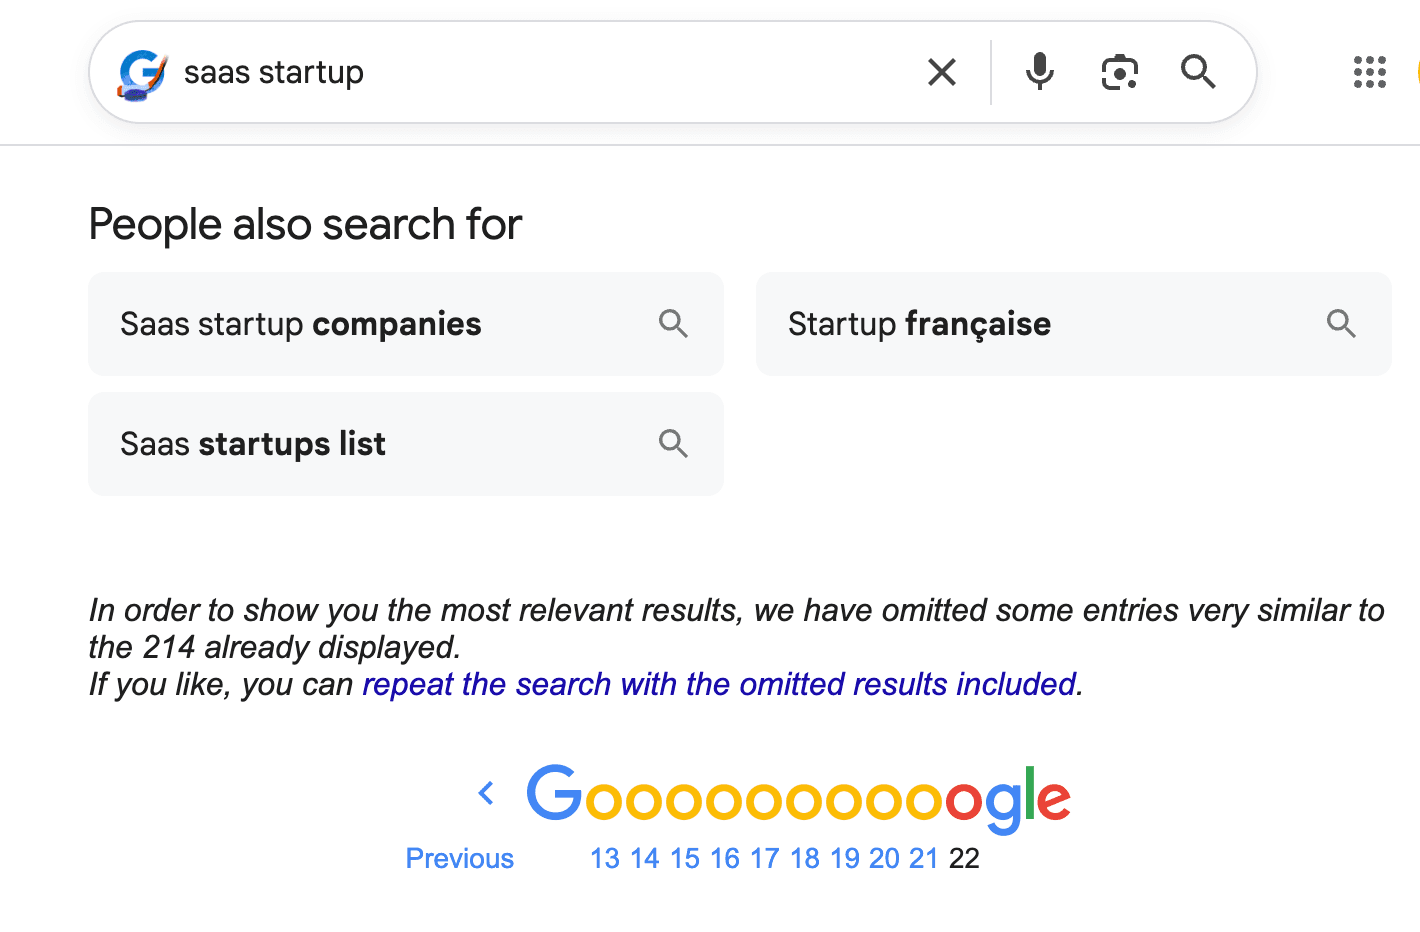
Le nombre estimé de résultats affiché pour une recherche générale ne correspond pas forcément au nombre de pages que vous pourrez réellement récupérer. Les pages disponibles varient selon la requête.
Si vous parcourez de nombreuses pages de résultats pour une recherche générale, Google peut masquer les résultats similaires ou cesser d’afficher de nouvelles pages. Le nombre accessible varie d’une requête à l’autre.
En lead generation, une requête trop large peut passer à côté de niches pertinentes. Une recherche comme avocat France peut surtout faire ressortir de grands annuaires, tandis que avocat droit du travail Nantes révélera d’autres cabinets locaux.
Affinez vos recherches par ville, service ou secteur d’activité. Vous obtiendrez ainsi un éventail plus large d’URL à examiner, mais pas une liste exhaustive de toutes les entreprises.
La méthode multi-requêtes
Le scraping multi-requêtes consiste à décomposer une recherche générale en plusieurs requêtes plus ciblées qui peuvent se recouper. Au lieu de rechercher « Avocats en France », lancez par exemple « Avocats à Paris », « Avocats à Lyon », « Avocats à Nantes », « Avocats à Marseille » et « Avocats à Bordeaux ».
Chaque recherche locale peut renvoyer des pages différentes, même si un cabinet peut être bien classé dans plusieurs villes voisines. Conservez les propriétés de sortie Search Query et Result Link afin de comprendre pourquoi chaque page est apparue et de comparer les résultats qui se chevauchent.
Ces variations modifient ce que vous demandez à Google de trouver. Elles ne garantissent ni un classement précis ni un nombre donné d’entreprises uniques.
Utiliser l’IA pour varier les requêtes
Créer manuellement 100 variantes d’une requête prend du temps. Un LLM peut vous proposer des variantes, mais vérifiez les lieux et les termes avant de les utiliser dans un run payant. Supprimez les recherches presque identiques ainsi que celles qui ciblent une mauvaise intention de recherche.
Varier les requêtes par ville
La localisation est le moyen le plus simple de multiplier les résultats. Chaque pays dispose de listes de villes, départements ou régions.
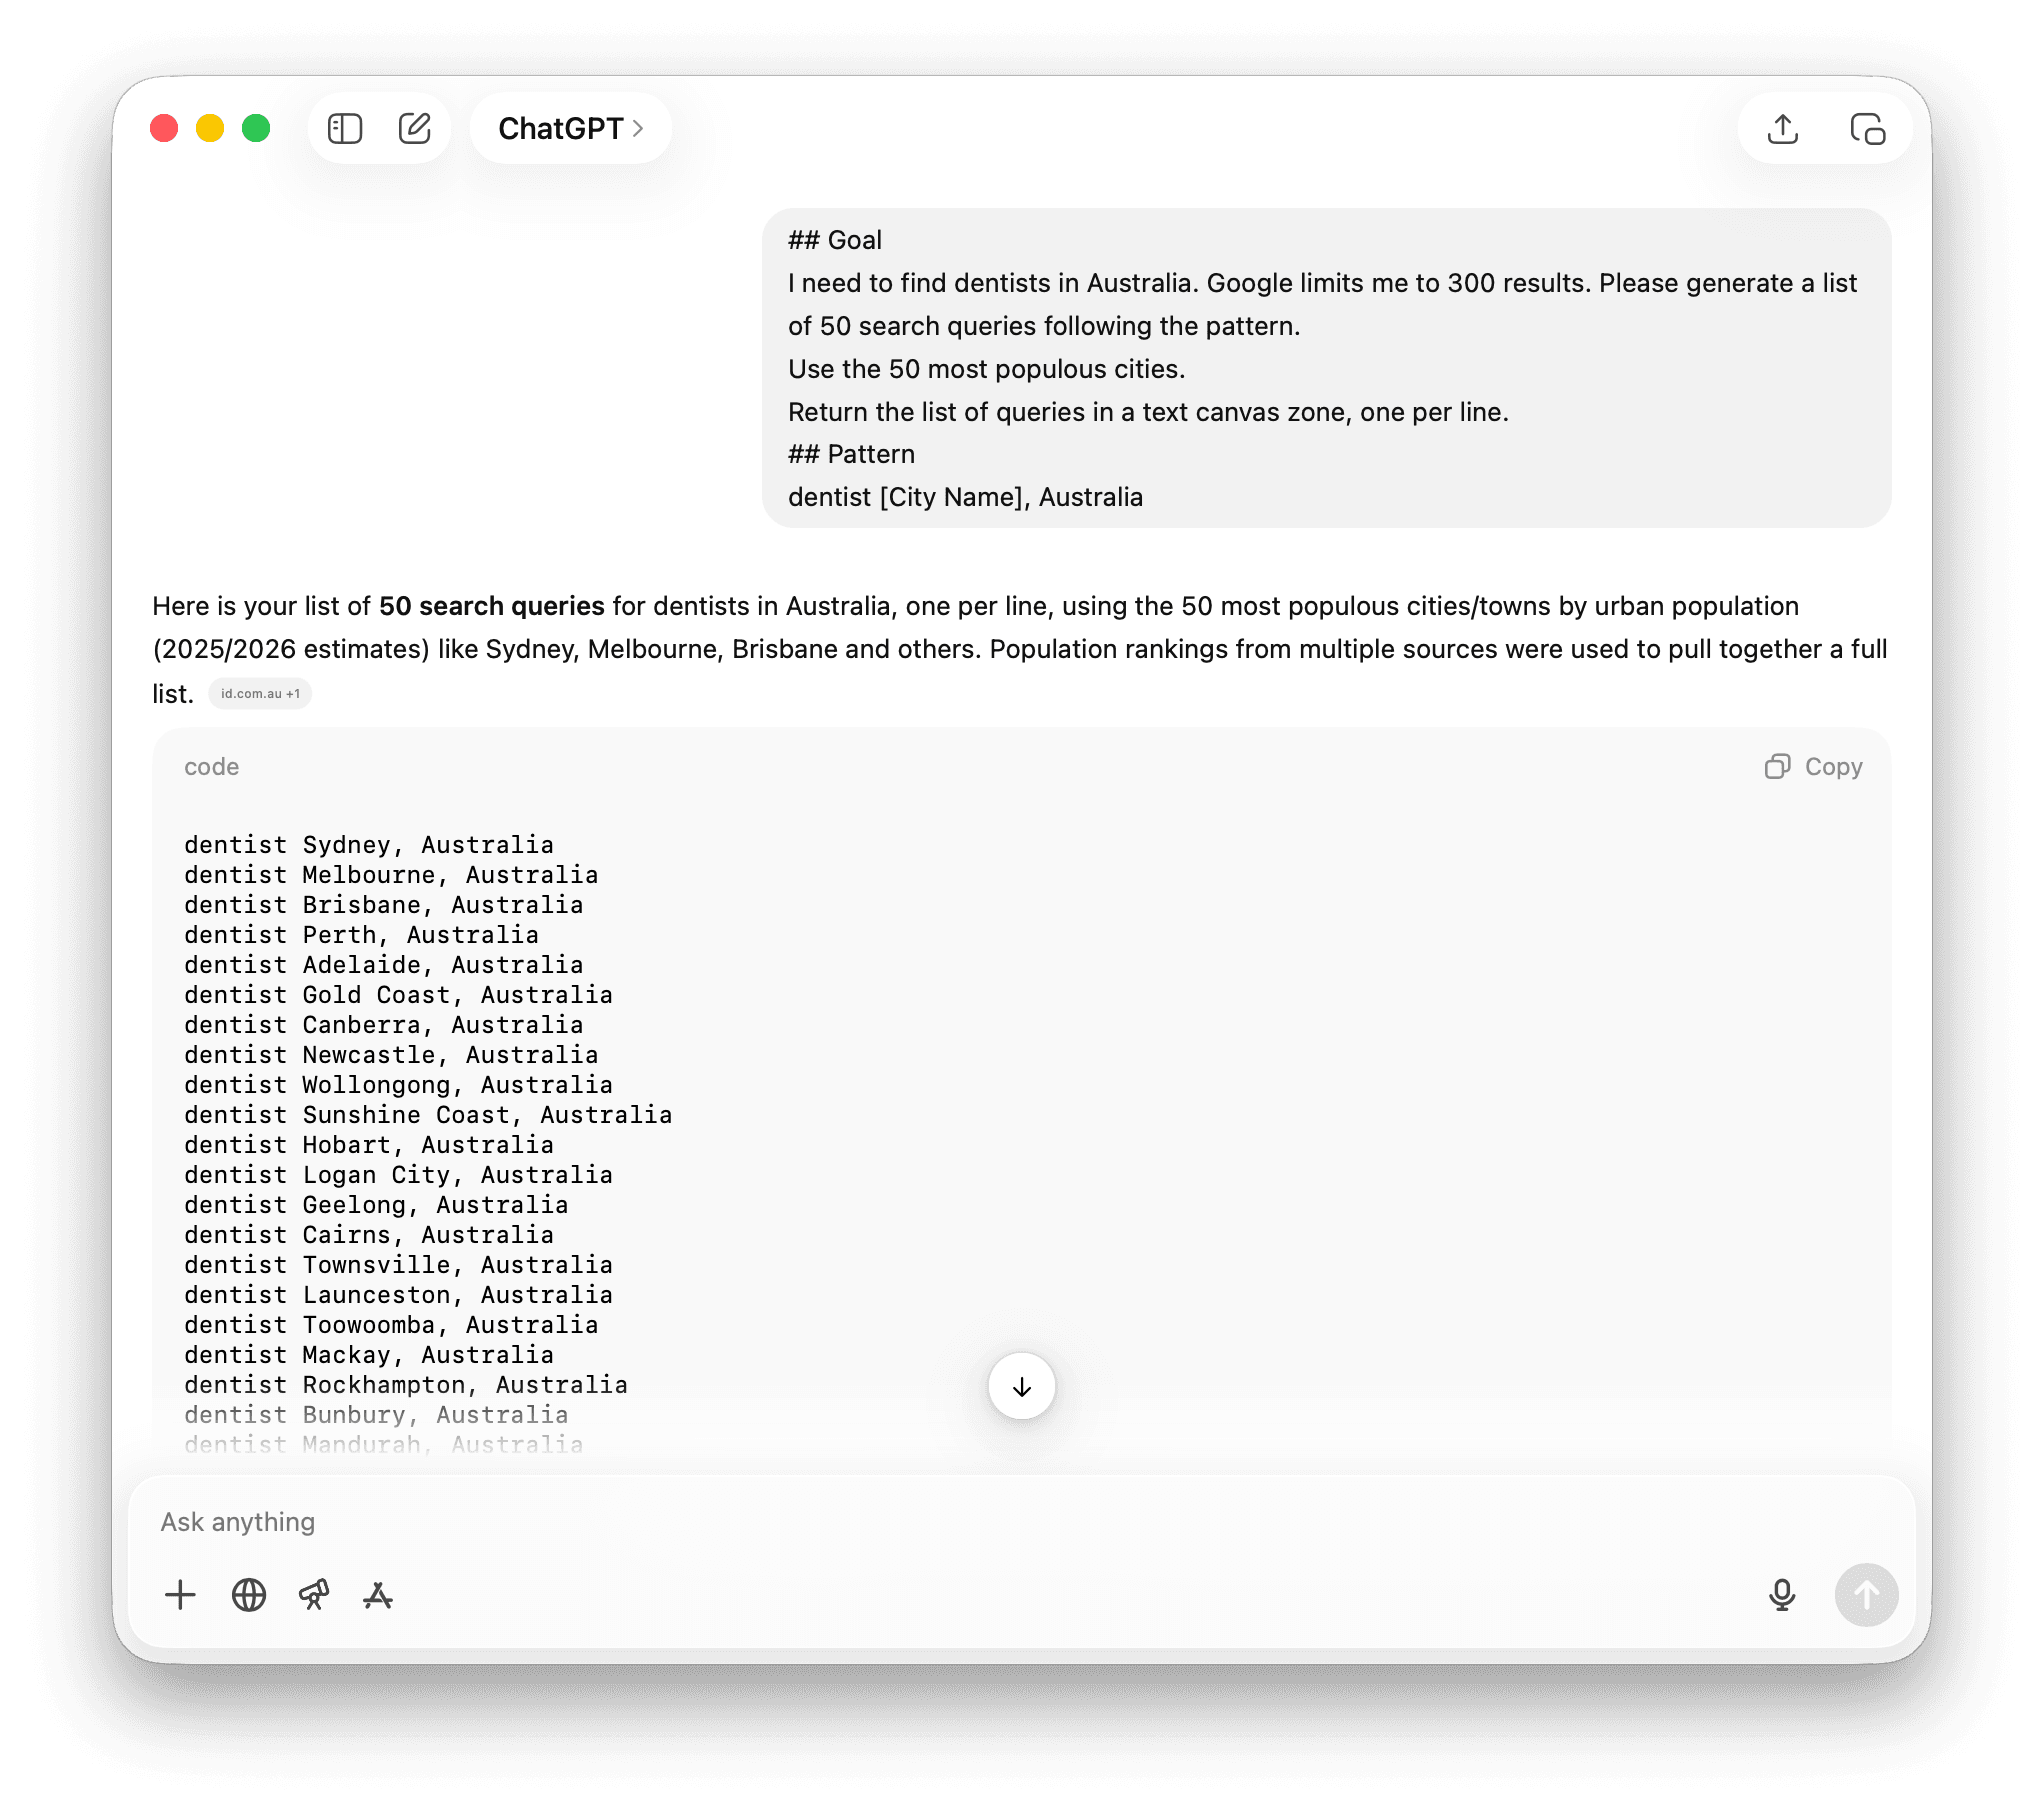
Je souhaite trouver des dentistes en France. Générez des requêtes de recherche pour les principales villes françaises en suivant le modèle ci-dessous.
Utilisez de vrais noms de villes, avec une requête par ligne, sans répéter de ville. Retournez uniquement les requêtes.
## Modèle {#modele-prompt-localisation}
dentiste [Nom de la ville], France
Varier les mots-clés
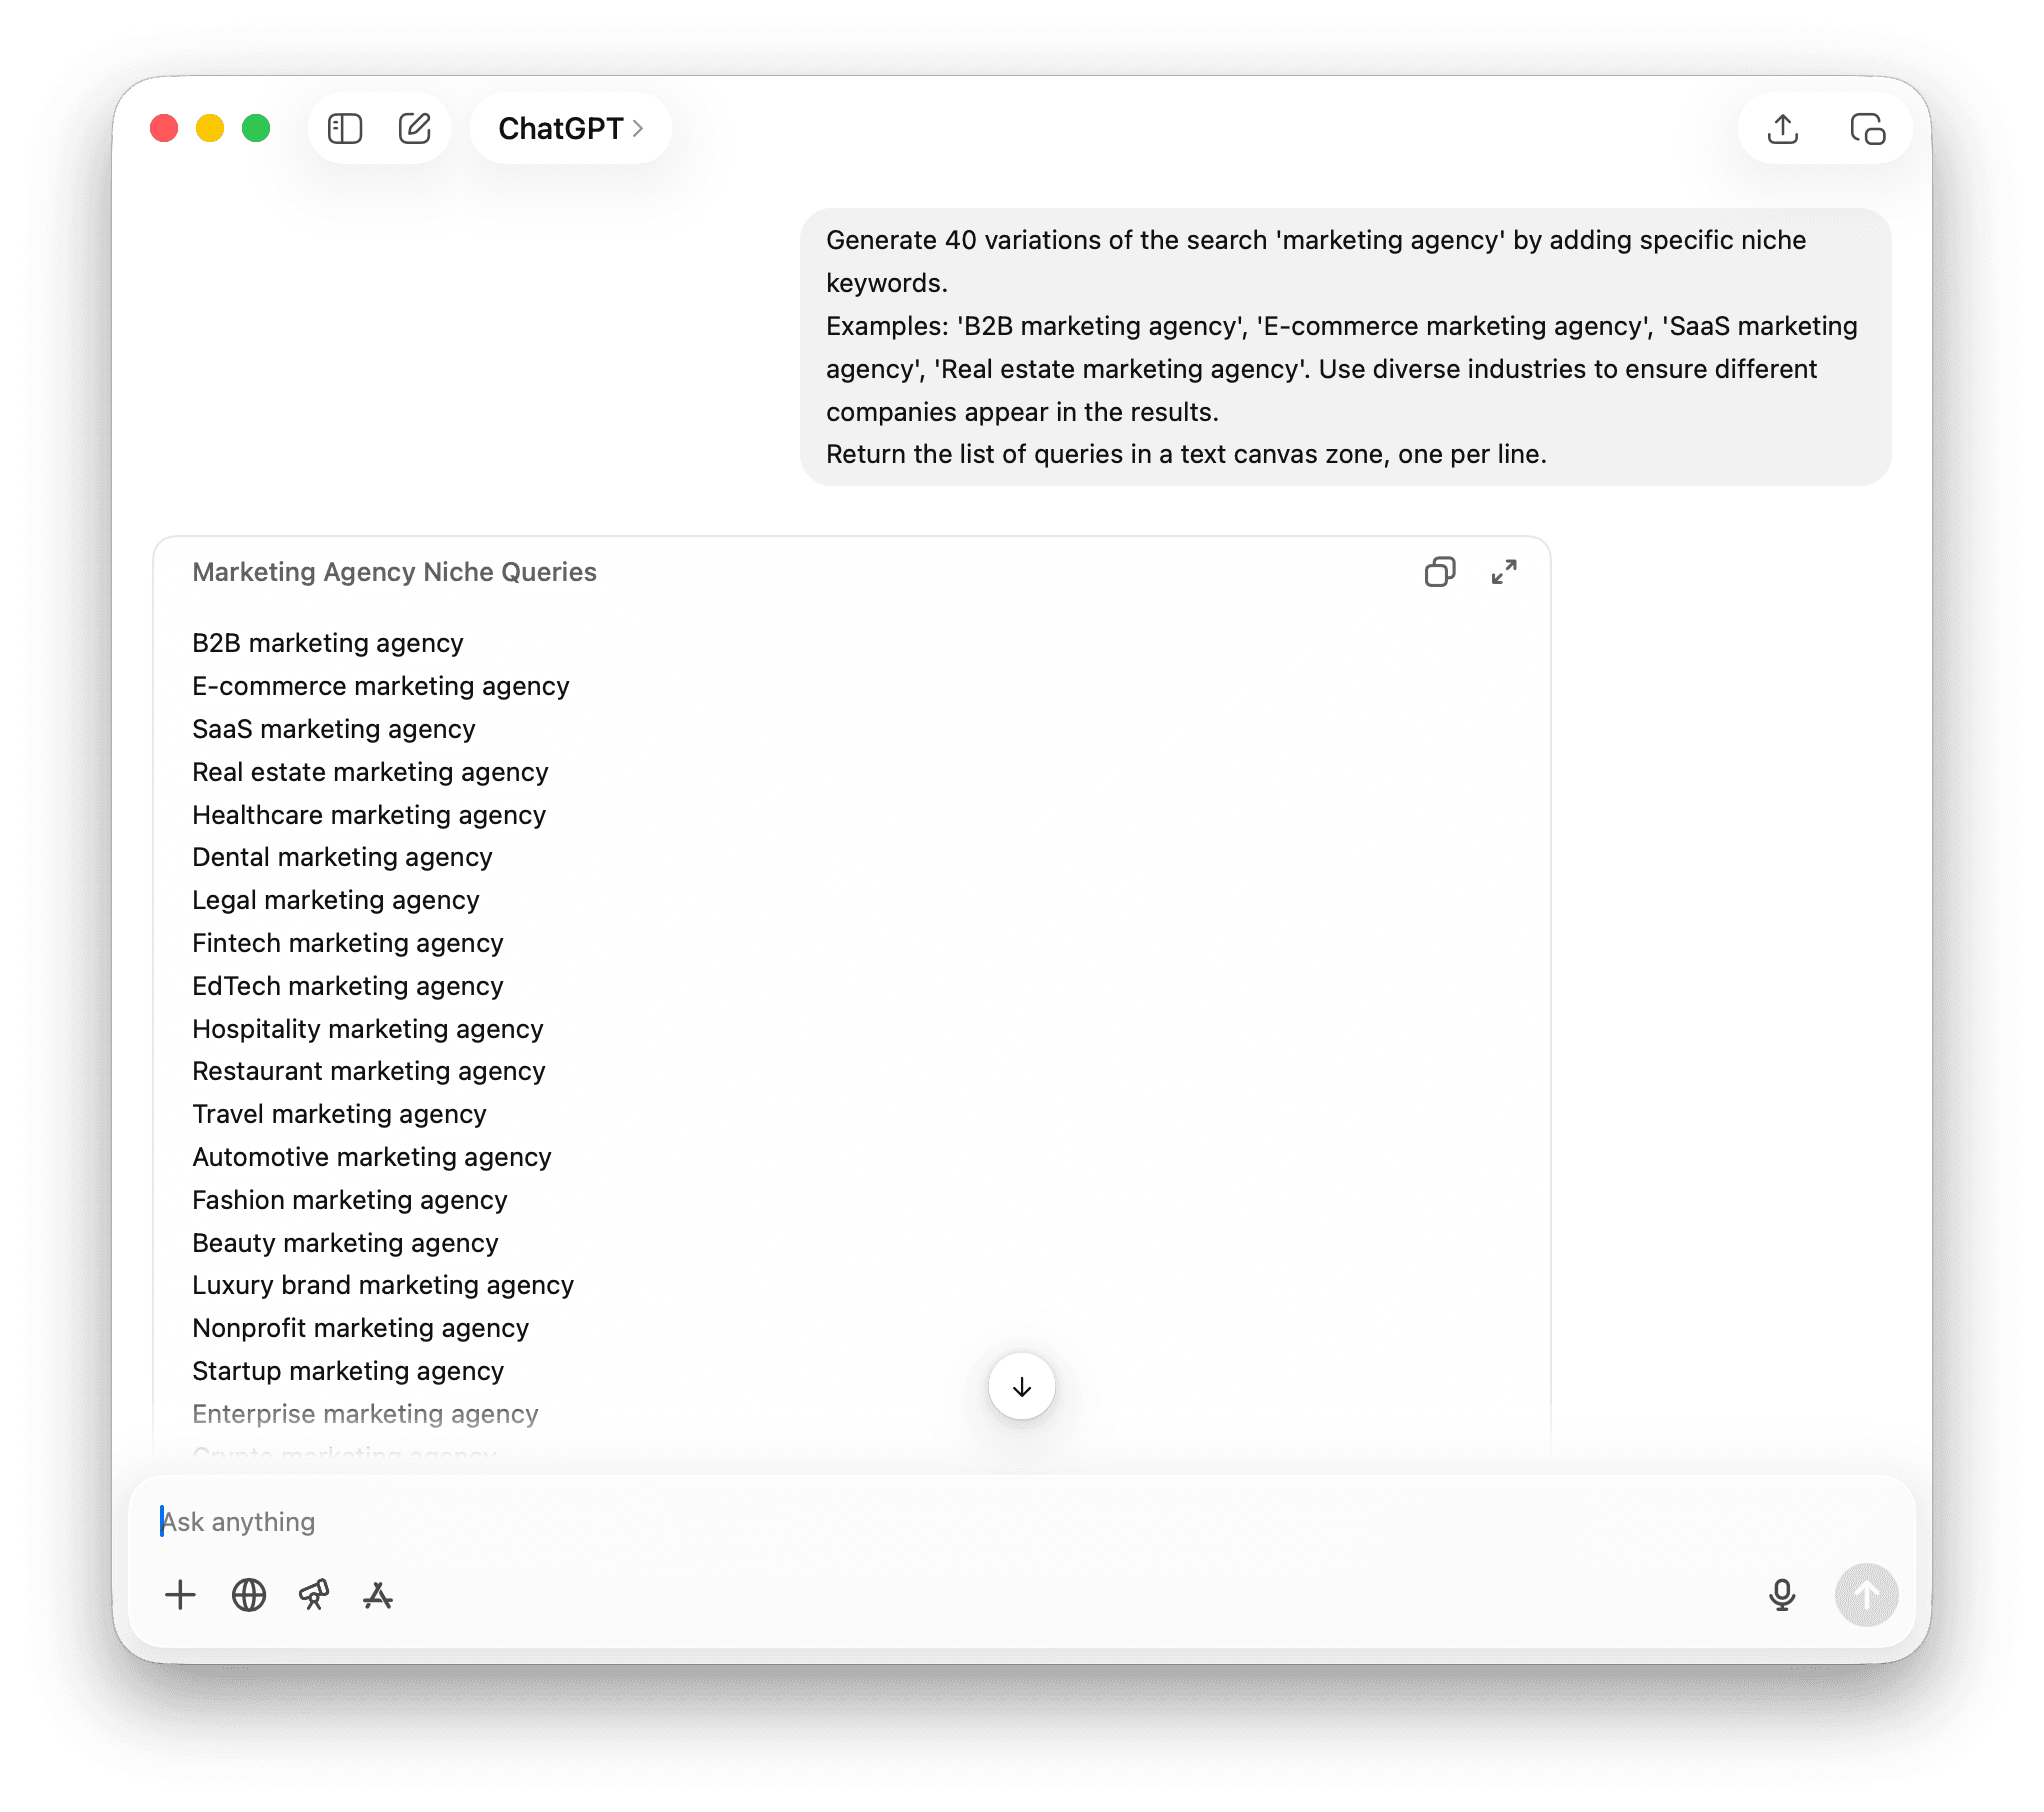
La localisation n’est pas toujours adaptée. Si vous recherchez des « agences marketing en remote », vous pouvez plutôt varier les mots-clés.
Exemples : « agence marketing B2B », « agence marketing e-commerce », « agence marketing SaaS », « agence marketing immobilier ». Utilisez des secteurs variés afin de faire apparaître différentes entreprises dans les résultats.
Retournez la liste des requêtes dans une zone de texte canvas, à raison d’une requête par ligne.
La stratégie de l’empreinte numérique
De nombreux sites utilisent des logiciels spécifiques. Ceux-ci laissent souvent une empreinte dans le code HTML ou le footer, et Google indexe ce texte.
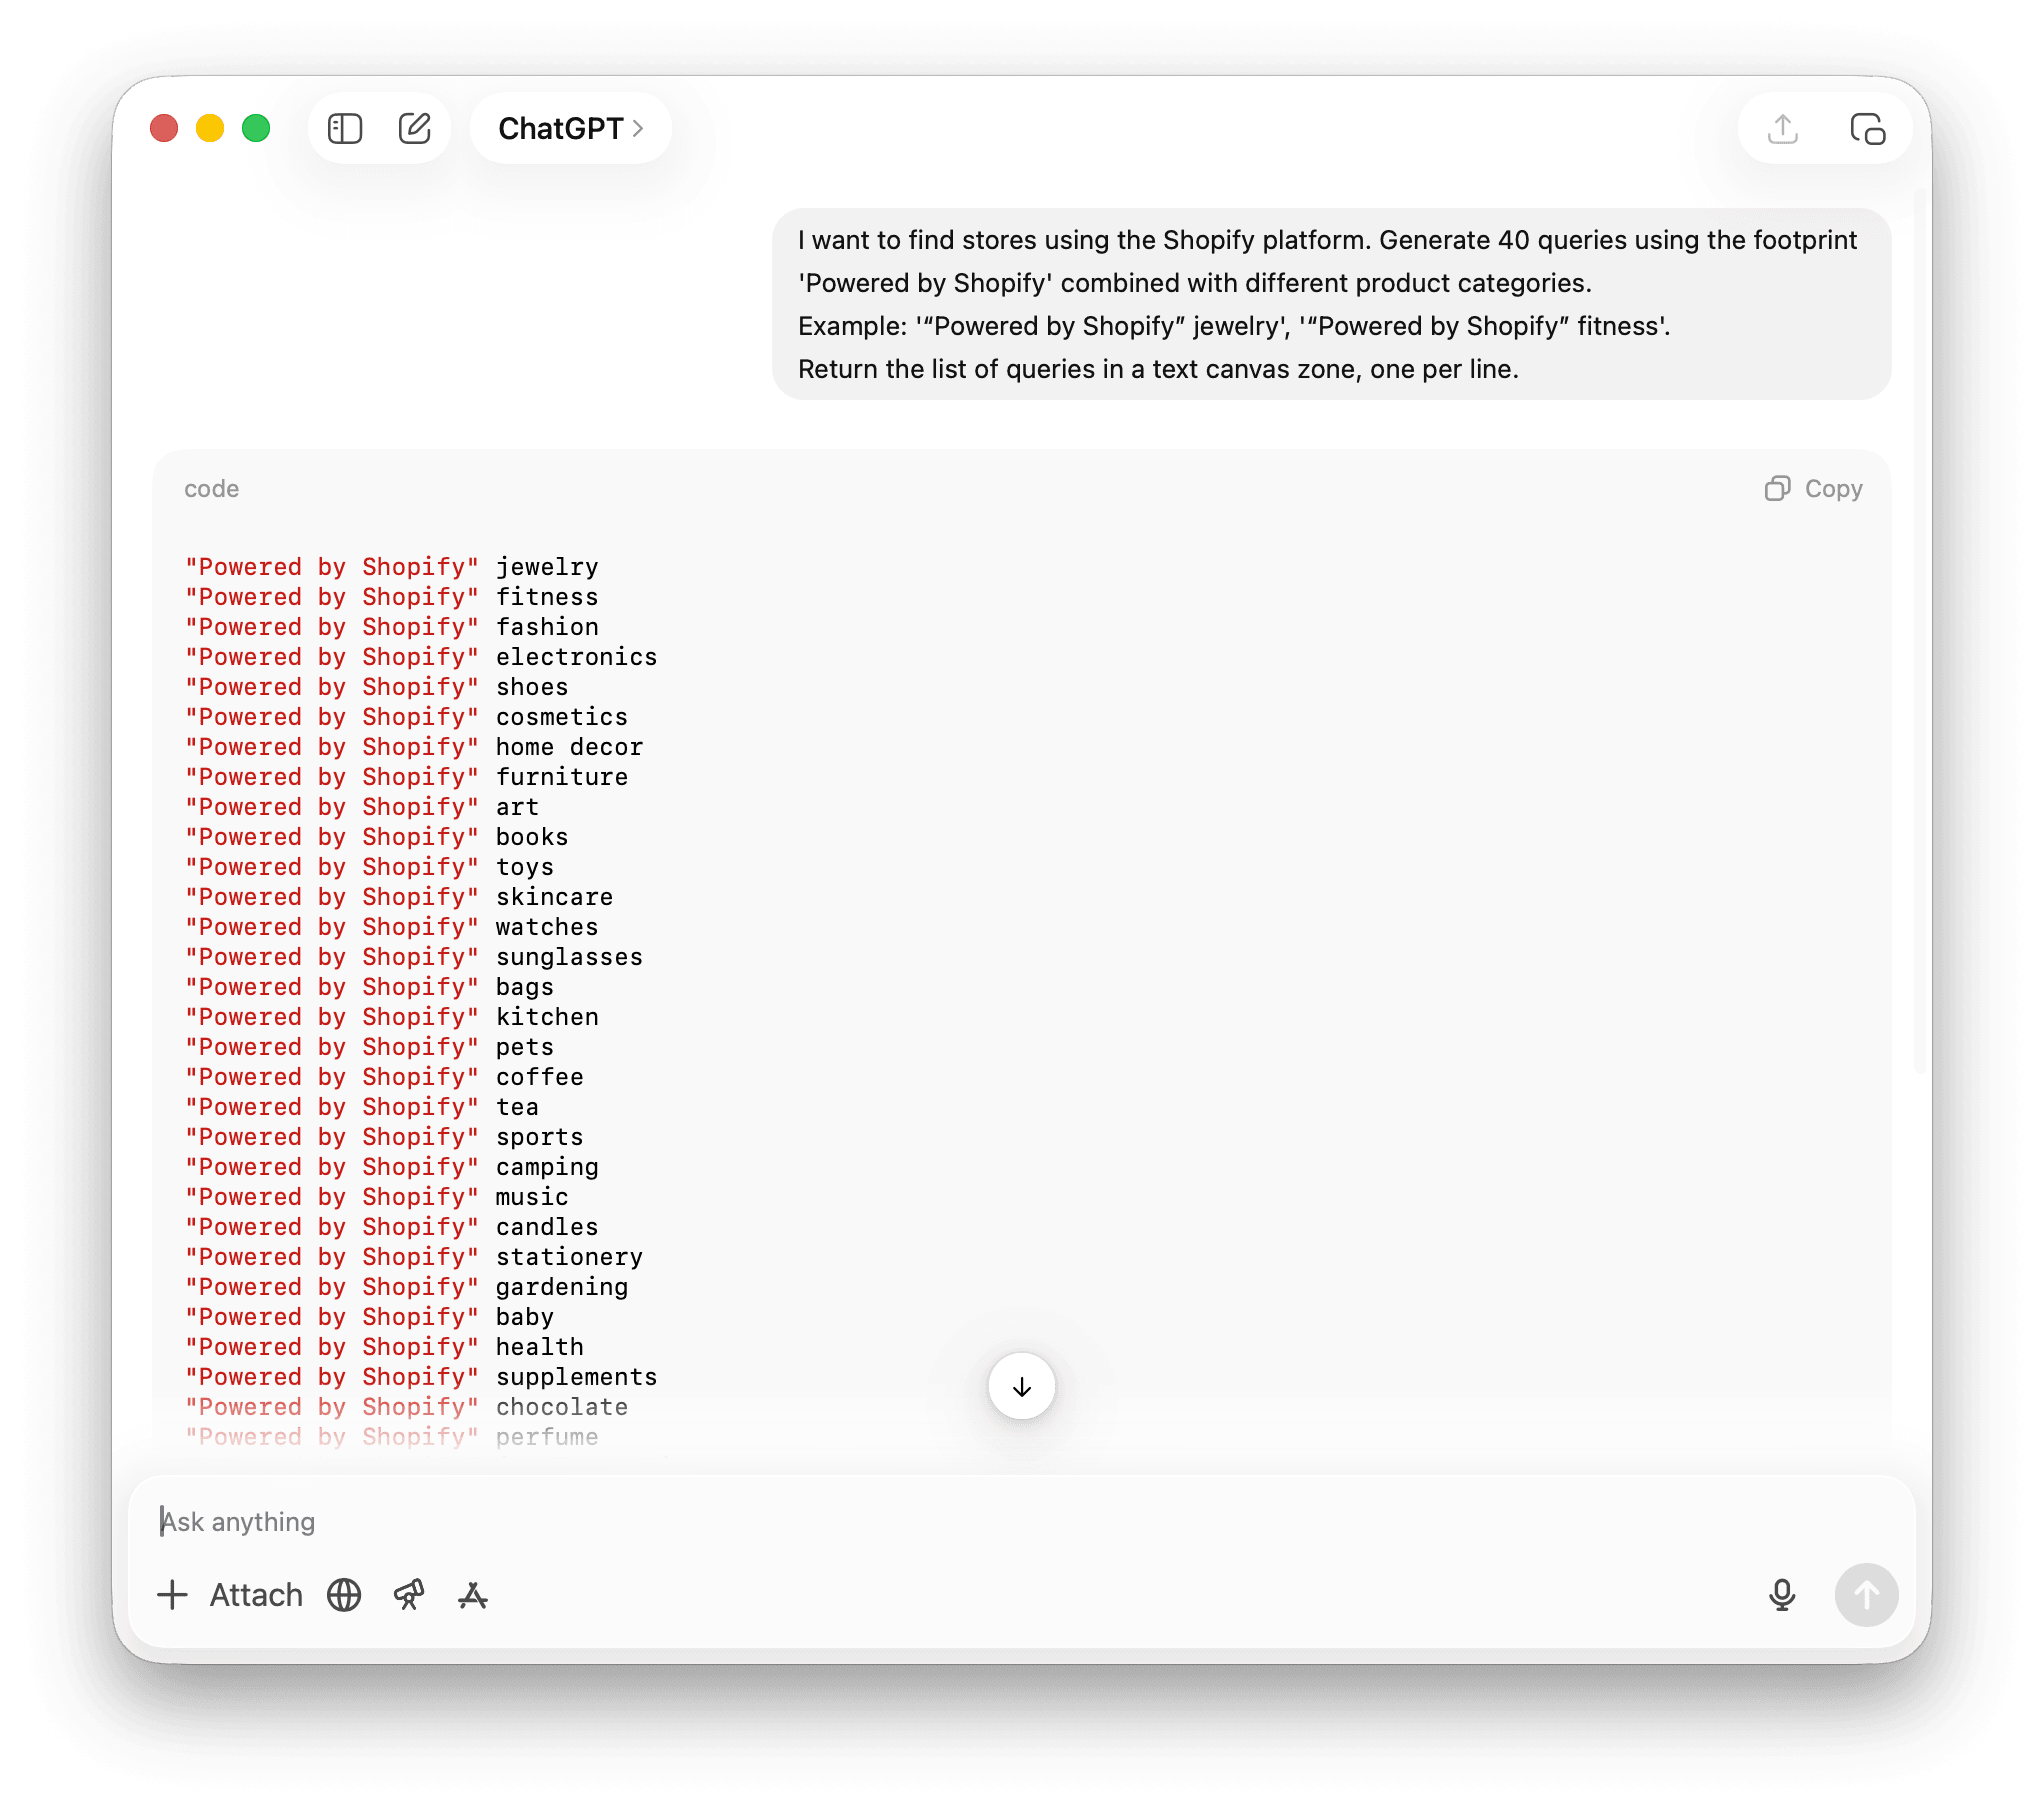
Exemples : « “Powered by Shopify” bijoux », « “Powered by Shopify” fitness ».
Retournez la liste des requêtes dans une zone de texte canvas, à raison d’une requête par ligne.
Guide du scraping Google multi-requêtes avec Datablist
Après avoir vérifié vos requêtes, vous pouvez les exécuter avec la source Datablist, sans avoir à développer votre propre scraper de navigateur. Commencez par un petit lot pour contrôler les données obtenues et la consommation de crédits.
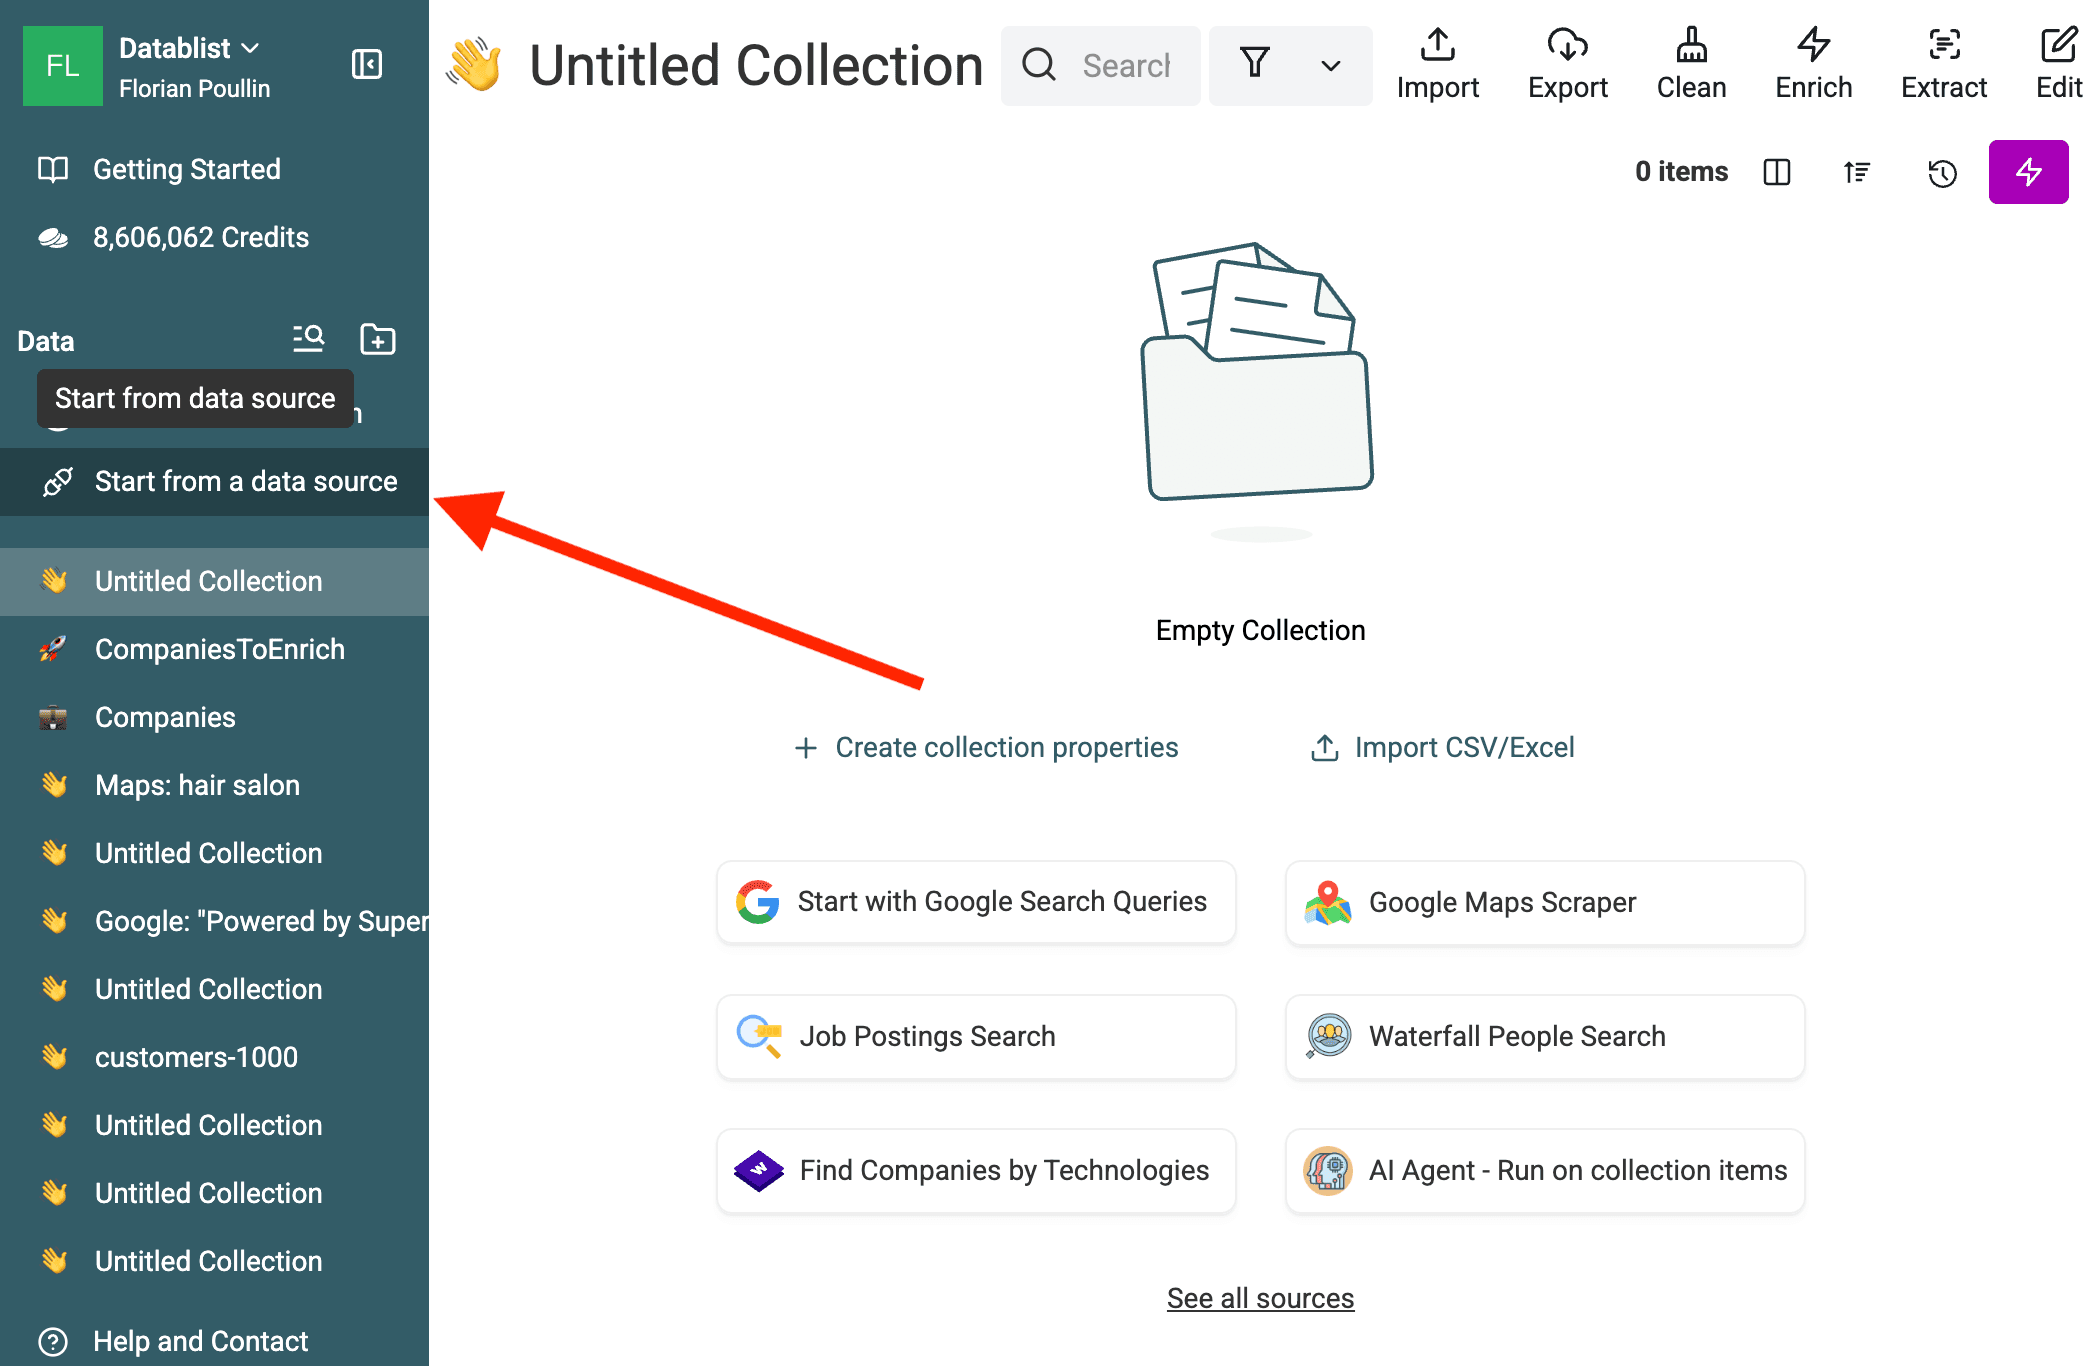
1. Accéder à la source de données
Ouvrez Datablist et cliquez sur Start from a data source dans la barre latérale.
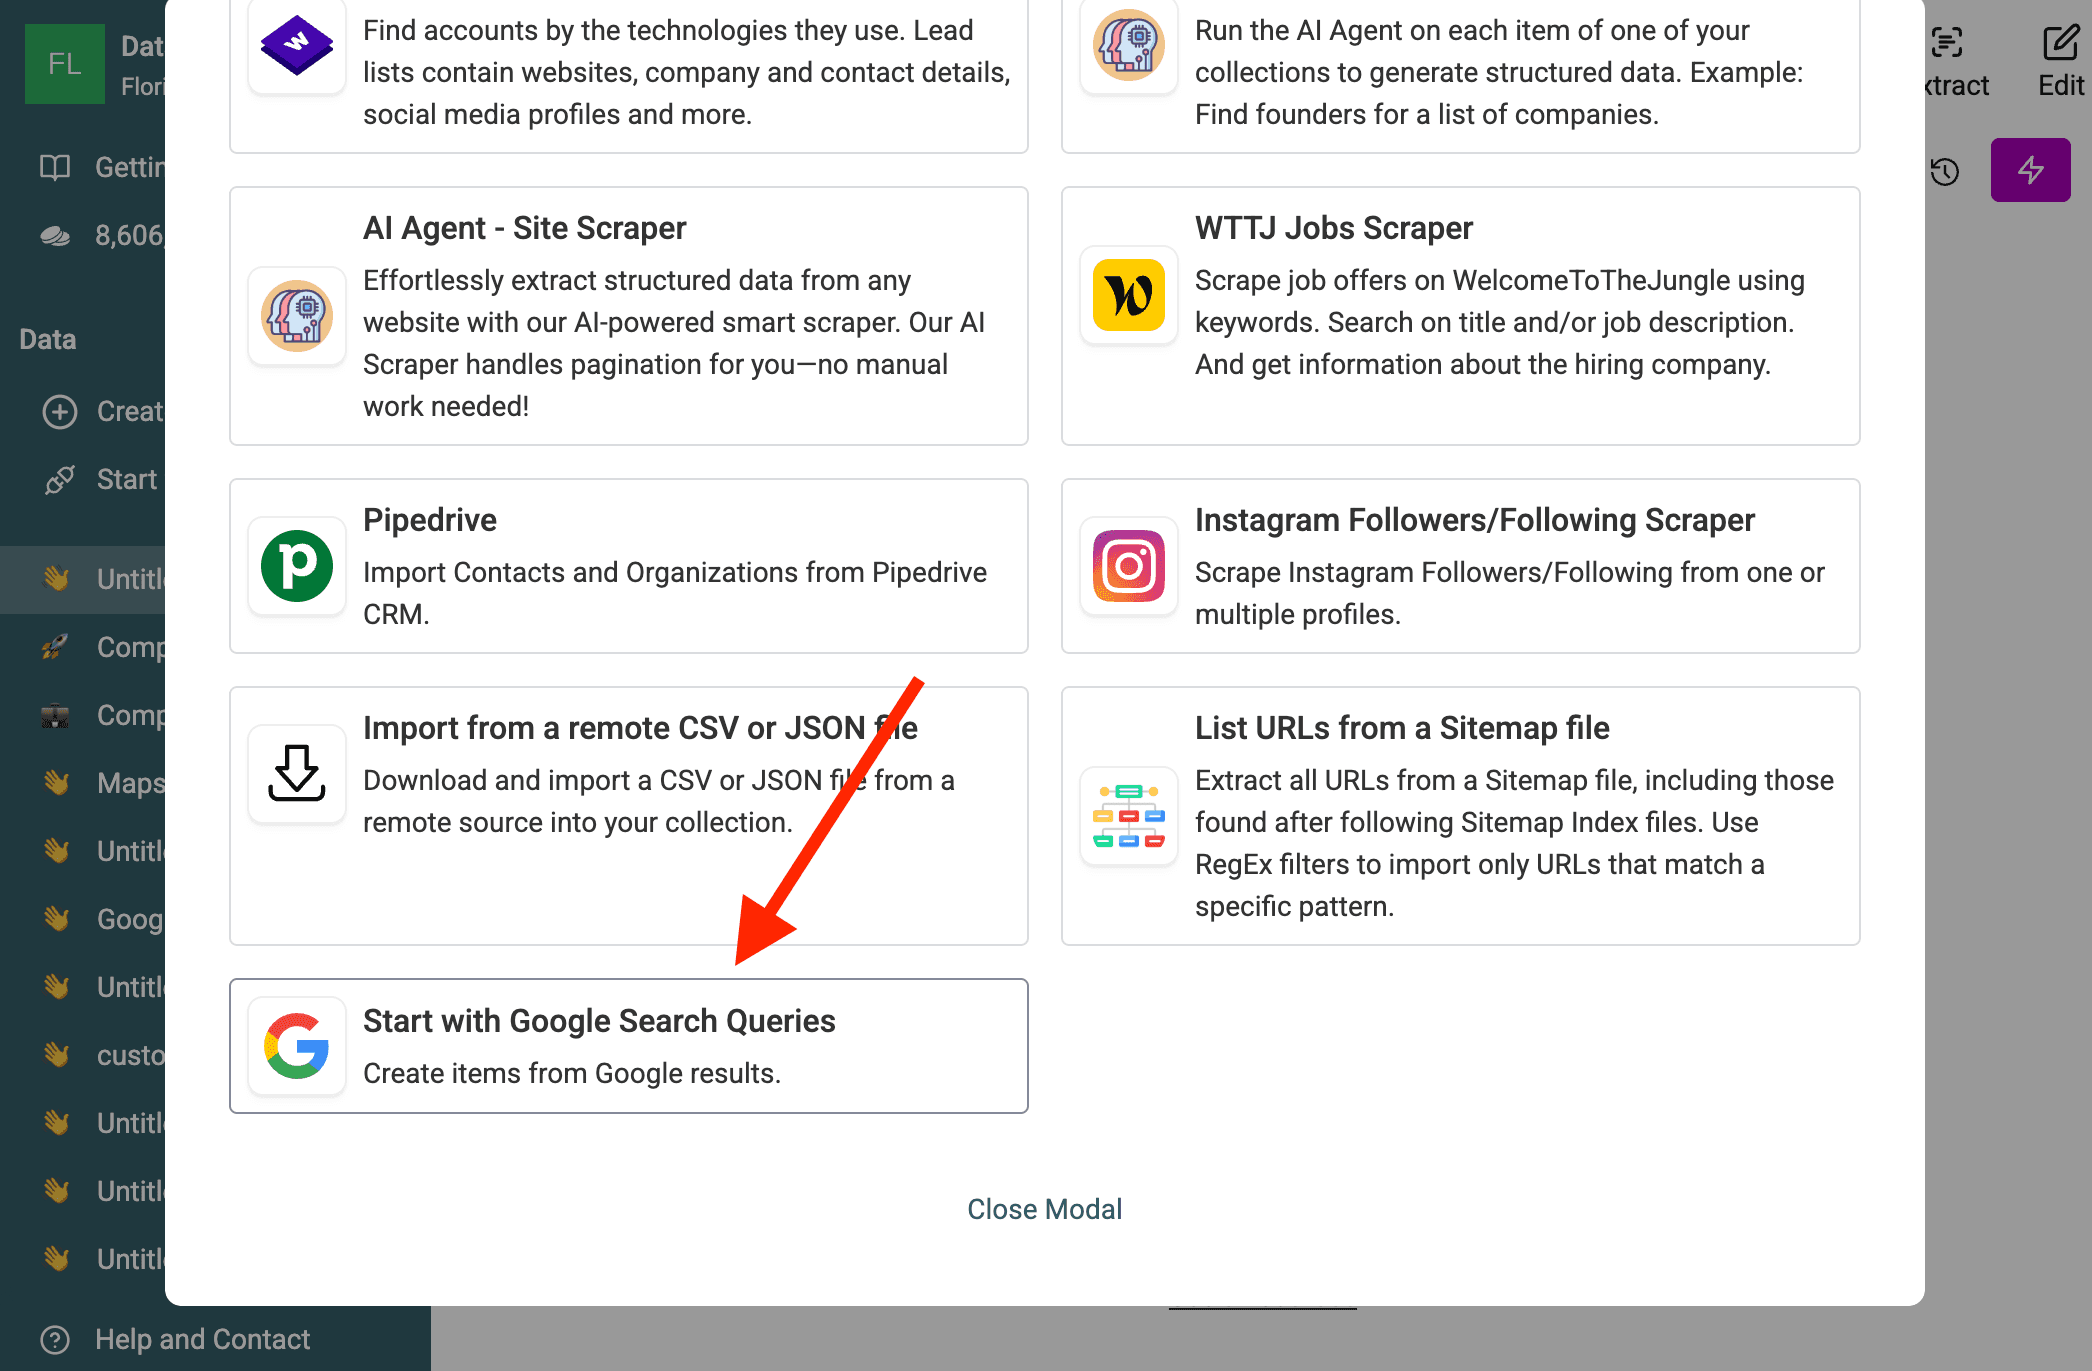
Sélectionnez Start with Google Search Queries dans le catalogue des sources.
2. Coller les requêtes et configurer la recherche
Collez la liste de requêtes vérifiées dans Google Search Queries, à raison d’une requête par ligne. Avec le plan gratuit, seule la première requête est traitée. Vérifiez donc votre plan et le mode de run sélectionné avant de lancer un batch multi-requêtes.
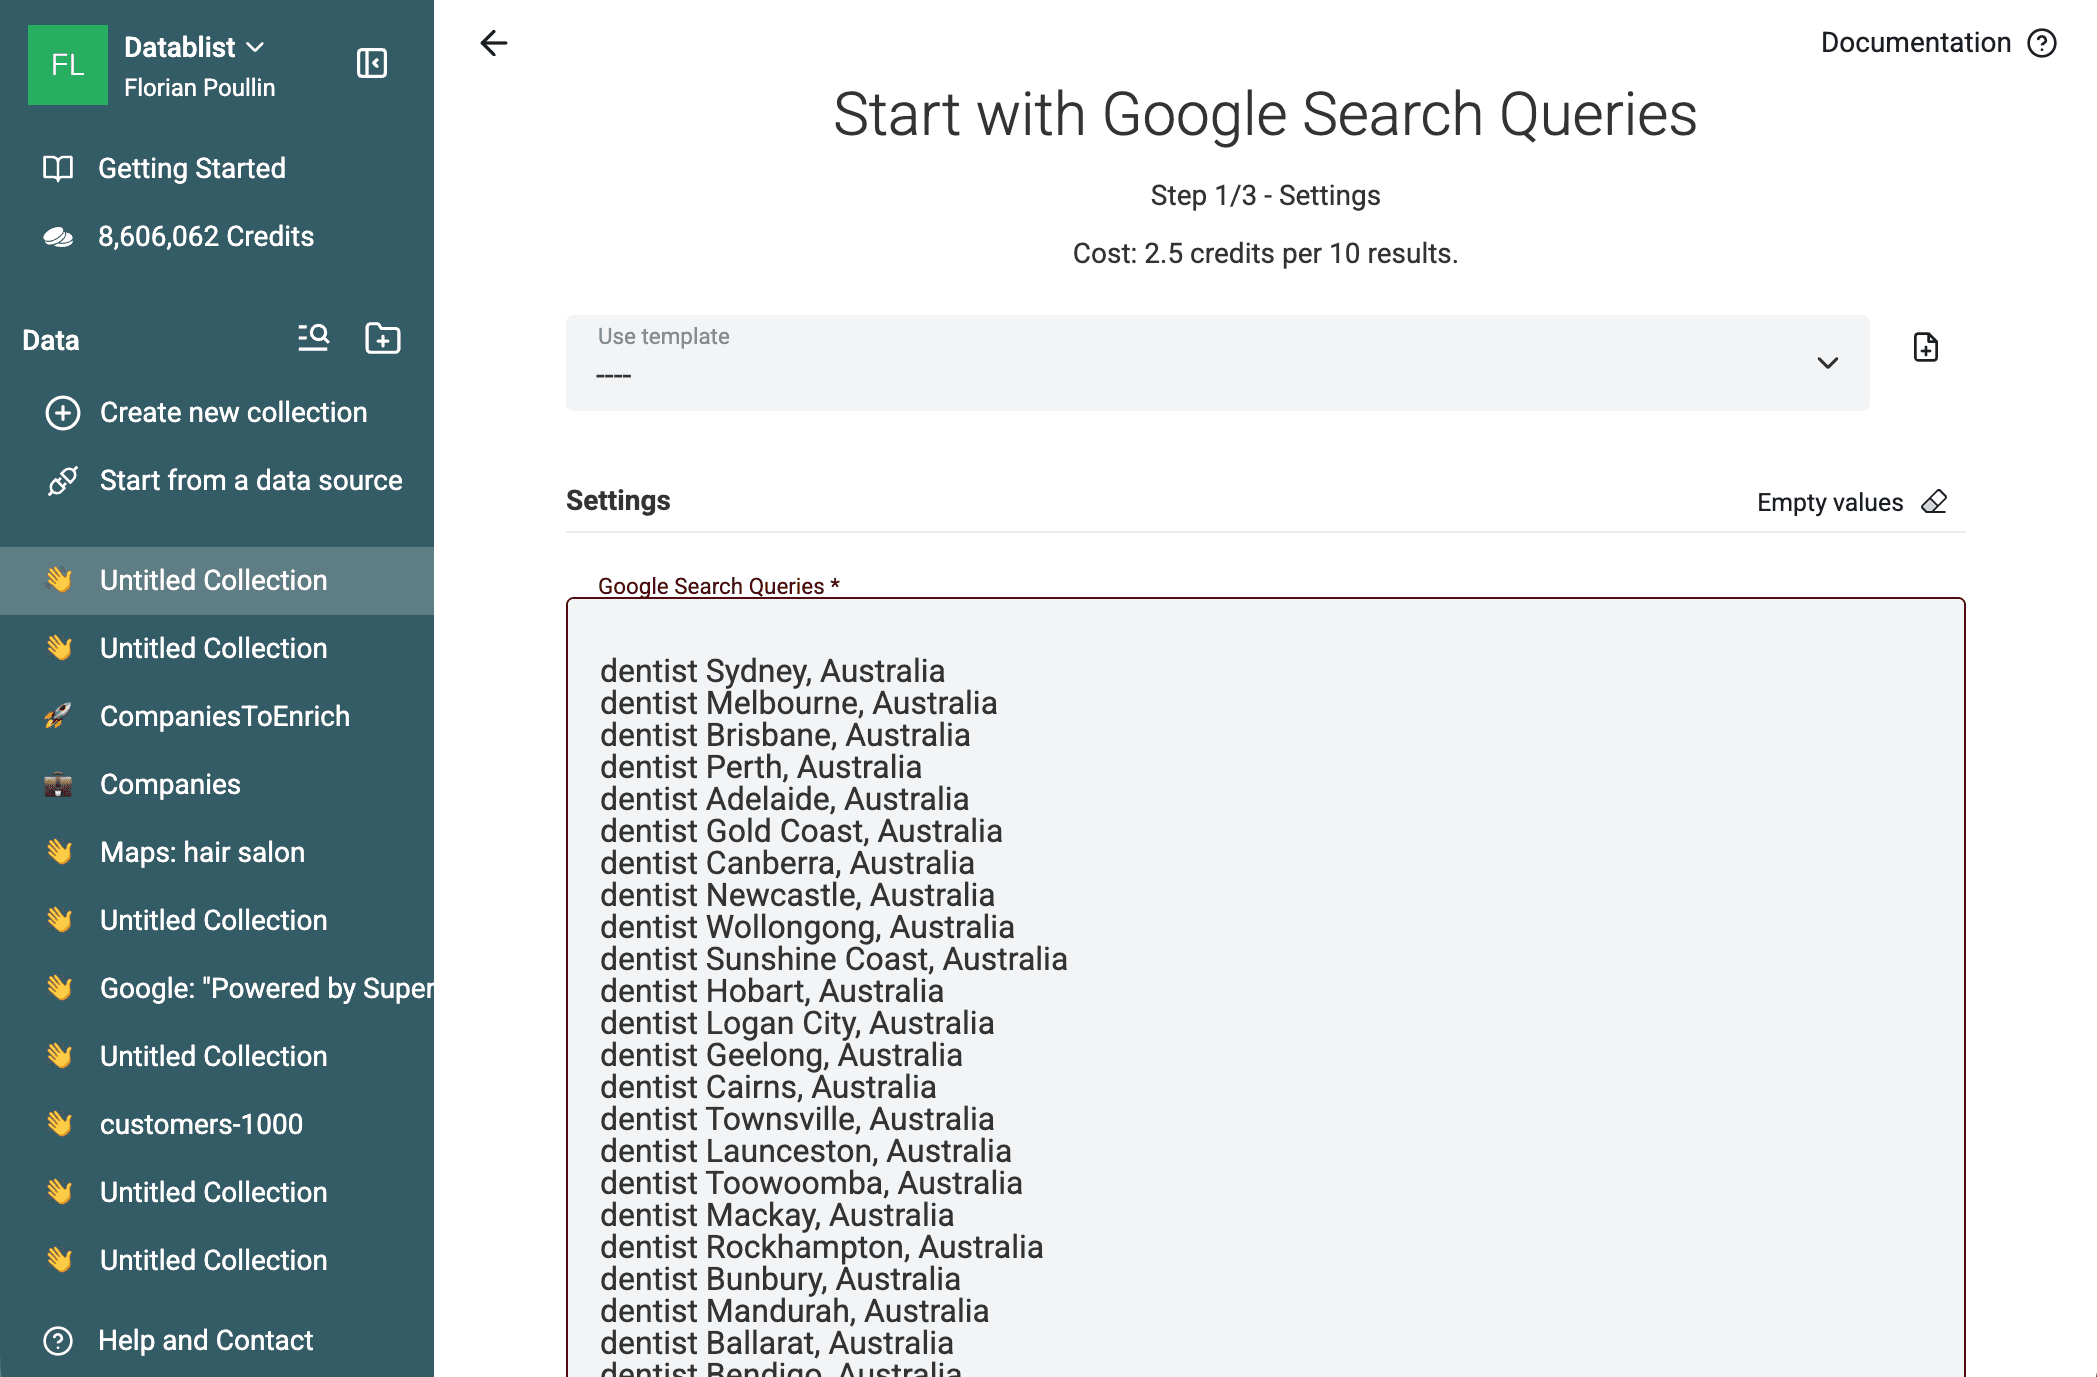
Définissez Search Country et Search Language en fonction du marché que vous souhaitez étudier. Utilisez Time Period si la fraîcheur des résultats est importante, et Limit Per Query pour plafonner le run. Le filtre temporel restreint la période de recherche, mais ne garantit pas que chaque entreprise renvoyée est encore en activité.
4. Lancer le run et patienter
Vérifiez l’estimation des crédits, puis lancez un petit batch. Datablist traite les requêtes et ajoute les pages trouvées à une collection.
Vous pouvez suivre en temps réel l’ajout des éléments dans votre collection.
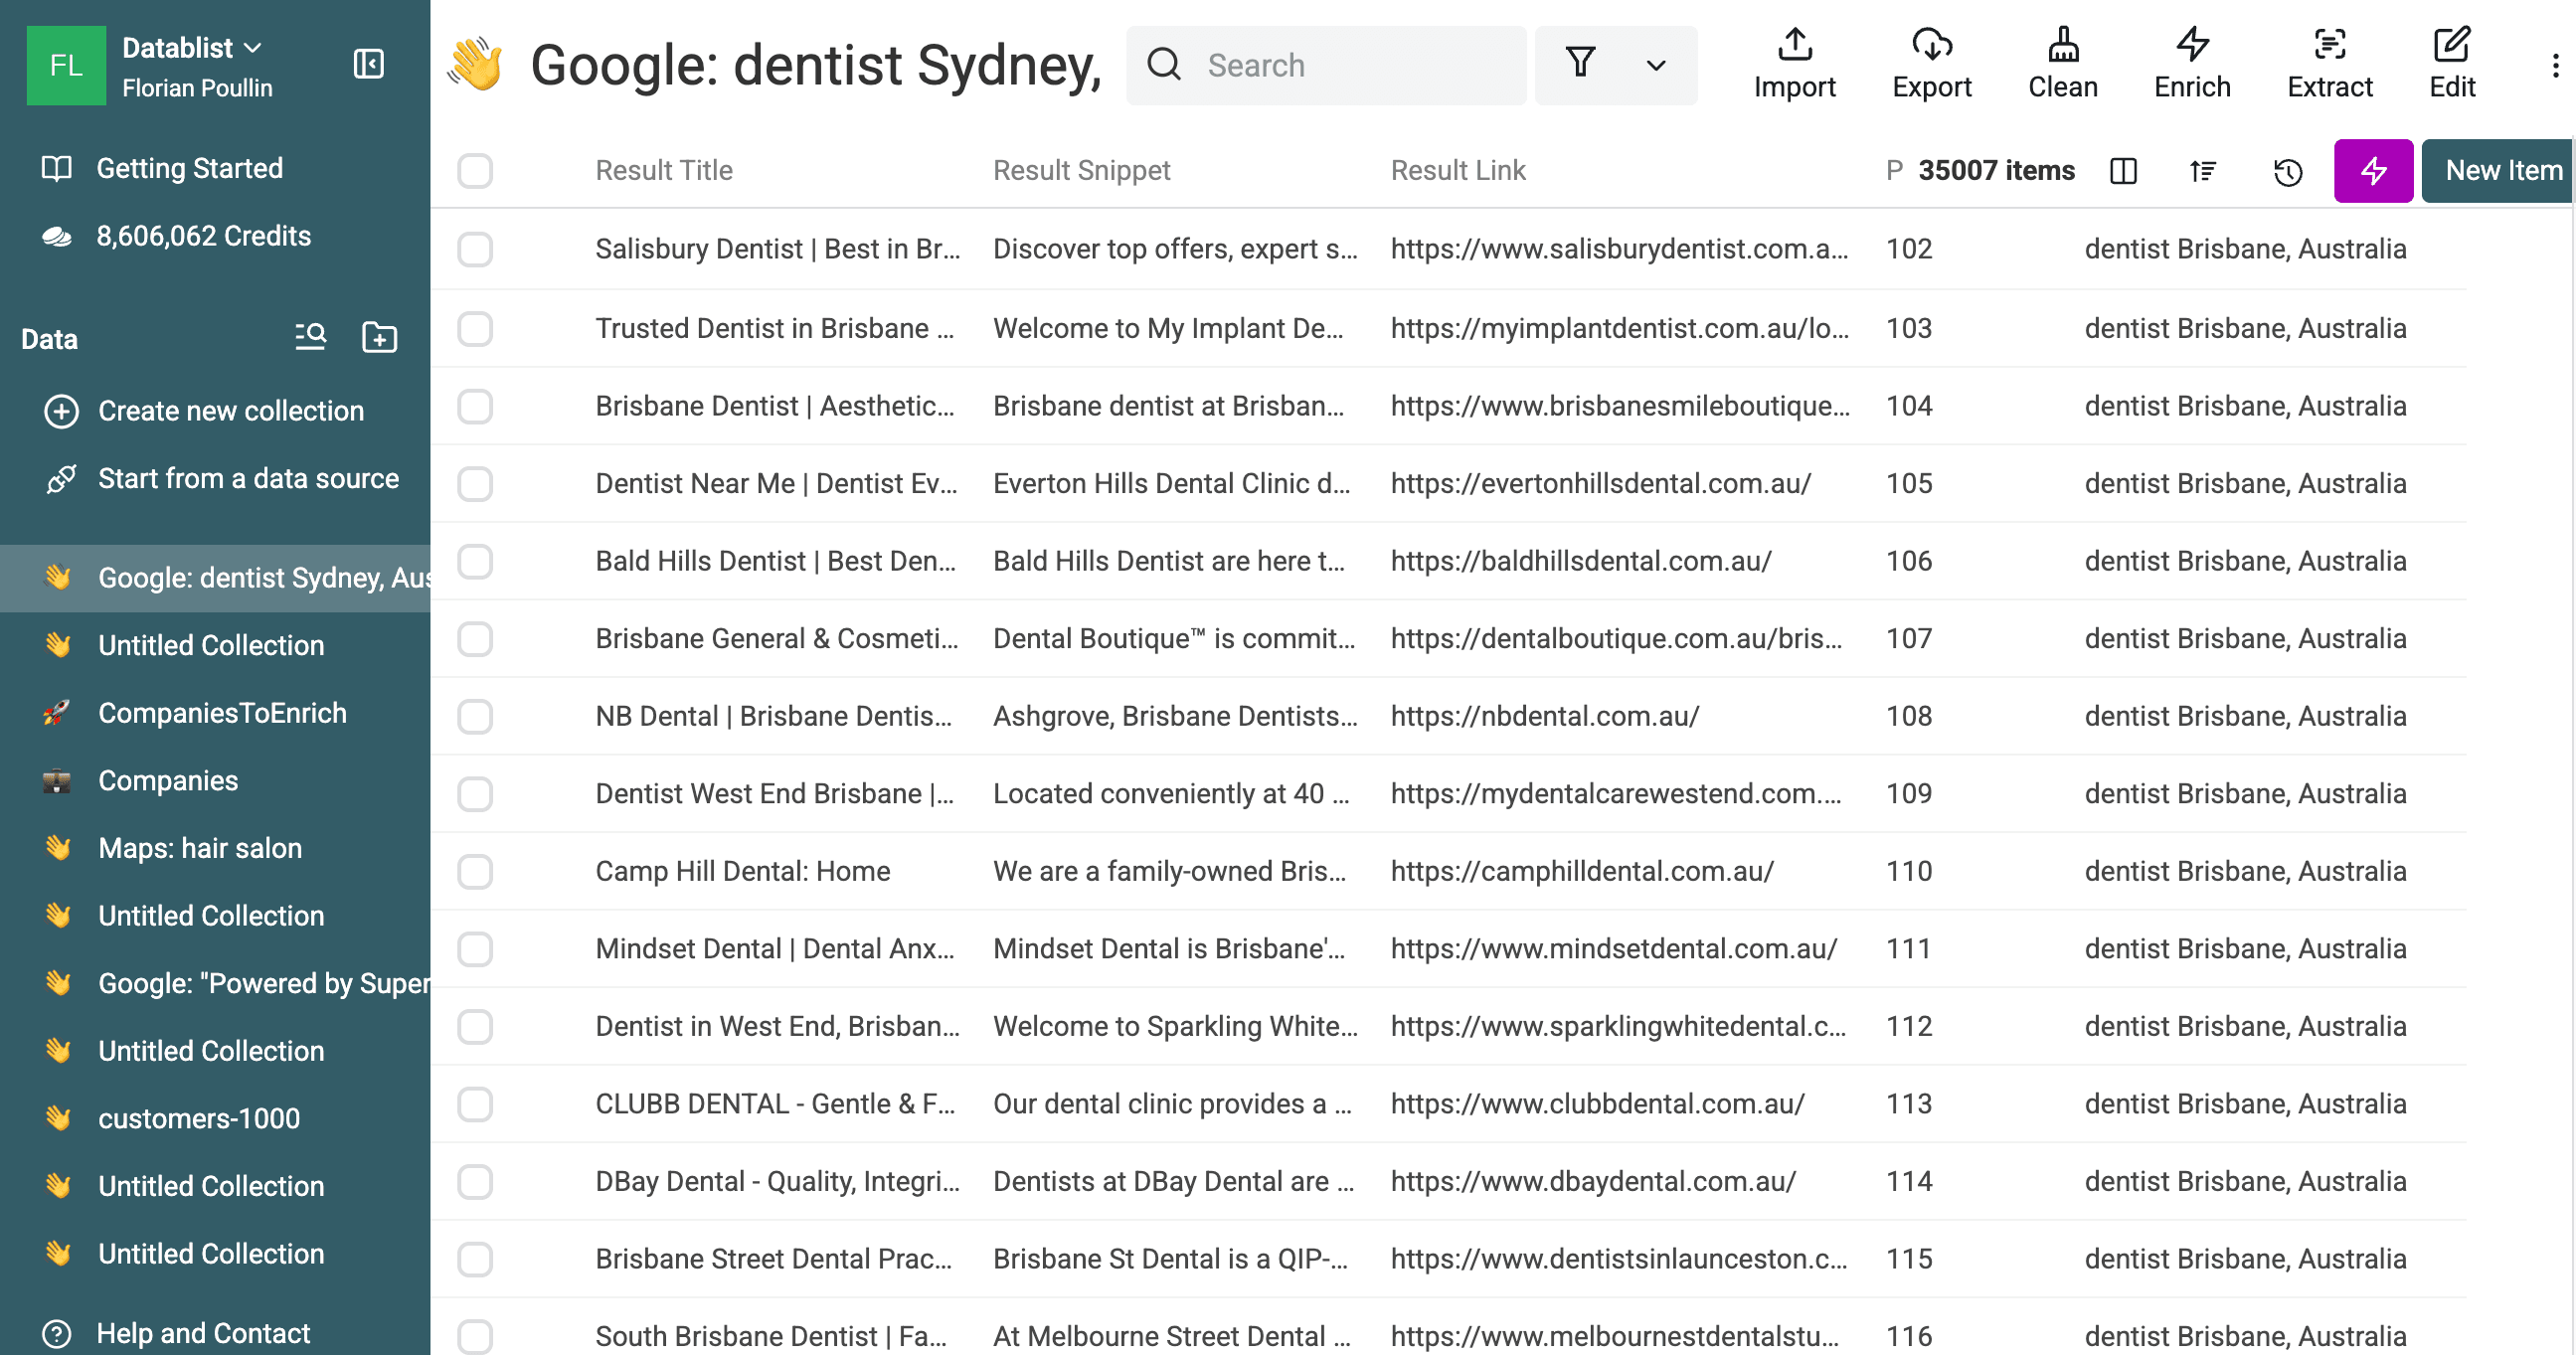
Nettoyer et dédupliquer vos données
Supprimer les doublons
L’un des principaux effets secondaires de 50 requêtes similaires est la présence de doublons. Un cabinet d’avocats reconnu peut être bien classé pour « Avocat Paris », « Avocat France » et « Avocat droit commercial ». En réunissant ces résultats dans une seule collection Datablist, vous obtiendrez trois lignes pour le même cabinet.
Vous devez dédupliquer vos données avant de lancer votre campagne d’outreach. Datablist intègre pour cela le puissant outil Duplicates Finder.
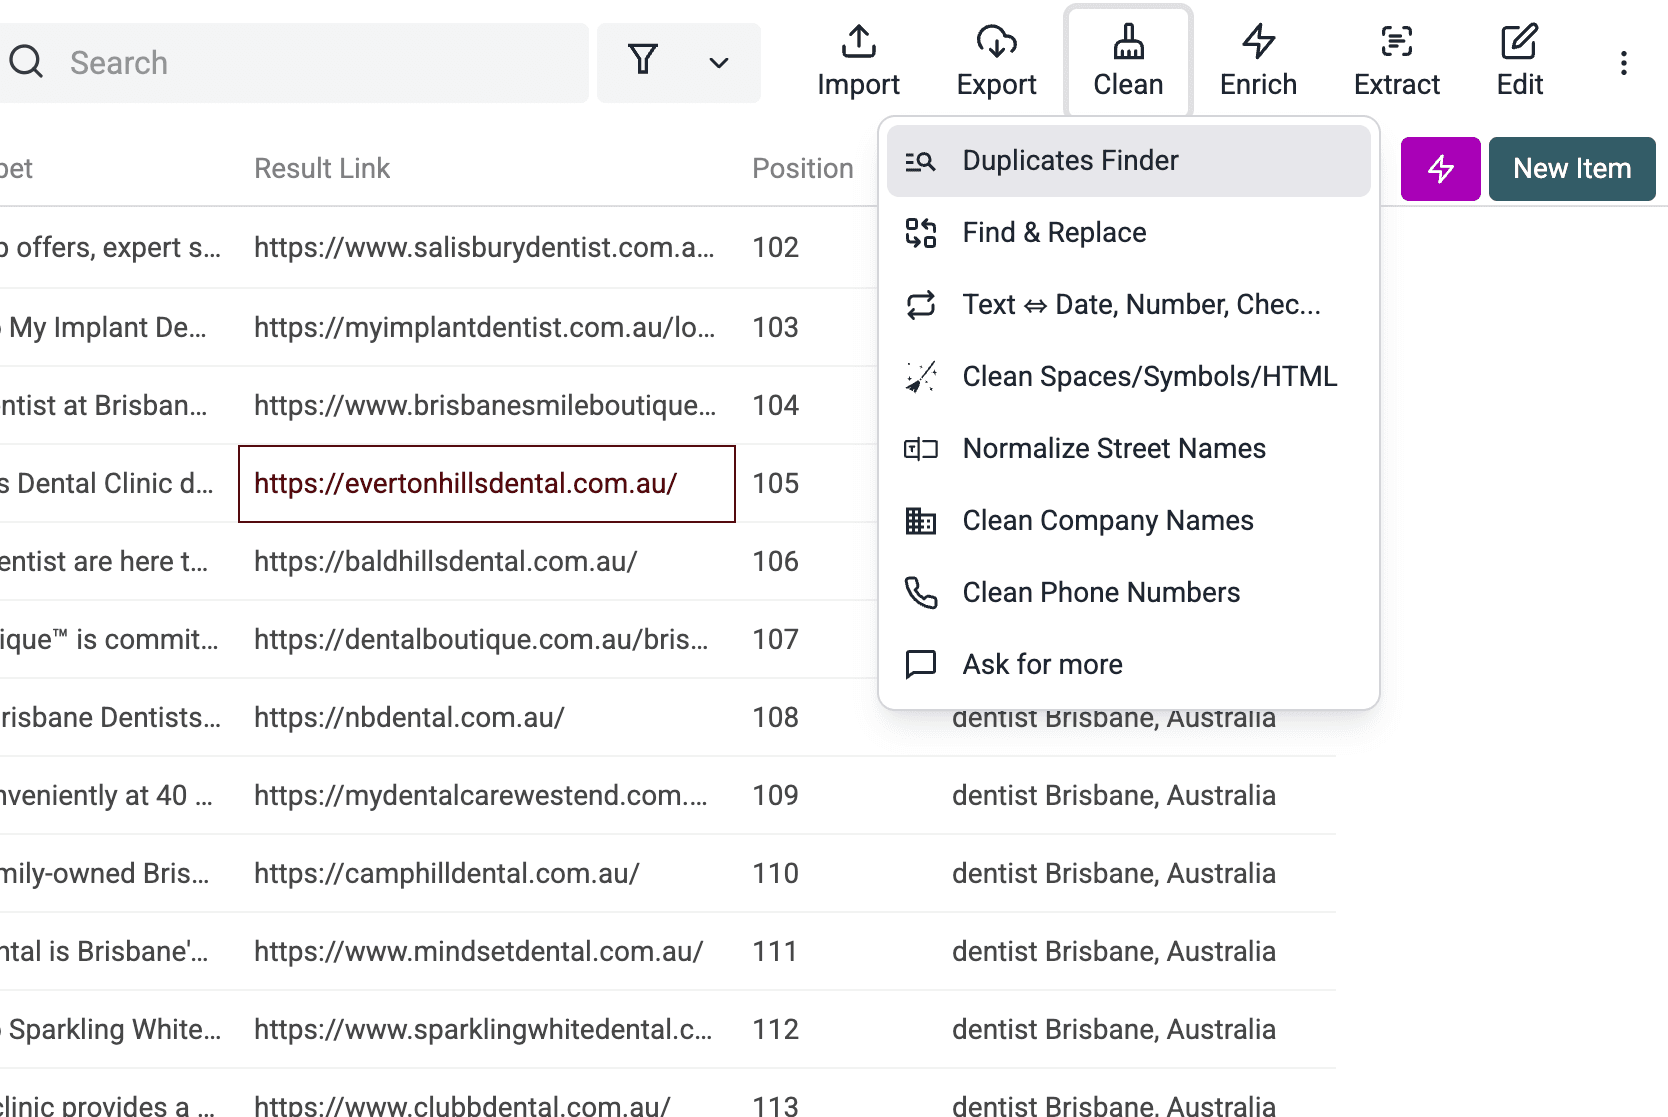
- Ouvrez le menu "Clean".
- Sélectionnez "Duplicates Finder".
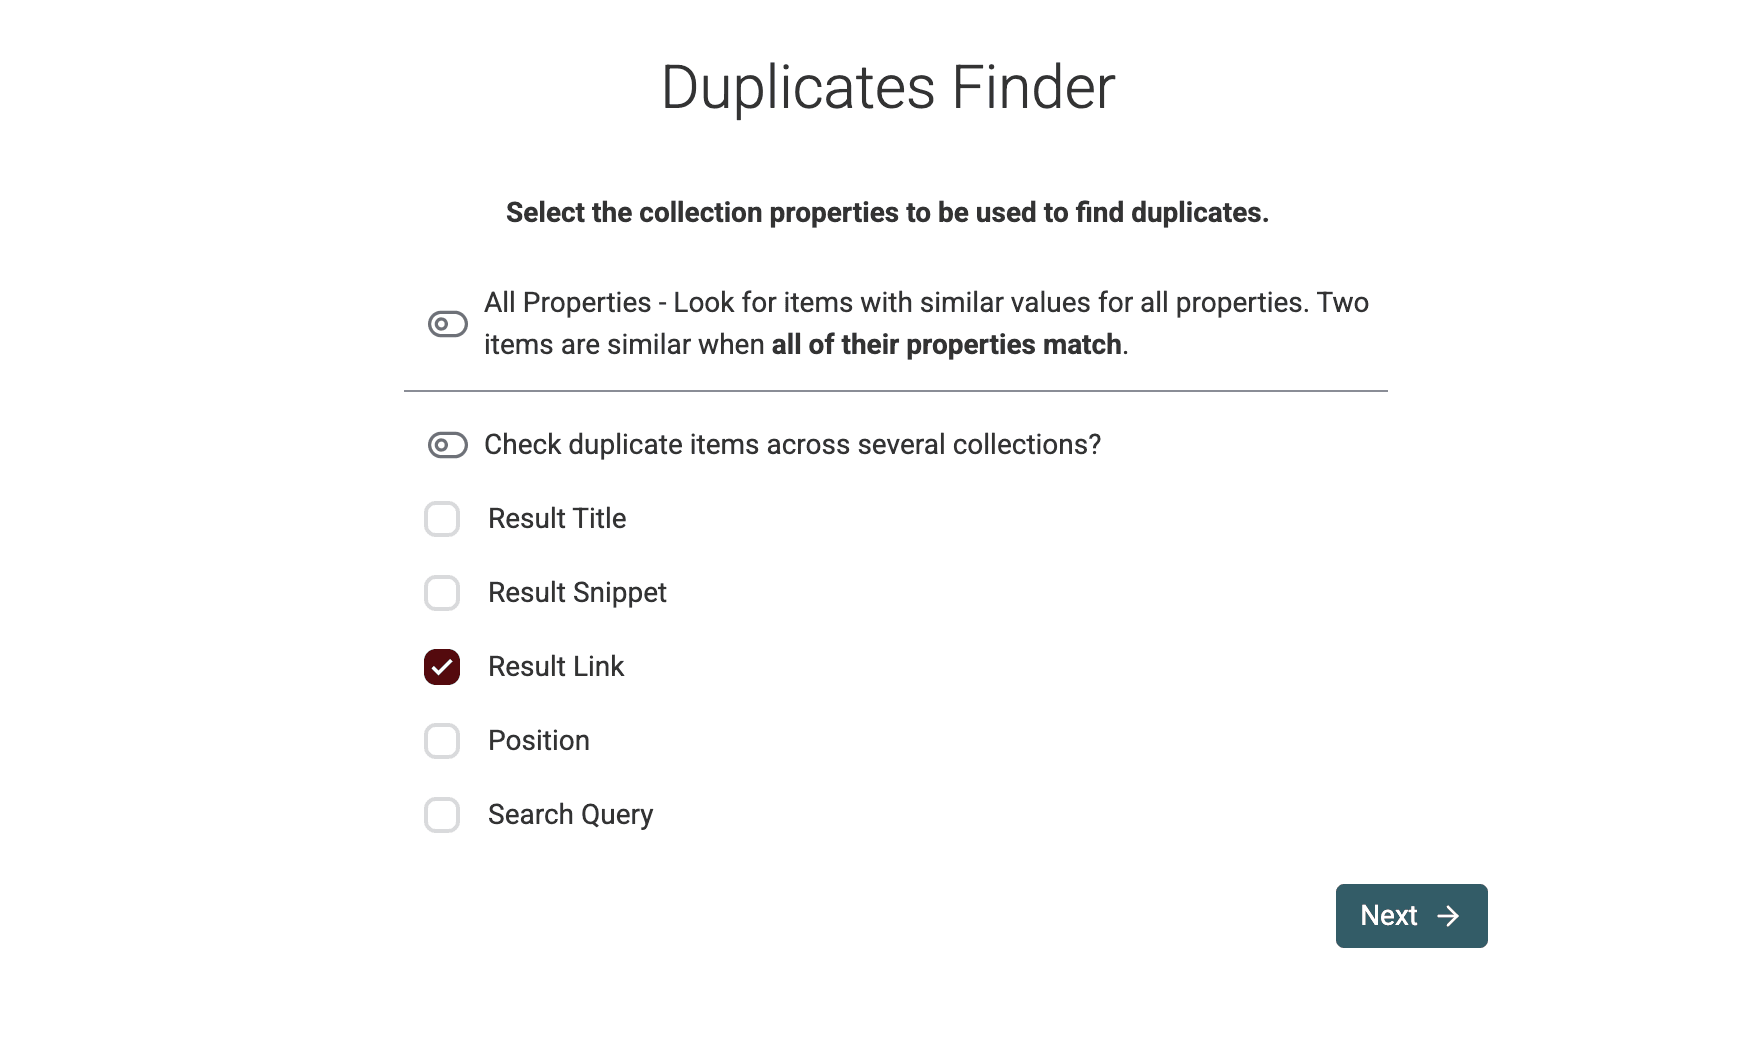
- Choisissez la propriété à comparer. Utilisez
Result Linksi vous souhaitez supprimer une même page renvoyée par plusieurs requêtes.
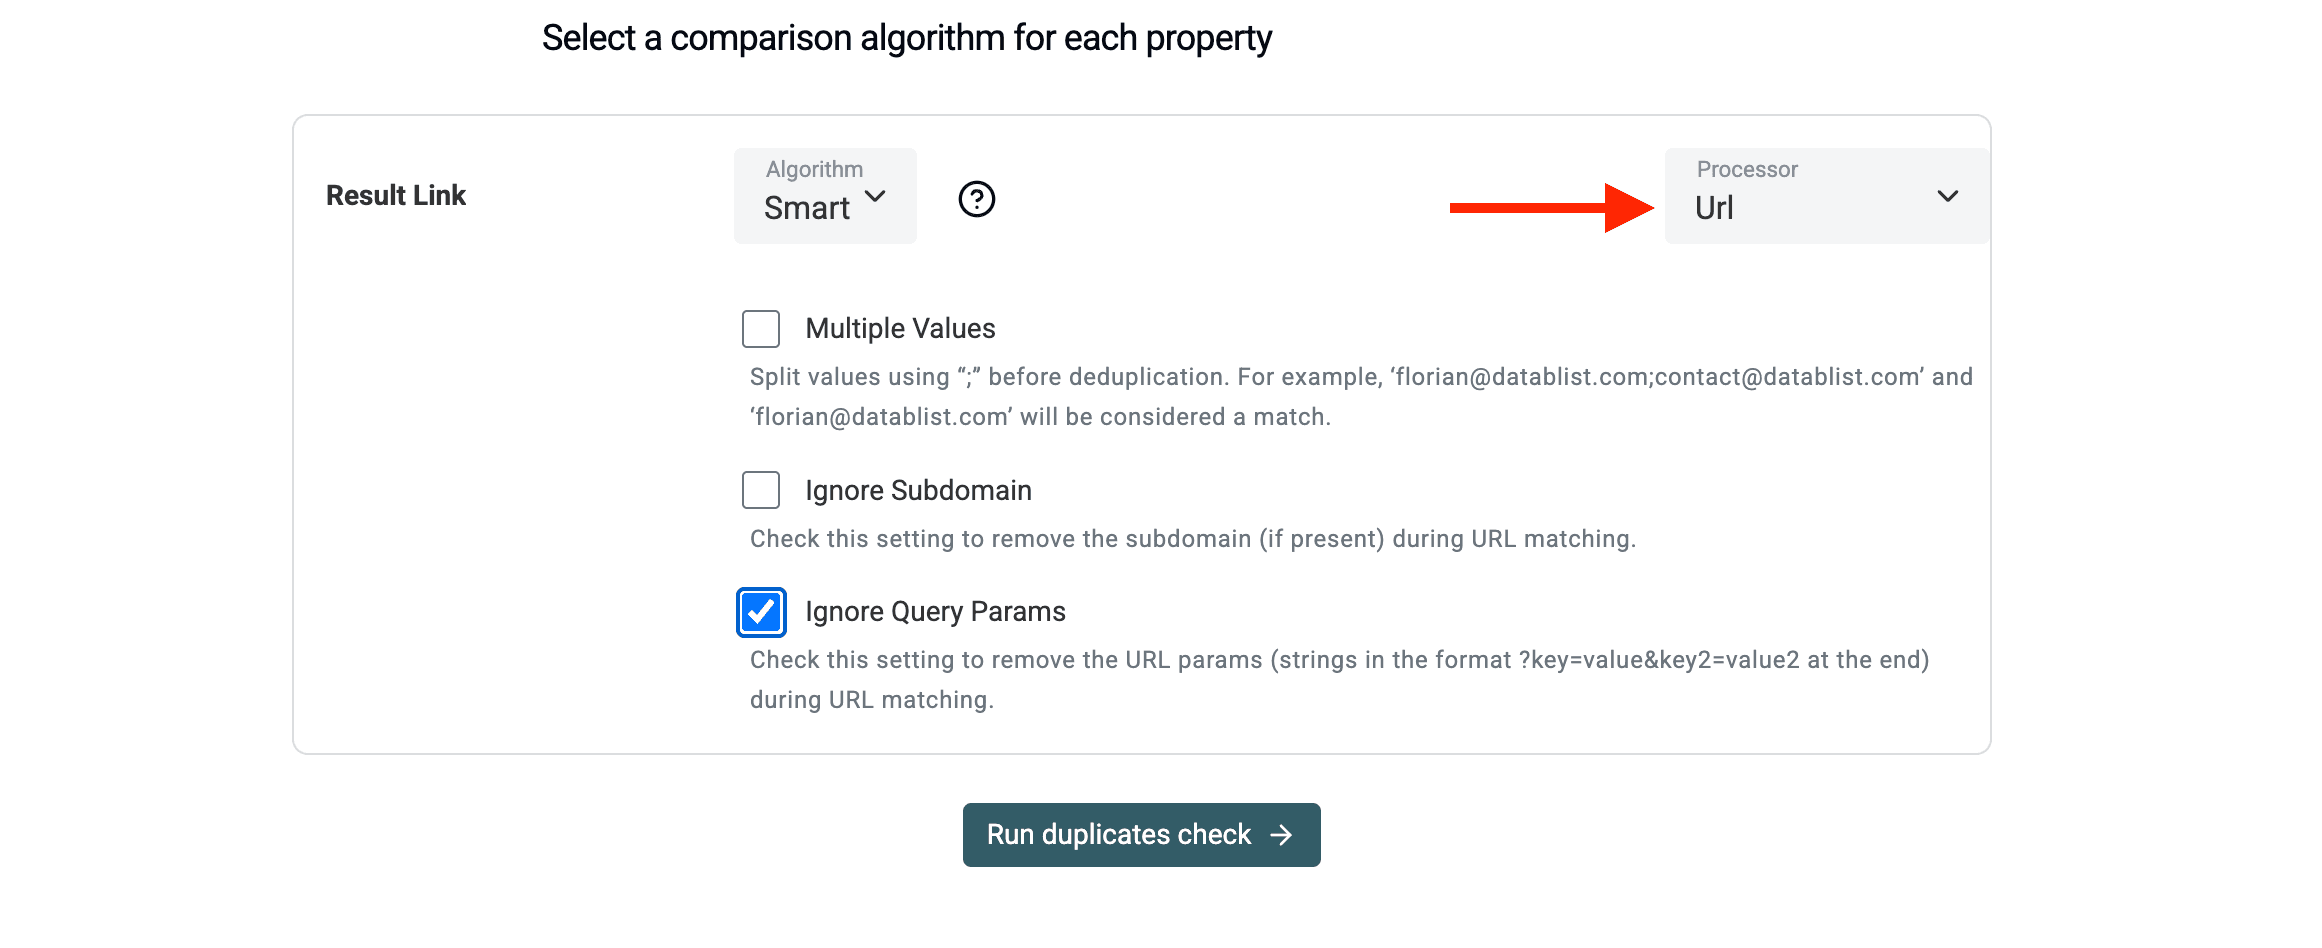
- Sélectionnez le processeur URL. Conservez les chemins si plusieurs pages d’un même domaine vous sont utiles. Activez Ignore Path uniquement si vous ne voulez garder qu’un enregistrement par domaine, puis vérifiez les groupes avant de les fusionner.
- Laissez l’outil identifier les lignes correspondantes, puis fusionnez-les ou supprimez les doublons.
Éliminer les résultats parasites
Le nettoyage consiste aussi à supprimer les résultats parasites. Google peut renvoyer des agrégateurs comme PagesJaunes, Yelp ou Tripadvisor. Vous souhaiterez probablement les écarter pour vous concentrer sur les sites officiels des entreprises.
Utilisez les filtres pour exclure les domaines d’annuaires les plus courants. Retrouvez la procédure détaillée pour gérer ces données dans ce guide du nettoyage de données.
Enrichir vos résultats de recherche
Une URL ou un titre de page suffit rarement pour mener une campagne commerciale. Une fois votre liste de sites dédupliquée, vous devez trouver les coordonnées des bons interlocuteurs. Datablist sert de hub d’enrichissement : vous pouvez transmettre les données scrapées à d’autres services.
Trouver des adresses email
-
Trouver des emails à partir de domaines d’entreprise
Si votre scraping renvoie des domaines d’entreprise, utilisez l’enrichissement "Waterfall People Search" de Datablist. Il trouve les personnes qui travaillent dans ces entreprises et renvoie les informations de leur profil ainsi que leur adresse email vérifiée. C’est la solution idéale pour créer des listes de contacts B2B ciblées. -
Trouver des emails à partir d’URL de profils LinkedIn
Si votre scraping renvoie des liens vers des profils LinkedIn, utilisez le Waterfall Email Finder de Datablist. Il trouve l’adresse email professionnelle à partir de la seule URL du profil LinkedIn. Suivez notre guide pas à pas : trouver une adresse email à partir de l’URL d’un profil LinkedIn.
Trouver les pages LinkedIn d’entreprises à partir des domaines
Si vous partez de sites d’entreprises, vous pouvez les convertir en données LinkedIn en un clic. Utilisez l’enrichissement LinkedIn Company Page Matcher. Il trouve la page LinkedIn officielle de chaque entreprise de votre liste.
Le potentiel est considérable : un simple résultat Google devient un profil d’entreprise complet, avec des données sur son secteur, sa taille et son activité.
Une fois les correspondances trouvées, vous pouvez récupérer des informations détaillées avec :
Vous passez rapidement d’URL brutes à des données B2B structurées.
Utiliser un AI Agent pour visiter les sites
Un site web ne livre pas toujours ses informations les plus utiles au premier regard. C’est là que l’AI Agent intervient.
L’AI Agent visite chaque site à votre place et en lit les pages comme le ferait une personne.
Il peut :
- Catégoriser les entreprises selon le contenu de leur site
- Classer les leads comme "High Priority" ou "Low Priority"
- Extraire les coordonnées depuis les pages Contact ou À propos
Au lieu d’ouvrir 500 onglets et de lire chaque site, confiez ce travail à l’agent.
Exemple : transformer des requêtes locales en liste exploitable
Imaginons que vous recherchiez des cabinets dentaires en France. Commencez par trois requêtes : dentiste Paris, dentiste Lyon et dentiste Marseille. Lancez un petit échantillon, puis examinez Result Link, Result Title et Search Query. Excluez les annuaires si vous recherchez les sites des cabinets, puis comparez les URL exactes avant de déterminer si plusieurs pages d’un même domaine correspondent à la même entreprise.
N’ajoutez d’autres villes qu’après avoir confirmé la pertinence des sites obtenus avec le premier batch. Cet exemple illustre la méthode, mais ne permet pas de prévoir le nombre de résultats ou de cabinets uniques que vous trouverez.
Coût du scraping Google avec un petit budget
Comparez le coût du run à la valeur des pages dont vous avez réellement besoin. Les résultats de recherche sont des URL candidates, pas des leads qualifiés. Un batch trop large peut renvoyer des annuaires ou plusieurs fois les mêmes domaines.
Si une API vous fournit du JSON alors que vous avez besoin d’un tableur, le JSON to CSV Converter peut aplatir la réponse avant son nettoyage ou son enrichissement.
Le catalogue des sources indique un tarif de 2,5 crédits pour 10 résultats Google. À titre indicatif, 1 000 résultats à ce tarif correspondent à 250 crédits. L’estimation réelle du run dépend des requêtes et de la limite sélectionnées. Une recharge actuelle de 20 $ fournit 20 000 crédits. Il n’est pas possible d’acheter une recharge de 1 $, et ni une longue liste de requêtes ni une limite élevée ne garantissent d’obtenir autant de leads pertinents.
Commencez par un petit batch. Vérifiez les URL obtenues, les doublons et les crédits consommés avant d’ajouter d’autres requêtes.
Astuces : utiliser les opérateurs de recherche Google
Pour améliorer la qualité de vos données scrapées, utilisez les opérateurs de recherche Google suivants dans vos requêtes.
Ces opérateurs indiquent précisément à Google où rechercher vos mots-clés.
- site: Limitez les résultats à une plateforme précise. Pour trouver des profils LinkedIn, utilisez
site:linkedin.com/in/. - inurl: Recherchez des mots dans l’URL. Pour trouver des pages de contact, utilisez
inurl:contact. - intitle: Recherchez des mots dans le titre de la page.
intitle:"Index of"permet souvent de trouver des répertoires ouverts. - filetype: Recherchez des documents selon leur format.
filetype:pdf "plan marketing"permet de trouver des documents stratégiques publics. - - (signe moins) : Excluez des mots. Si vous cherchez des avocats, mais pas des cabinets de recrutement, utilisez
avocat -recrutement.
Associés au scraping multi-requêtes, ces opérateurs offrent un ciblage chirurgical. Par exemple :
site:instagram.com "concept store" -inurl:/p/
Cette recherche peut faire ressortir des pages Instagram qui mentionnent des concept stores, tout en excluant les URL de publications contenant le chemin /p/. Vérifiez chaque résultat : une page correspondante n’est pas nécessairement un influenceur, un concurrent ou un lead qualifié.
📘 Consultez notre guide Rechercher et scraper des profils Instagram par catégorie et mots-clés pour approfondir la recherche de profils Instagram avec Google
FAQ
Pourquoi une requête Google générale manque-t-elle des résultats ?
Les résultats de recherche sont classés et paginés, et le nombre estimé ne garantit pas l’accès à toutes les pages correspondantes. Des recherches plus précises peuvent révéler d’autres pages, mais elles peuvent aussi se recouper et manquer certains sites pertinents.
Le scraping de Google est-il légal ?
Avant de collecter ou d’utiliser des résultats de recherche, vérifiez les conditions d’utilisation des sites concernés ainsi que les règles de confidentialité applicables à votre cas d’usage, surtout si les résultats contiennent des données personnelles.
Puis-je scraper Google Maps avec cet outil ?
La source "Start with Google Search Queries" cible le moteur de recherche classique. Si vous avez besoin de données sur des établissements locaux, notamment les notes, les horaires d’ouverture et les coordonnées géographiques précises, utilisez le scraper Google Maps dédié. Les résultats Search sont plus adaptés aux sites web et aux profils numériques, tandis que les résultats Maps conviennent davantage aux lieux physiques.
Comment gérer les CAPTCHA ?
Datablist exécute la source Google Search Queries sans vous demander de configurer un scraper de navigateur. Une requête peut néanmoins échouer ou renvoyer moins de résultats que prévu. Vérifiez le statut du run et les données obtenues avant de considérer la collection comme complète.
Puis-je utiliser ces résultats dans mon CRM ?
Oui. Vérifiez et dédupliquez les URL, conservez la requête source, puis exportez les champs sélectionnés au format CSV ou Excel pour les importer dans votre CRM. Avant l’import, contrôlez les champs obligatoires du CRM et faites-les correspondre à vos données.