
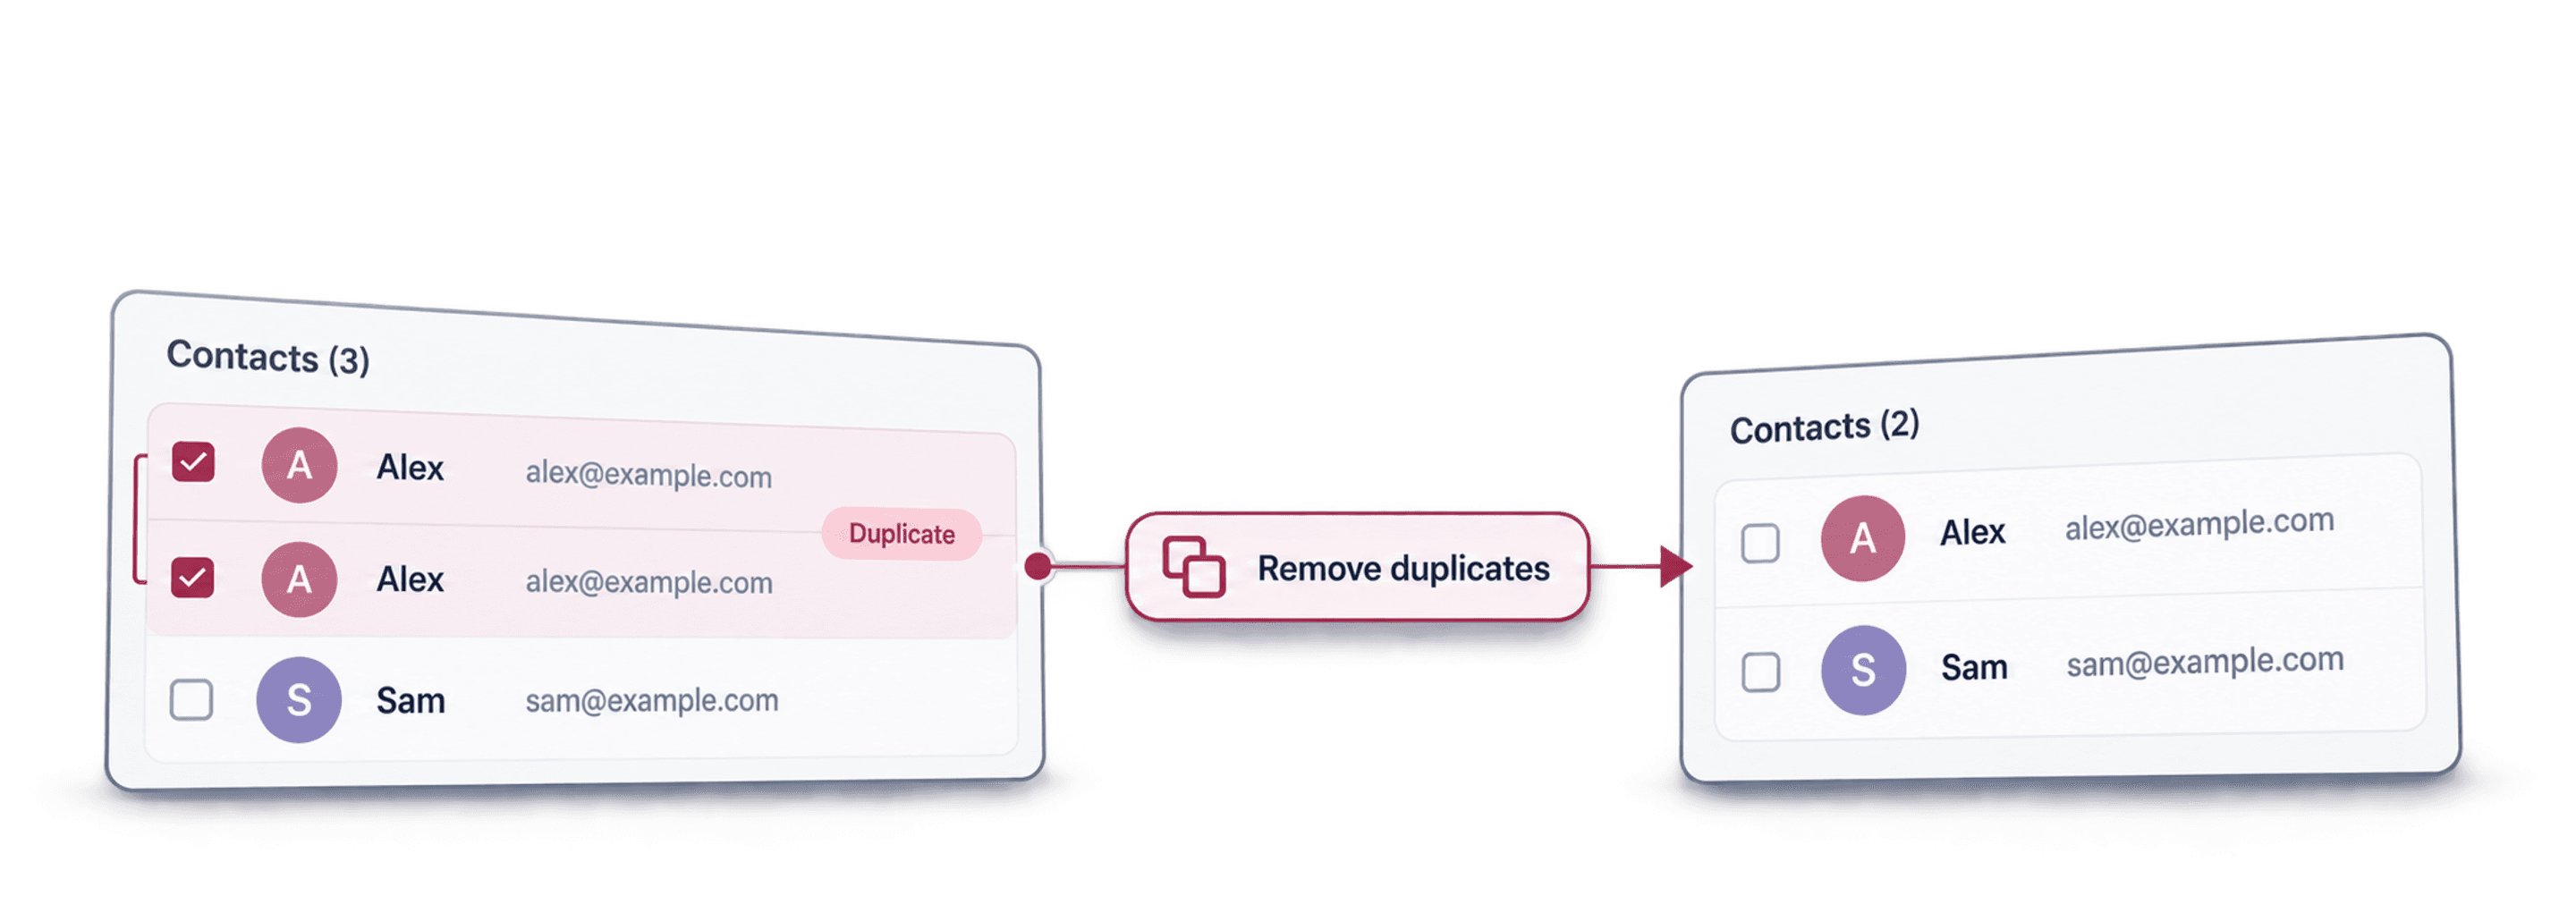
Per eliminare i duplicati da una lista online, inizia scegliendo il campo che identifica una persona, un’azienda o un prodotto. Esegui un primo controllo rigoroso, verifica i gruppi di duplicati proposti, quindi unisci i valori utili o rimuovi le righe che non aggiungono informazioni. In questo modo, la pulizia resta veloce senza considerare automaticamente ogni valore simile come una corrispondenza sicura.
Datablist consente di fare tutto in un unico workflow nel browser. Importa un file CSV o Excel, scegli le proprietà da confrontare, esamina le righe, verifica i risultati ed esporta la lista pulita. Il controllo dei duplicati è in sola lettura finché non avvii un’azione Remove, Merge o un’elaborazione personalizzata.
Questa guida utilizza un file di esempio scaricabile con 1.000 righe, contenente copie esatte, alias email, varianti dei nomi aziendali, differenze negli URL e nella formattazione dei numeri di telefono, errori di ortografia, valori in conflitto e record complementari.
🔑 La regola per deduplicare in sicurezza
Cerca le corrispondenze usando l’identificativo affidabile più semplice, ma valuta l’intera riga per decidere quali dati conservare.
Eliminare i duplicati da una semplice lista di valori
Se la lista contiene un valore per riga, salvala come CSV a una colonna con un’intestazione come Email, Domain o Value. Importala in Datablist ed esegui Clean > Remove duplicates sulla colonna, scegliendo Exact. Controlla i gruppi, seleziona il record da conservare, elabora le righe duplicate ed esporta i valori rimanenti.
Per esempio, una lista dimostrativa contenente alpha.example, beta.example e alpha.example dovrebbe conservare un solo valore alpha e un solo valore beta dopo la rimozione della riga ripetuta. Si tratta di un esempio di input e output, non di un’ulteriore misurazione ricavata dal file scaricabile.
Questo è il metodo che userei per una lista di identificativi. Se il file contiene più colonne, invece, devi risolvere record duplicati: eliminando una riga, eliminerai anche tutti gli altri valori presenti al suo interno. Se un’email ripetuta è associata a un numero di telefono o a una nota utile in una seconda riga, usa il workflow di merge descritto più avanti.
Tieni separati gli identificativi vuoti. Nel confronto predefinito delle proprietà selezionate, un identificativo testuale mancante non determina una corrispondenza. Se devi eliminare le righe vuote, gestisci questa pulizia in modo esplicito anziché aspettarti che la deduplicazione stabilisca cosa rappresentano.
Scegliere cosa rende unico un record
Non partire dall’algoritmo di matching. Prima definisci l’entità.
Contatti, aziende, prodotti e transazioni richiedono identificativi diversi:
| Lista | Identificativi iniziali affidabili | Secondo controllo utile |
|---|---|---|
| Contatti | Email, telefono, URL LinkedIn | Nome completo più azienda |
| Aziende | Dominio del sito, ID azienda | Nome aziendale normalizzato |
| Prodotti | SKU, EAN, GTIN, URL del prodotto | Nome del prodotto più brand |
| Lead nel CRM | Email, telefono, ID CRM | Nome più dominio aziendale |
| Ordini | ID ordine | ID cliente più data dell’ordine |
Un solo controllo raramente intercetta tutti i duplicati. Un contatto può avere la stessa email in due righe, mentre un altro può aver cambiato indirizzo email mantenendo lo stesso numero di telefono. Esegui controlli separati per ciascun identificativo, invece di creare un’unica regola che includa tutte le proprietà.
Per esempio:
- Confronta i contatti in base all’email.
- Elabora i gruppi verificati.
- Normalizza i numeri di telefono, quindi esegui un controllo Exact sulla proprietà pulita.
- Esegui con cautela un controllo fuzzy su nome completo e azienda.
Scegli la regola per i valori vuoti prima di aggiungere più campi allo stesso controllo. Con Value required, un identificativo mancante può escludere un candidato utile.
Con Match on empty value, le proprietà vuote in entrambi i record ottengono un punteggio del 100% e possono alzare la media: una corrispondenza email più un cognome mancante produce un punteggio dell’87,5%; aggiungendo tre proprietà vuote in entrambi i record, il punteggio sale al 95%. Consulta l’esempio di calcolo con valori vuoti prima di concludere che un maggior numero di colonne fornisca prove più solide.
Quando un identificativo richiede una normalizzazione specifica, consulta le guide dedicate:
- Eliminare email duplicate e alias
- Trovare nomi aziendali duplicati
- Deduplicare un campo contenente più valori
- Normalizzare numeri di telefono locali e internazionali
Scaricare la lista di esempio con 1.000 righe
Scarica il CSV dimostrativo per la deduplicazione. Contiene 1.000 righe che rappresentano 800 entità create per il test.
Il file combina diversi casi di prova:
| Caso progettato | Gruppi di duplicati | Controllo di matching |
|---|---|---|
| Copie esatte dell’intera riga | 5 | All Properties con Exact |
| Alias e wrapper email | 100 | Email con Smart e il processor Email |
| Varianti di azienda e URL | 50 | Elaborazione Company Name o URL |
| Differenze di base nella formattazione dei numeri USA | 25 | Phone con Smart, solo formattazione |
| Refusi controllati nei nomi | 15 | Jaro-Winkler o Levenshtein |
| Varianti fonetiche del nome | 5 | Metaphone |
| Record senza duplicati progettati | 600 | Dovrebbero rimanere separati |
Questi sono conteggi di riferimento definiti durante la creazione del test, non la garanzia che ogni soglia fuzzy produca lo stesso risultato. Con una soglia bassa, il matching basato sulla distanza può includere candidati aggiuntivi. Controlla sempre i gruppi prima di elaborarli.
Ecco tre coppie presenti nel file:
| Caso d’uso | Primo valore memorizzato | Secondo valore memorizzato |
|---|---|---|
| Alias email | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Azienda e URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Formattazione di base del telefono | +1 (202) 555-0768 | 1 202 555 0768 |
Le righe presentano differenze anche in campi come qualifica professionale, owner, stato, fatturato, fonte, tag e note. Questi conflitti rendono il file utile per testare le regole di selezione del record principale e di conservazione dei singoli campi.
Importare la lista in Datablist
Apri Datablist e importa il file CSV o Excel in una collection. Una collection funziona come un foglio di calcolo strutturato: le righe sono gli elementi e le colonne sono le proprietà.
Durante l’importazione, controlla i tipi di proprietà rilevati:
- Le colonne con indirizzi email devono usare il tipo Email.
- Le colonne con siti web devono usare URL.
- Le colonne con numeri di telefono devono usare Phone.
- Le colonne con fatturato o quantità devono usare Number.
- Le date di attività e creazione devono usare DateTime.
Mantieni nella collection le colonne ID, fonte, owner, note e stato. Ti aiuteranno a selezionare il record corretto e a verificare quali dati verranno conservati dal merge.
Eseguire controlli Exact, Smart e fuzzy
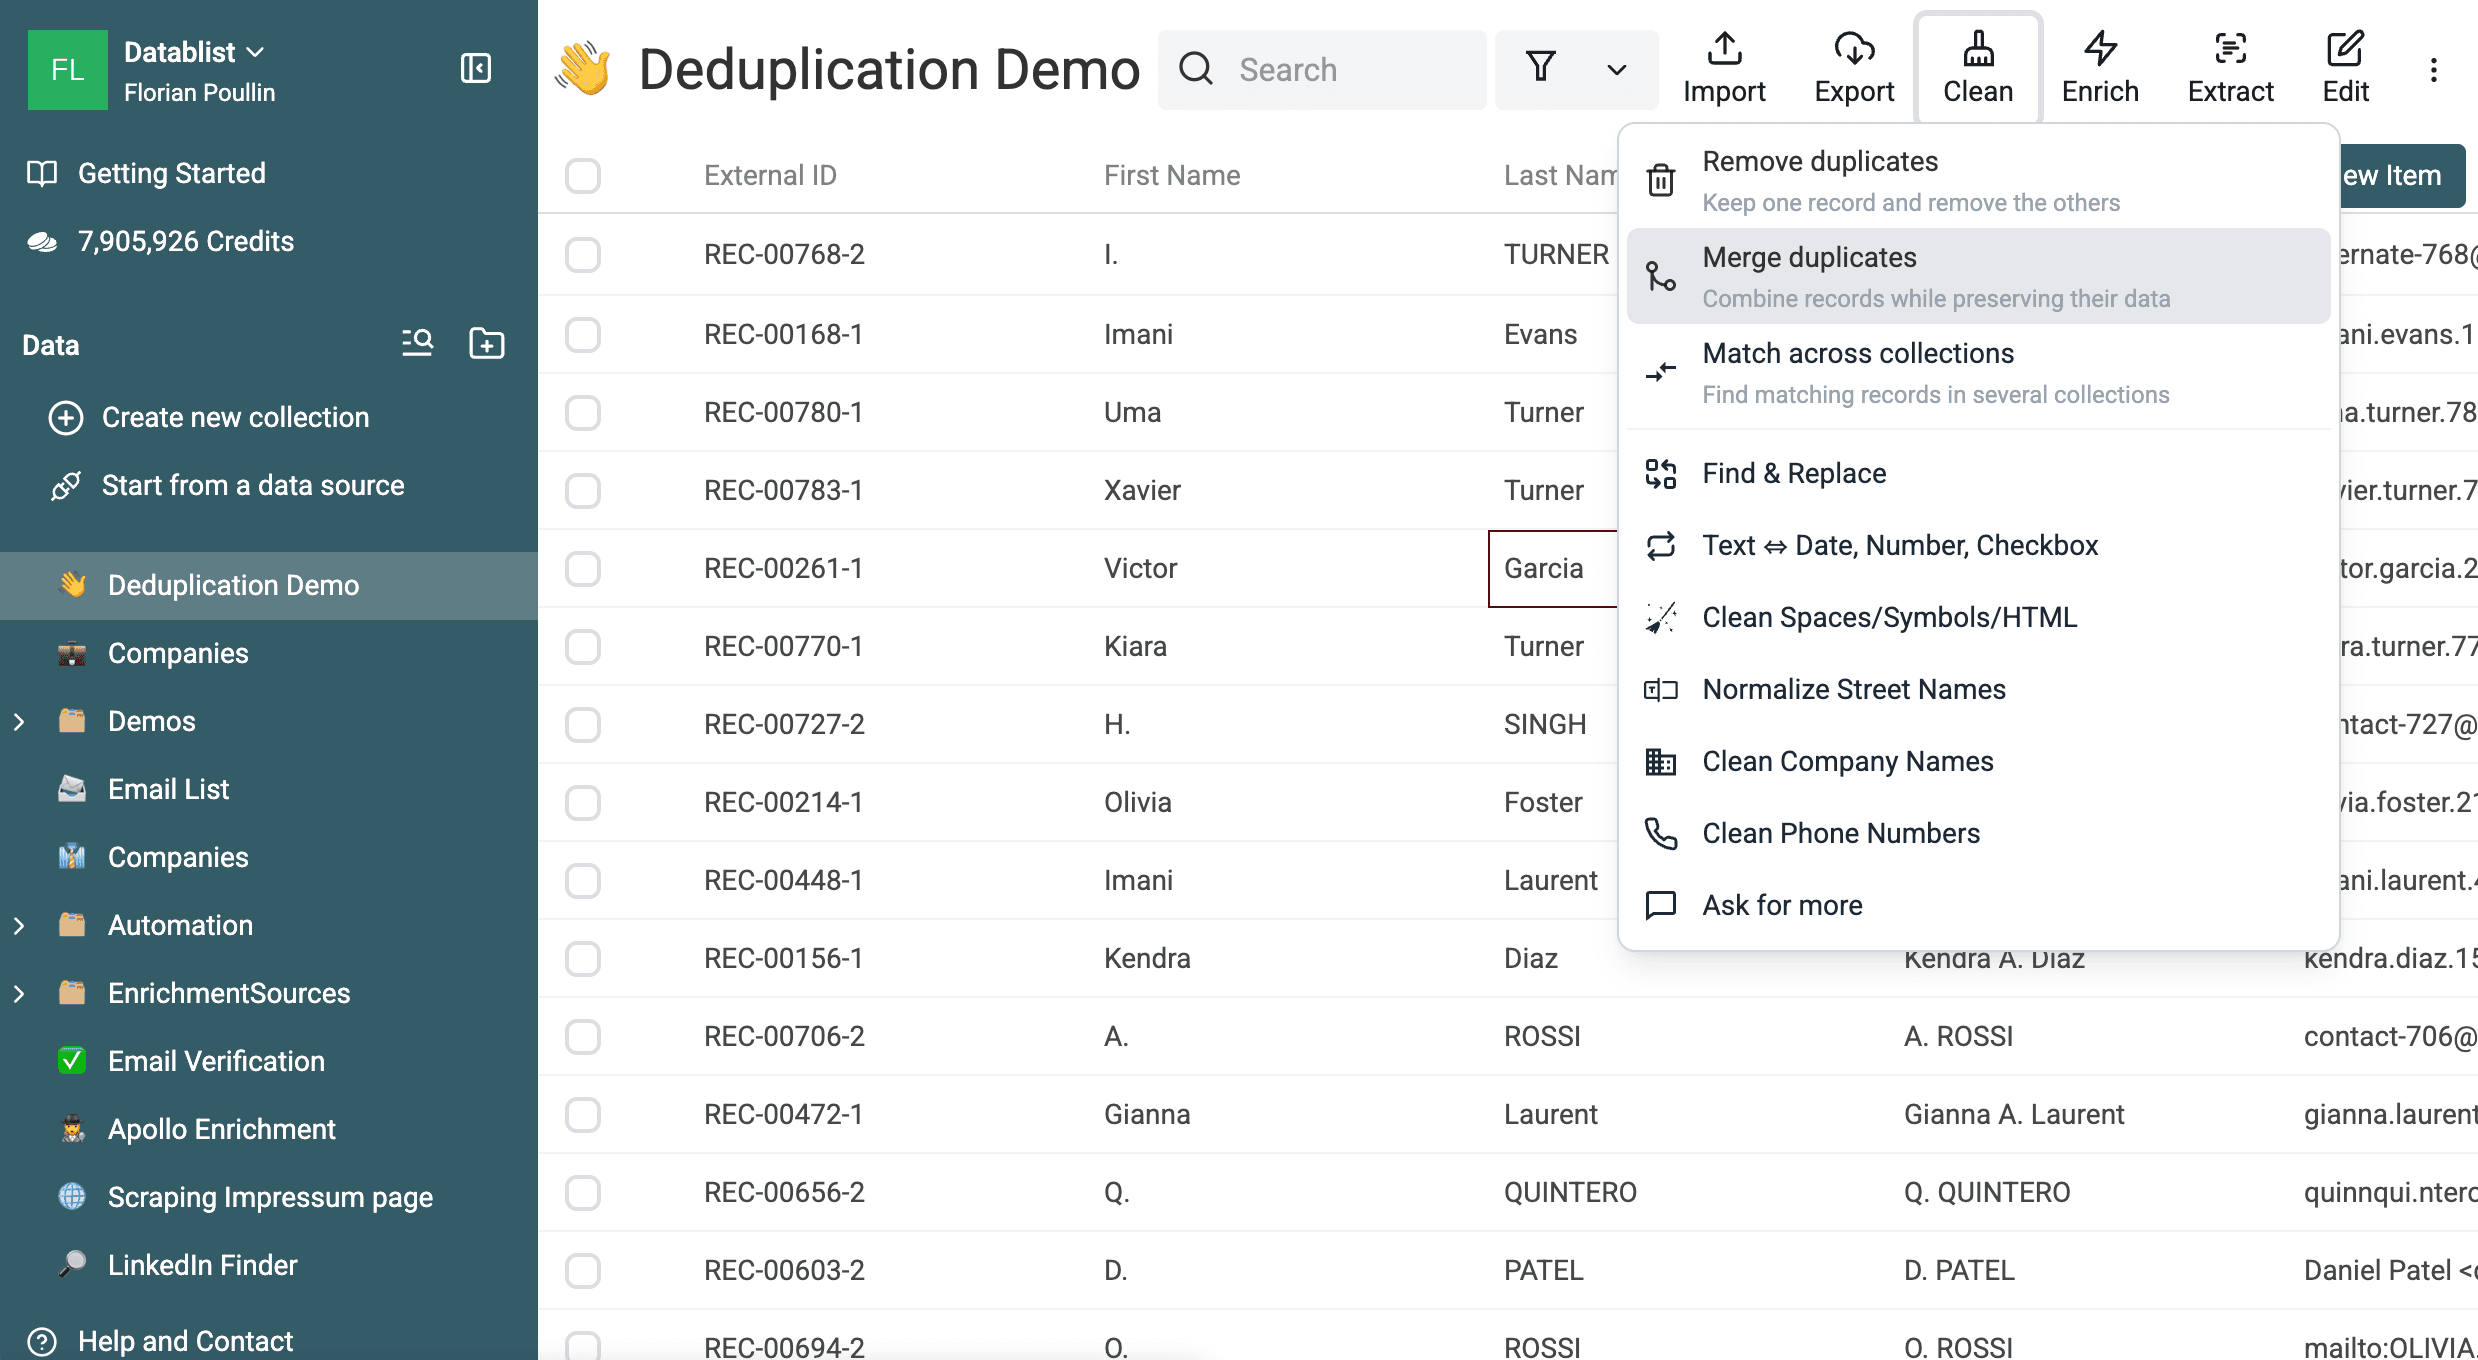
Apri Clean e scegli l’azione più adatta al tuo obiettivo:
- Remove duplicates se le righe secondarie possono essere eliminate.
- Merge duplicates se le righe contengono informazioni da conservare.
- Match across collections se i record si trovano in collection diverse.
Le prime due azioni utilizzano lo stesso motore di rilevamento. La differenza è la modalità di elaborazione già selezionata all’apertura dell’area dei risultati.
Iniziare con il matching Exact
Usa All Properties con Exact per individuare le righe copiate due volte senza modifiche. Scegli Selected Properties quando un campo specifico, come un ID esterno, deve essere identico.
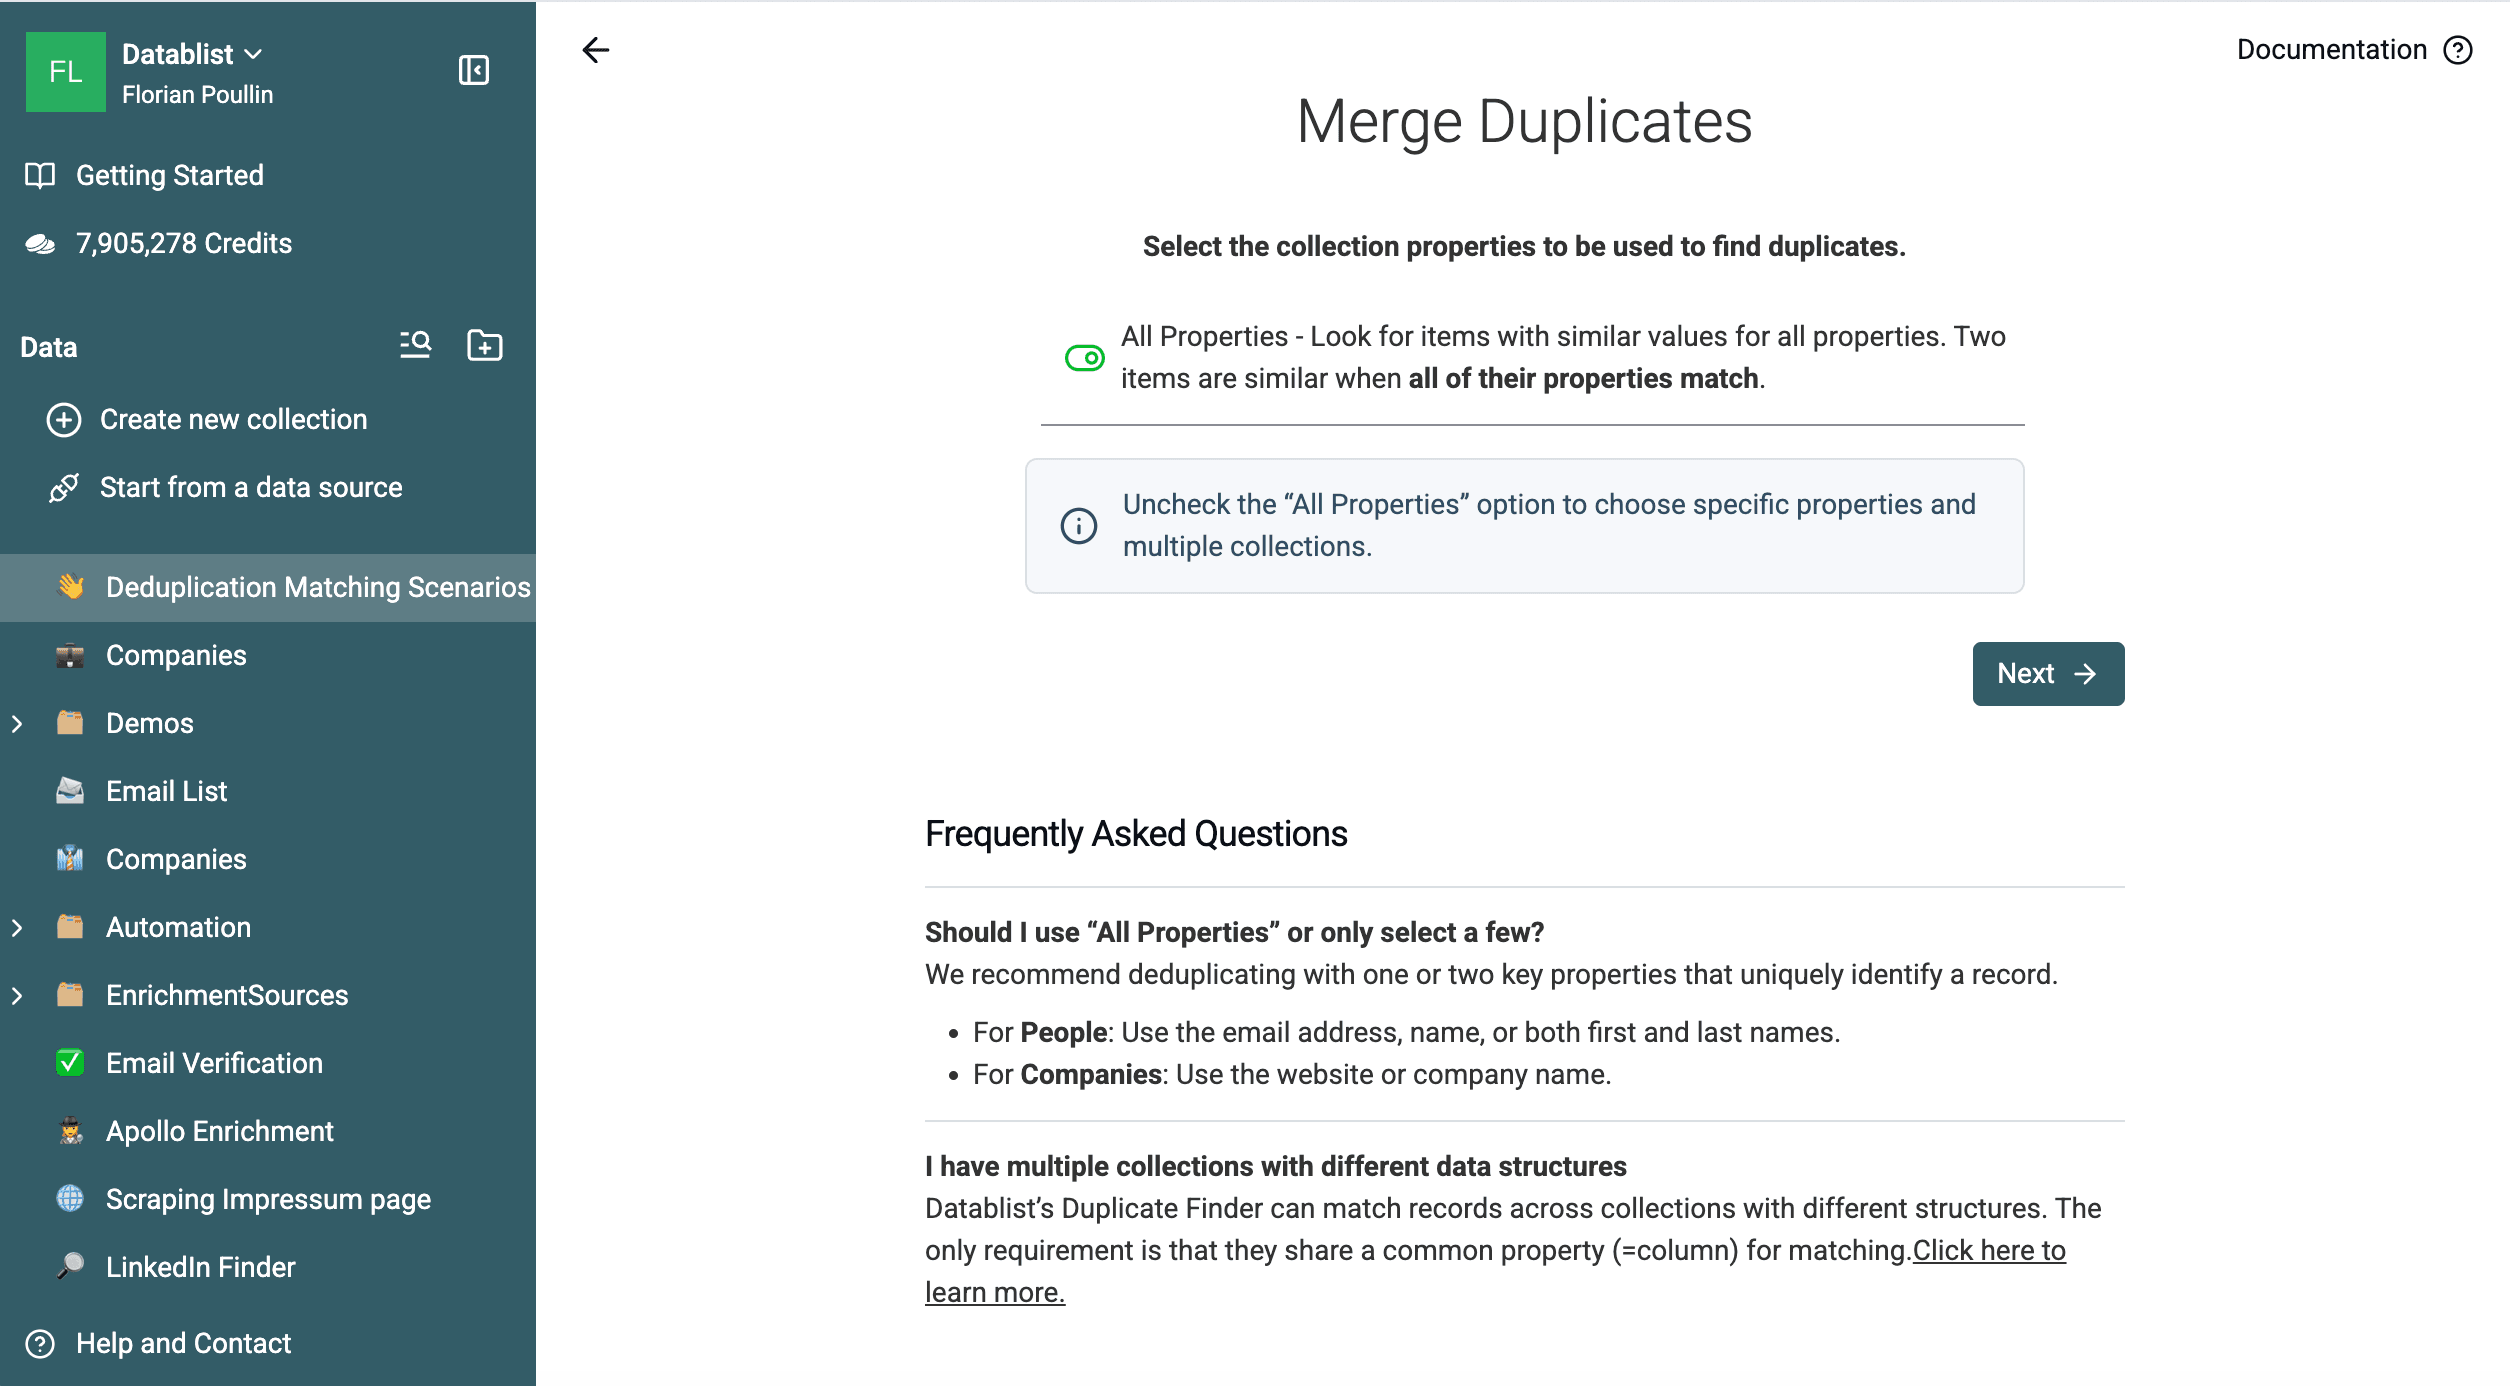
Sul file di esempio con 1.000 righe, questo controllo restituisce cinque gruppi di duplicati. Ogni gruppo contiene due righe con gli stessi valori in tutte le proprietà.
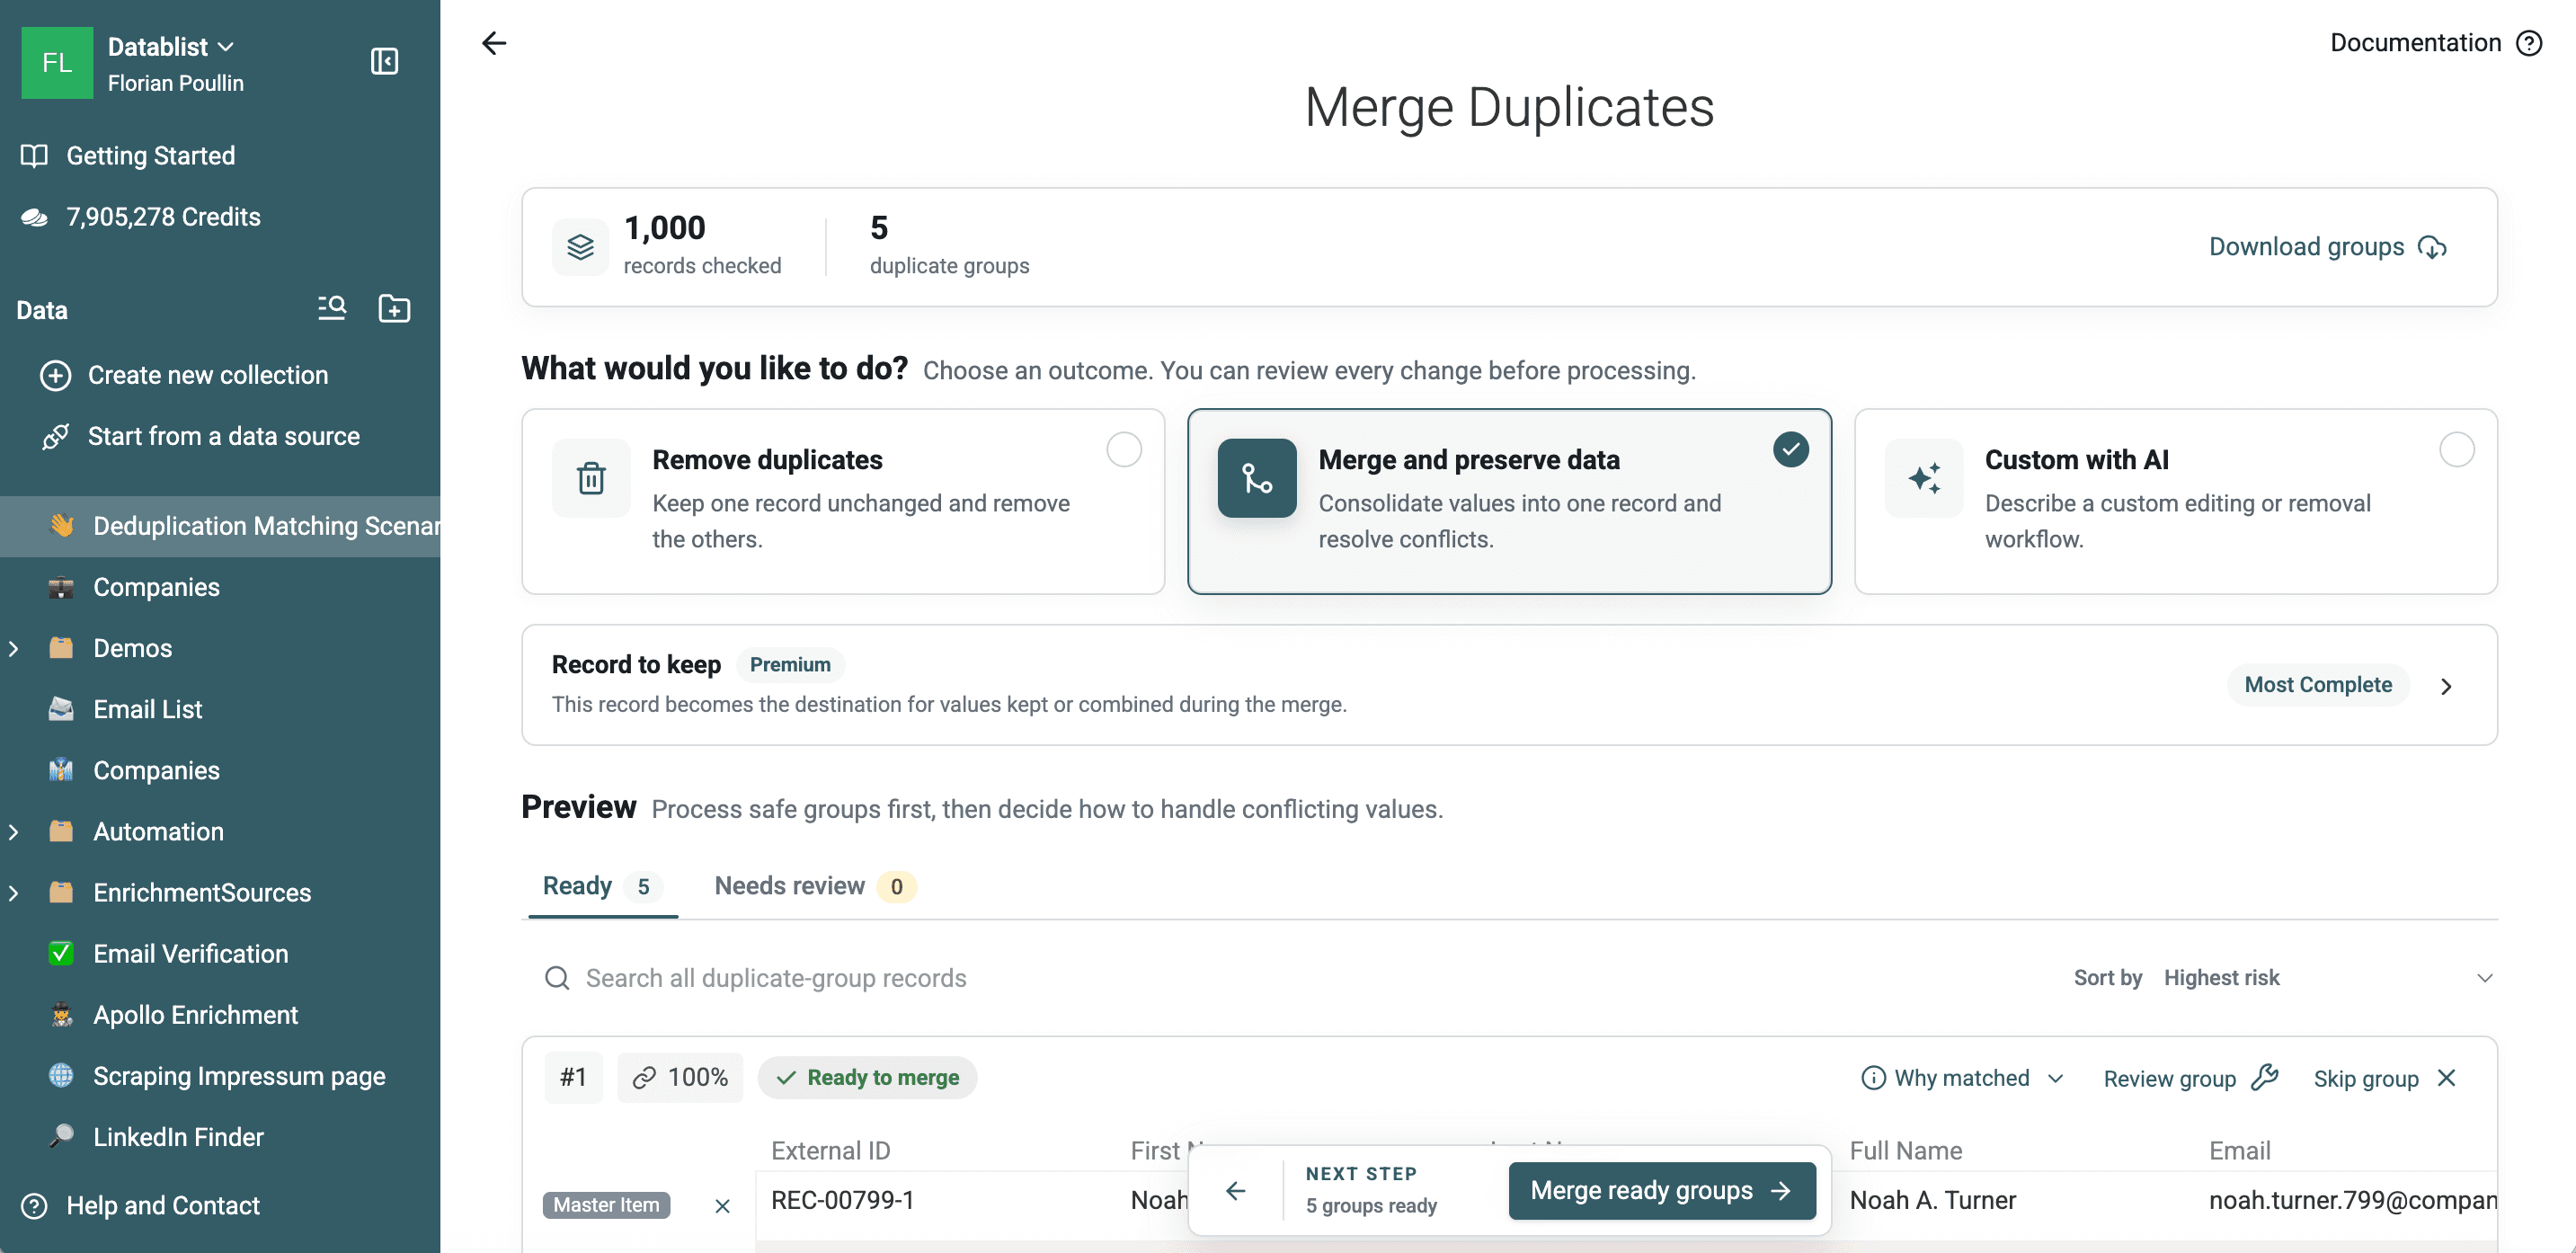
Exact è il controllo iniziale più sicuro perché ogni corrispondenza individuata soddisfa un confronto rigoroso. Non troverà Acme Inc. e Acme, un numero di telefono formattato diversamente o un alias email quando i valori memorizzati non coincidono.
Anche chi non ha effettuato l’accesso può eseguire un controllo Exact. Creando un account gratuito si sbloccano il confronto Smart e le altre funzionalità del piano Free.
Usare il matching Smart per i dati aziendali
Il matching Smart standardizza i valori ai fini del confronto senza modificare le celle memorizzate. Seleziona il processor adatto alla proprietà:
- Email gestisce maiuscole e minuscole, spazi iniziali e finali, alias con il segno più, punti negli indirizzi Gmail,
googlemail.com, wrapper con il nome visualizzato e valorimailto:. - URL può ignorare i protocolli e la barra finale, con controlli opzionali per sottodomini, percorsi e parametri di query.
- Phone ignora i caratteri di formattazione. Non convalida i numeri, non usa una proprietà Country e non deduce il prefisso internazionale mancante.
- Company Name rimuove i termini legali, commerciali e geografici più comuni.
- Text ignora accenti, spazi, punteggiatura, simboli, maiuscole e minuscole e ordine delle parole.
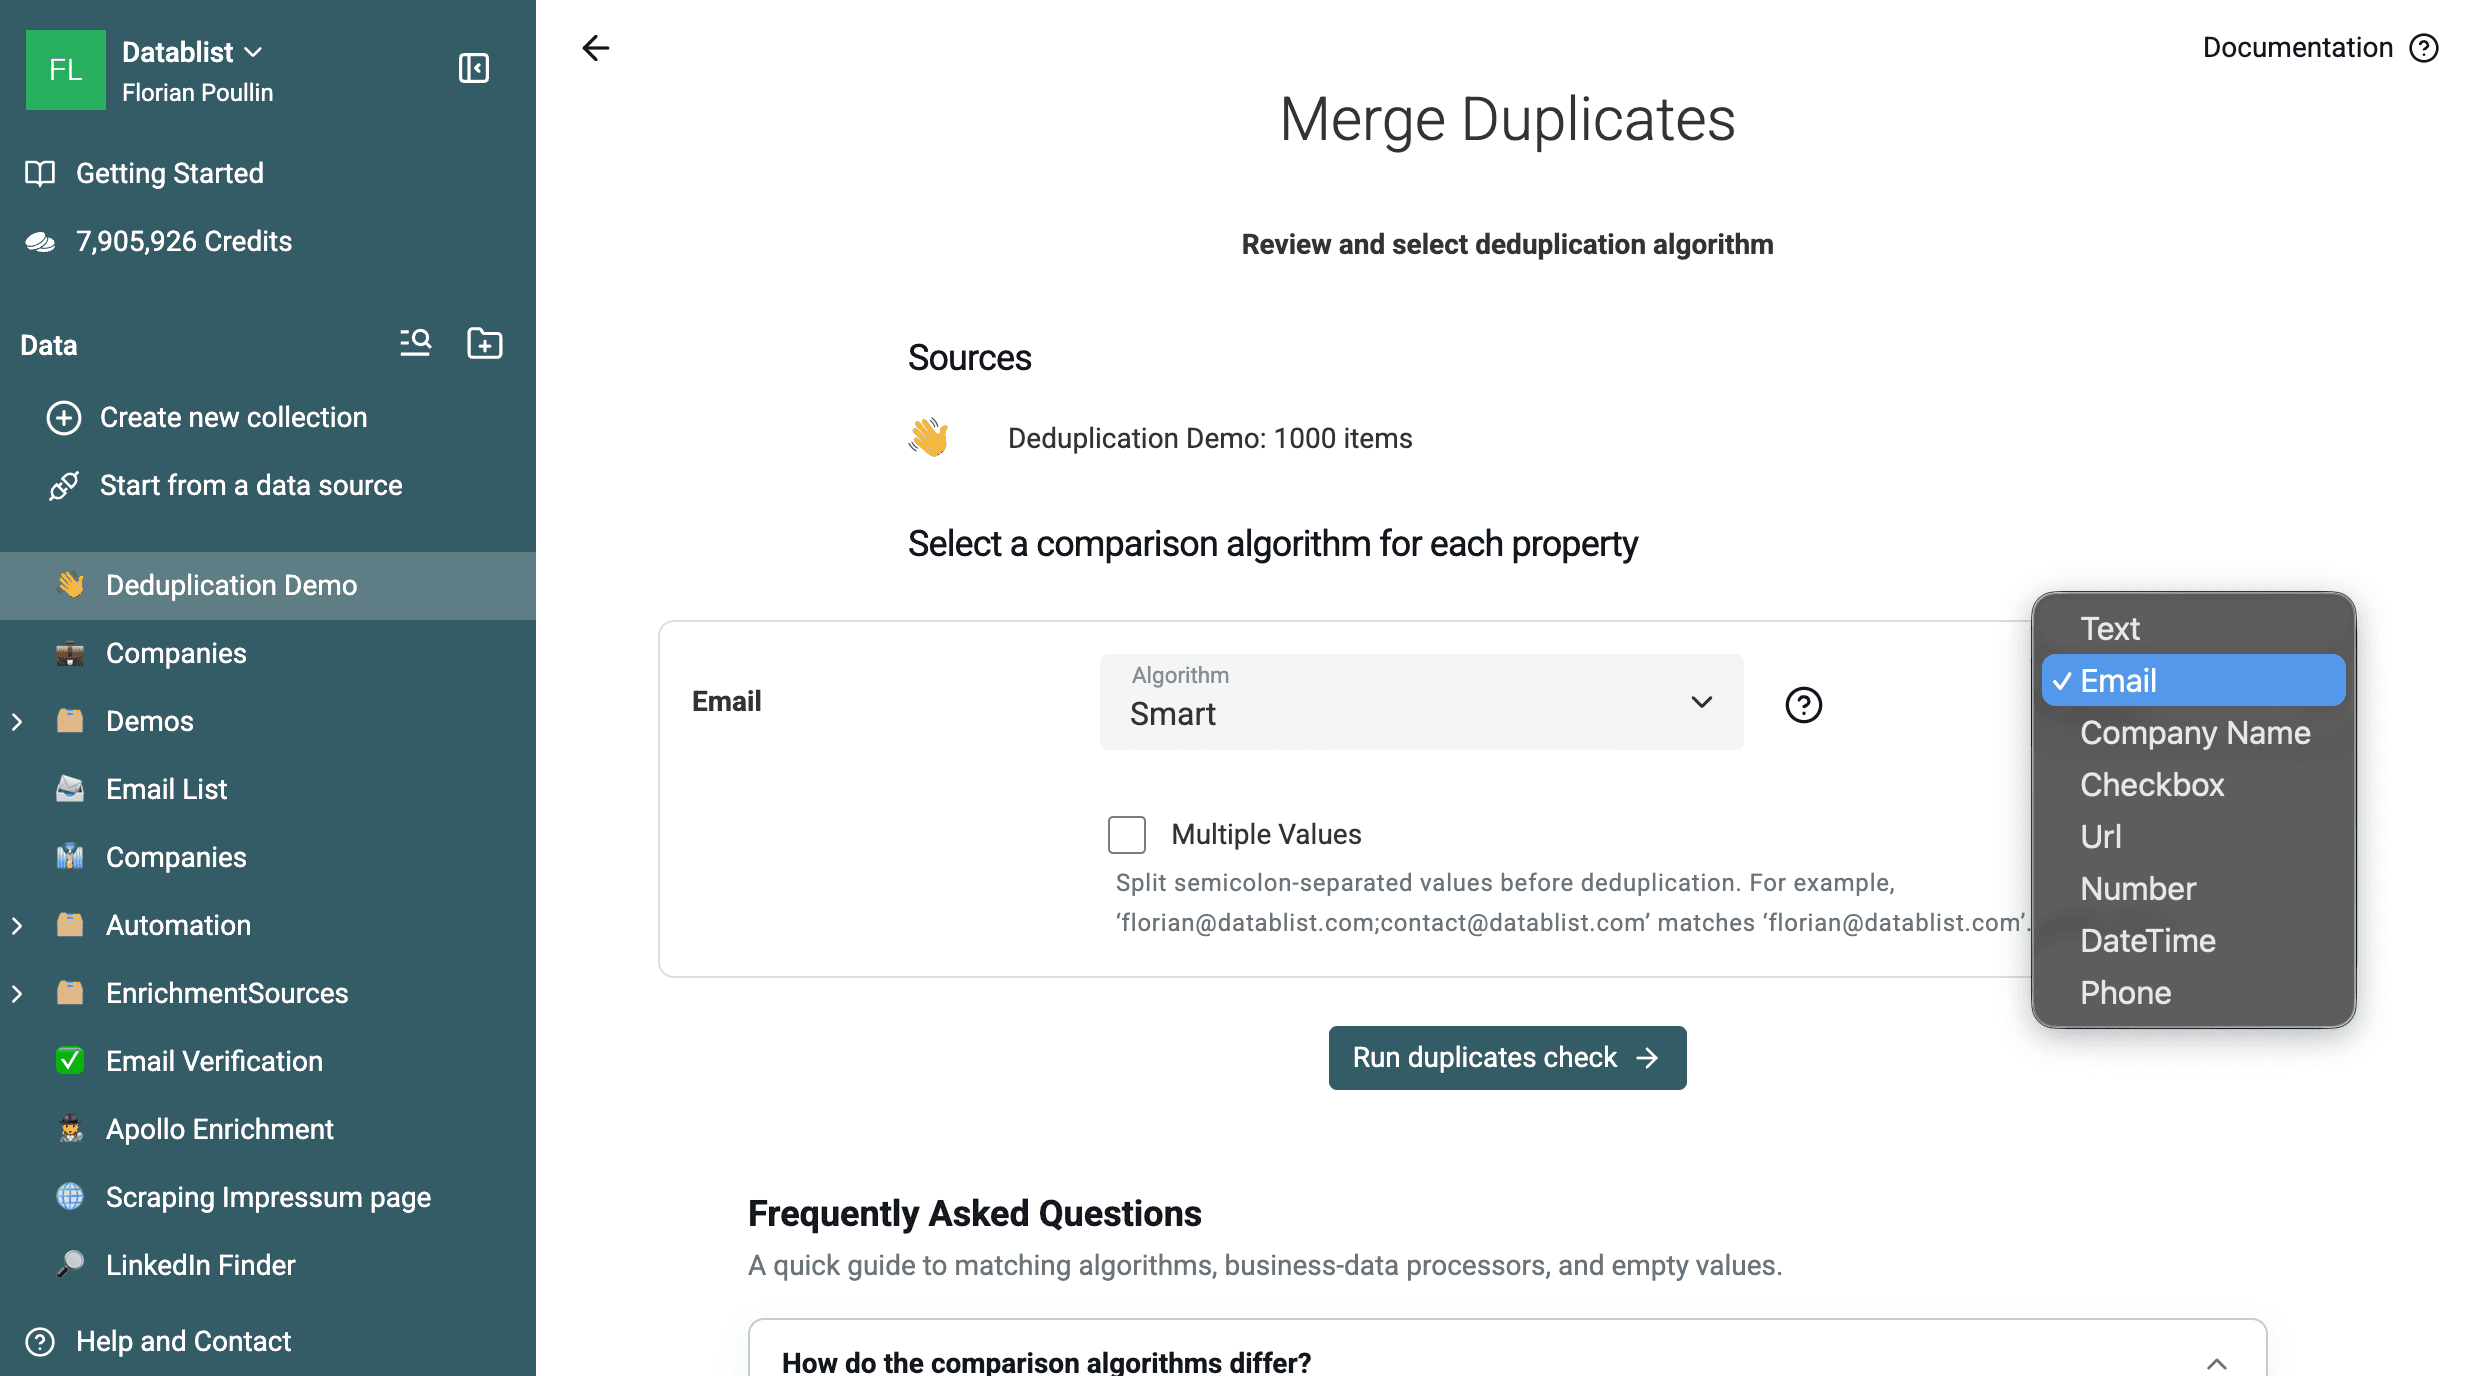
Il processor Company Name, il matching di valori multipli e gli algoritmi avanzati richiedono un piano a pagamento. Exact e Smart sono disponibili nel piano Free per il matching all’interno di una singola collection, anche se Smart richiede un account gratuito.
Quando una cella contiene più identificativi separati da punto e virgola, attiva Multiple Values. Datablist confronta ogni elemento e considera la proprietà corrispondente quando trova almeno una coppia uguale. Per esempio, una cella contenente primary@example.com;shared@example.com può corrispondere a una seconda cella contenente shared@example.com.
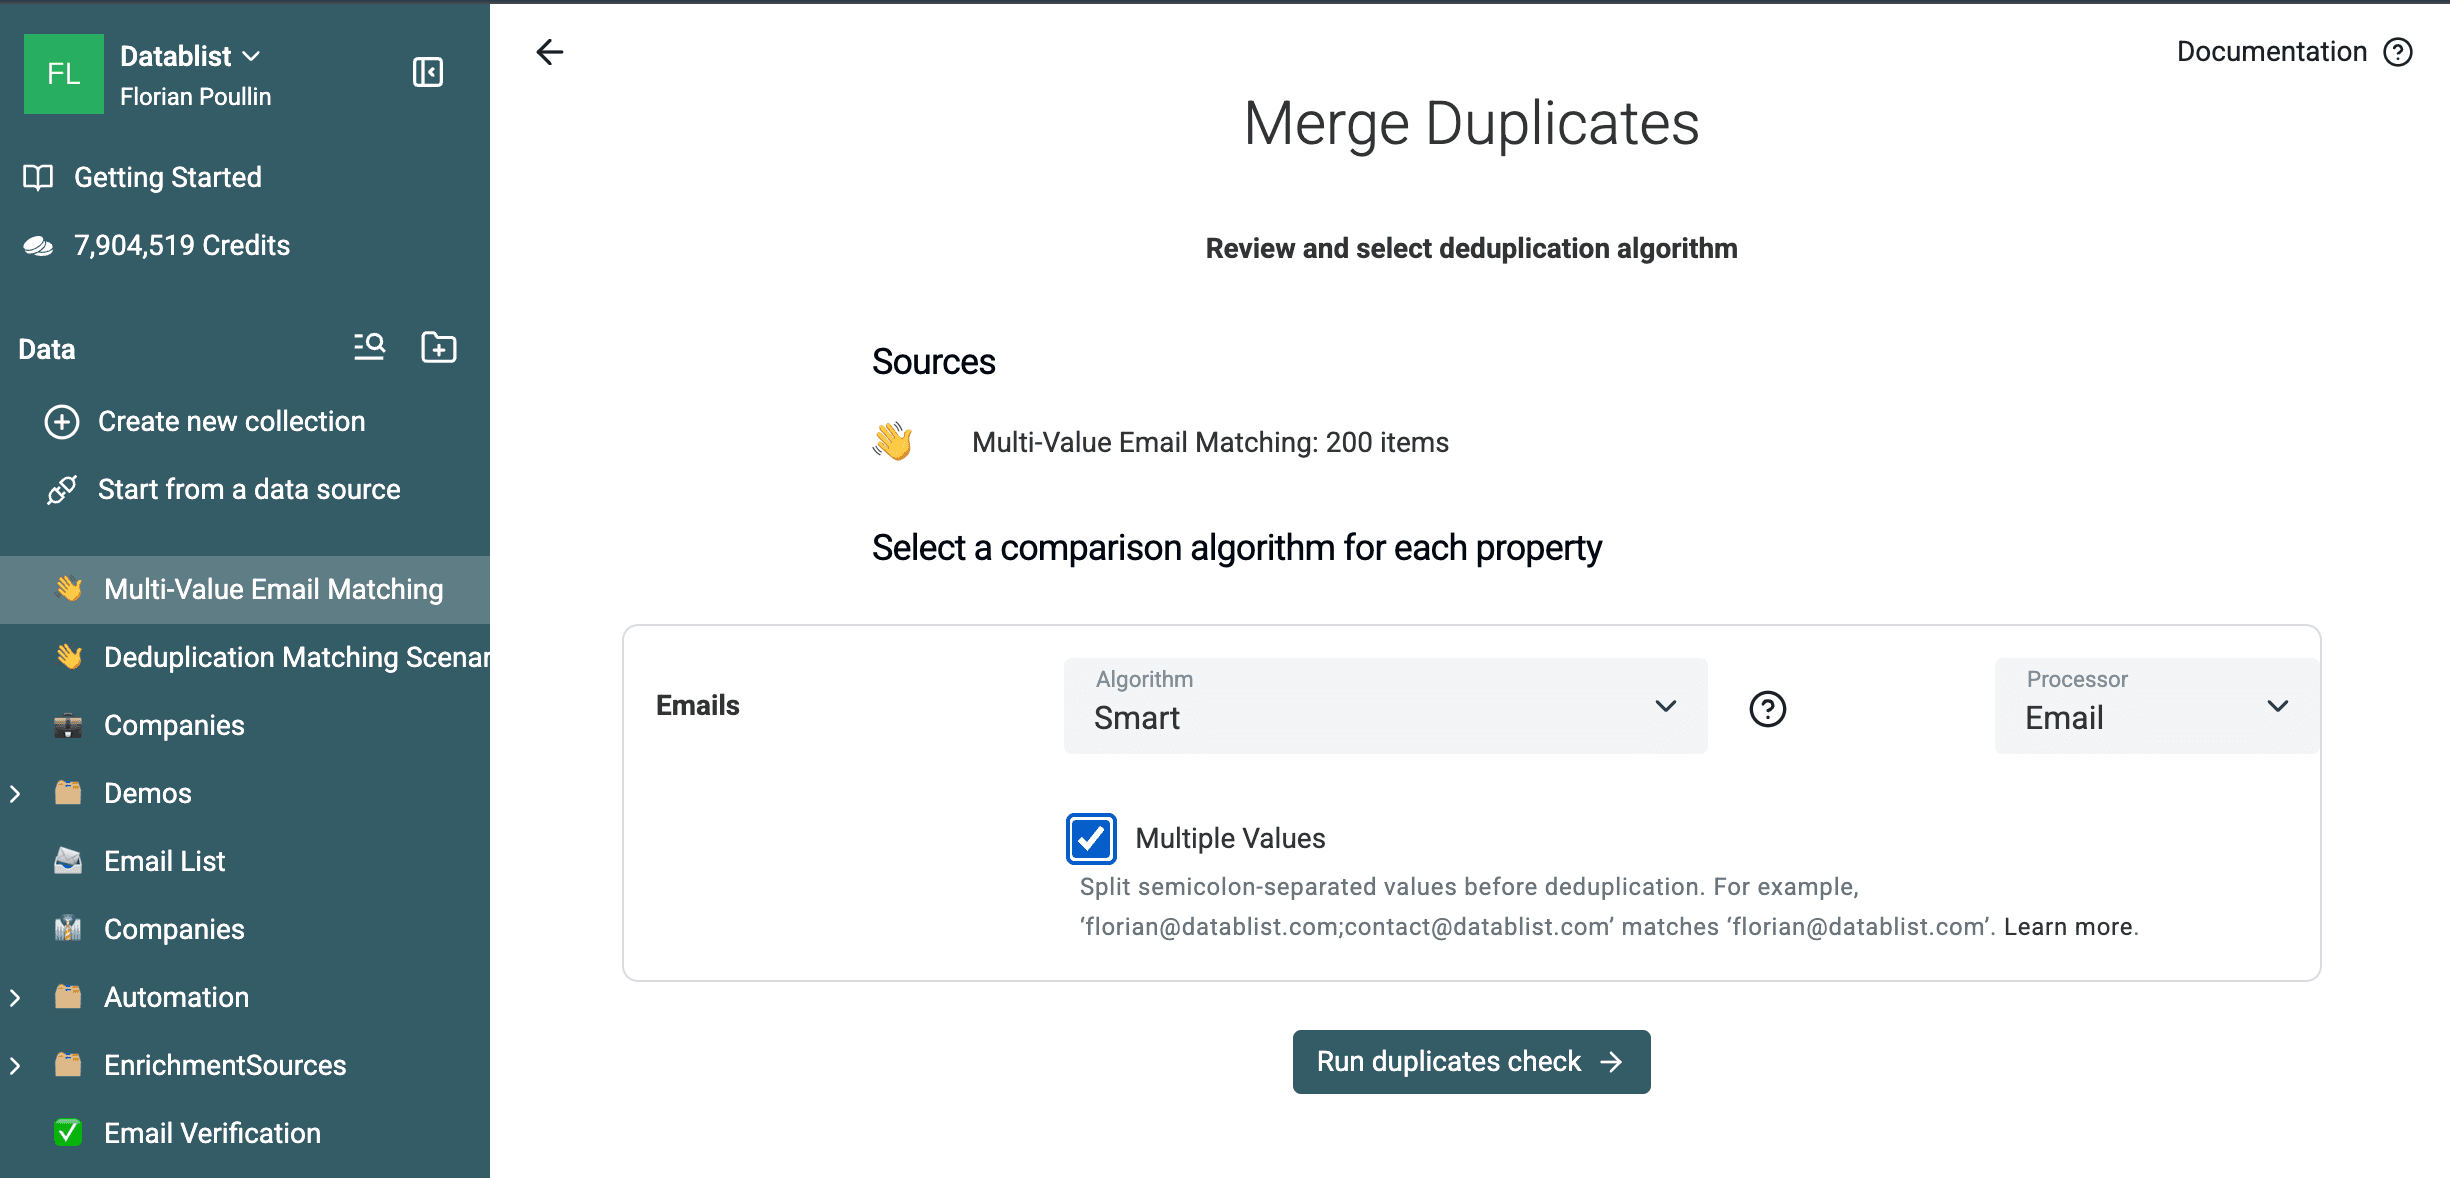
Sul file dedicato con 200 righe, questa configurazione ha restituito 60 gruppi da due righe. La verifica sui dati di riferimento ha individuato tutte le 60 coppie previste ed escluso tutti gli 80 record di controllo. Segui il workflow per deduplicare campi con più valori per scaricare il file di esempio e il CSV dei risultati e valutare le opzioni di merge.
Il controllo sulle email ha restituito 105 gruppi da due righe: 100 coppie create per testare la normalizzazione email e le cinque coppie di copie esatte, che condividono anche lo stesso indirizzo.
Normalizzare i numeri di telefono prima del matching
Il processor Smart Phone è utile in un caso specifico: valori composti dalle stesse cifre ma con spazi, parentesi, trattini o simboli diversi. Può associare (415) 555-0123 a 4155550123.
Non può però stabilire che un numero locale e uno internazionale siano uguali. Per esempio, 06 12 34 50 08 e +33 6 12 34 50 08 richiedono informazioni sul Paese prima di poter essere confrontati.
Usa Phone Number Cleaner prima di deduplicare in base al numero di telefono:
- Mappa la proprietà
Phoneoriginale. - Per una lista relativa a un solo Paese, selezionalo in Local Phone Countries. Per una lista internazionale, attiva Define country per item e mappa la proprietà
Country. - Scrivi il risultato dell’enrichment in
Clean Phone Numbersenza sovrascrivere il valore originale. - Controlla i risultati non riusciti o vuoti. Non devono partecipare al matching basato sul telefono.
- Esegui Duplicates Finder su
Clean Phone Numbercon Exact.
Scarica il file di esempio dedicato con 200 numeri di telefono. Contiene 50 coppie in formato locale e internazionale provenienti da Stati Uniti, Francia, Regno Unito, Germania e Spagna, oltre a 100 record di controllo senza corrispondenze. La verifica con la logica del cleaner in produzione ha restituito un numero normalizzato per tutte le 200 righe. Le 50 coppie previste convergono in 50 valori internazionali condivisi, mentre i record di controllo rimangono univoci.
Questo passaggio preliminare convalida anche il formato del numero. Mantieni le proprietà Phone e Country originali accanto al risultato pulito, così potrai esaminare ogni record prima del merge. Leggi cosa significa normalizzare un numero di telefono per comprendere il ruolo dei prefissi internazionali e dei numeri in formato internazionale.
Per i record aziendali, esegui un controllo separato su Website. Scegli Smart con il processor URL. Attiva Ignore Subdomain, Ignore Path e Ignore Query Params soltanto se questi componenti dell’URL non devono identificare aziende o sedi differenti.
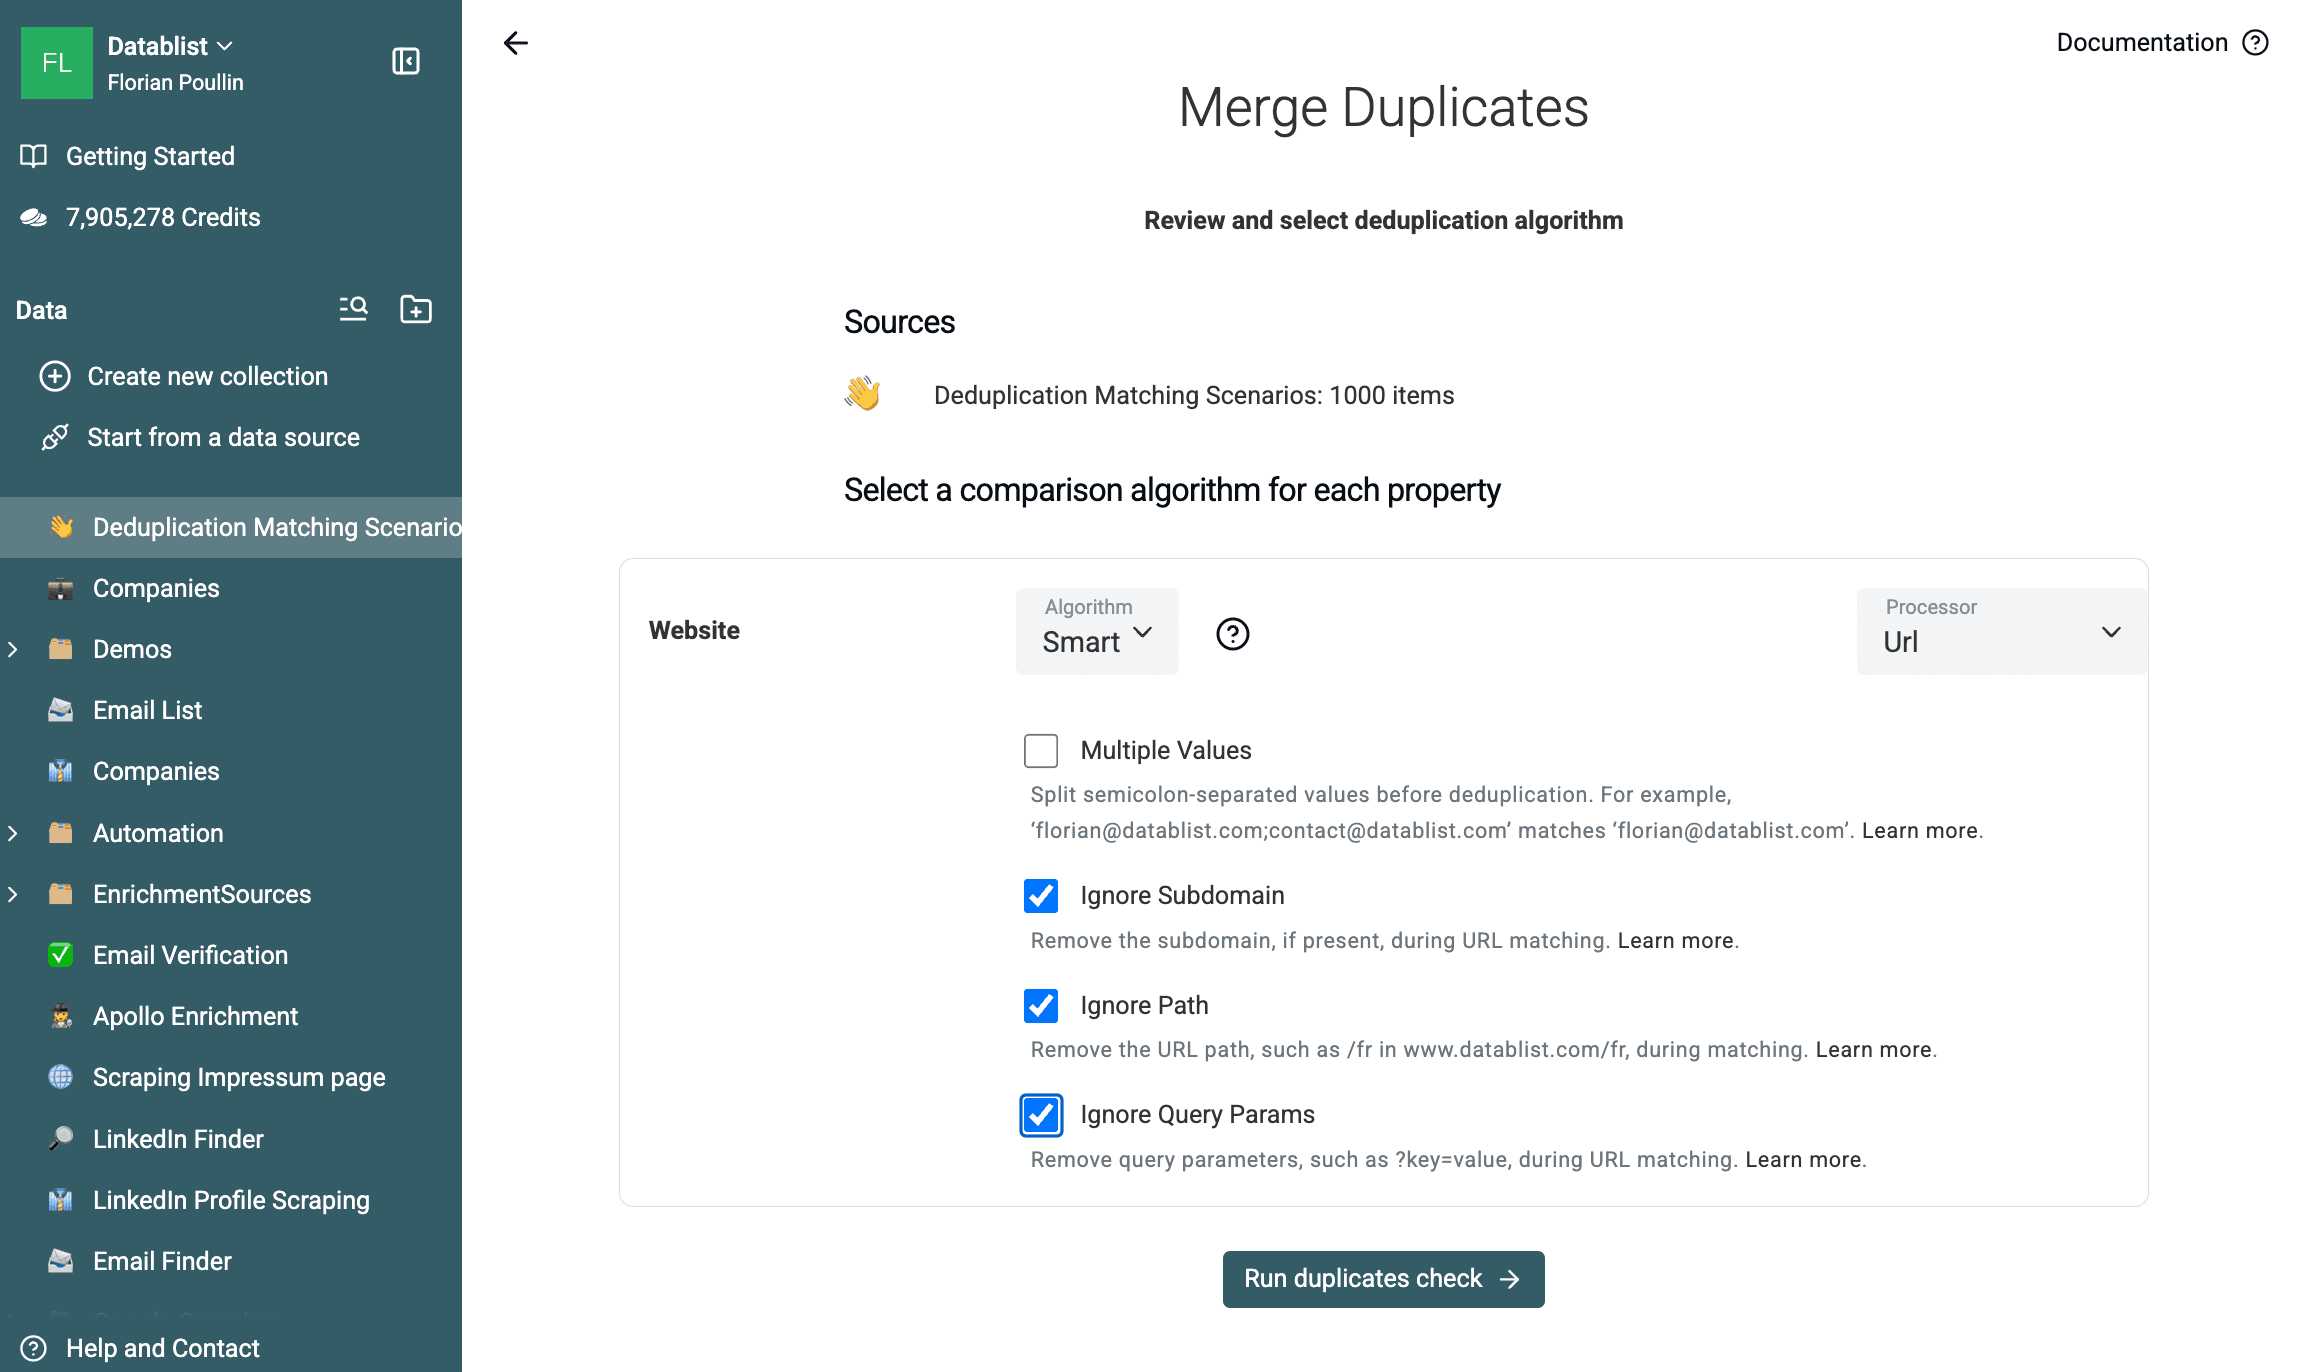
Sullo stesso file da 1.000 righe, questa configurazione ha restituito 200 gruppi da due righe. Cinquanta coppie contengono varianti di URL create appositamente, mentre 150 condividono già lo stesso sito web. In questo test, ogni coppia esportata è stata ricondotta allo stesso host normalizzato.
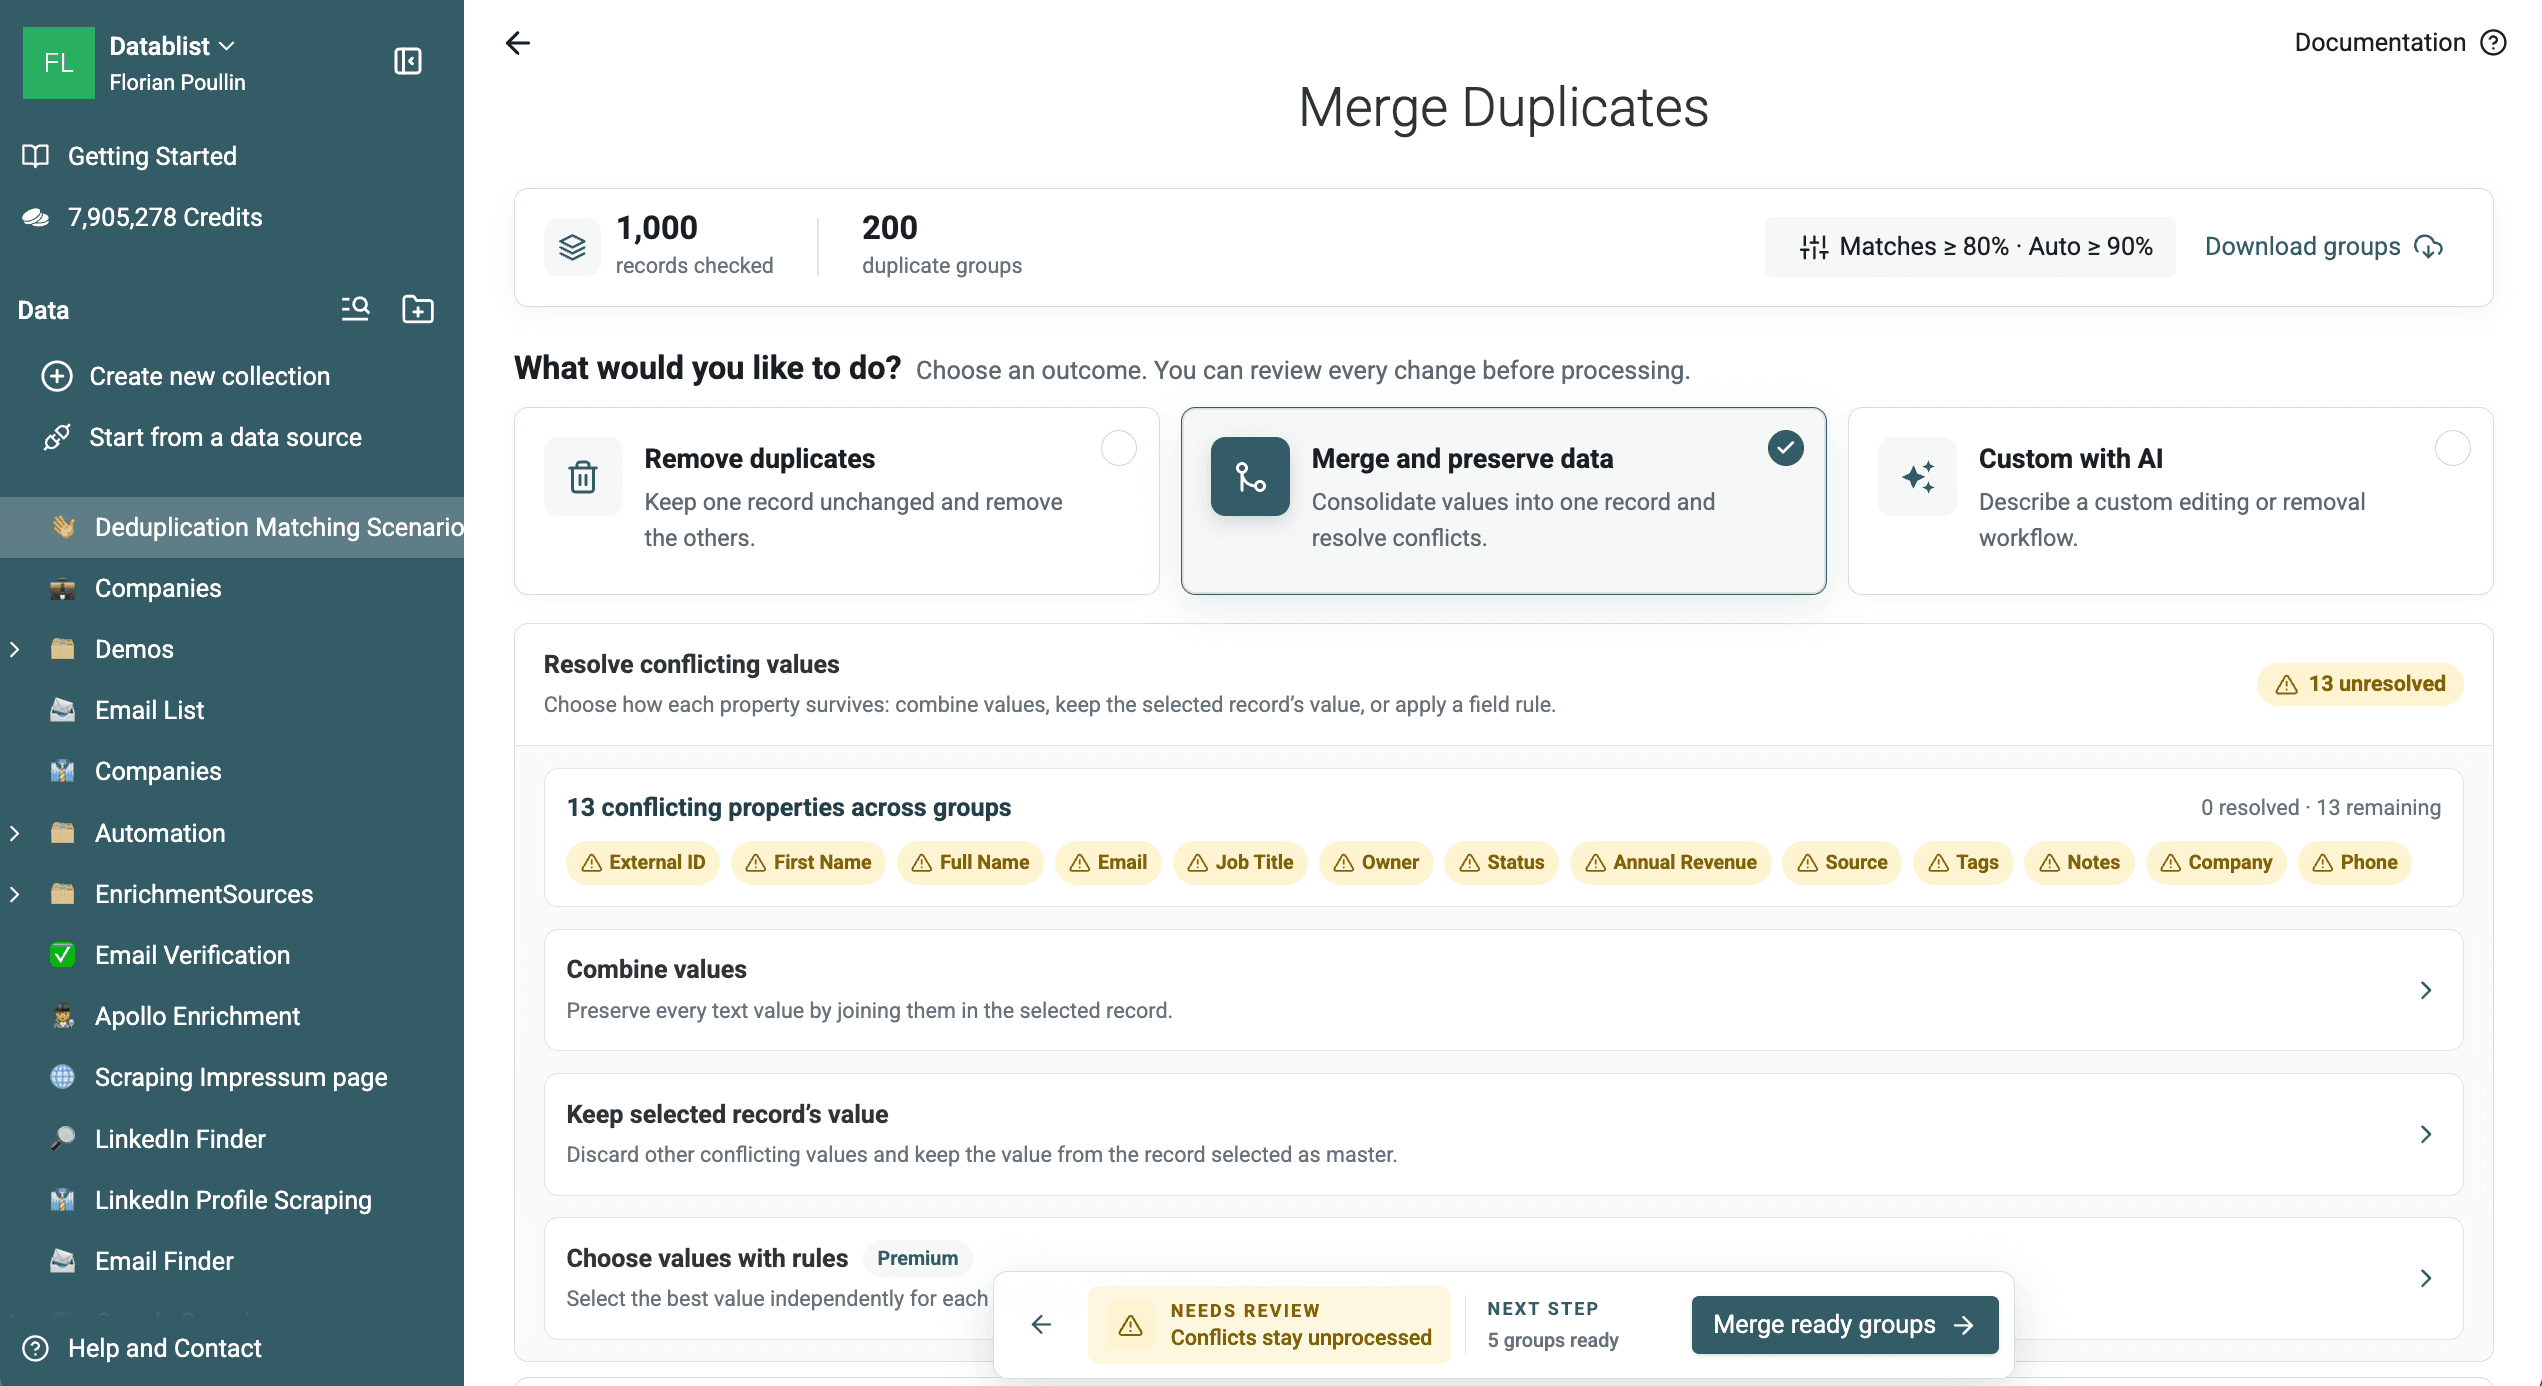
Scarica i 200 gruppi di siti web duplicati oppure consulta il workflow per deduplicare le aziende e applicare una strategia di matching basata prima di tutto sul dominio.
Usare il matching fuzzy o fonetico come controllo
Metaphone confronta la pronuncia dei testi. Jaro-Winkler e Levenshtein calcolano invece un punteggio di somiglianza, utile per trovare differenze ortografiche come Uma Turner e Uman Turner.
Le corrispondenze fuzzy sono candidati, non duplicati confermati. Parti da una soglia alta, esamina i gruppi meno affidabili e abbassa la soglia dei risultati solo se la revisione continua a produrre corrispondenze precise.
Per eseguire un controllo fuzzy misurabile, seleziona Full Name, scegli Distance con Levenshtein, mantieni il processor Text e imposta la soglia al 90%.
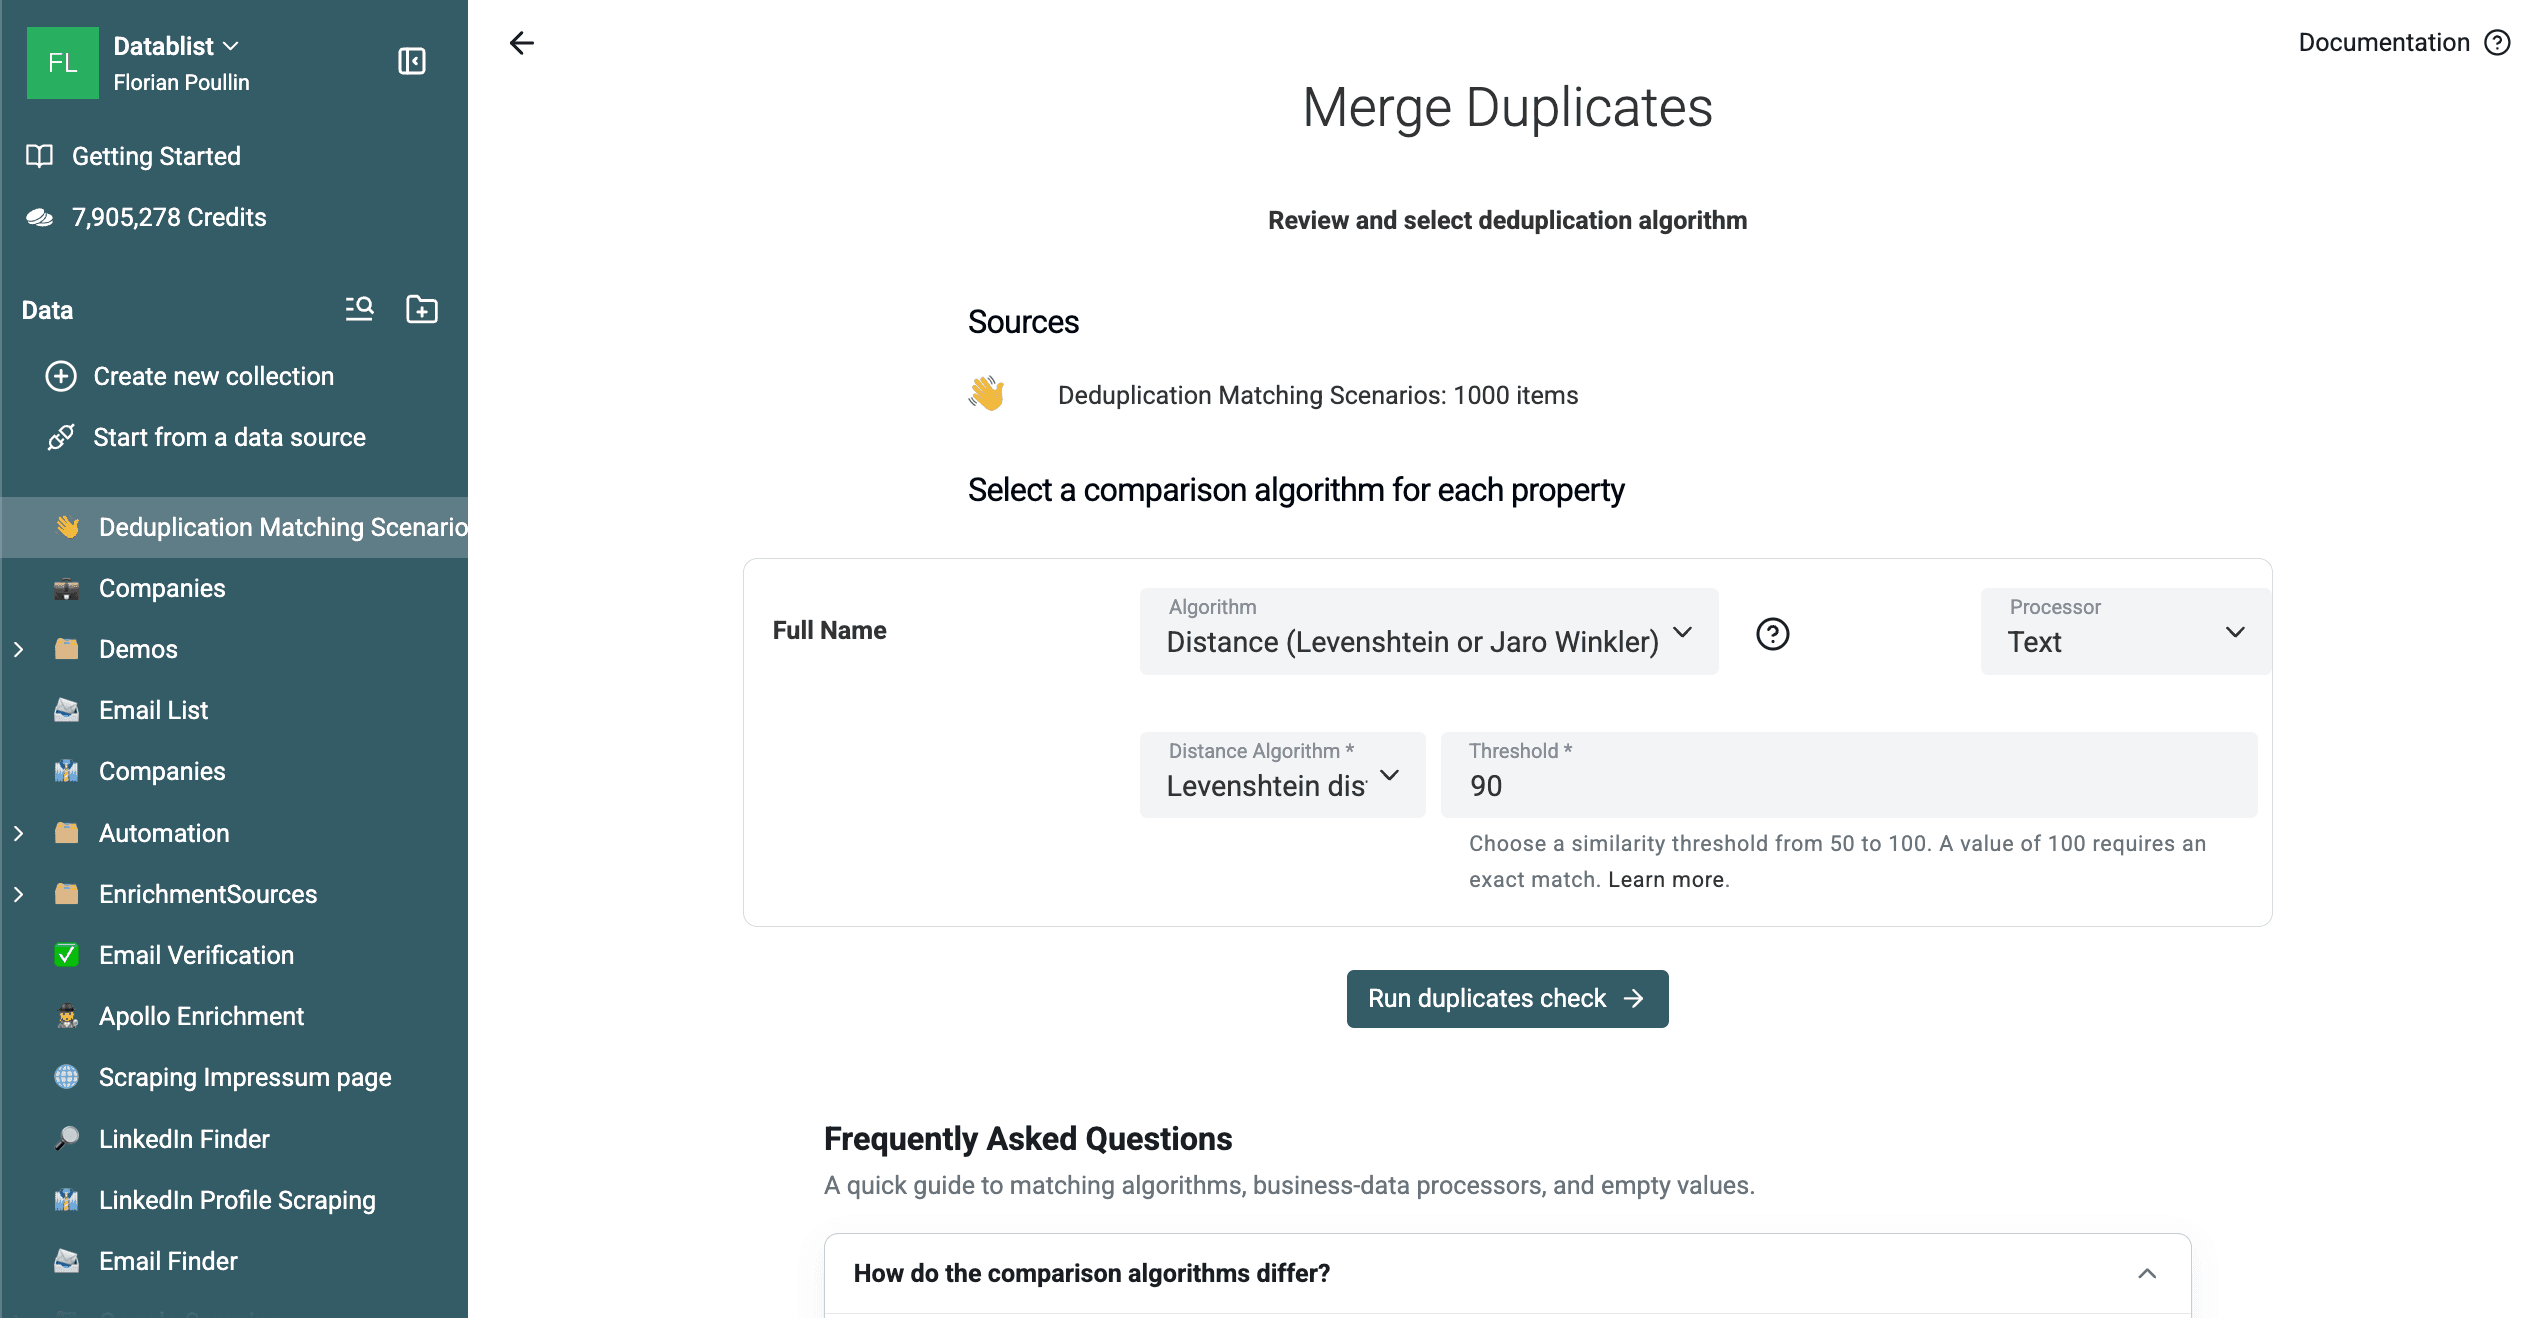
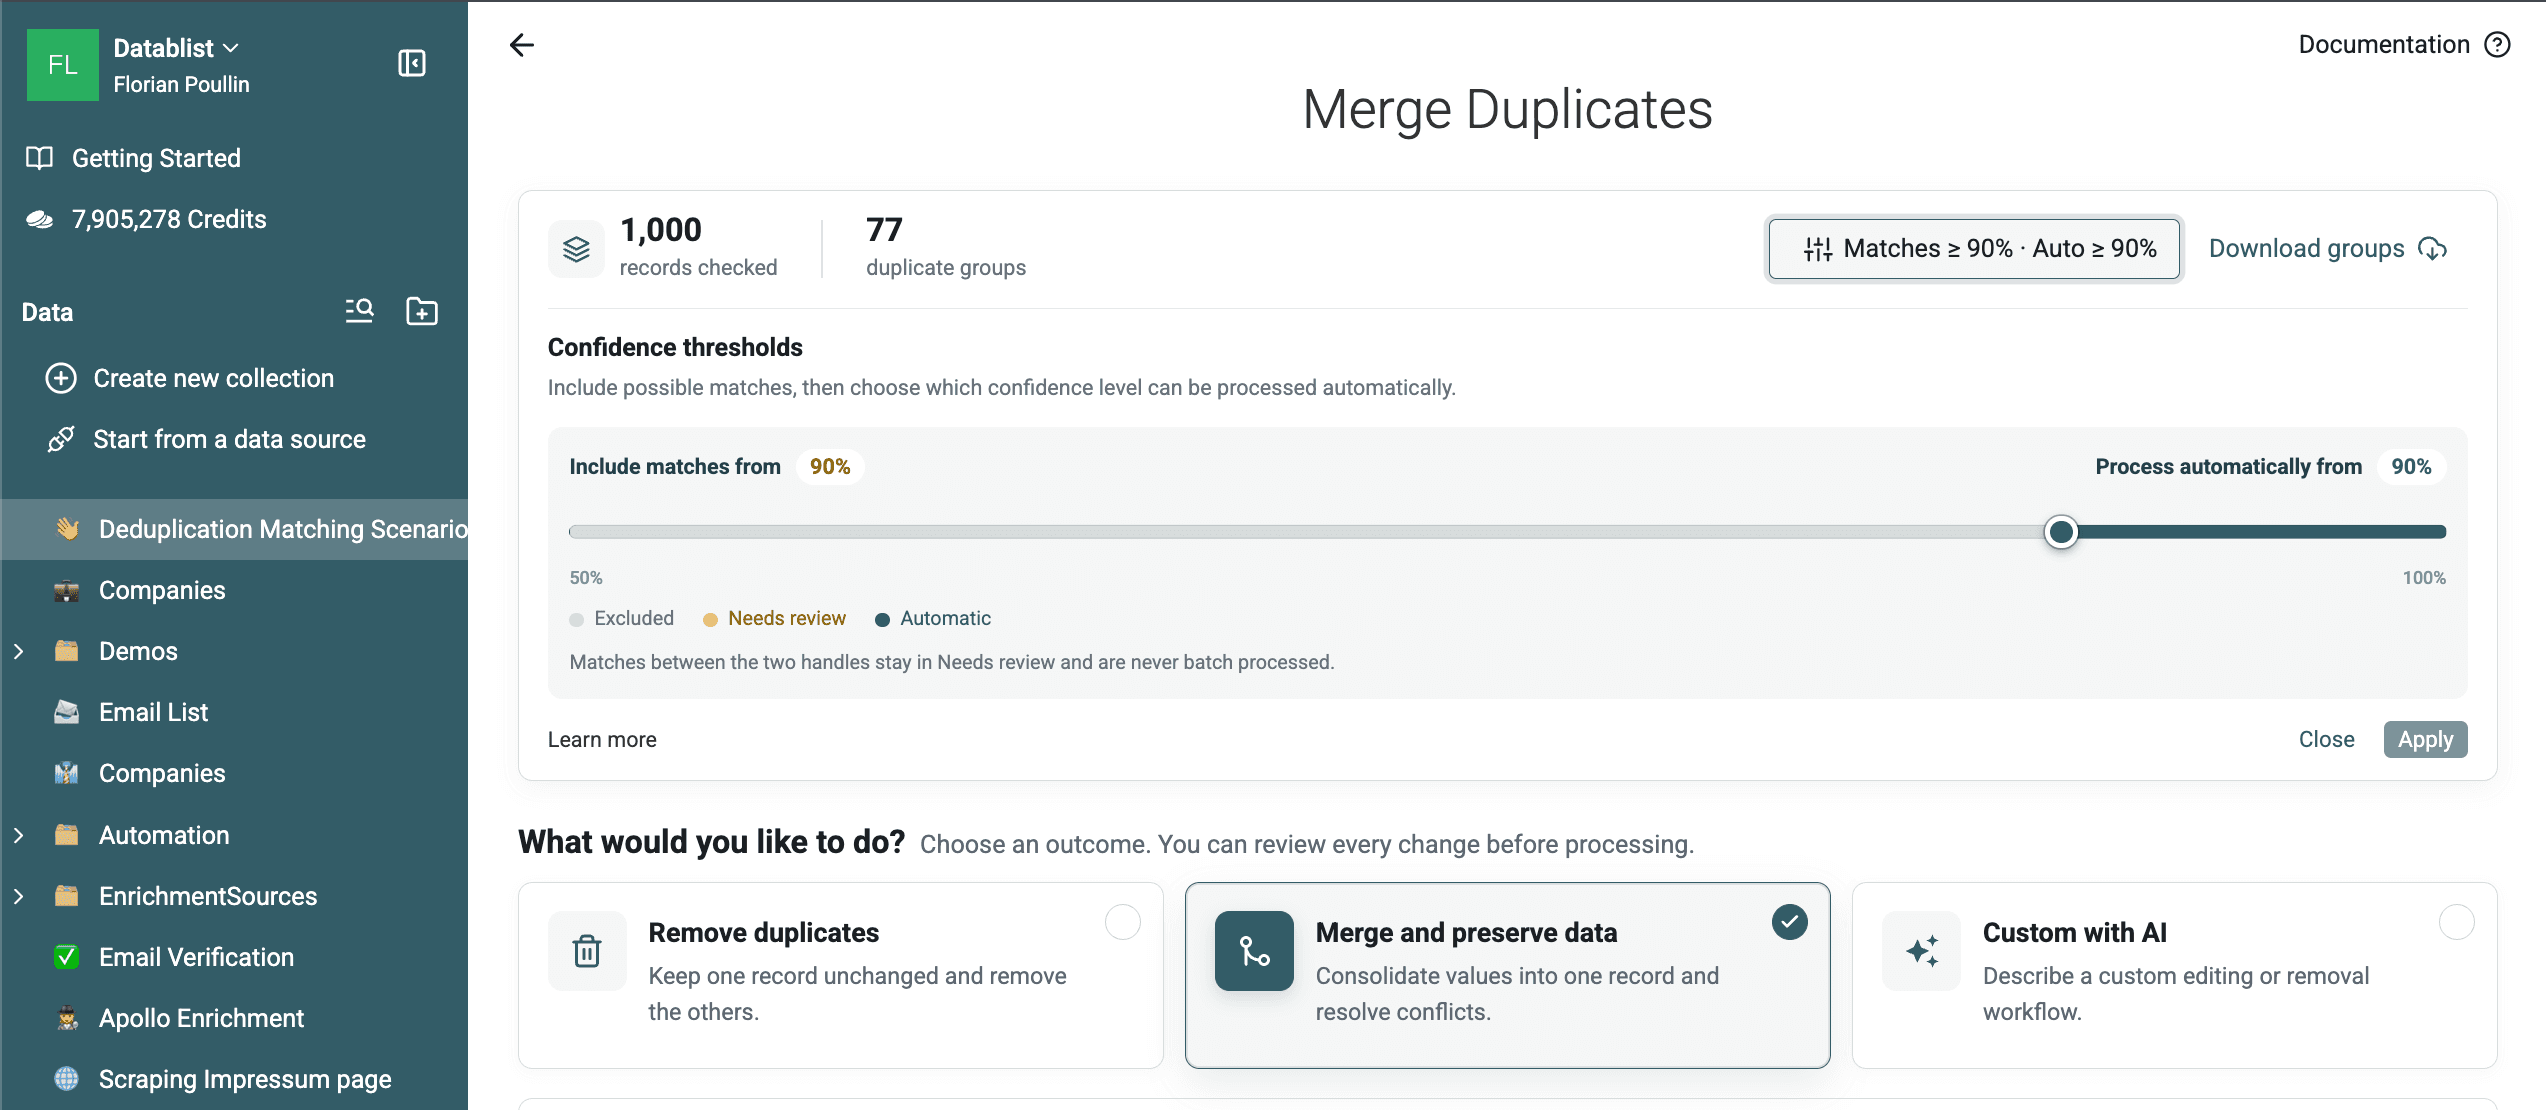
Questo controllo ha restituito 77 gruppi da due righe sul file di esempio con 1.000 record. La verifica sui dati di riferimento ha rilevato 21 gruppi relativi alla stessa entità e 56 gruppi che collegavano entità differenti. La maggior parte dei falsi positivi riguardava nomi abbreviati come G. Rossi, per i quali il solo valore Full Name non permette di distinguere due persone.
Il controllo intercetta varianti ortografiche previste, come Uma A. Turner e Uman A. Turner, ma dimostra anche perché le corrispondenze fuzzy basate solo sul nome richiedano una verifica.
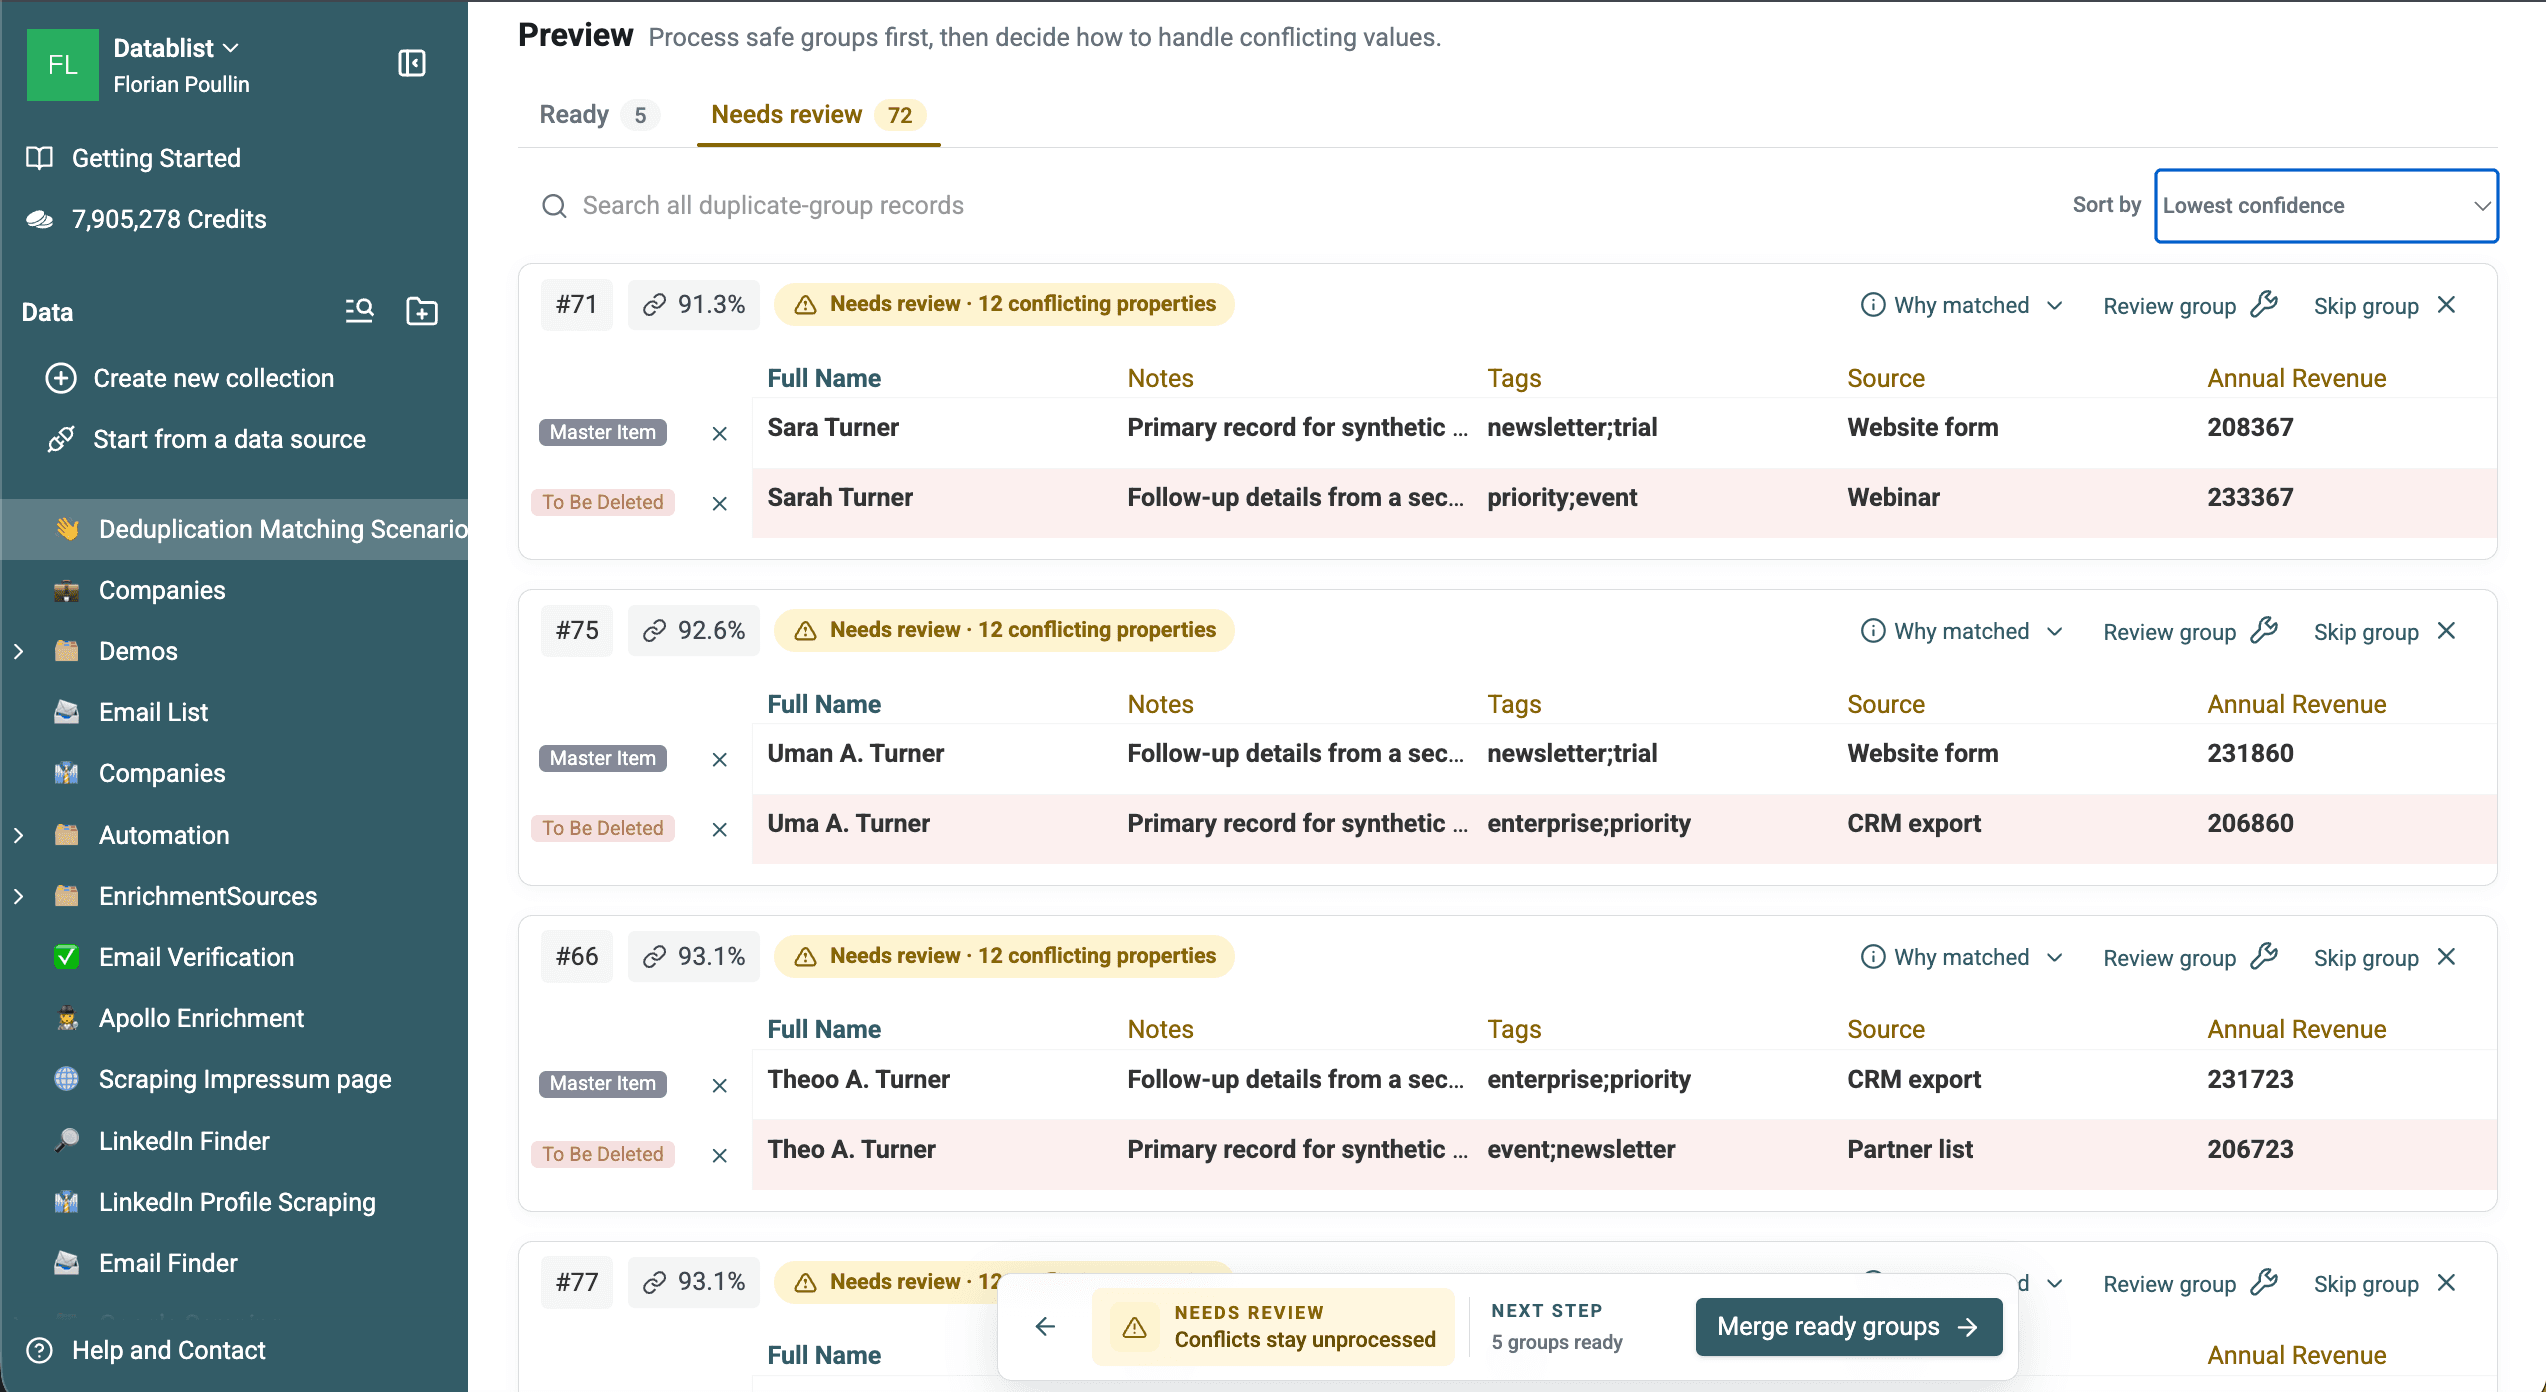
Scarica i 77 gruppi Levenshtein esportati per esaminare sia le corrispondenze utili sia i falsi positivi.
Per il matching fonetico, seleziona Full Name, scegli Metaphone e mantieni il processor Text.
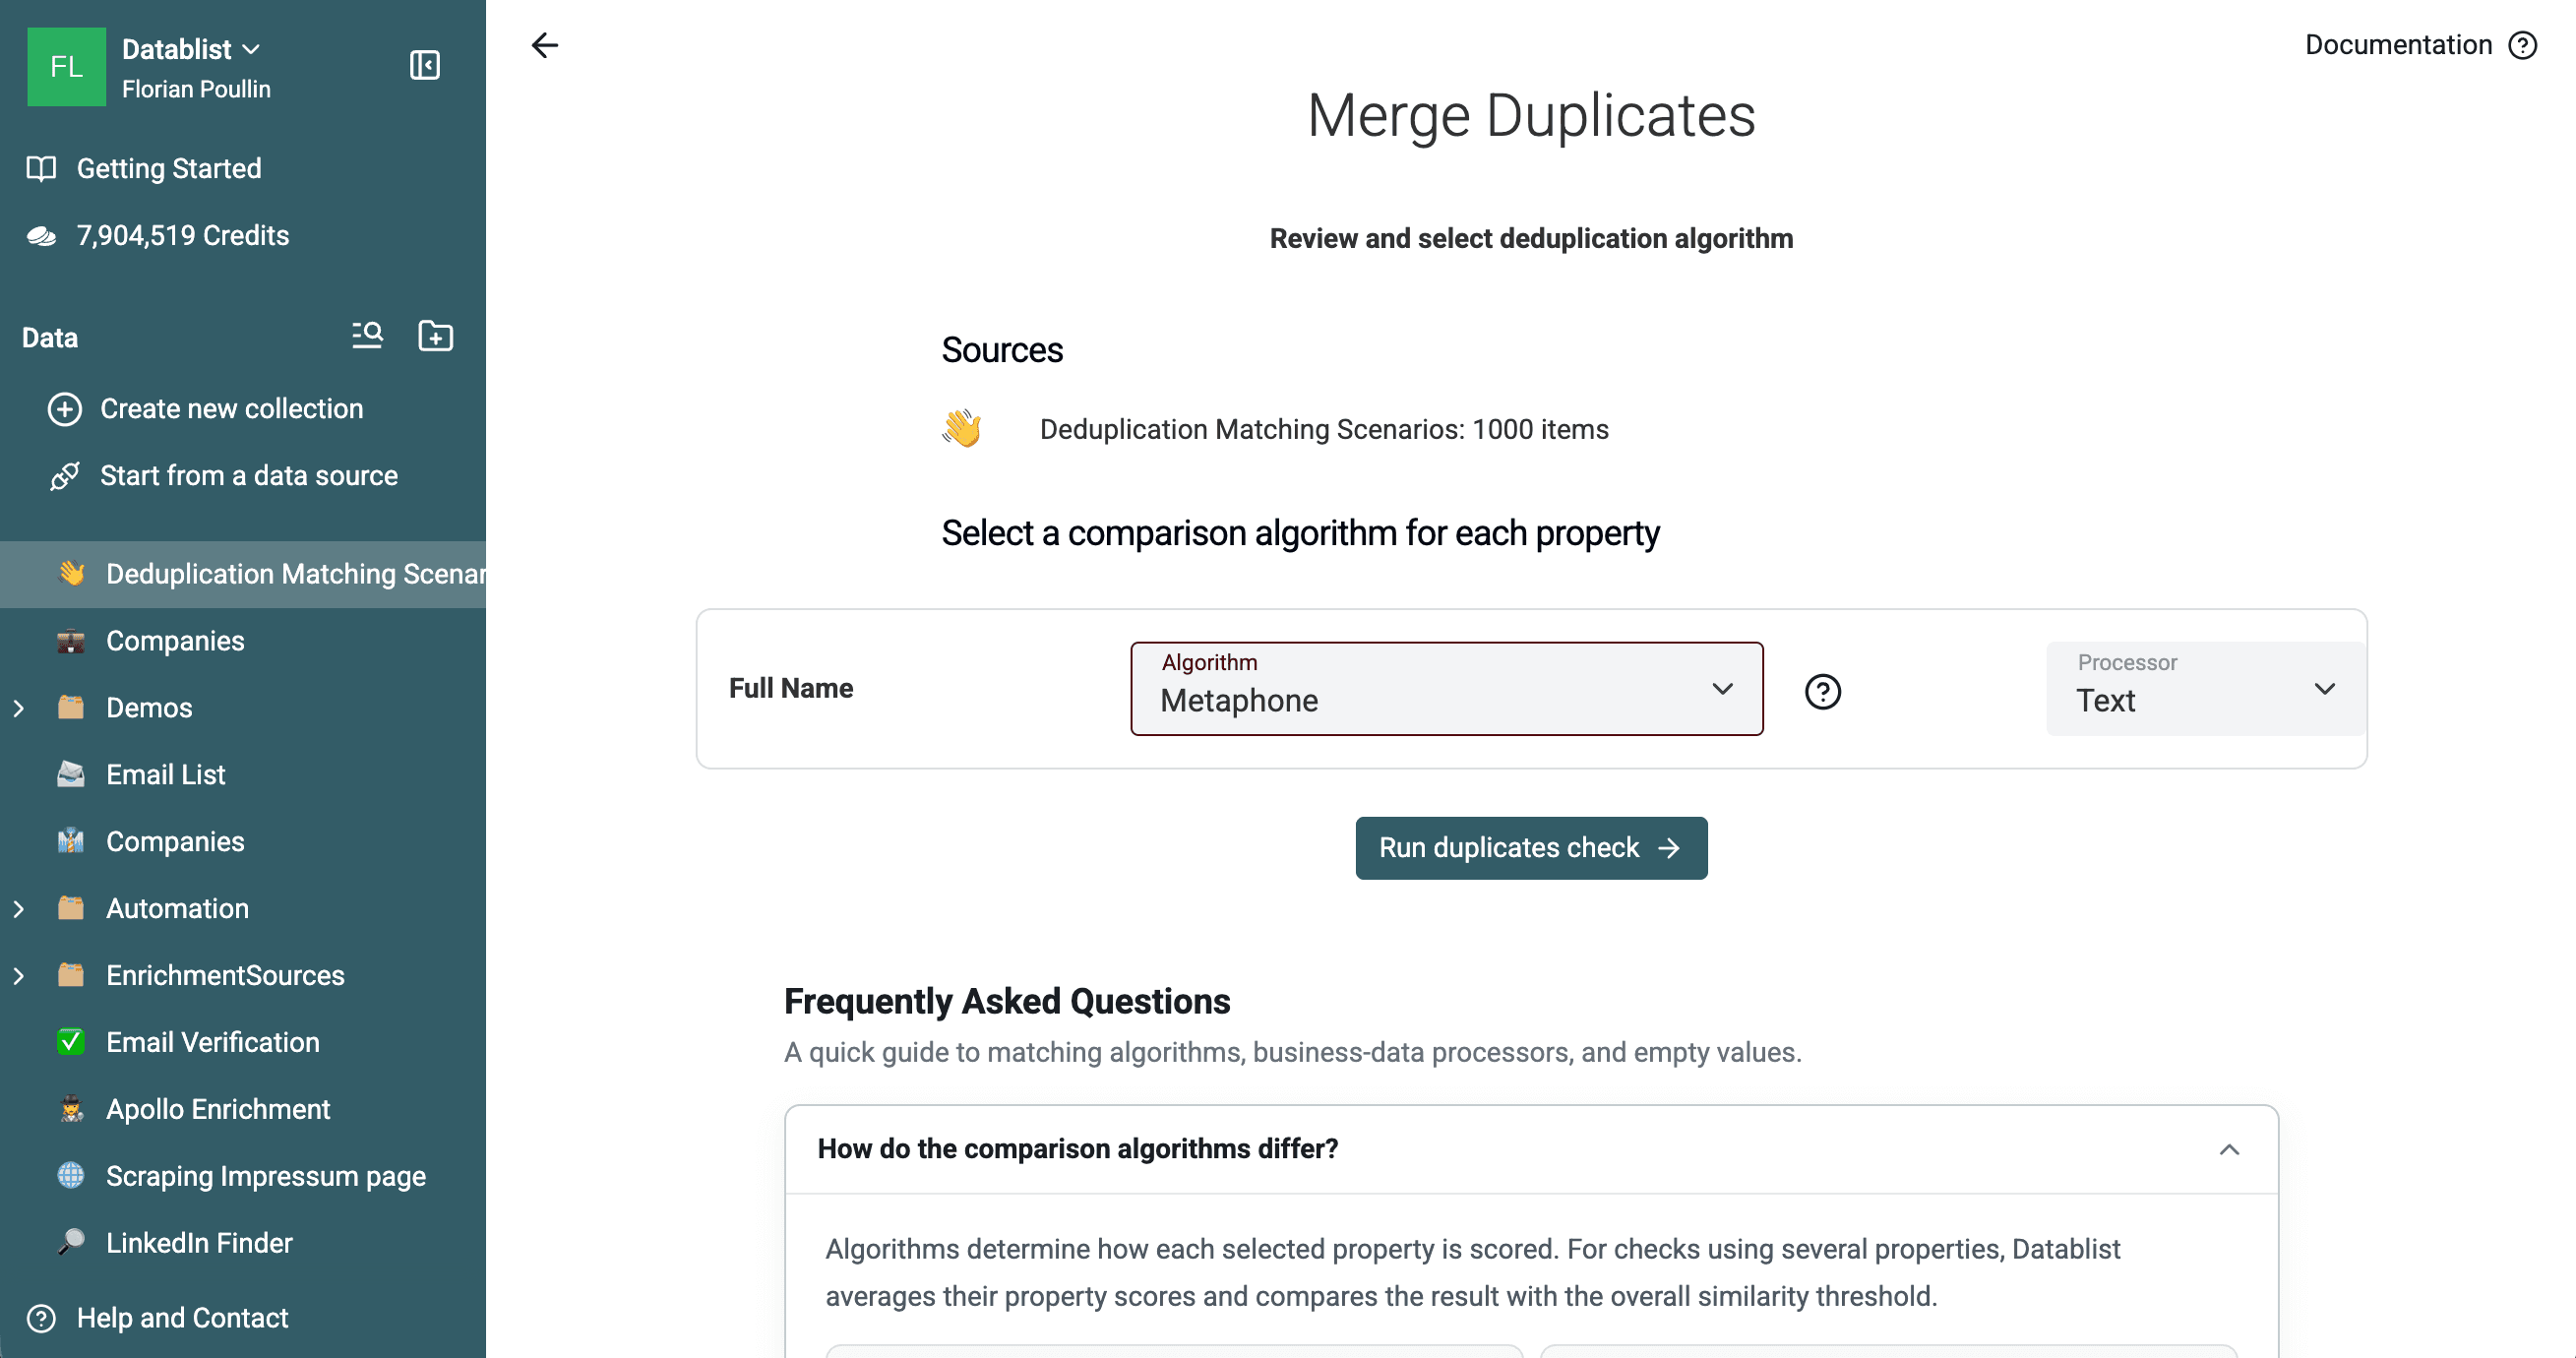
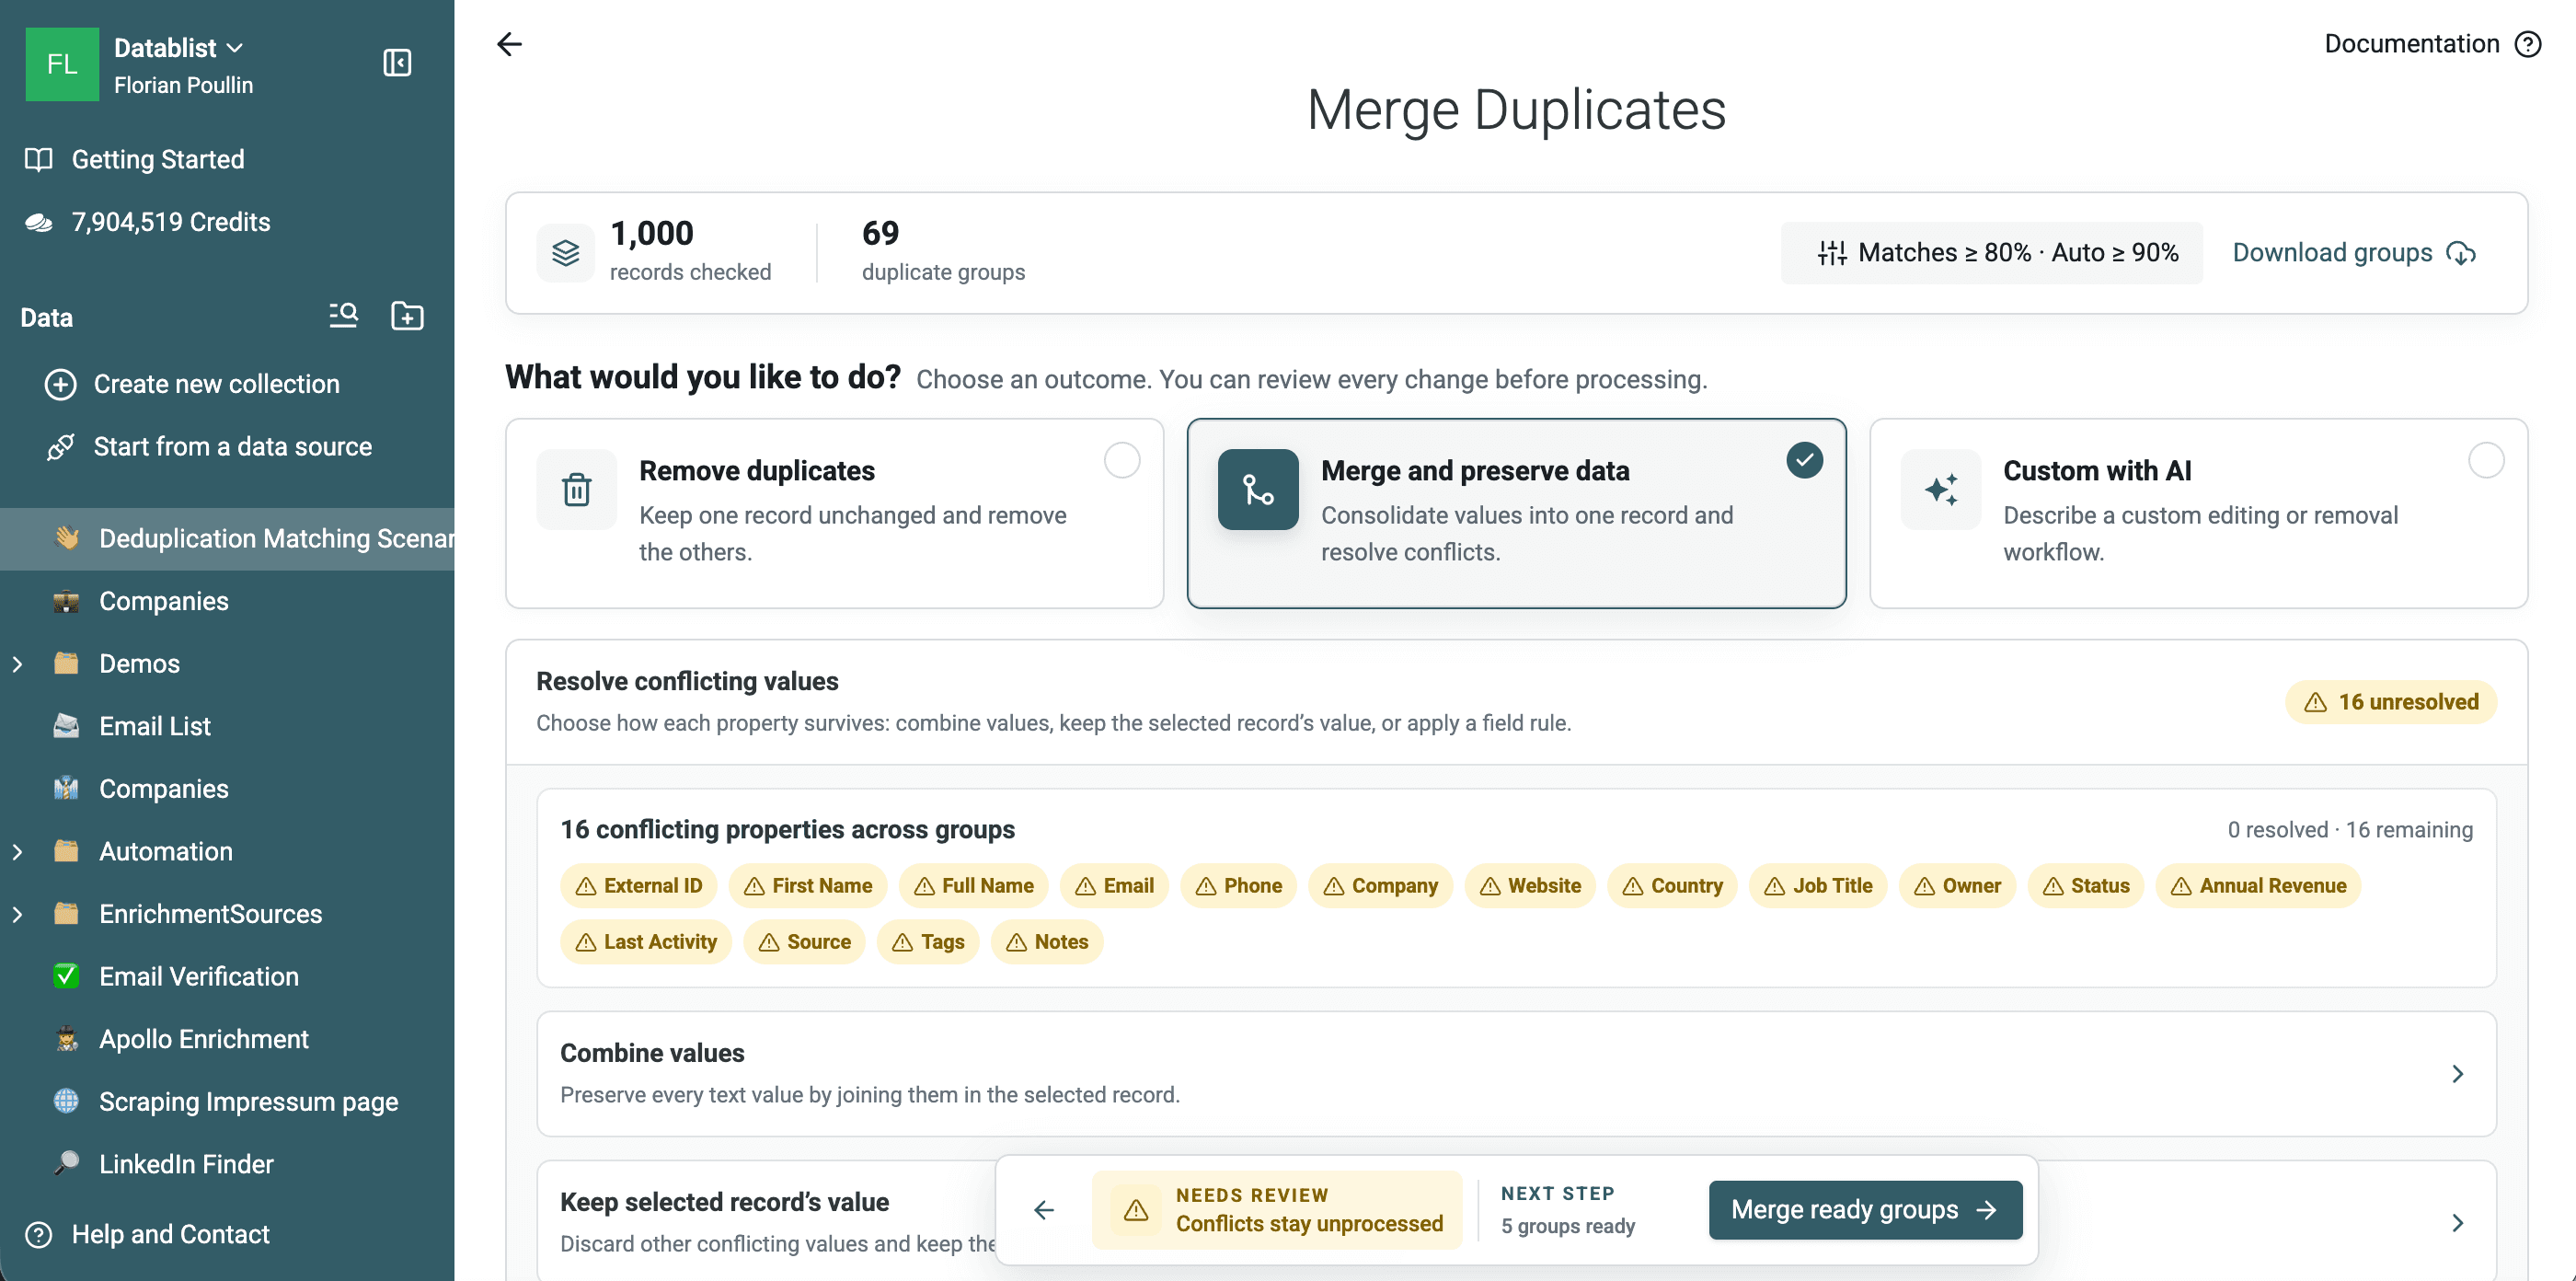
Questo controllo ha mostrato 69 gruppi: 5 Ready e 64 Needs review. I gruppi esportati contengono 188 righe. La verifica rispetto alle entità note del file di esempio ha trovato 19 gruppi composti esclusivamente dalla stessa entità e 50 gruppi che mescolavano persone diverse. Le dimensioni dei gruppi variano da due a sette righe.
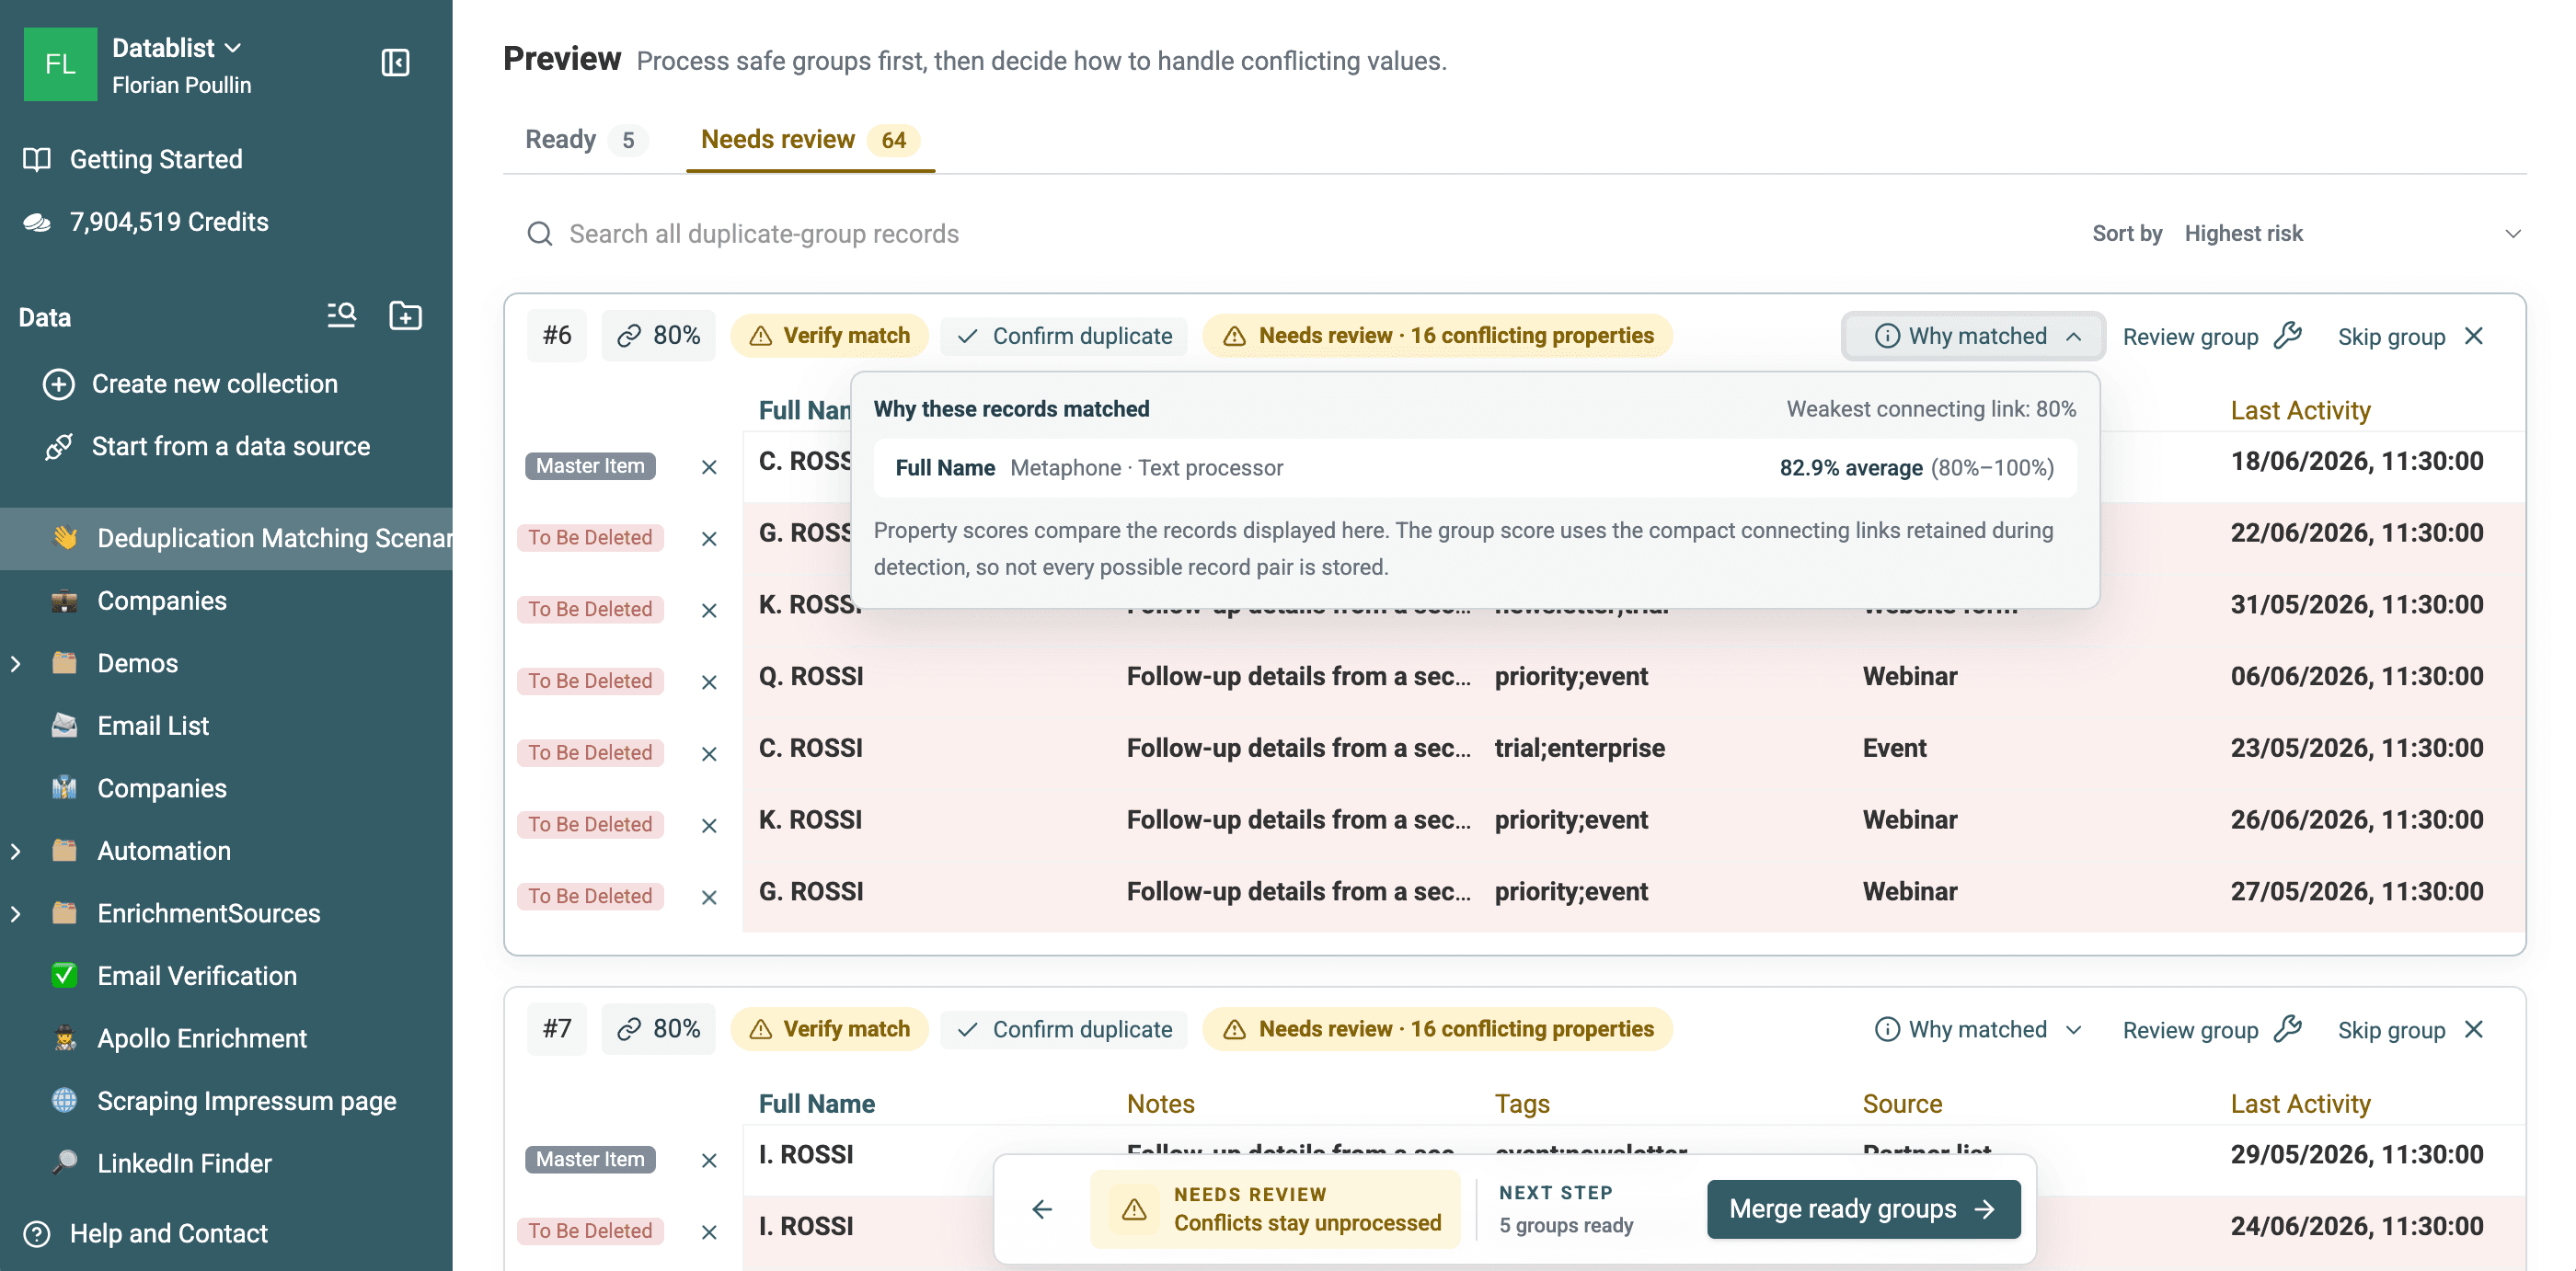
Why matched conferma la proprietà Full Name, l’algoritmo Metaphone, il processor Text e il punteggio del gruppo. Usa questi dettagli per verificare il confronto, non per sostituire un controllo dell’identità.
Scarica i 69 gruppi Metaphone esportati per esaminare le corrispondenze fonetiche utili e i falsi positivi. I gruppi di falsi positivi più grandi spesso combinano iniziali e cognomi comuni, per esempio diversi nomi abbreviati con Rossi. I loro codici fonetici si sovrappongono, ma i nomi da soli non forniscono prove sufficienti per un merge automatico.
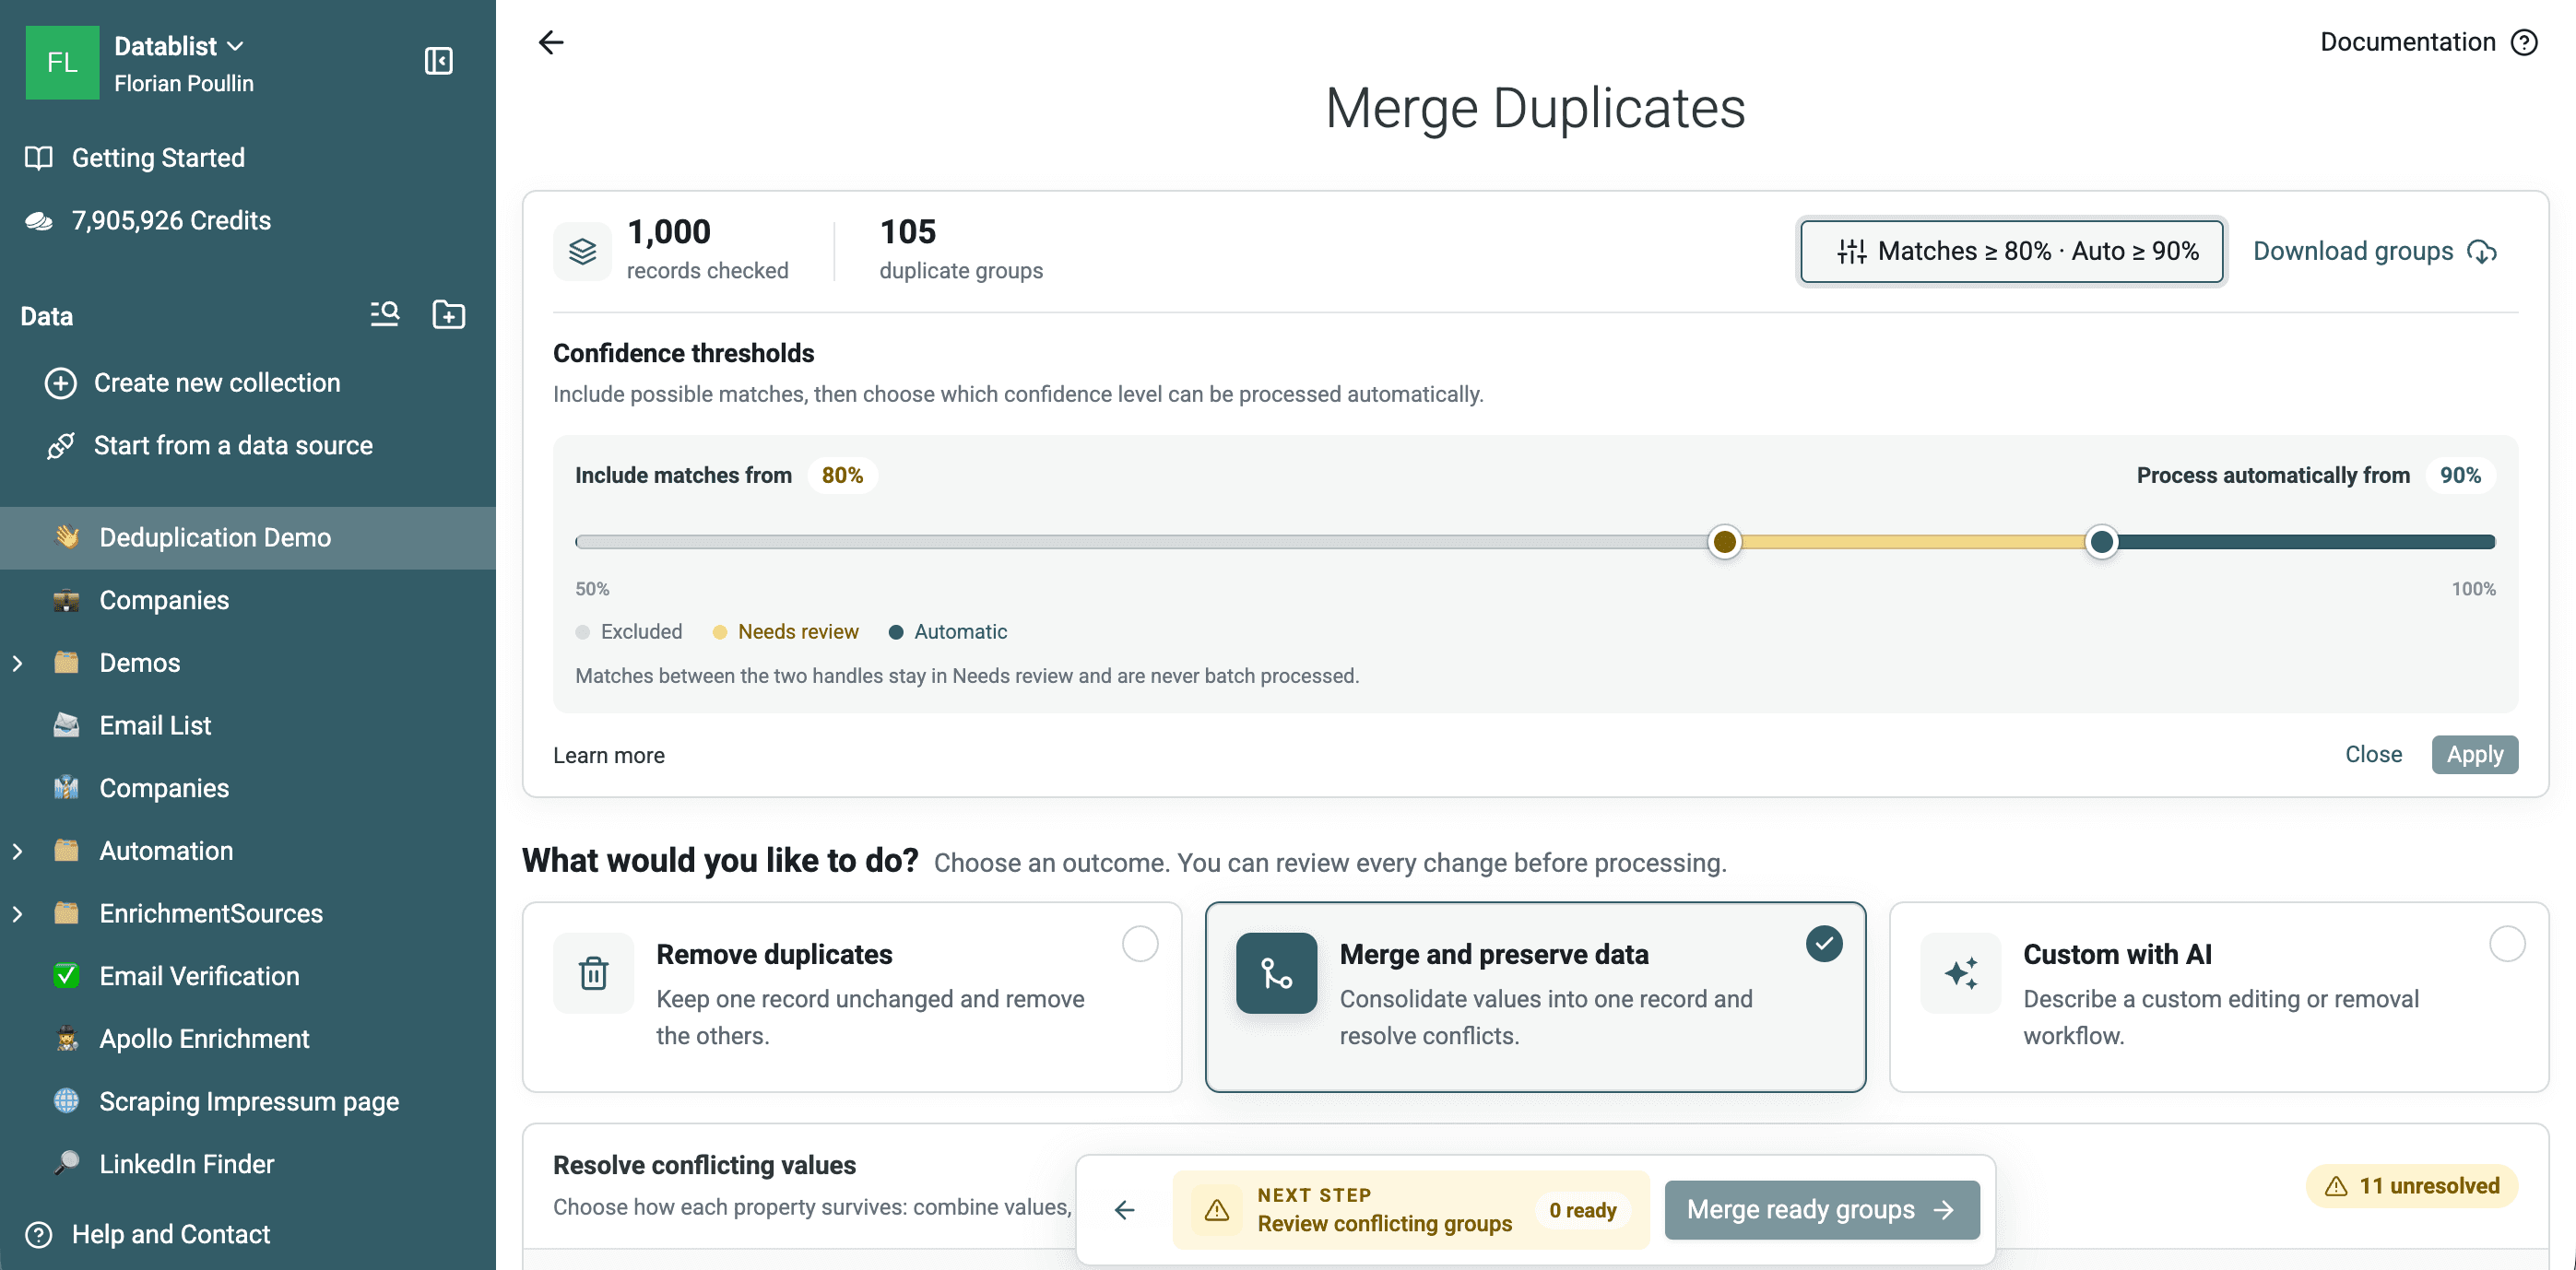
La pagina dei risultati contiene due controlli:
- Include matches from determina quali gruppi visualizzare.
- Process automatically from mantiene i gruppi meno affidabili in Needs review, escludendoli dall’elaborazione in blocco.
Questa separazione consente di esaminare un insieme ampio di candidati senza applicare a tutti la stessa regola di automazione.
Controllare i gruppi di duplicati
L’area dei risultati divide i gruppi di duplicati tra Ready e Needs review.
- I gruppi Ready hanno un risultato di elaborazione definito e soddisfano la soglia di affidabilità automatica.
- I gruppi Needs review hanno un’affidabilità inferiore, conflitti di merge irrisolti, una regola di selezione che non ha trovato un record oppure una regola personalizzata che li ha ignorati.
Per ogni gruppo incerto, verifica:
- Tutte le righe rappresentano la stessa persona, azienda o prodotto?
- Quale identificativo ha determinato la corrispondenza?
- Sono presenti valori complementari?
- Qual è la fonte più autorevole?
- Rimuovendo una riga perderesti un numero di telefono, un ID, uno stato, una data o una nota?
- Il gruppo è collegato attraverso un terzo record poco affidabile?
Usa Why matched per esaminare proprietà, algoritmi, processor e intervalli di punteggio utilizzati nel matching. Nei controlli fuzzy, la somiglianza del gruppo corrisponde al collegamento più debole necessario per mantenere uniti i record.
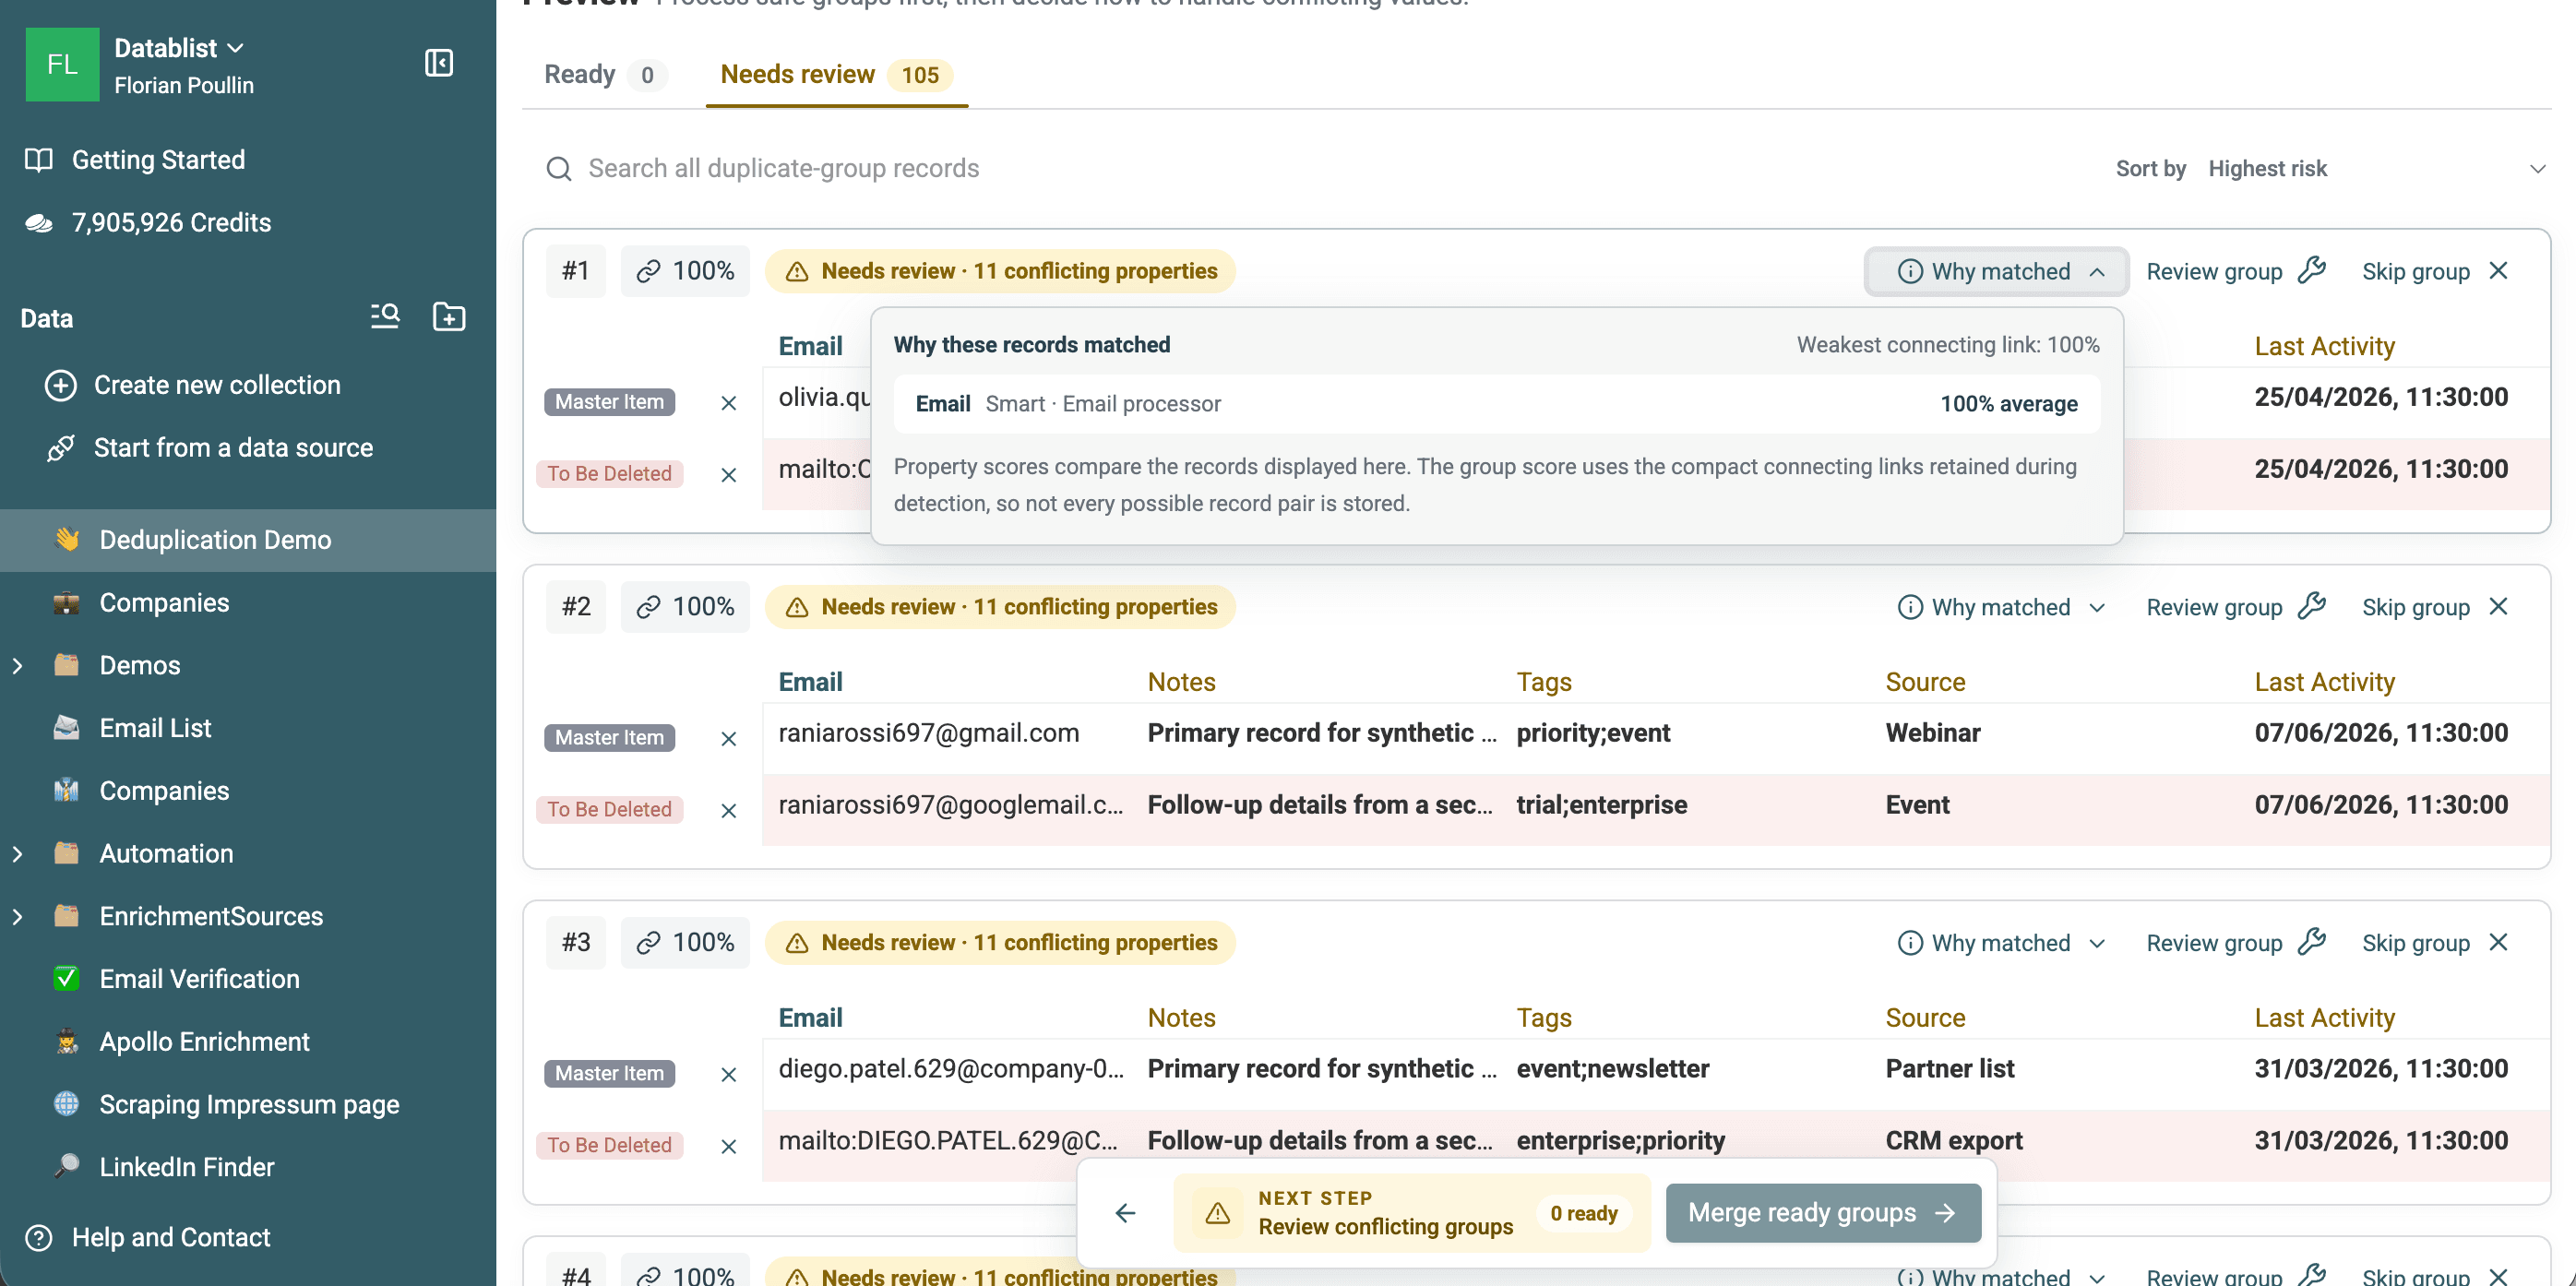
Puoi anche:
- Confermare una corrispondenza poco affidabile.
- Rimuovere un record dal gruppo senza eliminarlo.
- Ignorare il gruppo.
- Aprire e modificare un record.
- Controllare il gruppo nel Merging Assistant.
- Cercare tra tutti i gruppi rimanenti e ordinare prima i candidati più rischiosi.
⚠️ Non elaborare un gruppo fuzzy basandoti solo sulla percentuale
Nomi simili possono appartenere a persone diverse. Controlla gli identificativi e i campi circostanti prima di confermare il gruppo.
Verificare identificativi condivisi e mancanti prima del merge
Una casella condivisa come info@company.example può appartenere a più contatti. Due persone con quell’indirizzo potrebbero corrispondere in base all’email, pur restando persone distinte. Allo stesso modo, il dominio aziendale può identificare una sola impresa ma comparire nei record di molti dipendenti.
Escluderei questi gruppi dal merge automatico a livello di persona finché un altro identificativo non conferma la corrispondenza. Se invece vuoi ottenere una sola riga per azienda, il dominio condiviso potrebbe essere proprio la chiave di raggruppamento corretta. Definisci l’entità prima di interpretare il risultato.
Anche la regola per i valori vuoti modifica il confronto delle proprietà selezionate. Nei controlli su più proprietà con un confronto diverso da Exact, l’impostazione avanzata Empty Value Rule offre le opzioni Value required (default) e Match on empty value. La regola predefinita richiede la presenza dell’identificativo testuale, mentre consentire la corrispondenza dei valori vuoti rende il requisito meno rigido. Usa questa opzione solo quando gli altri campi forniscono prove sufficienti sull’identità: due email mancanti non dimostrano che due persone siano la stessa.
Per esempio, due righe con Email vuota e valori Full Name diversi non devono essere unite solo per ridurre il numero di righe. Un record senza email potrebbe comunque contenere un contatto da conservare o arricchire in seguito.
Rimuovere, unire o elaborare i duplicati con regole personalizzate
Trovare i duplicati e decidere come gestirli sono due operazioni distinte. Scegli la modalità di elaborazione dopo aver verificato quali dati contengono le righe secondarie.
Rimuovere i duplicati quando un record è autorevole
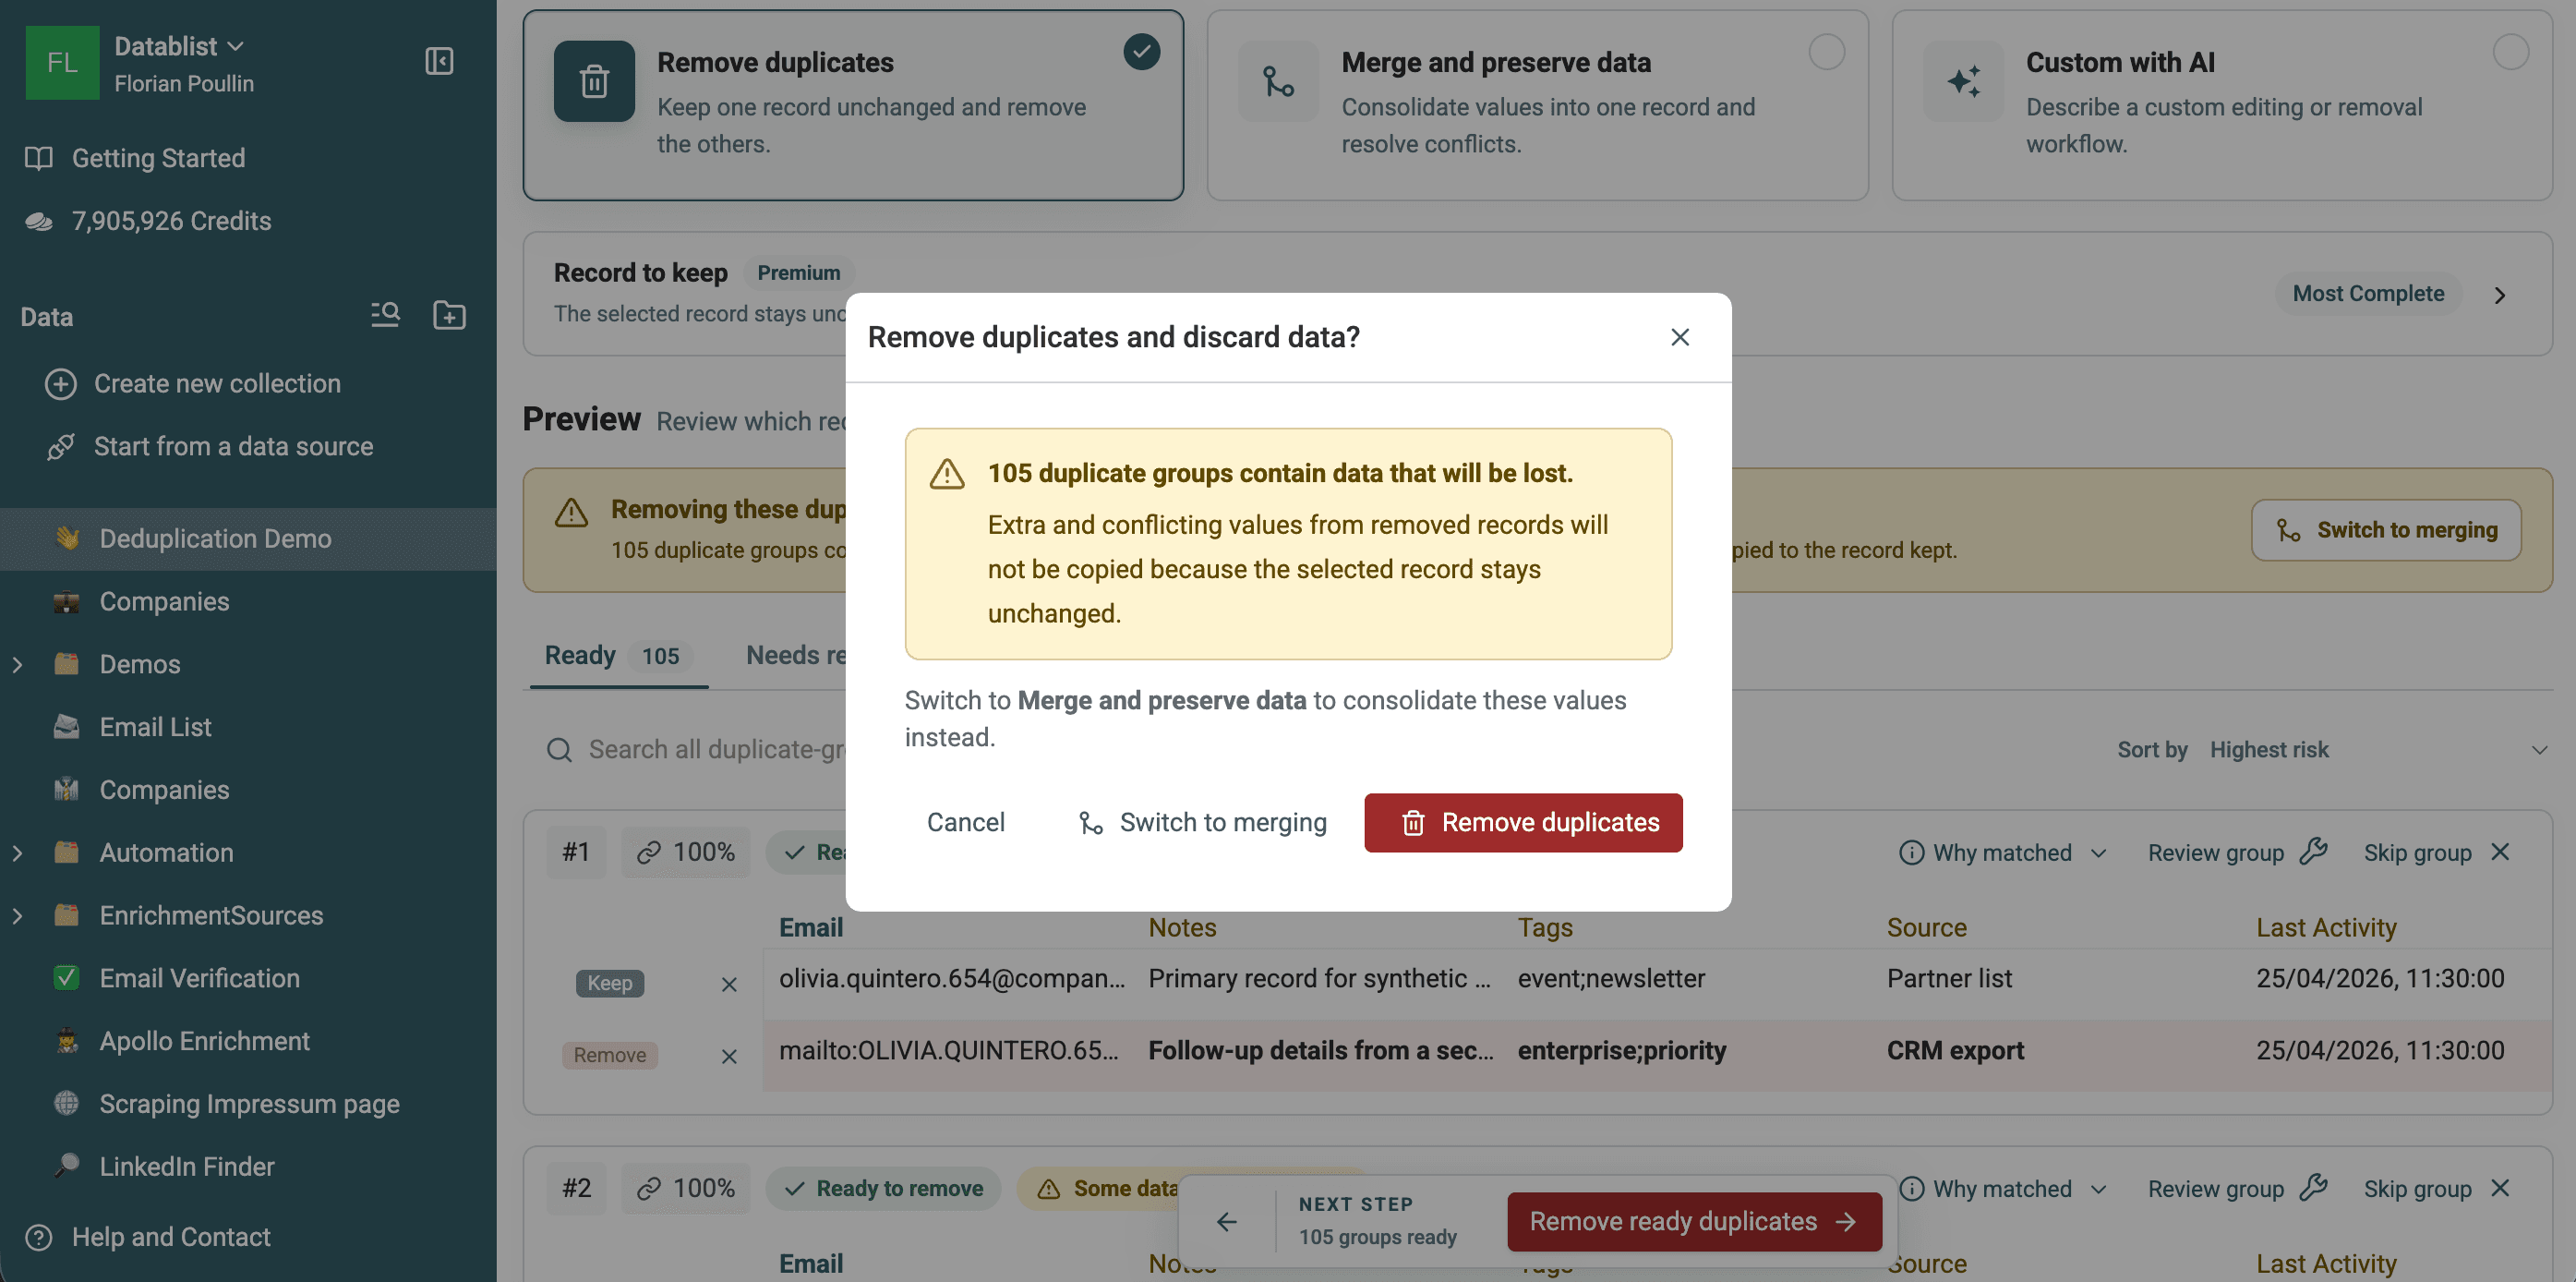
Remove duplicates conserva senza modifiche il record selezionato ed elimina le altre righe di ogni gruppo Ready.
Usalo per righe copiate, importazioni temporanee o record i cui valori secondari possono essere scartati. L’anteprima mostra un avviso quando i record da eliminare contengono informazioni aggiuntive o in conflitto. Questi valori non vengono copiati nel record conservato.
Unire i record quando contengono dati utili
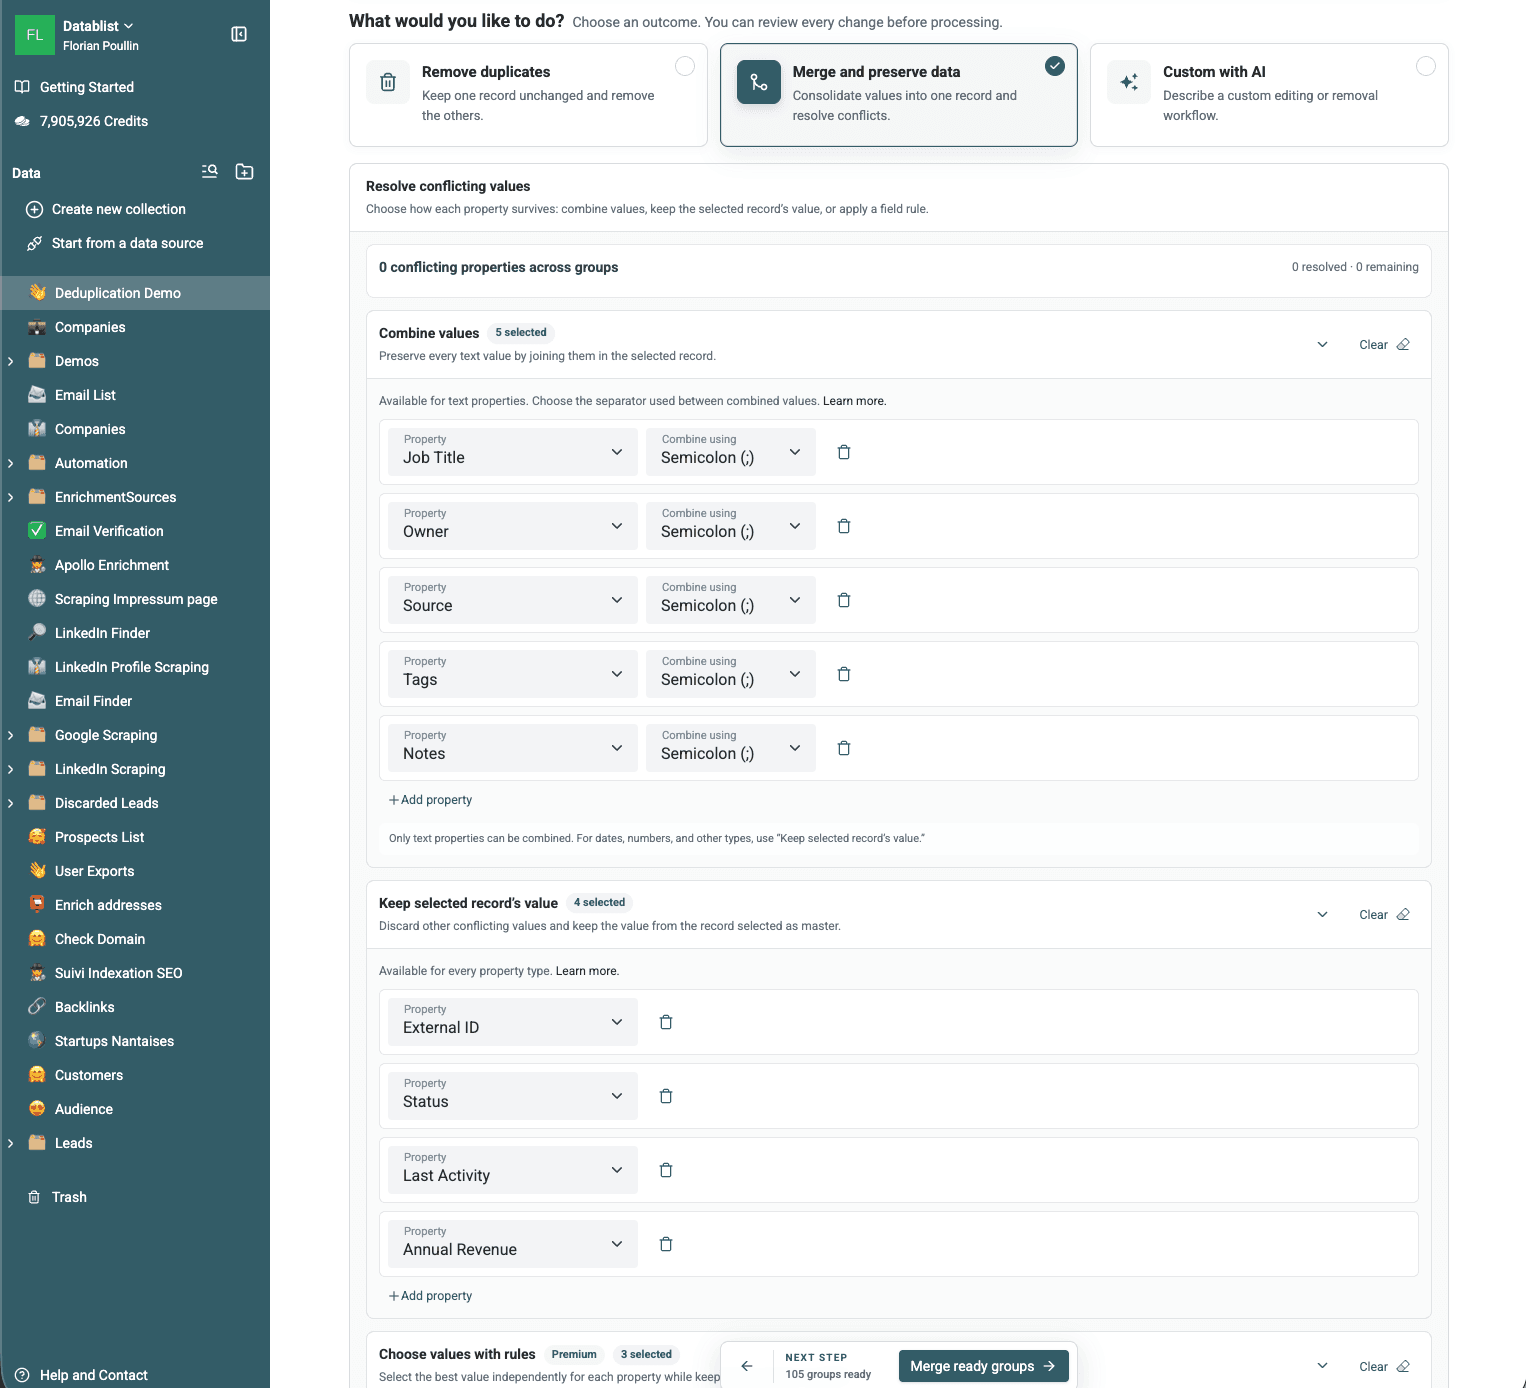
Merge and preserve data completa le proprietà vuote del record selezionato, risolve i conflitti secondo le regole configurate e infine elimina le righe secondarie.
Inizia dalla regola Record to keep. L’opzione predefinita è Most Complete. Con i piani a pagamento puoi scegliere regole basate sulla data di creazione o aggiornamento, sul valore più alto o più basso di una proprietà oppure sulla presenza obbligatoria di un determinato valore.
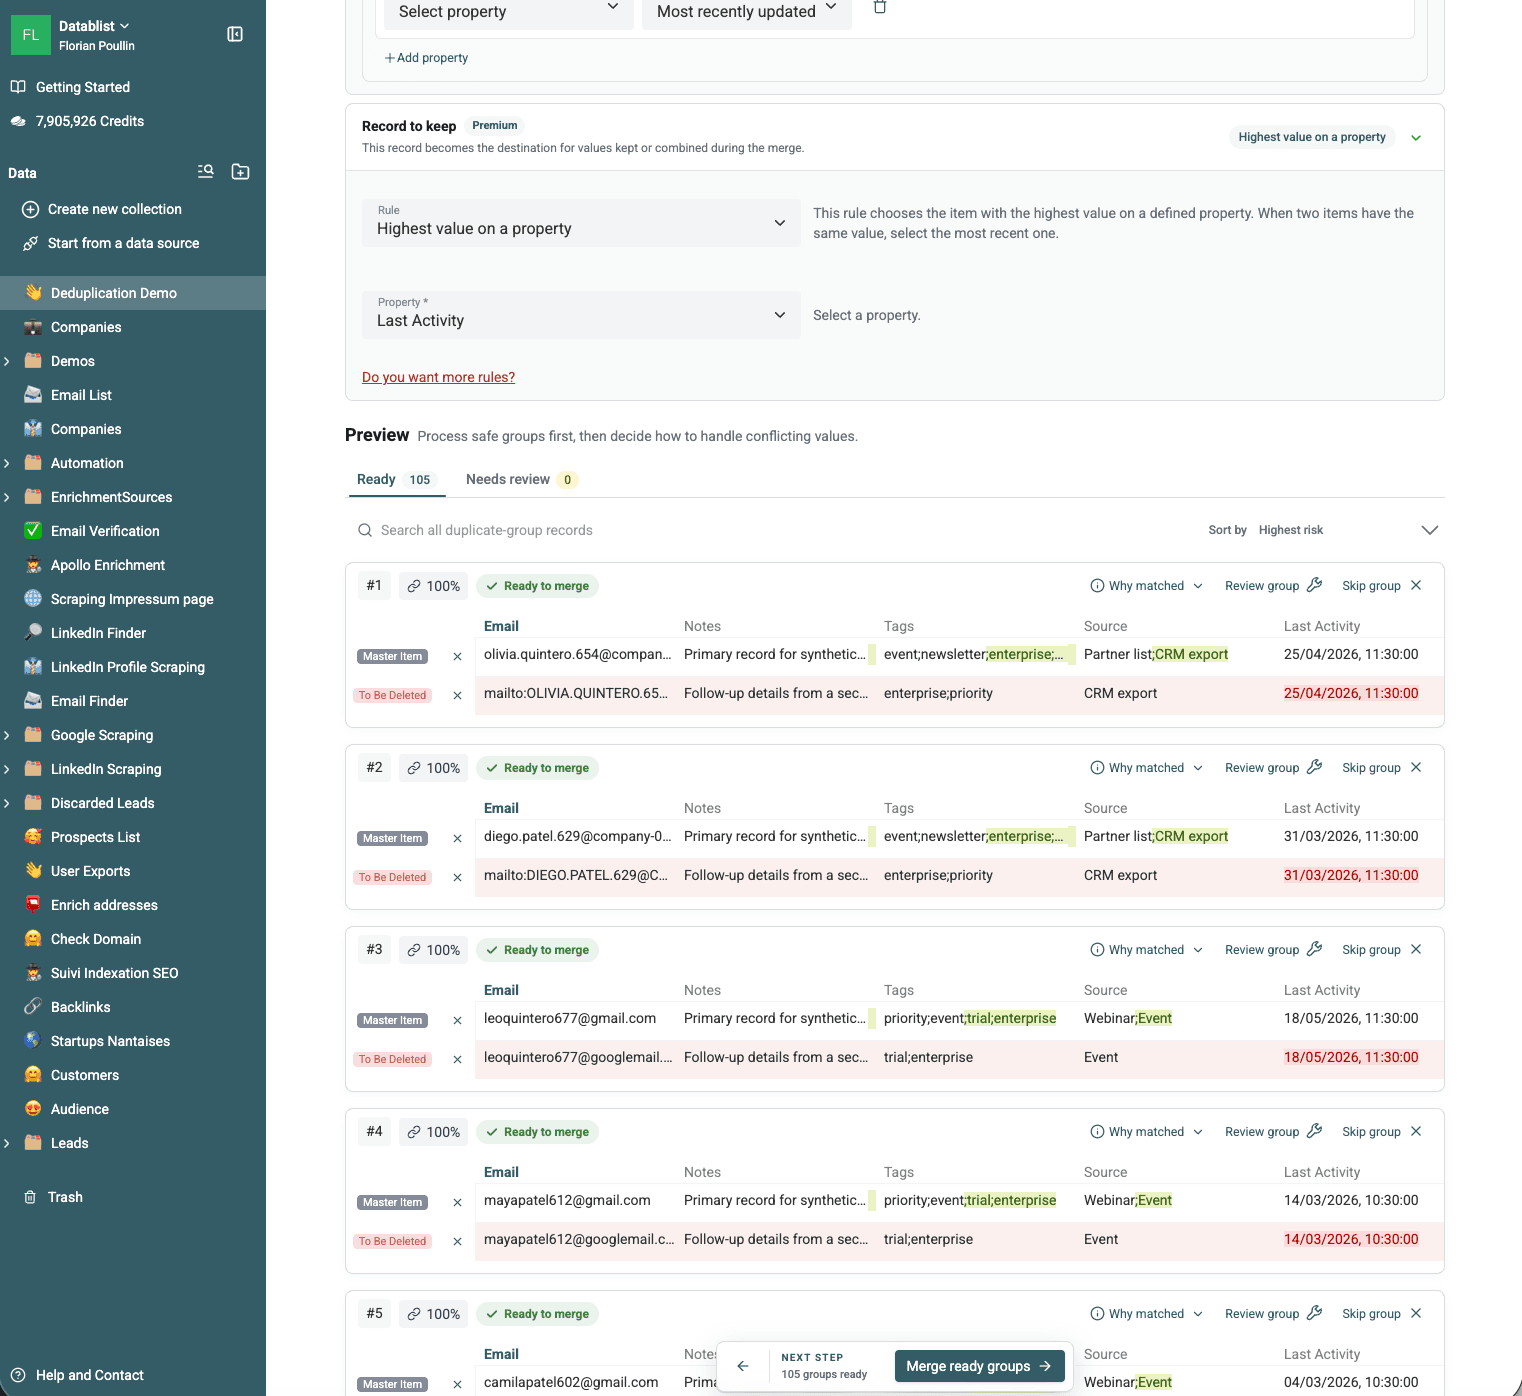
Decidi quindi come gestire ogni proprietà in conflitto:
- Combina i valori testuali distinti usando un separatore.
- Mantieni il valore del record selezionato.
- Con i piani a pagamento, scegli i valori in modo indipendente applicando regole come più recente, più vecchio, più lungo, più corto, più alto, più basso o più frequente.
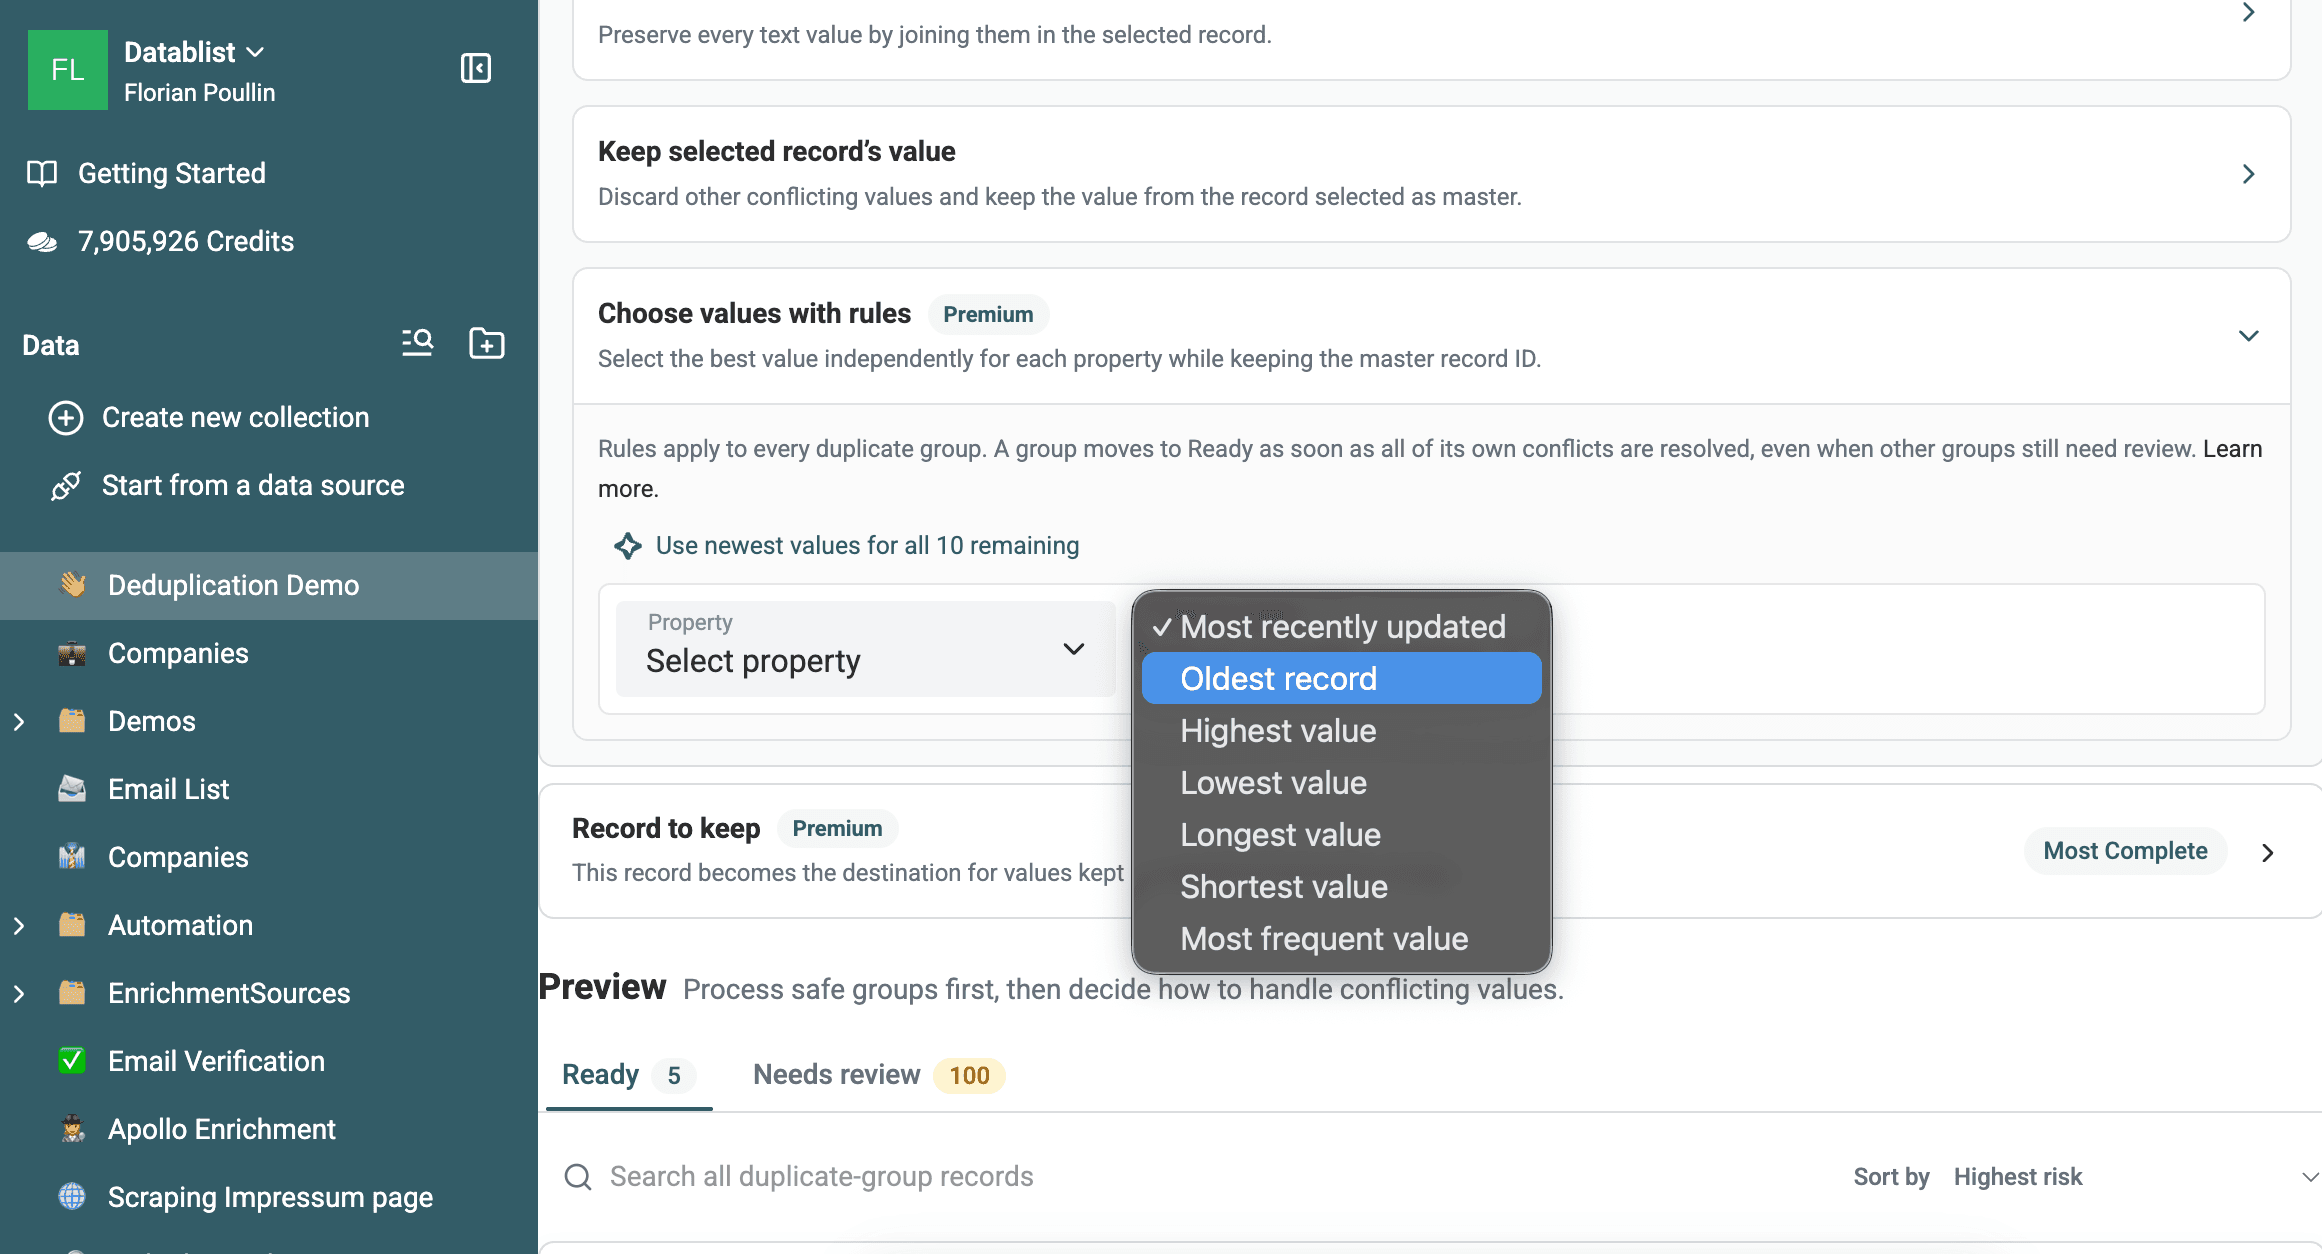
Usa regole specifiche per campo quando nessuna riga contiene il valore migliore per ogni proprietà. Puoi conservare l’ID del record selezionato e, allo stesso tempo, acquisire da altre righe una qualifica professionale più recente, un nome aziendale più completo e lo stato più frequente.
Aggiorna l’anteprima dopo aver modificato la soglia, il workflow, la composizione dei gruppi, le impostazioni per i conflitti o la regola di selezione del record.
Usare Custom with AI per regole specifiche per gruppo
Custom with AI genera un workflow per elaborare i gruppi a partire da un’istruzione in linguaggio naturale. Può selezionare un record, copiare o normalizzare valori, aggiungere una proprietà di stato, calcolare un totale per il gruppo, eliminare le righe secondarie oppure ignorare i gruppi che non soddisfano una condizione.
Per esempio:
Conserva il record il cui campo Source è CRM export. Copia il Job Title dal record più recente, combina le Notes distinte separandole con interruzioni di riga, aggiungi una casella Duplicate Reviewed, quindi elimina i record secondari.
Fai riferimento alle proprietà della collection con /Property o {{Property}}. Genera il workflow e controllane l’anteprima prima di eseguirlo. Custom with AI è disponibile per gli utenti autenticati con un piano a pagamento.
Per gestire singole eccezioni, apri Review group e usa il Merging Assistant, invece di complicare ulteriormente la regola di elaborazione in blocco.
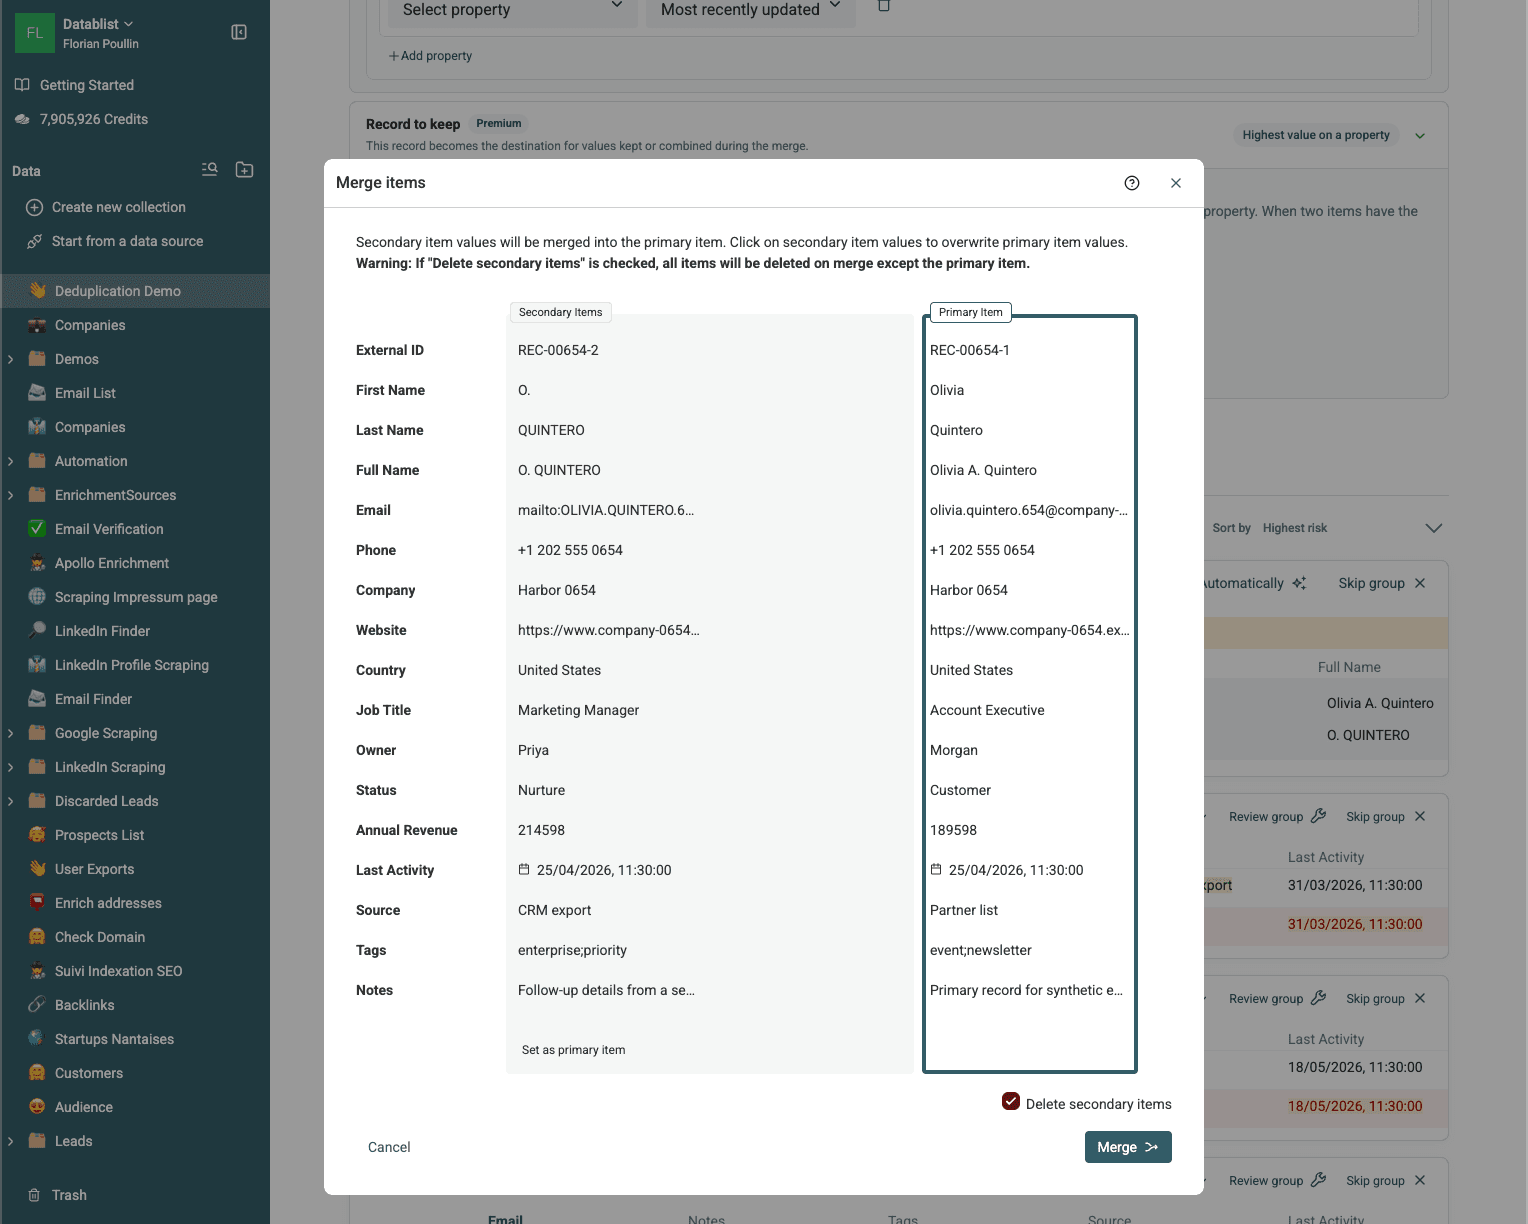
Verificare ed esportare la lista pulita
Prima di elaborare i gruppi Ready, verifica che:
- L’anteprima rifletta le impostazioni correnti.
- I gruppi poco affidabili e quelli con identificativi condivisi siano stati controllati.
- Il record selezionato contenga l’ID che devi conservare.
- I valori univoci di telefono, fonte, note e stato vengano mantenuti.
- I campi che ammettono un solo valore non vengano concatenati.
- Il numero di gruppi Ready visualizzato corrisponda all’insieme che vuoi elaborare.
Dopo l’elaborazione, verifica il numero di righe:
Righe iniziali - righe secondarie eliminate = righe finali
Nel controllo Exact di questa guida, Datablist ha unito cinque gruppi composti da due righe. La collection è quindi passata da 1.000 a 995 elementi.
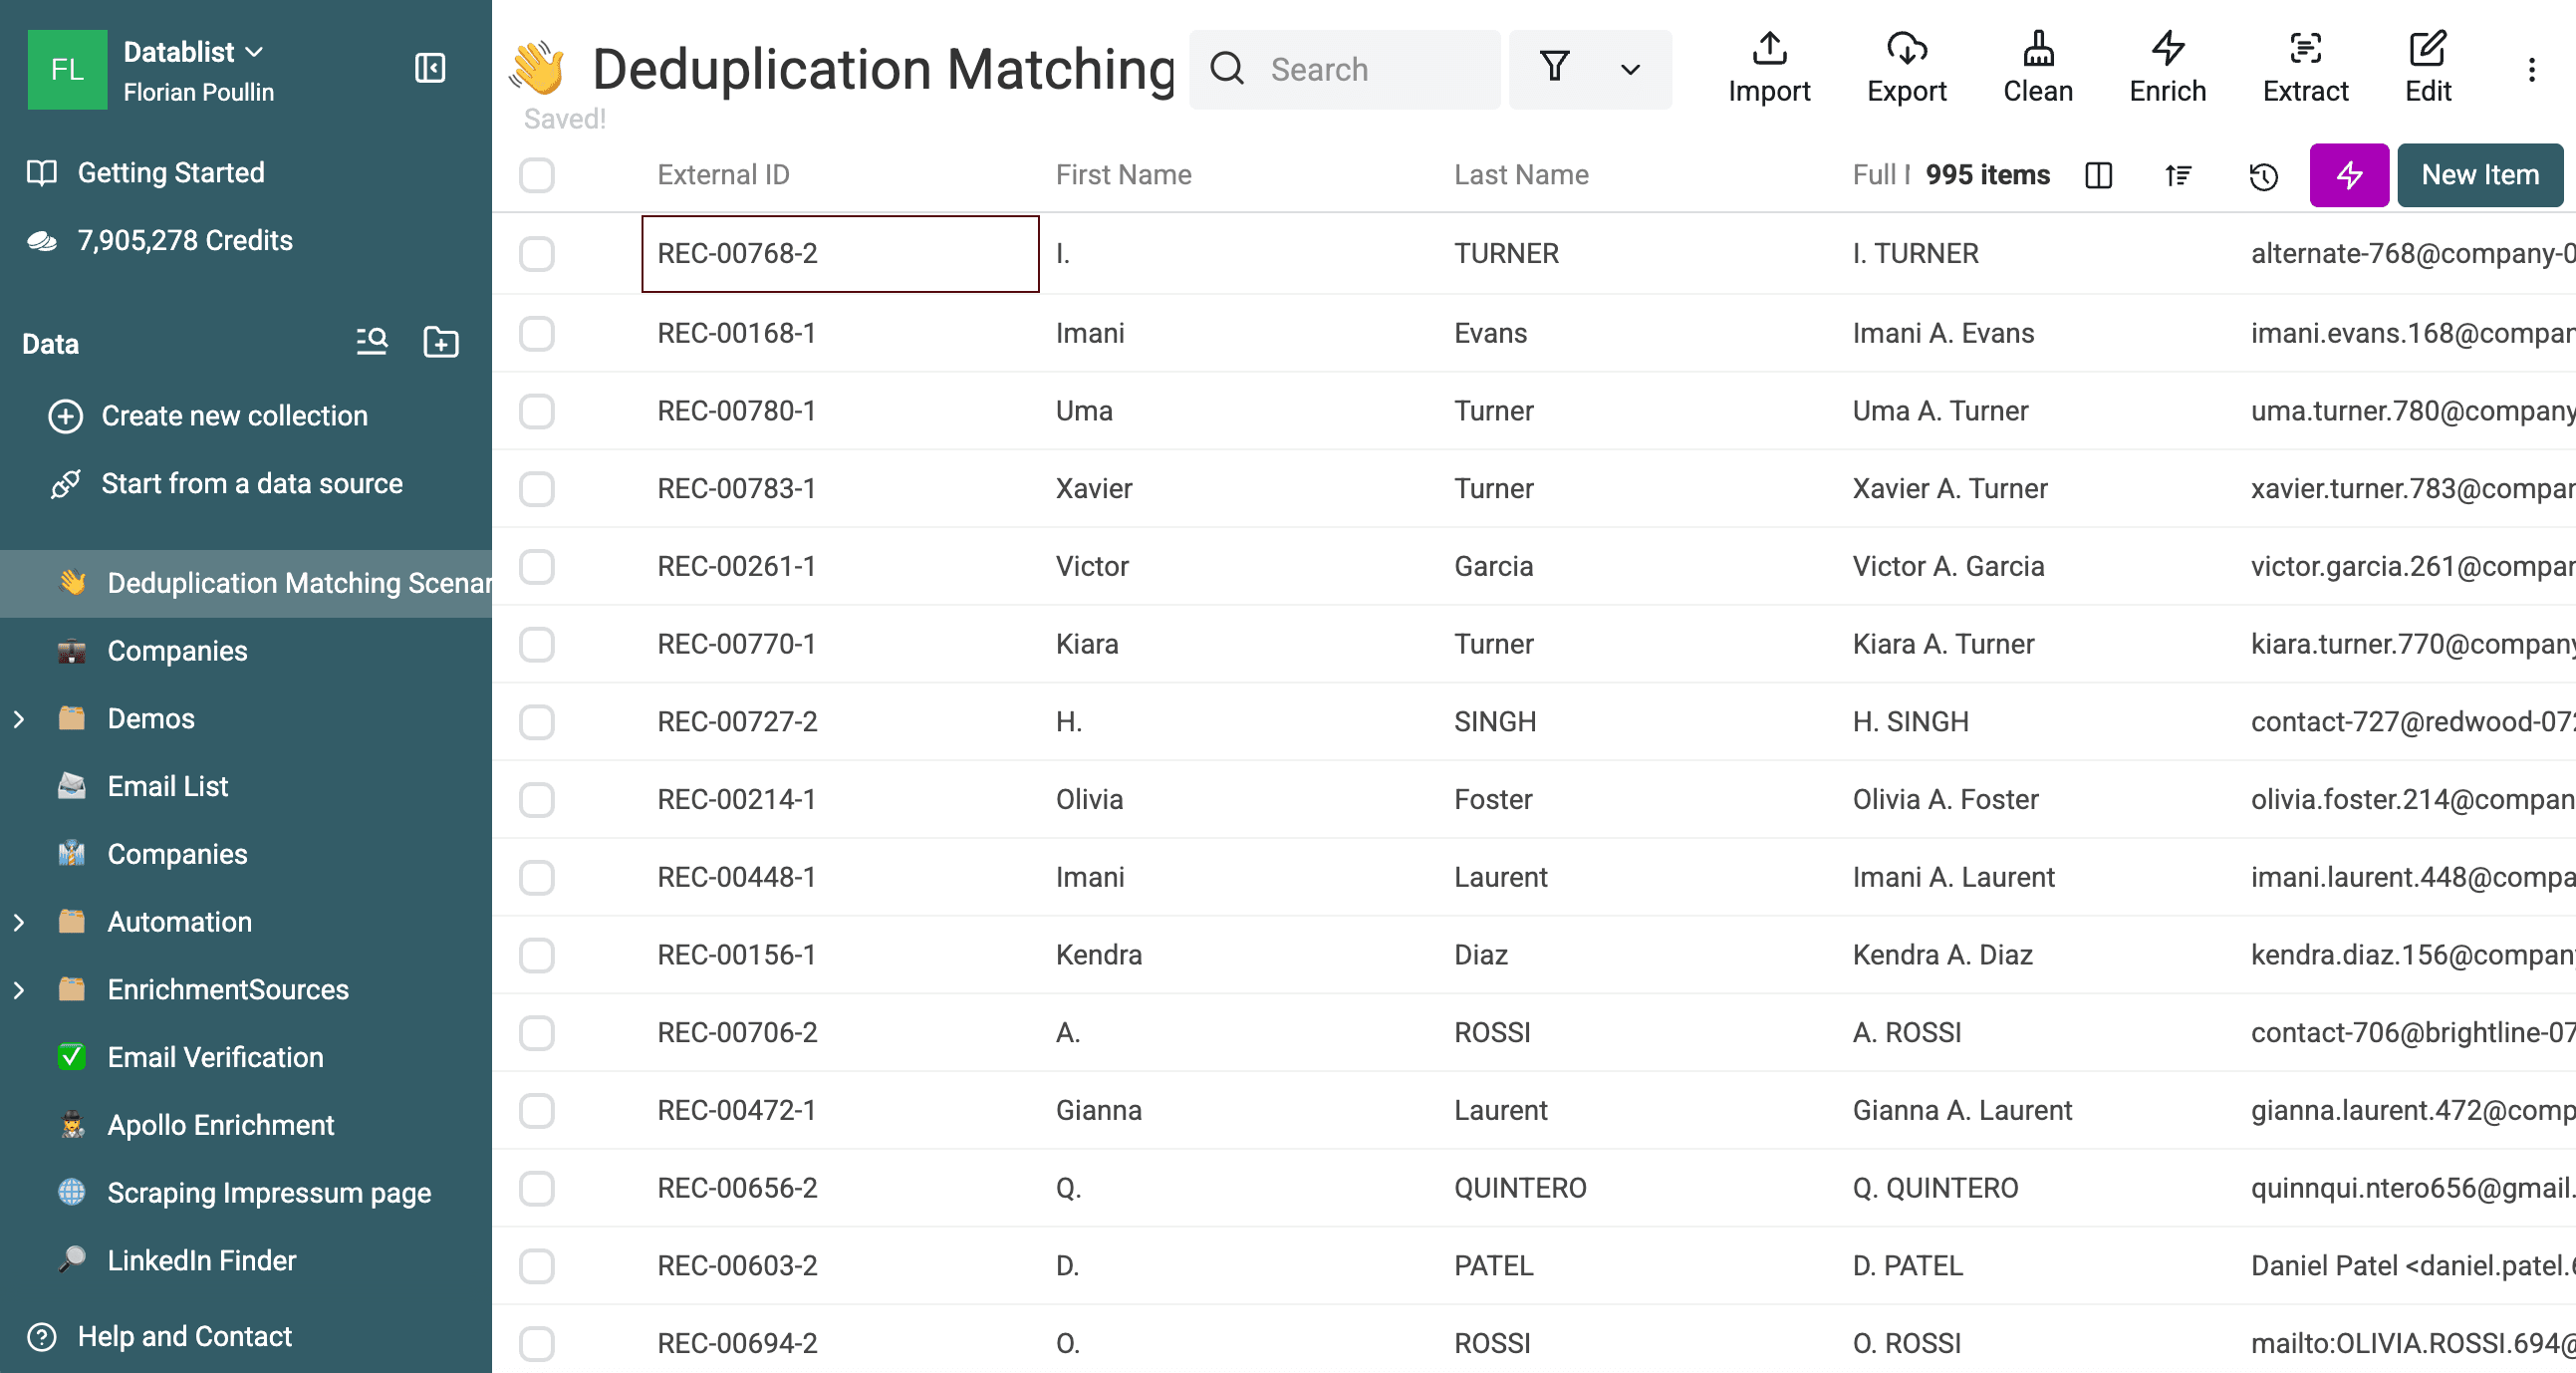
Scarica i gruppi di duplicati prima di elaborarli se ti serve un file esterno per la revisione. I piani a pagamento includono ID utilizzabili per i gruppi e il registro delle modifiche successive all’elaborazione. Il registro riporta gli ID Datablist eliminati e aggiornati, con i valori precedenti e quelli di destinazione.
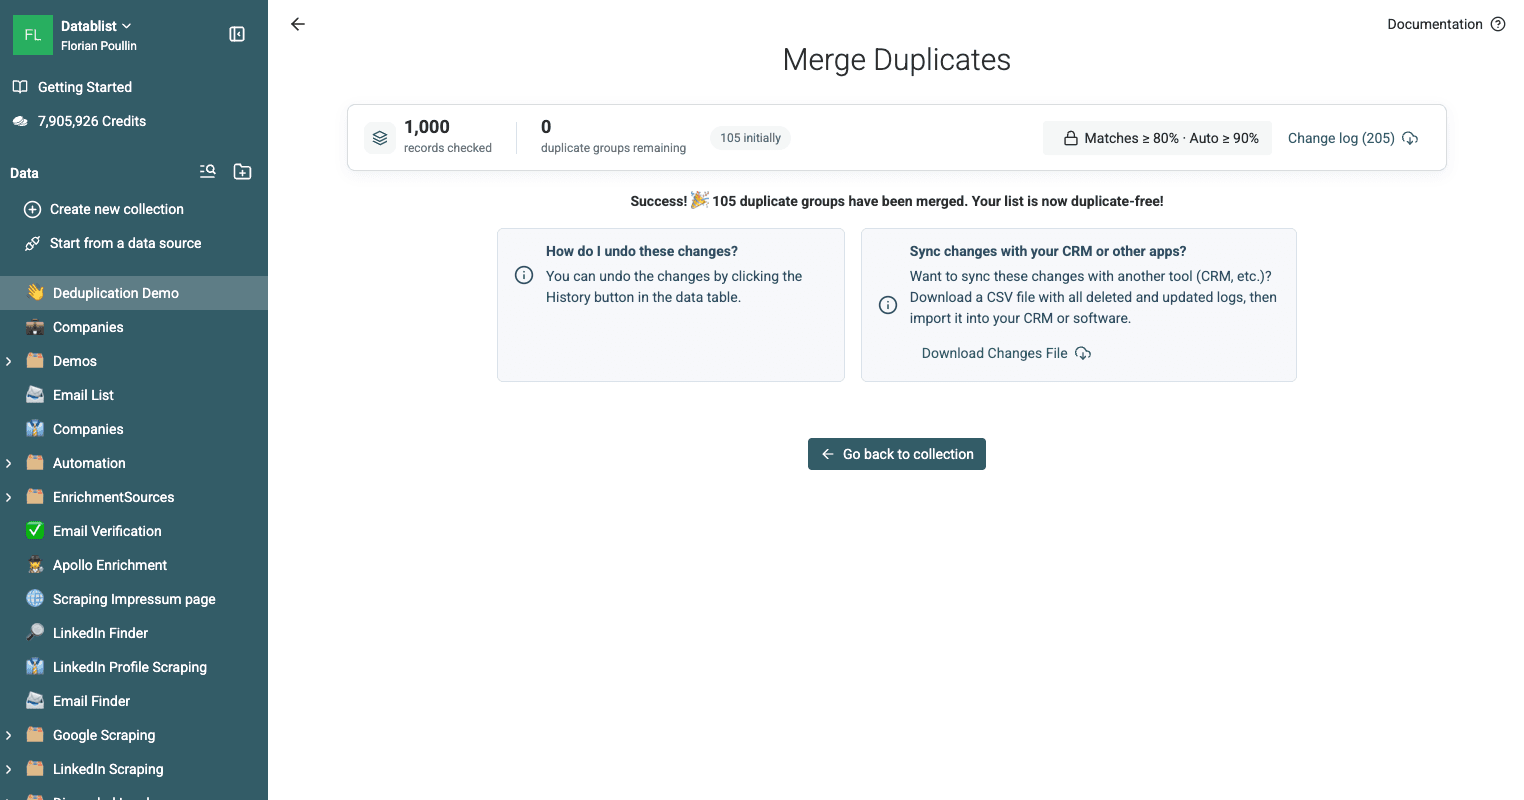
Le operazioni automatiche di rimozione e merge compaiono anche nella History della collection, da cui possono essere annullate.
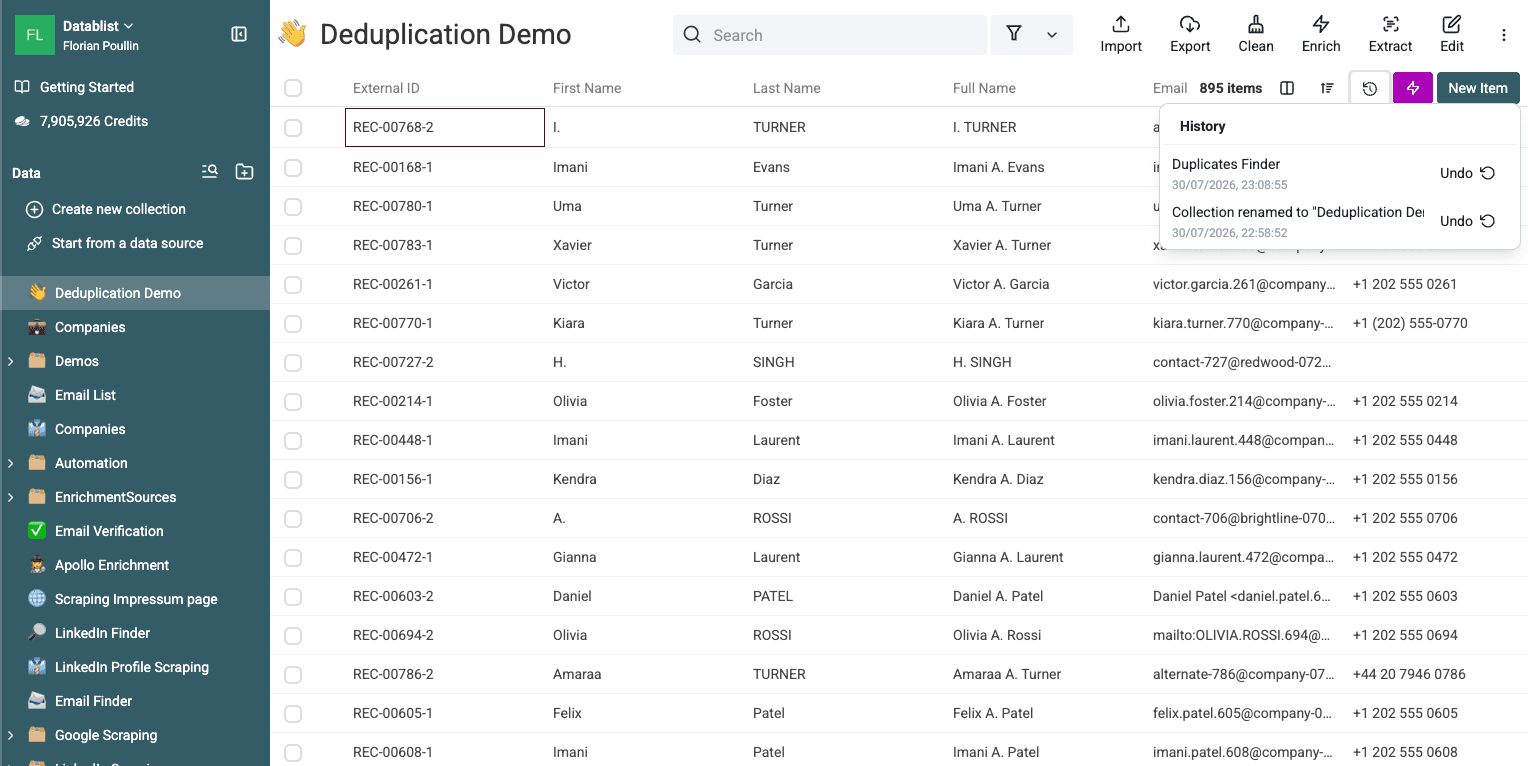
Torna alla collection e apri Export per scaricare il file CSV o Excel pulito.
Eliminare i duplicati da più liste
Usa il matching tra collection quando devi confrontare un nuovo file di Lead con un’esportazione dal CRM. Considera il CRM come lista di riferimento e rimuovi le corrispondenze dalla lista in entrata prima di importarla.
Scarica il file CRM dimostrativo e il file dell’evento dimostrativo per provare questo workflow. I due file hanno intestazioni differenti e contengono 100 sovrapposizioni email create appositamente. Ciascun file contiene inizialmente 250 righe.
Importa ogni file in una collection distinta, quindi apri Clean > Match across collections. Aggiungi entrambe le collection e mappa le proprietà corrispondenti, per esempio Email con Attendee Email.
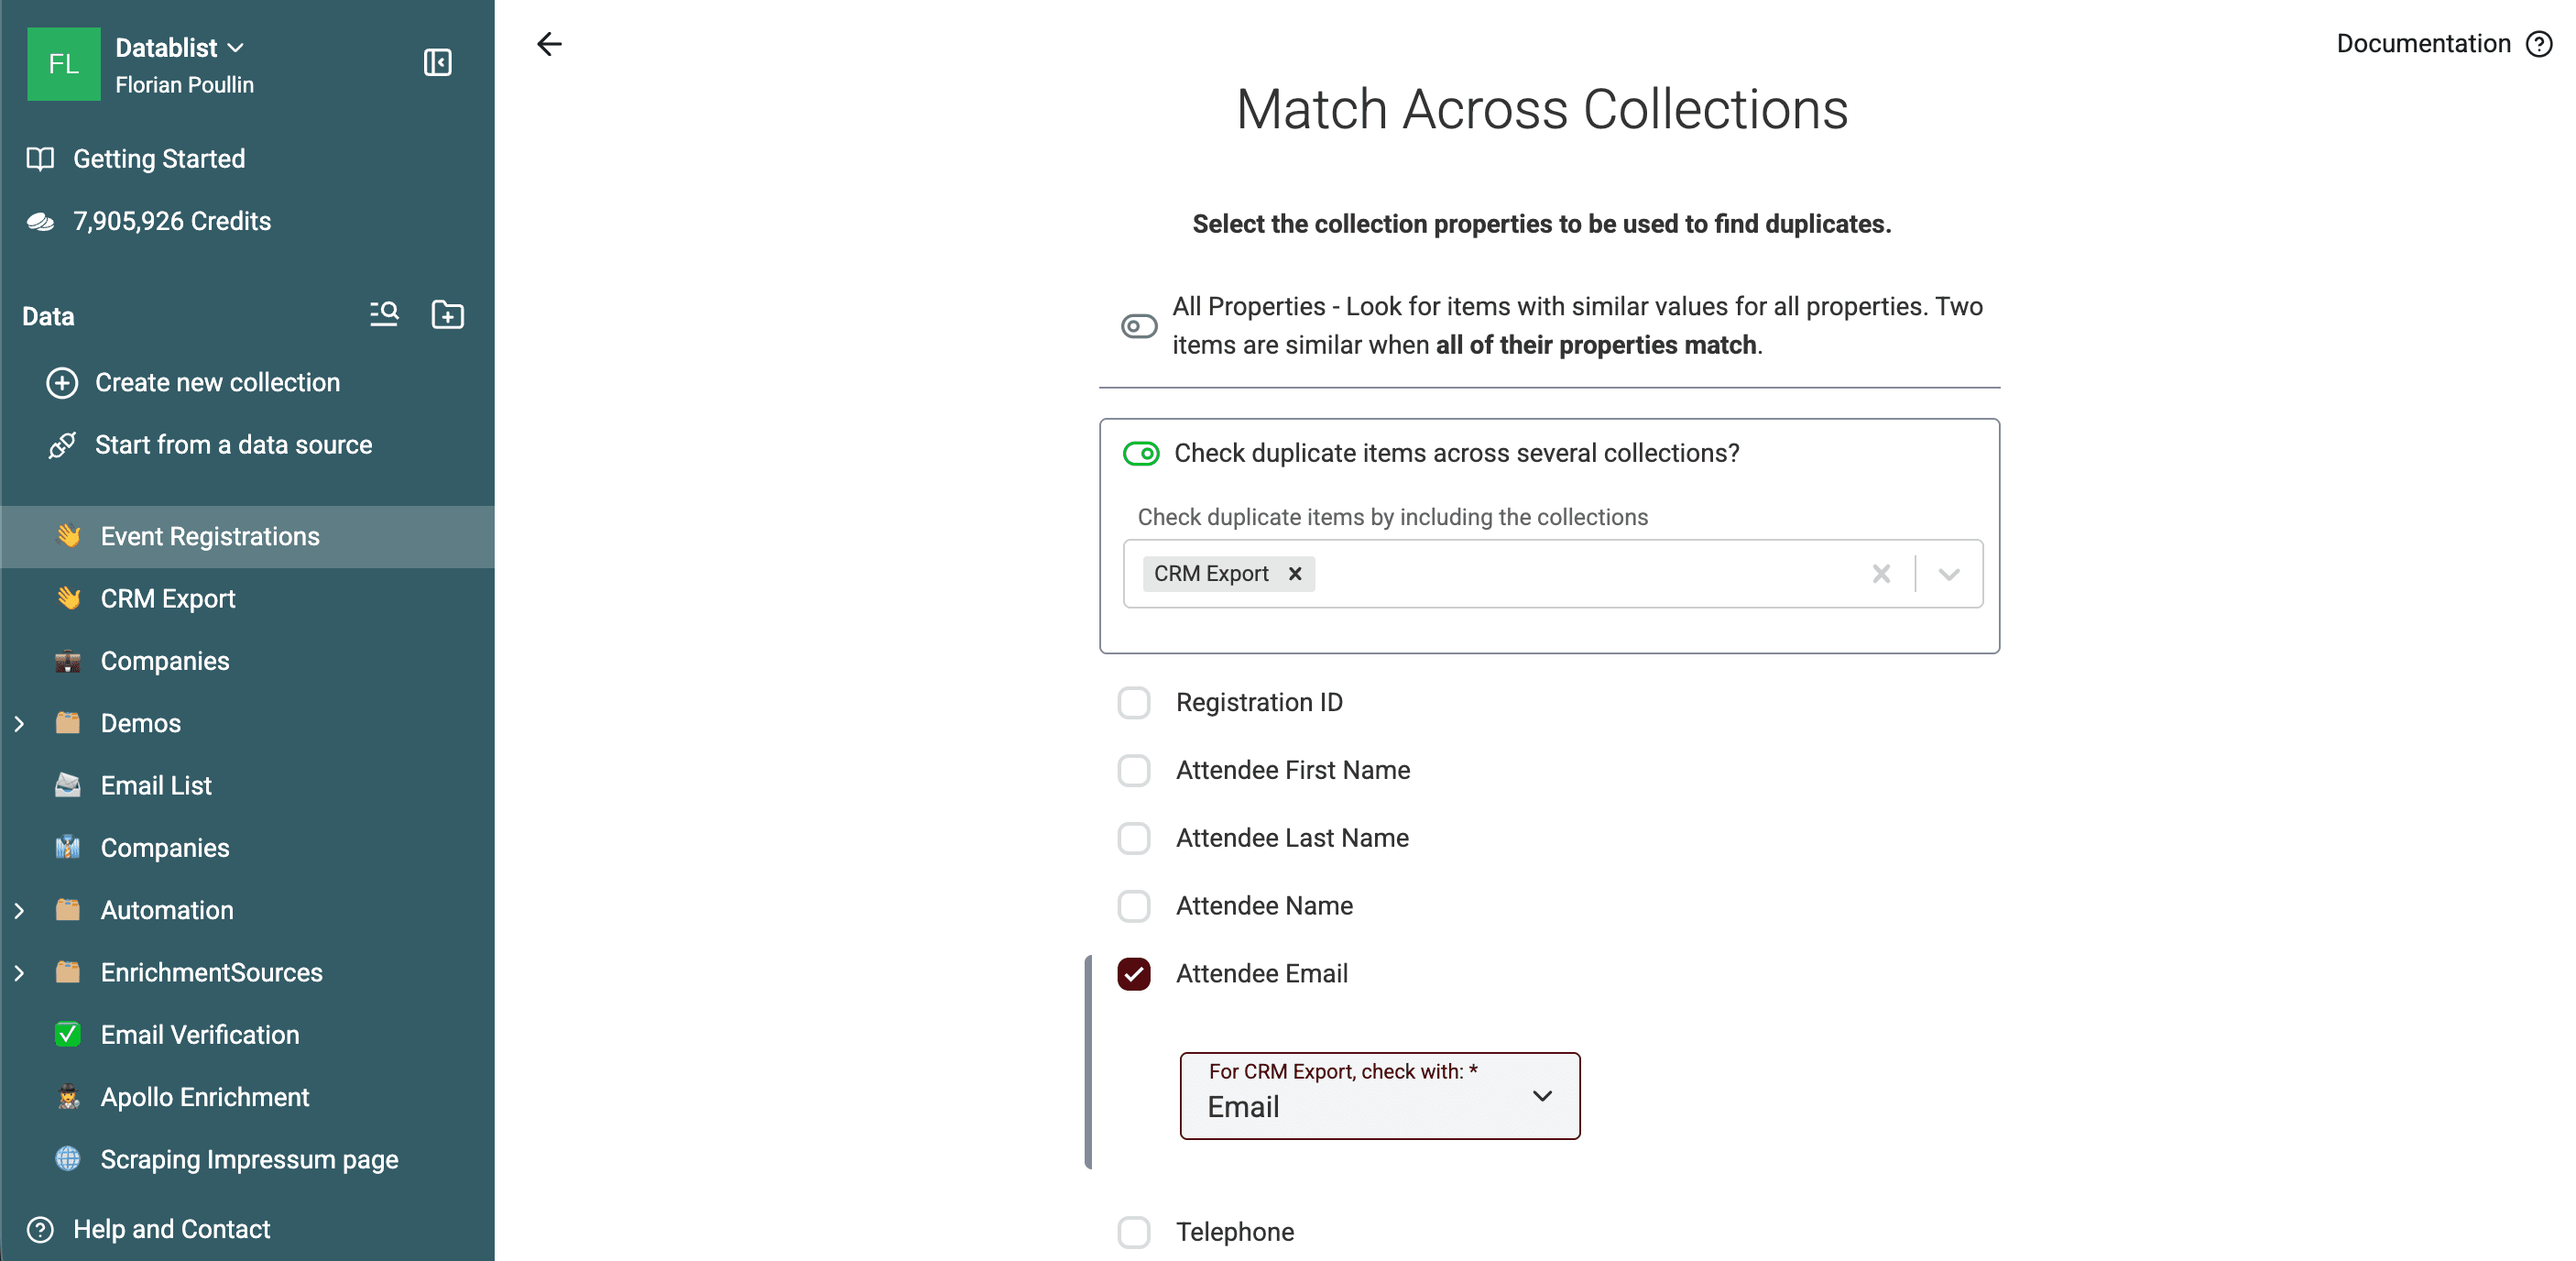
In questo test, il matching Smart con il processor Email ha restituito 100 gruppi tra collection su 500 record controllati. Seleziona Event Registrations in Remove duplicate items from collection {X} per lasciare invariato il CRM e rimuovere le relative corrispondenze dalla lista dell’evento.
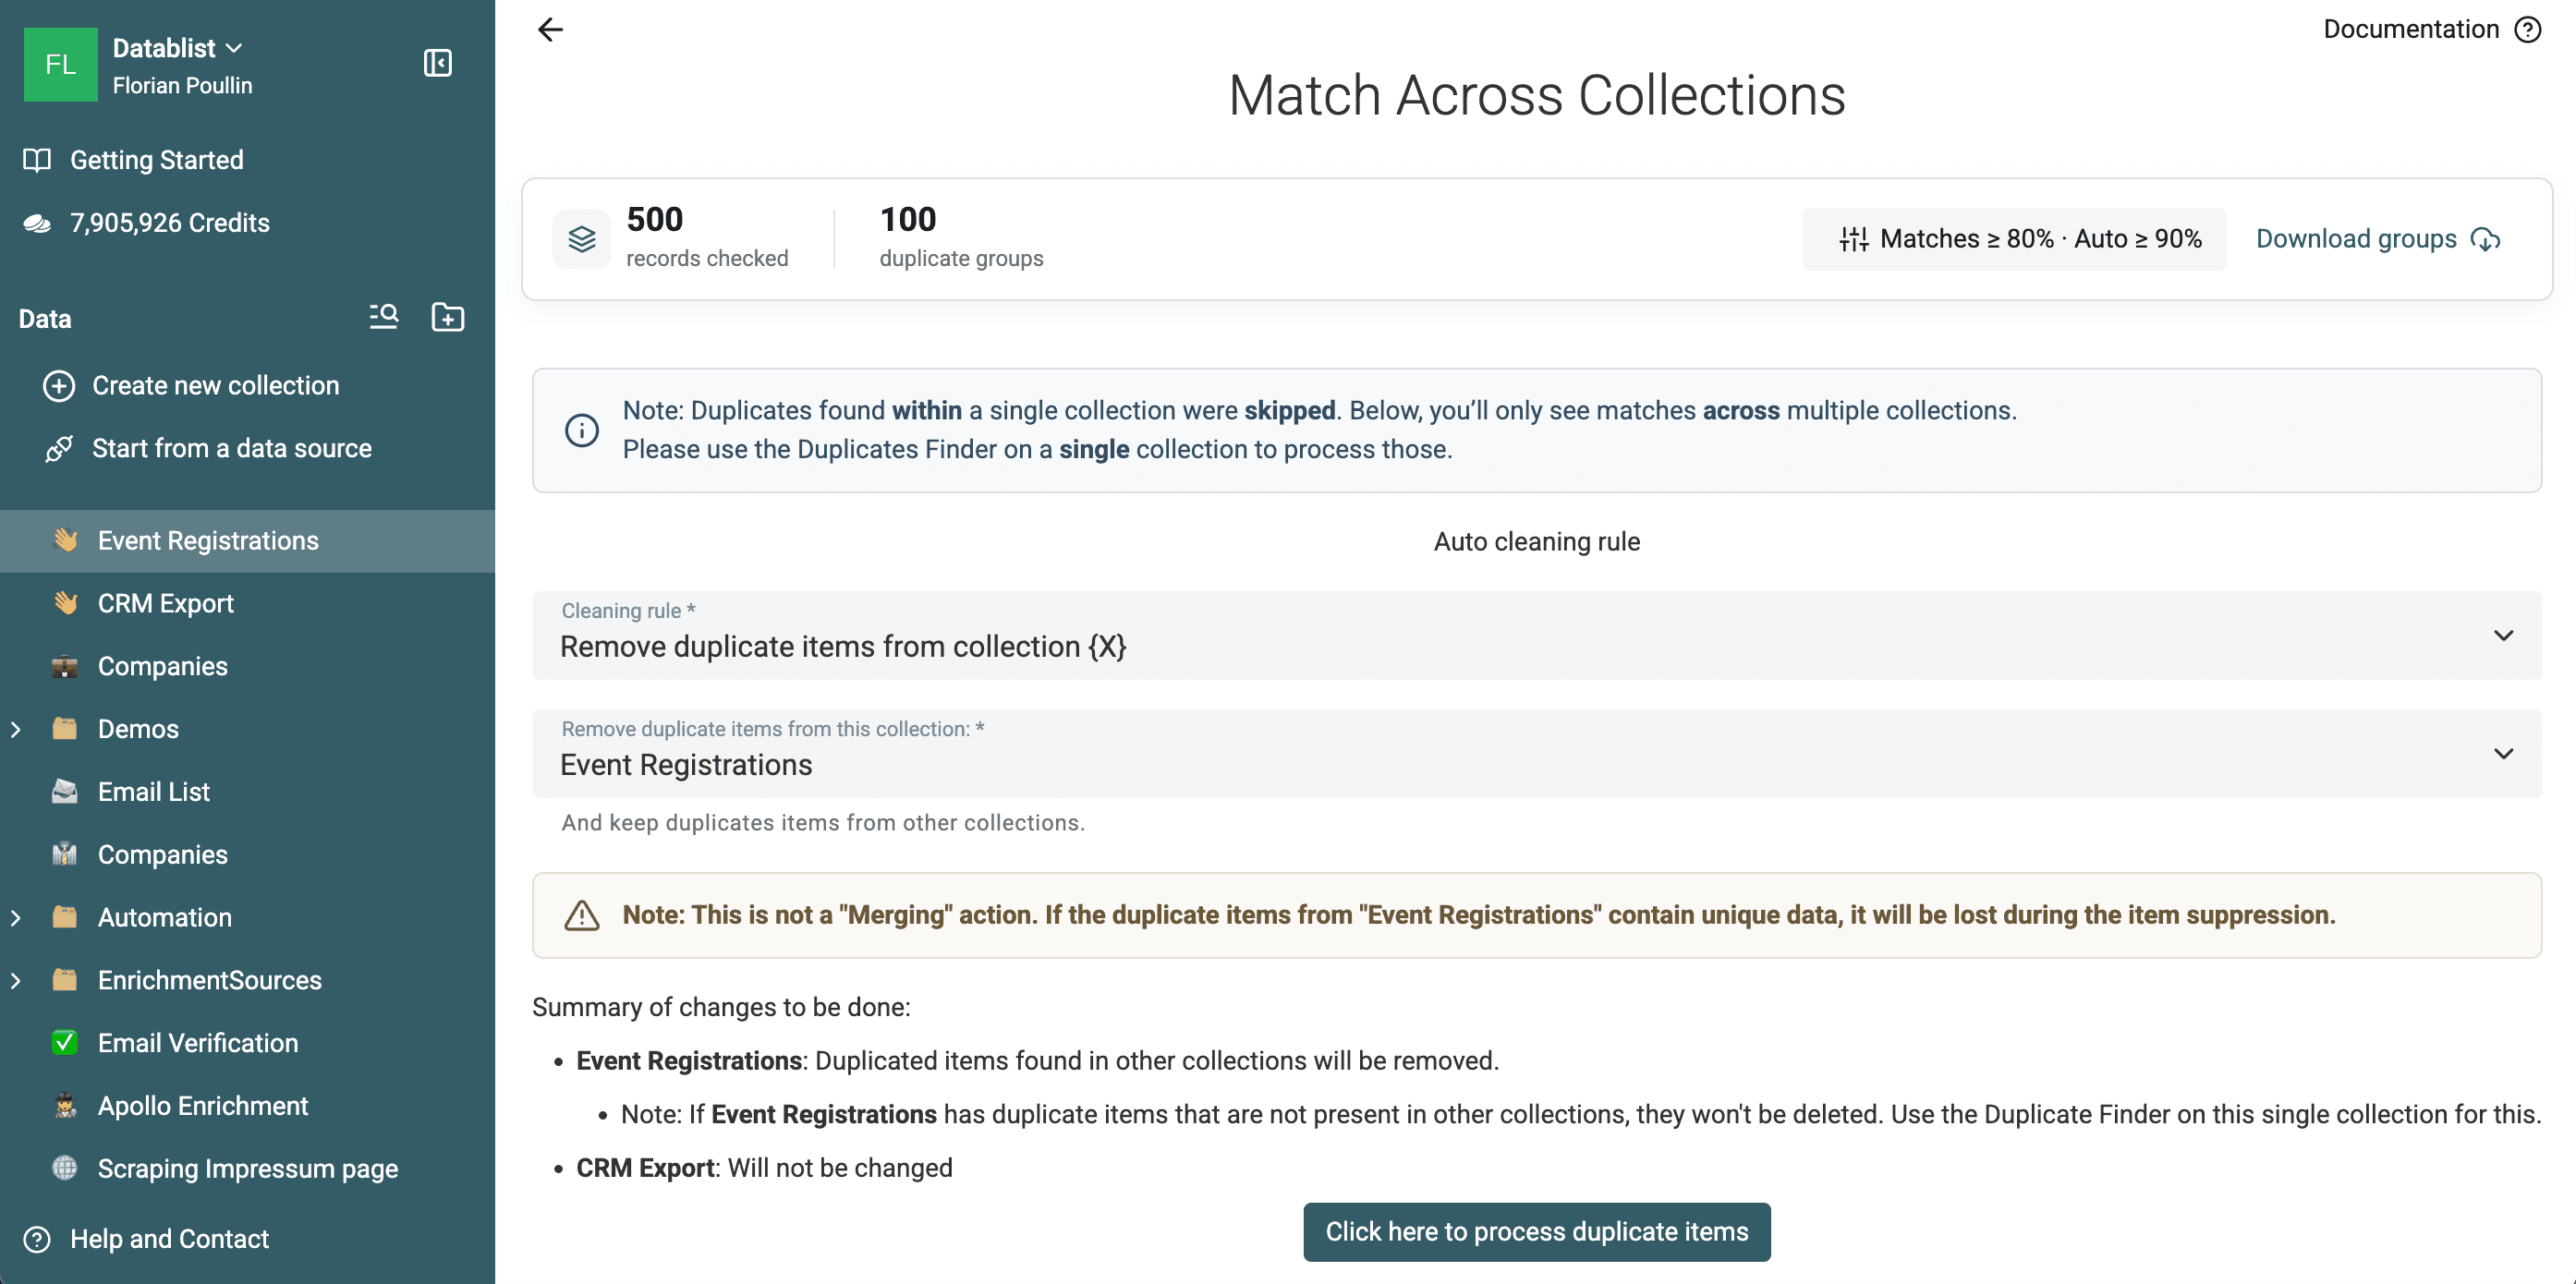
La pulizia automatica tra collection elimina le righe. Non unisce nel CRM i valori univoci provenienti dall’evento. Se i record in entrata contengono informazioni da conservare, esporta o controlla i gruppi prima dell’elaborazione.
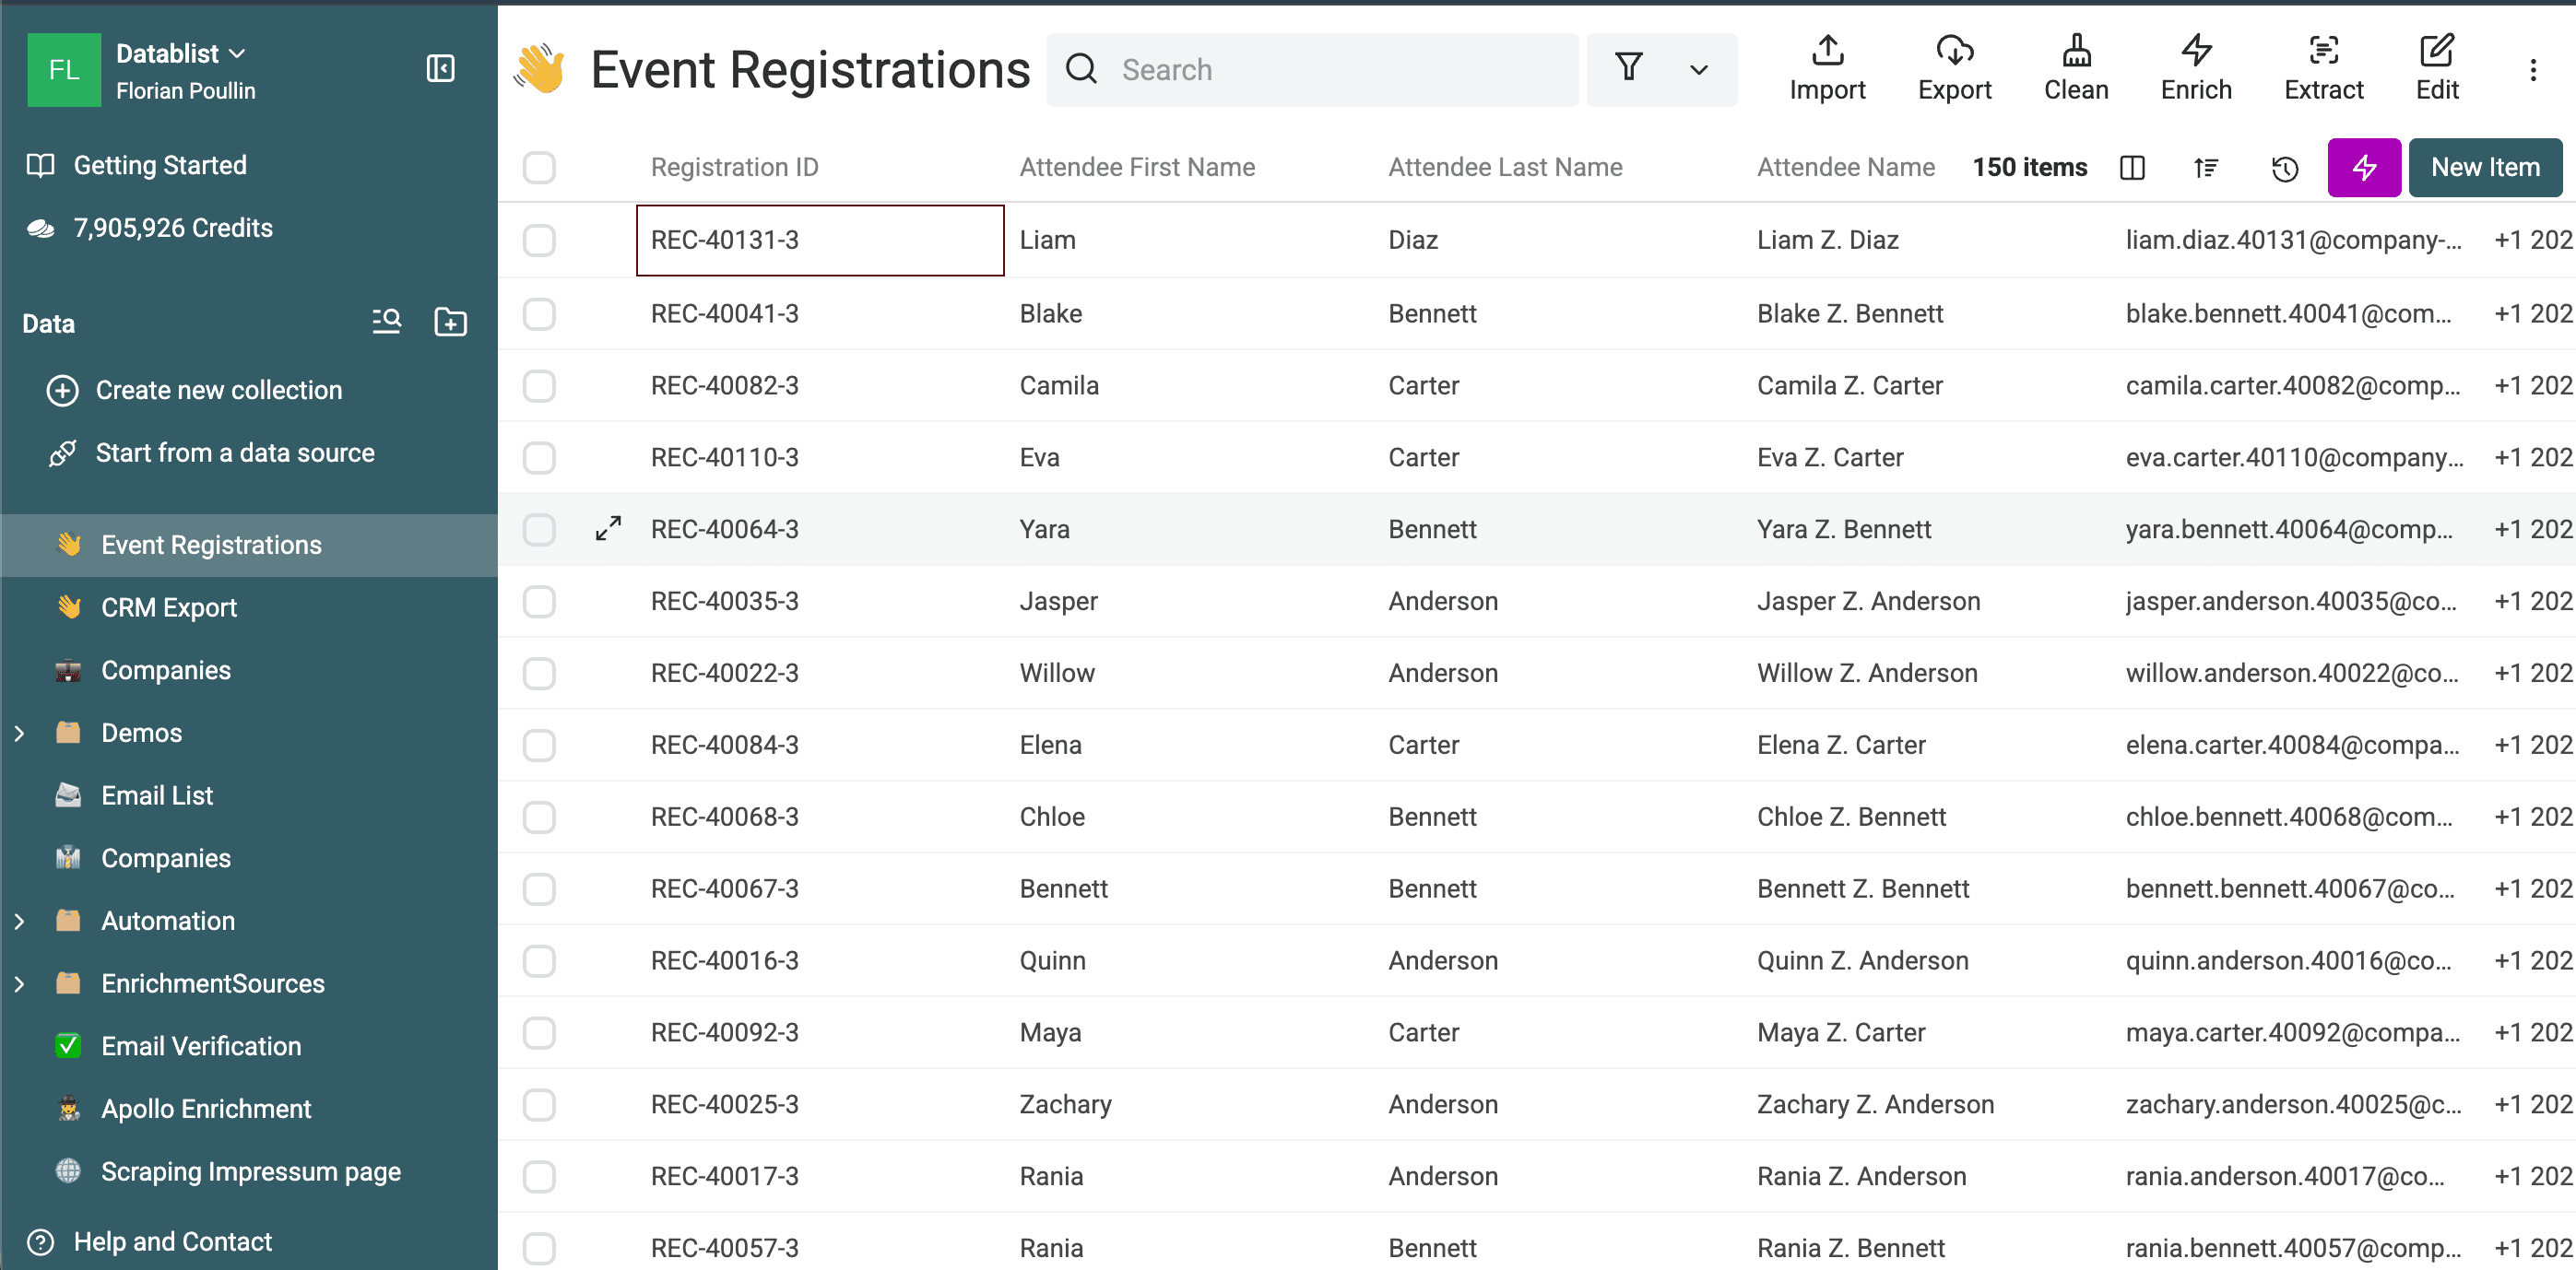
Dopo aver elaborato le 100 sovrapposizioni, Event Registrations contiene 150 nuovi contatti netti.
Il matching tra collection è una funzionalità Premium. Consulta la guida dettagliata per eliminare i duplicati da più file CSV o Excel e scoprire le opzioni di mapping ed elaborazione delle collection.
FAQ
Posso eliminare gratis i duplicati da una lista online?
Sì. Anche gli utenti anonimi possono eseguire un controllo Exact. Un account gratuito sblocca il matching Smart e le altre funzionalità del piano Free per una singola collection. Gli algoritmi fuzzy e fonetici, i processor avanzati, il matching tra collection, le regole configurabili per conservare i valori e Custom with AI richiedono un piano a pagamento.
Devo rimuovere o unire le righe duplicate?
Rimuovi le righe quando un record è autorevole e gli altri non contengono dati necessari. Esegui il merge quando le righe secondarie includono valori utili. L’anteprima di Remove mostra un avviso quando alcuni dati verrebbero eliminati.
Datablist trova i duplicati con errori di ortografia?
Sì. Jaro-Winkler e Levenshtein confrontano la somiglianza tra testi, mentre Metaphone ne confronta la pronuncia. Questi algoritmi avanzati richiedono un piano a pagamento e le corrispondenze individuate devono essere controllate.
Posso unire righe duplicate senza perdere dati?
Datablist può completare i campi vuoti, combinare valori testuali, mantenere il valore del record selezionato oppure applicare regole di conservazione a livello di campo. Controlla l’anteprima: ogni valore che decidi di scartare non comparirà nel record unito.
Quanto può essere grande la lista?
Il piano Free supporta fino a 1 milione di elementi per collection nella memoria del browser. I piani a pagamento consentono di importare fino a 2 milioni di elementi per collection. Le operazioni locali su grandi volumi dipendono comunque dal browser e dal dispositivo utilizzato.
Posso controllare i duplicati senza modificare la lista?
Sì. Il rilevamento è in sola lettura. Puoi esaminare i gruppi, modificare le soglie, usare Why matched, cercare e ordinare i risultati e scaricare le righe duplicate prima di avviare un’azione di elaborazione.
Per conoscere tutte le impostazioni e le limitazioni, consulta la documentazione completa di Duplicate Finder.