
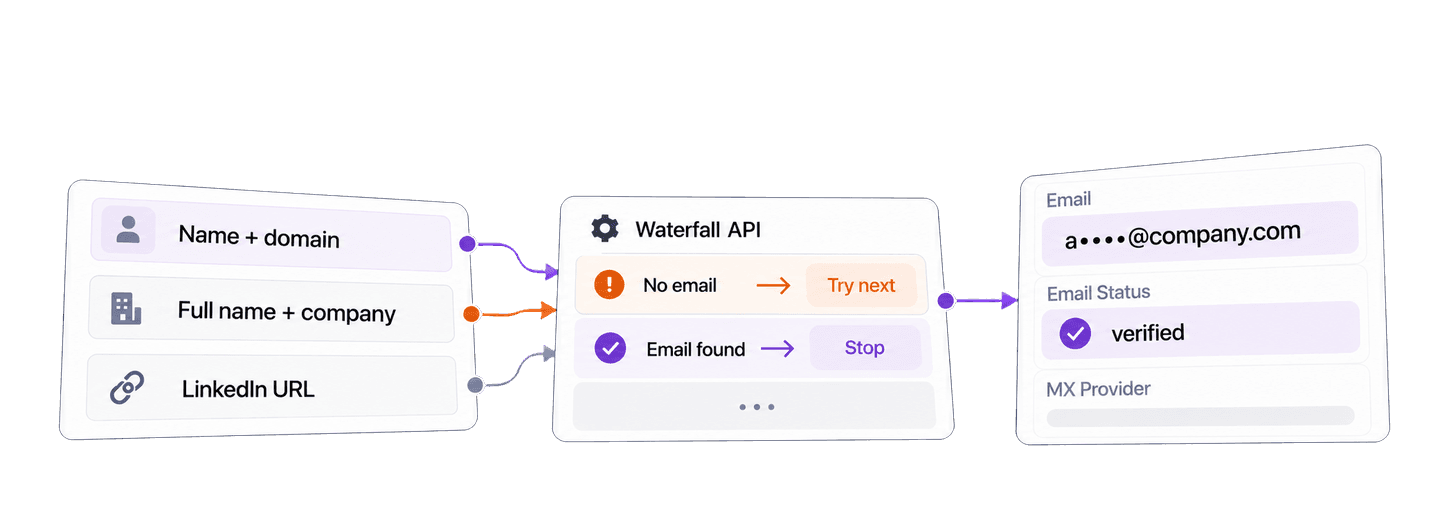
Per trovare email di lavoro in Python, invia il nome della persona e i dati dell'azienda, oppure l'URL di un profilo LinkedIn pubblico, alla Waterfall Email Finder API di Datablist usando la libreria Requests. L'API restituisce l'email di lavoro trovata, lo stato di deliverability dell'indirizzo e il relativo mail provider.
L'esempio completo qui sotto cerca Satya Nadella su microsoft.com e Reid Hoffman su greylock.com. Attende il completamento del task in background e recupera tutte le pagine dei risultati. In seguito riutilizzeremo questi dati per preparare in locale un elenco di contatti verificati da controllare prima della campagna.
📌 Riepilogo per chi va di fretta
Usa un'unica funzione Python per inviare i contatti noti alla Waterfall Email Finder API, attendere il completamento del task e raccogliere le email di lavoro trovate. Prepara quindi i contatti verificati per la revisione della campagna, mantenendo quelli irrisolti nell'elenco originale.
- Input: nome e cognome con il dominio aziendale, nome completo con il nome dell'azienda oppure URL di un profilo LinkedIn pubblico.
- Output: un'email di lavoro con
emailStatusemxProvider, seguita da un elenco locale contenente solo i contatti per cui è stata trovata un'email.
💡 Preferisci una soluzione no-code? Usa il Waterfall Email Finder di Datablist per trovare email di lavoro partendo da una collection, senza scrivere codice.
Configurare Python, Requests e la chiave API
Per questo esempio in Python utilizziamo il package requests. Crea un file chiamato find_work_emails.py, quindi installa Requests:
python -m pip install requestsCrea una Personal API Key dalla pagina API del tuo account Datablist. L'accesso alla REST API richiede il piano Growth. Esporta la chiave nel terminale dal quale eseguirai lo script:
export DATABLIST_API_KEY="your-api-key"Anche i risultati ottenuti con successo dal Waterfall Email Finder consumano crediti. La sezione dedicata ai costi distingue questi crediti dall'abbonamento che include l'accesso API.
Trovare email di lavoro con una funzione Python
Incolla lo script completo seguente in find_work_emails.py:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Eseguilo dallo stesso terminale:
python find_work_emails.pyPuoi anche scaricare l'esempio Requests aggiornato. Dopo aver compreso la versione bloccante, nel repository trovi anche un'alternativa asincrona basata su HTTPX.
La funzione effettua tre tipi di chiamate, in sequenza.
Per prima cosa, invia il task. Ogni inputId è l'ID stabile del contatto. L'oggetto data annidato contiene i campi utilizzati per la ricerca. La richiesta POST restituisce 202 Accepted insieme a @id, l'ID del task impiegato nelle chiamate successive. Prima dell'invio, il codice stampa uniqueId: se la risposta va persa, avrai comunque un valore per recuperare il task.
Poi controlla lo stato del task. Datablist elabora il task in background. Questo client Requests attende e verifica lo stato ogni tre secondi finché non diventa completed, failed oppure stopped. Requests rimane bloccato durante l'attesa, ma il task API resta asincrono.
Infine, recupera i risultati. Un task può produrre più pagine di risultati. Il ciclo continua a scaricarle finché nextCursor non assume il valore null. Per associare ogni risultato al contatto originale, usa inputId anziché l'ordine delle risposte.
Scegliere l'input giusto per i dati dei contatti
Ogni task utilizza una sola modalità di input. Mantieni la stessa funzione find_emails() e sostituisci i valori di settings e people con quelli adatti ai tuoi dati di partenza.
Quando possibile, scegli un inputId univoco all'interno del task e già associato al contatto originale. L'ID di un record CRM o un altro Lead ID persistente sono ottime opzioni. Datablist restituisce questo valore insieme al risultato, così puoi abbinare i record senza confrontare i nomi o presumere che l'ordine delle risposte coincida con quello degli input.
Se disponi di nome, cognome e dominio aziendale separati, usa sourceKind: "name_company". Un dominio noto è l'identificativo aziendale più chiaro:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Se i dati di partenza hanno un unico campo per il nome e includono il nome dell'azienda, abilita useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Se hai l'URL pubblico del profilo di una persona, usa la modalità LinkedIn:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Questa modalità accetta l'URL pubblico di un profilo linkedin.com/in/... come contesto della persona per la ricerca dell'email. Gli URL dei profili Sales Navigator non sono supportati.
Se vuoi scegliere le chiavi dei provider e il relativo ordine, consulta la guida al waterfall personalizzato. Il waterfall gestito utilizzato qui non richiede configurazioni specifiche per i singoli provider.
Come il waterfall gestito trova un'email
Per una richiesta basata su nome e azienda, l'API utilizza direttamente il dominio fornito. Se indichi il nome dell'azienda, prova prima ad associarlo a un dominio aziendale utilizzabile. Per una richiesta LinkedIn, ripulisce l'URL del profilo pubblico e trasforma i dati disponibili sulla persona e sull'azienda nel contesto richiesto dai provider idonei.
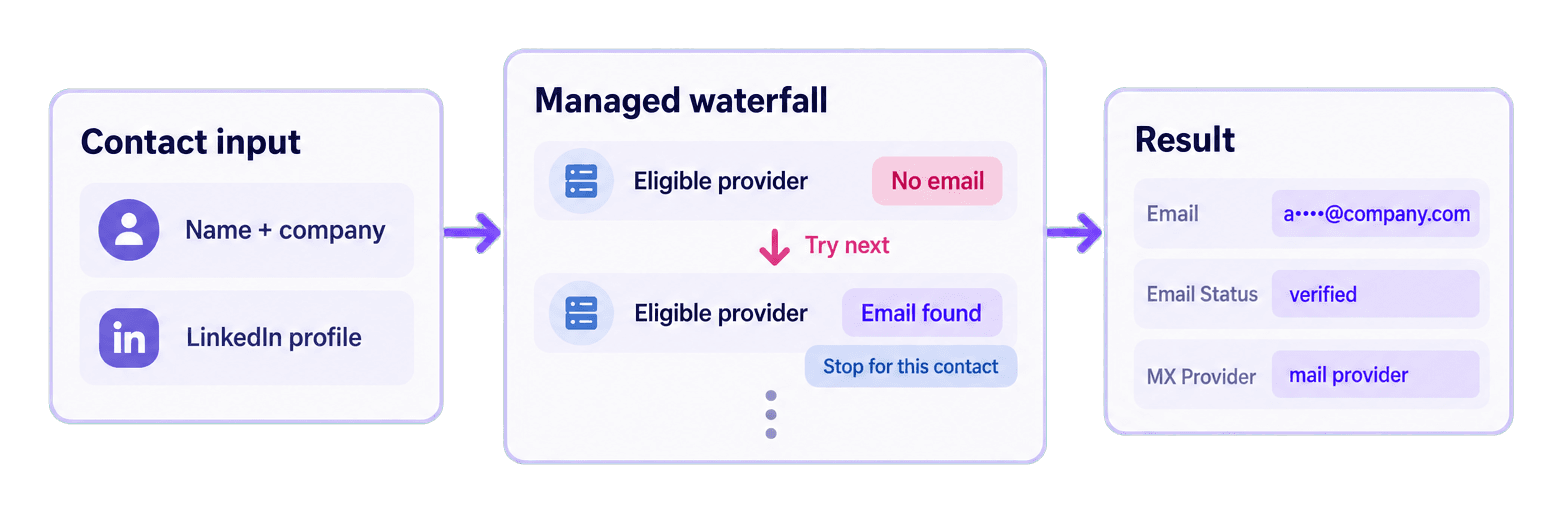
Il waterfall gestito invia un contatto irrisolto a un provider idoneo. Se non riceve un'email utilizzabile, un altro provider può effettuare un nuovo tentativo sullo stesso contatto. La sequenza si interrompe non appena viene accettata un'email di lavoro. La risposta predefinita non indica quale finder l'abbia trovata.
Perché un waterfall aiuta nell'outreach internazionale
I provider di email di lavoro utilizzano dataset differenti, perciò la loro copertura cambia in base al Paese e al mercato. Un provider potrebbe non trovare nulla per un contatto in una determinata area geografica, mentre un altro potrebbe disporre dei dati necessari per individuare l'indirizzo.
Per un team sales o growth, il waterfall offre a ogni contatto irrisolto un'ulteriore possibilità di essere trovato prima di escluderlo dalla lista di outreach. In questo modo puoi recuperare contatti che un workflow basato su un solo provider perderebbe, mantenendo al tempo stesso un processo tecnico uniforme per tutto il team.
Datablist gestisce la sequenza dei provider idonei dietro un'unica integrazione API. Invii il contatto una sola volta e ricevi i risultati in un formato unico, senza dover creare e mantenere un'integrazione separata per ciascun provider né unire manualmente le risposte.
Leggere tutti i risultati dell'API
Il task dell'esempio ha restituito due risultati positivi. Gli indirizzi email sono mascherati qui sotto.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound contiene l'email di lavoro restituita. emailStatus ne descrive la deliverability al momento della ricerca, mentre mxProvider identifica, quando disponibile, il provider che ospita la casella email. Entrambi i record sono verified e ciascuno ha utilizzato 25 crediti.
Il codice per la campagna riportato di seguito inserisce i risultati verified in campaign_contacts e gli altri indirizzi trovati in needs_verification. Il valore creditsUsed rappresenta l'addebito effettivo per ciascun risultato.
Il risultato predefinito del waterfall gestito non contiene finderProvider. Questo campo è un output condizionale disponibile per un workflow nome-azienda valido con chiavi personalizzate: lo script non deve quindi dedurlo da mxProvider.
Preparare le email per la revisione della campagna
Quando la ricerca diretta funziona, aggiungi questo blocco alla fine dello script, dopo aver ottenuto lookup_results. Il codice usa la ricerca appena eseguita per preparare in locale i contatti da controllare prima della campagna.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))results_by_id rende irrilevante l'ordine delle risposte. Per Satya, il ciclo legge contact-satya-nadella dall'elenco people originale, trova il risultato con lo stesso inputId, copia il record di partenza e aggiunge l'oggetto API completo sotto result. Poiché l'indirizzo è presente e il suo stato è verified, il contatto viene inserito in campaign_contacts. Reid segue lo stesso percorso anche se il suo risultato API arriva per primo.
Le tre condizioni rendono la logica decisionale facile da seguire. La prima salta un contatto se non è stato restituito alcun risultato corrispondente. La seconda esclude gli errori a livello di riga e gli altri stati diversi da success. La terza richiede la presenza effettiva di un valore emailFound. Allegando l'intero oggetto result, conservi stato, output, crediti utilizzati e campo di errore per i controlli successivi.
Un'email trovata con uno stato di deliverability diverso viene inserita in needs_verification. Un risultato assente, un errore di riga o un risultato privo di emailFound resta fuori da entrambi gli elenchi preparati. L'elenco people originale rimane disponibile per eventuali correzioni o ricerche successive.
Stimare i costi della Waterfall Email Finder API
Il waterfall gestito predefinito utilizza 25 crediti per ogni email di lavoro trovata. Una ricerca predefinita senza risultati consuma 0 crediti. Leggi creditsUsed in ogni risultato anziché moltiplicare per 25 il numero totale di contatti inviati.
Un'email trovata con stato unverified utilizza comunque 25 crediti, anche se il codice locale per la campagna la inserisce in needs_verification invece che in campaign_contacts.
Le due email trovate in questo esempio hanno utilizzato 50 crediti. Per pianificare i costi:
- 100 email di lavoro trovate utilizzano 2.500 crediti.
- 1.000 email di lavoro trovate utilizzano 25.000 crediti.
- Un elenco di input più ampio può consumare meno crediti rispetto a
contatti × 25, perché le ricerche senza risultati non vengono addebitate.
L'accesso alla REST API richiede il piano Growth. All'attuale tariffa di ricarica in USD, 20 $ acquistano 20.000 crediti, equivalenti a 0,001 $ per credito. A questa tariffa, 25.000 crediti hanno un valore di 25 $. L'abbonamento è separato dal calcolo dei crediti. Consulta la pagina dei prezzi di Datablist per verificare i dettagli aggiornati di piani e pacchetti.
Risolvere gli errori comuni e recuperare un task
La chiave API è assente. Prima di effettuare qualsiasi richiesta, lo script genera l'errore Set DATABLIST_API_KEY before running this script.. Esporta la variabile nel terminale corrente ed esegui nuovamente il file.
L'API restituisce un errore di autenticazione. raise_for_status() segnala l'errore HTTP. Copia una Personal API Key valida, verifica che l'header X-API-Key la utilizzi ed esegui di nuovo lo script solo dopo aver corretto le credenziali.
L'account non dispone di crediti sufficienti. Controlla il saldo dell'account. Aggiungi crediti oppure attendi la prossima assegnazione prevista dal piano prima di inviare altri task.
I campi di input non corrispondono alla modalità selezionata. Usa campi separati per nome e cognome oppure fullName con name_company; in alternativa, usa linkedInProfile con linkedin. Correggi il contatto e invialo utilizzando un'unica modalità coerente.
Il task è failed o stopped. Lo script genera un RuntimeError contenente l'ID del task, lo stato finale e l'eventuale errore disponibile. Esamina il task e tutti i risultati disponibili prima di decidere per quali contatti occorre ripetere la ricerca.
La risposta POST è andata persa. Copia il valore uniqueId stampato prima dell'invio. Elenca i tuoi task usando la stessa chiave:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Trova il task con il valore uniqueId stampato, copia il suo @id e prosegui con l'URL dello stato o dei risultati. In questo modo recuperi il task esistente senza inviare automaticamente una seconda volta gli stessi contatti. La documentazione della task API descrive il ciclo di vita e gli endpoint dei risultati.
Prossimi passi
Ora hai un'unica funzione Python Requests bloccante per le tre modalità di input supportate e un filtro locale che prepara le email trovate e verificate per la revisione della campagna.
Sostituisci i due contatti di esempio con un piccolo campione dei contatti che hai ricercato. Scegli la modalità di input adatta ai tuoi dati, esegui la ricerca e controlla emailStatus prima di utilizzare un indirizzo. Per lavorare su elenchi più ampi, scopri come trovare email su larga scala. Nel repository GitHub aggiornato trovi gli esempi Python bloccanti e asincroni da scaricare.