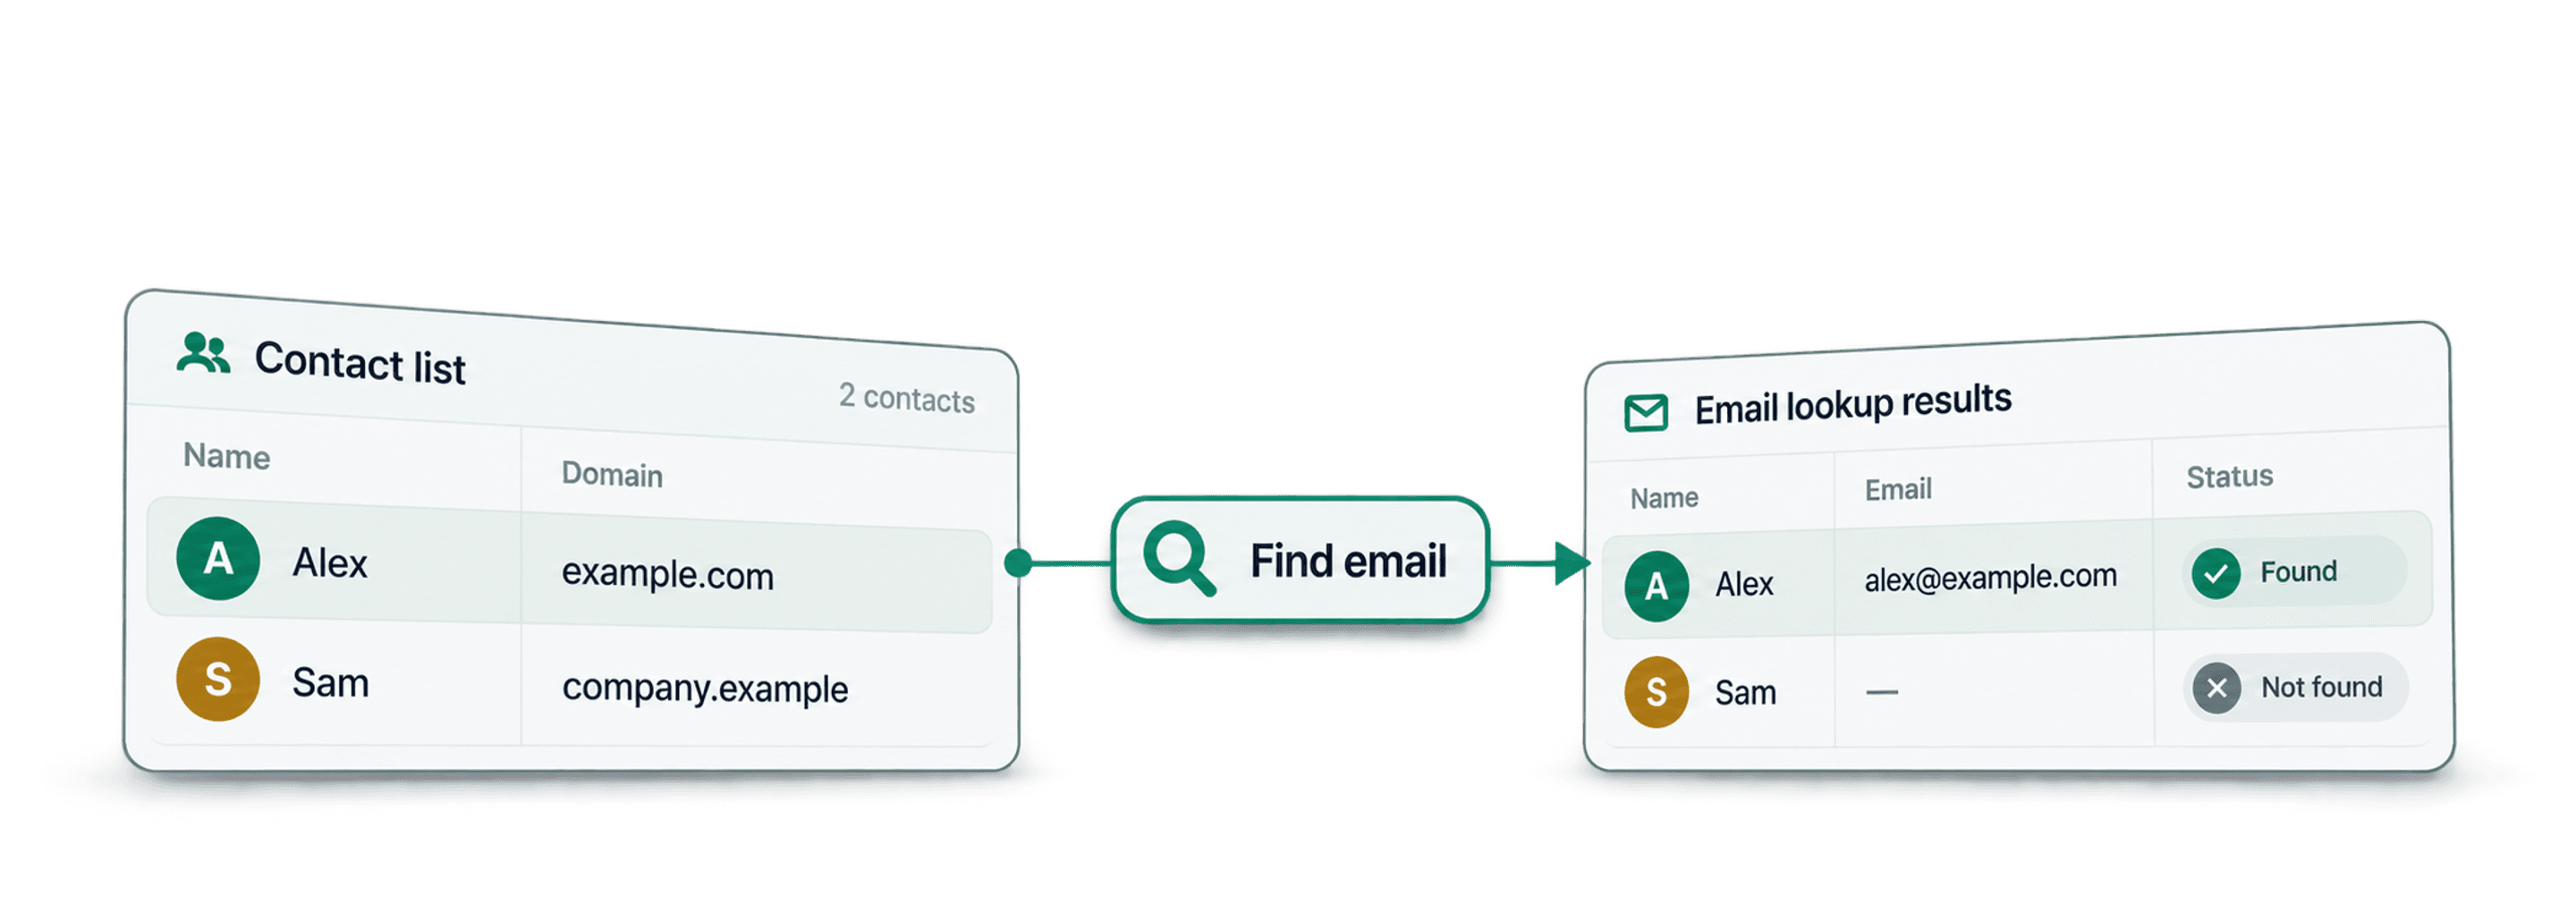
Per trovare email su larga scala, importa una lista di lead, associa i nomi delle persone e il nome o il dominio dell’azienda, quindi avvia il Waterfall Email Finder di Datablist. Puoi anche partire dagli URL standard dei profili LinkedIn. Il risultato include, quando disponibile, l’indirizzo email e uno stato di deliverability da controllare prima dell’esportazione.
Ti consiglio di iniziare con un campione rappresentativo e, quando disponibile, con un dominio aziendale noto. Associare un nome all’azienda sbagliata può produrre un risultato da non utilizzare, anche se l’email restituita è contrassegnata come verificata.
Il waterfall gestito interroga i provider idonei per ogni contatto ancora senza risultato. Per il metodo basato su nome e azienda, puoi anche configurare una sequenza personalizzata usando le API key dei provider supportati. Questa guida illustra gli input, la configurazione e i controlli necessari per ottenere una lista verificata.
📌 Scegli il metodo adatto al tuo file
- Nome e cognome: associa entrambi, insieme a Company Name o Domain.
- Nome completo: abilita Use Full Name, quindi associa le colonne del nome e dell’azienda.
- URL standard del profilo LinkedIn: seleziona By LinkedIn URL in Email Search Method.
Conserva gli ID originali dei lead e le colonne di origine. Controlla gli stati delle email e le righe senza risultato prima di esportare i dati in uno strumento di outreach.
Indice
- Cos’è un Waterfall Email Finder e come funziona?
- Guida passo passo per trovare email su larga scala
- Perché un Waterfall Email Finder è più efficace
- Alternative al Waterfall Email Finder
- Datablist a confronto con altri tool di data enrichment
Cos’è un Waterfall Email Finder e come funziona?
Un waterfall interroga in sequenza diversi provider idonei per i contatti presenti in una lista. Se un provider non restituisce un’email utilizzabile, il workflow può passare al successivo. In questo modo è possibile aumentare la copertura, senza però garantire un indirizzo per ogni persona.
È come avere a disposizione un team di ricercatori anziché una sola persona. Se il primo non trova l’email, l’incarico passa automaticamente al secondo, poi al terzo e così via.
Come funziona il Waterfall Email Finder
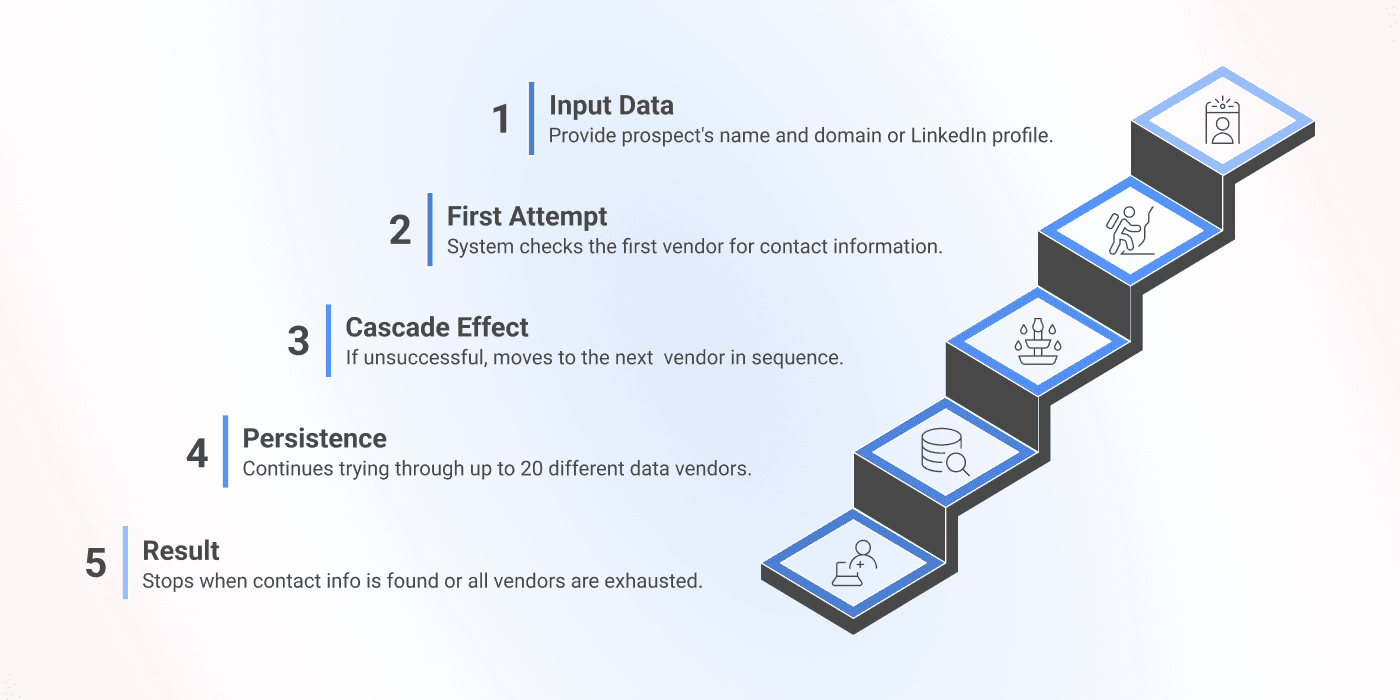
Se vuoi capire come funziona il metodo Waterfall Email Finder, ecco una semplice panoramica in 5 passaggi.
1️⃣ Input: parti dai nomi delle persone e dai nomi o domini aziendali. Puoi anche utilizzare gli URL standard dei profili LinkedIn.
2️⃣ Primo tentativo: il sistema interroga il primo provider della sequenza per cercare un’email corrispondente.
3️⃣ Effetto cascata: se non trova un’email utilizzabile, passa al provider idoneo successivo della catena.
4️⃣ Ricerca continua: le righe senza risultato vengono elaborate dai provider idonei finché Datablist non trova un’email o non esaurisce i tentativi disponibili.
5️⃣ Risultato: non appena viene trovata un’email utilizzabile, il processo si interrompe e restituisce l’indirizzo con il relativo stato di deliverability. Con il waterfall gestito paghi solo le email trovate.
La revisione resta fondamentale: la sequenza dei provider è automatizzata, ma devi comunque verificare la corrispondenza tra persona e azienda, controllare gli stati di deliverability e decidere quali risultati inserire nella lista di outreach.
Come usare il Waterfall Email Finder
Ti consiglio di preparare la lista di input prima di configurare l’elaborazione. Inserisci una sola persona per riga, con le informazioni sulla sua azienda attuale e un ID che permetta di ricollegare i risultati al file di origine.
📘 Qualche informazione prima di iniziare
Per trovare email su larga scala con Datablist puoi scegliere fra tre opzioni:
Opzione 1: utilizzare nome, cognome e dominio o nome dell’azienda
Opzione 2: utilizzare nome completo e dominio o nome dell’azienda per trovare l’indirizzo email
Opzione 3: trovare indirizzi email dall’URL di un profilo LinkedIn
Inoltre, puoi creare un custom waterfall con le API key dei tuoi provider.
Per semplicità, manterrò le impostazioni predefinite. Iniziamo!
Qui trovi un articolo che spiega come trovare indirizzi email dagli URL dei profili LinkedIn 👈🏽
Passaggio 1: registrati su Datablist
Vai su Datablist.com e crea un account.
Passaggio 2: carica i dati
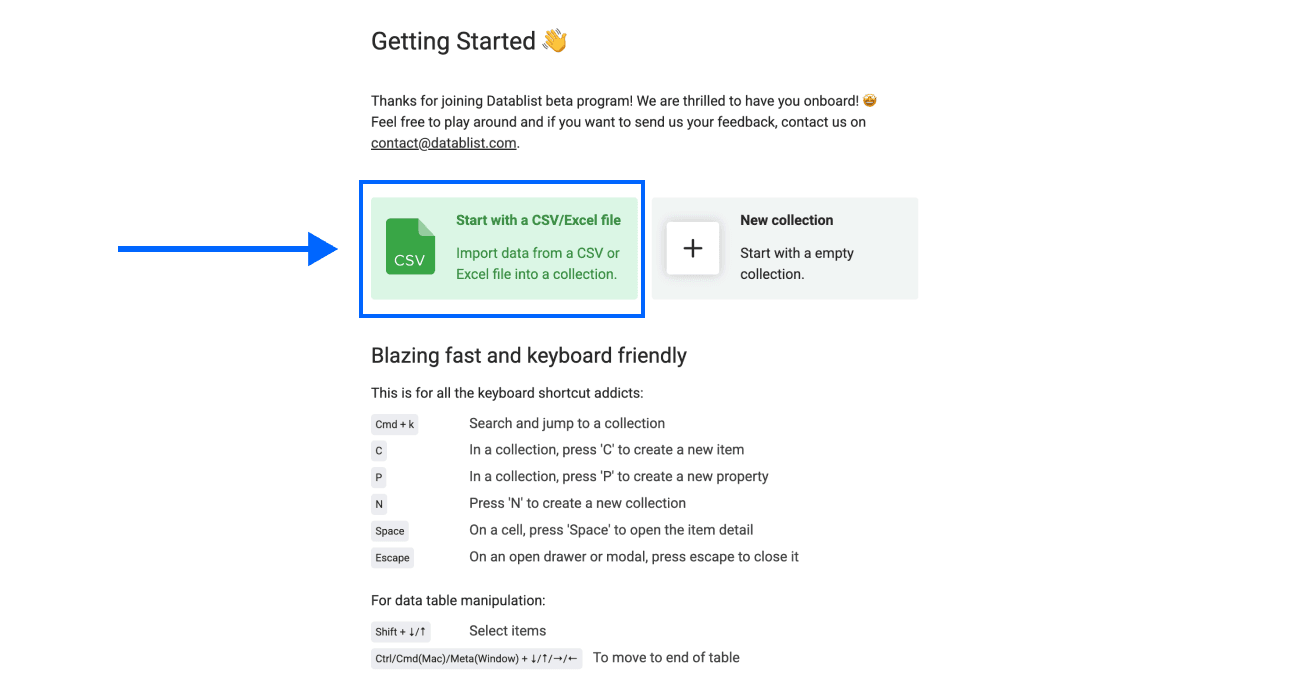
Nella pagina Getting Started, usa Upload per caricare il tuo file CSV o Excel. Per il metodo basato su nome e azienda, inserisci nome e cognome, oppure una singola colonna con il nome completo, insieme al nome o al dominio dell’azienda. Il dominio aziendale non è obbligatorio.
Passaggio 3: seleziona Waterfall Email Finder
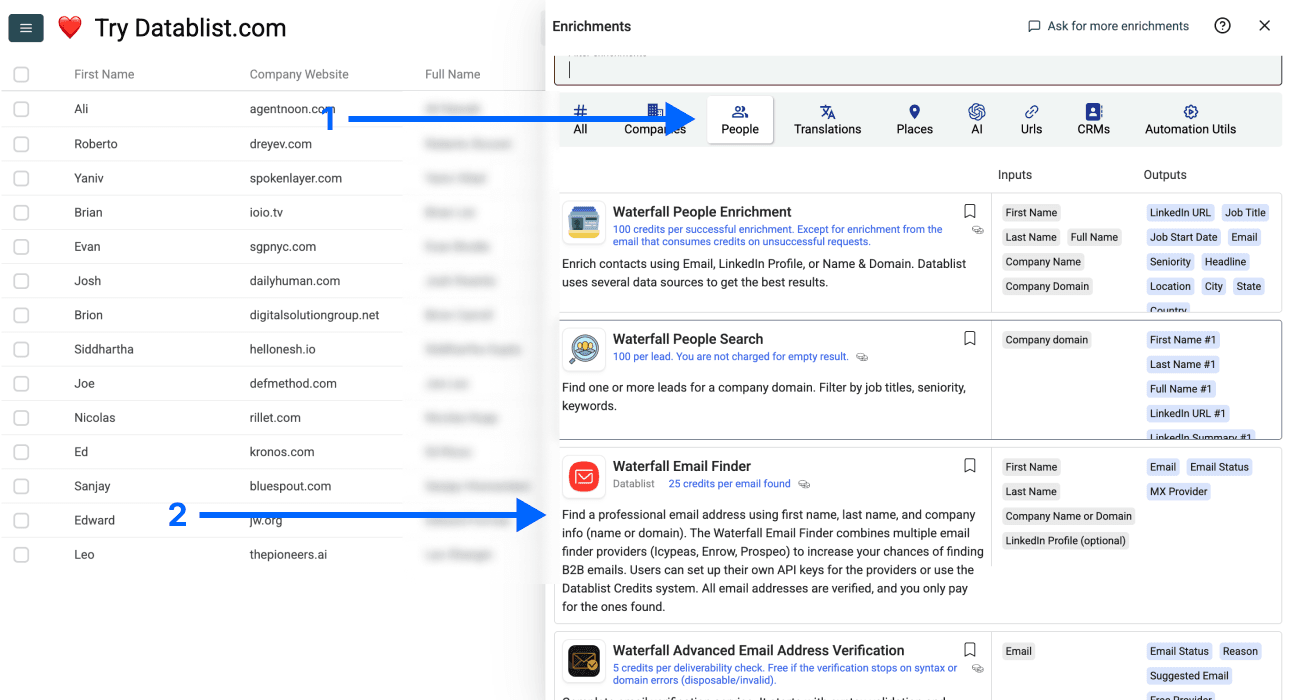
Fai clic su Enrich nel menu superiore dell’app.
Apri il pannello People.
Seleziona Waterfall Email Finder.
Passaggio 4: configura i campi di input
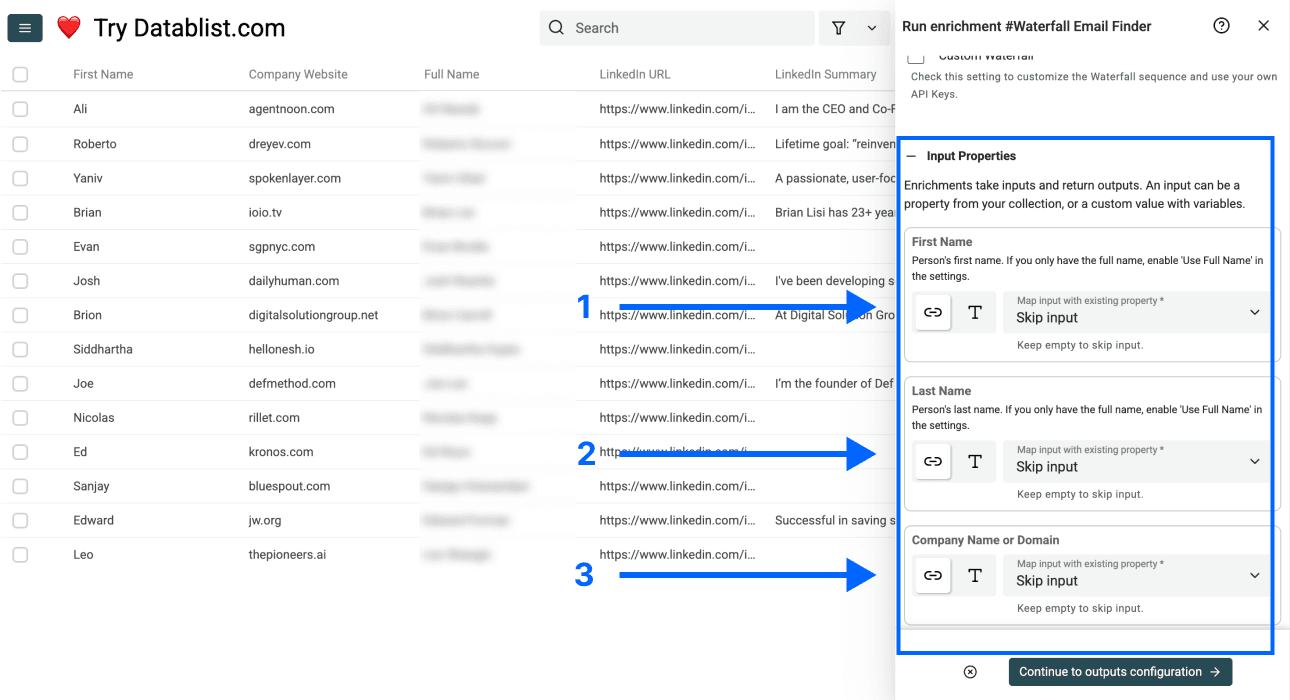
Associa le colonne del nome e del cognome oppure abilita Use Full Name e associa una sola colonna contenente il nome completo. Quindi associa una colonna con il nome o il dominio aziendale a Company Name or Domain.
Quando fornisci il nome di un’azienda, Datablist prova a individuare internamente un dominio convalidato prima di interrogare i provider di email. Non devi quindi eseguire prima un enrichment separato per ricavare il dominio dal nome aziendale. In presenza di nomi di aziende ambigui, un dominio noto resta comunque l’input più affidabile.
Controlla il metodo di input prima dell’avvio
In Email Search Method, seleziona By Name and Company (default) oppure By LinkedIn URL in base al contenuto del file. Le colonne richieste cambiano a seconda della scelta. Custom Waterfall è disponibile per il metodo basato su nome e azienda; non dare per scontato che la stessa sequenza personalizzata possa essere usata per una ricerca basata esclusivamente su LinkedIn.
Per l’input LinkedIn, utilizza l’URL standard del profilo personale nel formato linkedin.com/in/.... Questo campo non accetta gli URL dei profili Sales Navigator. Per maggiori dettagli, consulta la guida per trovare email dai profili LinkedIn.
Prima di elaborare il campione, verifica che:
- Nome e cognome siano associati ai campi corretti oppure, se l’opzione è abilitata, che sia associato il campo Full Name.
- L’azienda corrisponda effettivamente al datore di lavoro della persona e non a un’attività omonima.
- Il dominio aziendale appartenga al sito dell’azienda e non a una directory o a un profilo social.
- Gli input vuoti e i contatti duplicati siano esclusi dal batch che intendi elaborare.
Rimuovi i duplicati in base all’identità della persona, non soltanto al dominio aziendale. Più dipendenti della stessa azienda devono rimanere contatti separati. Conserva le colonne contenenti le email esistenti e salva il risultato della ricerca in una nuova proprietà di output, così da poterli confrontare.
Passaggio 5: seleziona gli output
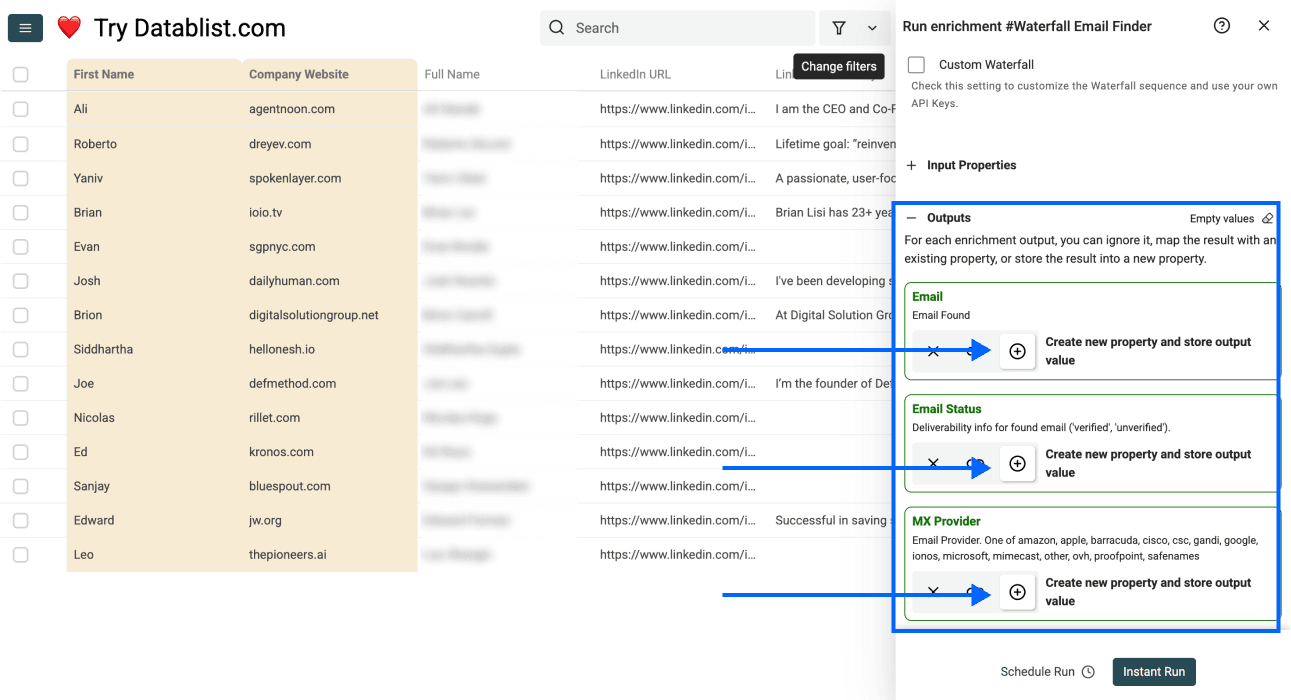
Ora puoi selezionare i campi di output e i dati che ti servono. Le opzioni disponibili sono:
- Email - Le email trovate
- Email Status - Informazioni sulla deliverability delle email trovate ('verified', 'unverified').
- MX Provider - Il provider email: amazon, apple, barracuda, cisco, csc, gandi, google, ionos, microsoft, mimecast, other, ovh, proofpoint o safenames
Passaggio 6: avvia l’enrichment
Per prima cosa, configura un piccolo campione nei controlli di esecuzione. Dopo aver verificato gli input e gli output del campione, elabora le altre righe previste nella collection o nella vista filtrata.
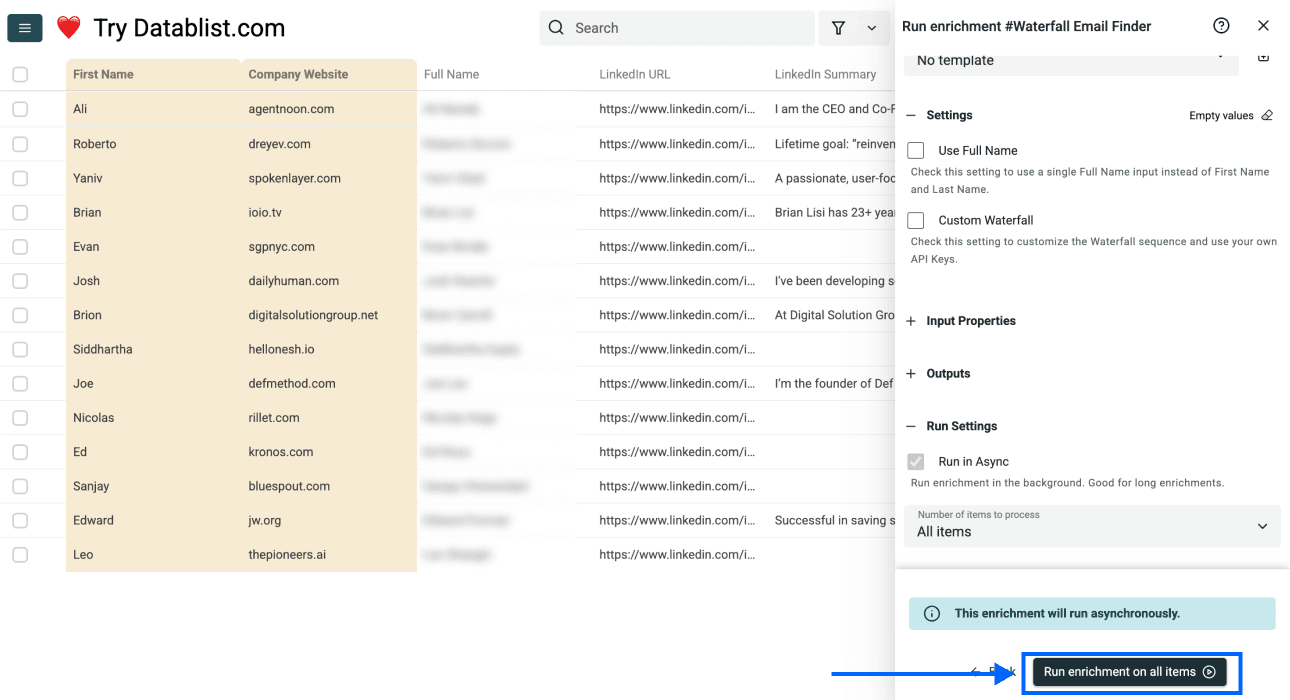
Dopo l’enrichment vedrai anche: Credits spent e Run Status, pensati per offrirti la massima trasparenza sui costi, sulla qualità dei dati e sugli eventuali errori.
Controlla separatamente le email trovate e le righe senza risultato
Un’elaborazione completata non equivale a una lista pronta per l’invio. Controlla Email Status insieme ai dati originali della persona e dell’azienda e all’email restituita. Lo stato verified riguarda la deliverability: non dimostra che il contatto sia il decision maker giusto o che sia interessato alla tua offerta.
| Risultato | Cosa controllare | Passaggio successivo |
|---|---|---|
Email restituita con stato verified | Identità della persona e dell’azienda, contatti esistenti e liste di esclusione | Conserva solo i record che superano i controlli previsti per l’outreach |
Email restituita con stato unverified | L’indirizzo è stato restituito senza una conferma della deliverability | Tienilo separato per un’ulteriore verifica o un controllo manuale |
| Nessun risultato | Verifica che gli input siano completi e si riferiscano alla persona corretta | Correggi le informazioni mancanti utili prima di decidere se riprovare |
| Input mancante o non valido | Associazione del nome, campo dell’azienda e formato dell’URL del profilo | Correggi la riga di origine prima di elaborarla di nuovo |
Nel workflow attuale di Run Status, gli input mancanti o non validi e i casi senza risultato vengono registrati come errori di esecuzione; non sono etichette di deliverability associate a un’email trovata. Controlla quindi sia i dettagli degli errori sia le colonne delle email. Una cella Email Status vuota, da sola, non spiega perché una riga non sia stata elaborata correttamente.
Per esempio, un campione potrebbe contenere un’email trovata ma unverified e una riga priva dell’azienda. Entrambe vanno escluse dall’esportazione verificata, ma per ragioni diverse: la prima richiede una verifica dell’indirizzo, mentre per la seconda bisogna correggere l’input relativo all’azienda. Ripetere la stessa ricerca con dati incompleti non risolve nessuno dei due problemi.
Ti consiglio di annotare il numero di input del campione, le email trovate, le email verificate, le righe senza risultato e i crediti utilizzati. Sono valori diversi. Usali per stimare il batch successivo sul tuo pubblico, senza aspettarti un tasso di successo fisso.
Dopo aver controllato l’intera elaborazione, esporta l’ID del lead, i campi originali della persona e dell’azienda, l’email scelta e il relativo stato. Mantieni le righe senza risultato in un set separato, così potrai migliorarne gli input senza elaborare nuovamente i contatti che hanno già superato i controlli.
Perché un Waterfall Email Finder è più efficace
Sceglierei un waterfall quando una singola fonte lascia irrisolti contatti potenzialmente utili e voglio ampliare la copertura con un unico workflow basato sulle righe. Confrontalo con il tuo sistema attuale sullo stesso mercato target, valutando i risultati utilizzabili e il costo totale anziché affidarti a una percentuale di miglioramento promessa.
Maggiore copertura dei provider
I provider dispongono di database e coperture geografiche differenti. Un waterfall può trovare email che un singolo provider non individua, perché passa le righe senza risultato a un’altra fonte idonea. Il tasso di successo effettivo dipende dalla qualità degli input, dal mercato target e dall’esistenza di un’email di lavoro reperibile per il contatto.
Migliore rapporto qualità-prezzo
- Con il waterfall gestito di Datablist, paghi le email di lavoro trovate. Prima di utilizzare il risultato, controlla lo stato
verifiedounverifiedrestituito. - Se hai già abbonamenti con alcuni provider, puoi creare un custom waterfall email finder usando le tue API key. L’elaborazione personalizzata utilizza gli account dei provider esterni anziché la sequenza gestita con crediti Datablist.
Risparmio di tempo e risorse
L’intero processo è automatizzato: non dovrai più perdere ore a cercare manualmente i recapiti o a passare continuamente da un tool all’altro.
Alternative al Waterfall Email Finder
Puoi utilizzare un email finder basato su un solo provider, un database di contatti esistente oppure una sequenza personalizzata di provider. La scelta migliore dipende dai dati di input già disponibili e dal livello di copertura di cui hai bisogno.
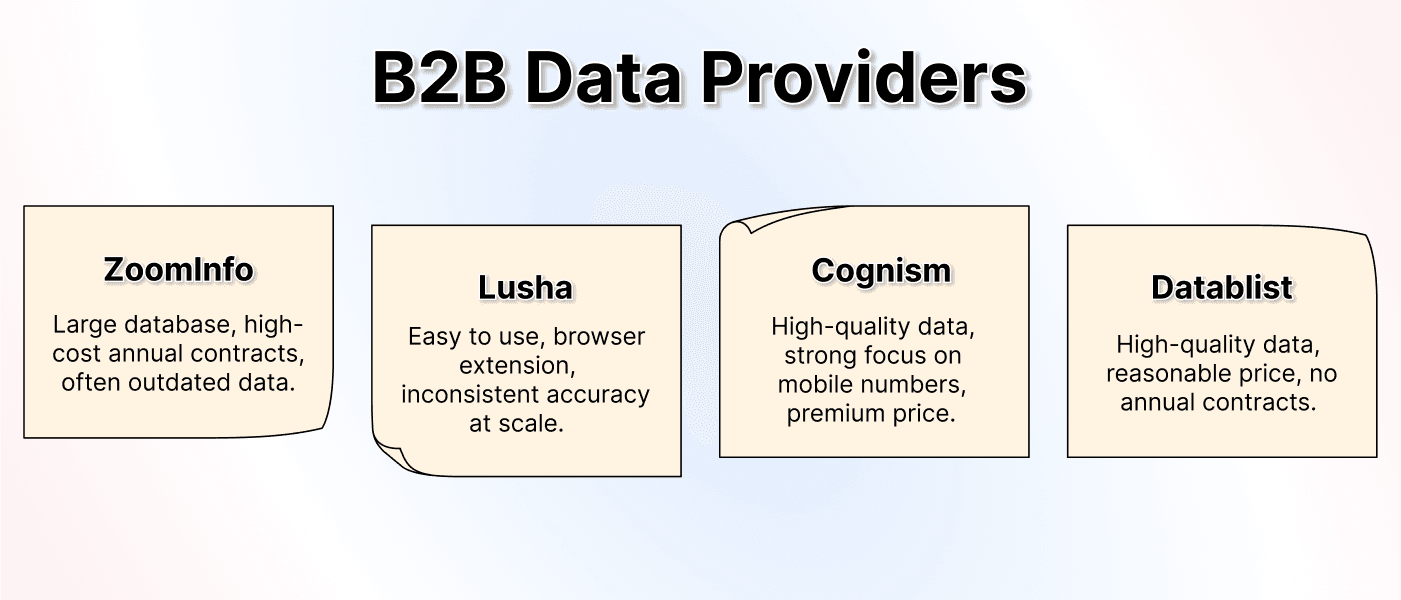
Confronterei le alternative usando un campione della tua lista:
- Accettano i nomi, i domini aziendali o gli URL dei profili in tuo possesso?
- Puoi controllare lo stato di deliverability separatamente dall’indirizzo trovato?
- I costi dipendono dai tentativi, dai risultati restituiti o dai limiti dell’abbonamento?
- Puoi conservare le righe senza risultato ed esportare i dati insieme agli ID di origine?
Un database può essere utile quando devi individuare i contatti oltre a recuperarne i dettagli. Un waterfall è indicato quando sai già quali persone cercare. Verifica il workflow e il piano attuale del provider, senza presumere che tutti i database offrano la stessa copertura o gli stessi prezzi.
Datablist a confronto con altri tool di data enrichment
Datablist esegue la ricerca sulle righe del tuo file CSV o Excel e salva i campi restituiti direttamente nella collection. Prima di esportare i record verificati, puoi controllare insieme i dati di origine, gli output e gli errori di esecuzione.
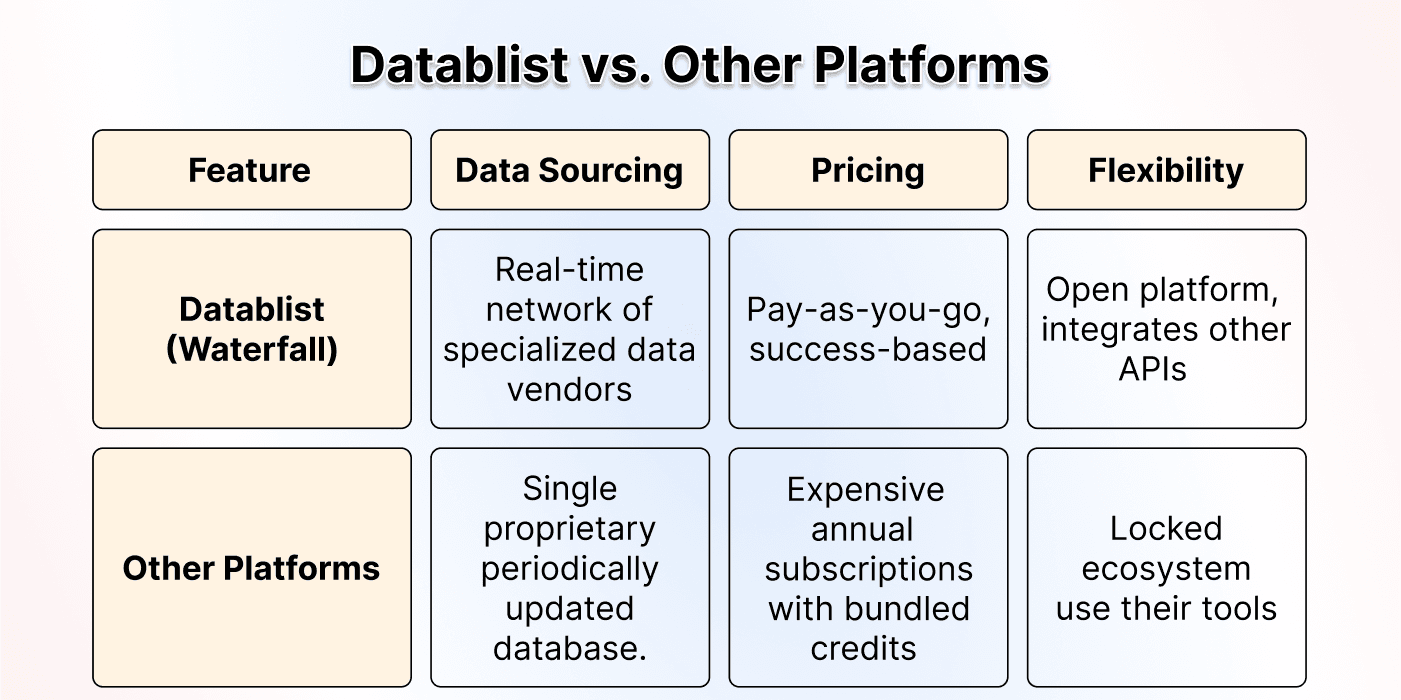
Il waterfall gestito usa i crediti Datablist per le email di lavoro trovate. Un custom waterfall valido utilizza gli account dei provider esterni supportati, ai quali continuano ad applicarsi i rispettivi costi. Scegli il metodo più adatto agli abbonamenti e agli input che possiedi: una sequenza personalizzata non combina automaticamente gli account esterni con la sequenza gestita.
Mantieni i risultati della ricerca separati dalla decisione finale sull’outreach. Né la corrispondenza di un provider né un’etichetta vincente in un’illustrazione garantiscono che sia opportuno contattare un determinato record.
In sintesi: basta pagare troppo per dati scadenti
Parti da nomi accurati e informazioni aziendali corrette, esegui un campione, quindi controlla separatamente le email restituite e le righe senza risultato. Passerei all’elaborazione su larga scala solo dopo aver verificato che il campione produca corrispondenze utilizzabili a un costo chiaro.
Conserva gli ID di origine durante l’esportazione, così potrai ricollegare i risultati ripuliti alla lista di lead originale. Per confrontare le diverse opzioni di ricerca, consulta la guida ai migliori email finder.
Domande frequenti su come trovare email su larga scala
Quanto costa trovare email con Waterfall Email Finder?
Il Waterfall Email Finder gestito costa 25 crediti per ogni email di lavoro trovata. Una ricarica da 20 USD offre 20.000 crediti, sufficienti per trovare fino a 800 email di lavoro. Il costo equivale a 0,025 USD per email trovata. Le righe senza risultato non vengono addebitate.
Posso usare i miei abbonamenti con Waterfall Email Finder?
Sì. Abilita Custom Waterfall e aggiungi le API key dei provider supportati nell’ordine desiderato. Un’elaborazione personalizzata valida usa i provider esterni al posto della sequenza gestita tramite crediti Datablist. Datablist non addebita crediti di enrichment per l’elaborazione personalizzata, ma ogni provider può applicare costi al tuo account esterno.
Quale precisione offre Waterfall Email Finder?
Non esiste un tasso di successo fisso valido per ogni lista. I risultati dipendono dalla qualità dei nomi, dall’ambiguità delle aziende, dall’area geografica, dalla copertura dei provider e dall’esistenza di un’email di lavoro reperibile. Esegui prima un campione rappresentativo e controlla gli stati di deliverability restituiti prima di elaborare l’intera lista.
Quante email posso elaborare con Waterfall Email Finder?
Puoi eseguire Email Finder sulle righe selezionate o su un’intera collection. Datablist elabora le attività di enrichment in batch e mantiene un Run Status per ogni riga. Se hai una lista molto grande, testa prima un campione per convalidare l’associazione degli input, la copertura prevista e l’uso dei crediti.
Come trovare migliaia di email su larga scala?
Importa un file CSV o Excel in Datablist ed esegui Waterfall Email Finder. Associa i nomi delle persone e il nome o il dominio dell’azienda oppure utilizza gli URL standard dei profili LinkedIn. Il sistema interroga in sequenza le fonti idonee e salva il risultato nella stessa collection.
Qual è il miglior tool per trovare migliaia di email?
Per una lista di lead esistente, scegli un tool che supporti input in bulk, più fonti di ricerca, stati di deliverability e risultati controllabili a livello di singola riga. Datablist riunisce tutti questi passaggi in un unico workflow simile a un foglio di calcolo. Per un confronto completo, consulta la guida ai migliori email finder.
Posso trovare un’email usando solo l’URL di un profilo LinkedIn?
Sì! Waterfall Email Finder può partire dal nome e dalle informazioni aziendali di una persona oppure direttamente dall’URL del suo profilo LinkedIn. Quando usi un URL LinkedIn, Datablist ricava internamente i dati del contatto e dell’azienda necessari al workflow dei provider. Questa preparazione non comporta un addebito separato di crediti di enrichment. Con il waterfall gestito paghi quando Datablist trova un’email di lavoro. Per saperne di più, leggi il nostro articolo su come ottenere indirizzi email dai profili LinkedIn.
Waterfall Email Finder è davvero così efficace?
Un waterfall offre a ogni riga senza risultato la possibilità di essere verificata da più provider. Spesso questo migliora la copertura rispetto a una ricerca che si ferma dopo il primo provider, ma non esiste una percentuale fissa valida per ogni mercato o file di input. Testa un campione rappresentativo e misura i risultati sulla tua lista.
Qual è il metodo migliore per trovare email su larga scala?
Per una lista di lead in formato CSV o Excel, un waterfall è utile quando vuoi interrogare più provider senza chiamare ogni API o spostare manualmente tra diversi tool le righe non risolte. Datablist mantiene inoltre i dati di origine, gli output e i Run Status in un’unica collection.
Ho migliaia di nomi e aziende: come trovo le loro email?
Carica la lista su Datablist, seleziona Waterfall Email Finder e associa le colonne contenenti i nomi delle persone e delle aziende. Datablist prova a individuare internamente i domini aziendali prima di avviare la sequenza dei provider. L’enrichment aggiunge l’email, lo stato di deliverability e l’MX provider, mentre la colonna Run Status tiene traccia degli errori e dell’avanzamento.