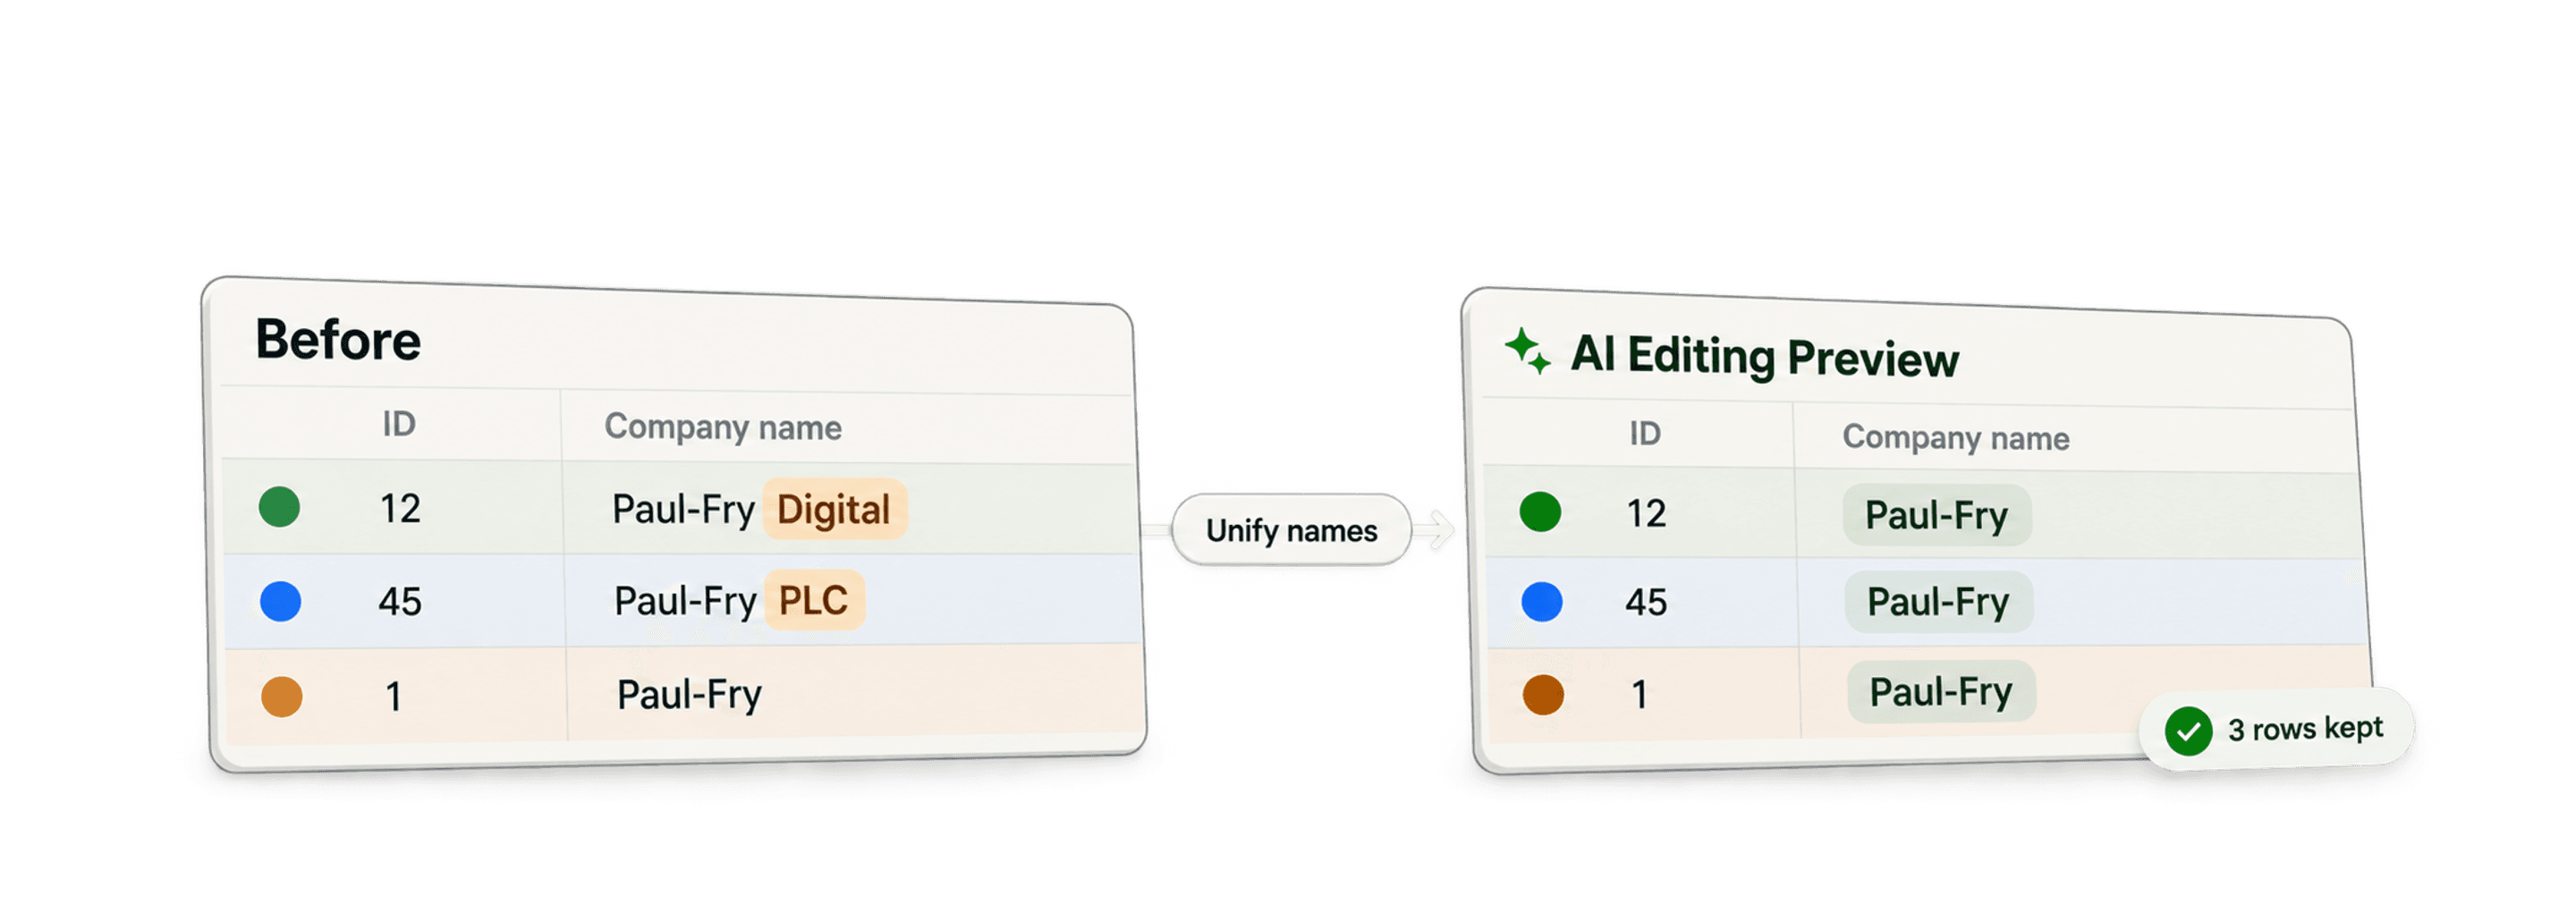
Per uniformare i valori di un campo senza unire le righe, individua i record che appartengono alla stessa entità, scegli un valore per il campo interessato e copialo in tutto il gruppo. In Datablist, usa Custom with AI nel Duplicates Finder e specifica chiaramente che ogni record deve essere mantenuto.
Prima di standardizzare i nomi delle aziende, raggrupperei i record usando un identificatore affidabile, come il sito web. Un nome simile, da solo, non dimostra che due aziende siano la stessa realtà. Mantenere separate le righe consente di conservarne ID e dettagli di origine, ma un raggruppamento errato può comunque propagare il nome sbagliato.
In questa guida scoprirai come normalizzare i valori di campi specifici nei gruppi di duplicati, mantenendo intatti i singoli record:
- Che cos’è la normalizzazione dei dati?
- AI Processing nel Duplicates Finder
- Come normalizzare i dati duplicati passo dopo passo
Che cos’è la normalizzazione dei dati?
In questo contesto, normalizzare i dati significa renderne uniforme il formato. Quando si lavora con i duplicati, è frequente trovare valori incoerenti in alcuni campi. Per esempio:
- Nomi aziendali: "Tech Solutions Inc.", "Tech Solutions, LLC", "Tech Solutions"
- Job title: "Software Engineer", "Software Dev.", "Eng., Software"
- Indirizzi: "Via Roma 123", "Via Roma, 123", "via roma 123"
- Paesi: "Italia", "IT", "ITA"
L’obiettivo della normalizzazione è scegliere un unico valore standard (come "Tech Solutions" o "Italia") e applicarlo al campo pertinente in tutti i record identificati come duplicati.
In questo modo, i dati diventano più puliti, facili da analizzare e affidabili per filtri e report, anche se i record duplicati restano separati. È un passaggio fondamentale del data cleaning.
AI Processing nel Duplicates Finder
Il Duplicates Finder di Datablist è già uno strumento potente per individuare record simili. Oltre a offrire solide opzioni per unire automaticamente o manualmente i duplicati, la modalità AI Processing garantisce una flessibilità ancora maggiore.
Al posto di regole di unione predefinite, AI Processing ti permette di definire la logica con un prompt in linguaggio naturale. Puoi spiegare all’AI esattamente come gestire i duplicati, ad esempio per:
- Selezionare un record master in base a criteri specifici (per esempio, quello aggiornato più di recente).
- Unire determinati campi mantenendone separati altri.
- Eseguire calcoli durante l’unione, come la somma dei valori.
- 👉 E, soprattutto per questa guida, aggiornare un campo specifico in tutti i duplicati con un unico valore normalizzato, senza unire i record.
Così, una complessa operazione di manipolazione dei dati diventa una semplice conversazione con la nostra AI, senza bisogno di scrivere codice.
Come normalizzare i dati duplicati passo dopo passo
Vediamo come usare AI Processing per normalizzare un campo, per esempio il nome dell’azienda, in più record duplicati.
Passaggio 1: prepara i dati
Per prima cosa, devi caricare i dati in Datablist.
- Crea una collection: fai clic sul pulsante "+" nella barra laterale per creare una nuova collection.
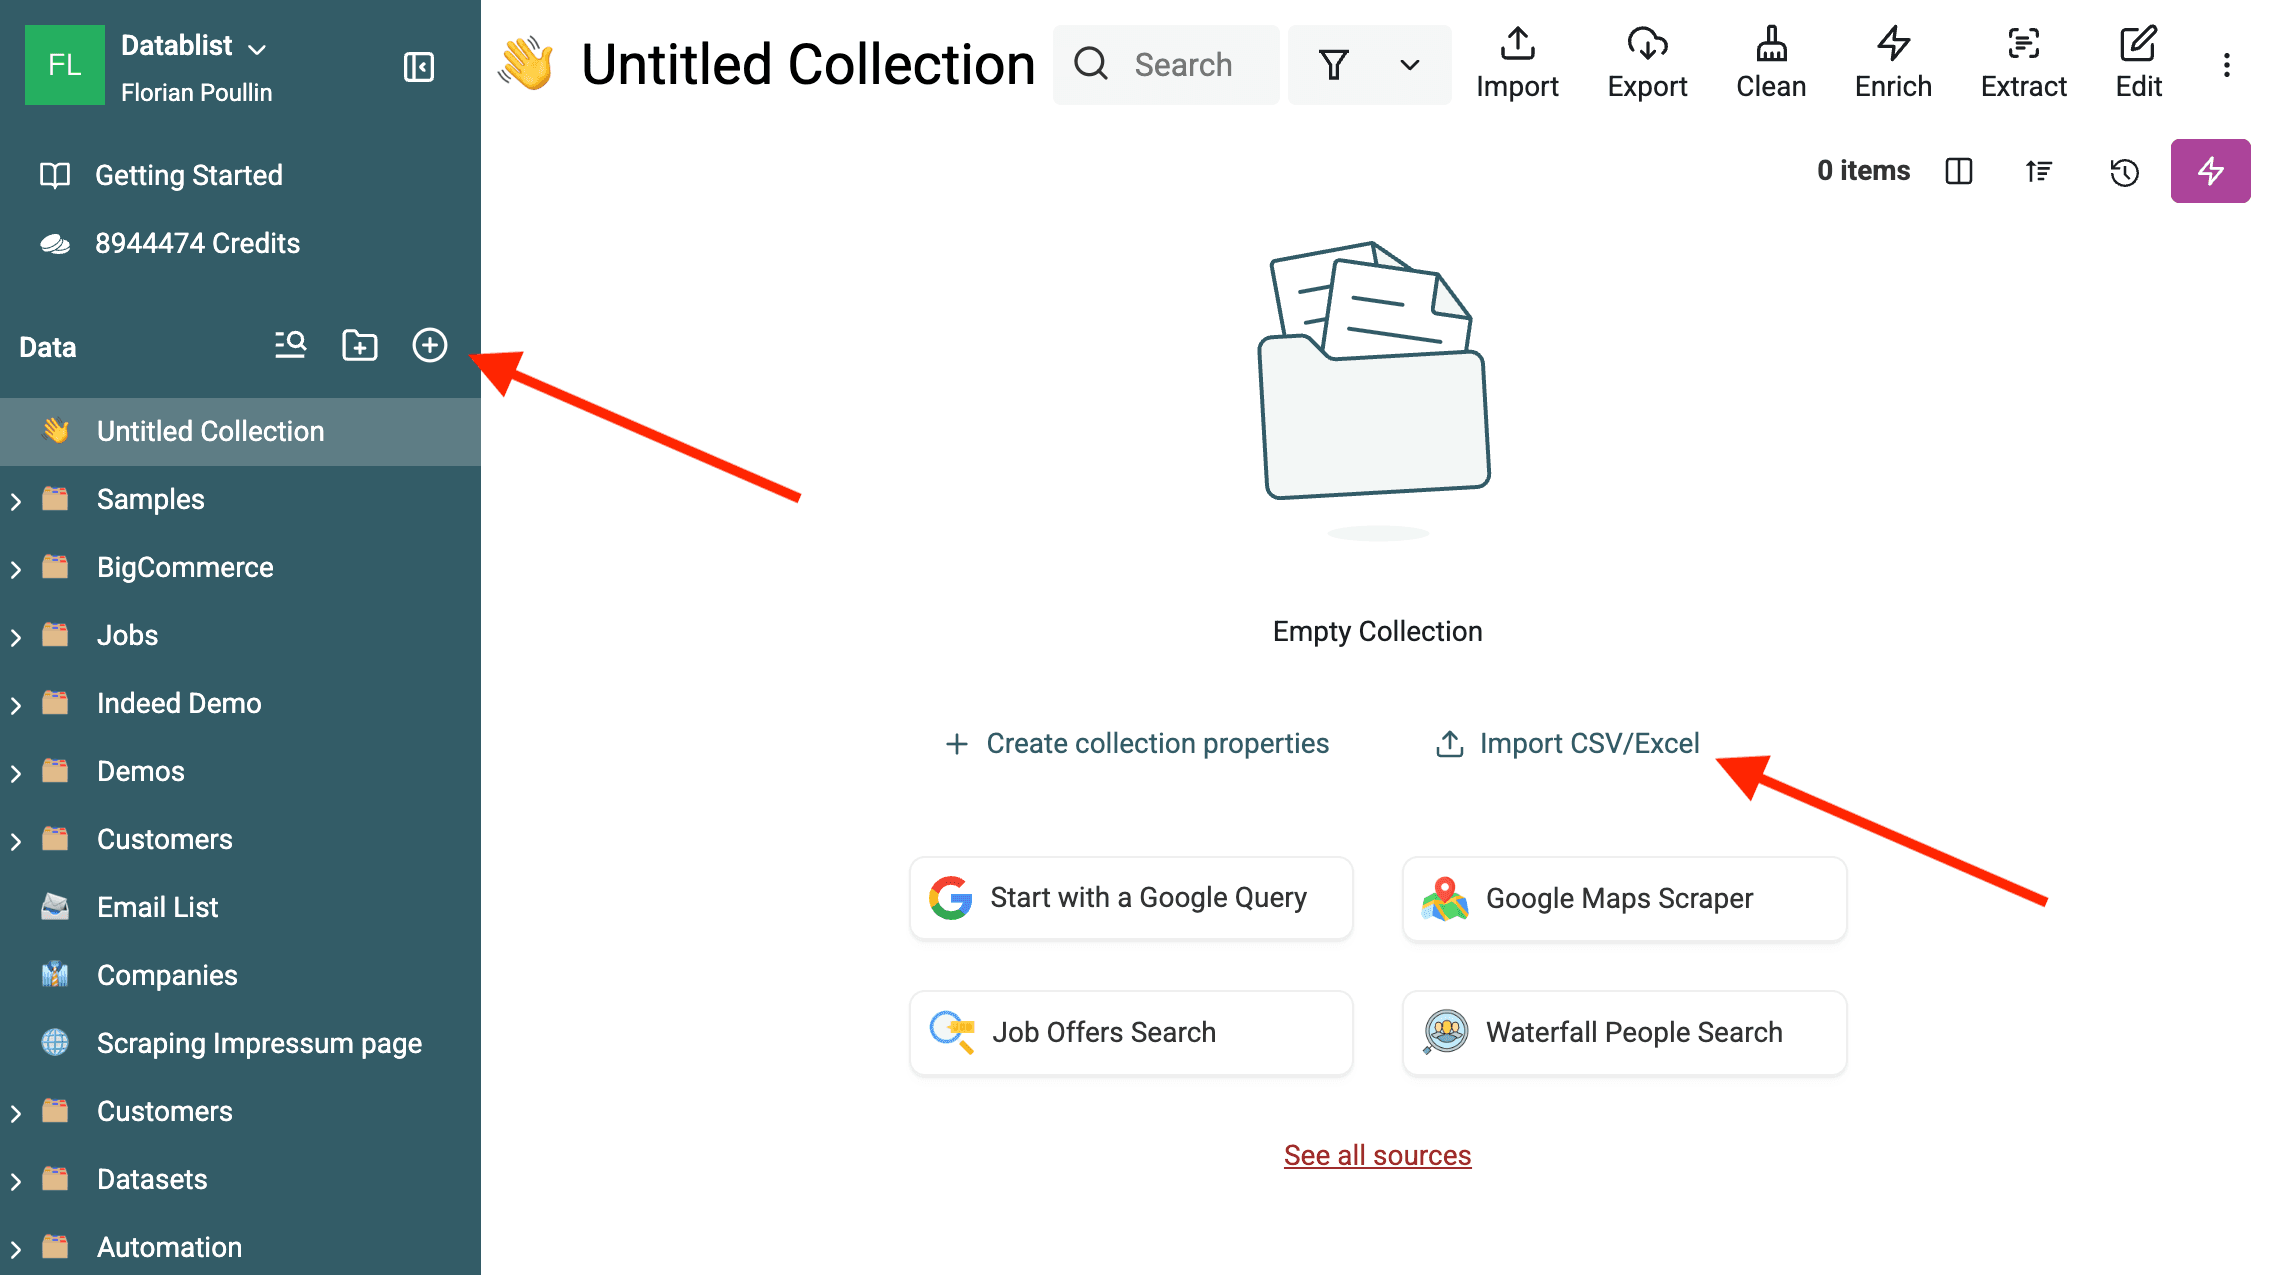
- Importa i dati: importa i dati da un file CSV o Excel. Se provengono da più file, importali nella stessa collection. Datablist ti guiderà nell’associazione tra colonne e proprietà. Assicurati che il campo da normalizzare, per esempio Company Name, e quelli da usare per identificare i duplicati, come Email o Website, siano importati correttamente.
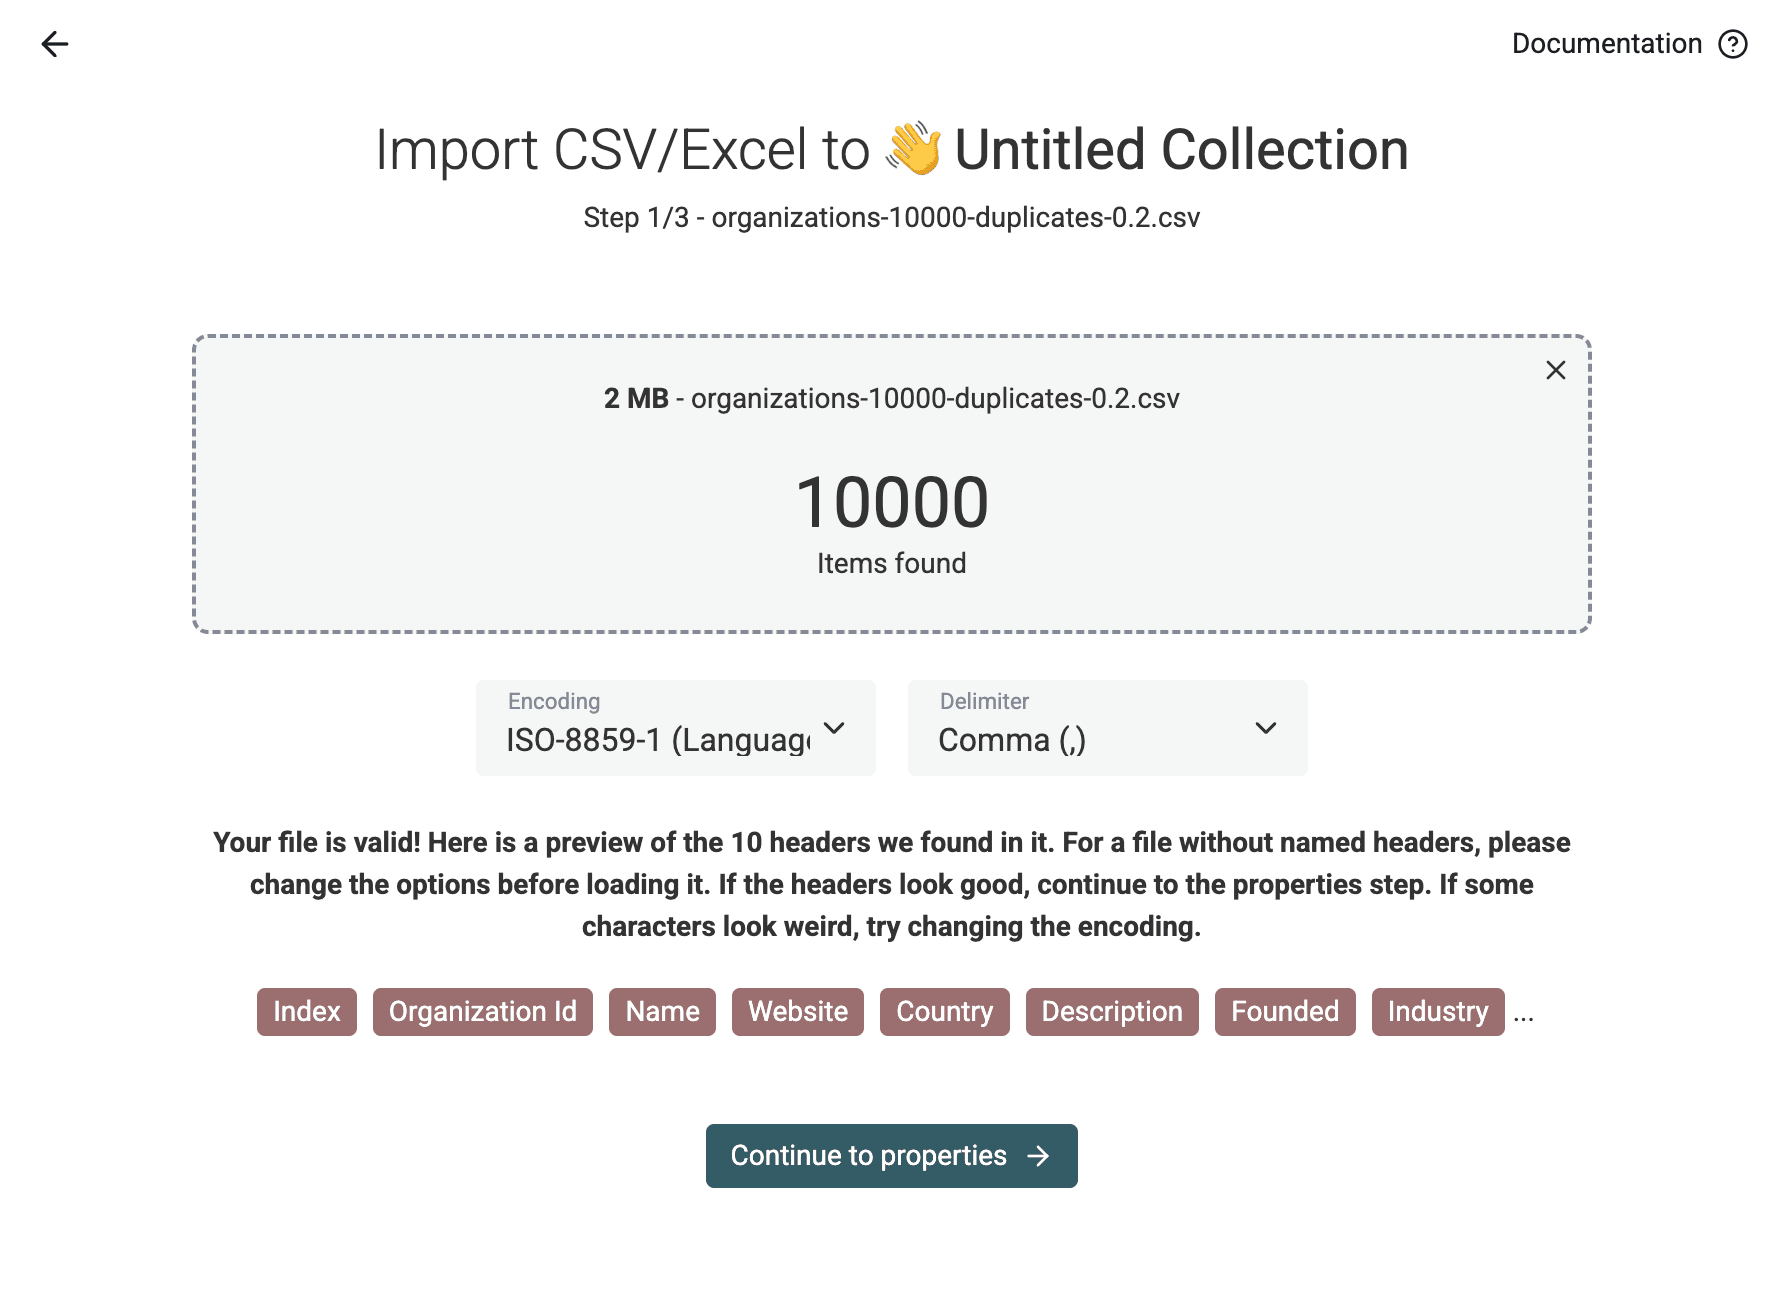
In questo dataset di esempio sono già visibili alcuni nomi aziendali duplicati da normalizzare.
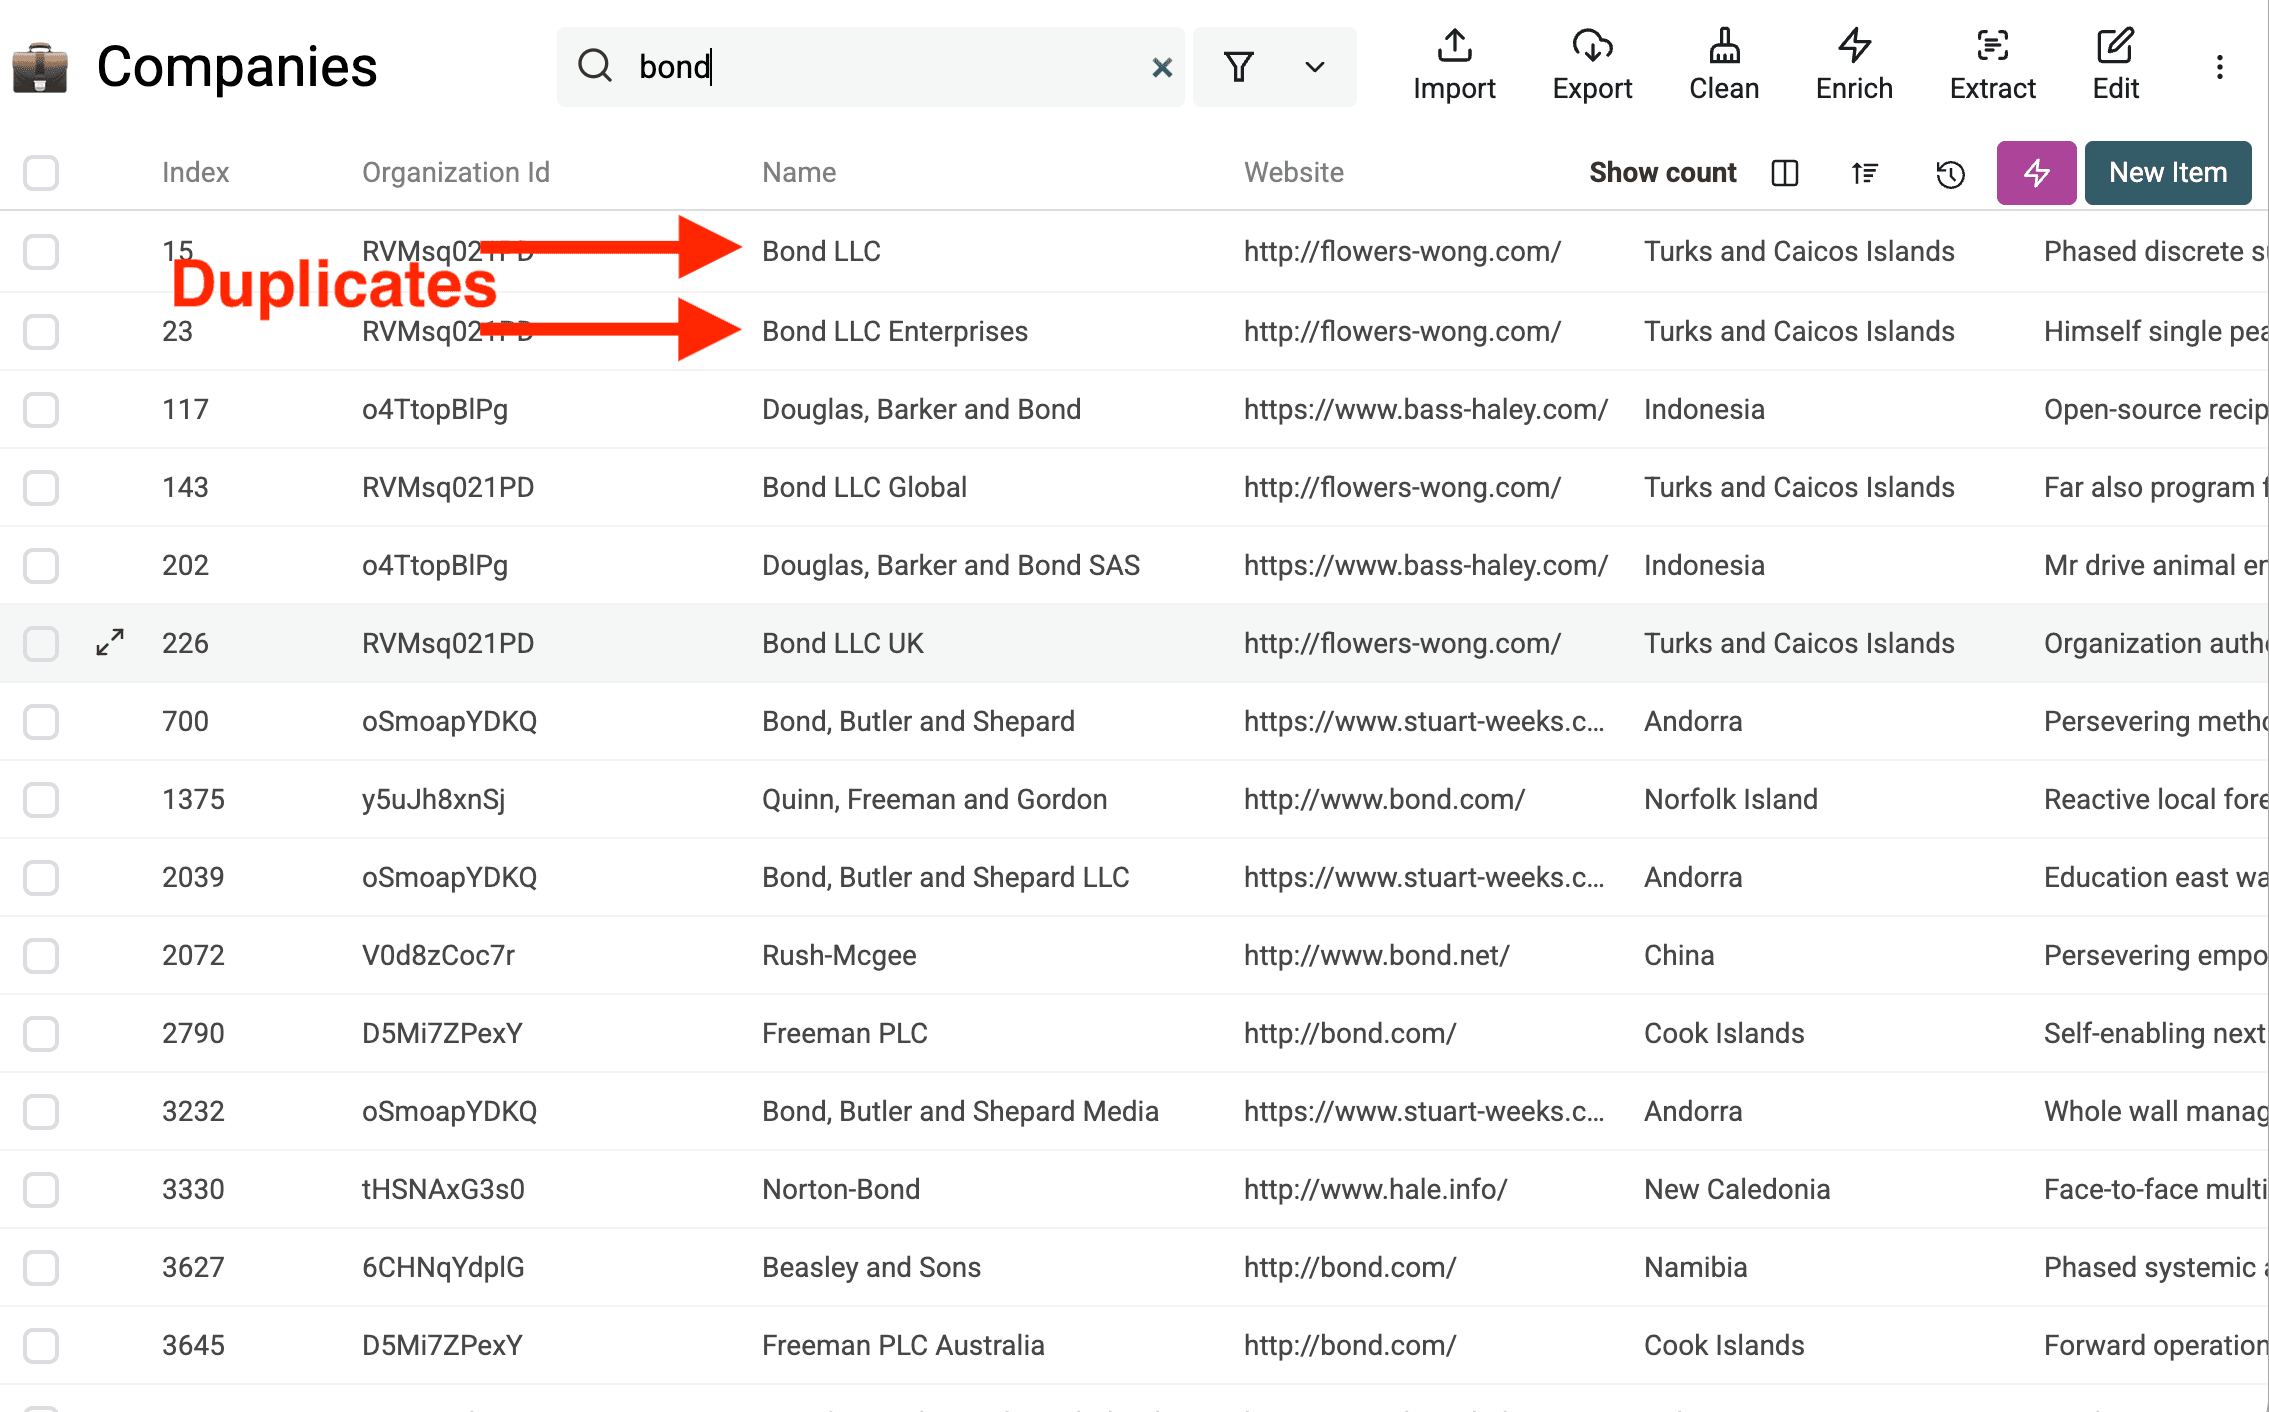
Passaggio 2: trova i duplicati
Ora individua i record duplicati.
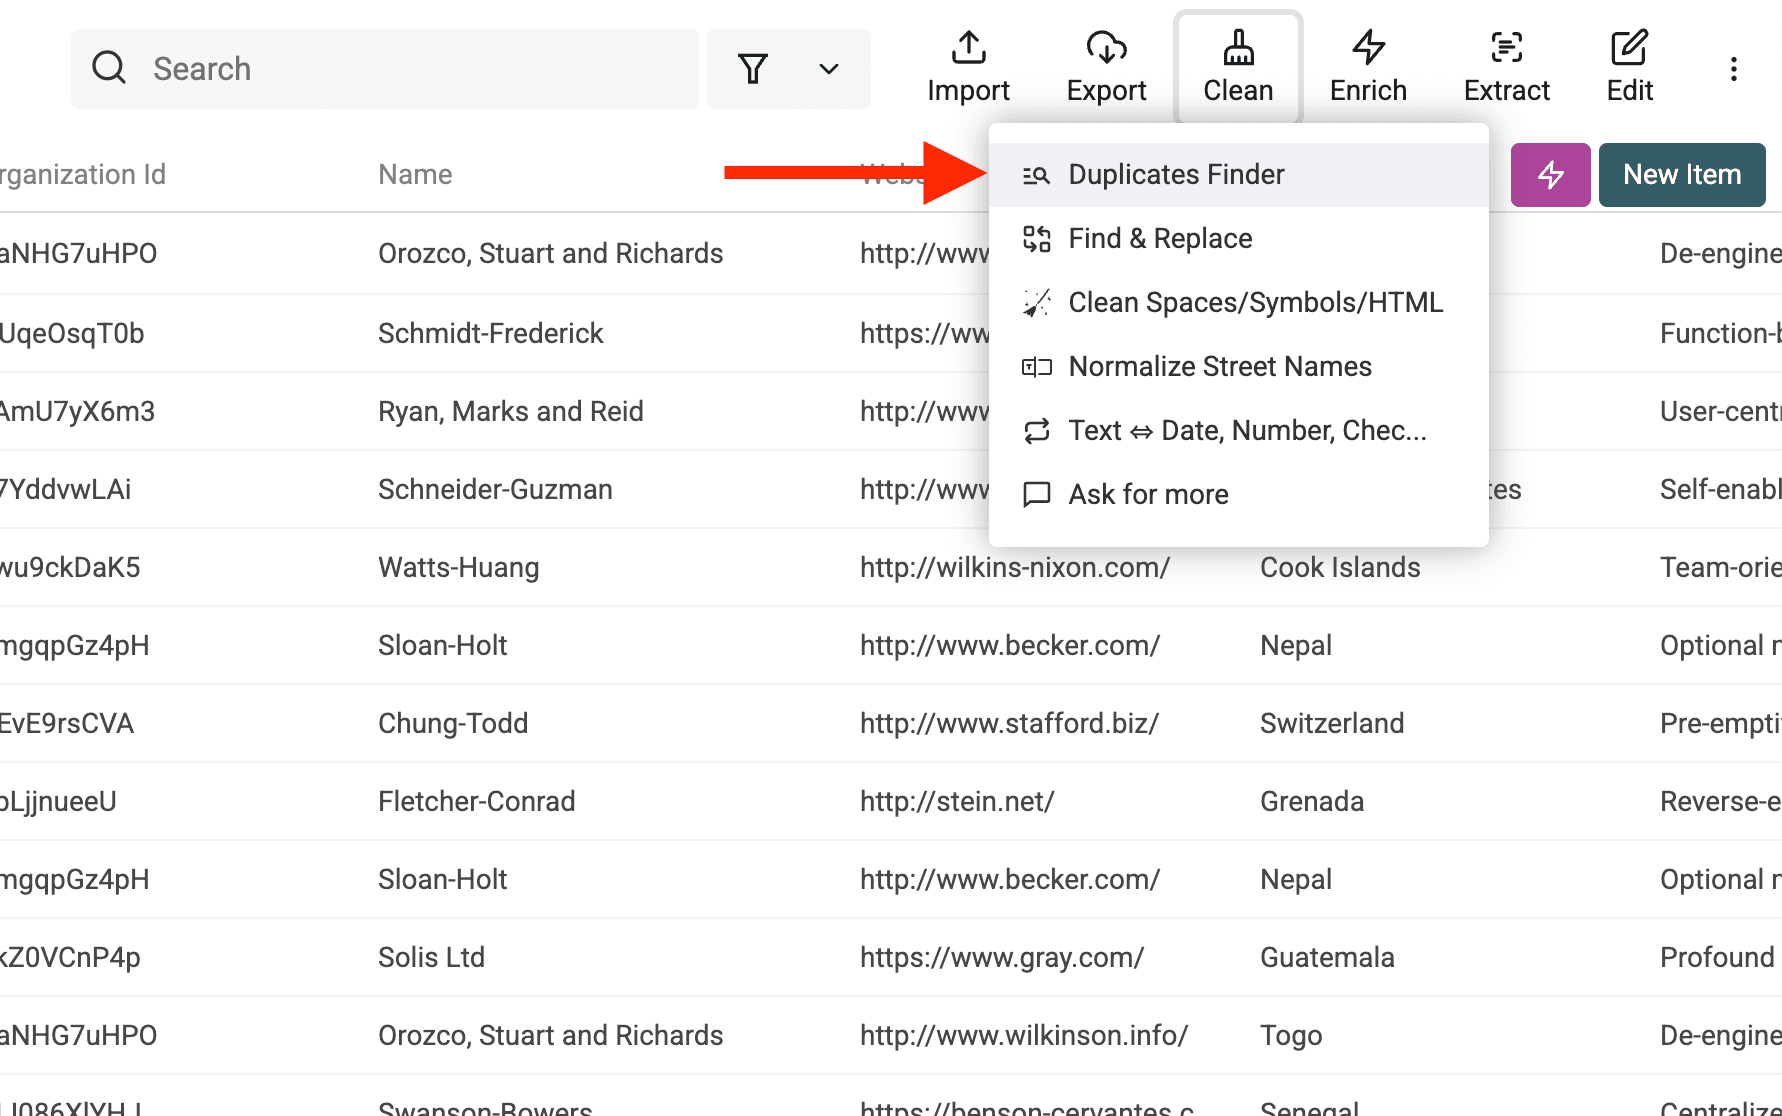
2.a. Apri Duplicates Finder
Apri Clean > Merge duplicates.
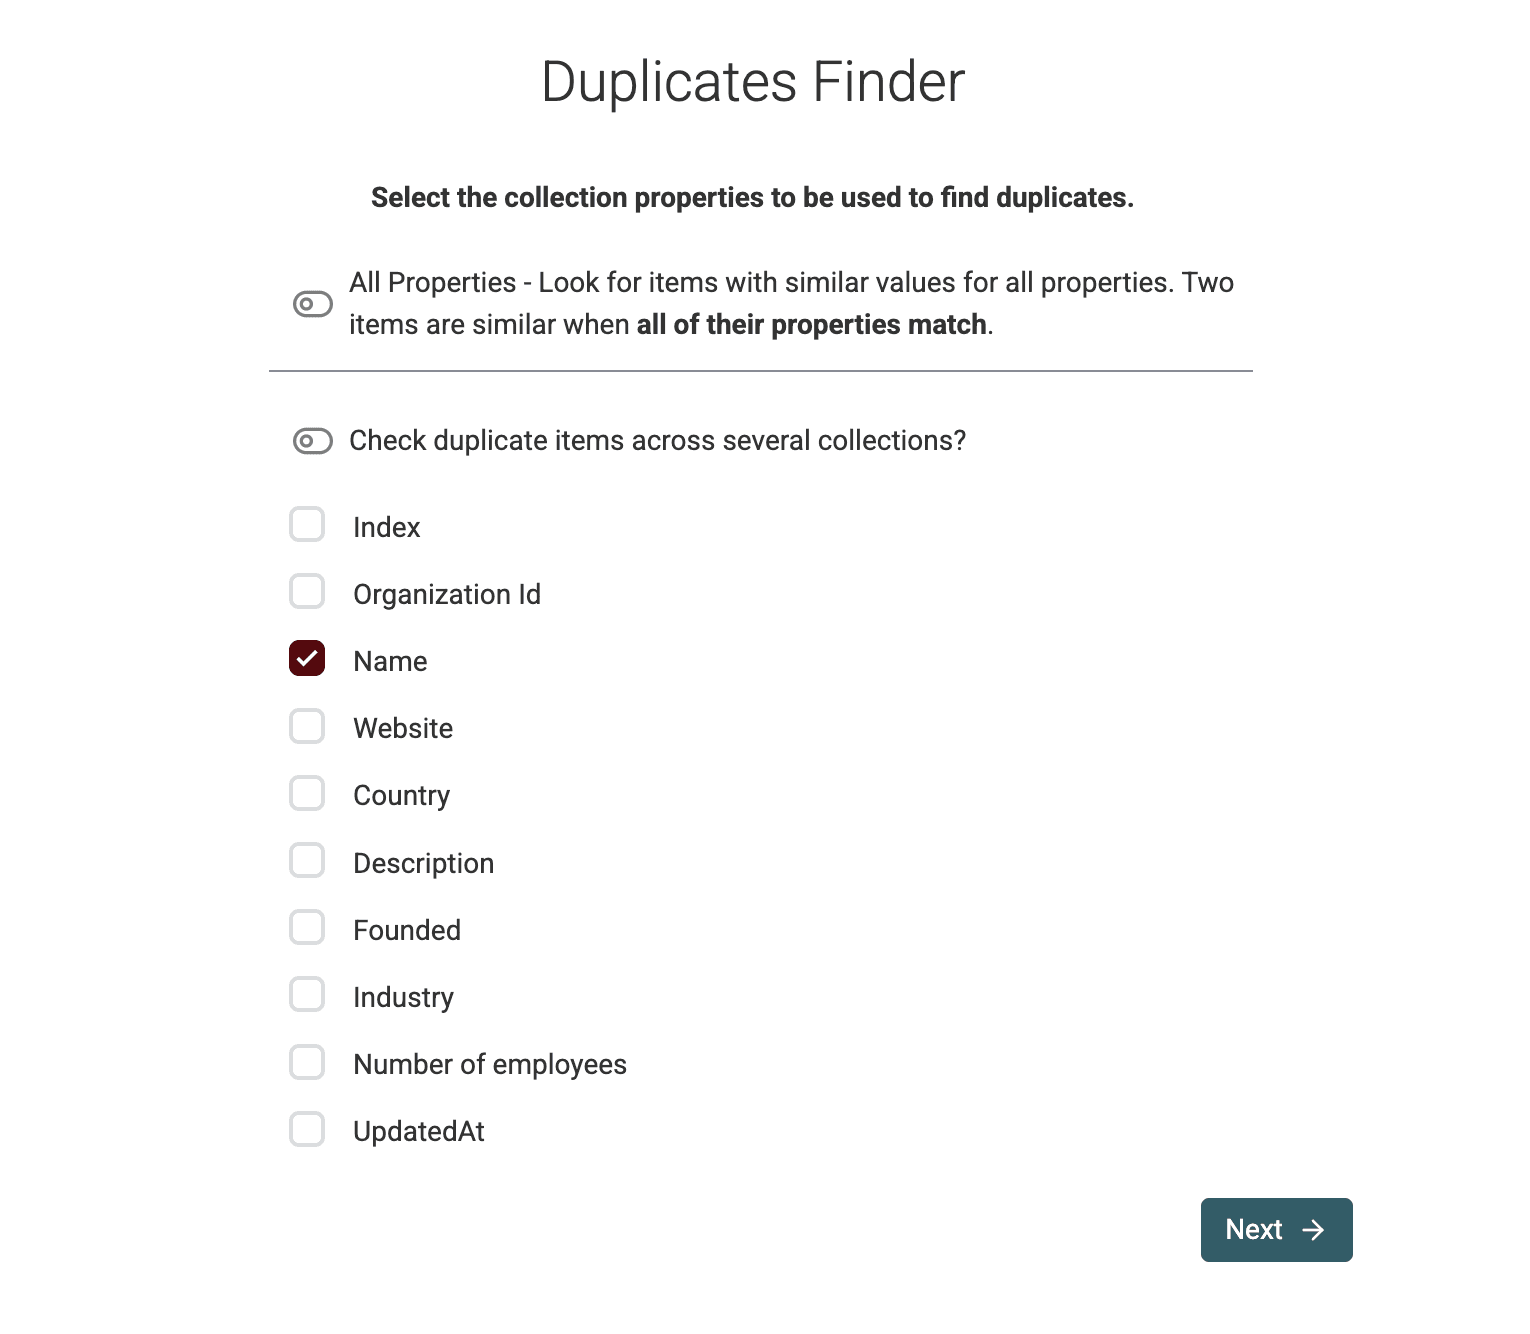
2.b. Scegli gli identificatori per la deduplicazione
Seleziona la proprietà, o le proprietà, che permettono di identificare in modo univoco un duplicato.
Quando possibile, usa un sito web condiviso o un ID aziendale. Se hai soltanto i nomi, consulta la guida al matching dei nomi aziendali e controlla ogni gruppo prima di normalizzarlo. Nomi simili e suffissi societari diversi possono riferirsi a entità distinte.
Per le aziende, puoi usare anche
Website URLoLinkedIn Company Page URL.Per i contatti, le scelte più comuni sono
Phone Number.
2.c. Configura l’algoritmo
Nel passaggio successivo, scegli l’algoritmo di matching.
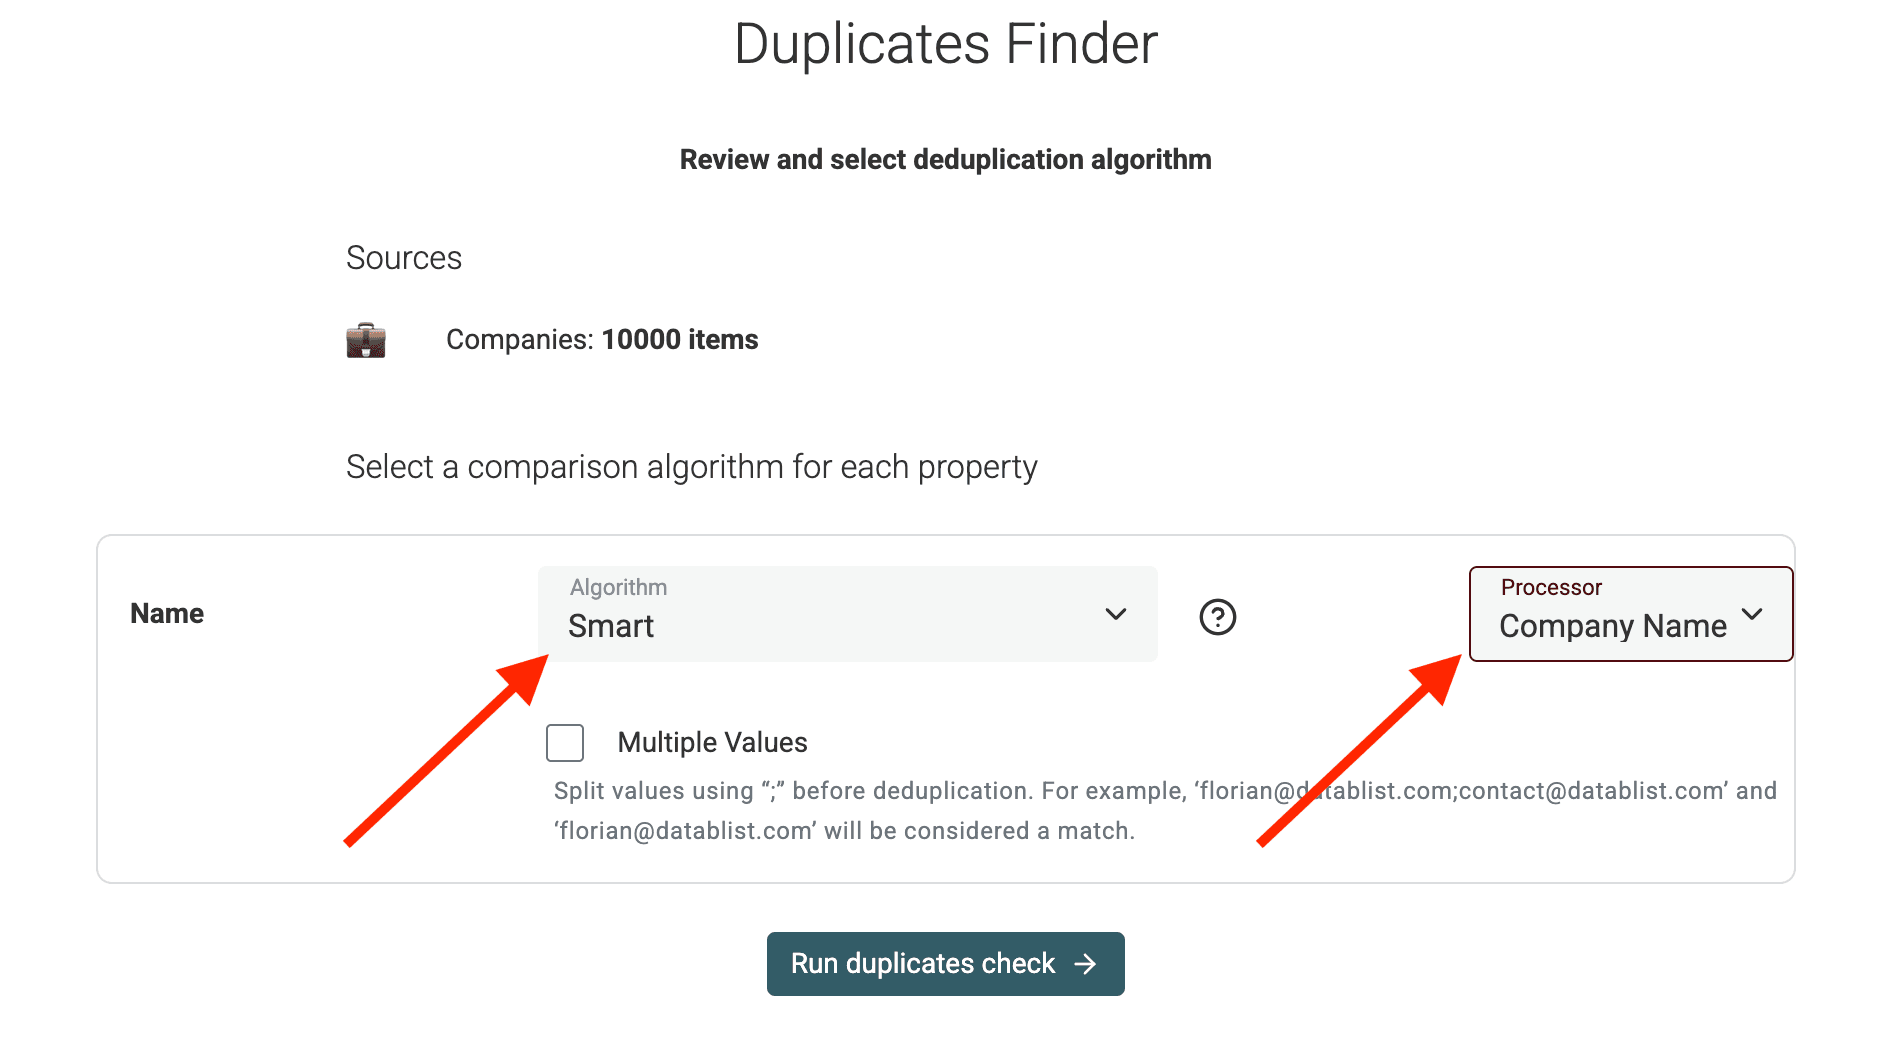
"Smart" funziona spesso bene con URL ed email, perché gestisce le piccole variazioni. "Exact" è più rigoroso. Per i nomi puoi anche ricorrere al matching fonetico o fuzzy.
Seleziona inoltre il Processor più adatto ai tuoi dati.
In questo caso scelgo il Processor Company Name, che gestisce specifiche varianti dei nomi aziendali, come suffissi societari e termini geografici.
2.d. Avvia il controllo
Fai clic su Run duplicates check.
Datablist analizzerà i dati e mostrerà i gruppi di potenziali duplicati.
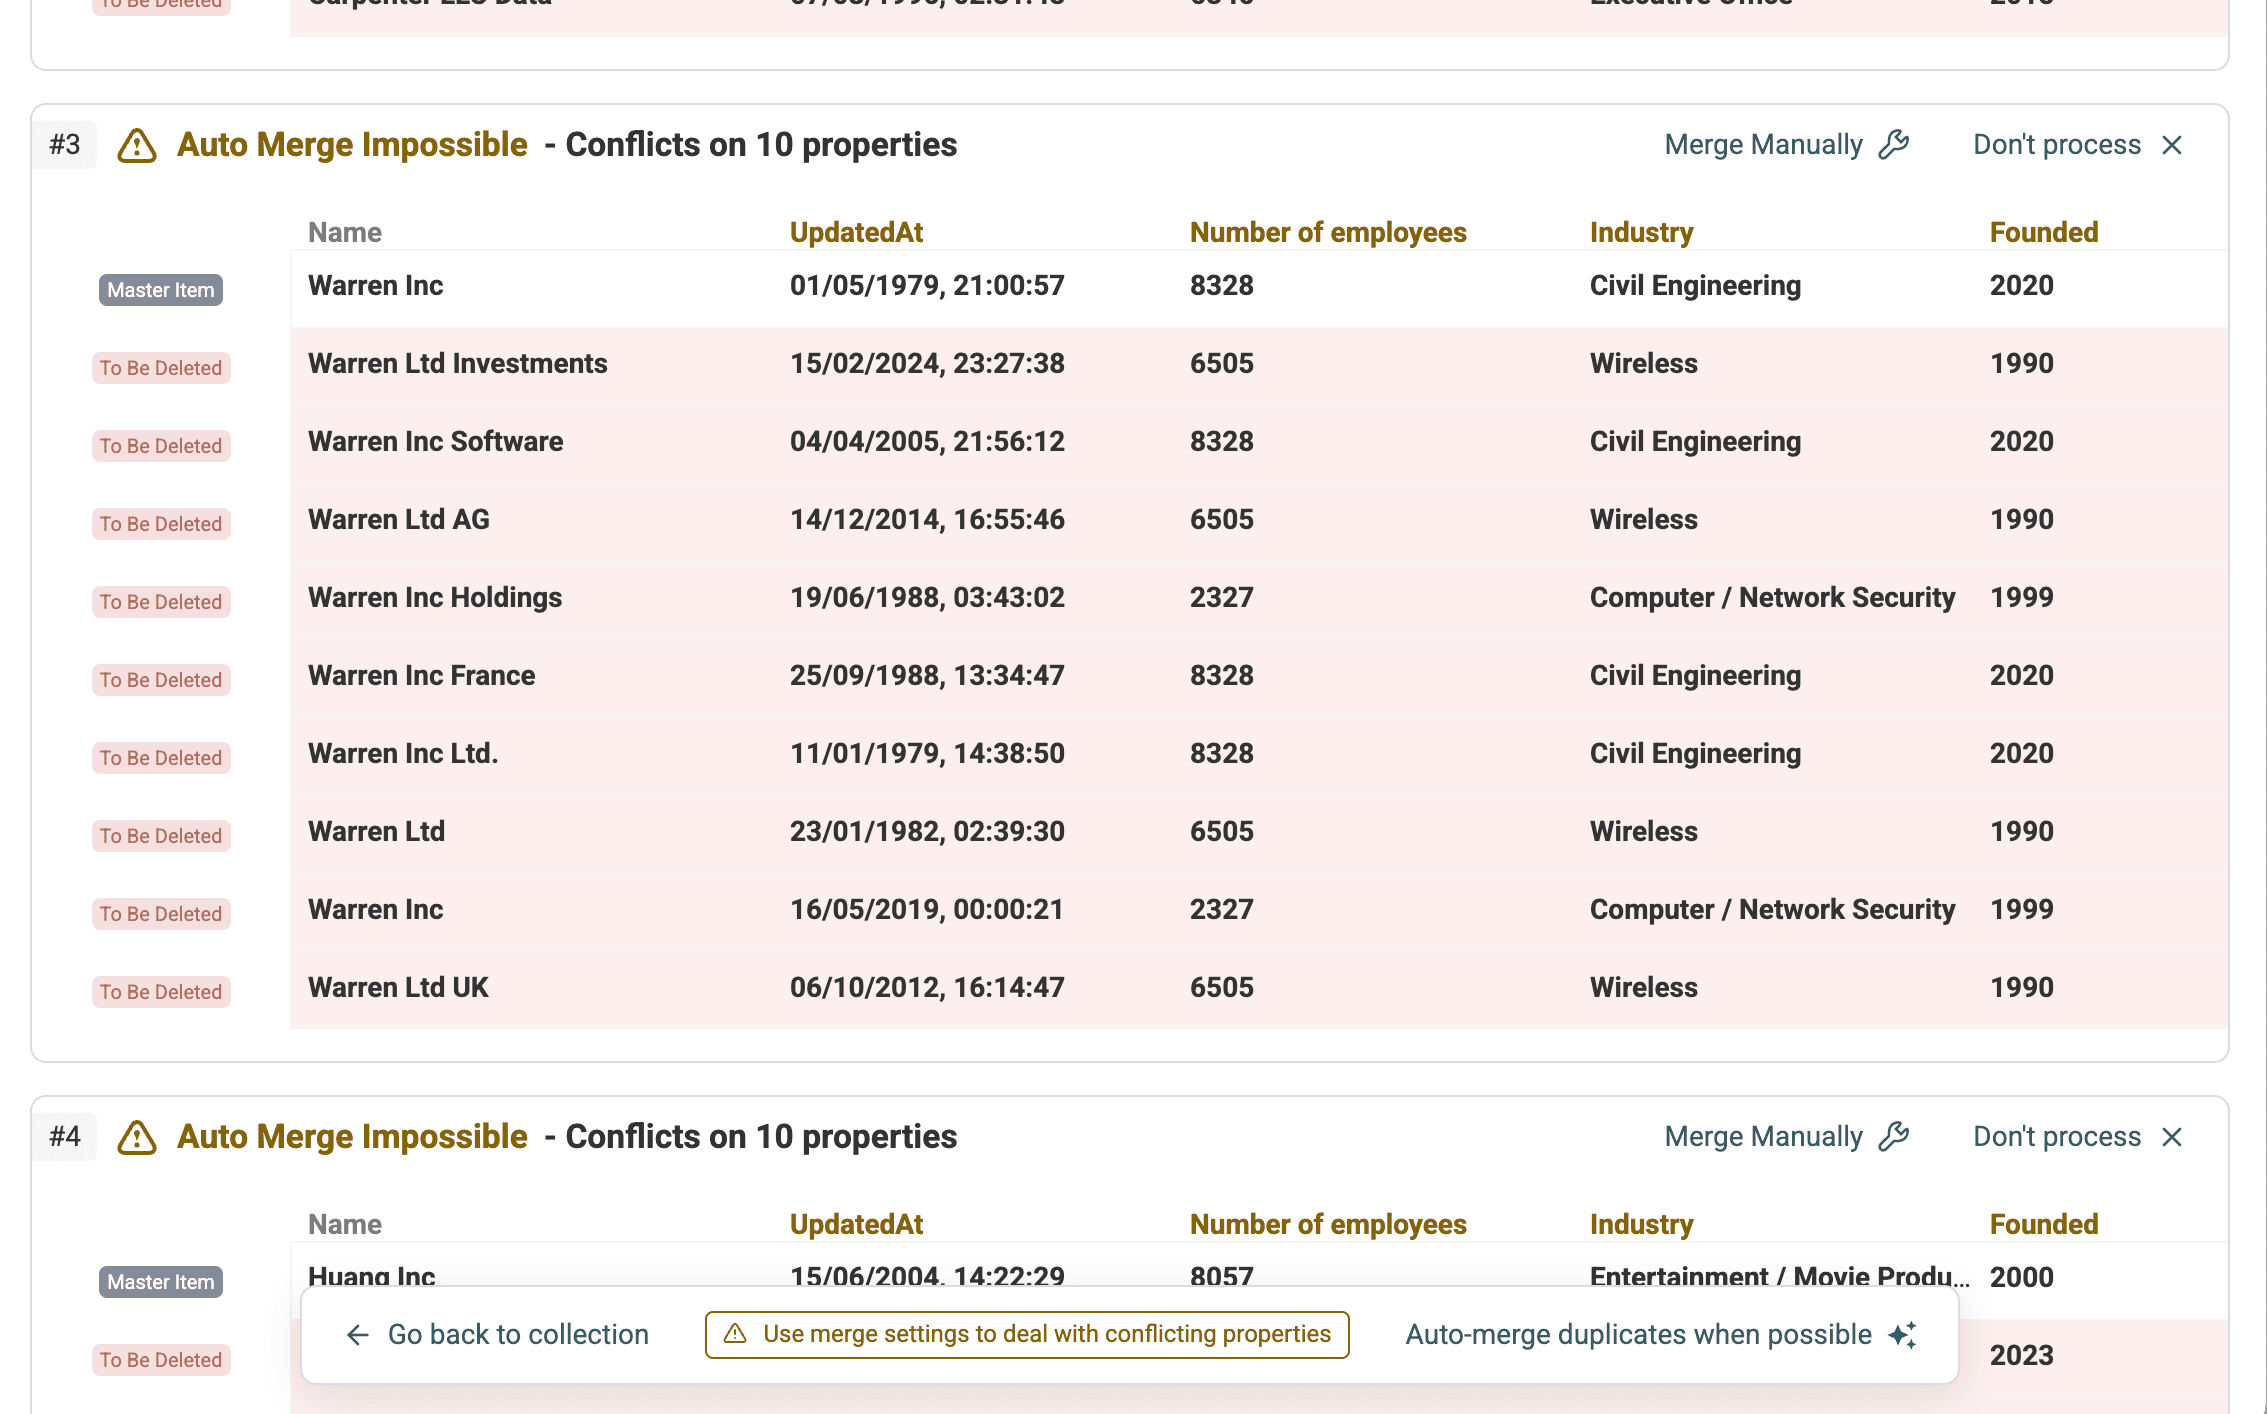
Passaggio 3: seleziona AI Processing
Nella pagina dei risultati dei duplicati, seleziona Custom with AI. Gli screenshot meno recenti riportati qui sotto mostrano ancora la precedente dicitura AI Editing. Questa modalità genera uno script a partire dalle tue istruzioni e da un piccolo campione di elementi, quindi mostra un’anteprima delle modifiche.
Passaggio 4: scrivi il prompt di normalizzazione
Qui devi spiegare all’AI che cosa fare. Chiedile di:
- Individuare il valore più frequente della proprietà interessata all’interno di ogni gruppo di duplicati.
- Aggiornare tutti i record del gruppo utilizzando quel valore per la proprietà specificata.
- Indicare esplicitamente di non eliminare alcun record.
Ecco un prompt di esempio per normalizzare la proprietà /Company Name:
Per ogni gruppo di duplicati, conta i valori non vuoti di /CompanyName usando corrispondenze testuali esatte. Se un valore compare più spesso di qualsiasi altro, copialo in /CompanyName per ogni record del gruppo, compresi quelli in cui CompanyName è vuoto.
Se tutti i valori sono vuoti o se due o più valori hanno la stessa frequenza massima, ignora il gruppo senza modificarlo. Ignora anche i gruppi in cui i valori sono già identici. Mantieni tutte le altre proprietà e non unire né eliminare alcun record.
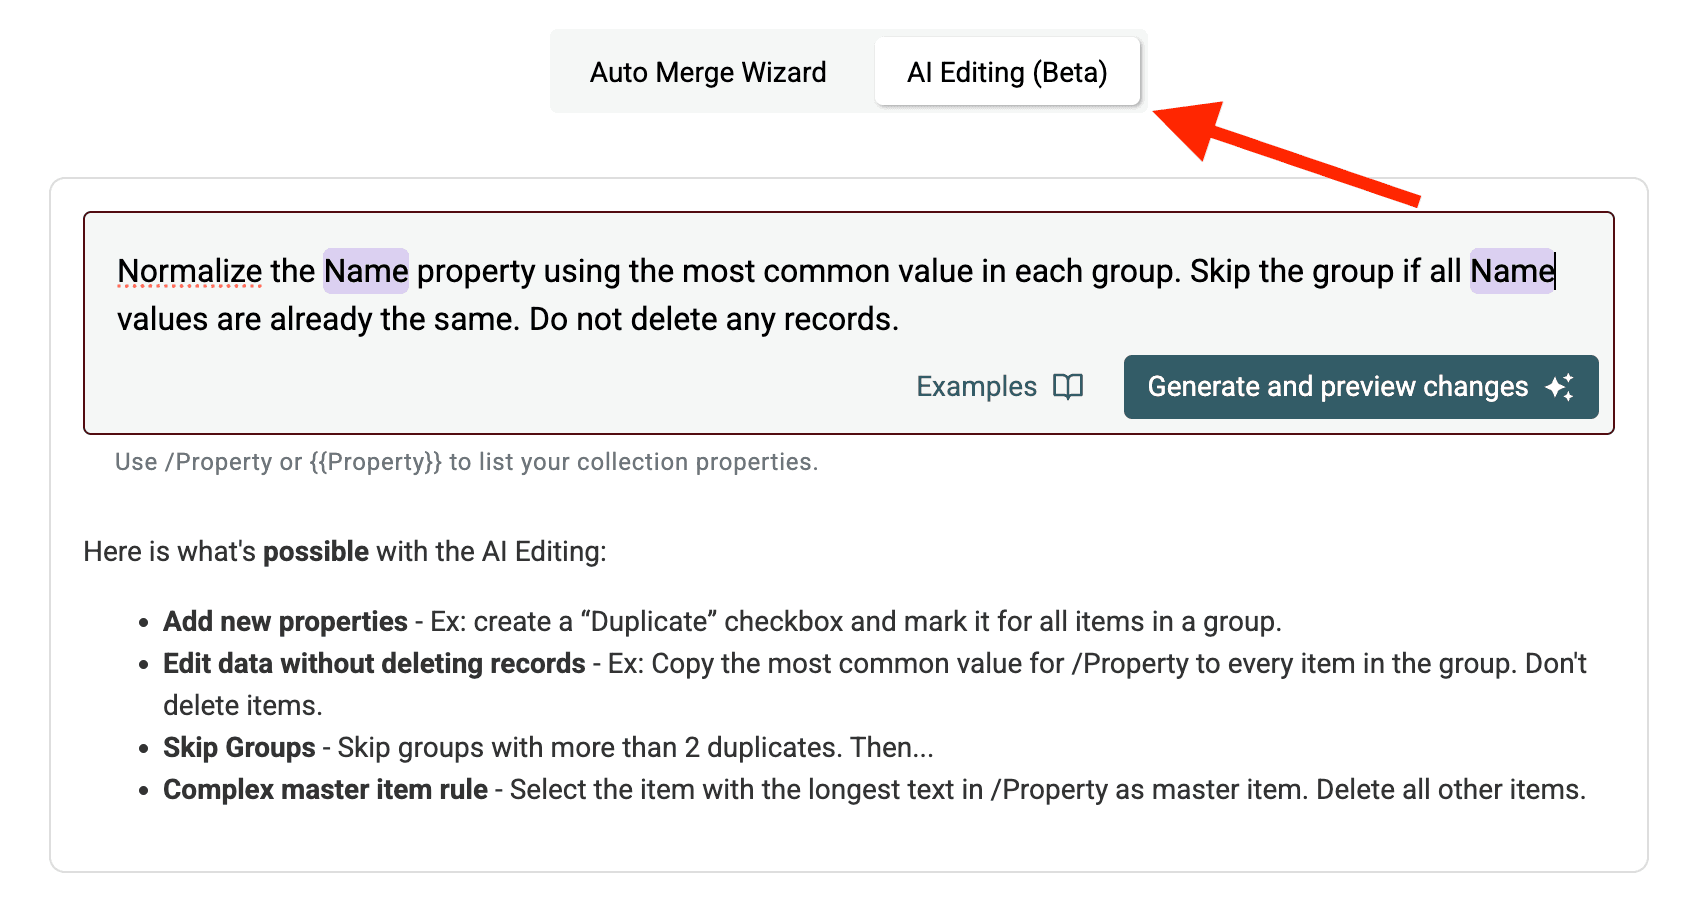
Analizziamo il prompt:
Normalizza la proprietà /CompanyName...: specifica il campo di destinazione. Usa/PropertyNameo{{PropertyName}}per fare riferimento alle colonne....conta i valori non vuoti usando corrispondenze testuali esatte.: definisce come scegliere il valore standard. I valori vuoti non possono prevalere e i gruppi con valori a pari merito vengono lasciati da verificare. Puoi anche adottare altri criteri, come "il valore più lungo", "il valore più breve", oppure fare riferimento a un altro campo, per esempio "usa il valore del record con la data /UpdatedAt più recente".Ignora il gruppo se tutti i valori di /CompanyName sono già uguali.: evita elaborazioni non necessarie.Non eliminare alcun record.: è un’istruzione essenziale per assicurarsi che vengano aggiornati soltanto i campi, senza unire o rimuovere record.
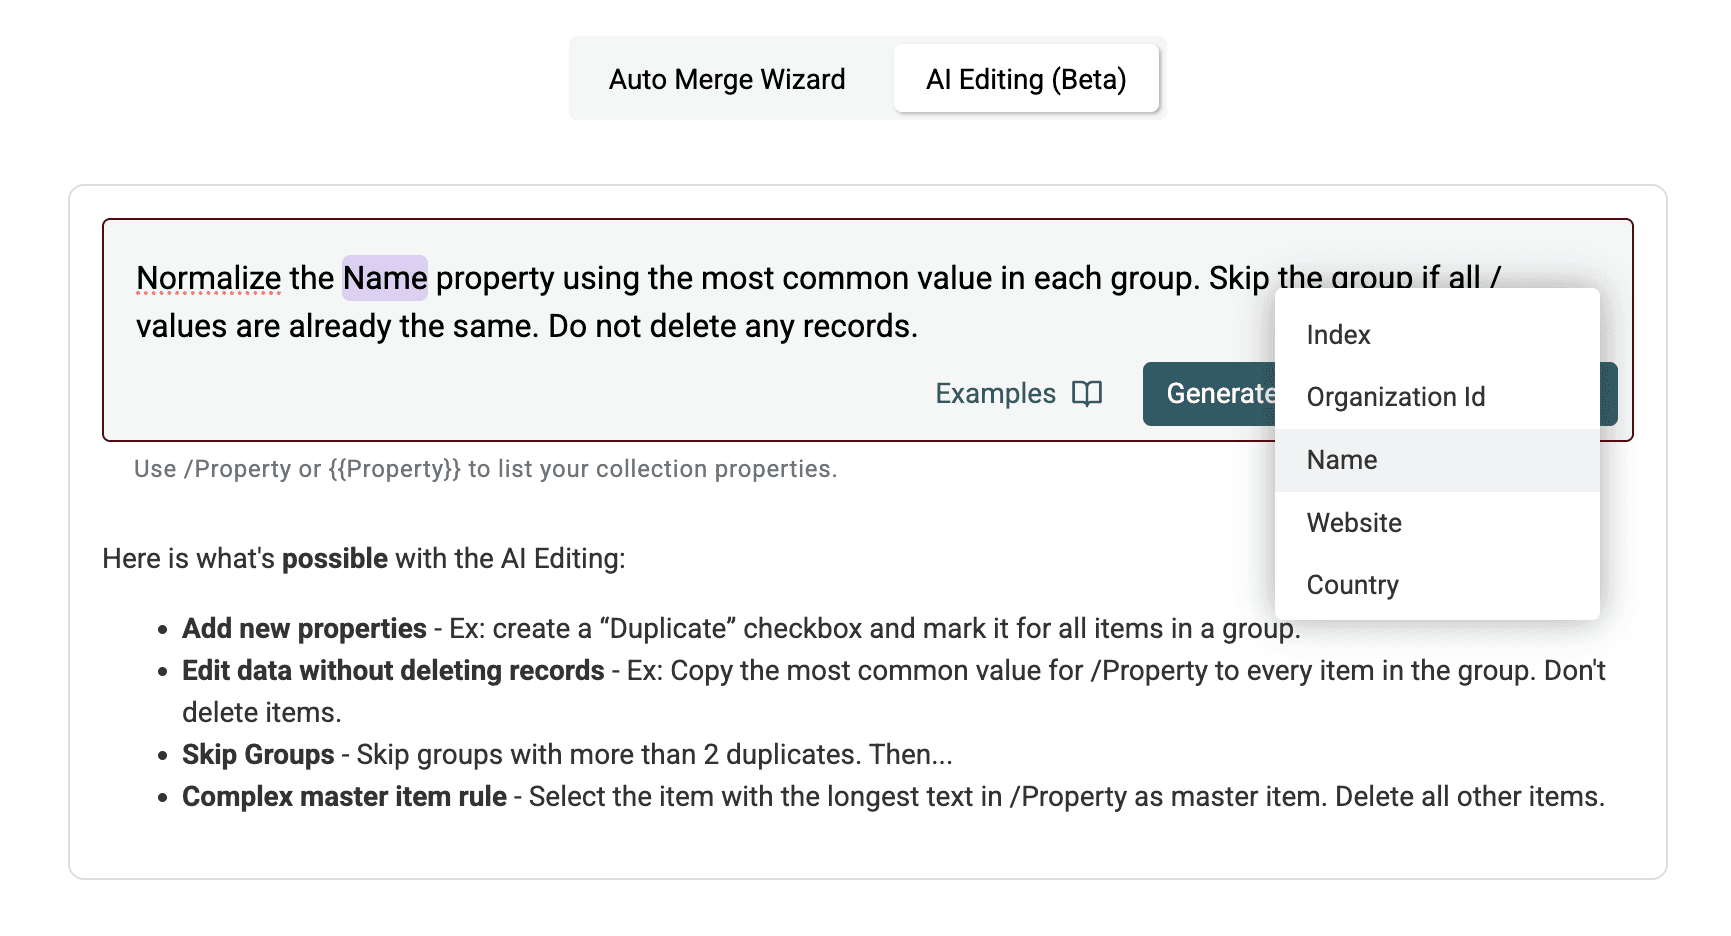
Passaggio 5: genera lo script e controlla l’anteprima
Fai clic su Generate and preview changes. L’AI di Datablist interpreterà il prompt e genererà uno script per eseguire l’operazione.
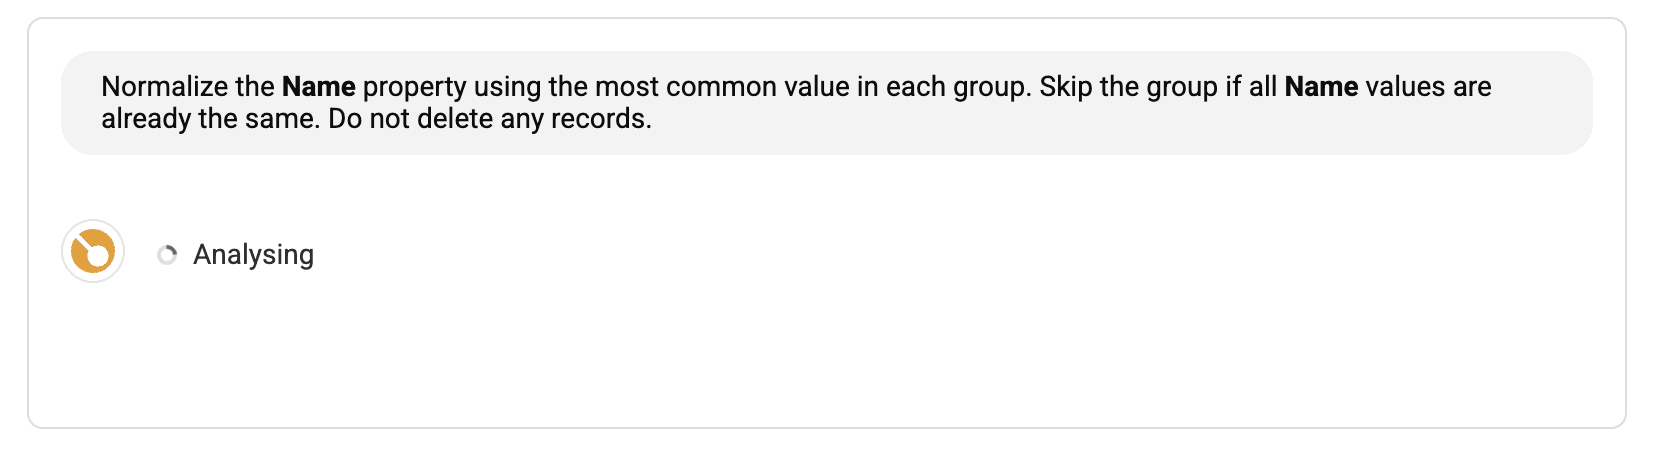
Non preoccuparti: non devi scrivere né modificare alcuno script.
- Script Explanation: una spiegazione in linguaggio naturale di ciò che farà lo script. Verifica che corrisponda al risultato desiderato.
- Result Preview: una tabella che mostra esattamente come lo script modificherà un campione dei gruppi di duplicati prima che le modifiche vengano applicate. Controlla il campo interessato, per esempio
/Company Name, e assicurati che nell’anteprima riporti il valore normalizzato previsto per tutti i duplicati del campione.
Per esempio, un gruppo che contiene Acme Ltd, Acme Ltd e Acme Limited deve conservare tre righe, tutte con Acme Ltd. Un gruppo con un solo Acme Ltd e un solo Acme Limited deve invece restare invariato, perché nessuno dei due valori è più frequente. Sono controlli esemplificativi da effettuare nell’anteprima, non risultati misurati.
Controlla sia i valori sia il numero di righe. Verifica che i campi vuoti vengano compilati solo in presenza di un vincitore chiaro, che i gruppi a pari merito restino invariati e che gli ID di origine e le proprietà non coinvolte vengano mantenuti.
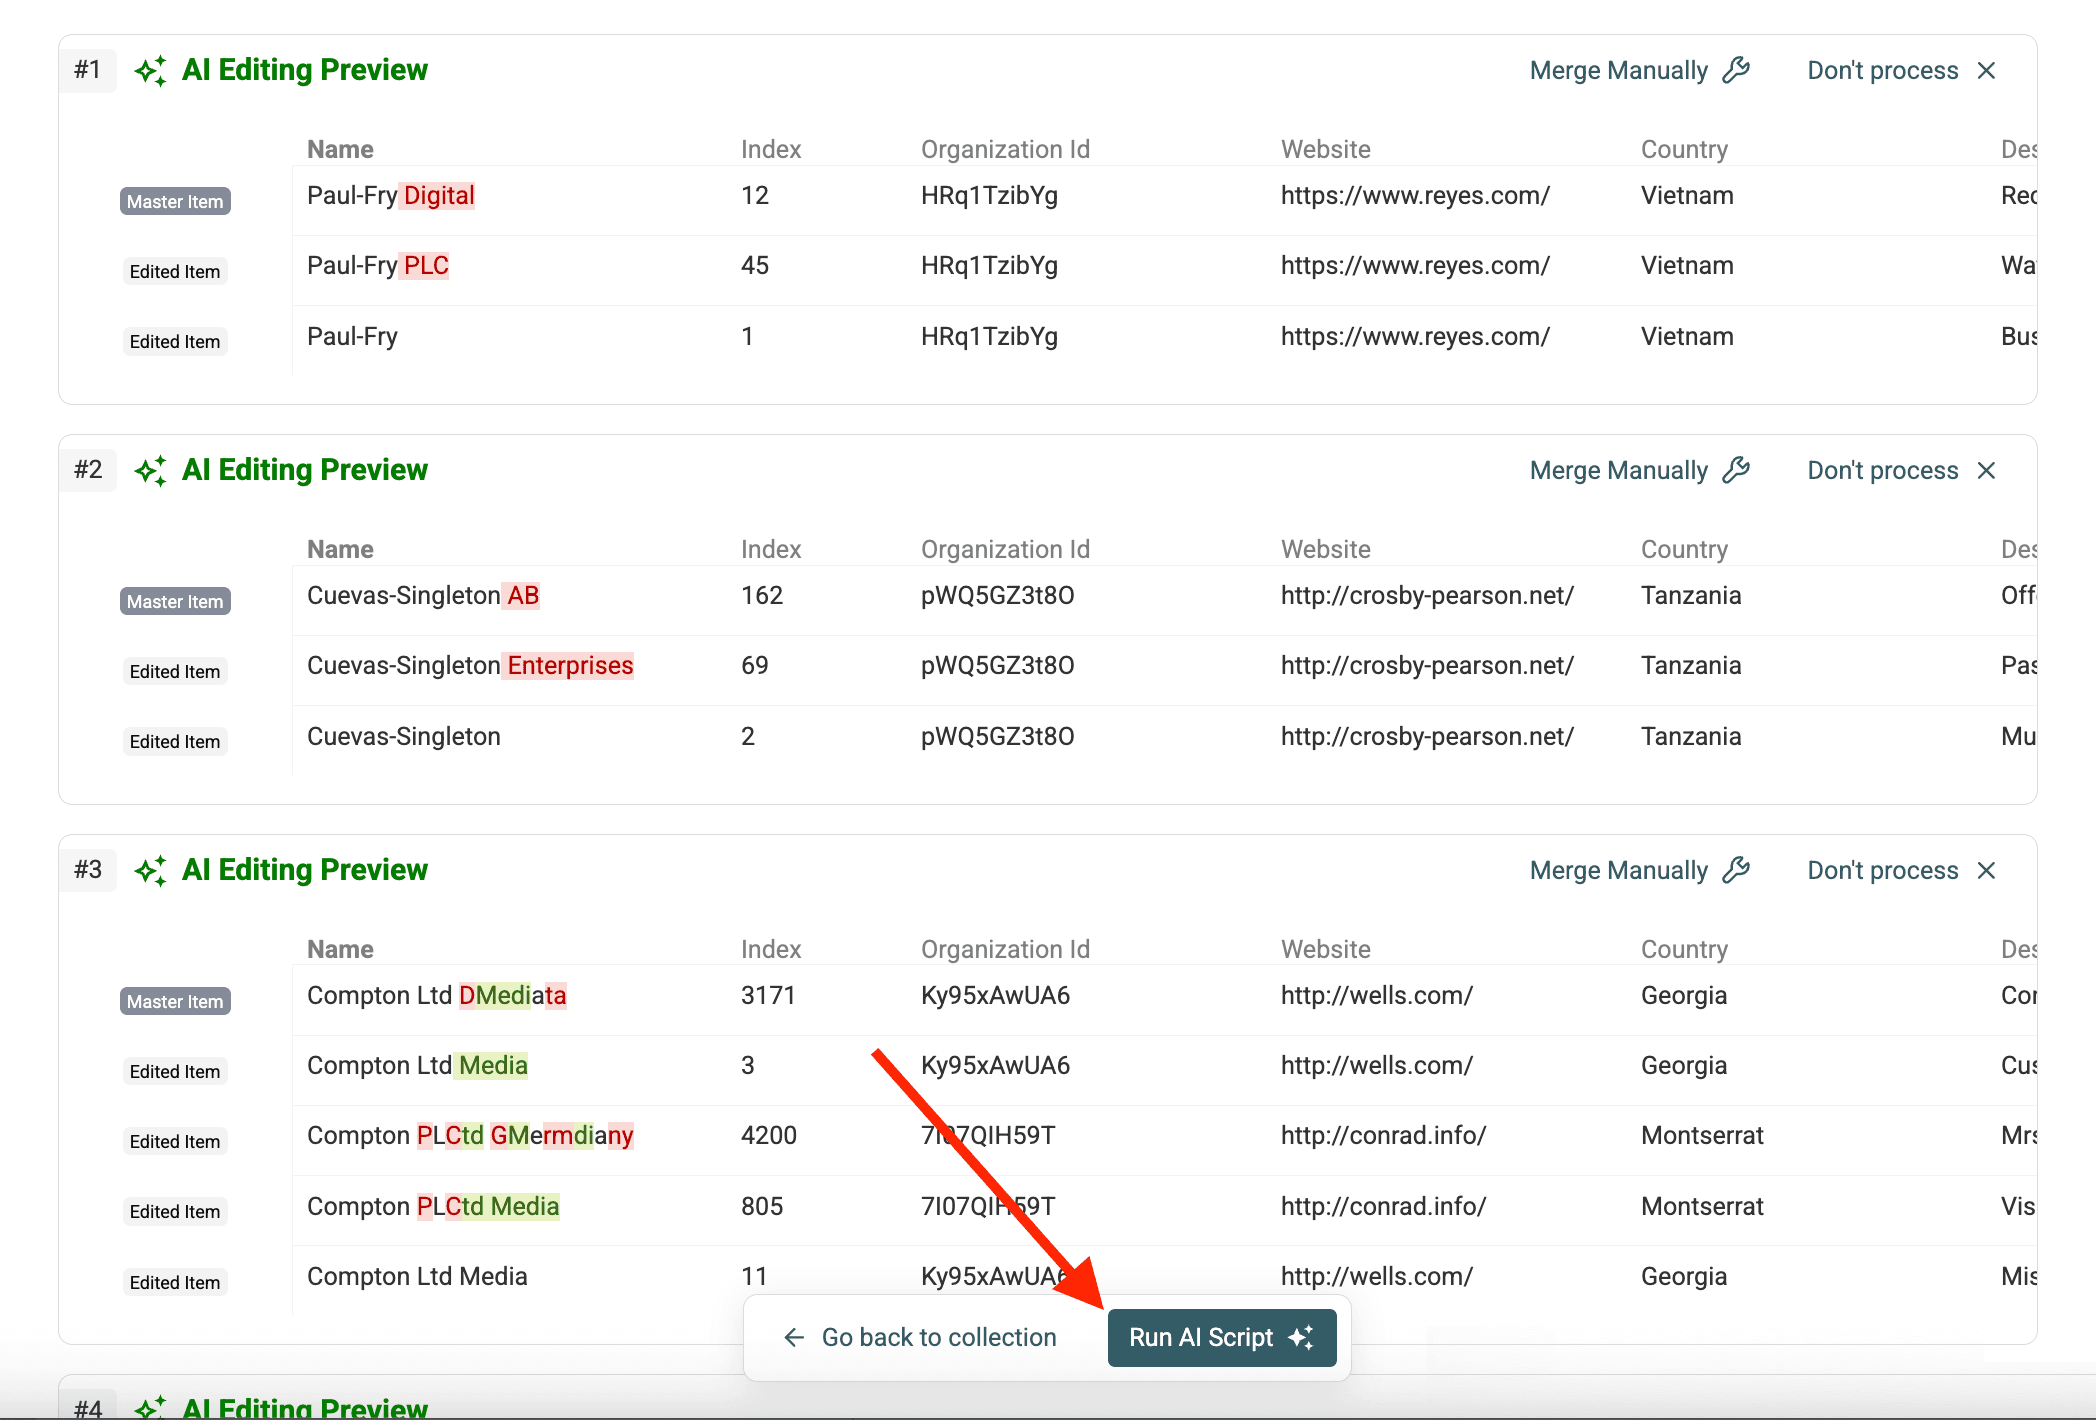
Passaggio 6: esegui lo script
Se la spiegazione e l’anteprima sono corrette, fai clic su Run AI rules. Datablist eseguirà lo script generato su tutti i gruppi di duplicati individuati.
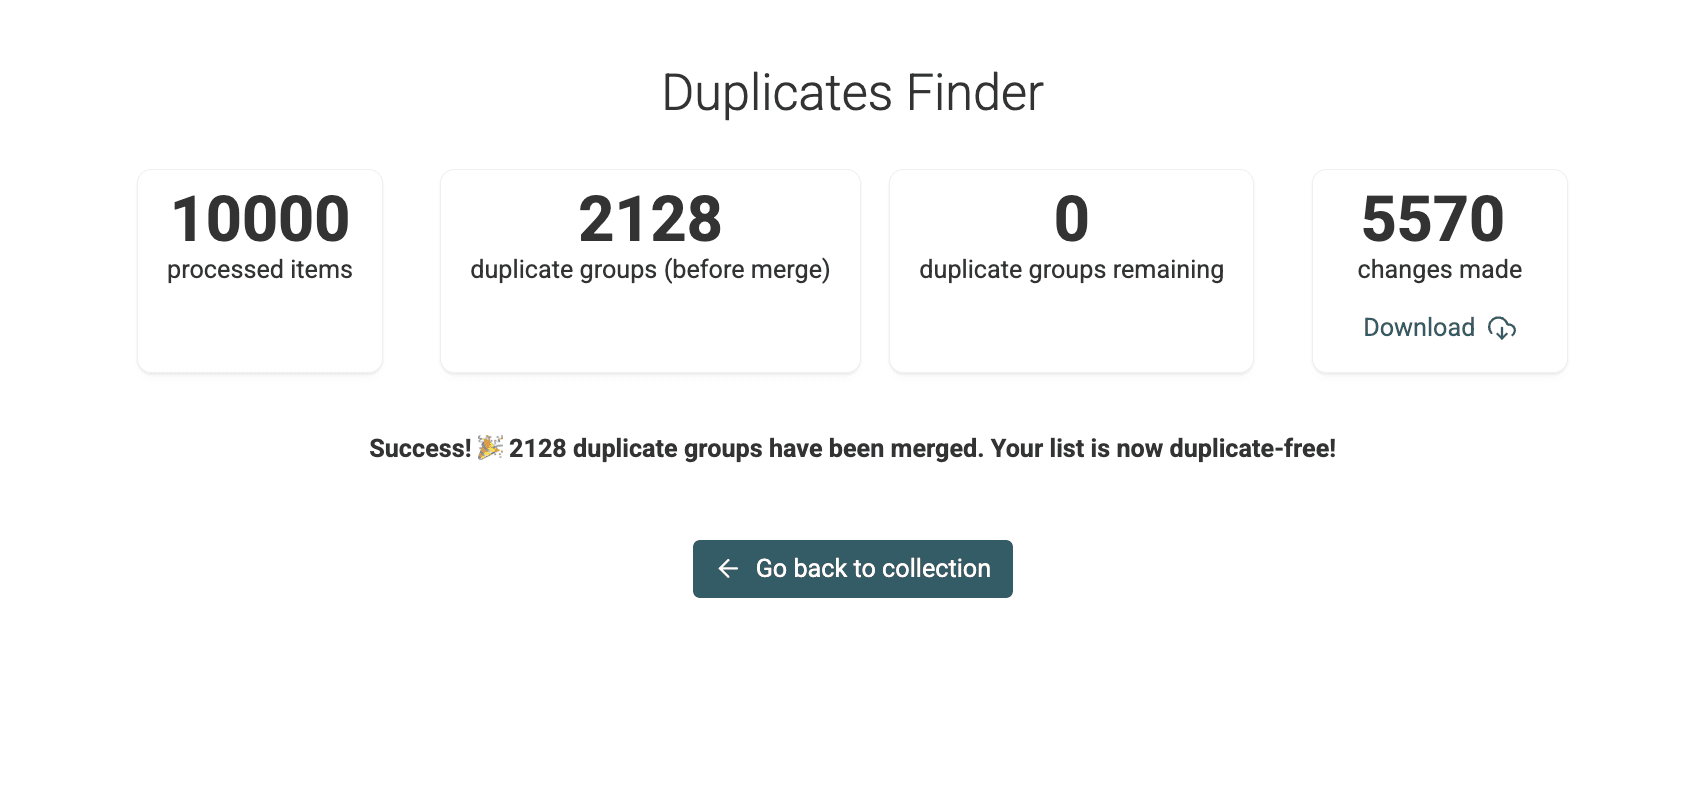
Passaggio 7: verifica le modifiche
Al termine dell’esecuzione, Datablist mostra un riepilogo e una Changes List scaricabile.
È utile quando devi replicare le modifiche in un sistema esterno, per esempio per modificare i Lead nel CRM.
Torna alla vista principale della collection. Il campo interessato, per esempio /CompanyName, ora sarà uniforme in tutti i record dei gruppi di duplicati, mentre i record continueranno a essere separati.
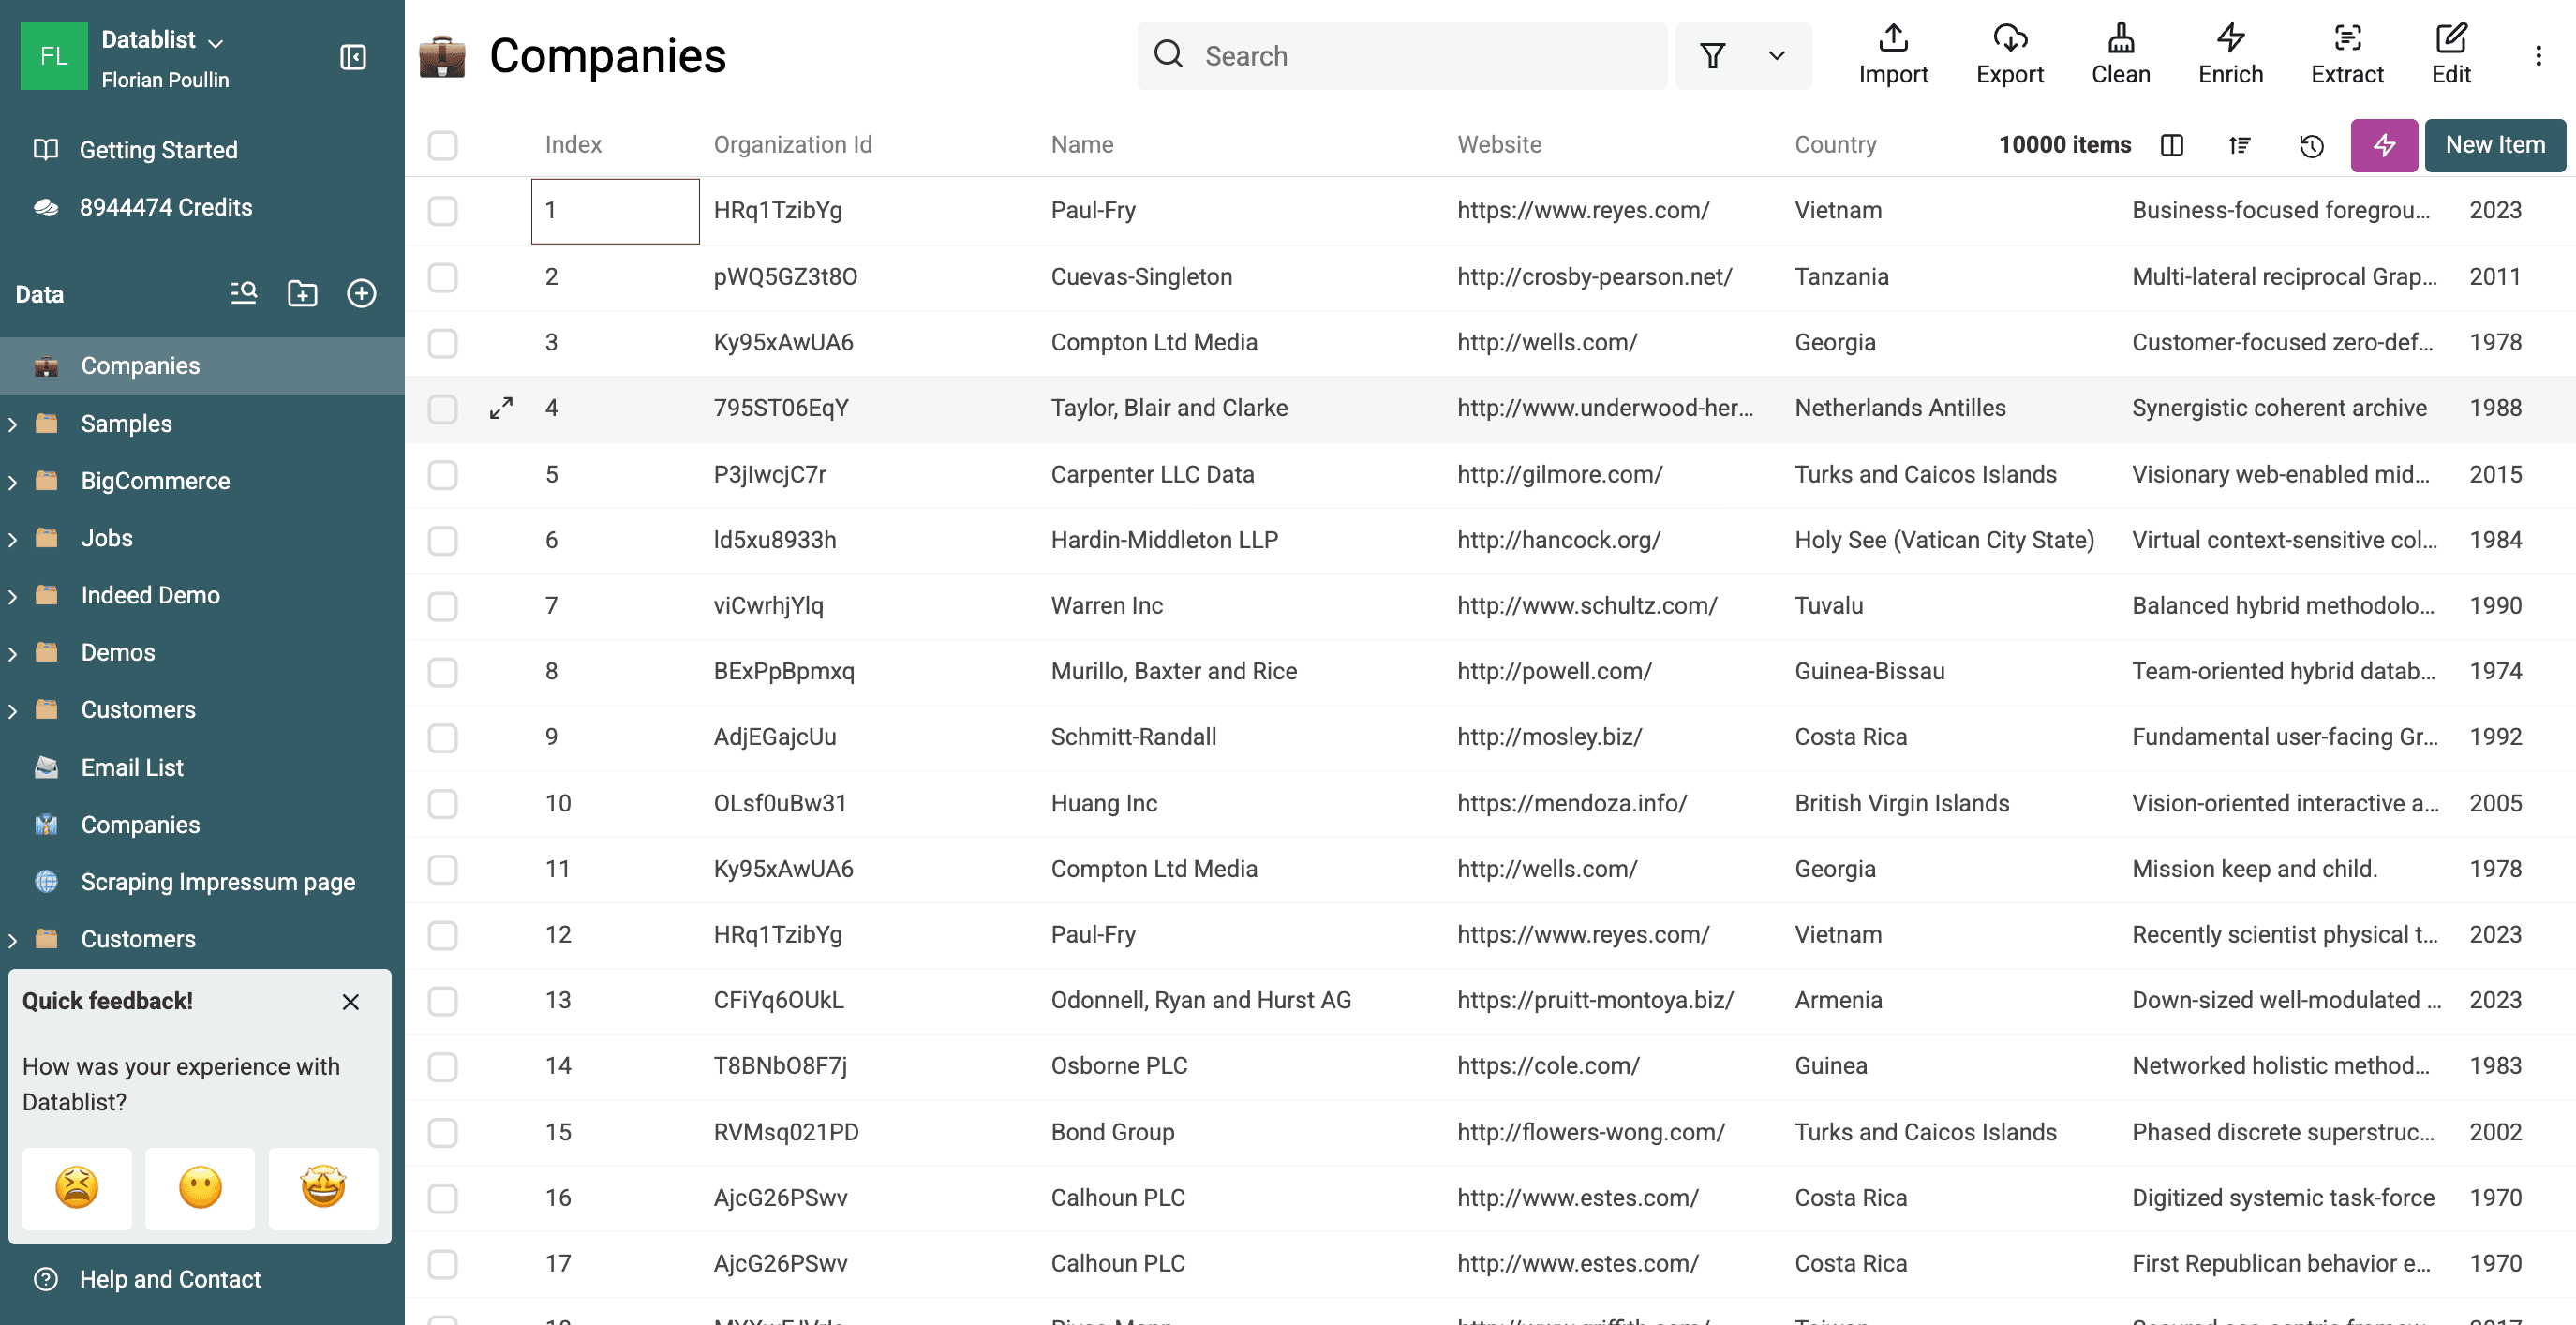
Hai normalizzato correttamente un campo nei duplicati senza unirli! 🚀
Quando normalizzare i duplicati senza unirli
Quando conviene normalizzare un campo anziché eseguire un’unione completa?
- Standardizzare i nomi di aziende o contatti: uniforma varianti come "Example Ltd", "Example Limited" oppure "Jon Doe", "Jonathan Doe" prima di scegliere la strategia di unione definitiva.
- Pulire i job title: uniforma titoli come "VP Marketing", "Vice President Marketing" e "Marketing VP" per rendere coerenti report e analisi.
- Normalizzare le località: usa nomi di Paesi coerenti, come "IT" e "Italia", o sigle e nomi delle province, come "MI" e "Milano", nei record di indirizzo duplicati.
- Preparare un’importazione o un aggiornamento nel CRM: standardizza i campi principali prima di importare i dati in un CRM con regole di convalida rigide, anche se mantieni temporaneamente i duplicati.
- Eseguire un data audit: conserva i record duplicati originali a scopo di audit o tracciamento storico, ma uniforma gli identificatori principali per semplificare l’analisi.
- Procedere con una pulizia incrementale: normalizza un campo alla volta all’interno di un processo più ampio di data cleaning, prima di procedere con un’unione o un’eliminazione completa.
Perché normalizzare i dati invece di unirli?
- Mantiene la granularità dei record: conserva intatti i singoli record duplicati, aspetto che può essere necessario per tracciarne l’origine, le interazioni specifiche o i dati storici associati a ciascuno.
- Gestisce i casi incerti: è utile quando i duplicati non corrispondono perfettamente. Normalizzare un campo chiave garantisce coerenza senza imporre un’unione potenzialmente errata tra record che presentano altri dati differenti.
- Consente un approccio graduale: permette di gestire il data cleaning in modo più controllato. Prima normalizzi, poi verifichi i dati e decidi se unire o eliminare i record.
- Semplifica l’operazione: l’intervento è mirato. Rendi coerente un solo campo senza modificare il resto dei dati nei record duplicati.
Conclusione
Parti da un gruppo verificato, definisci la regola per selezionare il valore e controlla l’anteprima. Dopo l’esecuzione, assicurati che il numero di righe sia rimasto invariato e verifica i gruppi ignorati a causa di valori a pari merito. Potrai quindi esportare nomi coerenti mantenendo separato ogni record di origine.
FAQ
-
AI Processing è incluso nel mio piano Datablist? AI Processing, compresa la generazione e l’esecuzione di script per la normalizzazione, è disponibile nei piani a pagamento di Datablist. Consulta la nostra pagina dei prezzi per maggiori informazioni.
-
Posso normalizzare più campi con un unico prompt? Sì, puoi scrivere un prompt che normalizzi più campi contemporaneamente. Per esempio: "Normalizza la proprietà /Company Name usando il valore più comune in ogni gruppo. Normalizza la proprietà /Country usando il valore più comune in ogni gruppo. Non eliminare alcun record."
-
Cosa succede se l’AI interpreta male il prompt? Controlla sempre con attenzione la spiegazione dello script e i risultati dell’anteprima prima di eseguirlo. Se l’anteprima non è corretta, rendi il prompt più chiaro e specifico, quindi genera nuovamente lo script.
-
Posso annullare le modifiche apportate dallo script AI? Una volta eseguito lo script, le modifiche vengono applicate direttamente. Datablist offre una funzione di annullamento per le azioni recenti eseguite all’interno della sessione, ma è sempre consigliabile clonare la collection prima di avviare trasformazioni importanti come questa, così da poter ripristinare i dati in caso di necessità.
-
Qual è la differenza rispetto all’opzione standard "Combine conflicting properties"? L’opzione standard "Combine" unisce i record duplicati in un unico record master e concatena in un solo campo i valori di testo in conflitto. Con il prompt giusto, AI Processing aggiorna invece il campo in tutti i record duplicati usando un unico valore e mantiene separati tutti i record. Non unisce i record né concatena i valori, a meno che non venga richiesto esplicitamente.