
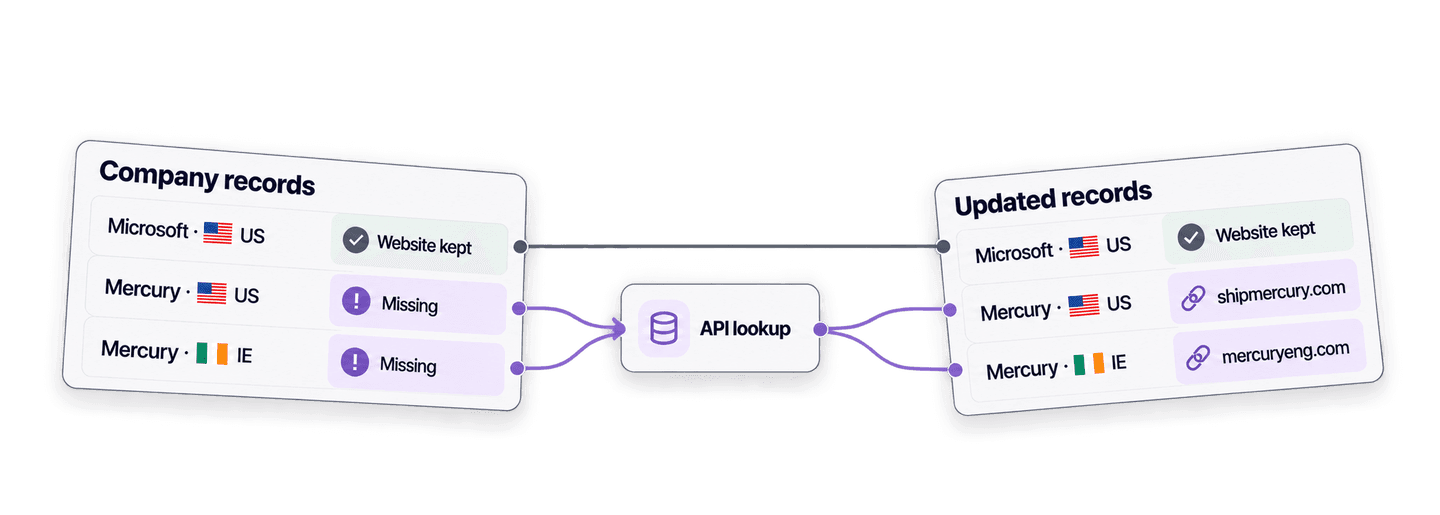
Pythonで会社名から企業Webサイトを特定するには、会社名と、利用可能であれば国情報をDatablistのCompany Name to Domain APIへ送信します。APIはバックグラウンドで検索を処理し、ドメインとWebサイトの完全なURLを返します。
まず、シンプルなPython APIリクエストをご紹介します。その後、同じ関数を再利用して、既存のURLを保持したまま、企業レコードのリストでWebサイトが未入力の項目だけを補完します。
スプレッドシート形式のインターフェースを使用したい場合は、会社名からWebサイトを一括検索するガイドをご覧ください。
💡 お急ぎの方向けの要約
会社名からWebサイトを検索するPython関数を1つ作成し、既知のURLを上書きせずに、Webサイトが未入力のレコードだけを補完します。
- 入力: 会社名と、任意の国情報。
- 出力: ドメイン、Webサイトの完全なURL、信頼度、結果ステータス、使用クレジット数。
PythonとDatablist APIキーをセットアップする
この例では、Requestsパッケージを使用して同期HTTPリクエストを送信します。仮想環境にインストールしてください。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsREST APIへのアクセスはGrowthプランの機能であるため、DatablistのGrowthプランも必要です。Datablist APIアカウントページでPersonal API Keyを作成し、環境変数に設定します。
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 すでにAPIキーをお持ちですか? 旧形式のキーは
auth0|<userId>:<accountId>:<secret>:1です。現在もサポートされていますので、既存のキーを生成時の形式のままお使いください。置き換えや再フォーマットは不要です。
上記のサンプル値を、アカウントページで生成したキーに置き換えてください。企業Webサイトの検索にはクレジットが消費されます。スクリプトをスケールする前に、1クレジットと2.5クレジットのケースについて後ほど説明します。最新のプラン内容はDatablistの料金ページで確認できます。
Pythonで企業Webサイトを1件検索する
find_company_websites.pyというファイルを作成します。このスクリプトは、1つの関数内で会社名を送信し、タスクの完了を待って結果を取得します。各入力のinputIdには変更されないレコードIDを使用するため、レスポンスの順序が変わっても、それぞれの結果を正しいレコードに対応付けられます。
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))キーをexportしたターミナルで実行します。
python find_company_websites.pyMicrosoftの結果は次のとおりです。
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}この結果を元のレコードに対応付けるには、inputIdを使用します。statusはsuccess、no_result、error、skippedのいずれかです。成功した結果には、companyDomain、完全なcompanyUrl、domainConfidenceが含まれる場合があります。creditsUsedはこの入力に対する消費クレジット数を示し、errorには項目単位のエラー内容が入ります。
この関数は、3種類のAPIコールを順番に実行します。
最初に、検索を送信します。 ペイロードには設定と企業レコードが含まれます。POSTは202 Acceptedを返し、@idが後続のコールで必要になるタスクIDです。
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]DATABLIST_API_KEYが設定されていない場合、HTTPリクエストが送信される前の環境変数参照時に、PythonでKeyErrorが発生します。変数をexportしてから、スクリプトをもう一度実行してください。変数に無効なキーが設定されている場合、POSTはAPIに到達しますが、HTTP 401が返されます。アカウントページから現在のPersonal API Keyをコピーし、無効な値を置き換えてください。
次に、タスクをポーリングします。 POSTによってバックグラウンド処理が開始されるため、スクリプトはステータスがcompleted、failed、stoppedのいずれかになるまで、3秒ごとにタスクを確認します。
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)クレジット不足でタスクが失敗した場合、エラー理由はcredits_errorになります。クレジットを追加するか、月次クレジットの更新を待ってください。すでに返された結果を確認したうえで、未完了の入力だけを新しいタスクとして送信します。
最後に、すべての結果ページを取得します。 各レスポンスの結果をリストに追加し、次のリクエストで使用するカーソルを受け取ります。
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breaknextCursorがnullになるまで、次のページを取得します。
スクリプトは、POSTの前に生成したuniqueIdを出力します。作成レスポンスを受信する前に接続が切れた場合は、別のタスクを作成する前にタスク一覧を取得し、ステータスを確認してください。
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"スクリプトが生成した値とuniqueIdが一致するタスクを探し、その@idをコピーします。一覧エンドポイントではenrichmentIdによる絞り込みはできますが、uniqueIdでは絞り込めません。その@idを、スクリプトと同じステータスURLおよび結果URLで使用します。タスクがまだ実行中なら、ポーリングを続けてください。停止または失敗している場合は、入力を再送信する前に部分的な結果がないか確認します。
データセット照合と国情報を使うフォールバック
このスクリプトでは、推奨されるデフォルト設定のdataset_googleを使用します。Datablistは、まず保有する企業データセットを確認します。一致する情報がない場合や結果が競合する場合は、フォールバックとしてGoogleを使用できます。候補を検証してから、信頼度を返します。
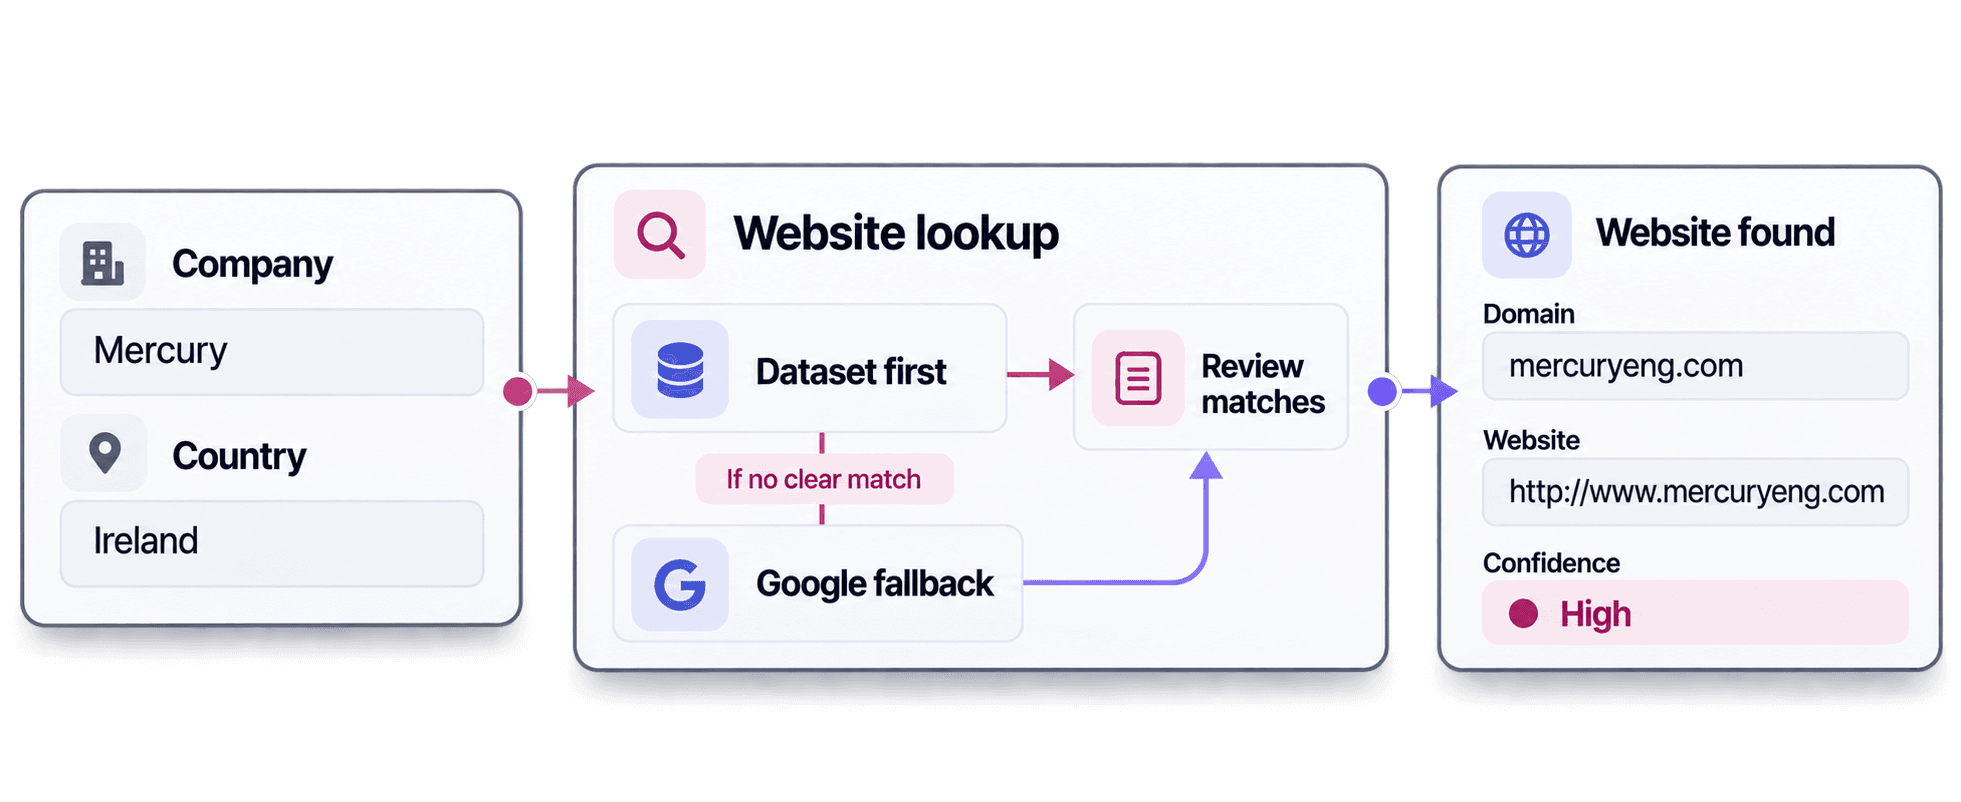
国情報は、曖昧な会社名の判別に役立ちます。この例では、同じ会社名でも異なる結果になりました。
MercuryとUSを指定すると、shipmercury.comとhttps://www.shipmercury.com/が返されました。MercuryとIEを指定すると、mercuryeng.comとhttp://www.mercuryeng.comが返されました。
どちらも信頼度はHighでした。国情報があれば、同名企業の候補を絞り込みやすくなります。また、信頼度を見れば、どの結果を確認すべきか判断できます。
業種、企業規模、その他のビジネス情報も照合に必要な場合は、AI Agentによるリサーチワークフローをご利用ください。AI Agentのプロンプトにそれらの情報を追加すると、より詳しいビジネスコンテキストを基に対象企業を調査できます。
レコード内の未入力Webサイトだけを補完する
find_domains()で会社名からWebサイトを検索できるようになったため、次はこの関数を再利用して、企業レコード内の未入力Webサイトだけを補完します。すでにWebサイトが登録されているレコードはAPIを経由しないため、値は変更されず、検索クレジットも消費しません。
find_company_websites.pyで、companies = [から最後のprintループまでを、以下のブロックに置き換えてください。その上にあるapi_keyの代入は残します。空欄チェックでは、None、空文字列、空白文字のみの値を判定できます。すべてのWebサイトが入力済みなら、APIコールは行われません。
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))コードは結果をinputIdでインデックス化した後、元のレコードを順番に処理します。website_lookupオブジェクトには、失敗した結果や欠落した結果も含め、各検索対象レコードの処理結果と確認用の詳細が保存されます。
crm-001ではMicrosoftのURLがすでに登録されているため、website_is_missing()はFalseを返します。このレコードはrecords_to_lookupに追加されないので、APIには送信されません。マージ後もWebサイトは維持され、ステータスにはnot_requestedが記録されます。
crm-002ではWebサイトが空欄なので、リクエストはパン屋の情報をinputId: crm-002として送信します。APIも同じinputIdを返します。results_by_idはこのIDを使って正しい結果を取得し、結果の順序に依存することなく、そのレコードへhttps://boulangerie-du-palais-lyon.eatbu.comを書き込みます。
| ID | 会社 | マージ後のWebサイト | ステータス | ドメイン | 信頼度 | クレジット |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
このパン屋には、ビジネス固有のサブドメインboulangerie-du-palais-lyon.eatbu.comが使われています。eatbu.comへ短縮せず、そのまま保持し、companyUrlから取得した正確なアドレスを保存してください。acceptNonRoot: trueの設定により、ホスト名の後にパスが続くホスティング型のビジネスページも許可されるため、どちらの場合も完全なURLが重要です。
完了したタスクにも、no_result、error、skippedの項目が含まれることがあります。この例でwebsiteを変更するのは、ステータスがsuccessで、かつcompanyUrlが存在する場合だけです。no_resultの場合、Webサイトは空欄のままで、ステータスはwebsite_lookupに残ります。まず会社名と国を確認してください。どちらかが誤っている場合は修正し、そのレコードを新しいタスクで送信します。入力が正しい場合は、手動確認の対象としてWebサイトを空欄のままにしておきます。
スケール前に検索クレジットを見積もる
サンプルの5件は、すべて信頼度Highのsuccessとなり、合計5クレジットを使用しました。
データセットで解決できた検索は1クレジットです。Googleで処理された検索は2.5クレジットです。両方ではなく、実際に使用された処理経路に対して課金されます。入力が1,000件の場合、すべてデータセットで解決すれば1,000クレジット、すべてGoogleを使用すれば2,500クレジットです。これらは計画用の試算であり、すべての検索が成功することを保証するものではありません。
スライダーを動かして、リストに必要なクレジット数を比較できます。
20,000クレジットが20ドルの場合、上記のケースにかかる費用はそれぞれ1ドルと2.50ドルです。Growthサブスクリプションの料金は別途必要です。現在は月間20,000クレジットが含まれ、追加購入分より先に使用されます。プランやパッケージの内容は変更される可能性があるため、最新の料金をご確認ください。
1つのタスクでは最大10,000件の入力を受け付けます。上限は入力1件につき16 KiB、リクエスト1件につき10 MiBです。この例では、同期型のRequestsコールを使用して、小規模なDatablist非同期タスクの送信、ポーリング、結果取得を行っています。メンテナンスされているリポジトリには、CSVのバッチ処理やノンブロッキング型クライアントのサンプルも用意されています。
次のステップ
取得したWebサイトが対象企業のものだと確認できたら、PythonでImpressumをスクレイピングし、法人情報と参照元となる法的情報ページのURLを同じ仕入先レコードへ追加できます。Webサイト照合の確認と、その後の情報抽出は分けて実施してください。
サンプルレコードを実データの一部に置き換えてからスクリプトを実行し、マージ後のレコードを確認してください。変更されないIDと国情報を保持し、既存のWebサイトが維持され、想定した空欄だけが補完されることを確認してからスケールアップします。ダウンロード可能なスクリプト、CSVのバッチ処理、非同期版が必要な場合は、GitHubでメンテナンスされているCompany Name to Domain APIのサンプルをご利用ください。