
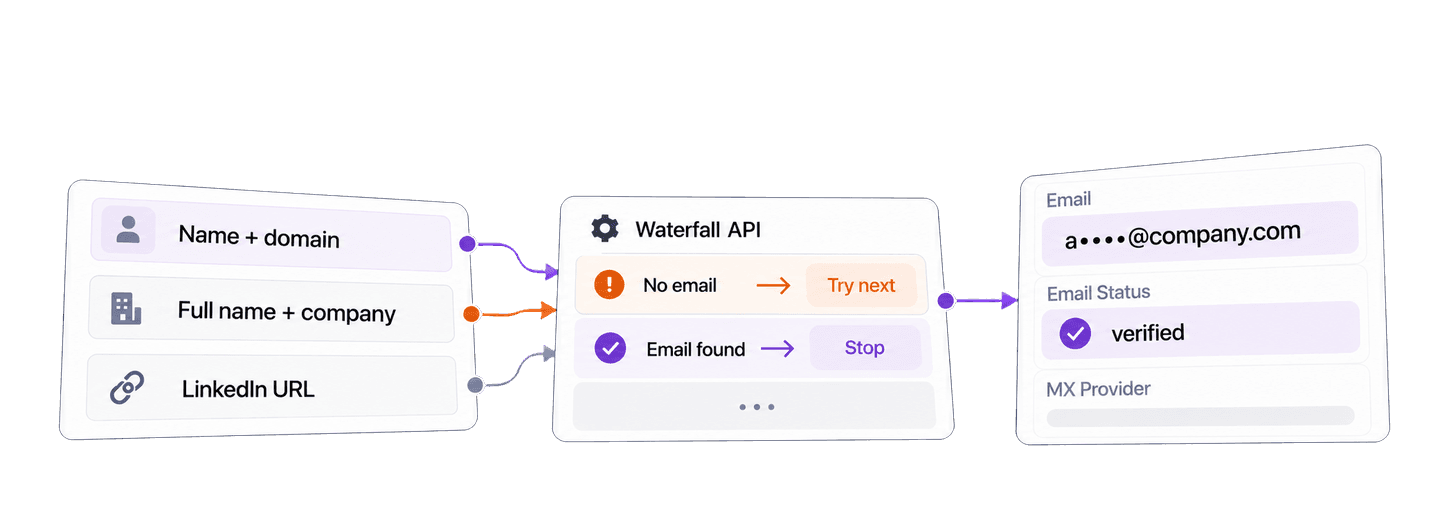
Pythonで仕事用メールアドレスを検索するには、Requestsライブラリを使い、氏名と企業情報、または公開LinkedInプロフィールURLをDatablistのWaterfall Email Finder APIへ送信します。APIからは、見つかった仕事用メールアドレス、配信可能性を示すステータス、メールプロバイダーが返されます。
以下の完全なサンプルでは、microsoft.comのSatya Nadella氏とgreylock.comのReid Hoffman氏を検索します。バックグラウンドタスクの完了を待ち、結果を全ページ取得します。その後、取得したデータを再利用し、キャンペーン確認用に検証済み連絡先のローカルリストを作成します。
📌 お急ぎの方向けまとめ
1つのPython関数で既知の連絡先をWaterfall Email Finder APIへ送信し、タスクの完了を待って、見つかった仕事用メールアドレスを取得します。その後、未解決の連絡先を元のリストに残したまま、検証済みの連絡先をキャンペーン確認用に整理します。
- Input: 姓名と企業ドメイン、フルネームと企業名、または公開LinkedInプロフィールURL。
- Output:
emailStatusとmxProviderを含む仕事用メールアドレス、およびメールアドレスが見つかった連絡先だけを収録したローカル確認リスト。
💡 ノーコードで対応したい場合
コードを書かずにコレクションから仕事用メールアドレスを検索するなら、DatablistのWaterfall Email Finderをご利用ください。
Python、Requests、APIキーを準備する
このPythonサンプルでは、requestsパッケージを使用します。find_work_emails.pyというファイルを作成し、Requestsをインストールしてください。
python -m pip install requestsDatablist APIアカウントページでPersonal API Keyを作成します。REST APIを利用するにはGrowthプランが必要です。スクリプトを実行するターミナルで、キーを環境変数として設定してください。
export DATABLIST_API_KEY="your-api-key"Waterfall Email Finderでメールアドレスが見つかった場合は、クレジットも消費されます。後述の料金セクションでは、APIアクセスを提供するサブスクリプションとクレジット費用を分けて説明します。
1つのPython関数で仕事用メールを検索する
次の完全なスクリプトをfind_work_emails.pyへ貼り付けてください。
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))同じターミナルから実行します。
python find_work_emails.pyメンテナンスされているRequestsのサンプルをダウンロードすることもできます。同期処理版の仕組みを理解したら、同じリポジトリにある非同期HTTPX版もご確認ください。
この関数は、3種類のAPI呼び出しを順番に実行します。
最初に、タスクを送信します。 各inputIdは、連絡先を一意に識別する固定IDです。入れ子になったdataオブジェクトには、検索に使用するフィールドを格納します。POSTリクエストが成功すると202 Acceptedと@idが返されます。この@idが、後続の呼び出しで使うタスクIDです。コードは送信前にuniqueIdを表示するため、レスポンスを受信できなかった場合も復旧用の値が残ります。
次に、タスクの状態をポーリングします。 Datablistはタスクをバックグラウンドで処理します。このRequestsクライアントは3秒ごとに状態を確認し、completed、failed、stoppedのいずれかになるまで待機します。待機中、Requestsの処理はブロックされますが、APIタスク自体は非同期で実行されます。
最後に、結果を取得します。 1つのタスクの結果が複数ページに分かれる場合があります。ループはnextCursorがnullになるまでページを取得し続けます。結果を元の連絡先と照合する際は、レスポンスの順番ではなくinputIdを使用してください。
連絡先データに合うInput方式を選ぶ
1つのタスクで使用できるInput方式は1種類です。同じfind_emails()関数を使い、元データに合う方式へsettingsとpeopleの値を置き換えてください。
inputIdには、タスク内で一意の値を指定します。可能であれば、すでに元の連絡先に紐づいているIDをお使いください。CRMのレコードIDや、長期的に変わらないLead IDが適しています。Datablistは結果とともに同じ値を返すため、氏名を比較したり、レスポンスの順番がInputと同じだと仮定したりせずにレコードを照合できます。
姓と名が別フィールドにあり、企業ドメインが分かっている場合は、sourceKind: "name_company"を使用します。既知のドメインは、企業を特定するうえで最も明確な情報です。
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)元データに氏名フィールドが1つしかなく、企業名が分かっている場合は、useFullNameを有効にします。
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)公開されている個人プロフィールURLがある場合は、LinkedIn方式を使用します。
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)この方式では、メール検索用の人物情報として、公開されているlinkedin.com/in/...形式のプロフィールURLを指定できます。Sales NavigatorのプロフィールURLには対応していません。
プロバイダーキーや実行順を指定する必要がある場合は、カスタムWaterfallガイドをご覧ください。ここで使用するManaged Waterfallでは、プロバイダーごとの設定は不要です。
Managed Waterfallでメールを見つける仕組み
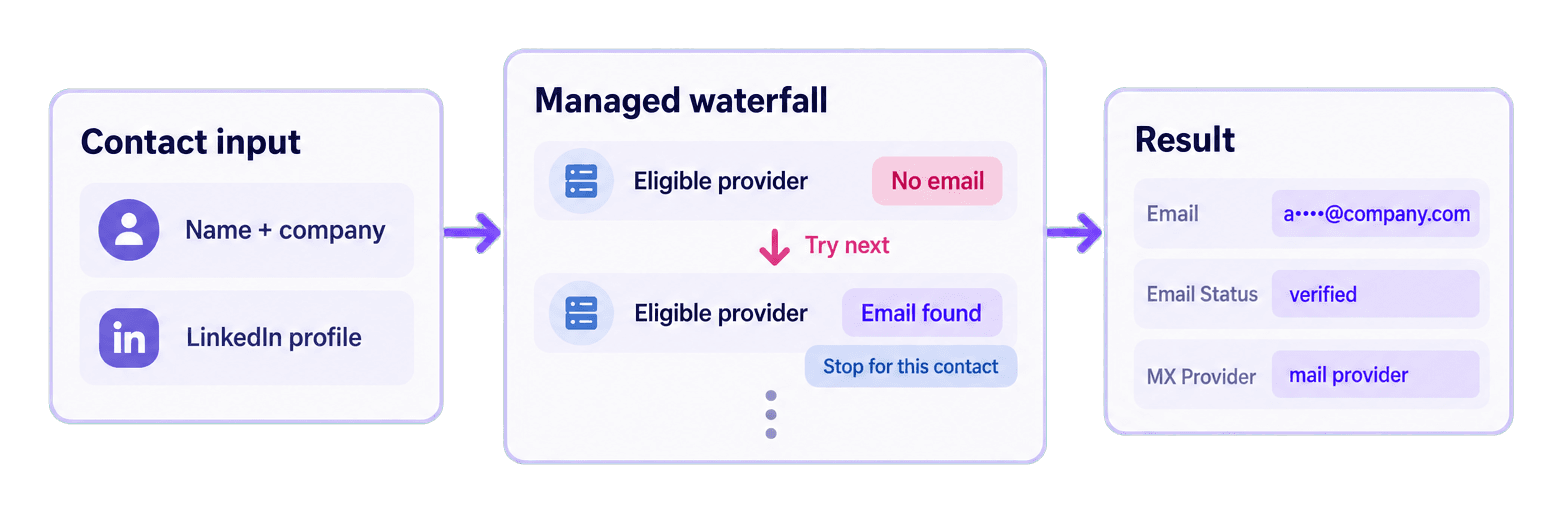
氏名と企業情報を使うリクエストでは、APIは指定されたドメインをそのまま使用します。企業名を指定した場合は、まずその企業名から利用可能な企業ドメインの特定を試みます。LinkedInリクエストでは、公開プロフィールURLを正規化し、利用可能な人物・企業情報を、条件を満たすメールプロバイダーが処理できる検索情報へ変換します。
Managed Waterfallは、まだメールアドレスが見つかっていない連絡先を、利用可能なプロバイダーへ送信します。有効なメールアドレスが返されなければ、別のプロバイダーが同じ連絡先を検索します。仕事用メールアドレスが採用された時点で、その連絡先の検索は終了します。デフォルトのレスポンスには、検索に成功したfinderの名称は含まれません。
Waterfallが海外Outboundに有効な理由
仕事用メールのプロバイダーはそれぞれ異なるデータセットを利用しているため、国や市場によってカバレッジが変わります。ある地域の連絡先について1社目のプロバイダーでは結果が得られなくても、別のプロバイダーならメールアドレスの特定に必要なデータを保有している場合があります。
営業チームやGrowthチームにとって、Waterfallは、未解決の連絡先をOutreachリストから除外する前に、別のプロバイダーで発見できる機会を提供します。技術的な運用を統一しながら、単一プロバイダーのワークフローでは取りこぼす連絡先を補完できます。
Datablistは、利用可能なプロバイダーの実行順を1つのAPI Integration内で管理します。連絡先を一度送信するだけで統一された形式の結果を受け取れるため、プロバイダーごとに個別のIntegrationを構築・保守したり、レスポンスを自分で統合したりする必要はありません。
すべての検索結果を確認する
サンプルタスクでは、2件とも検索に成功しました。以下ではメールアドレスを伏せています。
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}emailFoundは、返された仕事用メールアドレスです。emailStatusは検索時点の配信可能性を示し、mxProviderは、特定できた場合にメールホスティングプロバイダーを示します。どちらのレコードもverifiedで、それぞれ25クレジットを使用しています。
以下のキャンペーン用コードでは、verifiedの結果をcampaign_contactsへ、それ以外のステータスで見つかったアドレスをneeds_verificationへ振り分けます。各結果の正確な課金額は、creditsUsedの値で確認してください。
デフォルトのManaged Waterfallの結果には、finderProviderは含まれません。このフィールドは、有効なカスタムキーを使った氏名・企業情報ワークフローでのみ条件付きで返されます。そのため、スクリプトでmxProviderからfinderProviderを推測しないでください。
見つかったメールをキャンペーン確認用に整理する
直接検索が動作したら、lookup_resultsが返された後のスクリプト末尾に、次のブロックを追加します。すでに実行した検索結果から、キャンペーン確認用のローカル連絡先データを作成します。
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))results_by_idを使うことで、レスポンスの順番を考慮する必要がなくなります。Satya氏の場合、ループは元のpeopleリストからcontact-satya-nadellaを読み取り、同じinputIdを持つ結果を見つけ、元レコードをコピーして、完全なAPIオブジェクトをresultとして追加します。アドレスが存在し、ステータスがverifiedのため、この連絡先はcampaign_contactsへ追加されます。Reid氏のAPI結果が先に返された場合でも、同じ手順で処理されます。
3つの条件によって、判定ロジックが分かりやすく保たれています。1つ目は、一致する結果が返されなかった連絡先をスキップします。2つ目は、行単位のエラーやsuccess以外の状態をスキップします。3つ目は、emailFoundに実際の値があることを確認します。完全なresultオブジェクトを追加することで、ステータス、Output、クレジット使用量、エラーフィールドを後から確認できます。
見つかったメールアドレスが別の配信可能性ステータスだった場合は、needs_verificationへ追加されます。結果がない場合、行エラーがある場合、またはemailFoundのない結果は、どちらの準備済みリストにも追加されません。元のpeopleリストは、修正や追加調査のためにそのまま残ります。
Waterfall Email Finder APIの料金を見積もる
デフォルトのManaged Waterfallでは、見つかった仕事用メールアドレス1件につき25クレジットを使用します。デフォルト検索で結果が得られなかった場合、使用クレジットは0です。送信した連絡先の総数に25を掛けるのではなく、各結果のcreditsUsedを確認してください。
見つかったメールアドレスのステータスがunverifiedでも、25クレジットを使用します。ローカルのキャンペーン用コードでcampaign_contactsではなくneeds_verificationへ振り分けられる場合も同様です。
この例で見つかった2件のメールアドレスには、合計50クレジットが使用されました。目安は次のとおりです。
- 仕事用メールアドレスが100件見つかった場合は、2,500クレジットです。
- 仕事用メールアドレスが1,000件見つかった場合は、25,000クレジットです。
- 結果が得られなかった検索には課金されないため、大きなInputリストでも使用量が
連絡先数 × 25を下回る場合があります。
REST APIへのアクセスにはGrowthプランが必要です。現在のUSD建て追加購入レートでは、20ドルで20,000クレジット、つまり1クレジットあたり0.001ドルです。このレートでは、25,000クレジット相当の料金は25ドルです。サブスクリプション料金は、このクレジット計算とは別です。最新のプランとパッケージについては、Datablistの料金ページをご確認ください。
よくあるエラーの解決とタスクの復旧
APIキーが設定されていません。 スクリプトはリクエストを実行する前に、Set DATABLIST_API_KEY before running this script.というエラーを発生させます。現在のターミナルで環境変数を設定し、ファイルを再度実行してください。
APIから認証エラーが返されます。 raise_for_status()がHTTPエラーを報告します。現在有効なPersonal API Keyをコピーし、X-API-Keyヘッダーに設定されていることを確認してください。認証情報を修正してから再実行します。
アカウントのクレジットが不足しています。 アカウント残高をご確認ください。クレジットを追加するか、プランの次回クレジット付与まで待ってから、新しい処理を送信してください。
Inputフィールドが選択した方式と一致していません。 name_companyでは姓名を別々のフィールドで指定するか、fullNameを使用します。linkedinではlinkedInProfileを使用してください。連絡先を修正し、1つの統一された方式で送信します。
タスクがfailedまたはstoppedになっています。 スクリプトは、タスクID、終了時のステータス、取得可能なタスクエラーを含むRuntimeErrorを発生させます。どの連絡先を再検索する必要があるか判断する前に、該当タスクと取得可能な結果を確認してください。
POSTレスポンスを受信できませんでした。 送信前に表示されたuniqueIdをコピーします。同じキーを使ってタスク一覧を取得してください。
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"表示されたuniqueIdと一致するタスクを見つけ、その@idをコピーして、タスクステータスまたは結果のURLから処理を続けます。これにより、連絡先を自動的に再送信せず、既存のタスクを復旧できます。ライフサイクルと結果エンドポイントについては、タスクAPIドキュメントをご覧ください。
次のステップ
これで、対応する3つのInput方式を処理できる同期型のPython Requests関数と、見つかった検証済みメールアドレスをキャンペーン確認用に整理するローカルフィルターが用意できました。
2件のサンプル連絡先を、調査済み連絡先の一部に置き換えてください。データに合うInput方式を選択して検索を実行し、アドレスを使用する前にemailStatusを確認します。より大規模なリストのワークフローについては、メールアドレスを一括検索する方法をご覧ください。メンテナンスされているGitHubリポジトリでは、ダウンロード可能な同期型と非同期型のPythonサンプルを提供しています。