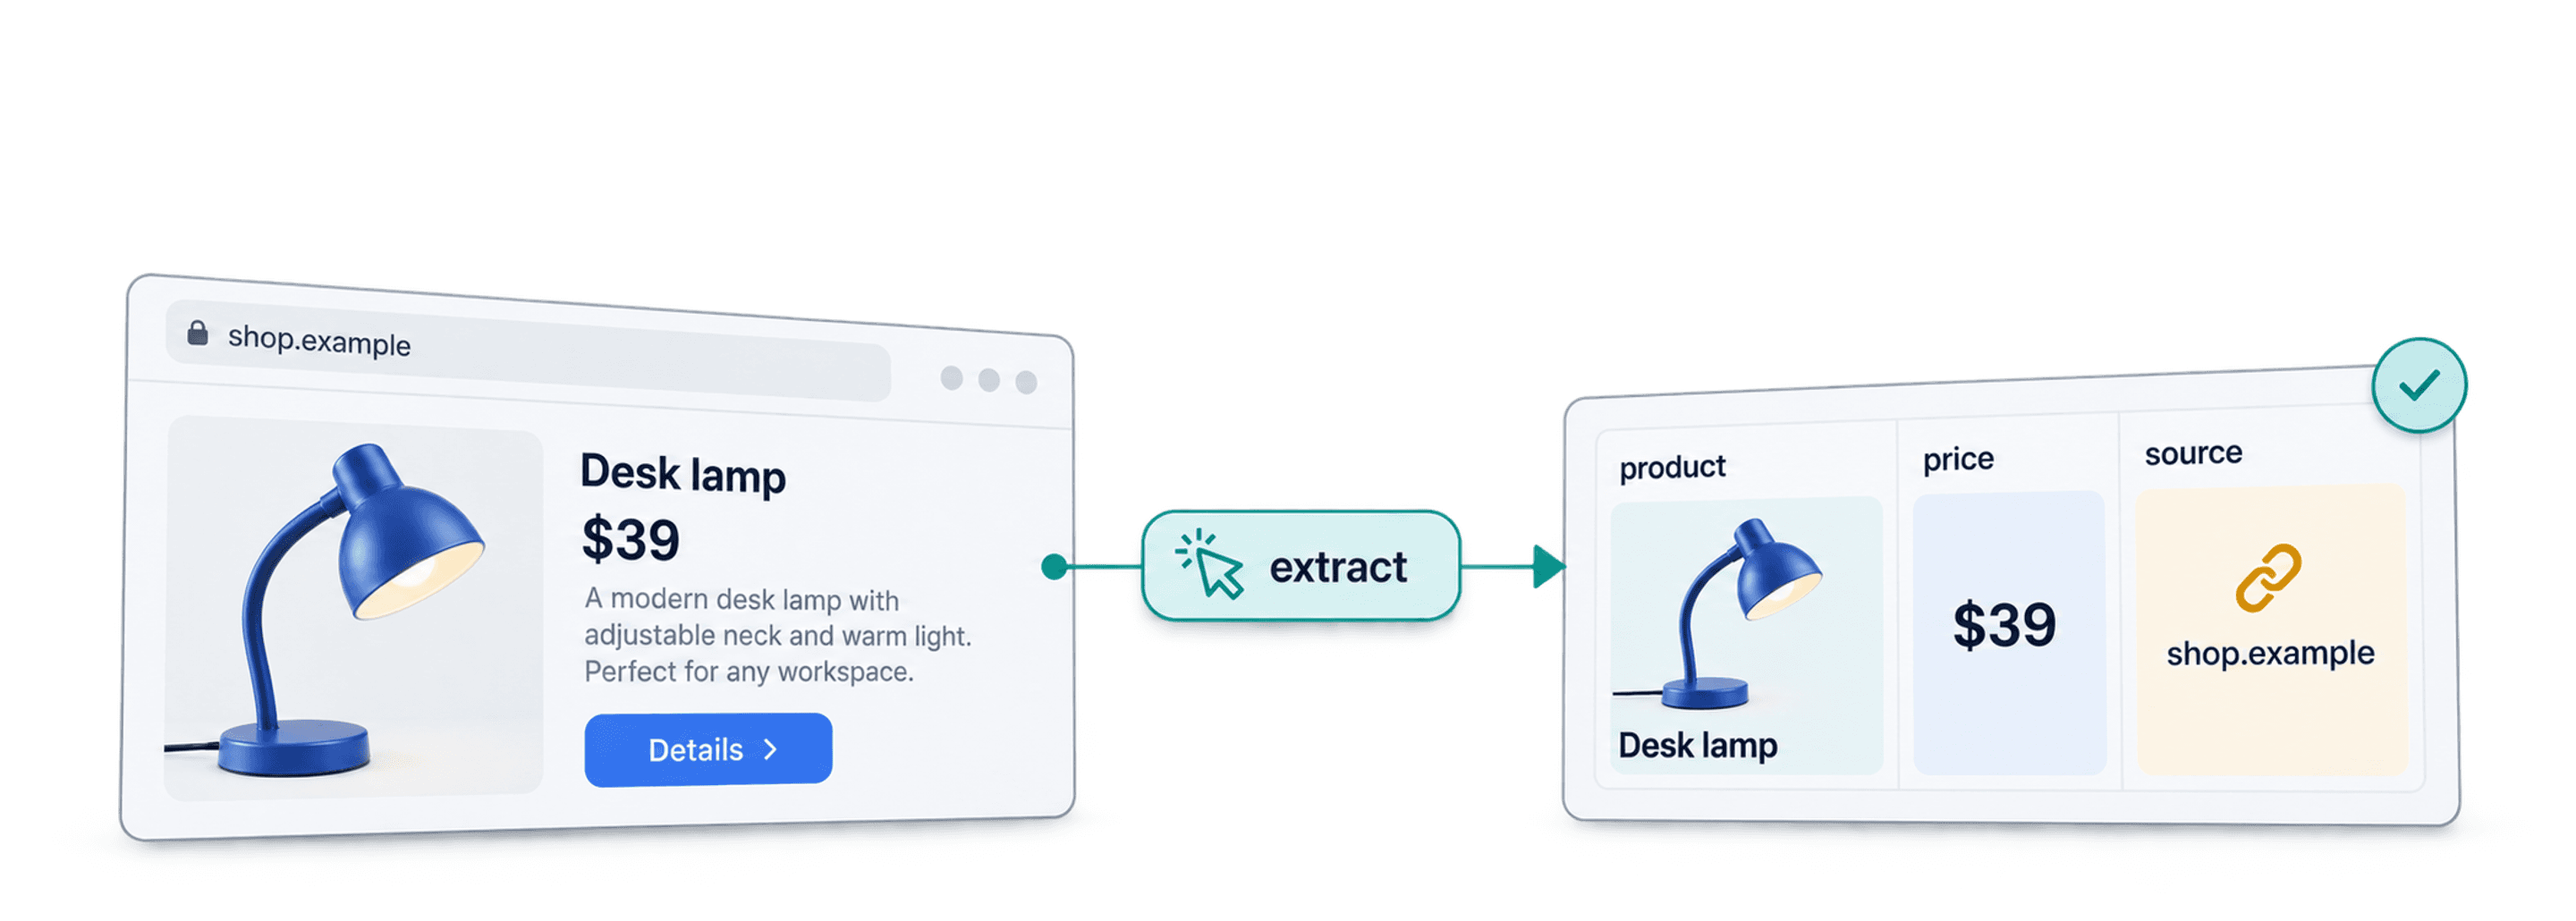
AI-webscraping gebruikt een AI-model om websitecontent te lezen en specifieke velden terug te geven, zoals een productnaam, prijs en bron-URL. In plaats van voor elk veld een CSS-selector te schrijven, beschrijf je welke informatie je nodig hebt en koppel je de output aan kolommen. Je moet het resultaat nog steeds controleren: een model kan een veld missen, twee pagina's door elkaar halen of een waarde geven die niet door de bron wordt ondersteund.
Geef een agent bijvoorbeeld een productpagina en vraag om Productnaam, Huidige prijs en Product-URL. Een bruikbare output bestaat uit één rij met deze drie velden, waarbij je de prijs controleert aan de hand van de bronpagina. Staat er geen zichtbare prijs op de pagina, laat dat veld dan leeg in plaats van te gokken. Deze gids legt uit hoe AI-extractie verschilt van rule-based scraping, welke workflow je kiest en wat je moet controleren voordat je de data gebruikt.
Wat je in deze gids leert
- Uitleg van AI-webscraping
- De belangrijkste voordelen van AI-scraping
- Praktische toepassingen van AI-scraping
- Verschillende methoden voor AI-datascraping
- De beste AI-scrapingtools op de markt
Wat is AI-webscraping?
De onderstaande termen beschrijven in grote lijnen dezelfde aanpak. De tool heeft nog altijd toegankelijke broncontent en duidelijke outputvelden nodig.
AI-webscraping, AI-scraping en AI-datascraping
AI-webscraping = AI-scraping = AI-datascraping
Al deze termen verwijzen naar het gebruik van een AI-model om informatie uit webcontent te herkennen en te structureren. Een traditionele scraper selecteert elementen meestal met een CSS-selector of XPath. Een AI-extractieworkflow gebruikt in plaats daarvan een prompt of schema om velden op basis van hun betekenis te herkennen. Dat kan helpen wanneer pagina's verschillende layouts hebben, maar je moet nog steeds rekening houden met ontoegankelijke pagina's, gewijzigde content en onjuiste output.
Waarom AI gebruiken voor scraping?
AI-extractie is handig wanneer hetzelfde gegeven op verschillende pagina's op een andere plek staat, of wanneer je ongestructureerde tekst wilt omzetten in kolommen. Rule-based scraping kan eenvoudiger en goedkoper zijn bij een stabiele, uniforme paginalayout. Kies de methode die past bij je bron en de output die je nodig hebt.
Geen code, geen API's
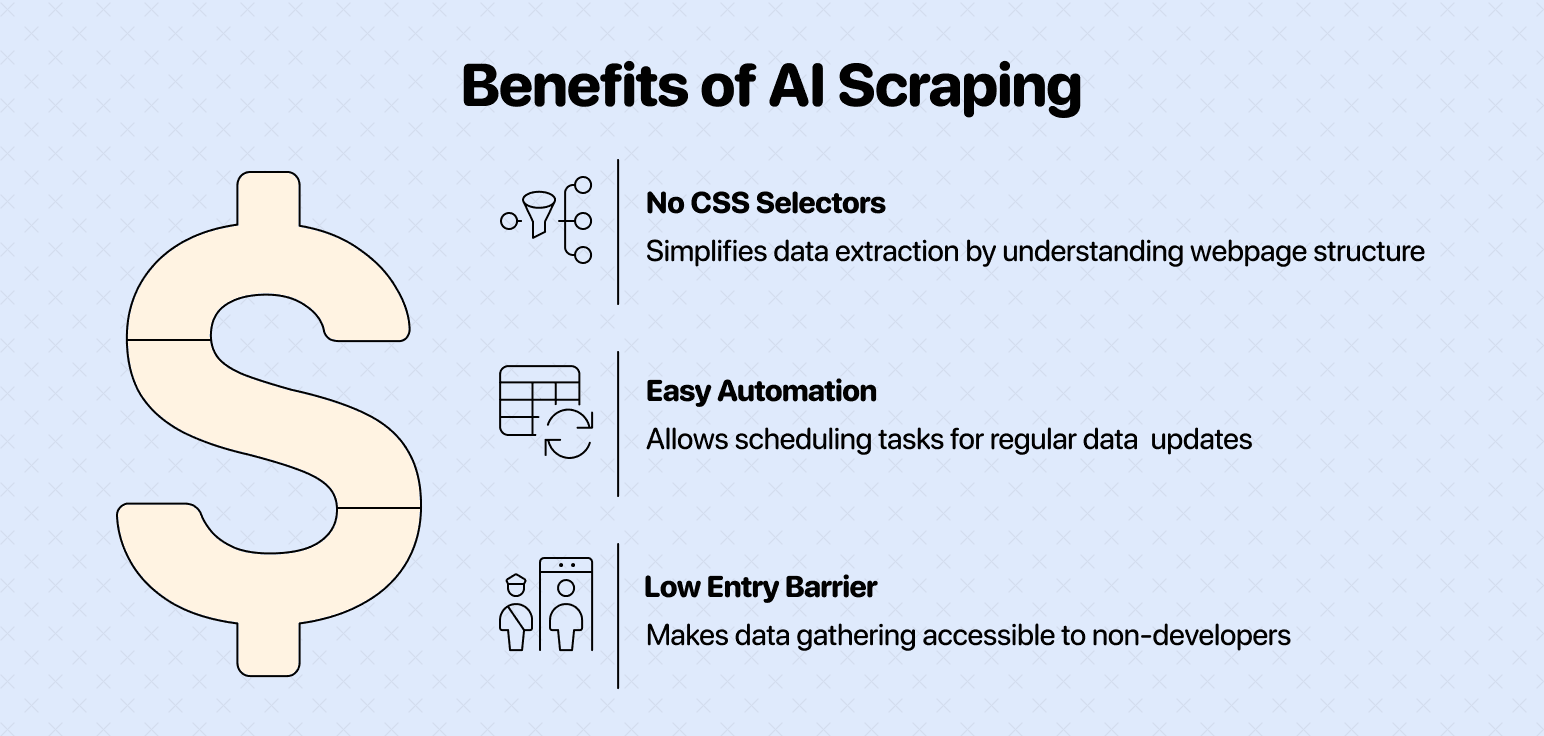
Sommige AI-scrapingtools accepteren een prompt in natuurlijke taal via een gebruikersinterface. Voor andere tools heb je een API of code nodig. Vermeld in je opdracht elk gewenst outputveld en leg uit wat er moet gebeuren als de pagina geen waarde bevat.
Geen CSS-selectors, XPath of onnodige complexiteit
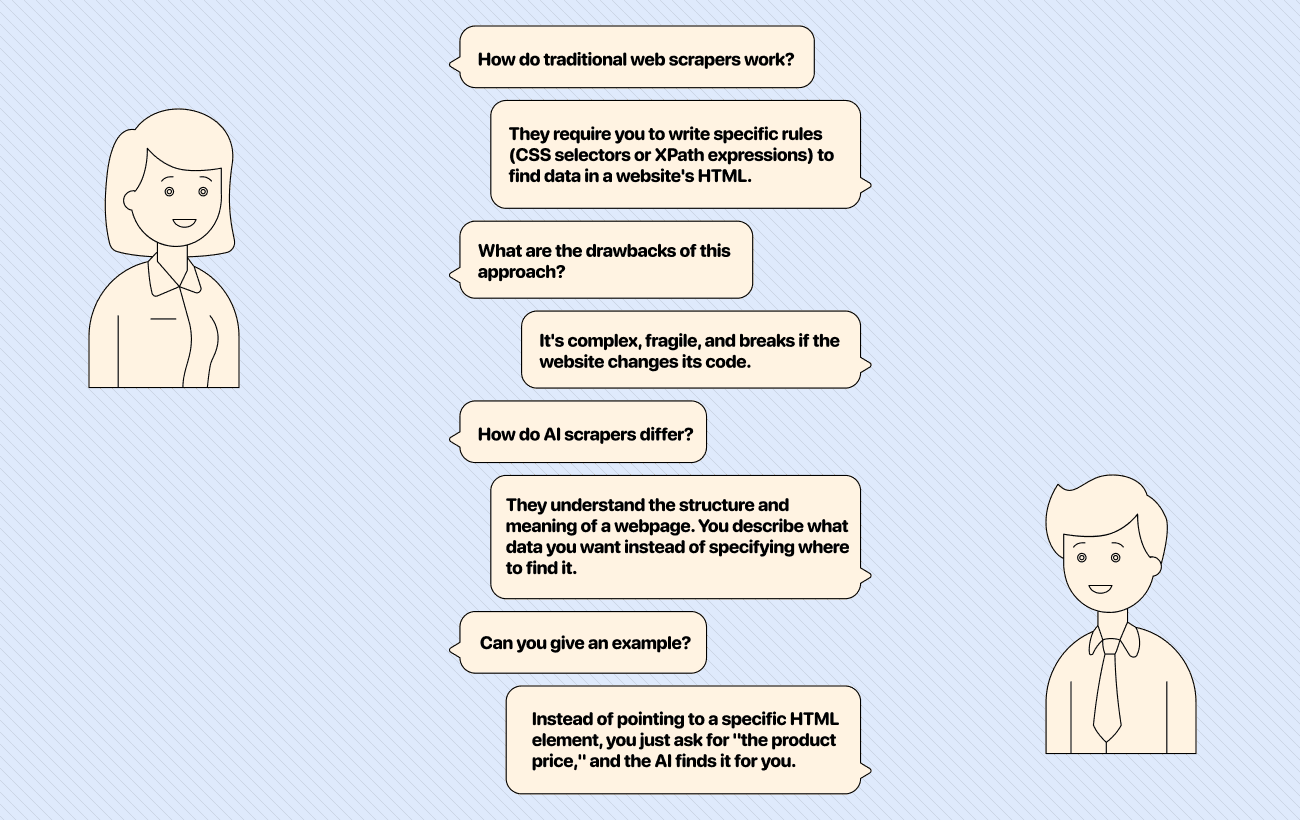
Bij een scraper op basis van selectors wijs je het HTML-element aan dat een waarde bevat. Met AI-extractie kun je op pagina's met uiteenlopende layouts om een veld als ‘huidige productprijs’ vragen. Test beide methoden op enkele representatieve pagina's. Een gewijzigde layout, geblokkeerde pagina of onduidelijke prijs kan alsnog een aangepaste prompt of handmatige controle vereisen.
Eenvoudig te automatiseren en laagdrempelig
Je kunt een AI-extractieworkflow uitvoeren op een lijst met URL's of beginnen met de URL van een website. Controleer vóór een herhaalde run een steekproef van de output op lege velden, verkeerde matches en wijzigingen in de structuur van de bronwebsite. Ook automatisering moet je blijven monitoren.
Toepassingen van AI-scraping
AI-scraping is voor vrijwel elk onderdeel van een bedrijf inzetbaar. Door dataverzameling op het web te automatiseren, krijgen teams belangrijke inzichten en kunnen ze efficiënter werken.
Dit zijn enkele toepassingen van AI-scraping:
- Webshops scrapen
- Teams kunnen uit duizenden productvermeldingen gegevens halen, zoals namen, prijzen, beschrijvingen en afbeeldingen.
- Dit is nuttig voor concurrentieanalyses, prijsmonitoring en het samenstellen van productcatalogi.
- Reviews scrapen
- Door klantreviews te verzamelen van sites als Yelp, G2 of Amazon krijgen bedrijven inzicht in het publieke sentiment.
- AI kan deze data analyseren om terugkerende thema's, productgebreken en factoren achter klanttevredenheid te herkennen voor concurrentieonderzoek.
- Prijspagina's monitoren
- Sales- en marketingteams kunnen automatisch de prijzen en promoties van concurrenten volgen.
- Zo kunnen bedrijven dynamische prijsstrategieën toepassen en concurrerend blijven.
- Klantcases scrapen
- Marketingteams kunnen klantcases van websites van concurrenten verzamelen om hun positionering en succesverhalen te doorgronden.
- Deze informatie helpt om de eigen marketingboodschappen en salespitches aan te scherpen.
- Data onderzoeken die niet in databases staat
- Sommige informatie is simpelweg niet beschikbaar in gestructureerde databases.
- AI-scrapers kunnen unieke data uit forums, blogs en nichewebsites halen voor marktonderzoek, wetenschappelijke studies of onderzoeksjournalistiek.
💡 Praktische gidsen om met AI-scraping te beginnen
Zo kun je klantcases scrapen 👈🏼
Zo kun je producten van webshops scrapen 👈🏼
Zo kun je gebruikersreviews van Trustpilot scrapen 👈🏼
Zo kun je accountgegevens vinden die niet in databases staan 👈🏼
2 methoden voor AI-scraping
AI-scrapingtools bieden verschillende werkwijzen voor verschillende taken. Hoewel de onderliggende technologie vergelijkbaar is, hangt je keuze af van de vraag of je een bestaande dataset wilt verrijken of een nieuwe website vanaf nul wilt verkennen.
Laten we de twee belangrijkste methoden bekijken:
- Een AI Scraping Agent uitvoeren op een lijst met items
- Een AI Scraping Agent als sitescraper gebruiken met een URL en prompt
Een AI Scraping Agent uitvoeren op een lijst met items
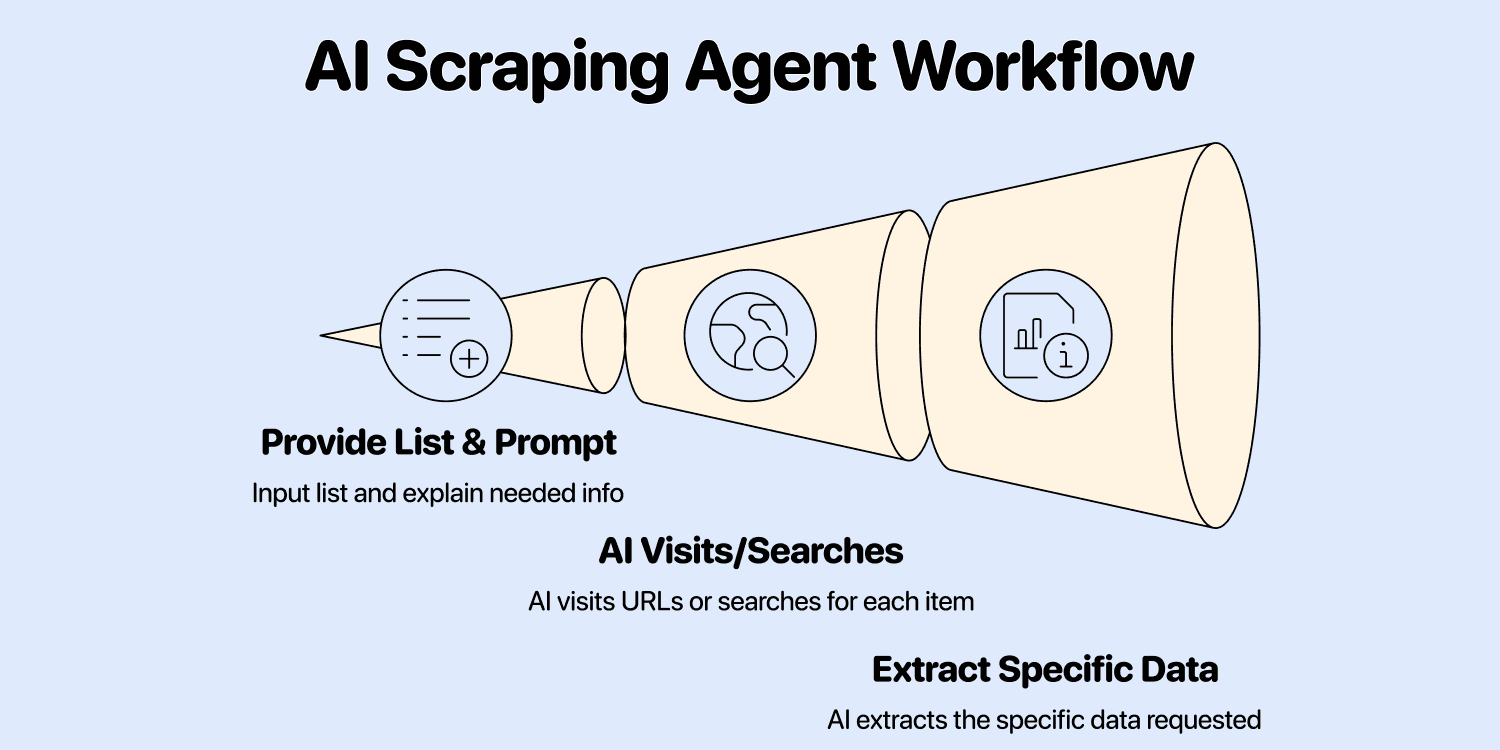
Deze methode is ideaal als je al een uitgangspunt hebt, zoals een spreadsheet met bedrijfsnamen of product-URL's. Je geeft de AI-agent je lijst en een prompt waarin je uitlegt welke aanvullende informatie je voor elk item nodig hebt.
De AI bezoekt vervolgens elke URL of voert voor elk item een zoekopdracht uit en haalt de gevraagde data op.
- Ideaal voor: Bestaande datasets verrijken, bijvoorbeeld de branche vinden voor een lijst met bedrijven of de naam van de CEO voor een lijst met accounts.
- Controle: Test eerst een kleine steekproef en bekijk de bronpagina's voor belangrijke velden.
Een AI Scraping Agent als sitescraper gebruiken met een URL en prompt
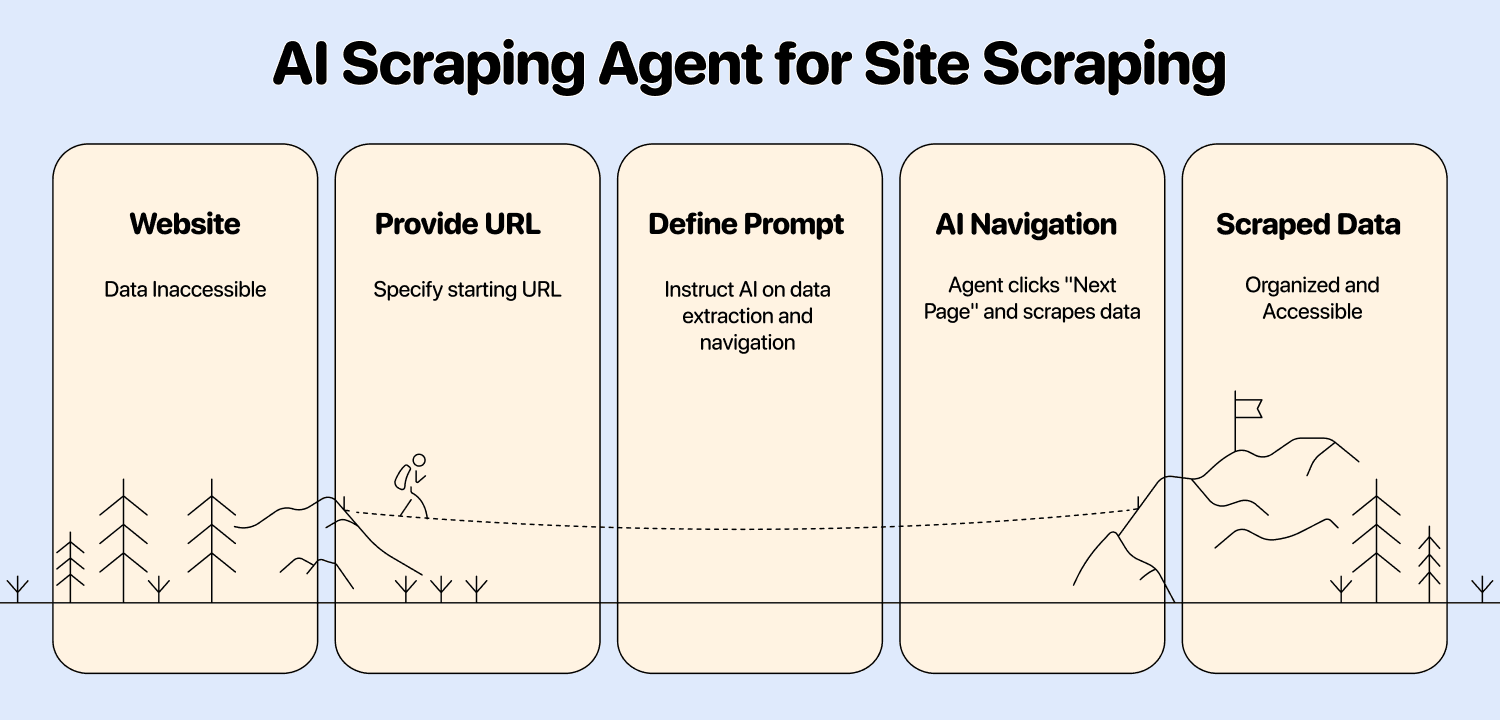
Deze methode is bedoeld om een volledige website of een gedeelte daarvan te verkennen en er data uit te halen. Je geeft een start-URL op, bijvoorbeeld een categoriepagina van een webshop, en schrijft een prompt die de AI vertelt waarnaar deze moet zoeken en hoe de site moet worden doorlopen.
Voor de website scraper van Datablist geef je een start-URL en een prompt op die beschrijft welke items moeten worden geëxtraheerd. Paginering is optioneel; stel deze in wanneer de bron meerdere resultaatpagina's heeft.
De gids over het instellen en steekproefsgewijs controleren van website scraping laat zien hoe je de output aan de prompt koppelt, rendering test en onderscheid maakt tussen een ontbrekend veld en een geblokkeerde pagina.
- Ideaal voor: Productvermeldingen scrapen van sites als Amazon of eBay, artikelen van een blog verzamelen of listings uit een directory halen.
- Controle: Begin met een beperkt aantal pagina's. Controleer vervolgens of de teruggegeven rijen van de bedoelde pagina's komen voordat je de run uitbreidt.
AI-scrapingtools
De markt voor AI-scrapingtools groeit snel. Welke tool bij je past, hangt af van je technische kennis, budget en specifieke behoeften. Hieronder vind je drie opties met hun vanafprijs bij maandelijkse facturering in Amerikaanse dollars.
| Tool | Belangrijkste toepassing | Vanafprijs | Inbegrepen gebruik per maand |
|---|---|---|---|
| Datablist | No-code scraping en spreadsheetverrijking | $25/maand | 5.000 credits |
| Firecrawl | Webdata en gestructureerde extractie voor apps | $19/maand | 5.000 credits |
| ScrapingBee | Scraping-API met AI-extractie | $19/maand | 75.000 API-credits |
De credits staan bij elke tool voor iets anders. Datablist rekent credits voor het gebruikte AI-model en de gebruikte tools; Firecrawl rekent per pagina en geselecteerd formaat; ScrapingBee telt AI-extractie op bij de basiskosten van de request. De onderstaande voorbeelden laten zien waarom het grootste aantal credits niet automatisch de goedkoopste workflow oplevert.
Datablist - Voor sales-, marketing- en operationele teams
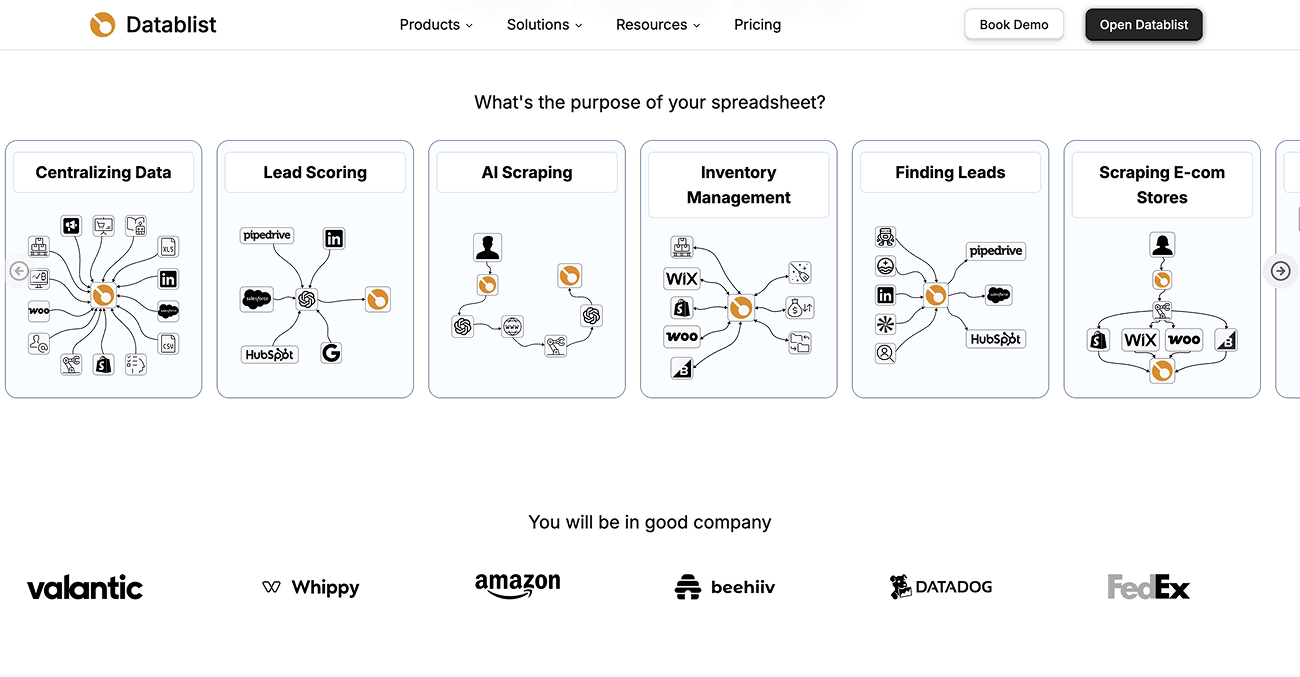
Datablist is een platform voor data-automatisering dat krachtige mogelijkheden voor AI-scraping combineert met een gebruiksvriendelijke spreadsheetinterface. Het is ontwikkeld voor sales-, marketing- en operationele teams die data willen verzamelen en verrijken zonder code te schrijven of API's in te stellen.
Belangrijkste functies:
- Prompts in natuurlijke taal: Beschrijf in gewone taal wat je nodig hebt en de AI-agent zoekt het voor je op. Je hebt geen code of ingewikkelde API-configuratie nodig.
- Twee uitgangspunten: Voer een AI Agent uit op bestaande rijen of begin met een website-URL, een prompt en optionele paginering.
- Run settings: De website scraper heeft een paginalimiet en een optionele instelling voor HTML-rendering. Test eerst een kleine run voordat je het aantal pagina's verhoogt.
- Gestructureerde output: Koppel de gevraagde velden aan kolommen in je collection, controleer de rijen en combineer ze zo nodig met andere enrichments.
Prijzen:
- Starter: $25/maand met 5.000 credits. Growth kost $50/maand en bevat 20.000 credits.
- Het creditverbruik voor AI-scraping varieert per model, gebruikte tools en bezochte pagina's. Als HTML-rendering is ingeschakeld, kost dit 2 extra credits per scrape.
- Voor een opdracht die 25.000 credits gebruikt, betaal je met Starter plus een top-up van 20.000 credits $45 ($25 + $20). Dit is een voorbeeld van een creditbudget, geen vaste prijs voor een bepaald aantal pagina's. Top-ups vereisen een actief abonnement en verlopen niet.
💡 De verborgen kracht van Datablist
Het voordeel van Datablist's AI Scraper is dat deze eigenlijk veel meer is dan alleen een AI Scraper. Het is een AI scraping agent die in Google kan zoeken, Google News kan bezoeken, API's kan aanroepen, data kan extraheren, websites kan pagineren en nog veel meer.
Firecrawl - Webdata-API voor AI-apps
Firecrawl is een opensource-webdata-API voor developers die websites omzet in data die direct geschikt is voor LLM's en AI-applicaties.
Belangrijkste functies:
- Gestructureerde extractie: Geef een URL en een JSON-schema of prompt op om de gewenste velden te beschrijven. Controleer de teruggegeven waarden aan de hand van de bronpagina.
- LLM-ready output: Ontvang data in verschillende formaten, zoals JSON, Markdown en screenshots, die direct klaar zijn voor AI-verwerking.
- Developer-first aanpak: Gebouwd met SDK's voor Python en Node.js, inclusief uitgebreide documentatie en voorbeelden.
Prijzen:
- Hobby: $19/maand met 5.000 credits. Standard kost $99/maand en bevat 100.000 credits. Dit zijn maandprijzen, niet de lagere tarieven bij jaarlijkse facturering.
- Een eenvoudige scrape van één pagina kost 1 credit. JSON selecteren kost 4 credits extra, waardoor één pagina met JSON-extractie 5 credits gebruikt. Andere modi kunnen het verbruik veranderen.
ScrapingBee - AI-scraper voor developers
ScrapingBee is een API-first scrapingtool die proxy's en browsers afhandelt. Developers kunnen de API vanuit code aanroepen; via integraties als n8n en Make kunnen teams de tool ook aan andere workflows koppelen. Je moet de request nog wel configureren en de teruggegeven data mappen.
Belangrijkste functies:
- AI-powered webscraping: Gebruikt AI om data te parsen en extraheren, waardoor de tool beter bestand is tegen wijzigingen aan websites.
- API-toegang: Ontworpen voor developers die scraping in hun eigen applicaties en workflows willen integreren.
- JavaScript-rendering: Kan moderne, dynamische websites scrapen die sterk afhankelijk zijn van JavaScript.
Prijzen:
- Hobby: $19/maand met 75.000 API-credits. Het Freelance-abonnement van $49/maand bevat 250.000 credits.
- AI-extractie kost 5 credits extra per request. Een eenvoudige request gebruikt 1 credit, of 5 credits met JavaScript-rendering, voordat de kosten voor AI-extractie erbij komen. Premium proxy-instellingen kunnen de basiskosten verder verhogen.
Wat kost een opdracht voor gestructureerde extractie?
Deze voorbeelden gaan uit van één request per pagina en de genoemde instellingen. Ze tonen de kosten van API-gebruik, niet het aantal correcte records dat je ervoor terugkrijgt.
| Tool en opdracht | Benodigde credits | Maandabonnement en kosten |
|---|---|---|
| Firecrawl: 1.000 pagina's met JSON-extractie | 5.000 | Hobby: $19 |
| Firecrawl: 10.000 pagina's met JSON-extractie | 50.000 | Standard: $99 |
| ScrapingBee: 10.000 requests voor AI-extractie, zonder JavaScript-rendering | 60.000 | Hobby: $19 |
| ScrapingBee: 10.000 requests voor AI-extractie, met JavaScript-rendering | 100.000 | Freelance: $49 |
Voor ScrapingBee zijn de laatste twee rijen berekend als 10.000 × (1 + 5) en 10.000 × (5 + 5). Door JavaScript-rendering overschrijdt de opdracht de limiet van Hobby. Voer bij Datablist eerst een kleine run uit om het creditverbruik van je model, prompt en bronpagina's vast te stellen. Vergelijk dat vervolgens met de 5.000 credits van het Starter-abonnement van $25 en de bovenstaande prijzen voor top-ups.
Resultaten van AI-scraping controleren
Controleer een steekproef van de rijen aan de hand van de bronpagina's voordat je de dataset gebruikt. Bevestig dat elke waarde bij het juiste item hoort, dat eenheden en valuta behouden zijn en dat ontbrekende waarden leeg blijven. Is de bronpagina ontoegankelijk of het resultaat onzeker, pas dan de prompt aan of controleer die rij handmatig. Herhaal de steekproef wanneer de bronwebsite verandert.
Veelgestelde vragen over AI-scraping
Kan ChatGPT websites scrapen?
Een AI-model kan velden extraheren uit webcontent die je aanlevert. Voor herhaalbare runs over veel URL's gebruik je een workflow die bron-URL's vastlegt, velden aan kolommen koppelt en je mislukte of onzekere rijen laat controleren.
Wat is AI-scraping?
AI-scraping gebruikt een model om gevraagde velden in websitecontent te herkennen en gestructureerde resultaten terug te geven. Je kunt de velden in een prompt beschrijven in plaats van CSS-selectors op te geven, maar belangrijke resultaten moet je altijd aan de bron toetsen.
Is scraping legaal?
De regels hangen af van de website, de data en het rechtsgebied. Controleer de voorwaarden van de website en de toepasselijke wet- en regelgeving voordat je data verzamelt of gebruikt, zeker als het om persoonsgegevens gaat.
Wat is datascraping?
Datascraping betekent dat je informatie uit een bron haalt, zoals een website of document. AI-scraping gebruikt een AI-model om de gevraagde informatie te herkennen of te structureren.
Hoe verschilt AI-scraping van traditionele webscraping?
Scraping op basis van selectors richt zich op specifieke elementen in de HTML van een pagina. AI-extractie gebruikt een prompt of schema om velden op basis van hun betekenis te herkennen. Beide methoden kunnen mislukken wanneer een website verandert of een pagina niet beschikbaar is. Vergelijk daarom de resultaten op representatieve pagina's.
Welke vaardigheden heb je nodig voor AI-scraping?
Met Datablist kun je een URL of lijst met rijen aanleveren, de gewenste velden beschrijven en de output mappen zonder code te schrijven. Je moet nog wel een steekproef van de resultaten controleren.
Kunnen AI-scrapers gewijzigde websitelayouts verwerken?
Soms. Een prompt kan een veld mogelijk nog steeds vinden nadat de layout is gewijzigd, maar geblokkeerde pagina's, ontbrekende content en onduidelijke labels kunnen fouten blijven veroorzaken. Controleer opnieuw een steekproef nadat de bronwebsite is veranderd.
Bronnen
- [1] Datablist. Starter kost $25/maand met 5.000 credits; Growth kost $50 met 20.000 credits en actieve abonnees kunnen top-ups met extra credits kopen.
- [2] Firecrawl. De maandprijzen voor Hobby en Standard bedragen $19 en $99; een eenvoudige scrape kost 1 credit per pagina en JSON kost 4 credits extra.
- [3] ScrapingBee. Hobby kost $19/maand voor 75.000 credits en Freelance $49 voor 250.000 credits; AI-extractie voegt 5 credits toe aan de basiskosten van de request.