
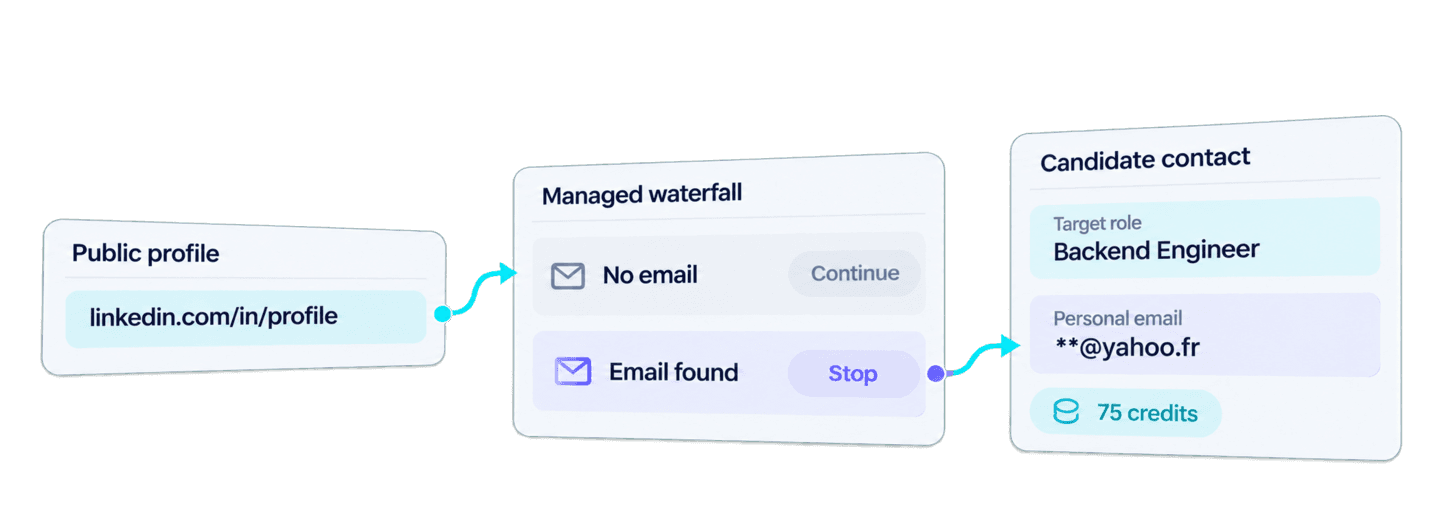
Osobiste adresy e-mail z LinkedIn możesz znaleźć w Pythonie, przesyłając publiczne adresy URL profili linkedin.com/in/... do API Waterfall Personal Email Finder od Datablist. API uruchamia zarządzaną sekwencję dostępnych dostawców danych e-mail i zwraca prywatny adres, gdy jeden z nich znajdzie wynik.
Kompletny przykład wykorzystujący Requests wysyła jedno zadanie w tle, czeka na jego zakończenie i pobiera wszystkie strony wyników. Gdy wyszukiwanie zadziała, wykorzystasz zwrócone obiekty do przygotowania rekordów kontaktowych dla rekrutacji. Każdy z nich zachowa imię i nazwisko kandydata, adres URL LinkedIn oraz docelowe stanowisko obok znalezionego adresu e-mail.
Ten proces wyszukuje osobisty adres e-mail niezależny od obecnego pracodawcy kandydata. Jeśli potrzebujesz adresu powiązanego z firmą danej osoby, skorzystaj z osobnego poradnika pokazującego, jak znaleźć służbowy e-mail na podstawie profilu LinkedIn.
🔑 Podsumowanie dla zabieganych
Podaj imiona i nazwiska kandydatów, publiczne adresy URL ich profili LinkedIn oraz docelowe stanowiska. Skrypt w Pythonie znajdzie dostępne osobiste adresy e-mail i połączy je z przekazanymi danymi rekrutacyjnymi.
- Dane wejściowe: Imiona i nazwiska kandydatów, publiczne adresy URL profili
linkedin.com/in/...oraz docelowe stanowiska.- Dane wyjściowe: Znalezione osobiste adresy e-mail połączone z danymi odpowiednich kandydatów.
💡 Wolisz rozwiązanie no-code? Użyj narzędzia Waterfall Personal Email Finder od Datablist, aby znajdować osobiste adresy e-mail bez pisania kodu.
Jeśli Twoje dane źródłowe zawierają imiona i nazwiska, ale nie adresy URL profili, najpierw znajdź publiczne profile LinkedIn w Pythonie, a następnie przekaż ich adresy URL do tego API.
Skonfiguruj Python, Requests i klucz API Datablist
W tym przykładzie używam Pythona z pakietem requests. Utwórz plik o nazwie find_personal_emails.py, a następnie zainstaluj Requests:
python -m pip install requestsUtwórz Personal API Key na swoim koncie Datablist i wyeksportuj go jako zmienną środowiskową:
export DATABLIST_API_KEY='your-api-key'Dostęp do REST API jest dostępny w planie Growth. Każdy skutecznie znaleziony osobisty e-mail zużywa również kredyty. Ich koszt obliczam w dalszej części poradnika.
Znajdź osobisty e-mail jedną funkcją w Pythonie
Edytowalna lista candidates w tym skrypcie zawiera jeden rekord rekrutacyjny. target_role to przykładowa wartość źródłowa, która pozostaje lokalnym elementem procesu rekrutacyjnego. Do danych przesyłanych do API trafiają wyłącznie candidate_id oraz linkedin_url.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Uruchom plik w tym samym terminalu:
python find_personal_emails.pyMożesz też pobrać aktualizowany synchroniczny przykład wykorzystujący Requests. Powyższy skrypt zachowuje tę samą sekwencję wysyłania zadania, sprawdzania jego statusu i pobierania kolejnych stron, a jednocześnie korzysta z identyfikatorów kandydatów pochodzących z rekordów źródłowych.
Wyślij zapytanie
Funkcja przekształca każdego kandydata w dane wejściowe API. Pole inputId otrzymuje stały identyfikator kandydata, a data.profileUrl — publiczny adres URL jego profilu osobowego na LinkedIn. Wymagany jest standardowy adres w formacie linkedin.com/in/.... Adresy URL z Sales Navigatora, strony firmowe, puste wartości oraz imiona i nazwiska bez adresów profili nie są prawidłowymi danymi wejściowymi dla tego enrichmentu.
Zapytanie używa waterfall-personal-email-finder jako enrichmentId oraz pustego obiektu settings, zgodnie z dokumentacją API Waterfall Personal Email Finder. Przed wysłaniem skrypt wyświetla wygenerowany uniqueId. Zachowaj tę wartość — pozwoli Ci zidentyfikować istniejące zadanie, jeśli po zaakceptowaniu zapytania przez API połączenie zostanie przerwane.
Oto kompletne body zapytania dla przykładu z jednym profilem:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
Po prawidłowym wysłaniu zadania API zwraca HTTP 202 Accepted z jego identyfikatorem w polu @id. Po otrzymaniu odpowiedzi przetwarzanie jest kontynuowane na serwerach Datablist.
Poczekaj na zakończenie zadania w tle
Skrypt wykorzystujący Requests lokalnie wstrzymuje dalsze działanie, gdy serwer wykonuje zadanie w tle. Co trzy sekundy sprawdza jego stan i kontynuuje, dopóki status to queued lub running. Status completed powoduje przejście do pobierania wyników. Status failed albo stopped zgłasza błąd zawierający identyfikator zadania i dostępną treść komunikatu.
Pobierz wszystkie strony wyników
Endpoint wyników zwraca dla każdego wiersza identyfikator źródłowy, status, dane wyjściowe, liczbę kredytów oraz błąd. Pierwsze zapytanie pobiera maksymalnie 100 wyników. Skrypt pobiera kolejne strony, dopóki nextCursor nie przyjmie wartości null.
Wyniki zadania zachowują kolejność danych wejściowych. Pole inputId nadal jednoznacznie łączy każdy wynik z rekordem odpowiedniego kandydata — także wtedy, gdy wyniki zajmują wiele stron.
Gdy dostosujesz przykład do większej liczby rekordów, zachowaj stałą wartość candidate_id z systemu źródłowego. Dzięki niej łączenie danych pozostanie przewidywalne nawet wtedy, gdy zadanie zwróci wiele stron wyników.
Jak waterfall znajduje osobisty adres e-mail
Datablist oczyszcza przesłany publiczny adres URL profilu LinkedIn, a następnie przekazuje nierozwiązany profil kolejno do dostępnych dostawców osobistych adresów e-mail. Jeśli jeden z nich nie zwróci użytecznego adresu, profil może trafić do kolejnego dostawcy. Gdy któryś dostawca znajdzie prawidłowy e-mail, sekwencja dla tego profilu zostaje zatrzymana, a adres trafia do pola outputs.emailFound.
Listą dostępnych dostawców zarządza Datablist, dlatego Twoja integracja nie wymaga osobnych zapytań do każdego z nich ani kodu obsługującego fallback. Publiczny wynik pokazuje rezultat wyszukiwania adresu e-mail, a nie stałą kolejność dostawców czy historię poszczególnych prób.
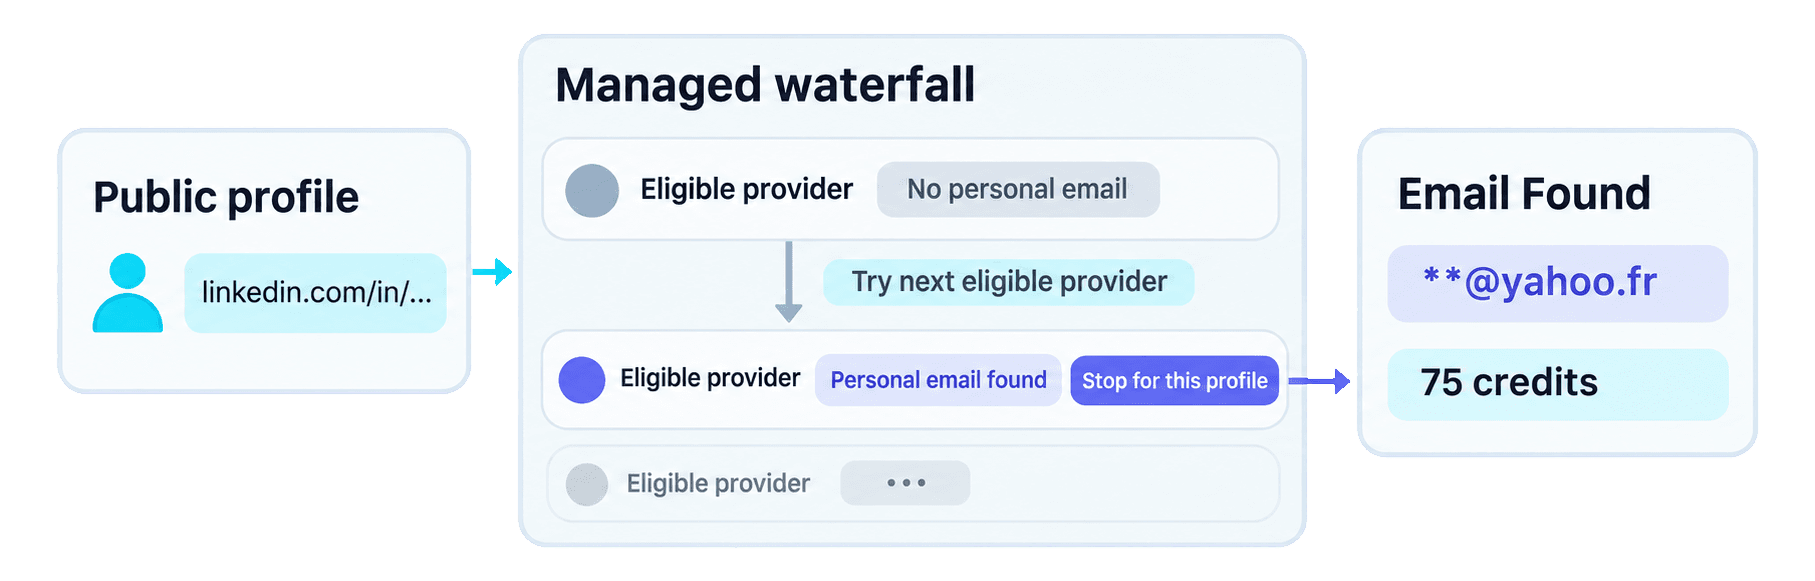
Waterfall jest metodą wyszukiwania. Polling pełni inną funkcję: pozwala klientowi w Pythonie poczekać na zakończenie pracy wykonywanej w tle.
Dlaczego waterfall pomaga międzynarodowym zespołom rekrutacyjnym
Dostawcy osobistych adresów e-mail korzystają z różnych zbiorów danych, dlatego ich skuteczność zależy od kraju i rynku. Jeśli pierwszy dostawca nie ma adresu kandydata, może go znaleźć kolejny dostawca w sekwencji waterfall.
Zespoły rekrutujące w kilku krajach zyskują szerszy dostęp do danych dostawców za pomocą jednej integracji API. Datablist zarządza całą sekwencją, dzięki czemu zespół może odnaleźć kontakty pominięte przez pojedynczego dostawcę bez integrowania i utrzymywania kilku osobnych API.
Odczytaj kompletny wynik
📘 Zamaskowany e-mail: Poniżej lokalna część adresu została zastąpiona znakami
**. Wynik z API zawiera pełną wartość.
Oto kompletna strona wyników dla przekazanego kandydata:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
Pole inputId jest kluczem łączącym wynik ze źródłowym rekordem kandydata. outputs.emailFound zawiera osobisty adres. creditsUsed to wiążąca liczba kredytów naliczonych za ten wiersz, a error: null oznacza, że API nie zwróciło błędu na poziomie wiersza. Kursor o wartości null potwierdza, że odpowiedź nie zawiera kolejnej strony wyników.
Traktuj ten adres jako jedną z możliwych form kontaktu powiązaną z przesłanym profilem i zweryfikuj go przed wykorzystaniem w rekrutacji.
Przygotuj dane kontaktowe kandydatów do weryfikacji
Po otrzymaniu wyników możesz przygotować lokalną listę do weryfikacji przez rekrutera bez wysyłania kolejnego zapytania do API. Poniższy blok ponownie wykorzystuje istniejące zmienne candidates oraz personal_email_results:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))W przypadku candidate-florian-poullin wyszukiwanie w słowniku znajduje wynik z takim samym inputId. Skopiowany rekord zachowuje imię i nazwisko Floriana Poullina, adres URL LinkedIn oraz przykładowe stanowisko docelowe Backend Engineer. Następnie dołącza kompletny obiekt API w polu result, w którym rekruter może odczytać result.outputs.emailFound.
Pętla rozpoczyna pracę od źródłowej listy kandydatów. Przyszły brak wyniku, błąd wiersza, brakujący wynik albo puste pole emailFound nie zmieni tej listy źródłowej, a dany rekord nie trafi do prepared_contacts.
Jeśli potrzebujesz szerszego procesu weryfikacji i innych kanałów kontaktu, przeczytaj poradnik o wyszukiwaniu adresu e-mail kandydata przez rekrutera.
Oszacuj koszt API Waterfall Personal Email Finder
Każdy znaleziony osobisty adres e-mail kosztuje 75 kredytów. Wyszukiwanie bez wyniku kosztuje 0 kredytów. Aby obliczyć rzeczywisty koszt, odczytaj creditsUsed przy każdym wyniku zamiast mnożyć łączną liczbę przesłanych profili.
Wzór do planowania kosztów wygląda następująco:
liczba znalezionych osobistych adresów e-mail × 75 kredytów
Jeśli na przykład prześlesz 100 profili, a dla 20 z nich zostanie znaleziony osobisty e-mail, zadanie zużyje 20 × 75 = 1500 kredytów. Jest to wyłącznie kalkulacja kosztów, a nie przewidywany współczynnik skuteczności. Przy większej skali 100 znalezionych adresów zużywa 7500 kredytów, a 1000 adresów — 75 000 kredytów.
Przy obecnej bazowej cenie doładowania w USD, $20 / 20 000 kredytów = $0,001 za kredyt. Znalezienie jednego adresu zużywa zatem kredyty o wartości $0,075, a znalezienie 100 adresów — $7,50. To wyliczenie dotyczy wartości wykorzystanych kredytów. Subskrypcja Growth wymagana do korzystania z REST API jest płatna osobno. Aktualne plany i pakiety kredytów znajdziesz w cenniku Datablist.
Napraw typowe błędy i odzyskaj istniejące zadanie
Większość problemów pojawia się przed wysłaniem zadania, na etapie zapytania HTTP albo w pojedynczym wyniku. Ustal miejsce wystąpienia błędu, aby wybrać właściwe działanie:
- Brak
DATABLIST_API_KEY: skrypt zatrzymuje się lokalnie przed wysłaniem zapytania. Wyeksportuj zmienną środowiskową, a następnie uruchom plik ponownie. - Błąd uwierzytelniania HTTP: sprawdź Personal API Key zapisany w
DATABLIST_API_KEY. Funkcja przesyła go w nagłówkuX-API-Key. Popraw dane uwierzytelniające przed ponownym wysłaniem zadania. - Nieobsługiwany adres URL profilu: zastąp adres z Sales Navigatora, stronę firmową, pustą wartość lub nieprawidłowy adres URL publicznym profilem osoby w formacie
linkedin.com/in/.... - Niewystarczająca liczba kredytów: przed wysłaniem kolejnych zadań sprawdź saldo konta i liczbę dostępnych kredytów.
- Zadanie ma status
failedalbostopped: sprawdź błąd zadania, dostępne wyniki i wykorzystanie kredytów, zanim zdecydujesz, które operacje trzeba uruchomić ponownie. - Wiersz nie zawiera wyniku albo zwraca błąd: zachowaj źródłowy rekord kandydata do weryfikacji lub kontaktu innym kanałem. Nieudane wyszukiwanie nie wyjaśnia, dlaczego adres był niedostępny.
Jeśli odpowiedź na zapytanie POST zostanie utracona, przed utworzeniem kolejnego zadania pobierz listę dotychczasowych zadań. W odpowiedzi wyszukaj uniqueId wyświetlony przez skrypt, a następnie skopiuj @id pasującego zadania:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Jeśli pasującego zadania nie ma w pierwszej odpowiedzi z historią zadań, użyj zwróconego kursora paginacji i sprawdź następną stronę. Kontynuuj sprawdzanie odzyskanego zadania lub pobierz jego dostępne wyniki, zamiast automatycznie tworzyć kolejne płatne zadanie. Dokumentacja zadań opisuje ich cykl życia, paginację oraz okres przechowywania wyników.
Kolejne kroki
Masz teraz jedną funkcję wielokrotnego użytku w Pythonie, wykorzystującą Requests do obsługi publicznych adresów URL profili LinkedIn, oraz mechanizm łączenia po stałych identyfikatorach. Pozwala on zestawić znalezione osobiste adresy e-mail z kontekstem źródłowym każdego kandydata.
Zastąp przykładową shortlistę niewielkim zestawem własnych rekordów kandydatów, zachowaj stały identyfikator i docelowe stanowisko dla każdego z nich, a następnie zweryfikuj wszystkie przygotowane kontakty przed użyciem ich w rekrutacji. Jeśli Twoja aplikacja wymaga nieblokującej współbieżności, jako kolejny krok wykorzystaj aktualizowany asynchroniczny przykład HTTPX.