
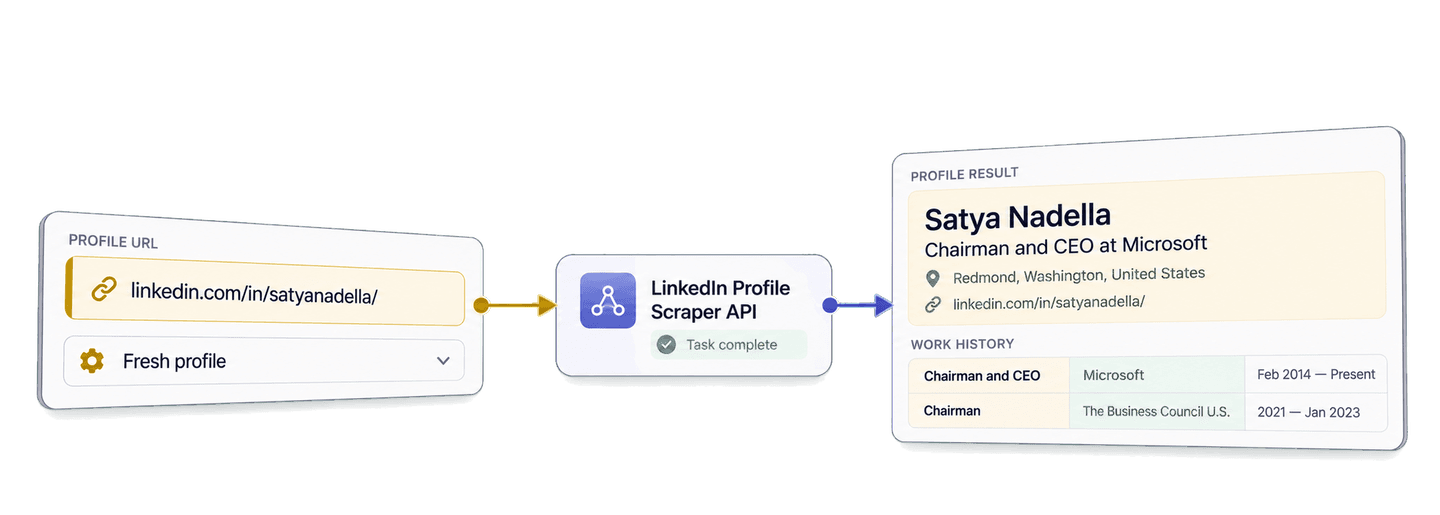
Profile LinkedIn możesz scrapować w Pythonie, wysyłając znane publiczne adresy URL profili do LinkedIn Profile Scraper API od Datablist za pomocą biblioteki Requests. API zwraca ustrukturyzowane dane o tożsamości, lokalizacji, historii zatrudnienia, wykształceniu i firmach. Możesz je wykorzystać do tworzenia list leadów oraz personalizacji Outbound z uwzględnieniem stanowiska i firmy.
W tym poradniku posłużymy się publicznym profilem Satyii Nadelli. Uruchomisz kompletne zadanie scrapowania profilu, przeanalizujesz zwrócone informacje o jego roli w Microsoft oraz daty zatrudnienia, a następnie połączysz wynik z rekordem źródłowym leada przed przygotowaniem Outbound.
🔑 Podsumowanie dla zabieganych: Wyślij do Datablist znane adresy URL profili osób na LinkedIn, aby otrzymać dostępne dane profilowe, lokalizację, historię zatrudnienia, wykształcenie i informacje o firmach w postaci ustrukturyzowanego JSON-a. Poniższy przykład w Pythonie zapisuje te dane przy każdym leadzie źródłowym, dzięki czemu możesz kwalifikować listę i przygotowywać trafniej dopasowany Outbound.
- Input: Znane adresy URL profili osób na LinkedIn.
- Output: Ustrukturyzowane dane profilowe zapisane przy każdym kontakcie źródłowym.
💡 Wolisz rozwiązanie no-code? Użyj LinkedIn Profile Scraper od Datablist, aby pozyskiwać dane ze znanych adresów URL profili bez pisania kodu.
Konfiguracja API Datablist i środowiska Python
Dostęp do REST API Datablist jest dostępny w planie Growth. Pobieranie profili zużywa również credits, których koszt omawiam w dalszej części poradnika.
Utwórz Personal API Key na stronie konta API Datablist. Oto przykładowy format Personal API Key:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Skrypt odczytuje klucz ze zmiennej środowiskowej DATABLIST_API_KEY i przesyła go w nagłówku X-API-Key.
W tym przykładzie korzystam z pakietu requests. Poniższe polecenia konfiguracyjne są przeznaczone dla powłoki systemu macOS lub Linux. Utwórz katalog projektu, otwórz go w terminalu i uruchom:
python -m venv .venv
source .venv/bin/activate
python -m pip install requestsNastępnie utwórz plik scrape_linkedin_profiles.py i wyeksportuj klucz:
export DATABLIST_API_KEY="your-personal-api-key"Pełne scrapowanie profilu LinkedIn w Pythonie
Rekord źródłowy w tym przykładzie zawiera stały identyfikator kontaktu oraz jeden znany adres URL profilu:
{
  "contact_id": "contact-satya-nadella",
  "profile_url": "https://www.linkedin.com/in/satyanadella/"
}
Skrypt przekazuje contact_id jako inputId API. Wyniki nie muszą przychodzić w tej samej kolejności co dane wejściowe, dlatego ten identyfikator pozwala niezawodnie przypisać każdy wynik do właściwego kontaktu źródłowego.
Wklej poniższy kompletny skrypt do pliku scrape_linkedin_profiles.py:
import json
import os
import time
import uuid
import requests
def scrape_profiles(source_contacts, api_key):
"""Submit one task, wait for completion, and return every result page."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": contact["contact_id"],
"data": {"profileUrl": contact["profile_url"]},
}
for contact in source_contacts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "linkedin-profile-scraper",
"uniqueId": unique_id,
"settings": {
"experiencesNb": "5",
"educationsNb": "3",
"acceptCachedProfiles": False,
"includeUrn": False,
"includePictures": False,
},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
source_contacts = [
{
"contact_id": "contact-satya-nadella",
"profile_url": "https://www.linkedin.com/in/satyanadella/",
}
]
profile_results = scrape_profiles(source_contacts, api_key)
print(json.dumps(profile_results, indent=2))Uruchom skrypt poleceniem:
python scrape_linkedin_profiles.pyUstawienia wymagają pobrania pięciu wpisów z historii zatrudnienia i trzech wpisów dotyczących wykształcenia. API oczekuje tych wartości w postaci stringów. Opcja acceptCachedProfiles: false wymusza pobranie aktualnych danych, natomiast opcje dotyczące zdjęć i wewnętrznych identyfikatorów pozostają wyłączone, ponieważ ten workflow wykorzystuje trwałe pola tekstowe i adresy URL.
Dla każdego rekordu wejściowego użyj standardowego publicznego adresu profilu /in/ lub adresu leada z Sales Navigator. Imię i nazwisko osoby, strona wyników wyszukiwania LinkedIn oraz strona firmy odnoszą się do innych zadań i nie są prawidłowymi danymi wejściowymi dla tego scrapera. Jeśli źródło zawiera linki z Sales Navigator, zwrócone pole profileUrl może zawierać znormalizowany adres publicznego profilu. W przypadku większej listy każdy inputId powinien być unikalny i stały — nie generuj go na podstawie pozycji wiersza.
Liczba wpisów historycznych określa, ile płaskich, numerowanych pól dotyczących zatrudnienia i wykształcenia może zwrócić API. Nie wpływa ona na stawkę credits za profil. Pobierz tyle historii, ile potrzebujesz do analizy, ale nie wybieraj dziesięciu stanowisk, jeśli zamierzasz sprawdzić tylko kilka najnowszych.
Do czego służą trzy wywołania API
Żądanie POST przesyła wybrane ustawienia i profile wejściowe. Datablist przyjmuje zadanie do wykonania w tle i zwraca jego @id. Skrypt wyświetla zarówno wygenerowany uniqueId, jak i zwrócony identyfikator zadania, dzięki czemu możesz później sprawdzić jego stan.
Pierwsze żądanie GET kontroluje status zadania co trzy sekundy. Klient Pythona pozostaje zablokowany podczas oczekiwania, ale zadanie API jest nadal wykonywane w tle. Pętla kończy się po uzyskaniu statusu completed, failed lub stopped.
Drugie żądanie GET pobiera wyniki w stronach zawierających maksymalnie 100 rekordów. Gdy nextCursor ma wartość, skrypt pobiera następną stronę. Kończy działanie, gdy nextCursor ma wartość null.
Odczyt wyniku i wybór ustawień pobierania
Przesłany adres URL określa profil, który pobierze scraper. Datablist obsługuje publiczne adresy profili osób oraz adresy leadów z Sales Navigator, w razie potrzeby normalizuje URL profilu i mapuje dostępne dane publiczne do płaskich pól profilu, zatrudnienia, wykształcenia i firmy.
Pobranie aktualnych danych wykorzystane w tym poradniku zakończyło się powodzeniem i kosztowało 25 credits. Oto kompletny wynik:
{
  "inputId": "contact-satya-nadella",
  "status": "success",
  "outputs": {
    "profileUrl": "https://www.linkedin.com/in/satyanadella/",
    "fullName": "Satya Nadella",
    "firstName": "Satya",
    "lastName": "Nadella",
    "linkedInHeadline": "Chairman and CEO at Microsoft",
    "linkedInSummary": "As chairman and CEO of Microsoft, I define my mission and that of my company as empowering every person and every organization on the planet to achieve more.",
    "linkedInProfilePicture": "https://media.licdn.com/dms/image/v2/C5603AQHHUuOSlRVA1w/profile-displayphoto-shrink_800_800/profile-displayphoto-shrink_800_800/0/1579726625483?e=1794441600&v=beta&t=I1sL---bTuvjxqb1vdbNsNy-fAsLCpBj3-WtJjOGbOc",
    "linkedInInternalIdentifier": "ACoAAAEkwwAB9KEc2TrQgOLEQ-vzRyZeCDyc6DQ",
    "linkedInLocation": "Redmond, Washington, United States",
    "linkedInCity": "Redmond",
    "linkedInState": "Washington",
    "linkedInCountryName": "United States",
    "linkedInCountryCode": "US",
    "linkedInLanguages": "",
    "linkedInConnections": 832,
    "linkedInlastExpTitle": "Chairman and CEO",
    "linkedInlastExpCompany": "Microsoft",
    "linkedInlastExpEmploymentType": null,
    "linkedInlastExpLocation": "Greater Seattle Area",
    "linkedInlastExpStartsAt": "2014-02-01",
    "linkedInlastExpEndsAt": null,
    "linkedInlastExpDescription": null,
    "linkedInlastExpCompanyWebsite": "https://news.microsoft.com/",
    "linkedInlastExpCompanyPage": "https://www.linkedin.com/company/microsoft/",
    "linkedInlastExpCompanyIndustry": "Software Development",
    "linkedInlastExpCompanyRange": "10001+",
    "linkedInlastExpCompanyDescription": "Every company has a mission. What's ours? To empower every person and every organization to achieve more. We believe technology can and should be a force for good and that meaningful innovation contributes to a brighter world in the future and today. Our culture doesn’t just encourage curiosity; it embraces it. Each day we make progress together by showing up as our authentic selves. We show up with a learn-it-all mentality. We show up cheering on others, knowing their success doesn't diminish our own. We show up every day open to learning our own biases, changing our behavior, and inviting in differences. Because impact matters. \n\nMicrosoft operates in 190 countries and is made up of approximately 228,000 passionate employees worldwide.",
    "linkedInlastExpCompanyLogo": "https://media.licdn.com/dms/image/v2/D560BAQH32RJQCl3dDQ/company-logo_200_200/B56ZYQ0mrGGoAM-/0/1744038948046/microsoft_logo?e=1793836800&v=beta&t=4wXD40LQU4IfLY4DiEvT2bwvjUoPQPGgi5_T-vPsbQ8",
    "linkedIn2ExpTitle": "Chairman",
    "linkedIn2ExpCompanyName": "The Business Council U.S.",
    "linkedIn2ExpEmploymentType": null,
    "linkedIn2ExpStartsAt": "2021-01-01",
    "linkedIn2ExpEndsAt": "2023-01-01",
    "linkedIn2ExpDescription": null,
    "linkedIn2ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQGcnaZNpjMvrw/company-logo_200_200/company-logo_200_200/0/1630557702704/the_business_council_us_logo?e=1793836800&v=beta&t=Ejb0D8lV5sMTFwcz_-FKdfQvIvq-mKx_Nl8vRMib53k",
    "linkedIn3ExpTitle": "Member Board Of Trustees",
    "linkedIn3ExpCompanyName": "University of Chicago",
    "linkedIn3ExpEmploymentType": null,
    "linkedIn3ExpStartsAt": "2018-01-01",
    "linkedIn3ExpEndsAt": null,
    "linkedIn3ExpDescription": null,
    "linkedIn3ExpLogo": "https://media.licdn.com/dms/image/v2/D4E0BAQGDP-PXY3u8dw/company-logo_200_200/B4EaENqZTQGoAM-/0/1791230580227/uchicago_logo?e=1793836800&v=beta&t=NJGoETr0tY868Z2pvlyXeh939iXwW0WbSFwRctabEVU",
    "linkedIn4ExpTitle": "Board Member",
    "linkedIn4ExpCompanyName": "Starbucks",
    "linkedIn4ExpEmploymentType": null,
    "linkedIn4ExpStartsAt": "2017-01-01",
    "linkedIn4ExpEndsAt": "2024-01-01",
    "linkedIn4ExpDescription": null,
    "linkedIn4ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQEQxk9y2rk7Hw/company-logo_200_200/company-logo_200_200/0/1631316692275?e=1793836800&v=beta&t=NVjljhe0oI5KzvJHodAJjss5EdvxaOIzQQ2rAGyh_AQ",
    "linkedIn5ExpTitle": "Board Member",
    "linkedIn5ExpCompanyName": "Fred Hutch",
    "linkedIn5ExpEmploymentType": null,
    "linkedIn5ExpStartsAt": "2016-01-01",
    "linkedIn5ExpEndsAt": "2022-01-01",
    "linkedIn5ExpDescription": null,
    "linkedIn5ExpLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQGF4eOou62nvQ/company-logo_200_200/company-logo_200_200/0/1664795263764/fredhutch_logo?e=1793836800&v=beta&t=dJWSO-KkuBPd6I6aRYBoIcQVzcSEmGLwqYy-VMFXJQc",
    "linkedInlastEduSchool": "The University of Chicago Booth School of Business",
    "linkedInlastEduDegree": null,
    "linkedInlastEduField": null,
    "linkedInlastEduStartsAt": "1994-01-01",
    "linkedInlastEduEndsAt": "1996-01-01",
    "linkedInlastEduPage": "https://www.linkedin.com/school/universityofchicagoboothschoolofbusiness/",
    "linkedInlastEduLogo": "https://media.licdn.com/dms/image/v2/D560BAQFZO05jhYKSkw/company-logo_200_200/company-logo_200_200/0/1692627816910/universityofchicagoboothschoolofbusiness_logo?e=2147483647&v=beta&t=BTjFA4UVU5iKIIyicg8d44rhoiuMbetNDB97BmqpwhQ",
    "linkedIn2EduSchool": "Manipal Institute of Technology",
    "linkedIn2EduDegree": "Bachelor’s Degree",
    "linkedIn2EduField": "Electrical Engineering",
    "linkedIn2EduStartsAt": null,
    "linkedIn2EduEndsAt": null,
    "linkedIn2EduPage": "https://www.linkedin.com/school/manipal-institute-of-technology/",
    "linkedIn2EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQHodG_7cUqs6w/company-logo_200_200/B4DZ8hC8AUJQAE-/0/1782965846314/manipal_institute_of_technology_logo?e=2147483647&v=beta&t=jqJK15_r7lxUNgWdbbzdMq47aLa_PqnkDYxg4Jun4Zo",
    "linkedIn3EduSchool": "University of Wisconsin-Milwaukee",
    "linkedIn3EduDegree": "Master’s Degree",
    "linkedIn3EduField": "Computer Science",
    "linkedIn3EduStartsAt": null,
    "linkedIn3EduEndsAt": null,
    "linkedIn3EduPage": "https://www.linkedin.com/school/uwmilwaukee/",
    "linkedIn3EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQE47QlO_LG8SQ/company-logo_200_200/company-logo_200_200/0/1729615751602/uwmilwaukee_logo?e=2147483647&v=beta&t=l-w3ttd1mZRc-_j5aCPXEzNiYJzl1iJjMGw7q8B3eRI"
  },
  "creditsUsed": "25",
  "error": null
}
Stanowisko, pracodawcę oraz daty rozpoczęcia i zakończenia pracy należy analizować łącznie. Wpis dotyczący Microsoft zaczyna się w lutym 2014 roku i nie ma daty zakończenia. Zatrudnienie w The Business Council U.S. trwało od 2021 roku do stycznia 2023 roku. Daty pozwalają odróżnić aktywne stanowisko od zakończonego i pokazują, że role mogą się nakładać.
Pola linkedInlastExpTitle i linkedInlastExpCompany zawierają bieżące lub ostatnie zmapowane doświadczenie zawodowe. Pierwszy zmapowany wpis może obejmować bardziej szczegółowe dane firmy, takie jak strona na LinkedIn, witryna, branża, opis i przedział liczby pracowników. Numerowane wpisy zawierają wcześniejsze stanowiska, pracodawców oraz daty. W tej odpowiedzi zwrócona witryna Microsoft to https://news.microsoft.com/. Ten adres zapewnia rekordowi leada przydatne źródło informacji o firmie obok historii stanowisk danej osoby.
Pola linkedInlastEduSchool, linkedIn2EduSchool i linkedIn3EduSchool wskazują kolejno The University of Chicago Booth School of Business, Manipal Institute of Technology oraz University of Wisconsin-Milwaukee. Wpis dotyczący Manipal zawiera tytuł Bachelor’s Degree w dziedzinie Electrical Engineering, a wpis Wisconsin-Milwaukee — Master’s Degree w dziedzinie Computer Science. Wartości kierunku i stopnia dla uczelni w Chicago są puste.
Użyj wartości "3", "5" lub "10" dla experiencesNb oraz "1", "3" lub "5" dla educationsNb, aby określić zakres potrzebnej historii. Gdy wspierają Twoją analizę, odczytuj te pola bezpośrednio z outputs. Pusta wartość opcjonalna nie oznacza niepowodzenia całego wyniku.
Tryb fresh sprawdza się podczas przygotowywania list leadów, gdy zależy Ci na nowym pobraniu dostępnych publicznie danych profilowych. Tryb cached może zwrócić zapisany wcześniej profil za mniej credits, a jeśli nie ma go w cache, wykonać świeże pobranie. Wybór zależy od wymaganej aktualności danych i budżetu credits.
Przygotowanie rekordów leadów do Outbound
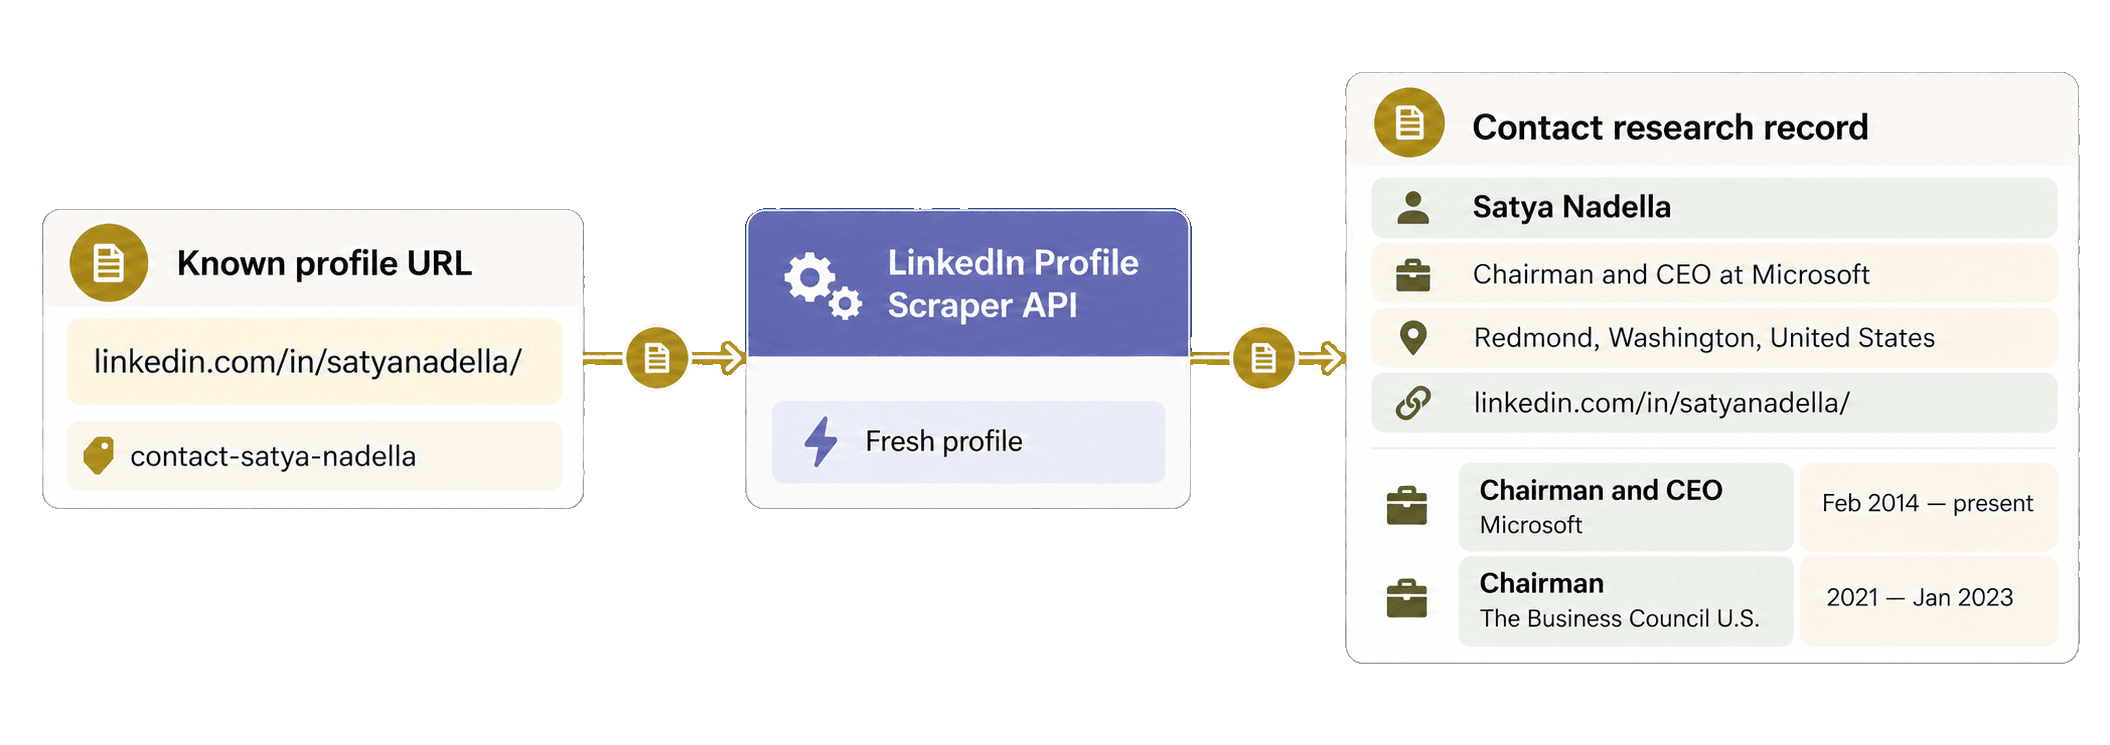
Gdy zmienna profile_results jest już dostępna, możesz połączyć każdą odpowiedź z kontaktem źródłowym bez wysyłania kolejnego zadania. Poniższy blok ponownie wykorzystuje zmienne utworzone przez kompletny skrypt:
results_by_input_id = {
result["inputId"]: result
for result in profile_results
}
contact_research = []
for contact in source_contacts:
result = results_by_input_id[contact["contact_id"]]
contact_research.append(
{
"contact_id": contact["contact_id"],
"source_profile_url": contact["profile_url"],
"result_status": result["status"],
"profile": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
research_record = contact_research[0]
profile = research_record["profile"]
print("Contact:", profile.get("fullName"))
print("Headline:", profile.get("linkedInHeadline"))
print("Location:", profile.get("linkedInLocation"))
print(
"First work entry:",
profile.get("linkedInlastExpTitle"),
"at",
profile.get("linkedInlastExpCompany"),
)Słownik indeksowany według inputId prawidłowo obsługuje odpowiedzi zwrócone w innej kolejności. contact-satya-nadella pozostaje zarówno identyfikatorem źródłowym, jak i identyfikatorem API, znany adres LinkedIn trafia do source_profile_url, a profile przechowuje oryginalny obiekt outputs bez zmian.
Taka struktura utrzymuje cały zwrócony profil razem ze źródłowym adresem URL, statusem API i zużyciem credits. Wyświetlony headline, lokalizację i pierwsze doświadczenie zawodowe możesz wykorzystać do kwalifikacji leada oraz dodania do Outbound trafnego kontekstu dotyczącego stanowiska lub firmy. Wiersze zakończone niepowodzeniem zachowują zwrócony status i błąd, dzięki czemu nadal są widoczne na liście leadów.
Możesz pobrać utrzymywany blokujący przykład dla Requests albo — po zapoznaniu się z przepływem blokującym — skorzystać z asynchronicznej wersji dla HTTPX.
Koszt scrapowania profili LinkedIn
Pobranie aktualnych danych kosztuje 25 credits za profil. Po włączeniu profili z cache dostępny zapisany wynik kosztuje 20 credits, natomiast brak profilu w cache może nadal spowodować świeże pobranie za 25 credits. Przykład Satyii Nadelli w trybie fresh wykorzystał 25 credits.
Dla 1000 profili pobranie zużyje więc 20 000 credits, jeśli wszystkie żądane profile będą dostępne w cache, lub maksymalnie 25 000 credits przy pobieraniu aktualnych danych. Dostęp do REST API Datablist wymaga planu Growth. Subskrypcja, zawarte w niej credits i opcjonalne pakiety dodatkowych credits to odrębne elementy kosztu. Aktualną ofertę znajdziesz na stronie cennika.
Przyjmując jako przykład obecną bazową cenę doładowania w USD — 20 USD za 20 000 credits — wykorzystane credits mają szacunkową wartość 20 USD dla 1000 profili dostępnych w cache lub 25 USD w trybie fresh. Kwoty te nie obejmują kosztu subskrypcji Growth.
Typowe błędy i odzyskiwanie zadania
- Brak
DATABLIST_API_KEY: skrypt zatrzyma się przed wysłaniem żądania. Wyeksportuj zmienną, a następnie ponownie uruchom plik. - API odrzuca klucz: sprawdź Personal API Key i przesyłaj wyłącznie dane uwierzytelniające
X-API-Keyużyte w tym przykładzie. - Brak adresu URL profilu lub nieprawidłowy format: użyj publicznego adresu profilu osoby na LinkedIn albo obsługiwanego adresu leada z Sales Navigator. Imię i nazwisko osoby, strona wyszukiwania ani strona firmy nie są prawidłowymi danymi wejściowymi profilu.
- Za mało credits: sprawdź saldo, a następnie przed utworzeniem kolejnego zadania wykorzystaj credits z planu lub kup dodatkowy pakiet.
- Zadanie ma status
failedlubstopped: sprawdź błąd, dostępne wyniki i zużycie credits, zanim zdecydujesz, czy konieczne jest kolejne płatne wysłanie. - Wynik jest niepełny albo ma status
no_resultluberror: sprawdź jego status i publiczny komunikat błędu, a następnie zweryfikuj URL oraz ustawienia. Dostępne pola mogą zależeć od profilu, jego widoczności i sposobu pobierania.
Jeśli połączenie zostanie przerwane podczas żądania POST, użyj wartości uniqueId wyświetlonej przed wysłaniem. Pobierz listę ostatnich zadań scrapera i porównaj ich wartości przed utworzeniem kolejnego zadania:
response = requests.get(
"https://api.datablist.com/v1/enrichments/tasks",
headers={"X-API-Key": api_key},
params={"enrichmentId": "linkedin-profile-scraper", "limit": 100},
)
response.raise_for_status()
printed_unique_id = "paste-the-printed-unique-id"
tasks = response.json()["tasks"]
matching_task = None
for task in tasks:
if task["uniqueId"] == printed_unique_id:
matching_task = task
break
if matching_task:
print("Task ID:", matching_task["@id"])Listę zadań można filtrować według enrichmentId, ale nie według uniqueId. Jeśli zadania nie ma na pierwszej stronie, podążaj za jego nextCursor. Po uzyskaniu identyfikatora zadania użyj tych samych adresów URL statusu i wyników co w głównej funkcji. Dokumentacja API zadań szczegółowo opisuje cykl życia, paginację i zachowanie po przerwaniu operacji.
Co dalej
Masz teraz jedną funkcję Python Requests wielokrotnego użytku, która zamienia znane adresy URL profili LinkedIn w ustrukturyzowane wyniki, oraz rekordy leadów dopasowane za pomocą stałego identyfikatora. Zastąp przykład niewielkim, zweryfikowanym zestawem adresów URL, wybierz tryb fresh lub cached w zależności od wymaganej aktualności i kosztu credits, a następnie wykorzystaj zwrócony kontekst stanowiska i firmy do kwalifikowania leadów lub personalizacji Outbound.
Jeśli najpierw musisz znaleźć adresy profili na podstawie imienia i nazwiska oraz słowa kluczowego firmy lub uczelni, przed uruchomieniem scrapera skorzystaj z osobnego poradnika pokazującego, jak znajdować profile LinkedIn w Pythonie przez API.