
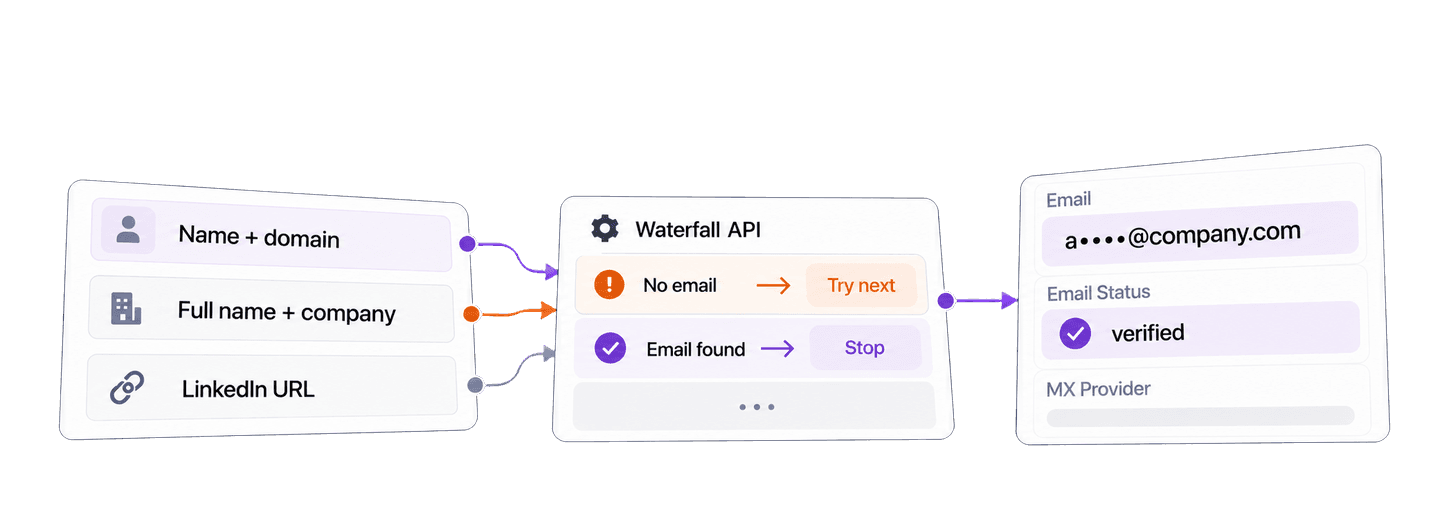
För att hitta jobbmejl i Python skickar du en persons namn och företagsuppgifter, eller URL:en till en offentlig LinkedIn-profil, till Datablists Waterfall Email Finder API med biblioteket Requests. API:et returnerar den jobbmejladress som hittas, adressens leveransstatus och dess mejlleverantör.
Det fullständiga exemplet nedan söker efter Satya Nadella på microsoft.com och Reid Hoffman på greylock.com. Skriptet väntar tills bakgrundsuppgiften är klar och hämtar alla resultatsidor. Därefter återanvänder jag resultaten för att skapa en lokal lista med verifierade kontakter inför kampanjgranskningen.
📌 Sammanfattning för dig som har bråttom
Använd en enda Python-funktion för att skicka kända kontakter till Waterfall Email Finder API, vänta på att uppgiften slutförs och samla in hittade jobbmejl. Förbered sedan verifierade kontakter för kampanjgranskning, samtidigt som olösta kontakter ligger kvar i källistan.
- Input: För- och efternamn med en företagsdomän, ett fullständigt namn med ett företagsnamn eller en offentlig URL till en LinkedIn-profil.
- Output: Ett jobbmejl med
emailStatusochmxProvider, följt av en lokal granskningslista som endast innehåller kontakter med en mejladress.
💡 Föredrar du en no-code-lösning? Använd Datablists Waterfall Email Finder för att hitta jobbmejl från en samling utan att skriva kod.
Konfigurera Python, Requests och din API-nyckel
I det här Python-exemplet använder jag paketet requests. Skapa filen find_work_emails.py och installera sedan Requests:
python -m pip install requestsSkapa en Personal API Key på din API-kontosida i Datablist. Åtkomst till REST API kräver Growth-planen. Exportera nyckeln i terminalen där du ska köra skriptet:
export DATABLIST_API_KEY="your-api-key"Lyckade resultat från Waterfall Email Finder förbrukar också credits. Kostnadsavsnittet längre ned skiljer dessa credits från abonnemanget som ger API-åtkomst.
Hitta jobbmejl med en enda Python-funktion
Klistra in följande fullständiga skript i find_work_emails.py:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Skicka en email-finder-uppgift, vänta och returnera alla resultat."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Uppgiftens uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Uppgift {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Ange DATABLIST_API_KEY innan du kör skriptet.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Kör skriptet från samma terminal:
python find_work_emails.pyDu kan också ladda ned det underhållna Requests-exemplet. När du har förstått den blockerande versionen finns även ett asynkront HTTPX-alternativ i repositoryt.
Funktionen gör tre typer av anrop i tur och ordning.
Först skickar den uppgiften. Varje inputId är ditt beständiga kontakt-ID. Det kapslade objektet data innehåller fälten som används i sökningen. POST-anropet returnerar 202 Accepted med @id, det uppgifts-ID som används i efterföljande anrop. Koden skriver ut uniqueId före anropet, så att du har ett återställningsvärde även om svaret skulle gå förlorat.
Därefter kontrollerar den uppgiftens status. Datablist bearbetar uppgiften i bakgrunden. Den här Requests-klienten väntar och kontrollerar uppgiften var tredje sekund tills statusen är completed, failed eller stopped. Requests blockerar medan klienten väntar, men själva API-uppgiften är fortfarande asynkron.
Slutligen hämtar den resultaten. En uppgift kan ha flera resultatsidor. Loopen fortsätter att hämta sidor tills nextCursor är null. Använd inputId, inte svarens ordningsföljd, för att koppla varje resultat till rätt källkontakt.
Välj input efter dina kontaktuppgifter
En uppgift använder ett enda input-läge. Behåll samma find_emails()-funktion och ersätt värdena för settings och people med det alternativ som passar dina källdata.
Välj om möjligt ett inputId som är unikt inom uppgiften och redan tillhör källkontakten. Ett post-ID från CRM-systemet eller ett annat beständigt Lead-ID fungerar bra. Datablist returnerar värdet tillsammans med resultatet, så att du kan matcha poster utan att jämföra namn eller anta att svaren följer samma ordning som input.
När du har separata namnfält och en företagsdomän använder du sourceKind: "name_company". En känd domän är den tydligaste företagsidentifieraren:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)När din källa har ett enda namnfält och ett företagsnamn aktiverar du useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)När du har URL:en till en offentlig personprofil använder du LinkedIn-alternativet:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Det här alternativet accepterar URL:en till en offentlig profil på linkedin.com/in/... som personkontext för mejlsökningen. Profil-URL:er från Sales Navigator accepteras inte.
Om du behöver välja leverantörsnycklar och deras ordning kan du läsa guiden om anpassade waterfalls. Den hanterade waterfall som används här kräver ingen leverantörsspecifik konfiguration.
Så hittar en hanterad waterfall rätt mejladress
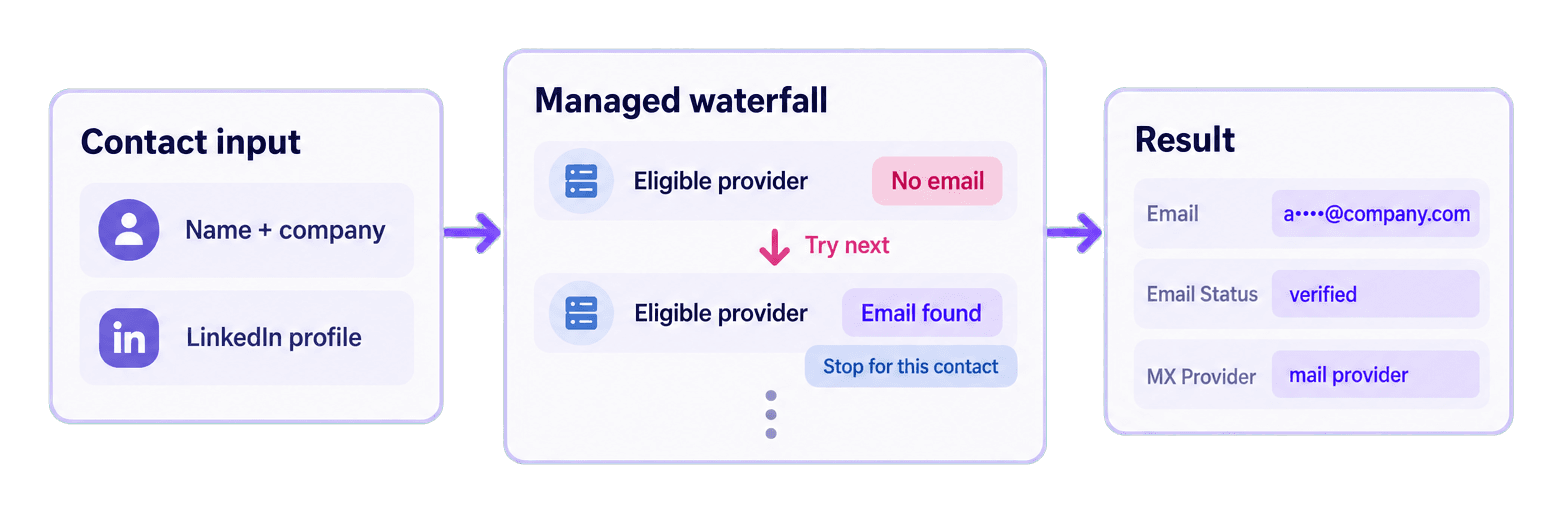
Vid en sökning med namn och företag använder API:et en angiven domän direkt. Om du anger ett företagsnamn försöker det först omvandla namnet till en användbar företagsdomän. Vid en LinkedIn-sökning rensar det den offentliga profil-URL:en och omvandlar tillgängliga person- och företagsuppgifter till den kontext som kompatibla mejlleverantörer behöver.
Den hanterade waterfall-lösningen skickar en olöst kontakt till en kompatibel leverantör. Om ingen användbar mejladress returneras kan en annan leverantör försöka hitta samma kontakt. Sekvensen avslutas för kontakten så snart ett jobbmejl godkänns. Standardsvaret anger inte vilken finder som användes.
Därför förbättrar waterfall internationell outreach
Leverantörer av jobbmejl använder olika datakällor, vilket gör att deras täckning varierar mellan länder och marknader. En leverantör kanske inte hittar något för en kontakt i en viss region, medan en annan har den data som krävs för att hitta adressen.
För ett sälj- eller growth-team ger en waterfall varje olöst kontakt ytterligare en chans att hittas innan den lämnas utanför outreach-listan. Det kan fånga upp kontakter som ett arbetsflöde med en enda leverantör skulle missa, samtidigt som teamet behåller en enhetlig teknisk process.
Datablist hanterar sekvensen av kompatibla leverantörer bakom en enda API-integration. Du skickar kontakten en gång och får ett enhetligt svarsformat, i stället för att bygga och underhålla separata integrationer för varje leverantör och själv slå ihop svaren.
Tolka de fullständiga resultaten
Exempeluppgiften returnerade två lyckade resultat. Mejladresserna är maskerade nedan.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound är jobbmejlet som returneras. emailStatus beskriver adressens leveransbarhet vid söktillfället och mxProvider identifierar leverantören som hostar mejlen, när den informationen finns. Båda posterna är verified och förbrukade 25 credits vardera.
Kampanjkoden nedan placerar resultat med statusen verified i campaign_contacts och andra hittade adresser i needs_verification. Värdet creditsUsed är den auktoritativa kostnaden för varje resultat.
Standardresultatet från den hanterade lösningen innehåller inte finderProvider. Det fältet är villkorad output för ett giltigt name-and-company-arbetsflöde med egna nycklar. Skriptet bör därför inte försöka härleda det från mxProvider.
Förbered hittade mejl för kampanjgranskning
När den direkta sökningen fungerar lägger du till följande block sist i skriptet, efter att lookup_results har returnerats. Det förbereder lokala kontakter för kampanjgranskning utifrån sökningen du redan har kört.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))results_by_id gör svarens ordningsföljd irrelevant. För Satya läser loopen contact-satya-nadella från den ursprungliga listan people, hittar resultatet med samma inputId, kopierar källposten och lägger till hela API-objektet under result. Eftersom adressen finns och dess status är verified hamnar kontakten i campaign_contacts. Reid följer samma flöde även om hans API-resultat kommer först.
De tre villkoren gör beslutet lätt att följa. Det första hoppar över en kontakt om inget matchande resultat returnerades. Det andra hoppar över fel på radnivå och andra statusar än success. Det tredje kräver att det faktiskt finns ett värde i emailFound. Genom att bifoga hela result-objektet bevaras status, output, kreditförbrukning och felfält för senare granskning.
Ett hittat mejl med en annan leveransstatus hamnar i needs_verification. Ett saknat resultat, ett radfel eller ett resultat utan emailFound hamnar inte i någon av de förberedda listorna. Den ursprungliga listan people finns kvar för korrigering eller vidare research.
Beräkna kostnaden för Waterfall Email Finder API
Den hanterade standardlösningen använder 25 credits för varje hittat jobbmejl. En resultatlös standardsökning använder 0 credits. Läs creditsUsed från varje resultat i stället för att multiplicera det totala antalet inskickade kontakter.
Ett hittat mejl med statusen unverified använder fortfarande 25 credits, även om den lokala kampanjkoden placerar det i needs_verification i stället för campaign_contacts.
De två hittade mejladresserna i exemplet använde 50 credits. Som planeringsunderlag:
- 100 hittade jobbmejl använder 2 500 credits.
- 1 000 hittade jobbmejl använder 25 000 credits.
- En större input-lista kan använda färre credits än
kontakter × 25, eftersom sökningar utan resultat inte debiteras.
Åtkomst till REST API kräver Growth-planen. Med det aktuella påfyllnadspriset i USD ger 20 dollar 20 000 credits, vilket motsvarar 0,001 dollar per credit. Med den prisnivån har 25 000 credits ett värde på 25 dollar. Abonnemanget tillkommer utöver denna kreditberäkning. Se Datablists prissida för aktuella uppgifter om planer och paket.
Lös vanliga fel och återställ en uppgift
API-nyckeln saknas. Skriptet visar felet Ange DATABLIST_API_KEY innan du kör skriptet. innan något anrop görs. Exportera variabeln i den aktuella terminalen och kör filen igen.
API:et returnerar ett autentiseringsfel. raise_for_status() rapporterar HTTP-felet. Kopiera en aktuell Personal API Key, kontrollera att headern X-API-Key använder den och kör skriptet igen först när inloggningsuppgiften har korrigerats.
Kontot har för få credits. Kontrollera kontots saldo. Lägg till credits eller vänta på planens nästa kredittilldelning innan du skickar in fler uppgifter.
Input-fälten stämmer inte med det valda läget. Använd separata namnfält eller fullName med name_company, eller använd linkedInProfile med linkedin. Korrigera kontakten och skicka den i ett konsekvent läge.
Uppgiften har statusen failed eller stopped. Skriptet utlöser ett RuntimeError som innehåller uppgiftens ID, slutstatus och tillgängliga felmeddelande. Granska uppgiften och eventuella tillgängliga resultat innan du bestämmer vilka kontakter som fortfarande behöver sökas.
POST-svaret gick förlorat. Kopiera det uniqueId som skrevs ut före anropet. Lista dina uppgifter med samma nyckel:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Hitta uppgiften med det utskrivna uniqueId, kopiera dess @id och fortsätt sedan med URL:en för uppgiftsstatus eller resultat. På så sätt kan du återställa den befintliga uppgiften i stället för att automatiskt skicka in kontakterna igen. Dokumentationen för task API beskriver livscykeln och endpoints för resultat.
Nästa steg
Nu har du en blockerande Python Requests-funktion för de tre input-alternativen och ett lokalt filter som förbereder hittade och verifierade mejladresser för kampanjgranskning.
Ersätt de två exempelkontakterna med ett mindre urval av dina researchade kontakter. Välj det input-alternativ som passar dina data, kör sökningen och granska emailStatus innan du använder en adress. För ett bredare listarbetsflöde kan du läsa om hur du hittar mejladresser i stor skala. Det underhållna GitHub-repositoryt innehåller nedladdningsbara exempel för både blockerande och asynkron Python.