公司名称转域名 API
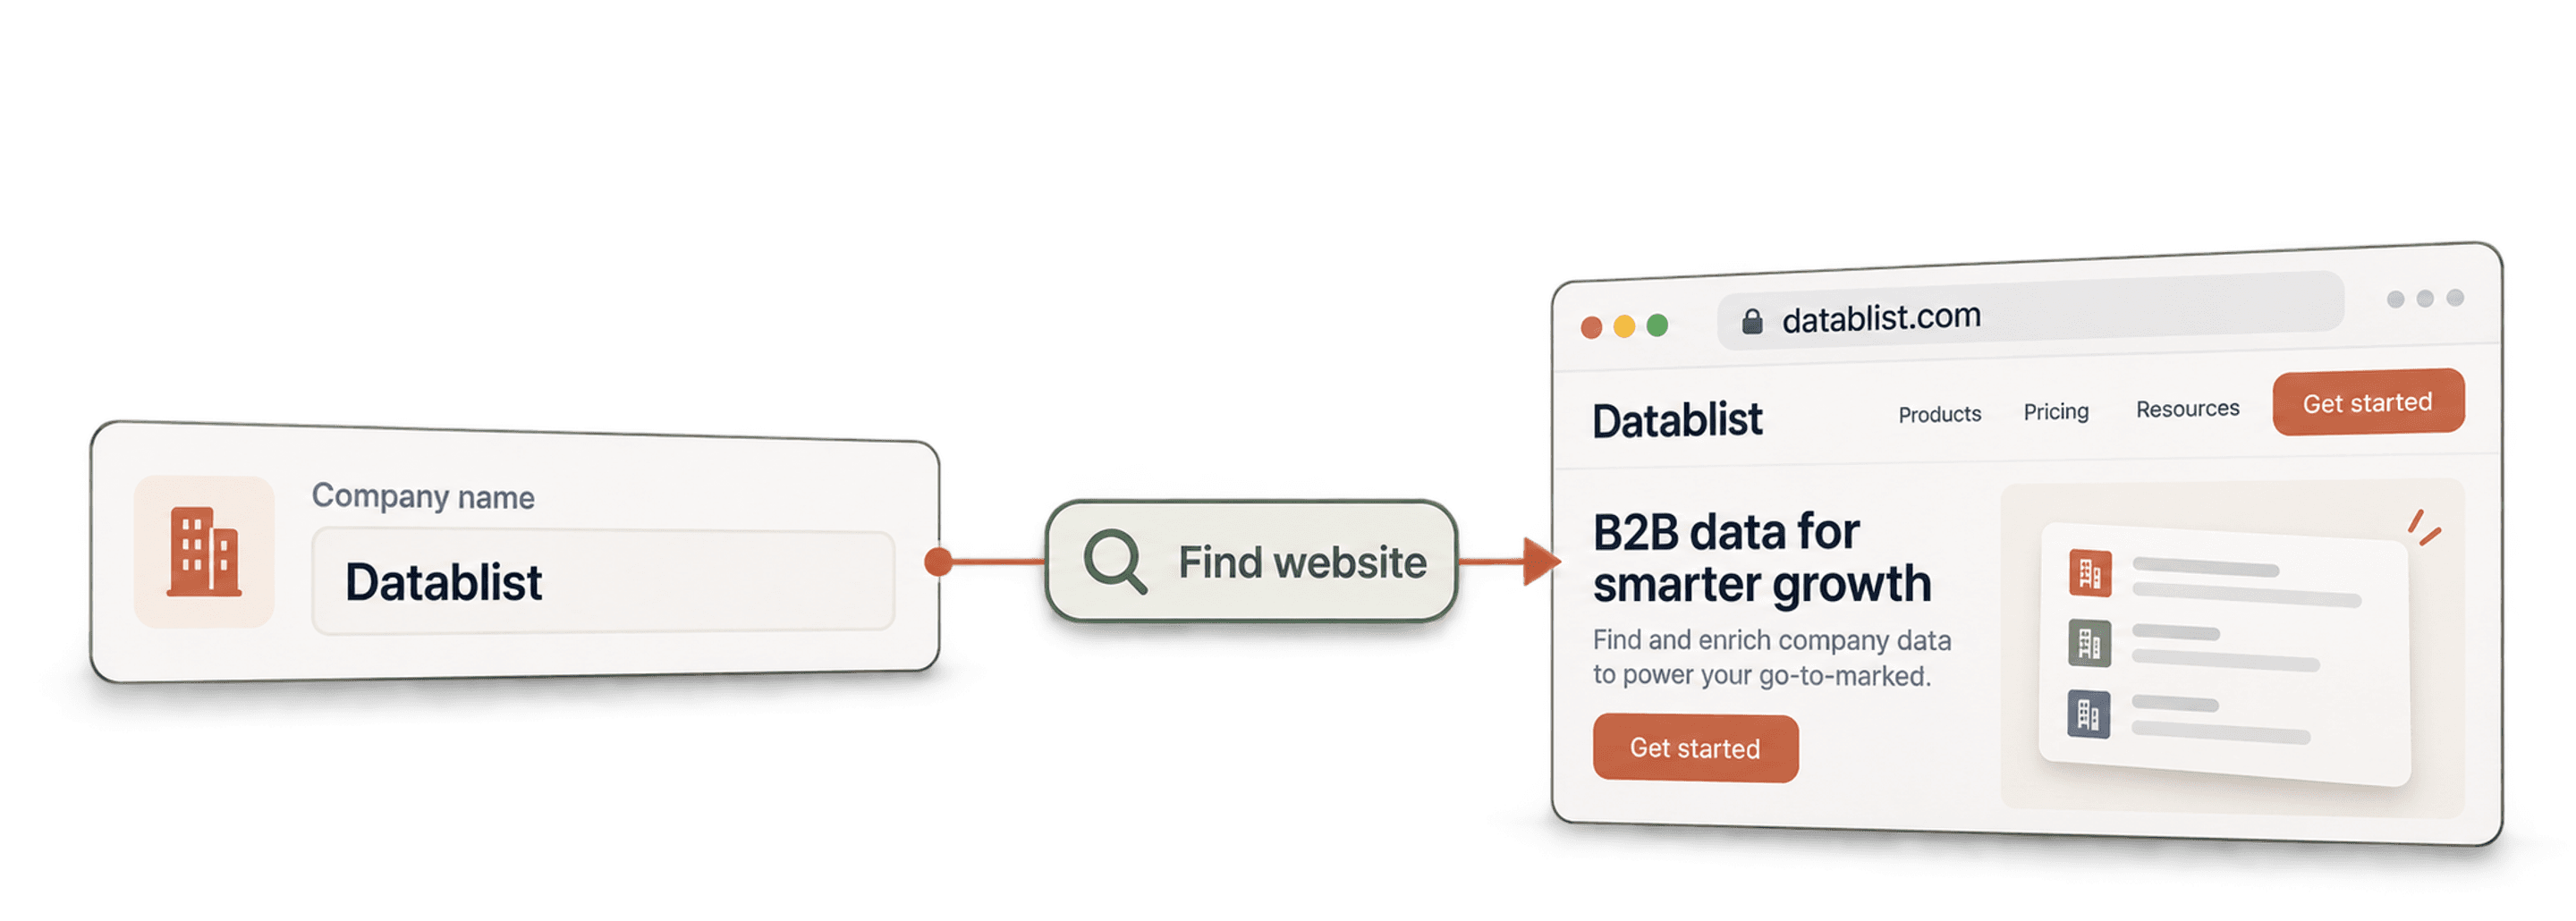
通过你的 AI 助手、无代码 workflow 或自有代码,查找每个公司名称对应的网站。
- 每个域名低至 $0.001
- 域名和完整 URL
- 每个任务最多 10,000 个域名
| 公司名称 |
|---|
| Brightwave Analytics |
| Northpeak Logistics |
| Juniper & Vale Studio |
深受初创公司及《财富》500 强团队中 38,000+ 名用户的信赖



适用于任何能够发送 HTTP 请求的工具
 Claude
 Cursor
 Codex
 Make
 n8n
 Zapier
- 你自己的代码
选择你的接入方式
让 AI 助手或自动化工具完成设置,也可以通过自己的代码直接调用 REST API。
粘贴设置 prompt
复制适用于 Claude Code、Codex、Cursor、Make、n8n 或 Zapier 的 prompt,然后粘贴进去。AI 会在你的电脑上创建 Datablist 文件夹并完成所有设置。
粘贴你的 API 密钥
当 AI 提示时,从 Datablist 应用复制 API 密钥,并粘贴到它打开的 .env 文件中。切勿将密钥粘贴到聊天中。
获取结果
发送名称列表,每个名称会返回一行结果:域名、网站和置信度,可直接用于电子表格或 CRM。
查看示例结果使用 Make、n8n 或 Zapier?以下是 HTTP 请求所需的全部字段
使用你的工具提供的 HTTP 请求模块或节点。只需三步:发送列表、等待,然后读取结果。
1. 发送你的列表(HTTP 请求)
- 方法
POST- URL
https://api.datablist.com/v1/enrichments/tasks- 请求头
X-API-Key= 你的 API 密钥Content-Type=application/json- 请求体(JSON)
- json{"enrichmentId": "company-name-to-domain","uniqueId": "company-name-to-domain-import-1","settings": {"workflow": "dataset_google","searchCountryCode": "US"},"inputs": [{"inputId": "row-1", "data": {"companyName": "Brightwave Analytics"}},{"inputId": "row-2", "data": {"companyName": "Northpeak Logistics"}},{"inputId": "row-3", "data": {"companyName": "Juniper & Vale Studio"}}]}
- 保存
- 保存响应中的
@id,它就是你的任务 ID。
2. 等待任务完成
添加短暂等待或延迟,然后向 https://api.datablist.com/v1/enrichments/tasks/TASK_ID 发送 GET 请求,并使用相同的 X-API-Key 请求头。重复执行,直到 status 为 completed。
3. 读取结果
GET https://api.datablist.com/v1/enrichments/tasks/TASK_ID/results?limit=50。将 outputs 映射到你的列。如果 nextCursor 不为空,请将该值附加在 &cursor= 后再次调用。
快速了解
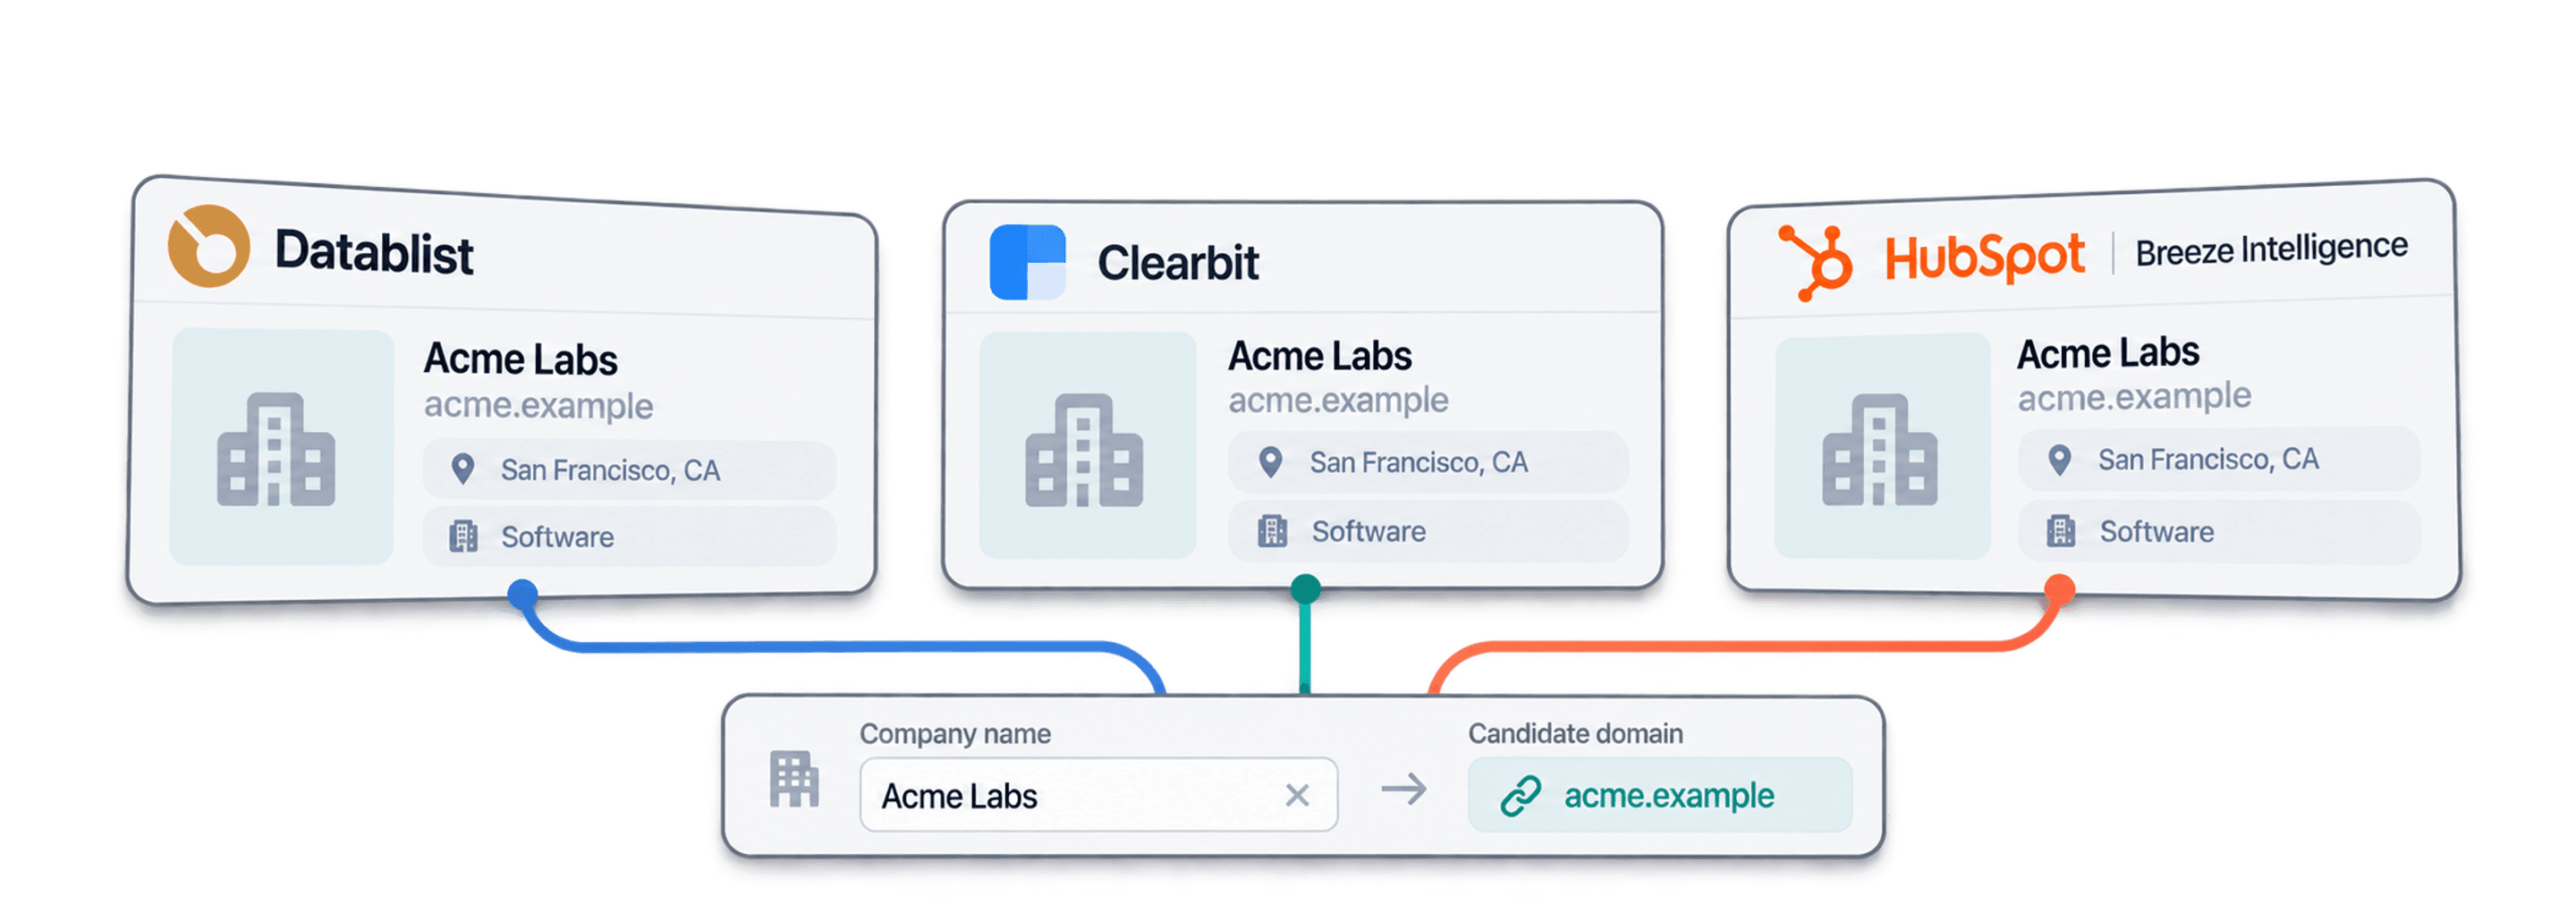
返回与公司名称匹配的域名和网站。可按国家/地区筛选以缩小结果范围。当多个域名匹配时,返回流量更高的域名。无需 Datablist workspace、collection 或导入操作。
团队可以用它构建什么
将公司名称转域名功能接入你的任意现有数据流程。
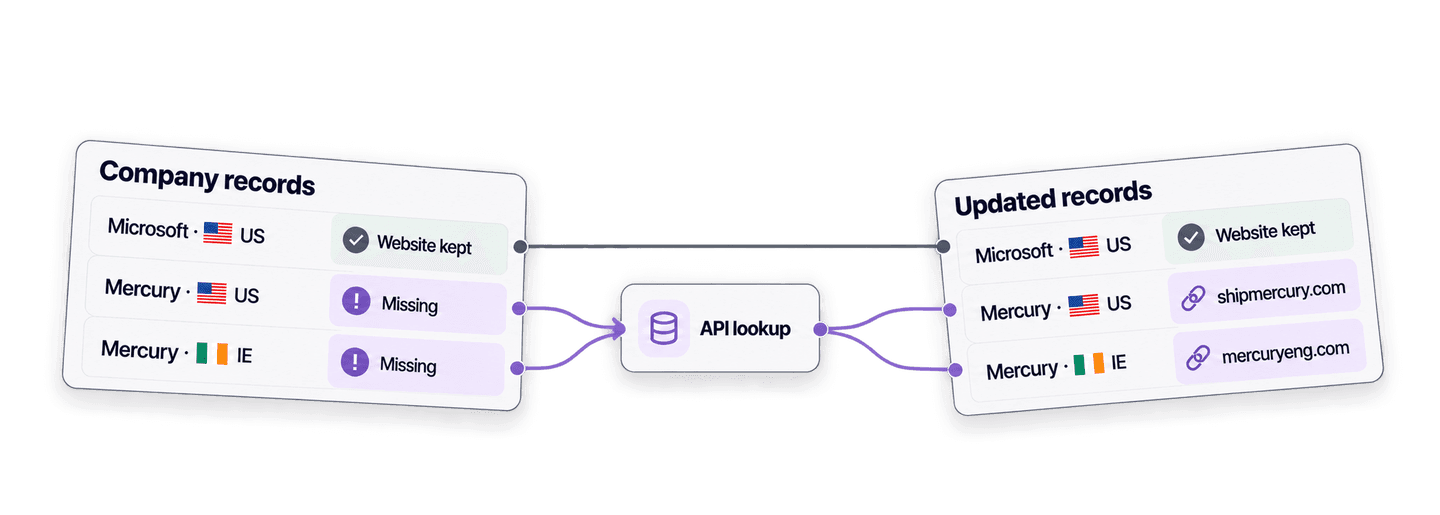
补全 CRM 中的客户账户
- CRM 中新增账户
- 将域名保存到记录
当新增账户缺少网站时自动执行查询,确保 HubSpot、Salesforce 或 Pipedrive 始终有可用于匹配的域名。
为你的数据 enrichment pipeline 提供输入
- 公司名称
- Emails、公司特征数据、LinkedIn
域名是多数其他 enrichment 所需的关键字段。先解析域名,再将其传递给公司数据 enrichment 或 email finder。
将活动名单转换为域名
- 展会或合作伙伴名单
- 去重并分配
将展会名单、合作伙伴导出数据或表单提交中的纯公司名称转换为域名,以便去重和分配。
需要花费多少?
使用 credits 按查询次数付费。API 访问权限从 Growth 套餐开始提供。
需要花费多少?
告诉我们需要解析多少个公司名称,我们会为你展示成本最低的方案。
= 1,450 credits:700 次数据库匹配,每次 1 credit;300 次 Google 查询,每次 2.5 credits
credits 如何计算
1,000 credits = $1,因此每个 credit 的费用为 0.1 美分。数据库匹配消耗 1 credit,且仅在返回域名时收费。Google 兜底查询消耗 2.5 credits,无论是否找到结果都会收费,因此两种查询的占比会直接影响账单。Google 结果会缓存 48 小时,因此在此期间更改设置并重新运行时,每行只需 1 credit,而不是 2.5 credits。套餐 credits 每月续发,未使用的部分会重置。追加购买的 credits 永不过期。
集成到你的代码中
直接调用 REST API 所需的一切:代码、响应、端点、字段、身份验证和限制。
datablist/company-name-to-domain-api
官方示例:cURL、使用 requests 和 HTTPX 的 Python,以及批量 CSV 处理。将密钥存入 DATABLIST_API_KEY 后即可运行。
复制、粘贴、运行
这是一个完整脚本,可创建任务、等待任务完成并打印所有结果。请将 YOUR_PERSONAL_API_KEY 替换为你的密钥。
# 1. Create the task (returns 202 Accepted and the task "@id")
curl --request POST 'https://api.datablist.com/v1/enrichments/tasks' \
  --header 'X-API-Key: YOUR_PERSONAL_API_KEY' \
  --header 'Content-Type: application/json' \
  --data '{
    "enrichmentId": "company-name-to-domain",
    "uniqueId": "company-name-to-domain-import-1",
    "settings": {
      "workflow": "dataset_google",
      "searchCountryCode": "US"
    },
    "inputs": [
      {"inputId": "row-1", "data": {"companyName": "Brightwave Analytics"}},
      {"inputId": "row-2", "data": {"companyName": "Northpeak Logistics"}},
      {"inputId": "row-3", "data": {"companyName": "Juniper & Vale Studio"}}
    ]
  }'
# 2. Poll every few seconds until status is completed, failed or stopped
curl 'https://api.datablist.com/v1/enrichments/tasks/TASK_ID' \
--header 'X-API-Key: YOUR_PERSONAL_API_KEY'
# 3. Read the results, then follow nextCursor until it is null
curl 'https://api.datablist.com/v1/enrichments/tasks/TASK_ID/results?limit=50' \
--header 'X-API-Key: YOUR_PERSONAL_API_KEY'API 返回内容
每项输入对应一条结果,其中包含你的 inputId、状态、outputs 和已使用的 credits。以下为示例数据。
{
  "taskId": "00000000000040008000000000000001",
  "results": [
    {
      "inputId": "row-1",
      "status": "success",
      "outputs": {
        "companyDomain": "brightwaveanalytics.com",
        "companyUrl": "https://www.brightwaveanalytics.com",
        "domainConfidence": "High"
      },
      "creditsUsed": "1",
      "error": null
    }
  ],
  "nextCursor": null
}
端点和字段
所有路径均相对于 https://api.datablist.com。字段定义来自 GET /v1/enrichments/company-name-to-domain(schema 版本 2026-09-12)。
查看 API schema(JSON) (在新标签页中打开)
- /v1/enrichments/company-name-to-domain
- 读取 schema,无需密钥
- POST
- /v1/enrichments/tasks
- 创建任务
- /v1/enrichments/tasks/{taskId}
- 轮询状态和进度
- /v1/enrichments/tasks/{taskId}/results
- 读取结果,每页 1 至 100 条
- POST
- /v1/enrichments/tasks/{taskId}/stop
- 取消正在运行的任务
- /v1/enrichments/tasks
- 任务历史记录,按最新优先排序
Schema 参考
每个任务仅发送一次 settings,每项输入发送一个 data 对象。随着 enrichment 功能演进,结果可能包含额外字段,因此解析 outputs 时请保留未知 key。
显示所有设置、输入和输出
设置
workflowWorkflow | Text | Datablist first uses a company dataset to match names with domains. Datablist might also perform a Google search on the remaining company names.允许的值: |
|---|---|---|
searchCountryCodeTarget Country | Text | Narrow down the search to a specific country. This setting filters the company dataset and is a country setting for the Google Search fallback.允许的值: |
countryOverwriteDefine target country per item. | Boolean | When enabled, a “Target Country” input will be added to configure the target country for each item. You can enter a country using its ISO 3166 code (Alpha-2 like “FR“, or Alpha-3 like “USA“) or its full English name (like “Portugal“). If the country is missing or invalid, Datablist will use the global “Target Country” setting as a fallback. |
acceptNonRootAccept non root websites | Boolean | By default, Datablist skips dataset and Google results that point to a page hosted below a domain the company does not own (eg: https://www.directory.com/mycompany). This is good to avoid company directories. But you can miss company websites that are hosted on platforms. For example: https://www.hostingplatform.com/mycompanypage. Use this setting to accept non-root websites while preserving and validating the full page URL. 👉 Datablist caches Google search results for 48 hours. If you change this setting after the first run, results come from the cache, costing only 1 credit. 启用条件: |
skipDomainsSkip following domains | Text list or Text | Additional domains to exclude when selecting company websites, as an array of domains. 启用条件: |
onlyProcessCachedResultsOnly Process Google Cached Results | Boolean | If enabled, Datablist will only use your saved Google search results from the cache. It won’t run new live searches. Use this to reduce costs and skip dataset results. 启用条件: |
输入(data)
companyName必填Company Name | Text | The name of the company to search for (ex: google). |
|---|---|---|
targetCountryTarget Country | Text | Narrow down the search to a specific country. This setting filters the company dataset and is a country setting for the Google Search fallback. If the country is missing or invalid, Datablist will use the global “Target Country” setting as a fallback. 启用条件: |
输出
companyDomainCompany Domain | Text | The company domain (ex: google.com), when found. |
|---|---|---|
companyUrlCompany Full Url | Text | The company full url (ex: https://www.google.com), when found.格式: |
domainConfidenceDomain Confidence | Text | Confidence level of the match: High, Medium, Low, or Very Low. |
一个请求头,限制清晰明确
在你的 Datablist 账户中创建 Personal API Key,并随每个需要身份验证的请求一起发送。
身份验证
在 X-API-Key 请求头中发送你的密钥。Datablist 会为你交换并续期 access token。
- 请求头:
X-API-Key: YOUR_PERSONAL_API_KEY - 可选:使用来自
POST /v1/account/token的Authorization: Bearer自行管理 token - 二选一:同时发送两个请求头会返回
400 AmbiguousCredentials - 仅限服务端:不要在 URL、浏览器代码和日志中暴露密钥
限制
- 每个任务的输入数:1 至 10,000
- 大小:每项输入 16 KiB,每个请求 10 MiB
- 运行时间:每个任务最长 24 小时
- 创建任务:每个账户每 60 秒最多 10 个请求
- 轮询和结果:每项操作每 60 秒最多 120 个请求
- 活跃任务:每个账户可同时运行约 20 个任务
- 保留期限:任务和结果保留 90 天
相关教程
通过详细的分步指南,学习最新 workflow。
常见问题解答
你或你的 AI 编程 agent 集成公司名称转域名 API 所需的一切:身份验证、请求、轮询、结果、限制和重试。
相关 API、Enrichment 和免费工具
在你的代码、Datablist 应用或免费工具中,将公司名称转域名功能与其他 enrichment 串联使用。
Enrichment API
- 公司名称清理 API在查询域名前,先清理格式混乱的公司名称。
- 公司转 LinkedIn API将公司网站与其 LinkedIn 公司主页进行匹配,也支持反向匹配。
- Waterfall Email Finder API根据姓名和公司域名查找已验证的工作 email。