
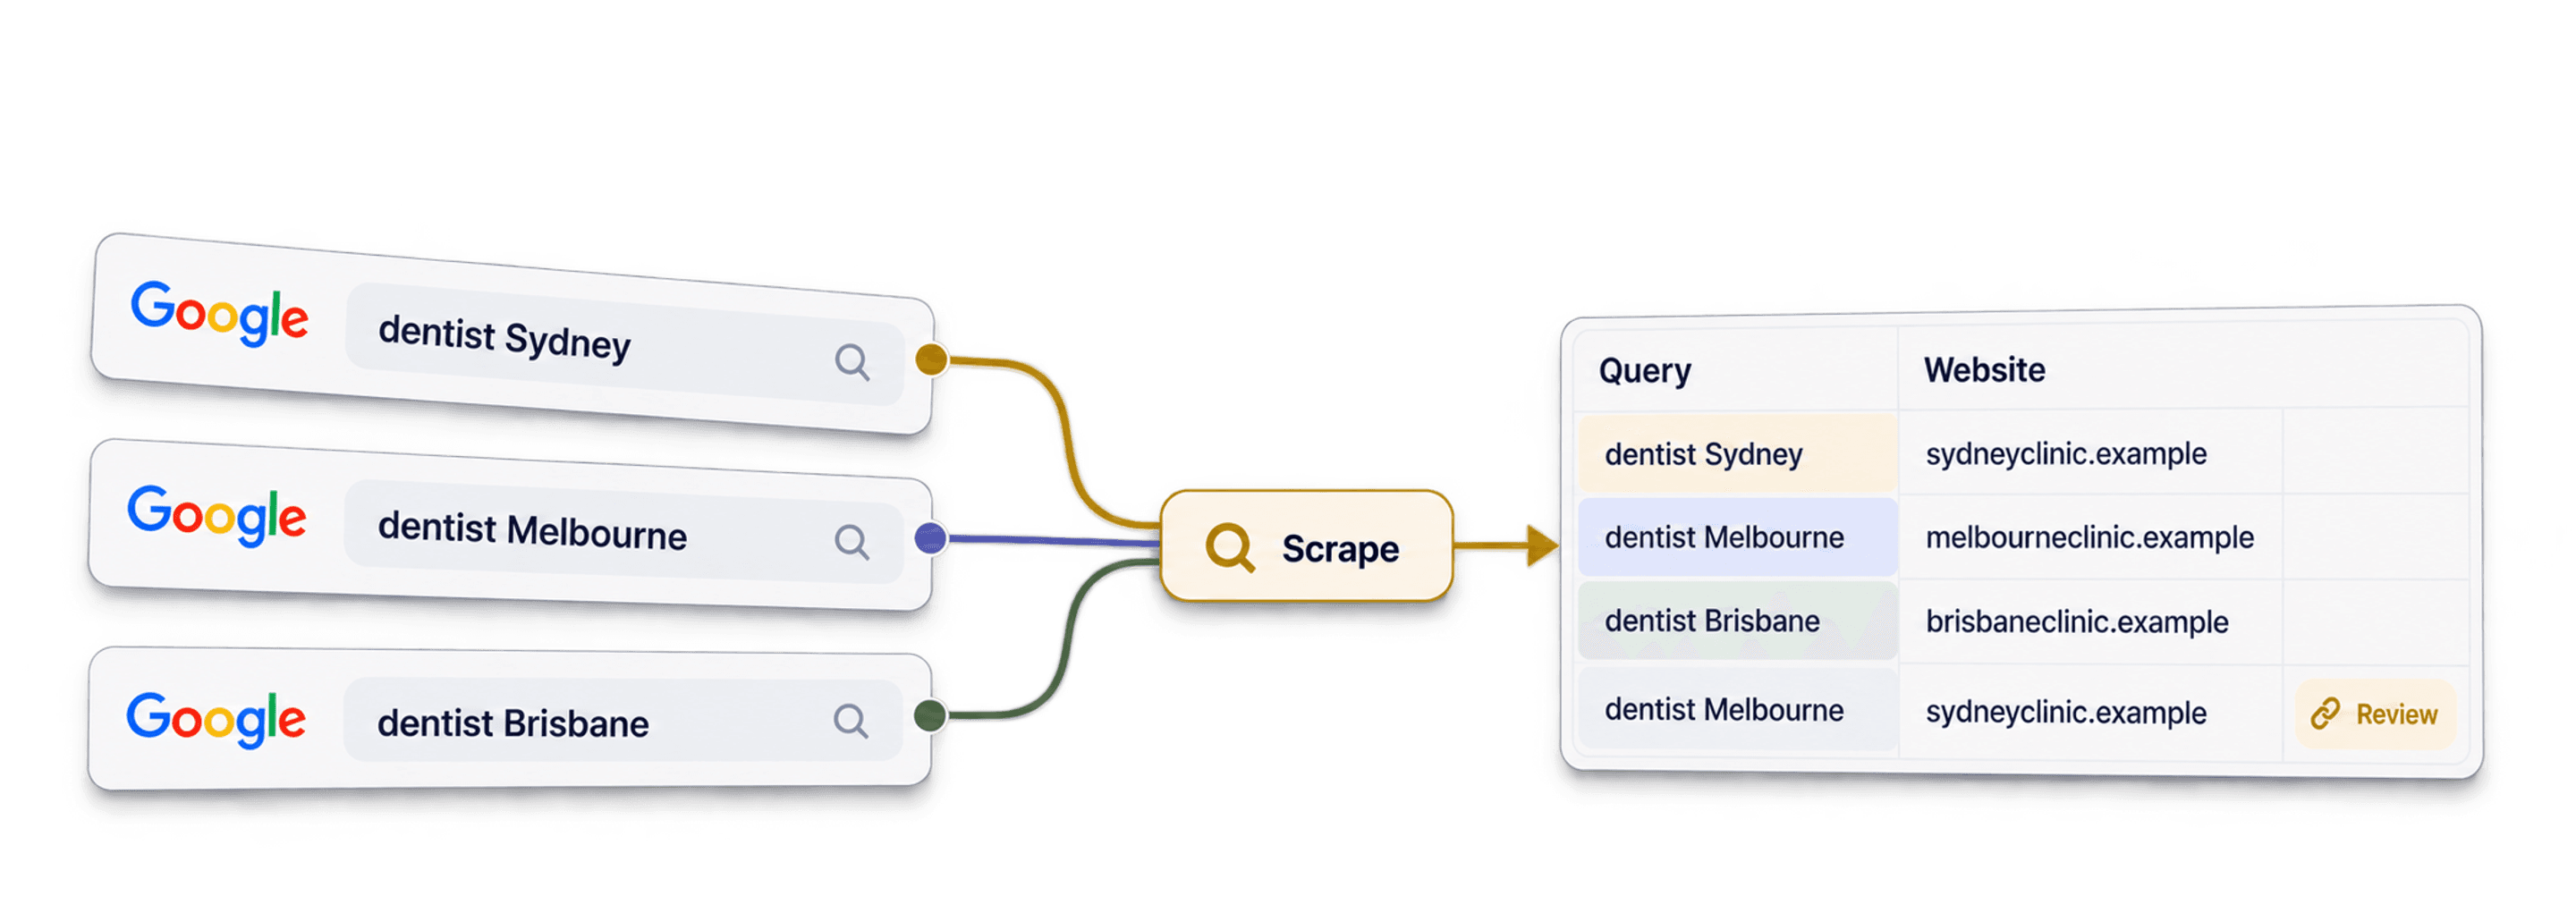
要批量抓取多组 Google 查询的搜索结果,先整理一份具体的搜索词列表,将其粘贴到 Datablist 的 Start with Google Search Queries 数据源中,再选择国家、语言和每条查询的结果上限,最后检查返回的 URL。例如,与其只使用宽泛的 dentist China,不如分别搜索 dentist Beijing、dentist Shanghai 和 dentist Shenzhen。
每条查询都可能返回不同的页面。实际结果取决于 Google 针对该搜索提供的内容,而且不同查询的结果可能重叠,因此最终数量并不等于“查询数 × 每条查询的结果上限”。免费方案每次仅处理第一条查询,且最多返回 200 条结果;如需批量运行多条查询,请使用符合条件的付费方案。消耗 credits 前,请先查看本次运行的预估费用。
📌 常见应用场景
- 创建包含 LinkedIn 个人资料的 Lead 列表
- 通过关键词搜索 Instagram 个人资料
- 按特定 Web 技术筛选目标公司
- 为数百座城市建立本地企业数据库
章节快速导航:
- 为什么一条宽泛查询会漏掉结果
- 多查询抓取方案与使用 AI 生成查询变体
- 使用 Datablist 批量抓取 Google 的详细步骤
- 清洗数据并删除重复项
- 丰富搜索结果数据
- 成本分析:低预算抓取 Google 数据
为什么宽泛查询会漏掉结果
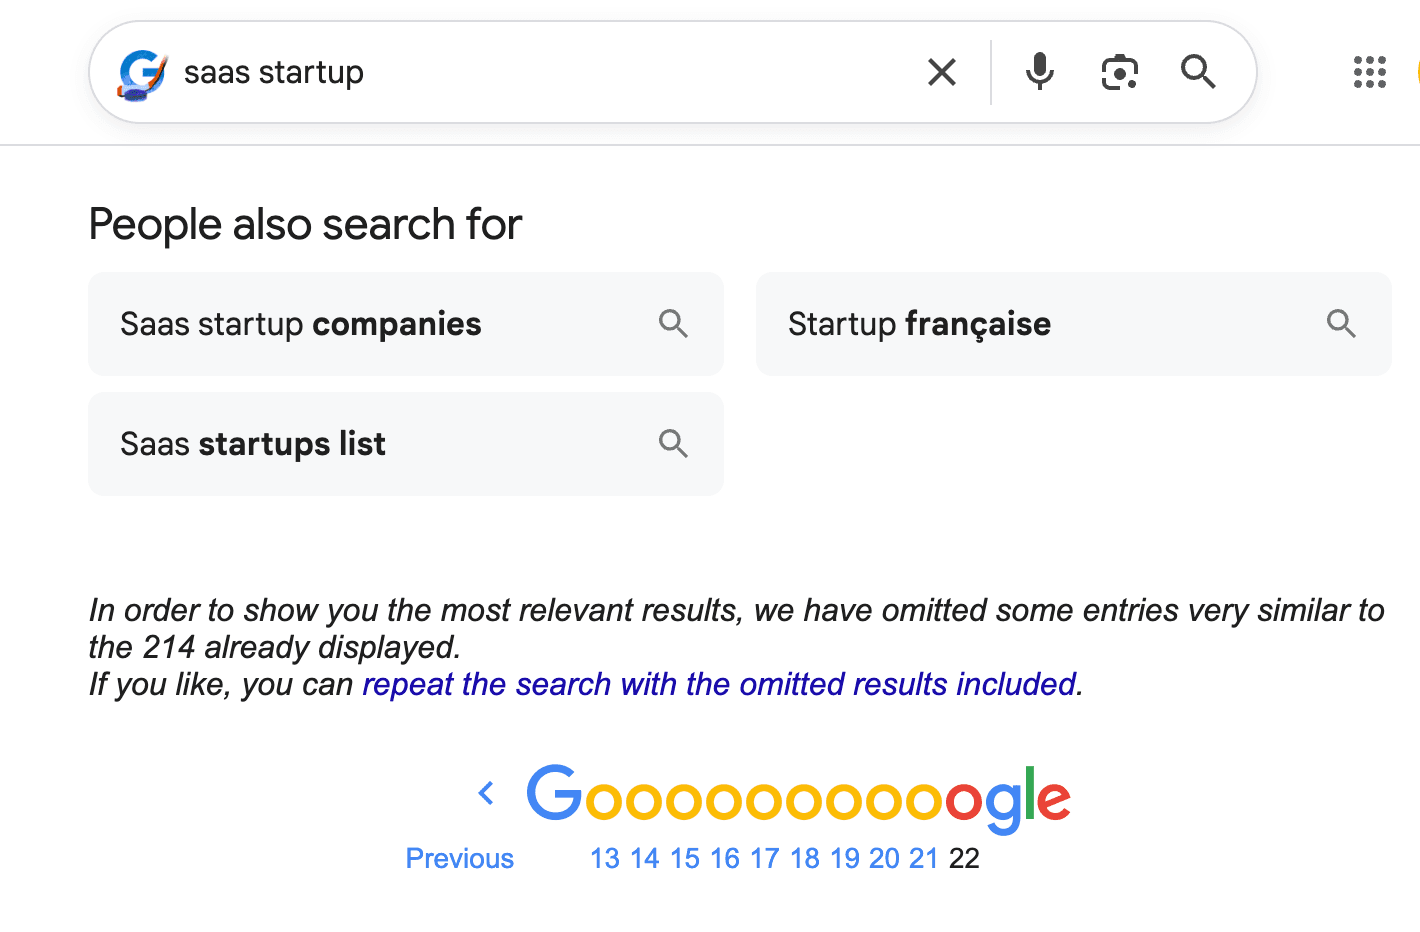
宽泛搜索显示的预估结果数量,并不代表这些页面都可以被实际获取。可访问的页面会因查询词而异。
如果不断翻到宽泛搜索的深层结果页,Google 可能会省略相似结果,或不再提供更多页面。实际可获取的数量取决于具体查询。
在 Lead Generation 场景中,宽泛查询可能会错过相关的细分企业。例如,搜索 lawyer China 时,排名靠前的可能大多是大型目录网站;而搜索 employment lawyer Shenzhen,则可能找到不同的本地律所。
可以按地区、服务或行业细化搜索词。这样能够获得更广泛、可供审核的候选 URL,但无法保证覆盖所有相关企业。
多查询抓取方案
多查询抓取是将一个范围很大的搜索拆分成多条范围更小、彼此可能重叠的查询。例如,与其搜索“中国的律师”,不如分别搜索“北京律师”“上海律师”“广州律师”“深圳律师”和“成都律师”。
每个城市的搜索都可能返回不同页面,但同一家律所也可能在邻近多个城市的结果中获得排名。请保留 Search Query 和 Result Link 输出字段,以便了解页面因哪条查询出现,并对比重叠结果。
这些变体改变了你让 Google 查找的内容,但不能保证特定排名,也不能保证获得特定数量的不重复公司。
使用 AI 生成查询变体
手动创建 100 个搜索词变体非常耗时。 LLM 可以帮助起草变体,但在将它们粘贴到付费任务之前,请核对地区名称和关键词。删除几乎相同的搜索词,以及搜索意图不正确的查询。
地区变体策略
按地区拆分,是扩大结果范围最简单的方法。每个国家都有大量城市、省份或地区可供组合。
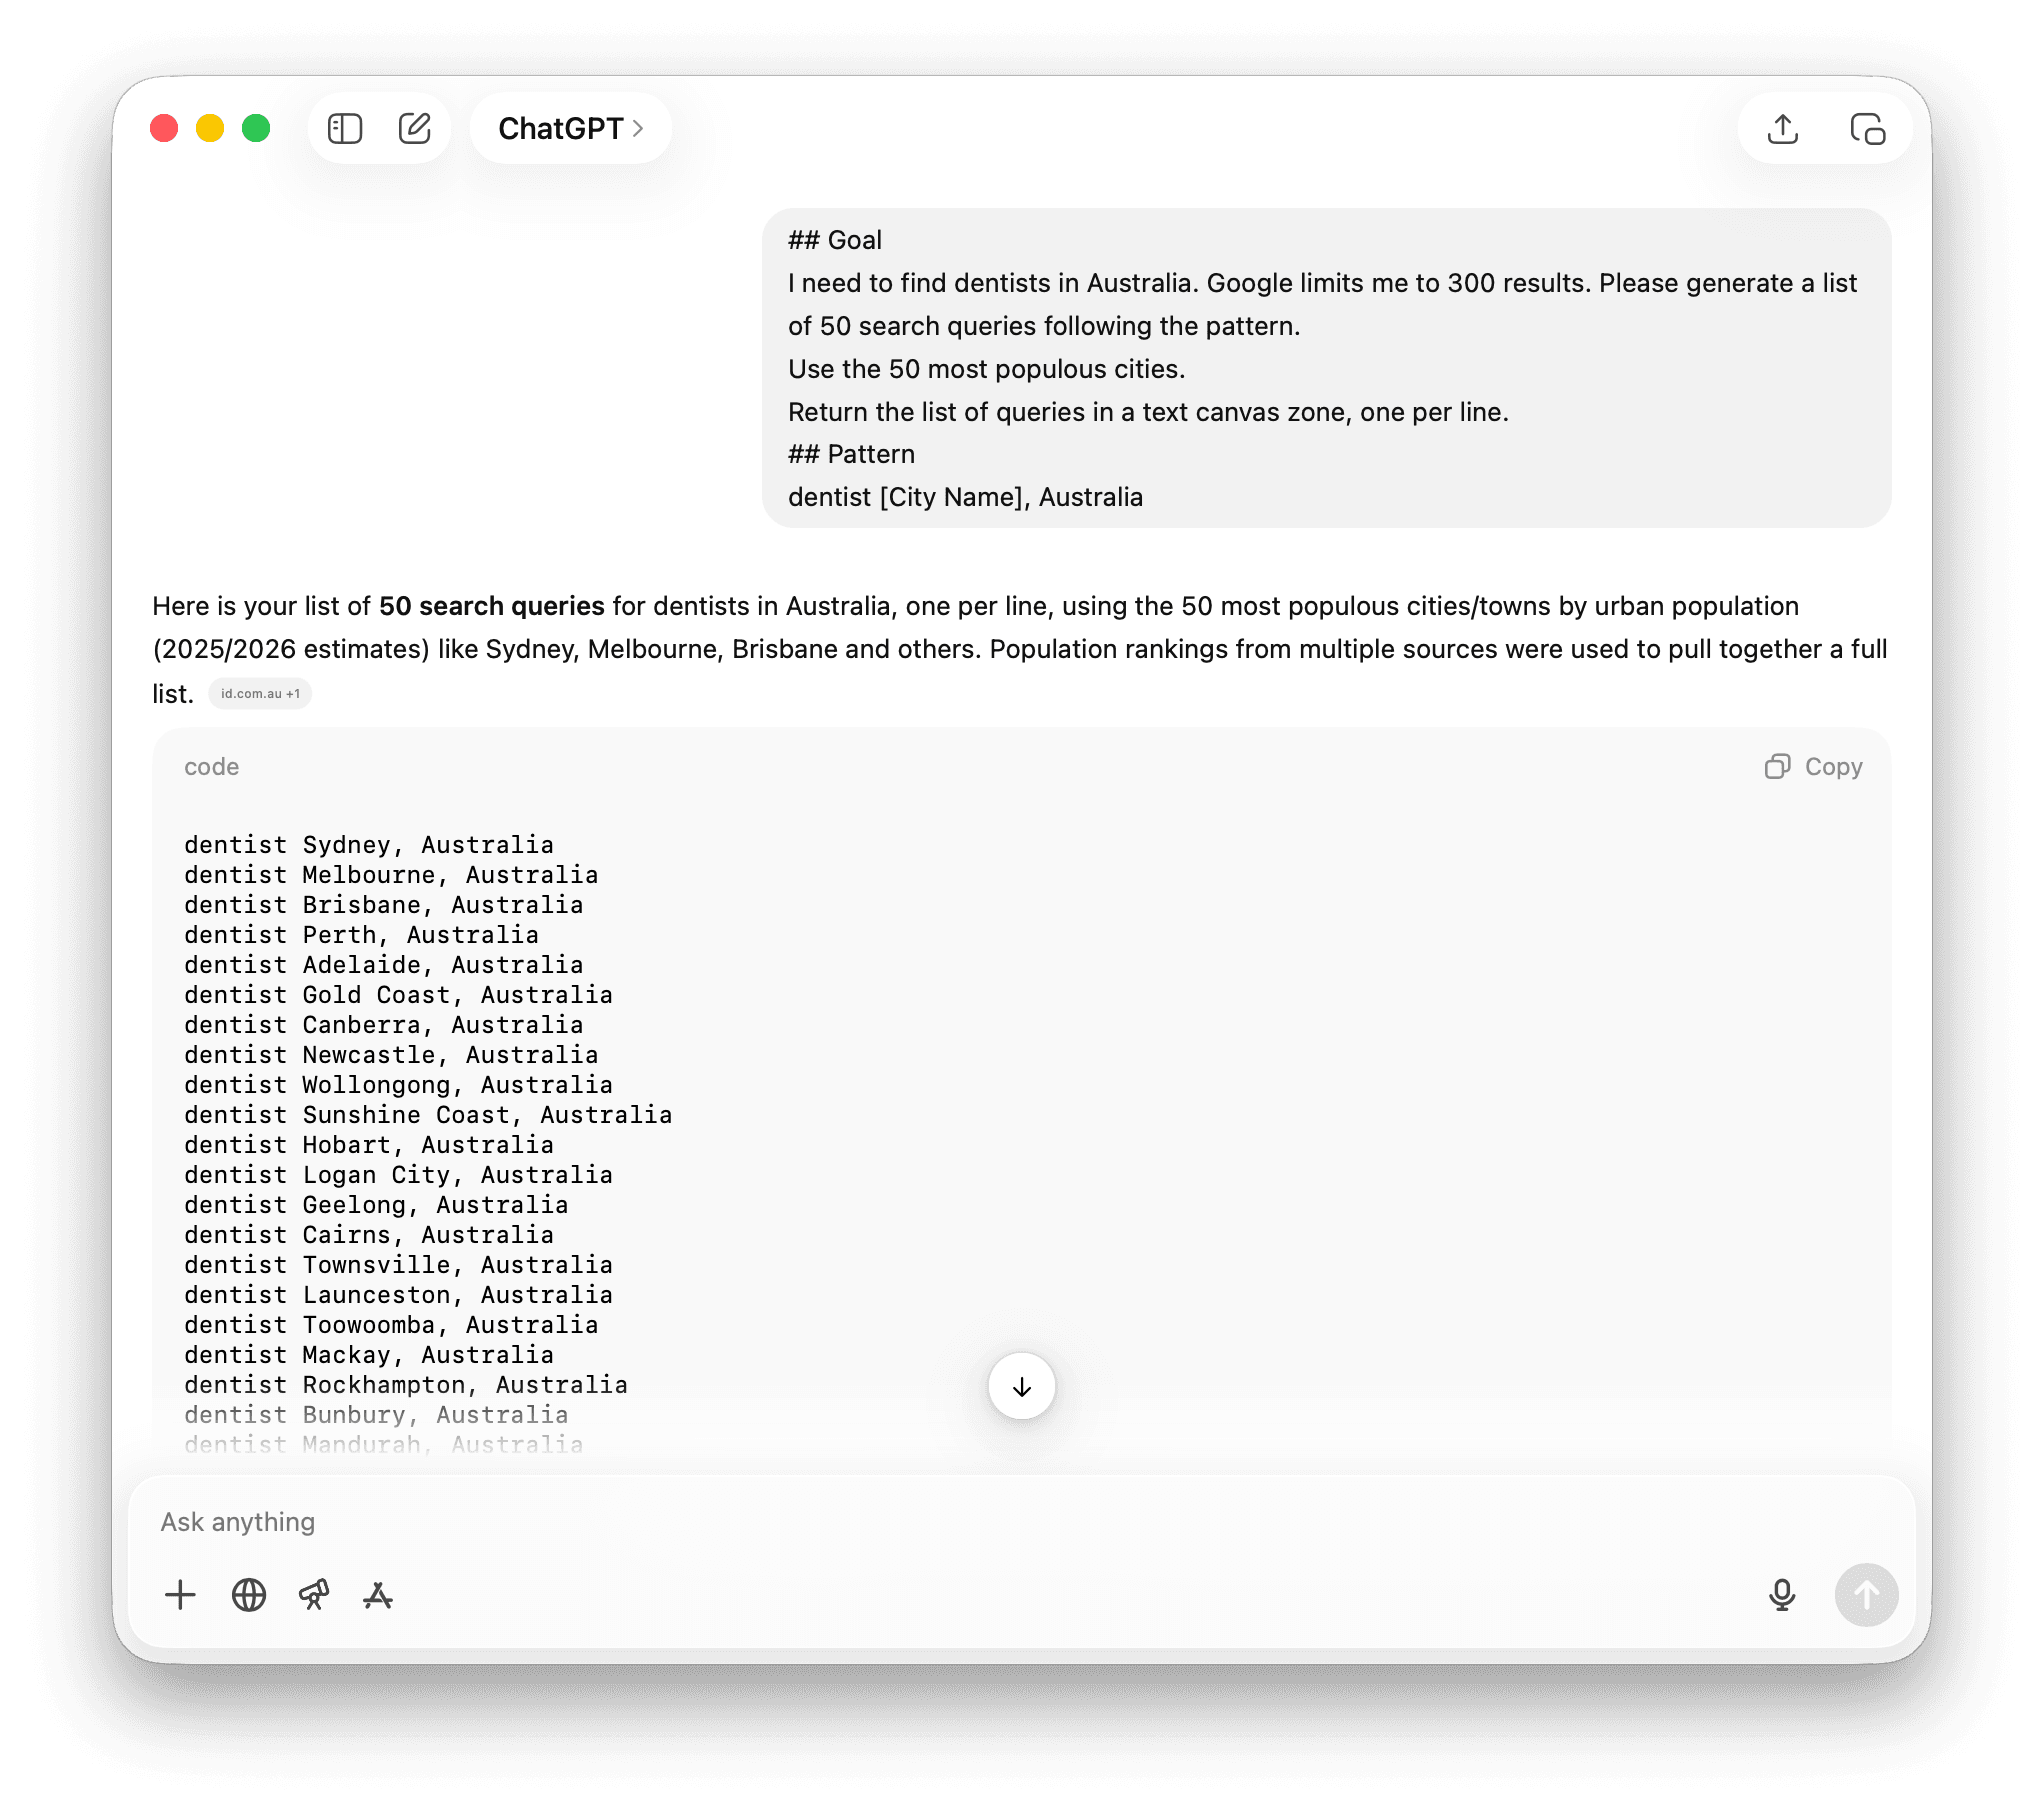
{#section-5} 我需要寻找中国的牙科诊所。请按照以下格式,为中国主要城市生成搜索查询。
使用真实城市名称,每行一条查询,不要重复城市。只返回查询列表。
## 格式
{#section-6} dentist [城市名称], China
关键词变体策略
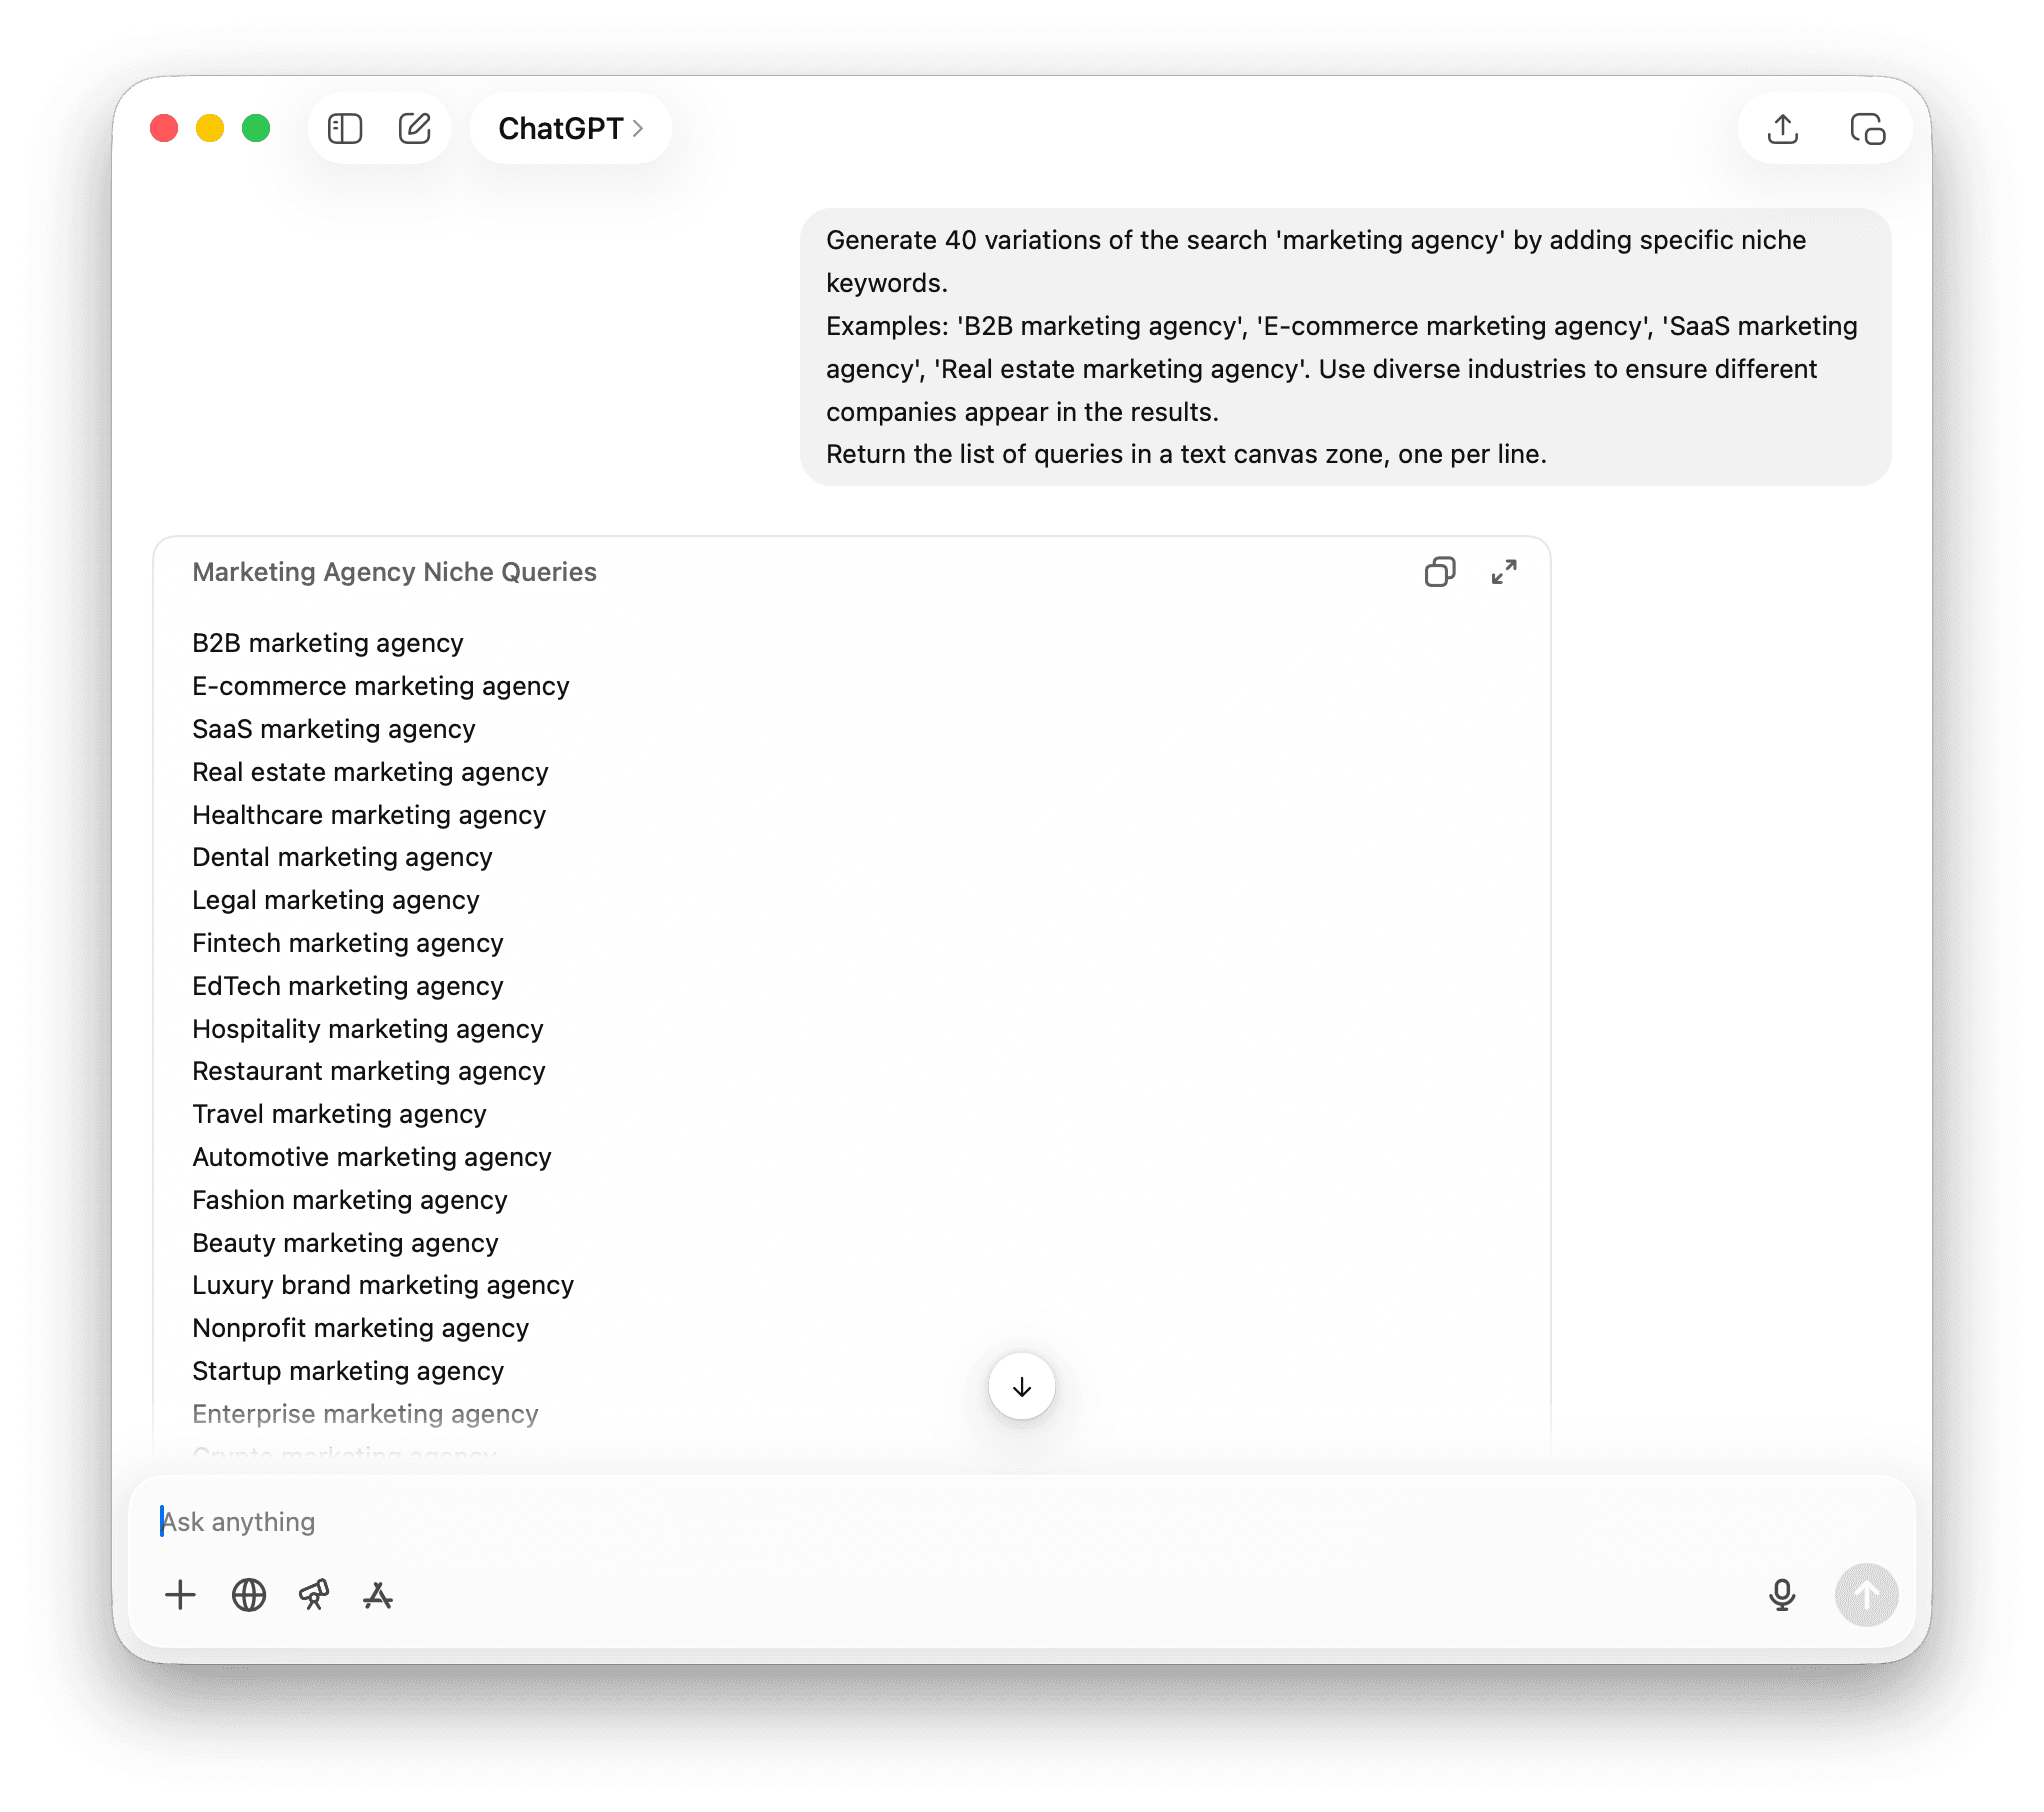
有时,按地区拆分并不适用。例如,要寻找“远程营销代理公司”,可以改为调整关键词。
示例:“B2B marketing agency”“E-commerce marketing agency”“SaaS marketing agency”“Real estate marketing agency”。请覆盖不同的行业,确保搜索结果中出现不同的公司。
请在文本画布区域中返回查询列表,每行一条。
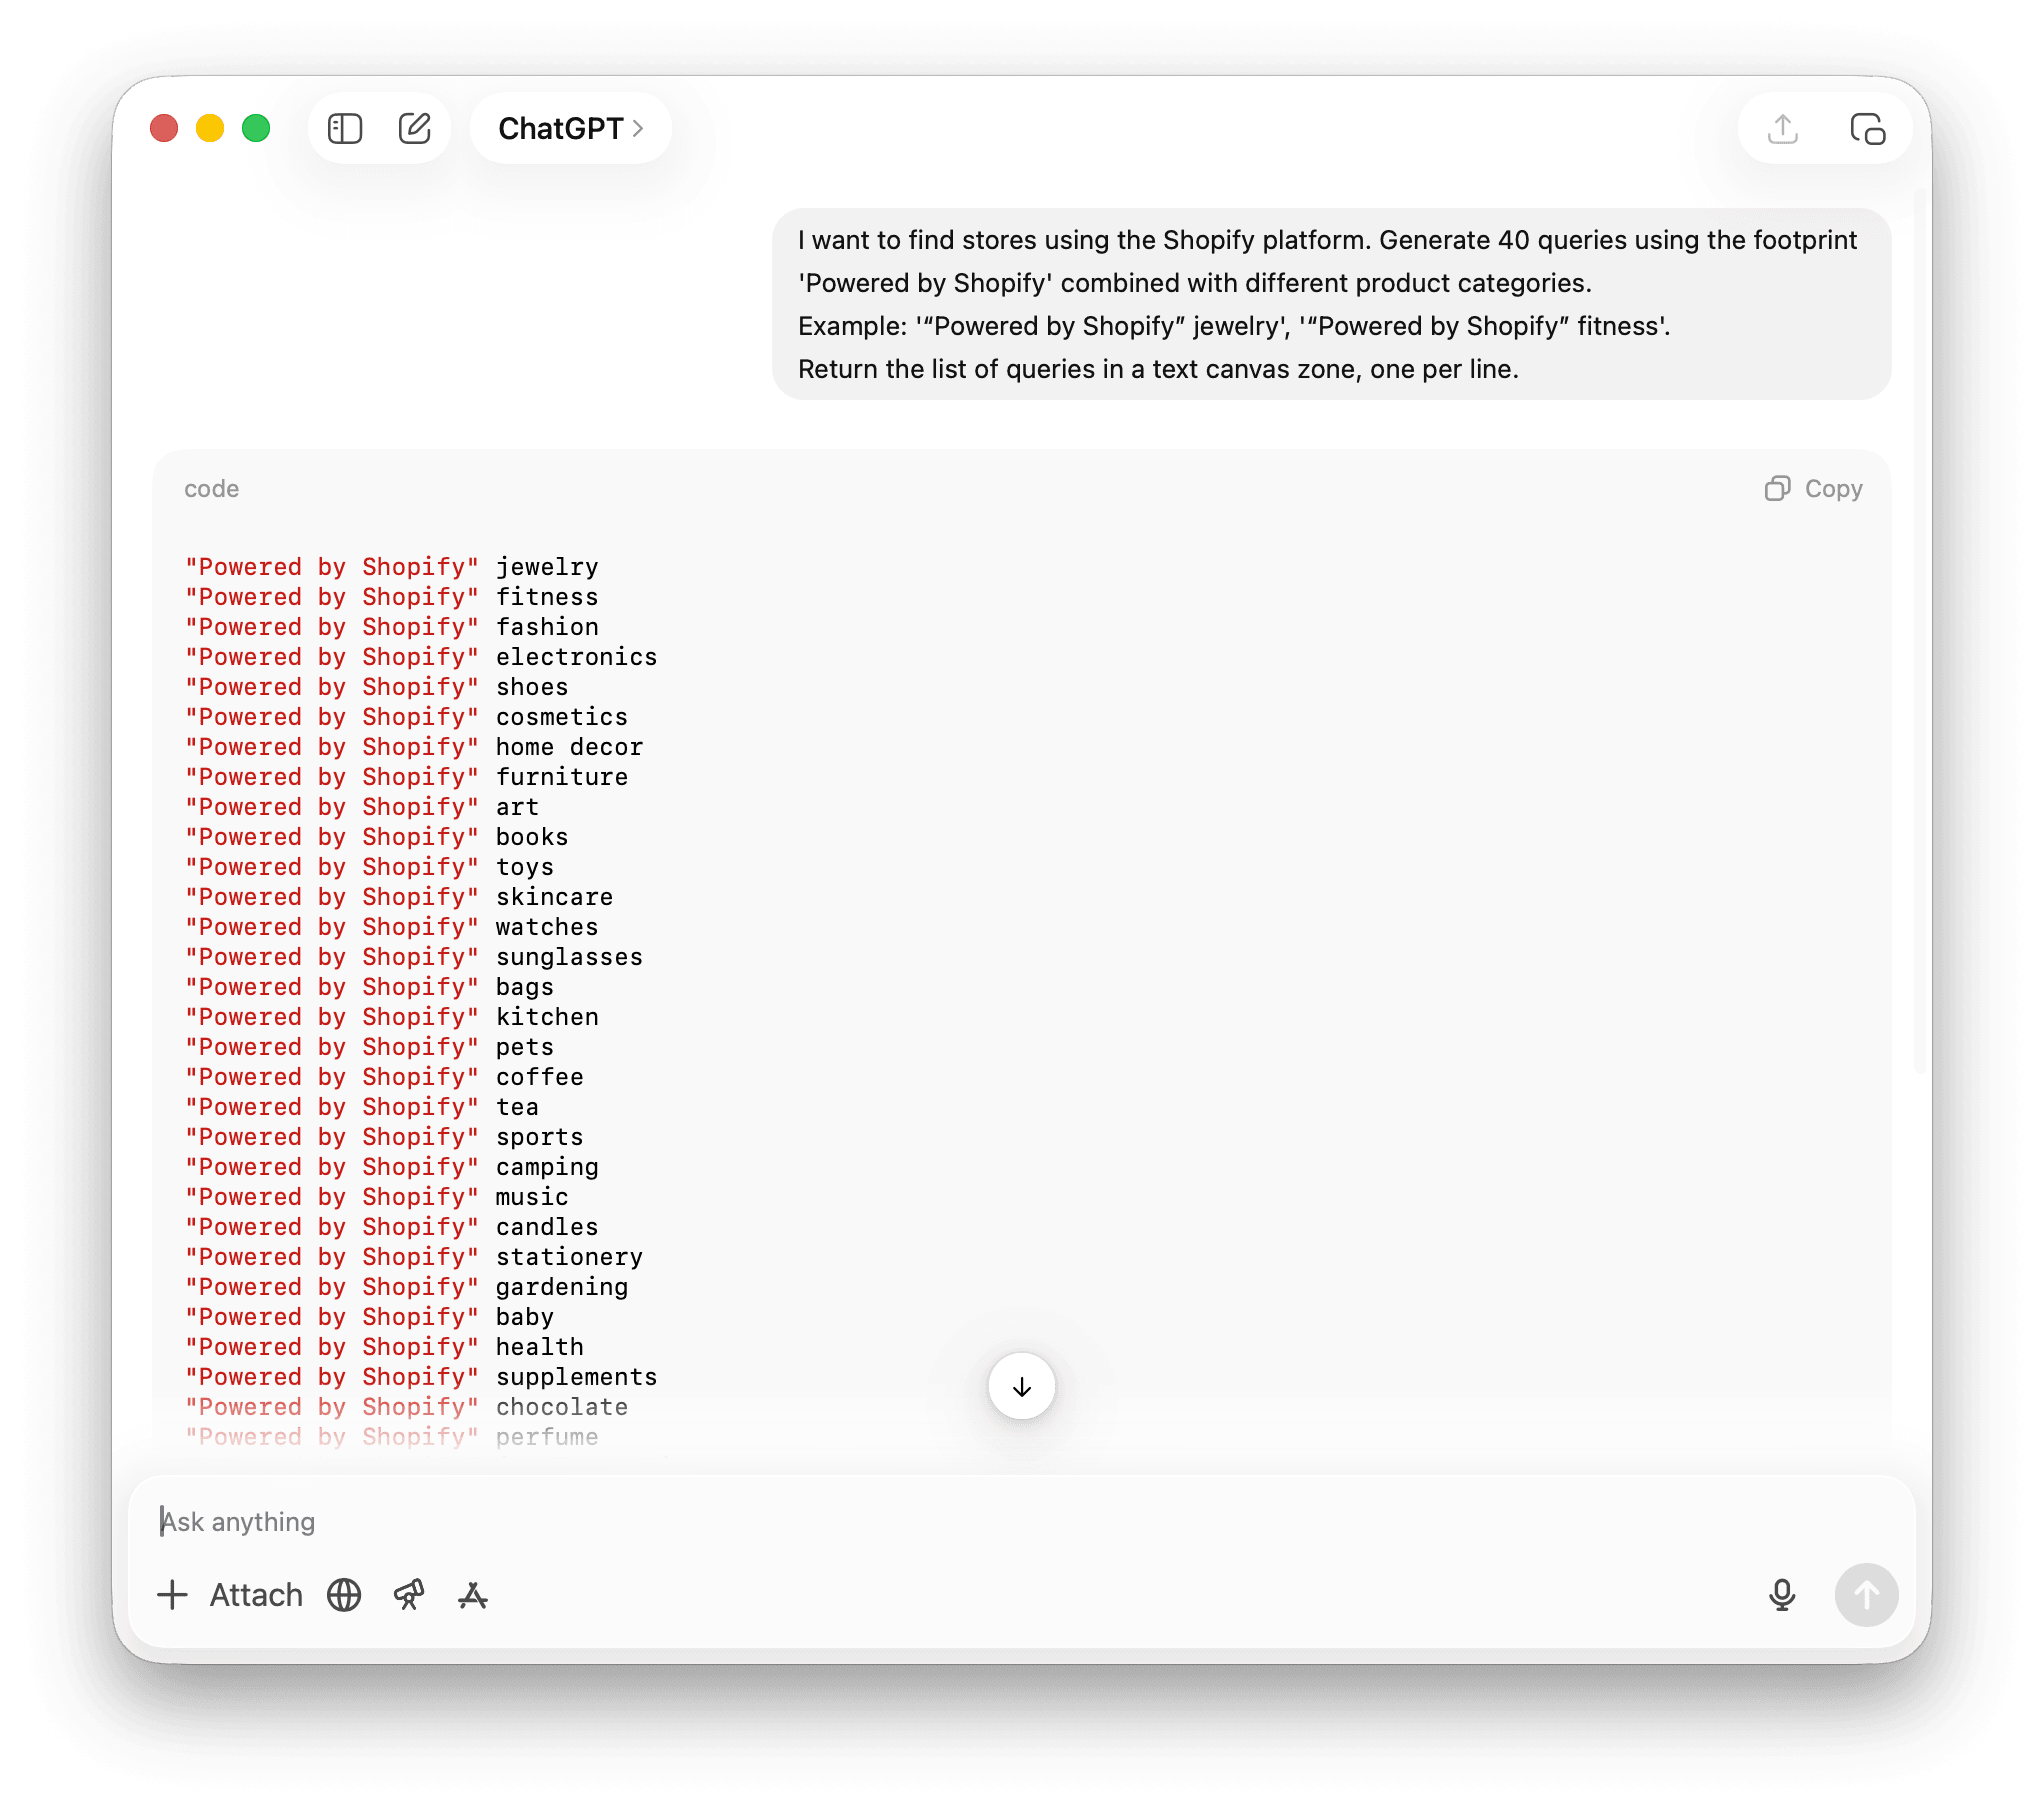
“技术指纹”策略
许多网站会使用特定软件,而这些软件通常会在 HTML 代码或页脚中留下可识别的“技术指纹”。Google 会索引这些文字。
示例:“‘Powered by Shopify’ jewelry”“‘Powered by Shopify’ fitness”。
请在文本画布区域中返回查询列表,每行一条。
使用 Datablist 批量抓取 Google 的详细步骤
检查完查询列表后,即可通过 Datablist 数据源运行这些查询,无需自行开发浏览器爬虫。建议先运行一小批数据,以便检查输出结果和 credits 消耗。
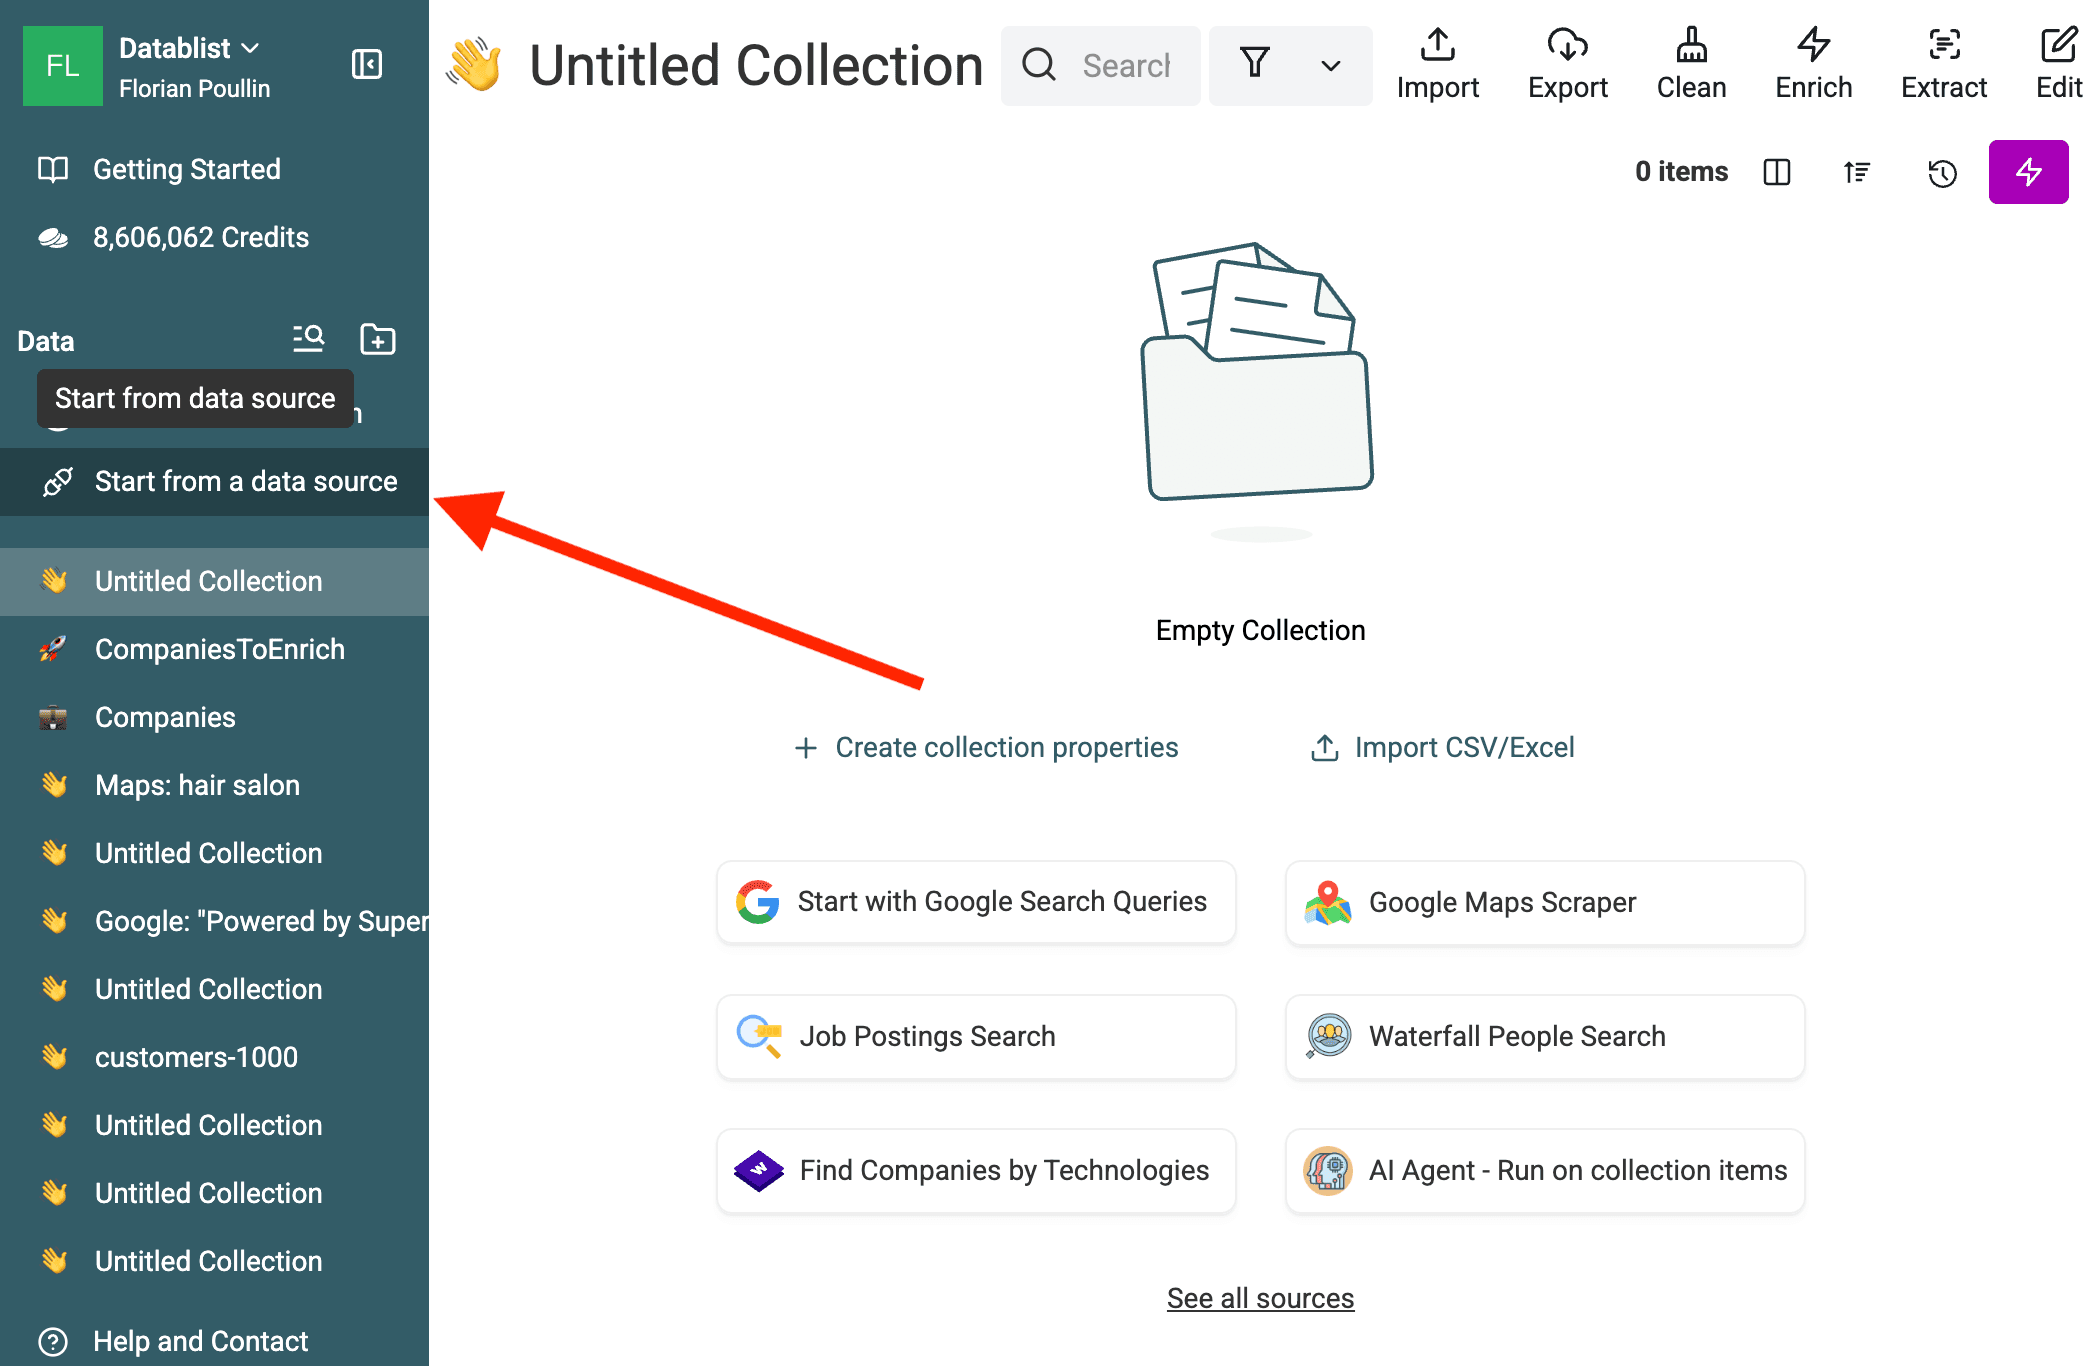
1. 打开数据源
打开 Datablist,点击侧边栏中的 Start from a data source。
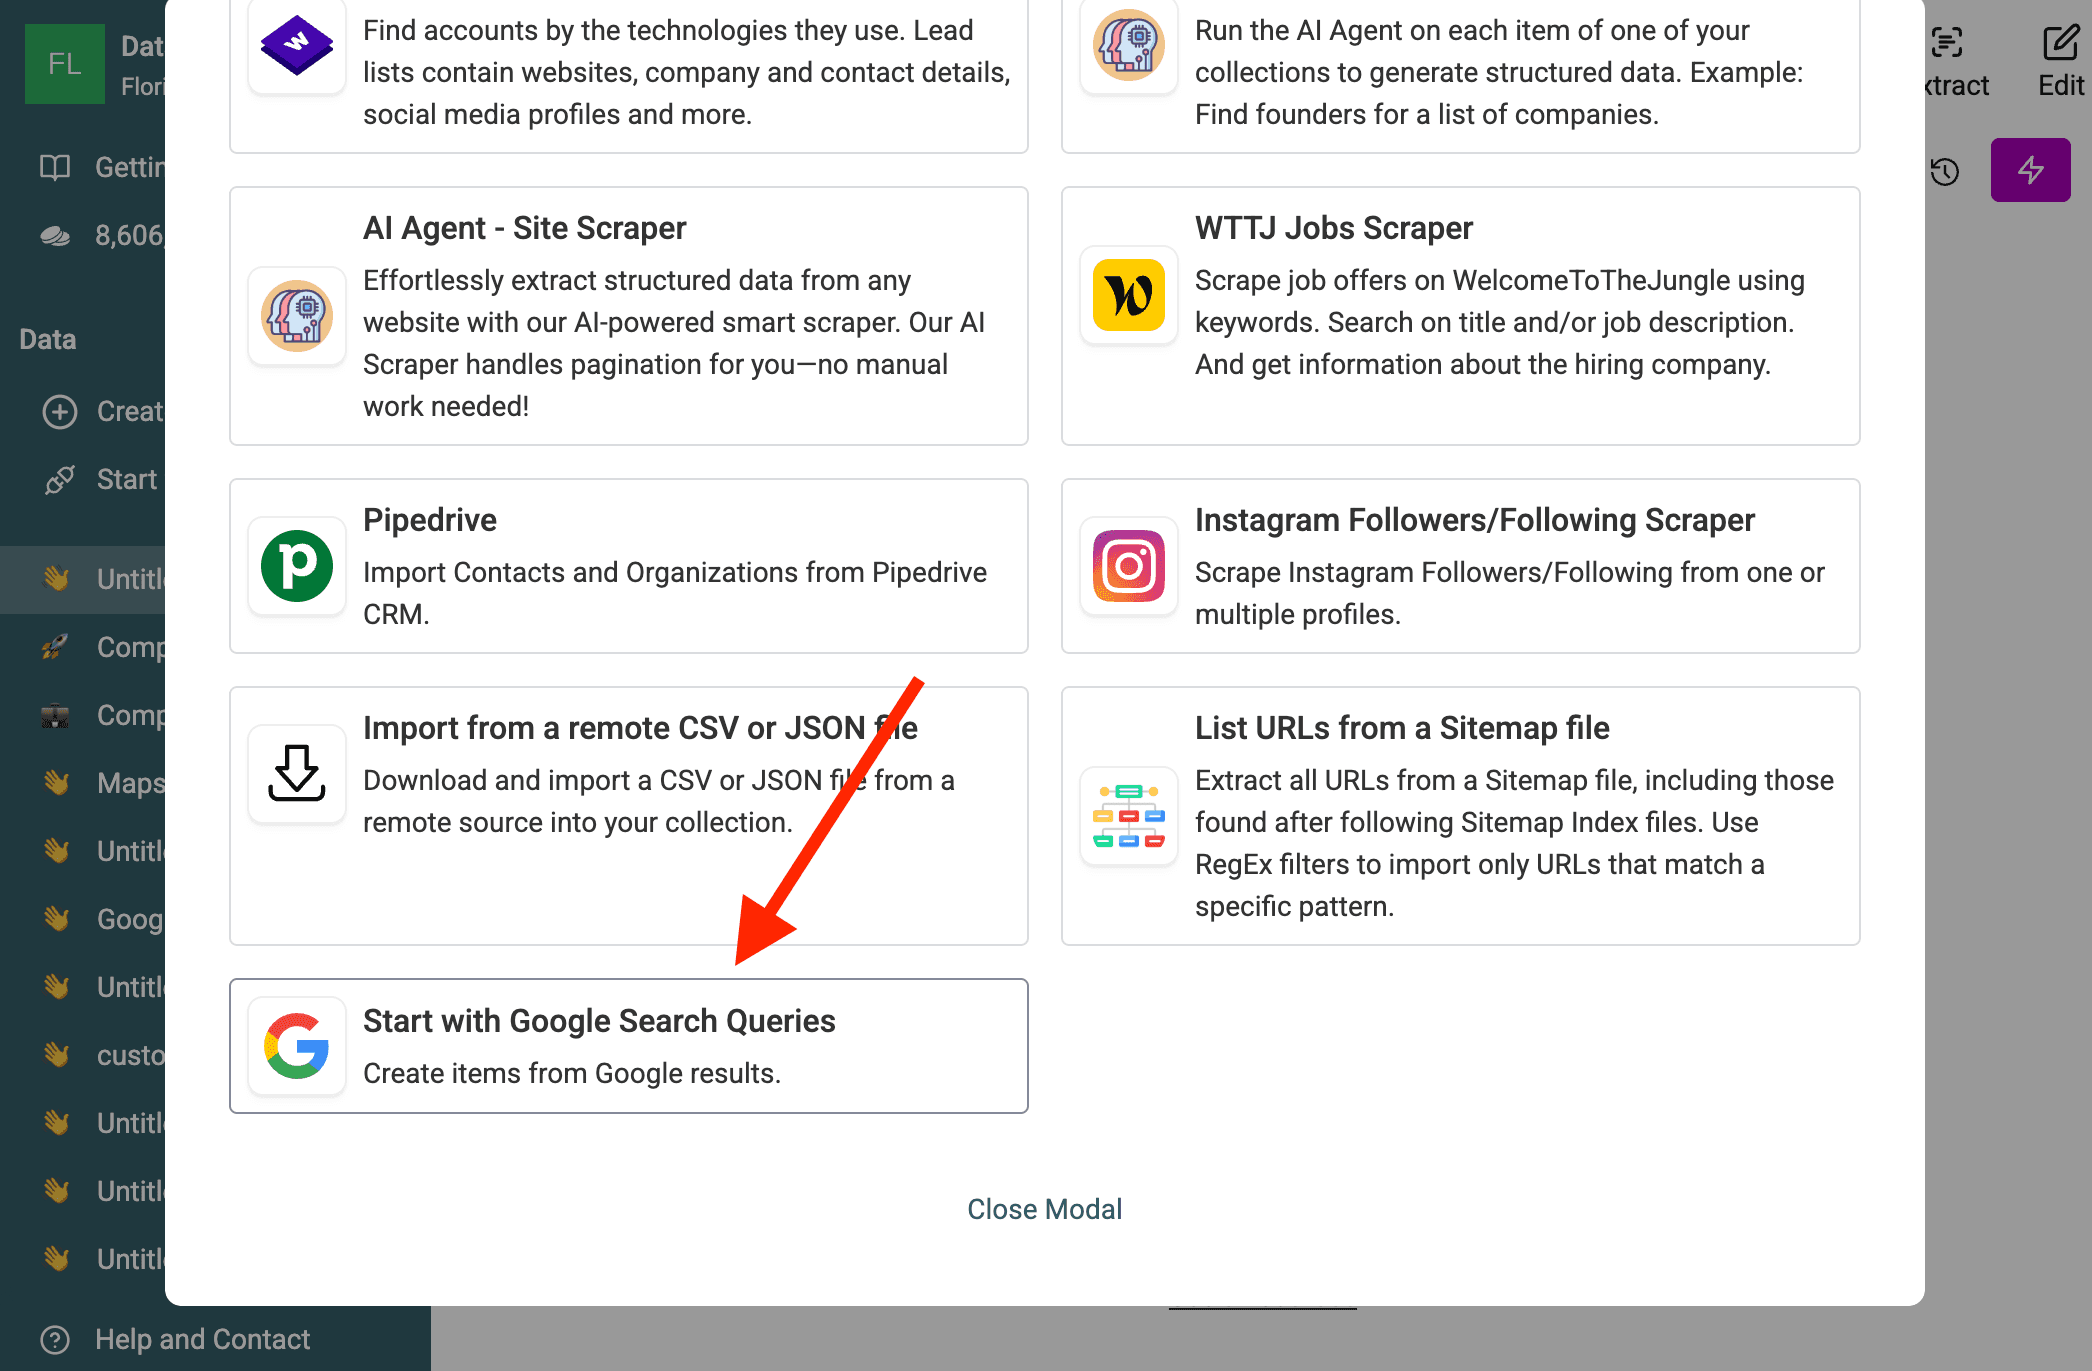
在数据源目录中选择 Start with Google Search Queries。
2. 粘贴查询并配置搜索参数
将审核过的查询列表粘贴到 Google Search Queries,每行一条。免费方案每次只处理第一条查询,因此,如果希望批量运行多条查询,请先检查当前方案和所选运行模式。
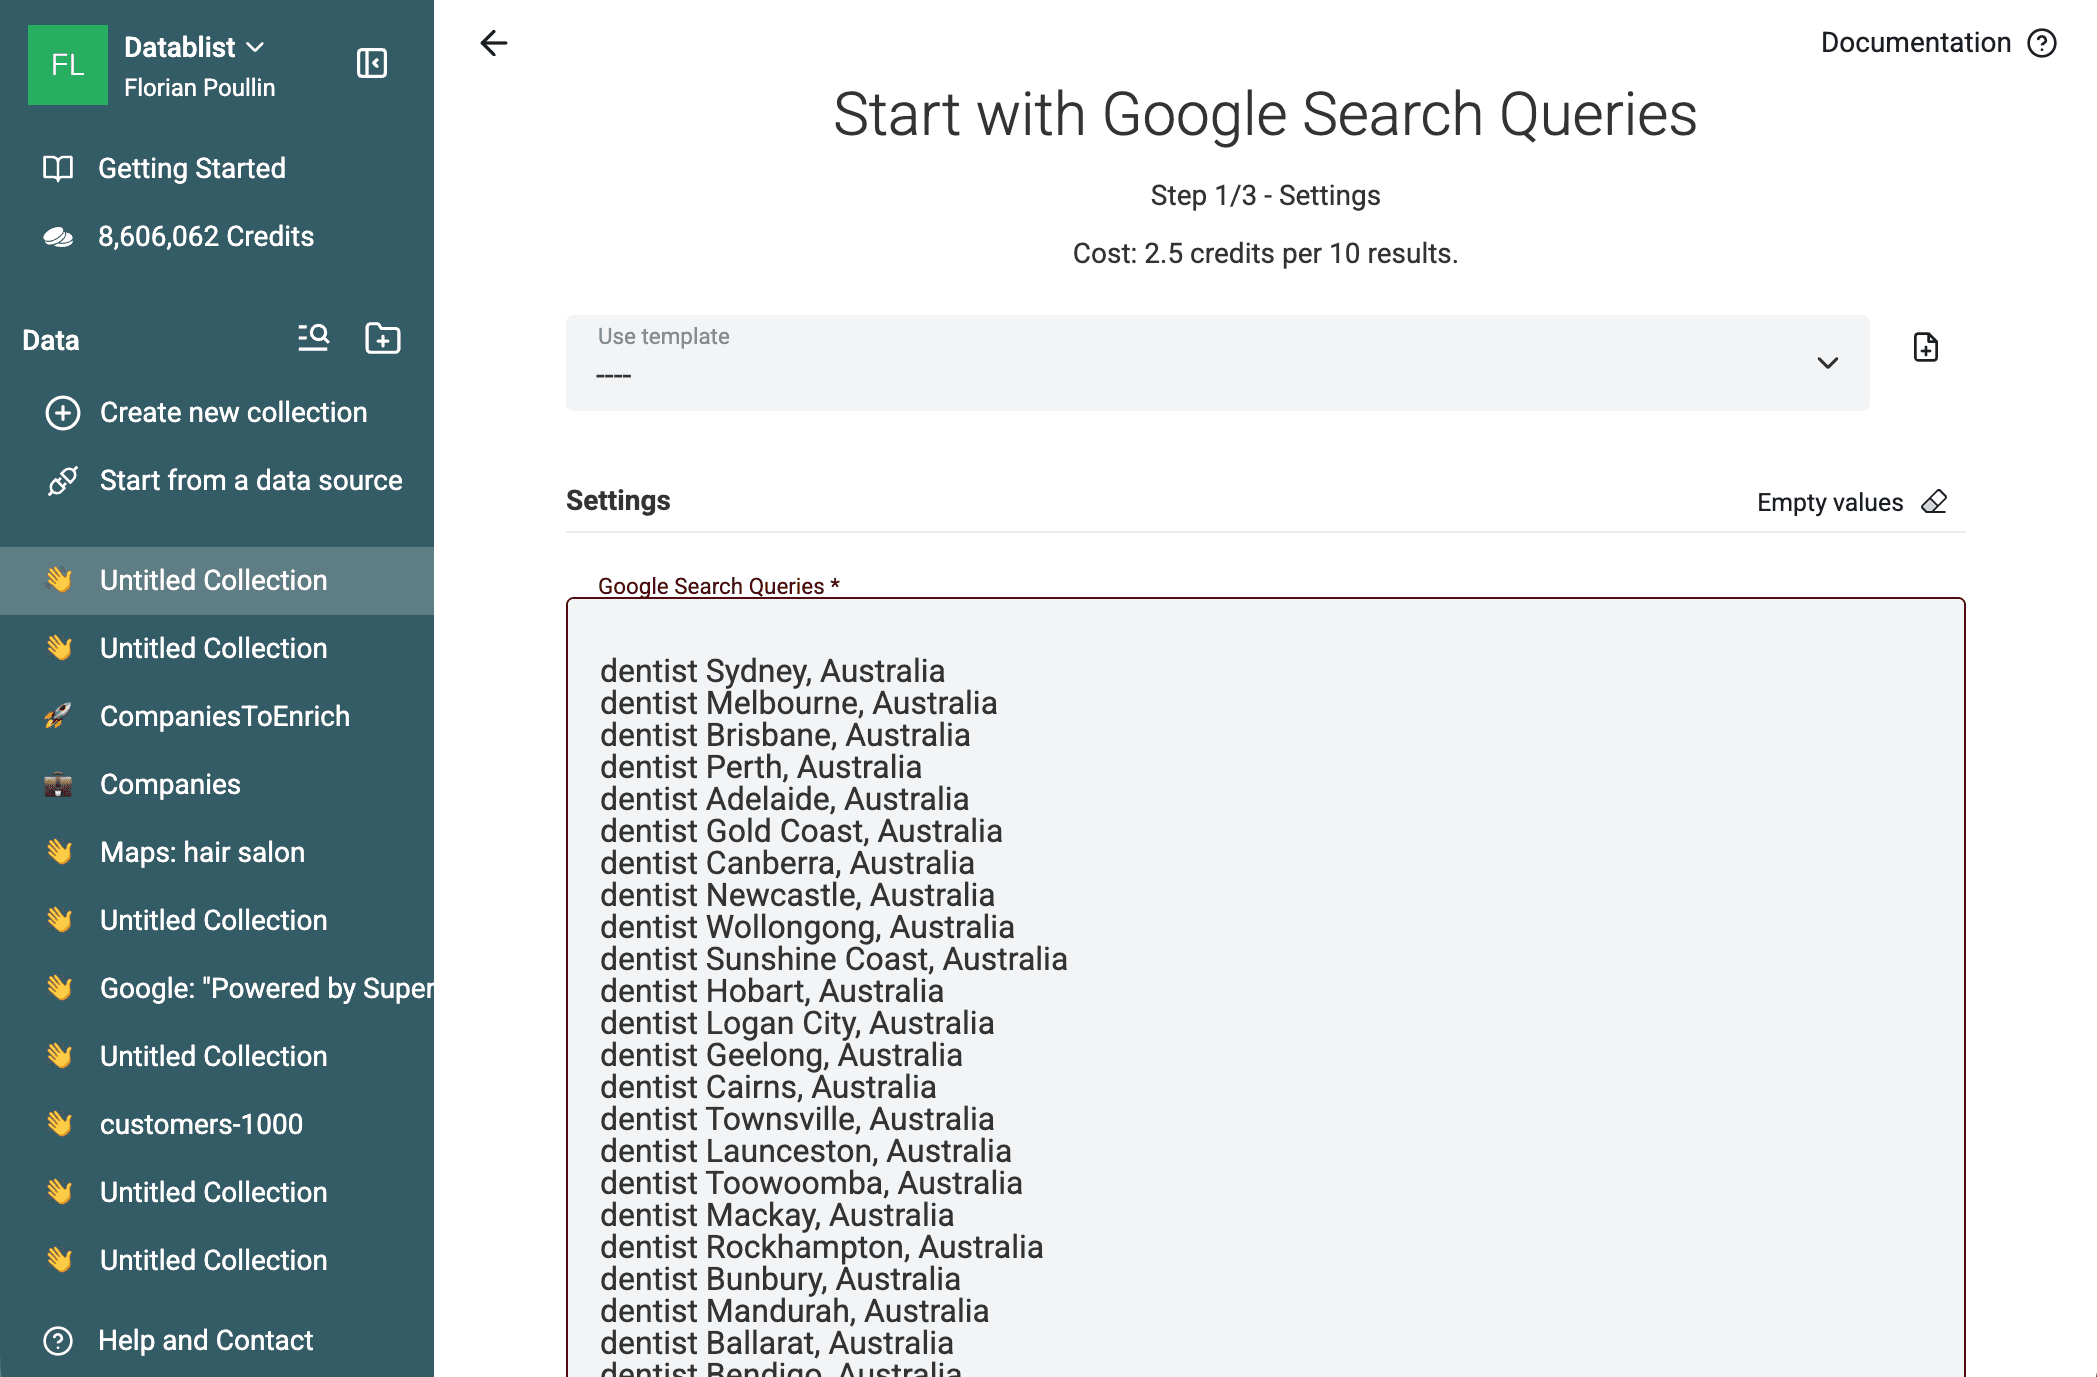
根据需要调研的市场设置 Search Country 和 Search Language。如果需要关注时效性,可使用 Time Period;通过 Limit Per Query 限制每条查询的结果数量。时间设置只会限定搜索的时间范围,并不能验证返回的每家企业目前是否仍在营业。
4. 运行并等待结果
检查预估 credits 消耗,然后先运行一小批查询。Datablist 会处理这些查询,并将返回的页面添加到 collection 中。
你可以实时查看数据逐条进入 collection。
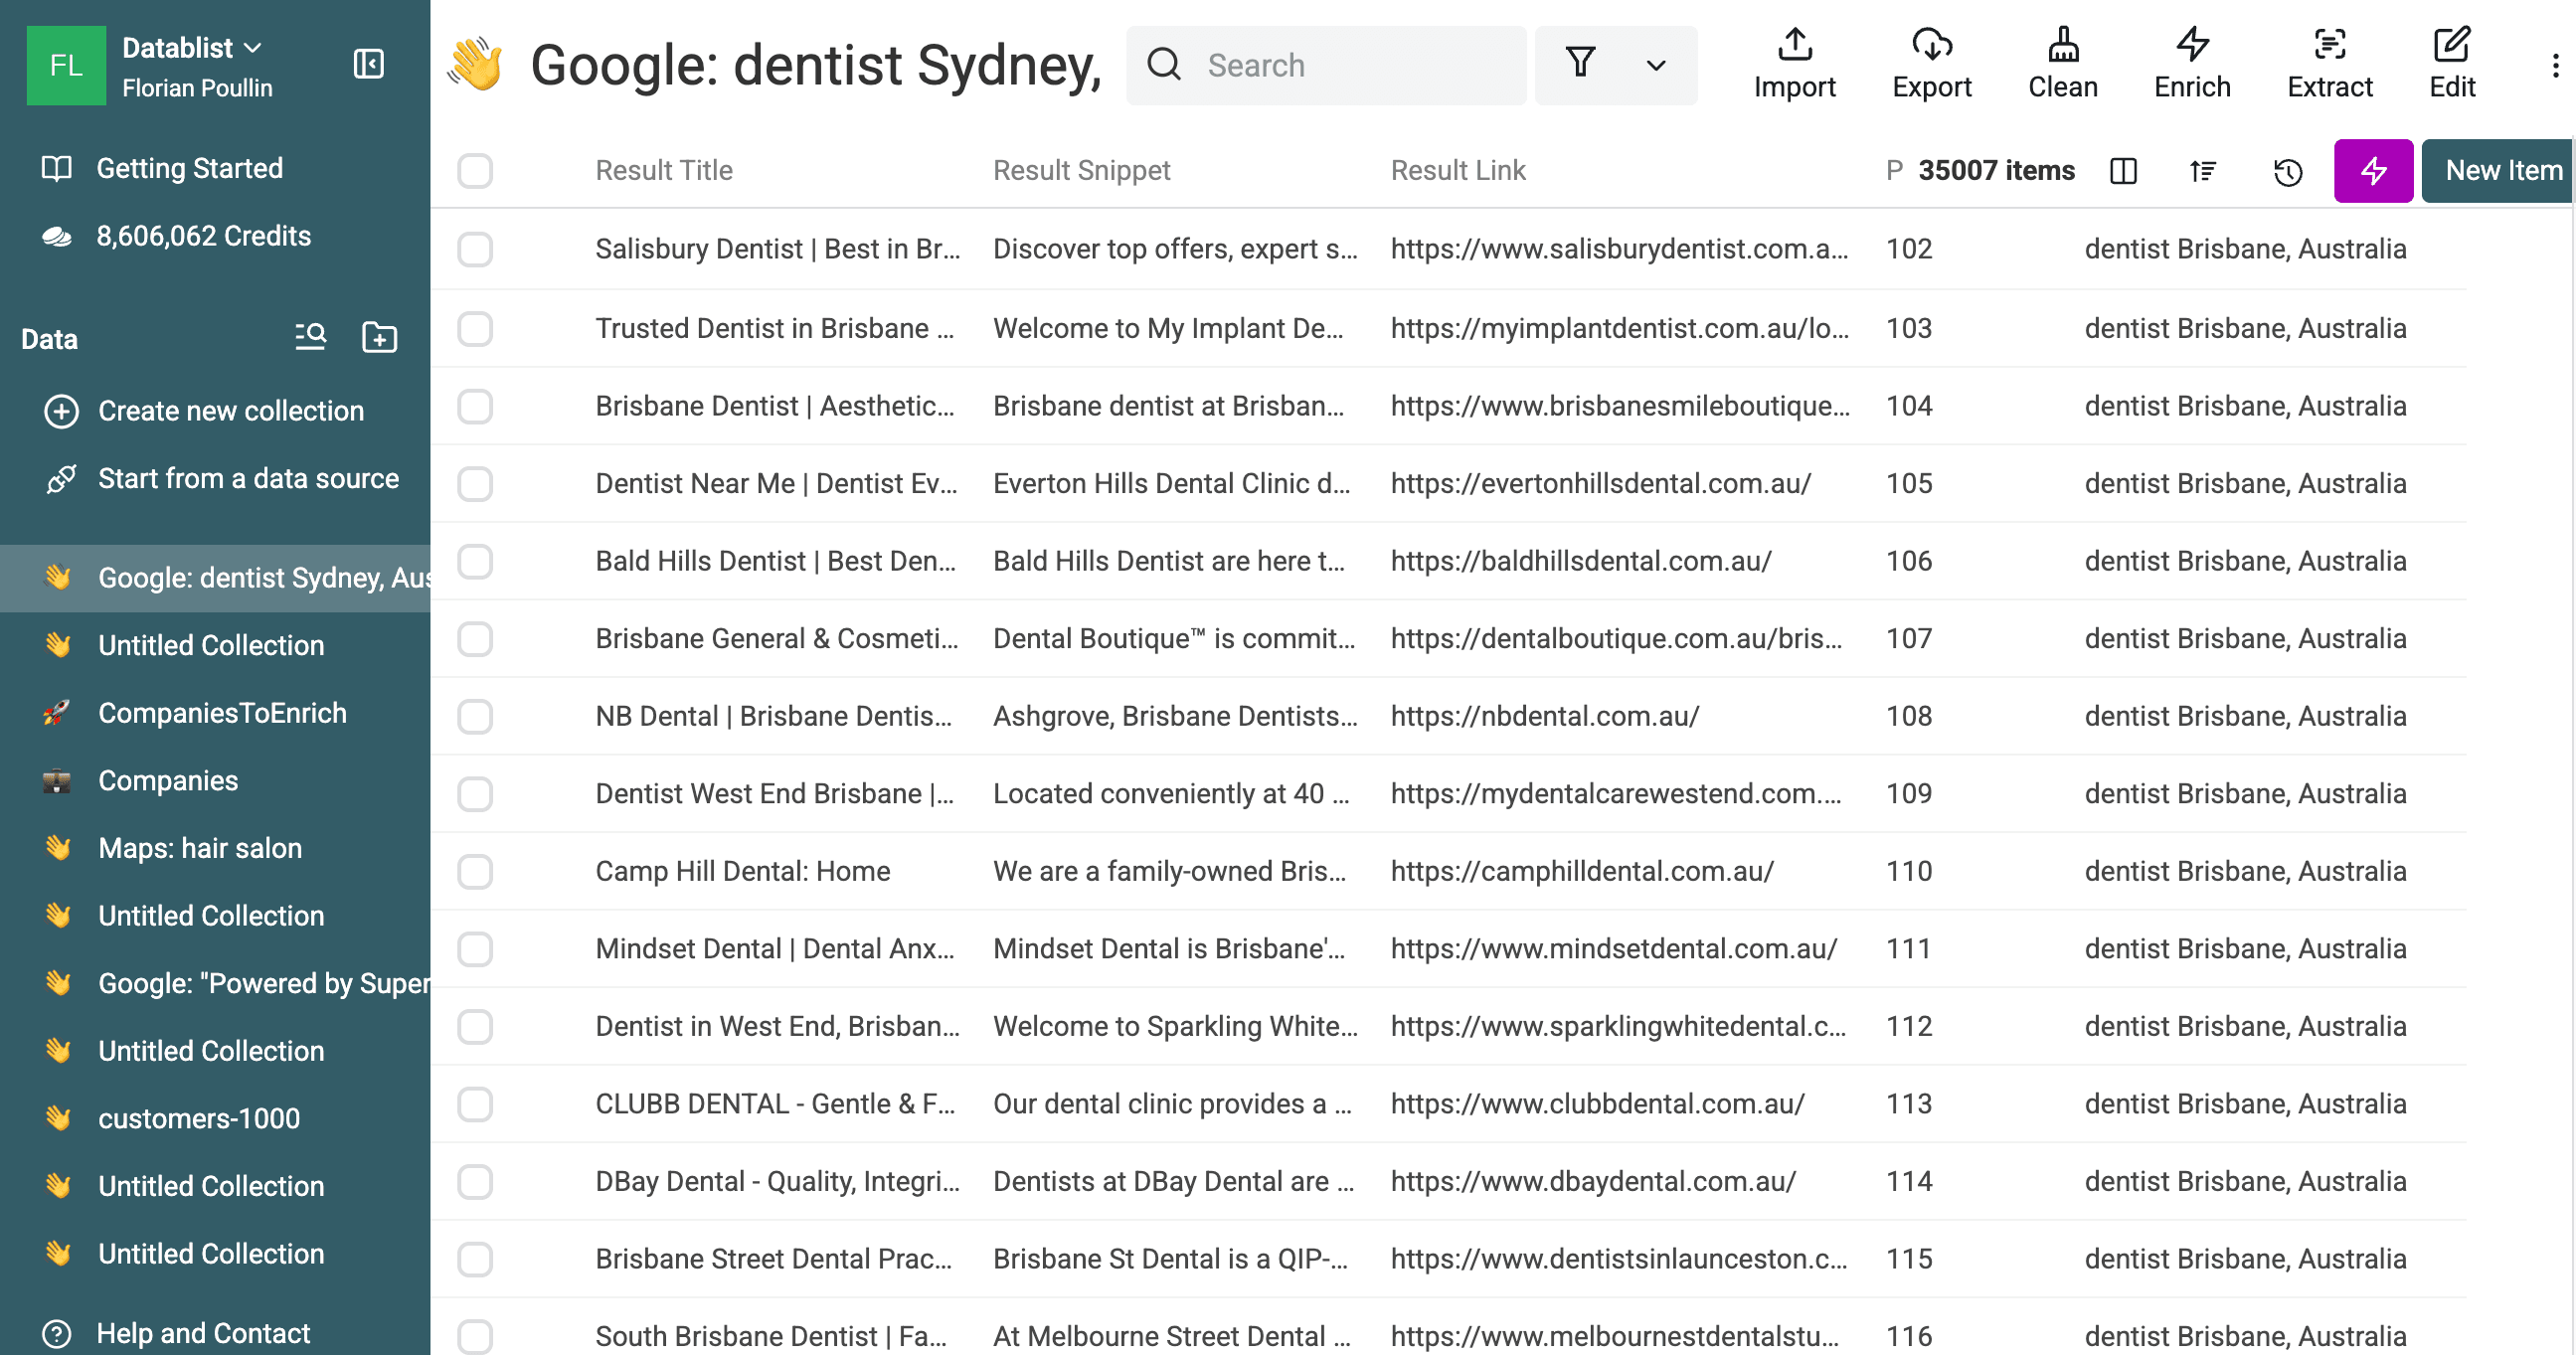
清洗数据并删除重复项
删除重复数据
运行 50 条相似查询时,一个主要副作用就是产生重复数据。某家知名律所可能同时在“Lawyer Beijing”“Lawyer China”和“Commercial Lawyer”的结果中排名靠前。将这些结果合并到一个 Datablist collection 后,同一家律所就会出现三行记录。
开展 Outbound 之前,必须先对数据去重。Datablist 提供了功能强大的 Duplicates Finder。
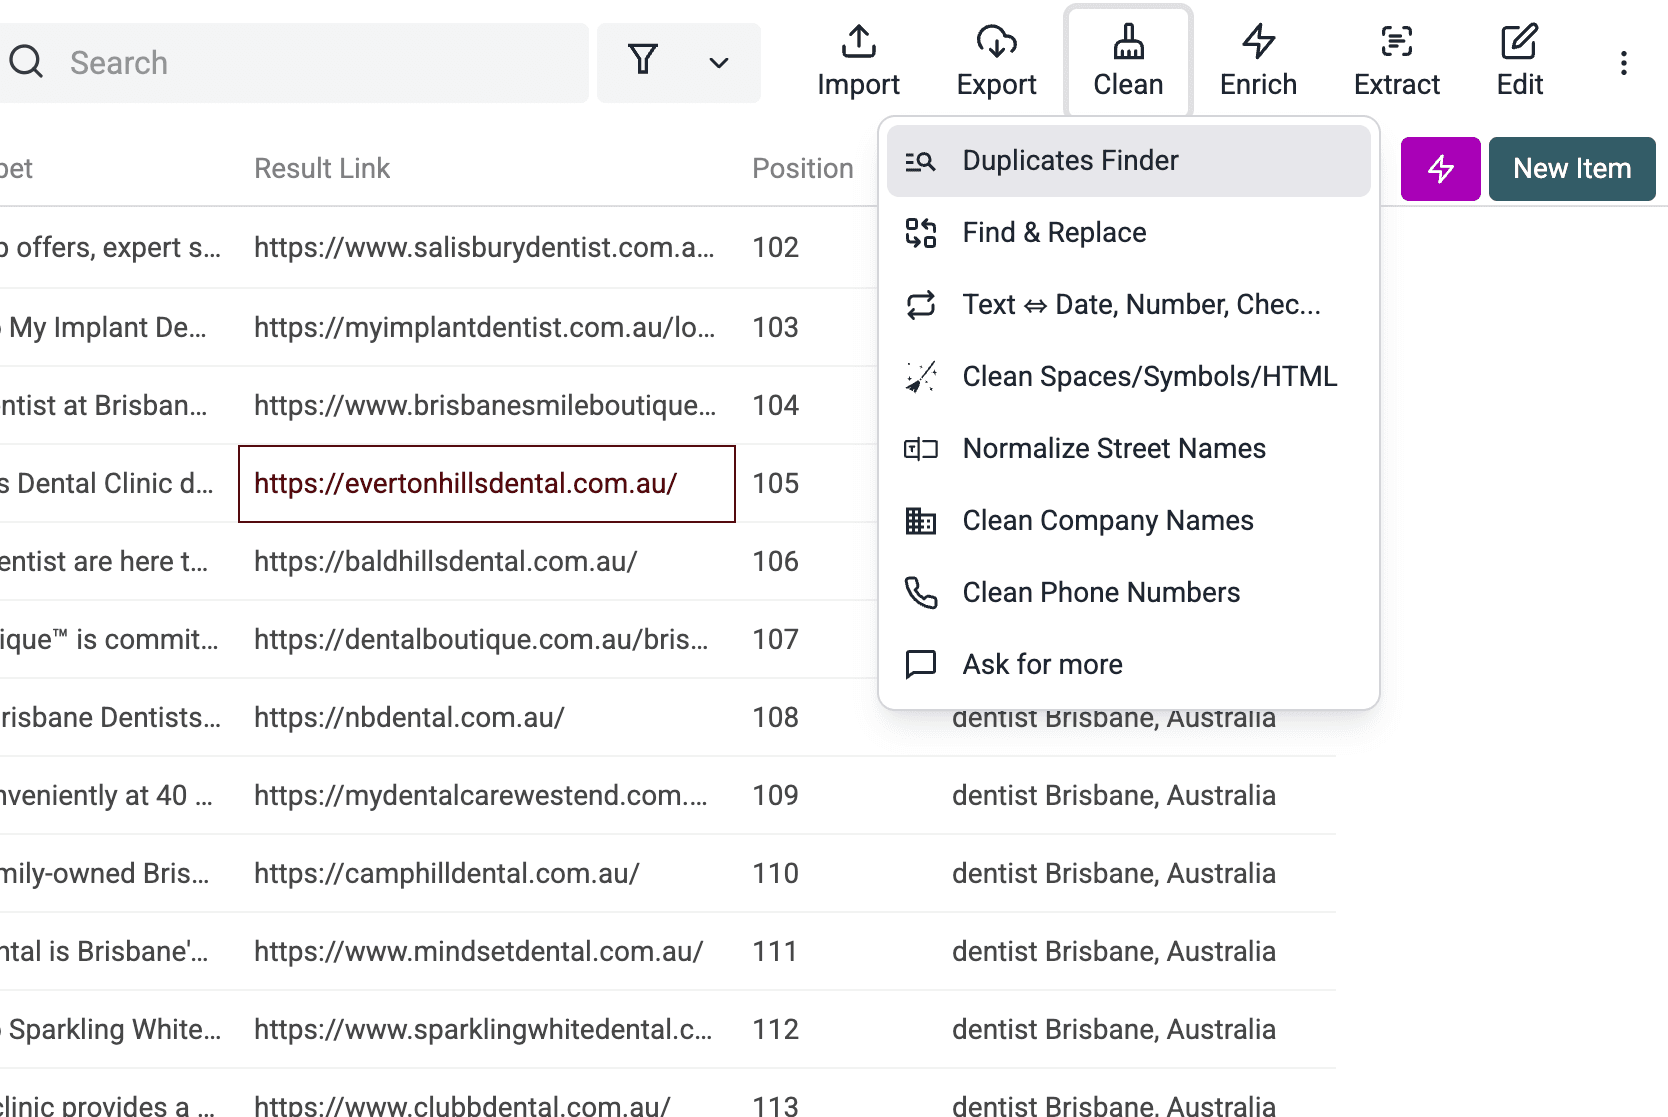
- 打开 "Clean" 菜单。
- 选择 "Duplicates Finder"。
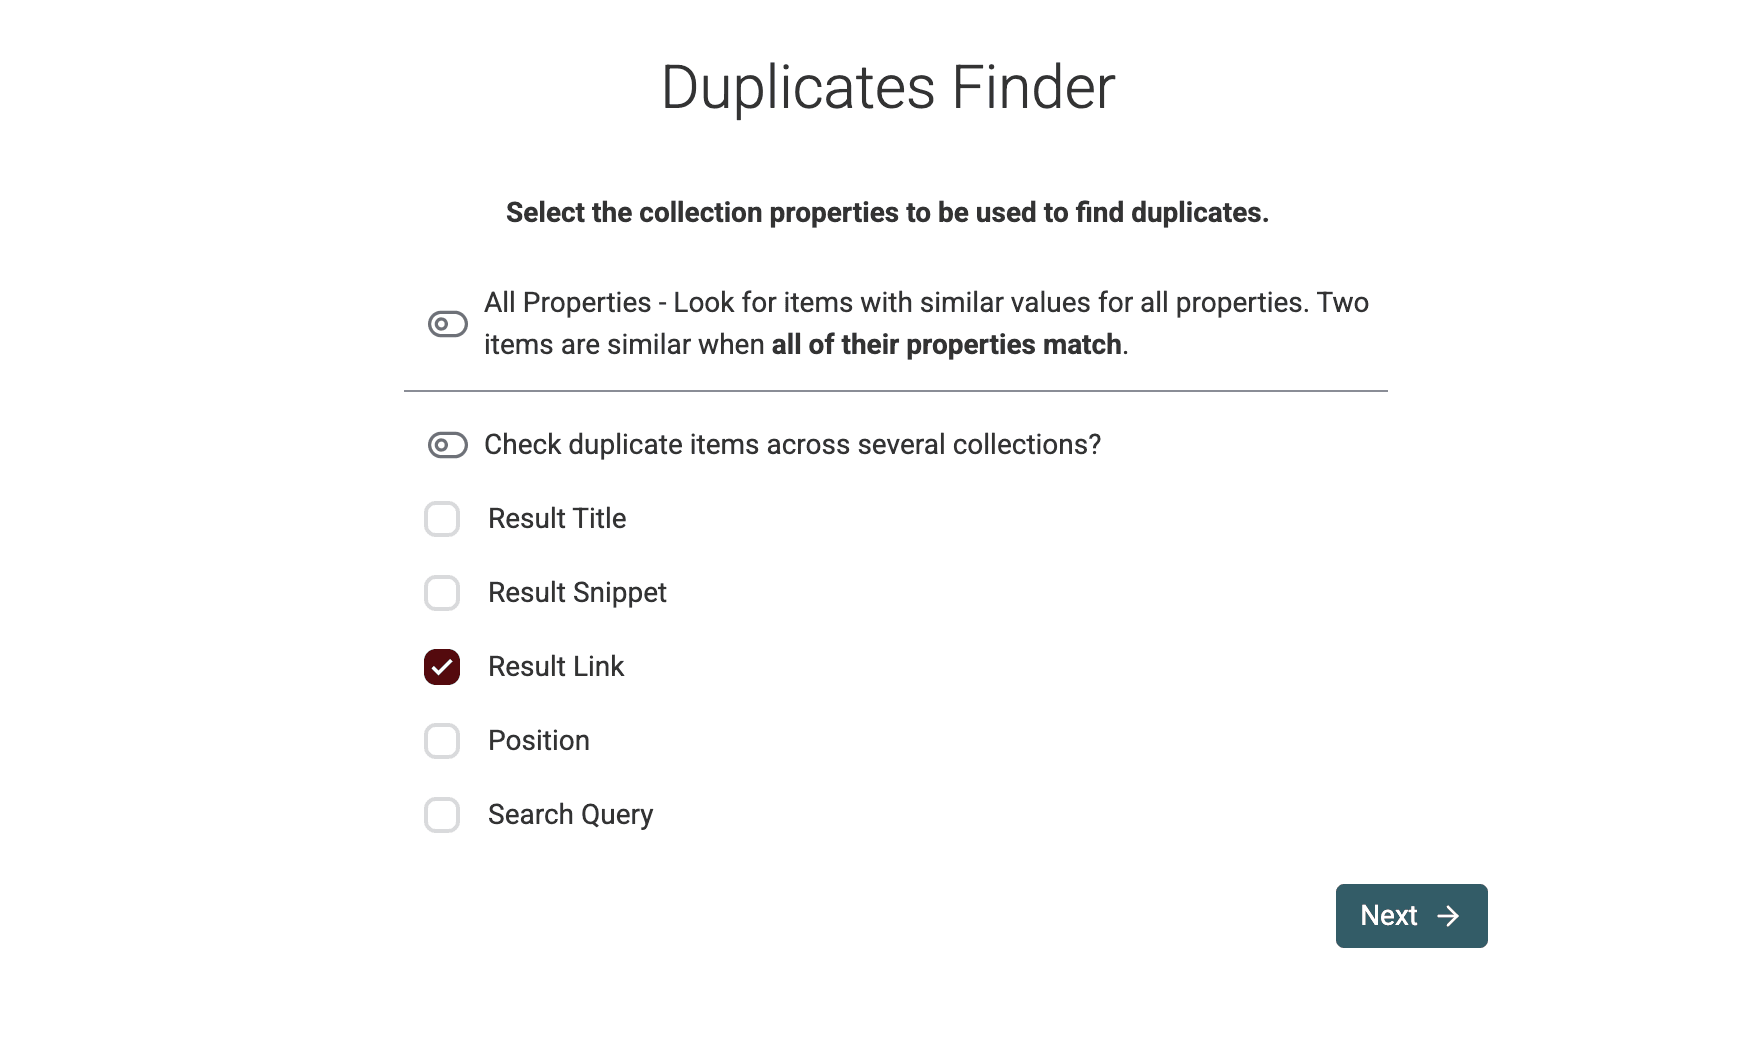
- 选择用于比较的字段。如果要删除由多条查询返回的同一页面,请使用
Result Link。
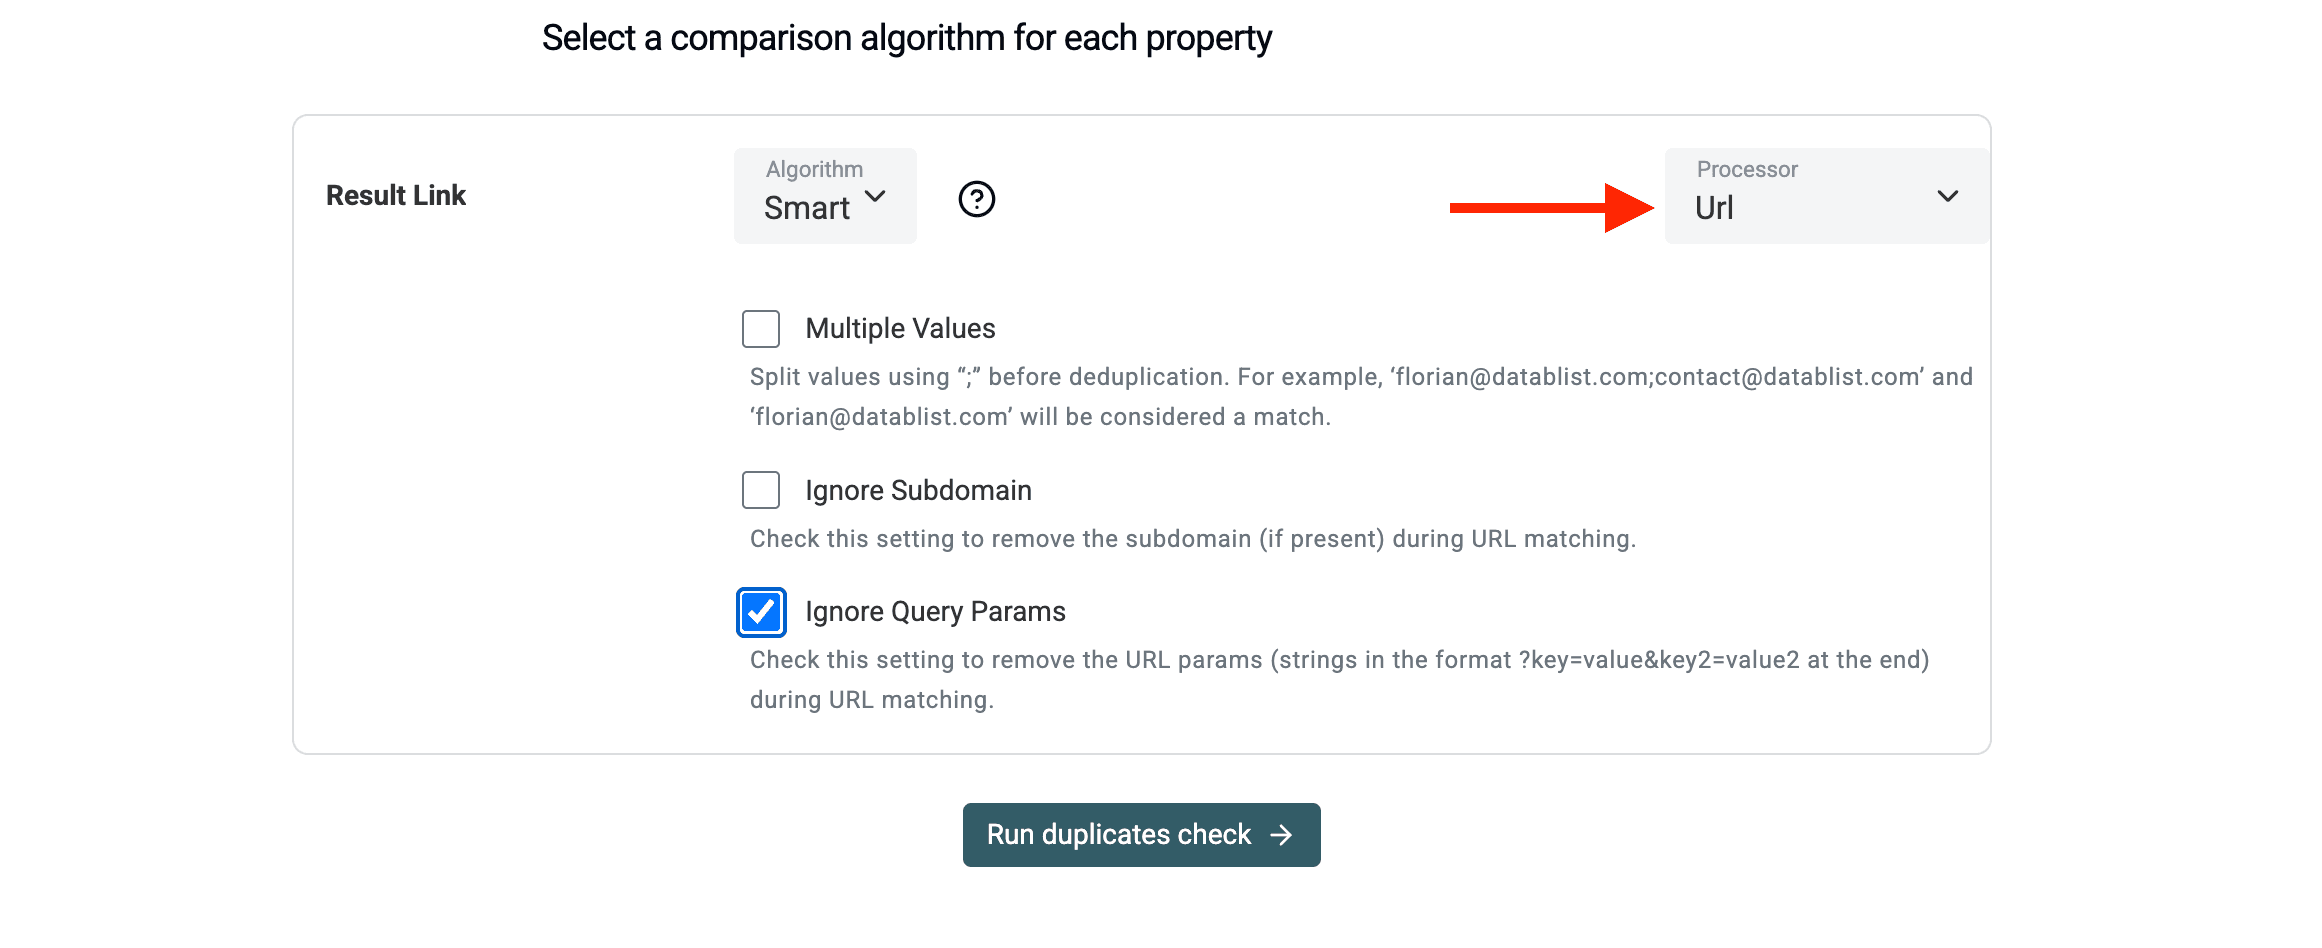
- 选择 URL processor。如果同一域名下的不同页面都有价值,请保留路径。只有在每个域名仅需保留一条记录时,才启用 Ignore Path;合并前请先检查分组。
- 让工具识别匹配的记录行,然后将其合并或删除多余项。
清除无关结果
数据清洗还包括移除无关结果。部分 Google 搜索结果来自 Yelp、黄页或大众点评等聚合平台。为了专注于企业官网,你通常需要将这些网站排除。
使用筛选功能排除常见的目录网站域名。有关处理这类数据的具体步骤,请参阅这篇数据清洗指南。
丰富搜索结果数据
只有 URL 或页面标题,通常不足以支持销售营销活动。获得一份去重后的网站列表后,还需要补充联系人信息。 Datablist 可以充当数据丰富中心,将抓取的数据传递给其他服务。
查找邮箱地址
-
通过公司域名查找邮箱地址
如果抓取结果中包含公司域名,可以使用 Datablist 的 "Waterfall People Search" enrichment。它会查找在这些公司任职的人员,并返回他们的个人资料和经过验证的邮箱地址,非常适合创建精准的 B2B 联系人名单。 -
通过 LinkedIn 个人资料 URL 查找邮箱地址
如果抓取结果中包含 LinkedIn 个人资料链接,可以使用 Datablist 的 Waterfall Email Finder。它只需 LinkedIn 个人资料 URL,即可查找职业邮箱地址。具体操作请参阅分步指南:通过 LinkedIn 个人资料 URL 查找邮箱地址。
通过域名查找 LinkedIn 公司主页
如果你手中已有公司网站,只需点击一次,即可将其转换为 LinkedIn 数据资产。 使用 "LinkedIn Company Page Matcher" enrichment,它可以为列表中的每家公司找到官方 LinkedIn Company Page。
这项功能非常实用:一条简单的 Google 搜索结果,可以被丰富为包含行业、规模和活跃度数据的完整公司资料。
匹配完成后,可通过以下 enrichment 获取详细的公司信息:
这样就能快速将原始 URL 转换为结构化 B2B 数据。
使用 AI Agent 访问网站
有些网站会把真正有价值的信息藏在深层页面中。 这正是 AI Agent 的用武之地。
AI Agent 会代替你逐一访问网站,像人一样阅读页面内容。
它可以:
- 根据网站内容对公司进行分类
- 将 Lead 标记为“高优先级”或“低优先级”
- 从 Contact 或 About Us 页面提取联系信息
你无需打开 500 个标签页逐个阅读,让 AI Agent 完成这些繁重工作即可。
示例:将地区查询转换为可审核列表
假设你正在调研中国的牙科诊所,可以先从三条查询开始:dentist Beijing、dentist Shanghai 和 dentist Shenzhen。运行一小批样本,并检查 Result Link、Result Title 和 Search Query。如果只需要诊所官网,请排除目录网站;然后对比完整 URL,再判断同一域名下的不同页面是否代表同一家企业。
只有在第一批查询返回相关网站后,再加入更多城市。这个示例旨在说明工作流程,并不能预测最终获得的结果数量或不重复诊所数量。
成本分析:低预算抓取 Google 数据
应将任务成本与真正需要的页面价值进行比较。搜索结果只是候选 URL,并不是已经通过筛选的合格 Lead;范围过大的批量任务可能会返回目录网站,或多次返回相同域名。
如果 API 返回 JSON,而你需要电子表格,可以先用 JSON to CSV Converter 将响应转换为扁平结构,再进行数据清洗或 enrichment。
数据源目录标明的价格为每 10 条 Google 结果消耗 2.5 credits。按此费率粗略估算,1,000 条结果对应 250 credits;实际预估消耗取决于所选查询和结果上限。目前充值 20 美元可获得 20,000 credits,且不支持充值 1 美元。无论查询列表多长、结果上限多高,都不能保证获得相同数量的有效 Lead。
请先运行一小批数据。确认返回的 URL、重复项和 credits 消耗符合预期后,再扩展到更多查询。
技巧:使用 Google 搜索运算符
为了提升抓取数据的质量,可以使用以下 Google 搜索运算符来构建查询。
这些符号可以告诉 Google 应该到哪里查找关键词。
- site: 用于抓取特定平台上的搜索结果。例如,要查找 LinkedIn 个人资料,可使用
site:linkedin.com/in/。 - inurl: 搜索 URL 中包含特定词语的页面。例如,要查找联系页面,可使用
inurl:contact。 - intitle: 搜索页面标题中包含特定词语的结果。
intitle:"Index of"通常可以找到公开目录。 - filetype: 用于查找特定类型的文档。
filetype:pdf "marketing plan"可以找到公开的策略文档。 - -(减号): 排除指定词语。例如,如果要寻找律师,但不希望看到招聘机构,可以使用
lawyer -recruitment。
将这些运算符与多查询抓取结合使用,可以实现更精准的搜索。例如:
site:instagram.com "concept store" -inurl:/p/
这条查询可以找出提及 concept store 的 Instagram 页面,同时排除路径中含有 /p/ 的帖子 URL。请逐一审核结果,因为匹配的页面并不一定属于网红、竞争对手或合格 Lead。
📘 延伸阅读:按类别和关键词搜索并抓取 Instagram 个人资料,了解如何使用 Google 搜索 Instagram 个人资料
FAQ
为什么宽泛的 Google 查询会漏掉结果?
搜索结果会经过排序和分页,预估数量并不代表所有匹配页面都能被访问。更具体的搜索可能会发现不同页面,但结果之间也会重叠,仍可能遗漏相关网站。
抓取 Google 搜索结果是否合法?
收集或使用搜索结果前,请根据具体应用场景检查相关网站条款和隐私要求,尤其是在结果中包含个人信息时。
可以用这个工具抓取 Google Maps 吗?
"Start with Google Search Queries" 数据源面向标准 Google Search。如果需要包含评分、营业时间和精确地图坐标的本地企业数据,应使用专门的 Google Maps scraper。Search 结果更适合获取网站和数字资料,Maps 结果则更适合查找实体地点。
如何处理 CAPTCHA?
Datablist 运行 Google Search Queries 数据源时,不需要你配置浏览器爬虫。不过,查询仍可能返回少于预期的结果,甚至运行失败;在将 collection 视为完整数据集之前,请检查任务状态和输出结果。
可以将这些结果导入 CRM 吗?
可以。先检查 URL 并删除重复项,同时保留来源查询,再将所需字段导出为 CSV 或 Excel,供 CRM 导入。导入前,请检查 CRM 的必填字段并完成字段映射。