
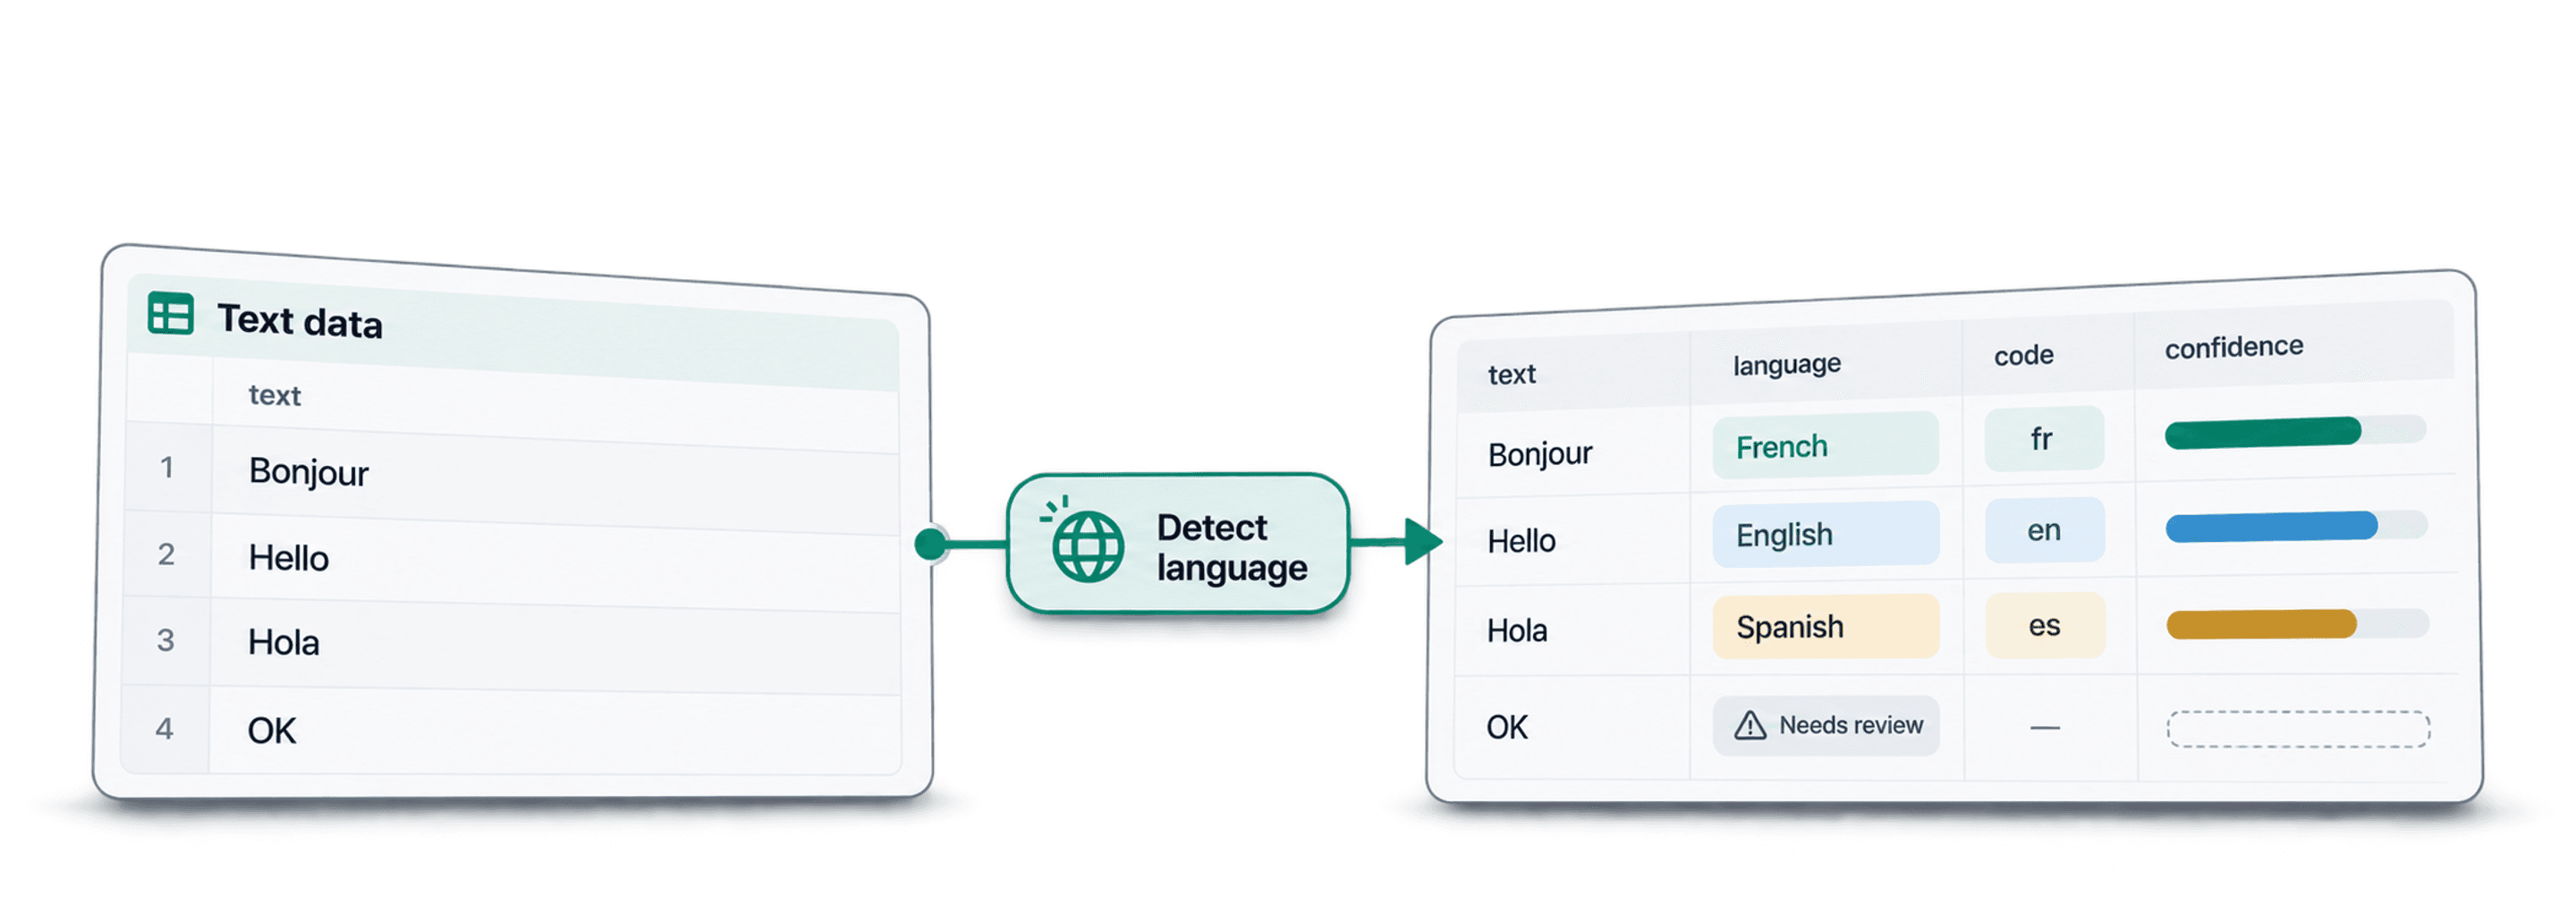
如果需要识别数据集中每一行所使用的语言,最清晰的做法是直接在现有文件中添加语言相关列。将 CSV 或 Excel 文件导入 Datablist,对文本列运行语言检测,检查置信度,再导出增强后的数据集,或继续执行翻译、分配和细分等操作。
相比把数据逐行复制到聊天机器人中,我更推荐这种方式,因为整个结果始终按行对应。每一行都会得到语言名称、ISO 语言代码和置信度,后续处理也会轻松很多:筛选法语行、将西班牙语行送去翻译、检查低置信度数据,或者删除没有有效文本的行。
本指南将使用一个多语言个人资料数据集进行演示,但同样的流程也适用于客服工单、问卷回答、评论、商品描述、抓取的网页内容和 CRM 备注。
🔑 优先使用专用检测工具
如果你的唯一任务是识别语言,请先使用语言检测 enrichment。只有在需要自定义规则或组合判断时,才使用 ChatGPT。
快速导航
- 直接答案
- 示例数据集
- 第 1 步:导入 CSV 或 Excel 文件
- 第 2 步:选择语言检测 enrichment
- 第 3 步:配置输入和输出
- 第 4 步:检查语言检测结果
- 第 5 步:筛选、导出或继续翻译
- 费用:按行收取固定 credits
- 替代方案:使用 ChatGPT 设置自定义规则
直接答案
要识别数据集中每一行的语言,请将 CSV 或 Excel 文件导入 Datablist,打开 Enrich 菜单,然后选择 Detect Language from a Text enrichment。在 Inputs 步骤中,选择需要分析的文本列。Datablist 会把识别出的语言名称、语言代码和置信度写入新列,固定价格为每行 0.05 credits。
其中最重要的是检查结果。语言检测本质上是一项分类任务,而置信度可以帮助你判断哪些行能够直接进入下一步,哪些行值得再次核对。高置信度数据通常可以直接进入后续工作流;低置信度、输入无效或没有结果的行,则应在导出前进行筛选。
当检测结果必须与原始行保持对应时,我会采用这套流程。电子表格公式或许能处理简单情况,但遇到多语言混合文本、短句、空单元格和格式混乱的导出文件时,往往就不够用了。聊天机器人可以判断少量示例,却无法直接生成每行对应一个结果的整洁数据集。
示例数据集
在本次演示中,我使用一份社交平台个人资料 CSV,其中包含五列:
| Profile ID | 姓名 | Headline | Bio | 公司 |
|---|---|---|---|---|
C8C1DXQBNP | Maya Collins | Founder building analytics tools for customer teams | I help sales teams clean messy lead lists... | Northstar Labs |
61M25JUEHM | Lucas Bernard | Responsable support client pour une marketplace | Je construis des workflows simples... | Market Loop |
Y45G9QU71C | Sofia Romero | Especialista en CRM y automatizacion comercial | Consultora de operaciones enfocada... | Talent Desk |
RL20HHREOT | Felix Wagner | Tech Recruiter fuer Produktteams | Ich helfe Teams dabei... | Cleanbase |
TT384W44MW | Aoi Nakamura | 営業チーム向けCRMコンサルタント | 多言語の問い合わせを分類... | Northstar Labs |
这份文件特意没有包含语言列,因为我要让 Datablist 添加这项信息,而不是验证一个已经提供的标签。
数据集中还包含一些不规整的行,例如空白 Bio、很短的 Headline、公司名称、账号名、URL、数字以及多语言混合片段。我喜欢用这类文件做测试,因为它能展示理想示例之外的真实情况。实际导出的数据里,总会有少量需要人工检查的行。
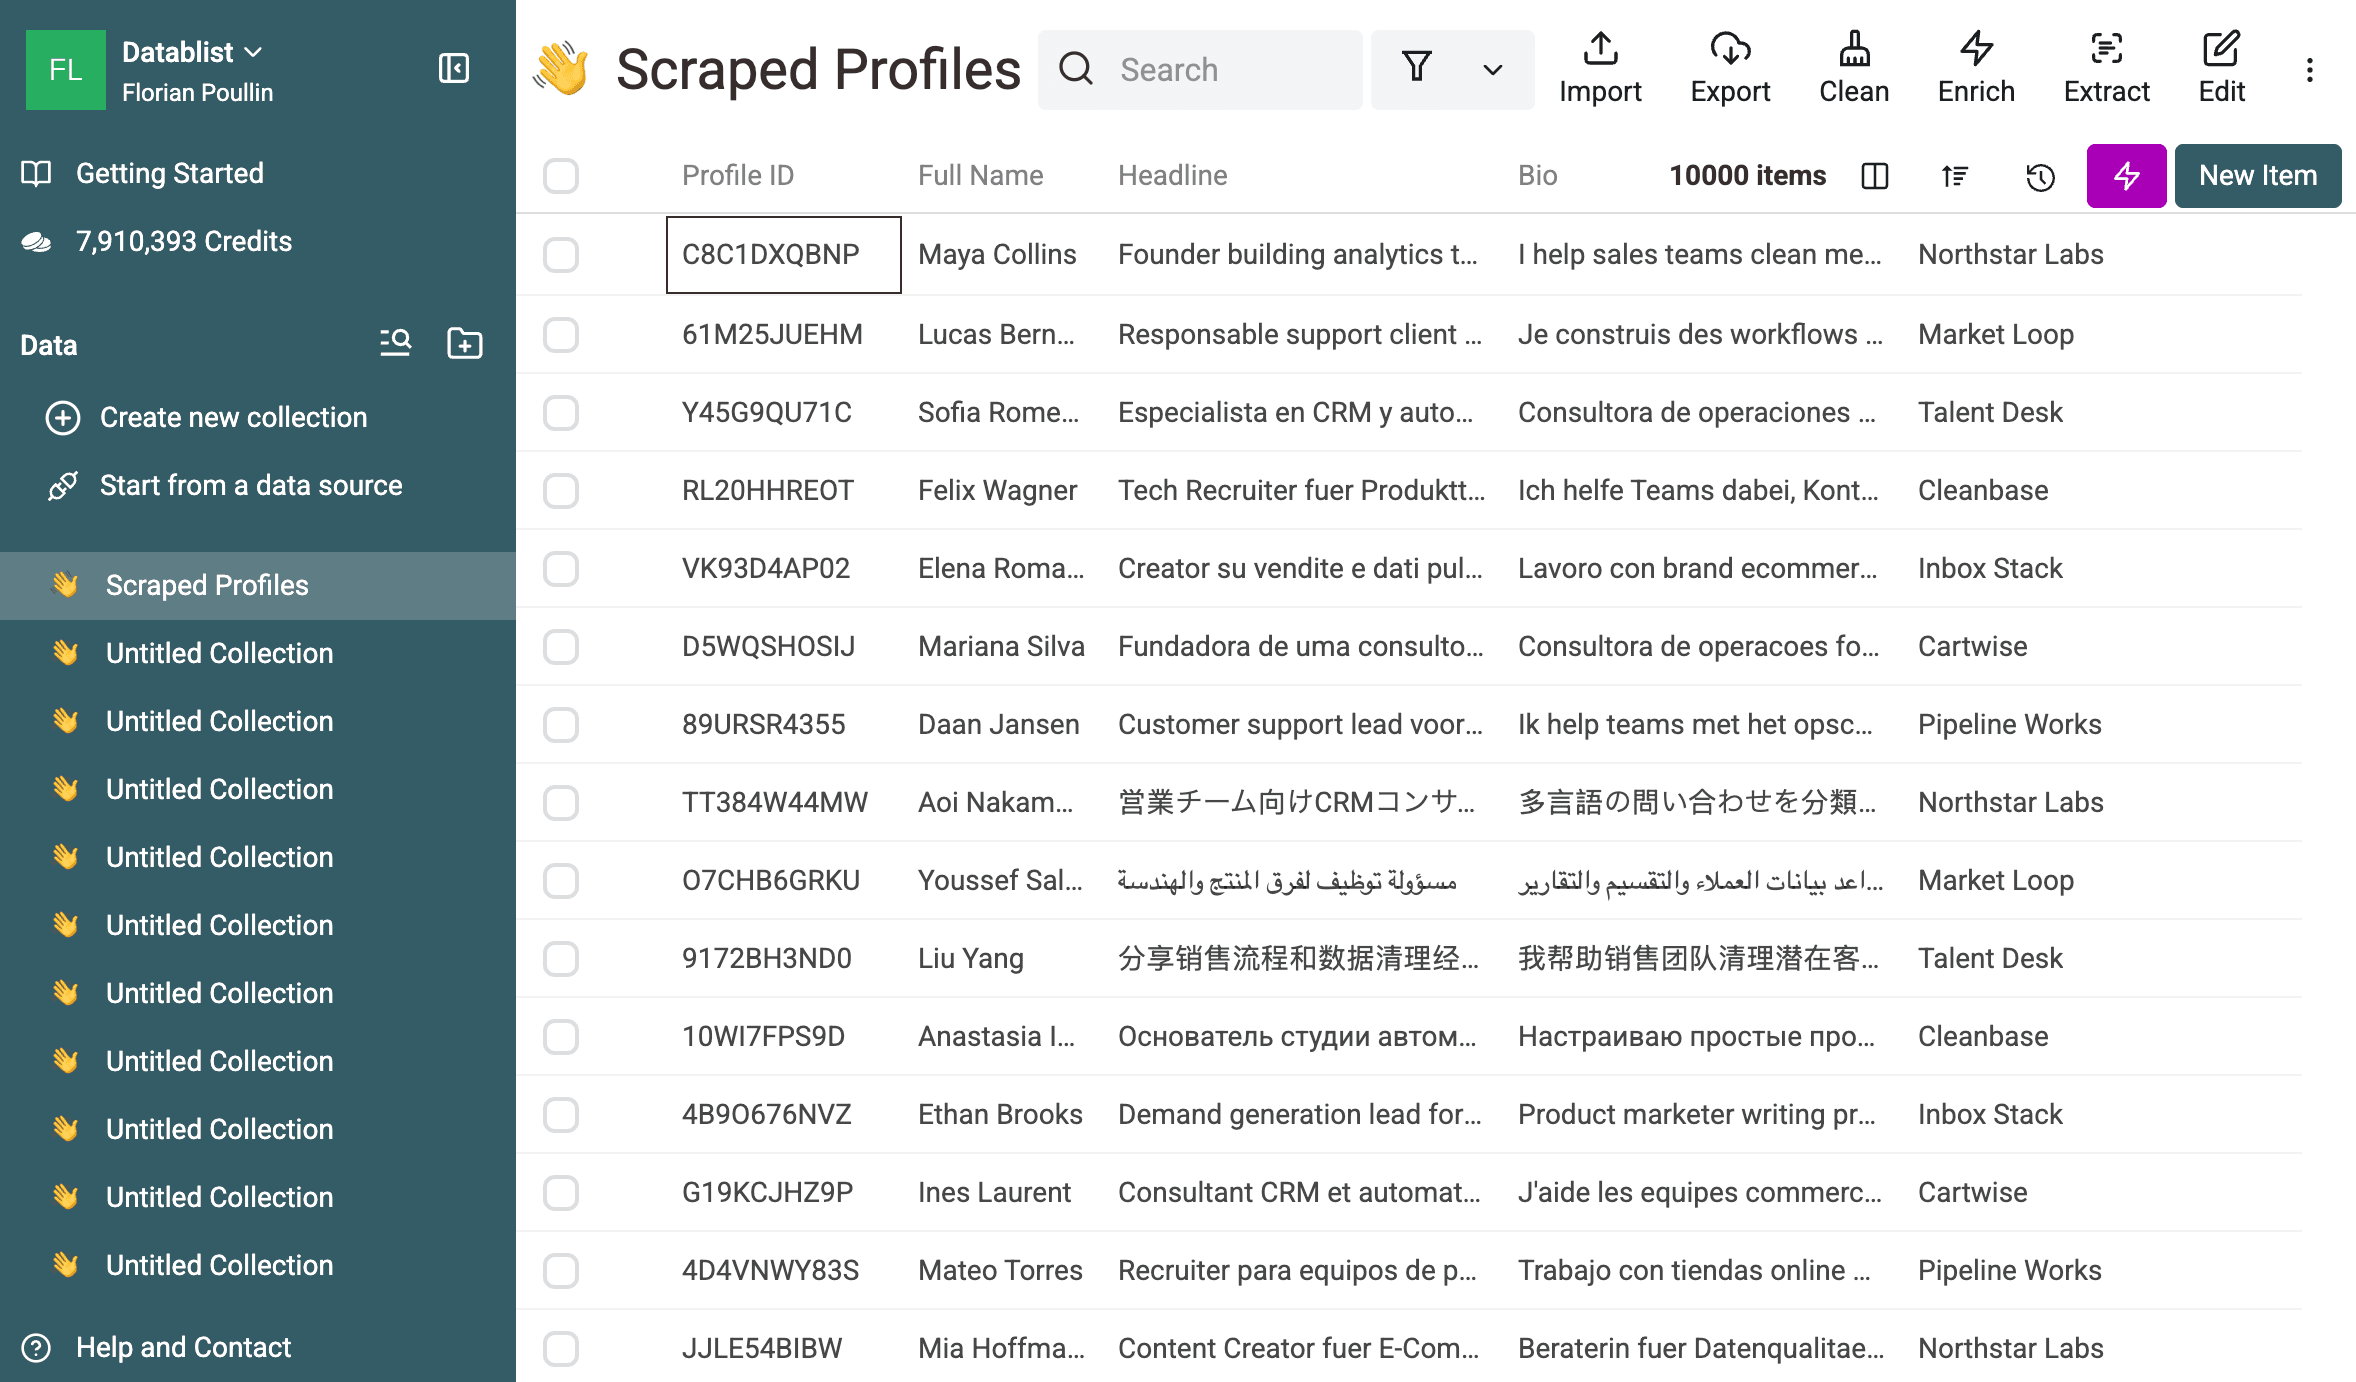
在这个示例中,我同时使用 Headline 和 Bio 作为语言判断依据。如果你的数据集在单个列中包含较长的客服工单或商品描述,只选一个输入列就足够了。如果每一行都由多个短字段组成,合并两个文本列通常能为检测工具提供更多上下文。
第 1 步:导入 CSV 或 Excel 文件
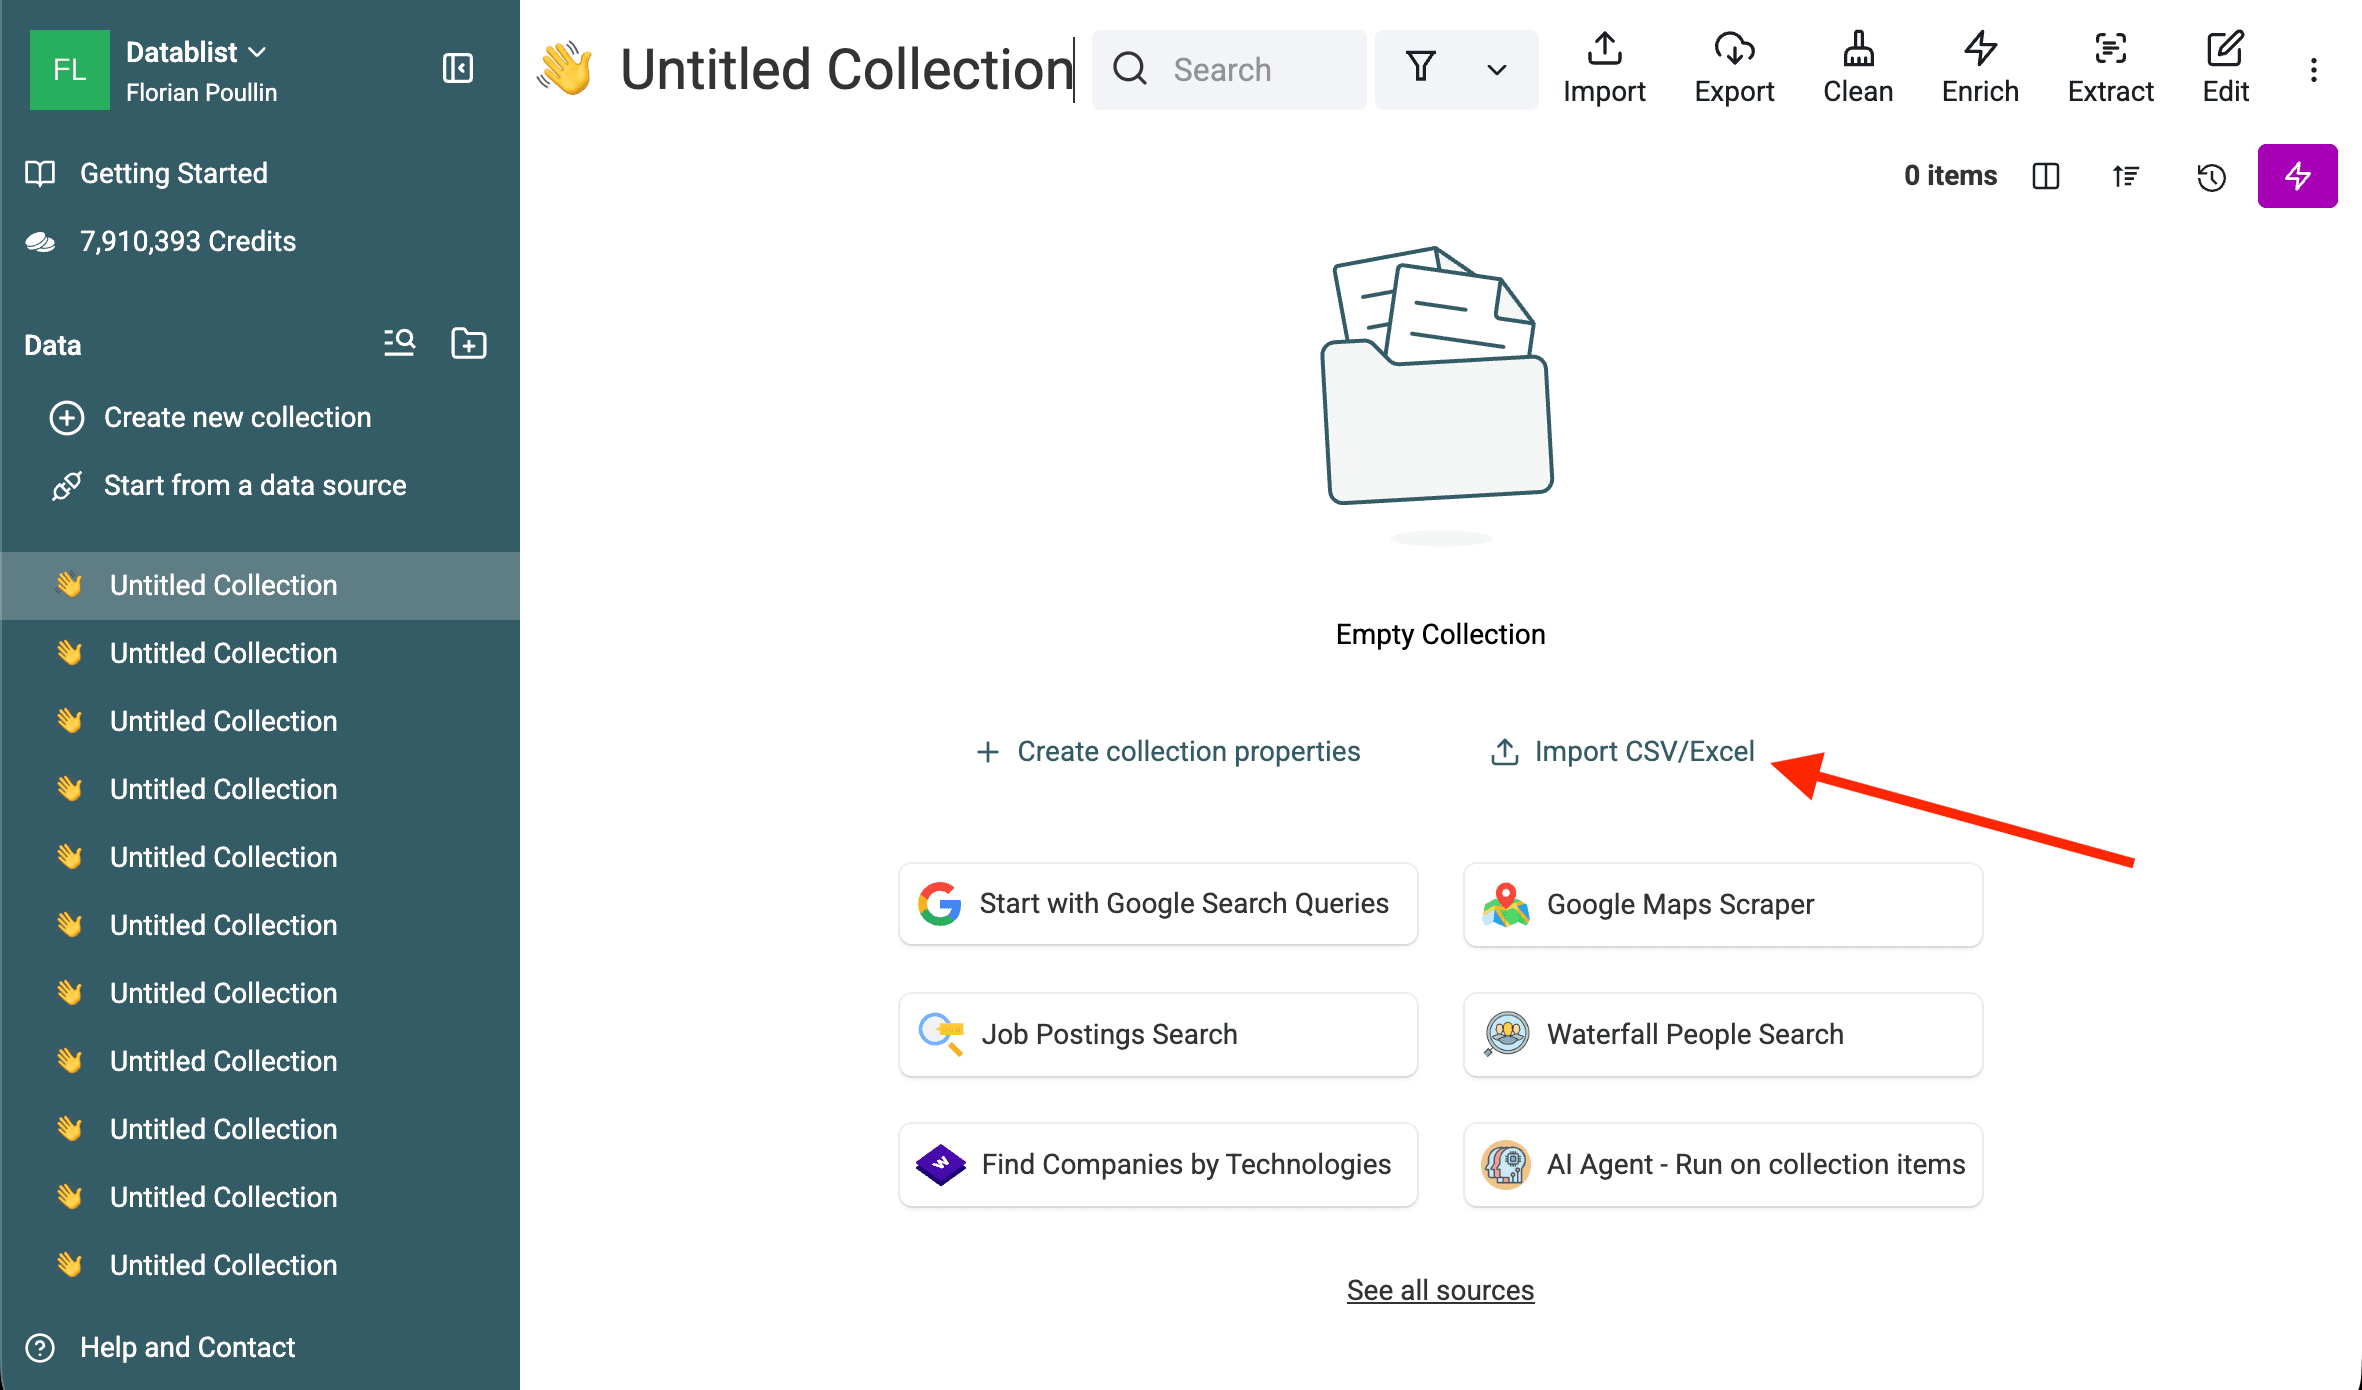
准备一份每条记录占一行、且至少包含一个文本列的 CSV 或 Excel 文件。打开 Datablist,创建一个 collection,然后导入文件。你也可以在这套流程中使用 Datablist 的 CSV editor。
在导入检查页面,核对列名,并确认有用的文本字段已按文本类型导入。在本例中,我关注的是 Headline 和 Bio。我不会使用 Full Name、Company 或 Profile ID 进行检测,因为这些字段提供的语言特征很弱。
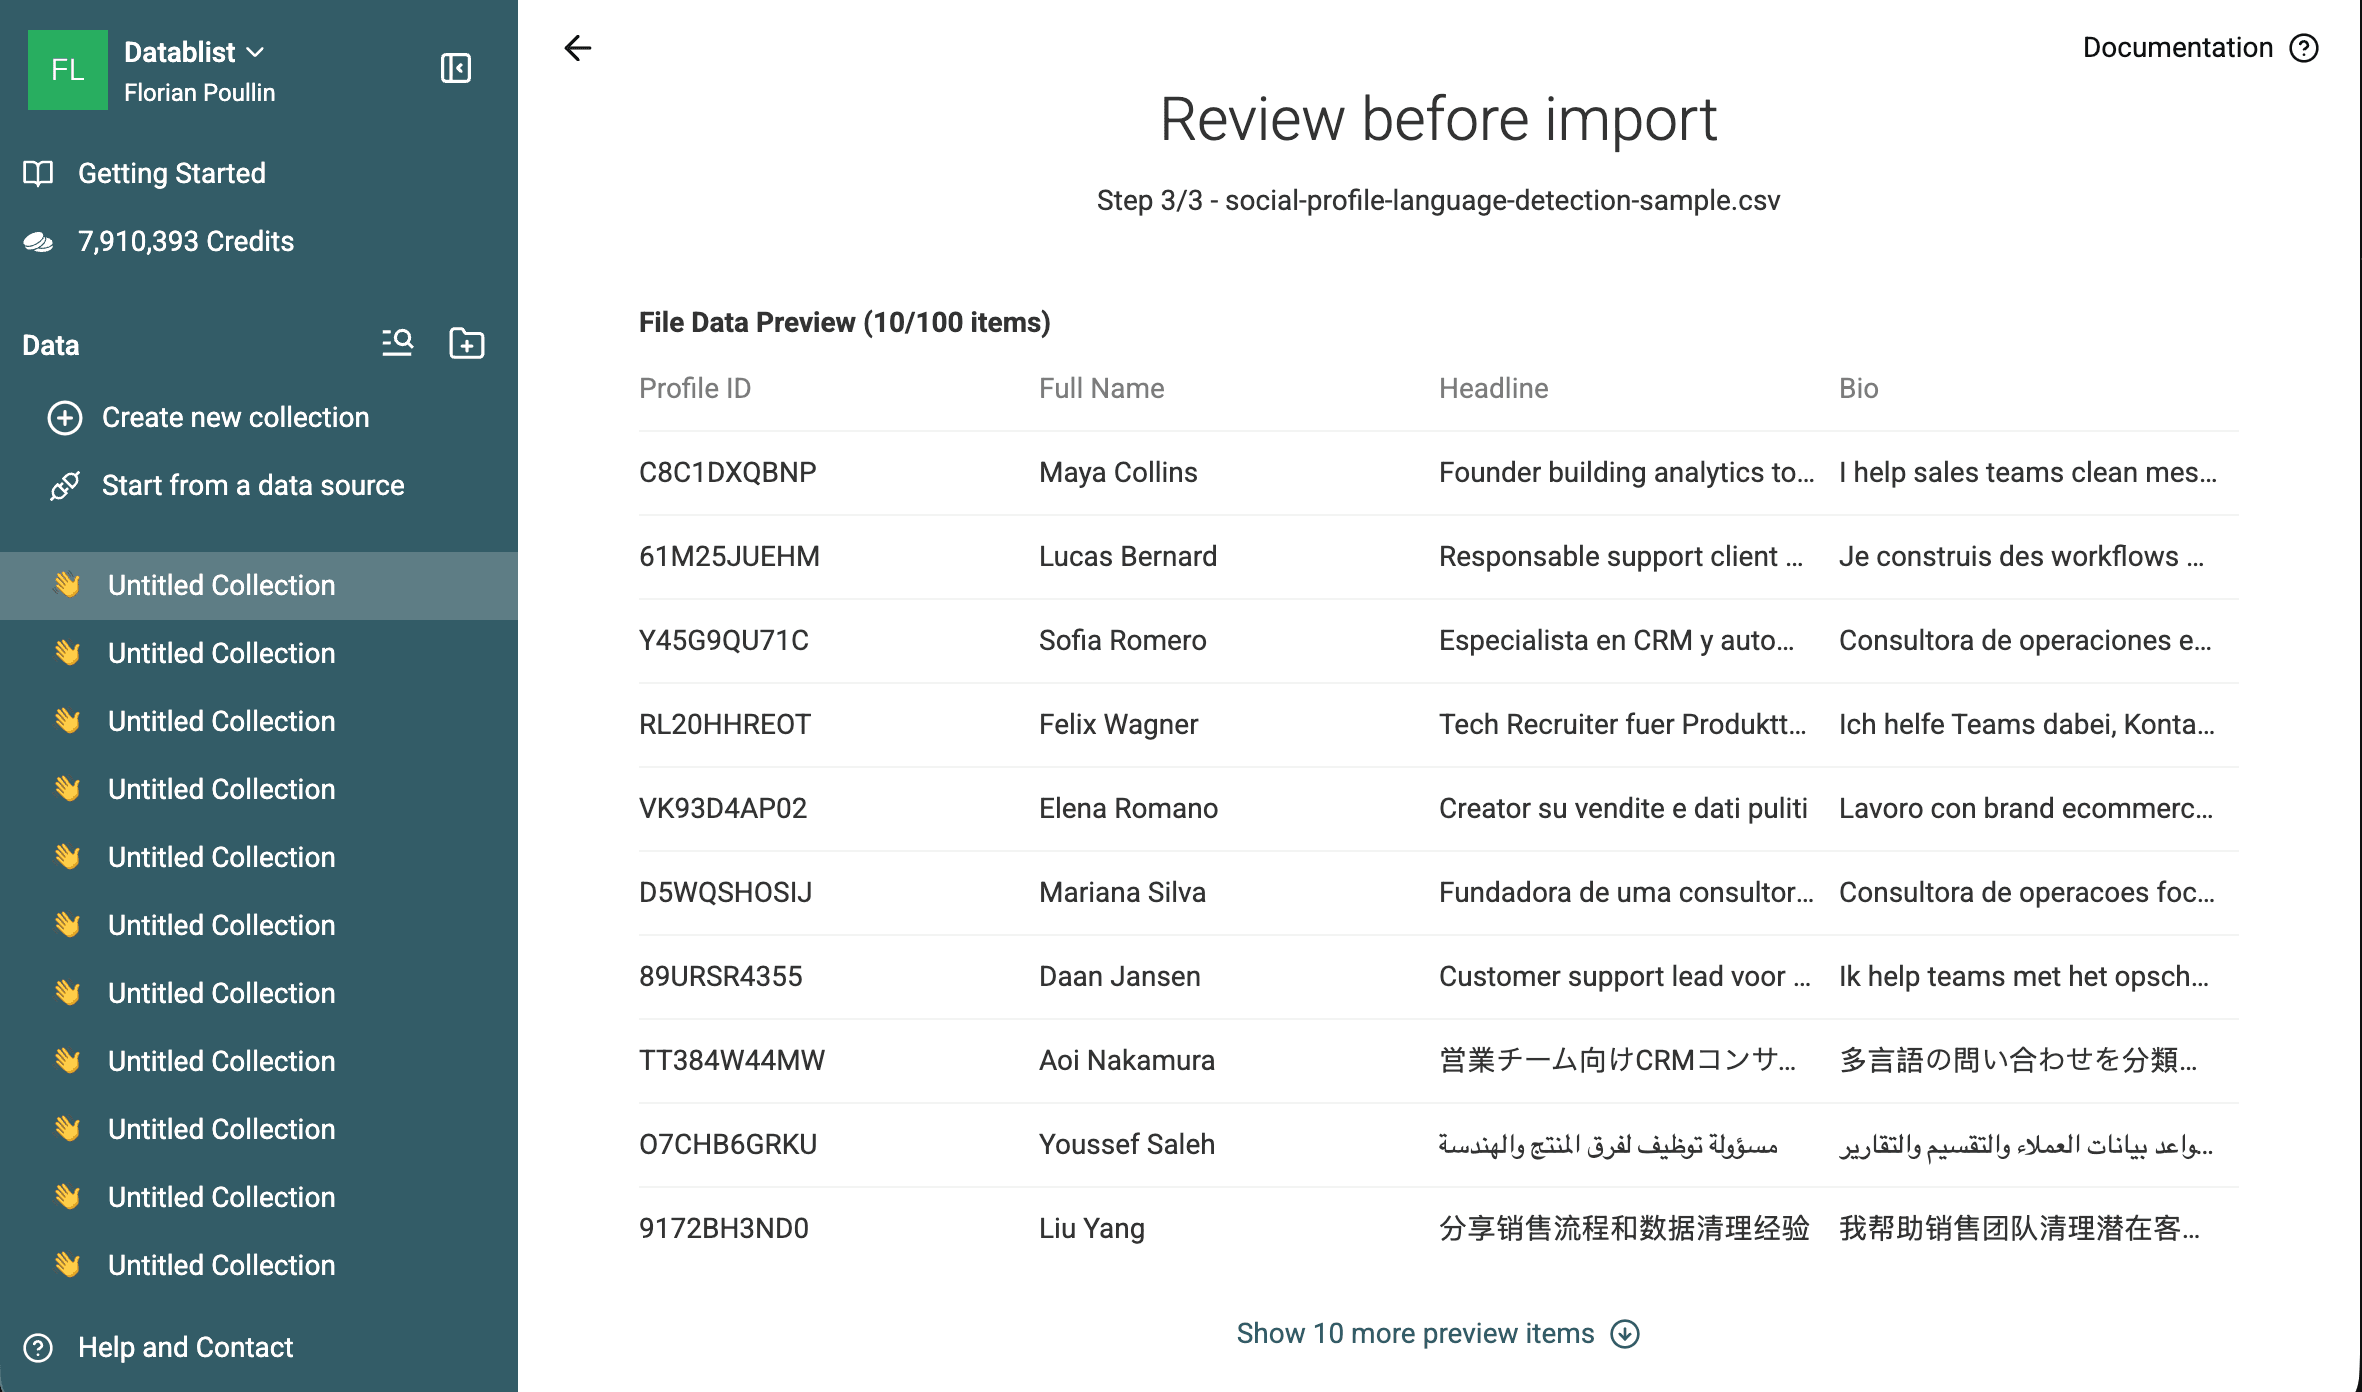
请保持原始文本列不变。我通常会新建输出列,而不是覆盖源数据,这样检查起来更方便。如果某个结果看起来不对,可以立即与原文进行比较。
💡 保留稳定的 ID 列
如果之后需要把文件重新导入其他系统,请保留
Profile ID、工单 ID、商品 SKU 或 CRM 记录 ID 等标识列。这样导出和匹配数据会更安全。
第 2 步:选择语言检测 enrichment
导入数据集后,打开 Enrich 菜单并搜索语言检测,然后选择 Detect Language from a Text enrichment。
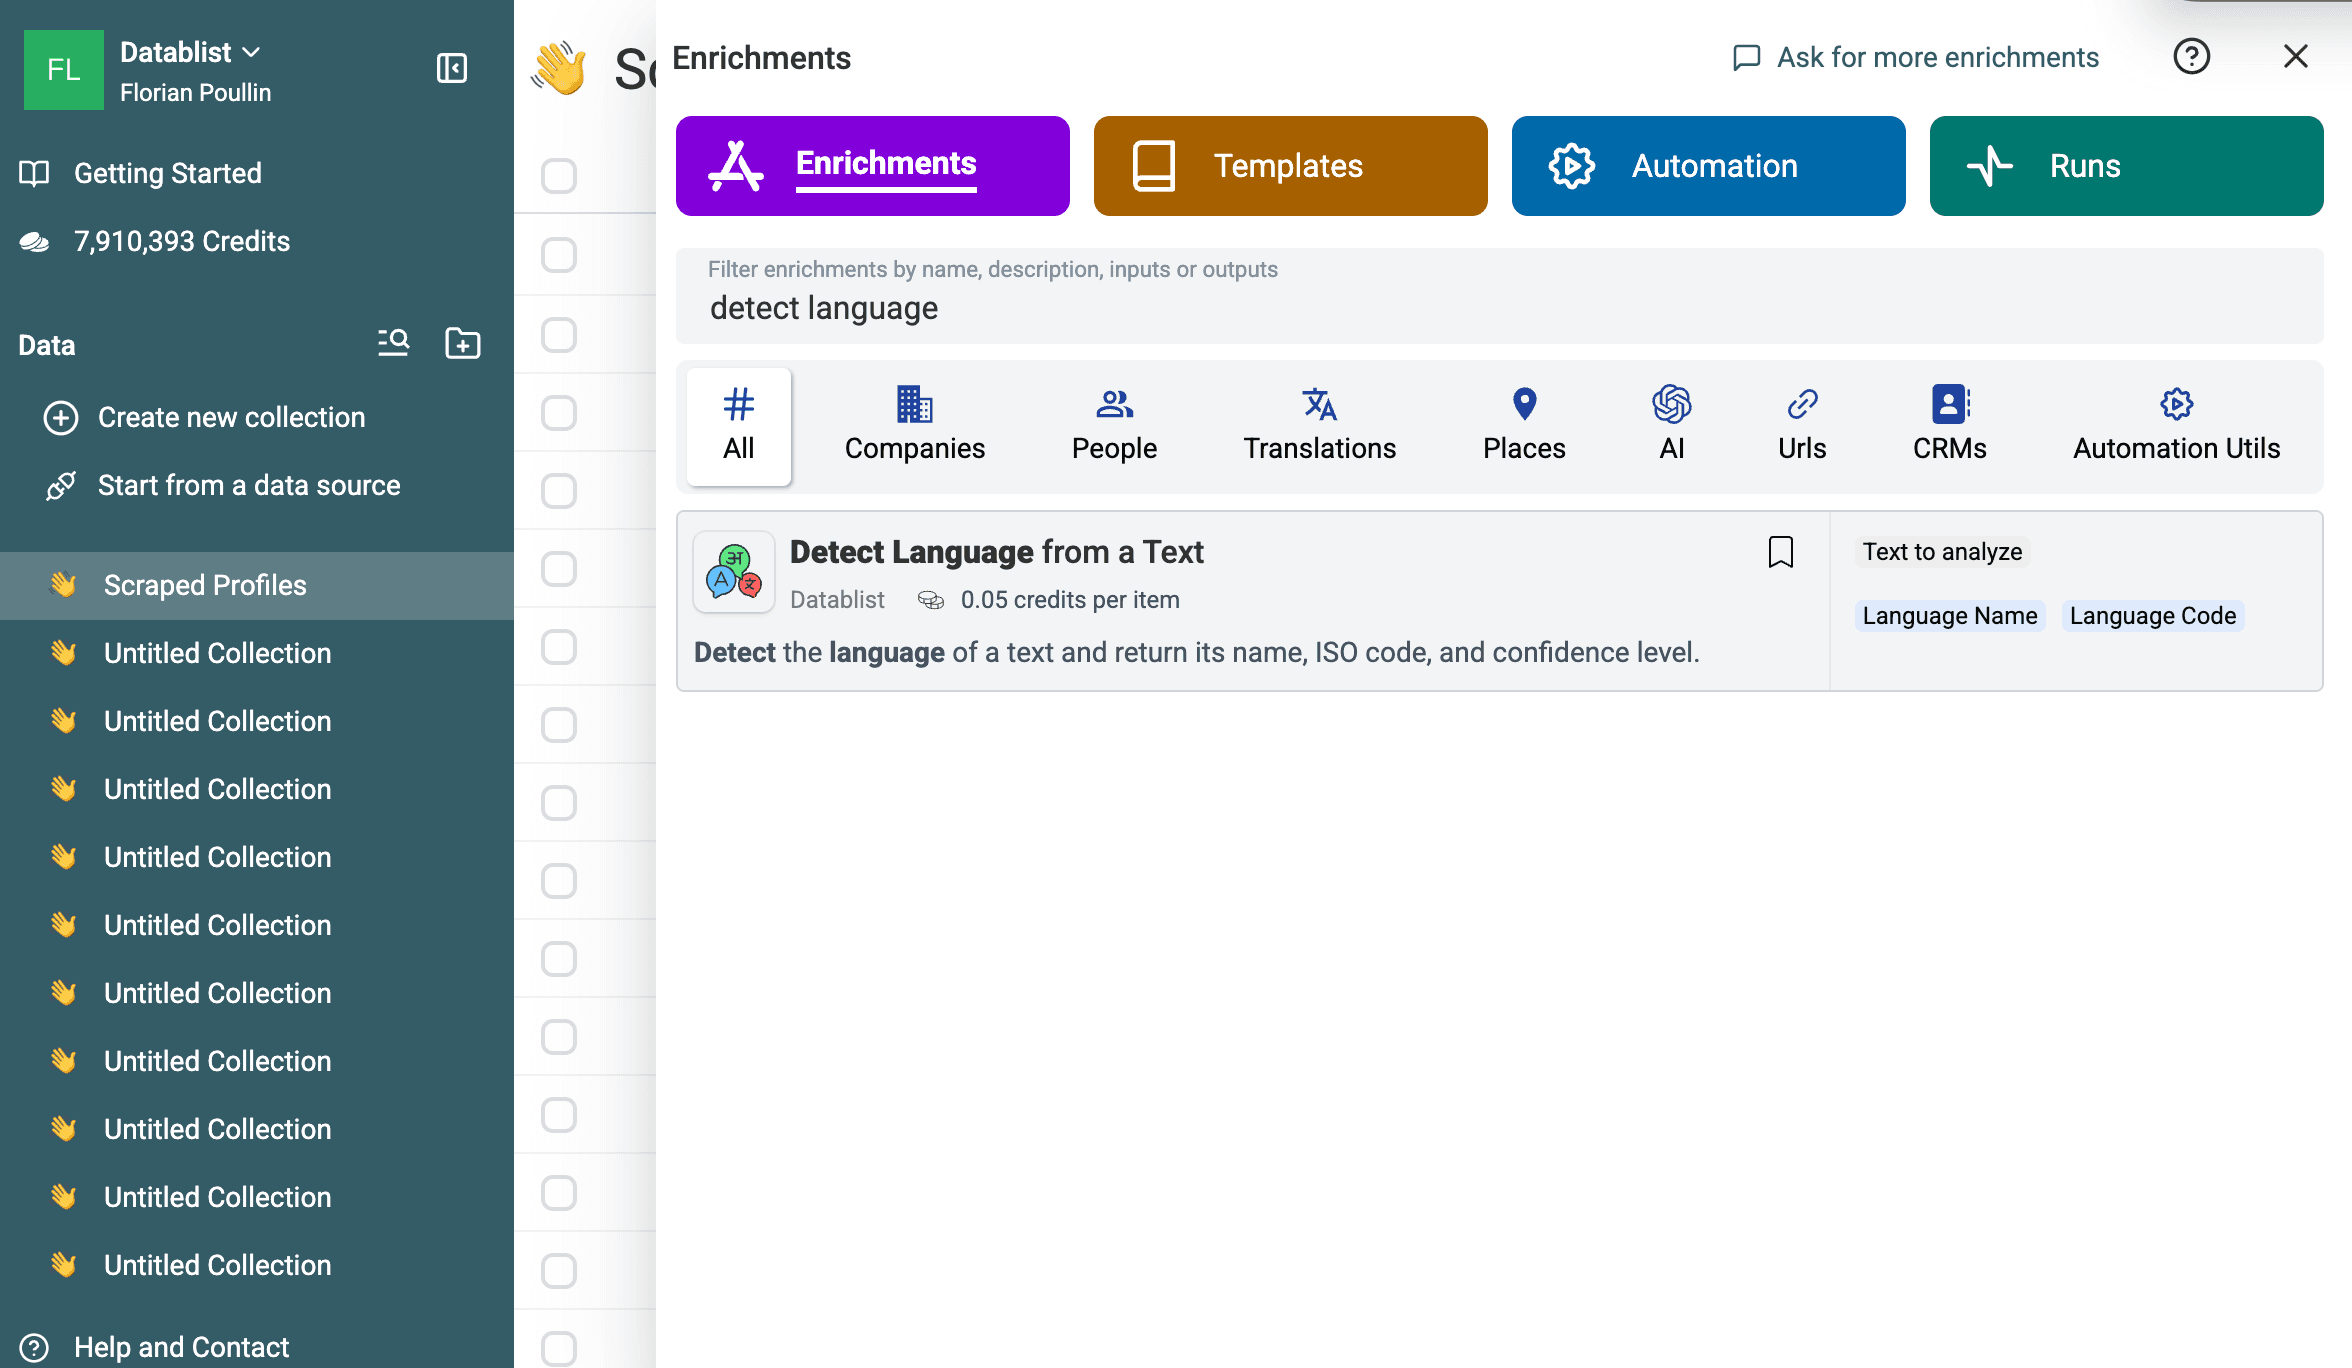
该 enrichment 会逐行运行。它会读取每一行的输入文本,并返回:
Language Name,例如 English、French、Spanish 或 German。Language Code,例如en、fr、es或de。Language Confidence,例如 High、Medium、Low 或 Very Low。
这种结果结构非常适合电子表格工作。语言名称便于阅读,语言代码适合自动化和翻译工具,而置信度则能告诉我哪些数据需要检查。
不要把姓名、ID、用户名、URL、数字代码或公司名称等弱特征字段作为唯一输入。这些内容通常无法提供足够的语言特征。如果数据集里的文本很短,请在运行 enrichment 前再选择一个文本字段。
第 3 步:配置输入和输出
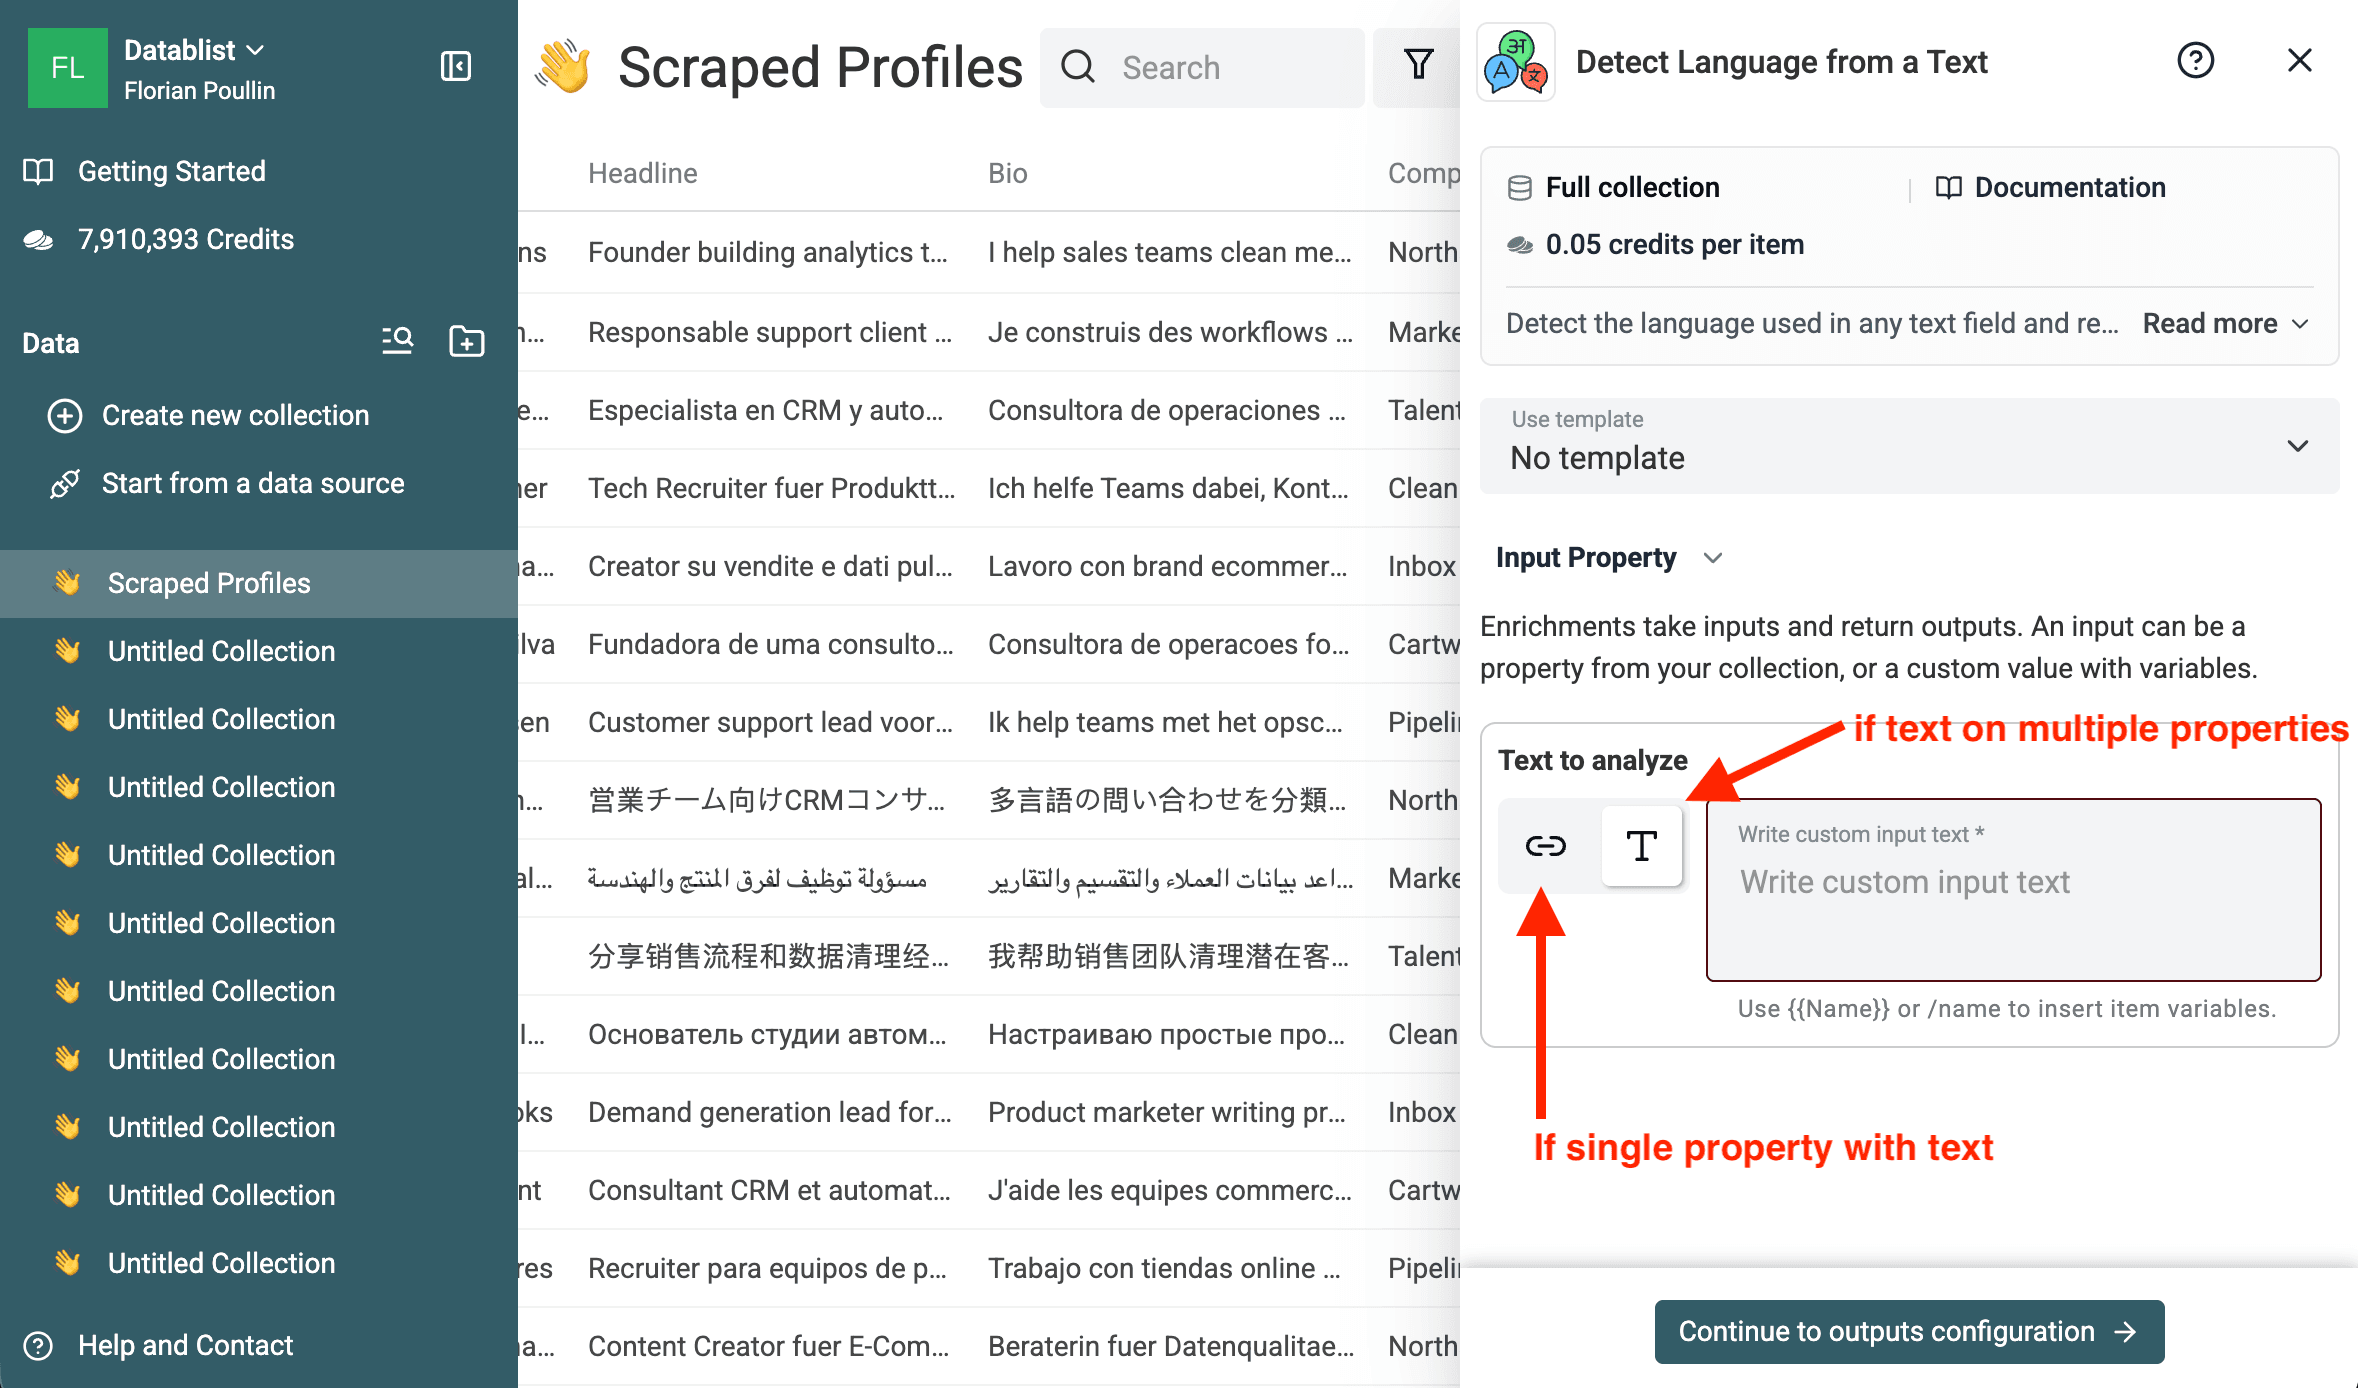
在 Inputs 步骤中,选择希望 Datablist 分析的文本。你可以选择一个 property,也可以使用多个 property 组合成自定义输入。
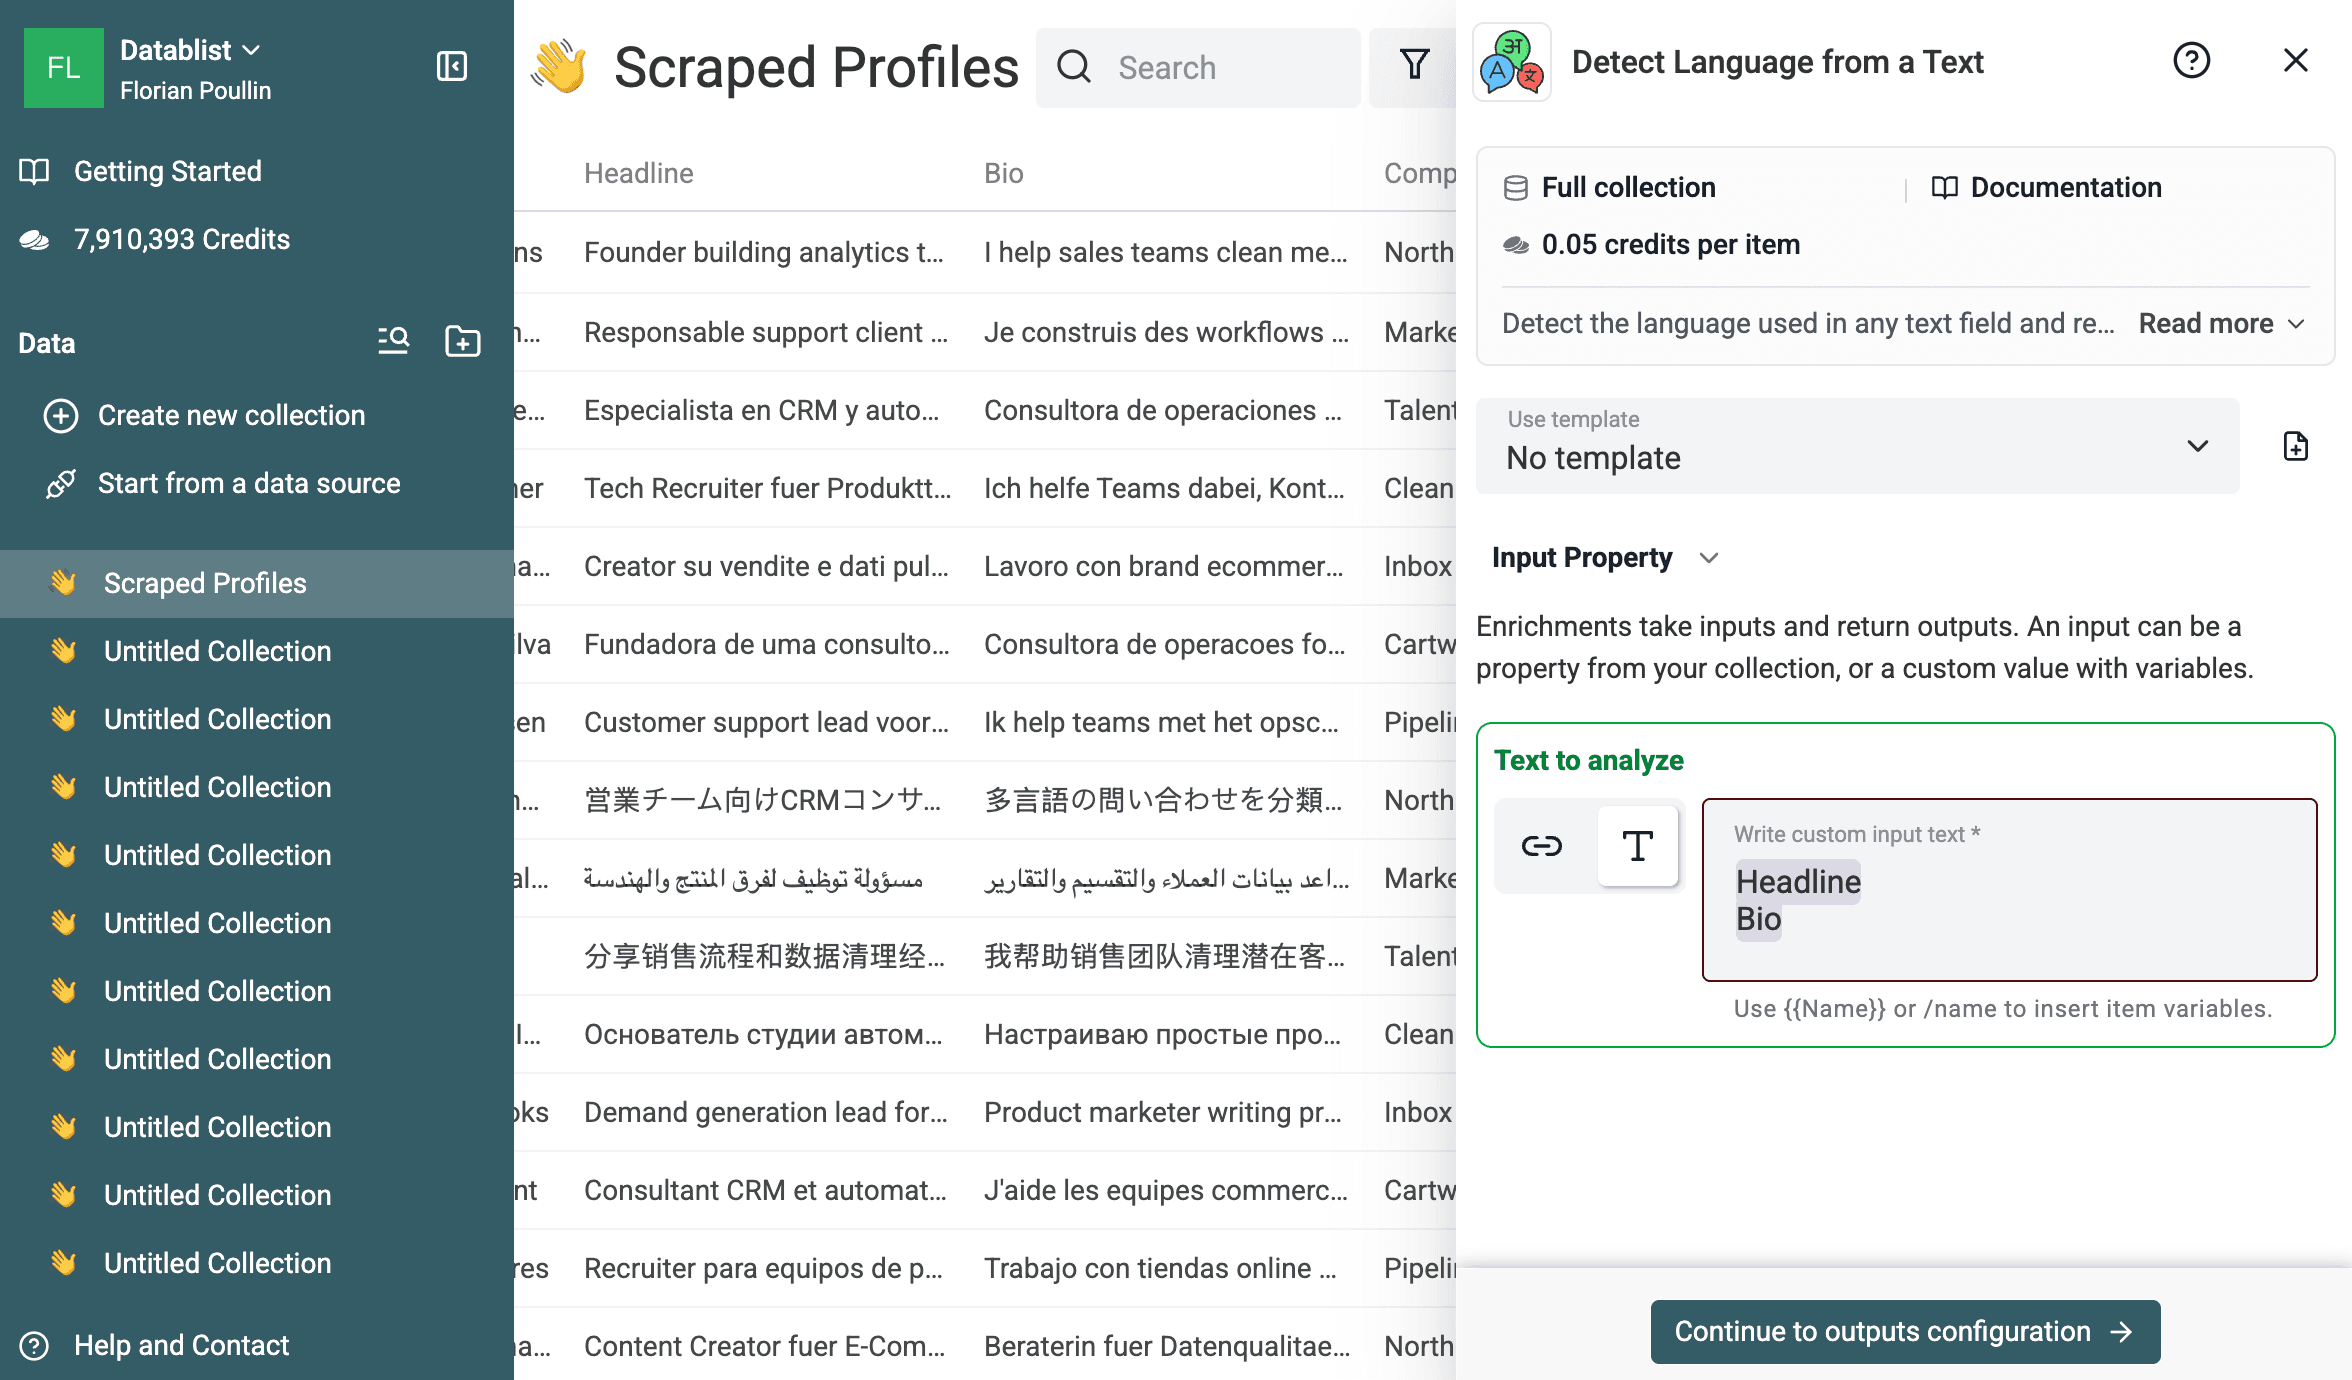
对于这份个人资料数据集,我用 Headline 和 Bio 创建自定义输入。这样做很重要,因为有些行的 Bio 很短,有些行的 Headline 更有价值,还有少数行的数据比较混乱。合并这两个字段可以提供更多上下文,而且无需手动创建新列。
接下来配置输出列。我通常会为以下结果创建新列:
Language NameLanguage CodeLanguage Confidence
运行状态列可以帮助你单独找出处理失败、输入无效或没有返回结果的数据。
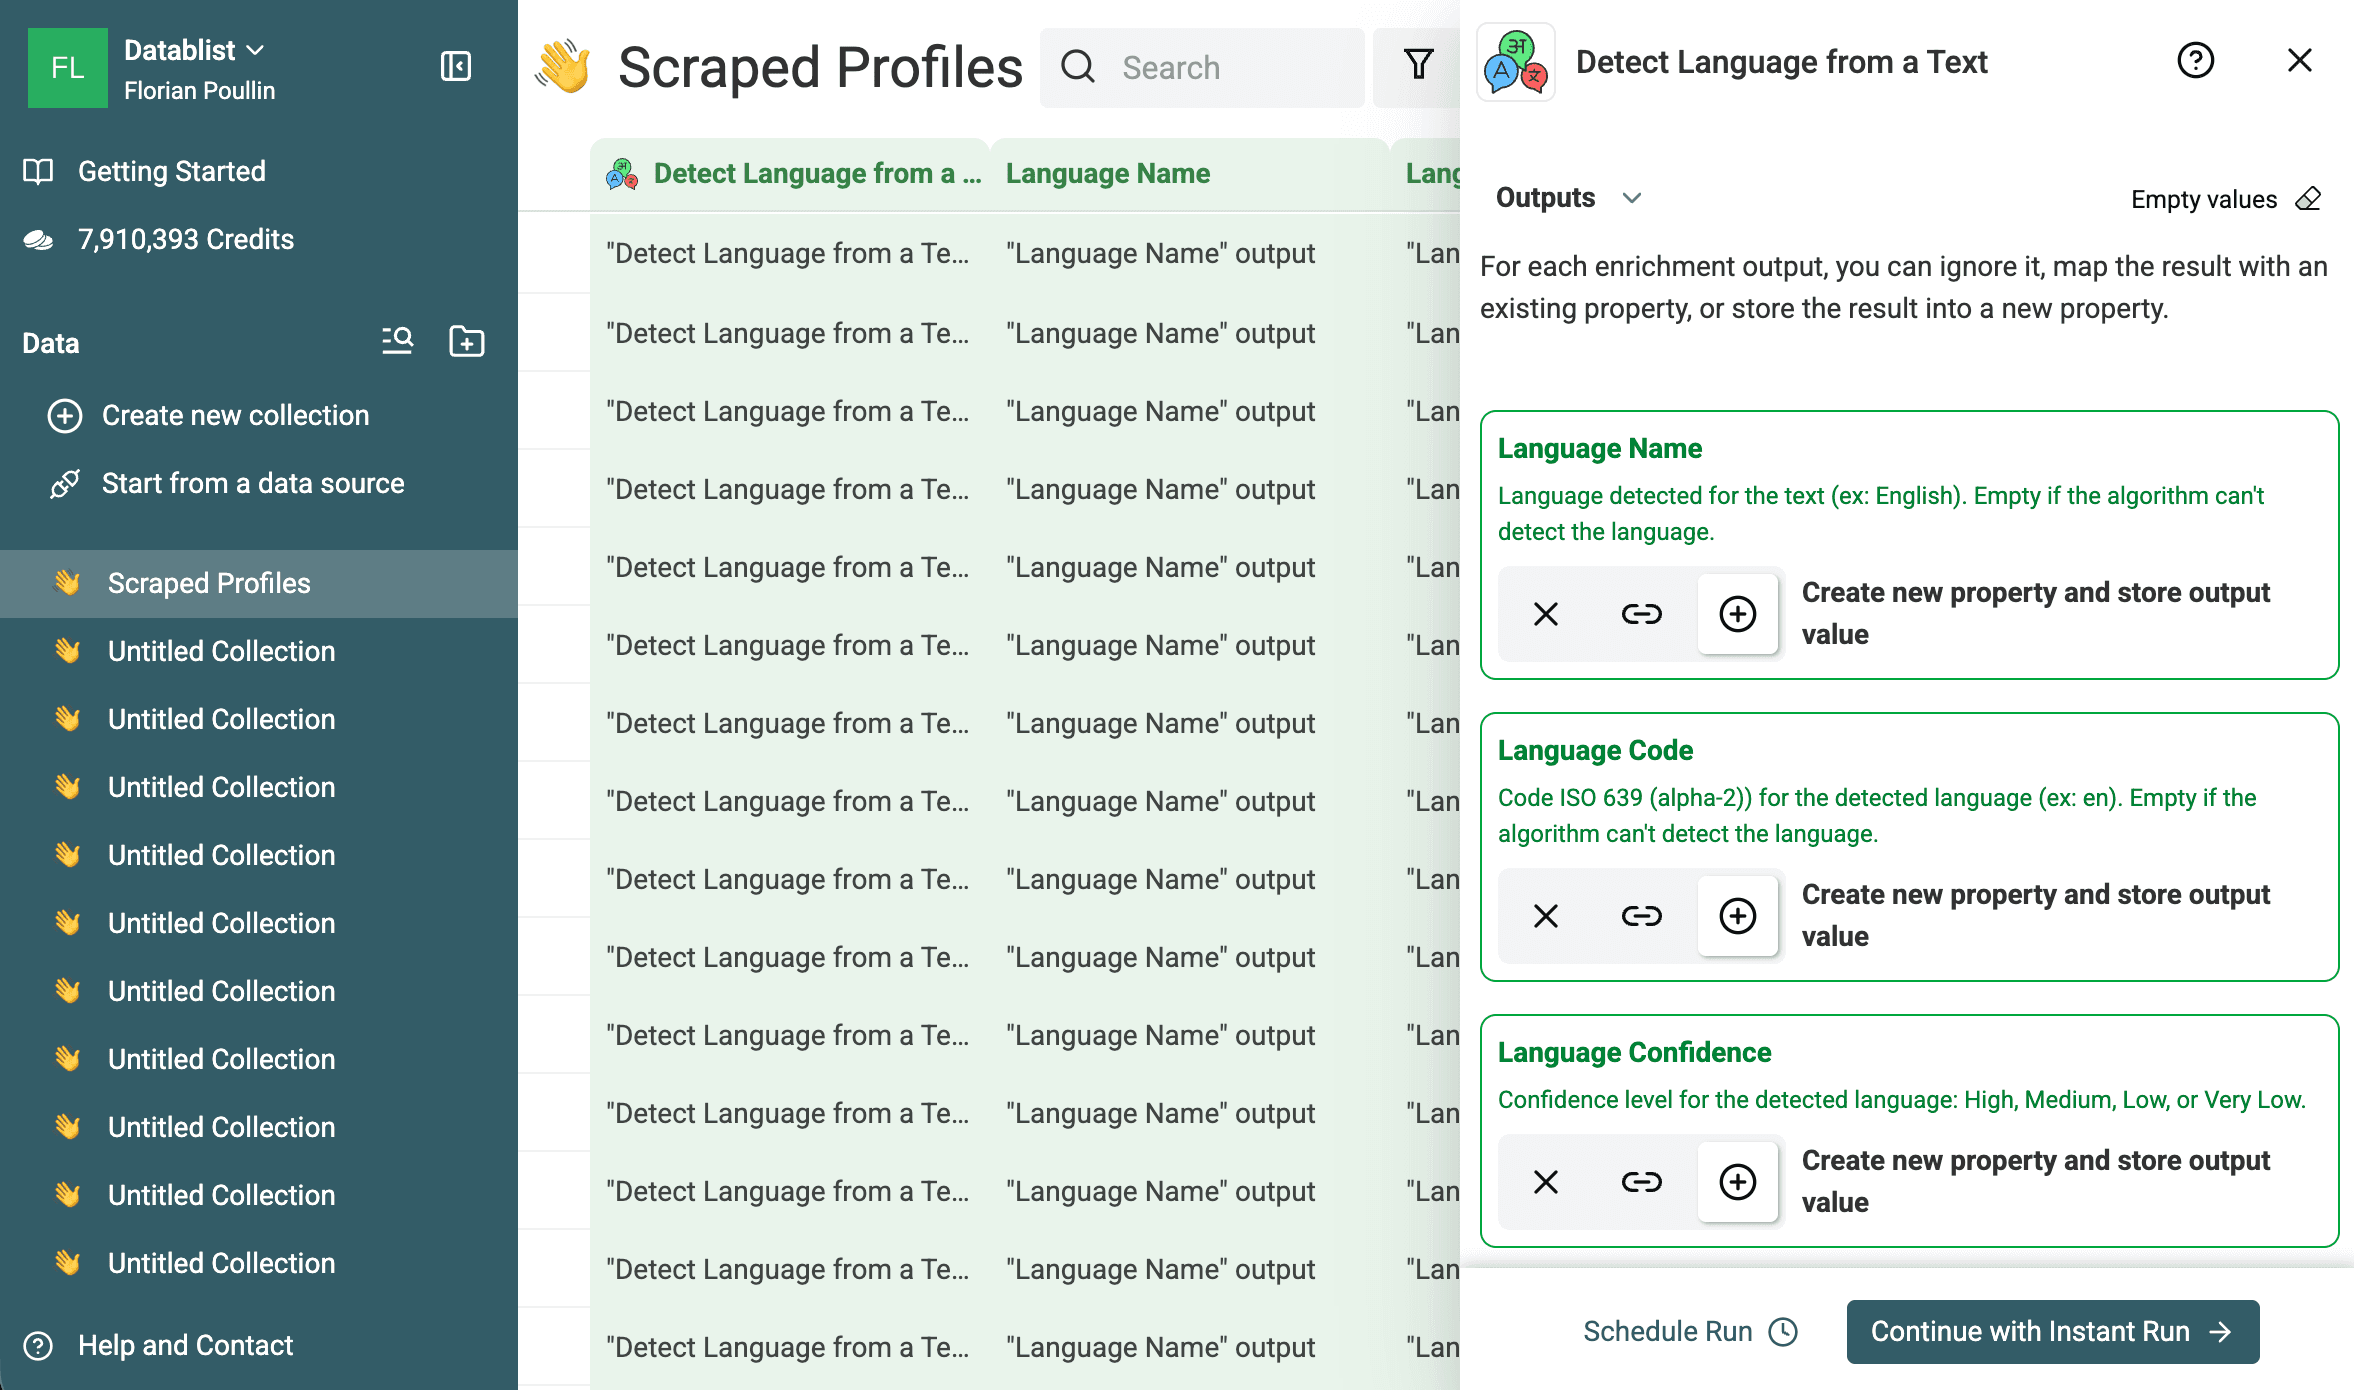
在处理整个文件之前,先对前 10 行运行 enrichment。即使工作流很简单,我也会这样做,因为它能迅速发现错误的输入映射。如果不小心选择了 Company 而不是 Bio,你会在为整个数据集消耗 credits 之前发现结果不理想。
⚠️ 短文本更难识别
单个词、品牌名、账号名、数字和 URL 可能无法提供足够的语言特征。应把低置信度或没有结果的行视为待检查队列,而不是处理失败。
确认首次运行的结果没有问题后,再处理其余数据。
第 4 步:检查语言检测结果
首次预览运行后,新的语言列应当出现在原始数据旁边。在下面的示例中,Datablist 在前几行识别出了英语、法语、西班牙语、德语、意大利语、葡萄牙语、荷兰语、日语、阿拉伯语和中文。
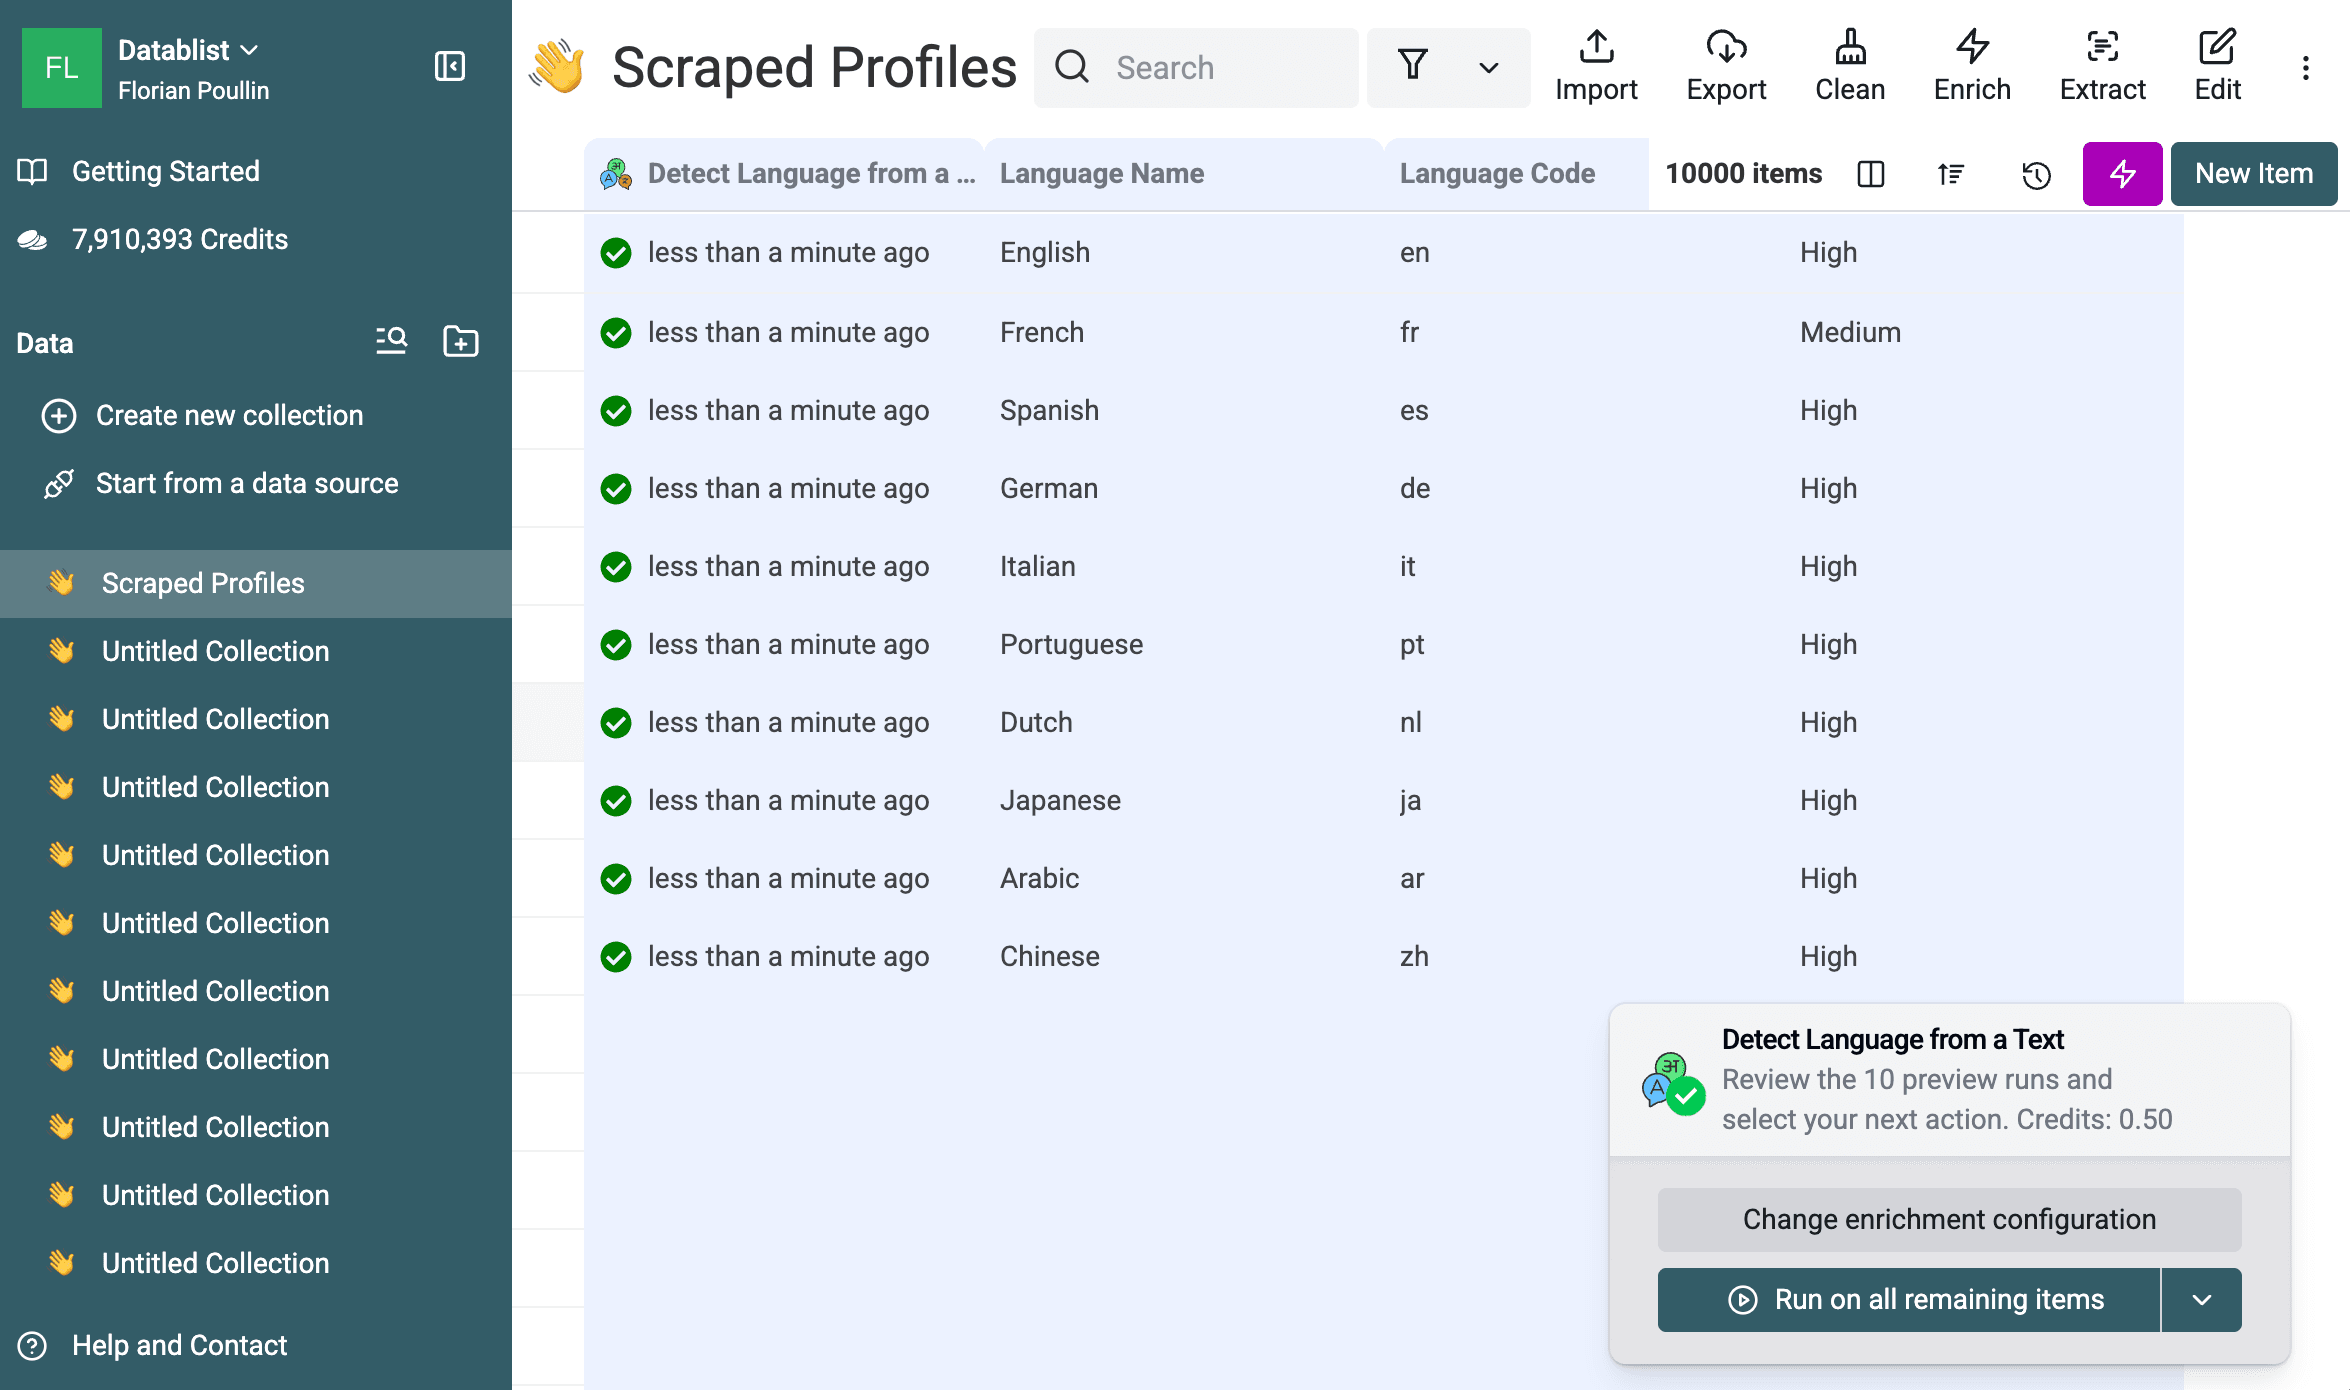
你可以预期得到类似下面的结果表:
| Profile ID | 文本特征 | Language Name | Language Code | 置信度 | 需要检查 |
|---|---|---|---|---|---|
C8C1DXQBNP | 英文 Bio | English | en | High | 否 |
61M25JUEHM | 法文 Bio | French | fr | Medium | 可能需要 |
Y45G9QU71C | 西班牙文 Bio | Spanish | es | High | 否 |
RL20HHREOT | 德文 Bio | German | de | High | 否 |
| 空白行 | Bio 为空且 Headline 特征不足 | 无结果或输入无效 | 空白 | 空白 | 是 |
| 仅有账号名的行 | @marketloop | 无结果或低置信度 | 空白 | Low | 是 |
我不会把置信度直接当作最终的业务决策,而是把它视为分流依据。如果下一步只是准备翻译或做粗粒度细分,High 和 Medium 通常已经足够。对于 Low、Very Low、输入无效和无结果的数据,则应在发送邮件、分配客服工单或更新 CRM 之前进行检查。
📘 用置信度快速定位检查重点
置信度不能代替人工判断,但可以告诉你应该优先关注哪些数据。
如果准确性很重要,请在运行后创建一个简单的 Needs Review 列。当置信度为 Low 或 Very Low、输入无效,或者 Datablist 没有返回结果时,将其标记为 Yes。这样就能把数据集中混乱的部分转化为一个规模较小的待处理队列。
语言检测是 AI classification 的典型应用:系统会将每一行分配到一个类别,而置信度能帮助你决定哪些数据可以继续流转。
第 5 步:筛选、导出或继续翻译
填充语言列后,请先筛选数据集,再导出或运行下一个工作流。
从置信度开始。打开 Language Confidence 列菜单,筛选低置信度数据。优先检查这些行,因为它们最有可能包含空文本、短片段、多语言混合内容或非语言值。
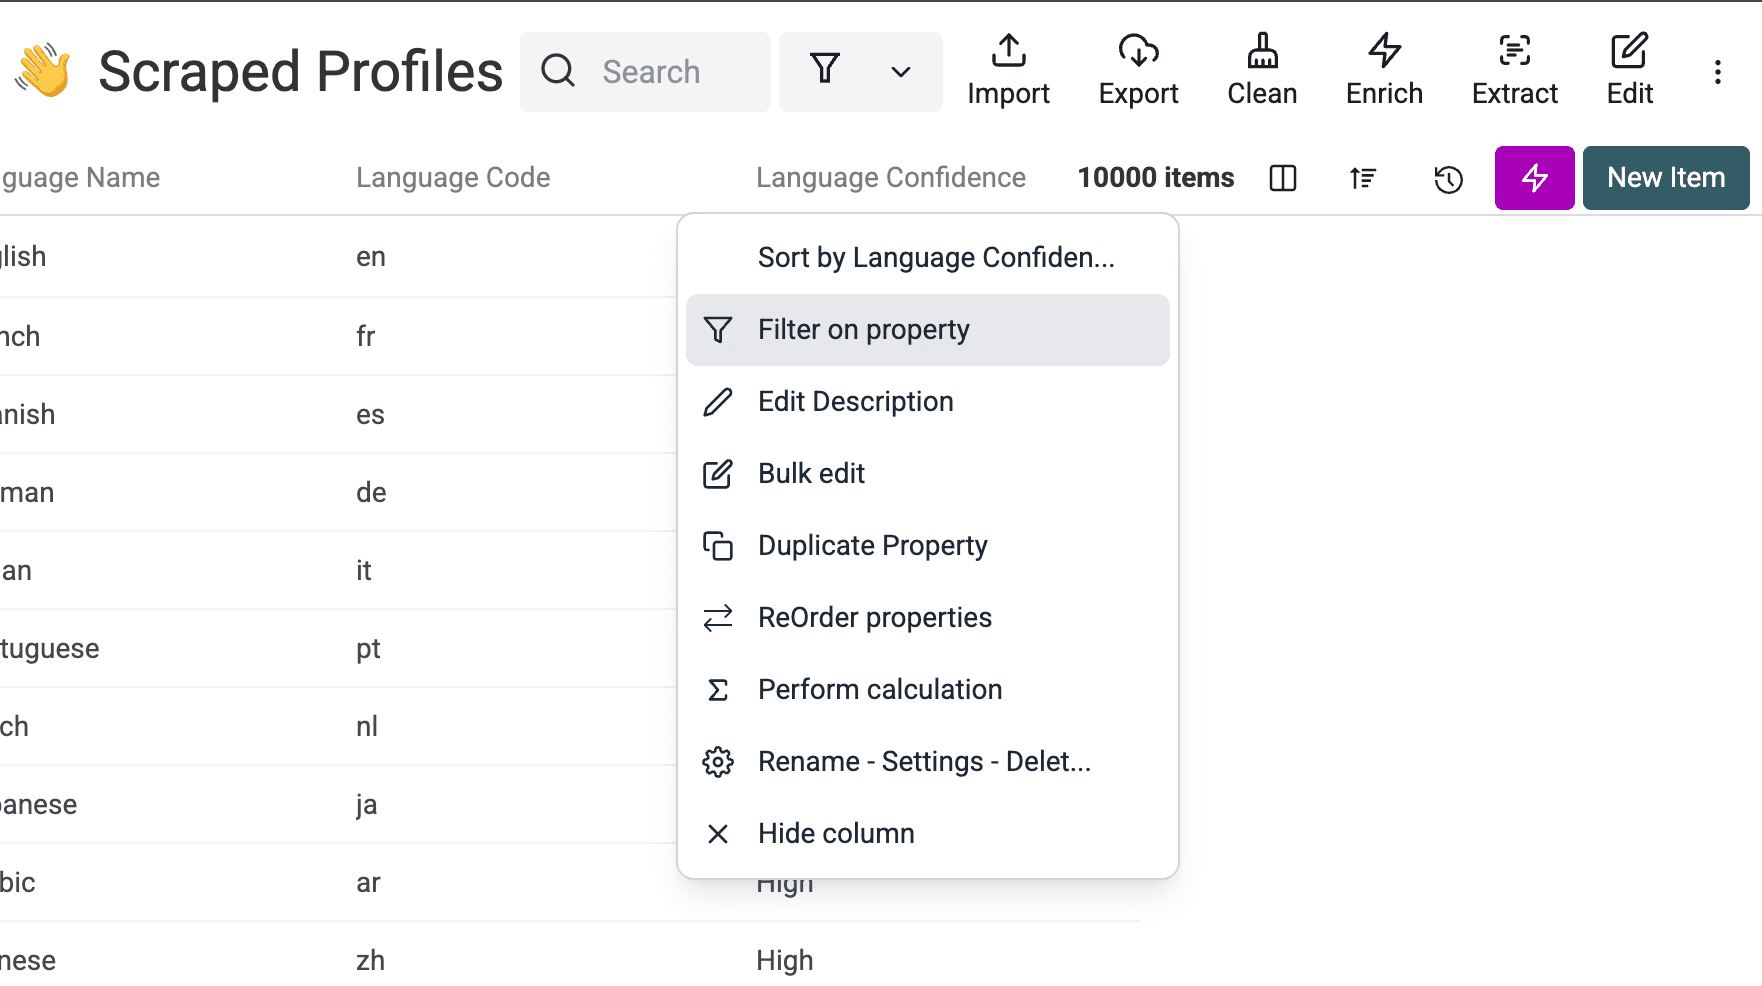
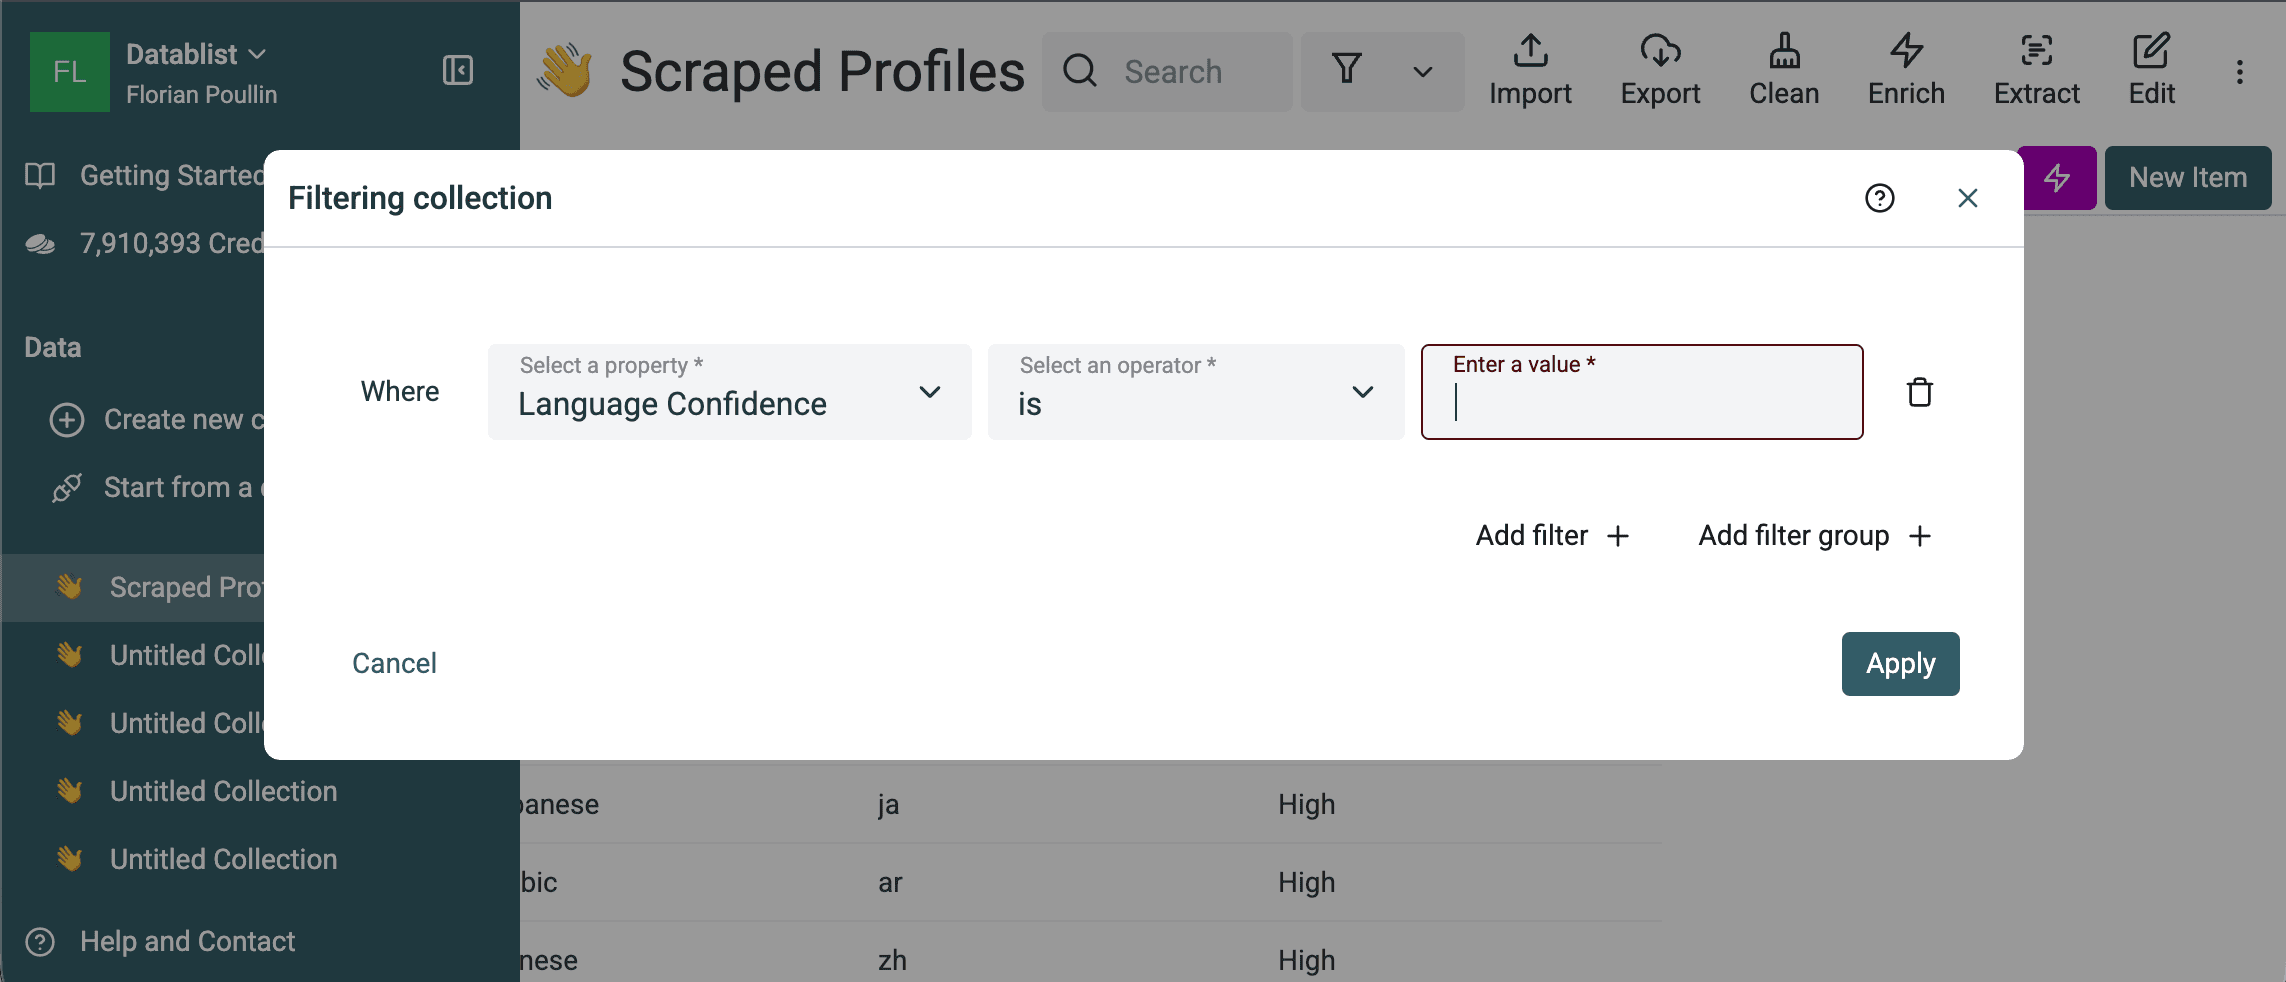
当你需要按语言细分数据时,再通过 Language Code 进行筛选。例如:
- 将
fr、es、de和it行送去翻译。 - 把
ja和zh客服工单分配给合适的团队。 - 为某个营销活动只保留英文行。
- 将文件导入 CRM 前删除无效行。
如果下一步是翻译,可以在在线翻译 CSV 文件之前,使用语言代码整理文件。对于包含多种语言的文件,我通常会先识别源语言。这样既能避免翻译已经是目标语言的行,也能让检查流程更可控。
确认数据集足够整洁后,将其导出为 CSV 或 Excel。请保留原始文本、语言名称、语言代码、置信度和检查字段。如果之后有人询问某一行为什么进入翻译、分配或人工检查流程,这些列就能说明原因。
费用:按行收取固定 credits
Detect Language from a Text enrichment 的价格为每行 0.05 credits,费用仅由行数决定。无论一行只包含简短的 Headline,还是包含较长的客服工单、商品描述、评论或网页摘录,单行价格都不会改变。
按照 Datablist credits 充值的起始档位计算,20,000 credits 售价为 20 美元,即 1 credit 等于 0.001 美元。大致费用如下:
| 行数 | 消耗的 credits | 预估费用 |
|---|---|---|
| 1,000 | 50 credits | $0.05 |
| 10,000 | 500 credits | $0.50 |
| 100,000 | 5,000 credits | $5.00 |
这也是我优先使用专用 enrichment、而不是一开始就尝试 ChatGPT 的原因之一。ChatGPT/OpenAI 的费用取决于输入和输出 token 数量。用 LLM 处理简短 Bio 的成本不高,但较长的工单、商品描述、评论和网页文本包含更多 token,因此费用也会增加。使用语言检测 enrichment 时,无论发送多少文本,每行都只需 0.05 credits。
使用企业域名邮箱注册的新用户还可以获得 500 个免费 credits 来测试这套流程。按每行 0.05 credits 计算,500 credits 足以完成 10,000 次语言检测。
替代方案:使用 ChatGPT 设置自定义规则
单纯的语言检测通常不需要 LLM。专用 enrichment 更适合作为首选,因为它的输出是固定的:语言名称、代码和置信度。它的单行成本也更容易预测,而 ChatGPT/OpenAI 的费用取决于 token 用量。
当语言结果需要结合业务逻辑判断时,可以使用 ChatGPT 或 OpenAI。例如,你可能希望:
- 将多语言混合行标记为
Mixed,而不是强行选择一种主要语言。 - 将语言检测与客户意图分类结合起来。
- 根据自己的阈值添加
Needs Review字段。 - 为含义模糊的行返回简短的审核原因。
- 按特定规则处理地区语言变体或产品名称。
Datablist 可以通过 Ask ChatGPT/OpenAI enrichment,在 CSV 或 Excel 的每一行上运行 ChatGPT prompt。使用 prompt variables 可将每行的值插入 prompt。
下面是适用于同一份个人资料数据集的简单 prompt:
识别以下文本的主要语言。

文本:
{{Bio}}

如果文本为空、主要由数字组成、是 URL,或内容太短而无法判断,请返回“No result”,并将 Needs review 标记为 Yes。
使用预先定义的输出:
| 输出名称 | 类型 | 说明 |
|---|---|---|
Language name | Text | Bio 或 Headline 的主要语言。如果没有足够的语言特征,则返回 No result。 |
ISO 639-1 code | Text | 两个字母的代码,例如 en、fr、es 或 de。没有结果时留空。 |
Confidence | Select 或 text | High、Medium 或 Low。 |
Needs review | Select 或 text | 对于空白、含义模糊、多语言混合或低置信度文本,返回 Yes;否则返回 No。 |
Reason | Text | 用于审核工作流的可选简短说明。如果只需要标签,可以跳过。 |
🔍 用 ChatGPT 处理规则,而非常规检测
如果输出需要判断的不只是“这是什么语言?”,ChatGPT 会很有用。如果只需要语言代码,请继续使用专用 enrichment。
最常见的错误是要求 ChatGPT 返回一整段文字,这会增加后续的数据清理工作。应将每项输出分别存入独立列,以便筛选、排序、导出和复用数据。
质量检查清单
使用增强后的文件之前,我通常会检查以下数据:
- 从多种已识别语言中随机抽查 20 至 50 行。
- 置信度为 Low 或 Very Low 的行。
- 输入无效或没有结果的行。
- 简短 Bio、账号名、URL、数字以及仅含公司名称的文本。
- “主要语言”判断可能存在主观性的多语言混合行。
- 下一个工具所要求的 ISO 代码。
合适的阈值取决于具体工作流。翻译准备可以接受少量人工检查任务;客服工单分配则需要更加谨慎,因为错误的语言判断可能会把工单交给错误的人员。Outreach 细分也需要检查,因为使用错误的语言发送消息会显得很不专业。
对于大多数文件,最快的处理方式很简单:信任 High;当文本较短时检查 Medium;对 Low、Very Low、输入无效和无结果的行进行人工复核。
应用场景与处理方式
客服团队可以在分配工单前识别其语言。当同一个收件箱收到来自多个国家或地区的消息,而团队需要快速完成初步分流时,这种方法很实用。
问卷团队可以在分析前识别开放式回答的语言。我会在翻译前完成这一步,以便保持源数据井然有序。
销售和招聘团队可以在开展 Outreach 前,按个人资料 Bio 的语言进行细分。语言代码列可以帮助团队分配负责人或准备本地化消息。
电商团队可以在本地化之前识别商品描述的语言。如果商品目录中混有来自不同供应商的内容,语言检测可以区分哪些内容需要翻译,哪些已经可以直接使用。
网页抓取工作流也适用同一种模式。从多个市场抓取页面后,可以先识别网页语言,再决定保留、翻译或丢弃哪些内容。
如果许多行的 Bio 列为空,可以对 Headline 运行 enrichment,或在输入中合并这两个字段。当每个字段都很短时,我通常会把它们组合起来;如果一个字段已经包含完整句子,则只使用该字段。
常见问题排查
如果文本为空,通常会得到输入无效或无结果的状态。筛选出这些行,再决定将其删除,还是补充另一个文本字段。
如果某一行只包含 URL、账号名、数字、ID 或品牌名,请不要直接相信检测结果。这些值无法为检测工具提供足够的语言特征。
如果一行包含多种语言,可以把检测结果视为主要语言,同时检查置信度。对于要求严格的工作流,可以使用 ChatGPT 或人工检查创建单独的 Mixed 标签。
如果文件中出现较少见的语言,请先抽样检查,再决定是否大规模采用结果。该 enrichment 支持许多常见语言,但最稳妥的做法仍然是在导出前检查边缘情况。
如果文件很大,请先运行前 10 行,必要时再测试更大的样本。确认输入映射和输出列无误后,再运行整个数据集。
总结
在电子表格中识别语言,最实用的方法是让整个流程保持逐行对应。导入 CSV 或 Excel 文件,选择 Detect Language from a Text,指定一个或多个文本列,创建语言名称、代码和置信度输出列,然后在导出前检查低置信度数据。
常规语言检测应使用专用 enrichment。无需编写代码或创建自定义 prompt,就能得到所需列,而且费用始终按行数固定计算。当你需要业务规则、多语言混合标签或额外的检查逻辑时,再使用 ChatGPT。
先对少量数据进行测试并检查结果,然后再处理整个文件。这个简单的检查通常能节省更多时间。
FAQ
如何识别 CSV 文件中每一行的语言?
将 CSV 导入 Datablist,从 Enrich 菜单中选择 Detect Language from a Text,在 Inputs 步骤中映射文本列,并将语言名称、代码和置信度存入新列。
不写代码也能识别 Excel 每一行的语言吗?
可以。将 Excel 文件导入 Datablist,并对文本列运行语言检测 enrichment。结果会写回数据集,之后可以导出为 CSV 或 Excel。
应该添加哪些输出列?
使用 Language Name、Language Code 和 Language Confidence。如果希望单独筛选 Low、Very Low、输入无效或无结果的数据,可以再添加 Needs Review 列。
语言置信度代表什么?
置信度表示语言检测结果可能有多可靠。请将其作为检查依据。High 和 Medium 通常可以继续进入下一步,而 Low 和 Very Low 则值得人工核对。
如何处理低置信度的语言检测结果?
将它们筛选到待检查队列中,确认文本是否太短、为空、包含多种语言,或仅由姓名、URL、账号名和数字组成。
可以先识别语言,再翻译多语言 CSV 吗?
可以。先识别源语言,再按语言代码筛选后进行翻译。这样可以避免翻译那些已经是目标语言的行。
批量语言检测的费用是多少?
Detect Language from a Text 的价格是每行 0.05 credits。按 20 美元购买 20,000 credits 计算,检测 1,000 行约需 0.05 美元,10,000 行约需 0.50 美元,100,000 行约需 5 美元。使用企业域名邮箱注册的新用户可获得 500 个免费 credits,足够完成 10,000 次检测。
批量语言检测应该使用 ChatGPT 吗?
需要自定义规则或组合分类时,可以使用 ChatGPT。对于普通语言检测,专用语言检测 enrichment 更简单,而且每行费用固定。如果每行包含较长文本,ChatGPT/OpenAI 的成本可能更高,因为 LLM 费用取决于 token 数量。
如果文本为空、只有 URL 或内容太短,会发生什么?
空文本属于无效输入,没有明确语言特征的文本可能不返回结果或只有较低置信度。请在导出或翻译前筛选这些行。
可以通过个人资料 Headline 而不是 Bio 识别语言吗?
可以,但 Headline 往往较短。如果条件允许,请在输入中合并 Headline 和 Bio,让 Datablist 获得更多可供分析的文本。
可以把语言名称和 ISO 语言代码导出到 CSV 或 Excel 吗?
可以。运行 enrichment 后,将包含原始文本、语言名称、语言代码、置信度和检查字段的数据集导出即可。