
要在线去重列表,首先要确定哪个字段能够唯一标识一个人、公司或产品。先执行严格匹配,检查系统识别出的重复组,再合并有用信息,或删除没有新增价值的行。这样既能高效清理数据,也不会把所有相似值都误判为可以安全合并的重复项。
Datablist 将整个流程整合在浏览器中。导入 CSV 或 Excel 文件,选择匹配属性,对比各行数据,检查结果,然后导出清理后的列表。在你启动 Remove、Merge 或自定义处理操作之前,重复项检测始终是只读的,不会修改原始数据。
本指南使用一份可下载的 1,000 行示例数据,其中包含完全相同的副本、Email 别名、公司名称变体、URL 差异、基础电话号码格式差异、拼写错误、冲突值以及信息互补的记录。
🔑 安全去重原则
使用最精简且可靠的标识符进行匹配,但要结合整行数据决定保留哪些信息。
简单列表在线去重方法
如果列表中每行只有一个值,请将其保存为单列 CSV,并添加 Email、Domain 或 Value 等表头。将文件导入 Datablist,然后在该列上运行 Clean > Remove duplicates,匹配方式选择 Exact。检查重复组,选择要保留的记录,处理重复行,最后导出剩余数据。
例如,一份演示列表包含 alpha.example、beta.example 和 alpha.example。删除重复行后,应保留一个 alpha 值和一个 beta 值。这只是输入与输出示例,并非来自可下载样本的另一项测试结果。
这种方法适合处理标识符列表。如果文件包含多列,你要解决的就是重复记录问题:删除一行时,该行的其他字段值也会一并删除。如果同一个 Email 对应的第二行中含有有用的电话号码或备注,请使用下文介绍的合并流程。
请将标识符为空的记录单独处理。在默认的所选属性比较中,缺失的文本标识符不能证明两条记录匹配。如果需要删除空行,应明确执行相应的数据清理操作,而不是让去重功能猜测这些空行代表什么。
确定记录的唯一标识符
不要先考虑匹配算法,而要先定义你要识别的实体。
联系人、公司、产品和交易需要使用不同的标识符:
| 列表类型 | 推荐的首选标识符 | 适合第二轮匹配的字段 |
|---|---|---|
| 联系人 | Email、电话、LinkedIn URL | 姓名加公司 |
| 公司 | 网站域名、公司 ID | 标准化公司名称 |
| 产品 | SKU、EAN、GTIN、产品 URL | 产品名称加品牌 |
| CRM Leads | Email、电话、CRM ID | 姓名加公司域名 |
| 订单 | 订单 ID | 客户 ID 加下单日期 |
一次匹配很少能找出所有重复项。同一位联系人可能在两行中使用相同 Email,也可能更换了 Email,但仍使用相同的电话号码。应针对不同标识符分别执行匹配,而不是把所有属性塞进同一条规则。
例如:
- 按 Email 匹配联系人。
- 处理检查过的重复组。
- 标准化电话号码,再对清理后的属性执行 Exact 检查。
- 使用姓名加公司的组合,谨慎执行 fuzzy matching。
在同一次检查中加入 Email、电话、姓名和公司会使匹配条件更加严格。记录必须满足完整配置,因此一个缺失值就可能导致真正的重复项被漏掉。
如果标识符需要专门的标准化处理,请参阅以下指南:
下载 1,000 行示例列表
下载去重演示 CSV。 文件包含 1,000 行数据,代表预先设计的 800 个实体。
文件混合了多种测试场景:
| 设计场景 | 重复组数量 | 匹配方式 |
|---|---|---|
| 整行完全相同的副本 | 5 | All Properties + Exact |
| Email 别名和包装格式 | 100 | Email + Smart + Email processor |
| 公司名称和 URL 变体 | 50 | Company Name 或 URL processor |
| 基础美国电话号码格式差异 | 25 | Phone + Smart,仅处理格式 |
| 受控的姓名拼写错误 | 15 | Jaro-Winkler 或 Levenshtein |
| 名字的语音变体 | 5 | Metaphone |
| 未设计重复项的记录 | 600 | 应保持独立 |
这些数字是预先设计的 ground truth,并不代表每个 fuzzy threshold 都会返回相同结果。阈值较低时,距离匹配可能纳入额外候选项。请先检查这些重复组,再进行处理。
以下是文件中的三组数据:
| 使用场景 | 第一个存储值 | 第二个存储值 |
|---|---|---|
| Email 别名 | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| 公司和 URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| 基础电话格式 | +1 (202) 555-0768 | 1 202 555 0768 |
这些行在职位、负责人、状态、营收、来源、标签和备注等字段上也存在差异。利用这些冲突,可以测试主记录选择规则和字段保留规则。
将列表导入 Datablist
打开 Datablist,将 CSV 或 Excel 文件导入一个 collection。Collection 类似结构化电子表格:每一行是一个 item,每一列是一个 property。
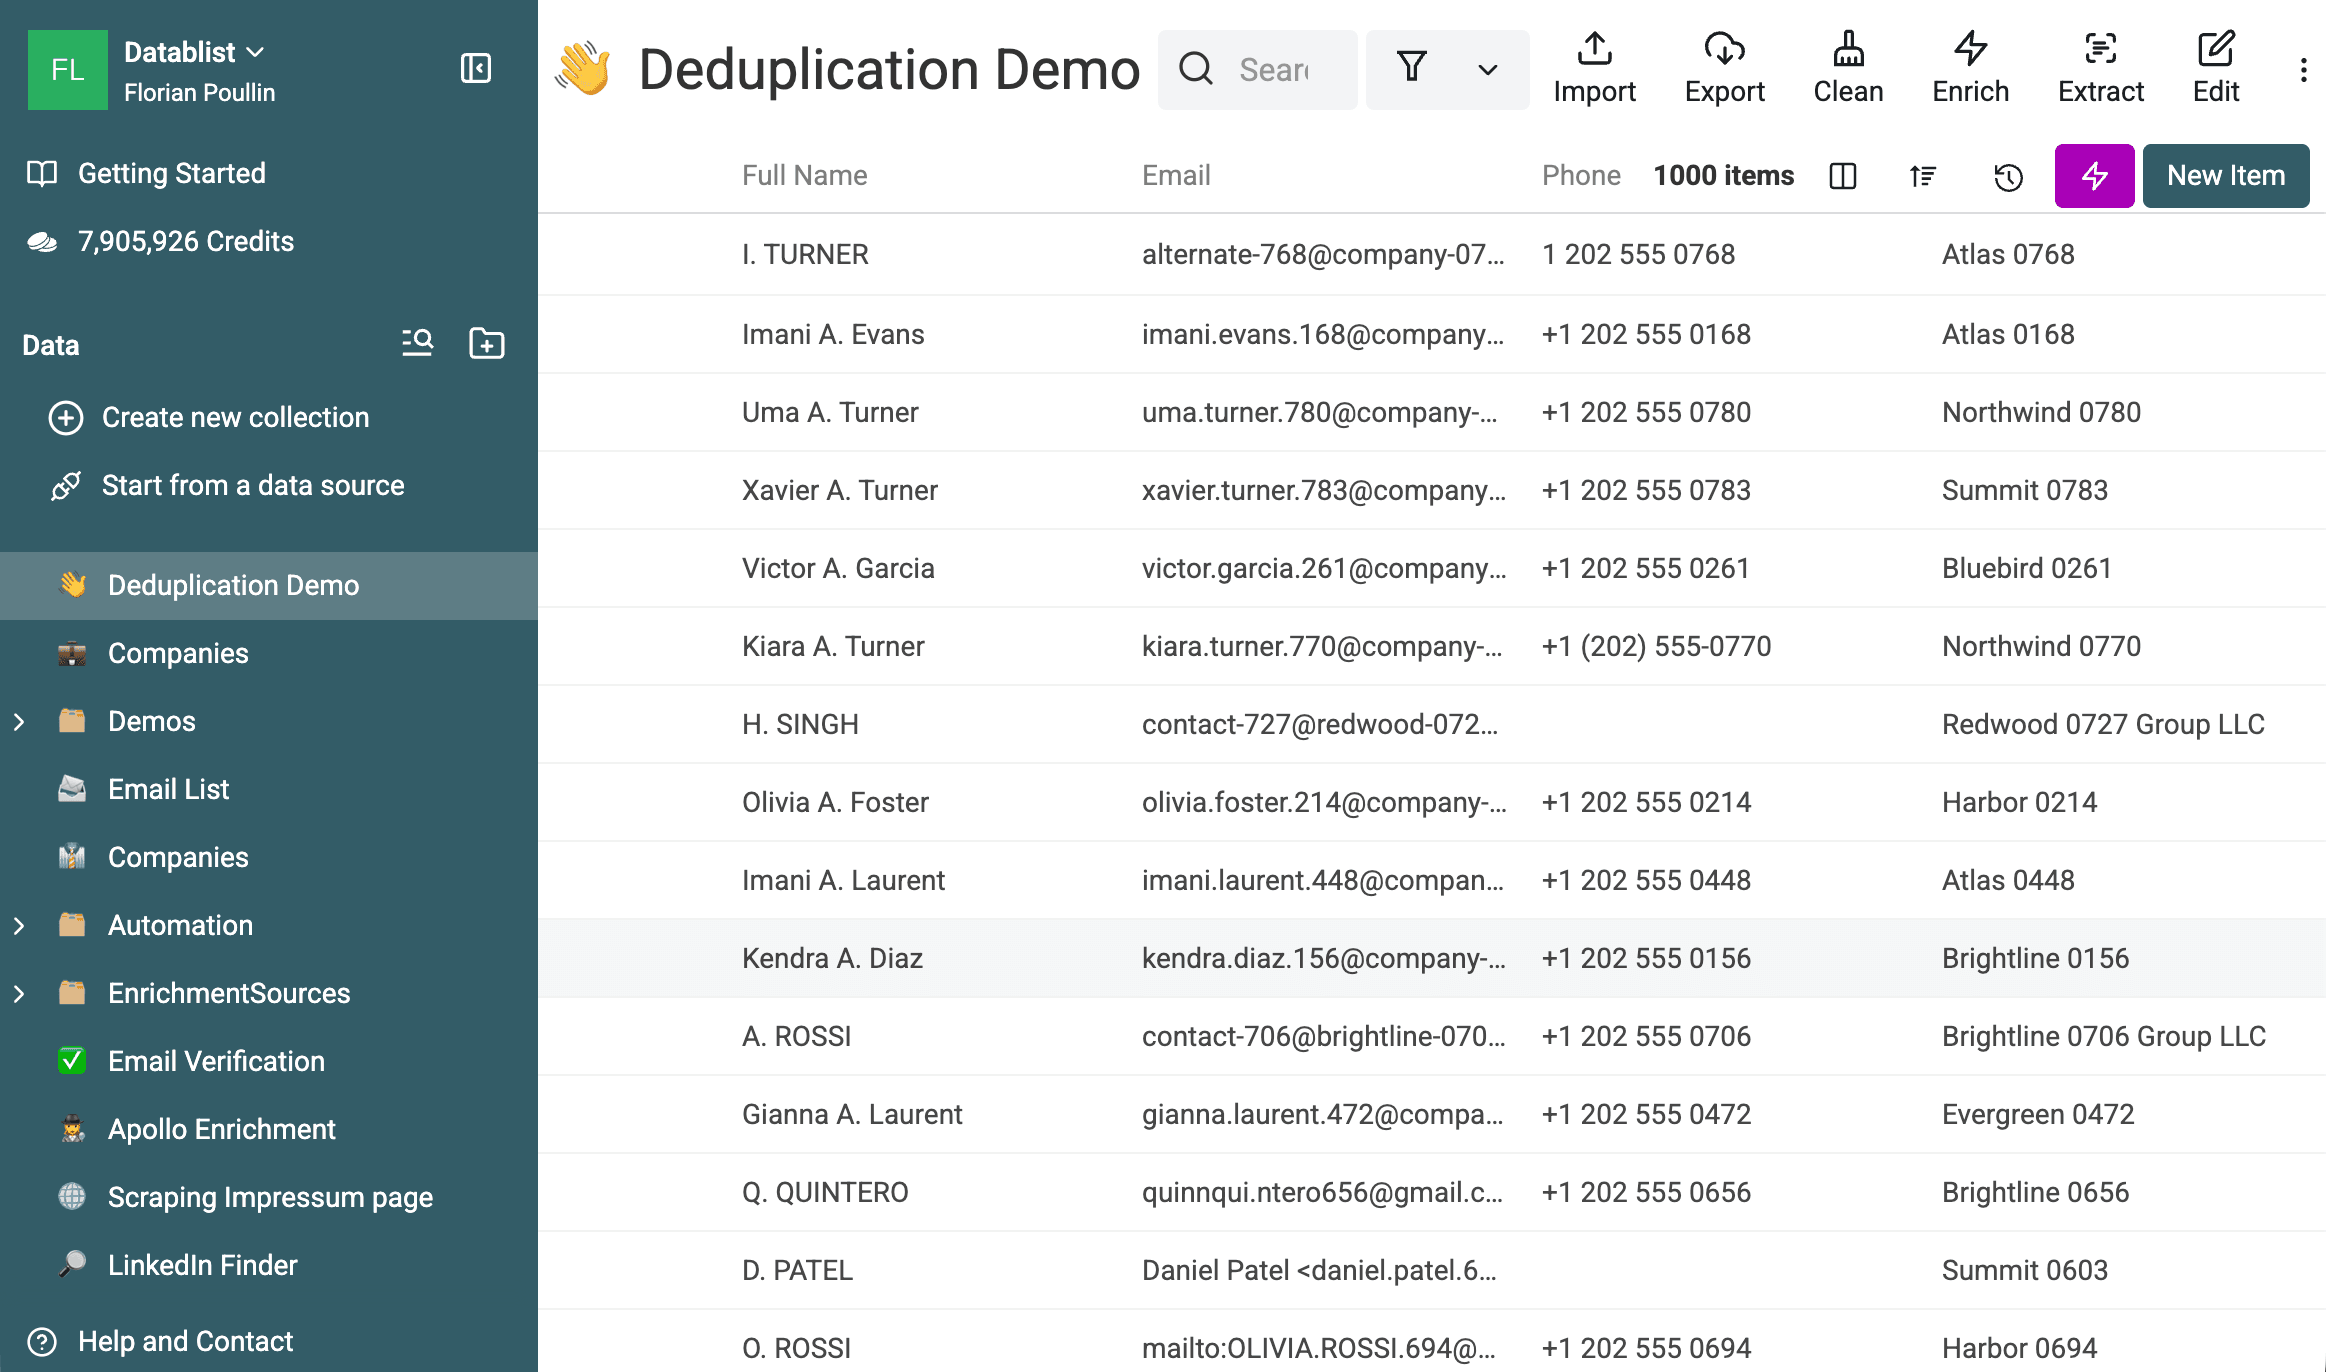
导入时,请检查系统识别出的 property type:
- Email 列应使用 Email type。
- 网站列应使用 URL。
- 电话列应使用 Phone。
- 营收或数量列应使用 Number。
- 活动日期和创建日期应使用 DateTime。
请在 collection 中保留 ID、来源、负责人、备注和状态列。这些信息有助于选择正确记录,并确认合并操作会保留哪些内容。
执行 Exact、Smart 和模糊匹配
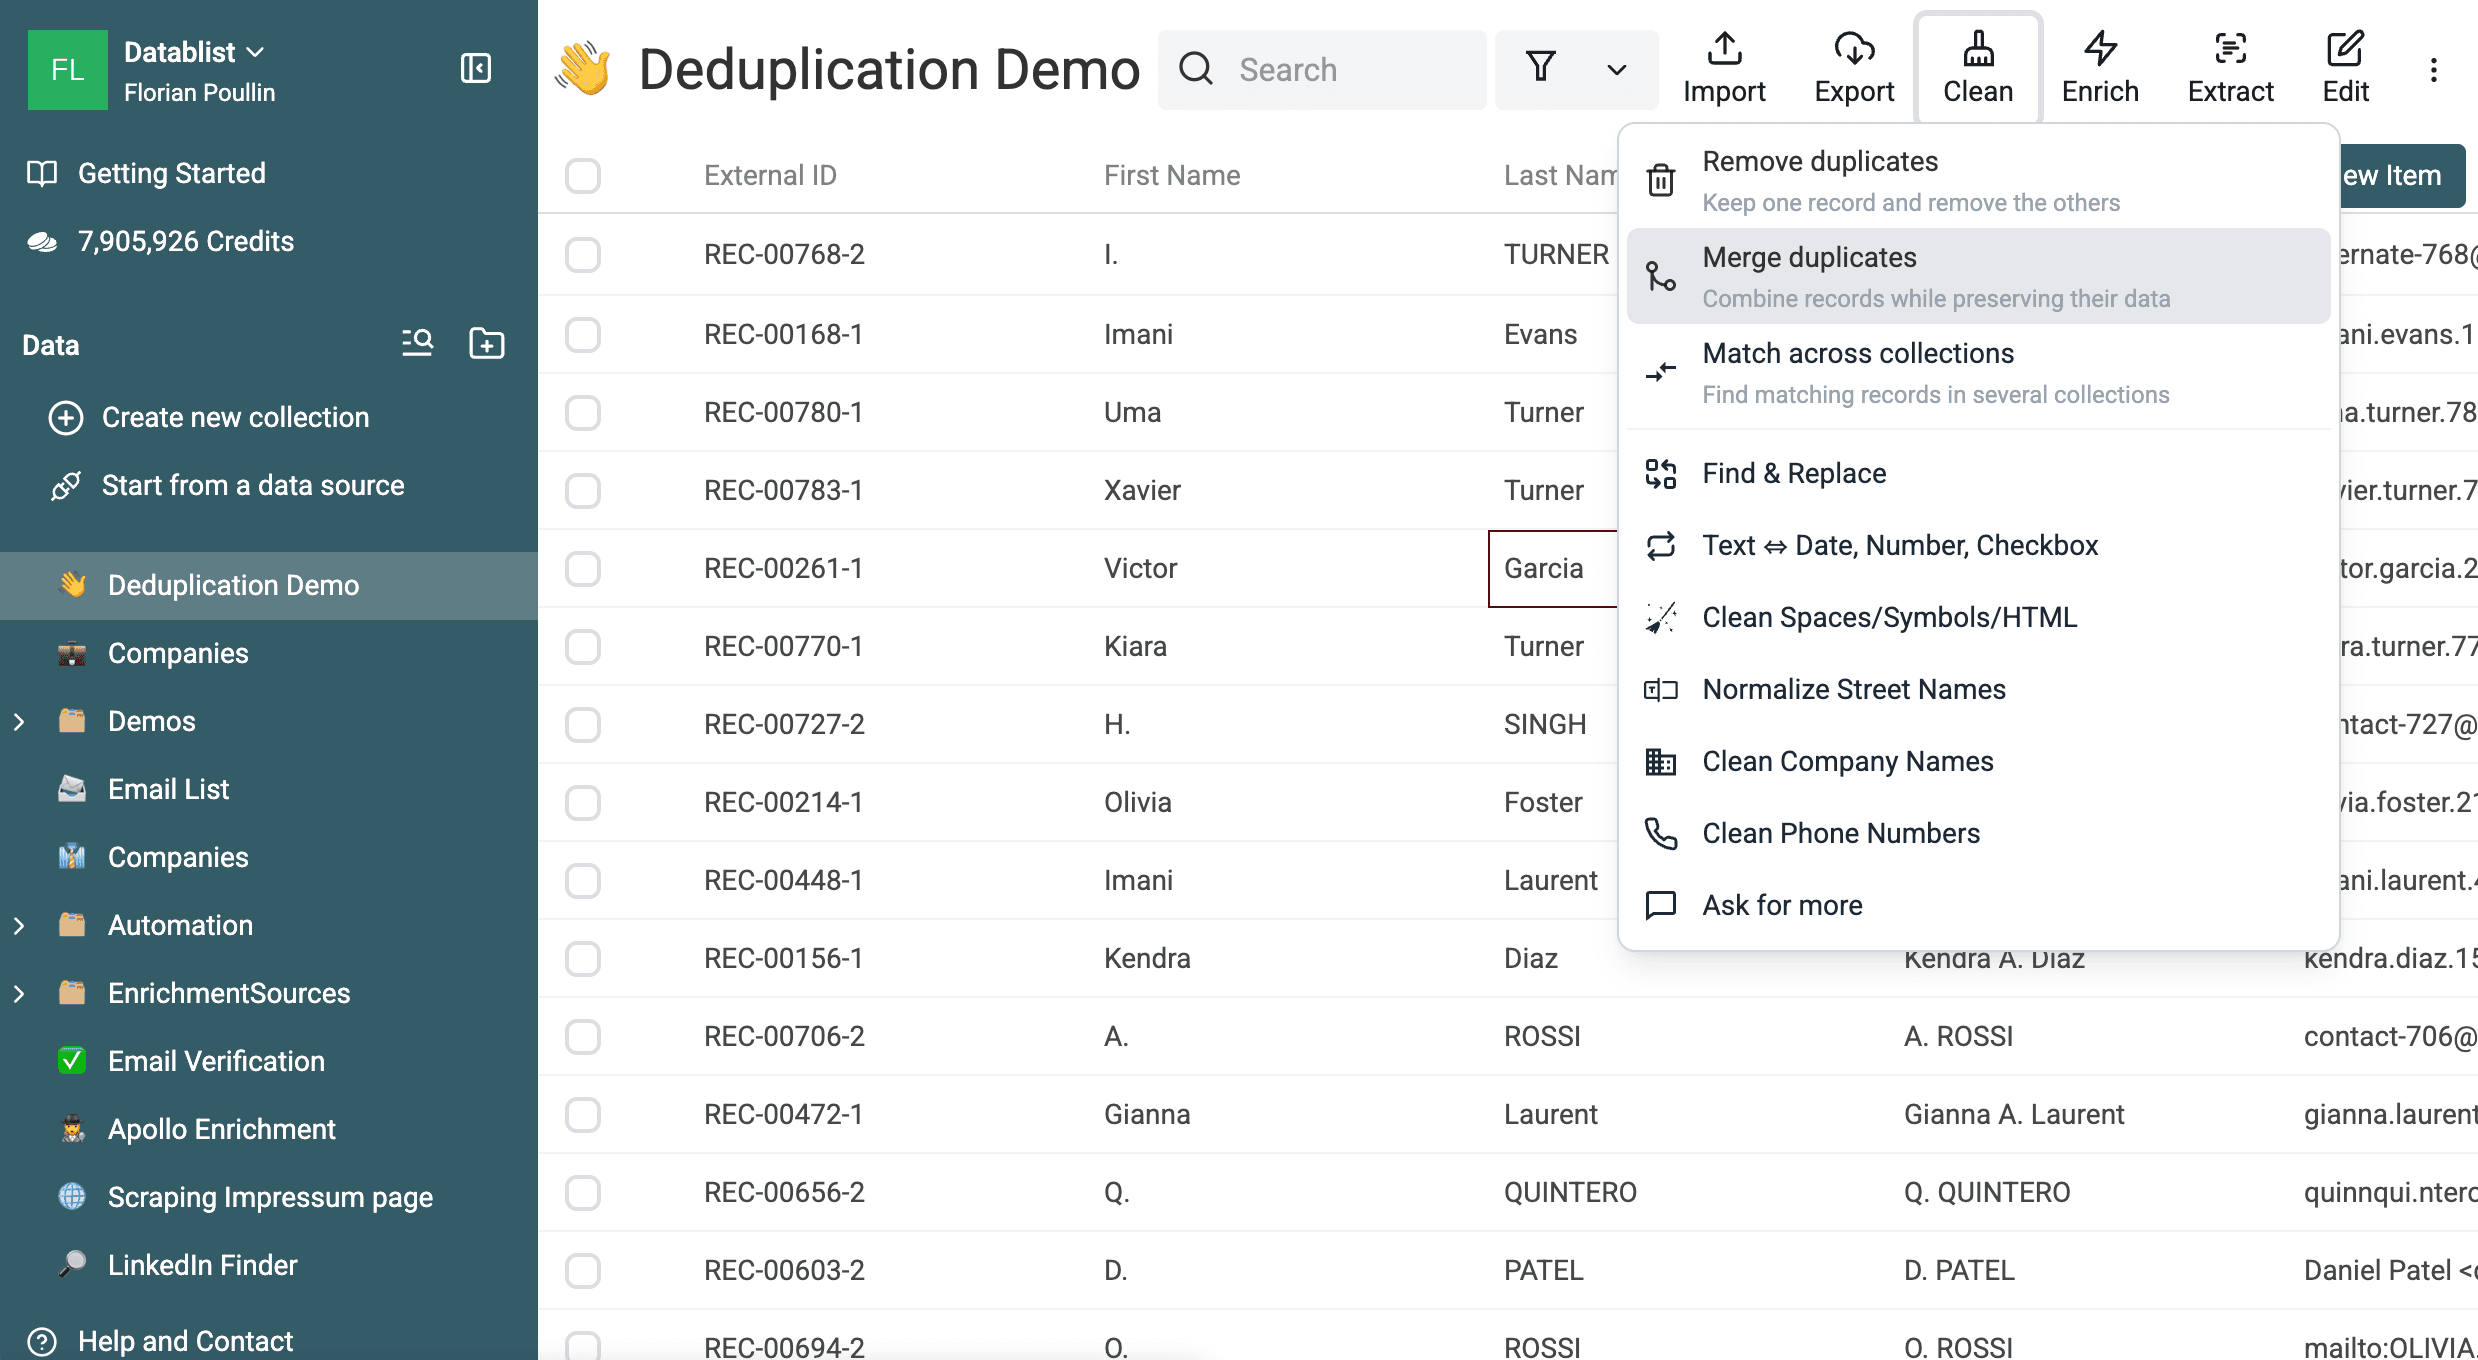
打开 Clean,根据目标选择相应操作:
- 如果可以舍弃次要记录,选择 Remove duplicates。
- 如果不同记录中有需要保留的信息,选择 Merge duplicates。
- 如果记录位于不同 collection 中,选择 Match across collections。
前两个操作使用相同的检测引擎,但打开结果 workspace 时会预选不同的处理模式。
从 Exact matching 开始
使用 All Properties 和 Exact 查找未经修改、被重复复制的整行记录。如果某个字段(例如外部 ID)必须完全一致,则使用 Selected Properties。
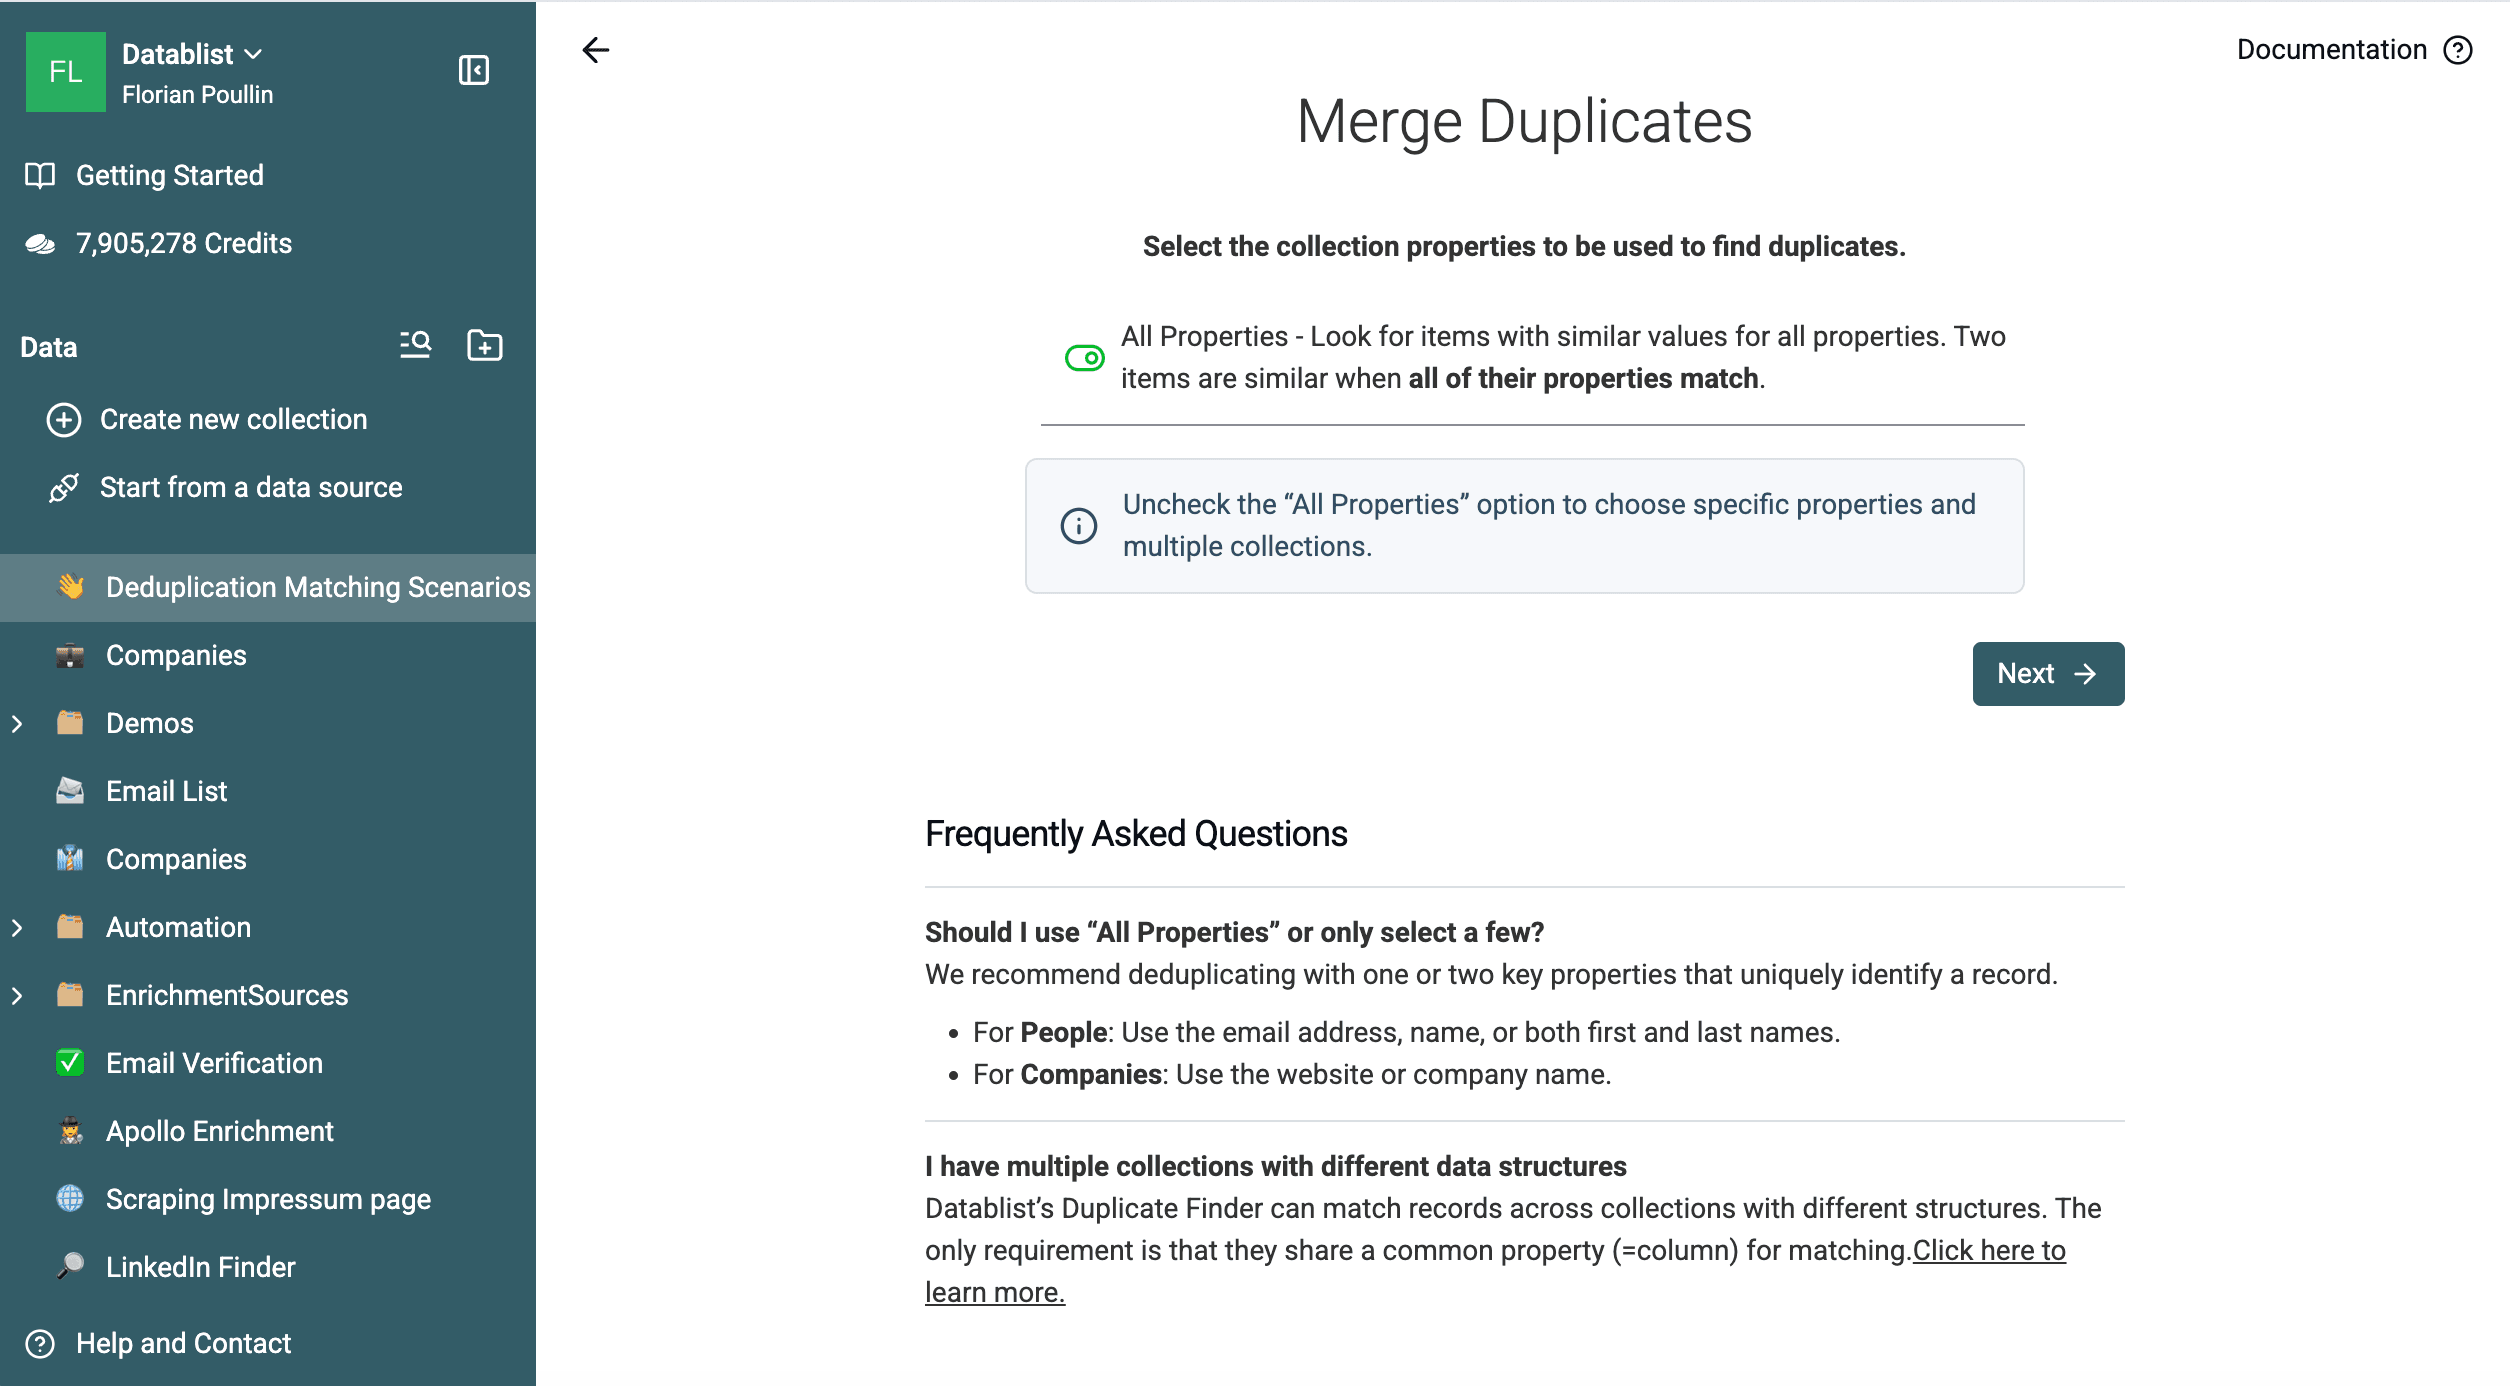
对于这份 1,000 行样本,本轮匹配会返回五个重复组。每组包含两行记录,并且所有属性值都完全相同。
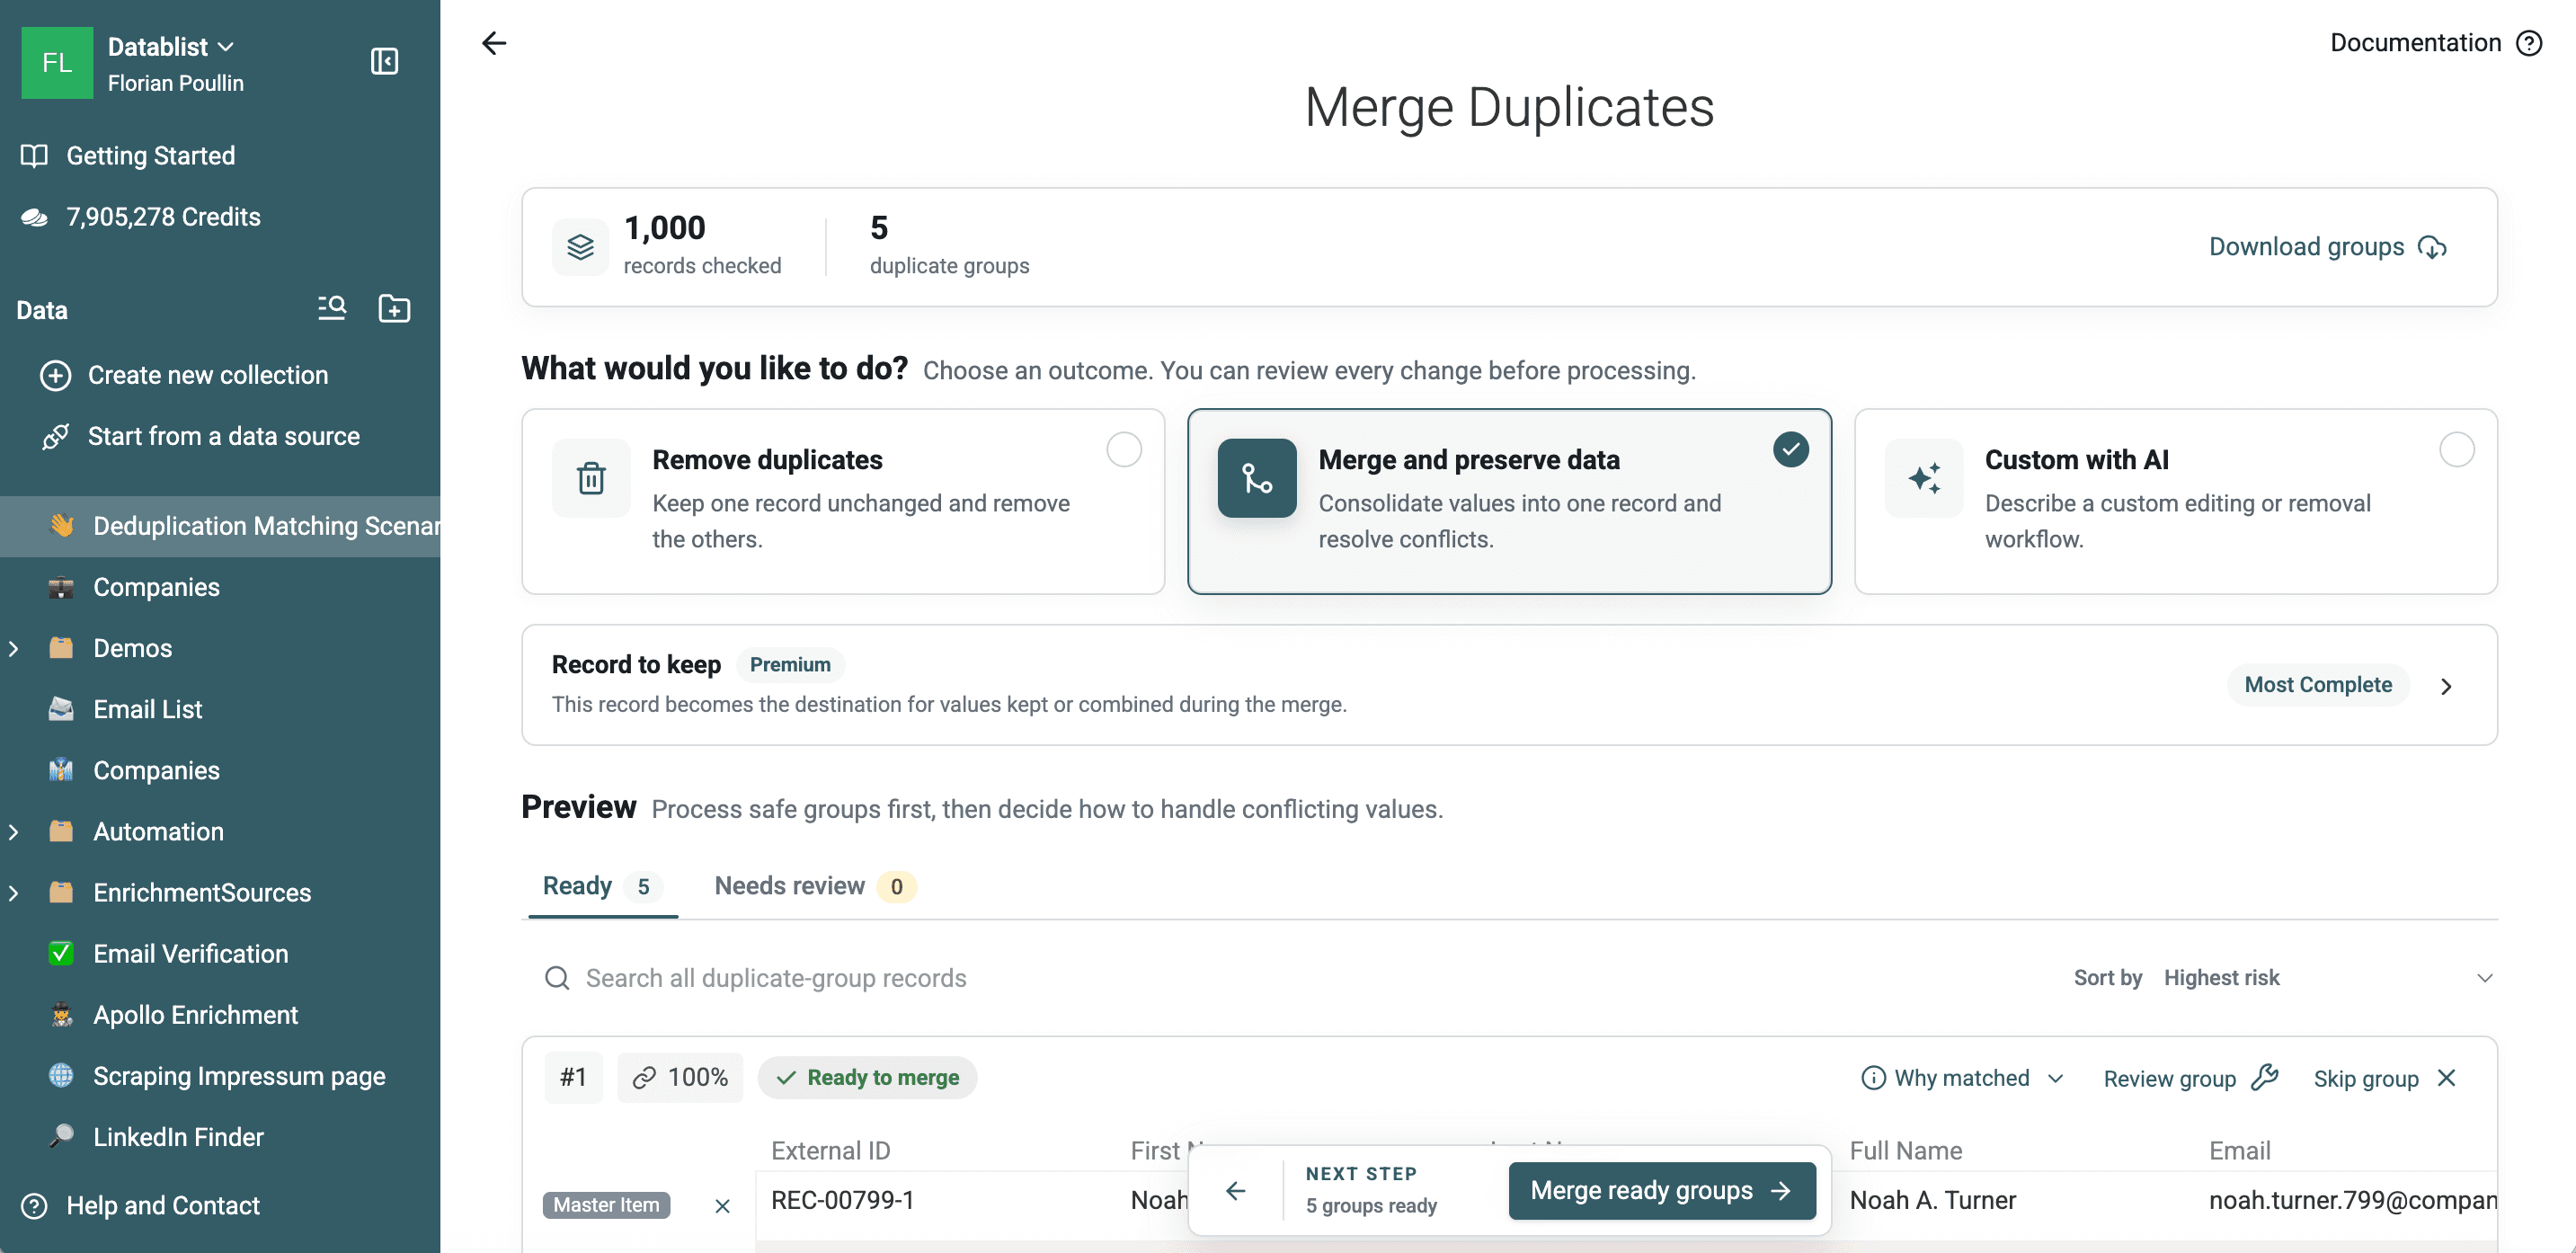
Exact 是最安全的第一步,因为保留下来的每个匹配项都满足严格比较条件。如果存储值不同,它无法识别 Acme Inc. 与 Acme、采用不同格式的电话号码或 Email 别名。
匿名访客可以运行 Exact 重复项检查。创建免费账户后,即可使用 Smart comparison 和 Free plan 的其他功能。
使用 Smart matching 匹配业务数据
Smart matching 会先标准化用于比较的值,但不会改写单元格中存储的原始内容。请根据属性选择对应的 processor:
- Email 可以处理大小写、首尾空格、plus alias、Gmail 点号、
googlemail.com、显示名称包装格式和mailto:值。 - URL 可以忽略协议和末尾斜杠,还可选择是否忽略子域名、路径和查询参数。
- Phone 会忽略格式字符,但不会验证号码、使用 Country 属性或推断缺失的国家代码。
- Company Name 会移除常见的法律实体、商业和地理相关词语。
- Text 会忽略重音符号、空格、标点、符号、大小写和词序。
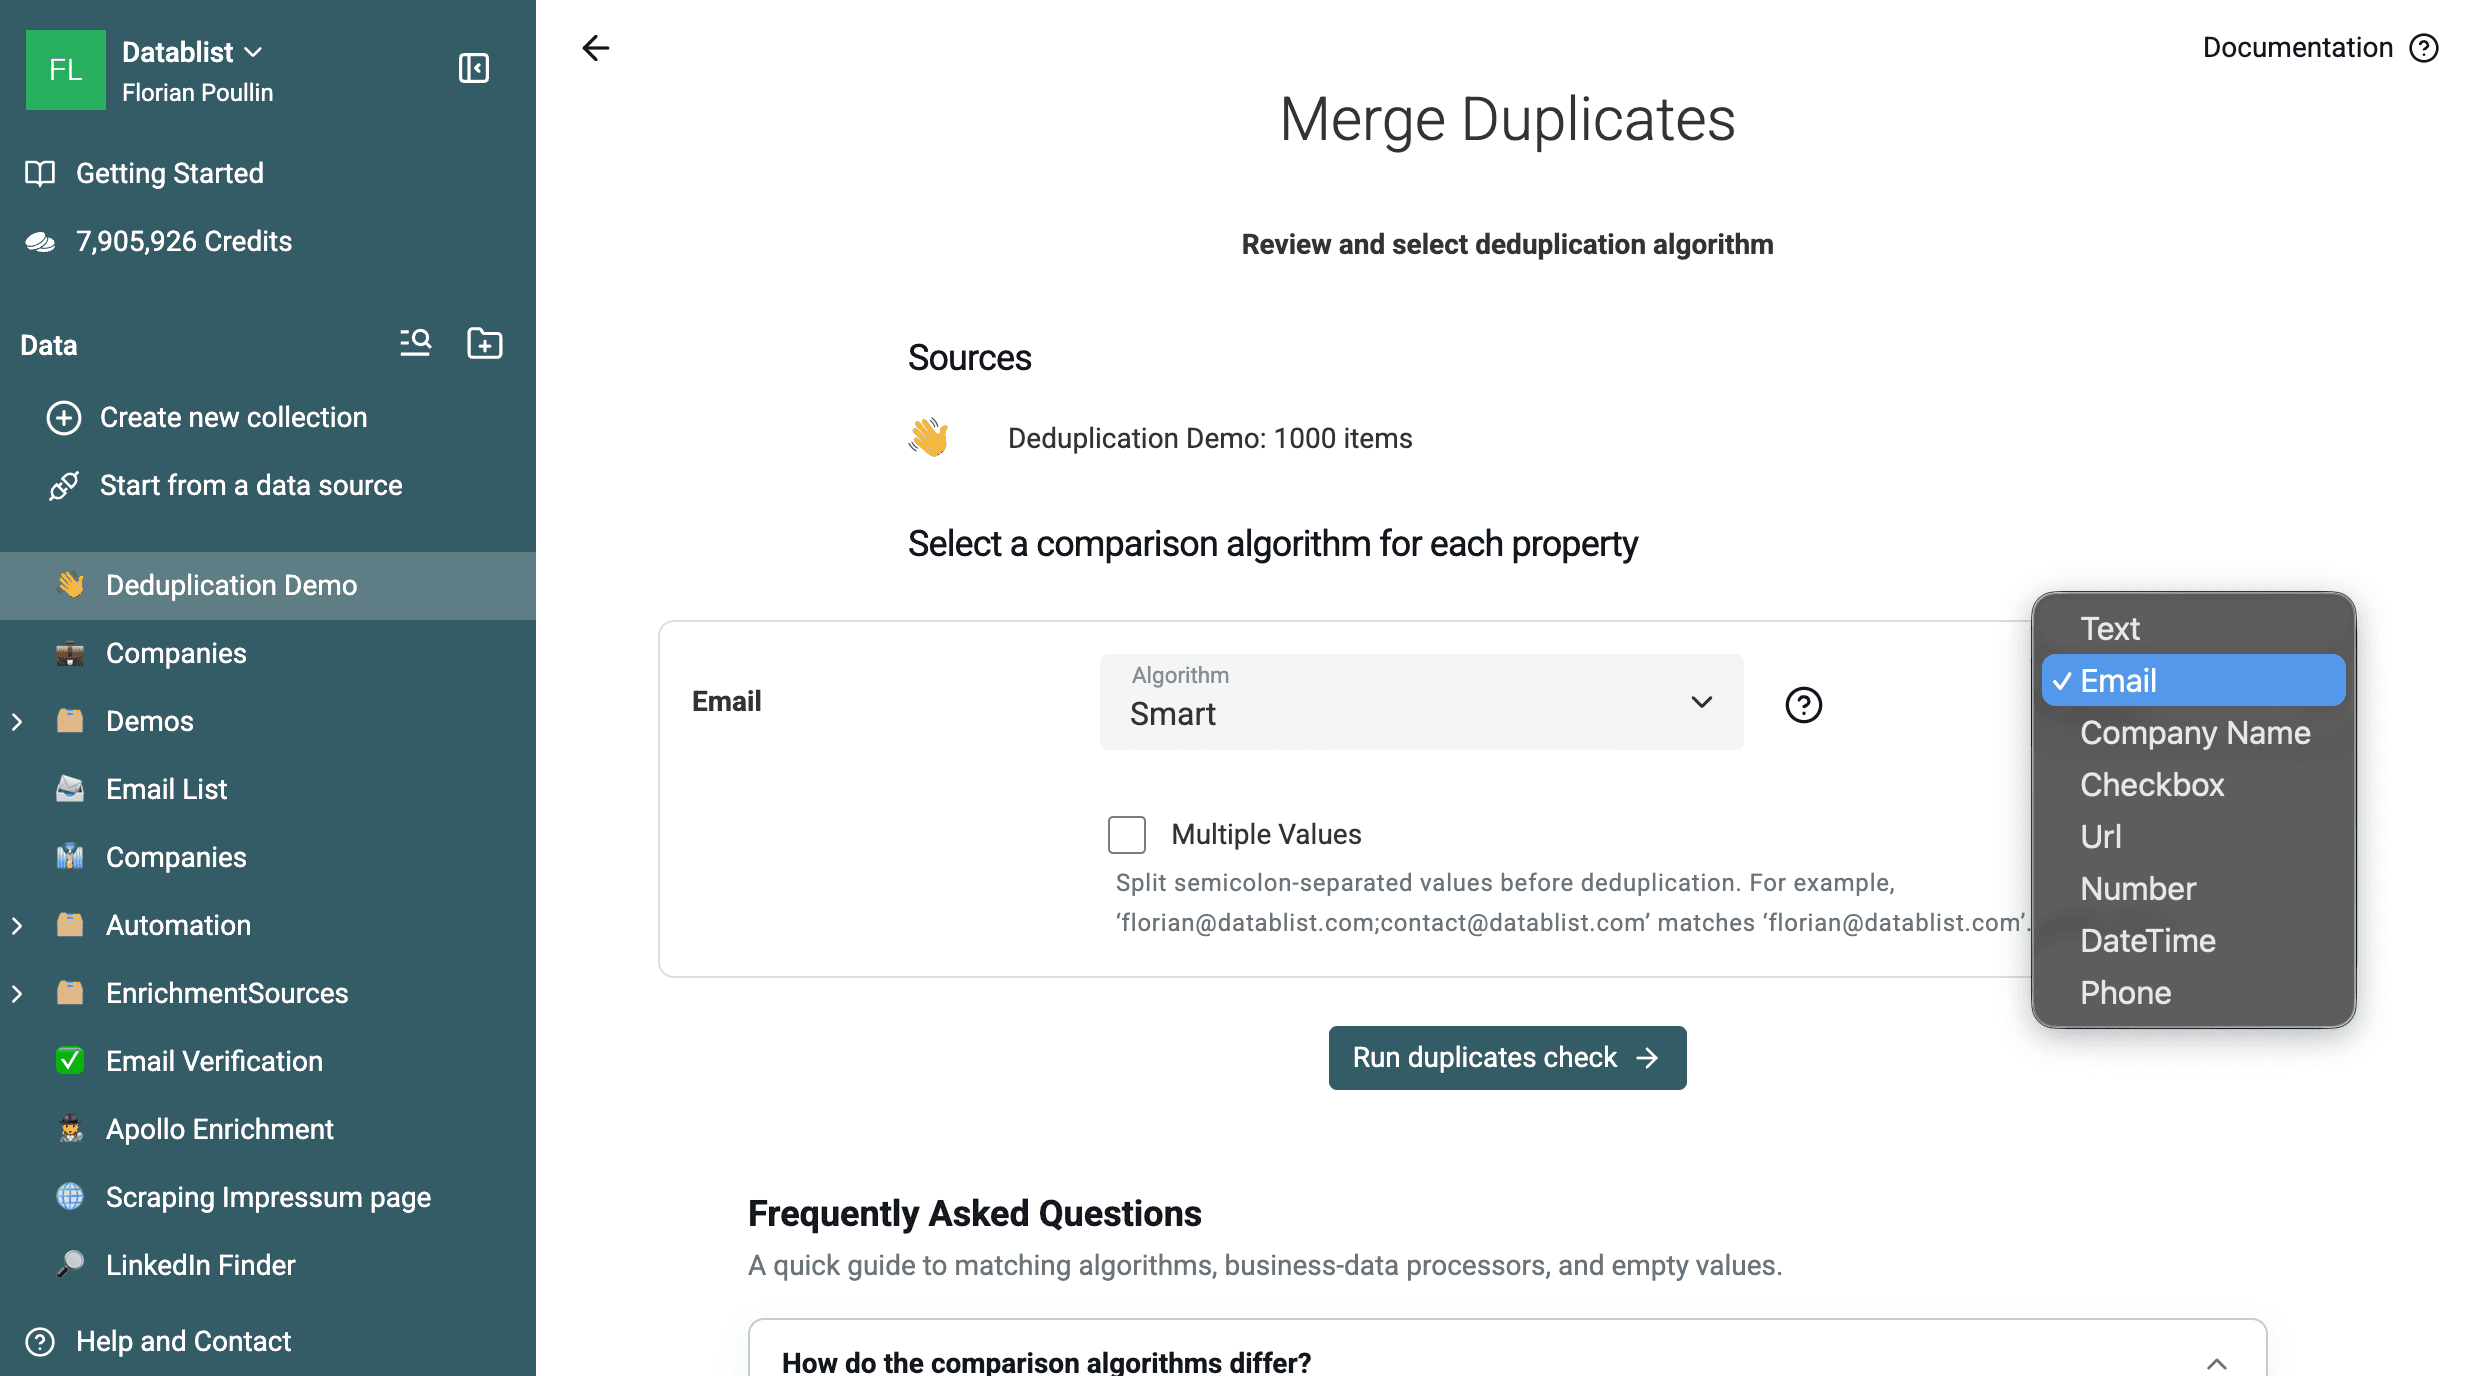
Company Name processor、multi-value matching 和高级算法需要付费套餐。Free plan 支持对单个 collection 使用 Exact 和 Smart,但 Smart 需要登录免费账户。
如果一个单元格包含多个以分号分隔的标识符,请启用 Multiple Values。Datablist 会逐一比较各个值,只要至少有一对匹配,该属性就会被视为匹配。例如,包含 primary@example.com;shared@example.com 的单元格,可以与包含 shared@example.com 的另一个单元格匹配。
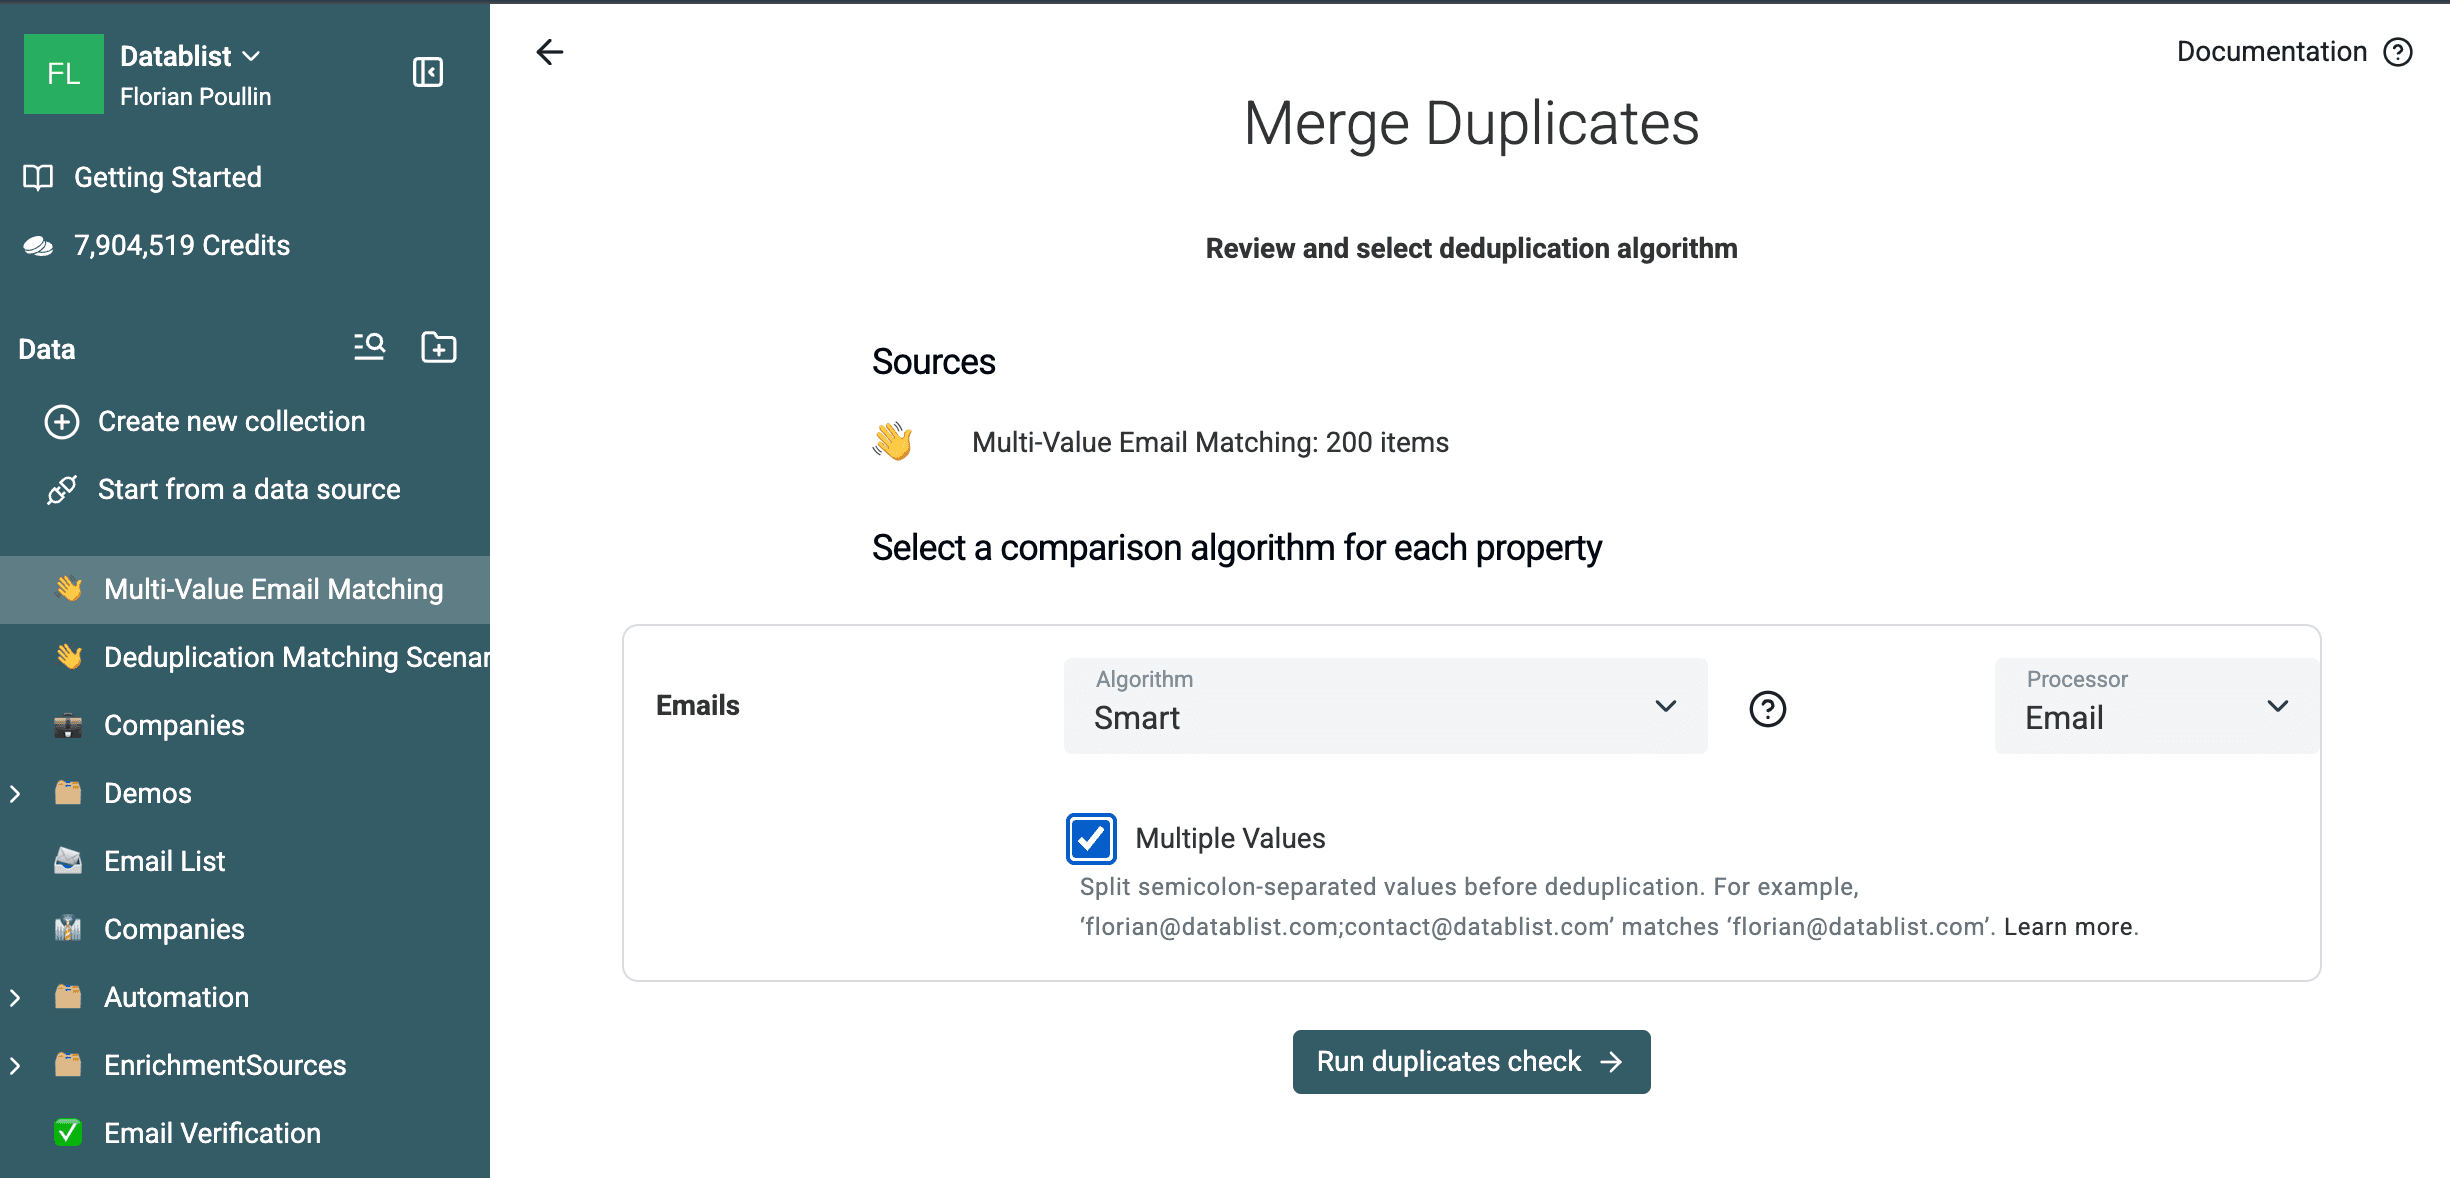
在专用的 200 行样本中,此配置返回了 60 个双行重复组。Ground truth 验证显示,它找到了全部 60 组预设匹配,并排除了全部 80 条对照记录。你可以按照多值字段去重流程获取样本文件、结果 CSV 和合并决策说明。
本轮 Email 匹配返回了 105 个双行重复组:其中 100 组是预设的 Email 标准化匹配,另外五组是 Email 也完全相同的整行副本。
匹配前先标准化电话号码
Smart Phone processor 适合一种明确场景:号码数字完全相同,仅空格、括号、连字符或符号不同。它可以匹配 (415) 555-0123 和 4155550123。
但它无法判断本地号码和国际号码是否相同。例如,比较 06 12 34 50 08 和 +33 6 12 34 50 08 前,需要先提供国家或地区信息。
在按电话号码去重前,请使用 Phone Number Cleaner:
- 映射原始
Phone属性。 - 对于仅含一个国家或地区的数据,在 Local Phone Countries 下选择对应国家或地区。如果列表包含多个国家或地区,请启用 Define country per item,并映射
Country属性。 - 将 enrichment 结果写入
Clean Phone Number,不要覆盖原始值。 - 检查处理失败或输出为空的记录。它们不应参与电话号码匹配。
- 对
Clean Phone Number运行 Duplicates Finder,并选择 Exact。
下载专用的 200 行电话号码样本。 其中包含来自美国、法国、英国、德国和西班牙的 50 组本地号码与国际号码,以及 100 条不匹配的对照记录。使用生产环境的清理逻辑验证后,全部 200 行都得到了一个标准化电话号码。50 组预设匹配最终得到 50 个相同的国际号码,对照记录则保持唯一。
该预处理步骤也会验证电话号码格式。请将原始 Phone 和 Country 属性保留在清理结果旁边,以便在合并前检查每条记录。你还可以阅读电话号码标准化的含义,了解国家代码和国际号码的作用。
对于公司记录,请单独对 Website 执行一轮匹配。选择 Smart 和 URL processor。只有在子域名、路径和查询参数不用于区分不同公司或办公地点时,才启用 Ignore Subdomain、Ignore Path 和 Ignore Query Params。
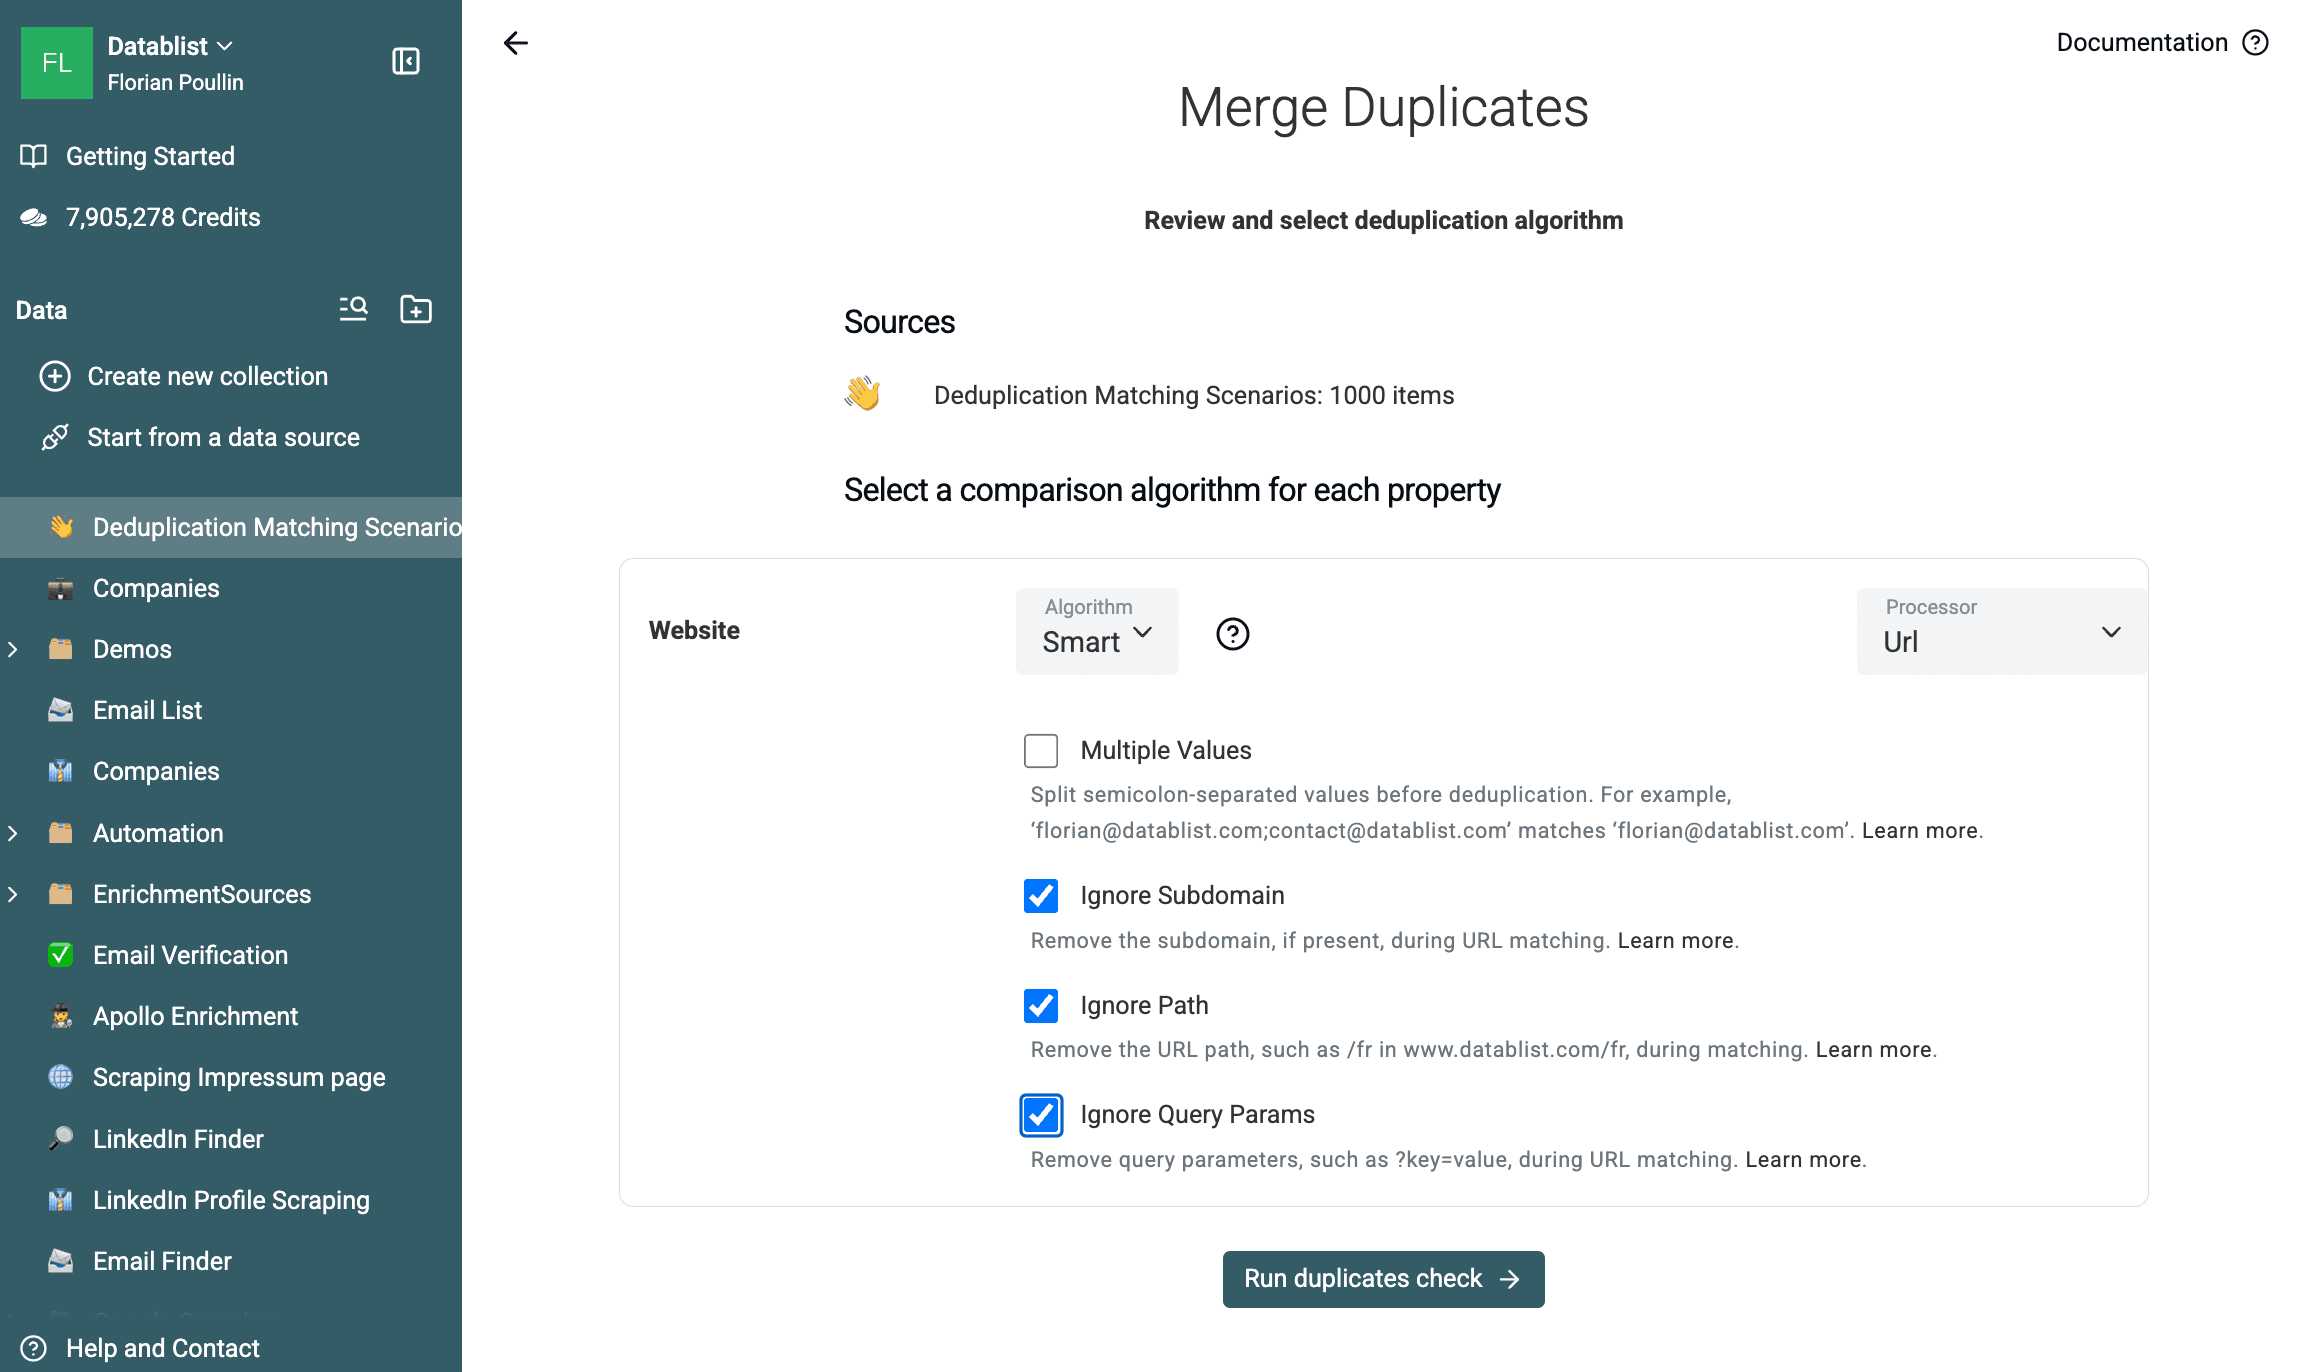
在同一份 1,000 行样本上,此配置返回了 200 个双行重复组。其中 50 组包含预设的 URL 变体,另外 150 组的网站地址原本就完全相同。本次测试中,导出的每一组都解析到了相同的标准化 host。
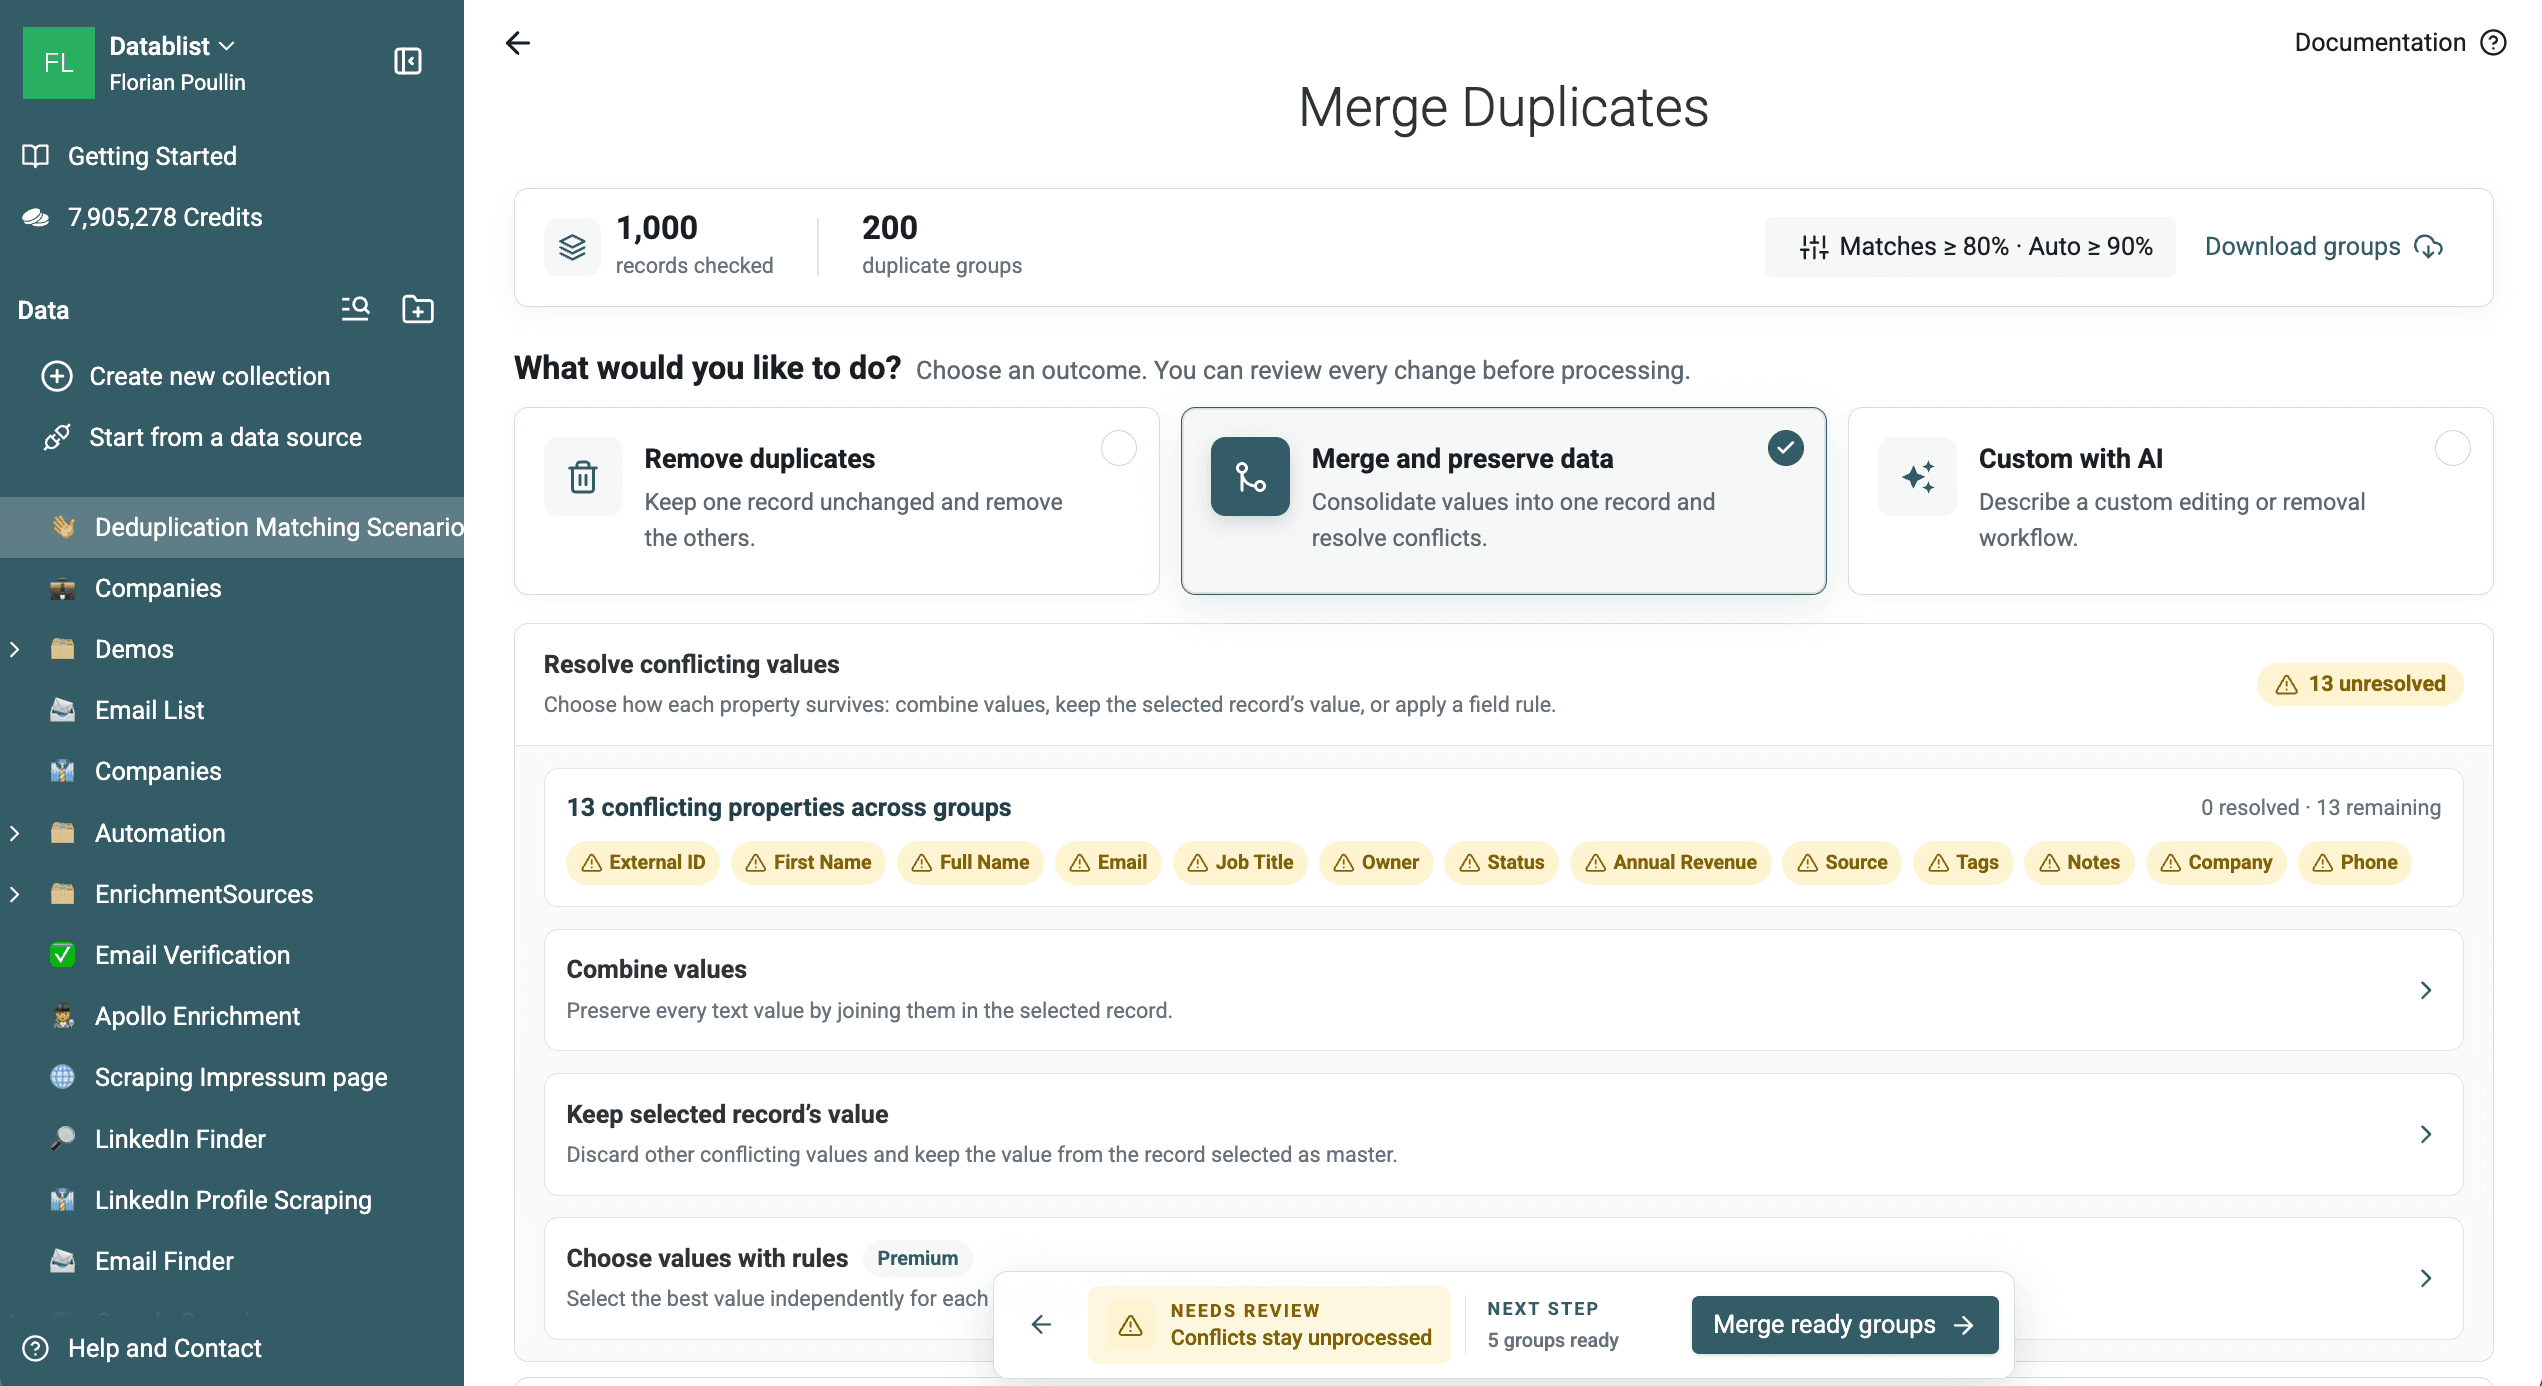
下载 200 个 Website 重复组,或查看公司去重流程,了解域名优先的匹配策略。
将模糊或语音匹配用于人工复核
Metaphone 比较文本读音。Jaro-Winkler 和 Levenshtein 会计算相似度分数,可用于查找 Uma Turner 和 Uman Turner 之类的拼写差异。
Fuzzy matches 只是候选项,并非已确认的重复记录。先设置较高的 threshold,检查分数最低的重复组;只有在结果仍然准确时,再逐步降低结果阈值。
如果要执行可量化的 fuzzy matching,请选择 Full Name,使用 Distance 和 Levenshtein,保留 Text processor,并将 threshold 设为 90%。
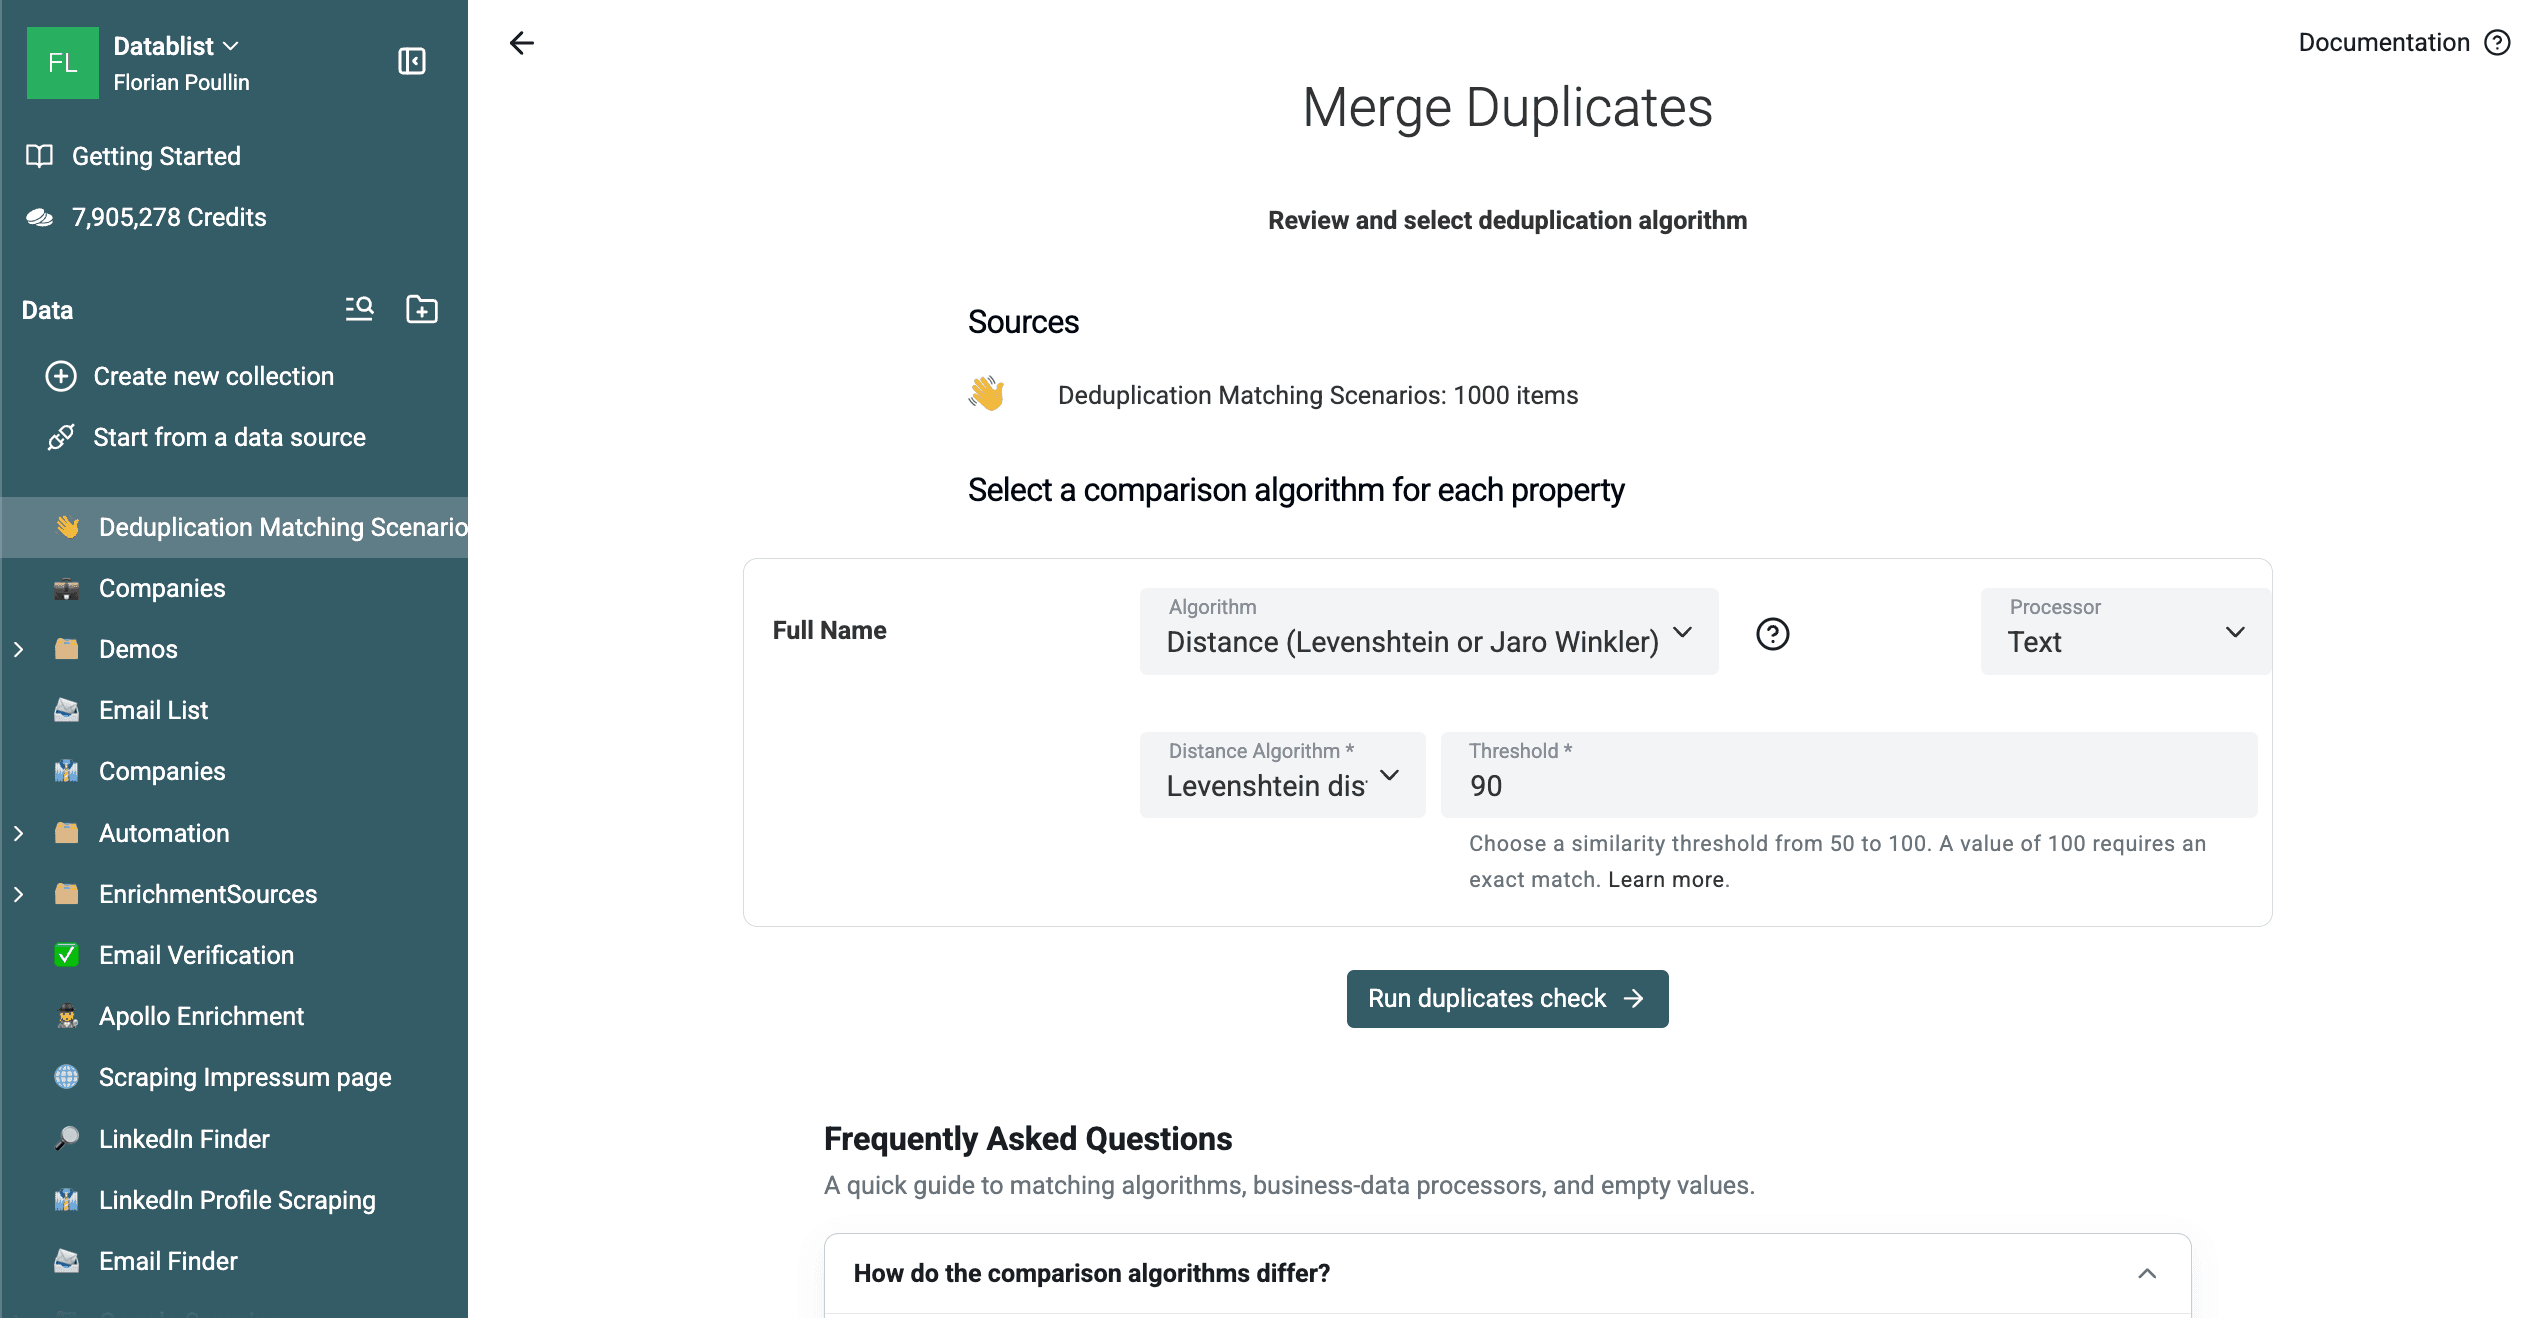
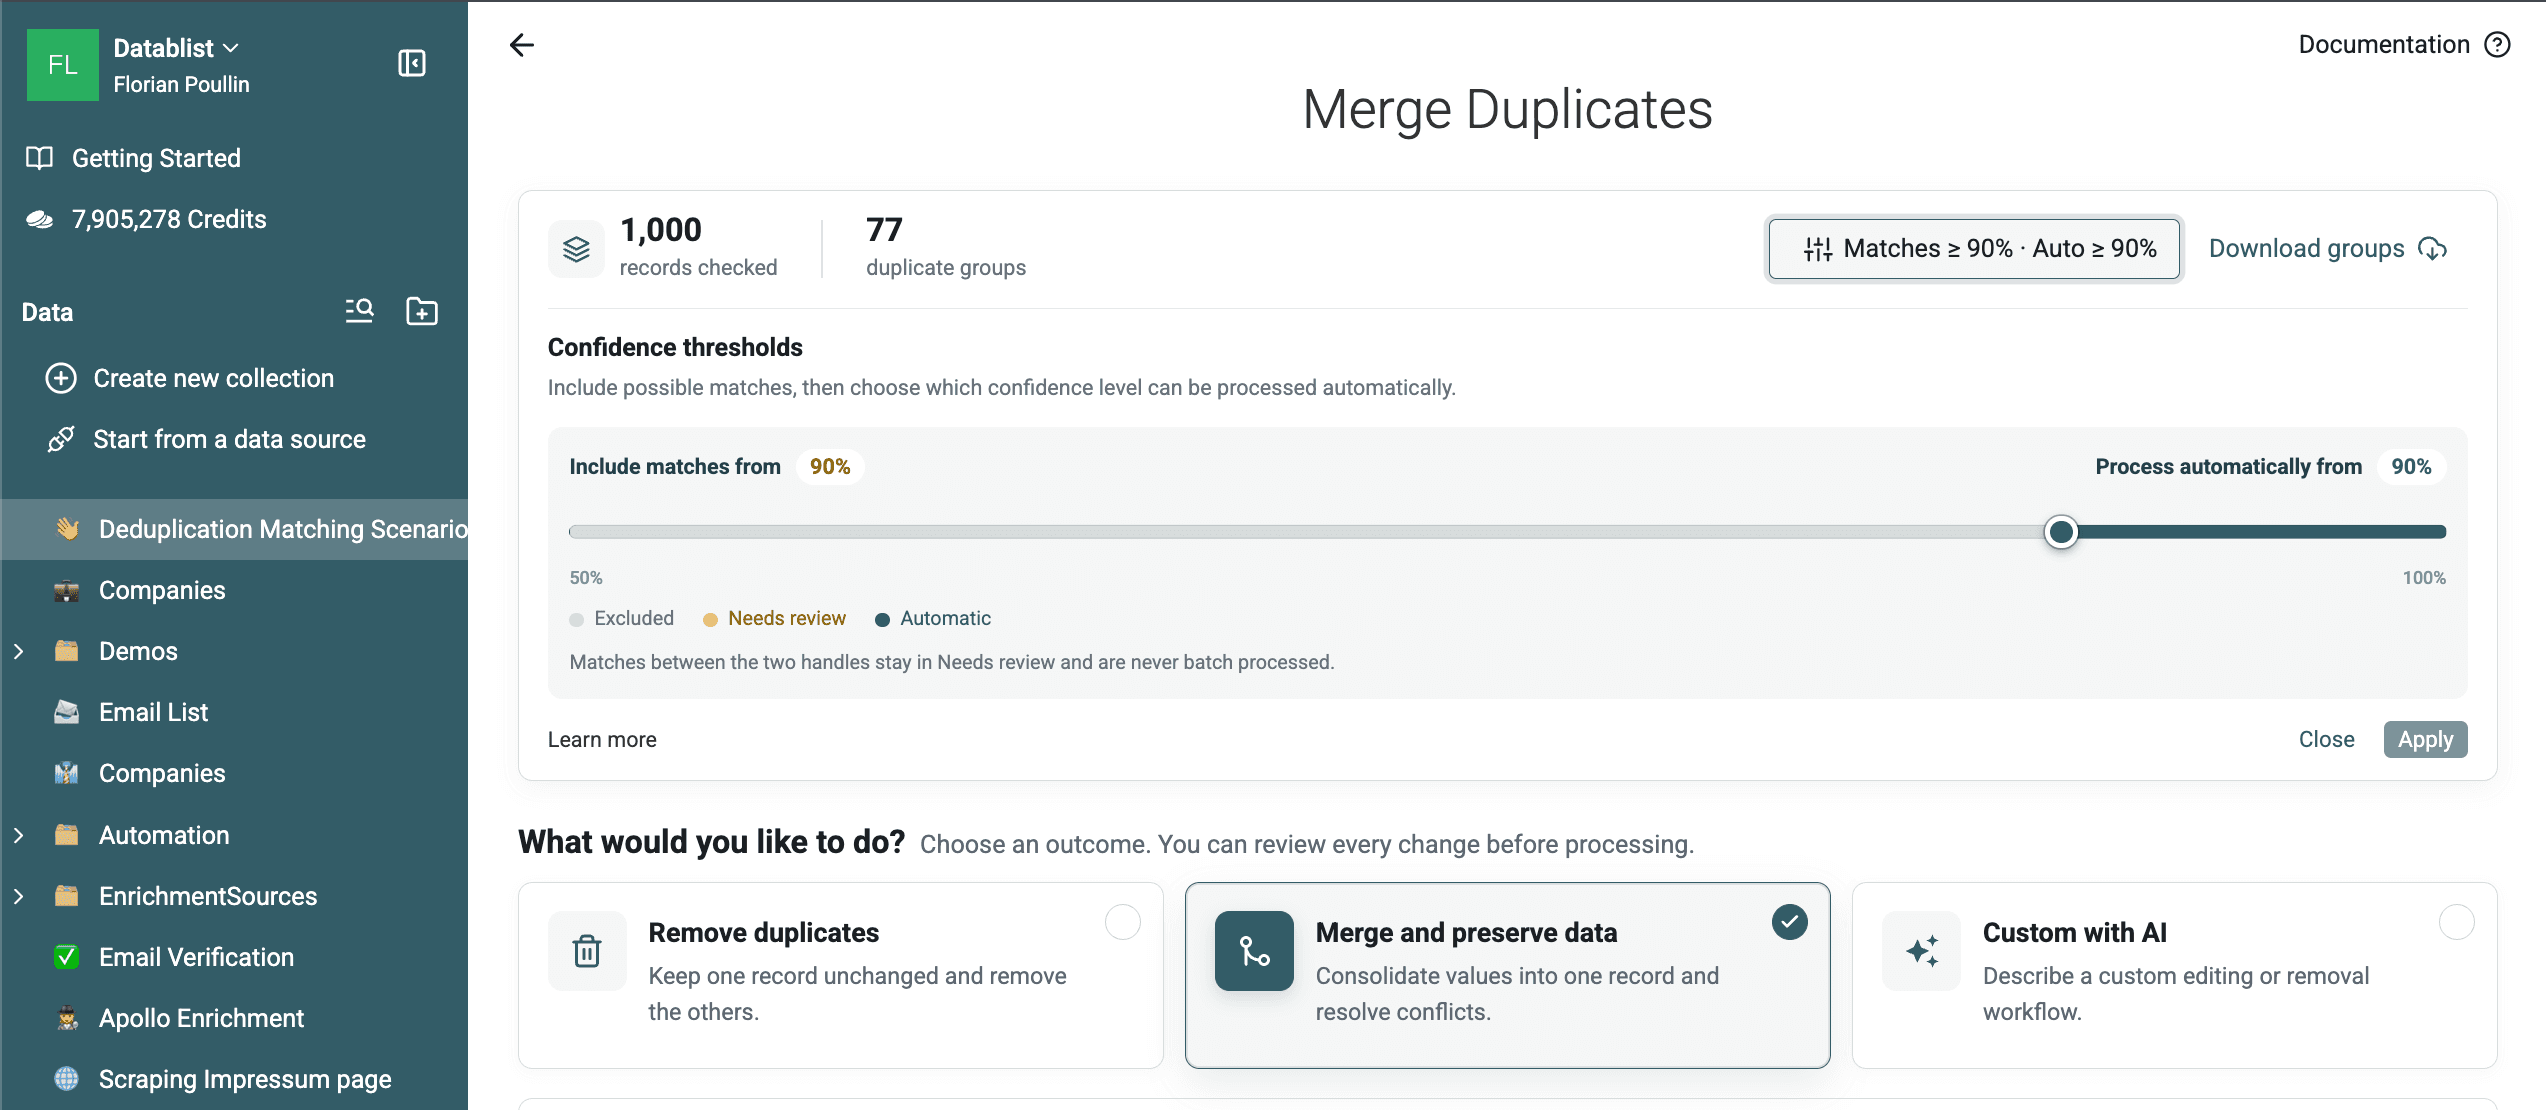
这项检查从 1,000 行样本中返回了 77 个双行重复组。Ground truth 验证发现,其中 21 组关联的是同一个预设实体,56 组则关联了不同实体。大多数 false positive 都来自 G. Rossi 之类的缩写姓名,因为仅凭 Full Name 无法区分这些人。
本轮匹配能找到 Uma A. Turner 和 Uman A. Turner 等预设拼写变体,但也说明了为什么只按姓名进行 fuzzy matching 必须人工复核。
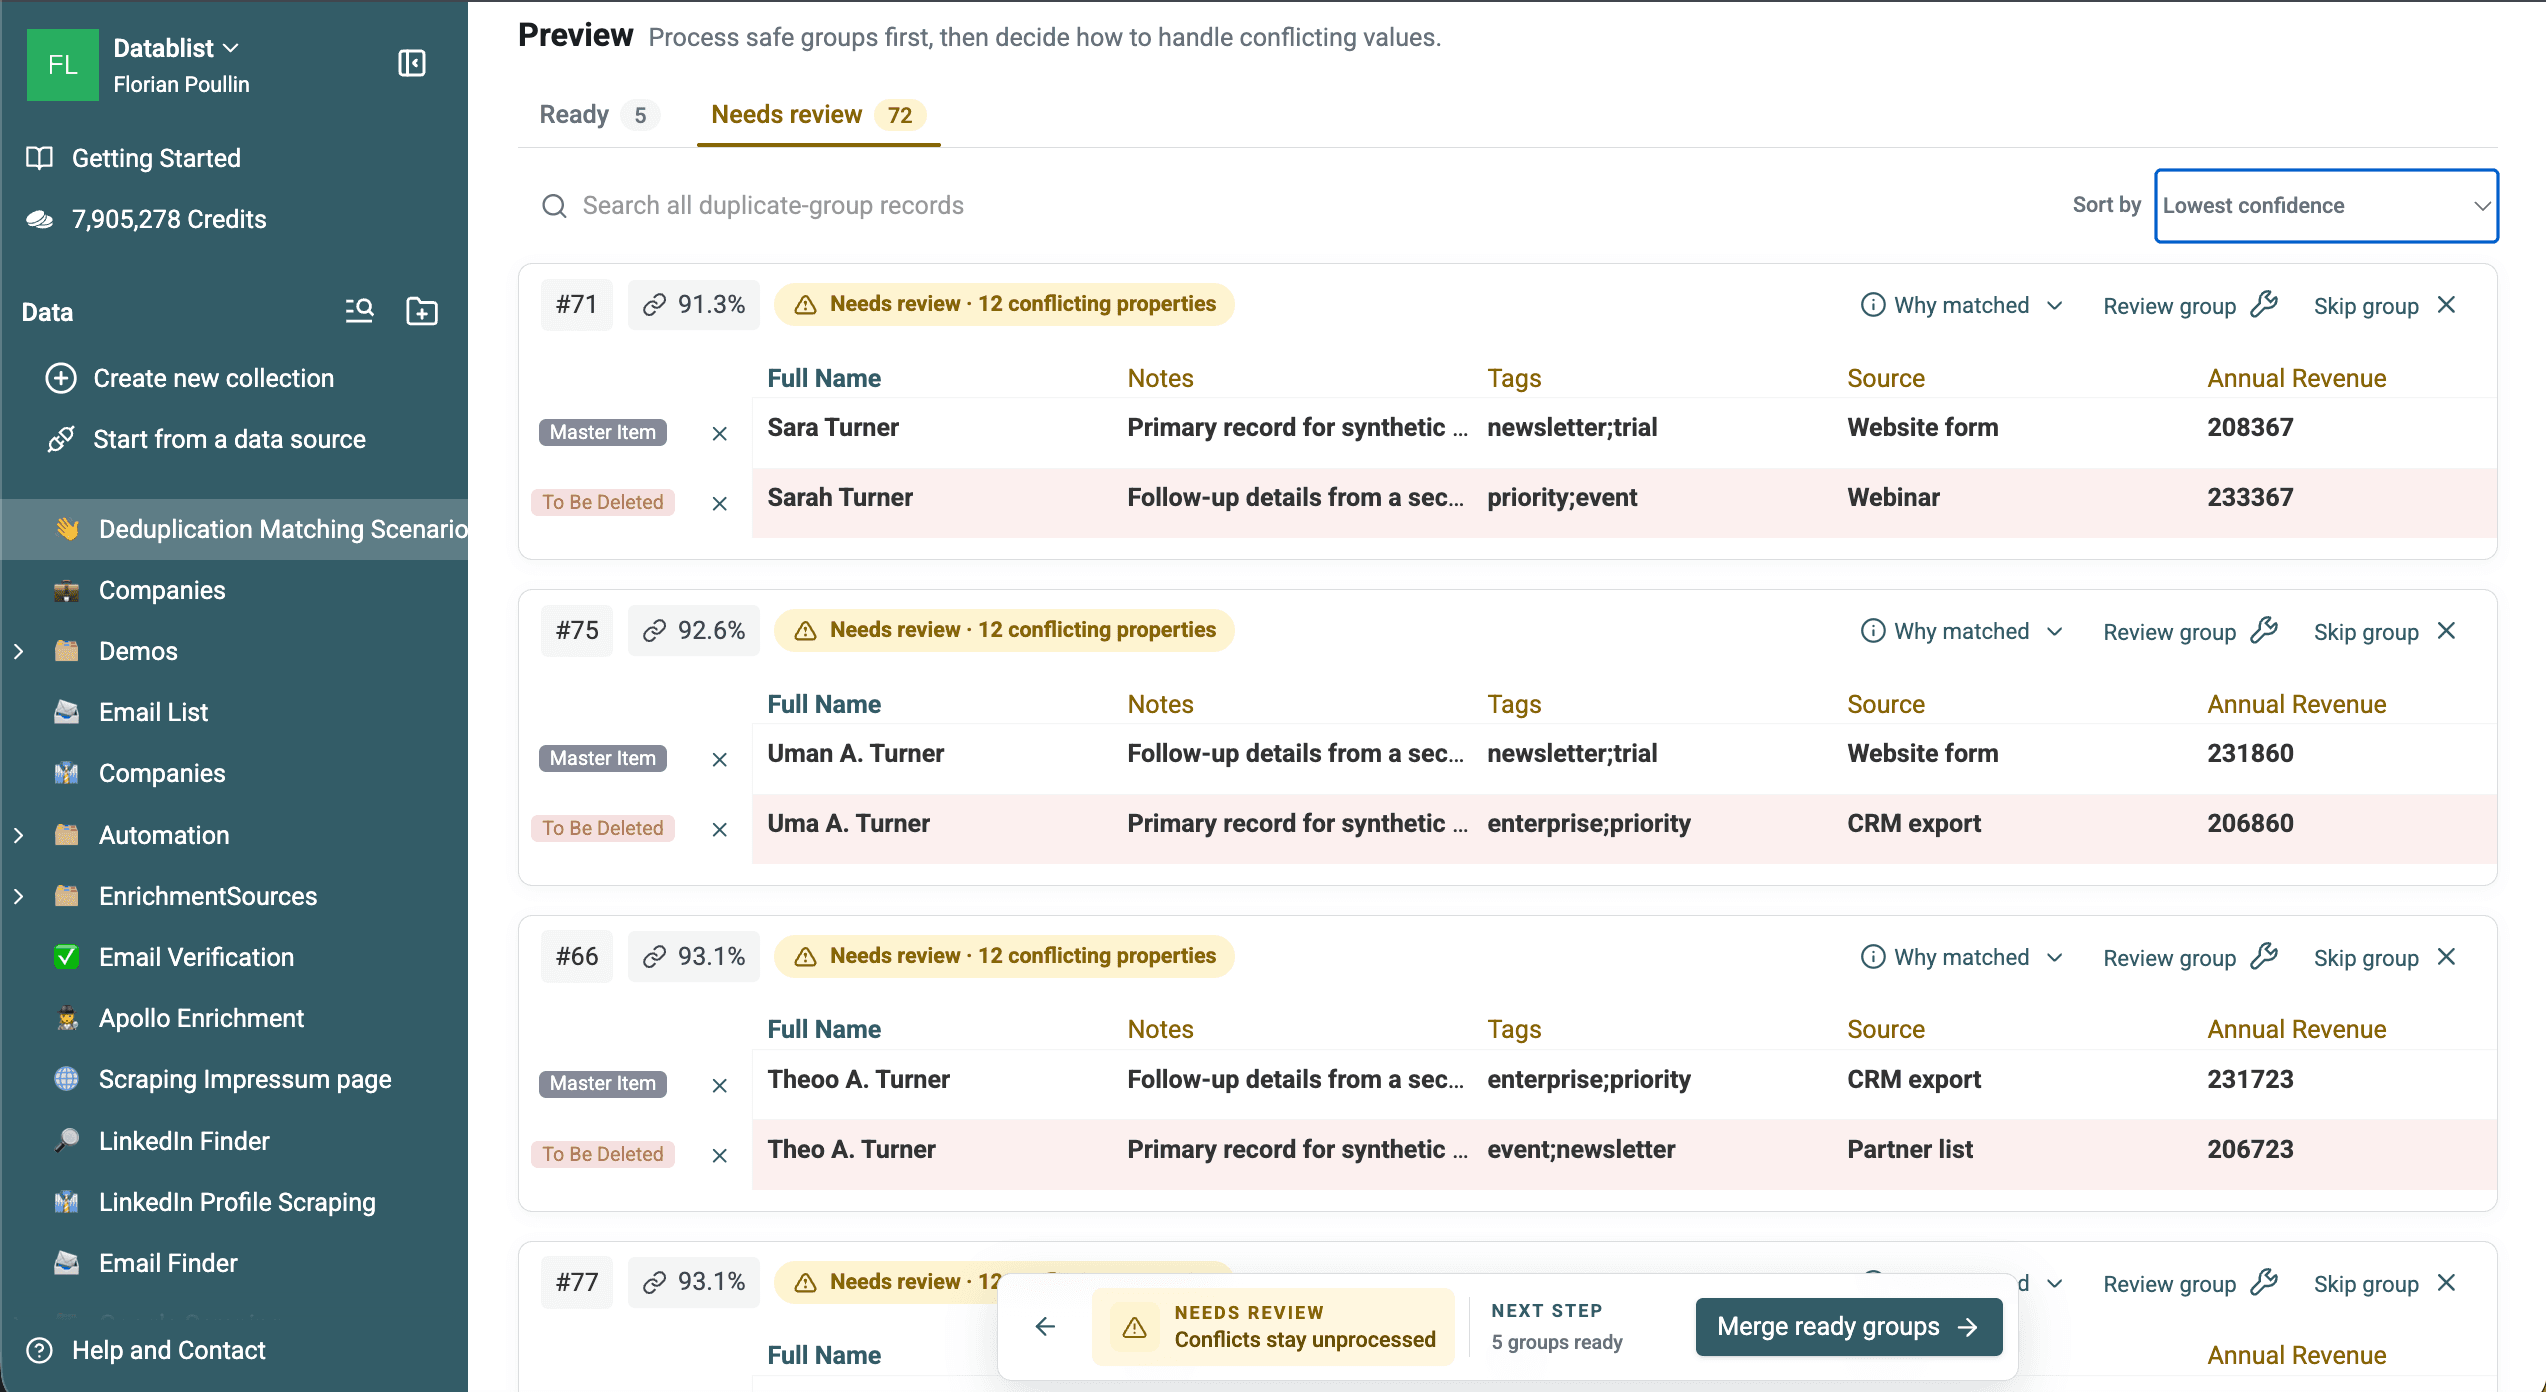
下载导出的 77 个 Levenshtein 重复组,检查有效匹配和 false positive。
如果要进行语音匹配,请选择 Full Name 和 Metaphone,并保留 Text processor。
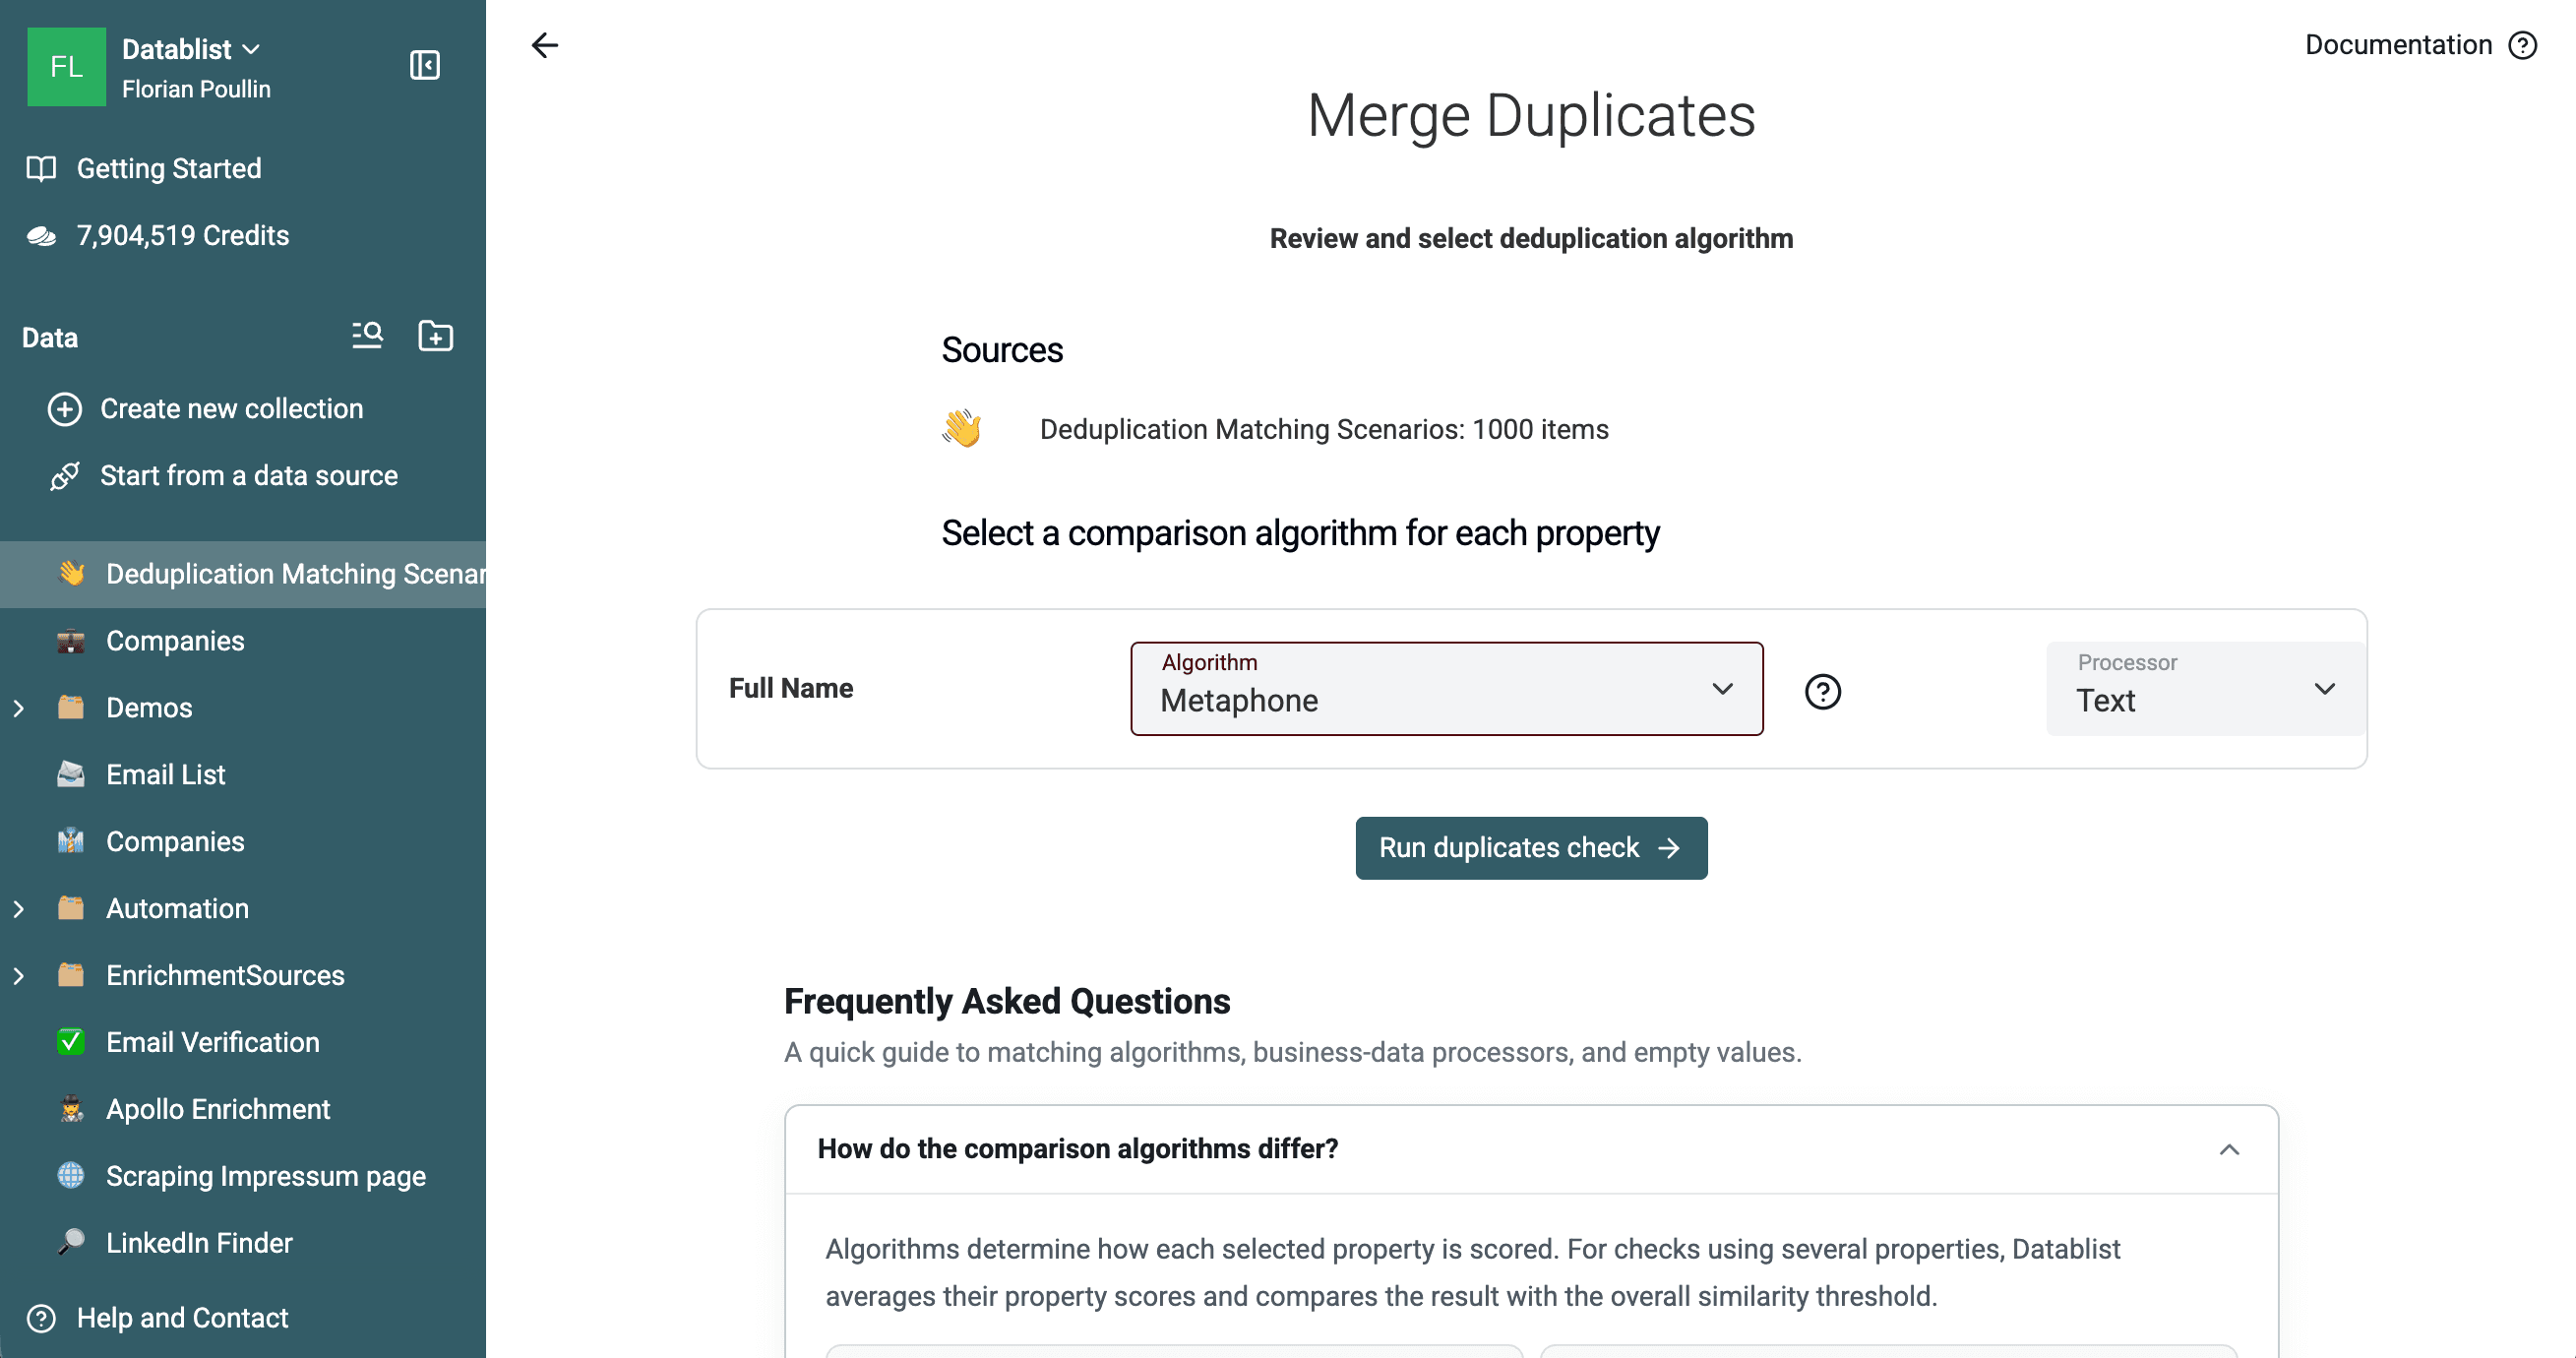
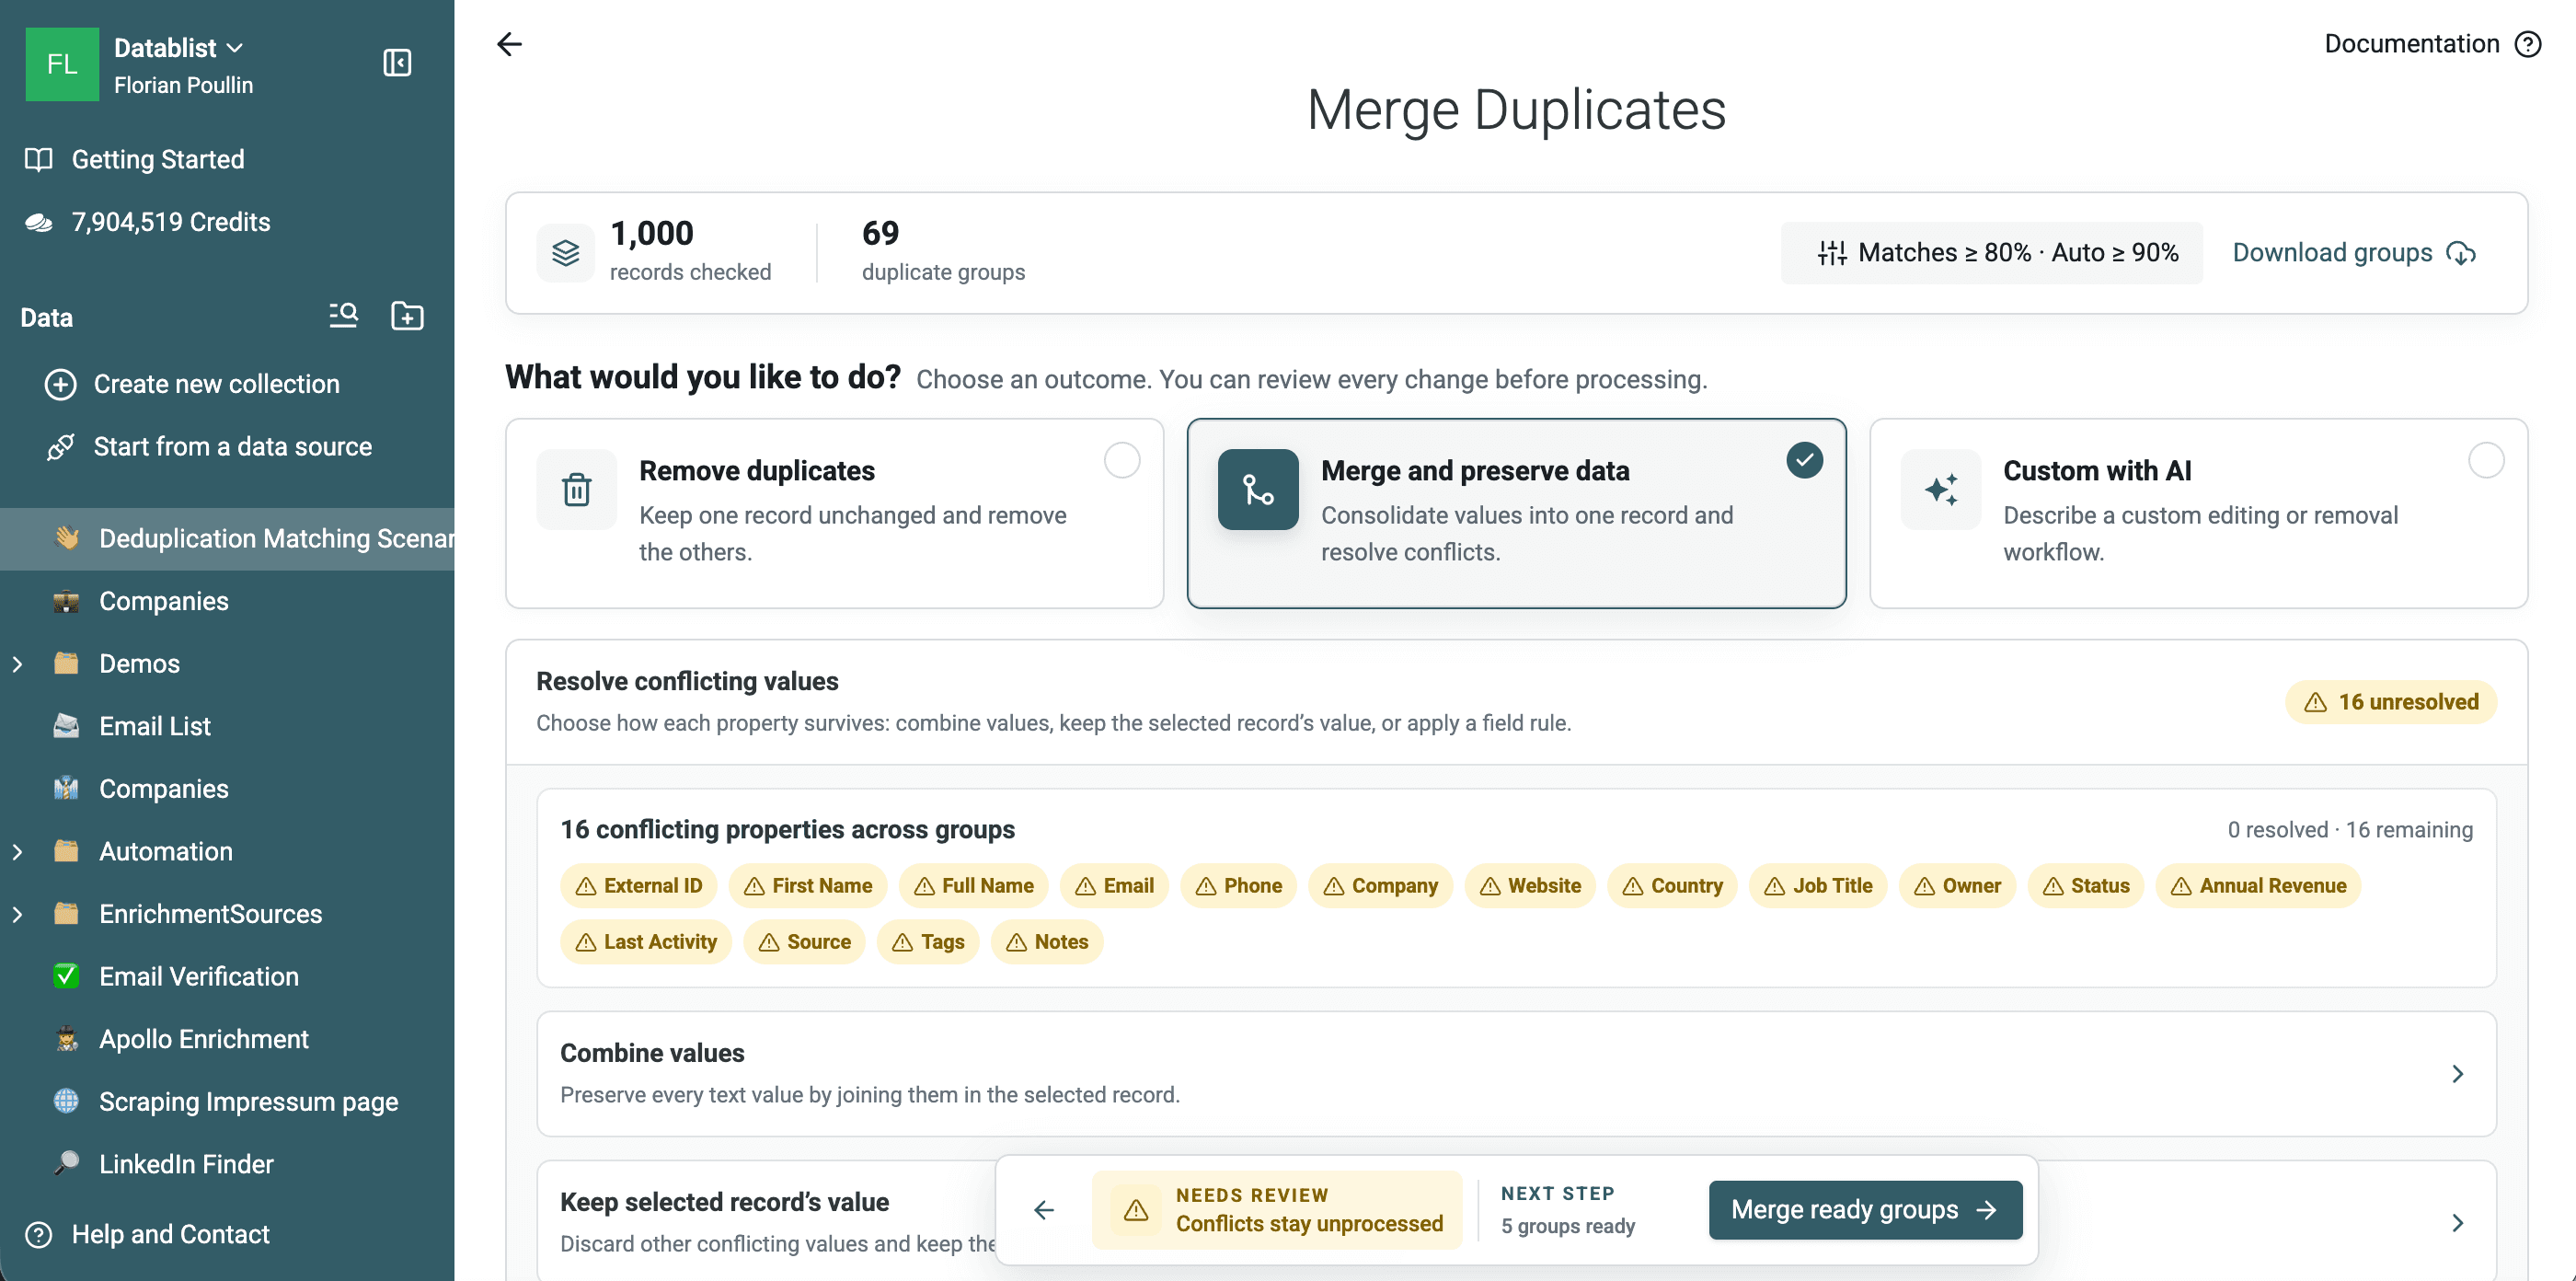
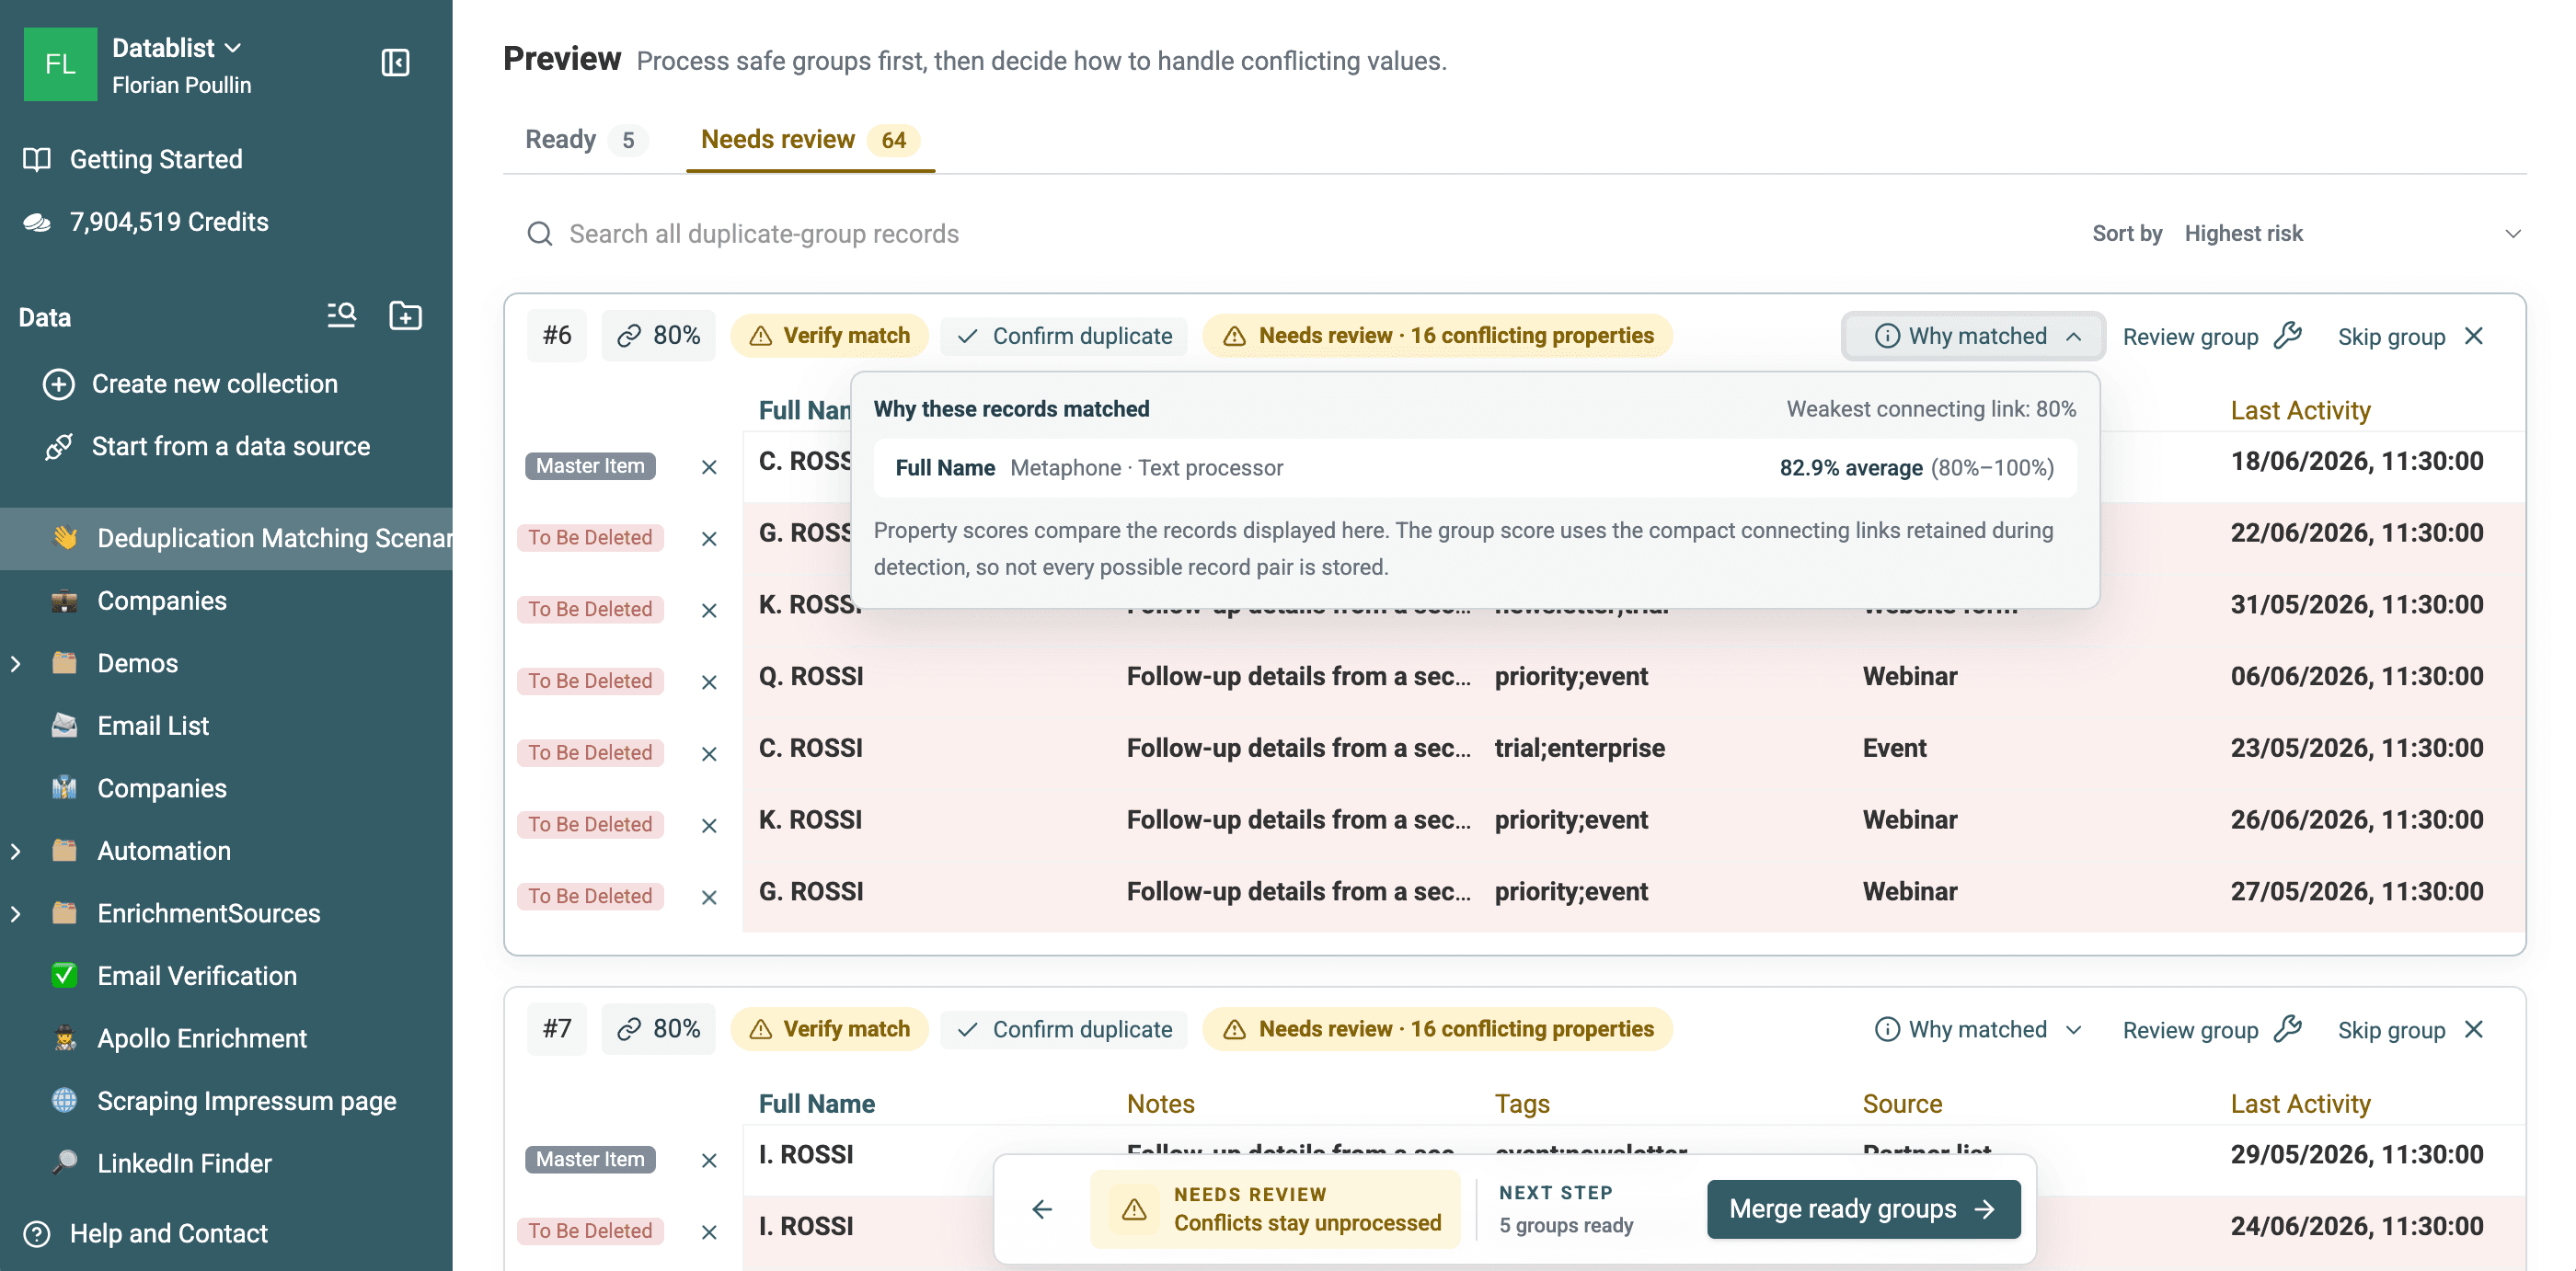
本轮匹配显示了 69 个重复组:5 个 Ready 和 64 个 Needs review。导出的重复组共包含 188 行。与样本中的已知实体进行验证后发现,19 个组只包含同一实体,50 个组则混合了不同的人。每组包含 2 至 7 行记录。
Why matched 会显示 Full Name 属性、Metaphone 算法、Text processor 和重复组分数。请用这些信息审查比较逻辑,而不要用它代替身份确认。
下载导出的 69 个 Metaphone 重复组,检查有效的语音匹配和 false positive。规模较大的误匹配组往往会把首字母缩写与常见姓氏组合在一起,例如多个缩写的 Rossi 姓名。它们的语音编码虽然重叠,但仅凭姓名不足以支持自动合并。
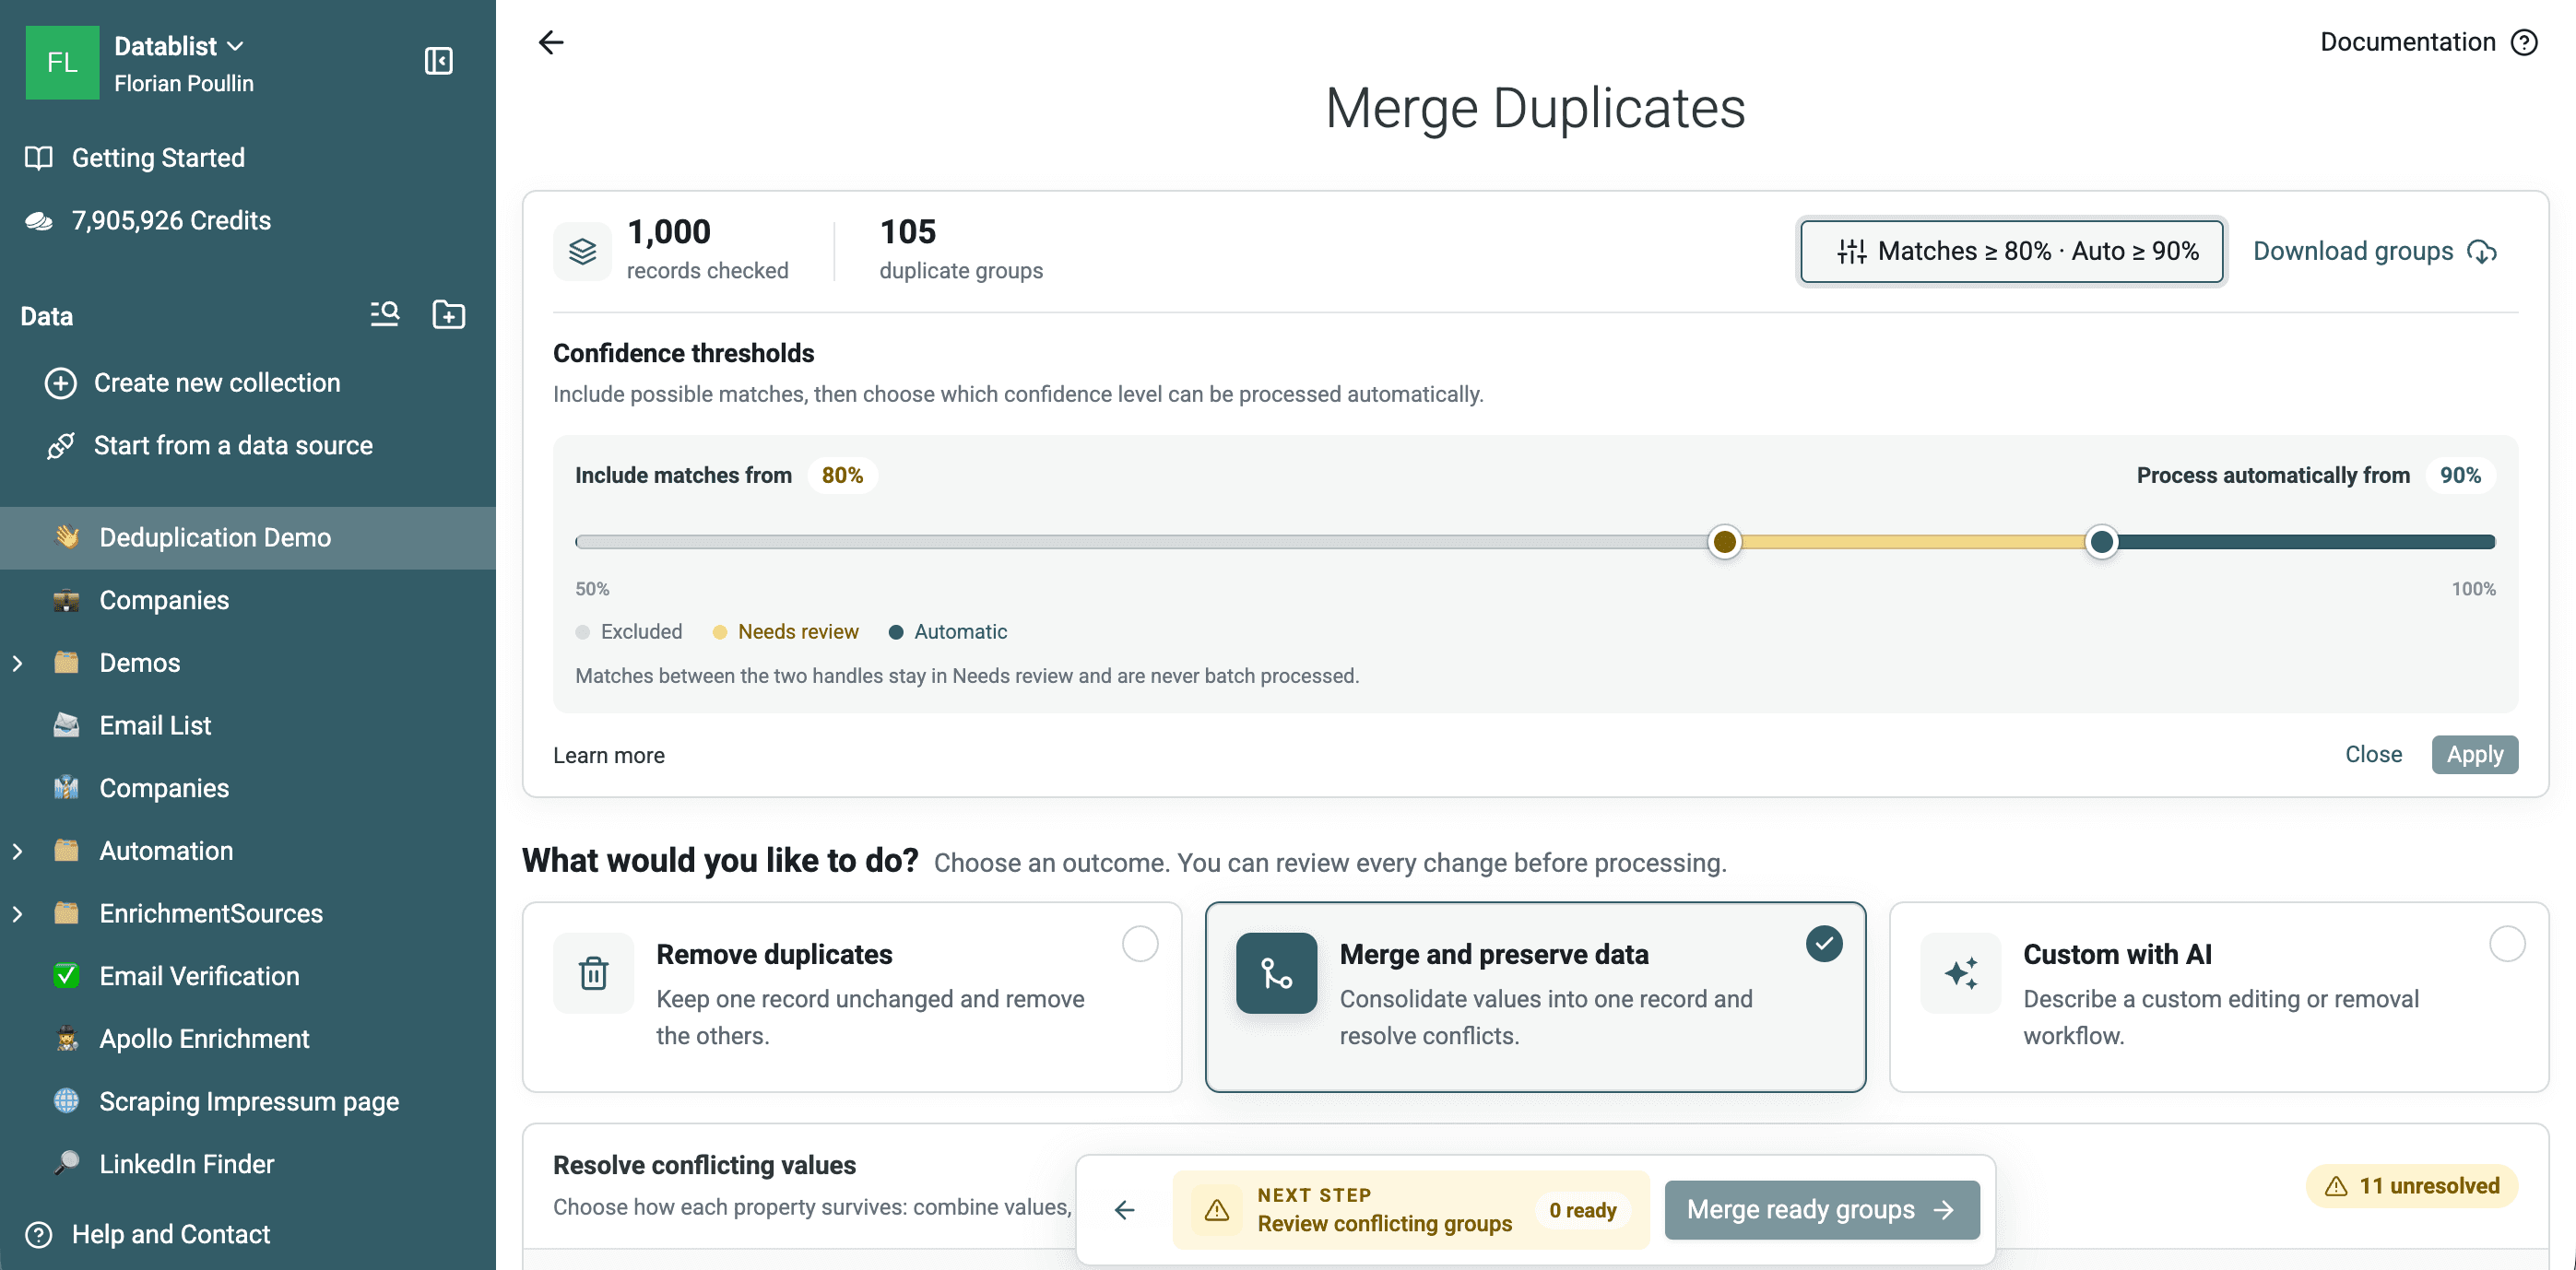
结果页面提供两个控制项:
- Include matches from 决定显示哪些重复组。
- Process automatically from 会将置信度较低的重复组保留在 Needs review 中,避免批量处理。
借助这种区分,你可以查看范围更广的候选项,而不必对所有候选项应用相同的自动化规则。
检查重复记录组
结果 workspace 会将重复组分为 Ready 和 Needs review。
- Ready 组已有明确的处理结果,并满足自动处理的置信度阈值。
- Needs review 组可能置信度较低、存在尚未解决的合并冲突、未满足记录选择规则,或被自定义规则跳过。
检查每个不确定的重复组时,请确认:
- 每一行是否代表同一个人、公司或产品?
- 哪个标识符触发了匹配?
- 不同记录中的信息是否互补?
- 哪个数据源最权威?
- 删除某一行是否会丢失电话、ID、状态、日期或备注?
- 该组是否通过一条可信度较低的第三方记录连接起来?
使用 Why matched 检查匹配属性、算法、processor 和分数区间。对于 fuzzy matching,重复组相似度代表维持该组连接所需的最弱有效关系。
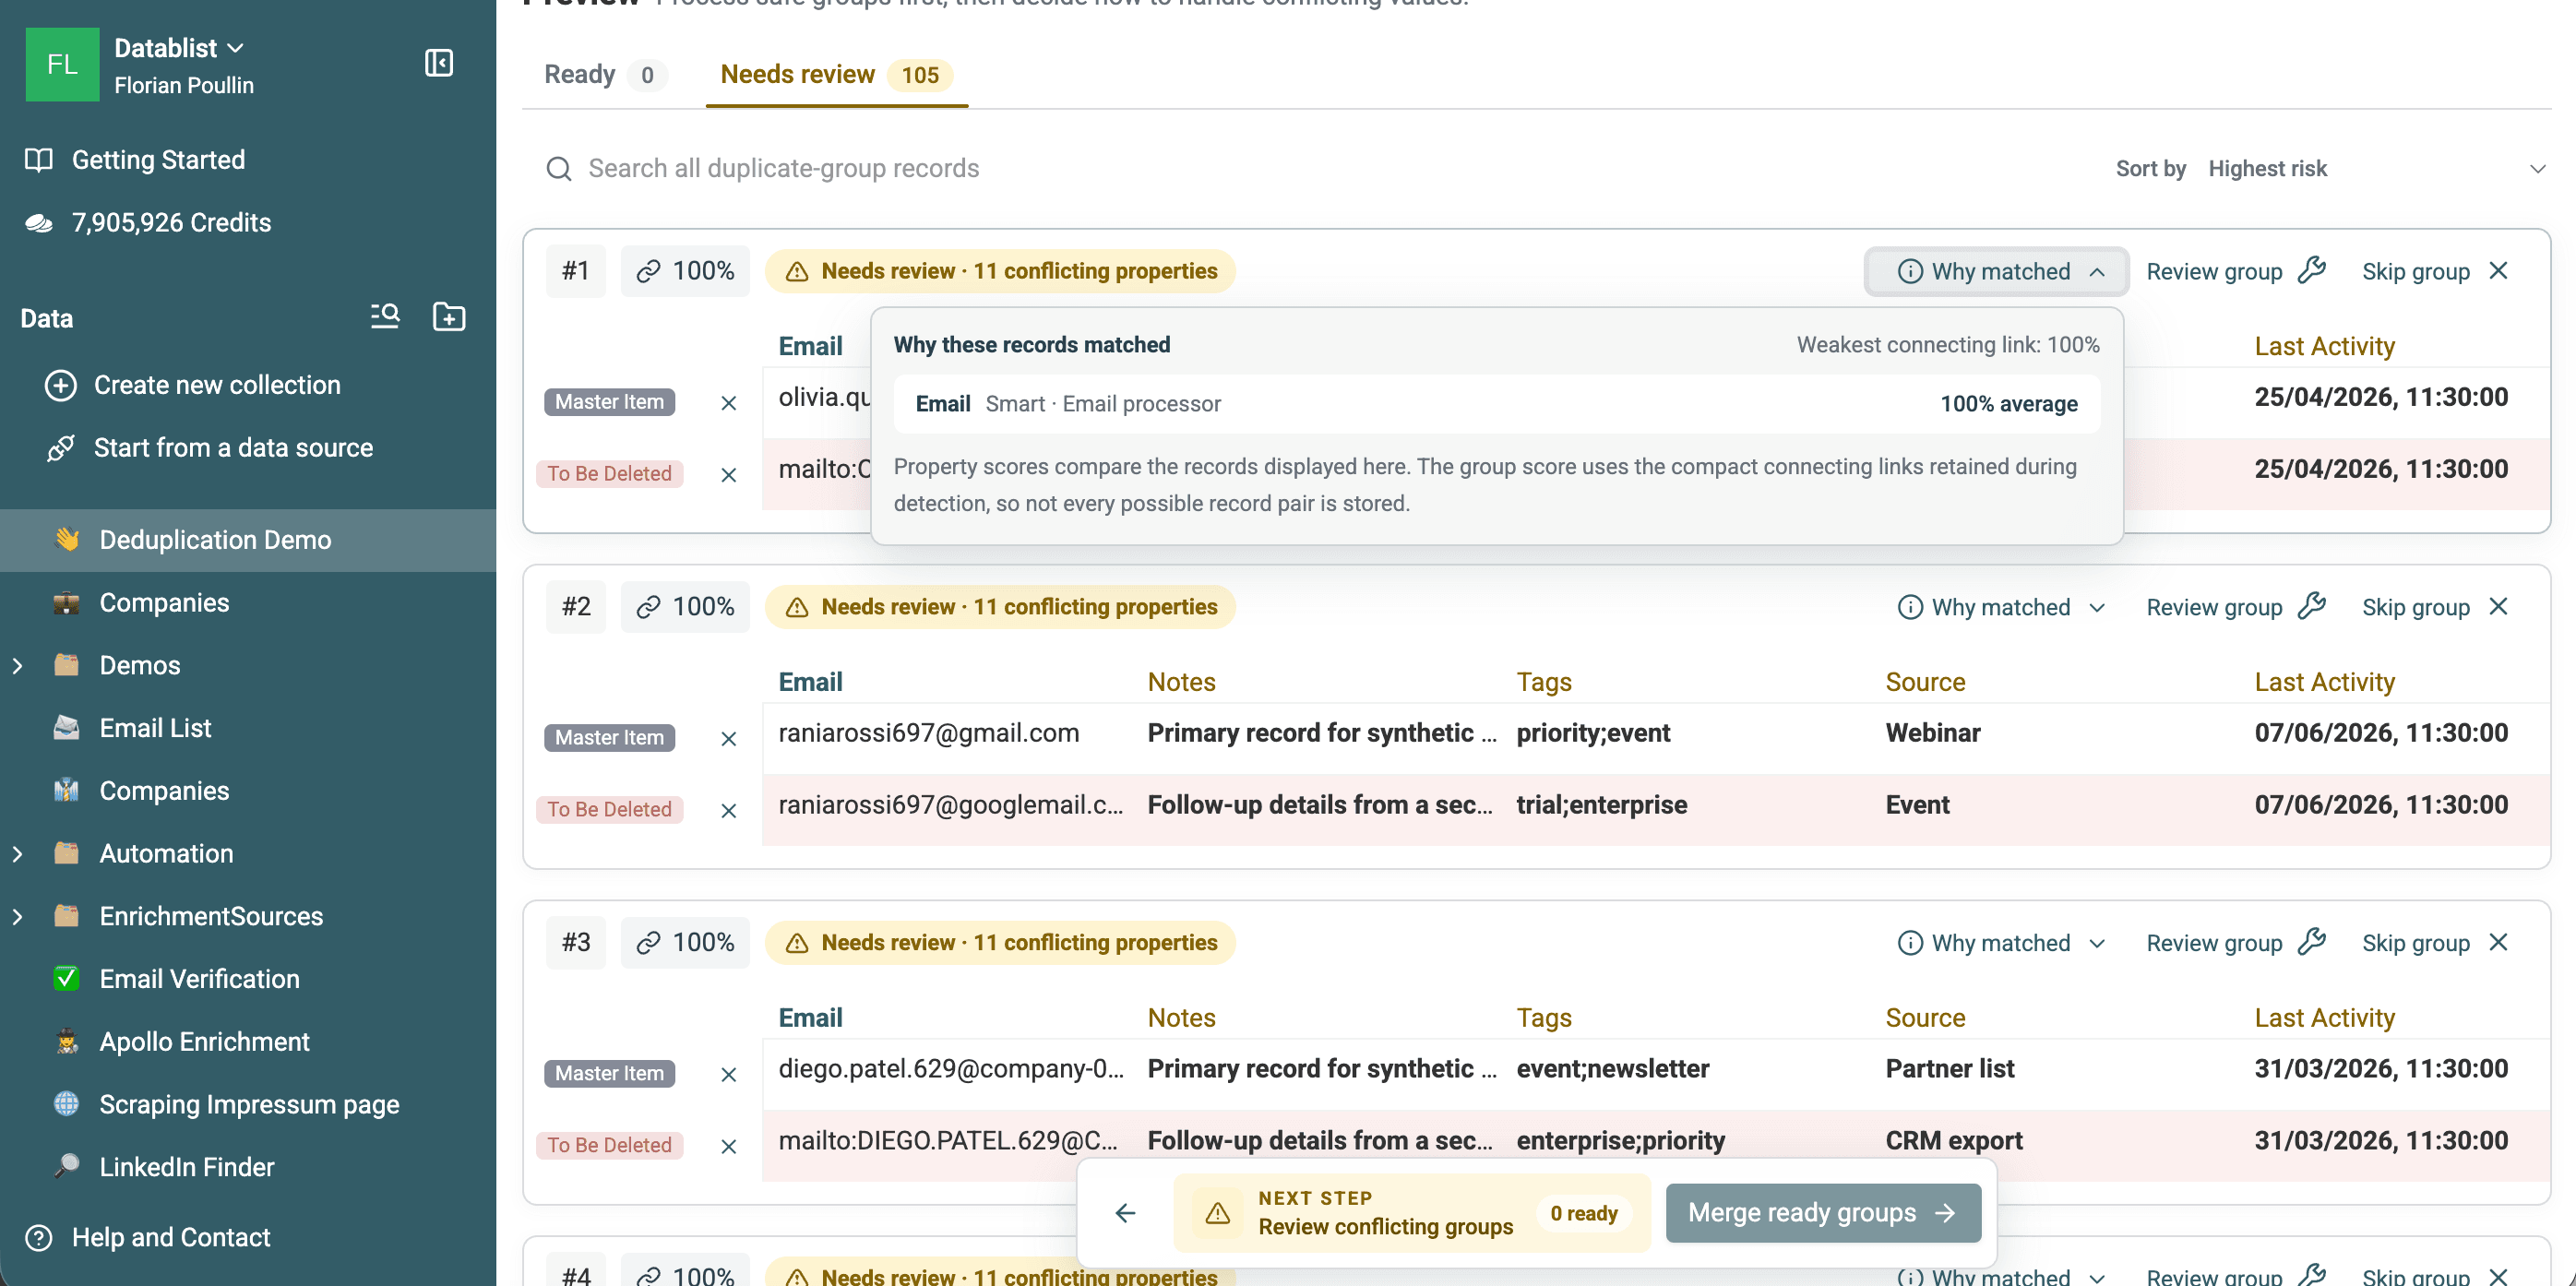
你还可以:
- 确认低置信度匹配。
- 从重复组中移除一条记录,但不删除该记录。
- 跳过该组。
- 打开并编辑记录。
- 在 Merging Assistant 中检查该组。
- 搜索所有剩余重复组,并优先查看风险最高的候选项。
⚠️ 不要只看百分比就处理 fuzzy matching 结果
相似姓名可能属于不同的人。确认重复组之前,请检查标识符和其他相关字段。
合并前检查共享和缺失的标识符
像 info@company.example 这样的公共邮箱可能由多名联系人共用。两个人即使在 Email 字段上匹配,也仍然可能是不同的人。同样,一个公司域名可以标识同一家企业,却会出现在多名员工的记录中。
在有另一个标识符支持匹配之前,不建议自动按人员维度合并这些重复组。如果你的目标是每家公司只保留一行,那么共享域名反而可能是正确的分组依据。解读结果前,请先定义实体。
空值规则也会影响所选属性的比较。对于使用非 Exact 比较方式的多属性检查,高级设置 Empty Value Rule 提供 Value required (default) 和 Match on empty value 两个选项。默认选项要求文本标识符必须存在;允许空值匹配则会放宽这一要求。只有当其他匹配字段能够提供足够的身份依据时,才应使用空值匹配,因为两个缺失的 Email 并不能证明两个人是同一人。
例如,两行记录的 Email 均为空,但 Full Name 不同,不能为了减少行数就直接合并。缺少 Email 的记录仍可能对应你需要保留或稍后进行 enrichment 的联系人。
删除、合并或自定义处理重复项
找出重复项和解决重复项是两个不同的决策。检查次要记录包含哪些信息后,再选择处理模式。
权威记录明确时删除重复项
Remove duplicates 会原样保留一条选中的记录,并删除每个 Ready 组中的其他行。
这种方式适用于完全复制的行、临时导入的数据,或可以舍弃次要字段值的记录。如果将被删除的记录包含额外信息或冲突值,预览会发出警告。这些值不会复制到保留的记录中。
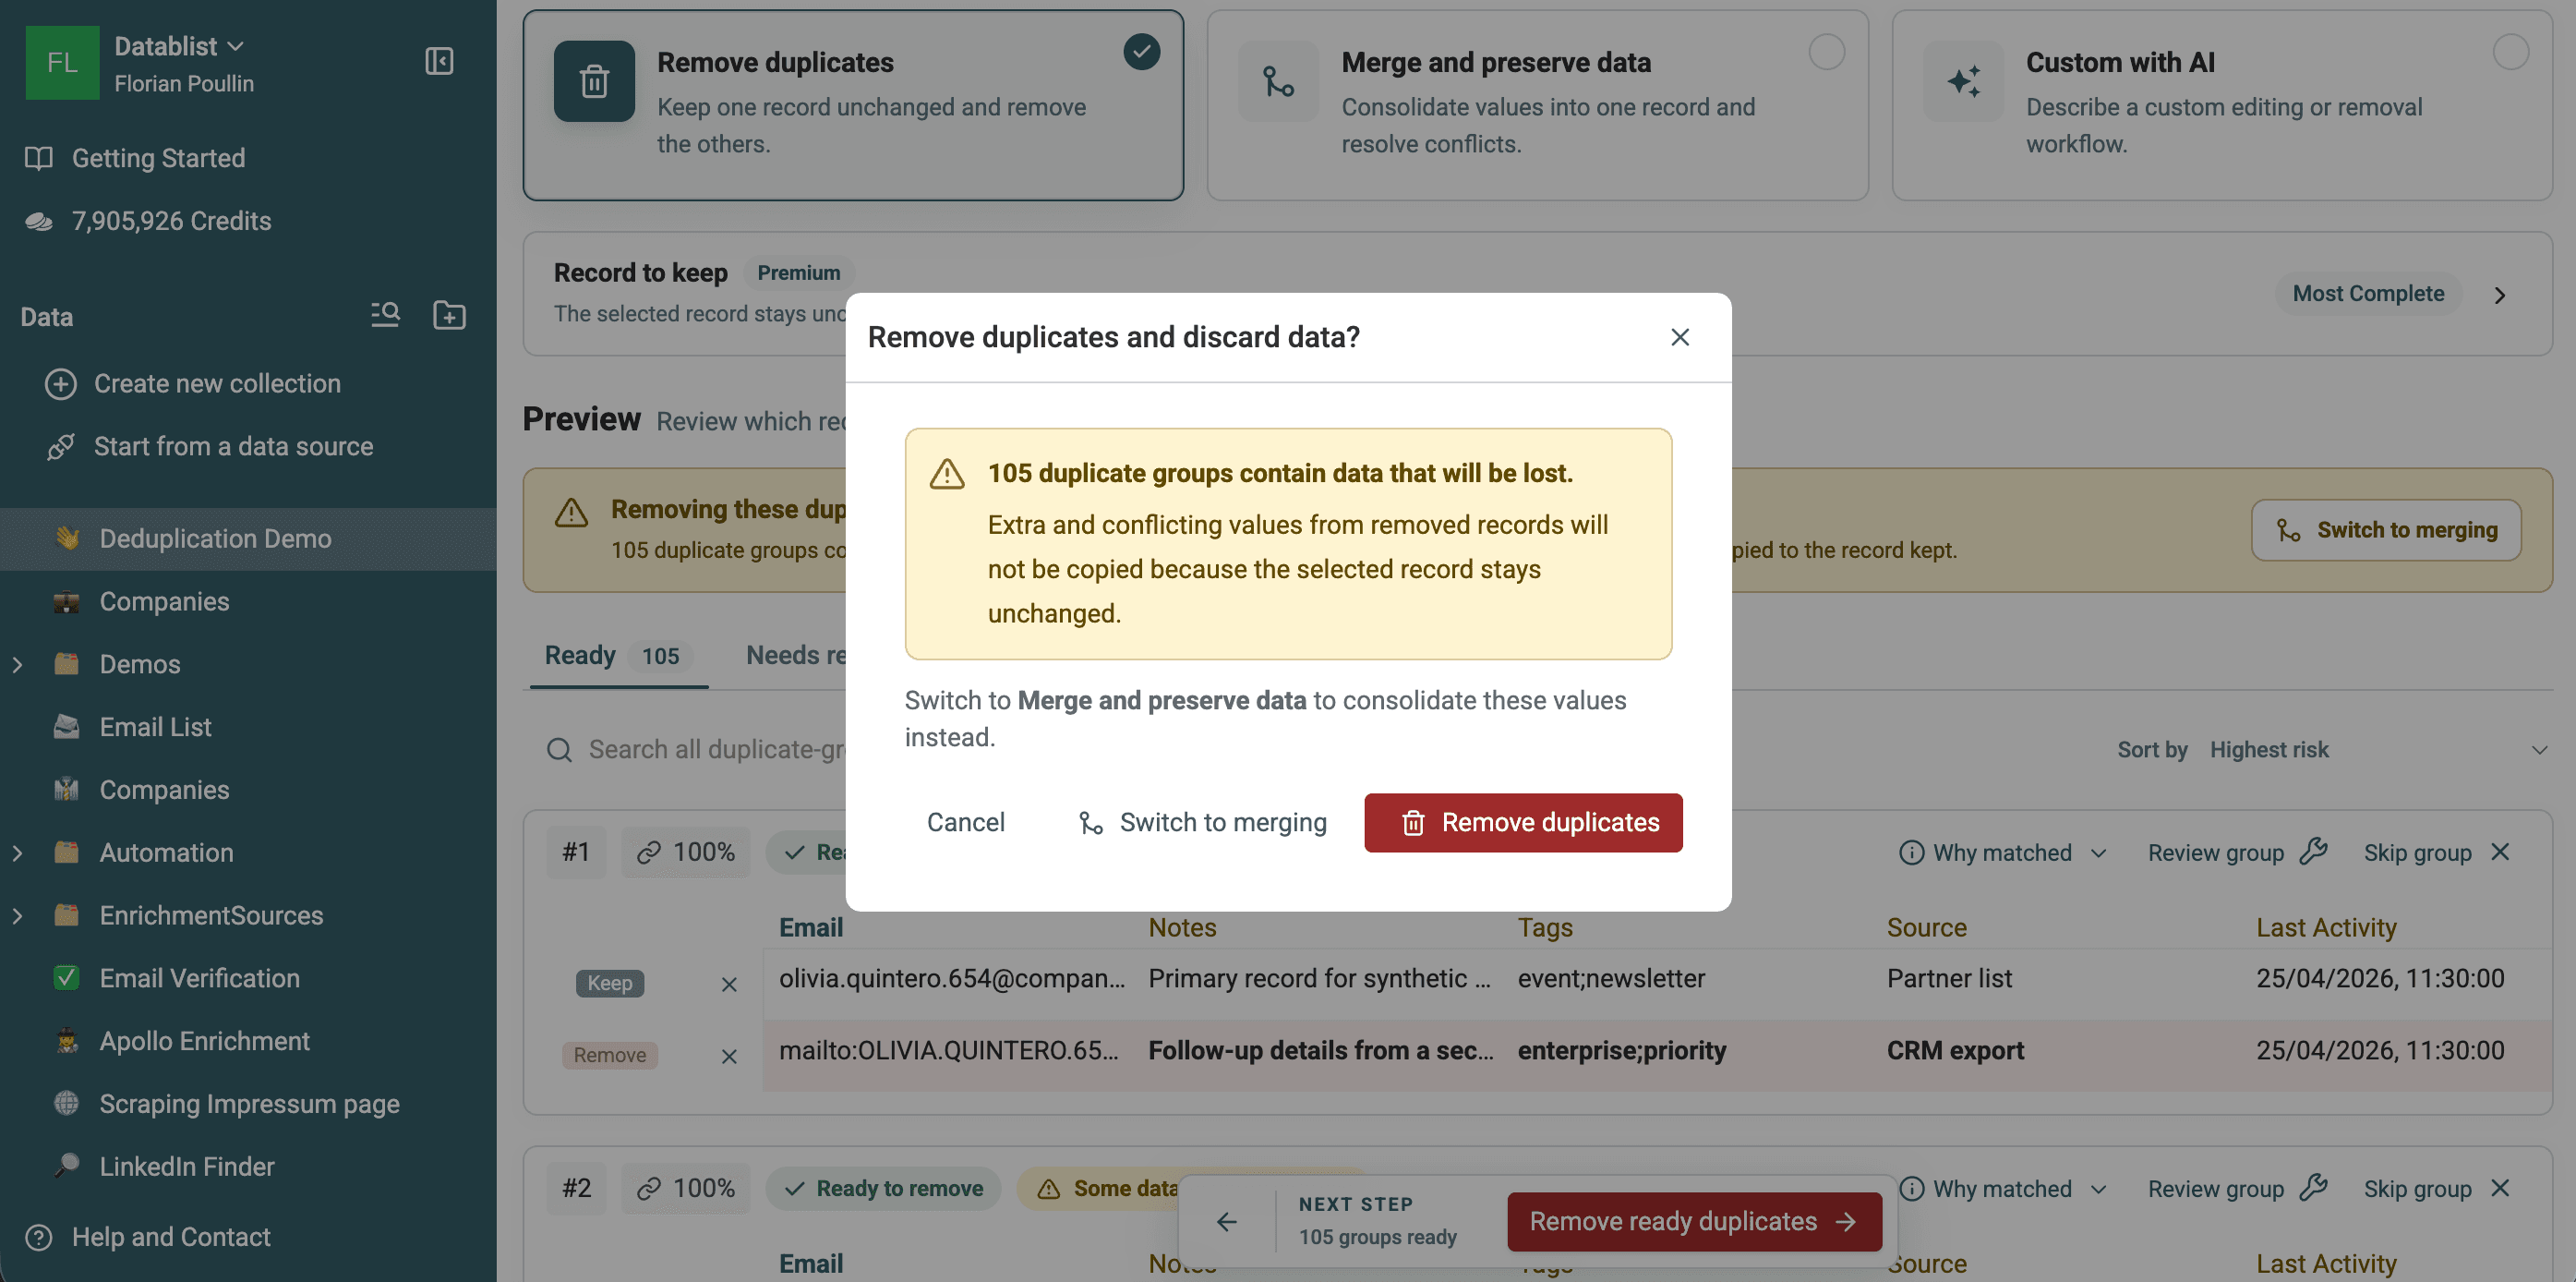
记录包含有用数据时进行合并
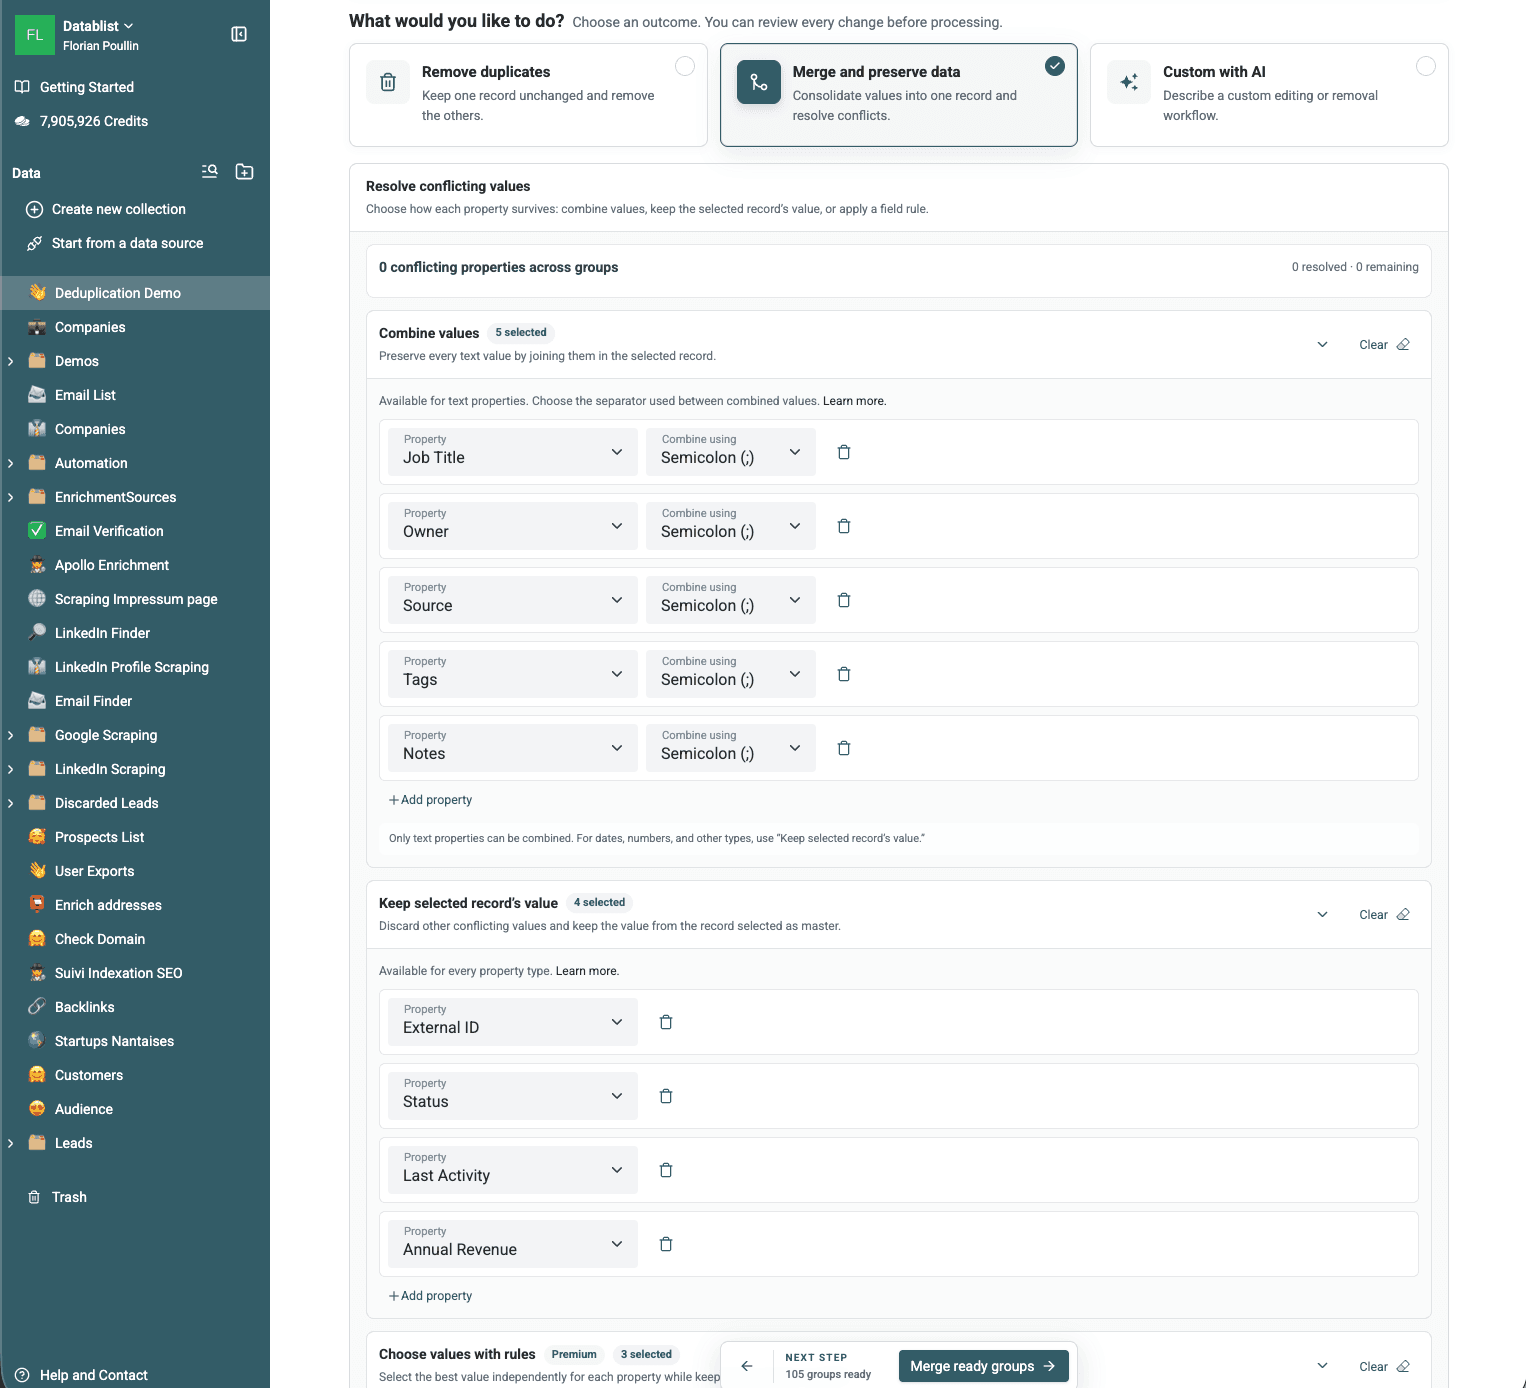
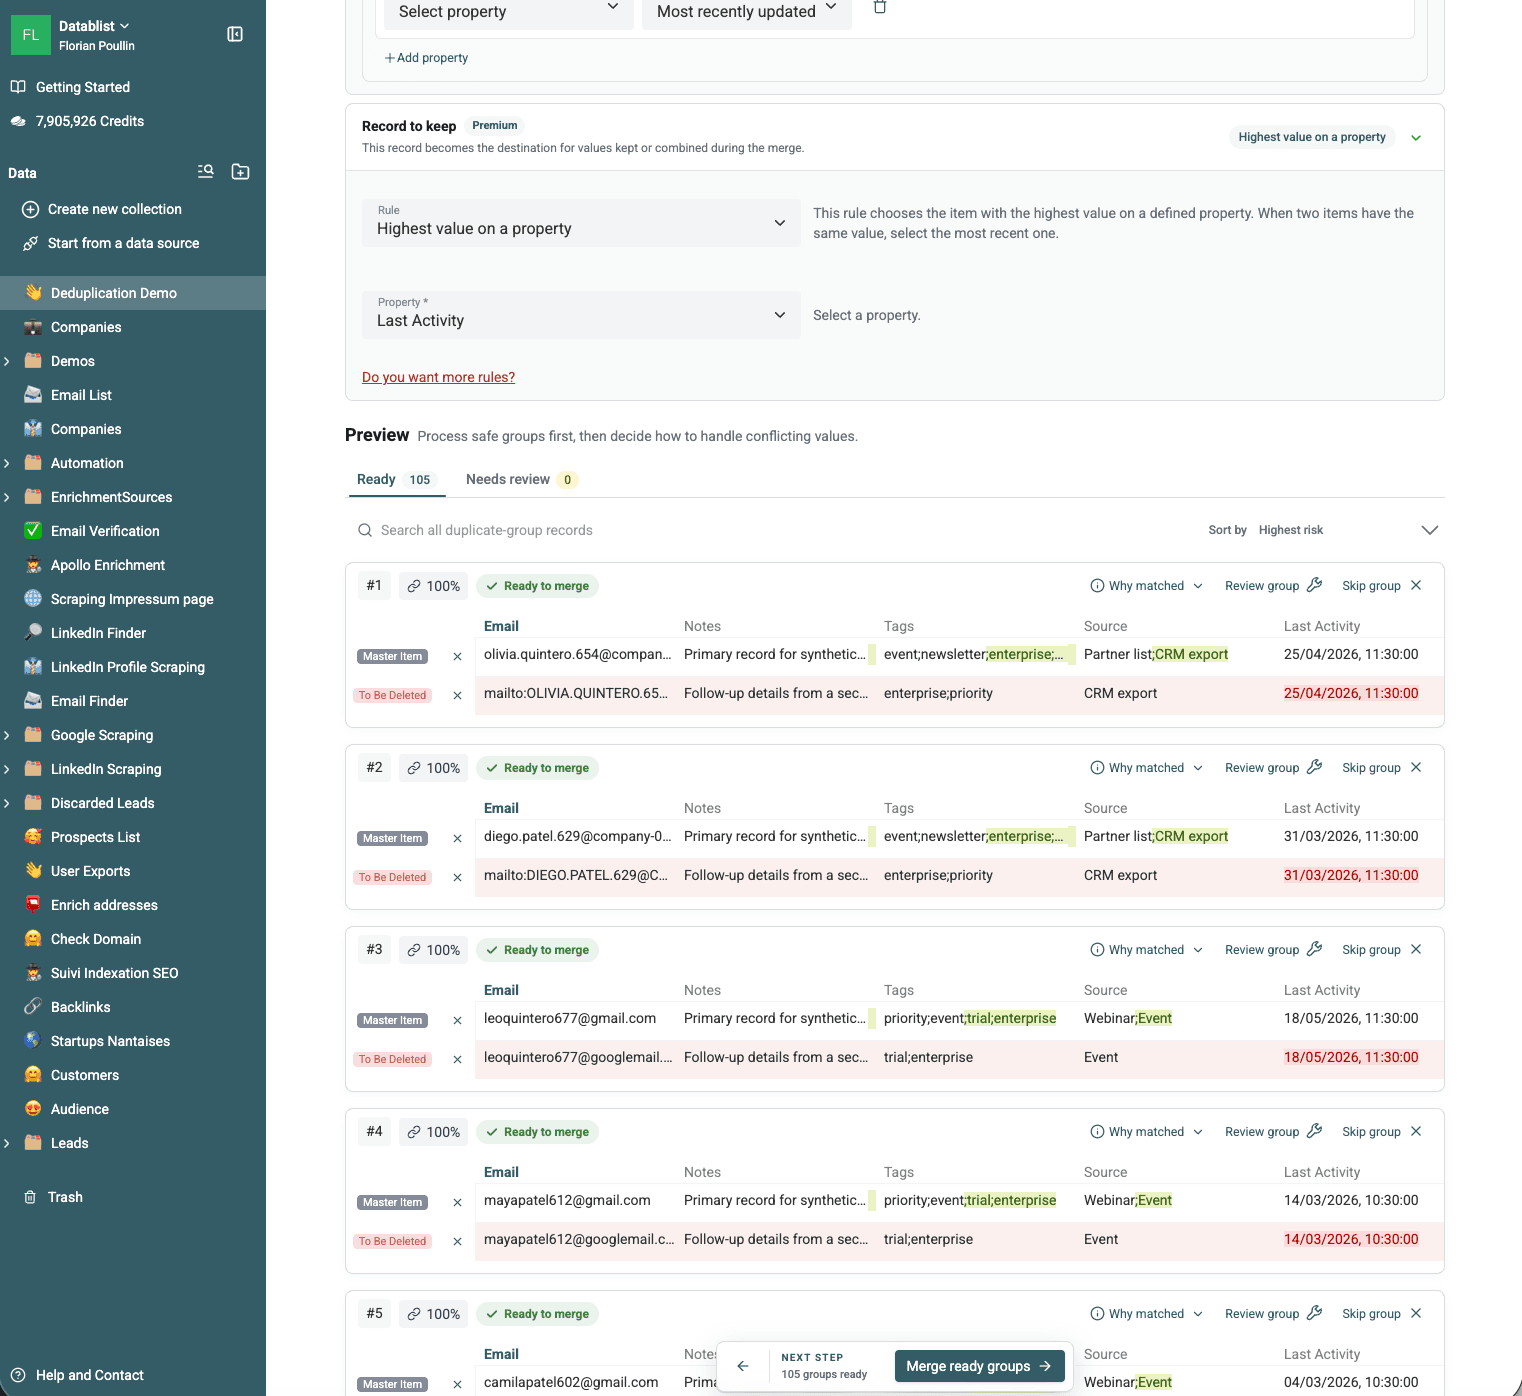
Merge and preserve data 会填充所选记录中的空属性,按照配置解决冲突,然后删除次要记录。
先设置 Record to keep 规则。默认选项是 Most Complete。付费套餐还可以根据创建时间、更新时间、属性值的最高或最低值,或某个必需属性值来选择记录。
然后决定如何保留每个冲突属性:
- 使用分隔符合并不同的文本值。
- 保留所选记录中的值。
- 付费套餐可以独立选择各字段的值,并使用最新、最早、最长、最短、最高、最低或最常见等规则。
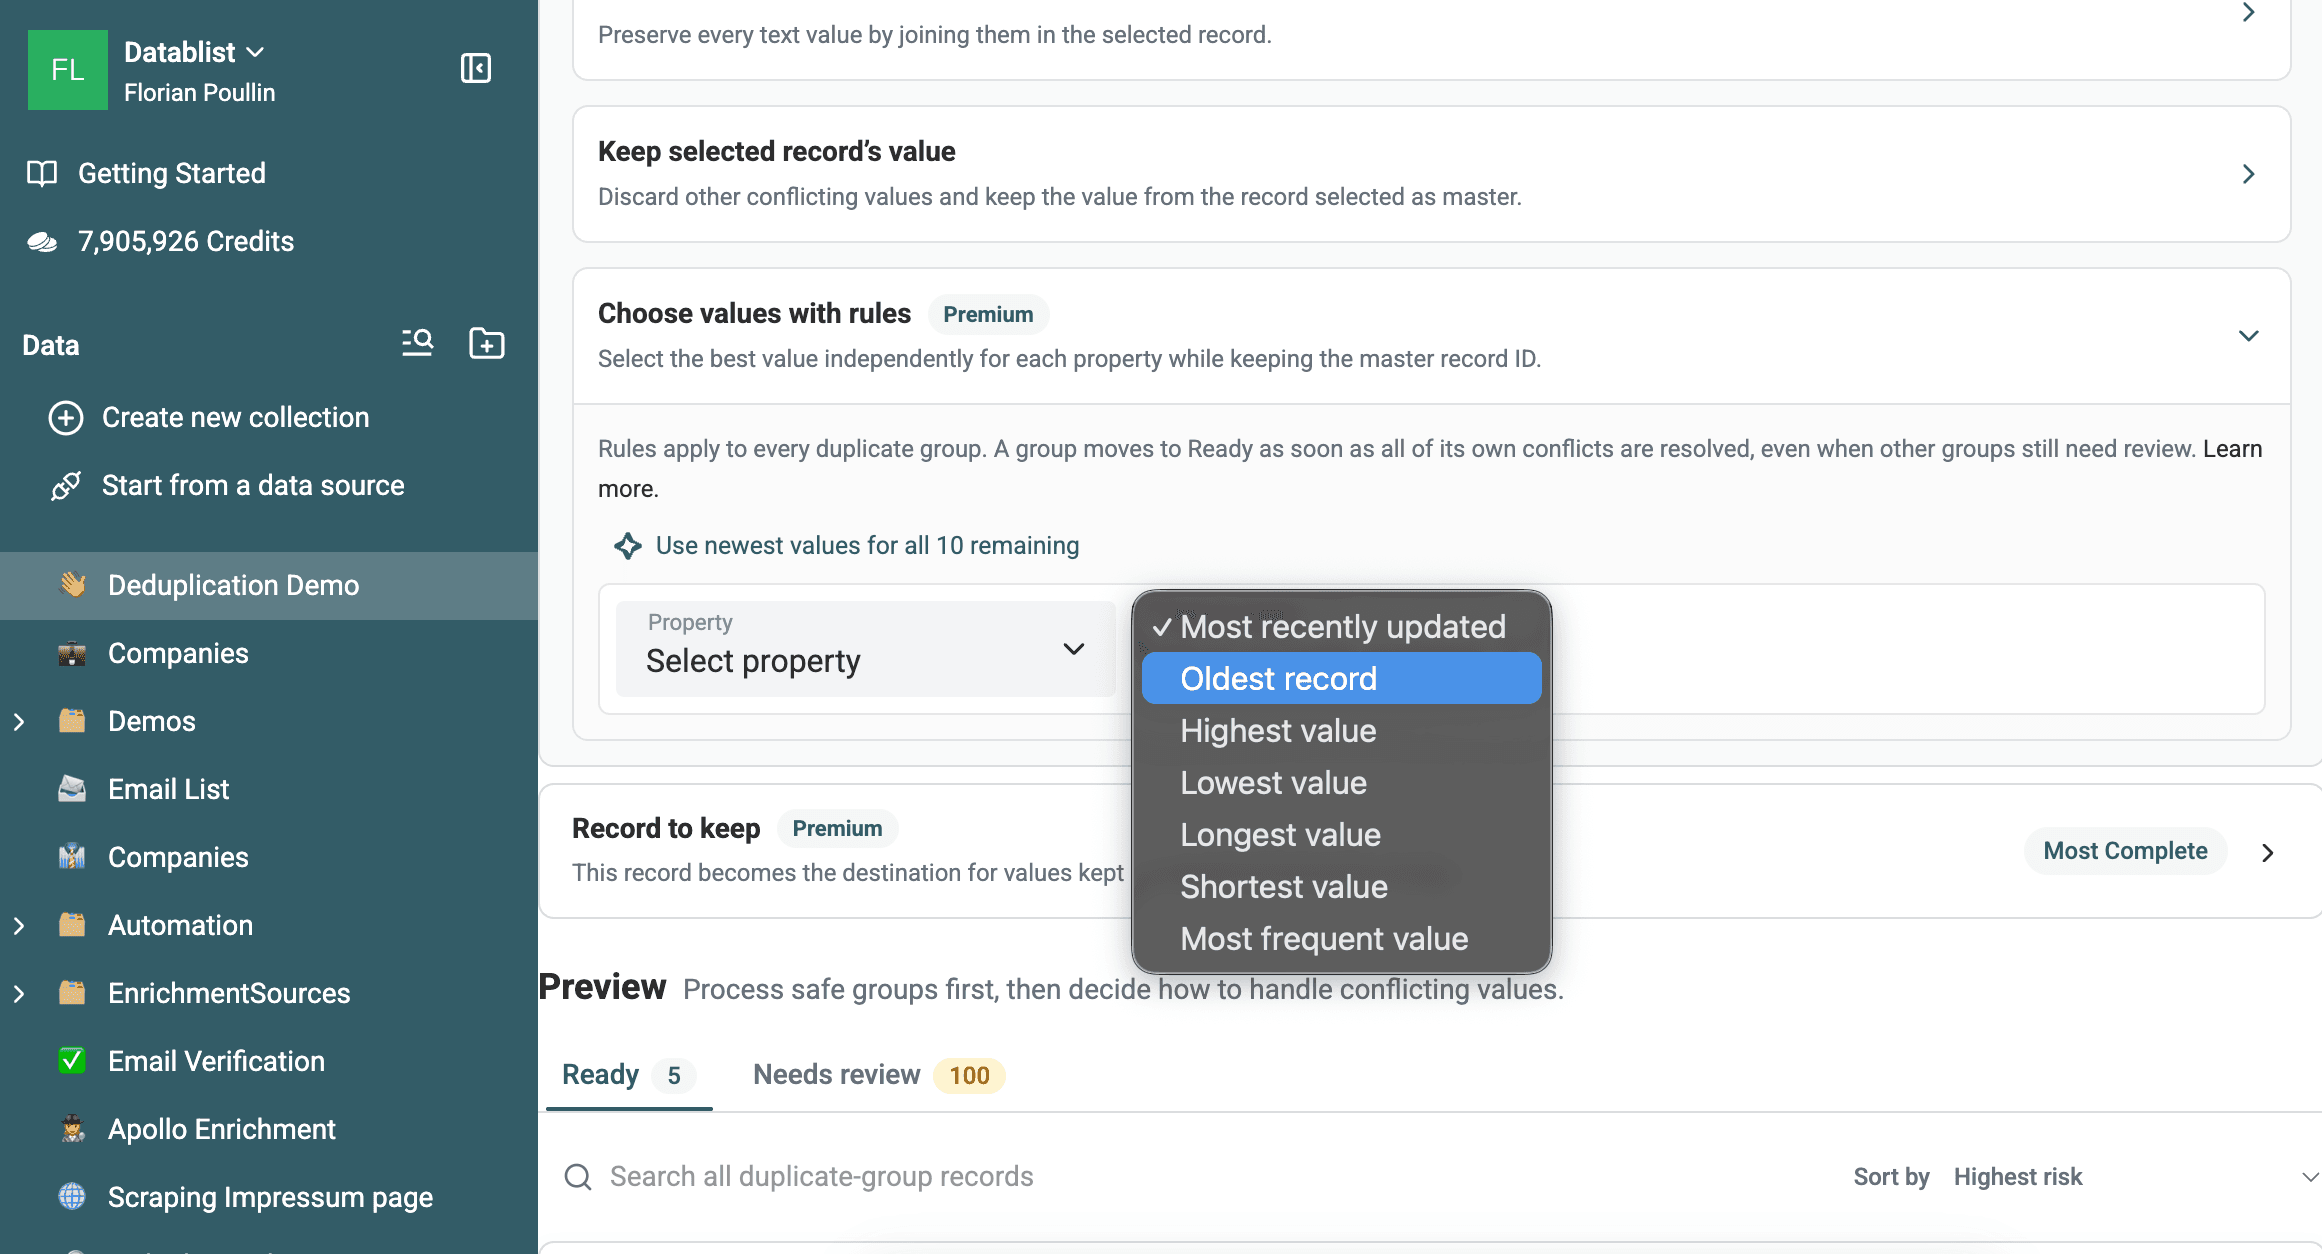
如果没有任何一行在所有属性上都拥有最佳值,请使用字段级规则。你可以保留所选记录的 ID,同时从其他行获取更新的职位、更完整的公司名称以及出现频率最高的状态。
修改 threshold、workflow、重复组成员、冲突设置或记录选择规则后,请刷新预览。
使用 Custom with AI 设置分组处理逻辑
Custom with AI 可以根据自然语言指令生成重复组处理 workflow。它可以选择记录、复制或标准化字段值、添加状态属性、计算组内合计、删除次要记录,或跳过不符合条件的重复组。
例如:
保留 Source 为 CRM export 的记录。从最新记录中复制 Job Title,用换行符合并不同的 Notes,添加 Duplicate Reviewed checkbox,然后删除次要记录。
使用 /Property 或 {{Property}} 引用 collection property。运行前,请先生成并预览 workflow。Custom with AI 仅面向已登录的付费套餐用户开放。
对于个别例外情况,请打开 Review group 并使用 Merging Assistant,无需让批量规则变得过于复杂。
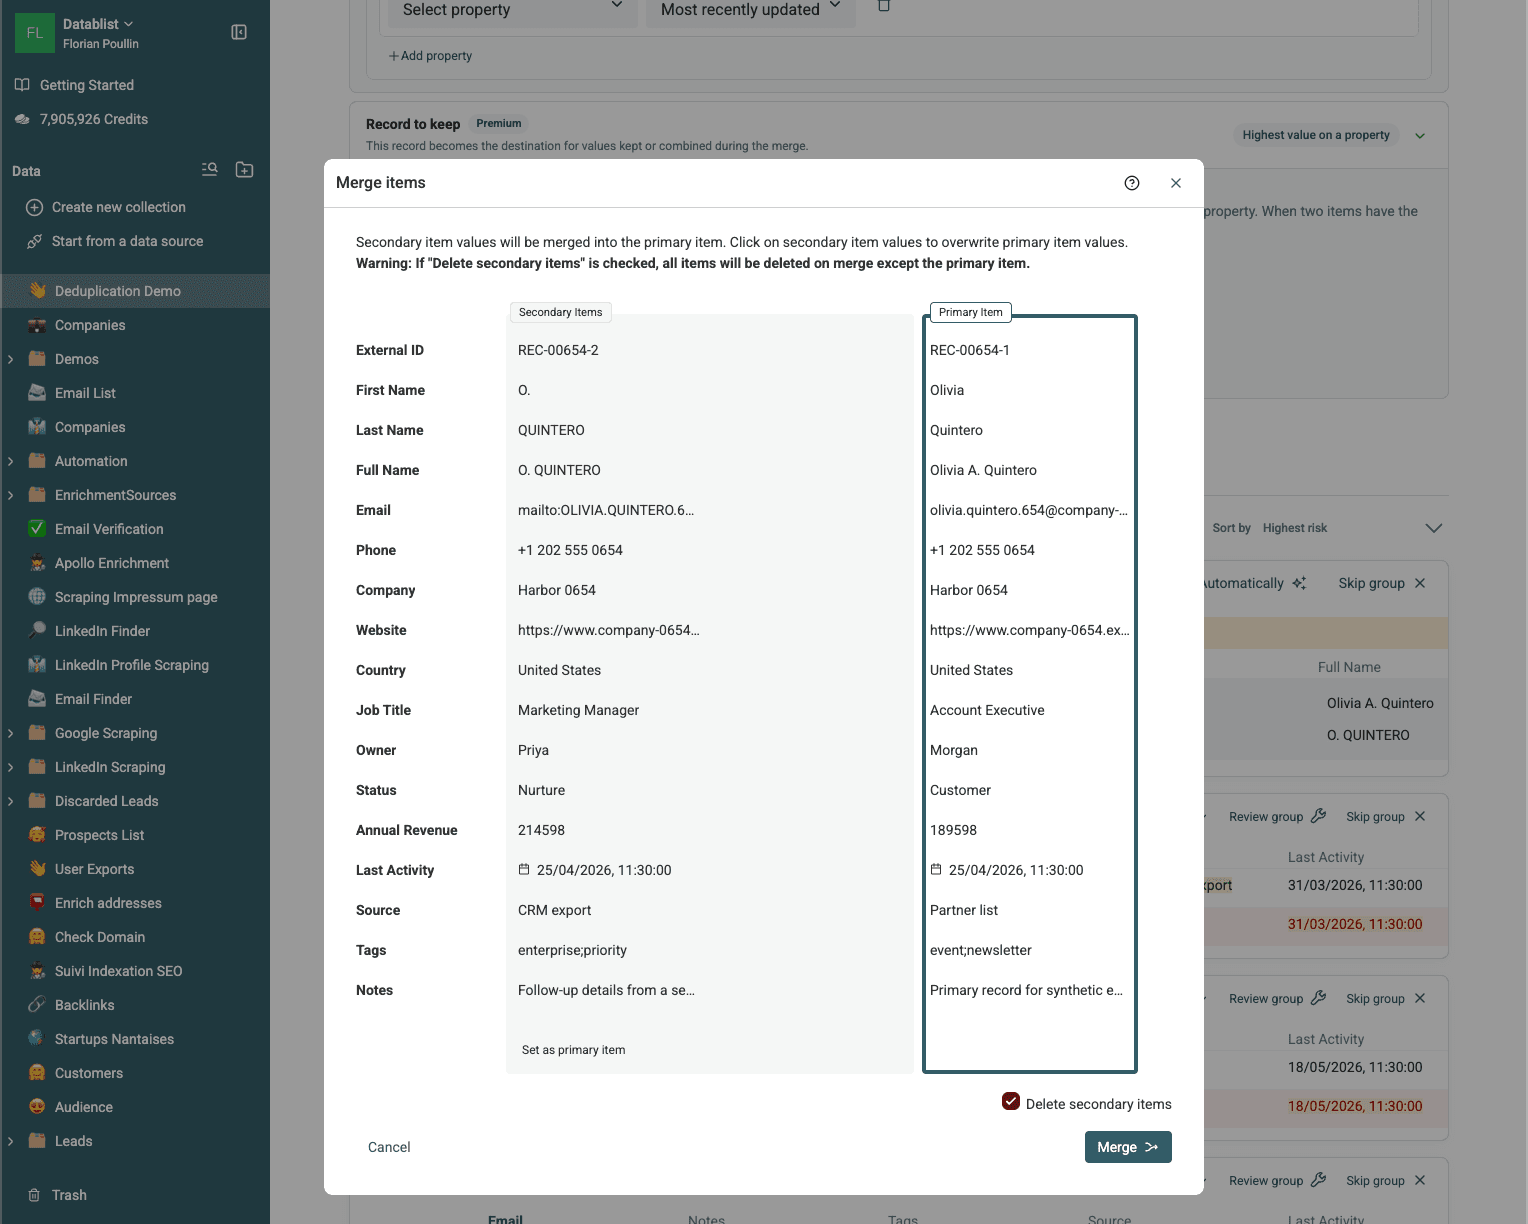
验证并导出去重后的列表
处理 Ready 组之前,请确认:
- 预览反映的是当前设置。
- 已检查低置信度组和使用共享标识符的重复组。
- 所选记录包含需要保留的 ID。
- 唯一的电话、来源、备注和状态值能够保留下来。
- 只能有一个有效值的字段不会被拼接。
- 页面显示的 Ready 数量与要处理的范围一致。
处理完成后,核对行数:
起始行数 - 已删除的次要行数 = 最终行数
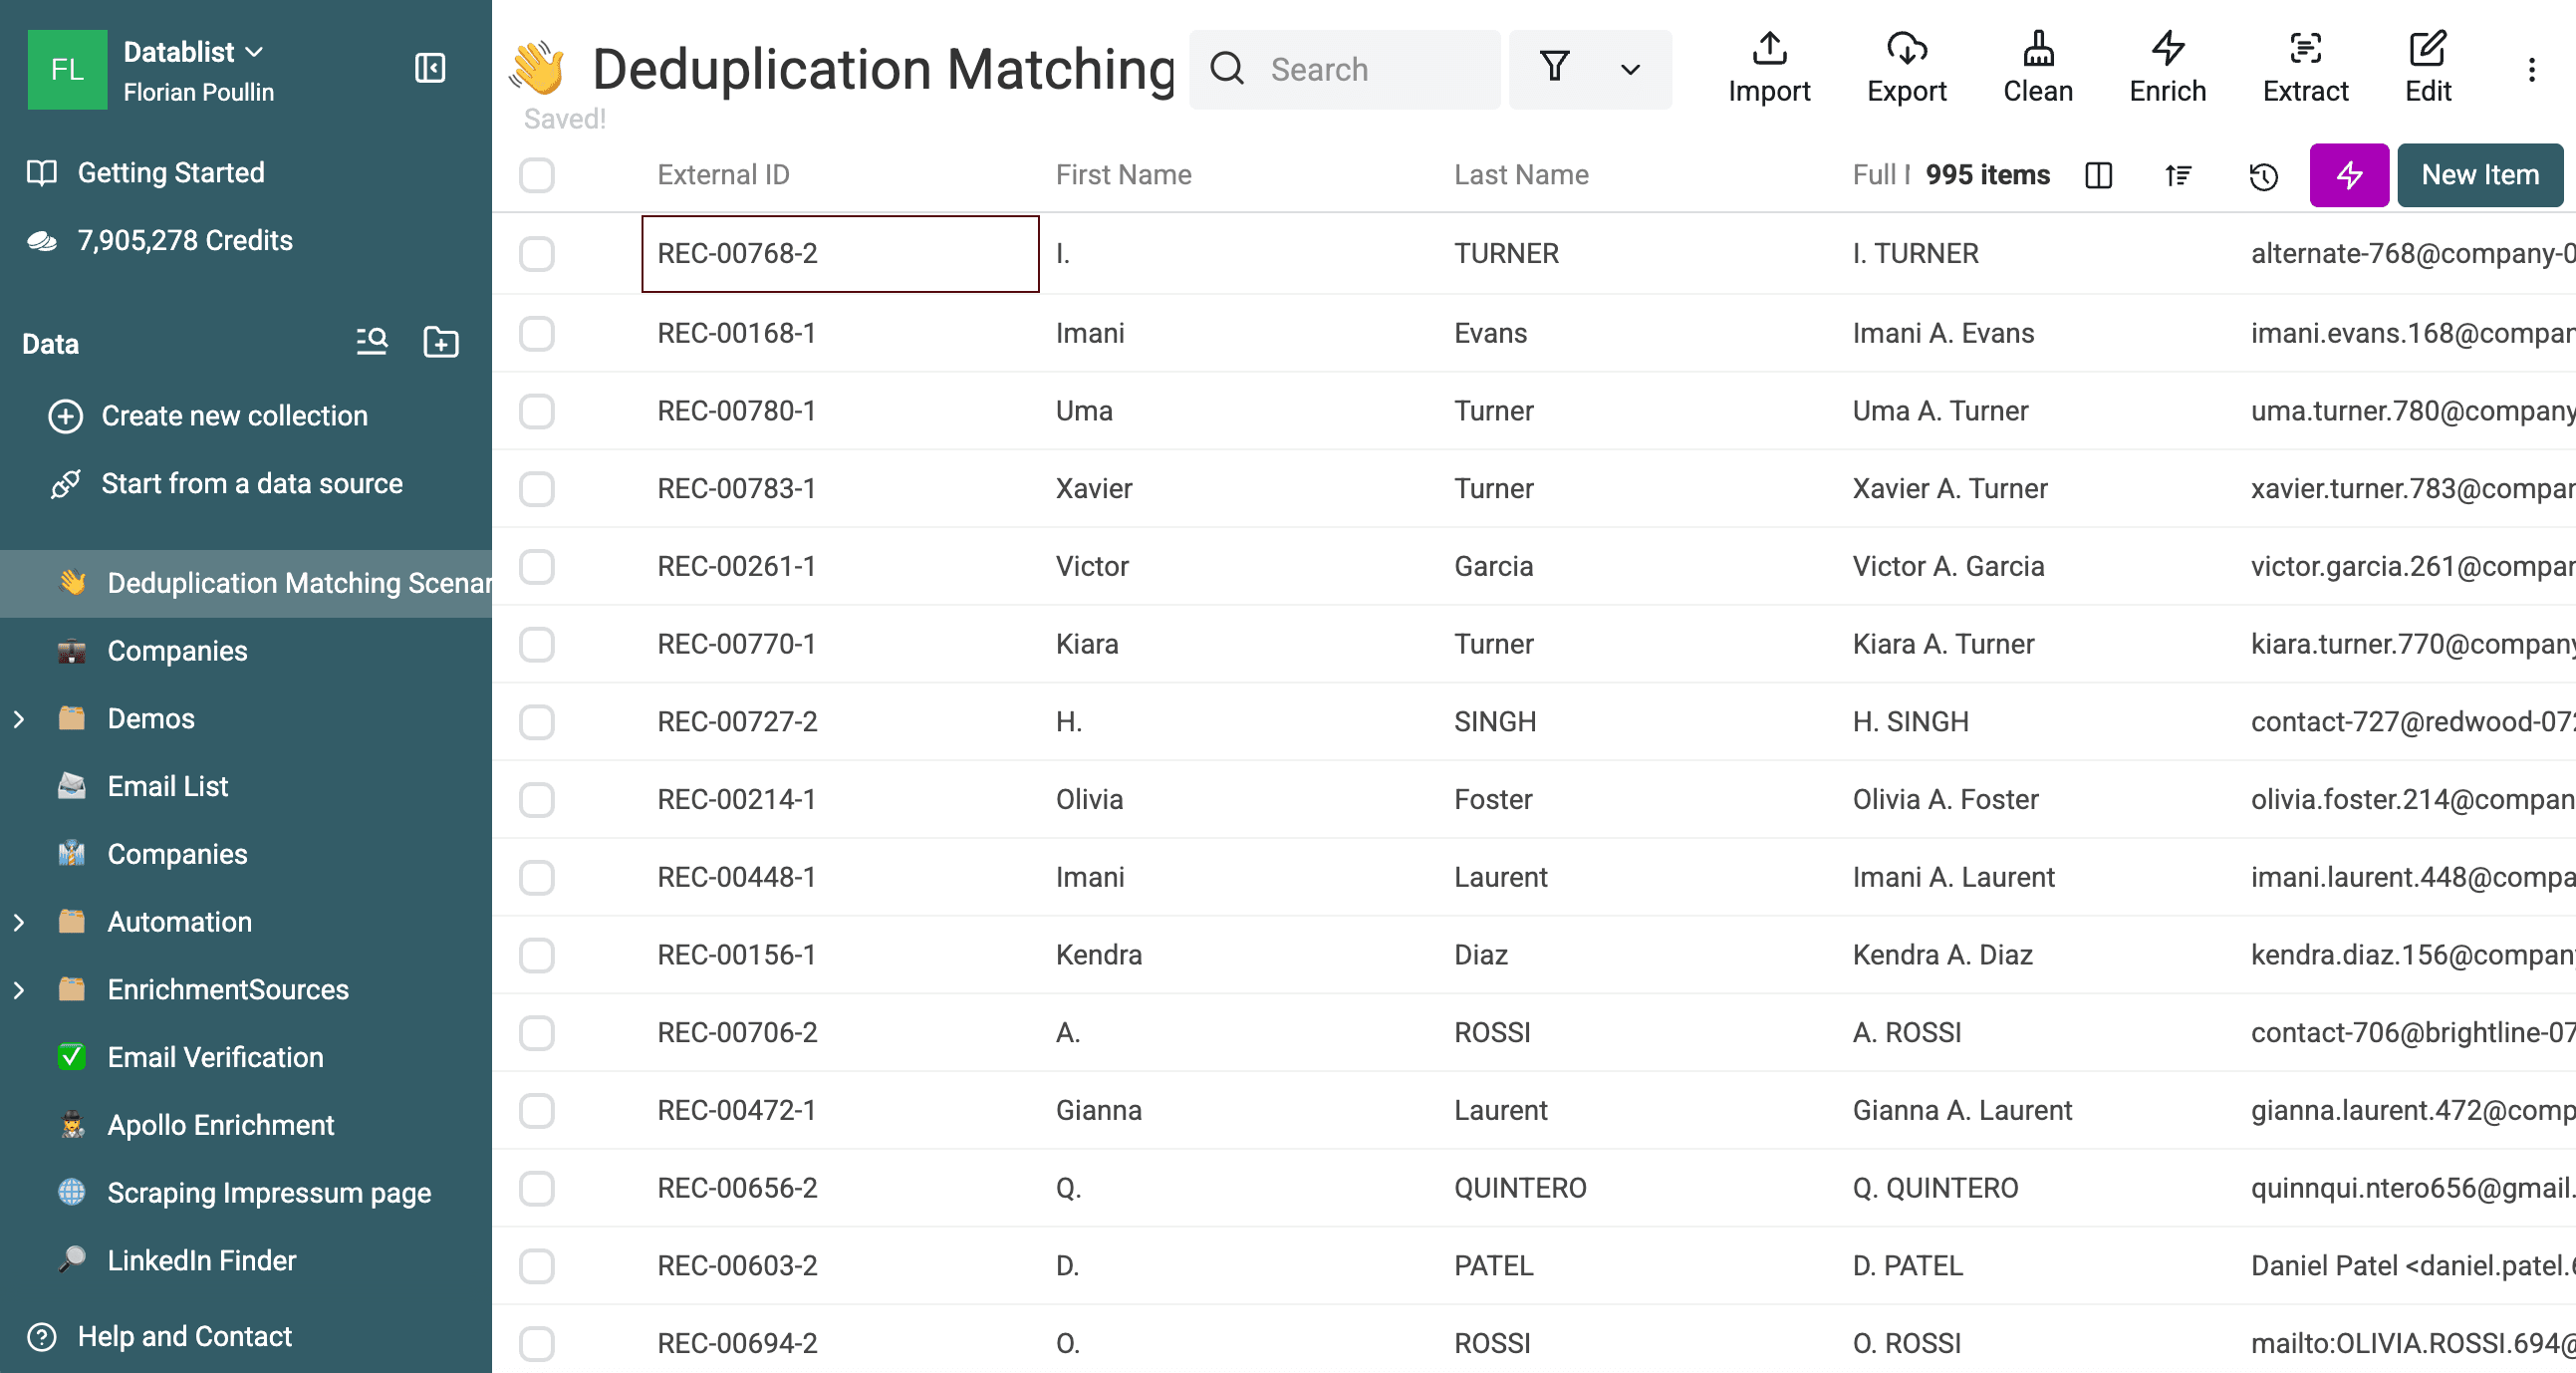
在本指南的 Exact 匹配中,Datablist 合并了五个双行重复组。因此,该 collection 从 1,000 个 item 减少到 995 个。
如果需要在外部检查数据,请在处理前下载重复组。付费套餐会提供可用的重复组 ID 和处理后的 change log。Change log 会记录已删除和已更新的 Datablist ID,以及修改前的值和目标值。
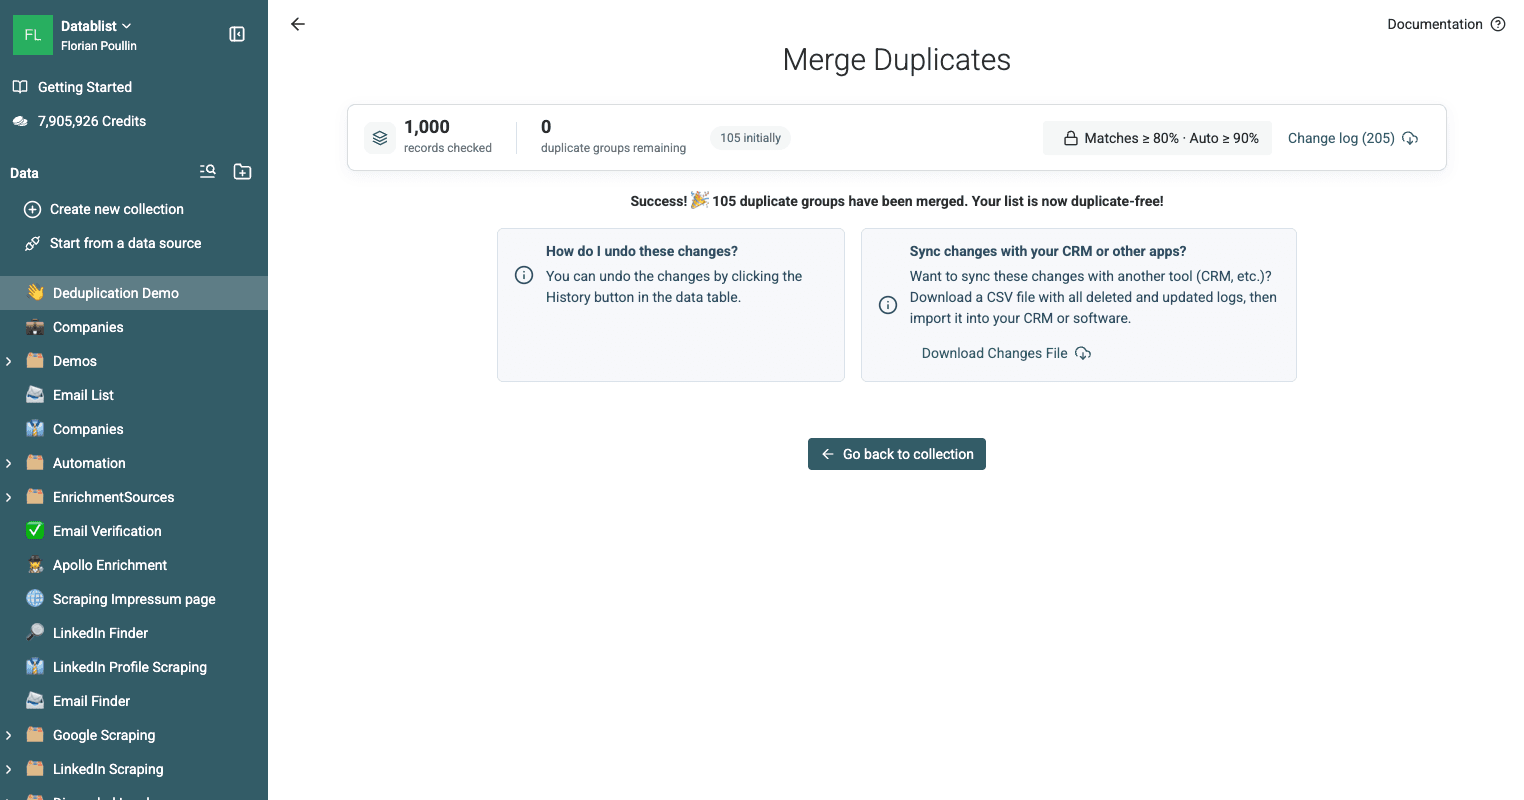
自动删除和合并操作也会显示在 collection History 中,你可以在那里撤销操作。
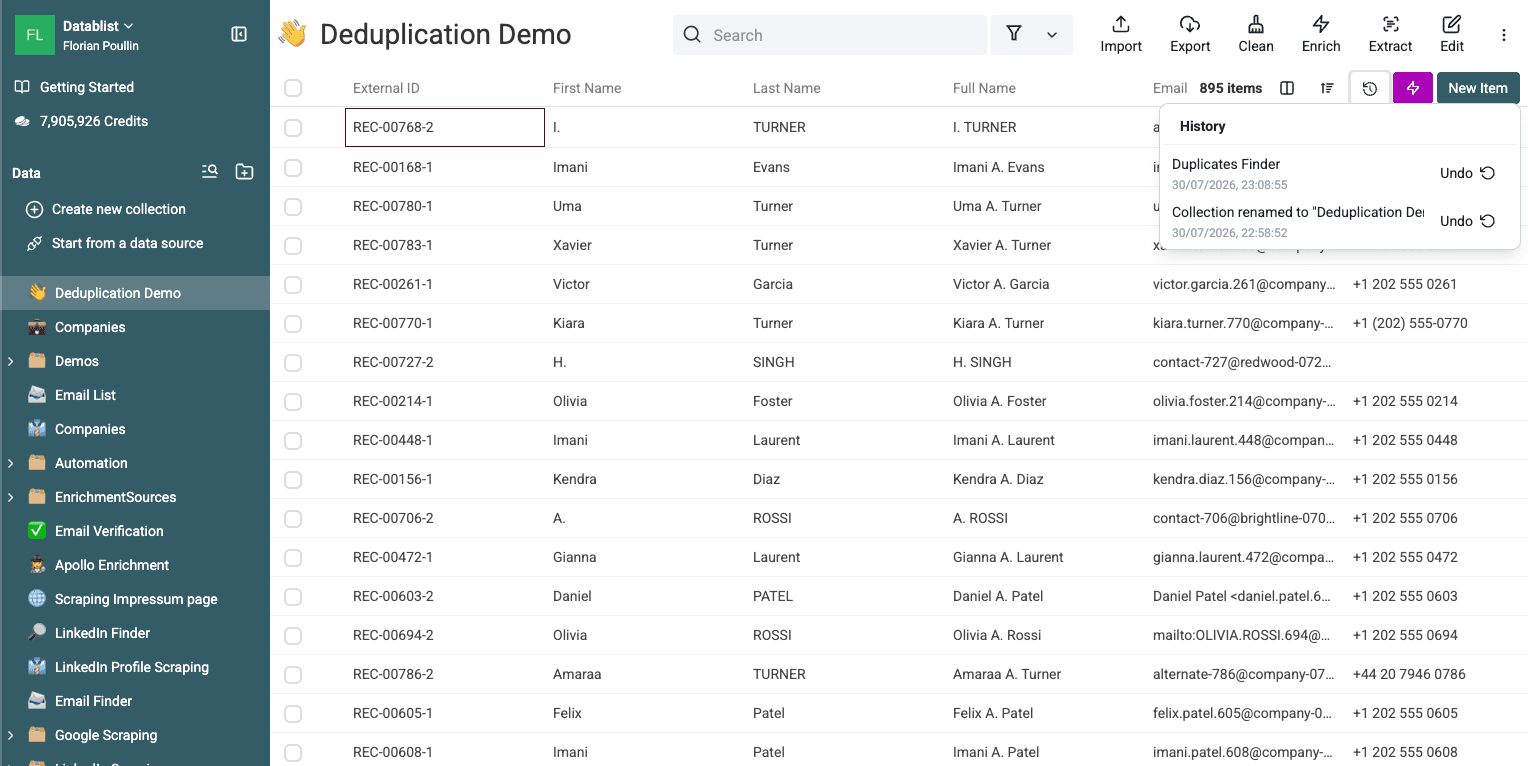
返回 collection,打开 Export,下载清理后的 CSV 或 Excel 文件。
多个列表去重
如果需要将新的 Lead 文件与 CRM 导出数据进行比较,请使用 cross-collection matching。将 CRM 作为参考列表,在导入新 Lead 前,从待导入列表中删除与 CRM 匹配的记录。
下载演示 CRM 文件和演示活动文件,测试此 workflow。这两个文件的表头不同,包含 100 组预设的 Email 重叠记录,每个文件最初都有 250 行。
将两个文件分别导入各自的 collection,然后打开 Clean > Match across collections。添加两个 collection,并映射对应属性,例如将 Email 映射到 Attendee Email。
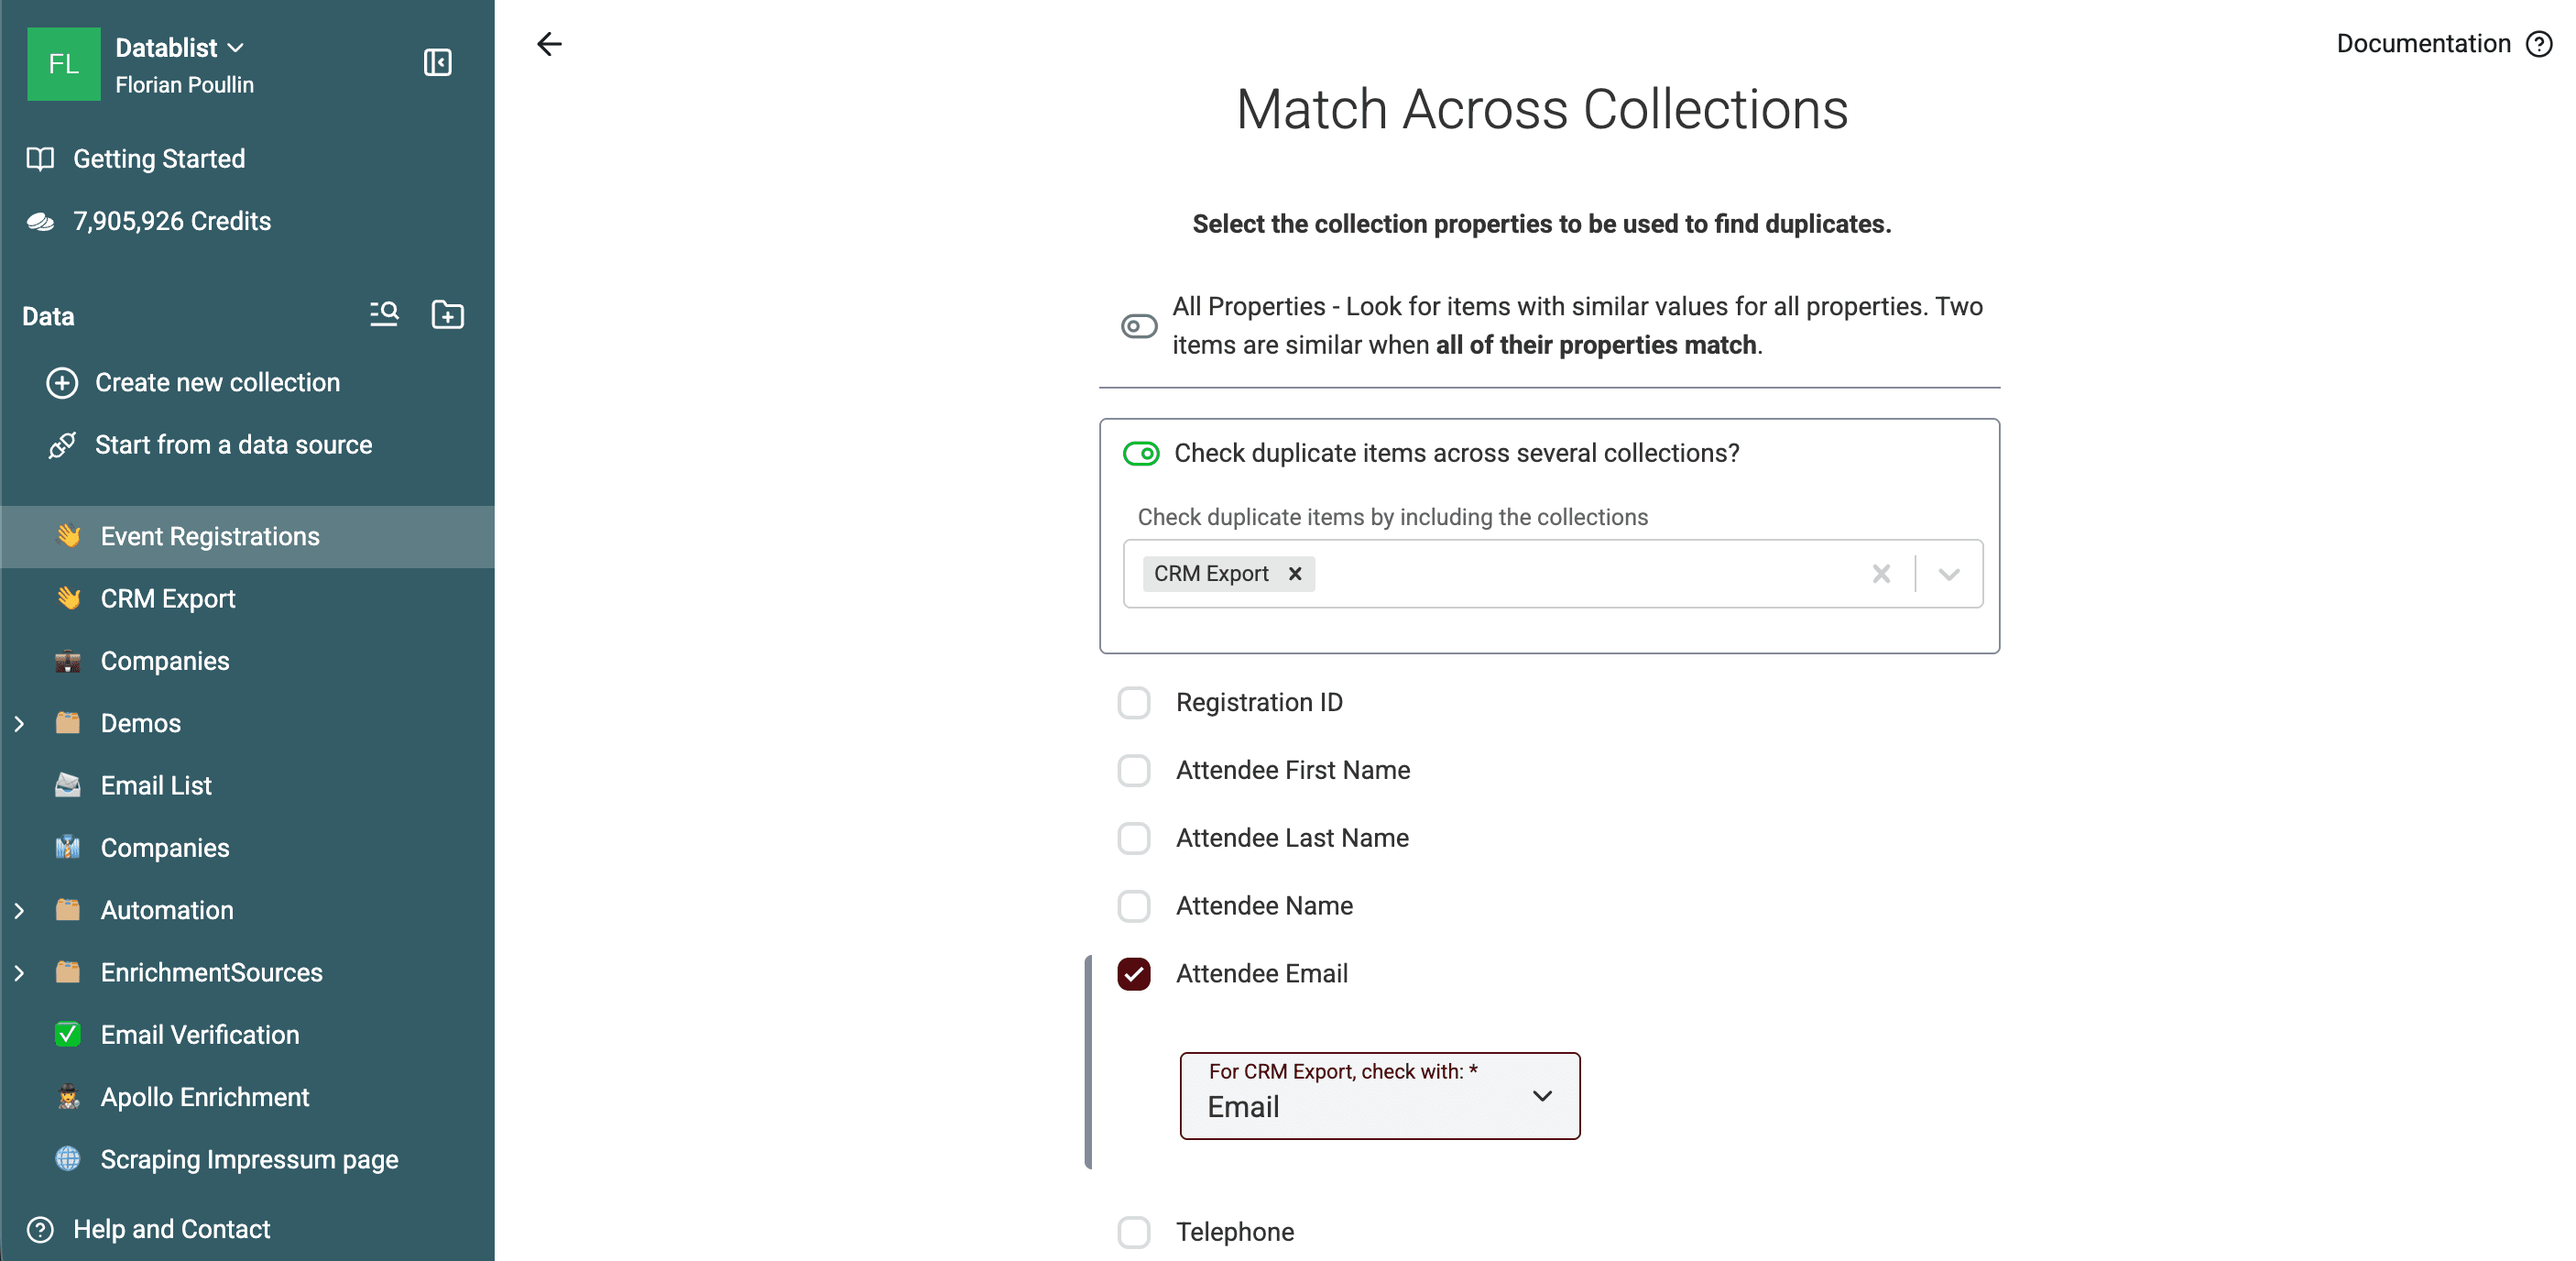
在本次测试中,使用 Email processor 的 Smart matching 从 500 条已检查记录中返回了 100 个跨 collection 重复组。在 Remove duplicate items from collection {X} 下选择 Event Registrations,即可保持 CRM 不变,并从活动列表中移除与 CRM 匹配的记录。
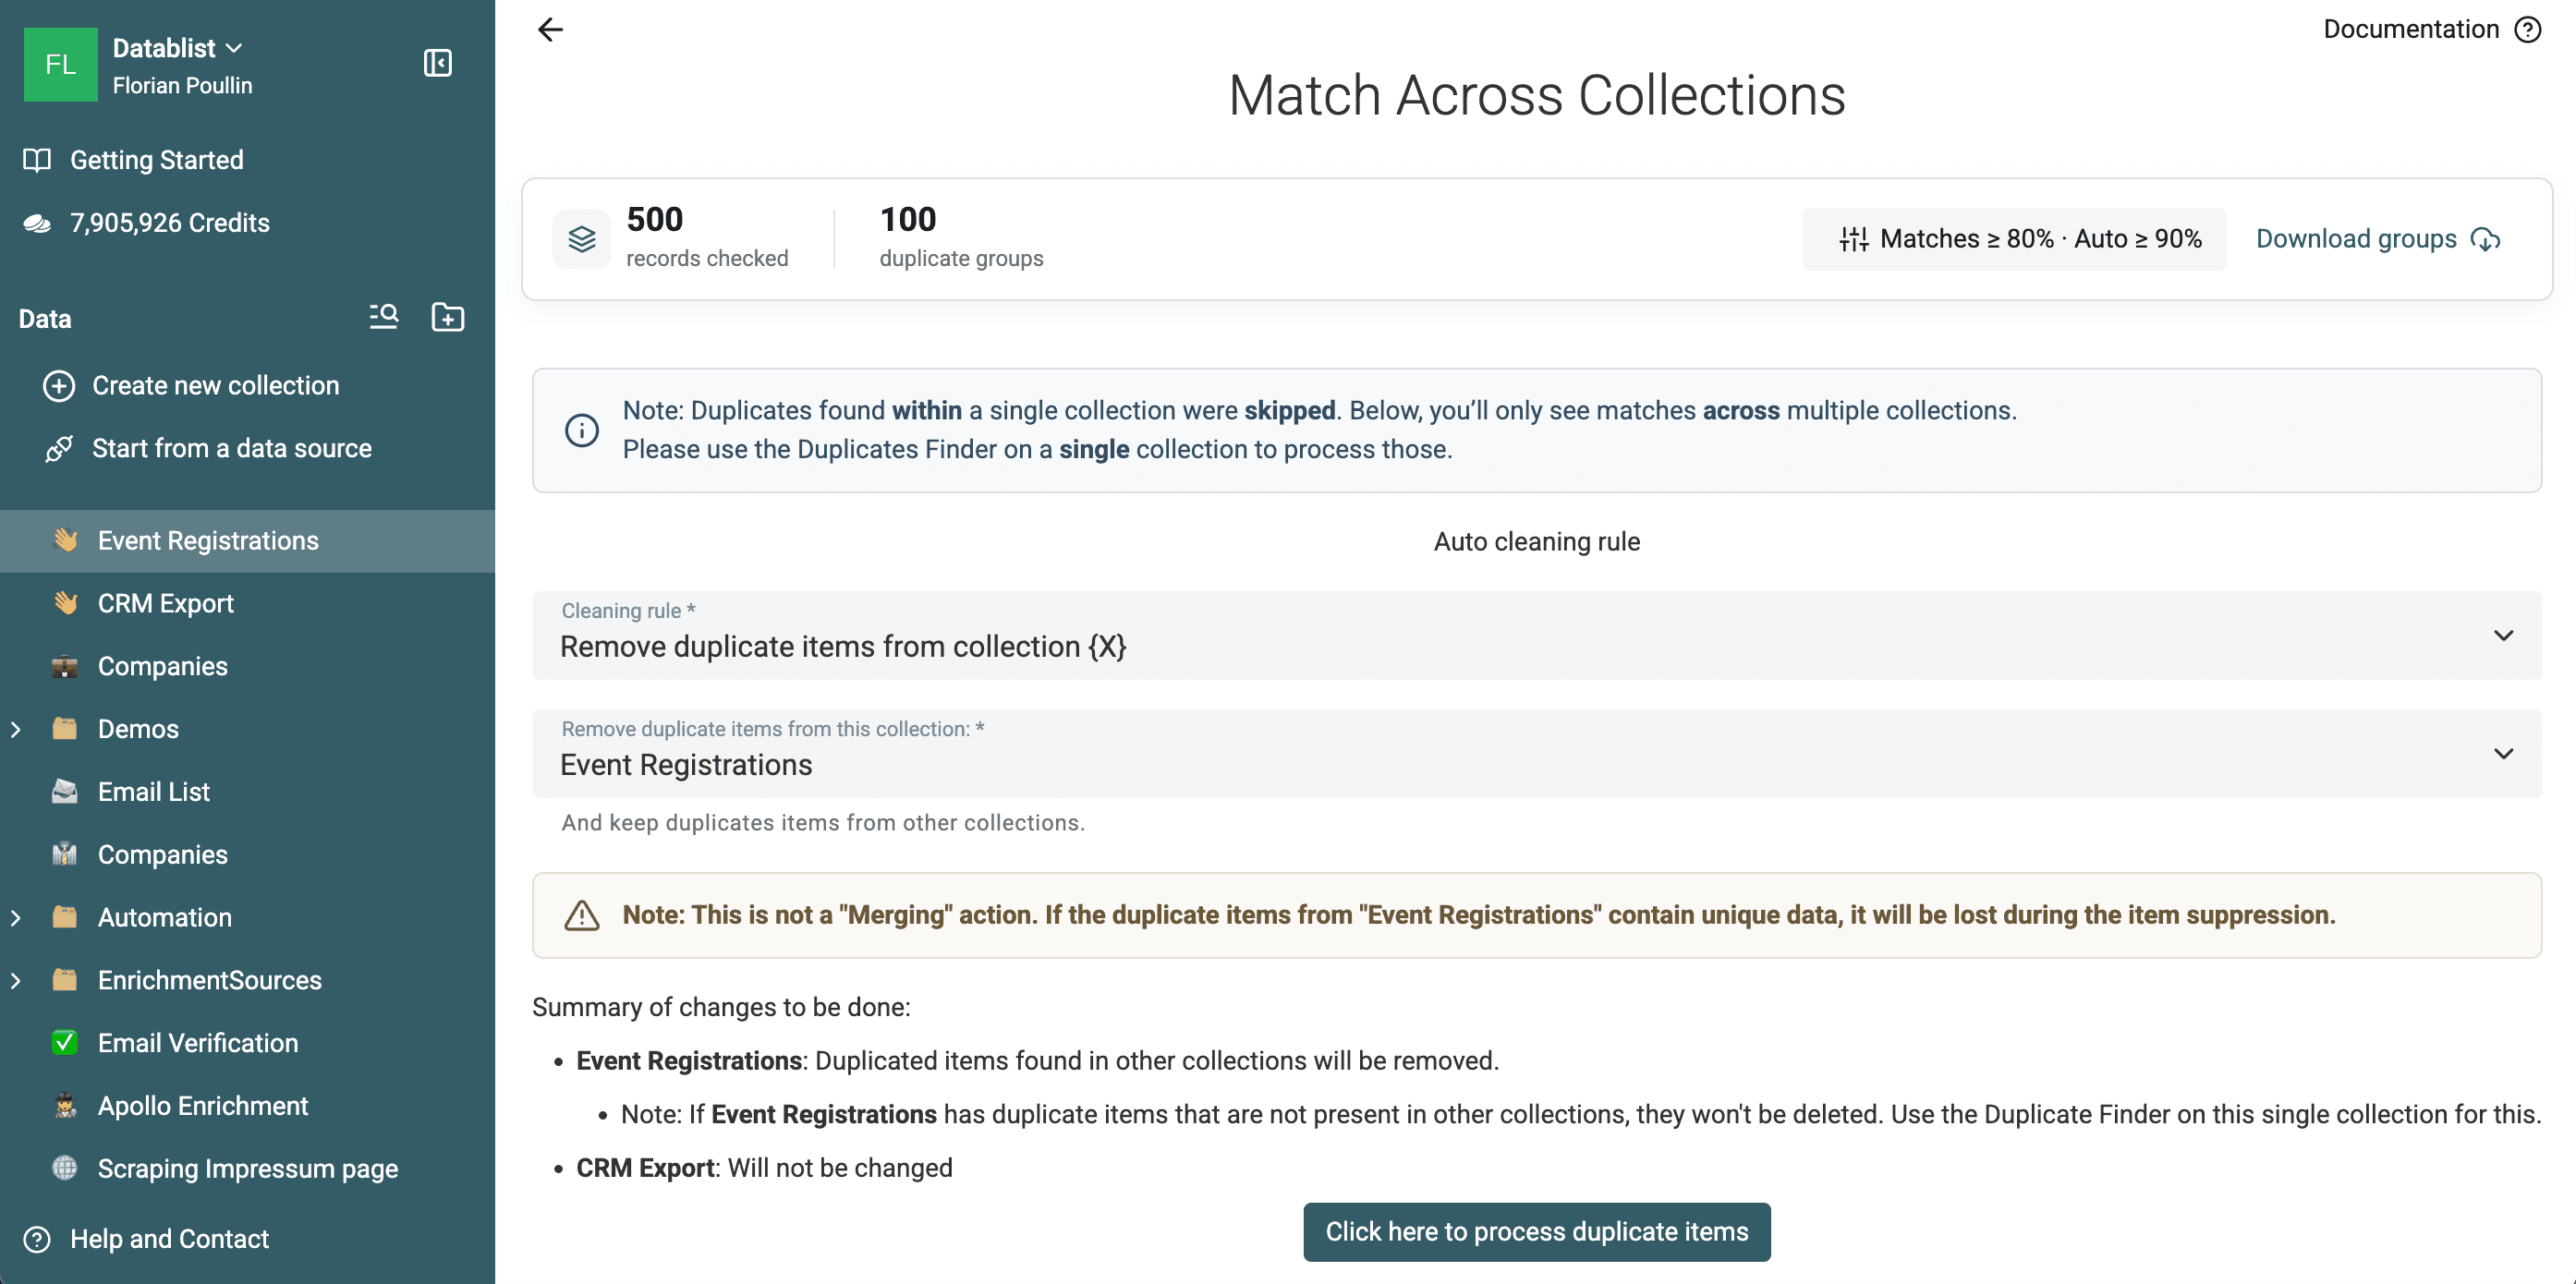
自动 cross-collection cleaning 会删除记录,但不会把活动数据中的唯一值合并到 CRM。如果待导入记录中包含需要保留的信息,请先导出或检查重复组。
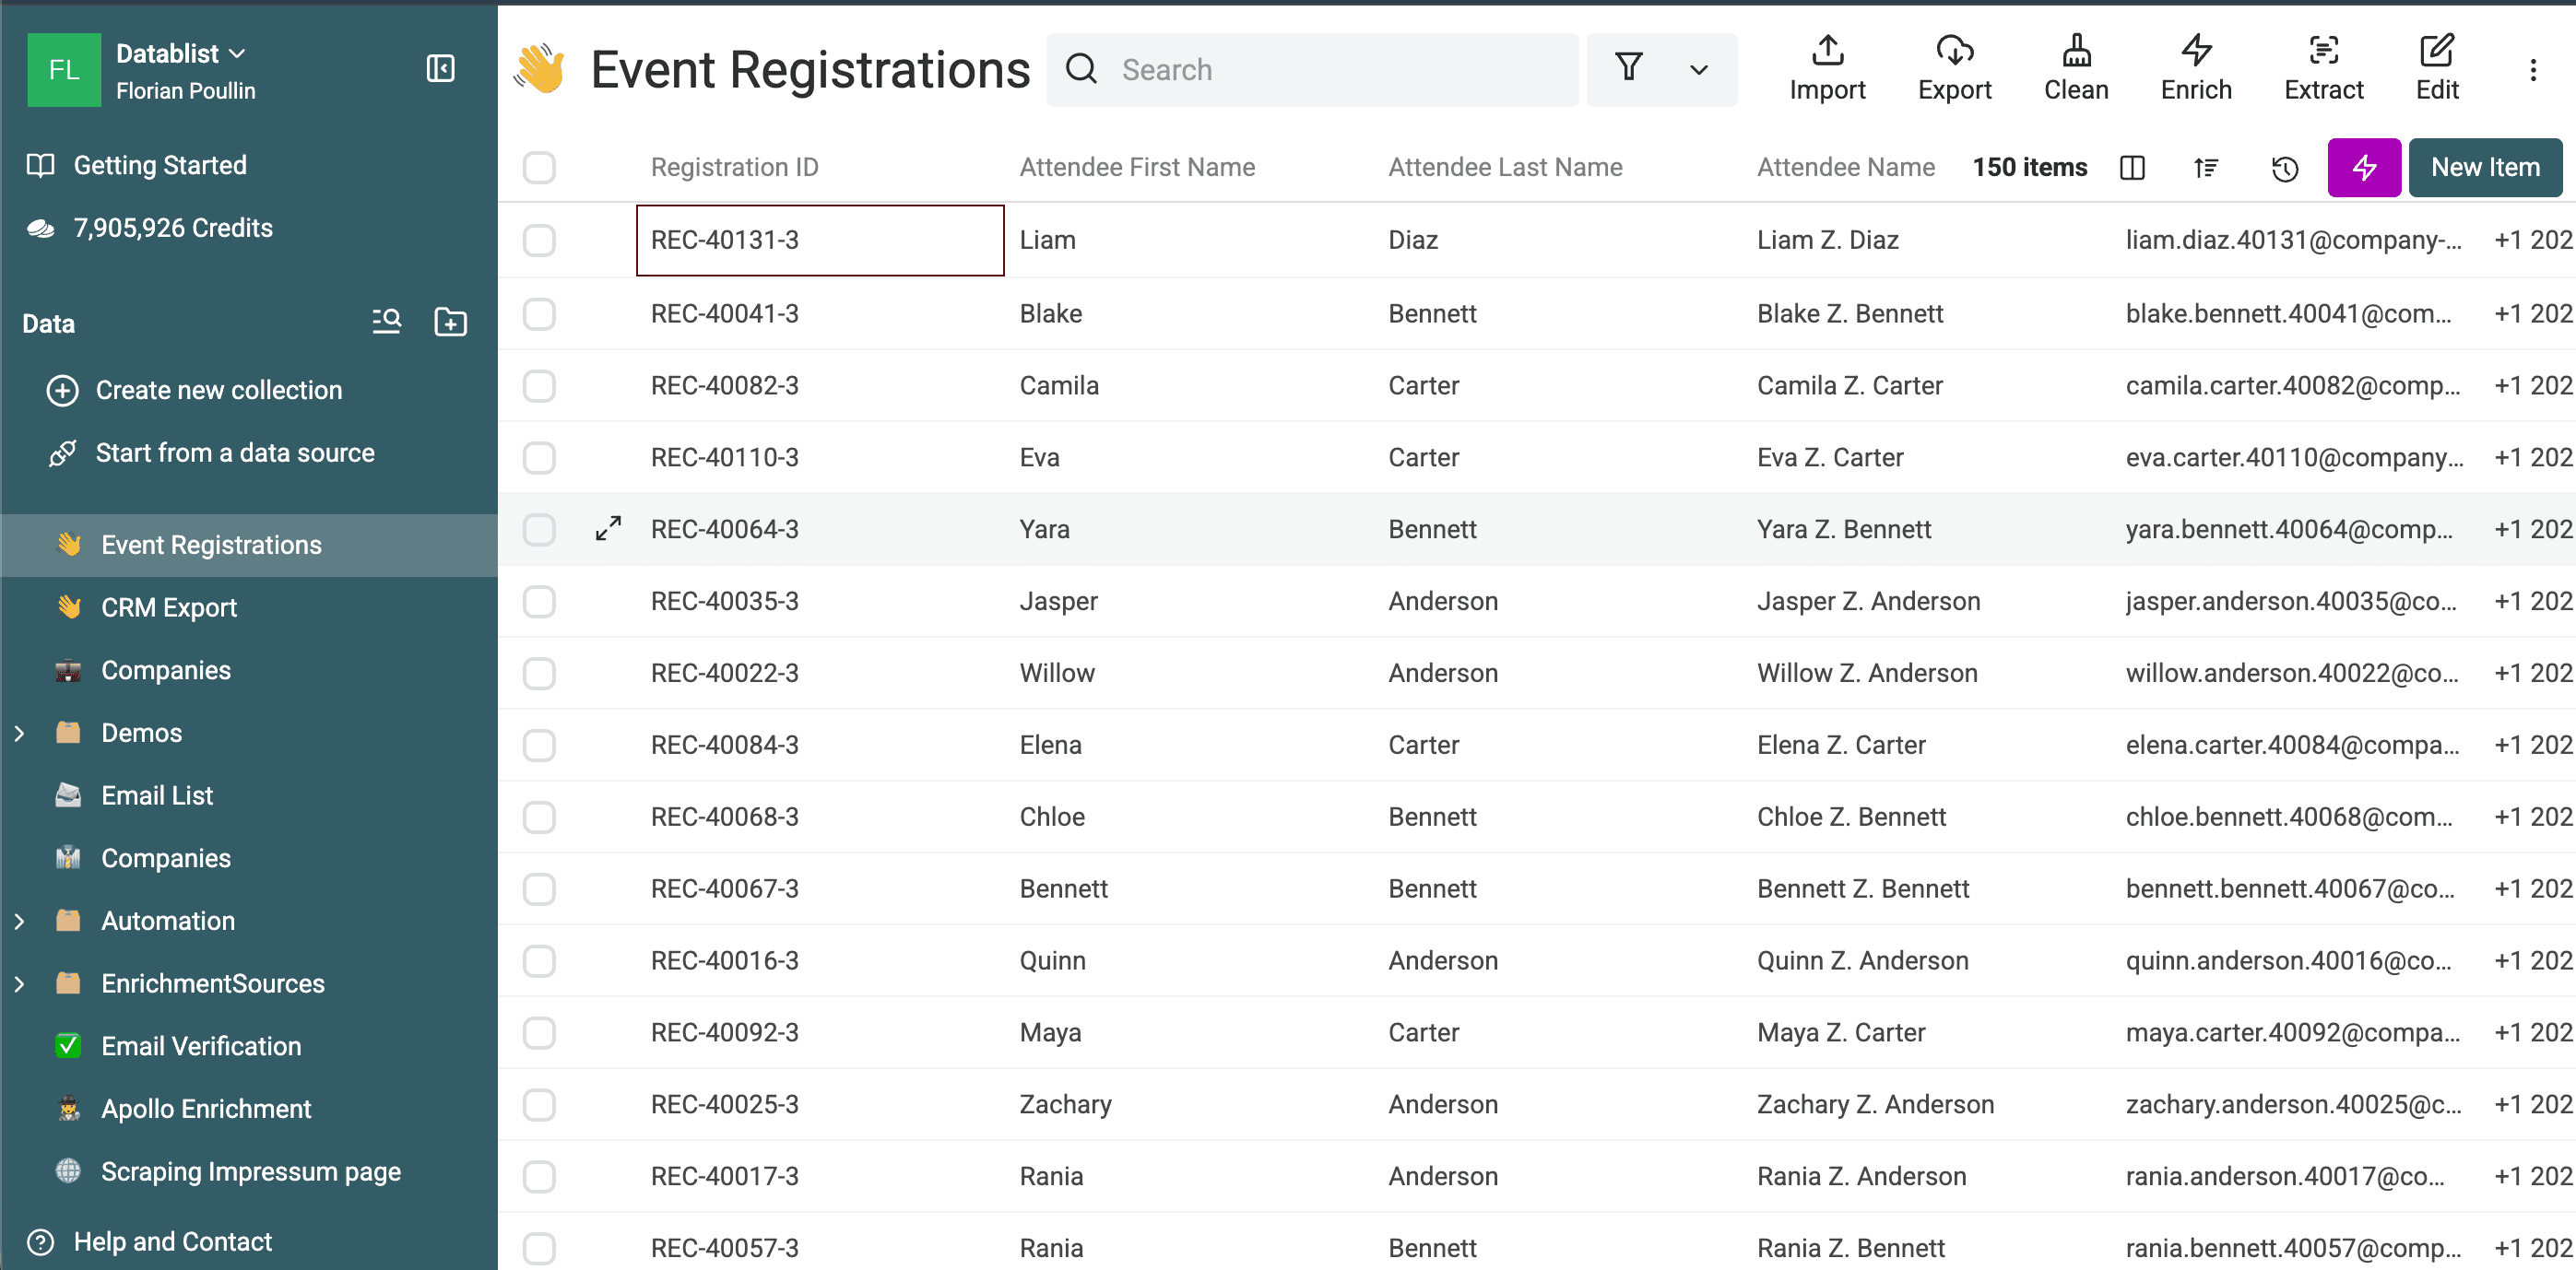
处理完 100 条重叠记录后,Event Registrations 中剩余 150 位全新联系人。
Cross-collection matching 是 Premium 功能。请阅读详细指南,了解如何对多个 CSV 或 Excel 文件去重,以及 collection 映射和处理选项。
常见问题
可以免费在线去重列表吗?
可以。匿名访客可以执行 Exact 检查。注册免费账户后,可以使用 Smart matching 和 Free plan 中面向单个 collection 的其他功能。Fuzzy 和 phonetic 算法、高级 processor、cross-collection matching、可配置的字段保留规则以及 Custom with AI 需要付费套餐。
应该删除还是合并重复行?
如果其中一条记录是权威记录,其他记录又不包含任何需要的信息,可以直接删除。如果次要记录包含有用字段值,则应合并。当操作会丢弃数据时,Remove 预览会发出警告。
Datablist 能发现存在拼写错误的重复项吗?
可以。Jaro-Winkler 和 Levenshtein 用于比较文本相似度,Metaphone 则比较文本读音。这些高级算法需要付费套餐,而且匹配结果应经过人工复核。
能否在不丢失数据的情况下合并重复行?
Datablist 可以填充空字段、合并文本值、保留所选记录的值,或应用字段级保留规则。请仔细检查预览,因为任何被选择舍弃的值都不会出现在合并后的记录中。
列表最多可以包含多少条数据?
Free plan 支持在浏览器存储中为每个 collection 保存最多 100 万个 item。付费套餐支持每个 collection 导入最多 200 万个 item。大型本地操作的实际表现仍取决于浏览器和设备性能。
可以只检查重复项而不修改列表吗?
可以。检测过程是只读的。在启动处理操作之前,你可以检查重复组、调整 threshold、使用 Why matched、搜索和排序结果,以及下载重复记录。
如需了解所有设置和限制,请阅读完整的 Duplicate Finder 文档。