
要使用 Datablist 批量合并 Pipedrive 中的重复数据,先导入 People 或 Organizations,再通过可靠的匹配字段找出候选重复组,预览主记录及冲突值,审核无误后将合并结果同步回 Pipedrive。请保留一份导出的变更文件,以便核对最终记录。
Pipedrive 已提供 Merge Duplicates 功能,建议先用它检查重复数据。其匹配规则会查找姓名相同,且 Email、Phone 或 Organization 也相同的联系人;对于公司,则匹配公司名称和地址。如果公司名称写法不一致,或最有效的匹配字段是 Website,这些规则就可能漏掉重复记录。
本指南将使用 Datablist:先通过 Email 或 Website 审核匹配结果,再根据实际情况使用公司名称相似度进行匹配。确认应保留哪条记录后,你可以导出合并变更,并将其应用到 Pipedrive。
如果每条源记录都必须单独保留,请改用统一重复记录中的字段值,但不合并行。这些字段更新应与下文介绍的 Pipedrive 合并操作分开处理。
如果上述匹配规则无法覆盖你的数据,Datablist Duplicates Finder 可以提供更多匹配字段和冲突处理选项。整个流程分为三个步骤,最后还会对比 Pipedrive 自带的重复数据匹配功能:
- 将 Pipedrive People 和/或 Organizations 导入 Datablist
- 使用高级算法查找并合并重复数据
- 将合并结果批量同步回 Pipedrive
- Pipedrive 自带重复数据合并功能的局限
步骤 1:导入 Pipedrive 联系人
首先,将 Pipedrive 数据导入 Datablist。请将 People 和 Organizations 分别放入不同的 collection,确保每次处理都使用正确的 ID 和匹配字段。
1. 新建 Datablist Collection
Datablist 中的 collection 类似于电子表格,可用于存储和清洗数据。每个 collection 用来保存 Pipedrive 联系人(People)或公司(Organizations)。
- 如果要对 People 去重,请创建一个 People collection。
- 如果要对 Organizations 去重,请创建一个 Organizations collection。
- 如果两类数据都要清洗,请创建两个独立的 collection:一个用于 People,另一个用于 Organizations。
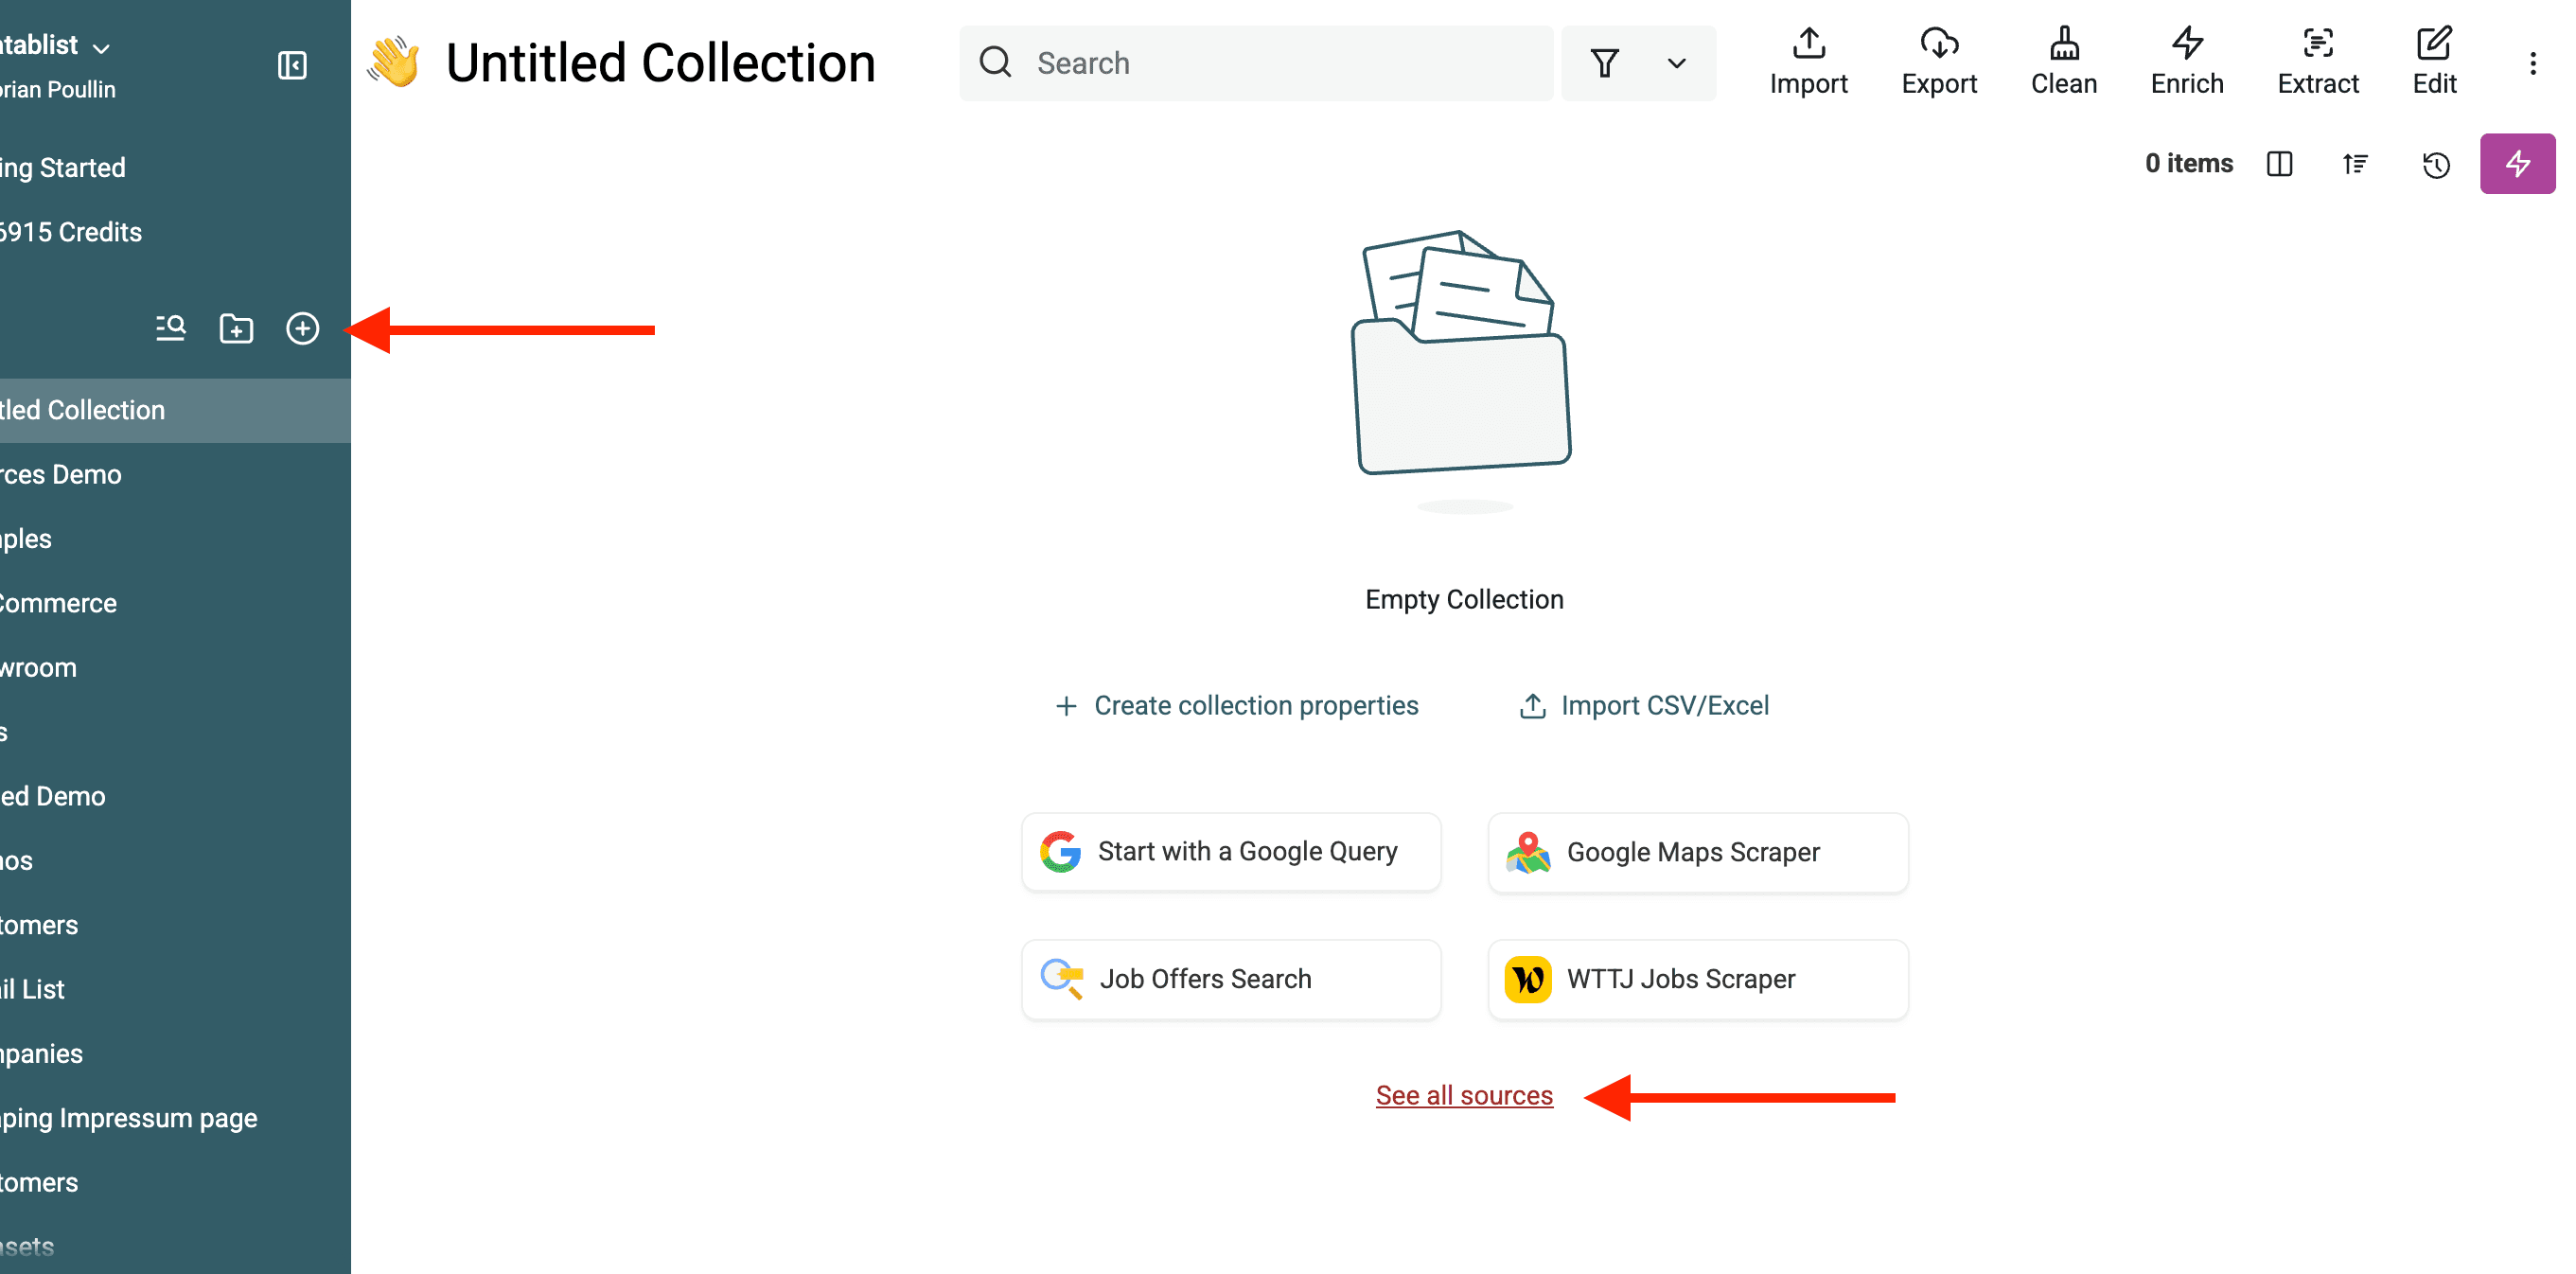
2. 选择“Source → Pipedrive”
Datablist 通过 API 直接连接你的 Pipedrive 账户。
在 Datablist collection 中,依次进入 Import → 选择 Source → 选择 Pipedrive。你也可以在 collection 起始页面点击“See all sources”链接进入。
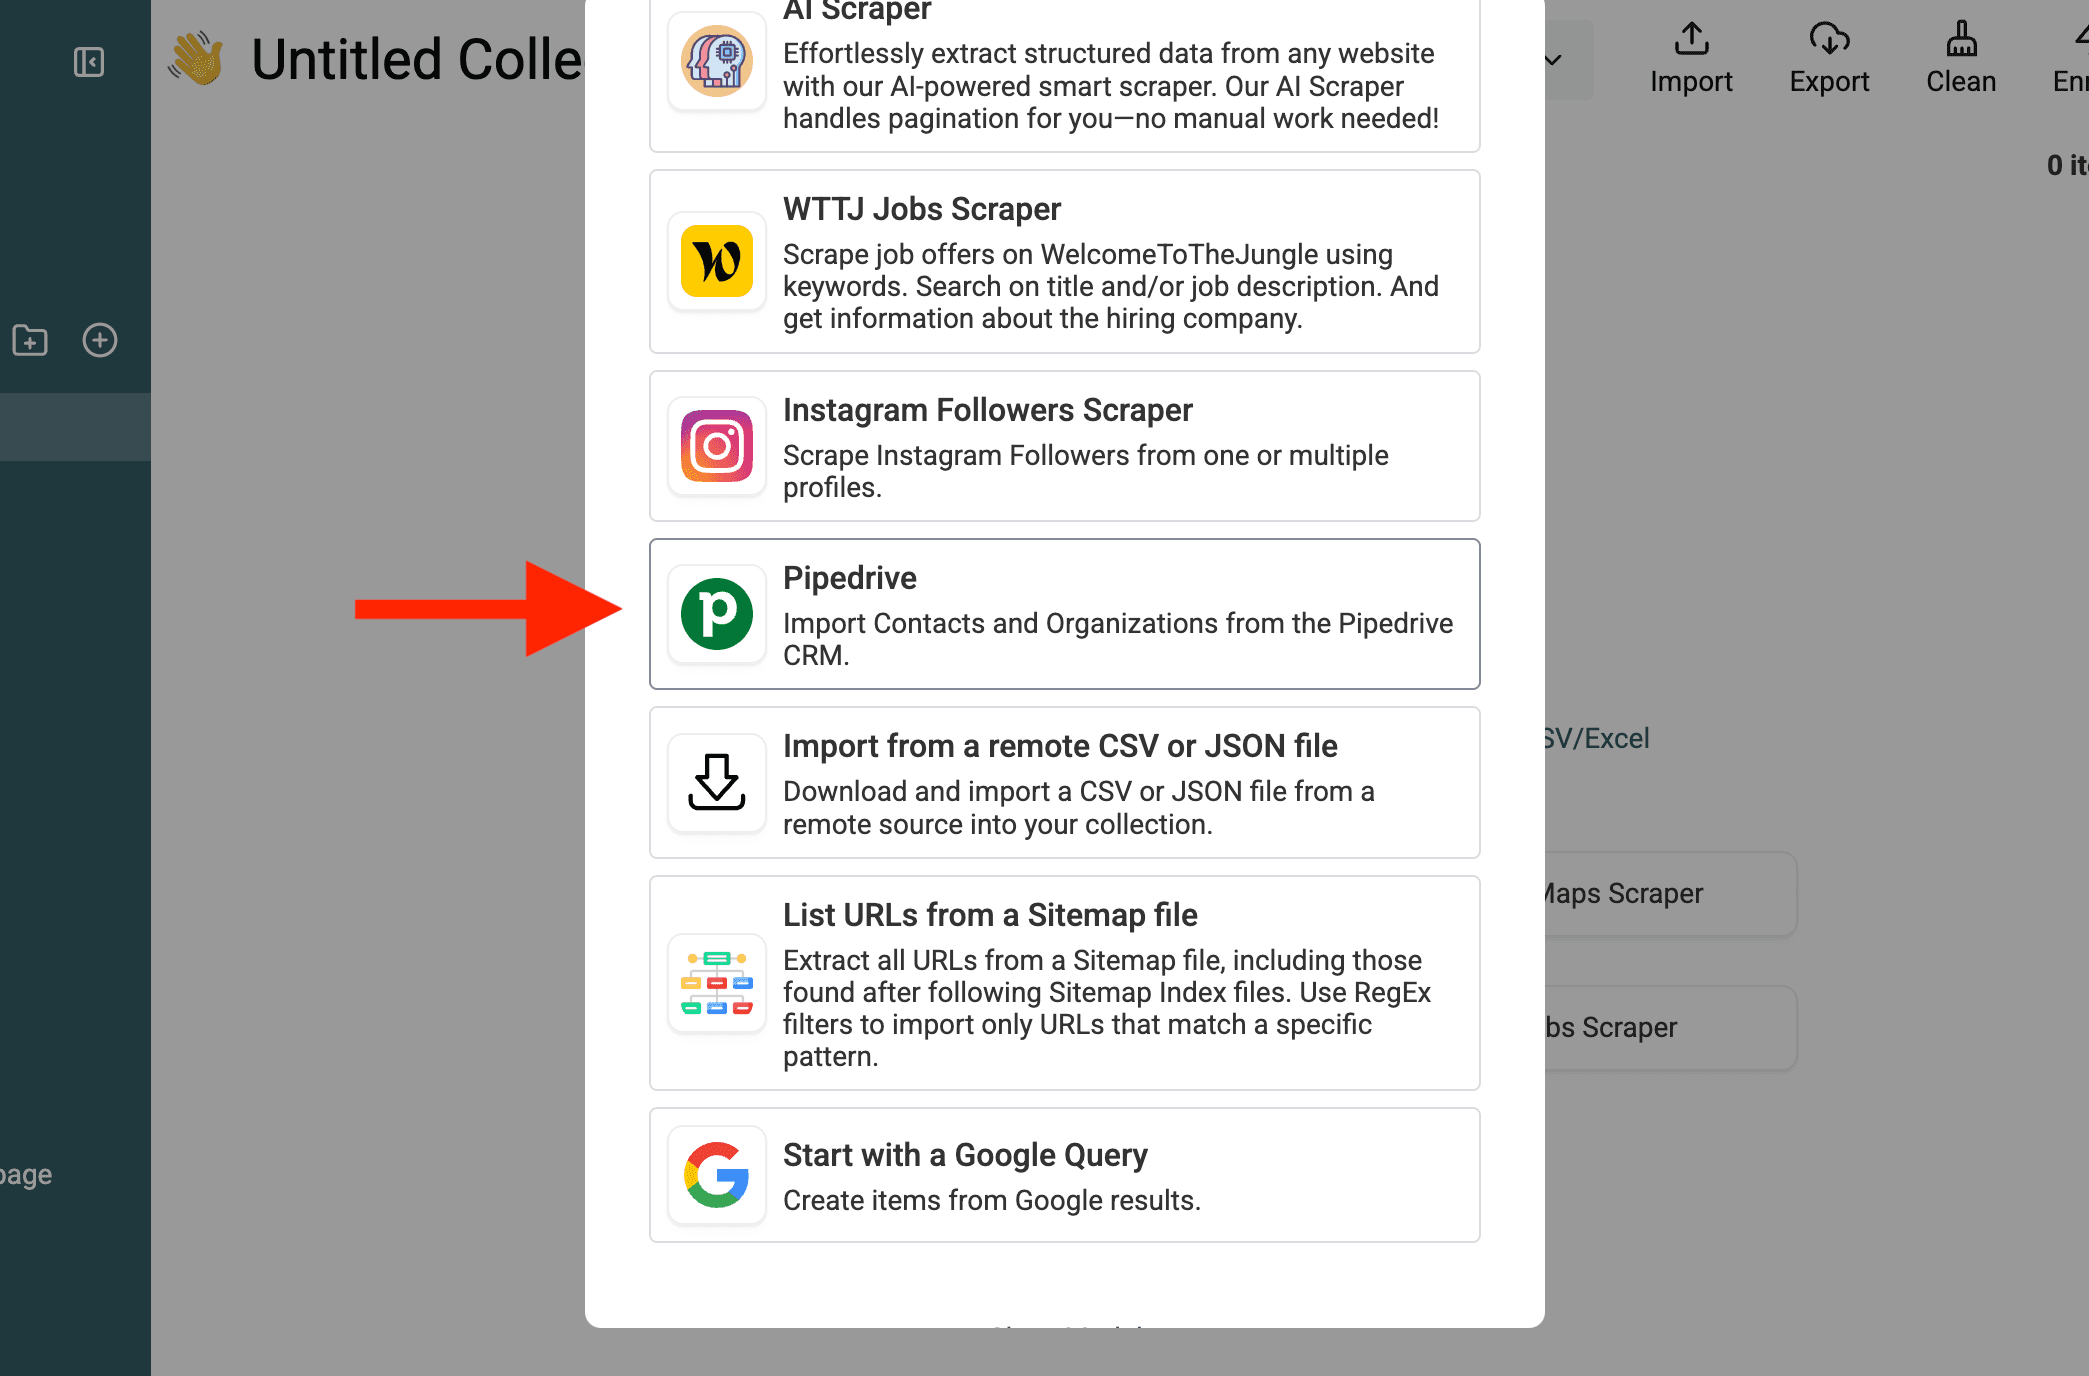
3. 获取 Pipedrive API Key
系统会提示你输入 Pipedrive API Key。
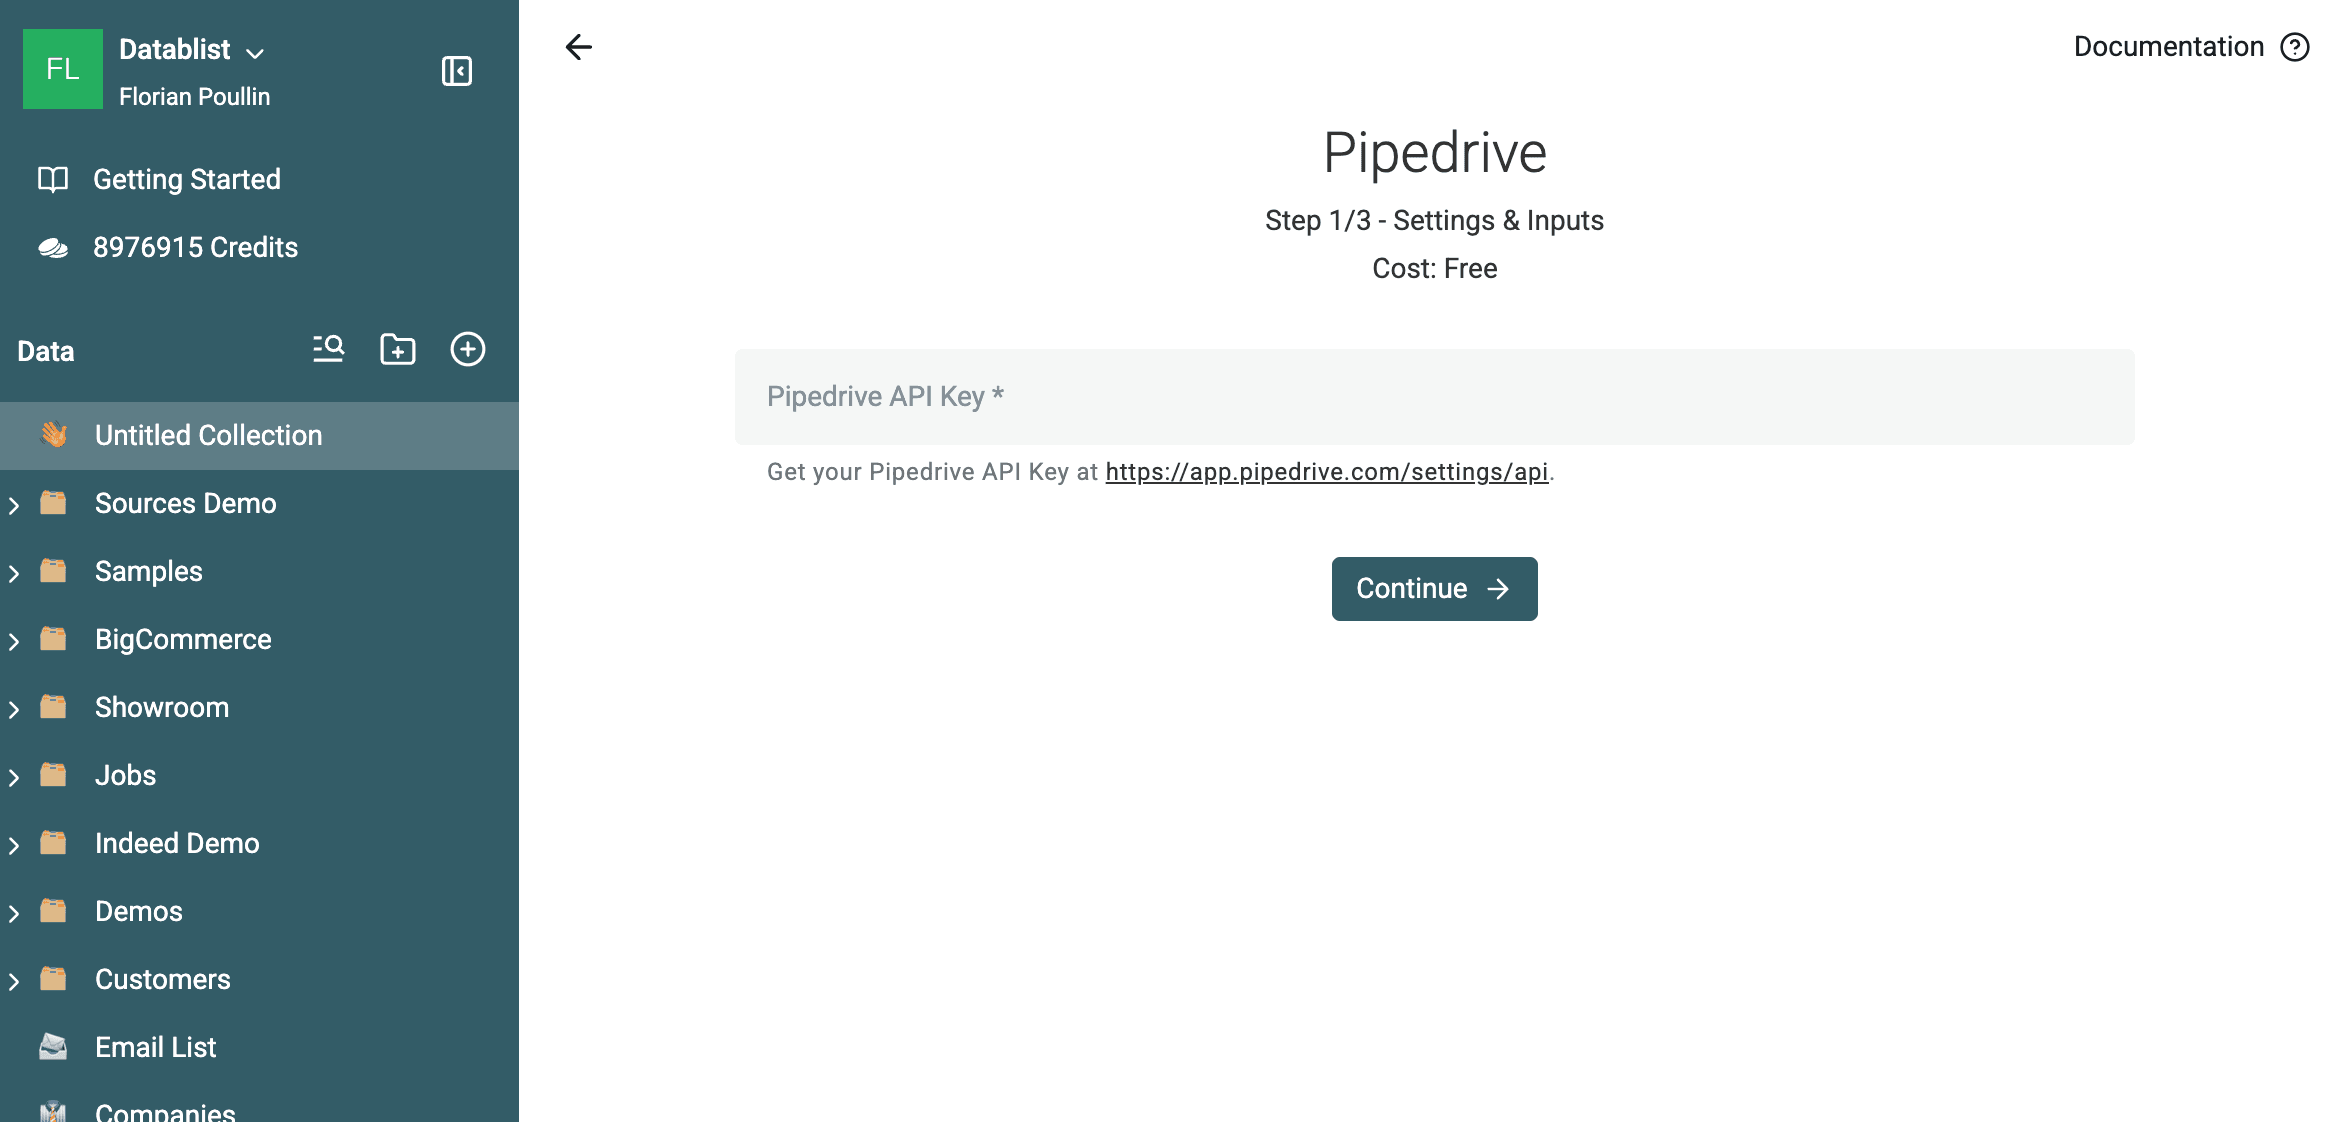
要将 Datablist 与 Pipedrive 账户连接,必须提供 Pipedrive API Key。前往 Pipedrive API Settings,复制你的个人 API Key,然后粘贴到 Datablist 中。
4. 选择 People 或 Organizations
连接成功后,选择要导入的数据:
- 如果要清理重复联系人,请选择 People。
- 如果要清理重复公司,请选择 Organizations。
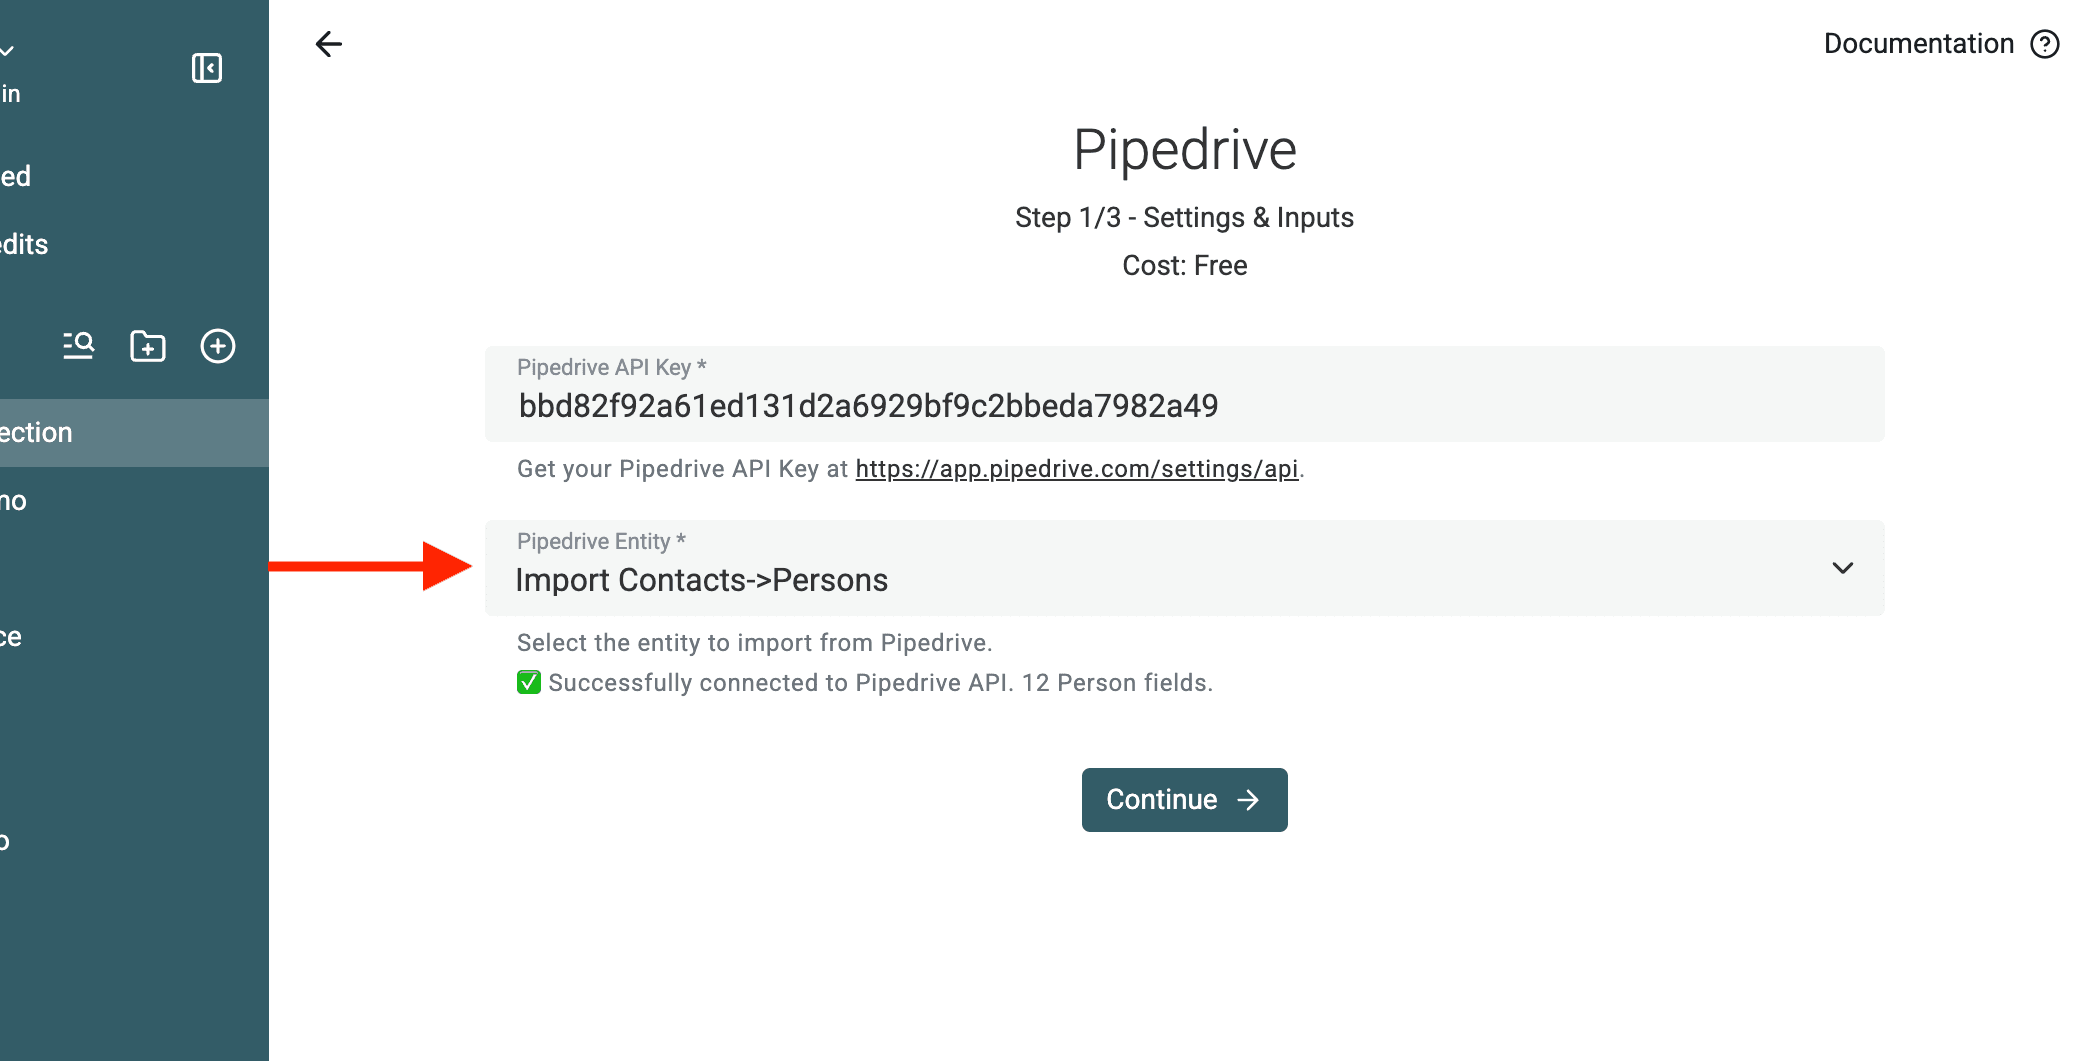
注意:如果两类数据都需要处理,请将它们分别导入两个不同的 collection。
为什么要分开? Pipedrive 对 People 和 Organizations 的存储方式不同,无法同时对两类数据混合去重。分开处理才能保证结果准确。
5. Datablist 获取所有 Pipedrive 字段
选择 People 或 Organizations 后,Datablist 会导入:
- Pipedrive 标准字段(Name、Email、Phone、Website 等)。
- 你在 Pipedrive 中创建的自定义字段。
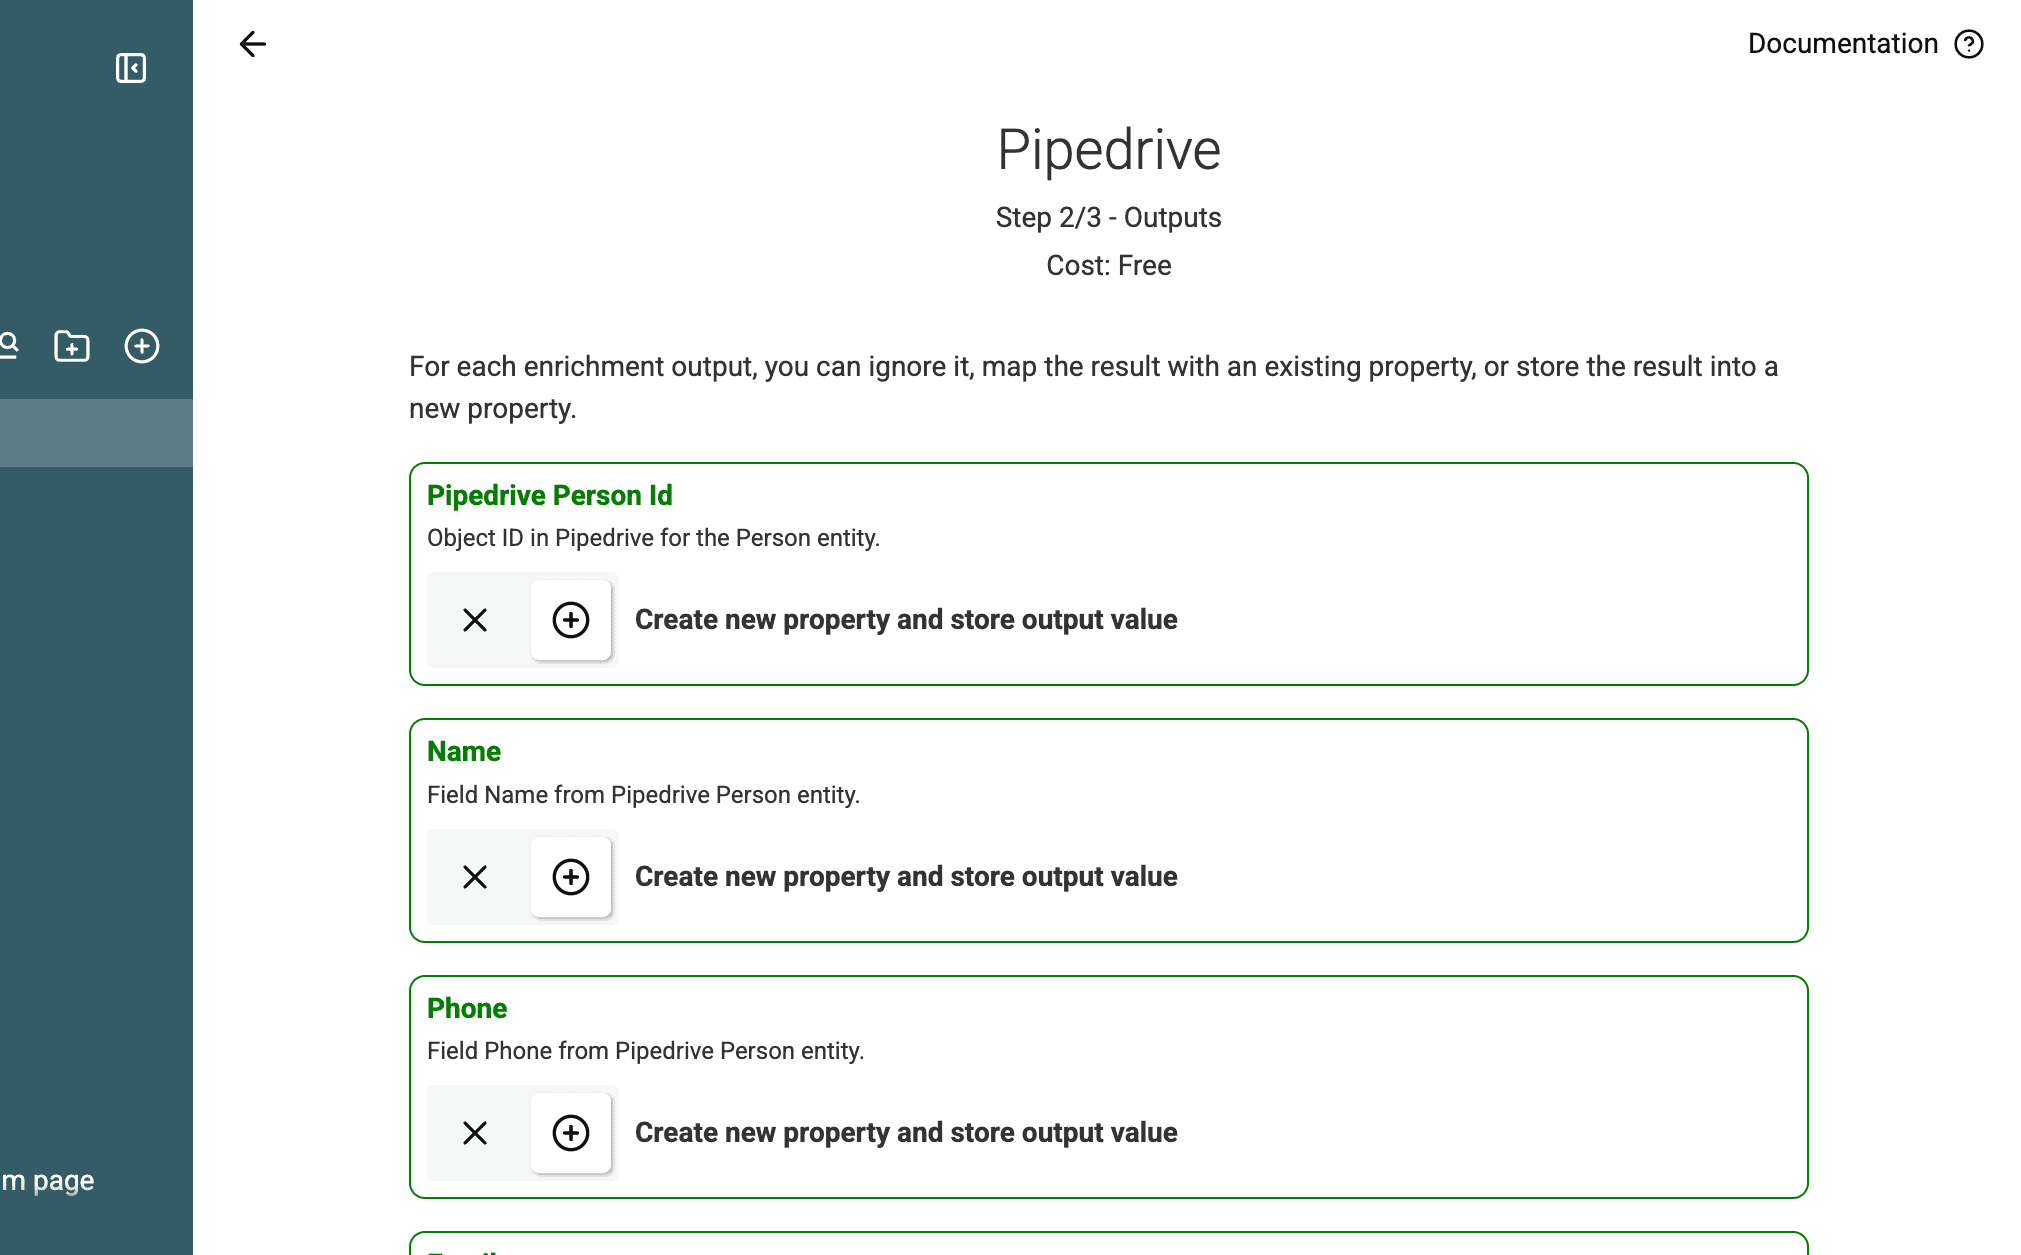
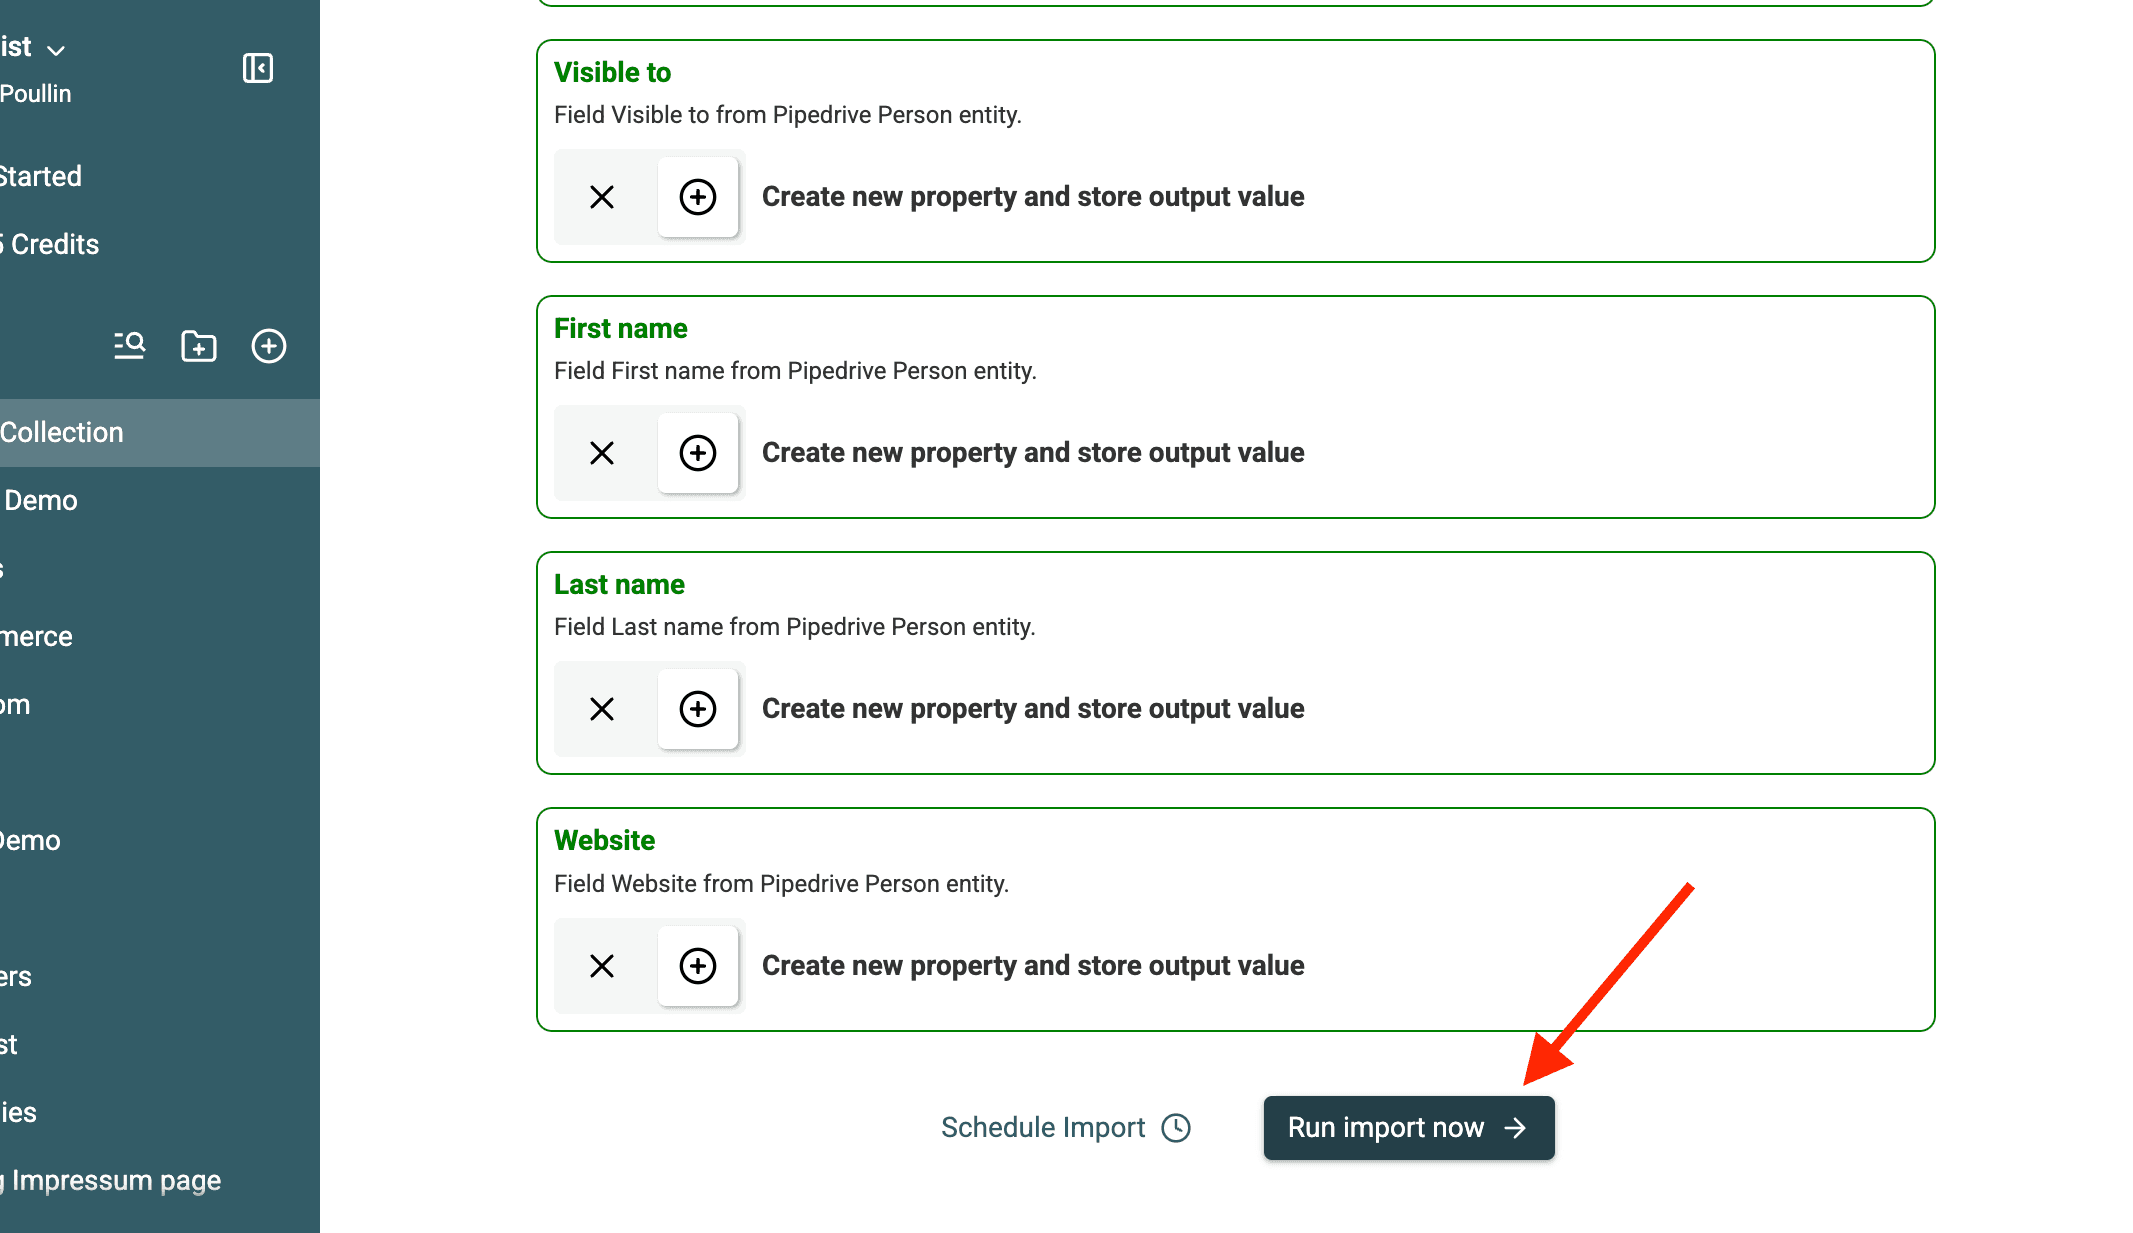
这样,去重所需的相关数据都会准备就绪。
6. 开始导入
点击 Import 开始获取数据。所需时间取决于记录数量。
Datablist 会处理联系人数据,并将其整理为适合去重的结构。
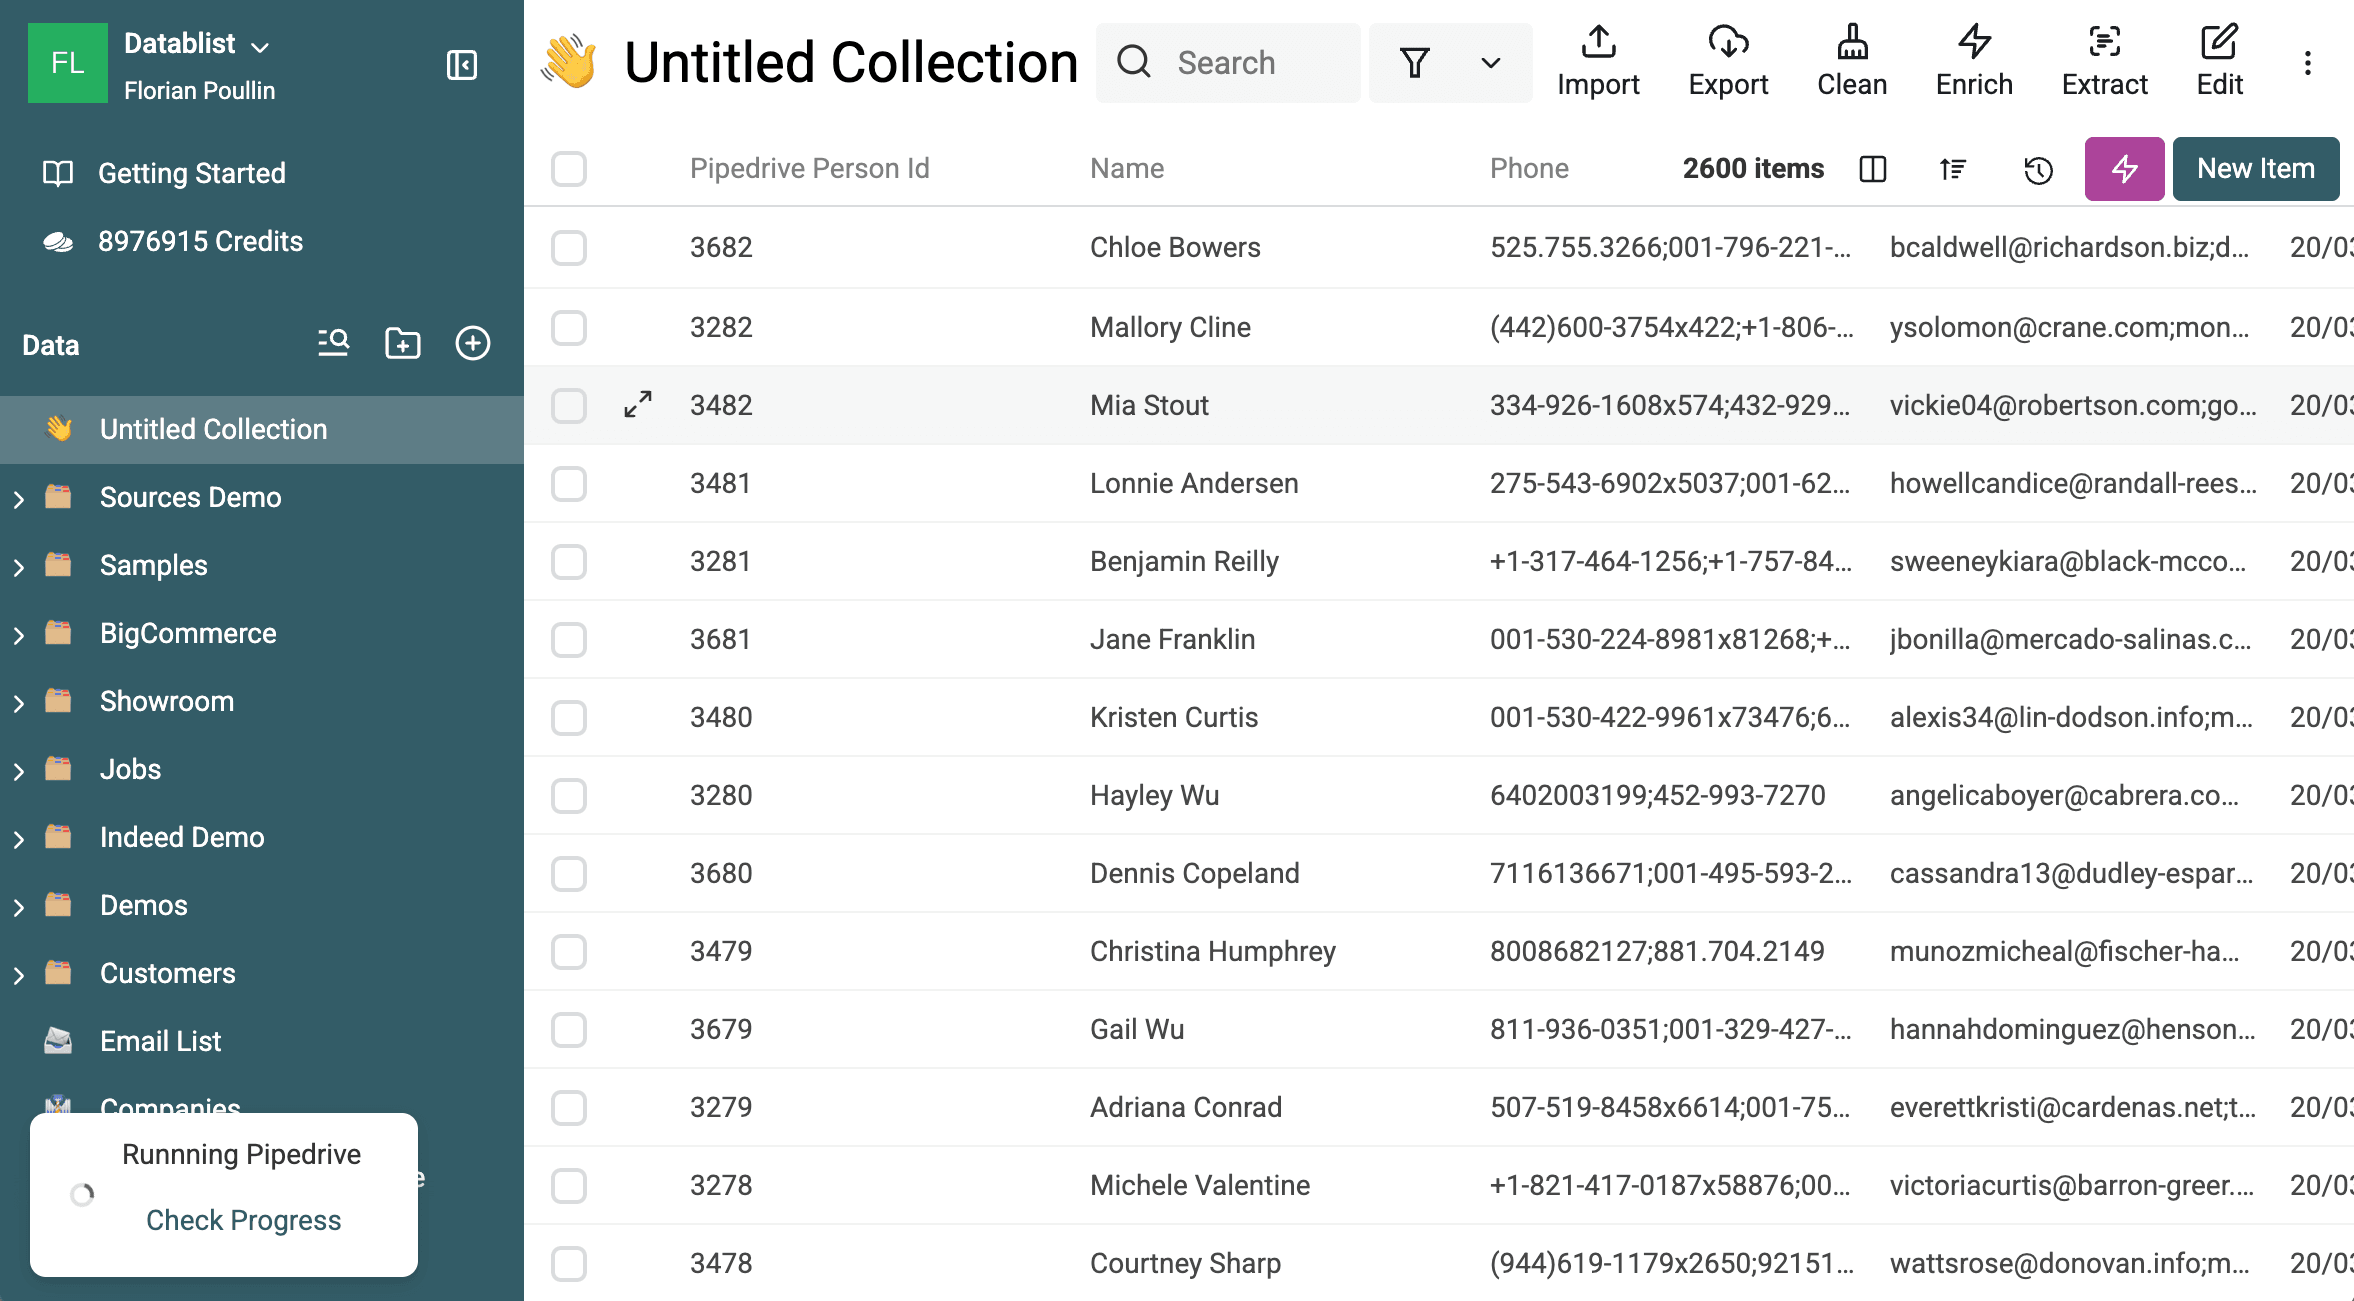
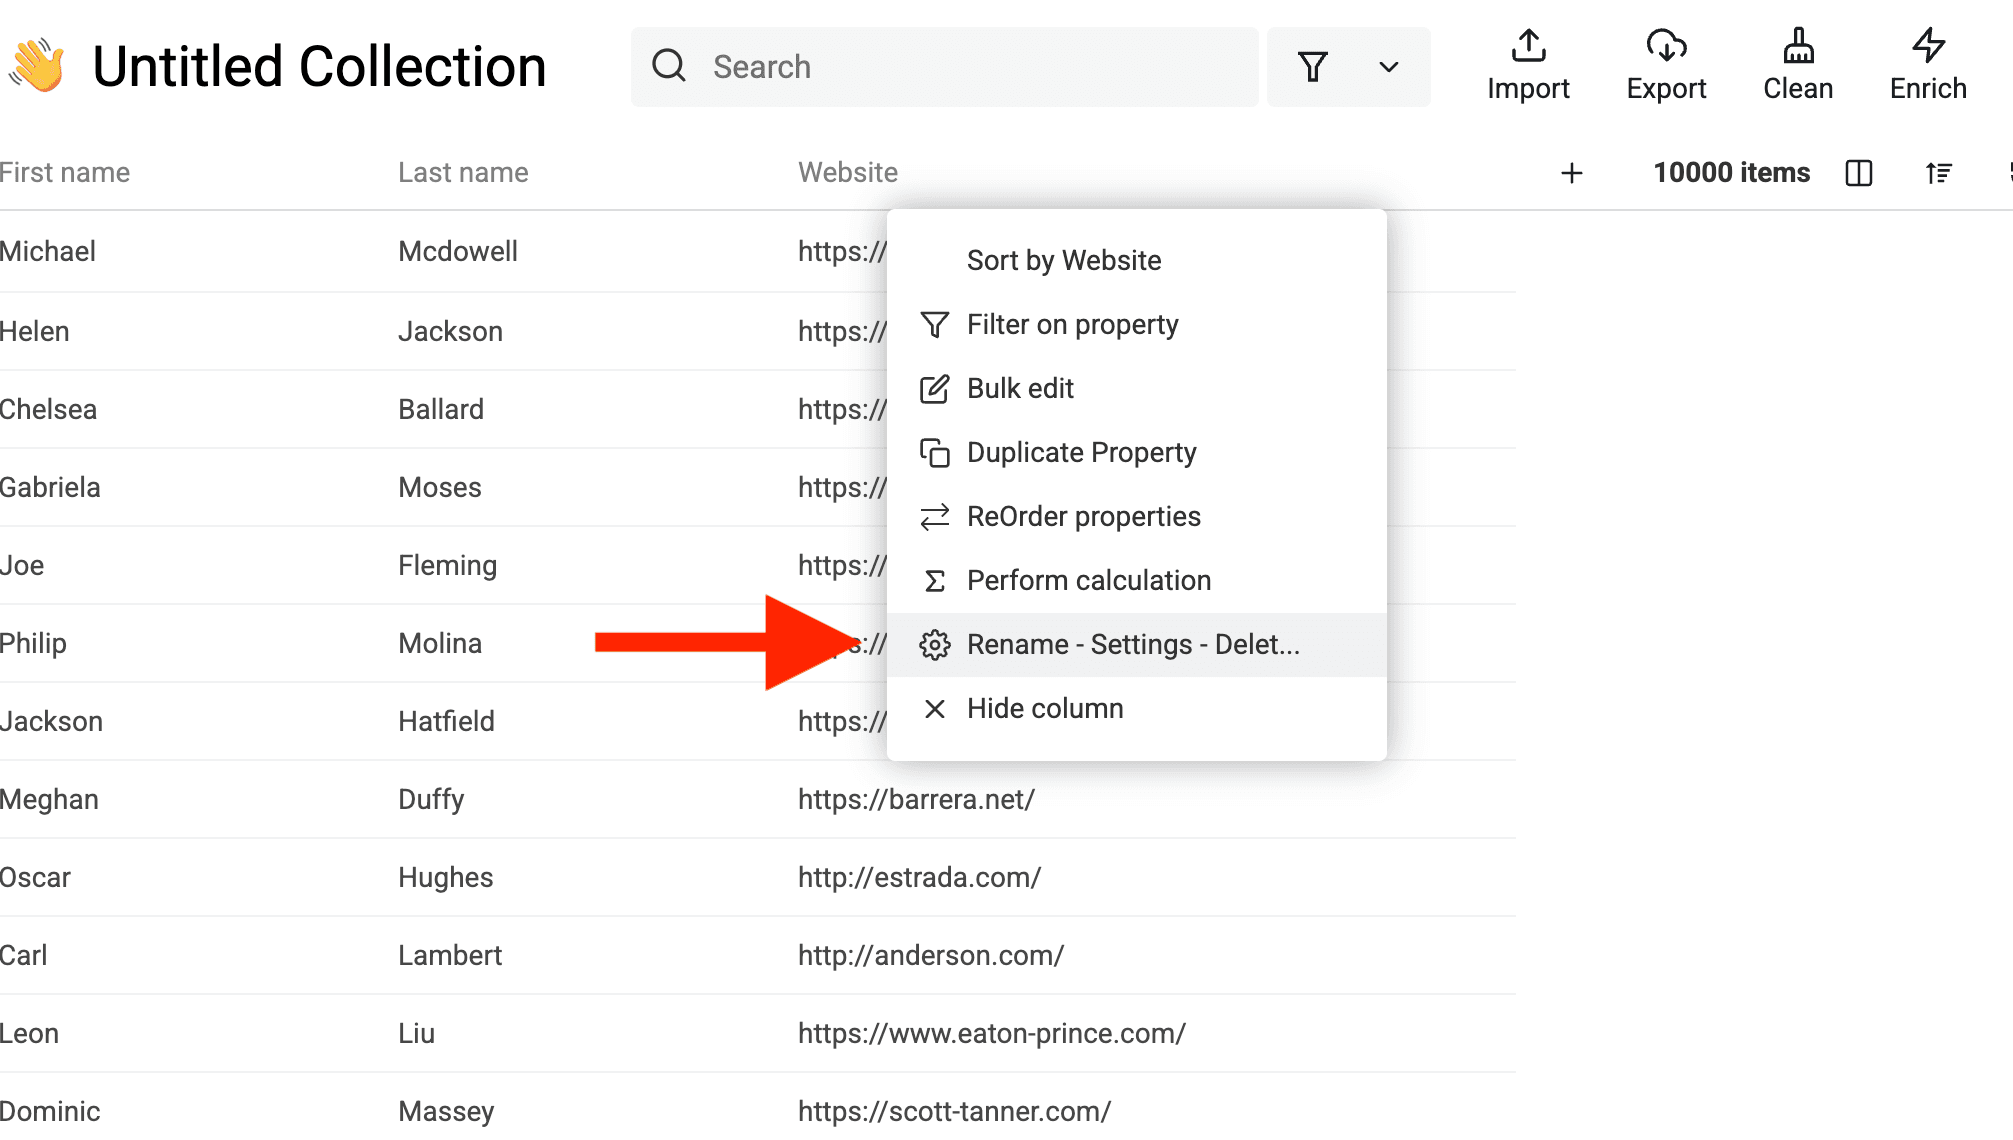
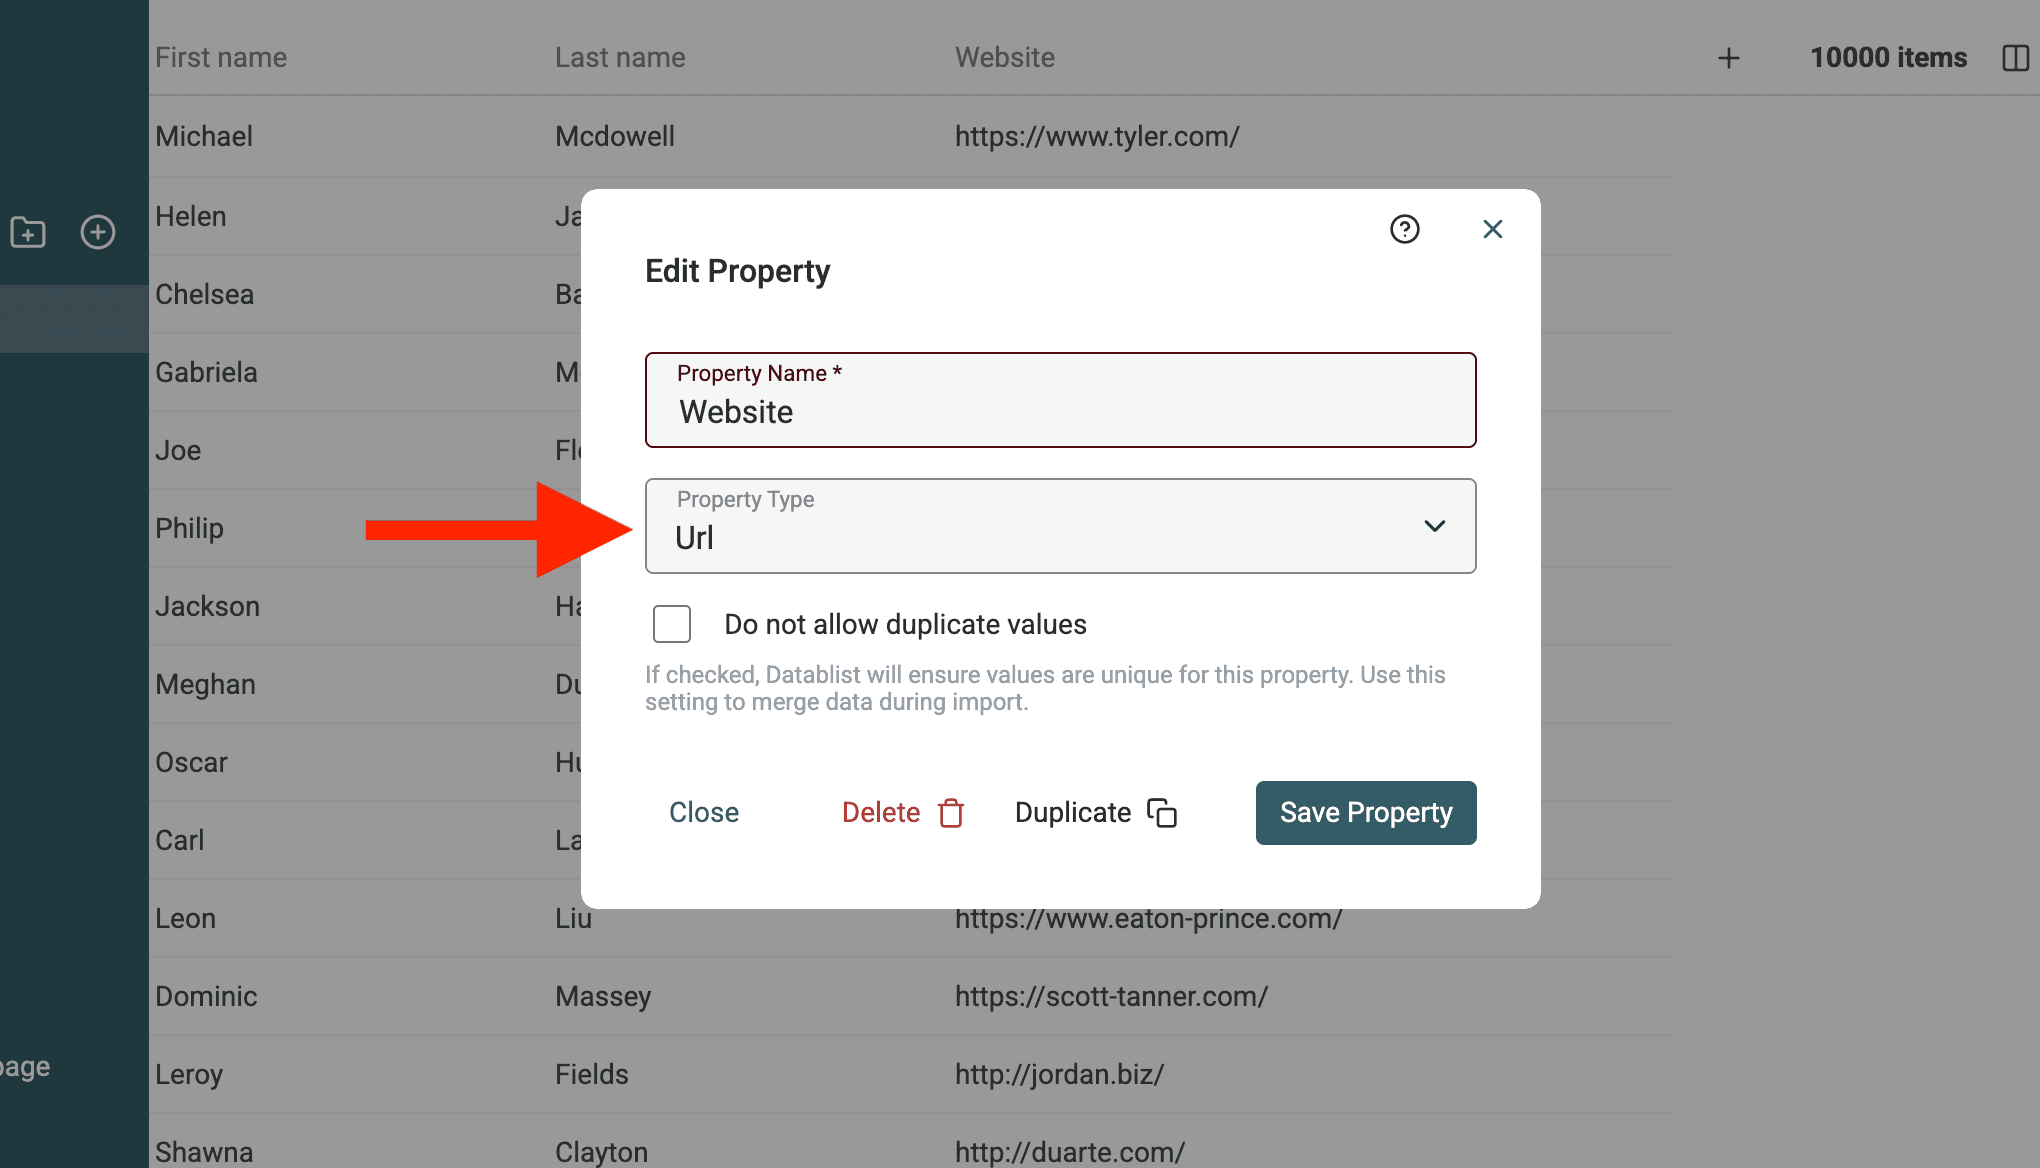
修改 URL 的数据类型
Datablist Duplicates Finder 提供专门的 processor,可处理 Emails、URLs 等数据。如果数据中包含 Website,请将对应 property type 改为 URL。
多个 Email 地址和 Phone 号码
如果一个联系人在 Pipedrive 中有多个 Email 或 Phone,系统会将它们合并到同一字段中,并用分号 ; 分隔。
示例:
- John Doe 在 Pipedrive 中有两个 Email:
john@company.com和j.doe@gmail.com。 - 在 Datablist 中会显示为:Email:
john@company.com;j.doe@gmail.com
这样,Datablist 就能在去重过程中正确处理多个值。
如果之后需要让每个 CSV 行只包含一个 Email 或 Phone,可以在导出清洗后的文件后使用 CSV Rows Splitter。
导入完成后,数据就可以开始去重了。接下来,我们将使用高级匹配技术查找重复记录。
步骤 2:查找 Pipedrive 中的重复联系人和公司
Pipedrive 联系人或公司数据导入 Datablist 后,就可以开始查找重复数据了。与 Pipedrive 自带工具不同,Datablist 使用高级匹配算法识别相似记录,即使名称略有差异或联系信息不完整,也能发现潜在重复项。
具体操作如下:
1. 打开 Duplicates Finder 并选择去重字段
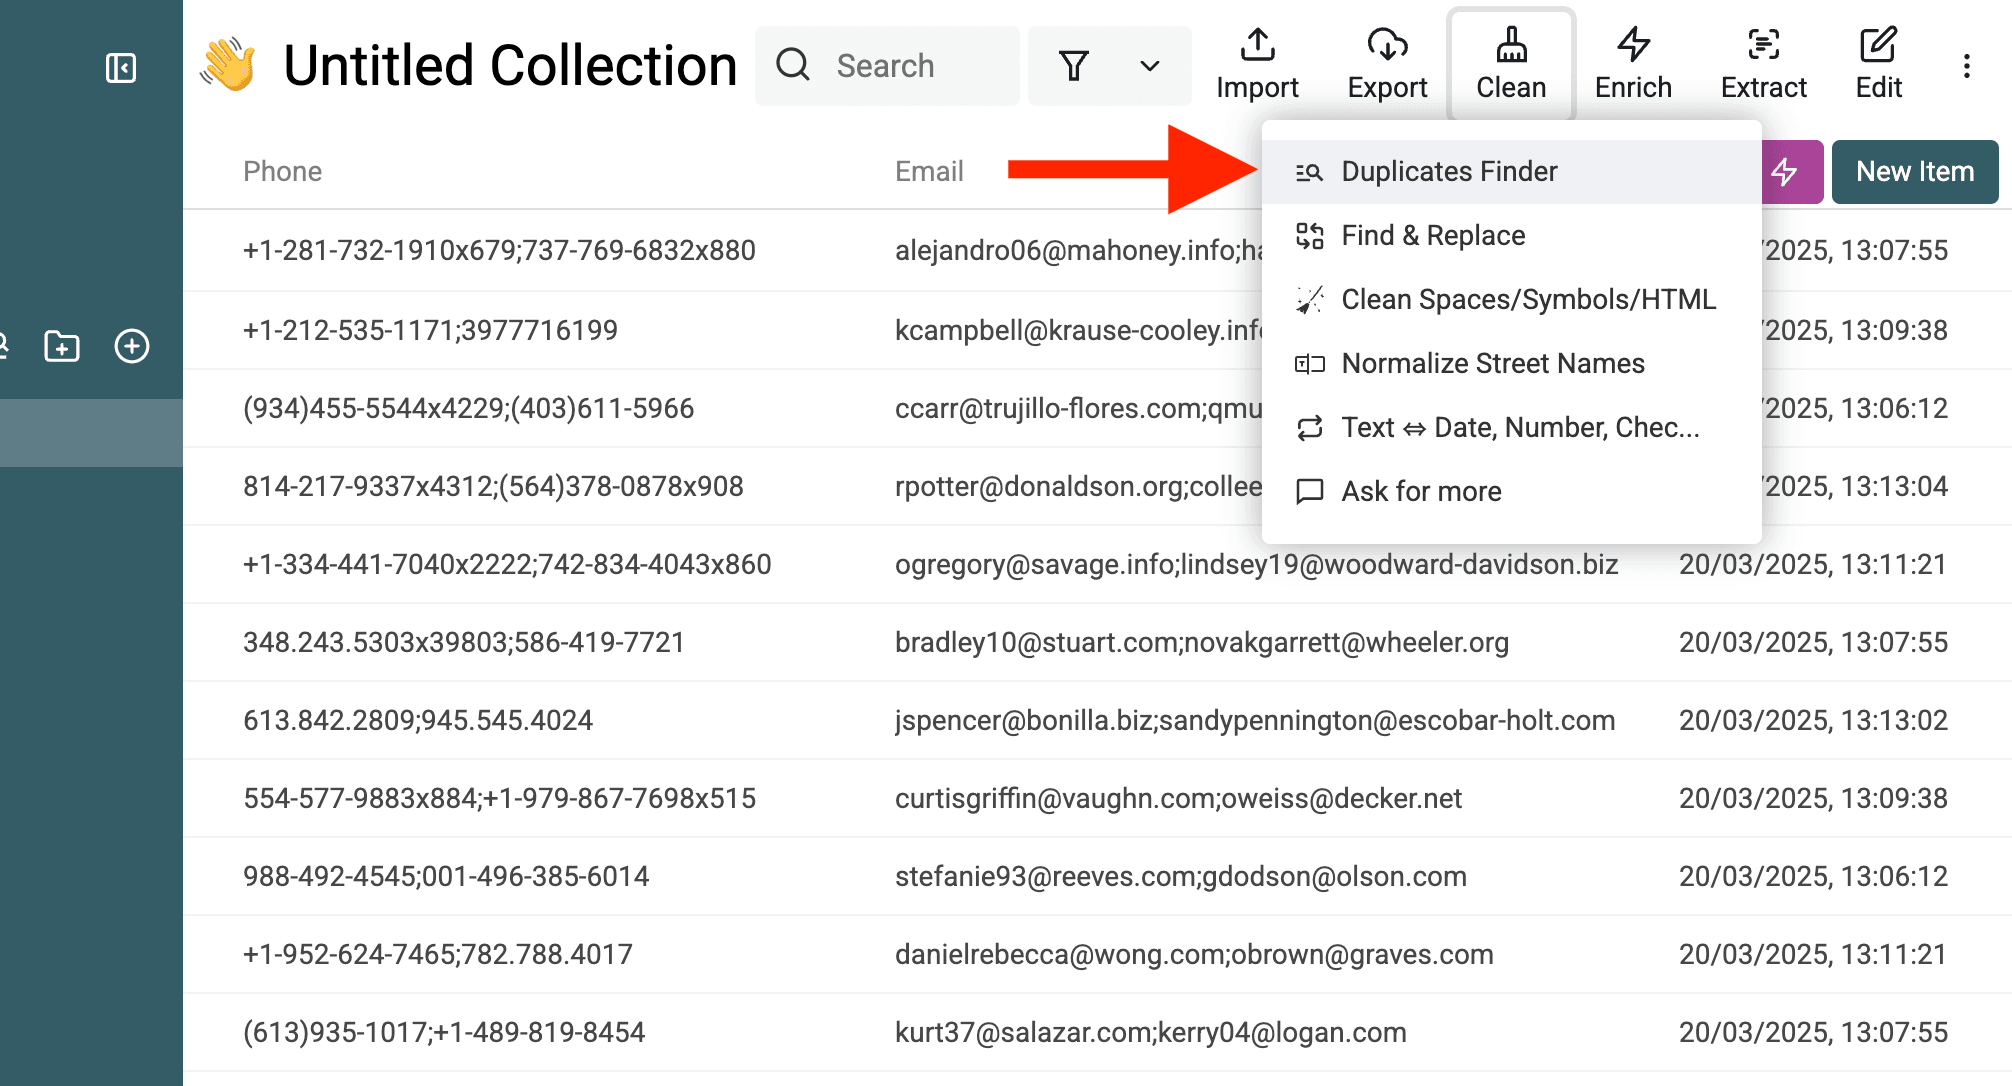
在 Datablist collection 中,进入 Clean → Duplicates Finder。
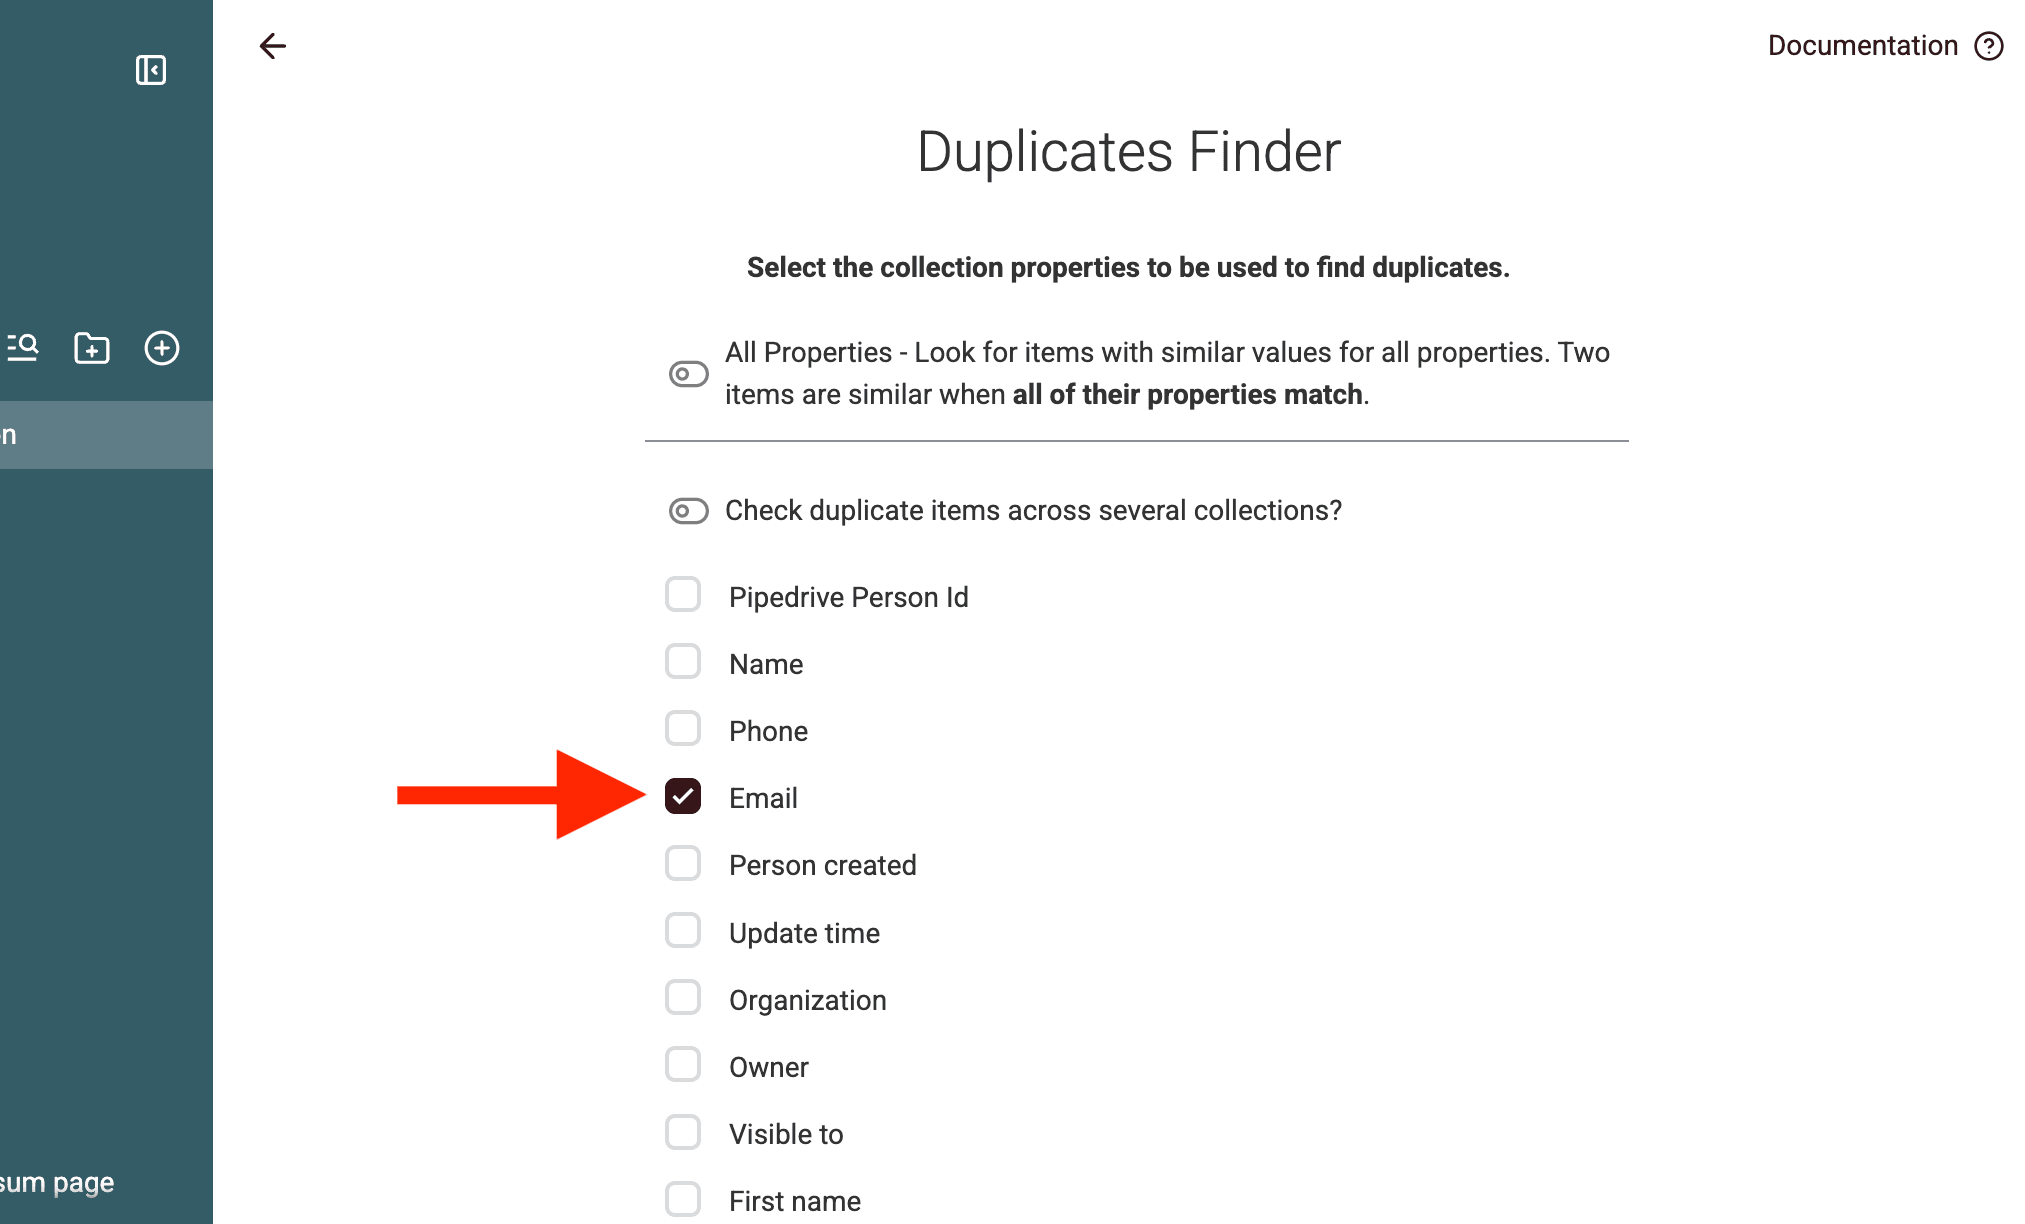
去重字段是 Datablist 用来查找重复记录的字段。最合适的字段取决于数据类型:
- **对于 People:**优先使用 Email(最可靠);如果 Email 缺失或不一致,则使用 Name。
- **对于 Organizations:**优先使用 Website;如果没有 Website,则使用 Name。
💡 示例:
- 如果“Google”有两条记录,一条写作
Google LLC,另一条写作Google,Datablist 会根据名称相似度将它们识别为重复记录。
2. 执行去重
为了获得最佳结果,不要一次性合并所有数据。建议分轮执行去重:
1️⃣ **第一轮:**People 按 Email 匹配,Organizations 按 Website 匹配,先找出可以明确判断的重复项。 2️⃣ **第二轮:**People 或 Organizations 按 Name 匹配,找出 Email 不同但实际属于同一实体的重复记录。
🔹 为什么要分两步?
- 如果同时用 Email + Name 合并,细微的姓名差异(例如“John Doe”和“Johnathan Doe”)可能导致匹配失败。
- 先按 Email 处理,可以优先解决 Email 完全相同的记录,减少出错风险。
谨慎处理多个 Email 和公司名称
部分 Pipedrive 字段可能包含多个值,例如 Emails 和 Phones。
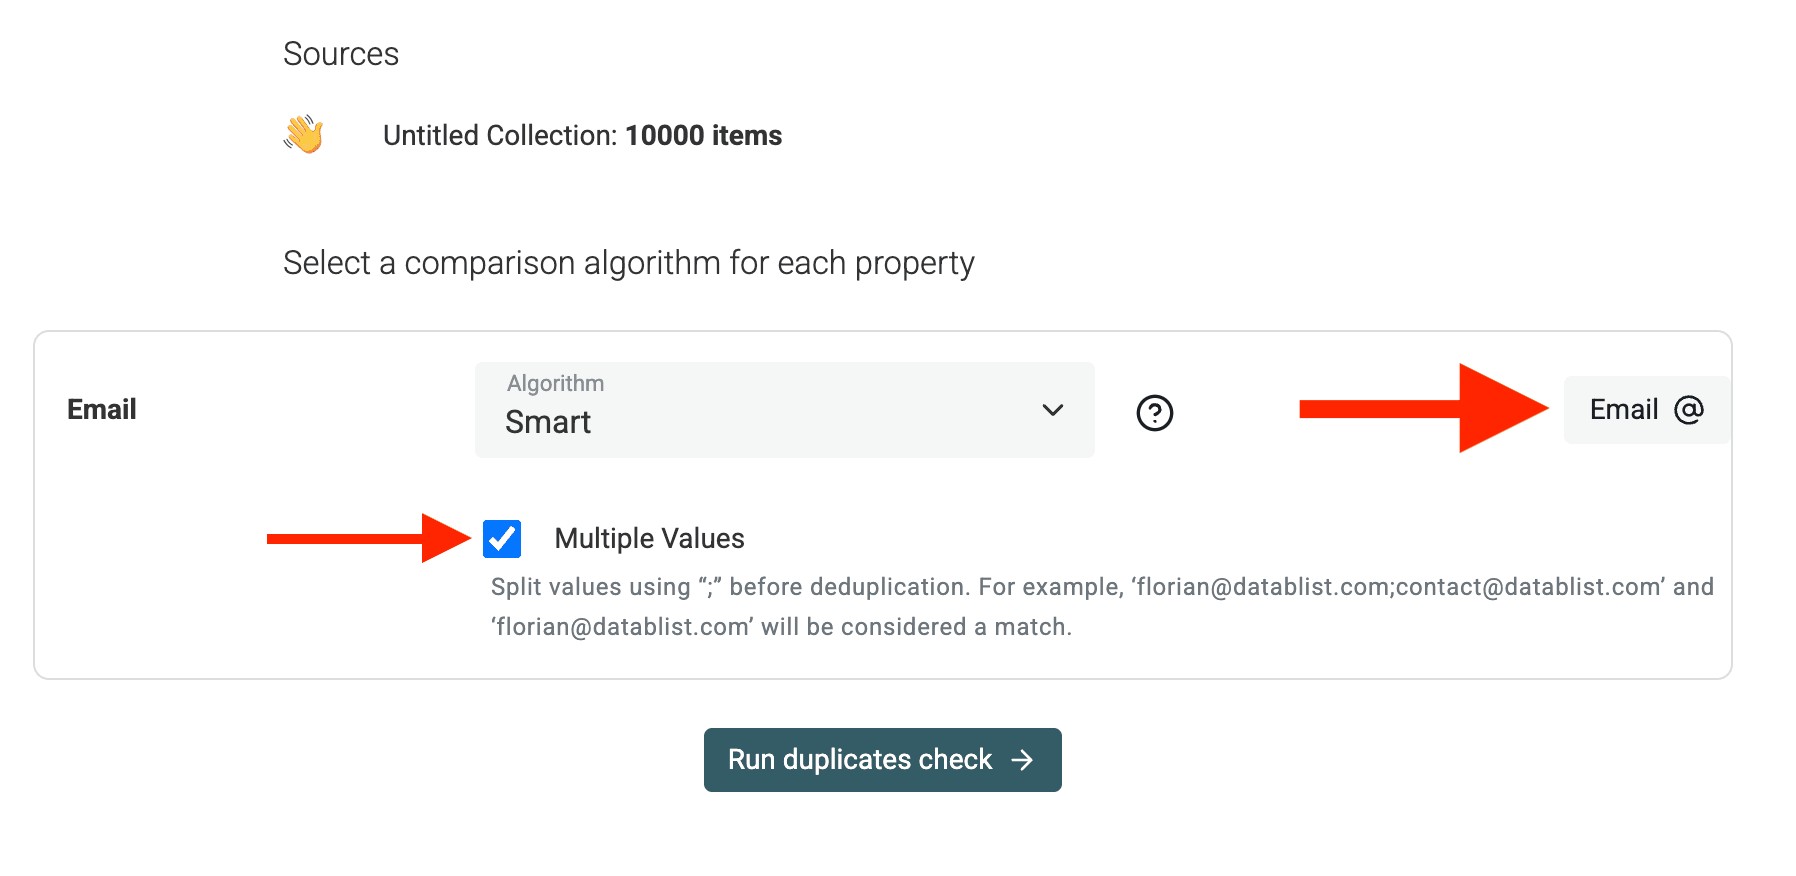
如果使用 Emails 或 Phones 等包含多个值的字段去重,且各个值由 ; 分隔,请在 Datablist 中启用 “Multiple Values”模式。这样,即使一条记录包含 john@company.com; j.doe@gmail.com,另一条只包含 john@company.com,系统仍能正确匹配。
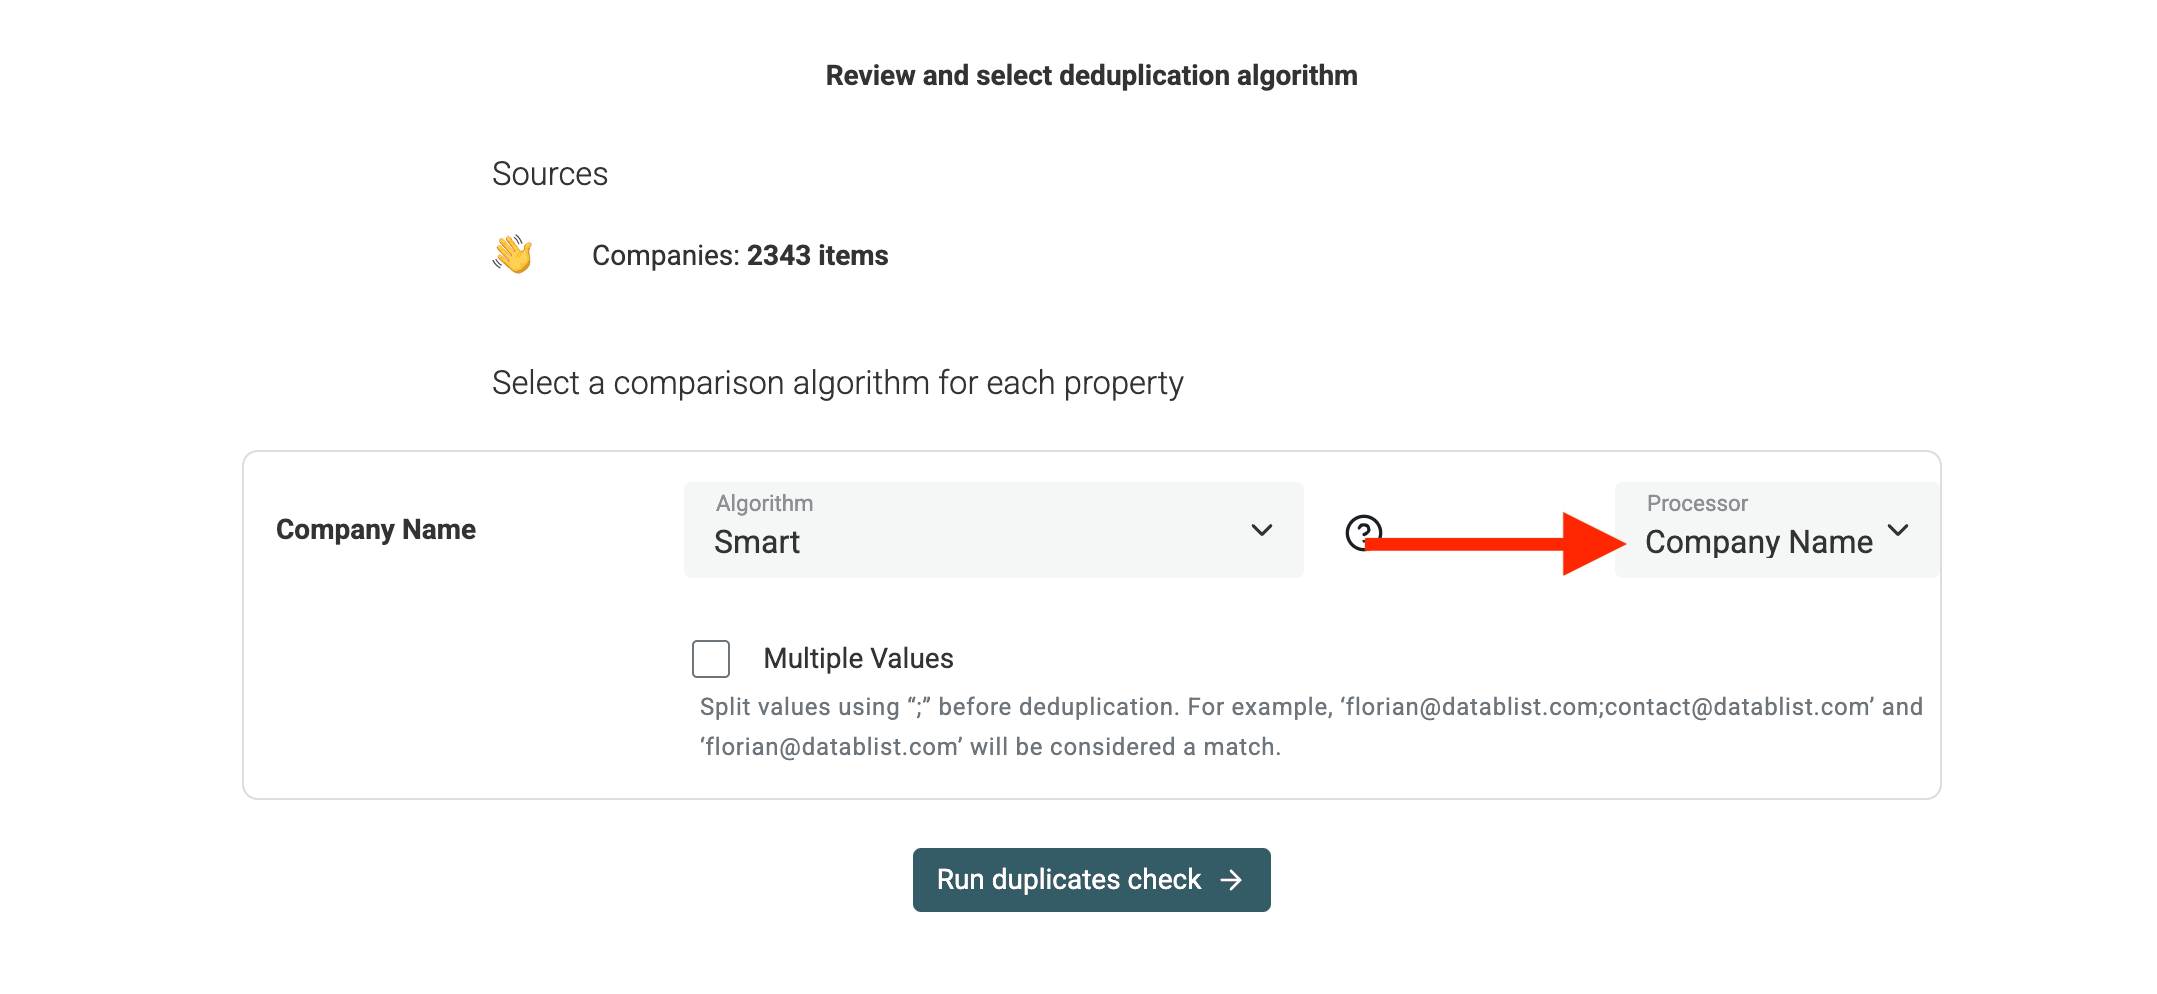
如果按公司名称去重,Datablist Duplicates Finder 提供专用 processor,可处理公司法律后缀和冗余词。
如果按 Website 去重,请使用
URLprocessor。
3. 审核检测到的重复项和冲突值
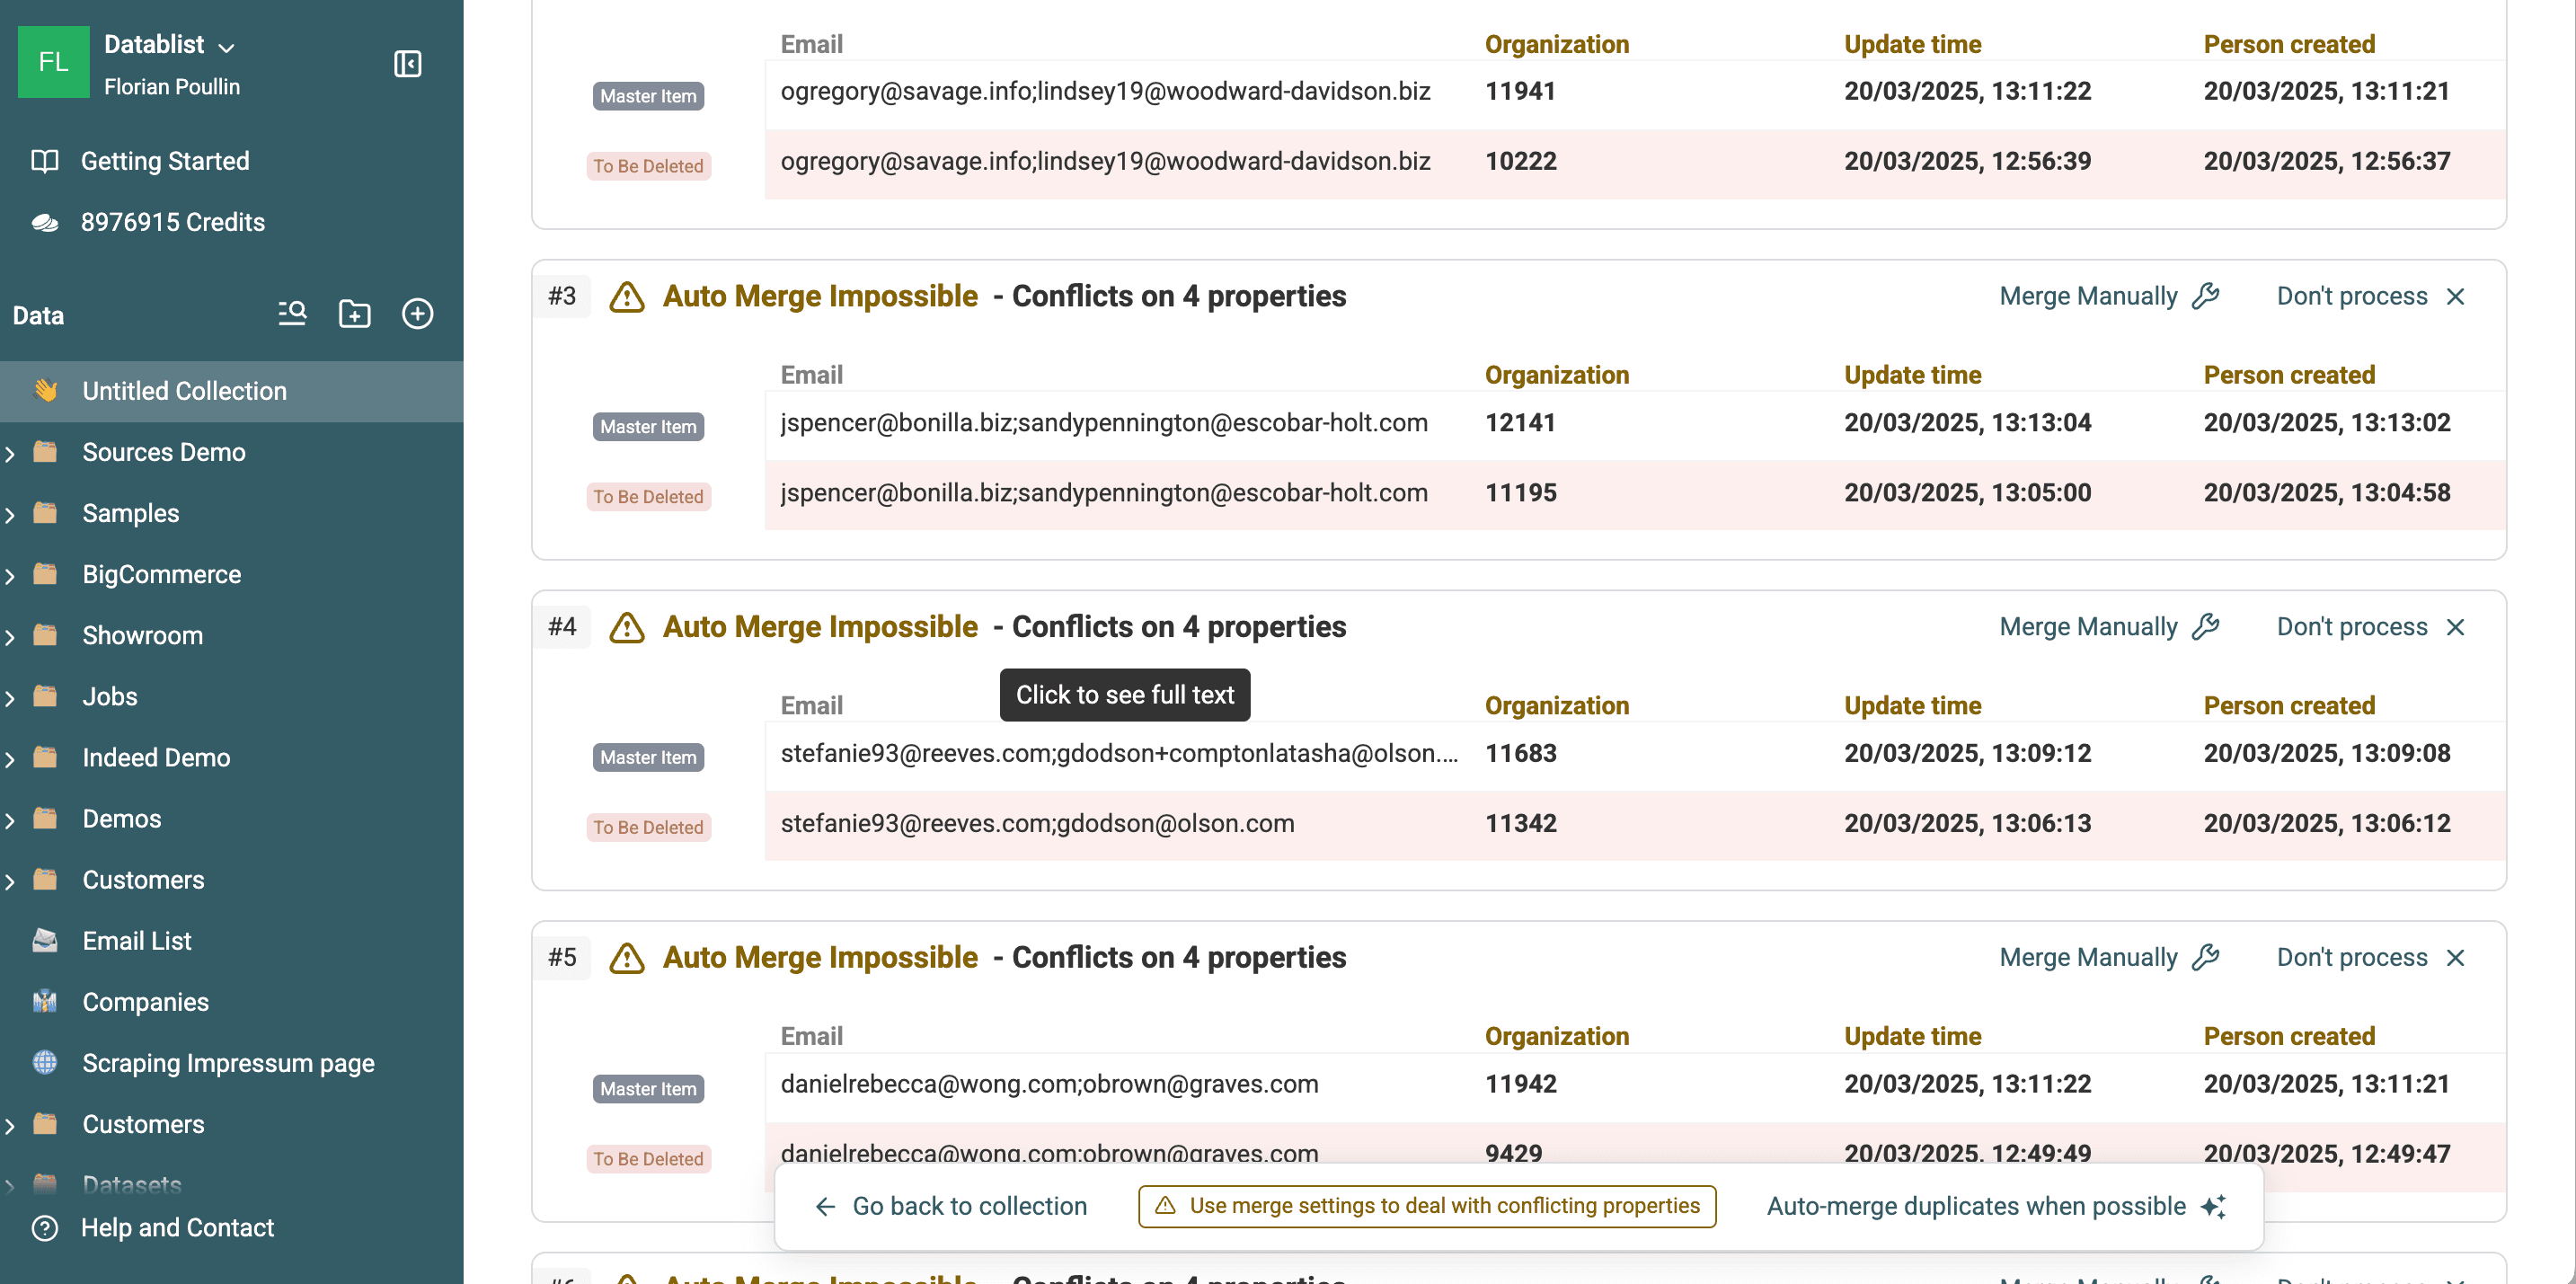
扫描完成后,Datablist 会将重复记录归入同一组。
- 你会看到由相似 People 或 Organizations 构成的 cluster,我们称之为“Duplicate Groups”。
- 每个组都会显示记录的匹配依据(Email、Name 或 Website),以及是否存在数据冲突。
3.a. 了解 Duplicate Groups
每个 Duplicate Group 都包含多条被判定为同一实体的记录。
- 部分组的数据完全相同或互为补充,可以自动合并。
- 其他组由于存在冲突信息,需要人工审核。
💡 示例:
- 如果两条“John Doe”记录的 Email 相同,但 Phone 不同,Datablist 会将它们识别为重复项,同时把 Phone 标记为冲突字段。
3.b. 设置冲突值合并规则
了解冲突
当重复联系人在同一字段中存在不同值时,就会产生冲突。例如,两条记录的职位或 Phone 可能不同。Datablist 会突出显示这些冲突,方便你决定保留哪个值。
如何处理冲突
Datablist 提供直观的操作界面,帮助你高效解决冲突,同时保证数据整洁、准确。
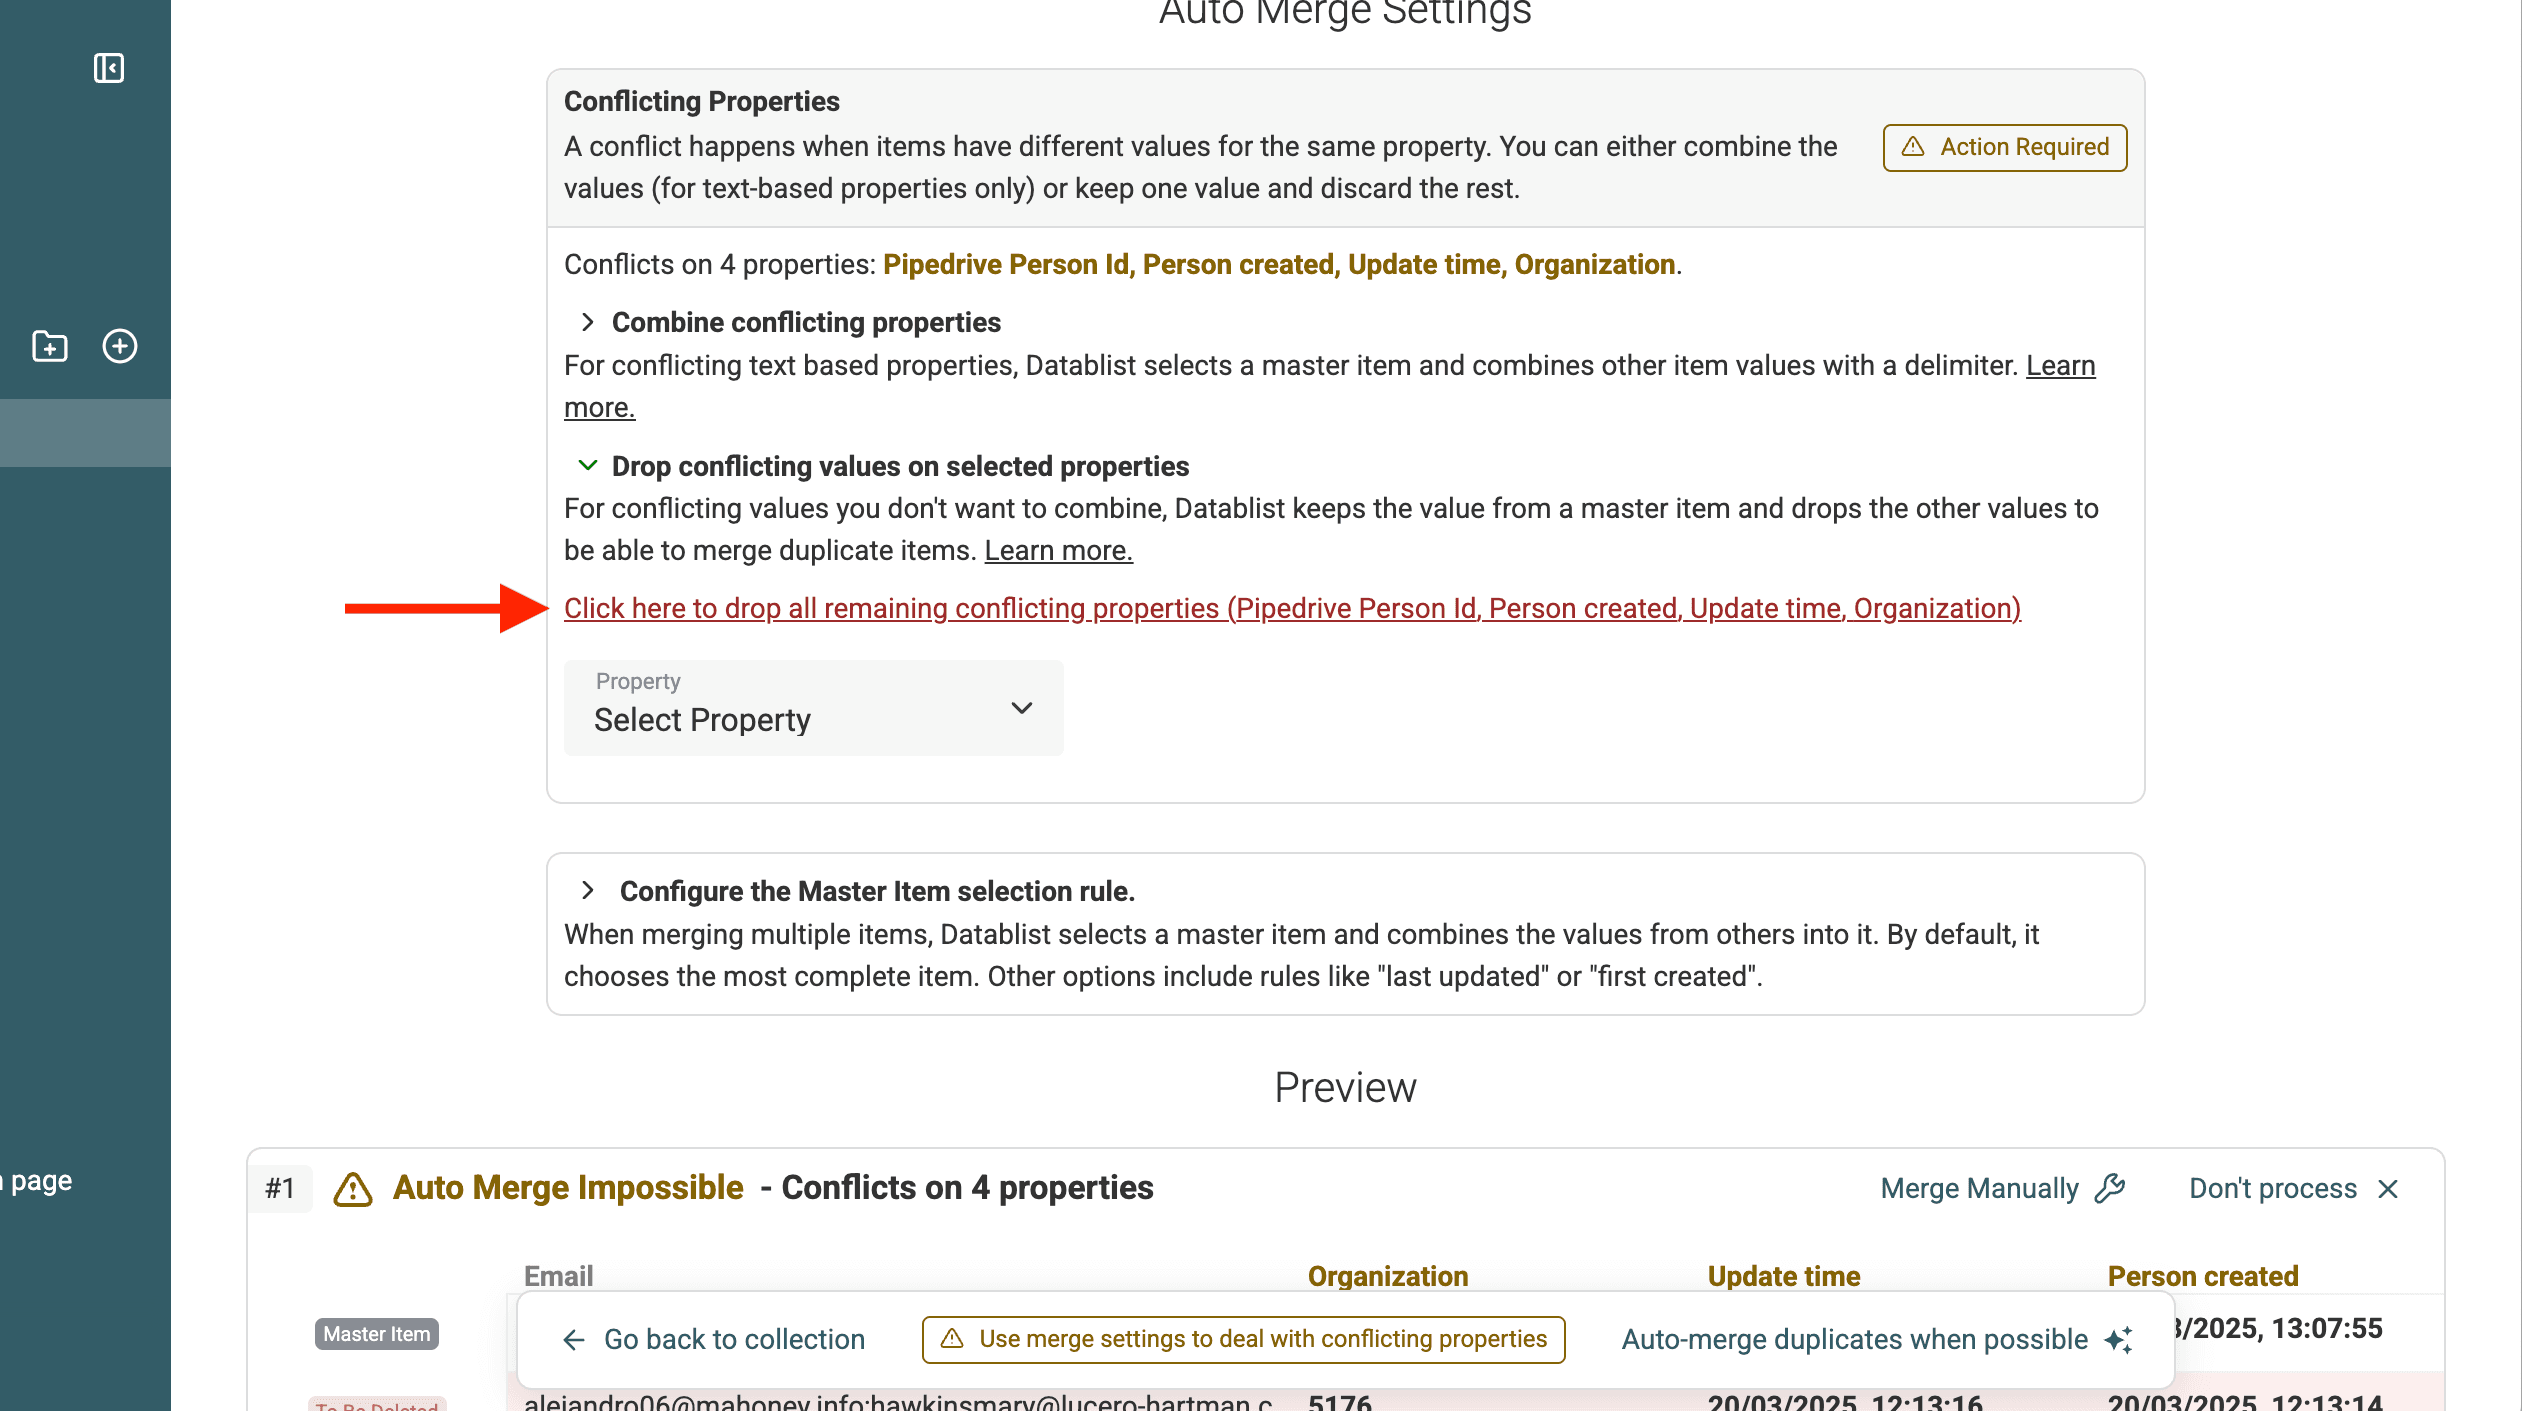
- Combine Values:如果多个值可以互相补充(例如多个 Phone 或 Notes),可将它们合并。
- 保留一个值并删除其余值:如果某条联系人记录明显更完整,并且你希望舍弃其他值,请选择“Drop conflicting values...”。
在 Combine conflicting values 和 Drop conflicting values 设置中,可以通过快捷链接自动选中所有存在冲突的 property。
选择主记录
你还可以配置 Datablist 选择主记录的方式。合并重复记录时,Datablist 会保留一条记录,更新其字段,并删除其他记录,最终只留下一个数据实体。
Datablist 提供多种主记录选择规则:
- Most Complete:选择已填写字段最多的记录。
- Last Updated:选择最近修改的记录。
- First Created:根据创建日期选择最早创建的记录。
- Highest Value:选择指定 property 值最高的记录。如果多条记录的值相同,则选择最近的一条。
- Lowest Value:选择指定 property 值最低的记录。如果多条记录的值相同,则选择最近的一条。
- Matching Value:选择指定 property 中包含特定值的记录。如果没有记录符合条件,则不会合并。
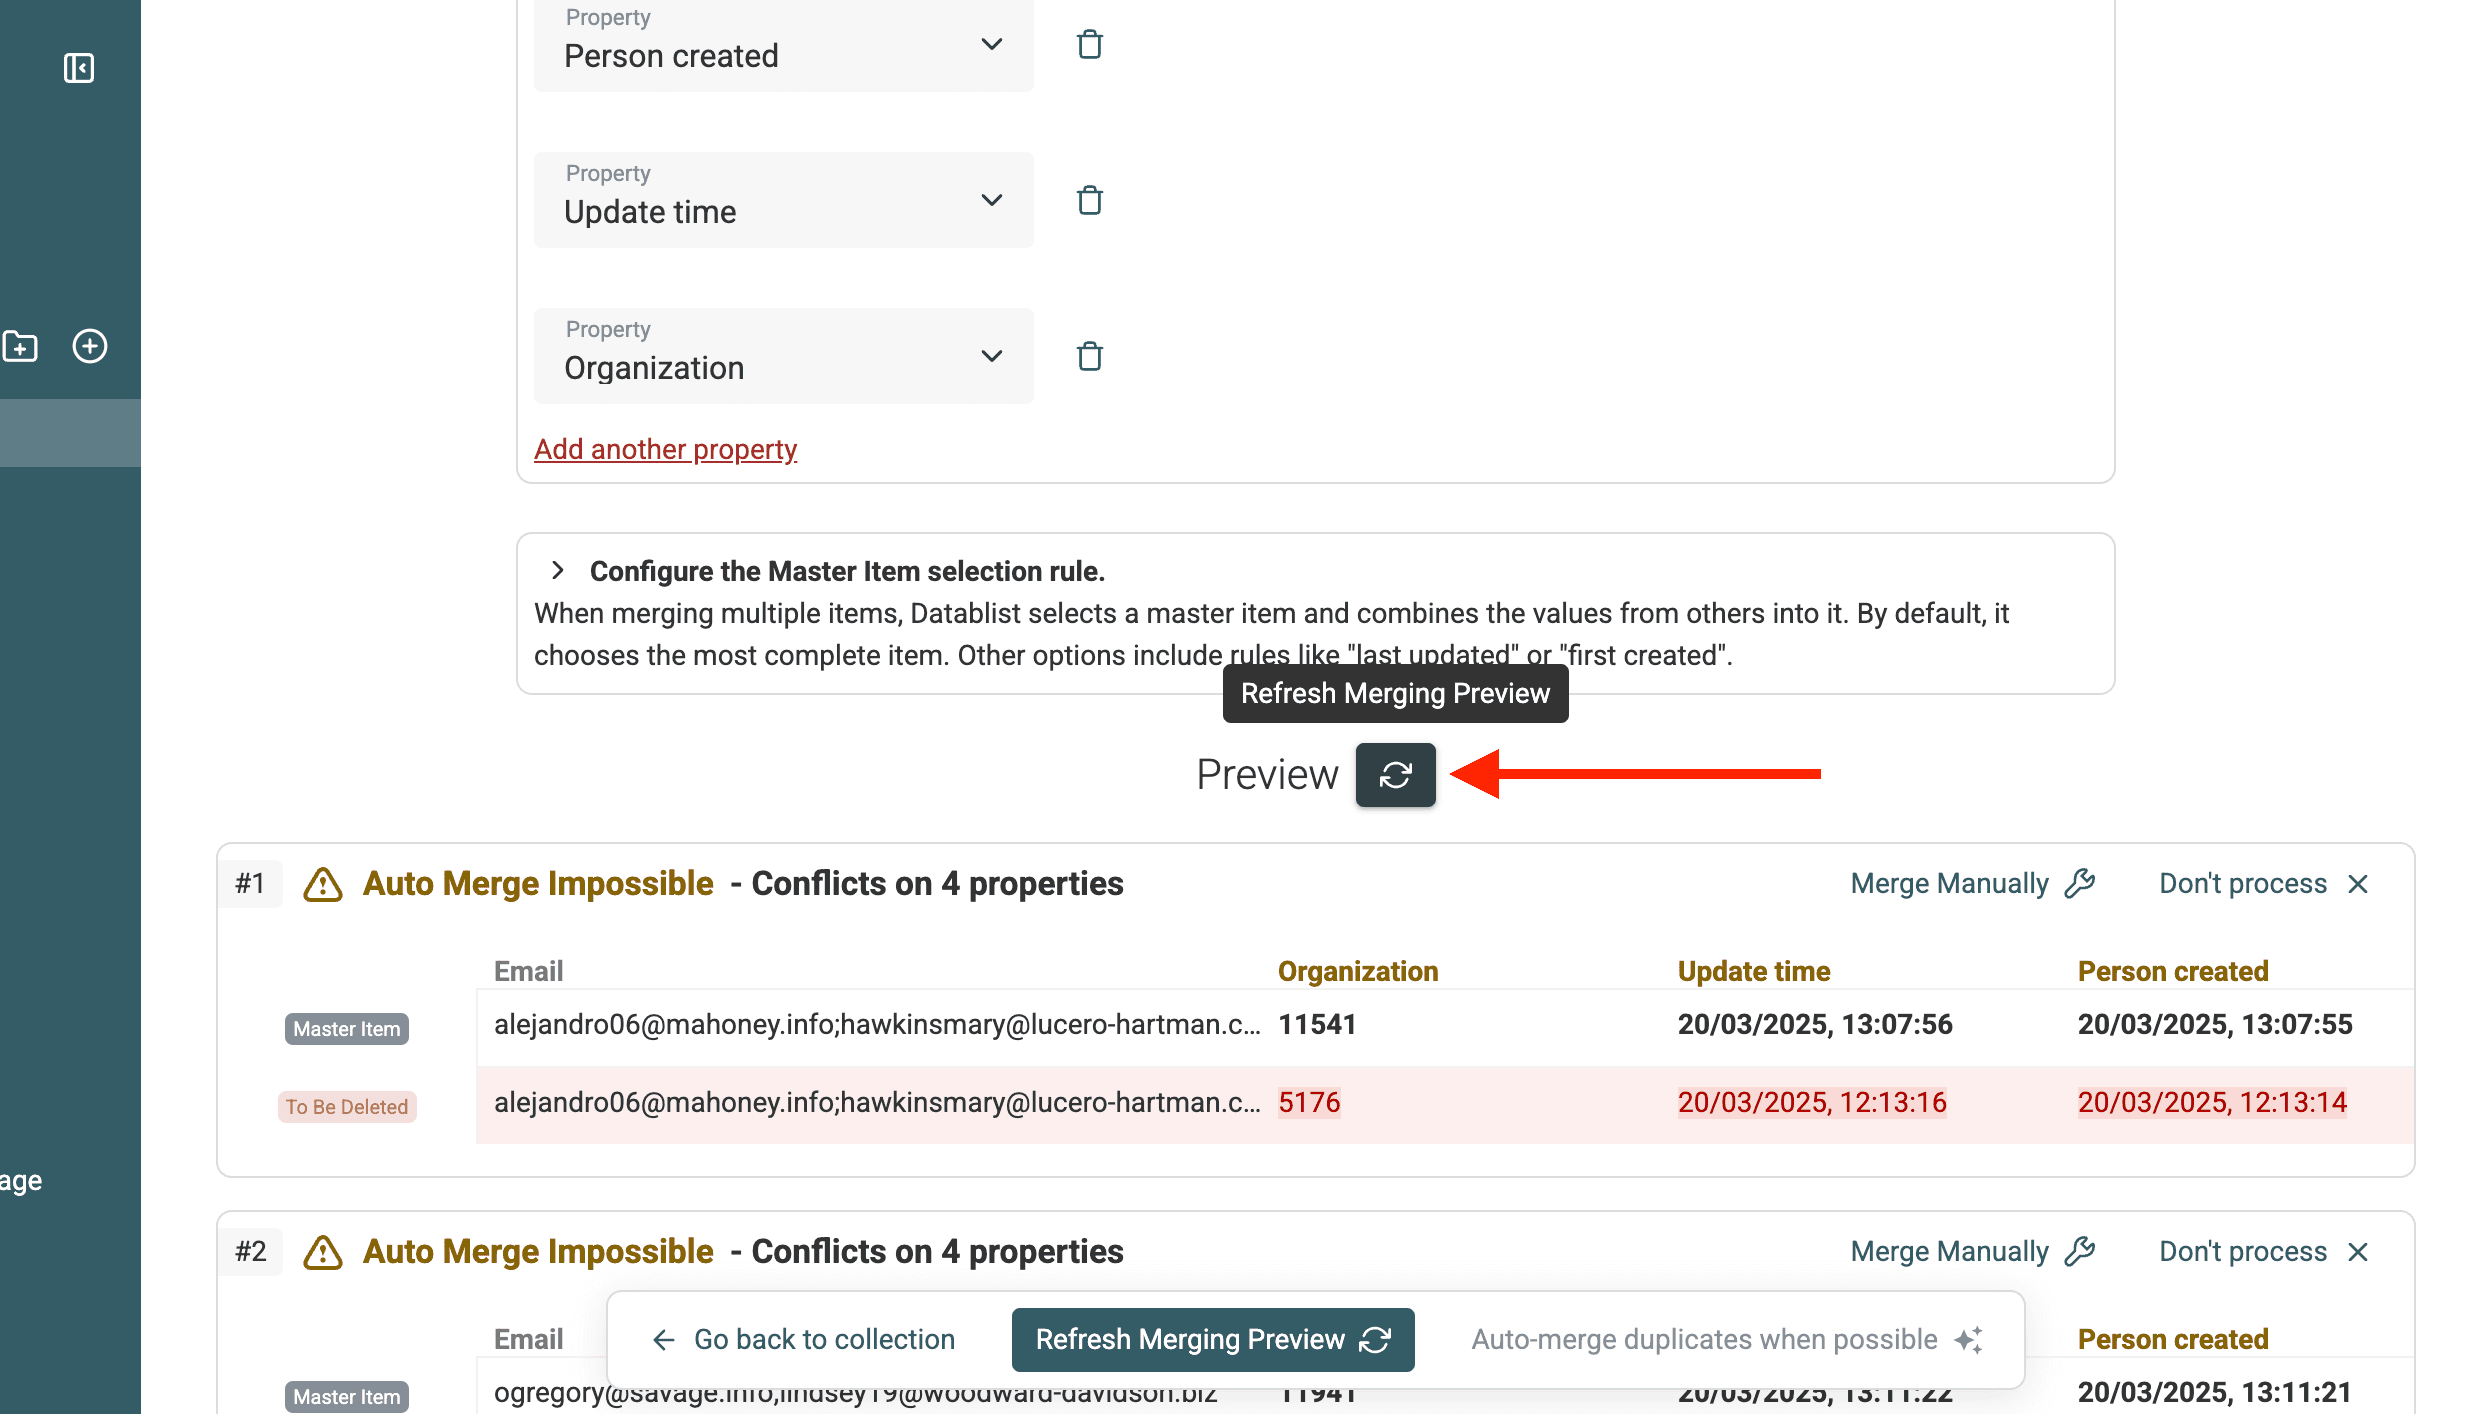
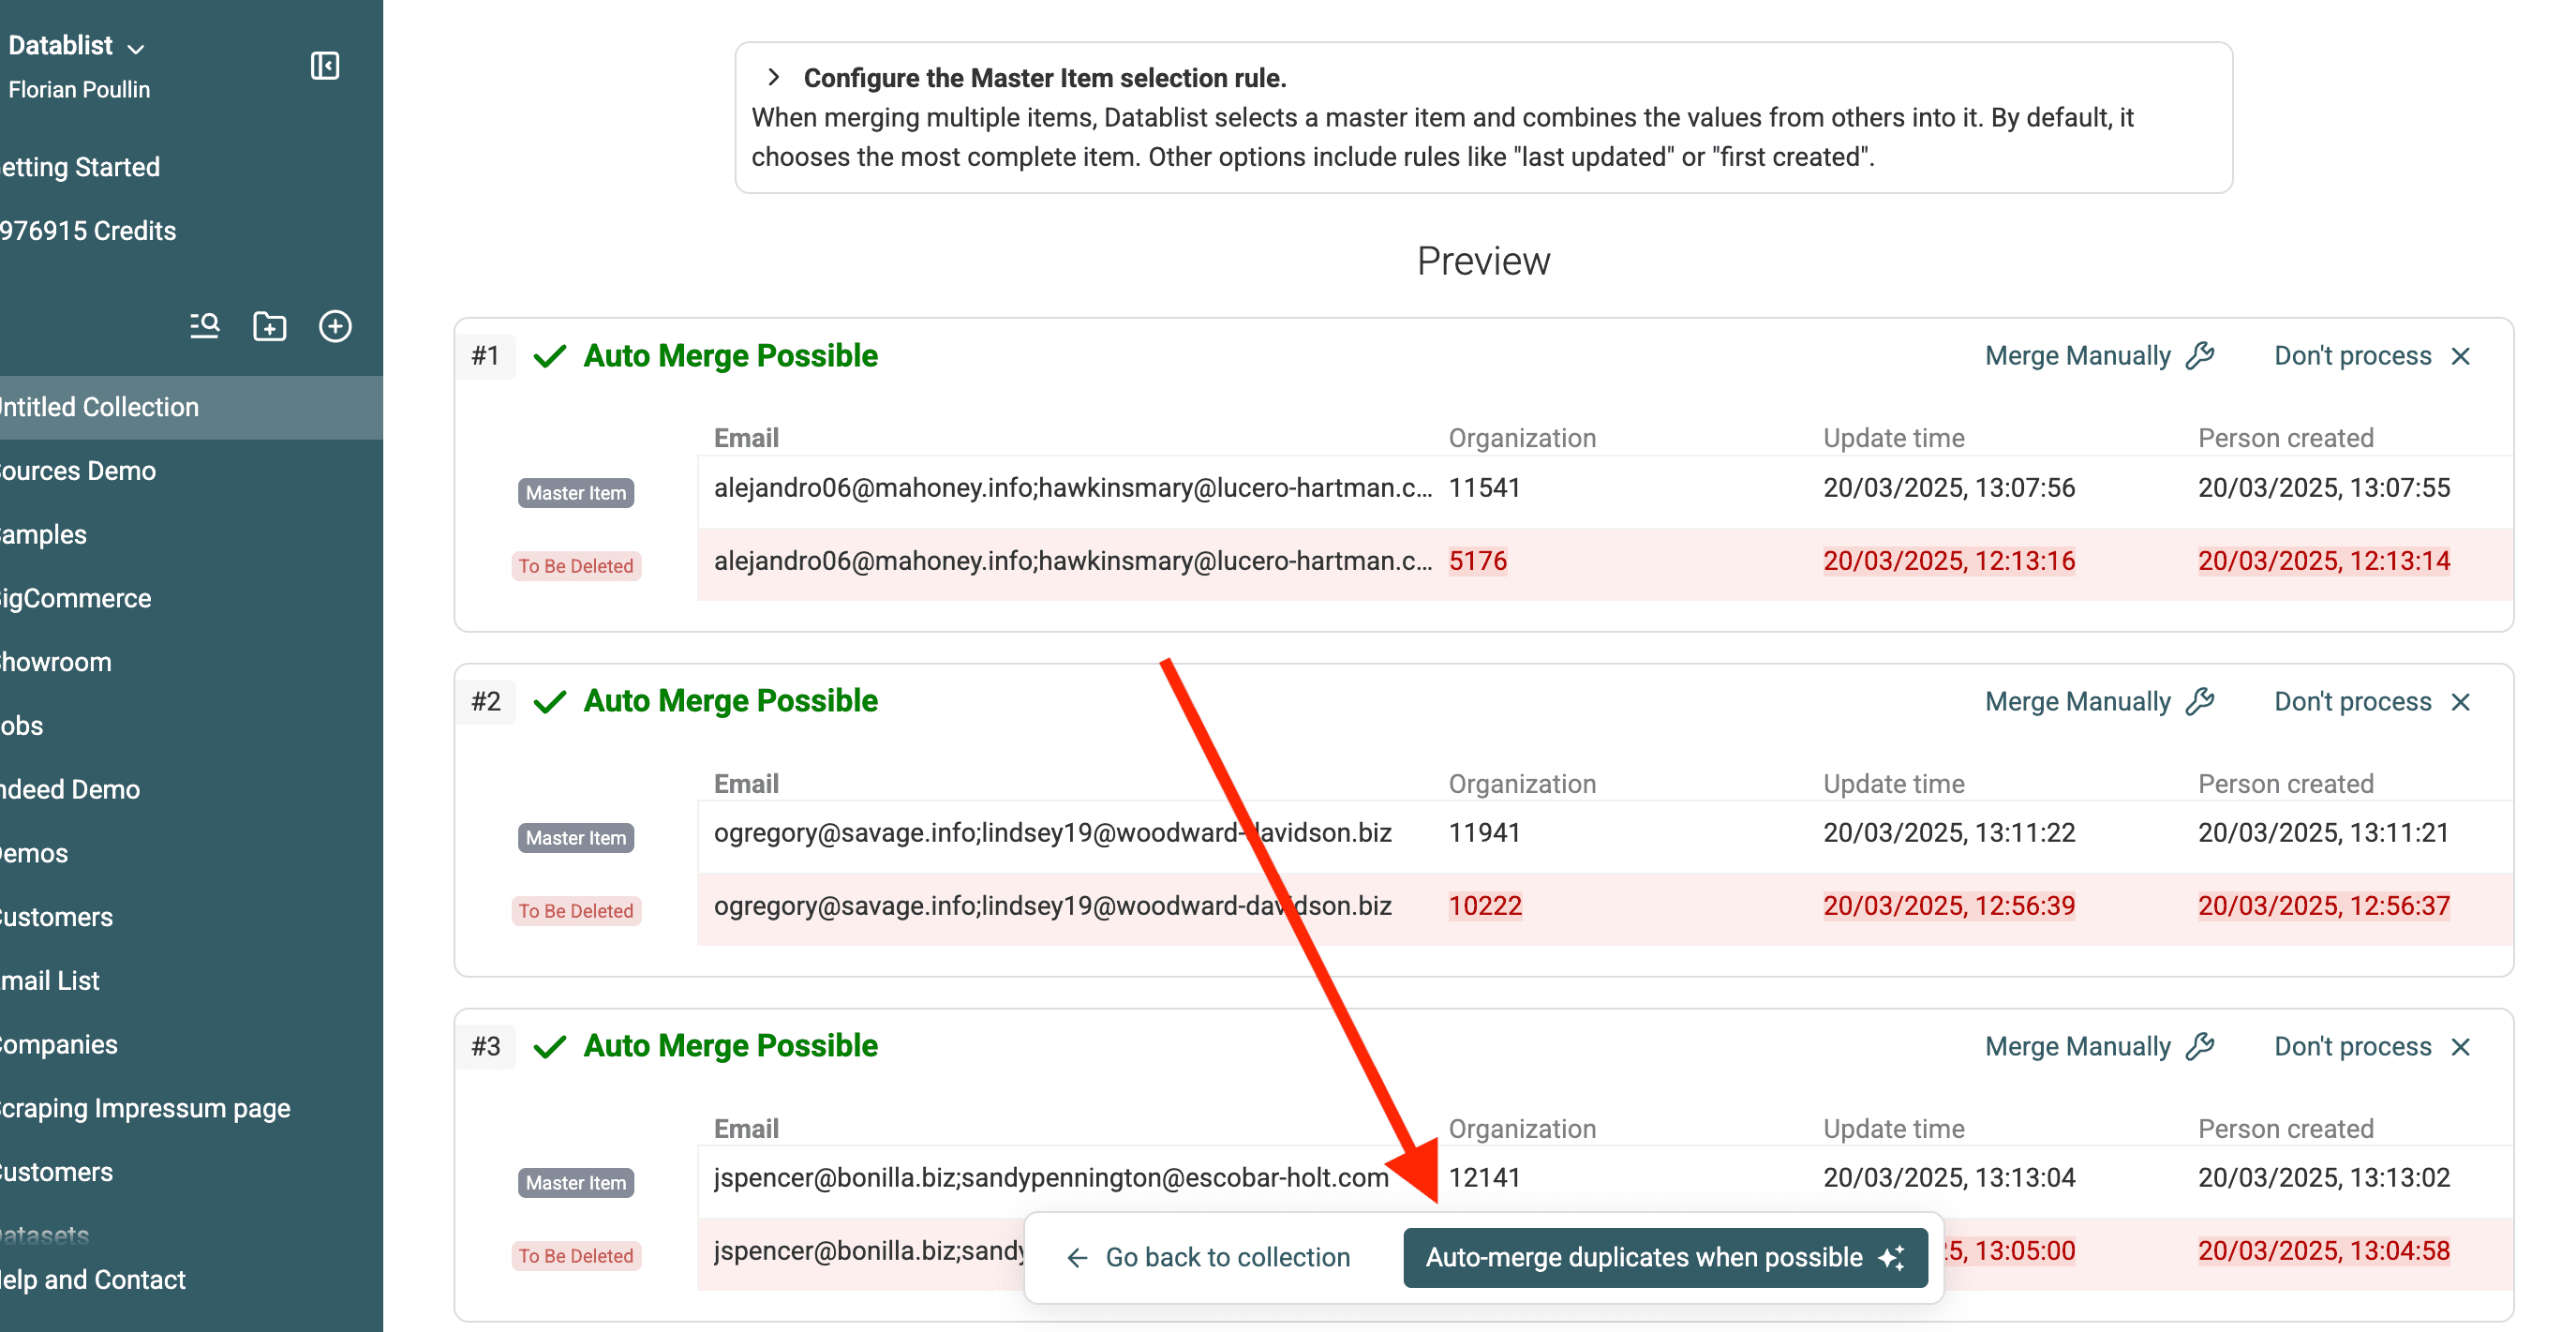
Datablist 会显示即将执行的变更预览列表。你可以看到哪些记录将被删除、哪些值将被合并等。
完成合并设置后,点击预览中的“Refresh”。
🔹 示例:合并两个联系人
以下示例展示了这些合并规则的执行结果:
- 对
Name字段使用 Drop Conflicting values。 - 对
Phone字段使用 Combine Conflicting values。
| 字段 | 联系人 1 | 联系人 2 | 合并结果 |
|---|---|---|---|
| Name | John Doe | Johnathan Doe | John Doe |
| john@company.com | john@company.com | john@company.com | |
| Phone | 555-1234 | 555-5678 | 555-1234; 555-5678 |
3.c. 自动合并重复数据
确认预览无误后,点击“Auto-merge duplicates when possible”。Datablist 会将合并规则应用到所有 Duplicate Groups。
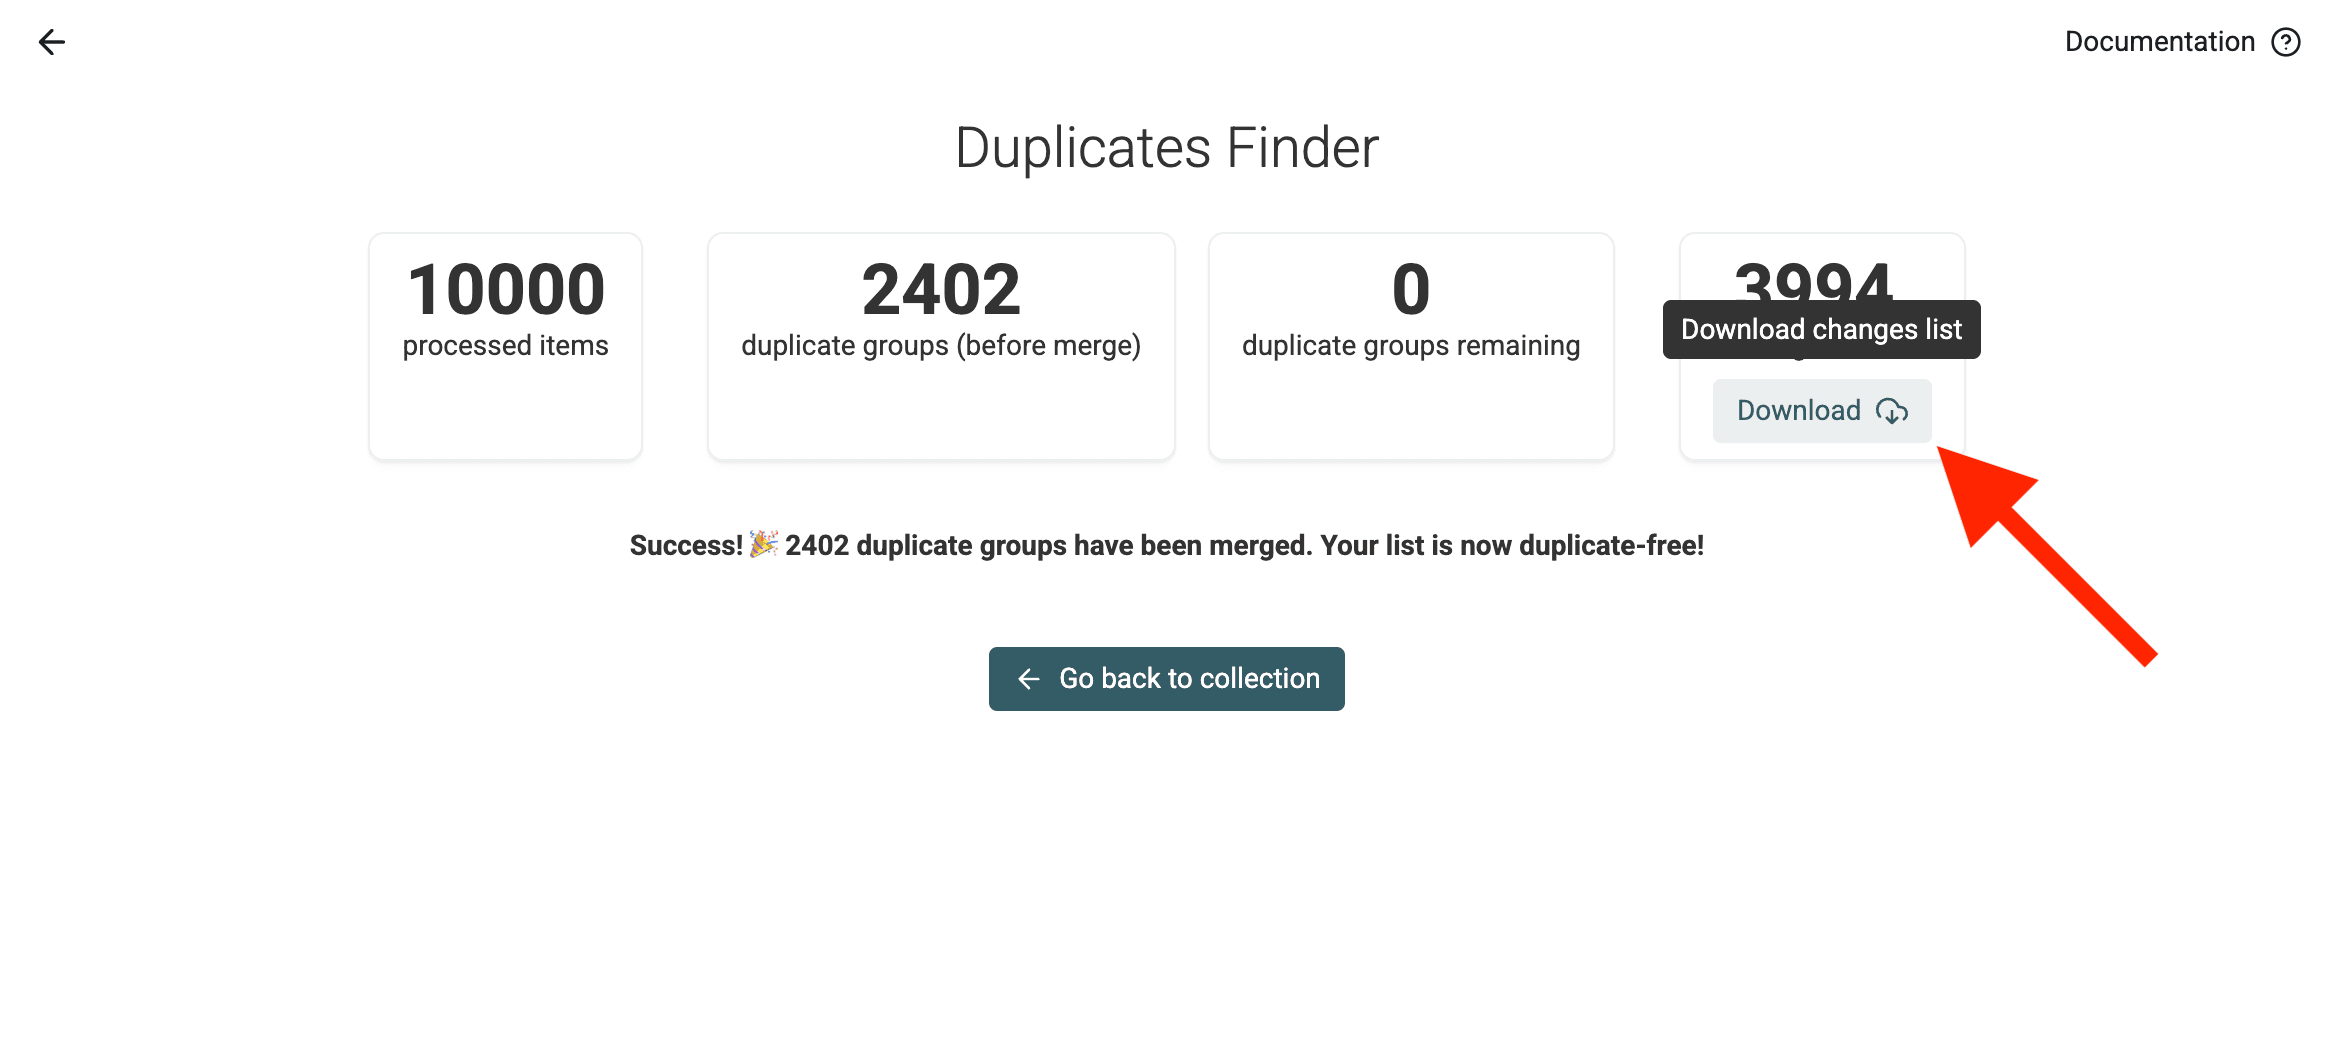
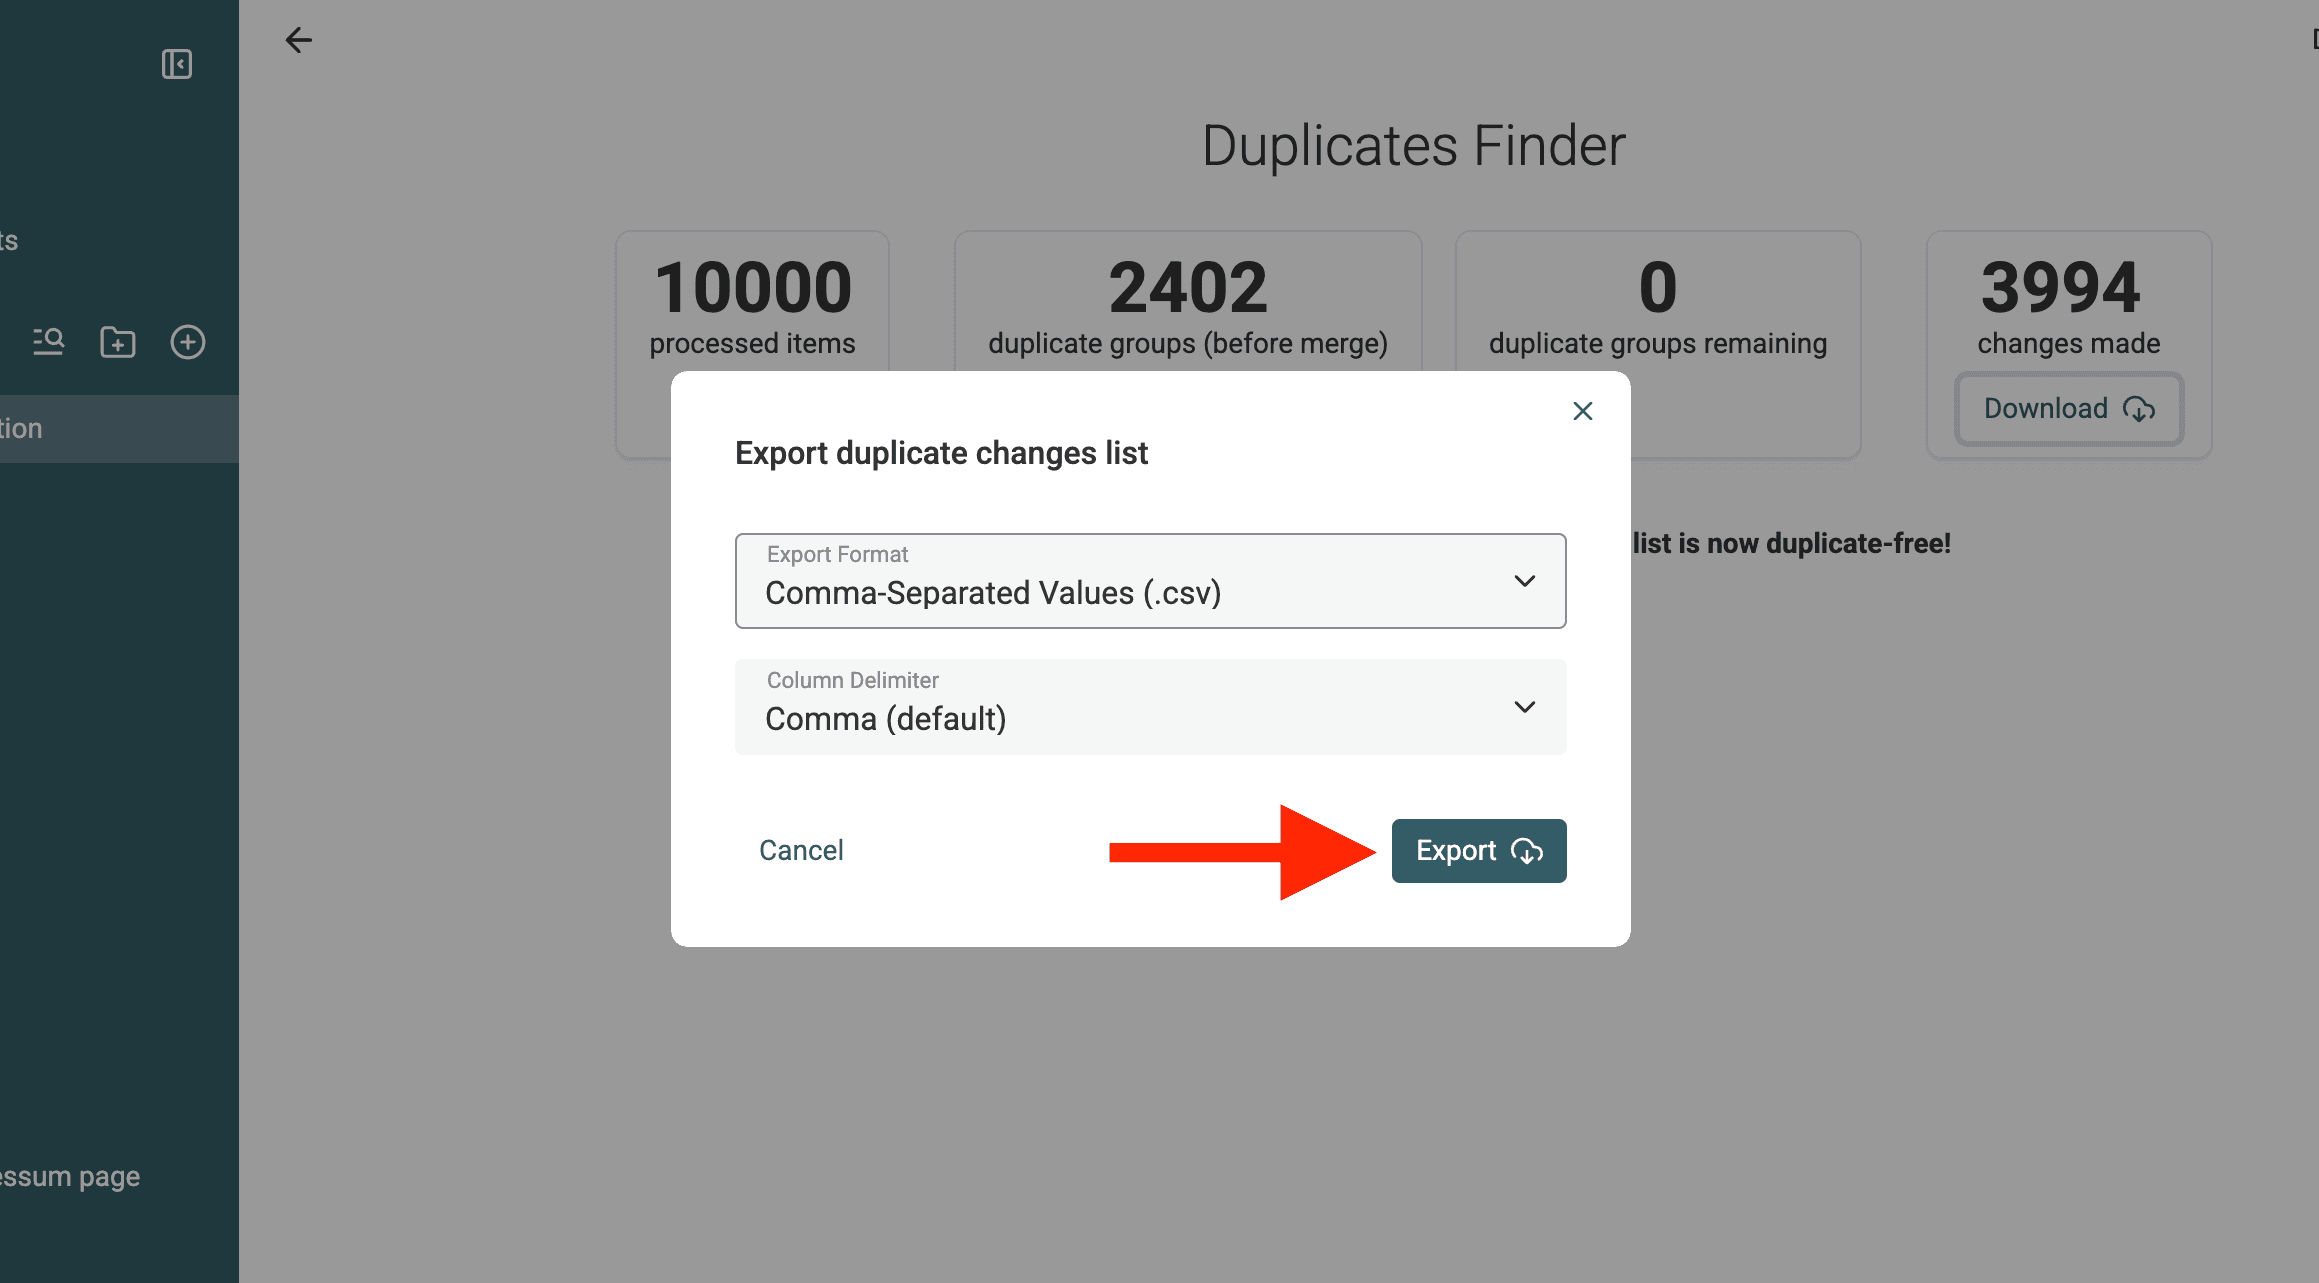
3.d. 下载变更文件
⚠️ 要在 Pipedrive CRM 中合并和更新记录,你必须保留这份变更文件。
步骤 3:将合并结果批量同步回 Pipedrive
现在,重复数据已经在 Datablist 中完成合并。最后一步是将清洗后的数据同步回 Pipedrive,确保 CRM 数据保持最新。
为此,我们将使用上一步下载的 Changes File(参见3.d. 下载变更文件)。该文件列出了所有已合并记录、已删除的重复项和已更新字段。
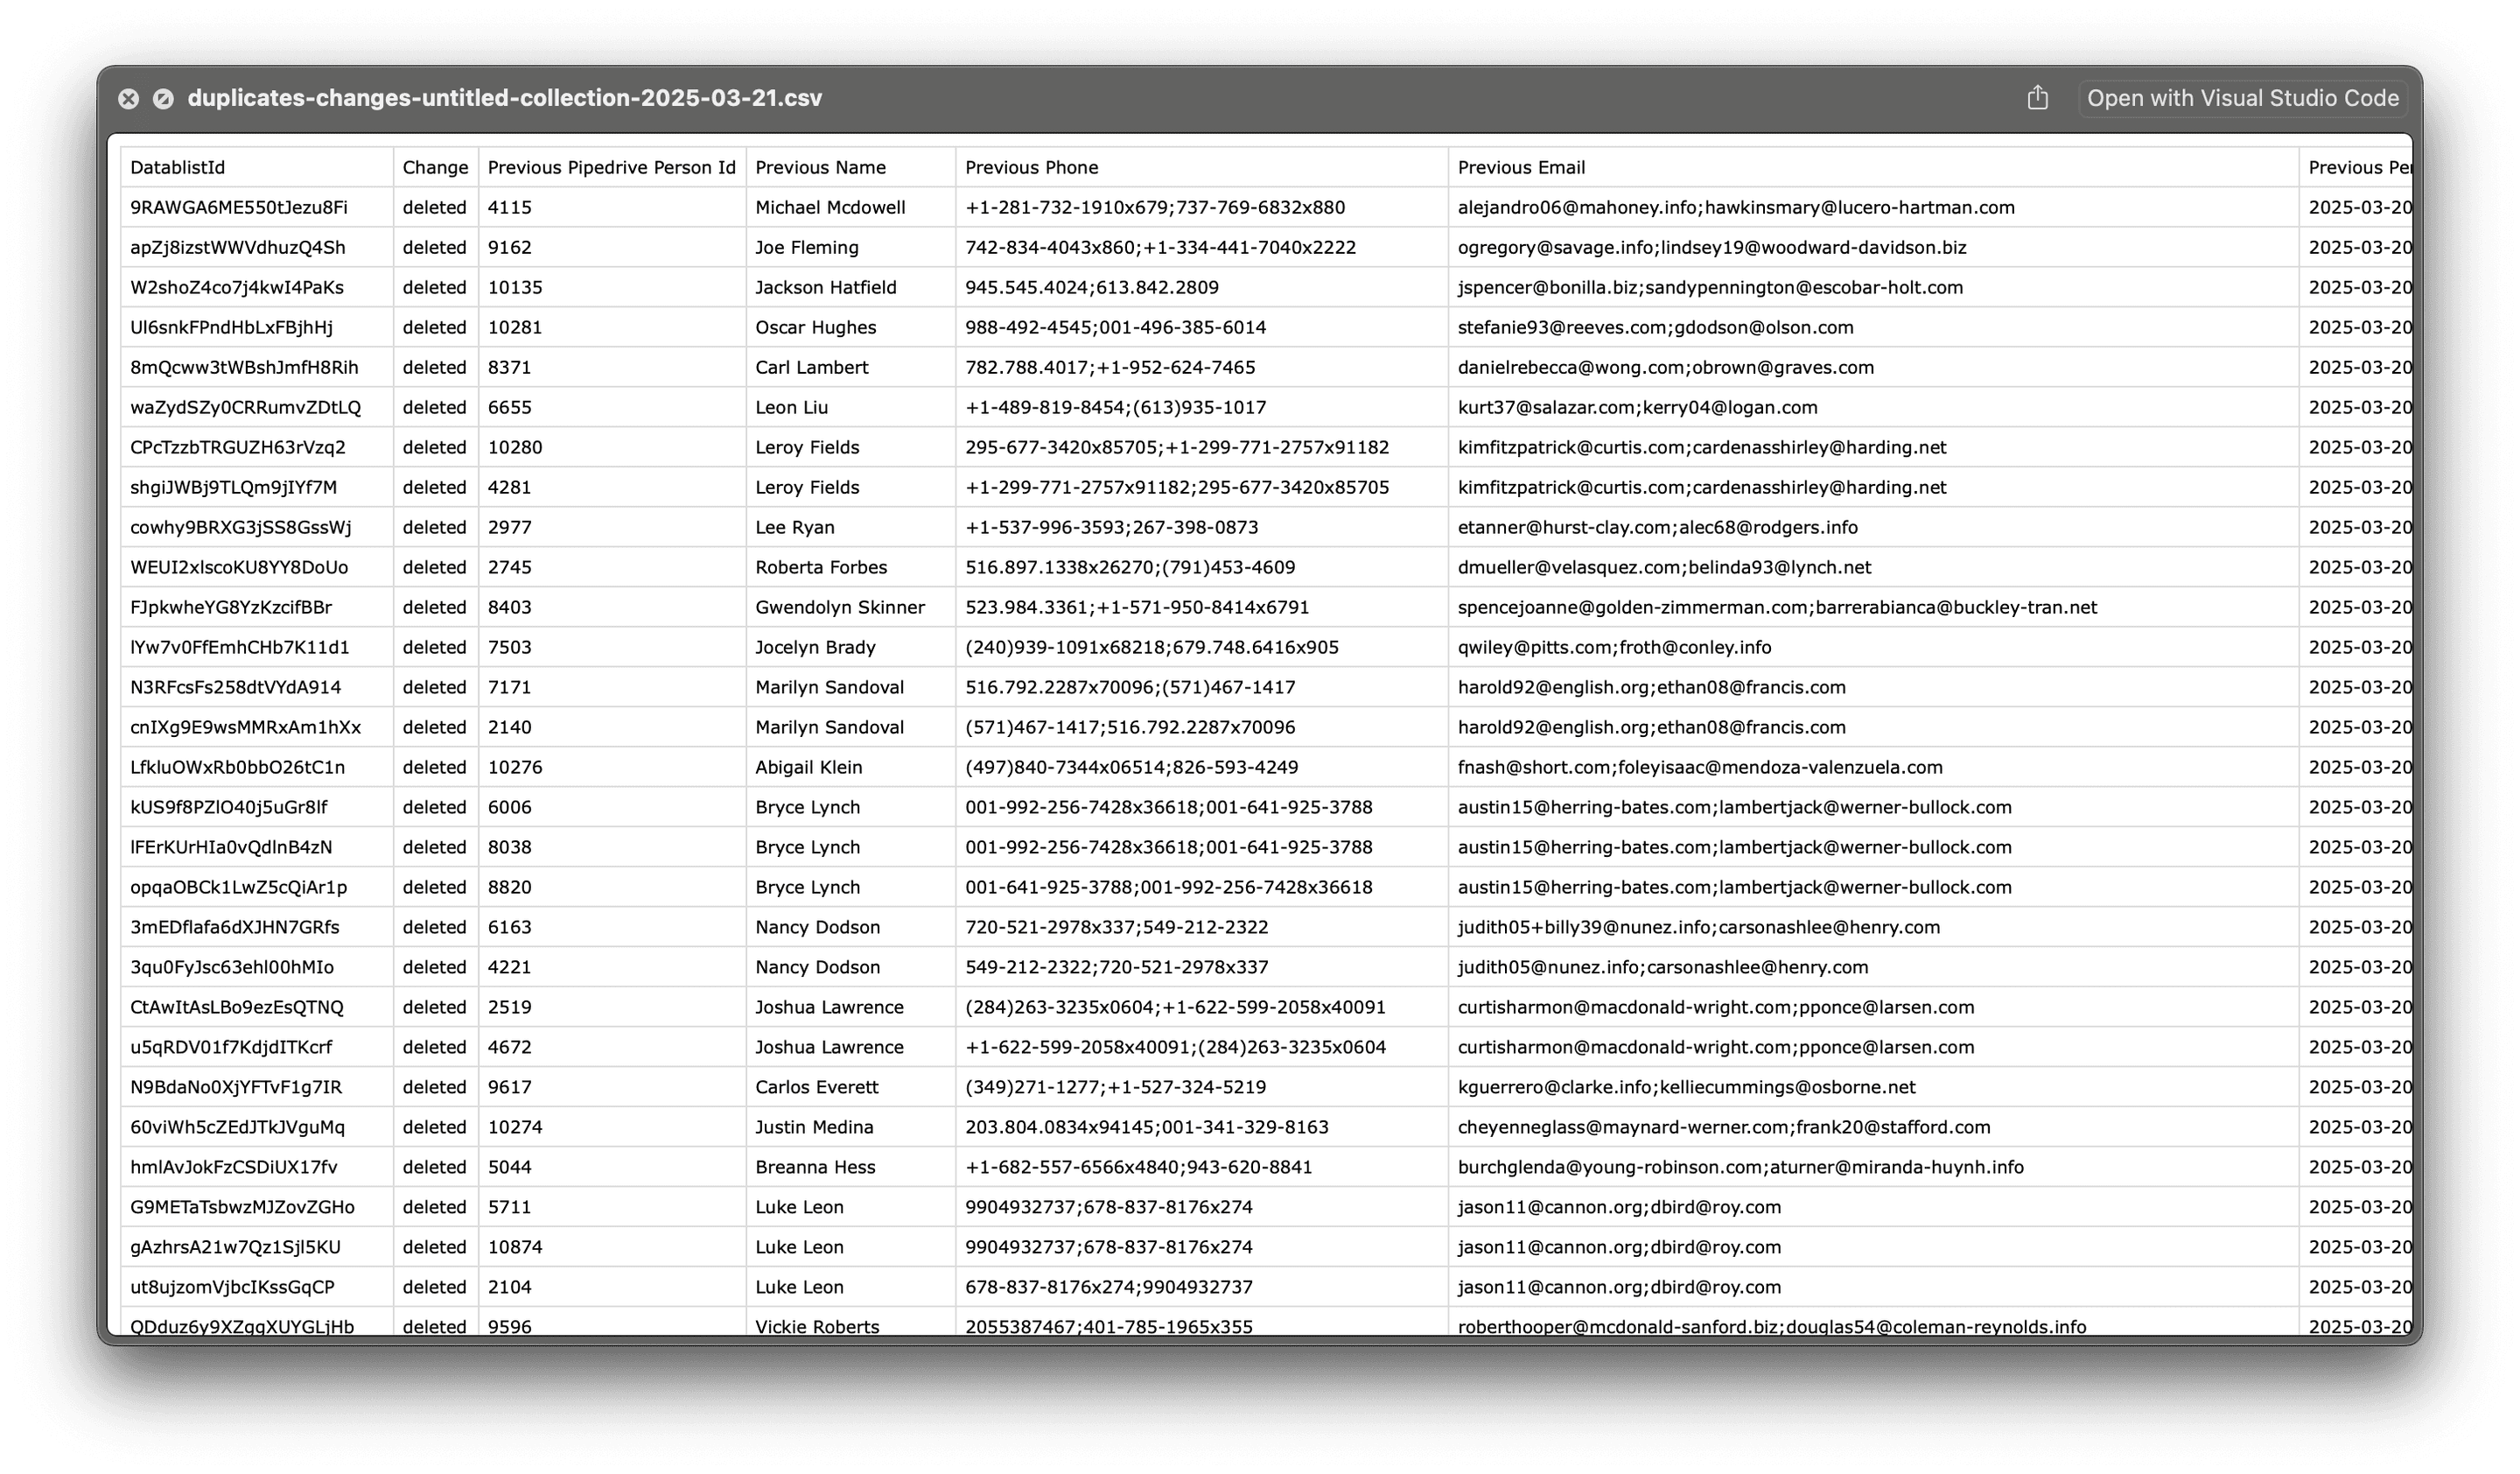
在 Changes Log 文件中,你可以看到:
✅ Updated Records → 已修改的联系人或公司,例如合并后的 Email、Phone 或 Name。文件中会同时显示更新前和更新后的数据。
✅ Deleted Records → 已合并到主记录中的重复记录。文件会显示被删除记录的 id,以及替代它的主记录 id。这些记录需要在 Pipedrive 中删除。
3.a. 将重复数据变更文件导入新 Collection
要将这些变更应用到 Pipedrive,请新建一个 collection,并上传 Changes File。
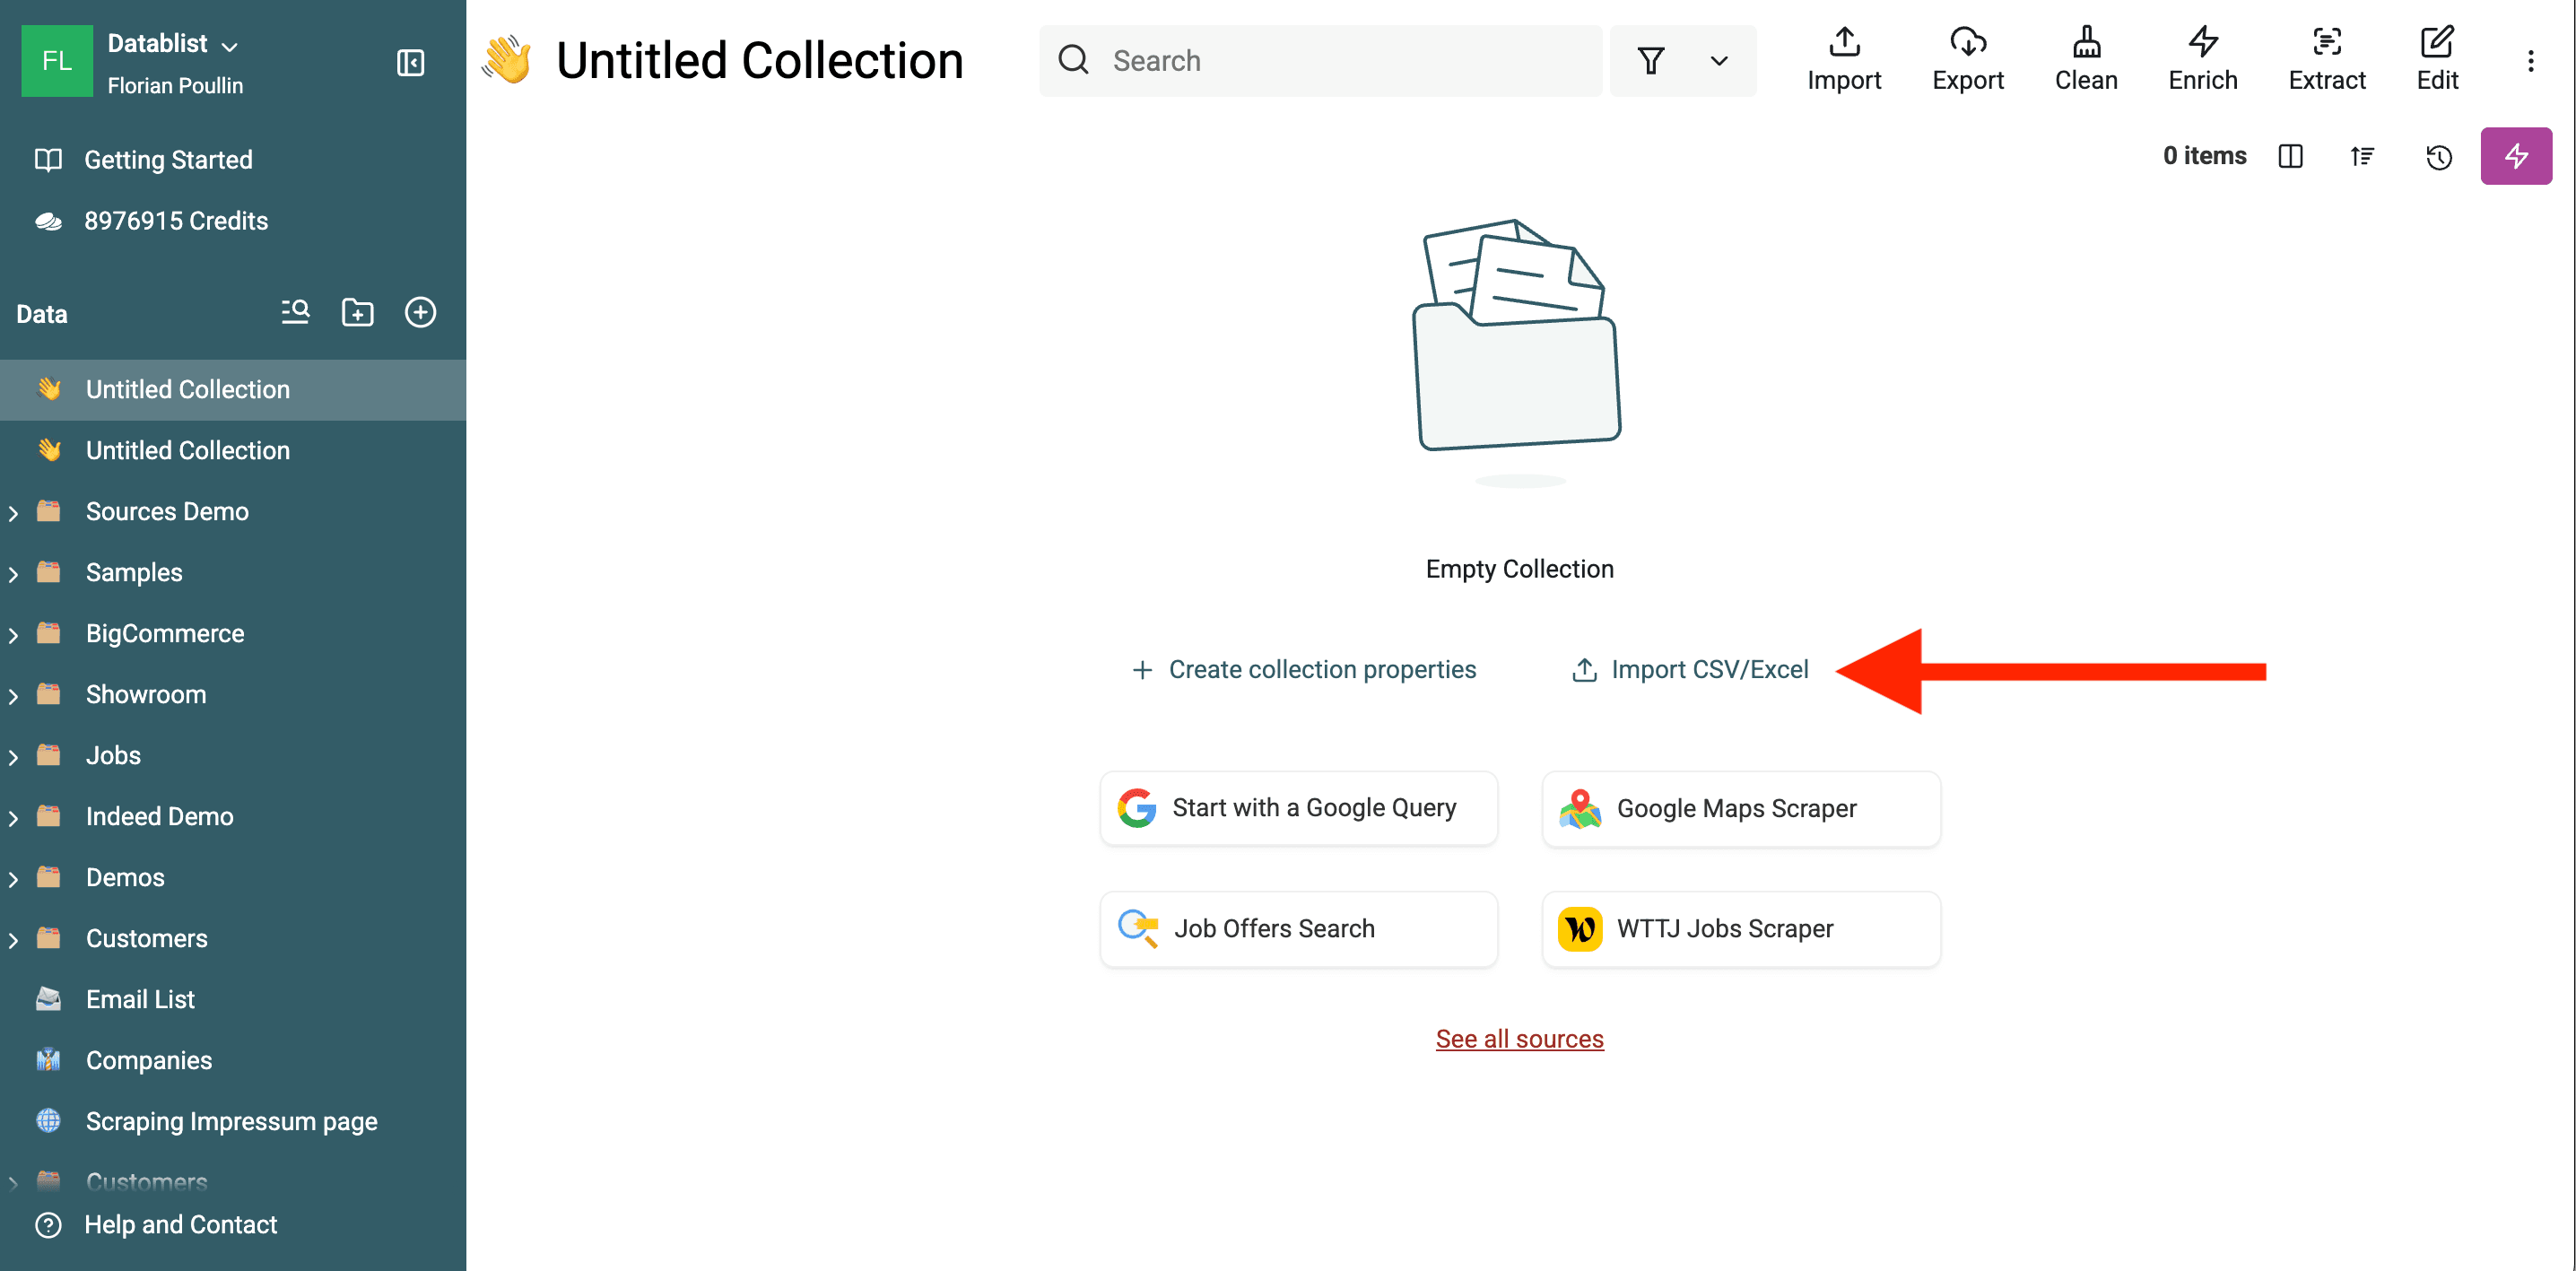
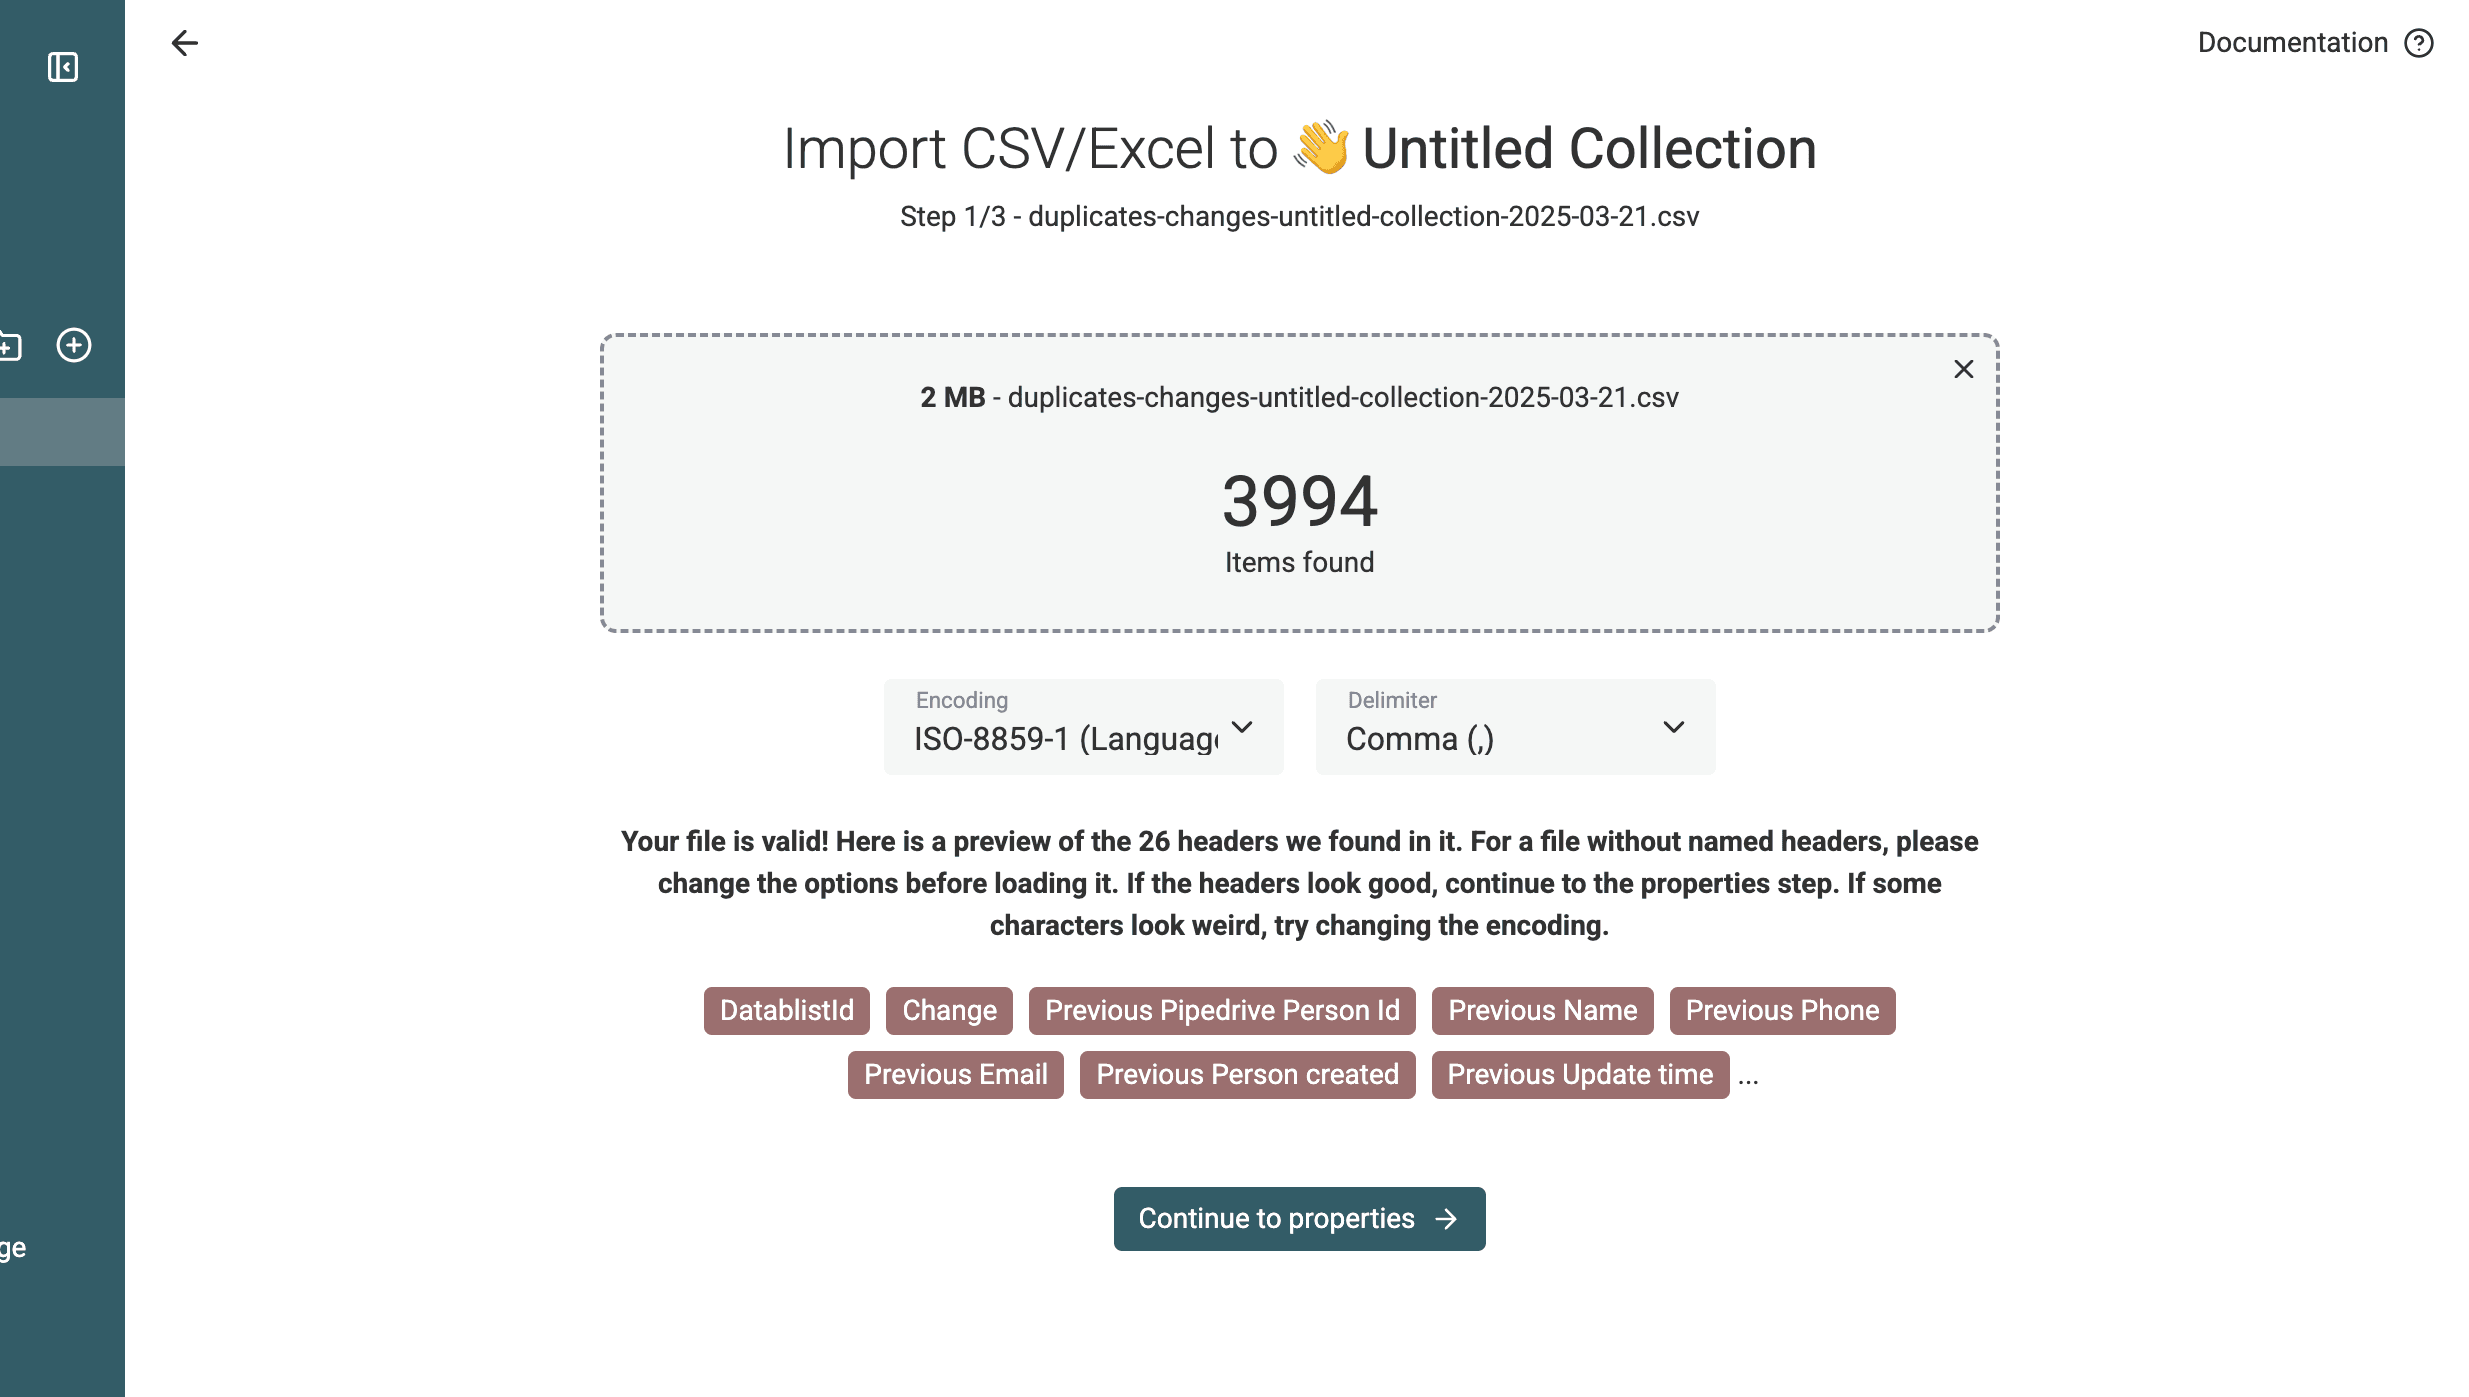
你将得到一个包含所有合并操作的 collection。
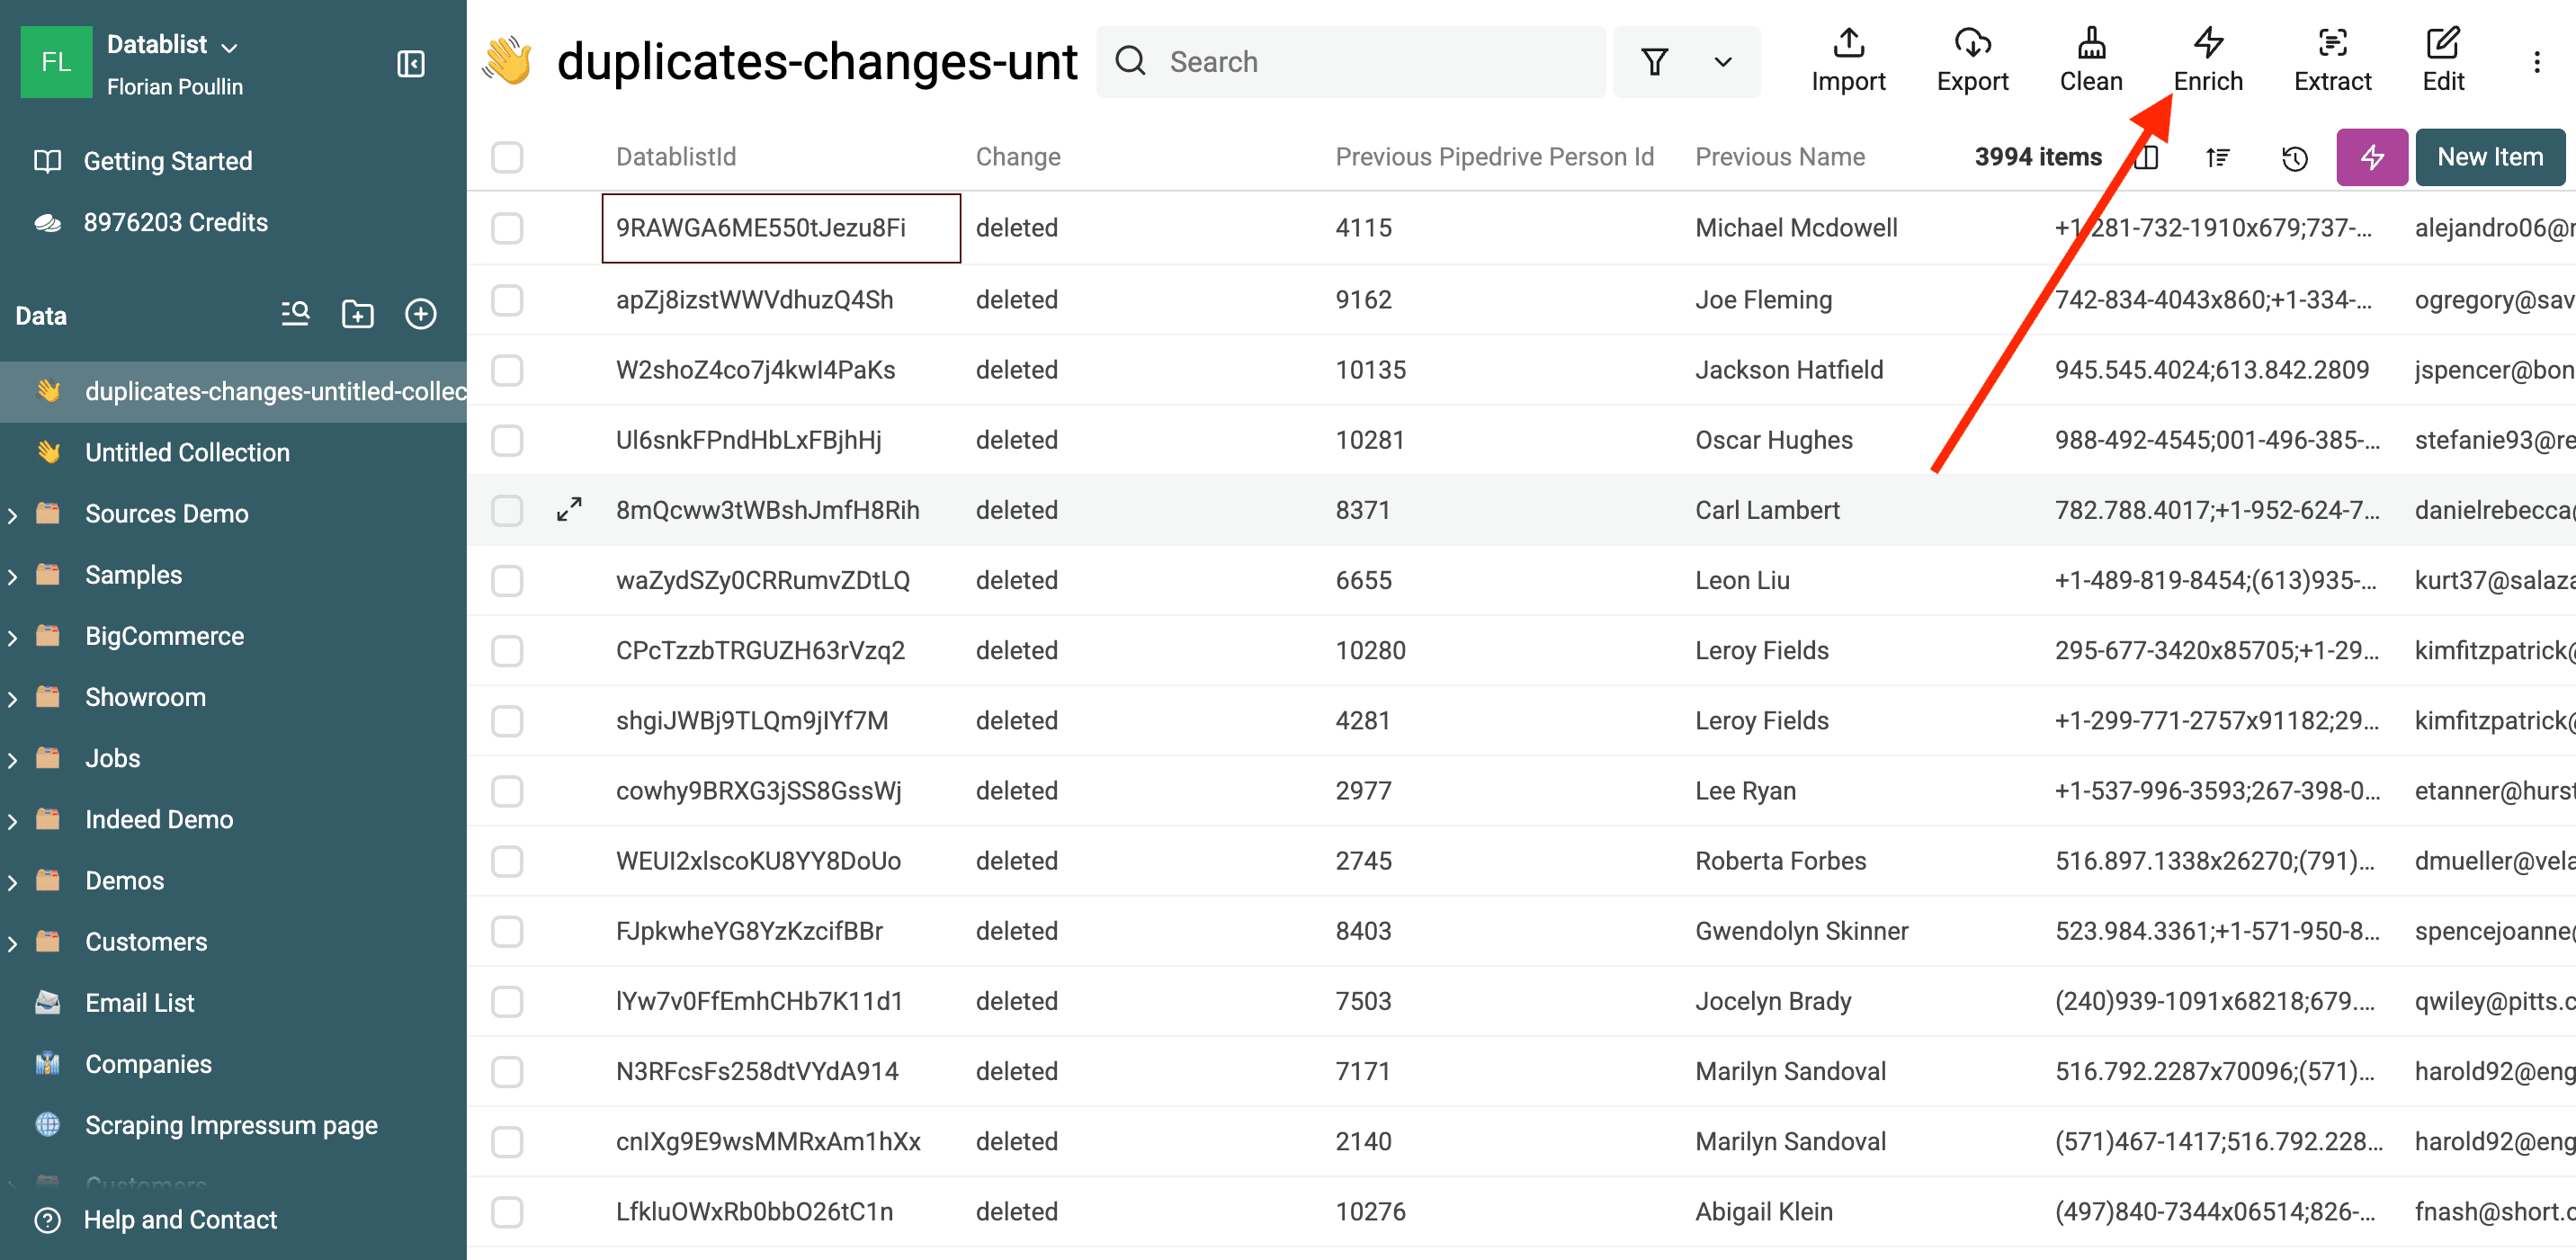
3.b. 合并并删除重复记录
要将这些变更应用到 Pipedrive,第一步是让 Pipedrive 把“deleted”记录合并到对应的“master”记录中。
Pipedrive 提供用于整合重复记录的 merge API,我们将通过它完成操作。
对于技术人员,Pipedrive API 的工作方式如下:
- Organizations 使用
/organizations/:id/mergeendpoint。 - People 使用
/persons/:id/mergeendpoint。 - 重复记录会被删除,其数据则会转移到主记录。
💡 API Request 示例:
PUT https://api.pipedrive.com/v1/persons/{duplicate_id}/merge?api_token=YOUR_API_KEY
{
  "merge_with_id": "{master_record_id}"
}
🔹 为什么使用 Merge API?
- 它能确保所有关联的 Deals、Activities 和 Notes 继续保留在主记录下。
- 没有冲突的数据,例如额外的 Phone 或 Email,会被自动保留。
不用担心——Datablist 提供原生 enrichment,可以代你调用这个 Pipedrive endpoint。
首先,只选择 change operation 为 deleted 的条目。
然后,在 Enrich 菜单中选择 Pipedrive Merge Duplicates。
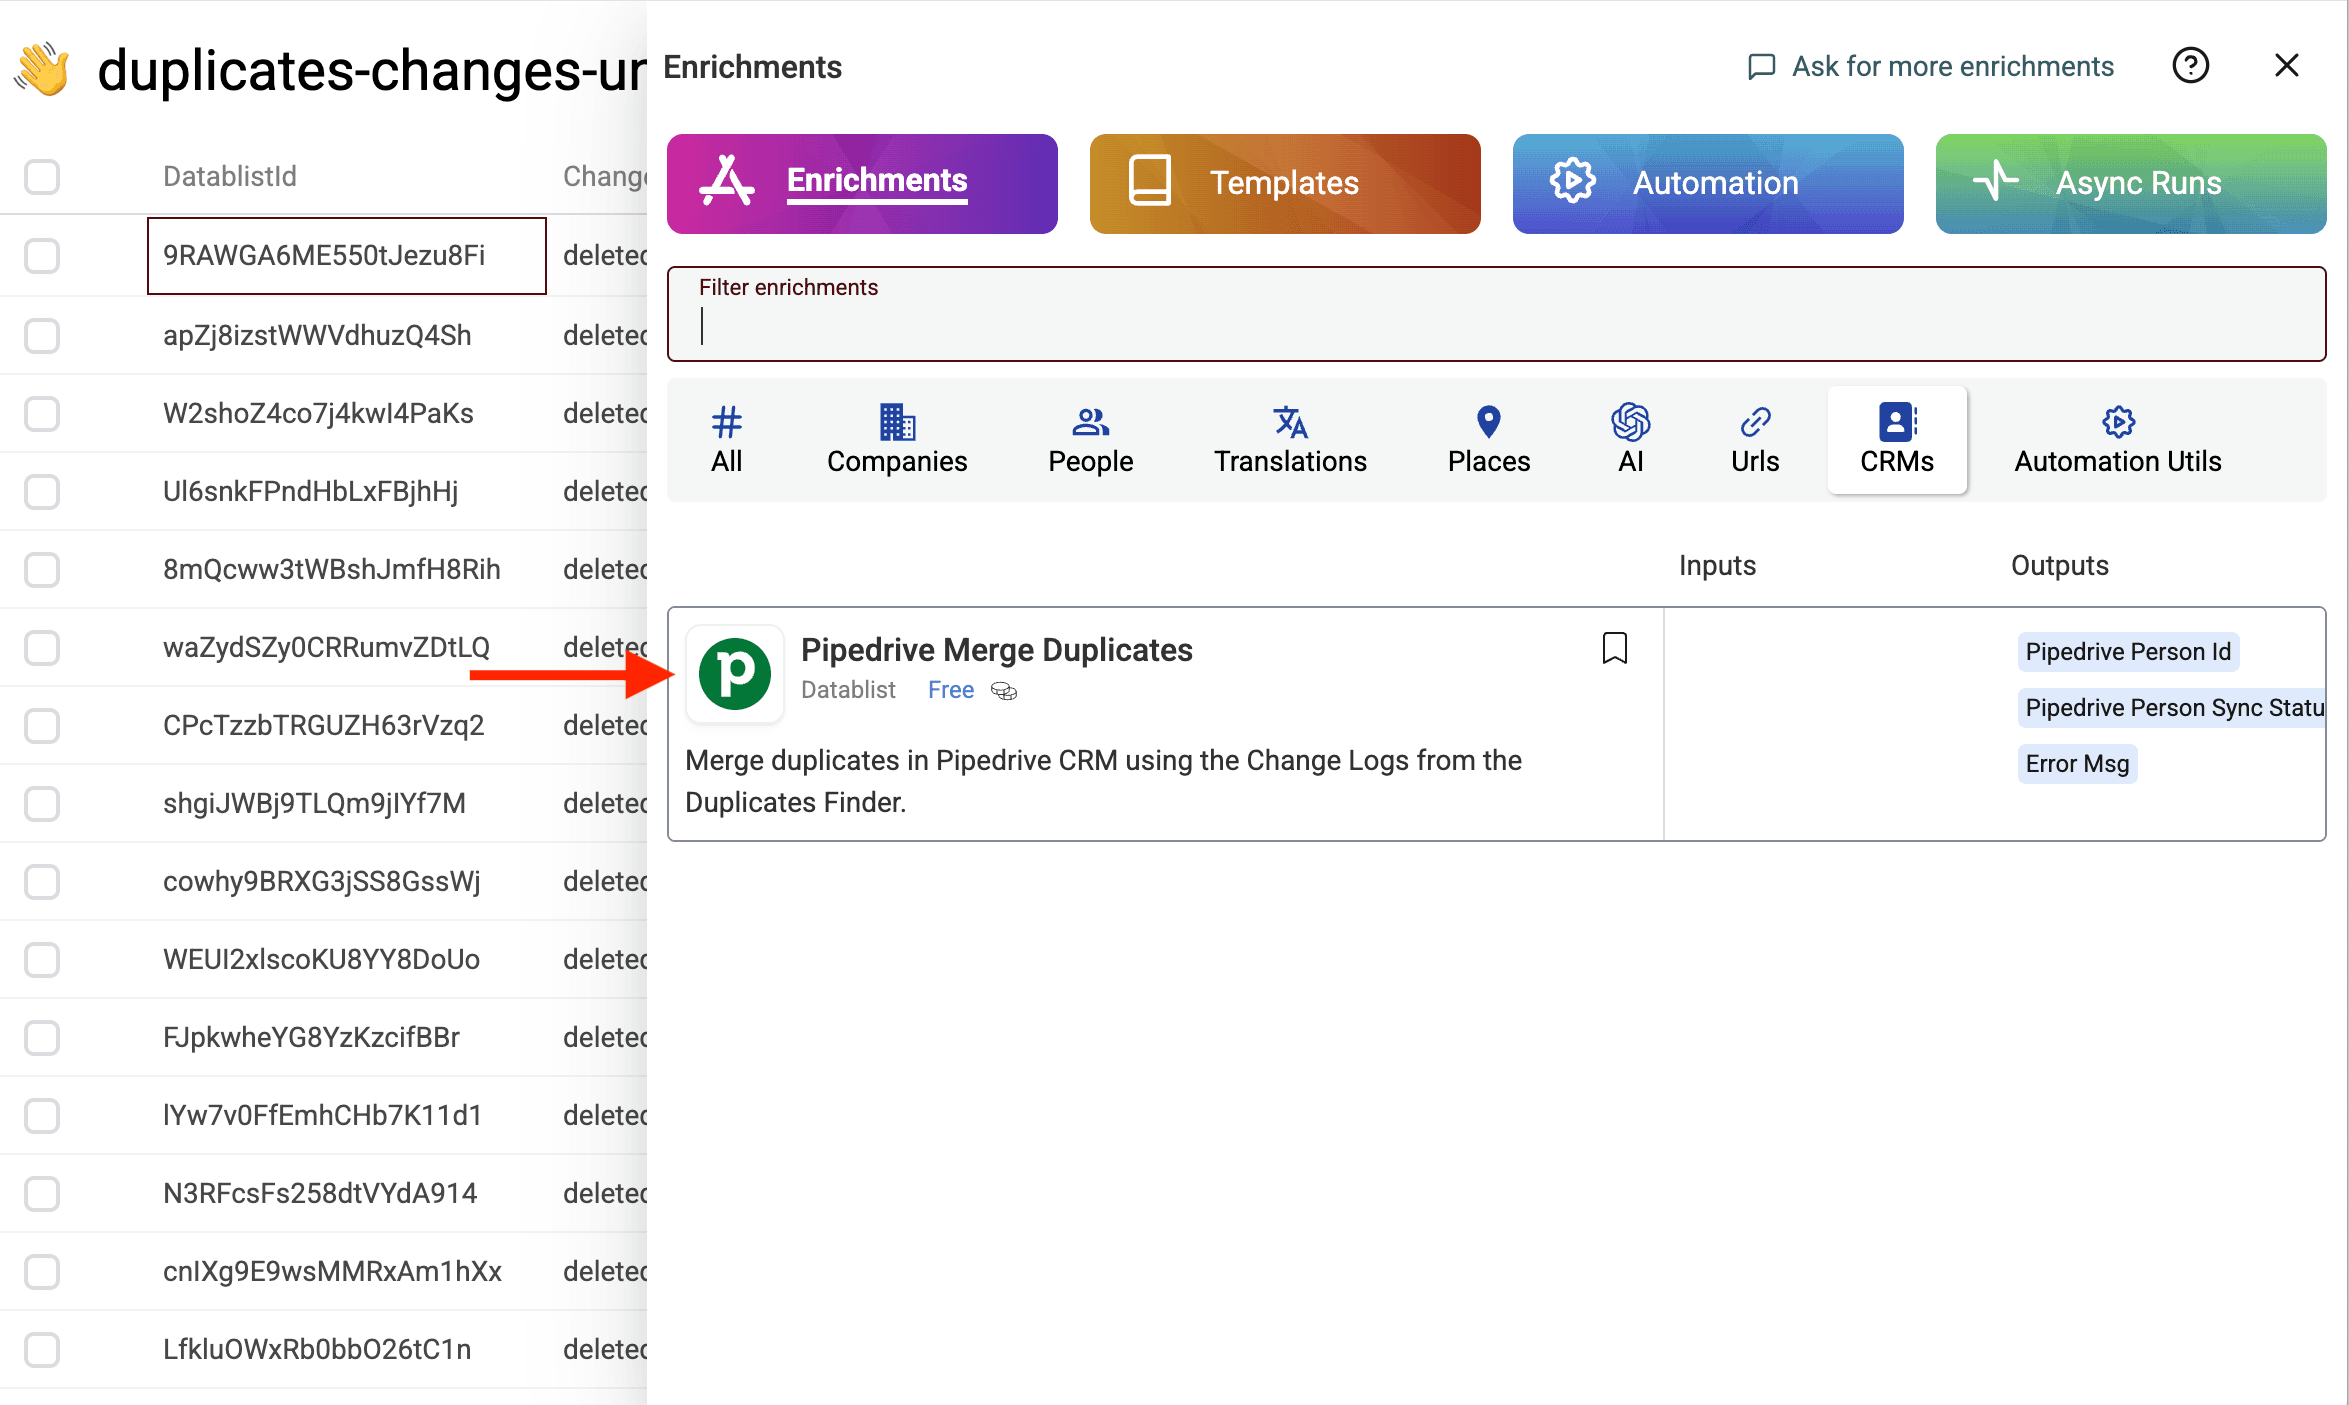
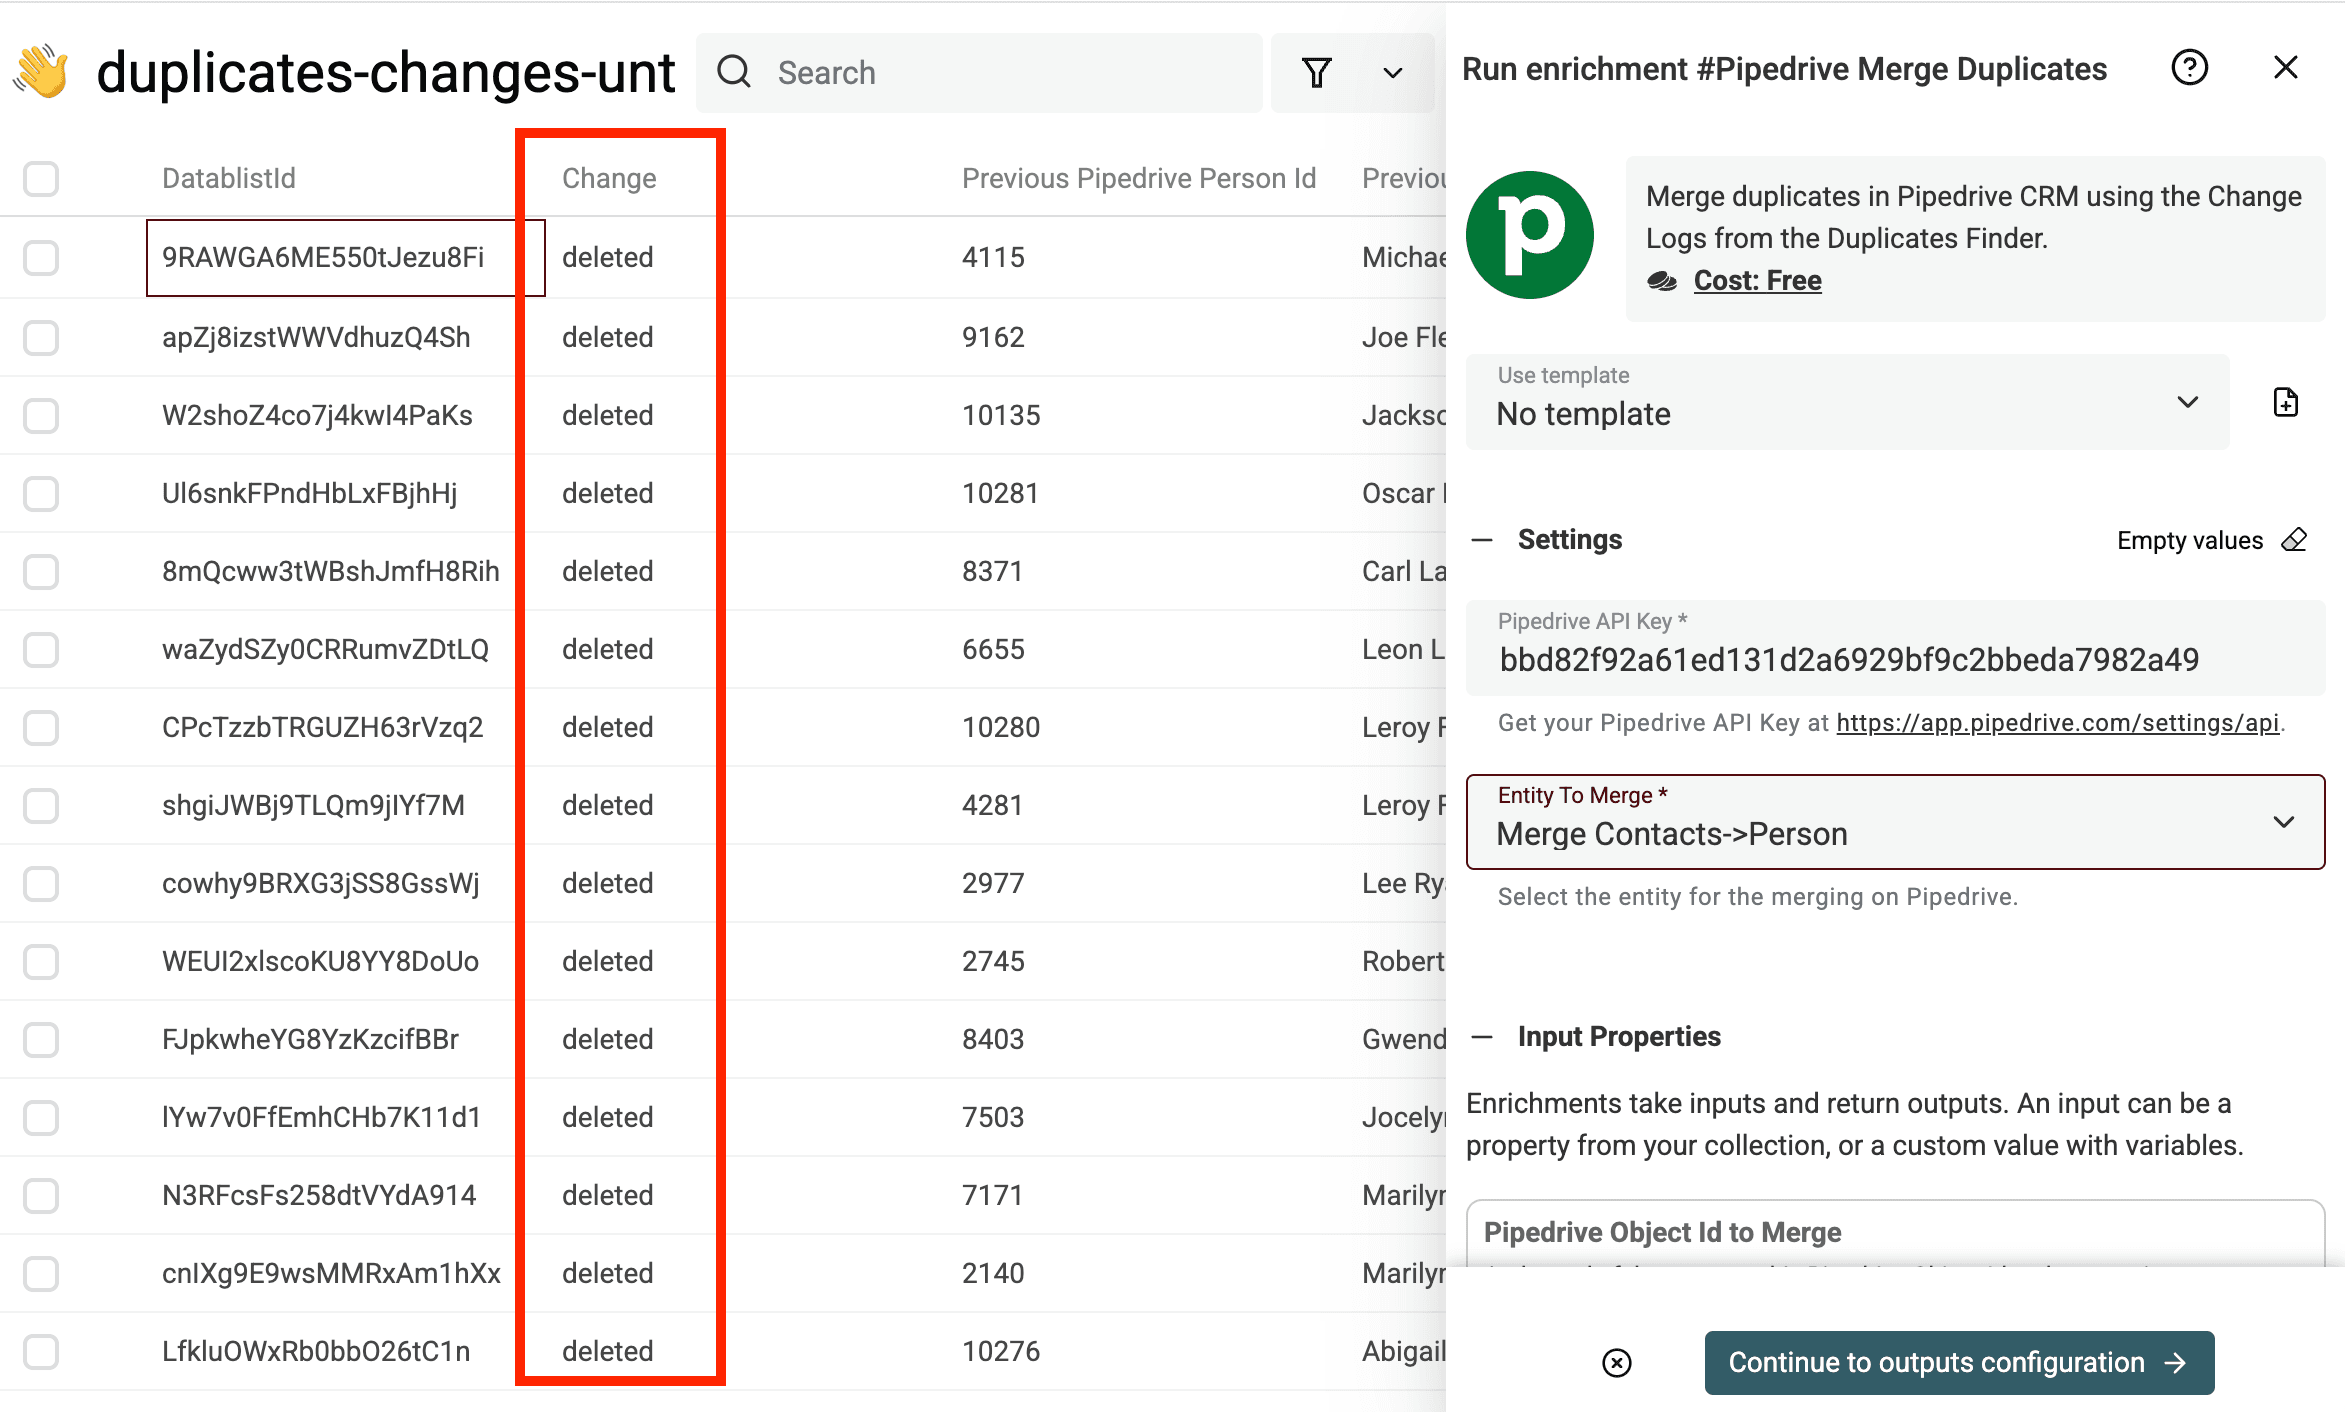
运行 Pipedrive Merge Duplicates enrichment 前,请确认 change 列中只显示“deleted”。
输入 Pipedrive API Key,并配置要合并的 Pipedrive entity。
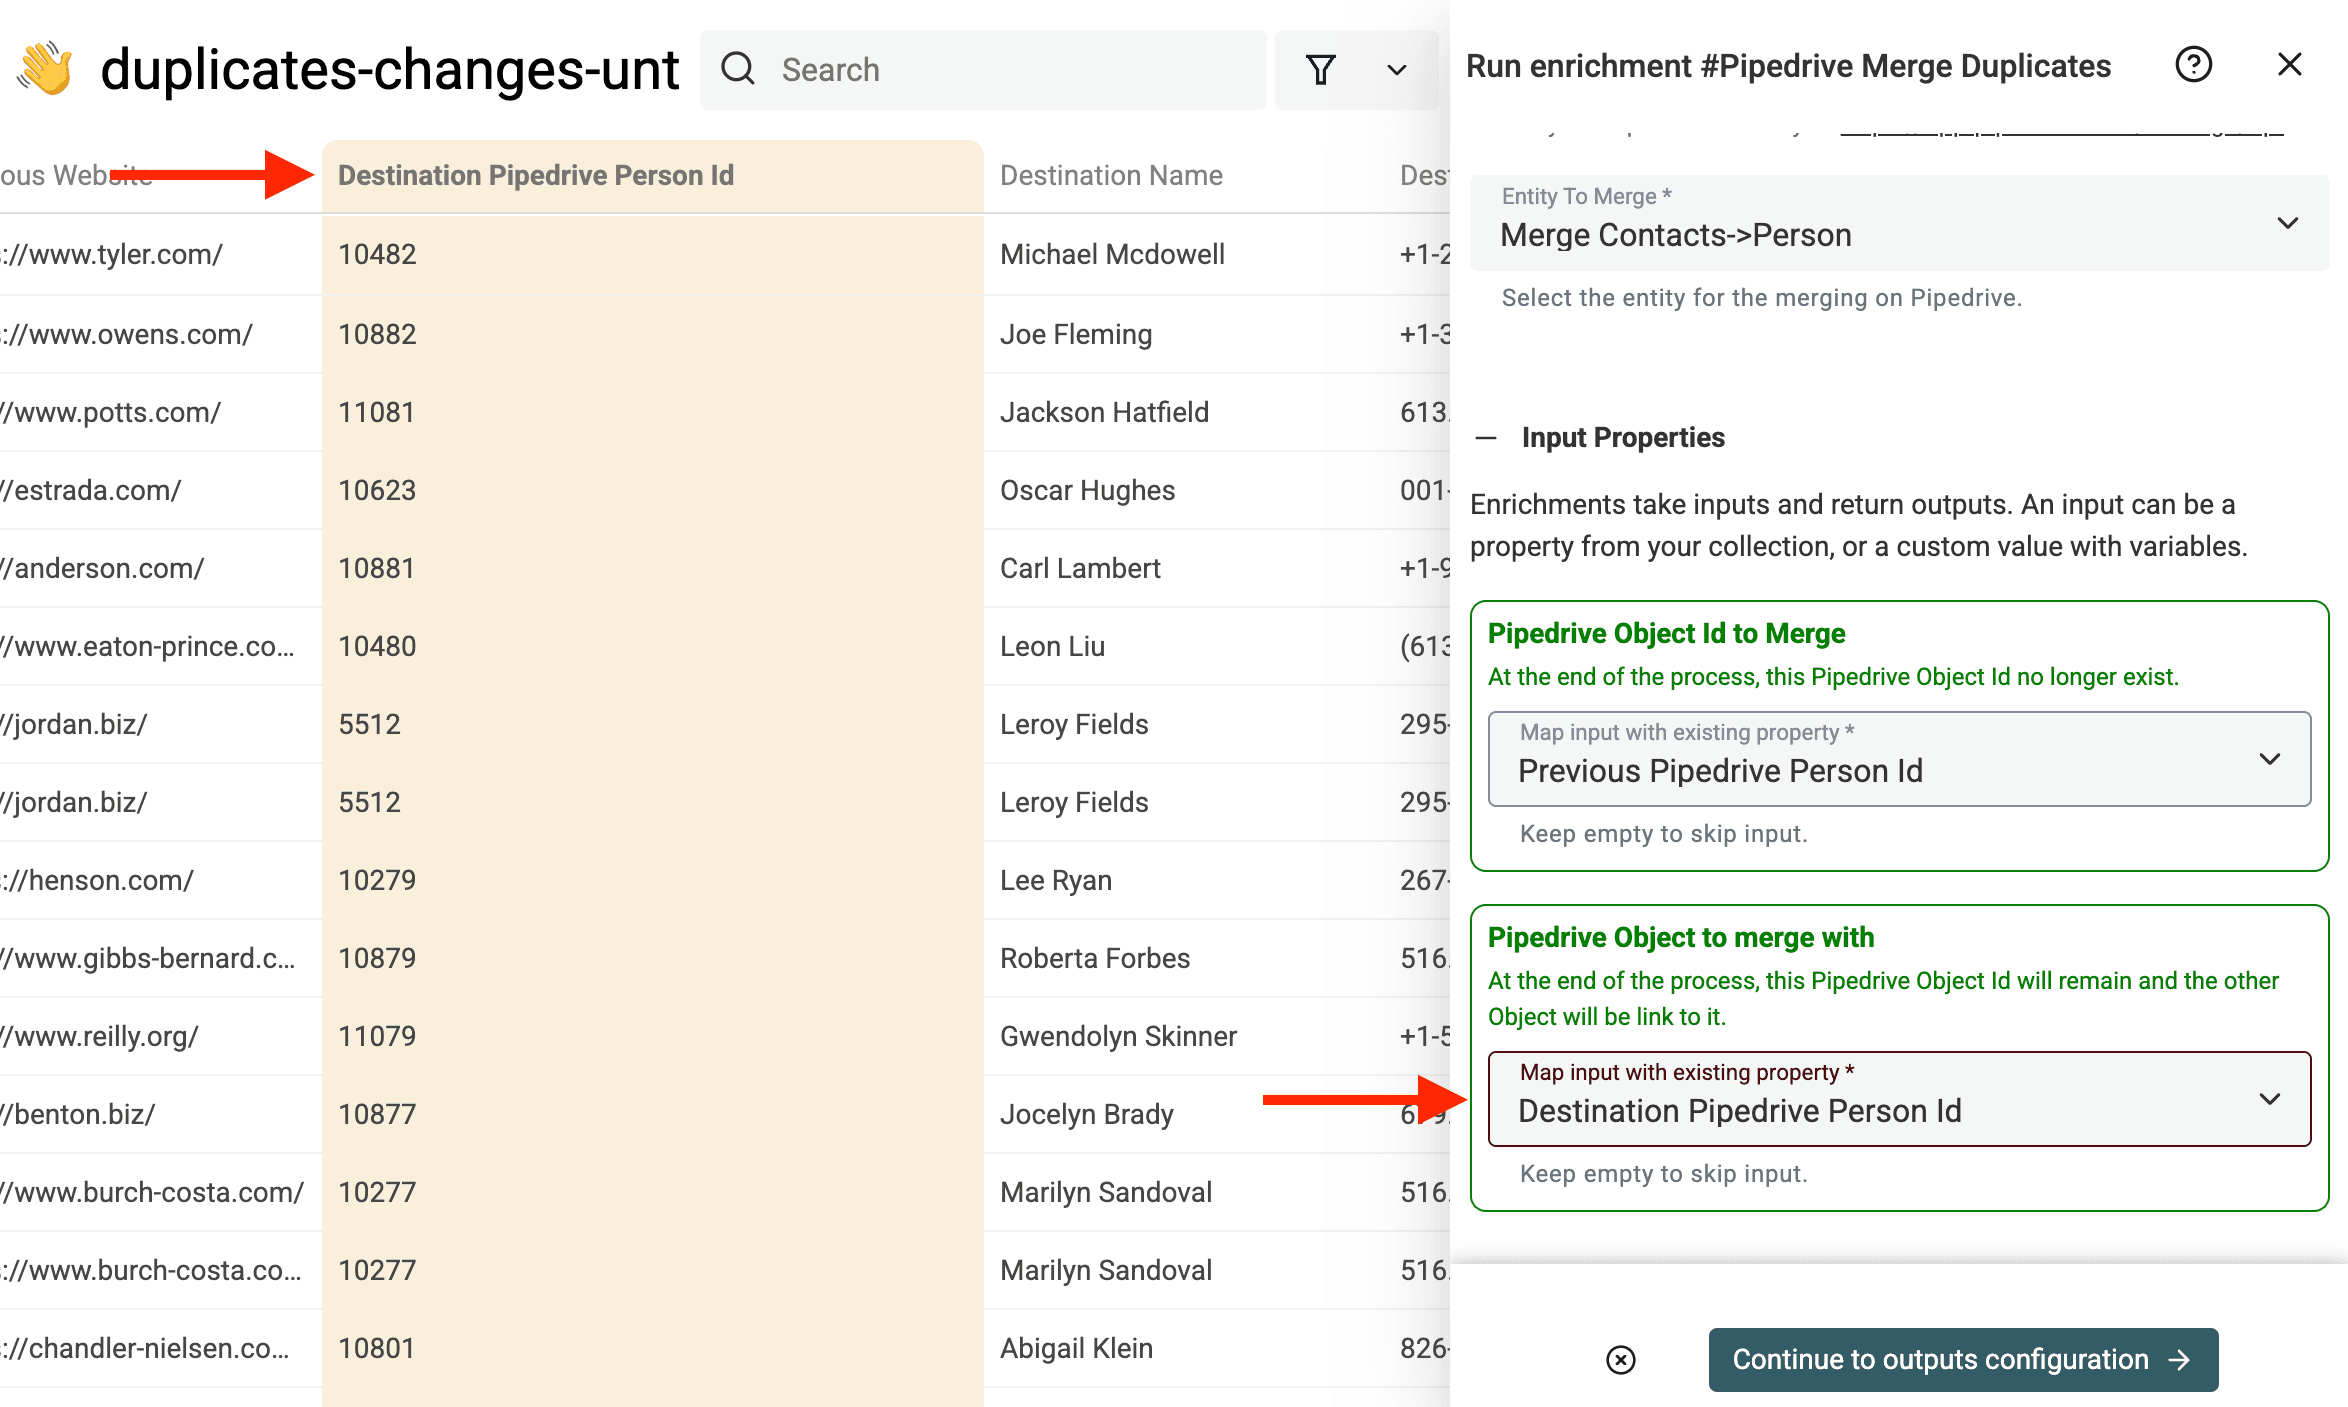
接着,在 Inputs 中,将 Pipedrive Object Id to Merge 映射到 Previous Pipedrive Person Id 字段。
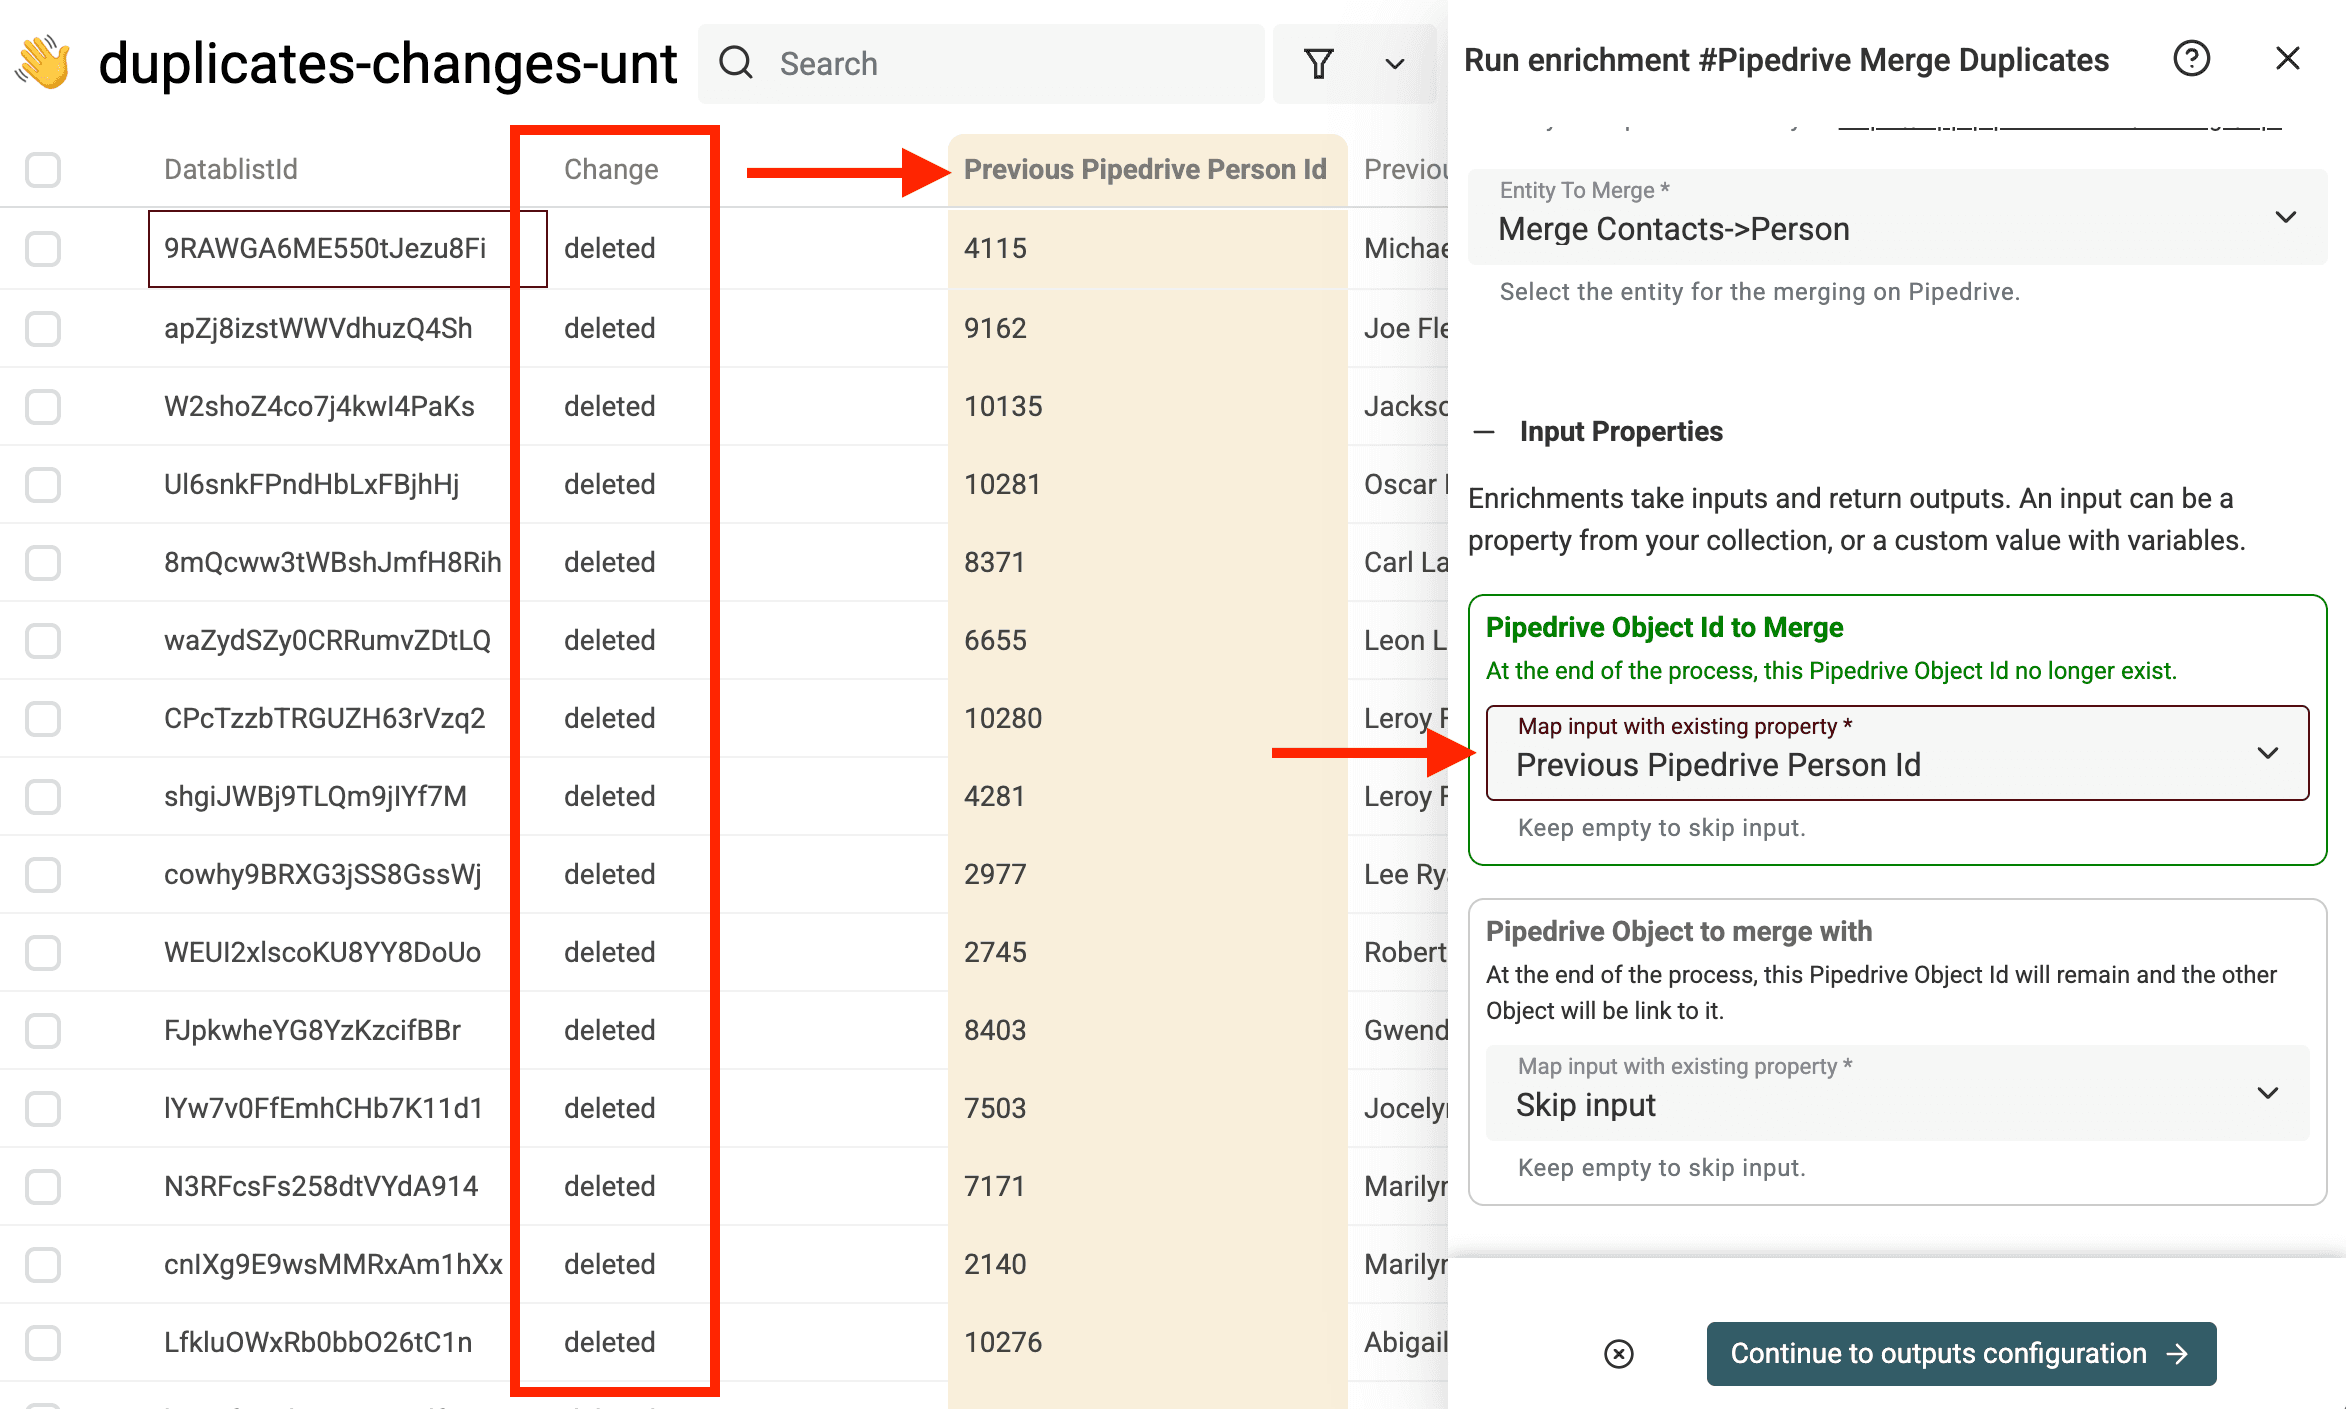
对于 Pipedrive Object to merge with,将其映射到 Destination Pipedrive Person Id 字段。
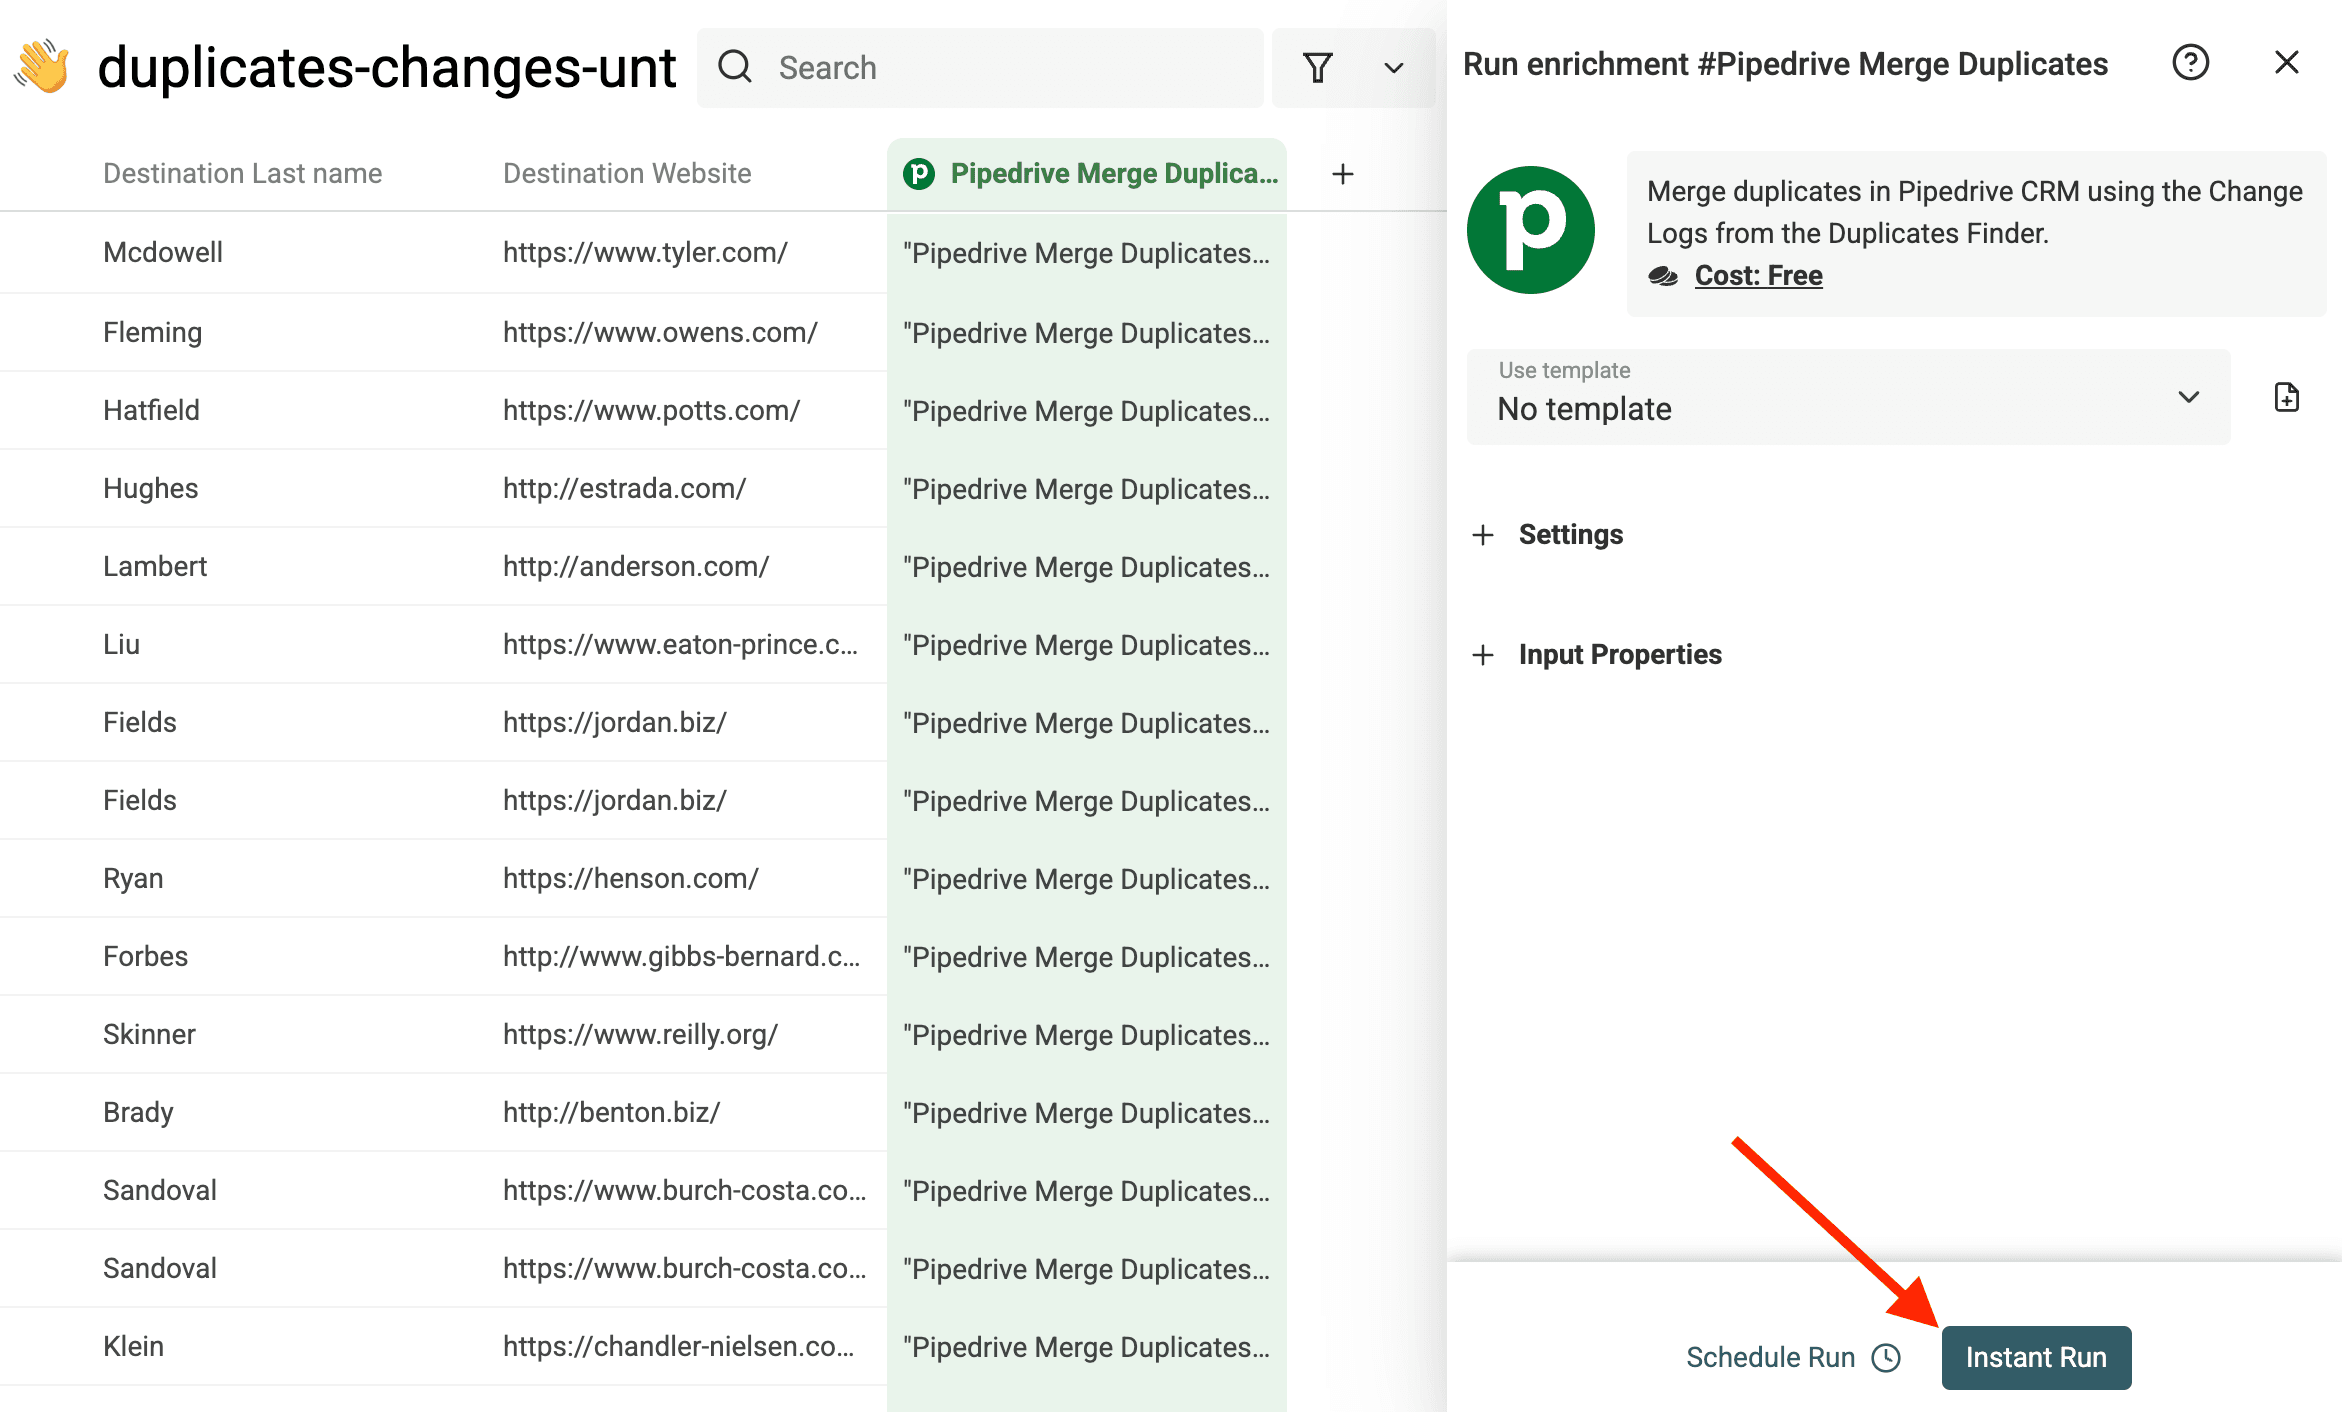
然后,启动合并流程。
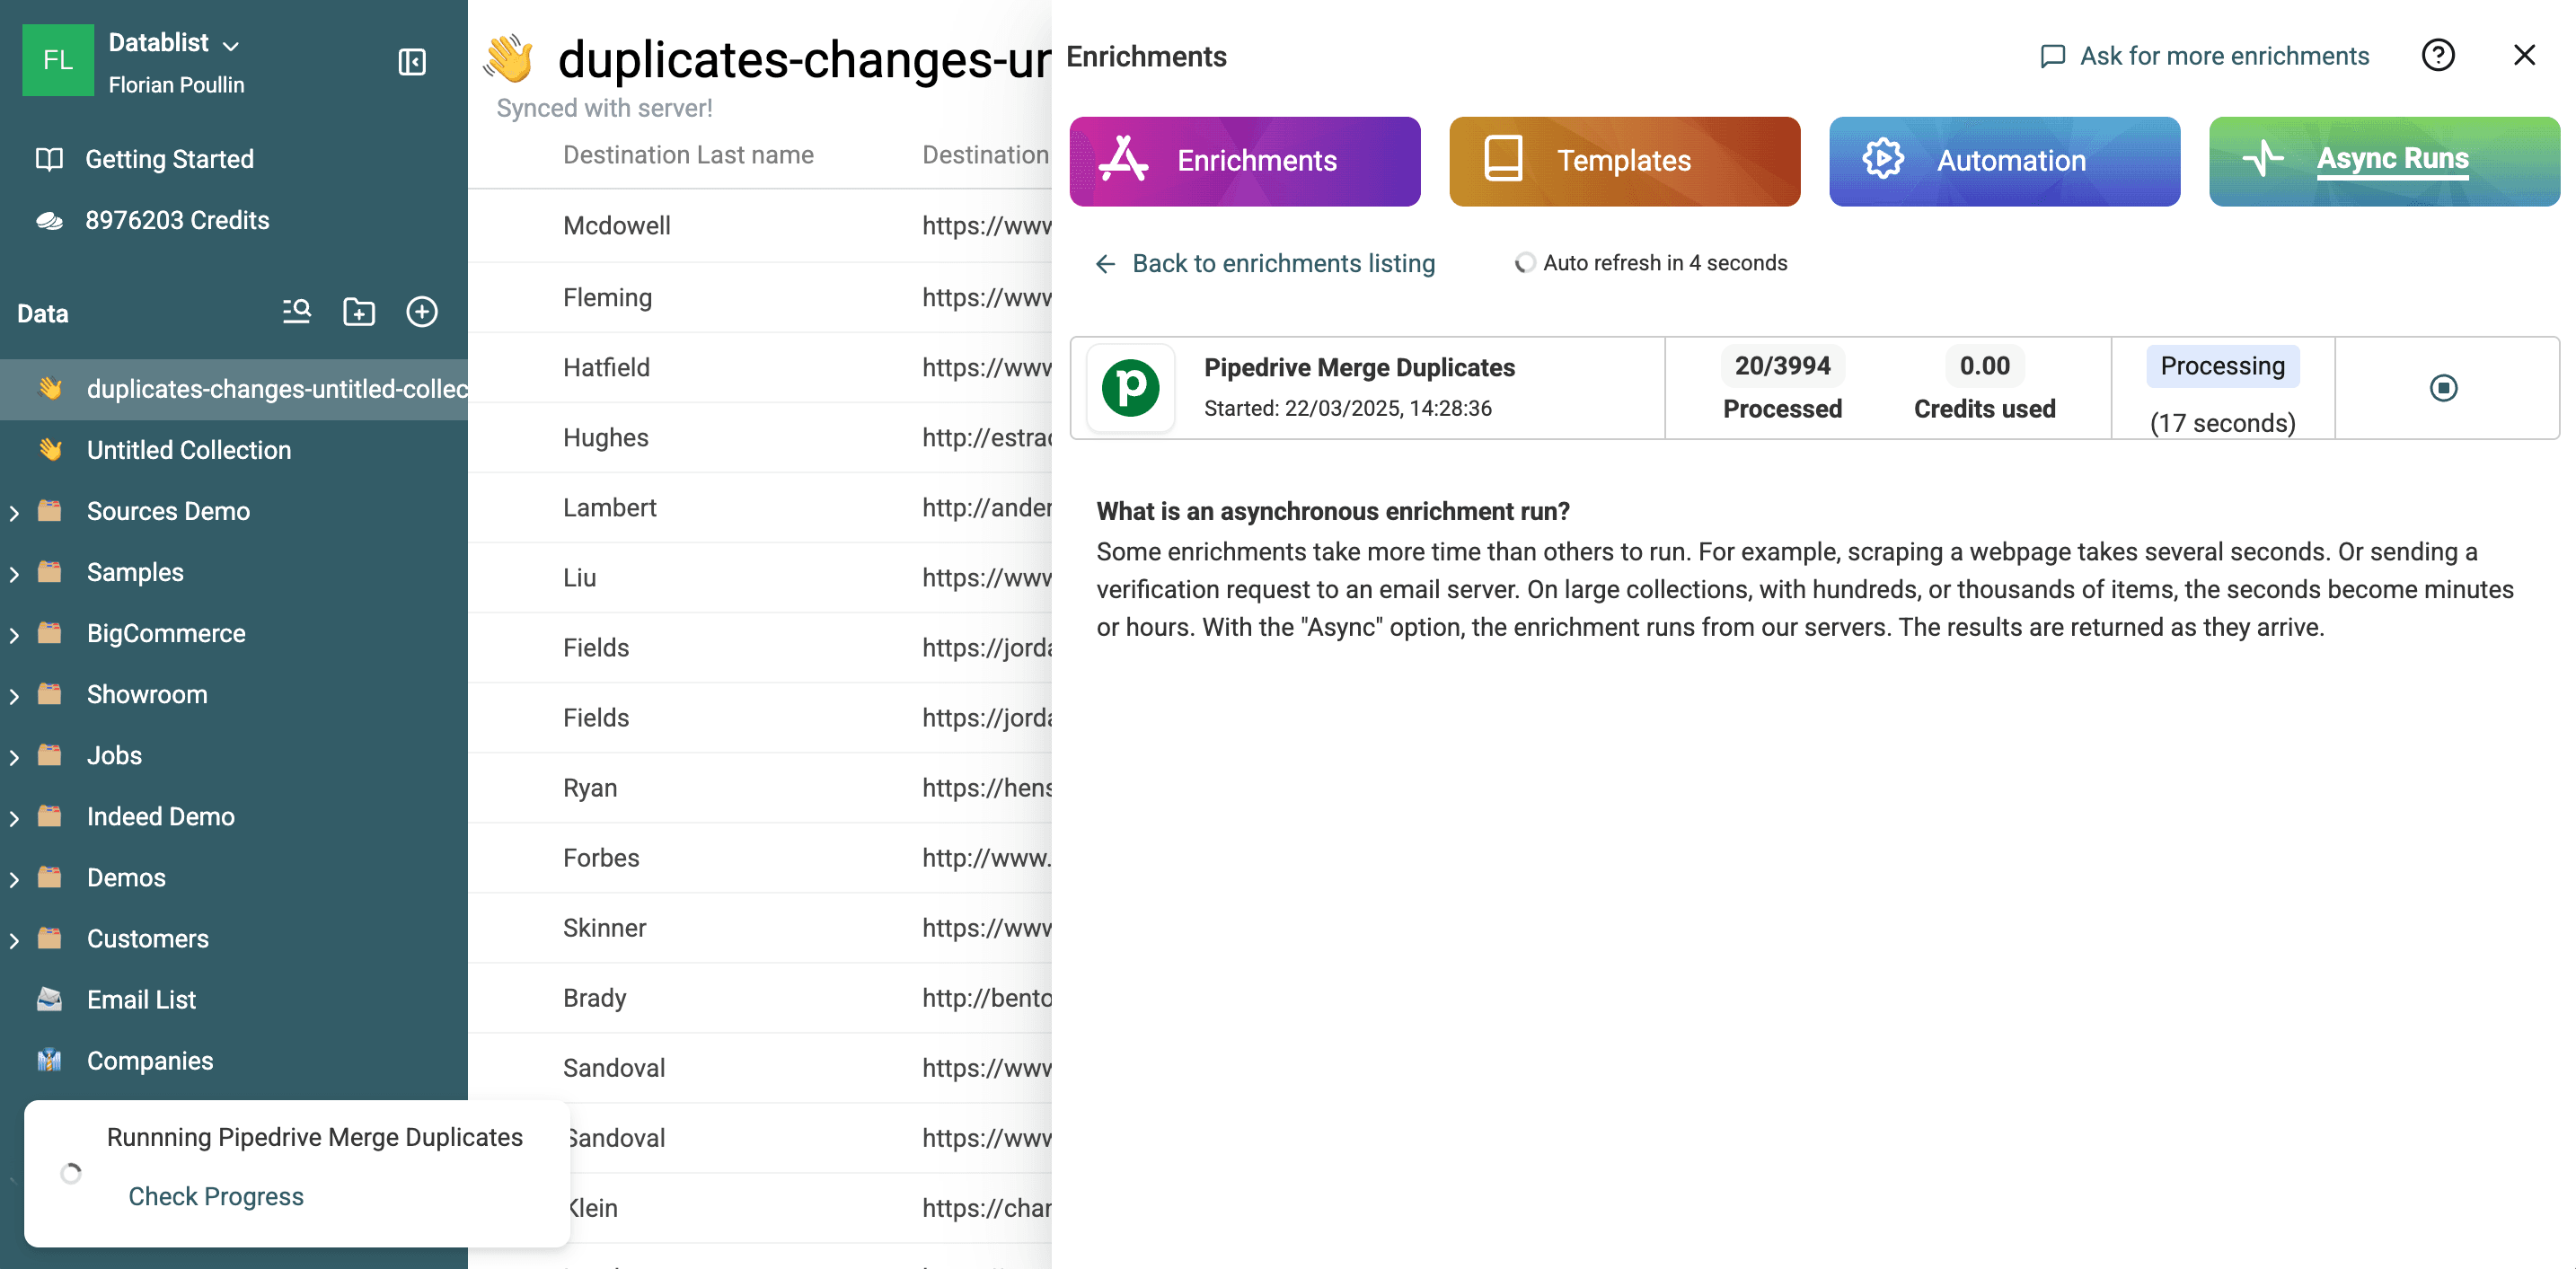
你可以直接在 Datablist 中查看进度。
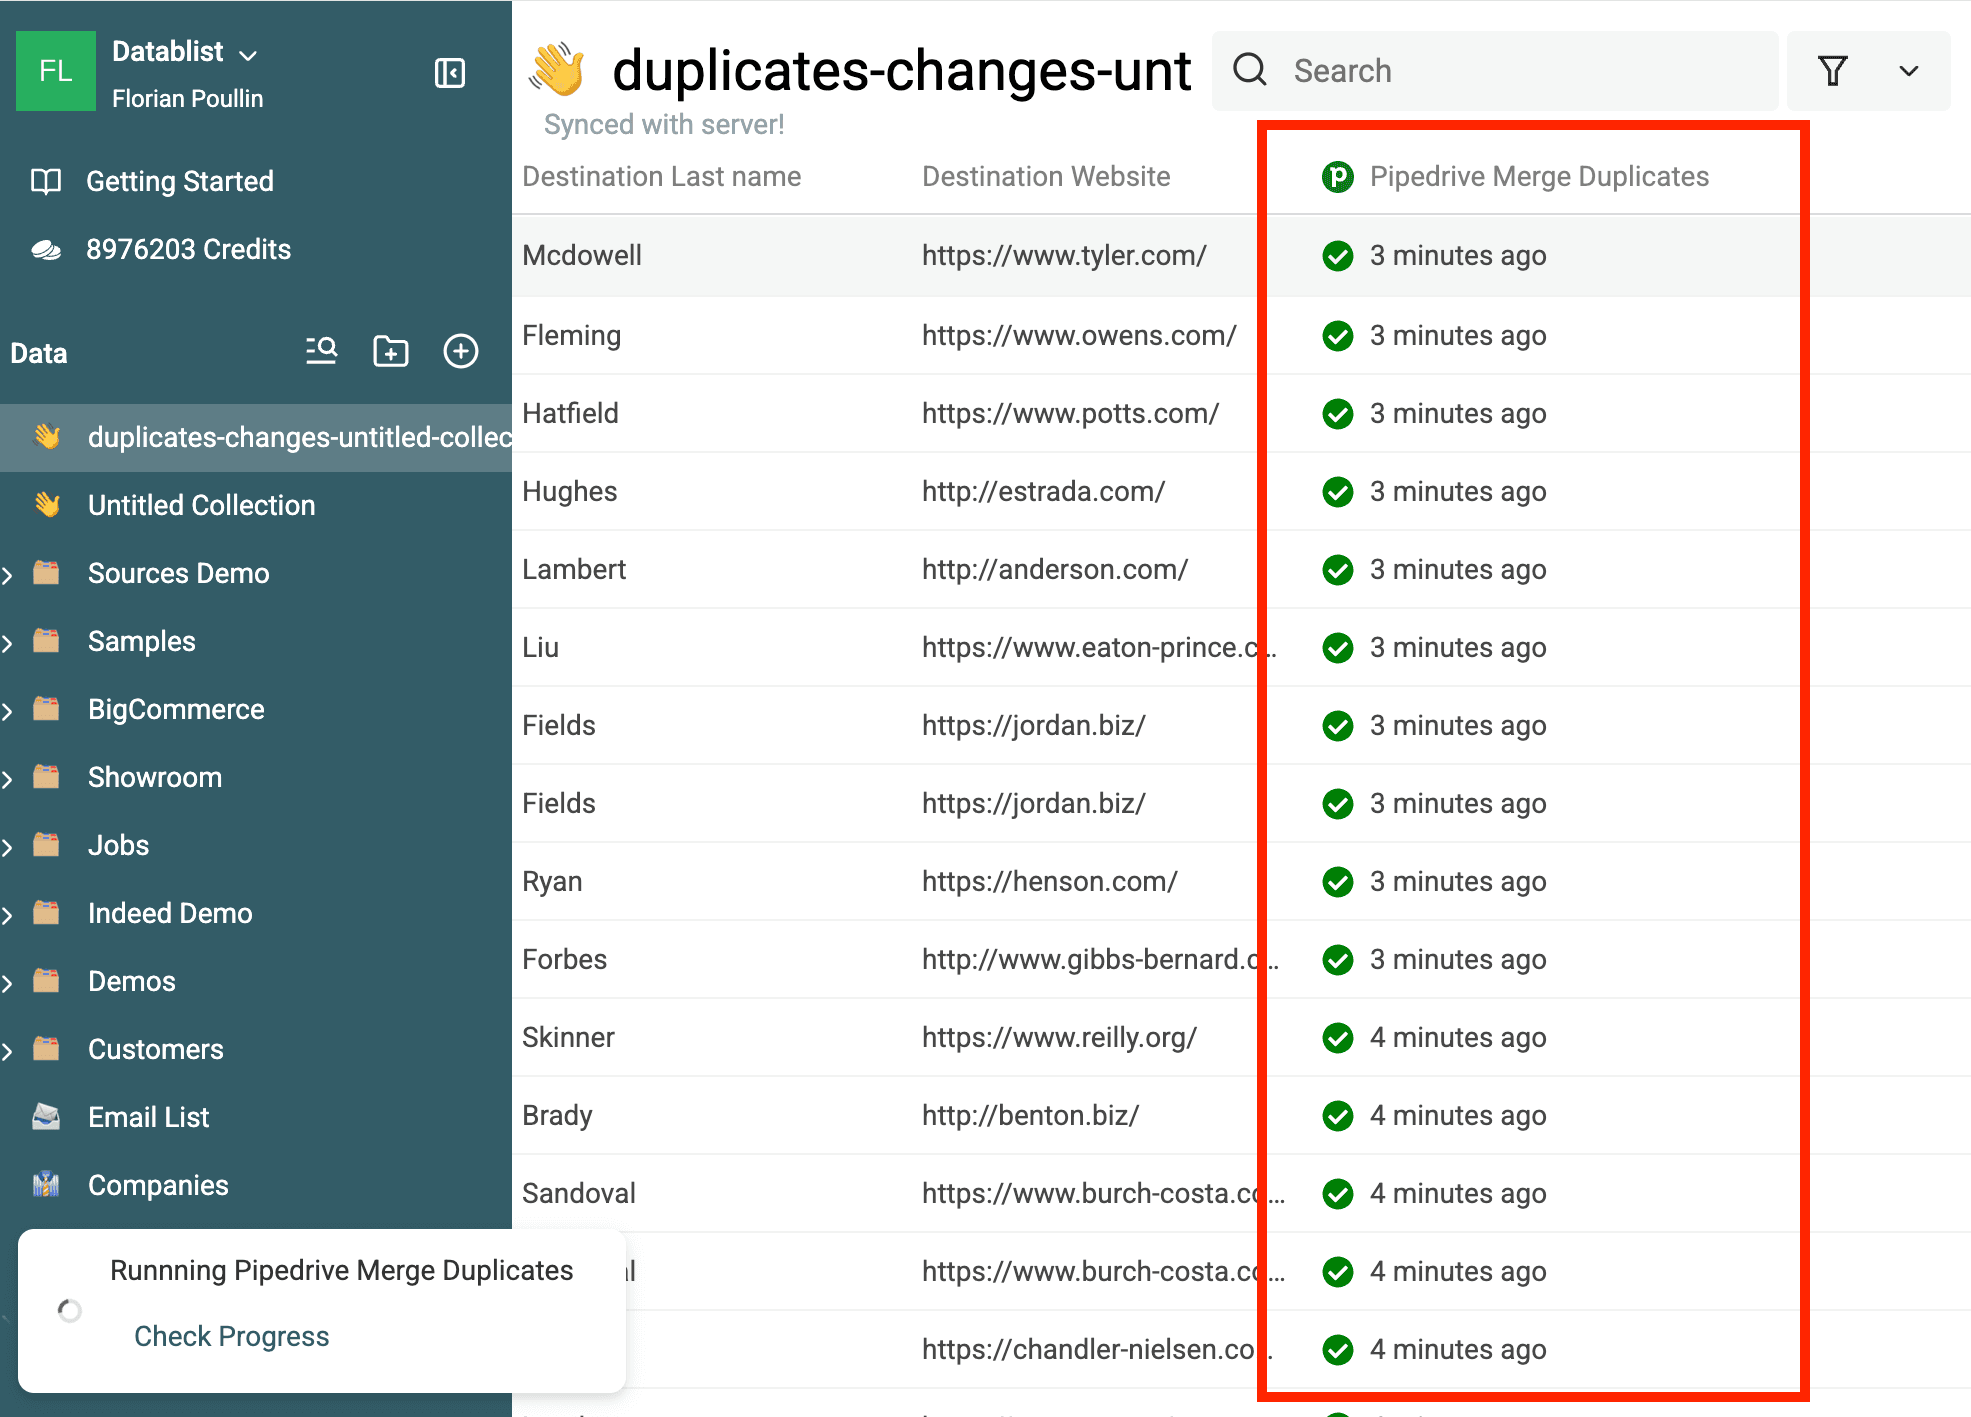
collection 中的每一行都会显示对应的合并状态。
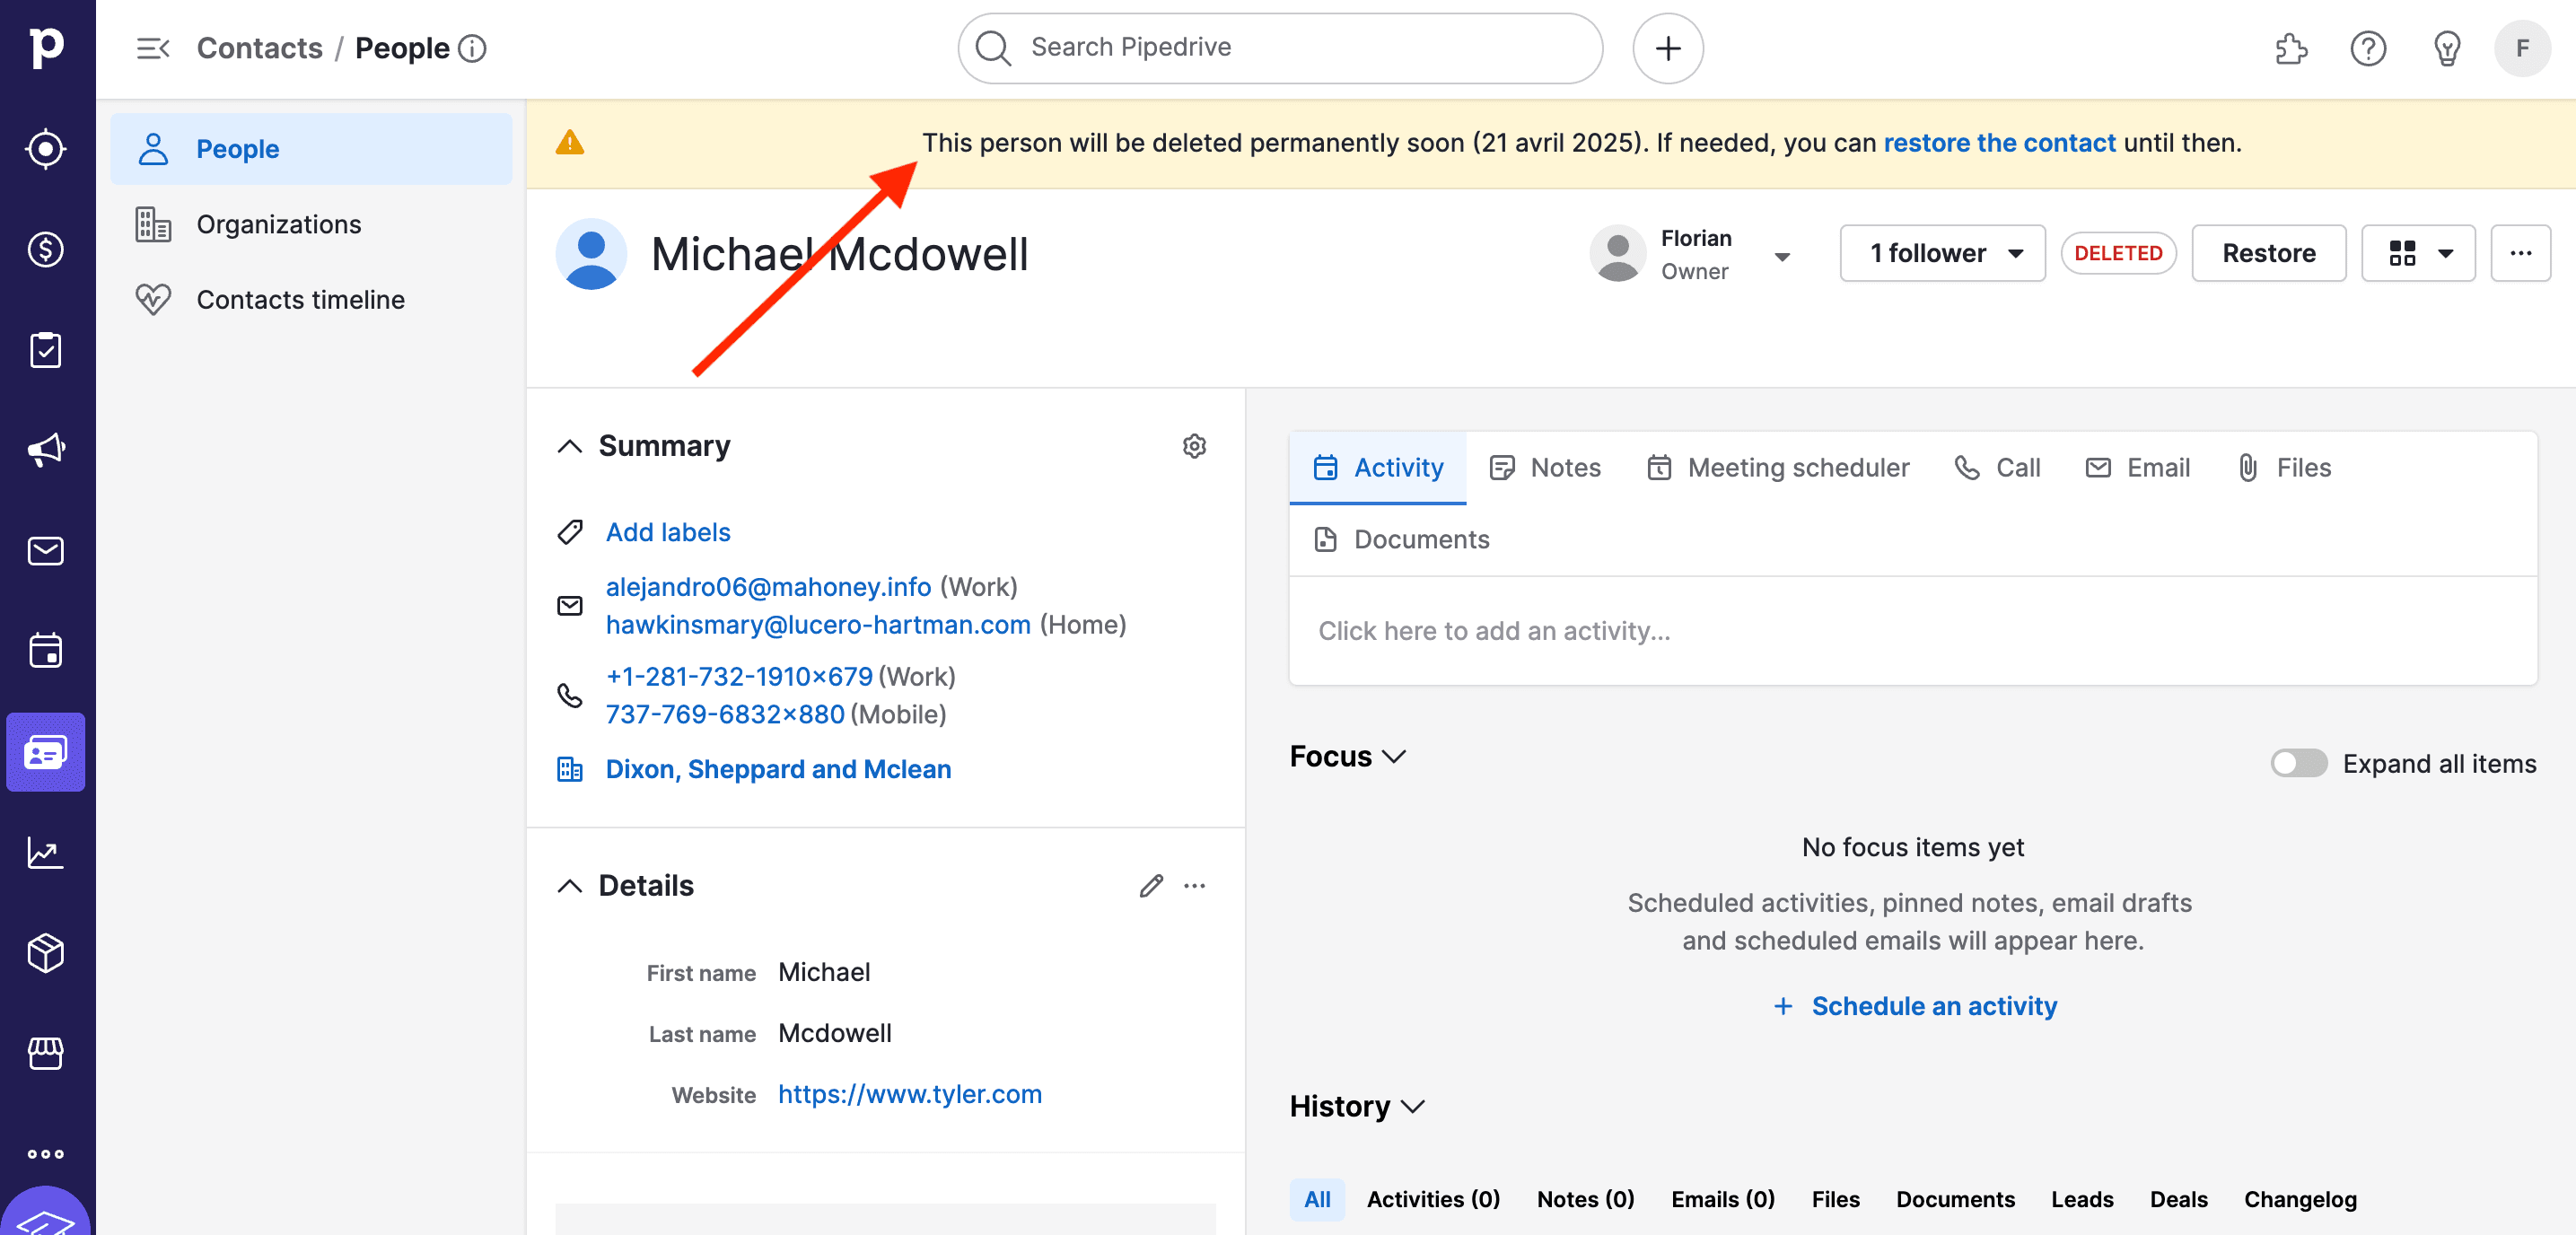
你可以检查即将在 Pipedrive 中删除的记录。打开该记录(对于 People,URL 为 https://app.pipedrive.com/person/:ID),页面顶部会显示一条提示信息。
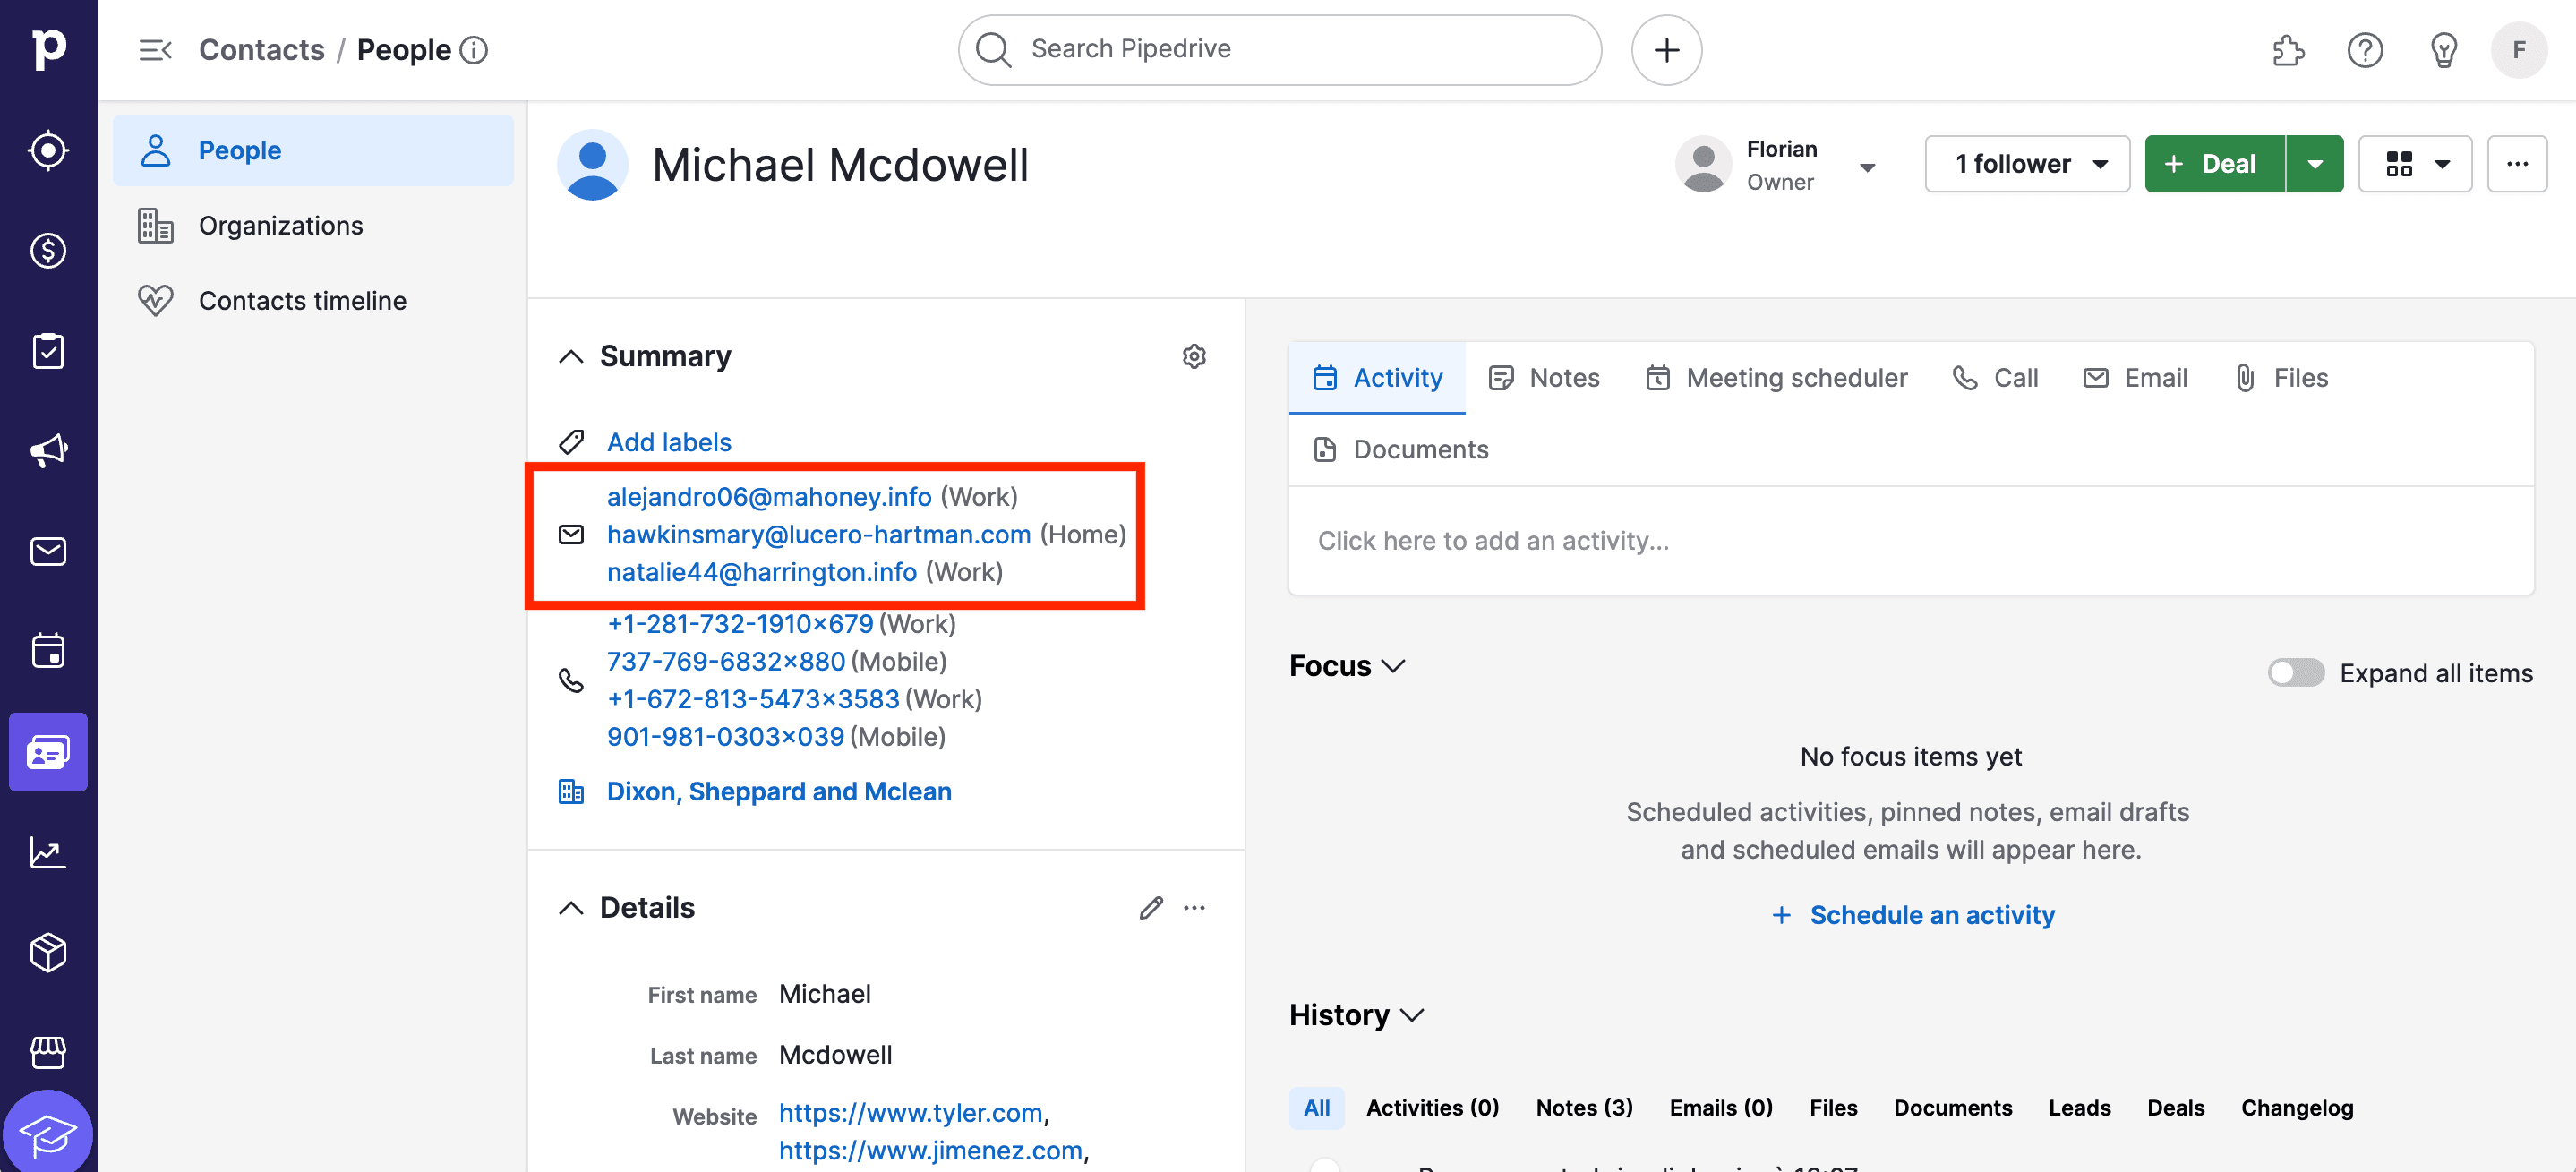
在主记录中,你也会看到合并后的数据。
3.c. 在 Pipedrive 中同步已更新记录
在上一步中,我们使用 Pipedrive merge API 将重复记录合并到了主记录。
但在合并过程中,Pipedrive 会把重复记录中的值添加到主记录中,因此最终可能出现多个相似的 Website 等数据。
为了解决这个问题,我们会使用 Datablist 合并后得到的干净数据,更新剩余的主记录。
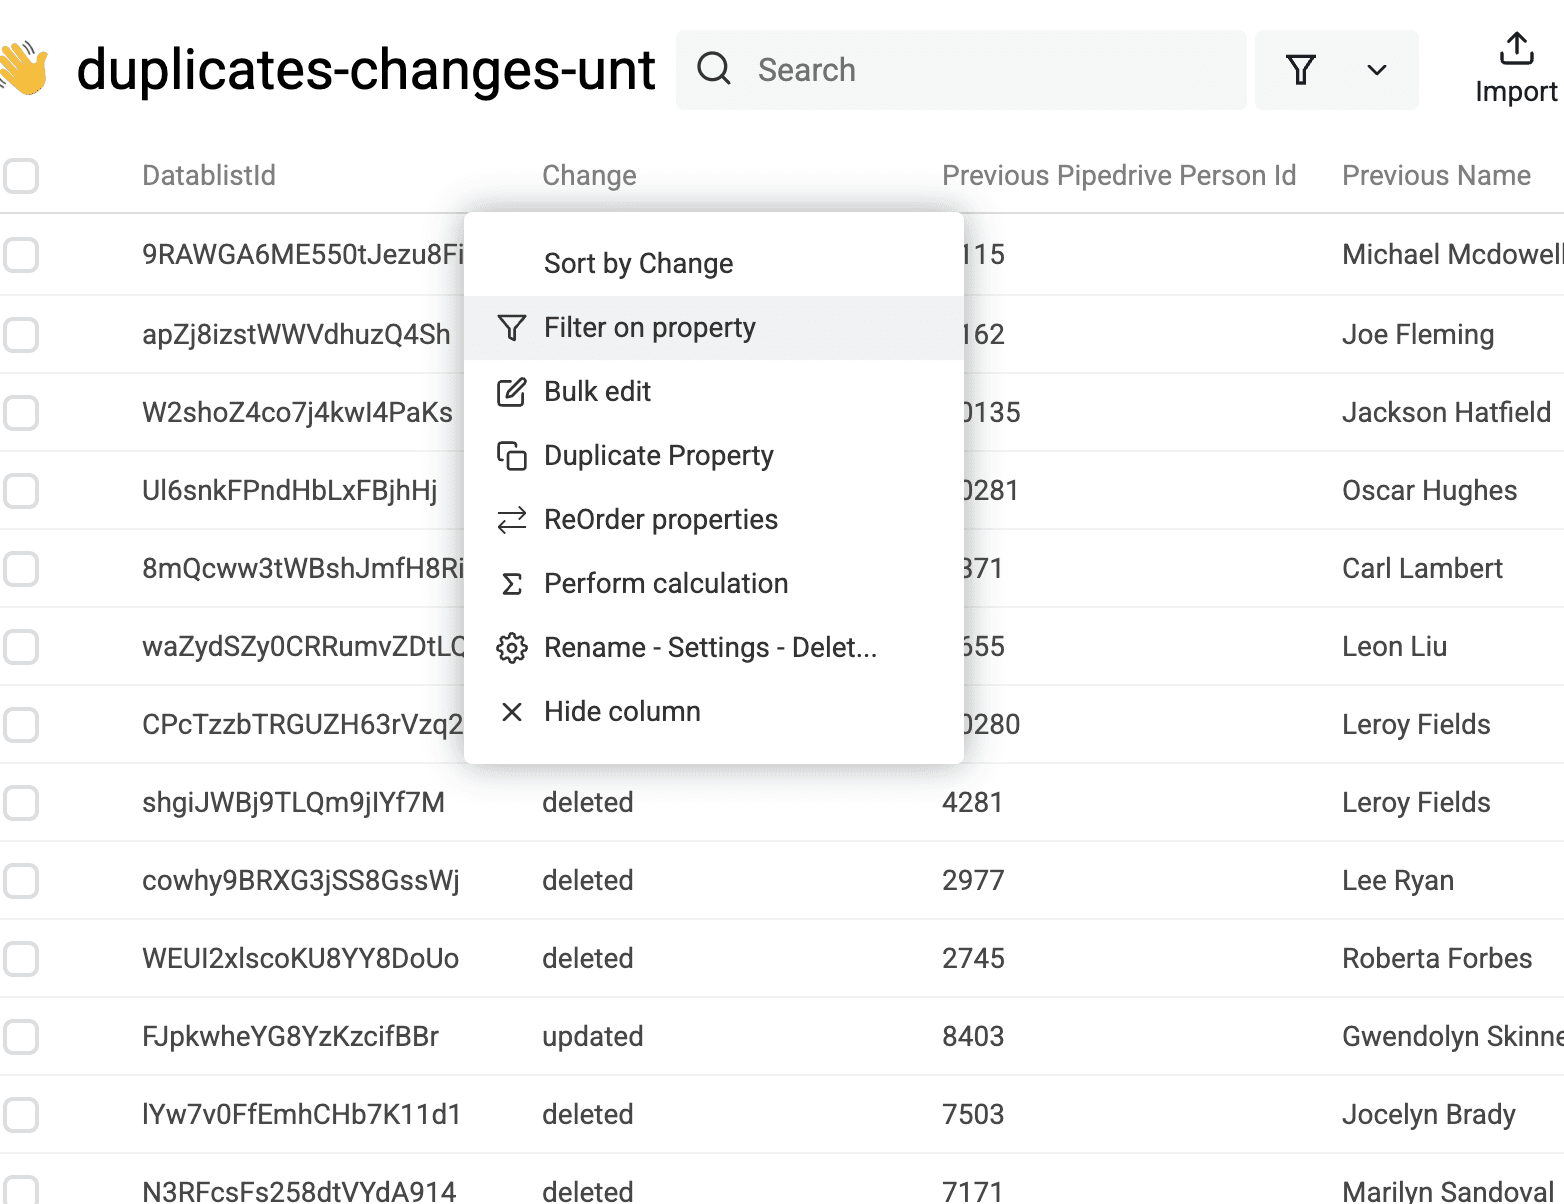
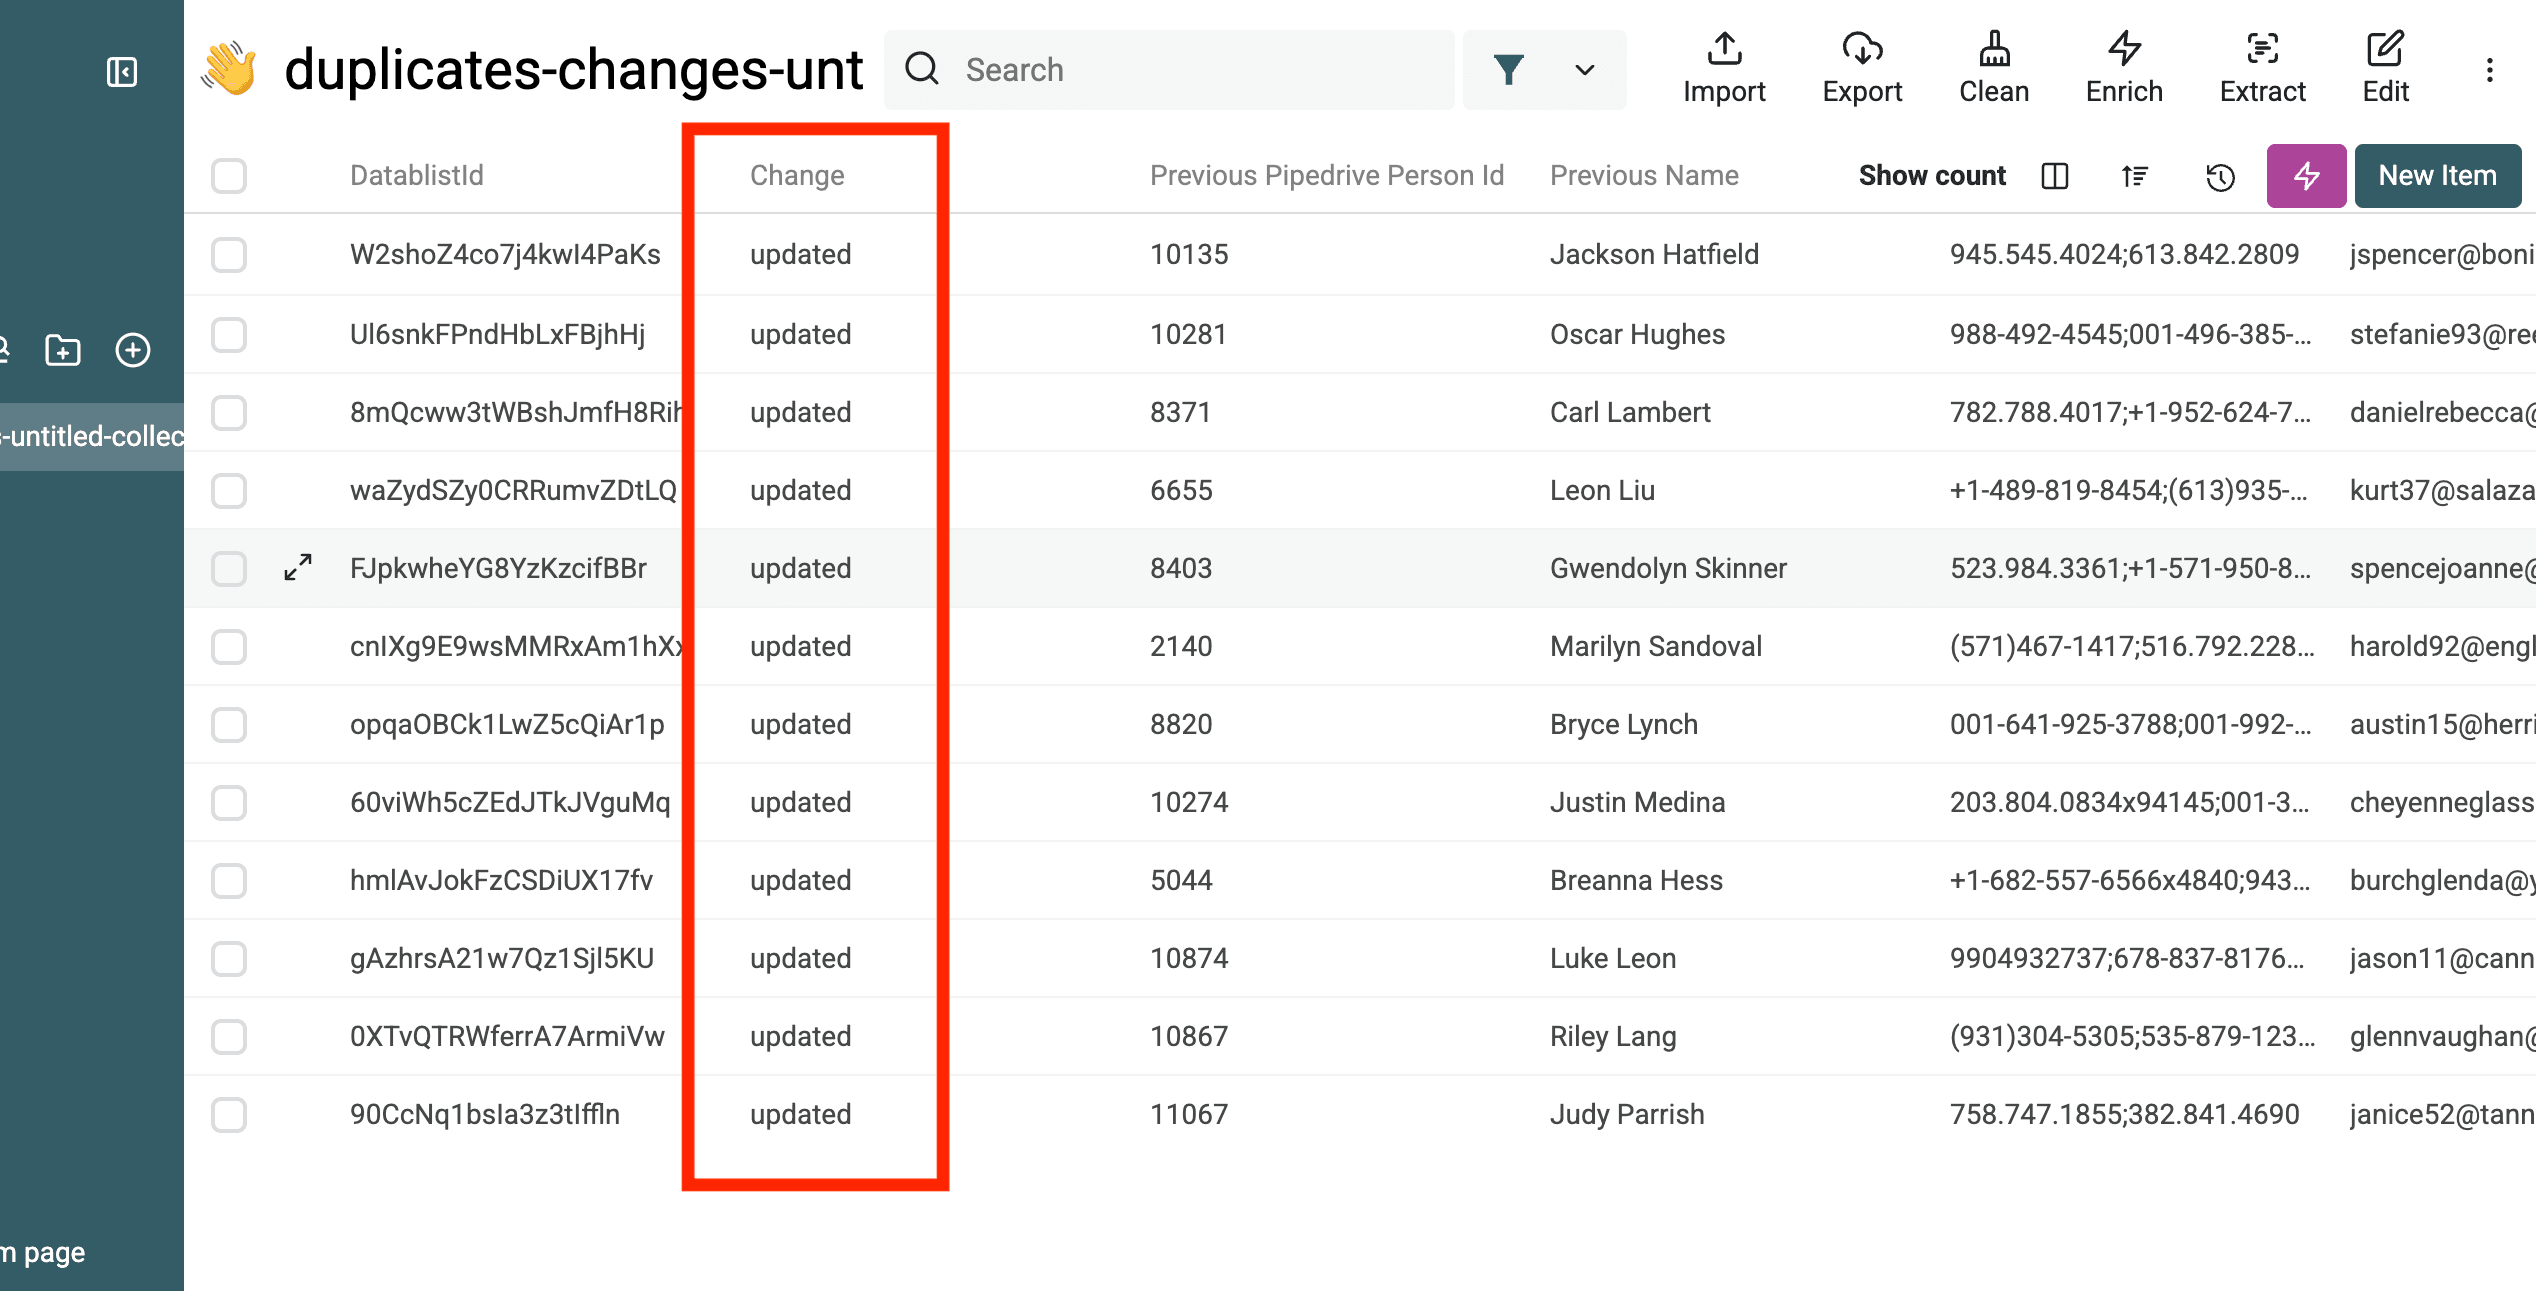
在同一个“Changes File”collection 中,对 change 列进行筛选,只显示 updated operation。
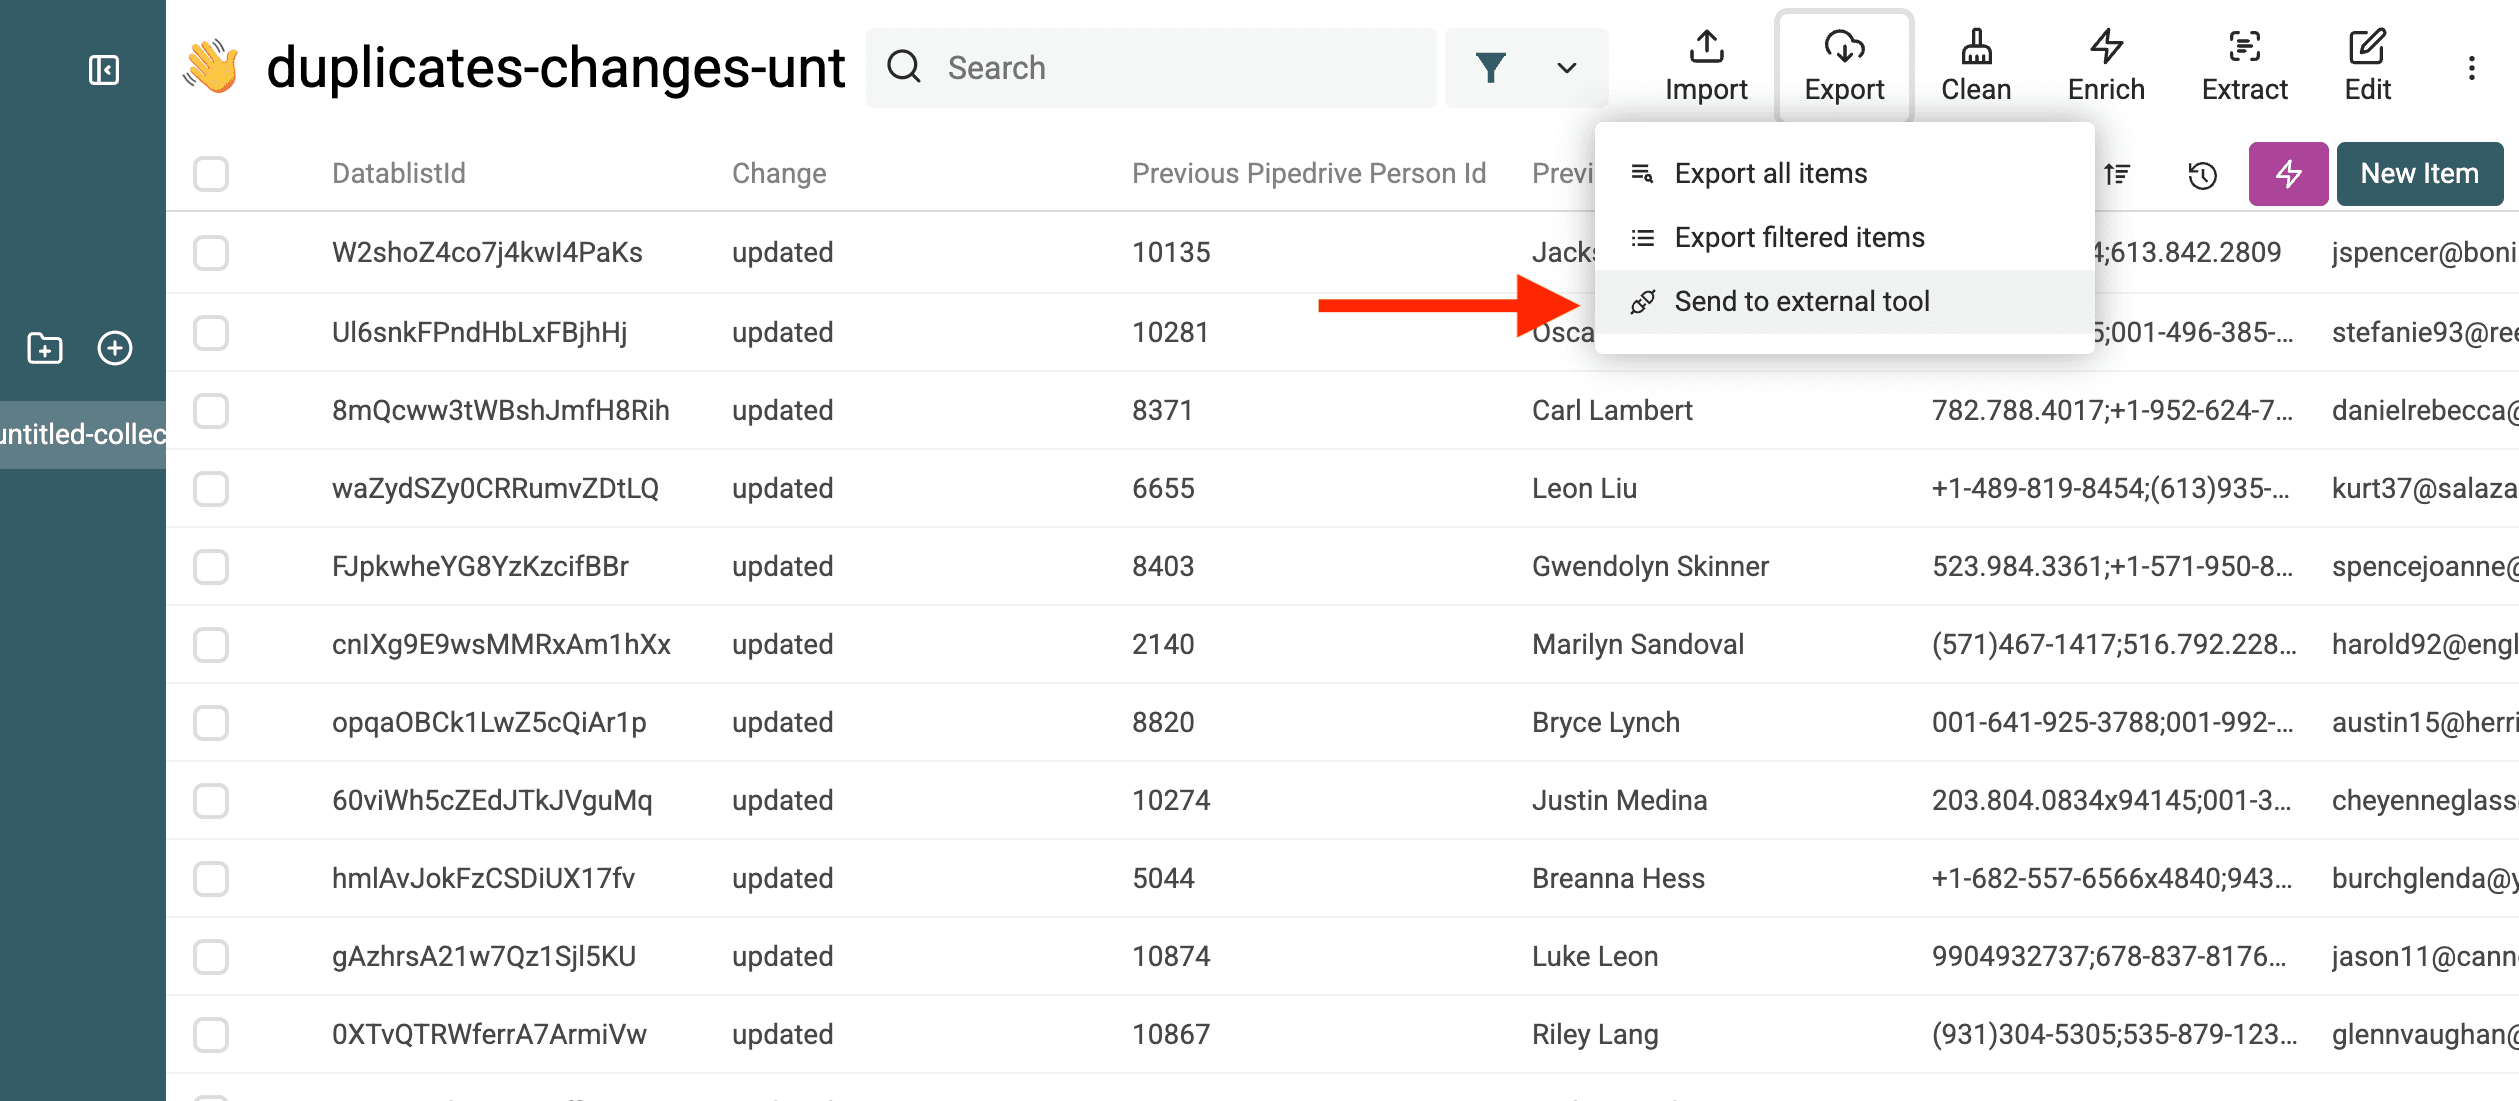
然后点击 Export → Send to external tool。
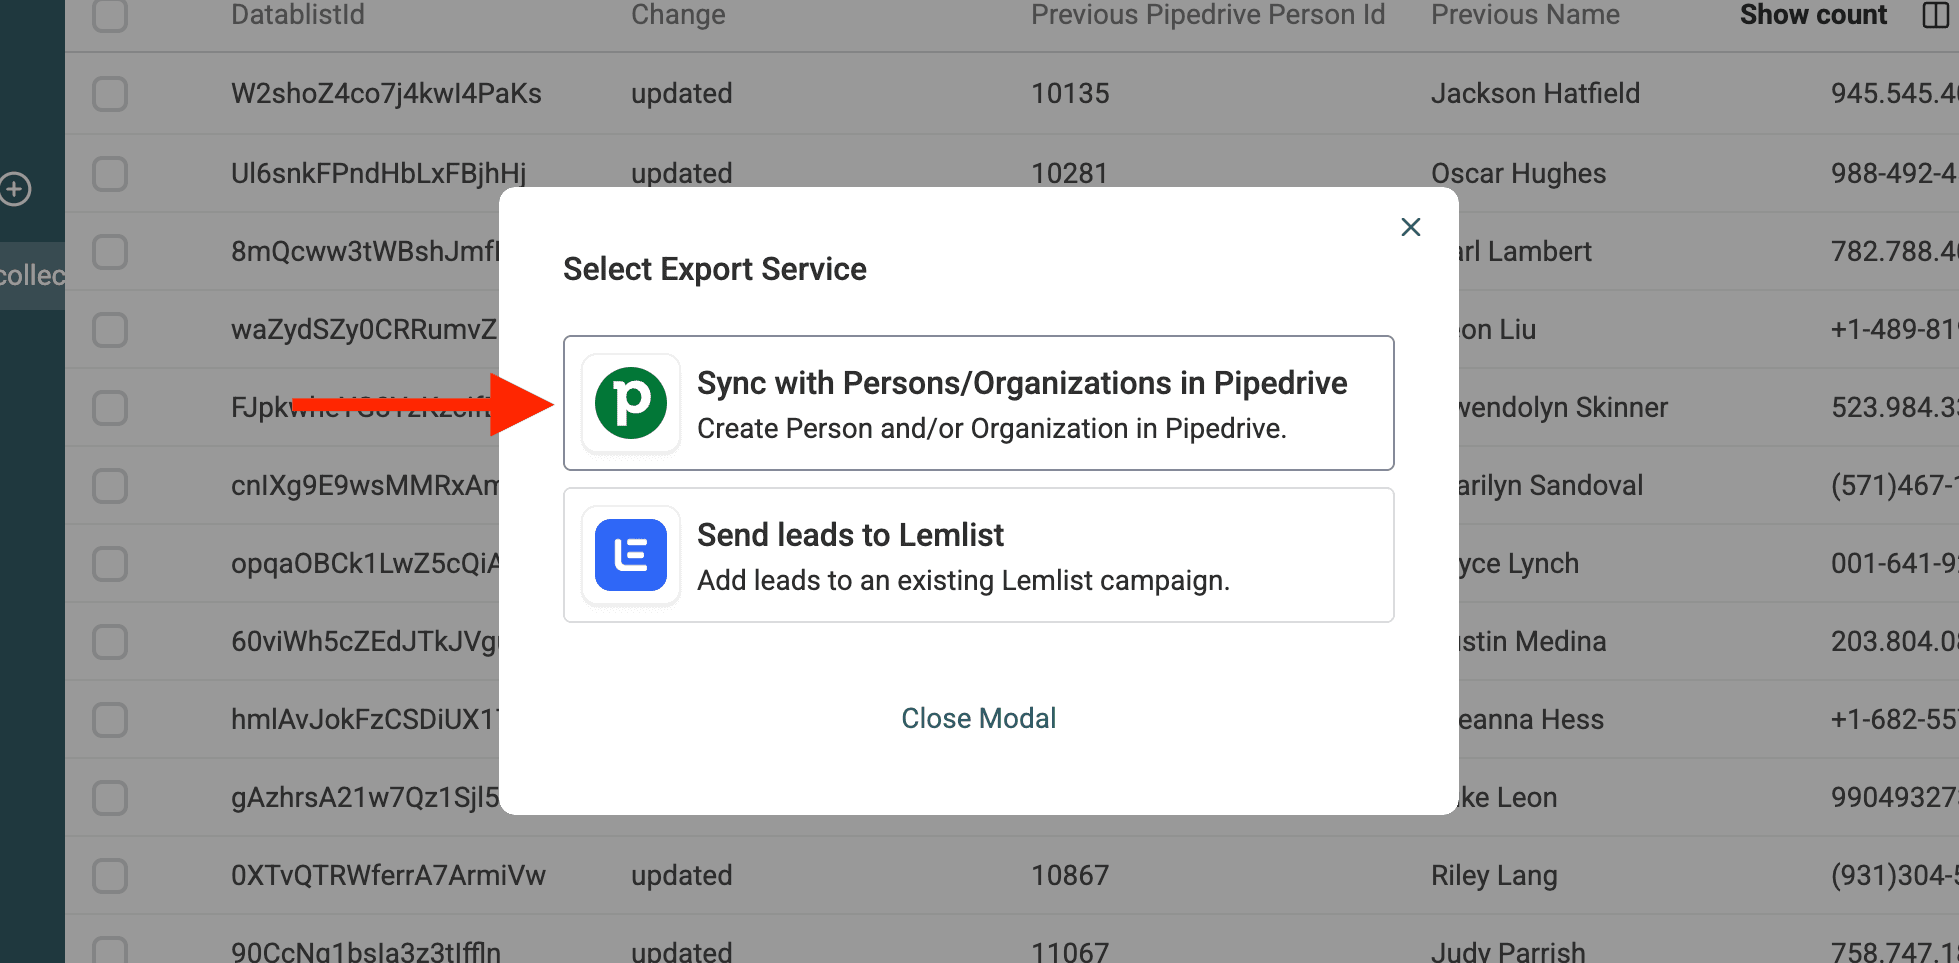
选择 Sync with Persons/Organizations in Pipedrive。
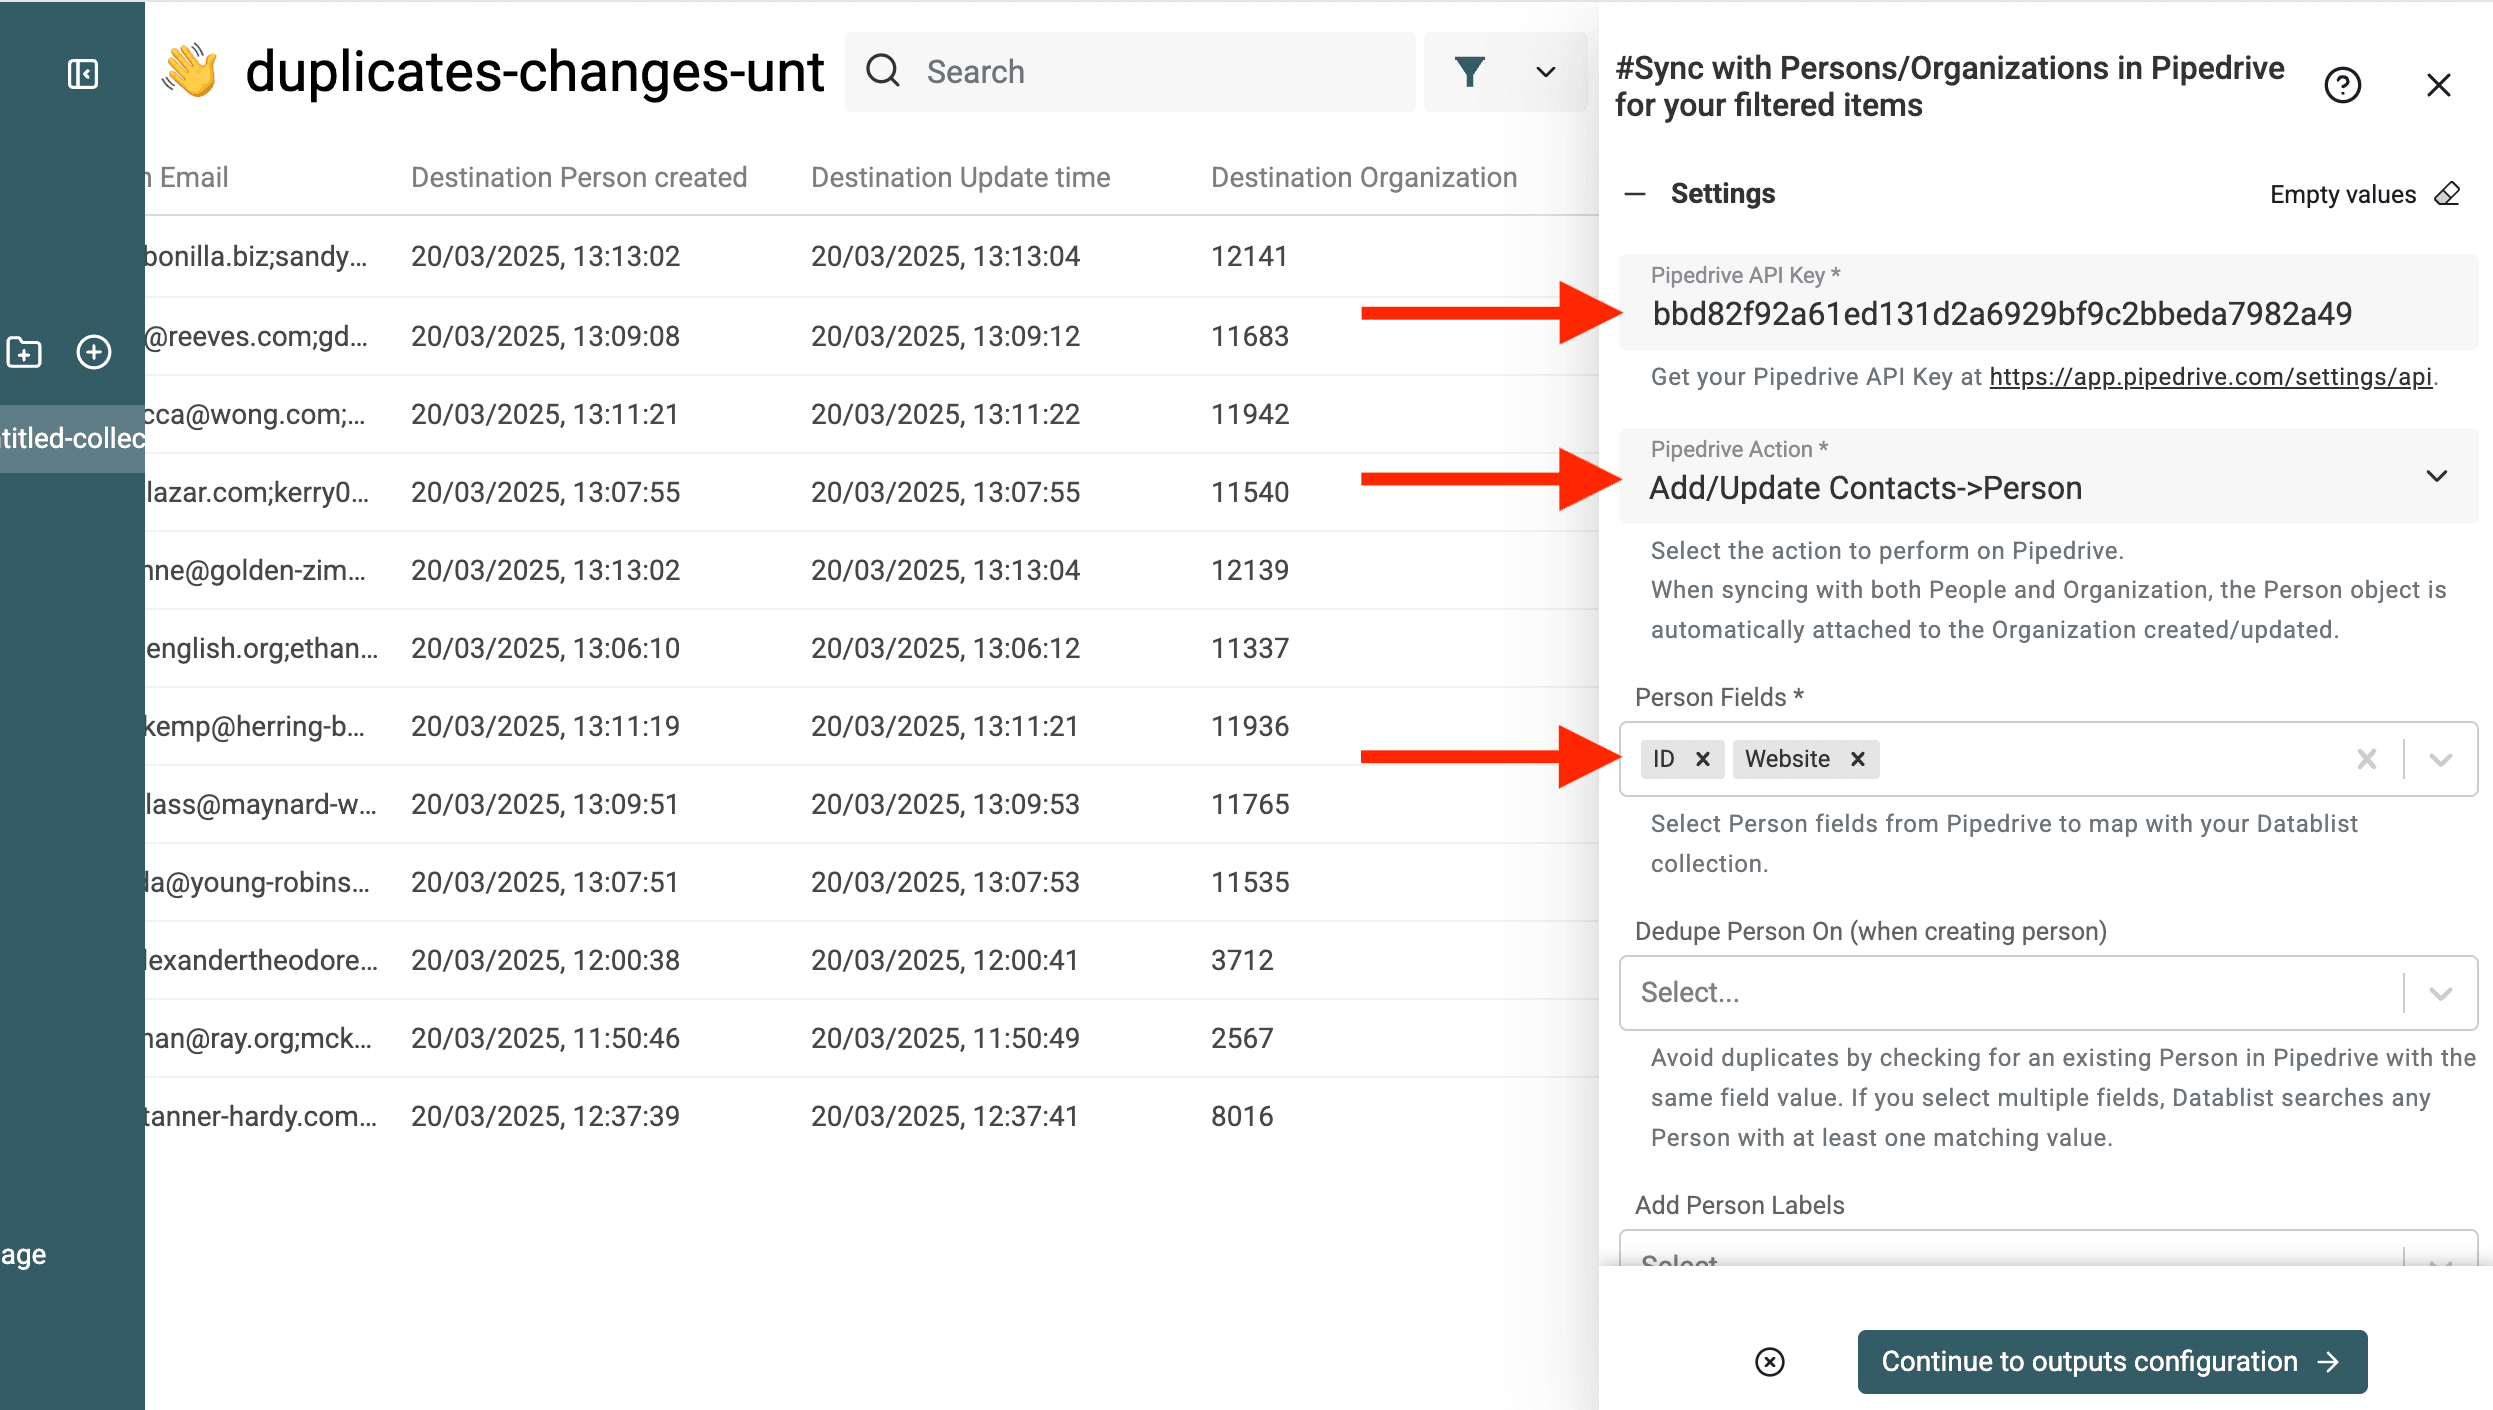
输入 Pipedrive API Key,并选择要更新的 entity(People 或 Organizations)。
选择 ID 字段,以及需要用清洗后数据更新的字段。
重要提示:必须选择
ID字段,才能更新现有数据,而不是创建新记录。
在本例中,我只更新 Website 字段,因此选择 ID 和 Website。
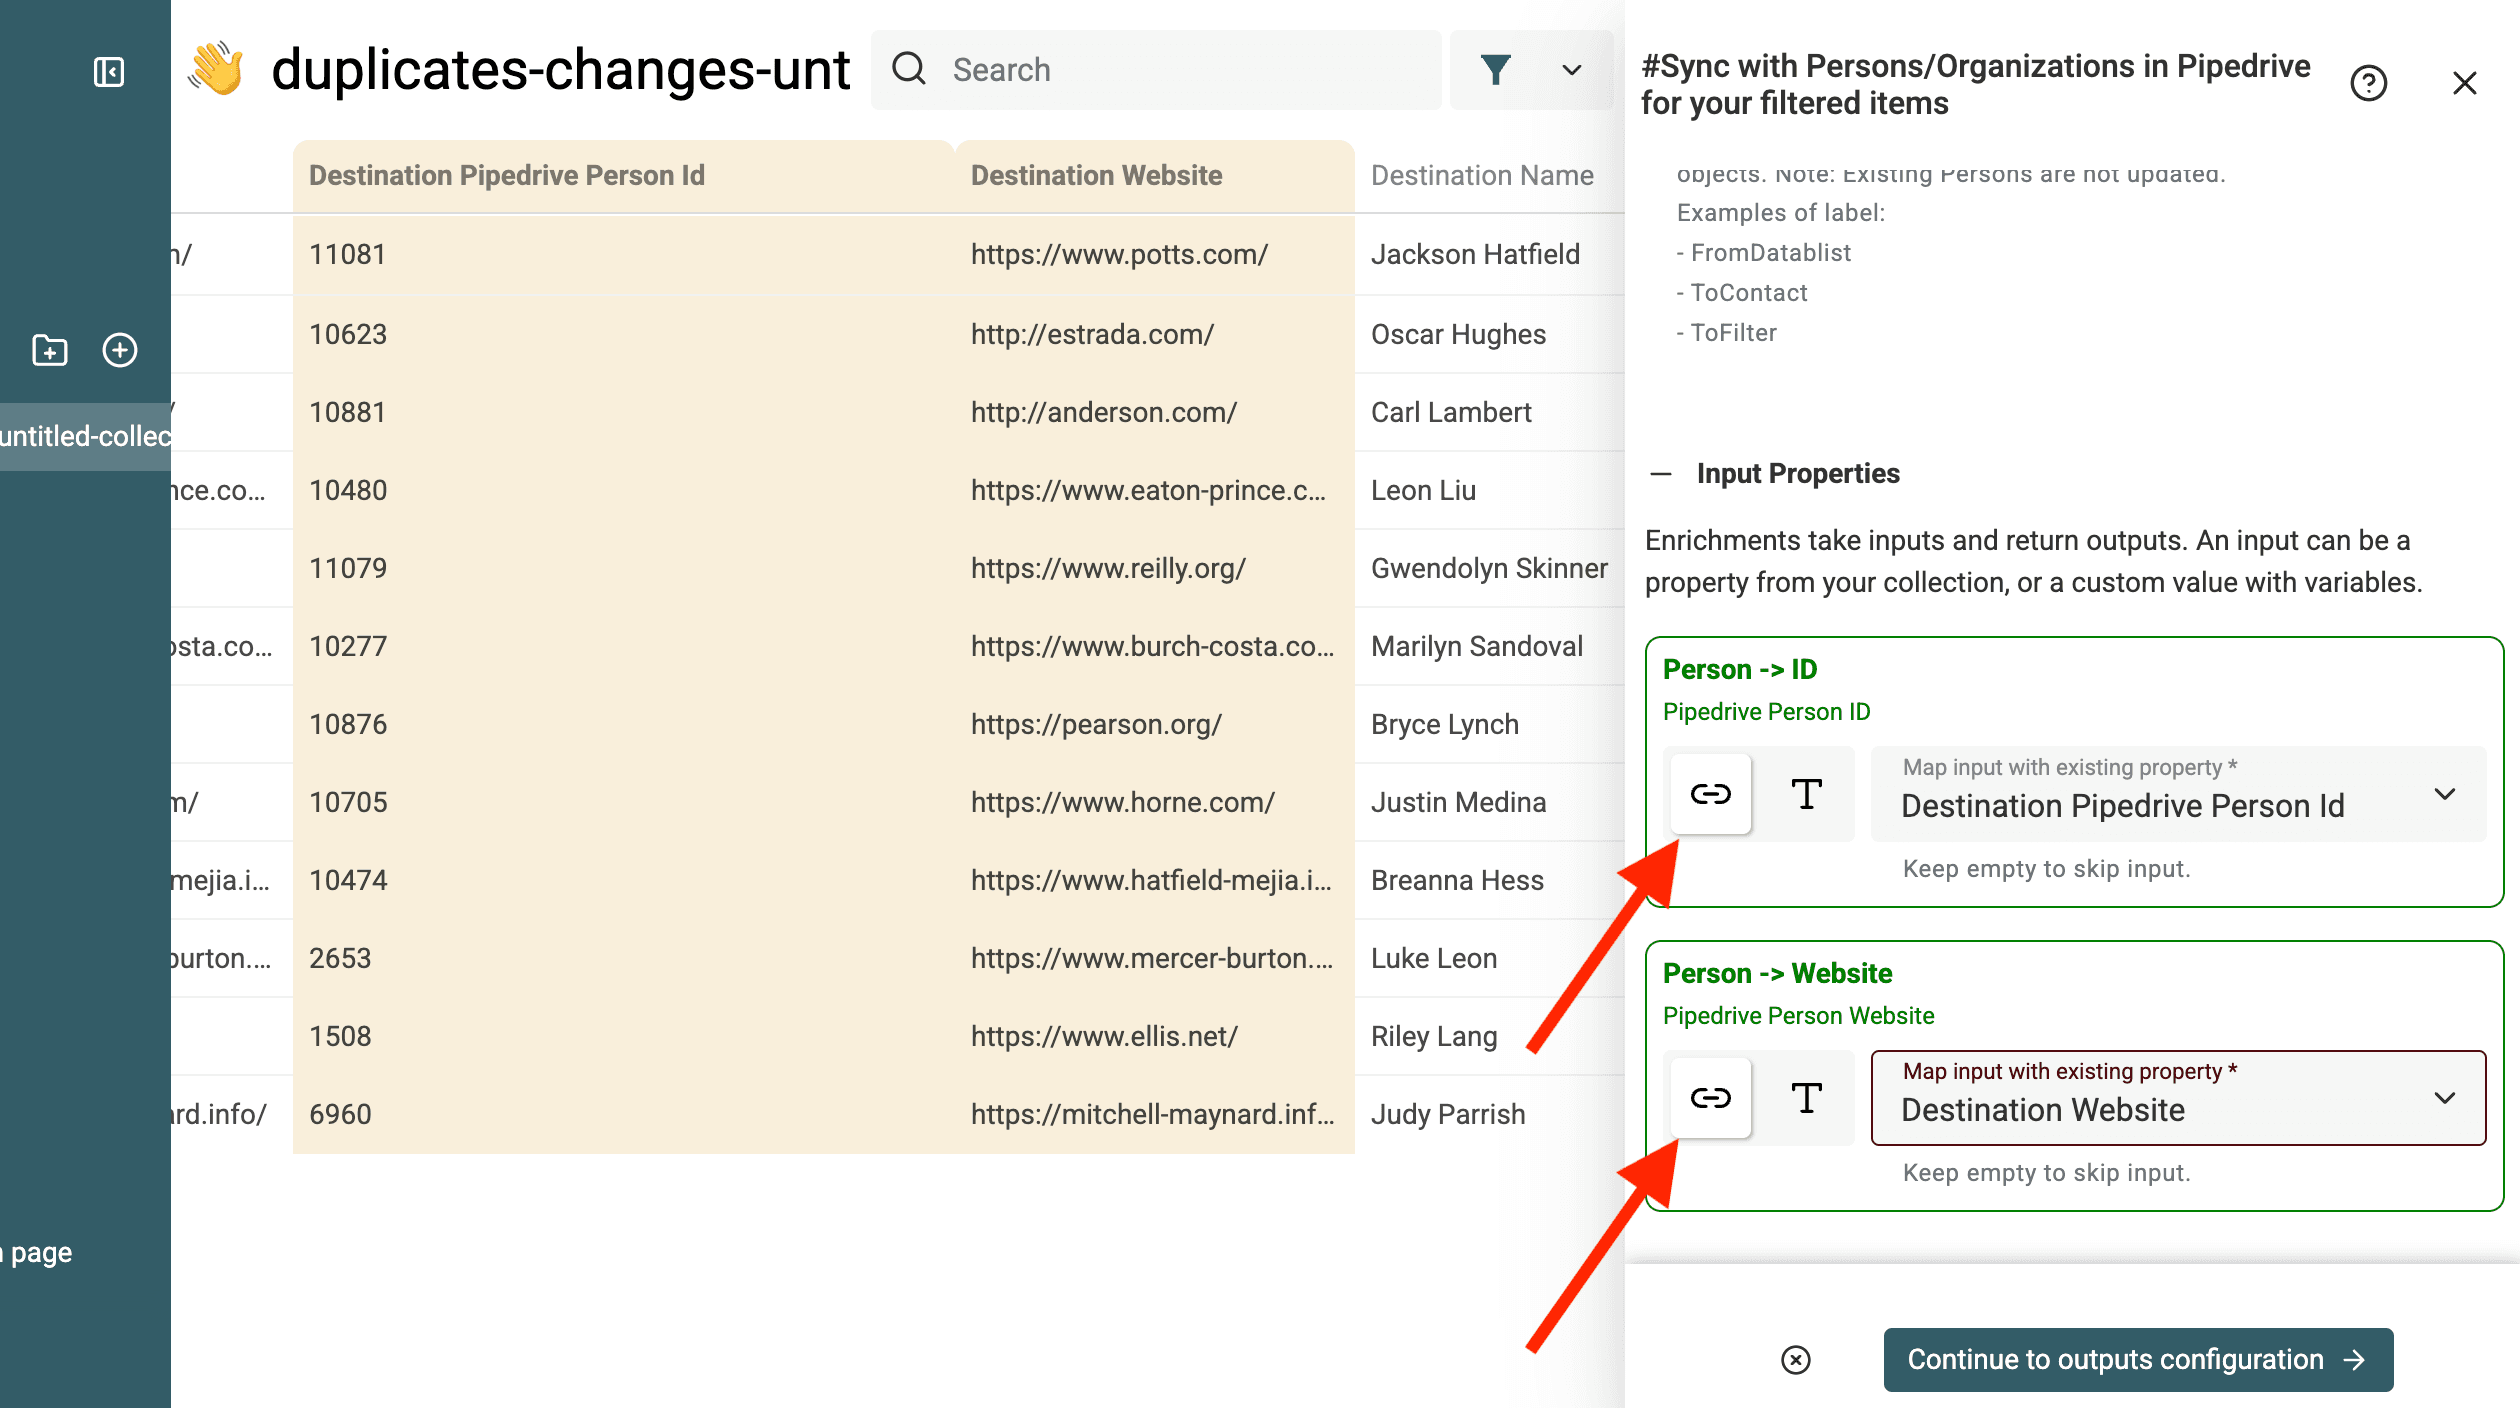
在 Inputs 部分,将各项映射到对应的 Destination XX 字段。
配置 Outputs,以记录更新状态。
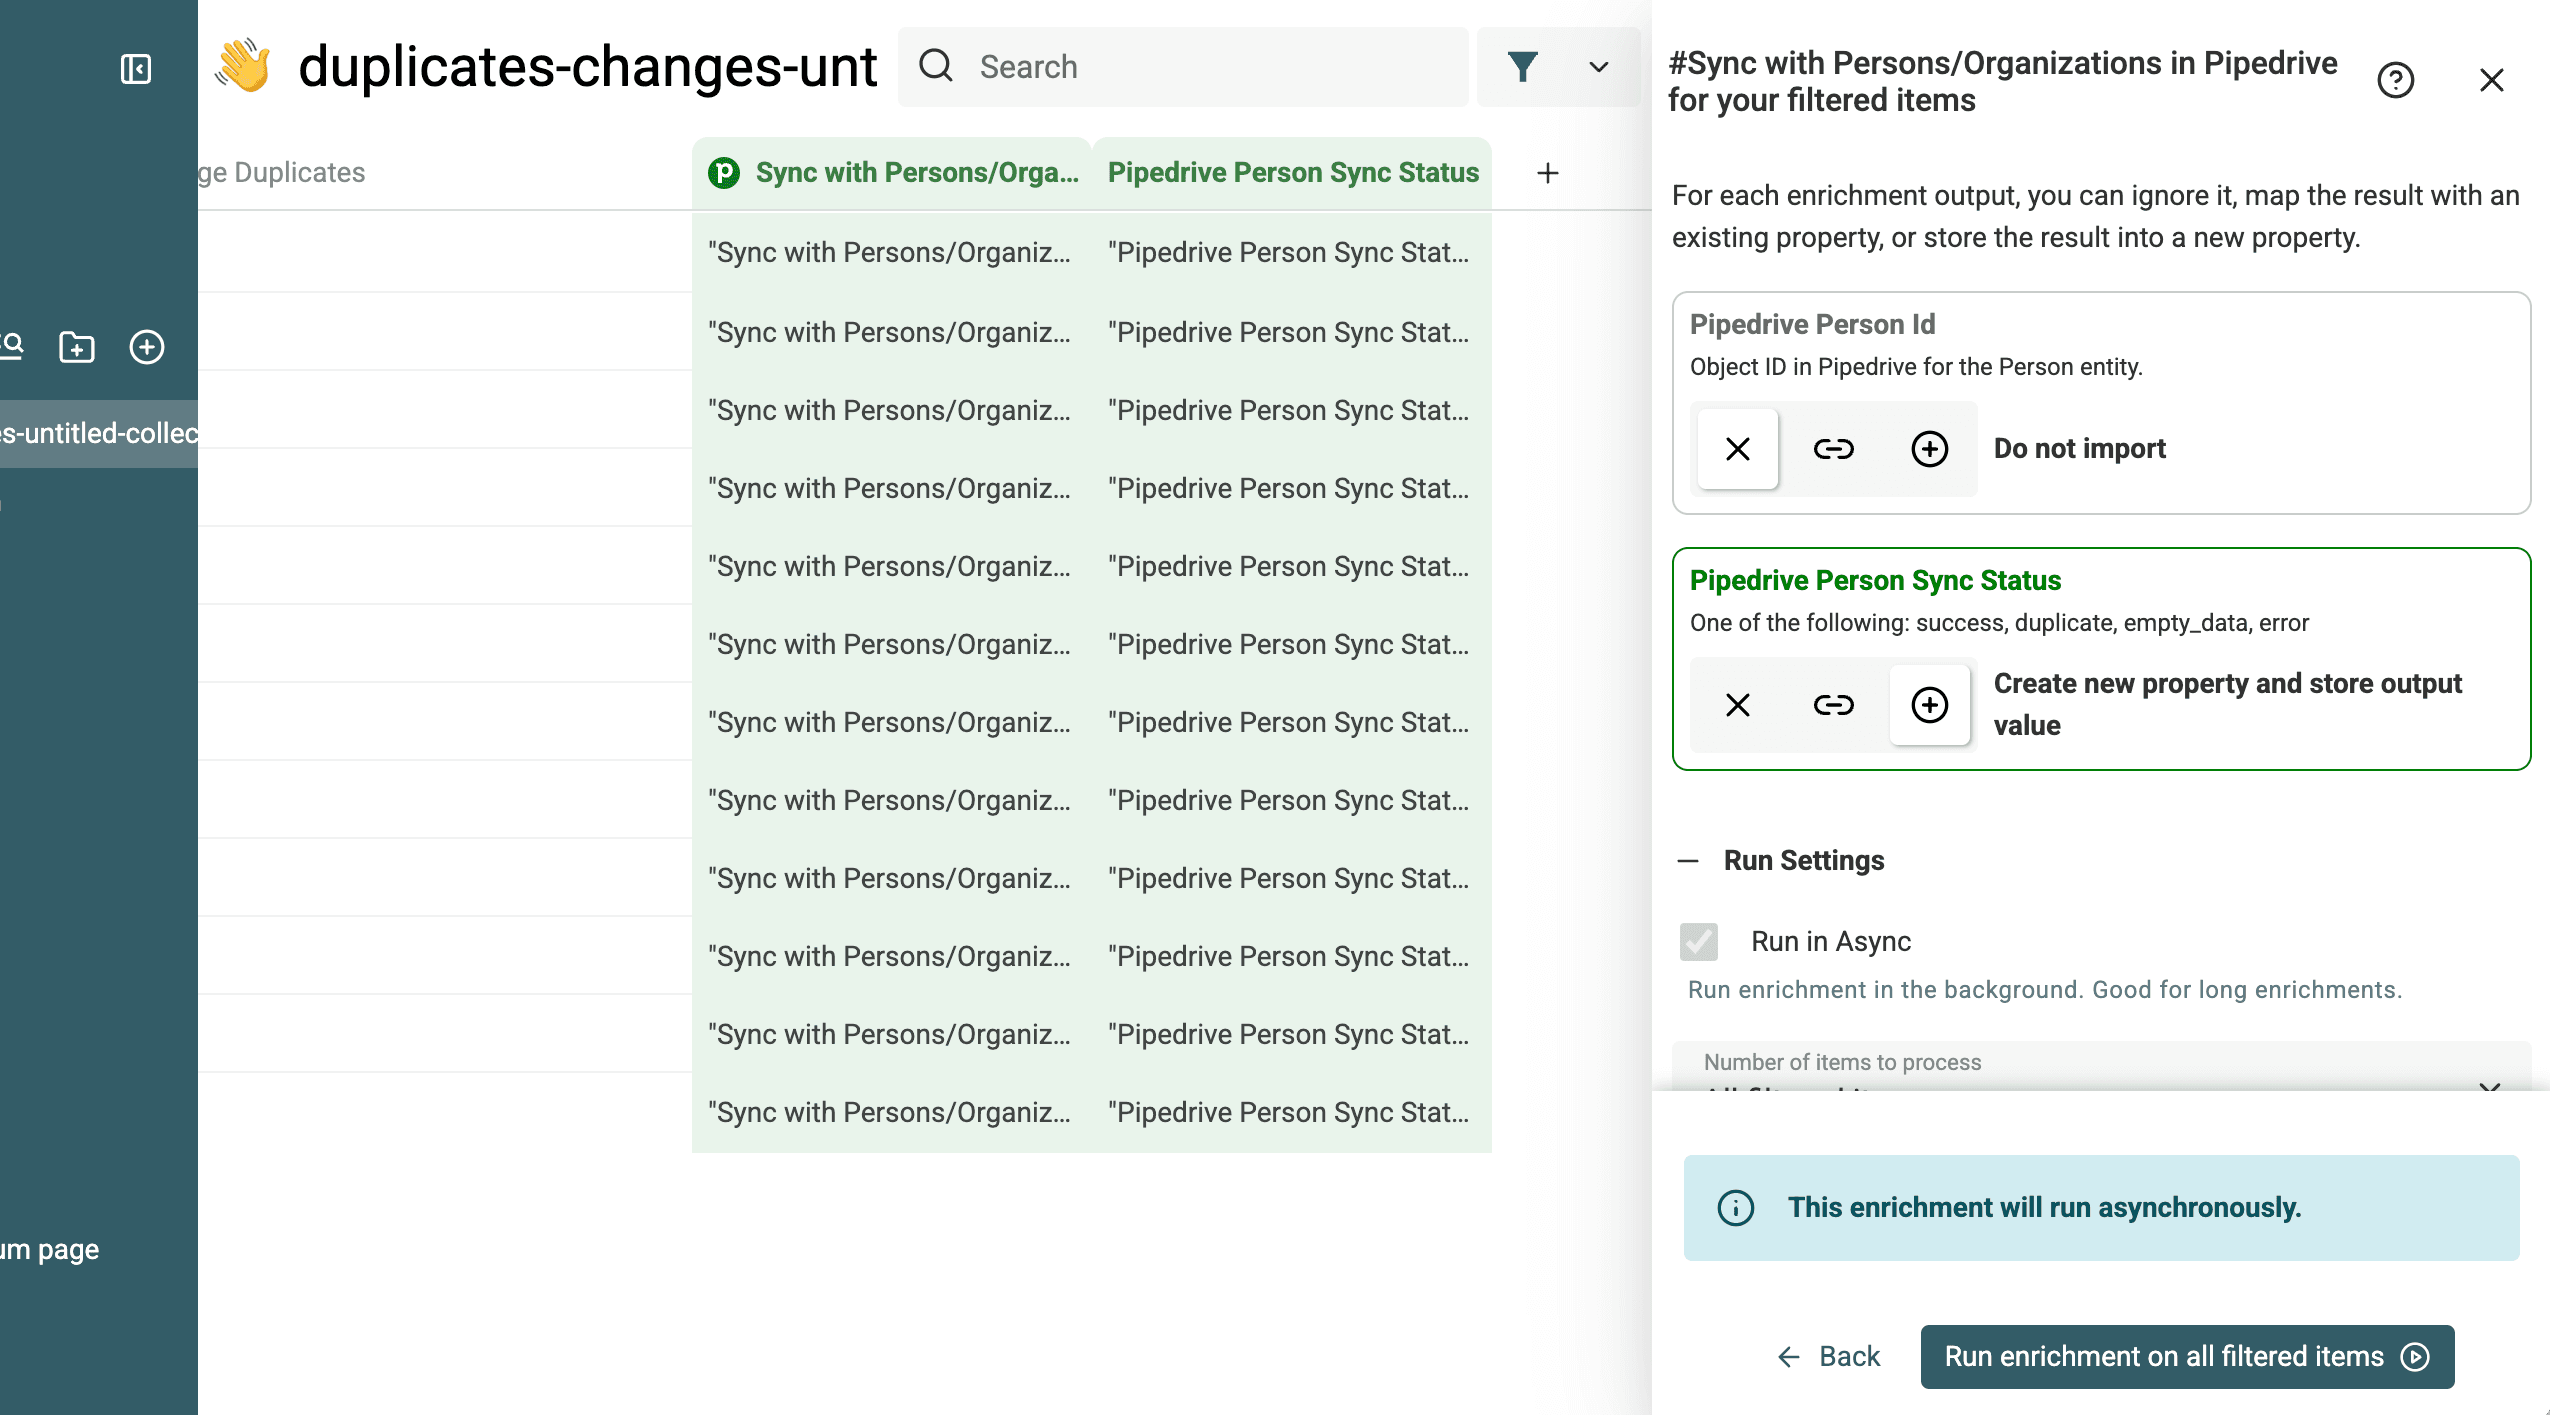
然后运行流程。
你可以进入 Pipedrive 记录的 Changelog 列表检查结果。
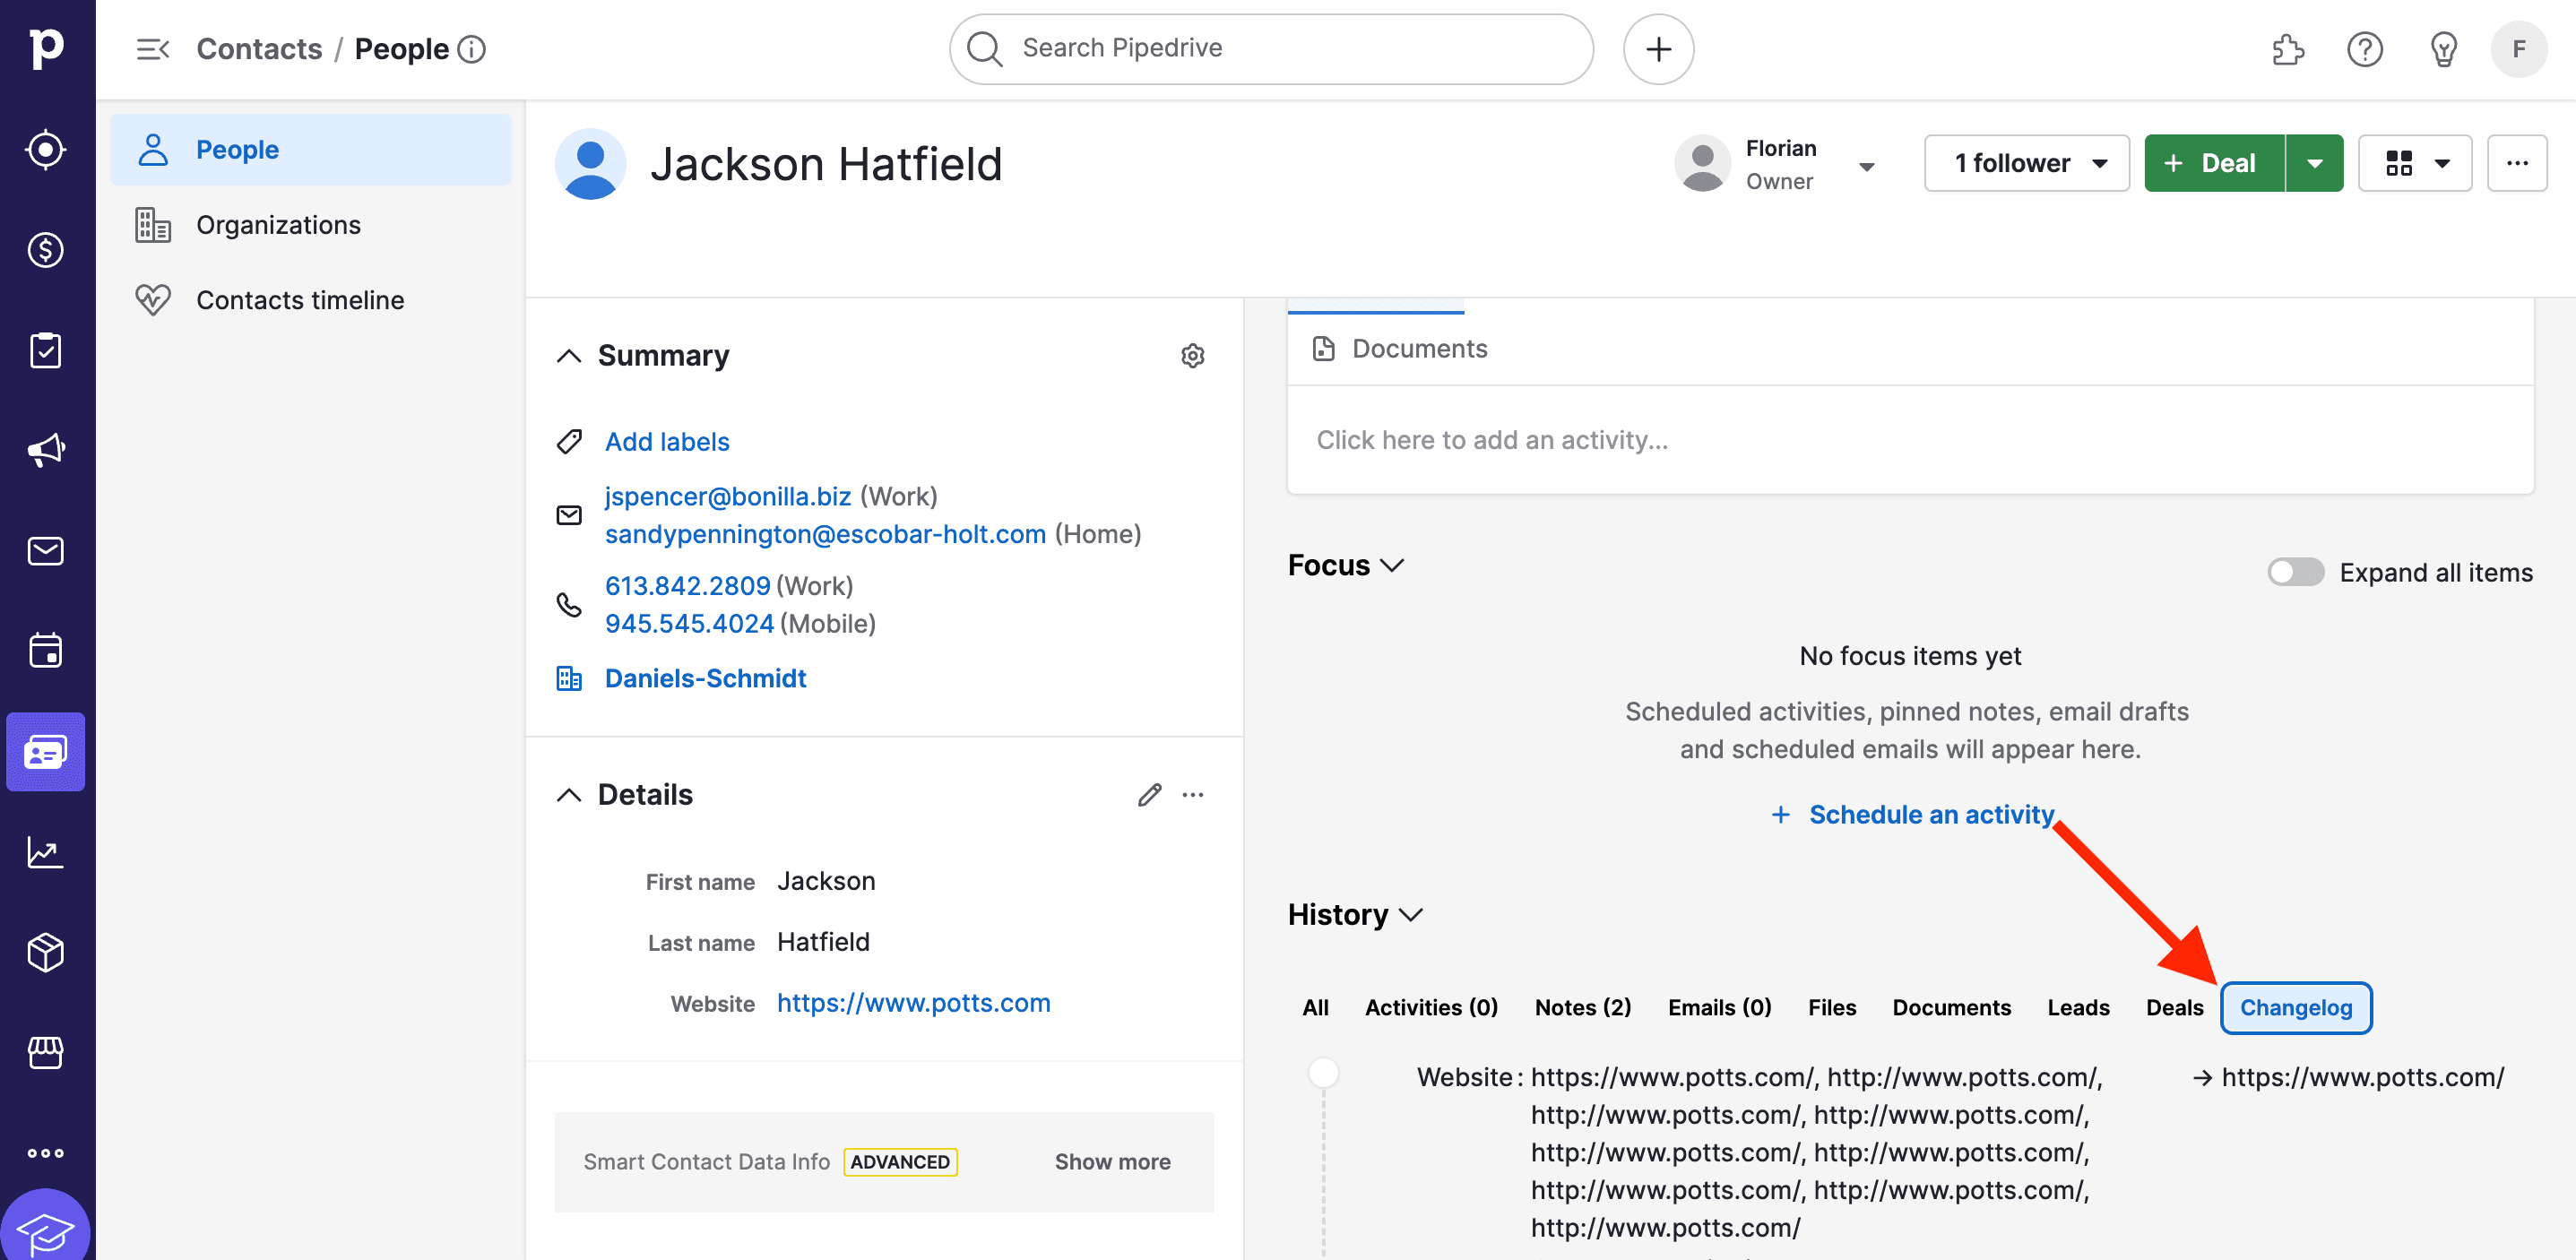
3.d. 在 Pipedrive 中检查合并后的记录
大功告成!你已经成功完成: ✅ 将数据导入 Datablist。 ✅ 使用智能算法查找并合并重复数据。 ✅ 将清洗后的数据同步回 Pipedrive。
请在 Pipedrive 中抽查多条目标记录,尤其是存在冲突字段的记录。在确认预期的 Activities 和联系人字段值仍然正确关联后,再将这批任务视为处理完成。
Pipedrive 自带重复数据合并功能的局限
对于符合官方匹配规则的重复记录,Pipedrive 自带工具非常实用。如果需要比较其他匹配字段,或希望在批量合并前审核重复组,则可以使用 Datablist。
1. 匹配字段
Pipedrive 会将联系人姓名与 Email、Phone 或 Organization 组合匹配。对于 Organizations,则匹配 Name 和 Address。仅凭相同 Website 并不符合其官方说明中的匹配条件。在 Datablist 中,可以先按 Email 匹配 People,或按 Website 匹配 Organizations,再单独审核基于 Name 找出的候选重复组。不要仅仅因为两个人属于同一 Organization 或姓名相同,就直接合并记录。
2. 审核大批量重复数据
Pipedrive 会提供潜在重复联系人的列表,供你审核。本指南中的 Datablist 流程则允许你检查各个重复组并导出 Changes File,然后仅对选中的行执行 Pipedrive merge 操作。批量合并大量记录前,请仔细审核预览,并先用一小批数据进行测试。
3. 字段冲突
Datablist 允许你选择主记录,并预览冲突值的处理方式。在 Pipedrive 中执行合并前,请确认这些选择符合预期。Pipedrive merge 操作本身可能会把重复记录中的值添加到目标记录,因此如果需要设置最终的干净字段值,请执行后续同步步骤。
4. 保留变更文件
执行合并前,请保存 Datablist 导出的数据合并变更日志。它会记录本流程中的源 ID 和目标 ID,便于之后核对结果或排查单条记录。但请注意,它不能替代 Pipedrive 数据备份。
如果 Pipedrive 自带的重复数据建议已经能够覆盖你的数据,直接在 Pipedrive 中审核即可。如果需要按 Website 匹配、清洗公司名称,或为批量数据设置冲突规则,请按照上述 Datablist 流程操作,并在 Pipedrive 中核验变更结果。