
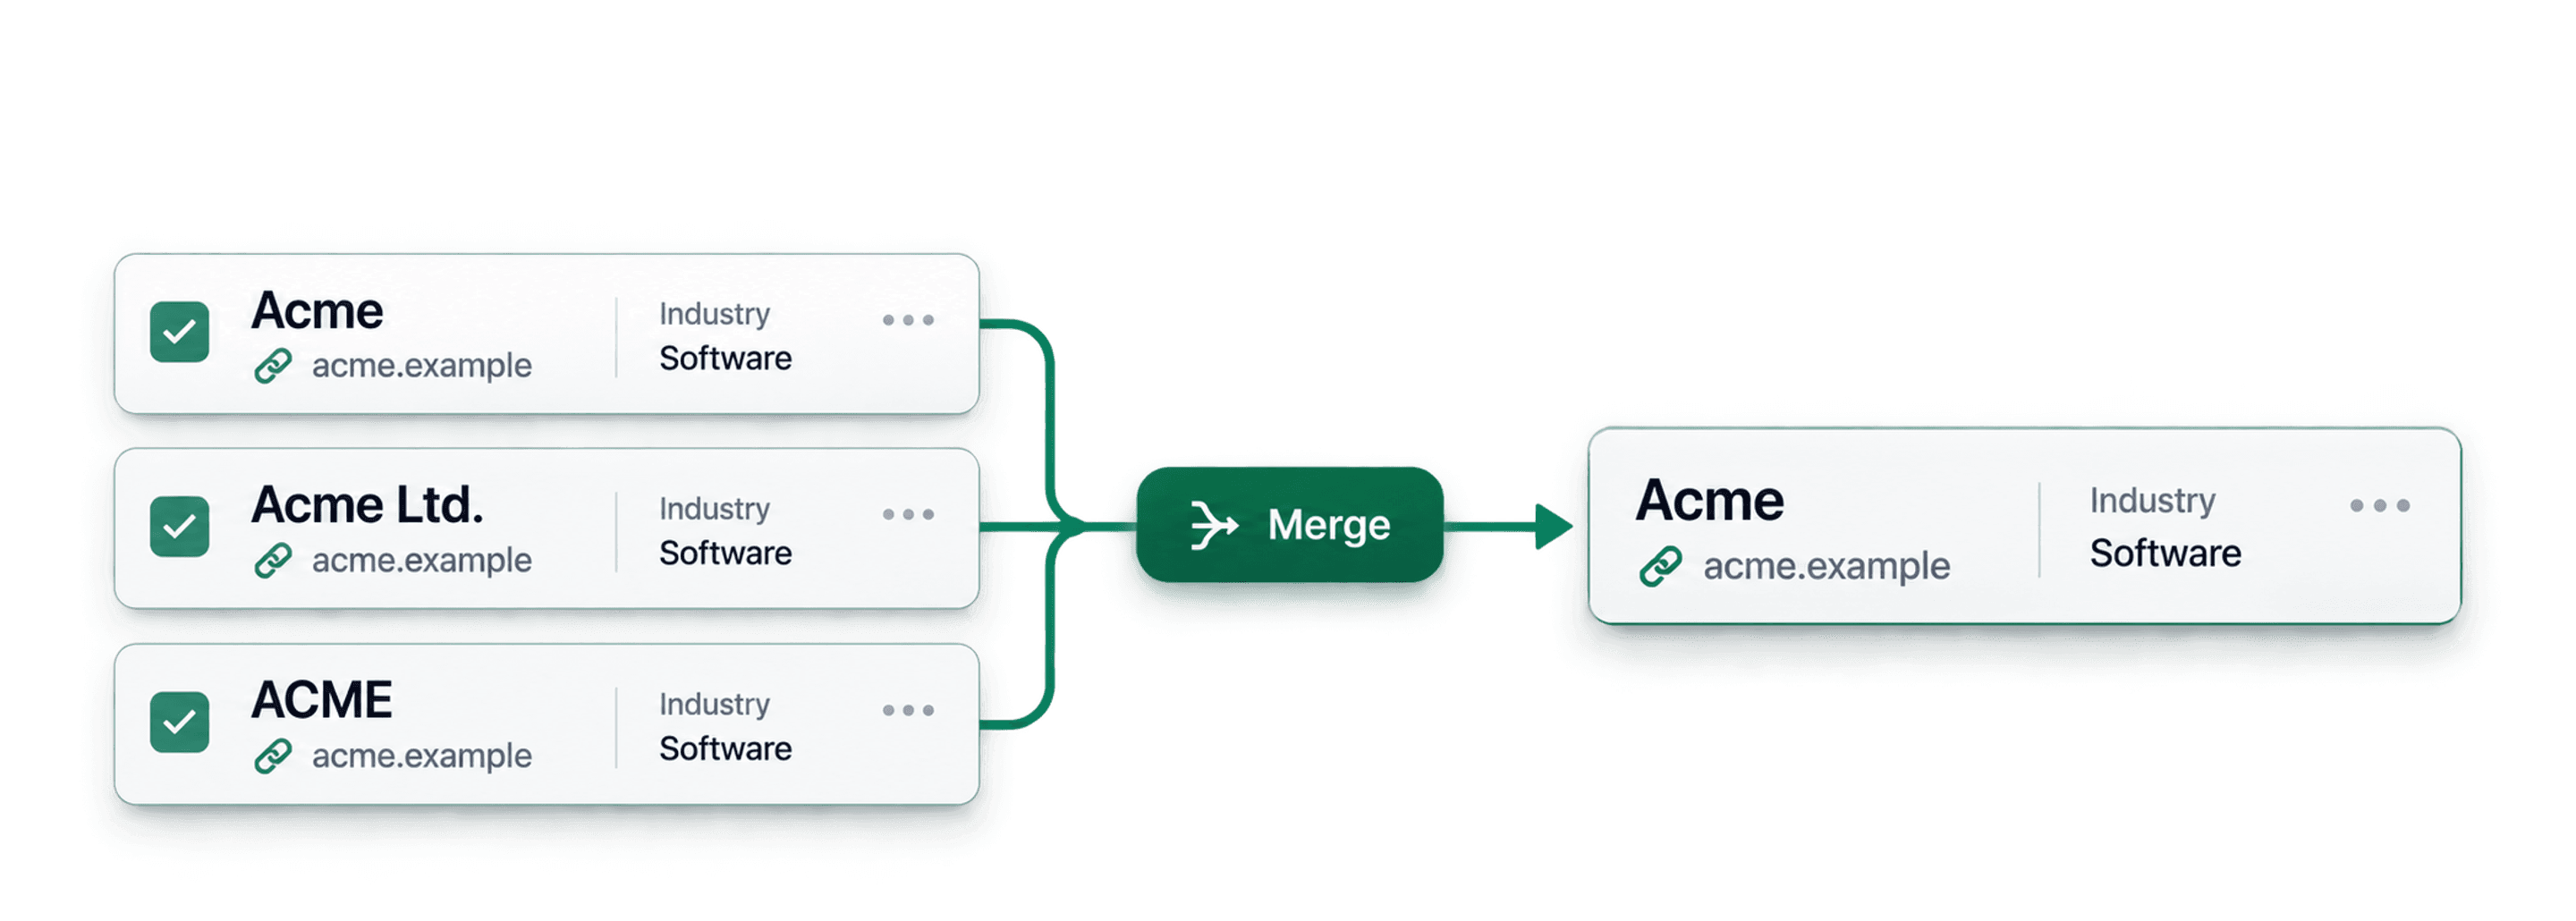
查找重复公司名称时,应先比对更稳定的域名;对于没有可靠网站信息的记录,再使用标准化公司名称匹配。合并前务必检查系统建议的分组,因为两家不同的企业也可能使用相同的简称或通用名称。
本指南将介绍如何:
公司名称去重的最佳实践
优先使用最可靠的标识符。 与公司名称相比,经过标准化的网站或域名更适合用于第一轮匹配,因为不同公司可能使用 Acme Services 这类相同名称。请将原始公司名称、网站和 CRM 记录 ID 分别保存在独立属性中,以便检查每个匹配结果,并将清理后的记录对应回原始数据。
第二轮再进行公司名称匹配。Company Name processor 会在比对前移除常见的法律实体、地区和商业词语。这样可以将 Cedar Group LLC 与 Cedar 识别为候选匹配项,但也可能让两家无关企业看起来相同。对于没有域名的记录,在决定合并前,还应比对国家、城市或地址等其他字段。即使公司名称的匹配度达到 100%,也不能直接认定它们属于同一实体。
如果同一分组中的电话号码、负责人或备注不同,请查看 Why matched,再决定保留哪些值。如果需要审计记录,可以先导出重复分组。只有在能够明确说明这些记录为何属于同一家企业后,才执行合并。
如果只需要为少量记录新增一个清理后的名称列,可以先使用免费的 Company Name Cleaner,再导入名单。请将原始名称与清理结果并列保留。名称清理可以降低比对难度,但不能代替你判断哪些公司应该合并。
第 1 步:导入公司名称名单
首先,将公司名单导入 Datablist。如果数据中包含域名或网站列,请一并保留。与单独的公司名称相比,域名通常是更可靠的公司标识符。
如需复现下文的实测流程,请下载包含 1,000 行数据的去重样本。该样本包含 800 个预设实体,其中有 50 对记录带有公司名称和网站写法变体。
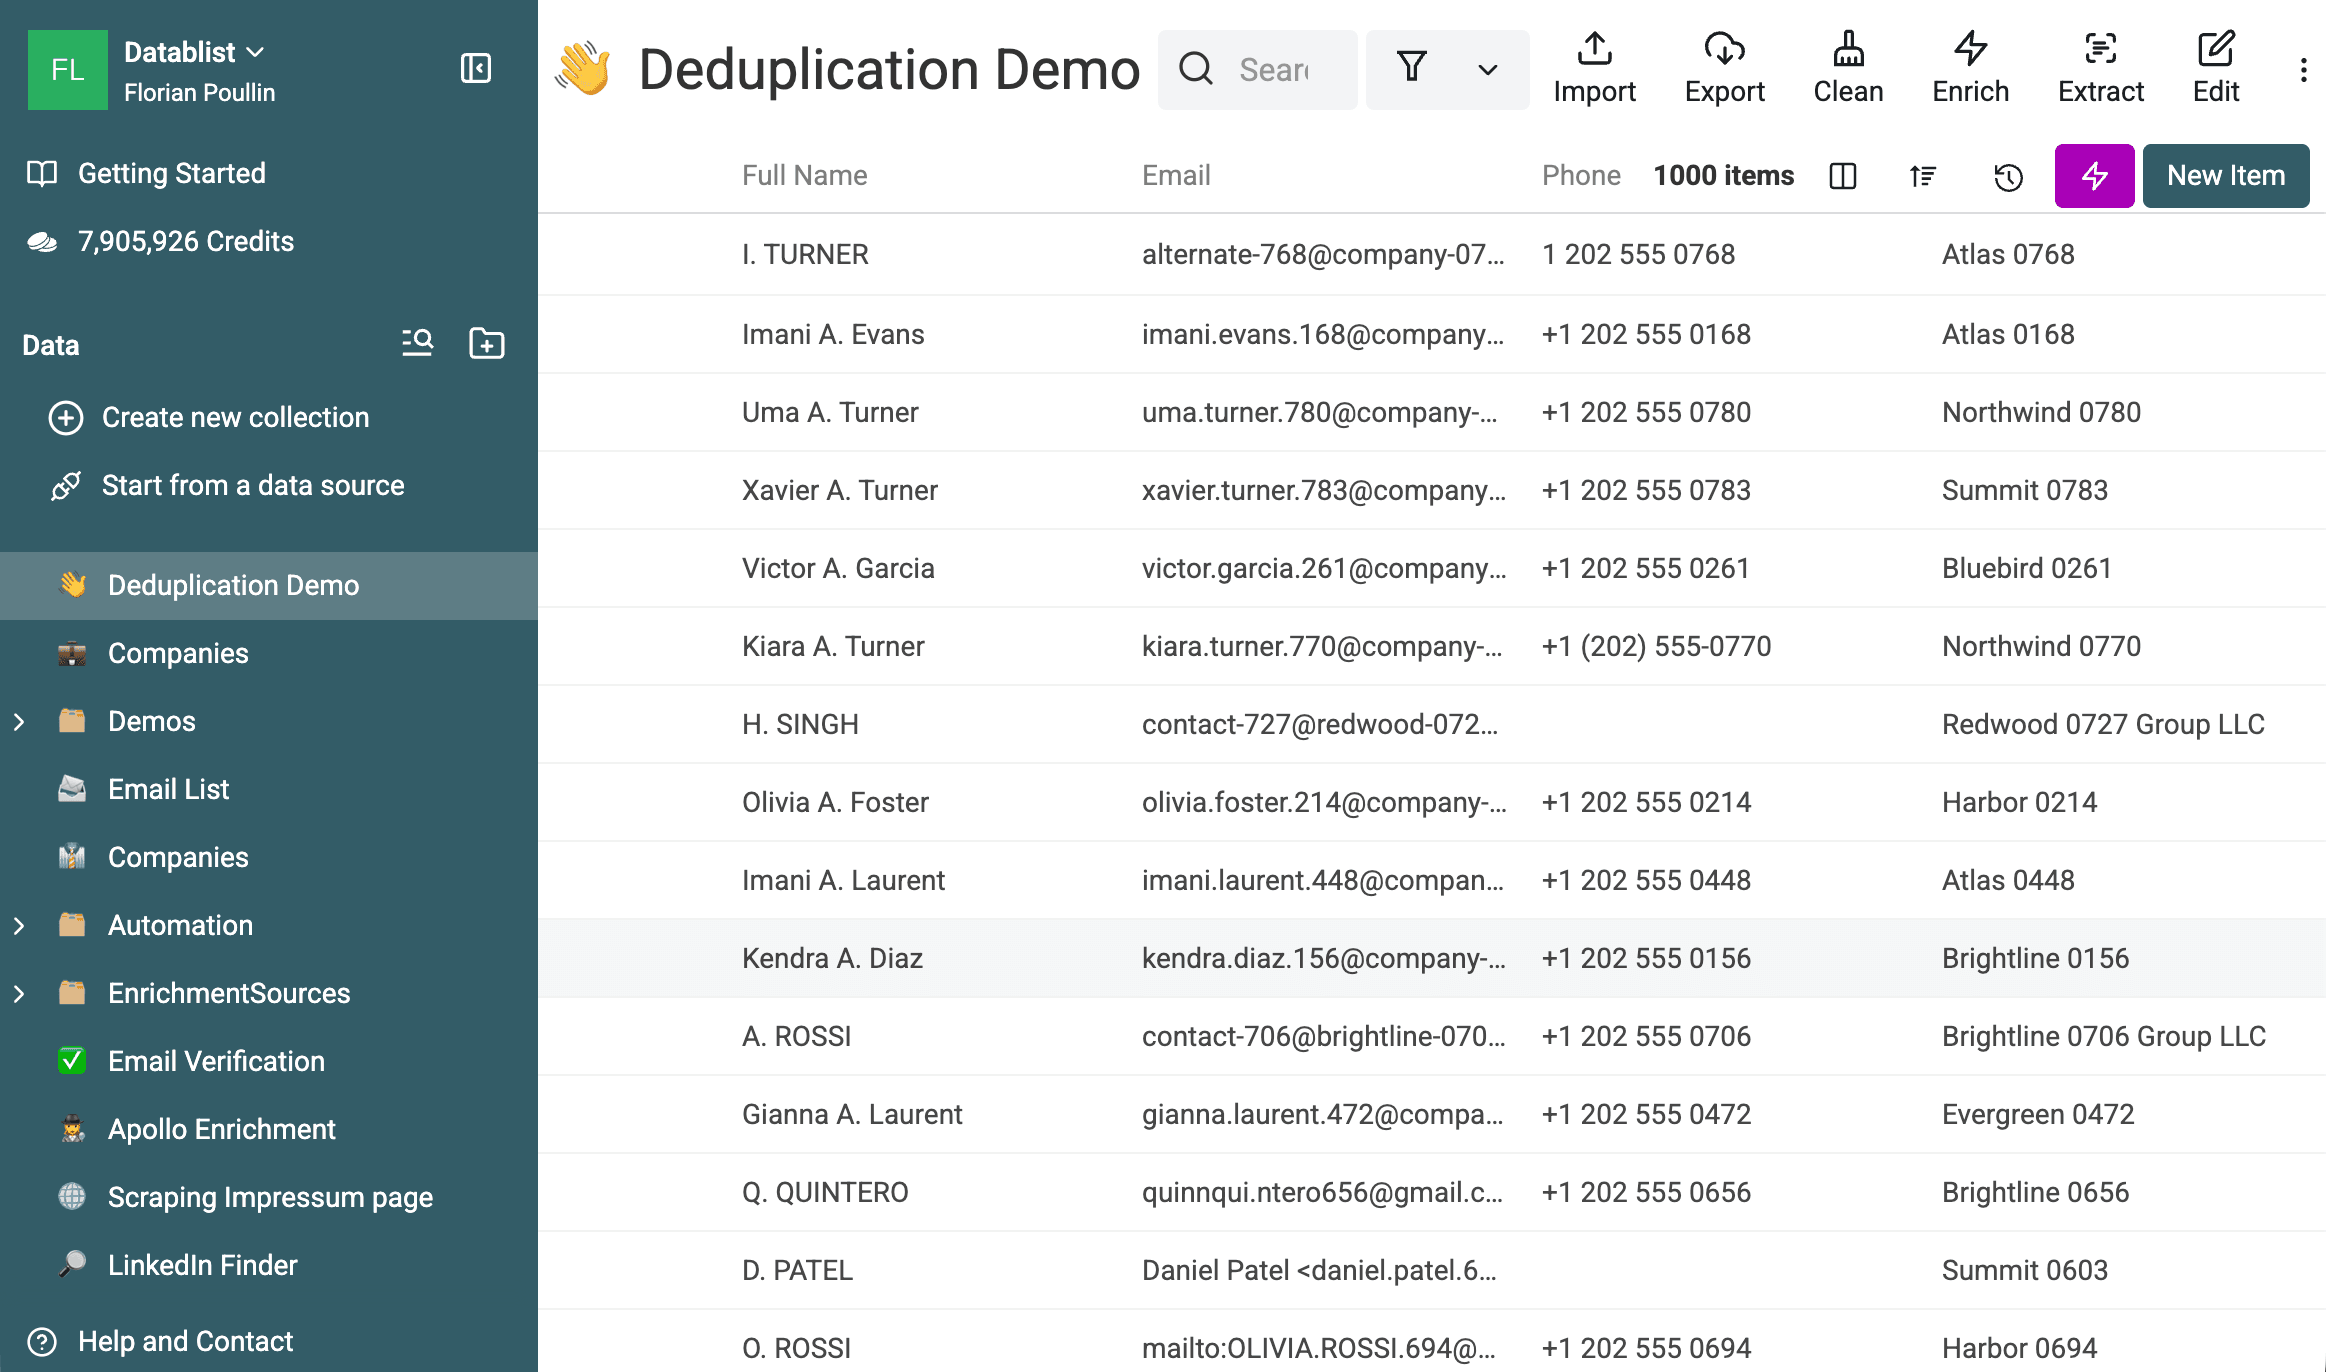
检查导入后的属性,并在适用时将 Website 设置为 URL 类型。Company 属性可以继续使用 Text 类型。
第 2 步:查找重复公司记录
打开 Clean > Merge duplicates,检测相互匹配的公司记录。
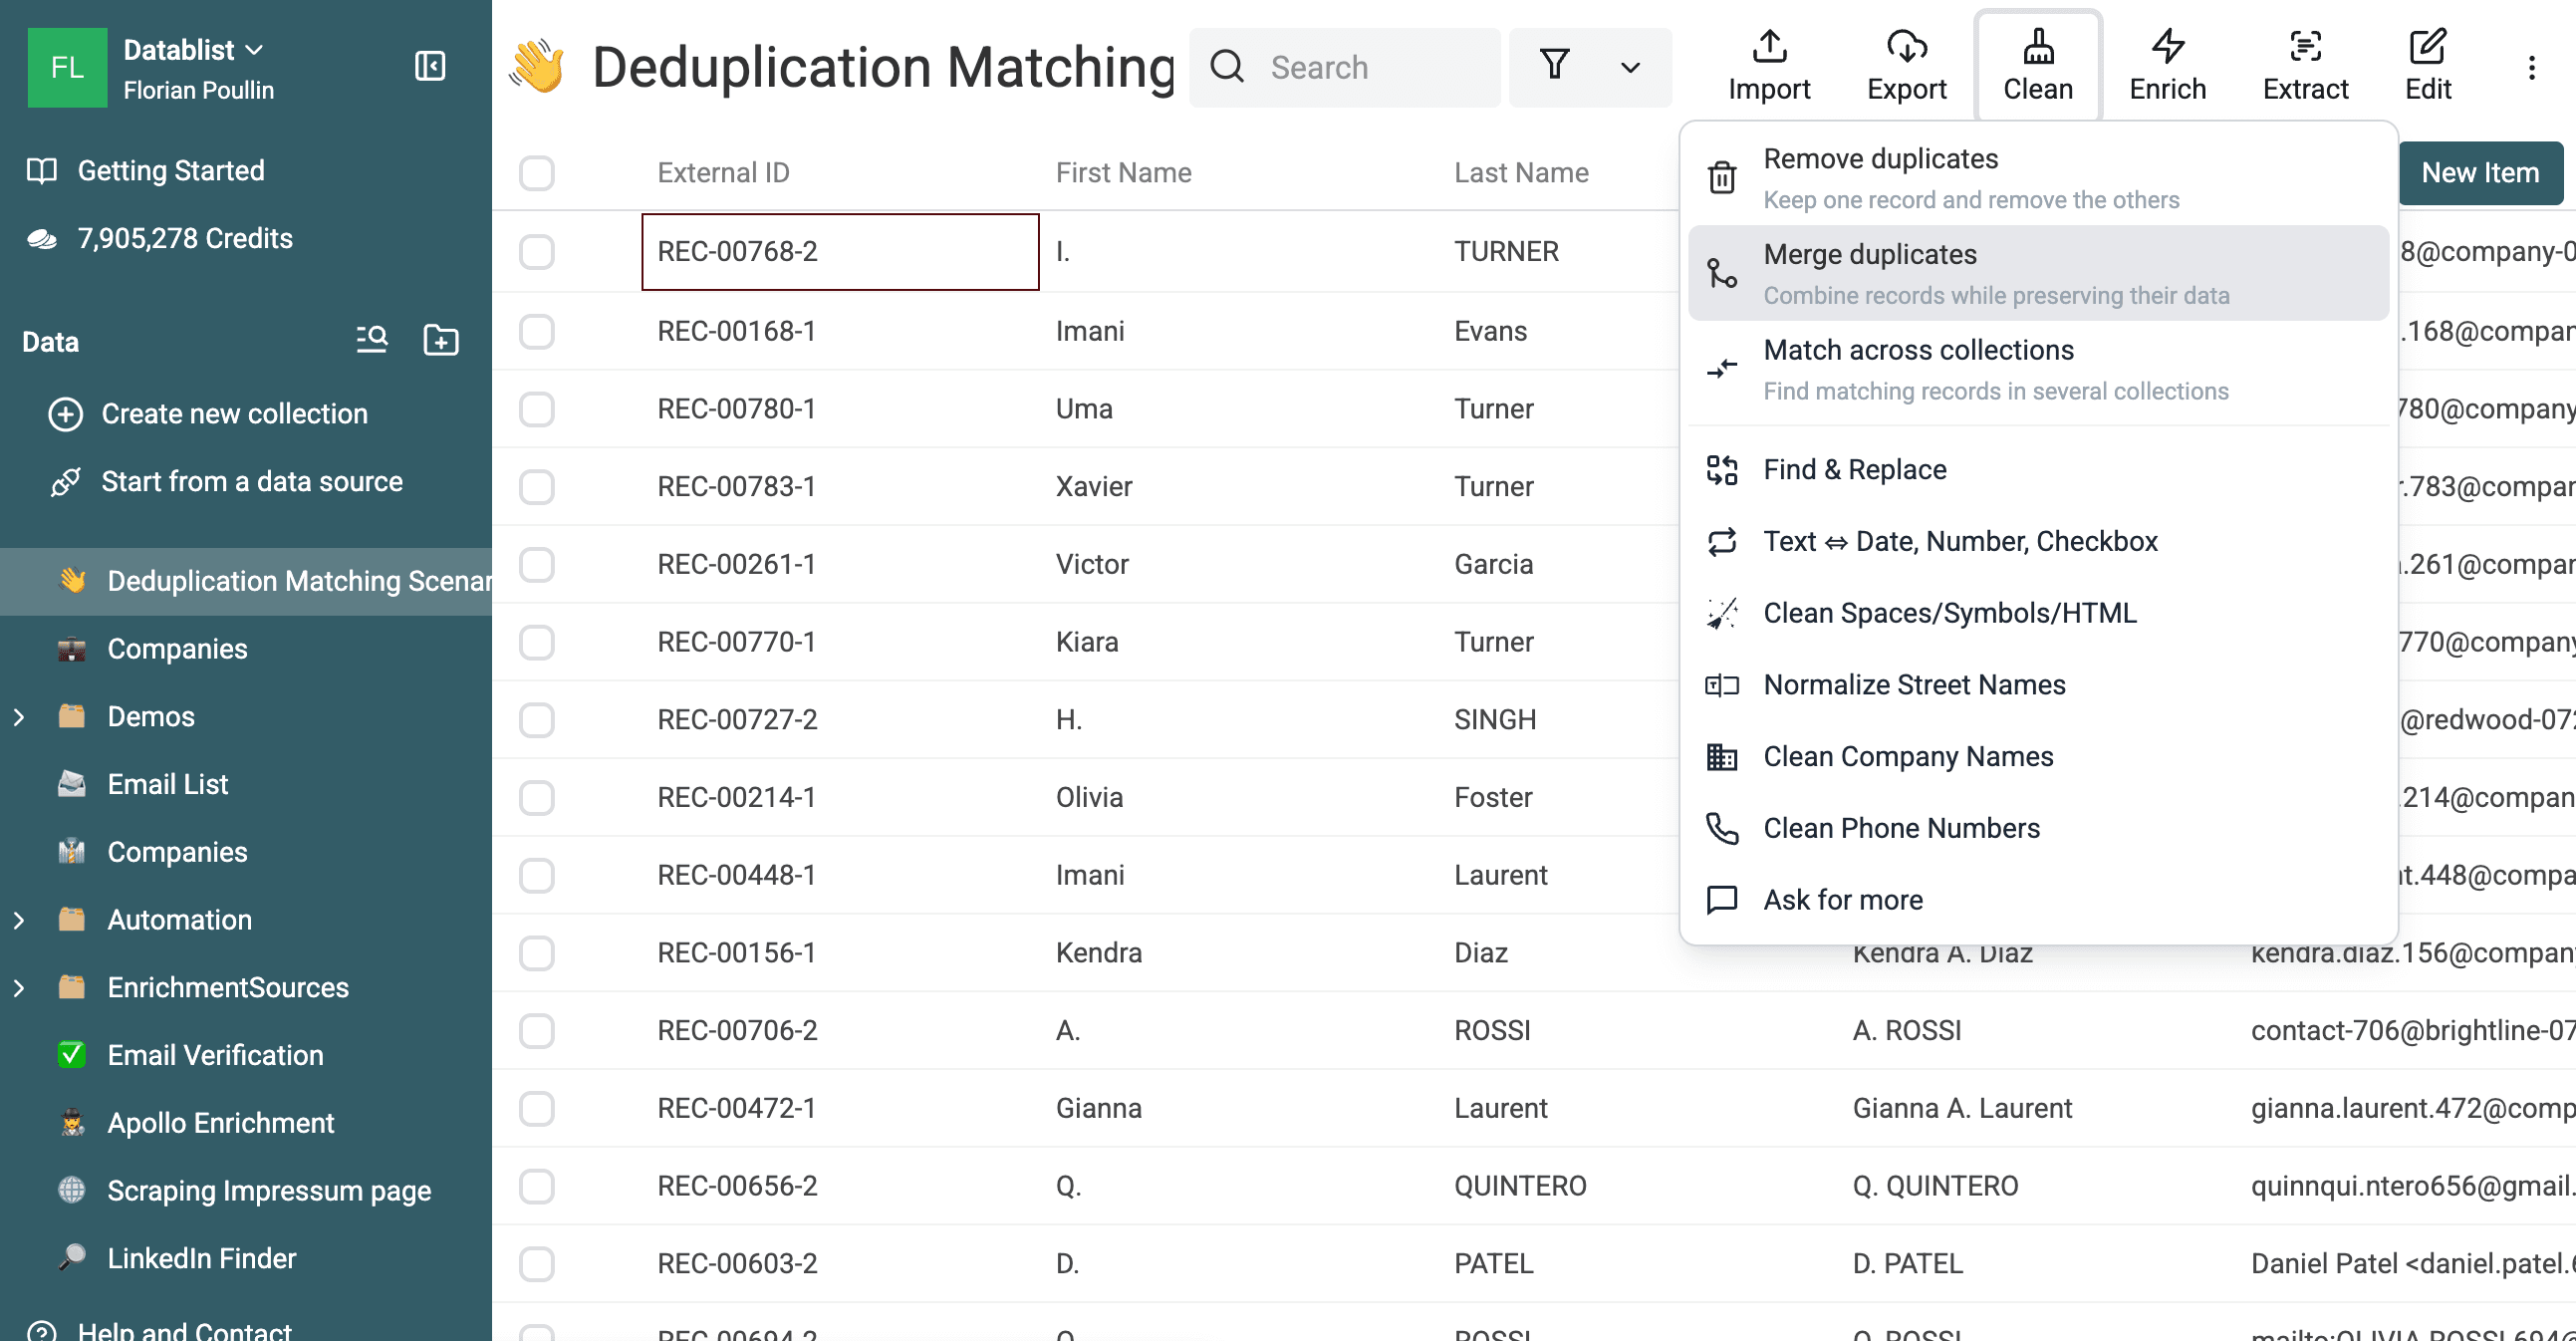
如果名单中包含网站信息,请先匹配网站。然后针对没有可靠网站或域名的记录,单独进行一轮公司名称匹配。
匹配公司网站
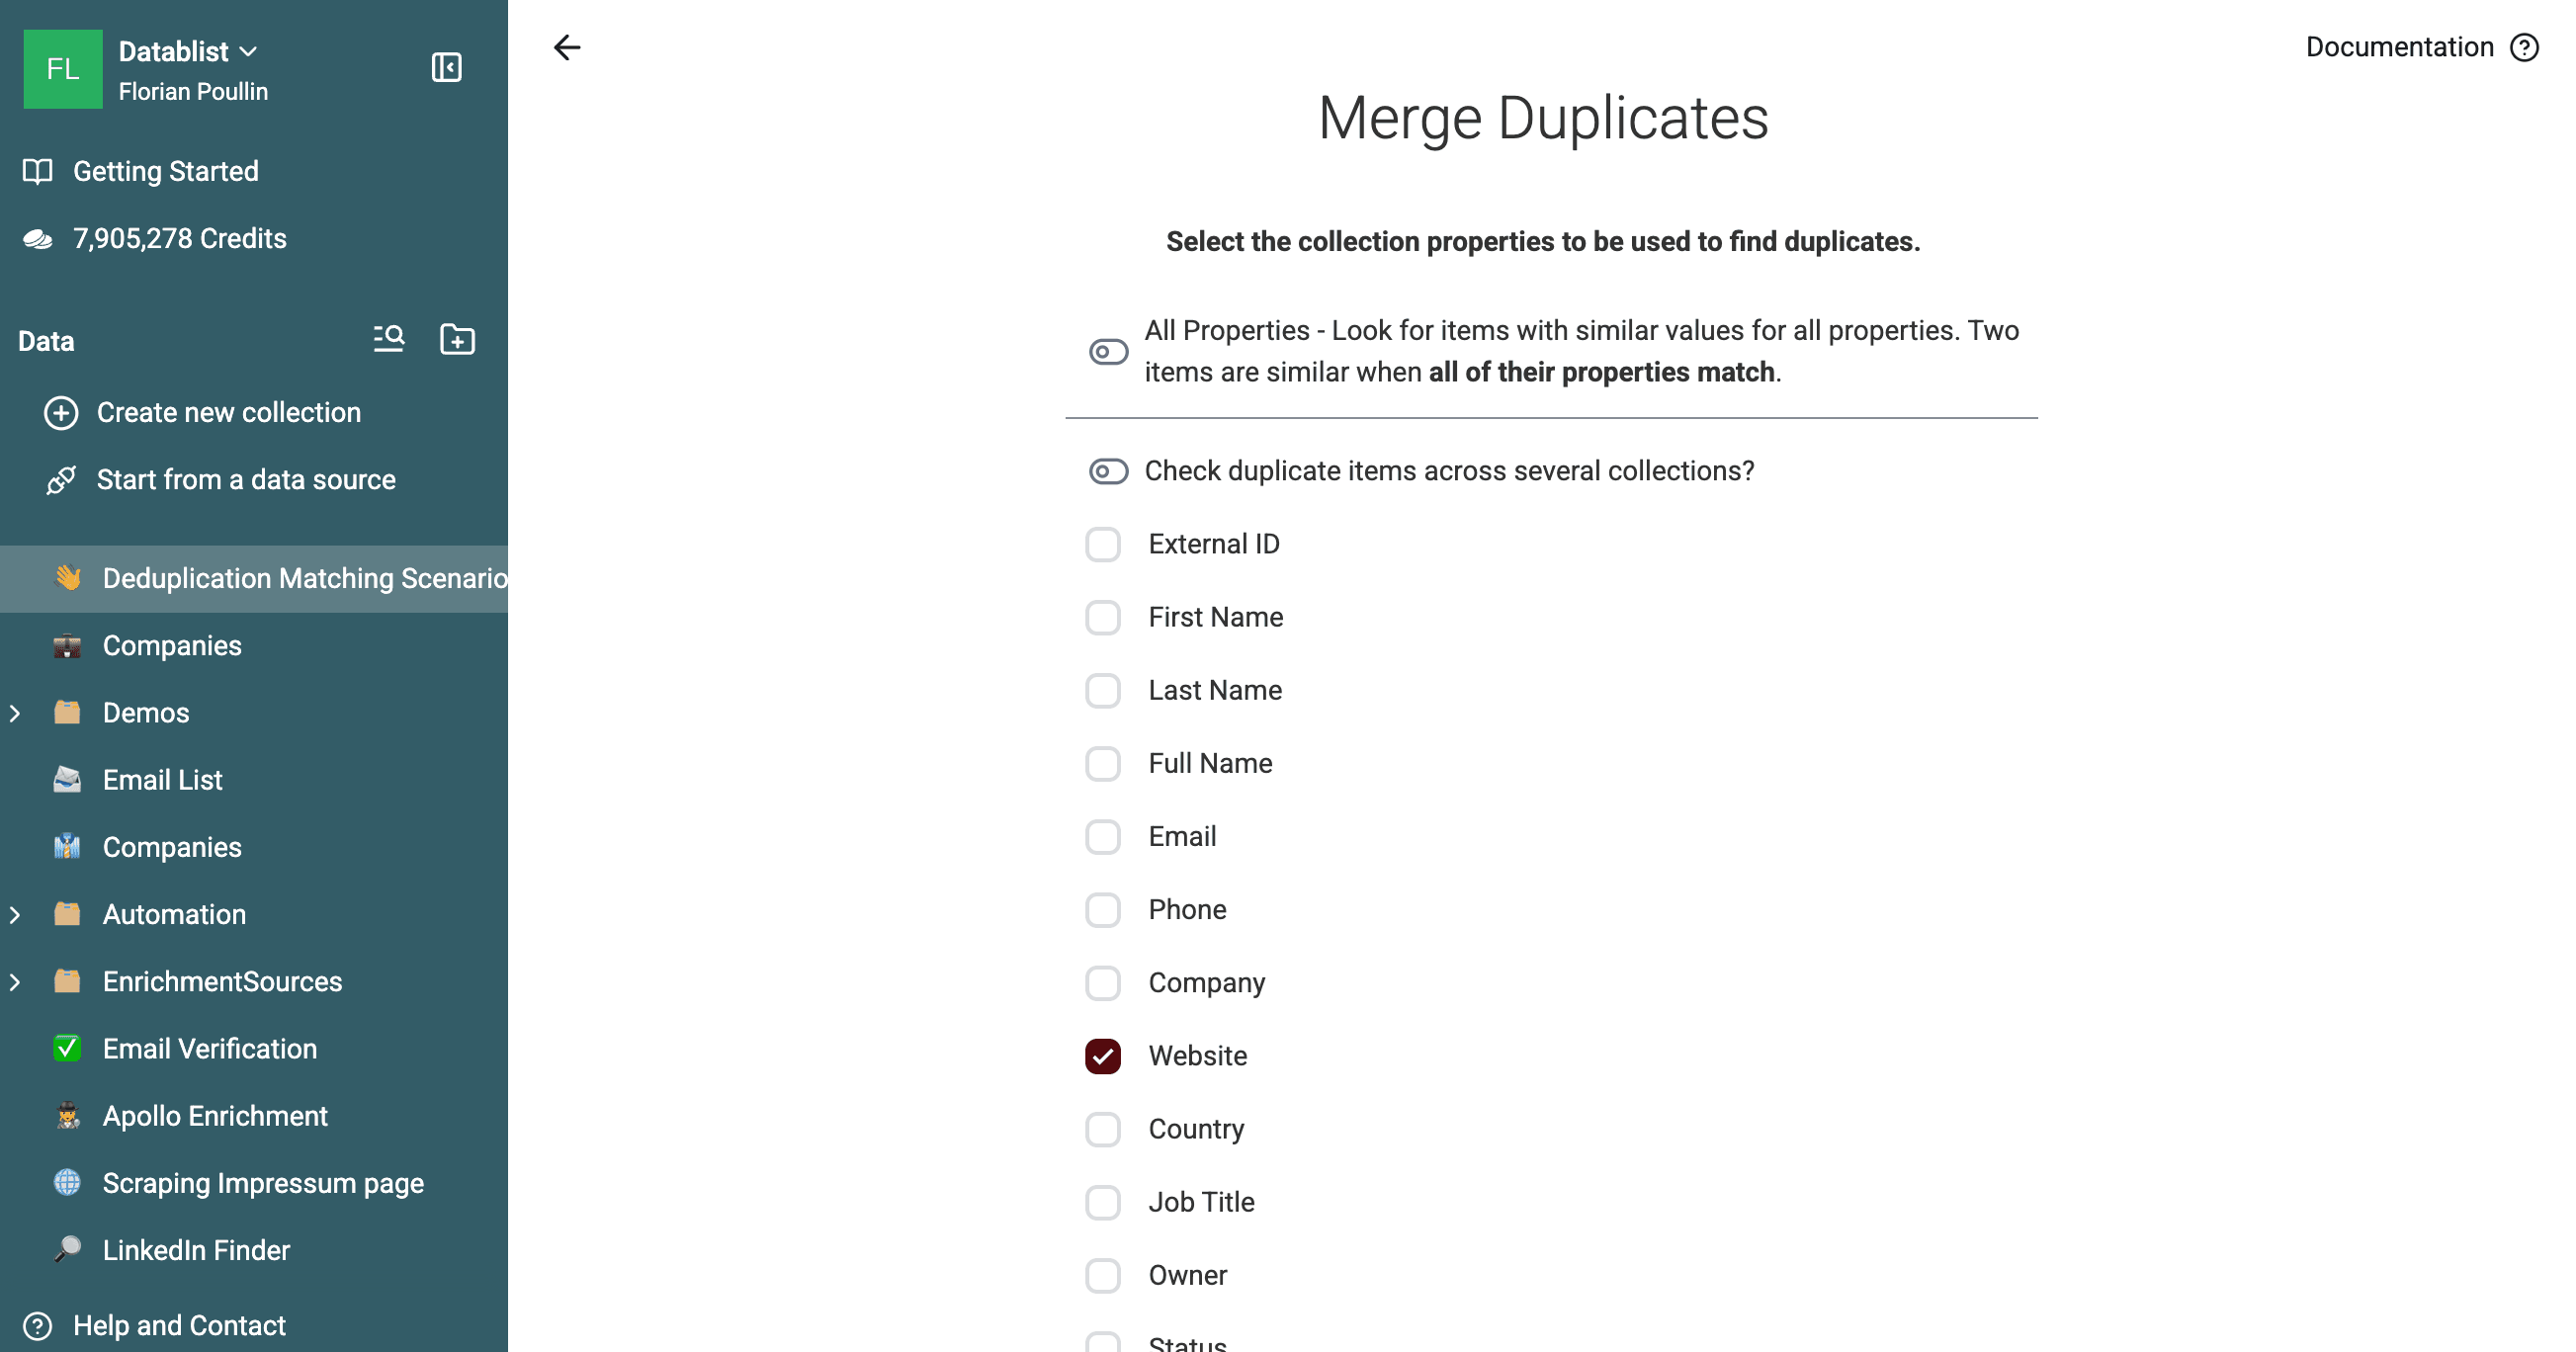
关闭 All Properties,仅选择 Website。
选择 Smart 和 URL processor。该 processor 会忽略协议差异和末尾斜杠。如果符合你的数据情况,还可以启用以下可选设置:
- Ignore Subdomain:将子域名视为同一个注册域名。
- Ignore Path:忽略页面路径,仅比较域名。
- Ignore Query Params:比对前移除追踪参数及其他查询参数。
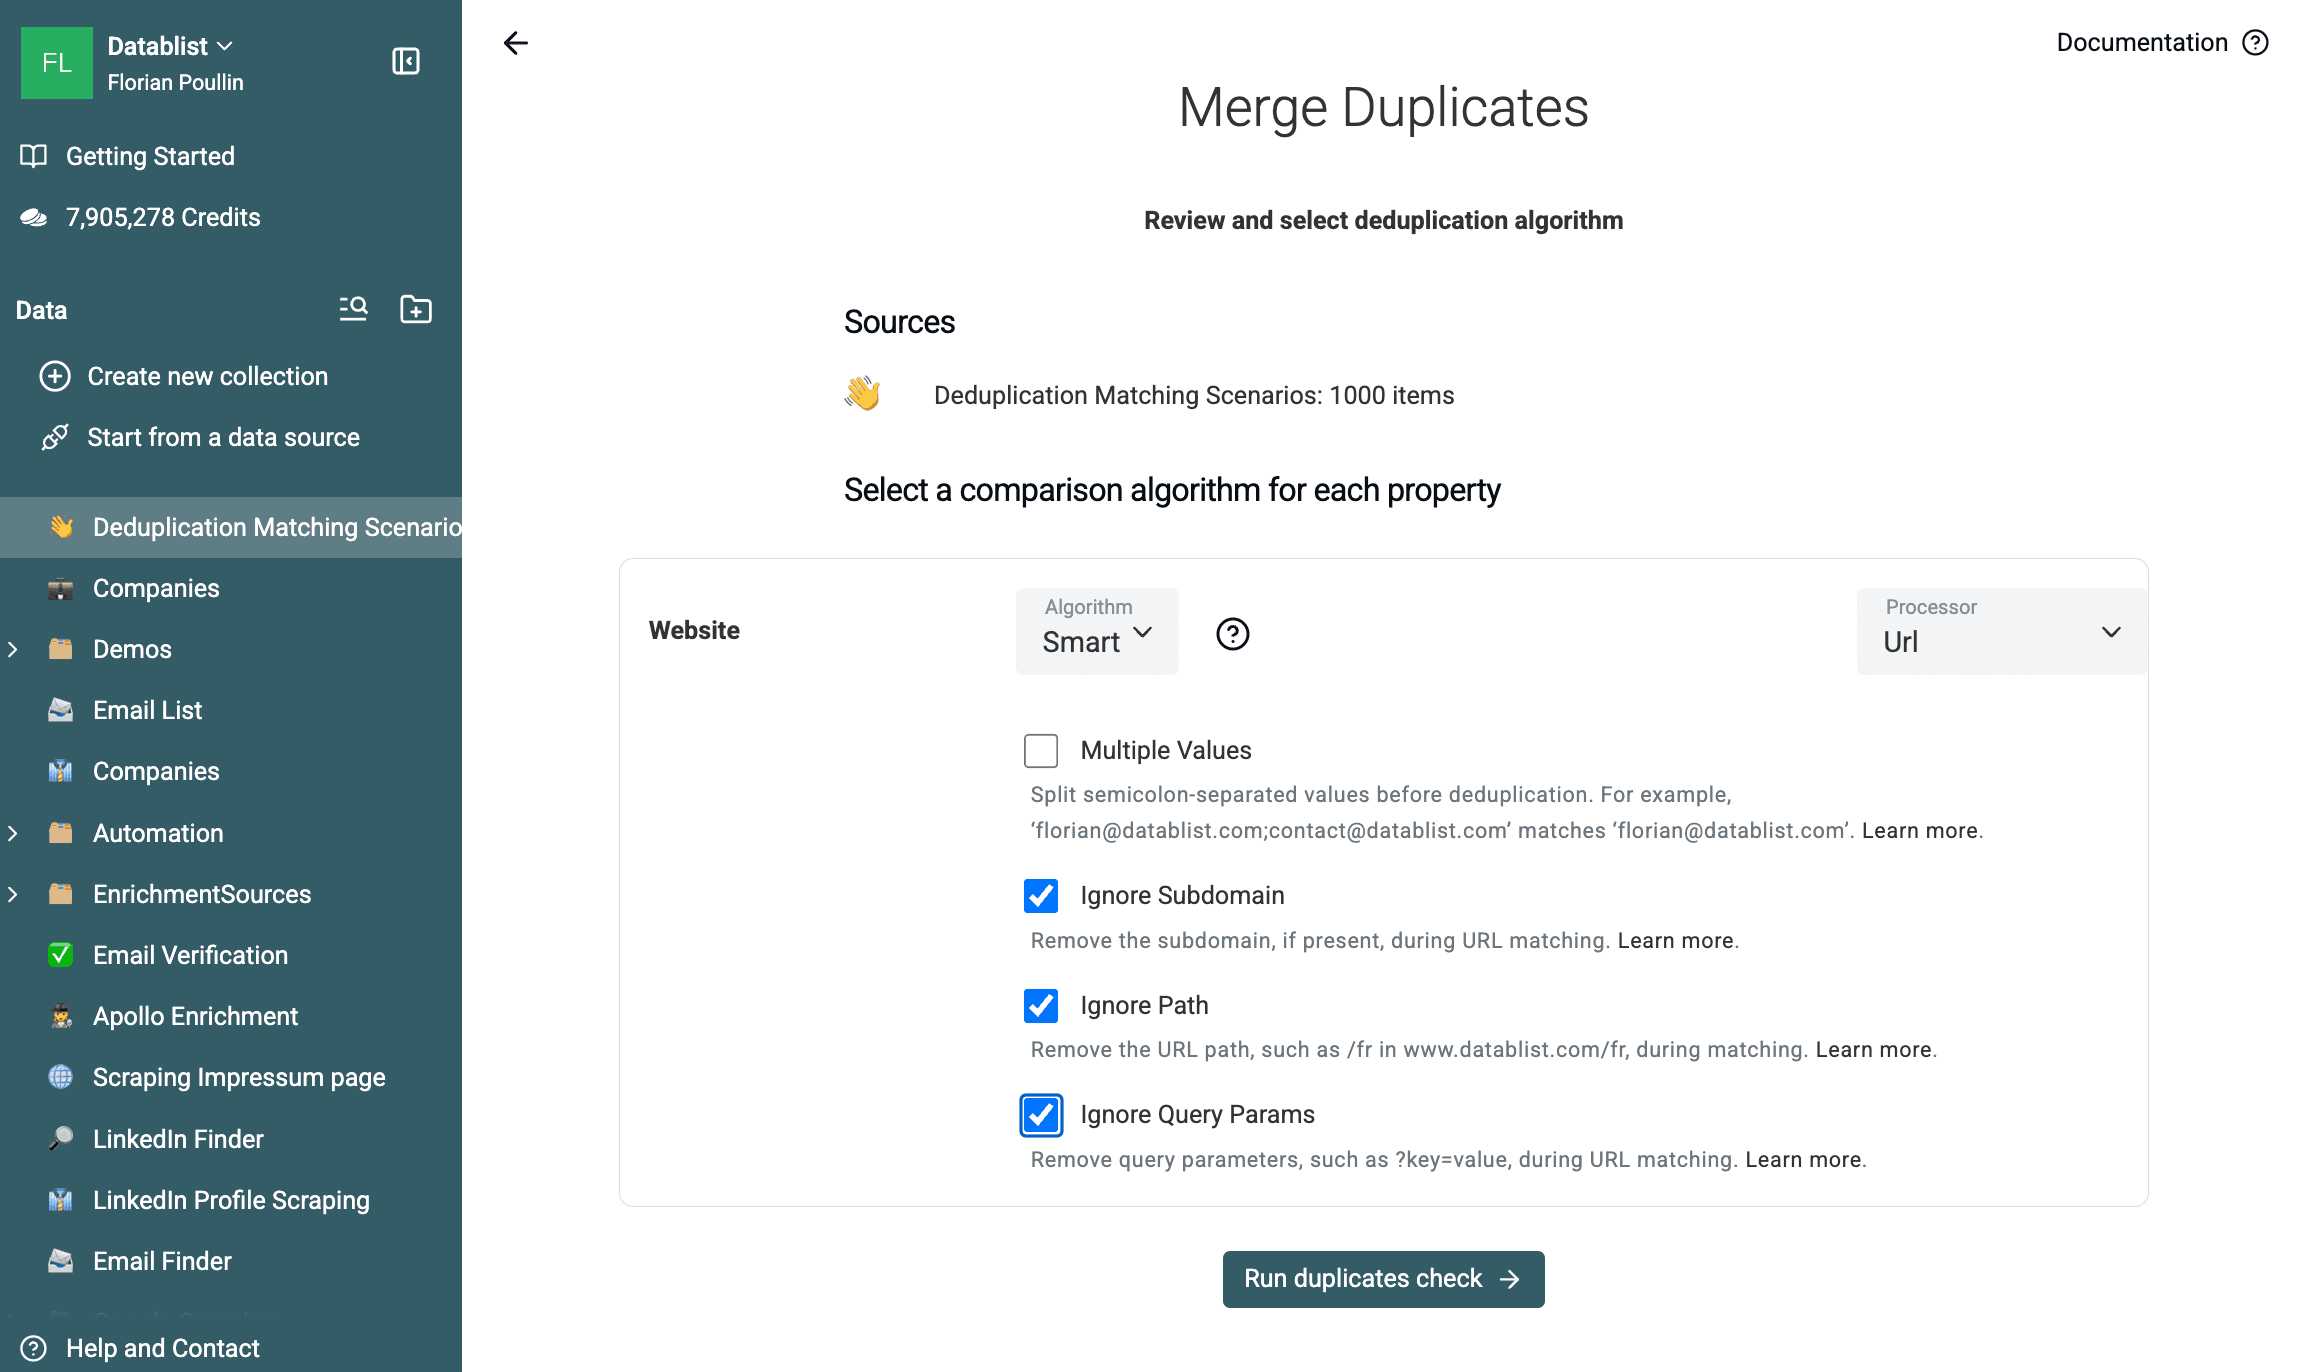
使用这些选项时要谨慎。不同的子域名或路径可能对应不同的账户、分支机构、产品或地点。如果这些差异对业务有意义,就应保留它们。
在这份 1,000 行样本中,Website 匹配得到了 200 个双记录分组。其中 50 对包含预设的 URL 变体,另外 150 对原本就具有相同的 Website 值。对导出分组进行验证后,没有发现跨实体误匹配。
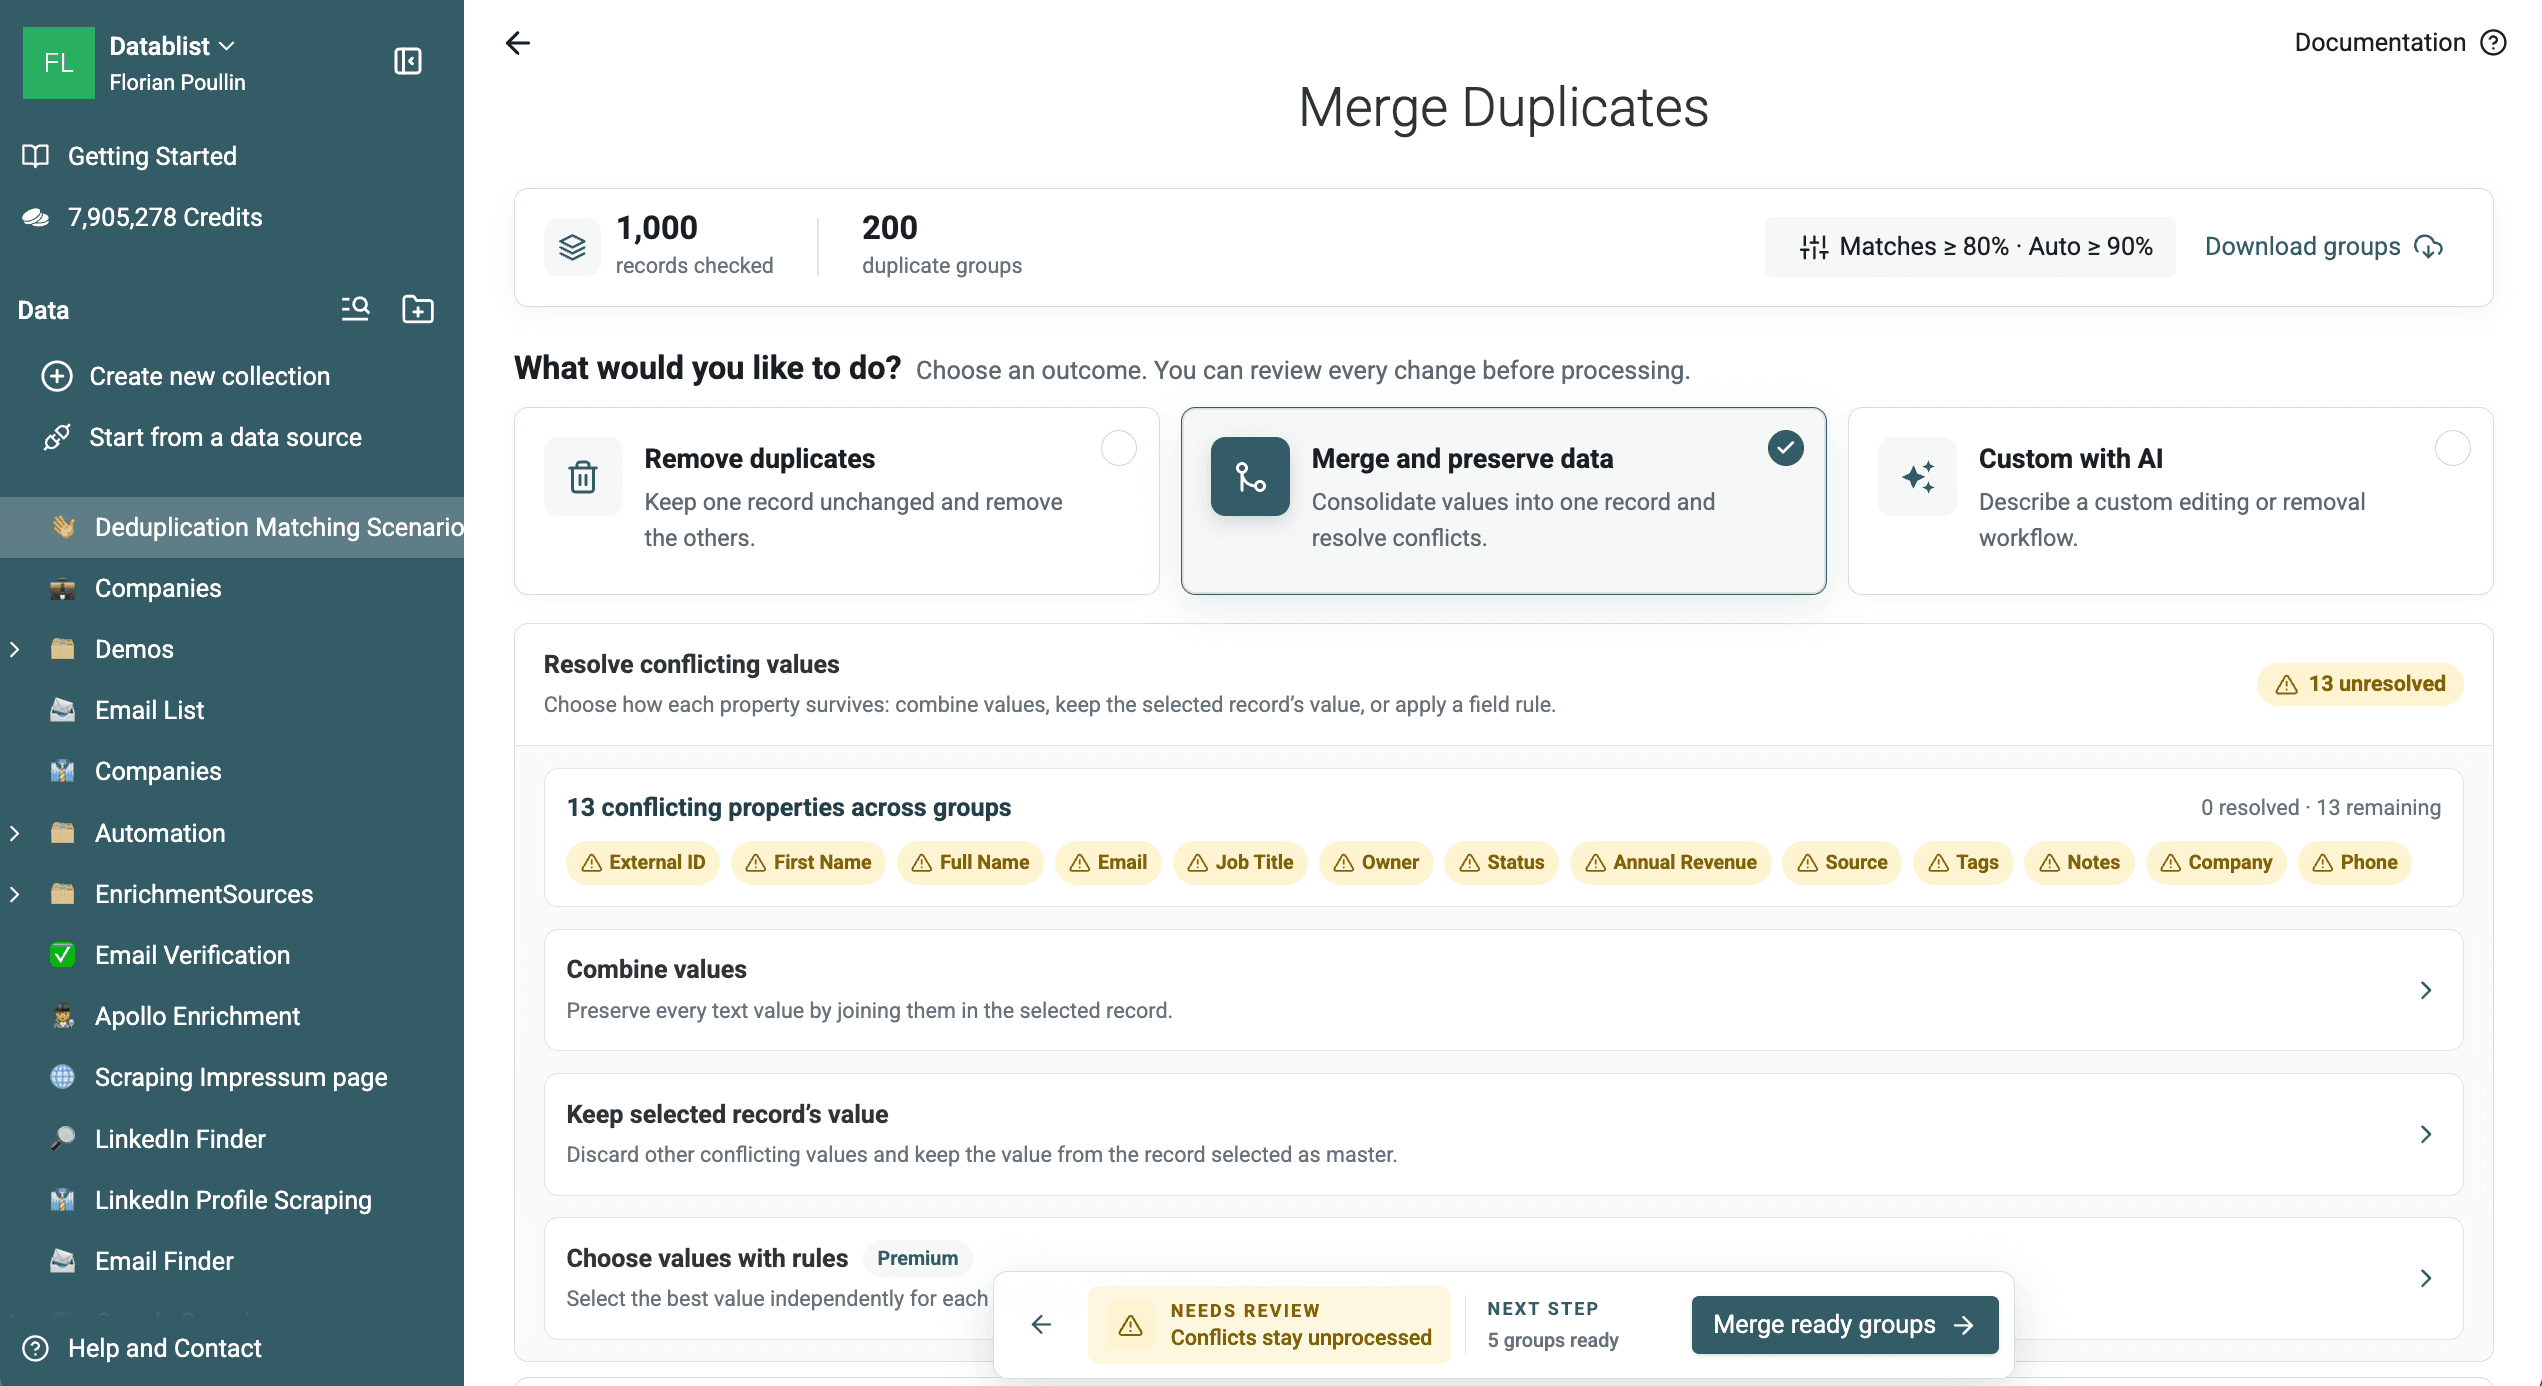
处理分组前,请先打开 Why matched。其中会显示 Website 属性、Smart 算法、URL processor、已启用的 URL 选项以及匹配分数。
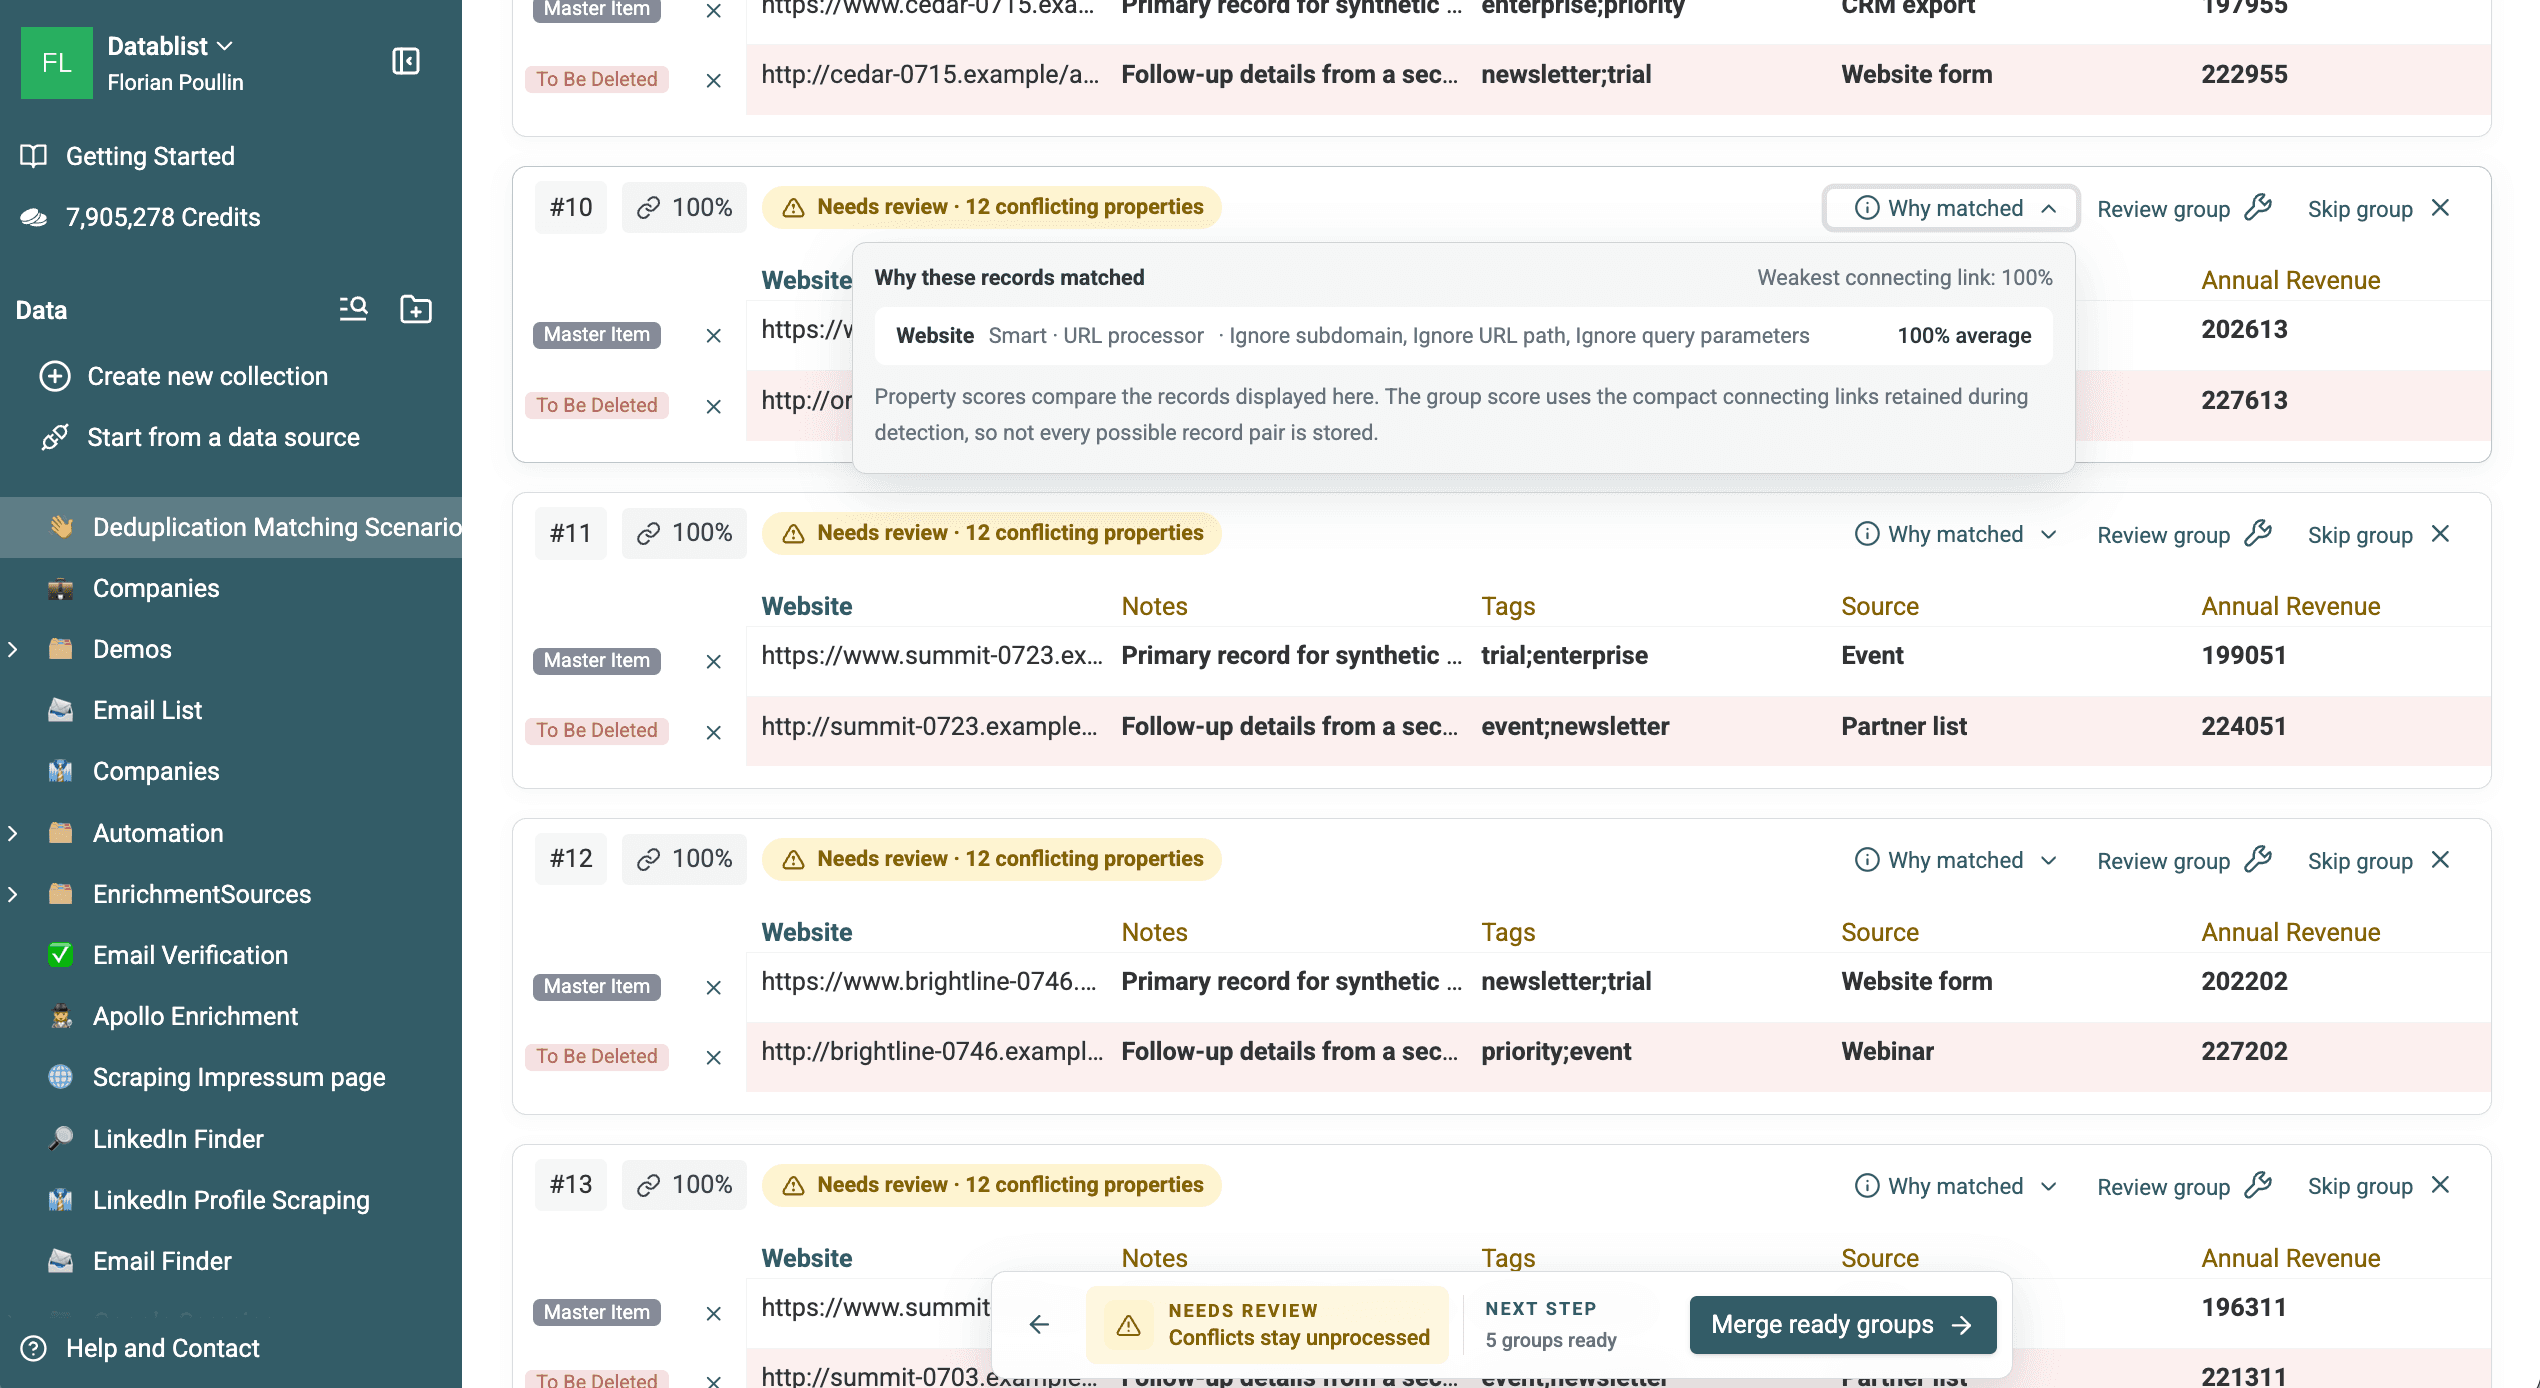
下载 200 个 Website 重复分组,检查系统匹配出的记录。
匹配标准化后的公司名称
在第二轮匹配中选择 Company。
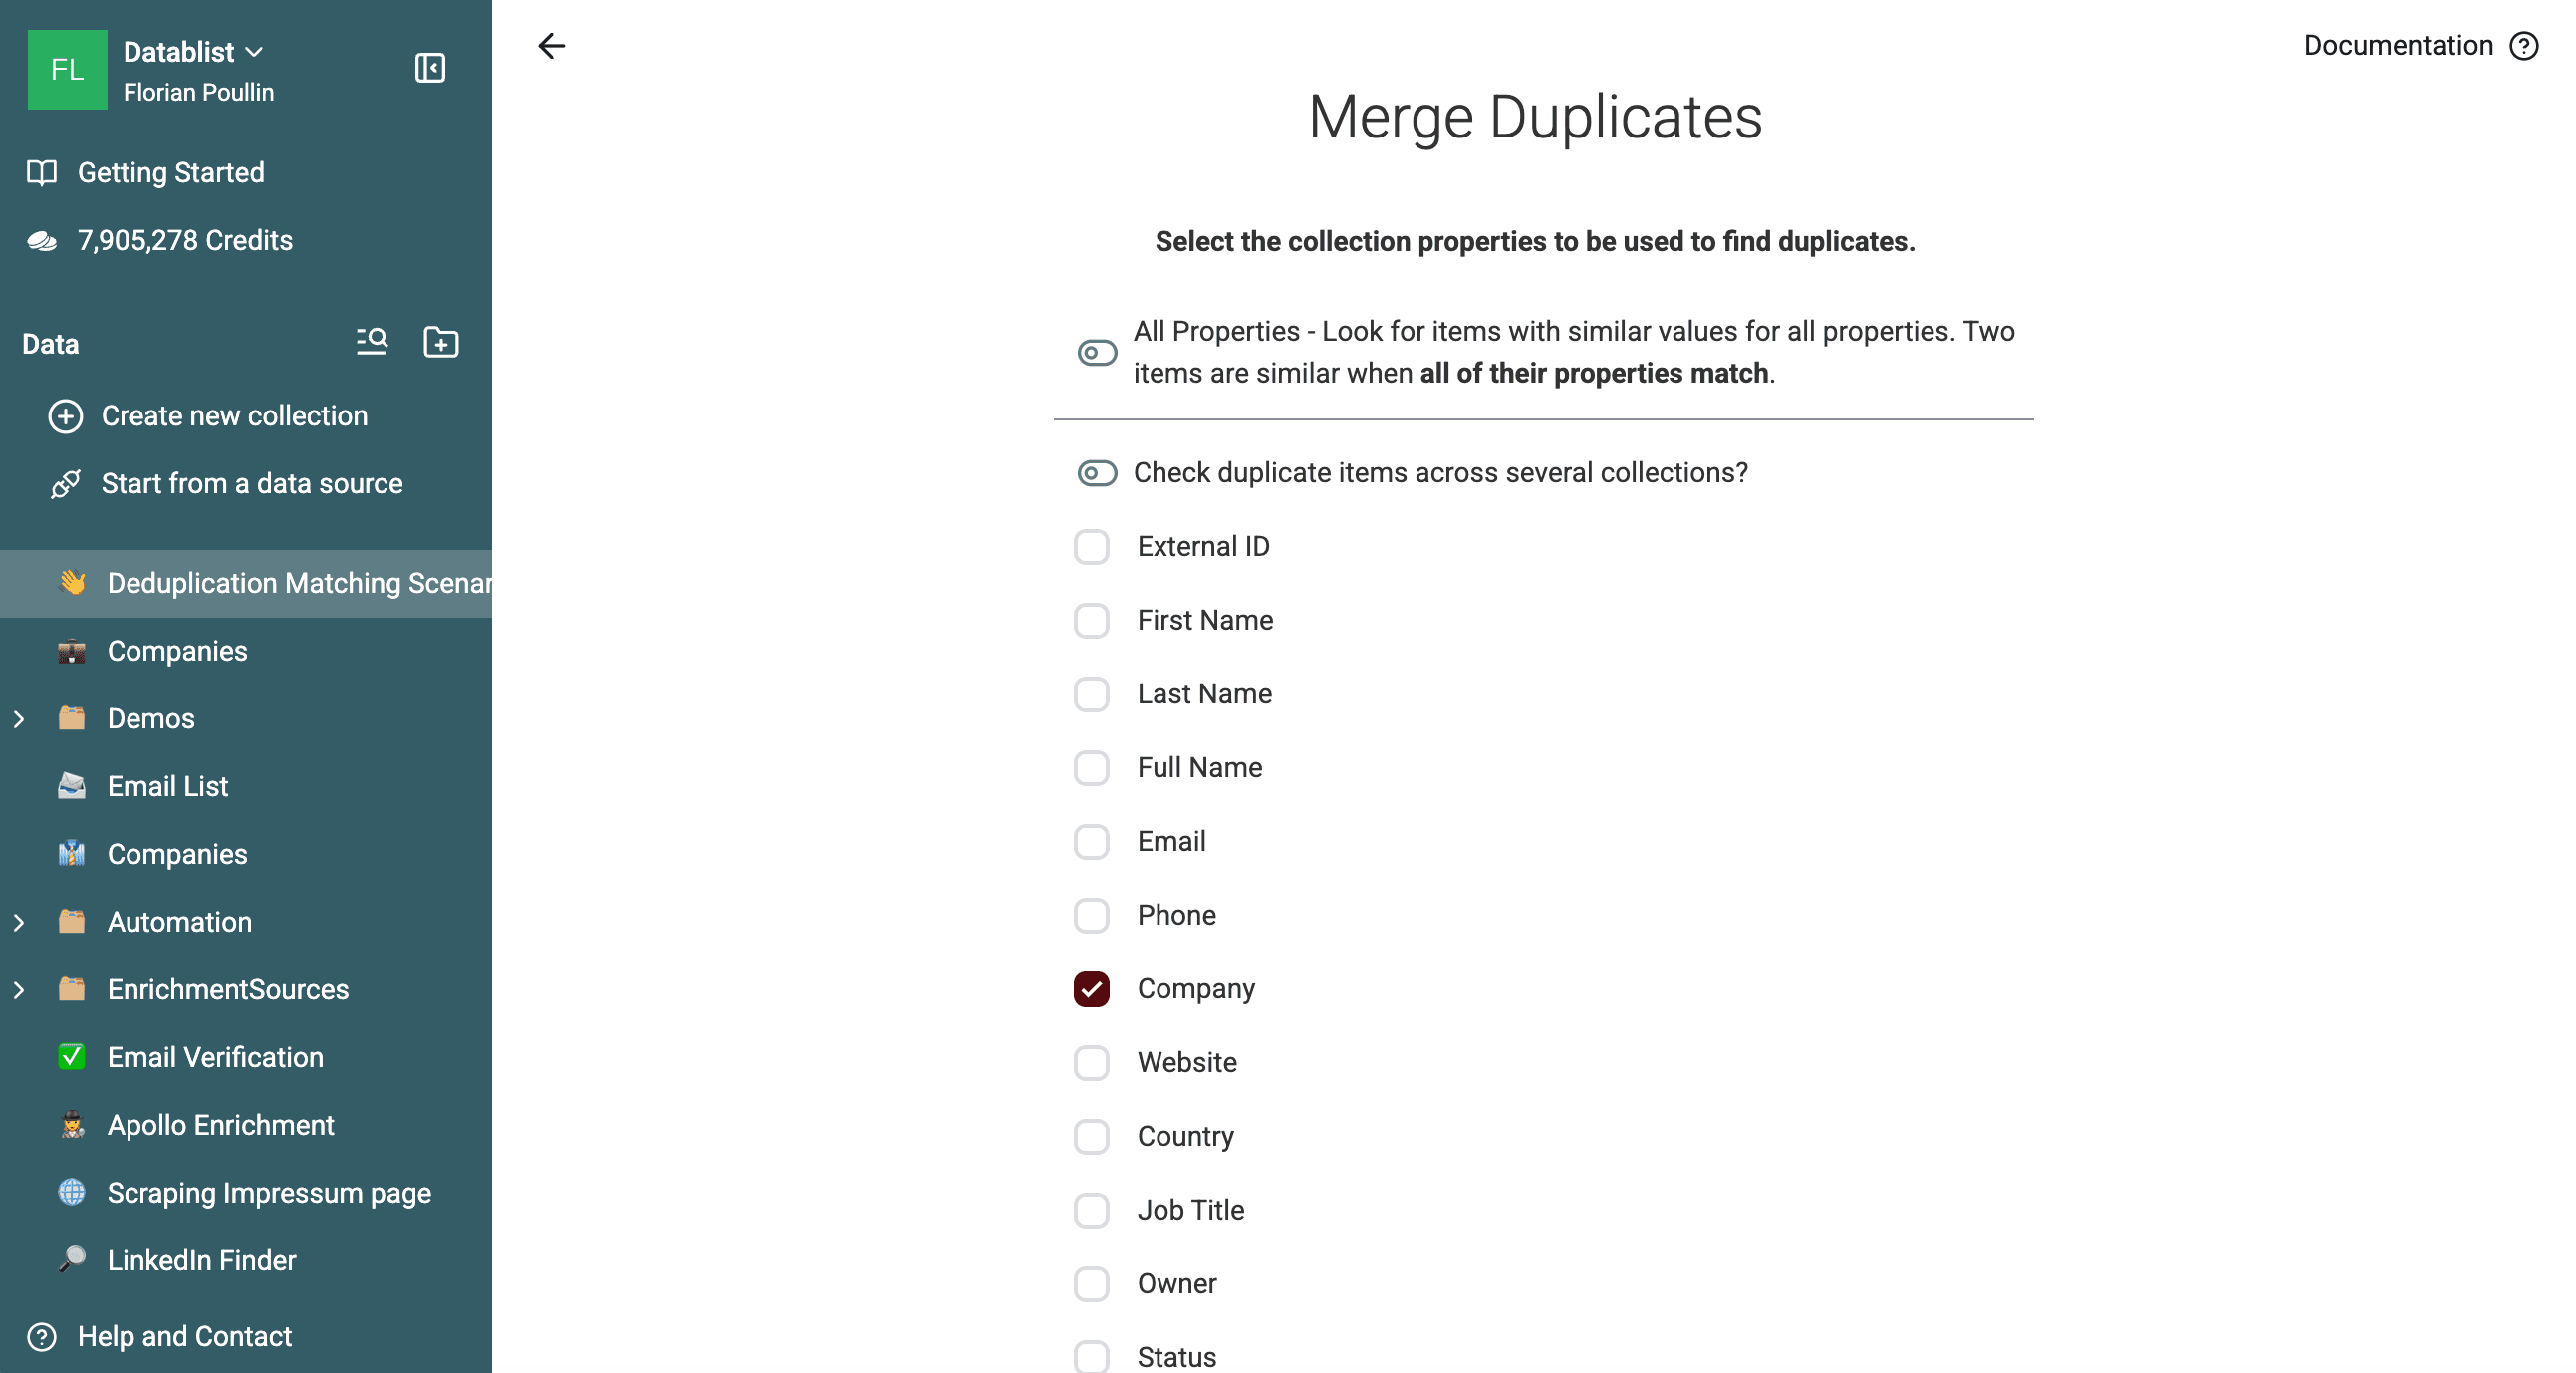
选择比对方式:
- 使用 Smart 和 Company Name processor,在比对前移除常见公司词语。
- 使用 Jaro-Winkler 或 Levenshtein 处理拼写变体。建议先设置较高的阈值,并将置信度较低的分组留在 Needs review 中。
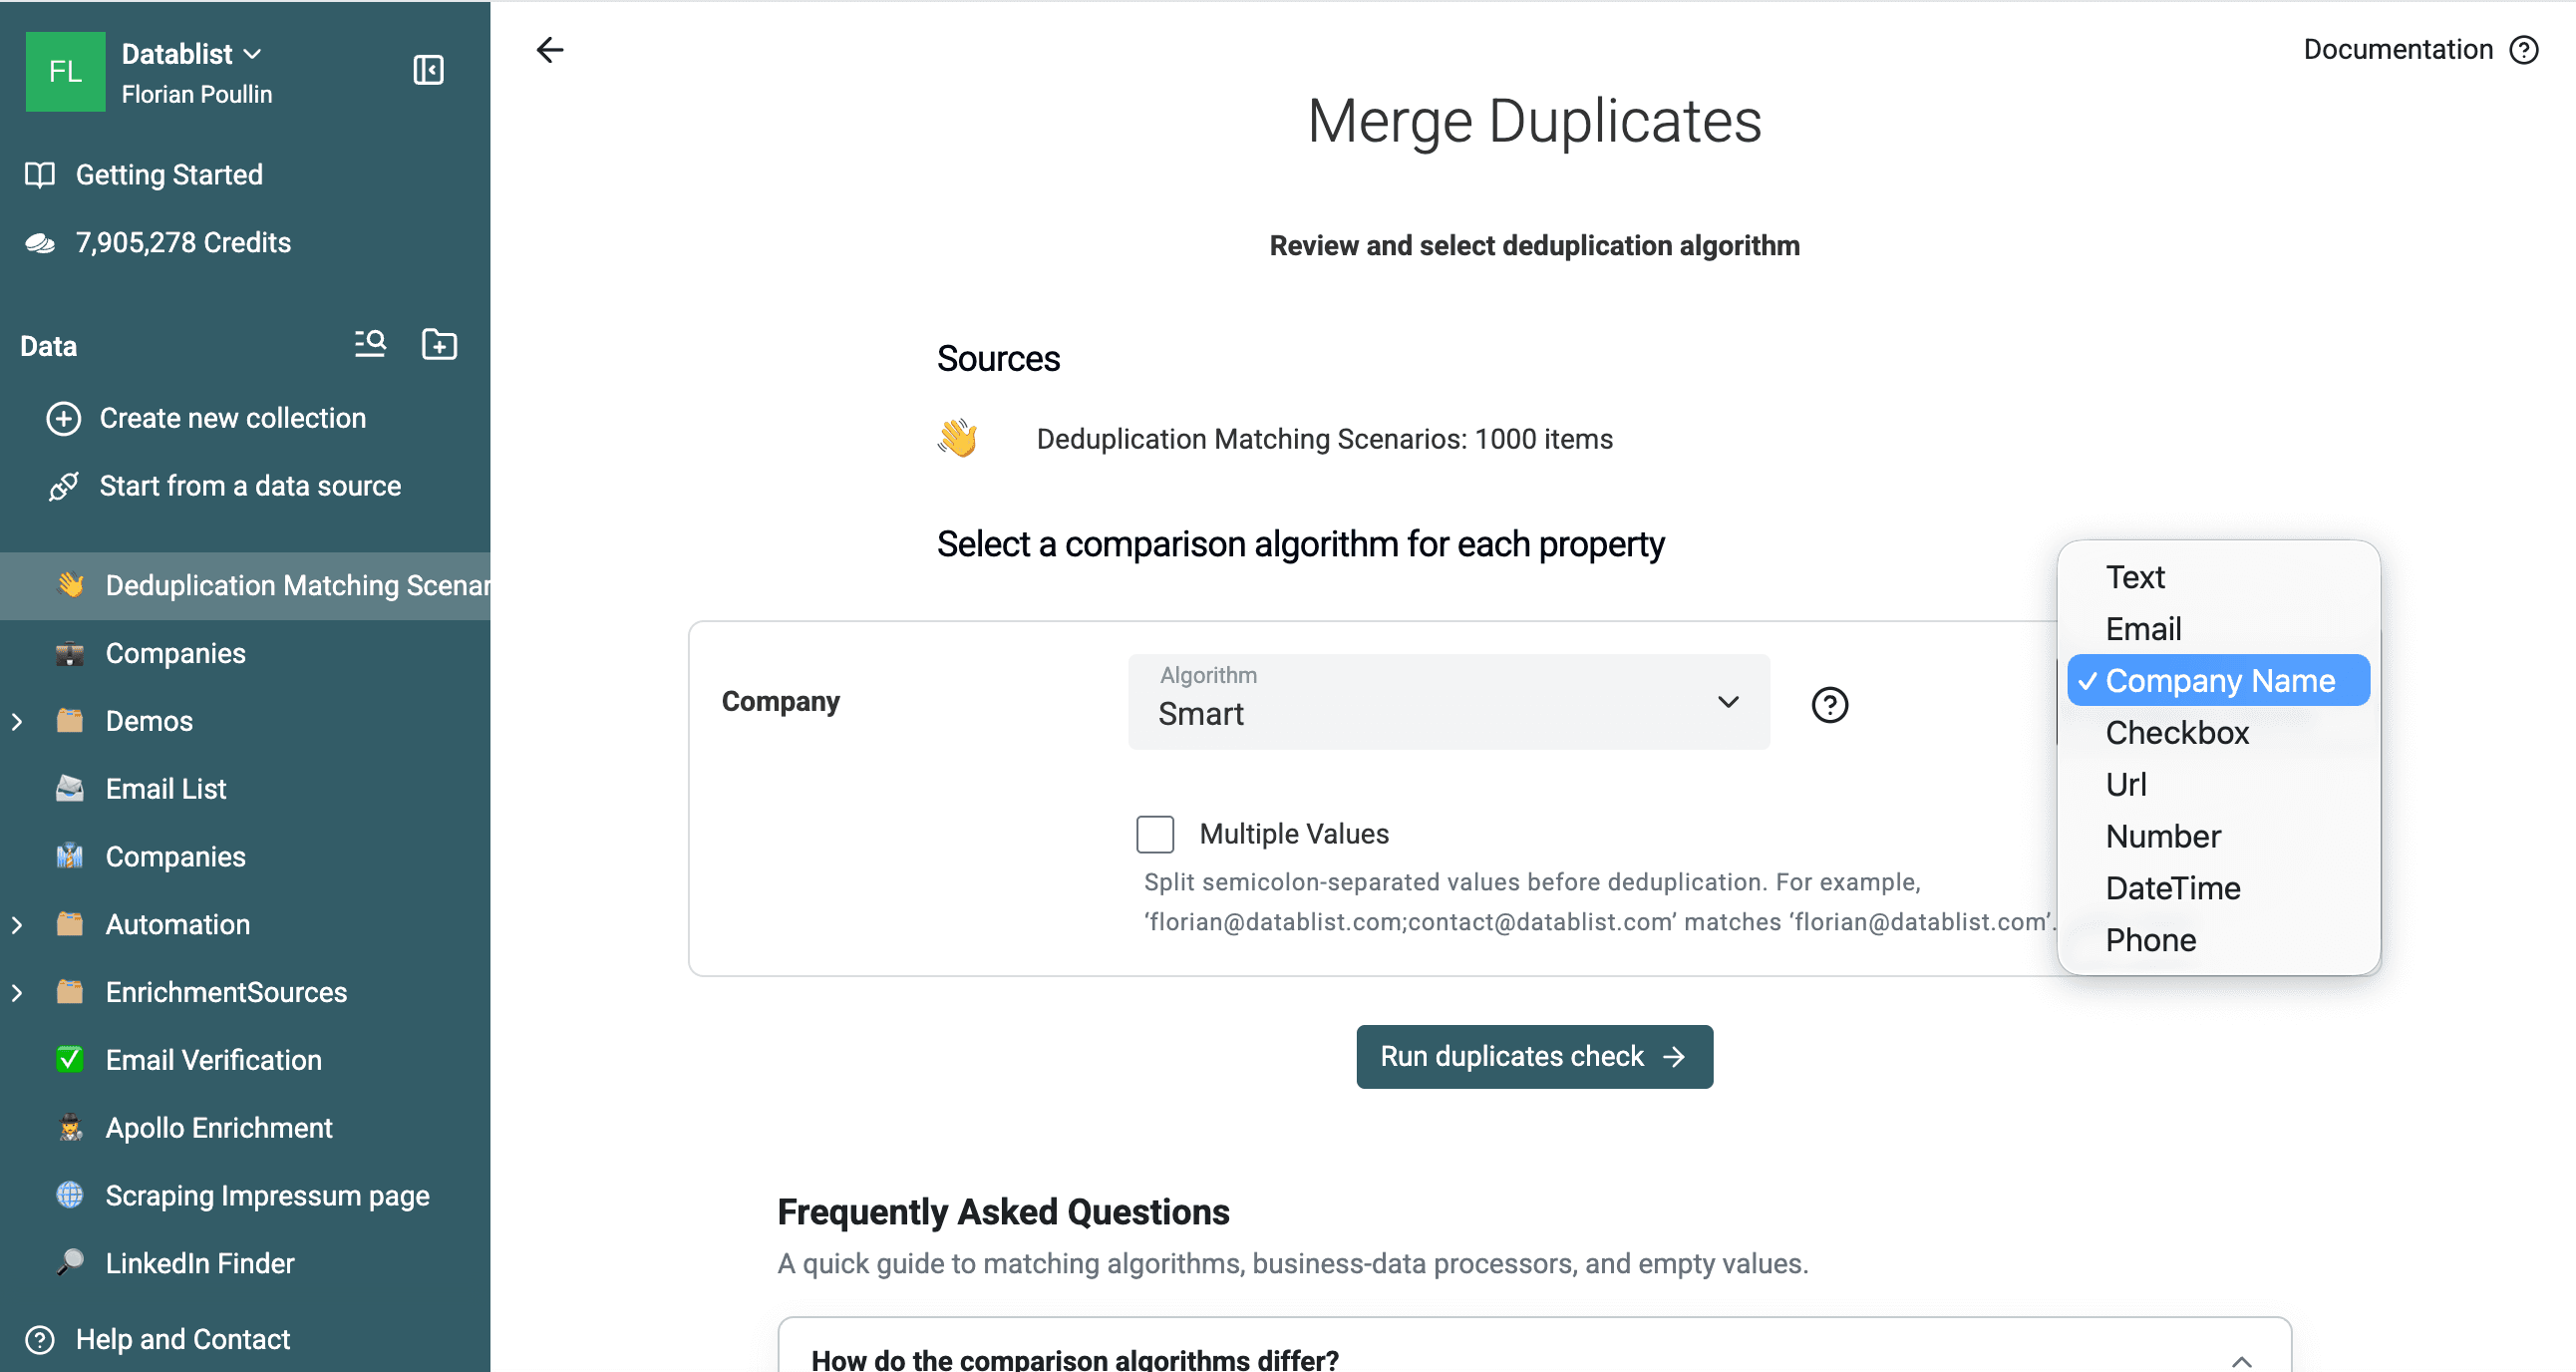
运行重复项检查,查找相互匹配的记录。
Company Name Processor 的工作原理
Company Name Processor 是一项专门用于在检测重复项之前标准化公司名称的工具。企业名称在数据中经常存在多种写法,因此这一步十分关键。
它会执行以下处理:
- 移除法律实体后缀:LLC、Inc.、Ltd. 等。
- 忽略地区词语:Europe、USA、UK 等。
- 删除常见商业关键词:Partners、Group、Technologies 等。
示例
| 原始名称 | 标准化名称 |
|---|---|
| Apple Inc. | Apple |
| Apple USA LLC | Apple |
| Apple Technologies | Apple |
| Microsoft Corporation | Microsoft |
| Microsoft Ltd. UK | Microsoft |
这些值可能会成为候选匹配项。Company Name processor 是付费功能;即便系统将记录归入同一组,你仍需确认它们确实属于同一家企业,才能执行合并。
1,000 行样本的实测结果
在检查的 1,000 条记录中,Company Name 匹配得到了 200 个双记录分组:
- 50 对包含预设的公司名称变体,例如
Cedar 0715, Inc.和Cedar 0715 Group LLC。 - 另外 150 对预设重复记录原本就具有完全相同的 Company 值。
在本次测试中,全部 200 个分组都正确对应到各自的合成实体,没有任何分组混入不同实体的记录。请注意,这只是生成样本的测试结果,并不代表普遍适用的准确率保证。
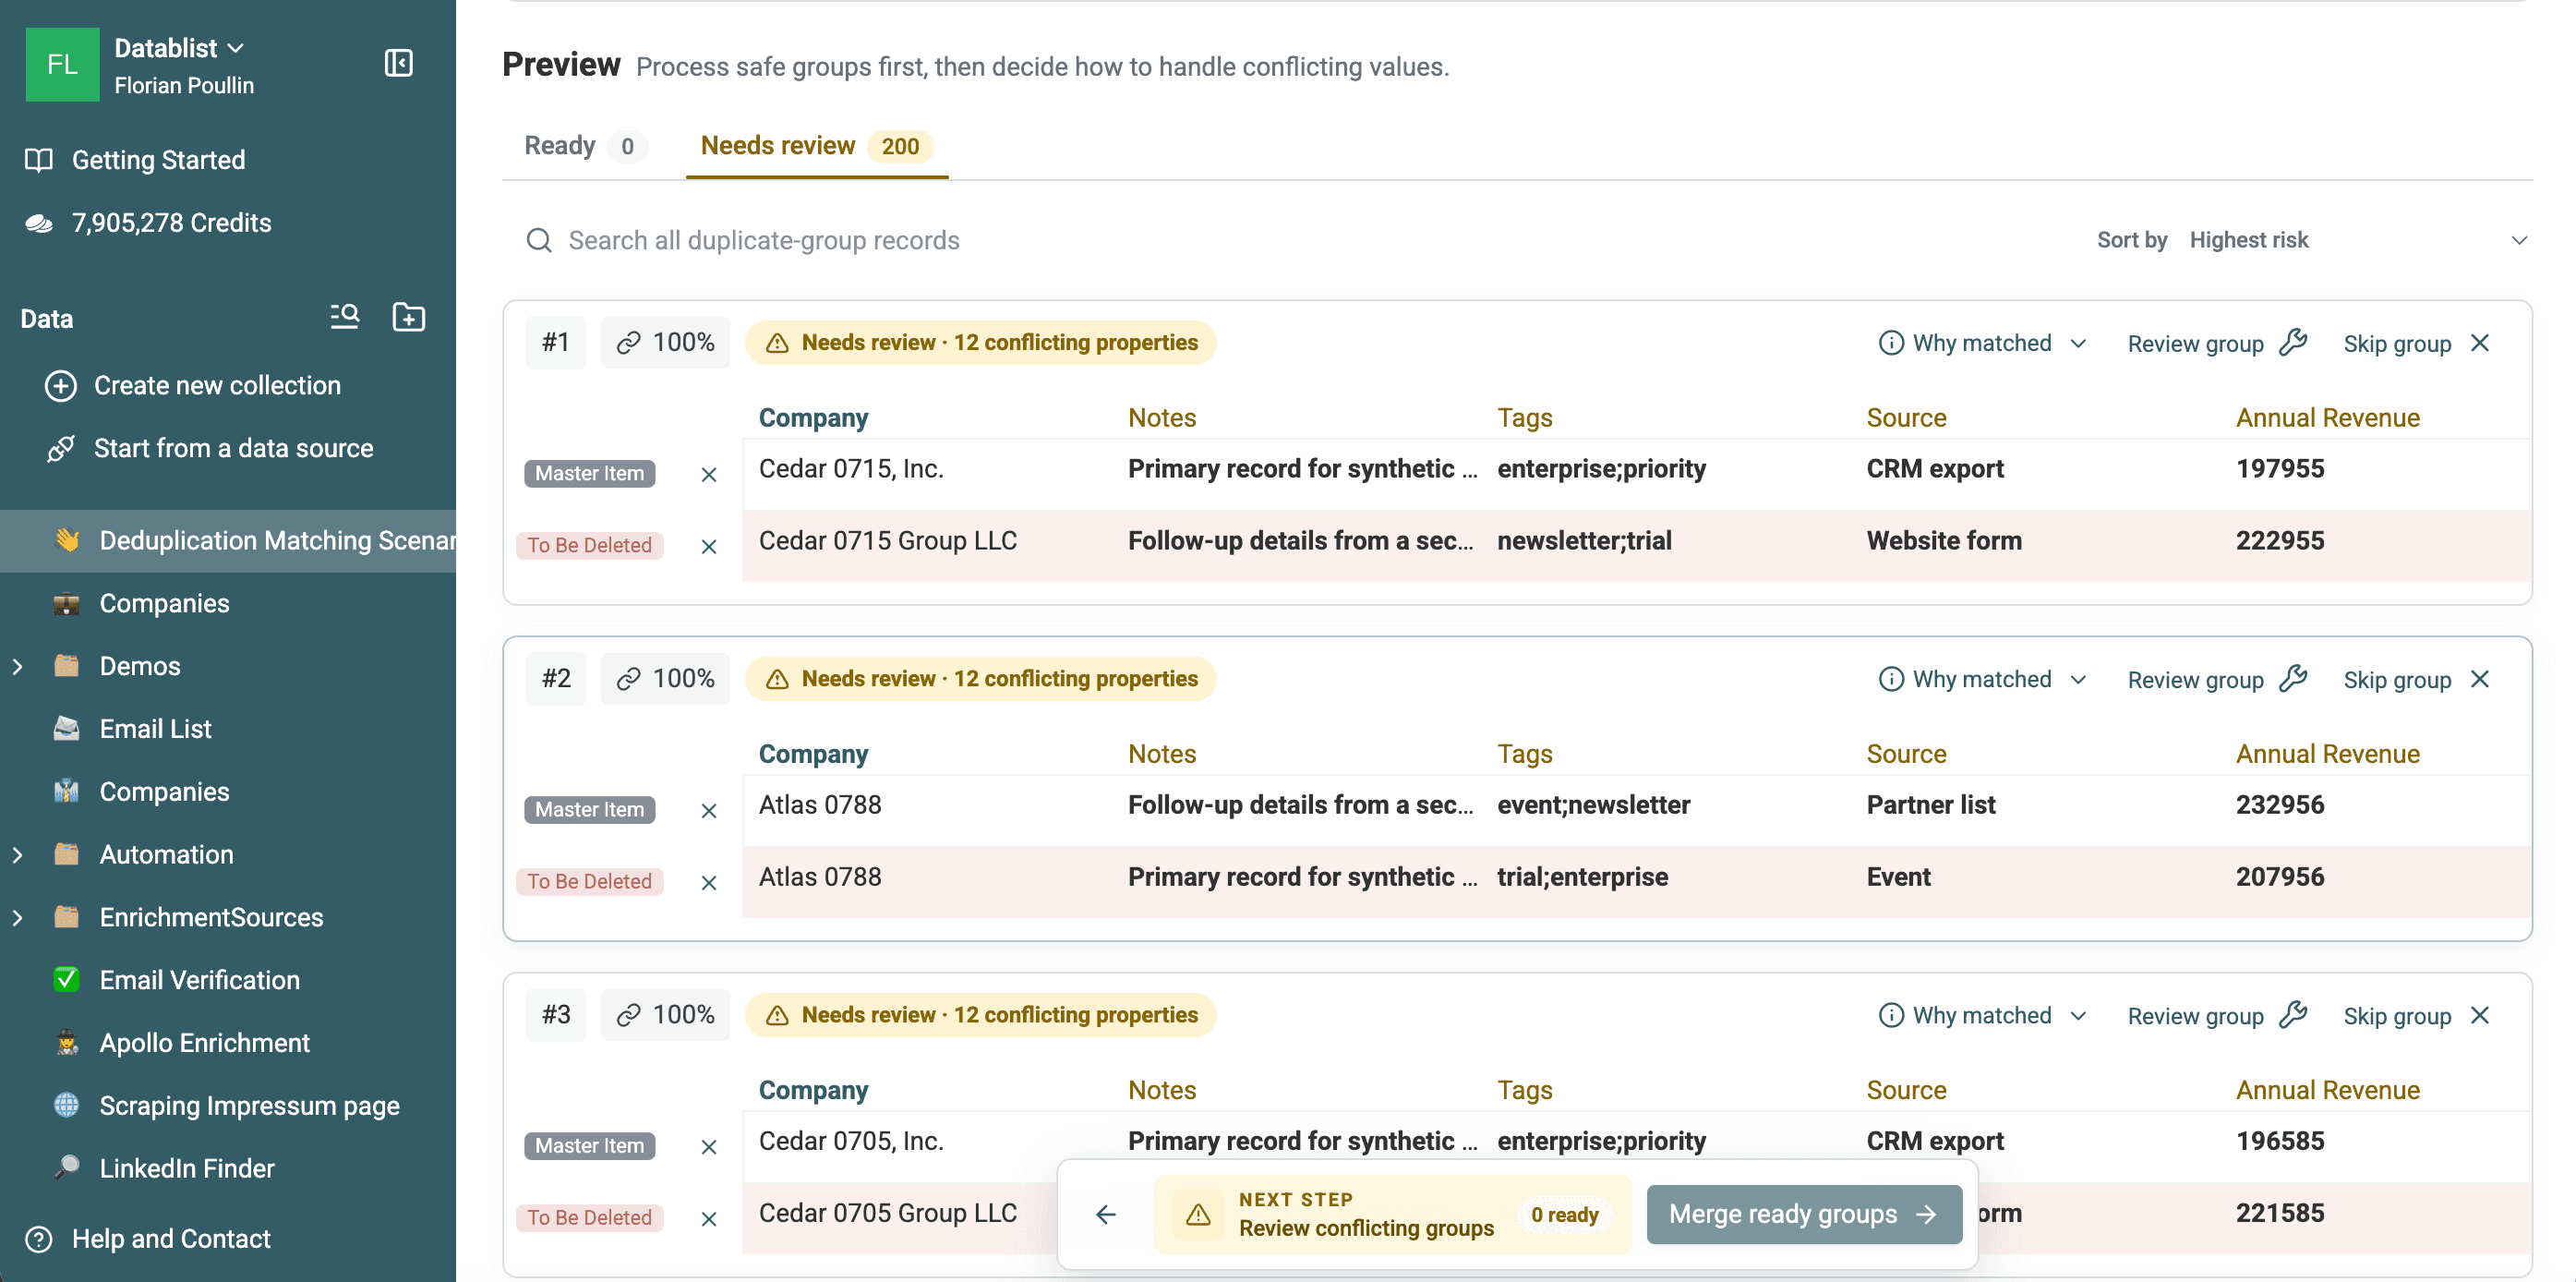
这些分组的匹配分数均为 100%。它们之所以出现在 Needs review 中,是因为其他属性存在冲突,并非公司名称匹配的置信度不足。
打开 Why matched,核对该分组使用的属性、算法、processor 和匹配分数。
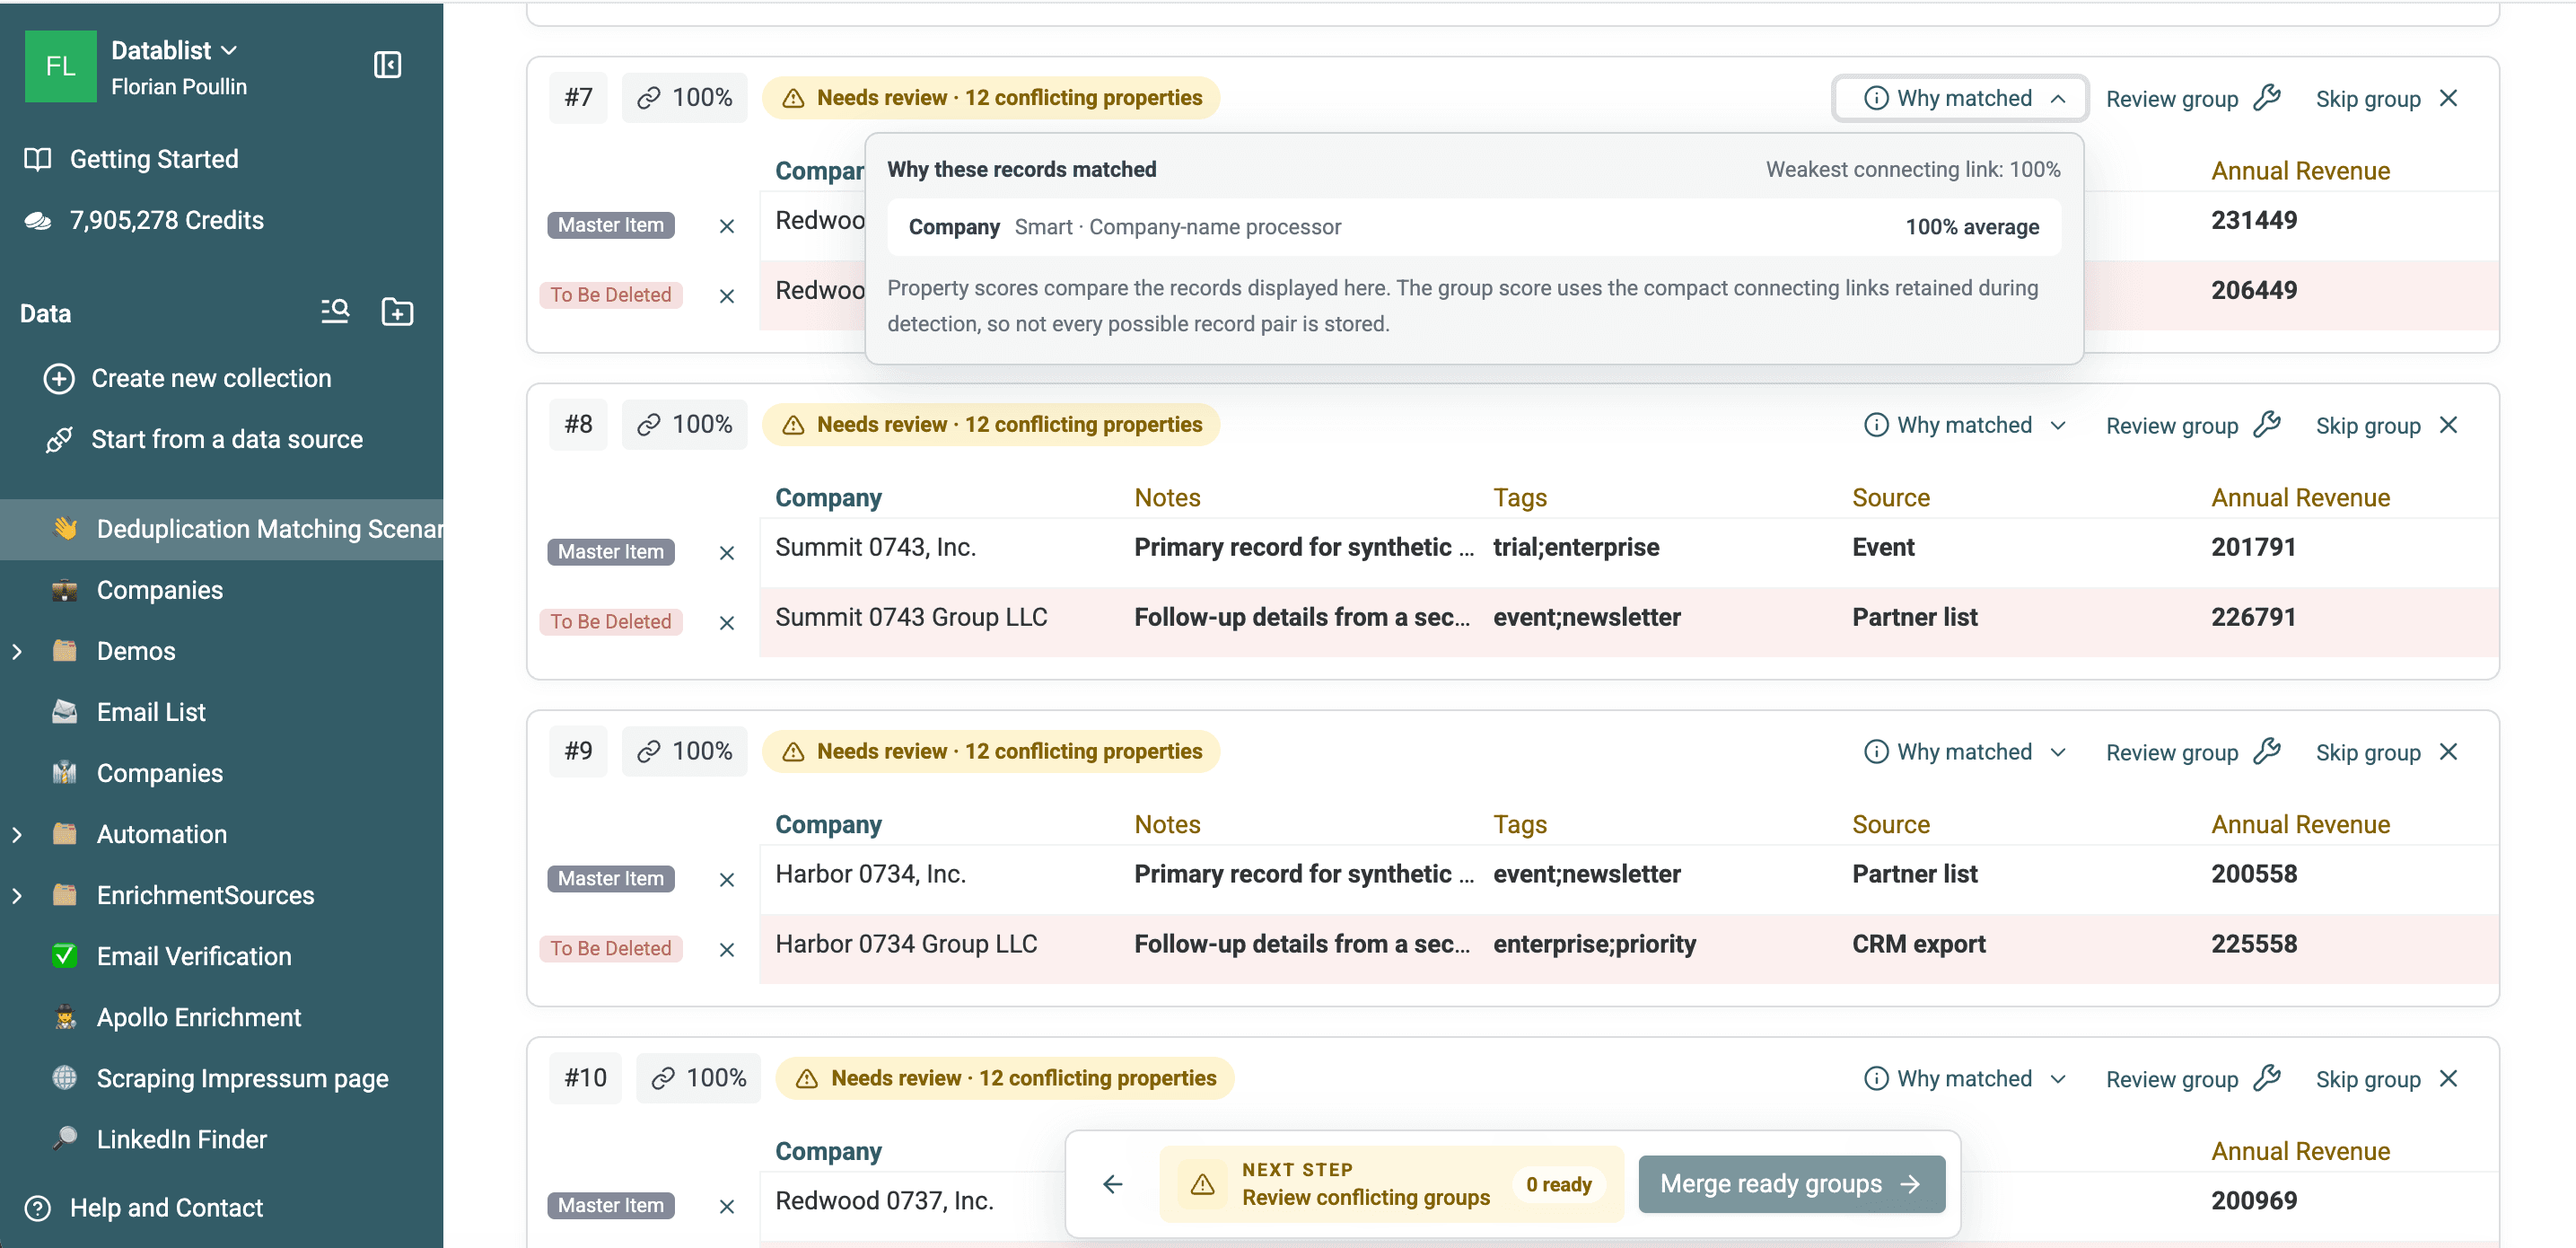
下载导出的 200 个重复分组,检查匹配记录和 DuplicateGroupId 值。
第 3 步:合并重复公司记录
如果只需要匹配结果列表,可以使用 Download groups,无需继续处理。如果希望在 Datablist 中整合这些记录,请继续以下步骤。
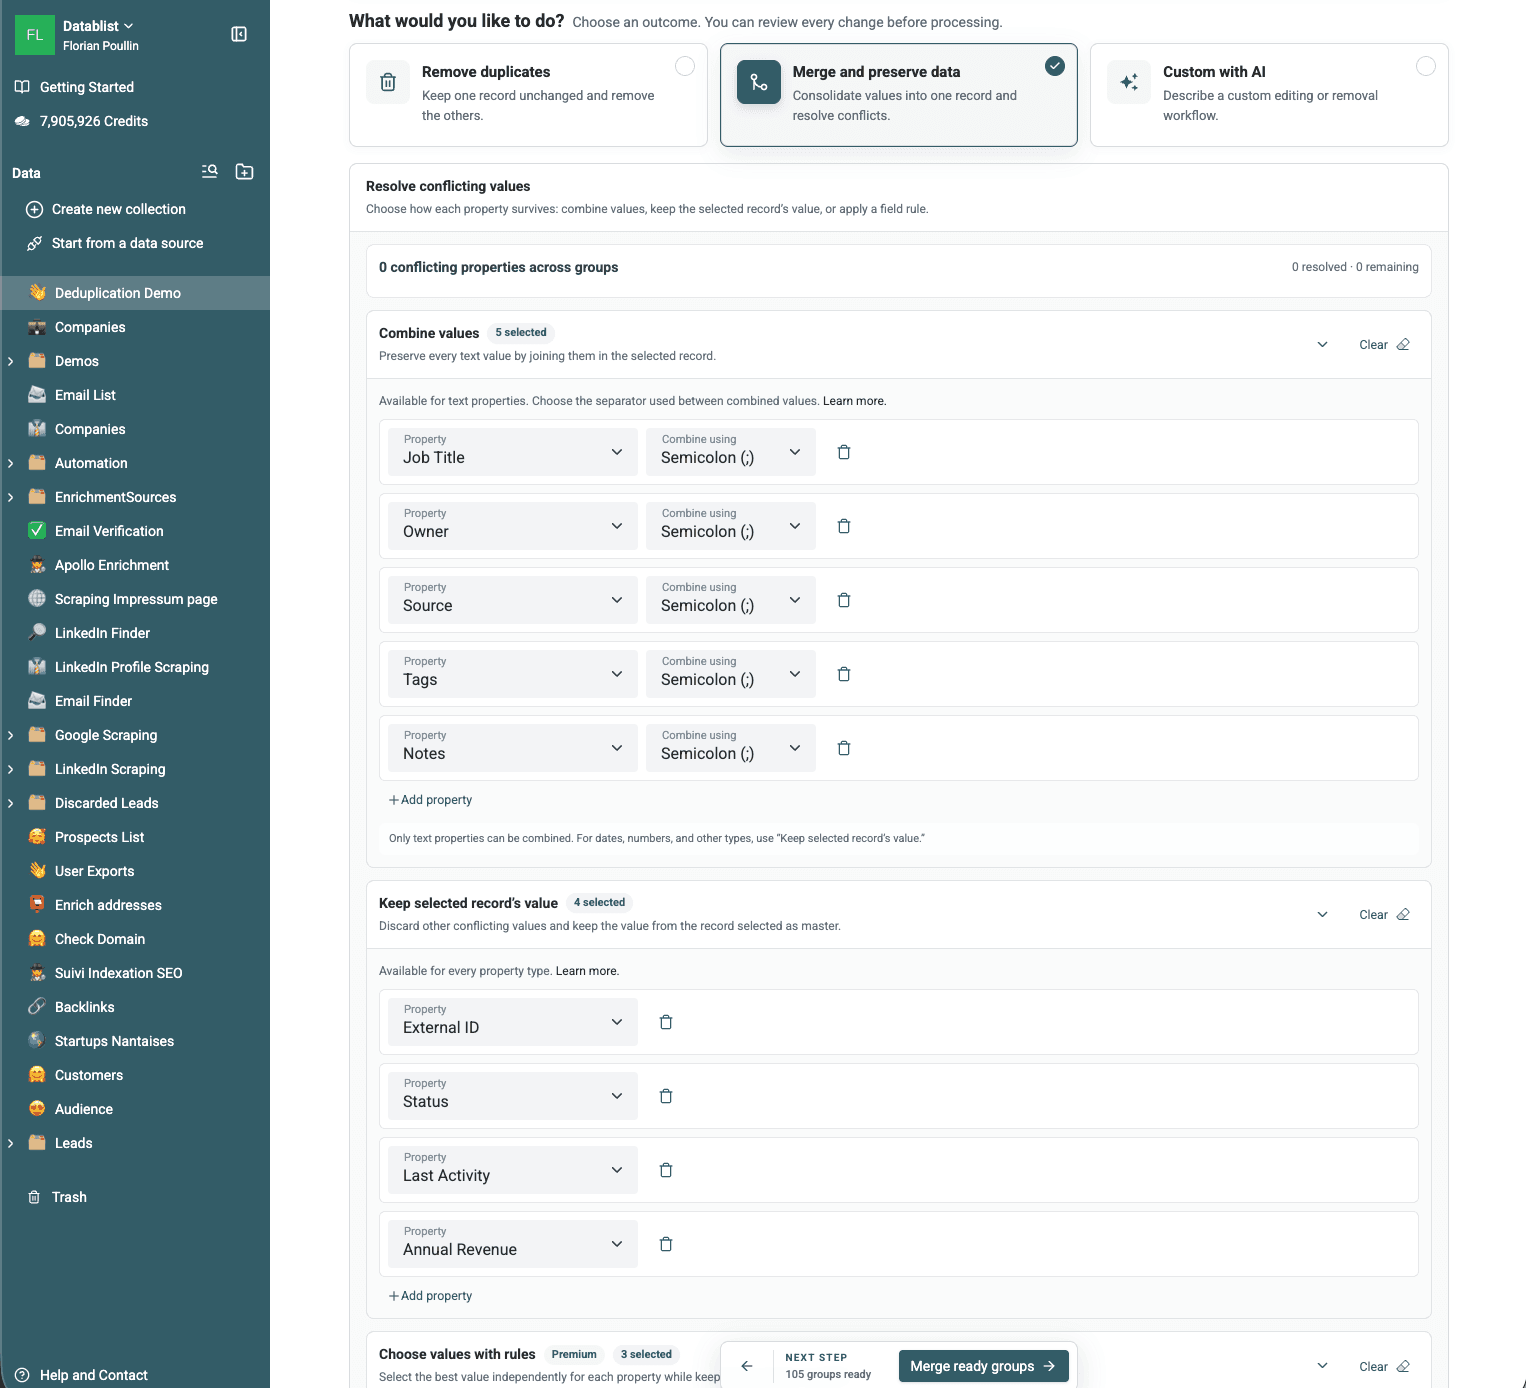
解决字段冲突
属性冲突表示系统识别出的重复记录在同一字段中包含不同的值。
如果重复记录的字段值不同,你需要决定如何合并这些内容。
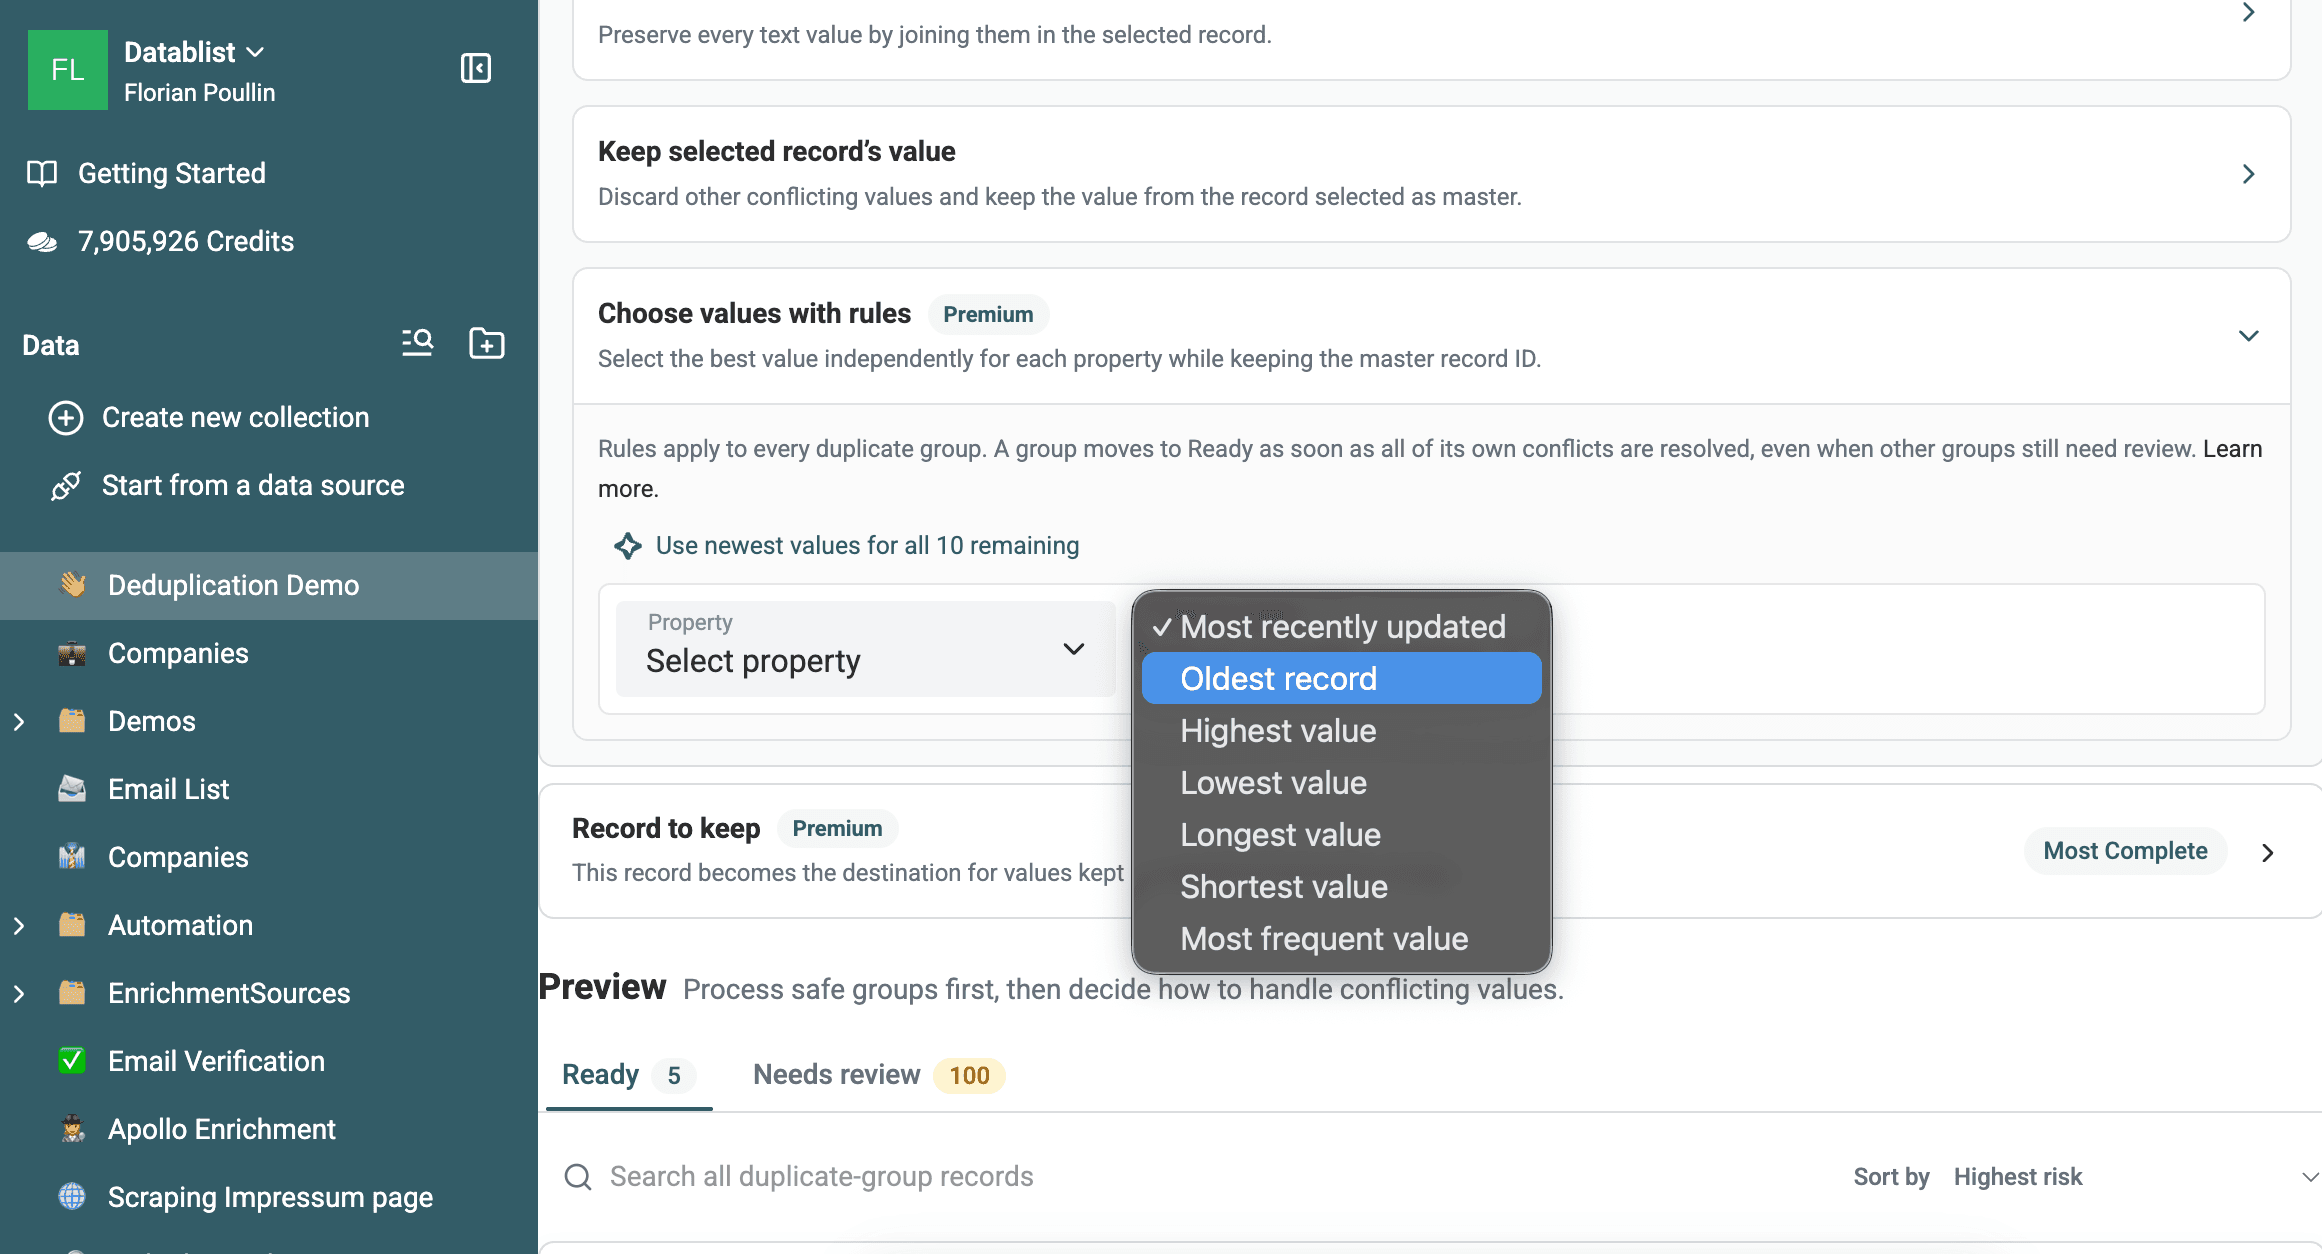
为每个冲突属性选择一条规则:
- Combine:使用分隔符保留不同的文本值。
- Keep the selected record's value:保留所选记录的值,并舍弃其他值。
- 在付费方案中,字段保留规则还可以选择最新、最早、最长、最短、最高、最低或出现频率最高的值。
可以使用快捷控制,为多个冲突属性批量应用同一规则,再按需要单独调整特定字段。
选择主记录
系统会将其中一条记录作为合并目标,并保留它的 Datablist ID。
你可以按照以下规则选择:
- Most Complete:保留已填写属性最多的记录。
- Last Updated:保留最近修改的记录。
- First Created:保留最早创建的记录。
- Highest Value 或 Lowest Value:比较指定属性的值。
- Matching Value:保留包含指定属性值的记录。
配置合并规则并选择主记录后,刷新预览,在正式提交更改前查看合并结果。
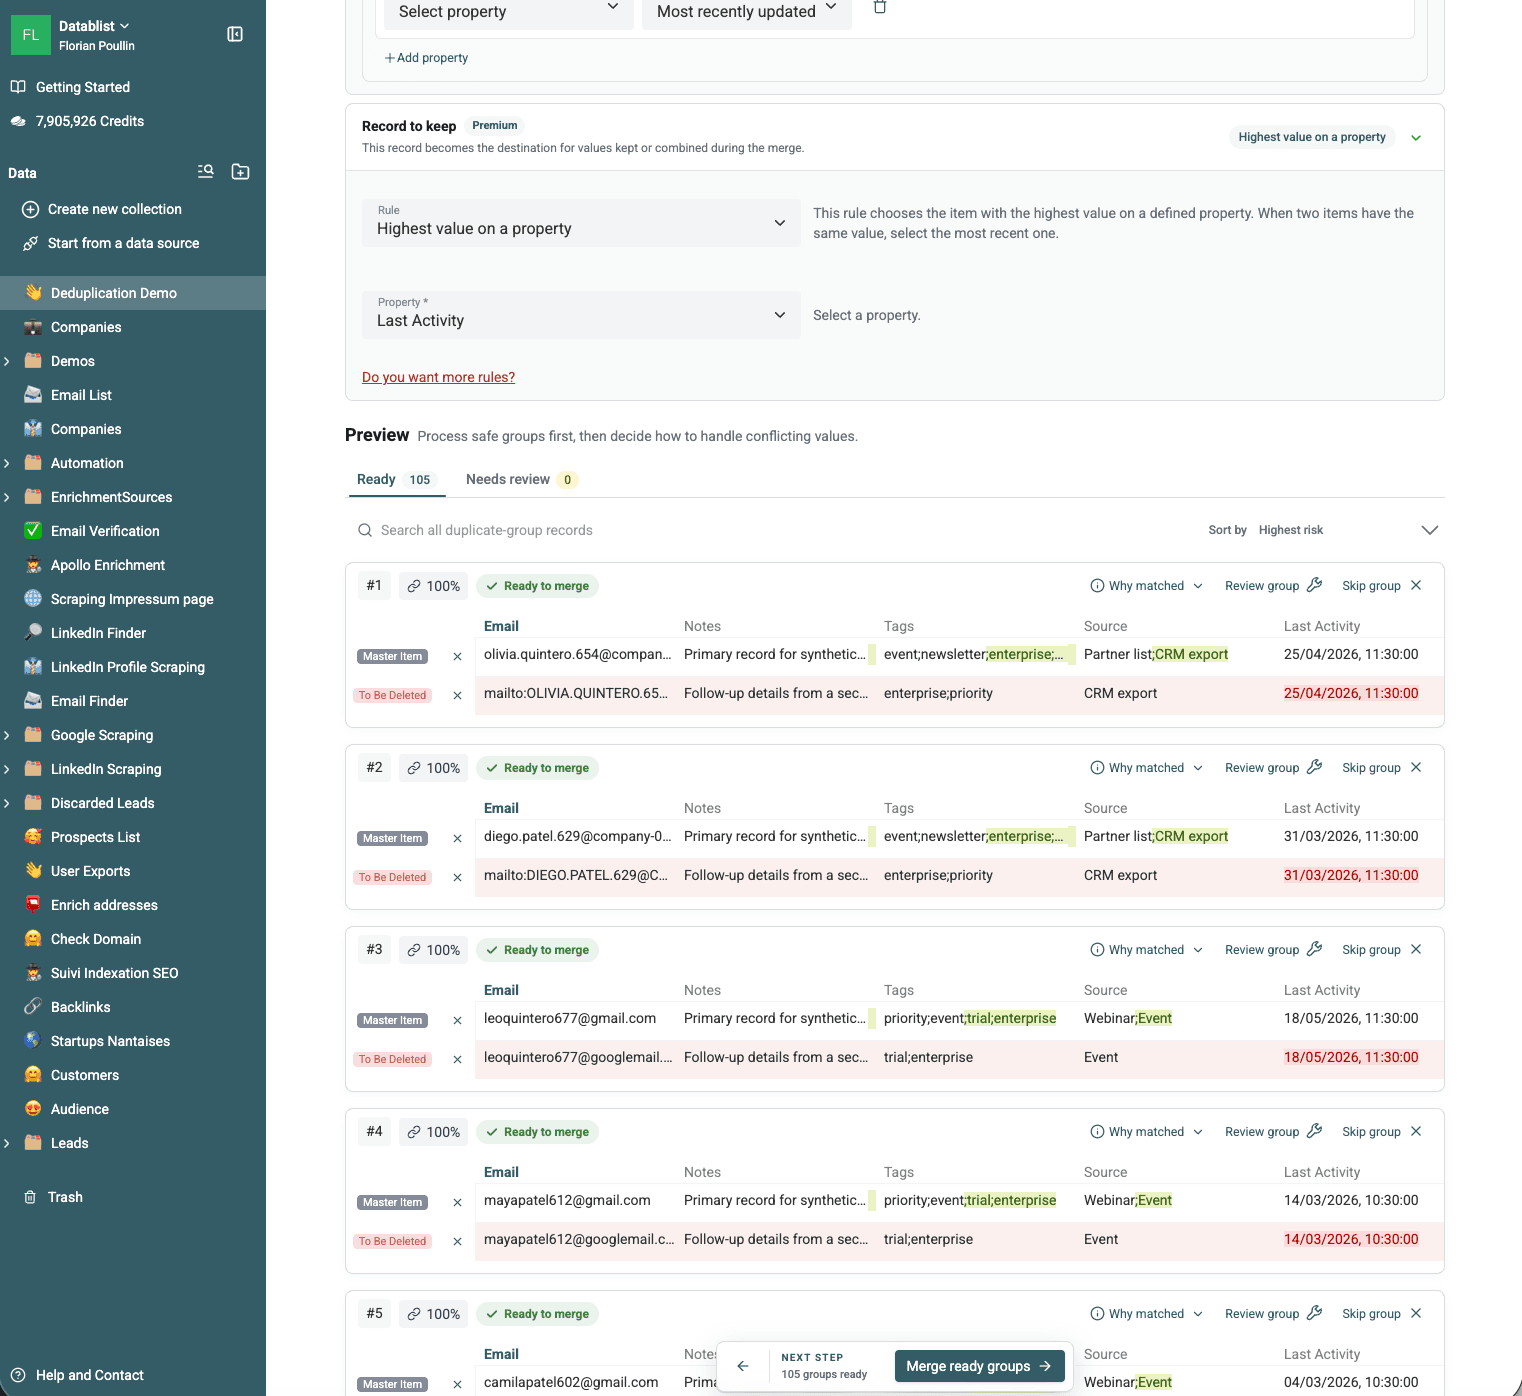
预览会显示每个重复分组中即将删除的值、将要合并的值,以及指定的主记录。
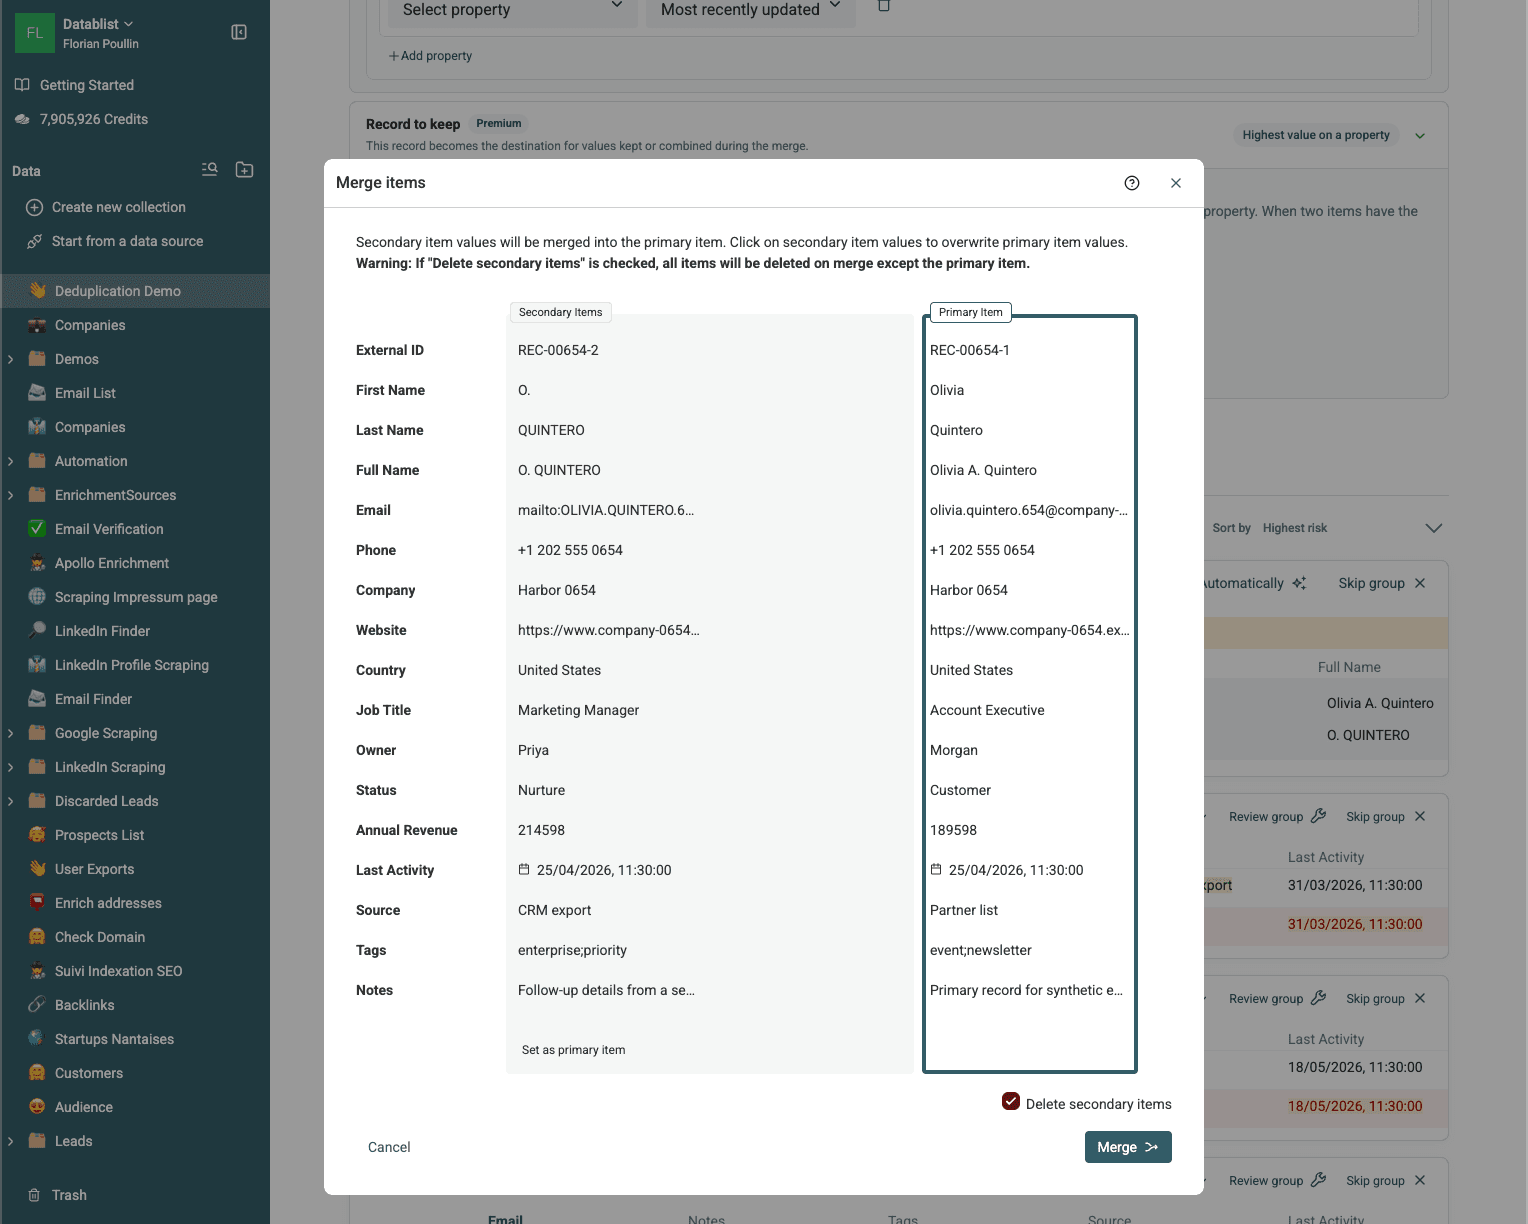
如需处理例外情况,请打开 Review group,手动选择要保留的值。
处理标记为 Ready 的分组。仍标记为 Needs review 的分组不会发生变化。
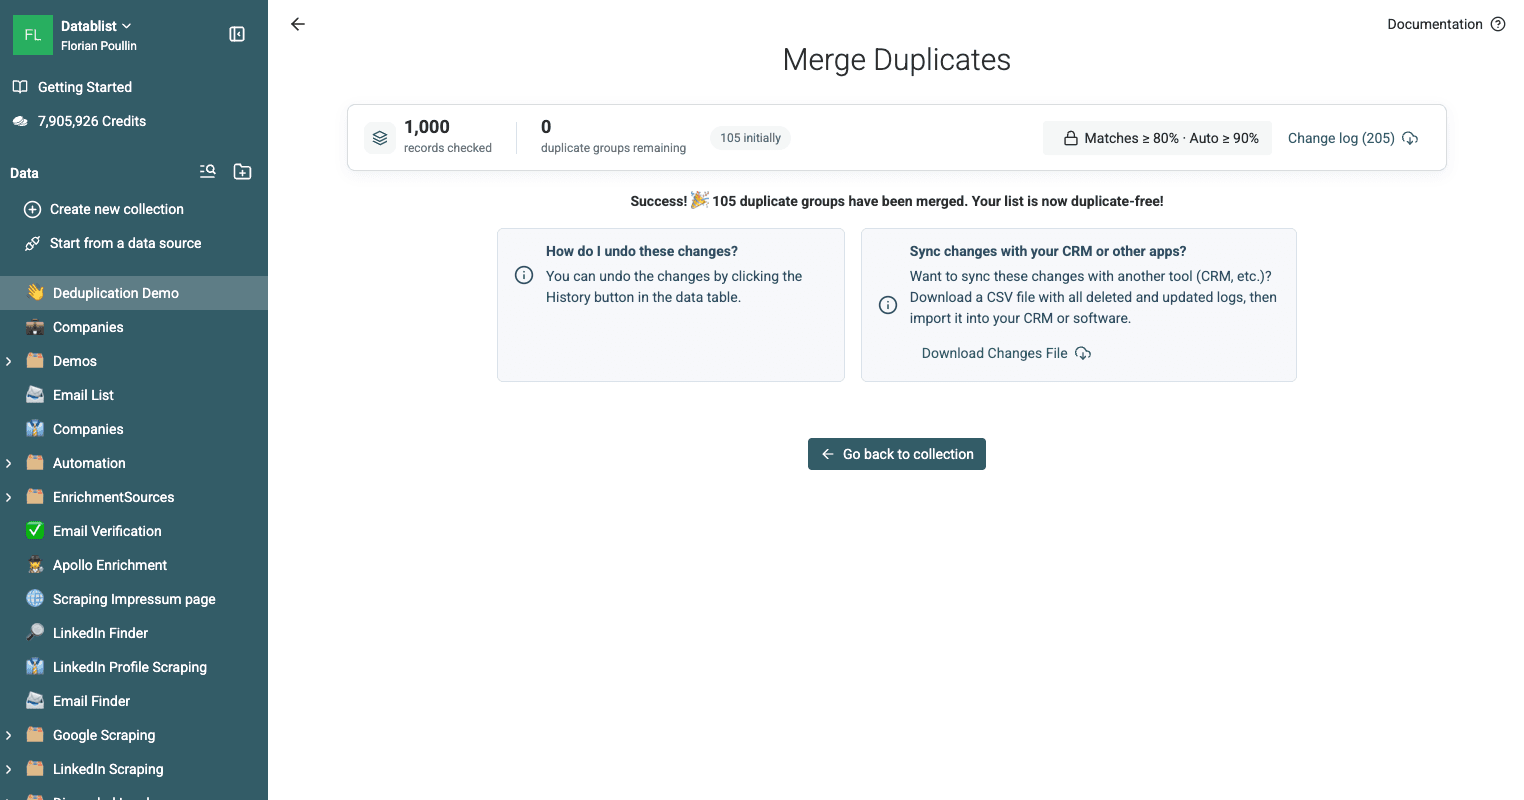
合并完成后,使用 collection 标题栏中的 Export,将清理后的名单下载为 CSV 或 Excel。处理后的变更日志会记录已删除和已更新的 ID,便于审计追踪。
如需了解完整的匹配、检查与合并设置,请阅读 Duplicate Finder 文档。