
无需写代码,只需向 Datablist 的 AI Agent - Site Scraper 提供一个商品分类 URL,并在 prompt 中说明需要提取的字段,即可抓取电商网站的商品列表。如果店铺有多个列表页,请开启分页并设置页面上限,然后核对首批结果中的商品 URL 和价格。本指南以 Gymshark 的分类页面为例;实际可抓取的商品数量和字段取决于店铺网站。
**输入:**每次运行提供一个分类页或全部商品页 URL。**输出:**每个抓取到的商品占一行,包含名称、商品 URL、页面显示价格,以及可获取时的图片 URL 等字段。**检查:**随机选择几行与源页面对照,并在导出前移除重复的商品 URL。
第 1 步:了解电商网站商品抓取
从电商网站抓取商品主要有两种方式:
你可以:
-
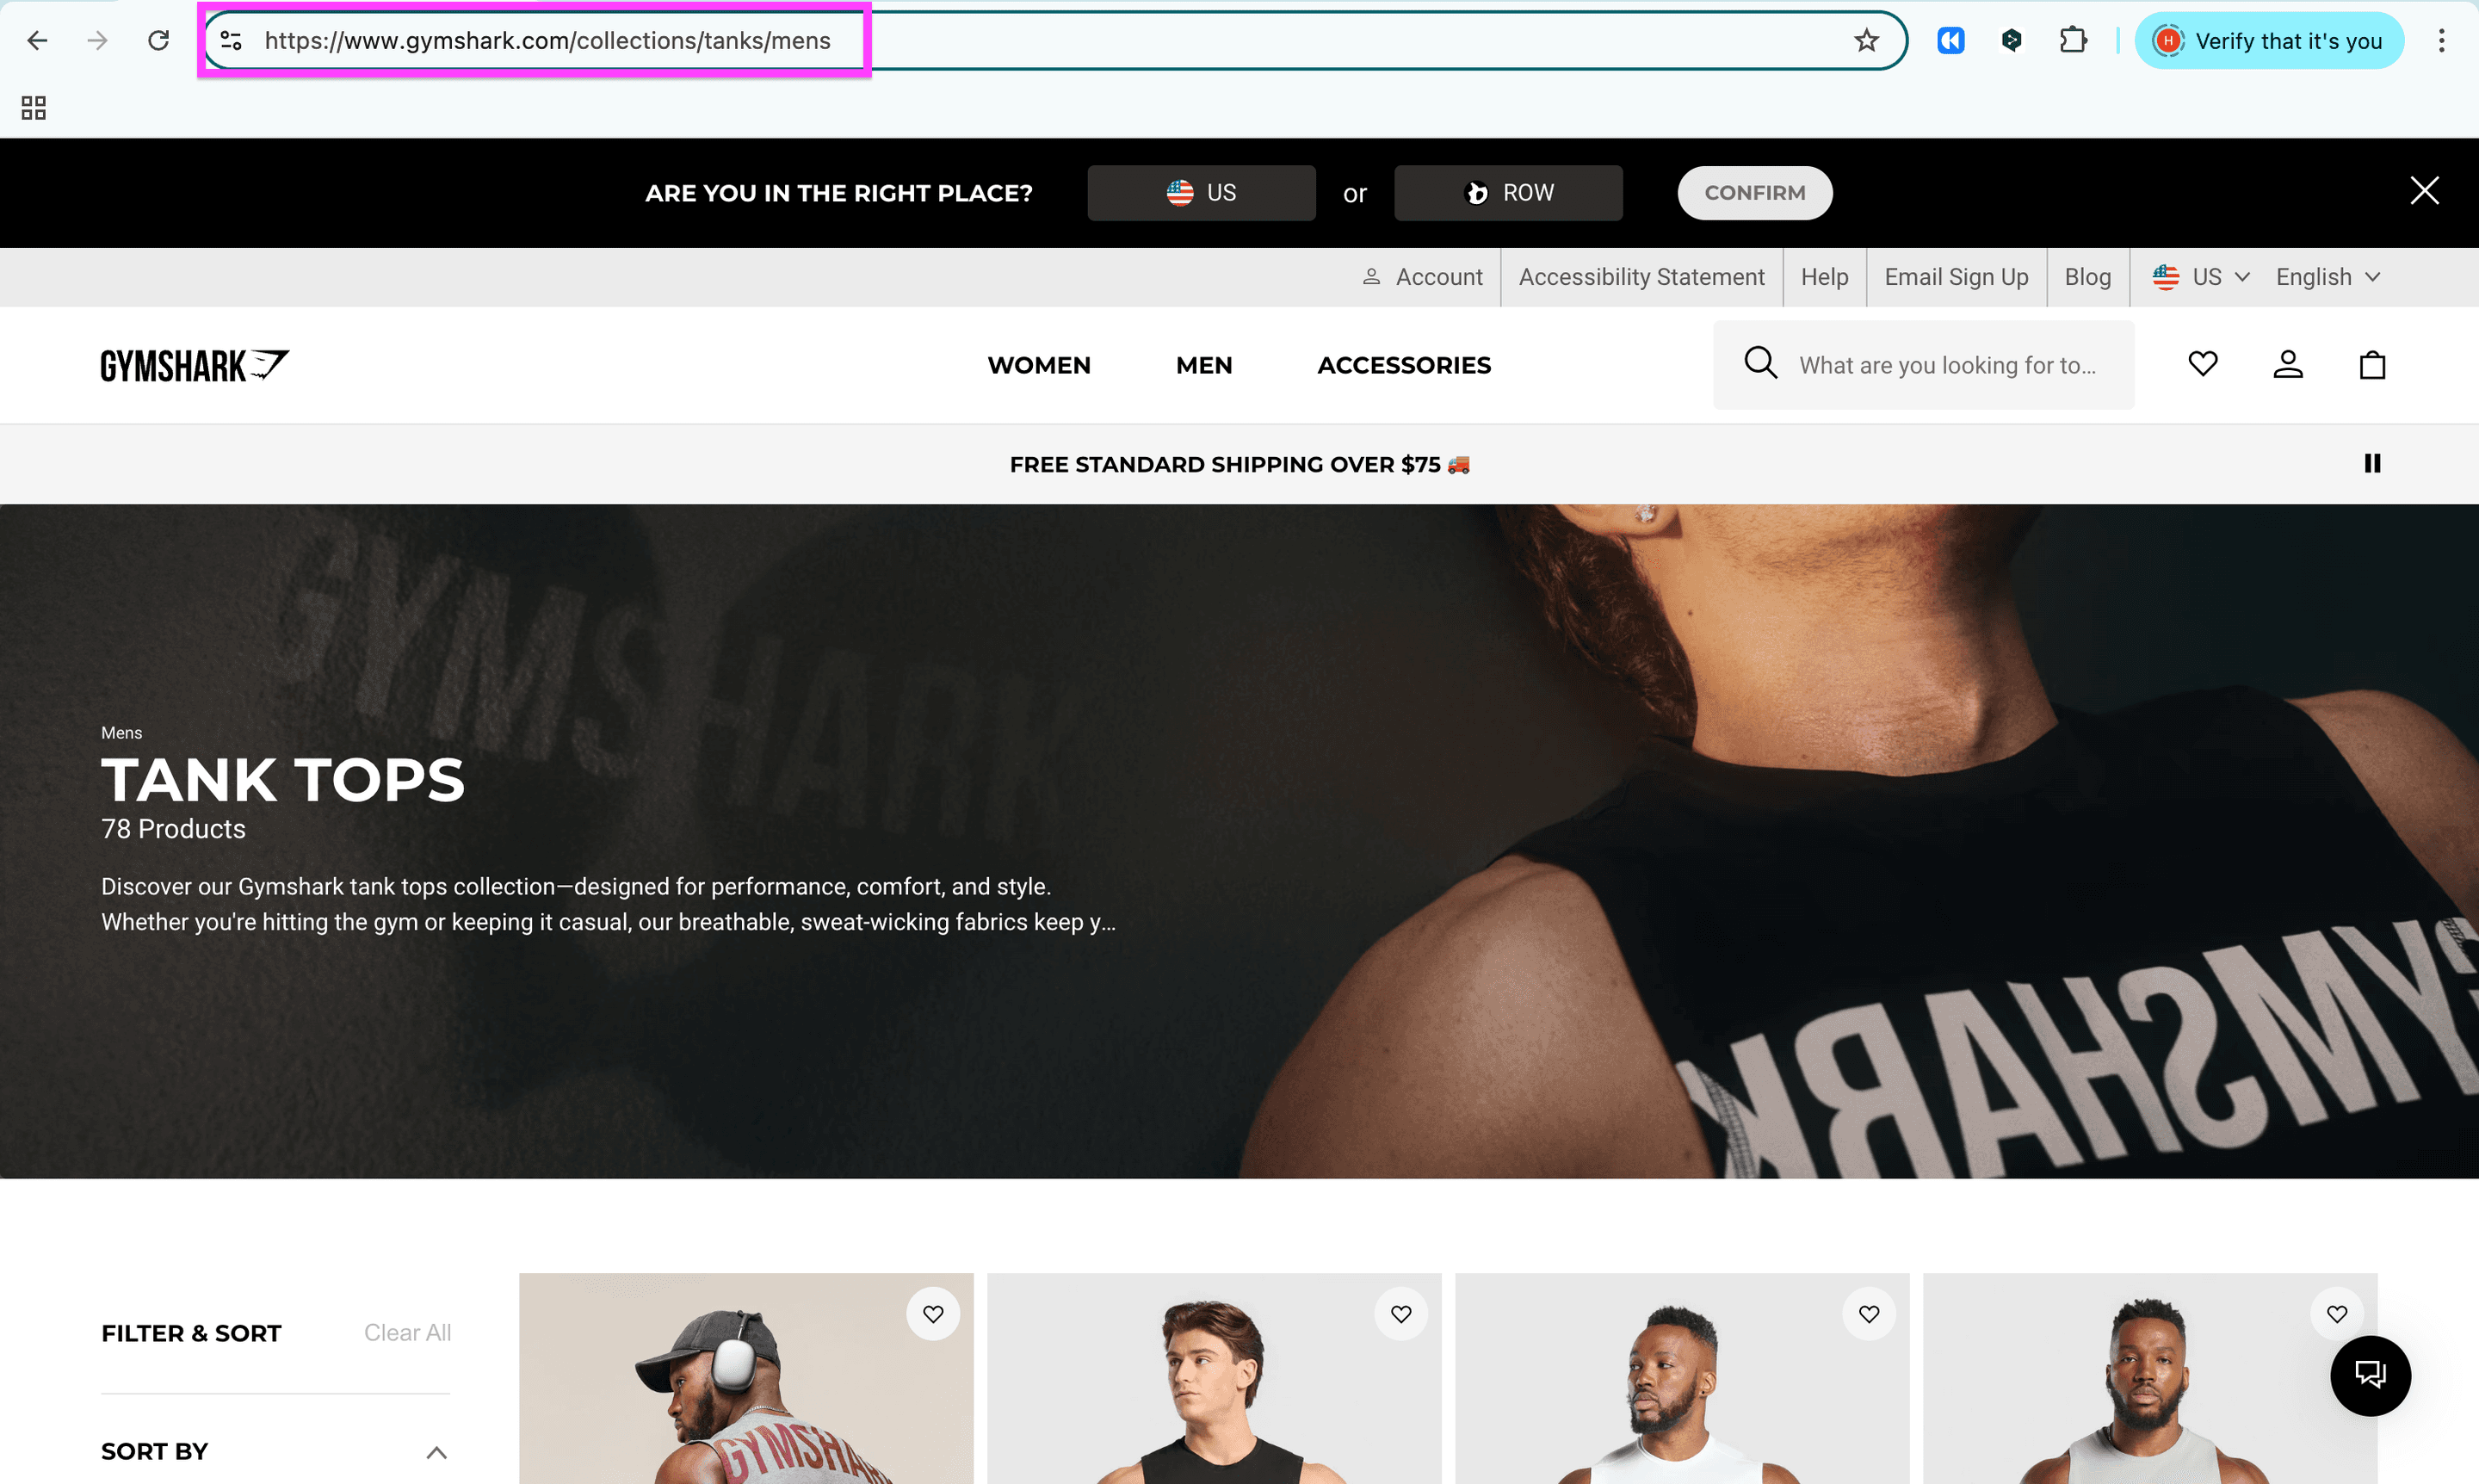
抓取“商品集合页/分类页”,从电商网站提取指定类别的商品 ⬅️ 这正是本文要采用的方法
本文用于抓取全部商品的分类页面 -
如果希望覆盖更广,可以从“全部商品”页面开始抓取。但最终结果仍会受到 Agent 可访问页面和所设页面上限的限制。
“全部商品”页面对抓取范围的控制较少
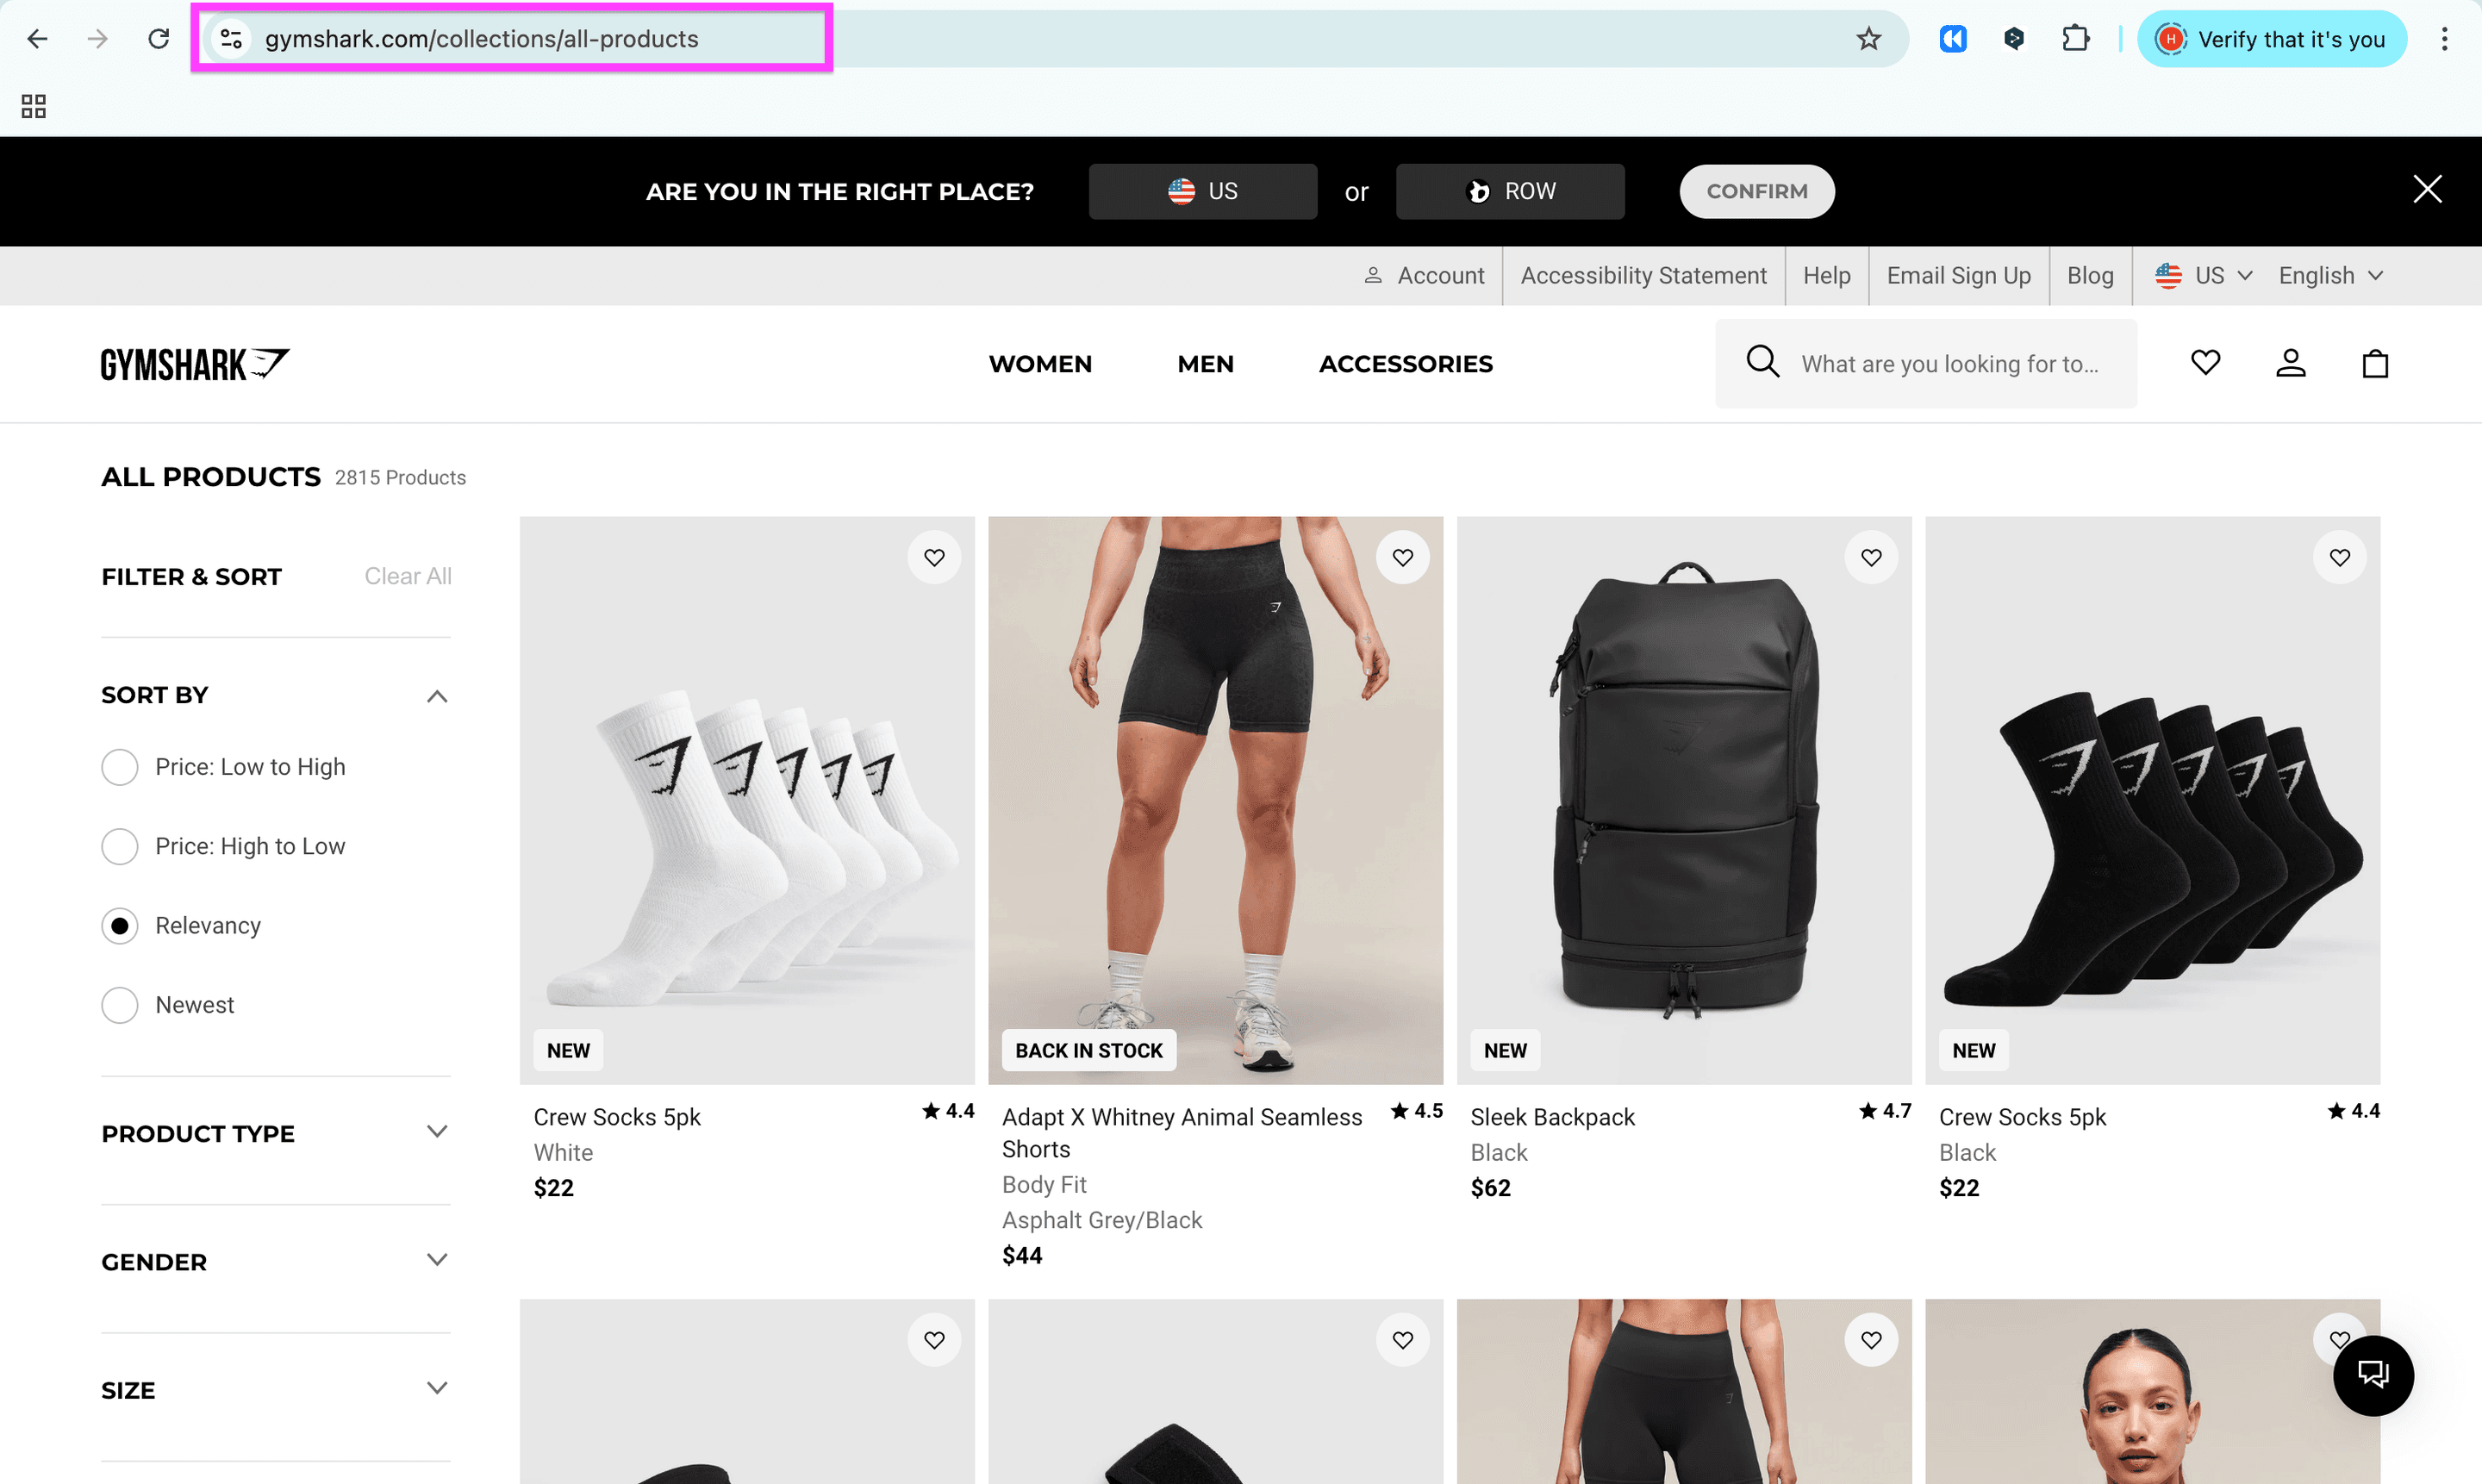
AI Agent 的配置方式完全相同,区别只在于起始页面。
第 2 步:准备抓取电商网站
准备工作做好了,抓取就成功了一半。开始抓取电商网站前,我们要完成以下步骤:
- 为目标店铺选择一个分类页或全部商品页 URL
- 注册 Datablist
- 在 Datablist 中创建一个 collection
现在开始!
要在不写代码的情况下抓取电商商品,你需要一款能理解自然语言指令的工具。Datablist 的 AI Research Agent 就是其中之一。

注册 Datablist 后,需要先设置自动化流程。下面我来说明具体操作!
点击加号创建新的 collection,也可以直接使用快捷键“N”。
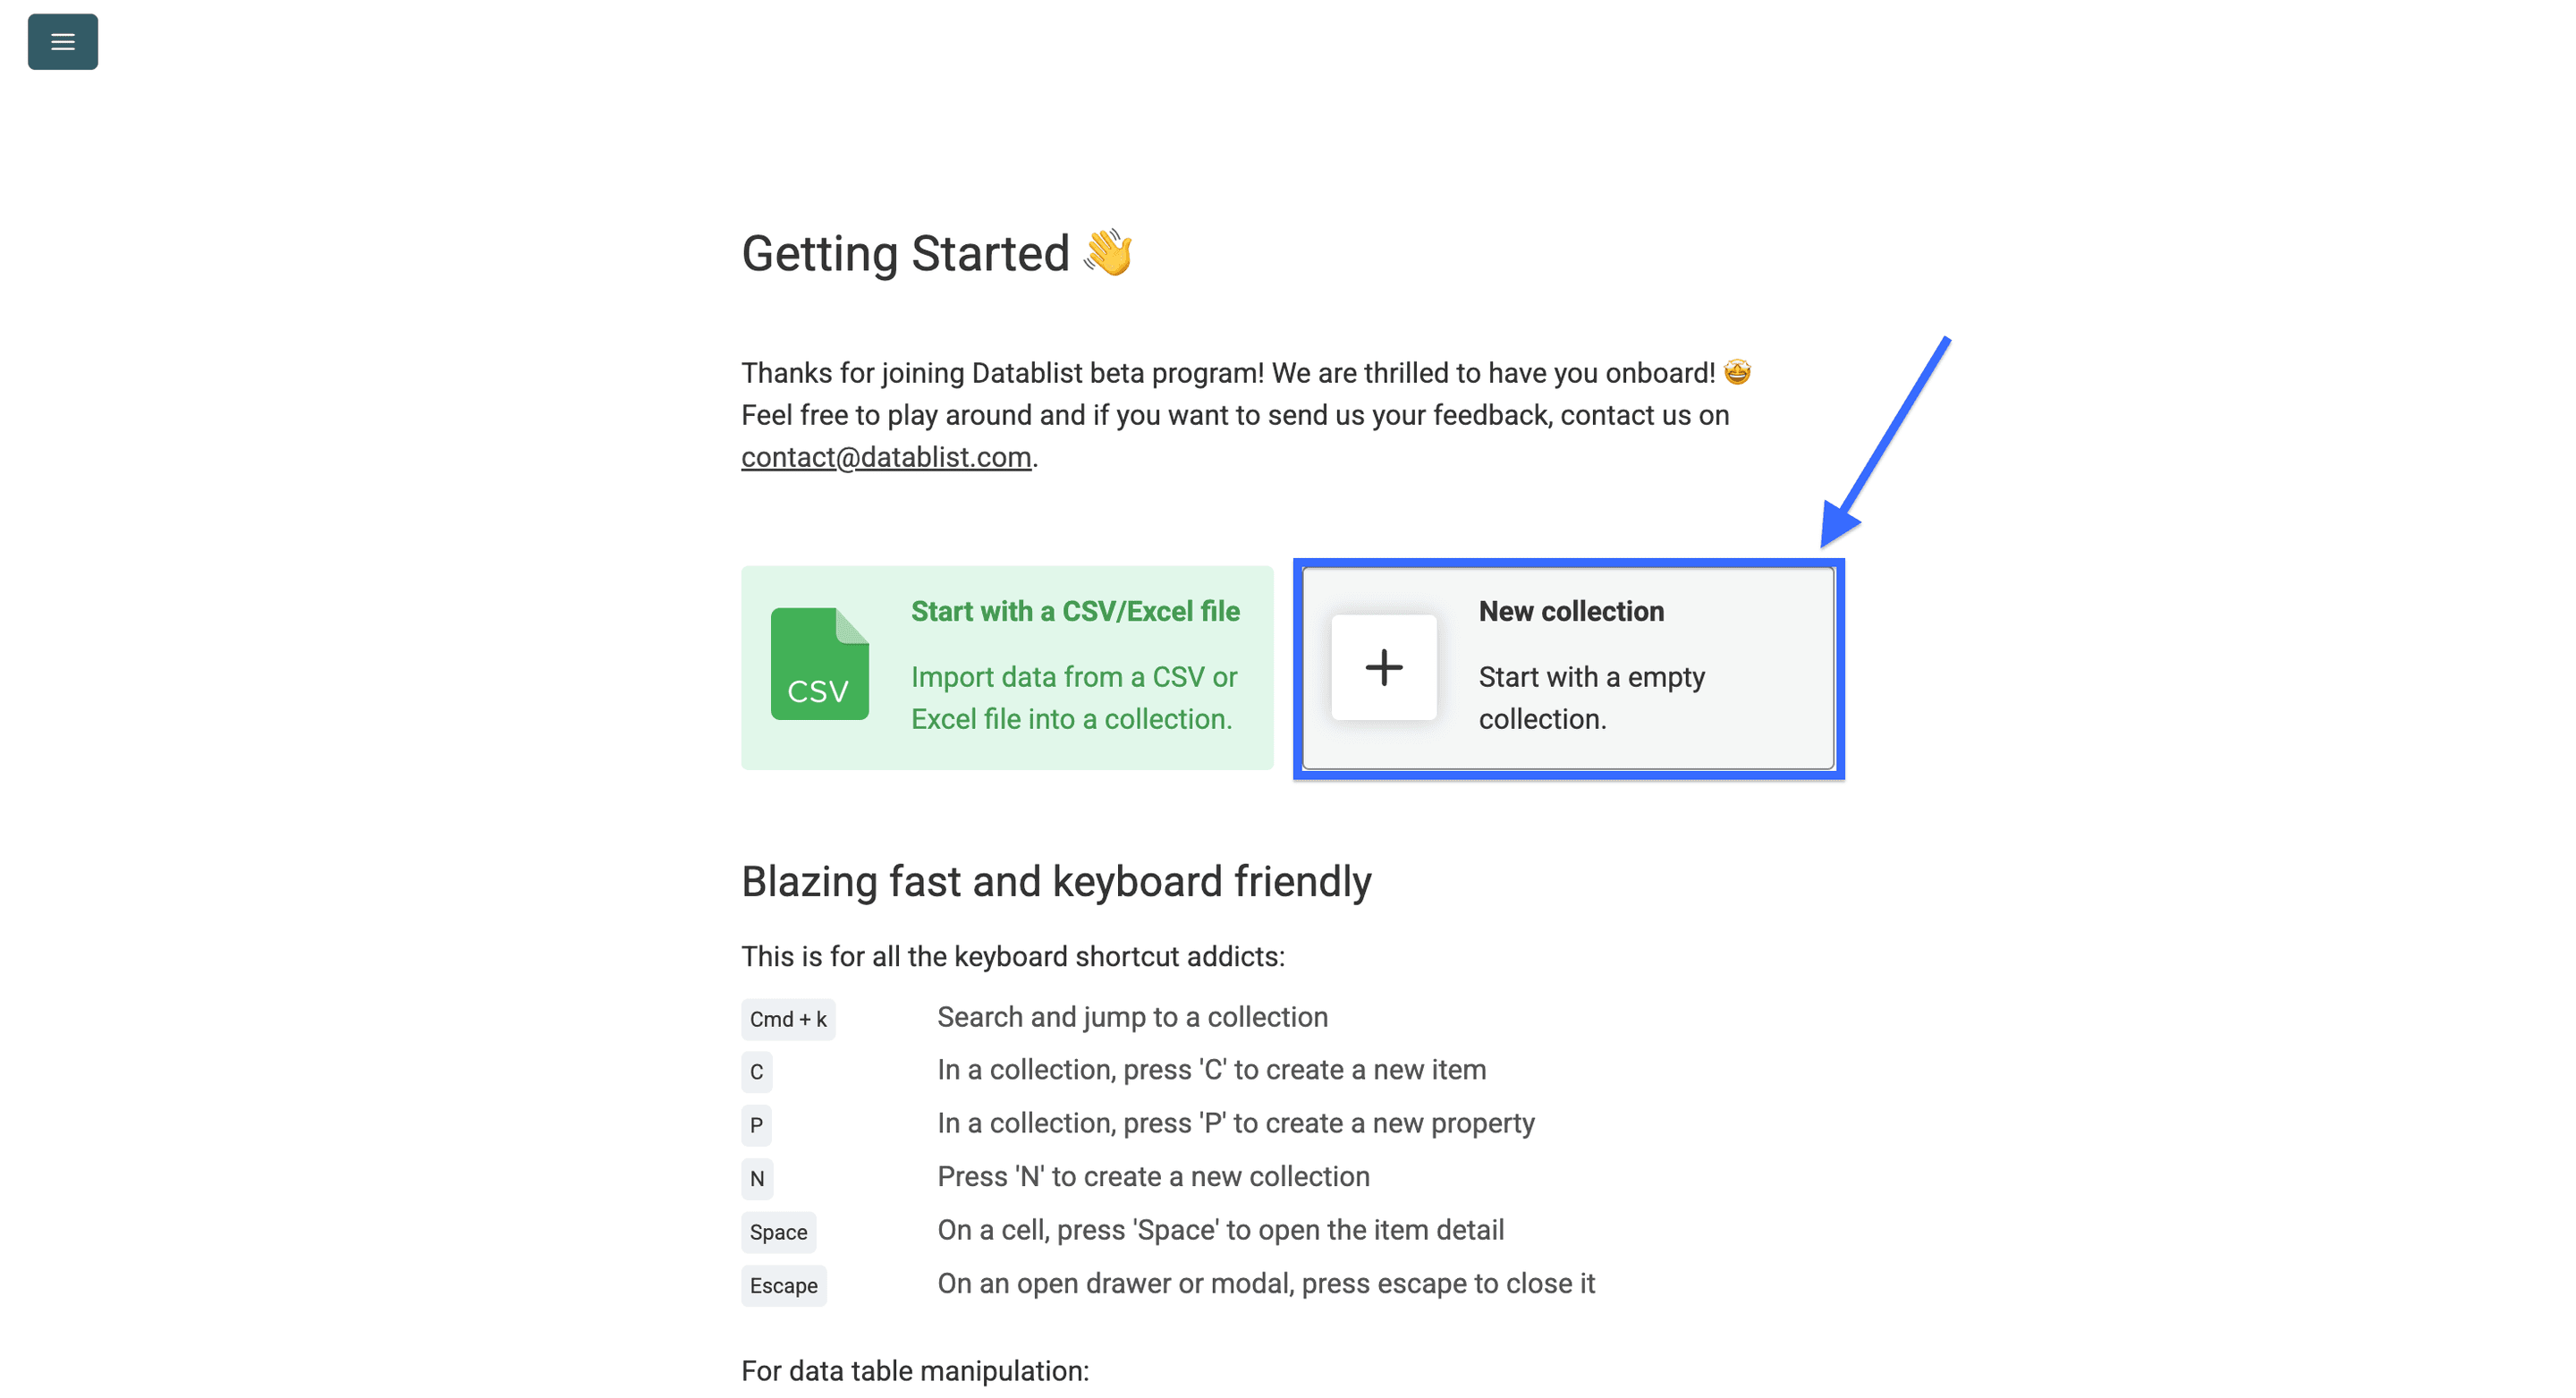
创建新 collection 时,你会看到这个界面。我已经给 collection 改了名称,还配了一个好看的 emoji。
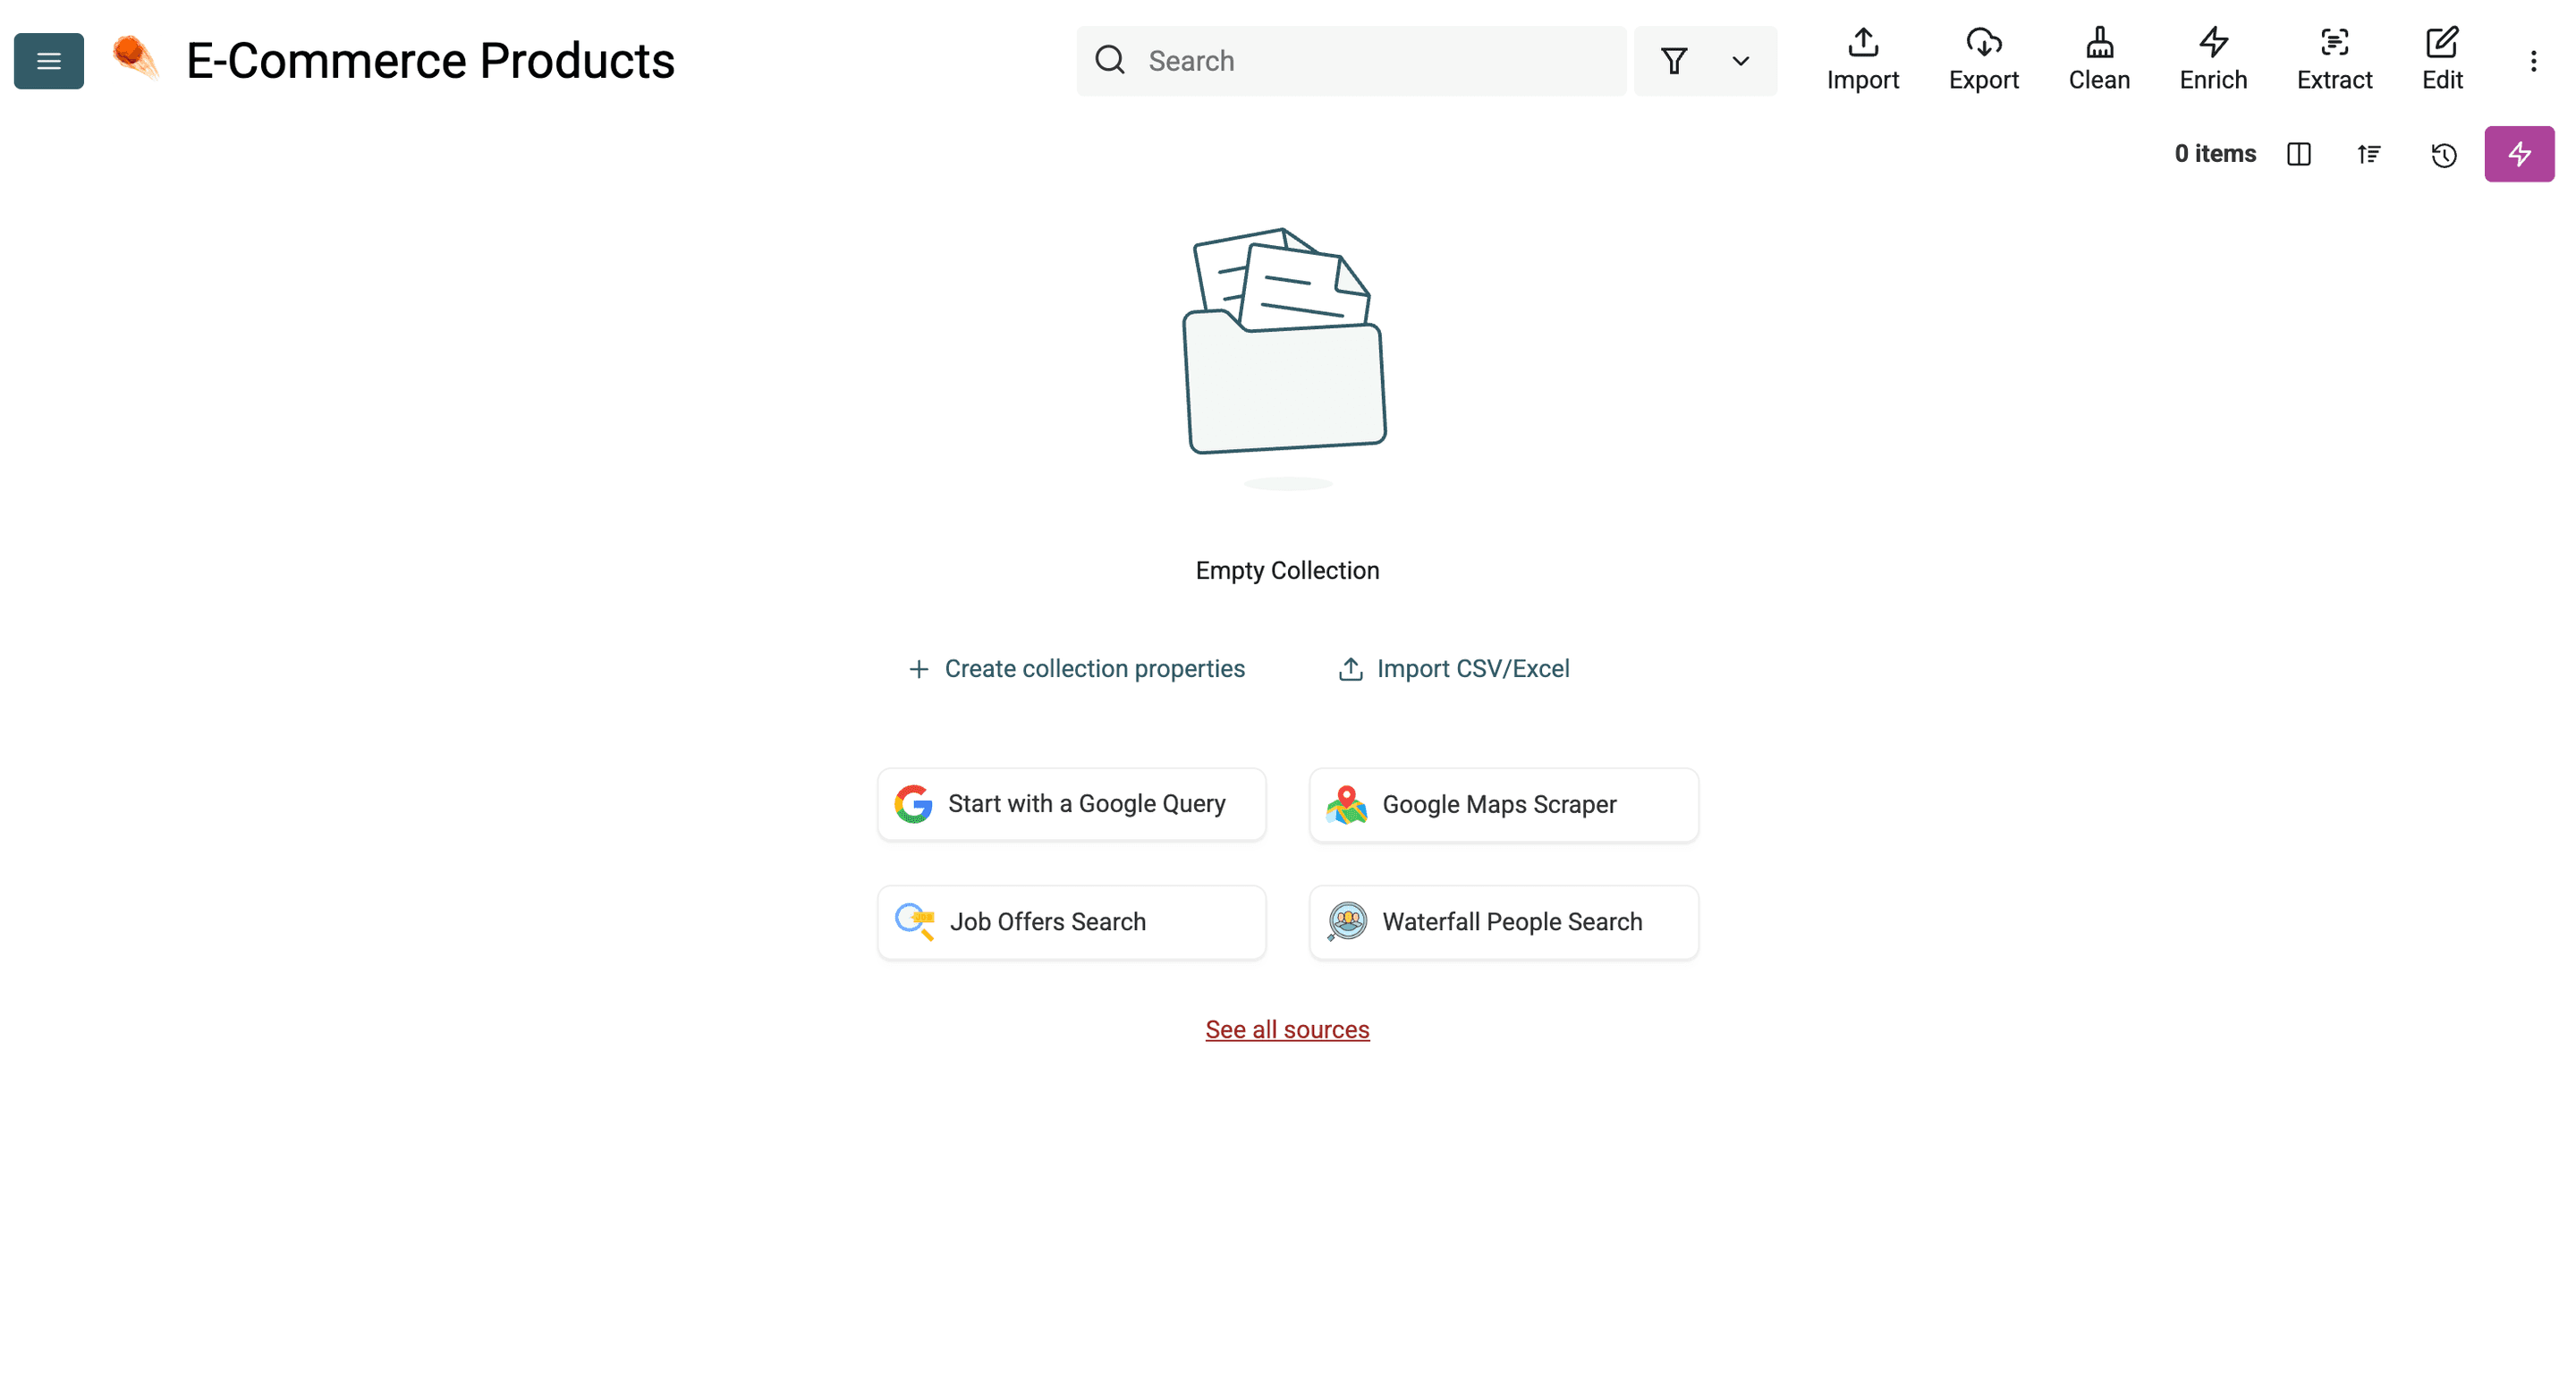
准备工作到此结束。接下来进入实际操作。
第 3 步:开始抓取电商网站商品
要开始抓取电商网站的商品,需要完成 3 件事:
- 选择“AI Agent - Site Scraper”作为数据源
- 粘贴 prompt,向 AI Agent 说明你的目标
- 为每种需要抓取的商品信息创建一个 output property
整个流程已经梳理清楚,现在开始抓取!
点击“See all sources”,开始配置用于抓取的 AI Agent。
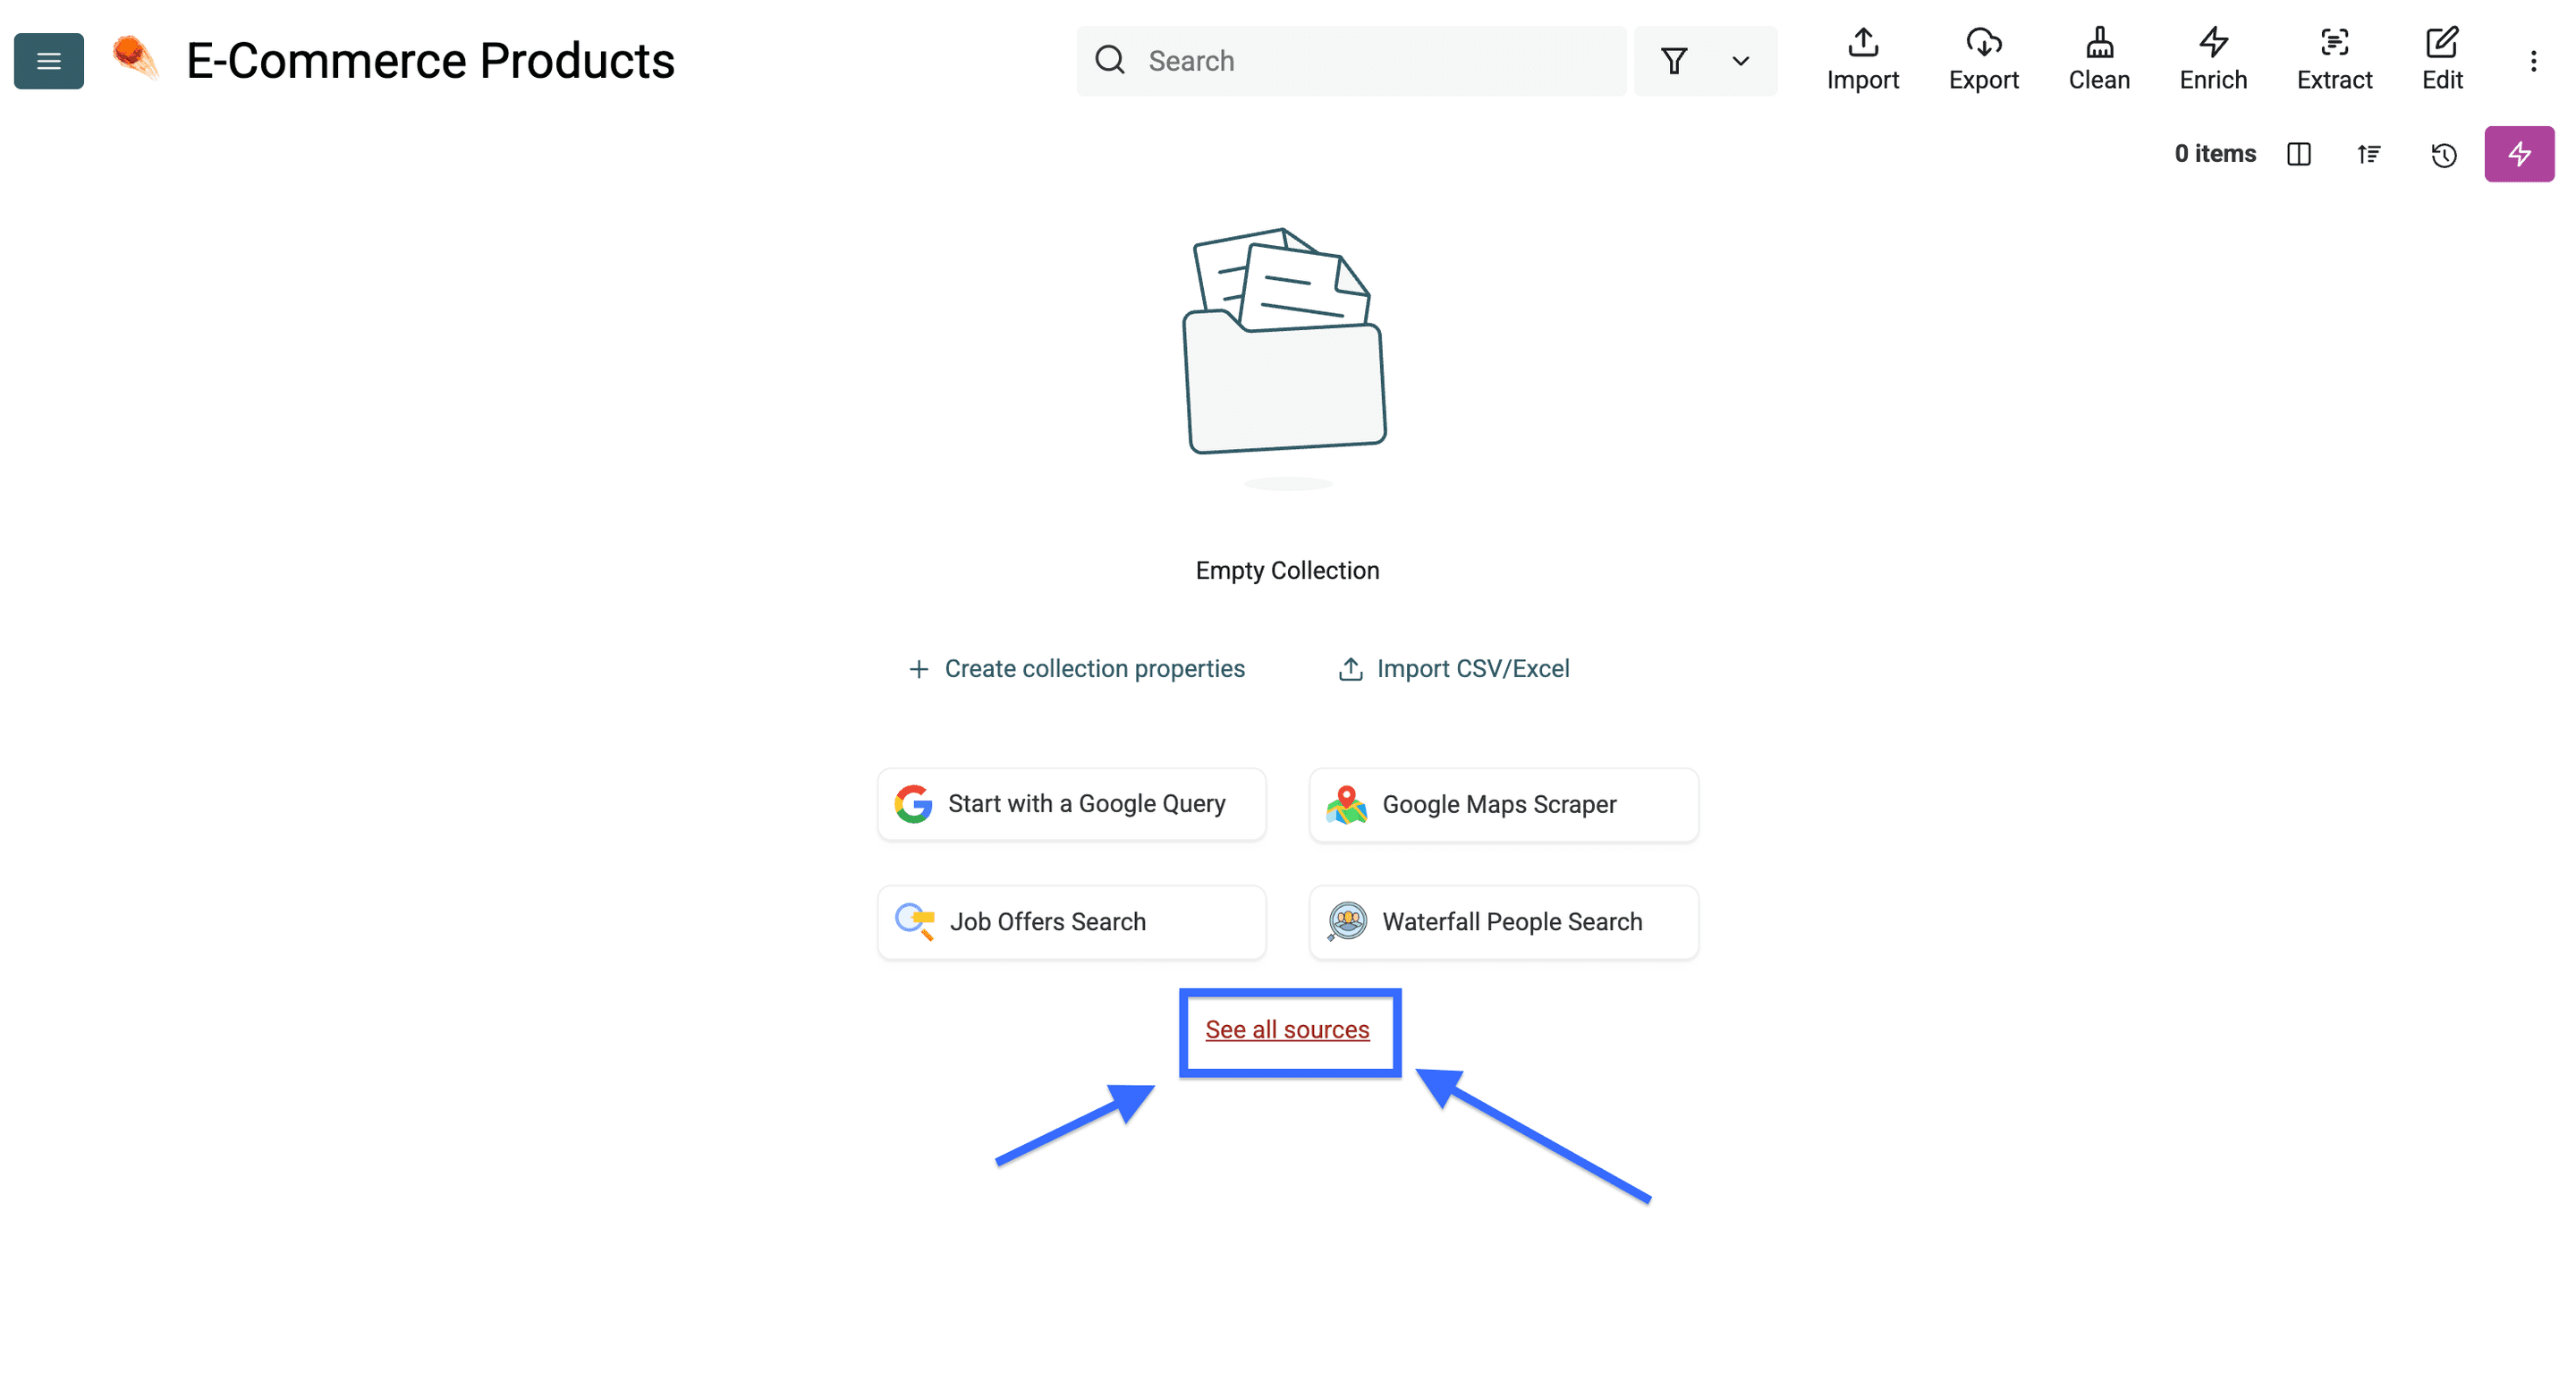
现在选择“AI Agent - Site Scraper”。
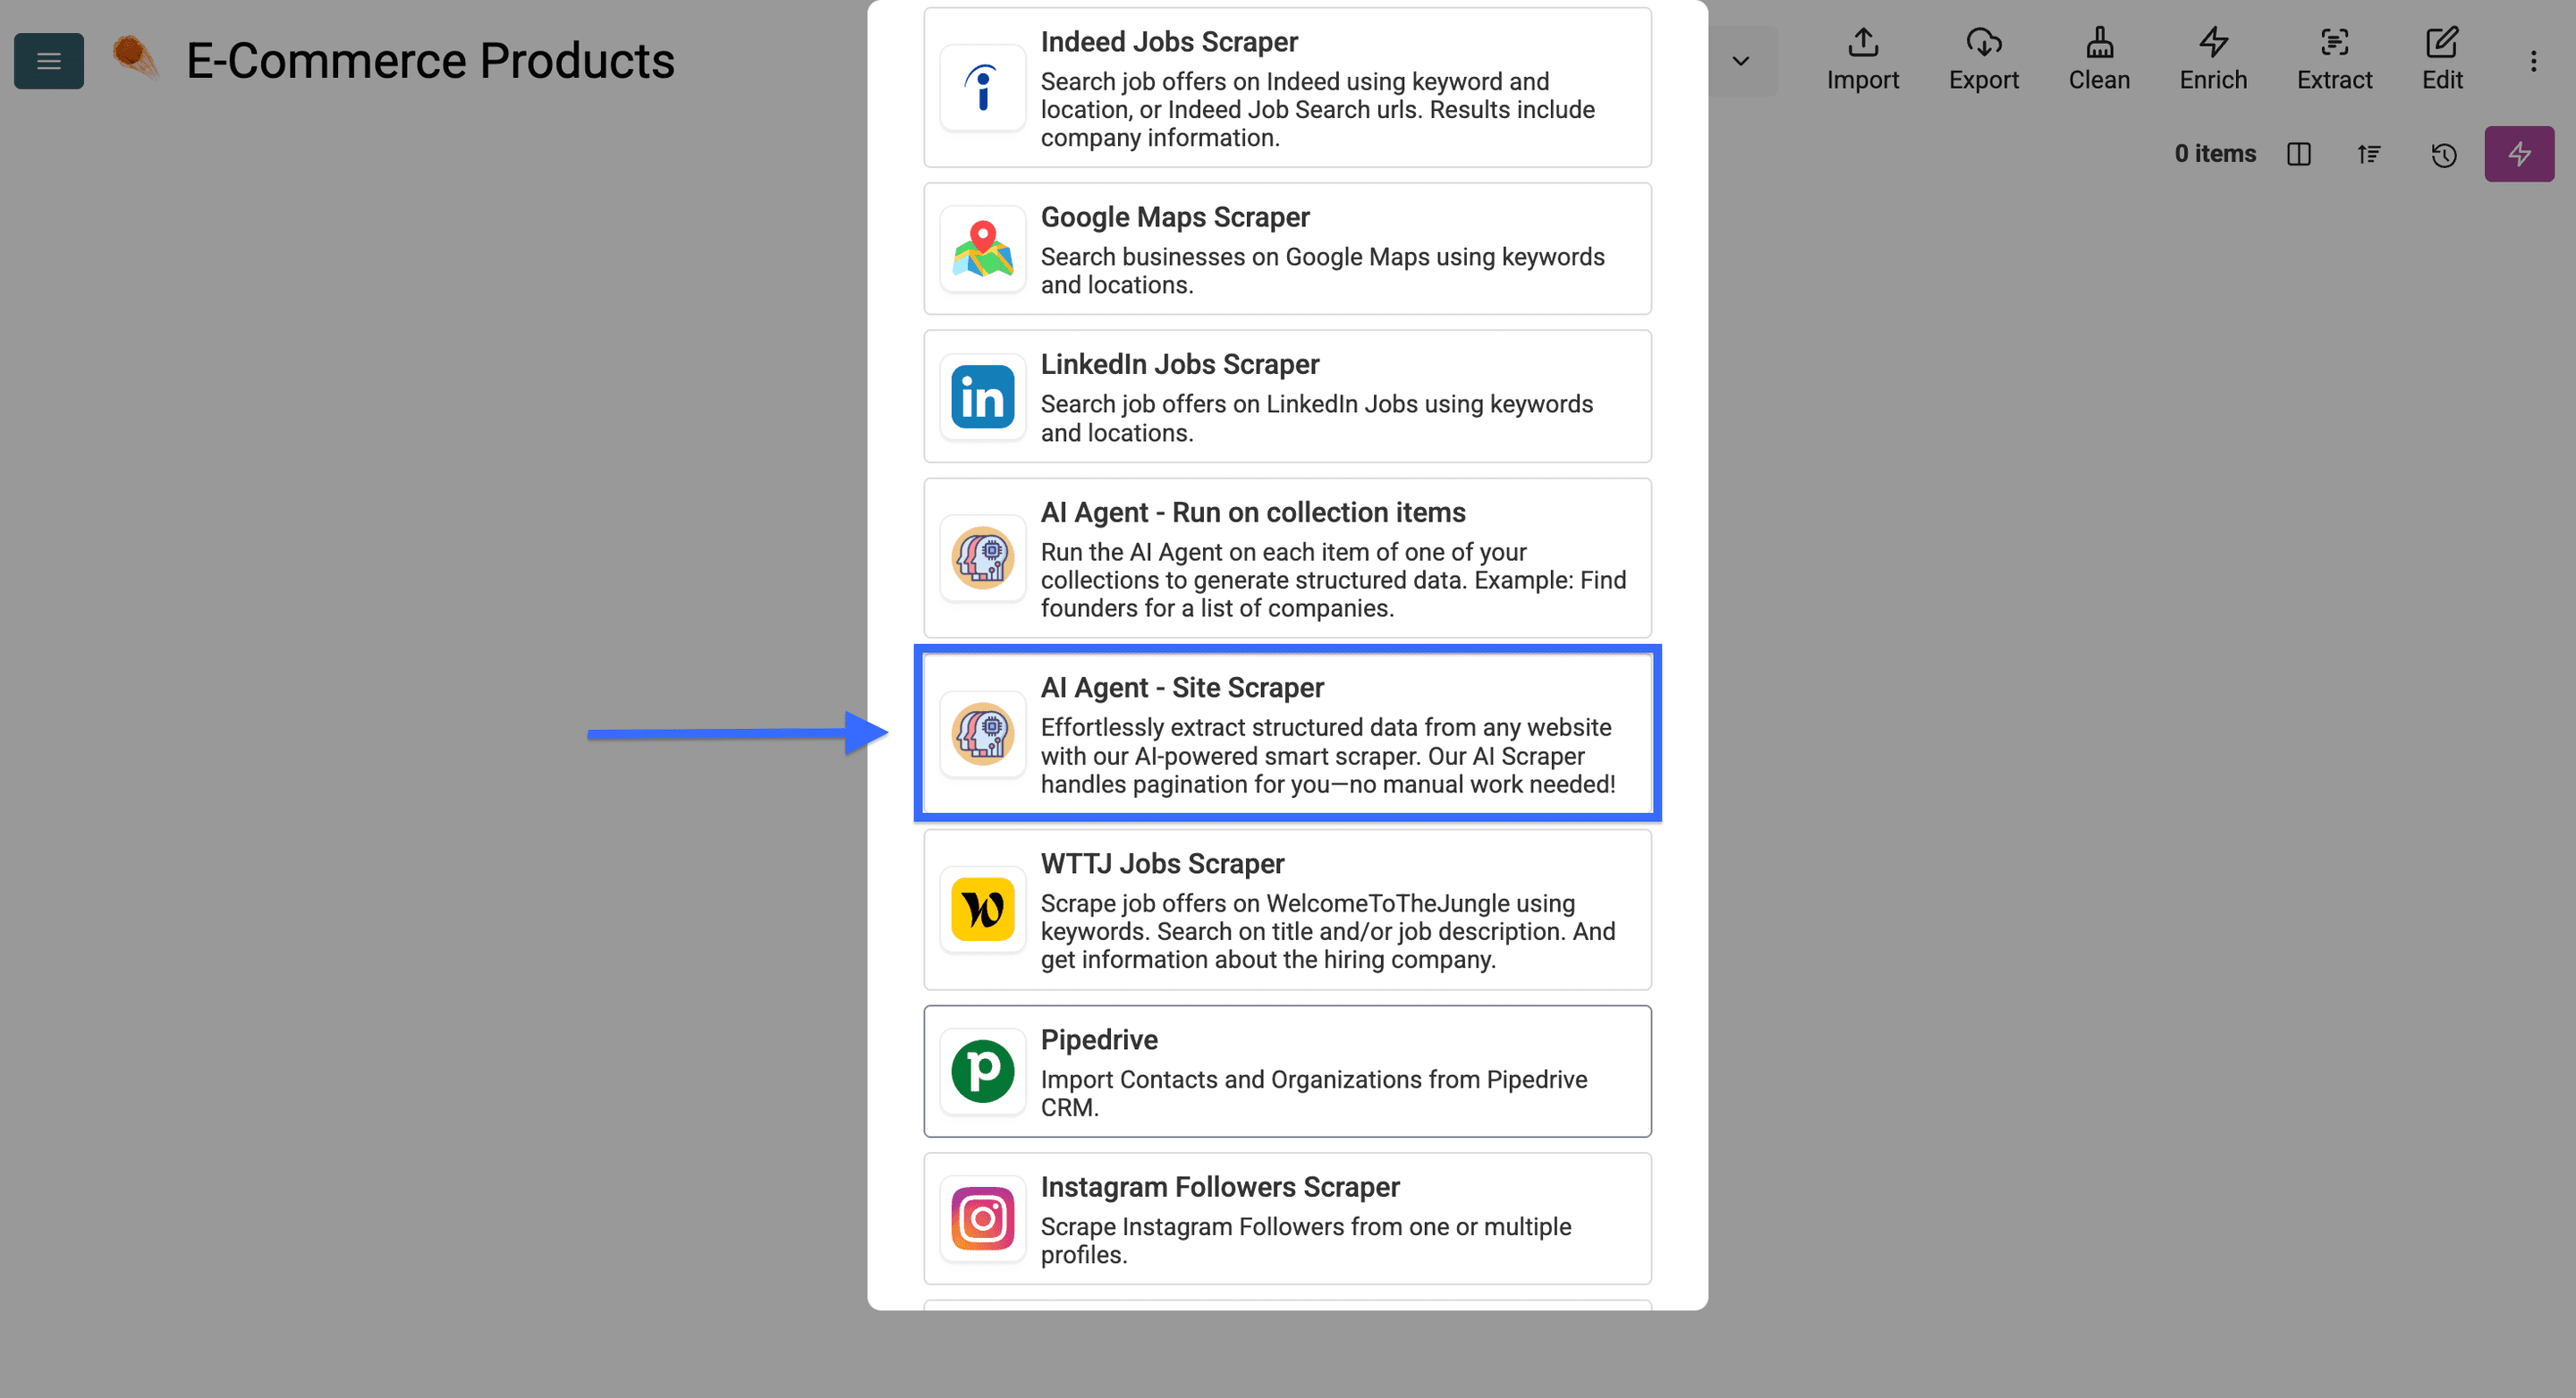
在第一个字段中粘贴你想抓取商品的网站 URL。
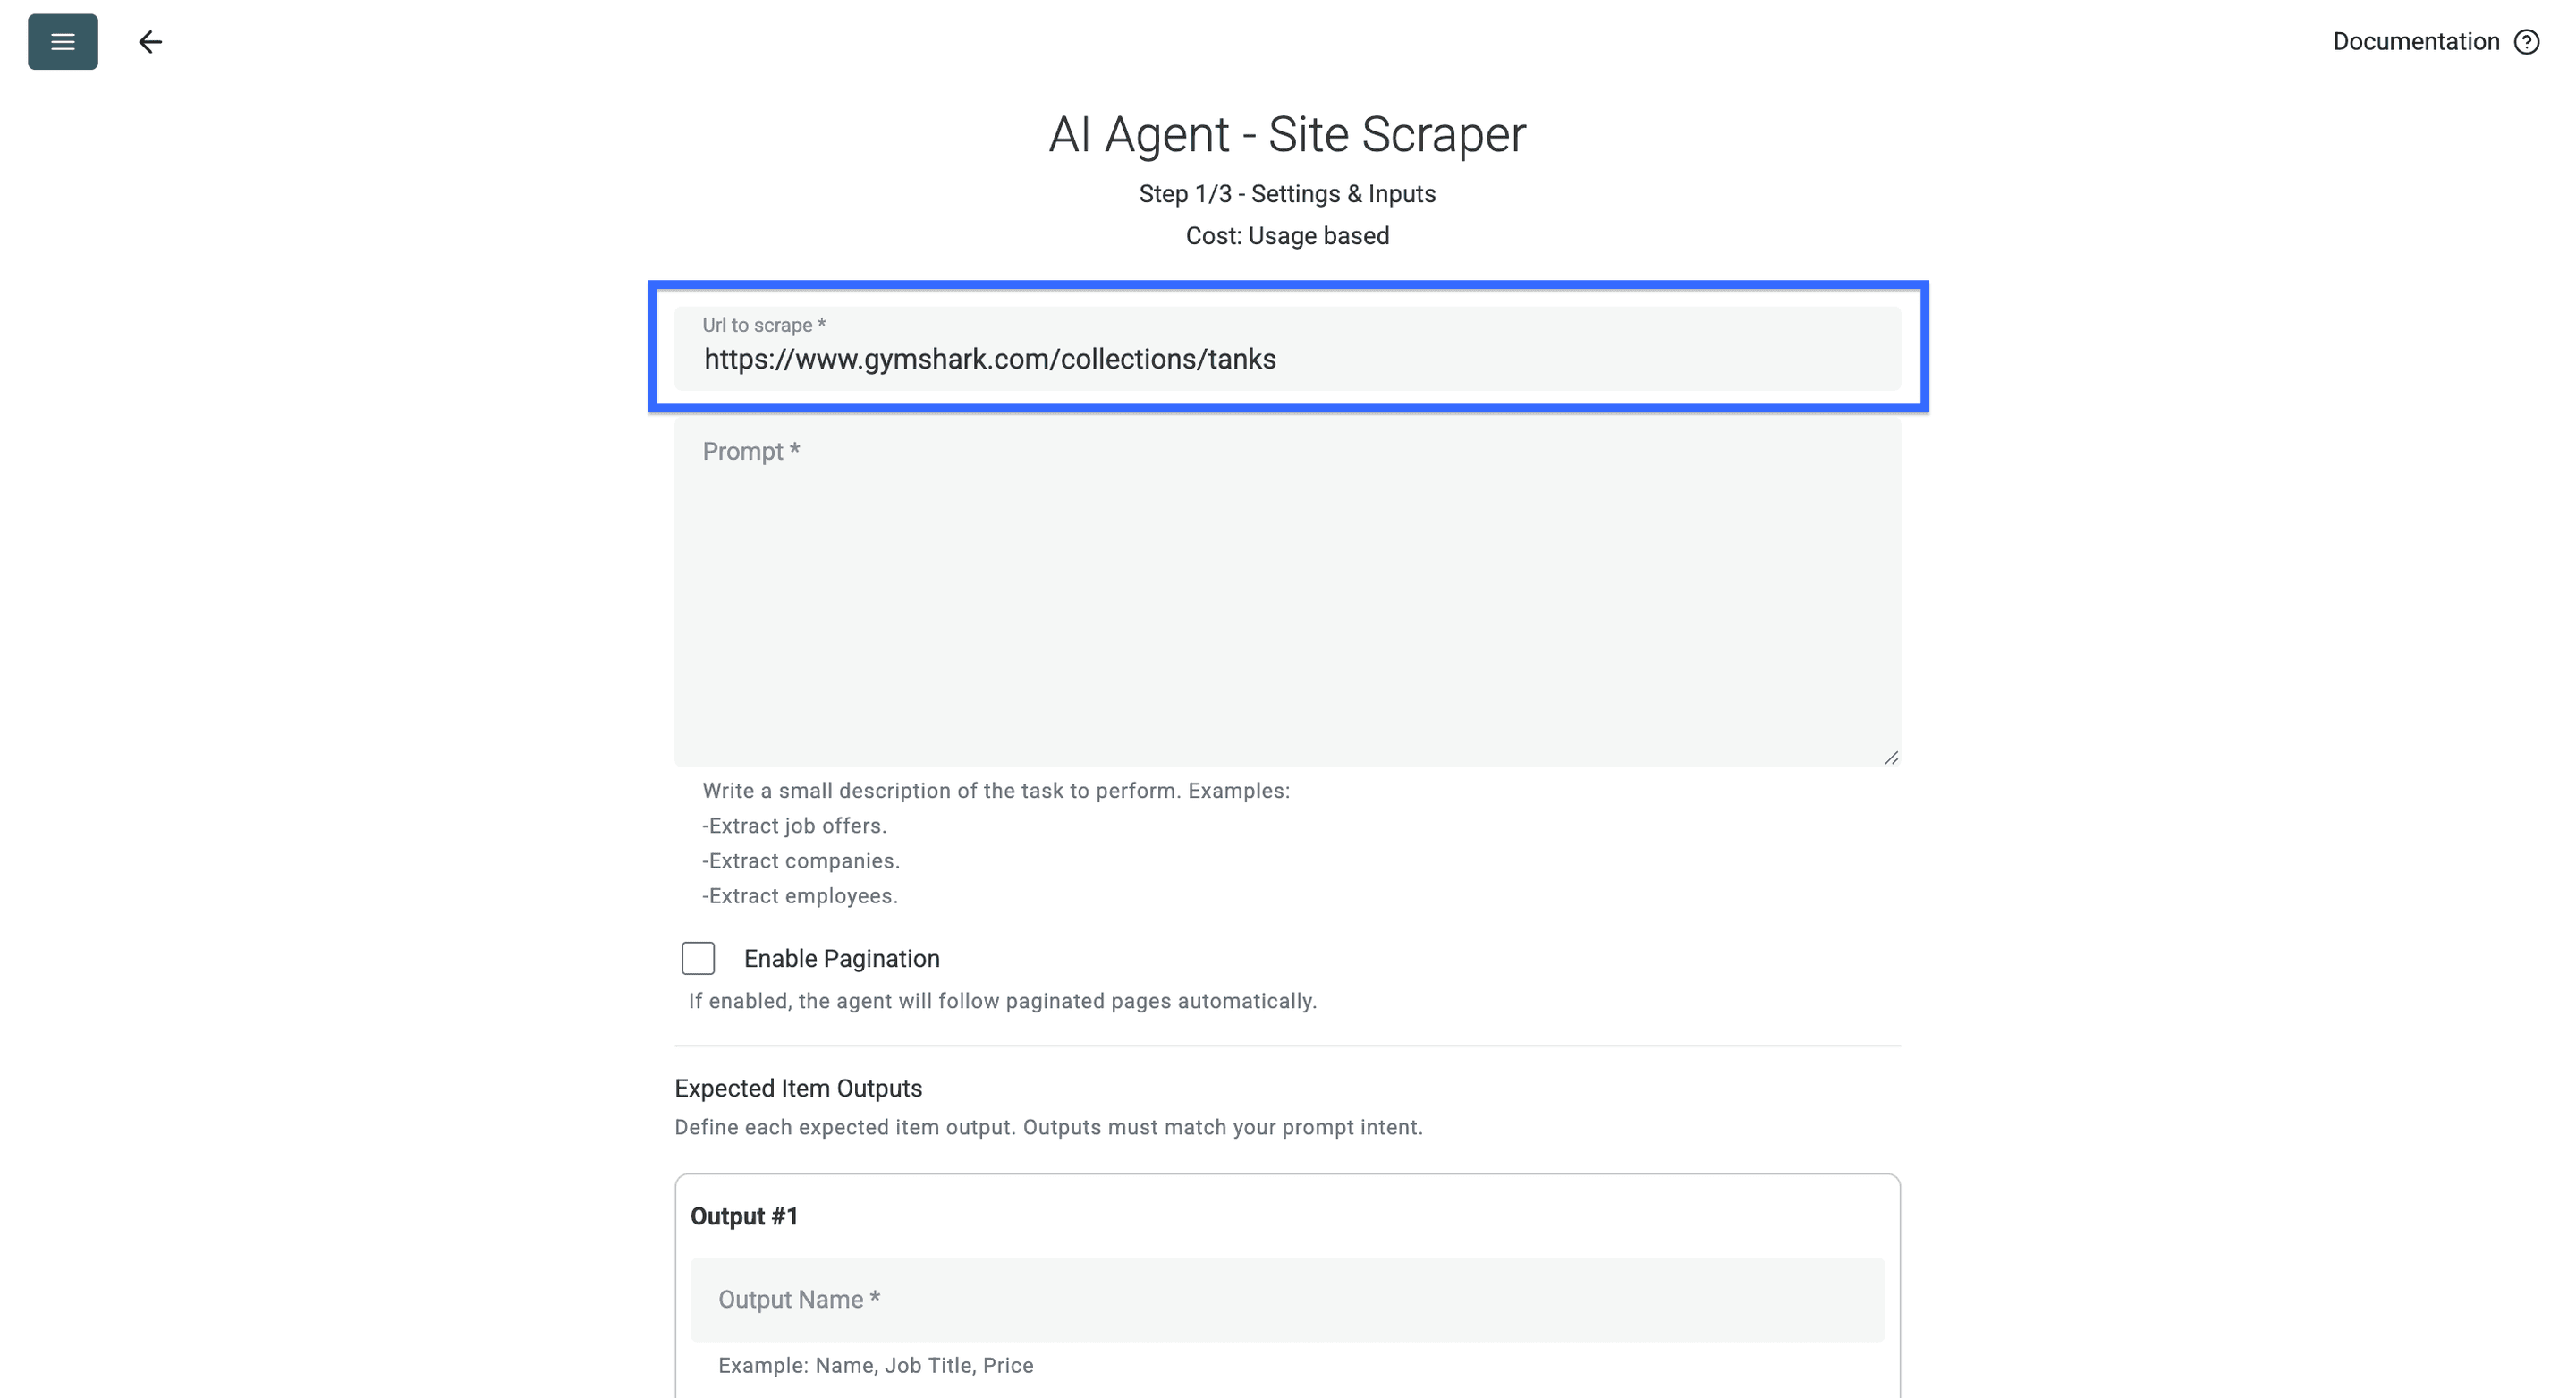
然后输入一段 prompt,告诉 AI Agent 你希望从该电商网站抓取哪些信息(也可以直接使用下面的 prompt)。
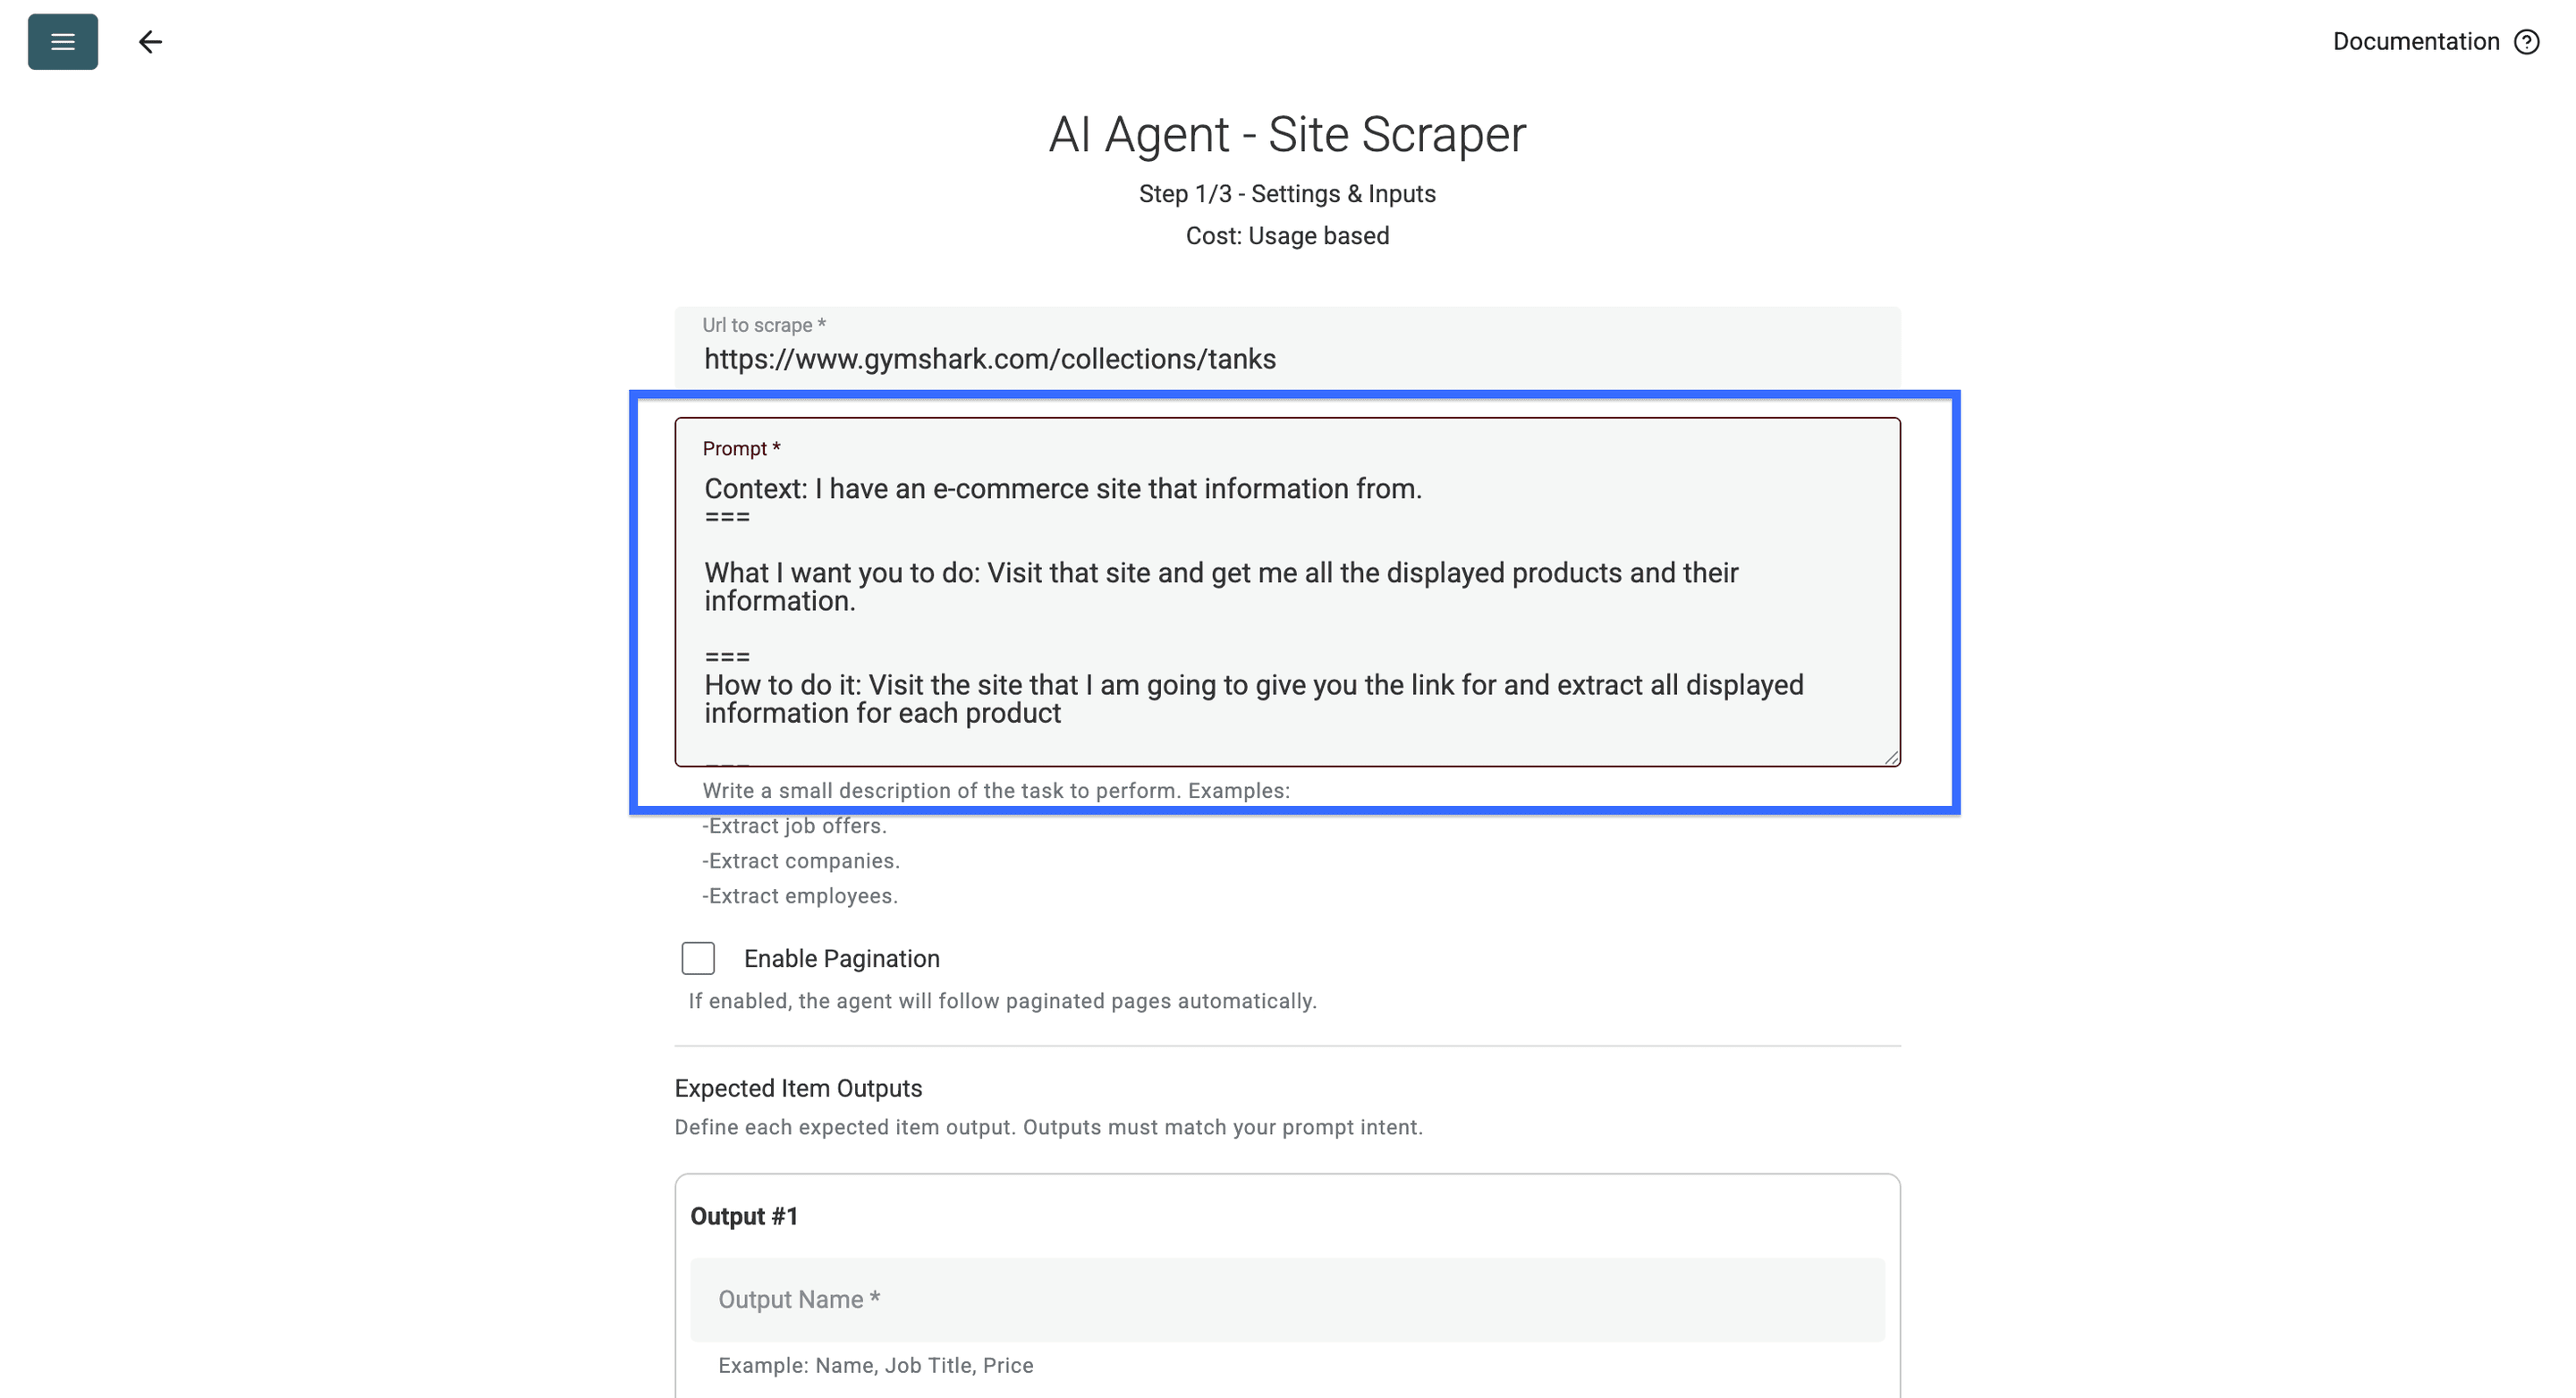
背景:我有一个展示商品列表的电商网站。
===任务:访问该网站,获取页面上展示的全部商品及其相关信息。
===操作方式:访问我提供链接的网站,提取每件商品在页面上展示的全部信息。
===任务注意事项:不要提取任何与商品无关的信息,例如 Call to Action。
===需要查找的信息如下:
- 商品名称
- 商品详情页链接
- 以页面所示币种表示的商品原价
- 商品分类:(例如:营养全面的即食餐、背心、短袜)
- 商品规格 1:(例如:紧身版型、40 克蛋白质、高级船袜)
- 商品规格 2:(例如:颜色、件数、份数)
- 特殊标签:(例如:新品、限量版、最后机会等;如无标签,返回“None”)
- 商品图片的绝对链接
- 折扣百分比(如有;如无折扣,返回“None”)
不要返回不属于上述数据类型的任何内容,并且每种类型只返回一条信息。
===数据注意事项:各页面的结构不一定相同,但商品标识都足够清晰,你应该能够区分不同的数据点。
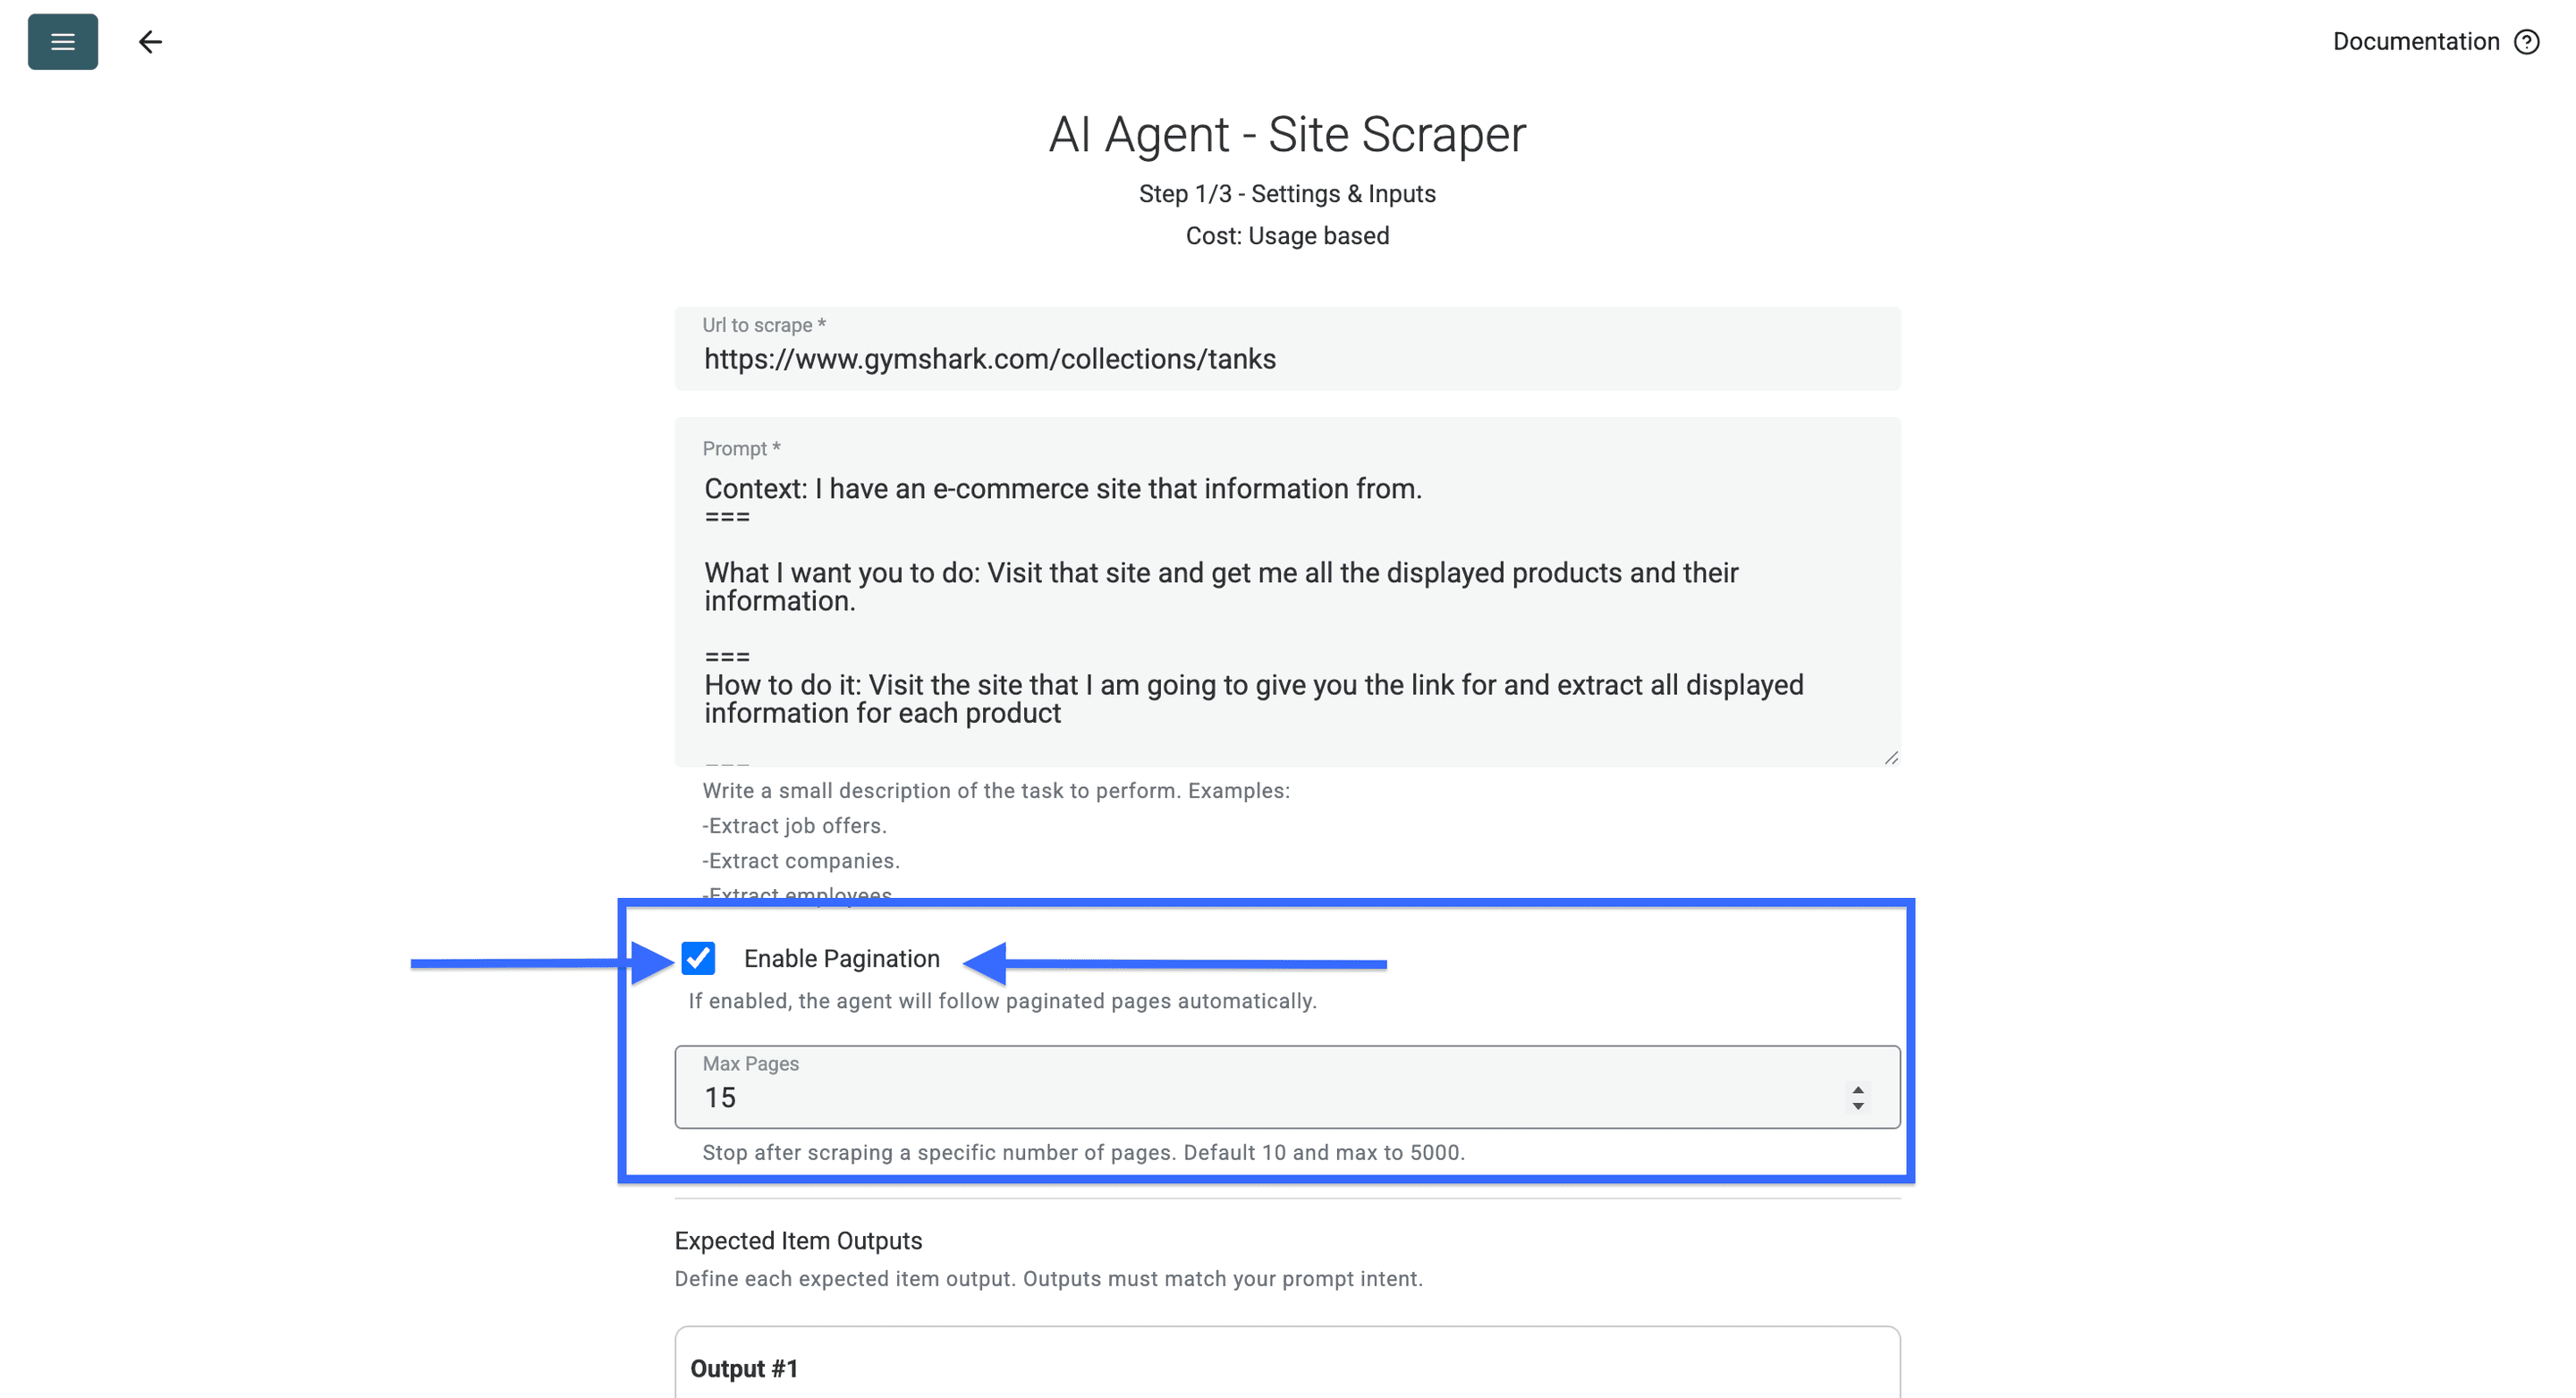
如果商品列表不止一页,请开启 Enable Pagination,并在首次运行时将 Max Pages 设置为较小的数值。页面上限控制的是访问页数,而不是返回的商品数量。请确认下一页链接可以正常访问;如果网站只有一页,或下一页被阻止访问,就无法获得完整的商品目录。
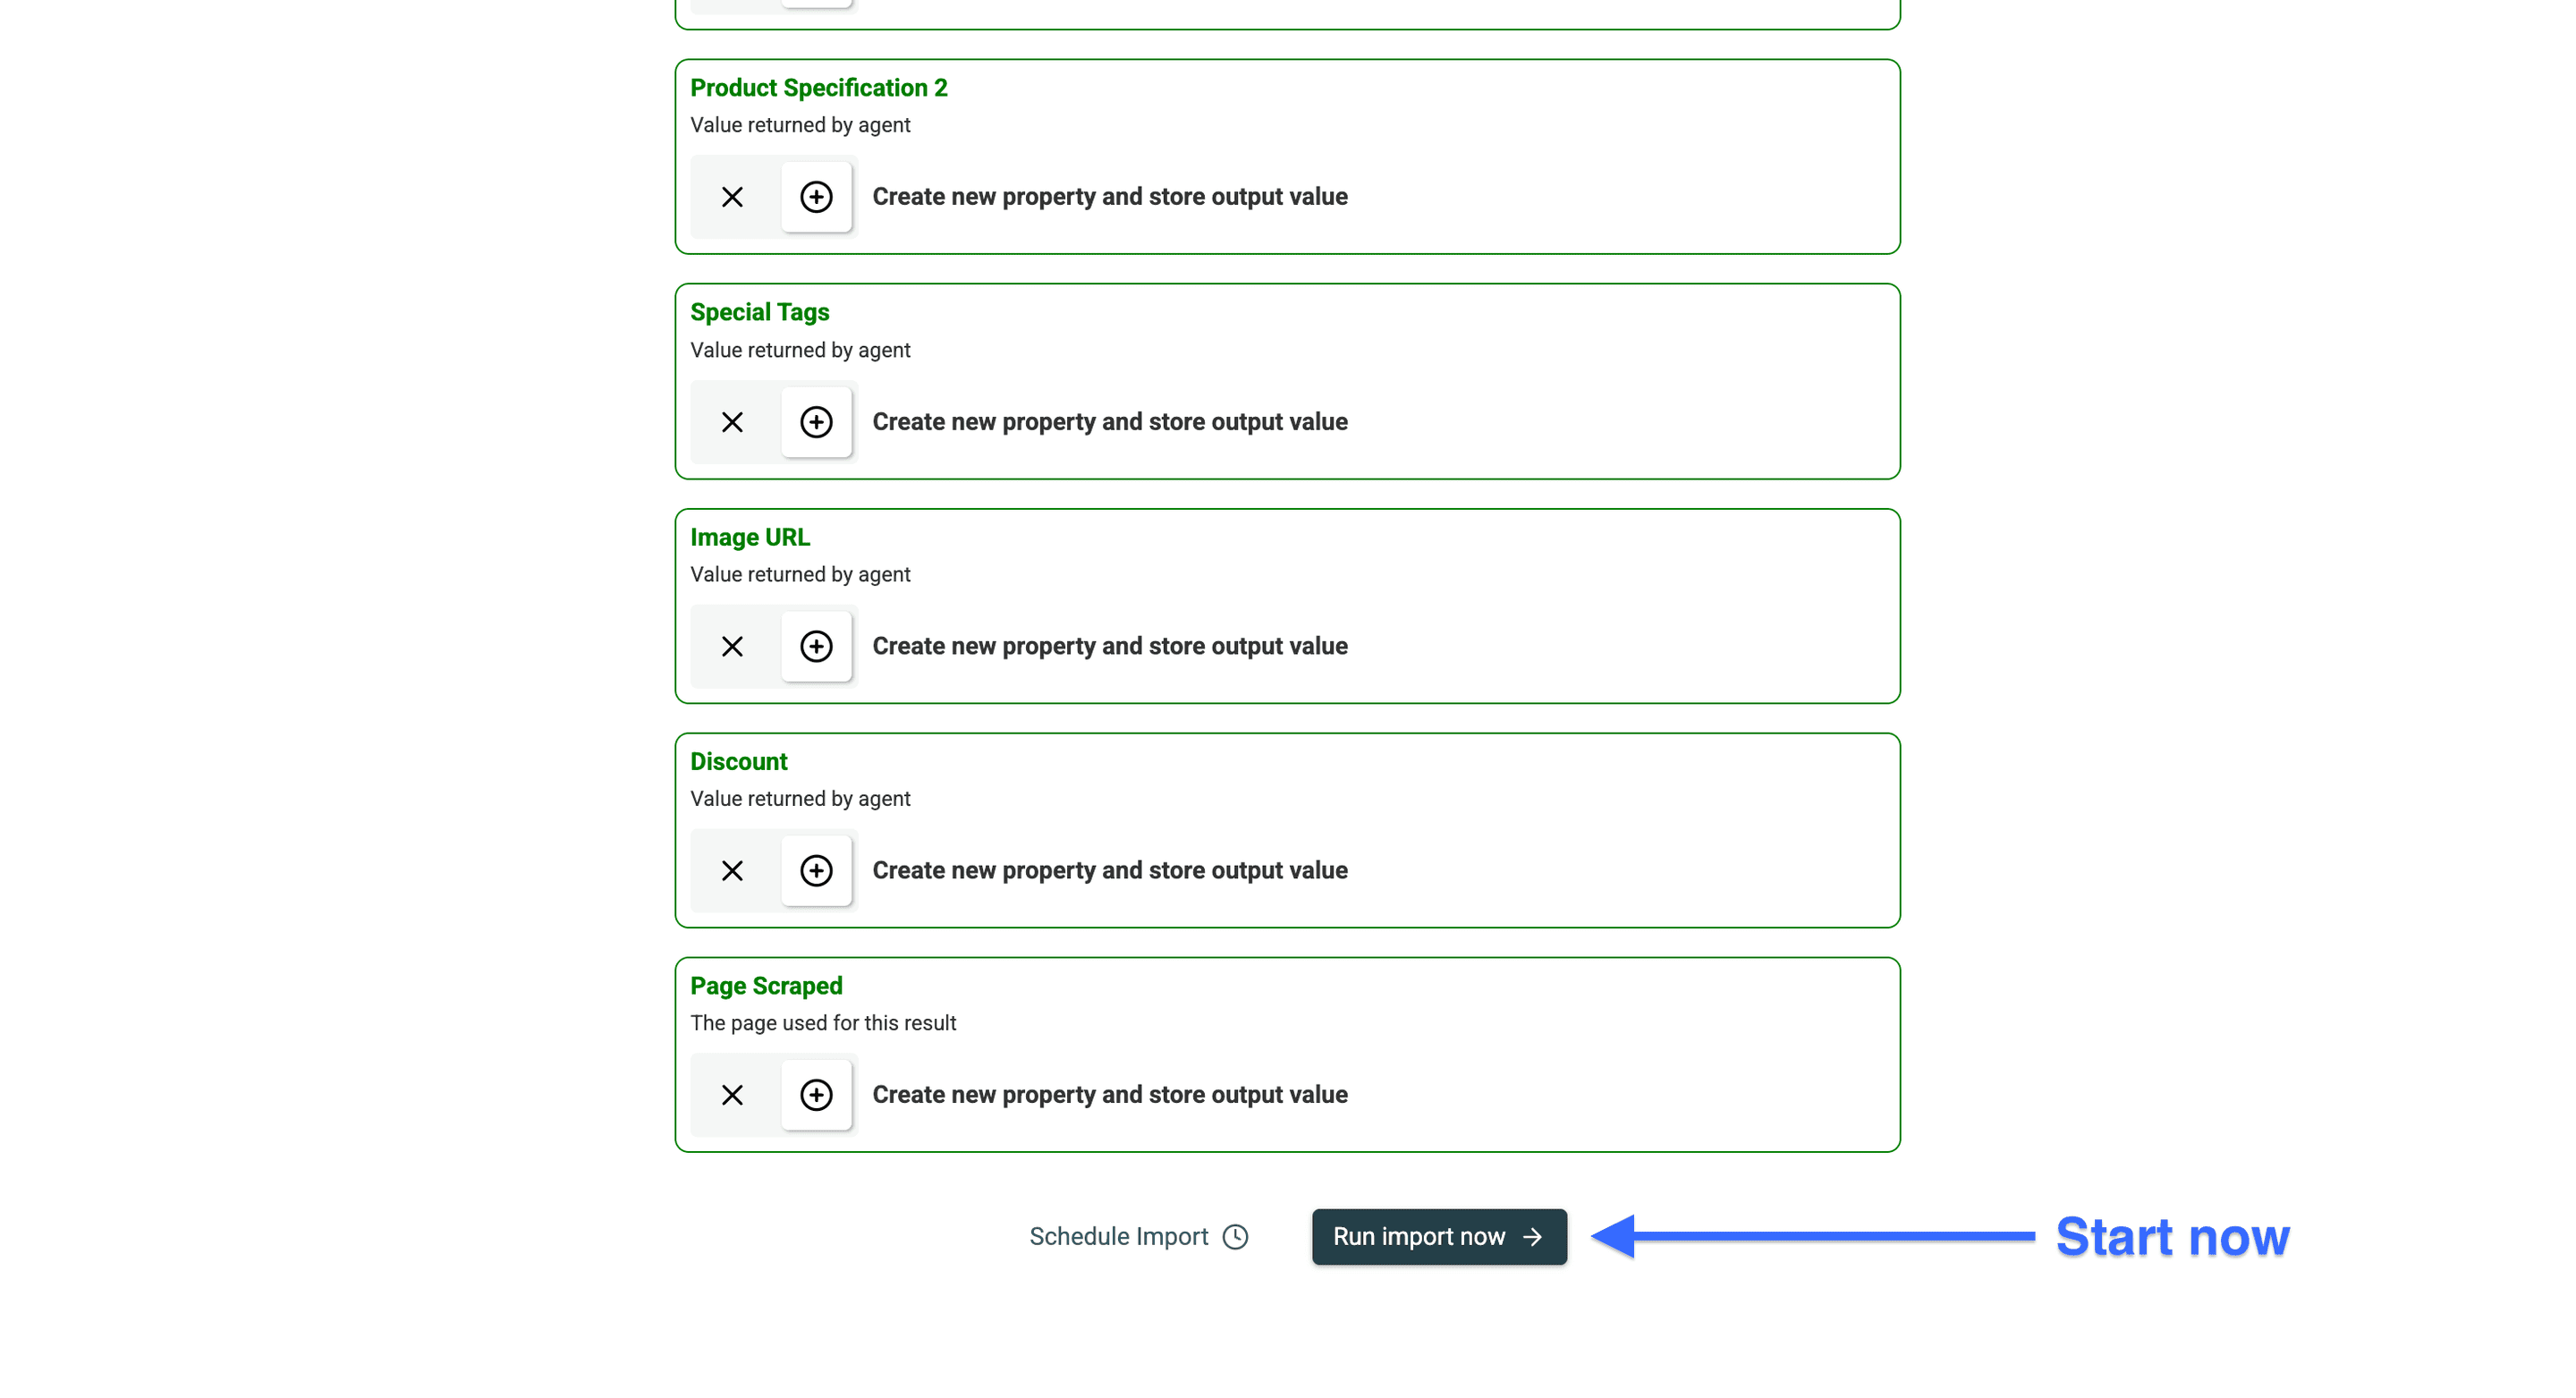
接下来,为每一种需要抓取的商品信息创建对应的 output field/column。
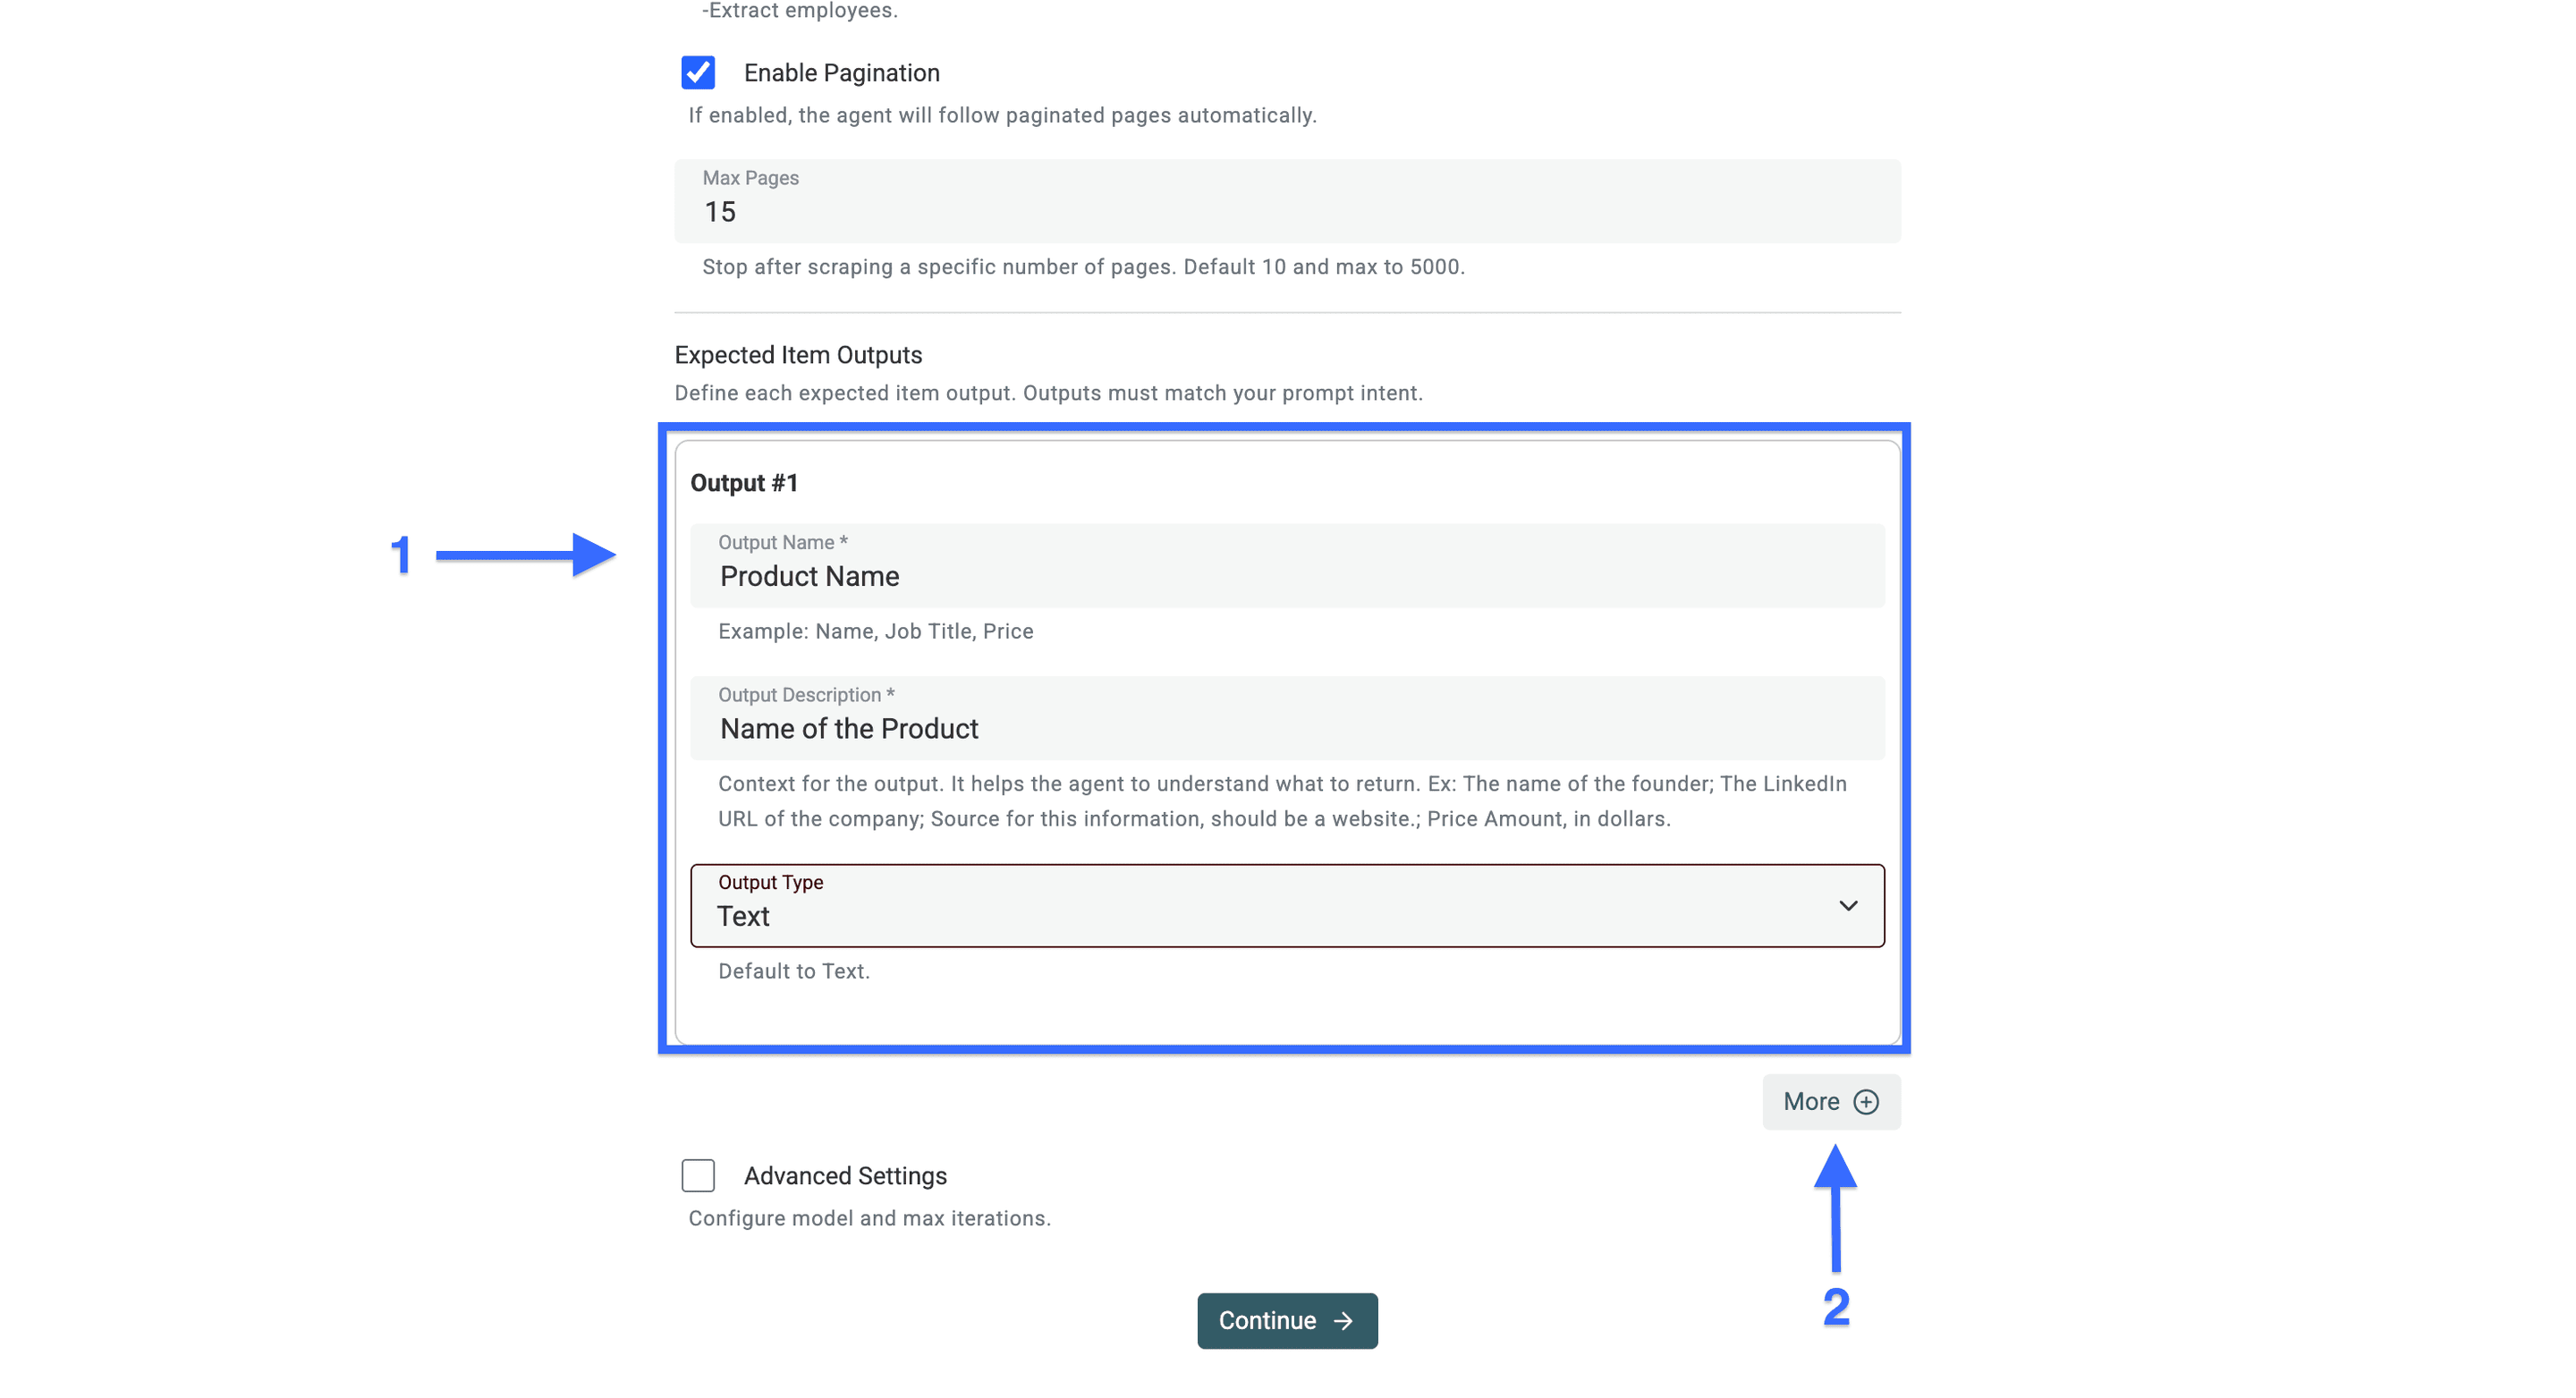
点击“More”创建更多 output field,重复此操作,直到每种信息都有对应的字段。
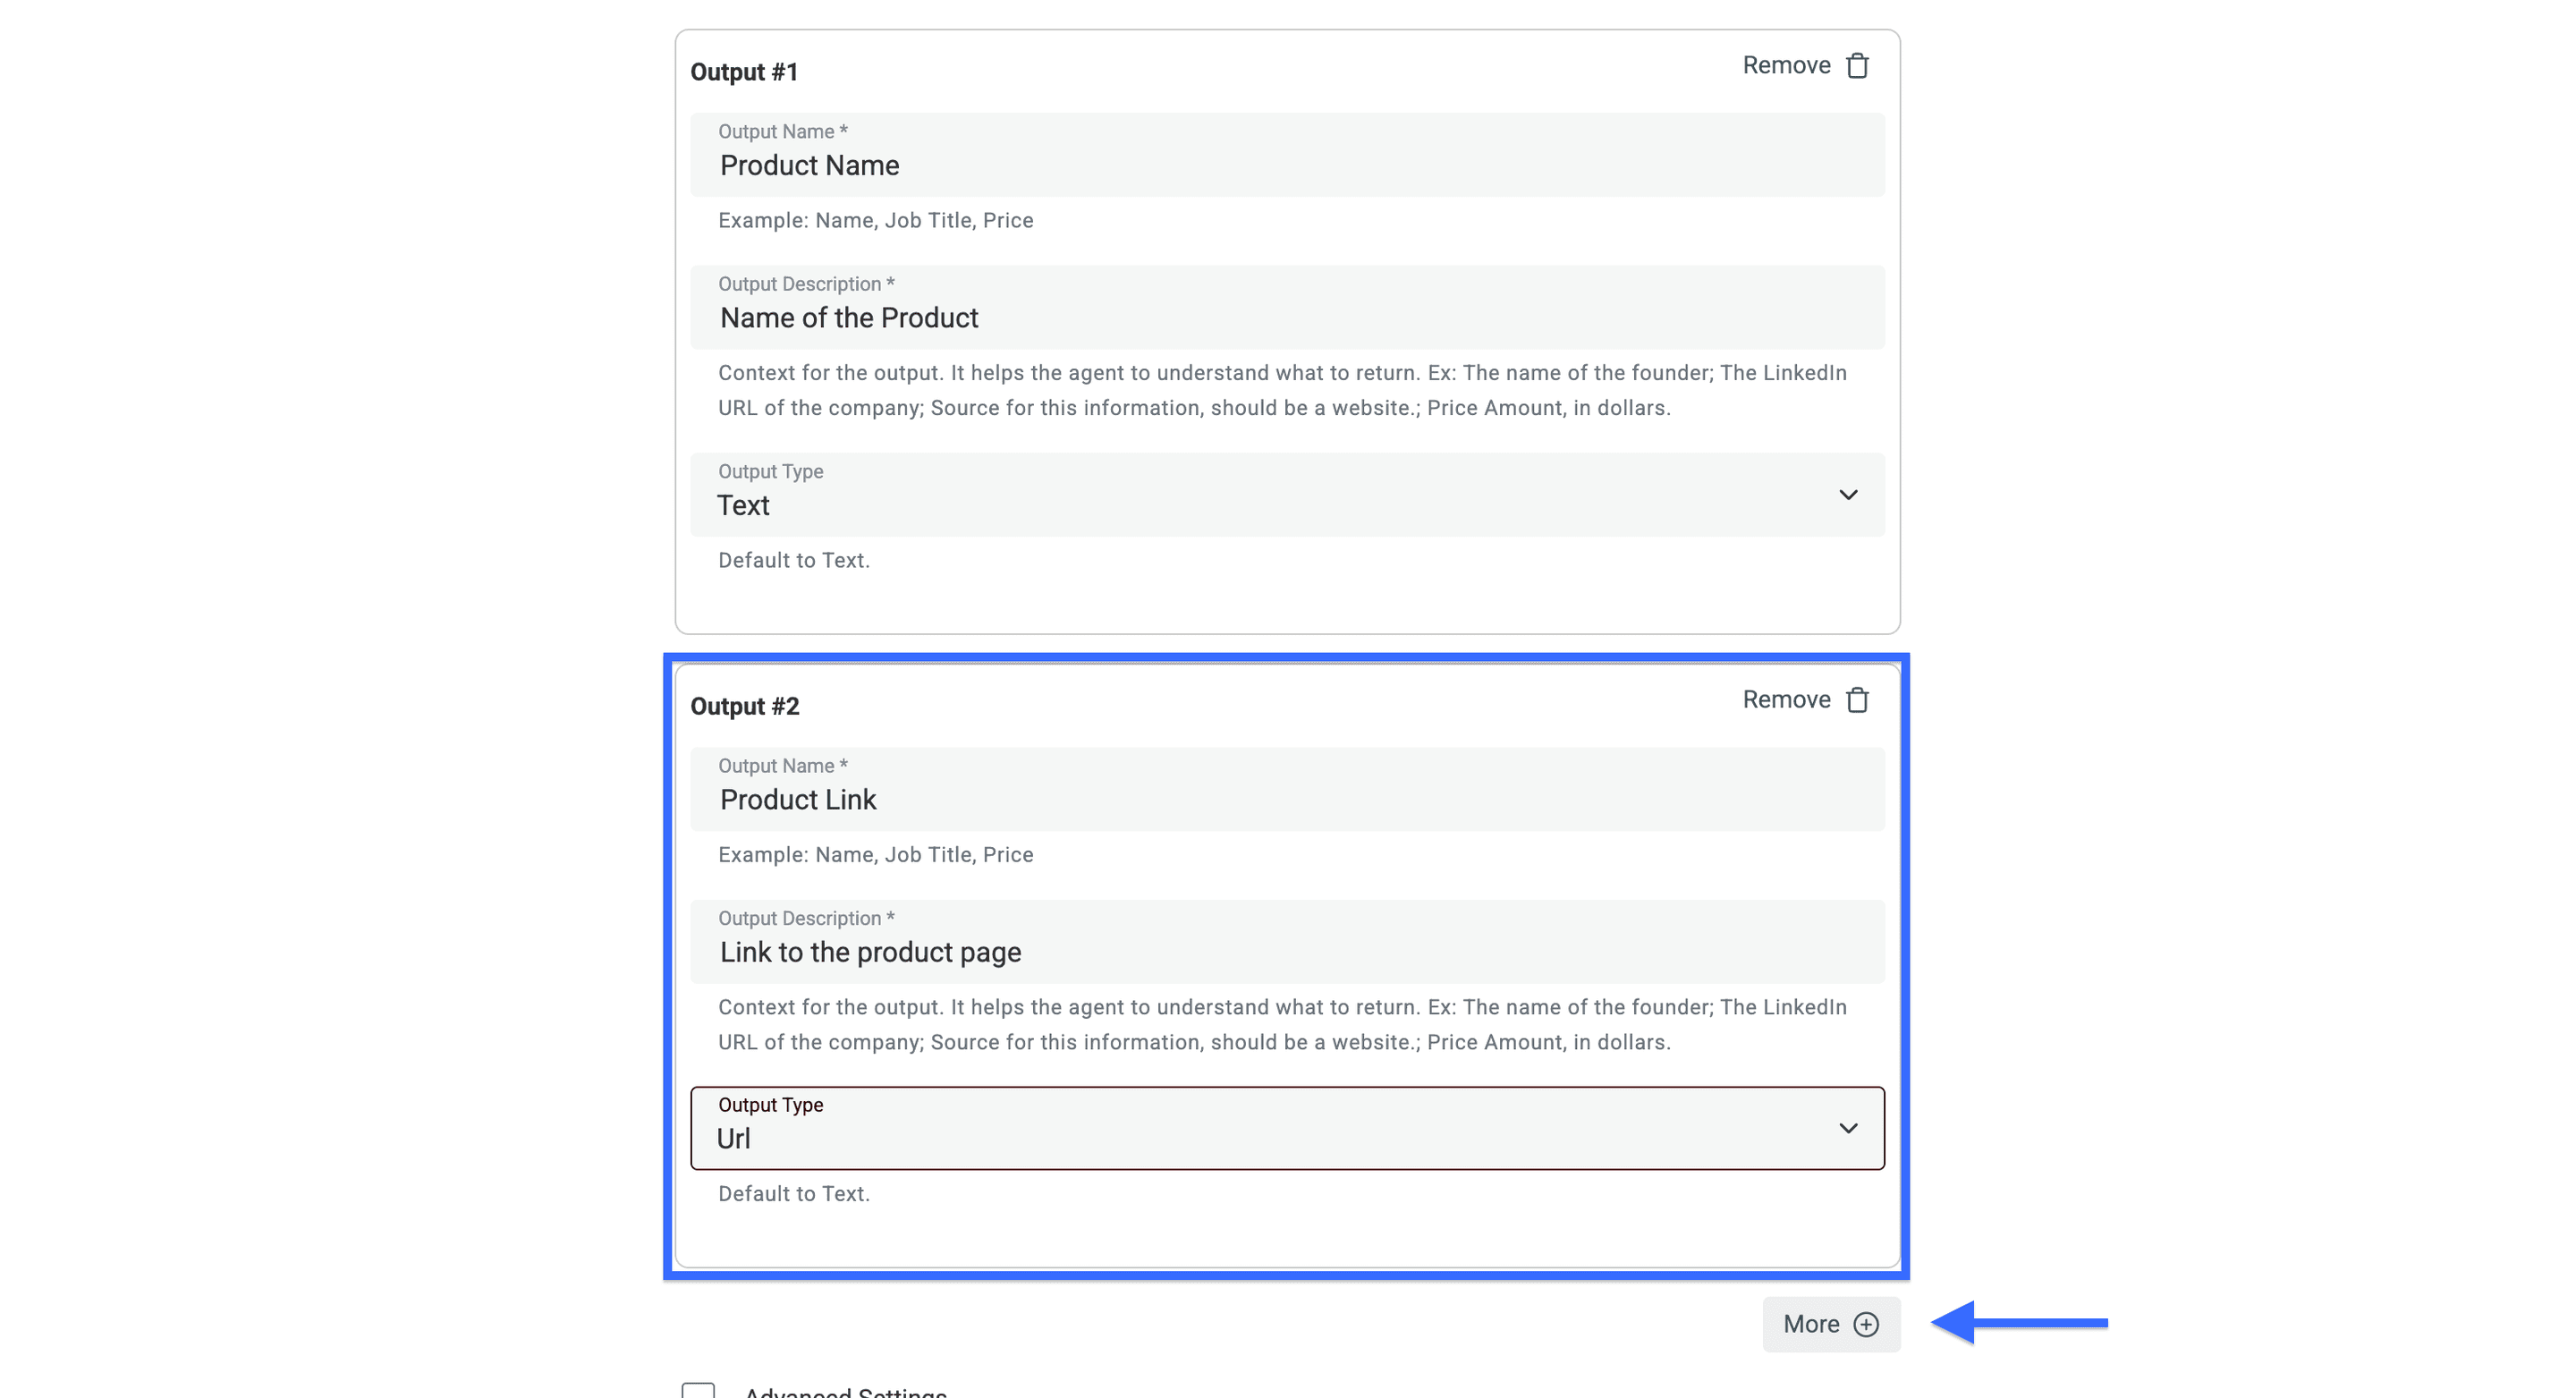
如果需要分别保存不同的商品规格,请为每项规格单独创建一个字段。示例如下:
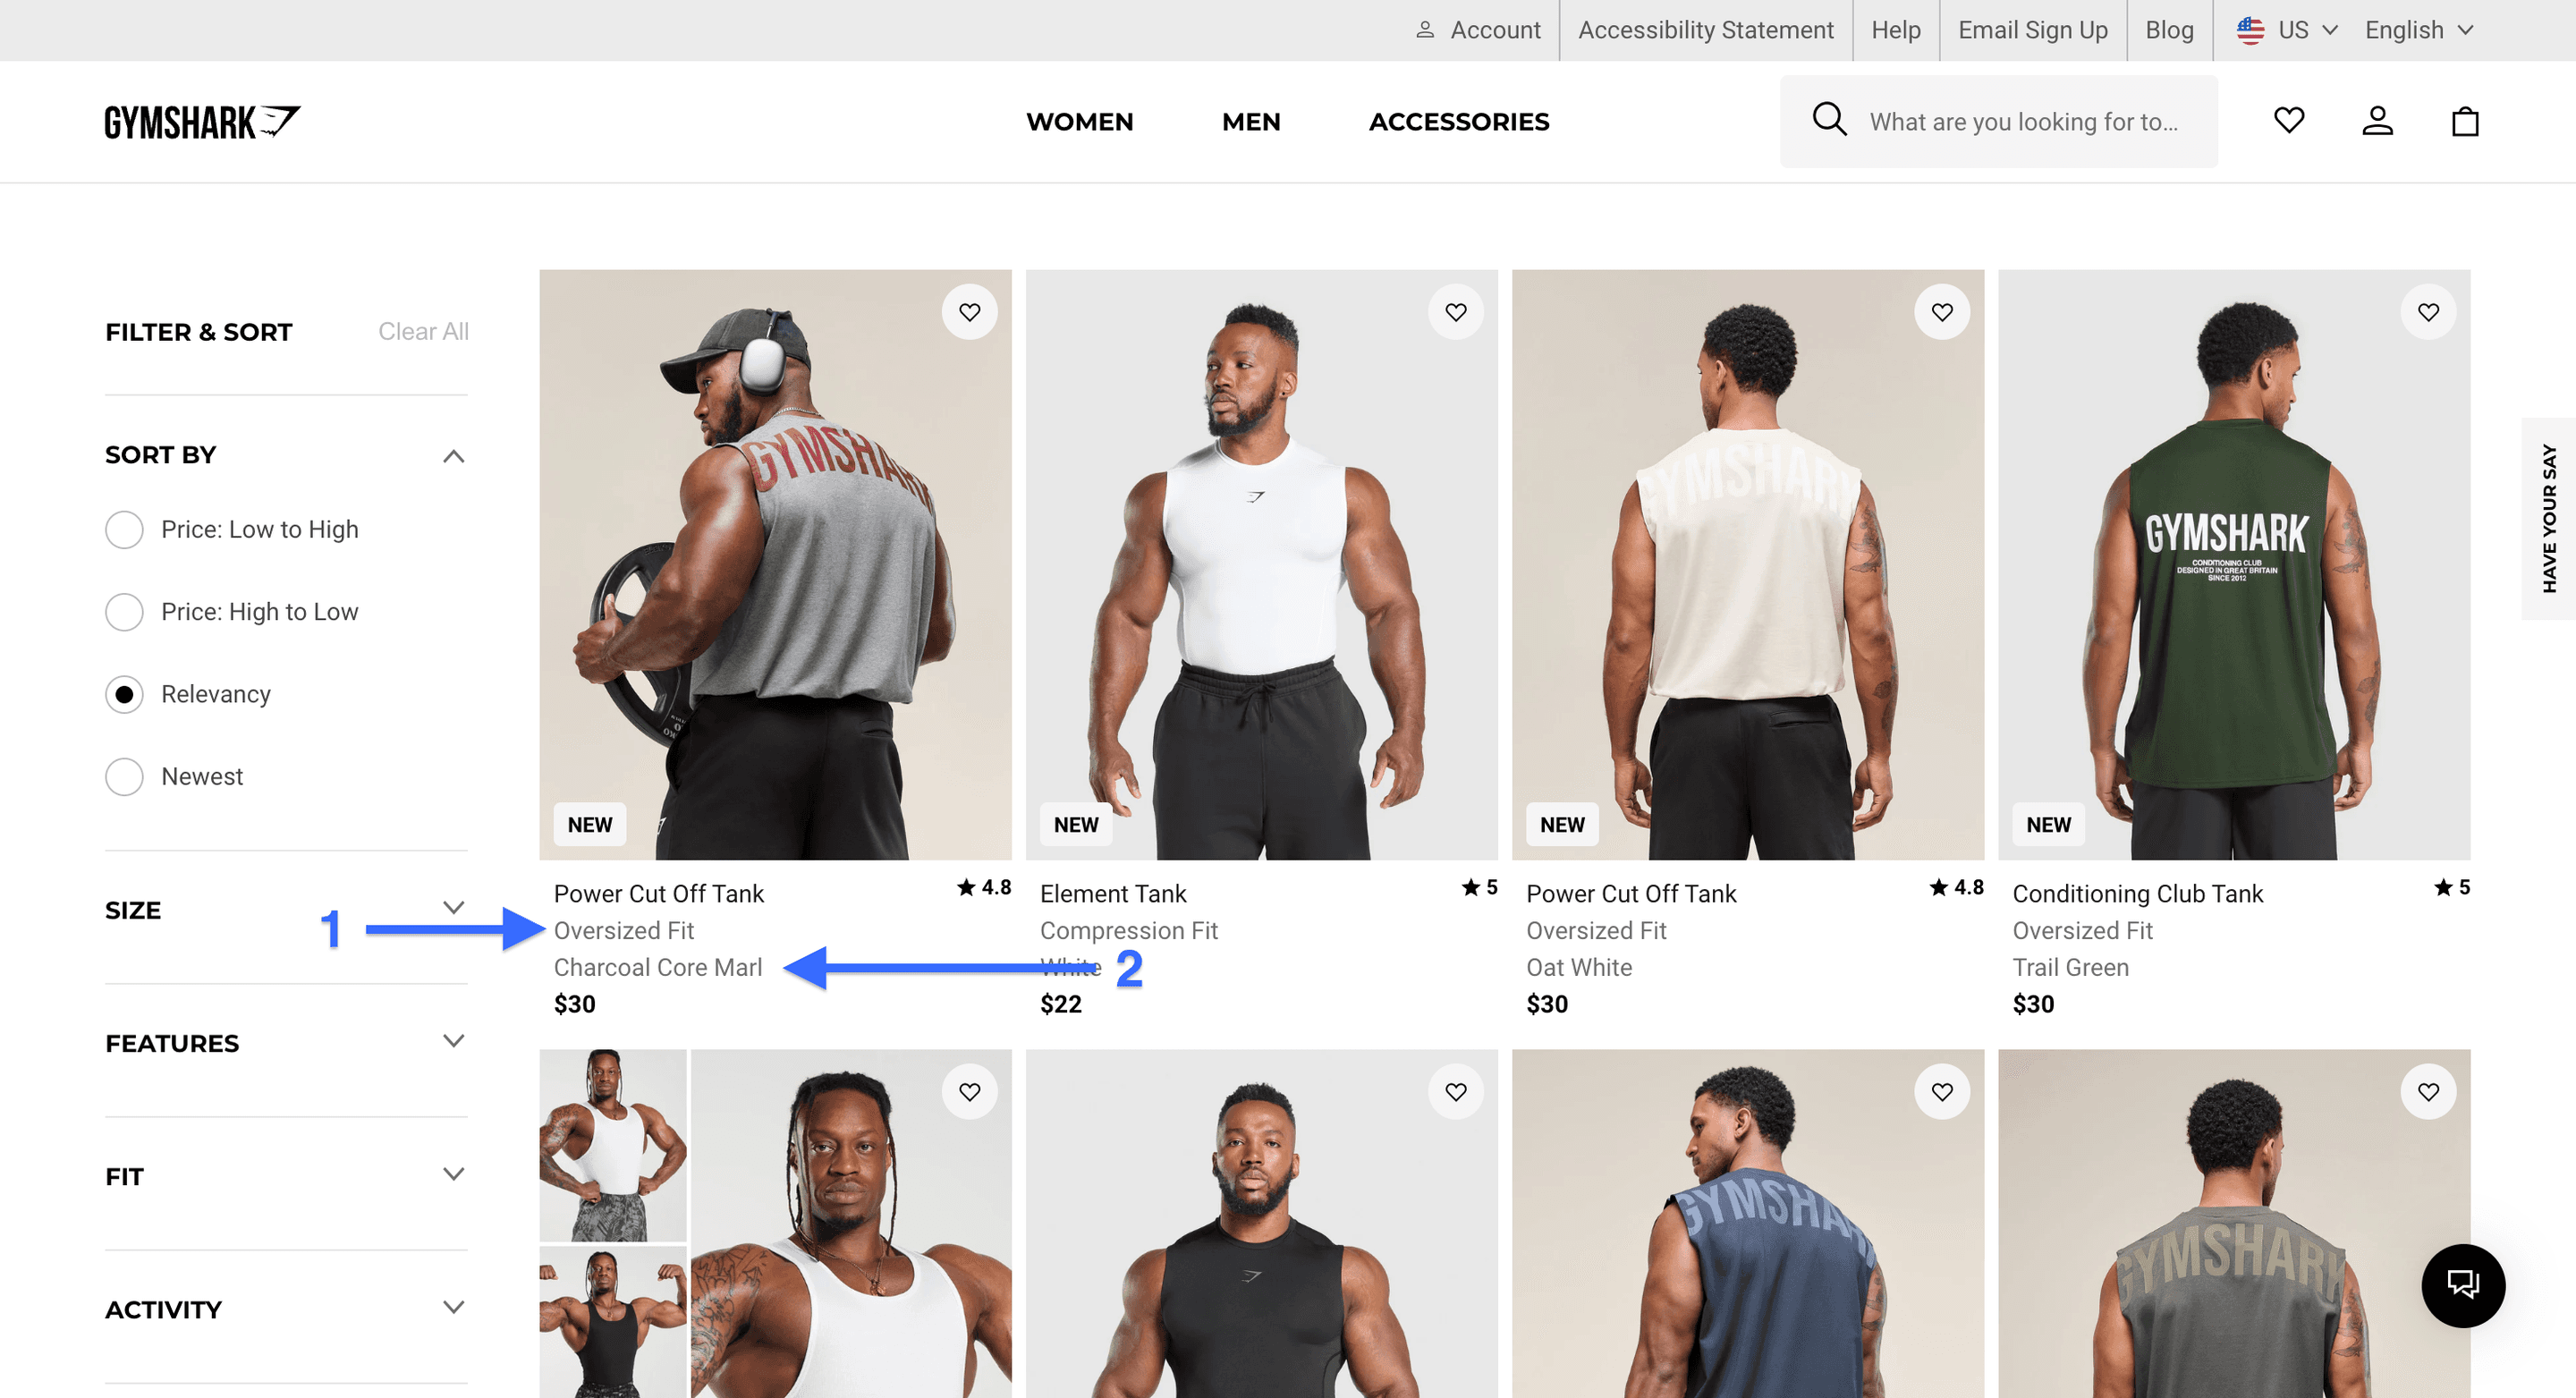
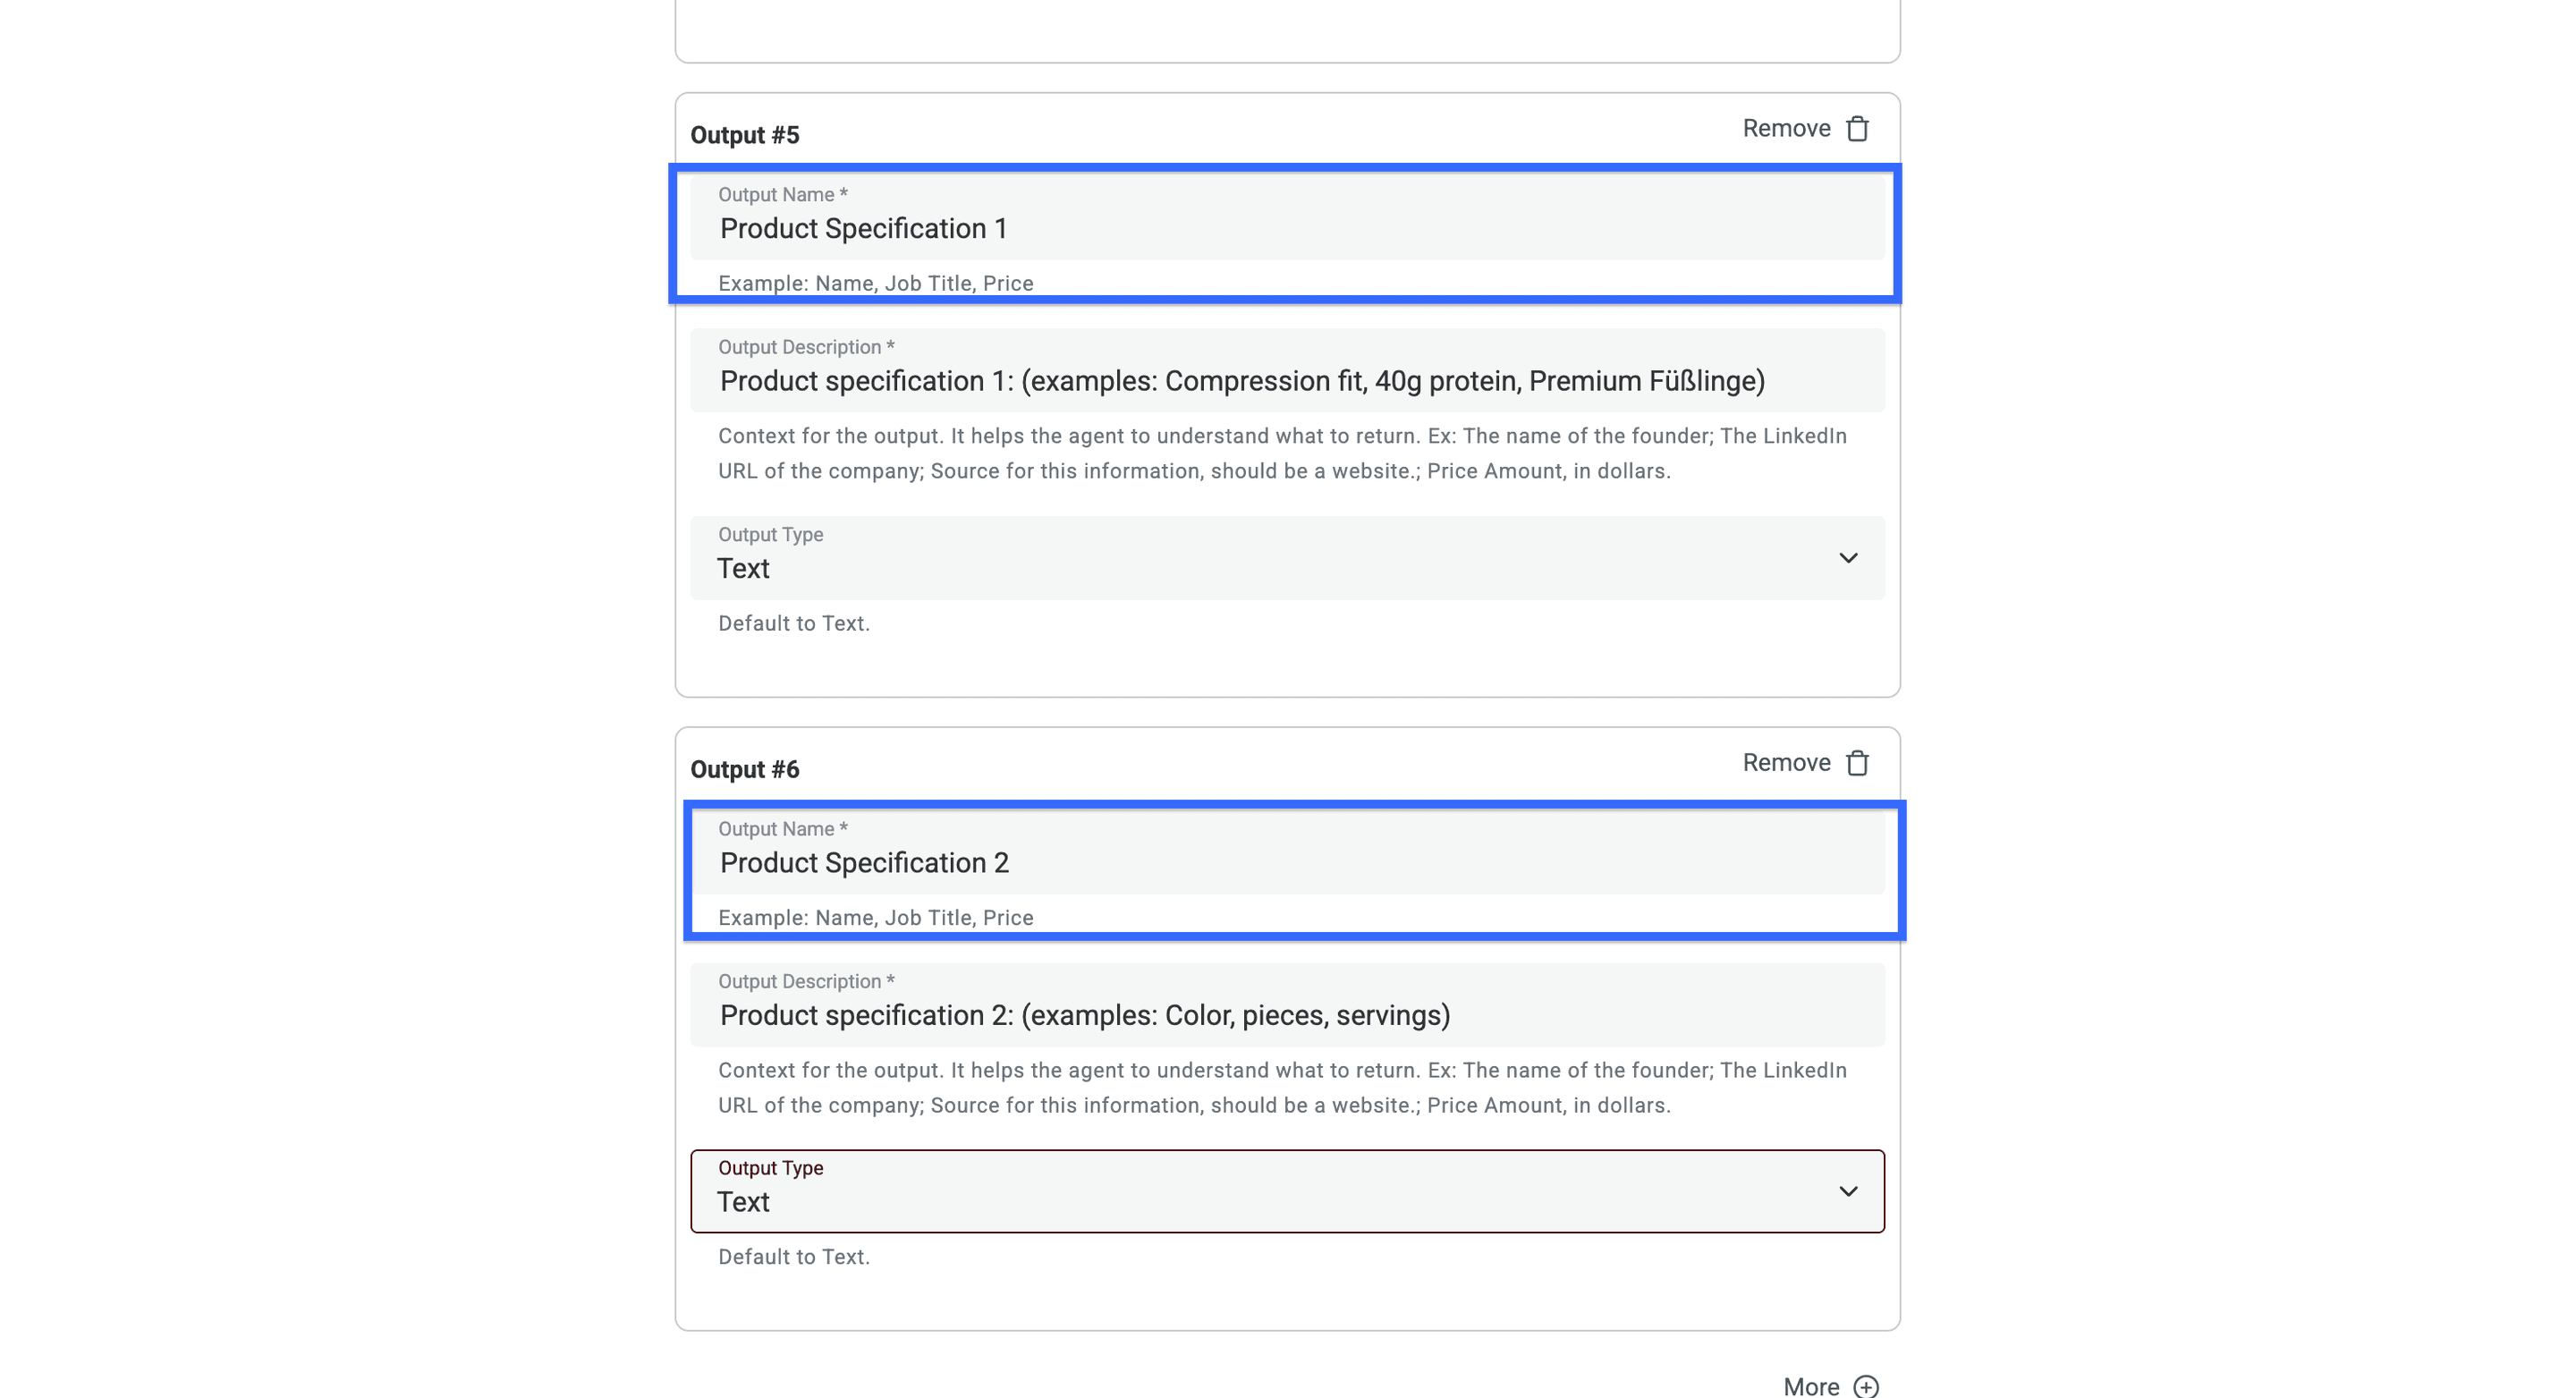
💡 这样做,抓取结果会更准确
向 AI Agents 明确提供你想获取的商品规格示例。以下示例基于 Gymshark 的背心商品(见上图):
商品规格 1:Slim Fit
商品规格 2:Black
为所有需要抓取的信息创建好 output field 后,勾选“Advanced Settings”。
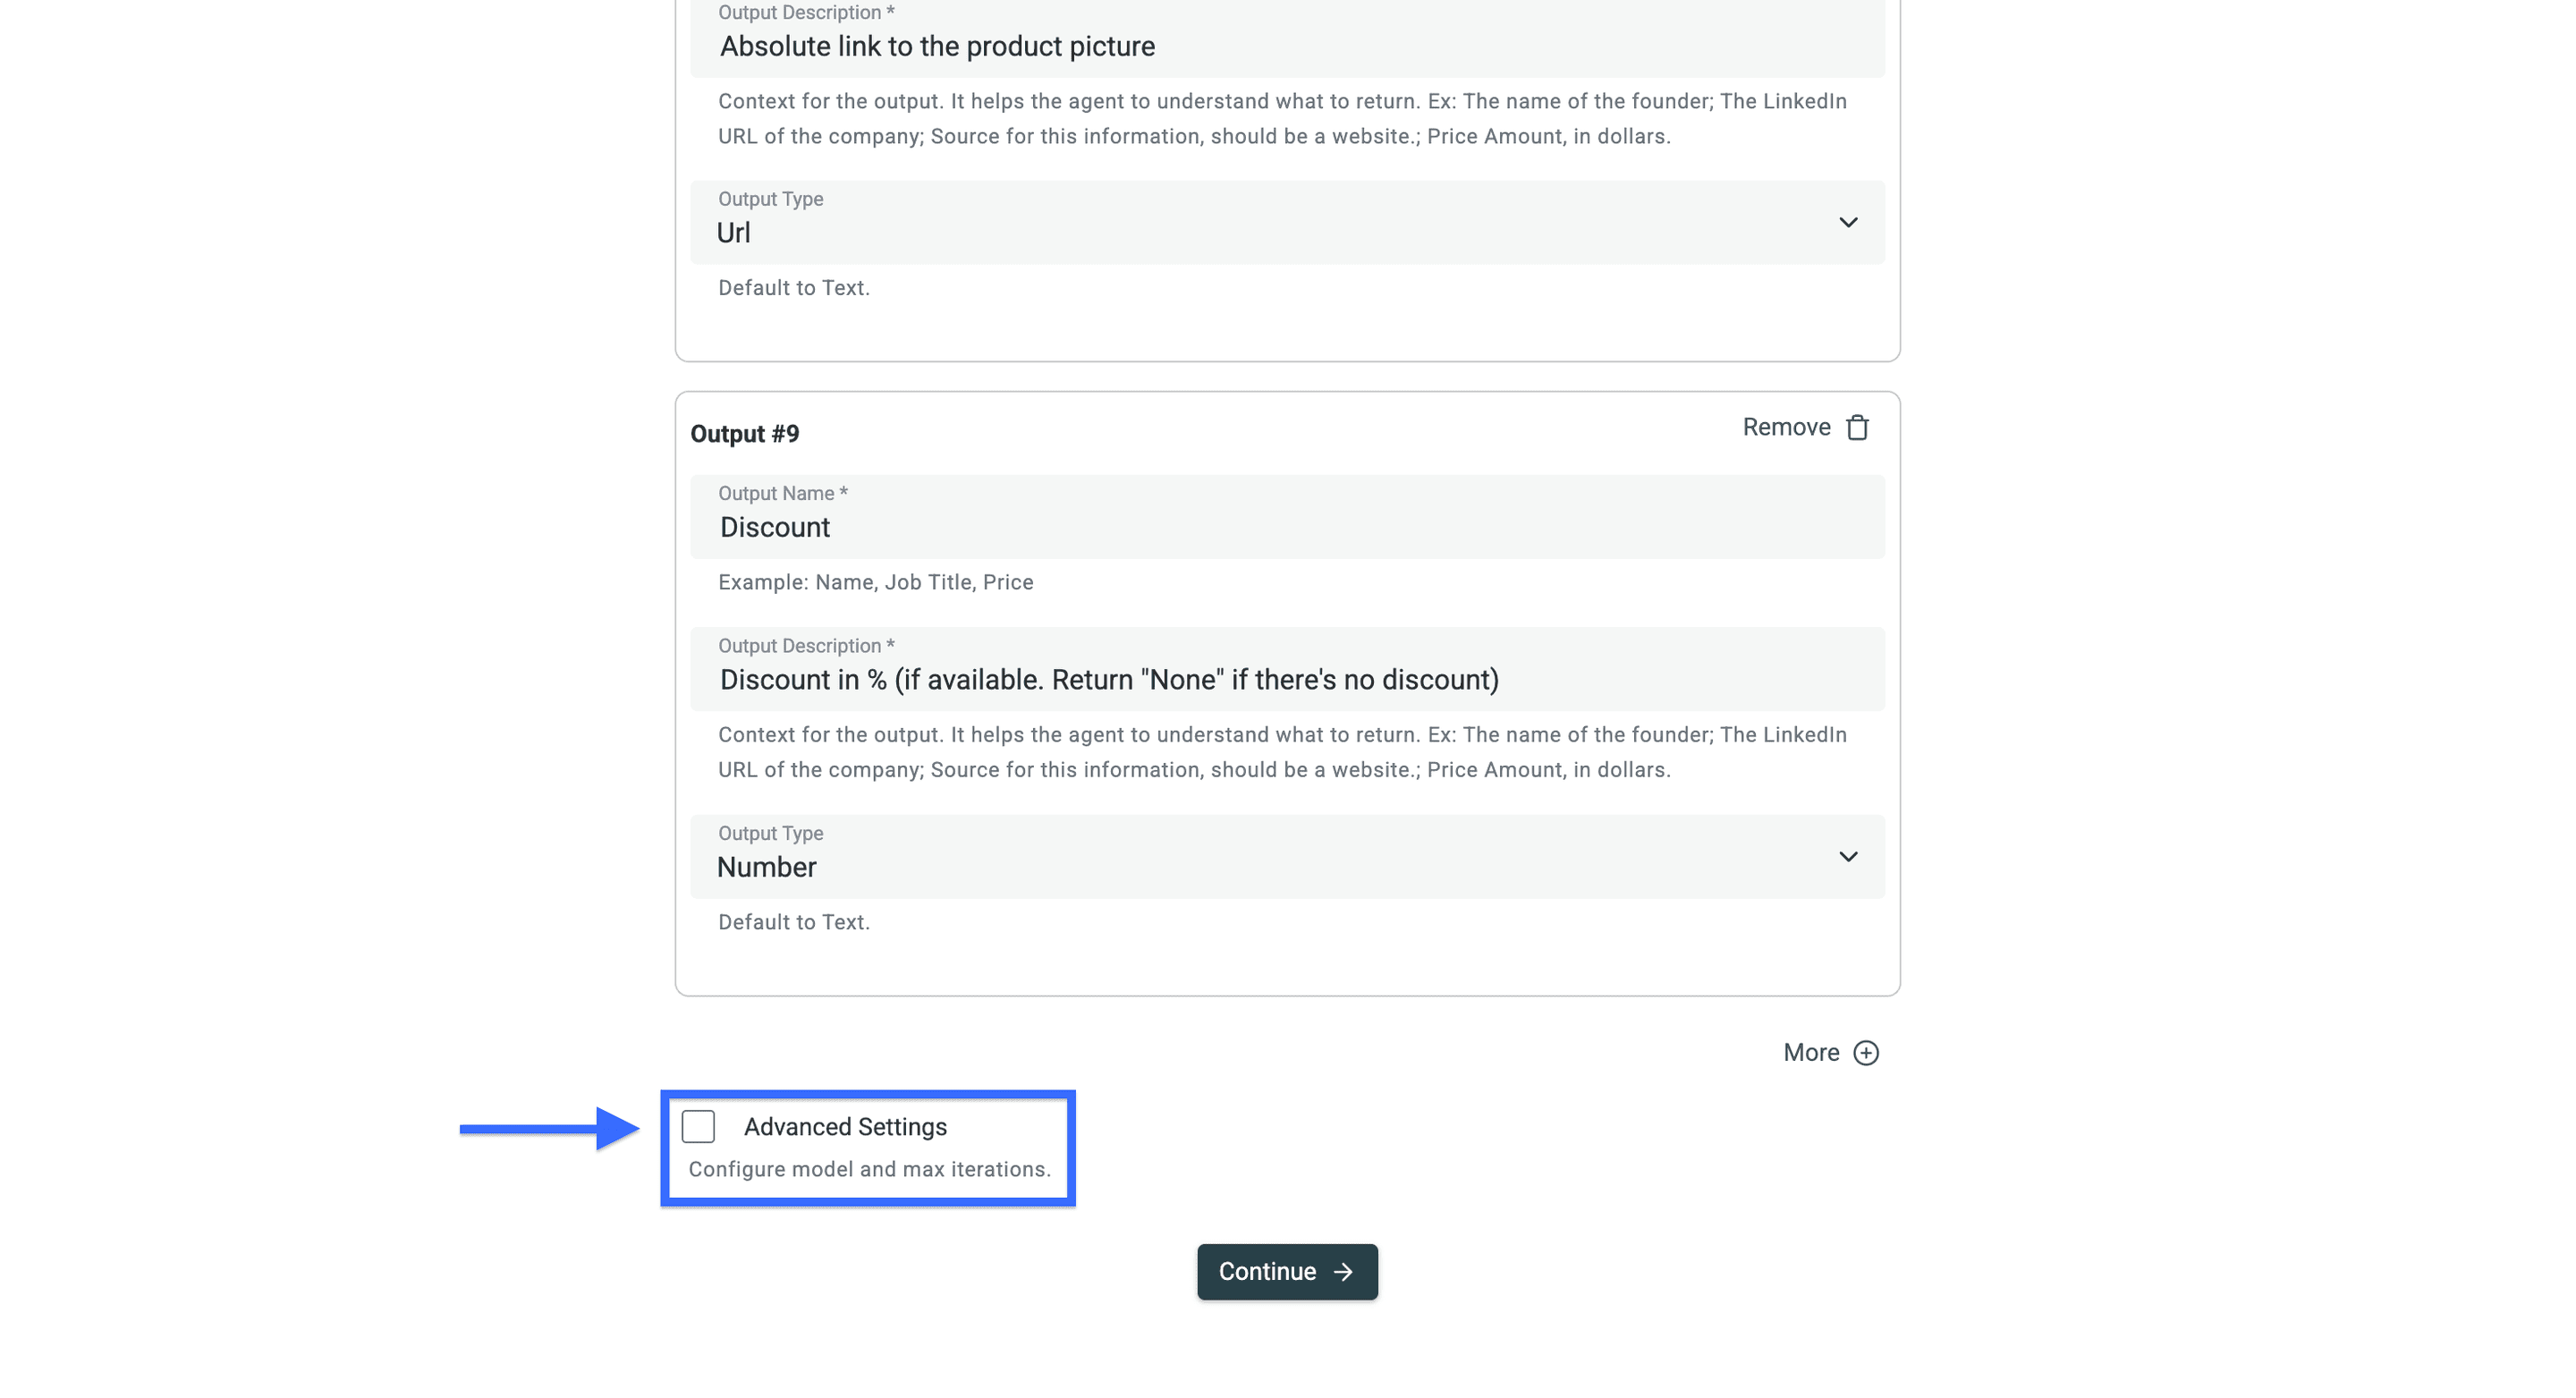
此时你可以:
- 如果默认模型不符合预算或提取需求,可以选择其他可用模型;在执行大规模抓取前,先用少量样本比较效果。
- 设置最大迭代次数。迭代次数越多,消耗的 credits 可能越多;了解 AI Agents 的工作原理。
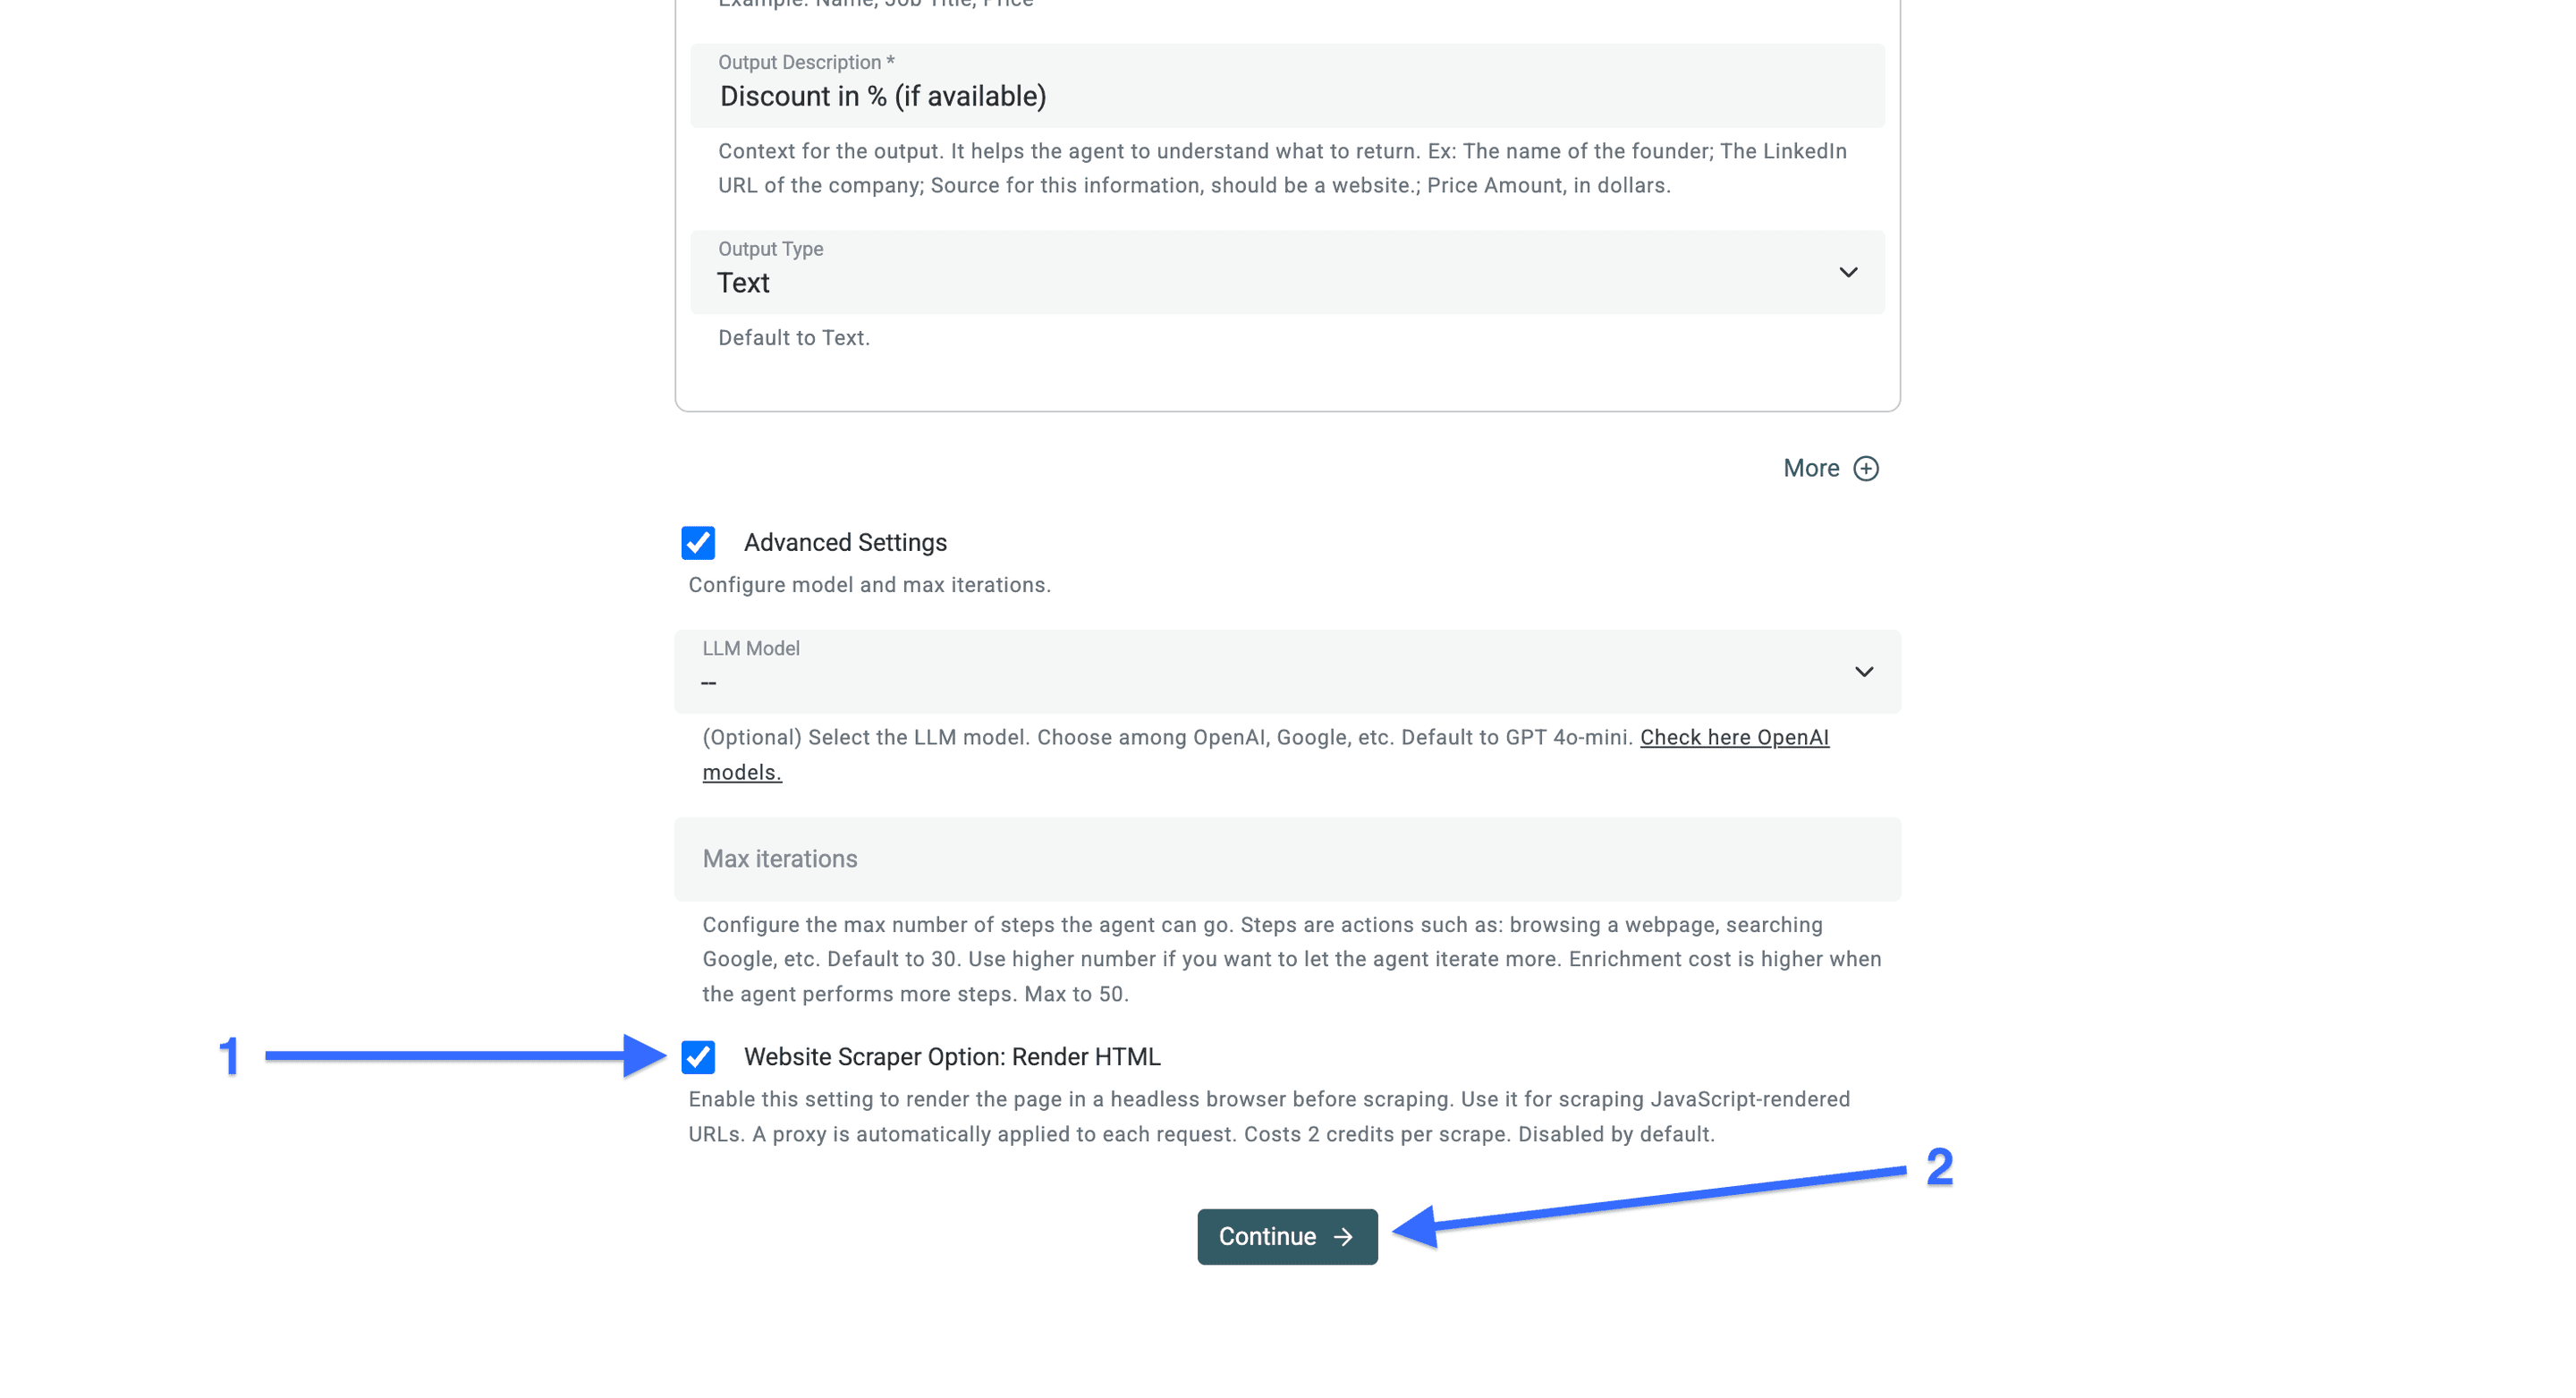
- 如果商品通过 JavaScript 加载,且首次运行没有返回可用数据,可以尝试开启 Render HTML。开启后请再次检查输出结果。
启用相关设置后,点击“Continue”。
然后点击 Run import now,从本次运行所配置的 URL 中提取商品。
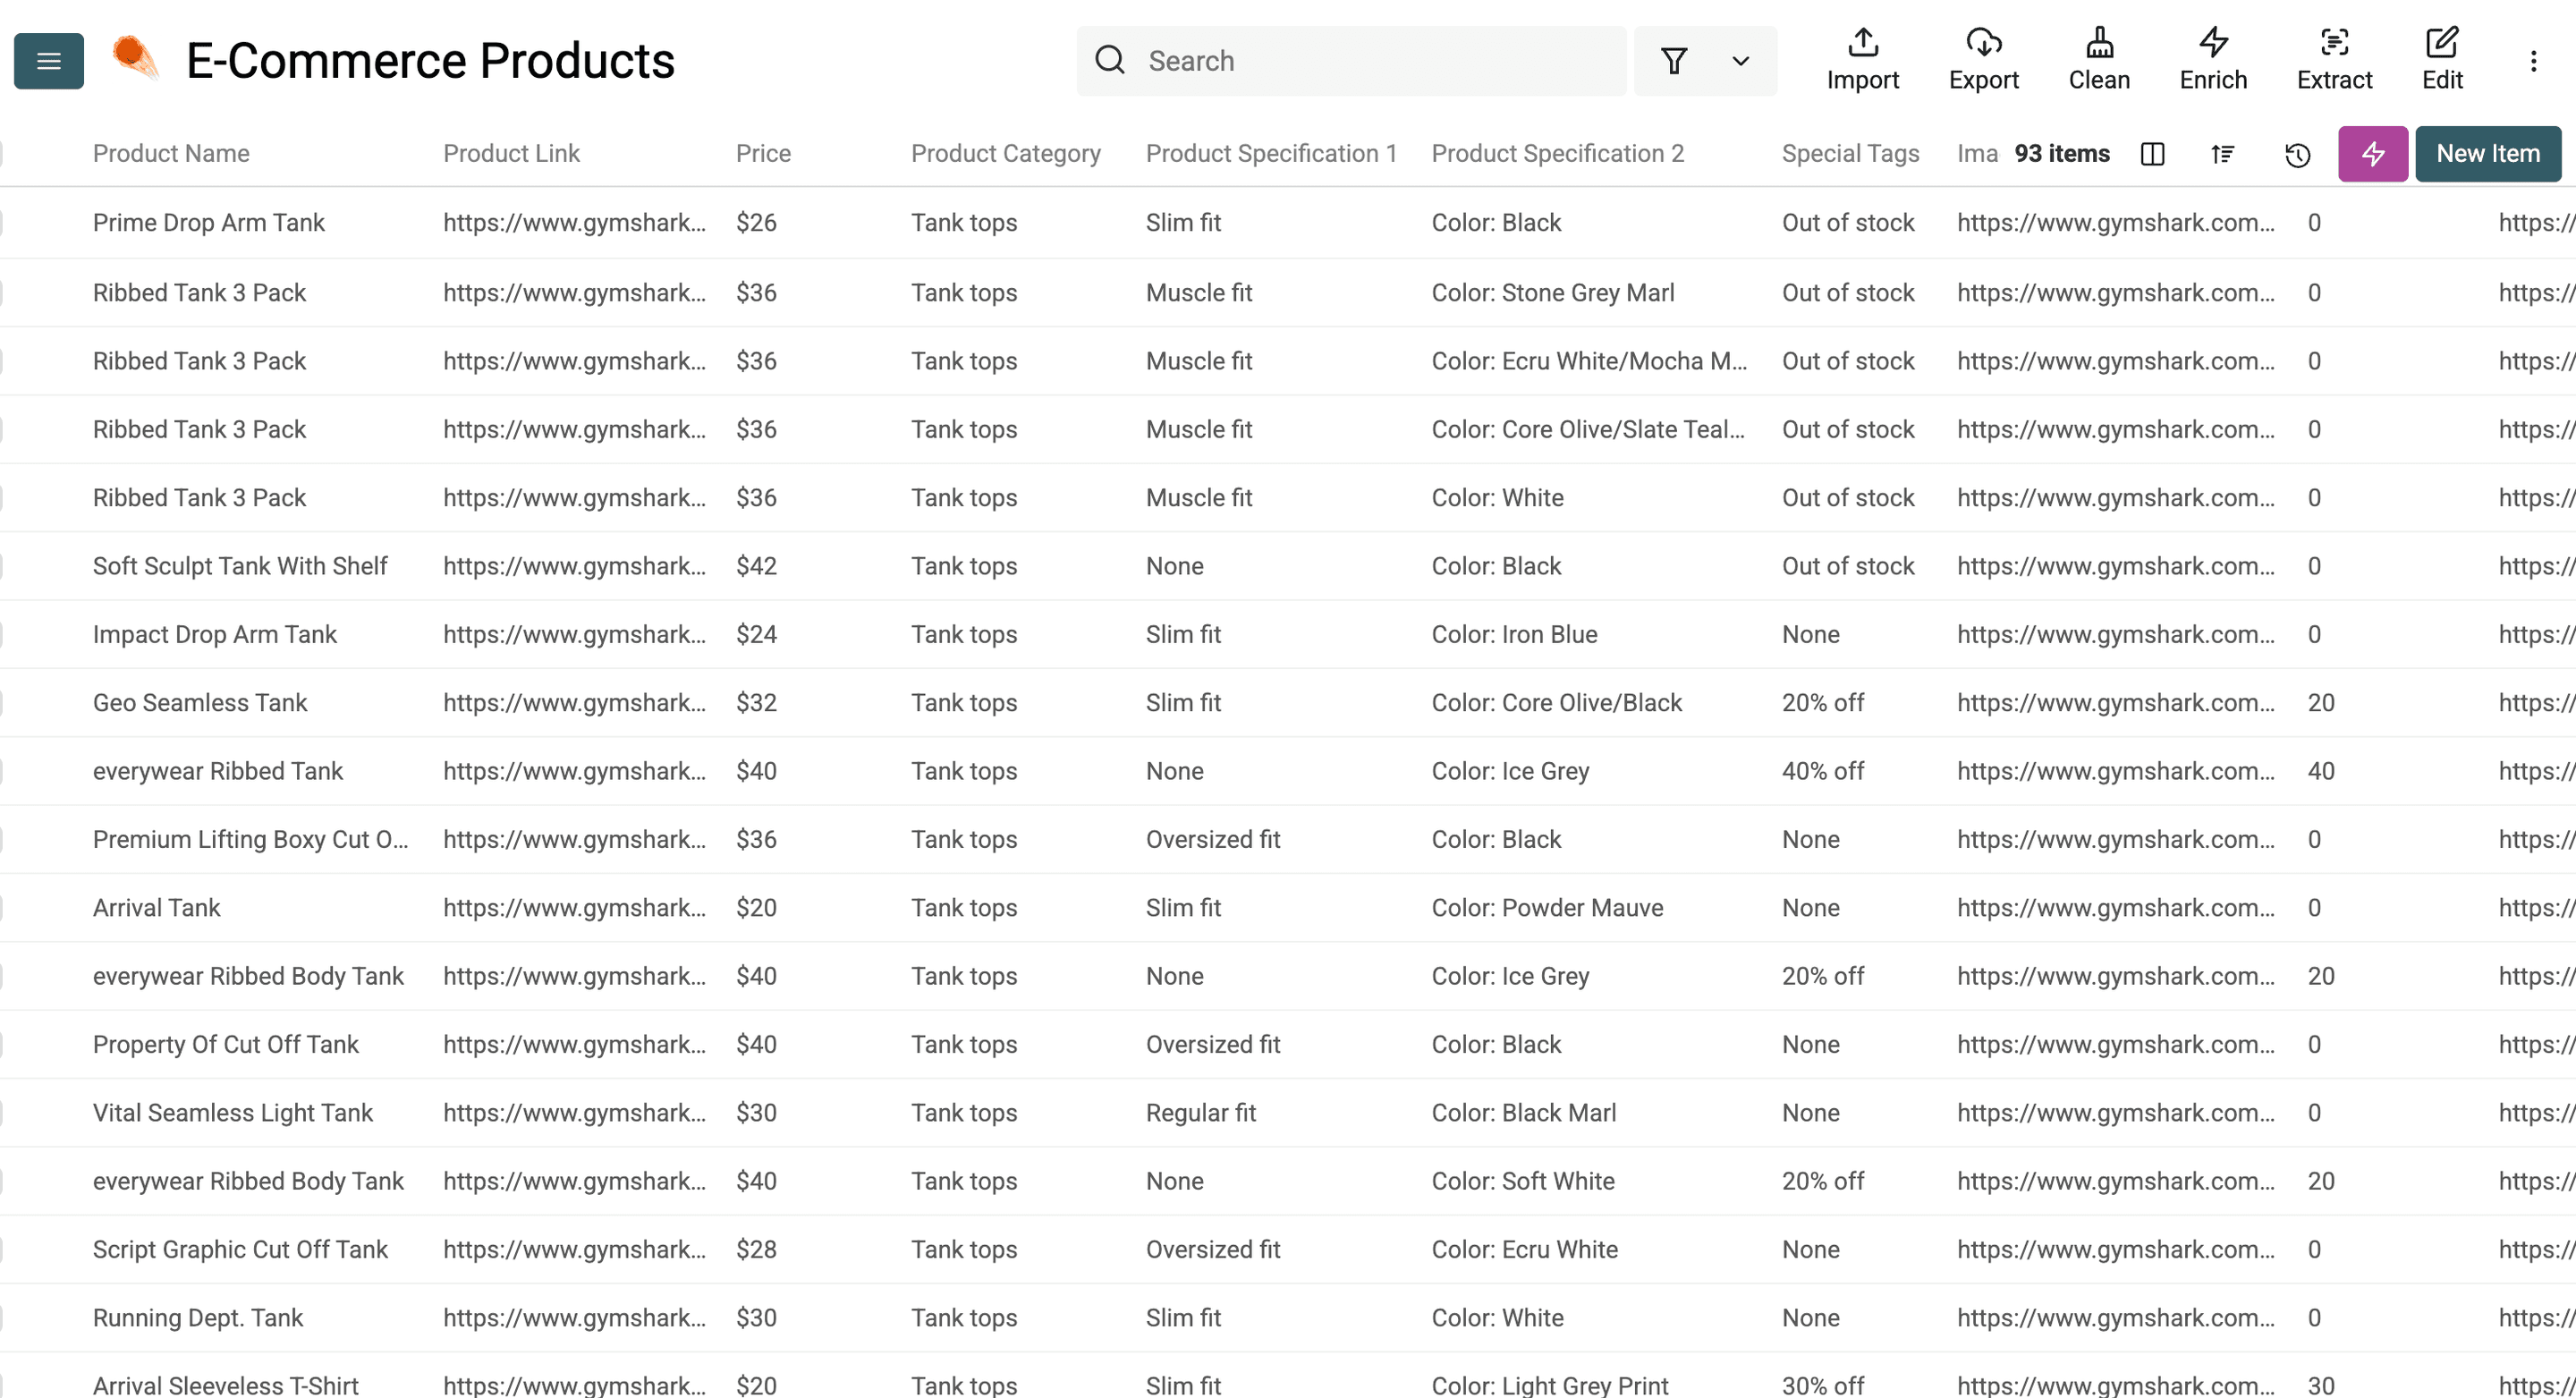
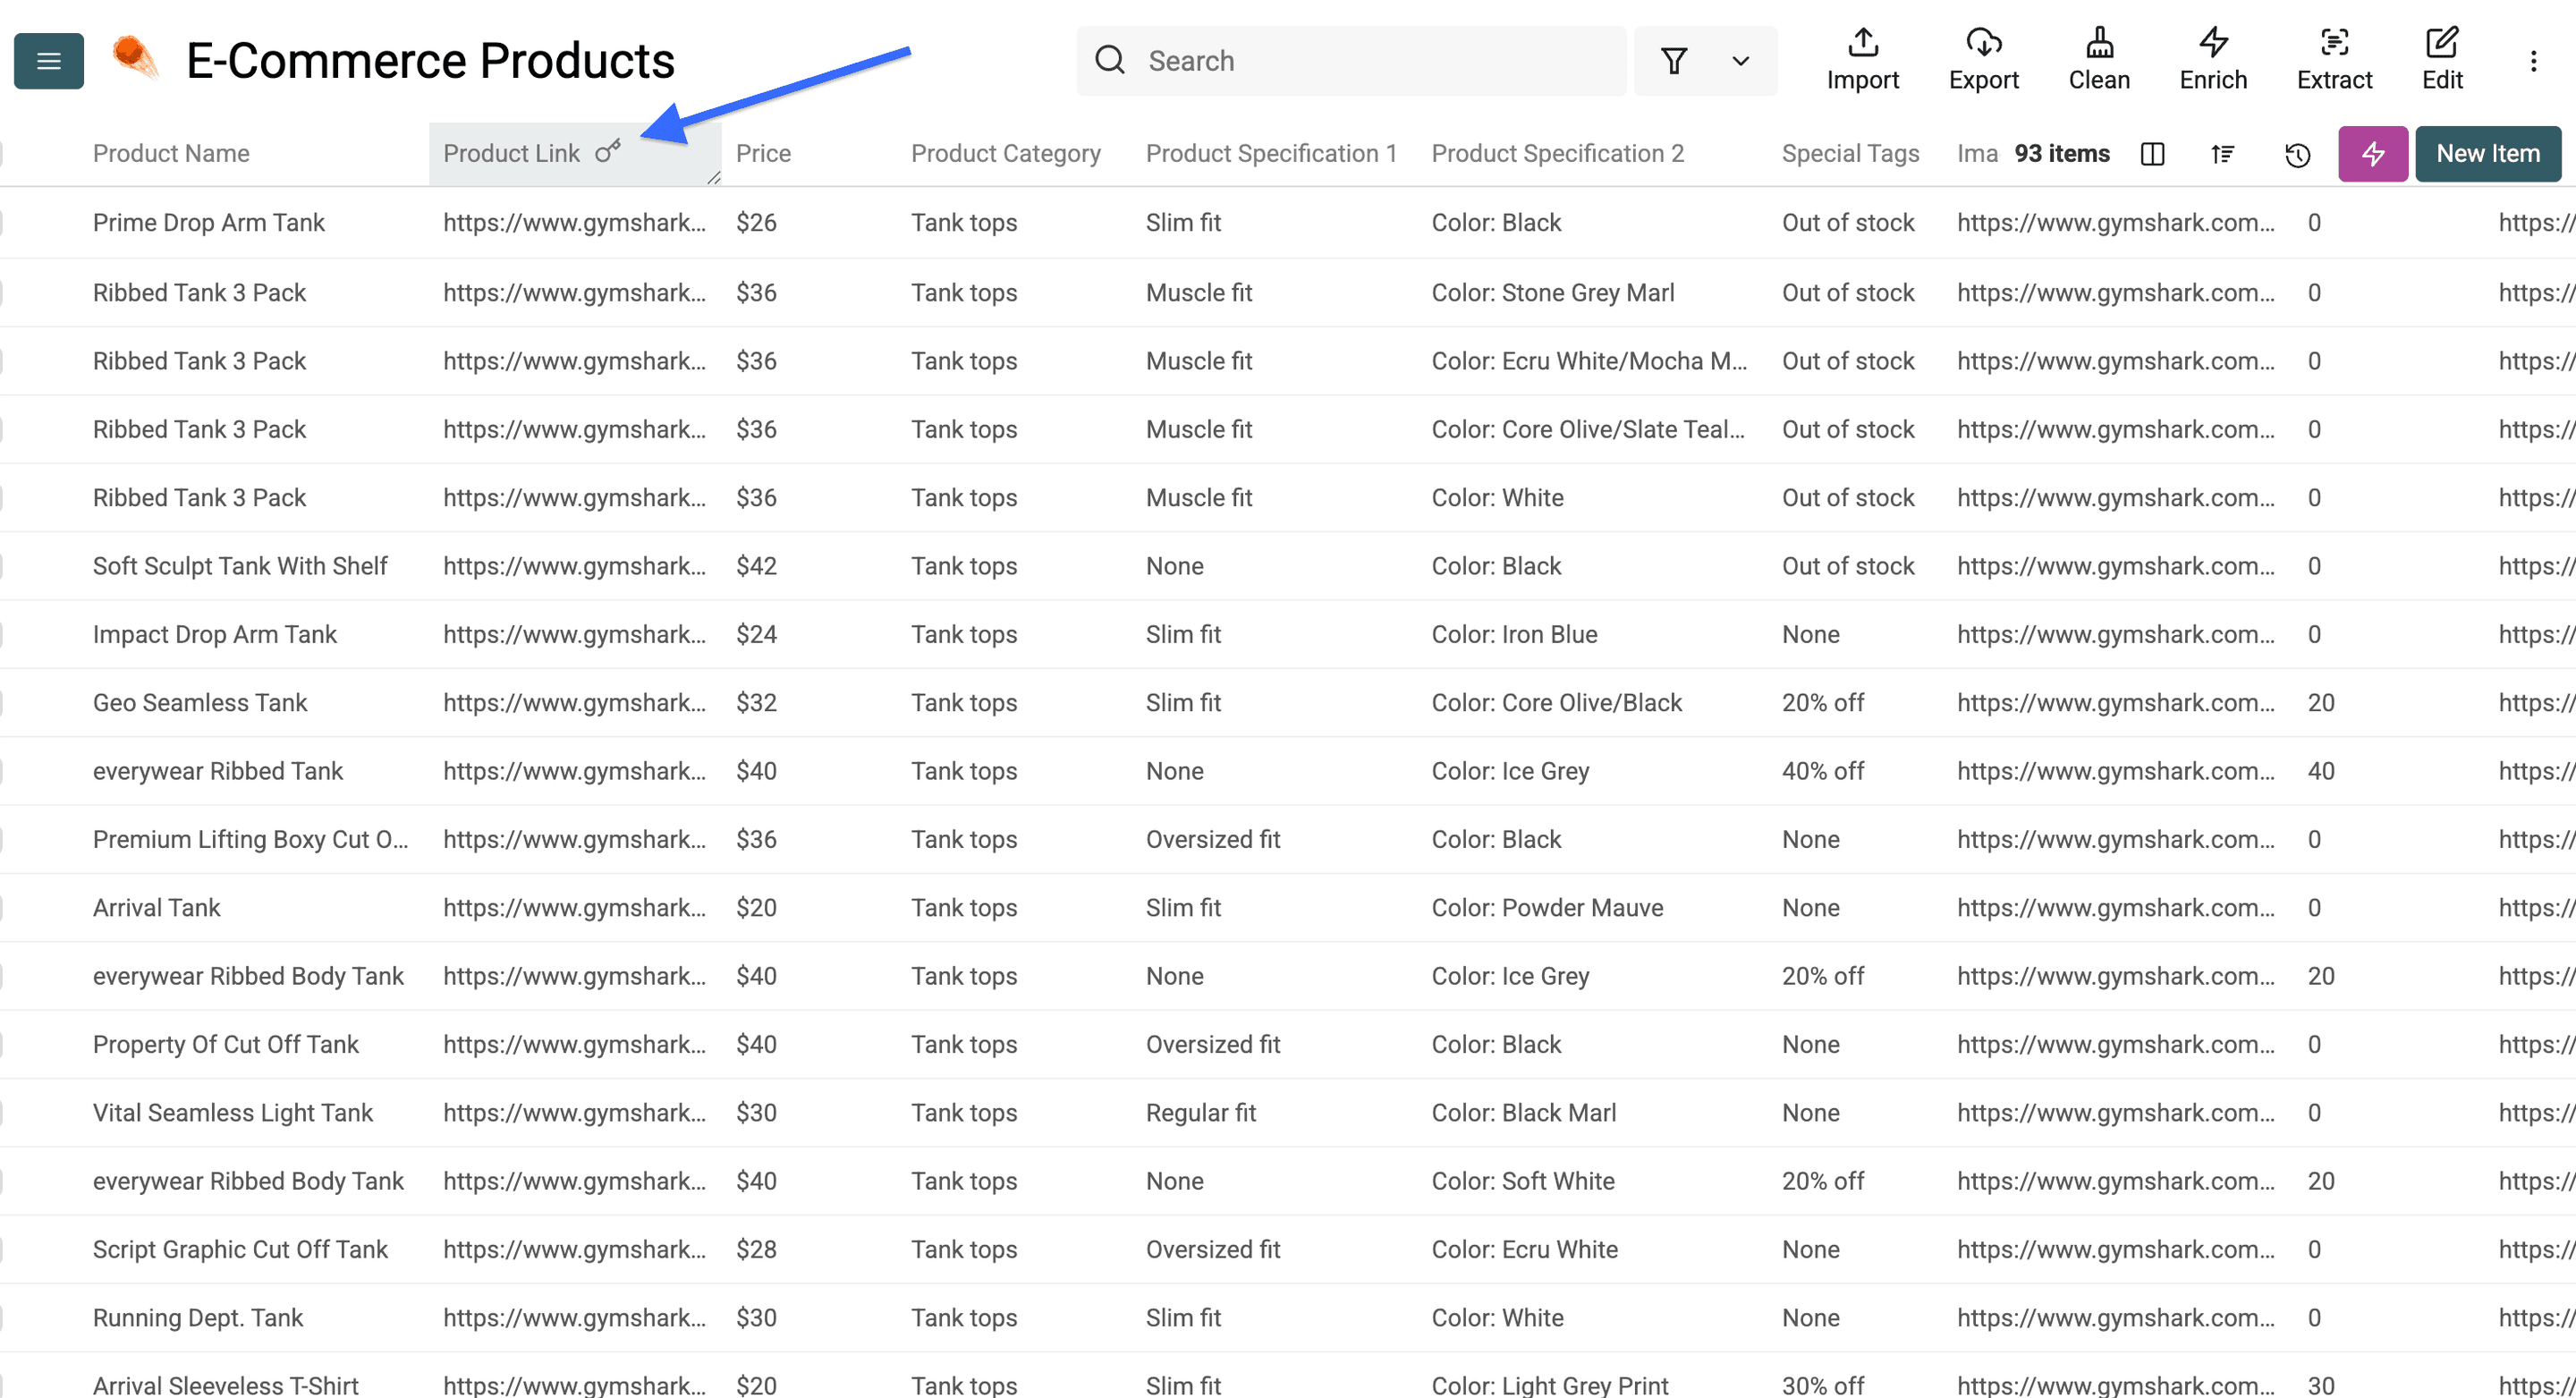
下面是 website scraper AI Agent 的结果示例。实际字段和行数取决于源页面及你的 prompt。
💡 这样做可以避免重复数据
如果店铺为每件商品提供稳定的 URL,请将 商品 URL 用作 unique identifier。不同尺码或款式可能使用相同的商品名称。唯一性设置可以防止 collection 中出现重复行,但无法阻止 Agent 再次访问页面,也不会避免后续运行产生 credits 消耗。
请按照下方步骤操作 ⬇️
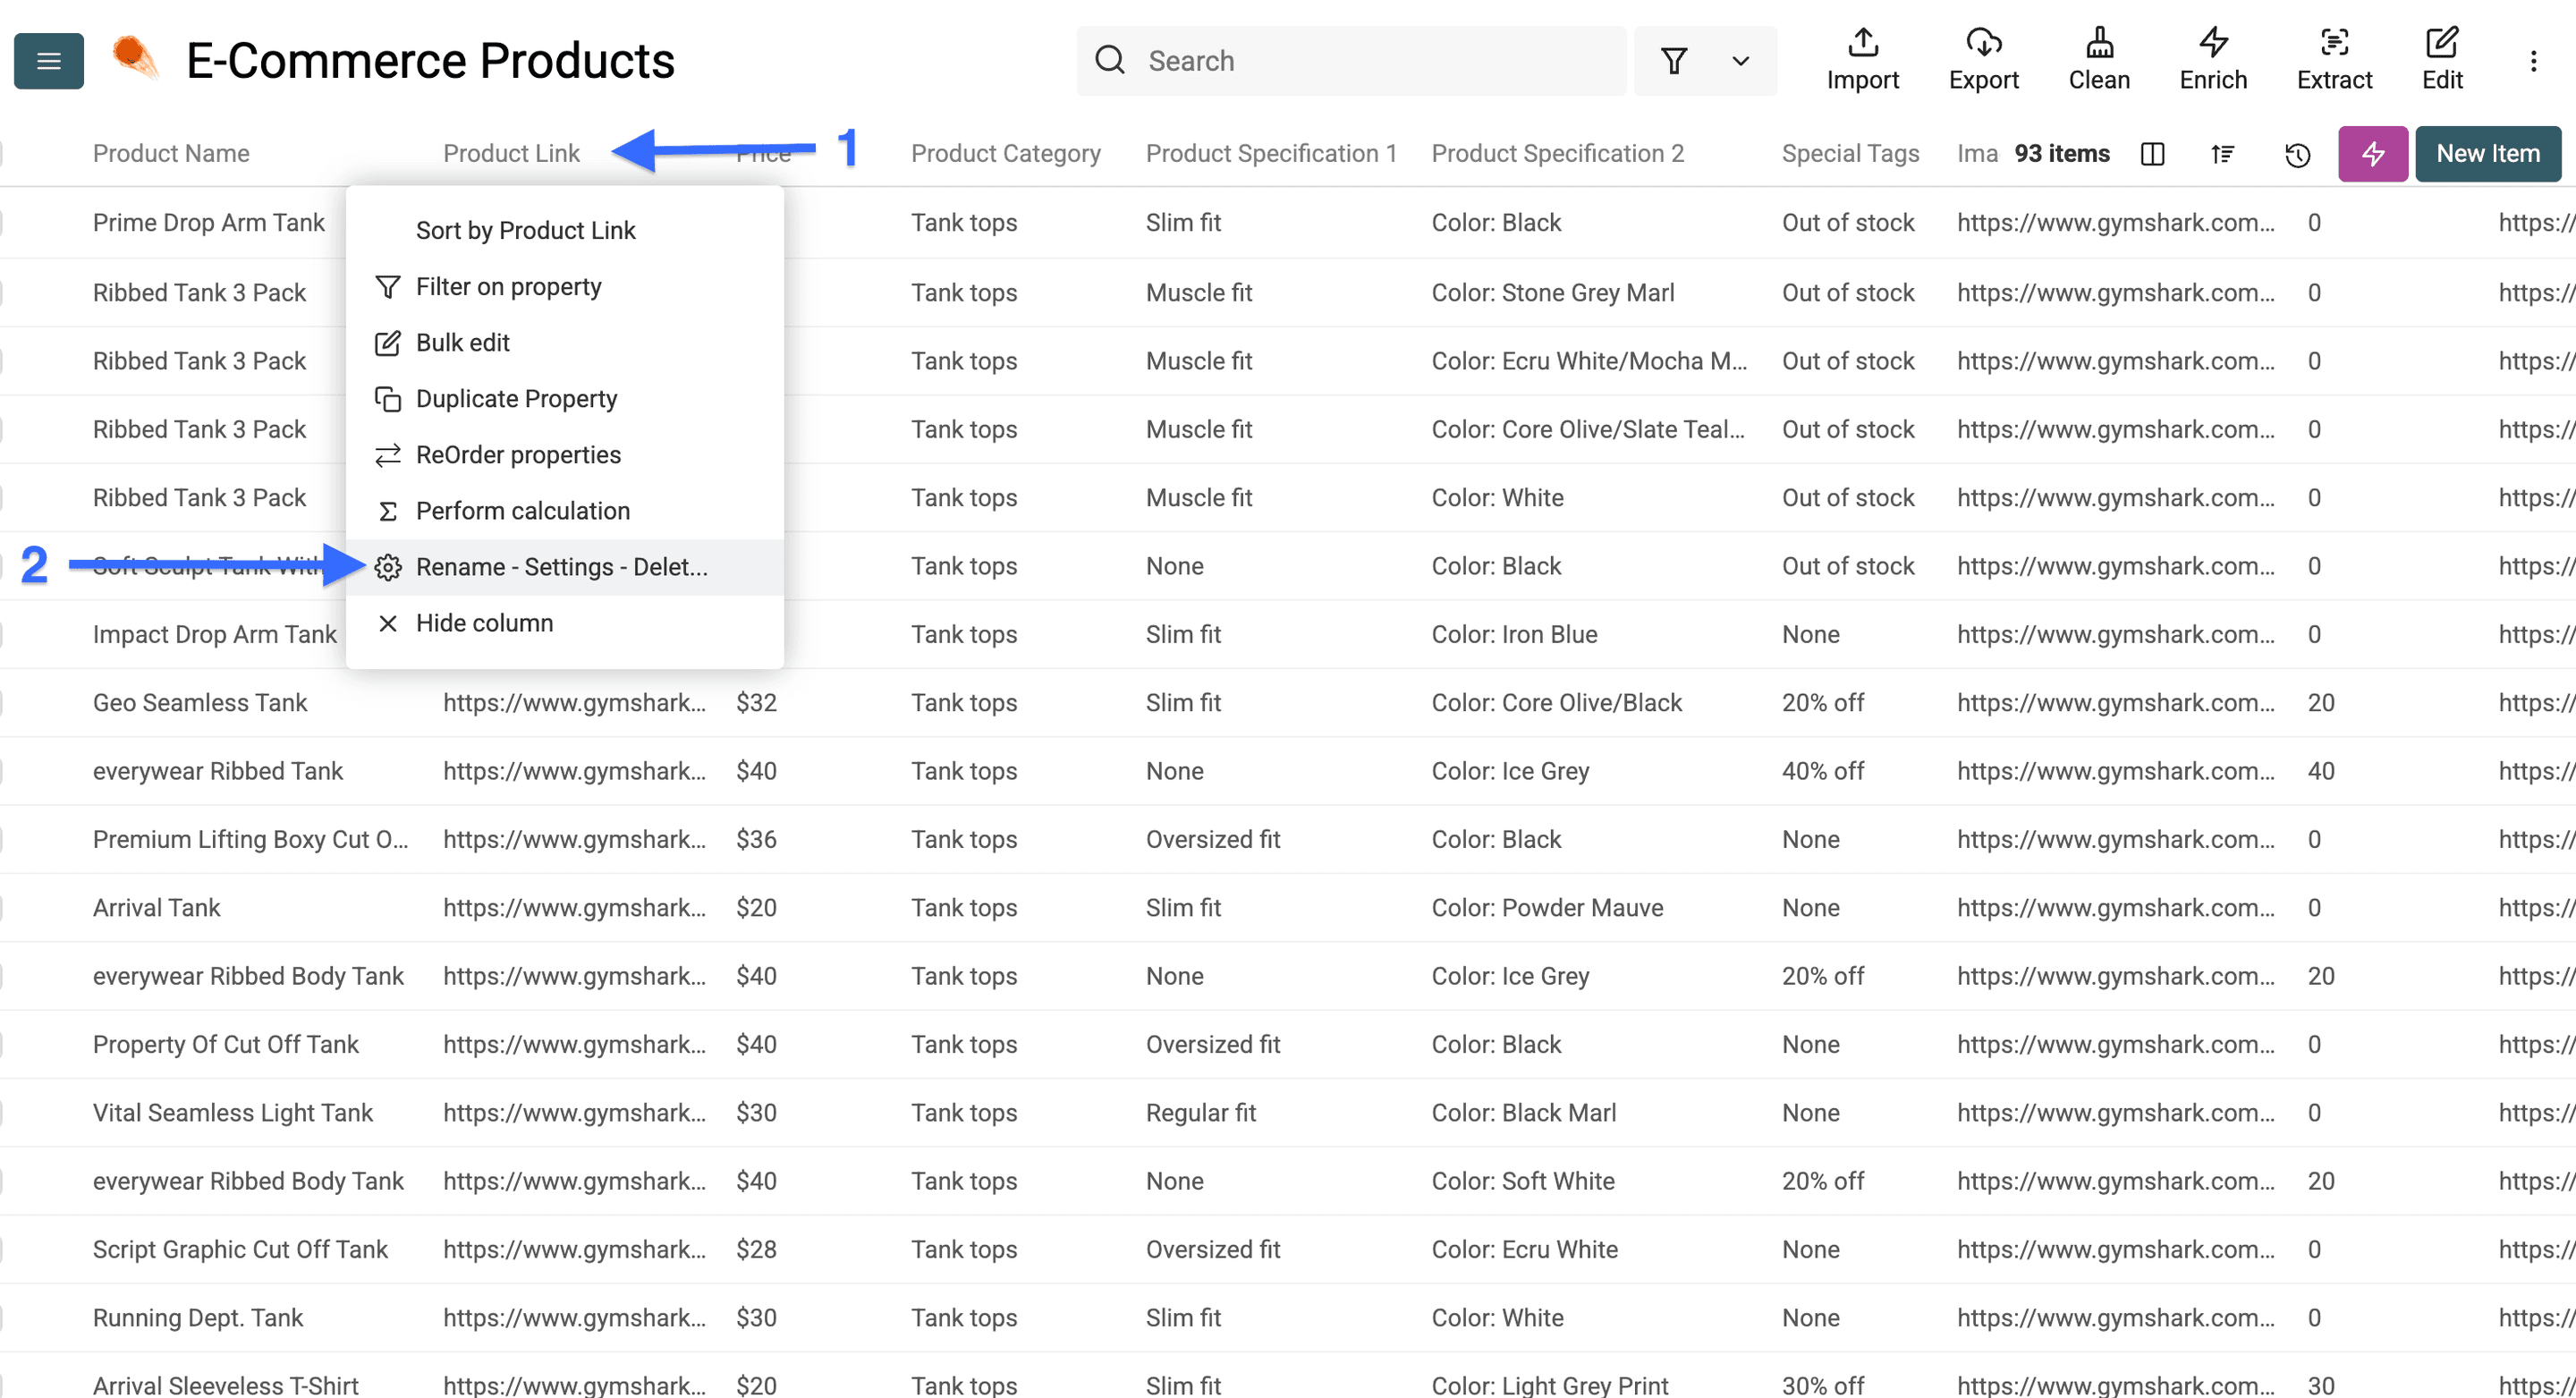
首先选择 unique identifier。这里我使用 商品链接,你也可以根据实际情况选择其他字段。
然后点击列标题,选择“Rename - Settings - Delete”。
勾选“Do not allow duplicate values”,再点击“Save Property”。
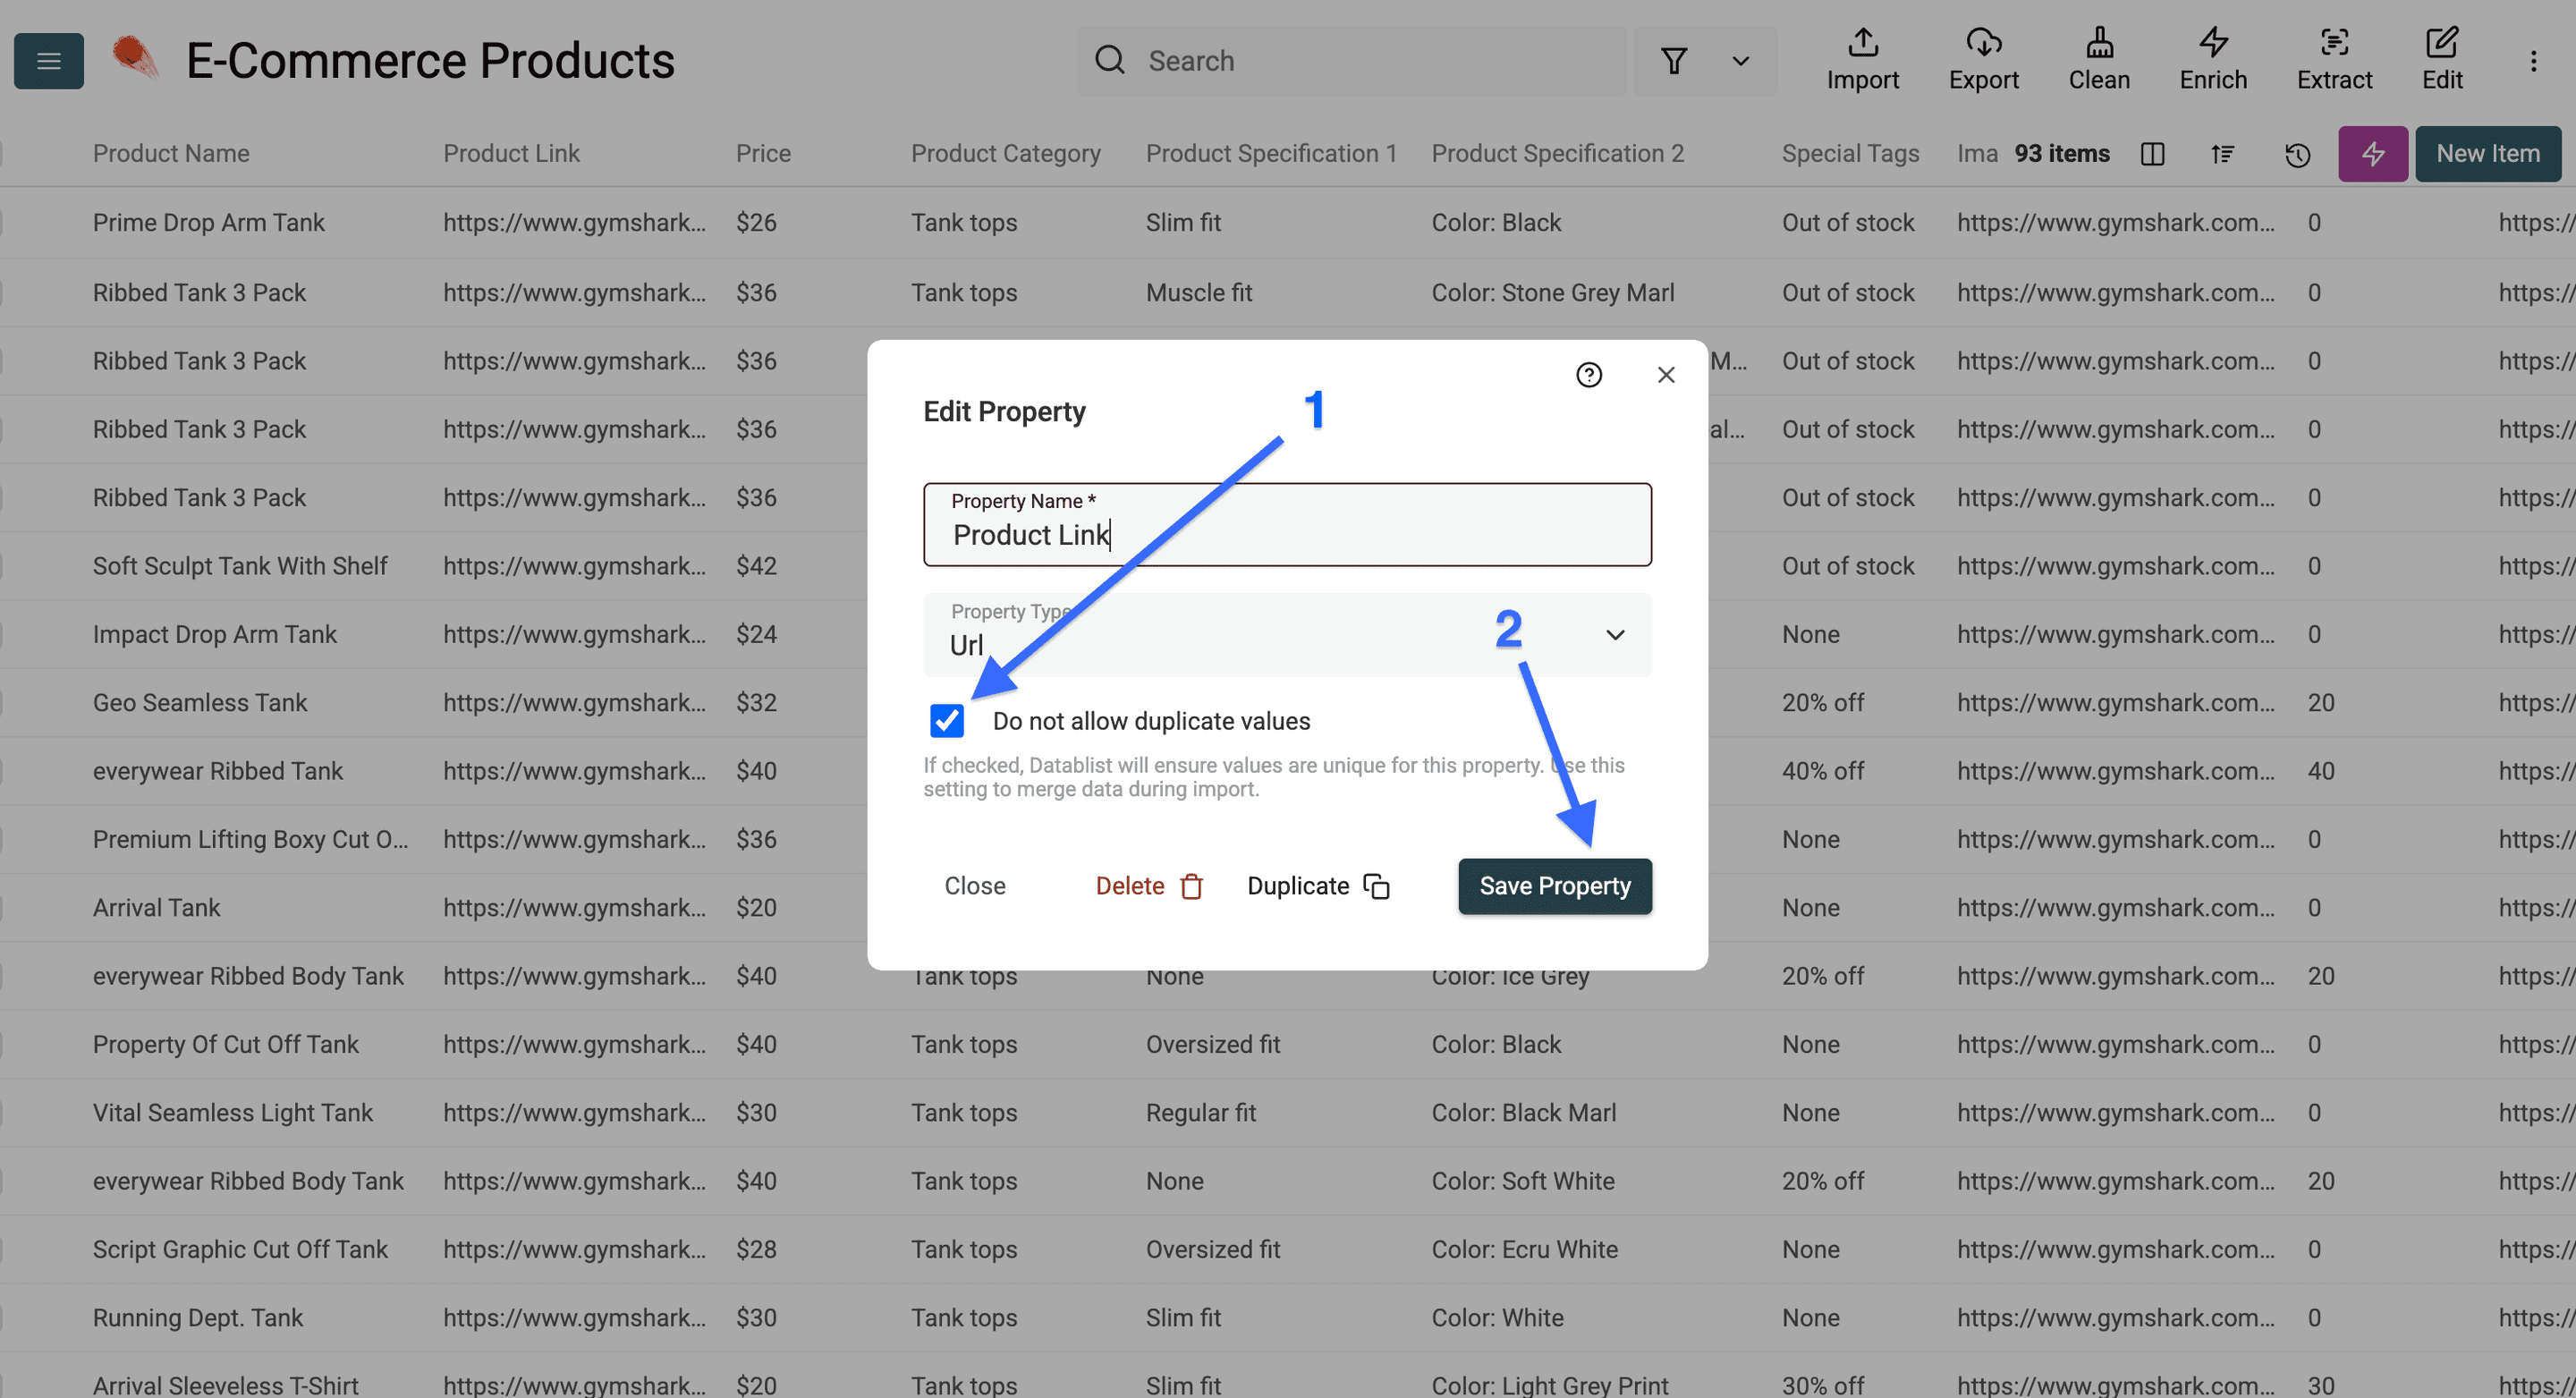
完成后,即使多次抓取同一家电商店铺,每件商品在 collection 中也只会出现一次。
此时,列标题中还会显示一个钥匙图标,表明该列已被设为 unique identifier。
总结
要获得真正可用的商品清单,应先选择正确的分类页 URL,只提取列表页上实际可见的字段,并控制首次运行的规模。在提高页面上限前,请检查价格、商品链接、缺失值和分页情况,同时遵守店铺的访问规则与服务条款。
无需写代码也能抓取电商网站吗?
可以。借助 Datablist AI,你可以使用自然语言指令抓取电商网站。只需用简单清晰的语言写出要求,其余技术环节由 AI Agent 处理。
如何监控电商网站的价格变化?
再次运行相同的商品列表抓取流程,并将新的价格列与之前导出的数据进行比较。使用稳定的商品 URL 匹配数据行;列表页价格可能与商品详情页不同,也可能因商品款式而变化。
如何抓取电商网站的商品信息?
提供一个分类页或全部商品页 URL,指定商品名称、URL、页面显示价格和图片 URL 等字段,再将每个字段映射到相应的 output property。提高页面上限前,先检查最初返回的几行数据。
如何同时抓取多个电商网站?
Site Scraper 每次运行只接受一个起始 URL。请分别为每家店铺或每个分类运行抓取任务,再根据需要将结果合并到同一个 collection 中。实际覆盖范围取决于 Agent 可访问的页面及你设置的页面上限。
抓取网站数据合法吗?
采集数据前,请查看每家店铺的服务条款并确认是否获得相应许可。数据公开可见并不等于允许抓取,而且具体规则会因网站和所在地区而异。