
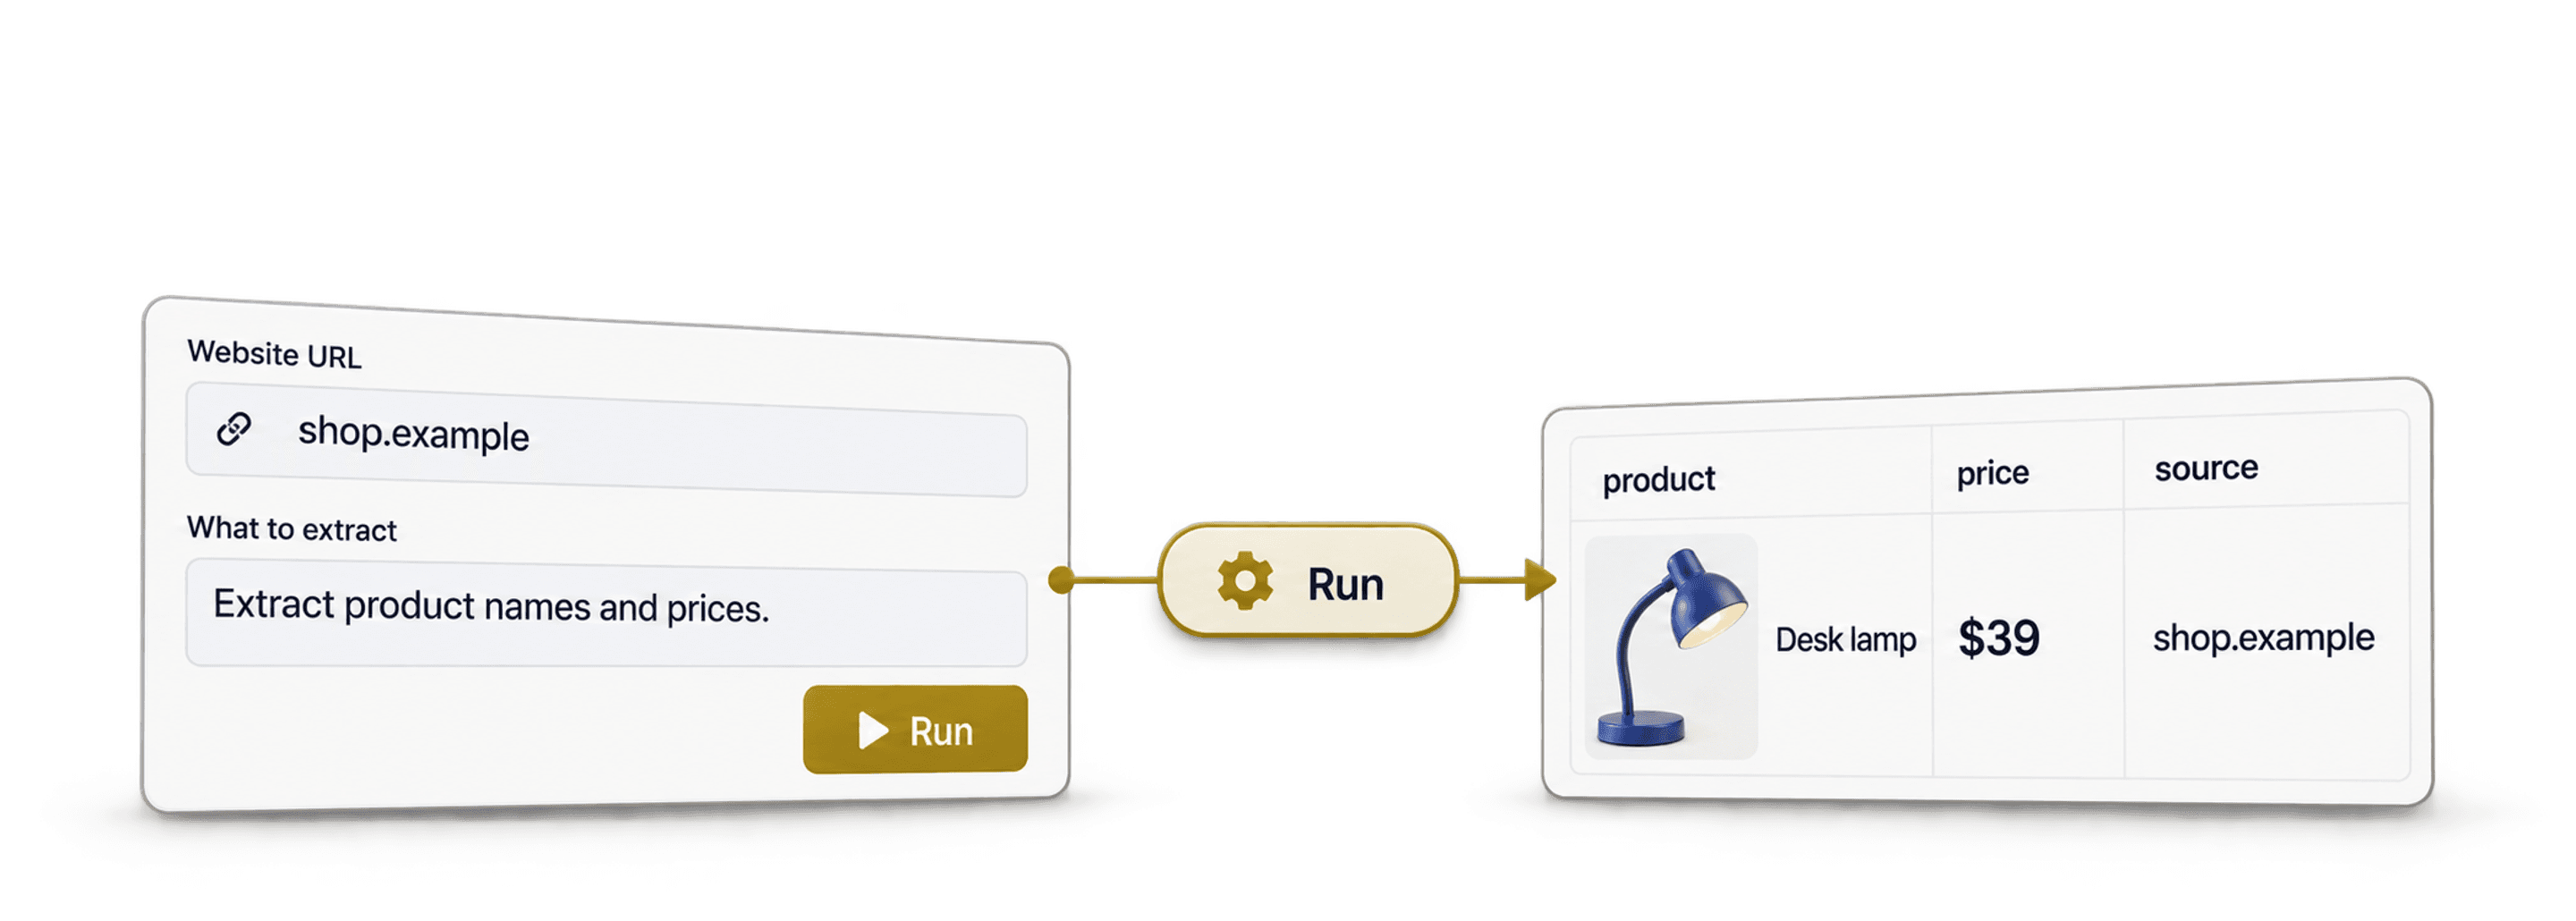
قبل بضعة أشهر، أطلقنا ميزة لم نتوقع أن تكون بهذه القوة.
واليوم، تُحدث هذه الميزة تحولًا في مجال استخراج بيانات الويب بدون كود.
الميزة التي أتحدث عنها هي مصدر “AI Agent - Site Scraper”. يستخرج هذا المصدر صفوفًا منظمة من محتوى المواقع المتاح، وفقًا لتعليماتك.
وبعد مرور بضعة أشهر، اكتشفت ثلاثة أمور:
- مجال استخراج البيانات بدون كود قائم على ادعاء مضلل كبير
- بنينا أفضل أداة لاستخراج البيانات بدون كود من دون أن ندرك ذلك
- وكلاء استخراج البيانات بالذكاء الاصطناعي أقوى وأسهل وأسرع من أي أداة No-Code Scraping سبقتهم.
📌 ملخص لمن لا يملكون الوقت
يشرح هذا المقال كل ما تحتاج إلى معرفته عن استخراج بيانات الويب الحقيقي بدون كود، ويوضح أنك لست بحاجة إلى APIs أو CSS selectors أو خبرة تقنية. إليك الخلاصة إن كنت مستعجلًا:
المشكلة: لا تزال أدوات استخراج البيانات «بدون كود» تتطلب معرفة تقنية، وتجبرك على فهم بنية المواقع ومشاهدة الشروحات وقضاء ساعات في الإعداد. ثم يتعطل كل شيء بمجرد أن يُجري الموقع تحديثًا بسيطًا.
لماذا تُعد مشكلة: لا ينبغي أن تضطر إلى تعلم APIs أو CSS selectors أو مشاهدة ساعات من الشروحات لمجرد استخراج بيانات من المواقع. فهذا يناقض تمامًا فكرة «بدون كود».
الحل: استخراج البيانات بالذكاء الاصطناعي من Datablist، عبر تعليمات واضحة بلغة طبيعية. تصف ما تريده، ويتولى AI كل ما تبقى.
ما ستتعلمه: يكشف هذا الدليل ادعاءات مجال No-Code Scraping، ويوضح الشكل الحقيقي لاستخراج البيانات بدون كود، ويقدم حالات استخدام عملية ونصائح لكتابة Prompts فعالة.
لماذا تستخدم Datablist لاستخراج البيانات بدون كود؟ ثلاثة أسباب رئيسية
- لا كود فعلًا؛ ما عليك سوى وصف المطلوب بلغة طبيعية
- يتعامل مع المواقع المعقدة التي تستخدم JavaScript وترقيم الصفحات والمحتوى الديناميكي
- يتكيف مع تغييرات المواقع، على عكس أدوات الاستخراج الهشة المعتمدة على CSS selectors
ما الذي يغطيه هذا المقال؟
- مجال No-Code Scraping وأبرز ادعاءاته
- الحل السهل: استخدم الكلمات بدلًا من APIs
- حالات الاستخدام ونصائح استخراج البيانات بالذكاء الاصطناعي
- الأسئلة الشائعة عن استخراج البيانات بدون كود
مجال No-Code Scraping وأبرز ادعاءاته
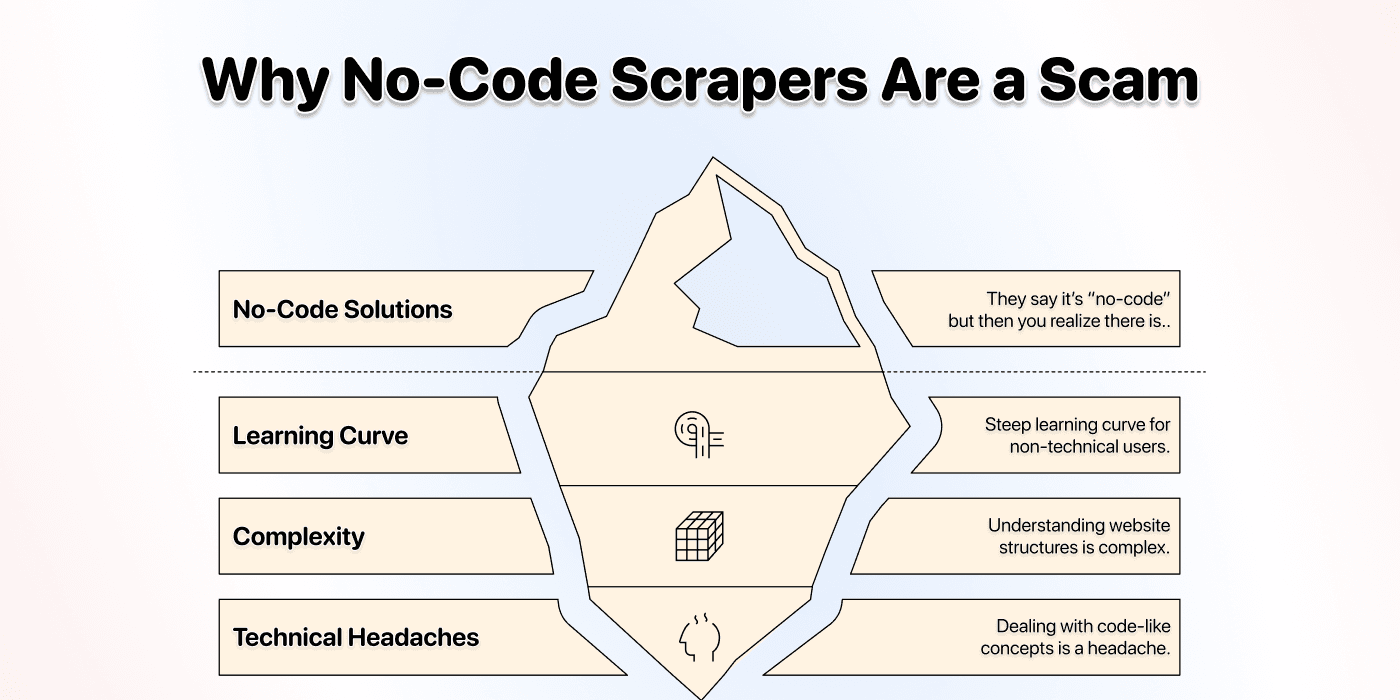
يخصص هذا القسم لتفنيد الخرافات والحيل الشائعة في مجال استخراج البيانات بدون كود. والحقيقة أن معظم أدوات «No-Code» ليست خالية من الكود فعلًا. لقد أعادت فقط تغليف التعقيد التقني في صورة مختلفة قليلًا.
لماذا لم يكن الكود هو المشكلة أصلًا؟
فكر في الأمر للحظة: لم يكن الكود هو المشكلة أصلًا. لو كنت تجيد البرمجة، لاستخدمت الكود في استخراج البيانات، ولما بحثت منذ البداية عن حل بدون كود.
أنت تبحث عن حلول No-Code لأنك لا تريد تعلم البرمجة لمجرد استخراج بيانات موقع. لكن البعض استغل ذلك ليبيعك حلًا لا يعمل إلا جزئيًا؛ حلًا لا يزال يتطلب:
- تجاوز منحنى تعلم حاد
- مشاهدة عدد كبير من الشروحات
- فهم بنية المواقع
وأحيانًا التعامل مع مفاهيم تشبه البرمجة، مثل CSS selectors.
لم تكن المشكلة الحقيقية يومًا في المفاضلة بين الكود وعدم استخدامه.
بل كانت دائمًا في منحنى التعلم والتعقيد والمتاعب التقنية.
ما الذي حاولوا بيعه لك؟
قد تتطلب الأساليب الثلاثة التالية بعض أعمال الإعداد عند إنشاء عملية استخراج مخصصة. ويمكن للقوالب الجاهزة والاكتشاف التلقائي للبيانات تقليل هذا العمل؛ لذا تحقق مما إذا كانت تغطي حقول موقعك وترقيم صفحاته.
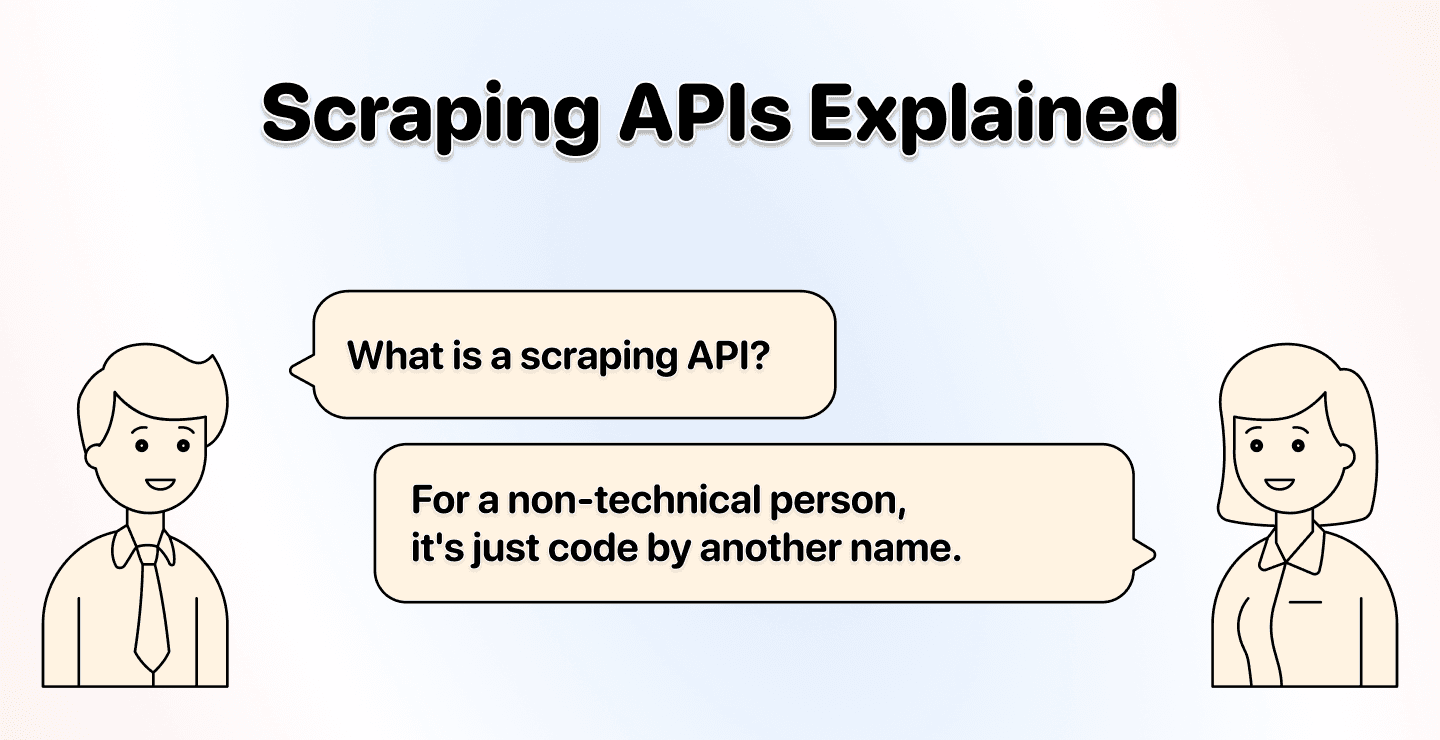
أدوات الاستخراج المعتمدة على API
تزعم هذه الأدوات أنها «بدون كود» لأنك لا تكتب Python أو JavaScript. لكن هناك بعض الأمور التي لا تخبرك بها.
لا يزال عليك التعامل مع:
- بنية DOM للموقع
- CSS selectors
- وسوم HTML
من الناحية التقنية، أنت لا تكتب كودًا، لكنك تنفذ عملًا لا يقل تقنية. فأنت تترجم احتياجات بشرية إلى محددات تستطيع الآلة قراءتها، وهذا في جوهره نوع من البرمجة بخطوات إضافية.
أدوات التأشير والنقر
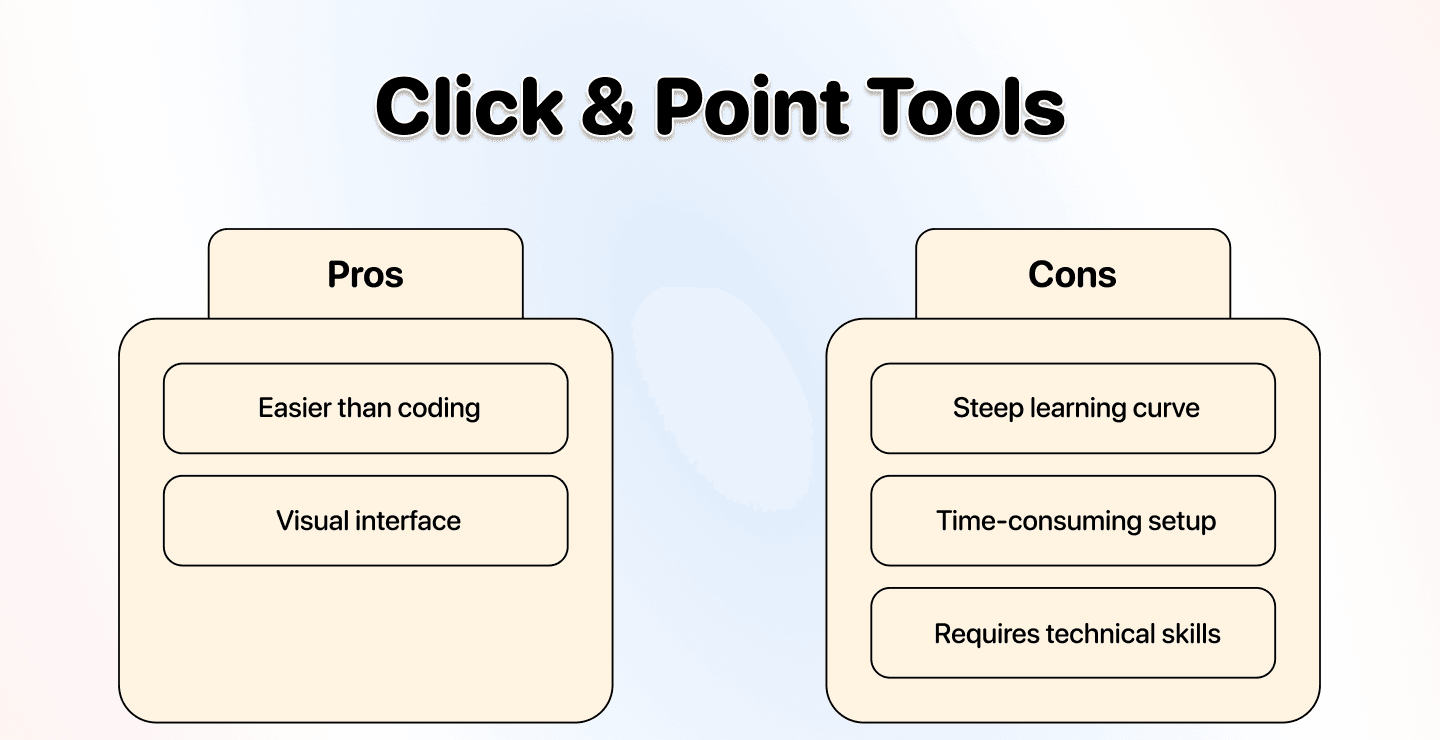
هذا الأسلوب أسهل، لكنه لا يزال يتطلب فهم طريقة بناء الموقع. تجعل هذه الأدوات العملية أبسط قليلًا بالسماح لك بالنقر على العناصر، لكنها لا تخلصك من المتاعب.
والمشكلة الأكبر؟ إذا تغيرت بنية الموقع، فعليك إعادة إعداد كل شيء من الصفر. وهذا يعني:
- مشاهدة الشرح مجددًا
- إعادة ضبط جميع المحددات
- والأمل في أن يعمل كل شيء هذه المرة
إضافات المتصفح
هي في الأساس أدوات للتأشير والنقر تعمل داخل متصفحك بدلًا من تطبيق مستقل. ويتوفر الكثير منها مجانًا، مثل Instant Data Scraper.
أبرز مشكلات هذه الأدوات:
- تغيير واحد في الموقع قد يجبرك على إعادة كل شيء من الصفر
- وظائف محدودة وصعوبة في التوسع
- احتمال حظر عنوان IP الخاص بك
📘 النمط الذي ينبغي أن تلاحظه
قد يغطي قالب جاهز مهمة قياسية بالفعل. توضح وثائق قوالب Octoparse كيفية إدخال URL أو كلمة مفتاحية من دون بناء سير عمل الاستخراج. كما يشرح دليل الاكتشاف التلقائي اكتشاف الحقول وأزرار الانتقال إلى الصفحة التالية.
قارن المعاينة بالحقول التي تحتاج إليها. وللصفحات المخصصة التي لا يناسبها قالب جاهز، يتيح لك AI Agent - Site Scraper من Datablist وصف هذه الحقول بلغة طبيعية. تتغير طريقة الإعداد، لكن مراجعة الصفوف الناتجة والتأكد من تغطية الصفحات يظلان جزءًا أساسيًا من المهمة.
ما الذي تريده فعلًا؟
لنكن صريحين بشأن ما تبحث عنه حقًا: أنت تريد استخراج البيانات بلا متاعب، لا مجرد استخراجها بلا كود. وهذا ما يعنيه استخراج البيانات بلا متاعب فعليًا:
بلا متاعب
- لا تجبرني على فهم CSS selectors
- لا تطلب مني مشاهدة شروحات تمتد لثلاث ساعات
- لا تتعطل عندما يحدّث الموقع تصميمه
بلا منحنى تعلم
- ينبغي أن أتمكن من البدء فورًا
- ينبغي ألا أحتاج إلى تعلم مهارة تقنية جديدة
باختصار، تريد وصف هدفك بلغة طبيعية والحصول على النتائج. أما كل ما عدا ذلك فهو احتكاك غير ضروري جعلته السوق يبدو أمرًا طبيعيًا.
الحل: استبدال No-Code Scraping بالذكاء الاصطناعي
حل مشكلة No-Code Scraping ليس واجهة أفضل للتأشير والنقر ولا API أبسط. الحل هو إزالة الطبقة التقنية بالكامل واستخدام اللغة الطبيعية.
كيف يجعل AI استخراج البيانات بلا كود فعلًا؟
كما يوحي الاسم، يتيح AI Scraping للذكاء الاصطناعي استخراج بيانات الموقع بدلًا منك. وهكذا تصبح مديرًا للعملية، لا مشغلًا تقنيًا لها.
مع No-Code Scraping المدعوم بالذكاء الاصطناعي، ما عليك سوى إخبار النظام بما ينبغي فعله وكيف ومتى. ويتولى AI كل التعقيدات التقنية خلف الكواليس.
لا حاجة إلى فهم:
- CSS selectors أو بنية HTML
- معمارية DOM للموقع
- API endpoints أو الوثائق التقنية
كل ما عليك هو كتابة تعليمات بلغة طبيعية، وسيحدد وكيل AI Scraping بقية التفاصيل. هكذا كان ينبغي أن يكون No-Code Scraping سهلًا منذ البداية.
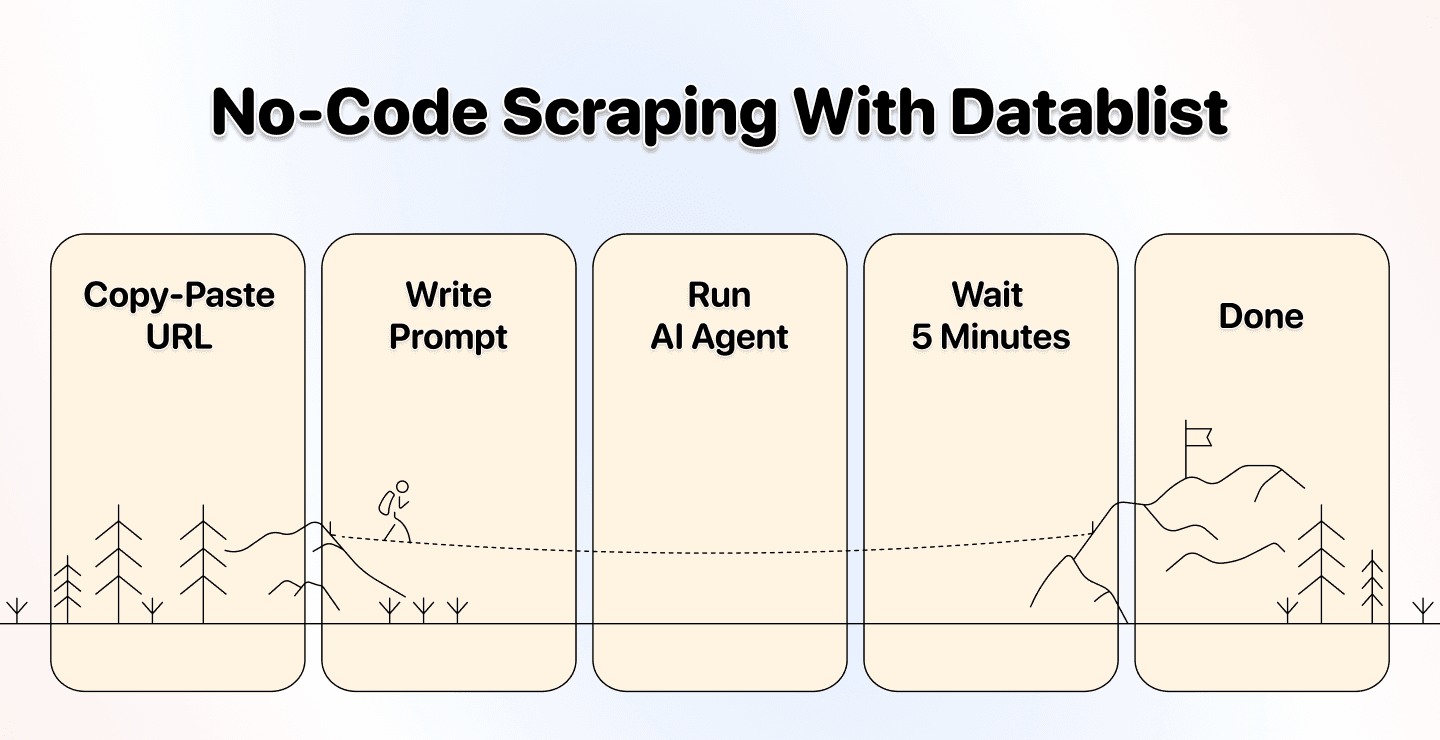
الشركة التي تقدم لك الحل: Datablist.com
كما ذكرت في البداية، لم نخطط لقلب مجال No-Code Scraping رأسًا على عقب؛ حدث ذلك بالمصادفة عندما احتاج أحد مستخدمينا إلى استخراج بيانات موقع، فبنينا له حلًا.
أنشأنا AI Agent يستطيع:
- فهم التعليمات المكتوبة بلغة طبيعية
- التنقل تلقائيًا في المواقع المعقدة
- التعامل مع الصفحات كثيفة JavaScript
- معالجة المحتوى المقسم على صفحات
- استخراج البيانات بذكاء
- …
ولم يكن الإنجاز الحقيقي في بناء أداة استخراج أفضل.
بل في إلغاء الحاجة إلى الخبرة التقنية تمامًا.
أخبر AI بما تريده، وسيعرف كيف يصل إليه.
لا CSS selectors، ولا فحص DOM، ولا شروحات مطولة.
ما هي Datablist؟
Datablist منصة لأتمتة سير عمل Lead Generation وإثراء البيانات وتنظيفها، صُممت للمستخدمين غير التقنيين في فرق المبيعات والتسويق والتوظيف.
استخدم مصدر الاستخراج لإنشاء الصفوف، ثم راجعها داخل collection ونظّف النتائج وصدّرها. ولا تختر عمليات إثراء إضافية إلا عندما تتطلبها الخطوة التالية.
لماذا تختار Datablist؟
يختلف نهج Datablist في No-Code Scraping عن بقية الحلول في السوق، لأننا لم نبع متاعب تقنية في غلاف جذاب؛ بل اتجهنا إلى AI Scraping.
إليك ما يعنيه ذلك لك:
حل No-Code حقيقي
- لا يتطلب أي معرفة تقنية
- لا حاجة إلى فهم HTML أو CSS
- راجع جودة الاستخراج عندما يتغير الموقع
كل ما تحتاج إليه هو كتابة Prompt
- اكتب ما تريده بلغة طبيعية
- يفهم AI السياق والهدف
قوالب لعمليات استخراج متعددة
- Prompts جاهزة لحالات الاستخدام الشائعة
- قوالب لاستخراج بيانات الأدلة
- قوالب لاستخراج بيانات التجارة الإلكترونية
- قوالب لاستخراج دراسات الحالة
أسهل حل لاستخراج بيانات الأدلة
- يعمل مع Yellow Pages وYelp وTripAdvisor وAlibaba
- يتعامل مع ترقيم الصفحات تلقائيًا
لن تضطر إلى دوامة التصدير والاستيراد بين عشر أدوات
- تنتقل البيانات مباشرة إلى واجهة تشبه جدول البيانات
- عدّل البيانات وصفّها وأثرها في مكان واحد
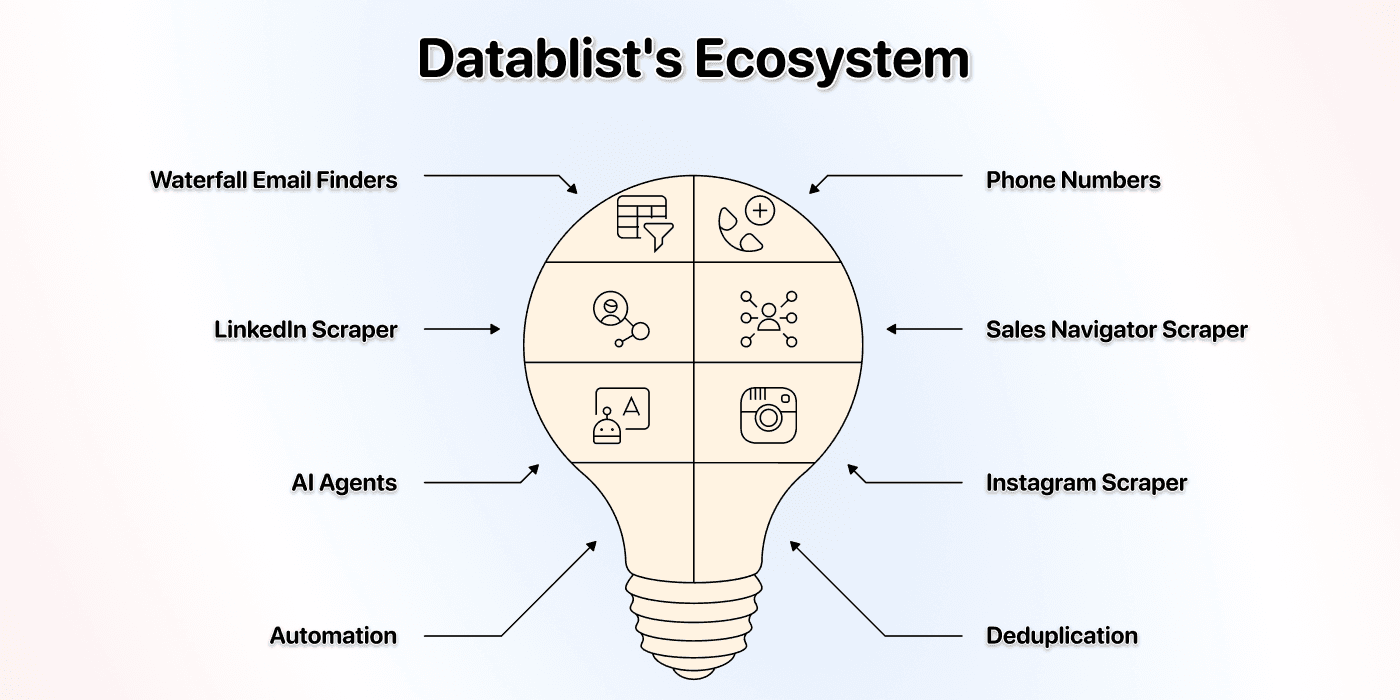
- استفد من منظومة متكاملة لـ Lead Generation
حالات الاستخدام ونصائح العمل
استخدام Datablist لاستخراج بيانات المواقع والأدلة، أو حتى توسيع نطاق البحث بالذكاء الاصطناعي، أمر سهل. فالنهج بسيط ولا يتغير: صف ما تريده بأكبر قدر ممكن من الدقة.
مقدمة سريعة إلى كتابة Prompts
قبل أن نستعرض حالات استخدام وكيل AI Scraping، دعني أوضح أولًا مدى سهولة إعطائه التعليمات.
قواعد كتابة Prompts:
كتابة Prompt جيد أمر بسيط. لا تحتاج إلى أن تكون خبيرًا؛ يكفي أن توضح ما تريده. إليك بعض النصائح التي ستساعدك على كتابة Prompts أفضل:
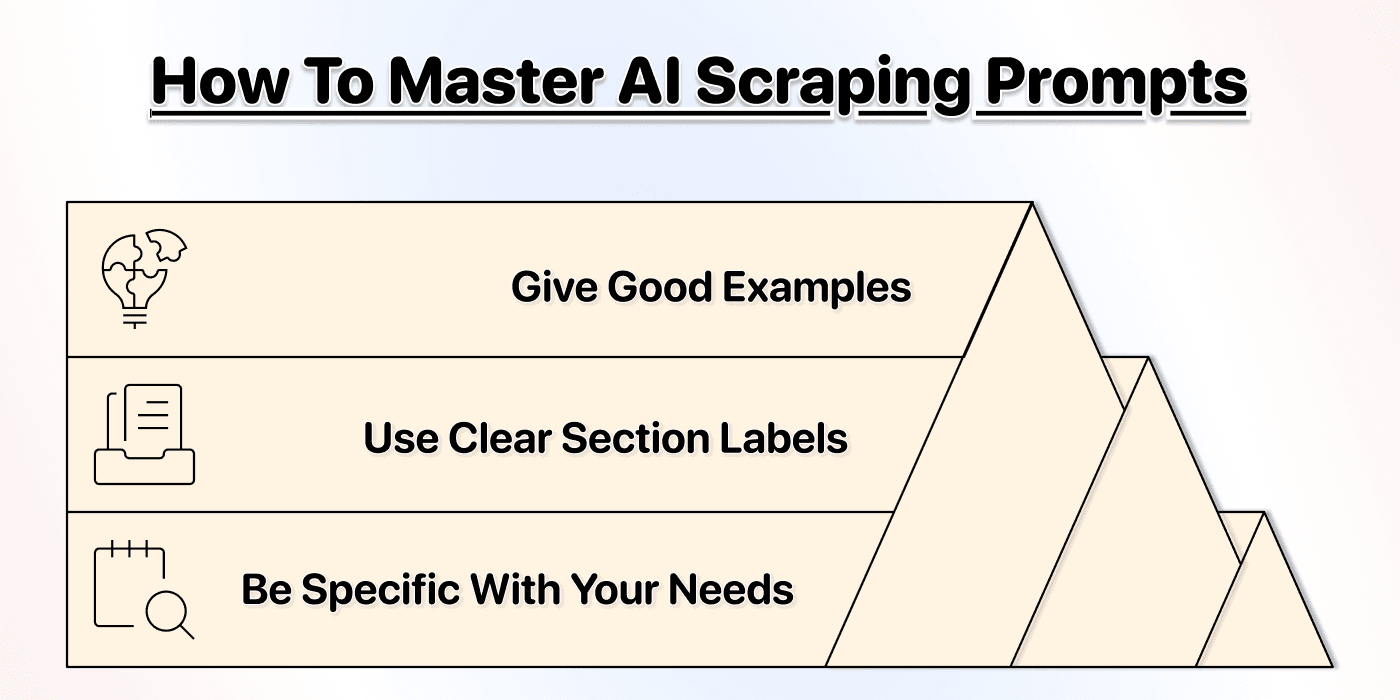
كن محددًا
- لا تقل: «اجلب معلومات المنتج»
- قل: «اجلب اسم المنتج وسعره وحالة توفره»
- أضف أمثلة كلما أمكن
يضمن ذلك حصولك على البيانات المطلوبة، ويقلل احتمال أن يسيء AI Agent تفسير طلبك.
استخدم عناوين للأقسام
- نظّم Prompt في أقسام واضحة
- الهدف: ما الذي تحاول إنجازه؟
- نقاط البيانات: ما المعلومات المحددة التي تحتاج إليها؟
- التنسيق: كيف تريد تنظيم البيانات؟
- القيود: ما الذي ينبغي تجنبه أو تضمينه؟
تساعد عناوين الأقسام AI Agent على فهم طلبك. وهي ليست شرطًا، لكننا وجدنا أنها ترفع الدقة بدرجة كبيرة.
قدّم أمثلة
لا يعرف AI Agent كل شيء، وبعض المواقع معقدة للغاية. ومن خلال تقديم أمثلة، تقلل النتائج الإيجابية الخاطئة وترفع الدقة وتخفض التكلفة.
💡 نصيحة احترافية: التعامل مع ترقيم الصفحات
يستطيع AI Agent من Datablist التعامل تلقائيًا مع المحتوى المقسم على صفحات. ما عليك سوى تفعيل pagination في الإعدادات وتحديد الحد الأقصى لعدد الصفحات. وسيتبع الوكيل روابط الصفحة التالية المتاحة ما دامت هناك نتائج وصفحات متبقية ضمن الحد المضبوط.
===
نقاط البيانات المطلوبة:- اسم المنتج (مثال: "قميص كلاسيكي")
- السعر (مثال: "$29.99")
- URL المنتج (الرابط الكامل)
- التوفر (متوفر / غير متوفر)
===
التنسيق:- أعد صفًا واحدًا لكل منتج
- استخدم "N/A" عند غياب البيانات
===
القيود:- تجاهل اللافتات الترويجية
- استخرج المنتجات الفعلية فقط، وليس صفحات الفئات
حالات استخدام No-Code Scraping
تكاد إمكانات No-Code Scraping تكون بلا حدود. وفيما يلي أشهر حالات استخدام AI Scraping وأكثرها فاعلية مما شاهدناه حتى الآن:
الأدلة
-
استخراج بيانات المطاعم من Yelp
-
استخراج معلومات الفنادق من TripAdvisor
-
استخراج كتالوجات الموردين من Alibaba
مواقع التجارة الإلكترونية
استخدامات أخرى
- استخراج جميع دراسات الحالة من موقع
- استخراج بيانات العارضين من مواقع المعارض التجارية
📘 كيفية استخراج البيانات من مواقع متعددة
إذا كانت لديك مواقع كثيرة متشابهة وتريد استخراج بياناتها، فيمكنك أيضًا استخدام AI Research Agent من Datablist لمعالجة قائمة من المواقع. ويوفر هذا الوكيل إمكانات إضافية تتيح لك تشغيل AI Search على نطاق واسع.
الخلاصة: حان الوقت لتغيير اسم No-Code Scraping
ينبغي تغيير اسم No-Code Scraping إلى «استخراج البيانات بلا متاعب تقنية»، لأن هذا هو ما يريده الناس فعلًا. فأنت لا تبحث عن No-Code Scraping لأنك عاجز عن البرمجة، بل لأنك لا تريد تعلم مهارات تقنية لمجرد استخراج البيانات.
لذلك، إذا لم يكن استخراج البيانات نشاطًا رئيسيًا يدر عليك أرباحًا كبيرة، فلا ينبغي أن تضطر إلى إهدار ساعات عليه. والحل ليس API أفضل ولا واجهات أنظف للتأشير والنقر.
الحل هو إزالة الطبقة التقنية بالكامل، أي استخدام AI Scraping.
ومع Datablist، يمكنك فعل ذلك تحديدًا، إلى جانب:
- الحصول على النتائج خلال دقائق بدلًا من ساعات
- التوسع من موقع واحد إلى آلاف المواقع
- وصف ما تريده بلغة طبيعية
- التكيف تلقائيًا مع تغييرات المواقع
لقد حُلّت أخيرًا مشكلة No-Code Scraping. وقد فعلنا ذلك بالمصادفة.
الأسئلة الشائعة عن No-Code Scraping
هل تستطيع Datablist استخراج بيانات الأدلة؟
نعم، يستطيع AI Scraping Agent من Datablist استخراج بيانات الأدلة بكفاءة، كما يتعامل الوكيل تلقائيًا مع ترقيم الصفحات، لتتمكن من استخراج آلاف القوائم من دون إعداد يدوي.
على سبيل المثال، نجحنا في استخراج بيانات من:
- تقييمات TripAdvisor والفنادق والمطاعم وغيرها
- قوائم الشركات في Yellow Pages
- كتالوجات العقارات في Airbnb
- قواعد بيانات الموردين في Alibaba
- معلومات الشركات في Yelp
- … وغيرها الكثير
هل يمكنني استخراج بيانات صفحات متعددة تلقائيًا؟
نعم، يدعم AI Scraping Agent من Datablist ترقيم الصفحات تلقائيًا. حدّد الحد الأقصى لعدد الصفحات في الإعدادات، وسيتمكن الوكيل من اتباع روابط الصفحة التالية المتاحة ضمن هذا الحد. وتحقق بعد ذلك من اكتمال التغطية.
يناسب ذلك:
- كتالوجات منتجات التجارة الإلكترونية
- قوائم الأدلة الممتدة عبر صفحات متعددة
- نتائج البحث المقسمة على صفحات
- أرشيفات المدونات
- …
ما تكلفة استخدام Scraping Agent من Datablist؟
يعتمد تسعير AI Agents من Datablist على الاستخدام، ويختلف وفقًا لتعقيد مهمة استخراج البيانات. وتكون التكلفة أقل بكثير مع أدلة مثل Yellow Pages، كما تتغير بحسب عدد الصفحات والمعالجة المطلوبة. نفّذ اختبارًا صغيرًا قبل تقدير تكلفة دفعة أكبر.
ما المقصود باستخراج البيانات بدون كود؟
No-Code Scraping هو استخراج البيانات من المواقع من دون كتابة كود أو امتلاك مهارات تقنية. ويعني No-Code Scraping الحقيقي أن تصف ما تريده بلغة طبيعية وتحصل على النتائج، من دون فهم HTML أو CSS selectors أو APIs.
هل تتعامل Datablist مع المواقع كثيفة JavaScript؟
نعم، يستطيع AI Agent من Datablist استخراج البيانات من المواقع كثيفة JavaScript. فعّل خيار "Render HTML" في الإعدادات المتقدمة لضمان انتظار الوكيل حتى يكتمل تحميل JavaScript قبل استخراج البيانات.
وهذا ضروري للمواقع الحديثة المبنية باستخدام React أو Vue أو Angular، والتي تحمّل المحتوى ديناميكيًا بعد التحميل الأولي للصفحة.
ما الفرق بين No-Code Scraping والاستخراج التقليدي؟
يتطلب استخراج بيانات الويب التقليدي معرفة برمجية، مثل Python وJavaScript، أو مهارات تقنية مثل CSS selectors وXPath. أما No-Code Scraping فيلغي هذا الشرط من خلال واجهات مرئية، أو من خلال فهم اللغة الطبيعية كما في Datablist.
كيف يختلف AI Scraping عن الاستخراج باستخدام CSS selectors؟
تعتمد أدوات الاستخراج القائمة على CSS selectors على البنية الدقيقة لـ HTML في الموقع. وإذا تغير تخطيط الموقع، تتعطل الأداة.
أما AI Scraping فيفهم معنى المحتوى، لا موقعه فقط. ويمكنه إدراك أن «هذا هو سعر المنتج» حتى لو تغيرت أسماء HTML classes. وقد يسمح ذلك بتحمل بعض تغييرات التخطيط، لكن يظل من الضروري مراجعة جودة الاستخراج عند تغير الموقع.
هل No-Code Scraping قانوني؟
تعتمد الإجابة على البيانات التي تجمعها، وكيفية استخدامها، والقوانين السارية. واستخدام أداة No-Code لا يغير هذه القواعد. وفي حالة البيانات الشخصية، لا يعني إتاحتها للعامة سقوط التزامات حماية البيانات. يوضح دليل CNIL حول إعادة استخدام بيانات الإنترنت هذا الفارق.
- احترم ملف robots.txt وأي قيود أخرى على الوصول.
- تجنب استخراج البيانات من الصفحات المحمية بتسجيل الدخول.
- اجمع الحقول التي تحتاج إليها فقط، والتزم بقواعد الخصوصية السارية.
- تجنب الطلبات المفرطة التي ترهق الموقع المصدر.
قبل اختيار الاستخراج بالذكاء الاصطناعي بدلًا من القواعد الثابتة، اقرأ مقارنة AI Web Scraping وفحوص الدقة. واختبر النهجين على صفحات ممثلة للموقع بدلًا من افتراض قدرة أي منهما على التعامل مع كل تغيير في التخطيط.
إعداد عملية No-Code Scraping والتحقق من النتائج
ابدأ بصفحة قوائم عامة. وفي AI Agent - Site Scraper، أدخل URL الصفحة، وصف محتوى صف واحد من النتائج، وحدد الحقول التي تحتاج إليها. بالنسبة إلى قائمة منتجات، قد تشمل هذه الحقول اسم المنتج والسعر المعروض والعملة وURL المنتج. واطلب إبقاء القيم المفقودة فارغة، والتعامل مع محتوى الموقع على أنه بيانات لا تعليمات.
نفّذ اختبارًا صغيرًا قبل توسيع نطاق الاستخراج. قارن أول صف وآخر صف بالصفحة، وتأكد من أن الأسعار تخص خيارات المنتجات المقصودة، وأن النتائج تتضمن URLs المنتجات لا URLs الفئات.
لا تفعّل pagination إلا عندما تعرض القائمة رابطًا للصفحة التالية. يستخرج المصدر هذا الرابط من الصفحة الحالية، ويواصل العمل ما دامت هناك نتائج وصفحات متبقية ضمن الحد الأقصى المحدد. الحد الأقصى سقف للعملية، وليس وعدًا بزيارة كل صفحة. وقد يؤدي الاستخراج الفارغ أو تعذر الوصول إلى الصفحة التالية إلى توقف الجمع مبكرًا.
قد يساعد Render JavaScript عندما لا يظهر المحتوى في HTML الأولي. لكنه لا يضمن تجاوز تسجيل الدخول أو CAPTCHAs أو الطلبات المحظورة أو أزرار «تحميل المزيد» التفاعلية. إذا أخفق الاختبار في جلب محتوى أساسي، فاستخدم تصديرًا متاحًا أو API مصرحًا به بدلًا من افتراض أن تشغيل عملية أكبر سيحل المشكلة. وأزل التكرارات باستخدام URL المنتج عند إعادة عمليات بحث متداخلة.
تقلل أداة No-Code الجيدة أعمال الإعداد، لكنك تظل مسؤولًا عن اختيار البيانات والتحقق من صلاحية الوصول وفحص النتائج وصيانة سير العمل عند تغير المصدر.