
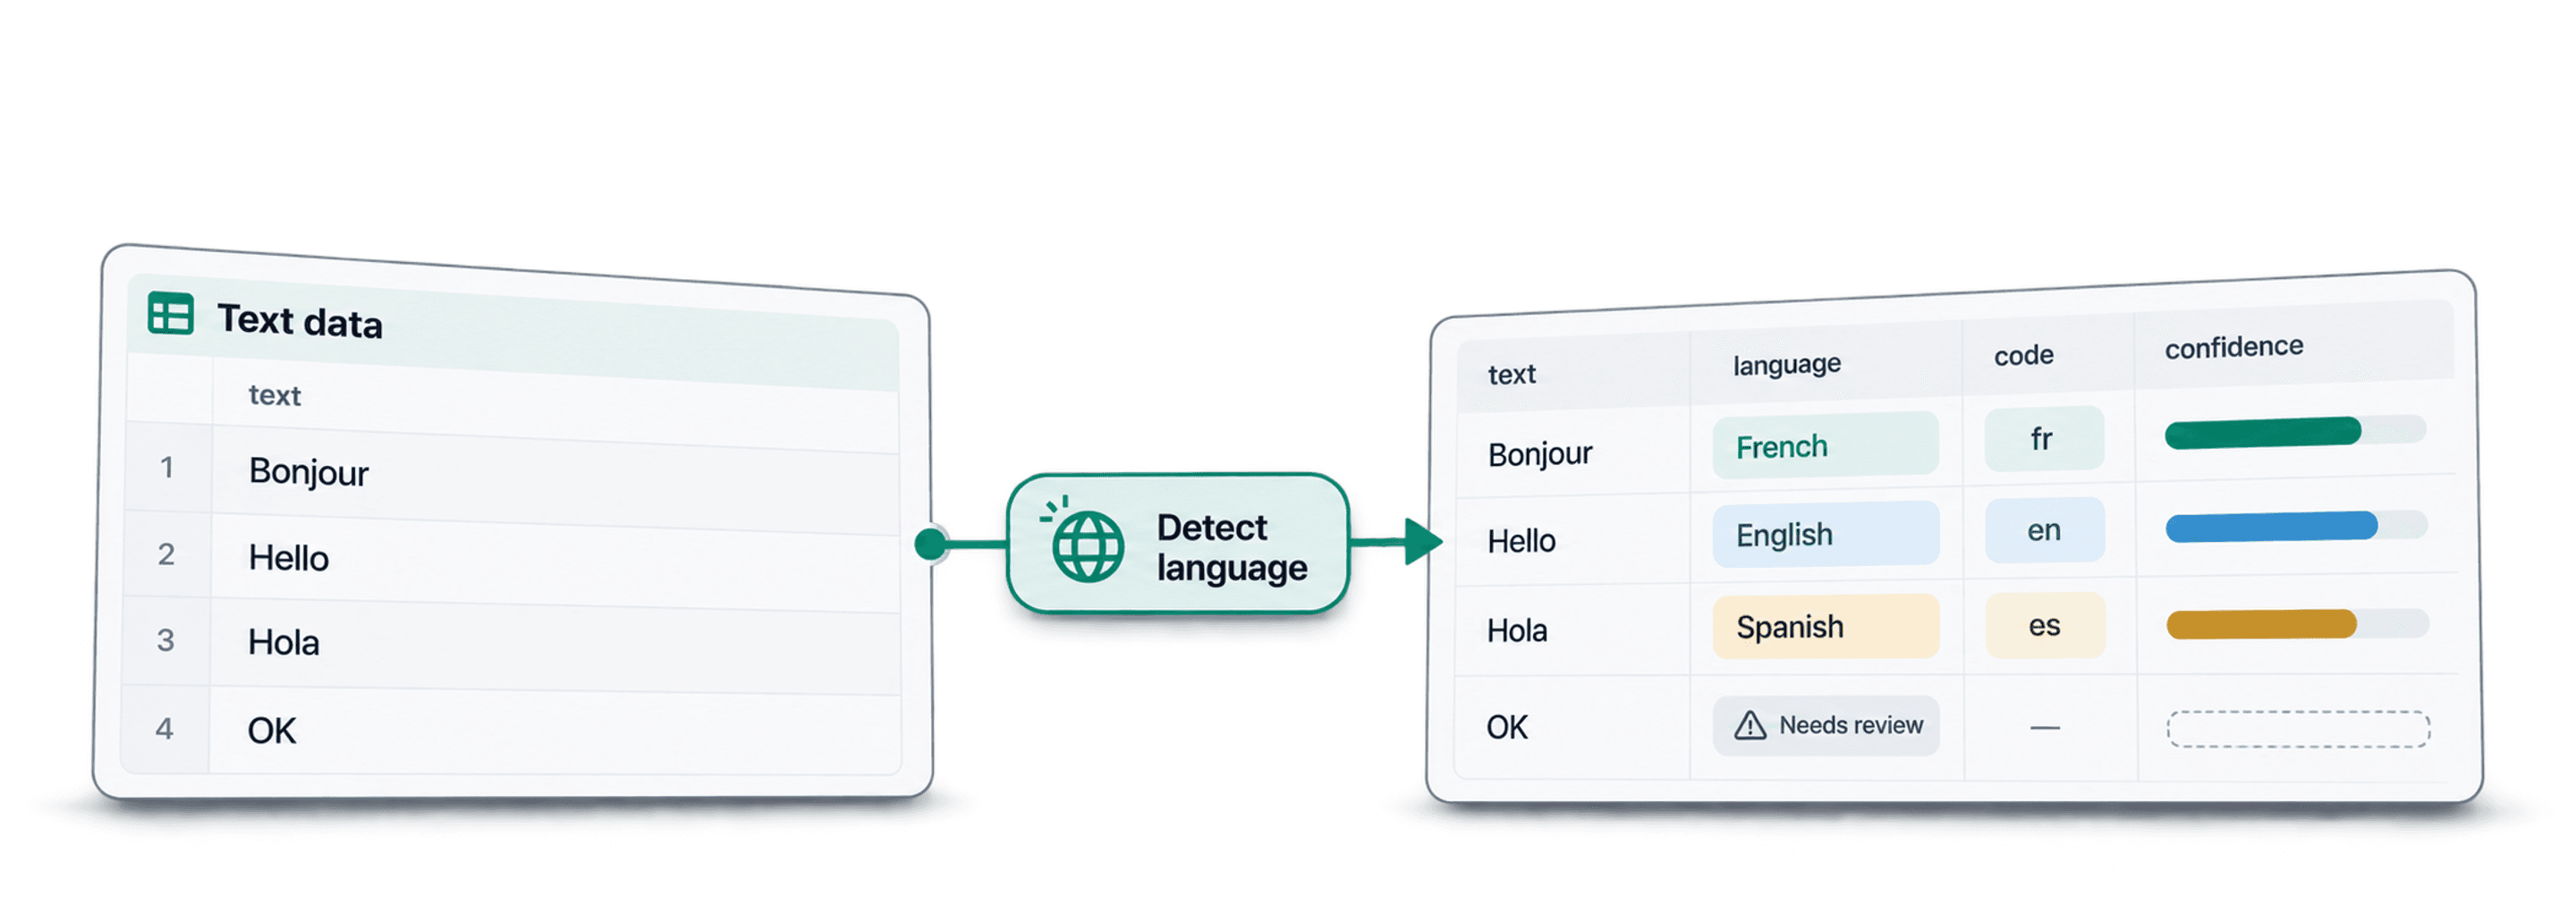
Si necesita detectar el idioma de cada fila de un dataset, la forma más sencilla es añadir las columnas de idioma directamente al archivo que ya utiliza. Importe el archivo CSV o Excel en Datablist, ejecute la detección de idioma en la columna de texto, revise los niveles de confianza y, después, exporte el dataset enriquecido o continúe con la traducción, el enrutamiento o la segmentación.
Prefiero este método a copiar filas en un chatbot porque los resultados permanecen asociados a cada fila. Obtendrá el nombre del idioma, su código ISO y un nivel de confianza para cada registro. Así, el siguiente paso resulta mucho más fácil: puede filtrar las filas en francés, enviar las filas en español a traducción, revisar los resultados con baja confianza o eliminar las filas sin texto útil.
En esta guía utilizaré un dataset de perfiles multilingües, pero el mismo proceso sirve para tickets de soporte, respuestas a encuestas, reseñas, descripciones de productos, páginas extraídas mediante scraping y notas de CRM.
🔑 Utilice primero el detector específico
Si solo necesita detectar idiomas, empiece por el enrichment de detección de idioma. Utilice ChatGPT únicamente cuando necesite reglas personalizadas o tomar una decisión combinada.
Enlaces rápidos
- Respuesta directa
- Dataset de ejemplo
- Paso 1: importe el archivo CSV o Excel
- Paso 2: seleccione el enrichment de detección de idioma
- Paso 3: configure las entradas y salidas
- Paso 4: revise los idiomas detectados
- Paso 5: filtre, exporte o continúe con la traducción
- Coste: créditos fijos por fila
- Alternativa: utilice ChatGPT para reglas personalizadas
Respuesta directa
Para detectar el idioma de cada fila de un dataset, importe su archivo CSV o Excel en Datablist, abra el menú Enrich y seleccione Detect Language from a Text enrichment. En el paso Inputs, elija la columna de texto que desea analizar. Datablist añade en nuevas columnas el nombre del idioma detectado, su código y el nivel de confianza, con un precio fijo de 0.05 créditos por fila.
La revisión es la parte importante del proceso. Detectar idiomas es una tarea de clasificación, y el nivel de confianza indica qué filas pueden avanzar y cuáles conviene comprobar. Por lo general, las filas con confianza alta pueden pasar al siguiente workflow. Antes de exportar, filtre las filas con confianza baja, entradas no válidas o sin resultados.
Este es el workflow que utilizo cuando el resultado debe permanecer vinculado a las filas originales. Una fórmula de hoja de cálculo puede servir en casos sencillos, pero suele fallar con textos que mezclan idiomas, fragmentos cortos, celdas vacías y exportaciones poco limpias. Un chatbot puede responder sobre algunos ejemplos, pero no le proporciona un dataset ordenado con un resultado por fila.
Dataset de ejemplo
Para la demostración utilizo un CSV de perfiles sociales con cinco columnas:
| ID del perfil | Nombre completo | Titular | Biografía | Empresa |
|---|---|---|---|---|
C8C1DXQBNP | Maya Collins | Fundadora que desarrolla herramientas de analítica para equipos de clientes | Ayudo a los equipos comerciales a limpiar listas de leads desordenadas... | Northstar Labs |
61M25JUEHM | Lucas Bernard | Responsable de soporte al cliente de un marketplace | Creo workflows sencillos... | Market Loop |
Y45G9QU71C | Sofia Romero | Especialista en CRM y automatización comercial | Consultora de operaciones enfocada... | Talent Desk |
RL20HHREOT | Felix Wagner | Tech Recruiter para equipos de producto | Ayudo a los equipos a... | Cleanbase |
TT384W44MW | Aoi Nakamura | Consultora de CRM para equipos de ventas | Clasifico consultas multilingües... | Northstar Labs |
El archivo no incluye una columna de idioma de forma intencionada. Quiero que Datablist añada esa información, no que confirme una etiqueta que ya he proporcionado.
El dataset también contiene filas desordenadas: biografías vacías, titulares cortos, nombres de empresas, nombres de usuario, URL, números y fragmentos en varios idiomas. Me gusta utilizar este tipo de archivo porque muestra lo que ocurre fuera de una demostración perfecta. Las exportaciones reales siempre incluyen algunas filas que requieren revisión.
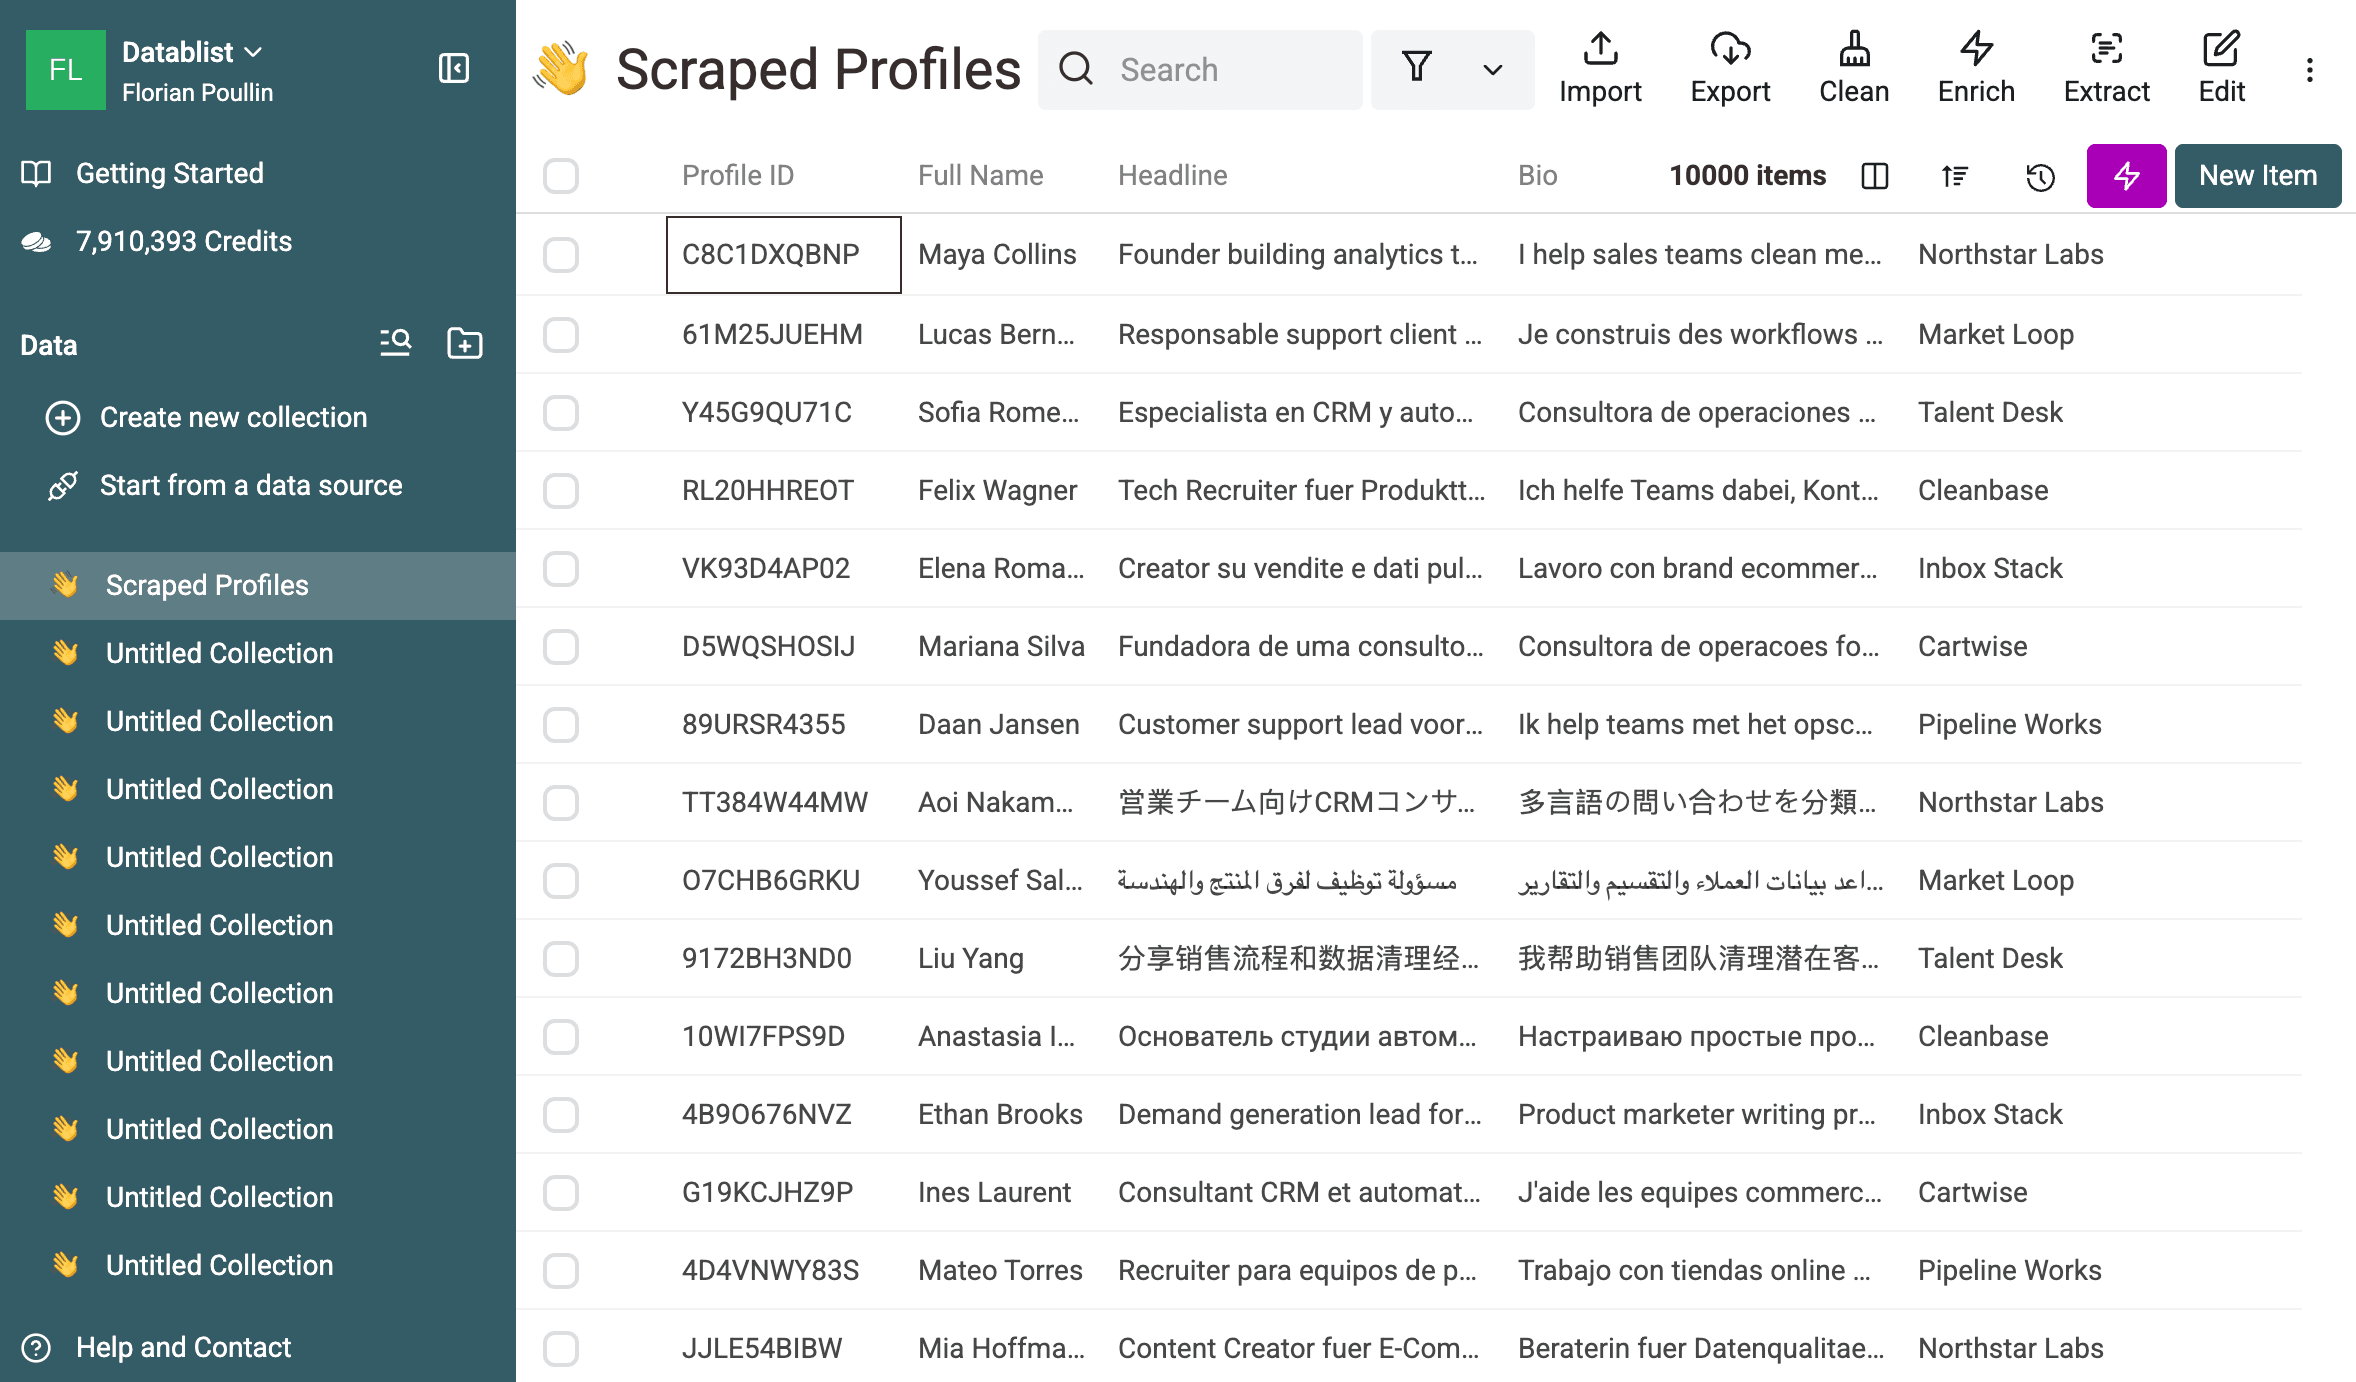
En este ejemplo utilizo tanto Headline como Bio como señales para identificar el idioma. Si su dataset incluye tickets de soporte largos o descripciones de productos en una sola columna, basta con una columna de entrada. Si cada fila contiene campos cortos, combinar dos columnas de texto suele proporcionar más contexto al detector.
Paso 1: importe el archivo CSV o Excel
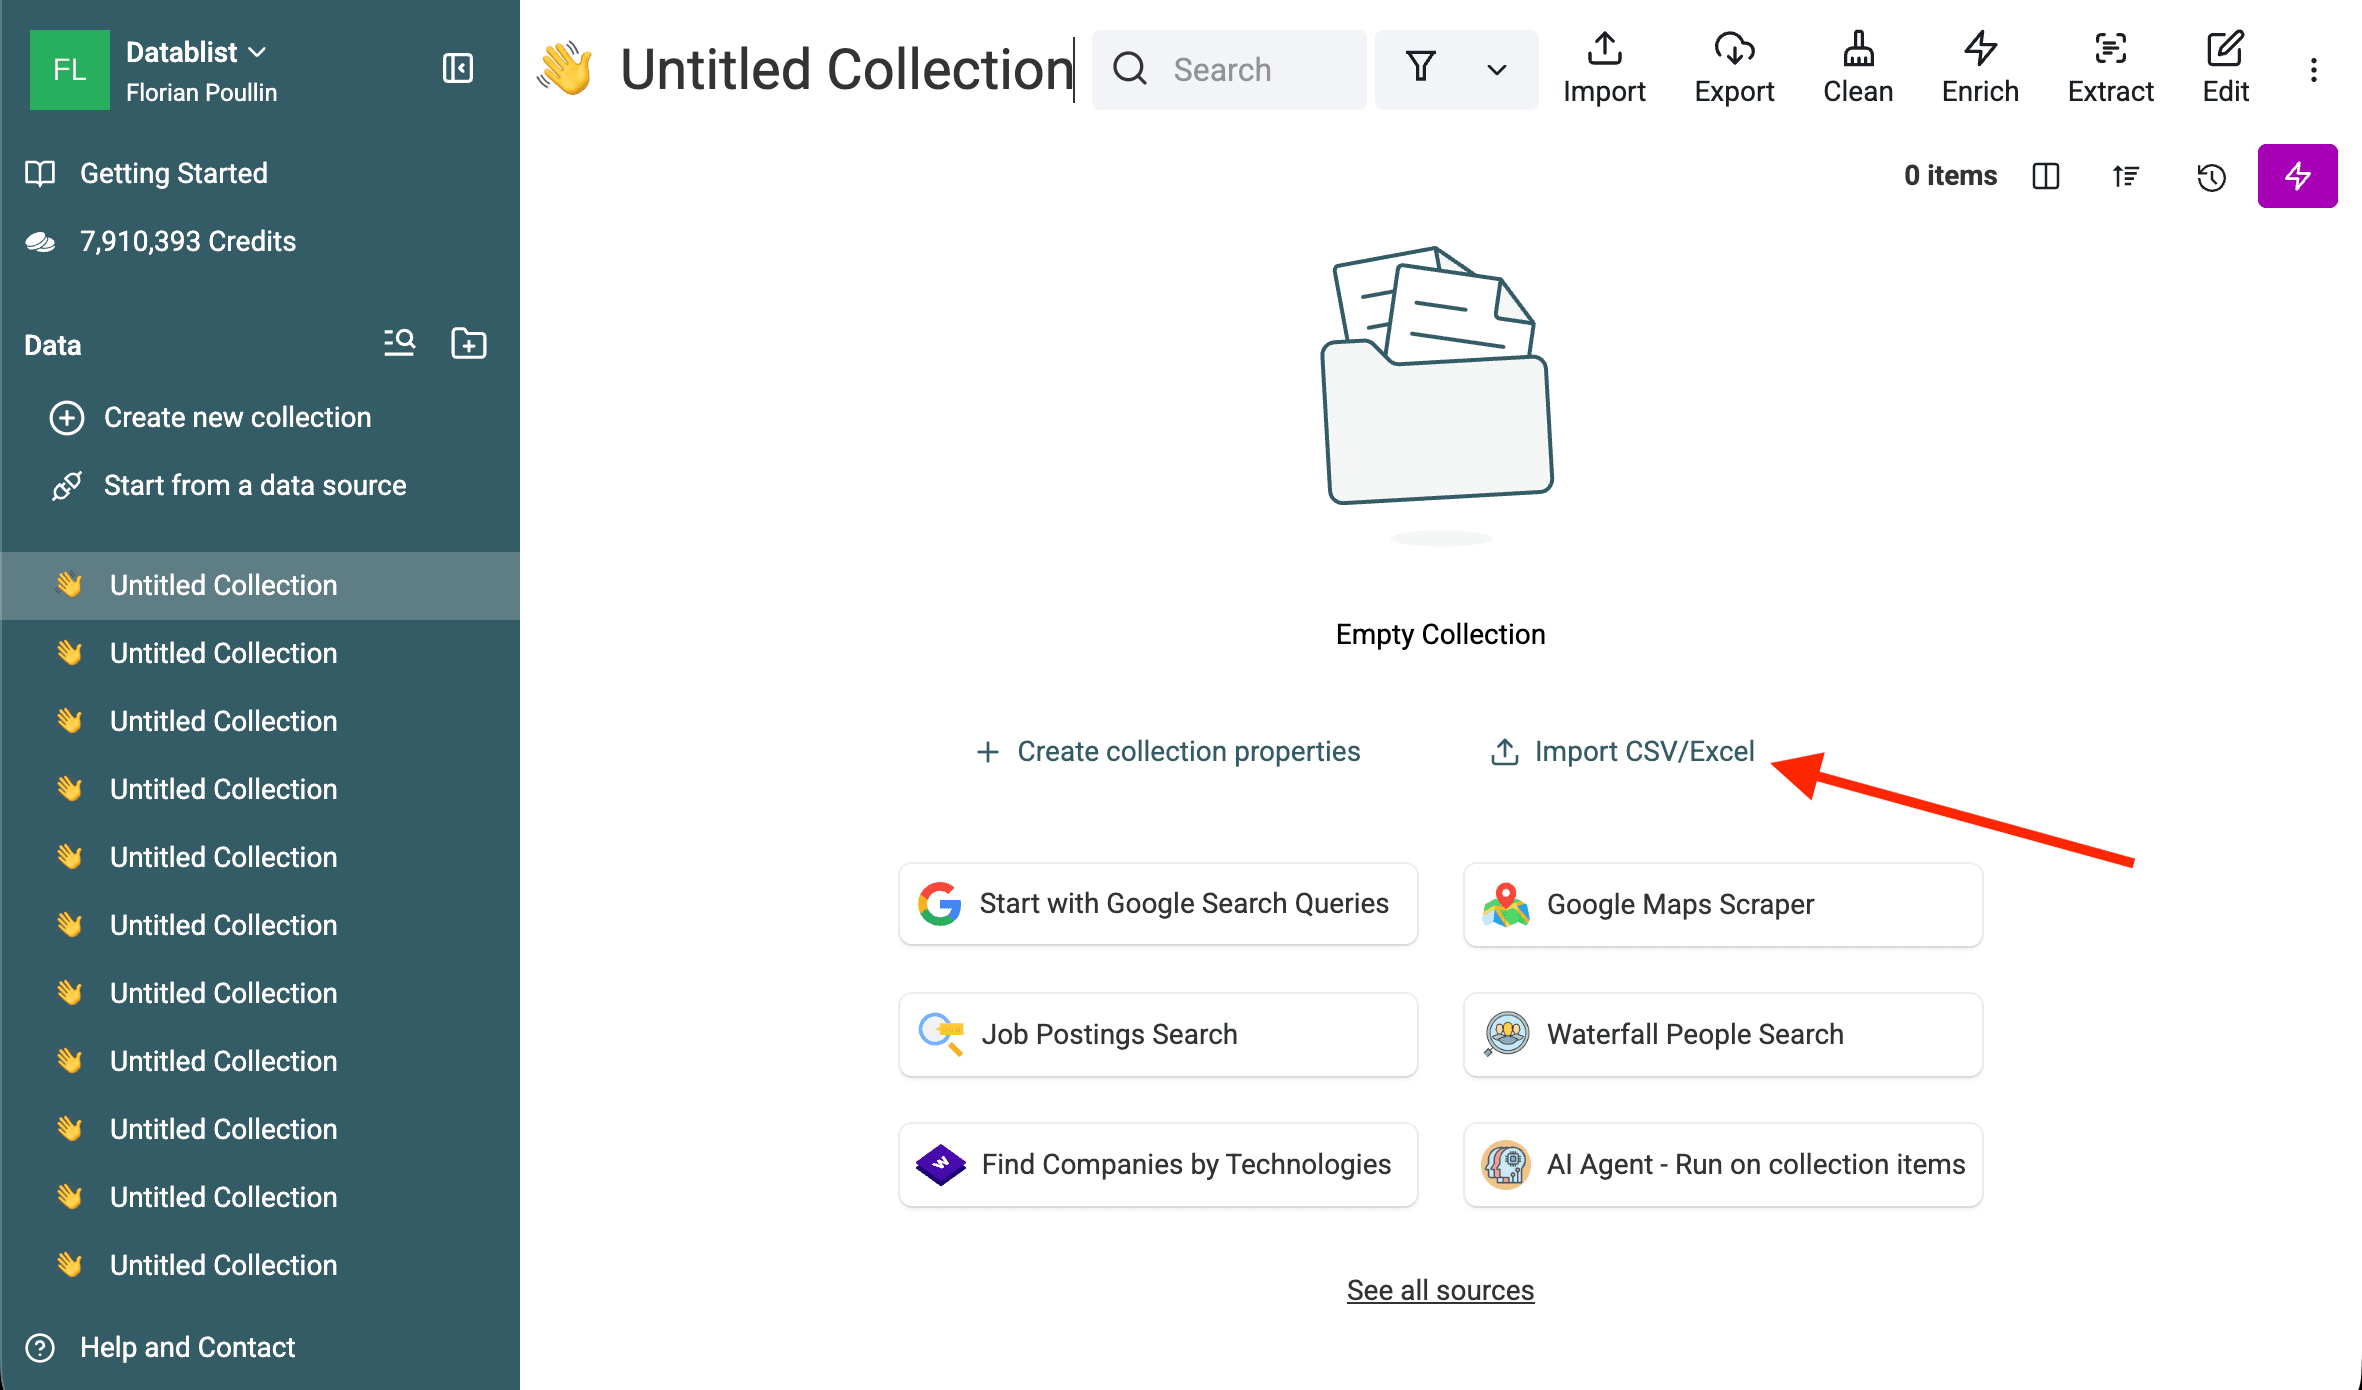
Empiece con un archivo CSV o Excel que tenga una fila por registro y, al menos, una columna de texto. Abra Datablist, cree una colección e importe el archivo. Puede utilizar el editor de CSV de Datablist para este workflow.
En la pantalla de revisión de la importación, compruebe los nombres de las columnas y asegúrese de que los campos de texto útiles se importen como campos de texto. En mi ejemplo, me interesan Headline y Bio. No utilizo Full Name, Company ni Profile ID para detectar el idioma porque ofrecen muy pocas señales lingüísticas.
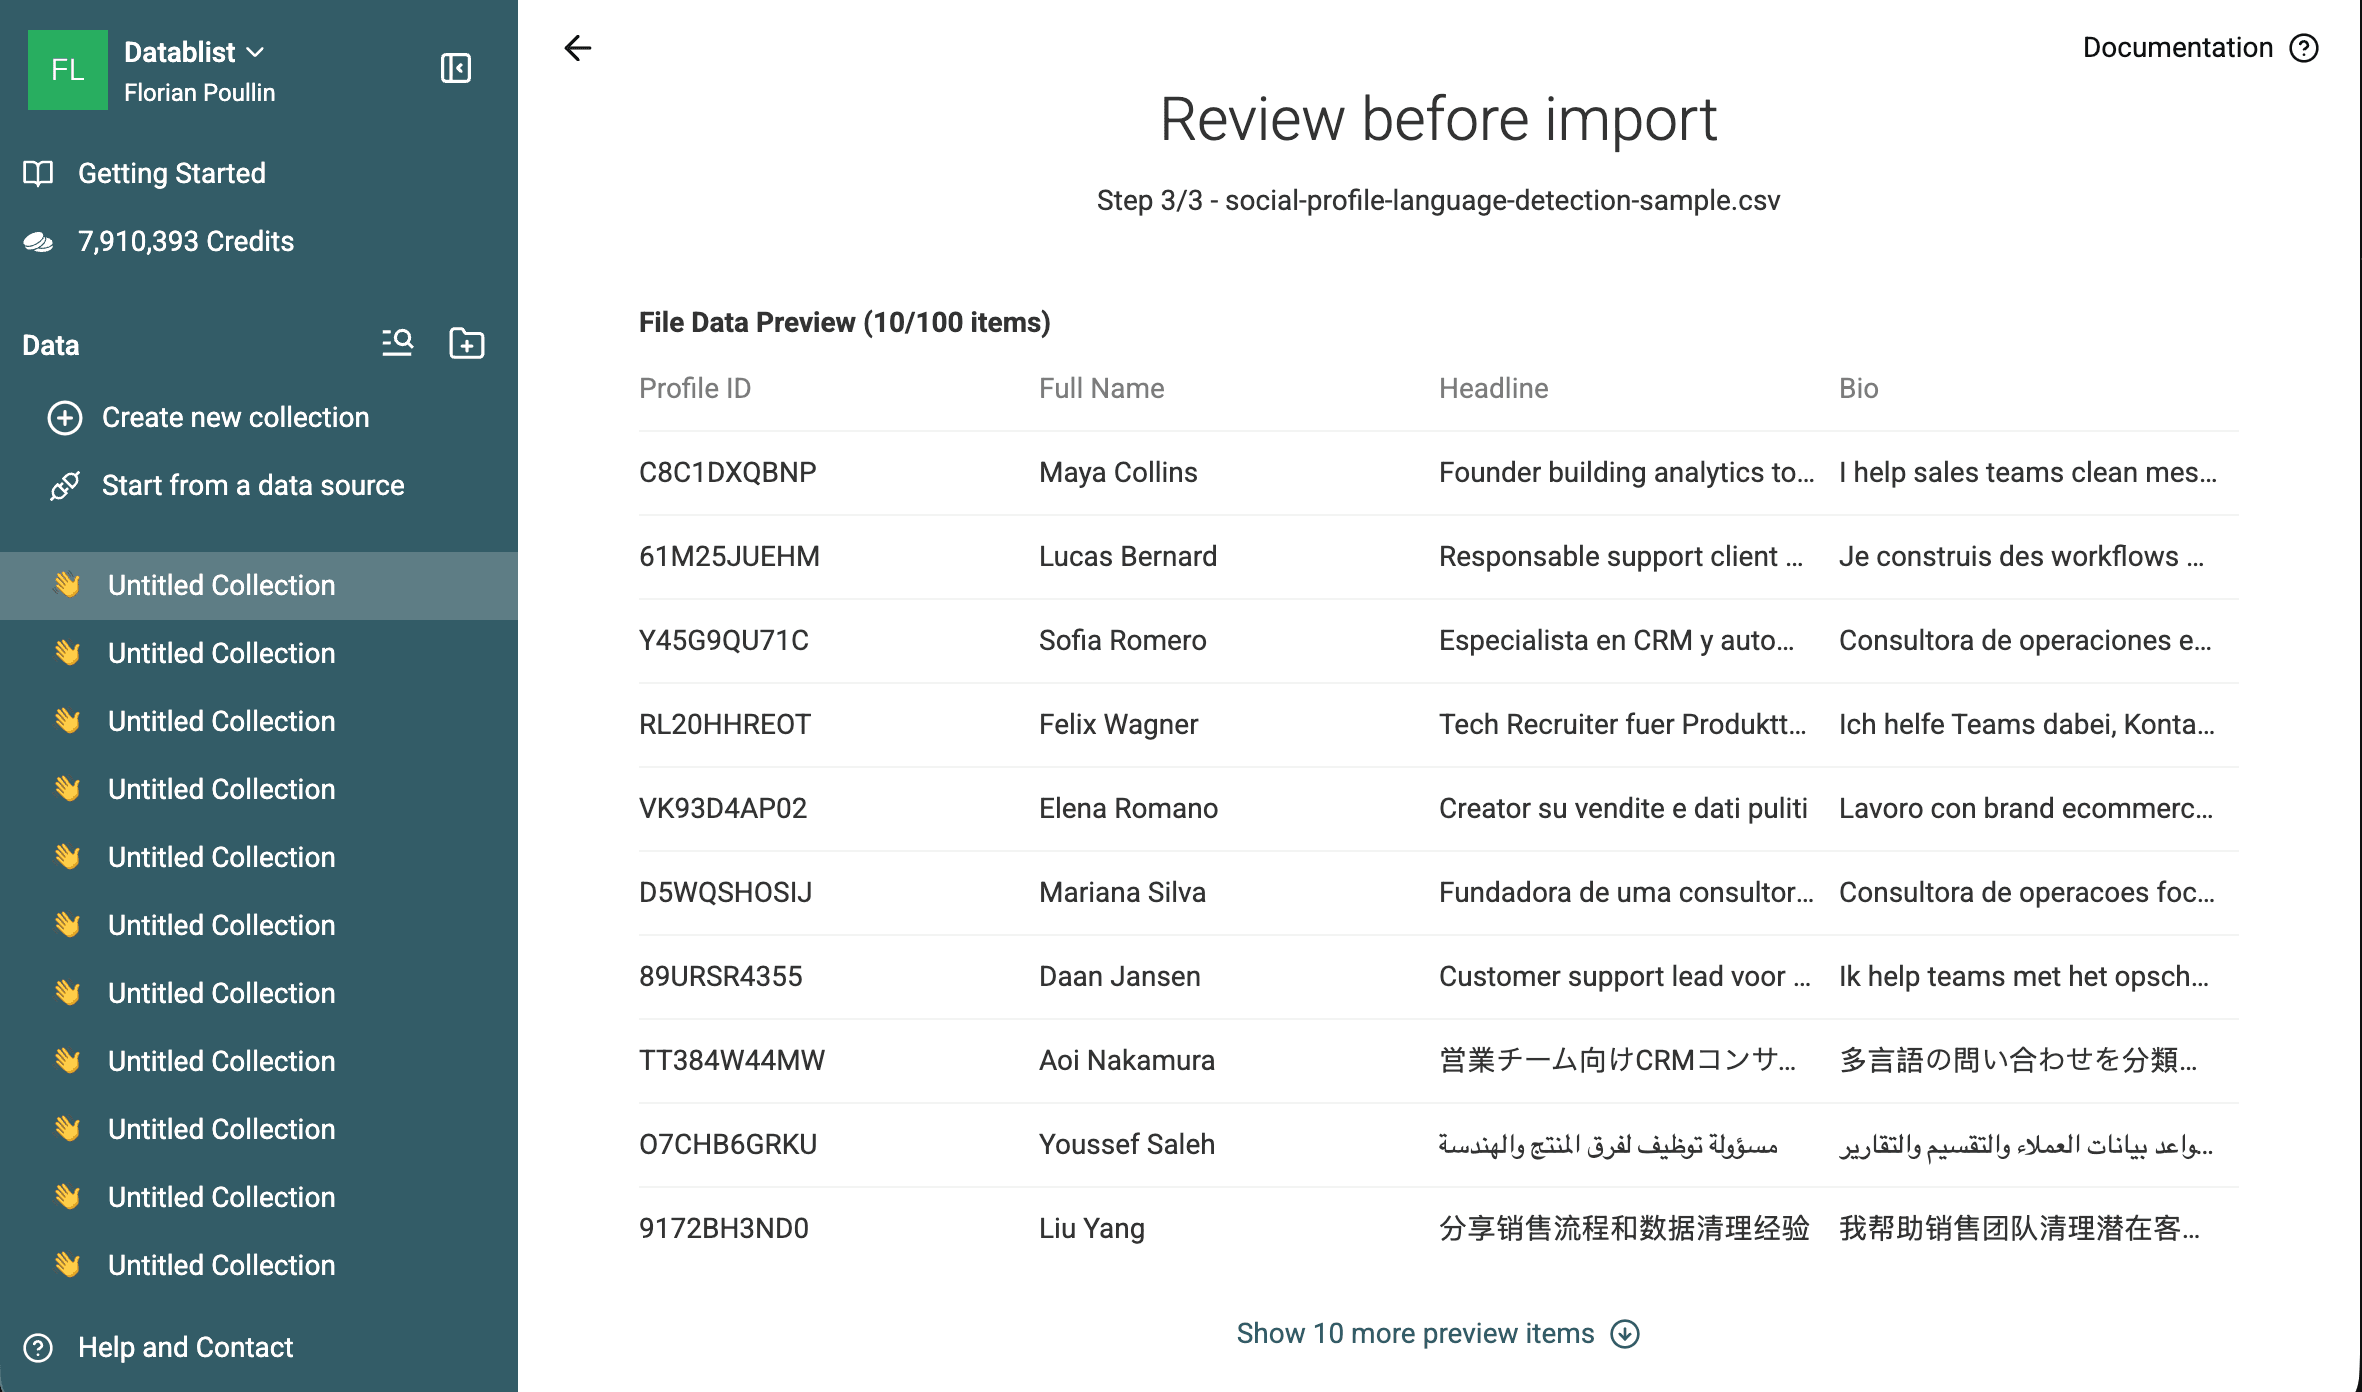
Mantenga intactas las columnas de texto originales. Normalmente añado columnas de salida nuevas en lugar de sobrescribir los datos de origen, ya que así resulta más fácil revisarlos. Si un resultado parece extraño, podrá compararlo de inmediato con el texto original.
💡 Conserve una columna de ID estable
Si más adelante necesita volver a cargar este archivo en otro sistema, conserve una columna de ID, como
Profile ID, el ID del ticket, el SKU del producto o el ID del registro en el CRM. Así, la exportación y la correspondencia de registros serán más seguras.
Paso 2: seleccione el enrichment de detección de idioma
Una vez importado el dataset, abra el menú Enrich y busque la detección de idioma. Seleccione Detect Language from a Text enrichment.
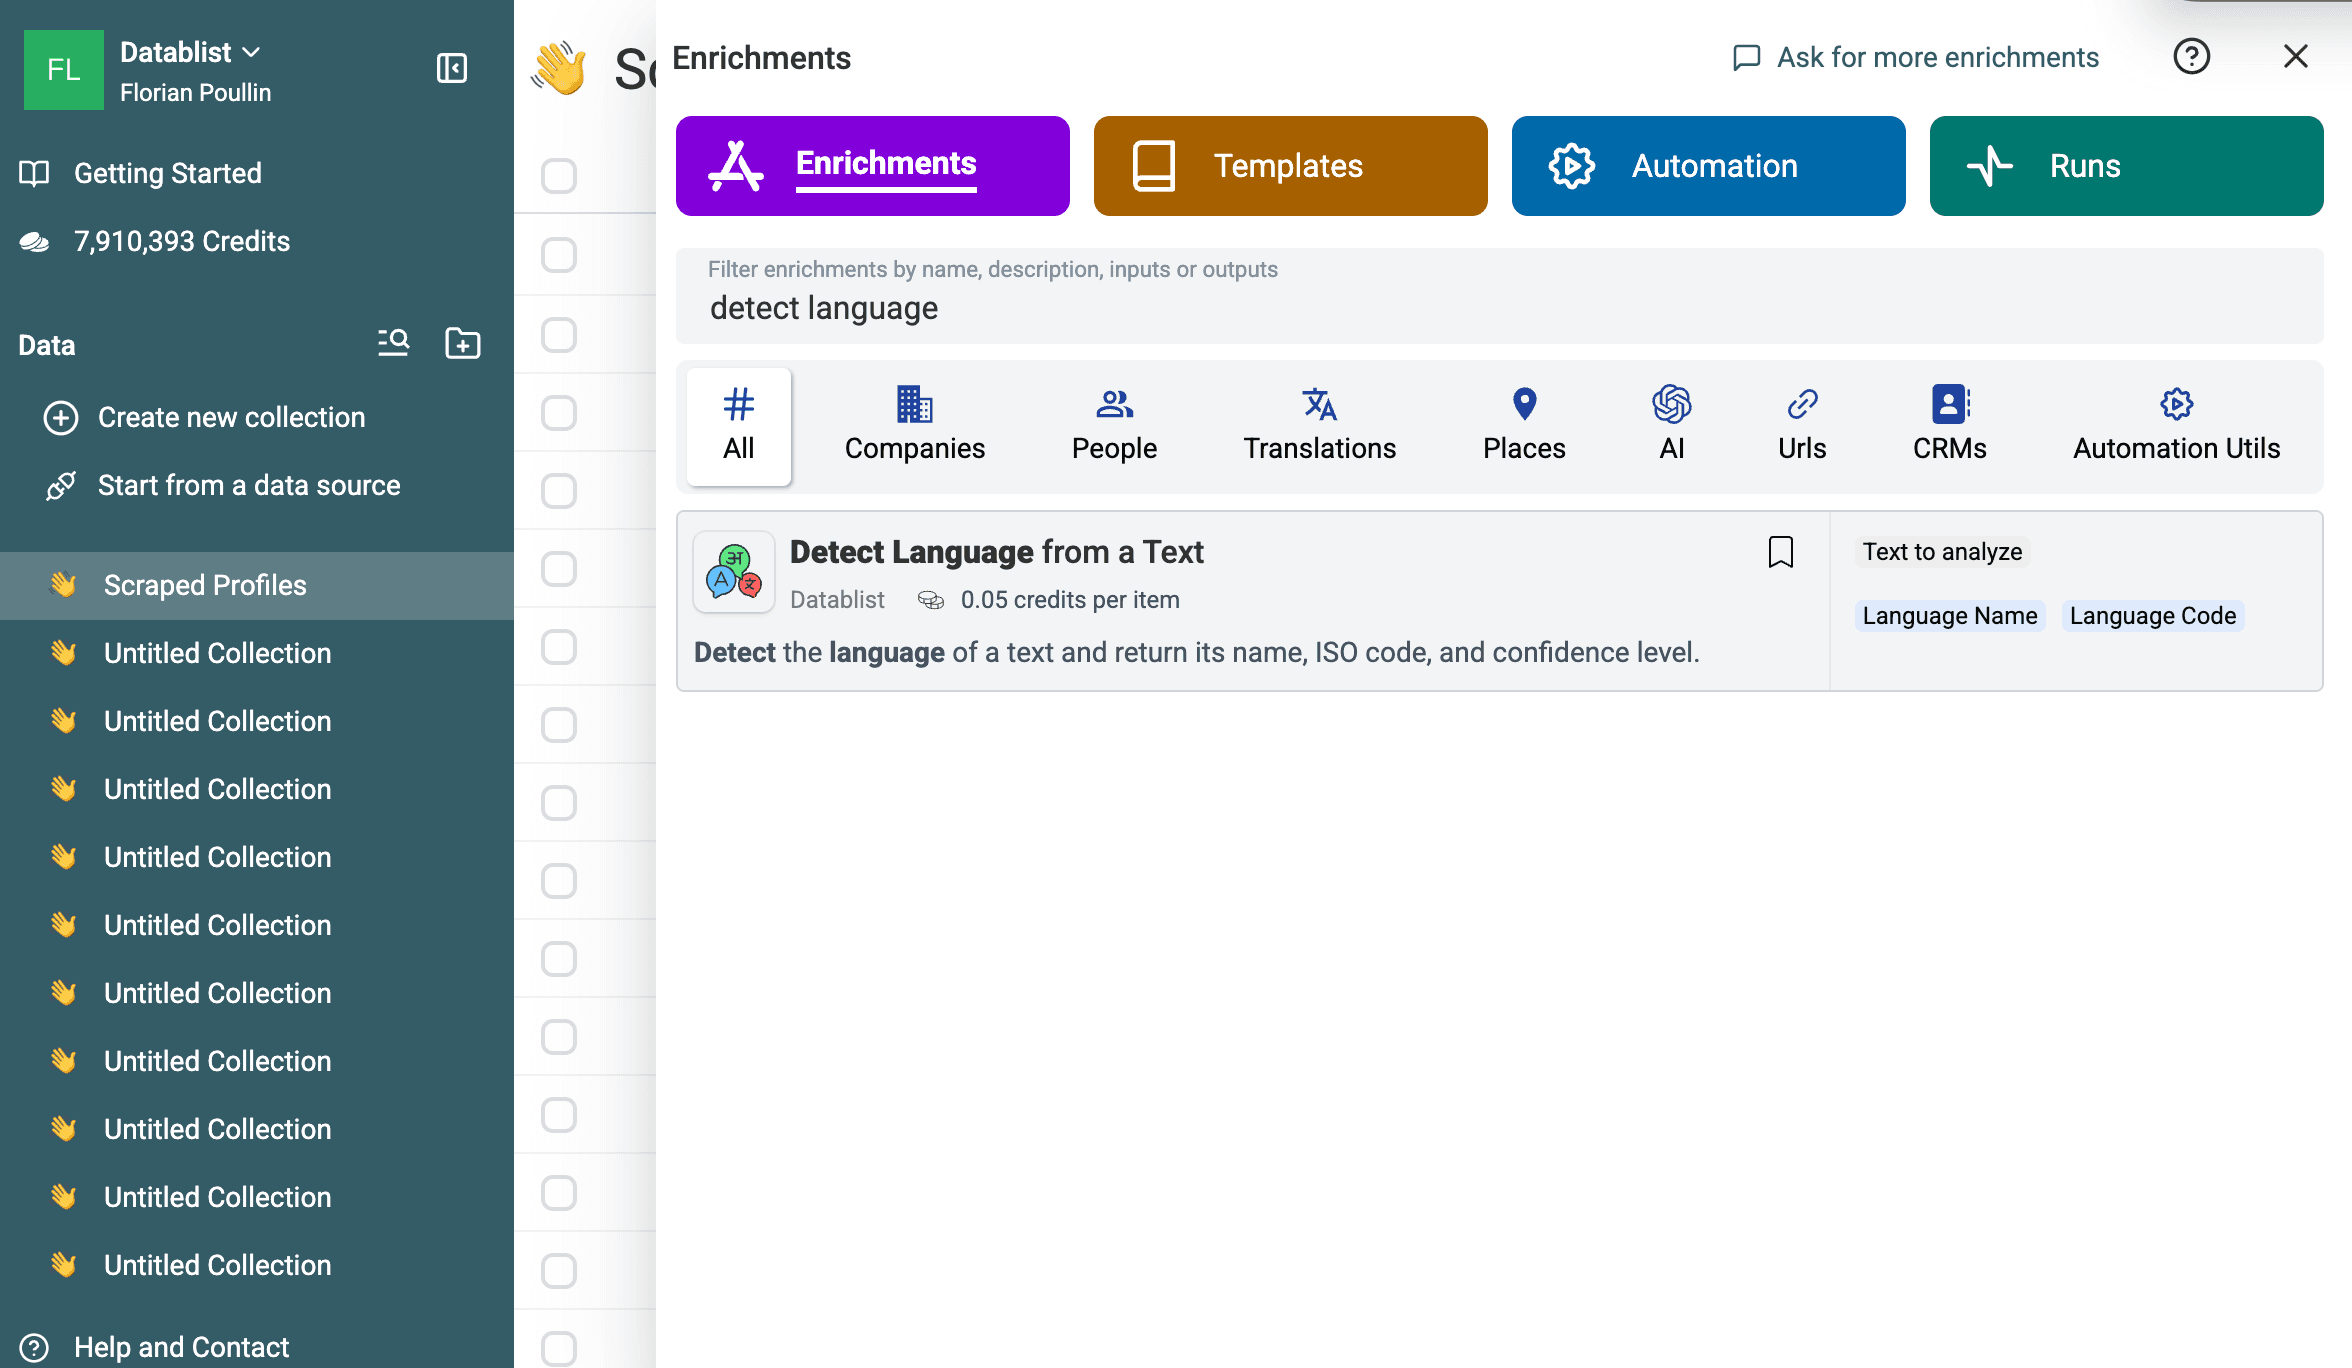
Este enrichment procesa las filas una a una. Para cada elemento, lee el texto de entrada y devuelve:
Language Name, como English, French, Spanish o German.Language Code, comoen,fr,esode.Language Confidence, como High, Medium, Low o Very Low.
Este es el formato de resultados que busco para trabajar con hojas de cálculo. El nombre del idioma es fácil de leer. El código resulta útil para automatizaciones y herramientas de traducción. El nivel de confianza indica qué registros hay que revisar.
Evite utilizar campos poco representativos, como nombres, ID, nombres de usuario, URL, códigos numéricos o nombres de empresas, como única entrada. A menudo no contienen suficientes señales lingüísticas. Si el dataset incluye textos cortos, seleccione un segundo campo de texto antes de ejecutar el enrichment.
Paso 3: configure las entradas y salidas
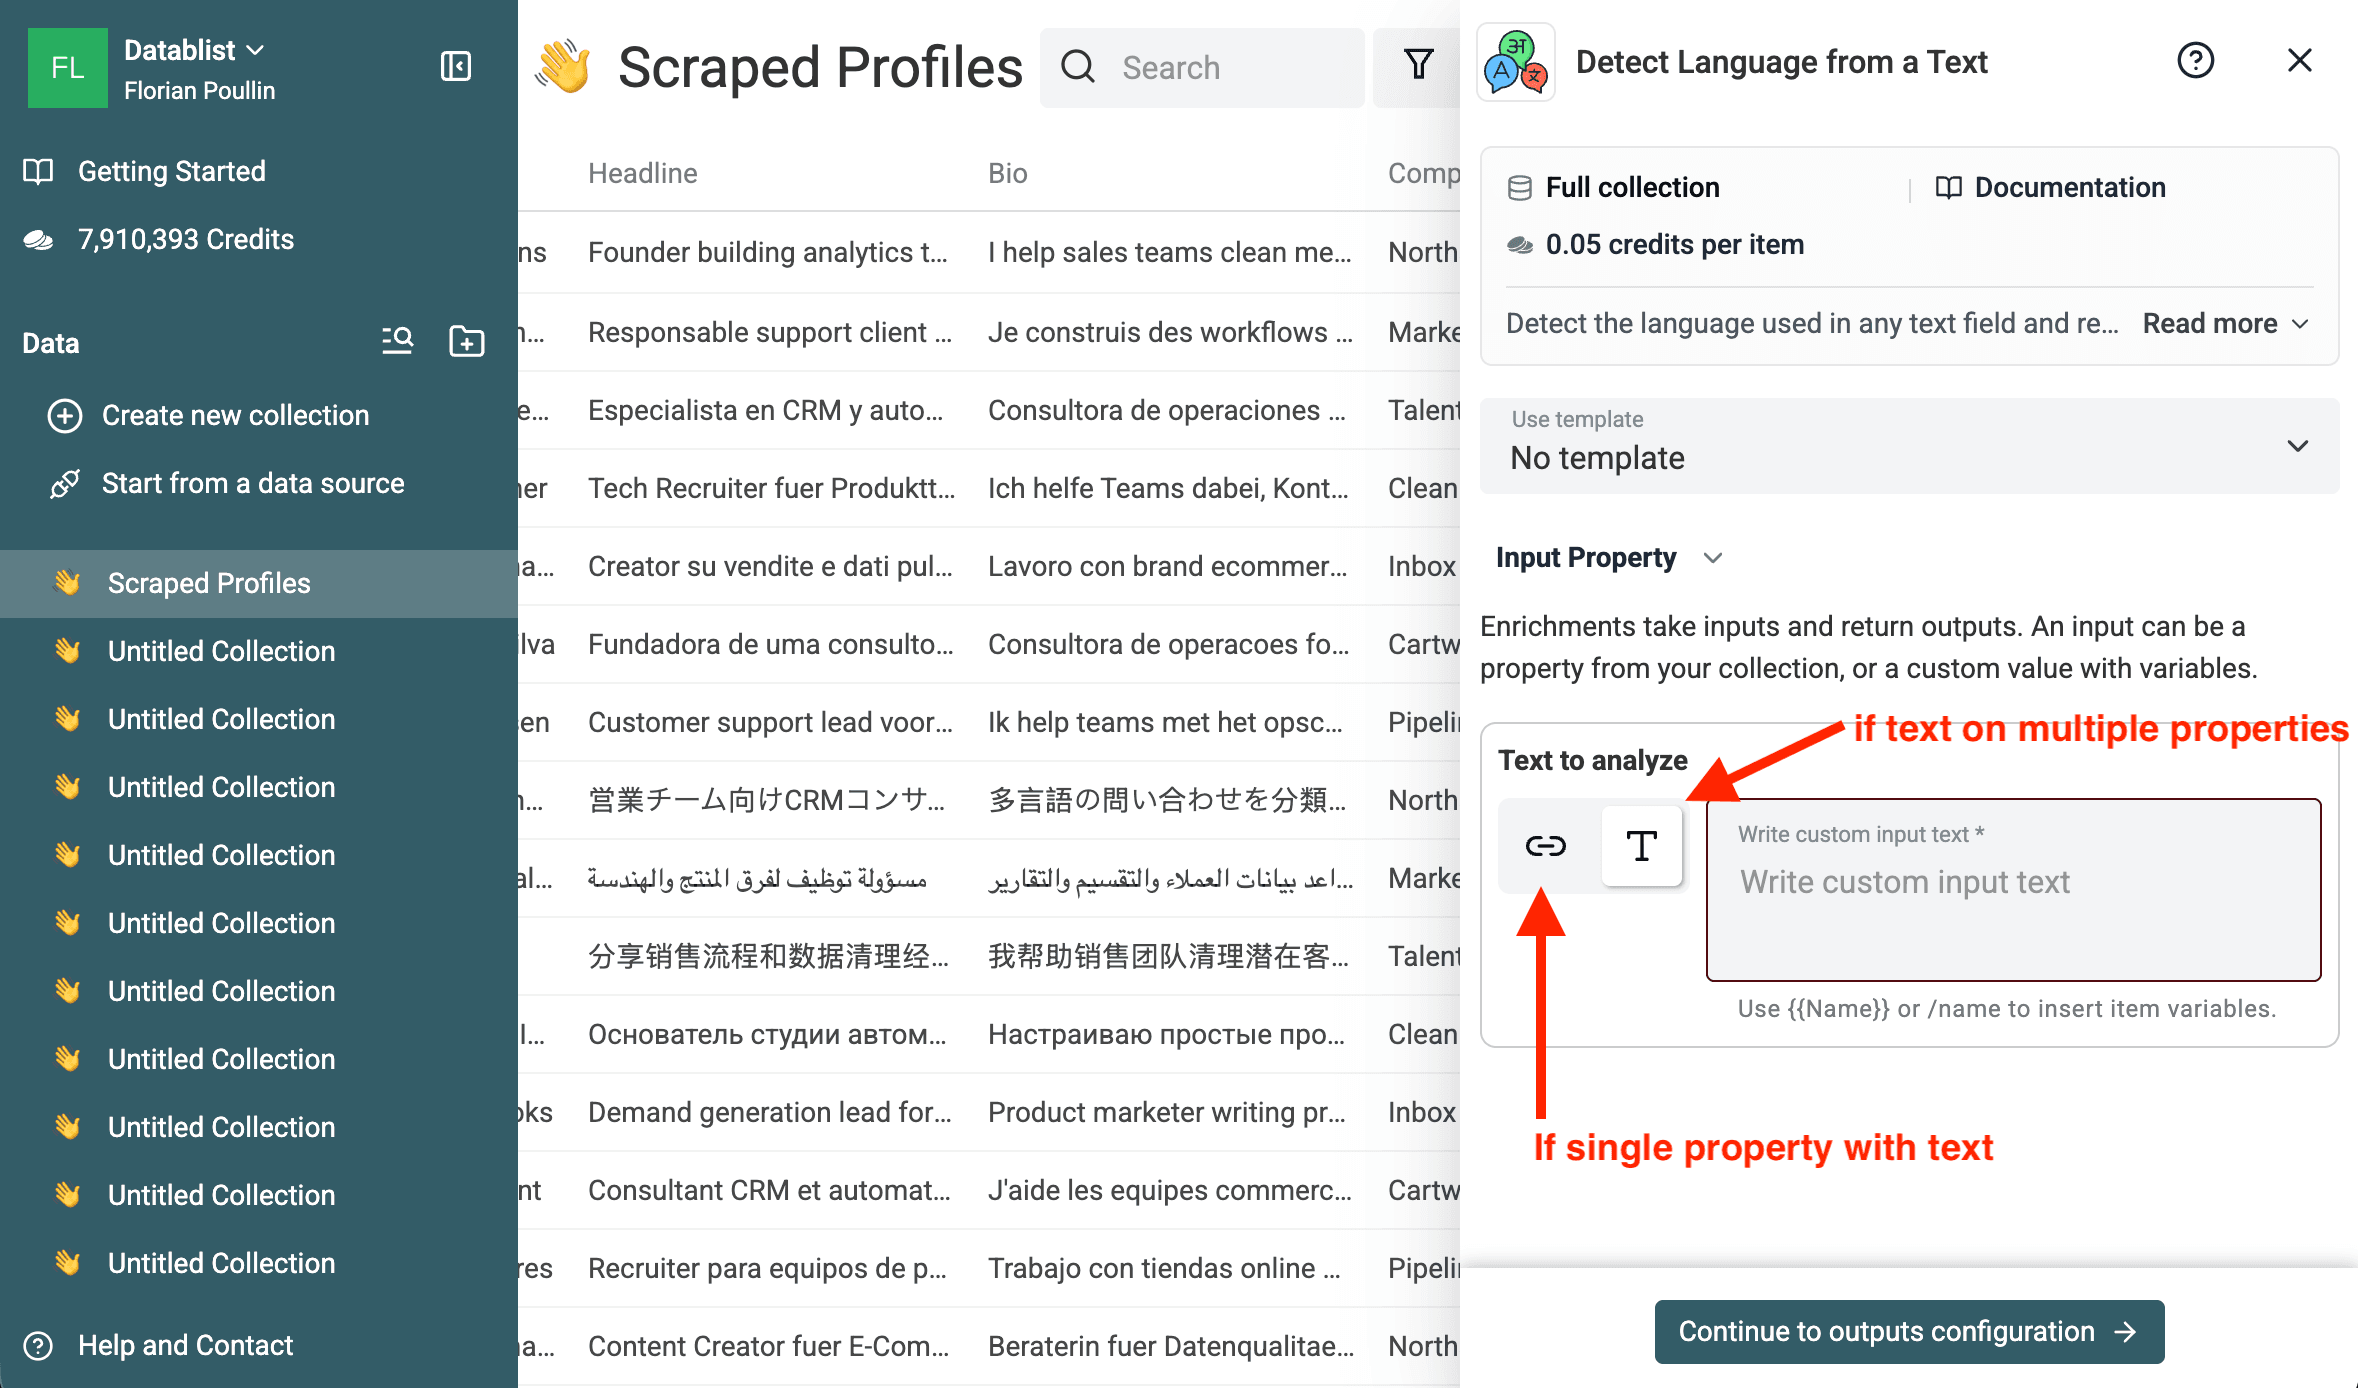
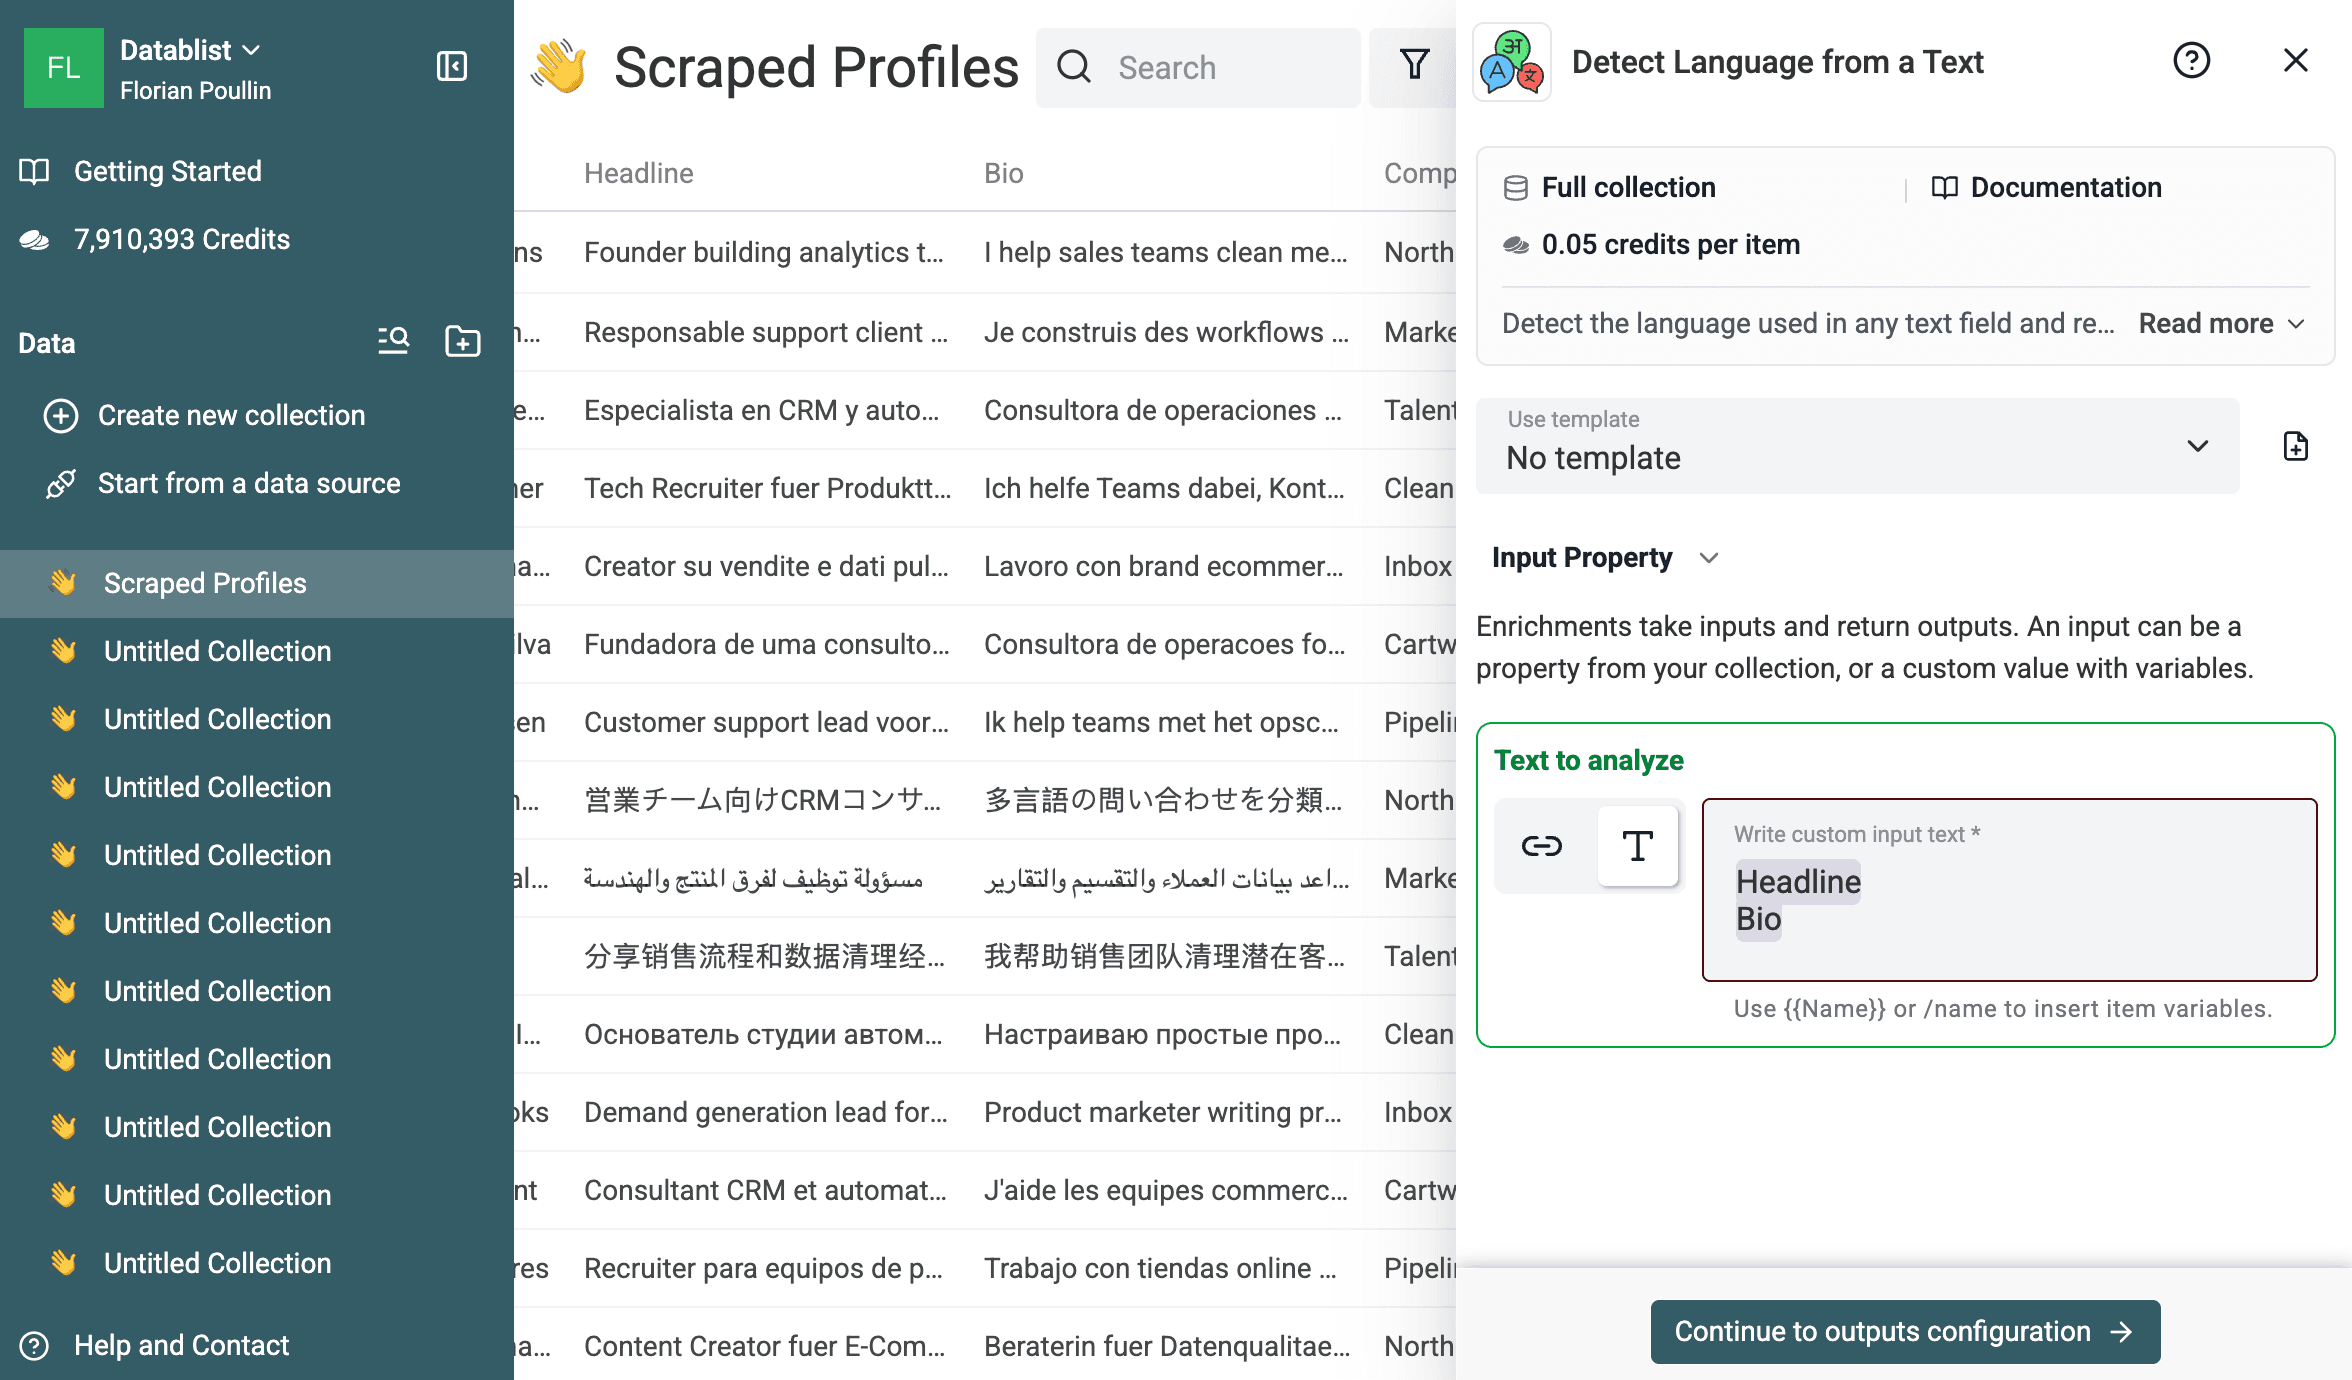
En el paso Inputs, elija el texto que debe analizar Datablist. Puede seleccionar una propiedad o crear una entrada personalizada a partir de varias propiedades.
Para el dataset de perfiles, utilizo una entrada personalizada con Headline y Bio. Esto es importante porque algunas filas tienen una biografía corta, otras incluyen un titular útil y unas pocas están desordenadas. Al combinar ambos campos, el detector obtiene más contexto sin que usted tenga que añadir manualmente otra columna.
A continuación, configure las columnas de salida. Normalmente creo columnas nuevas para:
Language NameLanguage CodeLanguage Confidence
Una columna con el estado de ejecución permite aislar las filas que han fallado, contenían una entrada no válida o no han devuelto resultados.
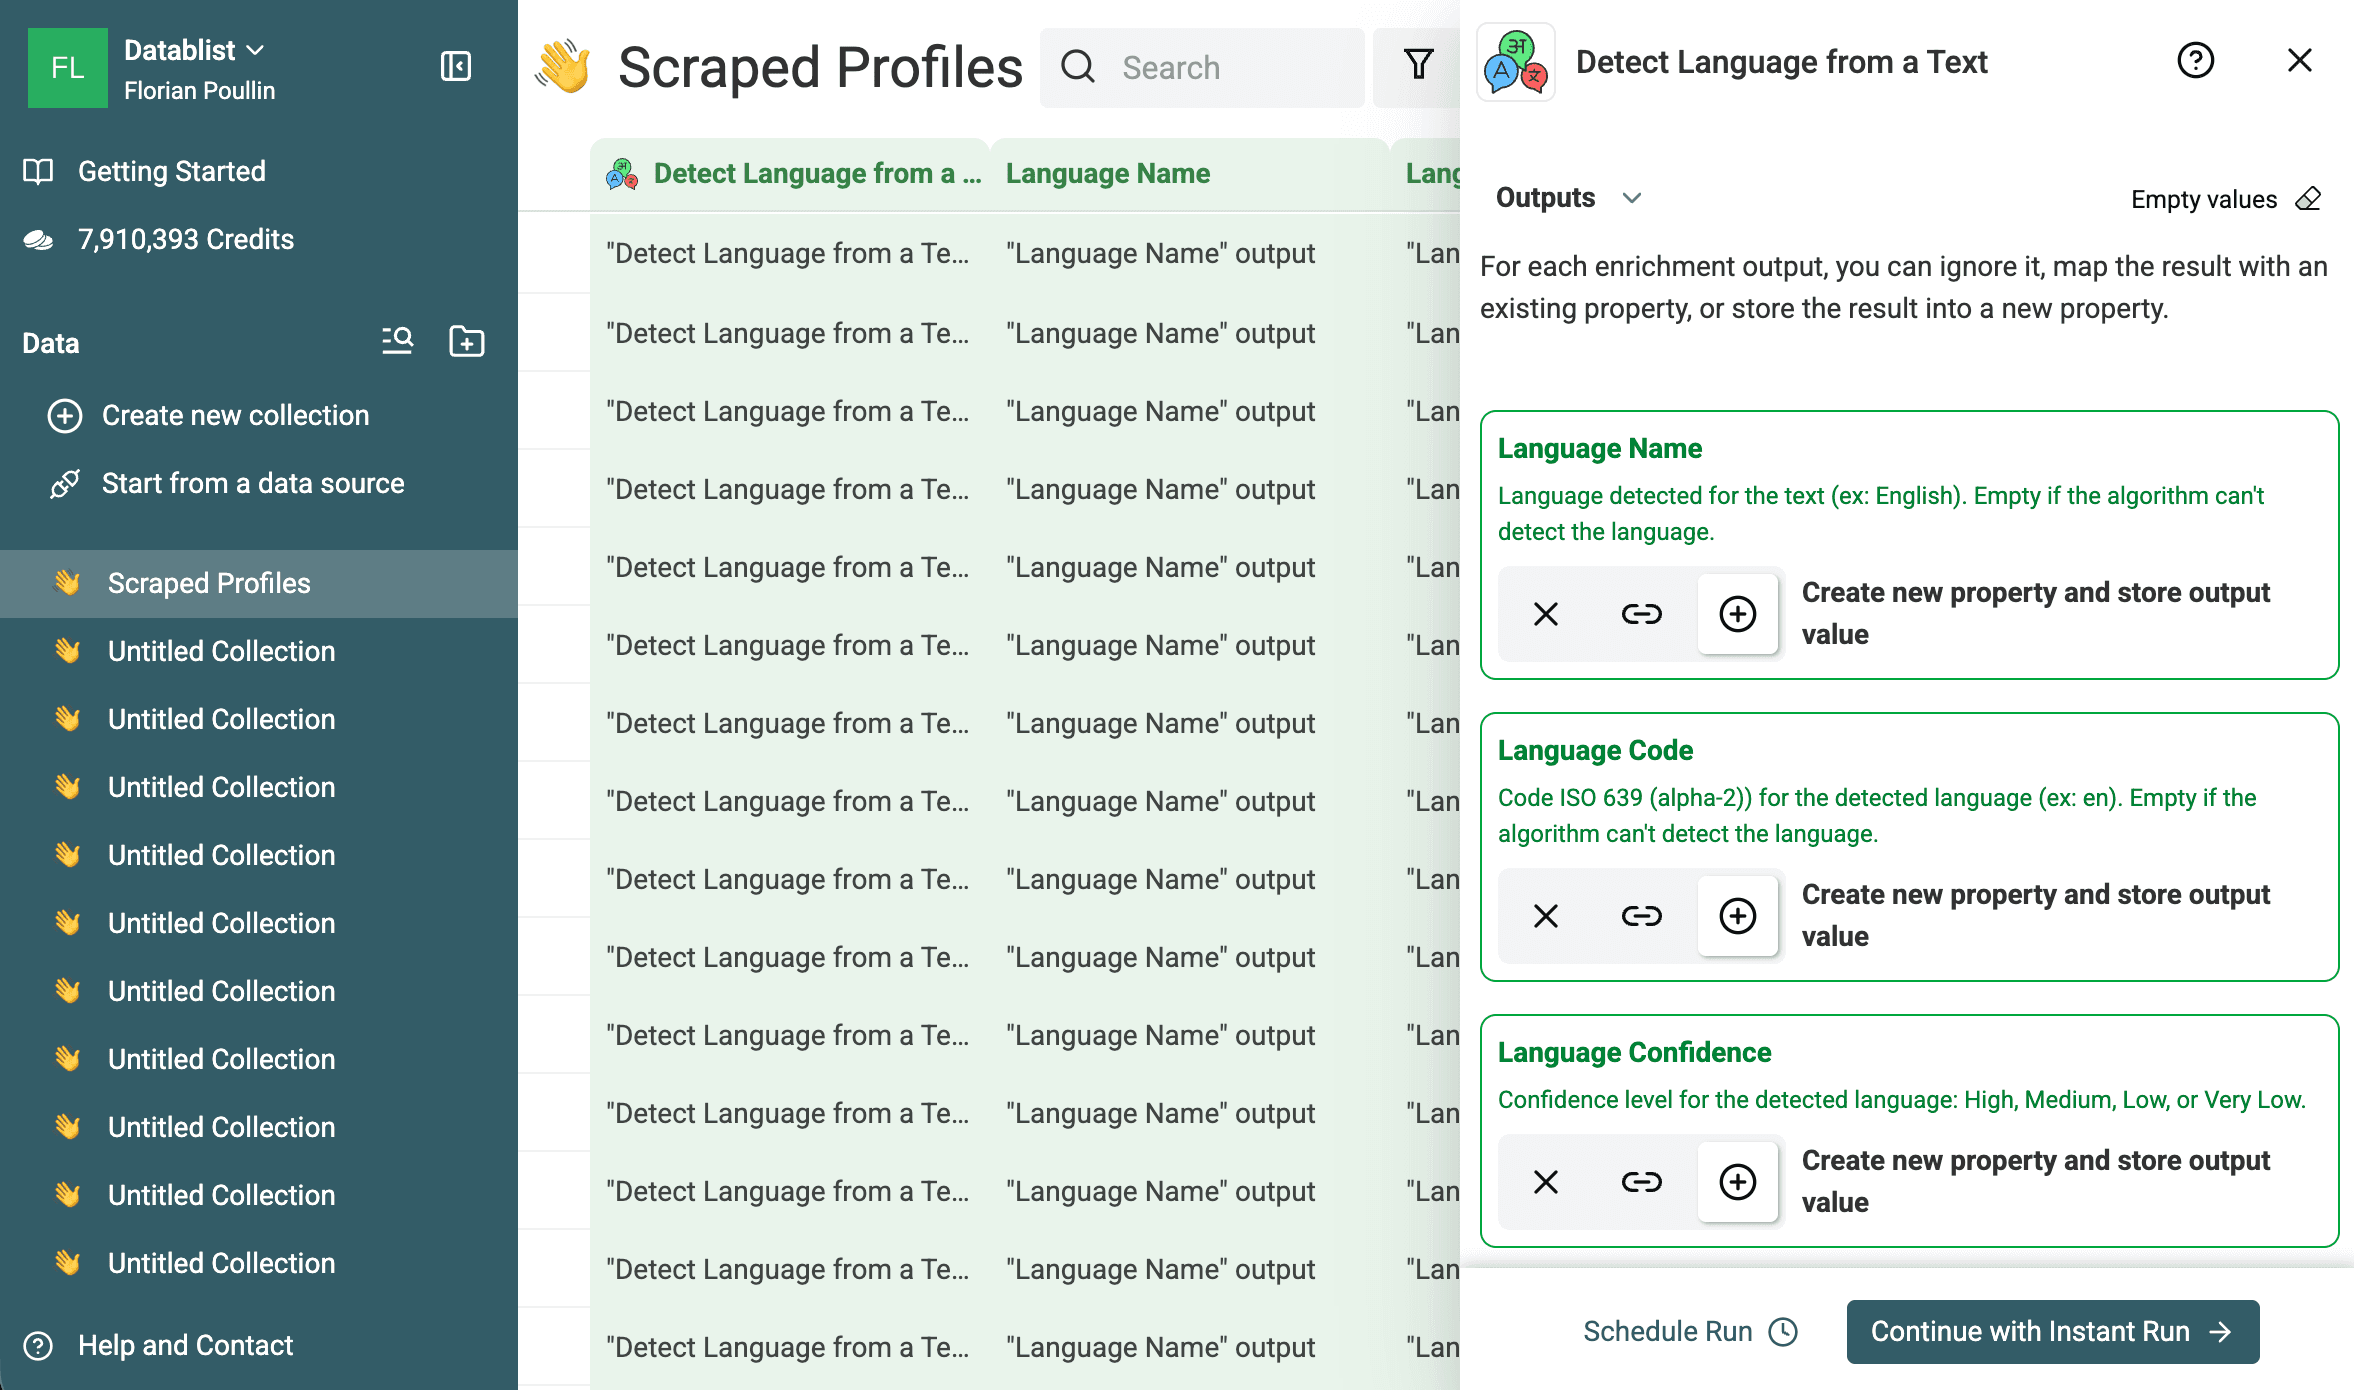
Antes de procesar todo el archivo, ejecute el enrichment en las primeras 10 filas. Sigo haciéndolo incluso en workflows sencillos porque permite detectar rápidamente una asignación incorrecta de las entradas. Si selecciona Company por error en lugar de Bio, verá que los resultados son deficientes antes de gastar créditos en todo el dataset.
⚠️ Los textos cortos son más difíciles
Los fragmentos de una palabra, marcas, nombres de usuario, números y URL pueden no contener suficientes señales lingüísticas. Considere las filas con confianza baja o sin resultados como una cola de revisión, no como errores.
Cuando los resultados de la primera ejecución sean correctos, procese las filas restantes.
Paso 4: revise los idiomas detectados
La primera ejecución de prueba debería mostrar las nuevas columnas de idioma junto a los datos originales. En el siguiente ejemplo, Datablist ha detectado inglés, francés, español, alemán, italiano, portugués, neerlandés, japonés, árabe y chino en las primeras filas.
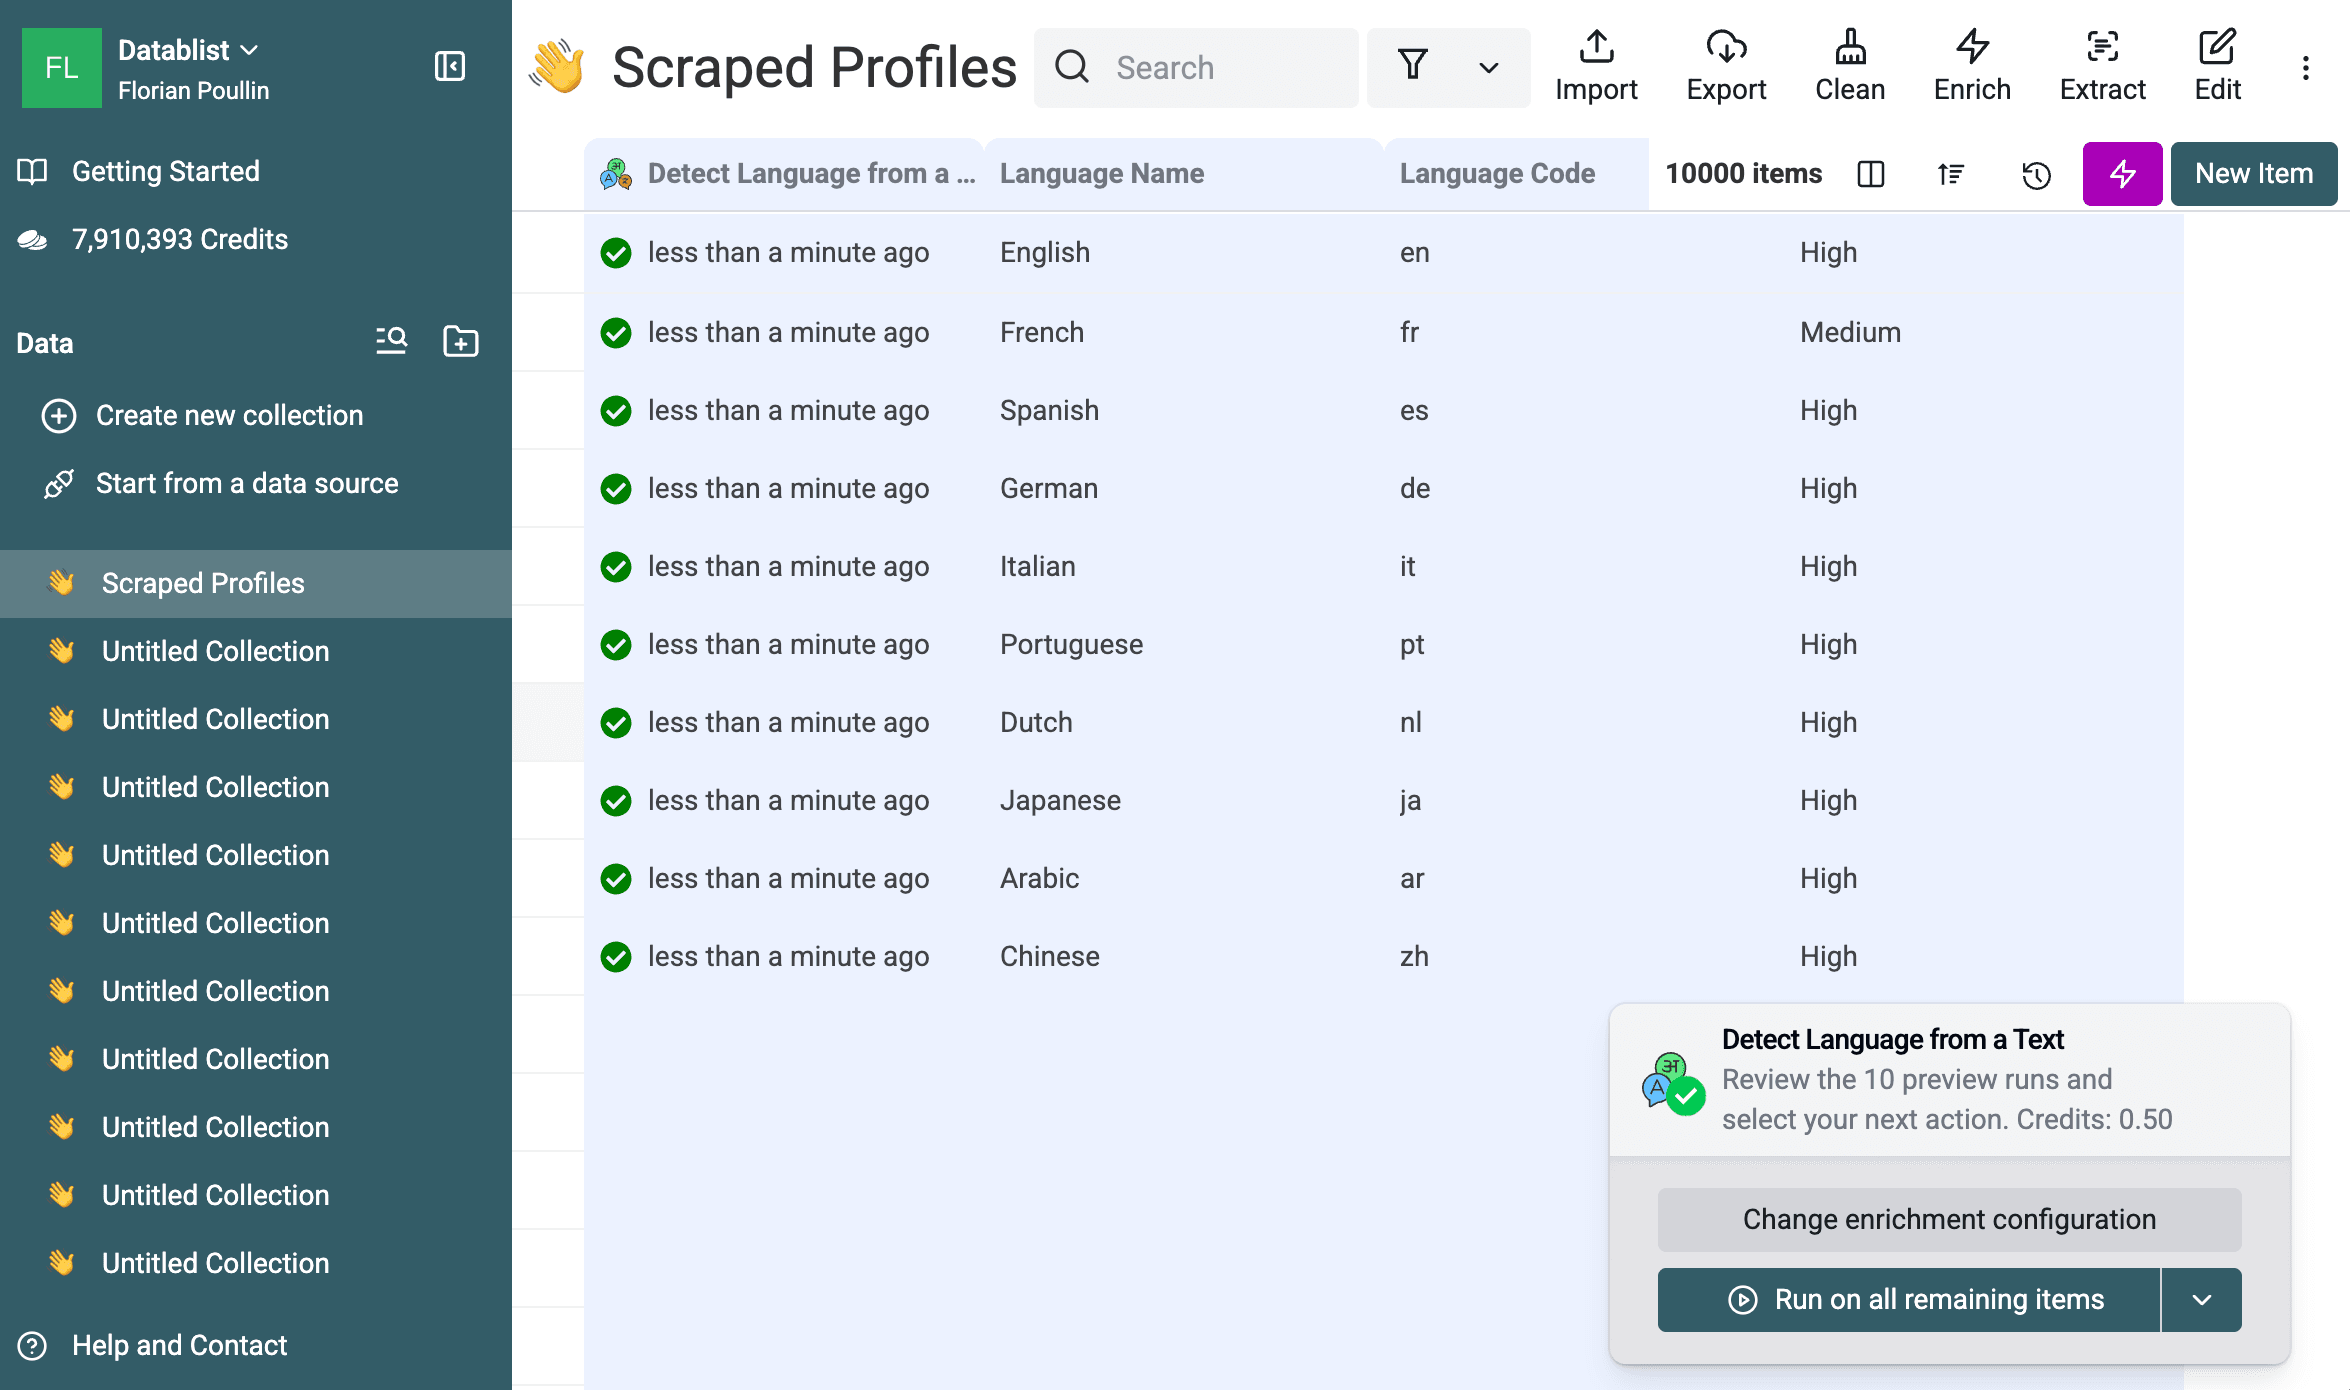
Puede esperar una tabla de resultados similar a esta:
| ID del perfil | Patrón del texto | Language Name | Language Code | Confianza | Requiere revisión |
|---|---|---|---|---|---|
C8C1DXQBNP | Biografía en inglés | English | en | Alta | No |
61M25JUEHM | Biografía en francés | French | fr | Media | Tal vez |
Y45G9QU71C | Biografía en español | Spanish | es | Alta | No |
RL20HHREOT | Biografía en alemán | German | de | Alta | No |
| fila vacía | Biografía vacía y titular poco representativo | Sin resultado o no válido | vacío | vacío | Sí |
| fila solo con nombre de usuario | @marketloop | Sin resultado o confianza baja | vacío | Baja | Sí |
No considero el nivel de confianza como una decisión de negocio definitiva, sino como una señal de enrutamiento. High y Medium suelen ser suficientes cuando el siguiente paso es preparar una traducción o realizar una segmentación general. Las filas Low, Very Low, no válidas o sin resultados deben revisarse antes de enviar emails, asignar tickets de soporte o actualizar un CRM.
📘 La confianza agiliza la revisión
El nivel de confianza no sustituye su criterio. Le indica dónde debe centrar primero su atención.
Si la precisión es importante, cree una columna Needs Review después de ejecutar el enrichment. Márquela como Yes cuando la confianza sea Low o Very Low, la entrada no sea válida o Datablist no devuelva resultados. Así convertirá la parte desordenada del dataset en una pequeña cola de trabajo.
La detección de idioma es un buen ejemplo de clasificación con IA: cada fila se asigna a una clase y el nivel de confianza le ayuda a decidir cuáles pueden avanzar.
Paso 5: filtre, exporte o continúe con la traducción
Cuando las columnas de idioma estén completas, filtre el dataset antes de exportarlo o de ejecutar el siguiente workflow.
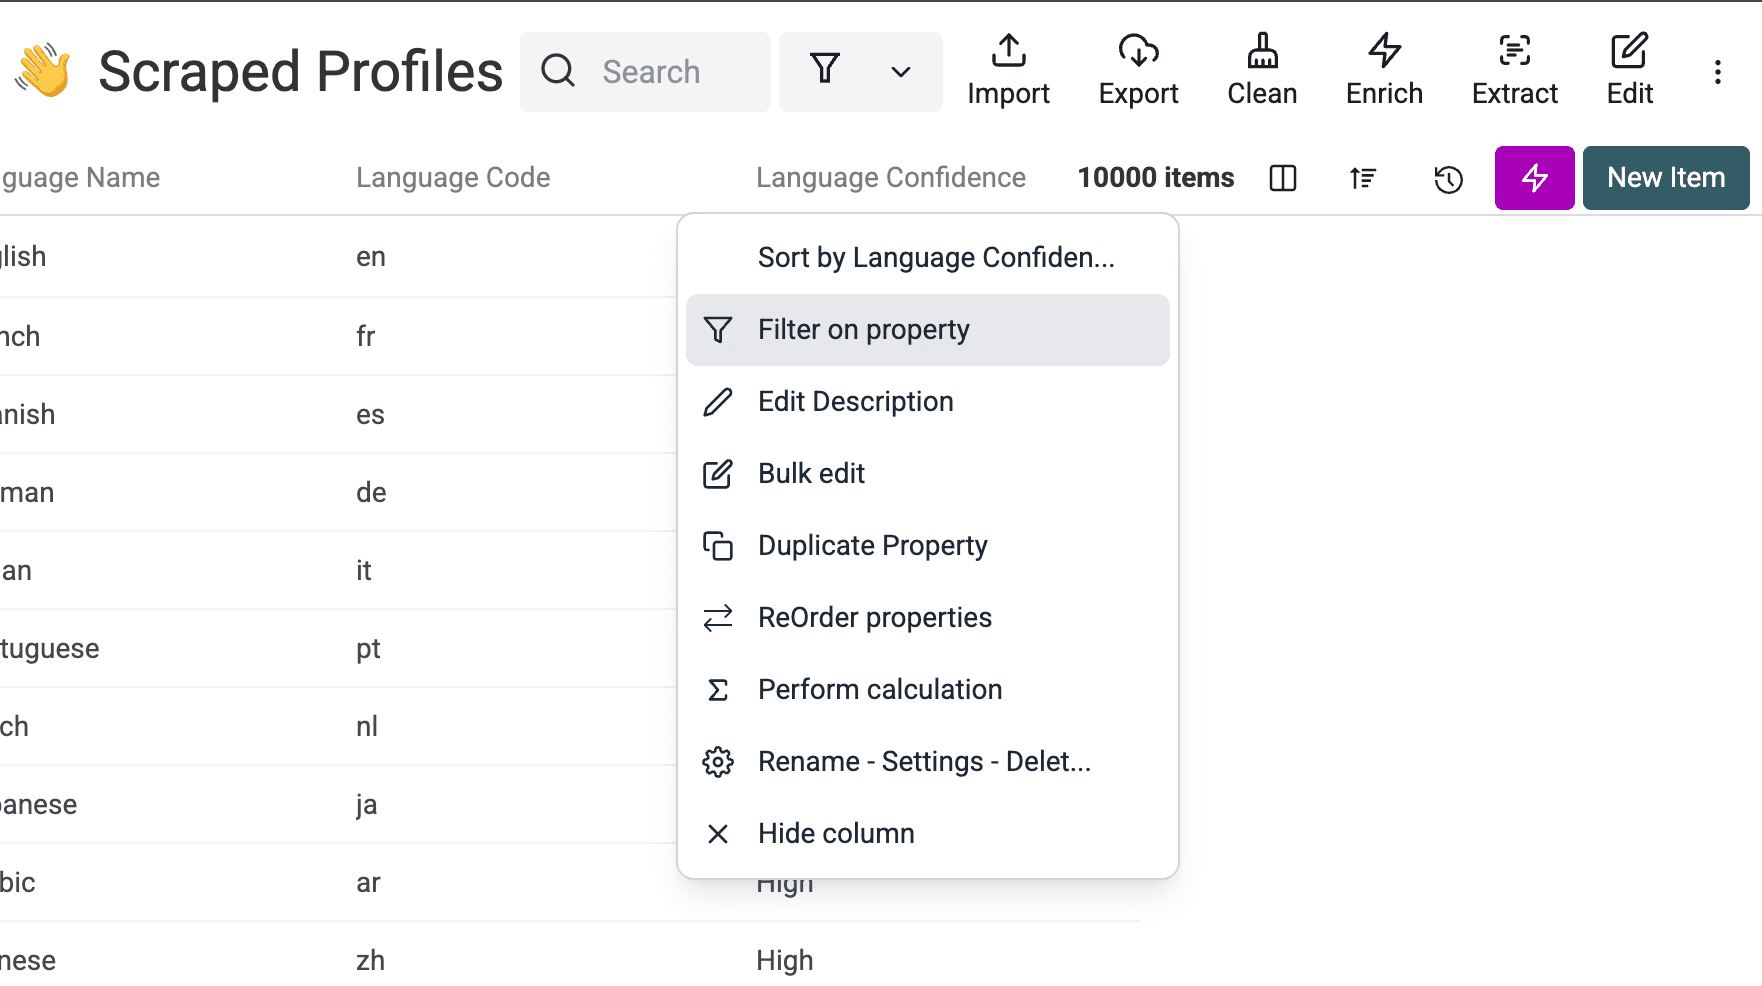
Empiece por el nivel de confianza. Abra el menú de la columna Language Confidence y filtre las filas con confianza baja. Revíselas primero, ya que son las que más probablemente contienen texto vacío, fragmentos cortos, contenido en varios idiomas o valores que no representan un idioma.
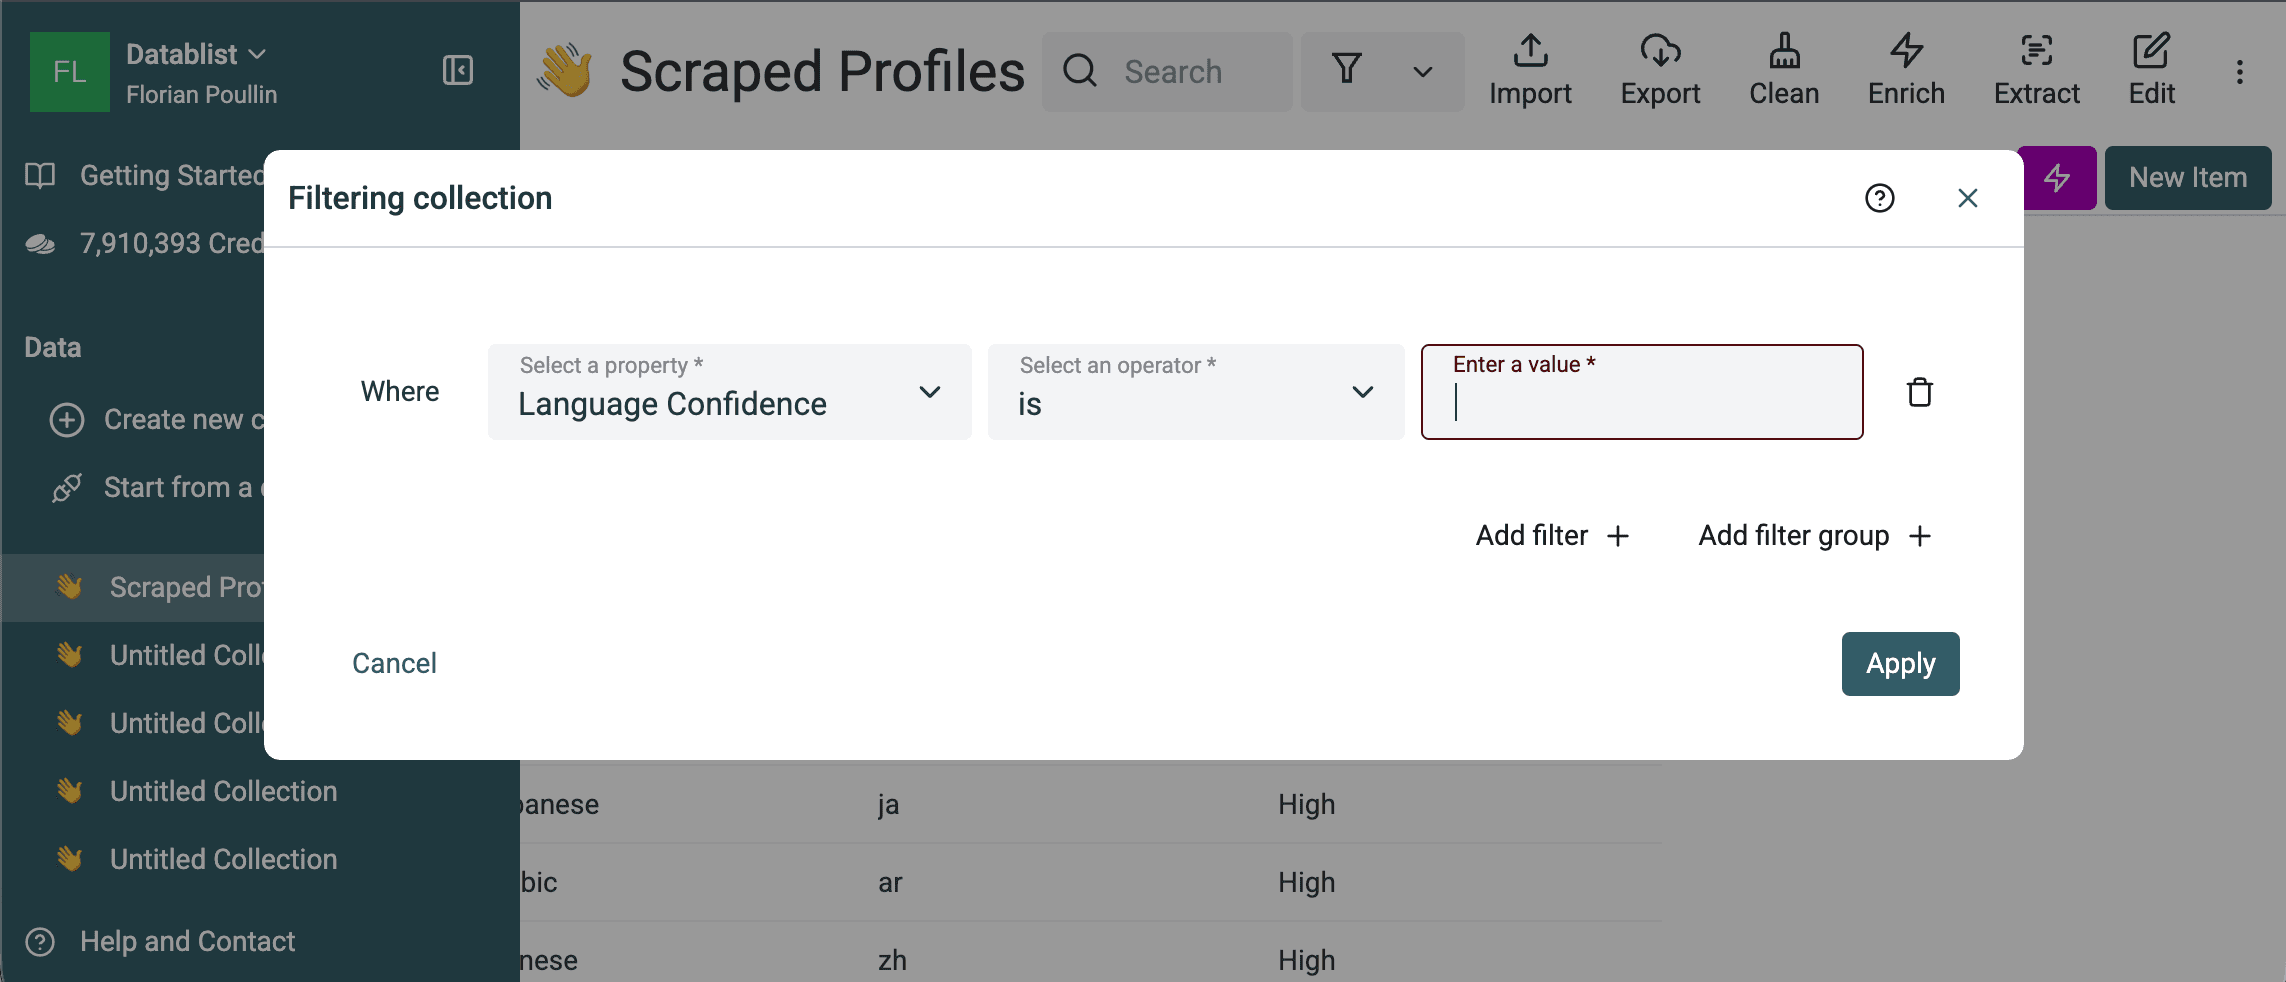
Después, filtre por Language Code cuando necesite segmentos específicos para cada idioma. Por ejemplo:
- Envíe las filas
fr,es,deeita traducción. - Dirija los tickets de soporte
jayzhal equipo adecuado. - Conserve únicamente las filas en inglés para una campaña.
- Elimine las filas no válidas antes de importar el archivo en un CRM.
Si el siguiente paso es traducir, utilice el código de idioma para preparar el archivo antes de traducir archivos CSV online. Cuando un archivo mezcla idiomas, normalmente prefiero detectar primero el idioma de origen. Así evita traducir filas que ya están en el idioma de destino y la revisión resulta más predecible.
Cuando el dataset esté limpio, expórtelo a CSV o Excel. Conserve el texto original, el nombre y el código del idioma, el nivel de confianza y los campos de revisión. Esas columnas permitirán explicar más adelante por qué una fila se envió a traducción, enrutamiento o revisión manual.
Coste: créditos fijos por fila
Detect Language from a Text enrichment cuesta 0.05 créditos por fila. El precio se fija según el número de filas. No cambia porque una fila contenga un titular corto y otra incluya un ticket de soporte largo, una descripción de producto, una reseña o el extracto de una página obtenida mediante scraping.
Si tomamos como referencia la recarga inicial de Datablist de 20 000 créditos por 20 $, cada crédito cuesta 0,001 $. Estos serían los costes aproximados:
| Filas | Créditos utilizados | Coste aproximado |
|---|---|---|
| 1.000 | 50 créditos | 0,05 $ |
| 10.000 | 500 créditos | 0,50 $ |
| 100.000 | 5.000 créditos | 5,00 $ |
Esta es una de las razones por las que utilizo el enrichment específico antes de probar ChatGPT. El precio de ChatGPT/OpenAI depende de los tokens de entrada y salida. Procesar una biografía corta con un LLM es barato, pero los tickets largos, las descripciones de productos, las reseñas y el texto de páginas cuestan más porque contienen más tokens. Con el enrichment de detección de idioma, cada fila cuesta 0.05 créditos, independientemente de la cantidad de texto que envíe.
Los nuevos usuarios también pueden probar este workflow con 500 créditos gratuitos si se registran con una dirección de email de un dominio empresarial. A 0.05 créditos por fila, esos 500 créditos permiten realizar 10.000 detecciones de idioma.
Alternativa: utilice ChatGPT para reglas personalizadas
La detección de idioma convencional no suele necesitar un LLM. El enrichment específico es la mejor opción para empezar porque su salida es fija: nombre del idioma, código y nivel de confianza. Además, ofrece un coste predecible por fila, mientras que el coste de ChatGPT/OpenAI depende del volumen de tokens.
Utilice ChatGPT u OpenAI cuando el resultado dependa de reglas de negocio. Por ejemplo, puede querer:
- Etiquetar las filas multilingües como
Mixeden lugar de elegir un idioma principal. - Combinar la detección de idioma con una clasificación de la intención del cliente.
- Añadir un campo
Needs Reviewsegún sus propios umbrales. - Incluir un breve motivo de auditoría para las filas ambiguas.
- Tratar de una forma específica las variantes regionales o los nombres de productos.
Datablist puede ejecutar prompts de ChatGPT en filas de CSV o Excel con Ask ChatGPT/OpenAI enrichment. Utilice variables de prompt para insertar en el prompt los valores de cada fila.
Este es un prompt sencillo para el mismo dataset de perfiles:
Detecte el idioma principal de este texto.

Texto:
{{Bio}}

Si el texto está vacío, contiene principalmente números, es una URL o resulta demasiado corto para decidirlo, devuelva "No result" y marque Needs review como Yes.
Utilice salidas definidas:
| Nombre de la salida | Tipo | Instrucciones |
|---|---|---|
Language name | Texto | Idioma principal de la biografía o el titular. Devuelva No result cuando no haya suficientes señales lingüísticas. |
ISO 639-1 code | Texto | Código de dos letras, como en, fr, es o de. Déjelo vacío si no hay resultados. |
Confidence | Selección o texto | High, Medium o Low. |
Needs review | Selección o texto | Yes si el texto está vacío, es ambiguo, mezcla idiomas o presenta una confianza baja. En caso contrario, No. |
Reason | Texto | Nota breve opcional para workflows de auditoría. Omítala si solo necesita etiquetas. |
🔍 Utilice ChatGPT para reglas, no para detecciones rutinarias
Si la salida requiere un criterio adicional a «¿en qué idioma está?», ChatGPT resulta útil. Si solo necesita códigos de idioma, utilice el enrichment específico.
El error más habitual es pedir a ChatGPT que devuelva un párrafo. Esto genera trabajo adicional de limpieza. Guarde cada salida en su propia columna para poder filtrar, ordenar, exportar y reutilizar los datos.
Checklist de control de calidad
Antes de utilizar el archivo enriquecido, suelo comprobar estas filas:
- Entre 20 y 50 filas aleatorias de varios idiomas detectados.
- Filas con confianza Low o Very Low.
- Filas con entradas no válidas o sin resultados.
- Biografías cortas, nombres de usuario, URL, números y textos que solo contienen el nombre de una empresa.
- Filas multilingües en las que el «idioma principal» puede ser subjetivo.
- Códigos ISO esperados por la siguiente herramienta.
El umbral adecuado depende del workflow. La preparación de traducciones puede admitir una pequeña cola de revisión manual. El enrutamiento de soporte al cliente exige más cuidado, ya que un idioma incorrecto puede enviar un ticket a la persona equivocada. La segmentación para Outbound también requiere revisión: enviar un mensaje en el idioma equivocado transmite una imagen poco profesional.
Para la mayoría de los archivos, la vía más rápida es sencilla: confíe en High, compruebe Medium cuando el texto sea corto y revise las filas Low, Very Low, no válidas o sin resultados.
Casos de uso y variantes
Los equipos de soporte pueden detectar el idioma de los tickets antes de dirigirlos al agente adecuado. Resulta útil cuando una misma bandeja de entrada recibe mensajes de varios países y el equipo necesita una primera clasificación rápida.
Los equipos de encuestas pueden detectar el idioma de las respuestas abiertas antes de analizarlas. Recomiendo hacerlo antes de traducirlas para mantener organizados los datos de origen.
Los equipos comerciales y de selección pueden segmentar las biografías de perfiles antes de iniciar acciones de Outbound. Una columna con el código del idioma facilita la asignación de responsables y la preparación de mensajes localizados.
Los equipos de ecommerce pueden detectar el idioma de las descripciones de productos antes de localizarlas. Si un catálogo combina contenido de distintos proveedores, la detección permite separar lo que debe traducirse de lo que ya está listo.
Los workflows de scraping se benefician del mismo enfoque. Cuando extraiga páginas de varios mercados, detecte el idioma de cada página antes de decidir qué conservar, traducir o descartar.
Si la columna Bio está vacía en muchas filas, ejecute el enrichment en Headline o combine ambos campos en la entrada. Suelo combinar campos cuando cada uno contiene poco texto y utilizar uno solo cuando ya incluye frases completas.
Solución de problemas
Si el texto está vacío, puede esperar datos no válidos o ningún resultado. Filtre esas filas y decida si desea eliminarlas o completar otro campo de texto.
Si la fila solo contiene una URL, un nombre de usuario, un número, un ID o una marca, no confíe automáticamente en el resultado. Esos valores apenas ofrecen señales lingüísticas al detector.
Si la fila mezcla idiomas, interprete el resultado como el idioma principal y revise el nivel de confianza. En workflows estrictos, cree una etiqueta Mixed independiente con ChatGPT o mediante una revisión manual.
Si aparece un idioma poco habitual en el archivo, revise una muestra antes de confiar en los resultados a gran escala. El enrichment admite muchos idiomas comunes, pero comprobar los casos límite antes de exportar sigue siendo la opción más segura.
Si el archivo es grande, procese primero 10 filas y, si es necesario, una muestra mayor. Cuando la asignación de entradas y las columnas de salida sean correctas, ejecute el proceso en todo el dataset.
Conclusión
La forma práctica de detectar idiomas en una hoja de cálculo es mantener un workflow basado en filas. Importe el archivo CSV o Excel, seleccione Detect Language from a Text, elija una o varias columnas de texto, cree salidas para el nombre y el código del idioma y el nivel de confianza, y revise las filas con baja confianza antes de exportar.
Utilice el enrichment específico para la detección de idioma habitual. Obtendrá las columnas que necesita sin escribir código ni crear un prompt personalizado, y el coste se mantendrá fijo según el número de filas. Recurra a ChatGPT cuando necesite reglas de negocio, etiquetas para contenido multilingüe o lógica de revisión adicional.
Empiece con una pequeña prueba, revise los resultados y, después, procese todo el archivo. Esta sencilla comprobación suele ahorrar mucho más tiempo del que requiere.
FAQ
¿Cómo detectar el idioma de cada fila de un CSV?
Importe el CSV en Datablist, seleccione Detect Language from a Text en el menú Enrich, asigne la columna de texto en el paso Inputs y guarde el nombre del idioma, el código y el nivel de confianza en columnas nuevas.
¿Puedo detectar idiomas en filas de Excel sin programar?
Sí. Importe el archivo Excel en Datablist y ejecute el enrichment de detección de idioma en la columna de texto. Los resultados se añadirán al dataset y podrá exportarlos a CSV o Excel.
¿Qué columnas de salida debo añadir?
Utilice Language Name, Language Code y Language Confidence. Añada una columna Needs Review si quiere aislar las filas Low, Very Low, no válidas o sin resultados.
¿Qué significa el nivel de confianza del idioma?
Indica la fiabilidad probable del idioma detectado. Utilícelo como señal para la revisión. Las filas High y Medium suelen poder avanzar, mientras que Low y Very Low requieren comprobación.
¿Qué hago con los resultados de baja confianza?
Filtre esos resultados para crear una cola de revisión. Compruebe si el texto es demasiado corto, está vacío, mezcla idiomas o se compone de nombres, URL, nombres de usuario o números.
¿Puedo detectar el idioma antes de traducir un CSV multilingüe?
Sí. Detecte primero el idioma de origen y filtre por código de idioma antes de traducir. Así evitará traducir filas que ya están en el idioma de destino.
¿Cuánto cuesta detectar idiomas de forma masiva?
Detect Language from a Text cuesta 0.05 créditos por fila. Con 20.000 créditos por 20 $, el coste aproximado es de 0,05 $ por 1.000 filas, 0,50 $ por 10.000 filas y 5 $ por 100.000 filas. Los nuevos usuarios que se registren con un email de dominio empresarial pueden probarlo con 500 créditos gratuitos, suficientes para 10.000 detecciones.
¿Debo utilizar ChatGPT para detectar idiomas de forma masiva?
Utilice ChatGPT cuando necesite reglas personalizadas o una clasificación combinada. Para una detección de idioma convencional, el enrichment específico es la opción más sencilla y tiene un coste fijo por fila. ChatGPT/OpenAI puede resultar más caro cuando las filas contienen textos largos, ya que el coste de los LLM depende de los tokens.
¿Qué ocurre si el texto está vacío, solo contiene una URL o es demasiado corto?
Un texto vacío no es válido, y un texto sin un idioma claramente identificable puede no devolver resultados o presentar una confianza baja. Filtre esas filas antes de exportarlas o traducirlas.
¿Puedo detectar el idioma a partir del titular en vez de la biografía?
Sí, pero los titulares suelen ser cortos. Si es posible, combine Headline y Bio en la entrada para que Datablist disponga de más texto que analizar.
¿Puedo exportar los nombres y códigos ISO de los idiomas a CSV o Excel?
Sí. Después de ejecutar el enrichment, exporte el dataset con el texto original, el nombre y el código del idioma, el nivel de confianza y los campos de revisión.