
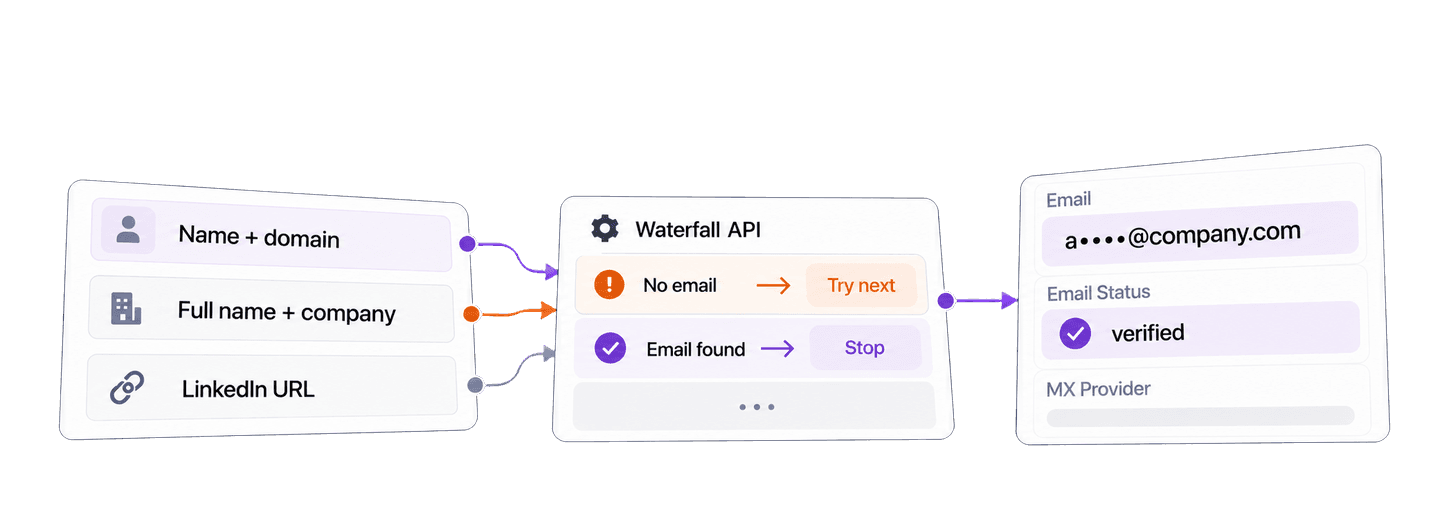
Para encontrar emails de trabajo con Python, envíe el nombre de una persona y la información de su empresa, o la URL pública de su perfil de LinkedIn, a la API Waterfall Email Finder de Datablist mediante la librería Requests. La API devuelve el email profesional encontrado, el estado de entregabilidad de la dirección y su proveedor de correo.
El ejemplo completo que aparece a continuación busca a Satya Nadella en microsoft.com y a Reid Hoffman en greylock.com. Espera a que finalice la tarea en segundo plano y recupera todas las páginas de resultados. Después, reutilizaremos esos resultados para preparar una lista local de contactos verificados y revisarla antes de lanzar una campaña.
📌 Resumen para quienes tienen prisa
Utilice una única función de Python para enviar contactos conocidos a la API Waterfall Email Finder, esperar a que termine la tarea y recopilar los emails de trabajo encontrados. Después, prepare los contactos verificados para revisar la campaña sin eliminar de la lista original aquellos que no se hayan podido resolver.
- Input: nombre y apellido junto con el dominio de la empresa, nombre completo con el nombre de la empresa o URL pública de un perfil de LinkedIn.
- Output: un email de trabajo con
emailStatusymxProvider, seguido de una lista local para revisión que solo contiene contactos con email.
💡 ¿Prefiere una solución no-code? Utilice Waterfall Email Finder de Datablist para encontrar emails de trabajo en una colección sin escribir código.
Configure Python, Requests y su clave API
Para este ejemplo con Python utilizamos el paquete requests. Cree un archivo llamado find_work_emails.py e instale Requests:
python -m pip install requestsCree una Personal API Key desde la página de su cuenta API de Datablist. El acceso a la REST API requiere el plan Growth. Exporte la clave en el terminal desde el que ejecutará el script:
export DATABLIST_API_KEY="your-api-key"Los resultados correctos de Waterfall Email Finder también consumen créditos. En la sección de costes separamos esos créditos de la suscripción que proporciona acceso a la API.
Encuentre emails de trabajo con una función de Python
Pegue el siguiente script completo en find_work_emails.py:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Ejecútelo desde el mismo terminal:
python find_work_emails.pyTambién puede descargar el ejemplo mantenido con Requests. Cuando tenga claro cómo funciona la versión bloqueante, encontrará en el repositorio una alternativa asíncrona con HTTPX.
La función realiza tres tipos de llamadas en este orden.
Primero, envía la tarea. Cada inputId es el identificador estable de su contacto. El objeto data anidado contiene los campos empleados en la búsqueda. El POST devuelve 202 Accepted con @id, el ID de la tarea utilizado en las llamadas posteriores. El código muestra uniqueId antes del envío para que conserve un valor de recuperación si se pierde la respuesta.
Después, consulta el estado de la tarea. Datablist procesa la tarea en segundo plano. Este cliente de Requests espera y comprueba la tarea cada tres segundos hasta que su estado sea completed, failed o stopped. Requests bloquea la ejecución mientras espera, pero la tarea de la API sigue siendo asíncrona.
Por último, recupera los resultados. Una tarea puede tener varias páginas de resultados. El bucle continúa recuperándolas hasta que nextCursor sea null. Utilice inputId, y no el orden de respuesta, para vincular cada resultado con su contacto de origen.
Elija el tipo de input para sus contactos
Cada tarea utiliza un único modo de input. Mantenga la misma función find_emails() y sustituya los valores de settings y people por los de la opción que corresponda a sus datos de origen.
Siempre que sea posible, elija un inputId que sea único dentro de la tarea y que ya pertenezca al contacto de origen. Un ID de registro del CRM u otro identificador de Lead duradero son buenas opciones. Datablist devuelve ese valor con el resultado, lo que permite vincular los registros sin comparar nombres ni suponer que la respuesta respeta el orden del input.
Si dispone del nombre y el apellido por separado, además del dominio de la empresa, utilice sourceKind: "name_company". Un dominio conocido es el identificador más claro de una empresa:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Si sus datos de origen incluyen el nombre en un solo campo y el nombre de la empresa, active useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Si dispone de la URL pública del perfil de una persona, utilice la opción de LinkedIn:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Esta opción acepta una URL pública de perfil con el formato linkedin.com/in/... como contexto de la persona para buscar su email. No se admiten URLs de perfiles de Sales Navigator.
Si necesita elegir las claves de los proveedores y su orden, consulte la guía para crear un waterfall personalizado. El waterfall gestionado que utilizamos aquí no requiere una configuración específica para cada proveedor.
Cómo encuentra un email el waterfall gestionado
En una solicitud basada en nombre y empresa, la API utiliza directamente el dominio proporcionado. Si facilita el nombre de una empresa, primero intenta asociarlo con un dominio corporativo válido. En una solicitud de LinkedIn, limpia la URL pública del perfil y convierte los datos disponibles de la persona y la empresa en el contexto que necesitan los proveedores de email compatibles.
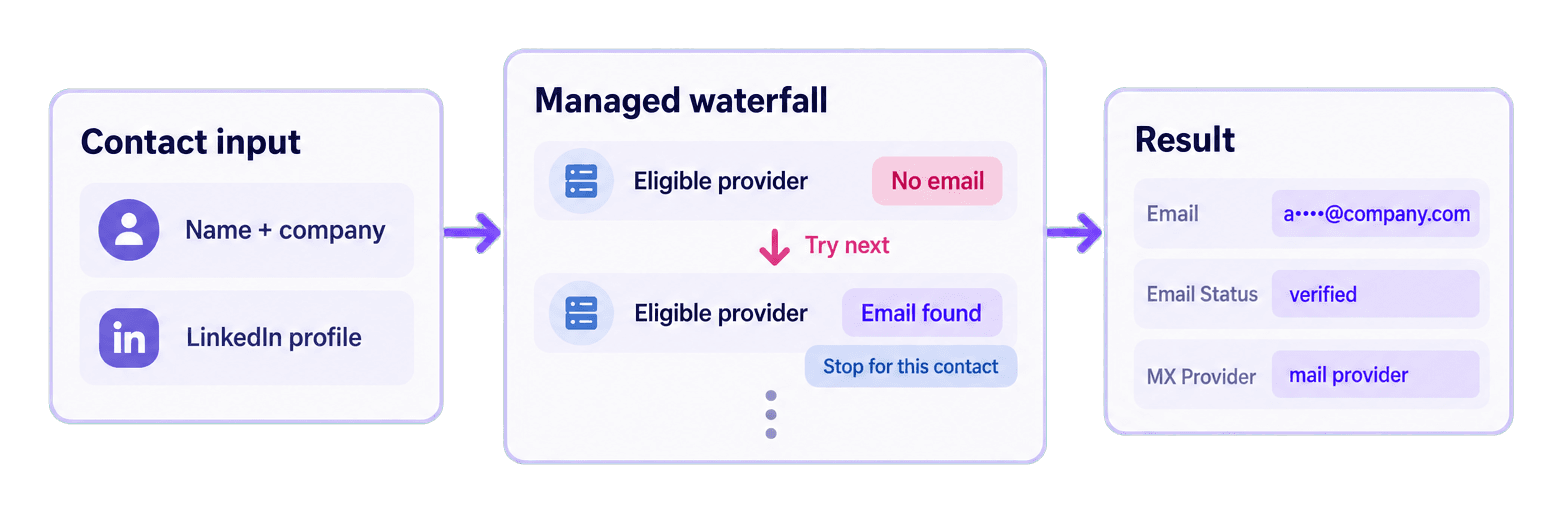
El waterfall gestionado envía el contacto aún sin resolver a un proveedor compatible. Si este no devuelve un email válido, otro proveedor compatible puede intentarlo con el mismo contacto. La secuencia se detiene para ese contacto en cuanto acepta un email de trabajo. La respuesta predeterminada no indica qué finder lo encontró.
Por qué un waterfall mejora el outreach internacional
Los proveedores de emails de trabajo utilizan conjuntos de datos diferentes, por lo que su cobertura varía según el país y el mercado. Es posible que un proveedor no encuentre resultados para un contacto de una región, mientras que otro sí disponga de los datos necesarios para localizar su dirección.
Para un equipo de ventas o growth, el waterfall ofrece a cada contacto pendiente nuevas oportunidades de ser encontrado antes de excluirlo de la lista de outreach. Así puede recuperar contactos que se perderían con un workflow basado en un solo proveedor, al tiempo que mantiene un proceso técnico uniforme para todo el equipo.
Datablist gestiona la secuencia de proveedores compatibles mediante una única integración con la API. Usted envía el contacto una sola vez y recibe un formato de resultados unificado, sin tener que crear y mantener una integración independiente para cada proveedor ni combinar las respuestas por su cuenta.
Consulte todos los resultados
La tarea del ejemplo devolvió dos resultados correctos. Las direcciones de email se muestran parcialmente ocultas.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound es el email de trabajo devuelto. emailStatus describe su entregabilidad en el momento de la búsqueda y mxProvider identifica al proveedor de alojamiento del correo cuando está disponible. Ambos registros aparecen como verified y cada uno ha consumido 25 créditos.
El código de campaña que aparece a continuación guarda los resultados verified en campaign_contacts y el resto de las direcciones encontradas en needs_verification. El valor creditsUsed es el cargo de referencia para cada resultado.
El resultado gestionado predeterminado no contiene finderProvider. Ese campo es un output condicional para workflows válidos de nombre y empresa con claves personalizadas, por lo que el script no debe deducirlo a partir de mxProvider.
Prepare los emails para revisar su campaña
Cuando funcione la búsqueda directa, añada este bloque al final del script, después de obtener lookup_results. El código prepara contactos locales para revisar la campaña a partir de la búsqueda que ya ha ejecutado.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))results_by_id hace que el orden de respuesta sea irrelevante. En el caso de Satya, el bucle lee contact-satya-nadella de la lista people original, busca el resultado con el mismo inputId, copia el registro de origen y adjunta el objeto completo de la API en result. Como la dirección está presente y su estado es verified, el contacto pasa a campaign_contacts. Reid sigue el mismo proceso, aunque el resultado de la API correspondiente llegue primero.
Las tres condiciones facilitan la lectura de la lógica de decisión. La primera omite un contacto si no se ha devuelto ningún resultado que coincida. La segunda descarta los errores de fila y otros estados distintos de success. La tercera exige que exista un valor emailFound. Al adjuntar el objeto result completo, conserva el estado, los outputs, el consumo de créditos y el campo de error para revisarlos más adelante.
Un email encontrado con otro estado de entregabilidad pasa a needs_verification. Un resultado ausente, un error de fila o un resultado sin emailFound queda fuera de ambas listas preparadas. La lista people original continúa disponible para hacer correcciones o investigaciones posteriores.
Calcule el coste de la API Waterfall Email Finder
El waterfall gestionado predeterminado consume 25 créditos por cada email de trabajo encontrado. Una búsqueda predeterminada sin éxito consume 0 créditos. Consulte creditsUsed en cada resultado en lugar de multiplicar el número total de contactos enviados.
Un email encontrado con el estado unverified también consume 25 créditos, aunque el código local de la campaña lo guarde en needs_verification en vez de campaign_contacts.
Los dos emails encontrados en este ejemplo consumieron 50 créditos. Como referencia:
- 100 emails de trabajo encontrados consumen 2.500 créditos.
- 1.000 emails de trabajo encontrados consumen 25.000 créditos.
- Una lista de input más extensa puede consumir menos créditos que
contactos × 25, porque las búsquedas sin resultados no se cobran.
El acceso a la REST API requiere el plan Growth. Con la tarifa actual de recarga en dólares estadounidenses, 20 USD permiten comprar 20.000 créditos, lo que equivale a 0,001 USD por crédito. Con esa tarifa, 25.000 créditos tienen un valor de 25 USD. La suscripción se cobra por separado de este cálculo de créditos. Consulte la página de precios de Datablist para conocer los planes y paquetes actuales.
Solucione errores comunes y recupere una tarea
Falta la clave API. El script genera el mensaje Set DATABLIST_API_KEY before running this script. antes de realizar ninguna solicitud. Exporte la variable en el terminal actual y vuelva a ejecutar el archivo.
La API devuelve un error de autenticación. raise_for_status() informa del error HTTP. Copie una Personal API Key vigente, confirme que el header X-API-Key la utiliza y no vuelva a ejecutar el script hasta haber corregido la credencial.
La cuenta no tiene créditos suficientes. Compruebe el saldo de la cuenta. Añada créditos o espere a la siguiente asignación de créditos del plan antes de enviar más tareas.
Los campos del input no coinciden con el modo seleccionado. Utilice campos separados para el nombre o fullName con name_company; para linkedin, utilice linkedInProfile. Corrija el contacto y envíelo con un único modo coherente.
La tarea tiene el estado failed o stopped. El script genera un RuntimeError que contiene el ID de la tarea, su estado final y cualquier error disponible. Revise esa tarea y los resultados disponibles antes de decidir qué contactos siguen necesitando una búsqueda.
Se ha perdido la respuesta del POST. Copie el uniqueId que se mostró antes del envío. Enumere sus tareas con la misma clave:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Busque la tarea que tenga el uniqueId mostrado, copie su @id y continúe con la URL del estado o de los resultados de la tarea. Así podrá recuperar la tarea existente en lugar de volver a enviar automáticamente los contactos. La documentación de la API de tareas explica el ciclo de vida y los endpoints de resultados.
Próximos pasos
Ahora dispone de una función bloqueante de Python con Requests para los tres tipos de input compatibles, además de un filtro local que prepara los emails encontrados y verificados para revisar la campaña.
Sustituya los dos contactos de ejemplo por una pequeña muestra de los contactos que ha investigado. Elija el tipo de input que corresponda a sus datos, ejecute la búsqueda y revise emailStatus antes de utilizar una dirección. Si necesita trabajar con una lista más amplia, consulte cómo encontrar emails a gran escala. El repositorio mantenido en GitHub ofrece ejemplos descargables de Python tanto bloqueantes como asíncronos.