
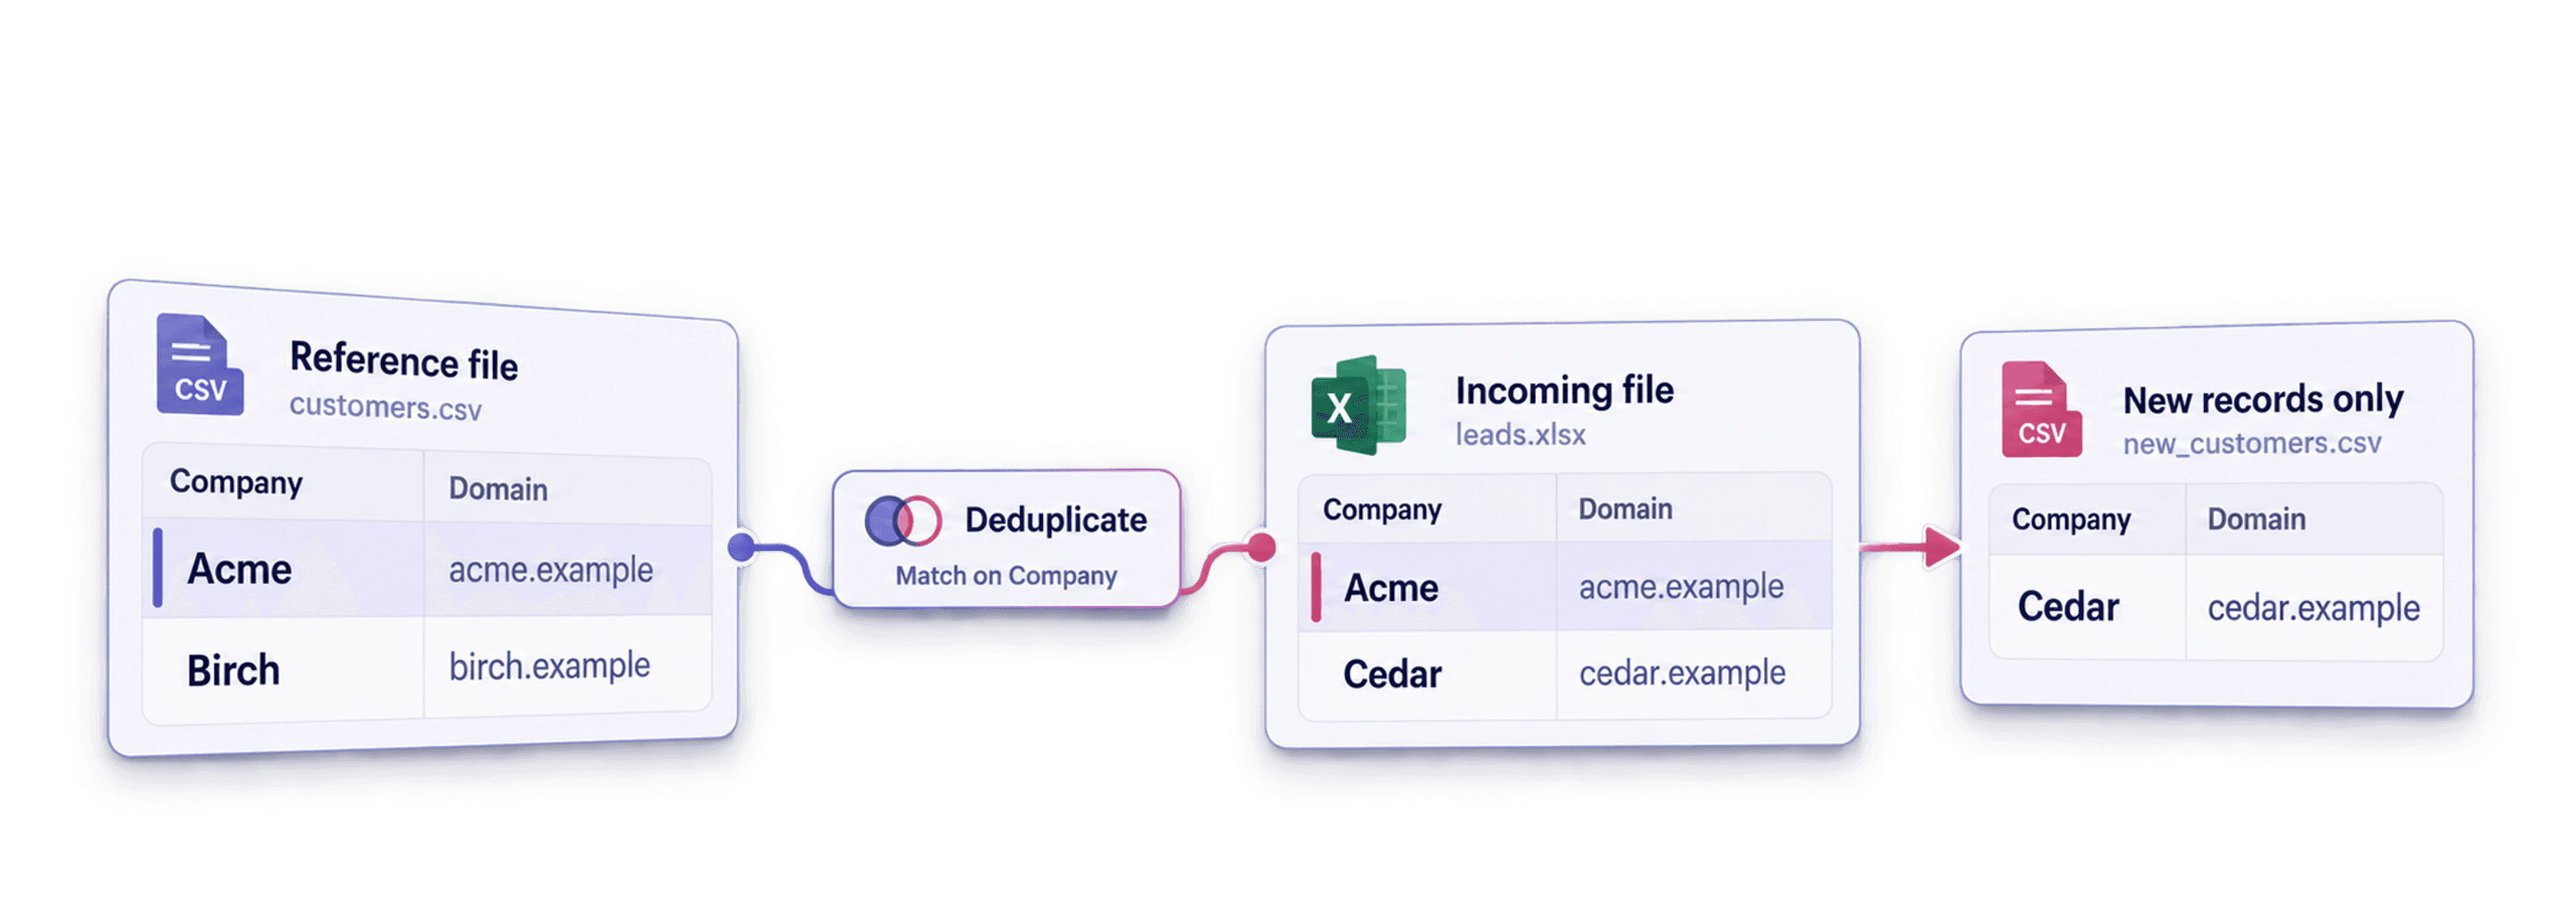
Pour dédupliquer plusieurs fichiers Excel ou CSV, conservez chaque fichier dans une collection Datablist distincte, associez les propriétés permettant d’identifier un même enregistrement, puis comparez les collections. Vous pourrez ensuite supprimer les lignes correspondantes d’une liste entrante sans modifier votre liste de référence.
Ce workflow est utile lorsque vous disposez d’un export CRM et d’un nouveau fichier de prospects. Il répond à une question précise : quels prospects figurent déjà dans le CRM ?
L’action automatique est une opération de suppression, et non de fusion. Elle retire les enregistrements correspondants de la collection que vous sélectionnez. Elle ne copie pas leurs valeurs uniques dans une autre collection.
Ce guide présente un test réel réalisé avec deux fichiers CSV de 250 lignes :
| Collection | Rôle | Lignes avant traitement | Propriété de correspondance |
|---|---|---|---|
CRM Export | Liste de référence à conserver | 250 | Email |
Event Registrations | Liste entrante à nettoyer | 250 | Attendee Email |
Les fichiers contiennent volontairement 100 doublons communs aux deux listes. Après leur suppression dans Event Registrations, il reste 150 nouveaux contacts issus de l’événement.
Dans cet exemple, la correspondance repose sur l’adresse email. Si certaines adresses manquent ou si vos listes comportent plusieurs identifiants de contact, consultez notre guide sur la déduplication de leads avant de décider quelles correspondances peuvent être supprimées sans risque.
Télécharger les deux fichiers d’exemple
Utilisez ces fichiers pour reproduire le test :
Les en-têtes sont volontairement différents. Le CRM utilise Email, First Name et Last Name. Le fichier de l’événement emploie Attendee Email, Attendee First Name et Attendee Last Name. L’association des propriétés entre collections permet ainsi de conserver la structure d’origine de chaque fichier.
Les données de test comprennent différentes mises en forme et variantes d’alias pour les adresses email. La comparaison Smart avec le processeur Email est donc plus pertinente qu’une simple comparaison exacte des valeurs brutes.
Importer chaque fichier dans une collection
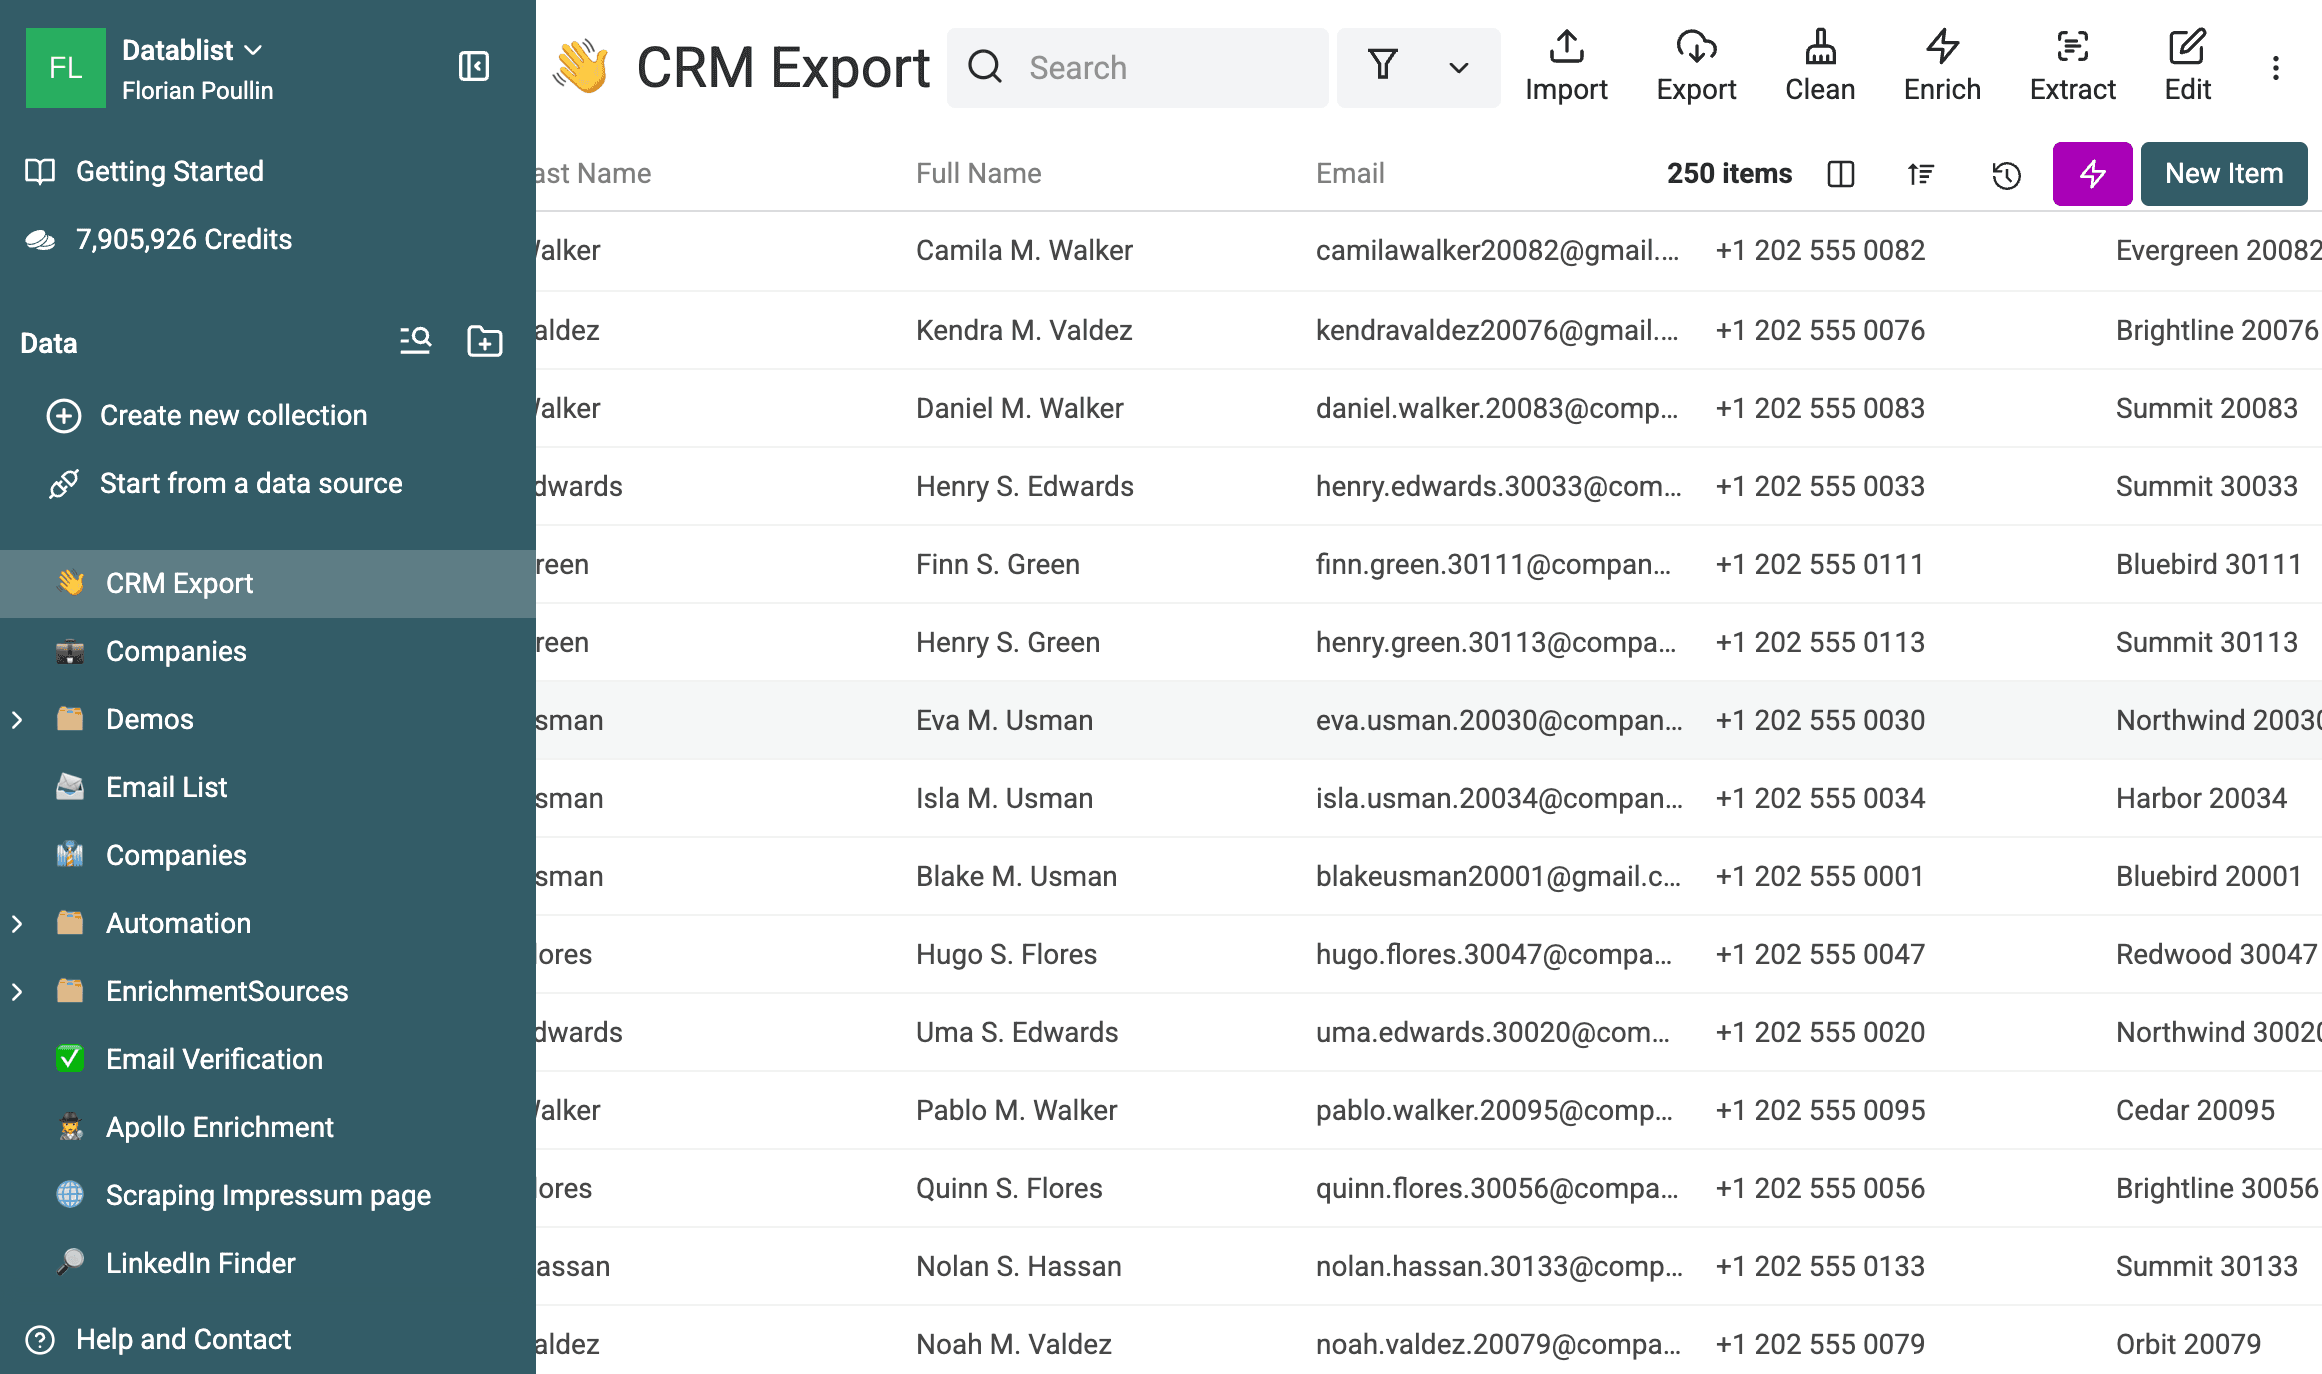
Ouvrez Datablist et importez chaque fichier CSV ou Excel dans sa propre collection. Nommez les collections selon leur rôle afin de pouvoir vérifier facilement la règle de nettoyage.
La première collection de ce test est la liste de référence du CRM. Elle contient 250 enregistrements et doit rester inchangée.
La seconde collection correspond à la liste entrante de l’événement. Elle contient elle aussi 250 enregistrements au départ.
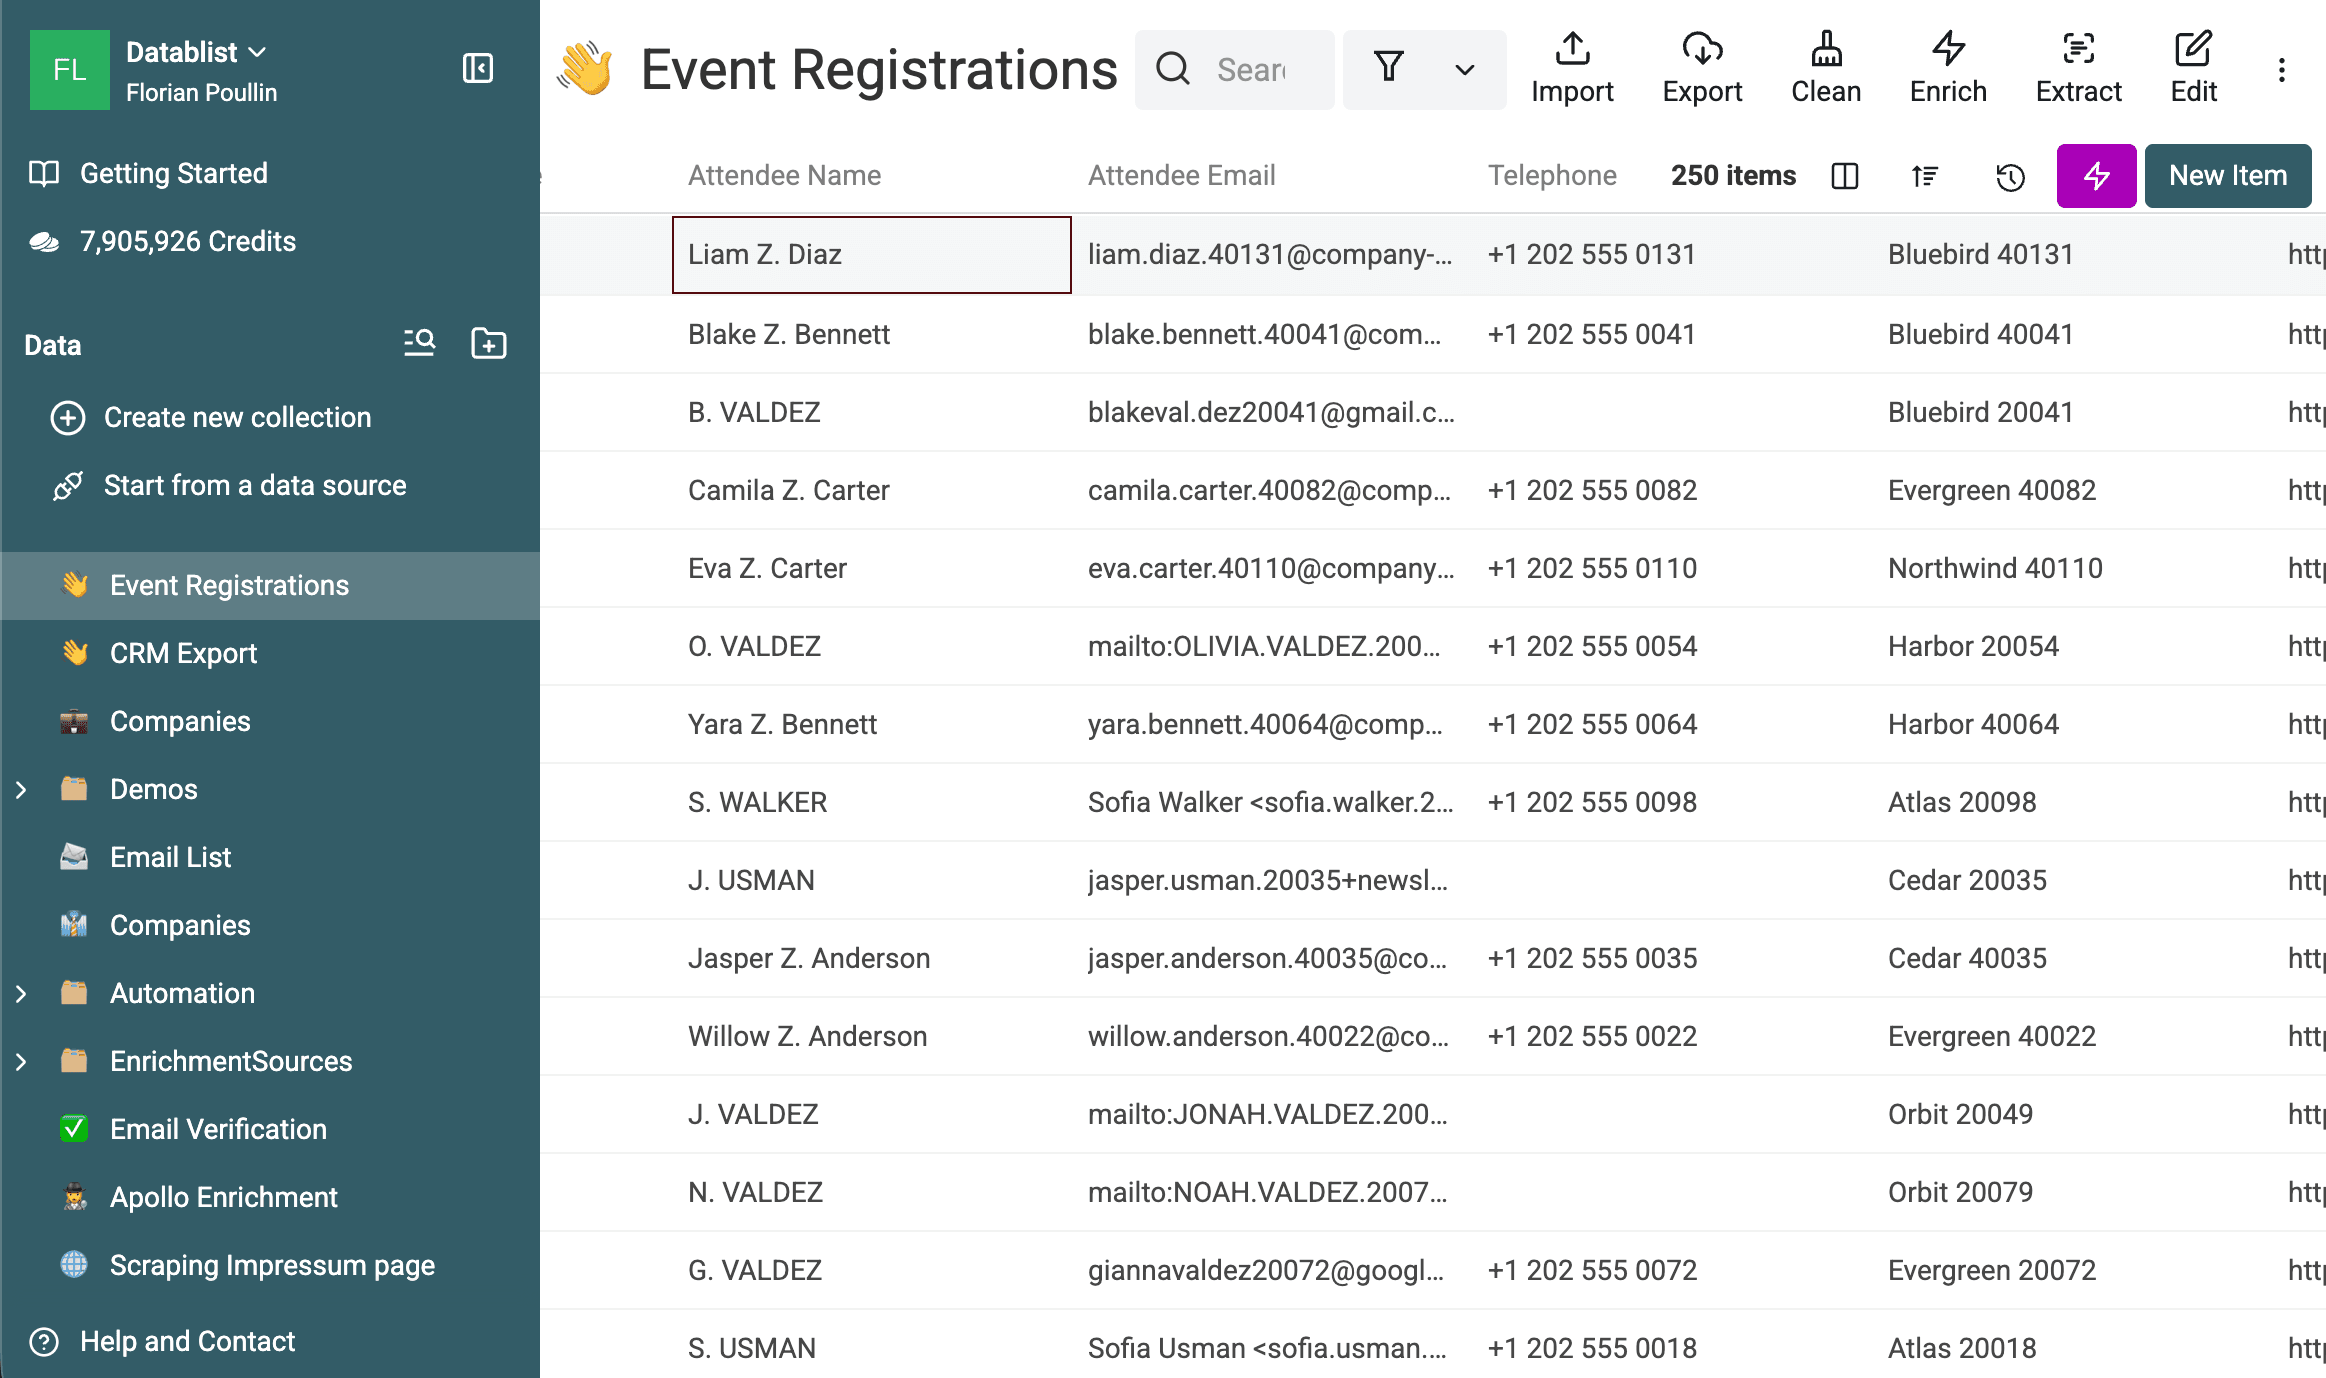
Vérifiez le type des propriétés pendant l’import. Définissez les deux colonnes d’adresses email sur le type Email. Conservez les identifiants externes, les noms, les numéros de téléphone et les autres champs : ils vous aideront à examiner les correspondances incertaines.
Associer les propriétés d’identification
Ouvrez la collection entrante Event Registrations. Sélectionnez Clean > Match across collections.
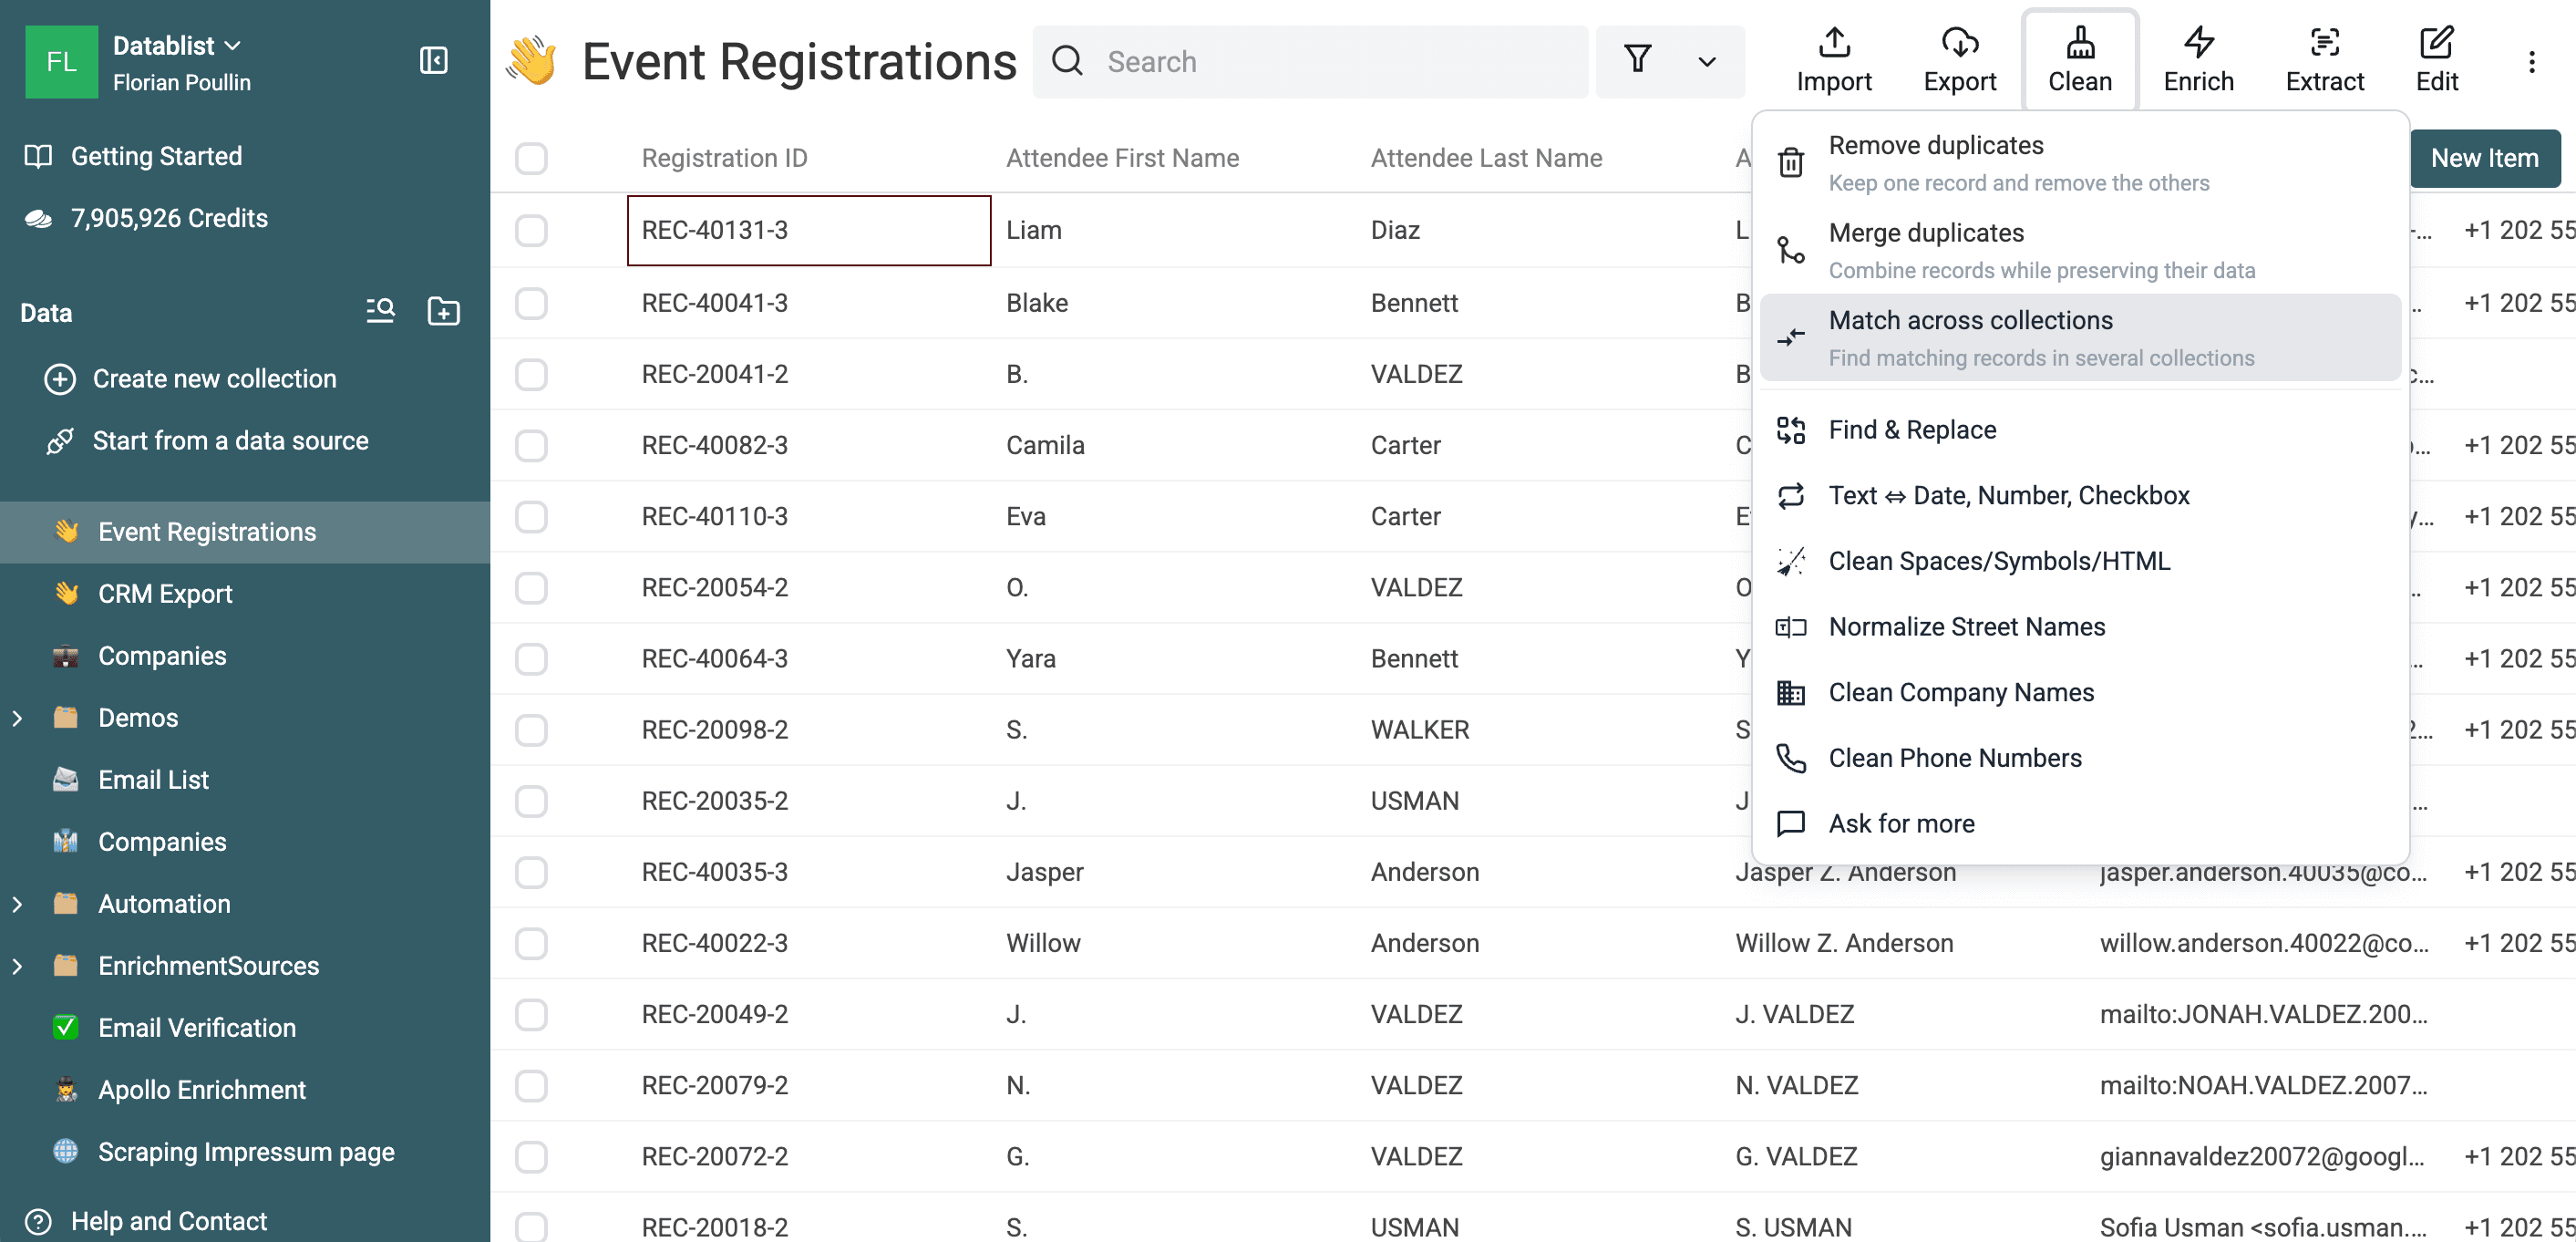
Activez Check duplicate items across several collections?, puis ajoutez CRM Export.
Sélectionnez Attendee Email dans la collection de l’événement et associez cette propriété à Email dans la collection CRM.
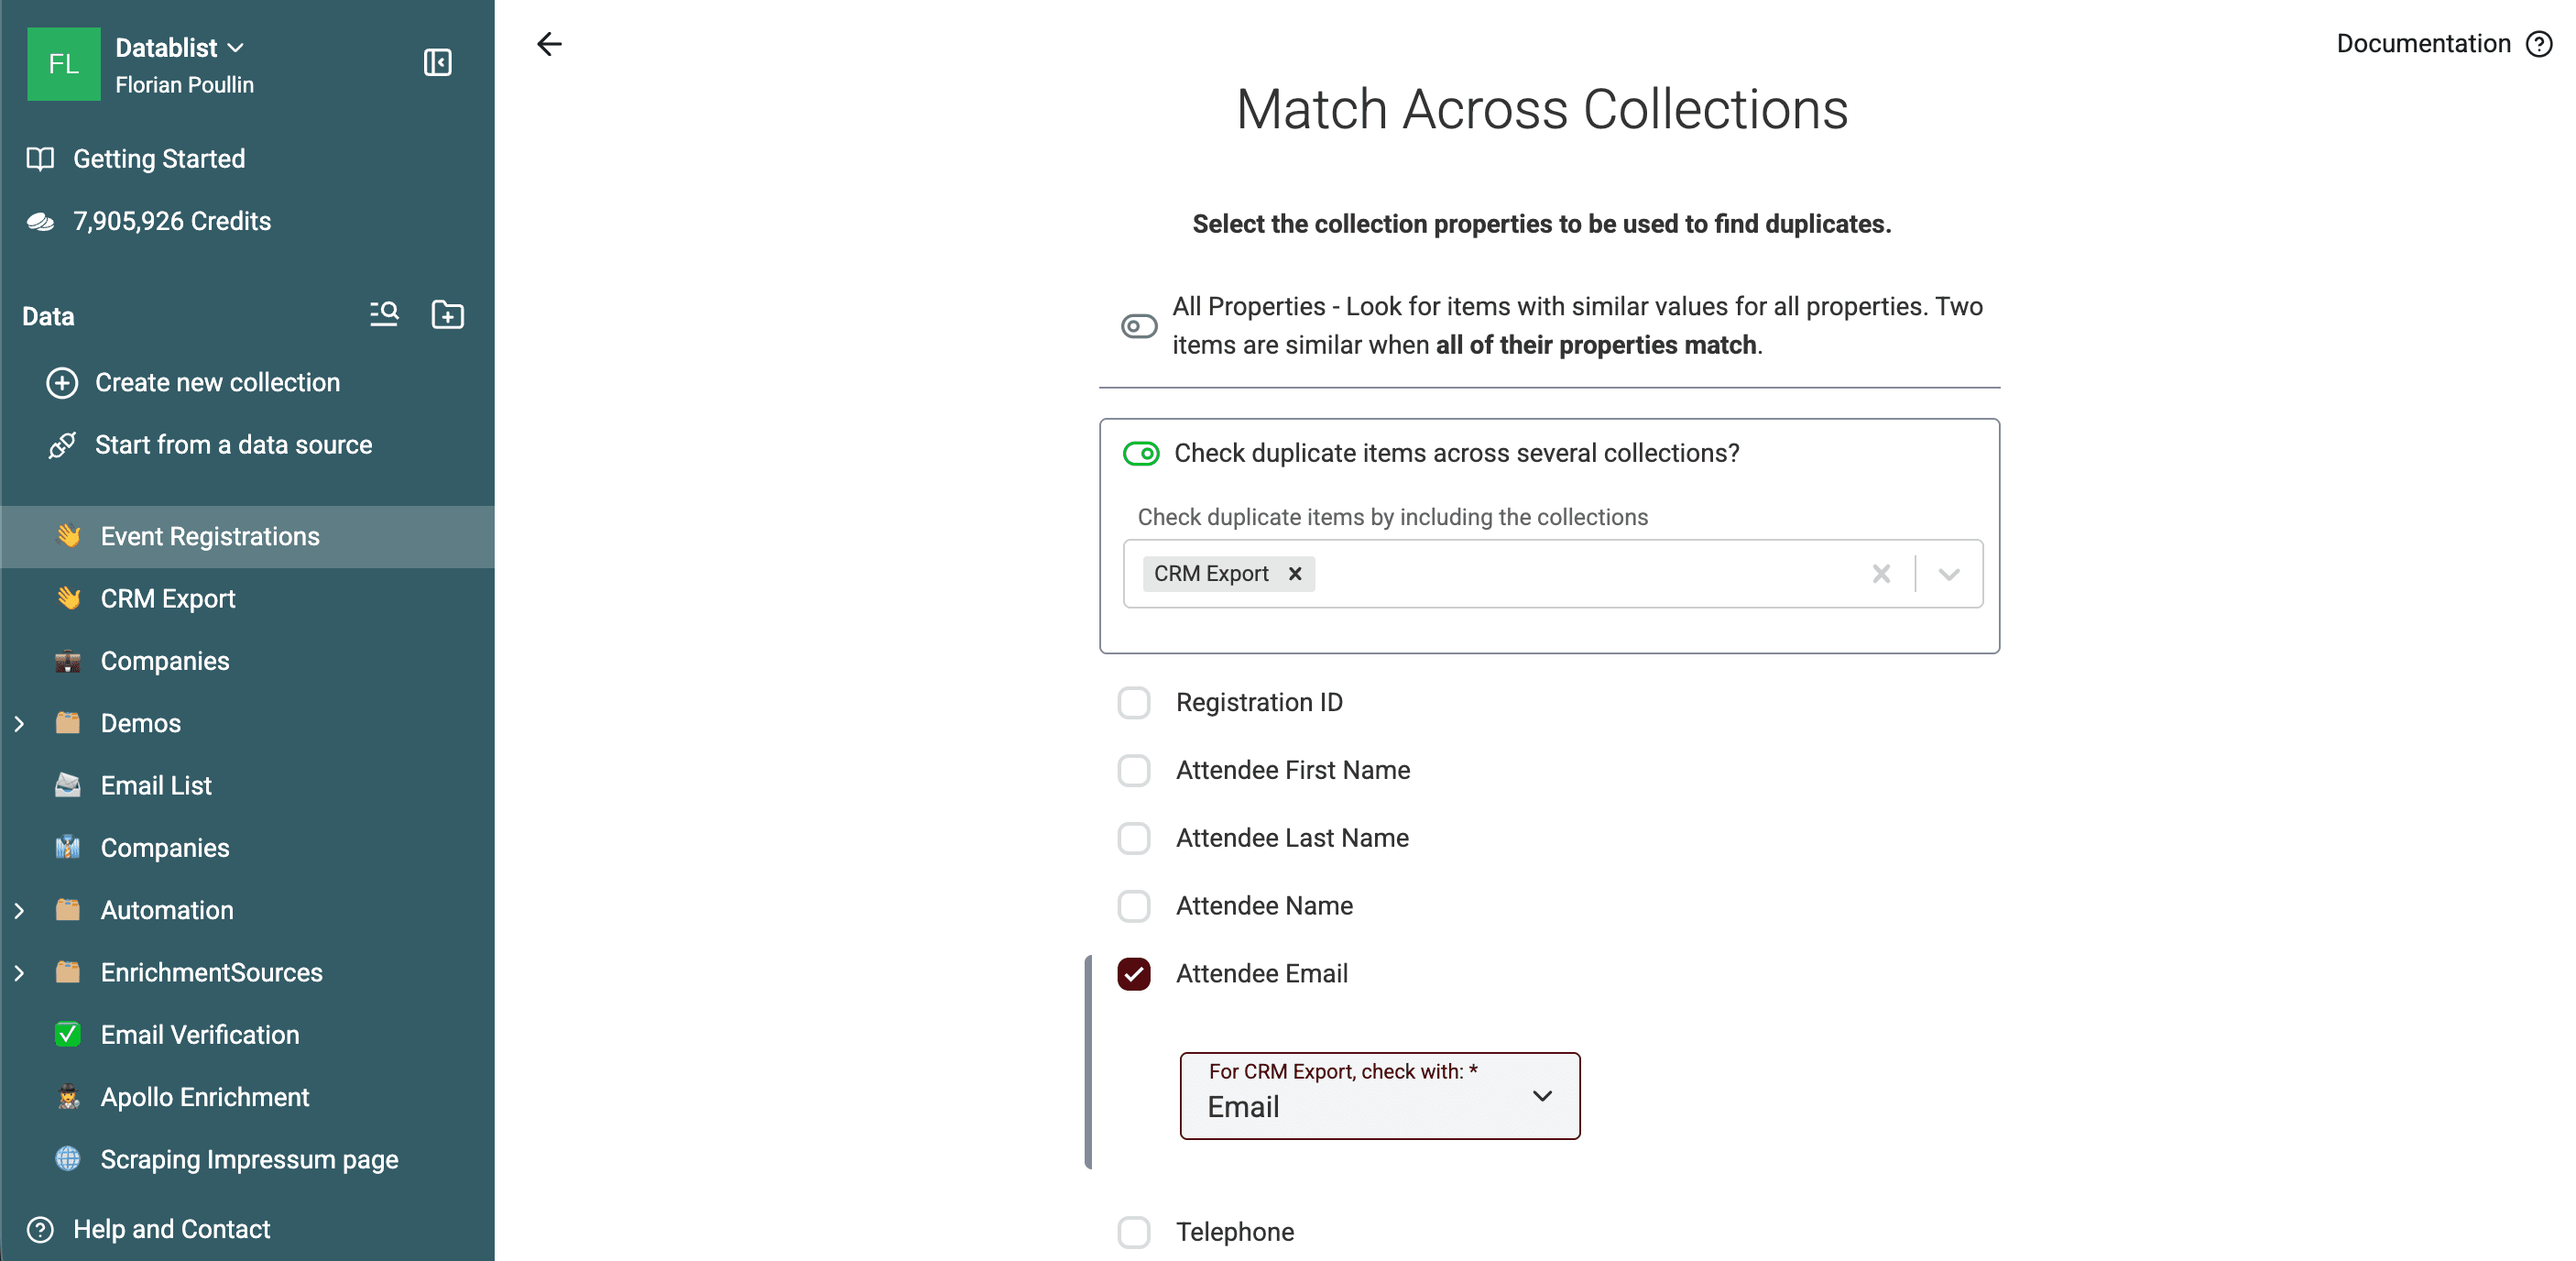
La fiabilité de l’identifiant compte davantage que le nom de la colonne. Voici quelques bons choix :
- L’adresse email pour les contacts.
- Le numéro de téléphone lorsque les deux fichiers utilisent des indicatifs de pays compatibles.
- L’URL LinkedIn pour les listes de prospects.
- Le domaine du site web pour les entreprises.
- Le SKU ou un autre identifiant stable pour les produits.
Évitez d’effectuer la comparaison sur le seul prénom. Plusieurs personnes peuvent porter le même prénom.
Si vous sélectionnez plusieurs propriétés, Datablist évalue leur score combiné. Lancez des vérifications distinctes si vous souhaitez comparer séparément les emails et les numéros de téléphone. Avec Match on empty value, deux propriétés vides obtiennent un score de 100 %, ce qui peut faire monter la moyenne. Examinez les identifiants renseignés et l’exemple de calcul avec des valeurs vides avant de supprimer un groupe.
Configurer la comparaison
Utilisez Exact pour les identifiants stables qui doivent être strictement identiques. Pour les adresses email, sélectionnez Smart avec le processeur Email.
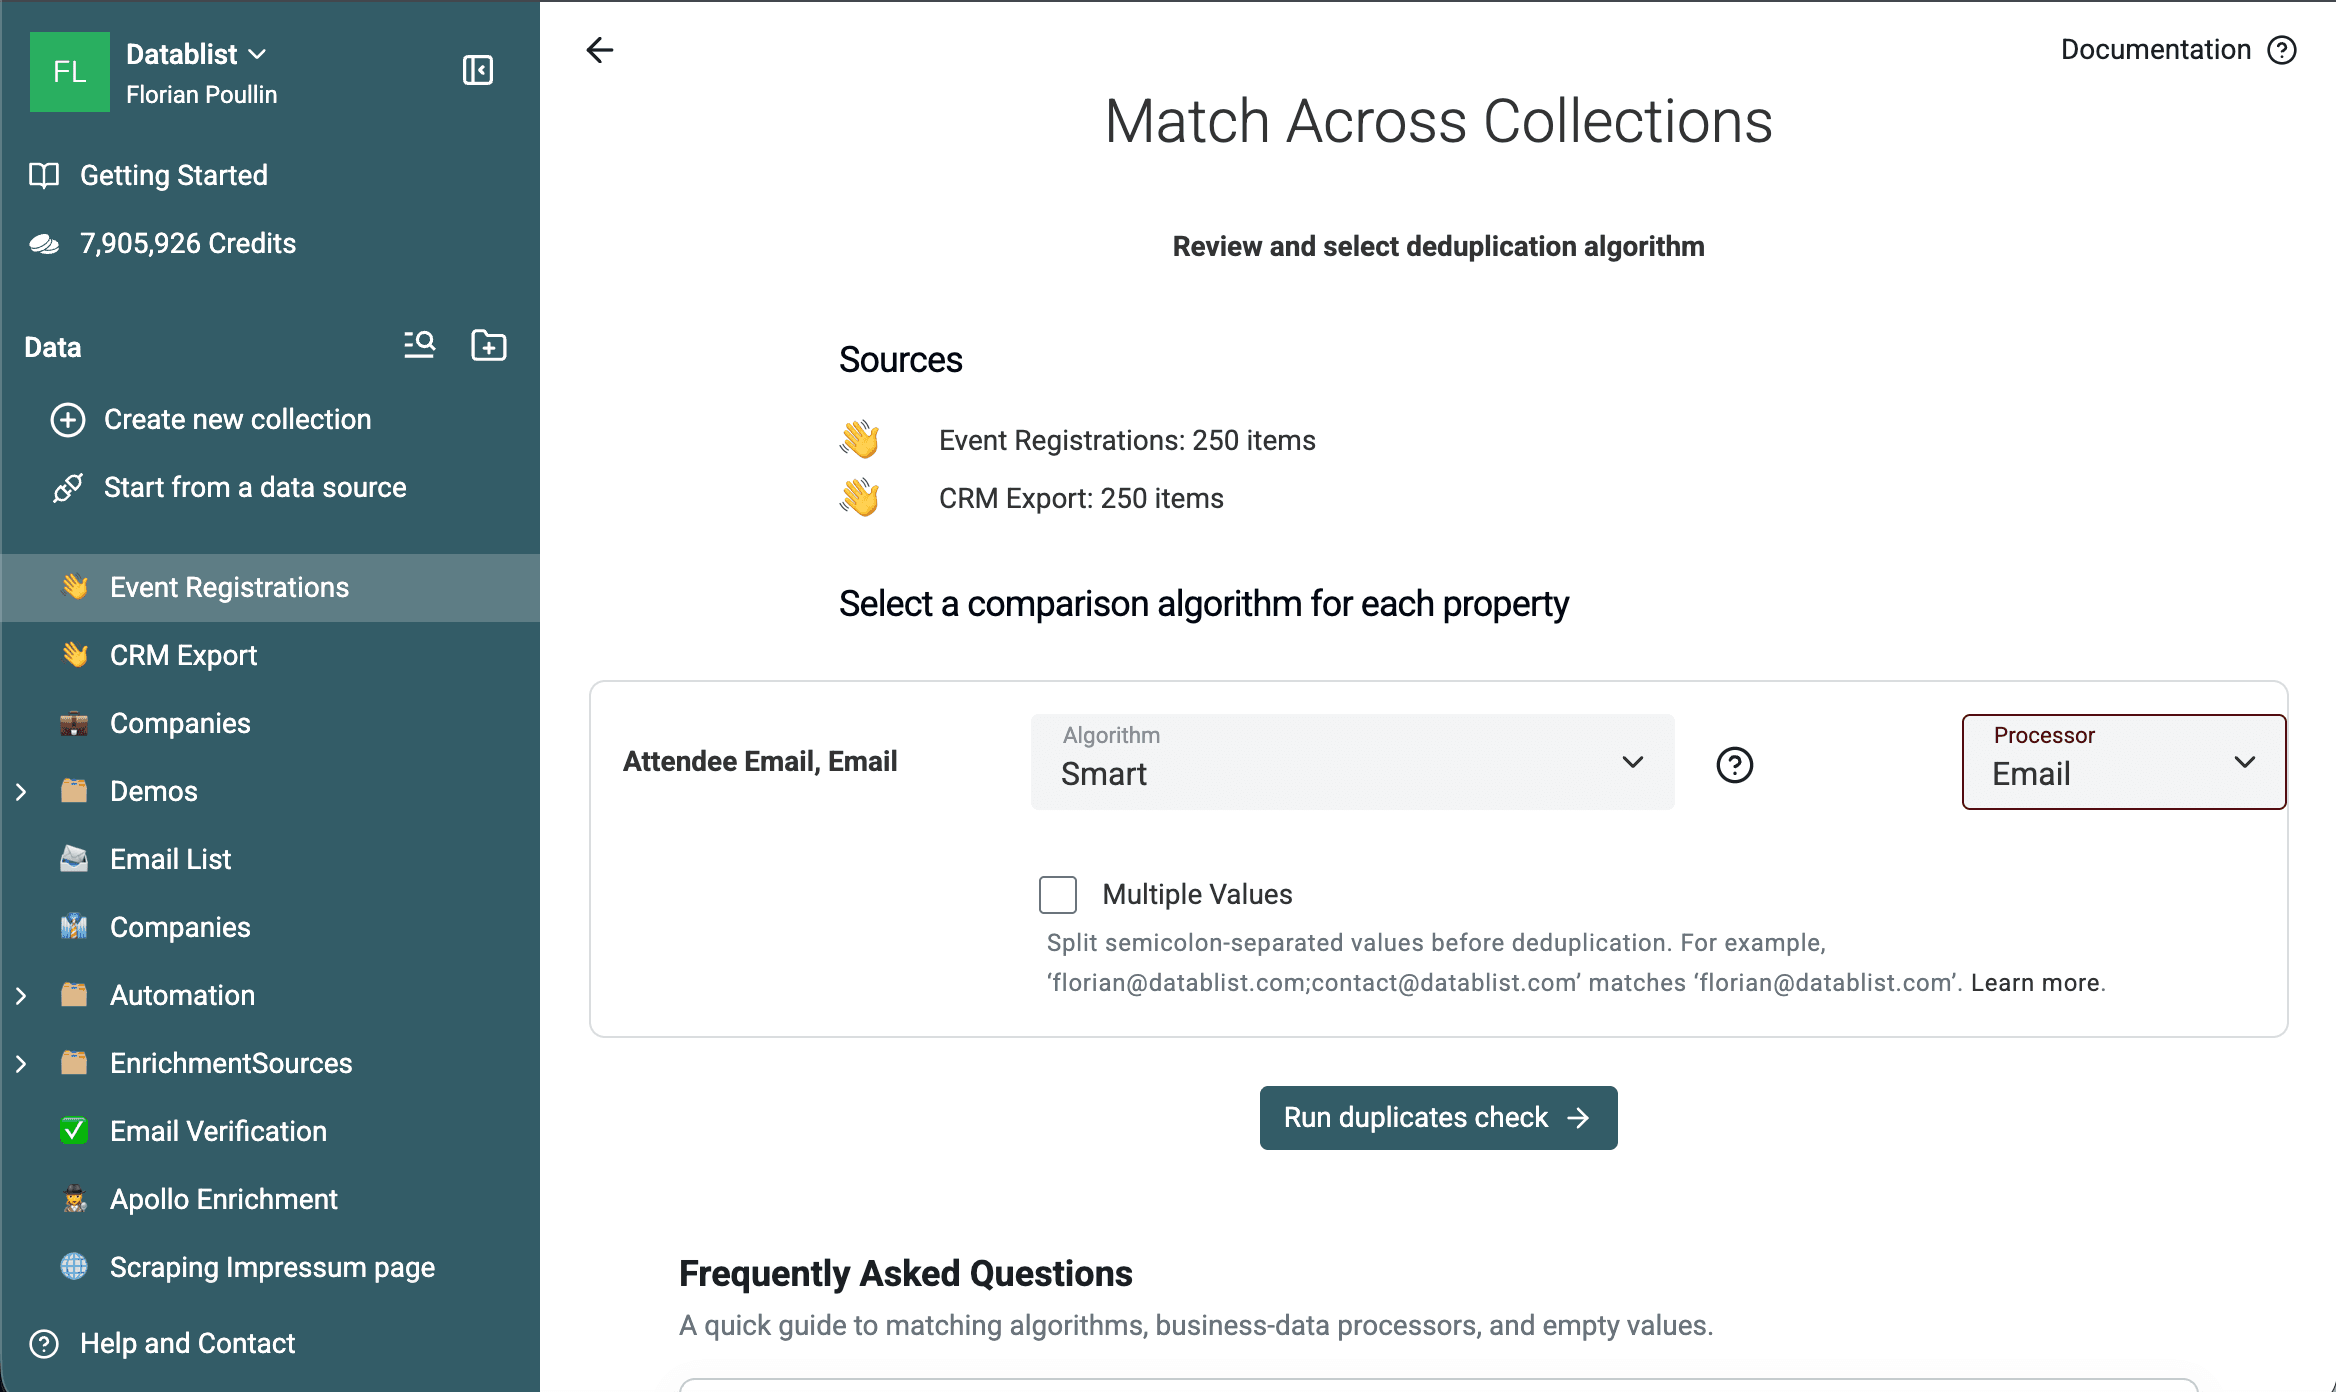
Le processeur Email normalise les variantes d’adresses prises en charge afin de les comparer sans modifier les cellules sources. Pour en savoir plus sur le comportement et les limites propres aux emails, consultez le guide consacré à la déduplication des adresses email et de leurs alias.
Cliquez sur Run duplicates check après avoir vérifié les deux sources, leur nombre d’éléments, les propriétés associées et les paramètres de comparaison.
Examiner les correspondances entre listes
Lors de ce test, 500 enregistrements ont été vérifiés et 100 groupes de doublons communs aux deux collections ont été détectés.
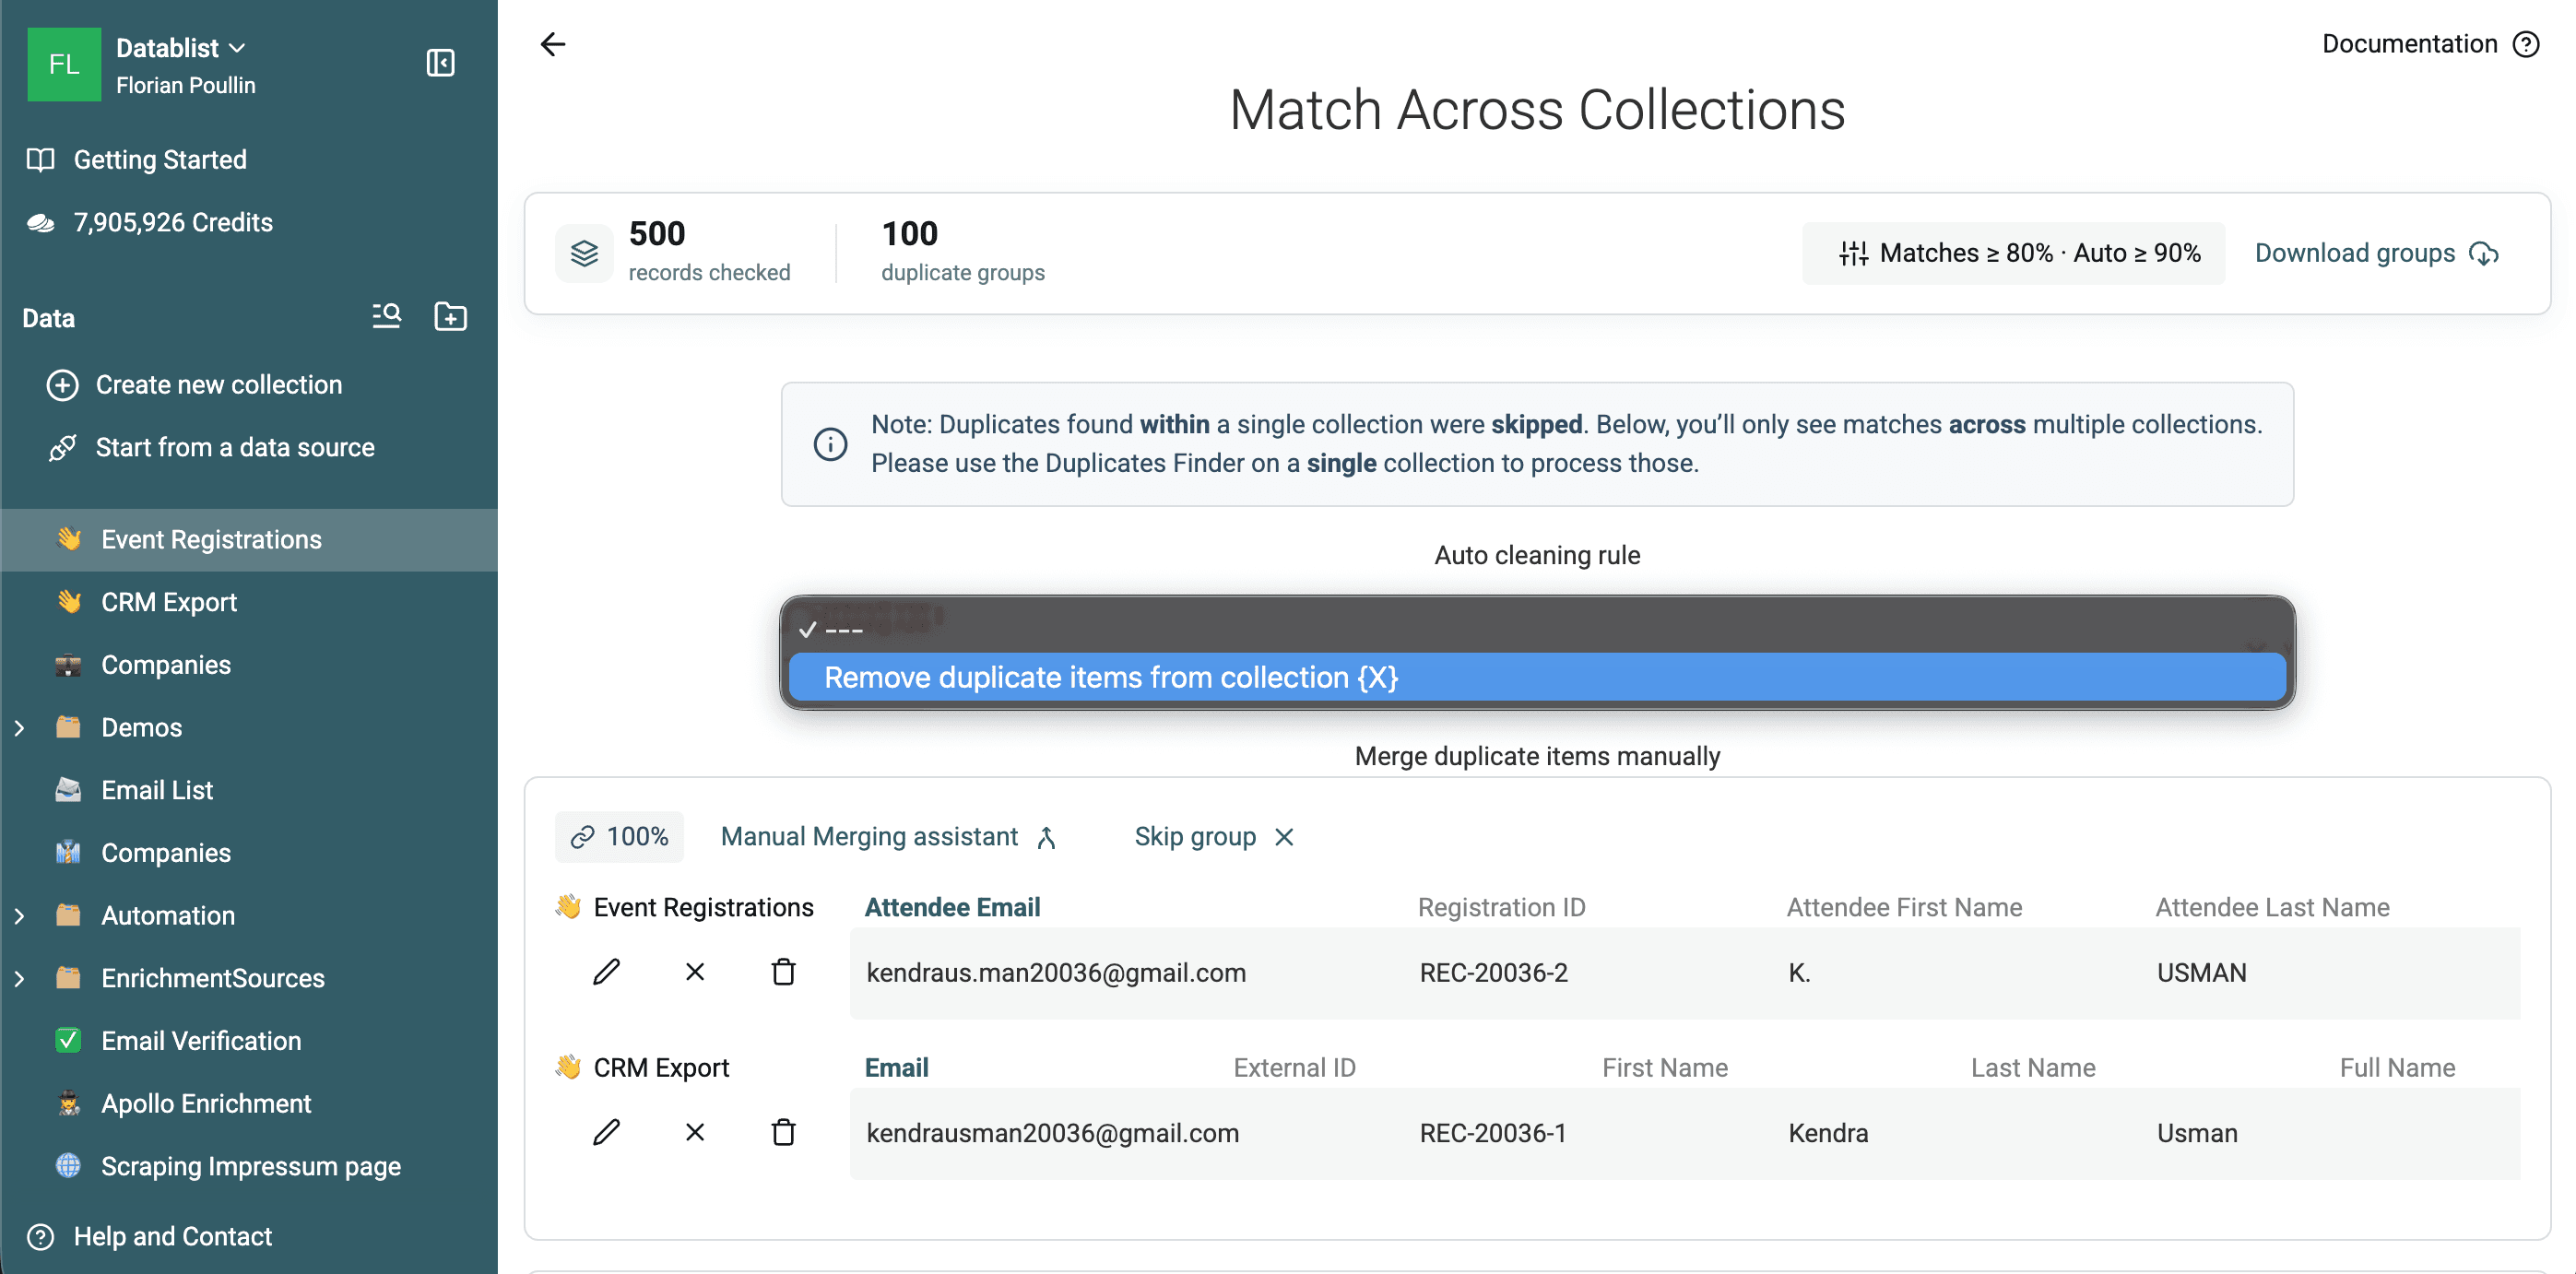
Le mode inter-collections renvoie uniquement les groupes qui contiennent des enregistrements provenant de plusieurs collections. Il ignore les doublons présents uniquement dans CRM Export ou uniquement dans Event Registrations.
Examinez les groupes avant toute suppression :
- Confirmez que l’identifiant associé correspond bien à la même personne ou entreprise.
- Vérifiez si la ligne entrante contient des données uniques.
- Identifiez clairement la collection qui sert de liste de référence.
- Téléchargez les groupes si une autre personne doit valider la suppression.
- Utilisez le Manual Merging Assistant lorsqu’un groupe doit être fusionné plutôt que supprimé.
Si vous devez également éliminer les doublons internes de l’un des fichiers, exécutez séparément le workflow Duplicates Finder sur la collection concernée.
Supprimer les doublons de la liste entrante
Choisissez Remove duplicate items from collection {X}, puis sélectionnez Event Registrations comme collection à nettoyer.
Datablist affiche les conséquences de l’opération avant son lancement :
- Les enregistrements correspondants de
Event Registrationsseront supprimés. CRM Exportrestera inchangée.- Les enregistrements de l’événement sans correspondance dans le CRM seront conservés.
- Les valeurs uniques présentes uniquement dans un enregistrement supprimé seront perdues.
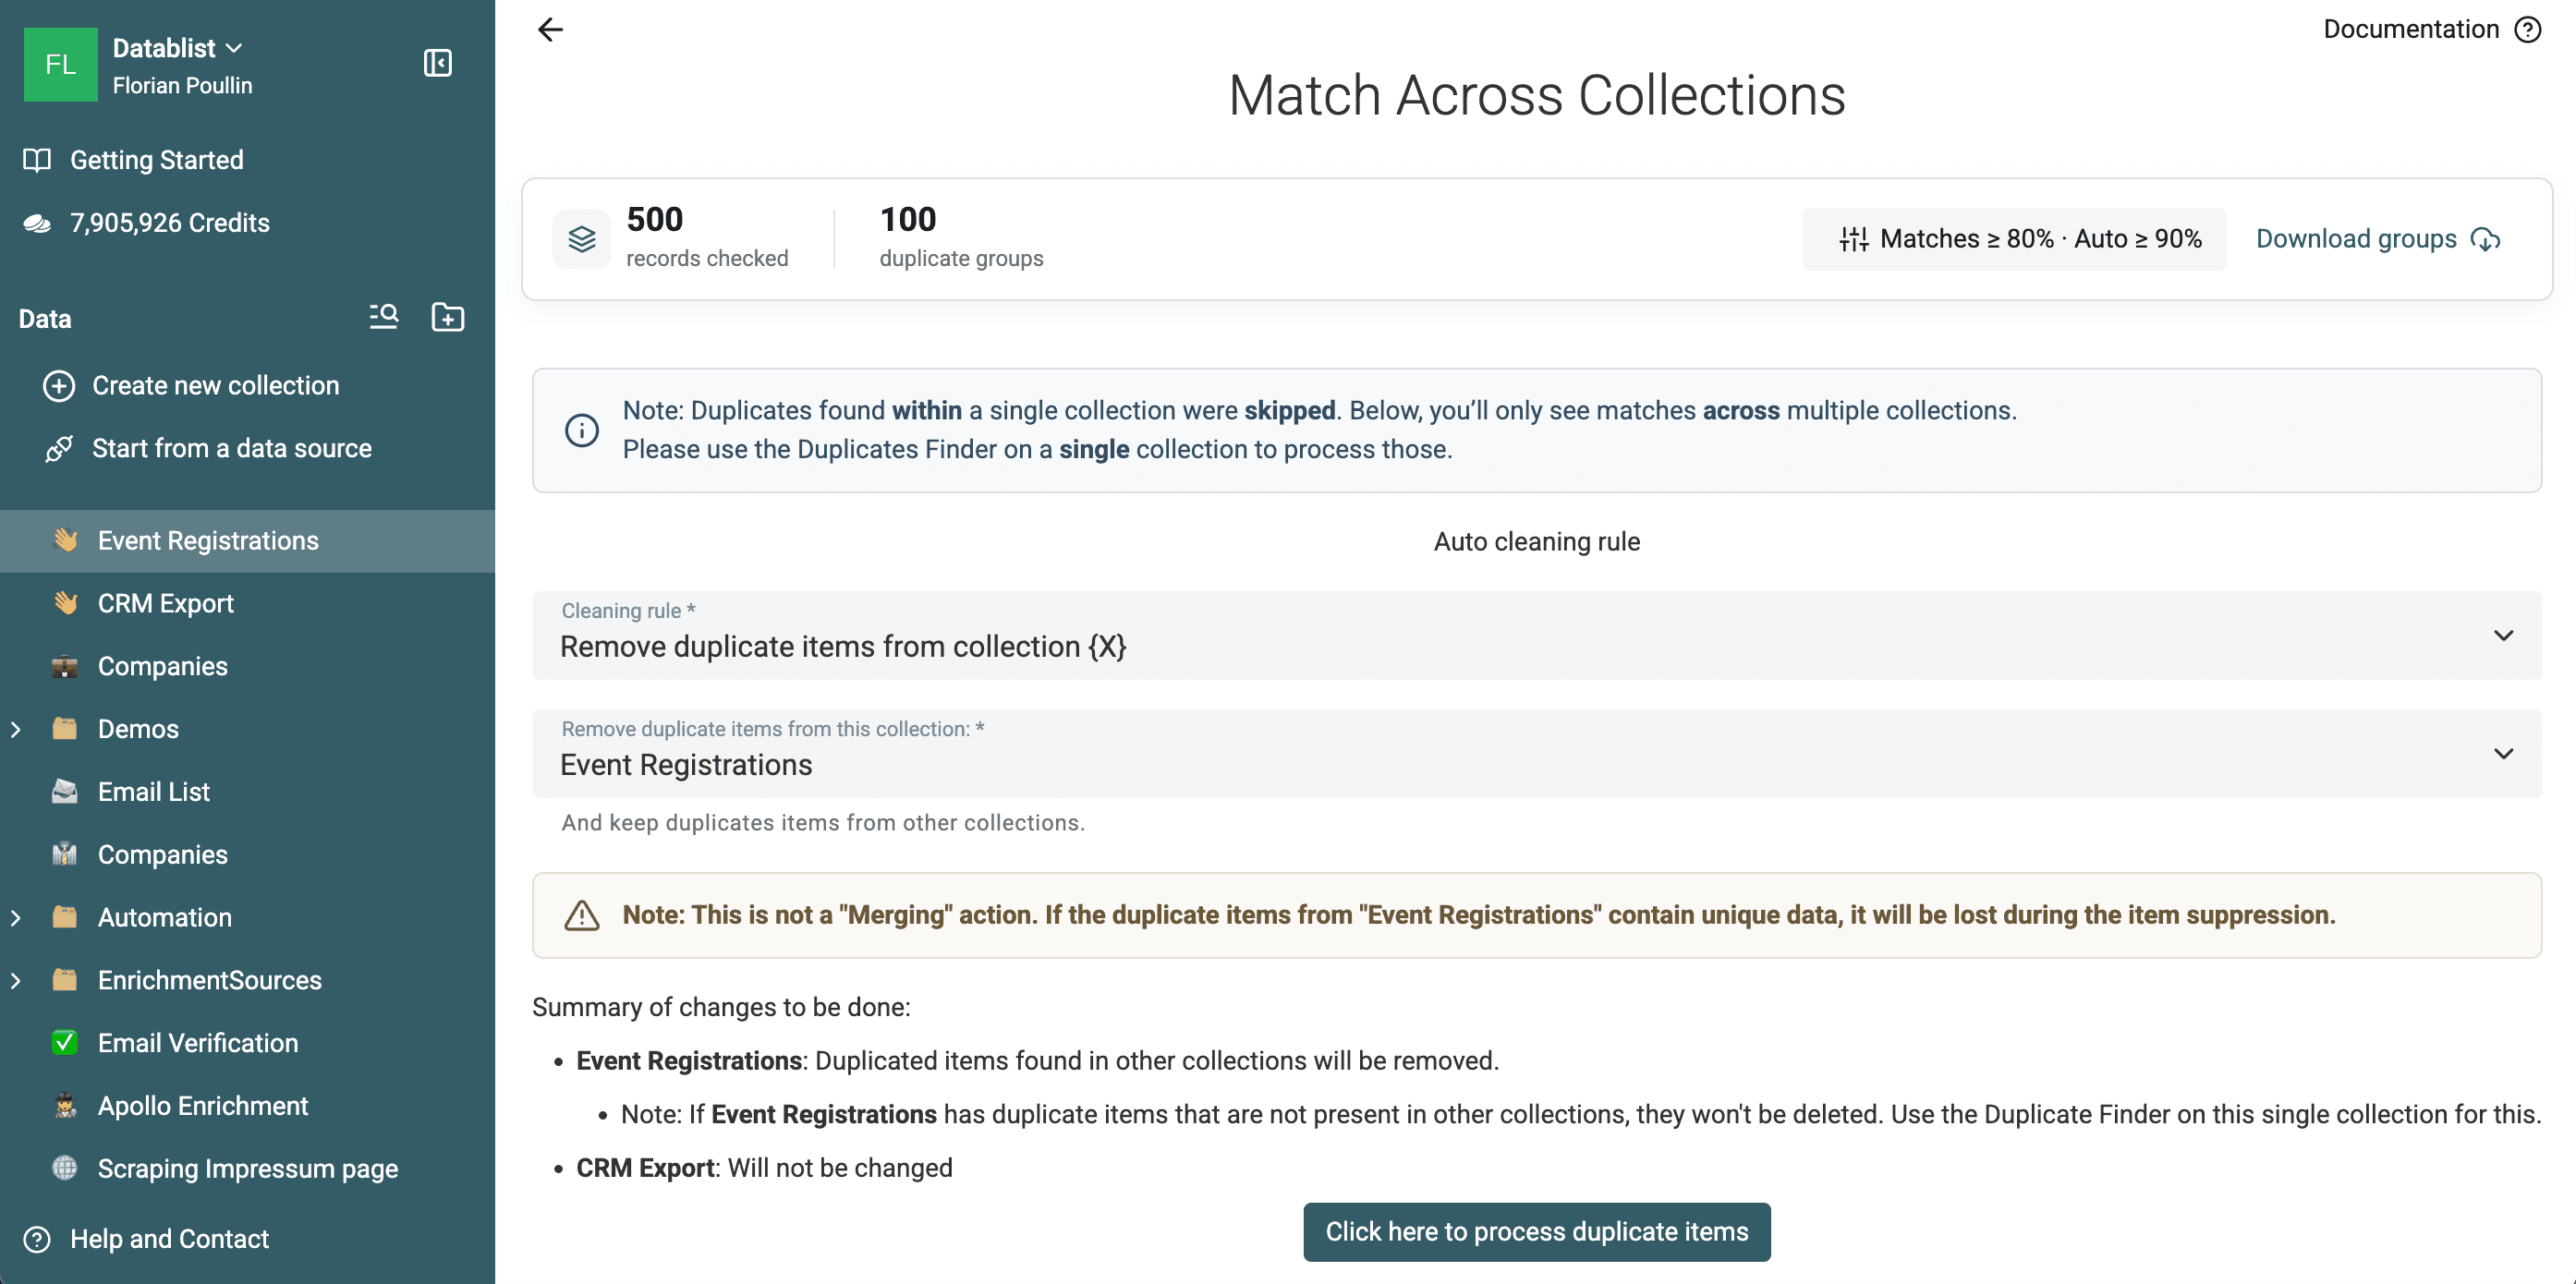
⚠️ Cette action ne fusionne pas les données dans le CRM
Si un enregistrement de l’événement contient un numéro de téléphone, une source, un champ de consentement ou une note utile absente du CRM, la suppression automatique ne copiera pas cette information. Examinez ou exportez d’abord les groupes, ou utilisez le Manual Merging Assistant pour les groupes concernés.
Avec trois collections ou plus, Datablist propose également une règle permettant de conserver les doublons dans une seule collection sélectionnée. Vérifiez attentivement le récapitulatif avant de lancer le traitement, car cette action peut supprimer des enregistrements dans plusieurs sources.
Cliquez sur Process duplicate items lorsque la collection sélectionnée et le récapitulatif correspondent bien à l’opération souhaitée.
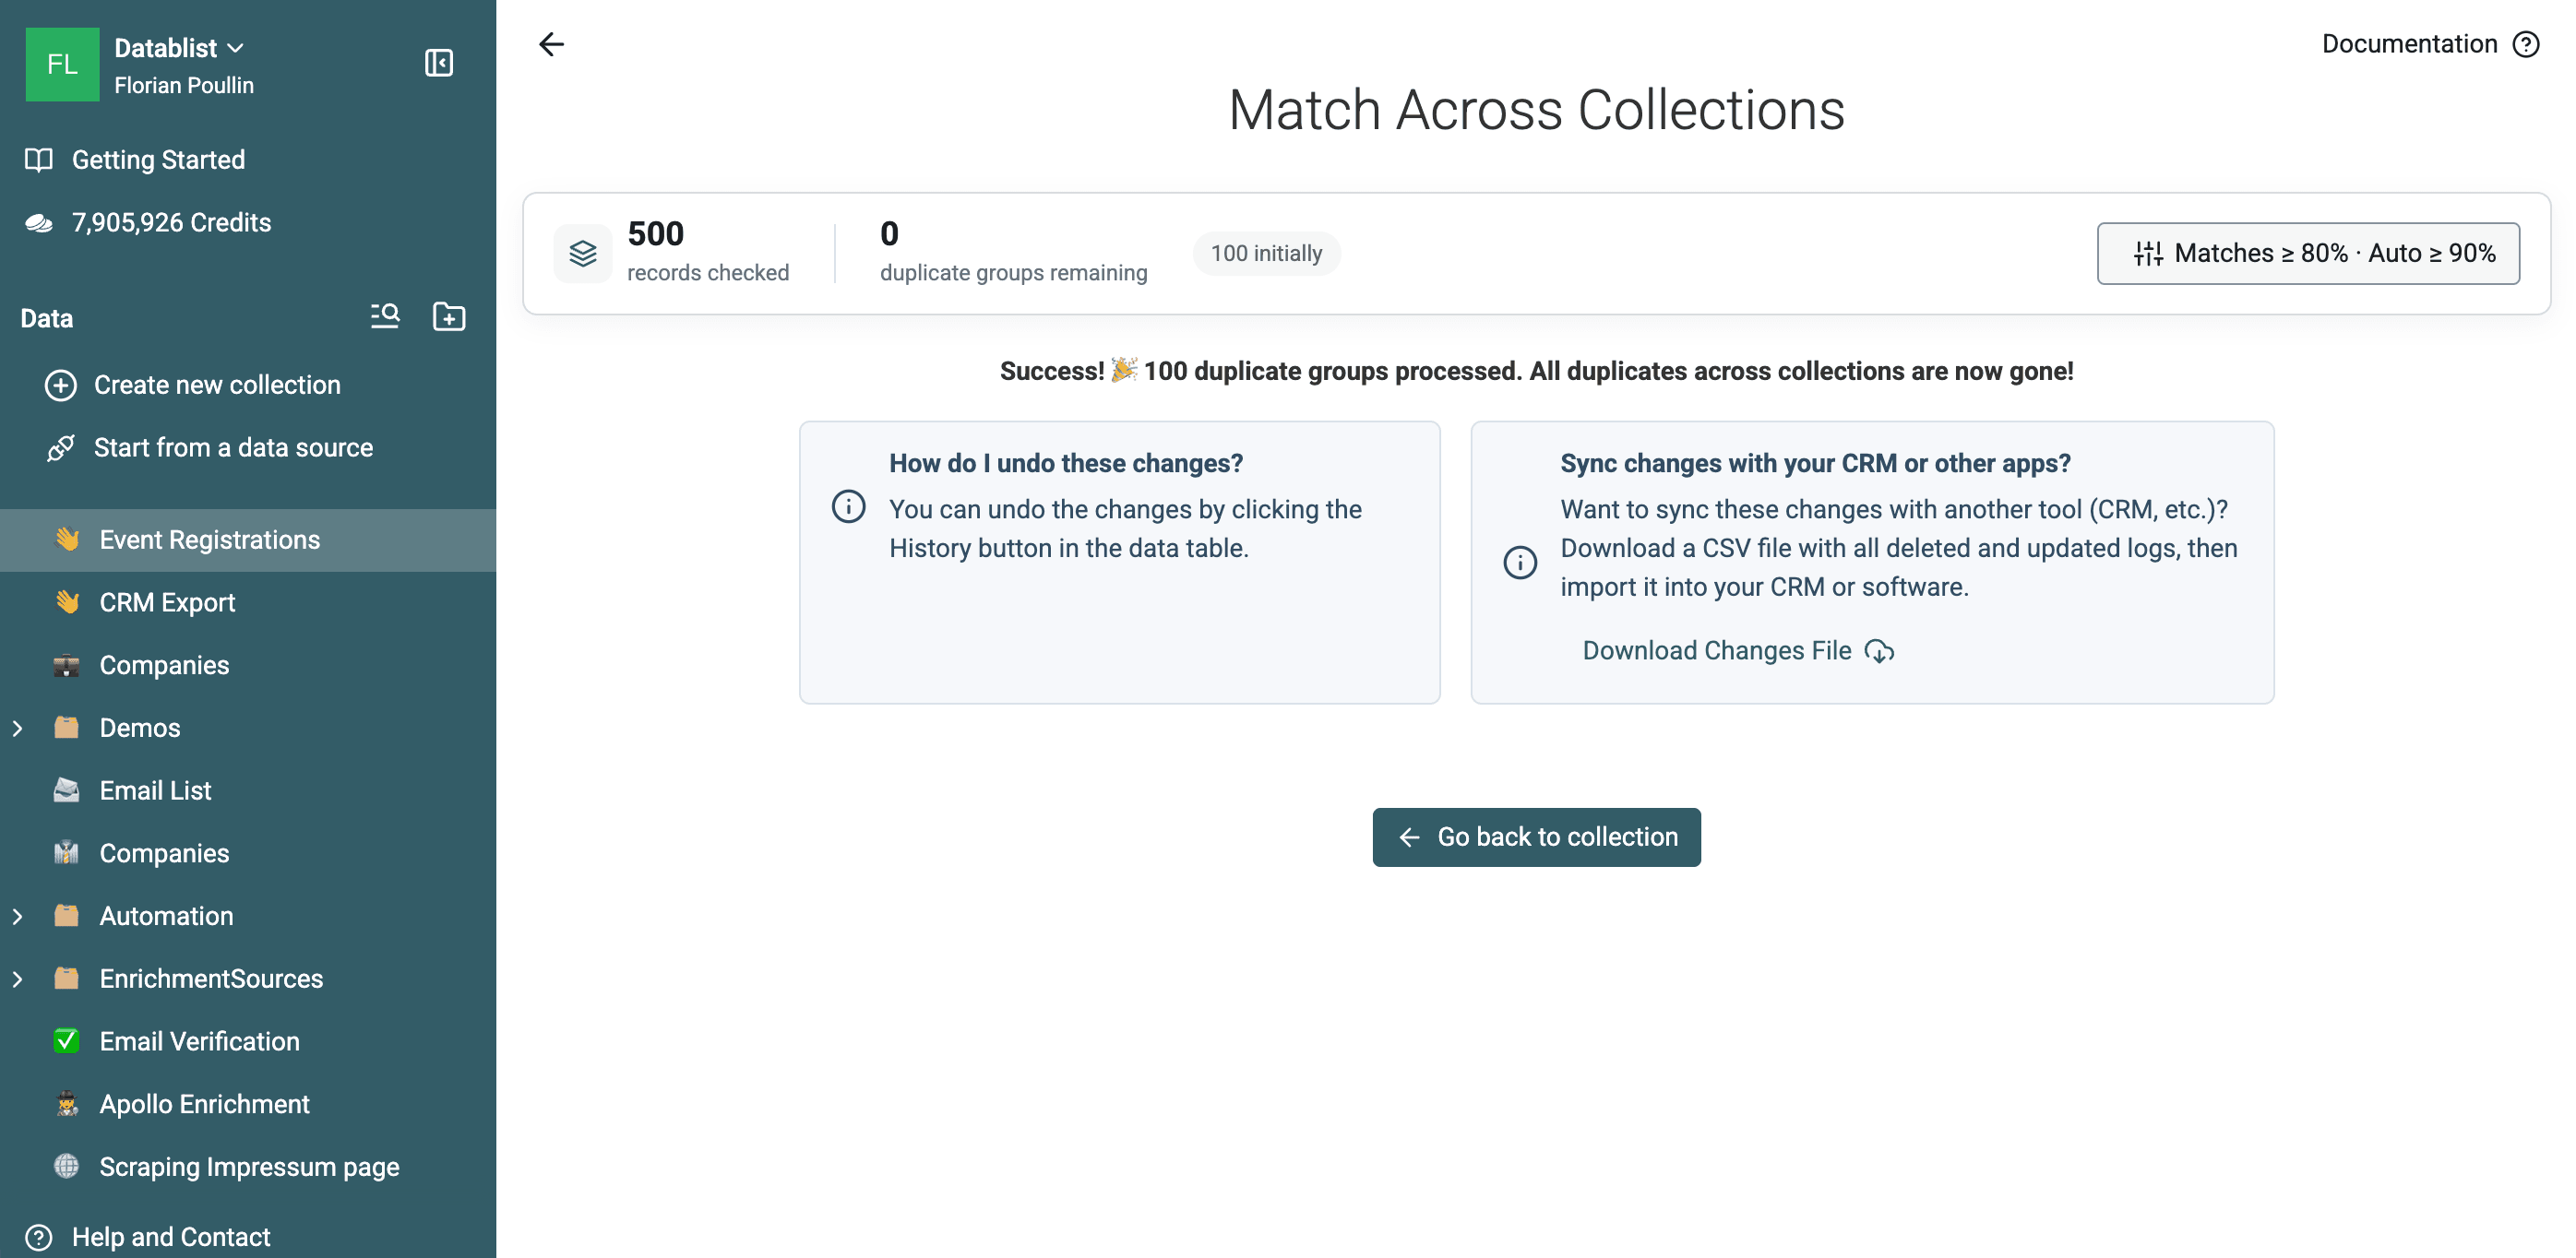
Datablist a traité les 100 groupes de doublons inter-collections lors de ce test. L’écran des résultats a ensuite indiqué qu’il ne restait aucun groupe.
Vérifier la liste nettoyée
Revenez dans Event Registrations. La collection contient désormais 150 éléments.
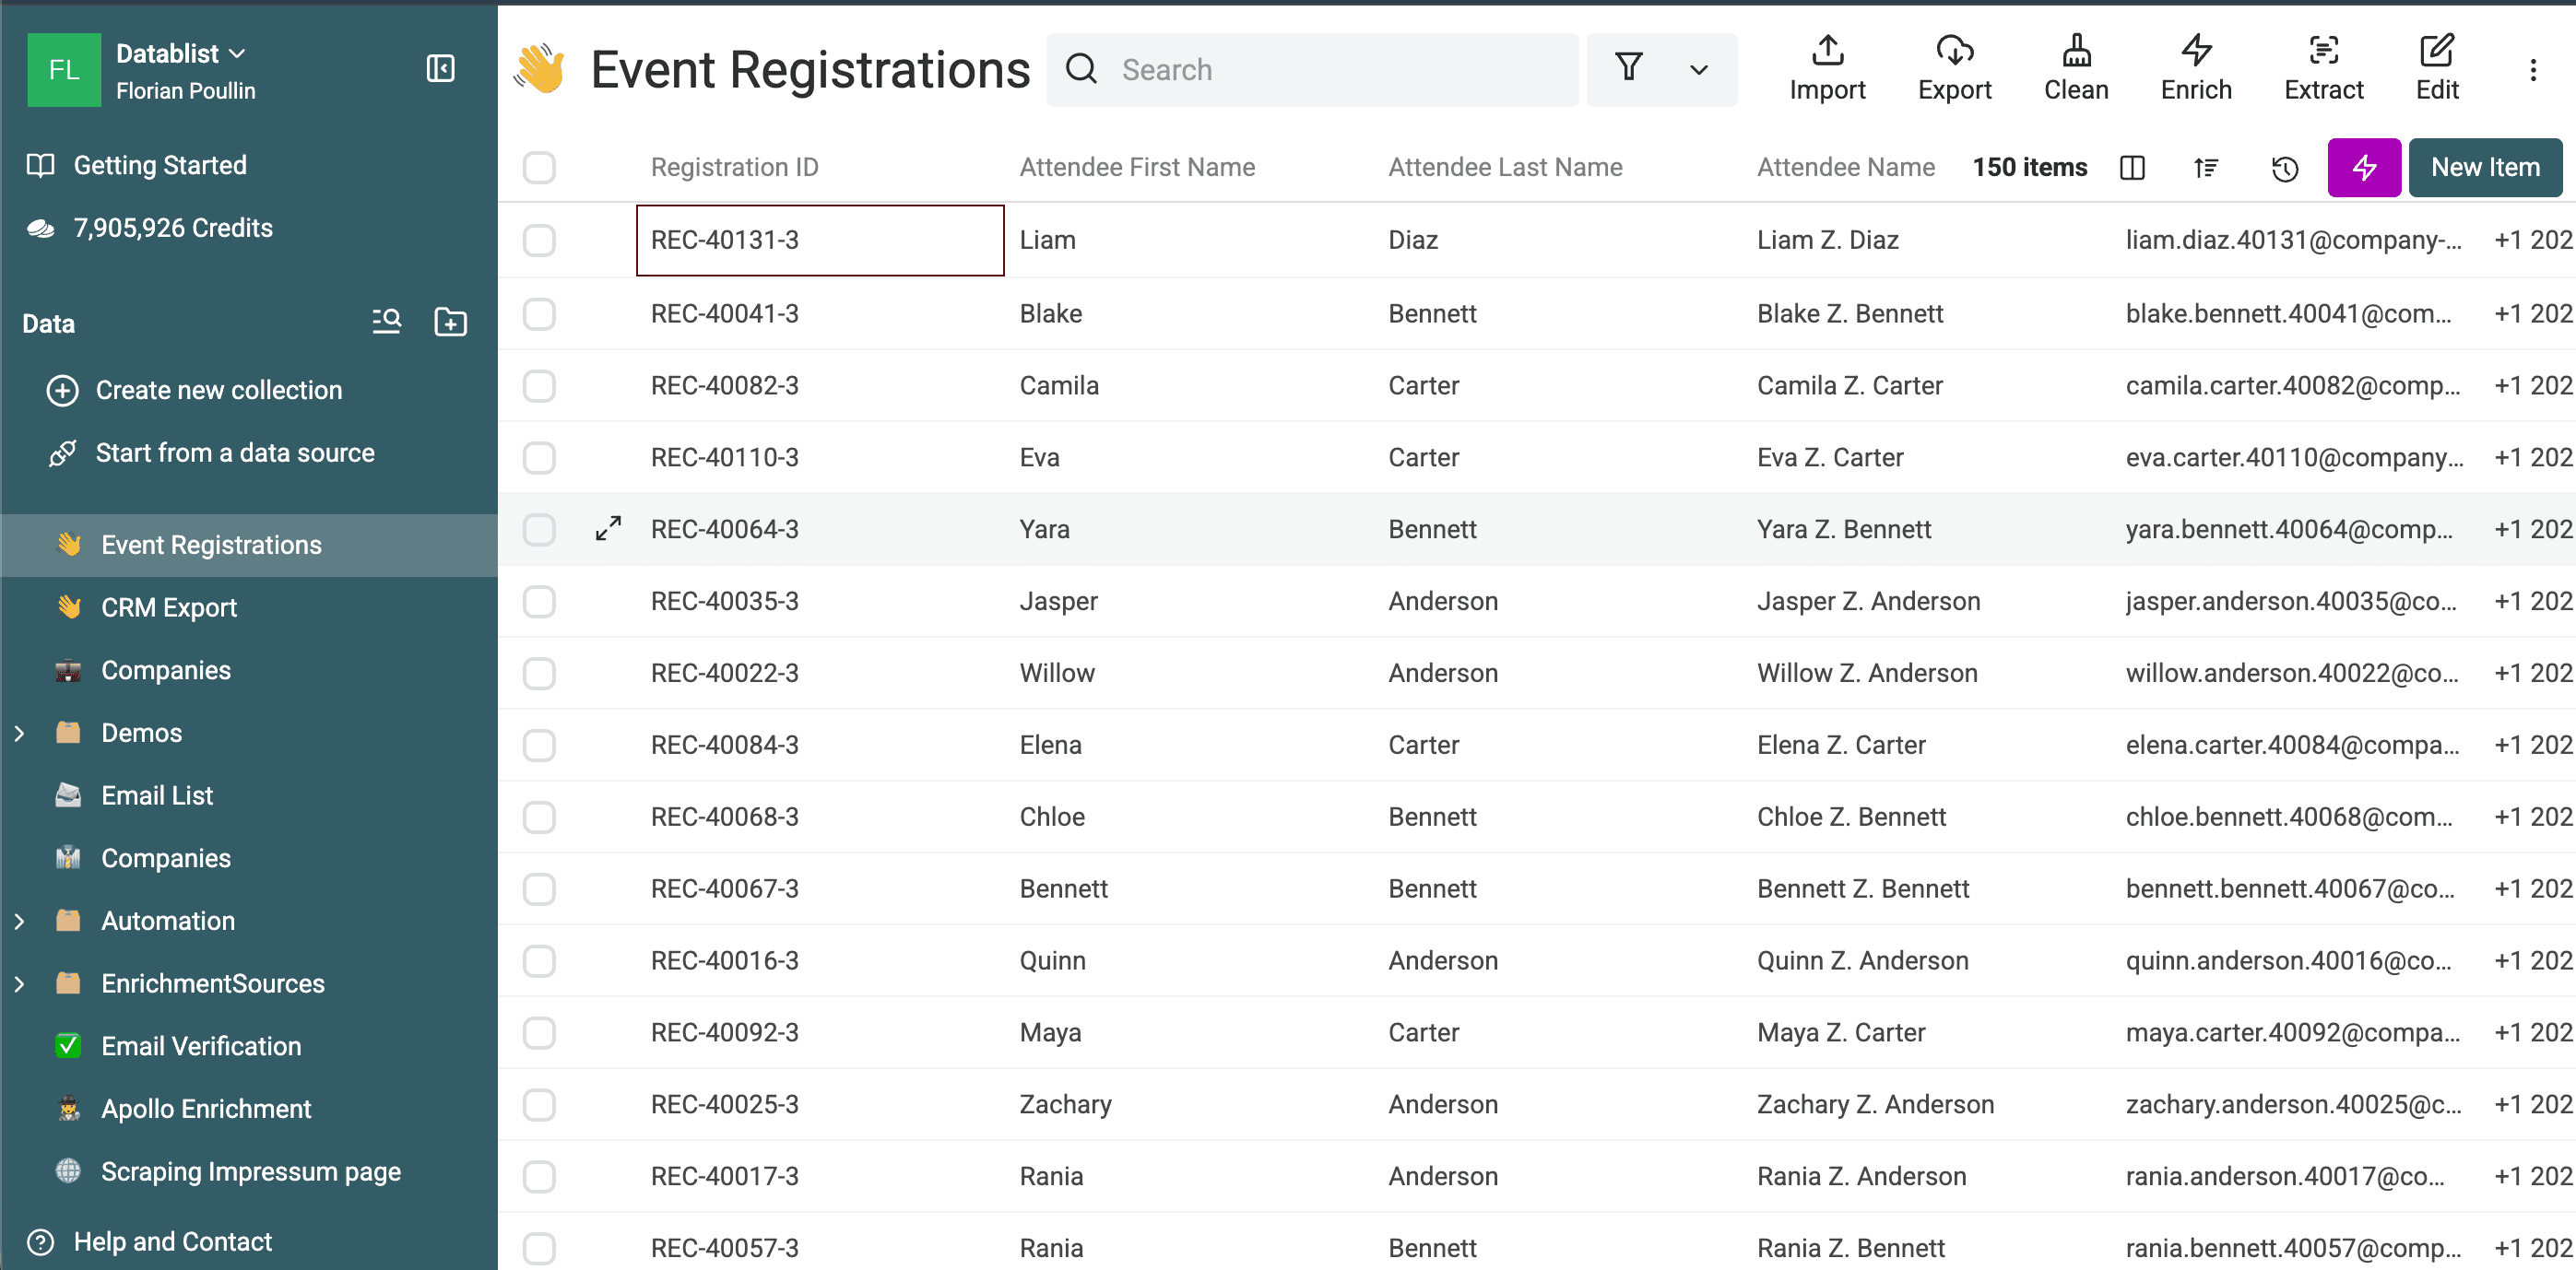
Le rapprochement du nombre de lignes est le suivant :
250 lignes entrantes - 100 contacts correspondant au CRM = 150 nouvelles lignes
Avant l’export, vérifiez les points suivants :
CRM Exportcontient toujours 250 éléments.Event Registrationscontient 150 éléments.- Quelques adresses email connues du CRM n’apparaissent plus dans la liste de l’événement.
- Les contacts de l’événement sans correspondance sont toujours présents.
- L’opération traitée apparaît dans History au cas où vous devriez l’annuler.
Exportez la collection nettoyée au format CSV ou Excel. Elle est maintenant prête pour un workflow de nouveaux leads, sans réimporter les contacts déjà enregistrés dans le CRM.
Limites de la déduplication entre collections
La comparaison entre collections répond à un besoin plus précis que la fusion de fichiers :
- Le traitement automatique supprime des enregistrements. Il ne regroupe pas les champs de plusieurs collections.
- Les doublons internes à une même collection sont ignorés.
- Chaque propriété utilisée pour la comparaison doit être associée dans toutes les collections sélectionnées.
- Les correspondances dépendent du score combiné des propriétés sélectionnées et des paramètres appliqués aux valeurs vides.
- Les comparaisons Smart, fuzzy et phonétiques peuvent produire des résultats qui nécessitent une vérification humaine.
- La comparaison entre collections nécessite un abonnement payant.
Utilisez ce workflow pour les listes de suppression, les contrôles avant import dans un CRM, le nettoyage des leads issus d’un événement, l’exclusion d’audiences de campagne ou tout autre processus dans lequel une liste doit rester la source de référence.
Si vous devez réunir plusieurs fichiers dans un seul tableau avant de les dédupliquer, suivez le guide pour fusionner des feuilles de calcul. Si vous souhaitez conserver des valeurs complémentaires au sein d’une même collection, utilisez le workflow pour fusionner des leads en double sans perdre de données.