
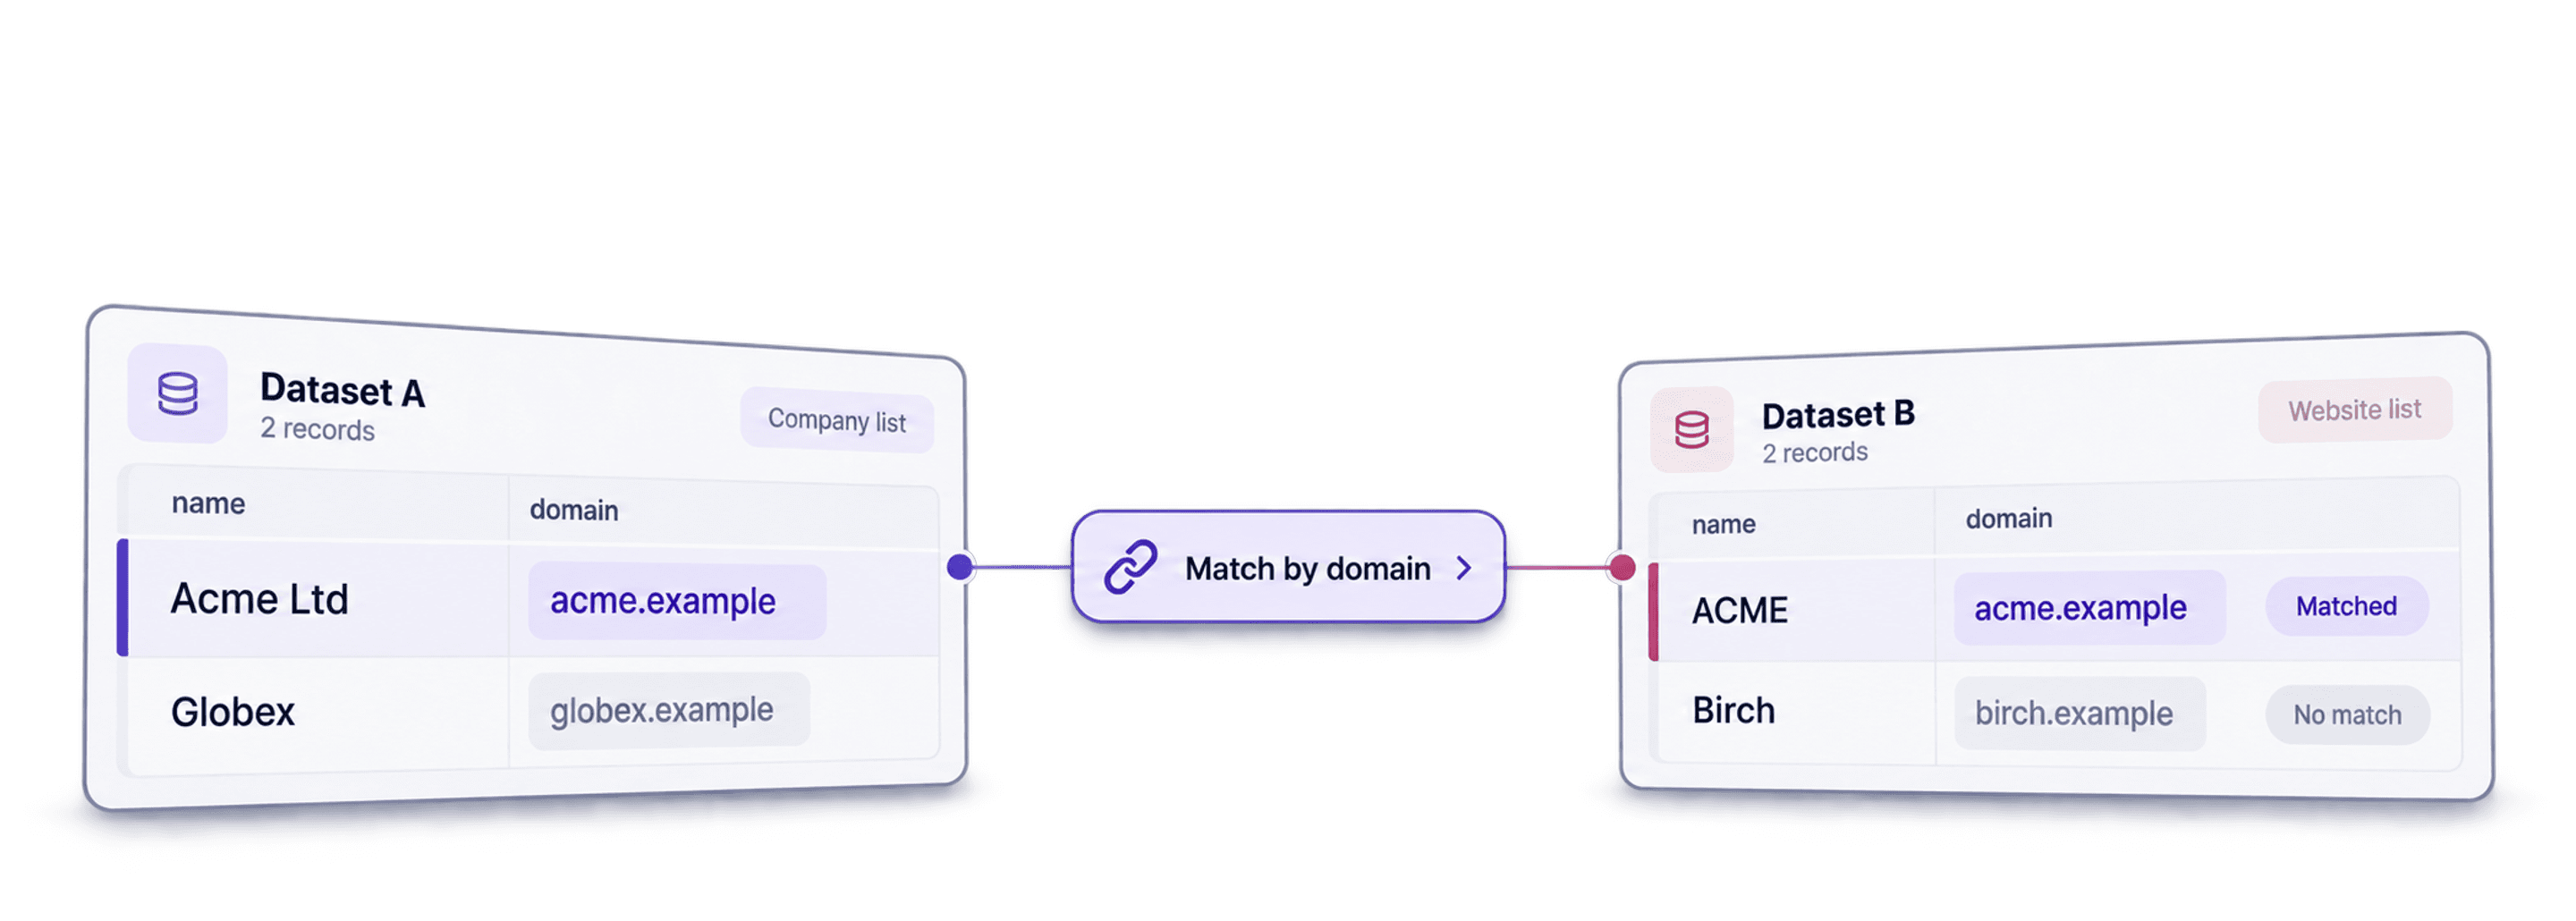
Utilisez un outil de rapprochement de données lorsque deux listes peuvent contenir les mêmes personnes ou entreprises sous des noms légèrement différents. Dans Datablist, importez les listes dans des collections, associez les colonnes à comparer, choisissez un algorithme de matching, puis examinez les groupes proposés avant de les fusionner ou de les exporter. Commencez par un identifiant exact, comme une adresse email ou un domaine d’entreprise. N’utilisez le fuzzy matching sur les noms qu’en l’absence d’identifiant stable, et vérifiez ses résultats à l’aide d’un second champ.
Par exemple, une liste de leads peut contenir Acme Ltd avec le domaine acme.com, tandis qu’une autre contient ACME avec le même domaine. La correspondance du domaine constitue un indice plus fiable pour relier ces lignes que la seule similarité des noms. Le Duplicates Finder de Datablist peut comparer les enregistrements au sein d’une collection ou entre plusieurs collections, puis afficher les groupes à vérifier. Les algorithmes avancés de matching phonétique et de fuzzy matching sont disponibles avec les offres payantes.
Voici un aperçu des étapes de rapprochement de données présentées dans cet article :
- Importer vos jeux de données
- Préparer, nettoyer et normaliser vos données
- Rapprocher des enregistrements dans une ou plusieurs collections
- Dédoublonner : supprimer ou fusionner les groupes
Vérifiez les correspondances avant toute fusion. Des noms similaires peuvent désigner des personnes ou des entreprises différentes, surtout s’ils sont courts ou abrégés.
Étape 1 : importer vos jeux de données
La première étape consiste à importer vos jeux de données dans Datablist. Datablist est un outil en ligne de gestion de listes. Vous pouvez afficher et modifier des fichiers CSV et Excel. C’est l’outil idéal pour gérer vos listes de leads, nettoyer vos données clients ou nettoyer des données extraites du web.
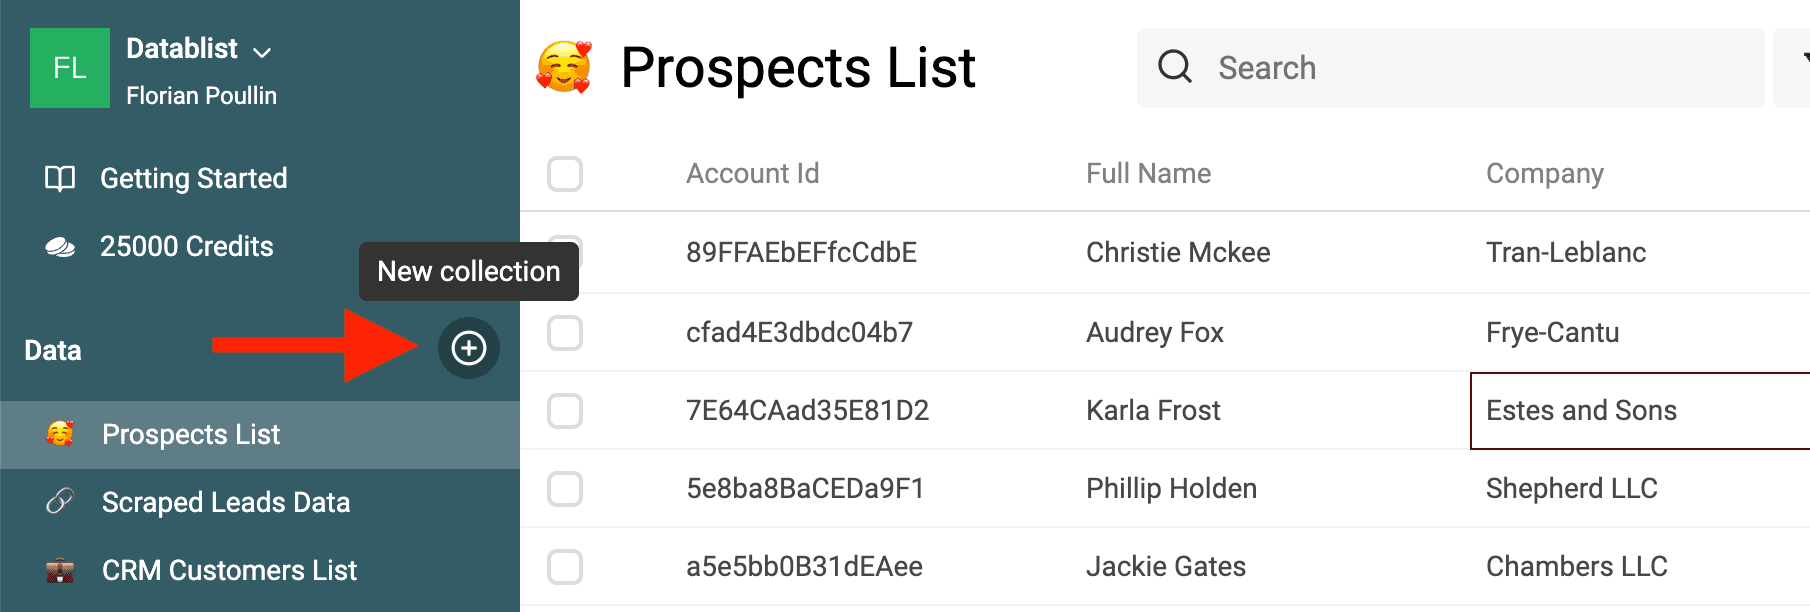
Pour commencer, créez une collection afin d’importer votre premier jeu de données.
Cliquez ensuite sur le bouton Import.
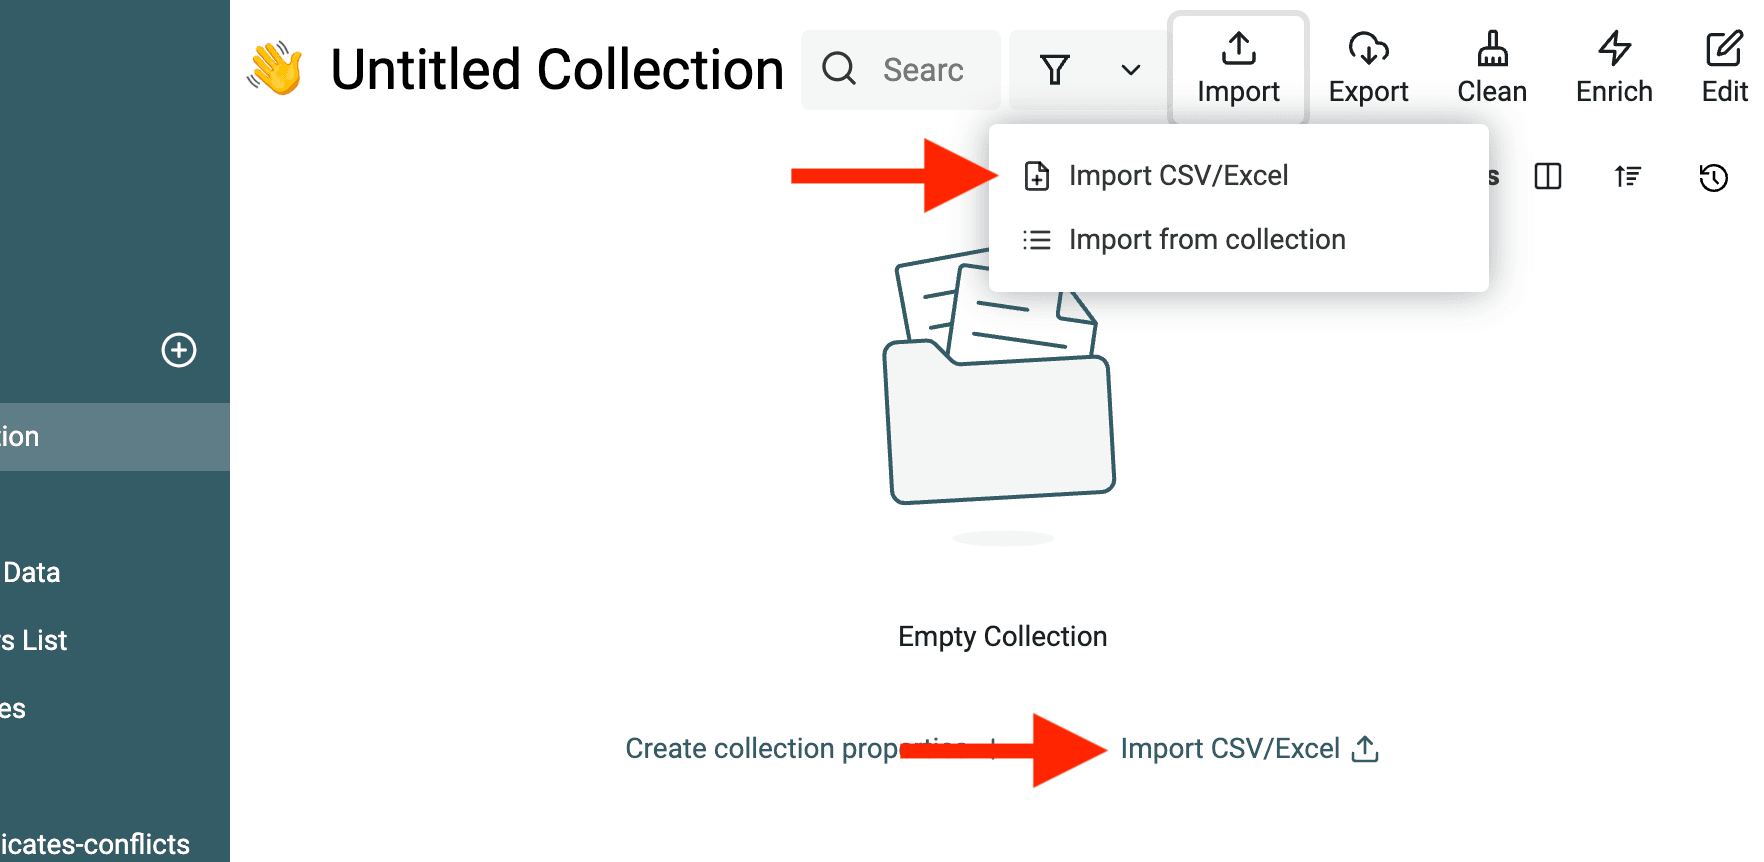
Une fois votre premier jeu de données importé, vous pouvez :
- Importer dans la même collection d’autres jeux de données ayant une structure commune.
- Importer dans de nouvelles collections les jeux de données dont la structure est différente.
Le Duplicates Finder de Datablist détecte les enregistrements similaires dans une seule collection ou dans plusieurs collections ayant des structures différentes.
Étape 2 : nettoyer et normaliser vos données
La deuxième étape est le nettoyage des données. Cette préparation est indispensable au rapprochement de données, car elle garantit la précision et la fiabilité du processus. Des données sales ou mal nettoyées peuvent produire de fausses correspondances et des résultats peu fiables. En bref, le nettoyage des données est la base d’un rapprochement réussi.
Lorsqu’ils apparaissent dans des noms de personnes ou d’entreprises, certains éléments parasites n’apportent aucune information et peuvent empêcher l’algorithme de dédoublonnage de détecter les doublons.
Datablist propose plusieurs outils de nettoyage des données intégrés :
- Supprimer les symboles et la ponctuation - Les textes extraits du web peuvent contenir des smileys, des symboles ASCII ou des noms avec de la ponctuation. L’algorithme de matching de Datablist les ignore lors du rapprochement, mais ils peuvent empêcher la fusion automatique pendant le processus de dédoublonnage.
- Supprimer les espaces superflus - Un simple espace en trop entre deux mots suffit à rendre deux chaînes différentes. Les algorithmes de matching de Datablist prétraitent les valeurs textuelles pour retirer ces espaces, mais ceux-ci peuvent tout de même empêcher la fusion automatique pendant le processus de dédoublonnage.
- Extraire des adresses email, des URL, etc. depuis un texte - Si vos données contiennent du texte non structuré avec des adresses email, des URL, des mentions de membres, des tags, etc., utilisez notre Data Extractor pour extraire ces entités et structurer vos données. Le rapprochement sera plus simple avec des entités structurées.
- Supprimer les balises HTML - Vous pouvez également convertir en texte brut des chaînes contenant des balises HTML. Cela permet de rapprocher des listes extraites du web avec vos autres jeux de données.
- Convertir du texte en DateTime, Number, Boolean, etc. - Datablist propose de véritables types de données natifs, notamment DateTime, Number et Boolean. La conversion du texte brut vers un format natif est une étape importante du nettoyage. Ces formats sont essentiels pour appliquer des règles de fusion avancées lorsqu’un enregistrement principal doit être choisi à partir d’une comparaison de valeurs, par exemple selon la date la plus récente.
- Modifier la casse pour uniformiser le format - La transformation de la casse est une opération simple, mais nécessaire. Datablist intègre plusieurs algorithmes de changement de casse).
- Scinder ou fusionner des propriétés - Cette fonctionnalité est idéale pour traiter les données multivaleurs. Si une propriété contient plusieurs adresses email séparées par des virgules, des points-virgules ou des espaces, l’outil Split Property de Datablist crée plusieurs propriétés ne contenant chacune qu’une seule adresse.
- Supprimer ou remplacer les valeurs vides - Utilisez les fonctionnalités de filtrage de Datablist pour filtrer les valeurs ou les lignes vides.
Consultez notre guide du nettoyage des données pour découvrir davantage d’exemples et d’instructions.
Normaliser les noms de personnes
Il est fréquent de travailler sur des fichiers de personnes lors d’un dédoublonnage de données. Les fichiers de clients, de leads et de prospects en sont de bons exemples. Dans le meilleur des cas, le rapprochement s’appuie sur des identifiants uniques, comme une adresse email ou un numéro d’identité. Sans ces identifiants, ou pour rapprocher des personnes entre plusieurs jeux de données, vous devrez utiliser leurs noms.
Le prétraitement des noms garantit un format homogène et réduit les erreurs de dédoublonnage.
Supprimer les éléments parasites des noms
Les noms de personnes peuvent varier fortement. Surnoms, abréviations, variantes orthographiques et caractères spéciaux sont monnaie courante.
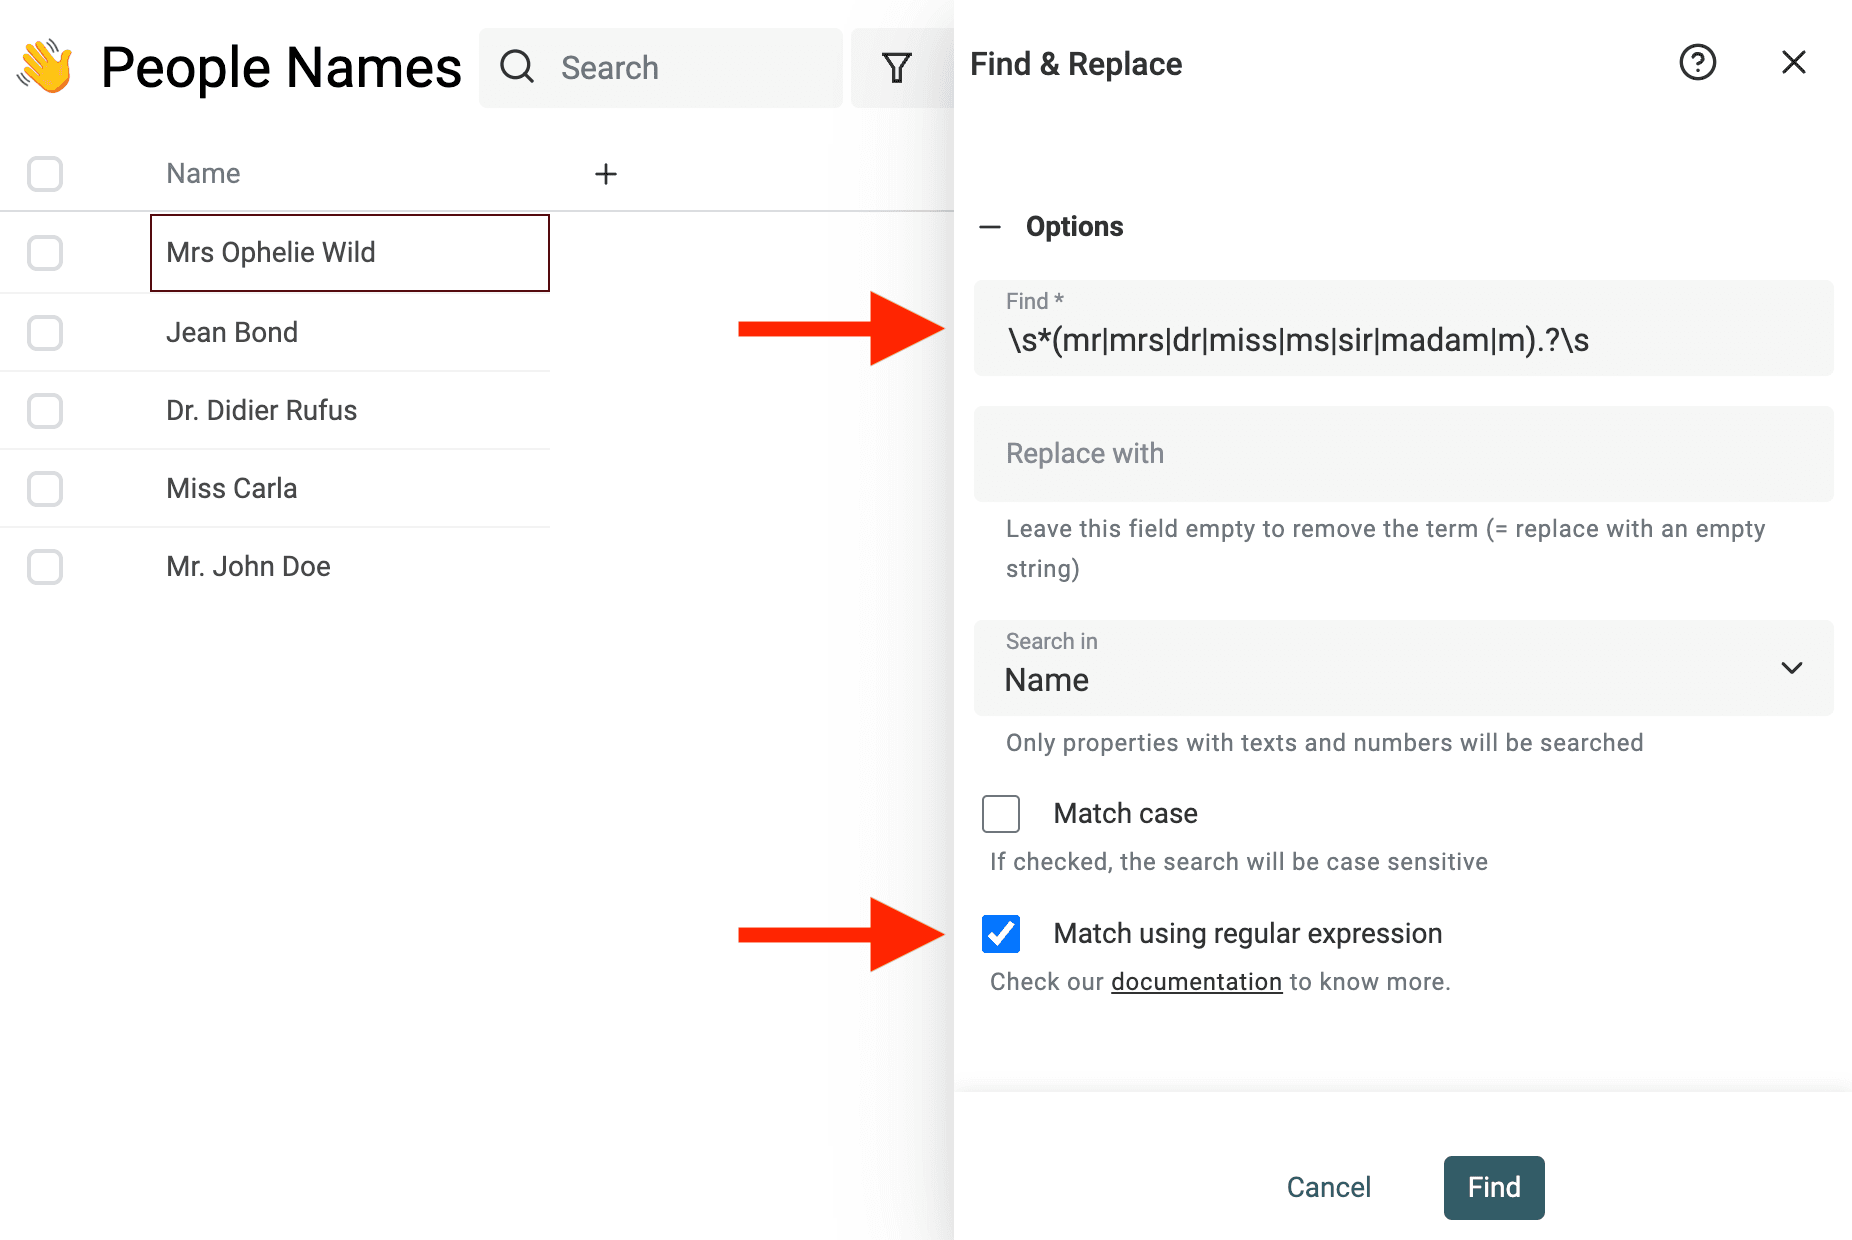
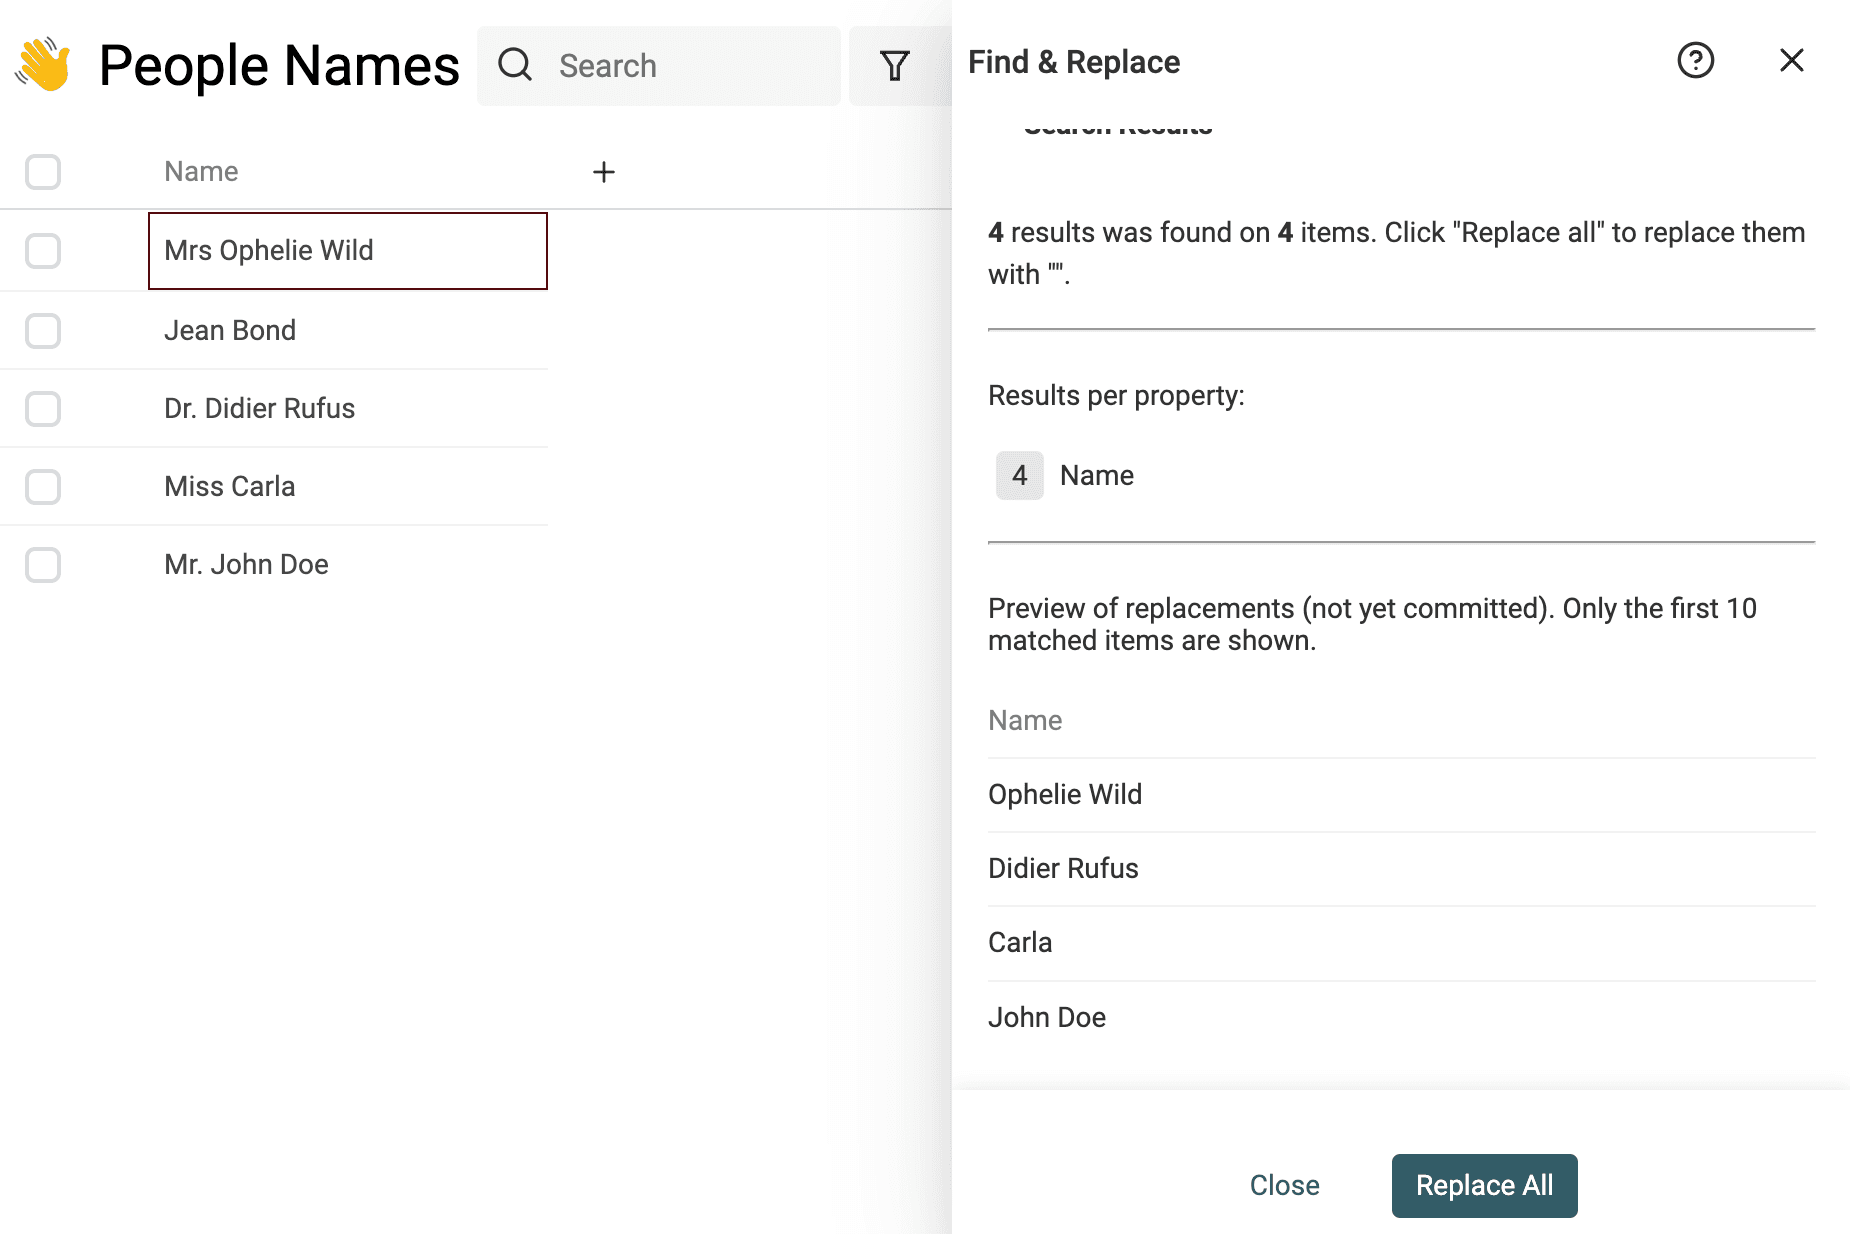
Utilisez le puissant outil Find & Replace pour supprimer les préfixes, suffixes, stop words, ajouts régionaux et autres mots inutiles.
Par exemple, vous pouvez utiliser cette expression régulière pour retirer les titres de civilité :
^\s*(mr|mrs|dr|miss|ms|sir|madam|m).?\s
Remplacez ensuite le résultat par une chaîne vide.
Remarque Si vous ne maîtrisez pas les expressions régulières, contactez-nous : nous vous aiderons à nettoyer vos données.
Décomposer un nom complet
Datablist ne se limite pas au nettoyage : l’outil propose aussi de l’enrichissement de données, comme l’enrichissement de leads ou la traduction de fichiers CSV avec DeepL.
Name Parser est un enrichissement parfaitement adapté au nettoyage des noms. À partir d’un nom complet, il extrait ses différentes parties : prénom, deuxième prénom et nom de famille. Il indique également le genre et le pays le plus souvent associés au nom.
Il s’appuie sur des données statistiques pour décomposer les noms complets.
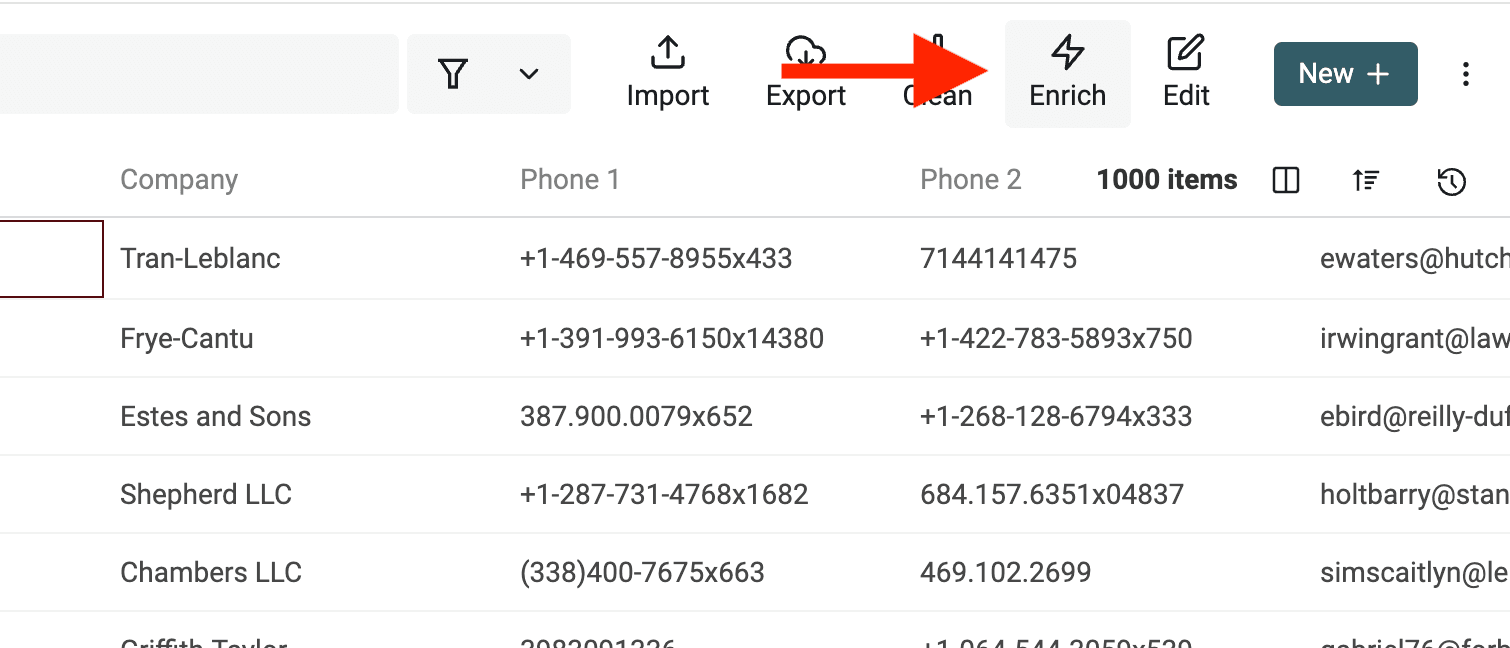
Pour l’utiliser, ouvrez le menu "Enrich Menu" depuis les boutons situés en haut de l’écran.
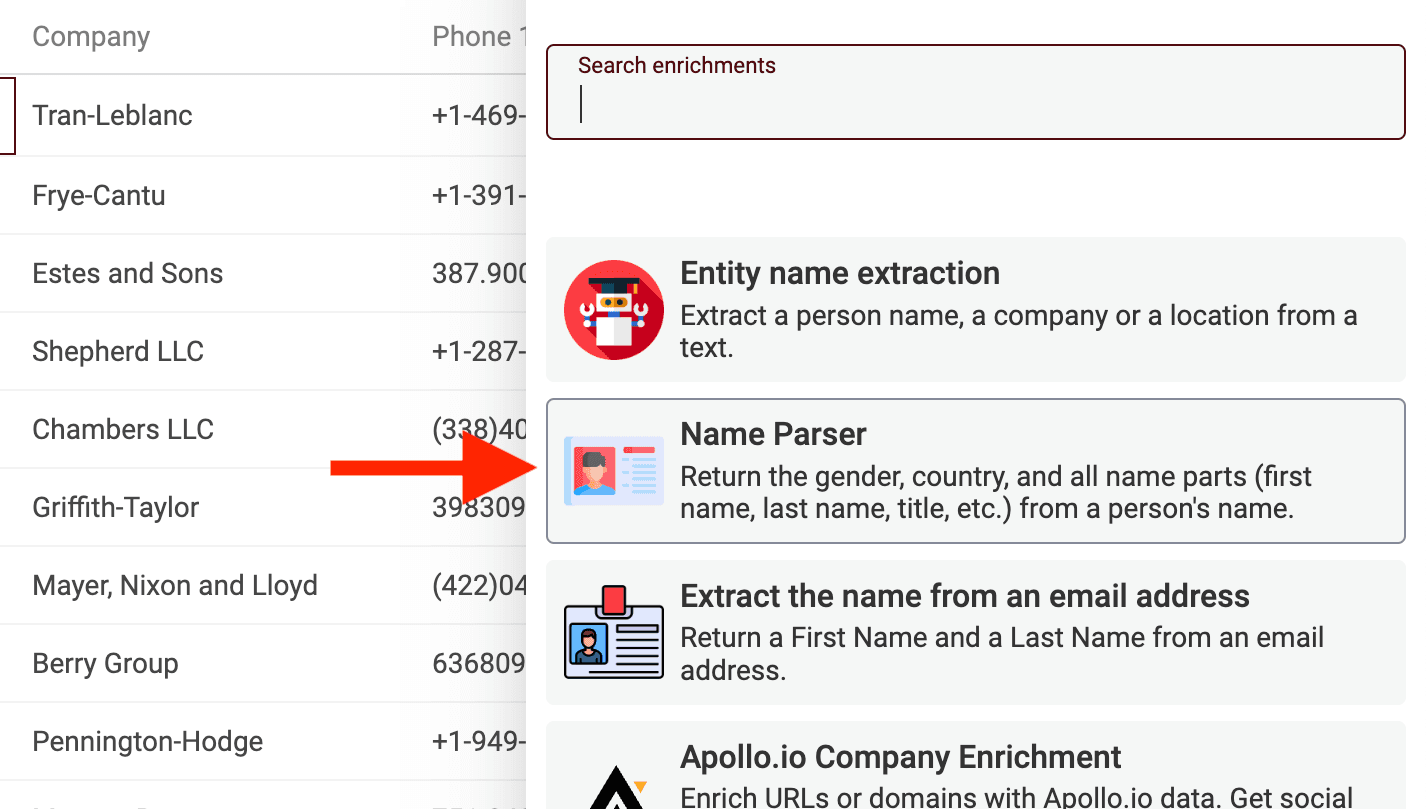
Sélectionnez ensuite "Name Parser".
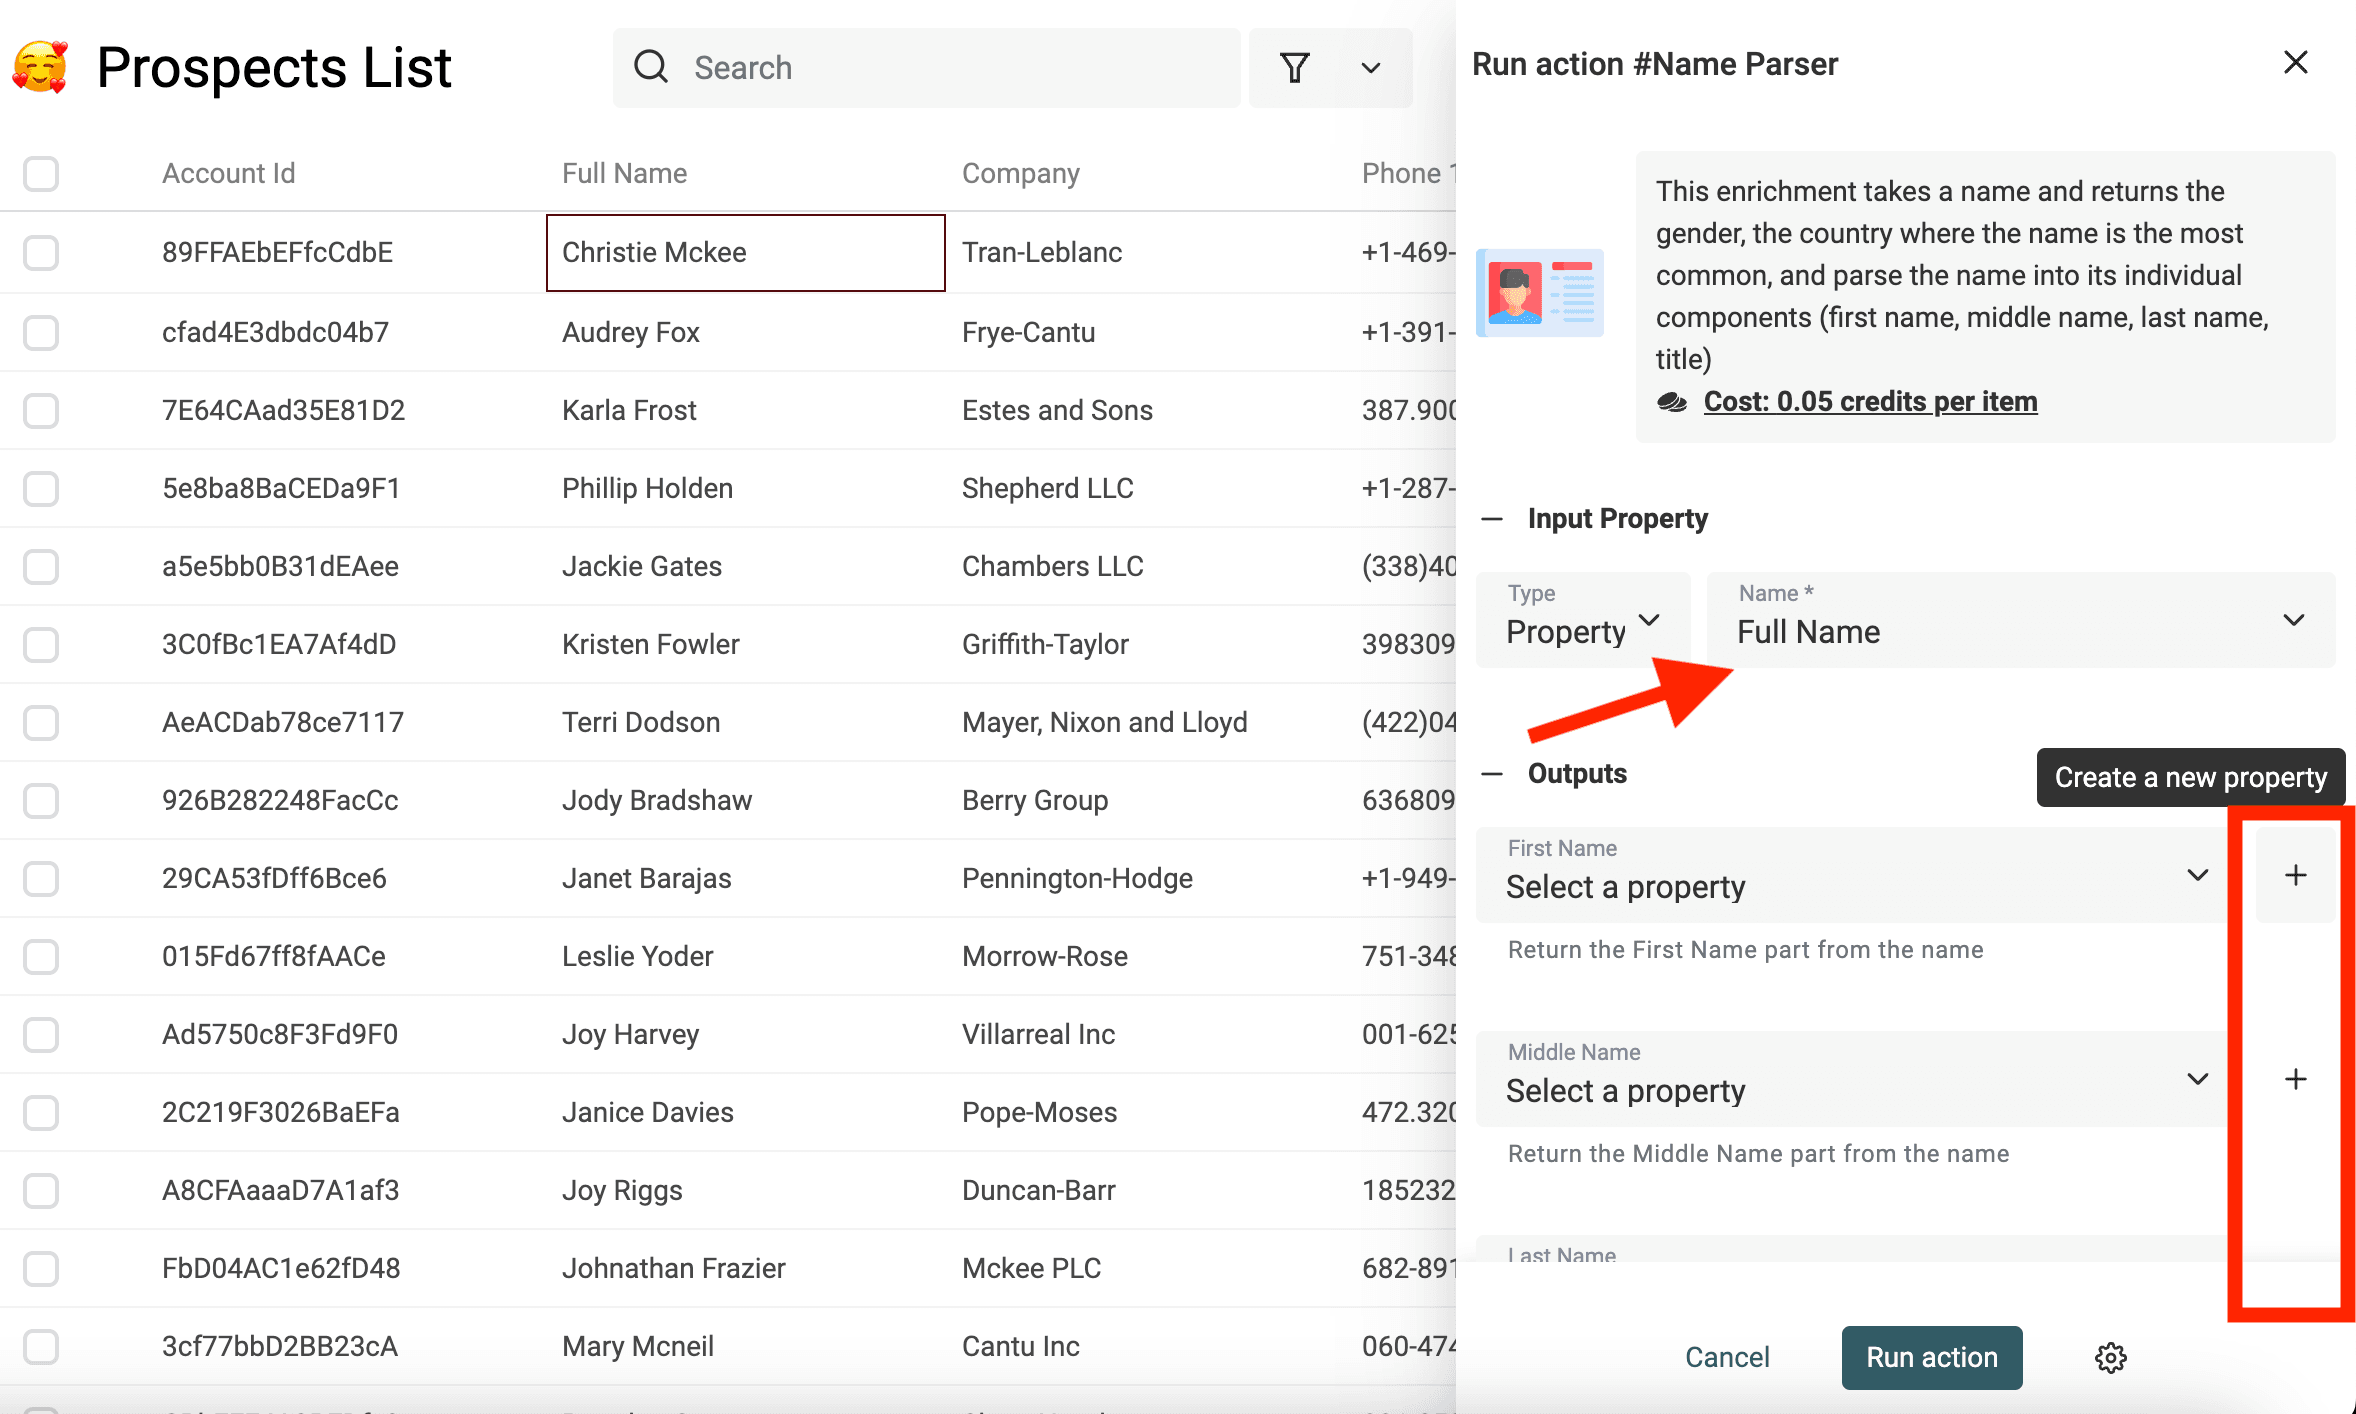
Choisissez la propriété contenant les noms, puis associez ou créez de nouvelles propriétés pour enregistrer les résultats. La propriété contenant le nom complet ne sera pas modifiée : seules les propriétés de sortie recevront les résultats.
Normaliser les noms d’entreprises
Vous pouvez également supprimer les éléments parasites des noms d’entreprises : préfixes, suffixes, stop words, ajouts régionaux ou autres termes susceptibles de nuire au matching.
Vous pouvez, par exemple, retirer les suffixes de formes juridiques comme "Inc." ou "GmbH".
Utilisez cette expression régulière dans l’outil Find & Replace :
,?\s(llc|inc|incorporated|corporation|corp|co|gmbh|ltd).?$
Remplacez ensuite le résultat par une chaîne vide.
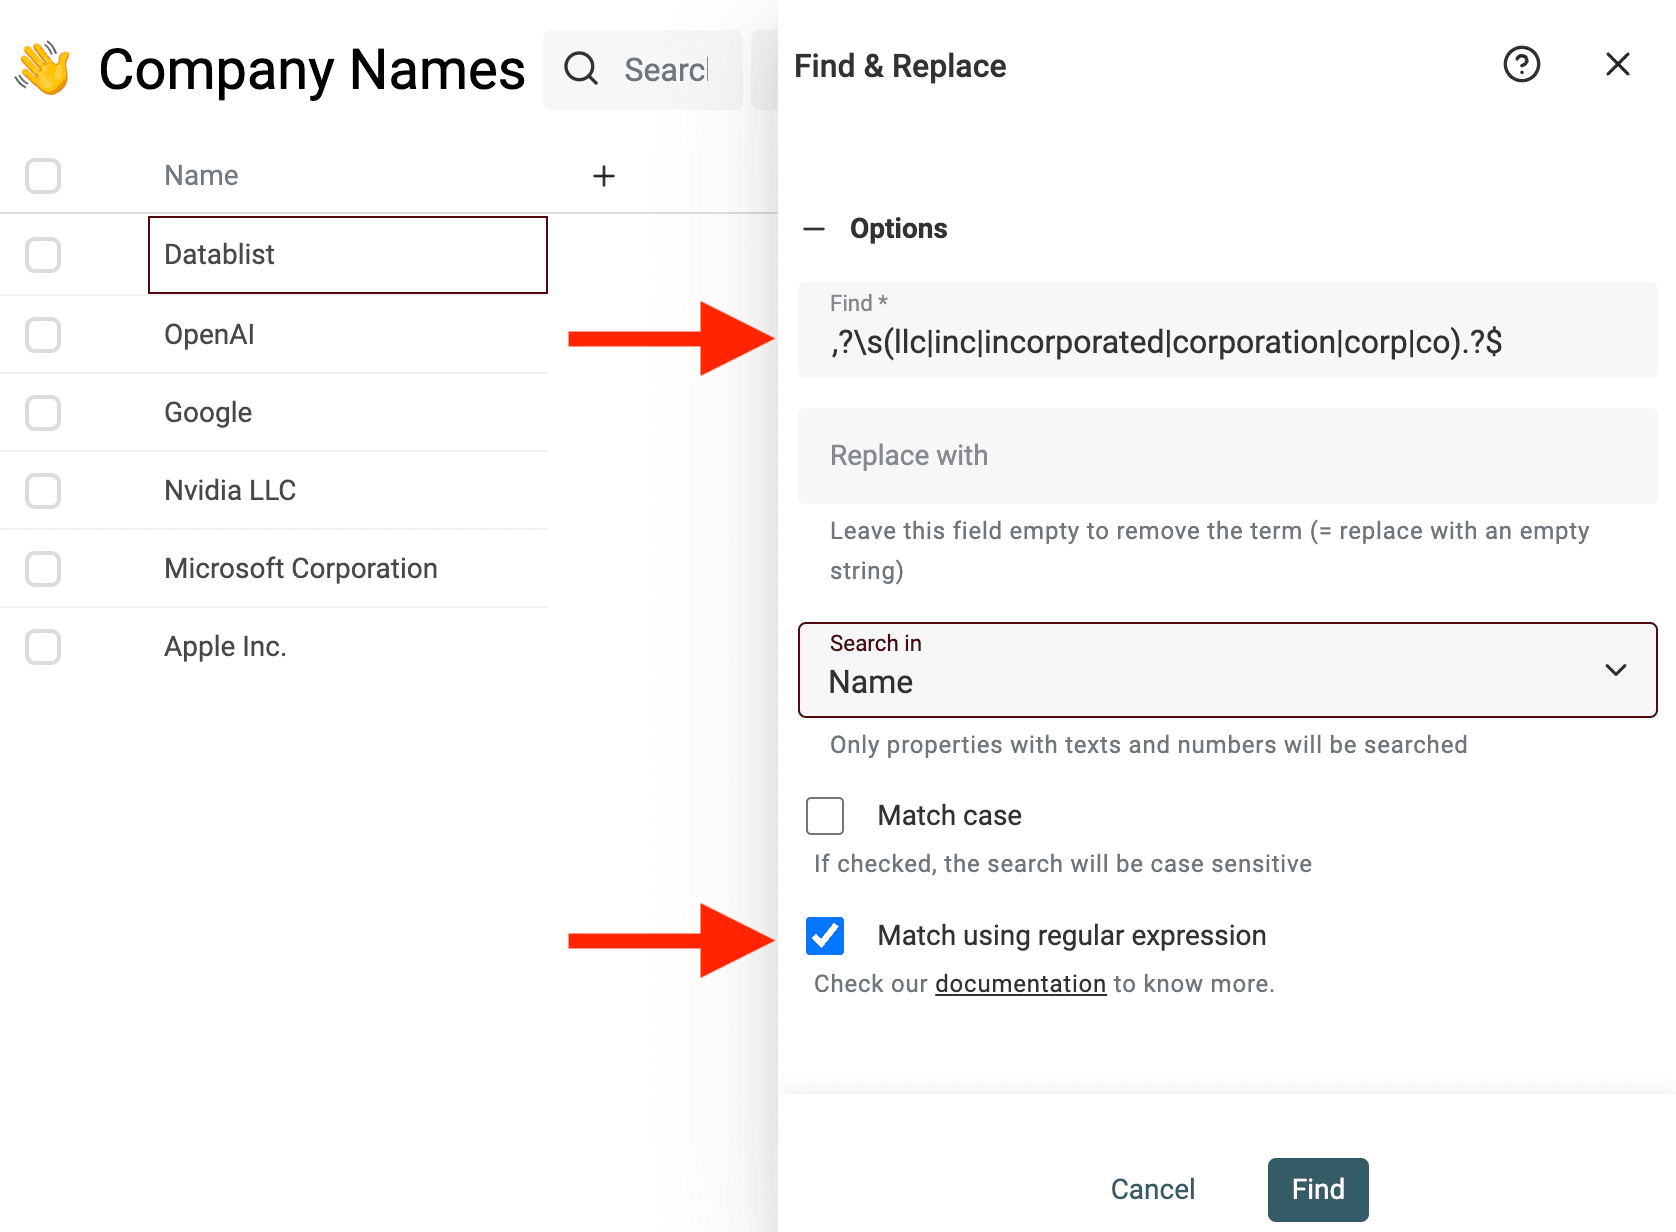
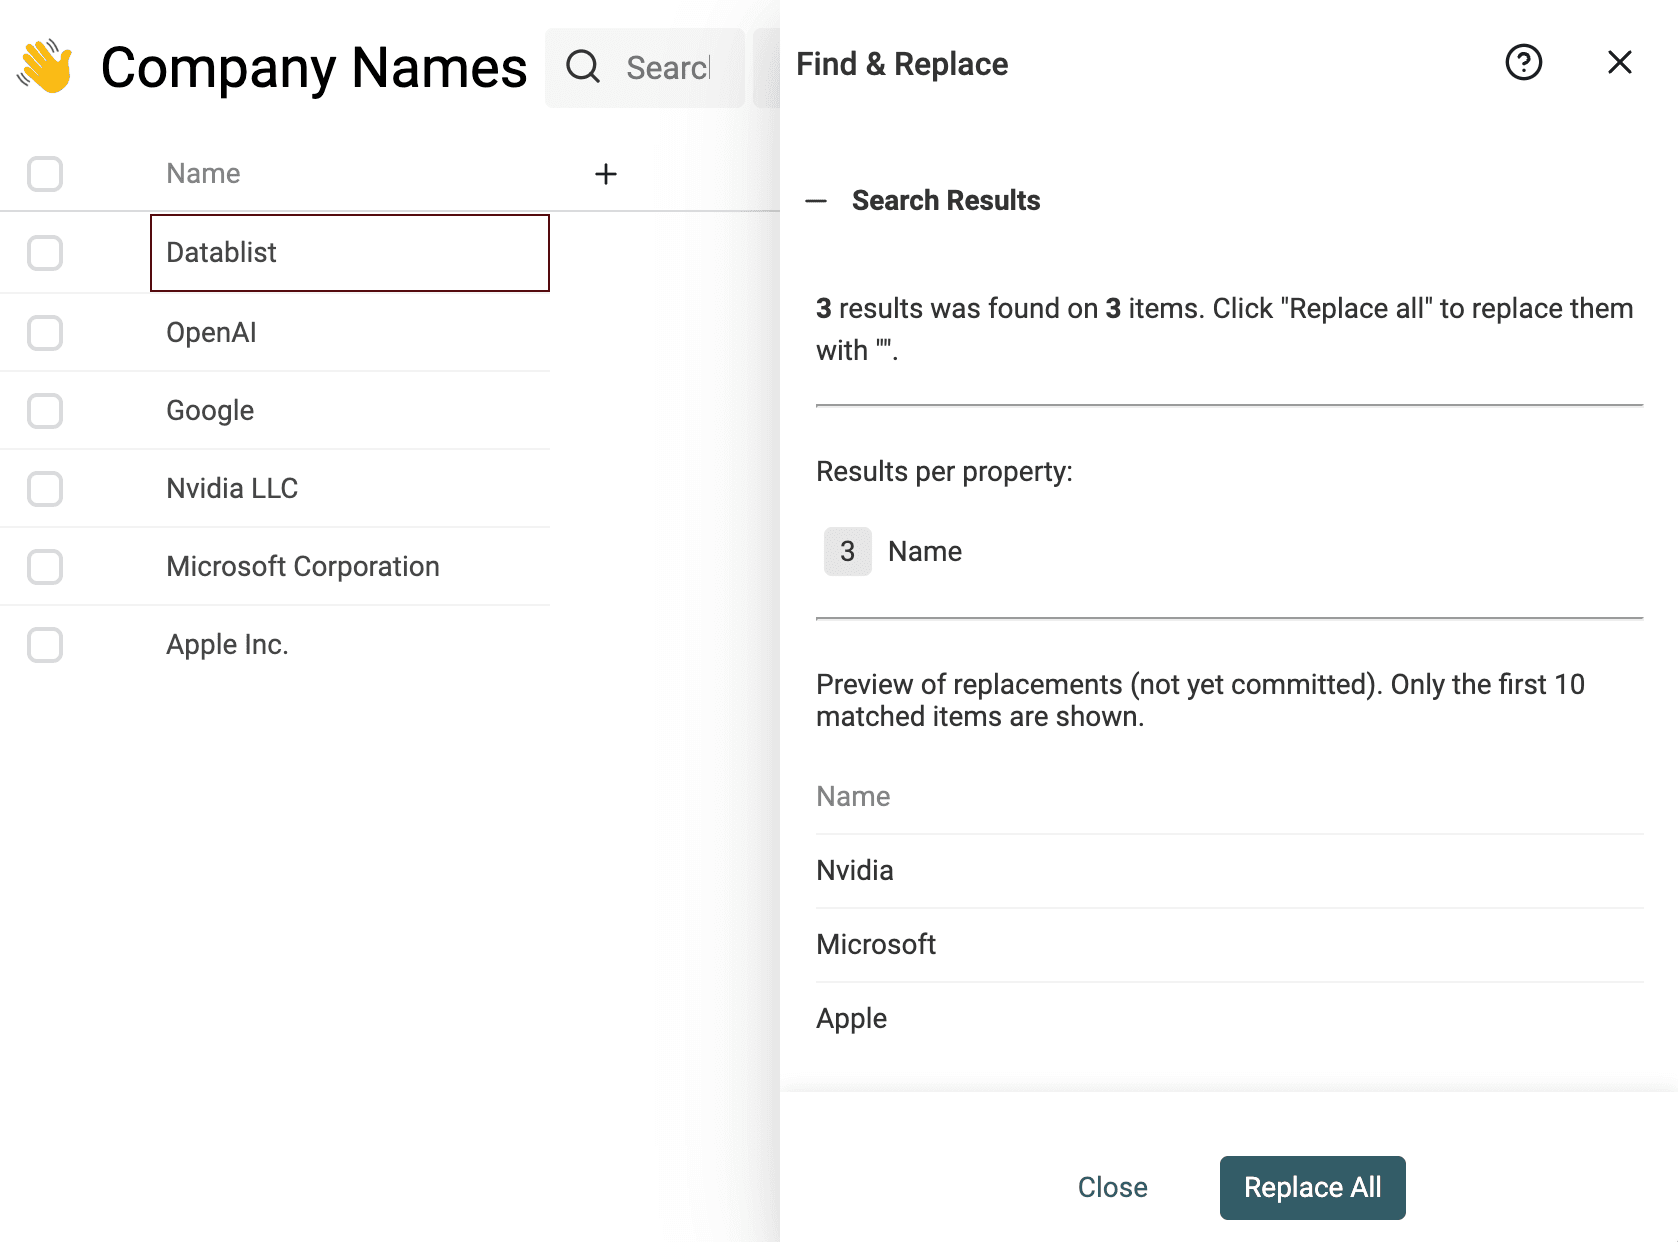
Il est important de normaliser les noms et les adresses des entreprises dans tous vos jeux de données afin d’obtenir un format standard.
Normaliser les noms de rues
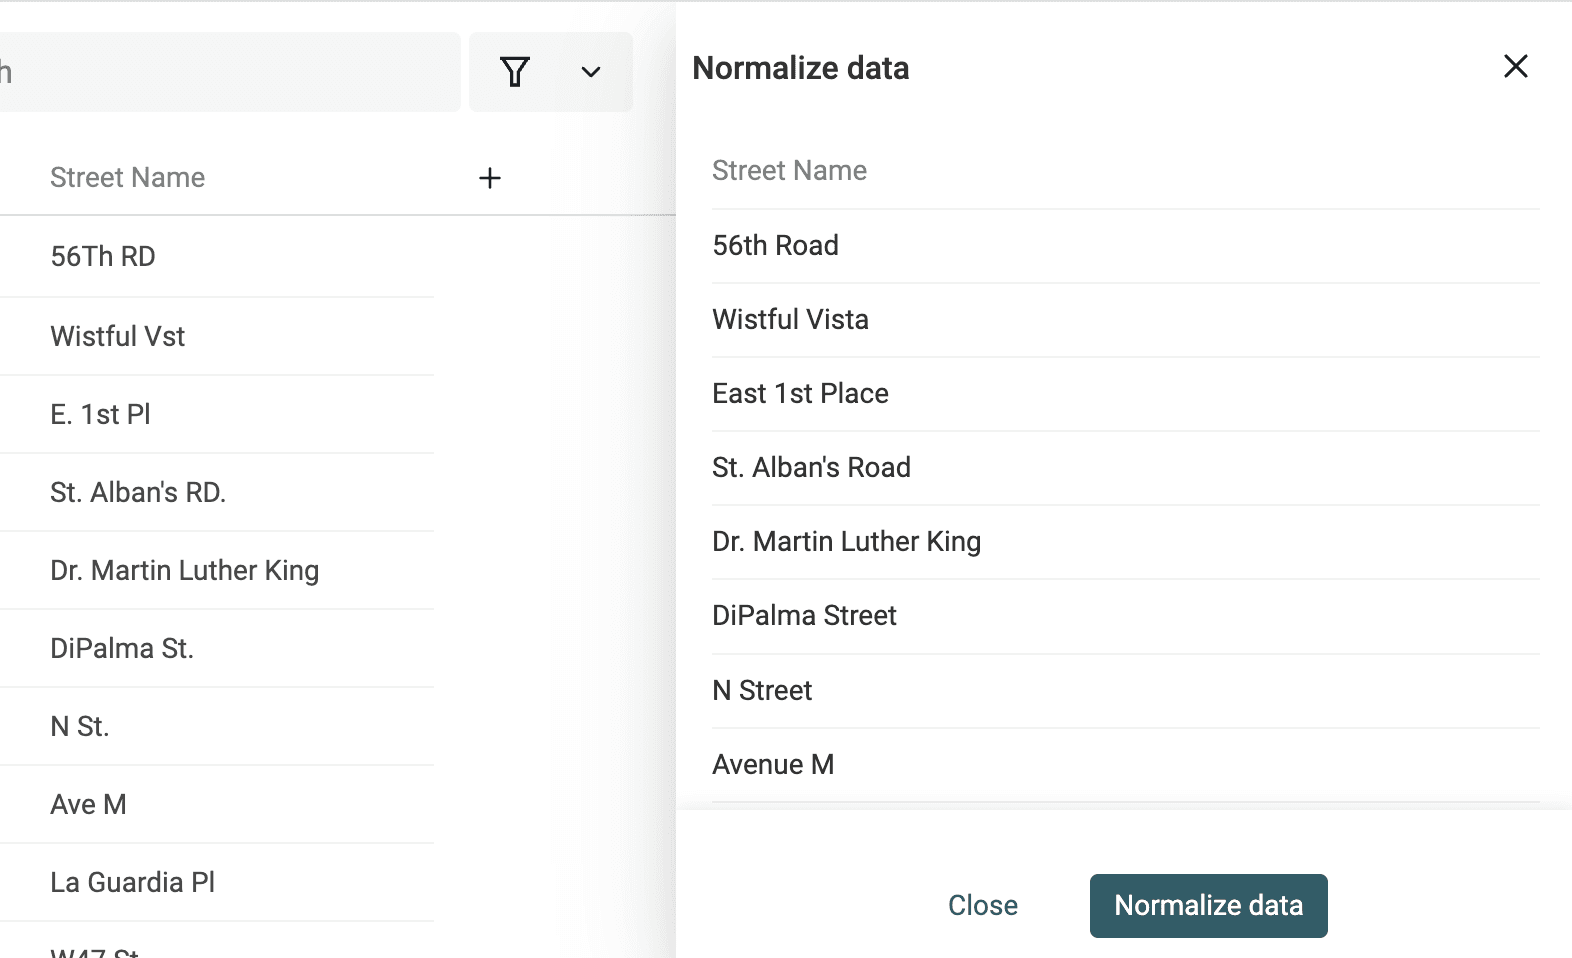
Si vous rapprochez des adresses postales, la normalisation des noms de rues est essentielle. Les adresses peuvent contenir des abréviations, des indications de direction ou des suffixes ordinaux. Sans normalisation, une même rue peut apparaître sous plusieurs formes, ce qui complique fortement le rapprochement.
Par exemple, Main 9 St, Main 9TH St. et Main 9th Street désignent la même rue, tout comme Washington Blvd et Washington Boulevard.
Utiliser des algorithmes fuzzy pour gérer ces variations est peu efficace. Plusieurs caractères séparent Washington Blvd de Washington Boulevard, et la distance de similarité calculée par les algorithmes de fuzzy matching serait élevée.
Il est plus efficace de normaliser les noms de rues. Un format unique garantit la cohérence des données.
Datablist propose une normalisation adaptée au format des rues anglophones. Elle uniformise notamment les abréviations et les numéros de rue.
Remarque
La normalisation des noms de rues fonctionne avec des adresses décomposées. Le nom de la rue doit se trouver dans une propriété distincte. Les adresses complètes ne sont pas prises en charge.
Cliquez sur "Normalize Street Names" dans le menu "Clean".
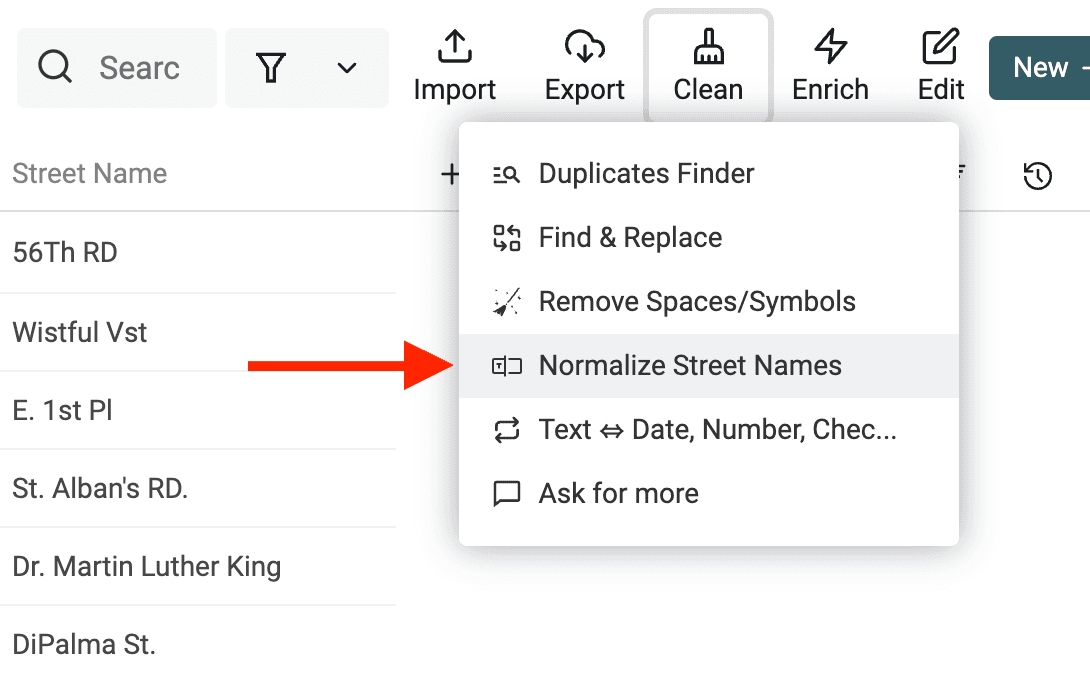
Sélectionnez ensuite la propriété contenant les noms de rues, puis choisissez "Normalize english street names".
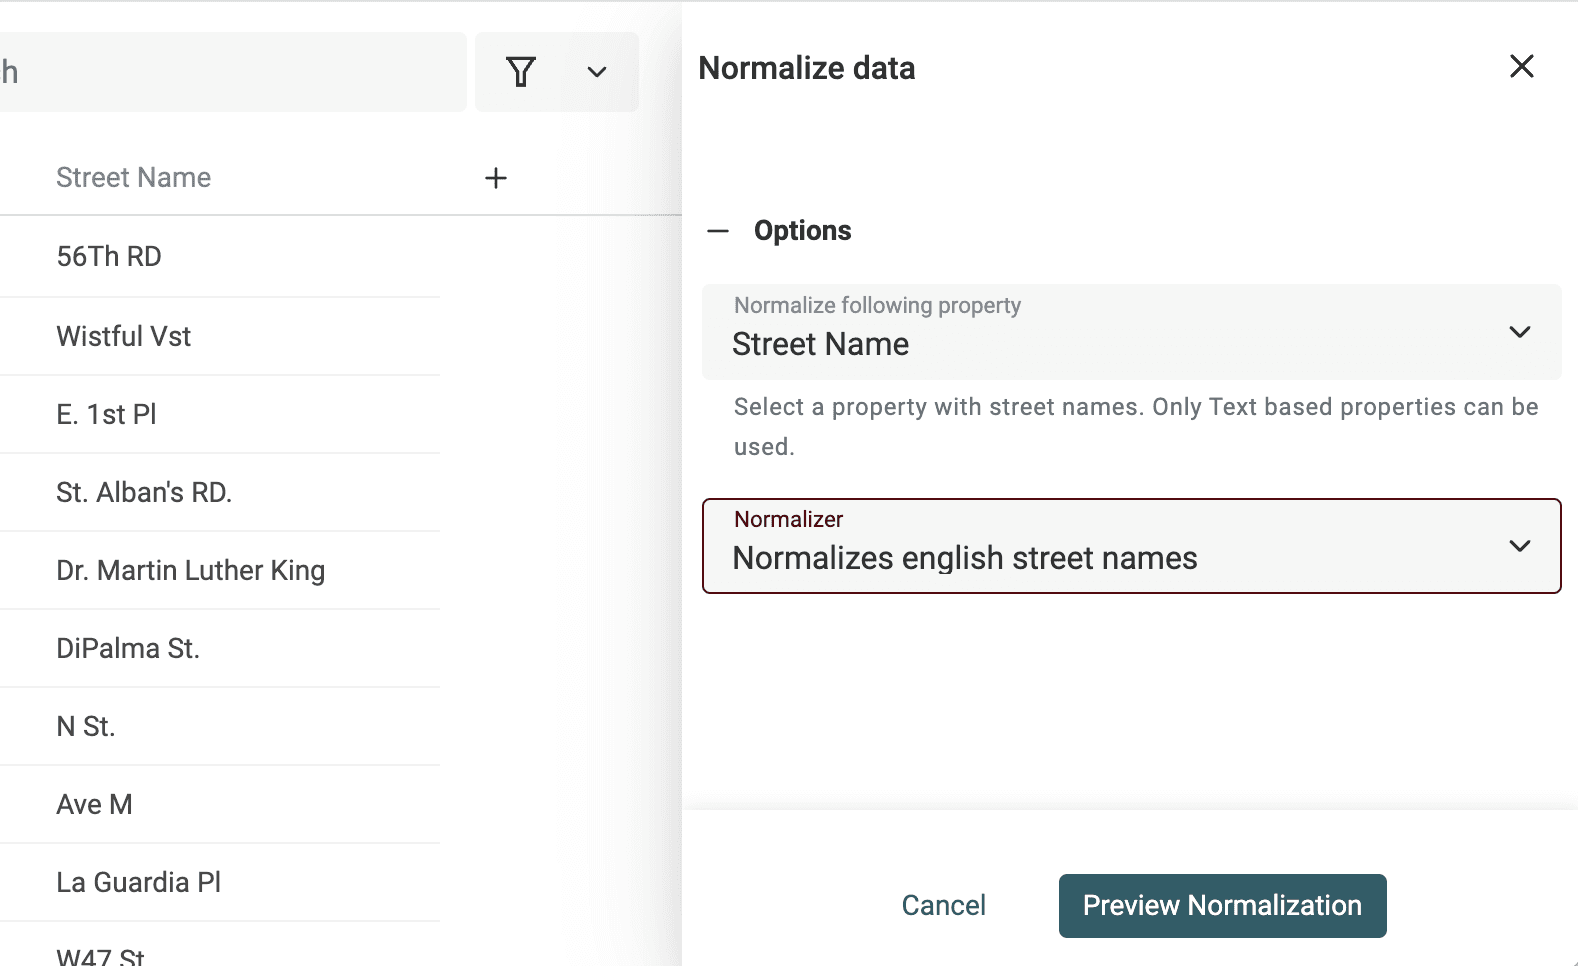
Vérifiez les modifications dans l’aperçu, puis cliquez sur "Run".
Étape 3 : rapprocher les enregistrements
Maintenant que vos données sont propres et normalisées, vous pouvez passer au rapprochement. L’objectif de cette étape est de regrouper les enregistrements similaires.
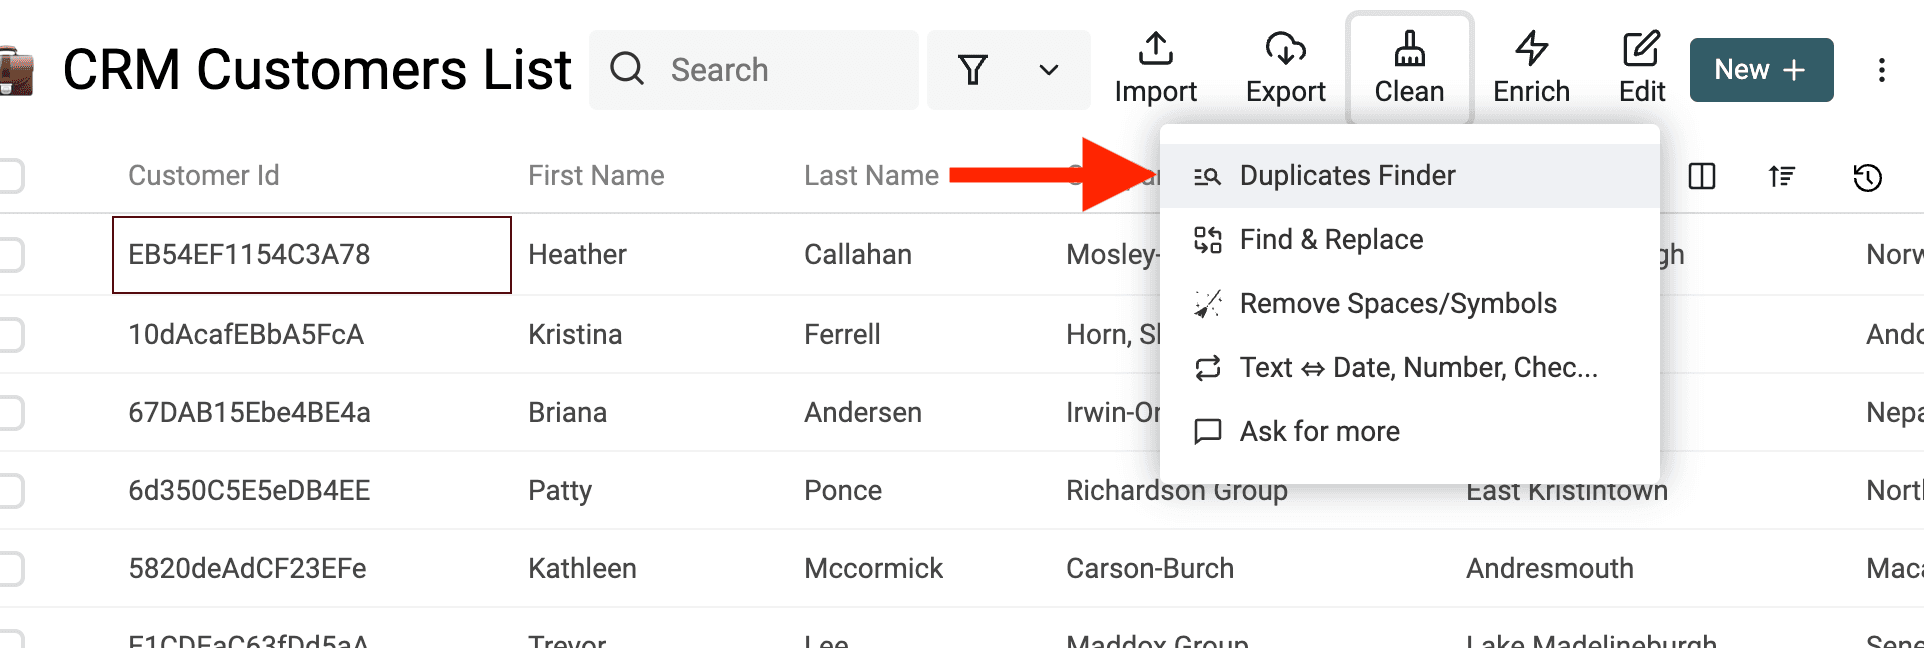
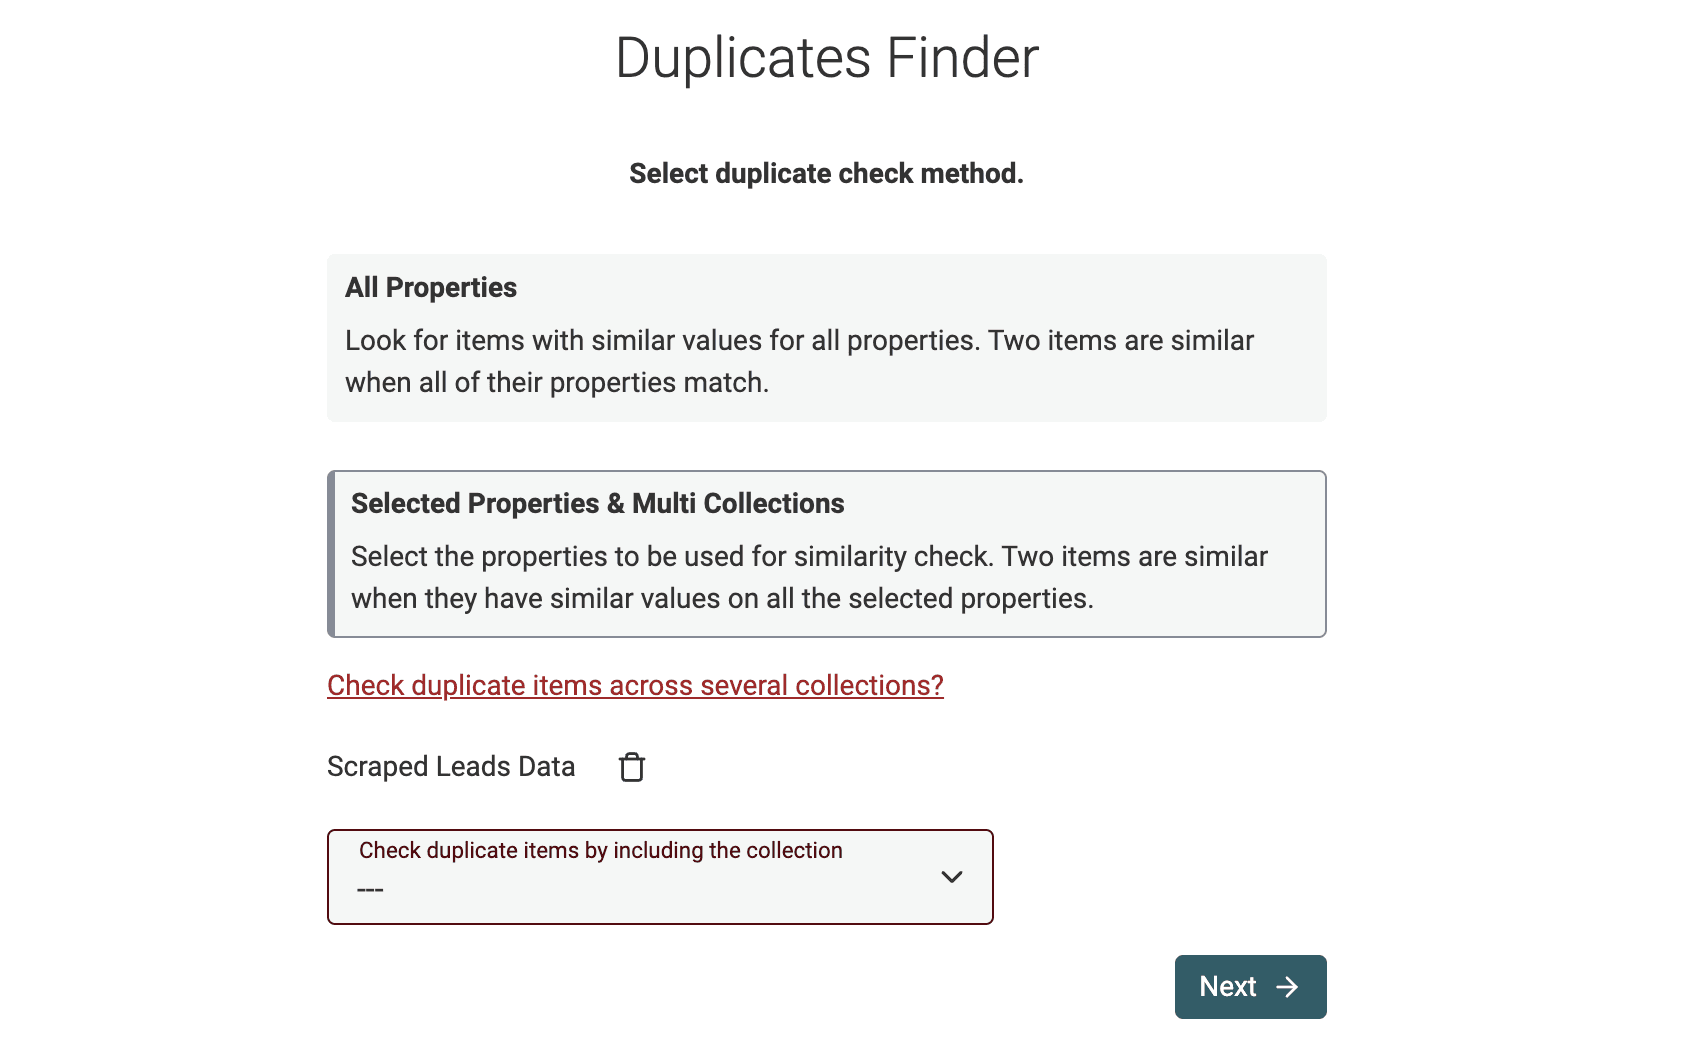
Datablist propose trois modes de départ :
- Selected Properties compare les champs que vous choisissez dans une collection.
- All Properties compare les enregistrements complets d’une collection.
- Match across collections associe et compare les propriétés de plusieurs collections.
Pour deux fichiers de leads contenant les champs Email et Company, commencez par associer les propriétés email. Si les adresses email sont absentes, comparez les noms d’entreprises et ajoutez, si possible, un site web ou une localisation. Le résultat prend la forme de groupes de correspondances possibles, et non d’une liste propre garantie. Ouvrez quelques groupes et contrôlez les valeurs sources avant de fusionner les enregistrements.
Sélectionner les propriétés à comparer
Pour la suite de ce guide, utilisez Match across collections.
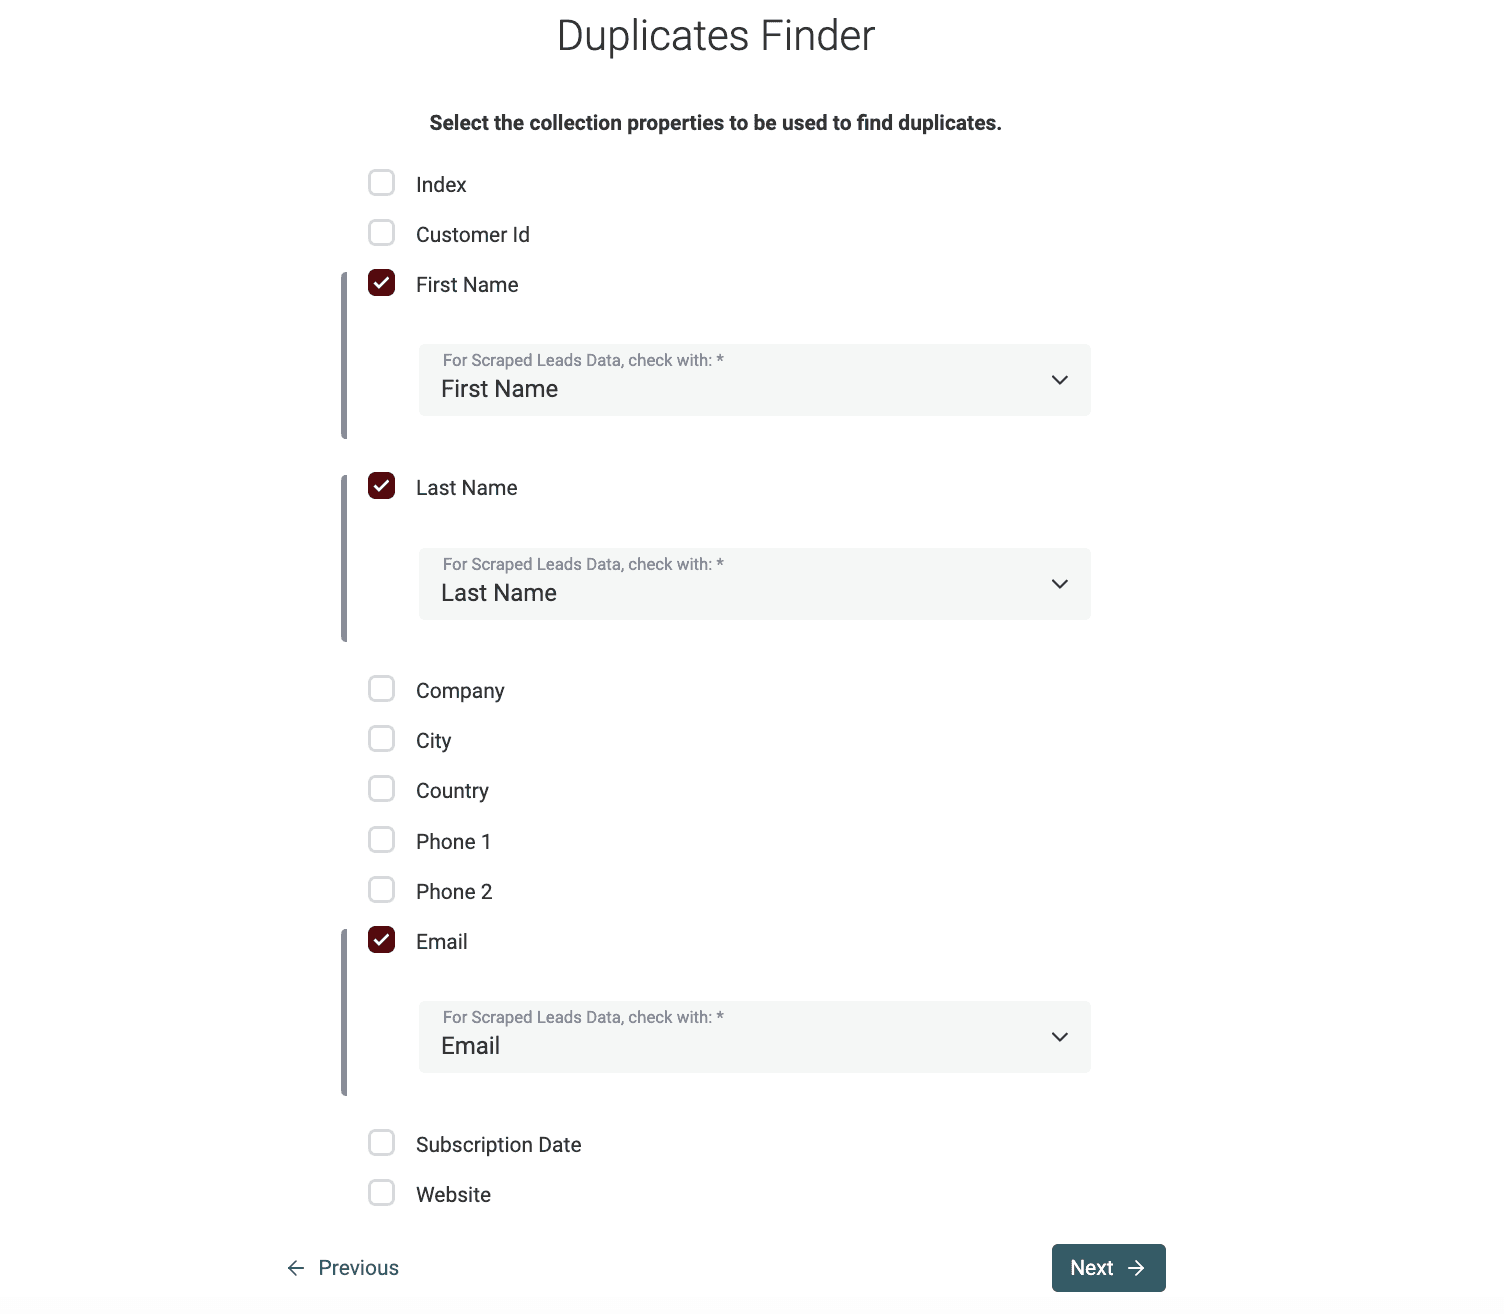
Vous devez ensuite sélectionner les propriétés utilisées pour le rapprochement. Si vous avez choisi plusieurs collections à l’étape précédente, Datablist vous demandera de sélectionner une propriété correspondante dans chacune d’elles.
Remarque
Datablist tentera d’associer automatiquement les propriétés des différentes collections à partir de leur nom.
Choisir l’algorithme de matching
À l’étape suivante, les propriétés sélectionnées sont affichées afin que vous puissiez configurer les algorithmes de comparaison.
Datablist propose les algorithmes de matching suivants :
-
Exact - L’algorithme Exact est recommandé pour les propriétés non textuelles comme DateTime, Number ou Boolean. Pour une propriété textuelle, une option permet de déterminer si la comparaison doit tenir compte de la casse. L’algorithme supprime les espaces placés au début et à la fin des textes.
-
Smart - L’algorithme Smart prétraite vos éléments afin de rapprocher les données présentant de légères variations. Il reconnaît les URL utilisant des protocoles différents et tient également compte de l’ordre des mots et de la ponctuation. "John-Doe" et "Doe John" seront ainsi considérés comme similaires.
-
Phonetic with Double Metaphone algorithm - Datablist utilise l’algorithme Double Metaphone pour le matching phonétique. Celui-ci convertit les mots en codes représentant leur prononciation. Deux mots à la sonorité proche obtiennent le même code Double Metaphone.
-
Fuzzy matching with distance algorithms - Datablist propose également du fuzzy matching fondé sur les distances de Jaro-Winkler et de Levenshtein. Vous devez alors définir un seuil de similarité. Plus ce seuil est élevé, moins les variations autorisées sont importantes.
Consultez notre documentation pour en savoir plus sur les algorithmes de matching.
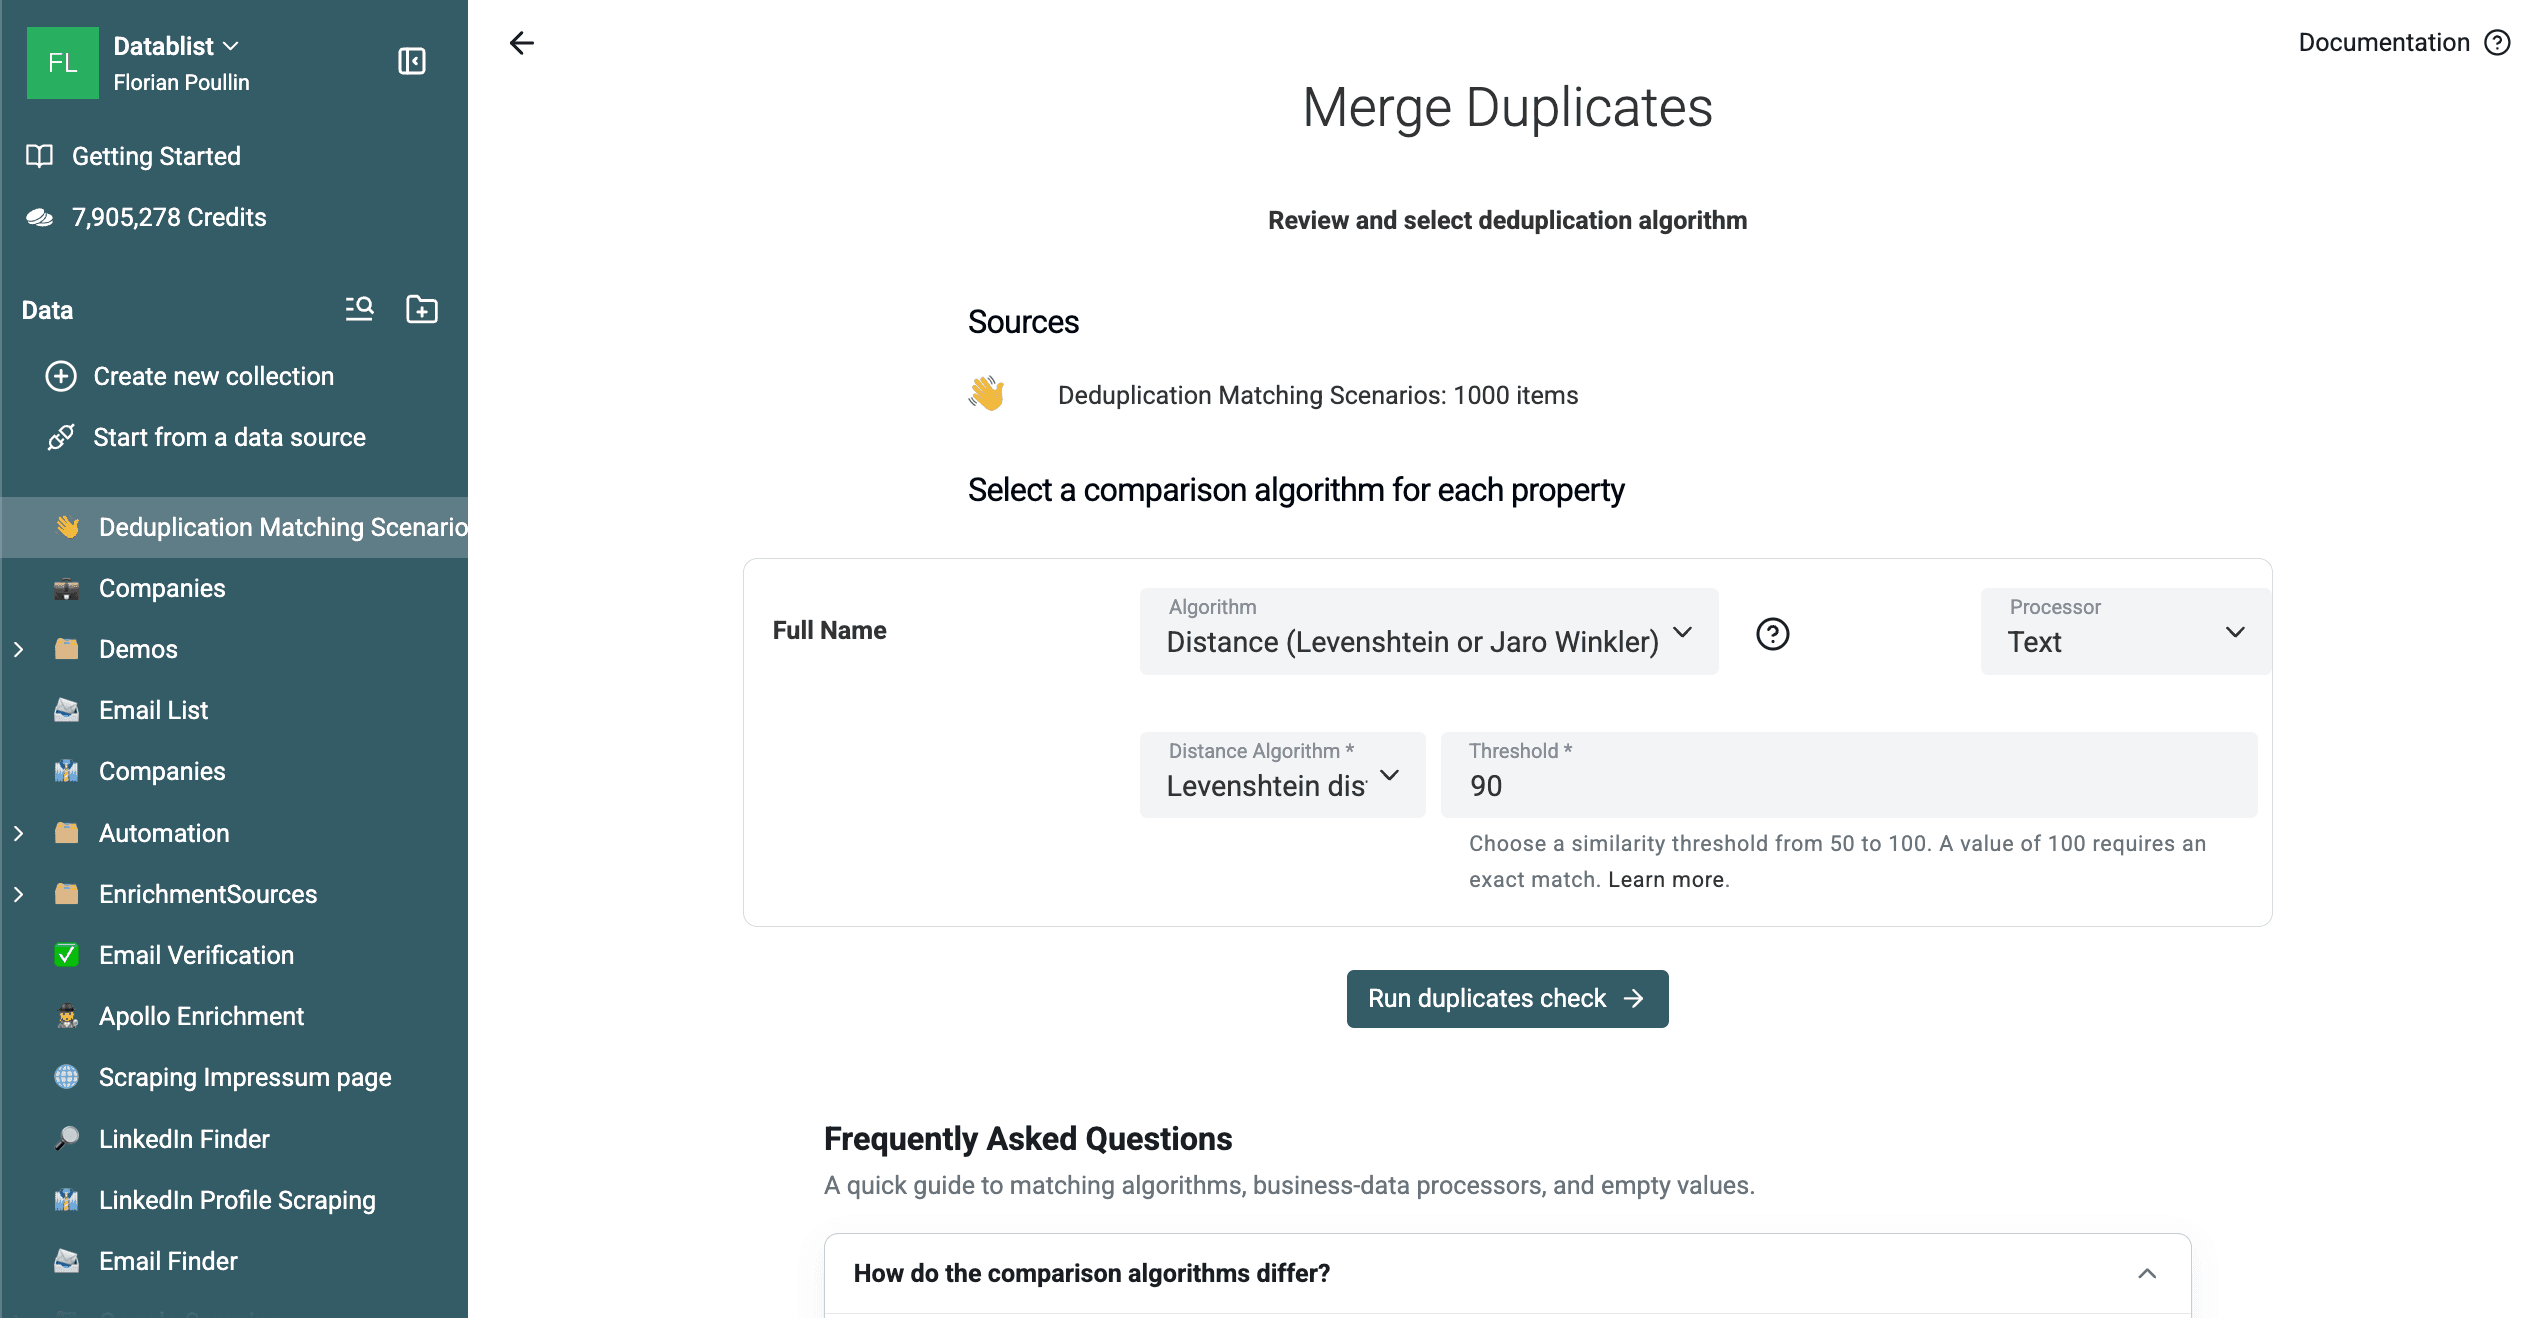
Sur l’échantillon de dédoublonnage de 1 000 lignes, cette configuration de Full Name a produit 77 groupes de deux lignes. La validation par rapport aux données de référence a identifié 21 groupes correspondant à la même entité prévue et 56 groupes associant des entités différentes. La plupart des faux positifs étaient des abréviations courtes et identiques, comme G. Rossi.
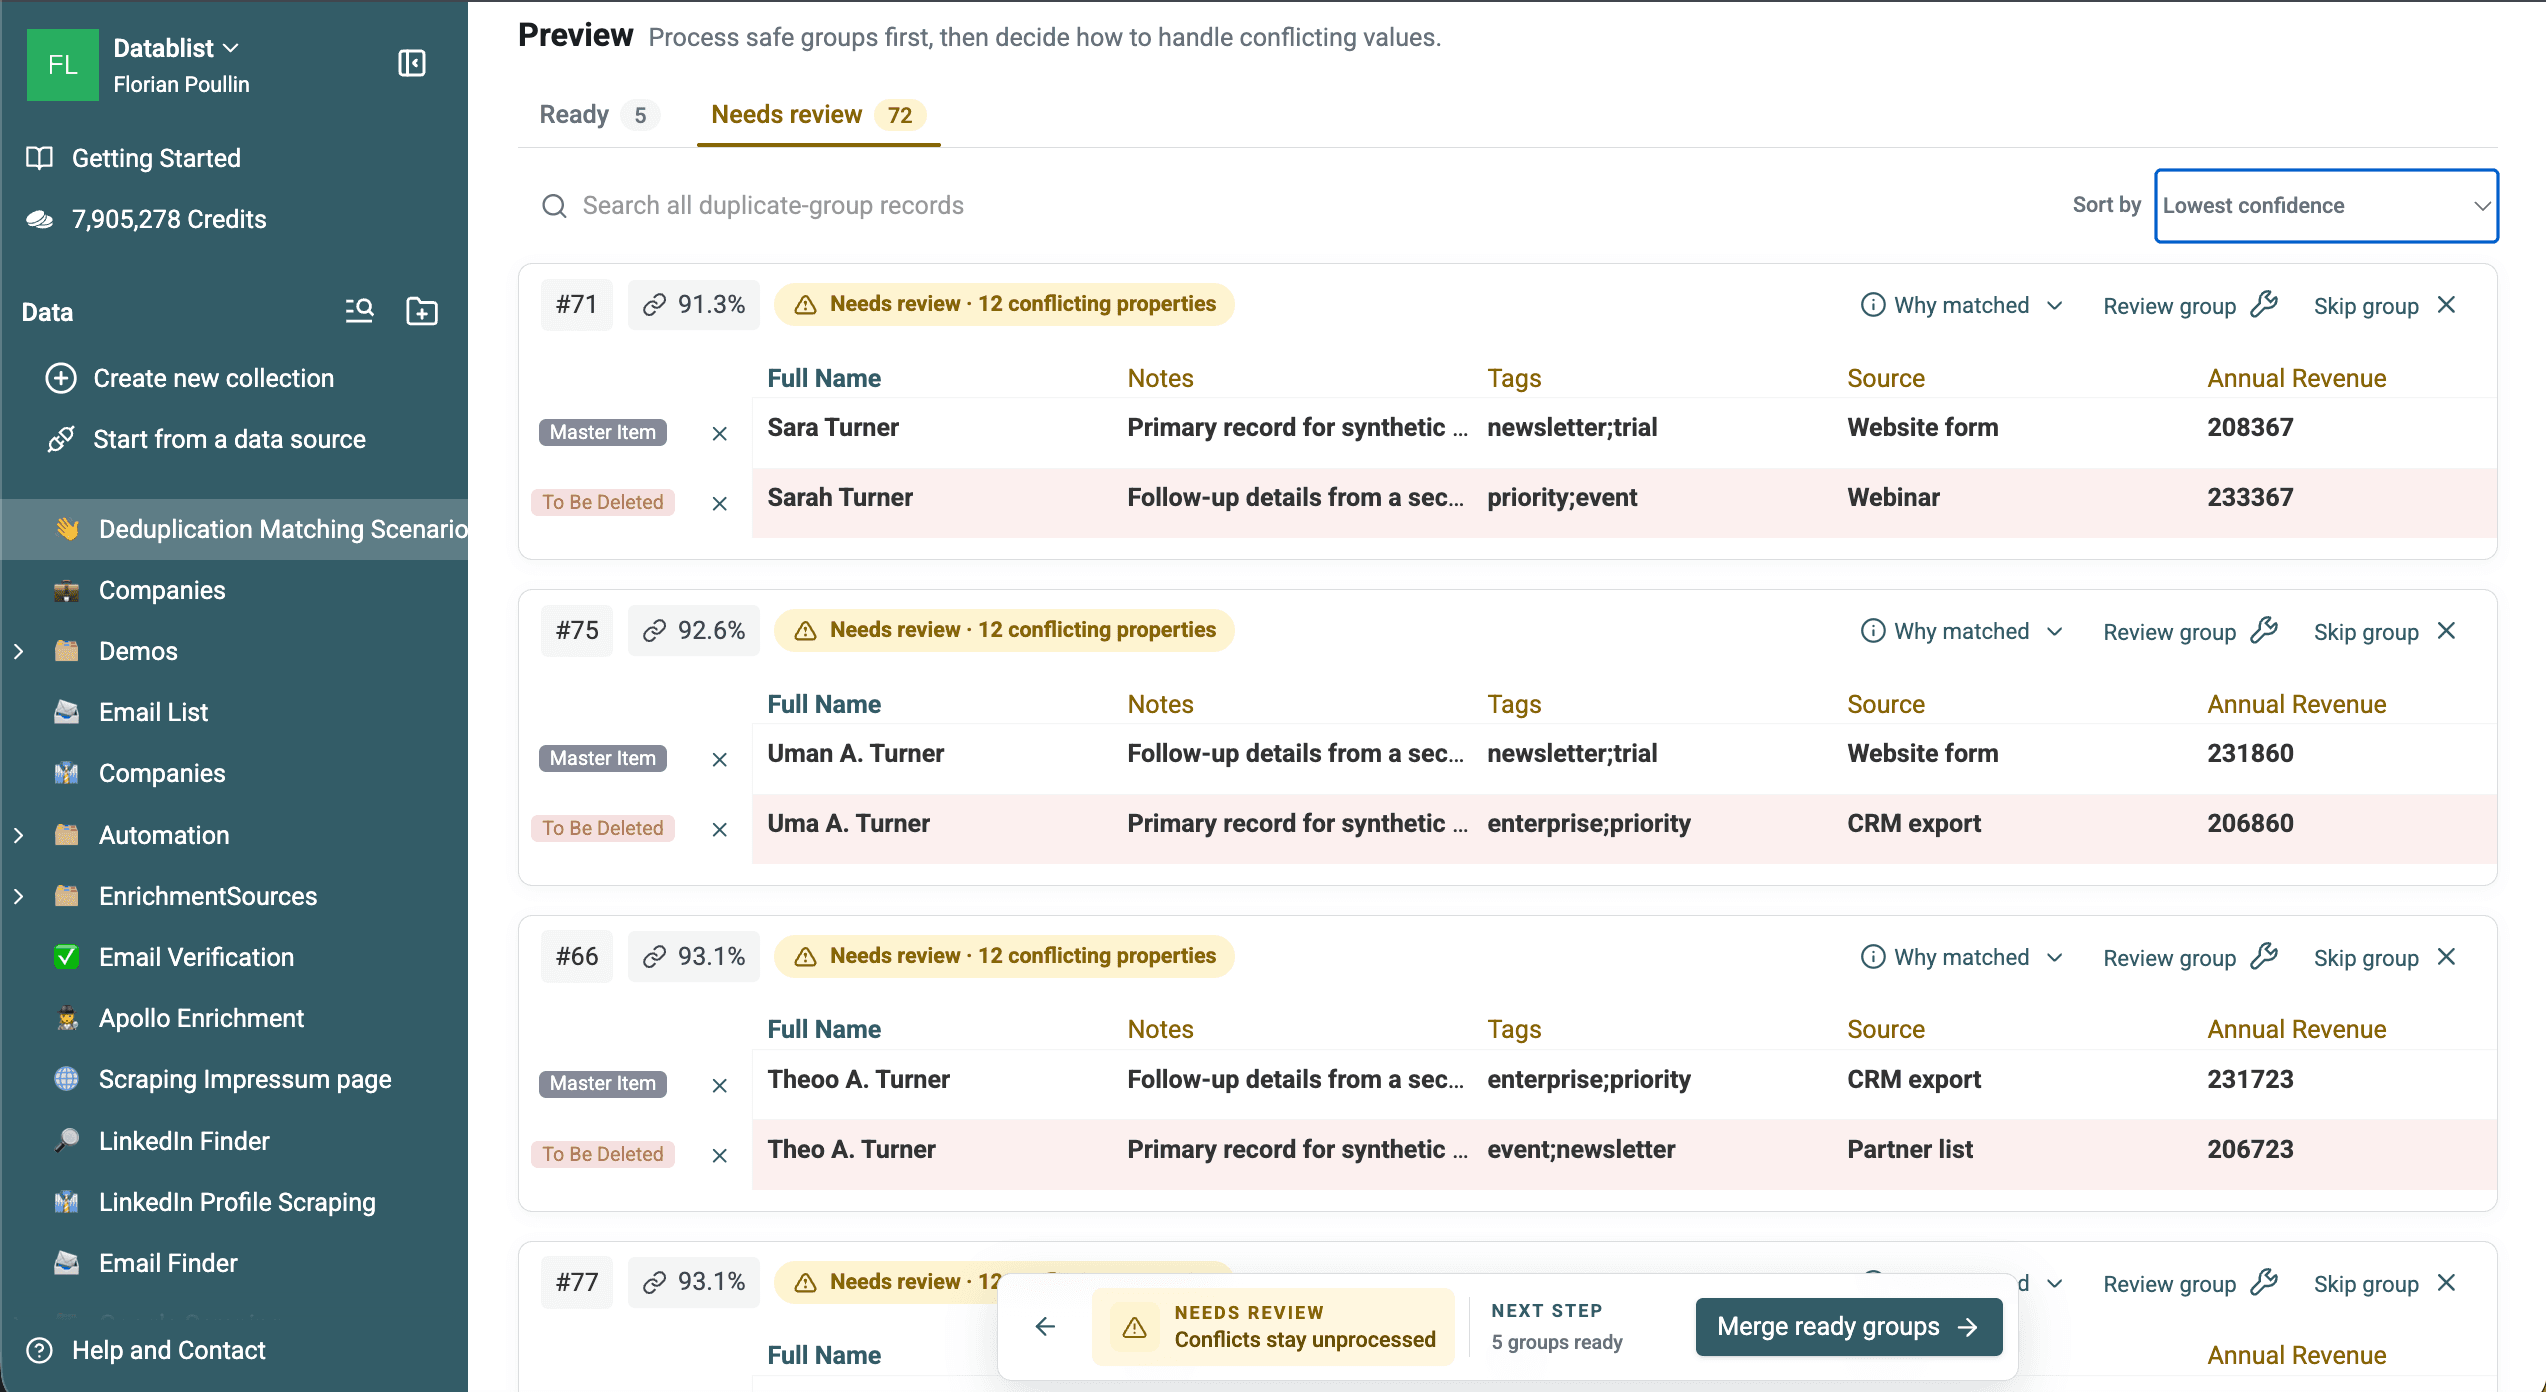
Utilisez un second identifiant, tel qu’une adresse email, un numéro de téléphone, une entreprise ou un site web, avant de traiter les correspondances de noms ambiguës. Téléchargez les 77 groupes exportés pour examiner le résultat.
Sur le même échantillon, Full Name avec le processeur Text et Metaphone a produit 69 groupes, soit 188 lignes regroupées. La validation par rapport aux données de référence a relevé 19 groupes ne contenant qu’une même entité et 50 groupes mélangeant différentes personnes.
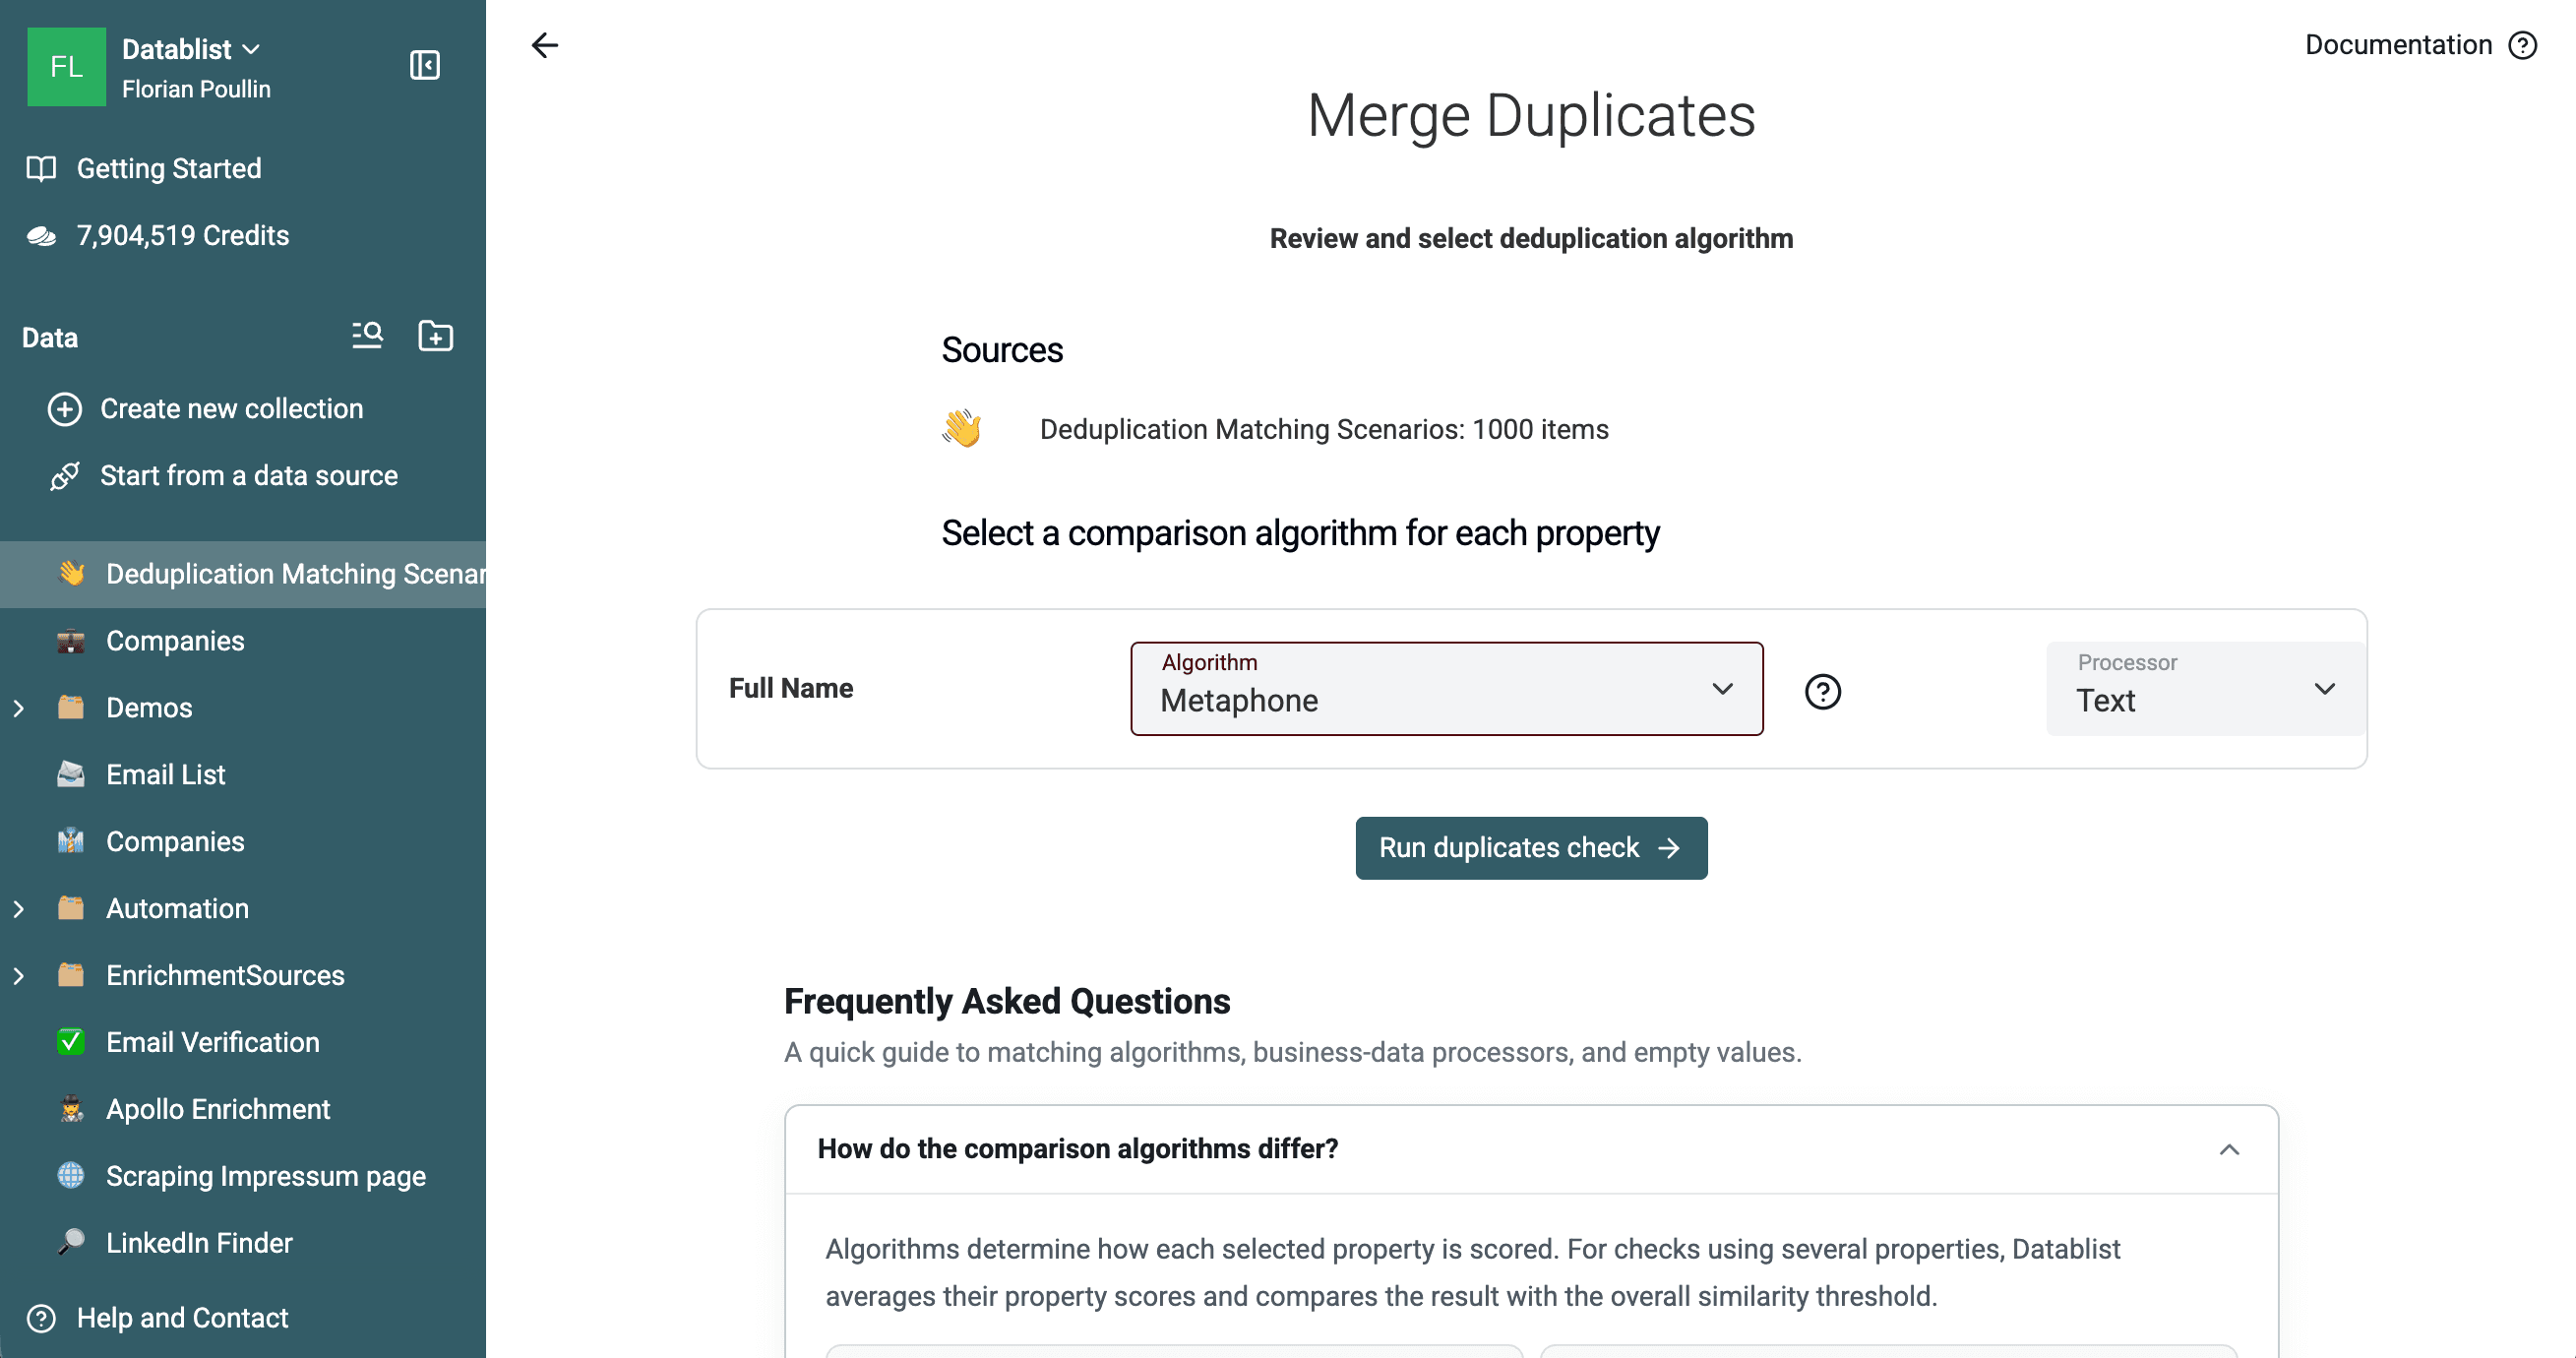
Le résultat comprenait de grands groupes de noms abrégés partageant le même nom de famille. La similarité phonétique aide à trouver des correspondances possibles, mais ne prouve pas que deux lignes désignent la même personne.
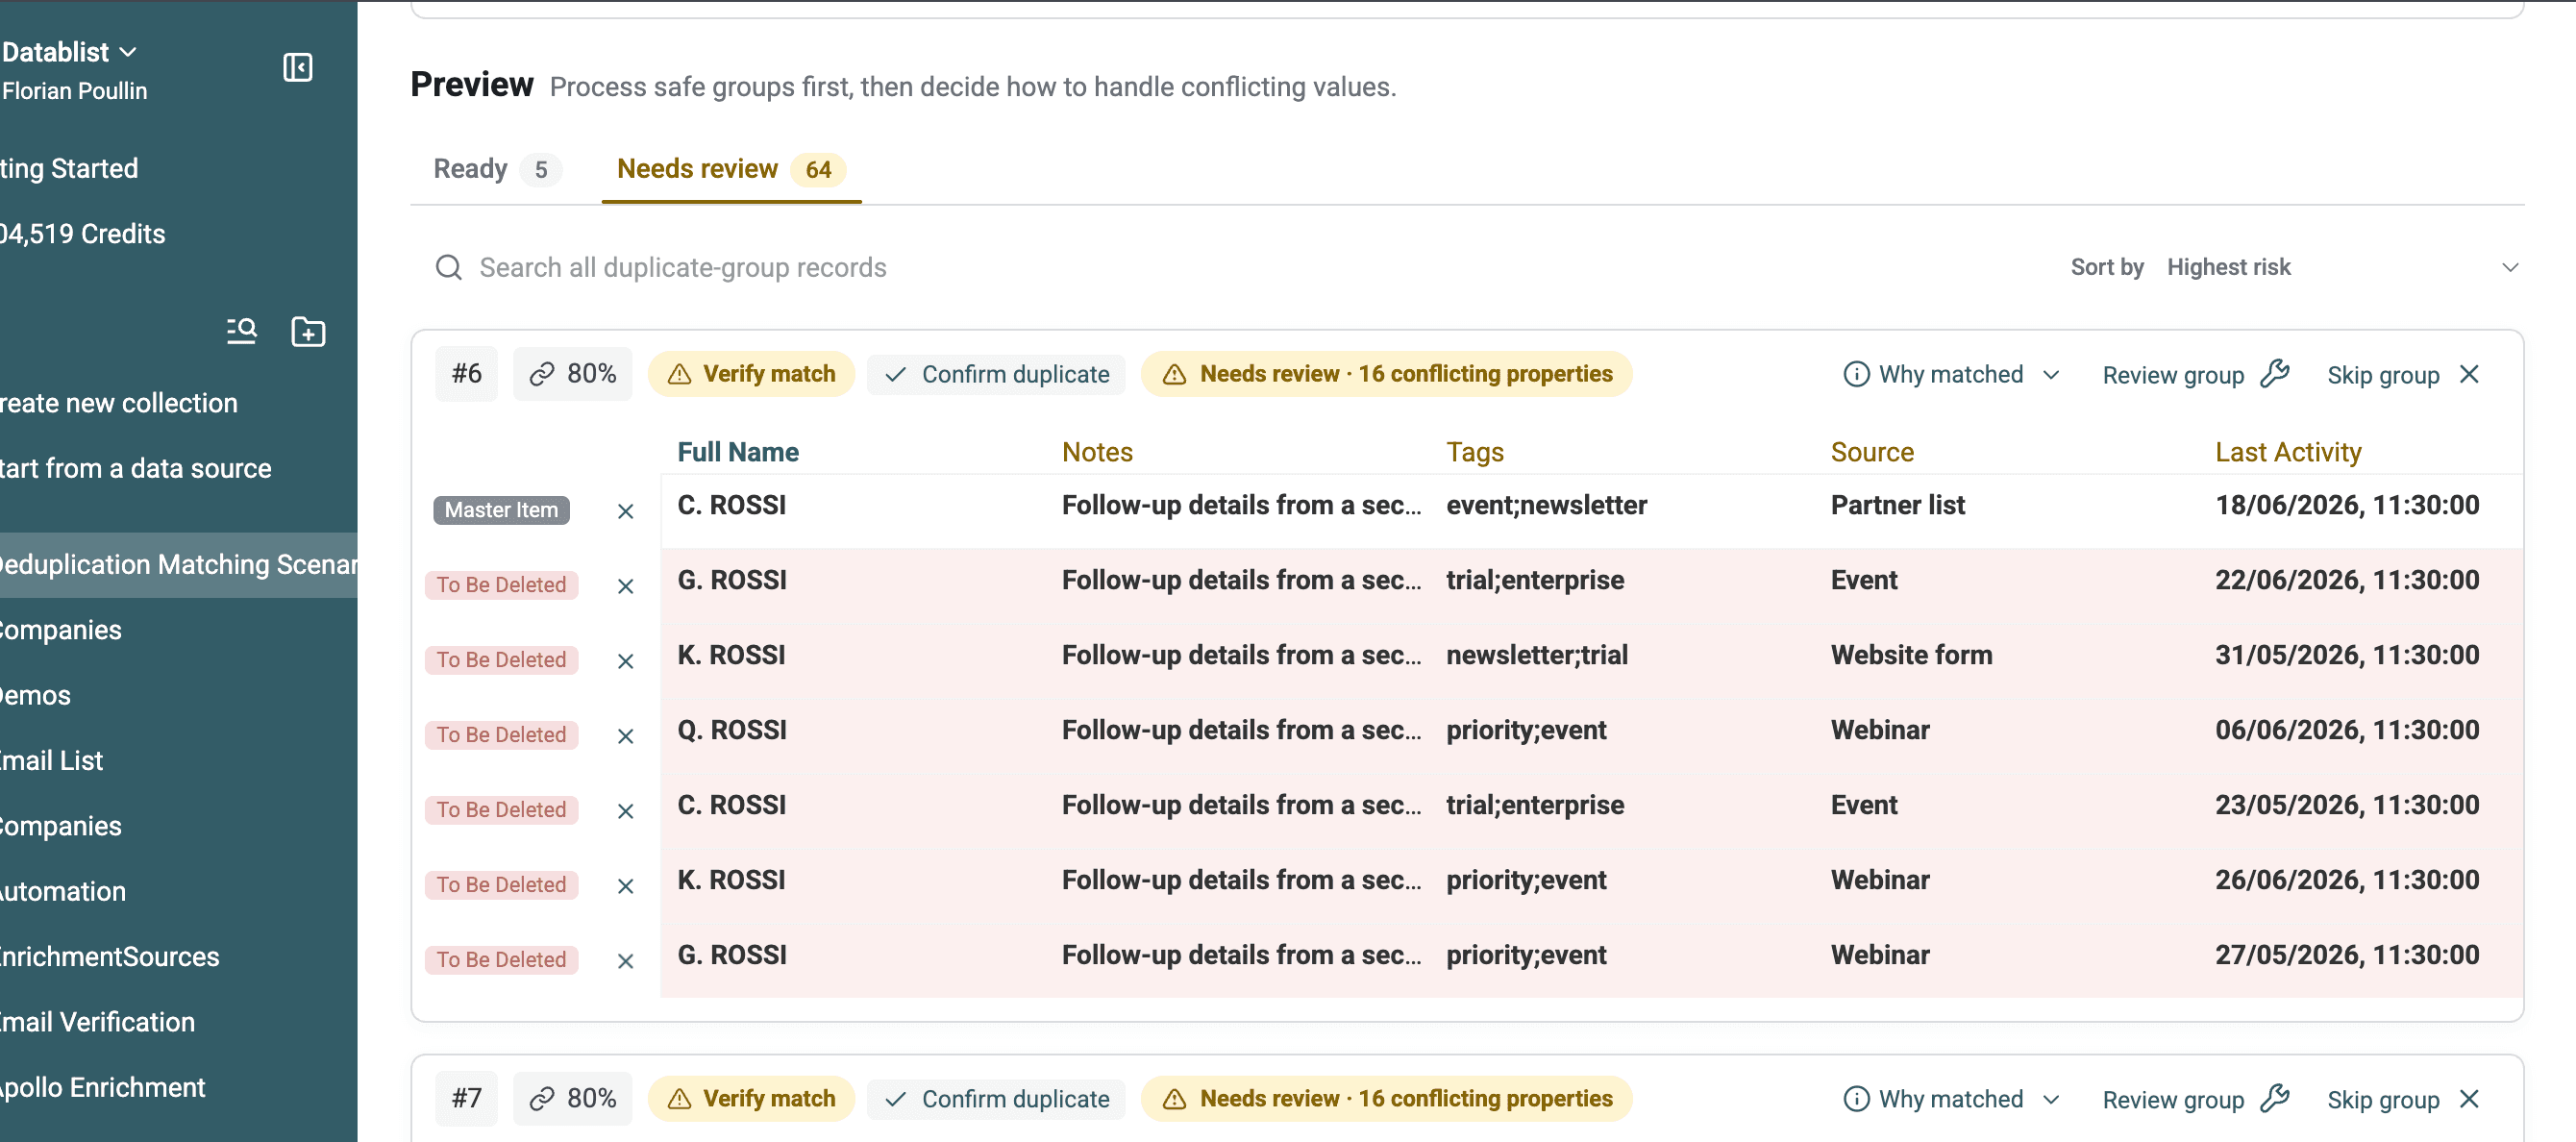
Téléchargez les 69 groupes Metaphone exportés pour examiner les groupes de deux à sept lignes et comparer les correspondances pertinentes aux faux positifs.
Remarques
- Les algorithmes Smart, Phonetic et fuzzy s’appliquent uniquement aux propriétés textuelles, notamment Email, Text et LongText.
- Les propriétés URL sont uniquement compatibles avec les algorithmes Exact et Smart.
Étape 4 : dédoublonner les groupes
Le Duplicates Finder de Datablist génère des groupes de correspondances à vérifier. La page de résultats explique pourquoi les lignes ont été rapprochées et sépare les groupes Ready de ceux qui nécessitent une vérification.
Fusion automatique dans une seule collection
Pour une seule collection, sélectionnez Merge and preserve data. Datablist renseigne les propriétés vides et applique vos règles de gestion des conflits et de sélection du Record to keep.
Remarque :
Cette fonctionnalité est uniquement disponible pour le dédoublonnage d’une seule collection. Lors d’un dédoublonnage entre plusieurs collections, leur structure de données peut être différente.
Fusion automatique sans conflit de données
Datablist marque un groupe Ready lorsque la fusion produit un résultat concret et qu’aucune condition ne reste à résoudre.
Le fonctionnement est le suivant :
- Si tous les doublons possèdent les mêmes valeurs de propriétés, un seul élément est conservé et les autres sont supprimés.
- Si les doublons sont complémentaires, l’élément contenant le plus d’informations devient l’élément principal. Ses propriétés vides sont complétées à partir des autres éléments, qui sont ensuite supprimés.
- Si des valeurs sont en conflit, configurez une règle ou laissez le groupe dans Needs review.
Fusion automatique avec résolution des conflits
Lors de l’exécution de l’algorithme de fusion automatique, le Duplicates Finder de Datablist détecte automatiquement les propriétés en conflit. Il y a conflit lorsque deux éléments possèdent des valeurs différentes pour une même propriété. Pour pouvoir les fusionner, vous devez choisir parmi les options suivantes :
- Combine concatène les valeurs textuelles distinctes avec le séparateur choisi.
- Keep the selected record's value ignore les autres valeurs.
- Les règles payantes de survivorship des champs permettent de sélectionner, pour chaque propriété, la valeur la plus récente, la plus ancienne, la plus longue, la plus courte, la plus élevée, la plus faible ou la plus fréquente.
Règles de nettoyage pour plusieurs collections
Lorsque vous utilisez l’outil de Data Matching de Datablist sur plusieurs jeux de données, la fusion automatique n’est pas disponible. Vos collections peuvent avoir des structures et des propriétés différentes.
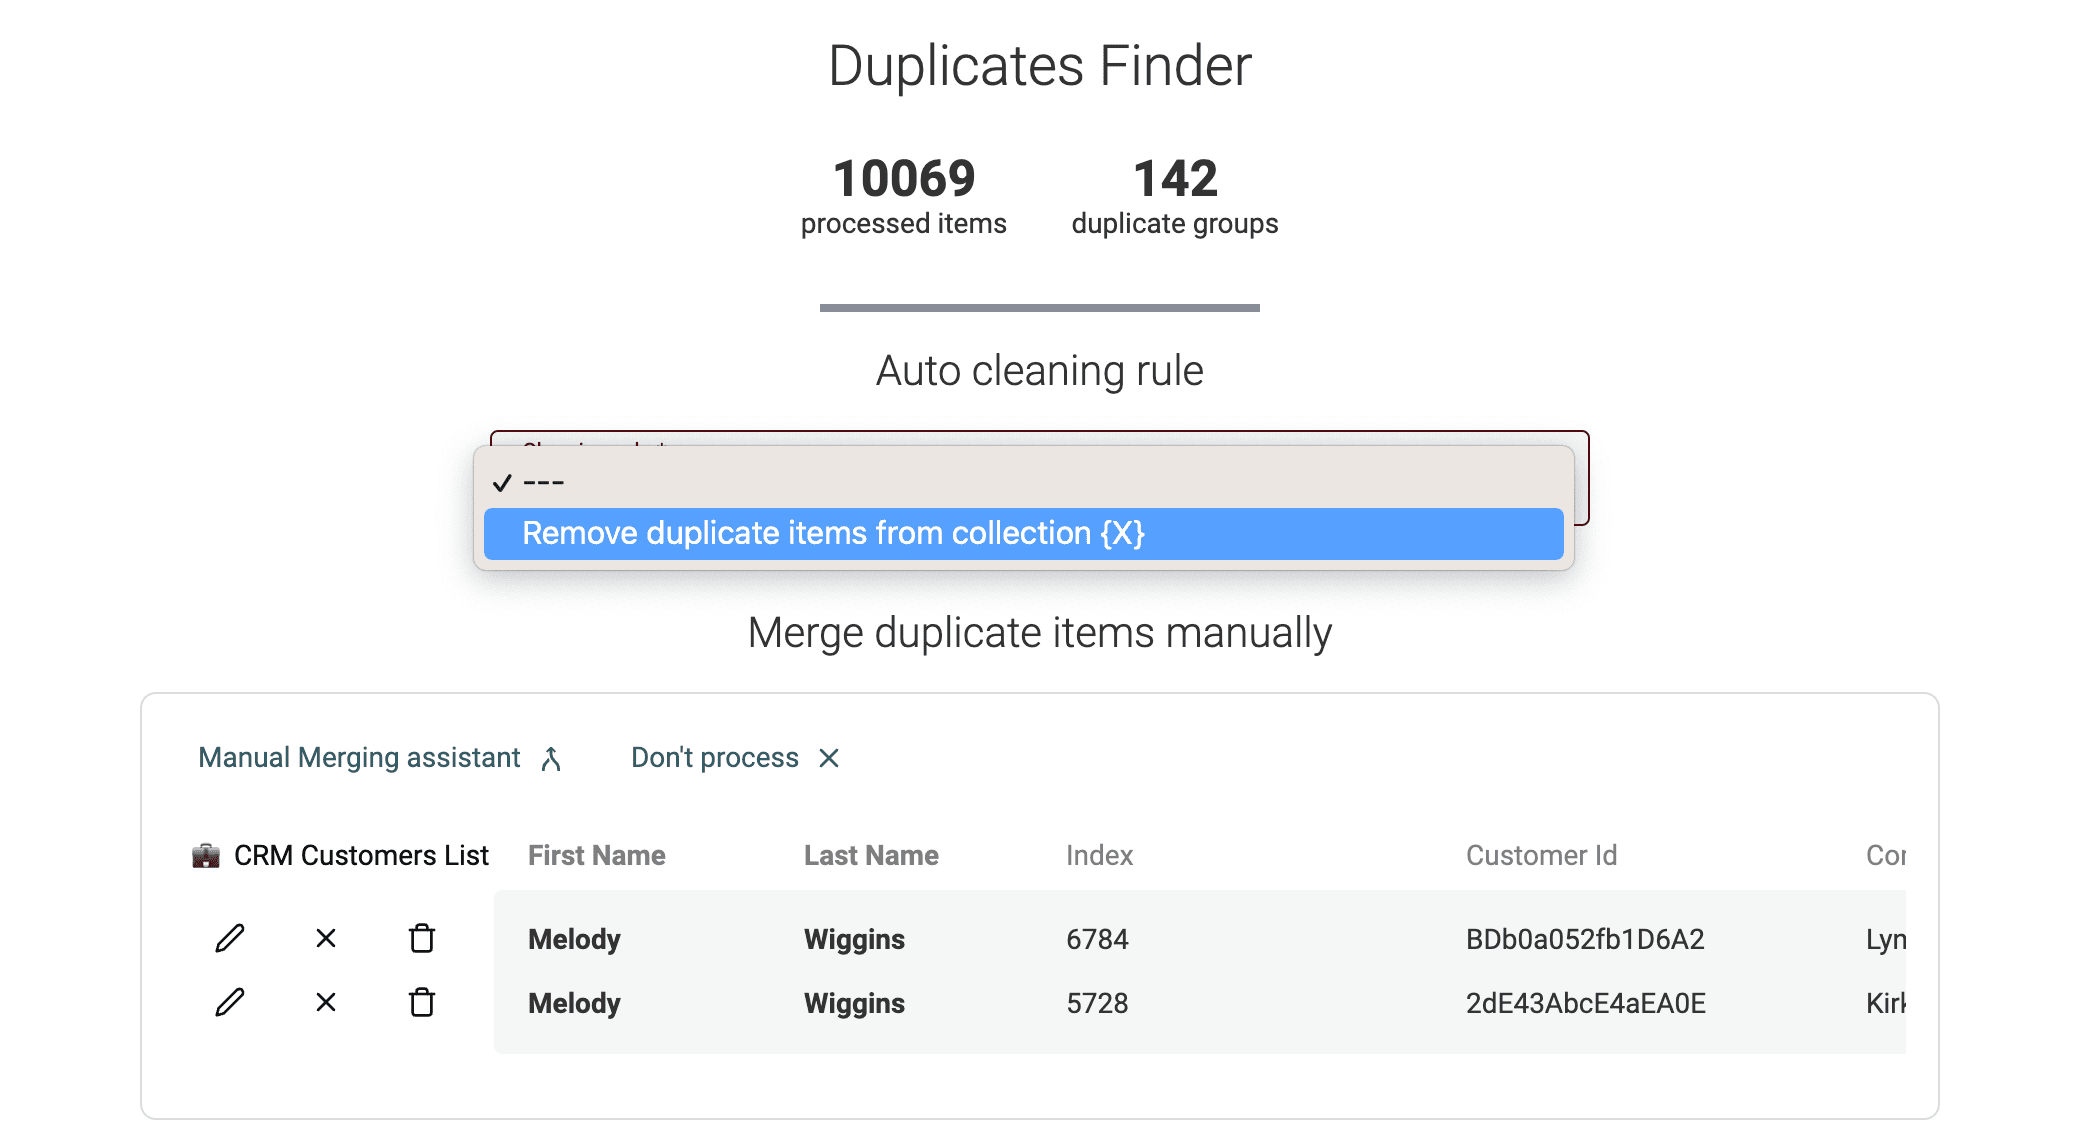
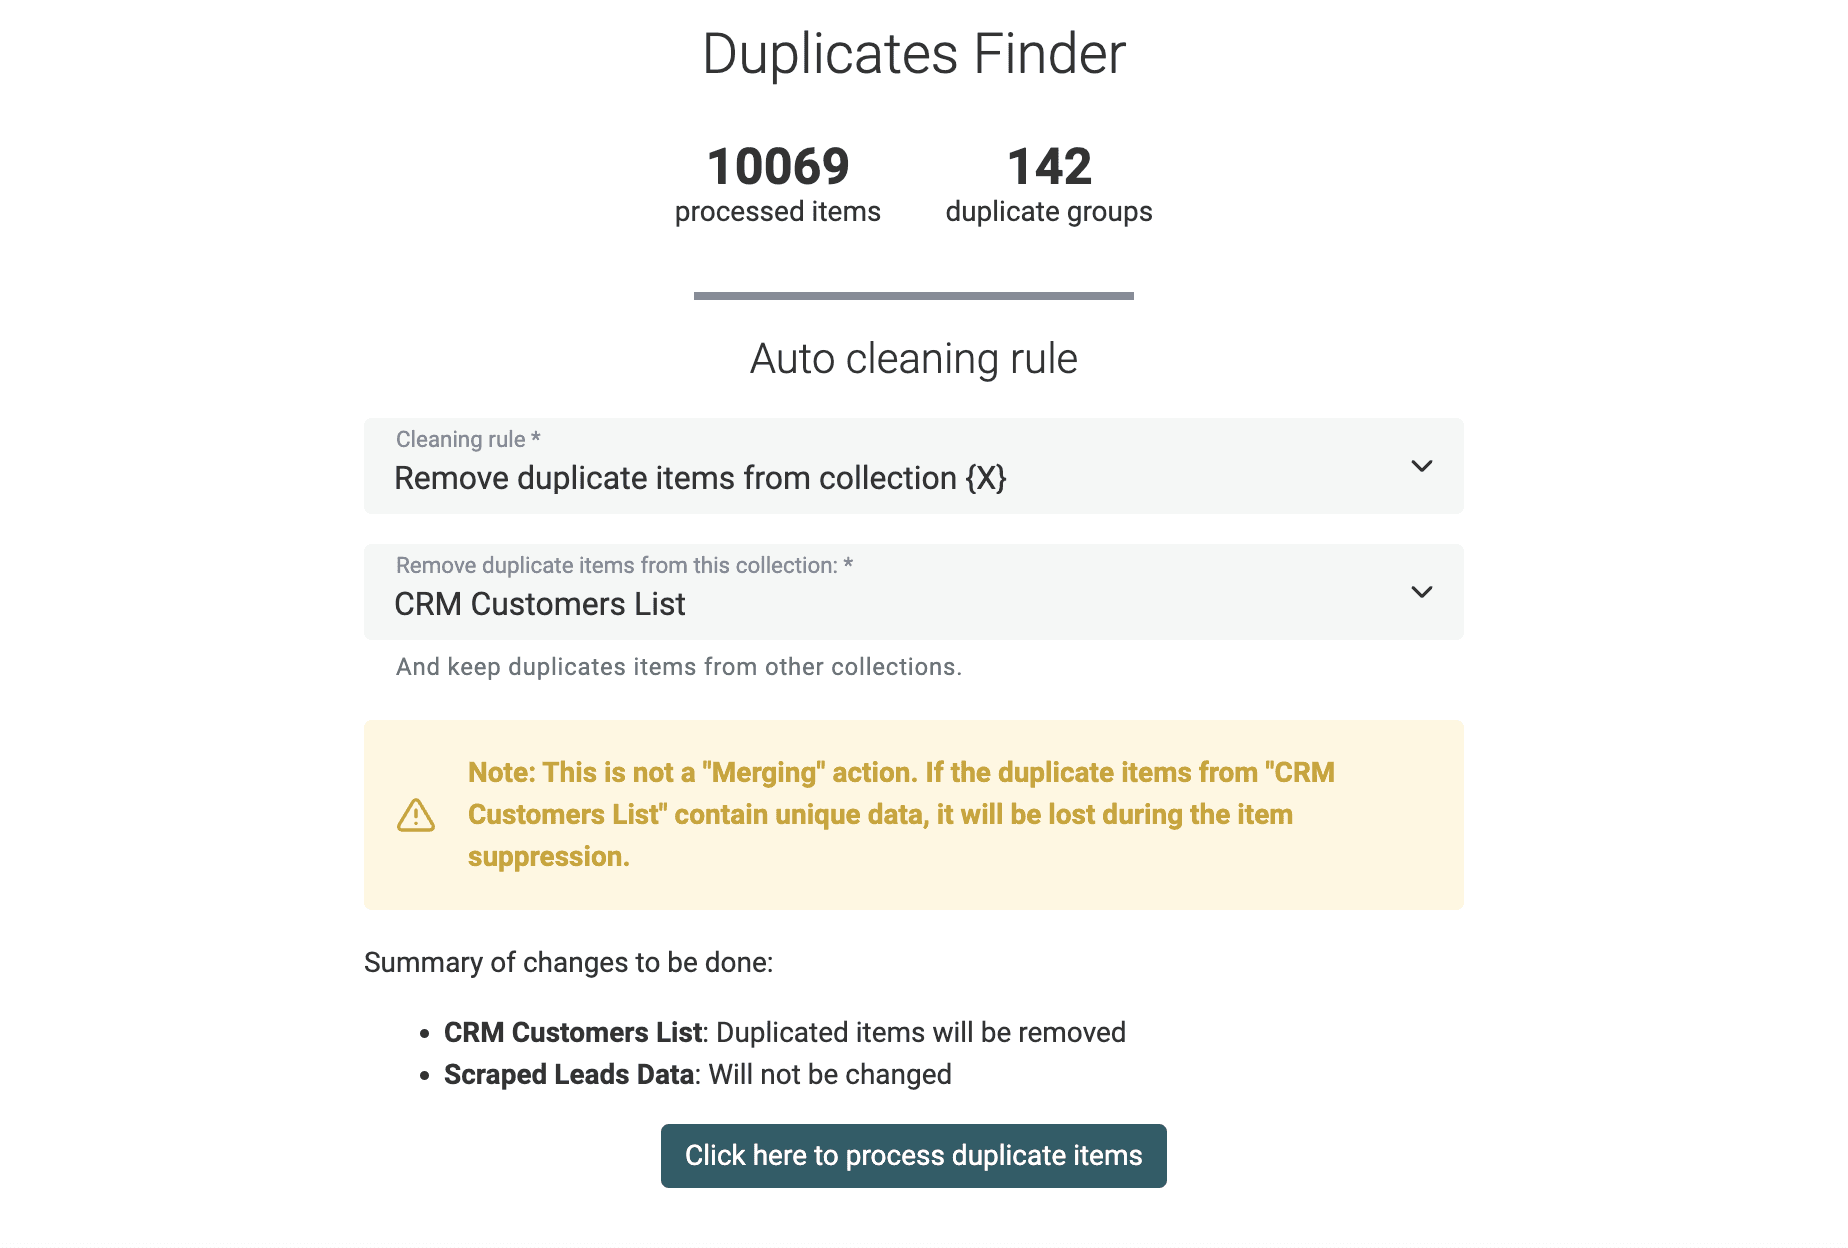
Datablist propose à la place une fonctionnalité de nettoyage qui supprime les doublons dans toutes les collections sauf une. Utilisez-la pour garantir l’unicité des éléments dans l’ensemble de vos jeux de données.
Un aperçu des modifications est affiché avant l’exécution de l’algorithme de nettoyage.
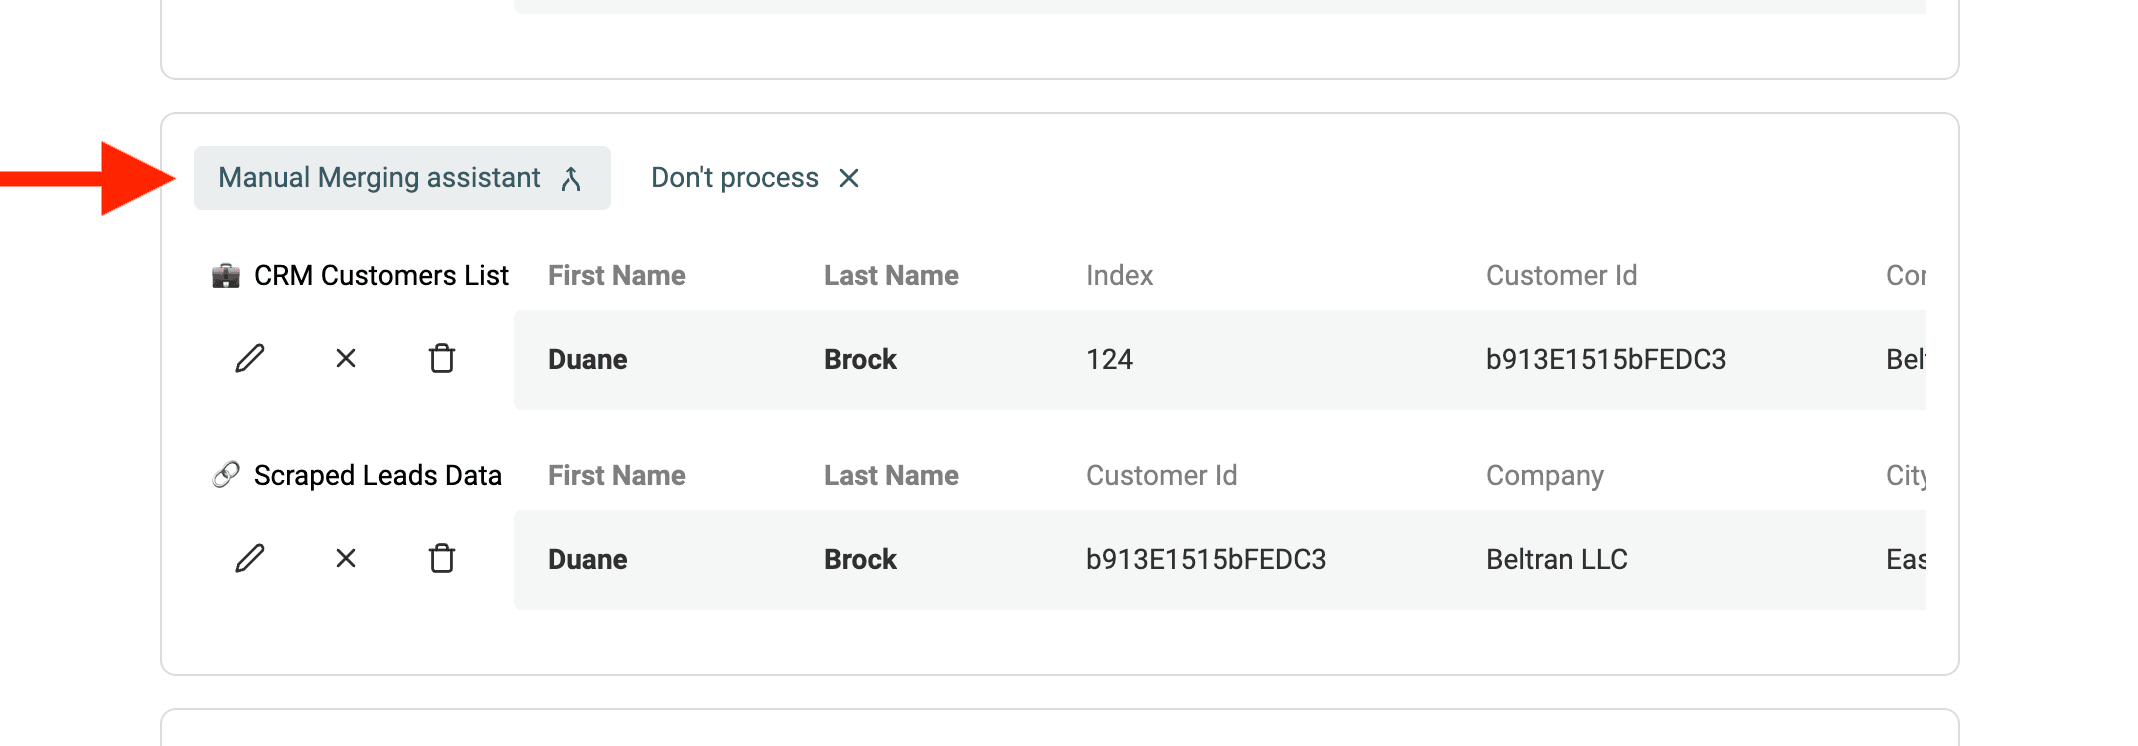
Fusion manuelle avec le Merging Assistant
Un assistant de fusion manuelle est disponible pour les doublons restants.
Cliquez sur Review group, puis ouvrez le Manual Merging Assistant.
L’outil de fusion s’ouvre. À droite figure un "Primary Item" et, à gauche, les autres doublons, appelés "Secondary Items". Datablist choisit comme "Primary Item" l’élément qui contient le plus de données.
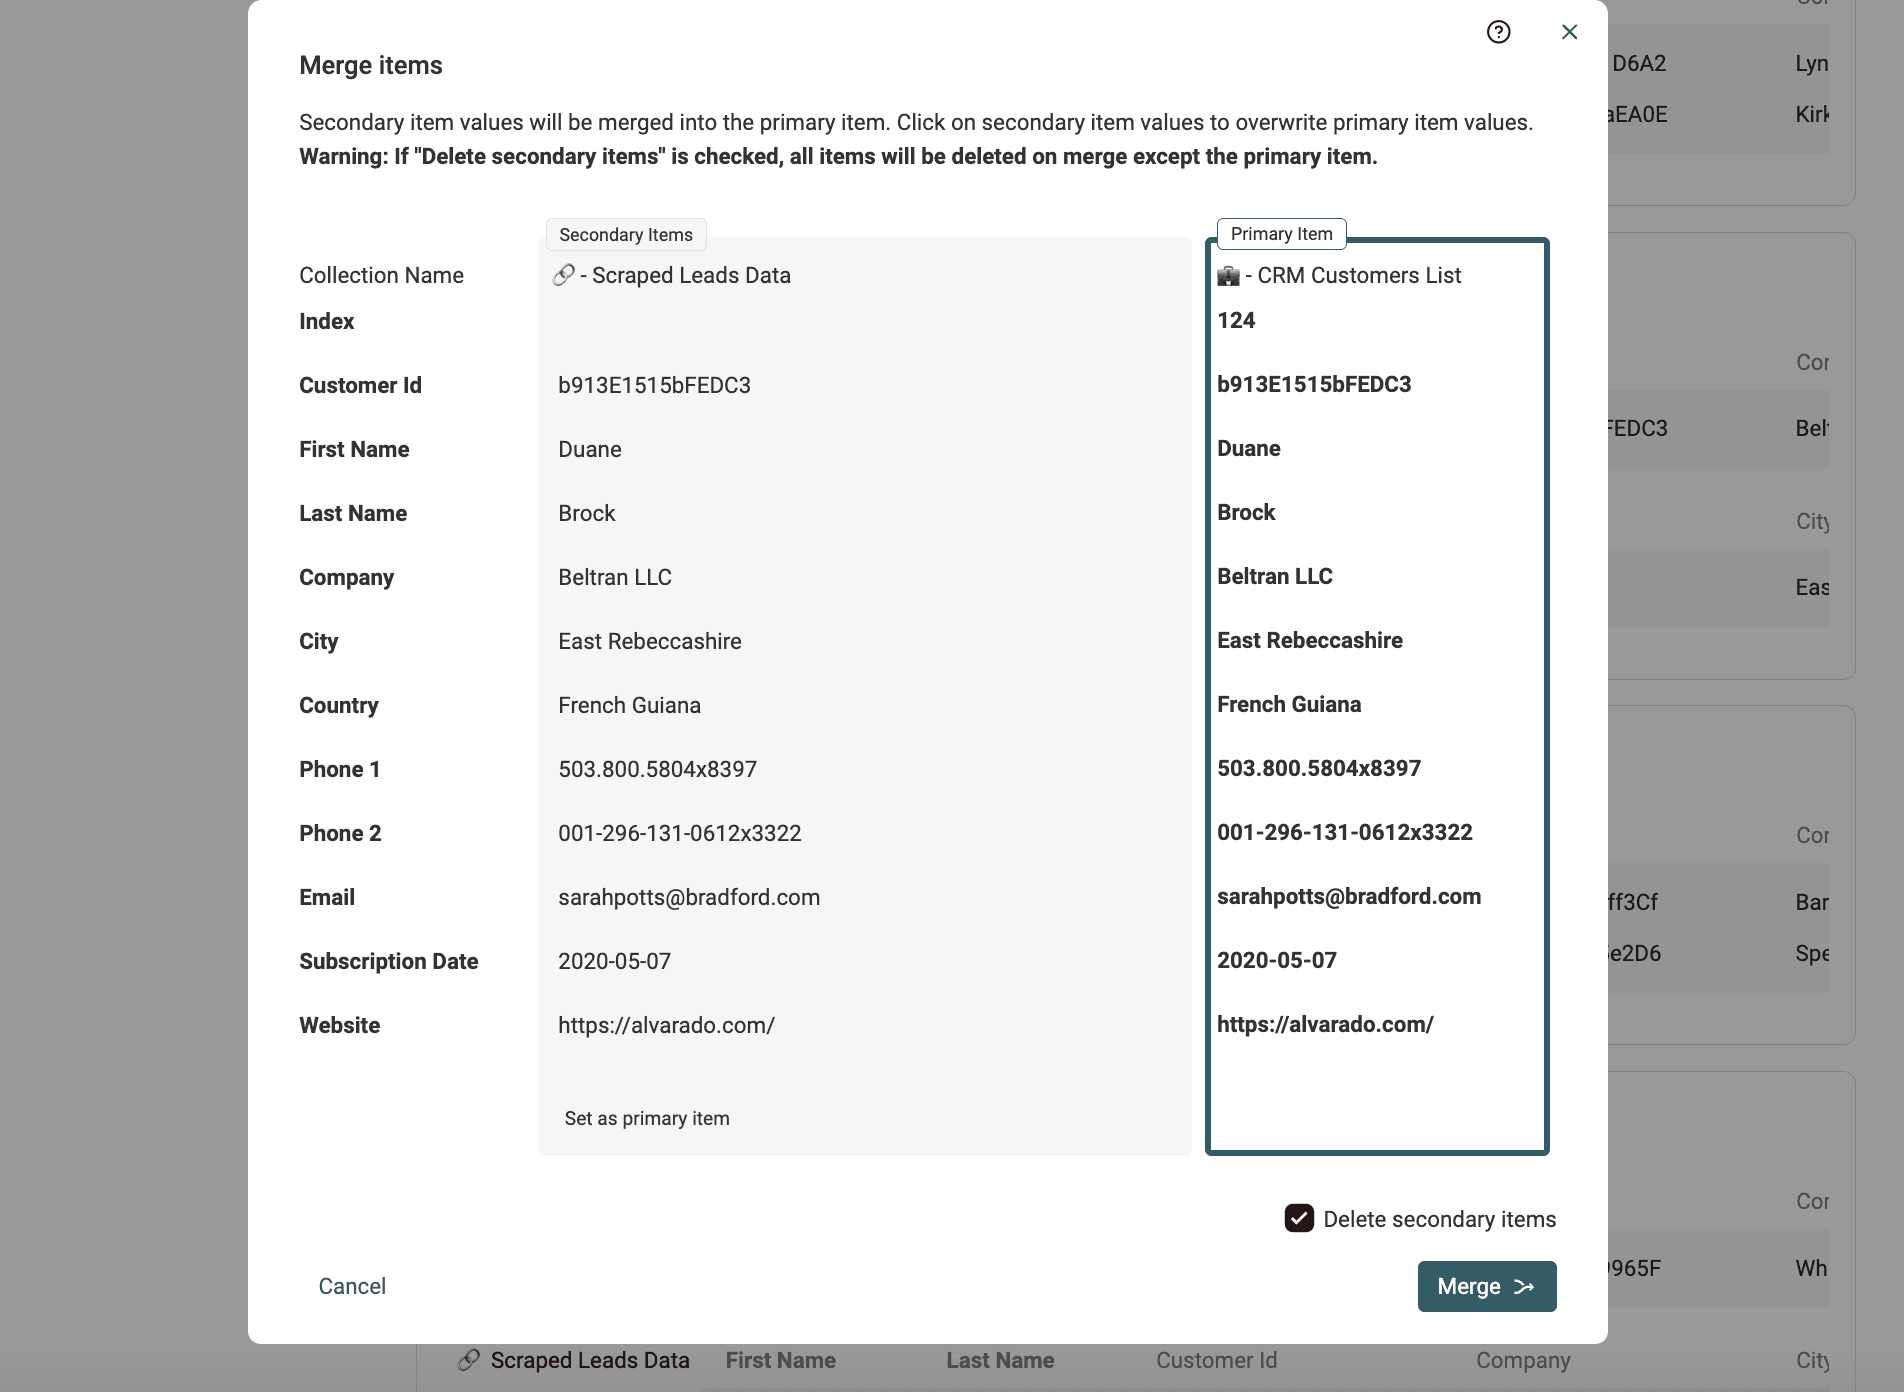
Lorsque c’est possible, les valeurs des propriétés des éléments secondaires sont automatiquement sélectionnées pour être fusionnées dans l’élément principal. Si plusieurs valeurs sont en conflit, vous devrez choisir celle à conserver.
Si le "Primary Item" obtenu vous convient, cliquez sur le bouton Merge pour confirmer la fusion. Tous les éléments secondaires seront supprimés afin de ne conserver qu’un seul enregistrement consolidé.
Remarque Le Manual Merging Assistant est disponible pour le dédoublonnage entre plusieurs collections lorsque celles-ci ont une structure similaire, avec les mêmes propriétés.
Exporter les groupes de doublons vers un autre outil
Enfin, l’outil de Data Matching de Datablist permet d’exporter les groupes de doublons détectés. Vous pouvez ainsi générer un fichier CSV ou Excel dans lequel tous les doublons apparaissent les uns à la suite des autres.
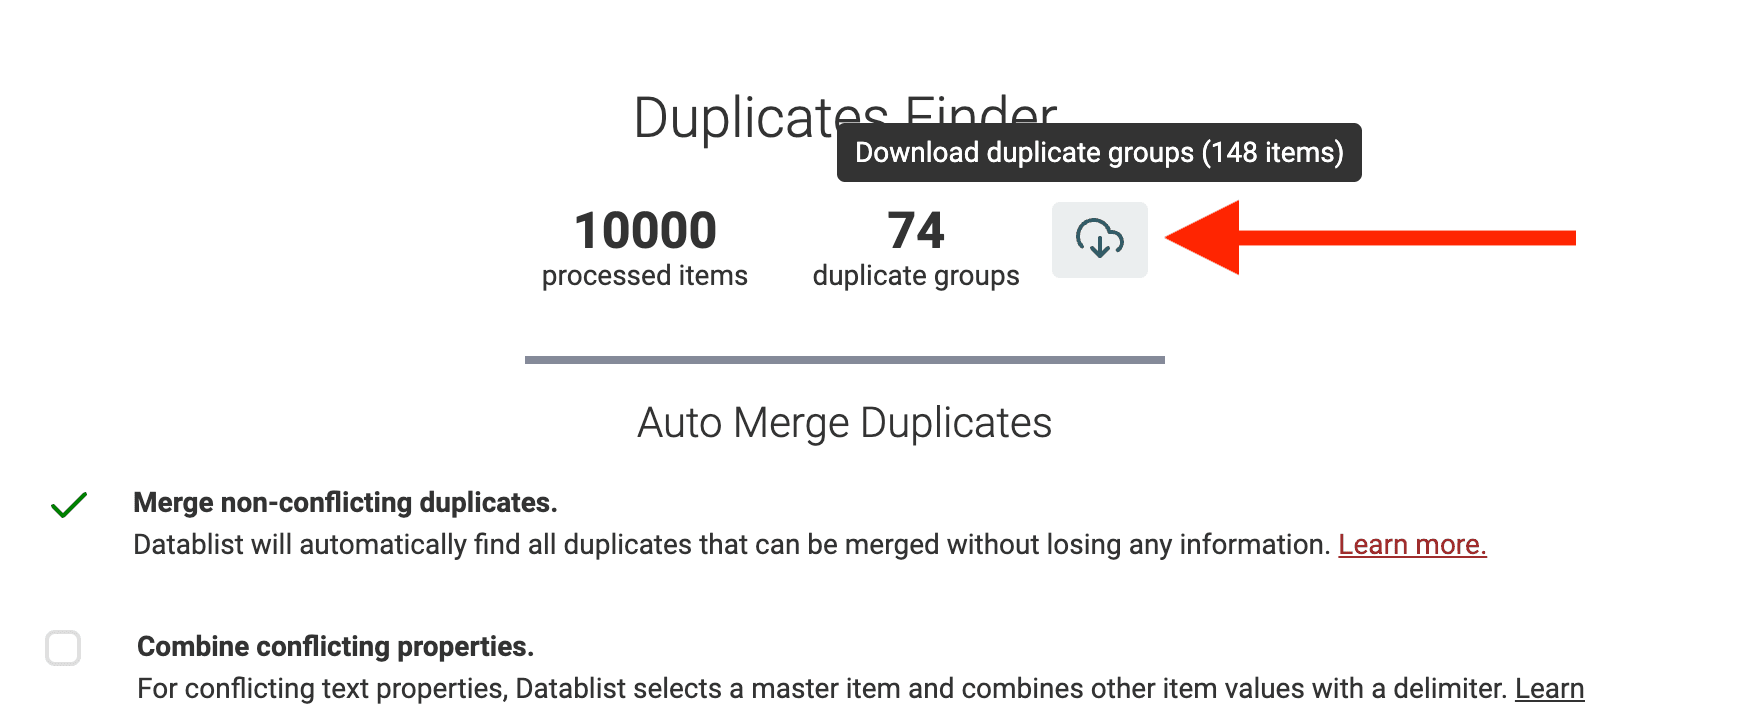
Utilisez ce fichier d’export pour nettoyer vos enregistrements avec un autre outil, comme un tableur, ou pour effectuer des analyses plus complexes.
FAQ
Qu’est-ce que le rapprochement de données ?
Le rapprochement de données, aussi appelé record linkage ou dédoublonnage, consiste à identifier et à relier des enregistrements associés au sein d’un ou de plusieurs jeux de données. Son principal objectif est d’améliorer la qualité, la précision et la cohérence des données en repérant et en regroupant les entrées identiques ou similaires qui représentent les mêmes entités, personnes ou objets.
Ce processus permet de nettoyer les jeux de données dans lesquels des doublons s’accumulent au fil du temps. Il sert également à combiner plusieurs fichiers dont les champs sont similaires ou se recoupent.
Le rapprochement peut s’appuyer sur des champs discriminants, comme une adresse email, l’URL d’un site web ou une chaîne ou un numéro d’identification. Il peut aussi combiner plusieurs attributs non uniques, comme le nom, la date de naissance, le nom de l’entreprise ou la localisation, afin de calculer un score de similarité entre les enregistrements.
Quelle est la vitesse du Data Matching de Datablist ?
L’outil de Data Matching de Datablist charge vos jeux de données en mémoire pour effectuer l’analyse. Il convient aux fichiers de moins d’un million d’enregistrements et réalise la plupart des rapprochements en quelques minutes.
Faut-il des compétences techniques pour rapprocher des données ?
Non. Datablist est une solution no-code conçue pour tous, des data analysts aux équipes marketing et commerciales.
Quand utiliser le rapprochement de données ?
Le rapprochement de données est utilisé dans de nombreux secteurs, notamment la finance, la santé, le marketing et la gestion client, partout où des données fiables sont nécessaires pour prendre des décisions éclairées ou intégrer des données à d’autres outils.
Ce processus facilite notamment la détection des fraudes, la consolidation des profils utilisateurs et l’enrichissement de données provenant de plusieurs sources.
Et maintenant ?
Si le nettoyage des données vous intéresse, ces guides devraient également vous être utiles :