
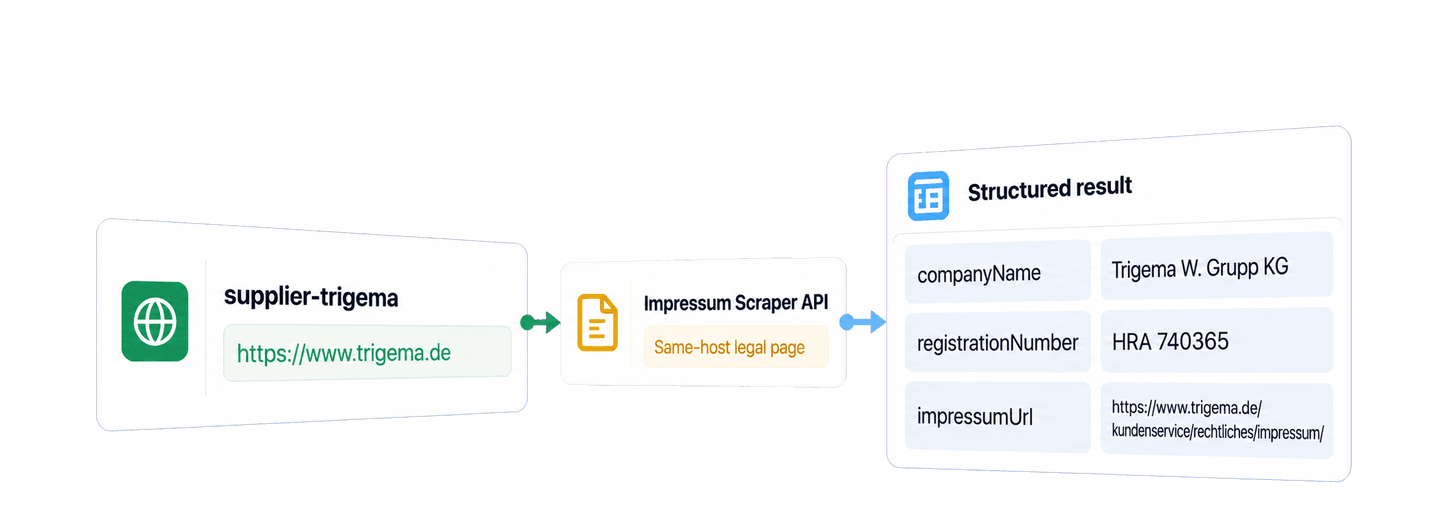
Per estrarre i dati Impressum in Python senza sviluppare un crawler personalizzato, usa l'API Impressum Scraper di Datablist insieme alla libreria Requests. Tu fornisci gli URL dei siti aziendali, l'API individua la pagina Impressum di ciascun sito ed estrae da quella pagina dati strutturati sull'azienda e sui contatti.
Per questo esempio utilizzo due noti brand tedeschi: il produttore di abbigliamento Trigema e il marchio outdoor VAUDE. Un breve esempio Python pronto all'uso esegue la ricerca e associa a ogni fornitore sia i dati estratti sia l'URL della pagina Impressum utilizzata come fonte.
📌 Riepilogo per chi ha poco tempo
Usa l'API Impressum Scraper di Datablist per trasformare i siti web di aziende tedesche in dati strutturati su società e contatti. L'esempio Python invia due siti, attende il completamento del task in background, recupera tutte le pagine dei risultati e conserva per ogni record l'URL della pagina legale individuata.
- Input: URL di siti web aziendali tedeschi.
- Output: Dati societari e di contatto, più il link alla pagina Impressum di origine.
💡 Preferisci una soluzione no-code? Usa Impressum Scraper di Datablist per estrarre questi dati aziendali senza scrivere codice.
Configura API key e ambiente Python
Crea un account Datablist, quindi genera una Personal API Key. L'accesso alla REST API è disponibile con il piano Growth. Ecco il formato di una chiave di esempio:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Esporta la tua chiave come DATABLIST_API_KEY:
export DATABLIST_API_KEY="your-personal-api-key"In questo esempio Python utilizzo il package requests. Crea un file chiamato scrape_impressum.py e installa il package:
python -m pip install requestsOgni sito inviato consuma 10 crediti. L'esempio seguente, con due siti, utilizza 20 crediti se entrambi gli input vengono elaborati.
Crea la funzione scrape_impressums()
Incolla questo script completo in scrape_impressum.py:
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))Esegui lo script completo con:
python scrape_impressum.pyLa funzione interagisce con l'API in tre passaggi: invia gli input dei siti web, attende il completamento del task e recupera tutte le pagine dei risultati.
Invia gli input dei siti web
Lo script trasforma ogni fornitore in un input per l'API come questo:
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId è un identificatore stabile definito da te. data.websiteUrl è la homepage aziendale che lo scraper analizzerà. Usa il sito ufficiale dell'azienda, non una directory o un profilo social. Il payload seleziona l'enrichment pubblico impressum-scraper e utilizza un oggetto settings vuoto perché questa API non richiede impostazioni pubbliche.
La richiesta POST crea un task in background. Datablist accetta la richiesta e restituisce un oggetto task il cui @id identifica quella specifica esecuzione. La funzione usa questo ID per costruire gli URL dello stato e dei risultati.
Ecco una versione abbreviata della risposta di creazione:
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}
queued indica che la richiesta è stata accettata, non che il risultato sia già pronto. Lo script riutilizza l'@id restituito nei due passaggi successivi, quindi non devi copiare manualmente gli URL del task. Inoltre, richiama raise_for_status() prima di leggere ogni risposta. In questo modo, un errore di autenticazione o validazione interrompe l'esecuzione in corrispondenza della richiesta HTTP non riuscita, anziché essere scambiato per una ricerca completata.
Attendi il task in background
Datablist elabora il task in background. L'esempio ne controlla lo stato ogni tre secondi finché non raggiunge completed, failed o stopped. Requests è una libreria Python bloccante: lo script locale resta quindi in attesa durante queste chiamate, anche se il task dell'API viene eseguito in background.
Se il task termina con failed o stopped, la funzione genera un errore che include l'ID del task e lo stato finale. Conserva questo ID per esaminare il task esistente, invece di inviare subito una seconda volta la stessa operazione a pagamento.
Recupera tutte le pagine dei risultati
Una volta completato il task, lo script richiede fino a 100 risultati alla volta. La regola di paginazione è semplice: recupera la pagina successiva finché nextCursor non è null. Quando il cursore contiene un valore, lo script lo invia con la richiesta seguente.
Non associare i record restituiti alla tua applicazione in base alla posizione nella lista. I risultati possono arrivare in un ordine diverso rispetto agli input inviati. Usa inputId come chiave di join.
Come l'API trova una pagina Impressum
La homepage è il punto di partenza, non la pagina da cui l'API prevede di estrarre i dati. Impressum Scraper usa l'AI per analizzare i link interni dell'host fornito e identificare una pagina Impressum o una pagina legale o di contatto equivalente. È un aspetto importante, perché il link potrebbe comparire sotto etichette come Rechtliches, Kontakt o Legal, anziché trovarsi nel percorso /impressum.
Se l'AI non trova un link interno adatto, lo scraper prova i percorsi comuni /impressum e /imprint sullo stesso host. Una volta raggiunta la pagina di origine, l'AI estrae in un unico risultato la ragione sociale, l'indirizzo, i contatti, i dati di registrazione, la partita IVA e i campi relativi alla fonte. Non utilizza un motore di ricerca e non passa a directory esterne.
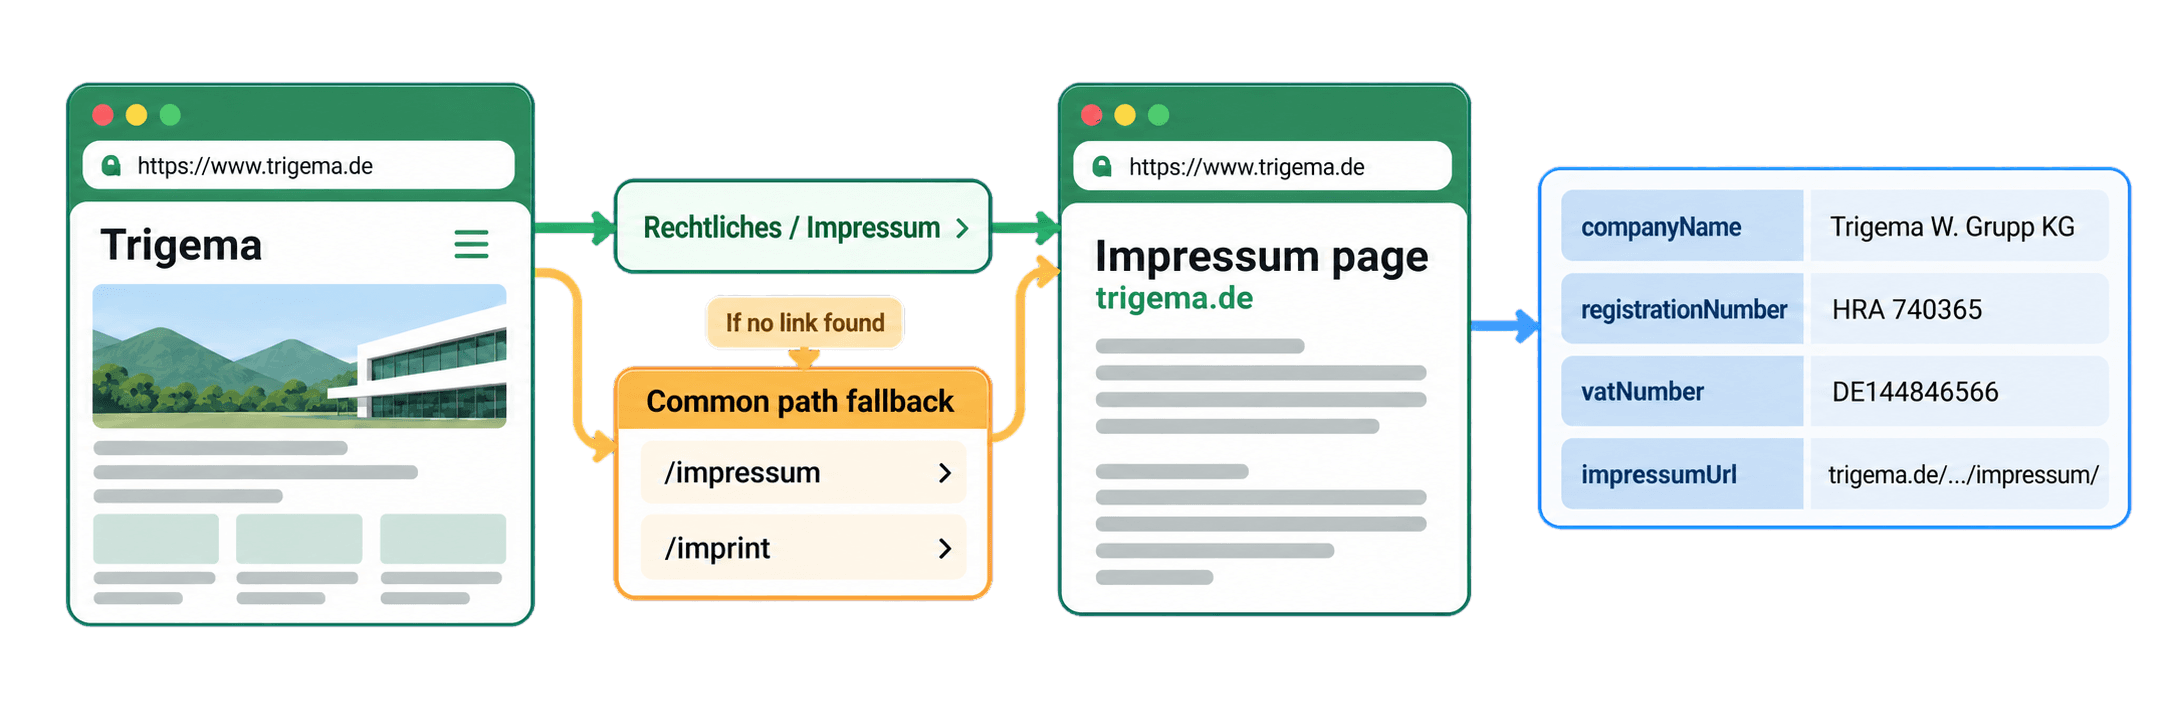
I due risultati mostrano concretamente come possano variare i percorsi. Per Trigema è stato restituito /kundenservice/rechtliches/impressum/, mentre per VAUDE /de/de/impressum.html. Conserva impressumUrl insieme a ogni risultato, perché registra la pagina esatta da cui provengono i campi estratti.
Analizza i risultati di Trigema e VAUDE
Ecco un estratto sintetico dei due risultati di esempio.
📘 Indirizzi email di esempio: qui sotto le email sono oscurate con
**. L'API restituisce gli indirizzi completi.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
Partiamo dai nomi. Trigema è l'etichetta del fornitore nell'input Python, mentre Trigema W. Grupp KG è la ragione sociale estratta dalla pagina Impressum. La stessa distinzione vale per VAUDE: l'etichetta di input è VAUDE, mentre l'azienda restituita è VAUDE Sport GmbH & Co. KG. Conservare entrambi i valori ti permette di mantenere il nome riconoscibile usato dal tuo team e, allo stesso tempo, aggiungere la persona giuridica indicata sul sito ufficiale. È particolarmente utile quando confronti il record di un fornitore con una fattura, un contratto o un altro dataset aziendale che potrebbe utilizzare la ragione sociale completa.
I campi restituiti rispondono a diverse esigenze di ricerca:
firstNameelastNamecontengono il nome dell'amministratore o del fondatore estratto dalla pagina, quando disponibile. In questo caso sono Wolfgang Grupp e Antje von Dewitz.postalAddresscontiene l'indirizzo aziendale estratto dalla pagina legale, mentre i campi email e telefono riportano i contatti pubblicati sulla stessa pagina.registrationNumberevatNumberconservano gli identificativi riportati sul sito. Per Trigema sonoHRA 740365eDE144846566; per VAUDE,HRA 631071eDE203894755. Sono valori concreti che puoi confrontare con gli identificativi già presenti nei dati dei tuoi fornitori.impressumUrlidentifica la pagina utilizzata per l'estrazione. È distinto dalla homepage inviata: la prima registra la fonte dei dati societari, mentre la seconda identifica l'azienda da cui è partita la ricerca.
Entrambi i record hanno status: success e hanno utilizzato 10 crediti. agentConfidenceScore è un indicatore da 0 a 100 che aiuta a stabilire le priorità di revisione, ma non rappresenta una percentuale di accuratezza. I campi di output possono comunque essere vuoti quando un valore non è presente nella pagina o non può essere estratto. Conserva quindi lo stato dell'elemento e apri l'URL Impressum restituito quando un dato è importante per il passaggio successivo.
L'output documentato può includere anche genere, numero di telefono e altri dati di contatto. Consulta la documentazione dell'API Impressum Scraper per lo schema aggiornato.
Trasforma l'output in record di ricerca fornitori
La chiamata API diretta è già funzionante. Ora inseriamola nel contesto di un'attività di ricerca sui fornitori. La fase di discovery o onboarding di un fornitore può fornirti un ID stabile, il nome breve utilizzato dal team e una homepage. Il risultato Impressum aggiunge la persona giuridica associata al sito, gli identificativi e i contatti pubblicati, oltre alla pagina in cui sono comparsi questi dati.
Il seguente snippet indicizza i risultati tramite inputId e crea record locali per la ricerca aziendale. Aggiungilo dopo la chiamata a scrape_impressums() nello script completo:
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))Per Trigema, il record conserva supplier-trigema, l'etichetta visualizzata Trigema e https://www.trigema.de. L'oggetto outputs annidato aggiunge Trigema W. Grupp KG, il relativo indirizzo e gli identificativi, il nome restituito di Wolfgang Grupp e l'URL Impressum di origine. Il record VAUDE segue lo stesso percorso: dall'etichetta VAUDE e dalla homepage a VAUDE Sport GmbH & Co. KG e alla relativa pagina di origine. Ora puoi confrontare o raggruppare i record per ragione sociale senza perdere l'identità originale del fornitore che ha avviato la ricerca.
Il record conserva insieme all'ID, all'etichetta e al sito del fornitore anche i dati restituiti, lo stato positivo dell'API, il consumo di 10 crediti e il valore pubblico dell'errore.
La regola di merge più importante è la ricerca nel dizionario tramite l'ID del fornitore. Questo metodo associa il risultato corretto anche se l'API restituisce VAUDE prima di Trigema. Lo snippet mantiene inoltre in company_research i risultati non riusciti a livello di singolo elemento, perché non applica filtri in base allo stato. Un elemento no_result o error rimane disponibile con il relativo ID e l'errore, anziché scomparire dalla coda di revisione.
Questo codice prepara record di ricerca locali. Puoi serializzare la lista o passarla al tuo codice downstream senza aggiungere un'altra chiamata API.
Stima il costo dell'API
Impressum Scraper utilizza 10 crediti fissi per ogni sito inviato. I due siti di esempio hanno consumato in totale 20 crediti. Con la stessa tariffa, 1.000 siti utilizzano 10.000 crediti.
Il piano Growth offre l'accesso alla REST API e include crediti nell'abbonamento. Se necessario, puoi acquistare crediti aggiuntivi con i top-up. L'accesso al piano, i crediti inclusi e gli acquisti di top-up sono componenti di costo separate: consulta i prezzi aggiornati di Datablist prima di pianificare un'elaborazione più ampia.
Risolvi i problemi senza ripetere operazioni a pagamento
Lo script si interrompe prima della richiesta
Se DATABLIST_API_KEY non è presente, lo script genera l'errore Set DATABLIST_API_KEY before running this script. Esporta la variabile nello stesso terminale ed esegui nuovamente il file:
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyL'API rifiuta la richiesta
response.raise_for_status() interrompe l'esecuzione in caso di errore HTTP. Verifica di aver fornito una Personal API Key valida e che il tuo account disponga dell'accesso alla REST API. Questo caso è diverso dall'assenza della variabile: un valore non valido raggiunge l'API e riceve una risposta HTTP.
Il task fallisce o si interrompe
L'errore generato contiene l'ID e lo stato del task. Prima di crearne un altro, controlla il task esistente, i relativi risultati e i campi dei crediti. Un task failed o stopped può comunque conservare risultati e crediti utilizzati; ripeterlo immediatamente potrebbe quindi duplicare un'operazione a pagamento.
Un risultato è incompleto
Un task completato può contenere output incompleti o elementi con stato no_result o error. Conserva inputId, status, impressumUrl quando disponibile e il valore pubblico error del record. Verifica che l'input sia la homepage ufficiale o il dominio principale dell'azienda, quindi controlla il sito prima di decidere se sia utile eseguire un'altra ricerca.
La documentazione sui task descrive in modo più approfondito gli stati, la paginazione dei risultati, la cronologia dei task, i limiti e i tempi di conservazione.
Prossimi passi
Ora hai un'integrazione Python Requests pronta all'uso che invia siti web di aziende tedesche, attende il task di Impressum Scraper, recupera tutte le pagine dei risultati e conserva nei record locali di ricerca sui fornitori i dati aziendali strutturati insieme agli URL di origine.
Sostituisci i due fornitori di esempio con i tuoi ID stabili e URL aziendali. Controlla quindi ogni impressumUrl restituito prima di utilizzare i campi estratti nel tuo processo downstream. Puoi scaricare l'esempio sincrono con Requests, mantenuto e aggiornato, oppure passare all'esempio asincrono con HTTPX disponibile nel repository quando hai bisogno di concorrenza non bloccante.